
تُعد معالجة البيانات النصية غير المهيكلة وتفكيك السلاسل المحرفية المعقدة في بيئات الجداول الحسابية، ولا سيما برنامج مايكروسوفت إكسل (Microsoft Excel)، من الركائز التقنية الأساسية التي يعتمد عليها محللو البيانات والباحثون في شتى الحقول الأكاديمية والتطبيقية. فعند التعامل مع قواعد البيانات الضخمة التي تحتوي على حقول نصية سردية، كمسميات الوظائف، أو العناوين الجغرافية، أو التوصيفات التشخيصية، أو الاستجابات المفتوحة في الاستبيانات المسحية، يبرز التحدي المتمثل في استخلاص مقاطع لغوية محددة تتمركز في نهايات الجمل. إن الحاجة إلى استخراج آخر ثلاث كلمات من خلية نصية ليست مجرد ترف تقني، بل هي ضرورة منهجية لعزل الكيانات المعرفية المستهدفة وتوحيد نسق المتغيرات النصية لتصبح مهيأة للنمذجة الرياضية والتحليل الإحصائي الدقيق.
تاريخياً، كانت هذه العملية الحسابية تتطلب صياغة معادلات بالغة التعقيد، تدمج بين دوال البحث والاقتطاع والتكرار، مما كان يشكل عبئاً ذهنياً كبيراً على المستخدم ويزيد من احتمالية وقوع أخطاء الإزاحة الحرفية وتدهور كفاءة المعالجة الحسابية في المصنفات ذات السجلات المليونية. ومع الطفرة التطويرية التي قادتها شركة مايكروسوفت (Microsoft Corporation) بإطلاق محرك المصفوفات الديناميكية والدوال النصية الحديثة، وفي مقدمتها دالة TEXTAFTER، أضحى تفكيك النصوص عملية خوارزمية رشيقة تنفذ بأقل قدر من التعقيد البرمجي وأعلى مستويات الدقة الرياضية.
يهدف هذا الدليل الأكاديمي الشامل إلى تقديم تفكيك نظري وإجرائي متعمق لكيفية استخراج آخر ثلاث كلمات من خلية في إكسل. سنستعرض عبر هذا البحث الأسس الميكانيكية لمحرك الحسابات، والتشريح الدقيق للدوال الحديثة، والبدائل الكلاسيكية المتوافقة مع الإصدارات القديمة، فضلاً عن تقديم حلول رصينة لمعالجة الحالات الحدية، والمسافات غير القياسية، وتطبيقات ذلك في تنقية البيانات البحثية وإدارتها المؤسسية بكفاءة وموثوقية عالية.
1. مقدمة منهجية لمعالجة النصوص وسلاسل البيانات في إكسل
1.1 أهمية تجزئة النصوص في تحليلات البيانات المتقدمة
تمثل البيانات النصية غير المهيكلة النسبة الأكبر من المدخلات الأولية في بيئات الأعمال والمؤسسات البحثية، حيث تتدفق السجلات على هيئة جمل وتراكيب لغوية متباينة الطول والتعقيد. إن تجزئة النصوص (Text Segmentation) تكتسب أهمية محورية لكونها الجسر الذي ينقل هذه البيانات من مجرد سرد لغوي وصفي إلى متغيرات تصنيفية قابلة للتحليل الكمي والنوعي. فعندما نقوم باستخلاص أجزاء محددة وموحدة من السلاسل النصية، فإننا نمكن خوارزميات الفرز والتجميع من التعرف على الأنماط المشتركة بين السجلات، مما يقلل من تشتت البيانات ويزيد من اتساقها المنهجي.
علاوة على ذلك، يتيح استخلاص الكلمات المفتاحية الأخيرة، والتي غالباً ما تحتوي في التسميات الوصفية على التصنيف النهائي أو الرمز المعياري أو اسم العائلة أو الحالة الإجرائية، تسريع وتيرة تصنيف السجلات الضخمة بأقل استهلاك للموارد الحاسوبية. إن الدقة في هذه المعالجة الآلية تحمي قواعد البيانات من أخطاء التحريف البشري، وتضمن بقاء البيانات الأصلية سليمة دون فقدان للبيانات الوصفية ذات الصلة، وهو ما ينعكس بصورة مباشرة على موثوقية القرارات المستندة إلى تلك التحليلات التجميعية.
1.2 التحديات الشائعة في التعامل مع النصوص المتغيرة الطول
يواجه المتخصصون في معالجة الجداول الحسابية تحديات هيكلية متأصلة في طبيعة اللغة البشرية عند تمثيلها داخل الخلايا؛ فالنصوص بطبيعتها تتسم بالتغير الديناميكي في الطول وعدد الكلمات. إذ قد تحتوي إحدى الخلايا على عبارة مكونة من أربع كلمات، بينما تحتوي خلية أخرى في نفس العمود على خمس عشرة كلمة. هذا التباين يجعل استخدام دوال الاقتطاع ذات المواضع الثابتة، مثل دالة RIGHT المجردة، أمراً غير مجدٍ، لأن عدد الأحرف التي تتكون منها الكلمات يختلف جذرياً باختلاف المفردات المستخدمة.
وتتفاقم هذه الصعوبة بفعل مشكلات المسافات الزائدة (Excess Spaces)، سواء كانت مسافات بادئة، أو لاحقة، أو فراغات متعددة تفصل بين الكلمات ناتجة عن عمليات الإدخال اليدوي غير المنضبط. تتسبب هذه الفراغات في تشويه الحسابات الرياضية للمحارف، مما يؤدي إلى فشل الخوارزميات التي تعتمد على عد المسافات لتحديد حدود الكلمات. من هنا، تنشأ الحاجة الملحة لتطوير حلول مرنة تمتلك القدرة الرياضية على تحديد نهايات النصوص وعزل الوحدات اللغوية المستهدفة بصرف النظر عن موضع الحرف الأول لكل كلمة.
1.3 التطور المعياري لدوال معالجة السلاسل النصية في بيئة إكسل
شهدت بيئة إكسل تحولاً جذرياً في فلسفة التعامل مع السلاسل النصية على مدار العقود الثلاثة الماضية. في الإصدارات الكلاسيكية، كان المستخدم مقيداً بمجموعة من الدوال البدائية الموروثة مثل MID و FIND و SUBSTITUTE و LEN. وكانت صياغة معادلة لاستخراج آخر ثلاث كلمات تتطلب دمجاً معقداً وابتكار حيل حسابية، مثل استبدال الفواصل بمسافات عريضة اصطناعية ثم تقليصها، وهو أسلوب يتطلب إدراكاً رياضياً عميقاً وعرضة لأخطاء الصيغ وصعوبة الصيانة.
ولمعالجة هذا القصور، قامت شركة مايكروسوفت في تحديثات عام 2022 لنظام ميكروسوفت 365 (Microsoft 365) وإكسل 2024 بطرح حزمة ثورية من دوال التلاعب بالنصوص، شملت TEXTAFTER و TEXTBEFORE و TEXTSPLIT. مثّل هذا الإطلاق تحولاً نحو الصيغ الرشيقة عالية الكفاءة الحسابية، التي تستغل محرك المصفوفات الديناميكية (Dynamic Arrays). ساعد هذا التحديث في التخلص تدريجياً من الاعتماد على الأكواد البرمجية المكتوبة بلغة Visual Basic for Applications (VBA) لصالح الدوال القياسية الأصلية فائقة السرعة والأمان.
2. البنية التركيبية والمفهوم النظري لدالة TEXTAFTER
2.1 التعريف البرمجي لدالة TEXTAFTER والغاية منها
تُعرّف دالة TEXTAFTER برمجياً بأنها أداة متخصصة مصممة لاقتطاع وإرجاع الجزء النصي الواقع بعد محرف أو فاصل محدد (Delimiter) داخل سلسلة نصية معطاة. وتأتي هذه الدالة كجزء من عائلة الدوال النصية الحديثة التي تهدف إلى تبسيط عمليات التحليل اللغوي دون الحاجة إلى تحديد أرقام مواضع البداية وطول النصوص المستخرجة كما كان متبعاً في السابق.
عند إجراء مقارنة وظيفية، نجد أن دالة TEXTAFTER تمثل النظير المكمل لدالة TEXTBEFORE، التي تستخرج النص السابق لفاصل معين، ولدالة TEXTSPLIT، التي تُقسّم السلسلة النصية بأكملها عبر صفوف أو أعمدة متعددة. وتكمن الميزة الجوهرية في دالة TEXTAFTER في قدرتها على إرجاع مخرجات نصية ديناميكية يمكن تمريرها فوراً كمدخلات لدوال تحليلية أخرى، مما يجعلها وحدة بناء أساسية ومرنة في خطوط أنابيب تنقية البيانات المتقدمة.
2.2 التشريح الهيكلي لمعاملات الدالة الرياضية
تتسم دالة TEXTAFTER بمرونة بنيوية فائقة بفضل احتوائها على معاملين إجباريين وأربعة معاملات اختيارية، وتأخذ الصيغة العامة الشكل التالي:
=TEXTAFTER(text, delimiter, [instance_num], [match_mode], [match_end], [if_not_found])
يوضح التحليل الهيكلي لهذه المعاملات ما يلي:
- النص (text): يمثل مرجع الخلية المستهدفة أو السلسلة النصية الأصلية المراد تجزئتها (مثل الخلية A2).
- الفاصل (delimiter): الرمز أو المحرف الذي يحدد نقاط الانقسام بين الكلمات، وغالباً ما يكون مسافة بيضاء
" "في سياق فصل الكلمات. - رقم التكرار (instance_num): وسيطة عددية تحدد رقم ظهور الفاصل الذي سيتم الاقتطاع بعده؛ حيث تحدد القيم الموجبة العد من بداية النص، بينما تتيح القيم السالبة آلية الفهرسة العكسية.
- نمط التطابق (match_mode): معامل اختياري لتحديد حساسية حالة الأحرف في اللغات اللاتينية (0 للحساسية، و1 لعدم الحساسية).
- مطابقة النهاية (match_end): يتحكم في كيفية تعامل الدالة مع نهايات السلاسل النصية كفواصل افتراضية.
- إذا لم يتم العثور (if_not_found): القيمة البديلة المرتجعة في حال غياب الفاصل المستهدف، لمنع ظهور رموز الخطأ البرمجية.
2.3 المعنى الهندسي لاستخدام القيم السالبة في وسيطة التكرار
يمثل إدخال القيم السالبة في معامل instance_num قفزة نوعية في هندسة الخوارزميات النصية لبرنامج إكسل؛ إذ تعتمد هذه الآلية على مفهوم “الفهرسة العكسية” (Reverse Indexing). ففي حين تبدأ الفهرسة التقليدية مسح المحارف من أقصى اليمين أو اليسار بحسب اتجاه السلسلة انطلاقاً من البداية، تقلب القيمة السالبة هذا المنطق ليقوم المحرك بمسح السلسلة من نهايتها متجهاً نحو بدايتها.
عند تعيين المعامل بالقيمة -3، يصدر أمر لمحرك الحسابات بتجاهل مئات المحارف الممتدة من بداية الخلية، والتركيز حصراً على رصد ظهور الفاصل المستهدف (المسافة البيضاء) الثالث انطلاقاً من نهاية السلسلة النصية. وبمجرد رصد هذا الفاصل الثالث من النهاية، تقتطع الدالة كل المحارف الواقعة بعده حتى نهاية النص، وهو ما يضمن رياضياً عزل آخر ثلاث كلمات بدقة مطلقة، بغض النظر عن إجمالي عدد الكلمات الموجودة في الجملة الأصلية.
3. الدليل الإجرائي المباشر: تطبيق صيغة استخراج آخر ثلاث كلمات
3.1 الصياغة القياسية للمعادلة وتوضيح عناصرها
لتحقيق الغاية الوظيفية باستخراج آخر ثلاث كلمات من خلية تحتوي على نص متعدد المفردات، نعتمد الصياغة القياسية المباشرة التالية:
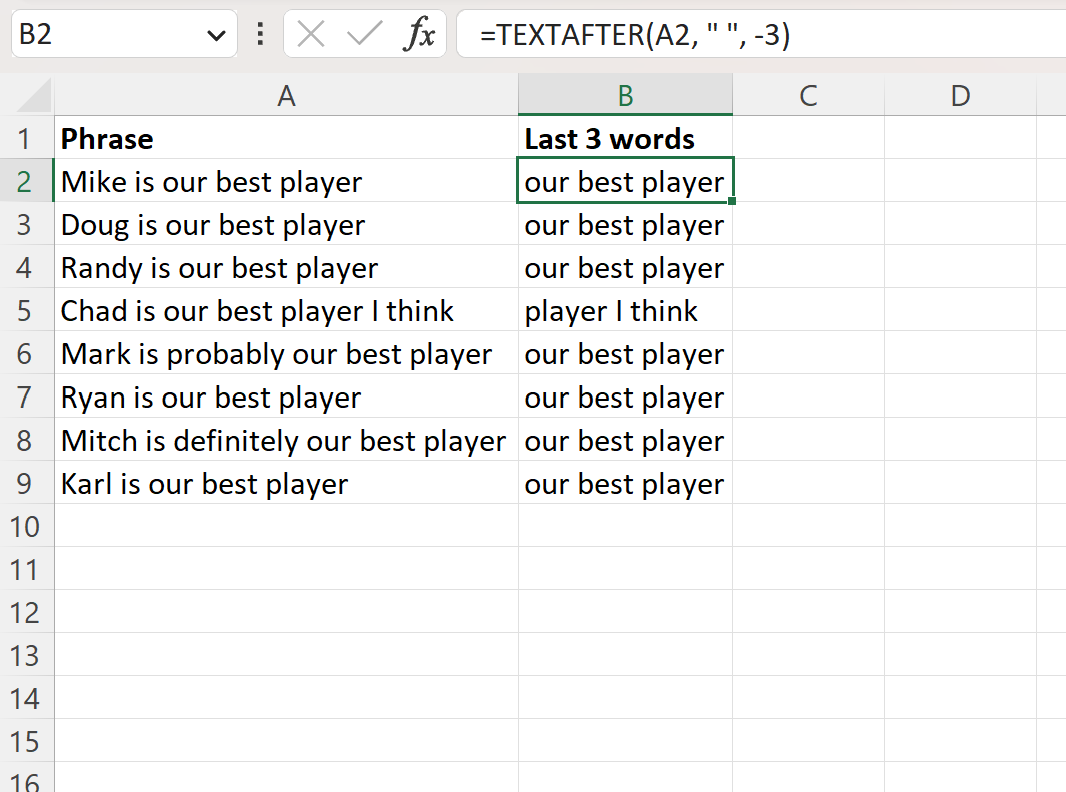
=TEXTAFTER(A2, " ", -3)
يقوم منطق هذه المعادلة على ثلاثة عناصر رئيسية: العنصر الأول A2 يمثل الإحداثي المرجعي للخلية التي تحتوي على السلسلة النصية الخام المراد معالجتها. العنصر الثاني " " هو المسافة الفاصلة القياسية المحصورة بين علامتي تنصيص مزدوجتين، وهي الإشارة التي يستند إليها البرنامج للتمييز بين كتلة لغوية وأخرى. أما العنصر الثالث -3 فهو الموجه التكراري العكسي الذي يحدد نقطة الانطلاق الاقتطاعية.
عند تطبيق هذه المعادلة على جملة مثل: “يعتبر التحليل الإحصائي ركيزة أساسية في البحث العلمي”، فإن المحرك يتجاوز المفردات الأولى، ويرصد المسافة الفاصلة بين “ركيزة” و”أساسية” باعتبارها الفاصل الثالث من النهاية، ليعيد فوراً السلسلة المستهدفة: “أساسية في البحث العلمي” إن كانت تشتمل على تلك التراكيب، مما يبرز الدقة الفائقة للصيغة في اقتناص المقطع النهائي بدقة متناهية.
3.2 خطوات التنفيذ العملي داخل ورقة العمل خطوة بخطوة
لتطبيق هذه التقنية بصورة عملية خالية من الأخطاء داخل ورقة العمل، يُرجى اتباع الخطوات الإجرائية التالية بعناية:
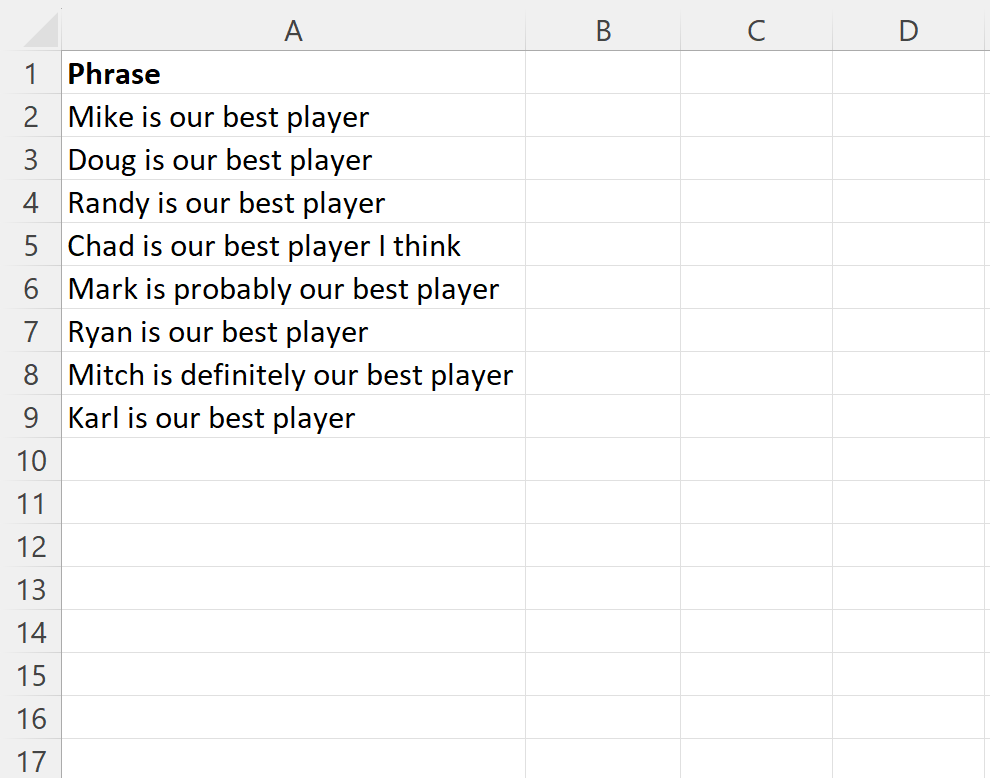
- الخطوة الأولى: تجهيز جدول البيانات بوضع النصوص المستهدفة في عمود مخصص، وليكن العمود A، والتأكد من وضوح الصفوف واستقلاليتها.
- الخطوة الثانية: الانتقال إلى الخلية المجاورة الأولى في عمود المخرجات، ولتكن الخلية B2، ثم تفعيل شريط الصيغ.
- الخطوة الثالثة: كتابة الصيغة بدقة:
=TEXTAFTER(A2, " ", -3)مع مراعاة استخدام علامات التنصيص المزدوجة اللاتينية السليمة للفصل. - الخطوة الرابعة: الضغط على مفتاح
Enterلتنفيذ المعادلة؛ حيث سيقوم محرك إكسل بإظهار الكلمات الثلاث الأخيرة فوراً في الخلية B2. - الخطوة الخامسة: تحديد الخلية B2 ووضع مؤشر الفأرة على الزاوية السفلية اليسرى (أو اليمنى حسب اتجاه الواجهة) حتى يظهر مقبض التعبئة التلقائية (Fill Handle)، ثم النقر المزدوج أو السحب لأسفل لتعميم المعادلة على آلاف السجلات بلحظات.
3.3 التحقق التجريبي من دقة المخرجات
عقب تعميم الصيغة على العمود بالكامل، تقتضي قواعد ضبط جودة البيانات إجراء مراجعة تدقيقية تجريبية للتحقق من سلامة المخرجات. يتم ذلك عبر فحص عينات عشوائية من النصوص الطويلة والقصيرة، للتأكد من عدم حدوث اقتطاع جزئي لأحرف الكلمات، أو ترك مسافات غير مرئية في البداية قد تشوه التحليلات اللاحقة.
يتضمن التدقيق أيضاً مراجعة تفاعل المعادلة مع الحالات التي تنتهي بعلامات ترقيم أو فراغات غير مقصودة، والتأكد من أن الناتج يحتوي حصراً على الكلمات الثلاث الأخيرة بكامل حروفها. يمنح هذا التحقق التجريبي الباحث الثقة الكاملة في الاعتماد على المخرجات لبناء الجداول المحورية (Pivot Tables) أو تصديرها إلى برمجيات التحليل الإحصائي المتقدمة دون خوف من تشوه بنية البيانات.
4. التحليل الميكانيكي الدقيق لآلية عمل محرك الحسابات
4.1 خوارزمية المسح العكسي للرموز والفواصل
لفهم الكيفية التي يعالج بها محرك إكسل الحسابي هذه العملية، يجب تفكيك الخوارزمية الداخلية للمسح العكسي. عندما يتلقى المحرك قيمة سالبة في وسيطة التكرار، فإنه يبدأ بقراءة السلسلة النصية من المحرف ذي الفهرس $N$ (حيث $N$ يمثل إجمالي طول السلسلة) نزولاً باتجاه المحرف ذي الفهرس رقم 1.
يقوم المؤشر الداخلي بمقارنة كل محرف تتم قراءته بالفاصل المحدد (المسافة البيضاء). وعند تطابق المحرف مع المسافة، يرفع المحرك عداد الفواصل بمقدار درجة واحدة. وتستمر حلقة التكرار (Loop) في الرجوع حتى يصل العداد إلى القيمة 3. في تلك اللحظة بالذات، يسجل المحرك الفهرس المكاني لتلك المسافة المكتشفة، ثم يقوم بعملية قص (Substring Operation) لجميع المحارف الواقعة على يمين ذلك الفهرس حتى نهاية السلسلة، ويمرر الناتج النهائي إلى الخلية المستهدفة كمخرجات نصية معزولة.
4.2 طبيعة الفاصل ودوره الحاسم في دقة النتائج
يعتمد نجاح هذه الخوارزمية الحسابية بالكامل على مفهوم “الفاصل الموحد”. فالمسافة الفارغة " " التي يتم إدخالها في وسيطة المعادلة تُعامل من قِبل النظام كمحرف أسكي قياسي (ASCII 32). غير أن دقة النتائج قد تتأثر بشكل مباشر إذا ما كانت النصوص الأصلية تحتوي على تباين في الفواصل، مثل استخدام المسافات المزدوجة أو وجود علامات ترقيم ملتصقة بالكلمات.
إذا كانت الكلمات مفصولة بفاصلة لغوية متبوعة بمسافة (مثل ، )، فإن الدالة عند البحث عن المسافة ستعتبر الفاصلة جزءاً لا يتجزأ من بنية الكلمة السابقة لها ولن تعتبرها فاصلاً مستقلاً، مما يبقيها ملتصقة بالكلمة المستخرجة. أما إذا كانت النصوص تستخدم فواصل صلبة أخرى كالفواصل المنقوطة أو الشرطات، فإن الدالة لن تنجز مهمتها ما لم يتم تعديل وسيطة الفاصل في المعادلة لتطابق الواقع التركيبي للسلسلة محل الفحص.
4.3 حسابات الحدود والمواضع داخل الذاكرة المؤقتة
تتم إدارة عمليات المعالجة النصية داخل بيئة إكسل عبر تخصيص كتل ذاكرية مؤقتة (Buffer Memory) للتعامل مع السلاسل النصية متغيرة الحجم. وعند تنفيذ المسح العكسي، لا يحتاج إكسل إلى إعادة بناء مصفوفة السلسلة بأكملها في الذاكرة، بل يكتفي بالمرور السريع عبر مؤشرات العناوين (Pointers) من نهاية السلسلة.
تحدد نقطة البداية للمخرج النصي استناداً إلى فهرس الحرف الذي يلي الفاصل المكتشف مباشرة ($Index + 1$). وتضمن هذه الإدارة الذاكرية الرشيقة استقرار الأداء الحسابي وعدم استهلاك الذاكرة العشوائية للجهاز، حتى في حال تطبيق الصيغة على جداول بيانات عملاقة تتجاوز مئات الآلاف من الصفوف النصية الطويلة، مما يمنع تجمد التطبيق أثناء إعادة الحساب التلقائي.
5. التعميم الرياضي: استخراج عدد غير محدد (N) من الكلمات الأخيرة
5.1 بناء معادلة ديناميكية تعتمد على مراجع الخلايا
لا تتوقف القيمة التطبيقية لهذه التقنية عند حدود الرقم 3، بل يمكن تعميم النموذج الحسابي ليصبح أداة استخراج ديناميكية مرنة قادرة على اقتطاع أي عدد متغير ($N$) من الكلمات الأخيرة. ويتحقق ذلك عبر استبدال القيمة العددية الثابتة -3 بمرجع خلية متغير، لتصبح المعادلة بالصيغة الآتية:
=TEXTAFTER(A2, " ", -C2)
في هذا النموذج الرياضي المرن، يمثل C2 خلية تحكم رقمية يدخل فيها المستخدم عدد الكلمات المراد استخلاصها (سواء كانت 2، أو 4، أو 7 كلمات). يقوم إكسل بضرب القيمة المدخلة في إشارة السالب تلقائياً عبر المعامل الحسابي، مما يتيح بناء لوحات تحكم تفاعلية (Interactive Dashboards) تمكن المستخدمين غير التقنيين من تعديل معايير الاستخراج النصي وتحديث التقارير اللحظية بمرونة فائقة ودون الحاجة لتعديل بنية المعادلات المعقدة.
5.2 المقارنة الوظيفية مع استخراج الكلمات الأولى (TEXTBEFORE)
لفهم التناظر الوظيفي في معالجة السلاسل، تبرز دالة TEXTBEFORE كمعادل هندسي معاكس تماماً لدالة TEXTAFTER. فإذا أردنا استخراج الكلمات الثلاث الأولى من جملة نصية، نستخدم المعادلة التالية:
=TEXTBEFORE(A2, " ", 3)
يكمن الفارق المنطقي الجوهري هنا في أن دالة TEXTBEFORE مع القيمة الموجبة 3 تأمر المحرك بمسح النص انطلاقاً من بدايته، والبحث عن المسافة الثالثة واقتطاع كل ما يسبقها. إن الجمع المتزامن بين الدالتين في أعمدة متجاورة يمنح محلل البيانات قدرة كاملة على تشريح النصوص، وعزل الأطراف، وفصل الأسماء المركبة، وتوزيع البيانات اللغوية المعقدة إلى قطاعات محددة بدقة بالغة تسهل جدولتها وتصنيفها.
5.3 الجمع بين الدوال لاستخراج نطاق وسطي محدد من الكلمات
تصل القوة التعبيرية لهذه الدوال أوجها عند دمجهما معاً لاقتناص نطاق نصي وسطي يقع في قلب الجملة، متجاوزين الكلمات الافتتاحية والختامية معاً. فلو افترضنا رغبتنا في استخراج الكلمات التي تقع بين الكلمة الثانية ونهاية الكلمة الخامسة، يمكننا صياغة معادلة مركبة تعتمد على التداخل الوظيفي:
=TEXTBEFORE(TEXTAFTER(A2, " ", 2), " ", 3)
تعمل الدالة الداخلية TEXTAFTER(A2, " ", 2) أولاً على التخلص من الكلمتين الأوليين واقتطاع ما بعدهما، ثم تستلم الدالة الخارجية TEXTBEFORE هذه السلسلة الناتجة لتقتطع منها الكلمات الثلاث الأولى التالية. يتيح هذا التركيب المتقدم للمحللين استخلاص مقاطع وصفية معينة من منتصف السجلات التوثيقية والتقارير الأكاديمية بدقة متناهية ودون استخدام أحرف فهرسة صلبة.
6. معالجة الحالات الحدية والأخطاء التشغيلية المحتملة
6.1 تشخيص أسباب ظهور الخطأ #N/A وكيفية قراءته
عند تعميم الصيغة =TEXTAFTER(A2, " ", -3) عبر مجموعات البيانات الواقعية، يظهر في بعض الأحيان رمز الخطأ البرمجي #N/A (غير متاح – Not Available). يعود السبب الرياضي المباشر لهذا الخطأ إلى “حالة النقص العددي”؛ أي عندما تحتوي الخلية المستهدفة على سلسلة نصية تشتمل على عدد كلمات أقل من المطلوب استخراجه (كلمة واحدة أو كلمتان فقط، وبالتالي تحوي فاصلاً واحداً أو فاصلين كحد أقصى).
في هذه الحالة، يفشل محرك البحث العكسي في العثور على التكرار الثالث للفاصل، مما يجعله يعيد خطأ عدم العثور على المرجع. يعد فهم هذا التشخيص أمراً بالغ الأهمية، فهو لا يشير إلى خلل في كتابة المعادلة، بل يعكس قصوراً في تلبية معطيات الخلية للشروط المنطقية المطلوبة، وهو ما يستدعي ضبط المعادلة برمجياً للتعامل مع هذه الحالات الحدية دون إيقاف تسلسل الحسابات.
6.2 توظيف المعامل match_end لمنع تعطل الصيغة
لتفادي ظهور أخطاء النقص العددي وتوفير معالجة تلقائية للحالات الاستثنائية، وفرت شركة مايكروسوفت المعامل الاختياري الخامس في بنية الدالة والمسمى match_end. عند تفعيل هذا المعامل، يُمنح المحرك تعليمات واضحة باعتبار بداية السلسلة النصية فاصلاً ضمنياً صالحاً للاقتطاع في حال عدم كفاية الفواصل الفعلية.
تتم كتابة الصيغة النموذجية الوقائية على النحو التالي:
=TEXTAFTER(A2, " ", -3, , 1)
أو باستخدام وسيطة القيمة البديلة if_not_found المتاحة كمعامل سادس:
=TEXTAFTER(A2, " ", -3, , , A2)
تضمن هذه الصيغة المتقدمة بقاء ورقة العمل نظيفة؛ فإذا كانت الخلية تحتوي على كلمتين فقط، تعيد الدالة النص الأصلي كاملاً بدلاً من إظهار رمز الخطأ #N/A، مما يجعل مخرجات التحليل سلسة ومكتملة دون انقطاع.
6.3 تأمين النتائج باستخدام دوال التحقق IFERROR و IFNA
على الرغم من فاعلية المعاملات المدمجة داخل دالة TEXTAFTER، فإن الممارسات المنهجية المتقدمة في بناء نماذج البيانات الرصينة توصي أحياناً بتغليف الصيغ بدوال التحقق المنطقي المستقلة مثل IFNA أو IFERROR لتوفير تحكم استثنائي في المخرجات البديلة. وتأخذ الصيغة الموصى بها الشكل التالي:
=IFNA(TEXTAFTER(A2, " ", -3), A2)
أو لعرض رسالة تدقيقية وصفية توجه مدخلي البيانات:
=IFNA(TEXTAFTER(A2, " ", -3), "النص يحتوي أقل من 3 كلمات")
يحقق هذا الأسلوب حماية مزدوجة للبيانات، حيث يعزل الأخطاء ويستبدلها بقيم إرشادية ذات مغزى تحليلي، مما يحفظ المظهر المهني للجداول والتقارير الإحصائية المرفوعة لصناع القرار ويمنع انتقال رموز الأخطاء إلى الرسوم البيانية والجداول المحورية المرتبطة بها.
7. تنقية البيانات الأولية وضبط الفواصل غير القياسية
7.1 معالجة معضلة المسافات المتعددة باستخدام دالة TRIM
تُعد المسافات المزدوجة والمتعددة بين الكلمات العدو الأول لدقة الصيغ النصية؛ فإذا احتوت الجملة على مسافتين متتاليتين بالخطأ قبل الكلمة الأخيرة، سيعتبر المحرك العكسي تلك المسافة الإضافية بمثابة فاصل مستقل، مما يؤدي إلى اقتطاع كلمتين فقط وفراغ بدلاً من استخراج الكلمات الثلاث المطلوبة.
لتحصين المعادلة ضد هذا التشويه الإدخالي، يجب دائماً دمج دالة TRIM لتطهير النص الخام قبل الشروع في تمريره إلى خوارزمية الاستخراج، بحيث تصبح المعادلة المعيارية الاحترافية كما يلي:
=TEXTAFTER(TRIM(A2), " ", -3)
تقوم دالة TRIM في هذه المنظومة بفحص السلسلة النصية وحذف أي مسافات بادئة في أول السطر، ومسح كافة المسافات اللاحقة في نهايته، مع تقليص أي مسافات بينية متكررة لتصبح مسافة واحدة نظامية، وهو ما يضمن صحة الفهرسة العكسية وتطابقها التام مع عدد الكلمات الفعلي.
7.2 التعامل مع المسافات غير القابلة للكسر والرموز الخاصة
من المشكلات الخفية التي تربك المحللين مشكلة المسافات غير القابلة للكسر (Non-Breaking Spaces)، والمعروفة برمز المحرف CHAR(160) في جداول ويندوز. تتولد هذه المحارف غالباً عند نسخ البيانات من صفحات الويب أو تصديرها من أنظمة إدارة قواعد البيانات السحابية (ERP). وتكمن معضلتها في أن دالة TRIM العادية تعجز عن إزالتها لأنها لا تراها كمسافة أسكي عادية (ASCII 32).
لحل هذه المعضلة الحسابية، نلجأ إلى تطهير النص بتسلسل مركب يستعين بدالة SUBSTITUTE لاستبدال المسافات الصلبة بمسافات عادية، بالإضافة إلى تطبيق دالة CLEAN لإزالة محارف السطور الجديدة (Line Breaks) غير المرئية، وفق المعادلة التالية:
=TEXTAFTER(TRIM(CLEAN(SUBSTITUTE(A2, CHAR(160), " "))), " ", -3)
تضمن هذه المعالجة الوقائية العميقة تحويل كافة أشكال الفراغات المشوهة إلى فواصل قياسية، مما يرفع موثوقية استخراج الكلمات الأخيرة إلى مستويات تقارب الكمال الإحصائي.
7.3 توحيد علامات الترقيم لتسهيل الفصل المنطقي
تشكل علامات الترقيم، مثل النقاط الختامية، وعلامات التعجب، والفواصل، والتنصيصات الملتصقة بنهايات الكلمات، عائقاً إضافياً أمام التحليل اللغوي الدقيق. فإذا انتهت الجملة بنقطة . ملتصقة بالحرف الأخير، ستنتقل تلك النقطة حتماً ضمن المخرجات المستخرجة، مما قد يعطل عمليات المقارنة اللاحقة (مثل دوال VLOOKUP أو XLOOKUP).
ولمعالجة ذلك، يمكن استخدام تقنيات الاستبدال المتسلسل أو توظيف التعابير النمطية (Regular Expressions) المتاحة حديثاً في إكسل (مثل دالة REGEXTEST و REGEXREPLACE) لتجريد نهايات الجمل من الرموز الشائبة قبل الاقتطاع. إن تنقية البيانات من هذه الملوثات الرمزية تمنح المخرجات نقاءً هيكلياً يساعد على معالجتها كمتغيرات نقية تخدم التحليلات الببليوغرافية والسلوكية بأعلى معايير الدقة العلمية.
8. الحلول البديلة للإصدارات القديمة من إكسل
8.1 التركيبة الكلاسيكية: MID و SUBSTITUTE و LEN و REPT
بالنسبة للمؤسسات التي ما زالت تعتمد على الإصدارات التقليدية من إكسل (مثل Excel 2013 أو 2016 أو 2019)، والتي تفتقر إلى محرك الدوال الحديثة، لا يمكن تطبيق دالة TEXTAFTER، حيث ستعيد فوراً خطأ عدم التعرف على الاسم #NAME?. في هذا السياق، تبرز الصيغة الكلاسيكية المبتكرة التي طورها خبراء إكسل عبر تركيبة عبقرية من الدوال الموروثة:
=TRIM(RIGHT(SUBSTITUTE(TRIM(A2), " ", REPT(" ", LEN(A2))), 3 * LEN(A2)))
تعتمد آلية عمل هذه الصيغة على استراتيجية تضخيم الفواصل (Space Padding Technique). يقوم التعبير LEN(A2) بحساب إجمالي طول النص في الخلية. ثم تقوم دالة REPT(" ", LEN(A2)) بإنشاء كتلة فراغية ضخمة تتكون من عدد مسافات يساوي طول النص الأصلي بأكمله. بعد ذلك، تستبدل دالة SUBSTITUTE كل مسافة مفردة في الجملة بتلك الكتلة الفراغية الضخمة، مما يخلق مساحات شاسعة تفصل بين الكلمات تعادل حجم النص نفسه.
وهنا يأتي دور دالة RIGHT باقتطاع شريحة كبيرة من أقصى يمين النص المضخم تعادل ثلاثة أضعاف طول النص الأصلي (3 * LEN(A2)). يضمن هذا البعد الحسابي التقاط الكلمات الثلاث الأخيرة والمسافات الاصطناعية الهائلة الفاصلة بينها، مع استحالة وصول الاقتطاع إلى الكلمة الرابعة من النهاية. وفي الختام، تتكفل دالة TRIM الخارجية بمسح كافة الفراغات الضخمة المصطنعة وإعادة المسافات المفردة بين الكلمات، مما يعيد الكلمات الثلاث الأخيرة نقية تماماً دون الحاجة لأي دالة حديثة.
8.2 بناء دالة مخصصة (UDF) باستخدام برمجية VBA
توفر بيئة التطوير عبر Visual Basic for Applications (VBA) بديلاً برمجياً متيناً وموثوقاً لمستخدمي الإصدارات الكلاسيكية، وذلك من خلال إنشاء دالة معرفة من قِبل المستخدم (User-Defined Function – UDF). تتيح هذه الطريقة تجاوز التعقيد الظاهري للصيغ الرياضية الطويلة وتقديم واجهة استخدام بالغة البساطة للمستخدم النهائي داخل ورقة العمل.
يمكن للمطورين إدراج الشيفرة البرمجية التالية داخل وحدة نمطية قياسية (Standard Module):
Function GetLastWords(TextCell As Range, NumWords As Integer) As String

    Dim Words() As String

    Dim CleanText As String

    Dim Result As String

    Dim i As Integer, StartIndex As Integer
CleanText = Application.WorksheetFunction.Trim(TextCell.Value)
If CleanText = "" Then Exit Function
Words = Split(CleanText, " ")
If UBound(Words) + 1 <= NumWords Then
GetLastWords = CleanText
Exit Function
End If
StartIndex = UBound(Words) - NumWords + 1
For i = StartIndex To UBound(Words)
Result = Result & Words(i) & " "
Next i
GetLastWords = Trim(Result)
End Function
بمجرد حفظ هذا الكود، يستطيع أي مستخدم كتابة الصيغة البسيطة =GetLastWords(A2, 3) مباشرة في خلايا الإكسل. ومع ذلك، تجدر الإشارة إلى أن ملفات الماكرو تتطلب الحفظ بصيغة .xlsm وتتطلب تفعيل إعدادات الأمان الخاصة بالماكرو لدى كافة المستخدمين، مما يجعلها خياراً مقيداً في بعض البيئات المؤسسية الصارمة.
8.3 استخدام أداة Power Query لتحويل واستخراج النصوص
تُمثل أداة باور كويري (Power Query) حلاً استثنائياً ومعيارياً لاقتطاع النصوص دون كتابة صيغ رياضية نهائياً، وهي أداة متوفرة في كافة إصدارات إكسل الحديثة والقديمة منذ إصدار 2010. تتميز هذه الأداة بقدرتها على التعامل مع تدفقات البيانات الضخمة وأتمتة مسارات التحويل وإعادة تطبيقها بنقرة زر واحدة.
تتم عملية الاستخراج داخل باور كويري عبر استيراد نطاق البيانات إلى محرر الاستعلام، ثم تحديد العمود النصي المطلوب، واختيار ميزة تقسيم العمود (Split Column) ثم بواسطة الفاصل (By Delimiter). في نافذة الخيارات، يتم تحديد المسافة كفاصل، مع اختيار التقسيم عند الفاصل في أقصى اليمين (Right-most delimiter)، وتكرار هذه العملية ثلاث مرات متتالية، أو كتابة صيغة مخصصة بلغة M تعتمد على الدالة Text.End ومصفوفات التقسيم. يوفر هذا الأسلوب أداءً فائقاً ومعالجة مؤتمتة تنعكس إيجابياً على سرعة تحديث النماذج الإدارية المتكررة.
9. التطبيقات العملية في تحليل البيانات السلوكية والأكاديمية
9.1 تفكيك الملاحظات الميدانية والتشخيصات في الدراسات الإنسانية
في ميدان الأبحاث السلوكية والتشخيصات النفسية، يقوم الباحثون والممارسون بتدوين ملاحظات ميدانية سردية مطولة تعقب جلسات الرصد والمتابعة الإكلينيكية. في كثير من الأحيان، تنتهي هذه السجلات بعبارات تقييمية معيارية موحدة تلخص الحالة السلوكية للمفحوص (مثل: “مستوى قلق مرتفع”، أو “اضطراب فرط الحركة”، أو “مستقر انفعالياً ومطمئن”).
يتيح تطبيق صيغة استخراج الكلمات الثلاث الأخيرة للباحثين تفكيك هذا السرد الضخم وعزل الخلاصة التشخيصية المكونة من ثلاث كلمات ووضعها في عمود مستقل. يسهم ذلك في ربط هذه التقييمات السلوكية بالمتغيرات الديموغرافية والبيئية دون الحاجة إلى القراءة اليدوية المضنية لآلاف السجلات، مما يرفع كفاءة التبويب الإحصائي للاستجابات السريرية (Borghouts et al., 2021).
9.2 معالجة استجابات الأسئلة المفتوحة في الاستبيانات
تمثل الأسئلة المفتوحة في الدراسات المسحية والاستطلاعية منجماً ثرياً للبيانات النوعية، إلا أن معالجتها تشكل تحدياً لوجستياً كبيراً. يميل المستجيبون غالباً إلى تضمين مقترحاتهم النهائية أو كلماتهم الختامية في نهاية الجمل التعبيرية (مثل قولهم: “… ونأمل توفير الدعم النفسي” أو “… نقترح تعديل بيئة العمل”).
من خلال استخلاص الكلمات الأخيرة وتصنيفها آلياً، يتمكن الباحثون من تتبع المصطلحات المحورية التي تتكرر في ختام آراء العينات، مما يسرع وتيرة التحليل الموضوعي (Thematic Analysis) للبيانات السردية. يدعم هذا الإجراء الاستكشاف المفاهيمي الأولي للأفكار السائدة قبل الغوص في الترميز النوعي المفصل، مما يوفر وقتاً ثميناً للفرق البحثية (Sloman et al., 1998).
9.3 توثيق وتدقيق مراجع البحوث والمصادر العلمية
في مشاريع المراجعة المنهجية وتحليل الميتا (Meta-Analysis)، تتدفق قوائم المراجع الببليوغرافية من قواعد البيانات الأكاديمية على هيئة فقرات نصية متصلة تتبع أنماط التوثيق المعتمدة (مثل دليل الجمعية الأمريكية لعلم النفس APA). غالباً ما تتوضع البيانات الببليوغرافية الحيوية، كسنة النشر ورقم المجلد أو النطاق الجغرافي للمجلة، في أواخر تلك السلاسل التوثيقية.
يساعد توظيف صيغ استخراج الكلمات الأخيرة الباحثين ومدققي الأطروحات العلمية على عزل بيانات الطبعة وسنة الإصدار ومطابقتها آلياً عبر الجداول للتحقق من سلامة التوثيق وحداثة المراجع المستخدمة. إن هذا التدقيق المكتبي الآلي يقلل من الأخطاء التوثيقية الشائعة في رسائل الماجستير والدكتوراه، ويعزز النزاهة المنهجية للإنتاج الأكاديمي (Kirschner & van Merriënboer, 2013).
10. أفضل الممارسات المتقدمة لتعظيم الكفاءة وقابلية التوسع
10.1 دمج TEXTAFTER مع الدوال المصفوفية الحديثة مثل LET و LAMBDA
يمثل استدعاء الدوال الحسابية بشكل متكرر في المصنفات الضخمة هدراً لطاقة المعالج؛ لذا يُنصح بالانتقال إلى بناء هياكل برمجية معيارية داخل الخلايا باستخدام دالتي LET و LAMBDA. تتيح دالة LET تعريف متغيرات داخلية وتخزين النصوص المنقاة لمرة واحدة في الذاكرة لتجنب تكرار الحسابات المستهلكة للوقت، كما في النموذج التالي:
=LET(

    CleanText, TRIM(A2),

    Result, TEXTAFTER(CleanText, " ", -3, , , CleanText),

    Result

)
وللارتقاء البرمجي إلى مستويات المؤسسات، يمكن تحويل هذه المنظومة إلى دالة مخصصة دائمة باستخدام دالة LAMBDA وحفظها في مدير الأسماء (Name Manager) تحت مسمى ExtractLastWords بتعريف الصيغة:
=LAMBDA(cell, n, TEXTAFTER(TRIM(cell), " ", -n, , , TRIM(cell)))
يتيح هذا التخصيص للمستخدمين في كافة أقسام المؤسسة كتابة =ExtractLastWords(A2, 3) كصيغة قياسية مدمجة، مما يحسن مقروئية النماذج الحسابية ويسهل صيانتها مستقبلاً بصورة استثنائية.
10.2 إدارة الأداء الحسابي في المصنفات الضخمة
عندما تتجاوز مصنفات إكسل مئات الآلاف من الصفوف، فإن بقاء الدوال النصية نشطة وقابلة لإعادة الحساب اللحظي (Volatile Calculations) قد يتسبب في بطء ملحوظ أثناء إدخال البيانات أو فتح الملف. تشير أفضل الممارسات الهندسية لإدارة الأداء إلى ضرورة تنفيذ خطة من خطوتين:
أولاً، تفعيل وضع الحساب اليدوي (Manual Calculation) أثناء بناء النماذج المعقدة لمنع المحرك من إعادة تقييم الدوال مع كل تعديل حرفي في المصنف. ثانياً، بعد الانتهاء من استخراج الكلمات وتدقيق النتائج، يوصى بنسخ عمود المخرجات ولصقه في نفس الموضع كقيم ثابتة عبر خيار اللصق كقيم (Paste as Values). يؤدي هذا الإجراء إلى حذف المحرك البرمجي للدوال من الذاكرة والاحتفاظ بالنصوص المستخرجة النهائية، مما يخفف حجم الملف بنسب هائلة ويوفر استجابة فورية لكافة العمليات اللاحقة.
10.3 وضع بروتوكول مؤسسي للتحقق من سلامة البيانات المستخرجة
تتطلب إدارة حوكمة البيانات في المؤسسات البحثية والشركات وضع بروتوكول رقابي صارم يضمن موثوقية السلاسل المستخرجة وصحتها قبل دمجها في تقارير الأعمال. يتمثل هذا البروتوكول في بناء أعمدة تدقيق منطقية تستخدم دالتي LEN و ISBLANK لفحص ومقارنة أطوال السلاسل والتأكد من خلو الخلايا من القيم الشاذة أو المسافات الصامتة.
كما يتضمن البروتوكول تصميم قواعد التحقق من صحة البيانات (Data Validation) لمنع إدخال نصوص تحتوي على محارف غير مألوفة، مع توثيق كافة الصيغ المستخدمة وأدلتها التشغيلية في “دليل المعايير القياسية للمشروع” (Standard Operating Procedure – SOP). يضمن هذا الالتزام المؤسسي اتساق المنهجية التحليلية عبر الزمن وحماية البيانات من التشوهات الناجمة عن تبدل فرق العمل أو تحديث البرمجيات.
خاتمة
في الختام، يظهر لنا بوضوح أن استخراج آخر ثلاث كلمات من خلية في إكسل يمثل مهارة جوهرية تنطلق من فهم هندسي دقيق لآليات معالجة السلاسل النصية ومحركات الحسابات المتقدمة. لقد نجحت دالة TEXTAFTER، المدعومة بالفهرسة العكسية، في إحداث ثورة منهجية يسرت التعامل مع البيانات النصية غير المهيكلة بعد عقود من الاعتماد على معادلات التضخيم الفراغي المعقدة والأكواد البرمجية الشاقة.
إن إتقان تطبيق هذه الصيغ الحديثة، مقرونة بتقنيات التطهير المسبق مثل TRIM و SUBSTITUTE، وضمان سلامتها عبر دوال التحقق من الأخطاء و LET و LAMBDA، يمنح الباحثين والمحللين أداة لا غنى عنها لتحويل النصوص السردية المشوشة إلى ركائز تصنيفية نقية ومهيأة للتحليل الإحصائي الرصين. إن تبني هذه الممارسات القياسية ليس مجرد تسريع للمهام الإدارية، بل هو ارتقاء بجودة البحث العلمي وإدارة البيانات نحو أعلى معايير الدقة والاحترافية.
المراجع
- Borghouts, J. W., Eikey, E. V., Mark, G. J., De Leon, C., Schueller, S. M., Schneider, M. L., et al. (2021). Barriers to and Facilitators of User Engagement With Digital Mental Health Interventions: Systematic Review. Journal of Medical Internet Research. https://doi.org/10.2196/24387
- Kirschner, P. A., & van Merriënboer, J. J. G. (2013). Do Learners Really Know Best? Urban Legends in Education. Educational Psychologist. https://doi.org/10.1080/00461520.2013.804395
- Sloman, S. A., Love, B. C., & Ahn, W.-K. (1998). Feature Centrality and Conceptual Coherence. Cognitive Science. https://doi.org/10.1016/s0364-0213(99)80039-1