
تُعد معالجة السلاسل النصية وضبط هياكل البيانات الاسمية من أكثر العمليات تكراراً وأهمية في بيئات العمل الإدارية والبحثية، ولا سيما عند إدارة قواعد البيانات الضخمة في برنامج مايكروسوفت إكسيل (Microsoft Excel). يواجه محللو البيانات ومدخلو السجلات الأكاديمية والتنظيمية تحدياً مستمراً يتمثل في توحيد المخرجات واختزال النصوص الطويلة وتحويل الأسماء الكاملة للأفراد والمشاركين إلى أحرف أولى أو رموز تعريفية موجزة وموحدة؛ وذلك لتلبية متطلبات تشفير الهوية، أو توليد المعرفات الفريدة، أو تحسين المظهر الجمالي والوظيفي للجداول والمخططات البيانية التلخيصية.
يتناول هذا المقال الدليل المتكامل والمؤصل علمياً وتقنياً لطرائق استخراج الأحرف الأولى من الأسماء داخل بيئة إكسيل بمختلف إصداراتها، بدءاً من المنظومة الحديثة القائمة على محرك الدوال الديناميكية في مايكروسوفت 365 (Microsoft 365) وإكسيل 2024، مروراً بالمعادلات الكلاسيكية المعقدة التي تعتمد على تفكيك المواقع الفهرسية للمحارف، ووصولاً إلى خوارزميات الذكاء الاصطناعي والاستقراء النصي المتمثلة في ميزة التعبئة السريعة، وأتمتة العمليات عبر محرر باور كويري ولغة البرمجة فيجوال بيسك للتطبيقات (VBA). كما يضع المقال هذه الإجراءات التقنية في سياقها المنهجي الدقيق من حيث أمن البيانات والامتثال لأخلاقيات البحث العلمي والخصوصية الرقمية.
سوف تكتسب من خلال هذا المرجع الشامل فهماً عميقاً لآليات اقتطاع النصوص، وكيفية التعامل مع التحديات اللغوية والتركيبية مثل تباين عدد مقاطع الأسماء، وتداخل المسافات غير المرئية، وإدارة حالات الشذوذ البرمجي؛ مما يُمكّنك من بناء أوراق عمل قوية ومرنة وقابلة للتطوير في مختلف التطبيقات المؤسسية والأكاديمية المتقدمة.
1. مقدمة تأصيلية لمفهوم استخراج الأحرف الأولى في إكسيل وأهميته البيانية
1.1 ماهية الأحرف الأولى (Initials) ودواعي استخدامها في معالجة النصوص
تُعرّف الأحرف الأولى (Initials) في سياق حوسبة النصوص ومعالجة الجداول الإلكترونية بأنها المتتالية الرمزية الناتجة عن اقتطاع المحرف الاستهلالي من كل مقطع اسمي مستقل يُشكل الاسم الكامل للشخص أو الكيان. تمثل هذه الأحرف صيغة مكثفة ومختزلة بيانياً تهدف إلى الإبقاء على دلالة الهوية مع تقليص المساحة المكانية والتخزينية اللازمة لعرض النص، وهو أمر بالغ الأهمية عند تصميم لوحات المعلومات التفاعلية (Dashboards) وبطاقات العمليات الرقمية التي تتطلب واجهات مستخدم مقتضبة وواضحة بصرياً.
تتجاوز دواعي استخراج الأحرف الأولى مجرد الرغبة في التنسيق البصري؛ إذ تشكل هذه الرموز الركيزة الأساسية لتوليد حسابات المستخدمين التلقائية وعناوين البريد الإلكتروني المؤسسية في المنظمات الكبرى، حيث يُدمج الحرف الأول من الاسم الأول مع الاسم العائلي الكامل. علاوة على ذلك، تُستخدم هذه التقنية في بناء المفاتيح الأساسية (Primary Keys) ومصفوفات الترميز المتقاطع، مما يسمح بالربط المنطقي بين الجداول المتباينة دون الحاجة إلى معالجة السلاسل النصية الطويلة ذات الاحتمالية العالية لتكرار الأخطاء الإملائية.
من الناحية الأكاديمية والبحثية، تبرز أهمية هذه العملية عند تهيئة السجلات المسحية وجداول جمع العينات الميدانية؛ حيث يسعى الباحثون إلى تمثيل أسماء المفحوصين بصورة محايدة داخل جداول التحليل الإحصائي، مما يحد من التحيزات الإدراكية أثناء تقييم البيانات ويسهل في الوقت ذاته قراءة الأنماط النصية ضمن مجموعات البيانات المعقدة والمتشابكة.
1.2 التحديات الهيكلية المرتبطة بتباين السلاسل النصية للأسماء
تعتبر معالجة الأسماء من أعقد مهام تنقية البيانات النصية في إكسيل؛ نظراً لعدم خضوع الأسماء البشرية لقالب هندسي ثابت ومحدد الطول. تتراوح البنى الاسمية داخل السجلات بين أسماء ثنائية بسيطة (الاسم الأول واسم العائلة)، وأسماء ثلاثية تتضمن الاسم الأوسط، وأسماء مركبة ورباعية وخماسية ذات امتدادات متعددة، الأمر الذي يجعل من تطبيق معادلة اقتطاع ذات طول حرفي ثابت أمراً غير مجدٍ ويقود حتماً إلى نتائج مشوهة أو مبتورة.
تتضاعف الصعوبة نتيجة إشكالية الشوائب المطبعية، وفي مقدمتها المسافات البادئة (Leading Spaces) التي تسبق الاسم، أو المسافات اللاحقة (Trailing Spaces) التي تأتي في ختامه، فضلاً عن المسافات المزدوجة والمتعددة التي تفصل بين المقاطع دون قصد. يتسبب وجود مسافة مفردة زائدة في بداية النص في دفع دوال الاقتطاع التقليدية إلى سحب الفراغ نفسه كحرف أولي، مما يُسقط القيمة الدلالية للرمز المستخرج ويؤدي إلى انهيار قواعد المطابقة اللاحقة.
يُضاف إلى ذلك البعد اللغوي الفارق بين الأبجديات؛ فالنصوص اللاتينية تتميز بحالة الأحرف (الأحرف الكبيرة والصغيرة Upper and Lower Case)، مما يجعل اقتطاع الحرف الأول معيارياً للتمييز البصري. في المقابل، تفرض اللغة العربية خصوصية هيكلية تتعلق باتصال الحروف وانفصالها، ووجود أدوات تعريف ولواحق وبادئات متصلة بالأسماء (مثل “ال” التعريف، والأسماء المركبة من قبيل “عبد الله” أو “نور الدين”)، مما يتطلب استراتيجيات تقنية استثنائية لعزل المقاطع وتحديد البدايات الفعلية للكتل المعجمية.
1.3 المعايير المنهجية لاختيار أسلوب المعالجة الأمثل في إكسيل
يتطلب اتخاذ القرار التقني السليم لمعالجة السلاسل النصية في إكسيل وزناً دقيقاً لثلاثة محددات رئيسية: حجم مصفوفة البيانات، ومستوى الديناميكية المطلوب في ورقة العمل، وبيئة التشغيل والإصدار البرمجي المعتمد. عندما يتعامل المحلل مع آلاف الصفوف المتجددة يومياً، تصبح كفاءة استهلاك الذاكرة وسرعة إعادة الحساب (Calculation Engine Overhead) هي المعيار الحاكم؛ إذ تؤدي الصيغ المعقدة وغير المحسوبة إلى بطء ملحوظ وتجميد لمصنف البيانات.
تبرز المفاضلة الجوهرية بين الحلول القائمة على المعادلات التلقائية (Formula-based Solutions) والحلول المؤتمتة بواسطة الشيفرات البرمجية أو الأدوات المدمجة. توفر المعادلات ميزة التحديث اللحظي؛ فإذا عُدِّل الاسم في العمود المرجعي ينعكس التغيير فوراً على خلية الأحرف الأولى، إلا أنها تتطلب فهماً عميقاً لبناء الدوال. في المقابل، تقدم أدوات مثل التعبئة السريعة (Flash Fill) سرعة فائقة للمهام المؤقتة التي لا تتطلب تحديثاً لاحقاً، بينما تمنح بيئات مثل Power Query استقراراً مطلقاً في خطوط معالجة واستخراج البيانات واسعة النطاق (ETL Pipelines).
يظل إصدار برنامج إكسيل هو القيد التقني الأبرز؛ إذ إن التحديثات الجوهرية التي أطلقتها مايكروسوفت في السنوات الأخيرة أعادت صياغة مفهوم معالجة النصوص عبر تقديم دوال مصفوفية مرنة للغاية، مثل دالتي اقتطاع النصوص ودالة تقسيم النصوص. غير أن الاعتماد الكامل على هذه الأدوات الحديثة يحول دون تشغيل الملف بسلاسة على بيئات الحوسبة القديمة كإصدارات 2016 و2019 وما دونها، مما يُلزم المحلل باختيار حل يكفل التوافقية الشاملة مع بقية أطراف العمل.
2. التشريح الوظيفي للصيغة الأساسية المعتمدة على دالتي TEXTBEFORE وTEXTAFTER
2.1 التحليل النظري لآلية عمل دالة LEFT في استخلاص المحارف
تُمثل دالة LEFT حجر الزاوية الكلاسيكي في منظومة الاقتطاع النصي داخل إكسيل. تقوم هذه الدالة بمهمة محددة بدقة رياضية: استخلاص عدد معين من المحارف بدءاً من أقصى الطرف الأيسر للسلسلة النصية، بصرف النظر عن طبيعة المحرف المستخرج سواء كان حرفاً أبجدياً، أو رقماً، أو مسافة فارغة، أو رمزاً خاصاً. التركيب النحوي القياسي للدالة يُصاغ على النحو التالي: LEFT(text, [num_chars])، حيث يمثل الوسيط الأول النص المستهدف أو المرجع الخلوي، بينما يُعبر الوسيط الثاني عن العدد الكمي للمحارف المراد عزلها.
تكتسب هذه الدالة فاعليتها الاستثنائية عند استخراج الأحرف الأولى من خلال ميزتها السلوكية الافتراضية؛ فعند إغفال تحديد الوسيط الثاني [num_chars] داخل الصيغة، يفترض محرك إكسيل تلقائياً أن القيمة المطلوبة هي واحد (1). وبناءً عليه، فإن كتابة LEFT(Text) تقتطع الحرف الأول حصراً، مما يختزل التعقيد النحوي للمعادلات الطويلة.
يكمن التحدي في أن دالة LEFT المجردة لا تملك أي قدرة إدراكية للتعرف على الحدود الفاصلة بين الكلمات داخل الجملة الواحدة؛ فهي تقرأ السلسلة كشريط مستمر من المحارف المتتالية. وبالتالي، فإن استخدامها بمفردها على اسم كامل مثل “John Doe” سيسفر فقط عن استخراج الحرف الأول من الاسم الأول (“J”)، عاجزةً عن رؤية بداية الاسم العائلي؛ ما يجعل تكاملها مع دوال الكشف عن المحددات النصية ضرورة حتمية لا غنى عنها.
2.2 دور دالة TEXTBEFORE في استخراج الاسم الأول بدقة
تُعد دالة TEXTBEFORE إحدى الإضافات النوعية الثورية التي أدخلتها مايكروسوفت على محرك إكسيل، حيث تم تصميمها لمعالجة النصوص بالاعتماد على المنطق السياقي والمحددات بدلاً من الاعتماد الحصري على الترقيم الفهرسي للمواضع الحرفية. تتولى الدالة فحص السلسلة النصية الممررة إليها من بدايتها، ومسح المحارف بصورة متسلسلة حتى تصطدم بالمحدد النصي المعين (كالمسافة الفاصلة مثلاً)، لتعيد على الفور كل ما يسبق ذلك المحدد وتتجاهل ما سواه.
يأخذ التركيب النحوي للدالة الصيغة: TEXTBEFORE(text, delimiter, [instance_num], [match_mode], [match_end], [if_not_found]). في التطبيق الأساسي لاستخراج الاسم الأول، نستخدم المحدد المتمثل في مسافة فارغة واحدة " ". عند تغذية الدالة باسم ثنائي مثل “Alan Turing”، تقوم الدالة بمسح النص وعند وصولها للمسافة الواقعة بين الاسمين، تقتطع النص “Alan” بالكامل ككتلة نصية نقية ومستقلة، محصورة قبل ذلك الفاصل.
تمتلك الدالة مرونة برمجية فائقة عبر وسيط التكرار [instance_num]، والذي يُضبط افتراضياً على القيمة 1 للإشارة إلى المسافة الأولى، مما يمنح المحلل تحكماً مطلقاً في عزل المقاطع النصية المحددة بدقة متناهية دون أدنى حاجة لإجراء حسابات تفريد المواضع الحرفية المعقدة.
2.3 وظيفة دالة TEXTAFTER في التقاط الاسم الأخير أو اللاحق
تعمل دالة TEXTAFTER كمرآة وظيفية معاكسة لدالة TEXTBEFORE؛ إذ تركز على اقتناص الكتلة النصية التي تعقب محدد المسافة المعين بدلاً من تلك التي تسبقه. تتولى الدالة فحص السلسلة ومسحها حتى ترصد المحدد المذكور، ومن ثم تقوم بإنشاء تدفق مخرجات يضم كل ما يلي تلك النقطة الزمنية والمكانية من حروف ورموز إلى نهاية النص الأصلي.
صيغة الدالة النحوية تماثل نظيرتها: TEXTAFTER(text, delimiter, [instance_num], [match_mode], [match_end], [if_not_found]). عند معالجة الاسم “Alan Turing” باستخدام مسافة كعلامة فاصلة، تلتقط الدالة فورا السلسلة “Turing”. تتيح هذه الوظيفة عزل مقطع الاسم العائلي في متغير نصي افتراضي مستقل داخل الذاكرة المؤقتة لمحرك المعادلات، مما يجعله جاهزاً للاستقبال والمعالجة اللاحقة عبر دوال أخرى.
التكامل العضوي بين دالتي الاقتطاع الموقعي والطرفي يتجلى في تمرير مخرجات دالة TEXTAFTER مباشرة كمدخل رئيسي لدالة LEFT، حيث تتولى الأخيرة اقتطاع المحرف الأول من تلك الكتلة النصية اللاحقة، وهو الحرف “T” في المثال المذكور، محققة بذلك التقاط بداية الاسم الأخير دون أي احتكاك مع بقية تفاصيل الكلمة.
2.4 معامل الدمج النصي (&) ودوره في توحيد المخرجات
يمثل معامل الدمج النصي (&) والمعروف تقنياً بـ (Ampersand) الأداة الرابطة المباشرة في لغة معادلات إكسيل لتنفيذ عمليات التسلسل النصي (Concatenation). يقوم هذا المعامل بربط سلسلتين نصيتين أو أكثر تم استخراجهما من مصادر أو دوال مختلفة، ودمجهما معاً في سلسلة نصية واحدة متماسكة تحتضنها خلية العرض النهائية.
في إطار مسألة استخراج الأحرف الأولى، يعمل هذا المعامل كجسر واصل يربط بين ناتج الجزء الأيسر من المعادلة (الحرف الأول من الاسم الأول) وناتج الجزء الأيمن منها (الحرف الأول من الاسم الأخير). هذا الدمج يتم دون إنشاء أي فراغات بينية افتراضية، مما يفرز النتيجة بصيغة رمزية مدمجة مثل “AT”.
علاوة على ذلك، يمنح معامل الربط المحلل حرية تنسيقية كاملة للتحكم في النمط النهائي للمخرجات؛ فبالإمكان إدخال نقاط فاصلة أو مسافات تنظيمية بين الأحرف عبر دمج نصوص ثابتة محصورة بعلامات اقتباس، كصياغة التركيب التالي: LEFT(...) & "." & LEFT(...) & "."؛ وهو ما يضمن مطابقة النتائج للمحددات الشكلية المعتمدة في التقارير المؤسسية والأكاديمية الرفيعة.
3. الدليل التطبيقي خطوة بخطوة لاستخراج الأحرف الأولى للأسماء الثنائية
3.1 إعداد بيئة البيانات وهيكلة الأعمدة المرجعية
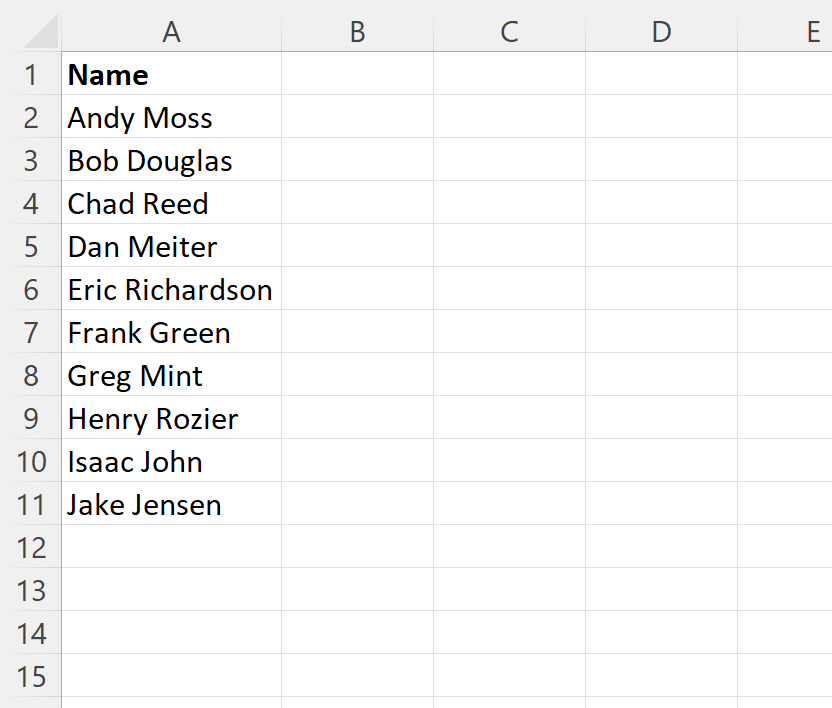
تبدأ الممارسة الرصينة لأي مشروع معالجة بيانات في إكسيل من التأسيس المنظم لبيئة العمل داخل ورقة الحساب. يتطلب ذلك تثبيت البيانات الأصلية غير المعالجة في عمود مرجعي مخصص، وليكن العمود A، على أن تبدأ المدخلات الفعلية للأسماء الكاملة من الخلية A2 تاركين الصف الأول بالكامل لعناوين الحقول (Headers) التوصيفية.
يجب تخصيص عمود مجاور ومستقل، وليكن العمود B، لحفظ واستعراض النتائج المستخلصة للأحرف الأولى. يهدف هذا الفصل الهيكلي الصارم إلى تجنب خطر الكتابة فوق البيانات المصدرية الأصلية وتأمين مسار مراجعة تدقيقي يتيح مقارنة النتائج بالمدخلات في أي وقت. ينبغي التأكد مسبقاً من ضبط تنسيق خلايا العمودين على التنسيق “نص” (Text) أو “عام” (General) لتفادي أي تحويلات حسابية تلقائية غير مرغوبة قد يفرضها البرنامج على بعض التركيبات الحرفية الخاصة.
من الخطوات الوقائية المحورية في هذه المرحلة فحص خلو الأسماء من أي رموز غريبة أو علامات ترقيم شاذة، والتأكد من أن كل خلية في العمود A تشتمل على مقطعين اسميين تفصل بينهما مسافة قياسية واحدة، حيث إن ضبط بيئة الإدخال هو الضمان الأساسي لكفاءة الصيغ التي سيتم تضمينها في الخطوة اللاحقة.
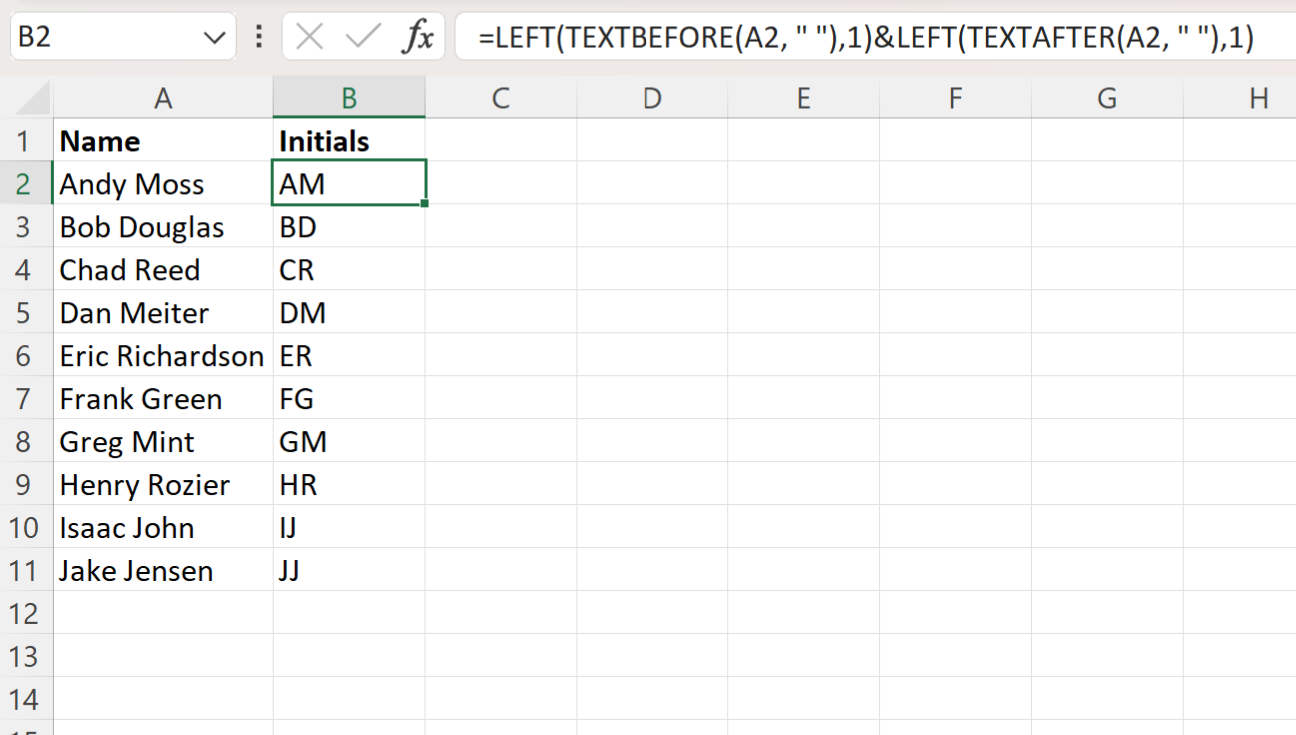
3.2 صياغة المعادلة المركبة وإدخالها في ورقة العمل
بعد تجهيز مسار البيانات، ننتقل إلى الخلية B2 لبناء وإدخال المعادلة المتكاملة المعنية باستخراج الأحرف الأولى من الاسم الثنائي المقابل في الخلية A2. تعتمد هذه المعادلة على توليف دقيق يجمع الدوال الأربع التي جرى تشريحها، وتُكتب الصيغة الرياضية كما يلي:
=LEFT(TEXTBEFORE(A2, " "), 1) & LEFT(TEXTAFTER(A2, " "), 1)
عند تفكيك هذه الصيغة منهجياً، نجد أن TEXTBEFORE(A2, " ") تعزل الاسم الأول بدقة، ثم تقتطع دالة LEFT(..., 1) الحرف المبتدأ به. تكرر الدالتان التاليتان العمل نفسه على الاسم الأخير المتبقي بعد المسافة بواسطة TEXTAFTER(A2, " ") واقتطاع أول حرف منه. يتولى الرمز & وصل الرمزين في قالب موحد. تجب العناية الفائقة بكتابة المسافة بين علامتي اقتباس مزدوجتين " " بمسافة مسطرة وحيدة ودقيقة، مع التحقق من الإغلاق المتوازن لجميع الأقواس الرياضية لضمان سلامة التنفيذ الحسابي للخلية دون ظهور أخطاء التركيب النحوي.
3.3 تعميم الصيغة وتطبيق السحب التلقائي على النطاق
بمجرد تثبيت الصيغة بنجاح في الخلية B2 والتحقق من ظهور الحرفين الأولين الصحيحين للاسم المقابل، يأتي دور تعميم المعالجة عبر كامل السلسلة البيانية في ورقة العمل. يُنفذ ذلك عملياً من خلال وضع مؤشر الفأرة على الزاوية السفلية من الخلية B2 حتى يتحول المؤشر إلى رمز علامة الزائد السوداء المصمتة والمعروفة بـ “مقبض التعبئة” (Fill Handle)، ومن ثم الضغط المزدوج بزر الفأرة الأيسر لإنزال الصيغة تلقائياً حتى آخر صف نشط في العمود A.
خلال هذا الانزلاق الرأسي، يعتمد إكسيل على آلية “الإسناد النسبي” (Relative Reference) لمراجع الخلايا؛ فالإشارة إلى الخلية A2 في الصف الثاني ستتحول تلقائياً إلى A3 في الصف الثالث، وإلى A4 في الصف الرابع، وهكذا دواليك؛ مما يضمن ارتباط كل خلية مستخلصة بسجل الاسم الموازي لها رأسياً دون أي تداخل في الذاكرة الحسابية.
لتحقيق مستوى أعلى من الأتمتة الاحترافية، يُفضل دائماً تحويل النطاق البياني بأكمله إلى “جدول إكسيل رسمي” (Excel Table) عبر النقر على الاختصار Ctrl + T. في هذه الحالة، بمجرد كتابة الصيغة في الخلية الأولى من عمود الأحرف الأولى، يقوم إكسيل بملء وتوليد العمود بأكمله بصورة فورية، كما تتمدد المعادلة تلقائياً لأي صفوف جديدة تضاف لاحقاً إلى السجل دون الحاجة لإعادة السحب اليدوي.
4. التعامل المتقدم مع الأسماء الثلاثية ومتعددة المقاطع
4.1 قصور الصيغة الثنائية البسيطة أمام البنى الاسمية المعقدة
تُظهر التجارب العملية الميدانية أن الصيغة الثنائية المعتمدة على TEXTBEFORE وTEXTAFTER البسيطة تنهار أو تفقد دقتها التحليلية بمجرد مواجهتها لأسماء تتألف من أكثر من مقطعين؛ كالأسماء الثلاثية الشائعة (مثل “John Fitzgerald Kennedy”) أو الأسماء العربية المركبة. يرجع هذا القصور إلى السلوك الطبيعي للدالة؛ إذ إن TEXTBEFORE المحددة بالمسافة الأولى ستقتطع بالفعل الحرف الأول من الاسم الأول (“J”)، ولكن دالة TEXTAFTER الافتراضية ستلتقط كل ما يلي المسافة الأولى (“Fitzgerald Kennedy”)، وعند تطبيق دالة LEFT عليها، ستقتطع الحرف الأول من الاسم الأوسط (“F”) متجاهلةً تماماً الاسم الأخير، لينتج لدينا الرمز (“JF”) بدلاً من الرمز الصحيح المكتمل (“JFK”).
يتسبب هذا السلوك في حدوث تشوهات بيانية فادحة في قواعد البيانات؛ حيث تُسقط هوية العائلة أو المقطع الختامي للاسم، وهو المقطع الأكثر تمييزاً في أغلب الثقافات والمؤسسات الإدارية. يتطلب تجاوز هذه الإشكالية الانتقال من منطق الفواصل الثنائية المنفردة إلى استراتيجيات معالجة متعددة المقاطع تستطيع التعامل مع عدد عشوائي ومتغير من الكلمات داخل السجل الواحد دون أن تتخلى عن أي من مقاطعه البادئة.
4.2 توظيف الدوال الديناميكية الحديثة: مصفوفة TEXTSPLIT
لحل هذه المعضلة البنيوية، طرحت مايكروسوفت دالة المصفوفات فائقة التطور TEXTSPLIT، والتي غيرت جذرياً من قواعد معالجة النصوص البرمجية داخل إكسيل. تتميز هذه الدالة بقدرتها على تقطيع الجملة الكاملة إلى مصفوفة خطية من الكلمات المستقلة بناءً على محدد نصي معين، حيث تُفرد كل كلمة كعنصر مستقل في الذاكرة الحسابية.
صيغة الدالة الأساسية هي: TEXTSPLIT(text, col_delimiter, [row_delimiter]). عند كتابة الصيغة TEXTSPLIT(A2, " ") على الاسم “Mohamed Ali Ahmed”، تقوم الدالة داخلياً بتوليد مصفوفة أحادية البعد تتألف من ثلاثة عناصر: {"Mohamed", "Ali", "Ahmed"}.
تكتسب هذه التقنية بريقها عند دمجها مع دالة LEFT؛ حيث تسمح ميزات المصفوفات الديناميكية (Dynamic Arrays) لدالة LEFT بالعمل المتزامن على كل عناصر المصفوفة المفرزة دفعة واحدة. بمجرد صياغة LEFT(TEXTSPLIT(A2, " "), 1)، يقوم محرك الحساب باقتطاع الحرف الأول من كل مقطع، لينتج مصفوفة فرعية تضم: {"M", "A", "A"}، مما يُمثل تفكيكاً دقيقاً وحصراً شاملاً لكافة الأحرف الاستهلالية دون إهمال أي مقطع وسيط أو ختامي.
4.3 بناء معادلة عامة مرنة تستوعب أي عدد من المقاطع الاسمية
تكتمل المنظومة الحديثة بمعالجة المصفوفة الناتجة وإعادة دمج عناصرها الحرفية المتفرقة ضمن خلية واحدة غير قابلة للتناثر عبر استخدام دالة الدمج المتقدمة CONCAT. تم تصميم هذه الدالة لتلتقط مصفوفات النصوص وتقوم بوصل محتوياتها دون إدراج أي محددات إلا إذا رغب المستخدم في ذلك.
المعادلة المركبة المتكاملة تصاغ نهائياً كالتالي:
=CONCAT(LEFT(TEXTSPLIT(A2, " "), 1))
تُمثل هذه الصيغة القمة التقنية في المرونة البرمجية داخل إكسيل 365؛ فهي معادلة شاملة تتكيف ديناميكياً مع أي بنية نصية تُلقى إليها. إذا احتوت الخلية A2 على اسم أحادي أخرجت حرفه الأول، وإذا تضمنت اسماً ثنائياً استخلصت حرفين، وإذا كان الاسم رباعياً أو خماسياً اقتطعت الأحرف الأولى من كافة المقاطع بالترتيب الصارم ودمجتها في متتالية واحدة دون أي حاجة للتعديل اليدوي على الصيغة، مما يجعلها الخيار النموذجي لبناء قواعد البيانات المركزية التي تستقبل مدخلات غير مقيدة بأطوال محددة.
5. الحلول البديلة في الإصدارات الكلاسيكية من إكسيل (Legacy Formulas)
5.1 استخراج الحرف الأول والأخير عبر مزيج LEFT وRIGHT وFIND
تفرض بيئات العمل التي تعتمد على إصدارات إكسيل الكلاسيكية (مثل Excel 2010 أو 2013 أو 2016) قيوداً هيكلية لعدم توفر الدوال الحديثة فيها، مما يتطلب من مهندس البيانات اللجوء إلى التفكير الخوارزمي التقليدي القائم على تحديد إحداثيات المحارف الرقمية. لاستخراج الحرف الأول من الاسم الأول والحرف الأول من الاسم الأخير في اسم ثنائي، يتم المزج بين دالتي LEFT وMID بالتعاون مع دالة البحث الموضعي FIND.
تُستخدم دالة FIND(" ", A2) لتحديد الترتيب العددي للموضع الذي توجد فيه المسافة الفاصلة داخل السلسلة. وبما أن الحرف الأول من الاسم الأخير يقع مباشرة بعد تلك المسافة، فإن موضعه الرياضي هو FIND(" ", A2) + 1. بالبناء على هذه الحقيقة الرياضية، تُصاغ المعادلة الكلاسيكية كما يلي:
=LEFT(A2, 1) & MID(A2, FIND(" ", A2) + 1, 1)
في هذا التركيب، تستخلص LEFT(A2, 1) المحرف الاستهلالي الأول للمدخل النصي. وتتولى دالة MID الاقتطاع من منتصف السلسلة عبر تغذيتها بثلاثة معطيات: النص المصدر (A2)، وموقع بداية الاقتطاع المحسوب عبر دالة البحث مضافاً إليه واحد، وعدد المحارف المطلوب اقتطاعها وهو محرف واحد. يُربط الناتجان معاً بواسطة معامل الدمج ليشكلا الناتج الرمزي المأمول بدقة متناهية تتوافق مع أقدم إصدارات البرنامج دون أدنى خلل تشغيلي.
5.2 تقنية الاستبدال المتقدمة باستخدام TRIM وSUBSTITUTE وREPT
عندما تزداد المهمة تعقيداً في الإصدارات القديمة وتكون الغاية استخراج الحرف الأول من المقطع الأخير في سلاسل غير معلومة عدد الكلمات، يقف مزيج LEFT وFIND عاجزاً عن التمييز. هنا ابتكر مطورو إكسيل تقنية معالجة كلاسيكية شهيرة تعتمد على توسيع الفضاء النصي اصطناعياً عبر مثلث الدوال: SUBSTITUTE وREPT وTRIM.
تعتمد الفكرة الخوارزمية لهذه التقنية على استبدال كل مسافة مفردة في الاسم بمصفوفة واسعة من المسافات الفارغة (وليكن طولها 100 مسافة) باستخدام الدالة REPT(" ", 100) متداخلة مع دالة الاستبدال SUBSTITUTE(A2, " ", REPT(" ", 100)). ينتج عن هذا تفجير وهمي للسلسلة النصية؛ حيث تتباعد الكلمات عن بعضها بمئات المحارف الفارغة في الذاكرة الحسابية.
للحصول على الحرف الأول من الاسم الأخير في هذا الفضاء الموسع، يتم استدعاء دالة RIGHT لاقتطاع كتلة ضخمة من الطرف الأيمن للنص تساوي 100 حرف، والتي ستشمل حتماً الاسم الأخير محاطاً بسيل من المسافات الفارغة السابقة له. تُمرر هذه الكتلة إلى دالة TRIM لتبديد كافة المسافات الزائدة وإبقاء الكلمة نقية، ليُقتطع منها الحرف الأول عبر دالة LEFT، وهو تكتيك حوسبي استثنائي لحل مشكلات المعالجة المعقدة دون وجود دوال مصفوفية مباشرة.
5.3 المفاضلة المعيارية بين الصيغ التقليدية والصيغ الحديثة
تكشف المقارنة التقنية بين النهج الكلاسيكي والنهج الحديث تفاوتاً جوهرياً في معايير كفاءة هندسة البرمجيات وأوراق العمل، ويمكن إيجاز أبرز هذه الفروق في النقاط التالية:
- مستوى التعقيد والمقروئية (Readability): تتميز الصيغ الحديثة بالوضوح الدلالي والتوافق مع التفكير المنطقي البشري؛ فقراءة صيغة مثل
CONCAT(LEFT(TEXTSPLIT(...)))تكشف للمحلل وظيفتها فوراً، بينما تفرض الصيغ الكلاسيكية كابوساً برمجياً في الصيانة والمراجعة نظراً لتكدس دوال المواضع وتكرار الإشارات الحسابية المعقدة. - احتمالية الأخطاء البشرية: ينطوي بناء الصيغ التقليدية على مخاطر مرتفعة لانزلاق الأقواس وفقدان إحداثيات الزيادة (+1) الخاصة بالمحارف، مما يرفع معدل حدوث الأخطاء النحوية في أوراق العمل الضخمة مقارنة بالبنى الحديثة المباشرة.
- التوافقية والشمولية (Compatibility): تتفوق الحلول الكلاسيكية بصورة مطلقة في جانب التوافق؛ حيث تضمن للمؤسسة تشغيل الملف على كافة الأنظمة والأجهزة القديمة، وحزم وتطبيقات الطرف الثالث، والبرمجيات السحابية التي لم تقم بعد بترقية محركات حساب إكسيل الخاصة بها إلى المعايير المستحدثة.
6. استخراج الأحرف الأولى بدون معادلات: استثمار ميزة التعبئة السريعة (Flash Fill)
6.1 الأسس الخوارزمية لخاصية Flash Fill في استقراء الأنماط النصية
تُمثل خاصية التعبئة السريعة (Flash Fill)، التي أدمجتها مايكروسوفت في إكسيل بدءاً من إصدار 2013، تطبيقاً عملياً متقدماً لخوارزميات التعلم الآلي والاستقراء البرمجي المؤتمت (Program Synthesis by Example). تعود هذه التقنية في أصولها الأكاديمية إلى الأبحاث الرائدة التي قادها العالم سوميت غولواني (Sumit Gulwani) وفريقه البحثي في مختبرات مايكروسوفت للأبحاث، والتي نشرت في المؤتمر المرموق ACM SIGPLAN Symposium on Principles of Programming Languages عام 2011 تحت عنوان أتمتة معالجة النصوص في الجداول الإلكترونية.
تعمل خوارزمية Flash Fill عبر مسح البيانات المجاورة لحظياً ورصد التحويلات النصية التي يجريها المستخدم بين العمود المصدر والعمود الهدف. تقوم الخوارزمية بإنشاء شجرة برامج تصف كافة التفسيرات الممكنة لكيفية تحول النص الأصلي إلى القيمة الناتجة؛ وعندما يكتب المستخدم مثالاً أو مثالين، تُسقط الخوارزمية المسارات غير المتسقة وتستنتج تلقائياً القاعدة المنطقية الأدق، كأن تفهم أن المطلوب هو استخلاص الحرف الأول من الكلمة الأولى والحرف الأول من الكلمة الثانية.
بالرغم من القوة المذهلة لهذه الخوارزمية، إلا أنها تتأثر بشدة بمستوى اتساق البيانات المدخلة؛ فهي تعتمد على التنبؤ الإحصائي والاستقرائي، وتفقد دقتها في حال وجود سجلات شاذة أو متضاربة في الهيكل ضمن نفس المصفوفة، مما يستدعي تدريباً إضافياً عبر تصحيح بعض العينات لتقويم مسار النموذج البرمجي المستنتج.
6.2 خطوات التنفيذ العملي لميزة Flash Fill
يتميز تطبيق التعبئة السريعة بالبساطة الانسيابية والسرعة التشغيلية الفائقة، ويتم تنفيذه عبر الخطوات القياسية المحددة التالية:
- تجهيز عمود الأسماء الكاملة (مثل العمود A) وتخصيص العمود الملاصق له مباشرة (العمود B) للمخرجات، مع التأكد التام من عدم وجود أعمدة فارغة تفصل بينهما؛ لتمكين الخوارزمية من الارتباط الموضعي المباشر بمصدر الاستقراء.
- الانتقال إلى الخلية B2، وكتابة الأحرف الأولى يدوياً بالصيغة المرغوبة تماماً (مثلاً: كتابة “JD” للاسم “John Doe” الموجود في الخلية A2)، ثم الضغط على مفتاح
Enterللانتقال إلى الخلية B3. - استدعاء أداة التعبئة السريعة عبر تنفيذ الاختصار اللوحي الشائع
Ctrl + E، أو الذهاب إلى شريط الأدوات الرئيسي (Ribbon)، ثم تبويب “بيانات” (Data)، والنقر على أيقونة “التعبئة السريعة” (Flash Fill) ضمن مجموعة أدوات البيانات. - تقوم الأداة فورياً بالتنبؤ بجميع الأحرف الأولى وتعبئة كامل العمود حتى نهاية الجدول. يجب على المحلل بعد ذلك مسح النتائج بحثاً عن أي أخطاء استقرائية؛ وعند العثور على اسم لم يُستخلص بصورة صحيحة (كالأسماء الثلاثية)، يتم تعديل تلك الخلية يدوياً ليقوم محرك الخوارزمية ذاتياً بإعادة تدريب النموذج وتصحيح كامل البيانات المتأثرة بتلك القاعدة.
6.3 المقارنة التحليلية بين Flash Fill والصيغ الحسابية الديناميكية
تضع هذه المقارنة حدود الفصل الفني بين المهام العارضة والمشاريع المؤسسية المستدامة. تتفوق خاصية التعبئة السريعة باكتساح في معيار السرعة والتنفيذ الفوري اللحظي؛ إذ لا تتطلب من المستخدم أي حفظ أو صياغة للمعادلات المعقدة، كما أنها تُريح موارد المعالج تماماً من استهلاك دورات الحساب، مما يجعلها مثالية لمديري البيانات الذين يرغبون في إعداد تقرير سريع لمرة واحدة (Ad-hoc Reporting).
في المقابل، يكمن القصور الجوهري لخاصية Flash Fill في طبيعة مخرجاتها؛ فهي تولد “قيماً نصية ثابتة” (Static Text) غير مرتبطة برابط تشغيلي مع البيانات المصدرية. هذا يعني بشكل قاطع أنه إذا تم تعديل اسم أحد الموظفين أو الطلاب في العمود A لاحقاً، فلن تتأثر الأحرف الأولى في العمود B على الإطلاق وستبقى محتفظة بقيمتها القديمة، مما يقود إلى تضارب وتلوث في السجلات.
تتفوق المعادلات والصيغ الرياضية في ميزة الديناميكية والتحديث التلقائي اللحظي؛ مما يجعل الحل الرياضي حتمياً في أوراق العمل المشتركة، وقواعد البيانات المفتوحة، وتطبيقات الاستقصاء التي تتطلب موثوقية تشغيلية مستمرة دون الحاجة لتدخل بشري لإعادة التعبئة مع كل تغيير في المدخلات.
7. إدارة الشوائب النصية والأخطاء الشائعة وحالات الشذوذ
7.1 تطهير النصوص من المسافات الزائدة باستخدام دالة TRIM
تُعد المسافات الطفيلية من أكبر مسببات فشل معادلات استخراج الأحرف الأولى في إكسيل. إذا احتوت الخلية A2 على مسافة بادئة غير مرئية قبل الاسم (مثل ” John Doe”)، فإن دالة LEFT(A2, 1) ستقتطع تلك المسافة الفارغة بدلاً من الحرف الأول “J”، مما ينتج رمزاً مفرغاً يشوه مصفوفة البيانات دون أن يلاحظ المستخدم ذلك بالعين المجردة بسهولة.
لضمان الحصانة الهيكلية، يجب دمج دالة التطهير TRIM في صلب أي معادلة نصية، حيث تتولى هذه الدالة مسح كافة المسافات البادئة واللاحقة واختزال أي مسافات بينية متعددة في مسافة مفردة ونظامية. تأخذ الصيغة المحصنة الهيكل التالي:
=LEFT(TEXTBEFORE(TRIM(A2), " "), 1) & LEFT(TEXTAFTER(TRIM(A2), " "), 1)
تزداد المشكلة حدة عند استيراد البيانات من متصفحات الويب وقواعد البيانات الشبكية، حيث تصدر تلك المنصات مسافات غير قابلة للكسر (Non-breaking Spaces) تُعرف بالرمز الحسابي CHAR(160)، وهي مسافات تعجز دالة TRIM التقليدية عن التعرف عليها أو إزالتها. في هذه الحالة، يتحتم على المحلل تطهير النص عبر استبدال هذه المحارف بمسافات نظامية عبر الدالة: SUBSTITUTE(A2, CHAR(160), " ") قبل تمريرها لمعادلات الاقتطاع لضمان السلامة الكاملة للمدخلات المعجمية.
7.2 معالجة الخلايا الفارغة وتفادي أخطاء #CALC! و#VALUE!
تتعرض معادلات النصوص للانهيار الفوري عند مواجهة خلايا فارغة في النطاق المرجعي أو خلايا تحتوي على نصوص تفتقر إلى المحددات الفاصلة المتوقعة؛ حيث يُلقي محرك إكسيل أخطاء تشغيلية قبيحة ومربكة مثل #VALUE! أو #CALC!، مما يؤثر سلباً على المظهر المهني للتقرير ويوقف تدفق العمليات الحسابية المرتبطة به في ورقة العمل.
يتحتم على المحلل بناء جدران حماية منطقية لتحصين المعادلات من هذه الانقطاعات؛ ويتم ذلك عبر مسارين رئيسيين: الأول هو استخدام دالة الحماية المباشرة IFERROR، والتي تلتف حول الصيغة البرمجية لتعيد قيمة بديلة مدروسة (مثل ترك الخلية فارغة "") في حال وقوع أي خطأ غير متوقع، كما في البناء التالي: =IFERROR(LEFT(TEXTBEFORE(...))..., "").
المسار الثاني والأكثر دقة منهجية هو الفحص الاستباقي للخلية عبر دالة IF الشرطية للتأكد من احتوائها على قيمة فعلية قبل إطلاق عمليات المعالجة المعقدة، كأن نقول: =IF(OR(A2="", ISBLANK(A2)), "", [الصيغة]). هذا النهج يمنع محرك إكسيل من إهدار الذاكرة في معالجة مئات الخلايا الفارغة في نهاية الجداول ويوفر بيئة عمل نظيفة ومستقرة تماماً من الناحية البرمجية.
7.3 معالجة الأسماء أحادية المقطع والبادئات الخاصة
تتطلب الأسماء المفردة المكونة من مقطع واحد دون مسافات (مثل “Plato” أو “Aristotle”) معالجة شرطية خاصة؛ فدوال مثل TEXTBEFORE تعتمد وجود المحدد لإتمام عملها، وغياب المسافة في الاسم الأحادي يؤدي تلقائياً إلى توقف الدالة وإطلاق خطأ فشل العثور على المحدد الحسابي. لتلافي ذلك، يمكن توظيف المعاملات الإضافية المدمجة في دالة TEXTBEFORE، وتحديداً وسيط [if_not_found] وضبطه ليعيد النص الأصلي كاملاً عند عدم وجود مسافة، مما يتيح لدالة LEFT العمل عليه واقتطاع حرفه الأول بنجاح.
تظهر إشكالية أخرى تتمثل في بادئات الأسماء والألقاب الأكاديمية والمهنية (مثل “Dr.”, “Prof.”, “Mr.”، أو باللغة العربية “د.”, “م.”, “أ.”). إذا تم إهمال هذه البادئات، فإن المعادلات ستستخلص الحرف الأول من اللقب الأكاديمي بدلاً من الاسم الفعلي للشخص، مما يجعل الحرف الأول للمخرجات هو “D” لجميع الأطباء في قاعدة البيانات، وهو ما يفسد القيمة التعريفية للأحرف الأولى بشكل كامل.
تستدعي معالجة هذه الحالة استبعاد هذه الألقاب إما بمرحلة تنقية مسبقة تعتمد على استبدال الألقاب الشائعة بقيم فارغة، أو عبر صياغة معادلات تفحص الكلمة الأولى؛ فإذا تطابقت مع قائمة الألقاب المحظورة، تتجاهلها الصيغة وتقفز مباشرة للبدء في تطبيق الاقتطاع من الكلمة اللاحقة.
8. تطوير دالة مخصصة (UDF) باستخدام لغة Visual Basic for Applications (VBA)
8.1 الأساس النظري لبناء الدوال المعرفة من المستخدم في إكسيل
على الرغم من القوة والشمولية التي توفرها الصيغ الحديثة المدمجة، إلا أن متطلبات العمل في المؤسسات الكبرى وكثافة المعالجة تتطلب في كثير من الأحيان اختزال الصيغ المعقدة والطويلة في دوال مبسطة وسهلة التداول للمستخدم النهائي. تتيح بيئة فيجوال بيسك للتطبيقات (VBA) إمكانية ابتكار وتطوير دوال مخصصة يُطلق عليها “دوال معرفة من قبل المستخدم” (User-Defined Functions – UDFs).
تتمثل الفلسفة النظرية للـ UDF في نقل عبء المعالجة والتفرع المنطقي من داخل شريط الصيغ في ورقة العمل إلى الشيفرة المصدرية في المحرر الخلفي؛ حيث تُصاغ الخوارزمية داخل وحدة نمطية برمجية (Module) بلغة هيكلية نقية، ويتم الإعلان عنها كدالة تتلقى وسائط نصية وتعيد مخرجات محددة. يمنح ذلك ميزة استثنائية؛ إذ يتحول التعبير المعقد ذو الأقواس المتعددة إلى دالة بسيطة ومقروءة وموجزة للغاية، مثل كتابة =GetInitials(A2) في ورقة العمل.
يسهم هذا الأسلوب المنهجي في توحيد معايير المعالجة عبر كامل أقسام المنظمة؛ فعند الحاجة لتحديث قواعد الاقتطاع أو معالجة حالة شذوذ جديدة، يتم تعديل الكود البرمجي في نقطة مركزية واحدة داخل محرر الفيجوال بيسك دون الحاجة للمرور على آلاف الخلايا لتعديل الصيغ الرياضية المتناثرة فيها.
8.2 التحليل البرمجي لكود استخراج الأحرف الأولى عبر VBA
لبناء دالة مرنة وقوية لاستخراج الأحرف الأولى عبر VBA تتكيف تلقائياً مع أي عدد من المقاطع الاسمية، يتم فتح محرر الأكواد عبر الاختصار Alt + F11، وإدراج وحدة نمطية جديدة (Standard Module)، وكتابة الشيفرة البرمجية المحكمة التالية:
Function GetInitials(TargetCell As Range) As String
    Dim Words() As String
    Dim CleanText As String
    Dim OutputText As String
    Dim i As Long

    If TargetCell.Cells.CountLarge > 1 Or IsEmpty(TargetCell) Then
        GetInitials = "": Exit Function
    End If

    CleanText = Application.WorksheetFunction.Trim(TargetCell.Value)
    If CleanText = "" Then GetInitials = "": Exit Function

    Words = Split(CleanText, " ")
    For i = LBound(Words) To UBound(Words)
        If Len(Trim(Words(i))) > 0 Then
            OutputText = OutputText & UCase(Left(Trim(Words(i)), 1))
        End If
    Next i

    GetInitials = OutputText
End Function
يقوم التحليل الوظيفي لهذا الكود على تنظيف النص أولاً من الشوائب والمسافات الزائدة باستخدام وظيفة WorksheetFunction.Trim الخاصة بإكسيل. بعد ذلك، تقوم دالة Split البرمجية بتفتيت النص وتخزين كلماته داخل مصفوفة ديناميكية من نوع نصوص Words() بالاعتماد على الفاصل المتمثل في المسافة. تنطلق بعد ذلك حلقة تكرارية For...Next تلف بدقة على عناصر المصفوفة من أول عنصر إلى آخر عنصر، حيث تقتطع الحرف الأول من كل كلمة بواسطة الدالة Left، وتضمن تحويله لحرف كبير (Capital) عبر دالة UCase، لتدمجه تباعاً في متغير التجميع النهائي المسمى OutputText وتُرجعه إلى الخلية المستدعية بدقة وسرعة متناهيتين.
8.3 إدارة المصنفات الحاوية على وحدات ماكرو وضوابط الأمان
يتطلب دمج الأكواد البرمجية داخل مصنفات إكسيل فهماً دقيقاً لضوابط الحفظ والحماية المتبعة في بيئة تشغيل مايكروسوفت أوفيس؛ إذ إن حفظ الملف بالصيغة التقليدية القياسية .xlsx سيتسبب فورياً في محو كافة أكواد الـ VBA والـ UDFs المكتوبة بشكل نهائي لا رجعة فيه عند إغلاق الملف، دون توجيه إنذارات مسبقة تعيد بناء الأكواد المفقودة.
يتحتم حفظ المصنف بصيغة تدعم الماكرو؛ وتحديداً امتداد .xlsm (Excel Macro-Enabled Workbook) أو صيغة الملفات الثنائية فائقة الأداء .xlsb. تضمن هذه الصيغ حماية الشيفرة المصدرية وتكاملها مع بنية ورقة العمل عند إعادة الفتح والتشغيل عبر المنصات المختلفة.
على الجانب الأمني، تفرض المؤسسات سياسات صارمة عبر “مركز التوثيق” (Trust Center) التابع لمايكروسوفت؛ حيث يتم حظر تشغيل الماكرو تلقائياً على الملفات غير الموثوقة تفادياً لتهديدات الشيفرات الخبيثة. لذلك، يجب توثيق المصنف أو وضعه في “موقع موثوق” (Trusted Location) على خادم العمل المحلي لضمان عمل الدالة المخصصة بسلاسة لجميع أعضاء الفريق، مع مراعاة أن دوال الـ UDF قد تشهد أداءً حسابياً أبطأ نسبياً مقارنة بالدوال المدمجة مسبقاً في لغة C++ الأساسية للبرنامج عند تطبيقها على ملايين الصفوف البيانية دفعة واحدة.
9. معالجة مجموعات البيانات الضخمة وأتمتة العمليات عبر Power Query
9.1 استيراد البيانات وتهيئتها داخل محرر Power Query
عندما تتجاوز متطلبات معالجة البيانات حدود الجداول الصغيرة وتدخل في نطاق مئات الآلاف من السجلات المؤسسية، يُصبح محرك Power Query هو الأداة الأكثر تفوقاً واستقراراً لإنشاء خطوط المعالجة وتطهير السلاسل النصية. يضمن هذا المحرك أداءً فائق الكفاءة؛ لأنه ينفذ تحويلات “غير مدمرة” للبيانات الأصلية ويفصل بيئة الاستيراد والمعالجة التمهيدية تماماً عن مساحة ورقة العمل الحسابية.
تبدأ العملية بتحديد جدول الأسماء والانتقال إلى تبويب “بيانات” (Data)، ثم الضغط على “من جدول/نطاق” (From Table/Range) لإطلاق نافذة محرر الباور كويري. داخل هذه البيئة، يتم تنفيذ الخطوات التطهيرية الأولية على عمود الأسماء بنقرات بسيطة ودون الحاجة لأي معادلات معقدة، حيث يتم تطبيق أوامر التشذيب النصي المسبق (Trim) وتنظيف المحارف غير القابلة للطباعة (Clean)، مع توحيد الأحرف إن كانت باللغة الإنجليزية لتجهيز العمود لعمليات الاستخلاص الهيكلية.
تتمثل ميزة هذا النهج في بناء سلسلة خطوات معالجة خطية (Applied Steps) مسجلة بدقة على واجهة المحرر؛ حيث يتم حفظ كافة التحويلات على هيئة تدفق إجرائي يعاد تطبيقه أوتوماتيكياً كلما تم تحديث البيانات المصدرية بنقرة واحدة على زر “تحديث” (Refresh)، متفوقاً بذلك على أساليب السحب اليدوي للمعادلات.
9.2 تطبيق تحويلات التقسيم والاستخراج المنهجية
يُتيح المحرر البصري للباور كويري تنفيذ عملية استخراج الأحرف الأولى عبر التتابع المنطقي للأدوات التحويلية المتضمنة في شريطه العلوي عبر الخطوات المعيارية التالية:
- تحديد عمود الأسماء المنقح، والتوجه إلى تبويب “إضافة عمود” (Add Column)، ثم النقر على “تقسيم العمود” (Split Column) واختيار “بواسطة المحدد” (By Delimiter)، مع تحديد محدد المسافة الفاصلة (Space) وتحديد خيار التقسيم عند كل ظهور للمحدد لإنشاء أعمدة جديدة منفصلة لكل كلمة من الاسم.
- تحديد كافة الأعمدة الناتجة عن التقسيم دفعة واحدة عبر زر
Shift، والتوجه لأيقونة “استخراج” (Extract) في تبويب التحويل، واختيار “المحارف الأولى” (First Characters)، وكتابة الرقم 1 في المربع الحواري. يؤدي هذا التحويل الفوري إلى استبدال الكلمات بالكامل بالأحرف الأولى المستخلصة منها فقط في كل عمود على حدة. - تظليل الأعمدة الحرفية المستخلصة حسب الترتيب الصحيح، والنقر بزر الفأرة الأيمن لاختيار “دمج الأعمدة” (Merge Columns)، وتحديد الفاصل “لا شيء” (None)، وتسمية العمود الجديد باسم “الأحرف الأولى” (Initials).
- حذف الأعمدة الوسيطة الزائدة إذا تطلب الأمر، ثم الضغط على أيقونة “إغلاق وتحميل” (Close & Load) في القائمة الرئيسية لترحيل عمود الأحرف الأولى المكتمل إلى ورقة عمل إكسيل بصورة جدول نهائي منسق ونظيف ومحمي بالكامل.
9.3 كتابة صيغ مخصصة باستخدام لغة M المتقدمة
للمحترفين الساعين وراء أقصى درجات المرونة والأناقة البرمجية دون الحاجة لتوليد أعمدة وسيطة متعددة داخل محرر الباور كويري، تتيح لغة إم (M Language) المتخصصة صياغة دالة أحادية مدمجة في خطوة واحدة لمعالجة السلسلة النصية مهما بلغ عدد مقاطعها الاسمية. يتم ذلك عبر إضافة “عمود مخصص” (Custom Column) وإدخال الصيغة التالية:
Text.Combine(List.Transform(Text.Split([FullName], " "), each Text.Start(_, 1)))
تقوم هذه الصيغة المتطورة بتطبيق المنطق البرمجي التكاملي عبر ثلاث طبقات معالجة داخلية متتالية: تبدأ بدالة Text.Split([FullName], " ") التي تُفكك الاسم في الخلية إلى قائمة نصوص (List) مجردة تضم كل الكلمات. تعقبها دالة List.Transform التي تمر على كل عنصر في تلك القائمة المستخلصة وتطبق عليه دالة Text.Start(_, 1) لاقتطاع المحرف الأول من كل كلمة حصراً.
في المرحلة الختامية، تلتقط دالة Text.Combine هذه الأحرف المستخلصة وتدمجها معاً في سلسلة نصية واحدة مصمتة دون فواصل. تتميز هذه الشيفرة بقدرتها الاستثنائية على تنفيذ المعالجة داخل محرك الذاكرة المباشر دون المساس بهيكل الجدول العام، مما يحافظ على ثبات وسرعة النماذج البيانية الضخمة التي تحتوي على مئات الآلاف من القيود الاسمية.
10. أفضل الممارسات الأكاديمية لحوكمة البيانات وضمان اتساق المخرجات
10.1 توحيد المعايير الشكلية وحالة الأحرف (Casing Standardization)
يفرض العمل الأكاديمي والتوثيقي المتقدم الالتزام بأقصى درجات الانضباط الشكلي فيما يخص تمثيل البيانات النصية؛ إذ يُعد التباين في حالة الأحرف (كأن يظهر بعضها كأحرف استهلالية كبيرة Upper-case وبعضها كأحرف صغيرة Lower-case) عيباً صريحاً في ضبط جودة قواعد البيانات. عند استخراج الأحرف الأولى من نصوص مدخلة بحروف غير متناسقة (مثل “john doe”)، يجب إجبار الصيغة على توحيد الناتج وتحويله لأحرف كبيرة من خلال تطويق المعادلة المستخرجة بدالة UPPER، كما يلي: =UPPER(CONCAT(...))، لضمان مظهر رمزي رسمي موحد (“JD”).
في الدراسات التوثيقية والسجلات الأرشيفية الصارمة، يُشترط تطبيق “التنسيق المنقط” المنهجي، وهو التنسيق الذي يفصل بين كل حرف أولي بنقطة نظامية (مثل: “A.B.C.”)؛ للدلالة الاصطلاحية على أن هذه المحارف هي اختزالات لأسماء محذوفة وليست كلمة اعتباطية مستقلة. يتحقق ذلك بسهولة في إكسيل عبر تعديل دوال الدمج أو إضافة نقاط تنقيط في مصفوفة TEXTSPLIT.
كما تجب العناية بتحديد الاتجاه البصري للنصوص (Text Direction) ومحاذاة الخلايا؛ فالأحرف اللاتينية يجب أن تُضبط لتنساب بصرياً من اليسار إلى اليمين (LTR) لمنع التداخل البصري والتشوه التنسيقي الذي يحدث عندما يحاول إكسيل محاذاة رموز لاتينية مختزلة من اليمين إلى اليسار ضمن واجهات الاستخدام العربية.
10.2 التحقق من صحة البيانات (Data Validation) والضبط المسبق للمدخلات
تقوم حوكمة البيانات المتقدمة على قاعدة ذهبية تنص على أن “الوقاية من إدخال البيانات الفاسدة أولى وأجدى اقتصادياً من تطهيرها لاحقاً”. لضمان نجاح واستدامة خوارزميات ومعادلات استخراج الأحرف الأولى عبر دورة حياة قاعدة البيانات، يجب تطبيق قواعد “التحقق من صحة البيانات” (Data Validation) على أعمدة الإدخال الأصلية لتقييد سلوكيات المستخدمين ومنع الأخطاء الشائعة استباقياً.
يمكن للمحلل وضع قيود إدخال مخصصة تمنع تسجيل الأسماء التي تفتقر للمسافات الفاصلة عبر تطبيق شروط صيغ التحقق مثل: =ISNUMBER(FIND(" ", A2))؛ مما يُلزم مدخل البيانات بتضمين الاسم الثنائي الكامل كحد أدنى ورفض إدخال الأسماء المفردة المبتورة. كما يمكن وضع قيود طولية لمنع إدخال النصوص شديدة الطول أو التي تحوي رموزاً حسابية غير مبررة.
يجب بالتوازي بناء مؤشرات تدقيق دورية تعتمد على التنسيق الشرطي (Conditional Formatting)؛ لتظليل السجلات التي تنتج أخطاء نصية تلقائياً باللون الأحمر داخل ورقة العمل، مما يتيح لفرق المراجعة التدقيقية رصد الحالات الشاذة ومراجعتها وتصحيحها فورياً قبل تصدير البيانات إلى مستودعات التحليل المؤسسي النهائي.
10.3 تحسين الأداء الحسابي في المصنفات الضخمة المعقدة
يواجه مستخدمو إكسيل مشكلات جدية في تجمد الملفات وبطء الاستجابة الحسابية عندما تُطبق الصيغ النصية المعقدة على مصفوفات تتجاوز عشرات الآلاف من الصفوف. يعود السبب التقني وراء هذا البطء إلى أن محرك الحساب يضطر لإعادة تقييم كافة السلاسل والمحددات النصية عند كل تعديل بسيط يطرأ على أي خلية داخل ورقة العمل، لا سيما إذا احتوت الصيغ على دوال مصفوفية متعددة.
لتحقيق الكفاءة الحسابية المثلى، يُوصى باتباع منهجية المعالجة المتدفقة ثم التجميد: بمجرد تطبيق الصيغ على عمود الأسماء والتحقق الشامل من دقة وسلامة الأحرف الأولى المستخرجة، يتم تحديد عمود النتائج بالكامل ونسخه Ctrl + C، ثم إعادة لصقه فوق موضعه نفسه باستخدام خاصية “لصق كقيم” (Paste as Values) عبر الاختصار Alt + E + S + V أو من قائمة اللصق الخاصة.
يؤدي هذا الإجراء الذكي إلى تحويل مئات الآلاف من الصيغ الحسابية النشطة والمعقدة إلى نصوص نهائية خفيفة ومستقرة في الذاكرة، مما يحرر معالج الحاسوب تماماً من أعباء إعادة الحساب المستمرة، ويوفر ملف عمل فائق السرعة جاهزاً للنشر والعرض المؤسسي دون أي تأخير برمجي، مع الاحتفاظ دائماً بنسخة احتياطية من المصنف تضم المعادلات الأصلية لأغراض التدقيق والتطوير المستقبلي.
11. الأبعاد المنهجية وأخلاقيات إدارة البيانات في البحوث والمنظمات
11.1 سرية البيانات وتوليد المعرفات غير المباشرة
يرتبط استخراج الأحرف الأولى في السياقات الأكاديمية والبحثية ارتباطاً وثيقاً بمسألة إدارة سرية بيانات المشاركين وحماية الهوية الفردية. يسود في بعض الأوساط البحثية تصور غير دقيق يفيد بأن تحويل أسماء المشاركين في التجارب السلوكية أو الطبية أو الاستقصاءات المسحية إلى أحرف أولى يُمثل إجراءً كافياً لتحقيق “إخفاء الهوية الكامل” (Anonymization). غير أن الفحص المنهجي الدقيق لمعايير حوكمة البيانات يثبت عكس ذلك بشكل قاطع.
وفقاً للمعايير الدولية الصارمة لحماية البيانات، مثل اللائحة العامة لحماية البيانات في الاتحاد الأوروبي (GDPR) وتشريعات خصوصية المعلومات الصحية (HIPAA)، فضلاً عن المبادئ الأخلاقية الصادرة عن جمعية علم النفس الأمريكية (APA Ethics Code 4.07)، فإن الأحرف الأولى لا تُعد بيانات مجهولة الهوية، بل تُصنف قانونياً ومنهجياً كمعرفات غير مباشرة بديلة أو مقنّعة (Pseudonymous Indirect Identifiers / Quasi-identifiers). يكمن الخطر في أن هذه الأحرف، عند دمجها في الجداول مع متغيرات وبيانات وصفية أخرى (كالسن، والرمز البريدي، والوظيفة، أو الفئة المستهدفة)، تجعل احتمالية إعادة تحديد هوية الشخص الحقيقية (Re-identification Risk) مرتفعة للغاية.
بناءً على ذلك، يتمثل التوجيه المنهجي الرصين في عدم الاعتماد على الأحرف الأولى كأداة وحيدة لتأمين سرية السجلات الحساسة، بل يجب أن يقتصر استخدامها على الأغراض التنسيقية والتنظيمية المؤقتة، مع اعتماد بروتوكول توليد أرقام تعريفية عشوائية أو تسلسلية محايدة تماماً (مثل PID_001 أو SUBJ_1024) كمعرفات رئيسية وحيدة في قواعد البيانات النهائية المتاحة للتحليل والنشر، بما يكفل الامتثال التام لأخلاقيات البحث العلمي وحماية الخصوصية الرقمية.
خاتمة
تناول هذا الدليل الاستقصائي والشامل مختلف الأبعاد التقنية والهندسية المرتبطة باستخراج الأحرف الأولى من الأسماء داخل برنامج مايكروسوفت إكسيل، بدءاً من تفكيك الأساس المنطقي للدوال الحديثة مثل TEXTBEFORE وTEXTAFTER وTEXTSPLIT وCONCAT في إكسيل 365، ومروراً بالحلول الموضعية المعقدة في الإصدارات الكلاسيكية، وتطبيقات الاستقراء الآلي في التعبئة السريعة، وصولاً إلى الأتمتة المتقدمة في محرر Power Query والبرمجة النصية عبر VBA. وقد تبين جلياً أن نجاح المعالجة لا يتوقف فقط على معرفة التركيب النحوي للدوال، بل يتطلب رؤية شمولية تراعي تنقية الشوائب النصية، والتحوط من أخطاء السلاسل الشاذة، والالتزام الصارم بمعايير حوكمة البيانات وحمايتها أخلاقياً وتنظيمياً، مما يمنح محلل البيانات الأدوات الاحترافية اللازمة لبناء قواعد بيانات متينة، مرنة، وموثوقة تدعم اتخاذ القرارات المؤسسية بكفاءة واقتدار.
المراجع
- Gulwani, S. (2011). Automating string processing in spreadsheets using input-output examples. ACM SIGPLAN Notices, 46(1), 317–330. https://doi.org/10.1145/1925844.1926423
- Microsoft. (n.d.). TEXTBEFORE function. Microsoft Support. Retrieved from https://support.microsoft.com/en-us/office/textbefore-function-d099c283-da60-4594-88ad-e470266157c8
- Microsoft. (n.d.). TEXTAFTER function. Microsoft Support. Retrieved from https://support.microsoft.com/en-us/office/textafter-function-290b39c0-138a-483a-bb52-24d6425600d4
- Microsoft. (n.d.). TEXTSPLIT function. Microsoft Support. Retrieved from https://support.microsoft.com/en-us/office/textsplit-function-b146e1e3-3ff0-424d-acba-079787e91547
- Microsoft. (n.d.). Using Flash Fill in Excel. Microsoft Support. Retrieved from https://support.microsoft.com/en-us/office/using-flash-fill-in-excel-3f9bcf1e-db93-4767-94a6-7e10c268837f
- Microsoft. (n.d.). Power Query documentation. Microsoft Learn. Retrieved from https://learn.microsoft.com/en-us/power-query/