
تُعد معالجة النصوص وسلاسل المحارف من الركائز الجوهرية في علم إدارة البيانات وتحليل النظم الرقمية، حيث تشكل البيانات النصية غير المهيكلة أو شبه المهيكلة نسبة بالغة الضخامة من إجمالي التدفقات المعلوماتية داخل المؤسسات الأكاديمية والشركات المهنية. وفي بيئات العمل المعتمدة على الجداول الإلكترونية، ولا سيما برنامج مايكروسوفت إكسل (Microsoft Excel)، يبرز استخراج النصوص الفرعية كعملية تأسيسية لا غنى عنها لتطهير السجلات، وفصل المعرفات المدمجة، وتفكيك الشفرات المركبة، وإعداد البيانات لمراحل النمذجة الإحصائية المتقدمة. يتيح الفهم المتعمق للآليات الرياضية والمنطقية الكامنة وراء دوال النصوص للمحللين القدرة على تحويل كتل ضخمة من النصوص الخام إلى متغيرات ذرية قابلة للقياس والتحليل المقارن بدقة متناهية.
يتطلب التعامل الاحترافي مع السلاسل النصية إدراكاً شاملاً للمفاهيم الهيكلية التي تحكم تخزين البيانات داخل خلايا المصنف، والتمييز الدقيق بين التخزين الرمزي النصي والتخزين العددي الحسابي، وتأثير هذا التمايز على كفاءة الخوارزميات الحسابية داخل المصنفات المعقدة. لا تقتصر عمليات استخراج النصوص الفرعية على مجرد اقتطاع عدد ثابت من المحارف انطلاقاً من طرف محدد، بل تمتد لتشمل صياغة خوارزميات ديناميكية متعددة الطبقات تستجيب للعلامات الفاصلة المتغيرة، وتتعامل بمرونة مع الفراغات والشوائب الطباعية، وتستفيد من أحدث التطورات المعمارية التي أدخلتها مايكروسوفت على محرك الحسابات، مثل دوال المصفوفات الديناميكية والمحددات المتقدمة.
يقدم هذا المرجع الأكاديمي الشامل دليلاً تحليلياً وتطبيقياً متكاملاً لاستخراج النصوص الفرعية في برنامج إكسل، متناولاً الأسس النظرية لفهرسة المحارف، والتشريح الدقيق للدوال التقليدية الثابتة، واستراتيجيات الدمج الهجين للدوال الموضعية والبحثية، وصولاً إلى أحدث الدوال الذكية مثل دالتي TEXTBEFORE وTEXTAFTER وأدوات التفكيك المصفوفي. يهدف هذا العمل إلى تزويد الباحثين ومحللي النظم بالأدوات المعرفية والتقنية الضرورية لتحقيق أعلى درجات الدقة والموثوقية في معالجة مجموعات البيانات الكبرى وتفادي الانزلاقات البرمجية الشائعة التي تعيب جودة التقارير والتحليلات التطبيقية.
1. الأسس النظرية لمعالجة النصوص وسلاسل المحارف في إكسل
1.1 مفهوم السلسلة النصية والنص الفرعي في التحليل الحاسوبي
في علوم الحاسوب وتحليل النظم، تُعرَّف السلسلة النصية (String) بأنها متتالية خطية مرتبة من المحارف الرمزية التي قد تشمل الحروف الأبجدية، والأرقام، وعلامات الترقيم، والمسافات البيضاء، والرموز الوظيفية غير المرئية. وتخضع هذه السلسلة لمبدأ الفهرسة المكانية الصارمة، حيث يُمنح كل محرف موقعاً إحداثياً محدداً يحدد ترتيبه النسبي داخل السلسلة انطلاقاً من المحرف الأول وحتى المحرف الختامي. وفي بيئة جداول إكسل، تبدأ الفهرسة المكانية دائماً من القيمة واحد (1-based indexing)، بخلاف بعض لغات البرمجة التي تعتمد الفهرسة الصفرية. ويُقصد بالنص الفرعي (Substring) أي جزء مقتطع أو متصل من المحارف يقع ضمن النطاق الحدودي لتلك السلسلة الأصلية، محتفظاً بتسلسله وترتيبه الداخلي دون أي تحوير.
يمثل التمييز بين المتغيرات النصية والمتغيرات الرقمية ركيزة بالغة الأهمية في هندسة المعادلات الحسابية؛ فالأرقام المخزنة كنصوص تُعامل كرموز شكلية مجردة لا تقبل العمليات الحسابية المباشرة بصورة افتراضية، مما يفرض استخدام تقنيات تحويل صريحة عند استخراج أجزاء رقمية من نصوص مدمجة. ويترتب على الخلط بين النوعين حدوث أخطاء عدم تطابق النوع أو إخفاق في عمليات الفرز والترتيب المنطقي. وتكتسب عملية تفكيك النصوص أهمية قصوى في معالجة وتجهيز مجموعات البيانات البحثية الضخمة (Data Wrangling)، حيث تأتي السجلات المستوردة من المستودعات الرقمية غالباً في صيغ مدمجة تضم معرفات متداخلة مثل الأكواد الوظيفية وسجلات التتبع الزمني في حقل واحد يتطلب عزلاً منهجياً.
تخضع كفاءة استخراج البيانات النصية لمعايير أداء دقيقة تتمثل في سرعة المعالجة الحسابية (Computational Latency)، والحد من استهلاك الذاكرة، وتقليل احتمالية حدوث أخطاء الإدخال البشري أو التحويل الآلي. تسهم أتمتة استخراج النصوص الفرعية عبر معادلات منضبطة في إلغاء التدخل اليدوي، مما يرفع من موثوقية قواعد البيانات الأكاديمية والمهنية ويضمن تطابق مخرجات التحليل مع المعايير القياسية لجودة البيانات.
1.2 تصنيف دوال إكسل المستخدمة في تجزئة النصوص
تُصنف دوال استخراج النصوص في إكسل أكاديمياً إلى فئتين رئيسيتين: الدوال المكانية التقليدية (Positional Functions) والدوال الشرطية الموجهة بالمحددات (Delimiter-Based Functions). تعتمد الدوال المكانية الكلاسيكية، والتي تمثلها الدوال التاريخية LEFT وRIGHT وMID، على تحديد الإحداثيات الرقمية الثابتة لنقاط البداية وأطوال المقاطع المستهدفة. وتُعد هذه الأدوات الخيار الأمثل للتعامل مع البيانات المهيكلة ذات الأطوال المعيارية المنتظمة والمحددة مسبقاً، حيث يكون لكل محرف موقع هندسي لا يتغير عبر كافة صفوف السجل البياني.
في المقابل، تمثل الدوال الحديثة القائمة على المحددات، وعلى رأسها الدالتان TEXTBEFORE وTEXTAFTER، نقلة نوعية في منهجية استقطاع النصوص؛ إذ تعتمد على البحث المنطقي عن محارف فاصلة معينة، مثل الفواصل، أو الشرطات، أو الرموز الخاصة، لاستخراج ما قبلها أو ما بعدها دون حاجة إلى حساب الطول العددي للمقطع المستهدف مسبقاً. يوفر هذا النهج مرونة فائقة عند التعامل مع البيانات النصية غير المتجانسة التي تتباين فيها أطوال المقاطع من سجل لآخر، مما يحرر المحلل من قيود المعادلات المركبة المعقدة التي كانت تجمع قديماً بين دوال الإزاحة ودوال حساب المواقع.
يعود التطور في معالجة النصوص إلى التحديثات الهيكلية التي أجرتها شركة مايكروسوفت على محرك حسابات إكسل، وبخاصة مع إطلاق محرك المصفوفات الديناميكية (Dynamic Arrays) في إصدارات Microsoft 365. سمح هذا التحديث بتمكين الدوال النصية الحديثة من إرجاع مصفوفات متعددة القيم دون الحاجة لصيغ المصفوفات التقليدية المعقدة (CSE formulas)، مما رفع من كفاءة المعالجة وجعل التعامل مع النصوص المتشعبة أمراً يتسم بالسرعة والبساطة الحسابية.
2. استخراج النصوص الفرعية من بداية السلسلة باستخدام الدالة LEFT
2.1 الصيغة الرياضية والبنية التركيبية للدالة LEFT
تُعد الدالة LEFT إحدى أقدم وأبسط الأدوات الحسابية المخصصة لاقتطاع المحارف من الطرف الأيسر للسلسلة النصية، وهو ما يتوافق مع بداية النصوص في اللغات المكتوبة من اليسار إلى اليمين كالإنجليزية، أو يمثل المحارف الأولى للسلاسل الرقمية والأكواد الموحدة بغض النظر عن اتجاه اللغة المعروضة. تُكتب الصيغة المعيارية للدالة على النحو التالي: LEFT(text, [num_chars])، حيث تمثل الوسيطة الأولى text السلسلة النصية الأصلية المراد الاقتطاع منها أو المرجع الجغرافي للخلية الحاضنة للنص، في حين تمثل الوسيطة الثانية num_chars عدداً صحيحاً موجباً يحدد كمية المحارف المستهدفة بالاستخراج.
تتسم وسيطة عدد المحارف بكونها اختيارية؛ ففي حال إغفال تحديدها وتمرير وسيطة النص وحدها، يطبق محرك إكسل السلوك الافتراضي الصارم للدالة، وهو إرجاع المحرف الأول المفرد فقط، أي ما يكافئ القيمة واحد (num_chars = 1). أما إذا كانت قيمة عدد المحارف المدخلة تتجاوز الطول الإجمالي الفعلي للسلسلة النصية، فإن الدالة تعيد النص بأكمله دون توليد أي أخطاء حسابية، في حين يؤدي إدخال قيمة سالبة إلى ارتداد الخطأ الشهير #VALUE! نتيجة تعارض المدخلات مع القيود المنطقية للدالة.
يواجه استخدام الدالة LEFT تحدياً متكرراً يتمثل في وجود المسافات الفارغة البادئة (Leading Spaces) أو الرموز غير المرئية في مستهل السلسلة النصية. فبما أن إكسل يعامل المسافة البيضاء كمحرف مستقل يشغل موقعاً فهرسياً قائماً بذاته، فإن وجود أي فراغ غير مقصود يؤدي بالضرورة إلى انزياح عملية العد واقتطاع أجزاء غير مكتملة أو مغايرة للهدف المنشود، مما يوجب دمج أدوات التطهير الأولي قبل التطبيق النهائي للمعادلة.
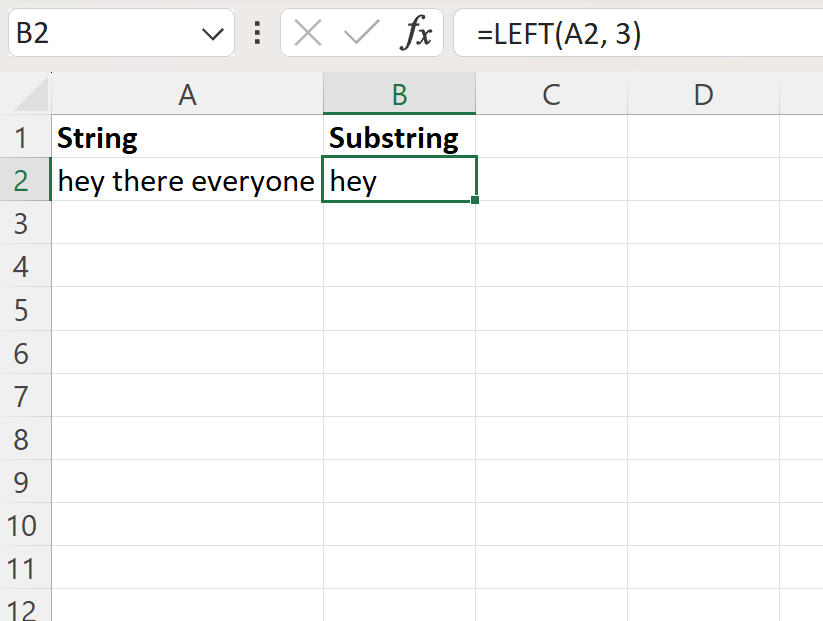
2.2 تطبيقات عملية ونماذج واقعية للدالة LEFT
تبرز التطبيقات العملية للدالة LEFT بوضوح في البيئات المؤسسية التي تعتمد أنظمة ترميز موحدة للأصول والموظفين والمنتجات. فعلى سبيل المثال، إذا كانت الشركة تعتمد كوداً وظيفياً للموظفين بصيغة ثابتة مثل “HR-89412-DEP”، حيث يعبر المقطعان الأولان دائماً عن رمز الإدارة، فإن استخدام الصيغة =LEFT(A2, 2) يكفل استخراج المقطع “HR” بدقة كاملة، مما يتيح تصنيف الموظفين وفق قطاعاتهم الإدارية عبر معادلات فرز مبسطة دون أي تعقيد برمجي.
كذلك تظهر الدالة كفاءة متقدمة في معالجة سجلات الاتصالات وأرقام الهواتف الدولية المخزنة بتنسيق نصي؛ فإذا تضمنت الخلية رقماً بصيغة “+966500000000″، فإن الصيغة =LEFT(A2, 4) تعزل رمز الدولة الدولي بدقة متناهية ليصبح “+966”. ويشيع هذا الاستخدام بصورة خاصة في تهيئة قواعد بيانات التسويق والمراسلات الأكاديمية لضمان توزيع الاتصالات الجغرافية وفق خطط انتشار مدروسة وتوزيع الحزم الاتصالية بناءً على الرموز القارية والإقليمية المستخلصة.
مع ذلك، يجب تقييم حدود كفاءة الدالة LEFT بموضوعية؛ فالدالة تفقد قدرتها التشغيلية المستقلة حينما تواجه سجلات غير منتظمة الطول، مثل فصل الاسم الأول من قائمة أسماء كاملة مدونة بصيغة متغيرة الطول مثل “محمد أحمد” و”عبد الرحمن خالد”. ففي مثل هذه البيئات الديناميكية، يتباين موقع نهاية المقطع الأول توازياً مع عدد حروف الاسم، مما يجعل استخدام وسيطة عددية ثابتة في الدالة LEFT غير مجدٍ، ويتطلب ربطها بدوال مساعدة تقوم بحساب موقع الفاصل المكاني بصورة لحظية.
3. استخراج النصوص الفرعية من نهاية السلسلة باستخدام الدالة RIGHT
3.1 الخصائص المعمارية والمعاملات المحددة للدالة RIGHT
تمثل الدالة RIGHT التوأم الوظيفي المتناظر لدالة LEFT، حيث صُممت معمارياً لاقتطاع عدد محدد من المحارف انطلاقاً من الطرف الختامي (الأيمن) للسلسلة النصية بالعد التنازلي نحو الداخل. تُصاغ الدالة رياضياً بالهيكل: =RIGHT(text, [num_chars])، محتفظة بذات القواعد البنيوية للوسيطات؛ حيث تُعامل وسيطة النص كمصدر مستهدف، وتُحدد وسيطة عدد المحارف حجم الكتلة النصية المقتطعة من أقصى النهاية، مع ضبط افتراضي لقيمة المحارف مساوياً لواحد عند الإغفال.
تتبع الدالة آلية فحص عكسية، حيث تبدأ باحتساب الموضع الأخير للسلسلة كأول محرف يُدرج ضمن المخرجات، وتستمر بالتحرك يساراً حتى استيفاء العدد المشروط. وإذا تطابق عدد المحارف المطلوب بدقة مع الطول الكلي للسلسلة (أو تجاوزه)، يُرجع المحرك السلسلة بالكامل كما هي. أما عند تصفير وسيطة عدد المحارف، تعيد الدالة نصاً فارغاً دون أن تسجل أي إخفاق هيكلي في ورقة الحساب.
تتجلى حساسية الدالة RIGHT البالغة تجاه المسافات البيضاء والرموز الخفية المتمركزة في أواخر النصوص (Trailing Spaces). فهذه الفراغات المهملة التي غالباً ما تنتج عن أخطاء النسخ واللصق أو التصدير اليدوي من متصفحات الويب تُحتسب كمحارف أصلية تستهلك حصة الاقتطاع دون أن تظهر للمستخدم بصرياً. ويؤدي ذلك إلى اقتطاع مقاطع تبدو مبتورة، وهو ما يحتم التدقيق في نظافة الحقول النصية للتأكد من خلو نهاياتها من أي شوائب رمزية مضللة.
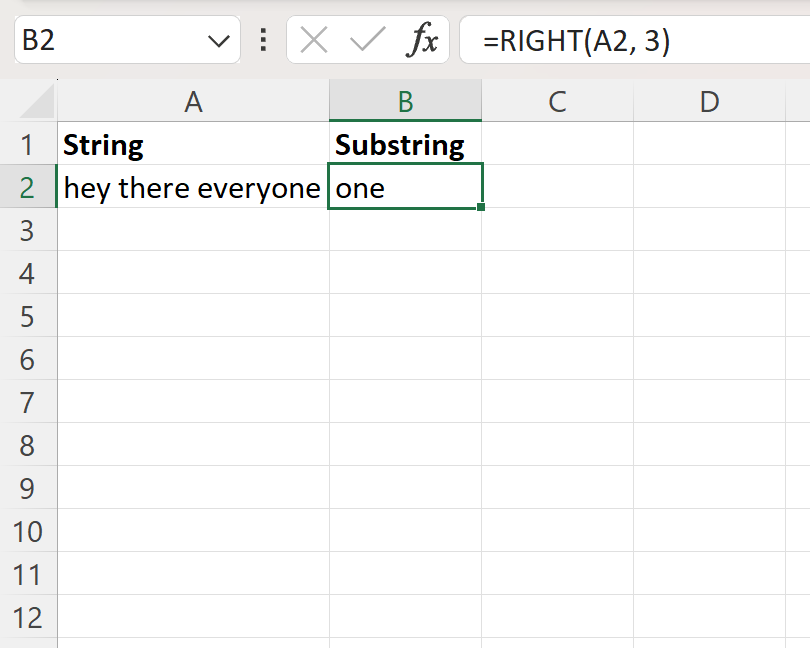
3.2 سيناريوهات تطبيقية متقدمة للدالة RIGHT
تتعدد السيناريوهات المهنية التي تبرهن على القيمة التحليلية للدالة RIGHT، ويأتي في مقدمتها استخراج امتدادات الملفات والوثائق الرقمية المخزنة داخل سجلات الأرشفة الإلكترونية. ففي حال وجود قائمة بأسماء ملفات ذات لواحق قياسية مثل “document_archive_2023.pdf” أو “analysis_dataset.csv”، يمكن استخدام الصيغة =RIGHT(A2, 3) لعزل امتداد الملف (“pdf” أو “csv”)، مما يمكن نظم إدارة المعلومات من تصنيف الوثائق آلياً وعزل الملفات التنفيذية أو التالفة عن قواعد البيانات التشغيلية.
كما تشكل الدالة ركيزة أمنية وإدارية في الأنظمة المصرفية والتأمينية التي تعتمد تقنيات الترميز المقنع (Masking) لأغراض الخصوصية؛ إذ يُطلب مراراً عرض الأرقام الأربعة الأخيرة فقط من بطاقات الائتمان أو الحسابات البنكية للمستفيدين مع طمس بقية البيانات الحساسة. فبتطبيق الصيغة =RIGHT(A2, 4) على رقم حساب مدمج، ينجح المحلل في عزل رمز التحقق الأخير، ومن ثم دمجه مع سلسلة تعمية عبر أدوات الربط النصي لإنتاج صيغة تحقق آمنة تحقق متطلبات الامتثال لحماية البيانات الشخصية.
إضافة إلى ذلك، تُستخدم الدالة بفاعلية لفصل التواريخ وسنوات التخرج الملحقة بنهايات الأكواد الأكاديمية للطلاب؛ فإذا كان السجل مدوناً بصيغة “BIO-DEPT-2022″، فإن الصيغة =RIGHT(A2, 4) تسترجع السنة “2022” كقيمة نصية مستقلة. يتيح ذلك للباحثين فرز الدفعات وتتبع التطور الزمني لمؤشرات الأداء عبر مصفوفات التحليل دون الحاجة إلى معالجة نصية يدوية شاقة.
4. استخراج المقاطع الوسيطة بدقة باستخدام الدالة MID
4.1 التشريح الدقيق لوسيطات دالة الاستقطاع الأوسط MID
تُعد الدالة MID الأداة الأكثر شمولاً وتطوراً ضمن حزمة الدوال المكانية الثلاثية في إكسل، إذ تمتلك القدرة على النفاذ إلى أي نقطة داخل السلسلة النصية واقتطاع شريحة محددة من أي موضع، متجاوزة بذلك القيد الطرفي المفروض على دالتي LEFT وRIGHT. تتأسس الدالة على ثلاث وسيطات إجبارية لا غنى عن أي منها، وتُكتب وفق البناء المعياري الآتي: =MID(text, start_num, num_chars).
تشير الوسيطة الأولى text إلى النص المصدر، بينما تمثل الوسيطة الثانية start_num نقطة الارتكاز البدئية، وهي عدد صحيح يحدد الترتيب المكاني للمحرف الأول الذي سينطلق منه الاقتطاع. أما الوسيطة الثالثة num_chars فتحدد الطول العددي للمقطع المطلوب سحبه انطلاقاً من تلك النقطة. وتخضع هذه الوسيطات لقواعد حاسوبية صارمة؛ فإذا كانت قيمة نقطة البداية أقل من واحد (1 > start_num)، يرفض المحرك الحسابي العملية ويُرجع الخطأ #VALUE! فوراً لكون الفهرسة تبدأ حصراً من المحرف الأول.
من الملاحظات الهندسية الجديرة بالاهتمام سلوك الدالة عند التعامل مع قيم متطرفة لوسيطة البداية؛ فإذا تجاوزت قيمة start_num الطول الإجمالي الفعلي للنص بكامله، فإن الدالة تُرجع نصاً فارغاً (“”) دون توقف أو إطلاق تحذير خطأ. وفي المقابل، إذا كانت نقطة البداية ضمن حدود النص ولكن وسيطة الطول num_chars تجاوزت المحارف المتبقية حتى نهاية السلسلة، فإن الدالة تستقطع كافة المحارف المتاحة انطلاقاً من موضع البدء وحتى الحرف الأخير وتتوقف تلقائياً دون إقحام مساحات فارغة مصطنعة.
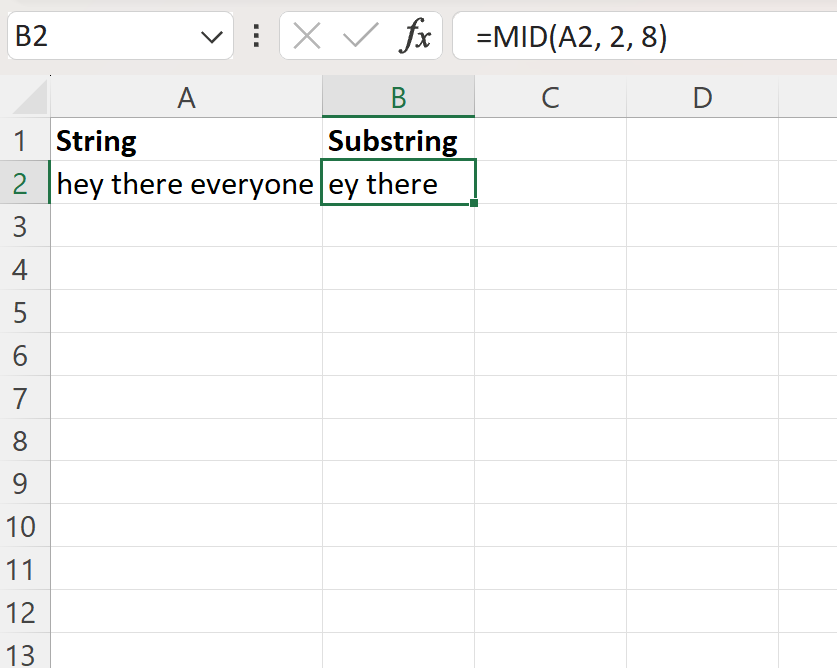
4.2 أمثلة عملية موثقة لاستخراج المقاطع المركزية
تتجلى الفائدة العظمى للدالة MID عند التعامل مع الأرقام القومية الموحدة وسجلات الهوية الوطنية المشفرة، والتي تعتمدها الدول لتسجيل بيانات المواطنين بصيغ نمطية متسلسلة. ففي النموذج المصري للرقم القومي البالغ طوله 14 رقماً، تعبر الأرقام من الموقع 2 إلى الموقع 7 عن تاريخ الميلاد (سنة، شهر، يوم). فباستخدام الصيغة =MID(A2, 2, 6)، يستخلص المحلل المقطع الممثل لتاريخ الميلاد بدقة، كما يمكنه استخراج كود محافظة الميلاد المتمركز في المحرفين 8 و9 عبر الصيغة =MID(A2, 8, 2)، مما يوفر جهداً هائلاً في التصنيف الديموغرافي للبيانات التعدادية الضخمة.
وفي قطاع التعليم العالي، تستخدم الجامعات رموزاً هيكلية للمقررات تشمل الكلية والقسم والمستوى والمحدد الفصلي مثل “SCI-MATH-301-F”. ولعزل التخصص الدقيق فقط (وهو “MATH” في هذا المثال)، يُطبق المحلل الصيغة =MID(A2, 5, 4). يؤدي هذا الاستقطاع إلى عزل اسم القسم الأكاديمي، ليصبح متغيراً تصنيفياً مستقلاً يمكن توظيفه في الجداول المحورية (Pivot Tables) لتحليل العبء التدريسي وتوزيع المخصصات المالية للأقسام العلمية.
كما تمتد تطبيقات الدالة MID إلى قراءة مخرجات أجهزة القياس الرقمية والمستشعرات المخبرية (IoT Sensors)، والتي تبث حزم بيانات مدمجة ككتلة نصية موحدة تضم درجة الحرارة، ونسبة الرطوبة، والضغط الجوي مفصولة بأطوال ثابتة. ومن خلال التحديد الدقيق لمواقع البدء وأطوال حزم المؤشرات، يستطيع الباحث صياغة أعمدة استخراج متجاورة تُنزل البيانات الخام في مصفوفات تفصيلية جاهزة للمعالجة الإحصائية المباشرة، مما يضمن تدفقاً سلساً للمعلومات من بيئات التجريب إلى بيئات التحليل دون وسائط برمجية خارجية.
5. تقنيات الاستخراج الديناميكي عبر دمج الدوال النصية مع SEARCH وFIND
5.1 المفاضلة المنهجية بين الدالتين SEARCH وFIND
عندما تفقد السجلات النصية انتظامها القياسي وتصبح أطوال المقاطع خاضعة لتقلبات عشوائية، تصبح الدوال المكانية المنفردة عاجزة عن تقديم نتائج دقيقة. هنا تبرز الحاجة المنهجية لدمج دوال الاستقطاع مع دوال الاستكشاف الموضعي، والمتمثلة في الدالتين FIND وSEARCH. تعمل كلتا الدالتين على فحص السلسلة النصية وتحديد الموقع الإحداثي الدقيق لبداية أول ظهور لمحرف أو مقطع نصي محدد، إلا أنهما تختلفان في سمتين جوهريتين تفرضان على المحلل دقة الاختيار.
تتمثل السمة الأولى في الحساسية لحالة الأحرف (Case Sensitivity)؛ فالدالة FIND تتسم بحساسية مطلقة لحالة الأحرف اللاتينية، مما يجعلها تميز تمييزاً قاطعاً بين الحرف الكبير “A” والحرف الصغير “a”، وصيغتها العامة هي =FIND(find_text, within_text, [start_num]). في المقابل، تتجاهل الدالة SEARCH حالة الأحرف بالكامل، مما يمنحها مرونة عالية عند التعامل مع مدخلات نصية غير منضبطة لغوياً، وصيغتها هي =SEARCH(find_text, within_text, [start_num]).
تتعلق السمة الثانية بدعم محارف البدل (Wildcards)؛ حيث توفر الدالة SEARCH إمكانية استخدام علامة الاستفهام (?) للدلالة على محرف فردي مجهول، والنجمة (*) للدلالة على أي عدد من المحارف غير المحددة، وهو ما تفتقر إليه تماماً الدالة FIND التي تبحث عن المطابقة الحرفية الصرفة. وتشترك كلتا الدالتين في استجابتهما عند إخفاق عملية البحث؛ فإذا لم يُعثر على المحرف المطلوب ضمن النص، تُطلق كلتاهما الخطأ الحسابي #VALUE!، مما يفرض تحصين المعادلات بآليات احتواء الأخطاء لضمان استقرار النموذج التحليلي.
5.2 صياغة معادلات هجينة ديناميكية متعددة الطبقات
تتحقق الكفاءة العظمى لمعادلات النصوص الكلاسيكية عند بناء صيغ هجينة تدمج الدوال المكانية بدوال البحث وحساب الأطوال. ففي مسألة شائعة تتمثل في استخراج الاسم الأول من حقل يضم الاسم الكامل للموظف بطول غير ثابت، يُدمج المحرف الفاصل (المسافة البيضاء) عبر الصيغة التفاعلية التالية: =LEFT(A2, SEARCH(” “, A2) – 1). تقوم الدالة SEARCH هنا بتحديد موقع الفراغ ديناميكياً لكل صف على حدة، ثم يُطرح منه الرقم واحد لاستبعاد المسافة نفسها من المخرجات، لتتولى الدالة LEFT اقتطاع الاسم بدقة تامة تتكيف مع تباين أطوال الأسماء.
وفي سيناريو أكثر تعقيداً يستهدف استخراج نص وسيط محصور بين علامتي حصر، كاستخراج المعرف الأكاديمي الواقع بين قوسين هلاليين “(ID_9874)” المدمج وسط نص وصفي، تُبنى معادلة متراكبة تستند إلى الدالة MID مع تكرار دالة SEARCH لتحديد نقطة البداية وحساب الطول الفاصل. وتُصاغ المعادلة على النحو الآتي: =MID(A2, SEARCH(“(“, A2) + 1, SEARCH(“)”, A2) – SEARCH(“(“, A2) – 1). تحسب الدالة الأولى موضع قوس الفتح وتضيف واحداً لتجاوزه، بينما تحسب الدالتان اللاحقتان المسافة الدقيقة بين القوسين لاستخلاص المعرف الصافي وتجريده من أدوات الحصر.
ولاستخراج المقاطع الختامية ذات الأطوال المتغيرة الواقعة بعد فاصل محدد، كاستخراج اسم النطاق أو اسم العائلة الأخير، تُدمج الدالة RIGHT مع دالتي LEN وSEARCH وفق الصياغة الهندسية: =RIGHT(A2, LEN(A2) – SEARCH(“@”, A2)). تعتمد هذه الاستراتيجية على قياس الطول الإجمالي للمحتوى عبر الدالة LEN، ثم طرح موقع محرف الفصل منه لتحديد الحجم الصافي المتبقي من الجهة اليمنى، مما يضمن عزل المقطع بدقة متناهية مهما بلغت درجة التباين في بنية السجلات المدخلة.
6. استخراج النصوص قبل محددات معينة باستخدام الدالة TEXTBEFORE
6.1 الخصائص المتقدمة والمميزات الحديثة لدالة TEXTBEFORE
أحدث إطلاق الدالة TEXTBEFORE في تحديثات Microsoft Excel 365 لعام 2022 تحولاً جذرياً في أساليب تجزئة النصوص؛ إذ ألغت الحاجة إلى تركيب الصيغ المعقدة المعتمدة على LEFT وSEARCH. صُممت هذه الدالة لتقوم بمهمة واحدة بالغة الأهمية: إرجاع كافة المحارف التي تسبق محدداً نصياً معيناً دون الخوض في حسابات المواقع والأطوال. وتتسم الدالة بمرونة استثنائية تنعكس في بنيتها التركيبية التوسعية: =TEXTBEFORE(text, delimiter, [instance_num], [match_mode], [match_end], [if_not_found]).
تتضمن الدالة وسيطات متطورة تمنح المحلل تحكماً مطلقاً في شروط الاستخراج. تتيح وسيطة المحدد delimiter تمرير فاصل فردي كنص، أو مصفوفة من محددات بديلة (مثل: {“,”, “-“, “/”})، حيث تستجيب الدالة لأي محدد يظهر أولاً. كما تمكن وسيطة رقم التكرار instance_num المستخدم من تحديد أي ظهور للمحدد يرغب في التوقف عنده؛ فوضع القيمة “1” يستخرج النص قبل أول ظهور، بينما تتيح القيم الموجبة اللاحقة النفاذ إلى تكرارات متقدمة، في حين تتيح الأرقام السالبة (مثل -1) استخراج النص قبل الظهور الأخير للمحدد بالعد العكسي.
إضافة إلى ذلك، توفر وسيطة match_mode إمكانية التبديل بين مطابقة حساسة لحالة الأحرف (القيمة 0 الافتراضية) أو غير حساسة (القيمة 1). وتحدد وسيطة match_end كيفية التعامل مع نهاية النص؛ ففي حال ضبطها على القيمة 1، تُعامل نهاية النص كمحدد افتراضي مما يمنع انكسار الصيغة عند غياب الفاصل، وتأتي وسيطة if_not_found لتتيح تخصيص قيمة بديلة أنيقة تُعرض للمستخدم في حال عدم العثور على المحدد بدلاً من ظهور رسائل الخطأ الافتراضية.
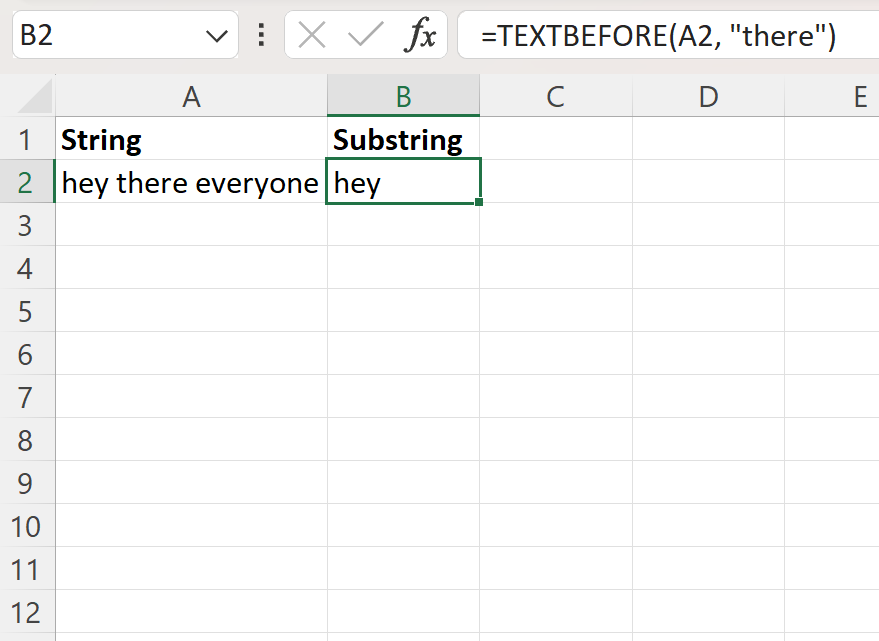
6.2 تطبيقات منهجية للدالة TEXTBEFORE في التحليل الأكاديمي
تمتد التطبيقات المنهجية للدالة TEXTBEFORE لتشمل طيفاً واسعاً من المعالجات الأكاديمية والبيانية الدقيقة. ومن أبرز هذه الاستخدامات وأكثرها شيوعاً استخراج أسماء المستخدمين الصافية من عناوين البريد الإلكتروني في قواعد بيانات الطلاب والباحثين؛ فبتطبيق المعادلة المباشرة =TEXTBEFORE(A2, “@”)، يُستخرج الاسم التعريفي بالكامل قبل علامة الإسناد متجاوزاً أي تفاوت في أطوال الأسماء أو تعقيداتها التركيبية بخطوة معيارية واحدة لا تتطلب دوالاً وسيطة.
كما تُوظف الدالة بكفاءة بالغة في تحليل الروابط التشعبية للمراجع الرقمية ومحددات المصادر الموحدة (URLs) عبر فصل البروتوكولات البرمجية أو أسماء النطاقات الفرعية. فعند الرغبة في عزل بروتوكول التوجيه الشبكي من الروابط، يمكن كتابة الصيغة =TEXTBEFORE(A2, “://”) لإرجاع “https” أو “http” بصورة منفصلة، مما ييسر للباحث تصنيف الموارد وتحديد الروابط الآمنة ضمن مصفوفة المسوح الميدانية للبيانات الرقمية.
كذلك تبرز قدرة الدالة في تنظيف قوائم المؤلفين والعلماء في قواعد البيانات البيبليومترية التي تسجل الأسماء مسبوقة بالألقاب العلمية أو الرتب الأكاديمية، مثل “Prof. Dr. Ahmed Zewail” أو “Assoc. Prof. Marie Curie”. فباستخدام وسيطة التكرار أو تحديد الفواصل الفراغية، يمكن للمحلل عزل الرتب وتجريد الأسماء لدراسة شبكات التأليف وتوزيع الباحثين وفق درجاتهم العلمية بسرعة ودقة استثنائية تعزز من موثوقية الدراسات الإحصائية التحليلية.
7. استخراج النصوص بعد محددات معينة باستخدام الدالة TEXTAFTER
7.1 البنية البرمجية والخيارات التوسعية لدالة TEXTAFTER
تمثل الدالة TEXTAFTER النظير الوظيفي المباشر لدالة TEXTBEFORE، حيث تتطابق معها في الفلسفة المعمارية والوسيطات التوسعية، إلا أنها تختص باسترجاع كافة المحارف التي تقع بعد محدد نصي مشروط. تُصاغ الدالة برمجياً بذات النسق المتين: =TEXTAFTER(text, delimiter, [instance_num], [match_mode], [match_end], [if_not_found])، مما يتيح التناغم الكامل في بناء المعادلات المتقابلة داخل أوراق العمل المشتركة.
تتجلى القوة الكامنة للدالة في دعمها لقيم التكرار السالبة ضمن وسيطة instance_num. ففي الكثير من الحالات التحليلية، يكون الهدف استخراج الجزء الأخير من سلسلة نصية تضم عدة فواصل متماثلة مجهولة العدد، مثل مسار مجلد شبكي أو تصنيف فرعي متعدد المستويات. إن إدخال القيمة (-1) في هذه الوسيطة يوجه محرك الحسابات للبدء من أقصى يمين السلسلة، والتقاط أول محدد يواجهه، ثم إرجاع كل ما يليه حتى نهاية النص، متجاوزاً بذلك كافة المحددات المتقدمة في خطوة حسابية واحدة وفائقة السرعة.
علاوة على ذلك، تُغني وسيطة المعالجة الاحتياطية المدمجة if_not_found عن الاستعانة بالدالة التقليدية IFERROR، والتي كانت تزيد من عبء إعادة الحساب في الجداول الضخمة. فبمجرد إدراج نص بديل مخصص مثل “غير متوفر” أو تركه فارغاً (“”) ضمن الوسيطة، تضمن المنظومة الحسابية عدم تشويه التقارير النهائية بأخطاء عدم العثور، مما يحافظ على التنسيق الجمالي والاتساق الهيكلي للجداول المعروضة لمتخذي القرار.
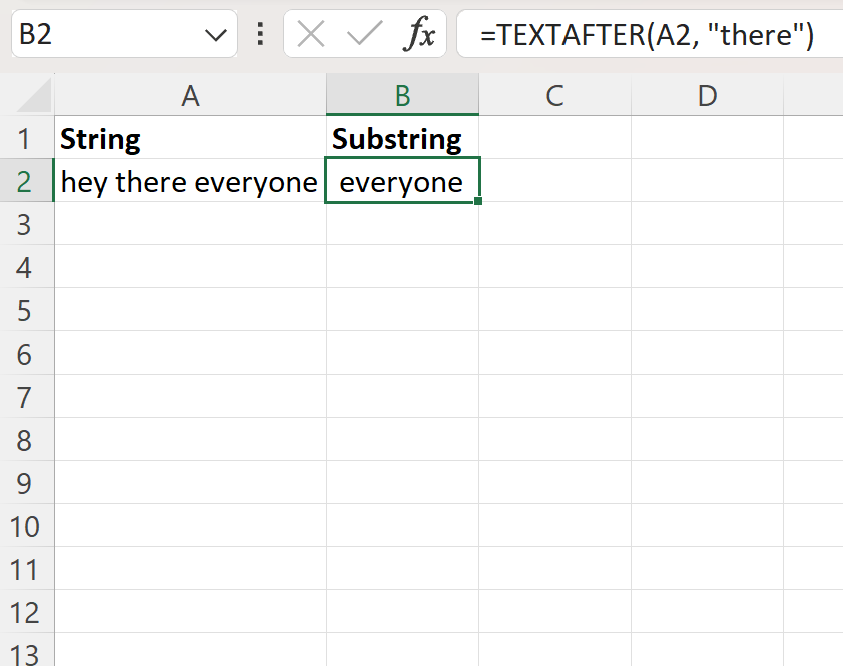
7.2 حالات تطبيقية متخصصة لاستخدام TEXTAFTER
تتبوأ الدالة TEXTAFTER مكانة مركزية في عمليات استخراج نطاقات الخوادم الإلكترونية (Domain Names) من عناوين البريد المدمجة؛ فباستخدام الصيغة البسيطة =TEXTAFTER(A2, “@”)، يحصل المحلل فوراً على اسم المؤسسة أو النطاق المزود للخدمة (مثل “university.edu” أو “company.com”). يتيح هذا الاستخراج تجميع جهات الاتصال وفرز المؤسسات الأكاديمية والشركاء التجاريين بصورة مستقلة تدعم بناء تقارير الانتشار المؤسسي بكفاءة متناهية.
وفي مجال تدقيق السجلات المالية وسندات القبض الإلكترونية، غالباً ما تُسجل المعاملات بنصوص وصفية تتلوها المبالغ المدفوعة مفصولة برمز العملة أو بنقطتين رأسيتين، كأن يُسجل القيد: “Payment for consulting services: 1500 USD”. من خلال توظيف الصيغة =TEXTAFTER(A2, “: “)، ينجح المحلل في عزل القيمة المالية وحجم التعامل عن الشرح التوصيفي، مما يمهد الطريق لتحويل الجزء المستخلص إلى قيمة رقمية صالحة للإدراج ضمن معادلات التجميع والتلخيص المحاسبي.
كما تخدم الدالة إدارة الموارد البشرية وشؤون الطلاب في تجريد الملاحظات الإدارية الملحقة بسجلات الحضور والانصراف، حيث تُلحق الحالات الاستثنائية بذيول حقول التوقيع مثل “08:15 AM – Late due to transport”. فبتطبيق الصيغة =TEXTAFTER(A2, ” – “)، تُفصل الملاحظة التشغيلية لتُنقل إلى جداول المتابعة والمساءلة، تاركة التوقيت الزمني في حقل نقي يمكن قياسه زمنياً وفق لوائح العمل المعمول بها في المنشأة.
8. استراتيجيات الاستخراج المتقدم والتفكيك المتعدد عبر دوال المصفوفات
8.1 توظيف الدالة TEXTSPLIT في التفكيك الموزع للنصوص
تمثل الدالة TEXTSPLIT ذروة التطور في هندسة معالجة النصوص في إكسل، حيث لا تقتصر على اقتطاع مقطع نصي مفرد، بل تقوم بتفكيك السلسلة النصية بأكملها وتقسيمها إلى عناصر ذرية متعددة تتوزع تلقائياً عبر الأعمدة أو الصفوف المجاورة باستخدام محرك المصفوفات الديناميكية المتدفق (Spill Engine). تُبنى الصيغة المعيارية للدالة على النحو الآتي: =TEXTSPLIT(text, col_delimiter, [row_delimiter], [ignore_empty], [match_mode], [pad_with]).
يتيح هذا التكوين الفريد للمحلل القدرة على تجزئة النص أفقياً عبر الأعمدة بتحديد وسيطة col_delimiter، أو رأسياً عبر الصفوف بتحديد وسيطة row_delimiter، أو في كلا الاتجاهين معاً لإنشاء جدول مصفوفي كامل انطلاقاً من نص مدمج ومفصول بعلامات مزدوجة (مثل الفواصل بين الحقول والفواصل المنقوطة بين السجلات). وتضمن وسيطة ignore_empty تجاوز المحددات المتتالية وتفادي إنتاج خلايا فارغة مشوهة للتوزيع الهندسي.
وعندما يقترن استخدام الدالة TEXTSPLIT بالدالة المرجعية INDEX، يتشكل سلاح تحليلي استثنائي لاستقطاع أي عنصر ترتيبي من السلسلة النصية دون تقسيمها فعلياً على خلايا متعددة. فإذا رغب المحلل في استخراج العنصر الثالث حصراً من مسار رقمي يضم عناصر مفصولة بشرطات مثل “A-B-C-D”، يمكنه كتابة الصيغة: =INDEX(TEXTSPLIT(A2, “-“), 3). تقوم TEXTSPLIT بتفكيك النص في الذاكرة اللحظية للحاسوب، بينما تقوم الدالة INDEX بالتقاط العنصر المطلوب مباشرة وإرجاعه إلى الخلية المنفردة، مما يوفر مرونة لا تضاهى في المعالجة البرمجية الصامتة.
8.2 التكامل مع دوال البحث والمطابقة الحديثة (XLOOKUP وFILTER)
تكتسب النصوص الفرعية المستخرجة قيمتها الكبرى عندما تتحول إلى مفاتيح بحثية وعلاقات ربط منطقية بين الجداول المتباعدة عبر قواعد البيانات. ومن خلال الدمج المباشر بين نصوص الاقتطاع والدوال المرجعية المتطورة مثل XLOOKUP، يستطيع المحلل تجاوز عقبة المفاتيح المركبة؛ حيث يُستخرج المعرف الذري من حقل مدمج ويُمرر كمحدد بحث مباشر دون الحاجة إلى إنشاء أعمدة مساعدة تستهلك مساحات تخزينية في المصنف.
تتجلى هذه الاستراتيجية في الصيغ المتقدمة التالية: =XLOOKUP(TEXTBEFORE(A2, “-“), DepartmentCodes[ID], DepartmentCodes[Name]). في هذا النموذج، تقوم الدالة TEXTBEFORE باقتطاع كود الإدارة من المعرف الوظيفي المركب، ثم تتلقى الدالة XLOOKUP هذا المخرج النصي لتبحث عنه فوراً في جدول مسميات الإدارات وتُرجع الاسم الرسمي للقسم. يضمن هذا التكامل إبقاء هيكل ورقة العمل نظيفاً وخالياً من الحسابات الوسيطة المكررة.
علاوة على ذلك، تتكامل النصوص الفرعية مع الدالة الشرطية FILTER لعزل وتصفية السجلات الضخمة ديناميكياً استناداً إلى خصائص جزئية؛ إذ يمكن تصفية جدول طلاب كامل لاستخراج أولئك المنتسبين لفرع دراسي محدد يُستدل عليه بمقطع وسيط من أرقامهم الجامعية. يسهم هذا النمط التحليلي في رفع كفاءة التحليل الاستكشافي، وتوليد التقارير التفاعلية التي تتكيف آلياً مع معايير الاختيار المتبدلة التي يحددها الباحث.
9. تنظيف البيانات ومعالجة الشوائب المصاحبة لعمليات الاستخراج
9.1 استخدام دوال التطهير النصي TRIM وCLEAN لضمان دقة النتائج
تتعرض عمليات استخراج النصوص الفرعية لمخاطر جمة ناتجة عن التلوث الرمزي والمسافات الدخيلة المرافقة لتدفقات البيانات الخارجية المستوردة من ملفات الويب، والأنظمة الإدارية القديمة، وتطبيقات إدارة الموارد (ERP). ولضمان عدم انحراف نتائج المعادلات، يتعين إخضاع النصوص لعمليات تطهير قياسية توظف فيها الدالتان TRIM وCLEAN كخط دفاع استباقي لا غنى عنه في هندسة البيانات.
تختص الدالة TRIM باستئصال كافة المسافات البيضاء الزائدة من السلسلة النصية؛ حيث تقوم بحذف المسافات البادئة والمسافات الختامية بالكامل، وتعمل على تقليص المسافات المتعددة المتتالية الواقعة بين الكلمات لتترك مسافة فردية معيارية واحدة فقط. وتُصاغ مدمجة في معادلات الاقتطاع بصورة وقائية مثل: =LEFT(TRIM(A2), 5)، مما يكفل انطلاق عملية العد من المحرف الفعلي الأول للنص وحماية الاستخراج من الإزاحة المكانية الناتجة عن الفراغات الطارئة.
أما الدالة CLEAN، فقد صُممت خصيصاً لإزالة المحارف غير القابلة للطباعة (Non-printable characters)، وهي المحارف منخفضة الترتيب في شفرة ASCII الممتدة من الرقم 0 إلى 31، والتي غالباً ما تنشأ عند تصدير الجداول من أنظمة التشغيل المركزية القديمة مسببة كسراً في عمل دوال البحث والاقتطاع. ويواجه المحللون أحياناً عائقاً إضافياً يتمثل في المسافة الثابتة غير المنكسرة ذات الكود CHAR(160)، والتي تعجز الدالة TRIM عن إزالتها افتراضياً؛ مما يستدعي استبدالها صراحة عبر الصيغة: =SUBSTITUTE(A2, CHAR(160), ” “) قبل تطبيق دوال الاستخراج، لضمان أعلى درجات النقاء للمصفوفة النصية.
9.2 معالجة وتحييد الأخطاء الشائعة في صيغ استخراج النصوص
تتنوع الأخطاء التشغيلية التي قد تعصف باستقرار أوراق العمل عند التعامل مع السلاسل النصية، ويأتي في مقدمتها الخطأ #VALUE! الذي ينشأ بصورة رئيسية عند استخدام دوال البحث FIND أو SEARCH في حال عدم تطابق المحرف المستهدف مع أي مقطع داخل الخلية، أو عند تمرير قيم ترقيمية سالبة في وسيطات البدء أو عدد المحارف في الدوال المكانية. ولتحييد هذا الخطأ وضمان استمرار التدفق الحسابي، تُغلف المعادلات بالدالة الوقائية IFERROR، كأن يُكتب: =IFERROR(LEFT(A2, FIND(“-“, A2)-1), A2)، حيث تعيد الدالة النص كاملاً في حال غياب الفاصل كإجراء احترازي منضبط.
كما يبرز في بيئات الحسابات الحديثة الخطأ المصفوفي #CALC!، وتحديداً عند استخدام دوال مثل TEXTBEFORE أو TEXTAFTER إذا كانت وسيطة رقم التكرار تتجاوز عدد المحددات الفعلي المتوفر في النص، ولم تكن وسيطة القيمة البديلة if_not_found قد غُذيت بقيمة محددة. يفرض ذلك على الباحثين ومصممي النماذج إدراج مخرجات احتياطية مدروسة بعناية لكل دالة تفادياً لانهيار سلاسل المعالجة اللاحقة المبنية على نتائج تلك الخلايا.
أخيراً، يقع الكثير من المحللين في فخ “الرقم النصي”؛ حيث يُستخرج مقطع يحتوي على أرقام حسابية (مثل استخراج الراتب من قيد وظيفي) ولكنه يظل محتفظاً بنوعه النصي، مما يحول دون خضوعه لعمليات الجمع أو المتوسط الحسابي. ولحل هذه الإشكالية جذرياً، تُدمج الدالة VALUE لتحويل الناتج النصي المقتطع إلى قيمة رقمية صريحة قابلة للعمليات الرياضية عبر الصياغة: =VALUE(MID(A2, 5, 3))، أو من خلال تطبيق العامل الحسابي الثنائي المعاكس (–MID(A2, 5, 3)) لإجبار المحرك على التحويل الرقمي اللحظي الآمن.
10. المعايير المنهجية وأفضل الممارسات لتحليل النصوص في إكسل
10.1 دليل اختيار الدالة المثلى وفق طبيعة البيانات والنسخة البرمجية
يتطلب التصميم الاحترافي للمصنفات وقواعد البيانات التقدير الموضوعي لبيئة العمل التقنية والجمهور المستهدف من المستخدمين قبل الاستقرار على دوال نصية محددة. وتوفر مصفوفة المقارنة المنهجية بين الدوال الكلاسيكية (LEFT/MID/RIGHT) والدوال الحديثة (TEXTBEFORE/TEXTAFTER/TEXTSPLIT) بوصلة دقيقة لاتخاذ القرار البرمجي الرشيد داخل المؤسسات.
تتمثل الميزة التنافسية الكبرى للدوال الكلاسيكية في التوافقية العكسية المطلقة (Backward Compatibility)؛ فهذه الدوال مدعومة في كافة إصدارات إكسل التاريخية منذ إطلاق البرنامج، وتعمل بسلاسة عبر تطبيقات الجداول الإلكترونية البديلة وتطبيقات الأجهزة المحمولة القديمة دون خطر التعطل. لذلك، عندما تُبنى نماذج مالية أو استبيانات مسحية موجزة مخصصة للتوزيع الواسع عبر جهات خارجية متعددة تتفاوت إمكاناتها البرمجية، يظل الاعتماد على الدوال الكلاسيكية الهجينة هو الخيار الأكثر أماناً وضماناً لعدم ارتداد الأخطاء.
في المقابل، تتفوق الدوال الحديثة بوضوح في تقليل استهلاك الذاكرة وتسهيل قراءة المعادلات وصيانتها لاحقاً؛ حيث تقلل من عدد الدوال المتداخلة وتختصر أسطر الصياغة بنسبة تفوق 60% في كثير من الحالات. ومع ذلك، عندما تتعاظم أحجام البيانات لتتجاوز مئات الآلاف من السجلات النصية المعقدة، يصبح استخدام معادلات أوراق العمل عبئاً يؤدي إلى إبطاء زمن إعادة الحساب (Calculation Latency). في مثل هذه الظروف، يُنصح منهجياً بنقل ثقل المعالجة إلى واجهة Power Query المدمجة في إكسل، والتي تتيح استخراج النصوص وتطهيرها عبر محرك ETL مخصص خارج طبقة الحساب المباشر، مما يحافظ على خفة ورقة العمل وسرعة استجابتها التشغيلية.
10.2 إرشادات التوثيق والحوكمة لنماذج البيانات الأكاديمية والمهنية
تشكل حوكمة البيانات وتوثيق النماذج المعيارية الركيزة الختامية لضمان استدامة الأنظمة المعلوماتية ونقل المعرفة المؤسسية بنزاهة واقتدار. يؤدي غياب التوثيق في المصنفات المعقدة المعتمدة على استخراج النصوص إلى تحولها إلى ما يُعرف برمجياً بـ “الصناديق السوداء”، حيث يعجز المحللون اللاحقون عن فك طلاسم المعادلات المتداخلة الطويلة وتتبع منطق الاستقطاع عند حدوث أي خلل في بنية المدخلات.
تقتضي أفضل الممارسات توثيق المنطق التحليلي الكامن خلف المعادلات النصية المركبة إما عبر استخدام تعليقات الخلايا التوضيحية (Cell Notes/Comments)، أو الاستعانة بالدالة التوثيقية LET التي أدخلتها مايكروسوفت لتعريف المتغيرات بأسمائها الصريحة داخل متن المعادلة ذاتها. يتيح استخدام الدالة LET تسمية نقاط البداية وأطوال المقاطع بأسماء دلالية واضحة تجعل قراءة المعادلة أشبه بقراءة شفرة برمجية موثقة ذاتياً، مما يقلل كلفة التدقيق والمراجعة ويحد من احتمالات الخطأ البشري عند تعديل الصيغ.
إضافة إلى ذلك، يجب الالتزام الصارم بمبدأ الفصل الهيكلي؛ بحيث لا يتم استخراج النصوص وتعديلها فوق الخلايا الأصلية، بل تُفرد الحقول المستخرجة في أعمدة مستقلة ذات تسميات قطعية الدلالة تبرز ماهية البيانات المفردة. ويتعين تعزيز هذا الإجراء بتفعيل قواعد التحقق من صحة البيانات (Data Validation) في حقول الإدخال، لمنع المستخدمين من إدراج نصوص تفتقر إلى المحددات القياسية المتفق عليها، مع إخضاع المخرجات النصية دورياً لعينات تدقيق عشوائية لاختبار دقة الاقتطاع وضمان مطابقة البيانات النهائية لأعلى المعايير الأكاديمية والمهنية المعترف بها دولياً.
خاتمة
يمثل استخراج النصوص الفرعية في برنامج إكسل مهارة محورية تتوسط العلوم الحاسوبية وتطبيقات التحليل الإحصائي وإدارة قواعد البيانات. وقد أظهر هذا العرض المفصل أن التمكن من تجزئة النصوص يتطلب فهماً متكاملاً يبدأ من إدراك الفهرسة المكانية للمحارف، ولا ينتهي عند صياغة الدوال المتقدمة والمصفوفات الديناميكية. إن الانتقال من الدوال الكلاسيكية الثابتة كـ LEFT وRIGHT وMID إلى الدوال المرنة الموجهة بالمحددات كـ TEXTBEFORE وTEXTAFTER يجسد تطور بيئات الأعمال نحو مزيد من الكفاءة والدقة وتقليل الاعتماد على التدخلات اليدوية المعرضة للزلل.
يتضح جلياً أن نجاح عمليات المعالجة النصية لا يرتبط باختيار الدالة الأكثر حداثة فحسب، بل يرتكز على تقييم شامل لطبيعة البيانات الأصلية، ومستوى انتظامها، ومتطلبات التوافقية البرمجية عبر المنصات المختلفة. ومن خلال المزاوجة المنضبطة بين تقنيات التنظيف الاستباقي للشوائب الرمزية، والتحصين المنطقي ضد رسائل الخطأ، وتوثيق نماذج البيانات وحوكمتها، يستطيع الباحثون والمحللون تحويل جداول البيانات النصية الخام إلى أصول معرفية تتسم بالصلابة والموثوقية العالية وتدعم اتخاذ القرارات الرشيدة المستندة إلى أسس برمجية متينة.
المراجع
- Alexander, M., Kusleika, D., & Walkenbach, J. (2019). Excel 2019 Bible. John Wiley & Sons.
- Bluttman, K. (2022). Excel Formulas and Functions For Dummies (6th ed.). John Wiley & Sons.
- Harvey, G. (2021). Excel 2021 All-in-One For Dummies. John Wiley & Sons.
- Jelen, B. (2022). Microsoft Excel Inside Out (Office 2021 and Microsoft 365). Microsoft Press.
- Microsoft Corporation. (n.d.). Excel functions (alphabetical). Microsoft Support. https://support.microsoft.com/en-us/office/excel-functions-alphabetical-b3944572-255d-4efb-bb96-c6d90033e188
- Microsoft Corporation. (n.d.). TEXTBEFORE function. Microsoft Support. https://support.microsoft.com/en-us/office/textbefore-function-d099c2fa-392f-4390-95ab-0e50f848c399
- Microsoft Corporation. (n.d.). TEXTAFTER function. Microsoft Support. https://support.microsoft.com/en-us/office/textafter-function-290b59c0-4e14-48e4-bef4-5f4252f9e896
- Walkenbach, J. (2015). Excel 2016 Formulas. John Wiley & Sons.