
تمثل إدارة البيانات الرقمية وتلخيصها إحدى الركائز الأساسية التي يعتمد عليها التحليل الإحصائي الحديث، وصناعة القرار في المؤسسات الأكاديمية والمهنية على حد سواء. يواجه الباحثون والمحللون يومياً تدفقات هائلة من السجلات الخام التي تتضمن تكرارات لا حصر لها للمعرفات النصية، مثل أسماء الأفراد أو المفحوصين أو الموظفين أو المنتجات. وبدون وجود آلية منهجية واضحة لإعادة هيكلة هذه البيانات واختزالها في أطر دلالية ذات مغزى، تفقد الأرقام قيمتها التفسيرية، وتتحول جداول البيانات إلى مجرد مخازن مشوشة يصعب استنباط الأنماط منها. لذلك، يُعد فهم وتطبيق تقنيات التجميع حسب الاسم في برمجية مايكروسوفت إكسل (Microsoft Excel) مهارة محورية تتجاوز المعرفة التقنية المجردة لتصبح أداة بحثية تضمن الدقة والموثوقية التحليلية.
تتعدد الأساليب التي يتيحها برنامج إكسل لتنفيذ عمليات التجميع والتلخيص؛ بدءاً من الدوال الرياضية والإحصائية الموجهة بالمعايير، ومروراً بالمصفوفات الديناميكية الحديثة، ووصولاً إلى محركات التحليل المتقدمة مثل الجداول المحورية (Pivot Tables) وبيئة باور كويري (Power Query). إن اختيار الأداة المناسبة لا يرتبط فقط بطبيعة الحسابات المطلوبة، بل يتوقف أيضاً على حجم البيانات، ودرجة ديناميكيتها، ومستوى الدقة المطلوب لتجنب الوقوع في أخطاء التطابق النصي أو التشويش الناتج عن البيانات الملوثة. تهدف هذه المقالة الموسعة إلى تقديم دليل مرجعي شامل، يغطي الجوانب المنهجية والرياضية والتقنية لتجميع البيانات حسب الاسم، مدعوماً بنماذج تطبيقية توضح كيفية الانتقال من الفوضى الرقمية إلى مصفوفات موجزة جاهزة للتحليل الإحصائي الرصين.
من الناحية المعرفية والعملية، يخدم التجميع حسب الاسم غايات جوهرية في بحوث الأداء والعلوم السلوكية والاجتماعية؛ حيث يسهم في تحويل القياسات المتكررة لنفس المفردة إلى مؤشرات أداء كلية، بما يقلل من تشتت البيانات ويتيح مقارنة المتغيرات بصورة أكثر تماسكاً. ولتحقيق هذه الغاية بأعلى معايير الرصانة العلمية، يستعرض هذا المقال الخطوات المعيارية التي تضمن سلامة البنية الجدولية وتنقية السلاسل النصية قبل الشروع في التجميع، فضلاً عن تقديم استعراض متعمق لكل مسار حسابي، مع معالجة الأخطاء الشائعة وحلولها البرمجية الدقيقة داخل بيئة إكسل المتطورة.
1. مفهوم تجميع البيانات حسب الاسم وأهميته في التحليل الإحصائي
1.1 التعريف المنهجي لعملية التجميع (Data Grouping)
يُعرف التجميع المنهجي للبيانات (Data Grouping) بأنه العملية الحسابية والمنطقية التي يتم من خلالها دمج السجلات المتعددة والمتفرقة في قاعدة البيانات، والتي تشترك في خاصية اسمية أو وصفية موحدة، ضمن فئة أحادية فريدة تمثل تلك الصفة المشتركة. في بيئات معالجة البيانات، تتولد السجلات المكررة نتيجة حدوث معاملات متكررة عبر الزمن لنفس الكيان الاسمي، مثل تسجيل قياسات متعددة لمفحوص واحد في تجربة نفسية، أو توثيق فواتير بيع متفرقة لمندوب تجاري محدد. يهدف التجميع إلى اختزال هذه الكثافة السجلية إلى مصفوفة مركزة تجمع الخصائص الكمية المبعثرة وتنسبها بوضوح للمعرف الفردي، مما يتيح للباحثين والمحللين قراءة النتائج الإجمالية بدلاً من الغرق في التفاصيل الإجرائية غير المنتظمة.
وتتجلى الأهمية الرياضية لتقليص حجم البيانات المعقدة في قدرتها على استخلاص مؤشرات الأداء الأساسية (Key Performance Indicators) بدقة متناهية؛ فالبيانات الضخمة غير المجمعة تحجب بطبيعتها التباينات الحقيقية وتصعب حساب مقاييس النزعة المركزية والتشتت. ومن الأهمية بمكان إدراك الفروق الجوهرية بين الفرز البسيط (Sorting) والتجميع التراكمي للبيانات (Aggregation). فالفرز يقتصر على إعادة الترتيب المكاني للسجلات وفق معيار هجائي أو رقمي دون تغيير بنيتها أو حجمها، بينما يتضمن التجميع إعادة صياغة هيكلية للبيانات من خلال دمج الأسطر وحساب مقادير رقمية تراكمية لكل فئة فريدة. ويلعب التطابق النصي الصارم دوراً حاسماً في نجاح هذه العملية، حيث يعتمد البرنامج على التطابق الثنائي للمحارف لتوحيد المدخلات، وأي تباين طفيف في التهجئة أو المسافات يؤدي حتماً إلى تفتيت الفئة الواحدة إلى فئات متعددة زائفة.
1.2 الأثر التحليلي لتجميع البيانات في بحوث السلوك والأداء
يمثل التجميع المعتمد على المعرفات الاسمية ركيزة منهجية بالغة الأثر في الدراسات السلوكية والأبحاث التجريبية؛ إذ يتيح للباحثين تتبع مسارات الأداء الفردي للمشاركين عبر تجميع استجاباتهم المتكررة ضمن جلسات الاختبار المتعددة. فعندما يخضع المفحوص لاختبارات متتالية لقياس أزمنة الاستجابة أو معدلات الدقة، فإن التجميع حسب الاسم يسمح بدمج مئات المحاولات الفردية واستخلاص متوسط استجابة واحد يعبر عن أداء المفحوص بصورة موثوقة. ويسهم هذا الإجراء الرياضي في تحويل البيانات المقطعية الطولية أو المتفرقة إلى مصفوفات قابلة للقياس الإحصائي المقارن واختبار الفرضيات عبر حزم التحليل المتقدمة.
علاوة على ذلك، يلعب التجميع دوراً محورياً في تقليل أخطاء القياس والتحيز الناتج عن تفاوت عدد القياسات المأخوذة لكل فرد، وهو ما يُعرف في الأدبيات الإحصائية بتباين أوزان العينة داخل التحليل. وقد أكدت الدراسات المنهجية المعنية بتقييم القدرات الفردية والأداء الذاتي، مثل أبحاث Dunning et al. (2004)، أن دمج وتلخيص القياسات السلوكية المتكررة يُعد خطوة تمهيدية حتمية لعزل التذبذبات العشوائية العابرة والوصول إلى تقديرات موضوعية مستقرة لسمات المفحوصين وكفاءاتهم الفعلية. كما يظهر الأثر ذاته في بيئات العمل الإدارية والإنتاجية، حيث يُمكن التجميع المؤسسات من تقييم الأداء الحقيقي للموظفين بموضوعية من خلال مقارنة مخرجاتهم التراكمية، بدلاً من الاعتماد على تقييمات انطباعية مبنية على رصد معاملات فردية متباعدة زمنياً، مما يضمن نزاهة المؤشرات المؤسسية واتساقها التحليلي.
2. متطلبات إعداد وهيكلة مجموعات البيانات قبل البدء بالتجميع
2.1 تنظيف السلاسل النصية وتوحيد الأسماء
تُعد مرحلة تنظيف النصوص والبيانات التمهيدية شرطاً لازماً لضمان موثوقية نتائج التجميع، حيث يتعامل برنامج إكسل مع النصوص بصرامة تامة، معتبراً أي اختلاف في المحارف – حتى وإن كان مسافة فارغة غير مرئية – دلالة على كيان مستقل تماماً. وتأتي في مقدمة الأدوات المستخدمة لمعالجة هذا الخلل دالة التجريد النصي TRIM، التي تعمل على حذف المسافات البادئة واللاحقة وكافة المسافات الزائدة بين الكلمات، مع الإبقاء على مسافة مفردة فقط. وتُكتب الصيغة الأساسية لهذه الدالة بالصورة =TRIM(A2)، مما يضمن استبعاد الفراغات غير المقصودة التي تنشأ عادةً عند إدخال البيانات يدوياً أو تصديرها من نظم برمجية وسيطة ذات معايير تشفير متباينة.
ولا يقتصر التنظيف النصي على المسافات، بل يمتد ليشمل توحيد صياغة الأحرف المتشابهة وحذف الفواصل غير المرئية ومحارف السطر الجديد (Line Breaks) التي قد تتسلل إلى السجلات، ويمكن هنا الاستعانة بدالة CLEAN لتطهير النصوص من الرموز غير القابلة للطباعة. كما ينبغي التحقق المسبق من اتساق كتابة الأسماء المركبة، ومواءمة الحروف ذات الأشكال المتعددة مثل همزات الألف والياء والتاء المربوطة في اللغة العربية، لتفادي توليد فئات فريدة وهمية تشتت دقة المؤشرات التراكمية. ولتطويق هذه المشكلة في مهدها وضمان جودة المدخلات اللاحقة، يُنصح بتطبيق أداة التحقق من صحة البيانات (Data Validation) عبر تخصيص قوائم منسدلة مغلقة للأسماء المعتمدة، مما يمنع المستخدمين من إدخال تنويعات إملائية خاطئة تخل باتساق قاعدة البيانات.
2.2 بناء الهيكل الجدولي المنظم للبيانات
يمثل التحول من استخدام النطاقات التقليدية (Normal Ranges) إلى جداول إكسل الديناميكية (Excel Tables) خطوة تحولية في بنية المعالجة الحسابية والتجميعية. يتم تفعيل هذه الخاصية بسهولة من خلال تحديد نطاق البيانات ثم الضغط على مفتاحي Ctrl + T، مما يُكسب النطاق مرونة تشغيلية هائلة؛ حيث تتسع الجداول تلقائياً عند إضافة أي صفوف أو سجلات جديدة في المستقبل، وتنتقل الصيغ الحسابية وتسميات الأعمدة إلى السجلات المستحدثة دون الحاجة إلى تعديل المراجع يدوياً. هذا الهيكل المنظم يمنح المتغيرات استقراراً بنيوياً يقلل بصورة جذرية من احتمالات تآكل المراجع المتقاطعة أثناء العمليات التحليلية المعقدة.
يتطلب التصميم الجدولي الرصين أيضاً فصلاً هيكلياً قاطعاً بين البيانات الاسمية (Nominal Identifiers) والمتغيرات الكمية القابلة للقياس الرياضي (Quantitative Variables)، بحيث يستقل كل حقل في عمود مخصص ذي رأس واضح لا لبس فيه. كما يجب التحقق الصارم من التنسيق الرقمي (Number Formatting) للحقول المراد حساب مجاميعها أو متوسطاتها؛ فالأرقام التي تُخزن عن طريق الخطأ كقيم نصية (Stored as Text) ستتجاهلها تلقائياً دوال التجميع الرياضية مثل SUMIF أو تؤدي إلى نتائج صفرية مضللة، مما يوجب تحويلها إلى تنسيق رقمي صحيح عبر أدوات التحويل أو الضرب في القيمة الحيادية، لضمان جاهزيتها الكاملة للتفاعل مع المعالجات التجميعية التالية.
3. استخراج الأسماء الفريدة ديناميكياً باستخدام دالة UNIQUE
3.1 الأساس النظري وبناء صيغة دالة UNIQUE
أحدث إدخال محرك المصفوفات الديناميكية (Dynamic Array Engine) في الإصدارات الحديثة من مايكروسوفت إكسل (تحديداً Microsoft 365 و Excel 2021) نقلة نوعية في التعامل مع البيانات، ومن أبرز معالم هذا التحول ظهور دالة UNIQUE المتخصصة في عزل السجلات المكررة آلياً. تعتمد هذه الدالة على مفهوم الانسكاب (Spill)، حيث يُدخل المستخدم المعادلة في خلية مفردة، لتقوم الدالة بحساب النتائج وتوزيعها تلقائياً على نطاق عمودي أو أفقي من الخلايا المجاورة دون الحاجة للضغط على التوليفة التقليدية للتحكم في المصفوفات Ctrl + Shift + Enter، مما يوفر بيئة حسابية تتسم بالانسيابية الفائقة والسرعة التشغيلية.
تأخذ الصيغة المعيارية العامة لدالة الاستخراج الهيكل البرمجي الآتي:
=UNIQUE(array, [by_col], [exactly_once])
حيث تمثل الوسيطة الأولى array النطاق المستهدف أو الجدول الذي يحتوي على الأسماء المكررة، بينما تحدد الوسيطة الاختيارية الثانية by_col اتجاه المقارنة (افتراضياً FALSE لمقارنة الصفوف)، وتتيح الوسيطة الثالثة exactly_once استخراج العناصر التي لم تتكرر على الإطلاق أو كافة العناصر المتمايزة (افتراضياً FALSE لاستخراج كافة الأسماء الفريدة). تكمن القوة الجوهرية لهذه الدالة في ارتباطها الديناميكي الدائم بمصدر البيانات؛ فبمجرد إضافة اسم جديد إلى الجدول المصدر، يتسع نطاق الانسكاب تلقائياً ليشمل الاسم الجديد دون أي تدخل يدوي من المستخدم، وهو ما يضمن استمرارية التحليل وتحديثه الآني.
3.2 تطبيق عملي: استخراج قائمة الأسماء المنفصلة خطوة بخطوة
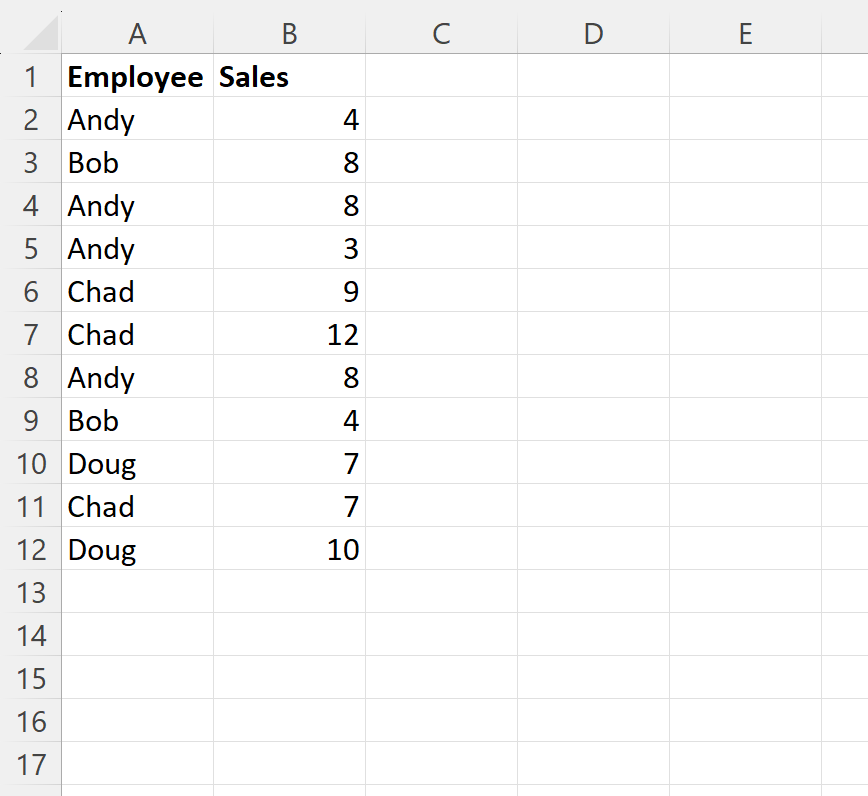
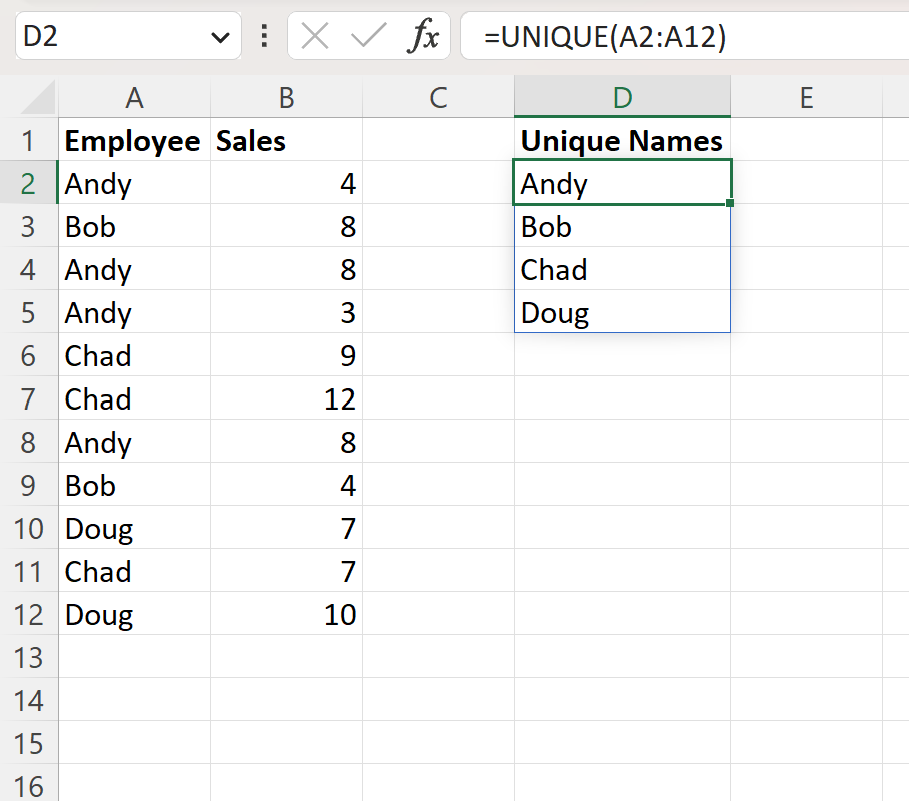
لتطبيق هذه الآلية عملياً، نفترض وجود جدول أداء يتضمن أسماء المشاركين في العمود A من الخلية A2 إلى A100، حيث تتكرر أسماء الأفراد تبعاً لتعدد الجلسات أو العمليات المسجلة. لاستخراج لائحة فريدة تتضمن أسماء الأفراد دون أي تكرار، ننتقل إلى خلية شاغرة في عمود مجاور، ولتكن الخلية D2، ثم ندخل الصيغة البسيطة التالية:
=UNIQUE(A2:A100)
بمجرد الضغط على مفتاح الإدخال، تنسكب الأسماء الفريدة إلى الأسفل محاطة بإطار أزرق رفيع يشير إلى حدود نطاق الانسكاب. وإذا صادف وجود نص مكتوب مسبقاً أو قيمة عشوائية في مسار الخلايا التي تحتاجها الدالة للانسكاب، سيظهر فوراً خطأ الانسكاب الشهير #SPILL!. ولحل هذا الإشكال، يكفي تفريغ الخلايا الواقعة أسفل معادلة الدالة ليتمدد النطاق بحرية تامة.
وللارتقاء بمستوى التنسيق وجعل المخرجات أكثر قابلية للقراءة والتوظيف، يمكن دمج دالة SORT مع دالة UNIQUE لترتيب المخرجات هجائياً بشكل متزامن من خلال صياغة المعادلة المركبة الآتية:
=SORT(UNIQUE(A2:A100))
أما في الحالات التي يحتوي فيها النطاق المصدري على خلايا فارغة، فقد تؤدي دالة UNIQUE إلى إرجاع القيمة الصفرية 0 كعنصر فريد يمثل تلك الفراغات. وللتغلب على هذا التشوه وتصفية النتائج بدقة، يمكن إدماج دالة التصفية FILTER لتجريد النطاق من الخلايا الشاغرة قبل معالجته، كما توضح الصيغة الاحترافية المتقدمة التالية:
=SORT(UNIQUE(FILTER(A2:A100, A2:A100"")))
تضمن هذه الصياغة المركبة توليد قائمة نقية، مرتبة أبجدياً، وخالية تماماً من الفراغات، مما يشكل قاعدة انطلاق مثالية لحساب المجاميع والمؤشرات اللاحقة عبر دوال التجميع الشرطي.
4. حساب المجاميع التراكمية لكل اسم باستخدام دالة SUMIF
4.1 التشريح المصدري لدالة SUMIF ومحدداتها الحسابية
تُعد دالة الجمع الشرطي SUMIF إحدى أقدم الأدوات الرياضية وأكثرها موثوقية في بيئة إكسل لمعالجة التجميع الفئوي؛ حيث تقوم بمقارنة كل عنصر في نطاق محدد بمعيار معين، ثم جمع القيم المقابلة له من نطاق كمي آخر. يتطلب بناء هذه الدالة فهماً دقيقاً لوسائطها الثلاث، وتُكتب وفق الصيغة العامة الآتية:
=SUMIF(range, criteria, [sum_range])
تمثل الوسيطة الأولى range نطاق الفحص الذي يحتوي على الأسماء الأصلية المكررة، في حين تمثل الوسيطة الثانية criteria المعيار المستهدف، وهو الاسم الفريد المراد تجميع قيمه. أما الوسيطة الثالثة sum_range فهي النطاق الفعلي الذي يتضمن المتغيرات العددية التي سيتم جمعها ومطابقتها مع المعيار المحدد.
تقتضي الرصانة الحسابية الانتباه الفائق لآلية تثبيت مراجع الخلايا؛ فعند استخدام الدالة بجوار قائمة الأسماء الفريدة، يجب استخدام المراجع المطلقة (Absolute References) بواسطة رمز الدولار $ لنطاق الفحص ونطاق الجمع، مثل $A$2:$A$100 و $B$2:$B$100. هذا التثبيت الصارم يمنع زحف النطاقات وتغير حدودها الحسابية عند تعميم المعادلة وسحبها للأسفل، في حين يُترك مرجع الخلية المحتوية على المعيار D2 كمرجع نسبي (Relative Reference) حر، ليتحرك بسلاسة ليطابق الاسم المقابل لكل صف، مما يمنع حدوث أخطاء الاقتطاع النطاقي التي تتسبب في تشويه دقة المجاميع المستخرجة.
4.2 خطوات التنفيذ لحساب إجمالي المبيعات بحسب الاسم
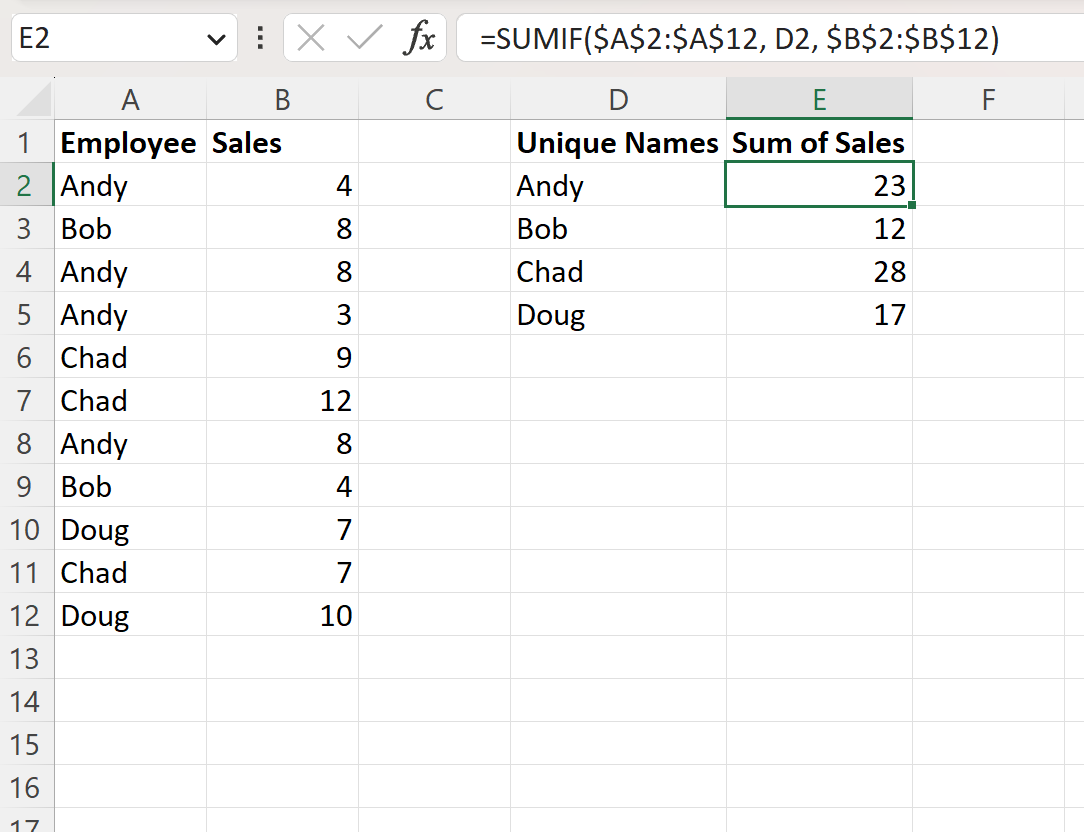
لتطبيق التجميع الحسابي التراكمي، نفترض أن العمود A يحتوي على أسماء الموظفين، والعمود B يتضمن قيم المعاملات أو المبيعات المحققة، بينما وُضعت الأسماء الفريدة المستخرجة مسبقاً في العمود D ابتداءً من الخلية D2. في الخلية المجاورة E2، نقوم بكتابة معادلة الجمع الشرطي بالصيغة الآتية:
=SUMIF($A$2:$A$100, D2, $B$2:$B$100)
بعد إدخال الصيغة، يتم سحب مقبض التعبئة التلقائية (AutoFill Handle) من زاوية الخلية E2 باتجاه الأسفل حتى نهاية قائمة الأسماء الفريدة، ليقوم البرنامج بحساب إجمالي كل اسم على حدة بصورة تراكمية فورية.
ولضمان السلامة المنهجية للبيانات المستخلصة، يُطبق اختبار التحقق التوازني؛ ويتم ذلك عبر حساب المجموع الكلي للعمود الأصلي =SUM($B$2:$B$100)، ومقارنته بالمجموع الكلي للقيم الناتجة عن التجميع =SUM(E2:E20). يجب أن يتطابق الرقمان بصورة تامة؛ وأي تفاوت يشير إلى وجود أسماء لم تُدرج، أو أخطاء تطابق نصي حرمت بعض السجلات من التجميع. علاوة على ذلك، في الإصدارات الحديثة التي تدعم مشغّل الانسكاب، يمكن ربط الدالة ديناميكياً بمصفوفة UNIQUE المستخرجة في D2# دون الحاجة للسحب اليدوي، من خلال الإشارة المباشرة إلى نطاق الانسكاب كمعيار:
=SUMIF($A$2:$A$100, D2#, $B$2:$B$100)
تضمن هذه الصيغة المتقدمة توليد عمود المجاميع تلقائياً بحجم مساوٍ لمصفوفة الأسماء، وتحديثه ذاتياً كلما طرأ تغيير على قائمة الأسماء المتمايزة.
5. توسيع المقاييس الإحصائية المجمعة: المتوسطات والعد ومؤشرات التباين
5.1 حساب معدل التكرار والأداء الفردي عبر COUNTIF و AVERAGEIF
لا يكتمل التحليل الوصفي لقواعد البيانات بمجرد حساب المجاميع التراكمية، بل يتطلب في كثير من الأحيان تفكيك هذه الأرقام إلى مقاييس نزعة مركزية تعبر عن تكرار النشاط ومتوسط حجم الإنجاز المنسوب لكل اسم. تتيح دالة العد الشرطي COUNTIF إحصاء عدد السجلات أو المعاملات المرتبطة بكل شخص، وتُبنى وفق التركيب الرياضي =COUNTIF(range, criteria). فإذا قمنا بإدخال الصيغة =COUNTIF($A$2:$A$100, D2) بجانب الاسم الفريد في الخلية F2، فإنها ستظهر بدقة متناهية عدد المرات التي ورد فيها هذا الاسم في السجل الإجمالي، مما يمثل مؤشر التكرار أو كثافة المشاركة لكل فرد.
بالتوازي مع ذلك، تؤدي دالة المتوسط الشرطي AVERAGEIF دوراً محورياً في قياس الكفاءة المتوسطة من خلال تقسيم المجموع التراكمي للقيم على عدد تكرارات الاسم، مستبعدة الحاجة للقيام بالعمليات الحسابية المتعددة يدوياً. تُكتب الصيغة في الخلية G2 على النحو التالي:
=AVERAGEIF($A$2:$A$100, D2, $B$2:$B$100)
يتيح الجمع بين مؤشر العد ومؤشر المتوسط للمحللين بناء مؤشر أداء مركب متوازن؛ إذ إن تقييم الفرد بناءً على إجمالي المبيعات وحده قد يكون مضللاً إذا كان ناتجاً عن صفقة استثنائية مفردة، في حين يكشف دمج التكرار مع المتوسط مدى استقرار وتواتر الأداء عبر الزمن ومستوى استمراريته المنهجية.
5.2 استخراج القيم القصوى والدنيا لكل اسم باستخدام MAXIFS و MINIFS
لاستكمال الصورة الإحصائية وتحديد حدود التشتت للأداء الفردي، وفرت التحديثات البرمجية المتقدمة في إكسل دالتي MAXIFS و MINIFS، اللتين تسمحان باستخراج القيم الحدية العليا والدنيا المرتبطة بكل اسم دون الحاجة إلى اللجوء لصيغ المصفوفات المعقدة سابقاً. تُصاغ دالة القيمة القصوى من خلال تحديد نطاق القيم أولاً ثم نطاق الفحص والمعيار المقابل، كما في المعادلة التالية:
=MAXIFS($B$2:$B$100, $A$2:$A$100, D2)
وعلى المنوال نفسه، يتم استخراج أدنى إنجاز أو قيمة مسجلة للاسم من خلال دالة الحد الأدنى:
=MINIFS($B$2:$B$100, $A$2:$A$100, D2)
يسهم استخراج هذين المؤشرين في حساب المدى الإحصائي (Range) للأداء الفردي من خلال طرح القيمة الدنيا من القيمة القصوى (MAX - MIN). يعكس هذا المدى درجة التباين والتذبذب في مخرجات الشخص الواحد؛ فالمدى الضيق يشير إلى أداء متسق ومستقر وموثوق، بينما ينبئ المدى المتسع عن وجود تباين حاد أو استجابات شاذة (Outliers) تستدعي فحصاً معمقاً لعزل الظروف العارضة التي أدت إلى تسجيل تلك التباينات الشديدة في مصفوفة البيانات، وهو إجراء تحليلي جوهري في بحوث قياس الأداء وضمان الجودة.
6. تجميع البيانات حسب الاسم باستخدام الجداول المحورية (Pivot Tables)
6.1 إنشاء جدول محوري مخصص لتلخيص البيانات الاسمية
تمثل الجداول المحورية (Pivot Tables) القمة التقنية لأدوات التلخيص التفاعلي في برنامج إكسل، وهي تقنية يعود الفضل في ابتكار نموذجها الأولي إلى بيتو سالاس (Pito Salas) في أواخر ثمانينيات القرن الماضي ضمن برمجية “Lotus Improv”، قبل أن تدمجها مايكروسوفت رسمياً في إصدار إكسل لعام 1994 لتصبح المعيار الصناعي لتحليل البيانات وتجميعها. يتميز الجدول المحوري بقدرته الفائقة على تجميع آلاف السجلات الاسمية وتلخيصها خلال ثوانٍ معدودة دون كتابة صيغة حسابية واحدة، مما يقلل احتمالات الخطأ البشري في بناء الدوال ويوفر واجهة تحليلية تفاعلية متعددة الأبعاد.
لبناء الجدول المحوري لتجميع البيانات حسب الاسم، يحدد المستخدم نطاق البيانات أو الجدول الديناميكي المصدري، ثم يتجه إلى شريط الأدوات ويختار علامة التبويب “إدراج” (Insert) ثم ينقر على “جدول محوري” (PivotTable). في النافذة المنبثقة، يتم تحديد موضع التقرير سواء في ورقة عمل جديدة أو داخل الورقة الحالية. تكمن الخطوة الجوهرية للتجميع في قائمة الحقول الجانبية (PivotTable Fields)؛ حيث يتم سحب حقل “الاسم” (Name) وإسقاطه بدقة داخل منطقة “الصفوف” (Rows). يقوم المحرك البرمجي للجدول المحوري في هذه اللحظة بدمج السجلات المكررة بصورة آلية وفورية، مستعرضاً قائمة بالأسماء الفريدة فقط. بعد ذلك، يتم سحب حقل المتغير العددي المُراد تلخيصه، كالمبيعات أو الساعات، وإسقاطه في منطقة “القيم” (Values)، ليقوم البرنامج بتطبيق عملية الجمع التراكمي التلقائي لكل اسم بموثوقية حسابية مطلقة.
6.2 تخصيص العرض والتحكم في مخرجات التجميع
تتجاوز قدرات الجداول المحورية مجرد الجمع الافتراضي؛ حيث تتيح للمستخدم تحكماً دقيقاً في طبيعة المعالجة الرياضية للحقول الرقمية المجمعة. من خلال النقر بزر الفأرة الأيمن على أي رقم داخل منطقة القيم واختيار “تلخيص القيم حسب” (Summarize Values By)، يمكن التحول الفوري من المجموع (Sum) إلى حساب المتوسط الحسابي (Average)، أو عدد المعاملات (Count)، أو رصد القيم القصوى والدنيا. بل ويمكن الذهاب إلى أبعد من ذلك عبر خيار “إظهار القيم كـ” (Show Values As) لاحتساب النسبة المئوية لمساهمة كل اسم من الإجمالي الكلي للبيانات (Percentage of Grand Total)، مما يمنح صانع القرار رؤية نسبية مباشرة للأوزان النسبية للأسماء المدروسة.
ولتعزيز الجانب التفاعلي للتقارير المجمعة، يُمكن إدراج “مقسمات طرق العرض” (Slicers) من علامة تبويب تحليل الجدول المحوري؛ وهي واجهات ترشيح مرئية تسمح بتصفية الأسماء والقطاعات بنقرة زر واحدة دون الحاجة للتعامل مع الفلاتر التقليدية المعقدة. ومع ذلك، تجب الإشارة إلى محدد بنيوي في الجداول المحورية مقارنة بالدوال الحسابية المباشرة؛ فالجدول المحوري لا يُحدث نتائجه تلقائياً بمجرد تعديل بيانات الجدول المصدري، بل يتطلب تنشيطاً يدوياً عبر النقر بزر الفأرة الأيمن واختيار “تحديث” (Refresh)، أو برمجة خيارات المصنف لتحديث البيانات آلياً عند الفتح، لضمان توافق التقرير التجميعي مع واقع المدخلات الخام بصورة دورية ومستمرة.
7. التجميع الهرمي والمجاميع الفرعية باستخدام أداة Subtotal
7.1 إعداد وتصنيف البيانات لتطبيق المجاميع الفرعية
تُعد أداة المجاميع الفرعية (Subtotal) من الميزات الهيكلية الكلاسيكية في برنامج إكسل، والتي توفر حلاً مثالياً للمستخدمين الراغبين في استعراض البيانات المجمعة مع الاحتفاظ بإمكانية رؤية السجلات التفصيلية الفردية تحت كل اسم ضمن نفس المخطط الجدولي. تعمل هذه الأداة عبر حقن صفوف مجاميع حسابية بشكل آلي عند كل نقطة تحول يطرأ فيها تغيير على القيمة النصية لعمود التصنيف. ولذلك، فإن الشرط التقني الإلزامي الذي لا غنى عنه قبل تشغيل هذه الأداة يتمثل في إجراء عملية فرز كاملة (Sorting) لقاعدة البيانات استناداً إلى عمود “الاسم” أولاً، سواء كان الترتيب تصاعدياً أو تنازلياً.
إذا أُهملت خطوة الفرز المسبق، فإن الأداة ستفشل فشلاً ذريعاً؛ حيث ستولد صف مجموع فرعي منفصل لكل سطر يظهر فيه الاسم إذا كانت السجلات غير متجاورة، مما يؤدي إلى تضخم هائل في حجم الورقة وفقدان المعنى التجميعي تماماً. بعد التأكد من تجميع كافة سجلات كل اسم في كتل متصلة عبر الفرز، يتجه المستخدم إلى علامة التبويب “بيانات” (Data) في الشريط العلوي، ثم يضغط على أيقونة “إجمالي فرعي” (Subtotal) ضمن مجموعة أدوات “مخطط تفصيلي” (Outline). تنبثق حينها نافذة الضبط التي يتم فيها تحديد الخيارات الحسابية بدقة: يُضبط حقل “عند كل تغيير في” (At each change in) على عمود “الاسم”، وتُحدد “استخدام الدالة” (Use function) وفق الغرض المطلوب (مثل الجمع Sum أو المتوسط Average)، ثم يُفعل خيار العمود العددي المراد تجميعه ضمن خانة “إضافة إجمالي فرعي إلى”، لتباشر الأداة إعادة تشكيل الجدول بصورة هرمية متسقة.
7.2 التحكم في مستويات المخطط التفصيلي للبيانات المجمعة
تولد أداة Subtotal فور تطبيقها نظام تحكم هرمي شجري على يمين أو يسار ورقة العمل (تبعاً لاتجاه واجهة البرنامج)، يتضمن ثلاثة أزرار ترقيم تمثل مستويات العرض التفصيلي. يمثل المستوى الأول (رقم 1) قمة الهرم التجميعي، حيث يخفي كافة التفاصيل الفردية والمجاميع الجزئية، عارضاً الإجمالي العام النهائي للمصنف بأكمله. في حين يمثل المستوى الثاني (رقم 2) الواجهة التحليلية المثالية المطلوبة لغايات التجميع؛ إذ يُخفي السجلات الفردية بالكامل ويعرض حصراً صفوف الأسماء المستقلة وبجانبها المجموع التراكمي لكل فرد، مما يمنح المستخدم جدولاً مجمعاً نقياً. أما المستوى الثالث (رقم 3)، فيعيد بسط ورقة العمل لعرض كافة المعاملات والسجلات التفصيلية الأصلية متبوعة بمجاميعها الفرعية.
تكمن إحدى أبرز المشكلات التقنية عند العمل مع المستوى الثاني الرامي لعزل المجاميع المجمعة في أن النسخ التقليدي للنطاق الظاهر (Ctrl + C) ينسخ في طياته الصفوف الخفية أيضاً، مما يؤدي إلى لصق كافة التفاصيل غير المرغوبة في الموضع الجديد. ولتجاوز هذا العائق باحترافية، يجب تفعيل المستوى الثاني، ثم تحديد النطاق الظاهر والضغط على التوليفة المختصرة Alt + ; (أو من خيار “البحث والتحديد” الذهاب إلى “انتقال إلى خاص” ثم اختيار “الخلايا المرئية فقط”). يضمن هذا الإجراء قفل التحديد على صفوف المجاميع المجمعة حصراً، مما يتيح نسخها ولصقها في أي ورقة أخرى كتقرير مجمع ومستقل. ومع هذه المزايا الهيكلية، تظل أداة المجاميع الفرعية مقيدة مقارنة بمرونة الدوال الديناميكية والجدول المحوري؛ إذ إنها تغير الطبيعة الهيكلية للنطاق ولا تتوافق مع “جداول إكسل الديناميكية” (Excel Tables)، وتتطلب إزالة التجميع يدوياً عند الرغبة في إعادة تعديل السجلات الأساسية.
8. أتمتة تجميع الأسماء وتجهيز التقارير المتقدمة عبر Power Query
8.1 استيراد البيانات وتحويلها داخل بيئة محرر الاستعلامات
يُمثل محرك باور كويري (Power Query) – المعروف في الواجهات الحديثة بمجموعة أدوات “الحصول على البيانات وتحويلها” (Get & Transform Data) – المنظومة المؤسسية الأقوى لمعالجة البيانات الضخمة وأتمتة مسارات استخراجها وتنقيتها وتجميعها. يتميز هذا المحرك بقدرته على معالجة ملايين السجلات دون إثقال ذاكرة ورقة العمل التقليدية، مع تسجيل كافة الخطوات التحويلية ضمن تسلسل خوارزمي قابل للتكرار التلقائي كلما وردت بيانات جديدة. تبدأ دورة العمل بتحديد جدول السجلات المطلوب تجميعه، ثم الانتقال إلى علامة التبويب “بيانات” والنقر على أمر “من ورقة” (From Sheet) أو “من جدول/نطاق” (From Table/Range)، ليفتح البرنامج فوراً نافذة محرر باور كويري المستقلة.
داخل بيئة المحرر، تخضع البيانات لسلسلة من إجراءات التحقق النوعي؛ حيث يتأكد المستخدم من تعيين نوع البيانات الصحيح لكل عمود (تحديد عمود الأسماء كنص Text، وحقل القيم كأرقام عشرية أو صحيحة)، إلى جانب تطبيق خطوات التنظيف المسبق مثل حذف الفراغات عبر أمر Trim وتطهير الرموز عبر أمر Clean المتوفرين بضغطة زر ضمن واجهة التحويل. بعد استتباب جودة البيانات، يتم التوجه إلى علامة التبويب “تحويل” (Transform) واختيار أداة “التجميع حسب” (Group By). تنبثق هنا نافذة التجميع المركزية، حيث يتم اختيار عمود “الاسم” كحقل التجميع الأساسي، مما يوجه المحرك لاختزال كافة الأسطر المتكررة ودمجها حول هذا المعرف المحوري بصورة صارمة ودقيقة برمجياً.
8.2 تطبيق العمليات الحسابية المتعددة وإعادة التحميل
تتيح نافذة “التجميع حسب” في محرر باور كويري مسارين: مسار التجميع البسيط ومسار التجميع المتقدم (Advanced). يوفر المسار المتقدم مرونة استثنائية لا تضاهيها الطرق التقليدية؛ إذ يسمح بحساب مؤشرات إحصائية متعددة ومتزامنة ضمن نفس خطوة المعالجة. على سبيل المثال، يمكن للمستخدم إضافة تجميع أول لحساب المجموع التراكمي للمبيعات (Sum)، وإضافة تجميع ثانٍ لحساب المتوسط الإحصائي (Average)، وثالث لحساب عدد الصفقات المنجزة (Count Rows)، ورابع لتحديد أقصى قيمة (Max)، كل ذلك في واجهة جدولية واحدة وموحدة يتم إنشاؤها في أجزاء من الثانية.
عند اكتمال بناء محددات التجميع وضغط زر الموافقة، يطبق المحرك التحويل المبرمج فوراً عبر لغة الاستعلامات M. تكتمل العملية بالانتقال إلى علامة التبويب “الصفحة الرئيسية” والضغط على زر “إغلاق وتحميل” (Close & Load). يقوم باور كويري هنا بإنشاء ورقة عمل جديدة تتضمن جدولاً نهائياً فائق التنسيق يحتوي على البيانات المجمعة حصراً، ويكون هذا الجدول مربوطاً بمسار تدفق برمجي مستمر (Data Pipeline). فإذا تم لاحقاً إضافة مئات السجلات الجديدة في الجدول الخام الأصلي، فلن يحتاج المحلل سوى النقر بزر الفأرة الأيمن على الجدول المجمع واختيار “تحديث” (Refresh)؛ ليقوم الاستعلام تلقائياً باستيراد السجلات الجديدة، وتطبيق خطوات التنظيف، وإعادة حساب التجميعات ونشر التقرير النهائي المحدث بدقة متناهية ودون أي جهد يدوي متكرر.
9. استكشاف الأخطاء الشائعة وحل مشكلات عدم تطابق الأسماء وتكرارها
9.1 معالجة التباينات النصية والمسافات غير المرئية
تُمثل مشكلات التطابق النصي العائق الأكبر الذي يقوض دقة مخرجات التجميع في برمجية إكسل؛ حيث تُبنى كافة الدوال والعمليات المنطقية على التطابق التام لسلاسل المحارف المشفرة ثنائياً. من أكثر الأخطاء الشائعة خفاءً وظهوراً في بيئات العمل وجود “المسافات غير المنقطعة” (Non-breaking Spaces)، والمعروفة برمز التشفير CHAR(160) في معايير ويندوز، وهي مسافات لا تستطيع دالة TRIM التقليدية رصدها أو حذفها لأنها مصممة لحذف المسافة المعيارية CHAR(32) فقط. تتسلل هذه المسافات عادة عند استيراد البيانات من متصفحات الويب أو قواعد البيانات المؤسسية الكبرى مثل SAP و Oracle، وتتسبب في فصل الاسم المتطابق ظاهرياً إلى صفين مجمعين مستقلين.
لعلاج هذا التشوه التقني بصورة جذرية، يتم دمج دالتي SUBSTITUTE و TRIM في معادلة تطهير قوية تستبدل المحرف غير المرئي بمسافة قياسية ثم تتخلص منه نهائياً، كما توضح الصيغة الآتية:
=TRIM(CLEAN(SUBSTITUTE(A2, CHAR(160), " ")))
تعمل هذه الصيغة على تنظيف النصوص من الرموز غير القابلة للطباعة واستبدال كافة أشكال المسافات المخفية وتجريدها. أما في حالات التباين الإملائي الناتج عن أخطاء الإدخال البشري (مثل كتابة “عبد الله” بمسافة وتارة أخرى “عبدالله” بدون مسافة)، فإن الدوال الكلاسيكية ستتعامل معهما ككيانين مختلفين. ويكمن الحل المنهجي هنا إما في توظيف ميزة “المطابقة التقريبية” (Fuzzy Matching) المدمجة داخل باور كويري، والتي تعتمد خوارزميات قياس التشابه النصي (مثل تشابه جاكارد ومسافة ليفنشتاين) لدمج الأسماء المتشابهة بنسبة معينة يحددها المحلل، أو من خلال تشييد جدول مرجعي للترجمة النصية يعيد تعيين الأسماء الخاطئة إلى صياغتها المعيارية قبل تطبيق عمليات التجميع.
9.2 تحديد وتصحيح أخطاء مراجع الخلايا وتباين الصيغ
ينشأ مصدر آخر للأخطاء الشائعة عن الاستخدام غير المنضبط لمراجع الخلايا عند تعميم المعادلات الحسابية؛ فالإغفال عن تثبيت نطاقات البحث باستخدام مراجع الدولار المطلقة في دوال مثل SUMIF و COUNTIF يولد خطأ انزياح النطاق (Range Creep). فعند سحب المعادلة من الخلية E2 إلى E3 دون تثبيت، ينزاح النطاق من A2:A100 إلى A3:A101، مما يؤدي إلى استبعاد السطر الأول تدريجياً مع كل صف جديد، فتفقد المجاميع دقتها دون أن يُظهر البرنامج أي رسالة تحذيرية صريحة تنبه المستخدم لوجود خطأ حسابي.
تتضمن قائمة المشكلات أيضاً أزمة تخزين الأرقام كنصوص، والتي تحدث بكثرة عند استيراد الأرقام المسبوقة بفواصل عليا أو علامات تنصيص. في هذه الحالة، تفشل دالة SUMIF في قراءة القيم الرقمية وتحتسب المجموع مساوياً للصفر (0) دون إشعار خطأ. يُعالج هذا الأمر بتحديد العمود المعني واستخدام أداة “نص إلى أعمدة” (Text to Columns) ثم الضغط مباشرة على إنهاء لإعادة تصنيف المحتوى كأرقام نقية، أو استخدام العمليات الحسابية المحايدة مثل ضرب العمود في 1. كما تجب مراقبة حالات الفراغ الإجمالي؛ إذ إن ترك خلايا فارغة ضمن عمود البحث قد يدفع دالة التجميع لاحتسابها كفئة مستقلة تظهر باسم 0، وهو ما يوجب إحاطة دوال التحليل بفلاتر تمنع معالجة الحقول الفارغة لضمان إخراج تقارير متسقة تخلو من التشوهات العددية المضللة.
10. تطبيقات ونماذج عملية متقدمة للتجميع حسب الاسم في بيئات العمل
10.1 نموذج تقييم ومتابعة المبيعات الإجمالية لممثلي المبيعات
يبرز التطبيق العملي لتقنيات التجميع حسب الاسم في بناء لوحات المتابعة ومراقبة الأداء المالي والتجاري لموظفي المبيعات داخل المؤسسات. في هذا السياق، تتدفق سجلات المعاملات اليومية متضمنة اسم المندوب، والمنطقة، وقيمة الصفقة الفردية وتاريخها. يتيح التجميع الممنهج تحويل هذا التدفق التفصيلي المشوش إلى لوحة مؤشرات قيادية تلخص حجم الأداء التراكمي المنجز بواسطة كل مندوب على حدة، وتكشف بوضوح عن الحصة السوقية النسبية لكل فرد من إجمالي المبيعات المحققة عبر كامل الفريق التجاري.
وللارتقاء بهذا النموذج وجعله أداة بصرية مؤثرة لمتخذي القرار، يتم ربط المخرجات المجمعة بقواعد “التنسيق الشرطي” (Conditional Formatting). يمكن مثلاً تطبيق “أشرطة البيانات” (Data Bars) أو “تدرجات الألوان” داخل عمود المجاميع لتمييز أصحاب الأداء المالي الأعلى بلون أخضر وتظليل الأداء المتراجع بلون متدرج نحو الأحمر. علاوة على ذلك، يتم دمج معادلات قياس الأهداف البيعية (Sales Quotas) لمقارنة المجموع التراكمي المحقق لكل مندوب بالهدف المطلوب منه بصيغة نسبية مئوية بسيطة:
=E2 / الحصة_المستهدفة
تسمح هذه الرؤية التجميعية المركبة للإدارة بتوجيه المكافآت التقديرية بناءً على أرقام تجميعية موثوقة ومطابقة لمعايير العدالة المؤسسية، والتنبؤ الدقيق بالمسارات البيعية المستقبلية للمنظمة.
10.2 نموذج رصد الساعات التشغيلية وتكاليف المشروعات للموظفين
يتجلى نموذج تطبيقي متقدم آخر في إدارة الموارد البشرية وإدارة المشروعات الهندسية والاستشارية، حيث يقوم الموظفون بتسجيل ساعات العمل اليومية المتفرقة عبر مهام وواجبات متعددة تتكرر أسبوعياً وشهرياً. يُشكل التجميع حسب اسم الموظف هنا الآلية المحاسبية المعتمدة لاحتساب إجمالي الساعات التشغيلية التي بذلها كل فرد عبر كافة المشروعات المشتركة، وتحويل تلك الساعات إلى تكاليف مالية مستحقة للصرف.
يبدأ هذا النموذج باستخراج قائمة الموظفين الفريدة، ثم تجميع إجمالي الساعات المسجلة لكل فرد بواسطة دالة SUMIF أو عبر جدول محوري متقدم. في الخطوة اللاحقة، يتم ضرب إجمالي الساعات المجمعة في التكلفة المعيارية لساعة العمل الخاصة بكل موظف (Hourly Billing Rate) بالصيغة:
=إجمالي_الساعات_المجمعة * معدل_أجر_الساعة
يتيح هذا التجميع الإداري الدقيق استخراج تقارير تكلفة العمل المستحقة لكل مشروع، ومقارنة التكاليف الفعلية المجمعة بالموازنات التقديرية المرصودة مسبقاً. كما يمنح مديري المشروعات القدرة على رصد حالات الإجهاد التشغيلي (Overtime) وتوزيع أعباء العمل المتوازنة بين أعضاء الفريق بصورة احترافية، فضلاً عن تصدير مستندات المطالبات المالية والأجور بصيغ تنفيذية موجهة مباشرة للإدارة المالية ولجان التدقيق المحاسبي.
خاتمة
استعرضت هذه المقالة الشاملة الأبعاد النظرية والتطبيقية لعملية التجميع حسب الاسم في برمجية مايكروسوفت إكسل، مبرهنة على أن هذه المهمة تتعدى مجرد الترتيب المظهري للبيانات لتشكل مدخلاً رئيساً لضمان دقة التحليلات وصلاحية المؤشرات الإحصائية المستخلصة. لقد تبين بوضوح أن نجاح عملية التجميع يرتبط ارتباطاً وثيقاً بسلامة الإجراءات التمهيدية؛ فتنظيف النصوص واستبعاد الفراغات غير المرئية وضبط البنية الجدولية وتوحيد أنماط البيانات تمثل خط الدفاع الأول ضد التشوهات والازدواجيات الحسابية المضللة.
كما بينت المقارنات الفنية أن بيئة إكسل توفر ترسانة متكاملة من الحلول التي تتناسب مع مختلف مستويات التعقيد؛ بدءاً من التكامل الديناميكي الحديث بين دالتي UNIQUE و SUMIF والمصفوفات المنسكبة التي تمنح مرونة وحداثة فورية، مروراً بالقوة التفاعلية للجداول المحورية وأداة المجاميع الفرعية، ووصولاً إلى القدرات المؤسسية الهائلة لمحرك باور كويري في أتمتة تدفقات البيانات الضخمة. إن إتقان هذه الأدوات، والوعي بكيفية تجنب أخطاء التطابق ومراجع الخلايا وتوظيف المؤشرات التجميعية في نماذج عملية متقدمة، يُمكّن الباحثين وصناع القرار من الانتقال ببياناتهم من طور التشتت الرقمي إلى أفق التحليل الموضوعي الرصين، مما يدعم اتخاذ قرارات مبنية على شواهد رقمية بالغة الدقة والموثوقية.
المراجع
- Dunning, D. A., Heath, C., & Suls, J. M. (2004). Flawed Self-Assessment. Psychological Science in the Public Interest. https://doi.org/10.1111/j.1529-1006.2004.00018.x