
تعد إدارة البيانات ومعالجتها من الركائز الأساسية التي يعتمد عليها التحليل الكمي المعاصر في شتى العلوم والمجالات التطبيقية. ومع تنامي حجم التدفقات البيانية وتعدد مصادرها، بات من النادر أن تتوفر كافة المؤشرات والمتغيرات التحليلية ضمن جدول منفرد ومغلق؛ بل أضحت السمة الغالبة هي انتشار البيانات عبر مصفوفات وجداول علائقية متفرقة تتطلب التوحيد والدمج المنهجي. وهنا تبرز الحاجة الملحة لعمليات الربط العلائقي، وعلى رأسها عملية “الربط الداخلي” (Inner Join)، بوصفها الآلية الدقيقة التي تمكن الباحث والمحلل من استخلاص التقاطعات المشتركة بين مصادر البيانات المختلفة دون الوقوع في شراك البيانات الناقصة أو الملوثة بقيم غير مكتملة.
يمثل برنامج مايكروسوفت إكسل (Microsoft Excel) البيئة الأكثر انتشاراً للتعامل مع البيانات المكتبية والتحليلات الأولية والمتقدمة. ورغم أن إكسل عُرف تاريخياً بالاعتماد على المعادلات المرجعية التقليدية كدوال البحث الرأسي، إلا أن إدماج محرك “باور كويري” (Power Query) أحدث نقلة نوعية في قدرات البرنامج التحليلية، محولاً إياه إلى منصة قادرة على تنفيذ العمليات الجبرية العلائقية بأعلى معايير الكفاءة والدقة الرياضية. يتيح هذا المحرك إجراء عمليات الربط بين الجداول استناداً إلى أسس نظرية المجموعات، مما يرفع من موثوقية النتائج ويقلل من الأخطاء البشرية الشائعة المرتبطة بتثبيت النطاقات أو تكرار المعادلات الحسابية المرهقة للذاكرة الحاسوبية.
يهدف هذا الدليل المرجعي الموسع إلى تقديم تأصيل علمي وتطبيقي شامل لعملية الربط الداخلي في إكسل. سنستعرض فيه الخلفية النظرية المستمدة من قواعد البيانات العلائقية، ونتتبع خطوة بخطوة كيفية تهيئة الجداول وهيكلتها، مروراً بالاستيراد والربط داخل بيئة باور كويري، وانتهاءً بتوسيع الأعمدة وتصدير النتائج إلى ورقة العمل، مع تقديم تشخيص منهجي للأخطاء الشائعة ومقارنة كفاءة الأداء مع الدوال التقليدية، ليكون هذا العمل مرجعاً تحليلياً متكاملاً يلبي متطلبات الباحثين والمحللين الماليين وعلماء البيانات التطبيقيين.
1. مقدمة تأصيلية لمفهوم الربط الداخلي (Inner Join) في بيئات معالجة البيانات
1.1 التعريف النظري والمنطقي لعملية الربط الداخلي
تستند عملية الربط الداخلي (Inner Join) من الناحية النظرية الصارمة إلى مبادئ الجبر العلائقي (Relational Algebra) ونظرية المجموعات الرياضية، والتي وضع أسسها الرائدة عالم الرياضيات والكمبيوتر إدغار كود في مطلع سبعينيات القرن العشرين. ينطلق المفهوم من فكرة دمج علاقتين رياضيتين أو جدولين (Relation $R$ و Relation $S$) عبر البحث عن الجداء الديكارتي (Cartesian Product) المقيد بشرط المساواة، وهو ما يُعرف اصطلاحاً بربط التساوي (Equijoin). في هذه الصياغة المنطقية، تُفحص كافة الصفوف في الجدول الأول بمقابلة كافة الصفوف في الجدول الثاني، ولا يُسمح بالمرور إلى مصفوفة المخرجات إلا لتلك الثنائيات التي يتحقق فيها تطابق دقيق ومطلق بين قيم السمة المحددة أو ما يُعرف بالمفتاح المرجعي (Key Attribute).
يترتب على هذا المنطق الرياضي أن مخرجات الربط الداخلي تنحصر حصراً في منطقة التقاطع المنطقي المتطابق بين المجموعتين. فإذا افترضنا أن الجدول الأول يحتوي على فضاء بيانات يمثل العينات المفحوصة، والجدول الثاني يمثل مقاييس معملية مستقلة، فإن ناتج الربط الداخلي سيتجاهل تماماً أي عينة لم تسجل قياسات في الجدول الثاني، كما سيهمل أي قياسات لا تنتمي إلى عينة مسجلة في الجدول الأول. هذه الانتقائية الحتمية تجعل العملية خالية من أي افتراضات إحصائية أو استدلالية؛ فالربط الداخلي ليس اختباراً بارامترياً ولا يفرز معاملات دلالة إحصائية كقيم ($p$-value) أو أحجام أثر، بل هو إجراء هيكلي تنظيمي ينتمي إلى معالجة البيانات الأولية وتحقيق اتساقها الهندسي.
إن استبعاد القيم المنفردة أو غير المتطابقة تلقائياً يضمن نقاء المجموعة البيانية المتكونة، ويحول دون تسرب الخلايا الفارغة أو المؤشرات المعطوبة إلى مراحل التحليل اللاحقة. في بحوث البيانات المتعددة المصادر، مثل دمج تسجيلات الاستجابات السلوكية مع الإشارات الفسيولوجية العصبية المتزامنة، يشكل هذا الفرز الذاتي حجر الزاوية لتفادي التقديرات غير المتزنة، وهو النهج الذي تعتمده الدراسات المعملية الدقيقة لضمان عدم مطابقة قياسات مجهولة المصدر مع مفحوصين مفقودين (Sharma et al., 2019).
1.2 المقارنة المنهجية بين الربط الداخلي وبقية أنواع الربط العلائقي
تتحدد هوية أي نوع من أنواع الربط العلائقي استناداً إلى تعامله مع البيانات التي لا تجد لها نظيراً في الجدول المقابل. في هذا الإطار، يبرز التباين الجوهري بين الربط الداخلي والربط الخارجي الكامل (Full Outer Join)؛ فالأخير يحتفظ بكافة السجلات من كلا الجدولين دون استثناء، ويقوم بتوليد قيم مفقودة (Nulls) في الخانات التي تفتقر إلى مطابقة متبادلة، مما يجعله ملائماً لحصر الشواغر واكتشاف أوجه النقص الشاملة، ولكنه غير مناسب للتحليلات التي تشترط اكتمال القياسات لكل وحدة تحليل.
أما بالنظر إلى الربط الأيسر (Left Outer Join) والربط الأيمن (Right Outer Join)، فإن الفلسفة الحاكمة لكليهما تتلخص في منح الأولوية الهيكلية لأحد الطرفين على حساب الآخر. في الربط الأيسر، يتم الحفاظ على جميع صفوف الجدول الأساسي (الأيسر)، وتُسحب البيانات المطابقة من الجدول الثانوي (الأيمن)، مع ملء الفجوات بقيم فارغة، والعكس صحيح تماماً في الربط الأيمن. يكمن الفارق هنا في أن الربط الداخلي يتسم بالتناظر التام وعدم الانحياز لأي من الجدولين؛ إذ تُعامل الأطراف بمساواة موضوعية، وتسقط أي صفوف لا تحقق التوافق المتزامن.
تتجلى حالات الاستخدام المثلى التي تستوجب اختيار الربط الداخلي حصراً في المواقف التي يتطلب فيها النموذج التحليلي توفر كافة المتغيرات مجتمعة لكل فرد أو عنصر دراسي. ففي الدراسات المقطعية الطولية التي تقيس أداء عينة محددة عبر مراحل متعددة، يعد الربط الداخلي الوسيلة الحاسمة لعزل الحالات التي حضرت جميع الجلسات فقط، مانعاً بذلك تحريف المتوسطات الحسابية أو تباينات المجموعات بسبب إدراج أفراد انسحبوا قبل إتمام بروتوكول التقييم.
1.3 أهمية الربط الداخلي في تعزيز موثوقية التحليلات في إكسل
يؤدي اعتماد الربط الداخلي في بيئة إكسل إلى إزالة التشويش البياني الناجم عن الصفوف المبتورة أو السجلات غير المكتملة التي تنشأ عادة عند استيراد البيانات من واجهات برمجية أو أنظمة إدارة علاقات العملاء وقواعد البيانات المفتوحة. عندما تترك الصفوف المشوبة بقيم ناقصة داخل أوراق العمل، فإن الدوال التلخيصية والمحاور الإحصائية (Pivot Tables) قد تقع في فخ احتساب قيم صفرية غير مقصودة أو تشويه فضاء العينة الفعلي، وهو ما يقوض التوزيع الطبيعي المفترض للبيانات في الدراسات التجريبية والكمية.
علاوة على ذلك، يرفع الربط الداخلي من كفاءة النمذجة الإحصائية عبر تجميع المقاييس المترابطة فقط، مما يتيح للباحث تأسيس علاقات ارتباطية موثوقة ونماذج انحدار خطي مستقرة البنية. فعندما يرتبط كل متغير تفسيري بمتغير استجابة حقيقي ومؤكد، تختفي مشكلات درجات الحرية الزائفة التي قد تنتج عن الحسابات العشوائية. يتوافق هذا الانضباط المنهجي مع مبادئ النمذجة الدقيقة للأنظمة التفاعلية والمعرفية التي تتطلب تزكية صارمة لكل مدخل تحليلي (Flemisch et al., 2019).
ومن المنظور التقني، يسهم الربط الداخلي في تحسين أداء أوراق عمل إكسل بشكل ملحوظ، لا سيما عند التعامل مع مجموعات بيانات ضخمة تحتوي على عشرات الآلاف من السجلات. من خلال بتر الصفوف الزائدة في مرحلة مبكرة قبل التحميل إلى شبكة الخلايا، يتم تقليص استهلاك الذاكرة العشوائية (RAM) للحاسوب، وتسريع وتيرة إعادة الحسابات وتحديث المخططات البيانية، مما يجنب المستخدم حالات التجمد البرمجي وانهيار المصنف التي تتكرر مع الملفات المحشوة بالصيغ التقليدية غير المضغوطة.
2. المتطلبات المسبقة وهيكلة البيانات قبل إجراء الدمج في إكسل
2.1 تحديد وتجهيز الأعمدة المفتاحية المشتركة (Key Columns)
تعتمد سلامة عملية الربط الداخلي في جوهرها على دقة اختيار المتغير المرجعي الحاكم للمطابقة بين الجدولين، والمعروف في أدبيات قواعد البيانات باسم “المفتاح الأساسي” (Primary Key) في الجدول الأول و”المفتاح الأجنبي” (Foreign Key) في الجدول المقابل. يجب أن يحمل هذا العمود قيمة تمييزية فريدة أو دلالية واضحة تمثل الوحدة المشتركة للتحليل؛ مثل المعرف الرقمي للعميل، أو الكود الوظيفي للموظف، أو الاسم المعياري للفريق أو المؤسسة المستهدفة بالدراسة.
من الضروري جداً التأكد من تطابق نوع البيانات (Data Types) بين العمودين في كلا المصدرين قبل الشروع في الدمج. يُعد التنافر بين الأنواع، كأن يُخزن المفتاح في الجدول الأول بتنسيق نصي (Text) بينما يُخزن في الجدول الثاني بتنسيق رقمي (Whole Number)، السبب الأكثر شيوعاً لفشل خوارزميات الربط في التعرف على التطابقات. في بيئة باور كويري، لا يُعتبر الرقم المخزن كنص مكافئاً للقيمة العددية ذاتها؛ فالنص “101” يختلف جوهرياً في تمثيله الثنائي في الذاكرة عن العدد الصحيح 101.
يتعين كذلك الحذر الشديد من الأخطاء المنطقية الناشئة عن الفروق الدلالية في مسميات القيم أو صياغاتها. فقد يشير الجدولان إلى الكيان ذاته لكن باستخدام اختصارات متباينة أو تهجئات مختلفة (مثل استخدام “USA” في جدول و”United States” في آخر، أو استخدام الهمزات واختلاف الياء المقصورة والمنقوطة في اللغة العربية). تتطلب هذه الحالات توحيداً معيارياً دقيقاً للمصطلحات لضمان قدرة الخوارزمية على إدراك التطابق دون إغفال أي سجلات حيوية.
2.2 إجراءات تنظيف وتوحيد معايير البيانات المستهدفة
تتطلب المعالجة الاستباقية للبيانات فحصاً صارماً للسلاسل النصية لاستبعاد المسافات غير المرئية التي قد تتخلل المفاتيح المرجعية. تعتبر المسافات البادئة (Leading Spaces) والمسافات اللاحقة (Trailing Spaces) والمسافات المزدوجة المتتالية من العوائق الخفية التي تؤدي إلى إخفاق الربط الداخلي؛ حيث يرى محرك إكسل أن القيمة “TeamA ” تختلف تماماً عن “TeamA”. يمكن التغلب على هذه المعضلة باستخدام دوال التنظيف النصي أو تطبيق أوامر التقليم والتشذيب التلقائية.
تفرض معالجة السلاسل النصية اللاتينية مراعاة خاصة لحساسية حالة الأحرف (Case Sensitivity). وعلى الرغم من أن بعض دوال إكسل الافتراضية تتجاهل الفروق بين الحروف الكبيرة والصغيرة، فإن محرك لغة (M) في باور كويري يتسم بحساسية مفرطة لحالة الأحرف بشكل افتراضي. وعليه، فإن القيمة “Excel” لا تتطابق برمجياً مع “excel” ما لم يتم اتخاذ تدابير استباقية مثل تحويل كافة المفاتيح النصية إلى أحرف صغيرة (lowercase) أو أحرف كبيرة (uppercase) موحدة في كلا الجدولين.
يمثل التعامل مع السجلات المكررة غير المقصودة ركيزة أخرى من ركائز التنظيف التحضيري. إذا احتوى عمود المفتاح في أحد الجدولين أو كليهما على تكرارات لنفس القيمة دون أن تكون العلاقة مبنية تصميماً على نمط “واحد إلى متعدد” أو “متعدد إلى متعدد”، فإن الربط الداخلي سيولد مضاعفات غير مرغوبة للصفوف عبر توسع ديكارتي محلي، مما يؤدي إلى تضخم حجم العينة وتشوه التحليلات الكمية التراكمية.
2.3 تهيئة بيئة إكسل وتفعيل محرك باور كويري (Power Query)
لضمان تنفيذ عمليات الربط الحديثة بكفاءة، يجب التحقق من تشغيل إصدار متوافق من مايكروسوفت إكسل. يتوفر محرك باور كويري كأداة مدمجة وأساسية في كافة إصدارات مايكروسوفت 365 (Microsoft 365) وإكسل 2016 وإكسل 2019 وإكسل 2021 وما تلاها. أما في إصدار إكسل 2010 وإكسل 2013، فيتطلب الأمر تثبيت المحرك كإضافة خارجية منفصلة (Add-in) للوصول إلى الوظائف الاستعلامية المتطورة.
تتموضع أدوات استعلام باور كويري داخل الشريط العلوي لإكسل تحت تبويب “بيانات” (Data)، وتحديداً ضمن مجموعة “الحصول على البيانات وتحويلها” (Get & Transform Data). تتيح هذه الواجهة للمستخدمين الاتصال بمئات المصادر البيانية المتنوعة وإدارتها من خلال محرر مرئي متطور يخفي وراءه تعقيدات لغة الاستعلام الوظيفية (M Formula Language)، مما يتيح للمحللين والباحثين بناء خطوط معالجة معقدة دون الحاجة إلى كتابة تعليمات برمجية شاقة.
يعتمد محرك باور كويري على معالجة البيانات عبر الذاكرة الداخلية المؤقتة (In-Memory Processing Engine) دون التأثير على البيانات الأصلية في ورقة العمل حتى لحظة التحميل النهائي. يسمح هذا التصميم بعزل خطوات تنظيف ودمج البيانات في شكل خوارزميات تسلسلية قابلة للإلغاء أو التعديل في أي وقت، مما يضفي مرونة استثنائية وأماناً رقمياً عالي المستوى أثناء معالجة الجداول الحساسة.
3. الخطوة الأولى: إعداد وإدخال بيانات المثال التطبيقي في المصنف
3.1 بناء هيكل الجدول الأول (بيانات أداء الفرق الرياضية)
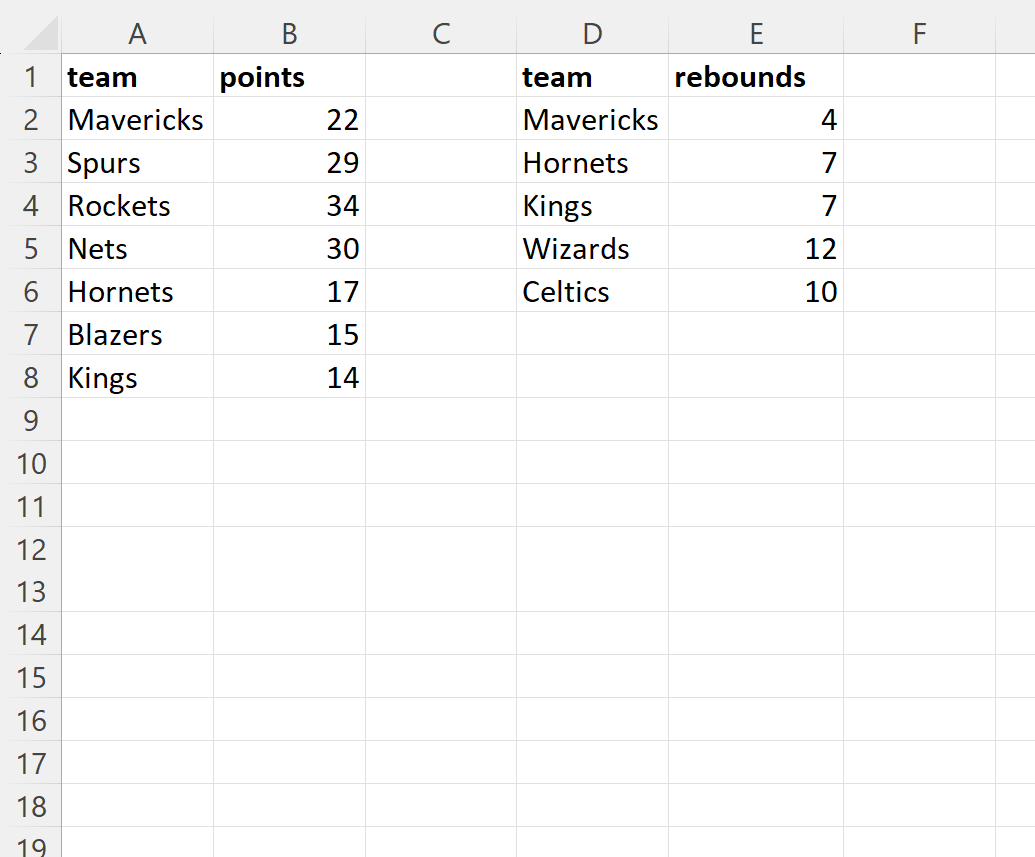
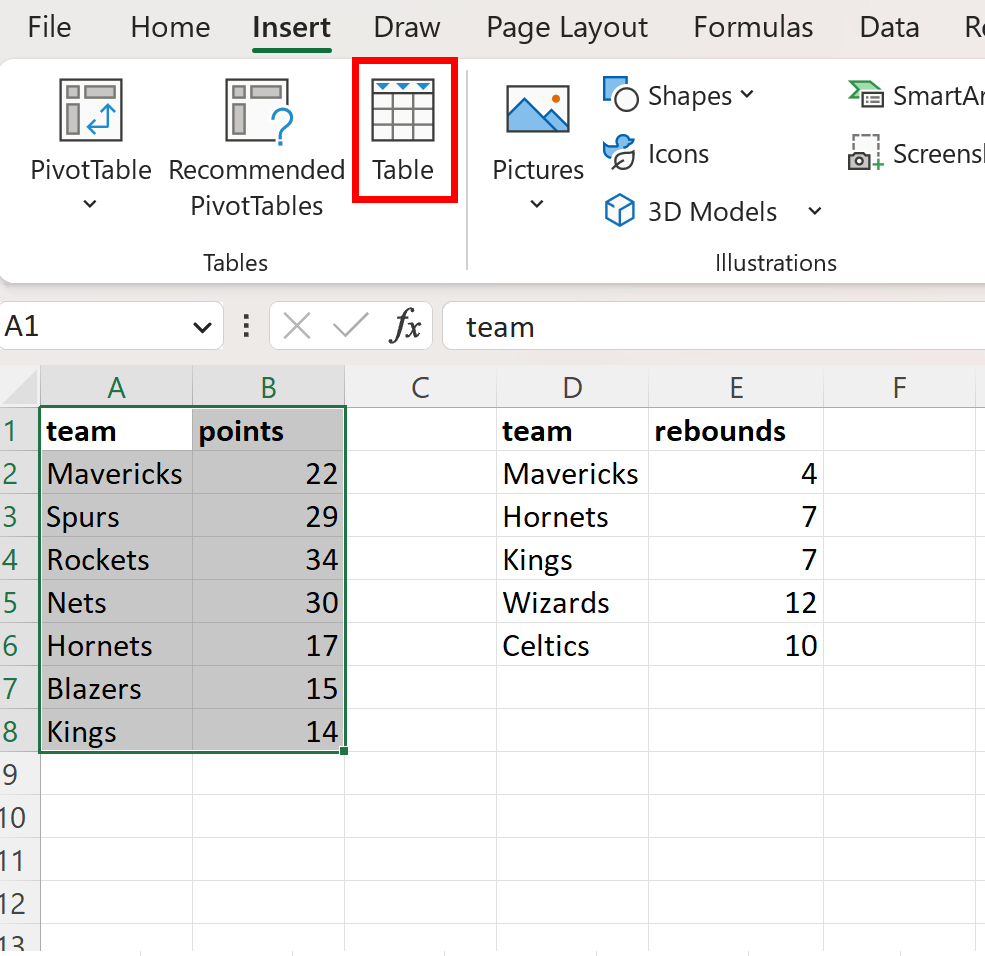
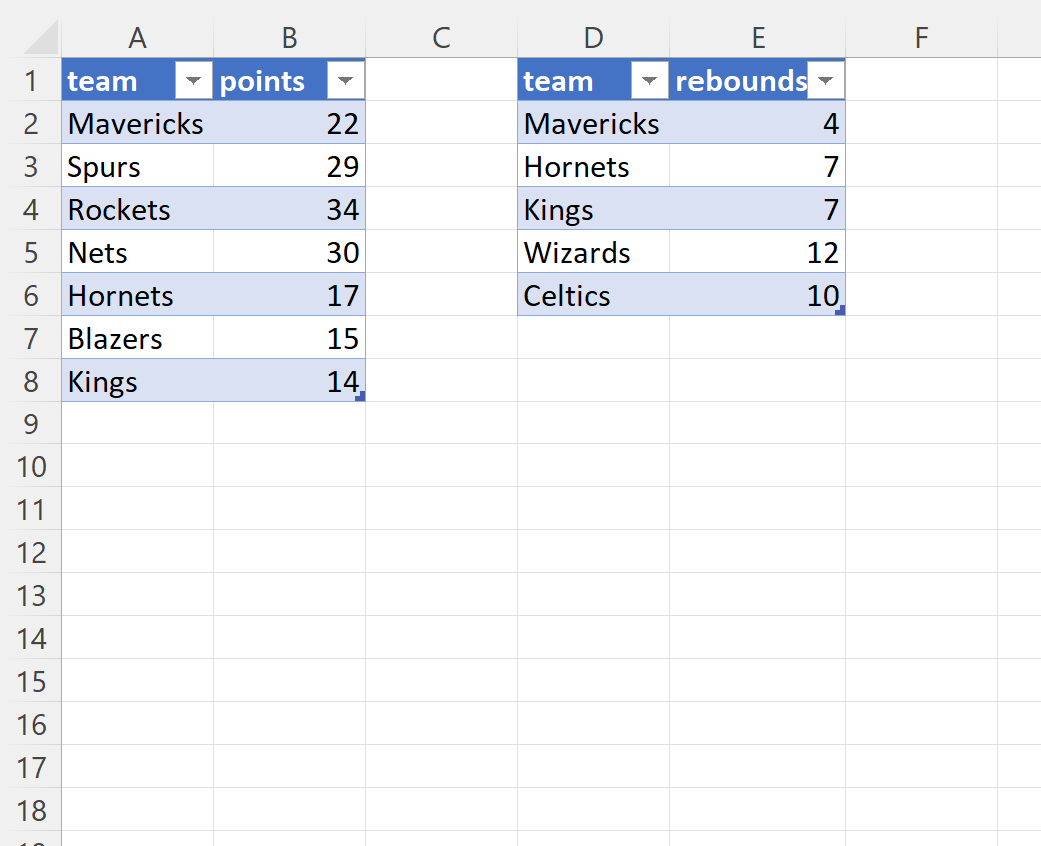
لتجسيد عملية الربط الداخلي بأسلوب عملي تطبيقي دقيق، سنفترض دراسة رياضية وإحصائية تهدف إلى تقييم أداء مجموعة من الفرق الرياضية وربط نتائجها التنافسية بمحدداتها المكانية وميزانياتها التشغيلية. نبدأ بإنشاء الجدول الأول داخل مصنف إكسل، مع تخصيص العمود الأول للمتغير المرجعي الذي سنطلق عليه اسم الفريق (Team)، ليمثل وحدة التحليل الأساسية التي سيتم الربط من خلالها.
نضيف إلى جانب عمود الفرق عموداً كمياً يمثل مقياس الأداء أو النقاط المحرزة (Points) لكل فريق خلال الموسم الرياضي المنقضي. ولأغراض المحاكاة الدقيقة واختبار كفاءة الفرز المنطقي، نقوم بإدخال السجلات التالية في الجدول الأول: الفريق (Team A) برصيد 88 نقطة، والفريق (Team B) برصيد 92 نقطة، والفريق (Team C) برصيد 79 نقطة، والفريق (Team D) برصيد 85 نقطة، وأخيراً الفريق (Team E) برصيد 95 نقطة.
روعي في اختيار هذه العينة تضمين عناصر سنقوم عمداً بمطابقتها في الجدول الثاني، بجانب عناصر أخرى سيتم إغفالها لتوضيح آلية الاستبعاد التلقائي التي يمارسها الربط الداخلي. يعكس هذا التصميم المنهجي الظروف الواقعية التي تواجه الباحثين، حيث نادراً ما تتطابق قوائم العينات المأخوذة من أقسام إدارية أو مصادر رصد مختلفة.
3.2 بناء هيكل الجدول الثاني (المعلومات الإحصائية والمكانية المكملة)
ننتقل بعد ذلك إلى موضع مجاور داخل نفس ورقة العمل، أو في ورقة عمل مستقلة داخل المصنف ذاته، لبناء هيكل الجدول الثاني الذي يحتوي على المتغيرات الإحصائية والمكانية المكملة للدراسة. ننشئ العمود الأول ونمنحه التسمية المعيارية ذاتها أو تسمية مكافئة تشير إلى الفرق (Team)، ليعمل كحلقة وصل مع الجدول الأول، ونضيف حقلين تحليليين هما: المقاطعة أو المدينة (Location) والميزانية السنوية بملايين الدولارات (Budget).
نقوم بتعبئة الجدول الثاني بسجلات مدروسة بعناية لاختبار المنطق العلائقي: ندرج الفريق (Team A) بمدينة “New York” وميزانية 120 مليون، والفريق (Team B) بمدينة “Chicago” وميزانية 95 مليون، والفريق (Team C) بمدينة “Los Angeles” وميزانية 110 ملايين. ولكن، بدلاً من إدراج الفريقين (Team D) و (Team E)، نقوم بإدخال فرق جديدة تماماً لم تكن موجودة في الجدول الأول، مثل الفريق (Team F) بمدينة “Miami” وميزانية 75 مليون، والفريق (Team G) بمدينة “Boston” وميزانية 85 مليون.
يخدم هذا الإسقاط المتعمد للبيانات هدفاً بيداغوجياً واضحاً؛ إذ يُبرز كيفية تعامل خوارزمية الربط الداخلي مع القيم الشاردة على كلا الجانبين. فالفريقان D و E يفتقران إلى معلومات الموقع والميزانية في الجدول الثاني، بينما الفريقان F و G يفتقران إلى سجلات النقاط والأداء في الجدول الأول، مما يضعهما في دائرة الاستبعاد الحتمي.
3.3 المعاينة البصرية ومطابقة العينات قبل المعالجة الآلية
قبل الانتقال إلى تشغيل محرك الأتمتة والدمج، يتعين على المحلل إجراء فحص بصري دقيق وفرز ذهني مسبق للمخرجات المتوقعة. ومن خلال مراجعة القائمتين، نجد بوضوح أن الفرق التي تشترك في كلا الجدولين تنحصر في ثلاثة فرق فقط هي: (Team A) و (Team B) و (Team C). هذه الحالات الثلاث تمثل التقاطع الرياضي الخالص ($Table_1 \cap Table_2$) الذي تنص عليه مبادئ الجبر العلائقي.
بالمقابل، نحدد بصورة استباقية العناصر المحكوم عليها بالحذف المنطقي؛ حيث يجب أن يستبعد الربط الداخلي الفريقين (Team D) و (Team E) من الجدول الأول لعدم وجود بيانات مقابلة لهما، كما يجب أن يسقط الفريقين (Team F) و (Team G) من الجدول الثاني لنفس السبب. إن وضع هذه الفرضية الرقمية الواضحة مسبقاً (توقع الحصول على جدول نهائي مكون من 3 صفوف فقط) يعد خطوة لا غنى عنها للتحقق من صحة عمل الخوارزمية وتجنب الثقة العمياء في المخرجات الرقمية دون مراجعة معيارية.
بالإضافة إلى ذلك، ينبغي في هذه المرحلة توثيق حدود النطاقات الجغرافية لكل جدول على شبكة إكسل، مع التأكد من ترك فواصل مكانية ملائمة (أعمدة فارغة) بين النطاقين إذا كانا في ورقة العمل ذاتها، لتفادي التداخل الخلوي غير المقصود أو حدوث أخطاء مرجعية عند تحويل النطاقات إلى هياكل جدولية مستقلة.
4. الخطوة الثانية: تحويل النطاقات العادية إلى جداول إكسل رسمية (Excel Tables)
4.1 إجراءات التحويل المنهجية عبر شريط الأدوات (Insert Table)
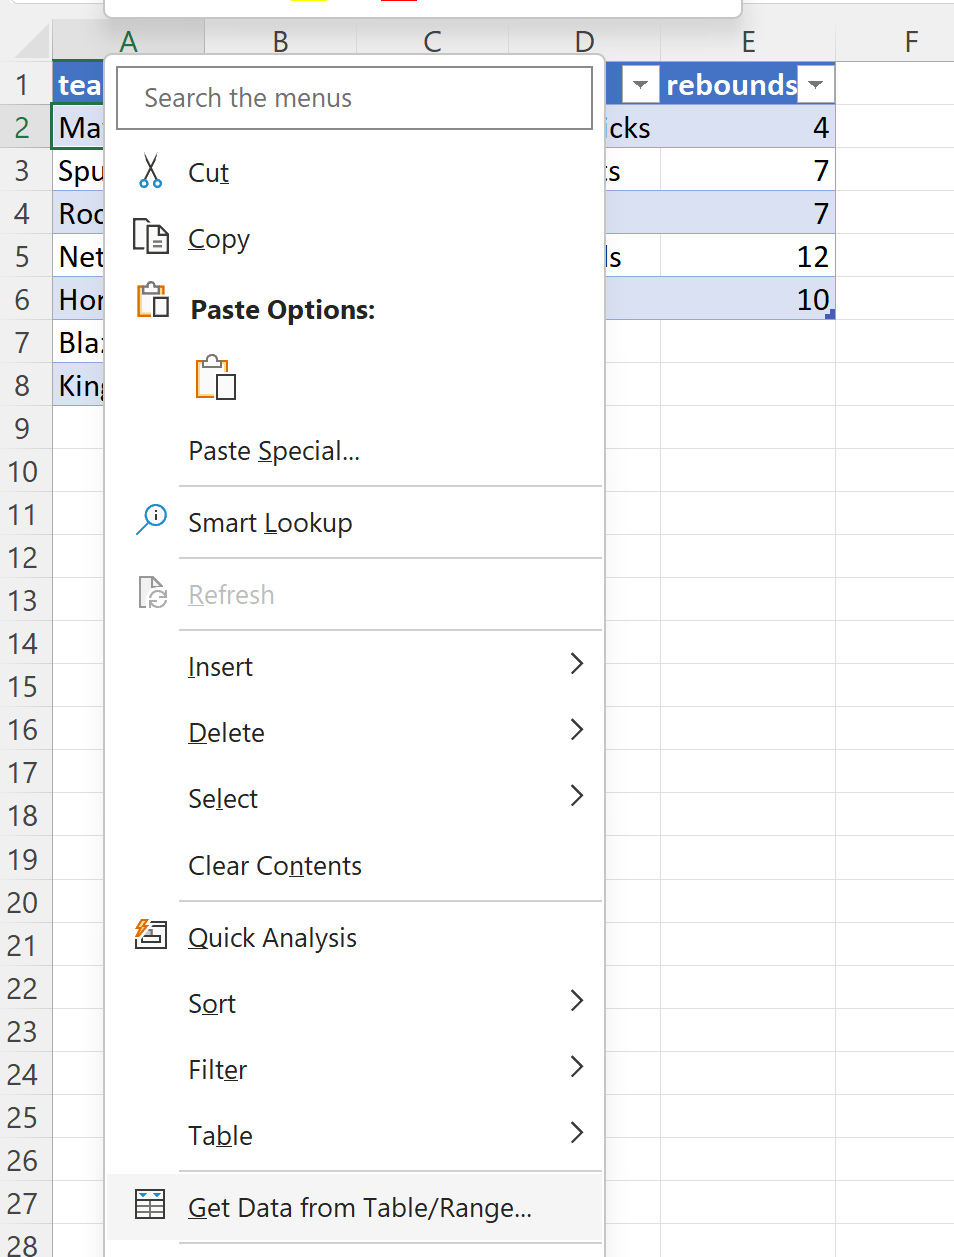
تتعامل برمجية إكسل مع الخلايا الافتراضية بوصفها “نطاقات حرة” (Standard Ranges) غير معرّفة بيانياً ككيانات موحدة، مما يجعل قراءتها بواسطة أدوات الربط الخارجية عرضة للارتباك. لذلك، تتمثل الخطوة المنهجية الأولى في تحويل هذه النطاقات إلى “جداول إكسل رسمية” (ListObjects) ذات حدود معرفية واضحة ومسجلة في شجرة الكائنات البرمجية للمصنف.
لتنفيذ هذا التحويل على الجدول الأول، نحدد أي خلية تقع ضمن نطاق بيانات أداء الفرق الرياضية، ثم نتوجه إلى التبويب العلوي “إدراج” (Insert) ونضغط على أمر “جدول” (Table)، أو نلجأ إلى الاختصار السريع لوحة المفاتيح بالضغط على مفتاحي (Ctrl + T). تنبثق على الفور نافذة حوارية تؤكد إحداثيات النطاق المختار، وتتضمن مربع اختيار بالغ الأهمية يجب النقر عليه لتفعيله، وهو خيار “يحتوي الجدول على رؤوس” (My table has headers)، لضمان تثبيت العناوين “Team” و “Points” وعدم معاملتها كصفوف بيانات عددية.
نكرر الإجراءات ذاتها بدقة متناهية وبنفس الخطوات الهيكلية على نطاق الجدول الثاني الذي يضم بيانات المواقع والميزانيات. يؤدي هذا التحويل إلى إضفاء تنسيق بصري منظم على البيانات (كتناوب ألوان الصفوف)، ولكن الأهم من ذلك هو التغيير البنيوي العميق الذي يطرأ على طريقة إدارة إكسل لهذه البيانات في الذاكرة الحية.
4.2 تسمية الجداول وإدارتها عبر إدارة الأسماء (Name Manager)
بمجرد تحويل النطاق إلى جدول رسمي، يقوم إكسل بإسناد اسم افتراضي عام لكل جدول مثل (Table1) و (Table2). وتعد هذه التسميات العشوائية من الممارسات الرديئة في منهجيات تحليل البيانات، إذ تزيد من احتمالية حدوث أخطاء الإسناد أثناء استدعاء الجداول داخل محررات الاستعلام أو نماذج العلاقات المعقدة، وتجعل توثيق تدفقات العمل شبه مستحيل على المحللين الآخرين.
لإعادة التسمية بطريقة معيارية، نضغط داخل الجدول الأول لتفعيل تبويب “تصميم الجدول” (Table Design) الذي يظهر في الشريط العلوي، ثم نتجه إلى أقصى اليمين نحو حقل “اسم الجدول” (Table Name)، ونقوم بإدخال اسم دلالي صريح وخالٍ من المسافات والفواصل، مثل “Table_Performance” أو “Teams_Performance”. يعكس هذا الاسم محتوى الجدول وهدفه التحليلي بدقة.
ننتقل بعد ذلك إلى الجدول الثاني ونغير اسمه عبر نفس المسار إلى “Table_Details” أو “Teams_Metadata”. يمكن دائماً مراجعة قائمة الجداول والأسماء المعرفة داخل المصنف من خلال التوجه إلى تبويب “صيغ” (Formulas) ثم فتح “إدارة الأسماء” (Name Manager)، حيث يمكن التحقق من صحة مراجع النطاقات وتعديلها إذا اقتضت الضرورة ذلك، مما يضع أساساً صلباً لخطوات المعالجة اللاحقة.
4.3 الخصائص الديناميكية المكتسبة بعد التحويل إلى جداول رسمية
يوفر تحويل البيانات إلى جداول إكسل رسمية مزايا وظيفية تتجاوز المظهر الجمالي المنسق؛ فالخاصية الأهم على الإطلاق هي قدرة الجداول على التوسع الديناميكي التلقائي (Automatic Dynamic Resizing). فعندما يضيف المستخدم صفوفاً جديدة في أسفل الجدول أو أعمدة جديدة على جانبه، يقوم الجدول بامتصاص تلك المدخلات ذاتياً وإدخالها ضمن نطاقه المعرف دون الحاجة لتعديل النطاقات يدوياً.
ينعكس هذا السلوك الديناميكي مباشرة على كفاءة تدفق البيانات باتجاه محرك باور كويري؛ إذ إن أي استعلام مرتبط بهذا الجدول سيقرأ السجلات المضافة حديثاً تلقائياً عند إجراء التحديث، وهو ما يلغي الحاجة إلى تعديل صيغ الاستعلام أو إعادة رسم حدود النطاق في كود لغة (M). تتشابه هذه البنية المرنة مع بروتوكولات الحوسبة السحابية ومعالجة البيانات المتدفقة التي تتطلب استيعاباً مستمراً للمتغيرات (Li et al., 2023).
إضافة إلى ذلك، توفر الجداول الرسمية ثباتاً حديدياً لترويسات الأعمدة وهيكلية البيانات؛ حيث تمنع الحذف العرضي أو الكتابة فوق الخلايا الحيوية، وتضمن بقاء المعرفات الحقلية سليمة ومتاحة للمحركات الاستعلامية، مما يحمي خطوط المعالجة الآلية من الانهيارات البرمجية الشائعة في النطاقات الحرة غير المحمية.
5. الخطوة الثالثة: استيراد الجداول إلى محرر باور كويري (Power Query Editor)
5.1 استدعاء الجدول الأول عبر خيار من جدول/نطاق (From Table/Range)
تبدأ أولى مراحل التفاعل الحقيقي مع محرك التكامل العلائقي من خلال جلب الجداول المستهدفة إلى مساحة العمل المتخصصة في باور كويري. وللقيام بذلك مع الجدول الأول الخاص بالأداء الرياضي، نحدد أي خلية داخل الجدول المسمى “Table_Performance”، ثم ننتقل إلى شريط الأدوات العلوي وننقر على تبويب “بيانات” (Data).
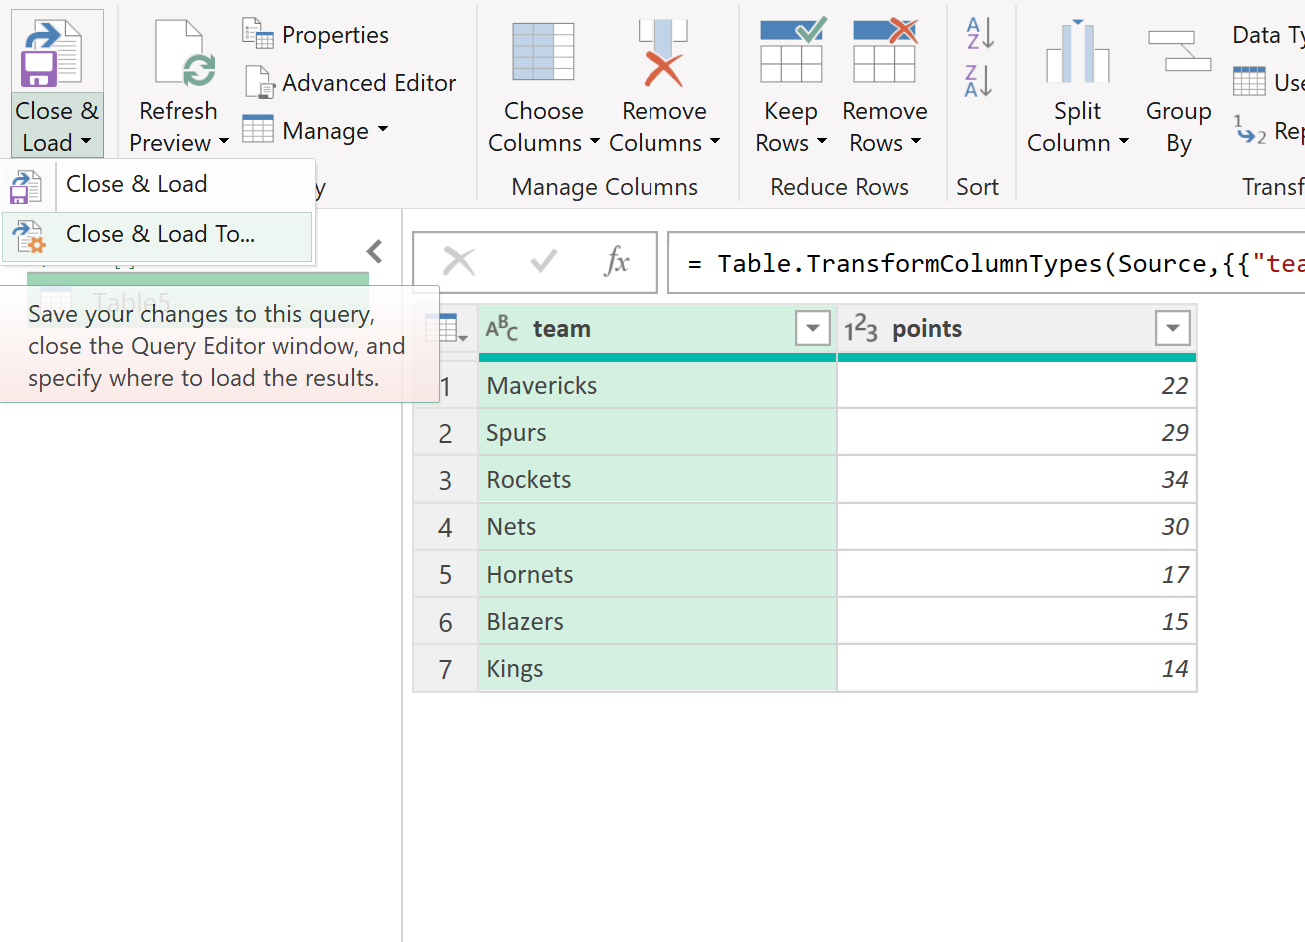
من داخل مجموعة “الحصول على البيانات وتحويلها” (Get & Transform Data)، نضغط على زر “من جدول/نطاق” (From Sheet أو From Table/Range). يؤدي هذا الإجراء فوراً إلى تشغيل نافذة محرر باور كويري المستقلة عن واجهة إكسل الرئيسية، حيث يقوم المحرك بتحميل محتويات الجدول تلقائياً، ويعرض في اللوحة الجانبية اليمنى خطوات التحويل المطبقة مبدئياً تحت عنوان “الخطوات المطبقة” (Applied Steps)، والتي تشمل عادة خطوة استدعاء المصدر (Source) وخطوة التغيير التلقائي لنوع البيانات (Changed Type).
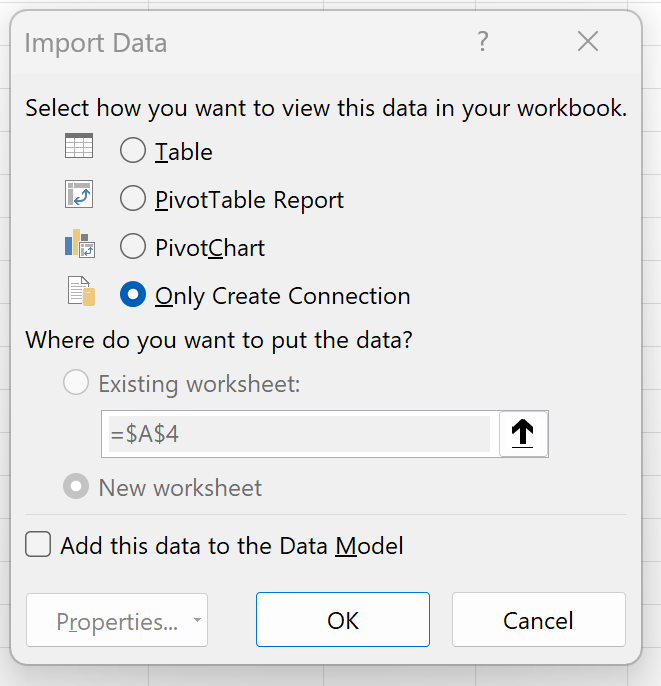
نظراً لأننا نريد استخدام هذا الجدول كطرف في عملية دمج لاحقة وليس إعادة تفريغه فوراً كما هو في ورقة العمل، فإننا نتجه إلى الزاوية اليسرى العليا من المحرر، وننقر على السهم الصغير المجاور لزر “إغلاق وتحميل” (Close & Load)، ونختار منه أمر “إغلاق وتحميل إلى…” (Close & Load To…). من النافذة المنبثقة، نحدد خيار “إنشاء اتصال فقط” (Only Create Connection) ثم نضغط “موافق”؛ مما يحفظ الجدول في ذاكرة المحرك كاستعلام جاهز للاستدعاء.
5.2 استدعاء الجدول الثاني وتثبيت الاتصال المصدري
نكرر بدقة منهجية متماثلة الخطوات السابقة على الجدول الثاني؛ حيث نعود إلى نافذة إكسل وننقر داخل الجدول المسمى “Table_Details”. ومن تبويب “بيانات”، نختار مجدداً أمر “من جدول/نطاق” لفتح محرر باور كويري مرة أخرى وتأسيس استعلام جديد مخصص لهذا الجدول.
داخل المحرر، نتأكد من أن أسماء الحقول الثلاثة (“Team”، “Location”، “Budget”) قد تم التقاطها بصورة سليمة، وأن أنواع البيانات المعينة لكل عمود تعكس طبيعته الحقيقية (نص للموقع والفريق، وقيم عشرية أو صحيحة للميزانية). يسمح هذا التدقيق الأولي باكتشاف أي انحرافات في تفسير البيانات قبل تثبيتها في المحرك.
عقب ذلك، نطبق الإجراء التحفظي ذاته؛ حيث ننقر على السهم المنسدل لأمر “إغلاق وتحميل” ونختار “إغلاق وتحميل إلى…”، ثم نحدد خيار “إنشاء اتصال فقط”. يضمن هذا الإجراء عدم توليد أوراق عمل مكررة تستهلك موارد الملف وتشتت تنظيم المصنف، مع إبقاء البيانات متأهبة في الذاكرة الوسيطة بانتظار أمر الربط المتبادل.
5.3 مراجعة لوحة الاستعلامات والتأكد من جاهزية المصادر للدمج
بعد حفظ كلا الاستعلامين كروابط اتصال فقط، تظهر في الجانب الأيمن أو الأيسر من نافذة إكسل الرئيسية (وفق لغة الواجهة المستخدمة) لوحة متخصصة تُدعى “الاستعلامات والاتصالات” (Queries & Connections). يجب على المحلل في هذه اللحظة إلقاء نظرة فاحصة على هذه اللوحة؛ للتأكد من وجود الاستعلامين باسميهما الصريحين “Table_Performance” و “Table_Details” مع ظهور إشارة تأكيد سلامة الاتصال بالمصدر المكتوب تحت كل منهما.
يتيح التمرير بمؤشر الفأرة فوق كل استعلام داخل هذه اللوحة ظهور نافذة منبثقة مصغرة للمعاينة، توضح عدد الأعمدة، ونموذجاً مصغراً للسجلات المحملة، وتاريخ آخر تحديث تم إجراؤه. تفيد هذه المعاينة في التيقن من عدم وجود رسائل تحذيرية برتقالية أو إشعارات فشل في الاتصال قد تنجم عن تحريك الجداول أو تغيير مسمياتها بعد الاستيراد.
يمثل التحقق من جاهزية المصادر وتسكينها في الذاكرة شرطاً حاسماً للنجاح الخوارزمي اللاحق؛ إذ يمنح محرك لغة (M) خارطة طريق واضحة للمراجع التي سيطلب استدعاؤها في بيئة الربط، محاكياً بذلك الإعدادات الصارمة المتبعة في إدارة المسارات التجريبية متعددة القنوات في البحوث المعرفية والإدراكية (Sirois et al., 2008).
6. الخطوة الرابعة: تنفيذ الربط الداخلي من خلال نافذة دمج الاستعلامات (Merge Queries)
6.1 الوصول إلى أمر دمج الاستعلامات وضبط المعلمات الأساسية
مع اكتمال تحميل وتجهيز الاستعلامين، ننتقل إلى جوهر العملية التقنية: تنفيذ الربط الداخلي. للوصول إلى بيئة الدمج، نتوجه إلى شريط الأدوات العلوي في إكسل ضمن تبويب “بيانات” (Data)، ومن مجموعة “الحصول على البيانات وتحويلها”، نضغط على القائمة المنسدلة لأمر “الحصول على البيانات” (Get Data)، ثم نتوجه نحو خيار “تجميع الاستعلامات” (Combine Queries)، ونختار منه أمر “دمج” (Merge) أو “دمج الاستعلامات كاستعلام جديد” (Merge Queries as New).
يُعد تفضيل خيار “دمج الاستعلامات كاستعلام جديد” ممارسة أكاديمية وتقنية فائقة الأهمية؛ لأنه يترك الاستعلامين الأصليين دون أي مساس أو تعديل داخلي، وينشئ استعلاماً ثالثاً مستقلاً تماماً يخصص لاحتضان مخرجات الربط. هذا الفصل بين المصادر الخام والمخرجات التحليلية يعزز من قابلية تتبع البيانات (Data Traceability) ويسهل اكتشاف الأخطاء أو التراجع عن الخطوات دون تعريض البنية المصدرية للمخاطر.
تنبثق على إثر ذلك النافذة المحورية المسماة “دمج” (Merge)، والتي تنقسم بنيوياً إلى قسمين رئيسيين؛ في الجزء العلوي، نجد قائمة منسدلة لاختيار الجدول الأساسي، فنقوم باختيار “Table_Performance” لتظهر معاينة تفاعلية لأعمدته وسجلاته الخمسة. وفي القسم المخصص أسفله مباشرة، نجد القائمة المنسدلة الثانية المخصصة للجدول الثانوي، فنقوم بتحديد “Table_Details” لتظهر معاينة بياناته المقابلة.
6.2 مواءمة الأعمدة المشتركة وتحديد المفتاح الدلالي
في هذه المرحلة الدقيقة من واجهة الدمج، يجب أن نحدد لمحرك باور كويري مسار المطابقة الدلالية الذي سيعتمد عليه في مقارنة الصفوف. ولتحقيق ذلك، نقوم بالنقر بالفأرة فوق ترويسة عمود الفريق “Team” في معاينة الجدول الأول العلوي، مما يؤدي إلى تلوين العمود بأكمله وتظليله باللون الأخضر كدليل على اختياره كمفتاح أول.
عقب ذلك مباشرة، ننزل إلى معاينة الجدول الثاني السفلي وننقر بالفأرة فوق ترويسة عمود الفريق “Team” المناظر له. نلاحظ فوراً تظليل العمود السفلي هو الآخر باللون الأخضر، مع ظهور رقم صغير (1) بجانب ترويسة كلا العمودين، مما يشير إلى أن خوارزمية الربط ستقوم بمطابقة القيم الواردة في السمة المرجعية الأولى للجدول الأول مع نظيرتها في الجدول الثاني وفق علاقة أحادية التناظر.
في الحالات التحليلية المعقدة التي تتطلب المطابقة بناءً على أكثر من معيار (كأن يتم الربط بناءً على الاسم ورقم الهوية معاً)، يمكن للمستخدم النقر مع الاستمرار بالضغط على مفتاح (Ctrl) لتحديد عدة أعمدة في كلا الجدولين بالتزامن. ولكن في مثالنا التطبيقي الراهن، نكتفي باختيار عمود “Team” المنفرد باعتباره المفتاح المعياري المتكامل الذي يحكم العلاقة المنطقية بين الجداول.
6.3 اختيار نوع الربط: الربط الداخلي (Inner: Only matching rows)
أسفل شاشات معاينة الجداول داخل نافذة الدمج، نصل إلى الإعداد الأهم على الإطلاق: القائمة المنسدلة المعنونة باسم “نوع الصلة” أو “نوع الربط” (Join Kind). عند النقر على هذه القائمة، يستعرض إكسل الأنواع الستة الكلاسيكية للربط العلائقي المستمدة من لغة الاستعلامات البنيوية (SQL) ونظرية كود العلائقية.
نقوم بتمرير المؤشر واختيار النوع المحدد بدقة: “داخلي (الصفوف المتطابقة فقط)” أو بالإنجليزية (Inner: only matching rows). بمجرد النقر على هذا الخيار، يقوم المحرك في أجزاء من الثانية بتشغيل فحص استكشافي سريع في الخلفية عبر الذاكرة، ويظهر في أسفل النافذة مؤشر نصي ذكي يوضح المآل الرياضي للعملية بنص يماثل: “يتطابق التحديد مع 3 صفوف من أصل 5 من الجدول الأول” (The selection matches 3 of 5 rows from the first table).
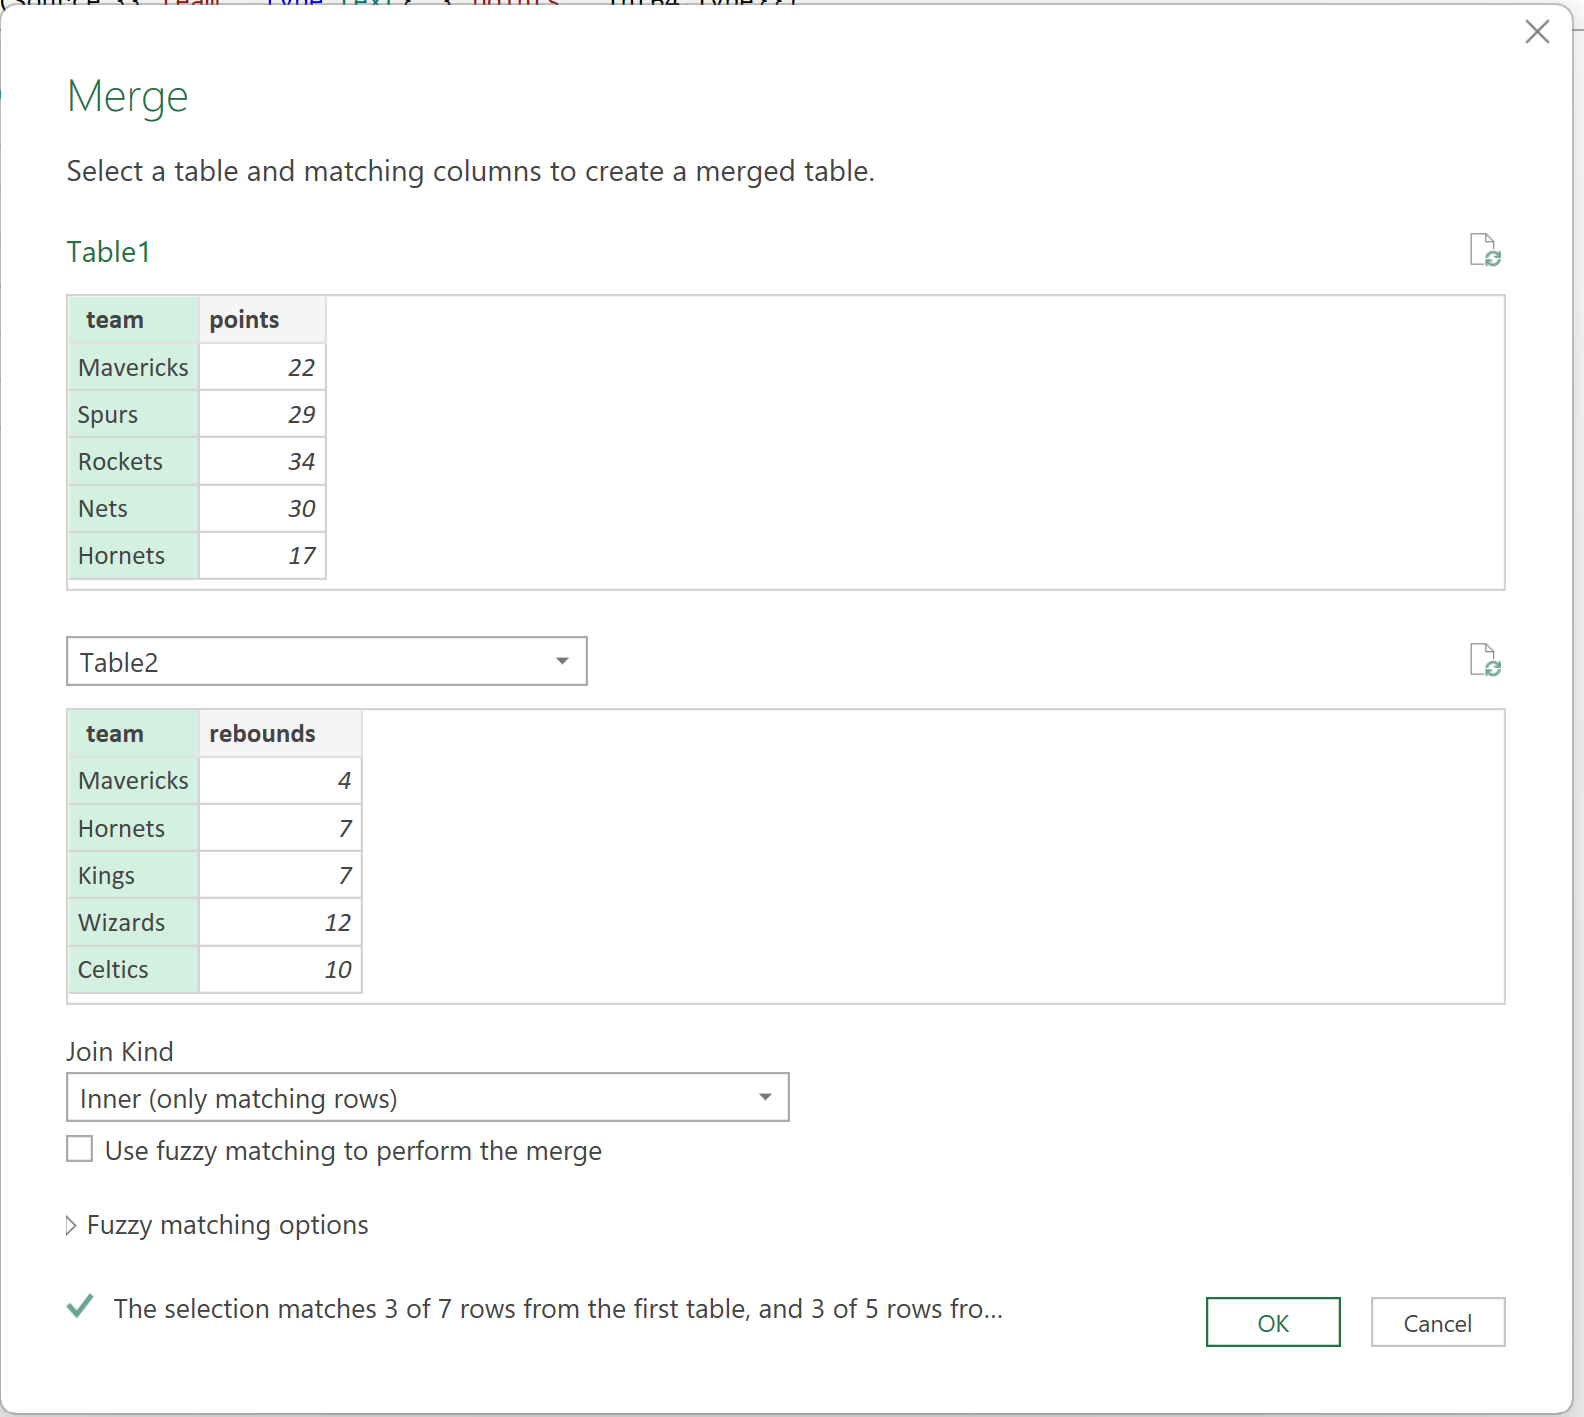
تعد هذه الإشارة النصية بمثابة تأكيد إحصائي فوري لصحة تنبؤاتنا المسبقة التي توصلنا إليها في مرحلة المعاينة البصرية؛ حيث استبعدت الخوارزمية تلقائياً الفريقين D و E دون الحاجة لكتابة أي صيغة شرطية يدوية. عند هذه النقطة، نضغط بثقة على زر “موافق” (OK) لاعتماد العملية، فيتم إغلاق نافذة الدمج ويفتح محرر باور كويري حاملاً مصفوفة النتائج الأولية للاستعلام الجديد.
7. الخطوة الخامسة: توسيع الأعمدة المدمجة واستخراج المتغيرات المطلوبة
7.1 فك حزمة البيانات المجمعة في العمود المرتبط (Expand Column)
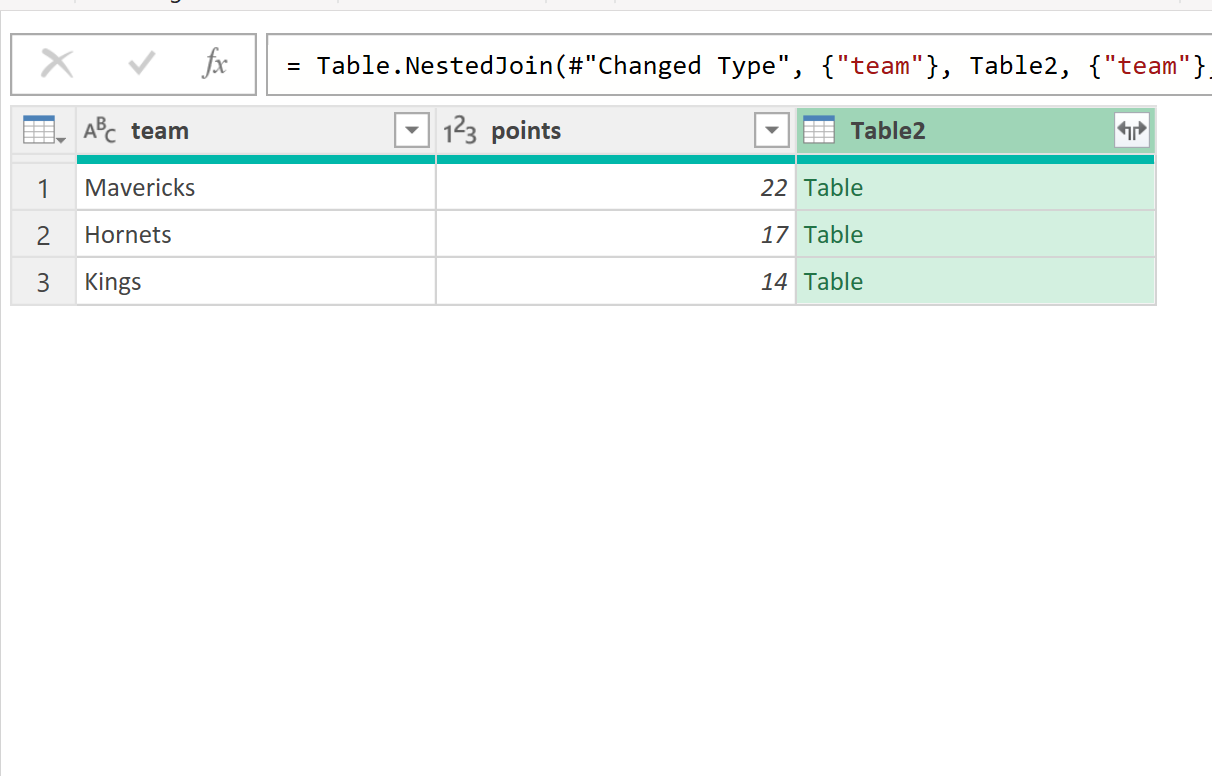
عند فتح استعلام الدمج الجديد في محرر باور كويري، سنلاحظ أن المحرك يعرض أعمدة الجدول الأول الأصلية (“Team” و “Points”) بجانب عمود جديد نشأ عن عملية الدمج ويحمل اسم الجدول الثانوي “Table_Details”. غير أن هذا العمود الجديد لا يعرض القيم بصورة مفردة ومباشرة، بل يحتوي في كل خلية من خلاياه على رابط تشعبي بنيوي يحمل كلمة جدول أو كائن مجمع ([Table]).
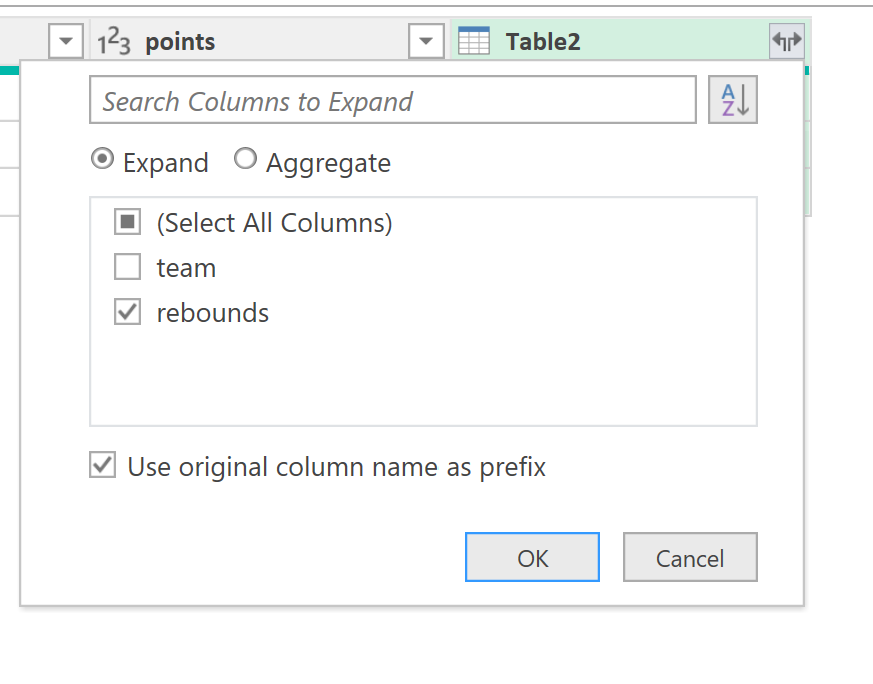
يعكس هذا السلوك الطبيعة التجميعية المتطورة للغة (M)، حيث يتم تخزين السجلات المطابقة ككيانات جدولية مصغرة متداخلة (Nested Tables) بانتظار تفكيكها وتسكينها في الأعمدة المستقلة. لاستخراج المتغيرات المحبوسة داخل هذا العمود، نتوجه إلى أقصى الزاوية اليمنى لترويسة العمود المدمج وننقر على “أيقونة التوسيع” (Expand Icon)، وهي أيقونة بصرية صغيرة تتخذ شكل سهمين متعاكسين يتجهان يمنة ويسرة.
بمجرد الضغط على الأيقونة، تظهر نافذة منسدلة تسرد كافة الحقول المتاحة داخل الجدول المتداخل. في هذه النافذة، نقوم بإلغاء التحديد عن عمود “Team” لتفادي تكراره؛ إذ إننا نملكه بالفعل في الجدول الأول، ونبقي فقط على علامات الاختيار بجانب الحقلين التحليليين المستهدفين: الموقع (Location) والميزانية (Budget). وقبل الضغط على موافق، نلغي تفعيل خيار “استخدام اسم العمود الأصلي كبادئة” (Use original column name as prefix) لضمان بقاء الترويسات موجزة وواضحة وخالية من التكرارات اللفظية الطويلة والمزعجة.
7.2 إعادة التسمية وتنظيم الترتيب المنطقي للحقول
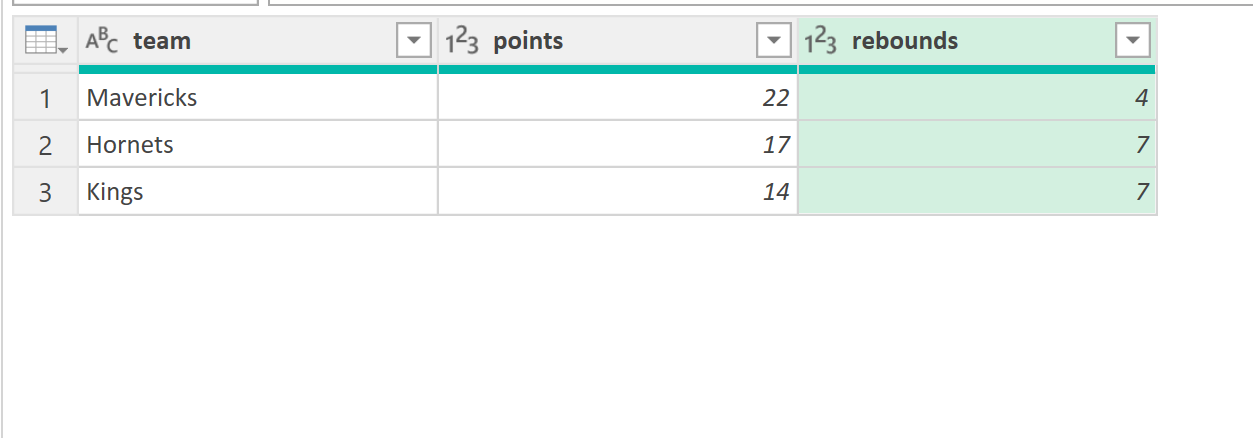
بعد فك حزمة الأعمدة وضغط زر الموافقة، تتوسع الخلايا فوراً لتكشف عن بيانات الموقع والميزانية لكل فريق من الفرق الثلاثة المتطابقة. يتعين الآن على المحلل الانتقال إلى مرحلة الضبط الشكلي والتنظيمي؛ لتحقيق أعلى درجات المقروئية والوضوح الأكاديمي، بما يجعل الجدول ممتثلاً للمعايير المهنية المعتمدة في التقارير المؤسسية.
يمكن إعادة صياغة أي ترويسة بسهولة عبر النقر المزدوج (Double Click) فوق اسم العمود وكتابة الاسم الجديد المرغوب. على سبيل المثال، قد نفضل استبدال “Budget” بـ “Annual_Budget_MUSD” لإبراز الوحدة القياسية بوضوح وتجنب أي لبس في التفسير الإحصائي. وبالمثل، يمكننا تغيير ترتيب ظهور الأعمدة عبر السحب والإفلات اليدوي لمواقعها، كأن نضع عمود الموقع “Location” بجانب عمود “Team”، يليهما عمود “Points” ثم عمود الميزانية، بما يحقق تسلسلاً منطقياً سلساً للبيانات.
يجب أيضاً فحص الجدول للتأكد من عدم وجود أي أعمدة مساعدة أو هامشية غير ضرورية للناتج النهائي للدراسة؛ فإذا وُجد أي عمود دخيل، يمكن حذفه بنقرة زر يمنى واختيار “إزالة” (Remove). تسجل كافة هذه التعديلات التجميلية كخطوات مستقلة متسلسلة في قائمة “الخطوات المطبقة” في باور كويري، مما يضمن تكرار تنفيذها تلقائياً عند أي عملية تحديث مستقبلية.
7.3 التدقيق النهائي للأنماط وتصحيح القيم قبل التحميل
تتطلب المعايير المنهجية إجراء تدقيق صارم لأنماط البيانات (Data Types Profiling) قبل تفريغ الجدول في بيئة العمل النهائية. يتميز باور كويري بوضع رموز تصويرية صغيرة إلى جانب اسم كل ترويسة تدل على نوع محتواها (مثل رمز “ABC” للقيم النصية، ورمز “123” للأرقام الصحيحة، ورمز “1.2” للأرقام العشرية الكسرية).
يجب التأكد من أن عمود “Points” يحمل نمط الأعداد الصحيحة أو العشرية، وأن عمود “Budget” مضبوط على نمط العملات أو الأرقام العشرية، بينما يحتفظ عمودا “Team” و “Location” بالنمط النصي الأبجدي. إن الإهمال في هذه الخطوة قد يؤدي إلى تصدير الأرقام بنمط نصوص، وهو ما يمنع دوال الجمع والتلخيص في إكسل (مثل SUM و AVERAGE) من التعامل معها رياضياً في مرحلة لاحقة دون إجراء تحويلات إضافية معقدة.
أخيراً، نتفحص الصفوف الناتجة بصرياً؛ لنتأكد بما لا يدع مجالاً للشك من خلوها من أي أخطاء قيمية (كظهور وسم #ERROR أو خلايا فارغة غير متوقعة)، والتأكد التام من اقتصار القائمة على السجلات الثلاثة الصافية: Team A و Team B و Team C، دون تسرب لأي من الفرق الأخرى، مما يؤكد نجاح الخوارزمية في تطبيق المنطق الرياضي الصارم للربط الداخلي.
8. الخطوة السادسة: تحميل مخرجات الدمج إلى ورقة العمل وإدارتها
8.1 خيارات التحميل النهائي عبر (Close & Load To)
مع الانتهاء الكامل من خطوات المعالجة والتحويل داخل محرر باور كويري، نصل إلى مرحلة حصد الثمار ونقل النتائج المكررة إلى مساحة العمل في إكسل. لإنجاز ذلك بصورة تحكمية مثلى، ننقر على السهم الصغير الواقع أسفل أيقونة “إغلاق وتحميل” (Close & Load) في أقصى يسار التبويب العلوي، ونختار تحديداً أمر “إغلاق وتحميل إلى…” (Close & Load To…).
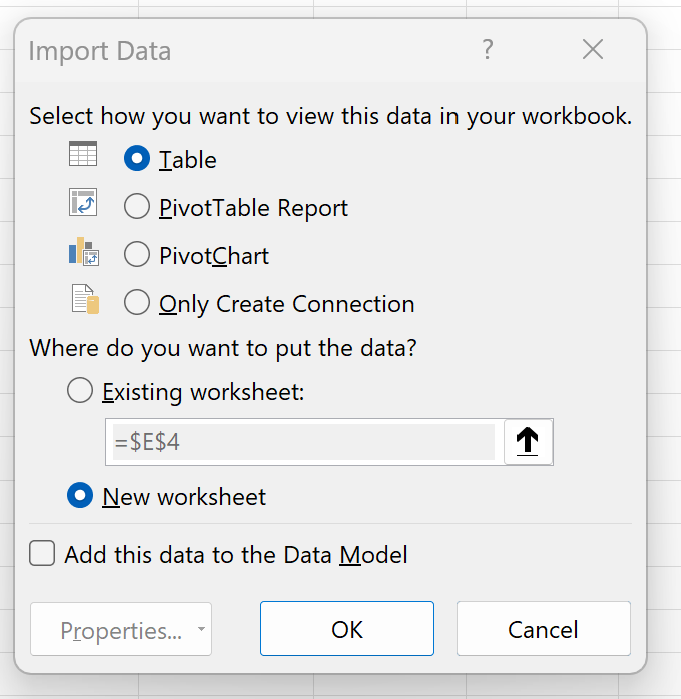
تنبثق نافذة استراتيجية تتيح للمحلل تحديد طبيعة المخرجات النهائية وشكل استعراضها. نوجه التحديد هنا إلى خيار “جدول” (Table) لعرض السجلات مباشرة في صورة شبكية تفاعلية، وتحت بند “أين تريد وضع هذه البيانات؟”، نحدد خيار “ورقة عمل جديدة” (New worksheet) من أجل إنشاء مساحة مخصصة ومعزولة للنتائج المدمجة، مما يحول دون تداخلها أو كتابتها فوق الجداول المصدرية السابقة التي بنينا عليها العمل.
في بيئات التحليل المتقدمة التي تشتمل على مئات الملايين من النقاط البيانية، يمكن للمستخدم في هذه المرحلة وضع علامة اختيار على مربع “إضافة هذه البيانات إلى نموذج البيانات” (Add this data to the Data Model). يتيح هذا الخيار تمرير مخرجات الربط الداخلي مباشرة إلى محرك التحليل السريع “باور بيفوت” (Power Pivot)، مما يؤسس لمرحلة جديدة من التحليلات الإحصائية متعددة الأبعاد وبناء المقاييس المعقدة عبر لغة (DAX).
8.2 فحص وتقييم النتيجة المعروضة في إكسل مقارنة بالمثال الأصلي
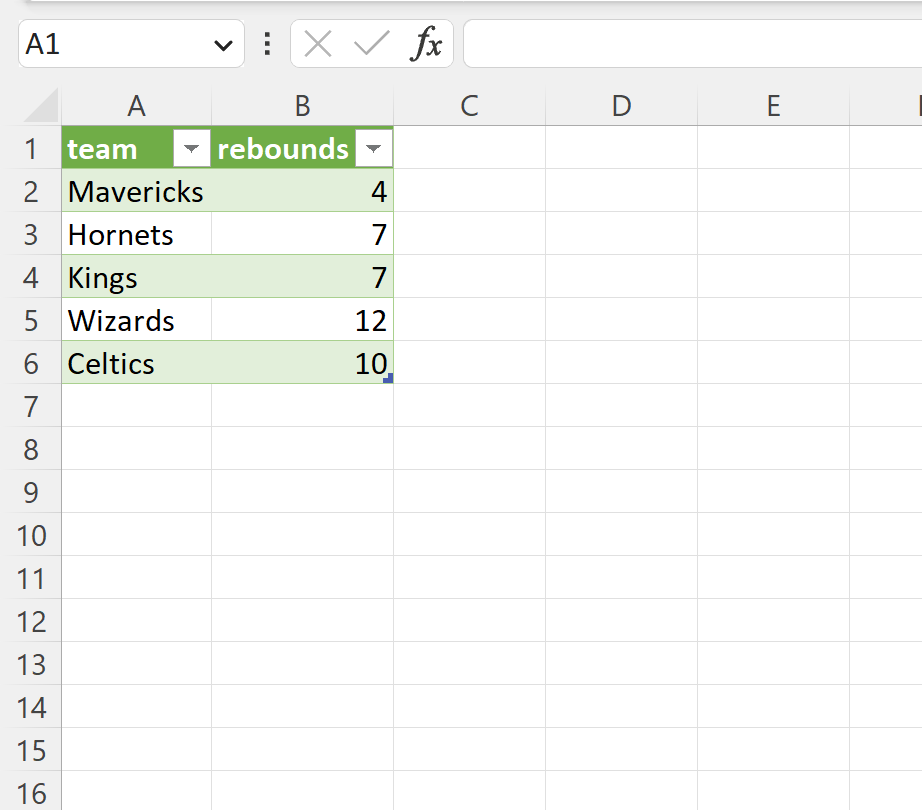
بمجرد الضغط على خيار “موافق”، يتم إنشاء ورقة عمل جديدة في ثوانٍ معدودة، وينبثق فيها جدول أنيق ومتكامل يحمل افتراضياً اسم استعلام الدمج (مثل Merge1). يتكون هذا الجدول بدقة متناهية من ثلاثة صفوف فقط، تتضمن الفرق (Team A، Team B، Team C) وتتراصف إلى جانبها نقاطها التنافسية المحرزة من الجدول الأول، ومواقعها الجغرافية وميزانياتها المالية المسحوبة من الجدول الثاني.
تؤكد هذه النتيجة العملية الفرضية العلمية التي انطلقنا منها؛ حيث تم إقصاء الفريقين D و E بنجاح تام لعدم وجود بيانات مقابلة في الجدول الإحصائي، كما أُهمل الفريقان F و G لغياب سجلاتهما عن جدول النقاط. يُظهر الجدول الناتج اتساقاً شكلياً وبصرياً ممتازاً، حيث تتمايز الترويسات بألوان متباينة، وتستجيب الأعمدة الرقمية لتنسيقات الفواصل والأرقام تلقائياً.
ينبغي في هذا السياق مراجعة لوحة “الاستعلامات والاتصالات” للتأكد من أن الاستعلام الجديد يعرض رسالة “تم تحميل 3 صفوف” (3 rows loaded). تعطي هذه القراءة اطمئناناً رقمياً كاملاً لسلامة العملية، وتمنح المحلل وثيقة برمجية مسجلة تثبت أن عملية التنقية والربط جرت عبر مسار جبري مقيد لم تشبه شائبة التدخل اليدوي أو التقدير غير الموضوعي.
8.3 آلية التحديث الديناميكي للبيانات المدمجة (Data Refresh)
تتمثل القوة الهائلة لاعتماد باور كويري في إجراء الربط الداخلي مقارنة بالنسخ واللصق اليدوي في “قابلية التحديث الديناميكي التلقائي” (Dynamic Data Refresh). لا تمثل النتيجة المحملة صورة ميتة أو جامدة للبيانات، بل هي قناة تدفق حية ومربوطة عضوياً بمصادرها الأساسية عبر خط أنابيب المعالجة (Data Pipeline) الذي صممناه خطوة بخطوة.
لاختبار هذه الديناميكية المذهلة، يمكن للمستخدم التوجه إلى الجدول الثاني “Table_Details” وإضافة سجل جديد خاص بالفريق المحذوف (Team D) متضمناً موقعه وليكن “Dallas” وميزانيته 90 مليون. بمجرد إدخال هذا السجل في الجدول المصدري والضغط على زر “تحديث الكل” (Refresh All) من تبويب “بيانات” أو النقر بزر الفأرة الأيمن فوق الجدول المدمج واختيار “تحديث” (Refresh)، يتولى المحرك إعادة تشغيل خوارزمية الربط الداخلي فوراً في أجزاء من الثانية.
تتوسع النتيجة الناتجة تلقائياً لتستوعب الصف الرابع الجديد (Team D)، بعدما أصبح يمتلك شروط التطابق الكامل في كلا الجدولين، بينما يظل الفريق E مستبعداً لعجزه عن تحقيق شرط الربط. علاوة على ذلك، يتيح إكسل برمجة هذا التحديث ليتم تلقائياً وبشكل دوري كل عدد معين من الدقائق، أو تشغيله ذاتياً في كل مرة يقوم فيها المستخدم بفتح ملف المصنف، مما يجعل هذا الحل مثالياً للتقارير التنفيذية الدورية التي تتطلب تغذية مستمرة بالبيانات المحدثة.
9. تشخيص الأخطاء الشائعة وحلولها التقنية أثناء تنفيذ الربط الداخلي
9.1 مشكلة فشل التطابق بسبب المسافات وتنافر المحارف
تعتبر مشكلة الفشل في رصد التطابقات المنطقية من أكثر المعضلات إحباطاً للمحللين؛ حيث يتفاجأ المستخدم أحياناً بظهور جدول فارغ تماماً بعد تنفيذ الربط الداخلي، على الرغم من تأكده البصري من وجود عناصر متطابقة في كلا الجدولين. يعود السبب الجذري لهذه الظاهرة في الغالبية العظمى من الحالات إلى وجود “مسافات خفية” (Trailing or Leading Hidden Spaces) تلتصق بالقيم النصية للمفاتيح المرجعية أثناء نقل البيانات من قواعد البيانات أو الأنظمة الخارجية.
يرى العقل البشري أن القيمة “Team A” في الجدول الأول متطابقة تماماً مع “Team A ” في الجدول الثاني، متجاهلاً المسافة الإضافية غير المرئية في نهاية الكلمة. ولكن بالنسبة لمحرك الحوسبة ولغة (M)، فإن السلسلتين مشفرتان بترميزات ثنائية مختلفة كلياً، مما يؤدي إلى فشل شرط المساواة الرياضية واستبعاد الصف من المخرجات. للتغلب على هذه المشكلة بصورة جذرية، يجب فتح الاستعلامات في محرر باور كويري، وتحديد أعمدة المفاتيح، ثم التوجه إلى تبويب “تحويل” (Transform)، ومن قائمة “تنسيق” (Format) يتم تطبيق أمر “تشذيب” (Trim) لإزالة المسافات الهامشية.
ينبغي أيضاً تطبيق أمر “تنظيف” (Clean) من نفس القائمة لحذف أي محارف تحكم غير مطبوعة (Non-printable characters) قد تتسرب إلى السلاسل النصية عند التصدير من أنظمة قديمة أو عبر بروتوكولات الويب (مثل فواصل الأسطر ورموز Tab). هذه الإجراءات الوقائية المسبقة تضمن توحيد البيئة المحرفية ورفع قدرة محرك الربط على اكتشاف النظائر الحقيقية بدقة متناهية.
9.2 تعارض أنواع البيانات بين الأعمدة المفتاحية
يقع كثير من الممارسين في فخ “تعارض الأنماط” (Data Type Mismatch)، وهي الحالة التي يبدو فيها المفتاح متطابقاً في قيمته الظاهرة، ولكنه متباين في قالبه الهيكلي داخل المحرك. يكثر هذا السيناريو عند استخدام أرقام الهويات أو الأكواد الوظيفية أو التواريخ كمفاتيح للربط؛ حيث يُخزن الكود في أحد الجداول كقيمة عددية (Whole Number)، في حين يُخزن في الجدول الآخر كسلسلة نصية (Text) بسبب احتواء بعض سجلاته على أحرف أو علامات ترقيم مسبقة.
عندما يواجه باور كويري عمودين بمفتاحين من نوعين مختلفين، فإنه يعطل عملية الربط كلياً أو يعيد نتائج صفرية، محذراً المستخدم في أحيان كثيرة من عدم توافق الأنواع. يكمن الحل المنهجي في فتح كل استعلام على حدة قبل تنفيذ خطوة الدمج، والنقر على الأيقونة الرمزية الصغيرة في ترويسة العمود المفتاحي، واختيار نوع موحد للطرفين، ويُفضل دوماً في المعرفات الرقمية تحويلها إلى نمط “النص” (Text)؛ لأن المعرفات لا تخضع لعمليات حسابية رياضية، ولأن النمط النصي أكثر صلابة وقدرة على استيعاب الأصفار البادئة (مثل 00123) التي قد تلتهمها الأنواع الرقمية تلقائياً.
يجب الانتباه أثناء التحويل من الأخطاء التي تنشأ عند محاولة إجبار سلاسل نصية هجينة غير قياسية على التحول إلى أرقام؛ إذ سيؤدي ذلك إلى ظهور قيم أخطاء (#ERROR) تفسد الاستعلام. لذا، يتوجب معالجة تلك القيم الشاذة وفلترتها قبل توحيد النوع، ضماناً لسلامة تدفق البيانات عبر مصفوفة الدمج.
9.3 تكرار السجلات وتأثيره على عدد الصفوف المخرجة (Cartesian Product)
من المفاهيم الخاطئة الشائعة لدى بعض المبتدئين في علم البيانات الاعتقاد بأن مخرجات الربط الداخلي لا يمكن بأي حال من الأحوال أن تتجاوز عدد صفوف الجدول الأصغر بين الجدولين. ورغم صحة هذه القاعدة عندما تكون المفاتيح فريدة ومميزة تماماً (Unique Keys)، إلا أنها تسقط كلياً بمجرد دخول “القيم المكررة” (Duplicate Keys) على طرفي الربط، مما يؤدي إلى حدوث ما يعرف رياضياً بـ “التوسع الديكارتي الجزئي” (Partial Cartesian Product).
إذا احتوى الجدول الأول على اسم الفريق “Team A” في صفين مختلفين (مثلاً تسجيل لأداء الفريق في بطولتين منفصلتين)، واحتوى الجدول الثاني على “Team A” في ثلاثة صفوف (تسجيل لثلاثة ملاعب مختلفة يملكها الفريق)، فإن خوارزمية الربط الداخلي ستقوم بضرب هذه السجلات تبادلياً، مما ينتج عنه ستة صفوف كاملة للفريق A وحده في الجدول النهائي ($2 \times 3 = 6$). هذا التضاعف المفاجئ قد يمر دون ملاحظة في المجموعات البيانية الضخمة، متسبباً في تضخيم المجموع الكلي للبيانات وتزييف المؤشرات الإحصائية.
لتفادي هذا الخلل، يتعين على المحلل حسم مستوى التحليل المطلوب (Unit of Analysis) بدقة قبل الشروع في الدمج؛ فإذا كانت الغاية دمج بيانات وحيدة التناظر (One-to-One)، فيجب تطبيق أمر “إزالة التكرارات” (Remove Duplicates) على العمود المفتاحي في أحد الجدولين أو كليهما داخل باور كويري، أو إجراء تجميع تلخيصي استباقي عبر ميزة (Group By) لدمج القيم المكررة في صف وحيد يمثل الإجمالي أو المتوسط، مما يضمن خروج نتائج الربط بأبعاد متزنة تعكس الواقع التجريبي بدقة وبلا أي تشويهات تضخمية.
10. مقارنة منهجية: باور كويري في مقابل الدوال التقليدية (XLOOKUP و VLOOKUP)
10.1 محاكاة الربط الداخلي باستخدام الصيغ والدوال المركبة
طالما اعتمد مستخدمو إكسل على مدار عقود على الدوال المرجعية لربط البيانات بين الجداول، وفي مقدمتها الدالة الشهيرة VLOOKUP، والدالتان المركبتان INDEX/MATCH، وصولاً إلى الدالة الأحدث والأكثر مرونة XLOOKUP. ومع ذلك، فإن هذه الصيغ في شكلها البسيط لا تؤدي وظيفة الربط الداخلي الحقيقي؛ إذ إنها مبرمجة لتعمل وفق منطق “الربط الأيسر” (Left Join)، حيث تحتفظ بكافة صفوف الجدول الأساسي وتعيد رسائل الخطأ الشهيرة (#N/A) أمام السجلات التي تعجز عن العثور على نظائر لها في الجدول الثاني.
لمحاكاة سلوك الربط الداخلي بالكامل داخل شبكة خلايا إكسل دون الاستعانة بباور كويري، يضطر المحلل في إصدارات مايكروسوفت 365 الحديثة إلى بناء صيغ مصفوفية ديناميكية مركبة ومعقدة. تتطلب هذه المحاكاة دمج دالة التصفية المتقدمة FILTER مع دالتي ISNUMBER و MATCH لتحديد النطاق المتقاطع حصراً، وفق نسق رياضي معقد يشترط استبعاد القيم المفقودة سلفاً، متبوعاً بدوال استرجاع لملء بقية الأعمدة، وهو ما يفرض عبئاً ذهنياً وبرمجياً كبيراً على المستخدم ويزيد من احتمالات الخطأ أثناء تعديل المعادلات.
فضلاً عن ذلك، تعاني الدوال التقليدية كـ VLOOKUP من قيود هيكلية أصيلة؛ مثل عجزها عن استرجاع بيانات تقع إلى يسار عمود البحث (ما لم يتم تضمين حيل تقنية)، وانهيارها المفاجئ إذا تم إدراج أعمدة جديدة في مسار البيانات دون تعديل رقم الفهرس المرجعي يدوياً، علاوة على الحاجة الدائمة لتطويقها بدوال معالجة الأخطاء مثل IFERROR، مما يجعل صيانة أوراق العمل التي تعتمد على مئات الصيغ المترابطة أمراً بالغ الصعوبة والتعقيد.
10.2 المقارنة من حيث كفاءة استهلاك الذاكرة وسرعة المعالجة
تتضح الفوارق الجوهرية بين باور كويري والصيغ المركبة بشكل صارخ عند الانتقال من أمثلة المقاعد الدراسية البسيطة إلى البيئات الإنتاجية الواقعية التي تتعامل مع مئات الآلاف من الصفوف. تعتمد الدوال المرجعية في إكسل على “إعادة الحساب التلقائي اللحظي” (Volatile and Dependent Recalculation)؛ فعند تعديل أي خلية في المصنف، يحاول البرنامج إعادة حساب كافة صيغ VLOOKUP أو XLOOKUP المنتشرة على امتداد الورقة، مما يؤدي إلى استنزاف حاد لطاقة المعالج المركزي (CPU) وتوقف استجابة البرنامج لفترات طويلة.
في المقابل، تم تصميم محرك باور كويري بمعمارية حوسبية فائقة التطور تعتمد على خوارزميات ضغط البيانات والتخزين الموجه للأعمدة، حيث تتم المعالجات الرياضية خارج شبكة خلايا العرض المباشرة. لا يستهلك باور كويري موارد الحاسوب إلا في اللحظة التي يطلب فيها المستخدم صراحة تنفيذ أمر “التحديث” (Refresh)، فيقوم بقراءة المصادر وضغطها ودمجها ثم تفريغ الناتج النهائي ككتلة بيانية مدمجة، مما يحافظ على خفة ورقة العمل وسرعة التنقل بين خلاياها.
يمنح هذا التفوق الهندسي ميزة حاسمة لباور كويري في مشاريع معالجة البيانات الكبرى (Big Data Wrangling)؛ إذ يتيح إنشاء خطوط عمل متكررة (Reproducible Pipelines) يمكن إعادة استخدامها شهراً بعد شهر وتطبيقها على ملفات متجددة بالكامل دون الحاجة لإعادة كتابة حرف واحد، وهو ما تعجز عنه الصيغ التقليدية التي تظل أسيرة الخلايا المرتبطة بها مكانياً داخل ورقة العمل.
10.3 معايير المفاضلة واختيار الأداة المناسبة وفق متطلبات العمل
على الرغم من التفوق الكاسح لباور كويري في العمليات البنيوية والعلائقية، إلا أن المحلل الخبير يجب أن يمتلك الحكمة المنهجية التي تمكنه من المفاضلة الموضوعية واختيار الأداة الأنسب وفق طبيعة المهمة وحجمها. إذا كانت الحاجة تقتصر على جلب معلومة سريعة من جدول لا يتعدى بضع عشرات من الصفوف ضمن جلسة عمل استكشافية خاطفة، فإن استخدام دالة سريعة ومباشرة مثل XLOOKUP يظل خياراً ممتازاً ويوفر الوقت المستغرق في فتح محرر الاستعلامات وإغلاقه وضبط معلمات الاتصال.
في المقابل، عندما يتعلق العمل ببيئات احترافية ومؤسسية تستهدف بناء لوحات معلومات تنفيذية (Dashboards)، أو تتطلب إجراء عمليات تنظيف مسبقة كدمج الحقول وتجريد السلاسل من المسافات وتوحيد التواريخ، فإن الاعتماد على باور كويري لإجراء الربط الداخلي يغدو خياراً حتمياً لا بديل عنه. يضمن هذا النهج اتساق تدفق البيانات ويوفر سجلاً تدقيقياً يوثق كل تحويل تم إجراؤه على المادة الخام، وهو ما يتسق مع أفضل الممارسات العلمية في توثيق المسارات المنهجية للأبحاث والتحليلات (Nyssen et al., 2016).
أخيراً، يتميز مسار باور كويري بقابليته الفريدة للتكامل والترقية المباشرة؛ فالمهارات والتعليمات المصممة داخله بلغة (M) قابلة للنقل الحرفي والفوري إلى منصات ذكاء الأعمال الأكثر تقدماً مثل مايكروسوفت باور بي آي (Power BI)، دون الحاجة لإعادة تصميم نماذج الربط أو تغيير المنطق العلائقي، مما يجعل الاستثمار في إتقان تقنيات الربط الداخلي عبر باور كويري استثماراً استراتيجياً في صلب مهارات المستقبل لتحليل البيانات وإدارتها بكفاءة.
خاتمة: استشراف تكامل البيانات وأفضل الممارسات التحليلية
يمثل إجراء الربط الداخلي (Inner Join) في برنامج مايكروسوفت إكسل ركيزة محورية لتحقيق التكامل المنطقي والرياضي بين مجموعات البيانات المستقلة. وكما اتضح من خلال التأصيل النظري والتطبيق العملي، فإن هذه العملية ليست مجرد دمج عشوائي للقيم، بل هي تطبيق دقيق لمبادئ الجبر العلائقي ونظرية المجموعات التي تستهدف استخلاص التقاطعات النقية واستبعاد الشوائب والمؤشرات المنقوصة، مما يحمي النماذج الإحصائية اللاحقة من التحيزات الناجمة عن معالجة بيانات مبتورة لا تعبر عن الواقع الميداني بدقة.
أظهرت المقارنة التقنية أن الانتقال من التفكير القائم على الصيغ التقليدية والخلايا المنفردة إلى تبني عقلية النمذجة الاستعلامية عبر محرك “باور كويري” يشكل تحولاً جذرياً في بيئة العمل التحليلية المعاصرة. إن الأتمتة التي يوفرها باور كويري، وقدرته على حفظ خطوات التحويل في مسار برمجي ديناميكي قابل للتحديث التلقائي بنقرة زر واحدة، تمنح الباحثين والمحللين حماية فائقة ضد الأخطاء البشرية المتكررة، وتوفر استهلاك الذاكرة الحاسوبية بشكل يتيح معالجة مجموعات البيانات الضخمة والمعقدة بأعلى درجات الانسيابية والأمان الرقمي.
وختاماً، فإن النجاح في توظيف الربط الداخلي يستوجب الالتزام الصارم بالإجراءات المنهجية التحضيرية؛ بدءاً من تنظيف البيانات وتوحيد معايير المفاتيح المرجعية، وضمان التوافق التام لأنماط الخلايا، وحسم مستويات التحليل لمنع التضخم غير المقصود في النتائج. إن إتقان هذه المهارات الهندسية لا يقتصر أثره على تعظيم الاستفادة من بيئة إكسل المكتبية فحسب، بل يمثل الجسر المعرفي المتين للعبور نحو تقنيات ذكاء الأعمال المتقدمة وهندسة البيانات الكبرى، مما يرسخ ممارسات تحليلية تتسم بالرصانة العلمية والموثوقية المطلقة.
المراجع
- Flemisch, F. O., Abbink, D. A., Itoh, M., Pacaux‐Lemoine, M., & Weßel, G. (2019). Joining the blunt and the pointy end of the spear: towards a common framework of joint action, human–machine cooperation, cooperative guidance and control, shared, traded and supervisory control. Cognition, Technology & Work, 21(4), 555–568. https://doi.org/10.1007/s10111-019-00576-1
- Li, K., Patel, O., Viégas, F. B., Pfister, H., & Wattenberg, M. P. (2023). Inference-Time Intervention: Eliciting Truthful Answers from a Language Model. Neural Information Processing Systems. https://doi.org/10.52202/075280-1797
- Nyssen, O. P., Taylor, S. J., Wong, G., Steed, L., Bourke, L., Lord, J. L., et al. (2016). Does therapeutic writing help people with long-term conditions? Systematic review, realist synthesis and economic considerations. Health Technology Assessment, 20(27), 1–368. https://doi.org/10.3310/hta20270
- Sharma, K., Castellini, C., van den Broek, E. L., Albu‐Schäffer, A., & Schwenker, F. (2019). A dataset of continuous affect annotations and physiological signals for emotion analysis. Scientific Data, 6(1), 196. https://doi.org/10.1038/s41597-019-0209-0
- Sirois, S., Spratling, M., Thomas, M. S. C., Westermann, G., Mareschal, D., & Johnson, M. H. (2008). Précis of Neuroconstructivism: How the Brain Constructs Cognition. Behavioral and Brain Sciences, 31(3), 321–331. https://doi.org/10.1017/s0140525x0800407x