
يمثل الاستدلال الإحصائي ركيزة جوهرية في البحث العلمي التطبيقي، حيث يسعى الباحثون عبر مختلف التخصصات، بدءاً من العلوم السلوكية والطبية إلى الاقتصاد القياسي وعلم الاجتماع، إلى التحقق من صحة الفرضيات وصياغة قرارات مبنية على شواهد بيانات موثوقة. وتحتل البيانات الفئوية الثنائية (Binary Categorical Data) موقعاً متقدماً في تصميمات البحوث التجريبية والمسحية؛ إذ غالباً ما يُعنى الباحث بقياس ما إذا كانت نسبة وقوع حدث معين—كالشفاء من اضطراب، أو الاستجابة لتدخل علاجي، أو تبني سلوك اجتماعي محدد—تختلف اختلافاً جوهرياً بين مجموعتين مستقلتين. وهنا تبرز الحاجة المنهجية لتطبيق أدوات قياسية صارمة لا تختبر فقط وجود تباين ظاهري بين نسب العينات، بل تفحص ما إذا كان هذا التباين يعكس فرقاً حقيقياً في مجتمعات الدراسة الأصلية أم أنه مجرد نتاج للتقلبات العشوائية وخطأ المعاينة.
في هذا الإطار، يعد اختبار Z لنسبتين (Two Proportion Z-Test) من أكثر الاختبارات البارامترية استخداماً وكفاءة عند التعامل مع العينات المستقلة ذات الأحجام الكافية. ويستند هذا الاختبار إلى نظرية الغاية المركزية (Central Limit Theorem)، التي تتيح تقريب التوزيع الثنائي للنسب إلى التوزيع الطبيعي المعياري، مما يمكّن من اشتقاق إحصائية اختبار دقيقة وفترات ثقة تحدد بدقة المدى الذي يقع فيه الفرق الحقيقي بين النسبتين في المجتمع. ومع تزايد تعقيد البيانات البحثية وحجمها، أصبح الاعتماد على البيئات البرمجية الإحصائية المتقدمة أمراً لا غنى عنه لضمان الدقة التحليلية وقابلية تكرار النتائج وسرعة استخراج المؤشرات المتقدمة للارتباط والفروق بين المجموعات.
يقدم نظام التحليل الإحصائي ساس (SAS) بيئة برمجية بالغة الدقة والتكامل لإجراء هذا النمط من التحليلات من خلال إجراء التكرارات المتقاطعة الشهير (PROC FREQ) وخياراته المتخصصة كخيار فرق المخاطر (RISKDIFF). ويهدف هذا المقال الأكاديمي الشامل إلى تقديم دليل منهجي وتطبيقي متكامل لكيفية تنفيذ اختبار Z لنسبتين في SAS، متناولاً الأسس النظرية والرياضية، وخطوات تجهيز مصفوفات البيانات، والبرمجة الدقيقة للأوامر، وتفسير المخرجات الإحصائية وفق التقاليد العلمية الرصينة، وصولاً إلى التوثيق الأكاديمي المعياري المتوافق مع دليل جمعية علم النفس الأمريكية (APA)، ومناقشة البدائل والاعتبارات المنهجية التي تضمن سلامة الاستنتاج الإحصائي.
1. الأسس النظرية لاختبار Z للنسبتين وسياقه الإحصائي
1.1 مفهوم اختبار Z للنسبتين ومجالات تطبيقه
يُعرَّف اختبار Z لنسبتين بأنه اختبار فرضيات استدلالي بارامتري صُمم لتقييم ما إذا كان الفرق الملاحظ بين نسبتي حدوث خاصية ثنائية معينة في عينتين مستقلتين مسحوبتين من مجتمعين مختلفين يُعد فرقاً ذا دلالة إحصائية. يرتكز التحليل على تحويل الفارق بين النسب الملاحظة إلى مقياس معياري (Z-score) يقارن الفرق الملاحظ بالخطأ المعياري المتوقع في ظل فرضية العدم. وتتجلى قوة هذا الاختبار في قدرته على اختزال الظواهر الثنائية المعقدة—التي تتبع توزيع برنولي (Bernoulli Distribution)—إلى نموذج استدلالي يسهل ربطه بالتوزيع الطبيعي المعياري ذي المتوسط صفر والتباين واحد.
تتعدد مجالات تطبيق هذا الاختبار بصورة واسعة في الدراسات النفسية والسيكومترية والاجتماعية؛ حيث يُستخدم على نطاق واسع لمقارنة معدلات انتشار الاضطرابات النفسية بين فئات ديموغرافية متباينة، أو لفحص نسب الاستجابة السلوكية بعد حملات التوعية المجتمعية. وقد أبرزت الدراسات المسحية واسعة النطاق أهمية هذه المقارنات؛ فعلى سبيل المثال، تناولت أبحاث المسح العالمي للصحة النفسية الفروق في نسب الإصابة بالأمراض النفسية الحادة وتحديد مؤشرات الفحص والفرز في عموم السكان باستخدام أدوات قياس دقيقة (Kessler et al., 2010). وبالمثل، في سياقات الأزمات الصحية الكبرى، تُستخدم مقارنة النسب لتقدير تباين نسب القلق والاكتئاب والاضطرابات السلوكية لدى الفئات السكانية المختلفة (Hossain et al., 2020).
وعلاوة على الدراسات المسحية، يكتسب الاختبار أهمية محورية في البحوث التجريبية وشبه التجريبية؛ ولا سيما في التجارب السريرية وتجارب التدخلات النفسية التي تعتمد تصميماً يتضمن مجموعة تجريبية تتلقى تدخلاً محدداً ومجموعة ضابطة تتلقى علاجاً وهمياً أو الرعاية المعتادة. في مثل هذه التصاميم، يكون المتغير التابع في كثير من الأحيان متغيراً ثنائياً يمثل “التحسن الإكلينيكي الملحوظ” أو “الوصول إلى معيار الشفاء”، مما يجعل اختبار Z الأداة الإحصائية المثلى لتحديد ما إذا كانت نسبة المستجيبين في المجموعة التجريبية تفوق نظيرتها في المجموعة الضابطة بدرجة لا يمكن عزوها إلى الصدفة وحدها.
1.2 صياغة الفرضيات الإحصائية للاختبار
تبدأ الممارسة الاستدلالية الرصينة بصياغة واضحة لا لبس فيها للفرضيات الإحصائية؛ فالفرضية الصفرية (Null Hypothesis – H0) تفترض افتراضاً أساسياً مؤداه انعدام الفروق الحقيقية بين نسبتي المجتمعين المستهدفين بالدراسة. ويتم التعبير عن هذه الفرضية رياضياً بالصيغة: H0: p1 – p2 = 0، أو بصيغة مكافئة: H0: p1 = p2، حيث يمثل p1 النسبة الحقيقية للخاصية المدروسة في المجتمع الأول، ويمثل p2 النسبة المناظرة في المجتمع الثاني. تضع هذه الفرضية عبء الإثبات على عاتق الباحث، وتفترض أن أي تفاوت يظهر بين نسبتي العينتين ما هو إلا تباين عشوائي ناتج عن خطأ المعاينة الطبيعي.
في المقابل، تتم صياغة الفرضية البديلة (Alternative Hypothesis – H1 أو Ha) وفقاً للأهداف المعرفية للبحث والإطار النظري الموجه للدراسة. تأخذ الفرضية البديلة شكلاً ثنائي الطرف (Two-Tailed Hypothesis) عندما يكون هدف الباحث استكشافياً يرمي إلى فحص ما إذا كان هناك اختلاف بين النسبتين دون تبني توجه مسبق حول اتجاه هذا الاختلاف؛ وتُكتب رياضياً: H1: p1 – p2 ≠ 0. يُعد هذا الشكل هو المعيار الافتراضي والتحفظي في كثير من التطبيقات العلمية لتجنب التحيزات التوجيهية وتوزيع منطقة الرفض بالتساوي على طرفي التوزيع الاحتمالي.
وعلى النقيض من ذلك، تتم صياغة الفرضيات البديلة أحادية الطرف (One-Tailed Hypothesis) في الحالات التي تسندها أدبيات سابقة ونظريات محكمة ترجح اتجاهاً بعينه. ففي حال التنبؤ بأن التدخل العلاجي سيرفع من نسب الشفاء، تُصاغ الفرضية البديلة لاختبار الاتجاه الأيمن (Right-Tailed) بالصيغة: H1: p1 – p2 > 0 (أي أن p1 > p2). أما إذا كان التدخل يهدف إلى خفض نسبة حدوث انتكاسة سلوكية، فتُصاغ الفرضية البديلة لاختبار الاتجاه الأيسر (Left-Tailed) بالصيغة: H1: p1 – p2 < 0 (أي أن p1 < p2). ويتطلب اختبار الفرضيات أحادية الطرف مبررات نظرية قاطعة، نظراً لتركيزه للقوة الإحصائية في طرف واحد من التوزيع الطبيعي، مما يغير من حدود القيم الحرجة ومناطق الرفض الإحصائي.
1.3 الافتراضات الإحصائية الواجب استيفاؤها
لكي تكون استنتاجات اختبار Z لنسبتين صالحة وموثوقة، يجب التحقق الصارم من استيفاء حزمة من الافتراضات المنهجية والإحصائية قبل الشروع في حساب الإحصائية. يأتي في مقدمة هذه الافتراضات “استقلالية الملاحظات” (Independence of Observations)؛ ويعني هذا الشرط أن انتماء المفحوص إلى إحدى المجموعتين وحدوث الاستجابة لديه لا يؤثر بأي شكل من الأشكال على استجابة أي مفحوص آخر داخل نفس المجموعة أو في المجموعة المقابلة. يقتضي هذا الشرط ألا تكون البيانات مقترنة أو طولية (كقياسات القبلية والبعدية لنفس الأفراد)، بل عينات مستقلة بالكامل تتألف من وحدات تجريبية منفصلة.
الافتراض الجوهري الثاني هو تحقق “التقريب الطبيعي” (Normal Approximation)، والذي ينص على أن توزيع المعاينة للفرق بين النسبتين يتبع تقريباً التوزيع الطبيعي. ونظراً لأن النسبة تمثل متوسط متغير برنولي، فإن نظرية الغاية المركزية تشترط أن يكون حجم كل عينة كافياً لضمان عدم تشوه التوزيع بالالتواء (Skewness). وتُقاس كفاية الحجم إحصائياً بقاعدة “النجاح والفشل المتوقع”؛ حيث يشترط أن يكون حاصل ضرب حجم العينة في نسبة النجاح، وكذلك حاصل ضربه في نسبة الفشل، مساوياً لعشرة على الأقل في كلتا المجموعتين بصورة مستقلة: (n1 * p1 ≥ 10) و (n1 * (1 – p1) ≥ 10) للمجموعة الأولى، و (n2 * p2 ≥ 10) و (n2 * (1 – p2) ≥ 10) للمجموعة الثانية. وعند التحقق من هذه الشروط عبر نسب العينات التقديرية، نضمن أن شكل توزيع المعاينة يقترب بصورة آمنة من التوزيع الطبيعي المتصل.
أما الافتراض الثالث فيتعلق بأسلوب المعاينة، حيث يشترط أن تكون العينات قد سُحبت بأسلوب العينة العشوائية البسيطة (Simple Random Sampling) أو عبر تخصيص عشوائي محكم (Random Assignment) في التجارب السريرية. يضمن التمثيل العشوائي الحد من تحيزات الاختيار المنهجية (Selection Bias)، ويجعل تقديرات نسب العينات مقدرات غير متحيزة (Unbiased Estimators) للنسب الحقيقية في المجتمعات الأصلية. وإذا ما تم خرق أي من هذه الافتراضات—ولا سيما شرط كفاية تكرارات الخلايا—فإن نتائج اختبار Z تصبح غير دقيقة، مما يملي اللجوء إلى اختبارات بديلة كالطرق التوزيعية الدقيقة.
2. البنية الرياضية والمعادلات المعتمدة في حساب الاختبار
2.1 معادلة إحصائية Z القياسية
ترتكز البنية الرياضية لاختبار Z على المفاهيم الكلاسيكية لتوحيد المقاييس (Standardization)؛ حيث يُحسب الفارق بين النقطتين التقديريتين للنسبتين المستخلصتين من العينات، ثم يُقسم هذا الفارق على الانحراف المعياري لتوزيع المعاينة لذلك الفارق، وهو ما يُعرف بالخطأ المعياري للفرق (Standard Error of the Difference). تتخذ المعادلة العامة لإحصائية Z الصيغة البنيوية التالية:
Z = (p̂₁ – p̂₂) / SE(p̂₁ – p̂₂)
يمثل بسط المعادلة (p̂1 – p̂2) الفرق الفعلي الملاحظ بين نسبتي العينتين؛ حيث تُعرَّف النسبة الأولى بـ p̂1 = x1 / n1 (حيث x1 تمثل عدد مرات حدوث الخاصية أو النجاح في العينة الأولى ذات الحجم n1)، وتُعرَّف النسبة الثانية بـ p̂2 = x2 / n2 (حيث x2 تمثل عدد مرات النجاح في العينة الثانية ذات الحجم n2). يمثل هذا البسط مقدار التباعد التجريبي المباشر بين المجموعتين المقارنتين.
أما مقام المعادلة، فيمثل الخطأ المعياري الذي يقيس مقدار التشتت أو التغير المتوقع بين الفروق في النسب نتيجة الصدفة وعشوائية المعاينة. ونظراً لأن التوزيع المرجعي للإحصائية هو التوزيع الطبيعي المعياري، فإن قيمة Z الناتجة توضح بعد الفرق الملاحظ عن الفرق المفترض تحت الصفر بوحدات الانحراف المعياري. إذا كانت القيمة المطلقة لإحصائية Z المحسوبة كبيرة، دل ذلك على أن الفرق الملاحظ يقع في ذيول التوزيع الطبيعي، مما يشير إلى ضعف احتمالية حدوثه بالصدفة وحدها.
2.2 حساب النسبة المجمعة والتباين المشترك
في سياق اختبار الفرضية الصفرية التي تنص على أن p1 = p2 = p، فإن المنهجية الإحصائية تفترض أن العينتين قد تم سحبهما في واقع الأمر من مجتمع واحد مشترك له نسبة حقيقية موحدة غير معلومة يرمز لها بالرمز p. وبناءً على هذا الافتراض البارامتري، لا يجوز حساب خطأ معياري منفصل لكل عينة باستخدام تباينها المستقل، بل يتعين حساب ما يُعرف بـ “النسبة المجمعة” (Pooled Proportion)، والتي يُرمز لها بـ p̂، لتمثيل أفضل تقدير غير متحيز لهذه النسبة المشتركة للمجتمعين معاً.
تُحسب النسبة المجمعة بدمج إجمالي حالات النجاح في العينتين وقسمتها على إجمالي حجم العينتين معاً، وفق المعادلة الصريحة التالية:
p̂ = (x₁ + x₂) / (n₁ + n₂)
تؤدي هذه النسبة المجمعة دوراً حاسماً في حساب التباين المشترك؛ حيث يُعاد بناء صيغة الخطأ المعياري تحت فرضية العدم لتصبح على النحو التالي:
SE_pooled = √[ p̂(1 – p̂) * ( (1 / n₁) + (1 / n₂) ) ]
وبالتبعية، تكتمل الصيغة الرياضية الشاملة لإحصائية Z المجمعة على النحو الآتي:
Z = (p̂₁ – p̂₂) / √[ p̂(1 – p̂) * ( (1 / n₁) + (1 / n₂) ) ]
تسهم الاستعانة بالنسبة المجمعة في تعظيم الكفاءة الإحصائية للاختبار وتركيز القوة الاحتمالية ضد فرضية العدم؛ إذ تتيح الاستفادة من حجم البيانات الكلي للعينتين لتقدير تشتت التوزيع الاستدلالي، بدلاً من إهدار درجات الحرية في تقدير معالم منفصلة لا تدعمها فرضية الصفر.
2.3 القيمة الاحتمالية ومناطق اتخاذ القرار
بمجرد حساب القيمة العددية لإحصائية Z، يتم الانتقال إلى مرحلة التقييم الاحتمالي عبر مقارنة هذه الإحصائية بخصائص التوزيع الطبيعي المعياري لتحديد “القيمة الاحتمالية” (p-value). تُعرَّف القيمة الاحتمالية بأنها احتمال الحصول على إحصائية اختبار مساوية للقيمة المحسوبة أو أكثر تطرفاً منها، بافتراض أن الفرضية الصفرية صحيحة تماماً. يعتمد حساب القيمة الاحتمالية على طبيعة صياغة الفرضية البديلة:
- في الفرضيات ثنائية الطرف (Two-tailed): تُحسب القيمة الاحتمالية بجمع المساحة تحت منحنى التوزيع الطبيعي المعياري في كلا الطرفين، أي: p-value = 2 * P(Z ≥ |Z_calculated|).
- في الفرضيات أحادية الطرف لليمين (Right-tailed): تُحسب المساحة في الطرف الأيمن فقط: p-value = P(Z ≥ Z_calculated).
- في الفرضيات أحادية الطرف لليسار (Left-tailed): تُحسب المساحة في الطرف الأيسر فقط: p-value = P(Z ≤ Z_calculated).
ترتبط القيمة الاحتمالية ارتباطاً مباشراً بمستوى المعنوية المحدد مسبقاً (مستوى ألفا α)، والذي يُحدد عادة في العلوم الاجتماعية والسلوكية والإكلينيكية بقيمة 0.05، أو بقيم أكثر صرامة مثل 0.01 أو 0.001 في الدراسات الدوائية والحيوية المتقدمة. عند مستوى دلالة α = 0.05 لاختبار ثنائي الطرف، تكون القيم الحرجة المقابلة في جدول التوزيع الطبيعي المعياري هي Z = ±1.96. وتتجسد قاعدة اتخاذ القرار الإحصائي في الآتي: إذا كانت القيمة الاحتمالية المحسوبة أقل من أو تساوي مستوى المعنوية (p ≤ α)، أو إذا وقعت قيمة Z المحسوبة في منطقة الرفض الحرج (|Z| ≥ 1.96)، يتم رفض الفرضية الصفرية وقبول الفرضية البديلة، مما يدل على وجود فرق ذي دلالة إحصائية بين النسبتين. أما إذا كانت القيمة الاحتمالية أكبر من ألفا، فإن الباحث “يخفق في رفض الفرضية الصفرية” لعدم كفاية الأدلة الإحصائية لنفيها.
3. هيكلية التحليل الإحصائي في نظام SAS وإجراء PROC FREQ
3.1 بيئة البرمجة الإحصائية في SAS لمعالجة البيانات الفئوية
يتميز نظام التحليل الإحصائي SAS ببنية معمارية صارمة ومصممة خصيصاً للتعامل مع مجموعات البيانات الكبيرة والمعقدة، مع ضمان أعلى درجات الدقة الحسابية والاستقرار الخوارزمي. تنقسم البرمجة في SAS بصفة عامة إلى نوعين رئيسيين من اللبنات البنائية: “خطوات البيانات” (DATA Steps) و”خطوات الإجراءات” (PROC Steps). تُعنى خطوات البيانات بإنشاء وتعديل وتجهيز وترشيح مصفوفات البيانات، في حين تتولى خطوات الإجراءات تنفيذ العمليات الإحصائية المتقدمة وتوليد التقارير والجداول والمخططات البيانية.
في ميدان تحليل البيانات الفئوية وجداول التوافق (Contingency Tables)، يحظى SAS بتقدير أكاديمي استثنائي نظراً لالتزامه بالخوارزميات المعيارية الدقيقة وتوفيره لاختبارات دلالة متعددة تلائم مختلف أنواع البيانات. يتيح النظام فحص جداول الاقتران ثنائية البعد (2×2) ومتعددة الأبعاد، واستخراج المقاييس اللامعلمية، ومؤشرات الارتباط التوافقي، ونسب الأرجحية، وفروق المخاطر بدقة متناهية لا تتأثر بمشكلات التقريب العددي التي قد تشوب بعض البرمجيات الأخرى.
تتمثل إحدى أهم مزايا الاعتماد على حزم SAS الإحصائية في التوثيق الرياضي والبرمجي المتين، والقدرة على إعادة إنتاج التحليلات بدقة وتتبع كل خطوة برمجية عبر سجل النظام (Log Window)، مما يجعله المعيار الذهبي في الهيئات الرقابية الدولية كإدارة الغذاء والدواء الأمريكية (FDA) والمراكز البحثية العالمية المتخصصة في الدراسات النفسية والطبية واسعة النطاق.
3.2 إجراء PROC FREQ والخيارات المتقدمة
يعد الإجراء التكراري PROC FREQ الأداة الأساسية والمحورية داخل بيئة SAS لتحليل التوزيعات التكرارية للبيانات الفئوية وتوليد جداول التوافق المتقاطعة. لا يقتصر دور هذا الإجراء على تقديم وصف كمي بسيط للتكرارات والنسب المئوية، بل يمتد ليكون منصة متكاملة للتحليل الاستدلالي المتقدم عبر تضمين حزمة واسعة من المعاملات والخيارات الإحصائية.
يتم تفعيل التحليل الاستدلالي للفروق بين المتغيرات الفئوية من خلال عبارة الجداول (TABLES Statement)، والتي تحدد البنية التقاطعية للمتغيرات (مثل Group * Outcome). ومن خلال إلحاق هذه العبارة بخيارات متخصصة بعد إشارة الخط المائل (/)، يمكن للباحث استدعاء اختبارات محددة؛ ومن أبرز هذه الخيارات:
- CHISQ: يوجه النظام لحساب اختبار كاي تربيع لاستقلالية المتغيرات واختبارات الارتباط المرتبطة به.
- MEASURES: يستخرج مؤشرات حجم الارتباط مثل معامل فاي ومعامل كرامر ونسب الأرجحية.
- RISKDIFF: الخيار المتخصص في حساب الفروق بين النسب المئوية للمجموعات وفترات الثقة المصاحبة لها واشتقاق إحصائية اختبار Z للنسبتين.
- EXACT: خيار استثنائي يُستخدم لاستخراج الاختبارات التوزيعية الدقيقة (كاختبار فيشر الدقيق) عندما تكون العينات صغيرة ولا تستوفي شروط التقريب الطبيعي.
3.3 الفرق بين الاختبارات المتاحة للبيانات التكرارية
عند التعامل مع جدول توافق ثنائي من رتبة (2×2)، يقع كثير من الباحثين في خلط منهجي بين اختبار كاي تربيع للاستقلالية (Chi-Square Test of Independence) واختبار Z لمقارنة نسبتين، أو يواجهون حيرة في اختيار المقياس الأنسب لاختبار فرضياتهم. رياضياً، يرتبط الاختباران ارتباطاً وثيقاً في الجداول الثنائية البسيطة؛ إذ يتطابق مربع قيمة إحصائية Z لنسبتين تماماً مع قيمة إحصائية كاي تربيع لبيرسون لنفس الجدول (Z² = χ²)، وتنتج عنهما نفس القيمة الاحتمالية للاختبارات ثنائية الطرف.
إلا أن الفارق المنهجي الجوهري يكمن في البنية الاستدلالية واتجاه الفرضيات؛ فاختبار كاي تربيع مبني بصورة أصيلة لاختبار فرضيات غير موجهة (Omnidirectional/Non-directional)، ويفحص مجرد وجود “استقلالية” أو “ارتباط” عام بين متغيرين تصنيفيين، ولا يمتلك آلية رياضية مباشرة لاختبار الفرضيات أحادية الطرف الموجهة (One-sided directional hypotheses). في المقابل، يتيح اختبار Z المستخرج عبر خيار RISKDIFF تقييم الفرضيات الموجهة (كأن نفترض أن نسبة الشفاء في المجموعة أ تفوق نسبتها في المجموعة ب) بدقة متناهية، مع توفير مؤشر خطي صريح للفرق وفترات ثقة قابلة للتفسير المباشر بوحدات النسبة المئوية.
علاوة على ذلك، يوفر خيار RISKDIFF في SAS إمكانية المفاضلة بين طريقتين لحساب التباين: طريقة النسبة المجمعة المفترضة تحت الفرضية الصفرية (Pooled / Null Variance)، وطريقة التباين غير المجمع المستند إلى تباينات العينات المستقلة (Unpooled / Sample Variance)، مما يمنح الباحث مرونة منهجية فائقة لمطابقة تحليله البرمجي مع الصياغة النظرية الدقيقة لفرضيته البحثية.
4. إعداد وتجهيز مصفوفات البيانات داخل SAS
4.1 إنشاء مجموعات البيانات الأولية عبر خطوة DATA
يمثل إدخال البيانات وتجهيزها الخطوة التأسيسية التي تُبنى عليها سلامة التحليل الإحصائي اللاحق. يتيح نظام SAS طريقتين رئيسيتين لتمثيل البيانات الفئوية الموجهة لاختبار Z لنسبتين؛ الطريقة الأولى هي إدخال “البيانات الأولية غير المجمعة” (Raw/Individual-Level Data)، حيث يمثل كل سجل (Record) أو صف داخل مصفوفة البيانات مفحوصاً أو مشاركاً فردياً واحداً، وتتضمن الأعمدة المتغيرات المستقلة والتابعة المقاسة لهذا الفرد.
يتم بناء مصفوفة البيانات الأولية عبر خطوة DATA واستخدام عبارة INPUT لتحديد أسماء المتغيرات ونوعها (رقمية أو نصية عبر استخدام علامة $)، متبوعة بعبارة DATALINES أو CARDS التي يُدرج تحتها متن البيانات الفعلي. وفيما يلي نموذج برمجي يوضح كيفية إنشاء مصفوفة بيانات أولية لدراسة افتراضية تقارن الاستجابة لتدخل علاجي بين مجموعتين:
DATA ClinicalTrial_Raw;
INPUT SubjectID Group $ Response $;
DATALINES;
101 Treatment Improved
102 Treatment Improved
103 Treatment NoChange
104 Control Improved
105 Control NoChange
106 Control NoChange
;
RUN;
عند ترميز المتغيرات الفئوية، يُنصح بتوثيق دلالات القيم بوضوح، سواء كانت نصية (مثل “Treatment” و “Control” لمجموعات الدراسة، و “Improved” و “NoChange” لنتائج التدخل) أو رقمية متبوعة بقوالب تنسيقية (FORMATS)، لضمان سهولة قراءة الجداول وتفادي اللبس الدلالي أثناء مرحلة التفسير الأكاديمي للنتائج.
4.2 تنظيم الجداول الموزونة وتطبيق عبارة WEIGHT
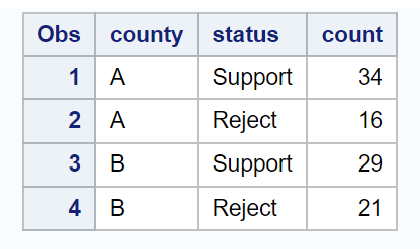
على الرغم من شيوع البيانات الأولية في الدراسات الميدانية، إلا أن واقع التحليل الإحصائي غالباً ما يتطلب التعامل مع “البيانات التكرارية المجمعة أو الملخصة” (Summarized/Aggregated Frequency Data). تظهر هذه الحالة بجلاء عند استخراج البيانات من تقارير إحصائية سابقة، أو دراسات مسحية منشورة، أو سجلات مستشفيات ملخصة، حيث يكون لدى الباحث جدول توافق يحتوي على التكرار العددي لكل خلية متقاطعة بين المتغيرين.
يوفر نظام SAS كفاءة فائقة في معالجة هذه البيانات عبر استخدام عبارة الوزن (WEIGHT Statement). ففي خطوات البيانات الملخصة، يتضمن ملف البيانات ثلاثة متغيرات أساسية: المتغير التصنيفي للمجموعات (Group)، المتغير التصنيفي للاستجابة (Response)، ومتغير رقمي يمثل التكرار العددي للأفراد الذين يجمعون بين تلك الصفتين (Count). بدون عبارة WEIGHT، سيتعامل SAS مع كل صف كحالة فردية واحدة، مما يؤدي إلى انهيار التحليل بالكامل وظهور نتائج خاطئة تعتمد على حجم عينة رمزي لا يمثل الواقع.
يوضح النموذج البرمجي التالي كيفية هيكلة البيانات التكرارية الملخصة وتفعيل عبارة WEIGHT داخل إجراء PROC FREQ:
DATA ClinicalTrial_Summary;
INPUT Group $ Response $ Count;
DATALINES;
Treatment Improved 65
Treatment NoChange 35
Control Improved 45
Control NoChange 55
;
RUN;
PROC FREQ DATA=ClinicalTrial_Summary;
WEIGHT Count;
TABLES Group * Response / RISKDIFF;
RUN;
تضمن عبارة WEIGHT هنا قيام SAS بتوسيع الصفوف افتراضياً ومضاعفة تأثير كل فئة وفقاً لقيمة المتغير Count، مما ينتج عنه حسابات مطابقة تماماً لتلك التي كانت ستنتج لو تم إدخال 200 سجل فردي منفصل.
4.3 التحقق المسبق من صحة البيانات
يعد التدقيق المسبق للبيانات مرحلة منهجية حاسمة لا غنى عنها قبل المضي قدماً في قراءة نتائج الاختبار الاستدلالي. يتطلب فحص البيانات في SAS مراجعة ثلاثة أبعاد رئيسية لضمان سلامة النموذج: القيم المفقودة (Missing Values)، التكرارات الصفرية أو غير المنطقية، وتحقق افتراضات أحجام الخلايا.
فيما يتعلق بالقيم المفقودة، يستبعد إجراء PROC FREQ افتراضياً أي سجل يتضمن قيمة مفقودة في أي من المتغيرات المحددة في عبارة TABLES، وهو ما قد يؤدي إلى انكماش حجم العينة الفعلي وتشويه النسب إذا كانت القيم المفقودة غير عشوائية (Missing Not at Random). يمكن للباحث فحص وجود القيم المفقودة عبر تنفيذ مراجعة سريعة للتكرارات الأحادية عبر خيار MISSING الملحق بعبارة الإجراء.
كذلك يجب فحص التوزيعات المشتركة للتأكد من عدم وجود خلايا خالية (Zero-count cells)، والتي تؤدي إلى فشل تقدير النسب الرياضية أو إنتاج أخطاء معيارية لا نهائية. والأهم من ذلك، يتعين إجراء فحص سريع للأحجام المتوقعة للنجاح والفشل داخل كل مجموعة؛ فإذا تبين أن التكرار الملاحظ أو المتوقع لأي خلية في جدول (2×2) يقل عن 5 أو 10 حالات، فإن ذلك يطلق إشارة تحذيرية تفيد بعدم ملاءمة اختبار Z التقريبي، وتوجب اللجوء إلى تصحيحات الاستمرارية أو تفعيل الاختبارات التوزيعية الدقيقة كما سيتم تفصيله لاحقاً.
5. الكود البرمجي التفصيلي لإجراء اختبار Z للنسبتين في SAS
5.1 صياغة استدعاء PROC FREQ وتحديد الجداول المتقاطعة
تتطلب الصياغة المنهجية المتقدمة لإجراء PROC FREQ في SAS دقة في تحديد معاملات الاستدعاء وهيكلة عبارة TABLES لضمان استخراج النتائج بوضوح واستبعاد المؤشرات الإحصائية الثانوية التي قد تزيد من تعقيد المخرجات دون حاجة بحثية. تبدأ الصيغة الأساسية بتحديد اسم مجموعة البيانات المستهدفة، متبوعة بعبارة الجداول التي تحدد ترتيب تقاطع المتغيرات المستقلة والتابعة.
يعد ترتيب المتغيرات في عبارة TABLES Group * Response أمراً محورياً في SAS؛ فالمتغير الأول (Group) يمثل دائماً صفوف الجدول (Rows)، ويُنظر إليه عادة كمتغير مستقل، في حين يمثل المتغير الثاني (Response) أعمدة الجدول (Columns)، ويُعبر عن المتغير التابع أو النتيجة. للتحكم في مظهر الجدول المستخرج وتركيز القراءة على النسب الجوهرية، يوفر SAS خيارات لتثبيط المخرجات التكرارية الزائدة، مثل خيار NOROW لمنع طباعة النسب المئوية للصفوف، أو NOCOL لمنع نسب الأعمدة، أو NOPERCENT لمنع طباعة النسبة المئوية الكلية للجدول.
يوضح المثال البرمجي التالي استدعاءً منسقاً يركز على استخراج مصفوفة التوافق المنظمة مع إبراز نسب الصفوف المفيدة لمقارنة المجموعات:
PROC FREQ DATA=ClinicalTrial_Summary;
WEIGHT Count;
TABLES Group * Response / NOCOL NOPERCENT;
RUN;
5.2 تضمين خيار RISKDIFF لاشتقاق إحصائية Z
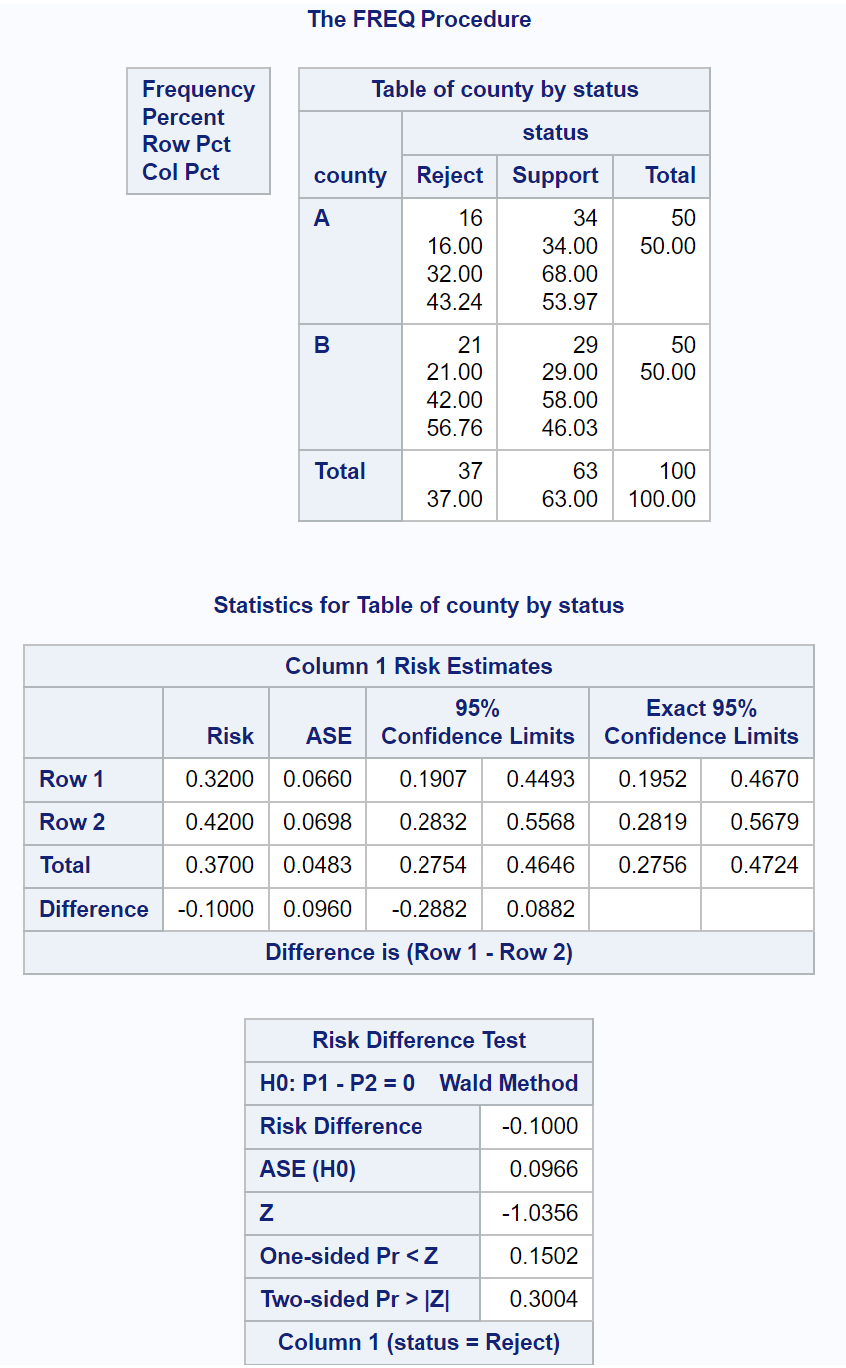
يعد خيار الفرق في المخاطر (RISKDIFF – Risk Difference) المحرك البرمجي الأساسي لاشتقاق اختبار Z لمقارنة نسبتين في SAS. عند تفعيل خيار RISKDIFF بعد إشارة الخط المائل في عبارة TABLES، يقوم الإجراء تلقائياً بإنشاء جداول مخرجات إضافية مخصصة لتقدير فرق النسب، وتحديد الخطأ المعياري، واشتقاق فترات الثقة، وحساب إحصائيات اختبار الفرضيات.
يتيح خيار RISKDIFF معاملات فرعية متقدمة (Sub-options) تمنح الباحث تحكماً دقيقاً في المنهجية الرياضية المتبعة لحساب التباين. فبشكل افتراضي، قد يقدم SAS فترات الثقة استناداً إلى تباين العينة غير المجمع، ولكن لاختبار فرضية الصفر التقليدية (H0: p1 – p2 = 0) باستخدام إحصائية Z المجمعة الكلاسيكية، يمكن تضمين المعامل المتقدم (EQUAL VAR=NULL). يوجه هذا المعامل النظام لاستخدام النسبة المجمعة تحت فرضية المساواة لحساب مقام إحصائية الاختبار.
بالإضافة إلى ذلك، يمكن التحكم في العمود أو الصف المستهدف بالمقارنة؛ إذ يعتمد SAS افتراضياً العمود الأول للمقارنة ما لم يتم توجيهه لخلاف ذلك عبر خيار (COLUMN=1) أو (COLUMN=2). توضح الشيفرة التالية التطبيق البرمجي المتكامل لاستخراج اختبار Z لنسبتين بالاعتماد على التباين المجمع:
PROC FREQ DATA=ClinicalTrial_Summary;
WEIGHT Count;
TABLES Group * Response / RISKDIFF(EQUAL VAR=NULL COLUMN=1);
RUN;
5.3 التحكم في اتجاه الفرضية ومستوى المعنوية
تستلزم الممارسة التحليلية الصارمة التحكم الكامل في المعالم الإحصائية للتجربة، وفي مقدمتها مستوى المعنوية (ألفا) ومستوى الثقة لفترات التقدير. يعتمد SAS افتراضياً مستوى معنوية α = 0.05، وهو ما ينتج عنه فترات ثقة بنسبة 95%. يمكن للباحث تعديل هذا المستوى بكل سهولة عبر إلحاق خيار ALPHA= بالصيغة؛ فإذا كان البحث يتطلب مستوى ثقة 99% (α = 0.01)، يُكتب الخيار كالتالي: ALPHA=0.01.
يقدم جدول مخرجات RISKDIFF في SAS بصورة تلقائية تقييماً لكلا نوعي الفرضيات البديلة: القيمة الاحتمالية ثنائية الطرف (Two-sided Pr > |Z|)، والقيم الاحتمالية أحادية الطرف لكل من الاتجاه الأيمن (One-sided Pr > Z) والاتجاه الأيسر (One-sided Pr < Z). ويتيح هذا التنوع للباحث مطابقة النتائج مباشرة مع صياغته المسبقة للفرضية دون الحاجة إلى إجراء تحويلات يدوية للقيم الاحتمالية.
ولتحقيق أقصى درجات الكفاءة وإدارة مخرجات النظام، يمكن استخدام نظام تسليم المخرجات (Output Delivery System – ODS) في SAS؛ حيث يتيح أمر ODS SELECT انتقاء وعزل الجداول الإحصائية ذات الصلة بالاختبار مباشرة، وتجاهل الجداول الوصفية الفرعية، كما هو موضح في البنية التالية:
ODS SELECT ContingencyTable RiskDiffCol1 RiskDiffTestCol1;
PROC FREQ DATA=ClinicalTrial_Summary;
WEIGHT Count;
TABLES Group * Response / RISKDIFF(EQUAL VAR=NULL) ALPHA=0.05;
RUN;
ODS SELECT ALL;
6. دراسة حالة تطبيقية: مقارنة نسب التدخل الإكلينيكي
6.1 توصيف السيناريو والفرضية النفسية التجريبية
لتجسيد التطبيق العملي لاختبار Z لنسبتين داخل بيئة SAS، نتناول دراسة حالة إكلينيكية افتراضية تستند إلى تصاميم التدخلات النفسية المبنية على الأدلة، كالعلاج المعرفي السلوكي المطبق في علاج اضطرابات القلق وما بعد الصدمة (James et al., 2015; Bisson et al., 2013). يُعنى هذا السيناريو بمقارنة فاعلية بروتوكول علاجي معرفي سلوكي مستحدث (المجموعة التجريبية: Treatment) مقابل بروتوكول الدعم النفسي الإكلينيكي المعتاد (المجموعة الضابطة: Control) في إحداث تعافٍ أو تحسن إكلينيكي ملموس لدى عينة من البالغين الذين يعانون من اضطراب نفسي بعد مضي 12 أسبوعاً من التدخل.
تتألف عينة الدراسة الكلية من 200 مريض تم توزيعهم عشوائياً وبأعداد متساوية إلى المجموعتين (100 مريض في المجموعة التجريبية، و100 مريض في المجموعة الضابطة). المتغير التابع هو مؤشر ثنائي للاستجابة الإكلينيكية (Response)، ويأخذ قيمتين: إما حدوث تحسن ملحوظ يفي بمعايير التعافي (Improved)، أو عدم حدوث تحسن ملموس (NoChange). وقد أظهرت الملاحظة التجريبية تحسن 65 مريضاً في المجموعة التجريبية مقابل 45 مريضاً في المجموعة الضابطة.
يتمثل التساؤل البحثي في: “هل يؤدي بروتوكول العلاج المعرفي السلوكي المستحدث إلى تحقيق نسبة تحسن تفوق بصورة دالة إحصائياً نسبة التحسن المحققة عبر بروتوكول الدعم المعتاد؟”. وبناءً عليه، تُصاغ الفرضيات الإحصائية على النحو التالي:
- الفرضية الصفرية (H0): p_Treatment – p_Control = 0 (نسبة التحسن متطابقة بين البروتوكولين في المجتمع الإكلينيكي).
- الفرضية البديلة ثنائية الطرف (H1): p_Treatment – p_Control ≠ 0 (توجد فروق دالة بين نسبتي التحسن).
- الفرضية البديلة أحادية الطرف الموجهة (H1): p_Treatment – p_Control > 0 (نسبة التحسن في العلاج المستحدث أعلى دلالة من العلاج المعتاد).
6.2 كتابة وتنفيذ الكود المتكامل للدراسة
لتنفيذ هذا التحليل بصورة مهنية داخل SAS، نقوم بكتابة برنامج متكامل يبدأ بتهيئة البيانات الموزونة، ويحدد ترتيب الفئات بدقة لضمان أن تكون المقارنة في الاتجاه الصحيح، ثم يستدعي إجراء PROC FREQ مع خيارات RISKDIFF المناسبة لفحص الفرضية المجمعة. نستخدم هنا خيار ORDER=DATA في رأس أمر PROC FREQ لضمان أن يتعامل SAS مع الفئات وفقاً لترتيب ظهورها في خطوة البيانات، بدلاً من الترتيب الأبجدي الافتراضي الذي قد يقلب المقارنة:
/* 1. إنشاء مصفوفة البيانات التكرارية الملخصة */
DATA CaseStudy_CBT;
INPUT Group $ Response $ Count;
DATALINES;
Treatment Improved 65
Treatment NoChange 35
Control Improved 45
Control NoChange 55
;
RUN;
/* 2. استدعاء التحليل الإحصائي لاختبار Z لنسبتين */
PROC FREQ DATA=CaseStudy_CBT ORDER=DATA;
WEIGHT Count;
TABLES Group * Response / RISKDIFF(EQUAL VAR=NULL COLUMN=1) ALPHA=0.05;
RUN;
عند تنفيذ هذه الأوامر في بيئة SAS، يتعين على الباحث التحقق فوراً من سجل التشغيل (SAS Log). يجب التأكد من عدم وجود رسائل خطأ (Errors) أو تحذيرات (Warnings) تشير إلى استبعاد أي سجلات، وملاحظة تأكيد النظام لقراءة 4 ملاحظات بمجموع أوزان يبلغ 200 حالة، مما يضمن اكتمال التنفيذ وموثوقية مصفوفة البيانات المعالجة.
6.3 استخراج الجداول الناتجة من جلسة التحليل
يولد هذا التنفيذ البرمجي حزمة مخرجات متسلسلة تشمل الجداول المحورية الثلاثة التالية:
أولاً: جدول التوافق المتقاطع (Table of Group by Response): يعرض مصفوفة الأعداد والنسب المئوية لكل خلية ومجاميع الصفوف والأعمدة. نلاحظ أن نسبة التحسن في مجموعة العلاج بلغت 65.00% (65 من 100)، بينما بلغت نسبة التحسن في المجموعة الضابطة 45.00% (45 من 100)، مع بلوغ إجمالي المتحسنين 110 من أصل 200 فرد (بنسبة مجمعة كلية قدرها 55.00%).
ثانياً: جدول فروق المخاطر للعمود الأول (Column 1 Risk Estimates): يوضح هذا الجدول الفرق النقطي المباشر بين النسبتين (Treatment – Control)، والذي يساوي: 0.6500 – 0.4500 = 0.2000 (أي فرق إيجابي مقداره 20% لصالح المجموعة التجريبية). كما يقدم الخطأ المعياري المقدر غير المجمع، وحدود فترة الثقة غير المجمعة بنسبة 95% والتي تتراوح بين [0.0632 إلى 0.3368].
ثالثاً: جدول اختبار الفرضيات المتكافئة (Risk Difference Test – Equal Variance Under Null): وهو الجدول الحاسم لاختبار Z الكلاسيكي؛ حيث يعرض قيمة إحصائية Z المحسوبة بالاعتماد على التباين المجمع، وتظهر بقيمة Z = 2.8442، مع عرض القيمة الاحتمالية ثنائية الطرف (Two-sided p-value = 0.0045) والقيمة الاحتمالية أحادية الطرف للاتجاه الأيمن (One-sided p-value = 0.0022).
7. تحليل وتفسير مخرجات اختبار Z في SAS
7.1 قراءة جدول الفروق بين النسب وتحديد التقديرات النقطية
يبدأ التفسير الإحصائي الرصين بالفصل المنهجي بين مرحلة “التقدير النقطي” (Point Estimation) ومرحلة “اختبار الفرضيات” (Hypothesis Testing). يظهر التقدير النقطي لفارق النسبتين في مخرجات SAS تحت مسمى “Risk Difference” بقيمة قطعية تبلغ 0.2000؛ وتفسر هذه القيمة بأن تطبيق بروتوكول العلاج المعرفي السلوكي المستحدث أدى إلى زيادة مطلقة قدرها 20 نقطة مئوية في معدل التحسن الإكلينيكي مقارنة ببروتوكول الرعاية المعتاد داخل العينة المدروسة.
من الضروري هنا أن ينتبه الباحث إلى التمييز بين تقديرين للخطأ المعياري يوردهما نظام SAS في جدول الفروق:
- الخطأ المعياري القائم على العينة (Sample / Unpooled Standard Error): ويُحسب استناداً إلى تباين كل عينة على حدة: √[(p̂1(1-p̂1)/n1) + (p̂2(1-p̂2)/n2)]. يُستخدم هذا الخطأ بصورة أساسية في بناء فترات الثقة لمقدار الفرق في المجتمع، وتبلغ قيمته في دراستنا 0.0700.
- الخطأ المعياري المجمع المفترض تحت الصفر (Null / Pooled Standard Error): ويُشتق من النسبة المجمعة (p̂ = 0.55)، وتبلغ قيمته: √[0.55 * 0.45 * (1/100 + 1/100)] = 0.07035. يُخصص هذا التقدير حصرياً لحساب قيمة إحصائية Z لاختبار فرضية انعدام الفرق.
7.2 تفسير إحصائية الاختبار Z والقيم الاحتمالية
يكشف جدول اختبار الفرضيات عن إحصائية Z قياسية محددة بـ 2.8442. يعني هذا رياضياً أن الفرق الملاحظ بين نسبتي التحسن (20%) يقع على مسافة تبلغ نحو 2.84 خطأ معياري أعلى من الفرق المفترض في ظل فرضية العدم (وهو صفر). تمثل هذه المسافة انحرافاً كبيراً في إطار منحنى التوزيع الطبيعي المعياري؛ إذ إن القيم التي تتجاوز القيمة الحرجة المعيارية (1.96) تقع في مناطق الذيل شديدة التطرف والندرة في حال صحة فرضية العدم.
ينعكس هذا التطرف الإحصائي على القيمة الاحتمالية المرافقة؛ فالقيمة الاحتمالية ثنائية الطرف الناتجة عن البرنامج هي p = 0.0045. وتدل هذه النتيجة على أنه بافتراض عدم وجود أي فرق حقيقي بين البرنامجين العلاجيين في الواقع، فإن احتمال الحصول على فرق في نسبتي عينتين يبلغ 20% أو أكثر في أي اتجاه نتيجة عشوائية المعاينة فقط هو 45 مرة من بين كل 10,000 تجربة مماثلة. وبما أن هذه القيمة الاحتمالية أقل بكثير من مستوى ألفا المحدد مسبقاً (0.0045 < 0.05)، فإن النتيجة تُعد دالة إحصائياً عند مستويات الدلالة 0.05 و 0.01.
أما بالنظر إلى صياغة الفرضية أحادية الطرف التوجيهية (المفترضة لتفوق العلاج المستحدث)، نجد أن القيمة الاحتمالية المستخرجة للاتجاه الأيمن تبلغ p = 0.0022. توفر هذه القيمة برهاناً احتمالياً أشد صرامة وقوة في دحض الفرضية الصفرية وتأكيد التفوق الإيجابي للبروتوكول التجريبي على البروتوكول الضابط.
7.3 تحليل فترات الثقة للفرق بين النسبتين
لا يكتمل التحليل الإحصائي الحديث بمجرد استخراج القيم الاحتمالية؛ بل يمثل تحليل فترات الثقة (Confidence Intervals) الركن المكمل لتقدير حجم الفرق ومستوى الدقة التحليلية. استخرج التحليل في دراستنا فترة ثقة بنسبة 95% لفارق النسب تراوحت بين حد أدنى مقداره 0.0632 وحد أقصى مقداره 0.3368 (أي بين 6.32% و 33.68%).
تخضع هذه الفترة لتفسير استدلالي منهجي دقيق؛ حيث يشير عدم شمول فترة الثقة للقيمة صفر (Null Value: 0.0000) إلى رفض حاسم للفرضية الصفرية عند مستوى دلالة α = 0.05. ويوضح ذلك بوضوح أن الفرق الإيجابي حقيقي في مجتمع الدراسة ولا يمكن اعتباره من قبيل الصدفة. وتفيد دلالة فترة الثقة بنسبة 95% أننا إذا كررنا إجراء هذه التجربة السريرية 100 مرة بسحب عينات عشوائية مستقلة متطابقة الحجم، فإن 95 من فترات الثقة المحسوبة ستتضمن بدقة الفارق الحقيقي بين نسبتي التعافي للمجتمعين.
وعلاوة على ذلك، يعكس اتساع فترة الثقة مستوى الدقة في التقدير؛ فالفترة المحصورة بين 6% و 34%، وإن كانت تؤكد الاتجاه الإيجابي لصالح التدخل المعرفي، إلا أنها تشير إلى هامش تذبذب مقبول مرتبط بحجم العينة البالغ 100 في كل مجموعة. ولو تضاعف حجم العينات البحثية، لانكمشت فترة الثقة بصورة ملحوظة حول التقدير النقطي (0.20)، مما يرفع دقة التنبؤ بالأثر الإكلينيكي على مستوى اتخاذ القرارات العلاجية.
8. اتخاذ القرار الإحصائي والتوثيق الأكاديمي وفق أسلوب APA
8.1 حسم القرار الإحصائي حيال الفرضية الصفرية
بناءً على المخرجات الرقمية المحكمة لاختبار Z المستخرج من نظام SAS، يُحسم القرار الإحصائي المنهجي برفض قاطع للفرضية الصفرية (H0)، وقبول الفرضية البديلة القائلة بوجود تباين دال إحصائياً بين نسبتي الاستجابة في المجموعتين لصالح المجموعة التجريبية. يستند هذا القرار إلى استيفاء معايير القرار المزدوجة: تجاوز قيمة Z المحسوبة (2.84) للقيمة الحرجة المجدولة (1.96)، وتدني القيمة الاحتمالية المقترنة (p = 0.0045) عن مستوى المعنوية المعتمد (α = 0.05).
يقتضي اتخاذ القرار الإحصائي تقييماً واعياً لاحتمالات الخطأ المنهجي؛ فبرفضنا للفرضية الصفرية، نتحمل هامش مخاطرة أقصاه 0.45% باحتمال الوقوع في خطأ النوع الأول (Type I Error) المتمثل في تأكيد وجود تفوق للعلاج في حين أنه غير موجود في الواقع، وهي نسبة مخاطرة آمنة للغاية في البحوث الإكلينيكية. في المقابل، فإن اعتماد حجم عينة متوازن واستيفاء شروط كفاية خلايا جدول التوافق يقلل من مخاطر خطأ النوع الثاني (Type II Error)، مما يمنح الدراسة قوة إحصائية عالية تضمن الكشف الموثوق عن الفروق الإكلينيكية الحقيقية وتفادي إغفال النتائج الواعدة.
8.2 تقييم الأهمية العملية وحجم الأثر
من القواعد المنهجية الجوهرية في التحليل الأكاديمي الرصين التمييز الحاسم بين “الدلالة الإحصائية” (Statistical Significance) و”الدلالة العملية أو الإكلينيكية” (Clinical Significance / Practical Importance). إن حصول الاختبار على دلالة إحصائية صريحة لا يعني بالضرورة أن الفرق المحقق يحمل وزناً تطبيقياً كبيراً؛ فالعينات الضخمة للغاية قد تبرز فروقاً هامشية تافهة بوصفها فروقاً دالة إحصائياً. لذا، يتعين تقييم مؤشرات حجم الأثر (Effect Size) المرتبطة بجدول التوافق.
في دراستنا الحالية، يُعد الفارق المطلق في النسب (Risk Difference = 0.20) في حد ذاته مقياساً واضحاً وبديهياً لحجم الأثر؛ إذ يمثل تحسن شخص إضافي مقابل كل خمسة أفراد يتلقون التدخل التجريبي، وهو ما يُعرف إكلينيكياً بالعدد المطلوب للعلاج (Number Needed to Treat – NNT = 1 / 0.20 = 5). ويعتبر مؤشر NNT = 5 أثراً علاجياً رفيع القيمة في دراسات التدخلات السلوكية والصحة النفسية.
بالإضافة إلى ذلك، يمكن حساب نسب الأرجحية (Odds Ratio – OR) والخطر النسبي (Relative Risk – RR) كمقاييس مرافقة لحجم الأثر؛ حيث تبلغ نسبة التحسن في العلاج 65/100 مقابل 45/100 في الضابطة، مما ينتج خطراً نسبياً RR = 0.65 / 0.45 = 1.44 (أي أن احتمالية التعافي تزداد بنسبة 44% لدى متلقي العلاج المستحدث). كما تبلغ نسبة الأرجحية OR = (65 * 55) / (35 * 45) = 2.27، مشيرة إلى أن فرص التحسن في المجموعة التجريبية تتجاوز ضعفي فرصتها في المجموعة الضابطة، مما يؤكد أن الدلالة الإحصائية المحققة مدعومة بجدوى تطبيقية ونفسية كبرى على أرض الواقع.
8.3 صياغة التقرير الإحصائي النهائي بمعايير جمعية علم النفس الأمريكية
تضع جمعية علم النفس الأمريكية (APA) في الإصدار السابع من دليلها المنهجي معايير دقيقة لكيفية توثيق اختبارات النسب والمقارنات الثنائية داخل النصوص الأكاديمية والجداول البحثية. تتطلب الصياغة الأكاديمية عرض التقديرات النقطية مصحوبة بأحجام العينات والنسب المئوية، وقيمة إحصائية الاختبار ودرجات الحرية (أو تحديد Z)، والقيمة الاحتمالية الدقيقة (وليس p < 0.05 إلا في حال تدنيها الشديد عن 0.001)، مع إلزامية توثيق فترة الثقة الكاملة.
فيما يلي النموذج الأكاديمي المعتمد لكتابة نتائج الدراسة السابقة داخل نص التقرير:
“أظهر اختبار Z لمقارنة نسبتين وجود فرق دال إحصائياً في معدلات التحسن الإكلينيكي بين المجموعتين، Z = 2.84, p = .005 (ثنائي الطرف). بلغت نسبة المرضى المتحسنين في مجموعة العلاج المعرفي السلوكي المستحدث 65.0% (n = 65)، في حين بلغت نسبة المتحسنين في مجموعة الدعم المعتاد 45.0% (n = 45)، محققة فرقاً إيجابياً في النسب قدره 20.0%، 95% CI [6.32%, 33.68%].”
كما يمكن توثيق هذه المقارنات الإحصائية في جدول منهجي موجز يلتزم بضوابط APA التنسيقية الخالية من الخطوط الرأسية:
| المجموعة | حجم العينة (n) | عدد المتحسنين | النسبة (%) | قيمة Z | الدلالة (p) | 95% CI للفرق |
|---|---|---|---|---|---|---|
| العلاج التجريبي | 100 | 65 | 65.0% | 2.84 | .005 | [0.063, 0.337] |
| المجموعة الضابطة | 100 | 45 | 45.0% |
9. الأخطاء الشائعة واستكشاف المشكلات البرمجية في SAS
9.1 الأخطاء في بنية الأكواد البرمجية لعبارة TABLES
يتعرض العديد من ممارسي التحليل في SAS لأخطاء برمجية خفية في بناء عبارة TABLES، قد لا توقف تنفيذ البرنامج لكنها تُفضي إلى تشويه المخرجات وتوجيه التفسير في الاتجاه المعاكس. من أبرز هذه الأخطاء “انعكاس ترتيب المتغيرات”؛ فصياغة TABLES Response * Group بدلاً من Group * Response تقلب هيكل المصفوفة، مما يجعل المقارنة تجري بين الفئات التصنيفية للاستجابة عبر المجموعات، بدلاً من مقارنة المجموعات عبر الاستجابة، وهو ما يربك حساب فرق المخاطر ويفقد الاختبار معناه السيكومتري المقصود.
الخطأ الشائع والمدمر الآخر هو “إغفال عبارة WEIGHT” عند معالجة البيانات الملخصة مسبقاً. في مثل هذه الحالة، سيتجاهل SAS متغير الأعداد (Count)، ويقوم بإجراء التحليل على أربعة سجلات فقط (تمثل سطور الأوامر)، مما ينتج تكرارات هزيلة تؤدي حتماً إلى فشل الاختبار وظهور تنبيهات كارثية بانعدام كفاية البيانات. لذا يتعين دائماً فحص إجمالي العينة المطبوع في رأس جدول PROC FREQ للتأكد من مطابقته لحجم العينة الحقيقي.
كما يقع بعض الباحثين في خطأ كتابة الخيارات الملحقة بإجراء PROC FREQ خارج موضعها المخصص؛ كأن توضع خيارات RISKDIFF بعد أمر PROC FREQ مباشرة بدلاً من وضعها بعد إشارة الخط المائل (/) التابعة لعبارة TABLES، مما يؤدي إلى ظهور رسائل خطأ في سجل SAS تفيد بعدم التعرف على المعامل وإلغاء استخراج إحصائيات الفرق.
9.2 انتهاك الافتراضات الإحصائية لحجم العينة الصغير
عندما تتعامل الدراسات مع عينات نادرة أو فئات سريرية محدودة الحجم، قد لا تستوفي البيانات شرط كفاية الخلايا المتوقعة (Expected Cell Counts ≥ 5). في هذه الظروف، يطلق نظام SAS تحذيراً صريحاً في سجل التشغيل وأسفل الجداول مفاده أن “التقريب الطبيعي قد لا يكون صالحاً نظراً لتدني التكرارات المتوقعة في بعض الخلايا” (Warning: 20% of the cells have expected counts less than 5).
إن تجاهل هذا التحذير والمضي في اعتماد إحصائية Z التقريبية يؤدي إلى نتائج مضللة وتضخيم خطأ النوع الأول؛ إذ يصبح شكل توزيع المعاينة الفعلي شديد الالتواء والتقطع، مما يجعل التوزيع الطبيعي المعياري مرجعاً غير دقيق. ولمعالجة هذه الإشكالية داخل الحدود التقريبية، يمكن تطبيق ما يُعرف بـ “تصحيح الاستمرارية” (Yates’ Continuity Correction)، والذي يعوض عن تقريب المتغير الفئوي المتقطع بمتغير طبيعي متصل عبر طرح قيمة 0.5 من البسط العددي، وهو خيار يوفره SAS تلقائياً في بعض جداول الفروق للحد من الإفراط في رفض الفرضية الصفرية.
ومع ذلك، تقتضي الرصانة الأكاديمية عند تكرار ظهور هذه التنبيهات عدم الاكتفاء بالتصحيحات التقريبية، بل التخلي المنهجي عن اختبار Z والانتقال إلى النماذج التوزيعية الدقيقة التي لا تتطلب افتراضات حول شكل توزيع المعاينة.
9.3 الخلط بين الفئات المرجعية في حساب الفروق
تعتمد آلية العمل التلقائية في إجراء PROC FREQ على ترتيب الفئات أبجدياً أو رقمياً تصاعدياً وفقاً لقيمها النصية أو الرقمية. هذا الترتيب الافتراضي غالباً ما يولد مفارقات محيرة للباحث؛ فعلى سبيل المثال، إذا كانت المجموعات تسمى “Control” و “Treatment”، فإن SAS سيضع “Control” في الصف الأول تلقائياً بحكم تقدم حرف C أبجدياً على حرف T. وبناءً على ذلك، سيحسب البرنامج فرق المخاطر بالصيغة: (Control – Treatment)، مما يعكس إشارة الفرق المحسوب ويجعله سالباً (-0.20) بدلاً من أن يكون موجباً.
يؤدي هذا الانعكاس غير المقصود إلى تناقض ظاهري خطير بين الصياغة النظرية لفرضية البحث (التي تتوقع أثراً موجباً للعلاج) والمخرجات الرقمية للبرنامج، وقد يدفع الباحث غير المتمرس إلى قراءة القيمة الاحتمالية لأحادية الطرف من الذيل الخاطئ، مما يبطل صحة قراره الإحصائي.
لتفادي هذا الخلط، يوفر SAS خيارين منهجيين صارمين للتحكم في الفئة المرجعية:
- استخدام خيار ORDER=DATA في رأس استدعاء PROC FREQ، مما يجبر النظام على ترتيب الفئات وفقاً لأسبقية ظهورها في خطوة إدخال البيانات، وبذلك نضمن وضع المجموعة التجريبية أولاً إذا كُتبت في السطر الأول.
- استخدام المعاملات الفرعية المتقدمة لخيار RISKDIFF(COLUMN=1) أو صياغة المتغيرات كمتغيرات رقمية مسبوقة بتنسيقات معيارية تضمن ترتيباً مرجعياً محكماً ومستقراً لا يخضع للمصادفات الأبجدية.
10. البدائل المنهجية المتقدمة لاختبار Z للنسبتين
10.1 اختبار فيشر الدقيق للعينات الصغيرة
عندما تُظهر مصفوفة البيانات انتهاكاً جسيماً لشروط الحجم الطبيعي وتكرارات الخلايا المتوقعة، يبرز “اختبار فيشر الدقيق” (Fisher’s Exact Test) كأفضل بديل منهجي وبارامتري لاختبار Z للنسبتين. لا يعتمد اختبار فيشر على تقريبات نظرية الغاية المركزية أو التوزيع الطبيعي، بل يحسب الاحتمال الدقيق لظهور التكرارات الملاحظة في جدول التوافق مباشرة استناداً إلى التوزيع فوق الهندسي (Hypergeometric Distribution)، بافتراض ثبات مجاميع الصفوف والأعمدة (Marginal Totals).
يتم تفعيل هذا الاختبار في SAS بمنتهى السهولة عبر إضافة عبارة EXACT المخصصة داخل إجراء PROC FREQ:
PROC FREQ DATA=SmallSample_Data;
WEIGHT Count;
TABLES Group * Response;
EXACT FISHER;
RUN;
يقدم اختبار فيشر قيم احتمالية دقيقة تماماً لكلا الطرفين (Two-sided) وللطرف الموجه (One-sided)، مما يمنح الباحث حماية تامة ضد أخطاء المعاينة والتضخيم الوهمي للدلالة الإحصائية في الدراسات الإكلينيكية النادرة والحالات السريرية المعقدة.
10.2 العلاقة مع اختبار كاي تربيع لاستقلالية المتغيرات الثنائية
تتجلى الوحدة البنائية للإحصاء الاستدلالي في العلاقة الرياضية المتطابقة بين اختبار Z لنسبتين واختبار كاي تربيع لبيرسون (Pearson Chi-Square Test) في جداول التوافق من رتبة (2×2). فإذا ما قمنا بتربيع قيمة إحصائية Z المجمعة المستخرجة من دراسة الحالة السابقة (Z = 2.8442)، فإننا نحصل على: (2.8442)² = 8.089. وهي ذاتها تماماً قيمة إحصائية كاي تربيع التي يستخرجها خيار CHISQ لنفس الجدول بدرجة حرية واحدة (df = 1).
ينعكس هذا التطابق الرياضي الكامل في تطابق القيم الاحتمالية ثنائية الطرف بين الاختبارين (p = 0.0045). ومع ذلك، تتفوق مخرجات اختبار Z المستخرجة عبر RISKDIFF في توفير مقياس صريح لاتجاه الفرق وإمكانية اختبار الفرضيات الموجهة أحادية الطرف وفترات الثقة لمقدار الفرق المباشر بين النسب، وهو ما يعجز اختبار كاي تربيع التقليدي عن تقديمه لكونه اختباراً معنياً بالمربعات والتشتت الكلي في اتجاهات غير خطية.
10.3 الانتقال إلى نماذج الانحدار اللوجستي عند تعدد المتغيرات
على الرغم من الكفاءة التحليلية العالية لاختبار Z لنسبتين، إلا أن حدوده المنهجية تقف عند المقارنات الثنائية البسيطة المعزولة عن سياق المتغيرات الأخرى (Bivariate Analysis). ففي الواقع التطبيقي للعلوم السلوكية والطبية، نادراً ما تتأثر النتيجة السريرية بنوع التدخل وحده؛ إذ غالباً ما تتدخل متغيرات وسيطة أو مفسرة مرافقة (Confounders/Covariates) كالعمر، والجنس، وشدة الأعراض في القياس القبلي، والتي قد تشوش على الفرق الملاحظ بين النسبتين (Vilagut et al., 2016; Blatt & Zuroff, 1992).
في هذه السيناريوهات المتقدمة، يصبح من الضروري منهجياً الانتقال من إجراء PROC FREQ إلى إجراء الانحدار اللوجستي (PROC LOGISTIC) في SAS. يتيح نموذج الانحدار اللوجستي الثنائي نمذجة لوغاريتم أرجحية حدوث الاستجابة كنتيجة خطية لمجموعة من المتغيرات التفسيرية في آن واحد:
PROC LOGISTIC DATA=DetailedClinicalTrial DESCENDING;
CLASS Group(REF=”Control”) Gender / PARAM=REF;
MODEL Response = Group Age BaselineSeverity;
RUN;
يمكّن هذا الانتقال الباحث من عزل وتثبيت أثر المتغيرات الدخيلة، وتحديد ما إذا كان الفرق بين نسبتي التحسن في المجموعتين يظل ثابتاً ودالاً إحصائياً بعد ضبط الفروق العمرية وشدة المرض القبلية، مع تقديم نسب الأرجحية المعدلة (Adjusted Odds Ratios) التي تمنح استنتاجات البحث موثوقية تفسيرية وتعميمية لا تضاهى في البيئات التطبيقية المعقدة (Muller et al., 2020; Van den Broeck et al., 2016; Aknin et al., 2010).
خلاصة منهجية
يقدم اختبار Z لنسبتين أداة استدلالية متينة لتقييم الفروق في المتغيرات الفئوية الثنائية بين المجتمعات المستقلة. ومن خلال البيئة التحليلية الصارمة لنظام SAS وعبر إجراء PROC FREQ وخيار RISKDIFF، يستطيع الباحثون استخراج المؤشرات الإحصائية بدقة، والتحكم في افتراضات التباين المجمع، وتفسير فترات الثقة والقيم الاحتمالية الموجهة بدقة بالغة. إن الفهم المنهجي العميق للأسس الرياضية للاختبار والافتراضات المصاحبة له يضمن للباحث اتخاذ قرارات علمية رصينة، وتجنب مشكلات التقدير الخاطئ، وتوثيق النتائج وفق التقاليد الأكاديمية العالمية، مما يثري الأبحاث الميدانية والإكلينيكية بشواهد موثوقة تسهم في تطوير المعرفة التطبيقية واتخاذ قرارات التدخل السليمة.
المراجع
Aknin, L. B., Barrington-Leigh, C. P., Dunn, E. W., Helliwell, J. F., Burns, J., Biswas‐Diener, R., et al. (2010). Prosocial Spending and Well-Being: Cross-Cultural Evidence for a Psychological Universal. Journal of Personality and Social Psychology. https://doi.org/10.1037/a0031578
Bisson, J. I., Roberts, N. P., Andrew, M., Cooper, R., & Lewis, C. (2013). Psychological therapies for chronic post-traumatic stress disorder (PTSD) in adults. Cochrane Database of Systematic Reviews. https://doi.org/10.1002/14651858.cd003388.pub4
Blatt, S. J., & Zuroff, D. C. (1992). Interpersonal relatedness and self-definition: Two prototypes for depression. Clinical Psychology Review. https://doi.org/10.1016/0272-7358(92)90070-o
Hossain, M. M., Tasnim, S., Sultana, A., Faizah, F., Mazumder, H., Zou, L., et al. (2020). Epidemiology of mental health problems in COVID-19: a review. F1000Research. https://doi.org/10.12688/f1000research.24457.1
James, A. C., James, G., Cowdrey, F. A., Soler, A., & Choke, A. (2015). Cognitive behavioural therapy for anxiety disorders in children and adolescents. Cochrane Database of Systematic Reviews. https://doi.org/10.1002/14651858.cd004690.pub4
Kessler, R. C., Green, J. G., Gruber, M. J., Sampson, N. A., Bromet, E. J., Cuitan, M., et al. (2010). Screening for serious mental illness in the general population with the K6 screening scale: results from the WHO World Mental Health (WMH) survey initiative. International Journal of Methods in Psychiatric Research. https://doi.org/10.1002/mpr.310
Muller, A. E., Hafstad, E., Himmels, J. P. W., Smedslund, G., Flottorp, S. A., Stensland, S. Ø., et al. (2020). The mental health impact of the covid-19 pandemic on healthcare workers, and interventions to help them: A rapid systematic review. Psychiatry Research. https://doi.org/10.1016/j.psychres.2020.113441
Van den Broeck, A., Ferris, D. L., Chang, C.-H. D., & Rosen, C. C. (2016). A Review of Self-Determination Theory’s Basic Psychological Needs at Work. Journal of Management. https://doi.org/10.1177/0149206316632058
Vilagut, G., Forero, C. G., Barbaglia, G., & Alonso, J. (2016). Screening for Depression in the General Population with the Center for Epidemiologic Studies Depression (CES-D): A Systematic Review with Meta-Analysis. PLoS ONE. https://doi.org/10.1371/journal.pone.0155431