
تُعد معالجة البيانات وإدارتها داخل بيئات الجداول الحسابية، وفي مقدمتها برنامج مايكروسوفت إكسل (Microsoft Excel)، ركيزة محورية في الدراسات الأكاديمية والتحليلات الإحصائية وتطبيقات ذكاء الأعمال. وتبرز في كثير من السيناريوهات العملية الحاجة الملحة إلى كسر الترتيب النمطي للبيانات وإعادة هيكلة مصفوفات السجلات وفق قواعد عشوائية غير متحيزة؛ إذ إن وجود البيانات في نسق ترتيبي محدد مسبقاً—سواء كان مبنياً على الترتيب الزمني لجمع الملاحظات، أو الترتيب الأبجدي للأسماء، أو التدرج الرقمي للمتغيرات المستقلة—قد يُلقي بظلال من التحيز المنهجي غير المرغوب فيه على مسار التحليل، مما يهدد سلامة الاستنتاجات العلمية وموثوقيتها.
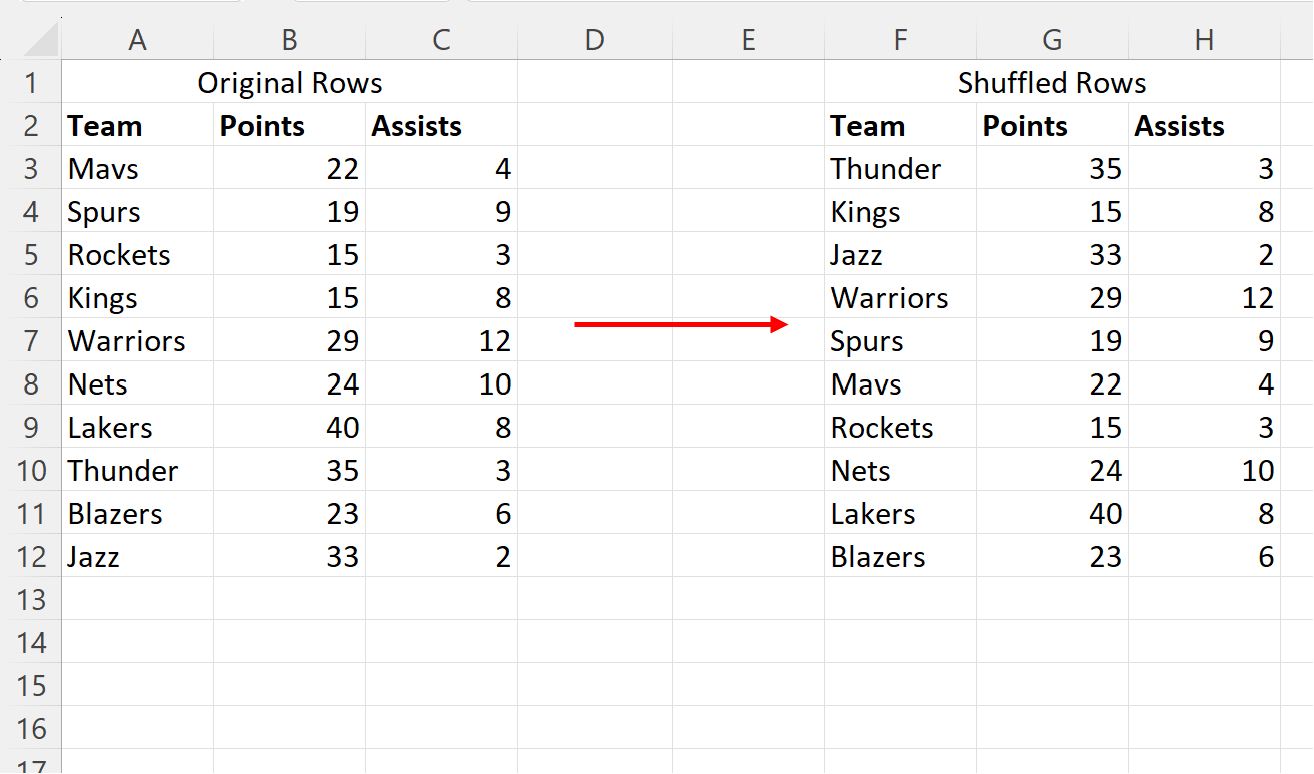
إن عملية “خلط الصفوف” (Row Shuffling) أو إعادة التوزيع العشوائي للمشاهدات، ليست مجرد إجراء شكلي أو خطوة تنسيقية عابرة، بل هي تدبير منهجي بالغ الحساسية يستند إلى نظريات الاحتمالات والتصميم التجريبي. يتطلب تنفيذ هذا الإجراء في برنامج إكسل فهماً دقيقاً للآليات الخوارزمية التي تحكم توليد الأرقام شبه العشوائية (Pseudo-Random Numbers)، وإدراكاً لطبيعة الدوال الحسابية المتقلبة، فضلاً عن الإلمام التام بالفوارق التقنية بين الطرق التقليدية المتوافقة مع كافة الإصدارات التاريخية للبرنامج، والحلول المصفوفية الديناميكية المتقدمة المتاحة في الإصدارات الحديثة مثل Microsoft 365 وExcel 2021 وما بعدها.
يهدف هذا المقال الأكاديمي الموسع إلى تفكيك كافة الأبعاد النظرية والتطبيقية المرتبطة بخلط الصفوف في برنامج إكسل. سنبدأ باستعراض الأسس الإحصائية للعشوائية ودواعي استخدامها في الأبحاث والمسوح الميدانية والنمذجة الرياضية، مروراً بالشرح الدقيق لآلية عمل دالة RAND ودوال المصفوفات الحديثة مثل SORTBY وRANDARRAY، وصولاً إلى تقديم دليل إجرائي خطوة بخطوة مصحوباً بمثال تطبيقي متكامل، مع تسليط الضوء على المخاطر الشائعة للفرز الخاطئ وكيفية توظيف تقنيات الخلط المتقدمة كالعشوائية الطبقية والأتمتة البرمجية عبر Visual Basic for Applications (VBA).
1. المفاهيم النظرية لخلط البيانات والصفوف في برنامج إكسل
1.1 مفهوم العشوائية وإعادة ترتيب المصفوفات
تُعرّف العشوائية الإحصائية (Statistical Randomness) في سياق معالجة البيانات بأنها غياب أي نمط أو تسلسل يمكن التنبؤ به في توزيع العناصر أو المشاهدات المستقلة. ومن الناحية البرمجية، لا تستطيع بيئات المعالجة الرقمية العامة توليد عشوائية مطلقة، بل تعتمد على خوارزميات توليد الأرقام شبه العشوائية (Pseudo-Random Number Generators – PRNG) التي تستند إلى معادلات رياضية حتمية تنتج سلاسل من الأرقام تتسم بخصائص إحصائية تجعلها تبدو كأنها عشوائية تماماً ومستقلة إحصائياً، شريطة توافر شروط التوزيع المنتظم وغياب الارتباط الذاتي بين القيم المتتالية.
إن إعادة ترتيب صفوف جدول البيانات بطريقة عشوائية تعني رياضياً ضرب مصفوفة البيانات بمصفوفة تبديل عشوائية (Random Permutation Matrix). هذه العملية تقضي على أي ارتباط زائف قد ينشأ بين موقع الصف الأصلي والمتغيرات المقاسة داخله. فعندما تُجمع البيانات في سياقات ميدانية أو تجريبية، غالباً ما تخضع لتأثيرات خفية ترتبط بزمن الإدخال، أو الإرهاق الذي قد يصيب جامع البيانات، أو التغيرات البيئية المحيطة؛ مما يجعل الترتيب الأصلي حاملاً لمعلومات ضمنية تؤدي إلى تحيزات خفية إذا ما تُركت دون معالجة.
ويكمن الفارق الجوهري بين الترتيب القائم على سمات البيانات والترتيب العشوائي البحت في الغاية المنهجية لكل منهما. فالفرز المعتمد على السمات (Attribute-Based Sorting)—كالترتيب التصاعدي للمداخيل أو الترتيب الهجائي لأسماء المشاركين—يهدف إلى تنظيم البيانات لتسهيل قراءتها واستكشاف أنماطها الخطية، ولكنه يعزز الاعتمادية الترتيبية بين السجلات المتجاورة. في المقابل، يهدف الترتيب العشوائي (Stochastic Permutation) إلى تفكيك كافة هذه الاعتماديات عمداً، لضمان أن كل صف في المصفوفة يمتلك احتمالية متساوية تماماً لشغل أي موقع ترتيبي جديد داخل الجدول، وهو شرط مسبق لتطبيق العديد من النماذج الإحصائية الخالية من الانحياز.
1.2 دواعي خلط الصفوف في التطبيقات البحثية والأكاديمية
تتعدد التطبيقات البحثية التي تجعل من خلط الصفوف ضرورة منهجية صارمة لا غنى عنها. ولعل أبرز هذه التطبيقات يتمثل في إجراءات “التوزيع العشوائي” (Random Assignment) للمشاركين على المجموعات التجريبية والضابطة في التجارب المعملية والميدانية. وقد أوضح كامبل وستانلي (Campbell & Stanley, 1963) في كتابهما التأسيسي حول التصاميم التجريبية وشبه التجريبية أن التوزيع العشوائي يمثل الحصن المنهجي الأقوى لتعزيز الصدق الداخلي (Internal Validity)، حيث يضمن تكافؤ المجموعات وتوزيع المتغيرات المربكة (Confounding Variables)—المعلومة منها وغير المعلومة—بالتساوي، مما يتيح للباحث عزل الأثر الحقيقي للمتغير المستقل.
ويختلف التوزيع العشوائي اختلافاً جوهرياً عن “المعاينة العشوائية” (Random Sampling)؛ إذ تهتم الأخيرة بسحب عينة ممثلة من مجتمع إحصائي أوسع بهدف تعظيم الصدق الخارجي وقابلية التعميم، بينما يهتم التوزيع العشوائي بإعادة توزيع عينة موجودة بالفعل بين مجموعات المعالجة المختلفة. وتاريخياً، تعود جذور هذا النهج إلى الأبحاث المبكرة التي قادها تشارلز ساندرز بيرس وجوزيف جاسترو (Peirce & Jastrow, 1885) في دراسات الإدراك الحسي، وتكرست منهجياً على يد السير رونالد فيشر (Fisher, 1925, 1935) الذي أسس عليها نظرية الاستدلال الإحصائي واختبارات الفرضيات القائمة على التباديل (Permutation Tests).
كما يبرز خلط الصفوف في دراسات القياس النفسي والسلوكي عند الرغبة في كسر نمطية استجابات الاستبيانات أو تدوير بنود الاختبارات لمنع أثر الترتيب أو انتقال أثر التعلم بين الفقرات. وعلاوة على ذلك، يُعد خلط السجلات خطوة أساسية في علوم البيانات والتعلم الآلي (Machine Learning) عند تقسيم مجموعات البيانات الضخمة إلى بيانات تدريب (Training Set) وبيانات اختبار وتحقق (Testing/Validation Sets)؛ حيث يؤدي تقسيم البيانات دون خلطها عشوائياً إلى تدريب الخوارزميات على عينات متحيزة زمنياً أو فئوياً، مما يسبب ظاهرة فرط التخصيص (Overfitting) وتدهور كفاءة النموذج عند تعريضه لبيانات جديدة مستخلصة من الواقع التطبيقي.
2. الآلية الرياضية لتوليد الأرقام العشوائية عبر دالة RAND
2.1 البنية البرمجية وطريقة عمل دالة RAND
تُعد دالة RAND الأداة الكلاسيكية الأكثر استخداماً داخل برنامج إكسل لتوليد الأرقام العشوائية. تنتمي هذه الدالة إلى فئة الدوال الرياضية والمثلثية، ولا تتطلب أي وسائط مدخلة داخل أقواسها؛ إذ تُكتب دائماً بالصيغة القياسية =RAND(). عند إدخال هذه الصيغة في خلية معينة، تُرجع الخوارزمية الداخلية للبرنامج عدداً حقيقياً (Real Number) يتبع التوزيع المنتظم المستمر (Continuous Uniform Distribution) المحدد بالفترة المغلقة-المفتوحة رياضياً: $U[0, 1)$.
هذا يعني من الناحية الحسابية أن الدالة قادرة على توليد أي رقم كسري يقع بين الصفر والواحد، بما في ذلك الصفر بدقة، ولكنه يقل بصورة مطلقة عن الواحد الصحيح. ويتميز التوزيع المنتظم المستمر بأن دالة كثافة الاحتمال (Probability Density Function) الخاصة به تكون ثابتة على طول المدى، مما يضمن أن أي فترة جزئية داخل المجال تمتلك نفس احتمالية احتواء الرقم المولد شريطة تساوي أطوال الفترات. وتعتمد خوارزمية الدالة على حسابات الفاصلة العائمة المزدوجة الدقة وفق معيار IEEE 754، مما يمنح الرقم المولد دقة تصل إلى نحو 15 رقماً عشرياً.
ونظراً لاتساع الفضاء الاحتمالي الناجم عن توليد أرقام بـ 15 منزلة عشرية، فإن احتمالية حدوث تطابق أو تكرار متماثل بين رقمين عشوائيين في مجموعات البيانات الاعتيادية (التي تتراوح بين عشرات ومئات الآلاف من الصفوف) تقترب من الصفر رياضياً. وتجعل هذه الخاصية دالة RAND أداة فريدة ومثالية لتوليد مفاتيح فرز فريدة (Unique Sorting Keys) يمكن الاعتماد عليها كلياً في إعادة ترتيب صفوف البيانات دون خشية حدوث نزاعات تراتبية ناتجة عن تعادل القيم المولدة.
2.2 طبيعة التحديث التلقائي والدوال المتقلبة (Volatile Functions)
تُصنف دالة RAND برمجياً ضمن فئة “الدوال المتقلبة” (Volatile Functions) في بيئة حسابات إكسل. وتختلف هذه الدوال اختلافاً جذرياً عن الدوال القياسية غير المتقلبة (مثل SUM أو AVERAGE)؛ فالأخيرة لا يُعاد احتسابها إلا إذا طرأ تغيير على إحدى الخلايا التي تشير إليها معادلاتها في شجرة الاعتمادية (Dependency Tree). أما الدوال المتقلبة، فيُطلق إكسل عملية إعادة احتسابها بالكامل مع كل حدث تعديلي يقع داخل أي جزء من مصنف العمل، حتى لو كان التعديل في ورقة عمل أخرى أو في خلية غير مرتبطة بها تماماً.
ويحدث هذا التحديث التلقائي المستمر عند فتح الملف، أو تغيير محتوى أي خلية، أو إدراج أو حذف صفوف أو أعمدة، أو عند الضغط اليدوي على المفتاح F9 المخصص لإعادة الحساب الشامل. ويتسبب هذا السلوك في تقلب مستمر للأرقام الناتجة؛ فإذا اعتمد الباحث على دالة RAND لإعادة فرز الصفوف دون اتخاذ تدابير لتثبيتها، فإن كل فرز جديد أو تعديل لاحق سيؤدي إلى توليد مصفوفة أرقام جديدة، وبالتالي سيتغير الترتيب العام للصفوف بصورة مستمرة، مما يحرم مجموعة البيانات من الاستقرار التشغيلي اللازم للتحليل.
ولتجاوز هذا التحدي الحسابي وضمان استقرار النتائج، توجد استراتيجية منهجية بالغة الأهمية تتمثل في تحييد هذا التقلب عبر تحويل الصيغ إلى قيم رقمية ثابتة (Static Values). يتم ذلك من خلال عزل القيمة الناتجة عن شجرة الحسابات التلقائية قبل الشروع في إجراء عمليات الترتيب أو الفرز النهائي، وهو ما سنستعرضه بالتفصيل العملي في المراحل اللاحقة، مما يتيح الحفاظ على العشوائية الناتجة مع حمايتها من التبدل العرضي أو غير المقصود أثناء تداول المصنف بين الباحثين والمحللين.
3. المرحلة الأولى: إعداد وهيكلة مجموعة البيانات التجريبية
3.1 تصميم جدول البيانات المعياري
تبدأ المعالجة المنهجية الناجحة لأي مجموعة بيانات في إكسل بتأسيس جدول بيانات معياري يخضع لشروط الهيكلة الصارمة التي تضمن عدم تشتت الحقول أثناء عمليات الفرز. يجب أن تُنظم البيانات على هيئة مصفوفة مستطيلة متصلة، حيث يمثل كل صف سجلاً مستقلاً يحمل وحدة ملاحظة واحدة (مثل بيانات طالب، مريض، عميل، أو عنصر تجريبي)، بينما يمثل كل عمود متغيراً محدداً من متغيرات الدراسة ذات الصلة بالتحليل.
ومن الأخطاء الجسيمة التي يجب تفاديها في هذه المرحلة وجود خلايا مدمجة (Merged Cells) أفقياً أو رأسياً داخل نطاق البيانات أو ضمن شريط العناوين؛ إذ تؤدي الخلايا المدمجة إلى إرباك محرك الفرز الداخلي في إكسل وإطلاق رسائل خطأ تشير إلى عدم تطابق أحجام الخلايا، أو الأسوأ من ذلك: حدوث إزاحة غير متوازنة للصفوف تؤدي إلى خلط حقول السجلات ببعضها وتدمير اتساق البيانات. كما يجب التأكد من عدم وجود صفوف فارغة تماماً أو فواصل بصرية داخل الجدول؛ لأن محرك البرنامج يعتبر الصفوف الفارغة فواصل لنطاقات مستقلة، مما يعيق التحديد التلقائي لكامل المصفوفة.
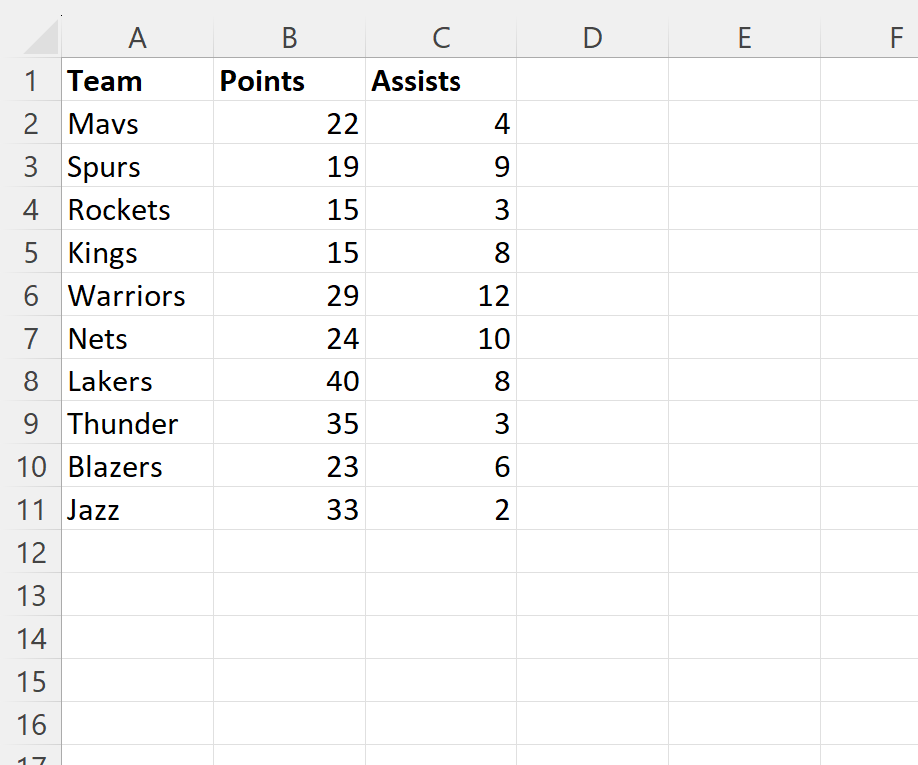
ولأغراض التوضيح العملي، سنفترض في هذا المقال وجود مجموعة بيانات تجريبية مكونة من 10 صفوف من المشاركين في تجربة بحثية لقياس الأداء. يحتوي هذا الجدول على أربعة أعمدة رئيسية هي: “المعرف الرقمي” (Participant_ID)، و”اسم المشارك” (Full_Name)، و”المجموعة الأصلية” (Original_Group)، و”درجة الاختبار القبلي” (Pretest_Score). ويجب أن تُحدد رؤوس هذه الأعمدة بدقة في الصف الأول، مع إعطائها تسميات وصفية قطعية تسهل التحكم بها في معالجات الفرز والدمج الإحصائي.
3.2 فحص سلامة البيانات قبل المعالجة
قبل إجراء أي تعديل عشوائي على موضع الصفوف، يتعين على الباحث التحقق من اكتمال المصفوفة وخلوها من القيم المفقودة غير المبررة أو التناقضات الإدخالية. فالصفوف التي تحتوي على حقول فارغة أو قيم غير متسقة من حيث النوع البياني (كنصوص مدخلة في حقول رقمية) قد تتصرف بصورة غير متوقعة عند الفرز؛ حيث يضع إكسل الخلايا الفارغة دائماً في نهاية النطاق المفرز سواء كان اتجاه الفرز تصاعدياً أو تنازلياً، مما يخل بالتوزيع العشوائي التام لجميع عناصر العينة.
علاوة على ذلك، ينبغي فحص ما إذا كانت الصفوف تحتوي على معادلات رياضية تعتمد على مراجع نسبية تشير إلى صفوف سابقة أو لاحقة داخل نفس الجدول. فإذا كان هناك عمود يُحسب بناءً على قيمة الخلية السابقة مباشرة (مثل: =A2-A1)، فإن خلط الصفوف سينتج عنه تبدل المراجع النسبية وظهور أخطاء مراجع دائرية أو تشوهات حسابية في المخرجات. لذلك، يجب التأكد من استقلال كل صف حسابياً عن الصفوف المجاورة له قبل تحريكه من موقعه الأصلي.
وتقتضي المسؤولية المنهجية وحوكمة البيانات إنشاء نسخة احتياطية كاملة ومستقلة من ورقة العمل الأصلية قبل تطبيق أي خوارزمية فرز. كما يُنصح بشدة بإضافة عمود دائم يحمل الترتيب المتسلسل الأصلي للبيانات (Index Column) وترقيمه تسلسلياً من 1 إلى $N$. تمنح هذه الخطوة الباحث قدرة مطلقة على التراجع عن الفرز واسترجاع الترتيب المرجعي الدقيق لمجموعة البيانات في أي وقت لاحق، وهو متطلب حاسم لضمان الشفافية وقابلية التدقيق العلمي.
4. المرحلة الثانية: بناء العمود المساعد وتوليد القيم العشوائية
4.1 إنشاء وتسمية العمود المساعد (Helper Column)
تعتمد الطريقة الكلاسيكية لخلط الصفوف في جميع إصدارات إكسل على مفهوم “العمود المساعد” (Helper Column). وهو عمود إضافي يتم إدراجه مؤقتاً في ورقة العمل ليعمل كحامل رياضي لمفاتيح الفرز العشوائية التي ستقود عملية إعادة التموضع لجميع الحقول المقابلة. ويضمن هذا الأسلوب الحفاظ على الترابط الأفقي الصارم بين المتغيرات التابعة والمستقلة لكل مشارك أثناء تحرك الصف داخل المصفوفة.
لإنشاء هذا العمود، يُفضل إدراجه إما مباشرة على يسار الجدول أو ملاصقاً لآخر عمود في الجهة اليمنى، دون ترك أي عمود فارغ يفصله عن البيانات الأصلية؛ لضمان اعتباره جزءاً لا يتجزأ من النطاق المترابط في نظر محرك الجداول. ويجب تعيين رأس واضح ومعبر لهذا العمود، مثل “الرقم العشوائي” أو “مفتاح الخلط” (Random_Key). يساعد هذا الوصف الدقيق في تمييز العمود المساعد بصرياً وإجرائياً، مما يمنع الباحث من الخطأ أثناء استدعاء معايير الفرز لاحقاً.
من الناحية التنظيمية، يُنصح بتطبيق تمييز لوني طفيف على رأس العمود المساعد (كإعطائه لون تعبئة رمادياً خفيفاً)؛ لتأكيد طبيعته المؤقتة ولتنبيه أي مستخدم أو باحث شريك إلى أن هذا الحقل هو متغير إجرائي تم إنشاؤه لغرض معالجة الترتيب فحسب، وأنه لا ينتمي إلى المتغيرات الأساسية المقاسة في الدراسة الميدانية أو التجربة المختبرية.
4.2 كتابة وتطبيق صيغة RAND على كافة الصفوف
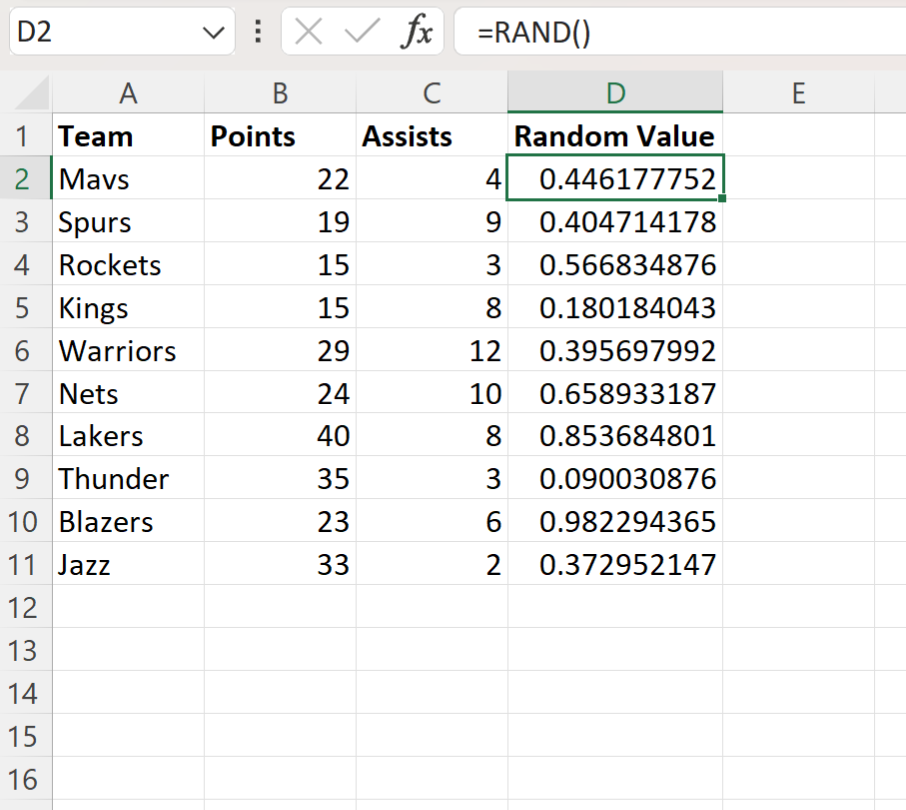
بعد إعداد العمود المساعد وتسميته، تبدأ مرحلة توليد الأرقام العشوائية المستقلة. يتم ذلك بالنقر على الخلية الأولى المخصصة للبيانات أسفل رأس العمود المساعد مباشرة (ولتكن الخلية E2 إذا كانت البيانات تشغل الأعمدة من A إلى D)، ثم كتابة الصيغة التالية تماماً:
=RAND()
بمجرد الضغط على زر الإدخال (Enter)، سيولد البرنامج رقماً كسرياً عشوائياً محصوراً بين الصفر والواحد الصحيح بدقة تصل إلى 15 رقماً عشرياً. ولتعميم هذه الصيغة على جميع الصفوف المتبقية في الجدول، لا نحتاج إلى كتابتها يدوياً في كل خلية؛ بل يُستخدم مقبض التعبئة التلقائية (Fill Handle)—وهو المربع الصغير الظاهر في الزاوية اليسرى السفلى من إطار الخلية النشطة—عبر النقر المزدوج السريع عليه، أو سحبه يدوياً إلى غاية آخر صف يحتوي على بيانات في الجدول.
إذا كانت مجموعة البيانات منسقة مسبقاً كـ “جدول إكسل رسمي” (Excel Table) عبر الأمر (Ctrl + T)، فسيقوم البرنامج بنشر الصيغة تلقائياً في كامل العمود المساعد بمجرد إدخالها في الخلية الأولى تحت اسم العمود المنسق [@Random_Key]. بعد اكتمال هذه الخطوة، يمتلك كل صف من صفوف البيانات رقماً عشوائياً فريداً ملازماً له، يعمل كمعرف احتمالي لحظي يحدد ثقل موقعه النسبي في عملية الفرز التالية.
5. المرحلة الثالثة: تنفيذ فرز الصفوف لإتمام عملية الخلط العشوائي
5.1 تحديد نطاق البيانات وفتح أدوات الفرز المتقدمة
يُمثل تحديد النطاق الخطوة الأكثر دقة وحساسية في هذه المرحلة؛ إذ إن أي خطأ في تحديد حدود الجدول سيقود حتماً إلى كارثة انفصال البيانات واختلاطها. يجب تحديد كامل مصفوفة البيانات، بما في ذلك جميع الأعمدة الأصلية إضافة إلى العمود المساعد الذي يحتوي على صيغ دالة RAND، مع شمول صف الرؤوس التوضيحية داخل التحديد. يمكن تنفيذ ذلك يدوياً عبر السحب والإفلات، أو بتحديد خلية واحدة داخل الجدول والضغط على الاختصار Ctrl + A (أو Ctrl + Shift + 8) للتأكد من شمول كامل النطاق المترابط.
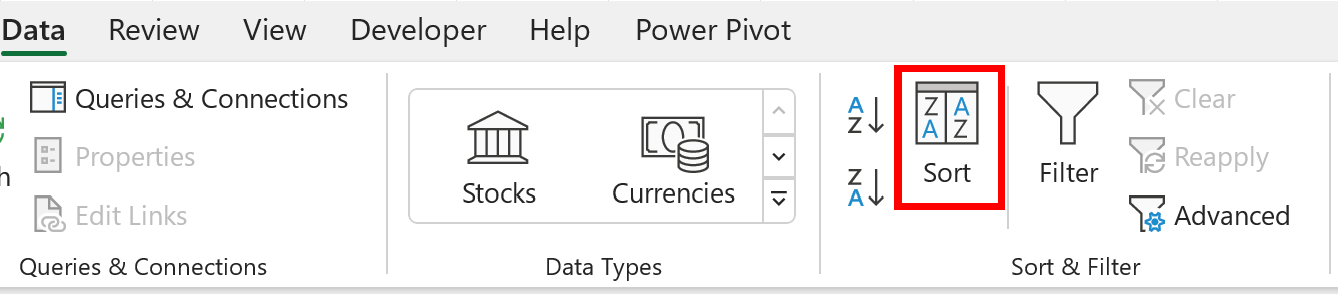
بعد إتمام التحديد بدقة، يتم الانتقال إلى شريط الأدوات العلوي، والضغط على تبويب بيانات (Data)، ومن ثم اختيار أمر فرز (Sort) الموجود ضمن مجموعة “فرز وتصفية” (Sort & Filter). يُفضل دائماً استخدام نافذة الفرز المتقدمة بدلاً من النقر المباشر على أزرار الفرز السريع (A-Z أو Z-A)؛ لضمان التحكم الكامل في اتجاه الفرز وتأكيد تضمين الرؤوس.
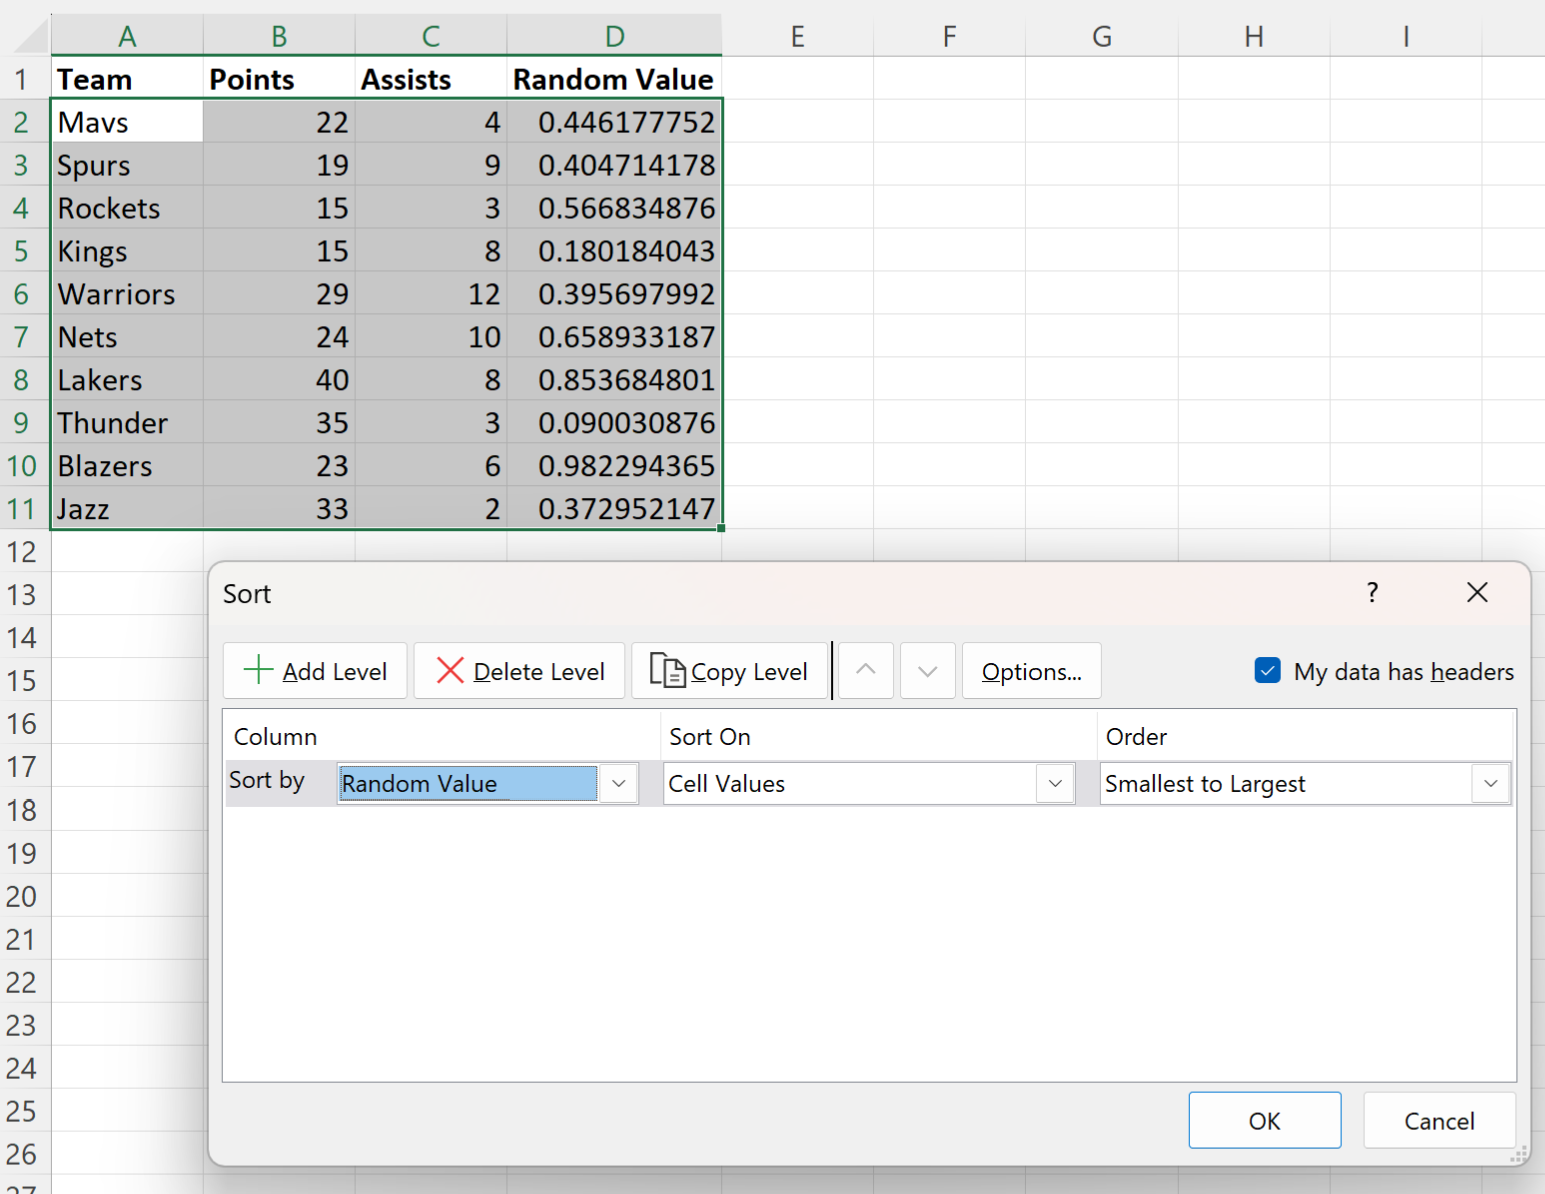
عند فتح نافذة “فرز”، يجب التحقق بصورة قاطعة من تفعيل الخيار المسمى تحتوي البيانات على رؤوس (My data has headers) الموجود في الزاوية العلوية اليمنى من مربع الحوار. يؤدي تفعيل هذا الخيار إلى استبعاد الصف الأول من عملية الخلط ليبقى ثابتاً في موقعه كعناوين معيارية، كما يُمكّن إكسل من قراءة أسماء الأعمدة الفعلية وعرضها في القوائم المنسدلة بدلاً من عرض تسميات الأعمدة الأبجدية المجردة (مثل العمود A، العمود B).
5.2 تطبيق معايير الفرز وتغيير تموضع الصفوف
داخل نافذة الفرز المنبثقة، يتم ضبط المعايير الرياضية والتطبيقية لإجراء عملية الخلط عبر الخطوات التالية المتتابعة:
- الفرز حسب (Sort by): نفتح القائمة المنسدلة ونختار اسم العمود المساعد الذي تم إنشاؤه (مثلاً: “الرقم العشوائي” أو “Random_Key”).
- الفرز وفقاً لـ (Sort On): نترك الخيار الافتراضي مضبوطاً على قيم الخلايا (Cell Values).
- الترتيب (Order): نحدد الاتجاه المطلوب، سواء كان من الأصغر إلى الأكبر (Smallest to Largest) أو من الأكبر إلى الأصغر (Largest to Smallest).
من الناحية الرياضية، لا يؤثر اختيار الترتيب التصاعدي أو التنازلي على جودة أو نزاهة العشوائية إطلاقاً؛ لأن الأرقام المولدة بدالة RAND موزعة بانتظام مستمر $U[0, 1)$ وتتسم بالتماثل الاحتمالي حول المتوسط الحسابي ($\mu = 0.5$). وبالتالي، فإن احتمالية ظهور أي سجل في الصف الأول متساوية تماماً بغض النظر عن اتجاه الفرز المختار.
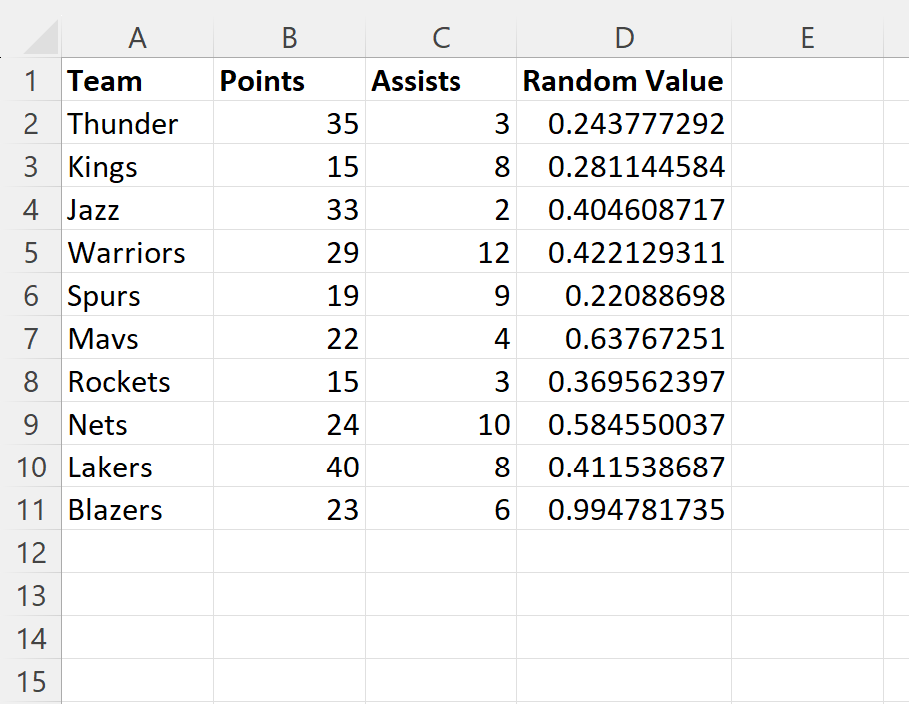
بمجرد الضغط على زر موافق (OK)، يقوم محرك إكسل بقراءة قيم العمود المساعد وإعادة ترتيب كافة الصفوف الأفقية كاملة بناءً على التدرج الرقمي لتلك القيم العشوائية. وستلاحظ على الفور أن السجلات قد تم خلطها بالكامل وتغيرت مواقعها الأصلية، مع احتفاظ كل مشارك أو حالة بكافة بياناتها المرتبطة بها في نفس الصف، دون أن يطرأ أي تداخل أو فقدان للاتساق البيني للمتغيرات.
6. تثبيت نتائج الخلط العشوائي وتحويل الصيغ إلى قيم ثابتة
6.1 مخاطر استمرار عمل الدوال التلقائية بعد الفرز
إن إتمام خطوة الفرز لا يعني اكتمال العملية بنجاح من منظور سلامة البيانات؛ فالخلل الأكبر الذي يقع فيه المستخدمون هو ترك صيغ =RAND() نشطة داخل العمود المساعد. وكما بيّنا سابقاً، تُعد هذه الدالة متقلبة، وبمجرد الضغط على زر الفرز، فإن عملية الفرز ذاتها—أو أي إدخال لاحق لأي رقم في المصنف—تُطلق دورة إعادة احتساب فورية للأرقام داخل العمود المساعد.
يؤدي هذا إلى مفارقة خطيرة: تصبح الأرقام الظاهرة في العمود المساعد بعد الفرز مباشرة مختلفة عن الأرقام التي استند إليها محرك إكسل أثناء تنفيذ الفرز قبل جزء من الثانية. ونتيجة لذلك، إذا نظر مدقق خارجي إلى الملف، فلن يجد العمود المساعد مرتباً تصاعدياً أو تنازلياً كما يفترض! والأسوأ من ذلك، أنه إذا حاول الباحث إعادة الفرز للتأكد من النتيجة، فستتولد مجموعة أرقام جديدة تماماً، مما ينسف الترتيب المحقق ويعيد خلط الصفوف مرة ثانية بصورة عشوائية جديدة، وهو ما يقضي على إمكانية إعادة الإنتاج والتحقق المستقل (Reproducibility) في العمل العلمي.
لهذا السبب، فإن مرحلة “التجميد” أو التثبيت الرقمي تمثل مطلباً منهجياً صارماً؛ لتحويل الحالة الاحتمالية الديناميكية إلى حالة رقمية قطعية وثابتة توثق الحالة التي استقر عليها ترتيب السجلات لحظة اتخاذ قرار الخلط.
6.2 إجراءات النسخ واللصق كقيم (Paste as Values)
لتحييد تقلب دالة RAND وتجميد ترتيب الصفوف النهائي، يجب اتباع بروتوكول النسخ واللصق كقيم باتباع الإجراءات التقنية التالية بدقة:
- أولاً: تحديد كامل نطاق الخلايا التي تحتوي على معادلات دالة RAND داخل العمود المساعد (دون الحاجة لتحديد باقي أعمدة الجدول).
- ثانياً: نسخ هذا النطاق إما بالضغط على زر الفأرة الأيمن واختيار نسخ (Copy)، أو باستخدام الاختصار المرجعي المباشر
Ctrl + C. - ثالثاً: إبقاء التحديد على نفس النطاق، ثم الضغط على زر الفأرة الأيمن، ومن قائمة خيارات اللصق المتقدمة اختيار أيقونة قيم (Values) التي تظهر برمز الأرقام “123”، أو عبر التوجه إلى شريط الأدوات الرئيسي (Home) ثم النقر على لصق (Paste) واختيار لصق خاص -> قيم (Paste Special -> Values).
بإتمام هذه الخطوة، تُستبدل الصيغة الحسابية =RAND() بالأرقام العشرية الثابتة الناتجة عنها. ويمكن التأكد من ذلك بالنظر إلى شريط الصيغة (Formula Bar)؛ حيث سيظهر الرقم العشري الثابت مجرداً من إشارة المساواة، مما يعني تحييده نهائياً عن التحديث التلقائي.
بعد تجميد القيم وثبات الترتيب، يصبح الباحث أمام خيارين إجرائيين: إما الإبقاء على هذا العمود وتسميته “معرف الخلط الثابت” كمرجع توثيقي للتدقيق الإحصائي، أو حذفه بالكامل عبر النقر بزر الفأرة الأيمن على رأس العمود واختيار حذف (Delete) إذا لم تعد هناك حاجة تنظيمية له، دون أن يتأثر الترتيب العشوائي الجديد للصفوف على الإطلاق.
7. الطرق الحديثة: استخدام الدوال المصفوفية البديلة (SORTBY و RANDARRAY)
7.1 خلط الصفوف ديناميكياً باستخدام دالة SORTBY في إكسل الحديث
مع إطلاق بيئة الدوال المصفوفية الديناميكية (Dynamic Array Formulas) في اشتراكات Microsoft 365 والإصدارات المكتبية الحديثة من إكسل، أصبحت عملية خلط الصفوف قابلة للإنجاز بصورة أكثر رقياً وأماناً، دون الحاجة إلى إنشاء أعمدة مساعدة يدوية، ودون اللجوء إلى مربعات حوار الفرز التقليدي، مع الحفاظ الكامل على سلامة الجدول الأصلي سليماً دون مساس.
تعتمد هذه الطريقة على دمج دالة SORTBY—المصممة لفرز مصفوفة بناءً على قيم مصفوفة موازية أخرى—مع دالة RANDARRAY ودالة ROWS في معادلة واحدة متكاملة وغاية في الأناقة الرياضية. وتُكتب الصيغة المعيارية على النحو التالي:
=SORTBY(DataRange, RANDARRAY(ROWS(DataRange)))
حيث تمثل DataRange نطاق البيانات المراد خلطه بالكامل (دون الرؤوس لتجنب خلط الرأس مع البيانات، مثل A2:D11). وتعمل هذه المعادلة وفق تسلسل منطقي محكم: تقوم دالة ROWS(DataRange) بحساب العدد الإجمالي للصفوف الموجودة داخل النطاق، ثم تُمرر هذه النتيجة إلى دالة RANDARRAY التي تولد مصفوفة أرقام عشوائية رأسية بنفس عدد صفوف الجدول الأصلي تماماً، لتتولى دالة SORTBY استخدام هذه الأرقام كمفتاح افتراضي لفرز الجدول واستخراجه في نطاق جديد مستقل.
تتميز هذه التقنية بمبدأ “المعالجة غير التدميرية” (Non-Destructive Processing)؛ فالجدول الأصلي يظل في ترتيبه المصدري دون أي تعديل، بينما يُسكب (Spills) الجدول الجديد المفرز عشوائياً في موضع آخر من ورقة العمل. ويقلل هذا الأسلوب احتمالية ارتكاب الأخطاء البشرية الناتجة عن إزاحة البيانات أو الفرز الجزئي، ويمنح المحلل مرونة فائقة في إجراء المقارنات الآنية.
7.2 الاستفادة من دالة RANDARRAY لتوليد مصفوفات متعددة الأبعاد
تمثل دالة RANDARRAY قفزة نوعية في هندسة الحسابات العشوائية داخل إكسل؛ إذ تتفوق بصورة واضحة على دالة RAND التقليدية في كفاءتها الحاسوبية وإمكاناتها التركيبية. وتأتي الصيغة البنائية الكاملة لدالة RANDARRAY على النحو التالي:
=RANDARRAY([rows], [columns], [min], [max], [whole_number])
تتيح هذه الدالة توليد مصفوفات متعددة الأبعاد دفعة واحدة، مع إمكانية تحديد القيمة الصغرى والقيمة الكبرى للأرقام، وتحديد ما إذا كانت الأرقام الناتجة أعداداً كسرية مستمرة أم أعداداً صحيحة (Integers). فعلى سبيل المثال، إذا أردنا توليد مصفوفة عشوائية مكونة من 10 صفوف وعمود واحد بأرقام صحيحة تتراوح بين 1 و 100، يمكن كتابة: =RANDARRAY(10, 1, 1, 100, TRUE).
أما في سياق خلط الصفوف، فإن ترك المعاملات الاختيارية بدون تحديد واستدعاء دالة الصفوف فقط: RANDARRAY(ROWS(DataRange)) يُنتج مصفوفة أحادية العمود من الأرقام الكسرية المستمرة بين 0 و1، مما يُلغي الحاجة إلى استهلاك الذاكرة عبر كتابة آلاف المعادلات الفردية في الخلايا كما هو الحال مع دالة RAND التقليدية. وتُعد هذه الخاصية بالغة الأهمية عند معالجة الجداول الكبيرة التي تحتوي على عشرات الآلاف من السجلات، حيث تقلل الجهد الحسابي الواقع على المعالج المركزي (CPU) وتُسرّع من زمن الاستجابة البرمجية.
ومع ذلك، تجدر الإشارة المنهجية إلى أن هذه الدوال المصفوفية غير مدعومة في إصدارات إكسل القديمة مثل Excel 2010 أو 2013 أو 2016؛ ولذلك يجب على الباحث مراعاة بيئة العمل المشتركة عند مشاركة المصنفات؛ لضمان التوافقية وعدم ظهور خطأ عدم التعرف على الدالة #NAME? لدى المستخدمين الذين يعتمدون على بيئات برمجية سابقة.
8. تقييم العشوائية والتحقق من النزاهة الإحصائية للترتيب الناتج
8.1 اختبارات التوزيع واستقلالية الملاحظات
لا تنتهي الممارسة البحثية الصارمة بمجرد النقر على زر الفرز وظهور صفوف مبعثرة بصرياً، بل تتطلب التحقق الإحصائي والشك المنهجي في نزاهة الترتيب الناتج. فالعشوائية الحقيقية قد تُنتج أحياناً وبمحض الصدفة تجمعات ظاهرية تبدو غير عشوائية للمراقب البشري؛ ولذلك يتعين إجراء اختبارات إحصائية ملائمة للتحقق من استقلالية الملاحظات وعدم وجود انحياز نظامي أو عطب في خوارزمية التوليد.
من أبرز الاختبارات المستخدمة في تقييم تسلسل البيانات الناتجة “اختبار التتابعات” (Runs Test for Randomness)، وهو اختبار لا معلمي (Non-parametric test) يُستخدم للتحقق من فرضية العشوائية المتبادلة في سلاسل المتغيرات ثنائية القيمة (Dichotomous Variables). يمكن للباحث تصنيف المشاهدات بناءً على كونها أعلى أو أقل من الوسيط الحسابي للمتغير الأساسي، ثم فحص عدد التتابعات المتتالية ومقارنتها بالقيمة المتوقعة نظرياً تحت فرضية العدم (Null Hypothesis) القائلة باستقلالية الترتيب.
كما يُستخدم اختبار كولموجوروف-سميرنوف (Kolmogorov-Smirnov Test) لمقارنة التوزيع التجريبي للأرقام العشوائية المولدة بالتوزيع المنتظم المستمر النظري؛ للتأكد من أن دالة RAND قد عملت ضمن حدود التوافق المعياري المقبول دون انحرافات ذات دلالة إحصائية ($p > 0.05$). بالإضافة إلى ذلك، يجب على الباحث فحص توازن المتغيرات الديموغرافية والأساسية (مثل العمر والجنس ومستوى الدخل) بين شطري الجدول بعد الخلط، للتأكد من أن العشوائية قد حققت التكافؤ الإحصائي المطلوب بين المجموعات الفرعية ولم تُحدث تركيزات شاذة في جهة دون أخرى.
8.2 التوثيق المنهجي لعملية الخلط في الأوراق البحثية
يفرض دليل جمعية علم النفس الأمريكية (American Psychological Association – APA, 7th ed.) والارشادات الدولية لتقارير التجارب السريرية (مثل إرشادات CONSORT) معايير شفافة وصارمة في توثيق آليات العشوائية وإخفاء التخصيص (Allocation Concealment). لا يكفي أن يذكر الباحث في منهجية دراسته أنه “تم خلط الصفوف عشوائياً”، بل يجب تقديم وصف تفصيلي وقابل للتحقق يعكس جودة الإجراءات العلمية المتبعة.
يجب أن يتضمن التوثيق المنهجي تحديد البرنامج المستخدم بدقة (مثل: Microsoft Excel for Microsoft 365, Version 2402)، مع ذكر الدوال البرمجية المعتمدة (مثل: RAND أو SORTBY مدمجة مع RANDARRAY). وإذا كان البحث يعتمد على محاكاة احتمالية تتطلب التكرار المطابق، فيجب توثيق ما إذا تم استخدام “بذرة عشوائية” (Random Seed) ثابتة عبر كود VBA، أو تم تجميد الأرقام العشوائية وحفظها في مستودع بيانات مفتوح (Open Data Repository) بصيغة ملفات نصية كـ CSV لضمان التحقق المستقل من جانب المراجعين والباحثين الآخرين.
علاوة على ذلك، يتطلب الامتثال للأخلاقيات البحثية التأكد من أن إعادة ترتيب الصفوف قد جرت بمعزل تام عن معرفة هوية المشاركين أثناء عملية التوزيع (Blinded Allocation)؛ منعاً لتسرب تحيز الباحث (Researcher Bias) إلى اختيار العينات أو توجيه بعض المشاركين عمداً نحو معالجة معينة، وهو ما يضمن الحفاظ على الصدق التجريبي والأمانة الأكاديمية للدراسة.
9. الأخطاء الشائعة أثناء خلط الصفوف في إكسل وكيفية تجنبها
9.1 أخطاء تحديد النطاق وفقدان اتساق الصفوف
يُعد خطأ “الفرز الجزئي” (Partial Sort) الكارثة الأكثر شيوعاً وتدميراً لسلامة البيانات في بيئة إكسل. ويحدث هذا الخطأ الفادح عندما يقوم المستخدم بتحديد عمود واحد فقط (كالعمود المساعد أو عمود الأسماء) ويقوم بالنقر على أمر الفرز، متجاهلاً الأعمدة المجاورة. ورغم أن إكسل الحديث يعرض نافذة تحذيرية تسأل عما إذا كان المستخدم يرغب في “توسيع التحديد” (Expand the selection)، إلا أن الضغط الخاطئ على خيار “المتابعة مع التحديد الحالي” يؤدي إلى إعادة ترتيب العمود المحدد فقط، مع بقاء كافة الأعمدة الأخرى في أماكنها دون حراك!
ينتج عن هذا الخطأ تفكك فوري وشامل لروابط البيانات داخل كل صف؛ حيث يُنسب اسم المشارك الأول فجأة إلى درجات وبيانات المشارك العاشر، وتضيع العلاقة السببية والارتباطية بين المتغيرات التابعة والمستقلة بالكامل دون رجعة، وإذا لم ينتبه الباحث إلى هذه المشكلة فور وقوعها ويستخدم أمر التراجع Ctrl + Z، فإن مجموعة البيانات برمتها تصبح تالفة وغير صالحة للاستخدام العلمي، وقد تقود إلى نتائج مضللة بصورة فاجعة.
ولتفادي هذا الخطأ، يجب الالتزام بقاعدة ذهبية: تحويل النطاق إلى “جدول إكسل رسمي” (Excel Table) بالضغط على Ctrl + T قبل البدء في عمليات الفرز. فالجداول المنسقة رسمياً تتعامل مع الصفوف ككيانات بيانات مدمجة ومتماسكة عضوياً (Structural Entities)، ولا تسمح إطلاقاً بفرز عمود واحد بمعزل عن باقي الصفوف؛ مما يوفر طبقة حماية برمجية متينة تمنع تفكك السجلات مهما كان نوع الفرز المنفذ.
9.2 سوء فهم آليات الترتيب التلقائي وتكرار القيم
من المفاهيم الخاطئة الشائعة الاعتقاد بأن دالة RAND تولد أعداداً صحيحة فقط أو أن احتمالية تكرار الأرقام فيها شائعة كالقرعة البسيطة. هذا الفهم المغلوط يدفع بعض المبتدئين إلى اللجوء لدوال أخرى مثل RANDBETWEEN(1, 10) لبناء العمود المساعد في عينة تحوي 100 صف! يؤدي استخدام RANDBETWEEN في هذا السياق إلى توليد أرقام مكررة بكثافة بين 1 و10، مما يخلق تعادلات رقمية (Ties) كثيرة بين الصفوف تضطر محرك الفرز إلى اللجوء لترتيب الصفوف المتعادلة وفق موضعها الأصلي، وبالتالي تضيع جودة العشوائية ويبقى جزء كبير من الانحياز الترتيبي قائماً دون تفكيك.
لذلك، يجب التأكيد على أن خلط الصفوف الفردية يتطلب دائماً استخدام دالة RAND() أو نظيرتها RANDARRAY بوضع القيم الكسرية الافتراضي؛ حيث تمنح الدقة العالية (15 منزلة عشرية) مفاتيح فرز شبه فريدة تماماً. وحتى في العينات الضخمة جداً، تظل احتمالية التعادل شبه معدومة إحصائياً، مما يضمن فرزاً متدرجاً وسلساً لجميع الصفوف دون الاعتماد على مواضعها السابقة لفك التعادلات.
كما يُغفل كثير من الباحثين إنشاء عمود الفهرس الأصلي (Original Index) قبل الشروع في الخلط، وعندما يرغبون في مراجعة البيانات الأصلية أو مقارنة الفروق بين الترتيب السابق واللاحق، يجدون أنفسهم عاجزين عن استعادة النسخة التأسيسية. إن إدراج عمود مرقم تسلسلياً (1، 2، 3…) وتجميده مسبقاً هو صمام الأمان الوحيد الذي يتيح إعادة الترتيب إلى أصله بضغطة زر واحدة عبر فرز ذلك العمود تصاعدياً في أي وقت.
10. تطبيقات وسيناريوهات عملية متقدمة لخلط الصفوف في معالجة البيانات
10.1 الخلط الطبقي للبيانات (Stratified Randomization)
في كثير من الدراسات الميدانية والتجارب المعملية المتقدمة، لا يكون الخلط العشوائي البسيط كافياً بمفرده؛ خاصة إذا كانت العينة غير متجانسة وتحتوي على فئات فرعية هامة (Strata) يجب تمثيلها بتوازن دقيق في مجموعات الدراسة المختلفة (مثل توازن الجنسين: ذكور وإناث، أو التوزيع الجغرافي، أو الفئات العمرية). يُعرف هذا الإجراء في المنهجية الإحصائية باسم “العشوائية الطبقية” (Stratified Randomization).
لتطبيق الخلط الطبقي داخل إكسل، نتبع منهجية الفرز متعدد المستويات (Multi-Level Sorting) عبر الخطوات التالية:
- إدراج العمود المساعد وتوليد قيم دالة RAND بالطريقة القياسية وتثبيتها كقيم.
- تحديد جدول البيانات بالكامل بما فيه عمود المتغير الطبقي وعمود الأرقام العشوائية.
- فتح نافذة فرز (Sort)، وضبط المستوى الأول للفرز حسب المتغير الطبقي (مثل: “الجنس” أو “Gender”).
- الضغط على زر إضافة مستوى (Add Level) داخل نفس النافذة، وضبط المستوى الثاني للفرز حسب العمود المساعد (“الرقم العشوائي”).
ينتج عن هذا الإجراء إعادة خلط وترتيب الصفوف بصورة عشوائية تامة ولكن داخل كل فئة طبقية على حدة. تظل جميع إناث العينة في قسم مستقل من الجدول ولكن بتموضع عشوائي كامل بينهن، وتظل جميع الذكور في قسم آخر بتموضع عشوائي مستقل تماماً. يتيح هذا التوزيع المنضبط للباحث اختيار النصف الأول من كل فئة للمجموعة التجريبية والنصف الثاني للمجموعة الضابطة، مما يضمن التكافؤ التام في توزيع المتغير الحاسم بين المجموعتين ويلغي أثر التباين الداخلي على التجربة.
10.2 أتمتة عملية الخلط باستخدام وحدات الماكرو وVBA
عند الحاجة إلى تكرار عملية خلط الصفوف لمئات المرات المتتالية—كما هو الحال في دراسات محاكاة مونت كارلو (Monte Carlo Simulations)، أو اختبارات التباديل وتوليد عينات البوتستراب (Bootstrap Resampling)—تصبح الطرق اليدوية غير عملية ومهدرة للوقت. هنا تبرز قوة الأتمتة البرمجية عبر لغة Visual Basic for Applications (VBA) المدمجة داخل برنامج إكسل.
يمكن للمحلل كتابة إجراء برمجي فرعي (Subroutine) بسيط يقوم بتوليد الأرقام العشوائية في مصفوفة داخلية، وفرز النطاق بضغطة زر واحدة، ثم محو المفاتيح المساعدة فوراً. يوضح الكود التالي خوارزمية نموذجية لأتمتة هذه العملية على نطاق محدد في ورقة العمل النشطة:
Sub ShuffleRowsQuickly()
Dim ws As Worksheet
Dim lastRow As Long
Dim lastCol As Long
Dim helperCol As Long
Set ws = ActiveSheet
lastRow = ws.Cells(ws.Rows.Count, “A”).End(xlUp).Row
lastCol = ws.Cells(1, ws.Columns.Count).End(xlToLeft).Column
helperCol = lastCol + 1
Application.ScreenUpdating = False
ws.Cells(1, helperCol).Value = “Temp_Sort_Key”
With ws.Range(ws.Cells(2, helperCol), ws.Cells(lastRow, helperCol))
.Formula = “=RAND()”
.Value = .Value
End With
ws.Range(ws.Cells(1, 1), ws.Cells(lastRow, helperCol)).Sort _
Key1:=ws.Cells(1, helperCol), Order1:=xlAscending, Header:=xlYes
ws.Columns(helperCol).Delete
Application.ScreenUpdating = True
End Sub
يعمل هذا الكود البرمجي على تحديد آخر صف وعمود في الجدول تلقائياً، وإدراج عمود مساعد مؤقت، وتوليد صيغ RAND وتجميدها فوراً إلى قيم ثابتة، ثم فرز النطاق بأكمله، وحذف العمود المساعد واستعادة مظهر الجدول الأصلي في أجزاء من الثانية. ولتشغيل هذا الماكرو، يلزم حفظ المصنف بصيغة تدعم وحدات الماكرو مثل Excel Macro-Enabled Workbook (*.xlsm)، مع مراعاة ضبط إعدادات الأمان في مركز التوثيق (Trust Center) لتشغيل الأكواد الموثوقة بسلاسة وأمان.
خاتمة
استعرضنا في هذا الدليل الأكاديمي الشامل الأسس المنهجية والتقنية لعملية خلط الصفوف في برنامج مايكروسوفت إكسل؛ حيث تبين أن هذا الإجراء، رغم بساطته الظاهرية، يمثل آلية محورية لضمان الصدق الداخلي وكسر التحيزات الترتيبية في التطبيقات البحثية والإحصائية المتنوعة. وقد تتبعنا المسار الإجرائي المتكامل للطريقة الكلاسيكية القائمة على العمود المساعد، بدءاً من البنية الرياضية لدالة RAND كأداة لتوليد قيم تتبع التوزيع المنتظم المستمر $U[0, 1)$، مروراً بكيفية التعامل مع طبيعتها المتقلبة وتثبيتها عبر تقنية اللصق كقيم، وصولاً إلى تنفيذ الفرز الشامل المتسق.
كما سلطنا الضوء على النقلة النوعية التي قدمتها الإصدارات الحديثة من إكسل عبر الدوال المصفوفية الديناميكية، وبخاصة الاقتران البرمجي الفعال بين دالتي SORTBY وRANDARRAY، الذي أتاح خلط البيانات بطريقة ديناميكية غير تدميرية تحافظ على بنية البيانات الأصلية وتوفر بيئة معالجة متقدمة تضاهي الأدوات البرمجية المتخصصة. واختتمنا باستعراض سبل التحقق الإحصائي والخلط الطبقي والأتمتة البرمجية عبر لغة VBA.
إن الالتزام بالقواعد المنهجية الصارمة أثناء إعداد وهيكلة البيانات، وتجنب أخطاء الفرز الجزئي، وتوثيق آليات التوزيع العشوائي بشفافية وقابلية للتكرار، يضمن للباحثين والمحللين تحويل جداول البيانات من مجرد سجلات رقمية مكدسة إلى مصفوفات متزنة علمياً تشكل أساساً متيناً لبناء النماذج الاستدلالية واتخاذ القرارات المبنية على الحقائق الخالية من الانحياز.
المراجع
- Campbell, D. T., & Stanley, J. C. (1963). Experimental and quasi-experimental designs for research. Rand McNally.
- Fisher, R. A. (1925). Statistical methods for research workers. Oliver and Boyd.
- Fisher, R. A. (1935). The design of experiments. Oliver and Boyd.
- Microsoft Corporation. (2024). RAND function. Microsoft Support. https://support.microsoft.com/en-us/office/rand-function-4cbfa695-8869-4e88-8d63-026a5942da54
- Microsoft Corporation. (2024). SORTBY function. Microsoft Support. https://support.microsoft.com/en-us/office/sortby-function-cd2d7a62-1b93-435c-b561-d6a35134f28f
- Microsoft Corporation. (2024). RANDARRAY function. Microsoft Support. https://support.microsoft.com/en-us/office/randarray-function-21261e55-3bec-44cf-86a8-10e729a3bf32
- Peirce, C. S., & Jastrow, J. (1885). On small differences in sensation. Memoirs of the National Academy of Sciences, 3, 73–83.