
يمثل التوزيع العشوائي ركيزة جوهرية في المنهجية العلمية الحديثة، حيث يستند إليه الباحثون وصناع القرار لضمان النزاهة الإحصائية والحد من التحيزات المنهجية التي قد تشوب عمليات تقسيم الأفراد أو العينات التجريبية. وتتجاوز تطبيقات التوزيع العشوائي حدود المختبرات الأكاديمية والسريرية لتشمل بيئات الأعمال، والتعليم، والمؤسسات التدريبية؛ إذ تبرز الحاجة المتكررة إلى تشكيل فرق عمل متوازنة، أو توزيع الطلاب على مجموعات دراسية متكافئة، أو تقسيم العملاء إلى مجموعات ضبط وتجربة لاختبار منتجات وخدمات جديدة. في هذا السياق، تظهر برمجيات الجداول الحسابية كأدوات لا غنى عنها لإنجاز هذه المهام المعقدة بكفاءة ومرونة استثنائية.
ويحتل برنامج مايكروسوفت إكسيل (Microsoft Excel) مكانة الصدارة بين الأدوات المكتبية والإحصائية الأكثر انتشاراً واعتمادية في العالم؛ لما يمتلكه من محرك حسابي قوي ومكتبة ثرية من الدوال الرياضية والمنطقية. إن قدرة إكسيل على التعامل مع مصفوفات البيانات وتحويل النظريات الإحصائية المجردة إلى تطبيقات برمجية مباشرة تجعل منه بيئة مثالية لإجراء التوزيع العشوائي المنضبط بدقة متناهية، دون الحاجة إلى استخدام لغات برمجة معقدة أو حزم إحصائية مرتفعة التكلفة تتطلب تدريباً تخصصياً شاقاً.
يهدف هذا الدليل المنهجي الشامل إلى تقديم إطار تطبيقي وتحليلي متكامل لكيفية إنشاء مجموعات عشوائية متساوية في برنامج إكسيل، من خلال تفكيك الخطوات الرياضية والتقنية واستعراض دراسة حالة مفصلة تشمل توزيع 12 مشاركاً على 3 مجموعات متكافئة. سنناقش بعمق الخصائص الإحصائية للدوال المستخدمة، ونوضح المفاهيم النظرية الكامنة وراء خوارزميات التوزيع، مروراً بمعالجة الإشكاليات التقنية الشائعة مثل تطاير البيانات، ووصولاً إلى استعراض الحلول البديلة في الإصدارات الحديثة وتدقيق صدق وموثوقية المخرجات النهائية.
1. مقدمة منهجية حول التوزيع العشوائي في برنامج إكسيل
1.1 أهمية التوزيع العشوائي في الأبحاث والتطبيقات العملية
يقوم مفهوم التوزيع العشوائي (Random Assignment) على مبدأ إحصائي يضمن أن يمتلك كل فرد أو عنصر في مجتمع الدراسة فرصة احتمالية متساوية ومستقلة تماماً للانضمام إلى أي من المجموعات المشكلة. يختلف هذا المفهوم اختلافاً جوهرياً عن الاختيار العشوائي (Random Selection)؛ فبينما يركز الأخير على كيفية سحب العينة من المجتمع الأصلي لحماية الصدق الخارجي (External Validity) وتعميم النتائج، يهتم التوزيع العشوائي بكيفية توزيع أفراد العينة المختارة فعلياً على شروط التجربة أو مجموعات العمل، وهو ما يحمي الصدق الداخلي (Internal Validity) ويسمح باستنتاج العلاقات السببية بشكل لا لبس فيه.
تتمثل الوظيفة المحورية للتوزيع العشوائي في تحييد التحيز المنهجي وتوزيع المتغيرات المربكة (Confounding Variables)—سواء كانت مرئية ومقاسة كالسن والخبرة، أو كامنة وغير مقاسة كالحافز الداخلي والقدرات الذهنية—بالتساوي التام عبر المجموعات. رياضياً، يحقق هذا التوزيع افتراض الاستقلال الخارجي الذي يرمز له إحصائياً بالصيغة $E[epsilon mid X] = 0$، مما يعني عدم وجود أي ارتباط بين أخطاء القياس والانتماء إلى مجموعة محددة. وبالتالي، فإن أي فروق لاحقة تُرصد بين المجموعات يمكن عزوها بيقين إلى المعاملة التجريبية أو المتغيرات المستقلة المطبقة، وليس إلى وجود فروق أولية متأصلة بين الأفراد قبل بدء الدراسة.
وفي التطبيقات العملية الميدانية وسياقات العمل الجماعي والمؤسسات التعليمية، يوفر التوزيع العشوائي حلاً جذرياً لمشكلات الاصطفاء الذاتي والمحسوبية والشللية. فعندما يُترك الأفراد ليختاروا فرقهم بأنفسهم، تميل المجموعات إلى التكتل وفق تقاربات سابقة أو تفاوتات حادة في الكفاءة، مما يؤدي إلى ظهور مجموعات متفوقة للغاية وأخرى ضعيفة. يضمن التقسيم العشوائي تفتيت هذه التجمعات وبناء فرق متنوعة ومتجانسة في توزيع المهارات، مما يرفع من جودة التفاعل والتعلم والإنتاجية العامة في سياقات المشاريع وفرق التطوير التقني والإداري.
1.2 دور برنامج إكسيل كأداة فعالة لإدارة البيانات وتجميعها
يتميز برنامج مايكروسوفت إكسيل بقدرة فائقة على إدارة وتحليل العينات الصغيرة والمتوسطة، حيث يوفر واجهة معالجة بصرية فورية وسريعة تتيح تنظيم البيانات في هياكل جداول ثنائية الأبعاد (صفوف وأعمدة). يتيح هذا التصميم البصري للمستخدم تتبع كل مرحلة من مراحل التحويل الرياضي، بدءاً من إدخال السجلات الأولية وحتى توليد المجموعات النهائية، مما يقلل من احتمالات الخطأ الإجرائي ويمنح المستخدم سيطرة كاملة على تدفق العمليات الحسابية دون غموض الأكواد البرمجية البرمجية المعزولة.
بالإضافة إلى ذلك، يحتوي إكسيل على محرك إحصائي ورياضي مدمج يضم مئات الدوال الجاهزة القادرة على توليد سلاسل عددية، وتحديد الرتب النسبية، وتقريب الكسور بدقة حسابية عالية. تعمل هذه الدوال المترابطة بالتوافق مع بنيات معالجة البيانات الحديثة، مما يتيح بناء نماذج توزيع مرنة يمكن تعديلها وتطبيقها على أحجام عينات مختلفة بأدنى مجهود، فضلاً عن سهولة مشاركة هذه الملفات ونماذج العمل عبر مختلف الأنظمة دون القلق من مشكلات التوافقية التقنية الشائعة في البرمجيات الإحصائية المتخصصة.
ومن منظور الحوكمة الأكاديمية والشفافية المؤسسية، يسهل إكسيل عملية توثيق وتكرار خطوات التقسيم العشوائي بشكل دقيق. يستطيع الباحث أو المحلل تسجيل المعادلات المطبقة خطوة بخطوة، والاحتفاظ بالبيانات الخام ومسارات التحويل الحسابي، مما يتيح للجهات المراجعة أو المدققين العلميين مراجعة سلامة التقسيم والتحقق من عدم وجود أي تدخل يدوي متعمد لتوجيه الأفراد نحو مجموعات بعينها. يتماشى هذا التوثيق الدقيق تماماً مع معايير الشفافية العلمية القابلة للتدقيق (Auditability) المعمول بها في مراكز الأبحاث المرموقة.
2. المفاهيم الرياضية والإحصائية لدوال التوزيع العشوائي في إكسيل
2.1 طبيعة عمل دالة التوليد العشوائي RAND
تُعرّف دالة `RAND` في إكسيل كدالة رياضية غير مدخلية (لا تتطلب وسائط) تقوم بتوليد أرقام حقيقية مستمرة تتوزع توزيعاً منتظماً وتكون محصورة حصراً في النطاق النصفي المفتوح $[0, 1)$، أي أنها تشمل الصفر تماماً وتستثني الرقم واحد رياضياً. يخضع هذا التوليد الإحصائي لخاصية التوزيع المتجانس (Uniform Distribution)، والتي تعني أن أي فترة فرعية داخل هذا النطاق تمتلك الاحتمالية ذاتها لظهور الأرقام، مما يوفر بيئة رياضية مثالية لتوليد قيم غير متحيزة يمكن استخدامها كأساس عادل للترتيب والمقارنة بين السجلات المختلفة.
تعتمد المعالجات الحسابية لبرنامج إكسيل في الإصدارات الحديثة على خوارزميات توليد الأرقام شبه العشوائية (Pseudorandom Number Generators – PRNG)، وتحديداً خوارزميات متطورة مستندة إلى مبادئ شبيهة بخوارزمية “ميرسين تويستر” (Mersenne Twister) أو خوارزميات الجمع التوليفي المتقدمة. تضمن هذه الخوارزميات فترات دورية فائقة الطول تمنع تكرار النمط الرقمي عبر مليارات العمليات الحسابية، كما تجتاز بنجاح الاختبارات القياسية الصارمة للاستقلالية الإحصائية والتشتت العشوائي، وهو ما يجعل مخرجاتها قريبة جداً من العشوائية المطلقة للأغراض البحثية والتطبيقية العامة.
ومن الخصائص البنيوية الحاسمة لدالة `RAND` هي خاصية “التطاير الديناميكي” (Volatility). وتعني هذه الخاصية البرمجية أن إكسيل يعيد تقييم وحساب ناتج الدالة في كل خلية تلقائياً عند إجراء أي تعديل على ورقة العمل، أو عند فتح الملف، أو حتى عند إدخال قيمة في خلية منفصلة لا ترتبط إطلاقاً بصيغة العشوائية. ورغم أن هذا السلوك الديناميكي يضمن تحديث العشوائية باستمرار، إلا أنه يمثل تحدياً منهجياً يتطلب تدخلاً تقنياً لاحقاً لتثبيت المجموعات وحمايتها من التغير غير المرغوب فيه أثناء التطبيق الميداني.
2.2 التكامل الوظيفي بين دالتي الترتيب RANK والتقريب ROUNDUP
يتطلب التحول من مجرد توليد أرقام عشوائية مجردة إلى تشكيل مجموعات منتهية ومنتظمة دمج دوال وسيطة تتولى معالجة المخرجات. هنا تبرز دالة الترتيب `RANK` (أو صيغتها الحديثة `RANK.EQ`) كأداة إحصائية تحدد الموضع الترتيبي النسبي لقيمة معينة مقارنة بقائمة من القيم الأخرى. عندما نطبق هذه الدالة على نواتج دالة `RAND`، فإنها تحول القيم العشرية العشوائية غير المحدودة إلى سلسلة من الأعداد الصحيحة المتتالية والفريدة التي تتراوح تماماً من 1 إلى $N$ (حيث $N$ يمثل الحجم الكلي للعينة)، محققة بذلك ما يُعرف إحصائياً بالتخصيص التبادلي الكامل (Permuted Allocation).
ولتحويل هذا التسلسل الترتيبي الممتد من 1 إلى $N$ إلى مجموعات محددة ذات حجم ثابت (وليكن حجم المجموعة $k$)، تتدخل دالة التقريب للأعلى `ROUNDUP`. تمتاز هذه الدالة بقدرتها على تقريب أي كسر عشري باتجاه القيمة الموجبة المطلقة التالية، بغض النظر عن كون الكسر أصغر من 0.5. ومن خلال قسمة الرتبة الناتجة من دالة `RANK` على الحجم المستهدف للمجموعة الواحدة وتمرير الناتج إلى `ROUNDUP` مع تحديد عدد المنازل العشرية بـ 0، فإننا نقوم بتعيين كل نطاق من الرتب إلى رقم صحيح متطابق يمثل رمز المجموعة.
تتمثل المعادلة الرياضية الشاملة المدمجة لهذه العملية بالصيغة العامة التالية:
$$\text{Group ID} = \left\lceil \frac{\text{Rank}}{k} \right\rceil$$
حيث تمثل علامة التقريب للأعلى دالة `ROUNDUP`، بينما يمثل $k$ السعة المستهدفة للمجموعة الفرعية الواحدة. تضمن هذه المعادلة توزيعاً منتظماً للأفراد بدقة متناهية؛ إذ تحصل المجموعة الأولى حصرياً على الأفراد أصحاب الرتب من 1 إلى $k$، وتحصل المجموعة الثانية على الرتب من $k+1$ إلى $2k$، وتستمر العملية حتى توزيع كامل العينة دون حدوث أي نقص أو زيادة في حصة أي مجموعة.
3. الخطوة الأولى: إعداد وتنظيم البيانات الأولية في جدول إكسيل
3.1 بناء الهيكل المنهجي لجدول البيانات
تبدأ الممارسة العلمية السليمة بتهيئة بنية جدول البيانات بطريقة تضمن الفصل الكامل بين المتغيرات والمعاملات الحسابية لتفادي أخطاء التداخل. يجب تخصيص ورقة عمل نظيفة تبدأ بإنشاء أعمدة محددة الوظائف بوضوح منهجي؛ حيث يُخصص العمود الأول للمُعرّف الرقمي التسلسلي للمشارك (Participant ID)، والعمود الثاني لاسم المشارك الكامل أو كوده السري، بينما يُخصص العمود الثالث لتوليد القيمة العشرية العشوائية، ويُحجز العمود الرابع والأخير لاحتواء معادلة تصنيف المجموعة النهائية.
من الضروري إدخال أسماء العينة المستهدفة بشكل رأسي منتظم ومستمر، بحيث يمثل كل صف سجلاً مستقلاً لكائن إحصائي واحد (مشارك أو عنصر). ينبغي تجنب ترك أي صفوف فارغة بين السجلات؛ لأن وجود الفراغات الرأسية يقطع استمرارية النطاقات الحسابية ويعطل عمل التعبئة التلقائية، كما قد يتسبب في حدوث أخطاء مرجعية صامتة أثناء تقييم مجالات الدوال الإحصائية.
علاوة على ذلك، يجب فحص البيانات الأولية بدقة قبل تطبيق أي معادلات للتحقق من عدم وجود تكرارات غير مقصودة في الأسماء أو المعرفات. يمكن الاستعانة بأداة “إزالة التكرارات” (Remove Duplicates) المتوفرة في تبويب “بيانات” (Data) لضمان أن كل صف يمثل فرداً فريداً تماماً، مع التأكد من إزالة أي مسافات بادئة أو لاحقة في النصوص باستخدام دالة `TRIM`، لمنع حدوث التباسات تصنيفية إذا ما رغب الباحث في استخدام دوال بحث متقدمة لاحقاً.
3.2 تجهيز معطيات المثال التطبيقي (12 مشاركاً)
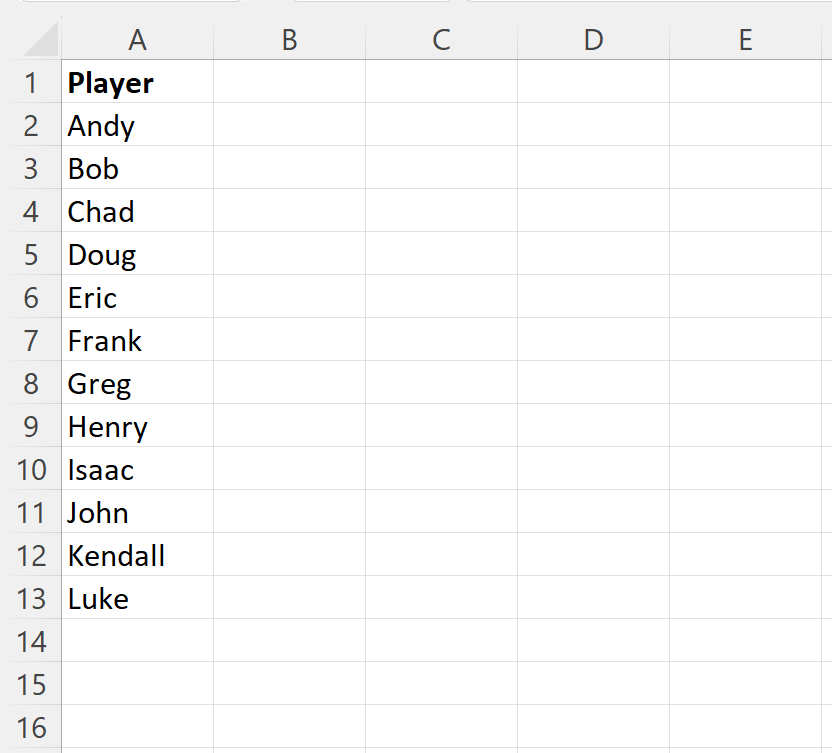
لتوضيح المنهجية بشكل عملي ومباشر، سنعتمد في هذا الدليل دراسة حالة معيارية تتكون من عينة تضم 12 مشاركاً مطلوب تقسيمهم بالتساوي الصارم إلى 3 مجموعات فرعية، بحيث تضم كل مجموعة 4 مشاركين بالتمام والكمال. يتم إدراج هذه القائمة في ورقة عمل إكسيل ابتداءً من الصف الثاني وحتى الصف الثالث عشر، وتحديداً في النطاق الرأسي من الخلية `A2` إلى الخلية `A13`، تاركين الصف الأول بالكامل لعناوين الأعمدة التوضيحية.
تتمثل أسماء المشاركين الاثني عشر في العينة الافتراضية التالية: أحمد، ومحمد، وسارة، وفاطمة، وخالد، وعمر، ونور، وزينب، وحسن، ومريم، ويوسف، وهند. ويعد الهدف الإحصائي المحدد لهذه العملية هو القضاء على أي تحيز شخصي أو ترتيب أبجدي أو أولوية تسجيل، وضمان أن فرصة كل فرد من هؤلاء الاثني عشر في الانضمام للمجموعة رقم 1 أو 2 أو 3 هي ثلث تماماً (حوالي 33.33%) قبل بدء التوزيع.
يجب كتابة تسميات واضحة ومحددة في الصف الأول لتمييز البيانات والمعادلات، كالتالي:
- الخلية A1: الاسم (Participant Name)
- الخلية B1: القيمة العشوائية (Random Value)
- الخلية C1: المجموعة المعينة (Assigned Group)
يوفر هذا التحديد الدقيق لرؤوس الأعمدة أساساً ممتازاً لتوثيق التحليل، ويجعل مراجعة الصيغ المركبة وفهم المراجع المتقاطعة عملية سلسة للغاية لأي طرف ثالث يتولى فحص ورقة العمل لاحقاً.
4. الخطوة الثانية: توليد الأرقام العشوائية باستخدام دالة RAND
4.1 تطبيق صيغة التوليد العشوائي في عمود الأرقام
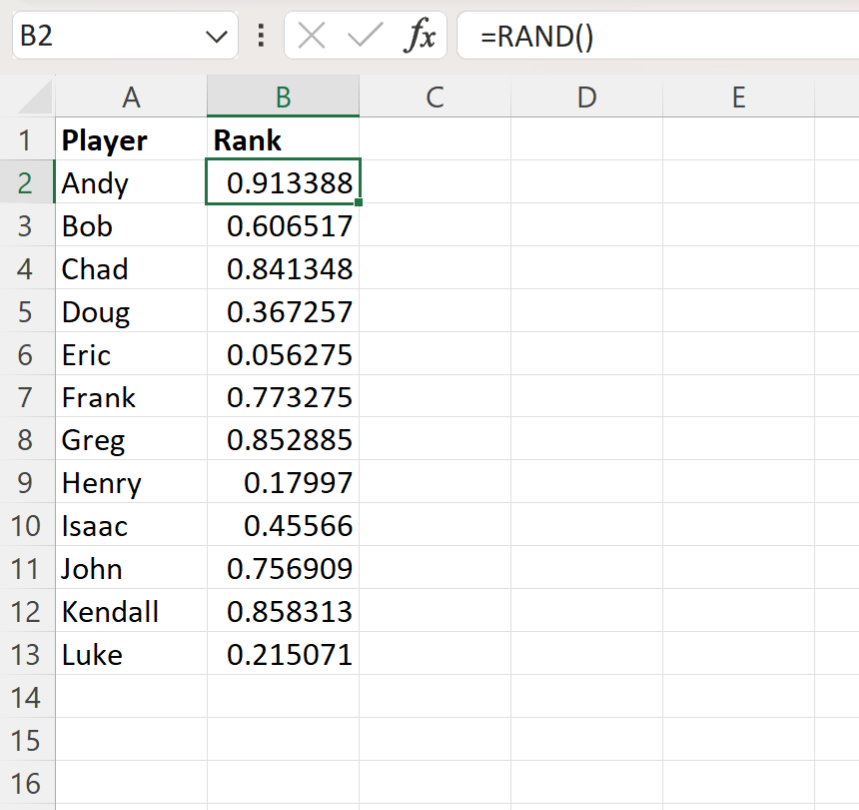
بعد تجهيز هيكل الجدول وأسماء العينة، ننتقل إلى مرحلة التوليد الرياضي العشوائي. نقف بمؤشر الفأرة في الخلية `B2`—المجاورة مباشرة لاسم المشارك الأول “أحمد”—ثم نقوم بكتابة الصيغة الرياضية البسيطة التالية:
=RAND()
لا تتطلب هذه الصيغة تمرير أي معاملات بين القوسين. بمجرد الضغط على مفتاح الإدخال (Enter)، سيقوم معالج إكسيل فورياً بحساب القيمة وإظهار كسر عشري يتكون من عدة منازل كسرية (مثال: 0.742819) داخل الخلية المحددة.
لتطبيق هذه الدالة على باقي أفراد العينة، نستخدم أداة مقبض التعبئة التلقائية (Fill Handle). يتم ذلك من خلال النقر على المربع الصغير الموجود في الزاوية اليسرى السفلية (أو اليمنى السفلية بحسب اتجاه واجهة البرنامج) للخلية `B2`، ثم سحبه لأسفل باتجاه عمودي حتى الوصول إلى الخلية `B13` المقابلة للاسم الأخير. بدلاً من السحب، يمكن أيضاً النقر المزدوج السريع على مقبض التعبئة ليقوم إكسيل بملء العمود تلقائياً حتى نهاية نطاق البيانات المجاورة في العمود `A`.
بإتمام هذه الخطوة، يحصل كل مشارك من المشاركين الاثني عشر على قيمة كسرية عشوائية مستقلة ومختلفة تماماً في النطاق `B2:B13`. وتعد هذه الأرقام بمثابة “تذاكر قرعة رقمية” محايدة ترتبط بكل اسم، وتمهد الطريق لإجراء الفرز والتقسيم في المرحلة اللاحقة دون أي تدخل بشري.
4.2 الخصائص الإحصائية للقيم العشرية المتولدة
تمتاز الأرقام الناتجة من دالة `RAND` باتساع نطاقها العشري؛ إذ يقوم إكسيل بتوليد هذه الأرقام بدقة تصل إلى 15 رقماً عشرياً وفق معيار الحوسبة النقطية المزدوجة (IEEE 754 Floating-Point Standard). تضمن هذه الدقة الحسابية العالية شبه استحالة حدوث تطابق أو تعادل تام (Tie) بين قيمتين عشوائيتين داخل عينة مكونة من 12 فرداً أو حتى عينات تحتوي على عشرات الآلاف من السجلات، مما يلغي تماماً الحاجة إلى خوارزميات معقدة لفض النزاعات والتعادلات الترتيبية.
وبما أن هذه الأرقام تخضع لقانون التوزيع المتجانس المستمر على الفترة $[0, 1)$، فإن الترتيب الناتج عنها يضمن فرزاً عادلاً تماماً؛ حيث لا توجد أي أفضلية رقمية لأي مشارك بناءً على موقعه في الجدول الأصلي. وتمنح كل قيمة احتمالية متكافئة لكل اسم ليكون في قمة الترتيب أو في قاعه، وهو ما يحقق جوهر التوزيع العشوائي التام المنشود في التجارب العلمية المقيدة.
مع ذلك، يجب على المستخدم استيعاب خاصية إعادة الاحتساب الافتراضية؛ فأثناء تفاعلك مع الجدول، ستلاحظ أن القيم الموجودة في النطاق `B2:B13` تتغير باستمرار وتولد أرقاماً جديدة عند إدخال أي معادلة أخرى أو تعديل قيمة أي خلية. هذا السلوك متوقع تماماً في هذه المرحلة ولا يمثل خطأ برمجياً، وسيتم التعامل معه وحفظ النتائج النهائية بشكل ثابت لاحقاً عبر تقنيات التجميد المنهجي.
5. الخطوة الثالثة: تطبيق دالتي RANK و ROUNDUP للفرز والتجميع
5.1 تفكيك وبناء الصيغة الحسابية المركبة
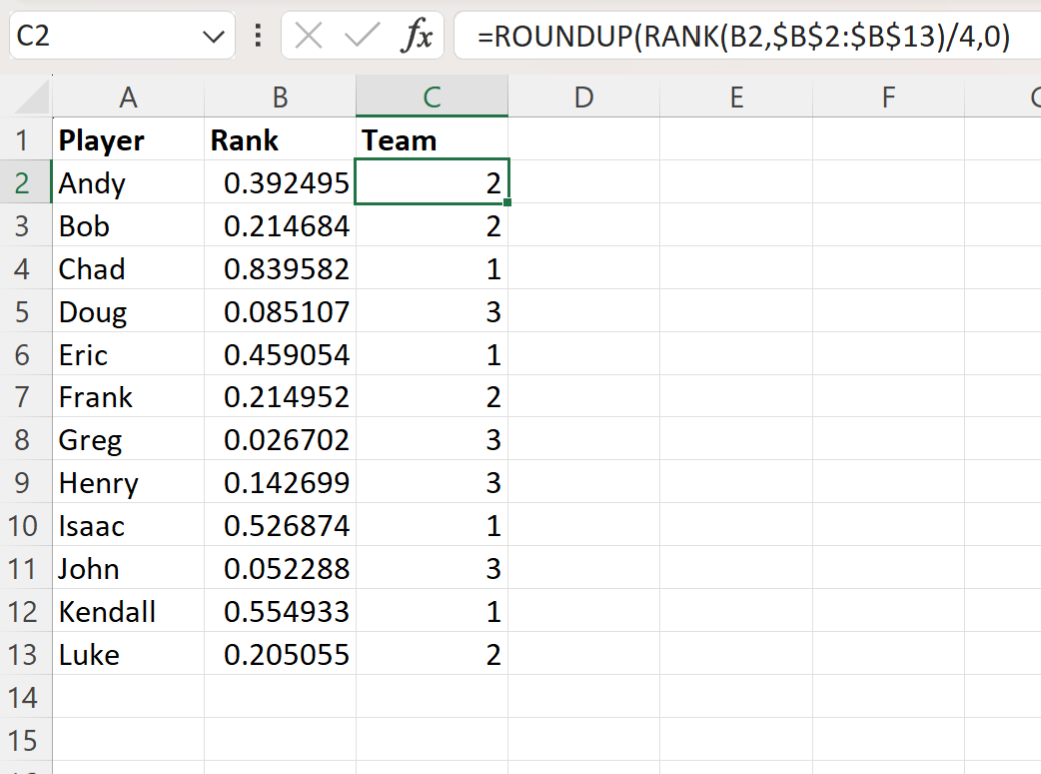
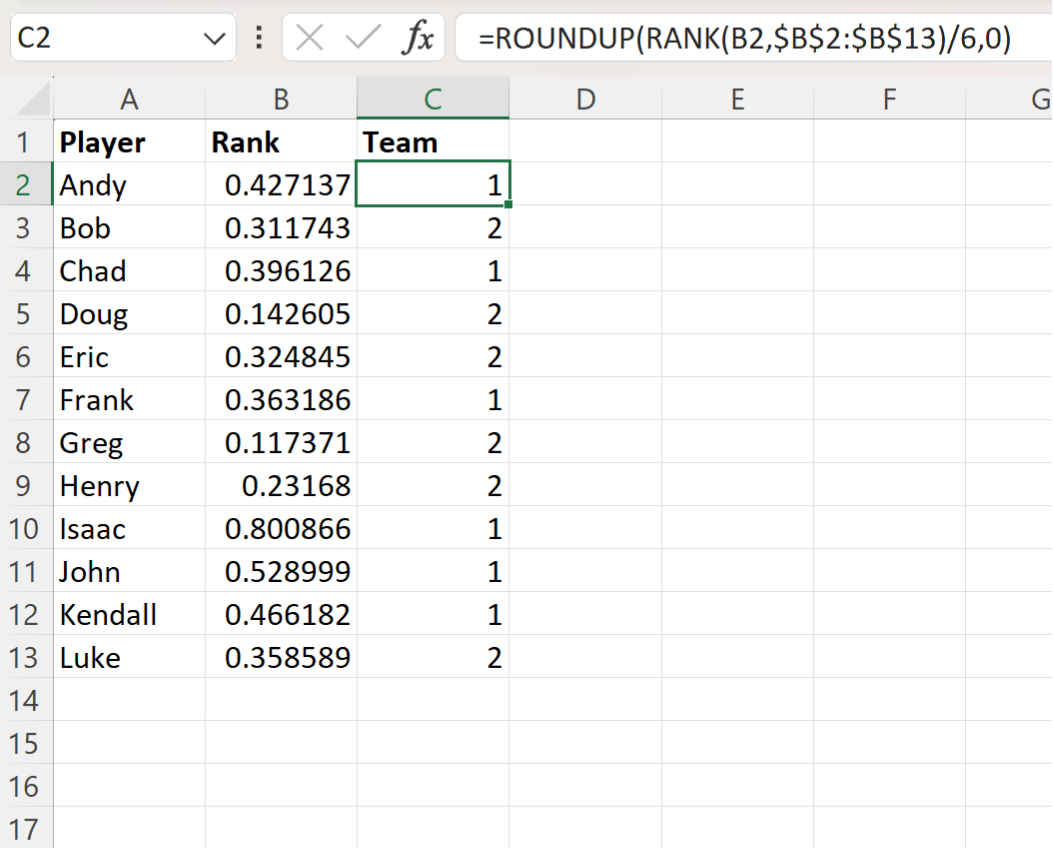
لتحقيق الغاية النهائية المتمثلة في توزيع المشاركين على المجموعات الثلاث، نقوم بصياغة معادلة رياضية مدمجة تجمع بين دالتي الترتيب والتقريب. نتوجه إلى الخلية `C2` المقابلة للاسم الأول والقيمة العشوائية الأولى، ثم ندخل الصيغة التالية بعناية فائقة:
=ROUNDUP(RANK(B2, $B$2:$B$13) / 4, 0)
بمجرد إدخال هذه الصيغة والضغط على مفتاح الإدخال، ستُظهر الخلية رقماً صحيحاً ينحصر حصراً بين (1، 2، 3). نقوم بعد ذلك بسحب مقبض التعبئة للخلية `C2` لأسفل حتى الخلية `C13` لنشر الصيغة على كافة المشاركين.
تستحق هذه الصيغة تحليلاً تفصيلياً لمكوناتها المترابطة؛ فالجزء الداخلي `RANK(B2, $B$2:$B$13)` يتولى مقارنة القيمة العشوائية الموجودة في الخلية `B2` بكامل نطاق الأرقام العشوائية للعينة. من الأهمية المنهجية والتقنية بمكان استخدام علامة الدولار (`$`) لتثبيت النطاق المرجعي ليصبح مرجعاً مطلقاً (`$B$2:$B$13`)؛ إذ يضمن هذا التثبيت بقاء نطاق المقارنة ثابتاً دون انزياح عند سحب المعادلة لأسفل، بحيث يقارن كل صف نفسه مع كامل مجتمع العينة الاثني عشر وليس مع جزء مبتور منه.
يمثل الرقم `4` في مقام عملية القسمة “سعة المجموعة الفرعية” (Group Size)، وهو ناتج قسمة الحجم الكلي للعينة ($N=12$) على العدد المستهدف للمجموعات ($G=3$). وتحدد هذه القيمة المعيارية عتبة الانتقال بين أرقام المجموعات. أما الرقم `0` في وسيط دالة `ROUNDUP` الأخير، فيحدد عدد المنازل العشرية المطلوبة في الناتج، مؤكداً لرسم الحساب رغبتنا في الحصول على أرقام صحيحة خالية من أي فواصل عشرية.
5.2 آلية توزيع الرتب على الفئات العددية
لفهم المنطق الداخلي الذي يحكم عمل هذه المعادلة المركبة، يجب تتبع مسار المعالجة الرياضية التي تجريها إكسيل في جزء من الثانية لكل صف على حدة. أولاً، تقوم دالة `RANK` بتعيين رتبة تسلسلية فريدة لكل قيمة عشوائية، تتراوح بدقة من الرقم 1 (لأعلى قيمة عشوائية) إلى الرقم 12 (لأدنى قيمة عشوائية).
ثانياً، تقسم هذه الرتبة التسلسلية على معامل سعة المجموعة (الرقم 4)، مما يولد نواتج كسرية تقع ضمن فترات عددية محددة. وتتضح آلية التحويل عبر التقسيم الرياضي التالي:
- الأفراد ذوو الرتب 1 و2 و3 و4: ينتج عن قسمة رتبهم على 4 القيم: 0.25، 0.50، 0.75، 1.00. وعند تطبيق دالة `ROUNDUP` على أي من هذه القيم لتقريبها للأعلى إلى أقرب عدد صحيح، يكون الناتج دائماً هو 1. وبذلك ينضم هؤلاء حصرياً إلى المجموعة الأولى.
- الأفراد ذوو الرتب 5 و6 و7 و8: ينتج عن قسمة رتبهم على 4 القيم: 1.25، 1.50، 1.75، 2.00. وعند تقريبها للأعلى، يقفز الناتج حتماً إلى 2. وبذلك ينضم هؤلاء إلى المجموعة الثانية.
- الأفراد ذوو الرتب 9 و10 و11 و12: ينتج عن قسمة رتبهم على 4 القيم: 2.25، 2.50، 2.75، 3.00. وتقرب جميعها للأعلى لتستقر عند 3. وبذلك ينضم هؤلاء الأفراد إلى المجموعة الثالثة.
تضمن هذه الآلية الرياضية الصارمة عدم حدوث أي اختلال في الحصص النسبية للمجموعات؛ إذ يستحيل أن تضم أي مجموعة أكثر أو أقل من 4 مشاركين، وهو ما يحقق توزيعاً متوازناً وكاملاً للعينة وفق مبادئ التوزيع المقيد (Constrained/Permuted Allocation).
6. دراسة حالة تطبيقية مفصلة: تقسيم عينة من 12 فرداً إلى 3 مجموعات
6.1 المعاينة الرقمية للمدخلات والمخرجات خطوة بخطوة
لتجسيد العملية بمخرجات فعلية ورؤية النتائج بشكل لا يدع مجالاً للغموض، يعرض الجدول التالي محاكاة رقمية متكاملة لبيانات العينة الاثني عشر بعد تطبيق الدوال المشروحة سابقاً، موضحاً القيم العشوائية المولدة، والرتبة المحسوبة، والتصنيف النهائي للمجموعة المقابلة:
| المشارك (A) | القيمة العشوائية B) RAND) | الرتبة النسبية (محسوبة داخلياً) | المجموعة المعينة C) GROUP) |
|---|---|---|---|
| أحمد | 0.8923 | 1 | المجموعة 1 |
| محمد | 0.1452 | 11 | المجموعة 3 |
| سارة | 0.6734 | 4 | المجموعة 1 |
| فاطمة | 0.4312 | 7 | المجموعة 2 |
| خالد | 0.0811 | 12 | المجموعة 3 |
| عمر | 0.7845 | 2 | المجموعة 1 |
| نور | 0.5129 | 6 | المجموعة 2 |
| زينب | 0.3298 | 8 | المجموعة 2 |
| حسن | 0.7103 | 3 | المجموعة 1 |
| مريم | 0.2145 | 10 | المجموعة 3 |
| يوسف | 0.5891 | 5 | المجموعة 2 |
| هند | 0.2987 | 9 | المجموعة 3 |
من خلال تتبع بيانات الجدول، نلاحظ كيف تعاملت الخوارزمية مع المشارك “أحمد”؛ حيث حصل على أعلى قيمة عشوائية (0.8923) فاحتلت قيمته الرتبة 1. وبقسمة 1 على 4 وتقريب الناتج للأعلى، أُسند تلقائياً إلى المجموعة 1. وفي المقابل، حصل المشارك “خالد” على أدنى قيمة عشوائية (0.0811) فكانت رتبته 12، وبقسمة 12 على 4 ينتج 3.00، ليتم تسكينه مباشرة في المجموعة 3.
6.2 تحليل توزيع الأفراد وفق التكافؤ العددي
عند تجميع وتدقيق الأسماء المصنفة داخل كل مجموعة من المجموعات المشكلة بناءً على المحاكاة السابقة، نصل إلى التركيبة النهائية التالية:
- المجموعة الأولى: تضم (أحمد، سارة، عمر، حسن) — الإجمالي: 4 مشاركين.
- المجموعة الثانية: تضم (فاطمة، نور، زينب، يوسف) — الإجمالي: 4 مشاركين.
- المجموعة الثالثة: تضم (محمد، خالد، مريم، هند) — الإجمالي: 4 مشاركين.
يوضح هذا التحليل التماثل المطلق في الأحجام العددية للمجموعات دون أي اختلال؛ حيث استوعبت كل مجموعة ثلث العينة بالتمام. ويثبت الفحص النوعي للأسماء عدم وجود أي تأثير للموقع الأولي للمشاركين في قائمة الإدخال؛ فقد توزعت الأسماء التي كانت متجاورة في بداية الجدول (مثل أحمد، محمد، سارة) على مجموعات متباينة تماماً (المجموعة 1 و3 و1 على التوالي)، مما يؤكد كفاءة النموذج الرياضي في كسر أي ارتباط تسلسلي مسبق وتوفير توزيع متوازن ومحايد.
7. آليات تثبيت القيم العشوائية وضمان استقرار النتائج
7.1 التعامل مع إشكالية التطاير وتغير المجموعات المستمر
تعتبر خاصية التطاير التلقائي (Volatile Nature) لدالة `RAND` ميزة تقنية لتوليد أرقام متجددة، إلا أنها تتحول إلى إشكالية منهجية خطيرة بمجرد الوصول إلى التوزيع المستهدف. فبمجرد الضغط على مفتاح `F9` لإعادة الحساب، أو إجراء أي تعديل طفيف مثل فرز الجدول أو كتابة ملاحظة في خلية مجاورة، سيعيد إكسيل توليد كامل أرقام العمود `B`. سيؤدي هذا بالتبعية إلى إعادة حساب الرتب في العمود `C`، مما يترتب عليه إعادة توزيع الأفراد بالكامل وانتقالهم إلى مجموعات جديدة تختلف عن تلك التي وُزّعوا عليها في اللحظة السابقة.
يشكل هذا التغير المستمر خطراً فادحاً على سلامة التطبيق الميداني والبحثي؛ فمن غير المقبول علمياً أو إدارياً أن يتغير تشكيل الفرق أثناء إبلاغ المشاركين أو بعد مباشرة المجموعات لمهامها المحددة. إن عدم تثبيت التوزيع الأولي يفتح الباب للشكوك حول نزاهة الباحث أو المشرف، وقد يُفسر التغيير العرضي للمجموعات كمحاولة متعمدة لإعادة السحب حتى الوصول إلى توزيع مرغوب فيه ذاتياً، وهو ما ينتهك المعايير الأساسية للأمانة العلمية وقابلية تكرار التجربة.
لذلك، تصبح مرحلة “التجميد النهائي” خطوة إلزامية لا غنى عنها فور توليد التوزيع العشوائي لأول مرة بنجاح. يهدف هذا الإجراء إلى قطع الرابط البرمجي بين القيم المعروضة ومحرك التوليد التلقائي لإكسيل، وتحويل الصيغ الحسابية الديناميكية إلى قيم نصية ورقمية ساكنة ودائمة لا تتأثر بأي عمليات تحرير أو حسابات لاحقة داخل الملف.
7.2 تقنية النسخ ولصق القيم (Paste Special as Values)
يمثل أمر “لصق كقيم” (Paste as Values) الحل القياسي المباشر لتحييد تطاير دالة `RAND` وتثبيت التوزيع. لتنفيذ هذا الإجراء بمنهجية سليمة، نتبع الخطوات المحددة التالية:
- نقوم بتحديد نطاق الأرقام العشوائية بالكامل في العمود الثاني، وهو النطاق من `B2` إلى `B13`.
- ننسخ البيانات المحددة عبر الضغط على اختصار لوحة المفاتيح المرجعي
Ctrl + C(أوCmd + Cعلى أجهزة ماك)، أو بالنقر بزر الفأرة الأيمن واختيار أمر “نسخ” (Copy). ستظهر حواف متحركة متقطعة تحيط بالنطاق المنسوخ. - مع بقاء التحديد على نفس النطاق ابتداءً من الخلية `B2`، ننقر بزر الفأرة الأيمن لفتح القائمة السياقية، ثم نختار من خيارات اللصق أيقونة “قيم” (Values)—والتي تظهر عادة على شكل لوحة مرسوم عليها الأرقام 123—أو بالضغط على الاختصار
Ctrl + Alt + Vواختيار “Values” ثم الضغط على OK.
بمجرد إتمام هذا الإجراء، نلاحظ عند النقر على أي خلية في العمود `B` وفحص “شريط الصيغة” (Formula Bar) في الأعلى اختفاء الصيغة =RAND() وحلول الرقم العشري الثابت محلها بصورة دائمة. يضمن هذا الإجراء استقرار العمود `C` وتوقف أرقام المجموعات عن التغير، حيث أصبحت تستند الآن إلى مصفوفة رقمية مستقرة غير متطايرة.
ولضمان أعلى درجات الأمان المنهجي، يُفضل تكرار نفس إجراء “النسخ ولصق كقيم” على عمود المجموعات نفسه (`C2:C13`). يؤدي هذا إلى إزالة الدالة المركبة ROUNDUP(RANK(...)) واستبدالها بالأرقام الثابتة (1، 2، 3) كقيم صلبة. يحمي هذا الإجراء ورقة العمل من أي أخطاء مرجعية محتملة إذا ما رغب المستخدم لاحقاً في حذف عمود القيم العشوائية المساعد `B`، أو إعادة ترتيب وتصفية الصفوف أبجدياً أو وفق أرقام المجموعات لتسهيل طباعة الكشوف النهائية وتوزيعها.
8. طرق بديلة لإنشاء المجموعات العشوائية في الإصدارات الحديثة من إكسيل
8.1 التجميع السريع باستخدام دالتي SORTBY و RANDARRAY
مع التطور الجذري الذي أدخلته شركة مايكروسوفت على محرك حسابات برنامج إكسيل ودعم “المصفوفات الديناميكية” (Dynamic Arrays) في إصدارات Microsoft 365 وإكسيل 2021 والإصدارات الأحدث، أصبح بالإمكان الاستغناء بالكامل عن الأعمدة المساعدة والحلول الكلاسيكية متعددة الخطوات، واستبدالها بصيغ برمجية فائقة الإيجاز والكفاءة.
تتصدر دالتا `SORTBY` و `RANDARRAY` هذه التقنيات الحديثة؛ حيث تتيح دالة `RANDARRAY` توليد مصفوفة عشوائية متعددة الصفوف بطلب واحد، بينما تقوم دالة `SORTBY` بفرز نطاق بيانات معين بناءً على ترتيب مصفوفة أخرى موازية. وبدمج هاتين الدالتين مع دالة تنظيم الصفوف الحديثة `WRAPROWS`، نستطيع فرز الأسماء وتقسيمها إلى 3 مجموعات مباشرة في خطوة واحدة دون استخدام عمود عشوائي وسيط.
في خلية فارغة جديدة (ولتكن `E2`)، يمكن كتابة الصيغة الحديثة المتكاملة التالية:
=WRAPROWS(SORTBY(A2:A13, RANDARRAY(12)), 4)
تعمل هذه الصيغة الديناميكية وفق هندسة متقنة؛ حيث تقوم `RANDARRAY(12)` بإنشاء 12 رقماً عشوائياً في الذاكرة اللحظية للحاسوب، وتقوم دالة `SORTBY` بإعادة ترتيب أسماء المشاركين (`A2:A13`) بالكامل وفقاً لهذه الأرقام المولدة، ثم تتولى دالة `WRAPROWS` قطع هذه المصفوفة المفروزة عشوائياً وتوزيعها أفقياً على صفوف بحيث يحتوي كل صف على 4 مشاركين، مشكلة بذلك المجموعات الثلاث في نطاق شبكي منتظم وبمعادلة واحدة فقط في خلية مفردة تفيض مخرجاتها تلقائياً (Spill Range).
8.2 المقارنة التحليلية بين الطرق الكلاسيكية والحديثة
يستلزم الاختيار بين الطريقة التقليدية (الجمع بين `RAND` و `RANK` و `ROUNDUP`) والتقنيات الحديثة (المستندة إلى `SORTBY` و `RANDARRAY`) تقييماً منهجياً يراعي بيئة العمل، وأهداف المعالجة، ومستوى التوافقية التقنية المطلوب. يوضح الجدول المقارن التالي أبرز الفروق الجوهرية بين المدخلين:
| وجه المقارنة | الطريقة الكلاسيكية (RAND + RANK + ROUNDUP) | طرق المصفوفات الحديثة (SORTBY + RANDARRAY) |
|---|---|---|
| التوافقية البرمجية | شاملة ومطلقة (تعمل على كافة إصدارات إكسيل منذ 2003 وحتى اليوم). | مقيدة حصرياً بإصدارات Microsoft 365 و Excel 2021 والإصدارات السحابية. |
| الحاجة لأعمدة مساعدة | تتطلب عموداً مخصصاً للأرقام العشوائية وآخر للمعادلة المركبة. | لا تتطلب أي أعمدة مساعدة؛ تُكتب في خلية واحدة وتنتشر النتائج ذاتياً. |
| سهولة التدقيق والمراجعة | عالية جداً؛ يمكن تتبع الرتبة والقيمة العشوائية الفردية لكل مشارك. | منخفضة إلى متوسطة؛ العمليات تجري بالكامل داخل الذاكرة الافتراضية. |
| تثبيت وتجميد البيانات | يتطلب نسخ ولصق القيم للنطاق لتعطيل دالة RAND المتطايرة. | يتطلب تحويل مصفوفة الانسكاب بأكملها إلى قيم ثابتة لتجنب إعادة الفرز. |
| منحنى التعلم والصيانة | يتطلب فهم العلاقات النسبية والمطلقة وآليات التقريب الرياضي. | موجز ومباشر برمجياً، لكنه يتطلب فهماً لمفهوم السلوك الانسكابي للمصفوفات. |
يتضح من هذه المقارنة أن الطريقة الكلاسيكية تظل الخيار المنهجي الأفضل في السياقات البحثية والأكاديمية التي تتطلب توثيقاً دقيقاً لكل خطوة وإتاحة ورقة العمل لمراجعين قد يستخدمون إصدارات قديمة أو برمجيات جداول بديلة. في المقابل، تبرز الطرق الحديثة كخيار مثالي في بيئات الأعمال والمشاريع السريعة التي تعتمد بالكامل على البنية السحابية لشركة مايكروسوفت، حيث تكون السرعة والاختصار البرمجي هما الأولوية القصوى للمستخدم.
9. معالجة التحديات الشائعة والأخطاء المحتملة أثناء التوزيع العشوائي
9.1 التعامل مع الأحجام غير المتساوية للعينة الكلية
تنشأ إحدى أكثر العقبات المنهجية شيوعاً في التطبيق العملي عندما يكون الحجم الإجمالي للعينة ($N$) غير قابل للقسمة الصحيحة دون باقٍ على عدد المجموعات المستهدف ($G$). لنفترض، على سبيل المثال، أن العينة في دراستنا كانت تضم 14 مشاركاً بدلاً من 12، والمطلوب تقسيمهم إلى 3 مجموعات؛ في هذه الحالة ينتج عن القسمة كسر ($14 / 3 = 4.666$)، مما يجعل الحصول على مجموعات متطابقة تماماً في الحجم أمراً مستحيلاً من الناحية الحسابية البحتة.
إذا طُبقت المعادلة السابقة مباشرة دون ضبط دقيق لمقام القسمة في معادلة التقريب للأعلى، ستنشأ تشوهات في أحجام المجموعات؛ كأن تصبح المجموعة الأخيرة متضخمة أو مبتورة بشدة (تضم مشاركين اثنين فقط بينما تضم باقي المجموعات 5 مشاركين). لمعالجة هذه الإشكالية، يجب اعتماد استراتيجية توزيع البواقي المتوازنة وفق خطوتين منهجيتين:
- تحديد سعة السقف الأساسية: نقوم بحساب السعة المقربة للأعلى للمجموعة عبر المعادلة
INT(N/G) + 1للتعرف على الحجم الأقصى للمجموعات التي ستستقبل الفائض، أو استخدام دالة `ROUNDUP` بحذر من خلال صياغة المقام ليكون مساوياً للسعة القياسية المستهدفة. - استخدام صيغة الموديلو التناوبية (MOD): لتوزيع البواقي بعدالة مطلقة دون تضخيم مجموعة واحدة، يمكن اللجوء إلى معادلة تعتمد على باقي القسمة عبر دالة `MOD`. تُكتب الصيغة كالتالي في عمود المجموعات:
=MOD(RANK(B2, $B$2:$B$15) - 1, 3) + 1
تقوم هذه المعادلة الذكية بتدوير الرتب من 1 إلى 14 دورياً على الأرقام (1، 2، 3) بالتتابع؛ فيحصل الفرد الأول على 1، والثاني على 2، والثالث على 3، والرابع على 1، وهكذا دواليك. ينتج عن هذا التدوير مجموعتان تضمان 5 مشاركين ومجموعة واحدة تضم 4 مشاركين، وهو أدنى وأعدل فارق عددي ممكن رياضياً ($5, 5, 4$).
يضمن هذا الأسلوب الرياضي إدارة التفاوت الحجمي بأعلى قدر من التوازن المنهجي، مانعاً تركز الأفراد المتبقين في مجموعة واحدة، وهو ما يدعم استقرار التباين الإحصائي الداخلي للعينات أثناء الاختبارات البارامترية اللاحقة.
9.2 تصحيح أخطاء المراجع النسبية والمطلقة
يعد الخطأ الأكثر انتشاراً بين مستخدمي إكسيل أثناء تطبيق دالة `RANK` هو إغفال تثبيت النطاق المرجعي بالمراجع المطلقة (استخدام علامات `$`). فبدلاً من كتابة الصيغة السليمة RANK(B2, $B$2:$B$13)، يكتب البعض الصيغة بمراجع نسبية مجردة: RANK(B2, B2:B13).
عندما تُسحب هذه المعادلة الخاطئة لأسفل، ينزاح النطاق المرجعي تدريجياً مع كل صف؛ فالخلية `C3` ستفحص النطاق `B3:B14`، والخلية `C4` ستفحص النطاق `B4:B15`، وهكذا. يترتب على هذا الانزياح تشوه إحصائي جسيم؛ إذ تبدأ الدالة بمقارنة الأفراد بنطاقات فارغة أسفل الجدول، مما يؤدي إلى تكرار الرتب الأولى وظهور خلل فادح يتمثل في زيادة مفرطة في أعداد أفراد المجموعة رقم 1 وظهور رسائل خطأ مثل `#N/A` في الصفوف المتأخرة، وهو ما يقوض التوزيع بأكمله.
ولتصحيح هذا الخطأ المنهجي والوقاية منه، يُنصح بتطبيق الإجراءات التدقيقية التالية:
- استخدام مفتاح الاختصار F4 فور تحديد نطاق البيانات أثناء كتابة المعادلة، حيث يقوم إكسيل بإدراج علامات الدولار تلقائياً لتحويل المرجع النسبي إلى مطلق (`$B$2:$B$13`).
- استخدام أدوات تدقيق الصيغ من تبويب “صيغ” (Formulas)، وتحديداً أداة “تتبع السوابق” (Trace Precedents)، والتي ترسم أسهماً زرقاء مرئية توضح بدقة الخلايا التي تغذي المعادلة، مما يتيح التحقق الفوري من إحاطة الإطار بكامل نطاق الأرقام العشوائية لكافة الصفوف دون انحراف.
- التأكد من التنسيق الرقمي للعمود `B` وخلوه من المسافات المخفية أو الأرقام المخزنة كنصوص؛ إذ يؤدي تخزين القيم العشوائية كنصوص إلى عجز دالة `RANK` عن قراءتها، مسببة ظهور الخطأ الشائع `#VALUE!` وتوقف التسلسل الحسابي.
10. معايير التحقق من الصدق والعدالة في التوزيع العشوائي عبر إكسيل
10.1 فحص تكافؤ الخصائص والمتغيرات بين المجموعات المشكلة
لا تتوقف المسؤولية المنهجية عند مجرد الحصول على توزيع عشوائي متكافئ عددياً عبر الدوال، بل تمتد لتشمل فحص مدى نجاح هذا التوزيع في تحقيق التوازن الفعلي للمتغيرات الديموغرافية والنوعية المهمة (مثل: الجنس، والمؤهل الدراسي، وسنوات الخبرة). في العينات الصغيرة—مثل عينتنا المكونة من 12 فرداً—ترتفع احتمالية حدوث اختلالات عرضية بحتة بالصدفة (Chance Imbalance)، كأن تتركز الإناث جميعهن في المجموعة الأولى بالصدفة، مما يهدد بتلويث النتائج التجريبية بمتغير مربك لم يتم تحييده بنجاح.
لإجراء هذا التدقيق الإحصائي بكفاءة، يُعد استخدام الجداول المحورية (Pivot Tables) أسرع وأدق وسيلة عملية. نقوم بتحديد الجدول بالكامل ثم ندرج جدولاً محورياً نضع فيه “المجموعة” في حقل الصفوف، والمتغير الديموغرافي (مثل الجنس) في حقل الأعمدة، مع سحب معرف المشارك إلى حقل القيم مع ضبط المعيار ليصبح “العدد” (Count). سيعرض الجدول فوراً مصفوفة تقاطعية توضح توزع الذكور والإناث عبر المجموعات 1 و2 و3.
يمكن أيضاً تدقيق التكافؤ عبر الدوال المباشرة باستخدام دالة العد المشروط `COUNTIFS`. فلحساب عدد الإناث في المجموعة الأولى، نستخدم الصيغة التالية:
=COUNTIFS($C$2:$C$13, 1, $D$2:$D$13, "أنثى")
بافتراض أن عمود الجنس هو `D`. إذا كشف الفحص عن وجود تحيز صارخ لا يتناسب مع طبيعة التجربة (مثل تمركز 100% من فئة حرجة في مجموعة واحدة)، يحق للباحث منهجياً رفض هذا السحب المحدد وإعادة تفعيل التوزيع العشوائي من جديد قبل تثبيت البيانات، أو اللجوء إلى التوزيع العشوائي الطبقي (Stratified Randomization)؛ لضمان تمثيل كافة الطبقات بالتساوي في كل مجموعة منذ البداية.
10.2 التوثيق العلمي وتكرارية التوزيع العشوائي
تفرض معايير النزاهة العلمية المعاصرة—المتوافقة مع إرشادات النشر الأكاديمي الصارمة مثل بيان CONSORT للتجارب الميدانية—توثيقاً كاملاً ومفصلاً لآلية توليد المجموعات العشوائية لضمان قدرة الباحثين الآخرين على تكرار نفس الإجراءات بدقة (Replicability). إن الاكتفاء بذكر عبارة “تم التوزيع عشوائياً بواسطة إكسيل” لم يعد مقبولاً في الأوساط العلمية الرصينة دون بيان الآلية الرياضية المتبعة.
يتطلب التوثيق العلمي الرصين تضمين العناصر التالية في ملحق الدراسة أو تقرير التحليل الإحصائي:
- تحديد إصدار برنامج إكسيل المستخدم بدقة، وتوضيح الخوارزميات والدوال المطبقة في كل خطوة بالمعادلات الصريحة المكتوبة.
- الاحتفاظ بنسخة أرشيفية خام مشفرة ومؤرخة زمنياً من ملف العمل الأصلي قبل وبعد تطبيق إجراء “لصق القيم”، لحفظ الأرقام العشوائية الفعلية التي تولدت في اللحظة الأولى وسجلات الوقت الخاصة بها.
- بيان المعايير المتبعة للتعامل مع أي تفاوت في أحجام المجموعات، والإفصاح الكامل عن أي استبعاد لأي مشارك وأسباب ذلك الاستبعاد، وتوضيح ما إذا كانت هناك أي اختبارات قبلية لتوازن المتغيرات المصاحبة قد أُجريت عقب اكتمال التشكيل.
يسهم هذا المستوى العالي من الشفافية المنهجية في رفع موثوقية العمل، وحماية الباحث من أي اتهامات بالانحياز أو التلاعب بتركيبة المجموعات، ويمنح النتائج المترتبة على التجربة أو المشروع وزناً علمياً وقانونياً لا يمكن الطعن في سلامته الإجرائية.
خاتمة
تناول هذا الدليل المنهجي استعراضاً تحليلياً وتطبيقياً شاملاً لآليات إنشاء المجموعات العشوائية في برنامج مايكروسوفت إكسيل. من خلال تفكيك المنطق الإحصائي لدوال التوليد (`RAND`) والترتيب (`RANK`) والتقريب (`ROUNDUP`)، اتضح أن بناء مجموعات متكافئة بدقة ليس وليد الصدفة العشوائية غير المنضبطة، بل هو نتاج تطبيق صارم لمعادلات رياضية مصممة بعناية لضمان العدالة الاحتمالية والتوازن العددي التام، كما ظهر جلياً في دراسة الحالة المطبقة على 12 مشاركاً مقسمين إلى 3 مجموعات متساوية.
إن إتقان هذه المهارات البرمجية لا يقتصر على مجرد كتابة الصيغ داخل الخلايا، بل يمتد إلى الوعي بخصائص بيئة الجداول الحسابية كالتطاير وإعادة الاحتساب، وإتقان تقنيات التجميد المنهجي عبر “لصق القيم”، فضلاً عن مواكبة التحولات التقنية الحديثة عبر استخدام المصفوفات الديناميكية مثل `SORTBY` و `RANDARRAY`. بتطبيق المعايير الإحصائية للتحقق من تكافؤ الخصائص والالتزام بقواعد التوثيق العلمي الصارم، يتحول إكسيل من مجرد برنامج مكتبي يومي إلى مختبر إحصائي متكامل يضمن سلامة المنهجية وموثوقية المخرجات في شتى الأبحاث والتطبيقات العملية.
المراجع
- Field, A. (2018). Discovering statistics using IBM SPSS statistics (5th ed.). SAGE Publications.
- Matsumoto, M., & Nishimura, T. (1998). Mersenne Twister: A 623-dimensionally equidistributed uniform pseudo-random number generator. ACM Transactions on Modeling and Computer Simulation, 8(1), 3–30. https://doi.org/10.1145/272991.272995
- Microsoft Support. (n.d.). RAND function. Microsoft Corporation. Retrieved from https://support.microsoft.com/en-us/office/rand-function-4cbfa695-8869-4e88-8d90-021ea9f52113
- Microsoft Support. (n.d.). SORTBY function. Microsoft Corporation. Retrieved from https://support.microsoft.com/en-us/office/sortby-function-cd2d7a62-1b9a-435c-810d-9b321329c334
- Schulz, K. F., & Grimes, D. A. (2002). Generation of allocation sequences in randomised trials: Chance, not choice. The Lancet, 359(9305), 515–519. https://doi.org/10.1016/S0140-6736(02)07683-3
- Walkenbach, J. (2015). Microsoft Excel 2016 Bible. John Wiley & Sons.