
يمثل التعامل مع معضلات الفقدان في البيانات الإحصائية أحد أهم التحديات المنهجية والرياضية التي تواجه الباحثين والمحللين في مختلف التخصصات العلمية، لا سيما في ميادين القياس السلوكي والعلوم الاجتماعية والطب الحيوي. تتطلب المعالجة الرصينة للبيانات وجود أدوات برمجية مرنة ودقيقة تسبر أغوار الهياكل المصفوفية المعقدة دون الإخلال بخصائص المتغيرات أو تحميل بيئة التشغيل أعباء تحويلية لا مبرر لها. وضمن هذا السياق، تبرز بيئة نظام التحليل الإحصائي نظام التحليل الإحصائي SAS بوصفها منظومة رائدة وفرت ترسانة من الدوال الحسابية والمنطقية الموجهة خصيصاً لتعزيز كفاءة تنقية البيانات وتجهيزها للنمذجة المتقدمة.
تكتسب دالة CMISS في نظام SAS أهمية استثنائية بوصفها حلاً برمجياً متكاملاً يتجاوز القيود الصارمة التي فرضتها الدوال التقليدية الموروثة؛ إذ تم تصميم هذه الدالة لتعمل بمثابة عداد أفقي (Row-wise Counter) يرصد عدد المتغيرات المفقودة عبر سجلات البيانات لكل مفحوص أو وحدة تحليل تجريبية بشكل مستقل. وإن ما يمنح هذه الدالة تفوقها الملحوظ هو قدرتها المتأصلة على المعالجة المتزامنة للمتغيرات ذات الطبيعة المتباينة، متجاوزة الحاجز الحسابي التقليدي الفاصل بين الأعمدة الرقمية (Numeric Variables) والسلاسل الرمزية النصية (Character Variables).
يهدف هذا الدليل الأكاديمي الشامل إلى تفكيك الآليات الدقيقة لعمل دالة CMISS في نظام SAS، وتوضيح بنيتها النحوية وأدوارها الوظيفية من خلال دراسة تطبيقية معمقة ونماذج برمجية موثقة. سيتناول المقال الجوانب المنهجية المرتبطة بتشخيص أنماط الفقدان، ويوضح استراتيجيات توظيف معاملات النطاق وقواعد التصفية والتصنيف، مع التركيز على انعكاسات ذلك على بحوث القياس والتقويم السلوكي، بما يضمن سلامة النتائج وموثوقية الاستنتاجات الإحصائية النهائية.
1. مقدمة عامة حول دالة CMISS في نظام التحليل الإحصائي SAS
1.1 مفهوم الدالة CMISS وطبيعة عملها البرمجي
تُعرّف دالة CMISS في لغة SAS البرمجية بأنها دالة تجميعية أفقية تنتمي إلى عائلة دوال رصد القيم وتدقيق السجلات؛ حيث صُممت لتوليد قيمة عددية صحيحة تمثل مجمل القيم المفقودة ضمن مصفوفة المدخلات المحددة لكل صف (Observation) داخل خطوة معالجة البيانات (DATA Step). تختلف هذه الدالة جذرياً عن الإجراءات التلخيصية التي تحسب المفقودات عمودياً على مستوى العينة الكلية؛ إذ ينحصر نطاق عملها في رصد حالة المتغيرات الممررة إليها لحظياً ضمن ناقل بيانات البرنامج (Program Data Vector – PDV)، مما يجعلها الأداة الأساسية للتقييم الفردي لاكتمال استجابات السجلات المفردة.
تتيح الدالة مرونة برمجية فائقة من خلال إلغاء القيود النمطية المفروضة على بنية المتغيرات؛ فبينما تتطلب معظم الدوال الرياضية تجانساً تاماً في طبيعة البيانات، تمتلك CMISS القدرة الذاتية على فك شفرات السلاسل النصية والأرقام الحسابية في آن واحد، وفحص ما إذا كانت الخانات المخصصة لها خالية من المحتوى المفيد أو تحوي دلالات الفقدان القياسية. هذا السلوك البرمجي يرفع العبء عن كاهل المبرمج، حيث لا يتطلب استدعاؤها إجراء عمليات تحويل قسري للنوع (Type Casting) أو تجزئة الفحص إلى مراحل متعاقبة، مما يقلل من احتمالية حدوث أخطاء وقت التشغيل (Runtime Errors).
تتجلى الأهمية المحورية لهذه الدالة في مرحلة هندسة البيانات والتنظيف القبلي (Data Cleansing)؛ فالبيانات الخام نادراً ما تأتي مكتملة البنية، لا سيما تلك المجمعة من خلال الاستبانات الإلكترونية أو الاختبارات السلوكية المتعددة. إن استخراج عدّاد إجمالي للمفقودات على مستوى كل صف يُعد بمثابة مؤشر تشخيصي فوري يُمكّن الباحث من بناء معايير الفرز الأولي، واستبعاد الاستجابات العشوائية، وتهيئة مصفوفة التغاير للتحليلات البارامترية المعقدة دون الوقوع في مضلات الحذف التلقائي التي تمارسها إجراءات النمذجة الرياضية اللاحقة.
1.2 أهمية رصد القيم المفقودة في التحليلات الإحصائية السلوكية
تشكل البيانات المفقودة تهديداً جسيماً للخصائص السيكومترية لأدوات القياس، إذ يؤدي إهمال التعامل المنهجي معها إلى تقويض مستويات الصدق الداخلي (Internal Validity) والصدق الخارجي (External Validity) للبحوث النفسية والتربوية. عندما تنخفض أحجام العينات الفعلية نتيجة الحذف الإجمالي للحالات غير المكتملة (Listwise Deletion)، تتضاءل القوة الإحصائية (Statistical Power) للاختبارات، مما يزيد من احتمالية الوقوع في الخطأ من النوع الثاني (Type II Error) والعجز عن رصد الفروق أو التأثيرات الجوهرية حتى لو كانت موجودة فعلياً في مجتمع الدراسة.
علاوة على ذلك، فإن آليات الفقدان نادراً ما تكون عشوائية بحتة في القياس النفسي والسلوكي؛ فغياب الاستجابة عن فقرة معينة قد يرتبط بحساسية الموضوع، أو طول الاختبار، أو مستويات القلق والدافعية لدى المفحوص. يشير الباحث جيفري شينير في أطروحته المرجعية إلى أن جودة البيانات التشخيصية والسلوكية تعد الركيزة الأساسية للتنبؤ الدقيق بالأداء والتحصيل الأكاديمي، وأن أي اختلال في اكتمال سجلات الفحص المبكر يولد تشوهات مباشرة في نماذج الانحدار والتقدير المستقبلي (Chenier, 2012). بناءً على ذلك، يصبح رصد حجم الفقدان لكل مشارك خطوة إلزامية لتحديد أنماط الانحياز المحتملة وفرز البيانات ذات الوثوقية العالية.
تفرض التقاليد الأكاديمية الصارمة والمعايير التوجيهية للجمعيات العلمية، مثل الجمعية الأمريكية لعلم النفس (APA)، الشفافية المطلقة في توثيق نسب اكتمال البيانات عبر تقارير تفصيلية تبيّن حجم الاستجابات المفقودة وآلية معالجتها. يتيح توظيف أدوات فحص الفقدان الفردية، وفي مقدمتها دالة CMISS، إمكانية تصدير قياسات دقيقة تصف بدقة معدلات استجابة الأفراد للبنود، وتبرر قرارات الإبقاء أو الاستبعاد، وتدعم خيارات التعويض الرياضي لاحقاً، مما يضفي صبغة الرصانة المنهجية على النتاج البحثي ككل.
1.3 الفروق الجوهرية بين CMISS والدوال البديلة في SAS
تتضمن بيئة برمجة SAS عدداً من الدوال المصممة لفحص البيانات المفقودة، إلا أن كلاً منها يخضع لقيود بنيوية تميزها عن دالة CMISS. من أبرز هذه الأدوات دالة NMISS التقليدية؛ فرغم كفاءتها العالية في البيئات الحسابية، إلا أنها مقيدة بصرامة بالمتغيرات الرقمية فقط. فإذا تم تمرير متغير نصي إلى دالة NMISS، يقوم مترجم SAS بمحاولة تحويل السلسلة النصية إلى رقم، مما يولد تحذيرات خطأ في السجل البرمجي (SAS Log) ويؤدي غالباً إلى إسناد قيم مفقودة خاطئة ناجمة عن فشل التحويل بدلاً من رصد الفقدان الفعلي للمتغير ذاته.
في المقابل، تظهر دالة MISSING كأداة منطقية ثنائية (Boolean) تفحص حالة متغير واحد فقط في كل استدعاء؛ حيث تعيد القيمة الحسابية 1 إذا كان المتغير مفقوداً والقيمة 0 إذا كان مكتملاً. ورغم أن دالة MISSING تقبل كلاً من المتغيرات الرقمية والنصية، إلا أن استخدامها لاحتساب المفقودات عبر مصفوفة عريضة من المتغيرات يتطلب صياغة تكرارية مطولة عبر حلقات (DO Loops) واستخدام مصفوفات برمجية مؤقتة (Arrays)، أو كتابة عمليات جمع حسابية متسلسلة ومرهقة تزيد من احتمالية الخطأ الطباعي وتثقل كاهل الشفرة المصدرية.
يلخص الجدول المنهجي التالي الفروق الجوهرية بين هذه الدوال المتقاربة:
| خاصية المقارنة | دالة CMISS | دالة NMISS | دالة MISSING |
|---|---|---|---|
| نوع المتغيرات المدعومة | رقمية ونصية في آن واحد | رقمية فقط | رقمية أو نصية (أحادية) |
| عدد المدخلات المقبولة | مدخلات متعددة أو نطاقات متسلسلة | مدخلات متعددة أو نطاقات متسلسلة | مدخل فردي واحد فقط |
| طبيعة المخرج الحسابي | مجموع عددي للمفقودات (0، 1، 2، …) | مجموع عددي للمفقودات الرقمية | قيمة منطقية ثنائية (0 أو 1) |
| التحويل التلقائي للأنواع | لا يحدث (فحص ذاتي للنوعين) | تحويل إجباري فاشل للنصوص | لا يحدث (فحص مباشر للمدخل) |
تُظهر هذه المقارنة بوضوح تفوق دالة CMISS في التعامل مع التصاميم متعددة الأبعاد والاستبانات المعقدة التي تجمع في السجل الواحد بين السمات التصنيفية النصية (كالجنس، والمستوى التعليمي، والحالة الاجتماعية) والمقاييس المتصلة والمصفوفات الرقمية لاختبارات الأداء والمواقف.
2. البنية النحوية والصيغة البرمجية لدالة CMISS
2.1 الصيغة القياسية ومعاملات الدالة في SAS
تعتمد البنية النحوية العامة لدالة CMISS على نسق تركيبي مرن وسهل الاستيعاب للمبرمجين من مختلف مستويات الخبرة، حيث تُصاغ الدالة برمجياً وفق الهيكل الرياضي التالي:
CMISS(argument-1 <, argument-2, ...>)
تمثل المعاملات (Arguments) أسماء المتغيرات التي يرغب الباحث في إدراجها ضمن نطاق العد؛ وتتميز هذه المعاملات بكونها غير محدودة بعدد حرج، حيث يمكن للمحلل تمرير متغيرين اثنين أو العشرات منها داخل القوسين، مع الفصل الإلزامي بين كل متغير وآخر باستخدام الفاصلة اللاتينية المعتادة في صياغة توابع لغة SAS.
تعيد الدالة ناتجاً رياضياً ينتمي إلى فئة الأرقام الصحيحة الموجبة، يبدأ من الصفر (0) وينتهي عند إجمالي عدد المعاملات الممررة في حال كانت جميعها فارغة تماماً. تخضع هذه المعاملات لمعايير التحقق النحوي الصارم للغة، حيث يتم فحص وجود المتغيرات في مصفوفة البيانات المعنية مسبقاً، ويُشترط كتابة أسماء المتغيرات وفق قواعد التسمية القياسية للنظام دون إقحام رموز غير مدعومة خارج الأطر المعيارية.
2.2 استخدام معامل النطاق OF مع المتغيرات المتتالية
تتطلب كتابة الشفرات البرمجية ذات الكفاءة العالية في بيئة SAS استخدام الكلمة المفتاحية OF متى ما رغب المبرمج في تمرير قوائم أو نطاقات متسلسلة من المتغيرات داخل دوال التجميع. وتُعد هذه الكلمة بمثابة مؤشر نحوي يوجه المترجم إلى معاملة السلسلة التالية كقائمة من المتغيرات المستقلة المطلوب ضمها إلى المعاملات الحسابية، وليس كعملية طرح رياضية تقليدية، وهو الخطأ الشائع الذي يقع فيه العديد من المبتدئين.
تتيح لغة SAS عدة أساليب لصياغة النطاقات عند دمجها مع OF داخل دالة CMISS، من أبرزها:
- نطاق التسلسل الاسمي البسيط (-): ويُستخدم مع المتغيرات التي تشترك في جذر تسمية متطابق وتنتهي بأرقام تسلسلية صحيحة متتابعة، وتُكتب بالصيغة:
cmiss(of Item1-Item20)، حيث تشمل هذه التعليمة كافة البنود من الأول إلى العشرين دون استثناء. - نطاق الترتيب الفيزيائي المزدوج (–): ويُستخدم لتضمين كافة المتغيرات الواقعة بين متغير بداية ومتغير نهاية وفق ترتيبها الفعلي في مصفوفة البيانات بغض النظر عن أسمائها أو تجانس أنواعها، مثل:
cmiss(of Gender -- Final_Score). - نطاق البادئة المشتركة (:): ويُمكّن الباحث من فحص كافة المتغيرات التي تبدأ بحروف معينة دون الحاجة لمعرفة عددها الإجمالي، مثل:
cmiss(of Q_:)لفحص جميع الأسئلة الاستطلاعية التي تبدأ بالبادئة المحددة.
يسهم التوظيف السليم لمعامل النطاق في اختصار مئات الأسطر البرمجية في قواعد البيانات العريضة التي تحوي استبانات مقاييس الشخصية، مما يوفر جهداً كبيراً ويمنع حدوث السهو البشري الناتج عن إغفال بعض المتغيرات أثناء الكتابة اليدوية المطولة.
2.3 التعامل المتكامل مع المتغيرات الرقمية والنصية في آن واحد
من أهم المزايا التقنية التي تنفرد بها خوارزمية CMISS هي آليتها المتوازية في قراءة بنيات البيانات المختلفة؛ فعندما يمرر المبرمج قائمة مختلطة تضم أسماء وقياسات درجات وملاحظات كيفية، لا تقوم الدالة بمحاولة توحيد نوع البيانات في مساحة تخزين مؤقتة، بل توجه كل متغير إلى مسار التدقيق الخاص بنوعه مباشرة داخل نواة الدالة البرمجية.
في حالة المتغيرات النصية، تتحقق الدالة تلقائياً مما إذا كانت السلسلة الرمزية ذات طول صفري، أو تتألف بالكامل من مسافات بيضاء فارغة، أو تحتوي على الفراغ الحرفي القياسي الممثل بالمسافة (Blank). أما بالنسبة للمتغيرات الرقمية، فتتحقق الدالة مما إذا كانت الخانة تحمل النقطة الحسابية المفردة الدالة على الفقدان الأساسي، أو أياً من الرموز المفقودة الخاصة التي يدعمها نظام SAS. وتتم هذه السلسلة من العمليات التحليلية في نفس الدورة الزمنية لمعالجة الصف دون أي تباطؤ في سرعة التنفيذ الحسابي للبيانات.
تحمي هذه الآلية التكاملية الباحثين من رسائل التحذير المزعجة التي تملأ سجل النظام (SAS Log) عند محاولة تشغيل دوال غير مخصصة للخلط النوعي، كما تضمن بقاء المتغيرات الأصلية في حالتها التخزينية السليمة دون المساس بخصائصها أو تعريضها لأخطاء التشذيب الحسابي غير المتطابق.
3. بناء وتجهيز مجموعة بيانات افتراضية للتطبيق العملي
3.1 إنشاء مجموعة البيانات باستخدام خطوة DATA Step
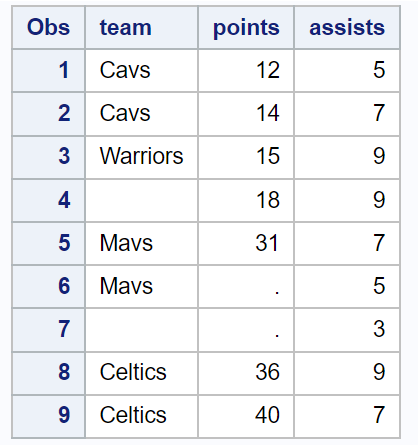
لإرساء التطبيق العملي على أسس إجرائية واضحة، سنقوم بإنشاء مصفوفة بيانات افتراضية تحاكي سجلات أداء رياضي وسلوكي لمجموعة من الرياضيين، بحيث تشمل متغيرات نصية ورقمية ذات أنماط فقدان متنوعة، بما في ذلك الفقدان الكامل، والجزئي، وحالات الاكتمال التام. تتضمن هذه المصفوفة المتغيرات التالية: اسم اللاعب (Player)، والفريق التابع له (Team)، وعدد النقاط المسجلة (Points)، وعدد المساعدات الحاسمة (Assists)، ومعدل الارتداد (Rebounds).
تُنفذ خطوة بناء البيانات عبر تعليمة DATA باستخدام صيغة الإدخال المباشر للأسطر (DATALINES)، حيث يتم تمثيل المفقودات الرقمية بالنقطة الرياضية المعتادة (.) وتمثيل المفقودات النصية بترك فراغ واضح أو استخدام مسافة فارغة محددة، كما يوضح الكود البرمجي التالي:
data athletes_data;
input Player $ Team $ Points Assists Rebounds;
datalines;
Ahmed Falcons 24 6 8
Zaid . 18 4 .
Omar Eagles . 9 5
Khalid . . . .
Tariq Hawks 31 . 11
Sami Lions 15 7 4
;
run;
يلاحظ في هذا الهيكل التجريبي أن سجل اللاعب “Ahmed” وسجل اللاعب “Sami” يمثلان حالات اكتمال تام تخلو من أي فقدان، في حين يتضمن سجل “Zaid” فقداً مزدوجاً في المتغير النصي (Team) والمتغير الرقمي (Rebounds). أما سجل اللاعب “Khalid” فيمثل حالة استثنائية من الفقدان شبه الكلي؛ حيث لم يتم تسجيل سوى الاسم فقط مع غياب كافة المؤشرات الأخرى، مما يجعله نموذجاً مثالياً لاختبار قدرات الفرز والتصفية اللاحقة.
3.2 استعراض الهيكل الأولي للبيانات عبر PROC PRINT
عقب إتمام معالجة خطوة DATA بنجاح وتأكيد خلوها من الأخطاء عبر السجل البرمجي، يُستدعى الإجراء التوثيقي PROC PRINT لعرض مصفوفة البيانات في نافذة المخرجات (SAS Output Viewer). تتيح هذه الخطوة الاستطلاعية للمحلل الإحصائي فحص البنية البصرية للبيانات والتحقق من محاذاة الأعمدة وسلامة استقبال النظام لقيم المدخلات المختلفة وفق التنسيق المحدد سلفاً.
يُصاغ أمر الطباعة الاستعراضي بصورة قياسية كالتالي:
proc print data=athletes_data noobs;
run;
يؤدي تشغيل هذا الإجراء إلى ظهور جدول منظم يوضح بدقة كيفية استيعاب النظام للقيم المفقودة؛ إذ تظهر الحقول الرقمية المفقودة على هيئة نقاط مفردة، بينما تظهر الحقول النصية الفارغة كمساحات بيضاء نظيفة. إن التحقق البصري المبدئي يمنح الباحث الثقة في أن مصفوفة البيانات تعكس تماماً الواقع التجريبي المصمم لاختبار أداء دالة CMISS قبل الاعتماد على مخرجاتها التلقائية في المعالجات الأعمق.
3.3 تحليل أنماط الفقدان الملاحظة في مصفوفة الاختبار
عند التعمق في فحص مصفوفة الاختبار المعدة، يتبين أنها تغطي تشكيلة متنوعة ومقصودة من حالات الفقدان المتباينة التي تصادف الباحثين واقعياً. وتتمثل هذه الحالات في:
- فقدان فردي نقي للمتغيرات النصية: كما هو الحال في بعض السيناريوهات التي يمتنع فيها المفحوص عن تحديد انتمائه الفئوي أو الجغرافي مع الإجابة عن كافة المؤشرات الكمية.
- فقدان متزامن مختلط: يجمع بين المتغيرات الفئوية (النصية) والمقاييس المستمرة (الرقمية)، كما تم تجسيده في حالة اللاعب “Zaid”.
- فقدان جزئي للمتغيرات الرقمية: حيث يغيب مقياس واحد فقط، كحالة اللاعب “Tariq” الذي يفتقر لبيانات المساعدات فقط مع تسجيل بقية القياسات.
- الفقدان الحرج المتعدد: والمتمثل في غياب الغالبية العظمى من البيانات (حالة “Khalid”)، والتي تستدعي عادة الإقصاء من التحليلات المعلمية في الدراسات الرصينة.
إن نمذجة هذه الحالات التنافسية المتباينة تسهم في إبراز قدرة دالة CMISS على تقديم تشخيص موحد ومتسق رياضياً دون الحاجة إلى تشغيل شفرات متعددة أو معقدة لكل فئة من المتغيرات على حدة.
4. التطبيق العملي: احتساب إجمالي القيم المفقودة لكل صف
4.1 صياغة استعلام SAS لحساب متغير إجمالي المفقودات
لحساب إجمالي المفقودات لكل صف بدقة ومرونة، نقوم بإنشاء خطوة معالجة جديدة (DATA Step) تعتمد على مصفوفة البيانات السابقة عبر تعليمة SET، ويتم من خلالها اشتقاق متغير جديد يحمل اسماً دلالياً واضحاً وليكن total_missing. سنعتمد في هذا التطبيق على تقنية النطاق الفيزيائي المزدوج لتضمين كافة المتغيرات الممتدة من عمود الفريق وحتى عمود الارتدادات.
يتم تطبيق الدالة وفق الشيفرة البرمجية المعتمدة التالية:
data athletes_calculated;
set athletes_data;
total_missing = cmiss(of team — rebounds);
run;
يُعنى أمر of team -- rebounds بتوجيه الدالة لحساب كافة الخانات الفارغة في أي متغير يقع فيزيائياً في ناقل بيانات البرنامج بين هذين الحدين، بما يشمل المتغيرات: Team (نصي)، وPoints (رقمي)، وAssists (رقمي)، وRebounds (رقمي). وعند تشغيل الشفرة، يُظهر سجل النظام اكتمال العملية بنجاح دون أي تحذيرات تتعلق باختلاف بنية المتغيرات أو تعذر القراءة.
4.2 تفسير المخرجات الرياضية ومقارنتها بالبيانات الأصلية
لاستجلاء النتائج والتحقق من صحتها الحسابية، نستدعي إجراء الطباعة لعرض مجموعة البيانات الجديدة المحتوية على عمود النتائج المكتشفة:
proc print data=athletes_calculated noobs;
run;
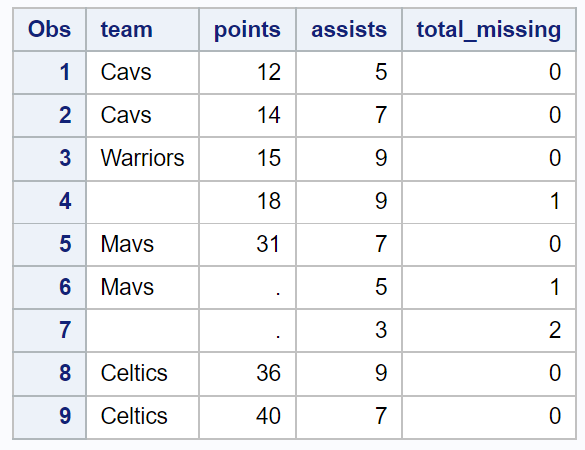
تتمخض عن هذه العملية المخرجات الإحصائية الموضحة في الجدول التحليلي التالي:
| Player | Team | Points | Assists | Rebounds | total_missing |
|---|---|---|---|---|---|
| Ahmed | Falcons | 24 | 6 | 8 | 0 |
| Zaid | 18 | 4 | . | 2 | |
| Omar | Eagles | . | 9 | 5 | 1 |
| Khalid | . | . | . | 4 | |
| Tariq | Hawks | 31 | . | 11 | 1 |
| Sami | Lions | 15 | 7 | 4 | 0 |
يؤكد التحليل التدقيقي للجدول دقة حسابات دالة CMISS؛ فاللاعبان “Ahmed” و”Sami” حصلا على القيمة 0، مما يشير بوضوح إلى خلو سجلاتهما من أي فقدان. أما اللاعب “Zaid”، فقد رصدت الدالة لديه قيمتين مفقودتين بدقة: إحداهما نصية والأخرى رقمية، ليصبح ناتج total_missing مساوياً لـ 2. وسجل اللاعب “Omar” فقداناً فردياً في النقاط (1)، في حين بلغت القيمة ذروتها لدى اللاعب “Khalid” برصيد 4 مفقودات تشمل كافة القياسات المستهدفة بالفحص، مما يثبت نجاح الدالة التام في قراءة شتى الحالات والظروف بكفاءة مطلقة.
4.3 كفاءة تقنية النطاق المزدوج (–) مقارنة بالسرد اليدوي
يوفر استخدام تقنية النطاق المزدوج (Double-Dash Range) ميزة تشغيلية كبرى مقارنة بالسرد اليدوي المفصل للمتغيرات، خاصة عندما تتسع المصفوفة الإحصائية لتشمل مئات الأعمدة. فالصيغة cmiss(of team -- rebounds) تتيح للمحلل اختزال الجهد والوقت بصورة ملحوظة، دون الحاجة لكتابة: cmiss(team, points, assists, rebounds)، الأمر الذي يقضي على فرص السهو ونسيان بعض المتغيرات الحرجة.
ومع ذلك، يجب على الباحث التحلي بالحذر المنهجي عند استخدام هذا الأسلوب؛ إذ إن النطاق المزدوج يعتمد كلياً على الترتيب الفيزيائي للمتغيرات في مساحة التخزين الداخلية لمجموعة البيانات. فإذا طرأ تغيير غير مقصود على موضع الأعمدة أثناء عمليات الاستيراد الخارجي أو الدمج الهيكلي، فقد يشمل النطاق متغيرات لم تكن في الحسبان، أو يستثني أعمدة مهمة. لذلك يُنصح دائماً بالتحقق المسبق من ترتيب المتغيرات عبر إجراء PROC CONTENTS، أو اللجوء إلى التسميات البادئة (Prefix Ranges) إذا كان الترتيب الفيزيائي عرضة للتغيير.
5. التعامل المتقدم مع المتغيرات النصية والرقمية بواسطة CMISS
5.1 آليات التعرف على السلاسل النصية الفارغة (Blank Strings)
تعتمد دالة CMISS في فحص المتغيرات النصية على خوارزمية ذكية لا تقتصر على التحقق من الطول الاسمي للحقل الرمزي، بل تمتد لتفحص القيمة المخزنة فعلياً في الذاكرة. في لغة SAS، إذا كان المتغير النصي يحتوي على فراغات فقط (سواء كانت مسافة واحدة أو سلسلة من المسافات الناتجة عن محاذاة الحقول)، فإن الدالة تحتسبه تلقائياً كقيمة مفقودة وتزيد عدّاد النقص بمقدار واحد صحيح.
مع ذلك، يجب الانتباه إلى النصوص التي قد يُدخلها جامعو البيانات كرموز تعبيرية عن الغياب أو الفقدان، مثل النصوص التوصيفية ‘NA’ أو ‘None’ أو ‘Missing’. هذه النصوص تُعتبر برمجياً سلاسل حرفية ذات قيمة حقيقية، ولن تحتسبها CMISS كبيانات فارغة. لذلك، تتطلب الممارسة التحليلية الرصينة إجراء مرحلة تطهير سابقة لدالة CMISS يتم فيها تحويل هذه النصوص الاصطلاحية إلى فراغات قياسية، مع استخدام دوال التشذيب مثل STRIP وTRIM لإزالة أي شوائب رمزية قد تضلل خوارزمية الفحص.
5.2 معالجة القيم الرقمية المفقودة القياسية والخاصة
تتفوق بيئة SAS على كثير من الحزم الإحصائية المنافسة بدعمها لمنظومة القيم المفقودة الخاصة (Special Missing Values). فبالإضافة إلى القيمة المفقودة القياسية المتمثلة بالنقطة الفردية (.)، يوفر النظام 27 رمزاً مفقوداً خاصاً تبدأ بنقطة يتبعها رمز حرفي (.A حتى .Z) أو نقطة يتبعها خط سفلي (._). وتُستخدم هذه الرموز المتقدمة في البحوث الميدانية المعقدة للتفريق المنهجي بين أسباب الفقدان المتنوعة (مثل: .R لرفض المفحوص الإجابة، و.N لعدم انطباق السؤال عليه، و.A لغياب المبحوث لظرف طارئ).
تمتلك دالة CMISS القدرة الرياضية التامة على رصد كافة هذه القيم المفقودة الخاصة ومعاملتها تلقائياً كقيم غائبة؛ فلو احتوى عمود النقاط على القيمة .R للدلالة على الرفض، ستقوم الدالة باحتساب هذا الحقل ضمن المفقودات وزيادة المتغير الإجمالي دون إثارة أي استثناء برمجي، مما يحافظ على استمرارية التنفيذ ويضمن شمولية المؤشرات الوصفية للفقدان بمختلف تفرعاته السببية.
5.3 مقارنة عملية لأداء الدالة بين الأنماط المتجانسة والمختلطة
في قواعد البيانات فائقة الضخامة (Big Data) التي تحوي ملايين القيود وعشرات المتغيرات، يصبح استهلاك موارد الخادم وزمن التنفيذ الحسابي (CPU Time) معياراً حاسماً للمفاضلة البرمجية. عند تطبيق دالة CMISS على مصفوفات متجانسة بالكامل (أرقام فقط أو نصوص فقط)، تُظهر الدالة سرعة فائقة تضاهي سرعة الدوال المتخصصة مثل NMISS، مستفيدة من التخصيص المحسن للمصفوفات داخل النواة الحسابية للنظام.
أما عند تطبيقها على المصفوفات المختلطة المعقدة، تبرز القيمة الاقتصادية الحقيقية للدالة؛ إذ تُغني الباحث تماماً عن الحاجة لتشغيل دورات استدعاء تحويلية مزدوجة تتطلب إنشاء مجموعات بيانات وسيطة واستخدام دوال مثل PUT أو INPUT لتوحيد أنواع الحقول. يؤدي الاستغناء عن خطوات التحويل الوسيطة إلى تقليص ملحوظ في استخدام الذاكرة العشوائية (RAM) وسرعة إنهاء عمليات تجهيز البيانات، مما يجعلها الخيار المثالي لاستطلاعات الرأي والمسوح الديموغرافية والاجتماعية متعددة الأبعاد.
6. تصفية ومعالجة البيانات استناداً إلى نتائج دالة CMISS
6.1 استبعاد السجلات غير المكتملة بشرط IF أو WHERE
يمثل اشتقاق متغير الفقدان الإجمالي عبر CMISS نقطة انطلاق جوهرية للتحكم في تدفق السجلات وتصفية العينات المستهدفة بالتحليل الإحصائي المتقدم. تتيح لغة SAS للمبرمجين استخدام عبارتي WHERE وIF لتحديد مصير الحالات بناءً على مؤشر الفقدان. إذا رغب المحلل في حصر العينة على الأفراد الذين يمتلكون بيانات مكتملة بالكامل (Complete-Case Analysis)، يمكنه توظيف جملة التصفية المباشرة:
data athletes_complete;
set athletes_calculated;
where total_missing = 0;
run;
من الناحية الحوسبية، توفر عبارة WHERE كفاءة أعلى في سرعة التنفيذ عند التعامل مع مجموعات البيانات الكبيرة المخزنة، لأنها تقوم بتصفية السجلات قبل دخولها إلى ناقل بيانات البرنامج (PDV). وفي المقابل، تتيح عبارة IF البرمجية فرصة أكبر لإجراء معالجات تفريعية معقدة، مثل فرز الحالات وتوجيهها في مسارات متفرقة؛ حيث يمكن مثلاً توجيه السجلات غير المكتملة إلى جدول بيانات مستقل لمراجعتها والتحقق من أسباب النقص الميداني عبر الشفرة:
data athletes_clean athletes_rejected;
set athletes_calculated;
if total_missing > 2 then output athletes_rejected;
else output athletes_clean;
run;
6.2 حساب معدلات ونسب الفقدان المئوية لكل مشارك
لا يقتصر التقييم المنهجي على احتساب العدد الخام للمفقودات، بل يتطلب استخراج النسبة المئوية للفقدان بالنسبة للعدد الإجمالي للبنود أو الأسئلة التي طُلب من المشارك الإجابة عنها؛ إذ تختلف الدلالة الإحصائية لفقدان 3 قيم في اختبار يتكون من 5 بنود عن فقدان نفس العدد في مقياس موسع يتضمن 100 بند. يُصاغ هذا المعيار التناسبي برمجياً من خلال قسمة ناتج الدالة على إجمالي عدد المتغيرات المقيسة وضرب الناتج في 100.
يوضح المثال التالي آلية حساب نسبة الفقدان المئوية وفرز الحالات التي تتجاوز عتبة منهجية معينة:
data athletes_percentages;
set athletes_calculated;
/* احتساب النسبة المئوية للمفقودات من أصل 4 متغيرات */
missing_ratio = (total_missing / 4) * 100;
format missing_ratio percent8.1;
run;
تتبنى البحوث السيكومترية المتقدمة عادة عتبات إقصاء واضحة (Cutoff Points)، تتراوح في الغالب بين 10% إلى 20% كحد أقصى مسموح به للفقدان الفردي قبل استبعاد المشارك نهائياً من التحليل. إن حساب هذه النسب بدقة يعزز الدفاع المنهجي عن إجراءات الفرز عند مراجعة الأوراق البحثية، ويوفر بياناً رقمياً صريحاً يؤكد عدم الإخلال بتمثيل العينة الأصلية.
6.3 تصنيف جودة البيانات وتوليد متغيرات ترتيبية رتبية
يمكن استثمار مخرجات CMISS لإنتاج مؤشرات رتبية تصف جودة السجلات البحثية بدقة تامة؛ إذ يمكن تقسيم مجتمع الدراسة إلى فئات نوعية تدعم استراتيجيات التحليل اللاحقة. باستخدام الجمل الشرطية IF-THEN-ELSE، يستطيع المحلل الإحصائي تصنيف كل مشارك وفق جودة استجابته:
data athletes_quality;
set athletes_calculated;
length Data_Quality $12;
if total_missing = 0 then Data_Quality = ‘ممتاز’;
else if total_missing = 1 then Data_Quality = ‘مقبول’;
else if total_missing >= 2 then Data_Quality = ‘غير صالح’;
run;
يساعد هذا التصنيف في تحويل مشكلة الفقدان من عبء حسابي مجرد إلى متغير ضابط أو معدل (Control or Moderating Variable) في النماذج الإحصائية؛ حيث يمكن إدراجه لاحقاً لفحص ما إذا كانت جودة استجابة المفحوصين تتباين بتباين خلفياتهم الديموغرافية، أو ما إذا كان تشتت الاستجابات يرتبط بعوامل منهجية مثل الإرهاق أو ضعف الفهم لتعليمات المقياس.
7. تطبيقات دالة CMISS في الدراسات النفسية والعلوم السلوكية
7.1 رصد معدلات الامتناع عن بنود مقاييس الشخصية والاستبيانات
تتضمن استبانات ومقاييس العلوم السلوكية غالباً عشرات البنود المصممة على وفق سلم ليكرت الخماسي أو السباعي لقياس سمات كامنة مثل الاكتئاب، والعصابية، والاحتراق النفسي. يُعد امتناع المشارك عن الإجابة عن أسئلة بعينها سلوكاً دالاً بحد ذاته؛ فقد يعكس ارتباكاً دلالياً في صياغة الفقرة، أو حساسية اجتماعية مفرطة تدفع المفحوص لتجنب الكشف عن توجهاته الحقيقية.
توفر دالة CMISS في هذه الحالة حلاً برمجياً لقياس كثافة الامتناع على مستوى الفرد الواحد. فعند تقييم مقياس تشخيصي مكون من 30 فقرة مرمزة برمجياً بالأسماء Item1 إلى Item30، يمكن للباحث بضغطة زر واحدة تشخيص استجابة كل مفحوص:
omitted_items = cmiss(of Item1-Item30);
تتيح هذه النتيجة التعرف الفوري على المشاركين الذين تركوا صفحات كاملة فارغة نتيجة الإرهاق المعرفي أو قلة الدافعية، مما يحمي مصفوفات الترابط السيكومتري من التشوه الحسابي ويمنع هبوط معاملات الاتساق الداخلي (كالفا كرونباخ) هبوطاً زائفاً ناجماً عن وجود تباينات وهمية شاذة.
7.2 التحقق من شروط التحليل الإحصائي المتقدم (SEM وANOVA)
تفرض النماذج الرياضية المعقدة، مثل نماذج المعادلات البنائية (Structural Equation Modeling – SEM) وتحليلات التباين للمقاييس المتكررة (Repeated Measures ANOVA)، شروطاً صارمة بخصوص تكامل مصفوفة التغاير (Covariance Matrix) واكتمال نقاط القياس عبر الزمن. إن فقدان نقطة قياس زمنية واحدة لدى أحد المشاركين في دراسة طولية قد يؤدي بالبرامج الإحصائية إلى إقصاء تاريخه التجريبي كاملاً، مما يهدر كميات هائلة من المجهود الميداني.
يسهم تطبيق دالة CMISS في الفحص الدوري لنقاط التتبع الزمني (Wave-level Attrition)؛ حيث يمكن للمحلل فحص ثبات المفحوصين في القياس القبلي والبعدي والتتبعي. كما يُمكّن الفرز المبكر من عزل الحالات التي تفتقر للحد الأدنى من المتغيرات الملاحظة المطلوبة لتعريف المتغيرات الكامنة (Latent Constructs)، مما يحمي مؤشرات جودة المطابقة (Fit Indices مثل CFI وRMSEA) من التدهور الحاد غير المبرر نظرياً.
7.3 تصنيف آليات الفقدان: العشوائي التام (MCAR) وغير العشوائي (MNAR)
في إطار الأدبيات المنهجية التي رسخها العالم دونالد روبين (Donald B. Rubin)، تُصنف آليات الفقدان إلى ثلاثة أطر نظرية رئيسية تفرض شروطاً مختلفة على استراتيجيات التحليل الرياضي:
- الفقدان العشوائي التام (Missing Completely at Random – MCAR): حيث لا يرتبط احتمال فقدان القيمة بأي من المتغيرات الملاحظة في الدراسة أو بالقيم المفقودة نفسها؛ $P(M mid Y_{\text{obs}}, Y_{\text{mis}}) = P(M)$. في هذه الحالة، تكون العينة المتبقية ممثلة تماماً للمجتمع الأصلي.
- الفقدان العشوائي المشروط (Missing at Random – MAR): حيث يعتمد الفقدان على متغيرات ملاحظة أخرى تم قياسها في الدراسة (مثل العمر أو الجنس)، لكنه مستقل تماماً عن القيمة الغائبة ذاتها بعد ضبط تلك المتغيرات؛ $P(M mid Y_{\text{obs}}, Y_{\text{mis}}) = P(M mid Y_{\text{obs}})$.
- الفقدان غير العشوائي (Missing Not at Random – MNAR): وتحدث هذه الحالة عندما ترتبط احتمالية الفقدان بالقيمة المفقودة ذاتها؛ $P(M mid Y_{\text{obs}}, Y_{\text{mis}}) \neq P(M mid Y_{\text{obs}})$، كأن يمتنع ذوو الدخل المرتفع جداً عن الإفصاح عن ثرواتهم.
تُعد المخرجات الرقمية لدالة CMISS خطوة أولى لتشخيص هذه الآليات؛ حيث يمكن استخدام مؤشر الفقدان الإجمالي كمتغير تابع في نماذج انحدار لوجستية لاختبار ما إذا كانت خصائص المفحوصين تفسر احتمالية غياب البيانات، فضلاً عن دعم التحقق من افتراضات ليتل (Little’s MCAR Test) لتحديد ملاءمة اللجوء لطرق التعويض الإحصائي المتعدد.
8. مقارنة تحليلية موسعة بين دالة CMISS ودوال SAS الشقيقة
8.1 المقارنة المفصلة بين دالتي CMISS وNMISS
رغم الاشتراك الاسمي في الدلالة على رصد النواقص، تفترق دالة CMISS عن شقيقتها NMISS في المنطق الحسابي والتشغيلي الداخلي. تقبل دالة NMISS المدخلات الرقمية حصراً، وعند إقحام متغير نصي ضمن نطاقها، يُصدر المترجم رسالة واضحة في السجل تفيد بمحاولة التحويل القسري، وينتهي الأمر غالباً باحتساب الخانة الرقمية المفقودة المتولدة عن الفشل الحسابي، مع تشويه الإحصاء الحقيقي للسجلات.
أما دالة CMISS فتوفر آلية شاملة لا تفرق بين النصوص والأرقام، وتتعامل مع الحقل بموجب طبيعته المعرفة مسبقاً في قاموس البيانات (Descriptor Portion). ورغم أن الفروق الحوسبية الزمنية بين الدالتين في البيئات الرقمية الصرفة تكاد تكون منعدمة ولا تتجاوز أجزاء من المليون من الثانية في المعالجات الحديثة، إلا أن السلامة المنهجية والاستقرار البرمجي يرجحان كفة CMISS متى ما كانت مصفوفة المتغيرات غير متجانسة بالكامل.
8.2 استخدام دالة MISSING الأحادية مقارنة بالدوال التجميعية
تختص دالة MISSING باختبار شرطي موضعي لمتغير بعينه؛ فهي تعمل كدالة مقارنة منطقية (Predicate) تعيد 1 أو 0. تبرز فائدتها القصوى في صياغة الشروط التفرعية البسيطة مثل: if missing(salary) then delete;. لكن قصورها يظهر فور مواجهة متطلبات التجميع الأفقي؛ إذ يعجز المبرمج عن كتابة missing(var1, var2) لأن تركيبها النحوي لا يقبل سوى معامل أحادي واحد.
إذا أراد الباحث استخدام دالة MISSING لحساب النواقص عبر عشرة متغيرات، سيكون مضطراً لكتابة صيغة مجهدة من قبيل:
total_miss = missing(v1) + missing(v2) + missing(v3) + ... + missing(v10);
إن هذه الصيغة المطولة تجعل الشفرة عرضة للخطأ وتزيد من صعوبة الصيانة والمراجعة الأكاديمية لاحقاً مقارنة بالأناقة والاختصار والسرعة التي توفرها دالة CMISS المباشرة.
8.3 التكامل مع دالتي N وNMISS في التقارير الإحصائية الوصفية
تكتمل المنظومة التشخيصية للبيانات في SAS من خلال توظيف دالة N بالتعاون مع دوال الفقدان؛ حيث تقوم دالة N باحتساب عدد المتغيرات الرقمية غير المفقودة لكل صف، في حين توفر دالة COUNTC أو فحص النصوص موازياً للأعمدة الرمزية. إن الجمع بين الدالتين يسمح للباحث بإنتاج جداول وصفية غاية في الدقة تلخص بنية الاستجابات لكل مفحوص عبر موازنة القيم الحاضرة بالقيم المفقودة.
تتجلى هذه المقارنة المتكاملة في الشفرة التالية التي تولد مؤشرات متزامنة لاكتمال الاستجابة:
data athletes_profile;
set athletes_calculated;
valid_numerics = n(points, assists, rebounds);
missing_numerics = nmiss(points, assists, rebounds);
total_absent = cmiss(of team — rebounds);
run;
تخدم هذه الشفرة المتضافرة أغراض التدقيق المنهجي الشامل، وتوفر للباحثين المادة الأولية لبناء مصفوفات الخصائص السيكومترية التي تطلبها لجان التحكيم في المجلات العلمية المصنفة.
9. الأخطاء الشائعة واستكشاف المشكلات البرمجية وإصلاحها
9.1 أخطاء استدعاء المتغيرات وإغفال الكلمة المفتاحية OF
من أكثر الأخطاء البرمجية شيوعاً بين مستخدمي لغة SAS عند التعامل مع دالة CMISS هو نسيان الكلمة المفتاحية الإلزامية OF عند الرغبة في استخدام النطاقات المتسلسلة. فإذا كتب المبرمج العبارة التالية:
missing_count = cmiss(item1 - item5);
فإن مترجم النظام لن يفسر الرمز الشرطي (-) كنطاق ممتد، بل سيعامله كمعامل طرح حسابي عادي يقوم بإنقاص قيمة item5 من item1، ومن ثم تمرير الناتج العددي الوحيد كمدخل مفرد لدالة CMISS! في هذه الحالة، ستفحص الدالة ما إذا كان ناتج الطرح الحسابي مفقوداً أم لا، لتعيد القيمة 0 أو 1 فقط، وهو ما يناقض تماماً رغبة الباحث في احتساب عدد المتغيرات الخمسة المفقودة.
لتفادي هذا الخطأ النحوي، يتعين الالتزام الصارم بإدراج الكلمة المفتاحية OF، لتصبح الصياغة الصحيحة الخالية من الالتباس:
missing_count = cmiss(of item1 - item5);
9.2 مخاطر الترتيب الهيكلي غير المقصود في نطاق المتغيرات (–)
ينطوي استخدام معامل الترتيب الفيزيائي المزدوج -- على مخاطر هيكلية خفية تتطلب حذراً بالغاً؛ فالمترجم يعتمد على الترتيب الداخلي للأعمدة كما هي مخزنة في واصفات الجدول (Table Descriptor). فإذا افترض الباحث أن الترتيب يمتد من Q1 إلى Q10، ولكن كان هناك متغير وسيط غير مستهدف (مثل Date_Of_Birth) أُدخل فيزيائياً في موضع وسيط أثناء بناء الجدول، فإن النطاق المزدوج سيشمل هذا المتغير تلقائياً في عدّاد الفقدان دون تنبيه صريح.
لدرء هذه المغالطات المنهجية، يُوصى دوماً باتباع الممارسات الوقائية التالية:
- التحقق من الترتيب الفعلي للأعمدة عبر استدعاء الإجراء الاستكشافي
PROC CONTENTS DATA=mydata POSITION; RUN;لمراجعة الترتيب الفيزيائي الحقيقي. - تفضيل النطاقات الاسمية الرقمية
(of Q1-Q10)عندما تكون المتغيرات موحدة التسمية ومتسلسلة عددياً. - استخدام الأسلوب القائم على البادئات المشتركة المتبوعة بالنقطتين
(of Q_:)لضمان حصر الفحص في المتغيرات ذات الدلالة المقصودة فقط.
9.3 معالجة المسافات البيضاء المخفية والرموز غير المرئية
تواجه معالجة البيانات النصية أحياناً إشكاليات خفية تنشأ عند استيراد البيانات من مصادر خارجية مثل ملفات Excel أو قواعد بيانات SQL أو الاستبانات البرمجية عبر الإنترنت. قد تحتوي بعض الحقول النصية على مسافات غير مرئية ناتجة عن الضغط غير المقصود على مفتاح المسافة، أو احتوائها على علامات تبويب جدولة (Tabs) ومحارف نهاية السطور التي لا تُعد فراغاً ناصعاً بموجب التعريف الداخلي الصارم للغة SAS.
في مثل هذه الحالات الشاذة، قد تعتبر الدالة أن الحقل النصي غير فارغ نظراً لوجود رمز خفي بداخله، مما يؤدي إلى عدم احتسابه كمفقود وتشويه دقة العداد. لمواجهة هذه المعضلة وضمان الدقة المطلقة، يُنصح بتطبيق دوال التطهير والضغط النصي، مثل دالتي COMPBL وCOMPRESS، قبل تمرير البيانات إلى CMISS:
data cleaned_input;
set raw_input;
text_var = strip(compbl(text_var));
/* ضمان تحويل المتغيرات ذات الطول الصفري إلى فراغ تام */
if text_var = ” then call missing(text_var);
run;
10. أفضل الممارسات المنهجية للتوثيق والتعويض الإحصائي اللاحق
10.1 التوثيق الصارم في دفاتر الشيفرات البرمجية (Codebooks)
تقتضي النزاهة العلمية الصارمة في البحوث الأكاديمية التوثيق المنهجي الشفاف لكافة عمليات تدقيق البيانات والمعايير المعتمدة في تقييم نسب الاكتمال؛ إذ ينبغي على الباحث ألا يكتفي بتطبيق الدوال الإجرائية في صمت، بل يجب تضمين شروحات مفصلة داخل الشفرات البرمجية باستخدام التعليقات التوضيحية (Comments) التي تشرح مبررات اختيار عتبات الاستبعاد وآليات رصد الفقدان.
علاوة على ذلك، يُلزم الباحث بالاحتفاظ بنسخ احتياطية ثابتة (Immutable Backups) لمجموعات البيانات الأولية الخام قبل إجراء أي عمليات حذف أو تصفية بناءً على مخرجات دالة CMISS. يضمن هذا الإجراء إمكانية التتبع وإعادة الإنتاج (Reproducibility) في حال طلبت لجان التحكيم العلمي التحقق من سلامة العينة، مع تضمين دفتر الشيفرات (Codebook) إحصاءات وافية توضح التوزيع التكراري لحجم الفقدان في كل مرحلة من مراحل التحليل.
10.2 التحضير لعمليات التعويض المتعدد (Multiple Imputation)
عندما تكون نسب الفقدان ضمن الحدود المقبولة منهجياً وتتوافق مع آليات الفقدان العشوائي (MCAR أو MAR)، يتجه المحللون لتطبيق استراتيجيات التعويض الإحصائي بدلاً من الإقصاء الكلي للحالات؛ وذلك بهدف الحفاظ على القوة الإحصائية للعينات. تقدم بيئة SAS إجراء PROC MI المتطور لتنفيذ خوارزميات التعويض المتعدد (Multiple Imputation) باستخدام سلاسل ماركوف مونت كارلو (MCMC) أو الانحدار المتتابع.
تلعب مخرجات دالة CMISS دوراً تمهيدياً فاصلاً في إعداد نماذج التعويض؛ إذ يتم الاستناد إليها في:
- استبعاد الحالات الميؤوس منها التي تعاني من غياب تام لكافة المؤشرات السلوكية، والتي يؤدي تعويضها اصطناعياً إلى إقحام ضجيج إحصائي يفسد بنية التباين المشترك.
- تحديد المتغيرات المساعدة (Auxiliary Variables) ذات نسب الاكتمال العالية لتوظيفها في دعم التنبؤ بالقيم المفقودة في المتغيرات التابعة.
- مقارنة النتائج التقديرية للنماذج قبل وبعد التعويض للتأكد من عدم توليد قيم افتراضية غير منطقية تخرج عن النطاق السيكومتري للمقاييس.
10.3 إعداد التقارير التلخيصية باستخدام PROC FREQ وPROC MEANS
عقب إتمام احتساب متغير الفقدان الإجمالي عبر دالة CMISS، يتعين على الباحث استخلاص الرؤى الكلية وتلخيصها في قوالب إحصائية تبرز ملامح جودة مصفوفة البيانات تمهيداً لكتابة التقارير النهائية. يُستدعى الإجراء PROC FREQ لاستخراج التوزيع التكراري والنسب المئوية التراكمية لمستويات الفقدان:
proc freq data=athletes_calculated;
tables total_missing / nocum plots=freqplot;
run;
كما يُستخدم إجراء النزعة المركزية PROC MEANS لاستخراج المتوسطات الحسابية والانحرافات المعيارية والمدى لمعدلات الفقدان، مما يمنح قراءة دقيقة لمستوى التجانس في أداء العينة ككل:
proc means data=athletes_calculated n mean std min max;
var total_missing;
run;
تُحول هذه المخرجات التلخيصية إلى جداول مهيأة للنشر وفق أسلوب الجمعية الأمريكية لعلم النفس (APA Style)، لتقدم للقارئ والباحث دليلاً كمياً قاطعاً على مدى رصانة عمليات جمع البيانات وسلامتها من الانحيازات المنهجية التي قد تقوض دقة الاستنتاجات العلمية.
خاتمة شاملة
استعرض هذا المقال المعمق الأبعاد المنهجية والتقنية لاستخدام دالة CMISS في نظام التحليل الإحصائي SAS، مبيناً موقعها الفريد كأداة برمجية تجمع بين المرونة في استقبال شتى بنى البيانات والدقة الحسابية العالية في رصد وتجميع مواضع الفقدان عبر الصفوف. لقد اتضح من خلال التحليل التطبيقي والمقارنات الهيكلية أن قدرة هذه الدالة على معالجة المتغيرات النصية والرقمية بصورة متزامنة تعفي المبرمج من التعقيدات الحسابية وتوفر حماية مشددة لسلامة الشفرات البرمجية من أخطاء عدم تطابق الأنواع.
إن توظيف هذه الدالة لا ينبغي أن يُنظر إليه كإجراء برمجي بحت، بل هو ركيزة أساسية ضمن منظومة المعالجة المنهجية للبيانات في العلوم السلوكية والنفسية والتربوية؛ حيث يفتح رصد الفقدان الباب واسعاً نحو التقييم الشفاف لجودة الاستجابات، والتشخيص الدقيق لآليات الغياب والامتناع، واتخاذ قرارات رصينة بشأن الاستبعاد أو التصفية أو التمهيد لإجراءات التعويض المتعدد المتقدمة. إن التمكن من دالة CMISS وتطبيقاتها الذكية يمثل خطوة فارقة في مسار تطوير مهارات هندسة البيانات لدى الباحثين، بما يرتقي بجودة المخرجات البحثية ويعزز مصداقيتها الأكاديمية في المحافل العلمية الدولية.
المراجع
Chenier, J. S. (2012). Using behavior screening data to predict scores on statewide assessments. Doctoral dissertation, Louisiana State University. https://doi.org/10.31390/gradschool_dissertations.1545