
تعد مسألة نمذجة الظواهر الطبيعية والسلوكية وتحديد بنيتها الاحتمالية إحدى الركائز الجوهرية التي يقوم عليها الاستدلال الإحصائي المعاصر. فعندما يواجه الباحث أو المحلل كميات ضخمة من البيانات المستقاة من التجارب المعملية أو الميدانية، تصبح الملاحظات الفردية مجرد شتات لا معنى له ما لم يتم إخضاعها لإطار نظري يفسر آلية توليدها العشوائي ويستخرج معالمها الكامنة. من هنا، تبرز ملاءمة التوزيعات الاحتمالية كعملية مفصلية تهدف إلى ردم الهوة بين التوزيع التجريبي للمشاهدات والتوزيعات الرياضية النظرية، محولةً الأرقام الخام إلى معلمات ذات دلالات استدلالية وتنبؤية عميقة.
في بيئة الحوسبة الإحصائية للغة R، تحتل دالة fitdistr مكانة رفيعة بوصفها واحدة من أقدم وأدق الأدوات البرمجية المخصصة لتقدير معلمات النماذج الاحتمالية بالاعتماد على مبدأ الإمكان الأعظم. تعود هذه الأداة في أصولها إلى حزمة MASS التاريخية المرافقة للمرجع الكلاسيكي لأساليب الإحصاء التطبيقي الحديث لمؤلفيه فينابلز وريبلي (Venables & Ripley). وبالرغم من التطور التكنولوجي وظهور مكتبات برمجية لاحقة، تظل هذه الدالة معياراً أساسياً ومحركاً موثوقاً يعتمد عليه الباحثون في شتى مجالات العلوم القياسية، والقياس النفسي، وتحليل البقاء، والنمذجة المالية، وذلك بفضل بنيتها الرياضية الصارمة وتكاملها الوثيق مع خوارزميات التحسين العددي الأساسية.
يهدف هذا الدليل المرجعي الموسع إلى تقديم تشريح أكاديمي وبرمجي شامل لكيفية استخدام دالة fitdistr في لغة R لملاءمة التوزيعات الاحتمالية المتنوعة بشقيها المستمر والمتقطع. سيتم التطرق إلى الأسس الرياضية لتقدير الإمكان الأعظم، وفحص آليات المعالجة البرمجية وضبط محركات التحسين، وتفصيل استراتيجيات تشخيص جودة الملاءمة والمقارنة بين النماذج المتنافسة، بالإضافة إلى استعراض الحلول المنهجية للأخطاء التقنية الشائعة وتطبيقات الأداة في القياس السلوكي المتقدم، مما يوفر للباحث الأكاديمي مرجعاً متكاملاً لا غنى عنه في تحليل البيانات المتقدم.
1. مقدمة إلى تقدير المعلمات وملاءمة التوزيعات في التحليل الإحصائي
1.1 المفهوم النظري لملاءمة التوزيعات الاحتمالية
تُعرَّف ملاءمة التوزيع الاحتمالي (Probability Distribution Fitting) بأنها العملية الإحصائية المنهجية التي تهدف إلى مطابقة مجموعة من البيانات التجريبية المرصودة مع نموذج احتمالي نظري محدد مسبقاً. ينطلق هذا المفهوم من الافتراض الإبستمولوجي القائل بأن المشاهدات العينية التي يجمعها الباحث ما هي إلا تجليات محسوسة لمتغير عشوائي يخضع لدالة كثافة احتمالية (Probability Density Function) في الحالات المستمرة، أو دالة كتلة احتمالية (Probability Mass Function) في الحالات المتقطعة. تكمن الغاية الأساسية لهذه العملية في اختزال الأنماط المعقدة والتشتت الظاهري للبيانات في عدد محدود من المعلمات (Parameters) التي تصف بدقة النزعة المركزية، والانتشار، والالتواء، والتفرطح للمجتمع الإحصائي المسحوبة منه العينة.
تكتسب هذه العملية أهمية قصوى في النمذجة التنبؤية واختبار الفرضيات الأكاديمية؛ إذ إن معظم النماذج الإحصائية الاستدلالية المتقدمة تشترط تحقق افتراضات توزيعية معينة حول بنية الأخطاء أو المتغير التابع ذاته. فعند إساءة تحديد التوزيع، تتعرض النتائج لخطر التحيز المنهجي، وتفقد اختبارات الدلالة قوتها الإحصائية، مما يقود إلى استنتاجات مضللة. من هذا المنطلق، يمثل تحديد التوزيع الصحيح حجر الزاوية لبناء محاكاة دقيقة للظواهر، وتقدير المخاطر الذيلية في العلوم المالية، وتوليد فترات التنبؤ الموثوقة.
تتجلى في هذا السياق الفروق الجوهرية بين المقاربات المعلمية (Parametric) وغير المعلمية (Non-parametric) في التحليل. فبينما تفترض الأساليب المعلمية شكلاً وظيفياً ثابتاً للمجتمع وتقتصر مهمتها على استنتاج معالمه، تعتمد الطرق غير المعلمية، مثل تقدير الكثافة بالنواة (Kernel Density Estimation)، على البيانات مباشرة دون تقييدها بقالب رياضي صلب. ورغم المرونة التي تتيحها الطرق غير المعلمية، فإن النماذج المعلمية تتفوق بشكل حاسم في كفاءة الاستدلال ودقة التقدير، شريطة أن يكون التوزيع النظري المختار ممثلاً بحق للآلية الحقيقية لتوليد البيانات، مما يعزز دور الاستدلال الإحصائي في تعميم الخصائص المستقرأة من العينة نحو المجتمع الشامل.
1.2 مبدأ الإمكان الأعظم (Maximum Likelihood Estimation – MLE)
يقوم مبدأ الإمكان الأعظم، الذي صاغه وطوره عالم الإحصاء الشهير رونالد فيشر في بدايات القرن العشرين، على بديهية رياضية أنيقة: البحث عن قيم المعلمات التي تجعل احتمال رصد العينة الفعلية المشاهدة عند أعلى مستوى ممكن. رياضياً، بفرض أن لدينا عينة مستقلة ومتماثلة التوزيع مكونة من مشاهدات تخضع لدالة كثافة احتمالية تعتمد على متجه من المعلمات، فإن دالة الإمكان (Likelihood Function) تُعرَّف بأنها حاصل الضرب التراكمي لكثافات هذه المشاهدات الفردية. ونظراً للصعوبات الحسابية المرتبطة بإجراء العمليات التفاضلية على حواصل الضرب المعقدة، يتم اللجوء دائماً إلى اللوغاريتم الطبيعي لدالة الإمكان، والمعروف بدالة لوغاريتم الإمكان (Log-Likelihood)، والتي تحول حواصل الضرب إلى مجاميع عددية تبسط عمليات الاشتقاق الرياضي دون المساس بموقع القيمة العظمى.
تمتلك مقدرات الإمكان الأعظم حزمة من الخصائص التقاربية المثالية التي جعلتها المعيار الذهبي في التحليل الإحصائي الحديث. تشمل هذه الخصائص: الكفاءة التقاربية (Asymptotic Efficiency)، مما يعني أن تباين هذه المقدرات يبلغ الحد الأدنى النظري المعروف بحد “كرامر-راو” مع كبر حجم العينة؛ والاتساق (Consistency)، حيث تقترب القيمة المقدرة باحتمال يؤول إلى الواحد الصحيح من المعلمة الحقيقية للمجتمع؛ بالإضافة إلى خاصية التوزيع الطبيعي التقاربي (Asymptotic Normality). هذه المزايا تمنح طريقة MLE تفوقاً ملحوظاً على أسلوب العزوم (Method of Moments) الكلاسيكي، لا سيما في النماذج المعقدة وحالات البيانات ذات الذيول الثقيلة أو الالتواءات العالية.
تستند عملية تقدير الأخطاء المعيارية للمعلمات في أسلوب الإمكان الأعظم إلى مفهوم “مصفوفة معلومات فيشر” (Fisher Information Matrix)، والتي تعبر عن القيمة المتوقعة للاشتقاق الثاني السالب لدالة لوغاريتم الإمكان بالنسبة للمعلمات. تمثل هذه المصفوفة رياضياً مقدار الانحناء في سطح دالة الإمكان حول القيمة العظمى؛ فكلما كان الانحناء حاداً، زادت كمية المعلومات التي توفرها البيانات حول المعلمة، وصغرت الأخطاء المعيارية المقابلة. وبحساب مقلوب مصفوفة المعلومات المقدرة (المعروفة بمصفوفة التباين والتباين المشترك المقاربة)، يستطيع الإحصائي استخراج الأخطاء المعيارية وحساب فترات الثقة الدقيقة للمعلمات المقدرة.
1.3 أهمية ملاءمة التوزيعات في أبحاث القياس النفسي والسلوكي
تواجه أبحاث القياس النفسي والعلوم السلوكية تحديات مستمرة تتمثل في أن الظواهر الإنسانية نادراً ما تتبع النمط التوزيعي الطبيعي التناظري المثالي الذي تفترضه النظريات الإحصائية التقليدية. ومن أبرز الأمثلة التجريبية على ذلك ظاهرة أزمنة الاستجابة (Reaction Times) في المهام المعرفية والإدراكية؛ حيث تتميز هذه البيانات بطبيعتها الموجبة الصارمة والتوائها الإيجابي الحاد نحو اليمين نتيجة وجود استجابات بطيئة ناتجة عن التردد أو تشتت الانتباه. إن محاولة إخضاع مثل هذه البيانات للنماذج الخطية الكلاسيكية دون التحقق من توزيعها الفعلي يؤدي إلى تشويه المقاييس السيكومترية وفقدان القدرة على رصد الفروق الفردية الدقيقة.
علاوة على ذلك، تتميز درجات المقاييس النفسية، مثل استبيانات قياس الاكتئاب أو القلق أو الرضا الوظيفي، بوجود تجمعات للبيانات عند أطراف المقاييس وظهور التواءات هيكلية واضحة تفرضها طبيعة السلوك المقاس. يتطلب هذا الوضع تجاوز الفرضية المبسطة للتوزيع الطبيعي والانتقال نحو نماذج أكثر ثراءً، مثل توزيعات غاما (Gamma)، واللوغاريتمي الطبيعي (Lognormal)، وتوزيعات ويبل (Weibull)، والتي تتيح للم الباحثين فحص خصائص الأداء والتكيف بمستويات موثوقية عالية.
إن تفسير السلوك البشري من خلال دوال التوزيع الاحتمالية التراكمية يسمح لعلماء القياس بتطوير أدوات تقييم سيكومترية ذات حساسية متباينة لمختلف مستويات السمة الكامنة، وهو ما يلتقي مع أحدث توجهات القياس النفسي في دراسة دقة الشبكات الإحصائية المعقدة ومصداقيتها التحليلية؛ حيث برهنت الدراسات الحديثة، مثل دراسة Christensen and Choi (2026)، على أن ضبط خصائص النماذج العشوائية وتحديد توزيعاتها البنيوية بدقة يمثل العامل الحاسم لضمان استقرار التحليلات الإحصائية وتفادي التقديرات الزائفة في القياسات السلوكية المتطورة.
2. البنية البرمجية وحزمة MASS: آلية عمل دالة fitdistr()
2.1 تثبيت حزمة MASS واستدعاء البيئة البرمجية في R
تُعد حزمة MASS (المشتقة من عنوان المرجع التأسيسي Modern Applied Statistics with S) واحدة من أكثر الحزم الإحصائية عراقة وأهمية في بيئة R. تم تطوير هذه الحزمة وصيانتها من قبل عالمي الإحصاء البارزين وليم فينابلز وبراين ريبلي، ونظراً لأهميتها المحورية ومحتواها الغني بالوظائف الرياضية المتقدمة ونماذج الانحدار والانحدار الخطي المعمم والتحليل متعدد المتغيرات، تم تضمينها كحزمة أساسية موصى بها (Recommended Package) مدمجة مع تثبيت لغة R الأصلي، مما يعني أنها متوفرة تلقائياً في كافة منصات التشغيل دون الحاجة لتثبيتها عبر خوادم CRAN الخارجية في الظروف العادية.
بالرغم من وجودها المسبق، يمكن للباحث التأكد من تثبيتها وتحديثها عبر الأمر الإحصائي المباشر التالي:
install.packages("MASS")
ويتم استدعاؤها في جلسة العمل النشطة باستخدام:
library(MASS)
تجدر الإشارة هنا إلى قضية برمجية بالغة الأهمية تتعلق بإدارة بيئة العمل وتضارب مسميات الدوال (Namespace Masking). إذ تتضمن حزمة MASS دوالاً شائعة الاسم مثل دالة select، والتي تتعارض صراحة مع دالة select الشهيرة التابعة لحزمة dplyr ضمن منظومة tidyverse. لتفادي أي خلل في تدفق الأكواد البرمجية المستدامة، يُستحسن استدعاء الدالة إما عبر المشغل الصريح MASS::fitdistr() دون استدعاء كامل الحزمة، أو تنظيم ترتيب تحميل المكتبات بعناية لضمان عدم حجب الدوال الحيوية أثناء التحليل المعمق.
2.2 الصيغة التركيبية لدالة fitdistr() والمتغيرات الأساسية
تتميز دالة fitdistr بصياغة تركيبية مرنة تجمع بين القوة الرياضية والبساطة البرمجية، حيث تأخذ البنية العامة التالية في استدعائها التشغيلي:
fitdistr(x, densfun, start, ...)
يمثل الوسيط x المتجه العددي للبيانات المرصودة المراد ملاءمتها. يشترط في هذا المتجه أن يكون خالياً تماماً من القيم المفقودة (NA) أو القيم غير المعرفة (NaN)، وأن تتطابق خصائص أرقامه مع المتطلبات الرياضية الصارمة للتوزيع المستهدف، مثل اشتراط الإيجابية المطلقة للقيم في بعض التوزيعات.
أما الوسيط densfun، فيحدد التوزيع الاحتمالي المستهدف، ويقبل إما سلسلة نصية تشير إلى أحد التوزيعات القياسية المدعومة داخلياً مثل: “normal”، “lognormal”، “gamma”، “weibull”، “exponential”، “poisson”، “negative binomial”، “geometric”، “beta”، “t”، و”cauchy”، أو يقبل دالة كثافة مخصصة يكتبها المستخدم بنفسه لحالات النمذجة المتقدمة.
يشير الوسيط start إلى قائمة مسماة تحتوي على القيم التقديرية الأولية للمعلمات، وهو وسيط اختياري لبعض التوزيعات البسيطة التي تمتلك حلولاً تحليلية مغلقة، لكنه إلزامي لتوزيعات أخرى معقدة لا تتوفر لها مقدرات مباشرة. كما توفر الدالة وسائط إضافية مثل lower وupper لفرض قيود على فضاء المعلمات أثناء التحسين العددي. ينتج عن تنفيذ الدالة كائن برمجي من فئة “fitdistr”، يحتوي على مصفوفة بالقيم المقدرة للمعلمات، ومصفوفة التباين المشترك، وقيمة لوغاريتم الإمكان الأعظم المتحققة، وتعداد المشاهدات المعتمدة.
2.3 محركات التحسين العددي الكامنة خلف دالة fitdistr()
في الحالات التي لا تتوفر فيها حلول رياضية مغلقة (Closed-form Solutions) لمعادلات الإمكان الأعظم — وهي المعادلة الناتجة عن مساواة المشتقة الأولى لدالة لوغاريتم الإمكان بالصفر — تعتمد دالة fitdistr كلياً على المحرك العددي للأمثلية المتجسد في دالة optim() المدمجة في بيئة R. تعمل الدالة على تصغير القيمة السالبة لدالة لوغاريتم الإمكان (Negative Log-Likelihood)، وهو ما يكافئ رياضياً تعظيم دالة الإمكان الأصلية، وذلك للوصول إلى النقطة العظمى العامة في فضاء المعلمات.
تستخدم دالة fitdistr خوارزميات تحسين متقدمة وفقاً لطبيعة المسألة والشروط المقيدة المفروضة؛ ومن أبرز هذه الخوارزميات خوارزمية “BFGS” (Broyden-Fletcher-Goldfarb-Shanno) التي تُعد من أساليب شبه نيوتن المعتمدة على المشتقات التقريبية، وتتميز بسرعة تقاربها في البيئات الملساء. وفي حالات التحسين المقيد، تلجأ الدالة إلى خوارزمية “L-BFGS-B” التي تتيح للباحث وضع حدود دنيا وعليا للقيم المقبولة للمعلمات لتفادي الوقوع في قيم غير منطقية رياضياً (كالتباين السالب). كما يمكن اللجوء لخوارزمية “Nelder-Mead” البسيطة في الحالات الوعرة التي يصعب فيها حساب المشتقات بدقة.
تتوقف الخوارزمية عن التكرار الحسابي عند تحقق معيار التقارب المبرمج مسبقاً، والمتمثل في تضاؤل التغير النسبي في قيمة لوغاريتم الإمكان أو في متجه المعلمات دون حد معين من التسامح العددي (Convergence Tolerance). وعند بلوغ نقطة الحل، يقوم المحرك بحساب مصفوفة هيسيان (Hessian Matrix) المتضمنة للمشتقات الجزئية الثانية، ثم يقلب هذه المصفوفة عددياً لإنتاج مصفوفة التباين المشترك المقاربة، والتي يُستخرج منها الجذر التربيعي للقيم القطرية ليمثل الأخطاء المعيارية الدقيقة لكل معلمة مستنتجة.
3. التوزيعات الاحتمالية المستمرة المدعومة في fitdistr()
3.1 ملاءمة التوزيعات متماثلة الأطراف: الطبيعي واللوجستي وتوزيع t
تشكل التوزيعات متماثلة الأطراف البنية الأساسية للعديد من النظريات القياسية، وتدعم دالة fitdistr هذه الفئة عبر عدة خيارات نمذجة رئيسية. يأتي التوزيع الطبيعي (Gaussian Distribution) في مقدمة هذه التوزيعات، حيث تقوم الدالة بتقدير معلمتين رئيسيتين: المتوسط الحسابي (mean) الذي يحدد موقع القمة التناظرية، والانحراف المعياري (sd) الذي يحدد مدى اتساع المنحنى الجرسِي. يتميز التوزيع الطبيعي في fitdistr بأن تقديراته تتم تحليلياً وبشكل فوري؛ حيث يساوي مقدر الإمكان الأعظم للمتوسط الحسابي متوسط العينة المباشر، بينما يقدر الانحراف المعياري بقسمة مجموع المربعات على N وليس على (N – 1)، محققاً مقدر الإمكان الأعظم الدقيق بالرغم من تحيزه الطفيف في العينات الصغيرة جداً.
يمثل التوزيع اللوجستي (Logistic Distribution) بديلاً كلاسيكياً متماثلاً يشبه التوزيع الطبيعي شكلياً، ولكنه يتميز بذيول أطول نسبياً وقمة أكثر حدة، مما يجعله مفيداً للغاية في صياغة النماذج التراكمية والاحتمالية اللوجستية في القياس النفسي. تقدر الدالة معلمات الموقع (location) والمقياس (scale)، مما يوفر صياغة ملائمة للبيانات التي تظهر فيها تباينات سلوكية طفيفة تتجاوز حدود الانتشار الطبيعي.
أما بالنسبة للبيانات التي تحتوي على شواذ قيمية واضحة وأطراف ثقيلة تجعل التوزيع الطبيعي غير ملائم البتة، فإن توزيع t-Student يبرز كحل منهجي فائق الكفاءة. تستخدم دالة fitdistr خوارزميات عددية متقدمة لتقدير معلمات الموقع، والمقياس، ودرجات الحرية (degrees of freedom – df). تعمل معلمة درجات الحرية كمؤشر مرن للتعامل مع الذيول الثقيلة؛ فكلما صغرت قيمتها (مقتربة من 1 إلى 5)، دل ذلك على استيعاب التوزيع لمشاهدات شاذة ومتطرفة لا يمكن للتوزيع الطبيعي الصمود أمامها دون انحياز في تقدير تشتته، مما يجعله أداة متينة لحماية البحوث الميدانية من التحيزات الناتجة عن القياسات المتطرفة.
3.2 ملاءمة التوزيعات الملتوية موجبة القيم: غاما، ويبل، واللوغاريتمي الطبيعي
تتطلب العديد من الظواهر الطبيعية والسلوكية التعامل مع قياسات مستمرة تقع حصرياً في النطاق الموجب وتتسم بالانحراف والالتواء الإيجابي نحو اليمين. يُعد توزيع غاما (Gamma) خياراً نموذجياً في هذه السياقات، حيث يعتمد على معلمتين أساسيتين: معلمة الشكل (shape) المسؤولة عن تحديد درجة التواء التوزيع وتحدبه، ومعلمة المعدل (rate) أو المقياس (scale = 1/rate) المسؤولة عن تمدد أو انكماش التوزيع عبر المحور الأفقي. تتولى fitdistr تقدير هاتين المعلمتين عبر خوارزميات التقريب العددي نظراً لغياب حل تحليلي مباشر لمعادلات دالة ديغاما (Digamma) الناتجة عن تفاضل الإمكان.
من جهة أخرى، يفرض توزيع ويبل (Weibull) حضوره في دراسات تحليل البقاء والاعتمادية الزمنية، والتحليلات النفسية الفيزيائية للزمن المستغرق لإنجاز المهام. يُعرف التوزيع بمعلمتي المقياس والشكل؛ وتكتسب معلمة الشكل هنا دلالة تفسيرية فريدة: فإذا كانت مساوية للواحد الصحيح، انحدر ويبل ليصبح توزيعاً أسياً بمعدل فشل أو استجابة ثابت، بينما تعكس القيم الأكبر من الواحد معدل خطر أو حدوث متزايد زمنياً، وتشير القيم الأقل من الواحد إلى تناقص وتيرة الأحداث عبر الوقت.
أما التوزيع اللوغاريتمي الطبيعي (Lognormal)، فيُعد النموذج الأكثر انتشاراً لتمثيل البيانات الإيجابية التي تنشأ عن تفاعلات ضربية تضاعفية وليست جمعية بين المتغيرات. في هذا النموذج، يكون لوغاريتم المتغير عشوائياً موزعاً توزيعاً طبيعياً بمعلمتي meanlog وsdlog. تشترط كافة هذه التوزيعات خلو البيانات التام من الأصفار والأرقام السالبة، حيث يؤدي وجود مشاهدة واحدة تساوي صفراً أو تقل عنه إلى انهيار دالة الإمكان وتوقف التنفيذ البرمجي فورياً، وهو قيد رياضي لا يمكن تجاوزه إلا بالتحويل المنهجي أو استبدال نموذج النمذجة.
3.3 ملاءمة توزيعات الحالات المقيدة والخاصة: بيتا، كوشي، وتشي-تربيع
تتعامل دالة fitdistr ببراعة مع نماذج احتمالية ذات خصائص طوبولوجية ورياضية مقيدة؛ ومن أبرزها توزيع بيتا (Beta Distribution) المخصص للبيانات المستمرة المقيدة في المدى المفتوح المنحصر بدقة بين الصفر والواحد (0, 1). يكتسب هذا التوزيع أهمية بالغة في ملاءمة النسب المئوية، والمعدلات، والبيانات النفسية المحولة المشتقة من مقاييس بصرية تمثيلية. يتميز توزيع بيتا بمرونته الهائلة وقدرته على اتخاذ أشكال متناظرة، أو ملتوية، أو على شكل حرف U بناءً على تقدير معلمتي الشكل shape1 وshape2. تتطلب ملاءمة بيتا عبر الدالة استبعاد أي قيم تطابق الصفر أو الواحد تماماً لضمان عدم وصول الكثافة إلى ما لا نهاية.
وفي المقابل، يمثل توزيع كوشي (Cauchy Distribution) الحالة القصوى للتوزيعات ذات الذيول فائقة الثقل، وهو توزيع متماثل حول معلمة موقعه ولكنه لا يمتلك متوسطاً حسابياً أو تبايناً رياضياً معرفاً نظراً لعدم تقارب تكاملات عزومه الرياضية. تستخدم الدالة خوارزميات التحسين لتقدير معلمتي الموقع والمقياس لكوشي، مما يتيح اختبار الفرضيات النظرية في النظم الفوضوية أو فحص استقرار خوارزميات القياس المعرضة لهزات شاذة عنيفة.
كما تدعم الدالة ملاءمة توزيع تشي-تربيع (Chi-squared Distribution) لتقدير درجات الحرية المرتبطة بمجموع مربعات المتغيرات المستقلة الموزعة طبيعياً، وهو توزيع محوري في دراسة مكونات التباين وجودة الملاءمة. تواجه خوارزميات التحسين في هذه التوزيعات المحدودة تحديات تقارب معقدة، تتطلب أحياناً تدخلاً برمجياً عبر تمرير وسائط التحكم العددي لضمان بقاء البحث ضمن الفضاء المعلمي المسموح رياضياً وتجنب الدخول في مناطق التفرد الرياضي (Singularity).
4. التوزيعات الاحتمالية المتقطعة المدعومة في fitdistr()
4.1 توزيع بواسون (Poisson Distribution) لبيانات العد التكراري
يُعد توزيع بواسون النموذج الرياضي المرجعي لتمثيل بيانات العد التكراري (Count Data) التي ترصد تكرار وقوع أحداث معينة خلال وحدة ثابتة من الزمن، أو المساحة، أو المحاولات التجريبية. يعتمد التوزيع على معلمة إحصائية وحيدة هي لامبدا (lambda)، والتي تمثل في آن واحد المعدل المتوقع لحدوث الحدث، ومتوسط المجتمع، وتباينه الرياضي. يتميز هذا التوزيع بافتراض جوهري صارم يُعرف بالتساوي التشتتي (Equidispersion)، حيث يتطابق التباين تماماً مع المتوسط الحسابي:
Var(X) = E(X) = λ
عند استدعاء دالة fitdistr لملاءمة توزيع بواسون باستخدام الوسيط densfun = "poisson"، تقوم الدالة بحساب مقدر الإمكان الأعظم للمعلمة لامبدا بصورة تحليلية مباشرة، حيث يتطابق المقدر الرياضي مع المتوسط الحسابي البسيط للبيانات الملاحظة:
λ̂ = x̄
كما تستخرج الدالة الخطأ المعياري المقترن بالمعلمة، والذي يعادل رياضياً الجذر التربيعي للمتوسط الحسابي مقسوماً على حجم العينة، مما يسهل بناء فترات الثقة بنسبة 95% لمعلمة المعدل.
يُطبق توزيع بواسون على نحو واسع في الأبحاث السلوكية والطبية لرصد الحوادث النادرة، مثل عدد الأخطاء اللغوية المرتكبة أثناء اختبارات الطلاقة الشفهية، أو عدد نوبات الغضب المرصودة لدى الأطفال في بيئة مدرسية خلال أسبوع. ومع ذلك، فإن الطبيعة الصارمة لافتراض التساوي التشتتي تجعل هذا النموذج عرضة للقصور المنهجي عند تطبيقه على بيانات واقعية تظهر تفاوتاً كبيراً بين المتوسط والتباين، مما يستلزم الانتقال إلى نماذج أكثر مرونة لمعالجة التشتت الإضافي.
4.2 التوزيع ذو الحدين السالب (Negative Binomial) لبيانات التشتت الزائد
تُعاني معظم بيانات العد الواقعية في العلوم السيكومترية والسلوكية مما يُعرف بظاهرة “التشتت الفائق” أو الزائد (Overdispersion)، حيث يكون التباين التجريبي للبيانات أكبر بكثير من متوسطها الحسابي. ينشأ هذا التشتت عن الفروق الفردية الكامنة غير الملاحظة بين المفحوصين، أو نتيجة لتجمع الأحداث في نوبات مكثفة تخرق افتراض استقلالية الوقوع الذي يفرضه توزيع بواسون. في هذه البيئات الإحصائية المعقدة، يبرز التوزيع ذو الحدين السالب (Negative Binomial) كبديل متفوق ومعياري لاستيعاب التباين الفائض.
تستخدم دالة fitdistr صياغة معلمية مزدوجة للتوزيع ذي الحدين السالب تعتمد إما على تقدير معلمة الهدف والمتوسط (mu) ومعلمة التشتت أو الحجم (size أو k)، أو معلمتي الاحتمال والحجم الكلاسيكيتين. في صيغة المتوسط وحجم التشتت، تصبح العلاقة بين التباين والمتوسط علاقة تربيعية تعوض التشتت المتزايد:
Var(X) = μ + (μ2 / size)
فكلما صغرت معلمة التشتت، دل ذلك على تشتت زائد حاد، في حين أن اقتراب هذه المعلمة من المالانهاية يعيد النموذج إلى توزيع بواسون التناظري.
تتجلى قوة fitdistr في قدرتها على تقدير معلمات ذي الحدين السالب عبر الأمثلية العددية بكفاءة فائقة، متفوقة على النماذج التبسيطية. وتجد هذه الملاءمة تطبيقات واسعة في قياس تكرار السلوكيات المرضية؛ مثل رصد عدد النوبات الهلعية الشهرية لدى مرضى الرهاب، أو عد تكرار السلوكيات القهرية لدى المصابين باضطراب الوسواس القهري، حيث تتيح المعلمات المقدرة فهماً معمقاً للتباين السلوكي الجمعي دون الوقوع في أخطاء تضخيم الدلالة الإحصائية الناجمة عن إهمال التشتت الزائد.
4.3 التوزيع الهندسي (Geometric Distribution) لتسلسل الأحداث والمحاولات
يركز التوزيع الهندسي (Geometric Distribution) على نمذجة عدد المحاولات الفاشلة المتعاقبة قبل تحقيق أول نجاح في تجربة برنولي المستقلة، أو بدقة أكثر، نمذجة عدد الأحداث السلبية المتتالية إلى حين وقوع الحدث المستهدف. يعتمد هذا التوزيع المتقطع على معلمة احتمالية وحيدة هي prob، والتي تمثل احتمال وقوع النجاح في كل محاولة منفردة، ويتميز بخاصية رياضية فريدة تُعرف بـ “فقدان الذاكرة” (Memoryless Property)، والتي تفترض أن احتمال وقوع الحدث في المحاولة التالية لا يتأثر إطلاقاً بعدد الإخفاقات السابقة.
عند استدعاء densfun = "geometric" في دالة fitdistr، تقوم الدالة بحساب مقدر الإمكان الأعظم لمعلمة الاحتمال، والذي يربط بصورة مباشرة بين المتوسط الحسابي لعدد الإخفاقات واحتمال النجاح وفق الصيغة الرياضية المغلقة:
p̂ = 1 / (1 + x̄)
تستخرج الدالة أيضاً التباين المقارب والخطأ المعياري المقترن بهذا التقدير، مما يتيح اختبار الفرضيات حول ثبات كفاءة الأداء الفردي عبر سلسلة المحاولات التجريبية.
تُستخدم ملاءمة التوزيع الهندسي في القياس المعرفي والنفسي لتحليل زمن الانتظار الإدراكي ودرجة المثابرة والتحمل في الاختبارات الصعبة؛ مثل فحص عدد التمارين الخاطئة التي يرتكبها الطالب قبل استيعاب القاعدة المنطقية وحل المسألة بصورة صحيحة للمرة الأولى. ومع ذلك، تبرز محدودية هذا النموذج في الميادين السلوكية عندما يطرأ عامل التعلم (Learning Effect) أو الإنهاك العقلي (Cognitive Fatigue) عبر الزمن، حيث يؤدي ذلك إلى تغير ديناميكي في قيمة الاحتمال prob بين محاولة وأخرى، مما يخرق فرضية ثبات المعلمة ويستوجب مقارنة ملاءمة التوزيع الهندسي مع بدائل غير ثابتة.
5. التطبيق العملي خطوة بخطوة: ملاءمة التوزيع الطبيعي للبيانات
5.1 توليد البيانات الافتراضية واستكشافها بصرياً
لإدراك الآلية التشغيلية الدقيقة لدالة fitdistr، نستهل التطبيق العملي بمحاكاة عينة بيانات تجريبية خاضعة لرقابة صارمة، مما يتيح لنا مقارنة المعلمات المستخرجة بالقيم الحقيقية المعروفة مسبقاً. نستخدم دالة set.seed() لضمان استقرار نتائج التوليد العشوائي وقابلية إعادة الإنتاج الأكاديمي للدراسة، ثم نولد عينة تتكون من ألف مشاهدة مستقاة من توزيع طبيعي بمتوسط حقيقي مقداره 100 وانحراف معياري قدره 15، وهو ما يحاكي توزيع درجات اختبارات الذكاء (IQ Scores) القياسية:
set.seed(12345)
sim_data <- rnorm(n = 1000, mean = 100, sd = 15)
يبدأ التحليل الاستكشافي الأولي بفحص المؤشرات الوصفية للنزعة المركزية والتشتت باستخدام الدوال الأساسية في R مثل mean(sim_data) وsd(sim_data)، للتحقق من تقارب مؤشرات العينة مع معالم المجتمع المولد. كما يتم استخراج المدى الربيعي ومعاملات الالتواء والتفرطح لتأكيد النمط المتناظر الأولي. يعقب ذلك بناء مدرج تكراري (Histogram) يمثل التوزيع التكراري الفعلي للمشاهدات، مع تراكب منحنى تقدير الكثافة بالنواة التجريبية لتكوين انطباع بصري استباقي عن مدى نعومة وانسيابية القمة التناظرية وتطابق الذيول مع الشكل الطبيعي المفترض.
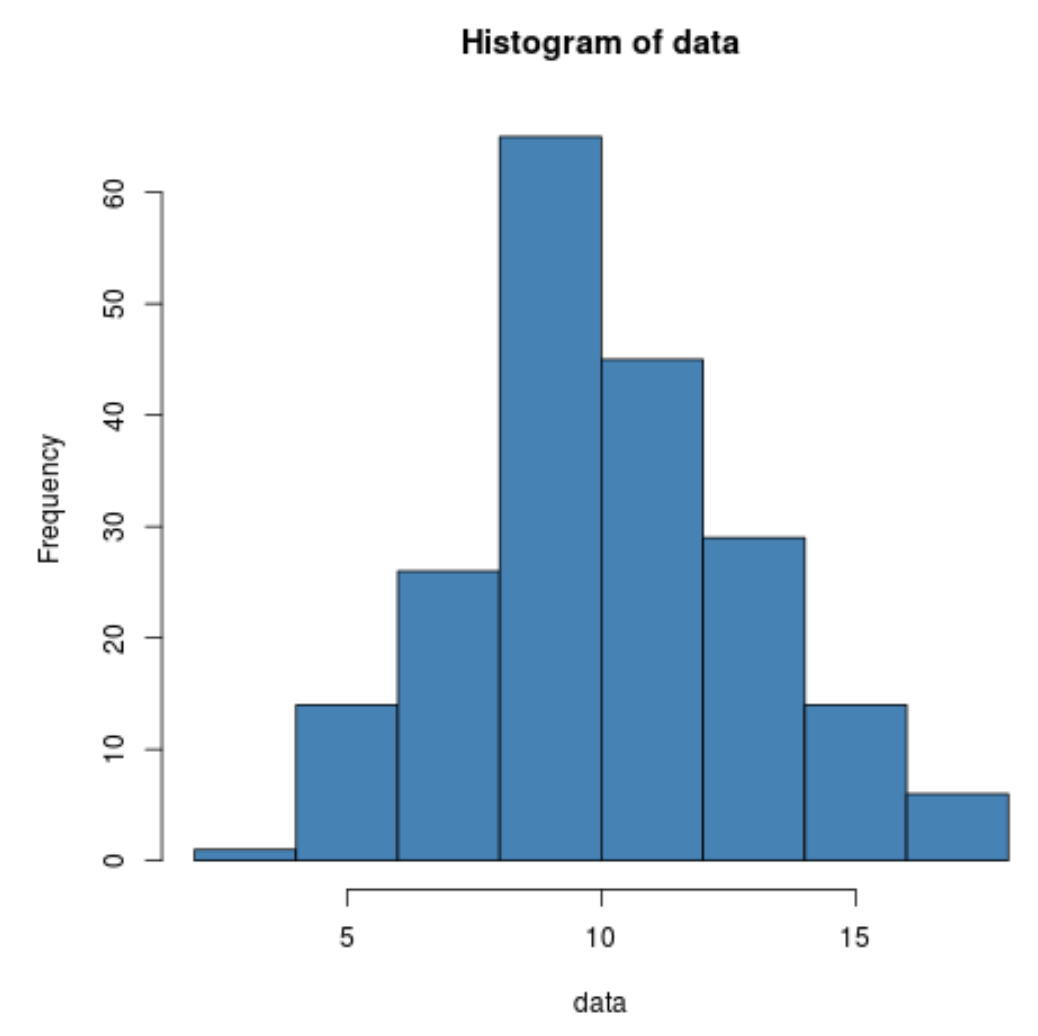
5.2 تنفيذ كود fitdistr() واستخراج المخرجات وتفسيرها
عقب مرحلة الاستكشاف الأولي، يتم تنفيذ دالة fitdistr لملاءمة التوزيع الطبيعي واستخراج التقديرات المعلمية الدقيقة عبر السطر البرمجي المباشر:
fit_norm <- MASS::fitdistr(sim_data, densfun = "normal")
print(fit_norm)
يُنتج هذا الأمر مخرجات إحصائية تتضمن تقديراً لمعلمتي الموقع (mean) والتشتت (sd)، يتبعهما مباشرة في السطر الأسفل الأخطاء المعيارية المقابلة لكل معلمة محصورة بين قوسين. على سبيل المثال، قد تسفر المخرجات عن قيمة مقدرة للمتوسط تبلغ 100.12 بخطأ معياري قدره 0.47، وانحراف معياري قدره 14.95 بخطأ معياري قدره 0.33. تعكس هذه الأخطاء المعيارية المنخفضة درجة اليقين الإحصائي المرتفعة بالنظر إلى حجم العينة الكافي (N = 1000).
لحساب فترات الثقة بنسبة 95% للمعلمات المقدرة استناداً إلى خاصية التوزيع الطبيعي التقاربي لمقدرات الإمكان الأعظم، يمكن استخدام دالة فترات الثقة المدمجة:
confint(fit_norm, level = 0.95)
يقوم هذا الإجراء بضرب الخطأ المعياري في القيمة الحرجة للتوزيع الطبيعي المعياري (1.96) وإضافتها وطرحها من القيمة المقدرة، مما يمنح الباحث مجالاً عددياً موثوقاً يؤكد احتواء القيمة الحقيقية للمجتمع الإحصائي بدقة إحصائية متناهية.
5.3 مطابقة النموذج المقدر بصرياً مع العينة الأصلية
تتطلب المعايير المنهجية الرصينة عدم الاكتفاء بالأرقام المجردة، بل تدعيم التحليل بمطابقة بصرية توضح مدى التوافق بين النموذج النظري والبيانات الأصلية. يتم ذلك عن طريق رسم المدرج التكراري للبيانات التجريبية بعد تحويل مقياس المحور الرأسي من التكرار المطلق إلى الكثافة الاحتمالية عبر الوسيط probability = TRUE، ثم استدعاء دالة curve() لتوليد دالة الكثافة المعلمية النظرية المقدرة باستخدام المعلمات المستخرجة من دالة fitdistr:
hist(sim_data, probability = TRUE, col = "grey90", border = "white", main = "ملاءمة التوزيع الطبيعي", xlab = "القيم")
curve(dnorm(x, mean = fit_norm$estimate["mean"], sd = fit_norm$estimate["sd"]), col = "darkblue", lwd = 2, add = TRUE)
لإنتاج مخرجات بيانية متقدمة تفي بمعايير النشر في المجلات العلمية المحكمة، يمكن توظيف حزمة ggplot2 من خلال دمج طبقة geom_histogram() مع دالة الكثافة الرياضية stat_function() الممرة بمعلمات fitdistr. يتيح هذا التمثيل البصري الفاحص للباحث التحقق بالعين المجردة من أي انحرافات غير مرغوبة للبيانات حول القمة المركزية أو تسطح غير طبيعي في الذيول، مما يشكل الخطوة التشخيصية التمهيدية قبل الانتقال إلى اختبارات جودة الملاءمة الاستدلالية الأكثر صرامة.
6. ملاءمة التوزيعات الملتوية المعقدة وتحديد القيم الابتدائية
6.1 ملاءمة توزيع غاما ومعالجة تحديات القيم الابتدائية (Starting Values)
على عكس التوزيع الطبيعي الذي يمتلك حلولاً تحليلية مباشرة، فإن ملاءمة توزيع غاما تتطلب تطبيق خوارزميات الأمثلية العددية على معادلات معقدة غير خطية. وكثيراً ما تواجه هذه الخوارزميات فشلاً ذريعاً في التقارب الحسابي، مصحوباً برسائل تحذيرية شهيرة مثل “optimization failed to converge”، وذلك في حال غياب التحديد الدقيق لمعالم البداية (Starting Values) التي ينطلق منها محرك التحسين للبحث عن قمة دالة الإمكان. إن إعطاء قيم أولية غير واقعية قد يؤدي بالخوارزمية إلى السقوط في فخ النهايات المحلية أو الانجراف نحو فضاءات رياضية غير معرفة.
تتمثل الاستراتيجية المنهجية الرصينة لحل هذه المعضلة في توظيف “طريقة العزوم” (Method of Moments) لحساب قيم البداية المعقولة وتمريرها عبر وسيط start. تستند طريقة العزوم لتوزيع غاما إلى العلاقة الرياضية التي تربط بين المتوسط والتباين ومعلمتي الشكل (shape) والمعدل (rate):
shapeinit = x̄2 / s2
rateinit = x̄ / s2
حيث يمثل x̄ متوسط العينة وs2 تباينها المحسوب.
يتم كتابة الكود البرمجي التنفيذي لتمرير هذه القيم في دالة fitdistr على النحو التالي:
m <- mean(gamma_data); v <- var(gamma_data)
start_vals <- list(shape = m^2 / v, rate = m / v)
fit_gamma <- MASS::fitdistr(gamma_data, densfun = "gamma", start = start_vals)
يضمن هذا الإجراء المنهجي تقارباً عددياً سريعاً ومستقراً للخوارزمية، متفادياً الانهيارات الحسابية الناتجة عن التخمينات العشوائية التلقائية للبرنامج.
6.2 ملاءمة توزيع بيتا للبيانات المقيدة بنطاق محدد
يفرض توزيع بيتا قيوداً صارمة على مجال التعريف الرياضي، حيث يجب أن تقع جميع المشاهدات ضمن النطاق المفتوح المنحصر بين الصفر والواحد الحقيقيين:
x ∈ (0, 1)
في الأبحاث السلوكية، غالباً ما تكون البيانات مقاسة وفق مقاييس ليكرت المتعددة، أو نسب مئوية محصورة في المجال المغلق [0, 100] أو [0, 1] شاملاً الأطراف تماماً. في مثل هذه الحالات، يجب أولاً تحويل البيانات عبر إزاحتها وتدريجها لتفادي القيم الصفرية والواحدية المطلقة التي تسبب تفجر دالة لوغاريتم الإمكان إلى المالانهاية السالبة، ويمكن استخدام تحويل سميثسون وفيركويك القياسي:
x_trans = (x × (N – 1) + 0.5) / N
لحساب القيم الابتدائية لمعلمتي بيتا (shape1 وshape2)، نلجأ مجدداً إلى طريقة العزوم التمهيدية اعتماداً على متوسط العينة المتحولة وتباينها:
shape1init = x̄ × [ (x̄ × (1 – x̄) / s2) – 1 ]
shape2init = (1 – x̄) × [ (x̄ × (1 – x̄) / s2) – 1 ]
وعند استدعاء fitdistr، نمرر هذه التقديرات مع تفعيل التحسين المقيد لحظر القيم السالبة للمعلمات:
fit_beta <- MASS::fitdistr(x_trans, densfun = "beta", start = list(shape1 = s1, shape2 = s2), lower = c(0.001, 0.001))
تساعد المعلمات المستخلصة بدقة في الكشف عن تمركز الاستجابات النفسية وانحيازها نحو الأطراف أو الوسط بمستوى عالٍ من الرصانة القياسية.
6.3 ملاءمة توزيع ويبل لتحليل البقاء والأزمنة المستمرة
يمثل توزيع ويبل الأداة الأثيرة لنمذجة الفترات الزمنية لانقضاء الأحداث أو الاستجابات السلوكية المستمرة. وعند ملاءمته باستخدام densfun = "weibull"، تتولى الدالة تقدير معلمة الشكل (shape) ومعلمة المقياس (scale). يوفر هذا النموذج كفاءة تفسيرية استثنائية في التحليل الفيزيائي والسلوكي؛ فإذا جاء تقدير معلمة الشكل مساوياً على سبيل المثال للقيمة 2.5، فإن ذلك يعكس رياضياً وسلوكياً أن احتمالية صدور الاستجابة تزداد اطراداً مع مرور الزمن (Wear-out or Aging effect)، وهو ما يُلاحظ في أزمنة حل المشكلات الصعبة التي تتطلب تفكيراً متراكماً.
تواجه ملاءمة ويبل عائقاً رئيسياً في حال احتواء سجلات الزمن على أصفار حقيقية ناجمة عن استجابات آنية أو أخطاء في أجهزة القياس والتسجيل الدقيق. نظراً لأن دالة كثافة ويبل غير معرفة عند الصفر أو القيم السالبة عندما تكون معلمة الشكل أكبر من واحد، فإن المعالجة المنهجية تقتضي إما استبعاد تلك المشاهدات اللحظية إن كانت ناتجة عن عوارض تجريبية شاذة، أو إضافة ثابت إزاحة إحصائي دقيق للغاية لا يؤثر على البنية التوزيعية العامة للبيانات.
يمكن تنفيذ ملاءمة ويبل بسلاسة عبر الأمر المباشر:
fit_weib <- MASS::fitdistr(time_data, densfun = "weibull")
حيث تنجح الخوارزميات في معظم الأحيان بتوليد قيم ابتدائية ملائمة تلقائياً لويبل بالاعتماد على تحويلات القيمة المتطرفة الكامنة (Extreme Value Analysis)، مما يجعل ملاءمته أسرع تقارباً من توزيع بيتا أو غاما في معظم التطبيقات العملية.
7. التقييم التشخيصي واختبارات جودة الملاءمة (Goodness-of-Fit)
7.1 الرسوم البيانية التشخيصية المتقدمة: مخططات Q-Q و P-P
لا ينبغي للباحث الرصين الاعتماد الأعمى على نجاح خوارزمية التحسين في تقارب المعلمات دون إخضاع النموذج المقدر لاختبارات تشخيصية بصرية متقدمة. يمثل مخطط المئين-المئين (Quantile-Quantile Plot المعروف اختصاراً بـ Q-Q Plot) الأداة الأكثر عمقاً وحساسية لرصد الانحرافات التوزيعية الدقيقة. يعتمد الأساس الرياضي لهذا المخطط على رسم المئينات التجريبية المستخلصة من العينة المرصودة على أحد المحاور في مواجهة المئينات النظرية المتوقعة من النموذج المقدر باستخدام دالة المئين العكسية (Quantile Function):
q = F-1(p; θ̂)
إذا كان التوزيع المقدر مطابقاً للبيانات بشكل مثالي، تصطف كافة النقاط على خط مستقيم بزاوية 45 درجة يمر عبر نقطة الأصل.
يتيح مخطط Q-Q للباحث تشخيص علل التوزيع بدقة سريرية؛ حيث يشير انحراف النقاط عن الخط المرجعي عند الأطراف العليا والسفلى على شكل حرف “S” إلى ثقل الذيول أو خفتها مقارنة بالنموذج المفترض، بينما يعكس التواء النقاط على شكل قوس وجود التواء منهجي (Skewness) لم ينجح النموذج في استيعابه.
وبالمثل، يركز مخطط الاحتمال-الاحتمال (Probability-Probability Plot أو P-P Plot) على رسم الاحتمالات التراكمية التجريبية في مواجهة الاحتمالات التراكمية النظرية:
F̂(x) vs F(x; θ̂)
يتميز مخطط P-P بحساسية مفرطة للتغيرات والانحرافات التي تقع في قلب التوزيع وحول قيمته المركزية، مما يجعله مكملاً جوهرياً لمخطط Q-Q الذي ينصب تركيزه البصري الأساسي على أطراف والذيول التوزيعية الشاذة.
7.2 الاختبارات الإحصائية الاستدلالية لجودة الملاءمة
بالتوازي مع الفحص البصري، يتعين إجراء اختبارات إحصائية استدلالية صارمة لاختبار الفرضية الصفرية القائلة بأن البيانات المرصودة تنحدر بالفعل من التوزيع النظري المقدر. يُعد اختبار كولموجوروف-سميرنوف (Kolmogorov-Smirnov Test) أشهر هذه الأدوات، حيث يقوم بحساب أقصى مسافة رأسية مطلقة (المعامل D) بين دالة التوزيع التراكمي التجريبية والدالة التراكمية النظرية المقدرة:
D = supx |Fn(x) – F(x; θ̂)|
غير أن تطبيق هذا الاختبار عبر الدالة التقليدية ks.test() في R ينطوي على محذور منهجي خطير يجب التنبيه إليه؛ إذ يفترض الاختبار الكلاسيكي أن معلمات التوزيع النظري محددة سلفاً ومستقلة تماماً عن العينة. أما عند تقدير المعلمات من نفس العينة الخاضعة للاختبار باستخدام fitdistr، فإن درجات الحرية الفعلية تنخفض وتصبح القيم الاحتمالية (p-values) الناتجة مفرطة في التحفظ ومضللة للباحث.
لتصحيح هذا القصور، يلجأ الباحثون إلى اختبارات أكثر حساسية وتخصصاً مثل اختبار أندرسون-دارلنج (Anderson-Darling Test) واختبار كرامر-فون ميزس (Cramér-von Mises Test)، والتي تمنح أوزاناً إضافية للفروق المتراكمة عند الذيول، مع تطبيق تعديلات ليلفورس (Lilliefors Correction) عبر تقنيات المحاكاة وإعادة المعاينة لتعديل القيم الاحتمالية بناءً على المعلمات المقدرة من العينة ذاتها، مما يمنح القرار الإحصائي بقبول أو رفض الملاءمة موثوقية أكاديمية متينة لا يرقى إليها الشك.
7.3 المقارنة بين النماذج المتنافسة باستخدام معايير المعلومات
في كثير من الأحيان، يجد الباحث نفسه أمام عدة توزيعات احتمالية متنافسة تمتلك جميعها ما يبررها نظرياً لملاءمة نفس مجموعة البيانات، كما هو الحال عند المفاضلة بين التوزيع اللوغاريتمي الطبيعي وتوزيع غاما وتوزيع ويبل لبيانات أزمنة الاستجابة. لحسم هذه المنافسة بصورة رياضية محايدة، نلجأ إلى استخراج قيمة أقصى لوغاريتم للإمكان (Maximum Log-Likelihood) المتحققة من كل كائن ناتج عن fitdistr عبر استدعاء دالة logLik(). ونظراً لأن النماذج ذات المعلمات الأكثر عدداً تميل بطبيعتها إلى تحقيق لوغاريتم إمكان أعلى نتيجة التعقيد الرياضي الزائد، يصبح لزاماً تطبيق معايير المعلومات التي تعاقب التعقيد لمنع فرط التخصيص (Overfitting).
يأتي معيار أكايكي للمعلومات (Akaike Information Criterion – AIC) في طليعة هذه المقاييس، ويُحسب وفق المعادلة التالية:
AIC = 2k – 2 × ln(L̂)
حيث تمثل k عدد المعلمات المقدرة في النموذج، بينما تمثل L̂ دالة الإمكان العظمى المتحققة.
كما يُحسب معيار بايز للمعلومات (Bayesian Information Criterion – BIC) وفق الصيغة:
BIC = k × ln(n) – 2 × ln(L̂)
والتي تفرض عقوبة أشد قسوة على زيادة المعلمات كلما كبر حجم العينة n.
تنص القاعدة المنهجية الصارمة على أن النموذج الأفضل هو الذي يحقق أدنى قيمة عددية لمعياري AIC وBIC. إن تحقيق فرق في قيمة AIC يتجاوز الدرجتين إلى الأربع درجات يُعد دليلاً إحصائياً ملموساً على تفوق النموذج ذي القيمة الأقل، في حين يشير الفارق الذي يتجاوز عشر درجات إلى غياب أي دعم إحصائي للنموذج المنافس، مما يوفر أداة فصل كمية قاطعة في اختيار البنية التوزيعية الأكثر مطابقة للواقع الظاهراتي المدروس.
8. استراتيجيات استكشاف الأخطاء الشائعة وحلها في fitdistr()
8.1 التعامل مع خطأ ‘optimization failed to converge’
يُعد خطأ “optimization failed to converge” من أكثر الرسائل البرمجية إحباطاً للمحللين عند استخدام دالة fitdistr، وينجم هذا الإخفاق عن عجز خوارزمية التحسين العددي الكامنة في دالة optim() عن استيفاء شروط التقارب المحددة مسبقاً قبل استنفاد الحد الأقصى المسموح به من التكرارات الحسابية. تعود الأسباب الرياضية لهذا الفشل إلى عدة عوامل؛ منها وعورة سطح دالة الإمكان وتعدد القمم المحلية الكاذبة، أو تسطح السطح لدرجة تتلاشى معها المشتقات التوجيهية وتتعذر معرفة اتجاه التقدم الحسابي، أو بسبب اختيار قيم ابتدائية شديدة البعد عن النطاق الحقيقي للمعلمات.
تتضمن الحلول البرمجية الفعالة لهذه الأزمة عدة خطوات متدرجة. تتمثل الخطوة الأولى في زيادة الحد الأقصى المسموح به من التكرارات الحسابية عبر تمرير وسيط التحكم control = list(maxit = 10000) داخل استدعاء fitdistr، مما يمنح الخوارزمية مدى زمنياً أطول للتحرك في الفضاءات الصعبة. وتتمثل الخطوة الثانية في تغيير خوارزمية التحسين ذاتها عبر تمرير الوسيط method؛ فإذا فشلت خوارزمية “BFGS” المعتمدة على المشتقات، يمكن التبديل إلى خوارزمية “Nelder-Mead” البسيطة التي تتسم بالقوة ومقاومة الانقطاعات الطوبولوجية في سطح الدالة، وإن كانت أبطأ نسبياً في الوصول إلى الحل الدقيق.
بالإضافة إلى ذلك، يلعب تدريج البيانات وإعادة قياسها (Data Scaling) دور المنقذ الحسابي في كثير من الأحيان. فعندما تكون الأرقام المدخلة ضخمة جداً (بملايين الوحدات) أو دقيقة جداً (بأجزاء من المليون)، يؤدي ذلك إلى فيض حسابي (Numerical Overflow) أو تلاشٍ يعطل حسابات المصفوفات؛ وهنا يكفي قسمة البيانات على ثابت قياسي معلوم (مثل 1000) لتسهيل التقارب العددي، ثم إعادة تعديل المعلمات المستخرجة رياضياً لتتوافق مع المقياس الأصلي.
8.2 معالجة خطأ ‘values must be positive’ والبيانات خارج النطاق
تفرض دوال الكثافة للتوزيعات الاحتمالية الملتوية والمقيدة، مثل غاما، وويبل، واللوغاريتمي الطبيعي، وتوزيع بيتا، اشتراطات رياضية حاسمة تحظر تواجد قيم خارج مجالات تعريفها الرسمية. فعند تمرير متجه يحتوي على الصفر أو قيماً سالبة إلى دالة غاما أو ويبل، تنهار العملية فورياً وتطلق بيئة R تحذيرها الصارم: “values must be positive”. ينبع هذا الاعتراض من حقيقة أن معادلات هذه التوزيعات تتضمن أخذ اللوغاريتم الطبيعي للمشاهدات، أو رفعها لأسس موجبة وسالبة، وهي عمليات تؤول إلى المالانهاية أو إلى قيم غير حقيقية عند مواجهة الأصفار والأرقام السالبة.
يتجه بعض الباحثين بدافع التسرع إلى حل هذه المعضلة عبر إضافة ثابت إزاحة رقمي بالغ الصغر (Offset Constant مثل 0.001 أو 0.0001) لكافة مشاهدات العينة لتجاوز الصفر قسرياً. غير أن هذا الإجراء ينطوي على مخاطر منهجية جسيمة تؤثر بشكل جوهري على دقة التقدير؛ إذ أثبتت الدراسات الإحصائية أن إضافة الثوابت تحرف تقدير معلمة الشكل وتغير من طبيعة سلوك التوزيع عند الذيل القريب من الصفر، مما يقود إلى انحياز حاد في استنتاجات الإمكان الأعظم، لا سيما إذا كانت نسبة الأصفار في البيانات تمثل نسبة ملموسة من حجم العينة.
يتمثل التصرف المنهجي الصائب في التمييز الحذر بين مصدر هذه القيم؛ فإذا كانت القيم الصفرية والسالبة ناجمة عن أخطاء تقنية في الإدخال أو عيوب في أجهزة الرصد، فإن استبعادها وتوثيق ذلك في المنهجية يُعد حلاً مشروعاً. أما إذا كانت الأصفار تمثل “أصفاراً حقيقية” تعكس غياباً أصيلاً للسمة المدروسة (مثل غياب التكرارات أو انعدام الإنفاق)، فإن الحل العلمي السليم لا يكمن في إقحام توزيعات مستمرة موجبة قسراً، بل بالتحول نحو عائلة “النماذج المكبوتة عند الصفر” (Zero-Inflated Models) أو “نماذج الحاجز” (Hurdle Models) التي تفصل بين آلية توليد الصفر وآلية توليد القيم المستمرة الإيجابية اللاحقة.
8.3 حل مشكلات حساب الأخطاء المعيارية ومصفوفة هيسيان (Hessian Matrix)
في بعض التطبيقات المعقدة، تنجح دالة fitdistr ظاهرياً في تقدير قيم المعلمات، ولكنها تصدر رسالة تحذيرية مفادها: “singular Hessian” أو عجز البرنامج عن حساب الأخطاء المعيارية للمعلمات، مما يؤدي إلى ظهور قيم الأخطاء المعيارية على هيئة قيم غير معرفة (NaN). يشير هذا العارض الرياضي إلى أن مصفوفة هيسيان (مصفوفة المشتقات الثانية لدالة لوغاريتم الإمكان) المحسوبة عند نقطة الحل العظمى هي مصفوفة شاذة (Singular Matrix) ذات محدد عددي يطابق الصفر، مما يجعل حساب مقلوبها المالي أمراً مستحيلاً رياضياً لتعذر القسمة على الصفر.
تنشأ مشكلة انعدام قابلية قلب مصفوفة هيسيان نتيجة وجود ارتباط خطي فائق بين المعلمات المقدرة (High Parameter Collinearity)، أو عندما تقع إحدى المعلمات المقدرة مباشرة على الحافة الرياضية القصوى للمجال المسموح به (Boundary Solutions)، أو عندما تتصف البيانات بوجود تكتلات شاذة تفرغ سطح دالة الإمكان من انحنائه المقعر الطبيعي وتحوله إلى سطح متعرج رديء التوصيف. لحل هذا التحدي، يتوجب على الباحث أولاً فحص فضاء البيانات وتطبيق خوارزميات تحسين بديلة تفرض شروطاً حدودية واضحة تمنع المعلمات من الاصطدام بالحواف الصفرية.
وفي الحالات المستعصية التي يتعذر فيها حساب الأخطاء المعيارية بالطريقة المقاربة الكلاسيكية، يبرز أسلوب “إعادة المعاينة التكرارية” (Parametric or Non-parametric Bootstrapping) كبديل تجريبي فائق القوة والمتانة. يقوم الباحث بسحب آلاف العينات العشوائية المتكررة مع الإحلال من البيانات الأصلية، وإعادة تطبيق fitdistr على كل عينة فرعية، ثم حساب الانحراف المعياري للتقديرات المعلمية الناتجة عبر هذه الدورات. يتيح هذا المسار استخراج أخطاء معيارية وفترات ثقة موثوقة ومقاومة للخلل العددي لمصفوفة هيسيان، مما يضمن سلامة الاستدلال الإحصائي في الأبحاث المتقدمة.
9. تطبيقات منهجية متقدمة في التحليل السلوكي والقياس النفسي
9.1 ملاءمة أزمنة الاستجابة السلوكية باستخدام التوزيعات الملتوية
تحظى بيانات أزمنة الاستجابة (Reaction Time – RT) باهتمام مركزي في تجارب علم النفس المعرفي، وعلوم الأعصاب السلوكية، ودراسات الانتباه والسرعة الإدراكية. تتسم هذه البيانات بنيوياً بحد أدنى فيزيولوجي لا يمكن تجاوزه (يمثل زمن نقل الإشارة العصبية في المسارات الحسية والحركية)، متبوعاً بذروة سريعة من الاستجابات الفعالة، ثم ذيل طويل يمتد نحو اليمين ليمثل الاستجابات المتأخرة الناتجة عن التردد الإدراكي أو تشتت الانتباه المؤقت. إن إخضاع هذه البنية للتوزيع الطبيعي يُعد خطأ فادحاً يطمس الفروق الفردية ويشوه النماذج التفسيرية.
يتيح تطبيق دالة fitdistr باستخدام التوزيع اللوغاريتمي الطبيعي (Lognormal) أو توزيع ويبل مقاربة هذه الأزمنة بموثوقية فائقة. ففي نموذج التوزيع اللوغاريتمي، تعكس معلمة meanlog السرعة المركزية لمعالجة المعلومات في القشرة المخية، بينما تعكس معلمة sdlog مدى استقرار الأداء المعرفي ومستوى التباين اللحظي لدى الفرد. كما يتيح توزيع ويبل، عبر معلمة شكله، تفسير الآلية الديناميكية لتراكم الأدلة الحسية؛ حيث ترتبط معلمة الشكل فوق الواحد الصحيح بتزايد دافعية الحسم وسرعة اتخاذ القرار بمرور أجزاء الثانية من عرض المثير البصري.
تستخدم هذه التقديرات المعلمية المستخرجة عبر fitdistr كمؤشرات سيكومترية مستقلة للمقارنة بين المجموعات الإكلينيكية والأسوياء في دراسات اضطراب فرط الحركة وتشتت الانتباه (ADHD) أو مرض التصلب المتعدد. حيث يظهر المرضى غالباً انحرافاً حاداً في اتساع الذيول التوزيعية دون اختلاف كبير في المتوسطات الكلاسيكية، مما يبرهن على أن النمذجة المعلمية الصحيحة لأزمنة الاستجابة تكشف عن بصمات تشخيصية كامنة تعجز الأساليب الإحصائية التقليدية عن رصدها.
9.2 نمذجة درجات الاستبيانات السيكومترية الخاضعة لظاهرة السقف والأرضية
تمثل تأثيرات السقف (Ceiling Effects) وتأثيرات الأرضية (Floor Effects) تحدياً بنيوياً مزمناً في القياس النفسي والتقييم المؤسسي؛ حيث تتكدس استجابات الأفراد عند الحد الأقصى للمقياس (كما في قياسات الرضا عن الخدمات الممتازة أو مقاييس الكفاءة الذاتية السهلة) أو عند الحد الأدنى (كما في مقاييس رصد الاكتئاب الحاد لدى العينات غير الإكلينيكية من عامة المجتمع). ينتج عن هذا التراكم تشويه حاد للمنحنى الطبيعي، وانحسار مصطنع في التباين، وخرق متكامل لافتراض خطية العلاقات في نماذج الانحدار.
يوفر توزيع بيتا المقدر عبر fitdistr حلاً إحصائياً بارعاً لهذه المعضلة المنهجية بعد تدريج درجات المقياس لتنحصر بدقة في المدى (0, 1). تتيح مرونة معلمتي بيتا (shape1 وshape2) تمثيل كافة أشكال التراكم الطرفي؛ فإذا كانت قيمة shape1 أصغر بكثير من shape2، دل ذلك على التواء شديد نحو اليمين وانحسار الدرجات عند الأرضية، بينما تشير الحالة المعاكسة إلى تراكم البيانات عند السقف. أما إذا قلت كلتا المعلمتين عن الواحد، فإن التوزيع يتحول لشكل حرف U عاكساً استقطاباً سلوكياً حاداً بين المشاركين.
تسهم هذه النمذجة الدقيقة في إعادة بناء المعايير المئينية (Percentile Norms) للمقاييس السيكومترية الوطنية وتطوير بنوك الأسئلة في نظرية الاستجابة للمفردة (IRT). فبدلاً من الاعتماد على الدرجات المعيارية التائية (T-scores) أو الزائية (Z-scores) التي تفترض التناظر قسراً وتؤدي إلى تصنيف خاطئ للمفحوصين في الأطراف، تضمن المعايير المبنية على ملاءمة بيتا تقييماً عادلاً ودقيقاً لمستوى السمة الكامنة لدى المفحوصين، مما يرتقي بجودة قرارات التوظيف والتشخيص الإكلينيكي المعتمدة على هذه الأدوات القياسية.
9.3 تحليل تكرار السلوكيات غير الشائعة عبر النماذج الاحتمالية المنفصلة
تتصف العديد من الظواهر السلوكية ذات الأهمية الإكلينيكية والاجتماعية بكونها أحداثاً متقطعة غير شائعة الظهور؛ مثل نوبات السلوك الاندفاعي لدى المراهقين، أو نوبات الغضب والعدوانية المفاجئة في المصحات، أو أيام الغياب المدرسي والمهني غير المبرر. تتميز هذه البيانات بالعديد من المشاهدات الصفرية والتكرارات المنخفضة، مع وجود قلة قليلة جداً من الأفراد يظهرون تكرارات مرتفعة للغاية، مما يولد تشتتاً فائقاً (Overdispersion) يعجز توزيع بواسون الكلاسيكي عن مجاراته دون تضخيم معدلات الخطأ من النوع الأول.
يمثل تطبيق دالة fitdistr لملاءمة التوزيع ذي الحدين السالب (Negative Binomial) الأداة الإحصائية الفضلى في هذا النطاق، حيث تقوم بتقدير معلمة المعدل ومقدار التشتت الفائق بدقة متناهية. تكتسب هذه المعلمات أهمية سريرية وتقييمية كبرى؛ إذ تمكن المعالجين والباحثين من تقييم كفاءة التدخلات العلاجية النفسية والبرامج السلوكية عن طريق رصد التراجع الإحصائي الدال في معلمة المعدل (mu) مع تتبع الزيادة التدريجية في معلمة التشتت الحجمي (size) نحو قيم أكبر تدل على عودة الاستقرار وتجانس السلوك عبر أفراد العينة.
علاوة على ذلك، يشكل هذا التقدير المعلمي حجر الأساس لتأسيس نماذج الانحدار الخطي المعمم (Generalized Linear Models – GLMs) التنبؤية المتخصصة في البيانات التكرارية. إذ يوفر التقدير الأولي للمعلمات عبر fitdistr فهماً متقدماً للارتباطات الاحتمالية الكامنة، مما يساعد على تصميم منظومات إنذار مبكر في العيادات السلوكية تتنبأ باحتمالية وصول المريض إلى عتبة الخطر الشديد بناءً على التاريخ التكراري السابق لنوباته، وهو ما يجسد التكامل الوثيق بين الحوسبة الإحصائية وتطوير الرعاية الإكلينيكية.
10. المقارنة النقدية، البدائل البرمجية، وأفضل الممارسات في R
10.1 مقارنة fitdistr() بحزمة fitdistrplus المتقدمة
بالرغم من المكانة التاريخية والموثوقية الاستثنائية التي تتمتع بها دالة fitdistr في حزمة MASS، شهدت بيئة الحوسبة الإحصائية في R تطوير حزمة متخصصة وشاملة بالكامل لملاءمة التوزيعات تحت مسمى fitdistrplus. تتميز هذه الحزمة اللاحقة بتوفير بنية برمجية تفاعلية تتضمن دوال فحص وتشخيص بصري تلقائية مدمجة؛ مثل دالة plotdist() لرسم التوزيع التجريبي، ومخطط كولين وفري (Cullen and Frey graph) عبر دالة descdist() الذي يرسم الالتواء المربع في مواجهة التفرطح لتحديد التوزيعات المرشحة تلقائياً للملاءمة.
علاوة على ذلك، تتفوق حزمة fitdistrplus في دعمها لأساليب تقدير بديلة متعددة تتجاوز مبدأ الإمكان الأعظم؛ مثل طريقة مطابقة العزوم (Moment Matching Estimation – MME)، ومطابقة المئينات (Quantile Matching Estimation – QME)، وتقدير تعظيم المسافة الإحصائية (Maximum Goodness-of-Fit Estimation – MGE). كما تمتلك دعماً بنيوياً متقدماً للتعامل مع البيانات الخاضعة للرقابة والبتْر (Censored and Truncated Data) الشائعة في التجارب السريرية والصناعية، وهو ما تفتقر إليه fitdistr الكلاسيكية التي تشترط بيانات كاملة غير منقوصة.
ومع ذلك، تظل دالة MASS::fitdistr() هي الخيار الأنسب والمفضل في العديد من السياقات البرمجية والبحثية؛ لا سيما عند الرغبة في بناء سكربتات تحليلية خفيفة وسريعة التنفيذ تعتمد حصرياً على الحزم القياسية الأساسية المدمجة في R دون إثقال بيئة العمل بتبعيات برمجية خارجية، أو عند دمج إجراءات الملاءمة داخل حلقات تكرارية ضخمة وتطبيقات المحاكاة المعقدة التي تتطلب سرعة حسابية واستقراراً لا يتأثر بتحديثات الحزم الفرعية.
10.2 البدائل البايزية: استخدام حزم rstan وbrms لتقدير التوزيعات
تمثل المقاربة البايزية (Bayesian Paradigm) تحولاً ابستمولوجياً جذرياً في الاستدلال الإحصائي مقارنة بالمنهج التكراري الكلاسيكي (Frequentist) الذي تستند إليه دالة fitdistr. فبدلاً من التعامل مع معلمات التوزيع على أنها قيم ثابتة مجهولة نسعى لاستخراج تقدير نقطي وحيد لها، تفترض المنهجية البايزية أن المعلمات ذاتها متغيرات عشوائية تمتلك توزيعات احتمالية خاصة بها. يتيح هذا الإطار للباحث دمج المعرفة والخبرات السابقة عبر صياغة “التوزيعات القبلية” (Priors) وضبط تقدير المعلمات، مما يقدم حلولاً متينة خصوصاً في حالات العينات المحدودة أو النادرة التي تعاني فيها مقدرات الإمكان الأعظم من التحيز وعدم الاستقرار.
تجسد الحزم الحديثة في R، مثل brms وrstan، الذروة التطبيقية لهذا المسار؛ حيث تعتمد على خوارزميات محاكاة سلاسل ماركوف مونت كارلو المتقدمة (MCMC)، وبشكل أخص خوارزمية “No-U-Turn Sampler” (NUTS). تقوم هذه الأدوات بتوليد آلاف العينات من فضاء “التوزيع البعدي” (Posterior Distribution) المشترك للمعلمات، مما يوفر رؤية مكتملة لحالة عدم اليقين القياسي عبر استخراج فترات المصداقية البايزية (Credible Intervals) التي تمتلك تفسيراً احتمالياً مباشراً وبديهياً يعجز مفهوم فترات الثقة التكراري التقليدي عن تقديمه.
تتفوق المقاربات البايزية في قدرتها على بناء نماذج هرمية متعددة المستويات تتيح ملاءمة توزيعات المعلمات مع مراعاة البنية العنقودية للمدارس أو العيادات أو الفئات الديموغرافية المتعددة. غير أن هذا التفوق المنهجي يقابله ثمن حسابي باهظ؛ إذ تتطلب عمليات المحاكاة البايزية وقتاً وموارد حوسبية تفوق بأضعاف مضاعفة السرعة الفائقة لـ fitdistr، مما يجعل الباحث يوازن بدقة بين حاجته لتضمين المعرفة القبلية والتعقيد البايزي وبين الكفاءة والسرعة الحسابية لتقدير الإمكان الأعظم في التحليلات الاستكشافية والموسعة.
10.3 دليل إرشادي لأفضل الممارسات الإحصائية في ملاءمة النماذج
لضمان التميز البحثي والالتزام بأعلى معايير الرصانة العلمية عند استخدام دالة fitdistr في إعداد التقارير الأكاديمية ونشر البيانات، يُنصح الباحثون باتباع مصفوفة الممارسات الإحصائية الفضلى التالية:
- التحقق المسبق من الافتراضات النظرية ومجال البيانات: فحص مدى مطابقة البيانات لقيود التوزيع المستهدف رياضياً (كالقيم الموجبة المطلقة في غاما وويبل، والمجال المفتوح الصارم في بيتا) قبل الشروع في كتابة أوامر التحسين لتفادي الأخطاء البرمجية والانحيازات الخفية.
- التكامل الإلزامي بين التشخيص البصري والاختبار الدلالي: عدم الركون إطلاقاً إلى القيمة الاحتمالية لاختبارات جودة الملاءمة وحدها نظراً لتأثرها الشديد بحجم العينة، وضرورة إقرانها دوماً بمخططات Q-Q وP-P التشخيصية لتقييم سلوك الذيول والقمة.
- التوثيق المنهجي الصارم للقيم الابتدائية والخوارزميات: الإفصاح الكامل في منهجية البحث عن الخوارزمية العددية المتبعة داخل الدالة (مثل BFGS أو Nelder-Mead)، وبيان طريقة حساب القيم الابتدائية (طريقة العزوم مثلاً) وقيم معايير التقارب لضمان قابلية إعادة الإنتاج العلمي التام (Replicability).
- المقارنة النموذجية متعددة المعايير: إخضاع الظاهرة السلوكية أو الطبيعية لعدة توزيعات احتمالية متنافسة تمتلك وجاهة منطقية، والمفاضلة بينها بالاستناد إلى معايير المعلومات الصارمة (AIC وBIC) مع مناقشة المبررات المفاهيمية لاختيار التوزيع النهائي.
- صياغة التقارير الإحصائية وفق ضوابط النشر المعتمدة (مثل معايير APA): تقديم مخرجات ملاءمة التوزيع بأسلوب أكاديمي منظم؛ بحيث تتضمن الجداول المعلمات المقدرة مقرونة بأخطائها المعيارية وفترات الثقة الدقيقة (95% CI)، وقيمة أقصى لوغاريتم للإمكان، مع إرفاق الرسوم البيانية عالية الجودة التي تظهر تراكب المنحنى النظري المقدر فوق توزيع البيانات التجريبية بوضوح تام.
خاتمة واستشراف منهجي
تظل عملية ملاءمة التوزيعات الاحتمالية الجسر المفاهيمي والرياضي الأهم الذي يربط بين الفوضى الظاهرية للمشاهدات التجريبية والانتظام الرياضي الرصين للنظريات العلمية. لقد أثبتت دالة fitdistr في بيئة لغة R، وعبر عقود من التطبيق في حزمة MASS المرجعية، أنها محرك تحليلي كلاسيكي يتسم بالمتانة والسرعة والأناقة الرياضية، متيحاً للمحللين استخلاص معالم الظواهر بالاعتماد على أسس تقدير الإمكان الأعظم دون تعقيد برمجي فائض.
إن الاستخدام الرشيد لهذه الأداة يتطلب من الباحث وعياً إحصائياً يقظاً يبدأ بالفهم المعمق لطبيعة الظاهرة ومتغيراتها، ويمر بالبراعة البرمجية في معالجة تحديات التحسين العددي وانتقاء القيم الابتدائية وتفادي التكتلات والاصطدام بالحواف الرياضية، ولا ينتهي عند مجرد استخراج المعلمات بل بإخضاع النموذج لسلسلة صارمة من التقييمات التشخيصية البصرية والاستدلالية. ومن خلال تبني هذه الممارسات المنهجية الرصينة، يستطيع الباحثون في مجالات القياس النفسي، والعلوم السلوكية، وسائر التخصصات الكمية تحويل بياناتهم الخام إلى نماذج احتمالية مفسرة بدقة، تعزز من موثوقية الاستدلال العلمي وتسهم في بناء معرفة استقرائية متينة تتفق مع أحدث المعايير الأكاديمية العالمية.
المراجع
Christensen, A. P., & Choi, J. (2026). Network accuracy across levels of analysis using stochastic block models. Psychological Methods. https://doi.org/10.1037/met0000853