
تحظى منظومة التحليل الإحصائي SAS بمكانة رائدة واستثنائية في مجالات معالجة البيانات الضخمة، والرعاية الصحية، والتحليلات الوبائية، والعلوم المالية، والبحوث الأكاديمية المتقدمة. يعود تاريخ هذه المنظومة إلى عام 1966 عندما بدأت كمشروع بحثي في جامعة ولاية كارولاينا الشمالية (North Carolina State University) بتمويل من المعاهد الوطنية للصحة (NIH) لدراسة وتحليل البيانات الزراعية والبيولوجية، بقيادة علماء بارزين مثل أنتوني بار (Anthony J. Barr)، وجيمس غودنايت (James H. Goodnight)، وجون سال (John P. Sall)، وجين هيلويغ (Jane T. Helwig). وقد تُوّج هذا المسار الأكاديمي بتأسيس معهد ساس (SAS Institute Inc.) في مدينة كاري بولاية كارولاينا الشمالية عام 1976، ليضع اللبنات الأولى للغة برمجية متخصصة قادرة على التعامل مع التعقيدات المنهجية لمعالجة وتجهيز الملاحظات الإحصائية.
تعتمد كفاءة أي تحليل إحصائي استدلالي بالدرجة الأولى على مدى دقة وجودة مراحل تجهيز وتنظيف ودمج البيانات في خطوة البيانات (DATA step). وضمن هذا الإطار المعماري، يبرز خيار IN= كأحد الخيارات البرمجية المحورية المدمجة التي توفر للمبرمجين والباحثين وسيلة دقيقة لمراقبة مسار السجلات والتحكم في تدفق الملاحظات أثناء عمليات الإلحاق والدمج والمطابقة. إن فهم الأبعاد العميقة لهذا الخيار يتجاوز مجرد معرفة صياغته الشكلية، ليمتد إلى استيعاب فلسفة عمل ناقل بيانات البرامج (Program Data Vector – PDV)، وكيفية إدارة المتغيرات المؤقتة، وضمان الاتساق المنطقي للبيانات المعقدة المستمدة من مصادر متعددة.
يهدف هذا المقال الأكاديمي الشامل إلى تقديم تفصيل منهجي وتطبيقي دقيق حول خيار IN= في نظام SAS، متناولاً أصوله البرمجية، وآليته التشغيلية الداخلية، وتطبيقاته العملية المتنوعة في دمجات البيانات البسيطة والمعقدة، والتحليلات الطولية، ومقارنته بالبدائل التقنية الأخرى كاستعلامات لغة الاستعلامات البنيوية (PROC SQL)، مع استعراض الأخطاء الشائعة وأفضل الممارسات البرمجية لضمان قابلية إعادة الإنتاج والامتثال لأعلى معايير النزاهة العلمية.
1. مقدمة شاملة حول خيار IN= في نظام SAS
1.1 مفهوم خيار IN= وطبيعته البرمجية
يُعرّف خيار IN= في بيئة SAS بأنه خيار مخصص لمجموعات البيانات (Data Set Option) يُكتب بين قوسين تالياً مباشرة لاسم مجموعة البيانات المدخلة ضمن تعليمات معالجة البيانات الأساسية، مثل SET أو MERGE أو UPDATE أو MODIFY داخل خطوة البيانات (DATA step). يتمثل الغرض الهيكلي لهذا الخيار في توجيه مترجم SAS لإنشاء متغير مؤقت ذي طبيعة منطقية ثنائية (Boolean Flag) يرتبط حصرياً بمجموعة البيانات المحددة التي أُلحق بها. يتخذ هذا المتغير إحدى قيمتين رقميتين فقط أثناء التنفيذ: إما القيمة (1) التي تعكس حالة الإيجاب المنطقي (True)، أو القيمة (0) التي تعكس حالة النفي المنطقي (False).
تتمثل الوظيفة الجوهرية لهذا المؤشر المنطقي في التحقق اللحظي مما إذا كانت مجموعة البيانات المعنية قد ساهمت فعلياً بالبيانات المكونة للسجل أو الملاحظة الحالية الموجودة قيد المعالجة داخل خطوة البيانات. وعلى خلاف المتغيرات التقليدية التي يعرفها المستخدم عبر جمل الإسناد الحسابية أو المنطقية، يتميز خيار IN= بارتباطه المباشر ببروتوكولات القراءة الداخلية للنظام؛ فهو لا يمثل قيمة مخزنة في الملفات المصدرية، ولا يستهلك مساحة تخزين دائمة في الهيكل الفيزيائي للجدول الناتج، بل يُعد أداة فحص برمجية متزامنة مع حركة مؤشرات القراءة من وسائط التخزين إلى الذاكرة المؤقتة.
تتجلى الفروق الهيكلية بين المتغير المتولد عن خيار IN= والمتغيرات العادية في أن الأول يُدار كلياً بواسطة محرك خطوة البيانات من حيث التهيئة وإعادة التعيين التلقائي. فعندما ينتقل المؤشر البرمجي لقراءة سجل جديد، يقوم النظام تلقائياً بتحديث حالة متغير IN= دون الحاجة لأي تدخل برمجي يدوي لتصفيره أو إعادة تقييمه، مما يوفر بيئة برمجية صارمة ومحمية من التداخلات غير المقصودة التي قد تطرأ على المتغيرات المعرفة يدوياً والتي قد تحتفظ بقيمها عبر دورات المعالجة في حال إساءة استخدامها.
1.2 أهمية التتبع المنطقي للبيانات في بيئات التحليل الإحصائي
في البيئات البحثية والأكاديمية المتقدمة، لا تقتصر معالجة البيانات على دمج الجداول رقمياً، بل تمتد لتشمل الحفاظ على نسب التتبع الصارم (Data Lineage) وإثبات أصل كل متغير وملاحظة تدخل في النموذج التحليلي. تبرز أهمية خيار IN= في هذا السياق كأداة تدقيق منهجي تضمن نزاهة البيانات وتمنع اختلاط الملاحظات بين المجموعات التجريبية (Experimental Groups) والمجموعات الضابطة (Control Groups)، لا سيما عندما تتشابه الهياكل التعريفية للمشاركين أو تتعدد مصادر الجمع الميداني عبر مراكز بحثية متعددة.
وعلاوة على ذلك، يكتسب التتبع المنطقي أهمية استثنائية في الدراسات الطولية (Longitudinal Studies) والدراسات الوبائية التي تتابع نفس المفحوصين عبر فترات زمنية متعاقبة (مثل موجات المسح المتتالية). يتيح خيار IN= للباحث تحديد ما إذا كان السجل الظاهر في خطوة الدمج يمثل استجابة متكررة لنفس الفرد، أم أنه يمثل حالة غياب وانقطاع في إحدى الموجات، أم أنه انضمام متأخر لعينة الدراسة. يحد هذا الرصد الآلي من احتمالية الخطأ البشري الناتج عن عمليات الفلترة اليدوية المعقدة التي تعتمد على قيم المتغيرات بدلاً من الاعتماد على مصدر السجل نفسه، وهو ما يعزز موثوقية القرارات الإحصائية النهائية.
إن تقليل احتمالية الخطأ في تصنيف مصادر البيانات ينعكس بصورة مباشرة على قوة الاختبارات الإحصائية وتجنب التحيزات النظامية (Systematic Biases). فعندما يتيقن الباحث من دقة عزل الحالات المتطابقة وغير المتطابقة، يصبح بالإمكان إجراء تحليلات حساسية (Sensitivity Analyses) دقيقة، وتطبيق معايير استبعاد وإدراج شفافة وموثقة برمجياً، تتماشى مع المعايير الدولية المعمول بها في نشر الأبحاث العلمية كمعايير CONSORT في التجارب السريرية أو STROBE في الدراسات الرصدية.
1.3 الفرق بين المتغيرات المؤقتة والدائمة في خطوة البيانات
لفهم السلوك التشغيلي لخيار IN=، يجب التمييز بدقة بين المتغيرات المؤقتة والمتغيرات الدائمة ضمن المعمارية الداخلية لنظام SAS، وتحديداً داخل ما يُعرف بناقل بيانات البرامج (Program Data Vector – PDV). يُعد ناقل البيانات البرمجي بمثابة مساحة الذاكرة المؤقتة المنطقية التي ينشئها النظام لتخزين قيم المتغيرات الخاصة بملاحظة واحدة أثناء تنفيذ خطوة البيانات. تنقسم المتغيرات المقيمة في هذا الناقل إلى قسمين رئيسيين: متغيرات تُكتب في نهاية الدورة إلى مجموعة البيانات الناتجة وتُحفظ بصورة دائمة على القرص، ومتغيرات تحكم مؤقتة تنتهي مهمتها بمجرد اكتمال دورة المعالجة للملاحظة الحالية.
ينتمي المتغير المنشأ عبر خيار IN= حكماً إلى فئة المتغيرات المؤقتة المسقطة تلقائياً (Automatically Dropped Variables). يدرج نظام SAS هذا المتغير في ناقل البيانات البرمجي ليستخدمه الباحث في المنطق الشرطي وبناء القرارات التحليلية، لكن النظام، وبصورة افتراضية صارمة، لا يقوم بتضمين هذا المتغير في مجموعة البيانات الناتجة عند انتهاء خطوة البيانات. يتم هذا الإسقاط دون الحاجة إلى استخدام تعليمة DROP الصريحة، وذلك في محاولة لتحسين استخدام الموارد وتفادي إغراق مجموعات البيانات النهائية بمتغيرات مساعدة مؤقتة.
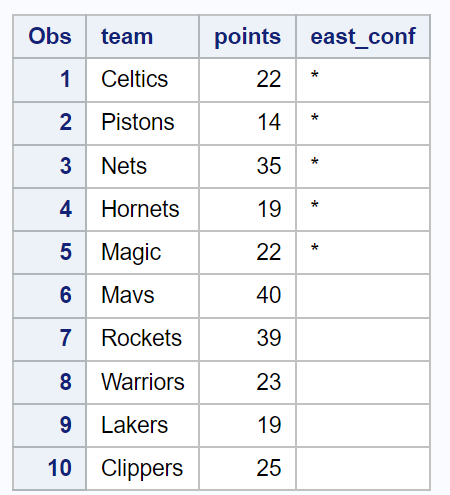
إذا اقتضت المنهجية البحثية الاحتفاظ بالمعلومات التي يوفرها مؤشر IN= واستخدامها في إجراءات إحصائية لاحقة مثل PROC FREQ أو PROC LOGISTIC، يتعين على المبرمج تحويل هذه القيمة المنطقية المؤقتة إلى متغير دائم. يتم ذلك صراحة من خلال إسناد قيمة متغير IN= إلى متغير جديد يتم تعريفه في خطوة البيانات عبر معادلة إسناد قياسية، مما يضمن نسخ القيمة المنطقية من حيز المتغير المؤقت إلى حقل دائم يتم حفظه وتوثيقه في سمات الملف الناتج.
2. الآلية البرمجية لعمل خيار IN= داخل خطوة البيانات
2.1 توليد المتغيرات المنطقية وقيمها الثنائية
تبدأ الآلية البرمجية لخيار IN= فور تفسير جملة الإدخال من قِبل مترجم SAS أثناء مرحلة الترجمة (Compilation Phase). يقوم المترجم بحجز موقع خاص في ناقل بيانات البرامج للمتغير المحدد بعد إشارة المساواة، وتحديد نوعه كمتغير رقمي بطول قياسي، وتعيين سمة خاصة له تشير إلى أنه متغير منطقي ثنائي غير مخصص للتصدير النهائي. تقتصر قيم هذا المتغير على الرقمين الصحيحين (1) و(0)، وهو ما يتوافق تماماً مع المنطق البولياني المعتمد في بيئة SAS لمعالجة الشروط.
تحمل القيمة (1) دلالة قطعية مفادها أن مجموعة البيانات المقترنة بهذا الخيار قد ساهمت بشكل مباشر وملموس بالبيانات الخاصة بالسجل الحالي الموجود داخل ناقل البيانات. في سياق جملة SET، تعني القيمة (1) أن السجل المقروء حالياً قد استُرجع فعلياً من هذا الملف تحديداً. أما في سياق جملة MERGE، فتعني أن السجل المقروء يمتلك قيماً حقيقية في هذا الملف مطابقة لقيم متغيرات الفرز المحددة في جملة BY، وأنه ليس مجرد سجل فارغ تم استكماله بقيم مفقودة ناتجة عن عدم التطابق.
على النقيض من ذلك، تشير القيمة (0) إلى غياب تام لأي مساهمة من مجموعة البيانات المعنية في السجل الحالي. قد ينشأ هذا الغياب إما بسبب انتقال مؤشر القراءة إلى مجموعة بيانات أخرى أثناء الإلحاق التتابعي، أو بسبب عدم وجود سجل مطابق للمفتاح المشترك في عملية الدمج المقترنة. تمنح هذه الدلالة الثنائية الصارمة الباحثين قدرة برمجية فائقة على بناء شروط منطقية متقدمة تعتمد على الجبر البولياني، مثل دمج الشروط عبر معاملات النفي المنطقي (NOT)، والوصل المنطقي (AND)، والفصل المنطقي (OR)، لفرز السجلات بدقة متناهية.
2.2 دورة حياة متغير IN= أثناء معالجة السجلات في خطوة البيانات
تخضع دورة حياة متغير IN= لقواعد دقيقة تحكم حركة ناقل بيانات البرامج (PDV) خلال مرحلة التنفيذ (Execution Phase). في بداية كل تكرار لخطوة البيانات وقبل استدعاء السجل من وسائط التخزين، يقوم النظام بتهيئة المتغيرات المؤقتة وإعادة تعيين قيمها المنطقية إلى الصفر الافتراضي (0). هذه الخطوة تضمن عدم بقاء أي أثر منطقي من دورة المعالجة السابقة قد يؤدي إلى استنتاجات خاطئة حول مصدر السجل الحالي.
بمجرد تنفيذ أمر القراءة المرتبط بجملة الإدخال، يتم فحص السجلات القادمة من مجموعات البيانات المصدرية. إذا ثبت أن السجل الحالي قد سُحب من مجموعة البيانات المعنية، يقوم محرك SAS فوراً بتحديث قيمة متغير IN= الخاص بها من (0) إلى (1) داخل ناقل بيانات البرامج. وتظل هذه القيمة مستقرة وثابتة طوال فترة تنفيذ الأوامر البرمجية والعبارات الشرطية اللاحقة داخل الدورة الواحدة للملاحظة، مما يسمح للباحث باختبارها واستخدامها في التوجيه الحسابي أو التعديل الهيكلي.
عند اكتمال معالجة كافة الأوامر والوصول إلى نهاية خطوة البيانات، تحدث عملية تفريغ تلقائية؛ حيث تُكتب قيم المتغيرات الدائمة إلى مجموعة البيانات المستهدفة، بينما يتم تجاهل متغيرات IN= وإسقاطها. ثم تعود خطوة البيانات لبدء تكرار جديد، وتُعاد دورة التهيئة من جديد، مما يمنح هذه المتغيرات استقلالية تامة ترتبط بكل صف من البيانات على حدة، ويمنع تراكم الحالات المنطقية غير المتطابقة عبر السجلات المتتالية.
2.3 التفاعل بين خيار IN= وأمر الإخراج OUTPUT
يمثل التفاعل بين متغيرات خيار IN= وأمر الإخراج الصريح OUTPUT أحد أقوى أساليب البرمجة المتقدمة في SAS لتوجيه البيانات بمرونة متناهية. في الحالة الافتراضية، تقوم خطوة البيانات بإخراج كل سجل تلقائياً عند الوصول إلى تعليمة RUN. ولكن عند إدخال أمر OUTPUT المشروط بقيم متغيرات IN=، تتغير هذه الديناميكية تماماً ليتحول التحكم في كتابة السجلات إلى سيطرة برمجية كاملة بيد المطور.
يتيح هذا التفاعل إمكانية توجيه السجلات المقروءة إلى مجموعات بيانات مخرجة متعددة ومتباينة في نفس خطوة البيانات الواحدة استناداً إلى انتماءاتها المصدرية. فعلى سبيل المثال، يمكن للمبرمج صياغة شرط يوجه السجلات التي تظهر قيمة مؤشرها (1) في الجدول الأول فقط إلى ملف مخصص للحالات غير المستجيبة، بينما يوجه السجلات التي تظهر قيمة (1) في كلا الجدولين إلى ملف مخصص للمشاركين المكتملين، وكل ذلك يتم عبر جمل IF-THEN OUTPUT المنطقية المترابطة.
يجب الانتباه هنا إلى أن استدعاء أمر OUTPUT يعطل آلية الإخراج التلقائي لنظام SAS؛ مما يعني أن أي سجل لا يستوفي الشروط المنطقية المحددة للـ OUTPUT سيتم إسقاطه نهائياً ولن يظهر في أي مجموعة بيانات ناتجة. توفر هذه الخاصية وسيلة بالغة الكفاءة لفلترة البيانات الملوثة أو غير المرغوب فيها في نفس لحظة الدمج، مما يختصر استهلاك الذاكرة وسرعة المعالجة عبر تجنب إنشاء جداول وسيطة ضخمة تتطلب عمليات تصفية وحذف لاحقة.
3. استخدام خيار IN= عند إلحاق مجموعات البيانات المتعددة
3.1 تطبيق خيار IN= مع تعليمة SET
يُعد إلحاق مجموعات البيانات رأسياً (Data Concatenation) من العمليات الشائعة عند تجميع البيانات الإحصائية المجموعة عبر فترات زمنية متعاقبة أو من عينات جغرافية منفصلة. عند استخدام تعليمة SET مع عدة مجموعات بيانات، يقرأ نظام SAS السجلات تتابعياً؛ حيث ينتهي أولاً من قراءة جميع ملاحظات المجموعة الأولى بالكامل، ثم ينتقل مباشرة لقراءة ملاحظات المجموعة الثانية، وهكذا دواليك حتى استنفاد كافة المصادر المحددة في التعليمة.
عند إقران خيار IN= مع كل مجموعة بيانات مدخلة في تعليمة SET، مثل كتابة SET study_center_a (IN=in_a) study_center_b (IN=in_b);، ينشئ النظام مؤشرين مستقلين لتتبع مسار القراءة التتابعية. أثناء قراءة سجلات المركز الأول، يكون المؤشر in_a مساوياً لـ (1) بينما يكون in_b مساوياً لـ (0). وبمجرد استهلاك آخر ملاحظة من المركز الأول والانتقال لأول ملاحظة من المركز الثاني، تنعكس الحالة المنطقية فوراً ليصبح in_a مساوياً لـ (0) ويتحول in_b إلى (1).
تتيح هذه الآلية للباحث مراقبة الانتقال التتابعي بين الجداول وفحص حدود التماس بين المجموعات البحثية المختلفة. كما تضمن المراقبة البرمجية الدقيقة التأكد من أن التجميع الرأسي قد تم بالترتيب المتوقع دون حدوث تشويه في تسلسل الملاحظات، وخاصة في الدراسات التي تعتمد على معالجة دفعات متسلسلة من البيانات المخزنة في قواعد بيانات موزعة.
3.2 إنشاء متغير تصنيفي دائم لتمييز مصدر البيانات
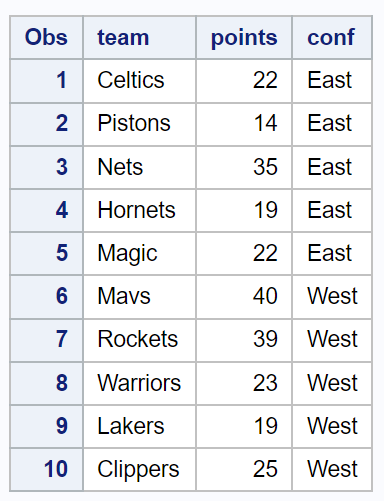
بما أن متغيرات خيار IN= تسقط تلقائياً كما أشرنا سابقاً، فإن تطبيقها الكلاسيكي مع تعليمة SET يستهدف في المقام الأول اشتقاق متغير تصنيفي دائم (Categorical Variable) يعكس مصدر البيانات. يكتسب هذا المتغير المصدر أهمية حاسمة في إجراء المقارنات الإحصائية اللاحقة؛ كاختبار الفروق بين المراكز العلاجية المتعددة، أو دراسة تأثير التباين الجغرافي باستخدام تحليلات التباين (ANOVA) أو نماذج الانحدار الخطي متعدد المستويات.
يتحقق ذلك عبر صياغة شروط منطقية واضحة تعتمد على المتغيرات المؤقتة لملء حقل دائم، كما هو موضح في البنية المنهجية التالية:
IF in_a THEN cohort_source = 'Center A';

ELSE IF in_b THEN cohort_source = 'Center B';
يضمن هذا الإجراء البرمجي الشفاف توثيق أصل كل ملاحظة بشكل دائم داخل مصفوفة البيانات النهائية. كما يمنع حدوث تضارب في المعاني الإحصائية في حال كانت معرفات المفحوصين (Subject IDs) مكررة أو تبدأ بنفس التسلسل الرقمي داخل كل مركز على حدة، إذ يتيح المتغير التصنيفي الجديد تكوين معرف فريد مركب يجمع بين كود المركز ورقم المفحوص، مما يحافظ على استقلالية المشاهدات وتفردها الإحصائي.
3.3 إدارة تضارب الهياكل البرمجية وأسماء المتغيرات أثناء الإلحاق
من التحديات التقنية البارزة التي تواجه الباحثين عند تجميع مجموعات بيانات متباينة هو تضارب الهياكل البرمجية؛ كأن يتواجد متغير معين في إحدى المجموعات ويغيب تماماً عن المجموعة الأخرى، أو أن تختلف الخصائص الوصفية للمتغيرات المشتركة كالأطوال (Lengths) أو الأنواع (Types). عند حدوث ذلك، يقوم نظام SAS بتعيين قيم مفقودة (Missing Values) للمتغيرات الغائبة في الملاحظات المستمدة من الملفات التي لا تحتوي على تلك الأعمدة.
يلعب خيار IN= دوراً فعالاً في إدارة ومعالجة هذه التضاربات الهيكلية. فبفضل معرفة المصدر الأصلي للسجل عبر المؤشر المنطقي، يستطيع المبرمج التدخل برمجياً لتعويض القيم المفقودة الناتجة عن اختلاف الهياكل، أو تطبيق عمليات تحويل وتوحيد مخصصة لمجموعة معينة دون المساس بالمجموعات الأخرى. فعلى سبيل المثال، إذا كانت إحدى المجموعات تقيس درجة الحرارة بالفهرنهايت والأخرى بالدرجة المئوية، يمكن استخدام مؤشر IN= لإجراء التحويل الحسابي حصرياً على بيانات المجموعة المعنية لتوحيد وحدة القياس عبر كامل الجدول المدمج.
بالإضافة إلى ذلك، يجب توخي الحذر الشديد للتأكد من توافق أطوال المتغيرات النصية؛ حيث يعتمد SAS طول المتغير في الجدول النهائي بناءً على أول ظهور له في تعليمة SET. وهنا يساعد خيار IN= في مراقبة دقة البيانات ومنع اقتطاع النصوص (Data Truncation)، من خلال تمكين المبرمج من كتابة تعليمات LENGTH استباقية وتأكيد سلامة نقل الحقول النصية بالكامل بغض النظر عن تفاوت أحجامها بين المجموعات المصدرية.
4. استخدام خيار IN= عند دمج ومطابقة مجموعات البيانات عبر MERGE
4.1 المطابقة الثنائية وتحديد مصدر الملاحظات
تمثل عملية دمج البيانات أفقياً عبر تعليمة MERGE بالاعتماد على متغير مفتاحي مشترك (BY variable) إحدى أكثر العمليات حساسية وتعقيداً في معالجة البيانات الإحصائية. تتطلب هذه العملية فرز مجموعات البيانات مسبقاً بنفس الترتيب للمتغير المحدد في تعليمة BY. وعند دمج جدولين، يعمل خيار IN= على تقييم مدى مطابقة السجلات في كلا الطرفين لكل مستوى من مستويات المتغير المفتاحي.
تتم المطابقة الثنائية عبر تخصيص مؤشر مستقل لكل جدول مدخل، كما في الصيغة القياسية: MERGE baseline_data (IN=in_base) follow_up_data (IN=in_fu); BY patient_id;. خلال تنفيذ هذه الخطوة، يقوم محرك SAS بقراءة السجلات التي تشترك في نفس قيمة patient_id ومقارنتها. وهنا تبرز أربع حالات منطقية ثنائية محتملة تحدد مصدر الملاحظة المشكلة في ناقل البيانات:
- الحالة الأولى (in_base = 1 و in_fu = 1): تدل على تطابق كامل؛ حيث يمتلك المشارك بيانات مسجلة في كلتا المجموعتين (خط الأساس والمتابعة).
- الحالة الثانية (in_base = 1 و in_fu = 0): تدل على ظهور المشارك في خط الأساس فقط وغيابه التام عن ملف المتابعة اللاحقة.
- الحالة الثالثة (in_base = 0 و in_fu = 1): تدل على وجود بيانات متابعة للمشارك دون وجود سجل أساسي مسجل له في ملف خط الأساس.
- الحالة الرابعة (in_base = 0 و in_fu = 0): وهي حالة مستحيلة منطقياً أثناء القراءة النشطة؛ لأن خطوة البيانات لا تنشئ سجلاً إلا بوجود مساهمة من مصدر واحد على الأقل.
يوفر هذا الفحص المنطقي الدقيق إطاراً عملياً لتوصيف اكتمال البيانات، ويمنح الباحث الأدوات اللازمة للتحقق من سلامة الربط العلائقي قبل المضي قدماً في النمذجة الإحصائية المتقدمة.
4.2 تنفيذ التقاطع الداخلي والربط الخارجي برمجياً
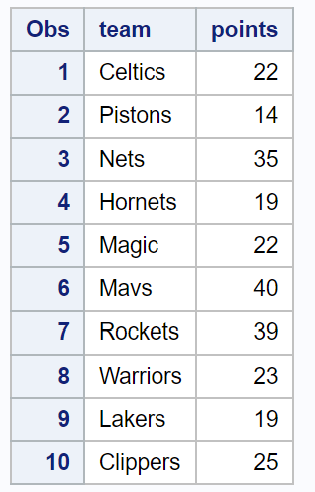
تتيح المتغيرات المنطقية المتولدة عن خيار IN= محاكاة كافة أشكال الربط المعروفة في نظرية المجموعات العلائقية وقواعد البيانات، والمعروفة في لغة SQL بعمليات الربط (Joins)، ولكن بأسلوب إجرائي يتميز بالتحكم المطلق والتنفيذ عالي السرعة داخل خطوة البيانات. يمكن استعراض هذه العمليات كالتالي:
- التقاطع الداخلي (Inner Join): يتم استخراج السجلات المشتركة فقط التي تظهر في كلا الجدولين عبر صياغة الشرط المنطقي الصريح:
IF in_base AND in_fu;. يؤدي هذا الشرط إلى استبعاد أي مريض لم يكمل مرحلة المتابعة أو أي سجل متابعة مجهول الأساس. - الربط الخارجي الأيسر (Left Outer Join): للحفاظ على كافة سجلات الجدول الأول (الأيسر) بغض النظر عن وجود مطابقة لها في الجدول الثاني، يُستخدم الشرط:
IF in_base;. تضمن هذه العملية عدم فقدان أي مشارك من خط الأساس مع جلب بيانات المتابعة للمشاركين المتطابقين وترك البقية كقيم مفقودة. - الربط الخارجي الأيمن (Right Outer Join): للحفاظ على كافة سجلات الجدول الثاني (الأيمن)، يُطبق الشرط المنطقي:
IF in_fu;، وهو ما يضمن استبقاء كافة قياسات المتابعة حتى لو لم يقترن بها ملف أساسي. - الربط الخارجي الكامل (Full Outer Join): يتحقق تلقائياً في SAS دون شروط، ولكن باستخدام خيار IN= يمكن تصنيف الحالات المنفردة بدقة عبر الشروط المتفرعة لتحديد أسباب عدم التطابق وتصنيف السجلات الناتجة.
تمنح هذه المرونة البرمجية لمحلل البيانات الإحصائية القدرة على اتخاذ قرارات الدمج بناءً على متطلبات بروتوكول البحث المعتمد، وتوثيق أعداد السجلات المستبعدة أو المضمنة في كل خطوة وفق تسلسل منطقي محكم.
4.3 التعامل مع السجلات غير المتطابقة في البحوث الطولية
في الأبحاث الطولية التي تمتد لعدة سنوات، يمثل تسرب المشاركين (Participant Attrition) أحد أكبر التحديات المنهجية التي تهدد الصدق الداخلي للدراسة. يؤدي الفقدان غير العشوائي للبيانات إلى إدخال تحيزات خطيرة في تقديرات المعلمات الإحصائية إذا لم يتم رصده ومعالجته بنماذج مناسبة مثل النماذج ذات التأثيرات المختلطة (Mixed-Effects Models) أو تحليل الحالات المكتملة.
يُعد خيار IN= الأداة المعيارية المعتمدة في بيئة SAS لإجراء تحليلات الفقد والانقطاع (Attrition Analysis). من خلال عزل الحالات التي تحقق الشرط المنطقي IF in_base AND NOT in_fu;، يستطيع الباحث تصدير السجلات غير المتطابقة إلى مجموعة بيانات مستقلة لدراسة خصائصها الديموغرافية والسريرية ومقارنتها بالحالات المكتملة باستخدام اختبارات الفروق الإحصائية مثل اختبار تي (t-test) أو اختبار كاي تربيع (Chi-Square).
تتيح هذه المقارنة التأكد مما إذا كان الفقد عشوائياً تماماً (Missing Completely at Random – MCAR) أو عشوائياً مشروطاً (Missing at Random – MAR)، وهو ما يحدد المسار المنهجي المناسب لمعالجة القيم المفقودة؛ سواء باستخدام أساليب التعويض المتعدد (Multiple Imputation) أو بتطبيق أوزان ترجيحية مخصصة لعلاج التسرب، مما يضمن اتساق التحليل وسلامة استنتاجاته الإحصائية.
5. تطبيقات عملية وأمثلة برمجية خطوة بخطوة
5.1 نموذج إلحاق مجموعتي بيانات رياضية أو بحثية
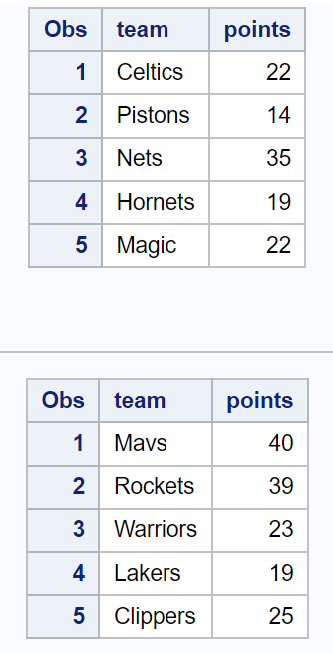
لتوضيح التطبيق العملي لخيار IN= في عمليات الإلحاق الرأسي، نفترض وجود دراسة ترصد اللياقة البدنية لدى مجموعتين من الرياضيين في منطقتين جغرافيتين مختلفتين. يتم إنشاء البيانات الأولية باستخدام خطوة البيانات وتعليمة DATALINES، مع تطبيق خيار IN= لتعيين مؤشر الانتماء لكل مجموعة:
DATA northern_region;

  INPUT athlete_id $ vo2_max heart_rate;

  DATALINES;

ATH01 55.4 142

ATH02 48.2 155

ATH03 61.0 138

;

RUN;
DATA southern_region;
INPUT athlete_id $ vo2_max heart_rate;
DATALINES;
ATH04 52.1 148
ATH05 49.8 160
;
RUN;
DATA combined_athletes;
SET northern_region (IN=in_north) southern_region (IN=in_south);
LENGTH region_label $ 15;
IF in_north THEN region_label = 'Northern Zone';
ELSE IF in_south THEN region_label = 'Southern Zone';
is_north = in_north;
RUN;
في هذا النموذج البرمجي، تم استدعاء الجدولين تتابعياً داخل تعليمة SET. وبناءً على الحالة المنطقية المؤقتة للمؤشرين in_north وin_south، تم إنشاء المتغير النصي الدائم region_label لتوثيق المصدر الجغرافي. كما تم إسناد قيمة in_north إلى المتغير الدائم is_north للاحتفاظ بالمؤشر الثنائي في مجموعة البيانات النهائية combined_athletes، مما يسهل استخدامه كمتغير وهمي (Dummy Variable) في نماذج الانحدار لاحقاً.
5.2 نموذج دمج بيانات الاستجابات ومقاييس الأداء
يتناول هذا النموذج التطبيقي عملية دمج أفقية لمطابقة نتائج درجات اختبارات الأداء الأكاديمي مع استبيانات القياس النفسي للطلاب، مع تصفية الحالات المكتملة وتصدير الحالات غير المتطابقة لفحص أسباب الخلل:
DATA academic_scores;

  INPUT student_id $ exam_score gpa;

  DATALINES;

STU101 88 3.45

STU102 92 3.80

STU103 75 2.90

STU104 81 3.15

;

RUN;
DATA psychological_traits;
INPUT student_id $ anxiety_level grit_score;
DATALINES;
STU101 18 4.2
STU102 12 4.8
STU104 22 3.5
STU105 15 3.9
;
RUN;
PROC SORT DATA=academic_scores; BY student_id; RUN;
PROC SORT DATA=psychological_traits; BY student_id; RUN;
DATA matched_students unmatched_audit;
MERGE academic_scores (IN=has_scores) psychological_traits (IN=has_psycho);
BY student_id;
IF has_scores AND has_psycho THEN OUTPUT matched_students;
ELSE OUTPUT unmatched_audit;
RUN;
في هذا الكود، تم فرز المجموعتين أولاً بواسطة PROC SORT كشرط إلزامي قبل تنفيذ MERGE. وفي خطوة البيانات المدمجة، تم توجيه السجلات التي حققت التطابق الكامل (الطالب STU101 وSTU102 وSTU104) إلى جدول matched_students. أما الحالات التي ظهرت في ملف دون الآخر (مثل الطالب STU103 الذي تغيب عن مقياس القلق، أو الطالب STU105 الذي يفتقر لبيانات التحصيل الأكاديمي)، فقد وُجهت مباشرة إلى جدول التدقيق unmatched_audit لتحليل أسباب عدم التطابق دون التأثير على عينة التحليل الأساسية.
5.3 فحص مخرجات العمليات البرمجية وتحليل سجل التنفيذ
لا يكتمل العمل البرمجي الأكاديمي في SAS بمجرد كتابة الكود وتنفيذه، بل يجب إخضاع المخرجات وسجل العمليات للفحص الصارم. يُستخدم إجراء PROC PRINT لمعاينة البيانات المدمجة والتأكد من صحة التعيينات المنطقية:
PROC PRINT DATA=matched_students NOOBS;

  TITLE 'المشاركون ذوو البيانات الأكاديمية والنفسية المكتملة';

RUN;
PROC PRINT DATA=unmatched_audit NOOBS;
TITLE 'سجل الحالات غير المتطابقة لأغراض التدقيق والمراجعة';
RUN;
بالتوازي مع فحص الجداول، يتعين على الباحث قراءة سجل SAS (SAS Log) بدقة متناهية. يحتوي السجل على إحصاءات حيوية توضح عدد الملاحظات التي قُرئت من كل مجموعة بيانات، وعدد الملاحظات التي كُتبت في كل جدول مخرج. يجب التحقق من عدم وجود رسائل تحذيرية مثل MERGE statement has more than one data set with duplicates of BY values التي تشير إلى وجود تكرار في المفاتيح المشتركة قد يؤدي إلى دمج كارتيزي غير مقصود وتشويه قيم المؤشرات المنطقية IN=.
6. تقنيات الفلترة الشرطية المتقدمة بالاعتماد على خيار IN=
6.1 استخراج السجلات الحصرية واستبعاد المتطابقات
تمثل الفلترة الحصرية (Exclusive Filtering) إحدى المنهجيات الأساسية لتدقيق جودة قواعد البيانات الكبيرة وتنظيفها. يُقصد بالاستخراج الحصري عزل تلك السجلات التي تنتمي فقط لمصدر بيانات محدد مع استبعاد أي سجلات تلتقي أو تتقاطع مع مجموعات البيانات الأخرى. توفر المؤشرات المنطقية الناتجة عن IN= أداة مثالية لتنفيذ هذا الإجراء دون الحاجة لكتابة استعلامات مقارنة حقلية معقدة ومرهقة محاسبياً.
تتحقق هذه التقنية من خلال صياغة شروط نفي مباشر؛ فعند دمج جدول العملاء النشطين مع جدول العملاء الذين قاموا بإلغاء اشتراكاتهم، يمكن استخراج السجلات التي تنفرد بها قاعدة البيانات الأولى حصراً عبر الشرط المنطقي: IF in_active AND NOT in_cancelled;. هذا التعبير البولياني يضمن استبعاد كافة المتطابقات وعزل الشريحة المستهدفة بدقة قطعية.
تكمن الأهمية المنهجية لهذه التقنية في بحوث التدخلات العلاجية والدوائية، حيث يُطلب من الباحث في كثير من الأحيان التحقق من أن أفراد المجموعة الضابطة لم يتلقوا أي جرعات مسجلة في ملفات المتابعة السريرية للمجموعة العلاجية، مما يسهم في منع تلوث العينات وضمان التباين التجريبي الحقيقي بين المجموعات الخاضعة للدراسة.
6.2 بناء شروط IF-THEN المعقدة عبر مؤشرات متعددة
تتجاوز كفاءة خيار IN= الدمج الثنائي لتصل إلى إدارة عمليات الدمج المتزامن لثلاث مجموعات بيانات أو أكثر في خطوة بيانات واحدة. في مثل هذه السيناريوهات المعقدة، يتم تخصيص مؤشر مستقل لكل مصدر، مثل: MERGE survey_wave1 (IN=w1) survey_wave2 (IN=w2) survey_wave3 (IN=w3); BY subject_id;. ينتج عن هذا الدمج المتعدد منظومة تتألف من ثماني حالات تواجد منطقية محتملة لكل مفحوص عبر الموجات الزمنية الثلاث.
يمكن تنظيم هذه الحالات وبناء مصفوفات قرار (Decision Matrices) تصنيفية عبر جمل IF-THEN-ELSE المتسلسلة لفرز نمط استجابة المشاركين، كما في المثال الهيكلي التالي:
LENGTH response_pattern $ 20;

IF w1 AND w2 AND w3 THEN response_pattern = 'Complete (All Waves)';

ELSE IF w1 AND w2 AND NOT w3 THEN response_pattern = 'Dropped at Wave 3';

ELSE IF w1 AND NOT w2 AND w3 THEN response_pattern = 'Intermittent Wave 2';

ELSE IF NOT w1 AND (w2 OR w3) THEN response_pattern = 'Late Enrollee';

ELSE response_pattern = 'Other Pattern';
تسهم هذه الاستراتيجية في اختزال عشرات الأسطر من الشيفرات البرمجية التي كانت ستعتمد على فحص القيم المفقودة للمتغيرات الفردية، مع توفير مؤشرات واضحة وموثوقة تعزز دقة النمذجة الإحصائية لسلوكيات الاستجابة والانقطاع عبر الزمن.
6.3 معالجة القيم الشاذة والملاحظات المتطرفة وفق المصدر
في الدراسات الإحصائية التجميعية (Data Pooling) التي تستقبل بيانات من مصادر ومختبرات متعددة، قد تتباين جودة البيانات ودقة أجهزة القياس المستخدمة في كل موقع. يتيح خيار IN= للباحث تطبيق قواعد فحص وتنقية مخصصة وشديدة الخصوصية لكل سجل بناءً على المصدر الذي نشأ منه، وذلك قبل دمج الملاحظات في المصفوفة النهائية المشتركة.
فعلى سبيل المثال، إذا كان أحد المراكز البحثية يعاني من خطأ معروف في معايرة جهاز قياس معين ينتج عنه تضخيم غير واقعي في القيم، يمكن صياغة قواعد تعديل أو استبعاد شرطية تستهدف فقط البيانات القادمة من ذلك المركز:
IF in_center_k AND lab_value > 250 THEN DO;

  flag_extreme_source = 1;

  lab_value = .;

END;
يضمن هذا الأسلوب توثيق أسباب معالجة أو استبعاد القيم المتطرفة وتبريرها منهجياً بالاعتماد على خصائص المصدر، بدلاً من تطبيق استبعاد عشوائي يعمم الشك على بيانات كافة المراكز البحثية الملتزمة بالمعايير القياسية، وهو ما يرفع من موثوقية التحليل ومصداقيته الأكاديمية.
7. الأخطاء الشائعة عند التعامل مع خيار IN= وكيفية تصحيحها
7.1 محاولة استخدام متغير IN= كمتغير إخراج مباشر
يُعد اختفاء متغير IN= من مجموعة البيانات الناتجة أحد أكثر الأخطاء إرباكاً للمبرمجين المبتدئين في بيئة SAS. يفترض الكثير من المستخدمين أن تعريف المتغير داخل القوسين مثل (IN=flag_a) يعني تلقائياً إضافته كعمود دائم في الجدول المستهدف، ليتفاجأ المبرمج بعد انتهاء التنفيذ بعدم وجود أي أثر لهذا المتغير عند استعراض الجدول عبر PROC CONTENTS أو PROC PRINT.
يرجع السبب الهيكلي لهذا السلوك إلى التصميم البرمجي الصارم لناقل بيانات البرامج (PDV) في محرك Base SAS؛ حيث تُمنح المتغيرات المعرفة عبر خيارات مجموعات البيانات سمة إسقاط داخلي افتراضية تمنع انتقالها إلى وسائط التخزين النهائية لتفادي استهلاك الذاكرة دون مبرر. يتمثل التصحيح البرمجي الوحيد والمعتمد لهذه المشكلة في إجراء عملية إسناد صريحة ومباشرة داخل خطوة البيانات لنسخ قيمة المؤشر المؤقت إلى متغير دائم جديد، كما في الصيغة الإلزامية:
DATA final_output;

  SET source_table (IN=temp_flag);

  permanent_flag = temp_flag;

RUN;
تضمن هذه الخطوة البسيطة تسجيل المتغير الدائم في فهرس البيانات الناتج، مما يتيح استخدامه لاحقاً في كافة الإجراءات الإحصائية والتحليلية دون عوائق تقنية.
7.2 إغفال فرز البيانات قبل تطبيق تعليمة MERGE
تتطلب الآلية الخوارزمية لتعليمة MERGE المقترنة بجملة BY أن تكون جميع مجموعات البيانات المدخلة مرتبة ترتيباً تصاعدياً (أو تنازلياً) وفقاً لقيم المتغيرات المفتاحية المشتركة. يؤدي إغفال تطبيق إجراء الفرز PROC SORT المسبق إلى توقف فوري في تنفيذ خطوة البيانات وظهور رسائل خطأ حرجة في سجل النظام (SAS Log) تفيد بحدوث خلل في تسلسل البيانات مثل ERROR: BY variables are not properly sorted on data set WORK.DATASET_NAME.
إذا كانت مجموعات البيانات مفهرسة بأسلوب غير منسق، فإن استجابة خيار IN= ستكون كارثية من الناحية التحليلية؛ حيث سيفشل النظام في مطابقة السجلات المتقاطعة، مما يترتب عليه تعيين قيم منطقية خاطئة (0 بدلاً من 1) للعديد من الحالات التي تمتلك في الأصل مطابقات فعلية في الجدول المقابل، وتوزيع الملاحظات على صفوف متعددة مشوهة محشوة بالقيم المفقودة.
لضمان تجنب هذا الخطأ الفادح، يجب الالتزام الصارم بتشغيل إجراء PROC SORT على كل مجموعة بيانات مدخلة بصورة مستقلة ومطابقة لمتغيرات الفرز المعتمدة في خطوة الدمج:
PROC SORT DATA=raw_data1; BY subject_id; RUN;

PROC SORT DATA=raw_data2; BY subject_id; RUN;
7.3 الخلط بين أسماء المتغيرات المنطقية وحقول البيانات
من الأخطاء البرمجية الشائعة التي تؤدي إلى سلوكيات غير متوقعة في التحليل هو استخدام أسماء لمتغيرات خيار IN= تتطابق مع أسماء متغيرات موجودة مسبقاً داخل مجموعات البيانات المصدرية، أو اختيار كلمات محجوزة (Reserved Words) في نظام SAS. عند حدوث هذا التطابق الاسمي، يقوم النظام بالكتابة فوق القيمة الأصلية للحقل واستبدالها بالقيمة المنطقية الثنائية (0 أو 1)، مما يترتب عليه فقدان محتوى البيانات الأصلية وتشويه التحليلات المبنية عليها.
ولتفادي هذا التداخل الخطير، تنص المعايير البرمجية الأكاديمية على اعتماد سياسات تسمية منضبطة وذات دلالة واضحة ومميزة للمتغيرات المؤقتة. يُنصح دائماً باستخدام بادئات اصطلاحية قياسية مثل in_ متبوعة باسم الجدول أو اختصار يوضح طبيعته، مثل in_demog أو in_labs، والامتناع التام عن استخدام أسماء عامة مثل x أو a أو أسماء الحقول التشخيصية والوصفية الفعلية في مجموعات البيانات.
تضمن استراتيجية التسمية الموحدة هذه مقروئية عالية للشيفرة المصدرية، وتسهل عمليات التدقيق والمراجعة التي يجريها باحثون ومراجعون آخرون للتحقق من كفاءة ونزاهة خطوات المعالجة الإحصائية المنفذة.
8. مقارنة خيار IN= مع البدائل البرمجية في SAS
8.1 المقارنة بين خيار IN= واستعلامات PROC SQL
توفر لغة الاستعلامات البنيوية داخل SAS عبر إجراء PROC SQL إطاراً علائقياً موازياً لمعالجة البيانات ومطابقتها من خلال تعليمات INNER JOIN وLEFT JOIN وFULL JOIN. وعلى الرغم من أن PROC SQL تحظى بشعبية واسعة بين المتخصصين القادمين من خلفيات تتعلق بإدارة قواعد البيانات العلائقية (RDBMS)، إلا أن خيار IN= داخل خطوة البيانات يتفوق عليها في عدة محاور هيكلية وتنفيذية جوهرية.
يتميز خيار IN= بقدرته الفائقة على تتبع وفحص كافة الحالات المنطقية المعقدة في مسار قراءة واحد (Single Sequential Pass)، في حين يتطلب تحقيق نفس المستوى من التصنيف الدقيق للحالات غير المتطابقة في PROC SQL كتابة جمل شرطية مطولة مثل CASE WHEN ... IS NULL أو بناء استعلامات فرعية متداخلة (Subqueries) واستعلامات اتحادية عبر UNION، مما يرفع من التعقيد الشكلي للشيفرة ويزيد من احتمالية الخطأ المنهجي.
أما من منظور استهلاك موارد النظام عند معالجة البيانات شديدة الضخامة (Big Data)، فإن خطوة البيانات المقترنة بـ IN= وتعليمة MERGE تتفوق في الغالب على PROC SQL؛ نظراً لاعتماد خطوة البيانات على الفرز الخطي المسبق ومعالجة الملاحظات سجلاً بسجل في الذاكرة دون الحاجة لبناء جداول مساعدة ضخمة في الذاكرة المؤقتة، وهو ما يقلل من زمن المعالجة (CPU Time) واستهلاك وسائط التخزين المؤقتة.
8.2 المقارنة بين خيار IN= واستخدام معاملات البحث المباشرة
يحدث أحياناً خلط اصطلاحي ومفاهيمي لدى المبرمجين بين خيار مجموعة البيانات IN= وبين معامل المقارنة المنطقي المباشر IN المستخدم في العبارات الشرطية لاختبار انتماء قيمة معينة إلى قائمة محددة من القيم الثابتة، مثل: IF diagnosis_code IN ('A01', 'B02', 'C03');. على الرغم من تشابه الكلمة المفتاحية، إلا أن الوظيفة البرمجية والسياق المعماري لكل منهما مختلفان تماماً.
يُعد معامل IN الشرطي أداة مقارنة قيم حقلية (Value-Level Operator) تفحص محتوى متغير داخل الملاحظة الحالية، بينما يمثل خيار IN= أداة فحص مصدرية على مستوى الملفات والجداول (Data-Set-Level Option) تحدد المساهمة الهيكلية للجدول في الملاحظة برمتها. لا يمكن لمعامل المقارنة المباشر تتبع ما إذا كان السجل قادماً من ملف الأساس أو ملف المتابعة إذا كانت المتغيرات متطابقة القيم، وتلك هي المهمة الحصرية التي صُمم خيار IN= لإنجازها بدقة متناهية.
إن إدراك الفارق بين هاتين الأداتين يتيح للمحلل توظيف كل أداة في مكانها الصحيح؛ حيث يمكن دمجهما معاً في خطوة بيانات واحدة لبناء شروط بالغة التحديد والدقة، كأن يتم اختبار مصدر السجل أولاً عبر خيار IN= ثم فحص الفئات التشخيصية داخل ذلك المصدر باستخدام معامل المقارنة IN.
8.3 تقييم الأداء واستهلاك موارد النظام
يخضع تقييم الأداء الحسابي في بيئات المعالجة المكثفة لمعايير صارمة ترتكز على سرعة الإدخال والإخراج (I/O Operations) وحجم الذاكرة العشوائية المستهلكة. يتميز خيار IN= بكفاءته الاستثنائية في هذا الجانب؛ نظراً لأن المؤشرات المتولدة عنه هي متغيرات منطقية ثنائية مؤقتة تُخزن وتُعالج بالكامل داخل ناقل بيانات البرامج (PDV)، دون أن تترتب عليها أي عمليات كتابة فيزيائية على القرص الصلب ما لم يُطلب ذلك صراحة.
مقارنةً بالحلول البديلة التي تتطلب إنشاء أعمدة تصنيفية مسبقة في مجموعات البيانات المصدرية قبل دمجها، يوفر خيار IN= قدراً هائلاً من المساحة التخزينية وعمليات المعالجة التمهيدية؛ حيث يغني المبرمج عن إجراء خطوات بيانات وسيطة لتوليد أعلام المصدر (Source Flags). يتم كل شيء ديناميكياً أثناء القراءة اللحظية، وهو ما يقلل من حركة البيانات بين المعالج ووحدات التخزين الفيزيائية (Disk Thrashing).
توضح الإرشادات الحسابية المعتمدة في هندسة بيانات SAS أنه عند التعامل مع ملفات تحتوي على عشرات الملايين من السجلات ومئات المتغيرات، فإن استخدام تعليمة MERGE المسبوقة بـ PROC SORT مع خيار IN= يمثل الخيار الأمثل هندسياً لتقليل وقت التنفيذ وتفادي استهلاك سعة خوادم التحليل المشتركة في المؤسسات البحثية والأكاديمية الكبرى.
9. أفضل الممارسات البرمجية لضمان جودة الأكواد الأكاديمية
9.1 قواعد التسمية والتوثيق للمتغيرات المنطقية
تقتضي معايير الجودة البرمجية المتبعة في المؤسسات البحثية الرصينة كتابة شيفرات تتسم بالوضوح الذاتي وقابلية التدقيق المستقل. وفي هذا السياق، تحتل قواعد تسمية متغيرات خيار IN= موقع الصدارة؛ حيث يتعين على الباحث الابتعاد تماماً عن استخدام التسميات المبهمة كالأحرف المنفردة أو الاختصارات المضللة التي تعيق فهم المنطق البرمجي عند مراجعة الكود من قِبل باحثين آخرين أو جهات تقييم النزاهة العلمية.
يُنصح دائماً باعتماد سوابق دلالية متسقة وموحدة، مثل استخدام السابقة in_ متبوعة باسم يعبر بوضوح عن محتوى الملف، مثل in_baseline أو in_registry_2023 أو in_mortality_data. كما يُفضل إدراج تعليقات برمجية وافية (Comments) في بداية خطوة البيانات توضح الغرض المنهجي من كل مؤشر منطقي تم إنشاؤه، وطبيعة الشروط التصفوية المقترنة به.
يسهم هذا التوثيق الدقيق في خفض التكلفة الزمنية لعمليات مراجعة الأكواد البرمجية (Peer Code Review)، ويسهل تحديث الشيفرات وصيانتها عند تكرار الدراسات المسحية أو إضافة موجات بيانات جديدة إلى السلاسل البحثية القائمة.
9.2 هيكلة الأكواد البرمجية لتعزيز قابلية إعادة الاستخدام والتكرار
تُعد قابلية إعادة الإنتاج (Reproducibility) حجر الزاوية في المنهج العلمي الحديث. لضمان تحقيق هذا المبدأ، يجب هيكلة الأكواد البرمجية في SAS بصورة معيارية تعزل بوضوح مراحل تجهيز البيانات وتنظيفها عن مراحل التحليل الإحصائي وبناء النماذج. ويشمل ذلك جعل خطوات الفلترة والدمج المبنية على خيار IN= خطوات مستقلة بذاتها تُنتج مصفوفات بيانات نهائية نظيفة وموثقة بالكامل.
تتمثل إحدى أفضل الممارسات في هذا الصدد في إجراء تحقق منهجي من نتائج الدمج عبر استدعاء إجراء PROC FREQ لفحص جداول التكرار المتقاطعة للمتغيرات المنطقية الدائمة قبل الانتقال لأي تحليل لاحق. يوضح الكود التالي هذا الفحص التوكيدي:
PROC FREQ DATA=combined_output;

  TABLES in_cohort_a * in_cohort_b / LIST MISSING;

  TITLE 'فحص التوزيع التكراري لمصادر البيانات وحالات التطابق';

RUN;
يوفر هذا التحليل التكراري صورة بانورامية سريعة تؤكد مطابقة أعداد العينات المدمجة مع الأعداد المتوقعة في بروتوكول البحث الأصلي، وتكشف أي خلل أو تسرب غير متوقع في البيانات في مرحلة مبكرة من خطة التحليل.
9.3 إدارة البيانات الحساسة وضمان الخصوصية أثناء الدمج
عند التعامل مع البيانات الحساسة المحمية بلوائح الخصوصية الصارمة (مثل بيانات السجلات الصحية للمرضى الخاضعة لتشريعات HIPAA أو اللائحة العامة لحماية البيانات GDPR)، يفرض بروتوكول الأمان عزل المعرفات الشخصية المباشرة وحذفها بأسرع وقت ممكن أثناء خط أنابيب معالجة البيانات (Data Pipeline). يساهم خيار IN= في تعزيز هذا الامتثال التنظيمي بطرق فعالة.
يمكن استخدام مؤشرات IN= لضمان حصر التحليل حصرياً في فئات المرضى الذين وقعوا استمارات الموافقة المستنيرة (Informed Consent)، وذلك من خلال مطابقة مصفوفة السجلات السريرية مع سجل الموافقات الأخلاقية واشتراط وجود المؤشر المنطقي الإيجابي لكلا الملفين، مع إسقاط السجلات غير المعتمدة فوراً دون كتابتها في أي وسيط تخزين دائم.
بالإضافة إلى ذلك، يتيح خيار IN= استبدال المعرفات الحقيقية بمؤشرات مشفرة (Pseudonymized IDs) أثناء خطوة الدمج ذاتها، مما يحد من فرص تسرب البيانات الشخصية الحساسة إلى ملفات التحليل الإحصائي النهائية التي يتداولها الباحثون والمحللون المساعدون.
10. الخلاصة والتطبيقات المتقدمة في معالجة البيانات المعقدة
10.1 موجز الفوائد المنهجية لاستخدام خيار IN=
يمثل خيار IN= في نظام SAS أداة برمجية لا غنى عنها لأي باحث أو محلل إحصائي يسعى إلى تحقيق أعلى درجات الدقة والتحكم المنطقي في السجلات والملاحظات. إن قدرته على توليد مؤشرات ثنائية لحظية داخل ناقل بيانات البرامج دون استهلاك موارد تخزينية تجعل منه الركيزة الأساسية لكافة عمليات الإلحاق الرأسي والدمج الأفقي المعقدة.
تتجلى الفائدة المنهجية العظمى لهذا الخيار في تمكين الباحث من إثبات موثوقية وأصل كل ملاحظة تدخل في نماذجه التحليلية، وتحويل عمليات الدمج الغامضة إلى مسارات تدقيق واضحة ومحددة رياضياً. ينعكس هذا التحقق المنطقي الصارم بصورة مباشرة على قوة الاستنتاجات العلمية، ويضمن خلو التقديرات الإحصائية من التحيزات الناتجة عن أخطاء الفقد أو المطابقة الخاطئة أو تشوه البيانات المصدرية.
10.2 أتمتة استخدام خيار IN= عبر لغة الماكرو في SAS
في المشاريع الإحصائية الضخمة التي تتطلب دمج عشرات الملفات القادمة من مسوح متعددة أو مراكز سريرية متعاقبة، تصبح كتابة الأكواد اليدوية لكل جدول عملية غير عملية وعرضة للخطأ. يتيح تكامل خيار IN= مع لغة الماكرو في SAS (SAS Macro Language) بناء وحدات برمجية مؤتمتة وقابلة للتكيف ديناميكياً لتنفيذ عمليات الدمج ومراقبة الجودة على عدد متغير من الجداول.
يمكن بناء دالة ماكرو تأخذ قائمة بأسماء الجداول وتولد تلقائياً مؤشرات IN= متسلسلة، مع بناء جداول المخرجات والتقارير الإحصائية لحالات التطابق بصورة آلية كاملة. تضمن هذه الأتمتة المتقدمة توحيد معايير معالجة البيانات عبر كافة مراحل المشروع البحثي، وتقلل التدخل البشري إلى أدنى مستوياته، مما يعزز كفاءة وسرعة خطوط أنابيب التحليل الإحصائي المؤتمتة.
10.3 آفاق التوسع نحو تحليلات البيانات المتقدمة
مع التطور المتسارع نحو تطبيقات تعلم الآلة (Machine Learning) والتحليلات التنبؤية في بيئة SAS Viya الحديثة، يظل الفهم العميق لخيارات معالجة البيانات مثل IN= ذا أهمية استراتيجية بالغة. تعتمد خوارزميات النمذجة المتقدمة على جودة وتوازن البيانات المدخلة؛ وهنا تلعب المؤشرات المصدرية دوراً محورياً في مراقبة تحيز البيانات (Bias Monitoring) ومراقبة انحراف المفاهيم (Concept Drift) عبر الزمن.
تُمكّن المؤشرات المتولدة عن خيار IN= المطورين من تدريب النماذج وتقييم أدائها على مجموعات بيانات تاريخية مختلفة مع تتبع دقيق لأصل الملاحظات، مما يتيح ضبط أوزان العينات بناءً على مصادرها وتجنب الإفراط في الملاءمة (Overfitting) الناتج عن بيانات مشوهة أو غير متوازنة، مؤكداً بذلك أن دقة التحليل النهائي تبدأ دائماً من الانضباط الهندسي في خطوات معالجة البيانات التأسيسية.
المراجع
- Barr, A. J., Goodnight, J. H., Sall, J. P., & Helwig, J. T. (1976). A User’s Guide to SAS 76. SAS Institute Inc.
- Cody, R. (2018). Learning SAS by Example: A Programmer’s Guide (2nd ed.). SAS Institute Inc.
- Delwiche, L. D., & Slaughter, S. J. (2019). The Little SAS Book: A Primer (6th ed.). SAS Institute Inc.
- SAS Institute Inc. (2020). SAS 9.4 Language Reference: Concepts (6th ed.). SAS Institute Inc. https://documentation.sas.com
- SAS Institute Inc. (2023). Base SAS 9.4 Procedures Guide: Statistical Procedures (5th ed.). SAS Institute Inc. https://documentation.sas.com