
تُعد معالجة البيانات النصية غير المهيكلة وشبه المهيكلة واحدة من أعقد التحديات التحليلية التي تواجه علماء البيانات والإحصائيين في بيئات العمل المتقدمة، لا سيما عند التعامل مع سجلات ضخمة تتطلب دقة متناهية في الفرز والتصنيف. وفي منظومة نظام التحليل الإحصائي (SAS)، تحتل دوال معالجة النصوص مكانة محورية في تمكين الباحث من استخلاص المعالم الدلالية ورصد الأنماط اللغوية المحددة بدقة متناهية ودون الوقوع في فخاخ التطابقات العرضية التي تلازم المقاربات السطحية للبيانات النصية.
تأتي دالة INDEXW كأحد أبرز الحلول الخوارزمية المتخصصة في التنقيب عن الكلمات المستقلة داخل السلاسل الرمزية، متفوقة على دوال البحث الفرعي العامة بفضل إدراكها البنيوي لمفهوم حدود الكلمة (Word Boundaries). إن التحول من منطق فحص السلاسل الفرعية المجردة إلى منطق تمييز الوحدات المعجمية المنفصلة يمثل نقلة نوعية في موثوقية التحليلات الإحصائية المتقدمة، حيث يمنع التداخلات غير المقصودة بين الكلمات المشتقة أو المركبة، ويضمن أن المعالجة الرياضية للنصوص تستند إلى كيانات لغوية حقيقية وليست مجرد تشكيلات متطابقة من المحارف الصامتة.
يهدف هذا الدليل المرجعي الموسع إلى تقديم تأصيل نظري وتطبيقي شامل لدالة INDEXW في لغة SAS البرمجية، متناولاً أبعادها الرياضية وخوارزميات عملها الدقيقة في الذاكرة أثناء خطوة معالجة البيانات. وسنستعرض عبر الفصول القادمة البنية النحوية للدالة، ومحددات الفصل التلقائية والمخصصة، والفروق الجوهرية بينها وبين نظائرها من دوال البحث والتقطيع، فضلاً عن تقديم تطبيقات برمجية متقدمة تبرز دورها في إدارة الحالات الحدية، وحساسية المحارف، وبناء نظم التصنيف والفرز الإحصائي بكفاءة حوسبية قصوى.
1. مقدمة تأصيلية لدالة INDEXW ومفهوم معالجة النصوص في نظام SAS
1.1 التعريف الرياضي والبرمجي لدالة INDEXW
تُعرّف دالة INDEXW من المنظور البرمجي والرياضي في بيئة SAS بأنها دالة بحث وتعيين مصفوفي محرفي تعمل على تحديد الموقع المكاني النسبي لأول ظهور لكلمة مستهدفة محددة داخل سلسلة نصية مرجعية، بشرط أن تكون هذه الكلمة وحدة معجمية مغلقة ومحاطة بفواصل ومحددات صريحة. على خلاف الدوال التي تبحث عن المتتاليات الصامتة المجردة، تعتمد هذه الدالة على خوارزمية تطابق مقيد (Constrained Pattern Matching) تفحص الحرف الذي يسبق المقطع المطلوب والحرف الذي يليه مباشرة، للتأكد من أن الكلمة لا تشكل جزءاً من بنية مورفولوجية أكبر أو لاحقة أو بادئة لكلمة أخرى مركبة داخل السجل المفحوص.
تُرجع الدالة قيمة عددية صحيحة تمثل الفهرس المكاني (Index) للبايت الأول أو المحرف الأول الذي تبدأ منه الكلمة المستهدفة في السلسلة النصية المصدرية. يبدأ هذا الفهرس الحسابي بالرقم واحد للدلالة على مطلع النص، ويتدرج تصاعدياً بالتناسب مع طول السلسلة المحرفية. وفي حال إخفاق الخوارزمية في العثور على الكلمة المستهدفة ككيان منفصل، ترجع الدالة القيمة الصفرية، وهي النتيجة الحسابية التي تمثل رياضياً المجموعة الخالية للتطابق، مما يسمح للمحلل الإحصائي باستخدام هذه النتيجة كمتغير ثنائي مشتق أو كمعامل شرطي مباشر داخل خوارزميات التصنيف والترشيح.
تتضح الأهمية التحليلية لهذه الدالة في معالجة البيانات النصية النوعية، مثل سجلات الرعاية الصحية والتقارير الطبية للمرضى، ومدونات الملاحظات السريرية، والاستبانات المفتوحة في الدراسات الاجتماعية. في هذه المجالات، يحمل وجود كلمة مفردة مدلولاً تشخيصياً أو إحصائياً دقيقاً لا يمكن مقايضته بتطابق جزئي عشوائي. على سبيل المثال، يمثل رصد كلمة مرضية معينة بصفتها كياناً مستقلاً فارقاً جوهرياً عن رصد نفس التتابع المحرفي داخل كلمة تدل على النفي أو داخل مصطلح طبي مغاير تماماً، مما يجعل الدالة حجر زاوية في تأمين سلامة واستقرار المخرجات الوصفية والاستدلالية.
1.2 أهمية التمييز بين معالجة الكلمات ومعالجة السلاسل النصية الفرعية
إن المعضلة الكلاسيكية في التنقيب عن النصوص تكمن في الخلط المنهجي بين معالجة المتتاليات الفرعية (Substrings) ومعالجة الكلمات الكاملة (Whole Words). عندما تستخدم الخوارزميات دوال البحث الجزئي غير المقيدة، تقع بصورة متكررة في خطأ “الإيجابية الكاذبة” (False Positive)، حيث تسجل وجود المعلم الدلالي في مواضع لا يمتلك فيها أي دلالة مقصودة. يتجلى هذا الخطأ عندما نبحث عن كلمات مقتضبة تتكرر محارفها صدفة داخل كلمات أطول وأكثر تعقيداً، مما يؤدي إلى تلوث مصفوفة البيانات بترميزات مشوهة تفسد التحليلات الإحصائية اللاحقة ونماذج التعلم الآلي المعتمدة عليها.
يحمي التمييز الدقيق لحدود الكلمة سلامة التمايز الدلالي أثناء استخراج المتغيرات النصية في SAS. إن الحفاظ على هذا التمايز يضمن بقاء العلاقة الرياضية بين المتغير التابع والمستقل نقية من الضجيج المحرفي. فعندما يبحث المحلل عن كلمة قصيرة تعبر عن استجابة محددة في استبيان مفتوح، يضمن منطق دالة INDEXW عزل تلك الاستجابة بدقة، دون احتساب الكلمات التي تشتمل عرضاً على ذات الحروف بترتيب مماثل، وهو ما يوفر حماية متقدمة للنماذج الإحصائية من التشتت وارتفاع التباين غير المبرر في تقدير المعلمات والانحدارات.
ينعكس هذا التمييز بصورة بالغة على جودة استخراج الأنماط في الأبحاث الاستكشافية القائمة على المقابلات أو استطلاعات الرأي واسعة النطاق. إن دقة عزل الكلمات المفتاحية تتيح للباحث تصنيف اتجاهات المستجيبين دون الحاجة إلى تشغيل خوارزميات معالجة لغة طبيعية شديدة التعقيد وباهظة التكلفة الحوسبية. ومن خلال توظيف الفحص المستند إلى حدود الكلمات، يتمكن نظام SAS من غربلة آلاف النصوص بسرعة هائلة مع الحفاظ على موثوقية أكاديمية تضاهي التدقيق البشري اليدوي وتتجاوزه في الاتساق والسرعة.
1.3 السياق العام للتعامل مع النصوص في خطوة معالجة البيانات (DATA Step)
تعمل لغة SAS البرمجية وفق معمارية معالجة فريدة تعرف بدورة معالجة خطوة البيانات (DATA Step Processing Cycle)، حيث تنفذ العمليات الحسابية والمنطقية بتدفق متسلسل وموجّه بالسجلات، صفاً تلو الآخر (Observation by Observation). في هذا السياق البنيوي، تُستدعى دالة INDEXW ضمن ناقل بيانات البرنامج المشهور باسم Program Data Vector (PDV)، مما يعني أن فحص السلسلة النصية يقع في الذاكرة الحية خلال زمن التنفيذ لكل سجل على حدة، وهو ما يفرض فهماً عميقاً لكيفية إدارة الموارد البرمجية وتخصيص مساحات المتغيرات النصية.
يتأثر أداء دوال فحص النصوص في لغة SAS مباشرة بالطريقة التي يُعرّف بها المتغير النصي من حيث الطول والتخزين. يتم تخصيص المتغيرات الحرفية في SAS بأطوال ثابتة افتراضياً، ما لم يتم التحكم بها صراحة. وإذا احتوى المتغير النصي على مساحات بيضاء لاحقة ناتجة عن التوسعة التلقائية الثابتة للحقول (Padding Blanks)، فإن دوال البحث تتفاعل مع هذه المساحات وفق معايير محددة. تتميز دالة INDEXW بقدرتها على التعامل مع هذه البنية الثابتة بكفاءة، شريطة أن يعي المبرمج أثر التخصيص التلقائي للمتغيرات المشتقة، لتفادي اقتطاع النصوص أو استنزاف الذاكرة غير الضروري عبر ملايين السجلات المجمعة.
علاوة على ذلك، فإن موقع استدعاء الدالة داخل تدفق أوامر خطوة البيانات يتحكم في التفاعلات المنطقية مع الشروط والتحويلات الأخرى. يمكن استخدام القيمة المرجعة من INDEXW فورياً لتحديد مسارات التفرع الشرطي، أو لضبط أوزان العينات، أو لتهيئة متغيرات مؤشرية (Flag Variables) جديدة تُستخدم لاحقاً في إجراءات التحليل الإحصائي الإنشائي والجدولة المتقاطعة مثل إجراء PROC FREQ أو إجراء PROC LOGISTIC. يوضح الجدول التالي ملامح البيئة التنفيذية للدالة داخل بنية نظام SAS:
| المعيار البرمجي | الخصائص والوظائف داخل نظام SAS |
|---|---|
| مرحلة المعالجة | تُنفذ في مرحلة التنفيذ (Execution Phase) لكل صف على حدة داخل ناقل البيانات (PDV). |
| نوع القيمة المرجعة | قيمة رقمية صحيحة (Numeric Integer) تمثل إحداثي البداية أو صفر في حال العدم. |
| استهلاك الذاكرة | معالجة موضعية خفيفة لا تتطلب مصفوفات ديناميكية إضافية كدوال التعابير النمطية المتقدمة. |
| نطاق الفحص الافتراضي | يتعرف تلقائياً على المحددات القياسية المضمنة كحدود حتمية تفصل بين الكلمات. |
2. البنية النحوية (Syntax) والمعاملات الأساسية لدالة INDEXW
2.1 المعامل الأول: السلسلة النصية المصدرية (Source)
يمثل المعامل الأول في دالة INDEXW السلسلة النصية المصدرية أو حقل النص الخام الذي ستجري فيه عمليات المسح والتحليل والتنقيب. يمكن لهذا المعامل أن يكون اسماً لمتغير نصي معرف مسبقاً في مجموعة البيانات، أو تعبيراً برمجياً معقداً يرجع نصاً بعد معالجته بدوال أخرى، أو قيمة نصية ثابتة ومباشرة (String Literal) محاطة بعلامات اقتباس فردية أو مزدوجة. يشترط في هذا المعامل أن ينتمي بنيوياً إلى النمط المحرفي (Character Type)، حيث يترتب على تمرير متغير عددي محاولة المترجم إجراء تحويل قسري ضمني مصحوباً بتنبيه تحذيري في سجل الأخطاء (Log).
يتطلب التعامل مع السلسلة المصدرية إدراكاً لطبيعة المسافات البيضاء البادئة واللاحقة المحيطة بها. فإذا كانت السلسلة النصية تحتوي على مساحات فارغة في بدايتها، فإن احتساب موقع بداية الكلمة المستهدفة يراعي تلك المساحات ويحتسبها ضمن الفهرس الرقمي النهائي بدقة تامة، إذ يمثل المرجع موقع البايت الفعلي داخل السلسلة الكلية المخزنة في الذاكرة. أما المساحات اللاحقة الناتجة عن الامتداد الثابت للمتغير الحرفي في SAS، فإنها تعامل افتراضياً كفواصل حدودية، ولا تعيق عملية البحث عن الكلمة إذا كانت تقع قبل نهاية السلسلة الفعلية.
في بيئات البيانات المتقدمة، يجب التأكد من عدم تجاوز السلسلة المصدرية للحدود القصوى للتخزين، خاصة مع المتغيرات النصية الطويلة التي قد تصل إلى 32,767 محرفاً في مجموعات بيانات SAS التقليدية. إن دقة فحص السلسلة المصدرية تقتضي ألا يطرأ عليها اقتطاع عرضي ناتج عن تعريفات الأطوال الضيقة، لأن اختفاء المحدد النهائي بفعل الاقتطاع سيجعل الكلمة الواقعة في الطرف تبدو كأنها كلمة ناقصة، مما يؤدي إلى فشل الخوارزمية في التعرف عليها ككلمة مكتملة الحدود وفق منطق الدالة المعياري.
2.2 المعامل الثاني: الكلمة المستهدفة للبحث (Excerpt)
المعامل الثاني الإلزامي هو الكلمة المراد التفتيش عنها وتحديد موقعها وتعرف تقنياً بمقتطف البحث (Excerpt). يجب أن يمثل هذا المعامل الكلمة النقية دون إدراج فواصل أو مسافات بيضاء ضمن محتواها الذاتي، لأن إدراج مسافة داخل هذا المعامل عند استخدام المحددات الافتراضية قد يربك الخوارزمية التي تعتبر المسافة أداة فصل وليست جزءاً بنيوياً من تكوين الكلمة المفردة. يمكن تمرير هذا المقتطف في صيغة متغير مستقل مستخلص من جداول أخرى، أو في صيغة نص ثابت بين علامتي اقتباس متطابقتين.
تتعامل دالة INDEXW مع المعامل الثاني بمبدأ التجريد الكامل؛ بمعنى أنها تبحث عن النمط المماثل تماماً للحروف المكونة له ككتلة واحدة غير قابلة للتجزئة داخل السلسلة المصدرية. وإذا تم تمرير كلمة ذات طول متباين أو متغير محرفي يتضمن مسافات فارغة لاحقة، يقوم مترجم SAS بتجريد تلك المسافات اللاحقة للمقتطف تلقائياً قبل بدء المطابقة لضمان عدم احتساب المساحة التخزينية كجزء من الكلمة المبحوث عنها، وهو سلوك وقائي يمنع الإخفاق الناجم عن اختلاف أطوال المتغيرات المخصصة في خطوة البيانات.
من المهم بمكان التنبيه إلى ضرورة تجنب تمرير سلاسل فارغة في هذا المعامل؛ إذ إن البحث عن مقتطف لا يحتوي على أي محارف يؤدي حسابياً ومنطقياً إلى إرجاع القيمة صفر في معظم السيناريوهات التشغيلية، كما قد يؤدي في بعض الإصدارات القديمة إلى إهدار دورات معالجة غير منتجة. لذا يوصى بالتحقق المسبق من جاهزية الكلمة المستهدفة وخلوها من الرموز غير المقصودة قبل إخضاعها للمطابقة، لا سيما في التطبيقات التي تعتمد على قوائم كلمات خارجية مستوردة من ملفات إكسل أو قواعد بيانات خارجية.
2.3 المعامل الاختياري: محددات الفصل بين الكلمات (Delimiter Argument)
تتيح دالة INDEXW لمبرمجي لغة SAS مرونة استثنائية من خلال إمكانية إضافة معامل ثالث اختياري يحدد صراحة الرموز والمحارف التي يجب أن تعتبرها الخوارزمية فواصل وحدوداً بين الكلمات (Delimiters). في حال غياب هذا المعامل، تطبق الدالة حزمة المحددات الافتراضية المدمجة في نواة النظام. أما عند تمرير هذا الوسيط، فإن المترجم يلغي فوراً القائمة الافتراضية ويستبدلها تماماً بالمحارف المحددة في هذا المعامل، مما يعيد تشكيل مفهوم حدود الكلمة داخل النص المصدر وفق متطلبات الباحث التحليلية.
يتيح هذا المعامل التغلب على التحديات الناتجة عن النصوص التخصصية؛ مثل السجلات المالية التي تفصل بين المصطلحات بنقاط وشرطات، أو البيانات الوراثية والبيولوجية التي تعتمد أحرفاً خاصة لفصل السلاسل الجينية، أو حتى عناوين الويب والمسارات الحاسوبية. ويجب أن يُمرر هذا المعامل كسلسلة محرفية تحتوي على كافة الرموز المراد اعتبارها فواصل دون الحاجة إلى وضع فواصل بين الفواصل ذاتها؛ فكل محرف يُذكر داخل هذا الوسيط يُعامل بصورة منفصلة ومستقلة كأداة فصل معتمدة لترسيم بداية ونهاية الكلمات المفحوصة.
تخضع تركيبة المعاملات لقواعد صارمة في الترتيب النحوي؛ حيث لا يجوز تقديم محددات الفصل على الكلمة المستهدفة، ولا يمكن تجاوز الكلمة للوصول إلى المحددات. وإذا تم تمرير وسيط المحددات بقيمة خالية أو غير صحيحة، يضطرب منطق الفصل تماماً مما قد يمنع الدالة من العثور على أية تطابقات، أو يؤول الأمر إلى دمج النص المصدر في كتلة واحدة صامتة يستحيل عزل مفرداتها. توضح الشفرة الوصفية التالية البنية الهيكلية المجردة لاستدعاء الدالة:
صيغة الاستدعاء العامة للدالة:
المتغير_العددي_للنتيجة = INDEXW(السلسلة_المصدرية, الكلمة_المستهدفة, المحددات_الاختيارية);
3. آلية عمل دالة INDEXW وقواعد المطابقة اللغوية وحدود الكلمات
3.1 تعريف الكلمة (Word Boundary) وفق منطق برمجيات SAS
يرتكز منطق برمجيات SAS في تمييز الكلمة (Word) على مفهوم الحوسبة المكانية لحدود الرموز (Lexical Tokenization)، حيث تُعرّف الكلمة بأنها تتابع متصل من المحارف غير الفاصلة، محاط بحافتين قطبيتين: حافة بداية وحافة نهاية. ولكي يتحقق التطابق الإيجابي في دالة INDEXW، يجب ألا تكتفي الخوارزمية باكتشاف التتابع المتطابق لحروف الكلمة، بل تفرض شرطاً حاسماً يتمثل في أن يكون المحرف السابق لمطلع الكلمة إما فاصلاً معتمداً أو بداية السلسلة النصية المطلقة، وأن يكون المحرف التالي لنهاية الكلمة إما فاصلاً معتمداً أو نهاية السلسلة النصية المطلقة.
هذا الفارق الدقيق بين الحرف الواقع على حافة الكلمة والحرف الممتد داخلها هو ما يمنح الدالة قوتها المتفردة. فعلى سبيل المثال، لو كانت السلسلة النصية تحتوي على عبارة مركبة، فإن وجود الكلمة المستهدفة كجزء عضوي في وسط كلمة أطول سيجعل الحرف المجاور لها حرفاً هجائياً وليس فاصلاً، وبالتالي تسقط الدالة هذا التطابق وتعتبره عدماً حوسبياً. يوضح هذا السلوك قدرة المنطق البرمجي لنظام SAS على إدراك الكيان اللغوي كفضاء مستقل محدد الأطراف والركائز داخل فضاء الذاكرة النصية.
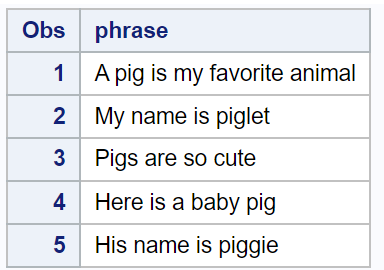
يتطلب هذا المفهوم انتباهاً خاصاً من الباحثين عند التعامل مع الكلمات التي تتصل بها زوائد لغوية، مثل حروف الجر المتصلة أو أدوات التعريف في بعض اللغات غير اللاتينية، أو حتى علامات الترقيم اللصيقة في التنسيقات الرديئة. فإذا اتصلت أداة ترقيم بالكلمة دون وجود مسافة، وكانت تلك الأداة غير مدرجة ضمن قائمة المحددات المعيارية المطبقة في الاستدعاء، فإن النظام لن يعتبر تلك النقطة حافة فاصلة، وسيتعامل مع الكلمة وعلامة الترقيم ككتلة واحدة غير مطابقة للمقتطف المستهدف، مما يستوجب ضبط المحددات بدقة متناهية.
3.2 المحددات الافتراضية للفصل وسلوكها التلقائي
عند استخدام دالة INDEXW في شكلها البسيط دون تمرير الوسيط الثالث، يُفعّل مترجم لغة SAS حزمة من المحددات الافتراضية القياسية التي صُممت لتلائم معظم النصوص الإنجليزية والغربية المكتوبة بتنسيق قياسي. تشمل هذه الحزمة الافتراضية المسافة البيضاء بمختلف تمثيلاتها (Blanks)، وعلامة النقطة (.)، والفاصلة العادية (,)، وعلامة الاستفهام (?)، وعلامة التعجب (!)، والفاصلة المنقوطة (;)، والنقطتين الرأسيتين (:)، ورموز الأقواس المتنوعة. تعمل هذه القائمة المدمجة كشبكة غربلة تلقائية تفصل بين التجمعات الحرفية.
عندما يبدأ المترجم في تحليل السلسلة النصية المصدرية استناداً لهذه القائمة، فإنه يقوم بمسح تتابعي من اليسار إلى اليمين (أو وفق اتجاه تخزين السلسلة). وإذا صادف المترجم تجاوراً لعدة محددات متتالية دون نصوص بينية—مثل وجود نقطة تليها مسافة أو تتابع عدة فواصل—فإن خوارزمية INDEXW تتعامل مع هذا التجاور بسلاسة تامة، حيث تعتبر المتتالية بكاملها بمثابة حد فاصل واحد ممتد. لا تفترض الدالة وجود “كلمات فارغة” بين المحددات المتتالية، بل تقفز عنها تلقائياً لتفحص التكتل الحرفي الحقيقي التالي.
يوفر هذا السلوك التلقائي متانة عالية للأكواد البرمجية، إذ يعفي المحلل من الحاجة المسبقة لتنظيف الفواصل المزدوجة أو إزالة علامات الترقيم المتكررة قبل الشروع في البحث. ومع ذلك، ينبغي الحذر إذا كانت النصوص قيد الدراسة تستخدم رموزاً رياضية أو فنية كأجزاء أصيلة من أسماء المتغيرات أو المصطلحات (مثل علامة الشَرطة أو الخط المائل)، حيث إن بعض هذه الرموز قد تكون أو لا تكون ضمن المحددات وفق بيئة النظام وإعدادات الترميز، مما يبرز أهمية الاعتماد على التحديد الصريح عند معالجة النصوص غير التقليدية.
3.3 آلية احتساب موقع البداية وتفسير القيم الصفرية
تعتمد آلية احتساب موقع بداية الكلمة على العد المحرفي الفيزيائي المطلق داخل السلسلة المصدرية. تبدأ الحوسبة بالرقم 1 للمحرف الأول الواقع في أقصى اليسار، وتستمر في الترقيم التسلسلي بايت تلو الآخر، بحيث يشمل العد كافة الرموز المكتوبة والمسافات البيضاء وعلامات الترقيم على حد سواء. وعندما تجد دالة INDEXW كلمة مستوفية للشروط اللغوية والحدودية، ترجع رقم الفهرس الذي يطابق الحرف الأول من تلك الكلمة، مما يمكن الباحث من معرفة مكانها الدقيق داخل النص بدقة مطلقة تخدم عمليات التقطيع والاستخراج اللاحقة.
أما في حال إخفاق الدالة في العثور على الكلمة—سواء لغياب أحرفها بالكامل، أو لوجودها مضمنة داخل كلمة أكبر، أو لعدم توفر الحدود الفاصلة المقبولة حولها—فإن الدالة تؤول منطقياً إلى إرجاع القيمة العددية 0 (صفر). يحمل هذا الصفر دلالة منطقية حاسمة في بيئة SAS؛ إذ يُفسر في السياقات الشرطية المنطقية (Boolean Contexts) على أنه قيمة كاذبة (False)، بينما يُفسر أي رقم موجب أكبر من الصفر على أنه قيمة صادقة (True). يتيح هذا التمايز استخدام استدعاء الدالة مباشرة كشرط تحكم دون الحاجة إلى مقارنات إضافية معقدة.
وللتحقق من صحة القيمة المرجعة، يلجأ الإحصائيون إلى مقارنة الفهرس المعطى بالموقع الفعلي للنص عبر استخدام دوال المراجعة، أو من خلال طباعة عينات الفحص وتتبع إحداثيات الأحرف. يمثل التحقق البصري المتقاطع خطوة أساسية لضمان عدم وجود مسافات بادئة غير مرئية قد تزحزح الفهرس العددي عن المتوقع، فضلاً عن التأكد من أن التشفير المتبع (مثل ASCII أو UTF-8) يتطابق مع افتراضات الدالة في احتساب البايتات مقابل المحارف متعددة البايت.
4. مقارنة منهجية معيارية بين دالة INDEXW ونظائرها (INDEX و FIND و SCAN)
4.1 المقارنة بين دالتي INDEXW و INDEX التقليدية
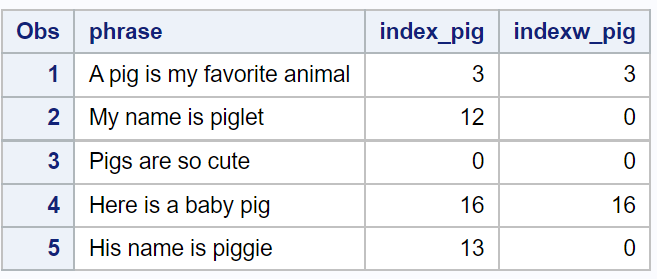
تمثل المقارنة بين دالتي INDEXW و INDEX الكلاسيكية النموذج الأبرز لتباين فلسفات التنقيب عن البيانات النصية في لغة SAS. تعمل دالة INDEX التقليدية على مبدأ البحث عن المتتالية الفرعية المجردة (Substring Matching)؛ فهي لا تكترث بالسياق اللغوي أو بحدود الكلمات، بل تكتفي بالتحقق من وجود تتابع المحارف المستهدفة في أي موضع من السلسلة المصدرية. فإذا بحثنا عن كلمة قصيرة تتألف من ثلاثة أحرف، فإن دالة INDEX سترجع موقعاً إيجابياً حتى لو كانت هذه الحروف الثلاثة تقع في منتصف كلمة كبرى مؤلفة من عشرة أحرف.
في المقابل، تم تصميم دالة INDEXW لتجاوز هذا القصور الهيكلي، حيث تتجاهل أي تطابق محرفي لا يمثل كلمة قائمة بذاتها. إن هذا الفارق الجوهري هو ما يحسم مسألة “الإيجابيات الكاذبة”. ففي التحليلات الصيدلانية، على سبيل المثال، قد يؤدي استخدام دالة INDEX للبحث عن اسم مركب علاجي إلى الوقوع في تطابق خاطئ مع مركبات دوائية أخرى تشترك في الجذع ذاته، في حين تضمن دالة INDEXW حصر النتائج في السجلات التي ورد فيها اسم الدواء المعني ككيان علاجي مستقل، مما يحافظ على نزاهة وموثوقية التجارب السريرية المنفذة.
من زاوية الكفاءة، تستهلك دالة INDEX التقليدية دورات معالجة أقل نسبياً نظراً لبساطة خوارزميتها المعتمدة على الفحص المتسلسل الساذج، بينما تتطلب INDEXW عمليات تحقق منطقية إضافية لفحص الحواف والمحددات المحيطة بالتطابق المحتمل. ومع ذلك، فإن الفارق في كفاءة المعالجة يعد ضئيلاً جداً بالمقارنة مع الكلفة التحليلية الكارثية المترتبة على الأخطاء التفسيرية الناتجة عن الاعتماد على التطابقات الجزئية، مما يجعل دالة INDEXW الخيار المفضل دون منازع عند دراسة الوحدات المعجمية الحقيقية.
4.2 أوجه التباين مع دالة FIND المتقدمة
تُعد دالة FIND من الإضافات الأحدث والأكثر مرونة في ترسانة معالجة النصوص داخل لغة SAS، وتتميز بتوفير معلمات إضافية تمكن المبرمج من التحكم في اتجاه المسح (البحث للأمام أو للخلف) وتجاوز حساسية حالة الأحرف عبر معدّلات برمجية (Modifiers) مدمجة. ومع ذلك، تشترك دالة FIND مع دالة INDEX في افتقارها الأصيل للمفهوم الذاتي لحدود الكلمة؛ فهي في جوهرها تبحث أيضاً عن سلاسل فرعية متتالية، ما لم يتم تقييدها بتعابير برمجية إضافية مجهدة تحاكي فحص الحواف يدوياً.
تتفوق دالة FIND في المهام التي تتطلب البحث عن نصوص فرعية مع تجاهل تام لحالة الأحرف باستخدام المعدّل الخاص، أو عندما يرغب الباحث في بدء المسح من إحداثي محدد داخل النص لتجاوز الأجزاء الأولى من السجل. أما دالة INDEXW، فتتميز بالتخصص الدقيق والصلابة الهيكلية في رصد الكلمات؛ فهي لا تحتاج إلى صياغة شروط إضافية للتحقق من الفواصل المحيطة، إذ إن هذه الميزة متجذرة في تصميمها الخوارزمي المباشر، مما يجعل كود INDEXW أكثر إيجازاً وقراءة وأقل عرضة للأخطاء البرمجية في مهام الفرز المعجمي.
عند اتخاذ القرار الأكاديمي والبرمجي لاختيار الأداة الأنسب بين FIND و INDEXW، يجب على الباحث تقييم غاية التحليل: فإذا كان الهدف هو التحقق من اشتمال المتغير على مقطع صوتي أو بادئة فنية في أي موضع، تكون FIND هي الأداة المثالية. أما إذا كان الهدف هو الإحصاء الدقيق لتردد مصطلحات معينة، أو التحقق من وجود كلمات دلالية مستقلة في نصوص الاستبيانات، فإن INDEXW تظل الأداة المنهجية التي تمنع انحياز النتائج وتحافظ على الصدق الداخلي للدراسة الإحصائية.
4.3 التكامل الوظيفي بين دالتي SCAN و INDEXW
بينما تركز دالة INDEXW على تحديد الإحداثي المكاني للكلمة المفردة عبر إرجاع رقم الفهرس، تؤدي دالة SCAN وظيفة مكملة تتمثل في استخراج الكلمة ذاتها بناءً على ترتيبها الرقمي في السلسلة (كالكلمة الأولى، أو الثانية، أو الأخيرة). تمثل العلاقة بين هاتين الدالتين تكاملاً وظيفياً نادراً في خطوة البيانات، حيث تجمع الأولى بين رصد الوجود والموقع، وتوفر الثانية آلية استخلاص المضمون النصي لإعادة استخدامه أو تخزينه في متغيرات منفصلة.
يمكن توظيف التكامل بين SCAN و INDEXW في بناء منظومات تدقيق متقاطعة (Cross-Validation) للبيانات النصية. على سبيل المثال، يمكن استخدام دالة INDEXW للتحقق من أن كلمة مفتاحية تقع في المتن، ثم استخدام دالة SCAN لاستخلاص الكلمة التي تليها مباشرة لتحليل الارتباط اللفظي والسياقي بين المفردات. هذا الأسلوب يُمكّن الباحث من بناء محللات لغوية قاعدية (Rule-Based Parsers) داخل نظام SAS لمعالجة السجلات الطبية والقانونية المعقدة دون الاستعانة ببرمجيات خارجية متخصصة.
علاوة على ذلك، في الحالات التي تتطلب استخراجاً متسلسلاً للكلمات المفتاحية وأجزائها المصاحبة، يُسهم الفهرس العددي المرتجع من INDEXW في توجيه عمليات تقطيع النصوص الفرعية بدقة، بينما تستخدم SCAN لتقسيم الجمل الطويلة إلى مفردات منفصلة في مصفوفات حرفية (Character Arrays). يتيح هذا الدمج المنهجي تحقيق أقصى استفادة من إمكانيات SAS في التعامل مع المصفوفات السريعة، مما يختزل زمن المعالجة ويزيد من كفاءة تدفق البيانات الحسابية. يوضح الجدول المقارن التالي الفروق الجوهرية بين هذه الدوال:
| اسم الدالة | الغاية الوظيفية الأساسية | التعرف التلقائي على حدود الكلمة | القيمة المرجعة |
|---|---|---|---|
| INDEXW | البحث عن موقع كلمة كاملة ومستقلة. | نعم، ذاتياً وعبر المحددات. | رقم صحيح يمثل بداية الكلمة (أو 0). |
| INDEX | البحث عن متتالية فرعية مجردة من المحارف. | لا، يطابق الأجزاء المضمنة. | رقم صحيح يمثل بداية التتابع (أو 0). |
| FIND | بحث متقدم عن سلاسل فرعية مع خيارات توجيهية. | لا، يتطلب معالجة إضافية للحدود. | رقم صحيح يمثل موقع التتابع (أو 0). |
| SCAN | استخراج كلمة أو رمز استناداً لترتيبها التسلسلي. | نعم، يعتمد على محددات التقسيم. | سلسلة نصية تمثل الكلمة المستخرجة. |
5. التطبيق العملي الأساسي: خطوات تنفيذ دالة INDEXW على بيانات فعلية
5.1 إعداد وتجهيز مجموعة البيانات التجريبية
لتطبيق المفاهيم النظرية في إطار عملي واقعي، نبدأ ببناء مجموعة بيانات تجريبية تحاكي الملاحظات الميدانية أو التشخيصات السريرية، مع تعمد تضمين حالات متطابقة كلياً وأخرى متطابقة جزئياً لاختبار دقة الدالة في الفصل والتمييز. نستخدم في لغة SAS أسلوب إدخال البيانات المباشر المضمن داخل شفرة البرنامج عبر عبارة DATALINES أو CARDS ضمن خطوة DATA Step، وهو النهج المعياري لبناء بيئات الاختبار البرمجية القابلة لإعادة التكرار والتدقيق.
يتعين في مرحلة الإعداد تخصيص أطوال المتغيرات النصية صراحة باستخدام عبارة LENGTH، لضمان عدم تعرض النصوص المقتبسة أو السجلات الوصفية للاقتطاع التلقائي عند قراءة الأسطر الأولى. ويراعى في تصميم العينة إدراج نصوص تحتوي على الكلمة المستهدفة في مطلع الجملة، وفي أواسطها، وفي نهايتها، إلى جانب إدراج كلمات مشتقة تحتوي على حروف الكلمة ذاتها لكنها مدمجة في كيانات مورفولوجية أكبر (مثل الكلمات المتصلة بزوائد لاحقة أو بادئة) لإبراز تفوق INDEXW في إهمال تلك الحالات غير المؤهلة.
بعد تجهيز الشفرة وقراءتها، يجري التحقق من استقرار مصفوفة البيانات في جدول SAS المؤقت، والتأكد من عدم وجود أخطاء في تفسير محددات الأسطر أو ترميز المحارف. يضمن هذا التأسيس السليم لعينة الاختبار إمكانية تتبع الأثر الخوارزمي للدالة على مستوى كل سجل بشكل مستقل، ويسهل مطابقة النتائج الحسابية مع التوقعات المعيارية للباحث.
5.2 كتابة وتنفيذ الاستعلام البرمجي داخل خطوة DATA
في هذه المرحلة، ننتقل إلى كتابة كود التنفيذ المباشر داخل خطوة البيانات لاستدعاء دالة INDEXW. نقوم بإنشاء متغيرات عددية جديدة في ناقل البيانات، تسند إليها مخرجات الدالة المباشرة عند فحص السلسلة النصية المصدرية. وتتم كتابة جملة التعيين الرياضية بصياغة واضحة تحدد المتغير المستهدف، تليها الكلمة المراد التفتيش عنها محاطة بعلامات اقتباس، لضمان قيام مترجم SAS بإجراء عملية المطابقة الموضعية لكل صف على حدة أثناء مروره في حلقة المعالجة التلقائية.
يتيح هذا التنفيذ البرمجي اختبار سيناريوهات متعددة بالتزامن؛ حيث يمكن كتابة سطر برمجي يستخدم دالة INDEXW، وبجانبه سطر آخر يستخدم دالة INDEX الكلاسيكية لنفس السلسلة المصدرية ولنفس الكلمة المستهدفة. يهدف هذا التصميم المقارن إلى إثبات التباين الحسابي في النتائج أمام أعين المحلل بصورة فورية، وإظهار الكيفية التي تحمي بها دالة INDEXW النموذج التحليلي من الوقوع في شرك الكلمات الفرعية غير المقصودة.
عقب انتهاء خطوة DATA، يتم استدعاء إجراء الطباعة الإحصائي القياسي PROC PRINT لعرض الجدول المخرج، مع تحديد المتغيرات المستهدفة والمؤشرات الناتجة لتسهيل فحصها. تتيح مخرجات هذا الإجراء تكوين رؤية شاملة حول استجابة الدالة للمواقع المختلفة للكلمات، وتثبت سلامة التنفيذ الحوسبي دون تسجيل أي أخطاء أو تحذيرات سلبية في سجل النظام (SAS Log).
شفرة تمثيلية لخطوة البيانات وتطبيق الدالة:
في هذه الخطوة البرمجية، تُنشأ مجموعة بيانات تحتوي على متغير الملاحظات، ويُحسب موقع كلمة “cat” باستخدام دالتي INDEXW و INDEX لتوضيح الفارق العملي:
DATA text_analysis;
LENGTH narrative $80;
INFILE DATALINES TRUNCOVER;
INPUT narrative $CHAR80.;
pos_indexw = INDEXW(narrative, ‘cat’);
pos_index = INDEX(narrative, ‘cat’);
DATALINES;
the cat is resting on the soft mat.
the publication was a catalog of art.
a stray cat appeared suddenly outside.
scattered clouds covered the cold sky.
;
RUN;
PROC PRINT DATA=text_analysis NOOBS; RUN;
5.3 قراءة وتحليل مخرجات التنفيذ والتحقق من صحتها
عند فحص الجدول المخرج من الشفرة المنفذة أعلاه، نلاحظ أن السجل الأول أرجع فيه المتغير pos_indexw القيمة العددية 5، وهو ما يتطابق فيزيائياً مع موقع حرف “c” في كلمة “cat” المنفصلة الواقعة بعد أداة التعريف ومسافة فارغة. كما أرجع المتغير pos_index القيمة 5 أيضاً، لكون الكلمة ظهرت بصورة نقية ومنفصلة، مما جعل كلا الدالتين تنجحان في التعرف على البداية الصحيحة لنفس الكيان المحرفي في ذلك السجل.
تتضح القوة الحقيقية لدالة INDEXW في السجل الثاني؛ حيث احتوى النص على كلمة “catalog” ولم ترد كلمة “cat” ككيان مستقل. أرجع متغير دالة INDEXW القيمة 0، معلناً بدقة فشل التطابق لغياب الحدود الفاصلة واعترافاً بأن “catalog” كلمة مستقلة بذاتها. في المقابل، أخفقت دالة INDEX الكلاسيكية في هذا التمييز وأرجعت القيمة 23، معتبرة أن بداية المقطع “cat” داخل كلمة “catalog” تطابق إيجابي، وهو الخطأ المنهجي الشائع الذي كان سيشوه التحليل لو تم الاعتماد على الدالة التقليدية وحدها.
وفي السجل الرابع الذي يحتوي على كلمة “scattered”، نجد تكراراً لنفس النتيجة النموذجية: أرجعت INDEXW القيمة 0، متجاهلة مقطع الحروف المتطابق الواقع في جوهر الكلمة الأطول، في حين أرجعت INDEX موقعاً موجباً غير صحيح تحليلياً. يثبت هذا التحليل العملي الموثق بالمخرجات أن دالة INDEXW تمثل صمام أمان لا غنى عنه في بحوث النصوص الإحصائية، حيث توفر استبعاداً صارماً للكلمات المشتقة، وتعطي نتائج عددية قاطعة تعكس الوجود الدلالي الحقيقي للمفردات المفحوصة.
6. تخصيص محددات الفصل (Custom Delimiters) للتعامل مع النصوص غير القياسية
6.1 تعريف المحددات المخصصة وتمريرها في الوسيط الثالث
في كثير من التطبيقات العملية، لا تتبع النصوص الميدانية القواعد الطباعية الكلاسيكية، بل تأتي مفصولة بمحارف اصطلاحية وتقنية تفرضها طبيعة الأنظمة المولدة للبيانات، مثل ملفات السجلات التقنية (Log Files) أو قواعد البيانات العلائقية المصدرة بتنسيقات مخصصة. توفر دالة INDEXW حلاً جذرياً لهذه المعضلة من خلال وسيطها الثالث؛ إذ يمكن للمحلل تحديد قائمة من الرموز المخصصة التي تلغي القائمة الافتراضية، وتجبر الخوارزمية على الانصياع الصارم للرموز المعرفة من قبل المستخدم كحدود وحيدة معترف بها للكلمات.
عند تمرير الوسيط الثالث، تُكتب المحددات المخصصة داخل علامتي اقتباس متتابعة دون مسافات إضافية، ما لم تكن المسافة بحد ذاتها محرف فصل مقصوداً. فإذا رغب الباحث في اعتبار علامة الخط المائل (/) وعلامة الشَرطة الواصلة (-) فقط كحدود معتمدة، يُكتب الوسيط في صيغة ‘/-‘. وفي هذه الحالة، لن تعتبر الدالة علامات الترقيم الأخرى مثل الفاصلة أو النقطة فواصل للكلمات، بل ستعاملها كأحرف متصلة تنتمي لمتن الكلمة ذاتها، ما يمنح المحلل تحكماً كاملاً في ميكانيكية التقطيع والتنقيب المعجمي.
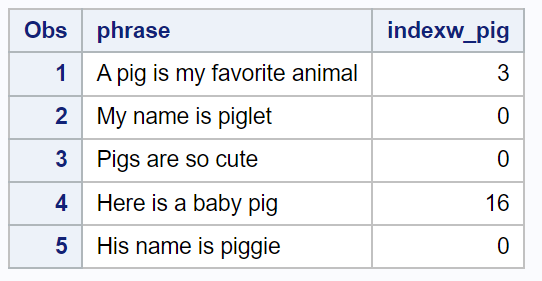
يتيح هذا التخصيص تجنب التشويش في مجموعات البيانات التي تحتوي على مصطلحات علمية أو أكواد منتجات تتضمن رموزاً مدمجة. فمن خلال تحديد الفواصل الحقيقية بدقة، نضمن ألا تنشطر الكودات المعقدة إلى شظايا عشوائية تتسبب في مطابقات زائفة، ونحافظ على وحدة الكلمات المفتاحية في بيئات عمل تتسم بالتنوع الهيكلي والتباين اللغوي الحاد.
6.2 معالجة النصوص المحتوية على علامات ترقيم معقدة ومتعددة
تواجه عمليات معالجة النصوص تحديات متزايدة عند التعامل مع بيانات تحتوي على علامات ترقيم متداخلة ومعقدة، كالنصوص القانونية التي تعتمد على الترقيم الهرمي بالأقواس المعقوفة، أو السجلات النصية التي تحيط فيها علامات الاقتباس المفردة والمزدوجة بالكلمات الهامة. في مثل هذه الظروف، قد يؤدي استخدام المحددات الافتراضية وحدها إلى استبعاد بعض الكلمات الحيوية أو إساءة تفسير نهاياتها، خاصة إذا تداخلت علامات الاقتباس مع الفواصل المنقوطة دون مسافات بيضاء تفصل بينها وبين المتن.
لتفكيك هذه النصوص المعقدة برمجياً، يلجأ مبرمج SAS إلى توسيع قائمة المحددات المخصصة لتشمل كافة الاحتمالات الواردة في العينة النصية. يتم إدراج الرموز الخاصة مثل علامة الأت (@)، وعلامة الشباك (#)، وعلامات التساوي، ومختلف صيغ الأقواس ضمن الوسيط الثالث. وبفضل خوارزمية الدالة التي تعتبر أي من هذه الرموز حاجزاً قطبياً فاصلاً، يتم تجريد الكلمات المحاطة بالأقواس أو المقتبسة تلقائياً، والتعامل مع متنها ككلمة مستقلة جاهزة للمطابقة مع المقتطف المبحوث عنه.
تضمن هذه الاستراتيجية المتقدمة فحص السجلات المعقدة دون الإخلال بالبنية الدلالية للنصوص ودون الحاجة لتنفيذ استبدالات متعددة وشاقة باستخدام دالة TRANWRD المكلفة زمنياً. يتم عزل الكلمة المستهدفة بسلاسة حتى لو كانت محاطة بعدة طبقات من الفواصل الرمزية، مما يجعل عملية الفهرسة النصية ذات اعتمادية فائقة وقادرة على معالجة البيانات النصية الخام كما هي دون تنظيف أولي جائر قد يغير ملامحها الأصلية.
6.3 التعامل مع النصوص الفنية والبيانات المهيكلة جزئياً
تعتبر السجلات الفنية، مثل عناوين البريد الإلكتروني، وعناوين بروتوكول الإنترنت (IP Addresses)، ومسارات الأدلة البرمجية، وسجلات الأخطاء البرمجية (Server Logs)، من أكثر صيغ البيانات شبه المهيكلة شيوعاً في التحليلات الحديثة. في هذه السجلات، تتراص المفردات والرموز الرقمية دون أي مسافة بيضاء تقليدية، معتمدة على الفواصل والشرطات المائلة لترسيم المكونات الفرعية للسلسلة الكلية المخزنة في النظام.
من خلال دالة INDEXW والمحددات المخصصة، يمكن للمبرمج البحث عن أسماء نطاقات محددة داخل عناوين بريد إلكتروني، أو استخراج أجزاء معينة من مسارات الملفات عبر اعتبار النقطة وعلامة الأت محددات فصل حصرية. فلو حددنا الوسيط الثالث بقيمة ‘@.’، فستتمكن الدالة من معاملة اسم المستخدم واسم الشركة ونطاق الدولة ككلمات منفصلة ومستقلة، مما يتيح التفتيش عن كلمة مؤسسية بعينها داخل العنوان دون أي تداخل مع الكلمات الأخرى المكونة له.
ينطبق هذا النموذج بفاعلية مطلقة على السجلات الطبية والمخبرية المقننة وفق تشفيرات قياسية مثل ICD أو LOINC، حيث تتجاور الأكواد التشخيصية وتفصل بينها فواصل منقوطة أو خطوط عمودية. يتيح استخدام الدالة مع المحددات المخصصة رصد كود تشخيصي كامل وتحديد موقعه الدقيق في السجل التاريخي للمريض بسرعة مذهلة، متفوقاً على تقنيات الفهرسة البطيئة، وموفراً مؤشرات إحصائية دقيقة تدعم اتخاذ القرارات السريرية وتغذي قواعد البيانات التحليلية الكبرى.
7. إدارة حساسية حالة الأحرف (Case Sensitivity) والتطبيع النصي
7.1 تأثير حالة الأحرف اللاتينية على تطابق الكلمات في INDEXW
تتسم دالة INDEXW في تصميمها القياسي بالحساسية الصارمة لحالة الأحرف اللاتينية (Case-Sensitive Matching)؛ حيث تعتمد على المقارنة البايتية والترميزية الدقيقة للأرقام الثنائية الممثلة للمحارف في جدول التشفير المعتمد (سواء كان ASCII أو EBCDIC أو UTF-8). وبناءً على هذا التطابق الحرفي الصارم، يختلف الحرف الكبير (Uppercase) جوهرياً عن الحرف الصغير المقابل له (Lowercase) في المنظور الخوارزمي للدالة، مما يجعل أي اختلاف في حالة الحرف الواحد مانعاً حسابياً لاكتمال التطابق.
يترتب على هذه الطبيعة الصارمة مخاطر تحليلية جسيمة عند التعامل مع نصوص واقعية كتبها مستخدمون أو دونت في ظروف ميدانية غير موحدة. فالكلمات التي تقع في بداية الجمل عادة ما تُكتب بحرف استهلالي كبير، في حين تُكتب الكلمة ذاتها في منتصف النص بحروف صغيرة بالكامل، وقد تُكتب أحياناً بحروف كبيرة للتوكيد. فإذا تم البحث عن الكلمة بصيغتها الصغيرة فقط، ستفقد الدالة كافة الحالات التي وردت فيها بحرف كبير، مما يؤدي إلى انحياز إحصائي ناجم عن النقص المصطنع في تردد الكلمات وتشويه نسب التواجد الحقيقية.
يبرز هذا التحدي أهمية إخضاع النصوص لعمليات المعايرة والنمذجة قبل الاعتماد على مخرجات المطابقة النصية. يجب على الباحث أن ينطلق من فرضية أن البيانات النصية الخام تحتوي على تباينات عشوائية في كتابة الأحرف، وأن الاعتماد على الدالة بصورتها المجردة دون ضبط لمعايير الأحرف الكبيرة والصغيرة سيقود حتماً إلى فقدان قدر كبير من المعلومات القيّمة، مما يقتضي دمج تقنيات التطبيع النصي المنهجي في خطوة البيانات.
7.2 الدمج المنهجي مع دوال التطبيع UPCASE و LOWCASE
للتغلب المنهجي على عقبة حساسية الأحرف وتأمين تطابق شامل دون تفويت السجلات المتفاوتة في التنسيق، يدمج مبرمجو SAS دالة INDEXW مباشرة مع دوال التطبيع والتحويل الحرفي؛ وأبرزها دالة UPCASE (لتحويل النصوص إلى حروف كبيرة) أو دالة LOWCASE (لتحويلها إلى حروف صغيرة). يتمثل هذا الأسلوب في تطبيق دالة التطبيع على كل من السلسلة المصدرية ومقتطف البحث المستهدف في آن واحد داخل نفس جملة الاستدعاء البرمجية.
تتم الصياغة النموذجية لهذه التقنية بتمرير السلسلة المصدرية مغلفة بدالة UPCASE كمعامل أول، وتمرير الكلمة المستهدفة مغلفة بالدالة ذاتها (أو مكتوبة بحروف كبيرة صراحة) كمعامل ثانٍ. على سبيل المثال، تؤدي الصياغة INDEXW(UPCASE(source_var), ‘TARGET’) إلى توحيد الغطاء المحرفي للنص بالكامل في الذاكرة اللحظية قبل إجراء المطابقة الخوارزمية، مما يضمن رصد الكلمة بصرف النظر عن هيئتها الأصلية (سواء كانت Target، أو target، أو TARGET).
الميزة البنيوية الفريدة لهذا الدمج المنهجي هي الحفاظ التام على الفهرس المكاني الصحيح لبداية الكلمة؛ إذ إن تحويل حالة الحرف في اللغات اللاتينية لا يغير من عدد البايتات أو الإحداثي الحسابي للمحرف داخل السلسلة في ترميز ASCII القياسي. وبالتالي، تُرجع الدالة الموقع الحقيقي للكلمة في النص الأصلي دون أي تزحزح مكاني، مما يتيح للباحث تصنيف السجلات واستخراج الجمل المحيطة بالكلمة المستهدفة بدقة متناهية ودون أي قلق بشأن القيود الحرفية المسبقة.
7.3 تطبيقات معالجة اللغات التي لا تتأثر بحالة الأحرف (مثل اللغة العربية)
على خلاف اللغات اللاتينية، تنفرد اللغة العربية بخصائص هيكلية ومورفولوجية مميزة؛ فهي لغة لا تعرف التمييز بين الأحرف الكبيرة والأحرف الصغيرة، إلا أنها تواجه تحديات تطبيعية موازية ترتبط ارتباطاً وثيقاً بتباين كتابة أشكال الحروف والهمزات، ووجود علامات التشكيل وحركات المد والتطويل (الكشيدة). في بيئة SAS المجهزة بترميزات متطورة مثل UTF-8، تتطلب معالجة النصوص العربية بدالة INDEXW فهماً دقيقاً لكيفية استقرار المحارف في الذاكرة الحسابية.
تمثل الهمزات والألف المتطرفة (مثل الاختلاف بين أ، إ، آ، ا، والألف المقصورة ى والياء ي) العائق الأبرز أمام اكتمال المطابقة في دالة INDEXW. فإذا بحثت الدالة عن كلمة “إحصاء” بينما كُتبت في السلسلة النصية “احصاء” دون همزة، فإن الاختلاف البايتي والرمزي بينهما سيعامل رياضياً كعدم تطابق تام، وسترجع الدالة القيمة صفر. لذلك، يسبق استدعاء دالة INDEXW في البيئات العربية تطبيق دوال التنظيف والتجريد الحرفي المخصصة، لتوحيد كتابة الهمزات وإزالة التشكيل وحركات المد مسبقاً.
إضافة إلى ذلك، يجب مراعاة أن دالة INDEXW تعتمد على البايتات في حوسبة المواقع، وفي ترميزات المحارف متعددة البايت (Multi-Byte Encodings) مثل UTF-8، قد يشغل الحرف العربي الواحد بايتين في الذاكرة. ولتفادي أي اضطراب في احتساب المواقع المحرفية في مجموعات البيانات العربية الضخمة، يُنصح باستخدام النسخ الداعمة للتوطين اللغوي مثل الدالة الشقيقة KINDEXW المصممة للتعامل مع المحارف متعددة البايت، مما يضمن دقة الفهرسة واستقرار خوارزميات الاستخراج النصي للمفردات العربية المنفصلة.
8. معالجة الأخطاء الشائعة وإدارة الحالات الحدية (Edge Cases)
8.1 التعامل مع النصوص الفارغة والقيم المفقودة (Missing Values)
تُعد معالجة القيم المفقودة (Missing Values) والنصوص الفارغة إحدى أهم ركائز البرمجة الدفاعية (Defensive Programming) في بيئة SAS الإحصائية. عند تمرير متغير نصي يحتوي على قيمة مفقودة كمعامل أول في دالة INDEXW، تتفاعل الخوارزمية مع هذه الحالة باحتساب السلسلة ذات طول صفري، وبالتالي تفشل عملية المطابقة فورياً وترجع الدالة القيمة الصفرية دون التسبب في إيقاف البرنامج أو إطلاق خطأ قاتل يؤدي لانهيار خطوة معالجة البيانات.
غير أن المشكلة المنطقية الأخطر تبرز عند تمرير قيمة فارغة كمعامل ثانٍ (أي عند محاولة البحث عن كلمة مستهدفة مفقودة). في هذه الحالة، لا تجد الخوارزمية أي نمط محرفي للمطابقة، وقد يؤدي ذلك إلى إرجاع القيمة صفر بصورة مضللة توحي بفشل العثور على الكلمة بينما المشكلة تكمن في غياب مقتطف البحث ذاته. في بعض السيناريوهات البرمجية التي تشتمل على استدعاءات ديناميكية مشتقة من متغيرات موازية، قد يؤدي غياب الكلمة إلى استهلاك دورات معالجة غير منتجة وتشويه نتائج الفهرسة العامة.
لتفادي هذه الأخطاء الحدية، يُوصى دوماً بتضمين فحوصات مسبقة باستخدام دوال التحقق من الفراغ مثل دالة MISSING أو دالة CALL MISSING قبل استدعاء INDEXW. يتيح هذا النهج استبعاد السجلات غير المؤهلة مبكراً أو معالجتها ضمن مسار استثنائي مخصص، مما يحافظ على نظافة سجل التنفيذ (Log) من التحذيرات التشغيلية، ويمنع تضخيم مصفوفات النتائج ببيانات غير مفيدة قد تؤثر على جودة التحليل الإحصائي اللاحق.
8.2 التعامل مع الكلمات المكررة وتحديد أول ظهور
من القواعد البنيوية الأساسية التي تحكم عمل دالة INDEXW أنها تقتصر وظيفياً على تحديد موقع أول ظهور فقط للكلمة المستهدفة داخل السلسلة النصية المصدرية. فإذا وردت الكلمة المفحوصة ثلاث أو أربع مرات في نفس الملاحظة، فإن الدالة ترجع فهرس البداية للتكرار الأول الواقع في أقصى يسار النص، ثم توقف خوارزمية البحث دون الالتفات إلى المواضع التالية أو إحصاء العدد الإجمالي لتكرار المفردة داخل السجل الواحد.
يفرض هذا السلوك المحدد تحدياً برمجياً إذا كان الغرض الإحصائي من البحث هو تقدير كثافة التكرار (Term Frequency) للكلمة داخل الوثيقة، أو معرفة كافة المواضع التي وردت فيها المفردة لتحليل تباعد المسافات الدلالية. لا يمكن لمرة واحدة من استدعاء INDEXW حل هذه المسألة، بل يتطلب الأمر بناء حلقة تكرارية برمجية (Iterative DO Loop) تتضافر فيها الدالة مع دوال التقطيع مثل SUBSTR للتقدم في فحص السلسلة النصية بعد كل تطابق مرصود وتتبع كافة التكرارات التالية بشكل تسلسلي منظم.
تعتمد خوارزمية تعقب التكرارات على أخذ الموقع المرجع من INDEXW كنقطة انطلاق، ثم استقطاع الجزء المتبقي من السلسلة الذي يلي تلك الكلمة لإعادة فحصه بدورة جديدة للدالة، مع مراعاة جمع الإحداثيات السابقة تراكمياً لتحديد المواقع الحقيقية في السلسلة الأصلية. هذا الهيكل التكراري يسمح برصد الظهور المتعدد للكلمة وتخزينه في مصفوفات (Arrays) دون فقدان أي موضع، مما يوسع من آفاق استخدام الدالة في مهام التحليل المعجمي المتقدم.
8.3 إدارة المساحات الإضافية والمسافات البيضاء المخفية
تمثل المساحات الإضافية غير المرئية، مثل المسافات المزدوجة المتتالية، ومحارف الجدولة (Tabs)، ومحارف نهاية السطور والرجوع لبداية السطر (Carriage Returns / Line Feeds) الناتجة عن استيراد النصوص من مصادر متعددة، أحد أكبر مصادر الخلل في عمليات الفهرسة المحرفية. على الرغم من أن دالة INDEXW تعامل المسافات المتعددة افتراضياً كفواصل، إلا أن الرموز المخفية الأخرى قد لا تصنف تلقائياً كمحددات قياسية، مما يمنع الدالة من رؤية حدود الكلمات بصورة صحيحة.
تتجلى أفضل الحلول البرمجية لهذه المشكلة في توظيف دوال التنظيف النصي التمهيدي مثل دالة COMPBL (التي تختزل المساحات المتعددة إلى مسافة مفردة واحدة) ودالة STRIP أو TRIM (لحذف المساحات البادئة واللاحقة وتجريد السلسلة من الشوائب الطرفية). كما يمكن الاستعانة بدالة COMPRESS مع خيارات خاصة لحذف علامات الجدولة والرموز غير المطبوعة، وإحلال مسافات معيارية محلها قبل إخضاع النص المصدر لعمليات الفحص والتحليل بدالة INDEXW.
يسهم هذا الإعداد المنظم في إزالة التشتت الرمزي المخفي، ويضمن أن تكون كل مسافة فاصلة داخل النص هي مسافة حقيقية تدركها الخوارزمية، مما يحول دون فشل المطابقات في سجلات البيانات المستوردة من نماذج الويب وصفحات PDF المعقدة. تتيح هذه الممارسة حماية تقارير الفهرسة الإحصائية من العيوب غير الظاهرة وتضمن دقة القياسات المكانية المستخرجة للمفردات.
9. تطبيقات متقدمة: دمج دالة INDEXW في الفلترة وتصنيف البيانات
9.1 توظيف INDEXW كشرط منطقي داخل عبارات IF-THEN و WHERE
ينطوي توظيف دالة INDEXW كمعامل شرطي داخل عبارات الفلترة مثل IF-THEN و WHERE على كفاءة تحليلية هائلة في بيئة SAS. نظراً لأن الدالة ترجع رقماً موجباً عند العثور على الكلمة المستهدفة والقيمة صفر عند عدم العثور عليها، فإن هذا المخرج يترجم ضمنياً داخل منطق SAS البولياني إلى قيمتي الصواب والخطأ (True/False) دون الحاجة إلى كتابة شروط مقارنة إضافية مثل IF INDEXW(…) > 0، مما يجعل الشفرة البرمجية غاية في الأناقة والسرعة.
تستخدم هذه التقنية بصورة واسعة في عزل وتصفية السجلات المؤهلة للدراسة الإحصائية؛ كأن يقوم المحلل بفلترة عينة ضخمة من المقابلات واستخراج الحالات التي وردت فيها مفردة محددة تهم الباحث فقط باستخدام جملة التصفية WHERE INDEXW(interview_notes, ‘Eligible’). يضمن هذا الأسلوب استبعاد كافة السجلات غير ذات الصلة قبل الدخول في مراحل المعالجة المعقدة، مما يوفر جهداً حوسبياً كبيراً ويسرع من زمن تنفيذ العمليات والتقارير الإحصائية المعتمدة عليها.
وعند مقارنة هذا النهج بعوامل التشغيل النصية الكلاسيكية مثل معامل LIKE في لغة SQL أو عبارات التطابق الفرعي، نجد أن دالة INDEXW تتفوق بشكل حاسم في منع الإيجابيات الكاذبة؛ حيث إن معامل LIKE ‘%word%’ سيطابق كافة الكلمات المشتقة والمضمنة، مما يربك نتائج الفلترة ويدخل صفوفاً غير مستوفية للشروط الدلالية. في المقابل، توفر INDEXW فحصاً نقياً وحدودياً يحفظ دقة العينات الإحصائية وتجانسها المنهجي.
9.2 تصنيف المتغيرات النوعية وترميز الاستجابات النفسية والاجتماعية
في البحوث النفسية والاجتماعية التي تستند إلى جمع البيانات الميدانية من خلال الأسئلة المفتوحة أو تفريغ جلسات التركيز الحوارية (Focus Groups)، تمثل عملية الترميز النوعي (Qualitative Coding) عبئاً تحليلياً كبيراً إذا ما نُفذت يدوياً. توفر دالة INDEXW إمكانية أتمتة هذه العملية برمتها داخل خطوة DATA، من خلال بناء شجرة شروط وقرارات تصنف الاستجابات تلقائياً إلى متغيرات فئوية ذات أوزان رقمية محددة.
يمكن للمبرمج كتابة منظومة شروط برمجية متتالية تفحص ظهور كلمات مفتاحية تعبر عن مشاعر محددة (مثل: راضٍ، قلق، محبط، متحمس) بصفتها مفردات مستقلة، ثم إسناد رمز رقمي محدد لكل فئة في متغير جديد. وبفضل دقة الدالة في تجاهل المقاطع العرضية المضمنة، يتأكد الباحث من أن التشفير الممنوح يعكس النية الحقيقية للمبحوث وليس تداخلاً لغوياً عشوائياً، مما يمكنه من بناء مقاييس إحصائية متدرجة تقيس شدة الاتجاهات والآراء بسرعة وموثوقية بالغة.
تتيح هذه الأتمتة تحويل آلاف الصفحات النصية غير المهيكلة إلى جداول تكرارية ونسب مئوية يمكن معالجتها في إجراءات التحليل المتعدد (Multivariate Analysis) ونماذج الانحدار اللوجستي. وبذلك تسهم دالة INDEXW في ردم الفجوة بين التحليل النصي الكيفي والتحليل الإحصائي الكمي، موفرة أداة جسرية تجمع بين رصانة الفحص اللغوي وسرعة الحوسبة الرقمية في لغة SAS.
9.3 استخراج وتجزئة البيانات النصية بالاشتراك مع دالة SUBSTR
تتجاوز قدرات دالة INDEXW مجرد التحقق من وجود الكلمة أو ترشيح السجلات لتصل إلى توجيه خوارزميات الاستخراج النصي السياقي (Contextual Extraction)، وذلك عند اقترانها المتزامن مع دالة استقطاع السلاسل الفرعية SUBSTR. تتيح القيمة المرجعة من INDEXW تحديد الموقع الدقيق لبداية الكلمة المفتاحية، مما يجعل هذا الفهرس إحداثياً مرجعياً يمكن استخدامه كنقطة انطلاق لاقتطاع جمل كاملة أو مصطلحات مرافقة تحيط بالكلمة لدراسة السياق الدلالي المحيط بها.
في التطبيقات التحليلية المتقدمة، قد لا يكتفي الباحث برصد المفردة بل يرغب في استخراج الكلمات العشرين التالية لها لتحليل مبررات المستجيبين أو قراءة التوصيف التشخيصي المرافق. يتم ذلك بتمرير القيمة المرجعة من INDEXW كمعامل بداية في دالة SUBSTR، مع تحديد الطول المطلوب اقتطاعه، كما يمكن طرح رقم محدد من الفهرس للرجوع إلى الوراء واقتطاع النص الذي يسبق الكلمة المستهدفة أيضاً، مما يشكل إطار عمل متكاملاً لتحليل المتون والمحتوى اللغوي.
يسهم هذا الأسلوب التكاملي في بناء مصفوفات استخراج متطورة تغذي خوارزميات تحليل المشاعر (Sentiment Analysis)؛ حيث يتم استخراج البيئة النصية الدقيقة المجاورة للكلمة المفتاحية واستبعاد الحشو البعيد في الملاحظات الطويلة. يقلل هذا التركيز السياقي من الضجيج النصي ويوفر لنماذج التصنيف التلقائي وحدات دلالية مركزة ترفع من كفاءة التنبؤ والتعميم الإحصائي. توضح الشفرة المرفقة كيفية توظيف هذا التكامل برمجياً:
تطبيق استخراج السياق النصي باستخدام INDEXW و SUBSTR:
DATA text_extraction;
LENGTH full_text $200 extracted_con\text$60;
full_text = “The clinical trial showed positive reaction in phase two testing.”;
target_pos = INDEXW(full_text, ‘reaction’);
IF target_pos > 0 THEN DO;
/* استخراج الكلمة مع 25 محرفاً تليها لقراءة السياق */
extracted_context = SUBSTR(full_text, target_pos, 25);
END;
RUN;
PROC PRINT DATA=text_extraction; RUN;
10. أفضل الممارسات البرمجية وتحسين كفاءة الأداء في مجموعات البيانات الضخمة
10.1 تحسين استهلاك الذاكرة ووقت المعالجة في SAS
عندما تتعامل منظومات SAS مع بيئات البيانات الضخمة التي تحتوي على مئات الملايين من السجلات المأخوذة من أنظمة مصرفية أو سجلات اتصالات، تصبح كفاءة المعالجة الحوسبية واستغلال الذاكرة المؤقتة مسألة حيوية تمس الجدوى الاقتصادية والتشغيلية للمشروع التحليلي بأكمله. إن استدعاء الدوال النصية ملايين المرات يستهلك دورات معالج مركزية (CPU Cycles) ملحوظة؛ ولذلك ينبغي ضبط استدعاء دالة INDEXW بأعلى درجات الترشيد الهندسي لتفادي أي هدر تشغيلي غير مبرر.
من أهم الاستراتيجيات المتبعة في هذا الصدد تقليل أطوال المتغيرات النصية إلى الحدود الحقيقية المطلوبة باستخدام عبارة LENGTH بدلاً من ترك النظام يخصص الأطوال الافتراضية الكبيرة للمتغيرات النصية. فكل بايت إضافي فارغ في السلسلة النصية يتطلب فحصاً وقراءة من الخوارزمية، مما يؤدي إلى تراكم التأخير الزمني عبر ملايين العمليات المتسلسلة. كما يُنصح بشدة بتنفيذ شروط الفلترة المسبقة لاستبعاد السجلات الخالية أو غير المؤهلة قبل الشروع في استدعاء الدوال النصية المعقدة، لتقليص حجم البيانات المعالجة داخل ناقل البيانات (PDV) إلى أضيق نطاق ممكن.
إضافة إلى ذلك، ينبغي تجنب الاستدعاء المتكرر لنفس الدالة داخل خطوة البيانات ذاتها؛ فبدلاً من استدعاء INDEXW عدة مرات داخل جمل شرطية منفصلة لفحص وجود نفس الكلمة، يُفضل استدعاؤها مرة واحدة وتخزين النتيجة في متغير رقمي وسيط، ثم استخدامه لاحقاً في كافة المقارنات والتفرعات الشرطية التالية. هذا التكتيك البرمجي البسيط يوفر آلاف دورات المعالجة ويقلل زمن التشغيل بنسب ملحوظة في مشاريع البيانات الكبرى.
10.2 معايير التوثيق الأكاديمي والبرمجي لكود معالجة النصوص
تمثل قابلية إعادة الإنتاج العلمي (Scientific Reproducibility) معياراً لا غنى عنه في الأبحاث الأكاديمية والتحليلات الإحصائية الموثوقة. ومن هذا المنطلق، يتعين على مبرمج SAS توثيق شفرات معالجة النصوص المصاحبة لدالة INDEXW بأسلوب تحليلي رصين يشرح المسوغات المنهجية المتبعة؛ كأن يوضح التعليق البرمجي سبب اختيار كلمة بحث محددة، والأساس المنطقي لاستبعاد المرادفات الأخرى، أو توضيح التداعيات الإحصائية لفصل متغيرات معينة دون غيرها.
يبرز التوثيق بأهمية مضاعفة عند استخدام المعامل الثالث لتمرير محددات فصل مخصصة. يجب على الباحث تبرير اختيار الرموز المحددة في التعليقات البرمجية، وتوضيح كيفية تأثير هذه المحددات على بنية السجلات المستهدفة، لضمان أن يفهم المحللون والمدققون اللاحقون سبب استبعاد أو تضمين بعض الرموز كالشرطات أو الفواصل. هذا التوثيق يمنع سوء الفهم ويضمن استمرارية المشروع البرمجي عند مراجعته من قبل لجان التحكيم العلمي أو فرق العمل الرقابية.
علاوة على ذلك، ينبغي صياغة الشفرات البرمجية بأسلوب بنائي معياري (Modular Coding) يعتمد على تسميات متغيرات دلالية تعبر عن فحواها، مثل استخدام بادئات تشير لنوع المؤشر المستخرج (مثل: flag_ أو pos_). يسهل هذا النهج المنظم قراءة الجداول وتكاملها مع برمجيات التحليل الإحصائي الأخرى، ويضفي طابعاً من الرصانة المؤسسية على العمل التحليلي بكامله.
10.3 خطوات التحقق من الجودة والاختبار الدوري (Unit Testing)
لا تكتمل منظومة البرمجة الإحصائية المتقدمة دون إرساء بروتوكول صارم لاختبارات الجودة والتحقق الدوري (Unit Testing) لكافة أكواد الفحص النصي. يجب على المحلل إنشاء مجموعات بيانات اختبار قياسية مخصصة (Test Datasets) تشتمل عمداً على كافة الحالات المتطرفة والشاذة؛ كالسجلات الفارغة، والسلاسل المحتوية على فواصل متتالية، والنصوص ذات الأحرف المتباينة، والكلمات المكررة، لاختبار ردود فعل دالة INDEXW والتأكد من انطباق التوقعات النظرية على المخرجات الحوسبية.
تشمل خطوات التحقق مراجعة سجل الأخطاء في لغة SAS (SAS Log) بدقة شديدة بعد كل تشغيل تجريبي، والتحقق من عدم وجود أي رسائل تفيد بإجراء تحويلات قسرية للبيانات من أنماط عددية إلى محرفية أو العكس، فضلاً عن التأكد من خلو السجل من تحذيرات اختصار النصوص (Truncation Warnings). إن النظافة التامة لسجل النظام تمثل الشهادة الأولى على سلامة الصياغة النحوية والمنطقية للكود البرمجي المكتوب.
وأخيراً، في التطبيقات الحساسة كالتجارب السريرية للدواء، يُستحسن إجراء مقارنات متقاطعة بين مخرجات دالة INDEXW ومخرجات دوال التعبير النمطي المتقدمة في SAS مثل دالة PRXMATCH على عينة عشوائية من السجلات. تتيح هذه المقارنة المعيارية التأكد من أن الفهرسة المستندة إلى INDEXW لم تتأثر بأي محرف خفي غير متوقع، وتؤكد وصول المنظومة البرمجية إلى أعلى مراتب الدقة والموثوقية قبل إطلاقها النهائي في خطوط الإنتاج والتحليل الإحصائي المعتمد.
خاتمة
استعرض هذا الدليل التأصيلي والشامل الأبعاد الرياضية والمنهجية والتطبيقية لدالة INDEXW في لغة SAS، مبرزاً مكانتها المتفردة كأداة لا غنى عنها في المعالجة الرصينة للبيانات النصية غير المهيكلة وشبه المهيكلة. ومن خلال التمييز الصارم بين مفهوم السلاسل النصية الفرعية المجردة ومفهوم الكلمات المستقلة القائمة على حدود لغوية واضحة، تقدم هذه الدالة للمحللين والإحصائيين حلاً فعالاً لتفادي الإيجابيات الكاذبة التي تلازم دوال الفحص التقليدية، مما يؤمن سلامة التحليلات الوصفية والاستدلالية.
تتجلى قوة الدالة في مرونتها النحوية الفائقة؛ بدءاً من تطبيق المحددات الافتراضية التي تلائم النصوص القياسية، مروراً بالقدرة على تخصيص الفواصل في الوسيط الثالث لإدارة النصوص الفنية المشفرة والسجلات الطبية المعقدة، ووصولاً إلى إمكانية دمجها المنهجي مع دوال التطبيع والتنظيف والتقطيع لتجاوز تحديات حساسية الأحرف وإدارة الحالات الحدية بكفاءة استثنائية. وبتطبيق أفضل الممارسات البرمجية واختبارات الجودة الدورية، تتحول دالة INDEXW إلى ركيزة يعتمد عليها في بناء نظم الفلترة المتقدمة وأتمتة التصنيف النوعي في مجموعات البيانات الضخمة بأقل استهلاك ممكن لموارد الذاكرة والحوسبة.
المراجع
- Cody, R. (2018). Cody’s Data Cleaning Techniques Using SAS (3rd ed.). SAS Institute.
- Delwiche, L. D., & Slaughter, S. J. (2019). The Little SAS Book: A Primer (6th ed.). SAS Institute.
- Horstman, D. W. (2017). Character Functions in SAS: Moving Beyond the Basics. SAS Global Forum Proceedings.
- SAS Institute Inc. (2020). SAS 9.4 Functions and CALL Routines: Reference (5th ed.). SAS Institute Inc.
- Tushinski, J. (2016). Working with Character Data in SAS: From First Steps to Advanced Parsing. Lex Jansen SAS Publications.