
تُمثّل بيئة نظام التحليل الإحصائي (SAS) أحد أرسخ النظم البرمجية وأكثرها موثوقية في مجالات الإحصاء التطبيقي، والمعالجة المتقدمة للبيانات، والبحوث السلوكية والطبية الحيوية عبر العقود الأخيرة. ومنذ انطلاق هذا النظام في أواخر ستينيات القرن العشرين ضمن أروقة جامعة ولاية كارولاينا الشمالية (North Carolina State University) عبر جهود رواد الحوسبة الإحصائية، ارتبطت كفاءته بآلية عمل «خطوة البيانات» (DATA Step) وقدرتها الفائقة على معالجة السجلات المعقدة والضخمة تدفقياً بكفاءة عالية واستهلاك مدروس لموارد الذاكرة.
في قلب هذه المعمارية التشغيلية تقع مجموعة من المتغيرات الداخلية التي يُنشئها المترجم البرمجي ويديرها بصورة آلية دون تدخل صريح من المستخدم، ويأتي في مقدمتها المتغير التلقائي الفريد _N_. لا يُمثل هذا المتغير مجرد رقم عابر، بل هو بوصلة التحكم ومؤشر التكرار التنفيذي الذي يُتيح للباحثين والمحللين ضبط مسارات المعالجة، وترقيم الحالات، وتصفية العينات، والتحقق من سلامة البنى البيانية على نحو بالغ الدقة والصرامة الإجرائية.
يسعى هذا المقال المرجعي المستفيض إلى تقديم دراسة معمقة وتأصيلية لطبيعة المتغير _N_ وآليات عمله داخل متجه بيانات البرمجة (Program Data Vector)، مستعرضاً أبعاده المفاهيمية، والفروق الدقيقة بينه وبين مؤشرات الرصد الأخرى، تليها ثلاثة أمثلة تطبيقية نموذجية تتناول استخراج الملاحظة المفتاحية الأولى، واستقطاب عينة فرعية من أولى الملاحظات لترشيد موارد الحوسبة، وتأسيس معرّف رقمي تسلسلي ثابت للحالات البحثية في الدراسات الطولية والتجريبية، مع استعراض شامل للأخطاء الشائعة وأفضل الممارسات المنهجية المتبعة أكاديمياً.
1. مقدمة تأصيلية للمتغير التلقائي _N_ في بيئة برمجة SAS
1.1 مفهوم المتغيرات التلقائية ودورها في خطوة البيانات (DATA Step)
تتميز لغة SAS المعيارية بوجود بيئة تنفيذية تعتمد على مرحلتين أساسيتين: مرحلة الترجمة (Compilation Phase) ومرحلة التنفيذ (Execution Phase). وأثناء تأسيس خطوة البيانات (DATA step)، يقوم النظام بإنشاء متغيرات داخلية مؤقتة تُعرف باسم “المتغيرات التلقائية” (Automatic Variables). هذه المتغيرات، مثل _N_ و_ERROR_، تُخلق تلقائياً بواسطة محرك المعالجة دون الحاجة إلى تعريف صريح في جملة الإدخال، وتهدف إلى متابعة وتوجيه الحالة التشغيلية للبرنامج لحظة بلحظة أثناء قراءة البيانات وتطويرها.
من أهم الخصائص التشغيلية لهذه المتغيرات التلقائية أنها تُعد مقيمة بصفة حصرية داخل الذاكرة الوسيطة المعروفة باسم متجه بيانات البرمجة (Program Data Vector – PDV). ونتيجة لذلك، يتم وسم هذه المتغيرات بسمة الإسقاط التلقائي (DROP attribute)، ما يعني أنها لا تُكتب ولا تُخزن بشكل افتراضي ضمن جدول البيانات الناتج أو الملف الإحصائي النهائي المسجل على القرص الصلب، إلا إذا تدخل المبرمج صراحةً لإسناد قيمتها إلى متغير مخصص ومستديم.
تنبع الأهمية المنهجية لهذه المتغيرات من قدرتها على تزويد الباحث بآلية دقيقة لمراقبة تدفق المعالجة التكرارية وتوجيه مسارات القرارات المنطقية. فمن خلالها، يستطيع المحلل رصد التحولات، وتحديد سلوك الحلقات التكرارية، والتحكم في إخراج السجلات أو إسقاطها استناداً إلى معطيات تنفيذية داخلية تتجاوز نطاق القيم الخام المتضمنة في الأعمدة الأصلية للبيانات المدخلة.
1.2 التعريف الرياضي والبرمجي للمتغير _N_ وآلية توليده
يُعرَّف المتغير التلقائي _N_ برمجياً ورياضياً بأنه عداد داخلي تراكمي يُسجل عدد مرات تكرار تنفيذ حلقة خطوة البيانات (DATA Step Loop Iterations). إن الوظيفة الجوهرية لـ _N_ ليست احتساب عدد الأسطر الفيزيائية في الملف، وإنما رصد الدورات الكاملة التي يقوم بها المترجم عبر كتلة الأوامر البرمجية الممتدة بين عبارتي DATA وRUN، بحيث يعمل كمقياس زمني وتكراري لمسار المعالجة.
تبدأ دورة حياة _N_ عند القيمة الابتدائية الصحيحة (1) مع بدء أول تكرار لمرحلة التنفيذ. ومع وصول مؤشر التنفيذ إلى نهاية التعليمات البرمجية وعودته تلقائياً إلى رأس خطوة البيانات لبدء معالجة جديدة، يزداد المتغير _N_ بمقدار وحدة رياضية واحدة مطردة (أي _N_ = _N_ + 1). وتستمر هذه العملية التراكمية بانتظام ما لم تصطدم المعالجة بعلامة نهاية الملف أو بتعليمات إيقاف قاطعة تُنهي عمل الخطوة كلياً.
تتضح العلاقة بين التكرار البرمجي وقراءة السجلات عند استخدام عبارات القراءة المعتادة مثل عبارة SET؛ ففي الحالات القياسية البسيطة التي تتضمن قراءة سجل واحد لكل تكرار كامل، يتساوق تزايد _N_ خطياً مع تدفق السجلات من المصادر المقروءة، مما يُعطي إيحاءً ظاهرياً بأنه رقم الملاحظة، بينما هو في حقيقته البنيوية تمثيل كمي لعدد الإجراءات التكرارية التي نفذتها الآلة الافتراضية للغة SAS حتى تلك اللحظة.
1.3 الفارق الجوهري بين رقم الملاحظة الفعلي وعدد دورات المعالجة
يقع كثير من المبتدئين في التحليل الإحصائي في خطأ منطقي ناتج عن الخلط بين رقم الملاحظة الفيزيائية (Record/Observation Number) في جدول البيانات، وبين قيمة العداد _N_. صحيح أن التطابق التام بينهما يتحقق في السيناريوهات الخطية القياسية حيث تقرأ عبارة SET ملاحظة واحدة في كل دورة وتُخرجها إلى الجدول الجديد دون إبطاء أو تفريع، إلا أن هذا التماثل ينفرط سريعاً بمجرد تطبيق آليات معالجة متقدمة.
من السيناريوهات الشائعة التي ينفصل فيها _N_ تماماً عن رقم الملاحظة: تضمين جملة قراءة داخلية ضمن حلقة تكرارية صريحة (مثل قراءة عدة سجلات باستخدام عبارة INPUT أو SET متعددة داخل دورة DO واحدة)، أو عند استخدام عبارات الحذف الشرطي (DELETE) التي تمنع كتابة السجل في الجدول النهائي مع استمرار تزايد _N_. ففي هذه الحالات، قد تكون قيمة _N_ قد بلغت (100) بينما لا يحتوي الملف المكتوب فعلياً إلا على (20) ملاحظة، أو العكس في حالات التوليد المتعدد للبيانات عبر أمر OUTPUT التكراري.
يعد الاستيعاب المفاهيمي لهذا التمايز أمراً بالغ الأهمية لتجنب الأخطاء المنطقية الكارثية في معالجة البيانات، لاسيما في القياسات السيكومترية والتحليلات الوبائية؛ إذ قد يؤدي الاعتماد الخاطئ على _N_ كمعادل لرقم الصف إلى اختلال ترتيب القياسات القبلية والبعدية للمشاركين، أو عزل حالات دراسية بطريقة لا تعكس موقعها الفعلي في العينة الميدانية المستهدفة.
2. الميكانيزم الداخلي لخطوة البيانات ودورة حياة المتغير _N_
2.1 مرحلة الترجمة ومرحلة التنفيذ وتأسيس متجه البيانات البرمجية (PDV)
تعتمد هندسة خطوة البيانات في لغة SAS على بناء متجه بيانات البرمجة المعروف اختصاراً بـ (Program Data Vector – PDV) خلال مرحلة الترجمة، وهو المساحة المنطقية المحجوزة في ذاكرة الوصول العشوائي (RAM) التي تُخصص فيها خانات محددة لكل متغير يظهر في نص البرنامج، سواء كان متغيراً مستورداً من ملف خارجي أو ناتجاً عن معادلة حسابية، بالإضافة إلى المتغيرات التلقائية المدمجة.
يقع المتغير _N_ ضمن البنية التحتية لـ PDV، ولكنه يحظى بوضعية معالجة خاصة؛ حيث توضع عليه علامة نظام غير قابلة للتغيير تمنع تصديره إلى المخرجات النهائية. وفي الوقت الذي تخضع فيه المتغيرات العادية لقواعد التصفير (Reset to Missing) عند بداية كل دورة معالجة ما لم يتم تثبيتها بعبارة RETAIN، فإن _N_ لا يخضع للتصفير مطلقاً بل يحتفظ بقيمته ويزيدها تلقائياً عند الرجوع إلى بداية الحلقة البرمجية.
يوفر الـ PDV قناة الربط اللحظية بين عمليات الإدخال والحساب والإخراج، حيث تتجاور خانة _N_ مع المتغيرات الأخرى لتمنح المعالج الإحصائي مرجعية فورية لتقييم الشروط الحسابية والمنطقية؛ مما يتيح للباحث توظيف موقعه الديناميكي لإجراء عمليات تحويلية معقدة قبل اتخاذ قرار تصدير البيانات إلى وسائط التخزين الدائمة.
2.2 ديناميكية تزايد قيمة _N_ مع كل تكرار برمجي
تبدأ ديناميكية التزايد التلقائي لـ _N_ في اللحظة التي يُغلق فيها المترجم دورة التنفيذ السابقة ويبدأ دورة جديدة بالانتقال إلى العبارة الافتتاحية لخطوة البيانات (السطر الذي يحتوي على كلمة DATA). في هذه الجزئية المحددة، يُجري النظام تقييماً أولياً، وتزداد قيمة _N_ تلقائياً بواقع درجة واحدة، لتبدأ معها مرحلة تنفيذ الأوامر المتتالية بالقيم المحدثة للمتغير.
تستمر هذه الديناميكية التكرارية بانسيابية حتى تصل عمليات القراءة إلى نهاية الملف (End-of-File – EOF). فعند محاولة عبارة SET أو INPUT قراءة سجل بعد السجل الأخير دون جدوى، يُصدر محرك الإدخال إشارة نظام توقف فوري لعملية التنفيذ، مما يمنع _N_ من متابعة التزايد ويقود مباشرة إلى إنهاء خطوة البيانات وتفريغ الـ PDV وكتابة البيانات في ملف الـ SAS النهائي، محتفظاً بسجل العمليات التشغيلية في نافذة المراقبة (SAS Log).
يمكن مراقبة هذا التدفق الحركي بدقة متناهية عبر أوامر الإخراج التتبعية مثل استخدام تعليمة PUT لطباعة قيمة _N_ في سجل النظام تزامناً مع كل تحول؛ مما يُتيح للمطور فحص سلوك التكرار بصورة تجريبية ومعاينة استقرار الحلقات ومعرفة النقطة الزمنية البرمجية التي توقفت عندها المعالجة بدقة بالغة.
2.3 سلوك المتغير _N_ عند استدعاء العبارات الشرطية والتكرارية
يحتفظ المتغير _N_ بثبات مطلق لقيمته خلال التكرار الواحد لخطوة البيانات، بغض النظر عن مدى تعقيد التعليمات التكرارية الداخلية مثل حلقات DO، وحلقات DO WHILE، وDO UNTIL. فحتى لو تم تنفيذ حلقة DO داخلية مئة مرة لإجراء حسابات مصفوفية أو محاكاة سيكومترية، فإن _N_ يظل يحمل قيمته المحددة لتلك الدورة ولا يرتفع بمقدار حبة واحدة نتيجة الدوران الداخلي، لأن التزايد منوط حصراً بالدورة الكبرى لخطوة البيانات.
أما على صعيد التفرع الشرطي المعتمد على عبارات IF-THEN/ELSE أو عبارة SELECT، فإن _N_ يعمل كمتغير قياسي يمكن استدعاؤه لتقييم المنطق الإجرائي. فالنظام يقارن قيمة _N_ الحالية بالقيمة المحددة في الشرط؛ وإذا تحقق المعيار، تتجه المعالجة إلى المسار المحدد دون أن يطرأ أي تعديل جانبي على قيمة _N_ ذاتها كأثر رجعي لهذا التقييم المنطقي.
هذا السلوك المستقر يجعل من _N_ ركيزة لا غنى عنها في هندسة تدفقات البيانات المعقدة؛ إذ يتيح للباحث عزل دورات معينة لتنفيذ عمليات محددة (كالتهيئة في الدورة الأولى، أو استخراج نتائج نهائية في دورة معينة)، مع ضمان كامل بأن الحسابات الداخلية وحلقات القياس الصغرى لن تُحدث اضطراباً في المؤشر العام لعدد الدورات الكلية.
3. تجهيز بيئة العمل ومجموعة البيانات التجريبية
3.1 إنشاء مجموعة البيانات التجريبية باستخدام عبارة DATALINES
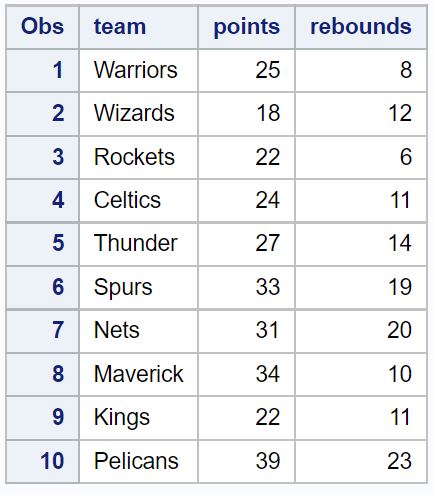
لإجراء التطبيقات العملية والمحاكاة المنهجية بدقة علمية قابلة للتكرار، سنقوم بتأسيس مجموعة بيانات تجريبية تحاكي أداء الفرق الرياضية في دوري كرة السلة، وهي بيانات قياسية تُستخدم بصورة متكررة في الأدبيات التوضيحية لشركة SAS وفي تدريس الإحصاء الرياضي. يحتوي جدول البيانات على ثلاثة متغيرات رئيسية: اسم الفريق (Team)، والنقاط المسجلة (Points)، وإجمالي المتابعات (Rebounds).
يتم بناء جدول البيانات المسمى basketball_data عبر استدعاء خطوة البيانات وتضمين السجلات مباشرة داخل الكود باستخدام عبارة DATALINES (أو CARDS كما كانت تُعرف في النسخ التاريخية الأولى التي وثقها Barr et al. في دليل SAS 76). يُتيح هذا الأسلوب استقلالية الكود وإمكانية تنفيذه الفوري في أي بيئة SAS دون الحاجة إلى ملفات خارجية:
DATA basketball_data;

    INPUT Team $ Points Rebounds;

    DATALINES;

Hawks 102 45

Celtics 110 50

Warriors 125 42

Bulls 95 38

Lakers 118 47

Nets 105 44

Heat 99 41

Suns 112 46

;

RUN;
تُعطينا هذه الأسطر جدولاً متوازناً يحتوي على ثماني ملاحظات، كل ملاحظة تُمثل فريقاً مستقلاً مع قياسين كميين متصلين. تبرز أهمية هذا التمثيل الموحد في توفير أرضية محاكاة منضبطة تسمح بقياس أثر كل تعليمة برمجية نستند فيها إلى _N_ لمعاينة كيفية استجابة النظام وتغير المخرجات باختلاف البنية المنطقية للشروط.
3.2 فحص البنية الهيكلية للبيانات باستخدام إجراء PROC PRINT
عقب إتمام معالجة خطوة إدخال البيانات، تقتضي القواعد الأكاديمية الصارمة فحص المخرجات للتأكد من مطابقة السجلات المقروءة للتصميم المستهدف قبل الشروع في إجراء التحليلات المتقدمة. يُعد إجراء الطباعة الإحصائي PROC PRINT الأداة المعيارية الأولى لفحص محتويات الجدول ومطابقة الأنماط البيانية:
PROC PRINT DATA=basketball_data;

RUN;
عند تنفيذ هذا الإجراء عبر محرك SAS، تظهر في نافذة المخرجات شبكة جدولية أنيقة تتضمن عموداً أيسر افتراضياً يحمل العنوان “Obs” (أي الملاحظة)، تليه أعمدة المتغيرات: Team، وPoints، وRebounds. يُمثل هذا العمود الافتراضي “Obs” ترقيماً تسلسلياً للعرض فقط، وهو غير مخزن فيزيائياً في جدول البيانات، ولكنه يتطابق في هذه الحالة البسيطة تماماً مع عدد دورات خطوة البيانات الثماني التي مر بها النظام أثناء القراءة من أسطر DATALINES.
يُتيح الفحص الهيكلي عبر PROC PRINT التحقق من غياب أي قيم مفقودة (Missing Values) ومن أن المتغير النصي للفريق تم قراءته بالطول والنوع الصحيحين، إضافة إلى التأكد من سلامة المتغيرات الرقمية. يوفر هذا الفحص خط أساس موثوقاً نستند إليه عند تقييم نتائج العمليات اللاحقة لتجزئة وتصفية البيانات باستخدام المتغير التلقائي _N_.
3.3 أهمية تمثيل العينات الإحصائية بدقة قبل المعالجة المتقدمة
في الأبحاث الميدانية، سواء في العلوم النفسية، أو السلوكية، أو الاقتصاد القياسي، يُعد التمثيل المنضبط لمجموعة البيانات ركيزة محورية لضمان صدق الاستدلالات الإحصائية (Statistical Validity). فاختيار عينات غير مكتملة أو الفشل في نمذجة المعطيات الأولية يؤدي حتماً إلى أخطاء تحيز العينة (Sampling Bias) وانحراف نتائج التحليل العاملي أو اختبارات الفروق المعلمية واللامعلمية.
يتطلب التحليل الدقيق توافق حجم البيانات المسحوبة ومواصفاتها البنيوية مع الغرض العلمي للدراسة؛ فاستخدام أدوات البرمجة في بيئة SAS 9.4 Language Reference: Concepts يُلزم الباحث بالتحقق من أبعاد المصفوفة قبل البدء في تصفية الصفوف أو ترقيم الحالات. إن أي انزياح ناتج عن سوء فهم لآليات القراءة التلقائية قد يؤدي إلى استبعاد غير مقصود لحالات دراسية حرجة تمثل فئات إحصائية نادرة.
وعليه، فإن بناء نموذج تجريبي مبسط ومضبوط معيارياً كنموذج فرق كرة السلة يُمثل ممارسة علمية تهدف إلى التحقق التجريبي من مسار التعليمات البرمجية قبل تعميمها على مجموعات البيانات الضخمة (Big Data) التي قد تحتوي على ملايين السجلات، حيث يصبح التدقيق البصري اليدوي مستحيلاً وتتعاظم تكلفة الأخطاء المنطقية غير المكتشفة.
4. المثال الأول: استخدام _N_ لاستخراج الملاحظة الأولى بدقة
4.1 البنية النحوية لعبارة IF _N_ = 1 ودلالاتها البرمجية
يتمثل الاستخدام التطبيقي الأول للمتغير التلقائي _N_ في عزل واستخراج الملاحظة المفتاحية الأولى من مجموعة البيانات. تتشكل الصياغة النحوية لهذا الإجراء داخل خطوة بيانات جديدة تعتمد على تقييم شرط مساواة منطقي مباشر، كما يظهر في الكود التالي:
DATA first_observation;

    SET basketball_data;

    IF _N_ = 1 THEN OUTPUT;

RUN;
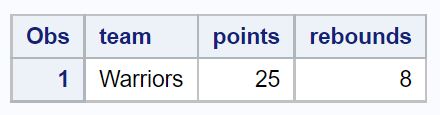
يقوم محرك SAS عند معالجة هذه التعليمات بقراءة الملاحظة الأولى من جدول basketball_data، وفي هذه اللحظة التنفيذية تكون قيمة العداد _N_ مساوية حسابياً للرقم (1). يتم تقييم العبارة الشرطية IF _N_ = 1 لتكون نتيجتها المنطقية صائبة (TRUE)، مما يدفع النظام لتنفيذ التعليمة التابعة THEN OUTPUT مباشرة، فيتم كتابة محتويات متجه البيانات البرمجية في تلك اللحظة إلى الجدول الجديد المسمى first_observation.
تكتسب هذه البنية النحوية فاعليتها من استغلال التزامن بين الدورة التشغيلية الابتدائية وقراءة أول صف مدخل. يتيح استخدام الأمر الصريح OUTPUT للمبرمج تجاوز سلوك الإخراج الافتراضي الذي يحدث عند نهاية الخطوة، ويجعل عملية الكتابة مشروطة كلياً ببلوغ النقطة المرجعية الأولى لمسار التنفيذ.
4.2 التحليل المنطقي لتنفيذ أمر OUTPUT عند الدورة الأولى وتجاوز البقية
لفهم الميكانيزم التنفيذي لهذا الكود تحليلياً، يجب متابعة ما يجري في الدورات اللاحقة؛ فعندما يفرغ النظام من الملاحظة الأولى، يعود المؤشر إلى رأس خطوة البيانات وتبدأ الدورة الثانية، فتصبح قيمة _N_ تساوي (2). عند هذه النقطة، تقرأ عبارة SET سجل الفريق الثاني (Celtics)، ثم ينتقل التنفيذ إلى الشرط المنطقي IF _N_ = 1. ونظراً لأن القيمة الحالية للعداد هي (2)، فإن ناتج التقييم الشرطي يكون غير صحيح (FALSE).
يترتب على فشل تحقق الشرط إحجام المعالج تماماً عن تنفيذ جملة OUTPUT. وبما أن خطوة البيانات تحتوي على أمر OUTPUT صريح ومخصص ضمن الشرط، فإن آلية الإخراج الضمني التلقائي (Implicit Output) التي تنفذها SAS عادةً عند بلوغ عبارة RUN تصبح معطلة وظيفياً لجميع الحالات التي لم ينطبق عليها الشرط. تتكرر هذه الدورة للسجلات من (3) إلى (8)؛ حيث يزداد _N_ وتُقرأ الملاحظات لكن دون تنفيذ أي أمر إخراج.
عند فحص الجدول الناتج first_observation عبر إجراء PROC PRINT، نجد أنه يحتوي حصرياً على صف واحد يمثل فريق (Hawks) بنقاطه البالغة (102) ومتابعاته (45). يُثبت هذا التحليل أن المنطق الإجرائي لـ _N_ = 1 قد نجح تماماً في تجاهل كافة الملاحظات اللاحقة واقتطاع الملاحظة الابتدائية بكفاءة برمجية لا شائبة فيها.
4.3 التطبيقات البحثية والمسحية لاختيار الملاحظة الرائدة
تتعدد التطبيقات المنهجية لاقتطاع الملاحظة الأولى في البحوث التطبيقية والمسوح الميدانية؛ ففي الدراسات التجريبية الطبية والسلوكية، يُمثل السجل الأول في كثير من الأحيان حالة القياس القاعدي (Baseline Observation) أو القيمة المعيارية المرجعية لحيوان التجارب أو المريض الخاضع للمعاينة قبل بدء التدخل العلاجي، حيث يُستخرج هذا السجل لاحقاً لمعايرة بقية الملاحظات بحساب نسب التغير المقارنة.
كما يبرز هذا التطبيق بقوة في معالجة الملفات الخام المستوردة من الأجهزة المعملية ومحطات القياس السيكوفيزيائي؛ إذ تحتوي الأسطر الأولى في تلك الملفات غالباً على معطيات وصفية (Metadata)، مثل زمن المعايرة، أو معرّف الجهاز، أو شروط بيئة الاختبار. وعبر صياغة IF _N_ = 1، يستطيع المحلل استخلاص هذه الترويسة المرجعية وتخزينها في جدول مخصص أو تحويلها إلى متغيرات عامة (Macro Variables) لتوظيفها في العمليات اللاحقة.
وفي القياسات السيكومترية المتعلقة بتحليل استجابات الاستبيانات المقننة، يُستفاد من هذه التقنية لاستخراج استجابة “المشارك النموذجي” أو مفتاح التصحيح المدمج في السطر الأول لبطاريات الاختبارات؛ حيث يتم استقطاب هذا الصف بمفرده ليكون معياراً تُقارن به مصفوفات الاستجابات الخاصة بكافة المفحوصين اللاحقين في العينة الإحصائية.
5. المثال الثاني: استخراج أول N ملاحظات لتحديد عينة الدراسة
5.1 صياغة المتباينة الشرطية IF _N_ <= 5 لاستقطاب عينة جزئية
يتناول الاستخدام التطبيقي الثاني مسألة تصفية واقتطاع عدد محدد مسبقاً من السجلات المتتابعة في مقدمة الملف، وهو ما يُعرف في الأدبيات باستخراج العينات التتابعية الأولى (Top N Observations). يتم صياغة هذا الإجراء عبر توظيف متباينة منطقية تستخدم معامل المقارنة “أصغر من أو يساوي” (<=) لتقييد الإخراج بحد زمني برمجي معين:
DATA first_five_teams;

    SET basketball_data;

    IF _N_ <= 5;

RUN;
تعتمد هذه الصياغة على مفهوم “جملة IF الفرعية للتصفية” (Subsetting IF Statement). ففي لغة SAS، إذا جاءت جملة IF متبوعة بتعبير منطقي دون عبارة THEN، فإنها تعمل كبوابة استبقاء؛ حيث يُسمح فقط للملاحظات التي يكون التعبير المنطقي فيها صائباً بالاستمرار في خطوة البيانات للوصول إلى نقطة الإخراج الضمني عند عبارة RUN، بينما يتم إقصاء وتجاوز أي دورة تكرارية لا تستوفي هذا الشرط.
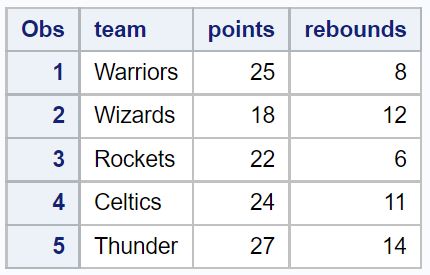
أثناء التنفيذ، تتطابق قيم _N_ للدورات الخمس الأولى (من 1 إلى 5) مع شرط <= 5، مما يؤدي إلى استبقاء الفرق الخمسة الأولى (Hawks، Celtics، Warriors، Bulls، Lakers) وكتابتها في جدول first_five_teams. وعند انتقال المؤشر للدورة السادسة، تصبح قيمة _N_ مساوية لـ (6)، فتسقط الملاحظة السادسة وما يليها تلقائياً، وتقتصر محتويات الجدول النهائي على حجم العينة المحدد تماماً.
5.2 كفاءة المعالجة وإيقاف التنفيذ باستخدام عبارة STOP لتوفير الموارد
على الرغم من النجاح الوظيفي لكود التصفية السابق، إلا أنه ينطوي على قصور تشغيلي جوهري يمس كفاءة استهلاك الموارد؛ فعند استخدام IF _N_ <= 5;، يستمر محرك SAS في قراءة كافة السجلات المتبقية في جدول الإدخال حتى نهاية الملف (EOF)، حتى لو كان الملف يحتوي على عشرات الملايين من الصفوف، على الرغم من علمه المسبق بعدم استبقاء أي سجل إضافي. هذا السلوك يستهلك دورات ثمينة من المعالج المركزي (CPU) ويزيد من عمليات القراءة من القرص (I/O Operations) دون أي عائد تحليلي.
لحل هذه المعضلة الحوسبية بأسلوب احترافي، يتم دمج عبارة الإيقاف الصريح STOP الموجهة بقيمة العداد _N_. تُصدر عبارة STOP أمراً مباشراً إلى محرك خطوة البيانات بإغلاق مرحلة التنفيذ فوراً والتوقف التام عن قراءة أي سجلات تالية، مع إغلاق الملفات وتفريغ الذاكرة، كما يوضح الكود المحسن التالي:
DATA first_five_optimized;

    SET basketball_data;

    OUTPUT;

    IF _N_ = 5 THEN STOP;

RUN;
في هذا التركيب البرمجي المتقن، يتم إخراج السجل الحالي في كل دورة تكرارية عبر أمر OUTPUT الصريح، وفور وصول قيمة _N_ إلى الرقم (5)، يُنفذ النظام كتلة الشرط THEN STOP، مما يضع نهاية حاسمة لخطوة البيانات برمتها. هذا التحسين يختصر زمن التنفيذ إلى الصفر تقريباً عند العمل على قواعد البيانات الضخمة، محولاً خطوة المعالجة من القراءة الشاملة المهدرة إلى عملية استقطاب محددة الهدف وعالية الكفاءة.
5.3 الأبعاد الإحصائية لاستقطاب العينات الأولى في البحوث الميدانية
يحمل استخدام العينات المحددة بأول N ملاحظة دلالات منهجية دقيقة في تصميم البحوث؛ إذ يُلجأ إليها كثيراً في المراحل التمهيدية والاستطلاعية (Pilot Studies) لتقييم كفاءة أدوات القياس السيكومترية وضبط موثوقية استمارات جمع البيانات الميدانية. ففحص الاستجابات الخمسين أو المئة الأولى يُمكّن الباحث من اكتشاف العيوب الصياغية أو إشكاليات إدخال البيانات قبل اكتمال المسح الوطني الشامل.
ومع ذلك، يجب التعامل مع هذا الاستقطاب بحذر إحصائي بالغ؛ فالاعتماد على الملاحظات الأولى يفترض ضمنياً أن ترتيب السجلات داخل الملف ترتيب عشوائي مطلق. أما إذا كانت البيانات مرتبة زمنياً، أو جغرافياً، أو مصنفة حسب مراكز تقديم الرعاية أو مستويات الدخل، فإن اقتصار العينة على السجلات الأولى يُدخل الباحث في فخ “تحيز الاختيار” (Selection Bias)، مما يجعل نتائج العينة غير قابلة للتعميم على المجتمع الإحصائي الكلي لغياب شرط التمثيل العادل.
في المقابل، يكون الاستقطاب التتابعي مبرراً ومنهجياً بامتياز في دراسات القياس الزمني ومراقبة الجودة الصناعية؛ حيث يكون الهدف رصد ديناميكية الإنتاج أو استجابة المستهلكين في الفترات الصباحية أو المراحل الافتتاحية للمشروع، مما يجعل المتغير _N_ بمثابة نافذة رصد زمنية منتظمة تُحدد أفق المعاينة المطلوب بأعلى دقة تقنية ممكنة.
6. المثال الثالث: ترقيم الملاحظات وتأسيس معرف فريد للسجلات
6.1 إسناد قيمة _N_ إلى متغير دائم (row_number = _N_)
يتمثل الاستخدام التطبيقي الثالث، وهو الأكثر شيوعاً في الممارسات الإحصائية الرصينة، في توظيف المتغير _N_ لبناء مؤشر تسلسلي أو معرّف رقمي فريد ومستقل لكل صف من صفوف البيانات. ولتحقيق هذه الغاية، يتم إجراء تعيين حسابي بسيط يُسند القيمة اللحظية لـ _N_ إلى متغير مستحدث يتم تسميته بوضوح، مثل row_number أو Subject_ID:
DATA basketball_indexed;

    SET basketball_data;

    row_number = _N_;

RUN;
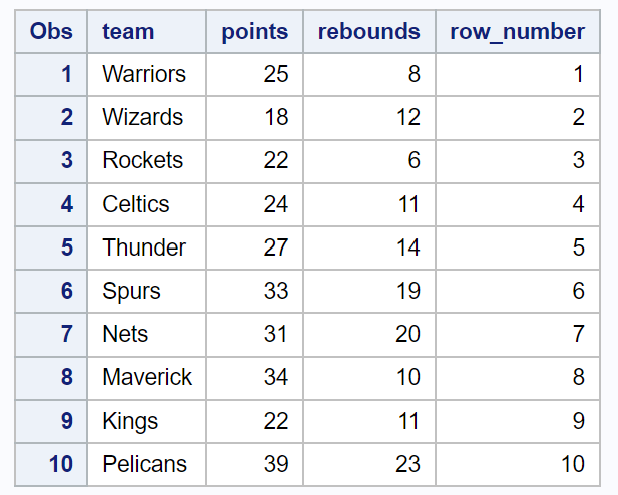
عند تنفيذ هذه التعليمة البرمجية، يقوم مترجم لغة SAS في مرحلة الترجمة بتسجيل متغير جديد باسم row_number في جدول الرموز البرمجي وضمن مسارات الـ PDV كمتغير رقمي دائم. وخلال مرحلة التنفيذ في كل تكرار، تُنقل القيمة الحالية للمتغير التلقائي _N_ إلى خانة المتغير row_number، لتستقر هناك وتُكتب تلقائياً في الملف الناتج مع استكمال دورة الإخراج.
يُحقق هذا الإجراء غاية برمجية جوهرية؛ إذ يعمل على تجميد الترتيب الأصلي لقاعدة البيانات وتثبيته في حقل فيزيائي مستقل. هذا التثبيت يحمي البنية الترتيبية من الضياع، ويتيح للباحث استعادة النسق التتابعي الأولي في أي مرحلة لاحقة من مراحل المعالجة الإحصائية مهما تعرضت البيانات لعمليات إعادة فرز، أو تصفية، أو دمج معقدة.
6.2 أسباب عدم بقاء _N_ تلقائياً داخل مخرجات مجموعة البيانات
تنبثق الطبيعة الزائلة للمتغير _N_ وعدم بقائه التلقائي في الجداول النهائية من الفلسفة الهندسية الراسخة التي أرساها مؤسسو SAS مثل Anthony James Barr وJames Goodnight منذ إطلاق النظام الأول عام 1976. تقوم هذه الفلسفة على الفصل الصارم بين متغيرات التحكم الإجرائية (Execution Control Variables) وبيانات النمذجة الإحصائية الفعلية (Substantive Data).
تم تصميم _N_ ليكون آلية قيادة داخلية تُحدد موقع المؤشر البرمجي في الذاكرة الحية فقط؛ ومن هنا يفرض النظام سمة الإسقاط التلقائي (Automatic Drop) عليه وعلى نظرائه مثل متغير الخطأ _ERROR_. لو تم تخزين هذه المتغيرات التشغيلية بصورة دائمة في كل جدول ينشئه المستخدم، لترتب على ذلك تضخم غير مبرر في أحجام الملفات على وسائط التخزين، وتلوث في مصفوفات البيانات بمتغيرات لا تحمل دلالة موضوعية مرتبطة بظاهرة البحث الخاضعة للقياس.
لذلك، تفرض اللغة على المطور والمحلل أن يكون مسؤولاً بصورة صريحة عن اتخاذ القرار بنقل أي معلومة تشغيلية إلى حيز الوجود الدائم. يُعد هذا المنهج أحد أسباب كفاءة نظام SAS في الحفاظ على سلامة الجداول واستقرارها الأرشيفي، مؤكداً أن ما يُكتب في المخرجات هو فقط ما يقصده الباحث بدقة ووعي كاملين لخدمة غايات التحليل والتوثيق.
6.3 أهمية الفهرسة وتتبع السجلات في التحليلات الطولية
تكتسب مسألة ترقيم وتثبيت هوية الحالات عبر Subject_ID = _N_; أهمية علمية استثنائية في التحليلات الإحصائية الطولية (Longitudinal Analysis) والدراسات السلوكية الممتدة؛ فغالباً ما تصل البيانات الميدانية من استبيانات ورقية مجهولة الهوية أو من حساسات قياس لا تُصدر معرّفاً فريداً لكل مشارك، مما يفرض ضرورة اصطناع مفتاح أولي ثابت (Primary Key) يُتيح تتبع الفرد عبر الزمن.
عند إجراء عمليات دمج البيانات لاحقاً عبر عبارة MERGE أو تقنيات الربط العلائقي في لغة الاستعلامات البنيوية المدمجة (PROC SQL)، يُشكل هذا المعرّف الرقمي المولد من _N_ الأساس الصلب لربط بيانات القياس القبلي مع القياسات البعدية عبر جلسات الفحص المتعاقبة. وبدون هذا التثبيت المنهجي، قد يؤدي تطبيق إجراءات الترتيب PROC SORT لأغراض تصنيفية إلى بعثرة الصفوف وخلط استجابات المفحوصين، مما يترتب عليه فساد سلاسل القياس المتكرر وفقدان القدرة على تقييم أثر التدخلات السلوكية بدقة.
كما يُسهم الترقيم الثابت في تيسير تدقيق الجودة والمراجعة الأكاديمية (Auditing)؛ ففي حال رصد قيم شاذة (Outliers) أو أخطاء إدخال فادحة أثناء الفحص الاستكشافي، يُمكّن المعرّف الرقمي فريق المراجعة من العودة المباشرة إلى الاستمارة الأصلية المطابقة لرقم السجل، مما يضمن اتساق القرارات البحثية ورصانتها وفق أعلى معايير النزاهة العلمية المعترف بها دولياً.
7. الفروق المنهجية بين _N_ والمفاهيم المشابهة في SAS
7.1 المقارنة المفاهيمية بين _N_ والمتغير التلقائي _ERROR_
يتكامل المتغير التلقائي _N_ وظيفياً مع شقيقه الميداني المتغير التلقائي _ERROR_ لتوفير بيئة مراقبة شاملة لأداء خطوة البيانات. فبينما يمثل _N_ متغيراً كمياً تراكمياً يعد دورات المعالجة بانتظام، يُمثل _ERROR_ متغيراً منطقياً ثنائياً (Binary Flag) يقتصر على أخذ القيمة (0) في الظروف التشغيلية السليمة، ويتحول إلى القيمة (1) فور حدوث خطأ تنفيذي يتعلق بالبيانات، مثل فشل تحويل النصوص إلى أرقام، أو حدوث عمليات قسمة حسابية على صفر.
تتجلى القوة المنهجية للدمج بين هذين المتغيرين عند بناء إجراءات تنظيف وتدقيق البيانات (Data Cleaning). فبدلاً من الاعتماد على رسائل الخطأ المجردة في السجل، يستطيع المبرمج صياغة أوامر تتبع مخصصة تستدعي كلا المتغيرين بالتوازي لرصد مواطن الخلل وحصرها بدقة عبر الشيفرة التالية:
DATA cleaned_data;

    SET raw_data;

    IF _ERROR_ = 1 THEN DO;

        PUT "Data anomaly identified at iteration count: " _N_ " for Subject ID: " ID;

    END;

RUN;
تُمكّن هذه المقارنة والمزاوجة البرمجية المحلل من عزل الحالات المعطوبة فوراً وتحديد رقم الدورة التشغيلية التي تعثرت عندها المعالجة؛ مما يحول دون توقف البرامج التحليلية الشاملة ويوفر سجلاً تشخيصياً بالغ التفصيل يعزز موثوقية قواعد البيانات الطبية والنفسية قبل اعتمادها نهائياً.
7.2 المقارنة بين _N_ وخيار POINT= في عبارة SET للوصول المباشر
يعتمد استدعاء البيانات في الحالات الاعتيادية المقترنة بـ _N_ على مبدأ “القراءة التسلسلية التراكمية” (Sequential Access)؛ حيث يُجبر النظام على تصفح السجلات بالترتيب من الأول إلى الأخير، ويقيس _N_ وتيرة هذا التقدم الخطي خطوة بخطوة. في المقابل، يُقدم خيار POINT= في عبارة SET نموذجاً مختلفاً تماماً يستند إلى “الوصول العشوائي المباشر” (Direct Random Access).
عند استخدام POINT=variable_name، يتجاوز محرك SAS القراءة الخطية ليقفز مباشرة إلى رقم الصف الفيزيائي المطلوب دون المرور على الملاحظات السابقة. ورغم الكفاءة الزمنية الهائلة التي يوفرها هذا الخيار عند الحاجة إلى استخراج سجل محدد من وسط ملف هائل يضم مليارات القياسات، إلا أنه يتطلب حذراً بالغاً؛ فخيار POINT= لا يضبط علامة نهاية الملف (EOF) تلقائياً، وإذا لم يُقيد بحلقة توقف محكمة، فإنه يدخل البرنامج في حلقة لا نهائية (Infinite Loop) تُعطل الموارد الحاسوبية كلياً.
من الناحية المنهجية، يظل _N_ أداة الرصد الآمنة التي تعكس دورات المعالجة الطبيعية وتضمن استقرار الانتقال بين السجلات دون مخاطر الانهيار البرمجي، في حين يُعد POINT= خياراً هندسياً متخصصاً يُفضل استخدامه حصراً من قبل مهندسي البيانات المتقدمين لتنفيذ مهام استهداف مباشر لا تتطلب قراءة الملف كاملاً.
7.3 التمييز بين _N_ ودالة التأشير NOBS في خطوة البيانات
من الفروق الدقيقة التي يجب على الباحث الإحصائي استيعابها التمييز بين المتغير _N_ وخيار التوصيف NOBS= (Number of Observations) المتاح ضمن عبارة SET. يكمن التباين الجوهري بينهما في البعد الزمني والمصدر المرجعي؛ فـ _N_ هو متغير ديناميكي لحظي يتغير ويزداد مع كل تكرار ليعبر عن موقع الدورة التنفيذية الآنية داخل الـ PDV.
في المقابل، فإن المتغير المرتبط بخيار NOBS= هو قيمة ثابتة مستقاة مباشرة من “واصف ملف البيانات” (Dataset Header Descriptor) المخزن مسبقاً، حيث يقوم محرك SAS بقراءة الحجم الكلي للملاحظات المسجلة في الجدول وتعيين هذا الرقم الثابت في المتغير المخصص حتى قبل أن تبدأ الدورة الأولى لتنفيذ قراءة السجلات الفعلية.
تفتح المزاوجة بين _N_ وNOBS= آفاقاً واسعة للتحكم البرمجي المتقدم؛ إذ تُمكّن الباحث من حساب مؤشرات التقدم النسبي المئوي أثناء قراءة البيانات (عبر حساب (_N_ / total_obs) * 100)، أو استهداف الملاحظة الأخيرة في الجدول الرياضي بدقة تامة وبأبسط تركيب برمجي ممكن عبر الشرط: IF _N_ = total_obs; دون الحاجة لفرز الملف أو عكس ترتيبه.
8. الأخطاء الشائعة وسوء الاستخدام لمتغير _N_ وكيفية تجنبها
8.1 الخلط بين _N_ وترتيب الملاحظات عند استخدام عبارة BY
يقع كثير من الإحصائيين في خطأ منهجي فادح عند تطبيق “معالجة المجموعات” (BY-Group Processing) في خطوة البيانات؛ حيث يُفترض خطأً أن المتغير _N_ سيعيد تصفير نفسه تلقائياً ليبدأ من القيمة (1) عند بداية كل فئة أو مجموعة تصنيفية جديدة (مثل إعادة الترقيم لكل مدرسة، أو لكل جنس، أو لكل عينة تجريبية).
الواقع التشغيلي المؤكد هو أن العداد _N_ يتجاهل تماماً تقسيمات عبارة BY، ويستمر في تراكمه التصاعدي الإجمالي عبر كامل الملف من البداية إلى النهاية دون أي انقطاع. ولإجراء ترقيم تسلسلي داخلي يعيد البدء من جديد مع كل مجموعة، يجب على المبرمج الاعتماد على المتغيرات التلقائية للمجموعات FIRST.variable وLAST.variable المقترنة بعبارة RETAIN، كما يظهر في التصحيح المنهجي التالي:
PROC SORT DATA=raw_trials OUT=sorted_trials;

    BY Group;

RUN;
DATA trials_indexed;
SET sorted_trials;
BY Group;
RETAIN within_group_id 0;
IF FIRST.Group THEN within_group_id = 1;
ELSE within_group_id = within_group_id + 1;
overall_iteration = _N_;
RUN;
يُبرز هذا النموذج الفارق الحاسم بين within_group_id الذي يتصفر منضبطاً مع كل فئة بحثية جديدة، وبين overall_iteration المستمد من _N_ الذي يواصل توثيق التتابع العام، مما يحمي الدراسة من اختلاط الترقيم وتداخل العينات المستقلة داخل التحليل.
8.2 تأثير عبارات الإدخال المتعددة والـ DO LOOPS على تزايد _N_
ينشأ خطأ شائع آخر عندما تحتوي خطوة البيانات الواحدة على جمل INPUT أو SET متعددة أو عندما يتم تضمين عمليات القراءة داخل حلقات DO صريحة لقراءة مصفوفات السجلات. ففي مثل هذه السيناريوهات المعقدة، يتوقع المبرمج غير المتمرس أن تزداد قيمة _N_ مع كل سطر يتم سحبه إلى الذاكرة، وهو تصور غير صحيح.
كما تم تأصيله سابقاً، فإن _N_ يرتبط حصرياً بالدورة التنفيذية الكبرى لخطوة البيانات. فإذا احتوت الدورة الواحدة على حلقة DO تقرأ ثلاثة أسطر متتالية باستخدام محدد السطر المزدوج (Trailing @@) أو استدعاءات INPUT متكررة، فإن قيمة _N_ تظل ثابتة على الرقم (1) طوال فترة قراءة تلك الأسطر الثلاثة مجتمعة، ولا ترتفع إلى (2) إلا بعد عودة التدفق البرمجي إلى قمة الخطوة.
يؤدي إغفال هذا السلوك إلى تباعد شاسع بين عدد السجلات المقروءة فعلياً وقيمة المتغير _N_؛ مما قد يُفسد العمليات المعتمدة على العداد إذا كان المقصود هو عد السجلات المفردة لا عد دورات التشغيل. ولمعالجة ذلك، يتعين على المحلل بناء عدادات تراكمية يدوية باستخدام عبارات الجمع التراكمي (Sum Statements: record_count + 1;) لضبط الترقيم على مستوى الملاحظة الفردية لا مستوى الدورة الحلقية الكبرى.
8.3 محاولات التعديل اليدوي على قيمة _N_ والمشكلات الناتجة عنها
يحاول بعض المستخدمين أحياناً التدخل في مسار التكرار عبر إسناد قيم حسابية مباشرة للمتغير التلقائي (مثل محاولة تصفيره بكتابة: _N_ = 1; أو إجباره على القفز عبر: _N_ = _N_ + 5;). تُعد هذه المحاولات خطيئة برمجية كبرى في بيئة SAS وتصطدم بقواعد الصرامة المنطقية للنظام.
على الرغم من أن مترجم SAS قد لا يُسقط التنفيذ فوراً في بعض النسخ، إلا أنه يرسل تحذيرات صريحة في سجل النظام (SAS Log)، ويتجاهل التعديلات اليدوية كلياً عند عودة الدورة إلى قمة الخطوة؛ حيث يُعاد فرض القيمة التشغيلية الحقيقية التي يحتسبها المحرك الداخلي تلقائياً. وفي أحيان أخرى، يؤدي هذا العبث إلى سلوكيات شاذة وغير متوقعة في تقييم الشروط اللاحقة وخلل في إدارة مؤشرات الذاكرة.
القاعدة الذهبية المتبعة في هندسة برمجيات SAS هي: المتغيرات التلقائية تُقرأ فقط ولا تُعدل أبداً (Read-Only Status). فإذا احتاج المحلل إلى عداد مرن يخضع للتعديل، أو القفز، أو التصفير الشرطي، فإن السبيل العلمي القويم هو إنشاء متغير مخصص ومستقل تماماً تُسند إليه قيمة _N_ الأولية ثم يُدار لاحقاً بالمعادلات الرياضية الملائمة لطبيعة المسألة الإحصائية دون المساس بالمتغير النظامي.
9. استراتيجيات متقدمة لدمج _N_ في إجراءات الفحص والتحقق من جودة البيانات
9.1 استخدام _N_ لإنشاء تقارير تشخيصية مخصصة في سجل النظام (SAS Log)
يُمثل المتغير _N_ أداة استثنائية لتطوير إجراءات استكشاف الأخطاء وتصحيحها (Debugging) ومراقبة جودة البيانات الضخمة أثناء المعالجة التدفقية. فبدلاً من إغراق سجل النظام بآلاف الأسطر، يمكن استخدام _N_ مع عبارة PUT لطباعة رسائل تشخيصية دورية أو مشروطة ترصد صحة المتغيرات بدقة:
DATA analyzed_sample;

    SET clinical_trials_large;

    IF MOD(_N_, 10000) = 0 THEN DO;

        PUT "Checkpoint Reached: Successfully processed " _N_ " records at " TIME=TIME8.;

    END;

    IF systolic_bp > 220 OR systolic_bp < 40 THEN DO;

        PUT "CRITICAL ANOMALY at observation iteration " _N_ " Patient ID: " Subject_ID " Blood Pressure: " systolic_bp;

    END;

RUN;
تُحقق هذه الاستراتيجية المتقدمة التوازن المثالي بين كفاءة المعالجة والمراقبة اللحظية؛ فالجزء الأول يمنح الباحث طمأنينة حول وتيرة تقدم معالجة الملايين من الحالات عبر طباعة نبضات تشخيصية كل (10,000) دورة، بينما يعمل الجزء الثاني كجهاز إنذار مبكر يرصد الشذوذ الفسيولوجي المفرط ويربطه فوراً برقم الدورة، مما يختصر مئات الساعات في الفحص والتدقيق اللاحق.
9.2 فحص اتساق البيانات واكتشاف الأخطاء عند حدود تكرار محددة
في التجارب السيكوفيزيائية وتجارب زمن الرجع (Reaction Time) المعقدة، يتوقع الباحث نمطاً محدداً من السلوك يتغير وفقاً للمراحل التجريبية (مثل مرحلة التدريب، ومرحلة الاختبار الفعلي). يمكن توظيف _N_ لوضع شروط منطقية تقارن اتساق الاستجابات مع الحد التكراري المفترض لتلك المراحل.
على سبيل المثال، إذا كانت أول خمسين دورة مخصصة لتدريب المفحوص، فيمكن كتابة شرط يتحقق من أن زمن الاستجابة في هذه المرحلة يقع ضمن هوامش التدريب التجريبي، مع رفع مستوى الصرامة في الفحص البرمجي للأدوار اللاحقة بعد _N_ > 50. وفي حال وجود تناقض ظاهري، يُصدر النظام تقريراً ينبه الباحث إلى أن المفحوص قد بدأ مرحلة الاختبار الحقيقي دون تجاوز معايير مرحلة التهيئة، مما يضمن الضبط المنهجي المحكم لظروف التجربة.
كما يُسهم هذا النهج في سرعة تتبع وتصحيح العيوب في مصفوفات الاستبيانات الطويلة؛ إذ يتيح تحديد الرقم التسلسلي الدقيق للاستمارة الورقية المعيبة فور اكتشاف تجاوز قيم المقاييس النفسية لحدود التوزيع الطبيعي أو تسجيل قياسات مستحيلة منطقياً، مما يرفع من جودة البيانات المعتمدة في التقارير الإحصائية النهائية.
9.3 أتمتة اختبارات الجودة للمصفوفات البيانية المعقدة
تتضمن استراتيجيات مراقبة الجودة الإحصائية الحديثة تطبيق “المعاينة المنتظمة” (Systematic Sampling) للتحقق المستمر من كفاءة خوارزميات الذكاء الاصطناعي ونماذج التنبؤ الإحصائي. ويُعد المتغير _N_ حجر الزاوية الرياضي لبناء مثل هذه العينات بأسلوب آلي فائق الانسيابية.
عبر توظيف دالة باقي القسمة الرياضية MOD(_N_, k)، يستطيع المحلل استقطاب عينة ممثلة دورية بانتظام دقيق (مثل استخراج حالة واحدة من كل مئة دورة، أو كل ألف دورة) لإخضاعها لاختبارات جودة معمقة وتأكيد التطابق المتبادل (Cross-Validation):
DATA validation_sample;

    SET massive_data_stream;

    IF MOD(_N_, 500) = 0 THEN OUTPUT;

RUN;
يضمن هذا الأسلوب البرمجي أخذ عينات متوازنة زمنياً وهيكلياً عبر كامل المدى الذي تغطيه مجموعة البيانات، ودون استهلاك طاقة حسابية إضافية في توليد أرقام عشوائية معقدة. إنها أتمتة منهجية عالية الكفاءة تعزز من دقة التحقق في مراكز البحوث العلمية وبيئات التحليل الإحصائي المتقدمة.
10. أفضل الممارسات الأكاديمية لتحسين أداء البرمجة باستخدام _N_
10.1 تحسين استهلاك الذاكرة وسرعة المعالجة في البيانات الضخمة
تفرض البيئات الأكاديمية ومختبرات تحليل البيانات الكبيرة اتباع أفضل الممارسات البرمجية لضمان تقليص الهدر في الذاكرة وتسريع زمن المعالجة الحوسبية. ومن أهم القواعد الذهبية عند استخدام المتغير _N_ لأغراض التصفية، المبادرة بتطبيق الشروط في أبكر موضع ممكن داخل خطوة البيانات لتجنب إجراء حسابات رياضية على صفوف مصيرها الاستبعاد.
علاوة على ذلك، يجب الدمج الذكي بين تصفية الملاحظات بـ _N_ واستخدام عبارتي KEEP أو DROP لحذف الأعمدة غير الضرورية من الـ PDV في مرحلة مبكرة. إن تقليص عدد الأعمدة بالتزامن مع إيقاف المعالجة الحلقية فوراً عبر عبارة STOP عند بلوغ الحد المطلوب من السجلات، يُمثل الإجراء الأمثل لتقليل عمليات التبادل بين الذاكرة والقرص الصلب (Paging and I/O Bottlenecks)، مما يؤدي إلى قفزة نوعية في سرعة التنفيذ واستقرار المخدمات التحليلية.
يوضح الجدول المقارن التالي الفروق الجوهرية والخصائص التقنية لمتغير _N_ مقارنة بالمفاهيم والأدوات المرتبطة به في بيئة SAS:
| المفهوم / الأداة | نوع المتغير والبيئة | آلية التزايد والتحديث | التخزين في المخرجات | الاستخدام الوظيفي الأبرز |
|---|---|---|---|---|
_N_ |
تلقائي نظامي (PDV) | تراكمي مع كل دورة لخطوة البيانات (+1) | يسقط تلقائياً (Drop) | رصد تكرار الحلقات، واقتطاع الصفوف، وتأسيس المعرفات. |
_ERROR_ |
تلقائي نظامي (PDV) | ثنائي (0 أو 1) يتحول عند أخطاء البيانات | يسقط تلقائياً (Drop) | اكتشاف وتوثيق أخطاء التحويل والحساب اللحظية. |
NOBS= |
خيار في عبارة SET | ثابت مسبق مستقى من واصف الملف | يبقى إذا أُسند لمتغير مخصص | معرفة الحجم الكلي للملف قبل بدء القراءة والتنفيذ. |
POINT= |
خيار وصول في SET | يدوي يوجه برقم الصف الفيزيائي | لا ينطبق (خيار تحكم) | الوصول المباشر العشوائي للملاحظات دون قراءة تسلسلية. |
10.2 توثيق المعالجة الخوارزمية وضمان إمكانية إعادة التكرار العلمي
يُمثل توثيق الشيفرة البرمجية ركيزة أخلاقية ومنهجية لا غنى عنها في الأبحاث العلمية الرصينة لضمان الشفافية وقابلية إعادة الإنتاج والتكرار (Replicability). فعند استخدام _N_ في إجراء أي تحويل أو تصفية للبيانات، يتعين على الباحث كتابة تعليقات شارحة (Comments) توضح الأساس المنطقي الذي بُني عليه هذا الاستخدام.
يجب أن تتضمن التوثيقات البرمجية إجابات واضحة: هل تم الاعتماد على _N_ بافتراض الترتيب العشوائي للبيانات؟ هل السجلات مفرزة مسبقاً وفق متغير زمني محدد؟ وما هي التدابير المتخذة لضمان ألا يؤدي استقطاب الصفوف الأولى إلى انحياز في النتائج؟ إن هذا التوثيق يمنح المحكمين والباحثين المستقلين القدرة على مراجعة المسار الخوارزمي بدقة والتحقق من صدق الإجراءات الإحصائية عند مراجعة البحوث للنشر في المجلات العلمية المحكمة.
كما يُنصح دائماً بالامتثال لبروتوكولات الشفافية المعيارية، مثل مبادئ FAIR (Findable, Accessible, Interoperable, and Reusable)، عبر إرفاق كود المعالجة التأسيسي المعتمد على SAS كملحق تكميلي مع الورقة البحثية، مما يُعلي من قيمة الأمانة الأكاديمية ويسهل البناء التراكمي على نتائج الدراسة في الأوساط العلمية المختلفة.
10.3 خلاصة التوجيهات لتسخير _N_ في البحوث الإحصائية المتقدمة
تتويجاً لهذا العرض المنهجي المستفيض، تبرز مجموعة من التوجيهات العملية الحاسمة التي ينبغي على كل مهندس بيانات وباحث إحصائي استصحابها عند التعامل مع المتغير التلقائي _N_ لضمان أعلى مستويات الدقة والاحترافية:
- الفهم الدقيق للهوية البرمجية: تذكر دائماً أن
_N_يعد “دورات تنفيذ خطوة البيانات” ولا يعد السجلات الفيزيائية بذاتها؛ لذا راقب بدقة بنية حلقاتك البرمجية لتتأكد من توافق الدورة مع السجل عند الحاجة. - الحفظ الصريح للأرقام المعرفية: نظراً لأن
_N_يزول تلقائياً من المخرجات، احرص في مستهل مشاريعك على تجميد الترتيب عبر متغير دائم (Subject_ID = _N_;) ليكون مرجعيتك الثابتة خلال مراحل الفرز والدمج اللاحقة. - ترشيد الموارد عبر الإيقاف المبكر: لا تكتفِ بعبارات التصفية السلبية (مثل
IF _N_ <= k;) عند التعامل مع قواعد البيانات الهائلة، بل ادمج عبارةSTOPبذكاء لإغلاق التنفيذ وتوفير الموارد الحاسوبية الثمينة. - الحذر عند معالجة المجموعات: لا تعتمد إطلاقاً على
_N_لترقيم الحالات داخل الفئات عند استخدام عبارةBY، بل وظف المتغيرات التلقائية المخصصة مثلFIRST.variableمعRETAINلإعادة الترقيم المنضبط. - التوظيف في مراقبة الجودة والتشخيص: سخّر
_N_بالتكامل مع_ERROR_ودوال الحساب الرياضي مثلMODلأتمتة استكشاف الأخطاء وتأسيس تقارير فحص دورية واختيار عينات منتظمة لتقييم النماذج الاستدلالية.
خاتمة
يُمثل المتغير التلقائي _N_ جوهرة برمجية متفردة في بنية لغة SAS؛ فرغم بساطة صياغته وتلقائية توليده، إلا أنه يختزل الهندسة التنفيذية العميقة لخطوة البيانات وتدفقاتها داخل متجه بيانات البرمجة (PDV). إن استيعاب أبعاده المنهجية يمنح الباحثين في العلوم الإنسانية، والاجتماعية، والتجريبية أداة قوية للتحكم بالبيانات وإدارتها، بدءاً من استخلاص الملاحظة المرجعية الأولى، مروراً باقتطاع العينات الاستطلاعية بدقة متناهية وترشيد لموارد الحوسبة، ووصولاً إلى تأسيس المعرفات الرقمية الثابتة التي تصون البنى الطولية وتضمن سلامة التحليلات الإحصائية المتقدمة وتكرارها العلمي الرصين.
المراجع
Barr, A. J., Goodnight, J. H., Sall, J. P., & Helwig, J. T. (1976). A User’s Guide to SAS 76. SAS Institute Inc.
SAS Institute Inc. (2016). SAS 9.4 Language Reference: Concepts, Sixth Edition. SAS Institute Inc. https://documentation.sas.com
Delwiche, L. D., & Slaughter, S. J. (2019). The Little SAS Book: A Primer, Sixth Edition. SAS Institute Inc.