
تُعد عملية بناء النماذج الإحصائية وتحديد المتغيرات التنبؤية الأكثر كفاءة ركيزة محورية في منهجية البحث العلمي المعاصر، لاسيما في ميدان العلوم السلوكية والنفسية والتربوية التي تتسم بتعددية الأبعاد وتداخل الظواهر المقاسة. في ظل الثورة المعلوماتية وتعاظم حجم البيانات المجمعة من الاختبارات النفسية المقننة، والاستبانات واسعة النطاق، ومقاييس الأداء الأكاديمي، يواجه الباحثون تحدياً منهجياً مزدوجاً يتمثل في كيفية استخلاص نموذج رياضي مقتصد (Parsimonious) يحقق أعلى قدرة تنبؤية ممكنة دون الوقوع في شراك فرط التخصيص أو التحيز التقديري. ومن هذا المنطلق، لم تعد الأساليب التقليدية القائمة على التجربة والخطأ أو الإدخال العشوائي للمتغيرات قادرة على تلبية متطلبات الدقة التحليلية الصارمة.
استجابة لهذه التحديات المنهجية والحسابية، طورت شركة SAS إجراءً إحصائياً متقدماً وفريداً يُعرف باسم PROC GLMSELECT، والذي يمثل قفزة نوعية في بيئة النمذجة الخطية العامة. يجمع هذا الإجراء بين المرونة الفائقة للنماذج الخطية العامة وأحدث خوارزميات تعلم الآلة والانكماش الرياضي، مما يتيح للباحثين استكشاف فضاء النماذج المعقدة بكفاءة استثنائية. يتجاوز هذا الإجراء القيود البنيوية التي عانت منها الإجراءات الكلاسيكية لعقود، موفراً ترسانة متكاملة من أدوات الضبط الإحصائي، وإعادة التعيين، والتحقق المتبادل التي تضمن استقرار النتائج وقابليتها للتعميم على مجتمعات دراسية أوسع.
يهدف هذا الدليل المرجعي الشامل إلى تفكيك البنية البرمجية والنظرية لإجراء PROC GLMSELECT في بيئة نظام SAS الإحصائي، وتقديم رؤية تطبيقية متعمقة موجهة للباحثين والأكاديميين في مجالات القياس النفسي والتربوي. سيتم التطرق بالتفصيل الدقيق إلى الأسس الرياضية لاختيار النماذج، ومقارنة الخوارزميات الكلاسيكية بالأساليب المنظمة الحديثة، واستعراض صياغة الشيفرات البرمجية، بالإضافة إلى تفكيك المخرجات الإحصائية وطرق التحقق المتقدمة وفحص الافتراضات التشخيصية وفق أعلى المعايير الأكاديمية وضوابط دليل النشر لجمعية علم النفس الأمريكية (APA).
1. مقدمة شاملة حول إجراء PROC GLMSELECT في SAS وأهميته الإحصائية
1.1 ماهية إجراء PROC GLMSELECT وموقعه في حزمة SAS الإحصائية
يمثل إجراء PROC GLMSELECT أداة برمجية وإحصائية متخصصة صُممت خصيصاً داخل بيئة SAS لإجراء عمليات انتقاء التأثيرات واختيار النماذج ضمن إطار النموذج الخطي العام (General Linear Model). يرتكز هذا الإجراء وظيفياً على معالجة المتغيرات التابعة المستمرة ذات التوزيع الطبيعي المرتبطة بدالة ربط متطابقة، مستهدفاً حل المسألة الجوهرية المتمثلة في تحديد المجموعة الجزئية المثلى من المتغيرات التنبؤية (Predictors) المستقلة من بين مصفوفة كبرى من المتغيرات المرشحة، بما يضمن صياغة معادلة خطية تتسم بالرصانة والدقة التنبؤية العالية دون إغفال التفسير النظري للظاهرة المدروسة.
تاريخياً، قُدم هذا الإجراء رسمياً إلى الأوساط الأكاديمية والمهنية عبر ورقة العمل التأسيسية التي أعدها روبرت كوهين (Robert Cohen, 2006) في مؤتمر مستخدمي ساس الدولي الحادي والثلاثين (SUGI 31, Paper 207-31). جاء تطوير هذا الإجراء لسد ثغرة منهجية وحسابية عميقة ظلت قائمة لسنوات طويلة؛ حيث كانت الإجراءات الكلاسيكية المتاحة تعاني من تباين هيكلي حاد، إذ افتقرت الإجراءات المتخصصة في الانحدار التدريجي إلى دعم المتغيرات التصنيفية بطريقة برمجية سلسة، بينما افتقرت إجراءات النماذج الخطية العامة إلى آليات آلية متطورة للاختيار والانكماش الإحصائي. ومن هنا، بزغ إجراء GLMSELECT ليؤسس معياراً برمجياً جديداً يتجاوز تلك المعضلات الموروثة.
تتجلى المرونة المنهجية للإجراء في قدرته العالية على معالجة مجموعات البيانات متوسطة وكبيرة الحجم، والتعامل مع الأبعاد المرتفعة التي قد تفوق فيها أحياناً أعداد المتغيرات التنبؤية حجم العينة الفعلية أو تقترب منها، وهي المعضلة الرياضية المعروفة بمسألة (Large p, Small n). يبتعد الإجراء عن المنطق الكلاسيكي المقتصر على تعظيم درجة الملاءمة السطحية للبيانات الحالية عبر تقليل مجموع مربعات الأخطاء داخل العينة، ليركز بشكل جوهري على تحسين “القدرة التنبؤية خارج العينة” (Out-of-Sample Predictive Generalizability)، مما يجعله جسراً وثيقاً يربط بين النظرية الإحصائية الكلاسيكية وتطبيقات تعلم الآلة الحديثة في بيئة عمل بحثية متكاملة.
1.2 الفروق الجوهرية بين PROC GLMSELECT وإجراءي PROC REG و PROC GLM
لفهم القيمة المضافة لإجراء PROC GLMSELECT، ينبغي إجراء مقارنة منهجية بنيوية بينه وبين الإجراءين التقليديين الأكثر انتشاراً في SAS: إجراء الانحدار PROC REG وإجراء النموذج الخطي العام PROC GLM. لطالما كان PROC REG الأداة الأساسية لانتقاء المتغيرات عبر الأساليب الكلاسيكية كالحذف الخلفي والإدخال الأمامي؛ غير أن قصوره البنيوي الفادح يكمن في غياب جملة CLASS، مما يجبر الباحث على إنشاء متغيرات وهمية (Dummy Variables) يدوياً لكل متغير تصنيفي، وهو أمر شاق وعرضة للخطأ البرمجي، في حين أن PROC GLM يدعم جملة التصنيف بكفاءة عالية غير أنه لا يحتوي مطلقاً على خوارزميات لانتقاء المتغيرات تلقائياً، مما يجعل الباحث مجبراً على اختبار النماذج يدوياً نموذجاً تلو الآخر.
يتفوق PROC GLMSELECT بصورة مطلقة على هذه القيود؛ فهو لا يكتفي بإتاحة جملة CLASS بصورة أصلية مدمجة، بل يوفر خيارات متقدمة لترميز الفئات مثل الترميز المرجعي (Reference Coding) وترميز التأثيرات (Effect Coding)، بل والأهم من ذلك تقنية “تجزئة التأثيرات” (Split-Effect Coding)، التي تسمح باختيار مستويات محددة من المتغير الفئوي ضمن النموذج واستبعاد المستويات الأخرى غير الدالة، وهو ما يعجز عنه تماماً كل من PROC REG وPROC GLM. علاوة على ذلك، يزود الإجراء الباحث بخوارزميات حديثة مثل خوارزمية لاسو (LASSO) والانحدار التدريجي الأقل (LAR) والشبكة المرنة (Elastic Net)، وهي أدوات غائبة بالكامل عن الإجراءات الكلاسيكية السابقة.
تظهر الفروق الجوهرية كذلك في مستويات الكفاءة الحسابية ودعم أساليب إعادة التعيين والتحقق المتقاطع (Cross-Validation). بينما يتطلب إجراء التحقق المتقاطع في الإجراءات القديمة كتابة شيفرات برمجية معقدة باستخدام لغة الماكرو وحلقات التكرار وتصدير مصفوفات البيانات، يوفر PROC GLMSELECT بنية برمجية مدمجة لإجراء التحقق المتقاطع وتقسيم العينة تلقائياً ضمن التحليل الأساسي. كما يتميز بآليات حسابية محسنة تتيح له إدارة المصفوفات عالية الأبعاد دون استهلاك مفرط للذاكرة العشوائية للجهاز، مما يجعله متفوقاً زمنياً وحسابياً عند التعامل مع المسوحات النفسية والتربوية الكبرى ذات الارتباطات البينية المعقدة.
1.3 دواعي استخدام اختيار النماذج في البحوث النفسية والتربوية
تشهد البحوث النفسية والتربوية المعاصرة تراكماً واسعاً للبيانات متعددة الأبعاد؛ حيث يقوم الباحثون بقياس مصفوفات واسعة من القدرات الإدراكية، والمقاييس السلوكية، والسمات الشخصية، والمتغيرات الديموغرافية والاجتماعية-الاقتصادية لتفسير ظواهر مركبة مثل التحصيل الدراسي، أو التوافق المهني، أو الاضطرابات النفسية. يفرز هذا الواقع الميداني معضلة التعددية المفرطة للمتغيرات (Predictor Proliferation)، حيث تتداخل الأبعاد السيكومترية وتتشابك فيما بينها بدرجة تزيد من صعوبة تحديد العوامل ذات الأثر السببي الحقيقي، وتجعل النمذجة الشاملة محفوفة بالمخاطر المنهجية التي تشوه التقديرات المعلمية.
يساهم اعتماد خوارزميات اختيار النماذج المنظمة في الحد من التحيز البشري الناجم عن الانتقاء الاعتباطي أو الحدسي للمتغيرات المستقلة؛ فغالباً ما يميل بعض الباحثين إلى تضمين متغيرات بناءً على قناعات مسبقة غير مدعومة كفاية، أو حذف متغيرات حاسمة تفادياً للتعقيد الحسابي. يعمل PROC GLMSELECT كحكم إحصائي صارم يعتمد على معايير رياضية ونظرية لتقييم المساهمة النسبية الحقيقية لكل متغير في تفسير تباين المتغير التابع، مما يرسخ الموضوعية العلمية في بناء النماذج السيكولوجية، ويضمن عدم إهدار التباين التفسيري الذي قد تقدمه المقاييس الفرعية الدقيقة في الدراسات الميدانية.
علاوة على ذلك، تتمثل الغاية الكبرى للقياس النفسي والتربوي في تحقيق مبدأ “الاقتصاد المعرفي” أو “البارسيمونية” (Parsimony)، والذي يستهدف بناء أدوات تشخيصية ونماذج قياس تحقق أقصى دقة تنبؤية ممكنة بأقل عدد ممكن من البنود أو المقاييس الفرعية. إن تقليص عدد المتغيرات التنبؤية لا يوفر فقط الموارد الزمنية والمادية اللازمة لتطبيق الاختبارات على الطلاب والمفحوصين، بل يقلل أيضاً من إجهاد المفحوصين النفسي، مما ينعكس إيجاباً على موثوقية الاستجابات وجودة البيانات الإجمالية المستخلصة في الميدان السلوكي.
2. الأسس النظرية لاختيار المتغيرات والنماذج الإحصائية
2.1 مشكلة فرط التخصيص والموازنة بين الانحياز والتباين
تُعد مشكلة فرط التخصيص (Overfitting) الخطر الأكبر الذي يهدد استقرار النماذج الإحصائية وقابليتها للتعميم في البحوث السلوكية؛ وتحدث هذه المعضلة عندما يصبح النموذج الإحصائي مفرط التعقيد لدرجة تجعله يتعلم عشوائية البيانات وتشويشها (Noise) الخاص بالعينة المتاحة بدلاً من استيعاب النمط البنيوي الحقيقي للمجتمع الإحصائي الأصلي. تظهر خطورة هذا الخلل عندما يُظهر النموذج قدرة تفسيرية مذهلة داخل العينة التجريبية، لكنه ينهار تماماً ويفشل في التنبؤ بسلوك عينات جديدة مستقلة مأخوذة من ذات المجتمع، مما يهدد المصداقية العلمية للنظريات النفسية المطروحة.
ترتبط هذه الظاهرة وثيقاً بالمعضلة الرياضية الشهيرة المعروفة بـ “الموازنة بين الانحياز والتباين” (Bias-Variance Trade-off). في هذه المعادلة، يمثل “الانحياز” الخطأ الناتج عن تبسيط الافتراضات التنبؤية لدرجة تؤدي إلى نقص التخصيص (Underfitting) وإغفال علاقات جوهرية؛ بينما يمثل “التباين” حساسية النموذج للتقلبات العشوائية في عينة التدريب، حيث يؤدي إقحام عدد مفرط من المتغيرات إلى انفجار تباين التقديرات التنبؤية. تتمثل مهمة إجراء PROC GLMSELECT في قيادة الباحث عبر منطقة وسطى تحسن نقطة التقاطع الحسابي، مما يضمن تقليل الخطأ الكلي لمتوسط المربعات التنبؤية إلى أدنى حد ممكن عبر فضاء الحلول الرياضية المتاحة.
يتماشى هذا النهج مع مبدأ فلسفي وإحصائي راسخ يُعرف باسم “نصل أوكام” (Occam’s Razor)، الذي يفترض أنه عند تعادل النماذج في قدرتها على تفسير الظاهرة، فإن النموذج الأبسط هيكلياً هو الأفضل والأكثر موثوقية. يفرض هذا المبدأ الابتعاد عن الاعتماد الكلاسيكي المضلل على قيمة معامل التحديد التقليدي ($R^2$)؛ حيث إن هذا المعامل يتسم بعيب حسابي متأصل يتمثل في زيادته الآلية الحتمية كلما أُضيف متغير جديد إلى النموذج، حتى لو كان هذا المتغير مجرد أرقام عشوائية لا صلة لها بالظاهرة السلوكية، مما يخدع الباحث ويدفعه إلى تبني نماذج متضخمة تفتقر للصدق التنبؤي الحقيقي.
2.2 معايير المفاضلة ونظرية المعلومات (AIC, BIC, SBC, AICC)
لتجاوز عيوب معامل التحديد التقليدي، تستند النمذجة الإحصائية الحديثة إلى نظرية المعلومات والدوال العقابية التي تفرض “جزاءً رياضياً” (Penalty) على تعقيد النموذج بما يتناسب طردياً مع عدد المعالم والمتغيرات المضمنة فيه. يبرز في هذا السياق معيار أكايكي للمعلومات (Akaike Information Criterion – AIC)، الذي يستند إلى قياس الفقد النسبي في المعلومات عبر تباعد كولباك-ليبلر (Kullback-Leibler Divergence). يهدف AIC إلى اختيار النموذج الأقرب إلى الحقيقة المجهولة التي ولدت البيانات، ومع ذلك، فقد أظهرت الدراسات ميل AIC إلى اختيار نماذج مفرطة التخصيص قليلاً في العينات الصغيرة، مما استوجب صياغة النسخة المصححة (AICC) التي تفرض عقوبة مضاعفة تراعي محدودية حجم العينة بالنسبة لعدد المعالم.
على الطرف المقابل، يبرز معيار شوارتز البايزي (Schwarz Bayesian Criterion – SBC)، والذي يُعرف بشكل ترادفي في الأدبيات باسم معيار المعلومات البايزي (BIC). ينطلق هذا المعيار من منطلق بايزي مفاده افتراض وجود النموذج الحقيقي الفعلي ضمن فضاء النماذج المرشحة، ويعمل على تعظيم الاحتمالية البعدية لذلك النموذج. يتميز SBC بمعاقبته الصارمة لتعقيد النموذج من خلال ضرب عدد المعالم في اللوغاريتم الطبيعي لحجم العينة ($ln(n)$)، مما يجعله أكثر ميلاً لاختيار نماذج شديدة البارسيمونية وأقل تعقيداً مقارنة بمعيار AIC، وهو ما يجعله خياراً مفضلاً في البحوث التربوية الرامية إلى عزل المتغيرات الأساسية فقط.
تتضمن ترسانة المعايير أيضاً معيار ميتي المعروف بـ (Mallows’ $C_p$)، والذي يركز على مقارنة الخطأ الكلي لمربعات التنبؤ للنموذج الفرعي بنظيره في النموذج الكلي المشبع؛ حيث تشير النماذج ذات القيمة القريبة من عدد المعالم المقدرة ($p$) إلى نموذج ذي انحياز منخفض واستقرار عالي. يكمن الفارق الجوهري بين هذه المؤشرات في الغاية المنهجية للباحث؛ فإذا كان الهدف هو التنبؤ البحت بسلوك مستقبلي بأعلى دقة، يميل الخبراء إلى تفضيل AIC أو AICC، أما إذا كان الهدف هو استنباط النموذج النظري الحقيقي المستقر ذي الصدق البنائي القوي، فإن كفة SBC/BIC ترجح بلا منازع.
2.3 دور التحقق التجريبي في استقرار النماذج السلوكية
لا يكتمل البناء النظري لاختيار النماذج بالاعتماد الحصري على المعايير الإحصائية المشتقة من مصفوفة البيانات ذاتها؛ إذ تظل تلك المعايير عرضة لما يُعرف في الأدبيات بـ “التفاؤل الإحصائي” (Statistical Optimism). يُقصد بهذا المفهوم التقدير المفرط لإحصاءات التوفيق وميل معاملات الانحدار إلى الظهور بقيم أكبر من قيمتها الحقيقية في المجتمع، نتيجة انتقاء النموذج الذي يتطابق بالصدفة مع التقلبات العشوائية للعينة المتاحة. للتصدي لهذا القصور، تفرض المنهجية الرصينة دمج أساليب التحقق التجريبي المستقل ضمن خوارزميات الاختيار.
يتحقق ذلك عبر استراتيجية التقسيم الهيكلي للبيانات إلى ثلاث مجموعات فرعية متمايزة وظيفياً: مجموعة التدريب (Training Set) التي تُستخدم لبناء النماذج وتقدير المعالم الأولية، ومجموعة التحقق (Validation Set) التي تُوظف لمقارنة النماذج المتسلسلة واختيار النموذج الأمثل وتحديد نقطة توقف الخوارزمية، ومجموعة الاختبار (Test Set) المستقلة تماماً التي لا تتدخل في أي قرار إحصائي وتُحفظ حصرياً لتقييم الأداء التنبؤي النهائي للنموذج المختار وتقدير خطأ التعميم الحقيقي. تضمن هذه المنهجية الحفاظ على الحياد الإحصائي وقطع دابر الاستقراء الدائري المضلل.
في سياق القياس السلوكي، يُعد التحقق التجريبي حجر الزاوية لتثبيت “الصدق المتقاطع” (Cross-Validity) للبطاريات السيكومترية. فعندما يثبت النموذج المختار كفاءته واستقراره عبر عينات مستقلة لم تشارك في تدريب الخوارزميات، تتولد الثقة العلمية في أن البناء النظري المستخلص يعكس بنية سيكولوجية حقيقية تتسم بالاستقرار الزماني والمكاني، ولا يمثل نتاجاً عرضياً لخطأ العينات أو الانحرافات العشوائية لبيانات جمعت في سياق زمكاني ضيق.
3. البنية التركيبية العامة لصيغة PROC GLMSELECT ومكوناتها البرمجية
3.1 جملة الإجراء وخيارات التحكم في البيانات
تبدأ الشيفرة البرمجية في SAS باستدعاء جملة الإجراء الأساسية عبر الصيغة العامة: PROC GLMSELECT DATA=dataset-name <options>;. يمثل خيار DATA= المحدد الأساسي لمكتبة ومجموعة البيانات المستهدفة بالتحليل؛ وإذا أُغفل هذا الخيار، فإن النظام يتجه تلقائياً لاستخدام آخر مجموعة بيانات تم إنشاؤها في جلسة العمل النشطة. ومع ذلك، تتطلب الحصافة الأكاديمية والبرمجية كتابة مسار البيانات بدقة لضمان تكرارية التحليل وسلاسة مراجعته من قبل الباحثين النظراء.
تتيح جملة الإجراء باقة واسعة من خيارات التحكم المتقدمة في تدفق المخرجات وإدارة المخططات الرسومية؛ حيث يلعب أمر PLOTS= دوراً محورياً في تفعيل الرسوم البيانية الإحصائية التفاعلية عبر نظام (ODS Graphics). يمكن للباحث طلب مخططات تفصيلية لمسار الانتقاء مثل PLOTS=CRITERIA لمراقبة تطور قيم معايير الاختيار (كـ SBC و AIC) عبر خطوات التحليل، أو PLOTS=COEFFICIENTS لتتبع مسار انكماش وتقدير معاملات المتغيرات، بالإضافة إلى مخططات المتبقيات والتحقق التنبؤي التي توفر فهماً بصرياً عميقاً لسلوك الخوارزمية في كل خطوة برمجية.
علاوة على ذلك، توفر خيارات الإجراء إمكانية التحكم في إدارة الذاكرة، وضبط البذور العشوائية لعمليات التقسيم الداخلي للبيانات عبر خيار SEED=، وهو أمر بالغ الأهمية لضمان تطابق النتائج الرياضية بدقة عند إعادة تنفيذ الشيفرة البرمجية في أوقات لاحقة أو على أجهزة أخرى. تكتمل جملة الإجراء بضبط دقة عرض الجداول التلخيصية، وإمكانية حجب بعض الجداول الثانوية للحد من التشتت والتركيز على الإحصاءات التفسيرية المركزية للدراسة.
3.2 الجمل الإلزامية: جملة CLASS وجملة MODEL
تقوم البنية التحليلية لإجراء PROC GLMSELECT على ركيزتين إلزاميتين لا غنى عنهما لتدشين النموذج: جملة التصنيف CLASS وجملة النموذج MODEL. تُعنى جملة CLASS بتعريف كافة المتغيرات المستقلة ذات الطبيعة الاسمية أو الفئوية أو الترتيبية (مثل نوع الجنس، أو التخصص الدراسي، أو المستوى الاقتصادي والاجتماعي)، حيث يقوم الإجراء تلقائياً بمعالجة هذه المتغيرات وبناء معاملات التصميم المناسبة لها دون الحاجة إلى تكويد يدوي مضنٍ ومشتت.
تتميز جملة CLASS في هذا الإجراء بمرونة فائقة تفوق نظيراتها في الإجراءات التقليدية؛ حيث تتيح خيار PARAM=REF لتحديد التكويد المرجعي وتحديد الفئة التي تُقاس إزاءها الفئات الأخرى، أو خيار PARAM=EFFECT لتكويد التأثيرات المحايدة بالنسبة للمتوسط الكلي. كما تبرز ميزة SPLIT الحصرية، والتي تمكن الإجراء من تفكيك مستويات المتغير التصنيفي والسماح للخوارزمية باختيار فئات محددة فقط تدخل في النموذج النهائي وتترك فئات أخرى للمرجع، مما يوفر بارسيمونية غير مسبوقة في التعامل مع المتغيرات النوعية ذات المستويات المتعددة في القياس النفسي.
أما جملة MODEL، فتمثل المعادلة الهيكلية التي تحدد ميكانيكية التحليل عبر الصيغة: MODEL dependent-variable = independent-effects / <options>;. يُحدد هنا المتغير التابع المستمر في الطرف الأيسر، بينما تُسرد المتغيرات المستقلة والتأثيرات المرشحة في الطرف الأيمن. يتيح الإجراء بناء حدود تفاعلية معقدة بين المتغيرات بصورة مباشرة وسهلة، مثل استخدام علامة النجمة للتفاعل الثنائي X1*X2 أو علامة الشريط العمودي للتفاعلات الشاملة والحدود الرئيسية X1|X2|X3@2، مما يفسح المجال لاختبار النظريات السلوكية ذات التأثيرات المعدلة والمتداخلة بمنتهى الانسيابية الحسابية.
3.3 جملة SELECTION والخيارات الفرعية المرتبطة بها
تُمثل جملة SELECTION العقل المدبر والقلب النابض لإجراء PROC GLMSELECT؛ فمن خلالها يوجه الباحث الآلية الرياضية التي ستعتمدها الخوارزمية في مسح فضاء النماذج واستخلاص التركيبة التنبؤية المثلى. يبدأ ضبط هذه الجملة بتحديد الخيار الرئيسي METHOD=، والذي يحدد الاستراتيجية العامة للاختيار، سواء كانت من الطرق الكلاسيكية المتدرجة كالانحدار الخطوي (STEPWISE)، أو من الخوارزميات المنظمة الحديثة كطريقة لاسو (LASSO) أو الانحدار التدريجي الأقل (LAR) أو طريقة الحصر الكلي للنماذج الفضلى (ALLSUBSETS).
تتفرع من هذه الجملة ثلاثة خيارات فرعية جوهرية تشكل معاً محددات القرار الحسابي؛ أولها خيار SELECT=، وهو المسؤول عن المعيار الإحصائي المعتمد لإضافة أو استبعاد التأثير في كل خطوة تجريبية فردية من مسار الاختيار (مثل الاعتماد على مستويات الدلالة SL، أو معيار AIC، أو معيار SBC). الخيار الثاني هو STOP=، ويحدد الشرط الرياضي الدقيق الذي يجب عنده إيقاف خوارزمية البحث ومنعها من الاستمرار في إدخال متغيرات أخرى قد تفاقم فرط التخصيص أو تستهلك درجات الحرية دون طائل تحليلي ملموس.
أما الخيار الثالث والأكثر حساسية فهو خيار CHOOSE=، والذي يفصل بصورة منهجية عبقرية بين عملية “بناء مسار النماذج” وعملية “اختيار النموذج النهائي”. فبينما قد تستمر الخوارزمية في توليد سلسلة من النماذج المتزايدة أو المتناقصة، يقوم خيار CHOOSE= بمسح كافة النماذج التي تم المرور بها خلال المسار، وانتقاء النموذج النهائي الذي حقق القيمة المثلى وفق المعيار المفضل للباحث (مثل أدنى قيمة لـ SBC أو أدنى خطأ تنبؤي لمجموعة التحقق VALIDATE). يتيح هذا الفصل الدقيق للباحث الجمع بين دقة خطوات الاختيار ورصانة التقييم النهائي المستقل للنموذج المختار.
4. إعداد مصفوفة البيانات النفسية والتربوية للتطبيق العملي
4.1 إنشاء مجموعة البيانات باستخدام DATA Step وتعريف المقاييس
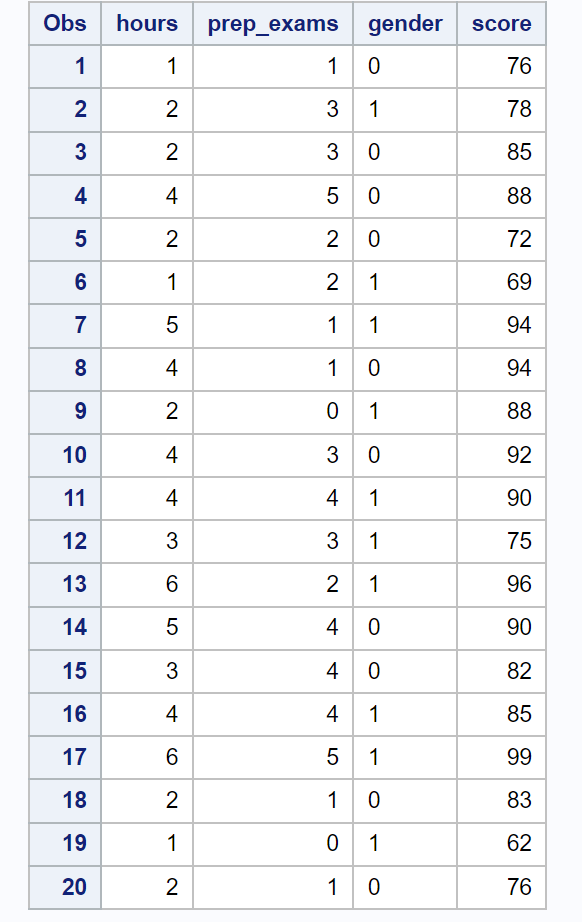
لتحقيق الربط التطبيقي الرصين بين المفاهيم النظرية والتنفيذ البرمجي، سنقوم بإنشاء مصفوفة بيانات أكاديمية تحاكي دراسة ميدانية في علم النفس التربوي تستهدف التنبؤ بـ “درجة الاختبار النهائي” (ExamScore) لدى طلاب المرحلة الثانوية. تشمل هذه الدراسة مصفوفة من المتغيرات المستقلة ذات الأبعاد السيكومترية والسلوكية المختلفة: ساعات الاستذكار الأسبوعية (StudyHours)، وعدد الاختبارات التجريبية التدريبية التي خاضها الطالب (PracticeExams)، ونوع الجنس (Gender)، بالإضافة إلى مستوى قلق الاختبار كمتغير نفسي مركب (TestAnxiety)، والحالة الاجتماعية-الاقتصادية للأسرة (SES).
يتم بناء ملف البيانات عبر خطوة البيانات DATA Step المعتمدة في SAS، حيث يُستخدم أمر INPUT لتعيين أسماء المتغيرات وأنماطها بدقة؛ مع تمييز المتغيرات النوعية برمز الدولار ($) للدلالة على قيمها الحرفية. يعقب ذلك استخدام أمر DATALINES أو CARDS لتدوين الأسطر الرقمية المستخلصة من عينة الطلاب المفحوصين، مع الحرص التام على ضبط التنسيق السيكومتري للمتغيرات ومراعاة الفروق الرياضية بين المتغيرات المستمرة والمتقطعة والثنائية، وتخزين هذه المصفوفة المنظمة داخل مكتبة العمل المؤقتة WORK.StudyData لتكون جاهزة للمناولة الإحصائية.
يوضح النص البرمجي التالي كيفية بناء وتغذية مصفوفة البيانات هذه في بيئة SAS:
DATA StudyData;

  INPUT ID Gender $ SES $ StudyHours PracticeExams TestAnxiety ExamScore;

  DATALINES;

  101 Female High  25.5 4 45.2 88.5

  102 Male   Mid  18.0 2 62.0 72.0

  103 Female Low  12.5 1 78.5 61.0

  104 Male   High 30.0 5 35.0 94.0

  105 Female Mid  22.0 3 55.4 81.5

  106 Male   Low  10.0 0 85.0 54.0

  107 Female High 28.5 4 40.0 91.0

  108 Male   Mid  16.5 2 68.2 69.5

  109 Female Mid  20.0 3 58.0 77.0

  110 Male   High 24.0 4 49.5 83.0

  ;

RUN;
تسمح هذه الصياغة النموذجية بدمج قياسات كمية مستمرة مثل ساعات الدراسة ومقياس القلق، مع مؤشرات نوعية فئوية متعددة الرتب مثل الوضع الاجتماعي والاقتصادي ومؤشرات ثنائية مثل الجنس، مما يخلق بيئة اختبار واقعية ومثالية لمحاكاة تحديات النمذجة الإحصائية الميدانية.
4.2 الفحص الاستكشافي للبيانات قبل إجراء النمذجة
تقتضي الرصانة الأكاديمية عدم الاندفاع الفوري نحو تشغيل نماذج الاختيار الآلية دون إجراء فحص استكشافي نقدي معمق للبنية الإحصائية للبيانات المجمعة. يُستهل هذا الفحص بتوظيف إجراء PROC PRINT DATA=StudyData(OBS=10); للتأكد البصري من سلامة تسجيل الحالات وقراءة SAS للأعمدة والرموز بصورة صحيحة وخالية من أخطاء الإزاحة الرأسية أو التداخل الطباعي أثناء الإدخال.
تنتقل المعالجة الاستكشافية بعد ذلك إلى تطبيق إجراء PROC MEANS لاستخراج مقاييس النزعة المركزية ومؤشرات التشتت لجميع المتغيرات المستمرة (المتوسطات الحسابية، والانحرافات المعيارية، والمدى، ومعاملات الالتواء والتفرطح)، يرافقه استدعاء إجراء PROC FREQ لتفحص التوزيعات التكرارية والنسب المئوية للمتغيرات التصنيفية ضمن فئاتها المختلفة. يوفر هذا الفحص خط دفاع جوهري لرصد أي قيم مفقودة (Missing Values) أو شاذة (Outliers) تقع خارج الحدود المنطقية لمقاييس القياس النفسي، والتي قد تشوه جوهرياً كفاءة خوارزميات الانكماش والتقدير.
يتوج هذا المسار الاستكشافي بتطبيق إجراء PROC CORR لتوليد مصفوفة معاملات ارتباط بيرسون بين جميع المتغيرات التنبؤية الكمية والمتغير التابع المستهدف. لا يقتصر هدف هذه الخطوة على التحقق من وجود علاقات خطية أولية تبرر إدراج المتغيرات في النموذج التنبؤي فحسب، بل يمتد لرصد مؤشرات التداخل والارتباط الخطي الداخلي المفرط (Multicollinearity) بين المتنبئات ذاتها؛ إذ إن الفهم المسبق لشبكة العلاقات المتبادلة يمنح الباحث بصيرة نقدية تمكنه من تقييم سلوك خوارزمية PROC GLMSELECT لاحقاً عندما تبدأ في تفضيل متغير واستبعاد آخر نتيجة تنافسهما الإحصائي على ذات التباين التفسيري.
5. خوارزميات وطرق اختيار المتغيرات المتاحة في PROC GLMSELECT
5.1 الأساليب التدريجية الكلاسيكية (Forward, Backward, Stepwise)
تُعد الأساليب التدريجية الكلاسيكية أقدم الخوارزميات المعتمدة استكشافياً في برمجيات الانحدار، وتعود أصولها الرياضية إلى الأعمال التأسيسية التي وضعها إفرويمسون (Efroymson, 1960). تنقسم هذه الأساليب إلى ثلاثة مسارات تكتيكية؛ أولها “طريقة الاختيار الأمامي” (Forward Selection)، والتي تبدأ من نموذج صفري فارغ لا يحتوي سوى على الثابت الإحصائي (Intercept)، ثم تختبر المتغيرات التنبؤية تباعاً، لتضيف في كل خطوة المتغير الذي يقدم أعلى مساهمة إحصائية معنوية في خفض مجموع مربعات الخطأ. يعيب هذه الطريقة أنها أحادية الاتجاه؛ فالمتغير الذي يدخل النموذج يظل محبوساً فيه إلى الأبد، حتى لو فقد معنويته لاحقاً بعد دخول متغيرات أخرى أقوى منه تشاركه التباين.
المسار الثاني هو “طريقة الحذف الخلفي” (Backward Elimination)، وهي تعمل بالاتجاه المعاكس تماماً؛ حيث تنطلق الخوارزمية من “النموذج المشبع الكامل” (Full Saturated Model) الذي يضم كافة المتغيرات المرشحة، ثم تبدأ في تقييم المساهمة الجزئية لكل متغير، وحذف المتغير صاحب الأثر الأضعف وغير الدال إحصائياً خطوة تلو الأخرى حتى تستقر جميع المتغيرات المتبقية ضمن معايير البقاء المحددة. يُفضل علماء الإحصاء غالباً هذه الطريقة على الاختيار الأمامي لأنها تتيح تقييم تأثير كل متغير في ظل وجود ومساندة كافة المتغيرات الأخرى، غير أنها تفشل حسابياً إذا كان عدد المتغيرات يتجاوز حجم العينة.
أما المسار الثالث فيتمثل في “الانحدار التدريجي ثنائي الاتجاه” (Stepwise Selection)، وهو الخوارزمية الهجينة الأكثر توازناً بين الأساليب الكلاسيكية. يبدأ المسار كطريقة الإدخال الأمامي بإضافة أفضل المتغيرات فرادى، غير أنه في كل خطوة جديدة يقوم بإعادة فحص معنوية جميع المتغيرات التي سَبق إدخالها في الخطوات الماضية؛ فإذا أصبح أحدها زائداً عن الحاجة أو فقد معنويته نتيجة التداخل التوزيعي للمتغيرات اللاحقة، تقوم الخوارزمية بطرده فوراً خارج النموذج. ومع ذلك، تواجه هذه الأساليب الكلاسيكية برمتها انتقادات أكاديمية عنيفة في الأدبيات السيكومترية الحديثة؛ نظراً لتحيز قيم الأخطاء المعيارية الناتجة، والمبالغة في خفض قيم الدلالة ($p$-values)، وتجاهلها لمعضلة التعددية الخطية، مما استوجب الانتقال نحو الحلول المنظمة الأكثر تقدماً.
5.2 الأساليب الحديثة والمنظمة: لاسو (LASSO) والانحدار التدريجي الأقل (LAR)
أحدثت أساليب التقنين والانكماش (Regularization and Shrinkage Methods) ثورة حقيقية في حقل الإحصاء المعاصر لمواجهة عيوب الطرق التدريجية الكلاسيكية. يبرز في طليعة هذه الأساليب خوارزمية “الانحدار التدريجي الأقل” (Least Angle Regression – LAR) التي ابتكرها برادلي إيفرون وتريفور هاستي وروبرت تيبشيراني وتياو جونستون (Efron, Hastie, Johnstone, & Tibshirani, 2004). تعمل LAR كخوارزمية مسار هندسية فائقة الكفاءة؛ حيث تدخل المتغيرات على طول اتجاهات متساوية الزوايا (Equiangular Directions) تتطابق طردياً مع معاملات ارتباط متبقيات النموذج الحالي، مما يقلل العبء الحسابي الهائل ويوفر أساساً رياضياً متيناً لتنفيذ أساليب الانكماش المقيدة بكفاءة مذهلة.
على هذه القاعدة الرياضية تنهض تقنية “لاسو” (LASSO – Least Absolute Shrinkage and Selection Operator) التي ابتكرها روبرت تيبشيراني (Tibshirani, 1996). لا تقتصر لاسو على تقليل مجموع مربعات الأخطاء التقليدية، بل تفرض عقوبة رياضية انكماشية صارمة تُعرف بجزاء المعيار الأول ($L_1$ Penalty) والمتمثلة في مجموع القيم المطلقة لمعاملات الانحدار ($\sum |\beta_j| le t$). يؤدي هذا القيد الرياضي الهندسي الفريد إلى خاصية “تصفير المعاملات”؛ حيث لا تكتفي الخوارزمية بتقليص قيم المعاملات المتضخمة كما في انحدار ريدج (Ridge)، بل تقوم بجعل معاملات المتغيرات غير المجدية تنبؤياً تساوي صفراً تماماً، مما يدمج عمليتي انتقاء المتغيرات وتقدير المعالم في خطوة رياضية متزامنة وغاية في الاستقرار.
ولمعالجة الحالات التي تتسم بتكتل متغيرات سيكولوجية عالية الارتباط المتبادل والتي قد تختار منها لاسو متغيراً واحداً عشوائياً وتهمل البقية، طور هوي زو وتريفور هاستي تقنية “الشبكة المرنة” (Elastic Net; Zou & Hastie, 2005)، والتي تدمج بين جزاء المعيار الأول $L_1$ (لاسو) وجزاء المعيار الثاني $L_2$ (ريدج). يتيح هذا الدمج خلق ما يسمى بـ “تأثير التجميع” (Grouping Effect)، حيث يتم الإبقاء على مصفوفة المتغيرات السلوكية المتداخلة أو إسقاطها معاً كوحدة بنائية متكاملة. كما أضاف زو لاحقاً تقنية “لاسو التكيفية” (Adaptive LASSO; Zou, 2006) التي تعطي أوزاناً عكسية للجزاء بناءً على تقديرات أولية متسقة، محققة “خاصية الأوراكل” (Oracle Property) التي تضمن نظرياً تصرف النموذج تماماً كما لو كان الباحث يعلم سلفاً النموذج الحقيقي الصحيح للظاهرة المقاسة.
6. تطبيق عملي خطوة بخطوة: كتابة الشيفرة البرمجية واختيار النموذج الأفضل
6.1 صياغة الكود الكامل للتحليل باستخدام خيار STEPWISE ومعيار SBC
لبناء النموذج التنبؤي المتكامل واختبار سلوك إجراء PROC GLMSELECT ميدانياً، نقوم بصياغة الشيفرة البرمجية التي تهدف إلى نمذجة درجات الاختبار النهائي للطلاب بالاعتماد على حزمة المتغيرات المستقلة المتاحة (ساعات الدراسة، الاختبارات التجريبية، قلق الاختبار، الوضع الاقتصادي والاجتماعي، والنوع). نعتمد في هذه المحاكاة على خوارزمية الانحدار التدريجي (STEPWISE)، مدعومة بمعيار شوارتز البايزي (SBC) لضبط القرارات الإحصائية عبر مسار البحث، نظراً لقدرة SBC المشهودة على معاقبة التعقيد وضمان الوصول إلى نموذج مقتصد يلائم أهداف البحث الأكاديمي.
تتضمن الشيفرة تفعيل بيئة الرسوم البيانية الإحصائية عبر أمر ODS GRAPHICS ON; قبل تشغيل الإجراء، مما يمكن الباحث من تفحص المخططات التتبعية الدقيقة لمعايير الاختيار في مخرجات SAS. يُدرج المتغيران الفئويان (Gender و SES) ضمن جملة CLASS مع استخدام خيار التكويد المرجعي لتعيين المستويات الأساسية التي تُقارن إزاءها الفئات، في حين تتولى جملة SELECTION مواءمة الخوارزمية عبر تخصيص خياري SELECT=SBC و CHOOSE=SBC لتوحيد معيار الاختيار في الخطوات الفردية مع معيار انتقاء النموذج النهائي الحاسم، كما يوضح الكود التالي:
ODS GRAPHICS ON;

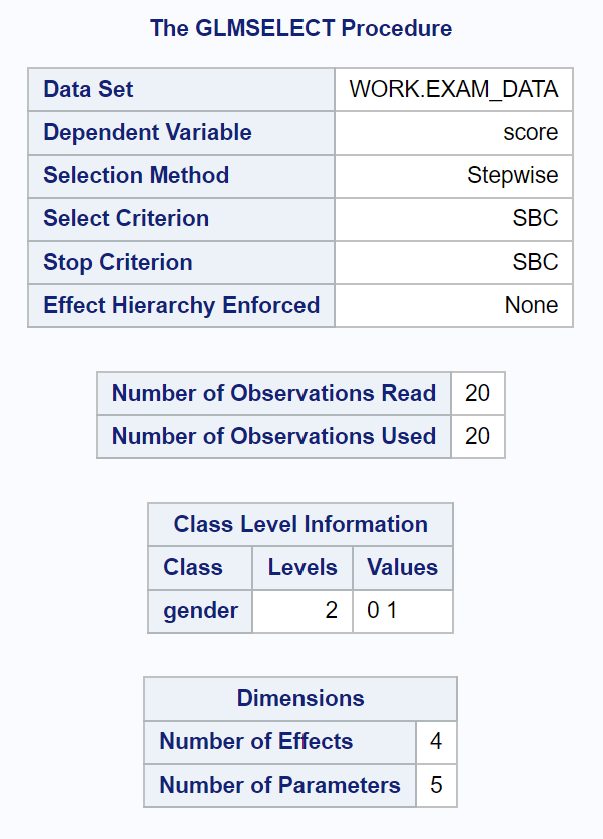
PROC GLMSELECT DATA=StudyData PLOTS=CRITERIA;

  CLASS Gender(REF='Male') SES(REF='Low') / PARAM=REF;

  MODEL ExamScore = StudyHours PracticeExams TestAnxiety Gender SES

        / SELECTION=STEPWISE(SELECT=SBC CHOOSE=SBC STOP=SBC);

RUN;

ODS GRAPHICS OFF;
إن تخصيص المعايير الثلاثة (SELECT و CHOOSE و STOP) بالاعتماد على مؤشر SBC يضمن تناغماً بنيوياً مطلقاً في حركة الخوارزمية؛ حيث لا يُقبل دخول أي متغير جديد ما لم يُحدث خفضاً حقيقياً في قيمة SBC يتفوق على الجزاء الرياضي المفروض على خسارة درجات الحرية، كما تتوقف الخوارزمية تلقائياً بمجرد عجز المتغيرات المتبقية عن تحسين هذا المعيار، مما يستبعد كلياً النزعة نحو التضخم التفسيري الاصطناعي.
6.2 تضمين حدود التفاعل والتأثيرات غير الخطية في التحليل
نادراً ما تسير الظواهر النفسية والتربوية وفق خطوط مستقيمة وبسيطة؛ فغالباً ما تخضع العلاقات السلوكية لتأثيرات تفاعلية معدلة (Moderation Effects) أو تأثيرات غير خطية ناتجة عن مبدأ تناقص العوائد المعرفية. في دراستنا التطبيقية، قد يفترض الإطار النظري أن أثر ساعات الاستذكار على درجات الاختبار يتأثر بمستوى قلق الاختبار لدى المفحوص (تفاعل كمي × كمي)، أو قد يتفاوت هذا الأثر باختلاف نوع الجنس (تفاعل كمي × فئوي)، فضلاً عن احتمال وجود مسار تربيعي (Quadratic Term) يجعل الإفراط المبالغ فيه في ساعات الاستذكار يؤدي إلى الإنهاك الذهني وتراجع التحصيل الإضافي.
يوفر PROC GLMSELECT قدرة فائقة على صياغة واختبار هذه التعقيدات التركيبية مباشرة داخل جملة MODEL، دون الحاجة إلى تكوين أعمدة التفاعل مسبقاً في خطوة البيانات. كما يدعم الإجراء تطبيق مبدأ “التسلسل الهرمي للنماذج” (Hierarchical Constraints) عبر خيار HIERARCHY=SINGLE؛ وهو شرط منهجي صارم يضمن عدم إبقاء أي حد تفاعلي مركب (مثل StudyHours*TestAnxiety) في النموذج النهائي ما لم تكن آثاره الرئيسية المفردة (StudyHours و TestAnxiety) محتفظاً بها بالفعل داخل النموذج، حفاظاً على التماسك التفسيري الرياضي وفق ما يوضحه النص البرمجي الآتي:
PROC GLMSELECT DATA=StudyData PLOTS=ALL;

  CLASS Gender(REF='Male') SES(REF='Low') / PARAM=REF;

  MODEL ExamScore = Gender SES StudyHours PracticeExams TestAnxiety

                    StudyHours*StudyHours

                    StudyHours*Gender

                    StudyHours*TestAnxiety

        / SELECTION=STEPWISE(SELECT=SBC CHOOSE=SBC HIERARCHY=SINGLE);

RUN;
يسمح هذا التضمين المنهجي للخوارزمية باختبار ما إذا كانت إضافة التأثيرات غير الخطية والحدود التفاعلية تقدم تحسناً حقيقياً وملموساً في التفسير السيكومتري يتجاوز “كلفة التعقيد” الرياضي، مما يضمن في نهاية المطاف صياغة نموذج يجمع بين الواقعية النفسية المعمقة والاقتصاد الرياضي التام في المعالم التقديرية.
7. قراءة وتحليل مخرجات PROC GLMSELECT بدقة وتفسير النتائج
7.1 جدول مسار الاختيار وملخص خطوات النمذجة (Selection Summary)
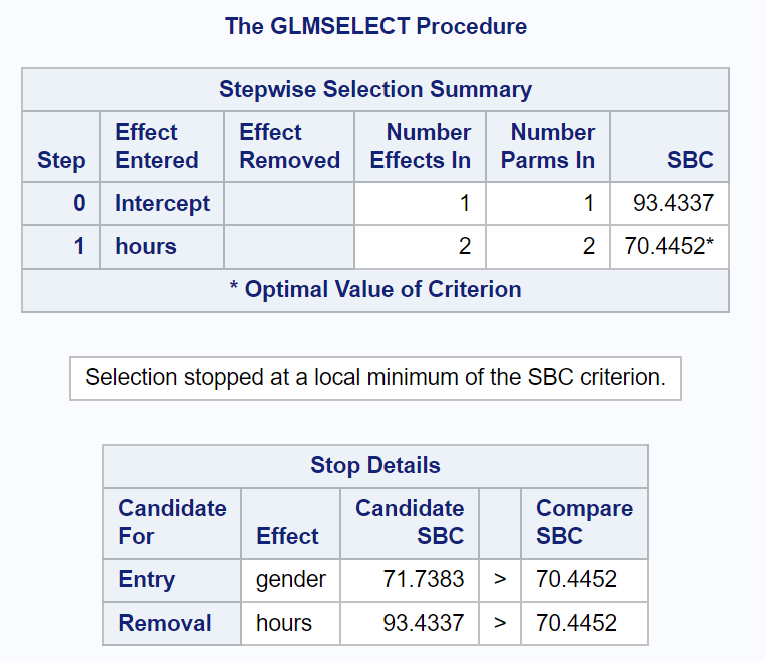
يُمثل جدول “ملخص الاختيار” (Selection Summary) الخريطة التتبعية الأساسية التي تُوثق بالتفصيل التاريخ الحسابي لكيفية تنقل الخوارزمية بين النماذج المتسلسلة خطوة بخطوة. يعرض هذا الجدول المنظم تسلسل الخطوات بدءاً من الخطوة الصفرية (التي تضم الثابت الإحصائي فقط)، موضحاً في كل صف المتغير الذي تم إدخاله (Effect Entered) أو حذفه (Effect Removed)، وعدد التأثيرات الإجمالية القائمة في النموذج عند تلك المحطة، والقيمة المتغيرة لمعيار الاختيار المستهدف (مثل قيمة SBC) مرافقة لقيمة معامل التحديد ($R^2$) وقيمة معامل التحديد المعدل.
عند تفحص هذا الجدول في سياق تطبيقنا التربوي، نلاحظ عادة انخفاضاً حاداً ومطرداً في قيمة SBC عند الخطوات الأولى؛ حيث يؤدي إدخال متغير “ساعات الدراسة” (StudyHours) في الخطوة الأولى إلى تقليص ضخم في مجموع مربعات الأخطاء يتجاوز بكثير الجزاء المفروض على إضافة معلم واحد، مما يخفض قيمة SBC بشكل ملموس. قد تلي ذلك إضافة متغير “قلق الاختبار” (TestAnxiety) في الخطوة الثانية ليواصل المعيار انخفاضه، معلناً استمرار تحسن الكفاءة التنبؤية للنموذج المقتصد وتكامل الأبعاد المعرفية والانفعالية في تفسير الأداء.
تتجلى اللحظة الحاسمة في هذا الجدول عند بلوغ “نقطة التحول الدنيا” لمعيار SBC؛ ففي خطوات تالية، قد يظهر الجدول أن إقحام متغيرات إضافية كـ “الاختبارات التجريبية” (PracticeExams) أو “نوع الجنس” (Gender) قد أدى إلى زيادة طفيفة في قيمة معامل التحديد التقليدي، لكنه في المقابل أدى إلى ارتفاع قيمة SBC بدلاً من انخفاضها. هنا يتعرف الباحث على سبب استبعاد تلك المتغيرات؛ فالتحسن التنبؤي الطفيف الذي قدمته لم يكن كافياً لموازنة الجزاء الرياضي لتعقيد النموذج، لتتوقف الخوارزمية عند الخطوة المثلى التي تُعلم عادة بنجمة إحصائية في مخرجات SAS مشيرة إلى استقرار “النموذج الأفضل المختار” (Optimal Selected Model).
7.2 جدول تحليل التباين وملخص النموذج النهائي (ANOVA and Fit Statistics)
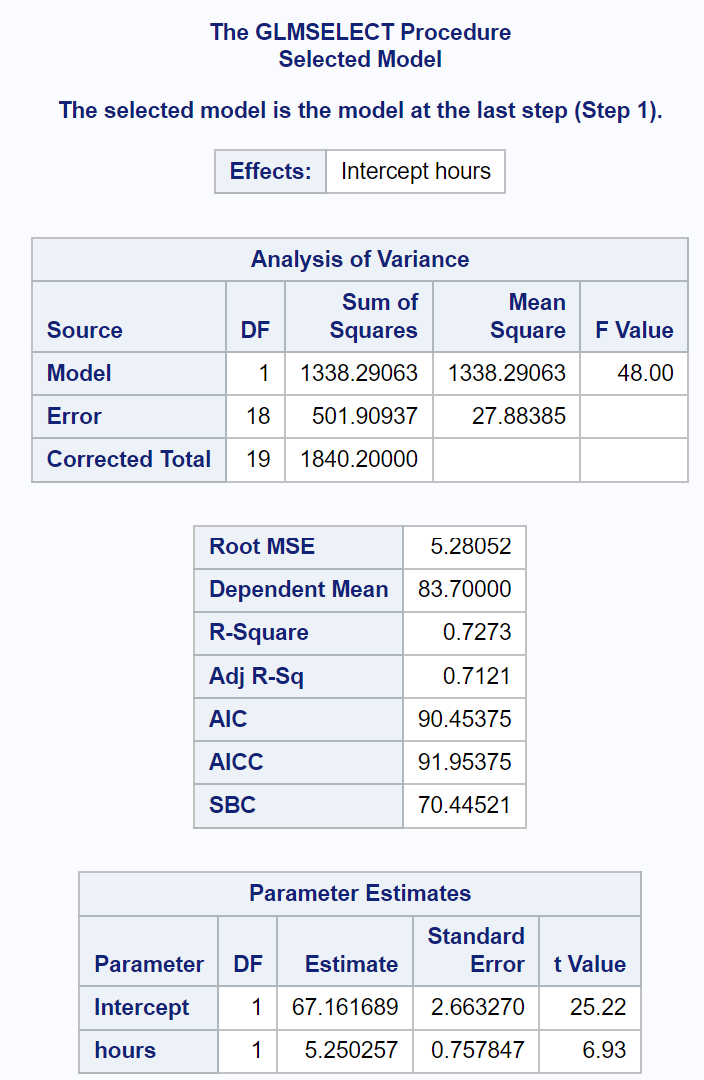
بمجرد تحديد النموذج الأمثل، يولد الإجراء مجموعة من الجداول الختامية المركزية؛ يأتي في مقدمتها جدول تحليل التباين (Analysis of Variance – ANOVA) المخصص حصرياً للنموذج المختار النهائي. يتضمن هذا الجدول تفكيكاً دقيقاً لـ مجموع المربعات الإجمالي (Total SS) إلى مجموع مربعات الانحدار المفسر بواسطة النموذج (Model SS) ومجموع مربعات الأخطاء أو المتبقيات العشوائية غير المفسرة (Error SS)، إلى جانب درجات الحرية المقابلة ومتوسط المربعات المحسوب لكل مصدر.
تكمن الأهمية التحليلية الأولى في فحص قيمة النسبة الفائية ($F$-Value) الشاملة للنموذج ومستوى دلالتها المقترن ($p$-value)؛ حيث تشير القيمة الاحتمالية البالغة (P < 0.0001) إلى الرفض القاطع للفرضية الصفرية التي تدعي تساوي كافة معاملات الانحدار بالصفر، مما يؤكد أن التركيبة المتآلفة من المتغيرات المختارة تمتلك قدرة تفسيرية حقيقية تتجاوز بكثير ما يمكن أن يُعزى للصدفة العشوائية لتوزيعات البيانات. تُمثل هذه الخطوة شرط الصلاحية الأول الذي يمهد الطريق لفحص المعالم الجزئية للنموذج دون الوقوع في أخطاء الاستدلال الزائف.
يتكامل جدول تحليل التباين مع جدول “إحصاءات الملاءمة والتوفيق” (Fit Statistics)، والذي يستعرض مؤشرات الأداء الحسابي للنموذج النهائي المستخلص. يبرز هنا “جذر متوسط مربعات الخطأ” (Root MSE)، والذي يمثل الانحراف المعياري للمتبقيات معبراً عنه بنفس وحدة قياس المتغير التابع (درجات الاختبار)، مما يمنحه معنى إجرائياً مباشراً في القياس السلوكي؛ إلى جانب معامل الاختلاف (CV) الذي ينسب التشتت إلى المتوسط العام، وقيم المعايير المعلوماتية النهائية (AIC, AICC, SBC) التي تتيح للباحث مقارنة كفاءة هذا النموذج النهائي بنماذج سابقة أو بديلة وردت في الأدبيات السيكومترية المقارنة.
7.3 تقديرات المعالم الإحصائية واختبارات الفروض السلوكية
يصل التحليل الإحصائي إلى ذروته التطبيقية والتفسيرية عند استعراض جدول “تقديرات المعالم” (Parameter Estimates) للنموذج المختار، وهو الجدول الذي يترجم العلاقات المجردة إلى معاملات انحدار كمية قابلة للتأويل الميداني المباشر. يحتوي هذا الجدول على قائمة التأثيرات المستبقاة في النموذج، ومستوياتها التصميمية، مقترنة بالمعامل غير المعياري المقدر ($\hat{\beta}$)، والخطأ المعياري لكل معامل (Standard Error)، وقيمة إحصاء $t$ لاختبار الدلالة الفردية، ومستوى المعنوية المقترن ($Pr > |t|$).
في تطبيقنا التربوي، يشير المعامل الموجب لمتغير ساعات الاستذكار (وليكن مثلاً $\hat{\beta} = 1.85, p < 0.001$) إلى أنه مع تثبيت بقية متغيرات النموذج، فإن زيادة ساعات الاستذكار بمقدار ساعة أسبوعياً ترتبط بزيادة متوقعة في درجة الاختبار النهائي قدرها 1.85 درجة؛ بينما قد يُظهر معامل قلق الاختبار قيمة سالبة دالة (مثل $\hat{\beta} = -0.32, p < 0.01$)، مما يعكس الأثر السيكولوجي المعيق لحدة التوتر والقلق على كفاءة استرجاع المعلومات وإنجاز المهام الاختبارية لدى المفحوصين، وهو ما يتسق بدقة مع النظريات السيكولوجية الرائدة في هذا الميدان.
بناءً على هذه التقديرات، يتم صياغة “المعادلة التنبؤية النهائية” بصورتها الرياضية الدقيقة:
$$\widehat{\text{ExamScore}} = \hat{\beta}_0 + 1.85(\text{StudyHours}) – 0.32(\text{TestAnxiety})$$
تُمكن هذه المعادلة الأخصائيين النفسيين والمرشدين التربويين من حساب الأداء المتوقع لأي طالب بصورة معيارية استباقية، وتقدير حجم التدخل السلوكي أو الإرشادي المطلوب لتخفيض درجات القلق أو تنظيم جداول الاستذكار للوصول بالتحصيل إلى المستويات الأكاديمية المستهدفة، متجاوزين بذلك مرحلة الوصف المجرد إلى مرحلة التحكم والتنبؤ العلمي الممنهج.
8. أساليب التحقق الإحصائي المتقدم (Validation Techniques) في PROC GLMSELECT
8.1 التحقق بتقسيم العينة عبر جملة PARTITION
يمثل الاستقرار التنبؤي خارج حدود العينة الأصلية حجر الزاوية للمصداقية السيكومترية، وهنا تتجلى العبقرية البرمجية لإجراء PROC GLMSELECT عبر دعمه الأصلي لجملة التجزئة PARTITION. تتيح هذه الجملة للباحث تقسيم مصفوفة البيانات المتاحة بطريقة تلقائية وعشوائية إلى مجموعات فرعية متمايزة وظيفياً دون الحاجة لكتابة أكواد فرز إضافية مشتتة؛ ويتم ذلك عبر تحديد نسب مئوية محددة باستخدام خيار FRACTION، كأن يتم تخصيص 70% من البيانات لنمذجة العلاقات وتدريب الخوارزمية، و 30% من الحالات للتحقق التجريبي المستقل، كما يظهر في الشيفرة التالية:
PROC GLMSELECT DATA=StudyData SEED=12345;

  PARTITION FRACTION(VALIDATE=0.3);

  CLASS Gender SES / PARAM=REF;

  MODEL ExamScore = StudyHours PracticeExams TestAnxiety Gender SES

        / SELECTION=LASSO(CHOOSE=VALIDATE);

RUN;
تتجلى القوة المنهجية لهذا الأسلوب عند ربط خيار الانتقاء النهائي بمعيار التحقق عبر كتابة CHOOSE=VALIDATE؛ حيث تقوم الخوارزمية بتقدير معالم النماذج المتسلسلة على عينة التدريب (Training Data)، ثم تقوم فوراً بتطبيق تلك المعادلات المقدرة على بيانات عينة التحقق (Validation Data) التي لم تتدخل في حساب المعاملات. يتم بعد ذلك رصد متوسط مربعات أخطاء التنبؤ الناتجة في عينة التحقق المجهولة (Average Square Error – ASE)، واختيار النموذج الذي يحقق أدنى قيمة خطأ تجريبي في تلك البيانات المستقلة.
كما تتيح الجملة استخدام متغير تقسيم مسبق التحديد موجود سلفاً في ملف البيانات عبر صيغة PARTITION ROLE=variable-name;، مما يمكن الباحثين في الدراسات الطولية أو عبر الثقافية من تحديد مراكز أو مدارس بأكملها كمجموعة تحقق مستقلة، لتقييم قدرة النموذج المستخلص على التعميم عبر بيئات تعليمية وثقافية مغايرة للبيئة الأصلية التي شُيد فيها النموذج، وهو ما يمثل أقصى درجات الضبط المنهجي في البحث النفسي المعاصر.
8.2 التحقق المتقاطع (Cross-Validation) ومعيار PRESS
على الرغم من النجاعة الفائقة لأسلوب تقسيم العينة عبر جملة PARTITION، إلا أنه قد يواجه عائقاً تطبيقياً حرجاً في بعض البحوث الإكلينيكية والتربوية التي تعاني من صغر أحجام العينات (Small Sample Sizes)؛ حيث يؤدي اقتطاع ثلث العينة للتحقق إلى إضعاف القوة الإحصائية (Statistical Power) اللازمة لتقدير المعالم في عينة التدريب. في مثل هذه السياقات، يبرز “التحقق المتقاطع” (Cross-Validation) كبديل منهجي فائق الدقة والاستقرار الرياضي.
يوفر PROC GLMSELECT إمكانية تنفيذ أسلوب التحقق المتقاطع متعدد الطيات ($k$-fold Cross Validation) عبر خيارات جملة SELECTION؛ حيث يتم تقسيم العينة بالتساوي إلى $k$ من الأجزاء (ولتكن 5 أو 10 طيات)، ويتم تدريب النموذج على $k-1$ من الأجزاء واختباره على الجزء المتبقي، وتكرار هذه الدورة الحسابية بالتناوب حتى تُختبر جميع الحالات، ويُحسب متوسط أخطاء التنبؤ التراكمي لتقييم كفاءة كل خطوة اختيار، كما يُمكن استخدام خيار استبعاد مفردة واحدة (Leave-One-Out Cross-Validation) في العينات السريرية النادرة والمحدودة للغاية.
يرتبط بهذا الأسلوب مؤشر إحصائي بالغ الأهمية يُعرف بـ “مجموع مربعات بواقي التنبؤ” (PRESS Statistic – Predicted Residual Sum of Squares). يقوم هذا المعيار بحساب متبقي كل مفحوص عند تطبيق معادلة انحدار تم تقديرها بالكامل بعد استبعاد ذلك المفحوص تحديداً من البيانات، ثم تجميع مربعات تلك المتبقيات المستقلة لجميع أفراد العينة. يتيح الإجراء توظيف هذا الإحصاء كمعيار مباشر للاختيار عبر الأمر CHOOSE=PRESS؛ حيث يضمن اختيار النموذج الذي يحقق أدنى قيمة PRESS وصول الباحث إلى تركيبة قياسية تقلل خطأ التنبؤ الفردي إلى أدنى المستويات الممكنة رياضياً.
9. تشخيص جودة النموذج وفحص الفروض الإحصائية الكلاسيكية
9.1 استخراج المتبقيات والقيم التنبؤية عبر جملة OUTPUT
لا تنتهي المهمة البحثية بانتقاء النموذج وتقدير معالمه؛ إذ تفرض أصول التحليل الإحصائي الرصين إجراء فحص تشخيصي صارم للمتبقيات لضمان عدم انتهاك الفروض الرياضية المؤسسة للنموذج الخطي العام. يتيح إجراء PROC GLMSELECT استخراج كافة المؤشرات الفردية التنبؤية والتشخيصية وتصديرها مباشرة إلى مجموعة بيانات جديدة متكاملة باستخدام جملة OUTPUT، مما يفسح المجال لإجراء تحليلات لاحقة معمقة للحالات الفردية الشاذة.
تتم صياغة جملة المخرجات عبر تحديد اسم ملف البيانات المستحدث OUT=Diagnostics، متبوعاً بأوامر استخراج المتغيرات الأساسية مثل: PREDICTED=PredExam للحصول على الدرجات التنبؤية المحسوبة للطلاب، و RESIDUAL=ResExam لاستخراج المتبقيات الأولية البسيطة. علاوة على ذلك، يوفر الإجراء إمكانية استخراج المتبقيات الطلابية المعيارية (Studentized Residuals)، ومسافة كوك (Cook’s D) لرصد الحالات ذات التأثير الشديد غير المتكافئ على مسار خط الانحدار، وقيم الرافعة التوزيعية (Leverage H) لرصد المفحوصين ذوي الاستجابات المتطرفة في فضاء المتغيرات التنبؤية المستقلة، كما توضح الشيفرة الآتية:
PROC GLMSELECT DATA=StudyData;

  CLASS Gender SES / PARAM=REF;

  MODEL ExamScore = StudyHours PracticeExams TestAnxiety Gender SES

        / SELECTION=STEPWISE(CHOOSE=SBC);

  OUTPUT OUT=Diagnostics P=PredScore R=Residual COOKD=CooksD H=Leverage;

RUN;
تسمح هذه البيانات المستخرجة بتدقيق الحالات الميدانية الشاذة؛ فالطالب الذي يمتلك قيمة مرتفعة لمسافة كوك تتجاوز العتبات المقبولة إحصائياً قد يمثل حالة استثنائية (كأن يكون قد مر بظرف قهري أثر على أدائه في الامتحان رغم كثرة استذكاره)، مما يستوجب فحص سجله بدقة قبل اتخاذ قرار إبقائه أو معالجته، لضمان عدم تزييف النتائج بفعل قراءات متطرفة معزولة.
9.2 فحص التوزيع الطبيعي واستقلالية وتجانس تباين الأخطاء
ترتكز كافة الاستدلالات المعنوية واختبارات الفروض ($t$-tests و $F$-tests) على الافتراض الجوهري القائل بأن الأخطاء العشوائية للمتبقيات تتوزع توزيعاً طبيعياً متماثلاً حول متوسط صفري، وبتباين ثابت ومتجانس عبر كافة مستويات المتغيرات التنبؤية المستقلة. يوفر تفعيل نظام الرسوم عبر ODS GRAPHICS داخل الإجراء حزمة آلية من “المخططات التشخيصية للنموذج” (Model Diagnostic Plots) التي تفحص بصرياً هذه الافتراضات التأسيسية بدقة متناهية.
يتم فحص فرضية “تجانس تباين الأخطاء” (Homoscedasticity) عبر مخطط القيم المتنبأ بها مقابل المتبقيات (Residual-by-Predicted Plot)؛ حيث يتطلع الباحث لرؤية سحابة نقطية عشوائية متجانسة التوزيع أفقياً دون اتخاذ أي شكل هندسي مميز (كالشكل البوقي أو القمعي). إن ظهور التباين القمعي (Heteroscedasticity) ينبئ باختلال التباين ويدل على أن دقة التنبؤ تتفاوت باختلاف مستويات أداء الطلاب، مما قد يستدعي اللجوء إلى تحويلات رياضية للمتغير التابع أو اعتماد أخطاء معيارية متينة لا تتأثر بخلل التجانس.
أما فرضية التوزيع الطبيعي للبواقي، فيتم تشخيصها عبر مخطط “التطابق الطبيعي الكمي” (Q-Q Plot) والمدرج التكراري للبواقي المرفق بمنحنى الكثافة الاحتمالية. يشير استقرار نقاط المتبقيات على طول الخط القطري المستقيم بزاوية 45 درجة إلى سلامة التوزيع الطبيعي؛ في حين يدل انحراف الأطراف العلوية أو السفلية عن الخط إلى وجود التواء حاد أو تفرطح شاذ في توزيع الأخطاء. كما يُمكن استخدام إجراء PROC UNIVARIATE DATA=Diagnostics NORMAL; لتوليد الاختبارات الرياضية الصارمة للتوزيع الطبيعي مثل اختبار شابيرو-ويلك (Shapiro-Wilk) واختبار كولموجوروف-سميرنوف لتأكيد الاستدلال البصري بأرقام إحصائية قاطعة ومحكمة.
9.3 فحص الارتباط الخطي المتعدد (Multicollinearity)
يُعد الارتباط الخطي المتعدد من أخطر المشكلات الرياضية المربكة في النمذجة الإحصائية الميدانية، ويقصد به وجود ارتباطات قوية ومفرطة بين متغيرين مستقلين أو أكثر في مصفوفة النموذج، مما يؤدي إلى تشارك شبه تام في التباين التفسيري. يُحدث هذا التداخل “تضخماً حاداً في الأخطاء المعيارية” لمعاملات الانحدار المقدرة، ويجعل الإشارات الحسابية للمعاملات غير منطقية أو متذبذبة بعنف؛ بل إنه قد يفرز حالة متناقضة يظهر فيها نموذج الانحدار ككل دلالة معنوية فائقة عبر اختبار $F$، بينما تفشل كافة معاملاته الفردية في تحقيق الدلالة الإحصائية عبر اختبارات $t$.
يُمثل فحص “عامل تضخم التباين” (Variance Inflation Factor – VIF) و”معامل التحمل” (Tolerance) المؤشرين الأكثر اعتماداً لتقييم هذه الظاهرة في النموذج المستخلص. تشير القاعدة الإحصائية العامة إلى أن تجاوز قيمة VIF للرقم 5 أو 10 يعكس تداخلاً خطياً حرجاً يشوه استقرار المعالم التقديرية. ورغم أن إجراء PROC GLMSELECT يفتقر إلى حساب VIF مباشرة داخل جدول الاختيار، إلا أنه يمكن استخراجه بسهولة بتطبيق إجراء PROC REG على المتغيرات التي استبقاها النموذج النهائي كخطوة تشخيصية متقدمة وتأكيدية.
وهنا تتجلى إحدى أروع المزايا المنهجية لإجراء PROC GLMSELECT وخوارزمياته الحديثة كالاسو؛ حيث تعمل الخوارزمية ذاتياً كمصفاة إحصائية ذكية ضد التداخل الخطي المتعدد. فعندما يتسابق متغيران شديدا الارتباط على دخول النموذج، تقوم الخوارزمية باختيار الأقوى منهما وتصفير أو استبعاد الآخر تلقائياً، حاميةً بذلك النموذج النهائي من التضخم المعلوماتي الزائد، وموفرة معاملات انحدار مستقرة تعكس الأثر الحقيقي المستقل لكل بُعد سيكولوجي دون تشويه ناتج عن الارتباطات البينية المفرطة.
10. أفضل الممارسات المنهجية وكتابة التقارير الأكاديمية وفق معايير APA
10.1 توثيق إجراءات اختيار النموذج في المنهجية الإحصائية
تفرض ضوابط الشفافية العلمية المعاصرة ومعايير تقارير البحوث الكمية التابعة لجمعية علم النفس الأمريكية (APA JARS) الإفصاح المنهجي الكامل والشفاف عن كافة خطوات التنقيب وانتقاء النماذج المنفذة آلياً، محذرة من إخفاء حقيقة استخدام الإجراءات الاستكشافية التلقائية وتقديم النموذج المستخلص النهائي وكأنه نموذج نظري محدد مسبقاً بصورة فرضية قبلية (Hypothesizing After the Results are Known – HARKing)، لما يمثله ذلك من تضليل منهجي يضر بتراكم المعرفة النفسية الرصينة.
يجب على الباحث في قسم المنهجية الإحصائية أن يوثق بالتفصيل: استخدام إجراء PROC GLMSELECT في بيئة حزمة SAS، مع تحديد رقم إصدار البرنامج بدقة، وذكر الخوارزمية المستعملة حرفياً (مثل خوارزمية Stepwise أو LASSO أو LAR). كما يتعين تحديد المعايير الإحصائية التي استندت إليها الخوارزمية في مسارها؛ موضحاً بوضوح المعيار المعتمد لإدخال وحذف المتغيرات (مثل SELECT=SBC)، والمعيار المحدد لفرز النموذج الأفضل النهائي (مثل CHOOSE=SBC)، وحدود التوقف الرياضية المطبقة لحسم انتهاء البحث الحسابي.
علاوة على ذلك، يقتضي التوثيق المنهجي الصارم شرح استراتيجية التحقق الإحصائي المعتمدة؛ فإذا استُخدمت جملة PARTITION، يجب بيان نسبة التقسيم المعتمدة وتحديد حجم عينة التدريب وعينة التحقق المستقلة وقيمة البذرة العشوائية (SEED) المستعملة لضمان تكرارية التحليل من قبل الباحثين النظراء. وفي حال استخدام التحقق المتقاطع (Cross-Validation)، يجب تبيان عدد الطيات ومؤشر خطأ التنبؤ المستهدف؛ إذ تمنح هذه الإفصاحات الدقيقة المحكمين والقراء ثقة تامة في نزاهة النتائج وتضمن خضوع النموذج لاختبارات التحقق التجريبية الصارمة قبل اعتماده علمياً.
10.2 عرض النتائج والجداول الإحصائية وفق دليل النشر (APA 7th Edition)
يتطلب إعداد تقرير نتائج النموذج المختار النهائي صياغة جداول إحصائية أنيقة تتوافق شكلياً ومضمونياً مع توجيهات الطبعة السابعة لدليل نشر جمعية علم النفس الأمريكية (APA 7th Edition). تقضي هذه التوجيهات بالابتعاد عن استعراض الخطوات المرحلية المطولة لمسار الاختيار، والتركيز بدلاً من ذلك على جدول تركيبي موحد يعرض معالم النموذج الأولي المشبع مقارنة بالنموذج المقتصر النهائي الذي استخلصه إجراء GLMSELECT، مما يبرز بوضوح القيمة المضافة لعملية الانتقاء والتحسين التنبؤي المتحقق.
يجب أن يتضمن الجدول المنسق وفق APA الأعمدة الأساسية التالية: المتغيرات التنبؤية المستبقاة، والمعاملات غير المعيارية ($B$) متبوعة بأخطائها المعيارية ($SE$), والمعاملات المعيارية ($\beta$)، وقيم إحصاء $t$، ومستويات الدلالة الدقيقة ($p$) دون كتابة أصفار مطلقة، فضلاً عن مجالات الثقة بنسبة 95% لكل معامل. يُختتم الجدول في أسفله بالإحصاءات الكلية الملخصة للنموذج: قيمة $R^2$ وقيمة $R^2$ المعدل، وإحصاء $F$ ودرجات الحرية وقيم المعايير المعلوماتية (SBC و AIC)، مع استخدام حواشي الجداول المعتمدة لشرح الرموز والمستويات المرجعية للمتغيرات التصنيفية بوضوح تام.
يُصاحب الجدول تعليق سيكومتري تحليلي محكم يربط النتائج الرقمية بالأطر النظرية للدراسة؛ ومثال ذلك: “أظهرت نتائج الانحدار التدريجي عبر إجراء PROC GLMSELECT، والموجه بمعيار شوارتز البايزي (SBC)، أن النموذج الأمثل المقتصد احتفظ بمتغيرين رئيسيين فقط من أصل خمسة متغيرات مرشحة؛ هما ساعات الاستذكار وقلق الاختبار، مفسراً ما نسبته 64% من التباين الكلي لدرجات الاختبار النهائي ($R^2 = .64, F(2, 97) = 86.22, p < .001$). وقد تبين أن ساعات الاستذكار تشكل المنبئ الإيجابي الأقوى بالأداء الأكاديمي ($B = 1.85, SE = 0.21, \beta = .58, p < .001$)، في حين شكل قلق الاختبار عائقاً سلبياً ذا دلالة إحصائية معنوية ($B = -0.32, SE = 0.08, \beta = -.29, p < .001$)…”.
10.3 المحاذير والأخطاء الشائعة عند استخدام PROC GLMSELECT
رغم القوة البرمجية والحسابية الهائلة لإجراء PROC GLMSELECT، إلا أن استخدامه غير الواعي قد يوقع الباحث في منزلقات منهجية ومفاهيمية جسيمة؛ يأتي في مقدمتها الوقوع في مغالطة “الخلط بين الأهمية التنبؤية والسببية” (Prediction vs. Causation). إن قيام خوارزمية آلية باختيار متغير معين كأفضل منبئ رياضي لا يعني مطلقاً وجود علاقة سببية حتمية بينه وبين المتغير التابع؛ فالخوارزميات تبحث عن الارتباطات والأنماط التوزيعية، بينما تُستمد السببية حصرياً من التصاميم التجريبية الصارمة والضبط المنهجي الميداني للمتغيرات الدخيلة، وهو ما يغيب غالباً عن الدراسات الارتباطية والمسحية.
يتمثل المنزلق الثاني الشائع في “الإقصاء الآلي للمتغيرات ذات الأهمية النظرية الجوهرية” لمجرد عجزها عن تلبية عتبة إحصائية صارمة لخفض مؤشر SBC أو AIC. يجب أن يتذكر الباحث دوماً أن النمذجة الإحصائية خادمة للنظرية العلمية وليست بديلة عنها؛ فإذا كانت الأدبيات السيكولوجية تؤكد مركزية متغير ديموغرافي أو سلوكي محدد، فإن استبعاده آلياً لا يبرر بالضرورة شطبه من النقاش المعرفي، بل قد يستوجب تثبيته مسبقاً في النموذج كمتغير ضابط عبر خيار INCLUDE=، لتقوم الخوارزمية باختيار بقية المتغيرات الإضافية في ظل وجوده المسبق الثابت.
وأخيراً، يحذر خبراء الإحصاء من خطورة الاعتماد الأعمى على الإجراء دون فحص المتبقيات وتشخيص التوزيعات؛ فالخوارزميات المتقدمة كـ LASSO أو Stepwise حساسة للغاية للقيم الشاذة المفرطة، والتي قد تقود الخوارزمية إلى اتخاذ قرارات إدخال أو استبعاد مضللة بالكامل. يكمن المسار المنهجي الأمثل في الموازنة النقدية المستمرة بين الصرامة الحسابية للأدوات البرمجية، والاستبصار النظري العميق للباحث السلوكي؛ فالنموذج الإحصائي الناجح ليس النموذج الذي يُرضي معادلات الكمبيوتر فحسب، بل هو النموذج الذي يقدم فهماً حقيقياً، وقابلاً للتطبيق والتفسير الإنساني الرشيد في واقع الممارسة الميدانية.
خاتمة
تناول هذا المقال الموسع تحليلاً شاملاً وتطبيقياً لإجراء PROC GLMSELECT داخل حزمة برمجيات SAS الإحصائية، مبرزاً مكانته الريادية كأحد أكثر الإجراءات تطوراً وكفاءة في انتقاء النماذج الخطية العامة وإدارتها في البحوث النفسية والتربوية المعاصرة. ومن خلال استعراض الفروق البنيوية التي تفصله عن الإجراءات الكلاسيكية، اتضح بجلاء كيف تمكن هذا الإجراء من حل معضلات مزمنة جمعت بين الإدارة المدمجة للمتغيرات التصنيفية وتطبيق أحدث خوارزميات الانكماش المنظم، ليرسخ معياراً جديداً في بناء نماذج سيكومترية بارسيمونية تجمع بين القوة التفسيرية والقدرة التنبؤية خارج حدود العينة.
إن التحول المنهجي من الاعتماد الساذج على قيم معامل التحديد التقليدي نحو تبني معايير نظرية المعلومات المتقدمة (مثل AIC و SBC)، وتوظيف تقنيات التحقق المتقاطع والتجزئة الميدانية المستقلة عبر جمل PARTITION و OUTPUT، يمثل الضمانة الأساسية لحماية البحوث السلوكية من مخاطر فرط التخصيص والتفاؤل الإحصائي الزائف. إن الاستخدام الرشيد لإجراء PROC GLMSELECT، المقترن بالالتزام الصارم بمعايير التوثيق الأكاديمي وفق دليل APA، يتيح للباحثين تفكيك تعقيدات الظواهر الإنسانية المتشابكة، وتشييد نماذج تنبؤية رصينة تدعم صناعة القرار التربوي والإكلينيكي على أسس علمية واستدلالية متينة لا يرقى إليها الشك.
المراجع
- Cohen, R. (2006). Introducing the GLMSELECT procedure for model selection. In Proceedings of the Thirty-First Annual SAS Users Group International Conference (SUGI 31, Paper 207-31). SAS Institute Inc.
- Efron, B., Hastie, T., Johnstone, I., & Tibshirani, R. (2004). Least angle regression. The Annals of Statistics, 32(2), 407–499. https://doi.org/10.1214/009053604000000067
- Efroymson, M. A. (1960). Multiple regression analysis. In A. Ralston & H. S. Wilf (Eds.), Mathematical Methods for Digital Computers (pp. 191–203). John Wiley & Sons.
- SAS Institute Inc. (2020). SAS/STAT 15.2 User’s Guide: The GLMSELECT Procedure. SAS Institute Inc. https://support.sas.com/documentation/onlinedoc/stat/
- Tibshirani, R. (1996). Regression shrinkage and selection via the lasso. Journal of the Royal Statistical Society: Series B (Methodological), 58(1), 267–288. https://doi.org/10.1111/j.2517-6161.1996.tb02080.x
- Zou, H. (2006). The adaptive lasso and its oracle properties. Journal of the American Statistical Association, 101(476), 1418–1429. https://doi.org/10.1198/016214506000000735
- Zou, H., & Hastie, T. (2005). Regularization and variable selection via the elastic net. Journal of the Royal Statistical Society: Series B (Statistical Methodology), 67(2), 301–320. https://doi.org/10.1111/j.1467-9868.2005.00503.x