
تمثل معالجة البيانات النصية غير المهيكلة والتنقيب في السلاسل المحرفية المعقدة أحد أكثر التحديات إلحاحاً وأهمية في بيئات التحليل الإحصائي الحديثة وعلم البيانات المؤسسي. في منظومة برمجية SAS (Statistical Analysis System)، تطورت أدوات المعالجة النصية عبر العقود لتواكب الاحتياجات المتزايدة للمحللين وعلماء البيانات والباحثين في المجالات الطبية والحيوية والاقتصادية. ومع أن الدوال التقليدية الموروثة قد قدمت حلولاً مقبولة في معالجة الأنماط الثابتة، إلا أن الطبيعة المتشعبة والديناميكية للمجموعات النصية الحديثة فرضت تبني أدوات تحليلية أكثر مرونة وقوة حوسبية، تستند إلى نظريات لغوية ورياضية رصينة.
تأتي دالة PRXMATCH كواحدة من أبرز هذه الأدوات المتقدمة التي أدمجتها شركة SAS لتوفير جسر برمجي بين قوة بيئة التحليل الإحصائي ومرونة التعبيرات النمطية المتوافقة مع لغة بيرل (Perl-Compatible Regular Expressions). إن استخدام هذه الدالة لا يقتصر على مجرد البحث عن كلمات محددة، بل يمتد إلى فحص البنى النحوية للسلاسل، واستكشاف الأنماط المشوشة، وتطهير المتغيرات النصية الضخمة من الشوائب والمدخلات غير المنتظمة بأعلى درجات الكفاءة التحليلية والدقة الرياضية.
يهدف هذا الدليل المنهجي الموسع إلى تقديم مرجع أكاديمي وتطبيقي شامل لكيفية توظيف دالة PRXMATCH في برمجية SAS. سيتناول الدليل الأسس النظرية والمفاهيمية للتعبيرات النمطية وتطورها التاريخي، مروراً بالبنية النحوية والقواعد البرمجية الصارمة للدالة، وصولاً إلى دراسات حالة وأمثلة تطبيقية واقعية معالجة خطوة بخطوة، مع تسليط الضوء على استراتيجيات تحسين الأداء الحسابي وتفادي الأخطاء الشائعة في بيئات الإنتاج ومجموعات البيانات الضخمة.
1. مقدمة إلى دالة PRXMATCH ومفهوم التعبيرات النمطية في برمجية SAS
1.1 ما هي دالة PRXMATCH وأهميتها المنهجية في تنقيب البيانات النصية
تُعرّف دالة PRXMATCH ضمن بيئة SAS بأنها دالة بحث ومطابقة نمطية متقدمة تعتمد على محرك Perl-Compatible Regular Expressions (PCRE) لتحديد موضع بداية نمط محرفي محدد داخل سلسلة نصية مستهدفة. من الناحية الحوسبية، لا تكتفي الدالة بالتحقق من الوجود المنطقي للنمط فحسب، بل تقوم بمسح دقيق للمتغير الحرفي عبر خوارزميات تطابق خطية متقدمة، لترجع بعد ذلك القيمة الرقمية الصحيحة التي تمثل الفهرس المحرفي (Character Position) لأول ظهور لهذا النمط. تكتسب هذه الدالة أهمية استثنائية في سياق تنقيب البيانات، حيث تتيح للمحللين والباحثين تجاوز قيود المطابقة الحرفية الصارمة والتعامل مع البيانات الواقعية التي تشوبها الأخطاء الإملائية وتعدد الصياغات.
تتجلى الأهمية المنهجية للدالة في قدرتها الفائقة على خفض التكلفة الحسابية لمعالجة النصوص. فبدلاً من اللجوء إلى تقنيات التكرار النصي التقليدية (Iterative Loops) التي تتطلب تفكيك السلاسل إلى محارف مفردة أو استخدام حلقات DO متداخلة لفحص كل موضع محتمل، تقوم PRXMATCH بتفويض عملية التحليل إلى محرك بيرل الداخلي المكتوب بلغة C والمعزز بآليات التجميع التلقائي. يضمن هذا النهج تقليصاً جذرياً في استهلاك دورات المعالج (CPU cycles) والذاكرة المؤقتة، لا سيما عند معالجة الجداول الإحصائية الضخمة التي تضم ملايين الملاحظات، مما يجعلها ركيزة أساسية في معالجة اللغات الطبيعية وهندسة الخصائص داخل SAS.
1.2 مدخل إلى التعبيرات النمطية (Perl Regular Expressions) المدمجة
تعود الجذور المعرفية لمفهوم التعبيرات النمطية (Regular Expressions) إلى منتصف القرن العشرين، وتحديداً إلى الأبحاث التأسيسية التي قادها عالم الرياضيات والمنطق الأمريكي ستيفن كول كلين (Stephen Cole Kleene). في عام 1951، قدم كلين ورقة تقنية تاريخية لمؤسسة راند حول نمذجة أحداث الشبكات العصبية والآلات المحدودة الحالة (Finite Automata)، والتي نُشرت رسمياً لاحقاً في كتاب أبحاث الأوتوماتا عام 1956 بتحرير كلود شانون وجون مكارثي. كانت تلك الدراسات الرياضية تسعى إلى صياغة لغات منتظمة تمثل مخرجات شبكات الخلايا العصبية المنطقية التي طورها وارن مكولوتش ووالتر بيتس، مما أسس لعلم اللغات الشكلية ونظرية الحوسبة الحديثة.
انتقلت هذه النظرية الرياضية التجريدية إلى التطبيق البرمجي في نظم التشغيل عبر أدوات مثل grep وsed، حتى بلغت ذروة نضجها التعبيري في أواخر الثمانينيات عندما صمم لاري وول (Larry Wall) لغة برمجة بيرل (Perl) عام 1987، مقدماً محركاً ثورياً لمعالجة النصوص. وفي عام 1997، قام فيليب هازل (Philip Hazel) في جامعة كامبريدج بتطوير مكتبة PCRE المكتوبة بلغة C لتمكين البرمجيات المختلفة من محاكاة قدرات بيرل الفائقة. قامت شركة SAS لاحقاً بدمج هذه المكتبة الرصينة في نواتها البرمجية، متيحة للمستخدمين توظيف الرموز الخاصة كالأقواس التجميعية والمحددات الكمية والبدائل المشروطة، مما منح المحللين مرونة تحليلية لا نهائية تتفوق كلياً على منطق البحث الحرفي التقليدي.
1.3 الفروق الجوهرية بين PRXMATCH ودوال البحث النصي التقليدية
لفهم القيمة المضافة لدالة PRXMATCH، يجب مقارنتها وظيفياً وتقنياً بالدوال النصية الكلاسيكية المدمجة في SAS مثل دالتي INDEX وFIND. تعمل دالة INDEX على البحث عن سلسلة فرعية ثابتة ومحددة بدقة داخل السلسلة الأصلية، وهي تفتقر تماماً إلى أي مرونة لمعالجة التغيرات الطفيفة في البنية، مثل غياب محرف معين أو تباين المسافات. ورغم أن دالة FIND تقدم تحسينات ملحوظة عبر دعم معلمات لتجاهل حالة الأحرف وتحديد اتجاه البحث، إلا أنها تظل محصورة في إطار السلاسل المتطابقة حرفياً، وتعجز بنيوياً عن معالجة التعبيرات المتغيرة كأرقام الهواتف ذات الصيغ المتعددة أو الرموز البريدية المركبة.
أما دوال التقطيع مثل دالة SCAN، فهي تركز أساساً على تجزئة السلسلة النصية إلى “كلمات” أو عناصر مفردة بناءً على محددات ثابتة (Delimiters)، مما يجعلها غير ملائمة لاكتشاف الأنماط المتداخلة التي لا تخضع لقواعد فصل مسبقة. تبرز معايير المفاضلة العلمية لمصلحة PRXMATCH عند التعامل مع مجموعات بيانات غير متجانسة المصادر؛ حيث تتيح الدالة صياغة نمط رياضي واحد قادر على رصد صيغ تاريخ متعددة، أو استخلاص أرقام وطنية تحتوي على مسافات أو شرطات فاصلة غير منتظمة، مما يحول دون الحاجة لكتابة شروط منطقية معقدة ومتعددة المستويات قد تثقل كاهل الكود البرمجي وتبطئ تنفيذه.
2. البنية النحوية والصيغة البرمجية الأساسية لدالة PRXMATCH
2.1 تحليل المعلمات البرمجية (Arguments) الإلزامية والاختيارية
تتميز دالة PRXMATCH ببنية نحوية محكمة وموجزة تضمن تكاملها السلس داخل عبارات المعالجة في خطوة البيانات (DATA Step). تأخذ الدالة بصورتها القياسية معلمين رئيسيين وفق الصيغة البرمجية التالية:
PRXMATCH(regular_expression_id | pattern_string, source_variable)
المعلم الأول يمثل التعبير النمطي، والذي يمكن تمريره بإحدى طريقتين: إما كسلسلة نصية ثابتة محاطة بعلامات تنصيص ومحددات نمطية، أو كمعرف نمطي رقمي (Pattern Identifier) تم تجميعه مسبقاً في الذاكرة عبر دالة PRXPARSE. يمثل تمرير المعرف المجمع عبر PRXPARSE الخيار البرمجي الأكثر كفاءة في السيناريوهات المعقدة والبيانات الضخمة، حيث يجنب المحرك إعادة تفسير النمط النصي مع كل صف جديد من البيانات.
أما المعلم الثاني، فهو المتغير النصي المصدر (Source Variable) أو التعبير الحرفي المراد إخضاعه للتدقيق والفحص النمطي. يتعين على المحلل التحقق من أن هذا المعلم يمثل قيمة نصية معرفة، مع إدراك أن تمرير متغير عددي سيؤدي إلى قيام برمجية SAS بإجراء تحويل ضمني (Implicit Conversion) من النمط العددي إلى النمط الحرفي، مصحوباً برسائل تحذير في سجل التشغيل (SAS Log)، مع احتمالية ظهور فراغات بادئة غير مرغوبة قد تؤثر على دقة نتائج المطابقة المتوقعة.
2.2 صياغة محددات التعبيرات النمطية والرموز الإحاطية (Delimiters)
عند صياغة التعبير النمطي مباشرة داخل دالة PRXMATCH، تشترط المعايير اللغوية لمحرك بيرل إحاطة التعبير بمحددات نمطية متطابقة (Delimiters). في الوضع الافتراضي والأكثر شيوعاً، يُستخدم رمز الخط المائل الأمامي (Slash /) لعزل النمط، كأن نكتب ‘/pattern/’. يحدد هذا الرمز لمترجم SAS بداية ونهاية نص التعبير النمطي، وتأتي بعد المحدد النهائي أي معدلات سلوكية إضافية (Modifiers) تؤثر على آلية عمل المحرك، مثل معدلات تجاهل حالة الأحرف.
ومع ذلك، تبرز إشكالية برمجية عندما يحتوي التعبير النمطي نفسه على خطوط مائلة كجزء من محتواه المطلوب مطابقته، مثل مسارات الملفات في نظم التشغيل أو عناوين المواقع الإلكترونية (URLs). في مثل هذه الحالات، يوفر محرك بيرل في SAS ميزة استخدام محددات بديلة لتفادي تداخل الرموز والاضطرار للهروب المكثف من المحارف. يمكن للمحلل استخدام علامة التعجب ‘!pattern!’ أو علامة النسبة المئوية ‘%pattern%’ أو علامة التلدة ‘~pattern~’. يساهم اختيار المحدد البديل المناسب في الحفاظ على وضوح الكود وسهولة قراءته وصيانته، ويقلل بشكل جوهري من أخطاء التحليل اللغوي الناتجة عن تكرار الرموز المحجوزة.
2.3 تفسير المخرجات الرقمية والقيم المرجعة من الدالة
تُرجع دالة PRXMATCH دائماً قيمة عددية صحيحة موجبة أو صفراً، وهي مخرجات محددة رياضياً ومنطقياً تعبر بدقة عن حالة التطابق داخل المتغير المصدر. تشير القيمة المرجعة الصفرية (0) بشكل قاطع إلى فشل المحرك في العثور على أي تطابق للنمط المحدد داخل النص المفحوص، أو أن المتغير المصدر نفسه كان فارغاً تماماً من أي محارف ذات مغزى يمكن مطابقتها مع التعبير المطلوب.
في المقابل، عندما تُرجع الدالة قيمة صحيحة أكبر من الصفر (مثل 1، 5، 12)، فإن هذا الرقم يمثل الإحداثي الحرفي الدقيق أو الفهرس الموضعي (Character Index) لأول محرف في السلسلة النصية تحقق عنده التطابق الكامل مع النمط. تتيح هذه القيمة المرجعة المحددة للمحللين استخدام الدالة بطريقتين مختلفتين: إما كأداة هندسية لحساب المواضع وتغذية دوال الاقتطاع مثل SUBSTR، أو كمتغير منطقي ثنائي (Boolean Flag) في الجمل الشرطية؛ حيث يُترجم الصفر إلى قيمة خطأ منطقية (False)، بينما تُترجم أي قيمة موجبة أكبر من الصفر تلقائياً في منطق SAS إلى صواب منطقي (True)، مما يسهل عمليات التصفية والفرز.
3. إعداد بيئة العمل وإنشاء مجموعات البيانات التجريبية
3.1 بناء مجموعة بيانات مرجعية للتحليل (نموذج my_data)
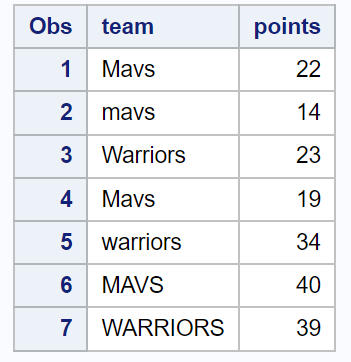
لتوضيح التطبيقات العملية والمنهجية لدالة PRXMATCH، سنقوم ببناء مجموعة بيانات نموذجية تحاكي سجلات رياضية لأندية وفرق مع تنوع في صياغات التسجيل، بما يشمل تباين حالات الأحرف والأخطاء الإملائية والمسافات غير المنتظمة. يتم إنشاء هذه المجموعة باستخدام خطوة بيانات أساسية (DATA Step) مع قراءة السجلات المضمنة عبر كتلة DATALINES، وفق الكود البرمجي التالي:
data my_data;
    length Team $20 Conference$10 Division $15;
    input Team & Conference & Division & Points;
    datalines;
Dallas Mavs       West  Southwest  110
Denver Nuggets    West  Northwest  115
dallas mavs       West  Southwest  105
PHOENIX SUNS      West  Pacific    108
DAL MAVS          West  Southwest  102
Boston Celtics    East  Atlantic   120
Orlando Magic     East  Southeast  98
Maverick Club     West  Southwest  95
;
run;
تتضمن مجموعة البيانات السابقة متغيراً نصياً باسم Team يضم حالات اختبار متنوعة، بما في ذلك كتابة الاسم بأحرف صغيرة كاملة، أو أحرف كبيرة بالكامل، أو استخدام اختصارات وكلمات مشتقة، مما يوفر بيئة اختبارية مثالية لقياس متانة خوارزميات البحث النمطي المطبقة.
3.2 فحص خصائص المتغيرات ونوعيتها قبل المعالجة
قبل البدء في كتابة استعلامات PRXMATCH، تقتضي المنهجية الأكاديمية والعملية فحص السمات الهيكلية للبيانات النصية المخزنة. يلعب طول المتغير النصي (Length) دوراً حاسماً في استقرار عمليات التحليل؛ حيث يؤدي عدم تخصيص طول كافٍ عبر عبارة LENGTH إلى اقتطاع السلاسل النصية الطويلة تلقائياً عند أول قراءة، مما يشوه الأنماط المطلوب مطابقتها ويقود إلى نتائج خاطئة تماماً دون صدور تحذيرات صريحة من المحرك.
علاوة على ذلك، يجب الانتباه إلى ظاهرة الفراغات اللاحقة (Trailing Blanks) التي يضيفها نظام SAS تلقائياً لإكمال الطول المخصص للمتغير النصي ذي الطول الثابت. في حين أن الفراغات اللاحقة لا تؤثر غالباً على أنماط البحث غير المقيدة بعلامات نهاية السلسلة، إلا أنها قد تتسبب في فشل مطابقات محددة تتطلب الوصول إلى نهاية النص بدقة ما لم يتم تنظيفها أو التعامل معها عبر دوال التجذيب المناسبة. كما يتعين التأكد من مطابقة ترميز المحارف المستخدم لقواعد محرك PCRE لضمان معالجة الحروف اللاتينية الخاصة أو المحارف متعددة البايت بكفاءة دون تشويه للقيم.
3.3 استعراض الهيكل المرجعي للبيانات عبر PROC PRINT
يعد استعراض الهيكل المرجعي للبيانات وتوثيق حالتها الأولية خطوة قياسية في مسار التحليل لضمان خلو المدخلات من أخطاء النقل أو الإزاحة الحقلية الناتجة عن مسافات الإدخال. يمكن التحقق من سلامة مجموعة البيانات المرجعية my_data عن طريق استدعاء الإجراء الطباعي PROC PRINT كما يوضح الكود التالي:
proc print data=my_data noobs;
    title "المجموعة المرجعية الأولية لتحليل أنماط دالة PRXMATCH";
run;
يوثق هذا الإجراء صحة توزيع المتغيرات عبر السجلات، ويتيح للمحلل تحديد حالات الاختبار المتوقعة لكل نمط قبل تطبيقه برمجياً. يساعد هذا التدقيق البصري المنهجي في التحقق من أن السجلات التي ينبغي أن تطابق الأنماط اللاحقة تحتوي فعلياً على المقاطع المحرفية المستهدفة في مواضعها الصحيحة، مما يضع خط أساس موثوقاً لتقييم صحة النتائج المحسوبة لاحقاً وتفسير مؤشرات الدالة.
4. المثال الأول: تحديد موضع نمط محرفي ثابت في السلسلة النصية
4.1 كتابة وتنفيذ كود البحث عن تطابق نمطي مباشر
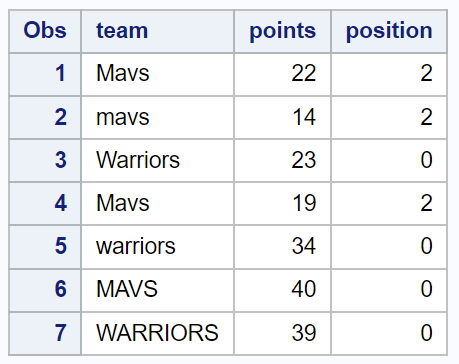
في هذا التطبيق العملي الأول، نستهدف فحص متغير الفريق Team للبحث عن مقطع محرفي ثابت محدد بحروف صغيرة هو “avs”. سنقوم بإنشاء خطوة بيانات جديدة تُشتق من المجموعة المرجعية وتضيف متغيراً عددياً جديداً يحمل اسم Position يوثق القيمة المرجعة من دالة PRXMATCH. يوضح الكود البرمجي التالي طريقة الصياغة والتنفيذ:
data pattern_position;
    set my_data;
    Position = prxmatch('/avs/', Team);
run;

proc print data=pattern_position;
    title "نتائج البحث عن النمط الثابت /avs/ باستخدام PRXMATCH";
run;
في هذا الكود، تم تمرير التعبير النمطي ‘/avs/’ محاطاً بالخطين المائلين الافتراضيين كمعلم أول، بينما تم تمرير المتغير Team كمعلم ثانٍ. تقوم SAS بتطبيق الدالة سطراً بسطر على كل ملاحظة ضمن جدول البيانات، وتخزين الناتج الرقمي مباشرة في المتغير العددي Position المنشأ حديثاً.
4.2 التحليل المنهجي والتفسيري لنتائج التطابق المحرفي
عند مراجعة مخرجات جدول pattern_position، نلاحظ تبايناً دقيقاً في القيم المسجلة يعكس آلية عمل محرك التعبيرات النمطية بدقة تامة. في السجل الأول “Dallas Mavs”، تُرجع الدالة القيمة الرقمية 9. يفسر ذلك بأن المقطع “avs” يبدأ عند المحرف التاسع في السلسلة (D-a-l-l-a-s-[مسافة]-M-a-v-s)، حيث يشغل حرف ‘a’ الموضع التاسع تماماً، وحرف ‘v’ الموضع العاشر، وحرف ‘s’ الموضع الحادي عشر.
في المقابل، نجد أن السجل الثالث “dallas mavs” قد سجل أيضاً القيمة 9 لأن المقطع الصغير يتطابق حرفياً وموضعياً. ولكن بالانتقال إلى السجل الخامس “DAL MAVS”، نجد أن الدالة أرجعت القيمة 0، رغم أن الكلمة هي نفسها دلالياً، والسبب يعود إلى أن المحرك التزم بالمطابقة الحرفية الصارمة، فوجد أحرفاً كبيرة “AVS” لا تتطابق مع التعبير النمطي الصغير المحدد. وبالمثل، في سجلات مثل “Denver Nuggets” و”Boston Celtics”، أرجعت الدالة صفراً لعدم وجود تسلسل المحارف المطلوب إطلاقاً، مما يؤكد دقة الدالة في الفصل الموضعي التام للسلاسل الحرفية.
4.3 التوثيق الإحصائي للمخرجات ومراجعتها
يمثل التوثيق الإحصائي للمخرجات مرحلة حيوية لتقييم مدى نجاح الاستعلام النمطي وتحديد مدى جدواه في معالجة البيانات النصية. يمكن للمحلل إجراء حصر سريع لتوزيع القيم المرجعة للتأكد من حجم التطابق مقارنة بإجمالي العينة عبر استدعاء إجراء الترددات PROC FREQ كالتالي:
proc freq data=pattern_position;
    tables Position / nocum;
    title "توزيع مواضع التطابق المحرفي للنمط /avs/";
run;
يظهر الجدول التكراري الناتج النسبة المئوية للملاحظات التي حققت تطابقاً إيجابياً مقارنة بتلك التي سجلت القيمة صفراً. يتيح هذا التوثيق للمحلل تقييم دقة التحديد الموضعي كنواة لاشتقاق متغيرات جديدة، أو اتخاذ قرارات بتوسيع نمط البحث ليشمل حالات أخرى لم يتم التقاطها بسبب قيود المطابقة الحرفية الصارمة.
5. المثال الثاني: معالجة حساسية حالة الأحرف وتجاهلها (Case-Insensitive Matching)
5.1 تحديات تباين حالة الأحرف (الكبيرة والصغيرة) في جودة البيانات
تعد مشكلة تباين حالة الأحرف (Capitalization Variants) من أبرز التحديات التي تقوض جودة البيانات النصية وموثوقية التحليلات الإحصائية المشتقة منها. في الواقع العملي، تنشأ البيانات من مصادر متعددة قد تفتقر إلى معايير إدخال موحدة؛ فقد يقوم موظف بإدخال اسم الفريق بحروف كبيرة كاملة للتأكيد مثل “MAVS”، بينما يدخله آخر بطريقة الحالة الاسمية (Title Case) مثل “Mavs”، أو بحروف صغيرة بالكامل “mavs”.
إن الاعتماد على المطابقة الصارمة لحالة الأحرف يؤدي حتماً إلى إسقاط ملاحظات صحيحة ومؤثرة من مجتمع الدراسة، وهو ما يمثل خطأ منهجياً في بحوث البيانات. ورغم أن الحل التقليدي في برمجيات التحليل يتضمن تحويل النص بأكمله إلى أحرف كبيرة عبر دالة UPCASE أو إلى أحرف صغيرة عبر LOWCASE قبل إجراء المطابقة، إلا أن هذا الأسلوب ينطوي على استهلاك إضافي لموارد الحوسبة عبر إنشاء سلاسل نصية مؤقتة في الذاكرة، مما يجعله خياراً غير مثالي في مجموعات البيانات الكبيرة والمتشعبة مقارنة بالحلول النمطية الأصيلة.
5.2 تطبيق معدّل التعبير النمطي الخاص بتجاهل الحالة (‘i’ Modifier)
يقدم محرك Perl المدمج في دالة PRXMATCH حلاً جذرياً وأنيقاً لهذه المشكلة من خلال دعم استخدام المعدلات السلوكية (Pattern Modifiers) التي تلحق بالمحدد النهائي للتعبير. ومن أهم هذه المعدلات المحرف ‘i’ الذي يرمز إلى تجاهل حساسية حالة الأحرف (Case-Insensitivity). لتطبيق هذا الحل، نقوم بصياغة التعبير النمطي كالتالي: '/avs/i'. يوضح الكود التالي كيفية تطبيقه عملياً:
data pattern_case_insensitive;
    set my_data;
    Position_Insensitive = prxmatch('/avs/i', Team);
run;

proc print data=pattern_case_insensitive;
    title "نتائج البحث باستخدام المعدل /avs/i لتجاهل حالة الأحرف";
run;
عند معالجة هذا التعبير، يقوم محرك PCRE بتحييد الفروق الثنائية بين المحارف اللاتينية الكبيرة ونظائرها الصغيرة أثناء مسح السلسلة. يتم هذا التحييد داخلياً على مستوى البايت دون الحاجة لإجراء تحويل نصي صريح لمتغير Team في ذاكرة SAS، مما يوفر سرعة معالجة استثنائية ويحافظ على البنية الأصلية للبيانات كما هي دون تعديل.
5.3 فحص النتائج وتقييم كفاءة رصد الكيانات المتطابقة
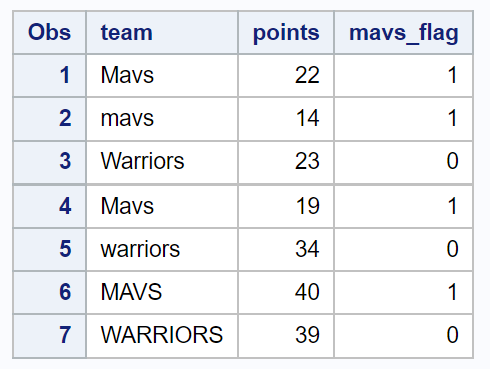
يُظهر فحص جدول المخرجات pattern_case_insensitive تحولاً جذرياً في دقة الرصد الموضعي للكيانات المستهدفة. نجد أن السجل الخامس “DAL MAVS”، والذي أرجع القيمة صفراً في المحاولة السابقة، قد سجل الآن القيمة 6 (D-A-L-[مسافة]-M-A-V-S)، حيث بدأ التطابق غير الحساس للحالة عند المحرف السادس بدقة متناهية.
كذلك تم التقاط السجل الثامن “Maverick Club” بقيمة موضعية تساوي 2، لأن المحارف الثلاثة الأولى من اسم النادي “Mav” تضمنت المقطع “av” غير الحساس للحالة بدءاً من الحرف الثاني. هذا التوسع الدقيق في التقاط الأنماط يرفع من كفاءة المعالجة ويضمن شمولية التحليل الإحصائي، مؤكداً قدرة معدلات PRXMATCH على تحسين استرجاع البيانات المتباينة دون التضحية بالدقة الحسابية أو سلامة النص الأصلي.
6. المثال الثالث: تصفية وفرز البيانات المشروطة باستخدام PRXMATCH
6.1 توظيف الدالة كمعيار منطقي داخل عبارة WHERE الإجرائية
لا تقتصر وظيفة دالة PRXMATCH على اشتقاق المتغيرات الإحصائية فحسب، بل تمتد لتكون أداة استعلام منطقية بالغة الفعالية داخل عبارات التصفية التابعة للإجراءات (WHERE Statements). بما أن الدالة تُرجع صفراً في حالة عدم التطابق، فإن أي قيمة موجبة تُمثل تحققاً للشرط المنطقي. يمكن صياغة استعلام لتصفية البيانات واستخراج السجلات التي تحتوي فقط على النمط المطلوب عبر الكود التالي:
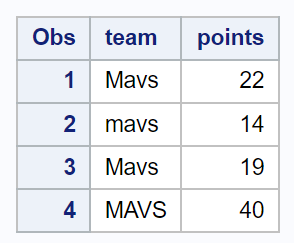
proc print data=my_data;
    where prxmatch('/Mavs/i', Team) > 0;
    title "السجلات المصفاة التي تطابق النمط /Mavs/i باستخدام عبارة WHERE";
run;
تتميز التصفية باستخدام عبارة WHERE في إجراءات SAS بكفاءة تشغيلية متفوقة مقارنة بعبارات التصفية اللاحقة؛ حيث تعمل التصفية هنا قبل تحميل الملاحظات غير المطابقة إلى الذاكرة التشغيلية للإجراء، مما يقلل بشكل كبير من عمليات القراءة والكتابة (I/O Operations) ويسرع إنتاج التقارير الإحصائية الموجهة.
6.2 تطبيق التصفية المشروطة في خطوة البيانات (DATA Step)
في العديد من سيناريوهات تنظيف البيانات وبناء خطوط الأنابيب التحليلية (Data Pipelines)، يُفضل تطبيق التصفية المشروطة مباشرة داخل خطوة البيانات لاستبعاد السجلات المشوهة أو فرز الملاحظات إلى مجموعات فرعية متعددة. يمكن استخدام جملة الحذف الشرطية (IF-THEN-DELETE) أو الإبقاء الإيجابي (IF-THEN-OUTPUT) استناداً إلى نتائج PRXMATCH، كما يوضح المثال التالي:
data filtered_teams non_matching_teams;
    set my_data;
    if prxmatch('/Mavs/i', Team) > 0 then do;
        Match_Status = "مطابق";
        output filtered_teams;
    end;
    else do;
        Match_Status = "غير مطابق";
        output non_matching_teams;
    end;
run;
يتيح هذا البناء المنطقي فرز البيانات بكفاءة عالية إلى جداول منفصلة مع إضافة مؤشرات نوعية، مما يساعد مهندس البيانات على فحص الملاحظات المستبعدة والتأكد من عدم وجود بيانات مفقودة عن طريق الخطأ قبل استكمال بقية مراحل النمذجة الإحصائية.
6.3 التحقق من موثوقية العينة المستخرجة وتحليل مخرجاتها
بعد إتمام عمليات التصفية المشروطة، يتعين إجراء تحقق تحليلي من موثوقية العينات المستخرجة وحجمها النسبي. يمكن مراجعة سجل تشغيل SAS للتأكد من عدد الملاحظات المقروءة والمكتوبة في كل جدول فرعي، ثم استعراض محتوى جدول filtered_teams للتأكد من عدم حدوث أي استبعاد زائف (False Negative) أو إدراج غير صحيح (False Positive):
proc print data=filtered_teams;
    title "المجموعة الفرعية المؤكدة لفرق Dallas Mavericks وما يرتبط بها";
run;
يُظهر استعراض الجدول المصفى أن جميع السجلات المتضمنة تعبر بدقة عن الكيان المستهدف بغض النظر عن حالة الأحرف أو سياق الجملة، مما يؤكد الموثوقية الرياضية لاستخدام PRXMATCH كمرشح منطقي دقيق داخل خطوط أنابيب معالجة البيانات النصية.
7. التعامل مع الأنماط المتقدمة والتراكيب المحرفية الخاصة
7.1 مطابقة مواضع البداية والنهاية عبر علامات التثبيت (^ و $)
توفر التعبيرات النمطية المتقدمة في SAS إمكانية التحكم الدقيق في سياق المطابقة الموضعي عبر استخدام علامات التثبيت (Anchors). يمثل رمز الإقحام (Caret ^) بداية السلسلة النصية، بينما يمثل رمز الدولار (Dollar Sign $) نهايتها. تلعب هذه الرموز دوراً محورياً في منع المطابقات الجزئية غير المرغوبة وحصر البحث في بدايات السلاسل أو أواخرها بدقة متناهية.
على سبيل المثال، إذا أردنا البحث عن السجلات التي تبدأ حصراً بالمقطع “Dal” بغض النظر عن بقية الجملة، نصيغ التعبير النمطي: '/^Dal/i'. أما إذا أردنا مطابقة كلمة تقع في نهاية السلسلة تماماً، فإننا نضع علامة الدولار في ختام التعبير كالتالي: '/Mavs$/i'. يوضح الكود التالي كيفية توظيف علامات التثبيت برمجياً:
data anchored_patterns;
    set my_data;
    Starts_With_Dal = prxmatch('/^Dal/i', Team);
    Ends_With_Mavs  = prxmatch('/Mavs$/i', strip(Team));
run;
تجدر الإشارة إلى استخدام دالة STRIP حول متغير Team في التعبير الثاني، وهو إجراء منهجي بالغ الأهمية في SAS لإزالة الفراغات اللاحقة التي قد تمنع علامة $ من الالتصاق بآخر محرف نصي حقيقي، مما يضمن استقرار المطابقة وتحقيق نتائج خالية من العيوب.
7.2 استخدام فئات المحارف ومطابقات المجالات الحرفية [ ]
تتيح فئات المحارف (Character Classes)، المعرفة باستخدام الأقواس المعقوفة [ ]، تحديد مجموعة محددة من المحارف يُسمح بظهور أي منها في موضع معين داخل السلسلة. يفيد هذا التركيب في معالجة الكلمات التي تحتمل تهجئات متعددة أو لغات متقاربة، كأن نبحث عن تهجئتين مختلفتين لكلمة واحدة مثل “gray” و”grey” عبر النمط '/gr[ae]y/'.
كما تدعم فئات المحارف تعريف المجالات (Ranges) باستخدام الشرطة الواصلة، مثل [0-9] للبحث عن أي رقم عشري، أو [a-zA-Z] لمطابقة أي حرف أبجدي. كما يمكن استخدام رمز النفي [^] في بداية الفئة لعكس منطق المطابقة؛ فالنمط '/[^0-9]/' يبحث عن أول محرف ليس رقماً. توفر هذه الفئات المرنة قدرة استثنائية على فحص حقول البيانات المعقدة كالرموز التعريفية للمرضى أو معرفات المنتجات التي تتبع قوالب معيارية محددة بدقة.
7.3 توظيف المحارف المعرفة مسبقاً لمطابقة الأرقام والفراغات (d, s, w)
يتضمن محرك Perl في SAS مجموعة من الرموز المختزلة المعرفة مسبقاً (Predefined Shorthand Metacharacters) التي تسهل صياغة الأنماط الطويلة وتجعل الكود أكثر إيجازاً وقابلية للقراءة. تشمل هذه الاختصارات الأساسية:
d: لمطابقة أي محرف رقمي عشري، وهو يكافئ تماماً الفئة[0-9].s: لمطابقة أي مسافة بيضاء، بما يشمل المسافات العادية والمسافات الجدولية (Tabs) وفواصل الأسطر.w: لمطابقة محارف الكلمات (Word Characters)، وتشمل الحروف الأبجدية والأرقام وشرطة التسطير السفلي (_).
يوضح الكود التالي تطبيقاً عملياً يبحث عن الأنماط التي تتألف من كلمة تليها مسافة بيضاء ثم أرقام، وهو ما يتكرر بكثرة في معالجة العناوين والرموز الطبية:
data character_shorthands;
    length Sample_Text $30;
    input Sample_Text &;
    Match_Pos = prxmatch('/w+s+d+/', Sample_Text);
    datalines;
Case 101
PatientID 4092
InvalidEntry
Item   999
;
run;
في هذا التعبير، يشير الرمز + إلى محدد تكراري يعني “ظهور واحد أو أكثر”، مما يسمح بالتقاط السجلات بغض النظر عن عدد المسافات الفاصلة بين الكلمة والرقم، وهو ما يجسد قوة محرك PRXMATCH في معالجة البيانات غير المتجانسة.
8. معالجة التحديات النصية واستكشاف الأخطاء البرمجية الشائعة
8.1 التعامل مع القيم المفقودة (Missing Values) والمسافات الفارغة
تفرض القيم المفقودة (Missing Values) والمسافات البيضاء الفارغة سلوكيات خاصة في معالجة البيانات النصية داخل برمجية SAS يجب إدارتها باحتراز منهجي. عندما يتم تمرير متغير نصي يحمل قيمة مفقودة كاملة (Blank Missing Value) إلى دالة PRXMATCH، فإن الدالة ترجع القيمة 0 دون التسبب في توقف تنفيذ الكود، وهو سلوك آمن من الناحية التشغيلية يسهل إدارة التدفق البرمجي.
ومع ذلك، تظهر مشكلات دقيقة عند محاولة مطابقة أنماط قد تقبل محارف فارغة بطبيعتها، كاستخدام محددات كمية صفرية مثل * (صفر أو أكثر). في هذه السيناريوهات، قد يُرجع المحرك القيمة 1 للمتغير الفارغ معتبراً أن غياب النص يمثل تطابقاً صالحاً للنمط الصفري، وهو ما يقود إلى استنتاجات خاطئة. لتجنب ذلك، ينبغي تطهير المتغيرات المصدرية باستخدام دوال مثل STRIP أو التحقق المسبق من وجود قيم نصية فعلية عبر الشروط المنطقية قبل إخضاعها للمطابقة النمطية المتقدمة.
8.2 تحديد وتصحيح أخطاء بناء التعبيرات النمطية (Syntax Errors)
يعد سجل تشغيل SAS (SAS Log) المصدر الأساسي لتشخيص أخطاء بناء التعبيرات النمطية التي تقع أثناء كتابة الكود. ومن أشهر هذه الأخطاء نسيان إغلاق الأقواس التجميعية أو نسيان المحدد النهائي (Closing Delimiter)، مما يولد رسائل خطأ صريحة من نوع “Invalid regular expression” تتسبب في تعطيل خطوة البيانات بالكامل.
كما تمثل مشكلة الهروب من المحارف الخاصة (Escaping Metacharacters) مصدراً متكرراً للأخطاء الصامتة. إذا كان الهدف هو البحث عن رمز له وظيفة بنائية في محرك بيرل—مثل النقطة . التي تعني أي محرف، أو علامة الدولار $—فإن إدراجها مجردة في التعبير سيؤدي إلى مطابقة سلوكية وليست حرفية. لتصحيح ذلك، يجب استخدام الخط المائل العكسي (Backslash ) قبل الرمز الخاص كالتالي: '/$100/' لمطابقة القيمة النصية “$100” بدقة، مما يحيّد وظيفة المحرف البنائية ويعيده إلى معناه الحرفي المجرد.
8.3 استراتيجيات التحقق من صحة الأنماط قبل التطبيق واسع النطاق
عند بناء حلول معالجة البيانات للمؤسسات الكبرى، يُحظر تطبيق التعبيرات النمطية المعقدة مباشرة على مجموعات البيانات الضخمة التي تحتوي على ملايين السجلات دون اختبارات معيارية مسبقة. تقتضي أفضل الممارسات اقتطاع عينة اختبارية صغيرة وممثلة عبر عبارة (obs=100)، وإخضاعها للتحليل ومراقبة استجابة الدالة بدقة.
إضافة إلى ذلك، يُنصح ببناء حالات اختبار حدية (Edge Cases) مصطنعة تشمل النصوص الفارغة، والسلاسل متناهية الطول، والنصوص المحتوية على محارف خاصة ومسافات متعددة وغير منتظمة. يساعد هذا الاختبار الصارم في تأكيد متانة التعبير النمطي وملاءمته لمعالجة كافة الانحرافات المحتملة للبيانات الواقعية، مما يقي من الأخطاء الكارثية في مراحل الإنتاج ويضمن استقرار خطوط التحليل الإحصائي اللاحقة.
9. التكامل بين دوال PRX المتقدمة في SAS لرفع كفاءة المعالجة
9.1 تحسين الأداء الحسابي عبر دمج PRXPARSE مع PRXMATCH
عند تنفيذ دالة PRXMATCH بتمرير التعبير النمطي كنص صريح مباشرة مثل prxmatch('/pattern/', text)، يقوم نظام SAS بترجمة وتحليل بنية التعبير النمطي داخلياً مع كل ملاحظة منفردة تتم قراءتها داخل خطوة البيانات. إذا كان جدول البيانات يضم ملايين السجلات، فإن هذا التكرار غير المبرر لعملية التحليل اللغوي يؤدي إلى إهدار جسيم في وقت المعالج وبطء ملحوظ في الأداء العام.
للتغلب على هذه العقبة التقنية، توفر SAS دالة PRXPARSE التي تتيح تجميع التعبير النمطي لمرة واحدة فقط في الذاكرة، ثم تمرير المعرف الرقمي الناتج (Pattern ID) إلى دالة PRXMATCH عبر استخدام جملة RETAIN والتحقق من التكرار الأول if _N_ = 1. يوضح الكود المتقدم التالي كيفية تطبيق هذه الاستراتيجية الاحترافية:
data optimized_matching;
    set my_data;
    retain PatternID;
    drop PatternID;

    if _N_ = 1 then do;
        PatternID = prxparse('/Mavs/i');
        if missing(PatternID) then stop;
    end;

    Match_Pos = prxmatch(PatternID, Team);
run;
يوفر هذا النهج المعماري تسريعاً هائلاً في زمن التنفيذ يصل في بعض الدراسات المعيارية إلى أكثر من 50% من وقت المعالجة، حيث يتعامل محرك PRXMATCH مع كائن نمطي مترجم وجاهز للتطبيق المباشر على مصفوفات الذاكرة.
9.2 المقارنة المنهجية بين PRXMATCH وPRXCHANGE في تنظيف النصوص
على الرغم من المكانة المحورية لدالة PRXMATCH، إلا أن حدودها الوظيفية تتوقف عند رصد وتحديد المواضع الجغرافية للأنماط داخل السلاسل النصية دون امتلاك القدرة على تعديلها أو إبدالها. عند الانتقال إلى مراحل تطهير البيانات النصية (Data Cleansing) وإعادة الهيكلة، تبرز دالة PRXCHANGE كشريك تكاملي لا غنى عنه لدالة PRXMATCH.
تستخدم دالة PRXCHANGE صيغة استبدال شبيهة بصيغة بيرل 's/pattern/replacement/'، مما يمكنها من استبدال المقاطع غير المرغوبة أو حذف المسافات الزائدة دفعة واحدة. في خطوط الأنابيب التحليلية المتقدمة، يتم الدمج المنهجي بين الدالتين؛ حيث تُستخدم PRXMATCH أولاً للتحقق المنطقي من استيفاء السجل للشروط المطلوبة، وعند ثبوت ذلك، يتم تمرير السلسلة إلى PRXCHANGE لإجراء التعديل اللازم، مما يحافظ على نظافة الكود ووضوح التدفق العملي لمعالجة النصوص.
9.3 استخدام دالة PRXPOSN لاستخراج المجموعات الفرعية المقيدة
يمثل مفهوم أقواس الالتقاط (Capture Groups) أحد أقوى ميزات التعبيرات النمطية في معالجة السلاسل النصية المعقدة. عبر وضع أجزاء من التعبير داخل أقواس هلالية ( )، يتمكن المحلل من تقسيم السلسلة النصية إلى مكونات دلالية فرعية يمكن استرجاعها لاحقاً بشكل مستقل دون الحاجة لكتابة استعلامات بحث إضافية.
تتكامل هذه الميزة في SAS عبر دالة PRXPOSN؛ فعند تنفيذ دالة PRXMATCH على تعبير يحتوي على مجموعات التقاط، يتم تسجيل إحداثيات ومواضع وأطوال كل مجموعة داخل المحرك. بعد ذلك، يمكن استدعاء دالة CALL PRXPOSN لتمرير رقم المجموعة واستخراج النص الفرعي المحصور بداخلها مباشرة وتخزينه في متغير جديد. يمثل هذا الحل أسلوباً فائق الدقة لاستخراج الرموز البريدية أو أسماء النطاقات من عناوين البريد الإلكتروني في خطوة برمجية واحدة متكاملة ومحكمة.
10. تطبيقات متقدمة وأفضل الممارسات البرمجية في بيئة SAS
10.1 بناء مؤشرات ثنائية وتصنيفات متقدمة لتحليل البيانات الاستقصائية
في الدراسات الإحصائية والبحوث الاستقصائية، تمثل الإجابات النصية المفتوحة (Open-ended Survey Responses) كنزاً معلوماتياً ثرياً يتطلب تحويلاً كمياً لدمجه في نماذج التحليل الرياضي كالانحدار اللوجستي أو التحليل العاملي. توفر دالة PRXMATCH وسيلة مثالية لتحويل النصوص الوصفية إلى مؤشرات رقمية ثنائية (Binary Indicators 0/1) تدل على وجود مصطلحات محددة أو انطباعات معينة.
يوضح الكود التالي تطبيقاً عملياً لتصنيف الملاحظات النصية إلى فئات موضوعية محددة استناداً إلى تعبير نمطي يفحص وجود كلمات رئيسية متعددة عبر استخدام المعامل المنطقي البديل (Pipe |):
data survey_classified;
    length Feedback $100 Category$15;
    input Feedback &;

    /* تصنيف النصوص باستخدام PRXMATCH */
    if prxmatch('/ممتاز|رائع|جيد|راضي/i', Feedback) > 0 then
        Sentiment_Flag = 1;
    else
        Sentiment_Flag = 0;

    datalines;
الخدمة كانت ممتازة وفوق المتوقع
لم يعجبني التعامل وكان سيئا
مستوى رائع وسرعة في الإنجاز
لا يوجد لدي تعليق محدد
;
run;
يمكن بعد ذلك تغذية المتغير المشتق Sentiment_Flag مباشرة إلى إجراءات النمذجة مثل PROC LOGISTIC أو تلخيصه إحصائياً عبر PROC FREQ لتقدير نسبة الرضا العام، مما يوضح قدرة PRXMATCH على تحويل البيانات النوعية غير المهيكلة إلى مدخلات كمية قياسية تخدم أهداف البحث العلمي والتطبيقي.
10.2 إرشادات تحسين سرعة التنفيذ عند التعامل مع مجموعات البيانات الضخمة
عند معالجة مجموعات البيانات فائقة الحجم (Big Data) التي تضم عشرات الملايين من السجلات في بيئات العمل المؤسسية، تصبح الكفاءة الحوسبية معياراً حاسماً لا يقبل التهاون. لتحقيق أقصى سرعة تنفيذ ممكنة عند توظيف دالة PRXMATCH، يجب مراعاة المبادئ الهندسية التالية:
- تجنب الاستدعاء العشوائي: قم دائماً بتجميع التعبير النمطي مسبقاً عبر دالة PRXPARSE وتخزينه باستخدام عبارة RETAIN لتفادي إعادة الترجمة المستمرة.
- الترتيب المنطقي للشروط: إذا كان الاستعلام يتضمن شروطاً متعددة، فاجعل الشروط الحسابية السريعة تسبق فحص PRXMATCH؛ حيث تضمن آلية التقييم المقصر (Short-Circuit Evaluation) عدم تشغيل محرك الأنماط النصية إلا عندما تكون بقية الشروط الرياضية متحققة بالفعل.
- الموازنة بين الدوال البسيطة والمعقدة: لا تلجأ إلى التعبيرات النمطية المعقدة إذا كانت المسألة تقتصر على مطابقة حرفية بسيطة وموحدة؛ ففي تلك الحالات، تتفوق الدوال الكلاسيكية مثل INDEX وFIND في السرعة الحسابية المجردة لخفتها البرمجية مقارنة بمتطلبات تشغيل محرك PCRE الكامل.
10.3 خلاصة الممارسات المهنية وأدلة التوثيق البرمجي المعتمدة
تتميز التعبيرات النمطية بقدرتها الفائقة على التعبير، ولكنها في الوقت نفسه قد تتسم بالغموض وصعوبة القراءة (Cryptic Syntax) للمحللين الآخرين أو حتى للمبرمج نفسه بعد مرور فترة من الزمن. تتطلب أفضل الممارسات البرمجية والمهنية توثيق التعبيرات النمطية المعقدة عبر تعليقات برمجية مسهبة داخل الكود تشرح وظيفة كل جزء من النمط والهدف المنهجي من استخدامه.
كما يدعم محرك بيرل في SAS إضافة المعدل 'x' (Extended Mode) في نهاية التعبير النمطي، والذي يسمح بتنسيق التعبير عبر أسطر متعددة وتضمين فراغات وتعليقات توضيحية داخل بنية التعبير ذاته دون احتسابها كجزء من عملية المطابقة النصية. يضمن هذا النهج التوثيقي المتقدم استمرارية البرمجيات وقابليتها للتدقيق والمراجعة المؤسسية، ويؤسس لبيئة عمل برمجية تجمع بين البراعة التقنية والشفافية المنهجية الرصينة.
خاتمة
استعرض هذا الدليل الأكاديمي المفصل الأبعاد النظرية والتطبيقية لاستخدام دالة PRXMATCH في برمجية SAS كواحدة من أقوى الأدوات المتاحة للتنقيب في البيانات النصية وتحليل السلاسل المحرفية المعقدة. من خلال دمج محرك Perl-Compatible Regular Expressions (PCRE) العريق، توفر هذه الدالة دقة متناهية في تحديد المواضع الحرفية، وتجاوز قيود الحساسية لحالة الأحرف، وإجراء التصفيات الشرطية المتقدمة بكفاءة عالية تفوق الأساليب التقليدية الموروثة.
إن إتقان توظيف دالة PRXMATCH والتكامل بينها وبين دوال منظومة PRX المتقدمة—مثل PRXPARSE وPRXCHANGE—يمثل مهارة أساسية لكل مبرمج ومهندس بيانات يسعى إلى بناء خطوط أنابيب تحليلية موثوقة وعالية الأداء قادرة على معالجة تحديات العالم الواقعي، وتحويل النصوص المشوشة إلى رؤى إحصائية متماسكة تدعم اتخاذ القرارات العلمية والمؤسسية الرشيدة.
المراجع
- Hazel, P. (2001). PCRE – Perl Compatible Regular Expressions. University of Cambridge Computing Service. https://www.pcre.org/
- Kleene, S. C. (1951). Calculation of events in nerve nets and finite automata (Research Memorandum RM-704). RAND Corporation.
- Kleene, S. C. (1956). Representation of events in nerve nets and finite automata. In C. E. Shannon & J. McCarthy (Eds.), Automata Studies (pp. 3–41). Princeton University Press.
- SAS Institute Inc. (2020). SAS(R) 9.4 Functions and CALL Routines: Reference, Fifth Edition. Cary, NC: SAS Institute Inc.
- Wall, L., Christiansen, T., & Orwant, J. (2000). Programming Perl (3rd ed.). O’Reilly Media.