
يعد تنظيم البيانات وتلخيصها الركيزة الأساسية التي يستند إليها أي تحليل إحصائي رصين، إذ لا يمكن استنباط دلالات علمية أو اتخاذ قرارات مبنية على شواهد تجريبية انطلاقاً من أرقام خام مبعثرة تفتقر إلى النسق والترتيب. ومن هنا، يبرز التوزيع التكراري بوصفه إحدى أقدم وأنجع الوسائل الرياضية المعنية بتحويل المدخلات المشوشة إلى هياكل بيانية منظمة تفصح عن الأنماط الكامنة والنزعات المركزية ومستويات التشتت داخل الظاهرة محل الدراسة. ومع التطور المتسارع لمنصات الحوسبة السحابية ومعالجة البيانات، أضحت جداول بيانات جوجل (Google Sheets) بيئة متقدمة تجمع بين الدقة الرياضية، وسرعة المعالجة الحسابية، والمرونة البرمجية المعتمدة على الدوال المصفوفية الحديثة.
يتناول هذا الدليل الأكاديمي الشامل آليات ومنهجيات حساب التكرارات داخل جداول بيانات جوجل، متبعاً تسلسلاً بنيوياً يبدأ من التأصيل النظري لأنماط القياس الإحصائي، مروراً بالتشريح البرمجي العميق للدوال التخصصية مثل FREQUENCY ودوال العد الشرطي COUNTIF وCOUNTIFS، وصولاً إلى استراتيجيات النمذجة المتقدمة عبر الجداول المحورية والتمثيل البياني الاحترافي. ويهدف هذا العمل إلى تمكين الباحثين والمحللين من تطويع هذه الأدوات لاختزال العينات الضخمة في توزيعات معيارية تعكس التكرار المطلق والنسبي والتراكمي بأقصى درجات الضبط العلمي والدقة الحسابية الممكنة.
سواء كنت تتعامل مع متغيرات اسمية نوعية لا تحتمل المفاضلة الترتيبية، أو مقاييس رتبية تتطلب تقييماً تراكمياً ومئينياً، أو متغيرات كمية متصلة تقتضي تقسيماً فئوياً متكافئاً وفق القواعد الإحصائية القياسية؛ فإن هذا المرجع يضع بين يديك الخطوات الإجرائية التفصيلية، معززة بالتطبيقات الرياضية، والتحذيرات التقنية لتفادي أخطاء التدفق والامتداد، وممارسات التحقق من التوازن الحسابي، بما يضمن سلامة المخرجات وقابليتها للنشر والتوظيف الأكاديمي الرصين.
1. مقدمة منهجية: مفهوم التوزيع التكراري وأهميته في جداول بيانات جوجل
1.1 ماهية التكرارات الإحصائية ودورها في تلخيص البيانات
يُعرَّف التكرار الإحصائي بأنه القيمة العددية التي تعكس معدل ظهور مفردة معينة، أو وقوع قياس محدد ضمن فئة رقمية معرّفة بدقة داخل فضاء العينة الخاضعة للدراسة. يمثل التكرار اللبنة الأولى في بناء الإحصاء الوصفي، حيث يسعى الباحث من خلاله إلى نقل البيانات من حالتها الفوضوية غير المصنفة إلى نمط رياضي يمكن استقراء دلالاته؛ إذ إن فحص مصفوفة تتألف من آلاف المشاهدات الفردية بصورة مباشرة يُعد أمراً مستحيلاً من الناحية الإدراكية والتحليلية، مما يستوجب اختزالها إلى جداول تكرارية تلخص المشهد العام دون الإخلال بخصائص البيانات الجوهرية.
تتجلى الأهمية الإبستيمولوجية للتوزيع التكراري في كونه أداة استكشافية تكشف عن مدى تجانس الظاهرة المقاسة أو تباينها؛ فمن خلال دراسة توزيع التكرارات عبر الفئات المختلفة، يستطيع المحلل رصد تركز المشاهدات حول نقاط مركزية بعينها، أو تشتتها نحو الأطراف، فضلاً عن تحديد القمم التكرارية التي تعبر عن المنوال الإحصائي للظاهرة. هذا الاختزال المنهجي لا يقتصر على مجرد التعداد الآلي، بل يشكل تمهيداً رياضياً لا غنى عنه قبل الانتقال إلى معالجة الفروض العلمية واختبارات الدلالة الإحصائية، إذ تفرض معظم النماذج البارامترية اشتراطات محددة حول طبيعة التوزيع واعتداليته.
قبل الشروع في كتابة الدوال واستدعاء الخوارزميات الحسابية داخل بيئات العمل البرمجية، يتعين على الباحث تأسيس إطار مفاهيمي واضح لطبيعة المتغير الخاضع للقياس؛ فالمعالجة الإحصائية الصحيحة مشروطة بمدى مواءمة المنهجية التكرارية لطبيعة البيانات الأصلية، وهو ما يتطلب تقييماً أولياً يحدد ما إذا كانت المتغيرات منفصلة بذاتها، أم أنها تمثل تدفقاً كمياً مستمراً يستلزم تصنيفاً فئوياً دقيقاً لتفادي تشويه دلالات القياس وتجنب الوقوع في فخاخ التعميم الخاطئ.
1.2 مكانة جداول بيانات جوجل كأداة لتحليل التوزيع التكراري
شهدت السنوات الأخيرة تحولاً جوهرياً في منهجيات معالجة البيانات، حيث برزت جداول بيانات جوجل كمنظومة سحابية متقدمة تنافس البرمجيات المكتبية التقليدية. تنبع قوة هذه المنصة من قدرتها الفائقة على المعالجة التشاركية للبيانات في الوقت الحقيقي؛ إذ يستطيع فرق البحث والتحليل العمل بالتزامن على نفس مصفوفات البيانات، مع مراقبة التحديثات الفورية التي تطرأ على التوزيعات التكرارية بمجرد ورود مدخلات جديدة من الميدان عبر النماذج الاستقصائية المرتبطة آلياً.
علاوة على ميزة العمل التشاركي، توفر بيئة جداول بيانات جوجل دعماً استثنائياً للدوال الإحصائية المصفوفية القياسية، التي تتعامل مع النطاقات المعقدة دون استنزاف موارد المعالجة المحلية للجهاز المستخدم؛ فالخوارزميات المنفذة سحابياً تستفيد من البنية التحتية الهائلة لمحركات جوجل الحسابية، مما يتيح معالجة مجموعات البيانات الكبيرة بكفاءة عالية، وتطبيق العمليات التكرارية المركبة بسلاسة تامة، مع ضمان الحفظ التلقائي وسجل التعديلات التاريخي لكل عملية إحصائية مجراة.
يتكامل هذا الأداء الحسابي الرصين مع محرك رسومي متطور يربط مخرجات الجداول التكرارية بالتمثيل البياني الفوري؛ فبمجرد صياغة مصفوفة التكرارات، يمكن للمحلل إنشاء مدرجات تكرارية ورسوم شريطية تفاعلية تتغير ديناميكياً مع تعديل حدود الفئات أو إدخال عناصر تجريبية جديدة، مما يجعل جداول بيانات جوجل بيئة متكاملة تجمع بين التأسيس الرياضي الصارم للمتغيرات وسهولة العرض الإيضاحي اللازم لصياغة التقارير الأكاديمية وصنع القرارات المؤسسية.
1.3 التمييز الإحصائي بين التكرار المطلق والنسبي والتراكمي
يستلزم التحليل المنهجي الرصين التمييز الصارم بين ثلاثة مفاهيم محورية للتكرار؛ الأول هو التكرار المطلق ($f_i$)، والذي يمثل العد الرقمي الخام لحدوث المفردة أو وقوع المشاهدة داخل فئة محددة دون ربط ذلك بحجم العينة الكلي؛ ورغم بساطة هذا المفهوم، فإنه يظل الأساس الذي تُبنى عليه كافة العمليات الإحصائية اللاحقة، حيث يعبر رياضياً عن المجموع المباشر لدوال المؤشر التي ترصد تحقق شرط الانتماء للفئة المستهدفة ضمن كامل فضاء القياس المتوفر لدى الباحث.
المفهوم الثاني هو التكرار النسبي ($p_i$ أو $rf_i$)، والذي ينقل التحليل من مجرد الرصد الكمي الخام إلى سياق التناسب والتقييم المقارن؛ إذ يُحسب بقسمة التكرار المطلق للفئة على الحجم الإجمالي للعينة ($N$). يكتسب التكرار النسبي أهمية بالغة عند مقارنة مجموعتين مختلفتين في الحجم الإجمالي؛ حيث يتعذر الاعتماد على التكرارات المطلقة لتحديد أي المجموعتين أكثر إظهاراً للظاهرة، في حين يوفر التكرار النسبي معياراً موحداً يتراوح مداه الحسابي بين الصفر والواحد الصحيح، ويمكن تحويله مباشرة إلى نسب مئوية متوازنة تعزز الفهم الوصفي للبيانات.
أما المفهوم الثالث، فيتمثل في التكرار التراكمي ($cf_i$)، وهو حاصل جمع تكرار الفئة الحالية مع كافة تكرارات الفئات السابقة لها في الترتيب؛ يُعد هذا المقياس أداة جوهرية في تحليل البيانات التي تمتلك على الأقل مستوى قياس رتبي، إذ يسهم في تحديد المواقع المئينية، وحساب الرتب المئوية، ومعرفة نسبة المفردات التي تقع دون حد معين أو تتجاوزه، مما يجعله عنصراً محورياً في تحديد مواضع الإرباعيات، والانحراف الربيعي، وتأسيس خرائط التوزيع التراكمي المستمر للظواهر المقاسة.
2. بنية وصيغة دالة FREQUENCY في جداول بيانات جوجل
2.1 التشريح الرياضي والبرمجي لدالة FREQUENCY
تحتل دالة FREQUENCY مكانة متميزة في مكتبة الدوال الإحصائية الخاصة بجداول بيانات جوجل، وتأخذ الصيغة البنائية القياسية التالية: FREQUENCY(data, classes). صُممت هذه الدالة هندسياً لتعمل كدالة مصفوفية متكاملة تقوم بتوزيع عناصر مصفوفة البيانات الأولية على مصفوفة الفئات المحددة، متفادية الحاجة إلى تكرار كتابة الدوال الشرطية لكل فئة على حدة، مما يوفر أداءً حسابياً فائق السرعة يخلو من التكرار البرمجي غير المجدي.
يكمن التفوق البرمجي لدالة FREQUENCY في سلوكها الإنتاجي التلقائي؛ فعند إدخال الدالة في خلية فردية واحدة، فإنها تقوم بتوليد مصفوفة عمودية تمتد تلقائياً إلى الأسفل لتغطي كافة الفئات المحددة، متجاوزة الحاجة إلى تطبيق اختصارات التنفيذ المصفوفي التقليدية المعقدة؛ إذ تدرك بيئة جداول بيانات جوجل المعاصرة الطبيعة المصفوفية للدالة تلقائياً وتقوم بتوزيع النتائج على النطاق الرأسي المقابل لكل فاصل رقمي بصورة آنية محكمة ومباشرة دون تأخير في معالجة الأرقام الكبيرة.
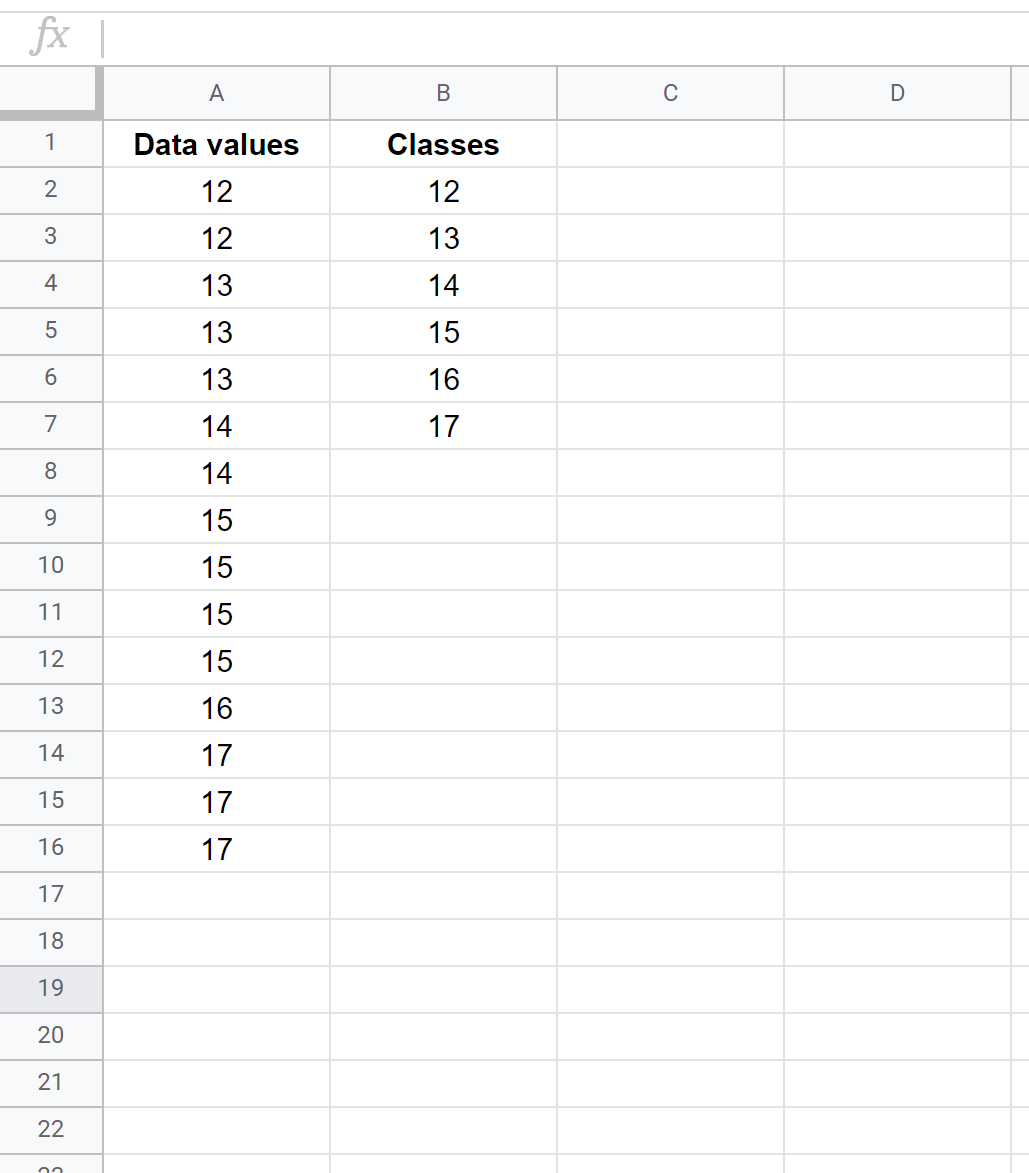
لتجنب حدوث أخطاء حسابية أو تشوهات في المخرجات، تستلزم دالة FREQUENCY مدخلات محددة الشروط؛ إذ تتطلب وسيطين أساسيين: الوسيط الأول data ويمثل النطاق الذي يحتوي على البيانات الرقمية الخام المراد تصنيفها، والوسيط الثاني classes ويمثل النطاق الذي يتضمن الحدود العليا للفئات الرقمية التي ستُفرز البيانات وفقاً لها؛ وأي إخلال بالبنية الرقمية لهذين الوسيطين يؤدي بالضرورة إلى انحراف النتائج الإحصائية، مما يفرض عناية فائقة في إعداد المصفوفات قبل استدعاء الدالة.
2.2 مفهوم مصفوفة البيانات (Data Array) والشروط الواجب توافرها
تُعرَّف مصفوفة البيانات (Data Array) بأنها النطاق المرجعي الحاوي لكافة المفردات والقيم الرقمية التي جُمعت ميدانياً أو تجريبياً، والتي تشكل موضوع التحليل الإحصائي المستهدف؛ قد تتألف هذه المصفوفة من عمود واحد أو عدة أعمدة متجاورة، إلا أن الممارسة القياسية تفضل تنظيم المتغير في شكل عمود رقمي مستمر وواضح المعالم لضمان سهولة الإسناد والتحقق من سلامة المراجع داخل المعادلات الرياضية.
يشترط في مصفوفة البيانات أن تكون مطهرة بالكامل من المدخلات النصية، والرموز الخاصة، والمحارف غير المرئية التي قد تتسلل أثناء عمليات الاستيراد؛ ذلك أن دالة FREQUENCY مبرمجة لتجاهل النصوص والقيم المنطقية والخلايا الفارغة تماماً، والتركيز الحصري على الأعداد الرياضية؛ وإذا احتوت المصفوفة على أرقام مخزنة بتنسيق نصي نتيجة خطأ في الاستيراد، فإن الدالة ستتجاوزها دون إدراجها ضمن التكرار، مما يقود إلى تآكل حجم العينة الفعلي وتشويه المجموع الكلي للتكرارات المحسوبة بصورة غير مرئية للمحلل المستعجل.
يتحدد التعامل مع مصفوفة البيانات أيضاً بنوع المتغير الكمي؛ فالمتغيرات المنفصلة (Discrete) التي تتضمن أعداداً صحيحة تتطلب دقة في تحديد فئات الفرز لتفادي سقوط القيم البينية، بينما تستلزم المتغيرات المستمرة (Continuous) التي تحتوي على كسور عشرية دقيقة ضبطاً صارماً لمستويات التقريب الرياضي ضمن نطاق البيانات، بما يضمن عدم إقصاء أي مشاهدة دقيقة خارج إطار الفئات التصنيفية المحددة مسبقاً من قِبل الباحث.
2.3 مفهوم مصفوفة الفئات (Classes / Bins Array) وآلية تصميمها
تمثل مصفوفة الفئات، أو ما يُعرف في الأدبيات الإحصائية والبرمجية بحاويات الفرز (Bins Array)، المخطط الهيكلي الذي يُسقط عليه توزيع البيانات؛ وهي عبارة عن نطاق عمودي يحتوي على أرقام تصاعدية تمثل الحدود الفاصلة بين المجموعات؛ وتعمل هذه الحدود كمحطات قياس متتالية تستخدمها الدالة لتحديد المسار الحسابي لكل قيمة من قيم مصفوفة البيانات الخام، وتصنيفها في وعائها التكراري الصحيح.
الآلية المحورية التي ترتكز عليها قراءة دالة FREQUENCY لمصفوفة الفئات تتمثل في أن القيم المدخلة تُعامل دائماً كحدود عليا (Upper Boundaries) للمجالات الحسابية؛ وهذا يعني أن الدالة تطبق قاعدة التضمين الرياضي القائلة بأن المشاهدة ($x$) تنتمي إلى الفئة ($i$) إذا كانت أكبر من الحد الأعلى للفئة السابقة ($B_{i-1}$) وأصغر من أو تساوي الحد الأعلى للفئة الحالية ($B_i$)، أي وفق المتراجحة المغلقة من اليمين: $B_{i-1} < x le B_i$.
يتطلب تصميم مصفوفة الفئات تحديداً دقيقاً لاتساع الفئة وعددها، وهو ما يستند عادة إلى المعايير الإحصائية المعتمدة كنظرية هربرت سترجس (Sturges’ Rule) لتجنب التوزيع المفرط الذي يشتت المعالم، أو التلخيص المخل الذي يطمس الفروق؛ ويجب أن تخلو مصفوفة الفئات تماماً من أي قيم نصية، وأن تُرتّب ترتيباً تصاعدياً صارماً من القيمة الصغرى إلى القيمة الكبرى؛ فالترتيب غير المنتظم يؤدي إلى نتائج مصفوفية مشوهة يصعب تفسيرها رياضياً.
3. الإعداد الأولي للبيانات وفرز الفئات باستخدام الدوال المساعدة
3.1 استخراج القيم الفريدة للمتغيرات باستخدام دالة UNIQUE
عند التعامل مع المتغيرات المنفصلة أو البيانات النوعية التي تتطلب حساب التكرار لكل مفردة مستقلة بذاتها، يواجه الباحث تحدي استخلاص قائمة خالية من التكرار تمثل فئات الفرز المستهدفة؛ وهنا تبرز دالة UNIQUE في جداول بيانات جوجل كواحدة من أقوى الأدوات المساعدة المتاحة لمعالجة هذه المعضلة الحسابية بسرعة ودقة استثنائية دون الحاجة للتدخل اليدوي العرضة للسهو والخطأ.
تعمل دالة UNIQUE من خلال صيغتها المباشرة: =UNIQUE(range) على مسح النطاق المستهدف المحدد في الوسيط، واستخراج كل عنصر فريد ظهر لمرة واحدة على الأقل، مستبعدة بصورة تلقائية كافة النظائر المكررة؛ فإذا كان لدينا عمود يحوي مئات المشاهدات لعلامات اختبار أو تصنيفات تجريبية متكررة، فإن تطبيق هذه الدالة في عمود مجاور يولد على الفور قائمة مرجعية نقية تتضمن البنية الأساسية التي ستعتمد لاحقاً كمصفوفة فئات لدالة التكرارات.
إن استخراج الفئات بهذه الكيفية الآلية يؤسس لمصفوفة فئات تتكيف تلقائياً مع تحديثات البيانات؛ ففي حال تم إدخال مفردات جديدة لم تكن موجودة سابقاً في النطاق، تتمدد مصفوفة دالة UNIQUE فورياً لتستوعب المتغير الجديد، مما يجعل المنظومة التحليلية برمتها ديناميكية ومحصنة ضد إغفال أي مستجدات تطرأ على مصفوفة البيانات الأصلية أثناء مراحل الرصد المستمر.
3.2 ترتيب الفئات تصاعدياً عبر دمج دالتي SORT و UNIQUE
على الرغم من قدرة دالة UNIQUE على استخلاص القيم المنفردة، إلا أنها تستخرجها وفق ترتيب ورودها التاريخي في مصفوفة البيانات الخام، وهو ما يتنافى مع المتطلب الإحصائي الصارم الذي يفرض أن تكون مصفوفة الفئات مرتبة ترتيباً تصاعدياً منطقياً لتسهيل القراءة وتفادي الاضطراب الحسابي أثناء الربط مع دوال التكرار المتقدمة؛ ولحل هذا الإشكال، يلجأ المحلل إلى دمج دالتي SORT وUNIQUE ضمن تعبير تركيبي واحد متماسك.
تتم صياغة هذه المعادلة الهجينة وفق الشكل البرمجي التالي: =SORT(UNIQUE(A2:A100))؛ حيث تقوم دالة UNIQUE باستخلاص الفئات الفردية أولاً، لتقوم دالة SORT المحيطة بها بترتيب تلك المخرجات المستخلصة ترتيباً تصاعدياً افتراضياً من الأدنى إلى الأعلى؛ وتوفر هذه الصياغة المركبة بنية معيارية نموذجية لمصفوفة الفئات تضمن أعلى مستويات الكفاءة المعالجاتية عند تمريرها إلى دالة FREQUENCY أو عند استخدامها في بناء الجداول التكرارية الشاملة.
يمتاز هذا التكامل البرمجي بقدرته على الحفاظ على التناسق الهيكلي للجدول الإحصائي مهما تغير حجم المدخلات؛ فالنطاق المرتب تصاعدياً يُسهل على المحلل الإحصائي فحص الاتساق الداخلي للبيانات، وتحديد موقع الفئات المفقودة في المتتالية العددية، فضلاً عن ضمان مطابقة الترتيب المنطقي للظاهرة المقاسة، لا سيما في البيانات الترتيبية التي تحمل دلالات متدرجة بطبيعتها مثل مستويات الرضا أو القياسات الحيوية المصنفة.
3.3 تنقية البيانات ومعالجة القيم المفقودة والشاذة
تعد مرحلة تنقية البيانات (Data Cleaning) شرطاً قبلياً لا يمكن تجاوزه في منهجية الحساب الإحصائي؛ ذلك أن وجود خلايا فارغة مشوهة، أو أصفار ناتجة عن خلل في التسجيل، أو قيم شاذة متطرفة (Outliers) تعود إلى أخطاء في الإدخال الميداني، من شأنه أن يفرز توزيعات تكرارية مضللة تعطي انطباعات كاذبة عن طبيعة المجتمع الإحصائي؛ لذا يتعين إخضاع النطاق لسلسلة من اختبارات الفحص والتحقق قبل تمريره لأي دالة تكرارية.
يمكن الاستعانة بأدوات الفرز والتصفية المدمجة في جداول بيانات جوجل للتحقق من سلامة الأرقام، كما يمكن كتابة شروط منطقية عبر التنسيق الشرطي لتمييز القيم التي تبتعد بشكل غير منطقي عن المتوسط الحسابي، أو تلك التي تقع خارج الحدود الممكنة للمقياس المستخدم؛ ففي المقاييس المعيارية المحدودة (كمقاييس ليكرت من 1 إلى 5)، يُعد ظهور قيمة مثل 50 أو -1 خطأ إدخال صريح يجب تصحيحه أو حذفه فورياً لضمان عدم إنشاء فئات زائفة تشوه الهيكل التكراري العام.
أما بخصوص القيم المفقودة، فيتعين على الباحث اتخاذ قرار منهجي واضح وموثق في تقريره العلمي؛ فإما أن تُعالج تلك الفجوات عبر أساليب التعويض الرياضي المقبولة إحصائياً، أو تُستبعد بالكامل من مصفوفة التحليل مع توثيق حجم الاستبعاد بدقة؛ ذلك أن تجاهل التحقق المسبق قد يؤدي إلى تصنيف الفراغات بشكل غير منضبط في بعض الدوال، أو التأثير السلبي على حجم العينة الفعلي المستخدم لاحقاً في حساب التكرارات النسبية والمئوية.
4. تطبيق دالة FREQUENCY لحساب التكرارات الفردية خطوة بخطوة
4.1 إدخال الصيغة وتحديد النطاقات الحسابية بدقة
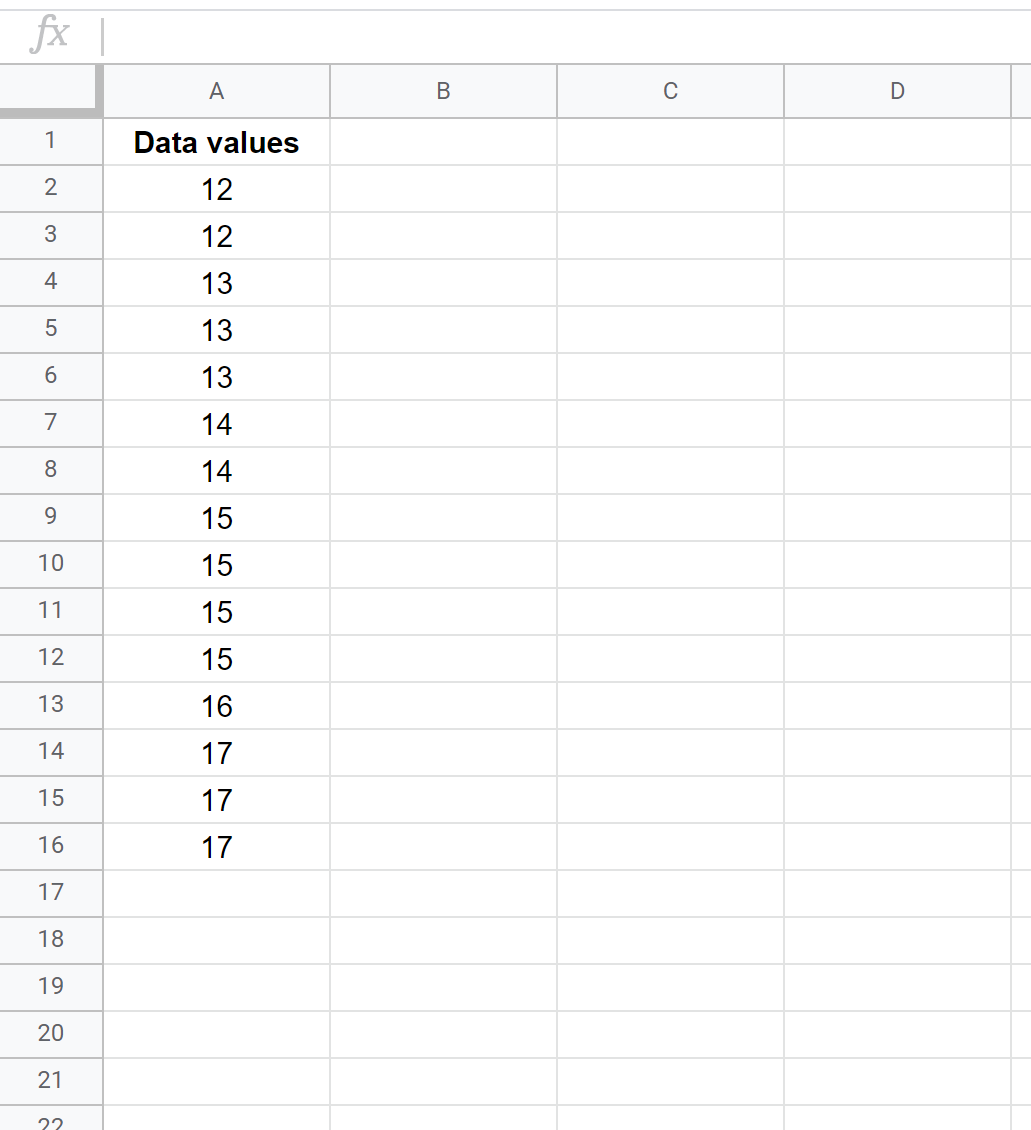
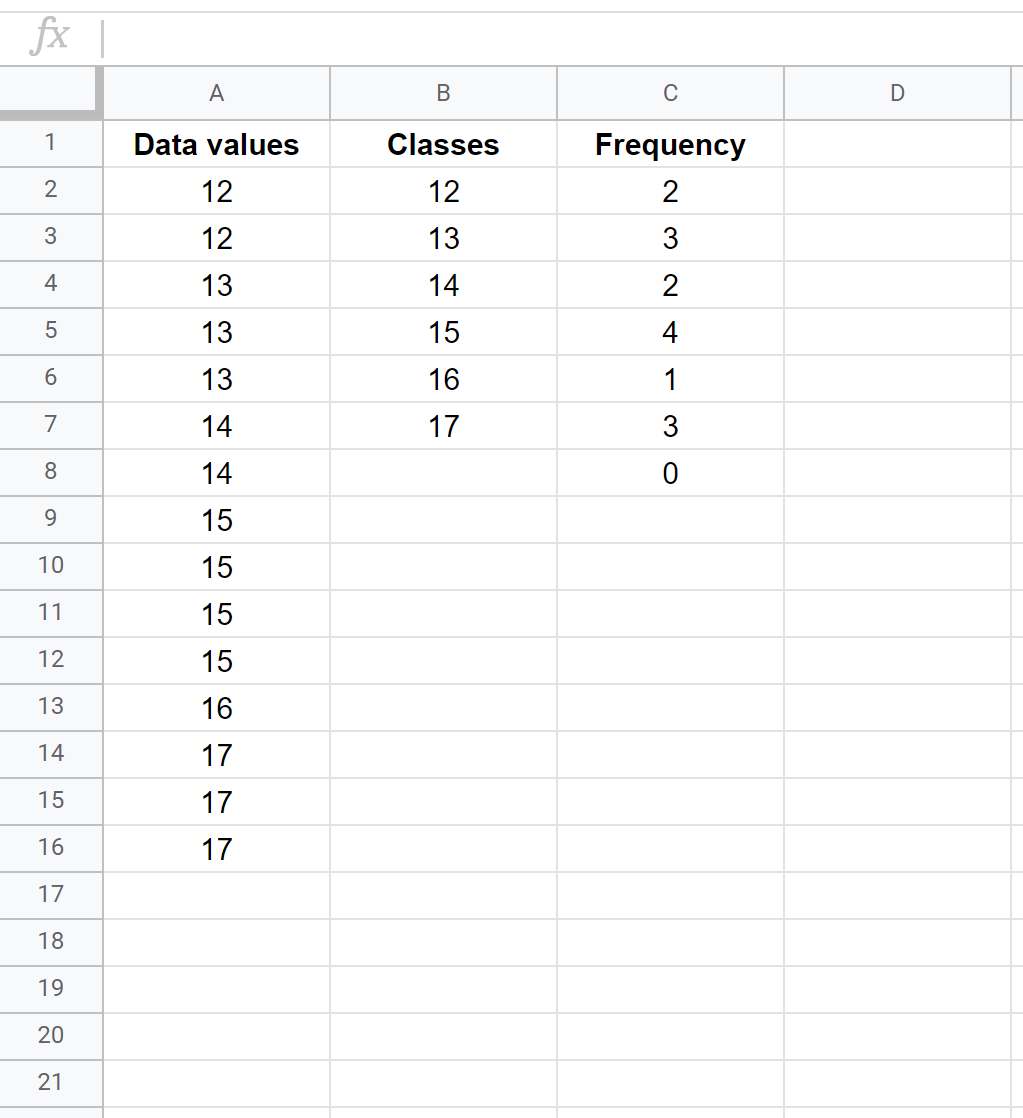
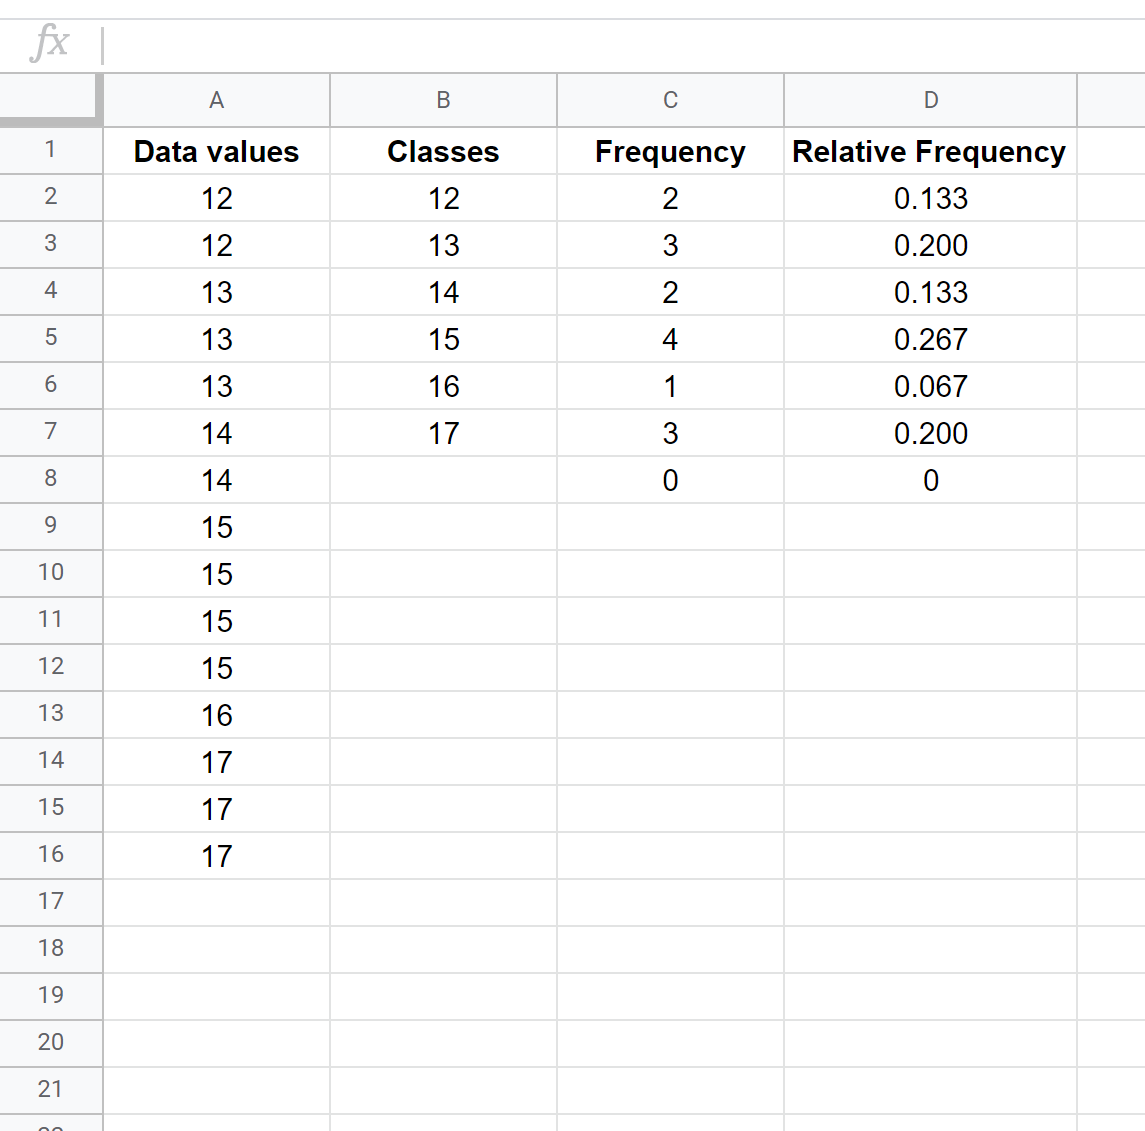
لتطبيق دالة FREQUENCY بصورة عملية، يستهل الباحث عمله بتحديد الخلية العلوية الأولى من العمود المخصص لاستقبال النتائج، ولتكن الخلية C2 على سبيل المثال؛ يكتب المحلل إشارة المساواة متبوعة باسم الدالة وقوس الفتح: =FREQUENCY(؛ ثم يقوم بتحديد نطاق مصفوفة البيانات الخام، مثل A2:A100، ويليه بفاصلة أو فاصلة منقوطة (بحسب الإعدادات الإقليمية للورقة)، ثم يحدد نطاق مصفوفة الفئات المستخرجة في العمود المجاور، مثل B2:B10، ثم يغلق القوس لتصبح المعادلة مكتملة: =FREQUENCY(A2:A100, B2:B10).
يجب مراعاة تثبيت النطاقات باستخدام علامة المرجع المطلق ($) عند الرغبة في نقل المعادلات أو استخدامها ضمن قوالب ممتدة، كأن تُكتب الصيغة بالشكل: =FREQUENCY($A$2:$A$100, $B$2:$B$10)؛ ورغم أن دالة التكرار لا تتطلب عادة نسخاً رأسياً نظراً لطبيعتها المصفوفية التوسعية، إلا أن استخدام المراجع المطلقة يقي التحليل من الانزياحات المرجعية غير المقصودة في حال جرى سحب الخلايا المجاورة أو نقل بنية الجداول من ورقة عمل إلى أخرى ضمن نفس المستند.
من الممارسات المتقدمة أيضاً الاستعانة بالنطاقات الديناميكية المفتوحة، مثل A2:A، والتي تتيح للدالة استقبال بيانات جديدة تُضاف مستقبلاً إلى نهاية العمود ومعالجتها تلقائياً؛ ومع ذلك، يقتضي هذا الأسلوب حذراً إضافياً للتأكد من عدم احتواء الخلايا السفلية من العمود على أي هوامش، أو نصوص تلخيصية، أو توقيعات قد تُفسر كمدخلات مشوشة، مما يتطلب إبقاء المسار الرأسي للعمود نظيفاً بالكامل لضمان سلامة العمليات الرياضية المستمرة.
4.2 فهم السلوك المصفوفي التلقائي (Array Functionality)
تتفرد دالة FREQUENCY بخاصية التدفق التلقائي (Spilling)، وهي ميزة هندسية برمجية تجعل الدالة تتمدد بمفردها لتملأ الخلايا الواقعة أسفل الخلية الحاوية على المعادلة بعدد عناصر يساوي عدد فئات الفرز مضافاً إليه خانة واحدة؛ وهذا يعني أن المستخدم ليس بحاجة إلى تظليل نطاق مسبق ولا إلى الضغط على مجموعات المفاتيح المركبة مثل Ctrl + Shift + Enter كما كان شائعاً في إصدارات البرمجيات المكتبية القديمة؛ بل يكفي الضغط على مفتاح Enter لترى المخرجات التكرارية تتدفق بالكامل في رمشة عين.
يقترن بهذا السلوك المصفوفي ضرورة الانتباه إلى ما يُعرف بـ “خطأ الامتداد” أو التعارض الموضعي؛ فإذا كانت أي من الخلايا الواقعة في المسار العمودي للتدفق التلقائي تحتوي على أي نص، أو رقم، أو حتى مسافة فارغة غير مرئية، فإن الدالة ستتوقف فوراً عن العمل، وتُظهر خطأ مرجعياً صريحاً (#REF!) مفاده تعذر توسيع النطاق بسبب وجود محتوى يحجب التدفق؛ ويكمن الحل الوحيد هنا في تفريغ كافة الخلايا الواقعة أسفل خلية الدالة لإتاحة المساحة الكافية لتمدد المصفوفة الحسابية.
من الخصائص البنيوية الجوهرية الأخرى التي يجب استيعابها في هذا السلوك، أن مصفوفة FREQUENCY تفرز دائماً خلية إضافية تقع أسفل آخر فئة مسجلة في مصفوفة الفئات؛ وتُخصص هذه الخلية الحسابية الإضافية لتجميع أي قيم في مصفوفة البيانات تتجاوز الحد الأعلى للفئة الأخيرة، وهو ما سنتناوله بالتفصيل لاحقاً؛ ويعد إدراك وجود هذا العنصر الإضافي أمراً بالغ الأهمية لتجنب ترحيل الصفوف وتداخل تسميات الفئات مع قيم التكرارات المحسوبة.
4.3 تفسير النتائج المستخرجة ومطابقتها إحصائياً
عقب إتمام الحساب المصفوفي، تبدأ مرحلة القراءة التفسيرية للنتائج، حيث يقابل كل رقم ناتج في عمود التكرارات حداً فئوياً محدداً في عمود الفئات؛ يتعين على الباحث التحقق من المنطق الإحصائي للمخرجات؛ فالفئة التي تحظى بالتكرار الأكبر تمثل القيمة المنوالية للعينة، في حين تشير الفئات ذات التكرارات الصفرية إلى وجود فجوات في التوزيع التكراري للظاهرة، وهو ما قد يحمل دلالات استكشافية بالغة الأهمية حول انقطاع التسلسل الطبيعي للبيانات في تلك المجالات.
تتمثل الخطوة المنهجية التي لا غنى عنها في إجراء عملية “المطابقة الإحصائية الكلية”؛ وتتحقق هذه المطابقة بتطبيق دالة الجمع =SUM() على كامل عمود مخرجات التكرار المستخرجة، ومقارنة هذا المجموع بالحجم الإجمالي لمصفوفة البيانات المحسوب بدالة =COUNT(A2:A100)؛ ويجب أن يتطابق الرقمان تطابقاً تاماً لا يحتمل أي فارق؛ فإذا كان مجموع التكرارات أقل من عدد البيانات، فإن ذلك يشير حتماً إلى وجود قيم نصية تم تجاهلها، أو قيم فائضة لم تُستوعب ضمن الفئات المحددة.
يوثق الباحث هذه الملاحظات في تقرير وصفي يوضح من خلاله أن التوزيع التكراري يغطي بنجاح 100% من مشاهدات العينة الخاضعة للقياس؛ مما يؤكد خلو العمليات الحسابية من أخطاء التحيز أو الإسقاط العشوائي للبيانات؛ ويشكل هذا التحقق الأولي أساساً صلباً يمكن الارتكاز عليه قبل الانتقال إلى حساب المؤشرات الإحصائية المتقدمة كالتباين، والانحراف المعياري، ومعاملات الالتواء والتفرطح للظاهرة المدروسة.
5. حساب التكرارات للفئات المجمعة والمجالات الرقمية (Binned Frequencies)
5.1 تحديد أبعاد الفئات وحساب المدى الإحصائي
في حالات المتغيرات المتصلة التي تتعدد فيها القيم الفردية ويستحيل حصرها فرادى، يلجأ التحليل إلى تقنية “الفئات المجمعة” (Grouped Bins) لضغط التوزيع التكراري في شرائح ذات مغزى؛ تبدأ هذه العملية رياضياً بحساب المدى الكلي للبيانات ($R$)، وذلك بطرح القيمة الصغرى من القيمة العظمى في مصفوفة البيانات عبر المعادلة: =MAX(range) - MIN(range)؛ ليمثل الناتج الفضاء الرقمي الشامل الذي تتوزع عليه كافة مفردات الظاهرة المدروسة.
تستند الخطوة التالية إلى تحديد عدد الفئات الأنسب ($k$)، وهنا يُستحسن أكاديمياً الاعتماد على قاعدة سترجس (Sturges’ Rule) الرياضية، والتي تتحدد بالصيغة القياسية التالية:
$$k = 1 + 3.322 \log_{10}(N)$$
حيث يمثل $N$ الحجم الإجمالي للعينة؛ وتمنع هذه القاعدة التقدير العشوائي لعدد الفئات، وتوفر توازناً مثالياً بين التبسيط والوضوح، بحيث لا يتجاوز عدد الفئات الحدود المقبولة التي تشتت النمط، ولا يقل عن الحد الذي يطمس الخصائص الجوهرية للتوزيع.
عقب تحديد عدد الفئات، يُحسب اتساع الفئة الواحدة ($W$) بقسمة المدى الكلي على عدد الفئات: $W = R / k$؛ ويُفضل دائماً تقريب الناتج إلى أقرب عدد صحيح مريح رياضياً للأعلى لضمان استيعاب كافة القيم، مما يؤدي إلى إنشاء مجالات متساوية الاتساع تتوالى فيها الفئات الرقمية بشكل منتظم يبدأ من القيمة الدنيا للعينة ويمتد تباعاً عبر إضافات دورية لقيمة الاتساع المحسوبة حتى تغطية القيمة القصوى تماماً.
5.2 بناء مصفوفة الحدود العليا للمجالات الرقمية
عند بناء مصفوفة الفئات لحساب تكرارات المجالات المجمعة بواسطة دالة FREQUENCY، يقع العديد من المحللين في خطأ كتابة المجال كنص مثل (10-19 أو 20-29)، وهذا يبطل عمل الدالة تماماً؛ إذ تتطلب المنظومة الرياضية للدالة تزويدها بالحدود العليا فقط لكل فئة كأرقام مجردة؛ فإذا كانت الفئة الأولى تغطي القيم من 1 إلى 10، والفئة الثانية من 11 إلى 20، فإن عمود الفئات يجب أن يتضمن الأرقام 10 ثم 20 على التوالي كقيم عددية منفصلة.
يرجع هذا المتطلب إلى المنطق التضميني الضمني للدالة؛ حيث تأخذ الدالة الحد الأعلى الأول (10) وتجمع كافة القيم التي تساوي أو تقل عنه لتشكل تكرار الفئة الأولى؛ ثم تنتقل للحد الأعلى الثاني (20)، وتجمع كافة القيم التي تزيد عن 10 وتساوي أو تقل عن 20 لتشكل تكرار الفئة الثانية، وهكذا دواليك عبر سلسلة المجالات؛ وعليه فإن العمود المخصص للوسيط الثاني في الدالة هو عمود رقمي صارم يمثل قمم المجالات الرقمية المغلقة من اليمين ($x le \text{Upper Limit}$).
لأغراض العرض التوثيقي الموجه للقارئ البشري، يقوم الباحث عادة بإنشاء عمود نصي إضافي إلى جوار عمود النتائج، يوضح من خلاله التسمية الكاملة للمجال بصيغة مقروءة، كأن يكتب: “من 1 إلى 10″، و”من 11 إلى 20″؛ غير أن هذا العمود يظل شأناً تنسيقياً وصفياً بحتاً، بينما يظل العمود المرجعي المستخدم داخل دالة FREQUENCY مقصوراً على الأرقام المجردة التي تمثل الحدود العليا لتلك الفئات لضمان صحة المعالجة الخوارزمية.
5.3 إدارة الخلية الفائضة (Overflow Bin) الناتجة عن الدالة
من أهم السمات التصميمية لدالة FREQUENCY التي تتطلب فهماً إحصائياً عميقاً هي “الخلية الفائضة”؛ وتتمثل في سطر النتائج الأخير الذي يظهر تلقائياً في نهاية مصفوفة التكرارات ويزيد بصف واحد عن طول مصفوفة الفئات المزودة في وسائط الدالة؛ وتُعنى هذه الخلية الحسابية برصد كافة القيم التي تتجاوز الحد الأعلى للفئة الأخيرة المحددة في مصفوفة الفئات؛ أي أنها تمثل رياضياً التكرار المفتوح للقيم: $x > \text{Max Bins}$.
إن إغفال وجود هذه الخلية يقود إلى ارتباك منهجي وتنسيقي شائع؛ إذ يميل المبتدئون إلى محاولة حذف هذه القيمة أو مسحها، فتتعطل الدالة المصفوفية بالكامل وتفرز خطأ تعارض؛ لذا فإن المنهج السليم يقتضي إدراج تصنيف وصفي مقابل لهذه الخلية في الجدول النهائي تحت مسمى “> الحد الأقصى”، أو دمجها إحصائياً مع الفئة الأخيرة في حال كان تصميم الفئات يستهدف أصلاً استيعاب كامل المدى المطلق لمفردات الظاهرة المدروسة.
إذا كانت مصفوفة الفئات قد صُممت بعناية لتغطي بالفعل أعلى قيمة موجودة في مصفوفة البيانات ($B_k ge \text{Max}(data)$)، فإن القيمة الحسابية لهذه الخلية الفائضة ستكون صفراً بصورة حتمية، مما يؤكد للباحث أن كافة المفردات قد استُوعبت بالكامل ضمن الشرائح المحددة؛ أما إذا أظهرت هذه الخلية رقماً موجباً، فهذا إنذار فوري للمحلل بوجود قيم متطرفة لم تغطها مصفوفة الحدود، مما يوجب مراجعة اتساع الفئات وتمديد حدودها العليا لاستيعاب الظاهرة بأسرها.
6. طرق بديلة لحساب التكرارات في جداول بيانات جوجل
6.1 استخدام دالة COUNTIF لحساب التكرارات الشرطية البسيطة
على الرغم من القوة المصفوفية لدالة FREQUENCY، إلا أن دالة COUNTIF تظل إحدى الأدوات الشائعة والمرنة لحساب التكرارات الفردية؛ وتأخذ الدالة الصيغة القياسية: =COUNTIF(range, criterion)؛ حيث يمثل النطاق (range) مصفوفة البيانات الأصلية، بينما يمثل المعيار (criterion) القيمة المستهدف حساب تكرار ظهورها داخل هذا النطاق، سواء كانت تلك القيمة مكتوبة بصورة مباشرة أو مشارة عبر خلية مرجعية مقابلة في جدول الفئات.
تتفوق دالة COUNTIF بصورة واضحة عند التعامل مع المتغيرات النوعية والاسمية (Nominal Variables) كالجنس، والتخصص الأكاديمي، والانتماء الجغرافي؛ فهذه المتغيرات تتألف من سلاسل نصية تعجز دالة FREQUENCY عن قراءتها لكون الأخيرة دالة رقمية حصرية؛ لذا فإن COUNTIF توفر هنا البديل المثالي لحساب تكرار كل تسمية نصية، كأن نكتب: =COUNTIF(A2:A100, "إناث")، أو نشير إلى الخلية الحاوية على النص لنحصل فوراً على التكرار المطلق المقابل لذلك الصنف.
ورغم هذه المرونة، يؤخذ على الاعتماد الحصري على دالة COUNTIF في المشاريع الكبرى استهلاكها المرتفع لموارد المعالجة؛ إذ يتطلب حساب التكرارات لفئات متعددة نسخ الدالة يدوياً أو آلياً في كل خلية من خلايا عمود النتائج، مما يعني أن المنظومة تقوم بإعادة فحص مصفوفة البيانات بالكامل بعدد الفئات الموجودة؛ فإذا كان لدينا 100 فئة في عينة تحوي 50,000 سجل، ستنفذ المنصة 5 ملايين عملية مقارنة شرطية، مما يسبب بطئاً ملحوظاً في زمن الاستجابة بالمقارنة مع السرعة الفائقة لدالة FREQUENCY التي تفحص البيانات بمسار قراءة أحادي منظم.
6.2 استخدام دالة COUNTIFS لحساب تكرارات المجالات المحصورة
عند الرغبة في حساب تكرارات الفئات المجمعة للمجالات الرقمية دون اللجوء للمصفوفات التوسعية لدالة FREQUENCY، تبرز دالة العد متعدد الشروط COUNTIFS كبديل برمجي دقيق؛ تتيح هذه الدالة تطبيق شروط مزدوجة لحصر عدد المشاهدات التي تقع بين حد أدنى وحد أقصى وفق الصيغة التركيبية التالية:
=COUNTIFS(A2:A100, ">="&C2, A2:A100, "<="&D2)
حيث تشير C2 إلى الحد الأدنى للفئة، بينما تشير D2 إلى حدها الأعلى المقابل في جدول الفئات المصمم مسبقاً.
تتميز دالة COUNTIFS بمرونة فائقة في التحكم بطبيعة التضمين الحسابي؛ فالمحلل يملك الحرية الكاملة في اختيار ما إذا كان المجال مفتوحاً من جهة ومغلقاً من جهة أخرى (مثل استخدام > فقط بدلاً من >=)، وهو ما يعالج بدقة متطلبات بعض التوزيعات المعيارية التي تفرض استبعاد الحد الأدنى من الفئة وتضمينه في الفئة السابقة، بخلاف دالة FREQUENCY التي تفرض نموذجاً تضمينياً صارماً وثابتاً لا يقبل التعديل الرياضي من جانب المستخدم.
غير أن هذه المرونة تقترن أيضاً بتعقيد في بناء الصيغ وزيادة في احتمالية الخطأ البشري؛ إذ يتطلب دمج المعاملات المنطقية كعلامات الأكبر من والأصغر من مع المراجع الخلوية استخدام الرمز الرابط (&) وعلامات التنصيص بدقة، مما يرفع احتمالية ارتكاب أخطاء كتابية تفرز نتائج مشوهة، بالإضافة إلى أن كل فئة تتطلب صيغتها الخاصة، مما يجعل تحديث المجالات أو تغيير عددها عملاً يدوياً شاقاً يستلزم إعادة كتابة وتعديل المعادلات في كل صف من صفوف الجدول على حدة.
6.3 المقارنة المنهجية بين دوال العد ودالة FREQUENCY
يوضح الجدول المنهجي التالي مقارنة شاملة بين الأدوات البرمجية المتاحة لحساب التكرارات في جداول بيانات جوجل، مبيناً خصائص كل أداة وسياقات توظيفها المثلى:
| المعيار | دالة FREQUENCY | دالة COUNTIF | دالة COUNTIFS |
|---|---|---|---|
| طبيعة المخرجات | مصفوفية تلقائية تمتد عمودياً | خلية فردية تتطلب السحب | خلية فردية تتطلب السحب |
| نوع البيانات المدعومة | رقمية حصراً (Continuous / Discrete) | نصية، رقمية، منطقية | نصية، رقمية، منطقية |
| كفاءة المعالجة (Big Data) | عالية جداً (مسار فحص أحادي) | منخفضة مع تعدد الفئات | منخفضة جداً مع تعدد الشروط |
| مرونة ضبط الحدود | ثابتة (أصغر من أو يساوي الحد الأعلى) | مرونة محدودة لشرط واحد | مرونة فائقة لكافة معاملات المقارنة |
| الاستخدام الأكاديمي الأمثل | المتغيرات الكمية والمدرجات التكرارية | المتغيرات الاسمية والرتبية البسيطة | المجالات غير المنتظمة والفئات الخاصة |
يتضح من خلال هذه المقارنة أن المفاضلة بين هذه الدوال ليست تفضيلاً مطلقاً، بل هي ملاءمة منهجية تتبع طبيعة المتغير وحجم العينة؛ ففي الأبحاث الميدانية الضخمة التي تعالج متغيرات قياسية مستمرة، تكون دالة FREQUENCY هي الخيار الأمثل دون منازع لتفوقها الأدائي وتلقائيتها؛ بينما تظل دوال العد الشرطي أدوات مساندة حيوية لا غنى عنها في معالجة المتغيرات الاسمية والفئوية المحدودة.
7. إنشاء وحساب التكرارات النسبية والمئوية المتقدمة
7.1 الأساس الرياضي لحساب التكرار النسبي والمئوي
يمثل التكرار المطلق الخطوة الأولى في التحليل الوصفي، إلا أن الباحث غالباً ما يحتاج إلى توحيد المقاييس لاستيعاب الأهمية النسبية لكل شريحة من شرائح العينة؛ فالقول بأن فئة معينة تكررت 45 مرة يظل معلومة ناقصة ما لم نعلم الحجم الكلي للمجتمع؛ فإذا كانت العينة تتألف من 50 مفردة، فإن 45 تعكس هيمنة كاسحة، أما إذا كانت العينة تتألف من 10,000 مفردة، فإن نفس الرقم يعكس ندرة إحصائية واضحة.
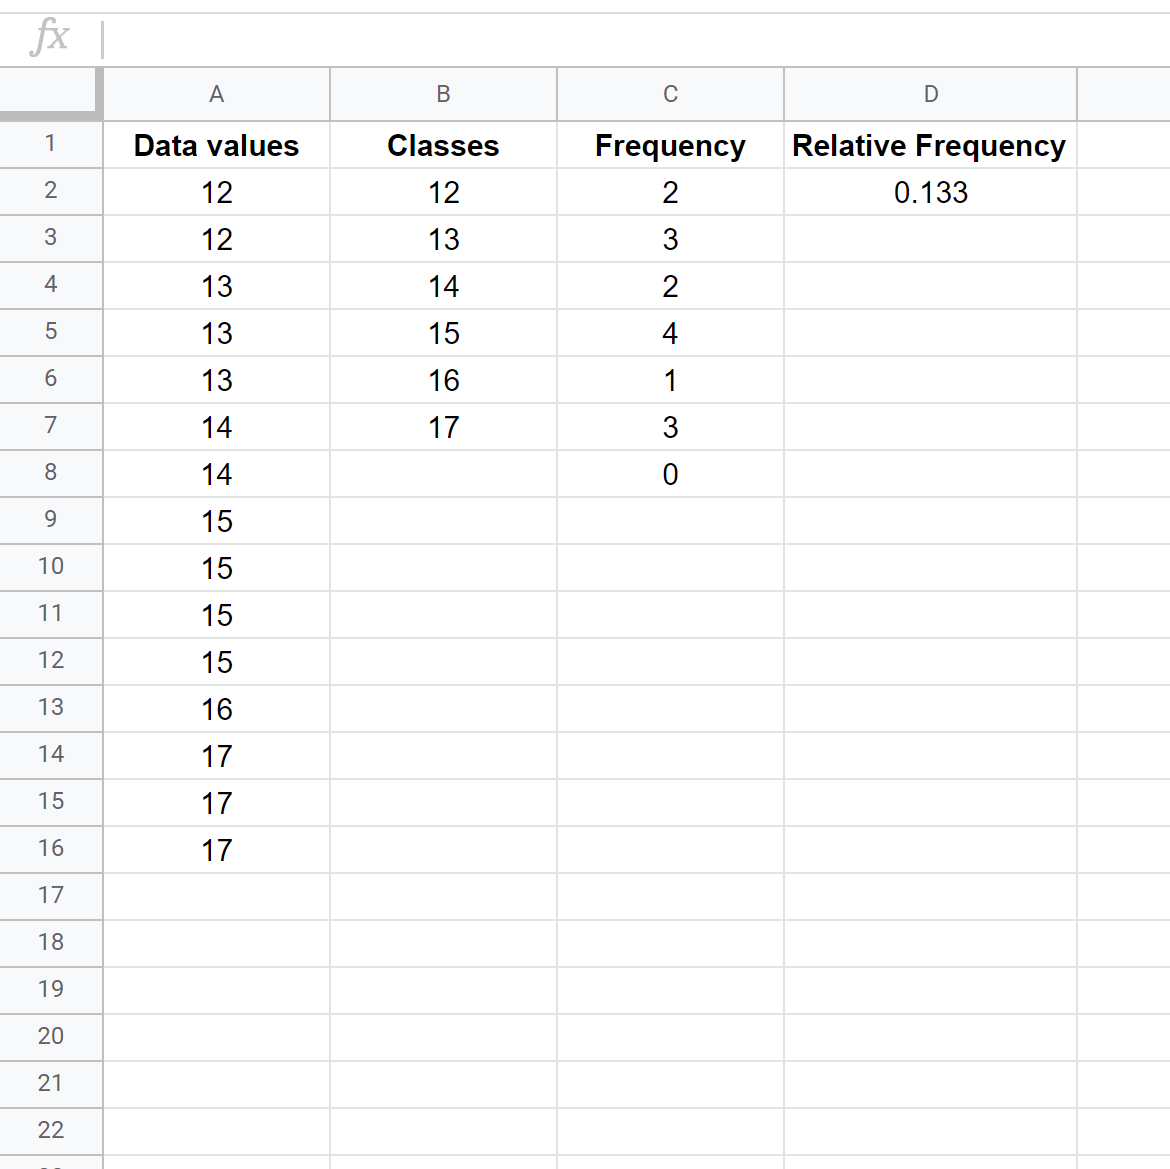
يُحسب التكرار النسبي ($rf_i$) بقسمة التكرار المطلق لكل فئة ($f_i$) على الحجم الإجمالي للعينة ($N$) وفق العلاقة الرياضية البديهية:
$$rf_i = \frac{f_i}{N}$$
ويتميز التكرار النسبي بخاصية رياضية جوهرية؛ إذ يجب أن ينحصر بين الصفر والواحد الصحيح دائماً ($0 le rf_i le 1$)، كما يجب أن يكون مجموع كافة التكرارات النسبية لجميع الفئات مساوياً للواحد الصحيح تماماً:
$$\sum_{i=1}^{k} rf_i = 1.00$$
وأي انحراف عن هذا المجموع يعكس إما خطأ في الحساب أو تراكماً لأخطاء التقريب الحسابي العشري غير المضبوط.
أما التكرار المئوي، فهو ببساطة حاصل ضرب التكرار النسبي في 100 لتحويل الكسر العشري إلى نسبة مئوية مألوفة الفهم؛ ويُعد التوزيع المئوي أداة الاتصال العلمي الأكثر وضوحاً في كتابة التقارير الإحصائية ومناقشة النتائج، نظراً لقدرته على تقديم صورة مجردة تعكس الحصة التوزيعية لكل فئة من مجمل الظاهرة دون إغراق القارئ في تفاصيل الأرقام الخام الكبيرة.
7.2 دمج دالة FREQUENCY مع SUM و ARRAYFORMULA آلياً
لتحقيق أقصى درجات الأتمتة البرمجية داخل جداول بيانات جوجل، يمكن تجاوز الطرق التقليدية التي تتطلب كتابة معادلات قسمة يدوية لكل صف، والاستعاضة عنها بصيغة هجينة واحدة تولد عمود التكرارات النسبية بضغطة زر؛ يتحقق ذلك عبر دمج دالة FREQUENCY مع دالة ARRAYFORMULA ودالة المجموع SUM في معادلة مصفوفية عليا.
تتم صياغة هذه المعادلة المتقدمة في الخلية الأولى المخصصة للنتائج النسبية كالتالي:
=ARRAYFORMULA(FREQUENCY(A2:A100, B2:B10) / SUM(FREQUENCY(A2:A100, B2:B10)))
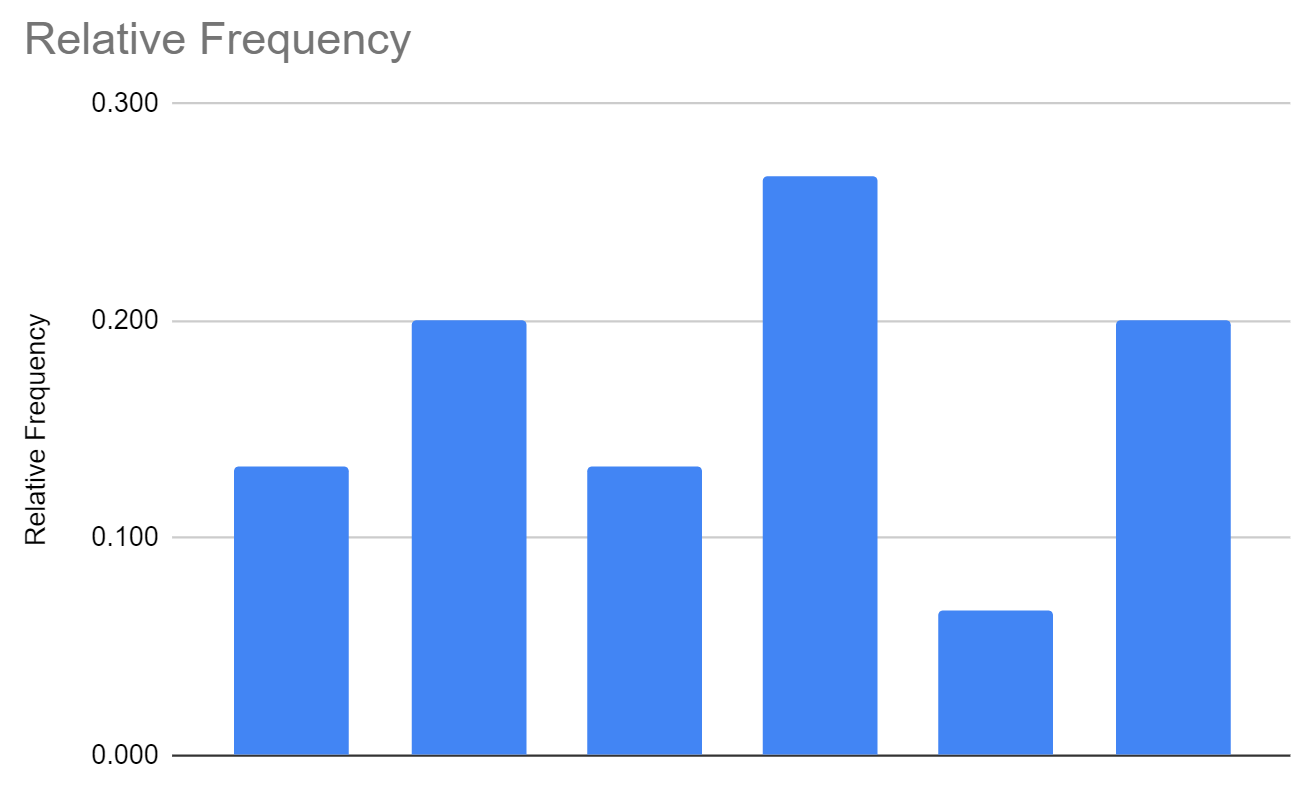
يقوم هذا التعبير البرمجي المعقد بحساب مصفوفة التكرارات المطلقة أولاً، ثم يقسم كل عنصر ناتج فيها بشكل متزامن على المجموع الكلي لكامل عناصر تلك المصفوفة، مما يفرز عموداً متكاملاً من التكرارات النسبية يتطابق طوله وأبعاده تماماً مع عمود الفئات المدرج في التحليل.
تكمن العبقرية البرمجية لهذا الأسلوب في كونه يلغي احتمالية عدم تطابق مقام النسبة مع بسطها؛ فالمقام هنا ليس رقماً ثابتاً مدخلاً يدوياً، بل هو ناتج جمع آلي لنفس المصفوفة، مما يضمن بصورة قاطعة أن مجموع التكرارات النسبية الناتجة سيساوي 1.00 بالتمام والكمال حتى في حال أُضيفت بيانات جديدة إلى مصفوفة الإدخال، لتظل المعادلة محصنة ذاتياً ضد أخطاء عدم الاتساق الرقمي التي تصيب الجداول الإحصائية اليدوية.
7.3 تنسيق مخرجات التكرار النسبي وفق المعايير الإحصائية
عقب استخراج مخرجات التكرار النسبي، تأتي خطوة التنسيق الرقمي لتقديم البيانات بصورة تلائم المعايير الأكاديمية الصارمة؛ توفر جداول بيانات جوجل أدوات مدمجة لتنسيق النسب المئوية عبر شريط الأدوات أو عبر المسار: تنسيق > رقم > نسبة مئوية (Format > Number > Percent)؛ ويؤدي تفعيل هذا الخيار إلى تحويل الكسور العشرية (مثل 0.1523) إلى مظهر مئوي مقروء (15.23%) دون المساس بالقيمة الرياضية الكامنة في الخلية.
يتعين على الباحث ضبط عدد المنازل العشرية بحكمة تتفق مع حجم العينة وطبيعة القياس؛ ففي معظم الأبحاث الاجتماعية والسلوكية، يُكتفى بمنزلتين عشريتين لتقديم الدقة المقبولة دون إرباك القارئ بتفاصيل هامشية؛ أما في الدراسات ذات الدقة المعملية أو المقاييس الصيدلانية، فقد يتطلب الأمر عرض ثلاث أو أربع منازل عشرية لتوثيق الفروق الدقيقة بين الفئات النادرة الحدوث التي قد تطمسها عمليات التقريب المتعجلة.
من الممارسات التوثيقية المتقدمة أيضاً تطبيق “التنسيق الشرطي” (Conditional Formatting) على عمود التكرارات النسبية؛ من خلال إنشاء تدرج لوني يعتمد على كثافة اللون لتمييز الفئات ذات الثقل النسبي المرتفع؛ يسهم هذا التمثيل اللوني المبرمج في لفت الانتباه الفوري إلى التركيزات الكبرى في التوزيع التكراري، مما يسهل عملية القراءة البصرية السريعة للأنماط المعقدة قبل الشروع في التفسير الإحصائي التفصيلي لمخرجات التحليل.
8. استخدام الجداول المحورية (Pivot Tables) لحساب التكرارات ديناميكياً
8.1 إنشاء جدول محوري لتلخيص التكرارات تلقائياً
تمثل الجداول المحورية (Pivot Tables) في جداول بيانات جوجل إحدى أكثر الأدوات التفاعلية قوة ومرونة في تلخيص التكرارات دون الحاجة إلى كتابة معادلات رياضية معقدة؛ لإنشاء هذا الجدول، يحدد الباحث كامل نطاق مصفوفة البيانات، بما في ذلك الصف الرأسي الذي يحمل عنوان المتغير، ثم ينتقل إلى القائمة الرئيسية ويختار: إدراج > جدول محوري (Insert > Pivot table)، مع تحديد إنشائه في ورقة عمل جديدة لضمان فصل البيانات الخام عن التقارير التحليلية.
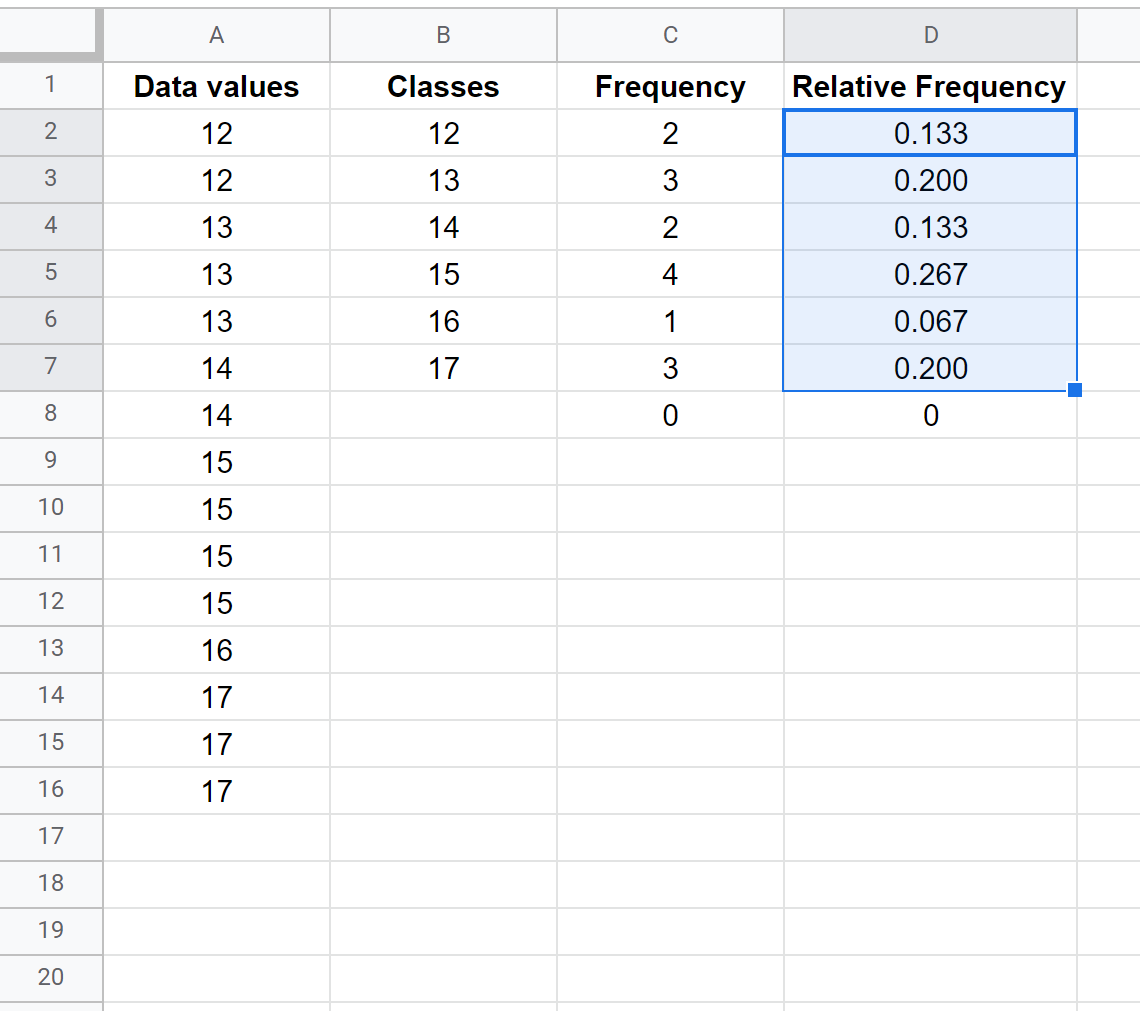
في لوحة محرر الجدول المحوري التي تظهر إلى اليمين، يقوم المحلل بسحب اسم المتغير المستهدف وإسقاطه في منطقة “الصفوف” (Rows)، ليقوم النظام تلقائياً باستخراج كافة القيم الفريدة لهذا المتغير وتنسيقها في عمود تصاعدي نظيف تماماً كما تفعل دالة UNIQUE المركبة مع SORT؛ ثم يقوم بسحب نفس المتغير مرة أخرى وإسقاطه في منطقة “القيم” (Values) لربطه بالمعالجة التلخيصية المستهدفة للبيانات.
الخطوة الجوهرية هنا تكمن في ضبط خيار “التلخيص حسب” (Summarize by) داخل حقل القيم؛ إذ يجب تغييره من خيار الجمع التلقائي (SUM) إلى خيار العد الحسابي (COUNT للمتغيرات الرقمية أو COUNTA للمتغيرات النصية والنوعية)؛ بمجرد تفعيل هذا الإعداد، يُنشئ الجدول المحوري على الفور عموداً يمثل التكرار المطلق الدقيق لكل فئة من الفئات المستخرجة، مصحوباً بصف نهائي يلخص المجموع الكلي للقيم بدقة متناهية.
8.2 تجميع البيانات الرقمية في فئات متكافئة عبر خاصية Grouping
لا تقتصر كفاءة الجداول المحورية على المتغيرات المنفصلة، بل تمتد لتنافس دالة FREQUENCY في معالجة الفئات المجمعة للمتغيرات المتصلة من خلال خاصية “التجميع المحوري” (Pivot Grouping)؛ ولتفعيل هذه الخاصية، يضغط الباحث بزر الفأرة الأيمن على أي خلية ضمن عمود الفئات الرقمية المستخرجة في الجدول المحوري، ثم يختار من القائمة المنبثقة: إنشاء قاعدة مجموعات محورية (Create Pivot group rule).
تفتح المنصة نافذة حوارية تتيح تحديد ثلاثة معايير رياضية بدقة: نقطة البداية للمجالات، ونقطة النهاية القصوى، وحجم الفئة أو اتساع المجال (Interval size)؛ فإذا كانت درجات الاختبار تتراوح بين 0 و100، يمكن تحديد البداية بـ 0 والنهاية بـ 100 وحجم الفئة بـ 10؛ ليقوم الجدول المحوري تلقائياً بدمج البيانات الفردية في شرائح تكرارية متكافئة تبدأ من 0-10، ثم 10-20، وهكذا تباعاً مع حساب تكرار كل شريحة بصورة آلية فائقة السرعة.
يوفر هذا النهج التجميعي مرونة تتفوق أحياناً على الصيغ الرياضية الجامدة؛ إذ يستطيع المحلل تعديل حجم الفئات واتساعها في ثوانٍ معدودة عبر تغيير رقم واحد في نافذة القاعدة التجميعية، ومراقبة كيفية إعادة تشكل التوزيع التكراري للبيانات فورياً، مما يجعله أداة استكشافية مثالية لاختبار حساسيات التقسيم الفئوي وتأثير اتساع الحاويات على شكل المنحنى التكراري للظاهرة قبل الاستقرار على التقسيم النهائي للتقرير.
8.3 عرض التكرارات كنسب مئوية من الإجمالي في الجدول المحوري
إلى جانب التكرار المطلق والتجميع الفئوي، تتيح الجداول المحورية إمكانية التبديل اللحظي بين التكرارات المطلقة والتكرارات النسبية دون الحاجة لبناء أعمدة مصفوفية إضافية؛ يتحقق ذلك بالعودة إلى محرر الجدول المحوري ضمن حقل “القيم”، وتعديل خيار “العرض كـ” (Show as) من القيمة الافتراضية إلى خيار نسبة مئوية من الإجمالي (Percent of grand total) أو نسبة مئوية من العمود (Percent of column).
يقوم المحرك الحسابي الداخلي للجداول السحابية بقسمة تكرار كل سطر بصورة ديناميكية على المجموع الكلي للمشاهدات، ويحول العرض فورياً إلى نسب مئوية مقروءة تظهر تآلفاً إحصائياً دقيقاً؛ بل ويمكن للباحث إضافة نفس المتغير مرتين في منطقة القيم؛ بحيث يضبط الحقل الأول ليعرض التكرار المطلق الخام، ويضبط الحقل الثاني ليعرض التكرار النسبي المئوي المقابل جنباً إلى جنب في ذات الجدول، مما يوفر لوحة تلخيصية متكاملة للمتغير المستهدف.
يتكامل هذا العرض مع أدوات التصفية المدمجة وعناصر التحكم في التقرير (Slicers)؛ حيث يمكن إضافة أزرار تصفية ديناميكية تسمح للمحلل بفحص التوزيعات التكرارية لعينات فرعية (كالفرز حسب نوع الجنس أو الفئة العمرية) بضغطة زر واحدة، مع مراقبة التحديث الآلي للتكرارات المطلقة والنسبية، مما يمنح البحث بعداً تحليلياً استكشافياً يستعصي تحقيقه بنفس السلاسة عبر الدوال المصفوفية الثابتة وحدها.
9. التمثيل البياني للتوزيعات التكرارية: الرسوم والمدرجات التكرارية
9.1 إنشاء المدرج التكراري (Histogram) المباشر من البيانات الخام
يعد المدرج التكراري (Histogram) الأداة الهندسية القياسية المعبرة بصرياً عن التوزيعات التكرارية للمتغيرات المتصلة؛ توفر جداول بيانات جوجل إمكانية توليد مدرج تكراري فوري ومباشر من مصفوفة البيانات الخام دون المرور الإلزامي بإنشاء جداول تكرارية وسيطة؛ ويتحقق ذلك بتحديد عمود البيانات الأصلية ثم التوجه إلى القائمة واختيار: إدراج > مخطط (Insert > Chart).
في لوحة محرر المخططات المرافقة، يقوم الباحث بالانتقال إلى تبويب “التهيئة” (Setup) وتعديل “نوع المخطط” (Chart type) ليختار المخطط المسمى المدرج التكراري (Histogram Chart)؛ بمجرد هذا الاختيار، يتولى المحرك البياني لمنصة جوجل قراءة مصفوفة البيانات، وحساب المدى التلقائي، وتقسيم المدخلات إلى حاويات تكرارية افتراضية متصلة ومتقاربة هندسياً تعكس التكرار عبر ارتفاع المستطيلات الممثلة لكل قطاع.
لإخضاع المدرج التكراري للمنهجية العلمية الصارمة، ينتقل المحلل إلى تبويب “تخصيص” (Customize) ثم قسم “المدرج التكراري” (Histogram)؛ حيث يستطيع هناك إلغاء الوضع الآلي لحجم الحاوية، وإدخال اتساع الحاوية (Bucket size) الذي توصل إليه مسبقاً عبر القواعد الرياضية كقاعدة سترجس؛ مما يحول الرسم البياني من مجرد شكل عشوائي مقترح إلى وثيقة قياس علمية محكمة تعكس طبيعة التفرطح، والالتواء، ومدى اقتراب توزيع الظاهرة من التوزيع الطبيعي المعياري.
9.2 تحويل مخرجات دالة FREQUENCY إلى رسم بياني شريطي (Column Chart)
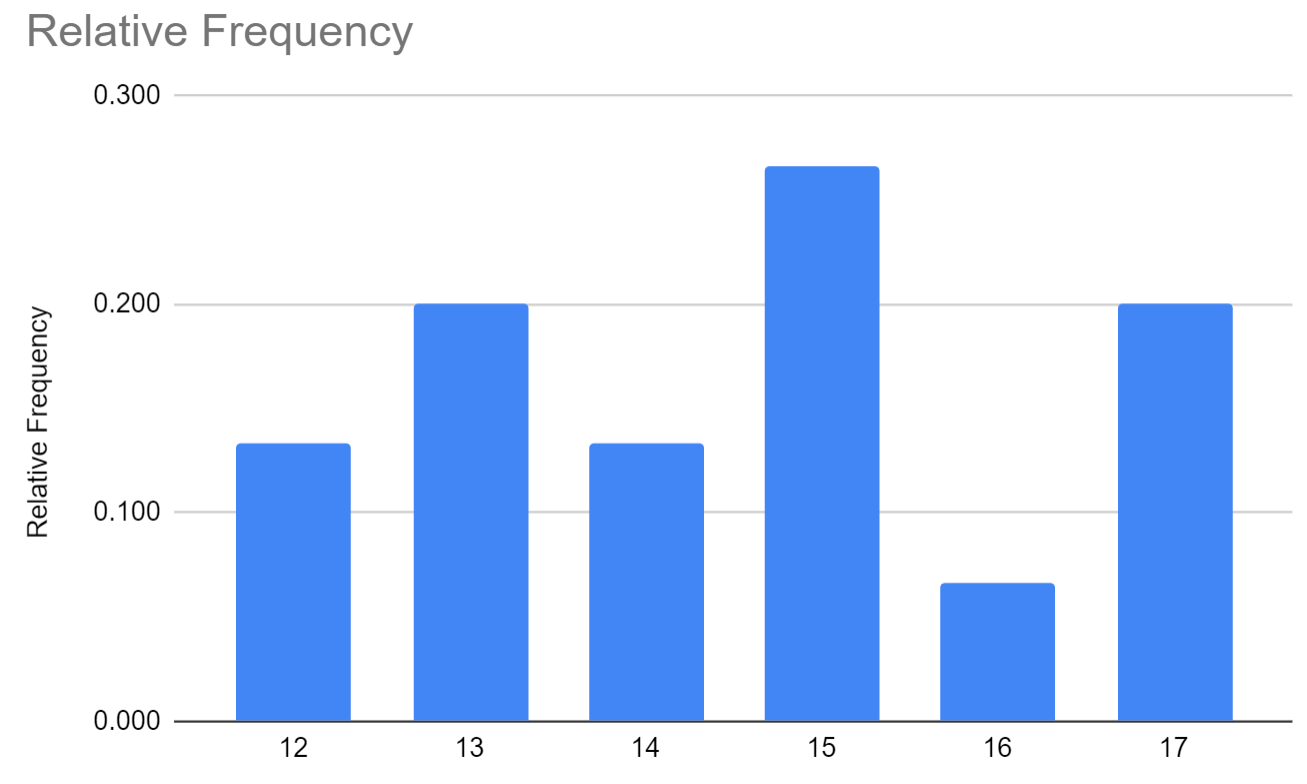
في السياقات التي يُفضل فيها الباحث التحكم الكامل في فئات العرض ومخرجات دالة FREQUENCY المحسوبة مسبقاً، يتحول الخيار المنهجي الأمثل إلى إنشاء رسم بياني عمودي شريطي (Column Chart) يستمد بياناته حصرياً من جدول الفئات والتكرارات المستخرج يدوياً؛ تضمن هذه الطريقة تطابقاً صريحاً بين البيانات الجدولية الواردة في متن التقرير العلمي والشكل البصري المعروض أمام القارئ.
تبدأ هذه العملية بتظليل عمود الفئات الرقمية (أو عمود التسميات الوصفية المرافقة لها) إلى جانب عمود التكرارات المحسوبة بواسطة دالة FREQUENCY، ثم اختيار إدراج مخطط وتحديد النوع كـ “مخطط شريطي عمودي”؛ يخصص المحور الأفقي ($X$) ليمثل حدود الفئات التصنيفية، بينما يمثل المحور الرأسي ($Y$) التكرارات المطلقة أو النسبية المقابلة لكل فئة، مع ظهور كل شريحة كعمود مستقل ومنتظم.
لتعزيز القيمة التحليلية للمخطط العمودي، يمكن إضافة “خط اتجاهي” (Trendline) من تبويب التخصيص ضمن إعدادات سلسلة البيانات (Series)؛ يتيح هذا الخط للباحث رصد المسار العام لتدرج التكرارات، وتحديد ما إذا كان التوزيع يتخذ منحى خطياً متزايداً، أو نمطاً أسياً، أو منحنى جرسياً مكافئاً للتوزيع الطبيعي، مما يثري المناقشة الإحصائية ويربط الأرقام المجردة برؤية بصرية واضحة للأنماط والاتجاهات العامة الكامنة داخل العينة.
9.3 تخصيص الرسوم البيانية لتلائم معايير النشر والتقارير العلمية
لا تتوقف صناعة الرسم البياني الإحصائي عند مجرد توليده برمجياً، بل تتطلب معالجة تنسيقية تخضع للمعايير المعترف بها في الأدبيات الأكاديمية (مثل معايير رابطة علم النفس الأمريكية APA)؛ يستهل الباحث ذلك بضبط المحاور، إذ يجب تسمية المحور الأفقي بوضوح متضمناً اسم المتغير ووحدة قياسه (مثل: “درجات اختبار الكفاءة اللغوية [بالدرجة] “)، وتسمية المحور الرأسي بمسمى التكرار المستخدم (مثل: “التكرار المطلق [$f$]” أو “التكرار النسبي [%]”).
يتعين كذلك تفعيل خاصية “تسميات البيانات” (Data Labels) من تبويب التخصيص، والتي تقوم بإظهار القيمة التكرارية الرقمية الصريحة أعلى كل عمود داخل المخطط؛ تمنح هذه الإضافة القارئ القدرة على استقراء التكرار الدقيق لكل فئة دون الحاجة لإسقاط بصري تقريبي على المحور الرأسي، مما يرفع من دقة وموثوقية التواصل الإحصائي للتقرير.
أخيراً، يجب مراعاة مبادئ التباين البصري والوضوح المعياري في اختيار ألوان الرسوم البيانية؛ وتجنب الخلفيات الملونة غير المجدية أو التأثيرات ثلاثية الأبعاد التي تشوه الإدراك الهندسي للارتفاعات التكرارية؛ ويفضل الالتزام بالألوان الأحادية المتباينة بتدرجات رمادية أو زرقاء داكنة مع خطوط شبكة أفقية خافتة، بما يضمن احتفاظ المخطط البياني بوضوحه التام ومقروئيته العالية حتى في حال طباعة التقرير بصيغة ورقية أحادية اللون.
10. معالجة الأخطاء الشائعة وأفضل الممارسات لضبط دقة الحساب
10.1 حل مشكلات النصوص والأرقام المخزنة كنصوص
تعد مشكلة الأرقام المخزنة كنصوص (Numbers Stored as Text) أحد أكثر الأفخاخ التقنية شيوعاً والتي تؤدي إلى إفساد الحسابات التكرارية دون إصدار تنبيهات خطأ واضحة من النظام؛ تحدث هذه الظاهرة غالباً عند استيراد البيانات من ملفات خارجية من نوع (CSV) أو استخراجها من قواعد بيانات تعتمد ترميزات نصية، حيث تبدو الخلية للعين البشرية كرقم عادي، بينما يتعامل معها المحرك الحسابي كمدخل نصي خالص.
نظراً لأن دالة FREQUENCY مبرمجة برمجياً لتجاهل النصوص كلياً كما أسلفنا، فإن هذه القيم المخزنة نصياً تسقط بصورة صامتة من الحساب التكراري، مما يؤدي إلى ظهور مجاميع تكرارية أدنى من الحجم الحقيقي للعينة؛ لتشخيص هذه المشكلة، يمكن استخدام الدالة المنطقية =ISNUMBER(cell) التي تفرز القيمة FALSE في حال كانت الخلية نصية رغم مظهرها الرقمي؛ أو ملاحظة محاذاة البيانات في الخلية؛ فالأرقام الحقيقية تُحاذى تلقائياً إلى اليمين، بينما تُحاذى النصوص إلى اليسار في الواجهات الإنجليزية والعكس في الواجهات المعربة.
لحل هذه المعضلة جذرياً وتصحيح كامل مصفوفة البيانات، يمكن استخدام دالة التحويل الصريح VALUE ضمن عمود مساعد: =VALUE(A2) ثم تعميمها على النطاق؛ أو تحديد العمود بالكامل والتوجه إلى قائمة: تنسيق > رقم > تلقائي (Format > Number > Automatic) لإجبار المنصة على تفسير المحارف كأعداد رياضية؛ كما يمكن اللجوء لعملية رياضية محايدة مثل ضرب العمود في الرقم 1 لتحويل التنسيق النصي قسرياً إلى نمط رقمي يستجيب لدوال التكرار الإحصائية بدقة متناهية.
10.2 التعامل مع خطأ امتداد المصفوفة (#REF! Spilling Error)
يمثل الخطأ المرجعي #REF! المقترن برسالة تعذر تمدد المصفوفة العائق التقني الأبرز لمستخدمي دالة FREQUENCY المصفوفية؛ يعود السبب الوحيد والحصري لهذا الخطأ إلى محاولة الدالة إنتاج مصفوفتها الرأسية التوسعية لتواجه وجود خلية غير فارغة تعترض مسار التدفق؛ حيث ترفض بيئة جداول بيانات جوجل تجاوز أو الكتابة فوق أي محتوى موجود مسبقاً في الورقة حفظاً لبيانات المستخدم من التلف غير المقصود.
للتعامل السريع مع هذا الخطأ، يكفي أن يقوم الباحث بالوقوف على الخلية الحاوية على الخطأ المرجعي لقراءة التنبيه الإرشادي الذي يوضح النطاق الذي تسعى المصفوفة لشغله (مثل: “لم يتم توسيع النطاق لأن الخلية D8 ليست فارغة”)؛ وهنا يتوجه المستخدم مباشرة إلى الخلية المشار إليها ويقوم بإفراغها من محتواها؛ وبمجرد خلو المسار، تتدفق المخرجات التكرارية تلقائياً لتملأ كامل النطاق المخصص لها دون الحاجة لإعادة كتابة المعادلة.
تتضمن الممارسة الاحترافية أيضاً مراقبة المسافات البيضاء المخفية (Invisible Whitespaces) التي قد يتركها المستخدم عن طريق الخطأ بالضغط على مسطحة المسافات داخل خلية فارغة؛ فالخلية التي تحتوي على مسافة تبدو للعين فارغة تماماً، إلا أن محرك الجداول يعتبرها قيمة نصية حاجزة للمصفوفة؛ لذا يُنصح بتحديد كافة الخلايا الواقعة أسفل معادلة التكرار والضغط الجماعي على مفتاح Delete لضمان النظافة التامة للمسار التدفقي للدالة المصفوفية.
10.3 أفضل الممارسات الأكاديمية في توثيق وحماية معادلات التحليل
يتطلب الإخراج العلمي الرصين للبيانات الإحصائية تأمين الحسابات وحمايتها من التعديلات العرضية غير المبررة؛ لذا يُعد من أفضل الممارسات الأكاديمية قفل وتأمين الخلايا الحاوية على الدوال المصفوفية المركبة؛ توفر جداول بيانات جوجل هذه الميزة عبر تحديد خلايا النتائج ثم الانتقال إلى: بيانات > النطاقات والأوراق المحمية (Data > Protect sheets and ranges)، وتعيين أذونات التعديل بحيث يقتصر حق التحكم وتغيير المعادلات على المحلل الإحصائي المسؤول دون سواه من الشركاء في الورقة التشاركية.
يقترن هذا التأمين الإجرائي بضرورة التوثيق البرمجي الداخلي؛ إذ يُستحسن استخدام ميزة “إضافة تعليق” (Insert Comment) أو “تدوين ملاحظة” على الخلايا الرأسية لتوضيح الأسس النظرية المتبعة في التحليل؛ كأن يوثق الباحث في ملاحظة خلوية أنه اعتمد على قاعدة سترجس في اختيار اتساع الفئات البالغ كذا وحدة، وأن العمود يمثل تكرار الحدود المغلقة من اليمين؛ تسهم هذه الملاحظات التوثيقية في تسهيل مهام التحكيم العلمي وتيسير فهم وتدقيق المنهجية من قِبل باحثين آخرين يعيدون تكرار التجربة لاحقاً.
أخيراً، يجب إجراء مراجعة دورية لاتساق الجداول عند إدخال دفعات تجريبية إضافية؛ وذلك ببرمجة خلايا تدقيق منطقي (Audit Cells) في أسفل الورقة تقارن بين مجموع التكرارات وحجم البيانات الفعلي باستخدام الدالة الشرطية: =IF(SUM(C2:C11)=COUNT(A2:A), "متطابق وسليم", "خطأ: هناك خلل في المطابقة")؛ تمنح هذه الآلية التحذيرية التلقائية الباحث راحة تامة واطمئناناً علمياً مستمراً إلى أن كافة العمليات التكرارية المنفذة على السحابة تعمل بأعلى معايير النزاهة الرياضية والدقة الإحصائية المعتمدة عالمياً.
خاتمة
تناول هذا الدليل الأكاديمي المتكامل الأسس النظرية والتطبيقية لحساب التوزيعات التكرارية داخل بيئة جداول بيانات جوجل، مبرزاً الأهمية الجوهرية لهذا الإجراء في تلخيص البيانات واستكشاف معالمها وتجهيزها للتحليلات المتقدمة. لقد استعرضنا بالتفصيل التشريح البرمجي لدالة FREQUENCY المصفوفية وكيفية تطويعها للتعامل مع الفئات المنفصلة والمجالات المجمعة، مع المقارنة المنهجية بينها وبين دوال العد التكراري الأخرى كـ COUNTIF وCOUNTIFS وفق ضوابط الأداء ونوع المتغيرات المقاسة.
كما بينت المباحث المتقدمة في هذا العمل سبل الارتقاء بالحسابات التكرارية من مجرد العد المطلق إلى التوزيعات النسبية والمئوية المؤتمتة باستخدام دوال المصفوفات، وتوظيف الإمكانيات الفائقة للجداول المحورية والتمثيل البياني الاحترافي عبر المدرجات التكرارية والرسوم الشريطية المصممة وفق أدلة النشر العلمي. إن تطبيق هذه الممارسات، إلى جانب استيعاب آليات معالجة الأخطاء الشائعة وحماية المعادلات وتدقيق تطابقها الكلي، يضمن للباحثين والمحللين بناء نماذج معالجة سحابية تتسم بالرصانة المنهجية، والموثوقية الإحصائية، والدقة التحليلية العالية.
المراجع
- جداول بيانات جوجل. (2024). دليل مستخدمي دوال جداول بيانات جوجل: دالة FREQUENCY. مركز مساعدة جوجل. https://support.google.com/docs/answer/3094286
- ستيفنز، إس. إس. (1946). نحو نظرية لمقاييس القياس. مجلة العلوم (Science)، المجلد 103، العدد 2684، الصفحات 677–680. https://doi.org/10.1126/science.103.2684.677
- سترجس، إتش. إيه. (1926). اختيار الفاصل الزمني ومجال الفئات في المدرج التكراري. مجلة الجمعية الإحصائية الأمريكية (Journal of the American Statistical Association)، المجلد 21، العدد 153، الصفحات 65–66. https://doi.org/10.1080/01621459.1926.10502161
- منظمة معايير التحليل الإحصائي الدولية. (2020). المعايير الإحصائية للمتغيرات الفئوية والكمية في معالجة البيانات. مطبعة المناهج الإحصائية.