
تعد مسألة سحب العينات واختيار المفردات عشوائياً من بين مجموعات البيانات النصية واحدة من أكثر المهام الحسابية شيوعاً في بيئات العمل الإدارية والبحثية والتقنية الحديثة. يمثل برنامج مايكروسوفت إكسل (Microsoft Excel) الأداة الحوسبية الأكثر انتشاراً للتعامل مع هذه المهام، نظراً لمرونته الفائقة وتكامله البرمجي والرياضي، فضلاً عن قدرته على نمذجة السيناريوهات الإحصائية المعقدة من خلال صيغ جدولية بسيطة. ورغم بساطة المظهر العام لعملية “اختيار اسم من قائمة”، فإن الأساس المنهجي والتقني لهذه العملية ينطوي على مفاهيم إحصائية وحوسبية جوهرية تتعلق بنظرية الاحتمالات، وخوارزميات توليد الأرقام شبه العشوائية (Pseudo-random Number Generators)، وسلوك محركات الحساب التفاعلية التي تميز بيئة الجداول الحسابية عن لغات البرمجة الخطية.
يتطلب التطبيق الاحترافي للاختيار العشوائي فهماً عميقاً لطبيعة البيانات المدرجة وضمان خلوها من العيوب الهيكلية التي قد تخل بمبدأ العدالة الإحصائية أو تؤدي إلى انحياز غير مقصود في التوزيع الاحتمالي. وتتنوع احتياجات المستخدمين المؤسسيين والباحثين بين الرغبة في استخراج اسم مفرد لأغراض تنظيمية، أو سحب عينة طبقية محددة بدقة لدراسة ميدانية، أو إجراء سحب متكرر خالٍ من التكرار لمجموعة من الفائزين أو الموظفين المعنيين بمهام رقابية. إن تلبية هذه المتطلبات المتفاوتة تفرض الإلمام الشامل بالأدوات الكلاسيكية المعتمدة على الأعمدة المساعدة والوظائف الرياضية الأساسية، بالتوازي مع استيعاب إمكانات المصفوفات الديناميكية (Dynamic Arrays) الحديثة التي أعادت تشكيل فلسفة الحساب داخل إكسل في إصداراته المتقدمة.
يهدف هذا الدليل المرجعي الموسع إلى تفكيك كافة الجوانب النظرية والتطبيقية لعملية السحب العشوائي للأسماء في إكسل، بدءاً من المعالجة القبلية للمدخلات وضبط البنى الهيكلية، مروراً بالمعادلات المركبة والخوارزميات البرمجية المعتمدة على لغة الفيجوال بيسك للتطبيقات (VBA)، ووصولاً إلى آليات التدقيق وضبط الجودة وتجميد النتائج التشغيلية. وسيعمل هذا العرض التراكمي على تزويد الباحث والمحلل المالي والإداري بالأدوات التحليلية الصارمة التي تحول جداول البيانات من مجرد سجلات ساكنة إلى بيئات حوسبة إحصائية متقدمة تتسم بالشفافية وقابلية التكرار والامتثال لمعايير الحوكمة والنزاهة المؤسسية.
1. الأسس المنهجية لعملية الاختيار العشوائي للأسماء في إكسل
1.1 مفهوم المعاينة العشوائية وأهميتها المنهجية
يستند مفهوم المعاينة العشوائية البسيطة (Simple Random Sampling) في جوهره الإحصائي إلى مبدأ التكافؤ التام في الفرص الاحتمالية بين جميع المفردات المكونة للمجتمع المدروس. وفي سياق القوائم الاسمية داخل جداول البيانات، يعني هذا أن أي اسم مدرج داخل نطاق يحتوي على $N$ من العناصر يجب أن يحظى باحتمال متطابق وثابت للاختيار الرياضي مقداره $P = \frac{1}{N}$. إن تحقيق هذه الحيادية المنهجية يعد الركيزة الأساسية لاستبعاد العامل البشري وأثره النفسي أو المعرفي في تفضيل أسماء بعينها، وهو ما يطلق عليه في الأدبيات المنهجية “الانحياز الإنساني في الاختيار” (Human Selection Bias)، والذي قد يتجلى في الميل لاختيار الأسماء الواقعة في بدايات القوائم أو تلك المألوفة بصرياً للقائم على المعالجة.
يوفر برنامج إكسل بيئة حوسبية منضبطة لتطبيق هذه المبادئ الاحتمالية عبر استدعاء خوارزميات التوليد الرقمي التي تُخضع كل مدخل نصي لقيمة ترجيحية مجردة تضمن استقلالية عمليات السحب. وتكتسب هذه الحيادية أهمية حاسمة في تطبيقات متعددة، تشمل البحوث الميدانية الاستقصائية التي تستوجب اختيار عينات تمثيلية غير موجهة من قواعد بيانات المستفيدين أو المرضى، وإجراء المسابقات والقرعات التي تتطلب مستويات صارمة من الشفافية لمنع الشبهات القانونية، بالإضافة إلى مهام توزيع أعباء العمل والتدقيق المؤسسي العشوائي على الموظفين لضمان كفاءة أنظمة الرقابة الداخلية وحياديتها التامة.
1.2 الفرق بين السحب مع الإرجاع والسحب بدون إرجاع
ينقسم السحب الاحتمالي من القوائم الاسمية إلى نمطين جوهريين تختلف معهما المعادلات الحسابية والنتائج الإحصائية اختلافاً جذرياً. النمط الأول هو “السحب مع الإرجاع” (Sampling with Replacement)، وفيه تظل العينة المسحوبة مؤهلة للظهور في مرات السحب اللاحقة؛ إذ يعود حجم المجتمع الإحصائي ليحتفظ بقيمته الأصلية $N$ مع كل دورة سحب، ويبقى احتمال اختيار أي مفردة ثابتاً عند $P = \frac{1}{N}$. يستخدم هذا النمط في عمليات المحاكاة الإحصائية وتجارب نظرية الألعاب التي تفترض استقلالية الأحداث، إلا أنه يمثل عائقاً جوهرياً في المهام الإدارية التي تستهدف توزيع مكافآت أو تعيين لجان عمل، حيث يؤدي ظهور الاسم ذاته أكثر من مرة إلى خلل تشغيلي وفقدان لعدالة التوزيع.
في المقابل، يمثل “السحب بدون إرجاع” (Sampling without Replacement) الخيار المعياري لأغلب التطبيقات العملية المرتبطة بالأسماء؛ وفيه يتم استبعاد كل اسم يتم اختياره من حوض السحب المستقبلي، مما يؤدي إلى تقلص متتابع في حجم المجتمع المتبقي بمقدار مفردة واحدة بعد كل سحب ($N-1$ ثم $N-2$). وتترتب على ذلك زيادة ديناميكية في احتمالية ظهور الأسماء المتبقية في المراحل اللاحقة، مع ضمان قاطع بعدم تكرار أي سجل اسمي داخل قائمة النتائج المستخرجة. كما يمارس الحجم الكلي لمجتمع البيانات تأثيراً مباشراً على حساسية الخوارزمية؛ فالقوائم الضخمة تقلل من تأثير التغير التدريجي في الاحتمالات، بينما تتطلب القوائم المحدودة ضبطاً دقيقاً للمعادلات لتفادي الأخطاء المنطقية كاستنزاف النطاق المتاح.
1.3 طبيعة الدوال المتطايرة (Volatile Functions) في إكسل
تعتمد النماذج العشوائية في إكسل بصورة أساسية على مجموعة محددة من الدوال التي يصنفها مهندسو البرمجيات تحت مسمى “الدوال المتطايرة” (Volatile Functions)، وعلى رأسها دالتا RAND و RANDBETWEEN. تتميز هذه الفئة من الدوال بسلوك حوسبي فريد؛ إذ إنها لا تنتظر حدوث تعديل في الخلايا المغذية لمعادلاتها لكي تعيد حساب قيمها، بل يتم إطلاق عملية إعادة تقييم شاملة لمخرجاتها فور وقوع أي حدث تحريري داخل أي خلية في أي ورقة عمل مفتوحة ضمن المصنف، بل وأحياناً عند مجرد فتح الملف أو حفظه أو الضغط على مفاتيح التوجيه والإدخال.
يترتب على هذا السلوك المتطاير أثران رئيسيان يجب على المحلل استيعابهما بدقة: الأول تقني، ويتعلق باستهلاك قدرات المعالجة الحاسوبية (CPU Overhead) وتباطؤ أداء المصنفات الضخمة نتيجة ملايين العمليات الحسابية المتكررة غير الضرورية؛ والآخر تشغيلي، يرتبط بعدم ثبات النتائج المسحوبة؛ حيث إن إدراج صيغة عشوائية متطايرة بجانب الأسماء يعني أن الفائزين أو الأسماء المختارة ستتغير تلقائياً وبشكل فوري بمجرد إدخال أي رقم في جدول آخر داخل المصنف ذاته. ومن هنا تنبع ضرورة وعي المستخدم بدورة حياة البيانات داخل ذاكرة إكسل وتوقيت إيقاف المتطايرات وتجميد النتائج لمنع الفوضى التشغيلية والارتباك الإداري الناتج عن تبدل الأسماء المختارة بغير قصد.
2. إعداد وتجهيز مصفوفة الأسماء لضمان دقة المعالجة
2.1 تنظيف البيانات وضمان اتساق المدخلات
تعد جودة البيانات النصية المدخلة عاملاً حاسماً يسبق تطبيق أي خوارزمية سحب عشوائي، حيث تؤدي العيوب المطبعية والفراغات غير المرئية إلى تشويه النتائج الرياضية واستدعاء مدخلات مشوهة. تبدأ عملية التنظيف الإلزامية بتطبيق دالة TRIM للتخلص الجذري من المسافات الزائدة في بدايات ونهايات الأسماء، وكذلك تقليص المسافات البينية المتعددة بين الاسم واللقب إلى مسافة واحدة نظامية، حيث إن وجود مسافة فارغة إضافية في نهاية أحد السجلات يجعل النظام يتعامل معه كسجل مختلف كلياً عن نظيره المكتوب بدقة، مما يربك عمليات المطابقة والبحث.
يتكامل مع ذلك استخدام أدوات تنقية البيانات لإزالة التكرارات غير المقصودة (Remove Duplicates) التي قد تنشأ عن دمج عدة ملفات أو تكرار إدخال الموظف نفسه بالخطأ؛ إذ إن وجود اسم شخص ما مرتين في القائمة الأصلية يضاعف فرصه الاحتمالية تلقائياً في السحب مقارنة ببقية زملائه ($2/N$ بدلاً من $1/N$)، وهو ما ينسف العدالة الإحصائية نسفاً تاماً. علاوة على ذلك، ينبغي توحيد الأنماط الهجائية للنصوص؛ مثل توحيد رسم الهمزات (أ، إ، آ، ا) والياء والألف المقصورة (ي، ى)، وضمان اتساق حالة الأحرف في السجلات المكتوبة بلغات أجنبية، لتفادي أخطاء الاسترجاع المرجعي التي قد تترتب على حساسية بعض الأدوات المتقدمة لطبيعة المحارف.
2.2 هيكلة النطاقات وتحويلها إلى جداول ديناميكية
يمثل الاعتماد على النطاقات العادية ذات المراجع الثابتة (مثل A2:A50) مصدراً متكرراً للأخطاء عند إدارة القوائم المتنامية التي تخضع للإضافة والحذف الدوريين. وتكمن الممارسة الفضلى في هندسة البيانات داخل إكسل في تحويل النطاق النصي إلى جدول رسمي معتمد (Excel Table) عبر الاختصار القياسي Ctrl+T. يوفر هذا التحويل مزايا هيكلية فائقة، يأتي في طليعتها التوسع التلقائي لأبعاد الجدول بمجرد كتابة اسم جديد في الصف التالي، مما يدمج المدخل الحديث تلقائياً ضمن نطاق العمليات الرياضية دون تدخل يدوي لتعديل حدود الخلايا في المعادلات.
بالإضافة إلى ذلك، تتيح الجداول الرسمية استخدام “المراجع الهيكلية” (Structured References)، وهي لغة صياغة واضحة تتيح الإشارة إلى عمود الأسماء بكتابة صيغة بديهية مثل Table1[EmployeeName] بدلاً من المراجع المادية المشفرة، مما يمنح المعادلات مرونة فائقة وقابلية ميسورة للصيانة والتدقيق المتبادل بين أعضاء الفريق. تضمن هذه الهيكلة بقاء خوارزميات السحب العشوائي متصلة بحجم البيانات الحقيقي على الدوام؛ فإذا زادت القائمة من خمسين اسماً إلى ألف اسم، تتكيف الصيغ فورياً مع التوسعة دون خطر إغفال الأسماء الإضافية أو قصر العينة على النطاق الجغرافي القديم للصفوف داخل ورقة العمل.
2.3 ترقيم السجلات وحساب أبعاد المصفوفة
تتطلب العديد من الصيغ الكلاسيكية للسحب العشوائي ربط المحتوى النصي بمحددات رقمية واضحة تعبر عن البعد الرأسي للمصفوفة. يبرز هنا التوظيف المنهجي لدالة ROWS، التي تقوم بحساب العدد الإجمالي للصفوف المكونة للنطاق أو الجدول بأسلوب ديناميكي خالص؛ إذ تعيد الدالة القيمة العددية الصحيحة الممثلة لعمق المجتمع الإحصائي بصرف النظر عن التغيرات التي تطرأ عليه، مما يزيل الحاجة إلى إحصاء الأسماء يدوياً أو كتابة أرقام ثابتة تعرض النماذج للعطب عند التحديث.
في سياقات البناء المتقدمة، يُفضل إنشاء معرفات رقمية فريدة (Unique Numeric IDs) متسلسلة لكل سجل اسمي، كأن يُخصص عمود يحمل الدالة SEQUENCE أو دالة الترقيم التسلسلي المستندة إلى دالة ROW، ليتحول كل اسم إلى كيان قابل للاستدعاء عبر مؤشره الموقعي. ويفرض هذا الترتيب ضرورة التحوط البرمجي ضد وجود صفوف فارغة تتخلل قائمة الأسماء؛ حيث إن قراءة محرك الحساب لخلية فارغة كعنصر قائم بذاته يؤدي إلى سحب نتائج خالية تشوه المخرجات وتتطلب إدراج شروط منطقية تستبعد الخلايا غير المشغولة من حسابات الحجم الإجمالي للنطاق النشط.
3. السيناريو الأول: اختيار اسم عشوائي واحد باستخدام دالتي INDEX و RANDBETWEEN
3.1 التحليل التركيبي والوظيفي للصيغة الرياضية
يعد التكامل الوظيفي بين دالتي INDEX و RANDBETWEEN أحد أكثر الحلول الكلاسيكية أناقة وكفاءة لاستخراج قيمة نصية مفردة عشوائياً من عمود محدد. تعمل دالة INDEX كأداة استرجاع موضعية بحتة، تستقبل مصفوفة من البيانات ونطاقاً رقمياً يحدد إحداثيات الصف المطلوب، لتقوم بقراءة محتوى تلك الإحداثيات وإرجاعه دون إجراء أي تعديل عليه. من الناحية الرياضية، تحتاج الدالة إلى تحديد دقيق للموقع النسبي للعنصر المستهدف، وهنا يأتي دور دالة RANDBETWEEN التي تعمل كمولد عشوائي متقطع محكوم بقيمتين حديتين، وتنتج رقماً صحيحاً عشوائياً يقع في المدى المغلق بين الحد الأدنى والحد الأعلى وفق توزيع احتمالي منتظم (Uniform Discrete Distribution).
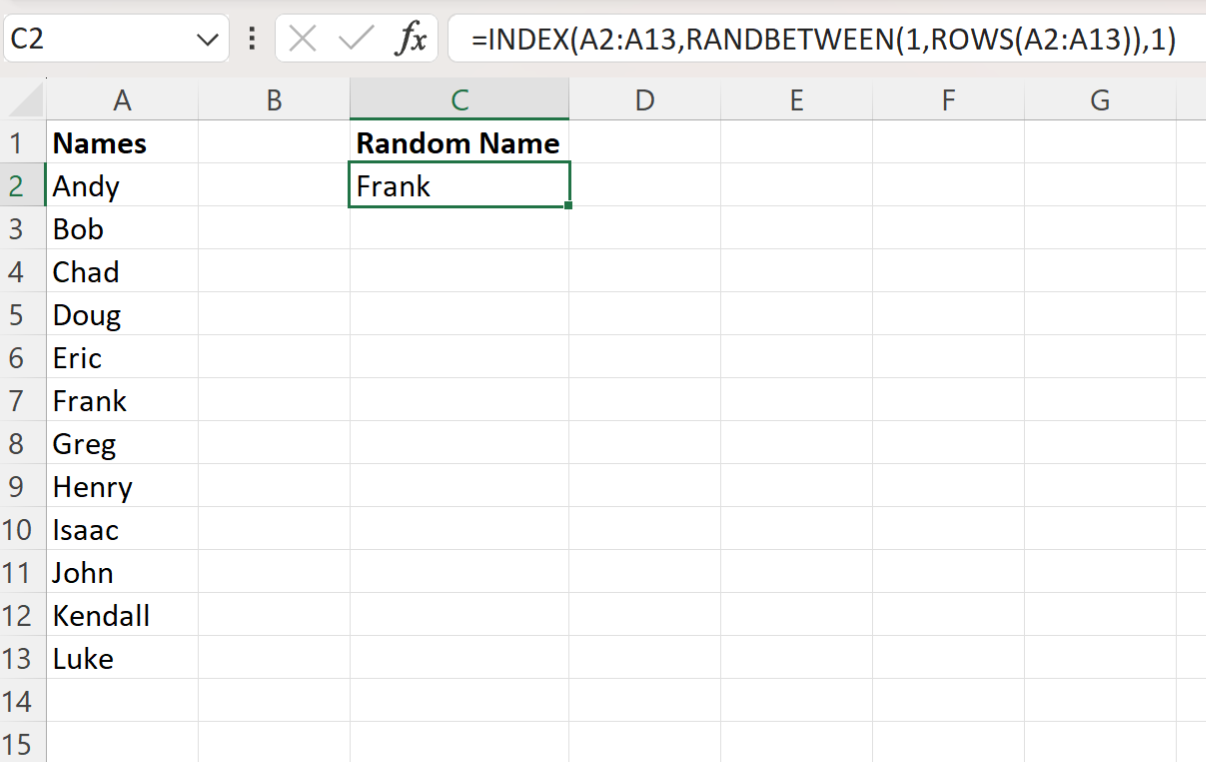
تتبلور الصيغة الرياضية الشاملة في الدمج الهيكلي التالي: =INDEX(A2:A13, RANDBETWEEN(1, ROWS(A2:A13)), 1). في هذا البناء التركيبي، يتم تمرير نطاق الأسماء A2:A13 إلى الوسيط الأول لدالة INDEX، بينما يُستعاض عن رقم الصف الثابت بالصيغة الديناميكية المتداخلة RANDBETWEEN، والتي يبدأ نطاقها من الرقم الصحيح 1 كحد أدنى إلزامي يمثل السجل الأول في النطاق المحدد، وينتهي بالحد الأقصى المولد عبر دالة ROWS التي تحسب تلقائياً عدد عناصر النطاق وتمرره كمعامل نهائي لمولد الأرقام، مما يخلق ربطاً برمجياً وثيقاً ومحكماً بين حجم القائمة وسلوك السحب الاحتمالي.
3.2 التطبيق العملي خطوة بخطوة لسحب اسم مفرد
لتطبيق هذا السيناريو عملياً داخل مصنف إكسل، يتعين على المستخدم تحديد الخلية المستهدفة التي ستستقبل الاسم المختار، وليكن موضعها في الخلية C2 على سبيل المثال. يتم إدخال الصيغة المركبة بدقة مع الانتباه لعلامات الترقيم والفواصل المتوافقة مع الإعدادات الإقليمية للنظام (فاصلة عادية أو فاصلة منقوطة). فور الضغط على زر الإدخال Enter، يقوم محرك الحساب باستدعاء دالة ROWS التي تحلل النطاق وتكتشف وجود 12 اسماً على سبيل المثال، فتمرر القيمة 12 إلى الحد الأعلى لدالة RANDBETWEEN. بعد ذلك، تولد الدالة رقماً عشوائياً موزعاً بنزاهة بين 1 و12 وليكن الرقم 7، لتتولى دالة INDEX أخيراً قراءة السجل السابع ضمن مصفوفة الأسماء وعرضه نصياً في الخلية C2.
وللتحقق من كفاءة المعادلة وترجيحها المتكافئ بين كافة العناصر، يمكن تكرار السحب لملاحظة تغطية الخوارزمية لمختلف أجزاء النطاق من البداية والوسط والنهاية. وتتيح بيئة إكسل إعادة تفعيل المعادلة وإجبارها على توليد سحب جديد بطريقتين رئيستين: الأولى والأساسية هي الضغط على مفتاح F9 من لوحة المفاتيح، والذي يصدر أمراً حوسبياً عاماً بإعادة حساب كافة المعادلات المتطايرة في المصنف المفتوح فوراً، مما يسفر عن ظهور اسم جديد في كل ضغطة؛ بينما تتمثل الطريقة البديلة في الدخول التحريري إلى الخلية عبر النقر المزدوج أو مفتاح F2 ثم الضغط مجدداً على Enter لإجبار تلك الخلية المعينة على إعادة التقييم الذاتي.
3.3 مقارنة دالة ROWS مع القيم الثابتة في المعادلة
يلجأ بعض المستخدمين المبتدئين إلى كتابة أرقام الصفوف بشكل يدوي ثابت داخل المعادلة، كأن يكتب الصيغة بالشكل: =INDEX(A2:A13, RANDBETWEEN(1, 12)). ورغم أن هذه الصيغة ستؤدي الغرض التشغيلي لحظياً، إلا أنها تنطوي على مخاطر هندسية جسيمة؛ فإذا قام مدير النظام لاحقاً بإضافة عشرة أسماء جديدة لتصل القائمة إلى الخلية A23، فإن المعادلة ستبقى مغلقة على الرقم 12، مما يعني أن الموظفين الجدد سيُحرمون حرمانًا مطلقاً من فرصة الدخول في السحب العشوائي وباحتمال اختيار يساوي صفراً مطلقاً، مما ينسف معيار النزاهة دون أن يظهر أي خطأ تقني يحذر المستخدم من الخلل الحسابي القائم.
وعلى النقيض تماماً، يضمن توظيف دالة ROWS مرونة برمجية مطلقة وقابلية مستمرة للتوسع والتكيف الذاتي؛ فالمعادلة تصبح كائناً حياً يستشعر تلقائياً امتداد المصفوفة المرجعية أو انكماشها. وإذا تم تطبيق الصيغة على جدول رسمي (Excel Table)، تصبح الصياغة أكثر متانة واحترافية: =INDEX(قائمة_الأسماء[الاسم], RANDBETWEEN(1, ROWS(قائمة_الأسماء[الاسم]))). تخدم هذه الممارسة معايير التدقيق المؤسسي والتوثيق الحسابي وتجعل مراجعة المنطق البرمجي أمراً بدهياً لأي مدقق خارجي يفحص نزاهة السحب، حيث يتضح بجلاء أن الحد الأعلى للاحتمال مرتبط ارتباطاً ميكانيكياً بالطول الحقيقي لقاعدة البيانات الحالية دون أي تقييد تحكمي مسبق.
4. البدائل الرياضية المتقدمة لاختيار اسم مفرد
4.1 استخدام دالة CHOOSERAND في بيئات إكسل الحديثة
في سياق التطوير المستمر لمنظومة الدوال في خدمات Microsoft 365 والحزم السحابية الحديثة، ظهرت اتجاهات برمجية لتوفير حلول مدمجة ومباشرة تغني المستخدم عن تركيب معادلات متعددة المستويات لاختيار المفردات العشوائية. توفر الدوال الحديثة المتخصصة في السحب قدرة فائقة على استخلاص عنصر أو مجموعة عناصر عشوائياً عبر استدعاء وظيفي مباشر يستهدف النطاق دون الحاجة إلى تحديد مؤشرات الصفوف أو حساب الأبعاد مسبقاً، مما يمثل تحولاً جذرياً نحو التبسيط البرمجي وتخفيف احتمالات الخطأ البشري في بناء الصيغ المركبة وتداخل الأقواس الرياضية.
تتميز هذه الحلول المستحدثة بالسرعة العالية في معالجة البيانات، حيث تُنفذ خوارزميات السحب على مستوى النواة الحسابية المباشرة لمحرك إكسل، متفوقة على بطء استدعاء الدوال المتعددة وتمرير الوسائط الوسيطة بين دالة وأخرى. وعلاوة على ذلك، تتمتع هذه الدوال بحساسية إحصائية فائقة تضمن توزيعاً عشوائياً متجانساً ومطابقاً للاختبارات القياسية لتوليد الأرقام شبه العشوائية، مما يمنحها موثوقية لا تضاهى في البيئات المؤسسية التي تتطلب توثيقاً رياضياً صارماً للنزاهة، مع الحفاظ على مقروئية الصيغة داخل شريط المعادلات لتبدو في غاية الوضوح والاقتضاب حتى لغير المتخصصين.
4.2 توظيف تركيبة OFFSET مع RANDBETWEEN
تمثل تركيبة دالتي OFFSET و RANDBETWEEN خياراً بديلاً واسع الانتشار، يستند إلى مفهوم هندسي مغاير لاسترجاع الخلايا مقارنة بدالة INDEX؛ حيث تعتمد دالة OFFSET على مفهوم الإزاحة المكانية انطلاقاً من نقطة مرجعية ثابتة (نقطة الارتكاز). وتصاغ المعادلة عادة على النمط التالي: =OFFSET(A2, RANDBETWEEN(0, ROWS(A2:A13)-1), 0). ينبغي هنا ملاحظة الفارق الرياضي الدقيق في وسيطات RANDBETWEEN؛ إذ تبدأ الإزاحة من الرقم 0 كحد أدنى لتمثيل الخلية الأولى نفسها (A2)، وتنتهي عند إجمالي عدد الصفوف مطروحاً منه واحد، نظراً لأن الإزاحة بمقدار $N$ لخلية تقع في بداية نطاق طوله $N$ ستقفز بالنتيجة إلى صف يقع خارج حدود المصفوفة المطلوبة.
ورغم قوة دالة OFFSET ومرونتها التاريخية، إلا أن هناك إجماعاً بين خبراء الحوسبة الجدولية على تفضيل دالة INDEX عليها في التطبيقات المتقدمة؛ ويعود السبب الرئيس في ذلك إلى أن OFFSET دالة متطايرة بطبيعتها الهيكلية حتى لو لم تقترن بدوال عشوائية، مما يضاعف العبء الحسابي على المصنف بصورة غير مبررة عند مقارنتها بـ INDEX التي تعتبر دالة غير متطايرة ومستقرة مرجعياً. ومع ذلك، تبقى OFFSET ذات قيمة تقنية عالية في الحالات الخاصة التي تتطلب إزاحة متعددة الأبعاد تشمل صفوفاً وأعمدة معاً أو عند العمل ضمن نطاقات ديناميكية تنزاح نقطة انطلاقها بمرونة وفق معايير شرطية خارجية متغيرة باستمرار.
4.3 استدعاء دالة CHOOSE مع مولدات الأرقام العشوائية
تبرز دالة CHOOSE كأحد الحلول الرياضية المباشرة التي تتيح المفاضلة بين قائمة محددة من المدخلات بناءً على رقم ترتيبي مستدعى. يمكن صياغة السحب العشوائي عبرها بدمجها مع RANDBETWEEN كالتالي: =CHOOSE(RANDBETWEEN(1, 4), "أحمد", "سارة", "خالد", "فاطمة")، أو بتمرير مراجع الخلايا المستقلة عوضاً عن النصوص المباشرة. تعمل هذه الدالة بكفاءة استثنائية وبساطة مطلقة عندما تكون قائمة الأسماء محصورة جداً ومحدودة التغير، كأن تقتصر على عدد ضئيل من المرشحين لتولي مهمة إدارية معينة، حيث يسهل سرد الخيارات بوضوح داخل المعادلة وتوليد مؤشر عشوائي يتنقل بينها بنزاهة احتمالية تامة.
إلا أن المآخذ المنهجية على دالة CHOOSE تتجلى بوضوح عند محاولة استخدامها مع مجموعات البيانات الكبيرة أو القوائم المتغيرة دورياً؛ حيث تفرض الدالة قيوداً صارمة تمنع تمرير نطاقات الخلايا المستمرة كمعامل مصفوفي واحد، وتلزم المستخدم بإدخال كل خلية أو اسم كمعامل منفصل يفصل بينه وبين الآخر بفاصلة، وهو ما يصبح مستحيلاً وعرضة للخطأ عند التعامل مع عشرات أو مئات الأسماء. وعليه، فإن معايير المفاضلة التحليلية تحصر استخدام CHOOSE في التطبيقات المصغرة والسيناريوهات الثابتة ذات النطاق الضيق، وتوجه الباحث تلقائياً نحو استخدام الحلول المصفوفية الأوسع كـ INDEX عند تجاوز القائمة لبضعة أسماء محدودة.
5. السيناريو الثاني: اختيار أسماء عشوائية متعددة دون تكرار باستخدام العمود المساعد
5.1 الأساس الرياضي لدالة RAND في توليد الكسور العشرية
تشكل دالة RAND اللبنة الأساسية لعمليات السحب العشوائي المتقدم الخالي من التكرار في البيئات الكلاسيكية لإكسل. على عكس دالة RANDBETWEEN التي تنتج أعداداً صحيحة وتتكرر مخرجاتها حتماً عند السحب المتعدد، تعمل دالة RAND على توليد أرقام كسرية عشوائية حقيقية تتوزع بانتظام على الفترة المفتوحة بين 0 و1، وتحديداً في المدى الرياضي $[0, 1)$. وتتميز هذه الأرقام بدقتها الإحصائية الفائقة؛ إذ يولدها إكسل بدقة تمتد إلى 15 منزلة عشرية استناداً إلى معيار الدقة المزدوجة IEEE 754.
تتمثل الميزة الاستثنائية لهذه الدقة المتناهية في الاستحالة الحسابية شبه المطلقة لتطابق كسرين عشريين تم توليدهما بواسطة RAND لقيمتين مختلفتين في القائمة نفسها، حيث تبلغ احتمالية حدوث تصادم رقمي وتكرار لقيمة كسرية من 15 خانة مستوى رياضياً يقترب عملياً من الصفر المطلق. يترتب على ذلك قدرة الدالة على إسناد “بصمة ترجيحية فريدة ومكافئة” لكل اسم في السجل؛ مما يجعل هذه الكسور بمثابة مؤشرات فرز مثالية تتيح إعادة ترتيب الأسماء عشوائياً دون أدنى خطر لدمج المفردات أو حدوث تضارب في الأولويات الحسابية.
5.2 إنشاء وتهيئة العمود المساعد (Helper Column)
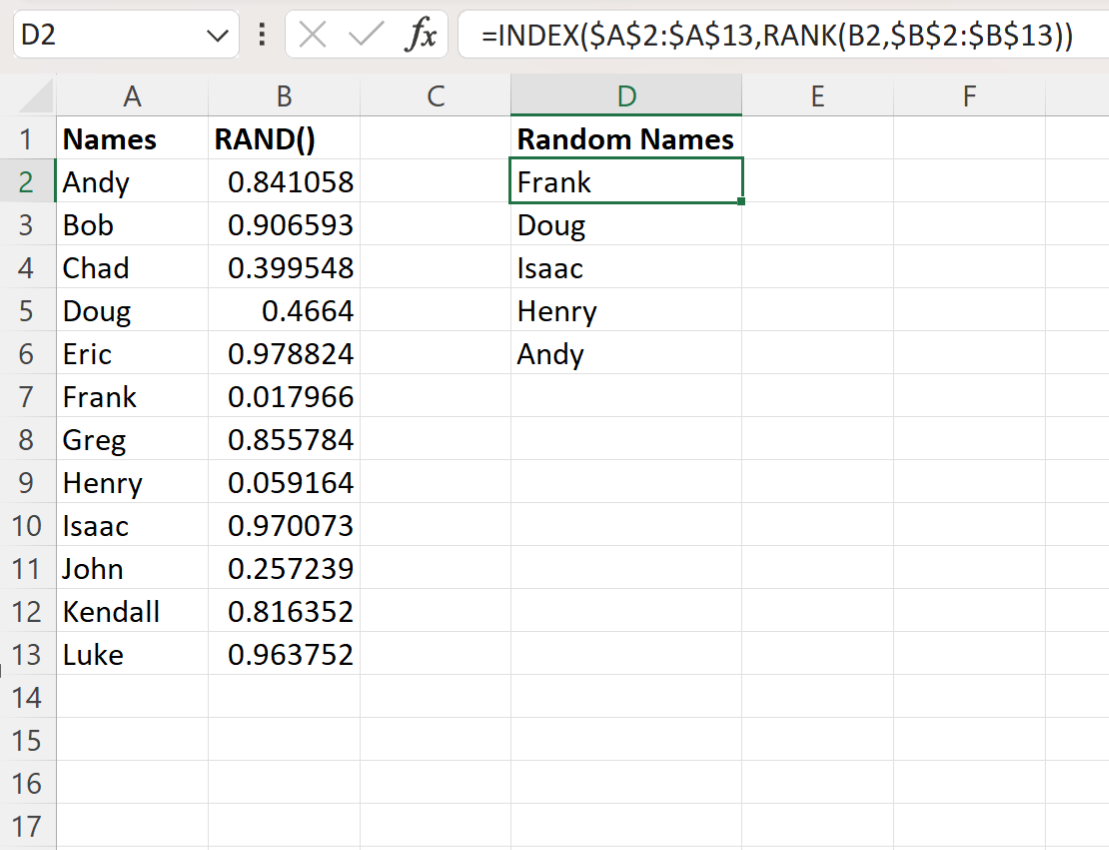
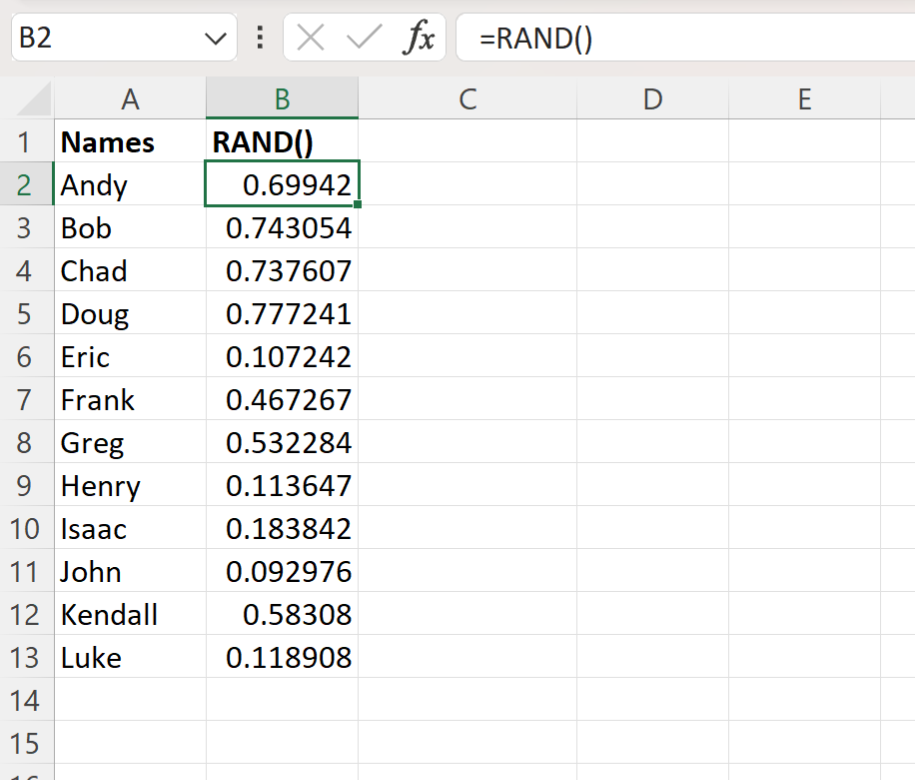
تعتمد المنهجية الكلاسيكية للسحب المتعدد بدون إرجاع على مفهوم “العمود المساعد” (Helper Column)، وهي تقنية إحصائية شائعة تهدف إلى عزل المعالجة التوليدية عن بنية البيانات الأصلية. تبدأ الخطوات العملية بإدراج عمود إضافي فارغ محاذٍ تماماً لقائمة الأسماء الأصلية، ويُفضل منحه اسماً دالاً في صف العناوين مثل “الرقم العشوائي” أو “مؤشر الفرز”. في الخلية الأولى من هذا العمود المقابلة للاسم الأول (ولتكن الخلية B2)، تتم كتابة الصيغة البسيطة الخالية من الوسائط: =RAND().
يتم بعد ذلك تعميم هذه الصيغة على امتداد القائمة بأكملها عبر النقر المزدوج على مقبض التعبئة التلقائي (Fill Handle) في الركن الأيسر السفلي للخلية أو بسحبها يدوياً لأسفل حتى محاذاة الاسم الأخير في النطاق. وبمجرد إتمام ذلك، يمتلئ العمود المساعد بكسور عشرية مختلفة تماماً ومخصصة لكل فرد في القائمة؛ وتعمل هذه العملية المنهجية على تحويل الأسماء الاسمية النوعية إلى منظومة رقمية كمية يسهل إخضاعها لقواعد الترتيب الرياضي والإحصائي الصارم، مما يمهد للخطوة التالية المتمثلة في استخلاص العينة المطلوبة بكفاءة ووضوح.
5.3 استخراج الأسماء المتعددة عبر الفرز أو دالتي INDEX و RANK
بعد اكتمال بناء العمود المساعد، يتوفر مساران تطبيقيان لاستخراج العينة العشوائية المتعددة دون تكرار. المسار الأول مسار يدوي سريع، يعتمد على تحديد بيانات الجدول بالكامل والانتقال إلى تبويب “بيانات” (Data) ثم اختيار أمر “فرز من الأصغر إلى الأكبر” (Sort Smallest to Largest) استناداً إلى عمود الأرقام العشوائية. يؤدي هذا الإجراء فورياً إلى بعثرة الأسماء وإعادة ترتيبها عشوائياً؛ ويمكن حينها للمستخدم ببساطة قراءة أول خمسة أو عشرة أسماء تتصدر القائمة كعينة فائزة أو مستهدفة، مع ضمان استحالة تكرار أي اسم لأن الفرز يعيد ترتيب المصفوفة القائمة ولا يستنسخ مفرداتها.
أما المسار الثاني فيمثل حلاً ديناميكياً مؤتمتاً لا يتطلب فرزاً يدوياً للمدخلات، ويعتمد على المزاوجة بين دالتي INDEX و RANK في نطاق استخراج منفصل. تقوم دالة RANK بحساب الترتيب النسبي لكل كسر عشري في العمود المساعد مقارنة ببقية الكسور، وبالتالي تعيد تسلسلاً يبدأ من 1 إلى $N$ دون أي تكرار. وعند دمجها بصيغة مثل: =INDEX($A$2:$A$13, MATCH(1, $C$2:$C$13, 0)) حيث يحتوي العمود C على رتب الكسور المولدة بدالة RANK، يتم سحب الاسم الحائز على الرتبة الأولى تلقائياً، وفي الخلية التالية يُسحب صاحب الرتبة الثانية، وهكذا دواليك حتى استيفاء الحجم المطلوب للعينة مع استحالة التكرار المنطقي.
6. الاختيار العشوائي للأسماء باستخدام مصفوفات إكسل الديناميكية الحديثة
6.1 دمج دالتي SORTBY و RANDARRAY للسحب الفوري
أحدث إدخال محرك المصفوفات الديناميكية (Dynamic Arrays Engine) في بيئات إكسل الحديثة ثورة تقنية قلبت المفاهيم الكلاسيكية للحساب المجدول، حيث ألغى الحاجة للأعمدة المساعدة ووفر إمكانية معالجة مجموعات البيانات ككتل بيانية متكاملة تتدفق تلقائياً (Spill) عبر الخلايا المجاورة. يرتكز السحب العشوائي المتعدد في هذا الإطار الحديث على الدمج المباشر بين دالتي SORTBY و RANDARRAY؛ حيث تقوم RANDARRAY بإنشاء مصفوفة افتراضية متطايرة من الأرقام العشوائية في ذاكرة الجهاز العشوائية اللحظية دون حجز خلايا في ورقة العمل، بينما تتولى دالة SORTBY مهمة إعادة فرز النطاق الأصلي بناءً على تلك المصفوفة الافتراضية المستترة.
تتمثل الصيغة القياسية المتكاملة لهذا الحل في الآتي: =SORTBY(A2:A13, RANDARRAY(ROWS(A2:A13))). في هذه المعادلة فائقة القوة، تقوم RANDARRAY بتوليد قائمة من الأرقام العشوائية بعدد يطابق تماماً ناتج دالة ROWS لنطاق الأسماء، ثم تستقبل دالة SORTBY نطاق الأسماء كمعامل أول وتفرزه بالاعتماد على قيم المصفوفة العشوائية المعامل الثاني. ينتج عن ذلك فوضى منتظمة وخاضعة للرقابة تعيد ترتيب كامل القائمة عشوائياً وتسكب مخرجاتها في عمود جديد بضغطة زر واحدة دون الحاجة لأي أعمدة إضافية أو حسابات تكميلية تشوش التصميم العام للنموذج.
6.2 تحديد حجم العينة المسحوبة بدقة باستخدام دالة TAKE
على الرغم من كفاءة الصيغة السابقة في خلط القائمة بالكامل، فإن المتطلب العملي السائد في أغلب المؤسسات يقتضي استخراج عدد محدد بدقة من الأسماء (كأن يُطلب سحب 3 أسماء فقط كفائزين أو 5 موظفين للتفتيش) بدلاً من إعادة عرض القائمة كاملة. لتحقيق ذلك بأقصى درجات الرشاقة البرمجية، يتم تطويق الصيغة السابقة بدالة TAKE، وهي إحدى أقوى إضافات المصفوفات الحديثة المصممة خصيصاً لاقتطاع جزء معين من المصفوفة المستلمة وتجاهل الباقي.
تصبح الصيغة الشاملة والنهائية كالتالي: =TAKE(SORTBY(A2:A13, RANDARRAY(ROWS(A2:A13))), 5). يعبر الرقم 5 الممرر في الوسيط الثاني لدالة TAKE عن حجم العينة المرغوبة ($n$)؛ فتقوم الدالة بقراءة المصفوفة المعاد ترتيبها عشوائياً بواسطة SORTBY، ثم تقتطع أول خمسة صفوف متصدرة فقط وتسقط الباقي من ذاكرة العرض فوراً. تتميز هذه المعادلة بمرونة فريدة؛ إذ يمكن استبدال الرقم الثابت 5 بمرجع خلية خارجية (ولتكن E1) يكتب فيها المستخدم أي رقم يريده، فيتعدل حجم قائمة الفائزين المنسكبة صعوداً وهبوطاً بصورة آنية وسلسة تتكيف فوراً مع التوجيهات الإدارية المتغيرة دون لمس الصيغة إطلاقاً.
6.3 مقارنة تقنية بين منهجية المصفوفات الديناميكية والطرق الكلاسيكية
تكشف المقارنة التقنية العميقة بين النهج التقليدي القائم على الأعمدة المساعدة ودوال الفرز، وبين نهج المصفوفات الديناميكية المعتمد على SORTBY و TAKE، عن تفوق ساحق للمنهج الحديث في مؤشرات الأداء الحوسبي وحوكمة النماذج. يسهم نهج المصفوفات في الحفاظ على النقاء البصري والهيكلي للمصنفات؛ إذ يمنع تشظي البيانات وتراكم الأعمدة العشوائية المساعدة التي قد يتعرض محتواها للحذف العرضي أو التشويه، فضلاً عن تقليص استهلاك الذاكرة عبر إدارة المصفوفات المؤقتة ضمن ذاكرة المحرك الحسابي الداخلية وإتلافها فور انتهاء العرض، مما ينعكس إيجاباً على سرعة استجابة الملفات الضخمة.
ومع ذلك، يظل التحدي الجوهري الذي يقيد الاستخدام المطلق لمنهجية المصفوفات الديناميكية متمثلاً في قضية التوافقية العكسية (Backward Compatibility). لا تتوفر دوال مثل SORTBY و RANDARRAY و TAKE في إصدارات إكسل الدائمة القديمة مثل Excel 2016 و Excel 2019 وما قبلهما، وتقتصر على حزم Microsoft 365 و Excel 2021 وما تلاها؛ مما يعني أن مشاركة الملف مع أطراف خارجية تعمل بإصدارات كلاسيكية سيؤدي حتماً إلى تعطل النموذج وظهور أخطاء مجهولة كـ #NAME?، وهي نقطة فاصلة توجب على مصمم النظام تقييم بيئة التشغيل المستهدفة قبل اعتماد المنهجية الأنسب.
7. الاختيار العشوائي المشروط والمعاينة الطبقية للأسماء
7.1 دمج الاختيار العشوائي مع دالة FILTER لتطبيق الشروط
تفرض البيئات التطبيقية في كثير من الأحيان قيوداً ومعايير محددة يجب استيفاؤها قبل إخضاع الأسماء لعملية السحب الاحتمالي، كأن يقتصر السحب على الموظفين العاملين في قسم تقنية المعلومات حصراً، أو يستهدف العملاء المقيمين في منطقة جغرافية بعينها. يتحقق هذا التخصيص عبر إدماج دالة FILTER التصفوية المتقدمة في البنية التركيبية لخوارزمية السحب، حيث تعمل الدالة كبوابة عزل تقوم بفحص عمود الشروط وتستخلص فقط الأسماء المحققة للمعايير المحددة، ثم تمرر هذه القائمة المصفاة رقمياً إلى دوال السحب العشوائي.
تتجسد الصيغة النموذجية لهذا الإجراء في التركيب التالي: =TAKE(SORTBY(FILTER(A2:A100, B2:B100="المبيعات"), RANDARRAY(ROWS(FILTER(A2:A100, B2:B100="المبيعات")))), 3). تفحص الدالة FILTER النطاق B2:B100 وتستخرج مصفوفة فرعية بأسماء موظفي قسم المبيعات فقط، لتخضع هذه النواة المستخلصة لعملية احتساب الأبعاد وفرز RANDARRAY واقتطاع أول 3 أسماء عبر TAKE. ومن الضروري هنا معالجة الحالات الحدية التي قد لا تسفر فيها التصفية عن أي اسم بتضمين وسيط الإرجاع البديل [if_empty] في FILTER تجنباً لارتداد خطأ #CALC! الذي قد يعطل كامل مسار العمليات اللاحقة في ورقة التقرير.
7.2 تطبيق المعاينة العشوائية الطبقية (Stratified Sampling)
تعتبر المعاينة العشوائية الطبقية (Stratified Sampling) إحدى أرقى المنهجيات الإحصائية التي تسعى إلى ضمان تمثيل عادل ومنصف ومتناسب لكافة الفئات أو الطبقات الفرعية المكونة لمجتمع البيانات الكلي. فعلى سبيل المثال، إذا كانت المؤسسة تضم أقساماً غير متكافئة في الحجم كالإدارة والتشغيل والمالية، فإن السحب العشوائي البسيط المطلق قد يسفر بمحض الصدفة عن عينة تخلو تماماً من ممثلي قسم الإدارة لقلة عددهم مقارنة بالتشغيل، مما يؤدي إلى خلل تمثيلي وانعدام توازن هيكلي في المخرجات.
يتم تطبيق هذا الأسلوب المتقدم في إكسل عبر تصميم كتل برمجية متوازية؛ حيث يتم تخصيص معادلة سحب مستقلة لكل طبقة إحصائية على حدة استناداً إلى دالة FILTER المشروطة. يُسحب من خلالها عدد محدد أو نسبة مئوية تتوافق مع الحجم النسبي لتلك الطبقة داخل المؤسسة؛ ومن ثم يتم دمج مخرجات العينات الطبقية المنفصلة وتجميعها عمودياً في جدول تقرير نهائي وموحد عبر استخدام دالة الدمج الحديثة VSTACK. يضمن هذا النهج الدقيق تلبية المعايير العلمية الصارمة للبحوث الميدانية، والتحقق الموثق من أن كل شريحة وظيفية أو ديموغرافية قد حظيت بحصتها العادلة والشفافة من التمثيل داخل العينة المسحوبة دون إخلال بعشوائية الاختيار الفردي داخل كل فئة.
7.3 التعامل مع الترجيح الاحتمالي والأوزان النسبية للأسماء
تتطلب بعض السيناريوهات الخاصة، كالقرعات التجارية ومكافآت التميز الوظيفي، الابتعاد عن مبدأ تساوي الفرص المطلق، وتطبيق ما يُعرف بـ “السحب الاحتمالي الموزون” (Weighted Random Selection)، حيث يُمنح أفراد معينون فرصاً إضافية للاختيار بناءً على معايير سابقة؛ كأن يحصل العميل على فرصة سحب إضافية مقابل كل 100 دولار ينفقها، أو يحظى الموظف الحاصل على تقييم امتياز بفرص مضاعفة مقارنة بغيره. لا تدعم الدوال العشوائية القياسية في إكسل مصفوفات الأوزان بشكل مباشر، مما يفرض بناء نموذج حسابي التفافي لمعالجة المسألة برمجياً.
تعتمد الآلية التطبيقية الأكثر استقراراً في هذا السياق على “تكرار السجلات الافتراضية” استناداً إلى قيمة الوزن النسبي؛ فإذا كان الاسم (أ) يمتلك الوزن 3 والاسم (ب) يمتلك الوزن 1، يتم تكرار الاسم (أ) ثلاث مرات في مصفوفة السحب التحتية، بينما يبقى الاسم (ب) مفرداً. يمكن تحقيق ذلك ديناميكياً باستخدام دوال مثل REDUCE و EXPAND أو بناء أعمدة تراكمية تستند إلى دالة الجمع التراكمي SCAN واستدعاء دالة XLOOKUP لربط رقم عشوائي كسرّي بالنطاق التراكمي للأوزان النسبية. يضمن هذا الإجراء رفع الاحتمال الرياضي الصرف لاختيار السجلات الثقيلة وفق أوزانها المحددة سلفاً وبدقة متناهية مع الحفاظ على عشوائية النتيجة النهائية ومصداقيتها المحاسبية.
8. تثبيت نتائج الاختيار العشوائي وضمان استقرار المخرجات
8.1 التحويل النهائي للصيغ إلى قيم نصية ثابتة
نظراً للطبيعة التشغيلية المتطايرة لدوال السحب العشوائي كـ RAND و RANDARRAY، تظل النتائج الظاهرة في ورقة العمل معرضة للتبدل والتغير المفاجئ عند أدنى إجراء تحريري يقوم به أي مستخدم للمصنف، وهو ما يشكل خطراً جسيماً في السياقات الإدارية؛ إذ لا يمكن إعلان أسماء فائزين أو اختيار عينة مراجعة رقابية ثم تفاجؤ الجميع بتغير الأسماء بمجرد إدخال رقم أو ضغط زر الحفظ. من هنا يبرز إجراء “تجميد النتائج” كضرورة حتمية لحماية استقرار المخرجات والاحتفاظ بالأسماء المختارة بشكل قطعي ونهائي.
تتمثل الطريقة المؤسسية المعيارية لتجميد النتائج في استخدام تقنية “اللصق الخاص كقيم” (Paste Special as Values). تبدأ العملية بتحديد الخلايا المشتملة على الأسماء المختارة عشوائياً، ثم نسخها باستخدام الاختصار القياسي Ctrl+C، تليها عملية اللصق الفوري في الموضع ذاته أو في موضع توثيقي مخصص عبر الاختصار Ctrl+Alt+V واختيار “القيم” (Values) أو استخدام اختصار لوحة المفاتيح المباشر Alt+E+S+V متبوعاً بـ Enter. يؤدي هذا الإجراء الحاسم إلى استئصال الصيغ الرياضية المتطايرة الكامنة خلف المظهر الخارجي للبيانات، واستبدالها بنصوص صلبة ومستقرة غير قابلة للتغير التلقائي، مما يحفظ الوضع النهائي للعملية ويسهل أرشفتها رسمياً دون أي قلق من الحسابات اللاحقة.
8.2 إدارة خيارات الحساب في مصنف إكسل
يوفر برنامج إكسل نظام تحكم هيكلي يتيح للمحللين ضبط آلية استجابة محرك الحساب وتعامله مع الدوال المتطايرة، وذلك عبر التحكم في “خيارات الحساب” (Calculation Options) المتاحة في تبويب “صيغ” (Formulas). في الوضع الافتراضي للبرنامج، يكون الحساب مضبوطاً على الخيار “تلقائي” (Automatic)، وهو ما يتسبب في إعادة التقييم المتكرر والمستمر لنتائج السحب مع كل تعديل يطرأ على البيانات؛ ولإيقاف هذا السلوك المضطرب أثناء العمل التفاعلي، يمكن للمستخدم تحويل وضع الحساب إلى الخيار “يدوي” (Manual).
عند تفعيل وضع الحساب اليدوي، يتوقف إكسل تماماً عن تحديث الدوال المتطايرة والصيغ العشوائية تلقائياً، ويدخل في حالة ثبات تشغيلي مؤقت، حيث تبقى الأسماء المسحوبة الأولى متجمدة في مواضعها دون تبدل بصرف النظر عن التعديلات والإضافات التي يجريها المستخدم في بقية الجداول. وعند الرغبة الحقيقية في إجراء عملية سحب جديدة أو تدقيق دورة سحب أخرى، يقوم المستخدم بالضغط المقصود على مفتاح F9 لإصدار أمر حوسبي صريح بإعادة الحساب الشامل لمرة واحدة فقط؛ كما يمكن استكمال هذا الانضباط بفرض حماية على ورقة العمل (Protect Sheet) وتأمين الخلايا برقم سري لمنع العبث اليدوي وتأكيد نزاهة البيئة الحسابية أمام لجان الرقابة والامتثال.
8.3 حفظ السجلات وإنشاء مسار تدقيق موثوق (Audit Trail)
تقتضي معايير الحوكمة والنزاهة المؤسسية، خصوصاً في العمليات المالية أو السحوبات التي تترتب عليها مكافآت ومسؤوليات قانونية، توفير “مسار تدقيق موثوق” (Audit Trail) يتيح للجهات الرقابية التحقق من صحة الإجراءات واستقلالية النتائج المسحوبة ومقارنتها بالسجلات التاريخية السابقة لضمان عدم وجود تلاعب برمجي خفي. يتطلب ذلك بناء جدول مخصص للأرشفة يسجل النتائج المستخرجة مقترنة ببيانات وصفية زمنية دقيقة (Metadata) تشمل الطابع الزمني للعملية (Timestamp)، واسم المستخدم الذي أجرى السحب، والحجم الكلي للمجتمع الإحصائي في لحظة السحب، ونوع المعادلة المطبقة.
ولتعزيز المصداقية المؤسسية، يُوصى باتباع ممارسات التوثيق المتعدد المستويات، كأخذ لقطات شاشة (Screenshots) كاملة لورقة العمل متضمنة شريط المعادلات وتاريخ النظام وساعته، أو تصدير النتائج فور استقرارها إلى مستندات رقمية غير قابلة للتعديل بصيغة PDF موقعة ومقفلة رقمياً؛ كما يمكن إدراج أكواد برمجية تسجل دورات السحب المتتالية في سجل نصي معزول (Log File) لا يمكن مسحه، مما يوفر أرضية صلبة وشفافة تدحض أي ادعاء بالانحياز أو الشبهات الإجرائية، وتؤكد أن عمليات الاختيار العشوائي جرت وفق المعايير المهنية الصارمة والمعتمدة عالمياً في بيئات الأعمال الرقمية.
9. أتمتة الاختيار العشوائي للأسماء باستخدام ماكرو وبرمجة VBA
9.1 كتابة خوارزمية فيشر-يتس (Fisher-Yates Shuffle) برمجياً
تمثل لغة البرمجة المدمجة في إكسل، Visual Basic for Applications (VBA)، الملاذ التقني الأقوى للأتمتة والتعامل مع العمليات المعقدة ومصفوفات الأسماء فائقة الضخامة التي قد تؤدي صيغ الجداول الحسابية التقليدية إلى إبطائها أو عجزها عن إدارتها. وتعد خوارزمية “فيشر-يتس” (Fisher-Yates Shuffle)، المعروفة أيضاً بخوارزمية كنوث (Knuth Shuffle)، المعيار الذهبي المعتمد عالمياً في علوم الحاسوب لخلط المصفوفات وإعادة ترتيبها عشوائياً بكفاءة زمنية متطورة تبلغ $O(N)$؛ حيث تمر الخوارزمية عبر عناصر القائمة وتستبدل كل عنصر بعنصر آخر يتم اختياره عشوائياً من بين العناصر التي لم يتم خلطها بعد.
لبناء وحدة نمطية (VBA Module) تعتمد هذه الخوارزمية، يتم استدعاء مصفوفة الأسماء من النطاق المحدد إلى الذاكرة الداخلية للماكرو لتفادي عمليات القراءة والكتابة المتكررة من خلايا الورقة، ثم يتم تشغيل حلقة تكرارية تبدأ من الحد الأعلى للمصفوفة نزولاً إلى الحد الأدنى، مع استدعاء دالة التوليد العشوائي المدمجة Rnd لتحديد موقع الاستبدال. يوفر هذا التطبيق البرمجي توزيعاً عشوائياً متكافئاً بصورة مطلقة يخلو من أي عيوب ترجيحية، ويتفوق جذرياً على الدوال الرياضية في معالجة مئات الآلاف من السجلات الاسمية في أجزاء من الثانية ودون استهلاك طاقة المعالجة المرئية لبرنامج إكسل.
9.2 تصميم واجهة تفاعلية وزر تشغيل بنقرة واحدة
تكتمل قوة الحلول البرمجية عبر VBA بنقلها من مجرد أكواد برمجية صامتة في محرر الأكواد إلى واجهة استخدام بصرية وسلسة تتيح للموظف غير المتخصص تنفيذ عمليات السحب المعقدة بنقرة زر واحدة. يتحقق ذلك من خلال فتح تبويب “المطور” (Developer) وإدراج “عنصر تحكم زر” (Form Control Button) على ورقة العمل، ثم ربطه بالماكرو المخصص، وإعادة تسمية الزر بنص توضيحي مثل “إجراء السحب العشوائي المعتمد”.
ولإضفاء طابع تفاعلي ذكي على النموذج، يمكن تطعيم الكود البرمجي بصناديق إدخال (InputBox) تظهر للمستخدم عند الضغط على الزر، تسأله عن حجم العينة المراد استخراجها أو معايير التصفية المطلوبة، مع إدراج آليات تحقق فورية تمنع إدخال نصوص أو قيم سالبة. وفور اكتمال الحساب في الذاكرة، يمكن للكود إظهار النتيجة في نافذة رسالة منبثقة منسقة وأنيقة (MsgBox) تعلن أسماء الفائزين، أو ترحيل النتائج المستخرجة وتسطيرها تلقائياً في جدول تقارير مخصص ومؤمن داخل المصنف، مما يمنح التطبيق طابع البرمجيات المؤسسية المستقلة والمتكاملة.
9.3 معالجة استثناءات الأخطاء البرمجية وضمان الأمان
يتطلب التطوير الاحترافي للماكرو تحصين الكود ضد الاستثناءات والأخطاء التشغيلية غير المتوقعة (Robust Error Handling) التي قد يرتكبها المستخدم دون وعي. يشمل ذلك إدراج شروط فحص مسبقة تتحقق من أن نطاق الأسماء المستهدف ليس فارغاً تماماً قبل الشروع في عمليات السحب، وتفحص ما إذا كان عدد الأسماء المطلوب سحبها يفوق الحجم الإجمالي المتاح في قاعدة البيانات، وهو ما يستدعي اعتراض العملية فوراً وإظهار رسالة تحذيرية مفهومة تمنع انهيار البرنامج أو الدخول في حلقات تكرارية لا نهائية.
من الناحية الأمنية، يجب تفعيل عبارة Randomize في مستهل الإجراء البرمجي لإعادة تهيئة نواة مولد الأرقام العشوائية في لغة VBA بالاعتماد على التوقيت الزمني الدقيق لساعة النظام، حيث يؤدي إغفال هذا السطر إلى توليد تسلسل الأرقام العشوائية ذاته بدقة في كل مرة يتم فيها فتح المصنف وإعادة تشغيل الماكرو، مما يدمر عشوائية النتائج ويفتح باب التنبؤ المسبق بها. وأخيراً، يفرض تضمين الأكواد البرمجية حفظ المصنف بنسق يدعم وحدات الماكرو، وتحديداً بصيغة مصنف إكسل ذي الماكرو (.xlsm) أو الثنائي (.xlsb)، مع توجيه المستخدمين لضبط إعدادات الأمان في مركز التوثيق (Trust Center) لتمكين تشغيل الماكرو الموثوق دون إضعاف المنظومة الدفاعية للجهاز ضد البرمجيات الخبيثة.
10. استكشاف الأخطاء الشائعة وحلولها التقنية أثناء المعالجة
10.1 معالجة أخطاء الصيغ الحسابية (#REF! و #VALUE! و #SPILL!)
تواجه عمليات السحب العشوائي مجموعة من الأخطاء الحسابية الشائعة التي تعيق تدفق البيانات وتتطلب معالجة تشخيصية دقيقة لفهم مسبباتها الهيكلية. يأتي في مقدمتها خطأ المرجع الشهير #REF!، والذي يظهر عادة عند استخدام مراجع خلايا ثابتة وحذف صفوف أو أعمدة تقع ضمن النطاق المرجعي الأصلي، مما يجعل دالة الاسترجاع تبحث عن إحداثيات مفقودة؛ ويكمن الحل الجذري لهذه الإشكالية في التحول إلى الجداول الديناميكية الرسمية واستخدام دالة ROWS لحساب الحدود بدلاً من كتابة أرقام نهائية ثابتة تتآكل بحذف السجلات.
أما في بيئة المصفوفات الديناميكية الحديثة، فيبرز خطأ الانسكاب #SPILL! كأكثر المشكلات إرباكاً للمستخدمين؛ ويحدث هذا الخطأ عندما تحاول دالة مصفوفية مثل SORTBY أو RANDARRAY سكب نواتجها المتعددة في عمود معين، فتجد خلية مشغولة بنص أو رقم أو حتى مسافة فارغة غير مرئية تعترض مسار الامتداد، ويزول الخطأ فورياً بمجرد تفريغ النطاق الممتد أسفل الخلية الحاضنة للمعادلة. وأخيراً، يرتبط خطأ القيمة #VALUE! غالباً بخلل في وسائط الدوال الرياضية؛ كإدخال نصوص داخل معاملات تتطلب قيماً رقمية حصراً في RANDBETWEEN أو تمرير مصفوفات غير متوافقة في الأبعاد لدالة SORTBY، ويتم تجاوزه بإخضاع المدخلات لدوال التدقيق المسبق والتأكد من توافق الأنماط البيانية.
10.2 تجنب ظاهرة انحياز التوزيع العشوائي للأرقام المولدة
تعتمد محركات الجداول الحسابية على خوارزميات برمجية لتوليد ما يُعرف رياضياً بـ “الأرقام شبه العشوائية” (Pseudo-random Numbers)، وهي أرقام تظهر للمستخدم كأنها عشوائية تماماً لكنها تخضع في جوهرها لمعادلات حسابية قطعية متسلسلة تبدأ من نقطة انطلاق تُعرف باسم “البذرة” (Seed). في الإصدارات القديمة من إكسل، كانت الخوارزمية المستخدمة تعاني من بعض العيوب المنهجية التي تؤدي إلى ترجيح خفيف لبعض الأرقام على حساب أخرى، أو تكرار الأنماط بعد دورات حسابية طويلة، مما يهدد شرط التوزيع الاحتمالي المنتظم المتكافئ لكافة الأسماء.
قامت شركة مايكروسوفت في التحديثات الكبرى بمعالجة هذه المسألة عبر تطوير خوارزمية RANDBETWEEN لترتكز على تقنيات توليد متقدمة مستمدة من خوارزمية “ميرسين تويستر” (Mersenne Twister) وما يماثلها، لضمان استقلالية النتائج واجتيازها لأعتى الاختبارات الإحصائية للنزاهة (مثل اختبارات Diehard). وللتحقق العملي من نزاهة التوزيع داخل النموذج المؤسسي، يُوصى بإجراء اختبار تكراري؛ حيث يتم تشغيل سحب عشوائي افتراضي لعشرة آلاف مرة ومراقبة وتيرة ظهور كل اسم عبر دالة COUNTIF ورسم مصفوفة التوزيع التكراري، للتأكد من أن كافة المفردات تدور حول متوسط التردد النظري المحسوب ($\mu = \frac{\text{Total Trials}}{N}$) دون وجود شذوذ إحصائي ملحوظ ينبئ بانحياز الخوارزمية.
10.3 التعامل مع الخلايا الفارغة والسجلات غير المكتملة
يؤدي إهمال تنقية النطاقات من الخلايا الفارغة والسجلات النصية غير المكتملة إلى هبوط ملحوظ في دقة خوارزميات السحب العشوائي وظهور مخرجات مشوهة تتجلى في سحب فراغات أو قيم صفرية بدلاً من الأسماء الحقيقية؛ فعندما تختار دالة RANDBETWEEN صفاً فارغاً داخل النطاق، تعيد دالة INDEX قيمة صفرية أو فراغاً نصياً يعتبره النظام اسماً مسحوباً، مما يؤدي إلى ضياع إحدى الفرص المقررة للسحب وإرباك آلية إعلان النتائج النهائية أمام أصحاب المصلحة.
تتمثل المعالجة الاحترافية لهذه المعضلة في بناء صيغ ذكية ومصفاة ذاتياً تستبعد الفراغات استباقياً قبل بدء الفرز والتوليد؛ كأن يتم تطعيم الصيغة بشرط منطقي يتجاهل الخلايا غير المشغولة: =FILTER(A2:A100, (A2:A100"") * (NOT(ISBLANK(A2:A100))))، ليتم تمرير هذه الكتلة المنقاة حصراً إلى دوال السحب اللاحقة. كما تسهم هذه الممارسة الرشيدة في تسريع وتيرة المعالجة الحوسبية وتفادي الإهدار غير المبرر لطاقة الجهاز في فحص مئات الصفوف الفارغة الممتدة أسفل الجدول، مما يحافظ على خفة المصنف وسرعة استجابته حتى في أضخم قواعد البيانات المؤسسية.
خاتمة
تجسد عملية الاختيار العشوائي للأسماء في برنامج إكسل نموذجاً متقدماً للتكامل بين النظرية الإحصائية الرياضية والحلول البرمجية الجدولية؛ حيث تنقل المعالجة الرقمية المنضبطة جداول البيانات من مجرد أوعية ساكنة لحفظ النصوص إلى بيئات حوسبة تتمتع بالنزاهة والشفافية التامة وقابلية التدقيق والمطابقة القياسية. وكما أظهر هذا الاستعراض الشامل، فإن إتقان السحب الاحتمالي يستوجب الإحاطة بكافة التفاصيل البنيوية؛ بدءاً من التجهيز المسبق للبيانات وتنظيفها من الشوائب والمسافات الزائدة، مروراً بالاختيار الدقيق للمنظومة الرياضية الأنسب سواء عبر التركيبات الكلاسيكية لدالتي INDEX و RANDBETWEEN أو عبر القوة الديناميكية الحديثة للمصفوفات المقترنة بـ SORTBY و RANDARRAY و TAKE، وصولاً إلى بناء حلول مخصصة باستخدام كود VBA لتطبيق أرقى خوارزميات الخلط العالمية كخوارزمية فيشر-يتس.
إن الركيزة الأساسية للنجاح المؤسسي في تطبيق هذه الأدوات تكمن في وعي المستخدم بطبيعة الدوال المتطايرة وحتمية تجميد النتائج في التوقيت التشغيلي المناسب لتحويل الاحتمالات المتغيرة إلى سجلات تاريخية صلبة ومستقرة، بالتوازي مع التوثيق المنهجي لكافة الخطوات لضمان الشفافية ومكافحة الانحياز البشري. وبتبني هذه الممارسات الهندسية الصارمة، يستطيع المحللون والباحثون والمديرون تطويع إمكانات إكسل بثقة مطلقة لإدارة السحوبات وإجراء المعاينات البحثية وتوزيع المهام المؤسسية بأعلى مستويات الدقة والعدالة المنهجية المتبعة في البيئات الرقمية المعاصرة.
المراجع
- Cochran, W. G. (1977). Sampling techniques (3rd ed.). John Wiley & Sons.
- Dalgaard, P. (2008). Introductory statistics with R (2nd ed.). Springer. https://doi.org/10.1007/978-0-387-79054-1
- Knuth, D. E. (1998). The art of computer programming: Seminumerical algorithms (Vol. 2, 3rd ed.). Addison-Wesley.
- Matsumoto, M., & Nishimura, T. (1998). Mersenne twister: A 623-dimensionally equidistributed uniform pseudo-random number generator. ACM Transactions on Modeling and Computer Simulation, 8(1), 3–30. https://doi.org/10.1145/272991.272995
- Microsoft Support. (n.d.). SORTBY function. Microsoft. https://support.microsoft.com/en-us/office/sortby-function-cd663a57-2295-4302-92b6-52b6551fa88e
- Microsoft Support. (n.d.). RANDARRAY function. Microsoft. https://support.microsoft.com/en-us/office/randarray-function-21261e55-3bec-4885-86a6-8b0a47fd4d33
- Microsoft Support. (n.d.). INDEX function. Microsoft. https://support.microsoft.com/en-us/office/index-function-a5dcf0dd-996d-40a4-a822-b56b061328bd
- Walkenbach, J. (2015). Microsoft Excel 2016 bible. John Wiley & Sons.