
تمثل جداول البيانات في بيئة برمجيات مايكروسوفت إكسيل (Microsoft Excel) الركيزة الأساسية لتحليل وإدارة البيانات الرقمية في مختلف الميادين التقنية والإدارية والبحثية. ومع ذلك، تصطدم هذه البيئة الحسابية المرنة بعوائق بنيوية جوهرية عند التعامل مع أنماط البيانات المركبة التي لا تنتمي حصراً إلى التصنيفات العددية القياسية أو السلاسل النصية الصرفة. وتأتي عناوين بروتوكول الإنترنت من الإصدار الرابع (IPv4 Addresses) في مقدمة هذه البيانات المعقدة؛ إذ تجمع في بنيتها الظاهرية بين الأرقام العشرية والفواصل النقطية، مما يوقع محركات المعالجة التلقائية في إرباك مفاهيمي حاد ينعكس مباشرة على عمليات الترتيب والفرز المنطقي.
يتجلى هذا التحدي بصورة ملحة ليس فقط لدى مهندسي الشبكات ومديري الأنظمة السحابية الذين يتعاملون مع سجلات الخوادم وجدران الحماية، بل يمتد كذلك إلى الباحثين الأكاديميين ومحللي البيانات الكمية في العلوم الاجتماعية والظواهر السلوكية الرقمية؛ حيث يُعتمد عنوان بروتوكول الإنترنت كأداة حيوية لتنقية العينات الاستقصائية المجمعة عبر المنصات الرقمية، والتحقق من عدم تكرار المشاركين (Participant Deduplication)، ورصد الأنماط الجغرافية لتدفق الاستجابات. إن غياب الترتيب الحسابي الدقيق لهذه السجلات يؤدي إلى تشويه التحليلات الإحصائية وتشتيت التوزيعات المكانية للعينات المدروسة، مما يفرض ضرورة التأسيس لفهم هندسي ومنهجي دقيق لآليات معالجة هذه البيانات داخل جداول إكسيل.
يهدف هذا الدليل الأكاديمي الشامل إلى تفكيك المعضلة الهيكلية والرياضية المرتبطة بفرز عناوين بروتوكول الإنترنت في مايكروسوفت إكسيل، مع تقديم استعراض تطبيقي متكامل للبدائل المنهجية المتاحة لمعالجة هذا القصور. سننطلق من التشريح النظري لبروتوكول الإنترنت وصولاً إلى استخدام أحدث الدوال الحسابية، وأدوات نمذجة البيانات المتقدمة عبر محرر الاستعلامات (Power Query)، وتقنيات الأتمتة البرمجية بواسطة لغة Visual Basic for Applications (VBA)، بما يضمن تزويد القارئ برؤية متكاملة توازن بين الدقة الرياضية الصارمة والكفاءة التشغيلية الميدانية.
1. مقدمة نظرية حول بنية عناوين IP وتحديات معالجتها في جداول البيانات
1.1 التركيب الرياضي والهيكلي لعنوان بروتوكول الإنترنت (IPv4)
يستند بروتوكول الإنترنت من الإصدار الرابع (IPv4)، الذي تم تقنينه لأول مرة بشكل رسمي في الوثيقة المعيارية RFC 791 الصادرة عن معهد أبحاث علوم المعلومات بقيادة جون بوستل عام 1981، إلى بنية رقمية ثنائية تتألف بدقة من 32 خانة ثنائية (Bits). ولتسهيل قراءة هذه البنية المعقدة من قِبل العنصر البشري وتفادي التعامل المباشر مع سلاسل الأصفار والآحاد الطويلة، تُقسّم هذه البنية الثنائية إلى أربعة مقاطع فرعية متساوية تُعرف في الأدبيات الهندسية بالمقاطع الثمانية (Octets)، حيث يتكون كل مقطع منها من 8 بتات متصلة.
يتم التعبير عن هذه المقاطع الثمانية وفق التدوين العشري النقطي (Dotted-Decimal Notation)، والذي يفصل بين كل مقطع وآخر بنقطة ارتكاز واضحة. ومن الناحية الحسابية، فإن القيمة الدنيا لأي مقطع ثماني، حينما تكون جميع خاناته الثنائية أصفاراً (00000000)، تعادل الصفر في النظام العشري، في حين تصل قيمته القصوى عندما تمتلئ خاناته بالآحاد (11111111) إلى العدد 255، وذلك وفق متوالية القوى الثنائية الحسابية التي تبدأ من 2 أس صفر وتتدرج تصاعدياً حتى 2 أس سبعة. وعليه، فإن أي عنوان IPv4 يمثل رياضياً فضاءً عددياً محصوراً بدقة بين 0.0.0.0 و255.255.255.255، ليشكل متصلًا تسلسلياً متماسكاً رياضياً ولكن معقداً في تمثيله السطحي.
إن طبيعة هذا التسلسل الهرمي للمجموعات الثمانية تعني أن كل مقطع يحمل وزناً رياضياً مضاعفاً بالنسبة للمقطع الذي يليه؛ فالمقطع الأول من جهة اليسار يمثل المراتب العليا في الفضاء الحسابي للعنوان، بينما يمثل المقطع الأخير أدنى المراتب وزناً. بيد أن إقحام الفواصل النقطية كأداة فصل بصرية بين هذه المراتب يجرّد القيمة الكلية للعنوان من استمراريتها الرقمية الظاهرة، ويحولها إلى تركيبة هجينة تجمع بين الرموز الرياضية والقيم العددية المجزأة، وهو ما يؤسس للإشكالية الهيكلية الكبرى عند إخضاع هذه العناوين للأنظمة الحاسوبية العامة غير المخصصة شبكياً.
1.2 طبيعة البيانات الرقمية والنصية في بيئة مايكروسوفت إكسيل
تعتمد النواة الحسابية لبرنامج مايكروسوفت إكسيل نموذجاً صارماً لتصنيف البيانات يقوم على الفصل التلقائي بين القيم العددية الخالصة (Numeric Values) والسلاسل الحرفية النصية (Text Strings). فعند إدخال أي بيان داخل الخلية، يقوم محرك المعالجة الداخلي بإجراء فحص استدلالي لمحتوى الخلية لتحديد كيفية تخزينها في الذاكرة الحية (RAM) وطريقة معالجتها لاحقاً في العمليات الحسابية والمنطقية. وتُخزن الأرقام الخالصة عادة بصيغة الفاصلة العائمة مزدوجة الدقة (Double-Precision Floating-Point) وفق معيار IEEE 754، مما يتيح للنظام إدراك قيمتها الكمية النسبية وإجراء عمليات المقارنة المباشرة مثل “أكبر من” أو “أصغر من” بيسر فائق.
في المقابل، عندما يواجه إكسيل خلية تحتوي على عنوان بروتوكول إنترنت بصيغته القياسية، مثل “192.168.1.1”، فإنه يتعامل مع الفواصل النقطية الثلاث بوصفها محارف نصية فاصلة وليست علامات عشرية رياضية، نظراً لاستحالة احتواء الرقم الرياضي الواحد في المنطق الحسابي على أكثر من فاصلة عشرية واحدة. ونتيجة لذلك، يسقط إكسيل فوراً هذا الإدخال في فئة السلاسل النصية (Strings). ويترتب على هذا التخزين الداخلي تحييد تام للخصائص الحسابية الكامنة في المقاطع الثمانية، حيث تتحول الأرقام من مقادير تعبر عن كميات إلى مجرد رموز بصرية رقمية مجردة من وزنها العددي الحقيقي.
إن هذا التصنيف النصي القسري ينعكس بشكل جذري على عمل كافة الخوارزميات التحليلية المدمجة في إكسيل؛ فبدلاً من تطبيق منطق المقارنة الرياضية المتصلة لفرز وتصنيف السجلات، تُجبر البرمجية على استدعاء خوارزميات المعالجة اللغوية والنصية، مما يؤدي إلى قطيعة معرفية وحسابية بين الدلالة الواقعية لعنوان IP في بنية الشبكات والتمثيل الداخلي المعتم الذي يستقر في ذاكرة ورقة العمل.
1.3 إشكالية التباين بين الترتيب الأبجدي الرقمي والترتيب الحسابي المنطقي
تتمحور المعضلة الأساسية لفرز عناوين بروتوكول الإنترنت في جداول البيانات حول الصدام التقني بين الترتيب المعجمي (Lexicographical Order) والترتيب الحسابي المنطقي (Numerical Magnitude). فعندما يصنف إكسيل البيانات كسلاسل نصية، يقوم محرك الفرز الداخلي بتطبيق آلية الفرز المعجمي، والتي تقارن المدخلات محرفاً تلو الآخر (Character by Character) من أقصى اليسار إلى أقصى اليمين، استناداً إلى الجداول المعيارية للمحارف، متجاهلة تماماً الدلالة الكلية للأعداد المركبة أو الحدود المنطقية للمقاطع الثمانية.
تؤدي هذه الآلية المعجمية إلى مفارقة ترتيبية شائعة تثير ارتباك المحللين؛ إذ تتقدم السلاسل النصية التي تبدأ بالمحرف “1” على أي سلسلة نصية تبدأ بالمحرف “2”، بغض النظر عن القيمة الفعلية للعدد المكون للمقطع. فعلى سبيل المثال، وفقاً للمنطق المعجمي الحرفي، فإن العنوان النصي “100.0.0.1” سيسبق العنوان “2.0.0.1” في جدول الترتيب التصاعدي، ببساطة لأن الرمز الطباعي الأول في السلسلة الأولى هو ‘1’، وهو يسبق الرمز ‘2’ وفق الترتيب الأبجدي الرقمي، على الرغم من أن المقطع الثماني الثاني يحمل من المنظور الشبكي والحسابي قيمة تقع في أدنى درجات الترقيم مقارنة بالمئة.
تتفاقم هذه الإشكالية داخل المقاطع الثمانية المفردة؛ فالرقم “10” يسبق “2” معجمياً، والرقم “192” يسبق “20”. ومن ثم، فإن محاولة الفرز التلقائي تؤدي إلى بعثرة شاملة في الترتيب الطوبولوجي للشبكات الفرعية والأجهزة المتصلة. ومن هنا تبرز الأهمية القصوى لإعادة الهيكلة الرياضية لتلك السلاسل النصية؛ حيث يتعين تحويلها عبر آليات المعالجة التنسيقية أو التحويلات الجبرية إلى صيغ قياسية تتماشى فيها المقارنة الحرفية مع القيمة العددية الصافية، لإلغاء هذا التباين واستعادة المنطق الترتيبي السليم.
2. قصور أدوات الفرز التقليدية في مايكروسوفت إكسيل
2.1 آلية عمل أداة الفرز المباشر (Sort A to Z / Smallest to Largest)
تحتوي واجهة مايكروسوفت إكسيل على أدوات الفرز السريع المدمجة، والمتمثلة في خياري “الفرز من الألف إلى الياء” (Sort A to Z) للنصوص، أو “من الأصغر إلى الأكبر” (Sort Smallest to Largest) للأرقام. وعند تحديد عمود يحتوي على عناوين IP غير المعالجة، يتعرف البرنامج تلقائياً على العمود بوصفه حقلاً نصياً، مما يجعله يعرض خيار الفرز الأبجدي بدلاً من الخيار العددي. وتعتمد هذه الأداة بصورة صارمة على مطابقة بايت المحرف عبر جدول الترميز المعياري، حيث تبدأ بمقارنة الخانة الأولى من كل سلسلة في الصفوف المستهدفة وتستمر في الفحص الموضعي حتى ظهور أول نقطة اختلاف.
إن الخلل الجوهري في هذه الخوارزمية يكمن في عماها الكامل عن مفهوم “المقطع الثماني” ككتلة حسابية متماسكة تتراوح قيمتها الكلية بين 0 و255. فالخوارزمية لا تفهم أن الرقم “192” هو كتلة عددية واحدة، بل تتعامل معه كثلاث محارف مستقلة: المحرف ‘1’ يليه المحرف ‘9’ ثم المحرف ‘2’. وبالتالي، إذا قورنت هذه السلسلة بعنوان يبدأ بالرقم “24”، فإن الخوارزمية تكتفي بمقارنة المحرف ‘1’ مع المحرف ‘2’، وتُصدر حكماً قطعياً وفورياً بوضع السلسلة التي تبدأ بـ “192” قبل السلسلة التي تبدأ بـ “24”، بصرف النظر عن كون الرقم 192 يفوق الرقم 24 بثمانية أضعاف من المنظور الحسابي.
ينتج عن تطبيق أداة الفرز المباشر تشويه كامل في الهيكل البنائي لمصفوفة البيانات المدخلة؛ حيث تتداخل عناوين الشبكات الكبيرة مع الشبكات الصغيرة، وتظهر نتائج الفرز في هيئة فوضوية غير قابلة للاستخدام التحليلي، مما يجعل الاعتماد على هذه الميزة الافتراضية خطأً منهجياً فادحاً في معالجة سجلات الأنظمة وهندسة البيانات الحاسوبية.
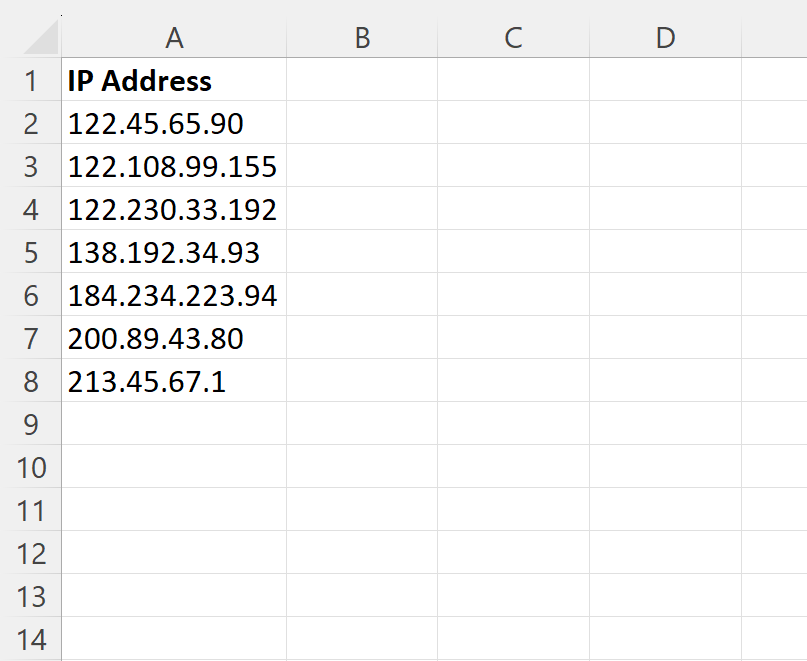
2.2 تحليل ظاهرة التصنيف النصي غير السليم للأعداد متعددة الخانات
لفهم الآثار السلبية للتصنيف النصي، يمكن دراسة حالة مقارنة عملية بين العنوان “122.45.65.90” والعنوان “10.0.0.1”. في العالم الرياضي وفيزيولوجيا عنونة الشبكات، يُعد العنوان الثاني (الذي يبدأ بـ 10) أقل رتبة وأسبق في التسلسل التدرجي من العنوان الأول؛ فالرقم 10 يسبق 122 بأشواط حسابية واضحة. ولكن، عند تطبيق خوارزمية الفرز النصي في إكسيل، تبدأ المقارنة بالمحرف الأول: ‘1’ مقابل ‘1’، فتتطابق القيمتان النصيتان. ينتقل المحرك بعد ذلك إلى المحرف الثاني: في العنوان الأول يجد المحرف ‘2’، بينما يجد في العنوان الثاني المحرف ‘0’. ولأن الرمز الطباعي ‘0’ يسبق الرمز ‘2’ في جدول المحارف، يستقر العنوان “10.0.0.1” قبل العنوان “122.45.65.90”.
حتى الآن، قد يبدو الترتيب متوافقاً ظاهرياً مع المنطق العددي بالمصادفة البحتة، ولكن الأزمة تظهر فوراً عند إقحام عنوان ثالث في المعادلة مثل “2.0.0.1”. في هذه الحالة، يقارن إكسيل المحرف الأول ‘2’ بالمحرف الأول في العنوانين السابقين (‘1’). ولأن ‘1’ يسبق ‘2’، يضع إكسيل كلاً من “10.0.0.1” و”122.45.65.90″ قبل “2.0.0.1”. وتكون النتيجة الكارثية ترتيباً يبدأ بـ 10 ثم 122 وينتهي بـ 2. يعود السبب الجذري لهذا التشويه إلى غياب الأصفار البادئة (Leading Zeros)؛ فالأعداد في النظام العشري الطبيعي تُكتب بحذف الأصفار غير المؤثرة جهة اليسار، مما يؤدي إلى تفاوت في طول السلاسل النصية المعبرة عن المقاطع الثمانية ما بين خانة واحدة وخانتين وثلاث خانات.
يترتب على هذا التفاوت في الأطوال الحرفية سقوط معايير المقارنة التناظرية؛ فالقيمة النصية لا تستوعب مفهوم الخانات العشرية (الآحاد والعشرات والمئات) بل تتعامل مع تسلسل الرموز فقط. وبالنسبة لمديري الأنظمة، فإن هذا الفرز المشوه يعني استحالة إجراء مراجعة بصرية سريعة، وفقدان القدرة على تقييم كثافة التوزيع الرقمي للأجهزة داخل نطاقات الشبكة بصورة موثوقة.
2.3 حالات تطبيقية ملموسة لقصور الترتيب في إدارة الشبكات
تتعدى تداعيات الفرز المعجمي الخاطئ مجرد المظهر الجمالي أو التنسيقي لجدول البيانات، لتتحول إلى مخاطر تشغيلية مباشرة في بيئات تقنية المعلومات وإدارة الشبكات المؤسسية. وتبرز هذه المشكلة بوضوح عند إدارة بروتوكول التكوين الديناميكي للمضيفين (DHCP). فعندما يحاول مدير النظام فرز جدول العناوين المخصصة لاكتشاف الثغرات في فضاء العناوين المتاحة أو التحقق من نفاد النطاق (Pool Exhaustion)، يؤدي الفرز النصي إلى تشتيت النطاقات المترابطة؛ إذ تتبعثر العناوين الواقعة بين 192.168.1.1 و192.168.1.254 وتنفصل عن بعضها البعض بفواصل نصية وهمية تمنع الفهم الدقيق للاستهلاك الرقمي.
تظهر حالة تطبيقية أخرى بالغة الحساسية عند محاولة عزل وتتبع أجهزة تابعة لشبكة فرعية موحدة (Subnet Masking). فإذا كانت المؤسسة تعتمد النطاق الفرعي 172.16.10.0/24 والنطاق 172.16.2.0/24، فإن الفرز العادي في إكسيل سيُقحم عناوين الشبكة 172.16.100.0/24 بين النطاقين السابقين بسبب البدء بالمحرف “1”، مما يجعل التحديد البصري لحدود الشبكات الفرعية أمراً شديد الصعوبة ومصدراً رئيساً لأخطاء التهيئة اليدوية في أجهزة التوجيه وجدران الحماية.
علاوة على ذلك، تلعب هذه الإشكالية دوراً سلبياً في تحليل سجلات تدقيق الأمان (Security Audit Logs) المصدرة من جدران الحماية (Firewalls) وأنظمة كشف التسلل (IDS). فعند محاولة رصد هجمات حجب الخدمة الموزعة (DDoS) أو استكشاف الأنماط المشبوهة لتدفق الحزم، يحتاج المحلل الجنائي الرقمي إلى فرز عناوين IP المصدرية لتجميع الحزم القادمة من نطاق محدد. إن الترتيب الخاطئ يشتت سجلات المهاجم الواحد عبر آلاف الأسطر المتباعدة في المصنف، مما يطيل زمن الاستجابة للحوادث السيبرانية ويضعف كفاءة اتخاذ القرار الأمني المبني على البيانات.
3. الأسس المنهجية لتسوية وتنسيق المقاطع الثمانية (Octets)
3.1 مفهوم تعبئة الفراغات بالأصفار البادئة (Zero-Padding Concept)
لمعالجة القصور المتأصل في الفرز المعجمي دون المساس بالقيمة الرياضية الكامنة في المقاطع الثمانية، تم ابتكار استراتيجية هندسية رصينة تُعرف في حقل علوم البيانات باسم “تعبئة الفراغات بالأصفار البادئة” (Zero-Padding). ترتكز هذه الاستراتيجية على مبدأ توحيد الطول الحرفي لجميع المقاطع؛ فبما أن القيمة القصوى للمقطع الثماني هي 255 (وهي قيمة تتألف رياضياً من 3 خانات)، فإن أي قيمة تقل عن ذلك يجب إجبارها بنيوياً على احتلال ثلاثة مواضع رقمية كاملة من خلال حشو مواضع اليسار الشاغرة بالصفر.
بموجب هذه القاعدة التنسيقية، تتحول القيمة المفردة للخانة الواحدة مثل العدد “1” إلى الصيغة الثلاثية “001”، بينما تتحول القيم المكونة من خانتين مثل “45” إلى الصيغة المتناظرة “045”، في حين تظل القيم المكونة من ثلاث خانات مثل “192” و”254″ على حالها دون تغيير لأنها تشغل الحيز الحرفي الأقصى بالفعل. ويكمن الأساس المنطقي لهذه العملية في تحييد آلية المقارنة الموضعية المعجمية وجعلها مطابقة تماماً للمقارنة الرياضية.
عندما تتساوى أطوال المقاطع النصية لتصبح ثلاثية في كافة المواضع، فإن محرف الصفر البادئ يلعب دور المعادل الترتيبي؛ فعند مقارنة “002” مع “010”، ستجد الخوارزمية النصية أن المحرف الأول في كلاهما هو ‘0’، وحين تنتقل للمحرف الثاني ستجد أن ‘0’ في السلسلة الأولى يسبق ‘1’ في السلسلة الثانية، وبالتالي تُفرز القيمة “002” قبل “010” بصورة صحيحة ومتطابقة تماماً مع المنطق العددي المجرد، مما يضمن التوازن البصري والرقمي الدقيق لكافة عناصر المتجه الترتيبي.
3.2 تحويل العناوين إلى صيغ ذات أطوال قياسية متساوية (12 خانة)
يمثل التوسيع المنهجي لمفهوم التعبئة بالأصفار البادئة عبر العناوين بأكملها خطوة محورية في التأسيس لبيئة فرز قياسية داخل إكسيل. يتطلب هذا الإجراء معالجة المقاطع الأربعة المكونة لعنوان بروتوكول الإنترنت، بحيث يصبح كل مقطع منها مستقراً على ثلاثة محارف بالضبط، ثم يُعاد ربط هذه المقاطع لإنتاج كتلة بيانية موحدة تتألف من 12 خانة رقمية مستمرة (أو 15 خانة في حال الإبقاء على الفواصل النقطية بصيغة 000.000.000.000).
تتمتع الصيغة القياسية الممتدة بخصائص رياضية ممتازة لعمليات المعالجة؛ حيث تضمن التماثل الشكلي لكافة السجلات المدرجة في ورقة العمل دون أدنى استثناء. فعنوان مثل “10.0.0.1” يتحول بموجب هذه المنهجية إلى السلسلة القياسية المتناظرة “010.000.000.001”، بينما يتحول العنوان المركب “192.168.10.254” إلى “192.168.010.254”. كما يمكن التخلي تماماً عن الفواصل النقطية أثناء عملية الدمج لإنتاج نسق رقمي مصمت مثل “010000000001” و”192168010254″.
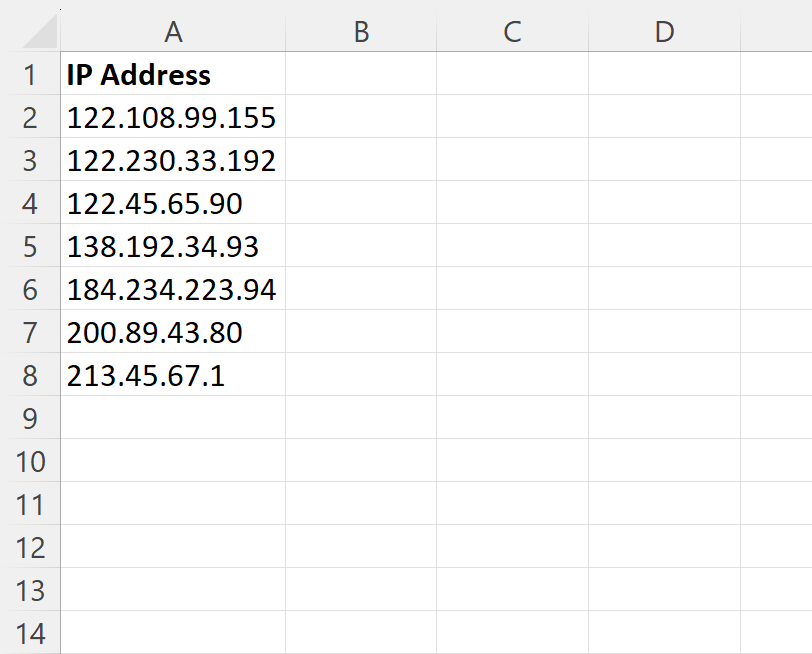
إن إزالة الفواصل النقطية مع توحيد الأطوال يلغي نهائياً أي تأثير سلبي ناتج عن الفواصل النصية العشوائية التي كانت تقطع التدفق العددي في العنوان الأصلي. ويقود هذا التوحيد الصارم إلى تحقيق تطابق كلي ومطلق بين مخرجات الترتيب الأبجدي ومخرجات الترتيب العددي؛ فالسلسلة ذات الاثنتي عشرة خانة ستُفرز بنفس الترتيب تماماً سواء تم التعامل معها كنص أو عولجت كقيمة عددية، مما يمنح محلل البيانات مرونة استثنائية وأماناً حسابياً كاملاً من أخطاء التقدير التلقائي.
3.3 أهمية التحويل إلى قيم رقمية موحدة لضمان الدقة الرياضية
على الرغم من أن توحيد الطول النصي إلى 12 خانة يحل معضلة الفرز في معظم السياقات، إلا أن التحويل المنهجي النهائي إلى قيمة عددية صحيحة نقية (Pure Integer) يمثل ذروة الدقة الهندسية والرياضية في معالجة البيانات داخل إكسيل. يمكن تحقيق هذا التحويل إما عبر إزالة الأصفار غير الفعالة الناتجة عن الدمج وتحويل السلسلة إلى عدد صحيح كبير (Big Integer)، أو من خلال تطبيق الصيغة الرياضية المكافئة لتحويل العنوان إلى قيمته الثنائية غير الموقعة المكونة من 32 بت (Unsigned 32-bit Integer)، والتي تُحسب بالمعادلة:
$$\text{القيمة الحسابية} = (A \times 256^3) + (B \times 256^2) + (C \times 256^1) + (D \times 256^0)$$
حيث تمثل المتغيرات $A$ و $B$ و $C$ و $D$ المقاطع الثمانية الأربعة للعنوان بالتتابع من اليسار إلى اليمين. يحول هذا النهج الرياضي الصارم عنوان IP المعقد إلى رقم ترتيبي تسلسلي مطلق يقع في النطاق المحصور بين 0 و 4,294,967,295.
تكمن أهمية هذا التحويل الرقمي المطلق في تحرير محرك الفرز الداخلي لإكسيل من أي قيود لغوية أو ثغرات مرتبطة ببيئة نظام التشغيل (Locale and Regional Settings). فالفرز النصي، حتى مع توحيد الخانات، قد يتأثر أحياناً بخصائص ترميز المحارف المعتمدة في النظام، أو بتفسير البرمجية لترتيب بعض علامات التنقيط في بعض اللغات غير اللاتينية. أما القيمة العددية الصافية، فإنها تخضع لقوانين الجبر الرياضي الثابتة التي لا تتبدل بتغير البيئة البرمجية، مما يضمن ثبات مخرجات الفرز وتطابقها المطلق مع الترتيب المادي الفعلي للأجهزة في طبقات الشبكة المعمارية.
4. الصيغة الرياضية المركبة لفرز العناوين: تفكيك البنية والوظائف
4.1 وظائف التفكيك النصي الحديثة: دالتا TEXTBEFORE وTEXTAFTER
قدمت التحديثات الأخيرة في بيئة مايكروسوفت 365 (Microsoft 365) وإصدارات إكسيل الحديثة نقلة نوعية في التعامل مع معالجة النصوص البرمجية عبر توفير دالات تفكيك نصي ديناميكية متقدمة، وفي مقدمتها دالتا TEXTBEFORE وTEXTAFTER. تتيح هاتان الدالتان تجاوز التعقيدات القديمة المرتبطة بتداخل الدوال الرياضية الطويلة وحساب أطوال النصوص بدقة بالغة وبأقل جهد كتابي ممكن، مما يفتح آفاقاً واسعة لتشريح عناوين IP وتفكيك مقاطعها الأربعة بدقة جراحية.
تُستخدم دالة TEXTBEFORE لاستخراج المقطع الثماني الأول من أقصى اليسار عبر استدعاء النقطة كمعامل فصل؛ حيث تكتفي الصيغة بالتوجيه للبحث عن النقطة الأولى واقتطاع كافة المحارف التي تسبقها مباشرة. أما لعزل المقطع الثماني الأخير (الرابع)، فيتم استدعاء دالة TEXTAFTER مع تحديد معامل التكرار بالرقم (3) أو الرقم (-1) للوصول إلى النقطة الأخيرة واقتطاع ما بعدها بالكامل، متجاوزة الحاجة لمعرفة عدد خانات المقاطع السابقة أو موضع النقطة المحدد في مصفوفة الأحرف.
تتجلى العبقرية البرمجية عند استخراج المقطعين الأوسطين (الثاني والثالث)؛ حيث يتم تطبيق التداخل الوظيفي بين الدالتين. فعلى سبيل المثال، لاستخراج المقطع الثاني، يُمكن تطبيق دالة TEXTBEFORE على المقطع الناتج من إزالة الجزء الأول عبر TEXTAFTER، أو تحديد الموضع المزدوج للبحث بدقة بين النقطة الأولى والثانية. ويتميز هذا التفكيك الحسابي بالمرونة العالية؛ إذ يتعامل بتلقائية مطلقة مع العناوين ذات الخانات المتفاوتة دون التسبب في أخطاء الإزاحة التي كانت تصيب الدوال التقليدية السابقة.
4.2 توظيف الدالة TEXT لتنسيق الثمانيات بنسق ثلاثي الأرقام
عقب إتمام مرحلة عزل المقاطع الثمانية الأربعة كأجزاء مستقلة، تأتي الخطوة الحيوية المتمثلة في إعادة صياغة التمثيل الشكلي لكل مقطع لتحقيق شرط التعبئة بالأصفار البادئة. وتضطلع الدالة النصية الشهيرة TEXT بهذه المسؤولية المحورية؛ حيث تعمل كأداة تحويل نمطي تجبر القيمة المستخرجة على اتخاذ مظهر رقمي محدد سلفاً من خلال قوالب التنسيق المخصصة (Format Codes).
يتم تطبيق القناع التنسيقي “000” كوسيط ثانٍ داخل دالة TEXT لكل مقطع يتم استخراجه. وتعتمد فلسفة عمل هذا القناع على إجبار النظام على إظهار ثلاثة أرقام على الأقل في الناتج النهائي؛ فإذا كان الرقم المستخرج مكوناً من خانة واحدة كالقيمة “7”، فإن الدالة تُقحم تلقائياً صفرين من جهة اليسار ليصبح الناتج “007”. وإذا كان الرقم مكوناً من خانتين كالقيمة “42”، تقحم الدالة صفراً واحداً ليصبح “042”. أما الأرقام التي تستوفي الشروط مسبقاً وتتألف من ثلاث خانات مثل “217”، فإن الدالة تبقي عليها دون تعديل.
يضمن هذا الإجراء استقرار التمثيل الرقمي الشكلي لكافة المقاطع المستخرجة وتحويلها إلى قوالب بيانية صلبة ومتجانسة بالكامل. إن دمج مخرجات دوال التفكيك النصي داخل أحشاء دالة TEXT يوفر ضمانة مؤكدة لتوحيد الأوزان البصرية قبل الانتقال إلى مرحلة التجميع الحسابي، مما يقضي جذرياً على التباين الحرفي الذي كان يضلل محرك الفرز الأصلي في إكسيل.
4.3 دمج السلاسل النصية وتحويلها لقيمة عددية عبر NUMBERVALUE
تتمثل المرحلة الختامية لبناء الصيغة الرياضية المركبة في دمج المقاطع الأربعة المنسقة لتشكيل الكيان الرقمي الموحد. يتم إنجاز هذا الربط إما عبر استخدام معامل التجميع التقليدي (&) أو عبر الدالة الحديثة TEXTJOIN. ولتكوين صيغة متكاملة تعتمد على تفكيك ودمج المقاطع بنسق ممتد خالي من الفواصل، يتم تجميع المقاطع الأربعة المنسقة وربطها معاً لتوليد سلسلة موحدة بطول 12 خانة رقمية كاملة.
وللارتقاء بالصيغة من مجرد سلسلة نصية ذات أطوال موحدة إلى قيمة عددية صحيحة تستجيب مباشرة للمنطق الحسابي، يتم تمرير الكتلة المجمعة بالكامل عبر دالة NUMBERVALUE، أو دالة VALUE التقليدية. تقوم هذه الدالة بتجريد السلسلة النصية الناتجة من صفاتها المعجمية وتحويلها في ذاكرة المصنف إلى عدد صحيح ممتد (مكون من 12 خانة)، مع إزالة أي محارف غير ظاهرة أو حساسيات إقليمية للفاصلة النصية.
تتبلور الصيغة المركبة الشاملة بالصيغة الحديثة والمدمجة كالتالي في الإصدارات الداعمة لدالة TEXTSPLIT:
=NUMBERVALUE(TEXTJOIN("", TRUE, TEXT(TEXTSPLIT(A2, "."), "000")))
أما في حال الاعتماد على دالات التفكيك المباشر (TEXTBEFORE / TEXTAFTER) فيمكن صياغتها برمجياً كالآتي:
=NUMBERVALUE(TEXT(TEXTBEFORE(A2, "."), "000") & TEXT(TEXTBEFORE(TEXTAFTER(A2, "."), "."), "000") & TEXT(TEXTBEFORE(TEXTAFTER(A2, ".", 2), "."), "000") & TEXT(TEXTAFTER(A2, ".", 3), "000"))
توفر هذه الصيغة المتكاملة الأساس المتين لإنشاء عمود الفرز المساعد؛ حيث تُنتج قيماً عددية ترتفع وتنخفض بما يتطابق مئة بالمئة مع الرتب الحسابية لعناوين بروتوكول الإنترنت، موفرة حلاً نهائياً وأنيقاً لمعضلة الفرز في جداول البيانات.
5. التطبيق العملي خطوة بخطوة: دليل الفرز النموذجي
5.1 تجهيز مصفوفة البيانات الأولية وتحديد حقول العمل
لبدء التطبيق العملي بصورة احترافية، يتعين إعداد مصفوفة بيانات نموذجية تعكس التحديات الحقيقية لفرز العناوين. سنفترض في هذا الدليل وجود جدول يحتوي على سجلات توزيع الأجهزة عبر نطاق الخلايا A1:A9، حيث تشغل الخلية A1 الترويسة الأساسية بعنوان “عنوان بروتوكول الإنترنت” (IP Address)، بينما تحتوي الخلايا من A2 إلى A9 على عينة عشوائية غير مفروزة تشمل العناوين التالية:
- A2: 192.168.1.1
- A3: 10.0.0.1
- A4: 172.16.0.5
- A5: 192.168.1.20
- A6: 2.2.2.2
- A7: 192.168.1.2
- A8: 10.0.1.1
- A9: 172.16.0.100
عند فحص هذه المصفوفة بالعين المجردة، نلاحظ وجود تباين شديد في أطوال المقاطع الثمانية وتوزيع العناوين؛ فالعنوان الموجود في A6 يبدأ بالرقم 2، ولكنه يقع في ذيل الجدول، بينما تتبعثر عناوين الشبكة 10 والشبكة 172 والشبكة 192 دون أي انتظام منطقي. ويجب قبل الشروع في كتابة أي معادلة، التأكد من خلو الخلايا المجاورة في العمود B من أي مدخلات حيوية سابقة، لتجنب حدوث أي استبدال غير مقصود للبيانات أثناء بناء واستدعاء الأعمدة المساعدة.
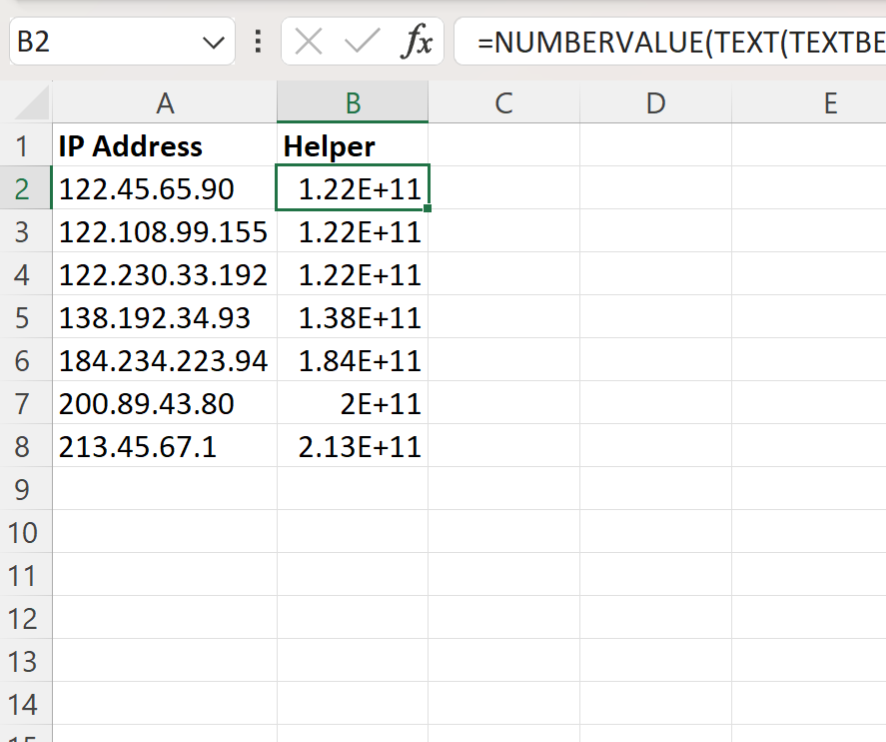
5.2 إنشاء وإعداد العمود المساعد (Helper Column) وتطبيق المعادلة
تبدأ الخطوة التنفيذية الأولى بتخصيص العمود B ليكون “عمود الفرز المساعد” (Helper Column). يتم تعيين الخلية B1 لوضع ترويسة تعريفية واضحة مثل “مفتاح الفرز الحسابي” (Sort Key). يساعد هذا التوثيق البصري على تمييز البيانات المشتقة وتسهيل فهم المصنف في حال تشاركه مع أعضاء الفريق البحثي أو مديري النظم الآخرين.
يتم الانتقال بعد ذلك إلى الخلية B2، وكتابة الصيغة الرياضية الحديثة المعتمدة على دمج TEXTJOIN مع TEXTSPLIT كالتالي:
=TEXTJOIN(".", TRUE, TEXT(TEXTSPLIT(A2, "."), "000"))
بمجرد الضغط على مفتاح الإدخال (Enter)، سيقوم إكسيل بمعالجة العنوان الأصلي “192.168.1.1” وتحويله مباشرة إلى النسق القياسي ذي الأطوال الموحدة: “192.168.001.001”. بعد التحقق من صحة ناتج الخلية الأولى، يتم النقر المزدوج على مقبض التعبئة التلقائية (Fill Handle) في الزاوية اليسرى السفلى للخلية B2، أو سحبه يدوياً إلى الأسفل حتى الخلية B9.
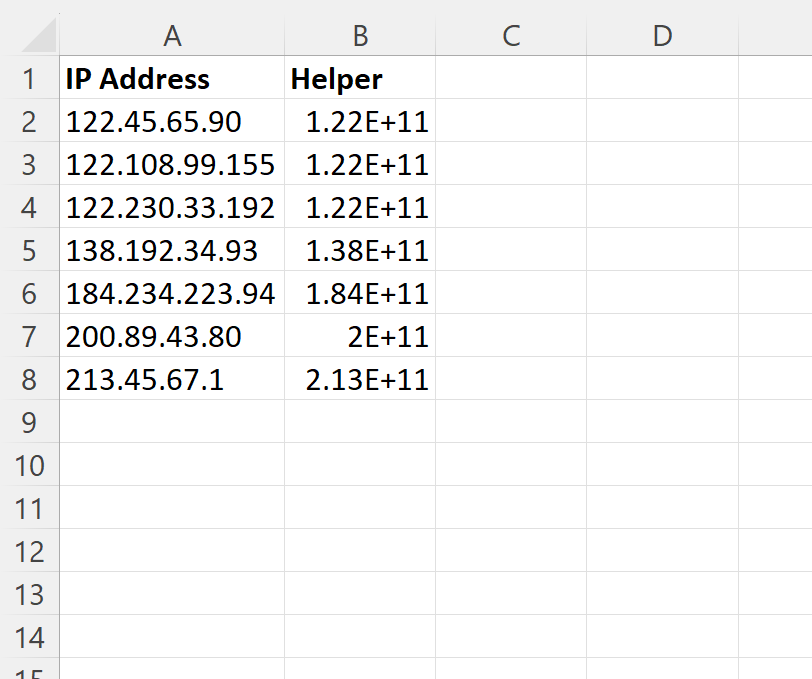
ستمتلئ خلايا العمود المساعد فوراً بالقيم المنسقة المعيارية المقابلة لكل عنوان، حيث ستتحول القيمة “10.0.0.1” إلى “010.000.000.001”، وتتحول “2.2.2.2” إلى “002.002.002.002”. تعكس هذه المخرجات التناسق التام والتماثل الطولي المطلوب لإنجاز خطوة الفرز الحسابي بدقة مطلقة دون أي تشويه في البنية الهيكلية للبيانات.
5.3 تنفيذ إجراءات الفرز متعدد الأعمدة وتثبيت الترتيب النهائي
عقب إعداد العمود المساعد وتأكيد دقة مخرجاته، يتم تحديد كامل نطاق مصفوفة البيانات المشترك الممتد من الخلية A1 إلى الخلية B9. من الضروري للغاية شمول كامل الأعمدة المترابطة في التحديد لضمان تحرك السجلات الأصلية جنباً إلى جنب مع مفاتيح الفرز الخاصة بها، وتفادي حدوث انفصال بين العناوين وحقولها التابعة في جداول البيانات الكبيرة.
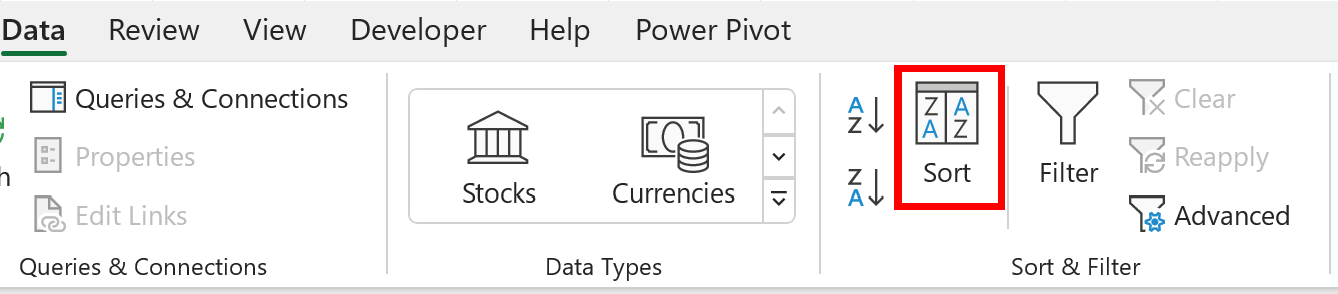
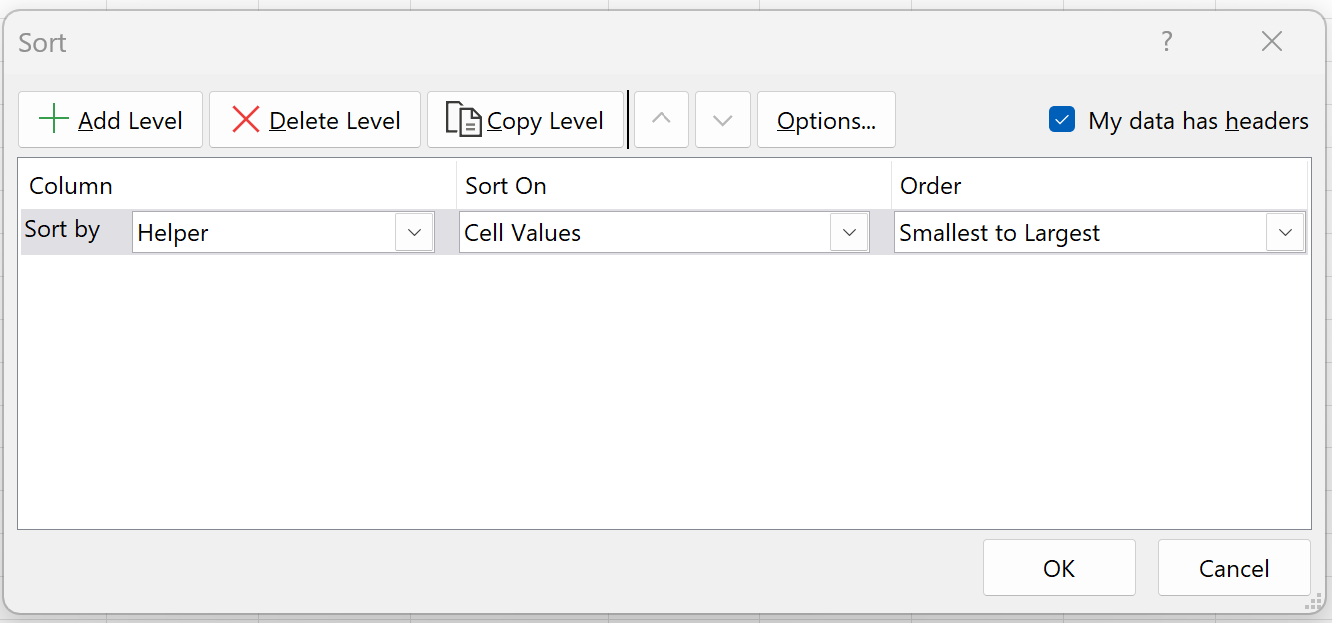
يتم الانتقال بعد ذلك إلى شريط الأدوات العلوي واختيار تبويب “بيانات” (Data)، ثم النقر على زر “فرز” (Sort) المتقدم لفتح نافذة خيارات الفرز المتكاملة. داخل مربع الحوار، يجب التحقق أولاً من تفعيل خيار “تحتوي بياناتي على رؤوس” (My data has headers) لضمان استثناء الصف الأول من عملية إعادة الترتيب. من القائمة المنسدلة “فرز حسب” (Sort by)، يتم اختيار العمود المساعد “مفتاح الفرز الحسابي” (Column B)، مع ضبط معيار “الترتيب” (Order) ليكون “من الألف إلى الياء” (A to Z) إذا كانت النتيجة نصية قياسية أو “من الأصغر إلى الأكبر” (Smallest to Largest) إذا طُبقت دالة التحويل الرقمي.
عند النقر على زر “موافق” (OK)، سيُعيد إكسيل تنظيم الصفوف وفق تسلسل منطقي ورياضي سليم مئة بالمئة، لتستقر المصفوفة في الترتيب التالي البديع:
- 2.2.2.2
- 10.0.0.1
- 10.0.1.1
- 172.16.0.5
- 172.16.0.100
- 192.168.1.1
- 192.168.1.2
- 192.168.1.20
يلاحظ هنا كيف تم تصحيح موقع العنوان 2.2.2.2 ليصعد إلى قمة الترتيب، وكيف استقر العنوان 192.168.1.2 قبل 192.168.1.20 وفق القيمة الحسابية الصافية، متجاوزاً بذلك كافة عيوب الفرز المعجمي القديمة. يمكن بعد ذلك للمستخدم إخفاء العمود B للحفاظ على المظهر العام للورقة دون كسر الترابط الوظيفي.
6. البدائل التقنية للتعامل مع الإصدارات القديمة من إكسيل
6.1 تفكيك العناوين باستخدام دمج دوال MID وFIND وLEN التقليدية
في بيئات العمل المؤسسية التي لا تزال تعتمد على إصدارات أقدم من مايكروسوفت إكسيل (مثل Excel 2016 أو Excel 2013 أو حتى الإصدارات الأسبق)، تغيب دوال المعالجة النصية الحديثة مثل TEXTSPLIT أو TEXTBEFORE. في هذه السيناريوهات، يصبح لزاماً على محلل البيانات بناء صيغ برمجية متداخلة تعتمد على الدوال الكلاسيكية الصامدة: LEFT وMID وRIGHT وFIND وLEN، لتفكيك بنية العنوان بدقة متناهية.
تعتمد المنهجية الكلاسيكية على تحديد المواقع الفيزيائية للفواصل النقطية الثلاث داخل النص. فالمقطع الأول يُستخرج بسهولة عبر الجمع بين LEFT وFIND لاقتطاع كل ما يسبق النقطة الأولى. أما المقطع الثاني، فيتطلب تحديد موضع النقطة الأولى وموضع النقطة الثانية عبر استدعاء مزدوج لدالة FIND، ثم توظيف دالة MID لاقتطاع المحارف المحصورة بينهما بدقة رياضية.
يتطلب استخراج المقطعين الثالث والرابع تكرار عملية البحث عن النقطة الثالثة، ثم استخدام دالة RIGHT لاقتطاع الجزء المتبقي من السلسلة استناداً إلى طول النص الكلي المحسوب عبر دالة LEN مطروحاً منه موضع النقطة الأخيرة. على الرغم من أن هذه الصيغة تبدو بالغة التعقيد في تركيبها الشكلي وتتجاوز أحياناً مئات المحارف في شريط الصيغ، إلا أنها تقدم توافقية رجعية كاملة (Backward Compatibility) تضمن تشغيل النموذج الرياضي في أي إصدار تاريخي من إكسيل دون الحاجة لأي ترقية برمجية.
6.2 استخدام ميزة تحويل النص إلى أعمدة (Text to Columns) كحل فيزيائي
بالنسبة للمستخدمين الذين يفضلون الحلول البصرية السريعة ويبتعدون عن كتابة المعادلات المركبة الطويلة، توفر أداة “تحويل النص إلى أعمدة” (Text to Columns) المدمجة في كافة إصدارات إكسيل حلاً فيزيائياً مباشراً وفعالاً لتفكيك عناوين IP وتجهيزها للفرز المتعدد. تعتمد هذه الأداة على التفكيك الفعلي للبيانات وتوزيعها عبر خلايا ورقة العمل دون الاعتماد على صيغ ديناميكية متصلة.
لتطبيق هذه الميزة، يقوم المستخدم بتحديد عمود عناوين IP، ثم التوجه إلى تبويب “بيانات” والنقر على زر “تحويل النص إلى أعمدة”. في الخطوة الأولى من المعالج التفاعلي، يتم اختيار نمط التفكيك المحدد بفاصل (Delimited)، وفي الخطوة الثانية يتم إلغاء تحديد علامات الفصل الافتراضية مثل المسافة أو الفاصلة العادية، وتفعيل خيار “أخرى” (Other) مع كتابة الرمز النقطي (.) في المربع المخصص.
يُظهر المعالج فوراً معاينة لانفصال عنوان IP إلى أربعة مقاطع مستقلة تتوزع عبر أربعة أعمدة متجاورة. في الخطوة الثالثة والأخيرة، يُوصى باختيار نوع بيانات الأعمدة ليكون نصياً أو عددياً خالصاً (General)، وتحديد نطاق الوجهة في أعمدة خالية منعاً للكتابة فوق البيانات الأصلية. وبمجرد إنهاء المعالج، تتفكك العناوين فيزيائياً إلى أربعة أرقام مفردة، يمثل كل عمود منها مقطعاً ثمانياً مستقلاً وقابلاً للمعالجة الحسابية المجردة.
6.3 تنفيذ الفرز متعدد المستويات على المقاطع المفصولة
بعد إنجاز عملية تقسيم العناوين فيزيائياً عبر أربعة أعمدة متتالية (لتكن الأعمدة B و C و D و E تمثل المقاطع الثمانية الأربعة بالتتابع)، يصبح الطريق ممهداً لتنفيذ الفرز الحسابي الأعمق من خلال خاصية “الفرز متعدد المستويات” (Multi-Level Sorting) التي يوفرها مربع حوار الفرز المتقدم في إكسيل.
يتم تحديد الجدول كاملاً بما يشمل عمود العناوين الأصلي والأعمدة الأربعة الناتجة عن التقسيم. عند فتح نافذة الفرز، يقوم المحلل بإنشاء أربعة مستويات ترتيب متتابعة باستخدام زر “إضافة مستوى” (Add Level). يتم ضبط المستوى الأول ليفرز حسب العمود B (المقطع الثماني الأول)، والمستوى الثاني حسب العمود C (المقطع الثماني الثاني)، والمستوى الثالث حسب العمود D (المقطع الثماني الثالث)، والمستوى الرابع والأخير حسب العمود E (المقطع الثماني الرابع)، مع التأكد الصارم من تعيين خيار الترتيب لكافة المستويات ليكون “من الأصغر إلى الأكبر” (Smallest to Largest).
يمنح هذا الترتيب الهرمي المتسلسل الأولوية المطلقة للمقطع الأول، ولا ينتقل لفحص المقطع الثاني إلا في حال تطابق قيم المقطع الأول، وهكذا دواليك حتى المقطع الرابع. ينتج عن هذه العملية فرز رياضي لا تشوبه شائبة يطابق في مخرجاته أعتى الحلول البرمجية. ويمكن للمحلل بعد ذلك إما الاحتفاظ بالأعمدة المفصولة للاستفادة منها في التحليلات الإحصائية، أو إعادة تجميعها في عمود جديد موحد باستخدام الدالة CONCATENATE أو معامل الدمج.
7. الفرز المتقدم لعناوين بروتوكول الإنترنت عبر Power Query
7.1 استيراد بيانات العناوين إلى واجهة محرر Power Query
يمثل محرر الاستعلامات المتقدم Power Query البيئة الأكثر احترافية ومتانة لإجراء عمليات تنقية وتحويل البيانات (ETL) داخل منظومة مايكروسوفت إكسيل. وتوفر هذه الأداة منصة استثنائية لفرز وتصنيف عناوين بروتوكول الإنترنت بصورة ديناميكية وقابلة للتكرار والتحديث التلقائي دون الحاجة لإعادة كتابة المعادلات أو تكرار الإجراءات اليدوية عند تدفق سجلات جديدة.
تبدأ العملية بتحويل نطاق العناوين الأصلي إلى جدول إكسيل رسمي ديناميكي من خلال النقر على الاختصار (Ctrl + T). بعد ذلك، ومن تبويب “بيانات” في الشريط الرئيسي، يتم النقر على خيار “من جدول/نطاق” (From Sheet / From Table/Range) في مجموعة “إحضار البيانات وتحويلها”. يؤدي هذا الإجراء إلى فتح واجهة محرر الاستعلامات المستقلة حاملاً بداخله مصفوفة العناوين المستهدفة.
تتمثل الخطوة التأسيسية الحرجة داخل واجهة Power Query في مراجعة خطوة “تغيير النوع” (Changed Type) المطبقة تلقائياً في شريط الخطوات المطبقة (Applied Steps). يجب التأكد قطعياً من تصنيف عمود عناوين IP كنص (Text) في هذه المرحلة الأولية، وتجنب أي محاولات تفسير تلقائية قد تشوه البيانات، لتهيئة الجدول لسلسلة من التحويلات الرياضية والهندسية المتتابعة.
7.2 تقسيم وتنسيق الأعمدة بالاعتماد على محدد الفاصلة النقطية
بمجرد استقرار البيانات داخل المحرر، يتم تحديد عمود عناوين IP والنقر بزر الفأرة الأيمن، ثم اختيار “تقسيم العمود” (Split Column) واختيار “بواسطة المحدد” (By Delimiter). في النافذة المنبثقة، يتعرف Power Query تلقائياً على النقطة كفاصل، ويتم تثبيت خيار التقسيم عند “كل ظهور للمحدد” (At each occurrence of the delimiter). ينتج عن هذا الإجراء انقسام فوري للعمود إلى أربعة أعمدة جزئية تحمل أسماء تلقائية مثل IP.1 و IP.2 و IP.3 و IP.4.
تأتي بعد ذلك الخطوة المفصلية التي تميز Power Query عن غيره؛ حيث يتم تحديد الأعمدة الأربعة المفصولة دفعة واحدة، وتغيير نوع بياناتها الحسابية من نوع نص (Text) إلى نوع “عدد صحيح” (Whole Number – Int64.Type). يؤدي هذا التحويل الصريح للنوع إلى إسقاط القناع النصي عن الأرقام، مما يدفع المحرك الداخلي إلى إدراكها كمقادير حسابية تتراوح قيمتها الفردية بين 0 و255.
يمكن للمطور في هذه المرحلة كذلك إنشاء عمود مخصص (Custom Column) إضافي مكتوب بلغة M لتوليد القيمة الحسابية الموحدة ذات الاثنتي عشرة خانة، أو الاكتفاء بالبنية المقسمة الحالية التي توفر مرونة هائلة لتنفيذ الفرز المباشر، مع ضمان التخلص من أي شوائب نصية غير مرئية قد تكون تسربت من ملفات السجلات الأصلية.
7.3 تطبيق الفرز المتتالي واسترجاع النتائج إلى المصنف
مع تحول المقاطع الثمانية إلى أرقام صحيحة نقية، يصبح تطبيق الفرز أمراً في غاية البساطة والسرعة داخل بيئة الاستعلام. يتم النقر على سهم القائمة المنسدلة في رأس العمود IP.1 واختيار “فرز تصاعدي” (Sort Ascending). بعد ذلك مباشرة، يتم النقر على رأس العمود IP.2 واختيار “فرز تصاعدي”، وتكرار نفس العملية بدقة للعمودين IP.3 و IP.4. يقوم محرك Power Query داخلياً بتسجيل هذه الخطوات على هيئة تسلسل ترتيبي تراكمي يضمن الحفاظ على الأسبقية الحسابية الهرمية للمقاطع من اليسار إلى اليمين.
بعد اكتمال الترتيب الرياضي الصارم، تتاح للمستخدم خيارات متعددة لاستعادة الشكل المألوف للعنوان؛ إذ يمكن تحديد الأعمدة الأربعة المنظمة بالترتيب، واختيار “دمج الأعمدة” (Merge Columns) من تبويب التحويل، مع تعيين الفاصل ليكون نقطة (.)، وإعادة تسمية الناتج باسم “عنوان IP المفروز”. تعيد هذه الخطوة تجميع العنوان الأصلي ولكن بعد تثبيت موضعه الترتيبي الصحيح بدقة متناهية.
تُختتم العملية بالنقر على زر “إغلاق وتحميل” (Close & Load) في الزاوية العلوية اليسرى. يقوم Power Query بتصدير مصفوفة البيانات المفروزة والمحدثة إلى ورقة عمل جديدة داخل المصنف كجدول بيانات متصل وقابل للتحديث التلقائي. تكمن القوة الهندسية لهذا الأسلوب في استدامته؛ فعند إضافة مئات السجلات الجديدة للجدول الأولي، يكفي النقر على خيار “تحديث” (Refresh) ليتم تطبيق مسار التحويل والفرز بالكامل في أجزاء من الثانية.
8. حلول الأتمتة المتقدمة باستخدام لغة VBA ووحدات الماكرو
8.1 برمجة دالة مخصصة (UDF) لتحويل عناوين IP إلى نسق قابل للفرز
توفر بيئة التطوير المدمجة Visual Basic for Applications (VBA) إمكانات أتمتة غير محدودة تتيح لمهندسي النظم ومحللي البيانات تجاوز قيود الدوال التقليدية عبر ابتكار دوال معرفة من قِبل المستخدم (User-Defined Functions – UDF). يمكن من خلال كتابة برمجية بسيطة ودقيقة بناء دالة مخصصة باسم NormalizeIP وظيفتها استقبال العنوان الخام وإرجاع سلسلة قياسية مهيأة تماماً للفرز المباشر.
تعتمد الدالة البرمجية داخلياً على دالة Split المدمجة في لغة VBA لتفتيت السلسلة النصية الواردة إلى مصفوفة ذات بعد واحد استناداً إلى المحدد النقطي. يقوم الكود بعد ذلك بالتحقق من اكتمال المصفوفة لتشمل أربعة عناصر متطابقة مع المعيار، ثم تطبيق دالة Format التنسيقية على كل عنصر على حدة داخل حلقة تكرارية قصيرة، لإجبار كل مقطع على اتخاذ النسق الثلاثي المعياري (000)، ثم إعادة دمجها معاً وإرجاع النتيجة للخلية.
يتيح هذا الكود المخصص للمستخدم استدعاء الدالة في أي مكان داخل ورقة العمل ببساطة عبر كتابة الصيغة =NormalizeIP(A2)، مما يلغي الحاجة لتذكر المعادلات المعقدة الطويلة أو كتابة صيغ متداخلة عرضة للأخطاء الطباعية، مقدماً إضافة نوعية لأدوات التحليل المتقدمة في المنشآت التقنية والبحثية.
8.2 تصميم ماكرو لأتمتة إنشاء العمود المساعد والفرز الفوري بنقرة واحدة
لتحقيق أعلى درجات الكفاءة التشغيلية، يمكن صياغة وحدة نمطية كاملة (Subroutine Macro) تقوم بأتمتة الدورة الإجرائية الكاملة لعملية الفرز بنقرة زر واحدة دون أي تدخل يدوي من المستخدم. يبدأ الماكرو البرمجي بتحديد النطاق الديناميكي المأهول بالبيانات في ورقة العمل لتجنب الالتزام بنطاقات خلايا ثابتة، مما يجعله متوافقاً مع أي مصفوفة بيانات تتراوح بين عشرات إلى مئات الآلاف من السجلات.
يقوم الكود البرمجي تلقائياً بإدراج عمود مؤقت إلى جانب حقل العناوين الأصلي، ثم حقن الصيغة الحسابية للفرز في خلايا العمود المساعد دفعة واحدة عبر خاصية FormulaR1C1 أو باستخدام تقنية تفريغ المصفوفات في الذاكرة. بعد احتساب مفاتيح الفرز، يستدعي الماكرو كائن الفرز التابع لورقة العمل (Worksheet.Sort) لتنفيذ فرز تصاعدي فوري شامل للبيانات استناداً إلى قيم العمود المؤقت.
عقب تثبيت الترتيب النهائي، يختتم الماكرو عملياته التشغيلية بحذف العمود المساعد برمجياً دون ترك أي أثر في واجهة العمل، مع إعادة ضبط تركيز المؤشر على البيانات الأصلية المنظمة. يختصر هذا الحل الآلي دقائق طويلة من العمل اليدوي المتكرر في ثانية برمجية واحدة، ويجعل من عملية فرز عناوين IP مهمة ميسرة حتى لغير المتخصصين عبر ربط الماكرو بزر تحكم تفاعلي داخل ورقة العمل.
8.3 مقارنة الكفاءة الحسابية بين الأكواد البرمجية والصيغ المدمجة
عند تقييم الحلول التقنية لمعالجة بيانات الشبكات، يتعين على محلل البيانات المفاضلة الدقيقة بين استخدام الصيغ الحسابية المدمجة (Native Formulas) واستخدام أكواد VBA ووحدات الماكرو، بالاعتماد على معايير الكفاءة الحسابية، وحجم البيانات، والأمان التشغيلي. تمتلك الصيغ المدمجة في محرك إكسيل الحديث ميزة تنافسية كاسحة من حيث السرعة وتعدد خيوط المعالجة الحسابية (Multi-threaded Calculation)؛ إذ يتم تجميعها وتنفيذها عبر لغة C++ التي كُتب بها محرك إكسيل مباشرة.
في المقابل، تعمل دوال VBA المخصصة وحلقاتها التكرارية ضمن خيط معالجة مفرد (Single-threaded Execution)، مما قد يؤدي إلى هبوط ملحوظ في الأداء وبطء في زمن استجابة المصنف عند تطبيقه على مصفوفات بيانات ضخمة تحتوي على أكثر من مئة ألف سجل شبكي. ومع ذلك، تتفوق أكواد VBA في قدرتها على التخلص النهائي من الأعمدة المساعدة وتخفيض حجم ملف المصنف عن طريق تثبيت القيم وفرزها ديناميكياً في الذاكرة دون إثقال شجرة الحسابات الدورية (Dependency Tree).
يبرز كذلك بعد الأمان والتوافقية كعنصر حاسم في المقارنة؛ فالمصنفات التي تحتوي على أكواد VBA تتطلب الحفظ بصيغة خاصة (.xlsm) وتواجه قيوداً أمنية مشددة في بيئات العمل المؤسسية وسياسات مكافحة البرمجيات الخبيثة، مما قد يمنع تشغيلها أو مشاركتها عبر منصات الحوسبة السحابية مثل Excel for the Web. في المقابل، تحافظ الحلول المعتمدة على الدوال المدمجة أو Power Query على امتداد الملفات القياسي (.xlsx)، وتوفر سهولة فائقة في الصيانة والمشاركة الآمنة بين الباحثين والمستخدمين من مختلف المستويات التقنية.
9. الأخطاء الشائعة واستراتيجيات استكشاف الأخطاء وإصلاحها
9.1 تأثير المسافات البيضاء والرموز الخفية على دقة المعادلات
يُعد تلوث السجلات بالمسافات البيضاء والرموز غير المرئية أحد أكثر الأسباب شيوعاً لفشل صيغ الفرز وتفكيك عناوين IP. تنشأ هذه الشوائب غالباً عند استيراد البيانات من تقارير نصية، أو عبر نسخ السجلات من واجهات إدارة الخوادم وصفحات الويب. وتحتوي هذه السجلات عادة على مسافات بادئة (Leading Spaces) أو مسافات لاحقة (Trailing Spaces)، أو الأسوأ من ذلك: المحرف غير المنكسر (Non-breaking Space) المعروف بالرمز ASCII 160، والذي لا تنجح المسافة التقليدية في إزالته.
يؤدي وجود مسافة بيضاء بادئة قبل عنوان IP مثل ” 10.0.0.1″ إلى تشويه تام لعمل دوال التفكيك النصي والفرز المعجمي؛ فالنظام يتعامل مع الفراغ بوصفه المحرف الأول في السلسلة، مما يمنحه وزناً معجمياً غير سليم يدفعه إلى قمة الترتيب بشكل مغلوط. ولمعالجة هذه الآفة، يتعين دائماً إخضاع حقل العناوين لعملية تنقية أولية باستخدام دالتي TRIM وCLEAN لضمان اقتطاع كافة الفراغات والرموز غير الطباعية قبل حقن البيانات في صيغ الفرز المركبة.
تتضمن استراتيجية التنقية كذلك التحقق من توحيد الرمز الفاصل؛ ففي بعض الحالات النادرة الناشئة عن الترجمة الآلية أو التنسيقات اللغوية المتضاربة، قد تُستبدل النقطة القياسية (.) بنقاط عربية أو فواصل سفلية. يُسهم استخدام دالة الاستبدال التلقائي SUBSTITUTE في توحيد كافة الفواصل غير القياسية لتتحول إلى النقطة العشرية المتعارف عليها دولياً، مما يضمن استقرار خوارزميات التفكيك.
9.2 معالجة أخطاء الصياغة الشائعة مثل #VALUE! و#CALC!
عند تطبيق الدوال المركبة على مصفوفات ضخمة، قد يفاجأ المستخدم بظهور رموز الخطأ الشهيرة في إكسيل مثل خطأ القيمة (#VALUE!) أو خطأ الحساب (#CALC!). يشير خطأ #VALUE! عادة إلى فشل إحدى الدوال في العثور على محدد الفصل المطلوب؛ ويحدث ذلك إذا احتوت الخلية على عنوان مشوه يتكون من نقطتين فقط بدلاً من ثلاث، أو عند احتواء الخلية على قيمة فارغة تماماً، مما يؤدي إلى انهيار دالة FIND أو TEXTAFTER لعجزها عن استيفاء المعاملات المنطقية.
أما خطأ #CALC! فيظهر بصورة أساسية في الإصدارات الحديثة عند استخدام الدوال المصفوفية الديناميكية (Dynamic Array Functions) مثل TEXTSPLIT إذا واجهت الدالة مدخلاً غير متوقع أو تم تمرير مصفوفة ذات أبعاد متباينة تحول دون استقرار الحساب التلقائي. ولحماية ورقة العمل من التوقف وضمان تدفق العمليات الحسابية بسلاسة، يجب تغليف الصيغ المركبة دائماً بالدالة الوقائية الشاملة IFERROR.
تتيح دالة IFERROR للمحلل تحديد مسار تعامل بديل في حال حدوث خطأ؛ حيث يمكن إرجاع نص تحذيري صريح مثل “سجل غير صالح” أو إرجاع قيمة رقمية صفرية تدفع السجل التالف إلى ذيل الجدول. كما يجب الانتباه الشديد إلى مسألة تثبيت المراجع؛ فإذا كانت الصيغة تعتمد على خلايا معيارية خارجية، يجب استخدام مراجع الخلايا المطلقة ($A$2) بدلاً من النسبية أثناء سحب مقبض التعبئة، لتجنب ترحيل نطاقات البحث والتسبب في أخطاء انتشار عشوائية عبر أسطر الجدول.
9.3 التعامل مع السجلات غير القياسية وعناوين IPv6 المعقدة
تنهار كافة النماذج الحسابية المصممة لفرز الإصدار الرابع (IPv4) عند اصطدامها بعناوين بروتوكول الإنترنت من الإصدار السادس (IPv6). يرجع ذلك إلى الاختلاف الهيكلي الجذري بين البروتوكولين؛ فعناوين IPv6 تتألف من 128 خانة ثنائية مقسمة إلى 8 مجموعات سداسية عشرية (Hexadecimal) تفصل بينها نقطتان رأسيتان (:)، وتخضع لقواعد اختزال متقدمة مثل حذف الأصفار المتتالية واستبدالها بالنقطتين الرأسيتين المزدوجتين (::).
إن محاولة تمرير عنوان مثل “2001:0db8:85a3::8a2e:0370:7334” عبر صيغ تعتمد على الفاصلة النقطية سيؤدي حتماً إلى إخفاق كامل للمعادلات وظهور أخطاء مستمرة. لذلك، تقتضي الممارسة المهنية الرصينة عزل وتصنيف السجلات مسبقاً قبل الشروع في عمليات الفرز. يمكن تحقيق ذلك من خلال إنشاء عمود فحص أولي يستخدم الدالة SEARCH للبحث عن النقطتين الرأسيتين (:) لتمييز عناوين IPv6، أو النقطة (.) لتمييز عناوين IPv4.
في حال تطلب المشروع البحثي أو التشغيلي فرز عناوين IPv6، يجب اتباع منهجية مختلفة كلياً تقوم أولاً على “توسيع” العنوان المختزل إلى صيغته الكاملة غير المضغوطة المكونة من 32 رمزاً سداسياً عشرياً (عبر فك اختزال الأصفار)، ثم تطبيق الفرز المعجمي المباشر، والذي ينجح تماماً مع عناوين IPv6 الموسعة نظراً لتماثل أطوالها وخضوع الأرقام السداسية عشرية لقواعد الترتيب الأبجدي الرقمي الصارم في إكسيل.
10. أفضل الممارسات الأكاديمية والمهنية لإدارة بيانات الشبكات في إكسيل
10.1 توثيق وتأمين الأعمدة المساعدة في مشاريع تحليل البيانات الكبيرة
تتطلب الإدارة الاحترافية لبيانات الشبكات في مشاريع التحليل واسعة النطاق اتباع بروتوكولات توثيق صارمة للأعمدة المساعدة (Helper Columns). يمثل العمود المساعد محركاً داخلياً لا ينبغي أن يشوش على المستخدم النهائي أو يؤثر على العرض التقديمي للبيانات؛ لذا يُعد “إخفاء” العمود المساعد (Hide Column) بدلاً من حذفه ممارسة مهنية معيارية تسمح ببقاء الصيغ نشطة وتضمن استمرارية الفرز التلقائي عند إدخال بيانات جديدة دون الإخلال بالمظهر البصري لورقة العمل.
ينبغي كذلك إرفاق تعليقات توثيقية وتفصيلية (Comments & Notes) في رأس العمود المساعد تشرح التركيب الرياضي للصيغة المستخدمة ودواعي اعتمادها، لتمكين محللي البيانات الآخرين من تدقيق المنهجية وتطويرها. كما يُوصى بشدة بتحويل نطاقات البيانات التقليدية إلى “جداول إكسيل الرسمية” (Excel Tables – ListObjects)؛ حيث تتميز هذه الجداول بخاصية التمدد التلقائي للمعادلات (Calculated Columns)، والتي تضمن تطبيق صيغة الفرز الحسابية آلياً على أي صفوف جديدة تضاف إلى أسفل الجدول دون الحاجة للسحب اليدوي المستمر لمقبض التعبئة.
علاوة على ذلك، يُفضل في بيئات المشاريع الكبيرة تلوين الأعمدة المساعدة بترويسات لونية محايدة ووضعها في أقصى يمين أو يسار الجدول، بعيداً عن حقول البيانات الحيوية، للمحافظة على الفصل الواضح بين المتغيرات الأصلية المقاسة والمتغيرات الوسيطة المشتقة لأغراض التحسين التقني والترتيب.
10.2 حماية تكامل البيانات ومنع التعديلات العشوائية
ترتبط جودة مخرجات الفرز الحسابي ارتباطاً وثيقاً بسلامة وتكامل المدخلات الأولية في مصفوفة البيانات. ولتحقيق هذه الحماية الوقائية، توفر أدوات مايكروسوفت إكسيل ميزة “التحقق من صحة البيانات” (Data Validation)، والتي تتيح للمشرف فرض قيود إدخال صارمة تمنع المستخدمين من إدخال نصوص عشوائية أو عناوين IP مشوهة داخل خلايا العمود المخصص.
يمكن تصميم قاعدة تحقق مخصصة عبر تطبيق صيغ نصية تفحص طول المدخل، وتتأكد من احتوائه على ثلاث نقاط بالضبط، واحتوائه على قيم عددية لا تتجاوز الحدود القصوى للمقاطع الثمانية. كما يُفضل تعيين رسائل تنبيه واضحة للخطأ (Error Alerts) تظهر للمدخل لتشرح له النسق الصحيح الواجب اتباعه (مثال: “يجب إدخال عنوان IPv4 عشري نقطي صحيح يتراوح بين 0.0.0.0 و 255.255.255.255”).
تكتمل منظومة الحماية من خلال تطبيق تأمين وحماية ورقة العمل (Protect Sheet)؛ حيث يتم فك قفل خلايا الإدخال المخصصة للعناوين الأصلية، مع قفل وتأمين الخلايا التي تحتوي على الصيغ الرياضية المركبة في الأعمدة المساعدة وإخفائها من شريط الصيغ، ثم تشفير الورقة بكلمة مرور قياسية. يمنع هذا الإجراء أي تلاعب غير مقصود بالبنية الحسابية للمصنف ويضمن استقرار خوارزمية الفرز ضد أي أخطاء بشرية عفوية أثناء دورات العمل الروتينية وتحديث السجلات.
10.3 معايير الانتقال من جداول إكسيل إلى أنظمة إدارة الشبكات المتخصصة
على الرغم من القدرات الحسابية الفائقة والمرونة العالية التي يوفرها مايكروسوفت إكسيل في معالجة وفرز البيانات، إلا أن له حدوداً بنيوية هندسية واضحة يجب إدراكها. يستقر الحد الأقصى لسعة ورقة العمل في إكسيل عند 1,048,576 صَفاً، ولكن الأداء الحسابي للبرنامج يبدأ في التراجع الملحوظ عند التعامل مع مئات الآلاف من السجلات التي تحتوي على صيغ نصية مصفوفية مركبة، مما يؤدي إلى استهلاك هائل للذاكرة وتأخير في زمن الاستجابة.
تتمثل نقطة التحول المعيارية (Tipping Point) التي توجب التخلي عن جداول البيانات في نمو حجم المؤسسة وتجاوز عمليات إدارة العناوين مرحلة “التحليل الاسترجاعي” إلى مرحلة “الإدارة الآنية والتشغيل المباشر”. في هذه المرحلة، يصبح الانتقال إلى حلول إدارة عناوين بروتوكول الإنترنت المتخصصة (IPAM – IP Address Management) ضرورة حتمية لا غنى عنها؛ حيث توفر هذه الأنظمة قواعد بيانات مخصصة قادرة على معالجة بنية العناوين دون أي تحويلات مساعدة، مع ربطها تلقائياً بخوادم DNS وDHCP.
كذلك، عندما يتطلب المشروع البحثي أو الأمني معالجة ملايين السجلات المستخرجة من تدفقات الشبكة الضخمة (NetFlow / sFlow)، يتعين تصدير البيانات من إكسيل والانتقال إلى قواعد البيانات العلائقية مثل PostgreSQL، والتي تدعم نوع بيانات مدمج فائق التطور مخصص للشبكات يُعرف بـ inet و cidr. تتيح هذه الأنظمة إجراء عمليات الفرز، والاستعلام عن الشبكات الفرعية، وحساب التقاطعات الحجمية بكفاءة رياضية فورية تفوق بمراحل إمكانات برمجيات الجداول الحسابية العامة.
خاتمة
استعرض هذا الدليل المتعمق الأبعاد النظرية والتطبيقية لإشكالية فرز عناوين بروتوكول الإنترنت (IPv4) في بيئة مايكروسوفت إكسيل، مبيناً أن جوهر الأزمة لا ينبع من قصور وظيفي في البرنامج ذاته، بل من التباين البنيوي بين التدوين العشري النقطي ذي الطبيعة الهجينة وخوارزميات الفرز المعجمي المعتمدة على الرموز الحرفية. وقد برهنت المعالجات المفصلة أن الحل الجذري يكمن دائماً في استعادة المنطق الرياضي الصافي؛ سواء عبر توحيد الأوزان البصرية للمقاطع بالاعتماد على تقنية التعبئة بالأصفار البادئة (Zero-Padding)، أو التحويل الكامل إلى القيم العددية الصافية غير الموقعة المكونة من 32 بت.
تتيح الترسانة التقنية المتاحة للمستخدم الحديث—بدءاً من الدوال المصفوفية الديناميكية في Microsoft 365، مروراً ببيئة التحويل المتقدمة في Power Query، ووصولاً إلى الأتمتة البرمجية عبر لغة VBA—مرونة فائقة لاختيار الحل الأنسب لطبيعة وحجم البيانات المستهدفة. ومن خلال مراعاة معايير تنقية السجلات، والتحوط ضد المسافات الخفية والشذوذ التركيبي، وتأمين وحماية مصفوفات العمل، يستطيع الباحثون ومحللو البيانات تحويل جداول إكسيل من أداة محاسبية تقليدية إلى منصة متماسكة وقوية لمعالجة وهندسة بيانات الشبكات بدقة أكاديمية ورصانة تشغيلية لا تلين.
المراجع
- Postel, J. (1981). Internet Protocol: DARPA Internet Program Protocol Specification (RFC 791). Internet Engineering Task Force. https://datatracker.ietf.org/doc/html/rfc791
- Droms, R. (1997). Dynamic Host Configuration Protocol (RFC 2131). Internet Engineering Task Force. https://datatracker.ietf.org/doc/html/rfc2131
- Deering, S., & Hinden, R. (2017). Internet Protocol, Version 6 (IPv6) Specification (RFC 8200). Internet Engineering Task Force. https://datatracker.ietf.org/doc/html/rfc8200
- Microsoft. (n.d.). TEXTBEFORE function. Microsoft Support. https://support.microsoft.com/en-us/office/textbefore-function-d099c282-dba8-448e-acac-376dd7b39233
- Microsoft. (n.d.). TEXTAFTER function. Microsoft Support. https://support.microsoft.com/en-us/office/textafter-function-c8db2546-5b51-4161-9050-e367b2f90ea4
- Microsoft. (n.d.). TEXT function. Microsoft Support. https://support.microsoft.com/en-us/office/text-function-20d5ac42-45e5-4298-89c0-681b9b9a6744
- Microsoft. (n.d.). Overview of Power Query in Excel. Microsoft Support. https://support.microsoft.com/en-us/office/about-power-query-in-excel-7104fbee-9e62-4cb9-a02e-5f1482f31d57
- Microsoft. (n.d.). Overview of Excel tables. Microsoft Support. https://support.microsoft.com/en-us/office/overview-of-excel-tables-7ab0bb7d-3a9e-4b56-a3c9-6c94334e492c