
يمثل الاستدلال الإحصائي الدعامة المنهجية الكبرى التي ترتكز عليها البحوث التجريبية والوصفية في العلوم السلوكية والاجتماعية والطبية؛ إذ يتيح للباحثين الانتقال المنضبط من حيز الملاحظات الجزئية المأخوذة من العينات العشوائية إلى فضاء التعميمات الكلية على المجتمعات الأصلية. ومن بين المنظومة المتكاملة للاختبارات المعلمية (Parametric Tests)، يحتل اختبار t للعينة الواحدة (One-Sample t-test) مكانة بالغة الأهمية بوصفه الأداة الأساسية لفحص الفروق بين متوسط عينة مفردة وقيمة معيارية مرجعية معلومة سلفاً أو مفترضة نظرياً، مما يجعله حجر الزاوية في دراسات القياس والتقويم ومعايرة الاختبارات النفسية.
تتجلى القيمة المعرفية لهذا الاختبار في قدرته الرياضية الفائقة على التعامل مع معضلة غياب المعالم الحقيقية للمجتمع الإحصائي، ولا سيما الانحراف المعياري للمجتمع، والتي طالما شكلت عائقاً أمام التطبيقات الإحصائية الكلاسيكية القائمة على التوزيع الطبيعي المعياري (z-test). وبفضل النمذجة الرياضية الدقيقة لتوزيع t، غدا بمقدور الباحثين اختبار الفرضيات العلمية بمستويات ثقة محكمة حتى في ظل العينات الصغيرة ومتوسطة الحجم، موفرين بذلك كلفة مادية وزمنية باهظة كانت تتطلبها المسوح الشاملة للمجتمعات الإنسانية الواسعة.
يهدف هذا المقال الأكاديمي الشامل إلى تقديم تفكيك نظري وتطبيقي متعمق لاختبار t للعينة الواحدة؛ حيث نتناول بالشرح المستفيض أصوله النظرية، وافتراضاته السيكومترية والرياضية الصارمة، وصيغته الجبرية ومكوناتها التحليلية، مع تقديم مثال تطبيقي محلول يدوياً بالكامل في ميدان علم النفس والتربية، فضلاً عن استعراض آليات تنفيذه عبر الحزم البرمجية الحديثة، ومناقشة البدائل اللامعلمية المناسبة في حال انتهاك شروطه، وذلك تزويداً للمجتمع البحثي بمرجع علمي دقيق ومتكامل.
1. مدخل نظري: تعريف اختبار t للعينة الواحدة وأسسه الإحصائية
1.1 التعريف المفاهيمي لاختبار t للعينة الواحدة
يُعرَّف اختبار t للعينة الواحدة في أدبيات القياس والإحصاء الاستدلالي بأنه إجراء إحصائي معلمي استدلالي (Parametric Inferential Procedure) يُستخدم لاختبار الفرضية الصفرية القائلة بأن متوسط مجتمع إحصائي محدد لا يختلف جوهرياً عن قيمة رقمية ثابتة ومعلومة مسبقاً، يُطلق عليها المتوسط المعياري أو النظري المرجعي. يرتكز الاختبار على مقارنة الفارق الملاحظ بين متوسط العينة التجريبية والقيمة المعيارية المحددة بالخطأ المعياري التقديري لمتوسط العينة، بهدف استنتاج ما إذا كان هذا الفارق الظاهري يمثل تبايناً حقيقياً يعكس خصائص المجتمع أم أنه مجرد تذبذب عشوائي ناجم عن أخطاء المعاينة الصدفية.
ينتمي هذا الإجراء بنائياً إلى فئة اختبارات الفروق في النظرية الإحصائية، حيث يمثل أبسط صور المقارنات الخطية، إلا أنه يكتسب خصوصيته من كونه يتعامل مع مجموعة واحدة من المشاهدات في مقابل معيار محدد سلفاً، بخلاف اختبار t لعينتين مستقلتين الذي يفحص التمايز بين مجموعتين منفصلتين، أو اختبار t للعينات المترابطة الذي يتتبع التغير لدى المجموعة ذاتها عبر قياسات متكررة. ويتحدد الموقع البنائي للاختبار في منظومة القياس النفسي كأداة للتحقق من مطابقة العينات للخصائص المعيارية المقننة، كما في تقييم مدى ابتعاد عينة إكلينيكية معينة عن مستويات خط الأساس الوطنية في مقاييس الشخصية أو الاكتئاب وفق ما وثقته دراسات القياس النفسي المعاصرة (Wendy Treynor et al., 2003).
يكمن الفارق الجوهري والمنهجي بين اختبار t للعينة الواحدة ونظيره اختبار z في طبيعة المعلومات المتاحة حول تباين المجتمع الإحصائي؛ فبينما يشترط اختبار z معرفة الانحراف المعياري الحقيقي للمجتمع الإحصائي، يبرز اختبار t كحل بديل ودقيق عندما يكون الانحراف المعياري للمجتمع مجهولاً تماماً، وهو الوضع الغالب في جل البحوث الاجتماعية والنفسية. في هذه الحالة، يستعيض الاختبار عن المعلمة المجهولة بتقدير غير متحيّز مستمد من الانحراف المعياري للعينة ذاتها، مع تعديل شكل التوزيع الاحتمالي ليتسع ويتلاءم مع حالة عدم اليقين الإضافية الناشئة عن هذا التقدير الداخلي للتباين.
1.2 السياق التاريخي وتطور توزيع t لستيودنت
تعود الجذور التاريخية والرياضية لصياغة توزيع t إلى مطلع القرن العشرين، وتحديداً إلى عام 1908، بفضل الإسهامات الرائدة للعالم الإحصائي والكيميائي البريطاني ويليام سيلي جوسيت (William Sealy Gosset). كان جوسيت يعمل لدى مصنع الجعة الشهير “غينيس” في دبلن، حيث واجه مشكلة تطبيقية بالغة التعقيد تمثلت في الحاجة إلى مراقبة جودة المحاصيل الكيميائية والخمائر باستخدام عينات صغيرة جداً لأسباب بيولوجية واقتصادية، مع استحالة معرفة التشتت الحقيقي للمجتمع الكامل لتلك المدخلات الزراعية.
ولما كانت القوانين الصارمة للشركة تمنع موظفيها من نشر أي أبحاث علمية حماية للأسرار الصناعية والميزة التنافسية، نشر جوسيت ورقته التاريخية الفاصلة في مجلة Biometrika تحت الاسم المستعار “Student” (الطالب)، ومن هنا اقترن هذا الاختبار وتوزيعه الاحتمالي باسم “توزيع t لستيودنت”. نجح جوسيت في إثبات أن استخدام الانحراف المعياري للعينة بدلاً من الانحراف المعياري للمجتمع عند تطبيق صيغة الدرجة المعيارية z يُفضي إلى توزيع لا يتبع المنحنى الطبيعي المعياري بدقة، بل ينتج عنه توزيع احتمالي جديد ذو أطراف أكثر سمكاً وأعلى تفلطحاً، مما يؤدي إلى زيادة احتمالية حدوث القيم المتطرفة مقارنة بالتوزيع الطبيعي الخالص.
أسس هذا الكشف الإحصائي لنقلة نوعية في منهجيات التجريب الميداني والعلوم السلوكية؛ حيث أتاح التعامل الصارم مع العينات التي يقل حجمها عن 30 مفردة دون الوقوع في خطأ التقدير المفرط للدلالة الإحصائية. وقد برهن هذا التحول الرياضي على أن شكل توزيع t ليس ثابتاً، بل يمثل عائلة لا نهائية من التوزيعات التي يتحدد شكلها الدقيق بناءً على ما يُعرف بدرجات الحرية؛ فكلما تزايد حجم العينة واقترب من اللانهاية، تناقص سمك الأطراف واقترب توزيع t تدريجياً وبشكل مقارب من التوزيع الطبيعي المعياري الغوسي، مما جعله أداة رياضية مرنة تستوعب مختلف حجوم العينات التجريبية بكفاءة استدلالية مطلقة.
1.3 الأهمية الإبستمولوجية للاختبار في بحوث العلوم السلوكية
تستند الأهمية المعرفية والإبستمولوجية لاختبار t للعينة الواحدة في فضاء العلوم السلوكية والتربوية إلى كونه الجسر الاستدلالي الذي يربط بين النظرية المجردة والواقع التجريبي؛ فالنظريات النفسية غالباً ما تصيغ تنبؤات كمية أو تحدد مستويات معيارية افتراضية لأداء الأفراد والوظائف المعرفية، مما يتطلب محكاً كمياً قاطعاً للحكم على مدى اتساق البيانات المجمعة مع تلك النماذج التفسيرية، مثلما يظهر في تقييم مهارات التنظيم الذاتي والتعلم ما وراء المعرفي في الأوساط التعليمية والتربوية (Gregory J. Schraw et al., 2006).
يتيح الاختبار للباحثين السلوكيين إمكانية تقييم فاعلية البرامج العلاجية والتدخلات النفسية الحديثة من خلال مقارنة متوسط درجات العينة الخاضعة للعلاج بمستويات خط الأساس (Baseline) أو بالدرجات المعيارية المشتقة من أدلة التشخيص الإكلينيكي المعتمدة. فبدلاً من الحاجة الدائمة إلى تخصيص مجموعة ضابطة غير متلقية للعلاج — وهو ما قد يصطدم في كثير من الأحيان بعوائق أخلاقية كحرمان مرضى من التدخل — يمكن للباحث مقارنة مؤشرات التعافي بدرجة الحياد أو بالمتوسطات الوطنية المنشورة سابقاً، مما يعزز من النزاهة العلمية للتصميم التجريبي دون الإخلال بالمبادئ الأخلاقية للبحث السريري.
علاوة على ذلك، يسهم الاختبار إبستمولوجياً في ترشيد استخدام الموارد البحثية؛ إذ يمنح الاستدلال من العينات الصغيرة والمتوسطة الممثلة قوة إحصائية كافية لدحض أو تأكيد الفرضيات السيكولوجية والتربوية المعقدة دون اللجوء إلى دراسات المسح الشامل التي ترهق الموازنات المؤسسية، مما يسرّع وتيرة التراكم العلمي واختبار النماذج المعرفية في سياقات ثقافية متنوعة تضمن رسوخ المفهوم المقاس وموثوقيته عبر الزمن.
2. دوافع ومبررات استخدام اختبار t للعينة الواحدة في القياس النفسي
2.1 استحالة الحصر الشامل للمجتمعات النفسية الواسعة
يواجه الباحثون في القياس النفسي والتربوي استحالة مادية وإجرائية مطلقة تحول دون تطبيق أدوات القياس على كافة أفراد المجتمع المستهدف؛ فعند دراسة سمة نفسية معينة مثل التفكير الاجتراري أو الضغوط الوالدية أو القلق العام، يمتد المجتمع الإحصائي في الغالب ليشمل مئات الآلاف أو الملايين من الأفراد الموزعين عبر نطاقات جغرافية متباينة وظروف اجتماعية واقتصادية شديدة التعقيد، مما يجعل أسلوب الحصر الشامل أمراً غير واقعي بالمرة ومهدراً للطاقات والجهود البحثية المتاحة.
تفرض هذه الاستحالة الواقعية اللجوء المنهجي إلى اختيار عينات عشوائية ممثلة لتقدير معالم المجتمع بدقة متناهية؛ وهنا تنشأ المعضلة المتمثلة في وجود خطأ المعاينة الحتمي الناتج عن قياس جزء من المجتمع بدلاً من كله. وتكمن الميزة الكبرى لاختبار t للعينة الواحدة في كونه لا يتجاهل هذا الخطأ العشوائي، بل يُخضعه للضبط والقياس الكمي الصارم عبر نمذجة تباين المعاينة وتقدير الخطأ المعياري، مما يمكن الباحث من التمييز الدقيق بين التغير الحقيقي في الظاهرة المقاسة والتشويش الإحصائي الناجم عن اقتصار القياس على عينة محددة.
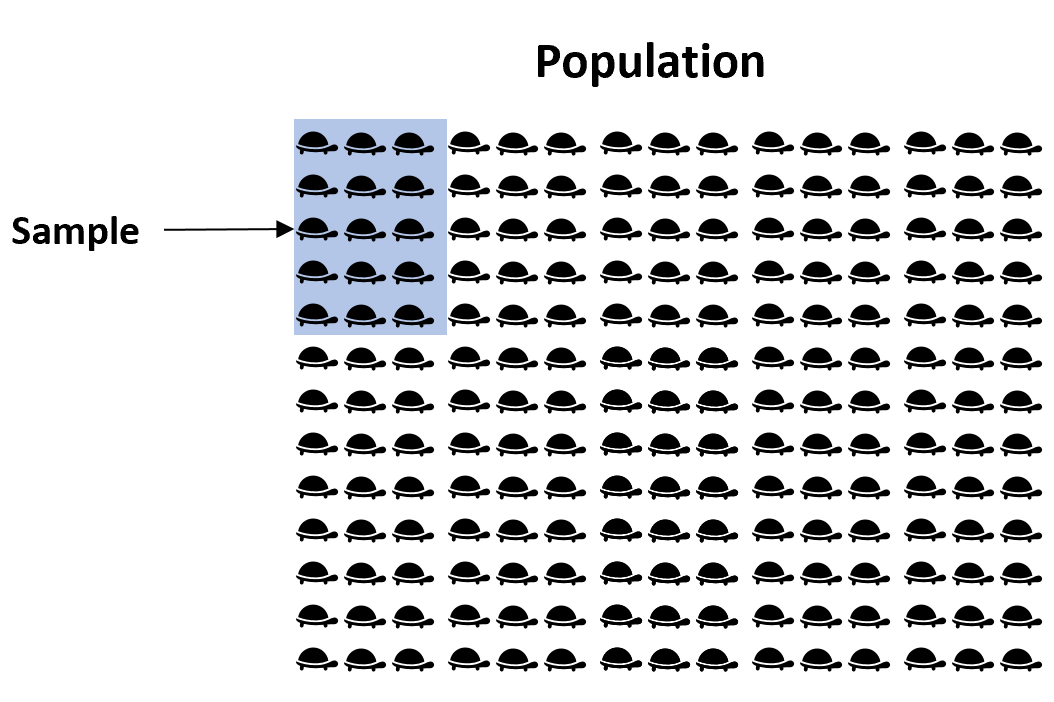
تظهر أهمية هذه المنهجية بصورة جليّة في دراسات التكيف الاجتماعي وسلوكيات التنمر والعدوان المدرسي التي رصدتها الدراسات التلوية الكبرى عبر عقود (David S. J. Hawker & Michael John Boulton, 2000)؛ حيث يستحيل فحص كافة التلاميذ في النظم التعليمية، ويكون الاعتماد على عينات مسحوبة بدقة ومقارنتها بمعايير التوافق النفسي المقننة هو السبيل الوحيد لتقييم درجات التدهور السلوكي أو فاعلية السياسات التربوية الوقائية بكفاءة علمية عالية وتكلفة منخفضة.
2.2 مقارنة عينة مقننة بقيمة مرجعية معيارية
ينبثق الدافع الثاني لاستخدام اختبار t للعينة الواحدة من البنية المقننة لأدوات ومقاييس علم النفس الحديث؛ حيث تتوافر لدى الباحثين والممارسين الإكلينيكيين معايير قياسية وطنية وعالمية مستقرة لكثير من السمات والقدرات الذهنية والاضطرابات الوجدانية، مثل الدرجات المعيارية لمقاييس الذكاء العالمية (مثل مقياس وكسلر أو بينيه) التي تمت معايرتها بحيث يكون المتوسط النظري العام للمجتمع ثابتاً عند القيمة 100 مع انحراف معياري قدره 15 درجة.
عندما يرغب باحث في تقييم القدرات المعرفية لأطفال يعانون من اضطراب جيني نادر أو تعرضوا لبيئة محرومة، فإن التساؤل المنهجي لا يتطلب جمع بيانات من مجموعة ضابطة موازية بقدر ما يتطلب معرفة ما إذا كان متوسط ذكاء هذه الفئة الخاصة ينحرف بصورة دالة إحصائياً عن المعدل الطبيعي للبشر (القيمة 100). ويمتد هذا المنطق الإحصائي إلى تشخيص وعلاج اضطرابات الحزن المعقد أو الصدمات النفسية وفق المحكات التشخيصية الحديثة المعتمدة في التصنيفات الطبية العالمية (Holly Gwen Prigerson et al., 2009)، حيث يُقارن متوسط العينة بالحد الفاصل المعتمد لتشخيص المرض.
كما يبرز هذا الاحتياج في ميدان علم النفس التنظيمي والصناعي؛ حيث تلجأ المؤسسات الكبرى إلى فحص مستويات التوافق المهني أو الرضا الوظيفي أو الاحتراق النفسي لدى العاملين لديها ومقارنتها بالمعيار النموذجي الذي تفرضه سياسات الجودة المؤسسية أو بالمؤشرات الوطنية للسعادة وجودة الحياة العامة للمجتمعات الإنسانية (Rafael Di Tella et al., 2003)، للتحقق مما إذا كانت بيئة العمل تقع ضمن النطاق الصحي المقبول أم تستدعي تدخلاً تنظيمياً عاجلاً.
2.3 تحديد الدلالة الإحصائية مقابل الفروق الصدفية
من المسلمات الرياضية في علم الإحصاء أن متوسط أي عينة عشوائية يُسحب من المجتمع لن يتطابق حرفياً مع متوسط المجتمع الأصلي أو القيمة المعيارية المرجعية؛ إذ يولد تباين المعاينة العشوائي دوماً فارقاً رقمياً مجرداً بين القيمة الملاحظة والقيمة الافتراضية. ويقود الاعتماد الساذج على الملاحظة البصرية المجردة لهذا الفارق إلى استنتاجات خاطئة تماماً، فقد يفسر الباحث فارقاً طفيفاً ناتجاً عن الصدفة المحضة على أنه أثر نفسي بارز، أو قد يتجاهل فارقاً جوهرياً بسبب حجم العينة.
يقدم اختبار t للعينة الواحدة الإطار الاحتمالي الصارم للفصل الدقيق بين الفروق الحقيقية التي تعكس تأثيراً تجريبياً أو خصوصية سيكولوجية، وبين الفروق الصدفية الزائفة الناتجة عن الصدفة وعشوائية الاختيار. ويعمل الاختبار على احتساب احتمالية حدوث الفارق الملاحظ في ظل افتراض صحة الفرضية الصفرية (أي عدم وجود أي فرق حقيقي في الواقع)؛ فإذا كانت هذه الاحتمالية متدنية للغاية وأقل من مستوى الشك المعياري المحدد مسبقاً، استنتج الباحث وجود دلالة إحصائية حقيقية تدعم قراراته السريرية أو النظرية.
يكتسب هذا التمييز الرياضي خطورة قصوى في ميادين التشخيص النفسي والعصبي؛ إذ إن اتخاذ قرار خاطئ بإدراج فئة معينة ضمن النطاق المرضي أو استبعادها منه يترتب عليه آثار علاجية وأخلاقية ومادية بالغة الأثر. لذلك، يعمل اختبار t بمثابة صمام أمان منهجي يحول دون الوقوع في شراك الأحكام الانطباعية السريعة، موفراً مبرراً رياضياً موضوعياً يدعم نزاهة التفسير العلمي واستقراره.
3. الافتراضات المنهجية والشروط الإحصائية لتطبيق الاختبار
3.1 مستوى قياس المتغير التابع واستقلالية المشاهدات
يستند التطبيق السليم لاختبار t للعينة الواحدة إلى ضرورة استيفاء حزمة من الافتراضات المنهجية والشروط الرياضية، وفي مقدمتها مستوى قياس المتغير التابع التابع للدراسة. يشترط الاختبار أن يكون المتغير التابع مقاساً على مستوى كمي متصل، وتحديداً ضمن مقياس فتري (Interval Scale) أو مقياس نسبي (Ratio Scale)؛ إذ تتطلب البنية الجبرية للاختبار حساب المتوسط الحسابي والانحراف المعياري، وهي مؤشرات إحصائية تفقد معناها الرياضي الرصين إذا ما طُبقت على بيانات اسمية تصنيفية أو رتبية تراتبية خالية من المسافات المتساوية.
علاوة على طبيعة المقياس، يمثل شرط استقلالية المشاهدات (Independence of Observations) الفرضية الأكثر حرجاً وحساسية في عموم النمذجة المعلمية؛ ويعني هذا الشرط أن قياس أو استجابة أي مفردة من مفردات العينة لا ترتبط ولا تتأثر ولا تؤثر بأي شكل من الأشكال في قياس أو استجابة أي مفردة أخرى داخل العينة ذاتها. إن حدوث أي شكل من أشكال التفاعل بين المبحوثين أثناء جمع البيانات النفسية، أو تطبيق أدوات القياس بشكل جماعي غير منضبط يتيح تداخل الإجابات، يؤدي مباشرة إلى انتهاك خطير لافتراض الاستقلالية، مما يُحدث خللاً فادحاً في تقدير الخطأ المعياري الفعلي وتضخيم معدل الخطأ من النوع الأول بشكل يفقد النتائج مصداقيتها.
ولضمان تحقق شرط الاستقلالية والتمثيل العلمي السليم، ينبغي على الباحثين اتباع إجراءات المعاينة العشوائية البسيطة أو الطبقية المضبوطة بعناية، والتأكد من إرساء بروتوكولات قياس معزولة ومقننة تمنع التلوث البيئي أو التأثير المتبادل بين المشاركين، وتلافي انحيازات الاختيار الذاتي الشائعة في الاستبانات الإلكترونية غير المقيدة، لضمان صمود البيانات أمام النقد المنهجي الرصين.
3.2 افتراض التوزيع الطبيعي للمتغير في المجتمع
يتمثل الشرط الثاني لتطبيق اختبار t للعينة الواحدة في افتراض أن المتغير التابع يخضع للتوزيع الطبيعي المعتدل (Normal Distribution) في المجتمع الإحصائي الأصلي الذي سُحبت منه العينة. يستند هذا الافتراض إلى أن الاشتقاق الرياضي لتوزيع t لستيودنت يفترض ضمناً أن البيانات الخام موزعة توزيعاً غوسياً متماثلاً حول متوسطها الحسابي، بحيث تتخذ هيئة الجرس المتناظر الذي تتطابق فيه قيم المتوسط والوسيط والمنوال وتتلاشى فيه قيم الالتواء والتفرطح الشديدين.
يخضع هذا الافتراض للفحص المنهجي الدقيق عبر مسارين متكاملين: مسار الفحص البصري البياني ومسار الاختبارات الإحصائية الصارمة. يتضمن الفحص البياني مراجعة المدرجات التكرارية (Histograms) ورسم المنحنى الطبيعي المترادف معها، بالإضافة إلى تفحص مخططات التوزيع الاحتمالي الطبيعي المعياري ومخططات الربعيات المتتالية المعروفة باسم مخططات Q-Q (Quantile-Quantile Plots)، حيث تشير استقامة النقاط واصطفافها المحكم على طول الخط القطري المائل إلى تحقق اعتدالية البيانات بدرجة عالية من الكفاءة والموثوقية.
أما على الصعيد الاستدلالي الصارم، فيُخضع الباحثون بياناتهم لاختبارات الاعتدالية الرسمية، وعلى رأسها اختبار شابيرو-ويلك (Shapiro-Wilk Test) الذي يُعد الخيار الأكثر دقة وقوة للعينات الصغيرة والمتوسطة، إلى جانب اختبار كولموجوروف-سميرنوف (Kolmogorov-Smirnov Test) مع تصحيح ليلفورس للعينات الكبيرة. ومع ذلك، تسعف نظرية النهاية المركزية (Central Limit Theorem) الباحثين في كثير من المواقف التطبيقية؛ حيث تقرر النظرية أنه كلما تضخم حجم العينة وتجاوز عتبة الـ 30 مفردة فأكثر، فإن توزيع متوسطات العينات المتكررة يميل نحو الاعتدالية بصرف النظر عن الشكل التوزيعي للمجتمع الأصلي، مما يجعل اختبار t متيناً نسبياً ومقاوماً للانتهاكات الطفيفة للاعتدالية في ظل العينات المعتدلة والكبيرة.
3.3 حساسية الاختبار للقيم المتطرفة والشاذة
يتميز اختبار t للعينة الواحدة بحساسية هندسية وجبرية فائقة لوجود القيم المتطرفة والشاذة (Outliers) داخل مصفوفة البيانات المقاسة؛ ويرجع سبب هذه الهشاشة إلى أن الصيغة الرياضية للاختبار ترتكز بشكل مباشر على مقياسين إحصائيين يتأثران بشدة بالقيم الطرفية غير العادية، وهما المتوسط الحسابي والانحراف المعياري. وتعمل القيمة المتطرفة الواحدة في اتجاه معين على سحب المتوسط الحسابي نحوها بعيداً عن مركز الثقل التوزيعي الحقيقي للبيانات، وفي الوقت نفسه تتسبب في تضخيم تباين العينة بصورة اصطناعية مفرطة، مما يؤدي إلى انتفاخ قيمة الخطأ المعياري وتثبيط قدرة الاختبار على اكتشاف الفروق الحقيقية.
يقتضي الالتزام المنهجي الصارم فحص مصفوفة البيانات بدقة متناهية لاكتشاف وتحديد مواقع القيم الشاذة قبل الشروع في حسابات الاختبار الاستدلالي. وتتعدد الطرق الاستكشافية المستخدمة في هذا السياق، بدءاً من مخطط التمثيل الصندوقي (Boxplot) الذي يعتمد على المدى الربيعي (Interquartile Range – IQR) لتحديد النقاط التي تبعد أكثر من 1.5 ضعف للمدى الربيعي عن الربعيات، وصولاً إلى فحص الدرجات المعيارية z؛ حيث تُعد المشاهدات التي تتجاوز درجاتها المعيارية المطلقة حاجز (+3) أو (-3) قيماً شاذة محتملة، وفي المستويات متعددة الأبعاد تُستخدم مسافة الماهالانوبيس ومقاييس كوك للكشف عن التأثيرات الحادة للمفردات.
عند التيقن من وجود قيم متطرفة تؤثر على استقرار النتائج، يُحظر على الباحث حذفها عشوائياً دون مسوغ علمي وموضوعي رصين؛ فالحذف مبرر فقط إذا تبين أن القيمة نجمت عن خطأ في القياس، أو خلل في إدخال البيانات، أو عدم استيفاء المفحوص لشروط مجتمع الدراسة. أما إذا كانت القيمة المتطرفة تمثل تجلياً أصيلاً وموثوقاً للتنوع السلوكي للفرد في السمة المقاسة، فينبغي على الباحث اللجوء إلى معالجات متقدمة مثل تحويل البيانات رياضياً (كاستخدام التحويل اللوغاريتمي أو الجذر التربيعي)، أو تطبيق المتوسطات المشذبة (Trimmed Means)، أو التحول الكامل نحو البدائل اللامعلمية المقاومة للتشويه التوزيعي لحفظ أمانة التحليل ومصداقية الاستنتاج.
4. بناء وصياغة الفرضيات الإحصائية في اختبار t
4.1 صياغة الفرضية الصفرية وفرضية العدم
تشكل مرحلة بناء وصياغة الفرضيات الإحصائية الإطار المنطقي الذي يستند إليه منطق الاستدلال في اختبار t للعينة الواحدة؛ إذ إن الفلسفة الكلاسيكية لاختبار الفرضيات (وفق نموذج نيمان-بيرسون وفريشر) لا تختبر صحة فرضية الباحث بصورة مباشرة، بل تنطلق من افتراض عدم وجود أي ظاهرة أو فارق حقيقي في الواقع، وتضع عبء الإثبات على البيانات التجريبية لدحض هذا الافتراض المبدئي بصورة قاطعة.
تُعرف هذه الفرضية الأساسية باسم “الفرضية الصفرية” أو “فرضية العدم” وتُرمّز اصطلاحياً بالرمز (H0)؛ وتُعبر بصورة رياضية محكمة عن عدم وجود فرق جوهري أو ذي دلالة إحصائية بين متوسط المجتمع الإحصائي الحقيقي المجهول (يرمز له بالحرف الإغريقي ميو: μ) والقيمة المعيارية المرجعية المحددة سلفاً (يرمز لها بالرمز: μ0). وتُكتب الصياغة الرمزية المعتمدة للفرضية الصفرية على النحو التالي:
H0: μ = μ0
يعكس هذا التعبير الرياضي افتراضاً بأن الفارق الظاهري الواقعي بين متوسط العينة الملاحظ والمتوسط المرجعي هو فارق تافه يساوي صفراً على مستوى المجتمع الكلي، ولا يُعزى إلا لتقلبات المعاينة الصدفية والخطأ الإحصائي التقديري. وتعتبر الفرضية الصفرية نقطة البداية ونقطة الارتكاز الرياضي لتحديد التوزيع الاحتمالي لمتبقيات المعاينة؛ حيث تُبنى حسابات القيمة الاحتمالية لاحقاً على فرضية مطلقة مفادها أن فرضية العدم هذه صحيحة تماماً وثابتة لا ريب فيها حتى يثبت العكس بأدلة تجريبية دامغة.
4.2 صياغة الفرضيات البديلة ثنائية الاتجاه
تُمثل الفرضية البديلة (Alternative Hypothesis) ويرمز لها بالرمز (H1) أو (Ha)، الموقف النظري والمنهجي الذي يتبناه الباحث كبديل واقعي ومقبول في حال نجاح البيانات في رفض ودحض الفرضية الصفرية؛ وتأخذ الفرضية البديلة أحد شكلين رئيسيين بناءً على طبيعة التراكم المعرفي والتنبؤات المسبقة: إما فرضية غير موجهة أو فرضية موجهة.
تُعرف الفرضية البديلة ثنائية الاتجاه (Two-tailed أو Non-directional Hypothesis) بأنها الفرضية التي تقرر وجود فارق جوهري ودال إحصائياً بين متوسط المجتمع الحقيقي والقيمة المعيارية المرجعية، ولكن دون تحديد مسبق لطبيعة واتجاه هذا الفارق؛ أي دون الجزم بما إذا كان المتوسط سيكون أعلى أو أدنى من القيمة المعيارية المحددة. وتُصاغ هذه الفرضية رياضياً ورمزياً على الصورة الآتية:
H1: μ ≠ μ0
يُلجأ حتماً إلى هذا النمط من الصياغة في البحوث الاستكشافية المبتكرة، أو عند فحص سمات واستجابات لمجتمعات وظواهر جديدة تفتقر إلى تراكم نظري سابق يحدد وجهة التأثير، كما في رصد تفاعلات الفئات الاجتماعية المستحدثة مع الروبوتات والتقنيات الذاتية الذكية (Terrence Fong et al., 2003). ويترتب على اعتماد هذا الاختبار ثنائي الطرف توزيع منطقة الرفض الإحصائي ومستوى الدلالة (α) بالتساوي التام على جانبي المنحنى التوزيعي؛ بحيث يُخصص نصف الاحتمال (α/2) للطرف الأيمن المتطرف، ونصف الاحتمال الآخر (α/2) للطرف الأيسر المتطرف، مما يعزز الحياد المنهجي ويحمي الباحث من التحيزات المسبقة.
4.3 صياغة الفرضيات البديلة أحادية الاتجاه
في المقابل، تُمثل الفرضية البديلة أحادية الاتجاه (One-tailed أو Directional Hypothesis) صياغة استدلالية محددة بدقة، لا تكتفي بتقرير وجود فارق دال بين متوسط المجتمع والقيمة المعيارية، بل تتنبأ صراحة وبشكل قاطع باتجاه هذا الانحراف، سواء كان بالزيادة أو بالنقصان. وتتخذ الصياغة الرياضية للفرضية أحادية الاتجاه إحدى الصيغتين التاليتين تبعاً لاتجاه التنبؤ العلمي:
- فرضية موجهة بالزيادة: H1: μ > μ0 (أي أن متوسط المجتمع أكبر دلالياً من القيمة المعيارية).
- فرضية موجهة بالنقصان: H1: μ < μ0 (أي أن متوسط المجتمع أدنى دلالياً من القيمة المعيارية).
يتطلب تبني هذا النمط الموجه اشتراطات إبستمولوجية ومنهجية بالغة الصرامة؛ إذ لا يجوز للباحث بأي حال من الأحوال اللجوء إلى الاختبار أحادي الطرف بدافع الرغبة البراغماتية في تسهيل الوصول إلى الدلالة الإحصائية؛ بل يتعين أن يستند التوجيه إلى أسس نظرية عميقة، وأدلة تجريبية قاطعة، ونتائج دراسات سابقة مستفيضة أجمعت على مسار الظاهرة دون مواربة، كما هو الحال عند تقييم خوارزميات التفضيل النفسي والاجتماعي المتقاطعة عبر ثقافات متعددة (Daniel Conroy‐Beam et al., 2019).
ينطوي الاختبار أحادي الاتجاه على ميزة إحصائية تتمثل في تركيز كامل القوة الإحصائية ومساحة منطقة الرفض (α كاملة) في طرف واحد محدد من أطراف التوزيع التكراري، مما يُخفض القيمة الحرجة المطلوبة لرفض الفرضية الصفرية ويزيد حساسية الاختبار لاكتشاف الأثر في ذلك الاتجاه. بيد أن هذا الإجراء ينطوي على مخاطرة منهجية جسيمة؛ فإذا تحركت نتائج العينة في الاتجاه المعاكس للتنبؤ النظري — مهما كان حجم هذا الانحراف كبيراً وصادماً — فلن يتمكن الباحث رياضياً من رفض الفرضية الصفرية، وسيُعد الأثر معدوماً تماماً في إطار ذلك التصميم، مما يفرض توخي الحذر الشديد عند اتخاذ هذا القرار المنهجي.
5. الصيغة الرياضية لاختبار t ومكوناتها التحليلية
5.1 المعادلة الرياضية العامة لاختبار t للعينة الواحدة
ترتكز البنية الرياضية والجبرية لاختبار t للعينة الواحدة على نمذجة النسبة المعيارية بين الفارق الملاحظ بين العينة والمعيار وبين التباين المقدر للمعاينة. وتُصاغ المعادلة الرياضية العامة لاختبار t على النحو التالي:
t = (x̄ – μ0) / (s / √n)
حيث ترمز الحروف والمصطلحات المكونة للمعادلة إلى الآتي:
- t: القيمة الإحصائية التائية المحسوبة من البيانات التجريبية.
- x̄: المتوسط الحسابي المحسوب لبيانات العينة العشوائية المستهدفة.
- μ0: المتوسط المعياري أو النظري المفترض للمجتمع (القيمة المرجعية محل الاختبار).
- s: الانحراف المعياري لدرجات العينة العشوائية.
- n: حجم العينة، أي إجمالي عدد المشاهدات أو الأفراد في العينة.
- s / √n: الخطأ المعياري المقدر لمتوسط العينة (ويرمز له اصطلاحاً بالرمز SE أو s_x̄).
يُظهر التحليل الهيكلي لهذه المعادلة أن بسط الكسر (x̄ – μ0) يمثل الفارق المطلق الملاحظ بين الواقع الميداني التجريبي والمعيار المرجعي المفترض؛ وهو مؤشر مباشر على حجم التأثير الأولي للظاهرة. أما مقام الكسر (s / √n) فيمثل وحدة القياس التقديرية لتشتت متوسطات العينات، وهو معيار للتشويش العشوائي المحتمل في عملية القياس. وبالتالي، فإن قيمة t المحسوبة هي ترجمة رياضية تعبر عن عدد وحدات الخطأ المعياري التي يبعد بها متوسط العينة عن القيمة المفترضة؛ وكلما تعاظم البسط مقارنة بالمقام، تضخمت قيمة t المحسوبة وابتعدت عن الصفر، مما يقدم دليلاً إحصائياً أقوى ضد سلامة الفرضية الصفرية.
5.2 حساب الانحراف المعياري للعينة والخطأ المعياري
يشكل الانحراف المعياري للعينة (s) حجر الزاوية في مقام معادلة اختبار t، ويتطلب حسابه اليدوي والبرمجي الالتزام بالتصحيح الإحصائي الدقيق لضمان الحصول على تقدير غير متحيّز لتباين المجتمع المجهول. تُحسب قيمة التباين المصحح للعينة (s²) أولاً عبر قسمة مجموع مربعات الانحرافات عن المتوسط (Sum of Squares – SS) على درجات الحرية المقيدة والمحددة بـ (n – 1)، وفق الصيغة الآتية:
s² = Σ (xi – x̄)² / (n – 1)
ويُستخرج الانحراف المعياري (s) بأخذ الجذر التربيعي الموجب لهذا التباين التقديري: s = √(s²). وتتجلى هنا أهمية استخدام المقسوم (n – 1) بدلاً من الحجم الكلي n؛ إذ أثبتت النظرية الرياضية أن قسمة مجموع الانحرافات على حجم العينة المجرد n في العينات المسحوبة يؤدي دوماً إلى تقليل مقصود ومتحيّز لتباين المجتمع الحقيقي، بينما ينجح المقسوم (n – 1) — المعروف بتصحيح بيسل (Bessel’s Correction) — في تعويض فقدان المعلومة الناتجة عن تثبيت المتوسط الحسابي، مما يعطي تقديراً عادلاً تماماً للتشتت الطبيعي للمتغير السلوكي.
بمجرد استخراج الانحراف المعياري للعينة، ينتقل الباحث إلى حساب الخطأ المعياري للمتوسط (Standard Error of the Mean – SE) وفق المعادلة: SE = s / √n. يكشف الفحص الدقيق لهذه العلاقة الرياضية عن التفاعل الحاسم بين تباين الظاهرة وحجم العينة؛ فالخطأ المعياري يتناسب طردياً مع تشتت الدرجات (s) ويتناسب عكسياً مع الجذر التربيعي لحجم العينة (√n). ويعني هذا بالضرورة المنهجية أن زيادة حجم العينة التجريبية تؤدي آلياً إلى تقليص الخطأ المعياري وتضييق خناق التشويش العشوائي، مما يعزز دقة التقدير ويرفع حساسية وقوة اختبار t في التقاط الفروق البسيطة بين المتوسطات وتأكيد دلالتها الإحصائية.
5.3 التفسير الرياضي لمفهوم القيمة المحسوبة t
تمثل القيمة المحسوبة t معاملاً قياسياً موحداً يُجرد البيانات من وحدات قياسها الأصلية (سواء كانت درجات في اختبار تحصيلي، أو مليثوانٍ في أزمنة الرجع، أو درجات ليكرت في مقياس نفسي)، محولاً إياها إلى درجات قياسية تمثل إحداثيات محددة على منحنى توزيع t لستيودنت. إن القيمة t هي ببساطة نظير “الدرجة المعيارية z”، ولكن مع فارق جوهري يتمثل في أن معايرتها تتم باستخدام انحراف مقدر من العينة يخضع بذاته لتباين المعاينة، بدلاً من انحراف ثابت مطلق للمجتمع.
تكتسب إشارة القيمة المحسوبة دلالة اتجاهية ومنطقية بالغة الوضوح في التفسير الإحصائي؛ فالقيمة الموجبة لـ t تعني رياضياً أن متوسط العينة التجريبية (x̄) يقع على يمين القيمة المعيارية المرجعية (μ0) ويتفوق عليها عددياً، في حين تشير القيمة السالبة لـ t إلى أن متوسط العينة يقع على يسار القيمة المعيارية ويهبط عنها كمياً. أما إذا تطابق متوسط العينة تطابقاً تاماً مع القيمة المفترضة، فإن البسط يتلاشى وتصبح قيمة t المحسوبة مساوية للصفر بدقة، وهي القمة الهندسية المتناظرة لمنحنى توزيع t التي تعبر عن التطابق الكامل مع الفرضية الصفرية.
كما يعكس الابتعاد المطلق للقيمة المحسوبة عن نقطة الصفر المركزية مقدار الشذوذ النسبي لبيانات العينة عن المنظومة النظرية المفترضة؛ فكلما كانت القيمة المطلقة لـ t كبيرة وتجاوزت الحدود الحرجة المألوفة (كأن تبلغ 2.5 أو 3 أو أكثر)، دل ذلك على أن الفارق الظاهري يمثل أضعافاً مضاعفة للخطأ العشوائي المتوقع للمعاينة، مما يجعل تفسير هذا الفارق كظاهرة صدفية أمراً مستبعداً إحصائياً، ويدفع باتجاه حتمي نحو رفض فرضية العدم والاعتراف بفاعلية المتغير التابع.
6. درجات الحرية والقيم الحرجة والدلالة الإحصائية
6.1 مفهوم درجات الحرية (Degrees of Freedom)
يعد مفهوم درجات الحرية (Degrees of Freedom) واختصاره (df) من أدق وأهم المفاهيم في الإحصاء الاستدلالي والمعلمي على وجه الخصوص. يُعرف هذا المفهوم رياضياً بأنه عدد القيم أو المشاهدات المستقلة داخل مجموعة البيانات التي تمتلك الحرية الكاملة للتغير والتنوع العشوائي دون أي قيود جبرية، عند تقدير معلمة إحصائية معينة مثل التباين.
في اختبار t للعينة الواحدة، تُحسب درجات الحرية دائماً بالصيغة الرياضية المباشرة التالية:
df = n – 1
حيث يمثل n حجم العينة الكلي. وينبثق التفسير المنطقي لفقدان درجة حرية واحدة من حقيقة أن حساب الانحراف المعياري للعينة (s) يتطلب مسبقاً حساب وتثبيت المتوسط الحسابي للعينة (x̄)؛ وبمجرد أن يُحسب المتوسط ويصبح ثابتاً، فإن مجموع انحرافات كافة الدرجات عن هذا المتوسط يجب جبرياً ورياضياً أن يساوي صفراً بشكل مطلق: Σ (xi – x̄) = 0. ويترتب على هذا القيد الرياضي الحتمي أن (n – 1) من الأفراد في العينة يمتلكون حرية امتلاك أي درجة سيكولوجية عشوائية، ولكن بمجرد تحديد درجات هؤلاء الأفراد جميعاً، تصبح درجة الفرد الأخير (رقم n) محددة مسبقاً ومجبرة على اتخاذ قيمة رقمية وحيدة تضمن تحقيق المجموع الصفري للانحرافات دون أدنى حرية للاختيار.
يمتد التأثير الهندسي لدرجات الحرية بصورة مباشرة إلى تحديد الشكل الدقيق لمنحنى توزيع t لستيودنت؛ فعندما تكون درجات الحرية صغيرة جداً (كما في حالة العينات الصغيرة n < 15)، يكون التوزيع مسطحاً وقصير القمة وذا أطراف سميكة وممتدة تزيد من احتمالية ظهور قيم t البعيدة. ومع تزايد درجات الحرية تزايداً مطرداً نتيجة لزيادة حجم العينة، تتقارب قمة التوزيع وترتفع، وتتقلص سماكة الأطراف تدريجياً وبسرعة، حتى يندمج شكل توزيع t بالكامل ويتطابق عملياً مع منحنى التوزيع الطبيعي المعياري عندما تقترب درجات الحرية من اللانهاية.
6.2 تحديد القيمة الجدولية ومستوى الدلالة (α)
يرتبط اتخاذ القرار الإحصائي في اختبار t بمقارنة القيمة المحسوبة بقيمة مرجعية قياسية تُعرف باسم القيمة الحرجة أو القيمة الجدولية (Critical Value: t_crit). وتُمثل القيمة الحرجة تلك النقطة المفصلية على محور التوزيع الاحتمالي لـ t التي تقسم مساحة المنحنى الكلية بدقة إلى منطقتين متمايزتين لا ثالث لهما: منطقة قبول الفرضية الصفرية (أو بدقة: منطقة عدم كفاية الأدلة لرفض الفرضية الصفرية) وتقع في المركز، ومنطقة الرفض الإحصائي (منطقة الدلالة أو الحرج) وتقع في الأطراف القصوى للتوزيع.
يتطلب استخراج القيمة الحرجة من الجداول الإحصائية المعتمدة توفير ثلاثة محددات منهجية محكمة:
- مستوى الدلالة المعياري (α): وهو أقصى احتمال يقبله الباحث للوقوع في الخطأ من النوع الأول، ويُحدد عرفياً في العلوم الإنسانية والنفسية عند القيمة 0.05، وفي البحوث الطبية والإكلينيكية الحساسة عند 0.01.
- طبيعة الفرضية البديلة: تحديد ما إذا كان الاختبار ثنائي الاتجاه (Two-tailed) حيث تُقسم α بالتساوي على الطرفين (α/2)، أم أحادي الاتجاه (One-tailed) حيث تتركز α بالكامل في طرف واحد.
- درجات الحرية المحسوبة: (df = n – 1) التي تحدد بدقة الجدول الرياضي والمنحنى المعتمد.
من خلال التقاطع المنهجي بين درجات الحرية ومستوى الدلالة المختار وطبيعة اتجاه الفرضية، تُستخرج القيمة الحرجة الدقيقة. وتعمل هذه القيمة كحارس إحصائي صارم؛ فإذا وقعت القيمة المحسوبة خارج النطاق المحصور بين القيمتين الحرجتين وتجاوزتهما نحو الأطراف القصوى، فإن ذلك يعني دخول البيانات رسمياً في منطقة الرفض المحددة بالاحتمال الضئيل α، مما يسوّغ للباحث منطقياً إعلان رفض فرضية العدم.
6.3 قواعد اتخاذ القرار الإحصائي وتفسير القيمة الاحتمالية (p-value)
تتمحور الخطوة الأخيرة في هذا المسار حول اتخاذ القرار الإحصائي الحاسم وربطه بالمنظور الاحتمالي الحديث؛ وتستند المقارنة الكلاسيكية إلى قاعدة قاطعة: يُرفض الفرض الصفري (H0) وتُقبل الفرضية البديلة (H1) إذا كانت القيمة التائية المحسوبة أكبر قطباً من القيمة الحرجة في الاختبار أحادي الطرف (أو أكبر من القيمة الحرجة المطلقة في الاختبار ثنائي الطرف: |t_calc| ≥ t_crit)، بينما يفشل الباحث في رفض الفرض الصفري إذا كانت القيمة المحسوبة أدنى من القيمة الحرجة.
ومع تطور الحوسبة الإحصائية، غدا الاعتماد الأساسي يرتكز على تفسير القيمة الاحتمالية المرافقة للاختبار والتي تُعرف باسم (p-value). تُمثل القيمة الاحتمالية (p) أدق تعبير رياضي عن احتمالية الحصول على نتائج تجريبية متطرفة مثل تلك الملاحظة في العينة، أو أكثر منها تطرفاً، على فرض أن الفرضية الصفرية صحيحة مئة بالمئة في المجتمع الأصلي. ويخضع القرار الإحصائي لقاعدة المقارنة المباشرة التالية:
- إذا كانت p ≤ α (أي في الغالب p ≤ 0.05): يُرفض الفرض الصفري ويُحكم بوجود فرق دال إحصائياً.
- إذا كانت p > α (أي p > 0.05): يُقبل الفرض الصفري وتعد الفروق الملاحظة مجرد أخطاء معاينة صدفية.
يستهدف هذا الضبط المنهجي الصارم وقاية الباحث من الوقوع في شرك الأخطاء الاستدلالية المشهورة؛ فالخطأ من النوع الأول (Type I Error ويرمز له بـ α) يتمثل في التسرع برفض الفرضية الصفرية وهي في الواقع صحيحة تماماً في المجتمع، مما يعني ادعاء وجود أثر نفسي أو ظاهرة سيكولوجية زائفة لا وجود لها. أما الخطأ من النوع الثاني (Type II Error ويرمز له بـ β) فيتمثل في الفشل في رفض الفرضية الصفرية في حين أنها في الحقيقة خاطئة تماماً، مما يفضي إلى إهدار اكتشاف حقيقي وتجاهل فاعلية تدخل علاجي قائم في الواقع، ويظل التحكم المتوازن بين هذين الخطأين رهناً بضبط حجم العينة والقوة الإحصائية المناسبة للاختبار.
7. تطبيق عملي محلول: قياس مستوى القلق النفسي لدى عينة طلابية
7.1 تحديد المشكلة البحثية وبناء الفرضيات
لتجسيد كافة الخطوات النظرية والرياضية المجردة في نموذج تطبيقي واقعي، نفترض إجراء دراسة ميدانية في علم النفس التربوي تهدف إلى فحص مستويات قلق الاختبار لدى طلاب السنة الأولى في إحدى الجامعات خلال موسم الامتحانات النهائية. تتوافر لدى الباحث معايير وطنية مقننة وثابتة لهذا المقياس النفسي المعتمد، حيث يشير الدليل السيكومتري للمقياس إلى أن المتوسط العام للمجتمع الطبيعي لطلاب الجامعات في الظروف الاعتيادية مستقر عند القيمة المعيارية المرجعية:
μ0 = 50 درجة
قام الباحث باختيار عينة عشوائية بسيطة وممثلة تألفت من 25 طالباً وطالبة (n = 25)، وطبق عليهم مقياس القلق المعتمد، وجاءت درجات الطلاب الخام على النحو الآتي:
54، 58، 52، 60، 62، 49، 55، 57، 63، 51، 59، 56، 61، 48، 53، 58، 64، 55، 57، 52، 60، 58، 56، 62، 50.
يتبنى الباحث مدخلاً استكشافياً غير موجه للتأكد مما إذا كانت عينة هؤلاء الطلاب تختلف في متوسط قلقها عن المعيار الوطني العام (سواء بالارتفاع أو الانخفاض)، مما يوجب صياغة الفرضيات الإحصائية في إطار ثنائي الاتجاه وبمستوى دلالة معياري مقداره (α = 0.05)، على النحو الصارم الآتي:
- الفرضية الصفرية: H0: μ = 50 (متوسط قلق الاختبار لدى العينة لا يختلف دلالياً عن المتوسط المعياري العام).
- الفرضية البديلة: H1: μ ≠ 50 (متوسط قلق الاختبار لدى العينة يختلف دلالياً عن المتوسط المعياري العام).
7.2 الحسابات اليدوية المفصلة خطوة بخطوة
لإجراء التحليل الاستدلالي يدوياً بدقة مطلقة، نمر عبر الخطوات الحسابية التراكمية التالية:
أولاً: حساب المتوسط الحسابي للعينة (x̄):
نقوم بجمع الدرجات الخام لكافة أفراد العينة (Σ xi):
Σ xi = 54 + 58 + 52 + 60 + 62 + 49 + 55 + 57 + 63 + 51 + 59 + 56 + 61 + 48 + 53 + 58 + 64 + 55 + 57 + 52 + 60 + 58 + 56 + 62 + 50 = 1412 درجة.
x̄ = (Σ xi) / n = 1412 / 25 = 56.48 درجة.
ثانياً: حساب مجموع مربعات الانحرافات (SS) والتباين المصحح (s²):
نقوم بحساب انحراف كل مفردة عن المتوسط الملاحظ (xi – 56.48)، وتربيع هذا الانحراف، ثم جمع تلك المربعات لجميع الأفراد، وتتلخص القيم المحسوبة في الآتي:
مجموع مربعات الانحرافات: Σ (xi – x̄)² = 478.24.
نحسب التباين المصحح بقسمة الناتج على درجات الحرية (n – 1 = 24):
s² = 478.24 / 24 = 19.9267.
ثالثاً: حساب الانحراف المعياري للعينة (s):
بأخذ الجذر التربيعي الموجب للتباين التقديري المصحح نحصل على:
s = √(19.9267) = 4.464 درجة.
رابعاً: حساب الخطأ المعياري لمتوسط العينة (SE):
SE = s / √n = 4.464 / √25 = 4.464 / 5 = 0.8928.
خامساً: حساب قيمة t المحسوبة بالتعويض في المعادلة العامة:
t = (x̄ – μ0) / SE
t = (56.48 – 50) / 0.8928
t = 6.48 / 0.8928 = 7.258.
سادساً: استخراج القيمة الجدولية الحرجة (t_crit):
بالرجوع إلى جداول توزيع t لستيودنت، عند درجات حرية: df = n – 1 = 24، وبمستوى دلالة ثنائي الطرف: α = 0.05، نجد أن القيمة الجدولية الحرجة تساوي بدقة:
t_crit = ± 2.064.
7.3 التفسير النفسي والإحصائي للنتائج المتوصل إليها
بإجراء المقارنة الإحصائية المنهجية بين القيمة المحسوبة والقيمة الحرجة، نلاحظ بوضوح أن القيمة المحسوبة (t = 7.258) تقع في أقصى الطرف الأيمن وتتجاوز بمراحل القيمة الجدولية الحرجة المطلوبة (2.064)؛ أي أن: |7.258| > 2.064. ويترتب على ذلك بالضرورة هبوط القيمة الاحتمالية المرافقة إلى ما دون مستوى الشك المعياري بكثير (p < 0.001)، مما يفرض رياضياً ومنهجياً اتخاذ القرار القاطع برفض الفرضية الصفرية (H0) والقبول الكامل بالفرضية البديلة (H1).
تتم صياغة التقرير الإحصائي المعياري المعتمد وفق أحدث إرشادات جمعية علم النفس الأمريكية (APA 7th Edition) على الصورة الآتية:
“أظهر اختبار t للعينة الواحدة وجود فرق دال إحصائياً بين متوسط قلق الاختبار لدى عينة الطلاب والمتوسط المعياري المعتمد؛ حيث بلغ متوسط العينة (M = 56.48، SD = 4.46)، متفوقاً بصورة دالة على المتوسط المعياري (μ0 = 50)، t(24) = 7.26، p < .001.”
أما على صعيد التفسير السيكولوجي والإكلينيكي، فإن هذه الدلالة الرقمية الكاسحة لا تمثل مجرد تفوق رقمي عابر، بل تعكس واقعاً نفسياً مأزوماً يعيشه طلاب الجامعة خلال فترة الامتحانات النهائية؛ فالفارق الظاهر البالغ نحو (6.48) درجات فوق المتوسط الوطني الطبيعي يبرهن على أن الضغوط الأكاديمية وظروف التقييم الجامعي تولد عبئاً وجدانياً واستجابات قلق حادة تستلزم من دوائر الإرشاد النفسي والعمادات الجامعية التدخل السريع من خلال تصميم برامج إرشادية وتدريبية لخفض التوتر وإدارة الضغوط الامتحانية بما يحول دون تحول هذا القلق المرتفع إلى اضطراب عام يعيق التحصيل والتوافق الأكاديمي.
8. تقدير حجم الأثر وفترات الثقة لاختبار t للعينة الواحدة
8.1 حساب وتفسير معامل كوهين (Cohen’s d)
كشفت الانتقادات الإبستمولوجية المعاصرة في فلسفة الإحصاء عن قصور فادح يكتنف الاعتماد الحصري على اختبارات الدلالة الإحصائية المجردة (p-value)؛ فالقيمة الاحتمالية لا تقيس حجم أو قوة الظاهرة السلوكية في حد ذاتها، بل تقيس بالدرجة الأولى درجة مطابقة البيانات للفرضية الصفرية تحت وطأة حجم العينة؛ فمن الممكن رياضياً لأي فرق تافه وغير ذي قيمة نفسية عملية أن يغدو دالاً إحصائياً إذا ما تم تضخيم حجم العينة إلى آلاف المفردات. ومن هنا تبرز الأهمية القصوى لحساب مؤشرات حجم الأثر (Effect Size) لتقييم الأهمية الميدانية والعملية للنتائج.
يعد معامل كوهين دي (Cohen’s d) المقياس المعياري الأكثر رسوخاً لحساب حجم الأثر في اختبار t للعينة الواحدة، ويُحسب بقسمة الفارق المطلق بين متوسط العينة والقيمة المعيارية المرجعية على الانحراف المعياري المقدر للعينة، وفق المعادلة المباشرة التالية:
d = (x̄ – μ0) / s
وبالتعويض بالقيم المستخرجة من تطبيقنا العملي السابق على درجات قلق الاختبار:
d = (56.48 – 50) / 4.464 = 6.48 / 4.464 = 1.452.
استقر العرف السيكومتري المستند إلى تصنيفات جيكوب كوهين (Jacob Cohen) على اعتبار قيمة d = 0.20 أثراً صغيراً، وd = 0.50 أثراً متوسطاً، وd = 0.80 أثراً كبيراً. وعند فحص القيمة المحسوبة لدينا (d = 1.45) يتضح أنها تتجاوز بكثير عتبة الأثر الكبير، وتندرج ضمن ما يُعرف في الأدبيات بالأثر “الهائل” أو “البالغ جداً” (Very Large Effect Size). ويوضح هذا المؤشر أن متوسط قلق العينة الطلابية ينزاح عن المعدل الوطني الطبيعي بمقدار يقترب من انحراف معياري ونصف كامل، مما يؤكد أن الظاهرة المكتشفة تمتلك وزناً سيكولوجياً وتطبيقياً حاسماً لا مراء فيه، ويوفر هذا التوثيق الدقيق لحجم الأثر الأساس الصلب لدراسات المراجعة التلوية المقارنة والتحليلات البعدية المتقدمة في المستقبل.
8.2 بناء وتفسير فترات الثقة (Confidence Intervals)
يمثل بناء فترات الثقة (Confidence Intervals) المنهجية الموازية والمكملة لاختبار الفرضيات؛ إذ يُقدم للمحلل والباحث تقديراً مجالياً (Interval Estimate) للموقع الحقيقي لمتوسط المجتمع بدلاً من الاكتفاء بالتقدير النقطي الأحادي المعرض لخطأ المعاينة. تعبر فترة الثقة 95% عن ذلك النطاق العددي المتصل الذي يمتلك الباحث ثقة إحصائية قدرها 95% بأن المعلمة الحقيقية المجهولة لمجتمع العينة (μ) تقع محصورة بين حدوده الدنيا والعليا في حال تكرار تجارب المعاينة بصورة لا نهائية.
تُحسب حدود فترة الثقة 95% لمتوسط العينة باستخدام الصيغة الرياضية التالية:
CI_95% = x̄ ± (t_crit * SE)
حيث تُمثل t_crit القيمة الحرجة المقابلة لدرجات الحرية (df = 24) عند مستوى دلالة 0.05 ثنائي الطرف (وهي 2.064 في مثالنا السابق)، وSE هو الخطأ المعياري المحسوب (0.8928). بالتعويض الجبري الدقيق نصل إلى:
الحدود = 56.48 ± (2.064 * 0.8928) = 56.48 ± 1.843
- الحد الأدنى لفترة الثقة: 56.48 – 1.843 = 54.637.
- الحد الأعلى لفترة الثقة: 56.48 + 1.843 = 58.323.
تُفسر هذه النتيجة إحصائياً بأننا على ثقة بنسبة 95% بأن المتوسط الحقيقي لقلق الاختبار لدى مجتمع طلاب الجامعة في موسم الامتحانات يقع محصوراً بين الدرجتين (54.64) و(58.32). ويكتسب هذا البناء التقديري قوة استدلالية مذهلة للتحقق من مصير الفرضية الصفرية؛ فالقاعدة المنهجية تقرر أنه إذا كانت القيمة المعيارية المرجعية محل الاختبار (μ0 = 50) تقع بالكامل خارج نطاق فترة الثقة المحسوبة (كما هو جلي هنا؛ إذ إن الحد الأدنى 54.64 يتفوق بمراحل على القيمة 50)، فإن ذلك يُعد برهاناً هندسياً قاطعاً على رفض الفرضية الصفرية عند مستوى α = 0.05 دون الحاجة حتى للرجوع لمعادلة t، علاوة على أن ضيق مسافة فترة الثقة يعكس دقة قياس استثنائية وانخفاضاً كبيراً في الخطأ العشوائي لتقدير العينة.
8.3 مفهوم القوة الإحصائية وحجم العينة المطلوب
تُعرف القوة الإحصائية (Statistical Power) للاختبار ويرمز لها رياضياً بالرمز (1 – β)، بأنها احتمالية نجاح الباحث واختباره الإحصائي في رصد واكتشاف الفروق أو التأثيرات الحقيقية القائمة بالفعل في المجتمع ورفض الفرضية الصفرية الخاطئة بصورة صائبة ومحكمة. إن ضعف القوة الإحصائية يُعد خللاً منهجياً فادحاً يهدد صدق البحوث السلوكية؛ إذ يقود الباحثين إلى الوقوع في الخطأ من النوع الثاني (إهدار وتجاهل فروق حقيقية ذات دلالة عملية والزعم بالباطل بأن التدخل التجريبي لم يفلح نتيجة صغر حجم العينة المستخدمة).
ترتبط القوة الإحصائية ارتباطاً شبكياً وثيقاً بثلاثة محددات رئيسية تتبادل التأثير فيما بينها:
- حجم العينة (n): زيادة عدد المفردات يُقلل التباين التقديري ويزيد القوة الإحصائية مباشرة.
- حجم الأثر المفترض (d): التأثيرات السلوكية الضخمة يسهل التقاطها حتى بعينات صغيرة، بينما تتطلب التأثيرات الدقيقة عينات ضخمة لكشفها.
- مستوى الدلالة المعتمد (α): كلما تساهل الباحث في تحديد α (مثلاً 0.05 بدلاً من 0.01)، زادت القوة الإحصائية للاختبار.
تفرض الممارسات المنهجية الصارمة المعاصرة إجراء ما يُعرف بتحليل القوة البعدي أو القبلي (A Priori Power Analysis) قبل الانخراط في جمع البيانات الميدانية، لتحديد أدنى حجم عينة يكفل بلوغ قوة إحصائية لا تقل عن المعيار الأكاديمي المتعارف عليه (Power = 0.80). وباستخدام حزم البرمجيات المتخصصة كبرنامج G*Power، يمكن للباحث النفسي أن يحدد بدقة متناهية عدد أفراد العينة المطلوب لسحبها، متفادياً إهدار الموارد البحثية في جمع عينات هائلة دون مبرر، وحامياً دراسته في الوقت ذاته من خطر الخفوت الإحصائي الذي يقوض فرص النشر والاعتماد الأكاديمي.
9. إجراء الاختبار وتفسير المخرجات عبر البرمجيات الإحصائية (SPSS و R)
9.1 تطبيق اختبار t للعينة الواحدة في برنامج SPSS
يمثل برنامج الحزمة الإحصائية للعلوم الاجتماعية (SPSS) البيئة البرمجية الأكثر شيوعاً بين باحثي وطلاب الدراسات العليا في التخصصات الإنسانية والنفسية لإجراء اختبار t للعينة الواحدة بدقة متناهية وسرعة فائقة. تبدأ الخطوات الإجرائية بإدخال الدرجات الخام للمتغير التابع في عمود مستقل داخل محرر البيانات (Data Editor)، وليكن اسم المتغير “Anxiety_Score”، مع تعريفه في نافذة المتغيرات (Variable View) كمتغير كمي ذي مقياس قياس متصل (Scale).
لتنفيذ الاختبار، يتبع الباحث المسار الإجرائي المباشر من القوائم العلوية للبرنامج:
Analyze -> Compare Means -> One-Sample T Test…
وعند فتح النافذة المنبثقة، يقوم الباحث بنقل متغير الدراسة المراد تحليله من الصندوق الأيسر إلى مربع متغيرات الاختبار (Test Variable(s)). والخطوة المنهجية الأكثر حرجاً هنا، والتي يغفلها كثير من المبتدئين، هي التوجه إلى أسفل النافذة وتحديد خانة “قيمة الاختبار” (Test Value)؛ حيث يُحظر تركها عند الصفر الافتراضي ما لم يكن الصفر هو المعيار النظري الحقيقي، بل يجب كتابة القيمة المعيارية المرجعية بدقة متناهية (وفي مثالنا نكتب الرقم 50). من خلال زر الخيارات (Options)، يمكن التأكد من ضبط مستوى فترة الثقة عند 95% ومراقبة معالجة القيم المفقودة، ثم الضغط على زر (OK) لتوليد المخرجات.
يولد البرنامج جدولين تحليليين متكاملين؛ يتضمن الجدول الأول الموسوم بـ (One-Sample Statistics) المؤشرات الوصفية الأولية للعينة، وهي: حجم العينة (N)، المتوسط الحسابي (Mean)، الانحراف المعياري (Std. Deviation)، والخطأ المعياري للمتوسط (Std. Error Mean). أما الجدول الثاني المحوري وهو جدول (One-Sample Test)، فيعرض القيمة التائية المحسوبة (t)، ودرجات الحرية المقابلة (df)، ثم عمود القيمة الاحتمالية ثنائية الطرف والمسمى في النسخ الحديثة بـ (One-Sided p و Two-Sided p) أو (Sig. 2-tailed). يقرأ الباحث قيمة p؛ فإذا كانت تظهر كـ (.000) تُكتب في التقارير (p < .001)، ويستعرض الجدول كذلك فارق المتوسطين (Mean Difference) وهو ناتج طرح القيمة المرجعية من متوسط العينة، إلى جانب حدود فترة الثقة 95% لهذا الفارق، مما يقدم قراءة استدلالية متكاملة لخصائص الظاهرة.
9.2 تنفيذ الاختبار وتحليله برمجياً باستخدام لغة R
توفر بيئة لغة البرمجة الإحصائية (R) مفتوحة المصدر منصة جبارة ومرنة لتنفيذ اختبار t للعينة الواحدة بدقة حسابية متقدمة وإمكانات رسومية فائقة. يبدأ الباحث بإدخال متسلسلة البيانات وتخزينها في متجه رقمي، ثم استدعاء الدالة القياسية المدمجة في بيئة R الأساسية t.test()، مع تمرير المعطيات والمتوسط المرجعي عبر المعامل الحسابي mu، كما يتضح في البناء المنطقي للشيفرة التالية:
يقوم الباحث بتعريف المتجه أولاً، ثم تطبيق دالة الاختبار: t.test(anxiety_scores, mu = 50, alternative = "two.sided", conf.level = 0.95). تُخرج هذه الدالة تقريراً نصياً شاملاً يتضمن قيمة t المحسوبة، درجات الحرية df، القيمة الاحتمالية p-value الدقيقة، الفرضية البديلة المعتمدة، فترة الثقة المئوية للمتوسط، والتقدير النقطي النهائي لمتوسط العينة.
تتيح لغة R ميزات إضافية لفحص الافتراضات واحتساب حجم الأثر آلياً؛ حيث يمكن استدعاء دالة shapiro.test(anxiety_scores) للتأكد المسبق من اعتدالية البيانات، وحساب معامل كوهين دي بدقة عبر حزمة effectsize من خلال استدعاء الدالة cohens_d(anxiety_scores, mu = 50). ولتتويج التحليل بتمثيل بياني جذاب يرقى لمستويات النشر في المجلات المصنفة عالمياً، يمكن استخدام حزمة ggplot2 الشهيرة لرسم توزيع البيانات الفعلي عبر مخططات الكمان (Violin Plots) المتراكبة مع الصناديق التوزيعية ونقاط البيانات الخام المتناثرة، مع تظليل المتوسط المرجعي بخط متقطع متباين اللون يبرز الفارق البصري بوضوح استثنائي للمتلقي.
9.3 التوثيق الأكاديمي للنتائج وفق دليل APA الإصدار السابع
تتطلب الكتابة العلمية الرصينة التزاماً حرفياً بالمعايير المقننة للتوثيق الإحصائي؛ ويُعد دليل النشر الصادر عن جمعية علم النفس الأمريكية في نسخته السابعة (APA 7th Edition) المرجع الحاكم والمقر لكيفية تضمين نتائج اختبار t للعينة الواحدة في المتن والتقارير الأكاديمية. تتجسد القاعدة الذهبية للدليل في تجريد العرض من الحشو الإنشائي، والتركيز على تقديم كافة المؤشرات الاستدلالية والوصفية اللازمة بصيغة مكثفة ودقيقة تُمكن القارئ من التحقق المستقل من سلامة الاستنتاج.
تُصاغ النتائج داخل المتن النصي باتباع النسق التالي: يُذكر اسم الاختبار المطبق بوضوح، يليه الغرض من التحليل، ثم تُعرض المؤشرات الوصفية للعينات بين قوسين متضمنة المتوسط الحسابي (ويرمز له بحرف M مائل: M) والانحراف المعياري (ويرمز له بحرف SD مائل: SD). بعد ذلك يُكتب الرمز الإحصائي للاختبار (حرف t مائل: t) متبوعاً بقيمة درجات الحرية بين قوسين ملتصقين بالحرف، ثم علامة التساوي، تليها قيمة t المحسوبة مقربة لأقرب منزلتين عشريتين. يعقب ذلك القيمة الاحتمالية الدقيقة (حرف p مائل: p) دون وضع صفر قبل الفاصلة العشرية لأن قيمتها لا يمكن أن تتجاوز الواحد الصحيح، ثم يُختتم العرض بتوثيق حجم الأثر (حرف d مائل: d) وحدود فترة الثقة 95%، كما يظهر في النموذج المعياري التالي:
“أشارت النتائج إلى أن درجات الطلاب في مقياس قلق الاختبار (M = 56.48, SD = 4.46) كانت أعلى بصورة دالة إحصائياً عن المتوسط المعياري المقنن البالغ 50 درجة، t(24) = 7.26, p < .001, d = 1.45, 95% CI [54.64, 58.32].”
وفي حال تضمين النتائج في جداول مستقلة، يوجب الدليل تصميم جداول ثلاثية الخطوط الأفقية الصامتة الخالية تماماً من الخطوط الرأسية المتقاطعة، مع تذييل الجدول بحواشٍ سفلية توضح الرموز الإحصائية المعتمدة ومستويات الدلالة الإحصائية المقابلة لمستويات الشك المعيارية (* p < .05, ** p < .01, *** p < .001)، مما يمنح البحث سمة الإتقان الأكاديمي والمهنية المنهجية الرفيعة.
10. المآزق المنهجية الشائعة والبدائل اللامعلمية عند انتهاك الافتراضات
10.1 أخطاء تفسيرية وتطبيقية شائعة في البحوث النفسية
تكشف المراجعات المنهجية للدراسات النفسية والتربوية المنشورة عن وقوع كثير من الباحثين في مآزق تفسيرية وتطبيقية جسيمة عند استخدام اختبار t للعينة الواحدة؛ ويأتي في مقدمة تلك المزالق الخلط المفاهيمي الحاد بين الدلالة الإحصائية (Statistical Significance) والأهمية الإكلينيكية أو العملية (Clinical/Practical Importance). إن الحصول على قيمة p صغيرة جداً لا يعني بالضرورة أن الفارق المكتشف يتمتع بأي وزن نوعي أو تطبيقي في الحياة الواقعية للمفحوصين؛ فقد يكون الفارق تافهاً ولكنه أظهر دلالة رقمية مصطنعة نتيجة تضخم العينة المبالغ فيه، وهو ما يفرض دوماً تلازم تفسير الدلالة مع حجم الأثر لضمان عقلانية الاستنتاج.
يتجسد الخطأ الفادح الثاني في الاستخدام الميكانيكي غير الواعي لقيمة الصفر (Test Value = 0) كقيمة مرجعية افتراضية داخل البرمجيات الإحصائية دون وجود مسوغ نظري أو سيكومتري يدعم ذلك؛ ففي القياس النفسي، نادراً ما يكون للصفر معنى مطلق أو مرجعي، واستخدام الصفر في مقياس ليكرت أو مقياس يبدأ من درجات موجبة يؤدي بالضرورة إلى مقارنة زائفة وفارغة علمياً لا معنى لها وتضخيم وهمي لقيم t المحسوبة دون طائل.
علاوة على ذلك، يقع باحثون كثر في شرك سوء تفسير القيمة الاحتمالية (p-value)، حيث يُنظر إليها خطأً على أنها “احتمالية أن تكون الفرضية الصفرية صحيحة”، أو “احتمالية أن تكون نتائج الدراسة قد حدثت بمحض الصدفة”. إن هذا الفهم خاطئ تماماً من الوجهة الرياضية؛ فالقيمة الاحتمالية هي احتمال مشروط للبيانات بافتراض صحة الفرضية الصفرية مقدماً: P(Data | H0)، وليست احتمال الفرضية الصفرية في ضوء البيانات الملاحظة: P(H0 | Data)، ويقود هذا اللبس المفاهيمي إلى تهويل غير علمي للأدلة الميدانية يفتقر إلى السند المنطقي السليم.
10.2 البدائل اللامعلمية: اختبار ويلكوكسون للإشارات والرتب
عندما تتعرض البيانات الميدانية المجمعة لانتهاكات منهجية حادة لا يمكن تداركها، كأن يفشل المتغير التابع فشلاً ذريعاً في استيفاء شرط التوزيع الطبيعي الاعتدالي في ظل عينات صغيرة جداً (n < 20)، أو عندما يكون مقياس القياس رتبياً تراتبياً (Ordinal Scale) لا فترياً، أو عند بروز قيم شاذة متطرفة يتعذر تصحيحها أو استبعادها، فإن الاستمرار في تطبيق اختبار t للعينة الواحدة يُصبح مغامرة إحصائية غير آمنة تفضي إلى نتائج مضللة وتضخم فادح في الخطأ من النوع الأول أو الثاني.
في مثل هذه المآزق التوزيعية، يتحول الباحث المنهجي نحو البديل اللامعلمي (Non-parametric Alternative) المقابل لاختبار t للعينة الواحدة، وهو “اختبار ويلكوكسون للإشارات والرتب للعينة الواحدة” (Wilcoxon Signed-Rank Test for One Sample). يتجاوز هذا الاختبار افتراض الاعتدالية البارامتري بالكامل؛ إذ إنه لا يتعامل مع القيم الخام أو المتوسطات الحسابية المتأثرة بالانحراف، بل يقوم على ترتيب الفروق المطلقة بين درجات العينة وقيمة الوسيط المرجعي المفترض (Hypothesized Median)، ثم إسناد الإشارات الأصلية (الموجبة والسالبة) لهذه الرتب ومقارنة مجموع الرتب الموجبة بمجموع الرتب السالبة.
يرتكز اختبار ويلكوكسون على فحص ما إذا كان وسيط المجتمع الحقيقي يتمايز عن الوسيط المعياري؛ ويتميز الاختبار بمتانة رياضية مذهلة (Robustness) تجعله محصناً ومقاوماً للقيم الشاذة والأشكال التوزيعية شديدة الالتواء والتفرطح. وعلى الرغم من أن الاختبارات اللامعلمية تفقد جزءاً ضئيلاً من القوة الإحصائية (يقدر بنحو 5% إلى 10% من قوة الاختبار المعلمي في حال كانت البيانات طبيعية حقاً)، إلا أن كفاءتها ومتانتها الفائقة عند انتهاك الشروط تجعلها الخيار الأكثر أماناً ومصداقية لحماية التحليل العلمي من التزييف التوزيعي، مما يعزز الثقة في الاستدلالات السيكومترية المستخلصة من العينات الميدانية الشائكة وفق ما تقرره منهجيات القياس الحديثة (James W. Pennebaker et al., 2015).
10.3 معايير اختيار المعالجة الإحصائية المثلى
لتيسير اتخاذ القرار المنهجي الصائب في الممارسة الميدانية، يمكن للباحثين اتباع خريطة تدفق منطقية واضحة المعالم تحدد المسار الإحصائي الأمثل خطوة بخطوة؛ تبدأ هذه الخريطة بفحص طبيعة المتغير التابع التابع ومستوى قياسه؛ فإذا كانت البيانات اسمية أو تصنيفية، يُستبعد اختبار t تماماً ويُوجه الباحث نحو اختبارات حسن المطابقة كاختبار مربع كاي. أما إذا كانت البيانات كمية متصلة ومقاسة على مقياس فتري أو نسبي، يُنتقل فوراً إلى فحص استقلالية المشاهدات وتصميم المعاينة؛ فإذا انعدم شرط الاستقلالية استُبعد الاختبار لصالح نماذج القياسات المتكررة أو المعادلات الخطية الهرمية المختلطة.
في الخطوة التالية، يُجرى التشخيص الاستكشافي للبيانات للكشف عن القيم المتطرفة الشديدة واختبار افتراض التوزيع الطبيعي عبر اختبار شابيرو-ويلك والمخططات البيانية (Q-Q plots)؛ فإذا استوفت البيانات شروط الاعتدالية وخلوها من القيم الشاذة، يُطبق اختبار t للعينة الواحدة كخيار أول فائق القوة. أما إذا انحرفت البيانات انحرافاً طفيفاً ولكن حجم العينة كبير (n ≥ 30)، فإن مرونة الاختبار واحتماءه بنظرية النهاية المركزية تجيز للباحث الاستمرار في تطبيق اختبار t مع توثيق حدود الاعتدالية بدقة وشفافية في متن التقرير.
أما إذا كان حجم العينة صغيراً (n < 30) وتزامن ذلك مع خرق صريح وواضح لاعتدالية التوزيع ووجود قيم متطرفة أصيلة، فيتعين على الباحث اتباع أحد خيارين متقدمين: إما التحول الصريح نحو البديل اللابارامتري المتمثل في اختبار ويلكوكسون للإشارات والرتب وتفسير النتائج بالاعتماد على الوسيط بدلاً من المتوسط، أو اللجوء إلى تقنيات إعادة المعاينة المتقدمة المعروفة بأسلوب البوتسترابينغ (Bootstrapping)، حيث يقوم الحاسوب بإنشاء آلاف العينات العشوائية التوليدية المشتقة من بيانات العينة الأصلية لبناء فترات ثقة تجريبية غير معلمية متينة وخالية من أي افتراضات مسبقة للشكل التوزيعي. إن التزام الباحث بهذه المعايير المنهجية الشفافة والتقرير الصادق عن القيود الإحصائية يمثل معيار النزاهة العلمية الذي يميز البحوث الرصينة عن المحاولات التلفيقية الساعية للوصول للدلالة بأي ثمن.
خاتمة
في الختام، يتضح بجلاء أن اختبار t للعينة الواحدة ليس مجرد صيغة رياضية جامدة أو خوارزمية إجرائية تُطبق بصورة ميكانيكية عبر الحزم البرمجية، بل هو منظومة استدلالية متكاملة وأداة إبستمولوجية بالغة القوة والأناقة تتيح للباحثين في شتى حقول المعرفة السلوكية والتربوية والطبية سبر أغوار الظواهر المعقدة واختبار الفرضيات النظرية مقابل المعايير الواقعية بأعلى درجات الضبط واليقين الاحتمالي. وتتجلى عبقرية جوسيت التاريخية في تصميمه لتوزيع احتمالي ديناميكي يتكيف بمرونة مع حجم المعلومات المتاحة عبر مفهوم درجات الحرية، محولاً عجز الباحثين القديم عن معرفة تباين المجتمعات الكاملة إلى ميزة استدلالية رصينة قوامها التقدير الدقيق للمعاينة والخطأ المعياري.
ومع ذلك، تظل القوة التفسيرية لهذا الاختبار رهينة بوعي الباحث ويقظته المنهجية الصارمة تجاه استيفاء افتراضات القياس الكمي، والاستقلالية المطلقة للمشاهدات، والاعتدالية التوزيعية، والتعامل الرصين مع القيم الشاذة والمتطرفة. كما تقتضي أمانة الممارسة العلمية المعاصرة عدم الوقوف الساذج عند حدود الدلالة الإحصائية الرقمية المجردة (p-value)، بل تدعيمها الحتمي والدائم بمؤشرات حجم الأثر كمعامل كوهين دي وبناء فترات الثقة التقديرية، والجرأة المنهجية في التحول نحو البدائل اللامعلمية الرصينة كاختبار ويلكوكسون أو أساليب البوتسترابينغ كلما دعت الضرورة التوزيعية لذلك. إن التزام الباحث بهذه المنظومة الأخلاقية والمنهجية هو الضمانة الحقيقية لتحويل الأرقام الصامتة إلى معرفة نفسية وسلوكية نافعة تُسهم بصدق في ترقية الفهم الإنساني وتطوير التدخلات التطبيقية على أسس علمية صلبة لا تتزعزع.
المراجع
Conroy‐Beam, D., Buss, D. M., Asao, K., Sorokowska, A., Sorokowski, P., Aavik, T., et al. (2019). Contrasting Computational Models of Mate Preference Integration Across 45 Countries. Scientific Reports, 9(1). https://doi.org/10.1038/s41598-019-52748-8
Di Tella, R., MacCulloch, R., & Oswald, A. J. (2003). The Macroeconomics of Happiness. The Review of Economics and Statistics, 85(4), 809–827. https://doi.org/10.1162/003465303772815745
Fong, T., Nourbakhsh, I., & Dautenhahn, K. (2003). A survey of socially interactive robots. Robotics and Autonomous Systems, 42(3–4), 143–166. https://doi.org/10.1016/s0921-8890(02)00372-x
Hawker, D. S. J., & Boulton, M. J. (2000). Twenty Years’ Research on Peer Victimization and Psychosocial Maladjustment: A Meta‐analytic Review of Cross‐sectional Studies. Journal of Child Psychology and Psychiatry, 41(4), 441–455. https://doi.org/10.1111/1469-7610.00629
Pennebaker, J. W., Boyd, R. L., Jordan, K., & Blackburn, K. (2015). The Development and Psychometric Properties of LIWC2015. Zenodo (CERN European Organization for Nuclear Research). https://doi.org/10.15781/t25p41
Prigerson, H. G., Horowitz, M. J., Jacobs, S., Parkes, C. M., Aslan, M., Goodkin, K., et al. (2009). Prolonged Grief Disorder: Psychometric Validation of Criteria Proposed for DSM-V and ICD-11. PLoS Medicine, 6(8), e1000121. https://doi.org/10.1371/journal.pmed.1000121
Schraw, G. J., Crippen, K. J., & Hartley, K. (2006). Promoting Self-Regulation in Science Education: Metacognition as Part of a Broader Perspective on Learning. Research in Science Education, 36(1–2), 111–139. https://doi.org/10.1007/s11165-005-3917-8
Treynor, W., Gonzalez, R., & Nolen–Hoeksema, S. (2003). Rumination Reconsidered: A Psychometric Analysis. Cognitive Therapy and Research, 27(3), 247–259. https://doi.org/10.1023/a:1023910315561