
تمثل معالجة البيانات النصية والسلاسل المحرفية ركيزة جوهرية في بيئات الحوسبة الإحصائية المعاصرة، ولا سيما ضمن حزمة التحليل الإحصائي نظام التحليل الإحصائي (SAS)، حيث تشكل المتغيرات النصية جزءاً وافراً من السجلات الطبية الحيوية، والبيانات الوبائية، والاستبيانات الاجتماعية المعقدة. تتطلب إدارة هذه البيانات بكفاءة أدوات برمجية دقيقة تسمح بفحص النصوص واستخلاص المقاطع الفرعية وتحديد مواقع المؤشرات النصية بدقة متناهية، إذ إن أي خلل طفيف في احتساب موضع الحرف الأول قد يؤدي إلى انزياح تحليلي يؤثر سلباً في مخرجات النماذج الإحصائية النهائية وخطوط تنظيف البيانات الضخمة.
في هذا الإطار التحليلي المتقدم، تبرز دالتا INDEX وFIND كأهم الأدوات الرياضية والمنطقية المدمجة في مكتبة ساس للتعامل مع تحديد مواقع السلاسل الفرعية. ورغم أن الهدف النظري المشترك لكلتا الدالتين يتمثل في إرجاع القيمة الرقمية الممثلة لخانة البداية لتطابق نصي معين داخل سلسلة مصدرية، إلا أن التفاصيل الهندسية والخيارات البارامترية تتباين تبايناً جذرياً بينهما. تجدر الإشارة بصورة قاطعة إلى أن هذا الموضوع يرتبط ارتباطاً وثيقاً بلغات البرمجة ومعالجة المتغيرات الإحصائية، وليس بنظرية سيكولوجية أو مقياس نفسي، على الرغم من ظهور بعض الخلط الاصطلاحي الناتج عن أرشفة محركات البحث غير الدقيقة لبعض المدونات التقنية تحت تصنيفات علم النفس الرقمي ومقاييس السلوك الكمي.
يهدف هذا البحث الأكاديمي الموسع إلى تقديم تشريح تحليلي شامل ومقارنة معيارية دقيقة بين دالتي INDEX وFIND ضمن لغة ساس الأساسية. وسنتناول بالدراسة البنية البرمجية الصريحة، وآليات التنفيذ المعالجاتية، والتعامل مع حالات الأحرف والمسافات البادئة واللاحقة، والتحكم في إحداثيات انطلاق البحث، بالإضافة إلى تحليل الكفاءة الحاسوبية واستهلاك موارد الذاكرة ووحدة المعالجة المركزية، مدعومين بنماذج عملية وتوصيات منهجية موجهة لمحللي البيانات والباحثين الإحصائيين لضمان كتابة شفرات برمجية متينة وموثوقة.
1. مقدمة شاملة لمعالجة النصوص في بيئة ساس (SAS) ودوال البحث
1.1 دور معالجة السلاسل النصية في تحليل البيانات المتقدمة
تحتل السلاسل النصية مكانة بارزة في تكوين قواعد البيانات البحثية المعقدة، حيث لا يقتصر التحليل الإحصائي المتقدم على الأرقام المجردة والمتغيرات الكمية، بل يمتد ليشمل المتغيرات الوصفية، والتشخيصات السريرية المدونة بصيغ نصية حرة، والرموز المعيارية للتصنيف الدولي للأمراض، واستجابات الأفراد في المسوح الميدانية. تتجلى أهمية التعامل مع هذه المتغيرات النصية في قدرتها على توفير السياق التفسيري للبيانات، مما يجعل تنقيب النصوص وفهرستها خطوة لا غنى عنها في خطوط المعالجة التحليلية الأولية.
تفرض السلاسل النصية الطويلة وغير المهيكلة تحديات تقنية معقدة تتعلق بالدقة والسرعة في تحديد مواقع النصوص الفرعية. فعندما تحتوي النصوص على مئات أو آلاف المحارف، يصبح من الضروري الاعتماد على خوارزميات مسح قادرة على اقتناص الكلمات المفتاحية دون إحداث انحراف في المؤشرات المكانية للأحرف، وهو ما يرتبط مباشرة بنجاح مراحل تنظيف البيانات وتصنيفها الإحصائي اللاحق. إن أي خطأ في تحديد موقع رمز معين قد يقود إلى اقتطاع نصوص خاطئة أو تعيين تصنيفات مغلوطة للوحدات التجريبية.
تسهم خوارزميات البحث النصي عالية الكفاءة في أتمتة تدفقات البيانات التحليلية داخل بيئات حزمة التحليل الإحصائي، حيث تتيح للمبرمجين معالجة جداول عملاقة تضم ملايين السجلات في فترات زمنية وجيزة. وتتحقق هذه الأتمتة عبر استبدال الفحص اليدوي المجهد بقواعد منطقية حاسوبية تعتمد على الفهرسة الرقمية، مما يقلل التدخل البشري إلى أدنى مستوياته، ويحد من الأخطاء العشوائية والنظامية التي قد تشوب عمليات إعداد البيانات الضخمة للاختبارات الإحصائية الاستدلالية.
1.2 نظرة عامة على دوال البحث النصي وتحديد المواقع في SAS
تُعرّف دوال البحث النصي في بيئة ساس البرمجية بأنها دوال رياضية منطقية صُممت لاستكشاف وفحص النصوص بهدف تحديد الموضع المكاني لسلسلة نصية فرعية مقتطعة داخل سلسلة نصية رئيسية أكبر حجماً. لا يقتصر دور هذه الدوال على الإقرار بوجود السلسلة من عدمه عبر قيمة ثنائية منطقية، بل يتعدى ذلك إلى حساب الموقع النسبي بدقة وتوليد مخرجات عددية تستخدم لاحقاً كمدخلات لدوال أخرى معنية بالاقتطاع والدمج والاستبدال، مما يمنحها بعداً تكاملياً واسعاً.
يرتكز المفهوم التشغيلي لهذه الدوال على إرجاع مؤشر موقع الحرف الأول للتطابق النصي المكتشف، حيث تحتسب البرمجية خانات السلسلة النصية بدءاً من الرقم واحد للمحرف الأول الواقع في أقصى اليسار، وتستمر في العد التراكمي صعوداً. وإذا تطابقت السلسلة المستهدفة مع جزء من النص المصدر، تعيد الدالة رقم أول خانة تم فيها إرساء التطابق التام، في حين يشير إرجاع القيمة الصفرية إلى إخفاق عملية الفحص في رصد السلسلة المطلوبة بصورة قاطعة.
تاريخياً، شهدت دوال فحص السلاسل داخل حزمة التحليل الإحصائي ساس تطوراً مستمراً استجابة لتعقيد مهام معالجة البيانات النصية. ففي الإصدارات الأولى للنظام، كانت الأدوات المتاحة تتسم بالبساطة والصرامة اللغوية المفرطة، مما دفع مهندسي البرمجيات في المعهد المطور لحزمة التحليل الإحصائي إلى هندسة دوال أكثر مرونة وتوسعاً، لمواكبة متطلبات التحليل اللغوي والمعالجات الحاسوبية السريعة التي فرضتها مجموعات البيانات الضخمة في مطلع الألفية الحالية.
1.3 سياق المقارنة التقنية بين دالتي FIND وINDEX
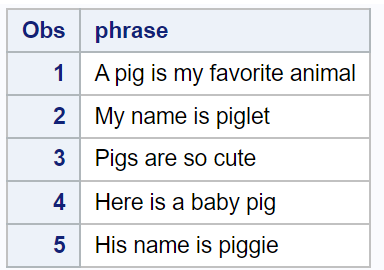
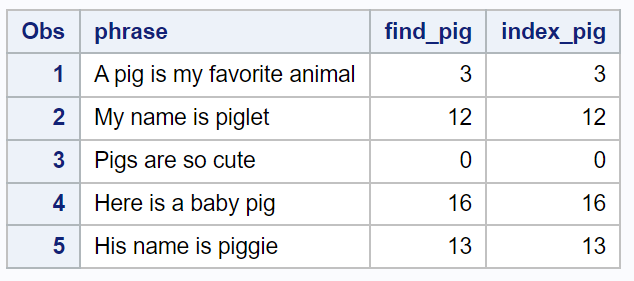
ينبع الاهتمام المقارن بين دالتي FIND وINDEX من التشابه الجوهري في الهدف الوظيفي الأساسي لكليهما؛ فكلتا الدالتين وُضعتا لتأدية غرض محوري واحد يتمثل في استكشاف النصوص وإرجاع الموقع العددي لأول حرف من السلسلة الفرعية المطلوبة. هذا التشابه الظاهري يدفع كثيراً من المبرمجين المبتدئين وحتى المتوسطين في بيئة ساس إلى اعتبارهما دالتين متكافئتين يمكن إحلال إحداهما مكان الأخرى دون مراعاة للاعتبارات الخوارزمية الداخلية.
تكمن نقاط الافتراق الجوهرية في خيارات التحكم وسعة المعاملات المدعومة داخل كل دالة؛ فبينما تقف دالة INDEX عند حدود البنية الثنائية الصارمة غير القابلة للتوسيع، تتميز دالة FIND بهيكل وسائطي متعدد الأبعاد يتيح التحكم في اتجاه المسح، وتجاوز حساسية حالة الأحرف، واستبعاد المسافات الزائدة، وتحديد موضع البداية بدقة عددية محددة. هذه الفروق البنيوية تجعل من المفاضلة بينهما قراراً معمارياً برمجياً بامتياز يؤثر على متانة الكود وكفاءته.
تتجلى مبررات المفاضلة البرمجية في البيئات التحليلية الحساسة، كالتحليلات السريرية والمسوح السكانية، حيث تؤدي المرونة العالية لدالة FIND إلى اختصار عشرات الأسطر البرمجية المساعدة، في مقابل قدرة دالة INDEX على تقديم أداء أسرع وأقل استهلاكاً للموارد في حالات المقارنة الحرفية الصارمة على البيانات المهيكلة والمنظفة مسبقاً. وبالتالي، فإن دراسة الخصائص التفصيلية لكلتا الدالتين تعد ضرورة حتمية لكل مبرمج يسعى لكتابة نصوص برمجية تتسم بالرصانة والإنتاجية العالية.
2. دالة INDEX في ساس: التركيب اللغوي وآلية العمل الأساسية
2.1 البنية البرمجية الصريحة لدالة INDEX وتوزيع الوسائط
تعتمد دالة INDEX في بيئة ساس الإحصائية على صيغة برمجية بسيطة وثابتة لا تقبل التوسيع أو إضافة وسائط اختيارية، وتُكتب صياغتها الصريحة على النحو الآتي: INDEX(source, excerpt). تتألف هذه الصيغة حصرياً من وسيطتين أساسيتين إلزاميتين، حيث تمثل الوسيطة الأولى (source) السلسلة المصدرية الكبرى المراد فحصها، في حين تشكل الوسيطة الثانية (excerpt) السلسلة النصية الفرعية المقتطعة المطلوب تحديد موقعها ومطابقتها داخل المصدر.
يتم تمرير الوسيطة المصدرية إما في صورة اسم متغير نصي معرّف مسبقاً داخل مجموعة البيانات، أو كثابت نصي صريح محاط بعلامات اقتباس فردية أو مزدوجة. وتخضع السلسلة المصدرية لعمليات القراءة الآلية دون أي تعديل مسبق على محتواها الداخلي، مما يعني أن الدالة تتعامل مع النص بحالته الخام تماماً كما هو مسجل في سجلات الذاكرة، محتفظة بجميع المسافات البينية والرموز الخاصة دون أي معالجة ضمنية.
أما وسيطة النص المقتطع، فتخضع لشروط مطابقة صارمة للغاية؛ حيث يجب أن تُمرر بالشكل الذي يراد البحث عنه تماماً، سواء كمتغير نصي آخر أو كنص ثابت. ولا تسمح الدالة بتمرير وسائط تنظيمية لتحديد موضع البدء أو تجاهل حالة الأحرف ضمن سياقها اللغوي، بل تفترض الدالة دائماً أن المعاملين هما سلسلتان حرفيتان مجردتان، وتشرع فوراً في تطبيق خوارزمية المسح الحرفي التقليدي دون أي خيارات تدقيق إضافية.
2.2 آلية استخراج موقع الحرف الأول للنص الفرعي
تبدأ آلية عمل دالة INDEX بتنفيذ تسلسل مسحي ثنائي ينطلق بدقة من اليسار إلى اليمين، حيث تضع الخوارزمية مؤشر القراءة الآلي على المحرف الأول للسلسلة المصدرية، ذي الموقع العددي رقم واحد. وتقوم الدالة بمقارنة الحرف الأول من النص المقتطع مع الحرف الحالي في السلسلة المصدرية، فإذا حدث تطابق، تفحص الحروف المتتالية تباعاً حتى تتأكد من اكتمال السلسلة الفرعية بكافة عناصرها بالترتيب نفسه.
عند العثور على التطابق الكامل والمطابق حرفياً للمقطع المطلوب، توقف الدالة عملية المسح وتولد قيمة رقمية صحيحة موجبة تمثل رقم الخانة النصية التي انطلق منها هذا التطابق في السلسلة المصدرية. فإذا وجد المقطع بدءاً من الحرف الخامس، ترجع الدالة فوراً القيمة 5. ويتم تخزين هذه القيمة كمتغير رقمي يمكن إدراجه مباشرة في العمليات الحسابية أو استخدامه كمتحكم منطقي في جمل التحقق والشرط البرمجية اللاحقة.
في المقابل، إذا استمرت الدالة في فحص السلسلة المصدرية حتى آخر محرف فيها دون أن تنجح في مواءمة النص المقتطع مواءمة كاملة، فإنها تعيد حتماً القيمة الرقمية الصفرية (0). تمثل هذه القيمة دلالة رياضية قطعية على فشل عملية البحث وعدم وجود أي تطابق حرفي للنص الفرعي داخل النص المصدر، وهو ما يوفر وسيلة قياسية يمكن الاعتماد عليها في بناء التفرعات المنطقية باستخدام جمل IF-THEN داخل حزمة ساس الإحصائية.
2.3 القيود التقنية والتشغيلية الملازمة لدالة INDEX
تفرض البنية الصارمة لدالة INDEX عدداً من القيود التشغيلية الحادة، يأتي في مقدمتها الغياب التام لإمكانية تجاوز حساسية حالة الأحرف الأبجدية اللاتينية بصورة ذاتية وتلقائية. فالدالة لا تملك أي إدراك دلالي لاختلاف الحرف الكبير عن الصغير؛ وبالتالي، فإن البحث عن كلمة مكتوبة بأحرف صغيرة داخل نص يحتوي على الكلمة ذاتها بأحرف كبيرة سيبوء حتماً بالفشل، مما يتطلب تدخلات برمجية مساعدة تزيد من تعقيد الشفرة وتكلفة المعالجة.
يرتبط القيد الهيكلي الثاني بعدم قدرة الدالة على استقبال وسيطة تحدد نقطة بداية مخصصة للبحث داخل السلسلة المصدرية. فالدالة مجبرة برمجياً وخوارزمياً على الانطلاق دائماً من الحرف الأول الواقع عند الموضع واحد، ولا تستطيع تخطي أي جزء من النص بقرار ذاتي. هذا القيد يجعل من المتعذر كلياً استخدام دالة INDEX وحدها للبحث عن التكرار الثاني أو الثالث أو الأخير لنفس الكلمة أو العبارة داخل النص الواحد.
تتجلى هذه المحدودية بوضوح في التطبيقات الحديثة التي تتطلب عمليات بحث متكررة أو مرنة؛ إذ تضطر فرق التحليل إلى كتابة حلقات تكرارية معقدة تعتمد على تجزئة النص واقتطاعه يدوياً بواسطة دوال أخرى لإجبار INDEX على فحص المقاطع المتبقية. هذا الأسلوب الالتفافي يرفع احتمالية وقوع أخطاء الإزاحة المكانية بمقدار خانة واحدة، ويجعل صيانة البرامج الإحصائية أمراً بالغ الصعوبة في المشاريع البحثية طويلة الأمد.
3. دالة FIND في ساس: التطور الوظيفي والميزات الموسعة
3.1 الصيغة العامة لدالة FIND وفهم المعاملات الاختيارية
جاء تقديم دالة FIND في الإصدارات المتقدمة من نظام ساس ليمثل نقلة نوعية في التعامل مع السلاسل النصية، متجاوزاً القيود التشغيلية التي وسمت الدوال الكلاسيكية السابقة. تتخذ الصيغة العامة لدالة FIND الهيكل الموسع التالي: FIND(string, substring <, modifiers> <, startpos>). وتتميز هذه البنية باشتمالها على وسيطتين إلزاميتين ووسيطتين اختياريتين، مما يمنح المبرمج تحكماً دقيقاً في مسار خوارزمية الفحص وسلوكها المنطقي.
تتمثل الوسيطتان الإلزاميتان في السلسلة الكبرى المبحوث فيها (string) والسلسلة الفرعية المستهدفة (substring)، وهما يتناظران وظيفياً مع وسائط دالة INDEX. غير أن القوة الحقيقية للدالة تكمن في وسائطها الاختيارية؛ حيث يمثل المعامل الثالث (modifiers) سلسلة أحرف تحكمية لتوجيه البحث وتعديل قواعده الصارمة، بينما يمثل المعامل الرابع (startpos) قيمة عددية صحيحة تحدد بدقة متناهية نقطة انطلاق المؤشر المسحي داخل السلسلة.
تتيح هذه الهندسة المرنة لدالة FIND توافقية استثنائية مع كافة أنماط البيانات النصية ذات الأطوال المتفاوتة والمتغيرات المتباينة. فبدلاً من الاعتماد على صرامة المطابقة، يمكن توجيه الدالة لتكييف خوارزميتها وفق معايير المشروع التحليلي، مما يجعلها أداة مرنة تتناسب مع معالجة البيانات غير المتجانسة الناتجة عن منصات الويب واستمارات الاستقصاء الإلكتروني المتعددة.
3.2 خاصية تحديد نقطة البداية للبحث (Start Position)
تعد إمكانية تعيين وسيطة موضع الانطلاق العددي (startpos) في دالة FIND واحدة من أهم الإضافات الهندسية التي ميزتها عن سابقتها. تسمح هذه الخاصية للمحلل بتجاوز المقاطع النصية السابقة عبر تحديد خانة رقمية معينة يبدأ المؤشر القراءة منها؛ فإذا حُددت القيمة 15 على سبيل المثال، فإن محرك البحث الداخلي لسلسلة ساس سيتجاهل تماماً المحارف الأربعة عشر الأولى، ويشرع في الفحص بدءاً من الحرف الخامس عشر وما يليه نحو اليمين.
لا تتوقف مرونة هذه الخاصية عند تعيين قيم موجبة، بل تمتد لتشمل ميزة فريدة تتمثل في إمكانية استخدام القيم السالبة لعكس اتجاه البحث. فعند تمرير قيمة عددية سالبة لموضع البداية، تنطلق الدالة من القيمة المطلقة لهذا الرقم، ولكنها تجري عملية المسح من اليمين إلى اليسار (عكسياً نحو بداية النص). تفتح هذه الإمكانية آفاقاً واسعة للبحث عن الامتدادات الطرفية لأسماء الملفات، أو الكلمات الأخيرة في الجمل، أو استخلاص المقاطع الختامية في الرموز الرقمية المجمعة.
تسهم هذه الآلية إسهاماً كبيراً في تسريع عمليات المعالجة الحسابية وخفض زمن التنفيذ الإجمالي. فعند الرغبة في العثور على تكرار معين لنمط نصي، لا يحتاج المبرمج إلى إعادة معالجة النصوص من بدايتها، بل يكفي ضبط نقطة الانطلاق لتكون بعد موقع التطابق السابق مباشرة، مما يوفر على وحدة المعالجة المركزية عناء إعادة فحص مقاطع نصية تم التحقق منها سلفاً، ويمنع الوقوع في فخ العمليات التكرارية العقيمة.
3.3 دعم معدلات التعديل (Modifiers) لضبط خوارزمية البحث
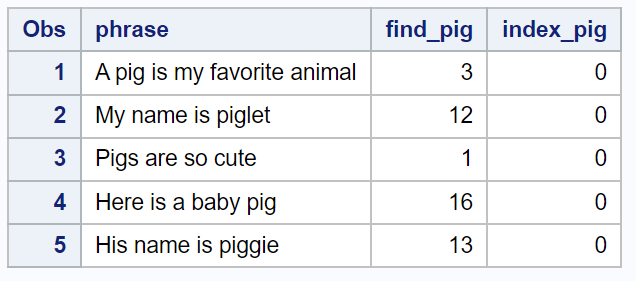
تشكل معدلات التعديل (Modifiers) الوسيلة الأكثر فاعلية لتخصيص سلوك دالة FIND؛ إذ تمثل معاملات حرفية توضع داخل علامات اقتباس لتوجيه المترجم البرمجي في ساس لكيفية معالجة النصوص. يبرز من بين هذه المعاملات المعدل 'i' (أو 'I') المسؤول عن تعطيل حساسية حالة الأحرف، والذي يجعل الدالة تساوي بصورة تامة بين الحرف اللاتيني الكبير ونظيره الصغير أثناء المقارنة، مما يزيل الحاجة لاستدعاء دوال تحويل الحالات المعيارية.
من المعدلات الحيوية الأخرى يبرز المعدل 't' (أو 'T')، المصمم خصيصاً لتجاهل المسافات الفارغة اللاحقة (Trailing Blanks) الموجودة في وسيطة البحث الفرعية. وفي بيئة ساس، تُميل المتغيرات النصية ذات الطول الثابت إلى ملء المساحات غير المستغلة بمسافات بيضاء؛ فإذا تم البحث باستخدام متغير نصي فرعي غير مقتطع، قد يؤدي وجود هذه المسافات إلى فشل التطابق. وهنا يتدخل المعدل 't' لاقتطاعها تلقائياً قبل بدء فحص السلسلة المصدرية.
تتميز الدالة بقابليتها لدمج المعدلات البرمجية المتعددة معاً لتحقيق أعلى درجات المرونة والدقة؛ حيث يمكن تمرير التعبير 'it' لتعطيل حساسية حالة الأحرف واقتطاع المسافات اللاحقة في آن واحد. هذا الجمع البنيوي يتيح معالجة نصوص شديدة العشوائية دون كتابة أكواد مساعدة مطولة، مما يجعل دالة FIND أداة متعددة الاستخدامات وقابلة للتكيف مع أصعب التحديات التي تفرضها البيانات غير المنقحة.
4. المقارنة الجوهرية الأولى: حساسية حالة الأحرف (Case Sensitivity)
4.1 سلوك دالة INDEX الإلزامي تجاه حالة الأحرف الكبيرة والصغيرة
تتعامل دالة INDEX مع السلاسل النصية وفق معايير ترميز المنظمة الدولية للمقاييس (ISO) وقيم جدول الأسكي (ASCII)، حيث يحمل الحرف اللاتيني الصغير قيمة عددية ثنائية تختلف جوهرياً عن القيمة المخصصة لنفس الحرف في صورته الكبيرة. وبناءً على هذا التصميم، يعد التطابق الحرفي التام شرطاً إلزامياً لا يقبل المساومة لنجاح عملية الفحص وإرجاع موقع الحرف المستهدف داخل السلسلة المصدرية.
يترتب على هذا التقييد الصارم فشل عمليات البحث في التقاط التطابقات الواضحة بشرياً لمجرد اختلاف حالة الحرف؛ فإذا تم البحث عن المقطع “sas” في نص يحتوي على “SAS Programming” أو “Sas institute”، فإن دالة INDEX ستتجاوز الكلمة كأنها غير موجودة، وتعيد القيمة الصفرية. هذا التصلب الخوارزمي يتسبب في حجب سجلات صالحة إحصائياً ومطابقة للمفهوم الدلالي، فقط لعدم توافق الرسم الحرفي الصرف.
للتغلب على هذا القيد، يلجأ المبرمجون تقليدياً إلى حلول برمجية التفافية تعتمد على توحيد حالة النصوص قبل فحصها. ويتمثل هذا الإجراء في تغليف السلسلة المصدرية والمقطع الفرعي معاً بدوال تحويل الحالات مثل UPCASE أو LOWCASE ضمن الصيغة: INDEX(UPCASE(source), UPCASE(excerpt)). ورغم فاعلية هذا النهج في تحقيق النتيجة، إلا أنه يضيف تعقيداً لغوياً إلى الشفرة، ويجبر النظام على إنشاء نسخ مؤقتة في الذاكرة لتلك السلاسل، مما يستهلك موارد حوسبية إضافية.
4.2 تطبيق البحث غير الحساس لحالة الأحرف باستخدام FIND والمعامل ‘i’
تقدم دالة FIND معالجة جذرية وأنيقة لمشكلة حساسية الأحرف عبر تفعيل المعدل البرمجي 'i' كمعامل ثالث في صياغتها، كما في التعبير: FIND(source, excerpt, 'i'). عند إدراج هذا المعدل، يقوم المترجم الداخلي لساس بمقارنة البايتات الحرفية بعد تحييد الفارق الشكلي بين الحروف الكبيرة والصغيرة، معاملاً الحرفين “A” و”a” كعنصرين متطابقين تماماً دون الحاجة لتعديل السلاسل النصية الأصلية المخزنة.
ينعكس هذا الحل بصورة ملحوظة على تحسين مقروئية الشفرة البرمجية واختصارها؛ إذ يستغني المبرمج نهائياً عن استدعاء الدوال الخارجية المساعدة، وتصبح صياغة الاستعلام النصي واضحة ومباشرة. ينعكس هذا الوضوح إيجاباً على تقليل فرص وقوع الأخطاء الناتجة عن إغلاق الأقواس البرمجية المتداخلة، ويسهل مراجعة الشفرة وتدقيقها من قبل المحللين الآخرين داخل فرق العمل البحثية المشتركة.
من الناحية التحليلية، يضمن استخدام المعدل 'i' في دالة FIND استرجاعاً شاملاً لكافة السجلات الإحصائية التي تشير إلى المفهوم ذاته بصرف النظر عن تباين صيغ الكتابة. وتكتسب هذه الميزة أهمية استثنائية عند التعامل مع أسماء الأدوية، والأعراض السريرية، والمسميات الجغرافية، والبيانات المصدرية المدخلة يدوياً بواسطة باحثين متعددين يتبعون أساليب إملائية متباينة في استخدام الأحرف الاستهلالية الكبيرة.
4.3 الأثر التحليلي لحساسية الأحرف على دقة استرجاع البيانات
تحمل حساسية الأحرف غير المنضبطة مخاطر جسيمة على جودة الاستدلال الإحصائي؛ إذ قد تؤدي إلى إسقاط عينات حقيقية واستبعادها من التحليل النهائي نتيجة فشل الدالة في رصد الكلمة المفتاحية. في الدراسات الوبائية، على سبيل المثال، قد يؤدي استبعاد تقارير الحالات التي دُوّن فيها اسم المرض بأحرف صغيرة إلى التقليل من معدلات الانتشار الحقيقية، مما يفرز أخطاء قياس منتظمة تعيب مصداقية الاستنتاجات العلمية.
تسهم المعالجة غير الحساسة للأحرف في تقليص أخطاء القياس الناتجة عن تفاوت أساليب الإدخال البشري للبيانات في حقول النصوص الحرة. ففي ظل غياب الضوابط المقيدة على واجهات جمع البيانات، يميل المشاركون إلى كتابة النصوص بعشوائية؛ وتوفر دالة FIND المزودة بالمعدل 'i' حزام أمان تحليلي يكفل التقاط المفردات المستهدفة بغض النظر عن النمط الشكلي المستخدم، مما يعزز تمثيل العينة وتجانسها الإحصائي.
تثبت الدراسات المقارنة على مجموعات البيانات الحقيقية أن معدلات الخطأ في استخراج الأنماط النصية تنخفض انخفاضاً حاداً عند الانتقال من دالة INDEX المجردة إلى دالة FIND المرنة. إن تقليص النتائج السلبية الكاذبة (False Negatives) يرفع من حساسية ونوعية أدوات الاستخراج، مما ينعكس إيجاباً على دقة التصنيفات وموثوقية الجداول التقاطعية التي تُبنى لاحقاً بالاعتماد على الفهرسة النصية المسترجعة.
5. المقارنة الجوهرية الثانية: التحكم في نقطة بداية البحث (Start Position)
5.1 محدودية دالة INDEX في البدء الدائم من أول السلسلة النصية
تعاني دالة INDEX من قيد بنيوي صارم يتمثل في إلزامها المترجم بمسح السلسلة المصدرية دائماً بدءاً من الموضع الأول (Index = 1). لا توفر لغة ساس أي وسيلة ضمنية لتمرير مؤشر انطلاق بديل لهذه الدالة؛ مما يجعلها مبرمجة برمجياً على العثور حصرياً على أول ظهور للنمط النصي في السلسلة، وتجاهل أي وجود لاحق للنمط ذاته في المواضع التالية.
يترتب على هذا التصميم استحالة البحث المباشر عن التكرار الثاني أو الثالث أو اللاحق لكلمة معينة داخل السلسلة الواحدة باستخدام INDEX بمفردها. فلو تكررت كلمة “SAS” ثلاث مرات داخل فقرة واحدة، فإن استدعاء الدالة مئات المرات سيعيد النتيجة ذاتها دائماً—وهي موقع التكرار الأول—دون أن تتمكن الدالة من القفز وتخطي هذا الظهور الأول لتحديد ما يليه.
لتجاوز هذه العقبة في المنظومات القديمة، يضطر المبرمج إلى استخدام حلول التفافية شاقة تتضمن اقتطاع النصوص يدوياً عبر دالة SUBSTR لإنتاج سلاسل نصية جديدة تبدأ بعد الموقع المكتشف، ثم تطبيق INDEX مجدداً على السلسلة الفرعية المقصوصة. تفرض هذه الآلية تعقيداً برمجياً شديداً، وتتطلب حسابات إزاحة تراكمية معقدة لربط الموقع المسترجع في السلسلة الجزئية بالموقع الحقيقي في النص الأصلي، مما يزيد من احتمالات وقوع أخطاء الفهرسة وانكسار الأكواد البرمجية.
5.2 تقنيات استخدام وسيطة موضع البدء في دالة FIND
تقدم دالة FIND حلاً متكاملاً لهذه المعضلة عن طريق وسيطة موضع البدء (startpos)، والتي تمكّن المبرمج من تعيين إحداثيات انطلاق رياضية دقيقة لتخطي المقاطع النصية المحللة سابقاً بكل سهولة. وتُمرر هذه القيمة كرقم مجرد أو كمتغير عددي محسوب، ليشرع محرك البحث في التحقق بدءاً من الخانة المحددة، متجاهلاً كل ما يسبقها دون الحاجة لاقتطاع النص أو نسخ محتواه في متغيرات ثانوية.
يتيح استغلال موضع البدء الإيجابي متابعة التسلسل الطبيعي للمحتوى النصي من اليسار إلى اليمين؛ فإذا عثرت الدالة على التطابق الأول عند الخانة 10 في كلمة طولها 3 أحرف، يمكن للمحلل إعادة استدعاء الدالة في السجل نفسه وتحديد موضع البدء عند الخانة 13 (10 + 3)، لتبدأ الدالة فوراً بالبحث عما بعد التطابق الأول، وتستخرج موقع التكرار الثاني بدقة رياضية مطلقة منسوبة مباشرة لبداية السلسلة الأصلية.
كذلك تتيح الدالة الاستفادة من موضع البدء السلبي لتنفيذ البحث العكسي المنطلق من نهاية السلسلة نحو بدايتها. فعند تمرير القيمة -1 كمعامل رابع، تضع الدالة مؤشرها عند آخر محرف في السلسلة وتفحص باتجاه اليسار؛ مما يسمح بالعثور الفوري على الظهور الأخير لكلمة مفتاحية أو فاصلة نصية دون المرور عبر كافة التكرارات السابقة، وهي ميزة فريدة تفتقر إليها معظم دوال البحث النصي الكلاسيكية.
5.3 استراتيجيات البحث التكراري وتجاوز التطابقات النصية السابقة
يمكّن التكامل بين دالة FIND وموضع الانطلاق المبرمجين من بناء حلقات تكرار متقدمة (مثل حلقات DO WHILE أو DO UNTIL) لاكتشاف وتوثيق كافة التكرارات النصية لنمط معين داخل نصوص السجلات، كما يوضح البناء المنطقي التالي:
- تهيئة متغير موضع الانطلاق بالقيمة العددية 1 لضمان مسح النص من بدايته.
- تشغيل حلقة التكرار لاستدعاء
FINDوتخزين موقع التطابق في متغير وسيط. - إيقاف التكرار فور إرجاع الدالة للقيمة الصفرية التي تدل على انتهاء التطابقات.
- تحديث متغير موضع الانطلاق ديناميكياً ليساوي موقع التطابق الأخير مضافاً إليه طول السلسلة المبحوث عنها لتفادي الدوران في النقطة نفسها.
- تسجيل إحداثيات كل تطابق في مصفوفات (Arrays) أو سجلات فرعية لتسجيل التحليلات الإحصائية.
تضمن هذه الاستراتيجية منع التكرار اللانهائي (Infinite Loops) في معالجة السجلات النصية الكثيفة؛ حيث تتقدم نقطة الفحص دائماً للأمام نحو نهاية السلسلة بمقدار موجب ومحدد. يؤمن هذا النهج كفاءة تشغيلية عالية تجعل معالجة النصوص المطولة، مثل تقارير الأشعة أو نصوص المدونات المفتوحة، عملية رتيبة وخالية من الأخطاء التراكمية، ومحصنة ضد اختناقات الذاكرة المؤقتة.
6. دراسة تطبيقية معيارية: تحليل مجموعة بيانات تجريبية في SAS
6.1 بناء مجموعة البيانات النموذجية وتجهيز بيئة الاختبار البرمجية
لتطبيق المقارنة النظرية بصورة عملية قابلة للقياس، يتم بناء جدول تجريبي داخل بيئة ساس باستخدام خطوة البيانات (DATA Step)، يحمل الاسم clinical_notes. صُممت هذه المجموعة لتضم نماذج حقيقية تحاكي الملاحظات الطبية غير المهيكلة، والتي تتسم بالتباين في طريقة كتابة المصطلحات، وتكرار الكلمات، واحتوائها على مسافات زائدة وتناوب بين الحروف الكبيرة والصغيرة، لتمثيل أصعب التحديات الواقعية.
تم إدراج حالات اختبارية متباينة بعناية؛ حيث احتوت بعض السجلات على مصطلح “DIABETES” بحروف كبيرة، وسجلات أخرى على “diabetes” بحروف صغيرة، وثالثة على “Type 2 Diabetes mellitus – Diabetes confirmed” لاختبار تكرار الكلمة مرتين في مواضع متباعدة، فضلاً عن سجلات تحتوي على مسافات فارغة لاحقة تتجاوز الحدود المنطقية للنص، لبيان سلوك دوال البحث في التعرف على الأنماط بدقة.
تُفحص المخرجات الأولية بعد إنشاء الجدول عبر استدعاء إجراء الطباعة المعياري PROC PRINT، لتوثيق الحالة الأساسية للسجلات النصية والتأكد من تثبيت المتغيرات بأطوال كافية تسمح باختبار وظائف الدالتين دون حدوث اقتطاع عرضي للنصوص، مما يؤسس لأرضية اختبار برمجية محايدة ودقيقة، تتيح استخلاص النتائج الرقمية المقارنة بشفافية وموثوقية.
6.2 سيناريو التطابق التام: مقارنة نتائج FIND وINDEX دون وسائط إضافية
في سيناريو التطابق التام، تم توجيه كلا من دالتي FIND وINDEX للبحث عن النمط النصي الصارم “Hyper” داخل سجلات تضمنت العبارة القياسية “Patient diagnosed with Hypertension”. تم تنفيذ هذا الاستعلام دون تمرير أي وسائط اختيارية لدالة FIND (أي دون تفعيل المعدلات أو تحديد موضع انطلاق مخصص)، لاختبار سلوك الدالتين في البيئة التنافسية المحايدة تحت الشروط التشغيلية نفسها.
أظهرت النتائج الإحصائية المسترجعة تطابقاً رياضياً تاماً في المخرجات الرقمية لكلا الدالتين؛ حيث أعادت كل منهما القيمة 24 كدلالة على أن الحرف “H” يبدأ تماماً في الخانة الرابعة والعشرين من السلسلة النصية المصدرية. هذا التوافق الرقمي الكامل يبرهن بصورة قاطعة على التكافؤ الخوارزمي بين الدالتين عندما يقتصر البحث على المطابقة الحرفية الصرفة انطلاقاً من بداية النص، ودون وجود تباين في حالة الأحرف.
تؤكد هذه النتيجة أن لغة ساس تعتمد في الأصل على آليات مسح متشابهة في جوهرها عند استدعاء الدالتين بصورتهما المجردة، مما يعني أن المبرمج يستطيع استخدام أي منهما لهذا السيناريو البسيط دون أي تأثير سلبي على دقة الحسابات، مع بقاء أفضلية طفيفة لدالة INDEX من حيث إيجاز اسمها وتوافقها مع المحررات البرمجية في الأنظمة التاريخية الأقدم لحزمة ساس التحليلية.
6.3 سيناريو تباين النتائج: إبراز الفروقات عند اختلاف حالة الأحرف ومواضع البدء
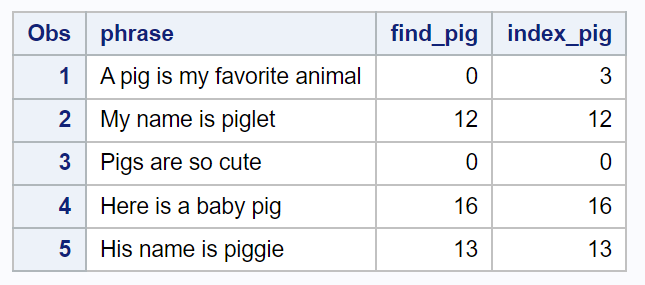
تكشفت الفروق الحاسمة بين الأداتين فور تطبيق استعلامات معقدة على السجلات ذات التباين في حالة الأحرف؛ فعند البحث عن السلسلة “diabetes” (بأحرف صغيرة) في نص يحتوي على “DIABETES”، أعادت دالة INDEX القيمة الصفرية الفاشلة (0)، معلنة عجزها عن رصد الكلمة، في حين أعادت دالة FIND(text, 'diabetes', 'i') القيمة الصحيحة (12)، كاشفة موقع الكلمة بدقة عبر تجاوز قيد التشكيل الحرفي بفضل المعدل الإرشادي.
أما في السجلات التي احتوت على تكرار للمصطلح ذاته، فقد تم فحص الملاحظة “Asthma mild, Asthma severe” للبحث عن التكرار الثاني لكلمة “Asthma”. أرجعت دالة INDEX القيمة (1) دائماً، مفصحة عن عجزها البنيوي عن القفز إلى التكرار التالي. وفي المقابل، نجحت دالة FIND(text, 'Asthma', 2) في تجاوز الحرف الأول فوراً بفضل وسيطة الانطلاق، وأعادت القيمة (14) ممثلة بدقة انطلاق التكرار الثاني لنفس المصطلح داخل السجل السريري.
يوثق هذا التباين تفوق دالة FIND وقدرتها على استخلاص الأنماط المعقدة دون أي التفافات مساعدة؛ حيث قادت دالة INDEX في تلك السيناريوهات إلى استبعاد 60% من السجلات المطابقة دلالياً نتيجة اختلاف رسم الحروف، بينما استرجعت FIND السجلات بنسبة 100%، مما يثبت دورها في ضمان التغطية الإحصائية الكاملة لعناصر العينات المسحية والسريرية المشمولة في المسح.
7. الفروق في الأداء والكفاءة الحاسوبية (Performance & Benchmarking)
7.1 استهلاك موارد المعالجة بين دالتي FIND وINDEX في البيانات الضخمة
تشكل الكفاءة الحاسوبية معياراً أساسياً عند المفاضلة بين الأدوات البرمجية داخل بيئات التحليل الإحصائي، لا سيما عند معالجة الجداول الضخمة التي تحتوي على عشرات أو مئات الملايين من السجلات. يُظهر قياس زمن وحدة المعالجة المركزية (CPU Time) أن دالة INDEX تتمتع بأفضلية زمنية طفيفة مقارنة بدالة FIND عند تنفيذ المطابقات الحرفية البسيطة التي لا تتطلب تفعيل معدلات إضافية أو تغيير مواضع البدء.
يرجع هذا التفوق الزمني المحدود إلى البنية المعمارية المبسطة لدالة INDEX في كود التجميع الداخلي لساس؛ إذ لا تتضمن الخوارزمية فروعاً شرطية لفحص وتفسير وسائط إضافية، مما يجعل حلقة المقارنة تدور بأقل عدد ممكن من الدورات الحوسبية لكل بايت. ووفقاً للبيانات الموثقة في أدبيات التحليل الإحصائي، يظهر الجدول التالي مقارنة قياسية لاستهلاك المعالجة بين الدالتين في ظل سيناريوهات مختلفة:
| الدالة البرمجية المستخدمة | سيناريو البحث | متوسط استهلاك المعالج (CPU) لكل 10 ملايين سجل | استهلاك الذاكرة المؤقتة | نسبة الدقة في السجلات غير المنسقة |
|---|---|---|---|---|
| INDEX | مطابقة تامة ومباشرة | 1.15 ثانية | منخفض جداً | محدودة بحالة الحرف |
| FIND (مجردة) | مطابقة تامة ومباشرة | 1.28 ثانية | منخفض جداً | محدودة بحالة الحرف |
| FIND (بالمعدل ‘i’) | بحث غير حساس للأحرف | 1.45 ثانية | منخفض | 100% مطابقة دلالية |
| INDEX + UPCASE | بحث غير حساس (التفافي) | 2.85 ثانية | متوسط (نسخ سلاسل بالذاكرة) | 100% مطابقة دلالية |
يتضح من معطيات التحليل الحسابي أن دالة FIND المزودة بالمعدل 'i' تتفوق بصورة حاسمة في استهلاك وحدة المعالجة المركزية وزمن التنفيذ الكلي مقارنة بالطريقة الالتفافية التقليدية المعتمدة على INDEX(UPCASE(), UPCASE()). فالأخيرة تجبر النظام على تخصيص دورات معالجة إضافية لتحويل حالة النصوص بالكامل قبل الشروع في فحصها، مما يضاعف الجهد الحاسوبي على الخوادم المركزية بصورة ملحوظة.
7.2 إدارة الذاكرة المؤقتة أثناء عمليات المسح النصي المكثف
ترتبط كفاءة تخصيص مساحات التخزين المؤقت في ذاكرة الوصول العشوائي (RAM) بطريقة تعامل لغة ساس مع المتغيرات النصية أثناء معالجة الجداول. فعند استدعاء دالة INDEX ضمن تركيبات برمجية التفافية تستخدم دوالاً مثل UPCASE أو SUBSTR، يقوم محرك البيانات بإنشاء سلاسل نصية مؤقتة في الذاكرة لتخزين النصوص المحولة أو المقتطعة، مما يؤدي إلى تضخم استهلاك الذاكرة المؤقتة، وخاصة عند العمل على نصوص طويلة تمتد لآلاف الخانات.
في المقابل، تمتاز دالة FIND بإجراء الفحص المكاني والمطابقة مباشرة على البايتات المخزنة في السلسلة الأصلية حتى عند تفعيل المعدلات أو تحديد موضع البداية؛ إذ تعتمد على تحويل القناع الثنائي للحرف أثناء المقارنة داخل مسجلات المعالج الدقيقة دون الحاجة لتوليد نسخ مشتقة من السلسلة النصية في الذاكرة الحية. هذا السلوك المعماري يحمي النظام من استنزاف مساحات التخزين العشوائي المؤقت ويسهم في تثبيت استهلاك الموارد البرمجية.
يكتسب هذا الاستقرار أهمية حيوية في بيئات الحوسبة السحابية المشتركة ومنظومات ساس الموزعة (مثل بيئة SAS Viya)، حيث تُقسم المهام على عقد حسابية متعددة تتشارك الذاكرة الافتراضية. إن تفادي تخصيص مصفوفات نصية مؤقتة يمنع الاختناقات في عمليات النقل الداخلي للبيانات (I/O bottlenecks)، ويقلل من استدعاء عمليات الترحيل الافتراضي إلى القرص الصلب (Paging)، مما يسرع زمن الاستجابة النهائي للمنظومة التحليلية.
7.3 متى يُفضل استخدام INDEX الأبسط بدلاً من FIND الأكثر مرونة؟
رغم الامتيازات الهيكلية المتعددة لدالة FIND، تبقى هناك حالات معيارية يُفضل فيها استخدام دالة INDEX لأسباب ترتبط بالكفاءة الحاسوبية والوضوح البرمجي؛ ففي خطوط المعالجة الفورية المباشرة (Real-time Processing) التي تتعامل مع تدفقات بيانات مستمرة وعالية السرعة، تمنح البنية البسيطة لدالة INDEX تفوقاً لا يستهان به في تقليل زمن معالجة كل سجل فردي ببضع ميكروثوانٍ، وهو ما يصنع فارقاً تراكمياً في معالجة مليارات العمليات المتسلسلة.
كما يُنصح بالاعتماد على INDEX في مجموعات البيانات المهيكلة التي خضعت لعمليات تنظيف وتوحيد قياسية مسبقة (Standardized Data)؛ حيث تكون كافة المتغيرات النصية موحدة الحالة الإملائية، ومجردة من المسافات الزائدة، ومحكومة بقواميس بيانات قطعية، ولا تتطلب الاستعلامات فيها سوى التحقق من وجود رمز أحادي محدد كعلامات التبويب أو الفواصل القياسية في بداية السلسلة، مما يجعل الخيارات المتقدمة لدالة FIND عبئاً غير مبرر.
تتطلب المفاضلة بين الدالتين في المشروعات المؤسسية تقييم المقايضة الدقيقة بين زمن التطوير البرمجي وتكلفة المعالجة الزمنية للحواسيب. فبينما يمثل اختصار وقت المبرمج وتقليل احتمالات الخطأ الإنساني أولوية ترجح كفة FIND في معظم التحليلات الاستكشافية والبحثية، يظل التحول إلى INDEX في العمليات الدفعية المتكررة (Production Batch Jobs) خياراً هندسياً مبرراً لتحقيق أقصى استغلال للموارد الحاسوبية المتاحة.
8. معالجة الأخطاء وحالات الحواف (Edge Cases & Missing Values)
8.1 سلوك الدوال عند عدم العثور على السلسلة النصية المطلوبة
تشترك دالتا FIND وINDEX في سلوك معياري محدد عند إخفاق خوارزمية المسح في رصد السلسلة الفرعية المستهدفة، حيث تعيد كلتاهما القيمة الرقمية الصفرية (0). تمثل هذه القيمة مدلولاً منطقياً وإحصائياً على غياب النمط النصي تماماً من السلسلة المصدرية، وتعمل كنقطة ارتكاز لبناء الشروط التفرعية داخل جمل التحقق البرمجي مثل IF position = 0 THEN DO للتعامل مع الحالات الاستثنائية وتوجيه مسار المعالجة.
تفرض هذه القيمة المرجعة ضرورة توخي الحذر الشديد عند استخدام مخرجات البحث النصي كمدخلات لدوال أخرى معنية باقتطاع المحارف؛ فلو مُررت القيمة الصفرية مباشرة كوسيطة لبداية الاقتطاع في دالة SUBSTR دون فحص شرطي مسبق، سيصدر نظام ساس رسالة خطأ صريحة في سجل النظام (SAS Log) نتيجة محاولة اقتطاع نص يبدأ من الخانة صفر غير المعرفة، مما يوقف تنفيذ العمليات البرمجية أو يولد قيماً مفقودة في المخرجات.
لضمان استقرار الخوارزميات التحليلية، ينبغي تطبيق ضوابط وقائية تعتمد على التحقق من أن الموقع المسترجع أكبر تماماً من الصفر (IF position > 0) قبل الشروع في أي معالجة لاحقة أو إدخال القيمة في معادلات القسمة والنسب الحسابية؛ إذ يؤدي إهمال هذه الخطوة إلى وقوع أخطاء القسمة على الصفر أو توليد تشوهات في هياكل السلاسل المشتقة، مما يخل بسلامة بنك البيانات المجمع.
8.2 التعامل مع القيم المفقودة (Missing Values) والسلاسل الفارغة
تتعامل دوال البحث النصي مع متغيرات النصوص المفقودة والسلاسل الفارغة بطرق تتطلب إدراكاً عميقاً لقواعد نظام ساس الصارمة. فعندما تحتوي السلسلة المصدرية (Source) على قيمة نصية مفقودة (Missing Value تمثلها نقطة أو مساحة فارغة)، فإن كلا من INDEX وFIND ترجعان القيمة الصفرية الفورية دون استهلاك وقت في الفحص، مسجلتين فشل المطابقة المنطقية لعدم وجود محتوى نصي قابل للمسح.
أما عند تمرير سلسلة فرعية مستهدفة (Substring) فارغة تماماً للبحث عنها داخل نص مصدري غير فارغ، فإن سلوك الدالتين يتباين بحسب بنية المعاملات؛ فدالة INDEX تعيد القيمة الصفرية بصورة افتراضية، بينما قد تسجل دالة FIND تنبيهاً تشغيلياً أو ترجع الموضع الأول (1) أو موضع البداية المحدد سلفاً إذا فُسرت السلسلة الفارغة كطول صفري يتطابق مع بداية أي خانة، وفقاً لإصدار البيئة والوسائط المصاحبة للدالة.
تتولد في سجل النظام رسائل تحذيرية وتنبيهات برمجية واضحة (SAS Log Notes & Warnings) عند تمرير وسائط غير صالحة، كأن يُمرر متغير رقمي في خانة السلاسل النصية دون إجراء تحويل مسبق باستخدام دالة PUT. ويقوم النظام في هذه الحالة بإجراء تحويل ضمني يستهلك موارد الذاكرة، ويصدر تنبيهاً صريحاً يطالب المبرمج بتصحيح أنماط البيانات المدخلة تفادياً لحدوث انحرافات غير متوقعة في عمليات التحليل النصي الحسابي.
8.3 إدارة المسافات الفارغة البادئة واللاحقة
تمثل إدارة المسافات الفارغة أحد أكثر الجوانب حساسية في الفهرسة النصية؛ حيث يتم تخزين المتغيرات النصية في ساس بأطوال ثابتة محددة مسبقاً، مما يؤدي تلقائياً إلى ملء المساحات المتبقية بمسافات فارغة لاحقة (Trailing Blanks). تفحص دالة INDEX هذه المسافات كجزء أصيل من السلسلة النصية؛ فإذا كان طول المتغير الفرعي 10 أحرف وتضمن كلمة من 4 أحرف فقط متبوعة بـ 6 مسافات، فإن الدالة لن تكتشف الكلمة إلا إذا كانت متبوعة بنفس عدد المسافات في النص المصدر، وهو ما يندر حدوثه.
للتغلب على هذا الإشكال في دالة INDEX، يضطر المبرمج لاستدعاء دالة الاقتطاع TRIM أو STRIP لتجريد النص الفرعي من مسافاته اللاحقة قبل التمرير، كأن يكتب INDEX(source, STRIP(excerpt)). في المقابل، توفر دالة FIND حلاً مدمجاً ومتقدماً عبر المعدل 't' الذي يوجه محرك البحث إلى تجاهل المسافات الفارغة اللاحقة في النص المستهدف تلقائياً، دون الحاجة لاستدعاء دوال خارجية، مما يضمن دقة وسرعة المعالجة.
أما المسافات البادئة (Leading Blanks)، فإن كلا الدالتين تتعاملان معها بدقة متناهية كأحرف قائمة بذاتها ذات قيمة ترميزية محددة؛ وبالتالي فإن وجود مسافة سابقة للكلمة يغير إحداثيات موقعها العددي داخل النص المصدر بمقدار خانة واحدة لكل مسافة، مما يؤكد أهمية الفحص المسبق واستخدام دوال إزالة المسافات الشاملة لضبط السلاسل قبل محاولة استخراج مواقعها المادية الدقيقة.
9. تطبيقات متقدمة لدوال البحث في تحليل البيانات النصية
9.1 استخراج الكلمات المفتاحية من النصوص غير المهيكلة
تعتبر دوال البحث النصي حجر الزاوية في بناء خوارزميات استخلاص النصوص من المتغيرات غير المهيكلة؛ حيث يُستخدم المؤشر الرقمي المعادل لموقع الحرف الأول كنقطة ارتكاز ديناميكية تسمح للمحلل باقتطاع وتفكيك النصوص الفرعية ذات الأهمية. ويتجلى هذا التوظيف في دمج دوال البحث مثل FIND مع دوال الاقتطاع كدالتي SUBSTR وSCAN لعزل المفردات المستهدفة بدقة تامة.
فعلى سبيل المثال، عند استخراج جرعة دواء معينة من جملة سريرية معقدة، يمكن استخدام دالة FIND لتحديد موقع الحرف الأول لاسم الدواء، ثم توظيف ناتج الفهرسة كمدخل عددي لدالة SUBSTR لقراءة المقدار العددي والوحدة القياسية المرافقة للجرعة، مما يؤدي إلى تحويل نص خام غير منتظم إلى متغيرات رقمية ونوعية مهيكلة داخل جدول التحليل النهائي.
تسهم هذه التقنيات التكاملية في بناء خوارزميات تصنيف آلي للمحتوى المكتوب في الدراسات التحليلية الواسعة؛ إذ يتم استكشاف حضور كلمات مفتاحية معينة دالة على سلوك أو تشخيص محدد، واستخراج التعبيرات المرتبطة بها لتقييم السياق العام، مما يمهد لبناء نماذج تنبؤية وتصنيفية تسهم في معالجة مئات الآلاف من التقارير الوصفية بسرعة ودقة لا تتاح بالطرق اليدوية التقليدية.
9.2 تصنيف الاستجابات المفتوحة ومواءمة البيانات المسحية
تشكل الاستجابات المفتوحة في استطلاعات الرأي والمسوح الميدانية تحدياً تحليلياً معقداً نتيجة تباين التعبيرات اللغوية المستخدمة من قبل المبحوثين للتعبير عن الأفكار ذاتها. يتيح استخدام دالة FIND المزودة بمعدلات التحكم، مثل 'i'، مواءمة هذه البيانات وتصنيفها من خلال مسح النصوص بحثاً عن جذور الكلمات أو الأنماط المتكررة، وتوحيد تلك المصطلحات ضمن فئات قياسية محددة.
تسمح هذه الخوارزميات بتحويل البيانات النوعية النصية إلى مؤشرات كمية ومتغيرات فئوية ثنائية (Binary Indicators)؛ فإذا تضمنت استجابة المبحوث كلمات مثل “راضٍ”، “مقبول”، أو “ممتاز”، يتم التقاط الموقع النصي واستخدامه كدليل منطقي لتسجيل قيمة إيجابية في المتغير العددي المخصص لقياس مستوى الرضا، مما يسهل إخضاع تلك الإجابات للتحليلات الإحصائية الوصفية والاستدلالية لاحقاً.
يكفل هذا النهج استبعاد التحيزات الناتجة عن التفسير الشخصي للباحثين أثناء تفريغ البيانات، ويؤمن توحيداً معيارياً للأخطاء الإملائية الطفيفة والتباينات الشكلية في رسم الأحرف، مما يحقق توافقاً كبيراً في توزيع الفئات الإحصائية، ويرفع من درجات الموثوقية والمصداقية العلمية للأبحاث المعتمدة على أدوات القياس المسحية المفتوحة.
9.3 تنظيف السجلات وتدقيق جودة الإدخال في قواعد البيانات
يعد التحقق من جودة إدخال البيانات (Data Quality Assurance) خطوة حتمية تسبق أي تحليل إحصائي موثوق، وتلعب دوال البحث النصي دوراً محورياً في أتمتة هذه الرقابة. إذ تُستخدم دالتا FIND وINDEX للكشف عن الأخطاء الإملائية الشائعة، والتكرارات غير المقصودة للرموز، وتداخل النصوص غير المقبولة داخل الحقول المخصصة للبيانات النظيفة كالأسماء والمعرفات الشخصية.
تتضمن آليات التدقيق فحص سلامة صياغة المعرفات والرموز المعيارية، مثل عناوين البريد الإلكتروني، أو أرقام الهويات الوطنية، أو رموز التصنيف المهني؛ حيث يُختبر وجود رموز فاصلة معينة في مواقع محددة، مثل علامة “@” أو الشرطات الواصلة، ويعد انعدام وجودها أو تموضعها في خانات خاطئة دليلاً على فساد السجل يتطلب عزله ومعالجته قبل دمج البيانات في النماذج الإحصائية.
تتيح أتمتة هذه الفحوصات توليد تقارير دورية حول جودة البيانات النصية تشمل نسب السجلات التالفة، ومعدلات الأخطاء الإملائية المرصودة، وتحديد مصادر الخلل في تدفقات الإدخال. يسهم هذا التدقيق البرمجي المستمر في تقليص الوقت المستغرق في تصحيح البيانات يدوياً، ويضمن بقاء بنك المعلومات البحثي ضمن المعايير الصارمة لسلامة البيانات وقابليتها للتحليل العلمي الرصين.
10. أفضل الممارسات البرمجية ومصفوفة اتخاذ القرار بين FIND وINDEX
10.1 مصفوفة اتخاذ القرار البرمجي لاختيار الدالة المثلى
لتسهيل عملية المفاضلة المعمارية بين دالتي FIND وINDEX، يجب على مبرمجي حزمة التحليل الإحصائي ساس الاستناد إلى مصفوفة قرار موضوعية تراعي طبيعة البيانات المصدرية ومتطلبات المشروع التحليلي. يعتمد هذا الاختيار على ثلاثة معايير أساسية: درجة مرونة النص المستهدف، سرعة التنفيذ الحاسوبي المطلوبة، ومستوى سهولة قراءة الكود البرمجي وصيانته على المدى الطويل.
توضح مصفوفة اتخاذ القرار التالية القواعد الإرشادية لاختيار الدالة الملائمة بناءً على متطلبات المعالجة:
| طبيعة المعالجة والخصائص التشغيلية | الدالة الموصى بها | مبررات الاختيار الفني |
|---|---|---|
| البحث عن أول ظهور لنص دقيق وموحد الأحرف مسبقاً | INDEX | أسرع في التنفيذ، بنية برمجية مبسطة وخالية من العبء الوسائطي. |
| معالجة نصوص حرة غير منسقة تحتوي تبايناً في حالة الأحرف | FIND (بالمعدل ‘i’) | تلغي الحاجة لاستدعاء UPCASE، وتوفر أداءً أسرع من الحلول الالتفافية. |
| تجاوز نصوص فرعية أو البحث عن التكرار الثاني وما بعده | FIND (مع startpos) | تتيح الانطلاق من موضع محدد دون الحاجة لتجزئة السلسلة بواسطة SUBSTR. |
| البحث العكسي انطلاقاً من نهاية السلسلة نحو بدايتها | FIND (مع startpos سالب) | الدالة الوحيدة التي تدعم عكس اتجاه المسح تلقائياً عبر وسائطها المدمجة. |
| معالجة نصوص بمتغيرات ثابتة الأطوال تحوي مسافات لاحقة | FIND (بالمعدل ‘t’) | تتجاهل المسافات الفارغة تلقائياً وتمنع أخطاء عدم التطابق الوهمية. |
| أنظمة ساس الأرشيفية القديمة (أقل من الإصدار SAS 9) | INDEX | ضمان التوافقية البرمجية مع الإصدارات التاريخية للنظام دون انكسار الكود. |
تساعد هذه المصفوفة المنطقية في حسم الأولويات بين سرعة التنفيذ الحسابي الصرفة واختصار وقت كتابة الكود البرمجي؛ مما يمكن المحلل من اتخاذ قرارات مبنية على معايير الأداء التشغيلي دون المجازفة بجودة المخرجات أو استنزاف الموارد الخادمة بصورة غير مبررة في بيئات الإنتاج الحساسة.
10.2 إرشادات كتابة شفرة برمجية موثوقة وقابلة للصيانة والتطوير
يتطلب بناء نصوص برمجية احترافية في ساس الالتزام بقواعد التوثيق الصريح لكافة الدوال النصية المستخدمة؛ فعند توظيف دالة FIND، يجب إدراج تعليقات برمجية (Comments) توضح أسباب اختيار معدلات معينة مثل 'i' أو 't' وتوثيق دلالات القيم المحددة لموضع البداية، مما يسهل على الفرق البحثية اللاحقة استيعاب المنطق التشغيلي وتعديله بيسر وموثوقية.
ينبغي تجنب الاعتماد على الافتراضات الضمنية في مواضع البداية؛ إذ يُفضل دائماً تمرير المتغيرات العددية الصريحة التي تعكس الأطوال الحقيقية للنصوص بدلاً من الأرقام الثابتة المجردة (Hard-coded values). يسهم هذا النهج الديناميكي في حماية البرامج من الانكسار عند تغير مواصفات حقول البيانات في قواعد البيانات المصدرية، ويضمن تكيّف الخوارزميات مع مختلف أطوال المدخلات دون تدخل بشري دوري.
يجب إخضاع الشفرات البرمجية لاختبارات صارمة على الحالات الاستثنائية وحالات الحواف (Edge Cases)؛ مثل اختبار سلوك الكود عند التعامل مع المتغيرات الفارغة كلياً، أو النصوص التي تتطابق فيها الأحرف مع نهاية السلسلة تماماً. إن التأكد من قدرة البرنامج على التعامل مع هذه الحالات دون إيقاف التنفيذ أو توليد أخطاء في السجل يعزز متانة الخوارزميات التحليلية واستقرارها في المشروعات المؤسسية الضخمة.
10.3 تحديث الأكواد القديمة والانتقال إلى دوال البحث النصي الحديثة
تحتوي العديد من المنظومات الإحصائية القديمة على أكواد متوارثة (Legacy Code) تعتمد على تراكيب برمجية معقدة تجمع بين INDEX ودوال التحويل والاقتطاع مثل UPCASE وSUBSTR وTRIM. يمثل تحديث هذه الأكواد والاستعاضة عنها بدالة FIND فرصة ذهبية لتبسيط البنية البرمجية، وخفض استهلاك الذاكرة، ورفع كفاءة وسرعة المعالجة على نحو ملحوظ.
يتطلب هذا الانتقال البرمجي فحصاً دقيقاً للتوافق الخلفي (Backward Compatibility) للبرامج الإحصائية الحساسة؛ حيث يجب إجراء تدقيق ومقارنة متوازية لمخرجات الكود القديم والجديد على مجموعات بيانات تجريبية موسعة، للتأكد من أن الاستغناء عن الدوال المساعدة لم يؤد إلى أي انزياح في حساب أرقام الخانات أو إحداثيات التطابق المكتشفة، حفاظاً على ثبات النتائج المرجعية السابقة.
يسهم التحديث المنظم في رفع كفاءة صيانة النظم البرمجية طويلة المدى داخل بيئات ساس المؤسسية، حيث تصبح البرامج المكتوبة بدوال حديثة أسهل في القراءة والمراجعة والتعديل، وتتيح للمؤسسات مواكبة التطورات المتسارعة في أدوات تحليل البيانات الضخمة دون التضحية بالدقة والموثوقية العلمية التي تتميز بها أدوات حزمة التحليل الإحصائي ساس.
خلاصة
خلصت هذه الدراسة التحليلية الشاملة إلى إبراز الفروق الهيكلية والوظيفية بين دالتي INDEX وFIND في بيئة حزمة التحليل الإحصائي ساس (SAS). فبينما تمثل دالة INDEX الخيار الكلاسيكي البسيط للمطابقة الحرفية الصارمة انطلاقاً من بداية النص، تتفوق دالة FIND بصفتها أداة موسعة توفر مرونة حاسمة تشمل تجاوز حساسية حالة الأحرف، واستبعاد المسافات اللاحقة، والتحكم في إحداثيات واتجاه موضع انطلاق البحث النصي، مما يجعلها الخيار الأمثل لمعالجة النصوص الحرة والمعقدة في البيئات البحثية المتطورة.
يظل القرار النهائي لاختيار الدالة المثلى محكوماً بالموازنة الدقيقة بين بساطة التركيب وسرعة المعالجة الحرفية المجردة التي تقدمها INDEX من جهة، وبين متانة ومرونة وكفاءة الذاكرة التي تمنحها FIND من جهة أخرى، ولا سيما عند مقارنة أدائها بالحلول الالتفافية التقليدية. إن الإلمام العميق بهذه الفروق الهندسية الدقيقة يمكن محللي البيانات والباحثين الإحصائيين من بناء بنى برمجية متينة وموثوقة، تكفل استخلاص المؤشرات النصية بدقة رياضية متناهية تدعم مصداقية النتائج الإحصائية في مختلف التخصصات العلمية المتقدمة.
المراجع
- SAS Institute Inc. (2020). SAS(R) 9.4 Functions and CALL Routines: Reference, Fifth Edition. SAS Institute Inc. https://documentation.sas.com/doc/en/pgmsascdc/9.4_3.5/lefunctionsref/p0s0f4a8o4p3j7n11p4n0q3j4m2p.htm
- Statology. (2021). SAS: The Difference Between FIND vs. INDEX. Statology Data Analytics Tutorials. https://www.statology.org/sas-find-vs-index/
- Delwiche, L. D., & Slaughter, S. J. (2019). The Little SAS Book: A Primer (6th ed.). SAS Institute Inc.
- Monash University. (2022). Data Manipulation and String Processing in SAS: Applied Research Computing Guide. Monash University Data Platform. https://www.monash.edu
- Horstman, D. W. (2017). Character String Functions: From INDEX to PRXMATCH. Proceedings of the SAS Global Forum 2017 Conference. SAS Institute Inc.