
يشكل تحليل البيانات واستخلاص المؤشرات الإحصائية الدقيقة الركيزة الأساسية للبحث العلمي وصناعة القرار في مختلف التخصصات، بدءاً من العلوم السلوكية والاجتماعية وصولاً إلى النمذجة الاقتصادية والتحليلات المؤسسية. وتعد مقاييس النزعة المركزية (Measures of Central Tendency) الأدوات الرياضية الأكثر استخداماً لتوصيف البنية التوزيعية للظواهر؛ إذ تختزل كميات ضخمة من الملاحظات في قيم مفردة تلخص السلوك العام للعينة. وفي حين يستأثر المتوسط الحسابي والوسيط باهتمام واسع عند معالجة البيانات الكمية المتصلة، يبرز “المنوال” (Mode) بوصفه الأداة الإحصائية الحصرية القادرة على تمثيل القيمة الأكثر تواتراً وظهوراً في المتغيرات النوعية، والفئوية، والاسمية، التي تعجز المقاييس الأخرى عن التعامل معها منهجياً.
مع تطور برمجيات الجداول الإلكترونية، وعلى رأسها برنامج مايكروسوفت إكسل (Microsoft Excel)، بات الباحثون والمحللون يعتمدون عليها كبيئة رئيسية لتنظيم البيانات وتحليلها. ومع ذلك، تصطدم الممارسة التحليلية بقصور بنيوي عند محاولة حساب المنوال المقيد بشروط أو معايير محددة (Conditional Mode)؛ حيث تخلو مكتبة دوال إكسل القياسية من دالة مباشرة تحمل اسماً مثل MODEIFS، على غرار دوال الجمع والعد المتوسط الشرطية الشهيرة (مثل SUMIFS وCOUNTIFS وAVERAGEIFS). ويتفاقم هذا التحدي التقني عندما لا تقتصر الرغبة التحليلية على البيانات الرقمية فقط، بل تمتد لتحديد النصوص والفئات الأكثر شيوعاً، وهو ما يفرض اللجوء إلى تقنيات المعالجة المصفوفية المتقدمة والجمع التركيبي بين عدة دوال منطقية وموضعية متداخلة.
يهدف هذا المقال الأكاديمي الشامل إلى تفكيك هذه الإشكالية المعقدة، وتقديم دراسة منهجية وتطبيقية متعمقة لكيفية هندسة صيغ رياضية مصفوفية لحساب المنوال الشرطي في إكسل بدقة متناهية، سواء للبيانات الرقمية أو الفئوية النصية. وسنتناول بالتشريح الدقيق البنية التركيبية للمصفوفات، والتكامل الوظيفي بين دوال INDEX وMATCH وMODE وIF، مع استعراض دراسات حالة تطبيقية، ومقارنة الفروق التقنية بين محركات الحساب الكلاسيكية والحديثة في بيئات العمل المعاصرة، فضلاً عن وضع أطر الحوكمة والتوثيق اللازمة لضمان الموثوقية وقابلية إعادة الإنتاج في الأبحاث والتقارير الاحترافية.
1. الأسس النظرية للمنوال الإحصائي وتحديات المعالجة الشرطية في جداول البيانات
1.1 المفهوم الرياضي للمنوال وأهميته في استكشاف البيانات
يُعرَّف المنوال إحصائياً بأنه القيمة أو المفردة الأكثر تكراراً في مجموعة بيانات معينة، وهو يمثل نقطة الكثافة الاحتمالية القصوى في التوزيعات التكرارية. تعود الجذور الاصطلاحية والمنهجية لهذا المفهوم إلى العالم الإحصائي كارل بيرسون (Karl Pearson, 1895) في دراسته التأسيسية المنشورة في الجمعية الملكية بلندن، حيث أرسى القواعد الرياضية للمنوال بوصفه إحداثي القمة العظمى في المنحنيات التكرارية المتصلة، مميزاً إياه عن الوسط والوسيط في التوزيعات الملتوية. ولا تقتصر أهمية المنوال على الإحصاء الوصفي البسيط، بل يمتد دوره إلى التحليلات الاستكشافية المعمقة، حيث يقدم صورة واقعية عن النمط الغالب الذي لا يتأثر بالقيم المتطرفة أو الشاذة (Outliers) التي قد تشوه المتوسط الحسابي تشويهاً كبيراً.
وفي إطار نظرية القياس، أكد العالم ستانلي سميث ستيفنز في تصنيفه المعياري لمستويات القياس (Stevens, 1946) أن المنوال يمثل المقياس الوحيد المسموح به رياضياً لقياس النزعة المركزية في المقاييس الاسمية (Nominal Scales). فعندما نتعامل مع متغيرات نوعية مثل الجنس، أو التخصص الأكاديمي، أو الانتماء الجغرافي، تصبح العمليات الحسابية كالجمع والقسمة بلا معنى رياضي، ويغدو تحديد الفئة الأكثر شيوعاً هو السبيل الإحصائي المعتبر للإفصاح عن الخصائص الجوهرية للعينة. كما يكتسب المنوال أهمية كبرى في الدراسات الاستقصائية والمسحية، حيث يساعد متخذي القرار في تحديد الخيار المفضل للأغلبية، أو رصد السلوك الاستهلاكي المهيمن بدقة تامة.
وعند الانتقال من النطاق الوصفي العام إلى التحليل الشرطي المقيد، تبرز الحاجة إلى حساب ما يمكن تسميته رياضياً بـ “المنوال الشرطي” (Conditional Mode)، والذي يمكن صياغته في نظرية الاحتمالات بالمعادلة: $\text{Mode}(Y mid X = c)$؛ حيث يمثل $Y$ المتغير التابع المستهدف (سواء كان رقماً أو نصاً)، بينما يمثل $X = c$ المعيار الحاكم أو الشرط المحدد المفروض على العينة الفرعية. وتتجلى هذه الحاجة في الدراسات المقارنة، كأن نبحث عن المركز الرياضي الأكثر شيوعاً داخل نادٍ معين دون غيره، أو النمط السلوكي الأكثر تكراراً لدى فئة عمرية محددة، مما يستدعي عزل البيانات وتصفيتها قبل استخراج القيمة المنوالية.
1.2 قصور الدوال القياسية المنفردة في إكسل مع البيانات النصية والمقيدة
على الرغم من الترسانة الرياضية الهائلة التي يوفرها برنامج مايكروسوفت إكسل، إلا أن معالجة المنوال تتسم بجمود تقني ملحوظ مقارنة بمقاييس النزعة المركزية الأخرى. فالدالة القياسية الكلاسيكية MODE (أو نسختها المحدثة MODE.SNGL) صُممت بمعمارية حسابية تعتمد حصراً على القيم العددية؛ مما يجعلها عاجزة عجزاً تاماً عن معالجة النصوص أو البيانات الفئوية؛ إذ ينتج عن تمرير نطاق نصي إليها خطأ عدم التوفر الرياضي #N/A فوراً، لعدم قدرة الخوارزمية الداخلية على بناء جدول تكراري للسلاسل النصية (Strings).
يتضاعف هذا القصور عند محاولة فرض شروط محددة على استخراج المنوال؛ إذ يلاحظ غياب دالة مدمجة تحت اسم MODEIFS في جميع إصدارات إكسل، بخلاف الدوال التراكمية الأخرى التي دُعمت بصيغ شرطية متعددة مثل COUNTIFS وSUMIFS. هذا الغياب ليس مجرد نقص في التسمية، بل يعود إلى التعقيد الخوارزمي لاحتساب المنوال؛ فالجمع والعد عمليتان تجميعيتان تراكميتان ذات تعقيد خطي بسيط، بينما يتطلب المنوال فرز التكرارات ومقارنتها عبر الذاكرة، وهو ما دفع مطوري إكسل لترك تركيب هذه العمليات المتقدمة للمستخدم عبر بناء صيغ مصفوفية مركبة تلتف حول هذه القيود البرمجية.
بناءً على ذلك، يجد المحلل نفسه ملزماً بابتكار مسار تحويلي يقوم أولاً بفلترة البيانات وفق الشروط المحددة، ثم تحويل السجلات النصية إلى نظائر رقمية تعكس مواضعها وهوياتها، ومن ثم تطبيق دالة المنوال الحسابية على تلك المصفوفة الرقمية المعقمة، وأخيراً إعادة ترجمة النتيجة الرقمية إلى النص الأصلي المقابل. هذا المسار التحويلي المركب يتطلب فهماً دقيقاً لكيفية تفاعل الدوال المتداخلة داخل الذاكرة المؤقتة للبرنامج لضمان الخروج بنتائج إحصائية منضبطة وموثوقة خالية من الأخطاء المنطقية.
1.3 فلسفة الفلترة الشرطية ضمن المصفوفات المتداخلة
تقوم فلسفة المعالجة المصفوفية في إكسل على تطويع الجبر المنطقي والعمليات البوليانية (Boolean Logic) لتوليد متجهات ثنائية الحالة تتألف من القيمتين الحقيقية TRUE والافتراضية FALSE. في هذا السياق، لا يتم التعامل مع الخلايا بوصفها كيانات فردية منعزلة، بل كمتجهات موضعية أحادية البعد (Vectors) يتم فحصها دفعة واحدة في مواجهة المعايير المستهدفة. وتعمل هذه المتجهات كأقنعة رقمية (Digital Masks) تسمح بمرور البيانات المتوافقة مع الشروط وتمنع ما دونها من الدخول في دورة المعالجة الإحصائية اللاحقة.
إن تطويع هذه المتجهات يستند إلى مصفوفات متداخلة تعمل في مستويات متزامنة؛ فالمستوى الأول يختص بتقييم الشروط وعزل المتغيرات التي لا تطابق معايير التحليل، واستبدالها بقيم منطقية فارغة لا تؤثر في التكرار النسبي. والمستوى الثاني يتولى فهرسة البيانات الفئوية وتحويلها إلى مصفوفات قيم متطابقة يمكن فرزها حسابياً. وتكمن الصعوبة الرياضية هنا في ضمان بقاء المحاذاة الموضعية (Positional Alignment) ثابتة بين مصفوفة الشروط ومصفوفة القيم الأصلية؛ حيث إن أي إزاحة غير مقصودة في الفهارس ستؤدي بالضرورة إلى ربط معيار سجل معين بقيمة سجل آخر، مما يُفسد دقة المخرجات.
وعلاوة على ذلك، تستوجب هذه الفلسفة موازنة حساسة بين كفاءة المعالجة الحسابية وسرعة استجابة ورقة العمل، لا سيما في قواعد البيانات الكبيرة. فتوليد المصفوفات المتداخلة وفحصها عبر تقنيات المقارنة الذاتية يتطلب استهلاكاً مضاعفاً لموارد المعالج والذاكرة العشوائية مقارنة بالصيغ المباشرة. لذلك، فإن بناء الصيغة يجب أن يرتكز على ترشيد النطاقات المستهدفة وحسن اختيار الدوال المساعدة، بما يحقق استخراج المؤشرات الإحصائية بأعلى درجة من النزاهة الرياضية دون التسبب في إجهاد بيئة الحساب أو تجميد التطبيق.
2. التفكيك المنهجي للصيغة المركبة: البنية التركيبية والدوال المكونة
2.1 الدور الوظيفي لدالة INDEX في استرجاع المخرجات الموضعية
تمثل دالة INDEX حجر الزاوية في استعادة البيانات وترجمتها داخل الصيغ المركبة؛ إذ تتلخص وظيفتها الرياضية في استقبال مصفوفة مرجعية وإرجاع قيمة الخلية الواقعة عند تقاطع فهرس صفي ومقدار عمودي محددين. وفي إطار استخراج المنوال الشرطي، تُستخدم دالة INDEX في نسختها أحادية البعد (Vector Form)، والتي تأخذ الصيغة القياسية التالية:
=INDEX(array, row_num)
حيث يمثل array نطاق البيانات الأصلي الذي يحتوي على القيم الفئوية أو النصية المراد تحديد الأكثر تكراراً من بينها، في حين يمثل row_num الفهرس الموضعي النسبي الناتج عن خوارزمية المنوال الرياضي.
تكمن قوة INDEX في كونها لا تتأثر بطبيعة المحتوى المخزن في النطاق المرجعي، سواء كان أرقاماً، أو نصوصاً، أو تواريخ، أو رموزاً خاصة؛ فهي تتعامل مع “الإحداثيات المكانية” فقط. وبمجرد أن تُنجز العمليات الحسابية المتداخلة مهمتها في تحديد رقم الصف النسبي الذي تنتمي إليه القيمة المنوالية الفائزة، تتدخل INDEX للولوج المباشر إلى ذلك الإحداثي واستخلاص النص المقابل له بدقة متناهية. هذا الفصل الوظيفي بين تحديد الموضع واستخراج القيمة يمنح النموذج الرياضي مرونة فائقة وتفادياً تاماً لأخطاء الإزاحة (Offset Errors) الناتجة عن اختلاف تنسيقات البيانات.
وتجدر الإشارة إلى أن النطاق المرجعي الممرر إلى INDEX يجب أن يتطابق بدقة تامة في عدد الصفوف ونقطة البداية مع النطاقات المستخدمة في الدوال الداخلية، وإلا فإن رقم الفهرس المردود سيشير إلى خلية مختلفة، مما ينتج عنه استخراج بيانات خاطئة دون ظهور أي رسالة خطأ تحذيرية من إكسل، وهو أخطر أنواع الأخطاء التحليلية التي يجب التحرز منها بعناية.
2.2 توليد المعرفات الرقمية للنصوص باستخدام دالة MATCH
بما أن دالة المنوال الإحصائية في إكسل تعجز عن مقارنة النصوص مباشرة، فإن الحل يكمن في ابتكار لغة وسيطة تحول الكلمات إلى أرقام تعكس تردداتها بدقة، وهنا يأتي الدور المحوري لدالة MATCH. تُستخدم هذه الدالة عادة للبحث عن موضع عنصر معين ضمن نطاق، وفق التركيب القياسي:
=MATCH(lookup_value, lookup_array, [match_type])
إلا أن توظيفها في صيغ المصفوفات يتخذ منحى غير تقليدي؛ حيث يتم تمرير النطاق النصي ذاته كوسيطين متطابقين للبحث وللنطاق المبحوث فيه: MATCH(Range, Range, 0)، مع ضبط نوع التطابق على الصفر المطلق لفرض التطابق التام.
تعمل تقنية المقارنة الذاتية للنطاق (Self-Referencing Technique) كمعالج تشفير داخلي فائق الذكاء؛ فلكل عنصر في النطاق، تبحث دالة MATCH عن أول ظهور له في المصفوفة وتُرجع رقم الصف النسبي لذلك الظهور الأول. ونتيجة لذلك، إذا تكررت كلمة مثل “Forward” في الصفين الثاني والخامس، فإن الدالة سترجع الرقم 2 في كلا الموضعين؛ لأن أول ظهور للكلمة كان في الصف الثاني. وبهذه الطريقة، تتحول الكلمات المتطابقة المتفرقة إلى أرقام موضعية متماثلة تعكس هويتها النصية وتكرارها التراكمي بدقة متكافئة.
إن إلزام خيار التطابق التام (match_type = 0) يكتسب أهمية بالغة في هذه الآلية؛ إذ يمنع الدالة من افتراض الترتيب التصاعدي أو التنازلي للبيانات، مما يضمن ثبات الإسناد ومطابقة النصوص كما هي. وتكون النتيجة مصفوفة أرقام صحيحة جاهزة رياضياً للمعالجة الإحصائية، مع الحفاظ الكامل على التمثيل النسبي لتكرارات البيانات النوعية الأصلية.
2.3 التطويع الشرطي عبر دالة IF وعزل القيم خارج المعيار
بعد نجاح دالة MATCH في إنشاء التمثيل الرقمي للنصوص، تبرز ضرورة تطبيق محددات العزل لعزل البيانات التي لا تحقق الشرط أو المعيار المحدد. وتتحقق هذه المعالجة الشرطية بواسطة دالة IF المنطقية، التي تأخذ التركيب:
=IF(logical_test, [value_if_true], [value_if_false])
ويتم هنا مقارنة نطاق المعايير بالقيمة المرجعية المستهدفة لإنشاء مصفوفة منطقية ثنائية مكونة من قيم TRUE لسجلات الحالات المطابقة، وقيم FALSE للحالات المستبعدة التي لا تحقق المعيار التحليلي.
السر التقني في هذا التطويع يكمن في تغذية دالة IF بمصفوفة الأرقام المولدة من MATCH كوسيط للقيمة الصحيحة (value_if_true)، مع إهمال وسيط القيمة الخاطئة (value_if_false) كلياً أو تركه فارغاً. وبموجب القواعد الحسابية لإكسل، فإن إهمال الوسيط الثالث يجعل الدالة تضع القيمة المنطقية FALSE تلقائياً أمام كل سجل لا يستوفي الشرط، مما يؤدي إلى إنتاج مصفوفة هجينة تضم أرقاماً تمثل مواضع البيانات المطابقة للشروط فقط، محاطة بقيم FALSE في كل موضع غير مطابق.
وتعد هذه الخطوة بمثابة عملية تعقيم إحصائي متقدمة؛ حيث تُعزل السجلات غير المعنية بالتحليل عزلاً محكماً دون المساس بالترتيب الهيكلي العام للمصفوفة أو أطوال متجهاتها. وبذلك تُغذى دالة المنوال اللاحقة ببيانات مفلترة بدقة، تمثل المجموعة الجزئية الخاضعة للدراسة دون أي تشويش من الفئات أو المجموعات الأخرى الموجودة في قاعدة البيانات الرئيسية.
2.4 التنفيذ الإحصائي النهائي بواسطة دالة MODE
تصل السلسلة الحسابية إلى مرحلة الحسم الإحصائي مع دالة MODE (أو MODE.SNGL). تستقبل هذه الدالة المصفوفة الهجينة المجهزة بواسطة دالة IF، وتشرع خوارزميتها في مسح عناصرها لحساب القيمة الأكثر تكراراً. ومن الخصائص البرمجية المحورية لدالة MODE في إكسل أنها تتجاهل القيم المنطقية (TRUE و FALSE) والنصوص الفارغة تلقائياً وبشكل افتراضي، وتركز اهتمامها الحسابي حصراً على الأرقام الصحيحة الواردة في المصفوفة.
ونتيجة لهذا التجاهل المنهجي لقيم FALSE، تُسقط جميع السجلات التي لم تحقق المعيار من معادلة التكرار الإحصائي، وتظل المنافسة محصورة بين الأرقام الدالة على مواضع النصوص المطابقة للشرط. وتقوم الدالة بعد ذلك بفرز التكرارات وتحديد الرقم الموضعي الذي تكرر بأكبر قدر ممكن ضمن المجموعة الجزئية المعقمة، وتتجاهل التكرارات التي حدثت خارج نطاق الشرط؛ لأنها عُطلت منطقياً في المرحلة السابقة.
وبمجرد وصول دالة MODE إلى الرقم الأكثر تكراراً، تُرجعه كفهرس عددي مفرد يمثل “الموضع الفائز”. هذا الرقم الناتج لا يحمل في ذاته معنى دلالياً للمستخدم النهائي، ولكنه يمثل حلقة الوصل الرياضية الحاسمة؛ إذ يتم تمريره فوراً إلى دالة INDEX الخارجية بوصفه وسيط رقم الصف (row_num). فتقوم INDEX باستخراج النص الموجود في ذلك الموضع من النطاق الأصلي، ليكتمل بذلك البناء الهندسي للصيغة وتظهر القيمة الأكثر شيوعاً والمقيدة بالمعيار داخل الخلية المستهدفة بنجاح واقتدار.
3. التشريح الميكانيكي الدقيق لمسار تنفيذ الصيغة: خطوة بخطوة
3.1 المرحلة الأولى: فحص التقييم الشرطي المقيد
لفهم الآلية الداخلية لكيفية عمل الصيغة داخل ذاكرة إكسل، يجب تتبع حركة تدفق البيانات خطوة بخطوة عبر مسار التنفيذ الحسابي. تبدأ المعالجة بالمقارنة المنطقية المباشرة المضمنة في وسيط دالة IF، والمتمثلة في التعبير الرياضي Criteria_Range = Criterion_Value. في هذه المرحلة، يقوم محرك الحساب بمقارنة كل عنصر في متجه المعيار بنقطة الإسناد المستهدفة بصورة فردية ومتزامنة، مما يؤدي إلى إنشاء متجه بولياني مؤقت بنفس أبعاد النطاق الأصلي.
فعلى سبيل المثال، إذا كان نطاق المعيار يحتوي على خمسة سجلات تمثل أسماء فرق رياضية كالتالي: {"A"; "B"; "A"; "C"; "A"}، وكانت القيمة المستهدفة هي الفريق "A"، فإن ناتج التقييم الشرطي الأولي يتبلور في المتجه التالي: {TRUE; FALSE; TRUE; FALSE; TRUE}. ويجب مراعاة أن عمليات المقارنة النصية الافتراضية في إكسل غير حساسة لحالة الأحرف (Case-insensitive) في اللغات التي تعتمد على ذلك كالإنجليزية، كما تتعامل مع الفراغات الزائدة والرموز بدقة؛ مما يجعل أي تباين طفيف في إدخال الرموز سبباً مباشراً في توليد القيمة FALSE واستبعاد السجل غير المتطابق.
يتشكل هذا المتجه المنطقي في طبقة الذاكرة المؤقتة (Volatile Heap) دون كتابته الفزيائية في أي خلية، ويبقى محتفظاً بالارتباط المكاني لكل صف؛ حيث تشير القيمة الأولى إلى حالة السجل الأول، والقيمة الثانية إلى حالة السجل الثاني، وهكذا دواليك عبر كامل أفق النطاق المحدد.
3.2 المرحلة الثانية: رسم الخريطة التكرارية الرقمية
بالتوازي مع التقييم الشرطي، يُفعّل المحرك دالة MATCH(Target_Range, Target_Range, 0) لرسم خريطة الهوية الرقمية للمصفوفة النصية المستهدفة. لنفترض أن نطاق القيم المستهدفة يمثل مراكز اللاعبين المقابلة للفرق السابقة كالتالي: {"Guard"; "Center"; "Forward"; "Guard"; "Guard"}. تبدأ دالة MATCH بفحص كل قيمة والبحث عن موضع أول ظهور لها ضمن النطاق كاملاً:
- القيمة الأولى
"Guard"تظهر أول مرة في الموضع 1، فيُسجل لها الرقم 1. - القيمة الثانية
"Center"تظهر أول مرة في الموضع 2، فيُسجل لها الرقم 2. - القيمة الثالثة
"Forward"تظهر أول مرة في الموضع 3، فيُسجل لها الرقم 3. - القيمة الرابعة
"Guard"ظهرت سابقاً في الموضع 1، فيُعاد تسجيل الرقم 1 لها مجدداً. - القيمة الخامسة
"Guard"تكررت أيضاً، فيُسجل لها مجدداً موضع ظهورها الأول وهو الرقم 1.
ينتج عن هذه المعالجة مصفوفة رقمية تمثل التوزيع التكراري الأولي للنصوص: {1; 2; 3; 1; 1}. وهنا يتدخل وسيط دالة IF لدمج المتجهين معاً؛ حيث يُطبق القناع المنطقي على المصفوفة الرقمية، مستبدلاً كل رقم يقابل FALSE بالقيمة المنطقية FALSE ذاتها، بينما يبقي على الأرقام المقابلة لـ TRUE كما هي. وبتطبيق ذلك على مثالنا، ينتج المتجه المدمج: {1; FALSE; 3; FALSE; 1}. ويلاحظ بوضوح استبعاد السجل الثاني (المركز “Center”) والسجل الرابع من حسابات الفريق “A”؛ لأن الشرط لم يتحقق في موضعيهما، لتبقى الأرقام المعبرة عن مواضع الفريق “A” فقط.
3.3 المرحلة الثالثة: احتساب القيمة المنوالية ورد الناتج النهائي
في المرحلة النهائية، يُمرر هذا المتجه المصفى {1; FALSE; 3; FALSE; 1} مباشرة إلى دالة MODE. تبدأ الدالة بفحص المكونات، فتتجاهل تلقائياً كل قيمة تحمل الوسم FALSE، مما يحصر فحصها الإحصائي الفعلي في المصفوفة المصغرة: {1; 3; 1}. وبتقييم تكرارات هذه الأرقام، تجد أن الرقم 1 تكرر مرتين، بينما تكرر الرقم 3 مرة واحدة فقط، فتعلن خوارزمية المنوال فوز الرقم 1 بوصفه القيمة الأكثر شيوعاً، وتخرجه كقيمة مفردة نهائية لعمليتها الحسابية.
تستقبل دالة INDEX هذا المخرج الرقمي (1) وتضعه كمعامل للصف: =INDEX(Target_Range, 1). فتنطلق الدالة نحو النطاق الأصلي للقيم المستهدفة {"Guard"; "Center"; "Forward"; "Guard"; "Guard"}، وتستخرج القيمة الواقعة في الموضع الأول بالضبط، وهي النص "Guard". تُختتم العملية الحسابية المتداخلة بإرجاع هذه الكلمة إلى الخلية التي كُتبت بها الصيغة، لتنتهي دورة معالجة معقدة استغرقت أجزاءً من الثانية في الذاكرة، محققة التكامل المنهجي التام بين المنطق البولياني والتحليل الإحصائي والاسترجاع الموضعي.
4. دراسة تطبيقية موثقة: تحليل مراكز اللاعبين في أندية كرة السلة
4.1 توصيف بيانات التجربة وتوزيع المتغيرات المستقلة والتابعة
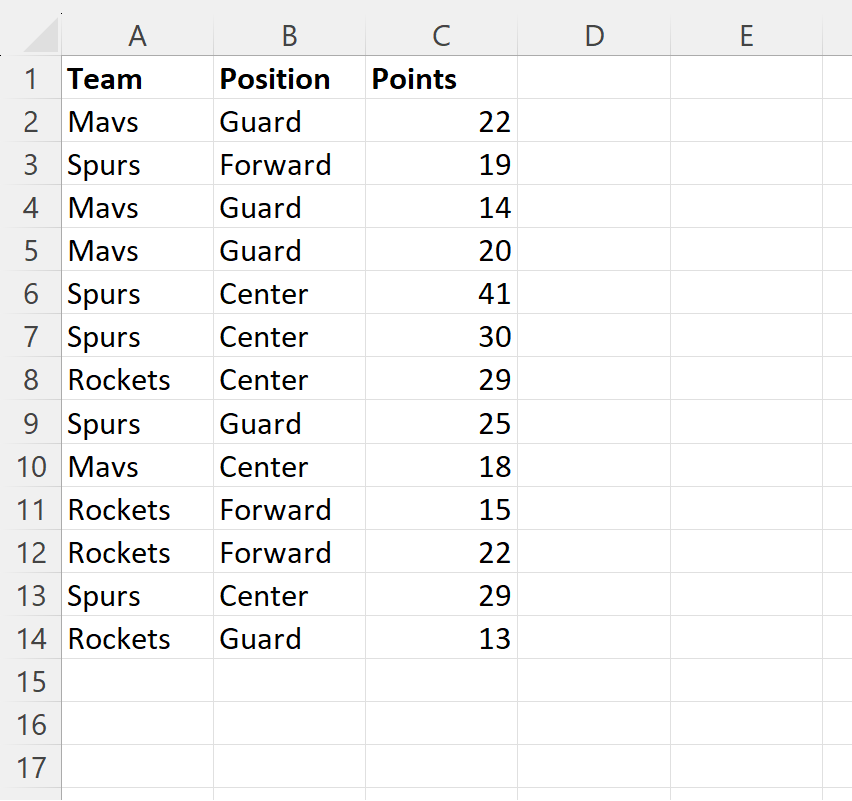
لتجسيد هذا البناء النظري في سياق واقعي ملموس، سنقوم بتطبيق الصيغة المركبة على قاعدة بيانات تجريبية تحاكي تشكيلات أندية كرة السلة للمحترفين. يشتمل نموذج الاختبار على جدول مكون من 13 لاعباً، موزعين على ناديين رئيسيين، مع تحديد المركز الرياضي لكل لاعب. يتضمن الجدول ثلاثة حقول أساسية: اسم اللاعب، واسم النادي (ويمثل المتغير المستقل الحاكم للشرط)، والمركز الميداني للاعب (ويمثل المتغير التابع المستهدف بحساب المنوال الفئوي).
تتوزع بيانات الجدول الفعلي عبر النطاق A2:C14 كما هو موضح في البنية الهيكلية التالية:
- العمود
A(نطاق المعيار – الفريق): يحتوي على أسماء الأندية؛ حيث ينتمي اللاعبون إما إلى فريق “Warriors” أو فريق “Lakers”. - العمود
B(نطاق القيم المستهدفة – المراكز): يحتوي على التسميات الفئوية لمراكز اللعب، وتشمل: صانع ألعاب أو حارس (Guard)، ومهاجم (Forward)، ولاعب ارتكاز (Center). - الخلية
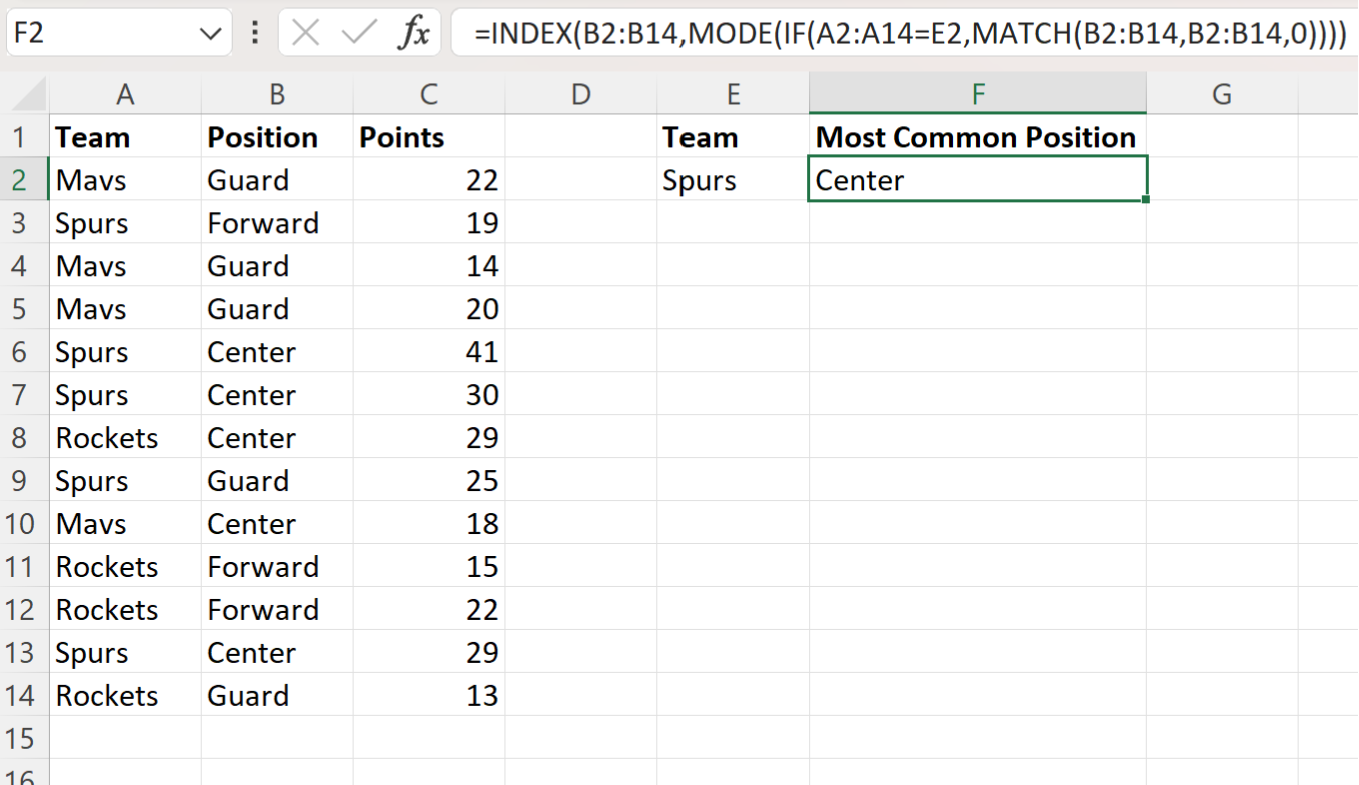
E2(خلية الإسناد المرجعية): تُخصص لكتابة اسم النادي المراد استخراج مركزه الأكثر شيوعاً (مثلاً: “Warriors”). - الخلية
F2(خلية النتائج): الموضع الهندسي الذي سنكتب فيه الصيغة المصفوفية لاستخراج المخرج الإحصائي المطلوب.
4.2 كتابة وتنفيذ الصيغة التطبيقية في إكسل
بناءً على التوصيف الهيكلي السابق، نقوم بصياغة المعادلة المصفوفية بدقة متناهية داخل الخلية F2 لاستخراج المركز الأكثر تكراراً للاعبي فريق “Warriors”. وتأخذ الصيغة الشكل التالي:
=INDEX($B$2:$B$14, MODE(IF($A$2:$A$14=E2, MATCH($B$2:$B$14, $B$2:$B$14, 0))))
يلاحظ في هذه الصيغة استخدام علامات الإسناد المطلق (علامة الدولار $) لتثبيت نطاق المراكز $B$2:$B$14 ونطاق الفرق $A$2:$A$14؛ وذلك لحماية حدود المصفوفات من الانزلاق أو التغير في حال رغبة الباحث في سحب المعادلة عمودياً لتشمل فرقاً أخرى مدرجة أسفل الخلية E2. في المقابل، تُركت الخلية E2 كمرجع نسبي لتتغير تلقائياً مع حركة الصيغة.
إذا كان التطبيق يجري في إصدارات إكسل الكلاسيكية (2019 والإصدارات السابقة)، يجب تنفيذ المعادلة بالضغط المتزامن على مفاتيح Ctrl + Shift + Enter، بينما يكفي الضغط على مفتاح Enter العادي في بيئة Microsoft 365 ومحركات الحساب الحديثة. وبمجرد تفعيل الصيغة، تُظهر الخلية F2 الناتج الفوري المتمثل في القيمة النصية: Guard، معلنةً أنه المركز الأكثر تكراراً لدى هذا الفريق المحدد ضمن العينة.
4.3 التحقق الرياضي واليدوي من صحة المخرجات الإحصائية
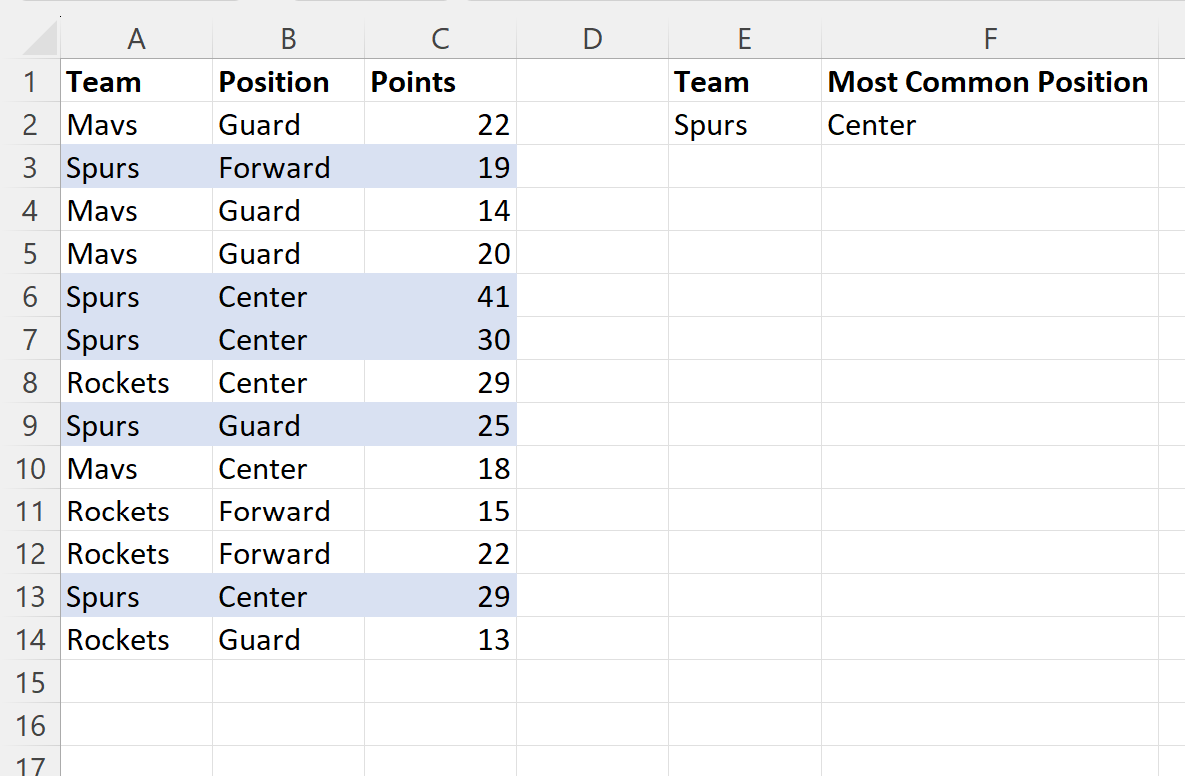
انطلاقاً من معايير التدقيق الأكاديمي الصارم، لا ينبغي قبول مخرجات النماذج الحسابية المعقدة دون إجراء فحص تحقق يدوي يثبت تطابق النتائج الآلية مع الواقع الإحصائي للعينة. للقيام بذلك، نقوم بتصفية الجدول الأصلي يدوياً لعزل سجلات فريق “Warriors” فقط، وحصر التكرارات المطلقة والنسبية لكل مركز من المراكز التابعة له عبر النطاق كما في الجدول التكراري التالي:
- مركز الحارس (Guard): تكرر لدى اللاعبين في الصفوف المقابلة لهذا الفريق 4 مرات.
- مركز المهاجم (Forward): تكرر لدى لاعبي الفريق ذاته مرتين فقط.
- مركز الارتكاز (Center): سُجلت له حالة ظهور واحدة فقط ضمن تشكيلة الفريق.
بإجراء المقارنة الإحصائية البسيطة بين التكرارات المطلقة، يتضح بجلاء أن مركز “Guard” يحوز التكرار الأعظم بواقع 4 مرات من أصل 7 لاعبين يمثلون الفريق، محققاً نسبة مئوية قدرها 57.1% من إجمالي التشكيلة. هذا التوزيع يؤكد بما لا يدع مجالاً للشك أن المنوال الإحصائي الصحيح للفريق هو بالفعل مركز “Guard”، وهو المخرج المتطابق كلياً وبدقة تامة مع القيمة التي استخرجتها صيغتنا المصفوفية، مما يقدم برهاناً عملياً قاطعاً على سلامة التصميم الرياضي للصيغة وقدرتها على عزل المعايير واستخراج النتائج الفئوية دون أي خطأ.
5. المقارنة التقنية بين بيئات التنفيذ: الصيغ المصفوفية الكلاسيكية والديناميكية
5.1 بيئة إكسل التقليدية ومتطلبات مفاتيح (Ctrl + Shift + Enter)
في بيئات إكسل التقليدية (إصدارات إكسل 2019، 2016، 2013 والإصدارات الأقدم)، يعتمد البرنامج على محرك حسابي قديم يتعامل مع الخلايا باعتبارها وحدات مستقلة ذات مخرجات فردية قياسية. وعند الرغبة في إجبار هذا المحرك الكلاسيكي على معالجة متجهات كاملة وإجراء مقارنات مصفوفية داخل وسائط الدوال التي لم تُصمم أصلاً للمصفوفات (مثل وسيط الفحص في دالة IF أو دالة MATCH متعددة المدخلات)، يبرز الإلزام التقني باستخدام الاختصار الشهير Ctrl + Shift + Enter، والمعروف اختصاراً بصيغ CSE.
يؤدي الضغط المتزامن على هذه المفاتيح الثلاثة إلى توجيه أمر مباشر لمترجم إكسل الداخلي لتخصيص مساحة مستمرة في الذاكرة ومسح النطاقات بنمط المصفوفة، وتتويج ذلك بإحاطة الصيغة تلقائياً بأقواس معقوفة { } تظهر في شريط الصيغ. هذه الأقواس لا تُكتب يدوياً على الإطلاق، بل تُمثل علامة فارقة يضعها النظام للدلالة على أن الصيغة تعمل بنمط المعالجة المتجهية الشاملة.
تتمثل المشكلة المزمنة في هذه البيئة القديمة في هشاشة النموذج أمام التعديل البشري؛ فإذا نقر أي مستخدم نقراً مزدوجاً داخل خلية الصيغة لتفقدها ثم ضغط على مفتاح Enter بمفرده، تفقد الصيغة وضع المصفوفة فوراً، وتتحول الأقواس المعقوفة إلى العدم. ويترتب على ذلك تحول الناتج الموثوق إلى أحد الأخطاء الحسابية مثل #VALUE! أو #N/A، نتيجة عجز المحرك التقليدي عن تقييم الوسائط المصفوفية المتداخلة بالأسلوب الحسابي الافتراضي، مما يمثل عائقاً حقيقياً أمام مشاركة الملفات ونقلها بين المستخدمين غير المتمرسين.
5.2 محرك الحسابات الحديث والمصفوفات الديناميكية في Microsoft 365
شهدت منظومة إكسل ثورة معمارية جذرية مع إطلاق محرك الحسابات المحدث (Dynamic Array Engine) في إصدارات Microsoft 365 و Excel 2021 وما بعدها. في هذا المحرك المتطور، أصبحت معالجة المصفوفات ميزة طبيعية مدمجة ومفعلة افتراضياً عبر كامل واجهة التطبيق؛ مما ألغى الحاجة نهائياً للضغط على Ctrl + Shift + Enter، وبات إدخال الصيغ المصفوفية يتم كأي معادلة رياضية اعتيادية بمجرد الضغط على مفتاح Enter.
يتميز المحرك الحديث بقدرته على معالجة المتجهات عبر الحساب الفوري المتوازي، مستفيداً من المعالجات المركزية متعددة الأنوية الحديثة لتقسيم العمليات الحسابية وتقليل زمن التنفيذ. كما يدعم المحرك خاصية السلوك التلقائي للتمدد أو “الانسكاب” (Spill Behavior)؛ حيث تتسع مخرجات المصفوفات تلقائياً عبر الخلايا المتجاورة عند استخدام الدوال الجديدة، وهو ما يوفر بيئة استقرار هائلة للصيغ المركبة التي تضمن استمرار عملها حتى لو تم تحريرها مراراً وتكراراً دون الخوف من فقدان خواصها المصفوفية المتداخلة.
ومع ذلك، تفرض هذه القفزة التقنية تحديات جسيمة تتعلق بـ “التوافق التنازلي” (Backward Compatibility)؛ فعند بناء نموذج يعتمد على محرك Microsoft 365 ثم مشاركة الملف مع مؤسسات أو باحثين يعتمدون على إصدارات مكتبية أقدم، قد تتعطل الحسابات أو تُحاط الصيغة بتعليمات _xlfn. التوافقية، أو تعود لتطلب تفعيل CSE يدوياً لضمان سلامة قراءة المعاملات، مما يفرض على المطور التحقق مسبقاً من البيئة المستهدفة للتشغيل قبل اعتماد النموذج النهائي.
5.3 كفاءة الأداء الحسابي واستهلاك الذاكرة في قواعد البيانات الضخمة
من المنظور الهندسي للبرمجيات وتحليل التعقيد الخوارزمي، تنطوي الصيغة المصفوفية INDEX/MODE/IF/MATCH على تعقيد زمني (Time Complexity) مرتفع نسبياً. فدالة MATCH(Range, Range, 0) تقوم بعملية مقارنة تربيعية تقريبية من الرتبة $O(N^2)$ في أسوأ الحالات؛ إذ تقوم لكل عنصر من عناصر النطاق $N$ بالبحث الخطي عبر كامل عناصر النطاق البالغ عددها $N$ للعثور على أول ظهور متطابق. وإذا أضفنا إلى ذلك تكلفة المعالجة المنطقية لدالة IF ومصفوفة الفرز في دالة MODE، فإن العبء الحسابي يتصاعد تصاعداً أسياً مع زيادة حجم البيانات.
في الجداول التي تحتوي على مئات الآلاف من الصفوف، يمكن لمثل هذه الصيغ المصفوفية المتداخلة أن تؤدي إلى بطء ملحوظ في استجابة ورقة العمل، وربما تجمد البرنامج بالكامل أثناء مرحلة إعادة الحساب (Recalculation cycle). وتزداد هذه المشكلة تفاقماً إذا قام المستخدم بخطأ شائع وشديد الخطورة، وهو الإشارة إلى أعمدة كاملة في الصيغة، كأن يكتب:
=INDEX(B:B, MODE(IF(A:A=E2, MATCH(B:B, B:B, 0))))
في هذه الحالة الكارثية، يُجبر إكسل على فحص ومعالجة ما يزيد عن 1,048,576 صفاً، حتى لو كانت البيانات الفعلية لا تتجاوز بضع مئات من الأسطر، مما يتسبب في استنزاف الذاكرة العشوائية وتوقف المحرك الحسابي.
لضمان الأداء الأمثل والكفاءة الحسابية، تبرز استراتيجيات تحسين إلزامية:
- حصر النطاقات بدقة متناهية لتطابق الحجم الفعلي للبيانات، مثل استخدام
$B$2:$B$500بدلاً من الأعمدة المفتوحة. - التحول إلى استخدام “جداول إكسل المنظمة” (Structured Excel Tables) التي تطبق مراجع الأسماء الديناميكية تلقائياً، مثل
Table1[Position]، والتي تتمدد فقط بمقدار البيانات المدخلة وتتقلص بتقلصها. - تجنب تكرار الصيغة المصفوفية ذاتها في مئات الخلايا المتجاورة، والاستعاضة عنها بجداول تلخيصية وسيطة أو بالدوال الحديثة مثل
FILTERفي حال توفرها، لتخفيف العبء الحسابي الإجمالي على معالج النظام.
6. توسيع النمذجة: استخراج القيمة الأكثر شيوعاً وفق معايير مركبة متعددة
6.1 تطبيق الجبر البولياني (Boolean Logic) لدمج الشروط المتعددة
في الواقع التطبيقي، نادراً ما تتوقف الأسئلة البحثية عند معيار واحد لعزل الظواهر؛ بل يمتد التحليل غالباً ليشمل شروطاً تقاطعية مركبة، مثل البحث عن القيمة الأكثر شيوعاً لدى الأفراد المنتمين لمنطقة معينة، والذين ينتمون في الوقت ذاته إلى شريحة دخل محددة. وهنا يبرز الجبر البولياني كوسيلة رياضية مثلى لدمج هذه الشروط المتعددة داخل المصفوفة دون الحاجة إلى دوال AND المنطقية التقليدية التي تعجز عن معالجة المتجهات وتختزلها دائماً إلى قيمة مفردة.
يقوم الجبر البولياني المصفوفي على مبدأ استخدام عملية الضرب الحسابي (*) كمعادل رياضي مباشر للبوابة المنطقية AND. فعندما نضرب متجهين منطقيين يتألف كل منهما من قيم TRUE و FALSE، يُجبر إكسل على تحويل هذه القيم إلى نظائرها الثنائية العددية؛ حيث يتحول TRUE إلى الرقم 1، بينما يتحول FALSE إلى الرقم 0. وبتطبيق قواعد الضرب الثنائي:
- $1 \times 1 = 1$ (تحقق كلا الشرطين معاً، وهو ما يوازي
TRUE). - $1 \times 0 = 0$ (تحقق أحد الشرطين وفشل الآخر).
- $0 \times 0 = 0$ (فشل كلا الشرطين معاً).
تُصاغ المعادلة متعددة المعايير بالصيغة الهندسية الموسعة التالية:
=INDEX(Target_Range, MODE(IF((Criteria_Range1=Crit1) * (Criteria_Range2=Crit2), MATCH(Target_Range, Target_Range, 0))))
تقوم مصفوفة النتائج الصفرية والواحدية الناتجة عن عملية الضرب هذه بعزل الحالات التي تتقاطع عندها كافة الشروط بدقة مطلقة، وتغذي دالة IF بقناع منطقي صارم لا يسمح بمرور مؤشرات MATCH إلا للسجلات التي حققت التوافق التام مع كافة المتطلبات المحددة في النموذج.
6.2 دمج المعايير النصية والكمية في سياق تحليلي واحد
تتجلى القوة التحليلية للجبر البولياني في مرونته وقدرته الفائقة على التوفيق المتزامن بين الشروط النصية الفئوية والمتباينات الرياضية الحسابية في آن واحد. ففي كثير من الأحيان، يتطلب البحث عزل فئة نصية معينة مقيدة بنطاق رقمي متصل، كأن نبحث عن المسار المهني الأكثر شيوعاً للموظفين التابعين لفرع محدد (معيار نصي) والذين تزيد رواتبهم أو تتجاوز أعمارهم حداً فاصلاً (معيار كمي).
تتم هذه المعالجة بدمج المقارنات الحسابية التي تستخدم معاملات المتباينة (مثل >، <، >=، <=) داخل الأقواس المنطقية جنباً إلى جنب مع مساواة النصوص. فتكون الصيغة على النحو التالي:
=INDEX(Target_Range, MODE(IF((Text_Range="Engineering") * (Age_Range >= 30), MATCH(Target_Range, Target_Range, 0))))
في هذا السياق، يقوم المحرك بمراجعة حقل النص للتأكد من مطابقة القسم، وبالتزامن يختبر حقل العمر للتحقق من تجاوزه الرقم 30، ولا يُنتج المتجه البولياني القيمة 1 إلا عند توافق الشرطين معاً على مستوى السجل الفردي.
ويجب على المحلل أن يكون حذراً من إشكالية “المصفوفات الفارغة منطقياً”؛ ففي حال تم وضع معايير متناقضة أو صارمة جداً بحيث لا يحققها أي سجل في قاعدة البيانات بأكملها، فإن ناتج عملية الضرب البولياني سيكون مصفوفة تتكون بالكامل من الأصفار: {0; 0; 0; ...; 0}. في هذه الحالة، تستبدل دالة IF كافة العناصر بقيم FALSE، ولا تجد دالة MODE أي رقم في المصفوفة لمعالجته، مما يؤدي فوراً إلى ظهور الخطأ الحسابي الشهير #NUM!، وهو ما يستوجب تضمين استراتيجيات المعالجة التشخيصية لتفادي إرباك واجهات التقارير كما سنفصل لاحقاً.
6.3 حالة تطبيقية واقعية: تقييم الأداء استناداً لمعياري القسم وسنوات الخبرة
لتأكيد كفاءة النموذج متعدد المعايير، نفترض سيناريو تحليلياً لإدارة الموارد البشرية في مؤسسة كبرى، يهدف إلى دراسة توزيع تقييمات الأداء السنوية (المصنفة فئوياً إلى: ممتاز، جيد جداً، مرضٍ) لمعرفة “التقييم الأكثر شيوعاً” لشريحة تخصصية دقيقة: موظفو قسم تقنية المعلومات (معيار نصي أول) الذين يمتلكون خبرة تتجاوز 5 سنوات (معيار كمي ثانٍ).
هيكل البيانات المعتمد في الجدول يتضمن:
- العمود
A(نطاق الأقسام –$A$2:$A$100): يحتوي على أسماء الأقسام (“IT”، “Finance”، “HR”). - العمود
B(نطاق سنوات الخبرة –$B$2:$B$100): يحتوي على أرقام صحيحة تمثل سنوات عمل الموظف. - العمود
C(نطاق التقييم السنوي –$C$2:$C$100): يحتوي على الكلمات الوصفية للأداء المستهدف بالدراسة. - الخلية
E2: تحتوي على المعيار الأول المتمثل في القسم النصي المطلوب:"IT". - الخلية
F2: تحتوي على الحد الأدنى لسنوات الخبرة الرقمية المستهدفة:5.
تُكتب الصيغة الرياضية المركبة لاستخراج التقييم الغالب لهذه الشريحة على النحو التالي:
=INDEX($C$2:$C$100, MODE(IF(($A$2:$A$100=E2) * ($B$2:$B$100 > F2), MATCH($C$2:$C$100, $C$2:$C$100, 0))))
عند تنفيذ هذه الصيغة، يستبعد النظام تلقائياً جميع موظفي الأقسام الأخرى بصرف النظر عن خبراتهم، ويستبعد كذلك موظفي تقنية المعلومات الذين تقل خبرتهم عن 5 سنوات، ويحصر الفرز الإحصائي لدالة MODE بين موظفي الشريحة المستهدفة حصراً. وإذا كانت النتيجة المردودة هي “ممتاز”، فإن ذلك يحمل دلالة إحصائية نوعية حاسمة تفيد بأن الكفاءة العالية هي السمة الغالبة على ذوي الخبرة في هذا القسم تحديداً، مما يقدم لصناع القرار مؤشراً كمياً نوعياً منضبطاً يُبنى عليه في خطط التحفيز والتطوير المؤسسي.
7. المعالجة التشخيصية للأخطاء الشائعة وحالات الشذوذ في البيانات
7.1 تشخيص وعلاج خطأ عدم وجود منوال (#NUM! و #N/A)
تعد الأخطاء الحسابية جزءاً لا يتجزأ من بيئة المعالجة المصفوفية عند اختلال توازن المدخلات مع المتطلبات الرياضية. ويعد الخطأ #NUM! العارض الإحصائي الأكثر شيوعاً عند التعامل مع دالة MODE؛ ويظهر هذا الخطأ لسبب رياضي محدد: عدم وجود أي تكرار بين القيم الرقمية المعروضة على الدالة. فإذا كانت جميع القيم في العينة الفرعية المصفاة فريدة تماماً وتكرار كل منها يساوي واحداً فقط، تفشل خوارزمية MODE في تحديد قيمة عظمى غالبة، فترد هذا الخطأ للدلالة على غياب المنوال الإحصائي للبيانات.
في المقابل، يظهر الخطأ #N/A عادة نتيجة فشل في عمليات المطابقة أو عدم تحقق المعيار الشرطي نفسه؛ كأن يبحث المستخدم عن قسم غير موجود أصلاً في قاعدة البيانات، مما يجعل ناتج دالة IF خالياً من أي قيمة صحيحة، أو نتيجة لفشل دالة MATCH في العثور على النظير المطلوب نتيجة تشوه في النصوص. وفي كلتا الحالتين، يمثل ظهور هذه الأخطاء الصريحة في واجهات المستخدم والتقارير التنفيذية عيباً تشغيلياً يخل بالاحترافية التحليلية.
لمعالجة هذه الإشكالية وتحصين النماذج الحسابية، يجب تطويق الصيغة المصفوفية بدوال المعالجة الشرطية الدفاعية، وتحديداً دالتي IFERROR أو IFNA. تأخذ الصيغة المحصنة الشكل المعماري التالي:
=IFERROR(INDEX($B$2:$B$14, MODE(IF($A$2:$A$14=E2, MATCH($B$2:$B$14, $B$2:$B$14, 0)))), "لا يوجد منوال متكرر")
بهذا التدريع التقني، تلتقط دالة IFERROR أي إخفاق في مسار التنفيذ المصفوفي وتستبدل رسائل الخطأ الغامضة بنص تفسيري واضح يُبلغ الباحث إما بعدم تحقق المعايير أو بغياب أي تكرار مرجح في العينة المدروسة، مما يحافظ على نظافة الواجهة وثبات النموذج التحليلي.
7.2 إدارة إشكالية تعدد المنوالات وتساوي التكرارات القصوى
من أخطر المزالق المنهجية في التحليل الإحصائي ما يُعرف بحالة “تعدد المنوالات” (Multimodal Distributions)؛ وهي الحالة التي تتساوى فيها قيمتان أو أكثر في حيازة التكرار الأقصى داخل المجموعة الفرعية نفسها (كأن يتكرر مركز “Guard” 4 مرات ويتكرر مركز “Forward” 4 مرات أيضاً في نفس الفريق). في هذا السيناريو المعقد، تُظهر دالة MODE (أو MODE.SNGL) قصوراً جوهرياً؛ حيث تقتصر برمجياً على إعادة “أول قيمة تظهر في الترتيب المكتبي للبيانات” من بين القيمتين المتنافستين، متجاهلة القيمة الثانية تماماً وبشكل صامت.
يمثل هذا السلوك المكتبي غير المفصح خطراً كبيراً على نزاهة البحوث العلمية؛ إذ يمنح المحلل انطباعاً زائفاً بأن القيمة الظاهرة هي الفائزة المطلقة بلا منازع، في حين أن التوزيع ثنائي المنوال (Bimodal) في حقيقته الميدانية. ولتفادي هذا القصور التفسيري، يجب تطبيق استراتيجيات تنبيه إحصائي تكشف وجود تساوٍ في التكرارات العظمى قبل اعتماد النتيجة الفردية.
يمكن بناء آلية رقابية مرافقة عبر استخدام دالة COUNTIF أو مجاميع التكرار لحساب مدى وجود قيم أخرى تشترك في نفس التكرار الأقصى. كما توفر بيئات إكسل الحديثة حلولاً متقدمة عبر دالة MODE.MULT القادرة على رصد وتمديد كافة القيم المتعادلة كما سنشرح في القسم التالي. وبصورة عامة، يجب على الباحث في قسم المنهجية والإجراءات في دراسته الإشارة بوضوح إلى كيفية التعامل مع البيانات متعددة المنوالات، لضمان عدم توجيه القرارات بناءً على قراءات إحصائية مجتزأة.
7.3 معالجة البيانات غير النظيفة والمسافات البيضاء والرموز الخفية
في الممارسات الواقعية، غالباً ما تُستورد البيانات من أنظمة تخطيط موارد المؤسسات (ERP) أو الاستبيانات الإلكترونية، وتكون محملة بالشوائب التشغيلية مثل المسافات البيضاء الزائدة في البداية أو النهاية، والرموز غير المطبوعة (Non-printing characters). تمثل هذه الشوائب كابوساً حقيقياً لدالة MATCH(Range, Range, 0)؛ فالنص "Guard " (متبوعاً بمسافة خفية) يُعامل لدى محرك الحساب كعنصر مستقل ومختلف كلياً عن النص النظيف "Guard"، مما يؤدي إلى تفتيت التكرارات الحقيقية للنص الواحد إلى مجموعات مشتتة وحرمان القيمة من الفوز المنوالي المستحق.
كذلك تبرز مشكلة الأرقام المخزنة كنصوص (Numbers Stored as Text) عند محاولة استخراج المنوال من حقول رقمية تلوثت أثناء التصدير بترميزات نصية. في هذه الحالة، تتوقف دوال الجمع والمنوال عن التعرف عليها، وتعتبرها مصفوفات غير متجانسة تفشل في توليد مخرجات صحيحة.
لضمان حماية الصيغة من تشوهات البيانات، يجب تنقية المدخلات عبر استراتيجيتين متكاملتين:
- الاستراتيجية المسبقة: تنظيف الأعمدة المستهدفة باستخدام دالتي
TRIMلإزالة كافة المسافات الزائدة، وCLEANلحذف الأحرف غير القابلة للطباعة قبل إدراجها في مسارات التحليل. - الاستراتيجية المضمنة: دمج دالة
TRIMمباشرة داخل الصيغة المصفوفية ذاتها؛ بحيث يتم تمريرTRIM($B$2:$B$14)كوسيط داخل دالتيMATCHوINDEX. وعلى الرغم من أن هذا الدمج يرفع من التعقيد الحسابي للمعالجة، إلا أنه يضمن تعقيم البيانات “أثناء الطيران” (On-the-fly) ويحمي النتائج من التشوهات الميكانيكية الشائعة.
8. الحلول البديلة المتقدمة عبر دوال إكسل الحديثة وتقنيات التحليل التجميعي
8.1 الاستعانة بدوال التصفية الديناميكية FILTER و UNIQUE
مع تطور بيئة الحساب في إصدارات Microsoft 365، أصبحت هناك بدائل هندسية تفوق الصيغة المصفوفية الكلاسيكية في الوضوح الدلالي وسهولة القراءة، وعلى رأسها تركيبة دالتي FILTER و UNIQUE مع دوال الفرز. تتيح دالة FILTER إمكانية استخراج المصفوفة المصفاة أولاً كطبقة وسيطة مستقلة وخالية تماماً من الشوائب، دون الحاجة للتعقيدات الموضعية لدالتي INDEX و MATCH.
تتمثل هذه المقاربة الحديثة في تصفية نطاق القيم المستهدفة أولاً بناءً على المعيار عبر الصيغة:
FILTER(Target_Range, Criteria_Range = Criterion)
ثم تمرير هذا المتجه الصافي مباشرة إلى المعالجة الإحصائية. وإذا كانت البيانات نصية، يمكن دمج ذلك مع دالة UNIQUE لحصر المفردات الفريدة، وتطبيق الدالة الموجهة COUNTIF لتحديد تكرار كل مفردة، ومن ثم فرز المصفوفة باستخدام دالة SORT أو دالة SORTBY تنازلياً للحصول على المفردة الأكثر تكراراً في رأس القائمة.
تتميز هذه التركيبة الحديثة ببنائها الخطي التدريجي الذي يسهل تتبعه وتدقيقه من قِبل المراجعين، مقارنة بالبنية الدائرية للصيغة الكلاسيكية التي تشير فيها دالة MATCH إلى النطاق ذاته مرتين. كما أن هذه الدوال الحديثة تتفوق في كفاءة إدارة الذاكرة واستبعاد السجلات خارج المعايير في مرحلة مبكرة جداً من دورة الحساب؛ مما يقلل من العبء الملقى على عاتق معالج الجهاز.
8.2 معالجة المنوالات المتعددة بواسطة دالة MODE.MULT الحديثة
قدمت مايكروسوفت حلاً حاسماً لمشكلة إخفاء المنوالات المتعددة عبر إطلاق دالة MODE.MULT، وهي النسخة المتطورة المصممة هندسياً لإرجاع مصفوفة عمودية تضم كافة القيم التي تشترك في أعلى تكرار إحصائي داخل العينة. تندمج هذه الدالة بانسيابية مذهلة مع محرك المصفوفات الديناميكية؛ حيث تنسكب (Spill) النتائج المتعددة تلقائياً في الخلايا الواقعة أسفل الخلية الحاوية للصيغة دون الحاجة إلى تحديد النطاق مسبقاً.
لاستخراج كافة النصوص الأكثر شيوعاً في حال التساوي مع تطبيق المعيار الشرطي، يمكن بناء صيغة متقدمة تدمج بين INDEX و MODE.MULT و FILTER:
=INDEX(Target_Range, MODE.MULT(IF(Criteria_Range=Criterion, MATCH(Target_Range, Target_Range, 0))))
في حال وجود مركزين متساويين في التكرار الأقصى، ستقوم الدالة فوراً بملء خليتين متتاليتين عمودياً، مستعرضة كلا المركزين للمستخدم بكل نزاهة وموثوقية رياضية. هذا السلوك يزيل تماماً التحيز التفسيري الذي تسببه دالة MODE.SNGL، ويوفر للباحث أداة قطعية للتحقق من طبيعة التوزيع الاحتمالي للبيانات النوعية محل الفحص.
8.3 استخدام الجداول المحورية (Pivot Tables) كبديل غير معادل بالصيغ
إلى جانب الحلول البرمجية بالمعادلات، تبرز “الجداول المحورية” (Pivot Tables) بوصفها الأداة التفاعلية الأكثر كفاءة وموثوقية في بيئة إكسل لاستعراض التوزيعات التكرارية واكتشاف المنوال الشرطي بصرياً دون كتابة سطر رياضي واحد. تعتمد هذه التقنية على المعالجة التجميعية المسبقة للبيانات عبر محرك الحساب الداخلي فائق السرعة، مما يجعلها مثالية للتعامل مع الملايين من السجلات التي تعجز الصيغ المصفوفية المركبة عن معالجتها بسلاسة.
يتم تطبيق هذا الحل عبر خطوات إجرائية محددة:
- إدراج جدول محوري من نطاق البيانات، وسحب حقل المعيار (مثل: “الفريق”) إلى منطقة عوامل التصفية (Filters) أو منطقة الصفوف (Rows).
- سحب الحقل المستهدف (مثل: “المركز”) إلى منطقة الصفوف (Rows)، وسحبه مرة أخرى إلى منطقة القيم (Values) مع ضبط إعدادات حقل القيمة ليعمل وفق دالة العد (Count).
- تطبيق عامل تصفية القيمة المتقدم: “أفضل 10” (Top 10 Filter)، وتعديل إعداداته ليصبح “أفضل 1” (Top 1) استناداً إلى حقل العد.
تؤدي هذه الإعدادات البسيطة إلى عزل المركز الأكثر تكراراً فورياً لكل فريق بصورة ديناميكية. وتتميز الجداول المحورية بحصانتها الكاملة ضد أخطاء بناء الصيغ، وبقدرتها الفائقة على إظهار كافة القيم المتعادلة تلقائياً دون أي كود مصفوفي معقد. إلا أن عيبها الوحيد مقارنة بالمعادلات يكمن في حاجتها إلى “التحديث اليدوي” (Refresh) عند تعديل البيانات الأصلية، في حين تستجيب المعادلات الرياضية اللحظية للمتغيرات بصورة فورية وتلقائية دون أي تدخل إضافي.
9. التطبيقات الميدانية للمنوال الشرطي في البحوث السلوكية والاجتماعية
9.1 تحليل استجابات مقاييس ليكرت وفق المتغيرات الديموغرافية
تحتل مقاييس ليكرت (Likert Scales) مكانة مركزية في استقصاء الاتجاهات السلوكية والرأي العام في العلوم النفسية والاجتماعية. ونظراً لطبيعتها الرتبية (Ordinal) التي تقترب في كثير من الممارسات من القياس الفئوي، فإن استخدام المتوسط الحسابي وحده لتلخيص درجات مقياس مثل (أوافق بشدة، أوافق، محايد، أعارض، أعارض بشدة) قد يولد قراءات مضللة تخفي استقطاب الآراء خلف أرقام كسرية لا تعبر عن أي خيار حقيقي على المقياس.
وهنا يبرز دور المنوال الشرطي كأداة لا غنى عنها لعزل الاتجاهات السلوكية الأكثر شيوعاً وفق المتغيرات الديموغرافية المستقلة، مثل مقارنة التوجه الغالب بين فئات الذكور والإناث، أو بين الفئات العمرية المتمايزة. ومن خلال تطبيق الصيغة المصفوفية INDEX/MODE/IF/MATCH، يستطيع الباحث صياغة نماذج مرنة تجيب عن تساؤلات محددة مثل: “ما هو الرأي الأكثر ترجيحاً وتكراراً لدى الفئة العمرية الشابة تجاه قضية معينة؟”، مما يوفر لمحة إحصائية أمينة تنقل صوت الغالبية الصامتة دون تشويه رياضي.
كما يسهم المنوال الشرطي في عزل تأثير “المتغيرات الوسيطة” (Mediating Variables) في الدراسات الميدانية؛ حيث يتيح للباحث تقسيم العينة الكلية إلى طبقات متعددة الأبعاد وفحص نمط الاستجابة السائد داخل كل طبقة على حدة، وهو ما يساعد في الكشف عن التغيرات في السلوك الجمعي التي قد تذوب وتختفي في المتوسطات الإجمالية للعينة الكلية.
9.2 رصد وتصنيف الأنماط المتكررة في المقاييس الإكلينيكية
في مجالات القياس النفسي والتشخيص الإكلينيكي، يعتمد المعالجون والباحثون على تتبع تواتر أعراض معينة عبر أدوات القياس السلوكي المقيدة بمدى زمني (مثل مقاييس تكرار نوبات القلق، أو سلوكيات فرط الحركة لدى الأطفال خلال جلسات الملاحظة). في هذه السياقات، لا تقتصر الرغبة على معرفة متوسط درجات العرض، بل يغدو حاسماً تحديد “العرض العيادي الأكثر ظهوراً وبروزاً” لكل مجموعة تشخيصية فرعية خاضعة للبروتوكول العلاجي.
يتيح تطبيق المنوال المقيد بالمعايير التشخيصية بناء “الملامح النفسية النموذجية” (Prototypical Clinical Profiles)؛ فعند توجيه الصيغة لفحص سجلات المرضى الذين تم تصنيفهم وفق متلازمة مرضية محددة (كالمعيار $X$)، يمكن استخراج السلوك المستهدف الأكثر تكراراً في الجلسات الأولى ومقارنته بالمنوال السلوكي في الجلسات الختامية المقيدة بظرف ما بعد العلاج. يوفر هذا الاستخدام مؤشراً نوعياً ملموساً يوضح التحولات في السلوك الغالب لدى الحالات، ويدعم تقييم كفاءة التدخلات العلاجية بدقة إحصائية تستجيب لخصوصية كل فئة تشخيصية على حدة.
9.3 تفسير القرارات السلوكية في التجارب المعملية المقيدة بظروف محددة
تضع التجارب السلوكية في علم النفس التجريبي والاقتصاد السلوكي المشاركين أمام مواقف اتخاذ قرار معقدة مقيدة بشروط وظروف معملية متغيرة؛ مثل قرارات المخاطرة في بيئات الضغط الزمني المرتفع، أو تفضيل خيارات الشراء تحت محفزات سعرية معينة. تتسم البيانات المتولدة عن هذه التجارب بكونها بيانات نوعية تمثل خيارات اسمية مجردة (مثل: الخيار أ، الخيار ب، الامتناع عن القرار).
باستخدام المنوال الشرطي، يستطيع الباحث الإمبيريقي استخلاص القرار المهيمن الذي يتوافق مع كل ظرف تجريبي مستقل بدقة بالغة. فبدلاً من اللجوء للتحويلات الرمزية المعقدة، تُمكن الصيغ المصفوفية الباحث من الاحتفاظ بالتسميات الأصلية للقرارات واسترجاع القرار الأكثر وروداً تحت بيئة الضغط النفسي بصيغته النصية الصريحة ومقارنته مباشرة بالقرار الغالب في ظروف الأمان التام. هذا الربط المباشر بين الشروط التجريبية والخيارات السلوكية الأكثر تكراراً يُعزز من القدرة التفسيرية للنتائج ويدعم صياغة النظريات السلوكية المستندة إلى أسس واقعية قطعية.
10. دليل الحوكمة والتوثيق الأكاديمي لجداول البيانات والنماذج الحسابية
10.1 استخدام النطاقات المسماة (Named Ranges) لتعزيز شفافية النماذج
تعد النماذج الرياضية في جداول البيانات عرضة للتعتيم الإدراكي وأخطاء القراءة عندما تعتمد على مراجع الخلايا المجردة مثل $A$2:$A$100؛ إذ يصعب على المراجع المستقل أو الباحث الزميل تفكيك دلالة هذه المراجع وسياقاتها الوظيفية بسرعة. وتزداد هذه المعاناة في الصيغ المصفوفية المتداخلة التي تتطلب تركيزاً ذهنياً عالياً لفهم ترابط عناصرها المنطقية.
تتمثل الحوكمة التقنية المثلى في استبدال المراجع المادية بـ “النطاقات المسماة” (Named Ranges) التي تخلع على البيانات أبعاداً دلالية معبرة. فعلى سبيل المثال، يمكن إعادة تسمية النطاقات المستخدمة في نموذجنا لتصبح الصيغة كالتالي:
=INDEX(PlayerPositions, MODE(IF(TeamNames=SelectedTeam, MATCH(PlayerPositions, PlayerPositions, 0))))
يحقق هذا التحول الدلالي فوائد منهجية جوهرية:
- تحسين مقروئية الصيغة بشكل فوري؛ مما يمكن أي مراجع خارجي من استيعاب المسار الحسابي دون الحاجة لتتبع حدود الخلايا يدوياً.
- تثبيت النطاقات وحمايتها تلقائياً من الانزلاقات غير المقصودة التي تحدث أثناء سحب المعادلات أو نسخها عبر صفحات العمل المختلفة.
- تقليص احتمالات الخطأ البشري إلى أدنى مستوياتها، وتحويل نموذج إكسل إلى بيئة برمجية شبه نصية تتوافق مع معايير التدقيق الأكاديمي والمؤسسي المتقدمة.
10.2 حماية الصيغ البرمجية والتحكم في صحة المدخلات (Data Validation)
يتطلب الحفاظ على موثوقية النماذج التحليلية على المدى الطويل وضع ضوابط هندسية صارمة تفصل بين مناطق إدخال المتغيرات ومناطق المعالجة الحسابية؛ إذ إن فتح ورقة العمل للتعديل الشامل يجعل الخلايا الحاوية للصيغ المصفوفية المعقدة عرضة للحذف أو التشويه غير المتعمد من قِبل المستخدمين العاديين.
تتضمن هذه الحوكمة تفعيل إجراءين وقائيين متزامنين:
- أولاً: تقييد خلايا المعايير (مثل خلية اختيار الفريق
E2) باستخدام أداة “التحقق من صحة البيانات” (Data Validation) واختيار نمط “القائمة” (List). يتم ربط القائمة بحصر دقيق وفريد للفرق المتاحة؛ مما يمنع المستخدم تماماً من كتابة أسماء تحتوي على أخطاء مطبعية أو مسافات خفية تتسبب في تعطل دالةMATCHوتوليد الأخطاء الحسابية. - ثانياً: قفل الخلايا (Locking Cells) التي تحتضن الصيغ المصفوفية المركبة، وحماية ورقة العمل بكلمة مرور تمنع التعديل في بنيتها الرياضية، مع إبقاء خلايا القوائم المنسدلة فقط مفتوحة للتفاعل. كما يُستحسن إدراج رسائل إرشادية وتلميحات توجيهية مدمجة تظهر للمستخدم لشرح حدود النموذج وطبيعة المدخلات المقبولة.
10.3 معايير التوثيق المنهجي للنتائج الإحصائية المستخرجة في الأوراق العلمية
تفرض النزاهة العلمية في النشر الأكاديمي الشفافية المطلقة حول الأدوات والخوارزميات البرمجية المستخدمة في اشتقاق النتائج والمؤشرات التلخيصية. وعند الاعتماد على المنوال الشرطي المشتق من بيئة إكسل في تحليل بيانات دراسة منشورة، لا يكفي القول بأن البيانات “حُللت إحصائياً”، بل يجب تضمين إفصاح منهجي دقيق في قسم المنهجية وإجراءات التحليل (Methodology Section).
يتعين على الباحث توثيق النقاط الجوهرية التالية لضمان قابلية إعادة الإنتاجية (Reproducibility):
- الإفصاح الصريح عن نسخة البرنامج المستخدم (مثل: Microsoft Excel 365, Version 2208) وطبيعة المحرك الحسابي المعتمد في تقييم الصيغ (صيغ مصفوفية تقليدية عبر
CSEأم مصفوفات ديناميكية). - كتابة الصيغة الرياضية الهيكلية المطبقة لاستخراج المنوال بدقة متناهية، وبيان آليات الفلترة الشرطية ونوع التطابق المعتمد.
- توضيح المعيار المنهجي المتبع في إدارة حالات “تعدد المنوالات” (Multimodal Distributions) والبيانات الشاذة؛ وهل تم الاكتفاء بالقيمة الأولى أم فحص التعادل وتوثيق وجود أكثر من نمط غالب.
- إيداع نسخة نظيفة وموثقة من ملف جداول البيانات كملحق تكميلي (Supplementary Material) في مستودعات البيانات المفتوحة، مع تزويدها بدليل بيانات (Codebook) يوضح بنية النطاقات والمتغيرات، التزاماً بالمبادئ التوجيهية للشفافية والانفتاح البحثي المعاصر.
خاتمة
لقد أثبت التحليل المنهجي والتطبيقي المستفيض أن استخراج القيمة الأكثر شيوعاً وفق معايير محددة في إكسل يمثل عملية هندسية إحصائية متكاملة، تتجاوز مجرد كتابة دالة فردية بسيطة لتصل إلى بناء منظومة مصفوفية متداخلة تحاكي خوارزميات البرمجة المتقدمة. ومن خلال التكامل الرياضي الدقيق بين قدرات الفهرسة الموضعية لدالة INDEX، والتشفير الرقمي للنصوص عبر MATCH، والتقييم البولياني الحازم لدالة IF، والفرز التكراري الموجه لدالة MODE، استطعنا التغلب على الغياب البنيوي لدالة قياسية مدمجة تحت مسمى MODEIFS، وفتحنا آفاقاً واسعة لتحليل المتغيرات الفئوية والاسمية المعقدة بكفاءة وموثوقية بالغة.
وعلاوة على ذلك، أظهرت المقارنة التقنية بين بيئات التنفيذ ضرورة وعي الباحث والمحلل بالفروق الهيكلية بين محركات الحساب الكلاسيكية التي تلزم استخدام مفاتيح Ctrl + Shift + Enter والمحركات الحديثة للمصفوفات الديناميكية في Microsoft 365، لما لذلك من أثر مباشر على استقرار النماذج وكفاءتها الحسابية عند معالجة قواعد البيانات الكبيرة. ومع مراعاة آليات التحصين التشخيصي للأخطاء، وتنقية البيانات، وإدارة المنوالات المتعددة، وتطبيق معايير الحوكمة والتوثيق الأكاديمي، تتحول جداول البيانات من مجرد أوراق عمل روتينية إلى منصات موثوقة للتحليل الكمي والنوعي تدعم صناعة القرار الرشيد والبحث العلمي الرصين.
المراجع
- Pearson, K. (1895). Contributions to the mathematical theory of evolution. II. Skew variation in homogeneous material. Philosophical Transactions of the Royal Society of London (A), 186, 343–414. https://royalsocietypublishing.org/doi/10.1098/rsta.1895.0010
- Stevens, S. S. (1946). On the theory of scales of measurement. Science, 103(2684), 677–680. https://www.science.org/doi/10.1126/science.103.2684.677