
تُمثّل معالجة النصوص والسلاسل المحرفية (Character Strings) إحدى الركائز الجوهرية في هندسة البيانات وإدارتها عبر بيئات التحليل الإحصائي المتقدمة. وفي إطار منظومة SAS (Statistical Analysis System)، التي تعود جذور ابتكارها وتطويرها الأول إلى عام 1966 في جامعة ولاية كارولاينا الشمالية على يد أنتوني بار (Anthony J. Barr)، وجيمس غودنايت (James Goodnight)، وجون سال (John Sall)، وجين هيلويغ (Jane Helwig)، وصولاً إلى التأسيس الرسمي لشركة SAS Institute Inc في عام 1976، تتخذ عمليات تنقية النصوص واقتطاع المقاطع النصية أهمية بالغة تتجاوز مجرد المعالجة السطحية للألفاظ إلى تنظيم البنى المعرفية والبيانية للمتغيرات المعقدة.
تكمن التحديات البرمجية في معالجة سلاسل المحارف داخل بيئة SAS في الاختلاف البنيوي بين الأنظمة الحديثة التي تعتمد على التحديد الديناميكي للأطوال والفهرسة المرنة من اليمين (مثل بايثون أو لغة آر)، وبين نظام التخزين الصارم في خطوة البيانات (DATA Step) في SAS. فالنظام يتعامل مع المتغيرات النصية بمساحات حجز ثابتة في الذاكرة ومبطنة بالفراغات اللاحقة (Trailing Blanks). ومن هنا، يبرز التساؤل المنهجي والتقني المتكرر بين محللي البيانات وعلماء الإحصاء الحيوي والاجتماعي: كيف يمكن استخراج سلسلة نصية فرعية من اليمين بدقة متناهية، وبشكل يحفظ كفاءة الحوسبة ويحول دون الوقوع في الأخطاء الصامتة أو التشوهات البنيوية؟
يقدم هذا المرجع الأكاديمي الشامل تحليلاً معمقاً وممنهجاً للآليات الحسابية والبرمجية المعنية باستخلاص المقاطع النصية اليمينية داخل نظام SAS. حيث سنقوم بتفكيك البنية الرياضية لدوال التقطيع، ومناقشة تفاعل دالة SUBSTR مع دوال القياس والتنقية مثل LENGTH وSTRIP وTRIM، واستعراض البدائل الحسابية مثل التقطيع العكسي عبر دالة REVERSE، واستخدام دالة SCAN، وصولاً إلى التعابير النمطية ومعالجة البيانات الضخمة (Big Data) بكفاءة واقتدار أكاديمي رصين.
1. الأسس النظرية لمعالجة البيانات النصية وسلاسل المحارف في نظام SAS
1.1 مفهوم المتغيرات النصية وتخزينها في بيئة SAS الأكاديمية
تخضع المتغيرات النصية (Character Variables) في بنية SAS لقواعد إدارة ذاكرة شديدة الصرامة مقارنة بلغات البرمجة المفسرة الحديثة. فعند تعريف متغير نصي داخل خطوة البيانات (DATA Step)، يقوم محرك النظام بتخصيص طول تخزيني ثابت يُقاس بالبايت (Byte Length) لكل متغير بناءً على أول إسناد له أو عبر تصريح صريح باستخدام عبارة LENGTH. يتم الحفاظ على هذا الطول المخصص عبر كافة سجلات مجموعة البيانات دون تغيير تلقائي، مما يعني أن أي نص يقل طوله الفعلي عن الحجم المحجوز يتم حشوه تلقائياً بمسافات فارغة متبقية في نهايته، تُعرف تقنياً باسم المسافات اللاحقة (Trailing Blanks).
يختلف هذا المنطق البنيوي جذرياً عن المتغيرات الرقمية (Numeric Variables) التي تعتمد دقة الفاصلة العائمة (Floating-Point Precision) بحجم قياسي مقداره 8 بايتات افتراضياً. إن وجود هذه المسافات الفارغة المتبقية داخل مساحة الذاكرة الثابتة يؤدي إلى إشكالية جوهرية عند محاولة قياس أبعاد النصوص برمجياً، إذ إن المتغير النصي يبدو للنواة البرمجية ممتداً حتى نهاية البايت الأخير المحجوز، حتى وإن كان المحتوى الدلالي يشغل بضعة أحرف فقط في بداية السلسلة. وتتطلب هذه الخاصية انتباهاً دقيقاً من الباحث؛ حيث إن التغاضي عن هذه المسافات يقود إلى خطأ منهجي فادح أثناء محاولة التقطيع، محولاً عملية الاستخراج من استهداف النصوص الفعلية إلى استهداف فراغات بيضاء غير مرئية في سجلات البيانات.
تتجلى خطورة هذه المسافات الفارغة في الأبحاث الكمية والمسحية التي تتعامل مع سلاسل ترميز متباينة الأطوال؛ حيث تُخزن الإجابات في مصفوفات ثابتة. وإذا لم يتم ضبط وتدقيق الأطوال المحجوزة والأطوال الفعلية، فإن العمليات التحويلية والحسابية اللاحقة، لا سيما عمليات المطابقة والدمج (Merging) والتصنيف، ستفقد دقتها القياسية، مما يفرض استخدام تقنيات برمجية واعية تنزع هذه الزوائد اللاحقة قبل إجراء أي استقطاع موضعي.
1.2 أهمية التقطيع النصي العكسي في تحليل البيانات واسترجاع المؤشرات
يمثل التقطيع النصي من اليمين (Right-Side Substring Extraction) أداة استرجاع لا غنى عنها في بروتوكولات معالجة البيانات الإحصائية وتنقيتها. ففي كثير من التصاميم المنهجية، تحتوي المتغيرات المعقدة والمركبة على لواحق (Suffixes) أو رموز تصنيفية نهائية تحمل دلالات تفريقية حاسمة. على سبيل المثال، قد يحمل المعرف الفردي للمشارك في دراسة تتبعية كوداً مركباً يتكون من رمز المركز الإقليمي في البداية، متبوعاً برقم المستجيب، ومنتهياً برمز الحالة أو نقطة القياس الزمني (مثل T1 أو T2). ولعزل هذه النقطة الزمنية، يحتاج المحلل إلى قراءة السلسلة من نهايتها بصرف النظر عن تباين أطوال المقاطع السابقة.
تمتد هذه الضرورة المنهجية إلى معالجة المتغيرات المعيارية والتواريخ وأكواد العينات الطبية أو السلوكية. فالأكواد الدولية للأمراض أو الترميزات المهنية قد تتضمن تفرعات نوعية في الحرفين الأخيرين للدلالة على التشخيص الدقيق أو شدة الأعراض. واستخراج هذه المؤشرات عبر التقطيع الموجه من اليمين يتيح تحويل السلاسل النصية الطويلة المشوشة إلى متغيرات فئوية نظيفة، جاهزة للتحليل في الإجراءات الإحصائية المتقدمة. إضافة إلى ذلك، يسهم التقطيع العكسي في تقليص أخطاء القياس؛ إذ يوفر آلية معيارية موحدة تلغي أثر التباين العشوائي في بدايات السلاسل، مما يرفع من صدق وثبات المؤشرات المستخرجة.
2. البنية التركيبية والديناميكية لدالة SUBSTR القياسية
2.1 الصيغة النحوية العامة ومعاملات دالة SUBSTR
تُعد دالة SUBSTR الدعامة الأساسية لاقتطاع السلاسل النصية داخل نظام SAS، وهي تندرج تحت فئتين استخداميتين: دالة استرجاعية حين تُوضع على يمين معامل الإسناد (Right of the equal sign)، وإجراء استبدالي موضعي حين تُوضع على يسار معامل الإسناد (Left of the equal sign). وفي سياق استخراج النصوص، تركز بنيتها النحوية على الصيغة العامة التالية:
SUBSTR(argument, position, <n>)
حيث يمثل المعامل الأول (argument) السلسلة النصية المصدرية أو اسم المتغير النصي المطلوب تجزئته، ويجب أن يكون من نوع محرفي (Character Type). أما المعامل الثاني (position)، فيشير إلى نقطة الانطلاق الحسابية، ويجب أن يكون عدداً صحيحاً موجباً يحدد الترتيب المكاني للبايت أو المحرف الذي تبدأ عنده عملية القراءة، مع الأخذ في الحسبان أن الترقيم في SAS يبدأ افتراضياً من اليسار برقم واحد (1-based indexing).
يمثل المعامل الثالث (n) طول المقطع النصي المراد استخراجه، مقاساً بعدد المحارف. ويُعد هذا المعامل اختيارياً في الصيغة النحوية؛ ففي حال حذفه تماماً، تستمر الدالة في قراءة واقتطاع كافة المحارف المتبقية بدءاً من موضع البداية وحتى أقصى الطرف الأيمن للسلسلة. وإذا تجاوزت القيمة المحددة لـ (n) عدد المحارف المتبقية في المتغير، أو إذا كانت قيمة البداية خارج النطاق الفعلي للمتغير، فإن الدالة تتعامل مع ذلك بإرجاع ما تبقى من محارف، أو قد يتولد خطأ تنفيذي في سجل التشغيل (SAS Log) في حال كان موضع البداية يتجاوز الطول الكلي للسلسلة، وهو ما يستدعي ضبطاً دقيقاً للمعاملات لضمان سلامة مسار المعالجة.
2.2 القيود البنيوية للبحث من اليسار والحاجة للتوجيه العكسي
تتمثل الفجوة الإجرائية الكبرى في دالة SUBSTR القياسية في افتقارها لخاصية الفهرسة العكسية التلقائية. فبخلاف لغات برمجية أخرى تسمح بتمرير قيم سالبة في معامل موضع البداية للإشارة إلى العد التنازلي من اليمين (مثل تمرير القيمة -3 لاستخراج المحارف الثلاثة الأخيرة)، فإن تمرير قيمة سالبة أو صفرية لمعامل الموضع في دالة SUBSTR داخل لغة SAS يُعد خطأً نحوياً وتنفيذياً صريحاً، ينتج عنه تسجيل ملاحظة تحذيرية في سجل التشغيل تفيد بعدم صلاحية المعامل الثاني، مع إسناد قيمة مفقودة للمتغير الناتج:
NOTE: Argument 2 to function SUBSTR at line ... is invalid.
يفرض هذا القيد البنيوي على المبرمج البحث عن آليات رياضية تعيد توجيه المنطق التحليلي، بحيث يتم تحويل الرغبة في التقطيع من اليمين إلى إحداثيات انطلاق تبدأ من اليسار، بما يتوافق مع الإطار التصميمي الصارم للدالة. وتتعقد هذه المسألة بصورة ملحوظة عند التعامل مع مصفوفات بيانات حقيقية تتسم بعدم تجانس أطوال النصوص داخل المتغير الواحد؛ إذ لا يمكن الاعتماد على رقم بداية ثابت لكل الحالات، بل يجب أن تحسب نقطة البداية بشكل ديناميكي فريد لكل ملاحظة إحصائية داخل سجلات البيانات.
3. المنطق الرياضي للربط التكاملي بين دالتي SUBSTR وLENGTH
3.1 اشتقاق معادلة نقطة البداية النسبية
للتغلب على غياب الفهرسة السالبة المباشرة، قام مطورو وخبراء لغة SAS بصياغة حل رياضي يقوم على حساب الإزاحة الموضعية (Positional Offset) باستخدام دالة قياس الطول. إذا كان لدينا متغير نصي ذو طول فعلي مقداره $L$، ونرغب في استخراج عدد $k$ من المحارف المتواجدة في أقصى اليمين، فإن نقطة البداية المطلوبة $P$ وفق المنطق التسلسلي من اليسار تُشتق رياضياً عبر المعادلة التالية:
$$P = L – k + 1$$
ولتوضيح هذا المنطق، نفترض وجود سلسلة نصية مكونة من 10 محارف ($L = 10$)، والمطلوب استخراج المحارف الثلاثة الأخيرة ($k = 3$). إذا طبقنا الفارق المجرد ($L – k$) فسنحصل على الموضع 7 ($10 – 3 = 7$). ولكن إذا انطلقت دالة SUBSTR من الموضع 7 واقتطعت 3 محارف، فإنها ستسترجع المحارف المتواجدة في المواضع (7 و8 و9)، متجاهلة المحرف الأخير المتواجد في الموضع 10. ومن هنا تنشأ الحاجة الرياضية لإضافة الثابت الرقمي واحد (+ 1) لتعويض إزاحة نقطة الانطلاق الشاملة، بحيث تصبح نقطة البداية هي الموضع الثامن ($10 – 3 + 1 = 8$)، مما يمكن الدالة من اقتطاع المحارف في المواضع (8 و9 و10)، وهي المحارف الثلاثة اليمينية المستهدفة تماماً دون أي إزاحة خاطئة.
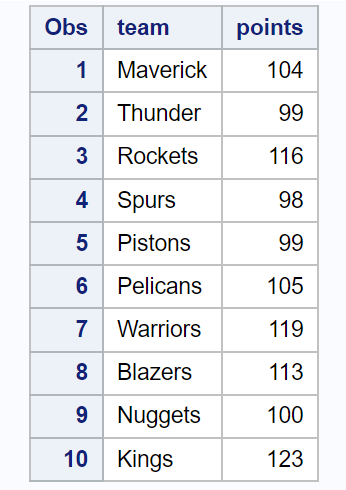
3.2 دور دالة LENGTH في تحديد الطول الفعلي للقيم النصية
تمثل دالة LENGTH حجر الزاوية في إنجاح المعادلة الرياضية السابقة؛ إذ تضطلع بمهمة قراءة السلسلة النصية وحساب موضع آخر محرف غير فارغ فيها، متجاهلة تلقائياً كافة المسافات اللاحقة (Trailing Blanks) التي يفرضها حجز الذاكرة الثابت في SAS. تعيد هذه الدالة قيمة رقمية صحيحة موجبة تمثل الطول الفعلي للمحتوى، وتتعامل مع السلاسل الفارغة كلياً بإرجاع القيمة 1 افتراضياً في الإصدارات القديمة، أو بحسب معايير الضبط المعتمدة.
من الأهمية بمكان التمييز المنهجي الدقيق بين دالة LENGTH القياسية ودوال القياس الشقيقة الأخرى مثل LENGTHC وLENGTHN. فدالة LENGTHC تُعيد الحجم الكلي المحجوز للمتغير بالبايتات متضمناً المسافات الفارغة، وبالتالي فإن استخدامها في معادلة الاستخراج العكسي سيؤدي إلى فشل ذريع، حيث ستقوم الدالة باقتطاع الفراغات المخفية بدلاً من النص المطلوب. أما دالة LENGTHN فتتشابه كلياً مع دالة LENGTH، لكنها تتفوق عليها في معالجة السلاسل الفارغة تماماً؛ حيث تعيد القيمة صفر (0) بدلاً من القيمة واحد، مما يمنحها موثوقية استثنائية في التحوط ضد الأخطاء البرمجية أثناء التعامل مع المتغيرات ذات الأطوال الديناميكية غير المتجانسة أو البيانات غير المكتملة.
4. التطبيق العملي خطوة بخطوة لاستخراج المقاطع النصية اليمينية
4.1 بناء مجموعة البيانات النموذجية واختبار المدخلات
لتطبيق هذه المبادئ الحسابية عملياً، نقوم بإنشاء خطوة بيانات نموذجية (DATA Step) تحاكي واقع السجلات في دراسات القياس الميداني، حيث تتباين أطوال الأسماء والأكواد داخل المتغير المصدر. يُعرف المتغير النصي بإضافة رمز الدولار ($) لتحديد طبيعته الحرفية، مع تعيين حجم تخزيني كافٍ لاستيعاب أطول مدخل محتمل:
data ResearchData;
    length ParticipantID $ 15;
    input ParticipantID $;
    datalines;
    SUB_CLIN_A01
    ID_B09
    PATIENT_CTR_C99
    CASE_D12
    EXP_E05
    ;
run;
يتضح من خلال هذه البيانات المدخلة أن أطوال السلاسل تتراوح ما بين 6 محارف إلى 15 محرفاً. وتبرز هنا قوة التصميم البرمجي؛ فالسجل الثاني ID_B09 يقل طوله الفعلي بمقدار تسعة محارف عن الحد الأقصى للمتغير (15 بايت)، مما يجعله محاطاً بتسعة فراغات لاحقة في الذاكرة. يتم التحقق من سلامة استيراد هذه البيانات وقراءتها عبر إجراء PROC PRINT، تمهيداً لإخضاعها لمعادلات الاقتطاع اليميني الممنهجة.
4.2 تنفيذ كود الاستخراج الموجه لليمين في لغة SAS
يتم تطبيق آلية الاستخراج الموجه لليمين داخل خطوة معالجة جديدة، حيث نستهدف استخلاص الرموز الثلاثة الأخيرة من المعرف (والتي تمثل كود الحالة الفردية للبحث). نعتمد هنا على الدمج التكاملي بين SUBSTR وLENGTH مسبوقة بدالة التنقية لضمان أعلى مستويات الدقة:
data ProcessedData;
    set ResearchData;
    length TargetCode $ 3;
    TargetCode = substr(strip(ParticipantID), length(strip(ParticipantID)) - 3 + 1, 3);
run;
يمكن تبسيط التعبير البرمجي أعلاه عبر الاستغناء عن المعامل الثالث لدالة SUBSTR؛ فطالما أن نقطة الانطلاق قد حُسبت بدقة لتمثل بداية المقاطع الثلاثة الأخيرة، فإن ترك المعامل الثالث فارغاً يدفع الدالة تلقائياً لقراءة السلسلة حتى نهايتها الطرفية:
TargetCode_Alt = substr(strip(ParticipantID), length(strip(ParticipantID)) - 2);
يقوم محرك SAS، عبر متجه بيانات البرنامج (Program Data Vector – PDV)، بقراءة كل سجل على حدة، وتطبيق دالة STRIP أولاً لتجريد المتغير من الفراغات، ثم استدعاء دالة LENGTH لتحديد الموضع الديناميكي، ثم تنفيذ التقطيع وحفظ الناتج في المتغير الجديد TargetCode، مع ضمان اتساق أطوال المتغيرات المنشأة ومنع أي هدر في مساحات التخزين.
4.3 معاينة المخرجات والتحقق الإحصائي من دقة الاستخلاص
عقب إتمام معالجة البيانات، تأتي مرحلة التدقيق المعياري للمخرجات للتأكد من عدم حدوث تشوهات بنيوية في النصوص المستخلصة. يتم استدعاء إجراء PROC PRINT لعرض النتائج جنباً إلى جنب مع المتغيرات الأصلية لمقارنة التطابق العيني:
proc print data=ProcessedData noobs;
    var ParticipantID TargetCode;
run;
تُظهر مخرجات التنفيذ استخلاص الأنماط التالية بنجاح تام: A01، B09، C99، D12، E05. وللتأكد من اتساق الأنماط وعدم تسرب أي فراغات أو محارف غير مرغوبة، يُستعان بإجراء التكرارات PROC FREQ لتلخيص توزيع القيم المستخرجة وفحص نقائها الإحصائي:
proc freq data=ProcessedData;
    tables TargetCode / missing;
run;
يقدم هذا الفحص التكراري دليلاً جازماً على أن كافة المستخرجات تتألف بدقة من ثلاثة محارف، بصرف النظر عما إذا كان المعرف الأصلي طويلاً كـ PATIENT_CTR_C99 أو قصيراً كـ ID_B09، مما يؤكد صلابة البناء الرياضي المعتمد.
5. معالجة إشكاليات المسافات البيضاء والرموز المخفية في نهايات السلاسل
5.1 تأثير المسافات الفارغة المتبقية (Trailing Spaces) على دقة الحساب
تُعد المسافات الفارغة المتبقية (Trailing Spaces) السبب الأكثر شيوعاً لتوليد ما يُعرف في الأدبيات البرمجية بالأخطاء الصامتة (Silent Errors). وهي أخطاء ينفذ فيها النظام الكود دون إصدار أي تحذيرات أو رسائل فشل في السجل (SAS Log)، لكنها تُنتج مخرجات بيانية خاطئة كلياً. يتضح هذا السيناريو عندما يقوم المبرمج باستدعاء دالة LENGTH مباشرة على متغير تم حجز مساحة كبيرة له، ثم جرى دمجه أو استيراده بطرق تحتفظ بالفراغات الداخلية أو اللاحقة داخل المتغير.
إذا احتوى المتغير النصي على مسافات متبقية، ولم يتم استخدام دوال التنقية المسبقة، فإن نقطة البداية المحسوبة ستنزاح نحو اليمين داخل منطقة الفراغات الفارغة. وبالتالي، فإن دالة SUBSTR ستقتطع أجزاءً من تلك الفراغات بدلاً من المحارف الهجائية المقصودة، لينتهي الأمر بالباحث بمتغير جديد يبدو فارغاً كلياً أو ناقصاً. وتتضاعف هذه المشكلة عند قراءة ملفات نصية ذات عرض ثابت (Fixed-Width Flat Files)؛ حيث تمتلئ الحقول غير المكتملة بفراغات وهمية تُربك معادلات الاستخلاص وتؤدي إلى فقدان المؤشرات الإحصائية لأهميتها القياسية.
5.2 التوظيف الاستراتيجي لدالتي TRIM وSTRIP لتهيئة البيانات
لضمان حماية مسارات العمل البرمجية من تداعيات الفراغات غير المرئية، توفر بيئة SAS دالتين أساسيتين لمعالجة النصوص: دالة TRIM ودالة STRIP. تقتصر وظيفة دالة TRIM على إزالة المسافات اللاحقة المتواجدة في نهاية السلسلة فقط، مع إبقاء المسافات البادئة (Leading Spaces) كما هي دون تعديل. بينما تمتاز دالة STRIP بكفاءة شمولية أعلى؛ حيث تزيل كلاً من المسافات البادئة والمسافات اللاحقة في آن واحد.
يعد استخدام دالة STRIP الخيار الأكثر أماناً وموثوقية في عمليات الاستقطاع النصي اليميني. فإزالة المسافات البادئة تحمي الدالة من احتساب إزاحات غير حقيقية تزيد من طول المتغير الكلي بصورة زائفة، بينما تضمن إزالة المسافات اللاحقة توجيه مؤشر دالة LENGTH إلى المحرف الأخير الفعلي. بناءً على ذلك، تتكامل الصيغة البرمجية المنيعة على النحو التالي:
Clean_Right_Var = substr(strip(Source), length(strip(Source)) - k + 1, k);
إن تطبيق هذا التهذيب المسبق يحمي الخوارزمية من التقلبات التنسيقية للبيانات الخام، ويضمن أن عمليات التقطيع الرياضية تتعامل حصرياً مع البيانات الفعلية المجردة من أي زوائد بيضاء.
6. التحليل المقارن للتقنيات والبدائل البرمجية في بيئة SAS
6.1 استخدام دالة SUBSTRN لتفادي أخطاء خروج المؤشر عن الحدود
تم إدخال دالة SUBSTRN في إصدارات SAS الحديثة كبديل متطور لدالة SUBSTR التقليدية، وهي مصممة خصيصاً للتعامل المرن مع الحالات التي قد يخرج فيها مؤشر الاستقطاع عن النطاق المتاح للسلسلة النصية. في الدالة الكلاسيكية، إذا كانت السلسلة أقصر من المعاملات الممررة، أو إذا تم تمرير طول استقطاع يتجاوز الحدود المنطقية، يتوقف التنفيذ جزئياً ويُسجل خطأ تنفيذي في سجل النظام. أما دالة SUBSTRN، فإنها تتفادى إصدار هذه التنبيهات الصارمة، وتكتفي بإرجاع سلسلة نصية فارغة (Null String) أو اقتطاع ما أمكن دون توقف.
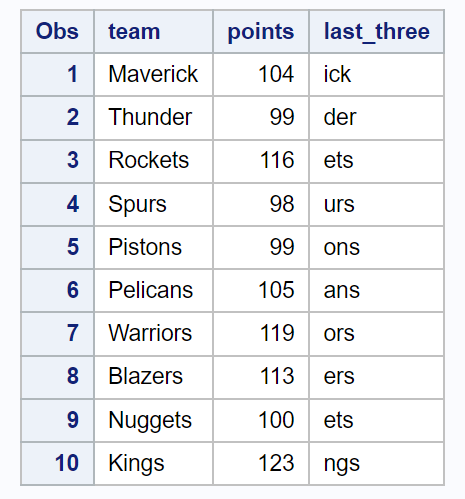
توفر SUBSTRN مرونة استثنائية عند التعامل مع تدفقات البيانات الضخمة التي لا يمكن للمحلل التنبؤ بكافة أطوال السجلات فيها. فعند الرغبة في استخراج 5 محارف من اليمين، ومصادفة سجل لا يحتوي إلا على 3 محارف فقط، تحول SUBSTRN دون انهيار المعالجة أو تشويه السجل الإحصائي بإنذارات غير مرغوب فيها، مما يجعلها الخيار المفضل لتطوير بنى برمجية مستدامة وقادرة على التكيف مع التباينات الحادة في المدخلات.
6.2 استخراج المقاطع باستخدام دالة SCAN ومحددات الفواصل
تُمثل دالة SCAN إحدى أقوى الأدوات في ترسانة SAS لمعالجة السلاسل النصية التي تتبع نمطاً هيكلياً يعتمد على محددات الفواصل (Delimiters) كالشرطات أو الفواصل أو المسافات. والميزة الكبرى لهذه الدالة، والتي تتفوق بها على SUBSTR في هذا السياق، هي دعمها المباشر للفهرسة السالبة (Negative Indexing). فعند تمرير قيمة سالبة لمعامل ترتيب الكلمة، تبدأ الدالة البحث والتقطيع تلقائياً من اليمين إلى اليسار.
تتضح هذه الآلية في التعبير التالي:
Last_Segment = scan(CompositeCode, -1, "_");
في هذا المثال، تقوم الدالة بالتقاط المقطع الأخير من اليمين المفصول بعلامة الخط السفلي دون الحاجة لمعرفة طول النص أو تطبيق أي معادلات إزاحة رياضية. ومع ذلك، يظل هذا الحل مقيداً بوجود فواصل واضحة ومحددة سلفاً؛ فإذا كانت السلسلة النصية مصمتة ولا تحتوي على فواصل تقسيم، فإن دالة SCAN تفقد فاعليتها، وتظل التركيبة الرياضية التكاملية بين SUBSTR وLENGTH هي الخيار الحتمي والأشمل.
6.3 دوال التعابير النمطية (PRX Functions) لاستخلاص الأنماط المعقدة
في الحالات المتقدمة التي تختلط فيها اللواحق اليمينية بمحارف عشوائية أو تراكيب متباينة لا تخضع لقواعد الطول الثابت أو الفواصل الموحدة، تبرز دوال لغة بيرل للتعابير النمطية (Perl Regular Expressions – PRX) المدمجة في SAS كأداة فائقة الدقة. تتيح دالة PRXCHANGE ودوال المطابقة الشقيقة إمكانية صياغة تعبير نمطي يستهدف اصطياد المحارف الأخيرة عبر محدد نهاية السلسلة القياسي ($).
فعلى سبيل المثال، لاقتطاع آخر ثلاثة أرقام تقع في نهاية نص معقد، يُمكن صياغة التعبير البرمجي التالي:
prx_id = prxparse("s/.*(d{3})$/$1/");
Result = prxchange(prx_id, 1, strip(SourceVar));
رغم المرونة الاستثنائية للتعابير النمطية وقدرتها على عزل اللواحق المتداخلة مع رموز غير متجانسة، إلا أنها تفرض تكلفة حوسبية (Computational Overhead) أعلى بكثير مقارنة بالدوال الحسابية الخفيفة مثل SUBSTR. ولذا، يوصي النهج الهندسي الرصين بقصر استخدام دوال PRX على البنى المعقدة التي تعجز الطرق الرياضية المباشرة عن معالجتها، خاصة عند معالجة ملايين السجلات في بيئات العمل الإحصائي الكبرى.
7. التعامل المتقدم مع الاستثناءات والقيم المفقودة والأطوال المتطرفة
7.1 معالجة المتغيرات التي يقل طولها عن الطول المستهدف للاستخراج
من المخاطر الحسابية التي تهدد متانة الكود البرمجي سيناريو مصادفة سلسلة نصية يقل طولها الفعلي عن عدد المحارف المطلوب استخراجها ($L < k$). في هذه الحالة، ستنتج المعادلة ($P = L – k + 1$) قيمة سالبة أو مساوية للصفر لنقطة البداية. وكما أسلفنا، فإن تمرير قيمة $le 0$ لمعامل الموضع في دالة SUBSTR يمثل خطأً نحوياً وتنفيذياً صريحاً يؤدي إلى توليد تحذير في السجل وإرجاع قيمة مفقودة مشوهة.
لتحصين الكود ضد هذه الاختناقات، يجب تضمين شروط منطقية دفاعية (Defensive Programming) باستخدام جمل الشرط IF-THEN/ELSE. يتولى هذا المنطق الدفاعي فحص طول النص قبل محاولة تقطيعه، وإدارة الحالات القاصرة بشكل منهجي:
if length(strip(TextVar)) >= 3 then do;
    Extracted = substr(strip(TextVar), length(strip(TextVar)) - 3 + 1, 3);
end;
else do;
    Extracted = strip(TextVar); /* الاحتفاظ بالنص كاملاً لقصره أو إسناد قيمة خاصة */
end;
إن تبني هذه المنهجية الاحترازية يضمن تدفق المعالجة بسلاسة، ويمنع توليد آلاف الملاحظات التحذيرية في سجلات التشغيل، وهو ما يعزز ثقة المحلل في سلامة البيانات ونظافة المخرجات النهائية.
7.2 إدارة القيم المفقودة (Missing Values) والبيانات الشاذة
تُمثل القيم المفقودة في المتغيرات النصية فراغاً مطلقاً (Blank Strings)، وسلوك الدوال حيالها يتطلب فهماً عميقاً لمنطق نظام SAS. فعند تمرير متغير فارغ تماماً إلى دالة LENGTH، فإنها تعيد افتراضياً القيمة 1 (ما لم تُضبط مسبقاً)، مما قد يؤدي في المعادلات اليمينية إلى احتساب إزاحات سالبة غير منطقية. للتعامل الاحترافي مع هذه الحالات، توفر لغة SAS دالة MISSING التي تسمح بفحص الحالة التخزينية للمتغير قبل الشروع في أي عملية رياضية أو تقطيعية.
if not missing(SourceVar) then do;
    CleanVar = strip(SourceVar);
    if lengthn(CleanVar) >= k then
        Result = substr(CleanVar, lengthn(CleanVar) - k + 1, k);
    else
        Result = CleanVar;
end;
else do;
    Result = "";
end;
يتيح هذا التوثيق الدقيق للاستثناءات منع تشويه قواعد البيانات بمؤشرات زائفة ناتجة عن التقطيع الخاطئ للقيم المفقودة، ويمنح فرق التحليل الإحصائي تقارير جودة عالية تُميز بدقة بين انعدام البيانات الأصلي وبين مشاكل المعالجة الحوسبية.
8. تحسين الأداء الحسابي وكفاءة استخدام الذاكرة في قواعد البيانات الضخمة
8.1 تحسين استخدام الذاكرة عبر تحديد أطوال المتغيرات المسبقة
في بيئات التحليل الإحصائي واسعة النطاق (Big Data Analytics)، كالسجلات الطبية الوطنية أو المسوح السكانية الشاملة التي تضم عشرات الملايين من الملاحظات، تصبح إدارة استهلاك الذاكرة (Memory Management) وسرعة عمليات الإدخال والإخراج (I/O Operations) عاملاً حاسماً في نجاح العمليات التحليلية. وإحدى الهفوات الشائعة التي يقع فيها المبرمجون هي إنشاء متغيرات التقطيع النصي دون تحديد مسبق لحجمها عبر عبارة LENGTH.
في حال إغفال تحديد الطول المسبق، فإن SAS قد يمنح المتغير الجديد افتراضياً نفس طول المتغير المصدر الأصلي، أو يخصص له حجماً قياسياً كبيراً (مثل 200 بايت في بعض البيئات). فإذا كان المطلوب استخراج ثلاثة محارف فقط، وتم تخصيص 200 بايت لها عبر 50 مليون سجل، فإن ذلك يتسبب في هدر هائل وغير مبرر في مساحات التخزين المؤقتة والدائمة، ويبطئ من تدفق قراءة البيانات من الأقراص الصلبة. والحل المنهجي يكمن دائماً في وضع عبارة LENGTH في مطلع خطوة البيانات:
data OptimizedExtraction;
    length FinalCode $ 3; /* حجز الحجم المطابق للاستخراج بدقة متناهية */
    set MassiveTable;
    FinalCode = substr(strip(CompositeID), length(strip(CompositeID)) - 2);
run;
8.2 تسريع المعالجة عبر تقليل التداخل الحسابي داخل الحلقات التكرارية
يتضمن المسار التنفيذي لخطوة البيانات في SAS تكراراً ضمنياً يمر عبر كل ملاحظة في مصفوفة البيانات. ومن ثم، فإن تكرار استدعاء الدوال المتطابقة داخل التعبير البرمجي ذاته يضاعف من استهلاك المعالج المركزي (CPU Cycles). ففي التعبير الشائع:
substr(strip(var), length(strip(var)) - 2)
يتم تنفيذ دالة STRIP مرتين منفصلتين لكل سجل فردي. ولتوفير الموارد الحوسبية وتسريع وتيرة التنفيذ، يُفضل تقليل هذا التداخل الحسابي عبر تفكيك العمليات أو تخزين الناتج المؤقت في متغير عمل وسيط، أو استخدام استراتيجيات المعالجة العكسية المبسطة مثل الجمع بين دالتي REVERSE وSUBSTR:
FinalCode = reverse(substr(reverse(strip(CompositeID)), 1, 3));
في هذه الاستراتيجية البديلة، يتم قلب السلسلة النصية أولاً عبر دالة REVERSE لتصبح النهاية اليمينية في البداية اليسارية، ثم يتم استخراج المحارف الثلاثة الأولى مباشرة وبشكل ثابت دون الحاجة لحساب أي معادلات إزاحة رياضية، ثم يُعاد قلب المقطع المستخرج ليعود إلى ترتيبه الطبيعي. ويمكن قياس كفاءة هذا التحسين الحسابي بتفعيل خيار التحليل OPTIONS STIMER FULLSTIMER; لمراقبة الفروق في أزمنة المعالجة (CPU Time) وحجم الذاكرة المستهلكة بدقة عبر سجل التشغيل.
9. التطبيقات الميدانية ودراسات الحالة في الأبحاث الإحصائية والسلوكية
9.1 معالجة الرموز والترميزات الميدانية في أدوات القياس والاستبيانات
تتضمن التصاميم التجريبية في أبحاث العلوم الاجتماعية والسلوكية استخدام معرفات مركبة للمشاركين تهدف إلى ضمان سرية البيانات مع الحفاظ على التتبع المنهجي. ففي دراسة نفسية واسعة النطاق تستهدف قياس أثر التدخلات العلاجية السلوكية المعرفية عبر الزمن، قد يأخذ المعرف البنية التالية: SITE01_COHORT2_T1_EXP، حيث يشير المقطع الأخير EXP إلى المجموعة التجريبية (Experimental)، في حين يحمل المشاركون الآخرون الرمز CTR للدلالة على المجموعة الضابطة (Control).
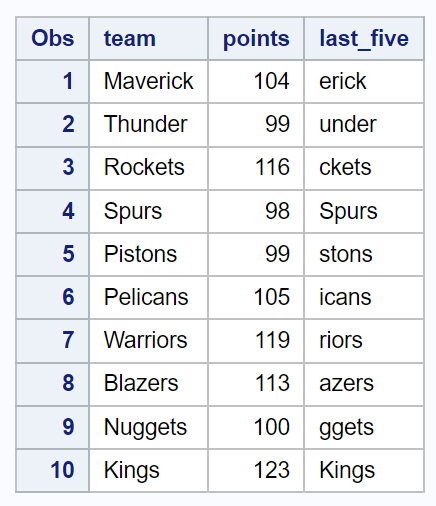
لاستخلاص هذه المؤشرات الميدانية وإعادة هيكلتها لنمذجة الفروق بين المجموعات عبر تحليلات التباين (ANOVA) أو النماذج الخطية المختلطة (Linear Mixed Models)، يتم تطبيق استخراج المقطع اليميني بدقة:
data ClinicalTrialPrep;
    set SurveyRaw;
    length TreatmentGroup $ 3;
    TreatmentGroup = substr(strip(ParticipantCode), length(strip(ParticipantCode)) - 2);
run;
يتيح هذا التقطيع المنهجي توحيد إجابات المسوح الميدانية وتنقيتها، وفصل مؤشرات التقييم الزمني اللاحقة، مما يسهل فرز البيانات وتجهيزها لاختبار الفرضيات الإحصائية دون تدخل يدوي عرضة للخطأ البشري.
9.2 إعادة هيكلة السجلات النفسية والبيانات الإكلينيكية المعقدة
تتطلب السجلات الإكلينيكية والملفات الطبية النفسية المتعددة المراكز عمليات دمج ومطابقة معقدة لمصفوفات البيانات الواردة من مستشفيات ومراكز استشارية مختلفة. وكثيراً ما تتضمن هذه السجلات متغيرات مركبة تتضمن تصنيف الخطورة الإكلينيكية أو مرحلة المتابعة في نهايات أرقام الملفات (مثل إضافة الحرف H للدلالة على الخطورة العالية High Risk، أو L للدلالة على الحالات المستقرة Low Risk).
تتجلى قوة تقنيات الاستقطاع اليميني في SAS عند بناء متغيرات ربط جديدة (Key Variables) تتيح إجراء عمليات المطابقة الرأسية والأفقية بين قواعد البيانات المنفصلة. فعبر عزل الحرف الأخير ومطابقته مع قواعد التصنيف الإكلينيكي المعتمدة، يستطيع المحلل تصنيف عينات المرضى بكفاءة مطلقة، وتوفير مجموعات فرعية متجانسة للدراسات المعمقة، مما يرفع من جودة البحوث الإكلينيكية ويسهم في دقة التنبؤ بالمسارات العلاجية.
10. أفضل الممارسات البرمجية ودليل استكشاف الأخطاء وتصحيحها
10.1 قراءة وتفسير رسائل سجل الأخطاء (SAS Log Diagnostics)
يُعد سجل التشغيل في SAS (SAS Log) المرجع التشخيصي الأول للمبرمج والمحلل الإحصائي لرصد الانحرافات واكتشاف الأخطاء أثناء معالجة السلاسل النصية. وإحدى أشهر الرسائل التشخيصية المرتبطة بدالة SUBSTR هي:
NOTE: Invalid second argument to function SUBSTR at line X column Y.
تشير هذه الرسالة بوضوح لا يقبل اللبس إلى أن المعامل الثاني (نقطة البداية) قد استقبل قيمة غير صالحة، كأن تكون قيمة سالبة، أو صفراً، أو رقماً يتجاوز الطول الإجمالي للمتغير المصدر. وتظهر هذه المشكلة عادة عند وجود نصوص قصيرة غير متوقعة أو قيم مفقودة لم يتم تحصين الكود ضدها. كما يبرز تحذير آخر يتعلق باقتطاع المحارف (Character Variable Truncation):
WARNING: Multiple lengths were specified for the variable...
يحدث هذا التحذير عندما يتم إسناد سلسلة مستخرجة ذات حجم يتجاوز الطول المصرح به للمتغير الجديد في عبارة LENGTH، مما يؤدي إلى بتر الأحرف النهائية وفقدان جزء من البيانات. ولتتبع سير التنفيذ الداخلي وحساب الإحداثيات أثناء المعالجة، يُنصح بشدة بتوظيف عبارات PUT التشخيصية لطباعة القيم ومواضع البداية المحسوبة لكل سجل مشكوك فيه داخل السجل:
if length(strip(TestVar)) < 3 then do;
    put "WARNING: Suspicious string length detected at ID=" ParticipantID "with value=" TestVar;
end;
10.2 قواعد كتابة كود SAS متين وقابل لإعادة الاستخدام والصيانة
لضمان استدامة الأكواد التحليلية وتسهيل صيانتها وتطبيقها عبر مشاريع بحثية متعددة، يُوصى ببناء وحدات ماكرو (SAS Macros) معيارية تؤتمت عملية الاستخراج من اليمين بمرونة وموثوقية عالية. يعمل الماكرو على عزل التعقيد الحسابي وتوفير واجهة برمجية موحدة وبسيطة تمنع تكرار كتابة المعادلات الرياضية اليدوية، وتقلل من احتمالية الخطأ:
%macro RightSubstr(SourceVar, K_Length, TargetVar);
    length &TargetVar $ &K_Length;
    if not missing(&SourceVar) then do;
        if lengthn(strip(&SourceVar)) >= &K_Length then
            &TargetVar = substr(strip(&SourceVar), lengthn(strip(&SourceVar)) - &K_Length + 1, &K_Length);
        else
            &TargetVar = strip(&SourceVar);
    end;
    else do;
        &TargetVar = "";
    end;
%mend RightSubstr;
يسمح هذا الماكرو للمحلل باستدعاء المعالجة بسطر واحد أنيق داخل أي خطوة بيانات:
data FinalAnalysis;
    set RawDataset;
    %RightSubstr(ParticipantCode, 3, ExtractedGroup);
run;
كما تشمل أفضل الممارسات توثيق الشفرة البرمجية بتعليقات وافية تشرح الغرض من كل خطوة ومنطق الإزاحة الرياضي، إلى جانب إجراء اختبارات تدقيق استباقية على عينات تجريبية من البيانات قبل اعتماد الكود في المعالجات الإنتاجية واسعة النطاق.
خاتمة
إن استخراج السلاسل النصية الفرعية من اليمين داخل بيئة SAS يمثل عملية برمجية دقيقة تتطلب استيعاباً عميقاً لآليات إدارة الذاكرة، وطبيعة التخزين النصي ذي العرض الثابت، والمنطق الرياضي المحدد للإزاحات الموضعية. وعلى الرغم من غياب دالة مباشرة تحمل اسم RIGHT() للاقتطاع النصي كما في بعض البرمجيات المكتبية، إلا أن التوظيف التكاملي المتقن بين دالة SUBSTR ودوال القياس والتنقية مثل LENGTH وSTRIP يوفر للمحلل أداة فائقة القوة والتحكم لمعالجة أدق السيناريوهات البيانية.
من خلال مراعاة التدابير الدفاعية ضد القيم المفقودة والأطوال المتطرفة، وضبط أحجام المتغيرات لمنع الهدر التخزيني في قواعد البيانات الضخمة، والاطلاع على البدائل المتقدمة كدوال SUBSTRN وSCAN والتعابير النمطية، يستطيع الباحث والمبرمج الإحصائي ضمان أعلى مستويات الدقة والموثوقية في تنقية البيانات وتجهيزها للتحليلات المتقدمة. إن الالتزام بهذه الممارسات الهندسية الرصينة يعزز من متانة البحث العلمي وجودة استخلاص المؤشرات المعرفية من السجلات الميدانية والإكلينيكية المعقدة.
المراجع
- Barr, A. J., Goodnight, J. H., Sall, J. P., & Helwig, J. T. (1976). A User’s Guide to SAS 76. SAS Institute Inc.
- SAS Institute Inc. (2013). SAS 9.4 Functions and CALL Routines: Reference. SAS Institute Inc. https://documentation.sas.com
- SAS Institute Inc. (2016). Base SAS 9.4 Procedures Guide: Statistical Procedures (5th ed.). SAS Institute Inc. https://support.sas.com
- Delwiche, L. D., & Slaughter, S. J. (2019). The Little SAS Book: A Primer (6th ed.). SAS Institute Inc.