
تُعد معالجة البيانات وإدارتها حجر الزاوية في الدراسات الكمية والتحليلات الإحصائية المتقدمة؛ إذ لا يمكن لأي نموذج استدلالي أو تجريبي أن يقدم نتائج ذات موثوقية عالية دون المرور بمرحلة دقيقة من التنقية، والتنظيم، والهيكلة المنطقية للمتغيرات. وفي هذا الفضاء البرمجي المتخصص، يبرز نظام التحليل الإحصائي SAS (Statistical Analysis System) كأحد أقوى البيئات الحاسوبية وأكثرها رصانة في الأوساط الأكاديمية والمؤسسات البحثية، نظراً لقدرته الفائقة على التعامل مع مجموعات البيانات الضخمة والمعقدة بكفاءة تشغيلية استثنائية.
ضمن هذه البيئة المتكاملة، يشكل إجراء لغة الاستعلام الهيكلية PROC SQL جسراً حيوياً يجمع بين المعايير القياسية العالمية لإدارة قواعد البيانات العلائقية وبين الأدوات الإحصائية الصارمة لنظام ساس. وفي حين يتيح هذا الإجراء تنفيذ عمليات معقدة تشمل الدمج، والتجميع، وتصفية السجلات، تظل عبارة ORDER BY الأداة المحورية التي لا غنى عنها لضبط تسلسل المخرجات، وفرض نسق ترتيبي يخدم الأغراض الاستكشافية والتحليلية، مما ينقل البيانات من حالتها الخام غير المنتظمة إلى مصفوفات مرتبة تتيح استنباط الأنماط والاتجاهات بكفاءة معرفية فائقة.
يتناول هذا المرجع التخصصي الشامل دراسة مستفيضة لآليات توظيف عبارة ORDER BY داخل إجراء PROC SQL، متتبعاً أصولها النظرية، وأبعادها النحوية، وسلوكياتها البرمجية الدقيقة في التعامل مع الأنماط المختلفة للبيانات، مثل السجلات الرقمية والنصية والقيم المفقودة. كما يستعرض المقال الفروق الجوهرية بين هذا الأسلوب وإجراءات الفرز التقليدية في ساس، مقدماً حلولاً هندسية متقدمة لتحسين استهلاك الذاكرة، ورفع كفاءة المعالجة الحوسبية في قواعد البيانات الضخمة، ليكون دليلاً أكاديمياً وتطبيقياً متكاملاً للباحثين ومحللي البيانات الإحصائية.
1. مقدمة نظرية لإجراء PROC SQL ودور عبارة ORDER BY في استعلامات SAS
1.1 مفهوم PROC SQL وأهميته في بيئة نظام ساس
يمثل إجراء PROC SQL واجهة تطبيقية متقدمة داخل بيئة ساس، تتيح للباحثين والمحللين كتابة شفرات تعتمد على لغة الاستعلام البنيوية القياسية (ANSI/ISO SQL). وعلى النقيض من الأدوات التي تميز ساس بنمطها الإجرائي الخاص، يفتح هذا الإجراء نافذة واسعة لاستثمار المفاهيم العلائقية (Relational Database Concepts) مباشرة داخل بيئة التحليل، مما يسهل معالجة البيانات، وإجراء العمليات الحسابية، وربط الجداول المتعددة، دون الحاجة إلى المرور بمراحل برمجية وسيطة متعددة.
وتكمن الأهمية الاستراتيجية لهذا الإجراء في قدرته على دمج قوة قواعد البيانات العلائقية مع المرونة التحليلية لنظام ساس؛ حيث يستطيع المحلل تنفيذ عمليات الاستعلام المعقدة، وحساب الإحصاءات التلخيصية، والفرز في كتلة برمجية واحدة تتسم بالدقة والوضوح النحوي. إن هذا التكامل يقلل من حجم الشفرات البرمجية المطلوبة، ويوحد لغة العمل بين فرق البحث المعتمدة على بيئات تقنية متباينة، مما يجعل إجراء PROC SQL ركيزة أساسية في معالجة مصفوفات البيانات الضخمة في مختلف العلوم المعرفية والإحصائية.
تتجلى الفروق التشغيلية بوضوح عند مقارنة هذا الإجراء بخطوة البيانات التقليدية DATA STEP. فبينما تعتمد خطوة البيانات على دورة قراءة إجرائية تسير سجلاً تلو الآخر (Record-by-Record Processing Loop)، يتبنى PROC SQL النموذج التقريري (Declarative Approach)، حيث يحدد المبرمج “ما يريده” من مخرجات دون الحاجة إلى التحكم اليدوي في آليات التكرار أو مؤشرات السجلات؛ وهو ما يمنح محرك النظام حرية تحسين مسار تنفيذ الاستعلام داخلياً للوصول إلى أعلى كفاءة حوسبية ممكنة.
1.2 دور عبارة ORDER BY في تنظيم البيانات المستخرجة
في نظرية قواعد البيانات العلائقية، تُعرف الجداول بأنها مجموعات غير مرتبة من السجلات؛ أي أن النظام لا يضمن أي تسلسل افتراضي للملاحظات عند استرجاعها ما لم يُنص على ذلك صراحة. من هنا، تبرز عبارة ORDER BY كأداة حتمية لفرض نظام خطي على مصفوفة النتائج، بحيث يتم فرز السجلات استناداً إلى قيم متغير أو مجموعة من المتغيرات المختارة، مما يحول البيانات الخام المشتتة إلى جداول ذات دلالة إبستمولوجية ومنطقية واضحة للباحث والمحلل الإحصائي.
إن إعادة الترتيب هذه تتجاوز مجرد التحسين الشكلي؛ إذ تلعب دوراً جوهرياً في تحسين القابلية التفسيرية للنتائج، وتيسير عملية التدقيق الاستكشافي للبيانات (Exploratory Data Analysis). فعندما تُفرز السجلات وفق متغيرات محددة كالأداء، أو الزمن، أو المجموعات التجريبية، يستطيع الباحث التعرف الفوري على التوزيعات المتطرفة، ورصد حالات الخلل الميداني في جمع العينات، وقراءة الفروق الفردية بين الحالات بصرياً قبل الانتقال إلى بناء النماذج المعقدة، مثل نماذج الانحدار الخطي أو تحليل التباين المتعدد.
علاوة على ذلك، يمتد الأثر المنهجي للفرز بواسطة ORDER BY إلى الإجراءات التحليلية اللاحقة؛ فالعديد من الخوارزميات الإحصائية وحزم التقارير، مثل إجراءات التقرير المجدول (PROC REPORT) وعمليات التقسيم الطبقي، تتطلب تسلسلاً منطقياً دقيقاً في مصفوفة المدخلات. يضمن الفرز المنظم إمكانية مقارنة الحالات المتطابقة وتوليد تقارير وسيطة خالية من التشوهات الترتيبية، مما يرفع من الموثوقية العامة للتحليل ويعزز اتساق النتائج العلمية وقابليتها للتكرار.
1.3 المقارنة بين الفرز في PROC SQL وإجراء PROC SORT التقليدي
يحتدم النقاش البرمجي غالباً حول المفاضلة بين استخدام ORDER BY داخل PROC SQL والاعتماد على الإجراء الكلاسيكي PROC SORT. من منظور إدارة الموارد، صُمم إجراء PROC SORT خصيصاً كأداة فرز متقدمة عالية الاستمثال تعتمد على خوارزميات فائقة السرعة تستغل خيوط المعالجة المتعددة ومساحات التخزين المؤقت، مما يجعله في كثير من الأحيان متفوقاً في معالجة الجداول العملاقة عندما تكون المهمة البرمجية مقتصرة حصرياً على الفرز الموضعي لمجموعة بيانات ساس.
في المقابل، تتجلى العبقرية البرمجية لعبارة ORDER BY في قدرتها الفريدة على الدمج البنيوي؛ إذ يمكن للباحث تصفية البيانات، وربط جداول متعددة، وحساب متغيرات مشتقة جديدة، وترتيب المخرجات في خطوة واحدة دون حفظ جداول وسيطة في المكتبة المؤقتة. هذا الأسلوب التكاملي يوفر دورات إدخال وإخراج كثيفة على وسائط التخزين (I/O Operations)، مما قد يجعل PROC SQL الخيار الأسرع والأنظف برمجياً في سيناريوهات التحليل التي تتطلب تحويلاً وفرزاً متزامنين للبيانات.
تستند المعايير الأكاديمية لاختيار الأداة الأنسب إلى طبيعة التدفق التحليلي للبيانات. فإذا كانت مجموعة البيانات ضخمة وتتطلب مجرد ترتيب بسيط ومستدام على القرص الصلب لاستخدامها في خطوات BY-Group Processing متكررة عبر إجراءات ساس الإحصائية، فإن PROC SORT يظل الأداة الموصى بها مالم تتداخل عمليات الربط والحساب. أما إذا كان المطلوب استخراج تقرير محدد ومفرز، أو تهيئة جدول نهائي للعرض المباشر والنشر الأكاديمي، فإن PROC SQL باستخدام ORDER BY يوفر مرونة صياغة استثنائية تقلل من تعقيد البنية البرمجية العامة.
2. البنية النحوية الأساسية لعبارة ORDER BY في لغة ساس
2.1 الصيغة العامة للجملة البرمجية وقواعد كتابتها
تلتزم عبارة ORDER BY بقواعد الصياغة النحوية القياسية للغة SQL داخل بيئة ساس، وتأتي دائماً كعنصر أخير في استعلام الاختيار البسيط. تتألف البنية الأساسية من الكلمة المفتاحية PROC SQL متبوعة بتعليمة SELECT لتحديد الأعمدة المطلوبة، ثم عبارة FROM لتحديد الجدول المصدر، وتُختتم الجملة بعبارة ORDER BY متبوعة باسم المتغير المستهدف بالفرز، مع إنهاء كل تعليمة برمجية بفاصلة منقوطة وفق أصول صياغة ساس.
عند الرغبة في الترتيب بناءً على متغيرات متعددة، يتم إدراج أسماء الأعمدة مفصولة بفواصل عادية، دون وضع فاصلة بعد المتغير الأخير وقبل الفاصلة المنقوطة النهائية. إن الإخلال بوضع هذه الفواصل يُعد من أكثر الأخطاء النحوية شيوعاً للمبرمجين المبتدئين في بيئة ساس؛ إذ يتسبب نسيان فاصلة أو وضع فاصلة زائدة في توقف الاستعلام وظهور رسالة خطأ صريحة في سجل النظام تفيد بوجود خطأ تركيبي يمنع معالجة الجداول.
من الأهمية بمكان التأكيد على ضرورة إنهاء إجراء PROC SQL بالعبارة الإجرائية QUIT; بدلاً من الاكتفاء بعبارة RUN; المعتادة في خطوات ساس الأخرى. يتميز إجراء PROC SQL بأنه بيئة تفاعلية مستمرة (Interactive Procedure)؛ فإذا نُفذت الشفرة باستخدام RUN فقط، تظل موارد الإجراء محجوزة في الذاكرة بانتظار استعلامات تالية، مما قد يعطل تحرير ملفات العمل المؤقتة ويؤدي إلى مشكلات في أداء النظام أو حجز الملفات المفتوحة ومنع تعديلها من قبل خطوات أخرى.
2.2 موضع عبارة ORDER BY داخل دورة تنفيذ استعلام SQL
يخضع استعلام SQL لدورة معالجة منطقية صارمة تختلف جوهرياً عن الترتيب المادي لكتابة الأوامر البرمجية في محرر النصوص. في هذه الدورة، يبدأ محرك النظام بتحديد الجدول المصدر عبر FROM، ثم يطبق شروط التصفية على السجلات الفردية عبر WHERE، وينتقل بعدها إلى تجميع البيانات في فئات عبر GROUP BY، ثم تصفية المجموعات عبر HAVING، وصولاً إلى استخراج المتغيرات وحساب التعبيرات عبر SELECT. وفقط في المرحلة الأخيرة تماماً، يتم استدعاء عبارة ORDER BY لفرز الصفوف الناتجة.
يترتب على هذا الترتيب المنطقي أن الفرز يُنفذ على مجموعة البيانات النهائية المتبقية بعد استبعاد كافة الملاحظات غير المستوفية للشروط؛ وهو ما يحقق كفاءة حوسبية قصوى؛ إذ لا يستهلك النظام طاقته في فرز بيانات سيتم استبعادها لاحقاً بواسطة عبارة WHERE. إن إدراك هذه الدورة يوضح للباحث سبب انعكاس تأثير الفرز حصرياً على هيئة المخرجات المعروضة أو المحفوظة في جدول الإخراج دون التأثير على آليات الحساب والتجميع الداخلي للاستعلام.
ينشأ ارتباك برمجي واسع النطاق عند محاولة إقحام عبارة ORDER BY قبل عبارات التصفية كـ WHERE أو HAVING؛ حيث يعد ذلك خرقاً لقواعد النحو القياسية للغة SQL. يؤدي وضع عبارة الفرز في موضع متقدم داخل الاستعلام إلى إصدار خطأ نحوي فوري في سجل ساس يفيد بتوقع كلمات مفتاحية أخرى، مما يبرز أهمية الالتزام الصارم بالتسلسل الهيكلي للأمر البرمجي لضمان تنفيذه بسلاسة ودون أخطاء تفسيرية.
2.3 التعامل مع المتغيرات والأعمدة المحسوبة والأسماء المستعارة
تتيح عبارة ORDER BY مرونة استثنائية تسمح بترتيب النتائج بناءً على متغيرات افتراضية جديدة أو أعمدة محسوبة تم إنشاؤها وتحديدها داخل عبارة SELECT ذاتها. يمثل هذا التوافق ميزة كبرى في التحليلات الإحصائية؛ حيث يمكن للباحث، على سبيل المثال، حساب مؤشر كتلة الجسم، أو درجة معيارية محولة، أو نسبة مئوية، ومن ثم فرز النتائج وفق تلك القيمة المحسوبة في خطوة واحدة متكاملة دون الحاجة إلى إنشاء حقول دائمة مسبقة في جدول المصدر.
ولتحقيق ذلك بنجاح في بيئة ساس، يُنصح المبرمج بالاستعانة بالكلمة المفتاحية CALCULATED عند الإشارة إلى اسم العمود المحسوب داخل استعلامات الفرز في بعض الحالات التركيبية المعقدة، مثل: ORDER BY CALCULATED ScoreDiff. تخبر هذه الكلمة المفتاحية محرك PROC SQL بأن المتغير المشار إليه ليس عموداً أصيلاً مخزناً في مصفوفة البيانات الأساسية، بل هو اسم مستعار ناتج عن عملية حسابية تمت صياغتها داخل جملة الاختيار، مما يمنع النظام من البحث الفاشل في الجدول المصدر.
ومع ذلك، وبفضل الموقع المنطقي الأخير لعبارة ORDER BY في دورة المعالجة (حيث تأتي بعد تنفيذ عبارة SELECT)، فإن نظام ساس يسمح في كثير من الأحيان بالإشارة المباشرة إلى الاسم المستعار (Column Alias) دون الحاجة الصريحة لكلمة CALCULATED، بخلاف عبارة WHERE التي تسبق التحديد في الدورة المنطقية. ومع ذلك، يظل التوثيق البرمجي الدقيق واستخدام المعاملات الموضحة للمعنى من أفضل الممارسات الأكاديمية لضمان قابلية قراءة الشفرة وصيانتها مستقبلاً من قِبل باحثين آخرين.
3. الترتيب التصاعدي باستخدام متغير واحد
3.1 آلية الترتيب الافتراضي بدون معاملات إضافية
تعتمد لغة SQL القياسية، بما في ذلك تطبيقها داخل إجراء PROC SQL في ساس، الترتيب التصاعدي كخيار افتراضي مطلق عند استخدام عبارة ORDER BY ما لم يحدد المبرمج خلاف ذلك صراحة. يمكن كتابة المعامل ASC (اختصاراً لكلمة Ascending) بعد اسم المتغير للدلالة على هذا الاتجاه، غير أن إغفاله لا يغير من النتيجة شيئاً؛ فالنظام مبرمج ذاتياً على البدء بالقيم الصغرى والتدرج نحو القيم العظمى.
فيما يتعلق بالمتغيرات الرقمية، يتبع النظام مقياس الأعداد الحقيقية في الترتيب؛ حيث تبدأ النتائج بأصغر قيمة عددية (بما في ذلك الأعداد السالبة شديدة الانخفاض) وصولاً إلى أكبر قيمة موجبة. وتتم هذه العملية بدقة متناهية تعتمد على تمثيل الفاصلة العائمة (Floating-point Representation) المعتمد في ساس، مما يضمن معالجة الكسور والفروق المتناهية في الصغر بدقة رياضية صارمة تجنب الباحث الوقوع في أخطاء التقريب أو خلط الرتب الحسابية.
أما بالنسبة للمتغيرات النصية (Character Variables)، فيعتمد الترتيب التصاعدي على التسلسل الهيكلي لمحارف الترميز المعتمدة في بيئة التشغيل، والتي تكون عادةً جدول ASCII أو نظام الترميز الموحد Unicode. يرتب النظام النصوص أبجدياً من الألف إلى الياء، أو من الحرف A إلى Z، آخذاً في الاعتبار المواقع المعيارية للرموز والمسافات، مما يتيح تنظيم الأسماء، والرموز التشخيصية، والمتغيرات النوعية بنسق معجمي قياسي منسق.
3.2 تطبيق عملي على مجموعة بيانات لاعبي كرة السلة
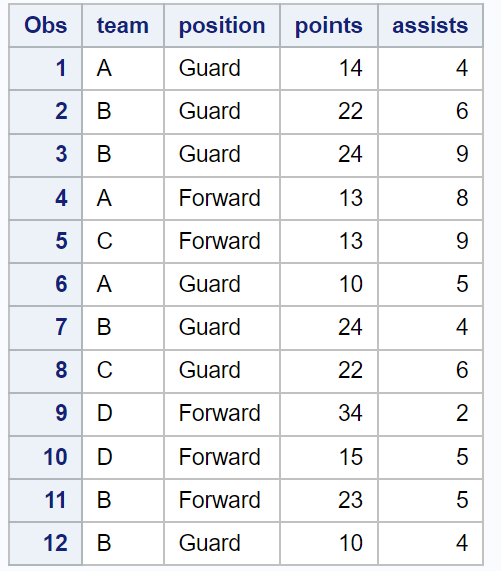
لتوضيح هذه الآلية البرمجية تطبيقياً، نفترض وجود مجموعة بيانات بحثية رياضية تحمل اسم BASKETBALL_DATA، تشتمل على متغيرات تخص اللاعبين مثل الفريق (Team)، المركز الميداني (Position)، عدد النقاط المسجلة (Points)، ومتوسط التمريرات الحاسمة (Assists). تمثل هذه البيانات نموذجاً كلاسيكياً يجمع بين المتغيرات الفئوية الاسمية والمتغيرات الكمية المستمرة المستهدفة بالتحليل.
لفرز هذه الملاحظات تصاعدياً استناداً إلى اسم الفريق لجمع أعضاء كل فريق معاً في مصفوفة متصلة، يُكتب الاستعلام البرمجي على النحو التالي:
PROC SQL;

SELECT Team, Position, Points, Assists

FROM BASKETBALL_DATA

ORDER BY Team;

QUIT;
عند تنفيذ هذه الشفرة داخل بيئة ساس، يقوم المحرك بمسح الجدول واسترجاع السجلات المحددة، ثم تطبيق خوارزمية الفرز على عمود Team. في نافذة النتائج، تظهر مخرجات التقرير في هيئة جدول منسق يبدأ بالفرق التي تبدأ بالحروف الأبجدية الأولى، مع ضمان بقاء بيانات كل لاعب مرتبطة بصورة صحيحة عبر الصفوف، مما يسهل التحقق البصري المباشر من انتظام الحالات الرياضية وتوزيع اللاعبين داخل كل كيان تدريبي.
3.3 الفروق الدقيقة بين المتغيرات النصية والعددية أثناء الفرز التصاعدي
تستوجب المعالجة الأكاديمية للبيانات الانتباه الشديد للفروق البنيوية بين المتغيرات الرقمية والنصية عند تطبيق الفرز التصاعدي؛ فالأرقام المخزنة كحقول نصية لا تخضع للمنطق الحسابي البديهي. فعلى سبيل المثال، إذا كانت أرقام قمصان اللاعبين أو درجاتهم مخزنة كنصوص، فإن النظام سيعامل القيمة النصية ‘100’ على أنها أصغر من القيمة ’20’، لأن المقارنة المعجمية تتم حرفاً بحرف من اليسار إلى اليمين؛ حيث يسبق الرمز ‘1’ الرمز ‘2’ في جدول التكويد، وهو ما يؤدي إلى اختلال خطير في الترتيب الرقمي المقصود.
كذلك تفرض مسألة حساسية حالة الأحرف (Case Sensitivity) في اللغات اللاتينية تأثيراً كبيراً على ترتيب النصوص؛ ففي ترتيب ASCII القياسي، تسبق جميع الحروف الكبيرة (Uppercase) نظيراتها الصغيرة (Lowercase)، مما يعني أن الاسم ‘boston’ قد يأتي في نهاية التقرير بعد الاسم ‘Atlanta’ و’Chicago’ فقط بسبب استخدام الحرف الصغير في بدايته. لتفادي هذا الاضطراب، يلجأ الباحثون المتمرسون إلى توحيد حالة الأحرف برمجياً داخل الاستعلام باستخدام دوال ساس مثل UPCASE() ضمن عبارة الفرز: ORDER BY UPCASE(Team).
يتطلب التحليل الرصين أيضاً فحص السجلات التي تحتوي على نصوص تتداخل معها أرقام (Alphanumeric Data)، كرموز المختبرات أو معرّفات المرضى في الأبحاث الطبية والسلوكية. في مثل هذه الحالات، يجب التأكد من ضبط أطوال المتغيرات ومحاذاة الخانات برمجياً لتفادي تقديم القيم الفردية على القيم المزدوجة بصورة غير مقصودة، مما يبرز دور التدقيق الأولي لأنماط المتغيرات (Data Types) كشرط جوهري لضمان اتساق وموثوقية مخرجات الفرز عبر ORDER BY.
4. الترتيب التنازلي باستخدام المعامل DESC
4.1 وظيفة الكلمة المفتاحية DESC وضوابط كتابتها
تُعد الكلمة المفتاحية DESC (وهي اختصار لكلمة Descending) الأداة النحوية المخصصة لعكس الاتجاه الافتراضي للفرز في لغة SQL؛ حيث توجه محرك النظام لإعادة ترتيب الملاحظات من القيمة الأكبر إلى القيمة الأصغر. تتم كتابة هذا المعامل مباشرة بعد اسم المتغير المراد عكس اتجاهه دون وضع أي فواصل بينهما، مثل: ORDER BY Points DESC.
من القواعد البنيوية الأساسية التي يجب ترسيخها أن معامل DESC يتميز بنطاق تأثير موضعي حصري؛ أي أنه يسري فقط وبصورة صارمة على المتغير الذي يسبقه مباشرة دون أن يمتد تأثيره إلى المتغيرات اللاحقة في القائمة. إذا احتوت العبارة على عدة متغيرات، فإن وضع DESC بعد المتغير الأول يجعله تنازلياً، بينما تعود المتغيرات التالية تلقائياً إلى النمط التصاعدي الافتراضي ما لم تُلحق صراحة بالمعامل ذاته.
يقبل إجراء PROC SQL في ساس الصيغة المختصرة DESC كما يقبل الصيغة الكاملة DESCENDING بمرونة تامة، على عكس بعض إجراءات ساس التقليدية التي تشترط أحياناً الصيغة الكاملة حصراً. هذا التوافق المزدوج يسهل على المبرمجين القادمين من خلفيات قواعد البيانات المتنوعة كتابة استعلامات صحيحة دون ارتباك لغوي، مما يحافظ على سلاسة الصياغة البرمجية وكفاءتها.
4.2 تحليل مثال تطبيقي لترتيب متغير واحد تنازلياً
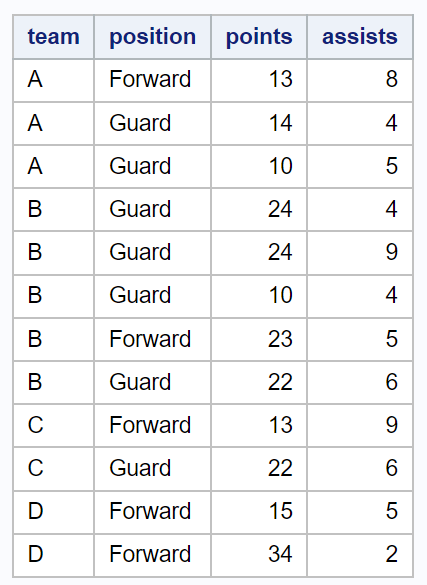
بالرجوع إلى مجموعة بيانات الرياضيين BASKETBALL_DATA، قد يقتضي الهدف البحثي تحديد اللاعبين الأكثر تهديفاً وتأثيراً في البطولة، وهو ما يتطلب فرز السجلات تنازلياً بناءً على إجمالي النقاط المسجلة (Points). في هذا السياق، تصاغ الشفرة البرمجية عبر إجراء PROC SQL على النحو الآتي:
PROC SQL;

SELECT Team, Position, Points, Assists

FROM BASKETBALL_DATA

ORDER BY Points DESC;

QUIT;
عند تشغيل هذا الاستعلام، يعيد النظام مصفوفة البيانات بحيث يحتل اللاعب صاحب أعلى رصيد نقطي الصف الأول في جدول المخرجات، وتتوالى السجلات نزولاً حتى نصل إلى أقل اللاعبين تسجيلاً في قاع الجدول. يتيح هذا العرض الهيكلي للمشرف الرياضي أو الباحث في فسيولوجيا الجهد البدني تقييم التباين الهرمي في الإنتاجية الميدانية بدقة بصرية وسرعة استثنائية.
يظهر فحص سجل العمليات (SAS Log) أن النظام نفذ عملية الفرز التنازلي بكفاءة بعد قراءة الجدول المصدر بالكامل؛ حيث يُلاحظ أن التغيير الهيكلي في جدول المخرجات لم يمس صحة العلاقات الأفقية بين المتغيرات، بل حافظ كل لاعب على فريقه ومركزه وتمريراته مقترنة بدرجته التنازلية الصحيحة، مما يعكس الأمان التام لمعالجات ORDER BY في الحفاظ على التكامل الداخلي للسجلات.
4.3 الأهمية المنهجية للترتيب التنازلي في الدراسات الإحصائية
يحظى الترتيب التنازلي بأهمية بالغة في التحليل الاستكشافي للبيانات التجريبية والكمية؛ إذ يمثل الخطوة الأولى في عزل الحالات المتطرفة الإيجابية (Upper Outliers) وفحص مدى شذوذها عن المتوسط الحسابي للعينة. إن وضع القيم الكبرى في الصدارة يُمكّن الباحث من التأكد الفوري من سلامة أدوات الإدخال وخلوها من الأخطاء المطبعية التي قد ترفع بعض الدرجات إلى مستويات مستحيلة إحصائياً.
علاوة على ذلك، يُعد الفرز التنازلي ركيزة أساسية في استخراج المقاييس الترتيبية والشرائح العليا في عينات البحوث النفسية والطبية؛ فبدلاً من صياغة استعلامات إحصائية معقدة لحساب المؤشرات المئينية أو أعلى 5% من أفراد العينة في زمن الرجع أو درجات القلق، يكفي فرز الملاحظات تنازلياً تمهيداً لاقتطاع الفئة المستهدفة بالدراسة المتعمقة عبر خيارات مثل OBS= أو تعبيرات التحديد اللاحقة.
كما يُسهم الترتيب التنازلي في تحسين الأداء الذهني لصناع القرار ومحللي البيانات السلوكية، من خلال تركيز الانتباه الفوري على الفئات ذات الأولوية القصوى، سواء كانت أدوية تحقق أعلى نسب شفاء، أو مراكز تسجل أعلى معدلات استجابة نفسية، مما يعزز سرعة اتخاذ القرارات العلاجية أو المنهجية بناءً على أدلة كمية منسقة بوضوح لا لبس فيه.
5. الفرز المتقدم بالاعتماد على متغيرات متعددة
5.1 منطق الفرز المتداخل وتحديد الأولويات التتابعية
نادراً ما تقتصر التحليلات الإحصائية الجادة على فرز البيانات وفق متغير منفرد؛ إذ تتشابك المتغيرات التصنيفية لتفرض هيكلية متعددة الطبقات. يتيح إجراء PROC SQL إمكانية تطبيق الفرز المتداخل (Nested Sorting) من خلال تمرير قائمة تضم عدداً من المتغيرات في عبارة ORDER BY، حيث يعتمد النظام مبدأ الأولوية التتابعية من اليسار إلى اليمين وفق التسلسل الدقيق للأسماء الواردة في الشفرة البرمجية.
وفق هذا المنطق الخوارزمي، يُعامل المتغير الأول كمعيار فرز رئيسي (Primary Key)؛ حيث تُقسم السجلات بموجبه إلى فئات متماثلة القيمة. وفي حال وجود قيم متطابقة (Ties) بين عدة سجلات في المتغير الأول، يتدخل المتغير الثاني المكتوب في العبارة كمعيار فرز ثانوي (Secondary Key) لفك هذا التعادل وترتيب الملاحظات المتطابقة داخلياً، وهكذا دواليك بالنسبة للمتغيرات الثالثة والرابعة.
إن التغيير في الترتيب المكاني لأسماء الأعمدة داخل جملة ORDER BY يُحدث تحولاً جذرياً في الشكل النهائي لمصفوفة المخرجات؛ فكتابة ORDER BY Team, Points تؤدي إلى تجميع الملاحظات بحسب الفرق أولاً ثم ترتيب النقاط داخل كل فريق، في حين أن كتابة ORDER BY Points, Team تجعل النقاط هي الحاكم الرئيسي للترتيب العام للجدول بغض النظر عن انتماءات اللاعبين لأنديتهم، مما يتطلب تخطيطاً مسبقاً ودقيقاً لأولويات العرض التحليلي.
5.2 الجمع بين الترتيب التصاعدي والتنازلي في استعلام واحد
من أبرز نقاط القوة النحوية في عبارة ORDER BY داخل بيئة ساس هي قدرتها السلسة على الجمع بين اتجاهات فرز متضادة داخل الاستعلام ذاته؛ حيث يستطيع المحلل فرز أحد المتغيرات تصاعدياً مع فرز متغير آخر في نفس الملاحظة تنازلياً، مما يمنح مرونة تحليلية غير محدودة لتنظيم المخرجات ذات الأبعاد المتعددة والمعقدة.
لتحقيق هذا التنوع الاتجاهي بدقة، يجب تثبيت المعامل DESC أو ASC خلف كل متغير بصورة مستقلة وواعية. على سبيل المثال، تؤدي صياغة ORDER BY Team ASC, Points DESC إلى فرز أسماء الفرق أبجدياً من الألف إلى الياء، في حين تُرتب درجات اللاعبين التابعين لكل فريق فردي بصورة تنازلية من الأعلى إلى الأدنى، محققة التوازن بين الترتيب الفئوي المعجمي والترتيب الكمي الهرمي.
من الأخطاء التحليلية الشائعة التي يجب الحذر منها هو الاعتقاد الخاطئ بأن وضع المعامل DESC في نهاية قائمة المتغيرات يعمم الترتيب التنازلي على جميع الأعمدة السابقة. إن القاعدة التقنية الصارمة في محرك PROC SQL تؤكد أن أي متغير لا يُكتب خلفه معامل صريح يُعامل فوراً وفق النمط التصاعدي الافتراضي، مما يستوجب تكرار الكلمة المفتاحية DESC خلف كل متغير مقصود بالفرز التنازلي على حدة وبلا استثناء.
5.3 دراسة حالة تفصيلية: فرز الفريق تصاعدياً مع نقاط اللاعبين تنازلياً
لتطبيق مفهوم الفرز المتداخل متعدد الاتجاهات تطبيقاً عملياً، نأخذ سيناريو يحتاج فيه الجهاز الفني إلى إصدار تقرير رسمي يعرض الفرق الرياضية بترتيب أبجدي منظم، مع إبراز هدافي كل فريق في صدارة القائمة الخاصة بفريقهم لتسهيل المقارنة الفردية بين نجوم التشكيلة. يُصاغ الاستعلام الإحصائي داخل PROC SQL على الوجه الأكمل كالآتي:
PROC SQL;

SELECT Team, Position, Points, Assists

FROM BASKETBALL_DATA

ORDER BY Team ASC, Points DESC;

QUIT;
عند معالجة هذا الاستعلام داخل ساس، يبدأ المحرك أولاً بفرز السجلات تصاعدياً استناداً إلى متغير Team؛ فتظهر كافة سجلات الفريق “A” مجتمعة، تليها كافة سجلات الفريق “B”، وهكذا. وداخل كل كتلة بيانات متجانسة للفريق الواحد، يتم تفعيل الترتيب التنازلي لمتغير Points، ليحتل اللاعب الأكثر تسجيلاً في ذلك الفريق الصف الأول داخل كتلته، ويليه زملاؤه الأقل إحرازاً للنقاط بالتتابع.
يكشف التقييم المنهجي لهذا الجدول النهائي عن دقة استثنائية في تحقيق متطلبات الاستعلام البحثي؛ حيث يجمع التقرير بين وضوح التقسيم الفئوي للعينات وبين سهولة قراءة الفروق الفردية في الأداء الرياضي داخل كل فئة دون أي تداخل مشتت بين الفرق، مما يقدم نموذجاً مثالياً لجداول البيانات المهيأة للقراءة التحليلية المباشرة في الأبحاث والمجلات العلمية.
6. إدارة القيم المفقودة أثناء استخدام ORDER BY
6.1 سلوك نظام SAS الافتراضي في معالجة القيم المفقودة
تُمثل معالجة البيانات المفقودة (Missing Data) إحدى الركائز الأكثر حساسية في المنهجية الإحصائية والحوسبية، ويمتلك نظام ساس سلوكاً داخلياً صارماً وفريداً في تعريف هذه القيم والتعامل معها رياضياً وبرمجياً. في بيئة ساس، تُعتبر القيمة الرقمية المفقودة (التي يُرمز لها عادةً بنقطة . أو بالحالات الخاصة المتقدمة من ._ إلى .Z) كأصغر قيمة عددية ممكنة رياضياً في الوجود، حيث تُصنف قيمياً بأنها دون أي عدد حقيقي سالب قد يصل إليه الحاسوب.
أما بالنسبة للمتغيرات النصية، فإن القيمة المفقودة تتمثل في سلسلة فارغة من المسافات البيضاء (Blanks)، وتُعامل في جدول المحارف المعياري على أنها تأتي قبل أي حرف أو رقم أو رمز قابل للطباعة. يضمن هذا التجريد الرياضي للنظام اتساقاً مطلقاً في تطبيق قواعد المنطق الجبري أثناء العمليات الحسابية والفرز دون التسبب في انهيار البرامج التنفيذية.
ينعكس هذا السلوك الداخلي بصورة مباشرة على مخرجات عبارة ORDER BY في استعلامات PROC SQL؛ فعند الفرز بالترتيب التصاعدي الافتراضي (ASC)، يحتل أي سجل يتضمن قيمة مفقودة صدارة جدول النتائج، لتظهر الملاحظات الفارغة أولاً قبل أصغر قيمة عددية حقيقية أو أول اسم نصي، وهو سلوك أصيل في ساس يجب على الباحث إدراكه بوعي كامل لتفادي التفسير الخاطئ للمخرجات الإحصائية.
6.2 موقع القيم المفقودة بين الترتيبين التصاعدي والتنازلي
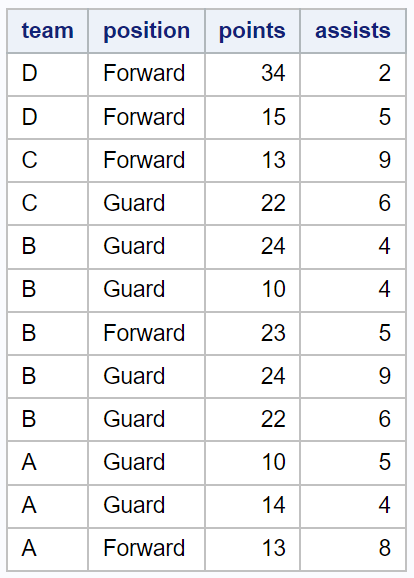
يترتب على السلوك الرياضي لساس أن مسار حركة القيم المفقودة يتبع بدقة متناهية اتجاه الفرز المحدد؛ ففي الترتيب التصاعدي، تطفو السجلات الفارغة إلى السطح وتتصدر الجدول كما سلف الذكر. أما عند تطبيق المعامل التنازلي DESC، فإن العملية تنعكس كلياً؛ وبما أن القيم المفقودة هي الأدنى مطلقاً، فإنها تُدفع تلقائياً إلى أسفل الجدول في أواخر السجلات المسترجعة، لتفسح المجال أمام القيم الحقيقية العظمى لتتصدر المشهد التحليلي.
يعد هذا النمط بالغ الأهمية عند إعداد الملخصات الإحصائية للعينات التجريبية؛ فالباحث الذي يرتب استجابات المفحوصين تصاعدياً لرؤية أدنى الدرجات قد يفاجأ بظهور عشرات الصفوف المكونة من نقاط فارغة . في مقدمة التقرير، مما يعيق الرؤية الفورية للبيانات الصالحة. في حين أن الفرز التنازلي يعزل تلك الفراغات في المؤخرة، محققاً تنقية بصرية شبه تلقائية لصدارة التقرير.
من الناحية المنهجية، يفرض هذا التباين ضرورة توخي الحذر الشديد لتفادي الوقوع في خطأ التحيز أثناء قراءة الملاحظات المفرزة؛ إذ قد يغفل المحلل وجود نسبة عالية من الفقد في بياناته إذا اكتفى بالنظر إلى صدارة جدول مرتب تنازلياً دون التمرير إلى نهايته، مما يستدعي دوماً فحص جدول المخرجات بأكمله أو تضمين تدقيقات مسبقة لفحص تكرار وأنماط القيم المفقودة في المتغيرات التابعة والمستقلة.
6.3 استراتيجيات برمجية متقدمة لتعديل موقع القيم المفقودة
في كثير من الحالات البحثية، قد يرغب المحلل في فرز البيانات تصاعدياً استناداً إلى القيم الحقيقية، مع اشتراط بقاء الملاحظات المفقودة في ذيل الجدول بدلاً من صدارته، تفادياً لتشتيت القارئ بالأرقام الفارغة في البداية. ونظراً لأن PROC SQL لا يدعم بشكل مباشر عبارة NULLS LAST القياسية المتاحة في بعض محركات SQL الأخرى، يلجأ المبرمجون المحترفون في ساس إلى صياغة تعبيرات شرطية متقدمة باستخدام عبارة CASE WHEN داخل ORDER BY.
يمكن تحقيق ذلك عبر إدخال حقل ترتيب وهمي يقسم البيانات أولاً إلى فئات مكتملة وغير مكتملة، كأن يُكتب الاستعلام على الهيئة التالية:
PROC SQL;

SELECT Player, Points

FROM BASKETBALL_DATA

ORDER BY CASE WHEN Points IS MISSING THEN 1 ELSE 0 END, Points ASC;

QUIT;
يقوم هذا التعبير المتقدم بتعيين القيمة 0 للبيانات العددية السليمة، والقيمة 1 للقيم المفقودة، مما يجعل النظام يفرز الملاحظات المكتملة أولاً بترتيبها التصاعدي المنطقي، ثم يلحق بها الملاحظات المفقودة في نهاية المصفوفة بكل إحكام ودقة.
وثمة استراتيجية برمجية بديلة بالغة الفعالية تتجسد في الاستبعاد المسبق للملاحظات الفارغة غير المرغوب في تمثيلها أصلاً داخل التقرير النهائي، وذلك عن طريق استدعاء عبارة WHERE لتصفية السجلات قبل وصولها إلى مرحلة الفرز، كأن يُصاغ الشرط: WHERE Points IS NOT MISSING. تضمن هذه المنهجية تحسين الكفاءة الحوسبية للاستعلام عن طريق إعفاء محرك الفرز من استهلاك موارده في تدوير مئات الصفوف التي لا تمتلك قيمة علمية مضافة في التحليل الإحصائي اللاحق.
7. استخدام الأرقام الدالة على الأعمدة في عبارة ORDER BY
7.1 مفهوم الإشارة الموضعية للأعمدة ومطابقتها
تدعم بيئة PROC SQL في ساس خاصية صياغة اختزالية تُعرف بالإشارة الموضعية للأعمدة (Positional Column Referencing)؛ حيث يُتاح للمبرمج استبدال كتابة الأسماء الصريحة للمتغيرات في عبارة ORDER BY بأرقام صحيحة موجبة تدل على الترتيب المادي لظهور تلك الحقول داخل جملة SELECT الأساسية للاستعلام.
بموجب هذه القاعدة النحوية، يدل الرقم 1 على العمود الأول المذكور بعد كلمة SELECT، ويدل الرقم 2 على العمود الثاني، وهكذا بالتتابع الحسابي الدقيق. فعلى سبيل المثال، إذا كانت جملة الاستعلام تبدأ بـ SELECT Team, Points, Assists، فإن صياغة ORDER BY 1, 2 DESC تطابق تماماً من الناحية التنفيذية كتابة ORDER BY Team ASC, Points DESC، مما يوفر أسلوباً برمجياً شديد الإيجاز.
لا تتوقف هذه الخاصية عند الترتيب البسيط، بل تدعم الإشارات الموضعية الجمع الكامل مع المعاملات الاتجاهية مثل DESC وASC لكل مؤشر رقمي على حدة. إن هذه المطابقة تجعل محرك النظام يربط داخلياً بين الرقم التسلسلي وبين اسم المتغير وموقعه في ذاكرة التخزين المؤقتة، محققاً ذات المخرجات الفرزية الصارمة التي توفرها التسميات النصية المباشرة للأعمدة.
7.2 الفوائد العملية ومحاذير استخدام المؤشرات الرقمية
تتمثل الفائدة العملية المباشرة للاعتماد على المؤشرات الرقمية في تسريع كتابة الشفرات واختصار مساحتها؛ لاسيما في مراحل الاستكشاف الأولي السريع للبيانات، أو عند التعامل مع متغيرات ناتجة عن دوال تحويلية طويلة وتعبيرات حسابية معقدة يصعب تكرار أسمائها المستعارة أو صياغاتها الرياضية المطولة داخل عبارة الترتيب، مما يجعل الرقم الموضعي بديلاً برمجياً عملياً لتسريع الإنجاز الميداني.
ومع ذلك، ينطوي هذا الأسلوب على محاذير منهجية خطيرة تهدد استقرار البرامج التحليلية طويلة الأمد؛ فإذا قام المحلل في وقت لاحق بتعديل ترتيب الأعمدة داخل عبارة SELECT كإضافة حقل جديد أو تبديل موقع عمودين لأغراض التنسيق الشكلي، فإن عبارة ORDER BY المعتمدة على الأرقام ستستمر في تنفيذ الفرز الموضعي على الأعمدة الجديدة التي حلت مكان القديمة دون إصدار أي تنبيه، مما يؤدي إلى فرز البيانات بناءً على متغيرات خاطئة بالكلية وتخريب النسق التحليلي للمخرجات دون لفت انتباه الباحث.
إن هذا الخلل المستتر يُعد من أصعب الأخطاء المنطقية اكتشافاً في خطوط معالجة البيانات الإحصائية (Data Pipelines)؛ حيث لا يتوقف البرنامج بإصدار خطأ نحوي، بل يستمر في إنتاج جداول مضللة تبدو سليمة شكلياً ولكنها مشوهة بنيوياً، مما يفرض توخي أقصى درجات الحيطة والتردد قبل تبني هذا النمط في المشروعات الحسابية المؤسسية أو الأبحاث المنشورة.
7.3 مقارنة الصيانة البرمجية بين الأسماء والمؤشرات الرقمية
في أدبيات هندسة البرمجيات الإحصائية ومعايير الأبحاث القابلة لإعادة الإنتاج (Reproducible Research)، تحتل مسألة “قابلية القراءة والصيانة” (Code Readability and Maintainability) الأولوية القصوى على حساب سرعة كتابة الكود العابرة. من هذا المنطلق، تتفوق الإشارة الصريحة لأسماء المتغيرات تفوقاً ساحقاً على استخدام الأرقام الموضعية داخل استعلامات PROC SQL.
فالشفرة التي تعتمد على أسماء الأعمدة تكون ذاتية التوثيق (Self-Documenting)؛ إذ يمكن لأي باحث مراجع أو مدقق إحصائي فهم المنطق الكامن خلف ترتيب الجدول بنظرة سريعة، دون الحاجة للرجوع إلى بداية الاستعلام لعد وترقيم مواقع الأعمدة في تعليمة SELECT والتأكد من مطابقتها لكل رقم في سطر الفرز، وهو ما يوفر الجهد الذهني ويقلل احتمالات الخطأ البشري أثناء المراجعة النظيرة للأكواد العلمية.
وتوصي المعايير الأكاديمية الصارمة بقصر استخدام الأرقام الدالة على الأعمدة على التجارب الحرة الفورية والاستكشاف السريع في المحرر البرمجي التفاعلي، في حين يجب تحويل كافة تلك الأرقام إلى أسماء متغيرات صريحة وموثقة بمجرد تثبيت الاستعلام واعتماده كجزء من خطة التحليل الدائمة أو الحزم البرمجية الموجهة للأرشفة والمشاركة المجتمعية بين الباحثين والمؤسسات العلمية.
8. تحسين الأداء الحسابي وإدارة الذاكرة في قواعد البيانات الكبيرة
8.1 استهلاك الموارد أثناء فرز البيانات الضخمة
تُعد عملية الفرز من أكثر العمليات الحوسبية استهلاكاً لموارد الأجهزة في بيئات قواعد البيانات؛ إذ تندرج نظرياً ضمن التعقيدات الحسابية غير الخطية، وتحديداً ضمن درجة التعقيد O(N log N)، حيث تمثل N عدد السجلات المراد معالجتها. يترتب على ذلك تزايد هائل في زمن المعالجة واستهلاك وحدة المعالجة المركزية (CPU) بمجرد قفز أحجام البيانات من آلاف الحالات إلى ملايين السجلات في الدراسات الوبائية والمسوح الوطنية الكبرى.
عند تنفيذ استعلام يتضمن عبارة ORDER BY على جدول ضخم، يعمد محرك ساس إلى استخدام الذاكرة العشوائية المخصصة للإجراء (Proc SQL Memory)، فإذا لم تتسع تلك الذاكرة لحجم المصفوفة المراد فرزها بالكامل، يُجبر النظام على إنشاء ملفات مساعدة مؤقتة (Utility Files) على القرص الصلب لتنفيذ عملية الفرز عبر تجزئة البيانات ودمجها المتتابع (External Merge Sort)، وهي خطوة تتسبب في تدهور ملحوظ في سرعة الإنجاز نتيجة بطء عمليات الإدخال والإخراج الميكانيكية والإلكترونية مقارنة بسرعة الذاكرة الحية.
للتخفيف من هذا العبء، تتمثل أولى الممارسات الموصى بها في تقليص عرض السجلات (Record Width) من خلال تجنب استخدام SELECT * نهائياً، واقتصار عبارة الاختيار على المتغيرات الجوهرية المطلوبة في التقرير فقط. إن تقليل عدد الأعمدة المسترجعة يقلل مباشرة من الحجم الإجمالي للبايتات التي يجب على خوارزمية الفرز تبديلها وتخزينها، مما يتيح إتمام العملية داخل حدود الذاكرة السريعة دون الحاجة إلى إنشاء ملفات وسيطة منهكة على وسائط التخزين.
8.2 دور الفهارس في تسريع عمليات الترتيب
تمثل الفهارس (Indexes) هياكل بيانات إضافية يتم بناؤها استباقياً على متغيرات الجداول لتسريع استرجاع السجلات بكفاءة استثنائية. وفي سياق عبارة ORDER BY، يمكن أن يلعب الفهرس المبني على المتغير المستهدف بالفرز دوراً حاسماً في إلغاء الحاجة المطلقة إلى إجراء فرز ديناميكي للبيانات في زمن التشغيل الفعلي للاستعلام.
عندما يستلم محرك الاستعلام في ساس أمراً يتضمن ترتيباً، يقوم “محسن الاستعلامات” (Query Optimizer) بفحص الجداول المصدرية؛ فإذا وجد فهرساً تصاعدياً قائماً بالفعل على العمود المحدد في ORDER BY، فإنه قد يتخذ قراراً ذكياً بقراءة السجلات مباشرة وفق التسلسل الفيزيائي المرتب داخل شجرة الفهرس (B-Tree)، متجاوزاً خطوة الفرز الحسابية المكلفة برمتها، وموفراً استهلاكاً هائلاً في موارد المعالج ووقت التنفيذ.
ومع ذلك، فإن بناء الفهارس يتطلب تخطيطاً دقيقاً وحساباً متوازناً لتكاليف التخزين والتحديث؛ فالفهارس تستهلك مساحات تخزينية ملحوظة، وتؤدي إلى إبطاء عمليات إدراج وتعديل البيانات الجديدة نظراً لحاجة النظام إلى تحديث شجرة الفهرس مع كل تغيير يطرأ. وبالتالي، يُوصى بحصر الفهارس في المتغيرات ذات الاستخدام المتكرر والمكثف في التصفية والفرز والدمج، وتجنب الإفراط العشوائي في فهرستها تجنباً لاستنزاف مساحات التخزين دون عائد أدائي حقيقي.
8.3 المفاضلة الحسابية بين PROC SORT المسبق وORDER BY المباشر
تفرض الكفاءة الحوسبية التوقف المتأني عند المفاضلة بين أسلوبين معتمدين في بيئة ساس: الفرز المسبق للجداول وتخزينها مرتبة نهائياً باستخدام PROC SORT، أو الاعتماد على الفرز اللحظي الديناميكي عبر عبارة ORDER BY داخل PROC SQL في كل مرة يُستدعى فيها الاستعلام. تعتمد هذه المفاضلة بشكل رئيسي على وتيرة استخدام المخرجات وحجم التدفقات الحسابية المرتبطة بها.
إذا كانت مجموعة البيانات ضخمة للغاية وتُستخدم بصفة متكررة عبر عشرات الإجراءات الإحصائية اللاحقة التي تعتمد على الفرز (مثل إجراءات PROC MEANS أو PROC FREQ المقترنة بعبارة BY)، فإن استخدام PROC SORT مرة واحدة لحفظ الجدول مرتباً فيزيائياً على القرص يمثل الاستراتيجية الأرشد استهلاكاً للموارد؛ إذ يُعفي النظام من تكرار استهلاك الذاكرة في إعادة فرز نفس البيانات في كل خطوة برمجية لاحقة.
من جانب آخر، يتطلب تشغيل استعلامات الفرز الكبرى رقابة دقيقة على مساحة المكتبة المؤقتة (WORK Library)؛ فإذا امتلأ هذا القرص المؤقت نتيجة لضخامة ملفات الفرز الوسيطة، يفشل الاستعلام فوراً ويتوقف تنفيذ كامل البرنامج البرمجي. يتعين على مديري الأنظمة والمحللين ضبط خيارات الذاكرة المتقدمة لسلوك الفرز مثل SORTSIZE= وMEMSIZE= لتزويد خوارزميات ساس بالحد الأقصى المتاح من الموارد الحية، مما يضمن تدفق عمليات الفرز بأعلى سرعة وبأقل معدلات إجهاد لمكونات الخادم المركزية.
9. معالجة الأخطاء الشائعة وحل المشكلات البرمجية في ORDER BY
9.1 الأخطاء النحوية وتعارض أسماء المتغيرات والألقاب
تُعد الأخطاء النحوية (Syntax Errors) المتعلقة بعبارة ORDER BY من العوائق المتكررة التي تواجه الباحثين، وغالباً ما تنتج عن أخطاء إملائية في أسماء الأعمدة أو الخلط بين أسماء المتغيرات في جداول المصدر والأسماء المستعارة الجديدة الممنوحة لها في عبارة التحديد. إذا أشار المحلل في عبارة الفرز إلى متغير غير مدرج في الجداول المصدرية، يتوقف الاستعلام فوراً معلناً عن تعذر التعرف على الحقل.
تظهر مشكلة التعارض النحوي بوضوح أيضاً عند استخدام علامات الترقيم بطريقة غير منضبطة؛ كإضافة فاصلة بعد آخر متغير في قائمة ORDER BY، أو الخلط بين الفاصلة العادية والفواصل المنقوطة، مما يربك المفسر الآلي للغة SQL في ساس. كذلك يقع البعض في خطأ وضع عبارة الفرز قبل شروط التصفية أو عبارات الربط، وهو ما يولد رسائل خطأ صريحة توجب إعادة هيكلة الجملة البرمجية بالترتيب المنطقي السليم لتبدأ بـ FROM ثم WHERE وتختتم بـ ORDER BY.
لحل هذه الإشكالات، يُنصح دائماً بالتحقق المسبق من أسماء المتغيرات باستخدام إجراءات تدقيق القواميس المدمجة مثل PROC CONTENTS، ومراجعة نصوص الاستعلامات بعناية، والتأكد من مطابقة الأسماء المستعارة المستخدمة مع تعاريفها الرياضية داخل عبارة SELECT، مع الالتزام التام بإلغاء الفواصل الفائضة التي تشكل سبباً رئيساً في توقف المعالجات الاستعلامية داخل بيئة ساس التفاعلية.
9.2 أخطاء الترتيب عند استخدام الدوال التجميعية والتجميع الفئوي
تنشأ تحديات برمجية معقدة عند محاولة استخدام عبارة ORDER BY بالتزامن مع التجميع الفئوي عبر عبارة GROUP BY واستخدام الدوال الإحصائية الملخصة كـ SUM وAVG. من الأخطاء المتكررة محاولة الترتيب بناءً على متغير تفصيلي تم استبعاده من عملية التجميع؛ مما يربك محرك النظام حول كيفية فرز المجموعات الملخصة بناءً على قيم متعددة ومتعارضة لحالات فردية متباينة.
ولضمان التنفيذ البرمجي السليم، يجب أن يرتكز الفرز عند استخدام GROUP BY إما على المتغيرات الفئوية المعتمدة ذاتها في التجميع، أو على نواتج الدوال الإحصائية التجميعية نفسها. فعلى سبيل المثال، لترتيب الفرق بحسب إجمالي نقاطها التراكمية، يُصاغ الاستعلام بالإشارة الصريحة إلى الدالة أو لاسمها المستعار المعرف في الاستعلام كالتالي: ORDER BY SUM(Points) DESC أو ORDER BY TotalPoints DESC.
كما يجب الانتباه إلى أن تطبيق عبارة ORDER BY على استعلام يحتوي على دوال تجميعية دون استخدام عبارة GROUP BY صريحة قد يؤدي إلى إعادة دمج البيانات بطريقة غير مقصودة (Remerging of Summary Statistics)؛ حيث يعيد ساس حساب الإجمالي الكلي ويضيفه كعمود متكرر بجانب كل سجل فردي ثم يفرز السجلات، وهو سلوك متقدم يتميز به ساس قد يفاجئ المبرمج غير المعتاد على هذه الآلية العلائقية الخاصة.
9.3 قراءة سجل النظام وتحليل رسائل التنبيه والخطأ
يمثل سجل العمليات SAS Log المرجع التشخيصي الأول والأهم لكل باحث ومبرمج؛ إذ لا يقتصر دوره على إظهار نجاح أو فشل التنفيذ، بل يقدم تقريراً تحليلياً شاملاً لسلوك محرك الاستعلام، متضمناً تحذيرات الدقة، وزمن المعالجة، وحجم الموارد المستهلكة أثناء معالجة عبارة ORDER BY.
من بين الرسائل الهامة التي يجب الانتباه إليها رسائل التحذير (WARNING) المتعلقة بإعادة فرز الجداول الكبيرة في وجود مؤشرات سابقة، أو رسائل الملاحظة (NOTE) التي تفيد بأن محرك الاستعلام قد اضطر إلى بناء جدول مؤقت في مكتبة WORK أو استخدام القرص الصلب لإتمام خوارزمية الفرز نتيجة لضيق الذاكرة المخصصة. تتطلب مثل هذه الرسائل مراجعة مباشرة لمعايير تحسين الأداء لتفادي الاختناقات التشغيلية عند الانتقال لمعالجة مجموعات بيانات أكبر حجماً.
لتفعيل المراقبة المتقدمة والتشخيص الاحترافي، يوصى بتشغيل خيارات التتبع التحليلي في ساس مثل OPTIONS FULLSTIMER; وOPTIONS MSGLEVEL=I; قبل تشغيل استعلام PROC SQL. تتيح هذه الخيارات طباعة تفاصيل استثنائية في السجل تكشف بدقة عن زمن وحدة المعالجة المركزية، والوقت الفعلي المنقضي، وحجم الذاكرة المستهلكة، وما إذا كان النظام قد استخدم فهرساً متاحاً أم لجأ إلى الفرز الكامل، مما يمنح الباحث الأدلة الرقمية اللازمة لتحسين استعلاماته برمجياً وهندسياً.
10. تطبيقات متقدمة في التحليل الإحصائي وإعداد التقارير الأكاديمية
10.1 تجهيز وتنظيم بيانات القياسات النفسية والسلوكية
تعتمد أبحاث علم النفس الكمي، والقياسات النفسية (Psychometrics)، والدراسات السلوكية اعتماداً جوهرياً على إدارة البيانات عبر PROC SQL وعبارة ORDER BY لتنظيم استجابات المفحوصين قبل الشروع في النمذجة الرياضية. وتتضح هذه الأهمية في مرحلة حساب درجات الثبات والصدق للمقاييس؛ حيث يتطلب تحليل التمييز للفقرات فرز الأفراد تنازلياً وفق مجموع درجاتهم الكلية لتحديد الفئتين الطرفيتين: الفئة العليا والدنيا (Top and Bottom 27%).
من خلال توظيف الاستعلام المفرز، يستطيع الباحث تصنيف المشاركين بدقة وتعيين الرتب المئينية لهم، مما يمهد لحساب معاملات التمييز ومعاملات الارتباط الثنائي النقطي (Point-Biserial Correlations) لكل فقرة اختبارية على حدة. إن هذا الترتيب الممنهج يلغي التداخلات الناتجة عن عشوائية إدخال الاستجابات، ويضمن اتساق المقارنات بين المجموعات الفرعية داخل بنية المقياس النفسي.
علاوة على ذلك، يُعد الفرز المتعدد عاملاً حاسماً في تنظيم التجارب السلوكية متعددة المراحل والقياسات المتكررة (Repeated Measures Design)؛ حيث يتم فرز السجلات بالاعتماد على معرّف المفحوص (Subject_ID) كمعيار رئيسي تصاعدي، يليه زمن القياس (Time_Point). يضمن هذا النسق التتابعي تراصف القياس القبلي والبعدي والمتابعة لكل مشارك في صفوف متصلة زمنياً، مما ييسر حساب فروق التغير الفردي وتحويل البيانات لاحقاً بين التنسيق العريض (Wide Format) والتنسيق الطولي (Long Format) بدقة متناهية.
10.2 إنشاء تقارير أكاديمية نهائية مهيأة للعرض والنشر
لا تتوقف وظيفة ORDER BY عند حدود التهيئة الحسابية، بل تمتد لتشكل أداة رئيسية في تنسيق وإخراج التقارير البحثية الموجهة للعرض العلمي والنشر المحكم؛ حيث تُدمج هذه العبارة بسلاسة فائقة مع نظام تسليم المخرجات في ساس (SAS Output Delivery System – ODS) لتصدير الجداول المفرزة مباشرة إلى ملفات نسقية متقدمة مثل PDF وRTF المنسجمة مع متطلبات المعايير الدولية للنشر العلمي، كتلك الصادرة عن جمعية علم النفس الأمريكية (APA Style).
من خلال تنظيم المخرجات عبر ORDER BY مسبقاً، تخرج الجداول الإحصائية المصدرة بحسب الترتيب الهرمي للمتغيرات (كالأهمية الإحصائية للنماذج، أو الحجم التنازلي لحجم الأثر Cohen’s d، أو الترتيب الأبجدي للمتغيرات المستقلة)، مما يلغي الحاجة إلى إعادة تحرير الجداول يدوياً في برامج معالجة النصوص، ويقلل إلى الصفر تقريباً من احتمالات وقوع أخطاء النسخ واللصق أثناء نقل النتائج الميدانية إلى مسودات البحوث المنشورة.
كما يسمح الربط بين ORDER BY وخيارات التقرير بتوليد تقارير وسيطة مجزأة تلقائياً، بحيث تظهر فواصل الصفحات أو العناوين الفرعية عند تغير قيمة المتغير المفرز تصاعدياً. يضمن هذا التدفق الشكلي الراقي تقديم نتائج التحليلات الاستكشافية والمقارنات البعدية في صورة وثائق أكاديمية تتسم بالوضوح والرصانة وقابلية الفهم الفوري من قِبل المحكمين وصناع القرار في مختلف المجالات البحثية والطبية.
10.3 أفضل الممارسات البرمجية الموصى بها في كتابة استعلامات الفرز
لضمان الاستخدام الأرشد لعبارة ORDER BY في المشروعات العلمية ومستودعات البيانات التحليلية طويلة المدى، يجب على الباحثين والمحللين الالتزام بحزمة من أفضل الممارسات البرمجية المستقرة؛ يأتي في مقدمتها التوثيق الإيضاحي الصارم (In-line Documentation) لكل عبارة فرز، من خلال إدراج تعليقات برمجية تشرح المنطق الرياضي أو المبرر الإحصائي الكامن خلف اختيار الترتيب التصاعدي أو التنازلي لمصفوفة النتائج.
كما يُنصح بشدة باعتماد اصطلاحات تسمية موحدة وواضحة (Consistent Naming Conventions) لكافة المتغيرات الأصلية والأسماء المستعارة، والابتعاد التام عن الأسماء الغامضة أو الرموز الفردية التي يصعب تتبعها في المشاريع المشتركة. ويجب كذلك الحرص على مراجعة مخططات البيانات (Data Schemas) دورياً للتأكد من اتساق أنماط الحقول المفرزة، وتجنب خلط القيم النصية مع الأرقام، وتفادي الفرز غير المبرر على أعمدة تشتمل على مساحات تخزين نصية شاسعة لا تخدم التحليل المباشر.
أخيراً، يتعين إجراء تدقيق دوري ومراجعة قياسية لكفاءة الاستعلامات المدمجة مع كل تحديث مؤسسي لبيئة ساس أو ترقية لمساحات التخزين والذاكرة المتاحة؛ فما كان يمثل عبئاً حوسبياً في الإصدارات السابقة قد تتوفر له خيارات أداء ومعالجات متوازية في النسخ الحديثة، مما يضمن بقاء الشفرات التحليلية في أعلى مستويات الأداء التقني، ويدعم موثوقية البنية الرقمية للمؤسسات البحثية والجامعية.
خاتمة
تناول هذا المقال المعمق دراسة شاملة لعبارة ORDER BY داخل إجراء PROC SQL في نظام ساس الإحصائي، مستعرضاً أسسها النظرية وقواعدها النحوية وآلياتها المتقدمة في تنظيم البيانات الرقمية والنصية وإدارة القيم المفقودة. ولقد تبين أن توظيف هذه الأداة بكفاءة يتطلب إدراكاً عميقاً لدورة التنفيذ المنطقية للاستعلام العلائقي، وللفروق الجوهرية بين الفرز المباشر واستخدام إجراءات ساس التقليدية كإجراء PROC SORT، لا سيما عند معالجة المصفوفات الكبيرة التي تتطلب إدارة دقيقة للذاكرة المؤقتة والفهارس الحسابية.
إن إتقان الباحثين لتقنيات الفرز المتداخل، والتنبه للمحاذير المترتبة على استخدام المؤشرات الموضعية، وتطبيق المعالجات المنهجية المتقدمة للبيانات السلوكية والنفسية، يشكل مدخلاً أساسياً لإنتاج تحليلات إحصائية دقيقة وتقارير علمية قابلة لإعادة الإنتاج ومطابقة لأرقى المعايير الأكاديمية العالمية. وتظل عبارة ORDER BY في هذا السياق أكثر من مجرد أمر نحوي لإعادة الترتيب؛ إنها أداة نمذجة هيكلية ترتقي بجودة البيانات، وتعزز الشفافية الاستكشافية، وتدعم بناء أحكام استدلالية رصينة في مجمل الأبحاث والدراسات الكمية المعاصرة.
المراجع
- Cody, R. (2018). Learning SAS by Example: A Programmer’s Guide (2nd ed.). SAS Institute Inc.
- Date, C. J. (2019). Database Design and Relational Theory: Normal Forms and All That Jazz (2nd ed.). O’Reilly Media.
- Lafler, K. P. (2013). PROC SQL: Beyond the Basics Using SAS (2nd ed.). SAS Institute Inc.
- SAS Institute Inc. (2020). SAS 9.4 SQL Procedure User’s Guide (4th ed.). SAS Institute Inc. https://support.sas.com/documentation/onlinedoc/94/index.html
- Stoltzfus, J. C. (2011). Data management and preparation for statistical analysis in clinical research. Academic Emergency Medicine, 18(10), 1099-1104. https://doi.org/10.1111/j.1553-2712.2011.01180.x