
تُعد منظومة التحليل الإحصائي SAS (Statistical Analysis System) واحدة من أكثر البيئات البرمجية رسوخاً وموثوقية في الأوساط الأكاديمية والمراكز البحثية والمؤسسات الصناعية المتقدمة حول العالم. منذ وضع لبناتها الأولى في جامعة ولاية كارولاينا الشمالية عام 1966 عبر جهود أنتوني بار (Anthony J. Barr) وجيمس جودنايت (James H. Goodnight)، وما تلا ذلك من انضمام جون سال (John Sall) وجين هيلويغ (Jane T. Helwig) وتأسيس معهد SAS رسمياً عام 1976، شكّل النظام معياراً صارماً لمعالجة البيانات الضخمة وإجراء التحليلات الكمية المعقدة. وتبرز داخل هذه المنظومة مجموعة من الإجراءات الإحصائية (Procedures) التي تؤدي أدواراً جوهرية في استكشاف البيانات وفحص بنيتها التوزيعية قبل الانتقال إلى النمذجة الرياضية المتقدمة، ويأتي في طليعة هذه الأدوات إجراء تلخيص البيانات الحسابية المعروف باسم PROC MEANS.
يتيح إجراء PROC MEANS للباحثين والمحللين استخراج المقاييس الوصفية الأساسية للمتغيرات الرقمية المستمرة، مثل المتوسطات الحسابية والانحرافات المعيارية والحدود القصوى والدنيا. غير أن القيمة التحليلية الحقيقية لهذا الإجراء لا تكتمل عند التعامل مع مصفوفة البيانات كوحدة صماء مجردة من السياق البنيوي؛ فالظواهر السلوكية والاقتصادية والطبية تتسم بطبيعتها بالتمايز الفئوي، حيث تتفرع العينات إلى مجموعات تجريبية وضابطة، أو مستويات دخل متفاوتة، أو تقسيمات ديموغرافية وجغرافية محددة. وهنا تبرز الأهمية المنهجية لعبارة CLASS، التي تمثل المحرك التصنيفي الداخلي القادر على تفكيك التباين الإجمالي وإعادة بناء النتائج الإحصائية في أطر مقارنة طبقية شديدة الدقة.
يهدف هذا المقال الأكاديمي الشامل إلى تقديم دراسة معمقة وتطبيقية لكيفية استخدام إجراء PROC MEANS مدعوماً بعبارة CLASS في نظام SAS. سنستعرض الأسس النظرية والمفاهيمية التي تحكم عمل هذه العبارة، ونحلل الاختلافات الجوهرية بينها وبين الأدوات البديلة مثل عبارة BY، فضلاً عن تقديم تطبيقات عملية تدريجية تبدأ من التصنيف الأحادي البسيط وصولاً إلى التصنيف المتقاطع متعدد الأبعاد. كما سنتطرق إلى استراتيجيات تخصيص المقاييس الإحصائية وتوليد مجموعات البيانات المخرجة والتعامل الرصين مع البيانات المفقودة، بما يتوافق مع أرقى المعايير المنهجية المعتمدة في النشر العلمي والبحوث التطبيقية الرصينة.
1. مقدمة شاملة لإجراء PROC MEANS وأهميته الإحصائية
1.1 ماهية إجراء PROC MEANS ودوره في التحليل الكمي
يمثل إجراء PROC MEANS في بيئة Base SAS الأداة التحليلية القياسية المخصصة لحساب الإحصاءات الوصفية الموجزة للمتغيرات الرقمية المستمرة. وظيفياً، يقوم الإجراء بمسح البيانات المتوفرة في جدول التحليل، وإخضاع القيم الرقمية لخوارزميات رياضية دقيقة تستهدف تقدير معالم النزعة المركزية (Central Tendency) ومؤشرات التشتت (Dispersion) والخصائص الشكلية للتوزيع مثل الالتواء والتفرطح. لا يقتصر دور هذا الإجراء على تقديم أرقام مجردة، بل يمثل حجر الزاوية في مرحلة التحليل الاستكشافي للبيانات (Exploratory Data Analysis)، حيث يتيح للمحقق الأكاديمي تكوين رؤية مبدئية وشاملة حول مدى تمركز المشاهدات وطبيعة التباين الداخلي المحيط بها.
تتجلى الأهمية التطبيقية لحساب المقاييس الوصفية الأولية في كونها الخطوة الاستباقية الضرورية لاختبار الفرضيات في البحوث الميدانية والتجريبية. فمن خلال التدقيق في مقاييس مثل المتوسط الحسابي والانحراف المعياري والمدى، يستطيع الباحث رصد أي شذوذ في البيانات أو أخطاء ناتجة عن الإدخال الميداني غير المنضبط. كما يوفر هذا الإجراء فحصاً أولياً لمدى تماشي البيانات مع افتراضات التوزيع الطبيعي، وهو ما يحدد المسار المنهجي لاختيار الاختبارات المعلمية (Parametric) أو اللامعلمية (Non-parametric) في المراحل اللاحقة للبحث العلمي.
يتكامل إجراء PROC MEANS بشكل عضوي وسلس مع حزم التحليل الإحصائي المتقدمة داخل SAS؛ حيث يتشارك في محركه الحسابي الأساسي مع إجراء PROC SUMMARY، ولكنه يتميز عنه بإرسال المخرجات الإحصائية افتراضياً إلى نافذة النتائج (Results Viewer) أو نظام تسليم المخرجات (ODS). هذا التكامل يجعله نقطة الانطلاق المثالية لتجهيز المؤشرات الإحصائية التي تُغذى بها إجراءات النمذجة المتقدمة، مثل إجراءات الانحدار الخطي (PROC REG) وتحليل التباين (PROC GLM)، مما يضمن بناء التحليلات المعقدة على أرضية وصفية صلبة وموثقة حسابياً.
1.2 الفروق الجوهرية بين التحليل التجميعي والتحليل الوصفي العام
يقوم التحليل الوصفي البسيط لكامل العينة على مبدأ دمج جميع الحالات والمشاهدات ضمن وعاء حسابي واحد، مستخرجاً مؤشرات إحصائية تعبر عن العينة في كليتها المطلقة. ورغم فائدة هذا الأسلوب في إعطاء لمحة عامة عن المتغير التابع، إلا أنه ينطوي على قصور منهجي فادح؛ إذ يفترض ضمناً تجانس العينة وخلوها من التمايزات البنيوية الداخلية. إن هذا التبسيط المفرط قد يحجب تباينات حرجة بين المجموعات الفرعية، بل قد يقود أحياناً إلى مغالطات إحصائية شهيرة مثل مفارقة سيمبسون (Simpson’s Paradox)، حيث تظهر الاتجاهات الإجمالية للعينة نتائج معاكسة تماماً لما هو متحقق فعلياً داخل طبقاتها المكونة لها.
من هنا تنبثق ضرورة التقسيم الطبقي للبيانات (Data Stratification) وفق المتغيرات المستقلة والوسيطة ذات الصلة بالظاهرة المدروسة. يتضمن هذا النهج تقسيم مصفوفة البيانات إلى أجزاء متجانسة داخلياً ومتباينة خارجياً بالاستناد إلى خصائص تصنيفية محددة، مثل النوع الاجتماعي، الفئات العمرية، مستويات التدخل العلاجي، أو القطاعات المؤسسية. يتيح التحليل التجميعي الموجه عبر هذه الطبقات للباحث فك الاشتباك بين التباين المنسوب للظاهرة المدروسة والتباين الناجم عن الخصائص الهيكلية للعينة، مما يوفر فهماً أعمق للسلوك الإحصائي الدقيق للمتغيرات قيد الفحص.
يؤثر التباين الداخلي بين الفئات الفرعية تأثيراً مباشراً وحاسماً على التفسير العلمي للنتائج الإحصائية وموثوقيتها. فعندما يكون التشتت الداخلي لإحدى المجموعات مرتفعاً للغاية مقارنة بمجموعة أخرى، فإن الاعتماد على المتوسط الحسابي العام للعينة ككل يؤدي إلى تشويه خطير لقوة التعميم. يمنح التحليل المصنف الباحثين القدرة على تقييم مدى استقرار القياس عبر مختلف القطاعات، وتحديد ما إذا كان التدخل التجريبي أو العامل المستقل يؤثر بشكل متكافئ على كافة الأطياف المدروسة، أو أن أثره مقصور على شريحة محددة دون غيرها، وهو ما يثري النقاش العلمي في أطروحات الدراسات العليا والأبحاث المحكمة.
1.3 دور عبارة CLASS في تنظيم وهيكلة المخرجات
تمثل عبارة CLASS إحدى الركائز النحوية والتنظيمية الأكثر فاعلية داخل بيئة إجراء PROC MEANS؛ إذ تعرّف الإجراء بالمتغيرات التصنيفية (Grouping Variables) التي يجب اعتمادها كمحددات لفرز وتصنيف المشاهدات أثناء إجراء العمليات الحسابية. تعمل هذه العبارة كأداة توجيه هيكلية تجبر النظام على الانتقال من النظرة الأحادية الشاملة إلى بناء مصفوفة تجميعية ديناميكية، حيث تُحسب كافة المقاييس الإحصائية المطلوبة بشكل مستقل ومفصل لكل مستوى من مستويات المتغيرات المحددة في العبارة.
تتمثل الآلية الوظيفية لعبارة CLASS في قدرتها على تحويل المتغيرات الفئوية الاسمية أو الرتبية إلى محاور تجميع متزامنة، من خلال بناء شجرة بيانات تفاعلية في الذاكرة العشوائية للحاسوب. يتيح هذا التصميم للنظام توليد الإحصاءات لجميع توليفات العوامل التصنيفية دفعة واحدة دون الحاجة إلى إعادة قراءة جدول البيانات الأصلي عدة مرات. وتظهر المخرجات في نهاية المطاف ضمن جدول إحصائي موحد، يدمج بدقة متناهية مستويات الفئات وأحجام عيناتها ومؤشراتها الإحصائية، مما يسهل عملية المقارنة البصرية والتحليلية عبر المستويات المختلفة.
تكتسب هذه الهيكلة قيمة علمية ومنهجية مضاعفة عند دراسة العينات في العلوم الاجتماعية والنفسية والسلوكية، حيث تتداخل العوامل وتتعدد مستويات التأثير. إن تقسيم العينات السلوكية إلى مجموعات متمايزة استناداً إلى متغيرات التصنيف يسمح بفحص الفروق الدقيقة في استجابات الأفراد، وتقييم فرضيات التفاعل المبدئية بين المتغيرات الديموغرافية والسمات النفسية المقاسة. ومن خلال هذا التنظيم المحكم، تسهم عبارة CLASS في تحويل البيانات الرقمية الخام المبعثرة إلى هيكل معرفي مترابط يدعم استخلاص البراهين العلمية بدرجة عالية من الرصانة والموثوقية.
2. البنية النحوية الأساسية لعبارة CLASS داخل إجراء PROC MEANS
2.1 الصياغة البرمجية القياسية لقاعدة الكود
تخضع البرمجة في بيئة SAS لقواعد صرفية ونحوية صارمة تستوجب ترتيباً منطقياً دقيقاً للعبارات البرمجية لضمان التنفيذ الأمثل للعمليات الحسابية. تبدأ كتلة التحليل باستدعاء الإجراء عبر العبارة الافتتاحية PROC MEANS، متضمنة تعيين مجموعة البيانات المراد معالجتها عبر محدد البيانات DATA=، متبوعة بالخيارات الإحصائية المطلوبة لضبط شكل المخرجات. تلي ذلك مباشرة عبارات التوجيه والتصنيف والتحليل، وتأتي عبارة CLASS في قلب هذا التركيب البرمجي لتحدد أبعاد التقسيم الطبقي، متناغمة مع عبارة VAR المخصصة لحصر المتغيرات المستمرة المستهدفة بالحساب.
من الناحية التركيبية، يجب أن توضع عبارة CLASS بين عبارة فتح الإجراء PROC MEANS والعبارة الختامية RUN؛ حيث يتسبب وضعها خارج هذا النطاق في توليد أخطاء صرفية تمنع المترجم من تفسير منطق المعالجة. يتم التصريح عن العبارة بكتابة الكلمة المفتاحية CLASS متبوعة بأسماء المتغيرات الفئوية تفصل بينها مسافات بيضاء، مع الالتزام التام بإنهاء العبارة بعلامة الفاصلة المنقوطة (;) التي تمثل في قواعد SAS حداً بنيوياً لا يمكن إغفاله. إن هذا التنسيق الصارم يضمن للنظام بناء مصفوفات التصنيف الداخلي قبل الشروع في جلب قيم المتغيرات الرقمية وإجراء التقديرات الإحصائية عليها.
تعتمد بيئة SAS الحساسية للتركيب المنطقي وليس لحجم الأحرف، ومع ذلك، فإن المعايير الأكاديمية الصارمة لكتابة الأكواد توصي باعتماد نمط طباعي موحد واستخدام مسافات الإزاحة البادئة (Indentation) لإبراز التبعية الهيكلية للعبارات التابعة للإجراء الرئيسي. يساعد هذا الانضباط الشكلي على تسهيل مراجعة الأكواد الإحصائية وتدقيقها من قبل المراجعين المستقلين، ويقلل من احتمالية السهو البرمجي كنسيان الفواصل المنقوطة أو تداخل أسماء المتغيرات، مما يرفع من جودة التوثيق الحوسبي في المشاريع البحثية المتقدمة.
2.2 شروط ومعايير اختيار متغيرات التصنيف
يتطلب الاستخدام الفعال لعبارة CLASS مراعاة جملة من الخصائص الرياضية والنوعية في المتغيرات المرشحة لأداء دور محور التصنيف. يجب أن تكون هذه المتغيرات ذات طبيعة فئوية متقطعة (Discrete Categorical Variables)، تتوزع قيمها على عدد محدد ومنطقي من المستويات أو الفئات، بحيث تعبر كل فئة عن شريحة ذات دلالة عملية أو علمية واضحة. إن إدراج متغيرات مستمرة تحتوي على مئات أو آلاف القيم المتفردة داخل عبارة CLASS يعد خطأ منهجياً فادحاً يثقل كاهل الذاكرة الحاسوبية ويفرغ التحليل التجميعي من جدواه التلخيصية.
يمتلك إجراء PROC MEANS مرونة عالية في التعامل مع كل من المتغيرات النصية (Character Variables) والمتغيرات الرقمية الفئوية (Numeric Categorical Variables) ضمن عبارة CLASS. فعند استخدام متغير نصي، مثل التسميات الجغرافية أو الأوصاف النوعية، يتعامل النظام مع السلاسل الحرفية كمعرفات للفئات مع مراعاة الترتيب الهجائي الافتراضي. أما في حالة المتغيرات الرقمية المرمزة، مثل ترميز النوع الاجتماعي إلى (1 و 2) أو المراحل التعليمية إلى رتب عددية، فإن الإجراء يوظف القيم الرقمية كفئات تجميعية مستقلة، ويمكن تعزيز مقروئيتها بربطها بتنسيقات SAS التعريفية (Formats) لطباعة التسميات التفسيرية بدلاً من الأكواد المجردة.
يرتبط نجاح عملية التصنيف كذلك بمستوى القياس المعتمد في المتغير، سواء كان مقياساً اسمياً (Nominal) كالتصنيفات المهنية ومجموعات العلاج، أو مقياساً رتبياً (Ordinal) كمستويات الرضا والتقييمات التقديرية. في كلتا الحالتين، تؤثر كفاءة التصنيف ونقاء الفئات على الدقة الرياضية للنتائج؛ لذا ينبغي للباحث التأكد المسبق من خلو متغيرات CLASS من التكرارات الزائفة الناجمة عن أخطاء التحرير الحرفي، مثل تباين المسافات الفارغة أو اختلافات التشكيل والحروف، لضمان دمج المشاهدات المتجانسة بدقة متناهية تحت مظلة فئوية موحدة.
2.3 تفاعل عبارة CLASS مع عبارة VAR
يقوم منطق التحليل الإحصائي في إجراء PROC MEANS على التكامل الوظيفي الثنائي بين عبارة CLASS وعبارة VAR؛ حيث تختص الأولى بتحديد “من هي المجموعات؟”، بينما تختص الثانية بتحديد “ما هي القياسات المستهدفة؟”. هذا الفصل المفاهيمي الدقيق بين المتغيرات التصنيفية والمتغيرات العددية الخاضعة للقياس يمثل صلب المنهجية العلمية السليمة، إذ يمنع الخلط بين العوامل المستقلة والنتائج أو المقاييس التابعة، ويسمح بتوجيه العمليات الرياضية حصراً نحو الأبعاد التي تمتلك معنى كمياً قابلاً للاشتقاق الإحصائي.
يعمل تضمين عبارة VAR داخل كود PROC MEANS كأداة ترشيح دقيقة تقصر حساب المقاييس الوصفية على المتغيرات الرقمية المذكورة صراحة فيها. فعلى سبيل المثال، عند دراسة أثر فئات الدخل والنوع على ضغط الدم ومستوى الكوليسترول، تُدرج المتغيرات الفئوية في عبارة CLASS بينما يُدرج ضغط الدم والكوليسترول في عبارة VAR. يحقق هذا الحصر كفاءة معالجة قصوى عبر استبعاد المتغيرات الرقمية الأخرى المتواجدة في جدول البيانات والتي لا ترتبط ارتباطاً مباشراً بالفرضية البحثية، مما يمنع تشويش المخرجات وحفظ مساحات العرض في التقارير النهائية.
على النقيض من ذلك، يؤدي إغفال عبارة VAR عند تحديد عبارة CLASS إلى سلوك افتراضي قد لا يكون مرغوباً فيه؛ حيث يقوم إجراء PROC MEANS تلقائياً بتحليل “كافة” المتغيرات الرقمية المتوفرة في مجموعة البيانات وتفكيكها عبر مستويات متغيرات CLASS. ويشمل ذلك المتغيرات الرقمية الفئوية ذاتها وأرقام المعرفات الشخصية (ID Numbers) وتواريخ التسجيل، وهي قيم لا يحمل استخراج متوسطاتها أو انحرافاتها المعيارية أي قيمة علمية ذات معنى. فضلاً عن ذلك، يتسبب هذا الإغفال في هدر طاقة المعالجة وتضخيم الجداول الإحصائية بمخرجات لا طائل منها، مما يفرض على الباحث الأكاديمي الحصيف إلزام نفسه بربط عبارة CLASS دائماً بعبارة VAR محددة بدقة.
3. مقارنة منهجية: إجراء PROC MEANS مع عبارة CLASS وبدونها
3.1 تحليل مخرجات PROC MEANS الافتراضية دون تصنيف
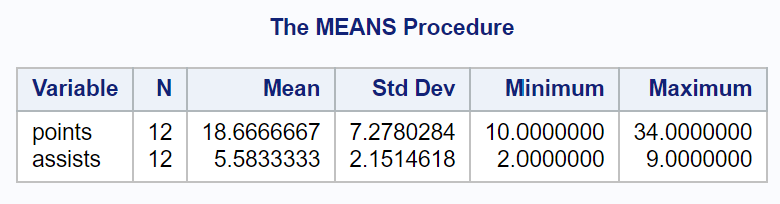
عند تنفيذ إجراء PROC MEANS على مجموعة بيانات دون إدراج عبارة CLASS أو تحديد خيارات إحصائية إضافية، يولد الإجراء جدولاً وصفياً قياسياً يعامل كامل العينة كمجتمع واحد غير مجزأ. يقدم هذا الجدول الافتراضي منظومة من خمسة مقاييس إحصائية كلاسيكية تعطي توصيفاً سريعاً لأبعاد التوزيع، وهي: حجم العينة الصالحة للتحليل (N)، المتوسط الحسابي (Mean)، الانحراف المعياري للعينة (Std Dev) المحسوب باعتماد مقام درجات الحرية (n – 1)، والقيمة الصغرى (Minimum)، والقيمة العظمى (Maximum). تمثل هذه الحزمة الافتراضية القاسم المشترك الأدنى لتوصيف البيانات الكمية في الأدبيات الإحصائية الرصينة.
يتسم هذا العرض الإجمالي بقدرته على توفير ملخص سريع للمعالم الكبرى للبيانات، مثل التحقق من مطابقة الحدود الدنيا والقصوى للنطاقات المنطقية للمقاييس المستخدمة، والتأكد من عدم وجود قيم شاذة متطرفة نتجت عن أخطاء إدخال البيانات. كما يفيد حساب المتوسط والانحراف المعياري لكامل العينة في تقديم صورة شمولية يستند إليها الباحث في توثيق خصائص العينة الكلية في مستهل التقارير الأكاديمية والرسائل الجامعية، تمهيداً للدخول في التفاصيل الاستدلالية الأكثر دقة وتفرعاً.
ومع ذلك، يعاني التحليل الإجمالي غير المصنف من قصور هيكلي في قدرته على كشف التباينات الكامنة بين القطاعات المكونة للعينة؛ إذ يفترض افتراضاً ضمنياً بأن العينة متجانسة كلياً حول هذا المتوسط المحسوب. هذا التعميم يخفي وراءه تمايزات حادة قد تتواجد بين فئات المجتمع المدروس، مما يؤدي إلى تضليل التحليل في حال كانت هناك مجموعات فرعية تعاكس بمسارها التوجه العام للعينة، الأمر الذي يجعل الاعتماد المنفرد على المخرجات الافتراضية العامة قاصراً عن تلبية متطلبات الفهم العميق للظواهر المعقدة.
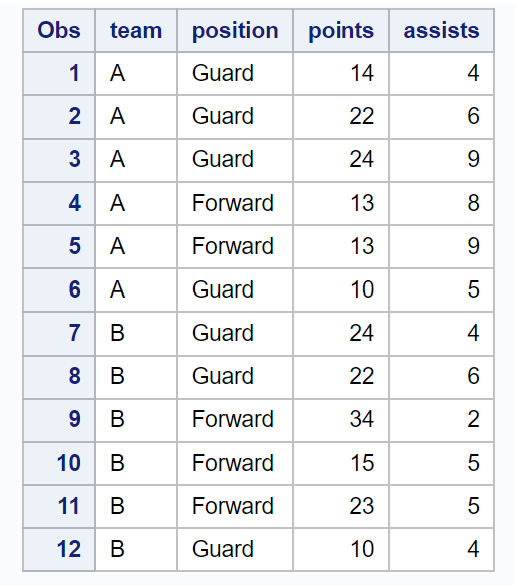
3.2 التحولات الهيكلية في الجداول عند تفعيل عبارة CLASS
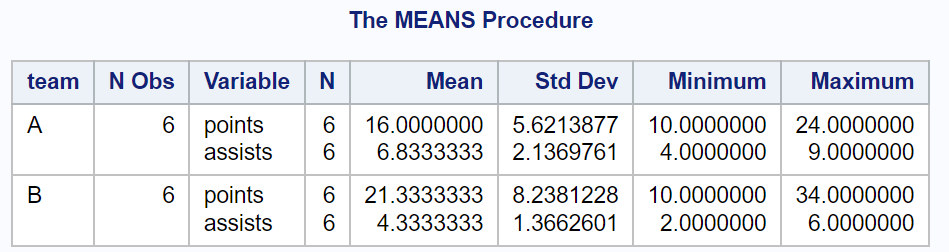
بمجرد إدراج عبارة CLASS ضمن كود الإجراء، يطرأ تحول جذري على الهيكل الرياضي والمصفوفي لجداول المخرجات التي ينتجها نظام SAS. تختفي الصياغة الأحادية المقتضبة لتفسح المجال أمام مصفوفة تفصيلية متعددة الطبقات، حيث يُخصص لكل مستوى فئوي من مستويات المتغير التصنيفي سطر مستقل يعرض فيه المقاييس الإحصائية المحددة لذلك المستوى حصراً. تعيد هذه الهيكلة تشكيل الفضاء البصري والتحليلي للمعلومات، محولة الأرقام الإجمالية الصامتة إلى مقارنات حية تبرز الفروق البيّنة بين المجموعات بشكل فوري ومباشر.
تتضمن المخرجات الجديدة حساب مقاييس النزعة المركزية والتشتت لكل فئة فرعية باستقلالية تامة؛ حيث يُحسب حجم المشاهدات الصالحة (N) والمتوسط والانحراف المعياري والمديات لكل طبقة بمفردها استناداً إلى بيانات الأفراد المنتمين إليها فقط. يتيح هذا التحول للمحلل الإحصائي مقارنة التشتت الداخلي للمجموعات؛ إذ قد يتضح مثلاً أن إحدى المجموعات تتسم بتجانس وتماسك عالٍ حول متوسطها الحسابي (انحراف معياري منخفض)، في حين تعاني مجموعة أخرى من تباين وتشتت واسع النطاق، وهو ما يستحيل ملاحظته عبر الجدول العام المجرد من التقسيم الطبقي.
إلى جانب ذلك، يُثري تفعيل عبارة CLASS جداول النتائج بإضافة أعمدة توثيقية ترصد الترددات وحجم العينات الفرعية المقابلة لكل مستوى، مما يمنح الباحث سنداً توثيقياً للتأكد من مدى توازن العينة وتكافؤ أحجام المجموعات المقارنة. يُسهم هذا التنظيم المصفوفي المتكامل في تزويد الباحثين بالبيانات الأساسية اللازمة لصياغة الجداول المقارنة الجاهزة للنشر الأكاديمي، بما يتماشى مع متطلبات توثيق المؤشرات الوصفية للطبقات في الدراسات المسحية والتجريبية المتقدمة.
3.3 مقارنة الدلالة الإحصائية بين الأسلوبين
تحمل المفاضلة المنهجية بين استخدام إجراء PROC MEANS بأسلوبه الإجمالي أو بتوظيف عبارة CLASS دلالات عميقة تتعلق بسلامة الاستدلال الإحصائي ودقته. فالتحليل الإجمالي يسقط في كثير من الأحيان في فخ التعميم المفرط، حيث يُنسب للمجتمع ككل خصائص قد تكون مدفوعة بالكامل بسلوك فئة فرعية واحدة مهيمنة عددياً أو ذات قيم شديدة التطرف، في حين يتم طمس خصائص المجموعات الأقل حجماً. تمنع عبارة CLASS هذا الانزلاق المنهجي عبر تفكيك المكونات البنيوية وتقديم تقدير عادل ومتوازن لخصائص كل فئة على حدة.
يكتسي هذا التفكيك أهمية حاسمة في الكشف عن المتغيرات الوسيطة (Mediating Variables) والمتغيرات المعدلة (Moderating Variables) في الدراسات الميدانية؛ إذ يُمكن الباحث من ملاحظة كيف يتغير سلوك المتغير التابع عند الانتقال من فئة إلى أخرى ضمن المتغير التصنيفي. فإذا كان الفارق بين متوسطات الفئات كبيراً بينما الانحراف الداخلي لكل فئة صغيراً، فإن ذلك يقدم دليلاً استكشافياً قوياً على وجود أثر حقيقي للمتغير التصنيفي يستوجب الفحص الاستدلالي عبر اختبارات التباين، وهو ما كان سيبقى محجوباً تماماً في ظل التحليل غير المصنف.
علاوة على ذلك، توفر المقارنة بين التشتت داخل المجموعات (Within-group Variance) والتشتت الإجمالي للعينة رؤية رياضية متقدمة حول جودة التصنيف ذاته؛ فإذا أسفر التقسيم الطبقي عبر عبارة CLASS عن مجموعات فرعية متجانسة داخلياً بدرجة أعلى بكثير من تجانس العينة الكلية، دل ذلك على أن المتغير التصنيفي يمتلك قدرة تفسيرية جوهرية تبرر اعتماده في النماذج الإحصائية اللاحقة، مما يرفع من القيمة المعرفية للدراسة ويسهم في توجيه قرارات النمذجة المتقدمة بأسلوب علمي رصين ومحكم.
4. تطبيق عملي: استخدام متغير تصنيفي واحد في عبارة CLASS
4.1 إعداد وتجهيز مجموعة البيانات التجريبية
لتوضيح الآليات التطبيقية لاستخدام عبارة CLASS في بيئة SAS، نقوم ببناء مصفوفة بيانات تجريبية تحاكي دراسة ميدانية في مجال علم النفس التنظيمي، تستهدف تقييم مستويات الرضا الوظيفي ومعدلات الإنتاجية الشهرية عبر قطاعات مؤسسية مختلفة. يتم إنشاء هذه المصفوفة من خلال خطوة المعالجة الأساسية DATA step، حيث يتم إدخال المشاهدات الخام مع تحديد أسماء المتغيرات ونوعياتها البرمجية باستخدام عبارة INPUT، مع ضبط المتغيرات النصية بإضافة علامة الدولار ($) لتعريف النظام بطبيعتها الحرفية.
في هذا السياق التجريبي، يتم تعيين متغير القطاع المؤسسي (مثل: “تقنية المعلومات”، “المالية”، و”الموارد البشرية”) ليكون المتغير الفئوي التصنيفي المستهدف، بينما تُعرف درجات الإنتاجية وساعات العمل الإضافية كمتغيرات عددية مستمرة. يراعي الباحث في مرحلة بناء وتجهيز البيانات سلامة ترميز الحالات وتجانس القيم المدخلة، متجنباً أي اختلافات في كتابة أسماء الفئات أو المسافات البادئة لضمان عدم معاملة الفئة الواحدة كفئتين مستقلتين من قبل المحرك البرمجي لـ SAS.
تخضع البيانات بعد ذلك لعمليات فحص اتساقية مبدئية لضمان مطابقة القيم للحدود المنطقية للقياس، والتأكد من عدم وجود بيانات ملتبسة قد تعرقل سير العمليات الحسابية داخل الإجراء. إن التأسيس المنهجي المحكم لملف البيانات يمثل الشرط المسبق الذي لا غنى عنه لأي تحليل إحصائي ناجح، إذ يتيح للإجراء الرياضي التعامل مع مصفوفة معيارية نقية تعكس بدقة الواقع الميداني المراد دراسته واستخلاص المؤشرات الوصفية منه.
4.2 صياغة وتشغيل الكود البرمجي لمتغير وحيد
تتم صياغة كود التحليل باستدعاء الإجراء عبر العبارة الافتتاحية الموجهة لمجموعة البيانات المعدة، تليها مباشرة عبارة CLASS محتوية على اسم المتغير الفئوي الفردي الممثل للقطاع الوظيفي، ثم عبارة VAR محددة لمتغير درجة الإنتاجية، مع إغلاق الكتلة بعبارة RUN لتأكيد بدء التنفيذ البرمجي، على النحو التالي صياغةً ومنطقاً:
تبدأ المعالجة بكتابة أمر استدعاء الإجراء وتحديد اسم جدول البيانات، متبوعاً بإدراج المتغير الفئوي ضمن عبارة التصنيف لتوجيه خوارزمية الحساب نحو تقسيم البيانات استناداً إلى مستويات هذا المتغير، وتعيين المتغير المستمر في عبارة التحليل الحسابي لتقييد المخرجات عليه دون غيره، مع إنهاء كل عبارة برمجية بالفاصلة المنقوطة كضابط صرفي أساسي في بيئة SAS.
عقب إرسال الكود للتنفيذ، يتوجه الباحث مباشرة إلى فحص سجل التشغيل (SAS Log)، والذي يمثل وثيقة الجودة والتحقق البرمجي الأولى في المنظومة. يتم التحقق من خلو السجل من رسائل الخطأ باللون الأحمر (Errors) أو التنبيهات باللون الأزرق (Warnings)، والتأكد من الرسائل التوثيقية المكتوبة باللون الأسود التي تفيد بعدد المشاهدات المقروءة من ملف البيانات وعدد المشاهدات التي اعتُمدت فعلياً في إجراء الحسابات الإحصائية. يضمن هذا الإجراء التدقيقي سلامة المعالجة وخلوها من أي مشاكل بنيوية قبل الانتقال إلى قراءة النتائج وتفسيرها.
4.3 قراءة وتفسير المخرجات الإحصائية المجمعة
تسفر عملية التنفيذ عن توليد مخرجات جدولية منظمة تعرض مستويات المتغير التصنيفي مرتبة هجائياً، حيث تظهر فئات “التقنية”، “المالية”، و”الموارد البشرية” في أسطر مستقلة، ويقابل كل منها حجم العينة الجزئية المحسوبة للمجموعة والمتوسط الحسابي للإنتاجية وانحرافه المعياري بالإضافة إلى القيمتين الصغرى والعظمى. يلاحظ المحلل فوراً التباينات الرقمية الظاهرة؛ حيث قد يسجل قطاع التقنية متوسط إنتاجية أعلى بشكل ملحوظ مقارنة بالقطاعات الأخرى، ولكنه قد يترافق في الوقت ذاته مع انحراف معياري مرتفع يعكس تبايناً داخلياً واسعاً في أداء أفراده.
تتيح قراءة هذه الفروق الظاهرية تكوين أحكام استكشافية متقدمة حول سلوك المتغير التابع عبر الفئات، وتساعد في تحديد ما إذا كانت الفروق بين المتوسطات جوهرية أو طفيفة، ومدى تداخل فترات التشتت بين المجموعات. إن فحص القيمتين الدنيا والقصوى لكل فئة يسهم كذلك في الكشف عما إذا كان الأداء المرتفع لقطاع ما مدفوعاً بوجود فرد ذي أداء استثنائي متطرف رفع المتوسط الحسابي للفئة ككل، أو أن التحسن يمثل نمطاً عاماً متجانساً ينطبق على غالبية أعضاء المجموعة.
تُصاغ الاستنتاجات العلمية المستخلصة من هذه المخرجات بلغة أكاديمية رصينة ومحايدة، تلتزم بتوثيق المؤشرات الإحصائية الدقيقة؛ حيث يُشار إلى أن النتائج الوصفية تشير إلى تفوق ظاهري لفئة محددة بمتوسط قدره كذا وانحراف معياري كذا، مع التشديد على أن هذه الفروق الوصفية تظل في طور المؤشرات الاستكشافية التي تتطلب اختبارات دلالة استدلالية لاحقة (مثل تحليل التباين الأحادي ANOVA) للحكم على معنويتها الإحصائية وقابليتها للتعميم على مجتمع الدراسة الأصلي.
5. تطبيق متقدم: إدراج متغيرات تصنيفية متعددة في عبارة CLASS
5.1 منهجية التصنيف المتقاطع (Cross-Classification)
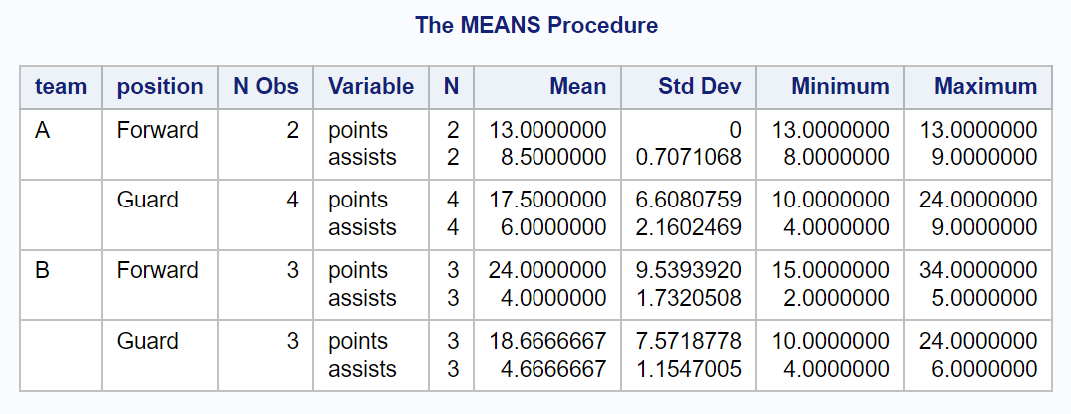
ترتقي المنهجية الإحصائية في معالجة الظواهر المعقدة عند الانتقال من دراسة العامل التصنيفي المنفرد إلى تطبيق منهجية التصنيف المتقاطع (Cross-Classification)، والتي تعنى برصد تباين المتغيرات التابعة تحت التأثير المشترك لمتغيرين مستقلين أو أكثر. ففي الواقع الميداني، نادراً ما تتصرف المتغيرات في معزل عن بعضها البعض؛ إذ يتشابك النوع الاجتماعي مع المستوى التعليمي، أو تتداخل فئات الجرعة العلاجية مع الفئات العمرية للمرضى، مما يولد الحاجة إلى تقييم التوزيعات الإحصائية عند كل نقطة تقاطع محتملة بين هذه العوامل المستقلة.
يقوم منطق التصنيف المتقاطع على توليد خلايا تحليل فرعية (Subgroup Cells) تمثل التوافيق الرياضية الممكنة بين مستويات المتغيرات المصنفة. فإذا اشتمل المتغير الأول على ثلاثة مستويات، والمتغير الثاني على مستويين، فإن الشبكة التصنيفية الناتجة تتكون من ست خلايا متمايزة تماماً، تخضع كل منها لحساب مستقل للمقاييس الوصفية من متوسط وتشتت وحجم عينة. يوفر هذا التقسيم الشبكي فضاءً غنياً بالمعلومات يمكن الباحث من رصد السلوك الإحصائي في أدق مستوياته التكوينية.
تتجلى الأهمية العلمية البالغة لهذا النهج في دراسة التفاعلات السلوكية والمركبة؛ إذ يتيح الكشف المبكر عما إذا كان تأثير أحد العوامل يتغير بتغير مستويات العامل الآخر (مفهوم التفاعل الإحصائي المبدئي). إن القدرة على فحص الخلايا المتقاطعة تحمي الدراسات الأكاديمية من الوقوع في شرك النتائج المضللة الناتجة عن إخفاء التباينات البينية تحت مظلة التأثيرات الرئيسية العامة، مما يعزز الرصانة المنهجية للبحث ويوفر بيانات وصفية متكاملة تدعم التفسيرات النظرية العميقة.
5.2 صياغة الكود البرمجي للمتغيرات المتعددة
تتم صياغة كود التصنيف المتقاطع في إجراء PROC MEANS بإدراج أكثر من متغير فئوي داخل عبارة CLASS الواحدة، حيث يتم الفصل بين أسماء المتغيرات بمسافات بيضاء وبترتيب يراعي البناء الهرمي المرغوب لعرض البيانات. على سبيل المثال، إذا رغب الباحث في تصنيف الأداء وفق قطاع العمل متبوعاً بالنوع الاجتماعي للعاملين، تُصاغ العبارة البرمجية بإدراج متغير القطاع ثم متغير النوع ضمن سياق عبارة CLASS، متبوعة بعبارة VAR للمتغيرات المستمرة المعنية.
يمارس ترتيب المتغيرات داخل عبارة CLASS تأثيراً مباشراً وحاسماً على التنسيق البصري والهيكلي لجدول المخرجات الناتج؛ فالمتغير المذكور أولاً يمثل المستوى التصنيفي الأعلى في الهرمية (Primary Stratification Factor)، في حين يعمل المتغير الثاني كمستوى تجميعي ثانوي يقع ضمن نطاق المستوى الأول. يترتب على ذلك تجميع كافة مستويات المتغير الثاني لكل مستوى منفرد من مستويات المتغير الأول قبل الانتقال إلى المستوى اللاحق، مما يسهل قراءة التدرج المقارن وتتبع التسلسل المنطقي للتوافيق الفئوية.
يدعم إجراء PROC MEANS خيارات متقدمة لضبط طريقة عرض هذه المصفوفات متعددة الأبعاد لمنع تشوه التنسيق الطباعي؛ حيث يمكن توظيف محددات التنسيق في ترويسة الإجراء للتحكم في كيفية احتواء الجداول على الشاشات ومطبوعات التقارير. إن هذا الضبط البرمجي الدقيق يضمن تقديم التوليفات الفئوية المعقدة في قوالب واضحة ومنسقة تخدم الباحث في استخلاص الدلالات المقارنة دون عناء، وتهيئ البيانات للتحويل المباشر إلى جداول مرجعية توافق متطلبات النشر العلمي الدولي.
5.3 تفكيك التفاعلات البينية وتفسير التقاطعات الفئوية
يتيح تفكيك جداول المخرجات متعددة الأبعاد فهماً تحليلياً متقدماً لمسارات التباين في المتوسطات الحسابية عبر التقاطعات الفئوية المختلفة؛ حيث يستطيع المحلل مقارنة المتوسطات الجزئية لكل خلية بالمتوسطات الهامشية للمستويات الفردية. يسهم هذا الفحص الدقيق في كشف الأنماط غير الخطية؛ كأن يتبين أن الذكور يسجلون أداءً أعلى في قطاع تقنية المعلومات بينما تسجل الإناث أداءً أعلى في قطاع الموارد البشرية، وهو النمط التفاعلي المعقد الذي يستحيل رصده عند تحليل كل متغير بمفرده وبشكل منعزل.
إلى جانب ذلك، يفرض الاستخدام المتقدم للتصنيف المتقاطع فحصاً نقدياً لكفاية أحجام العينات في الخلايا الفرعية (Cell Sample Sizes)؛ إذ يتسبب تجزيء العينة الكلية على عدد كبير من الخلايا المتداخلة أحياناً في تقليص أحجام بعض هذه الخلايا إلى مستويات حرجة (تصل إلى مشاهدات فردية معدودة). يمثل تناقص أعداد المشاهدات في الخلايا الفرعية تهديداً مباشراً للاعتمادية الإحصائية (Statistical Reliability)، حيث تصبح المتوسطات الناتجة غير مستقرة وعالية التأثر بالقيم الشاذة، مما يستوجب توخي الحذر الشديد عند محاولة تعميم نتائجها.
يختتم هذا التفسير الأكاديمي بتقييم شامل للاتساق الداخلي للمقاييس عبر التقاطعات، وربط النتائج الوصفية بالإطار النظري للدراسة. يتم توثيق التباينات المكتشفة كأرضية تجريبية تدعم الحاجة إلى استخدام اختبارات التباين متعددة الاتجاهات (Two-way or Multi-way ANOVA)، أو تطبيق نماذج الانحدار الخطي المشتملة على حدود التفاعل (Interaction Terms)، مؤكدين بذلك على الدور المحوري لعبارة CLASS في التحضير المنهجي والاستكشافي لبناء النماذج الاستدلالية الأكثر تقدماً ورصانة.
6. المقارنة التقنية والوظيفية بين عبارتي CLASS و BY في SAS
6.1 متطلبات الفرز المسبق وإدارة البيانات
تمثل المقارنة بين عبارتي CLASS و BY واحدة من أهم المسائل المنهجية والتقنية التي تواجه مبرمجي ومحللي SAS؛ فعلى الرغم من أن كلتا العبارتين تؤديان وظيفة التقسيم الطبقي للبيانات وحساب الإحصاءات للمجموعات الفرعية، إلا أن الآليات الحاسوبية المتبعة في إدارتهما تختلف اختلافاً جذرياً. ويأتي في مقدمة هذه الاختلافات متطلب الفرز المسبق للبيانات؛ إذ تفرض عبارة BY شرطاً تقنياً صارماً يقضي بضرورة فرز مجموعة البيانات سلفاً (Pre-sorted) وفق متغيرات التقسيم المعتمدة، أو تنظيمها ضمن فهارس مفهرسة مسبقاً (Indexed Data)، ويتسبب الإخلال بهذا الشرط في توقف التنفيذ فوراً وظهور رسالة خطأ صريحة في سجل التشغيل.
يستدعي استخدام عبارة BY في الغالب تنفيذ إجراء الفرز PROC SORT كخطوة معالجة استباقية مستقلة لترتيب المشاهدات تصاعدياً أو تنازلياً، مما يضيف سطوراً كودية إضافية ويزيد من وقت القراءة والكتابة على أقراص التخزين. في المقابل، تتميز عبارة CLASS بقدرتها الفائقة على معالجة البيانات غير المرتبة (Unsorted Data) بصورة تلقائية وفورية؛ حيث يقرأ الإجراء البيانات في حالتها الخام ودون أي فرز مسبق، متولياً مهمة التجميع الداخلي عبر خوارزميات برمجية ذكية، وهو ما يوفر مرونة استثنائية وسرعة في إعداد وتنفيذ الأكواد البرمجية الاستكشافية.
يعود هذا الاختلاف الهيكلي إلى كيفية تنظيم استهلاك العمليات الحسابية داخل المعالج المركزي؛ فعبارة BY تتعامل مع تدفق البيانات ككتل متتالية تنتهي بانتهاء المستوى الفئوي لتبدأ الفئة التالية، في حين تبني عبارة CLASS نموذجها التجميعي أثناء تصفح البيانات بشكل مستمر بغض النظر عن موقع المشاهدة في الترتيب الفيزيائي للملف، مما يجعل CLASS الخيار الأكثر سهولة وانسيابية من منظور تدفق العمل البرمجي المجرد من متطلبات الترتيب المعقدة.
6.2 كفاءة الأداء وإدارة استهلاك الذاكرة العشوائية
تنعكس الفروق الميكانيكية بين العبارتين بشكل مباشر على إدارة الموارد الحاسوبية للنظام، وتحديداً الذاكرة العشوائية (RAM) ووحدة المعالجة المركزية (CPU). تعتمد عبارة CLASS على بناء هياكل بيانات متقدمة في الذاكرة الحية، مثل جداول التجزئة (In-memory Hash Tables) وشبكات الأشجار التوافقية (Tree Structures)، لحساب وتخزين المقاييس الإحصائية لكافة التقاطعات الفئوية في وقت واحد. تمنح هذه الآلية عبارة CLASS سرعة معالجة استثنائية عند التعامل مع مجموعات البيانات ذات الأحجام المتوسطة أو تلك التي تشتمل على متغيرات تصنيفية ذات مستويات محدودة (Low to Moderate Cardinality).
ومع ذلك، تبرز نقطة ضعف عبارة CLASS عند التعامل مع البيانات الضخمة (Big Data) أو عند تصنيف متغيرات تحتوي على آلاف أو ملايين الفئات الفرعية المتفردة؛ حيث يتطلب الاحتفاظ بكافة هذه التقاطعات في الذاكرة مساحات تخزين حية هائلة قد تؤدي إلى استنزاف الذاكرة (Memory Exhaustion) وتوقف النظام عن العمل. في هذا السيناريو المعقد، تتجلى القوة التقنية المتفوقة لعبارة BY، والتي تتبع أسلوب المعالجة المتسلسلة المستقلة (Sequential Stream Processing)؛ إذ تقوم بمعالجة فئة تصنيفية واحدة فقط في كل دورة، وتفريغ ذاكرتها فور الانتهاء منها قبل الانتقال إلى الفئة التالية، مما يحافظ على استقرار مالي واقتصادي واستهلاكي ثابت للذاكرة العشوائية مهما بلغ حجم مجموعة البيانات أو عدد مستوياتها الفئوية.
يفرض هذا التباين الحوسبي على الباحث الإحصائي والمطور إجراء مفاضلة واعية تستند إلى حجم البيانات والبنية التحتية للحوسبة المتوفرة لديه. فبينما تمثل CLASS الخيار الأمثل للسرعة والمرونة التجميعية ضمن سعة الذاكرة المتاحة، تمثل BY الملاذ الحتمي والأكثر استقراراً في مشاريع البيانات فائقة الضخامة التي تتجاوز السعة الاستيعابية للذاكرة المؤقتة، مما يعكس نضج بيئة SAS وقدرتها على توفير أدوات بديلة تتلاءم مع مختلف قيود البيئات التشغيلية.
6.3 تنسيق المخرجات النهائية والشكل الجدولي
يمتد التباين بين العبارتين ليشمل الهيكل البصري والشكلي لتقارير المخرجات النهائية المولدة بواسطة نظام تسليم المخرجات (ODS)؛ حيث تتفوق عبارة CLASS في تقديم النتائج ضمن جدول تجميعي موحد ومدمج (Single Unified Table). تُعرض في هذا الجدول كافة المستويات الفئوية وتقاطعاتها التوافقية جنباً إلى جنب وبصورة متسلسلة، مما يسهل المقارنة المباشرة بين المجموعات دون الحاجة إلى التنقل بين صفحات متعددة أو جداول منفصلة، ويجعلها ملائمة جداً لإنشاء الجداول التلخيصية الأولية في البحوث الأكاديمية.
على الجانب الآخر، تتبع عبارة BY نمط العرض المنفصل؛ حيث تخصص جدولاً إحصائياً مستقلاً لكل فئة فرعية، يسبقه عنوان فرعي يعرّف باسم المستوى المعالج (BY-line). يؤدي هذا السلوك في تقارير الطباعة أو المستندات المنسقة إلى تقسيم المخرجات على صفحات متعددة، وهو ما قد يكون مرغوباً فيه عند بناء تقارير إدارية مستقلة تُعنى بإرسال نتائج كل فرع أو قطاع إلى إدارته المعنية على حدة، ولكنه يمثل عبئاً عند الرغبة في إجراء مقارنات مباشرة وسريعة بين الفئات ضمن سياق ورقة علمية محكمة.
تتكامل مخرجات عبارة CLASS كذلك مع متطلبات النشر العلمي من حيث التوافق مع إرشادات جمعية علم النفس الأمريكية (APA) لتصميم الجداول المقارنة، إذ يمكن تصدير الجدول الموحد بسهولة إلى برامج معالجة النصوص أو الجداول الحسابية وإعادة ضبطه كجدول معياري يشتمل على كافة الفئات في مساحة مكانية مركزة وموجزة، مما يرفع من جودة الإخراج الطباعي للمخرجات العلمية ويعزز انسيابية قراءتها وتقييمها من قبل المحكمين.
7. تخصيص واختيار المقاييس الإحصائية المخرجة
7.1 التحكم في مقاييس النزعة المركزية والتشتت
يوفر إجراء PROC MEANS مرونة فائقة واستثنائية تتيح للباحث التحرر من قيود الحزمة الافتراضية للمقاييس الخمسة، وتخصيص المخرجات بما يتطابق بدقة متناهية مع المتطلبات المنهجية للدراسة. يتم هذا التحكم عبر تضمين الكلمات المفتاحية الإحصائية (Statistic Keywords) مباشرة في عبارة PROC MEANS الافتتاحية. فعند طلب إحصاء واحد محدد على الأقل، يعطل الإجراء آلياً قائمته الافتراضية، ولا يُدرج في جدول المخرجات سوى المؤشرات التي تم النص عليها صراحة في نص الاستدعاء، مما يمنح المحلل سلطة كاملة في هندسة محتوى التقرير الإحصائي.
تمتد مكتبة الكلمات المفتاحية في الإجراء لتشمل طيفاً واسعاً من مقاييس النزعة المركزية المتقدمة والتشتت الدقيق، مثل طلب الوسيط الحسابي عبر الكلمة MEDIAN، وهو المقياس الأكثر رصانة وتمثيلاً للبيانات غير المتناظرة أو المحتوية على قيم متطرفة، وطلب المنوال عبر الكلمة MODE لتحديد القيم الأكثر شيوعاً وتكراراً. كما يمكن استخراج تباين العينة عبر الكلمة المفتاحية VAR، والمدى الربيعي التشتتي عبر IQR (Interquartile Range)، والربيعيات الأساسية (Q1 و Q3)، فضلاً عن معاملات الالتواء (SKEWNESS) والتفرطح (KURTOSIS) التي تقدم توصيفاً دقيقاً لشكل التوزيع التكراري الداخلي لكل مجموعة تصنيفية.
يسهم استبعاد المقاييس غير المرغوبة واختيار المقاييس المستهدفة بدقة في تبسيط الجداول الإحصائية المخرجة وتخليصها من الأرقام الزائدة التي قد تشتت ذهن القارئ أو ترهق تقارير النشر العلمي. يتيح هذا التخصيص الرصين للباحثين تصميم جداول مقارنة مركزة تسلط الضوء حصرياً على المؤشرات ذات الصلة بالفرضيات النظرية، مما يرفع من القيمة الأكاديمية للمخرجات ويعكس تمكناً منهجياً في إدارة الأدوات الإحصائية وتوجيهها لخدمة أهداف البحث بدقة واحترافية.
7.2 تضمين مقاييس الخطأ وفترات الثقة الإحصائية
لا تتوقف قدرات PROC MEANS عند حدود الوصف الإحصائي التلخيصي المجرد، بل تمتد لتغطي جوانب استدلالية تمهيدية بالغة الأهمية عبر إمكانية حساب مقاييس الخطأ وتقدير معالم المجتمع عبر فترات الثقة (Confidence Intervals). تكتسب هذه الميزة أهمية استثنائية عند الجمع بين إجراء المقاييس واستخدام عبارة CLASS، حيث يُمكن للباحث تقييم مدى دقة واستقرار المتوسطات المحسوبة لكل فئة فرعية على حدة، وتوفير مؤشرات استدلالية حول الحدود التي يُرجح أن تقع ضمنها معالم المجتمعات الأصلية الممثلة لتلك الفئات.
يتحقق هذا التضمين الاستدلالي باستخدام كلمات مفتاحية مخصصة، يأتي في مقدمتها الخطأ المعياري للمتوسط عبر الكلمة المفتاحية STDERR، والذي يقيس مدى التباين المتوقع في المتوسط الحسابي في حال إعادة سحب العينات من المجتمع ذاته. كما يتيح الإجراء طلب فترات الثقة للمتوسط الحسابي مباشرة عبر الكلمة CLM (Confidence Limits for the Mean)، أو طلب الحدود الدنيا والقصوى بصورة منفصلة باستخدام الكلمات LCLM (Lower Confidence Limit) و UCLM (Upper Confidence Limit). وتُحسب هذه الفترات افتراضياً عند مستوى ثقة 95%، مع إمكانية تعديل مستوى الدلالة المعنوية بدقة عبر خيار ALPHA= في ترويسة الإجراء.
يوظف الباحثون الأكاديميون هذه المقاييس في إجراء مقارنات بصرية واستدلالية أولية بين المجموعات المصنفة في عبارة CLASS؛ فإذا تبين عدم وجود أي تداخل بين فترات الثقة لمجموعتين مختلفتين، فإن ذلك يقدم مؤشراً أولياً قوياً على وجود فرق دال إحصائياً بين متوسطيهما في المجتمع الأصلي، حتى قبل إجراء اختبارات الدلالة الأكثر تقدماً مثل اختبارات t أو F. يعزز هذا النهج من عمق التحليل الاستكشافي، ويمنح التقارير الوصفية بعداً علمياً يتجاوز مجرد الوصف السطحي نحو الاستقراء الرياضي المنضبط.
7.3 ضبط التنسيق الرقمي وعدد المنازل العشرية
تشكل الدقة الرقمية والمظهر الطباعي للمخرجات عنصراً حاسماً في إعداد التقارير العلمية والنشر في الدوريات المحكمة؛ إذ يميل إجراء PROC MEANS افتراضياً إلى عرض الأرقام الكسرية بعدد مطول من المنازل العشرية تمليه المعايير الرياضية الداخلية للمعالج. قد يتسبب هذا السلوك في توليد جداول مزدحمة بصرياً بأرقام وكسور تتجاوز بكثير مستوى الدقة الممكن أو المطلوب في القياس الميداني، مما يفرض ضرورة التحكم في هذه المنازل وتوحيدها.
يوفر نظام SAS خياراً مباشراً وأساسياً للتحكم في هذه المسألة يتمثل في المحدد MAXDEC=، والذي يوضع ضمن خيارات عبارة استدعاء الإجراء PROC MEANS. يتيح هذا الخيار للباحث تحديد الحد الأقصى المسموح به للمنازل العشرية المعروضة لكافة الإحصاءات المحسوبة في الجدول النهائي (مثل ضبطه على MAXDEC=2 أو MAXDEC=3). يقوم النظام عند تفعيل هذا الخيار بتقريب القيم الناتجة تقريباً رياضياً دقيقاً، مما يمنح جدول المخرجات اتساقاً شكلياً مريحاً وموحداً يتماشى تماماً مع المعايير المعمول بها في النشر الأكاديمي الرصين.
إلى جانب ضبط المنازل، يمكن توظيف عبارات التنسيق القياسية (FORMAT Statement) لتهيئة المتغيرات التصنيفية والمتغيرات التابعة داخل الإجراء؛ حيث تسهم هذه العبارات في استبدال الأكواد الرقمية المجردة بنصوص تفسيرية واضحة، أو ضبط فواصل الآلاف في القيم المالية والكمية الكبرى. إن هذا التكامل بين ضبط المنازل العشرية وتطبيق صيغ العرض القياسية يرتقي بجودة المخرجات، ويقلل من الحاجة إلى إعادة التنسيق اليدوي للبيانات عند نقلها إلى مسودات البحوث والرسائل الجامعية، مما يوفر الجهد ويحد من أخطاء النقل البشري.
8. حفظ وتصدير النتائج عبر عبارة OUTPUT وتتبع المجموعات
8.1 إنشاء مجموعات بيانات جديدة للمخرجات الإحصائية
تتجاوز قدرات إجراء PROC MEANS مجرد طباعة الجداول والتقارير على الشاشة لتشمل جانباً حيوياً في مسارات معالجة البيانات، يتمثل في القدرة على حفظ المقاييس المحسوبة وتصديرها إلى مجموعات بيانات جديدة داخل بيئة SAS. يتحقق هذا الانتقال المنهجي عبر توظيف عبارة الإخراج المتقدمة OUTPUT OUT=، والتي تحول المخرجات الوصفية المؤقتة إلى جداول دائمة أو مؤقتة مخزنة في مكتبات النظام، مما يتيح استخدامها كمدخلات أساسية في خطوات برمجية لاحقة أو استثمارها في إعداد الرسوم البيانية والتحليلات المقارنة المعقدة.
تتميز عبارة OUTPUT بمرونة صياغتها؛ حيث تتيح للباحث تحديد الإحصاءات المحددة المراد حفظها وتسمية المتغيرات الجديدة الناتجة بدقة متناهية. تُكتب الصياغة القياسية بإدراج الكلمة المفتاحية OUTPUT متبوعة بمحدد التصدير OUT= متبوعاً باسم الجدول الجديد المراد إنشاؤه، ثم تحديد المقاييس الإحصائية المطلوبة وربطها بالأسماء الجديدة المقترحة بين قوسين؛ كأن يُطلب حفظ المتوسط الحسابي والانحراف المعياري لمتغير الإنتاجية تحت مسميات متخصصة تعكس طبيعة المقياس، مما يضمن وضوح البنية الدلالية للجدول الجديد وسهولة قراءته في العمليات التحليلية القادمة.
يمثل الاحتفاظ بالبيانات الملخصة عبر عبارة OUTPUT ممارسة منهجية قياسية في بحوث البيانات الضخمة؛ حيث يتم اختزال ملايين السجلات الميدانية إلى مصفوفة تجميعية مكثفة لا تتعدى بضعة أسطر تمثل الطبقات التصنيفية المحددة في عبارة CLASS. تسهم هذه العملية في تسريع خطوات المعالجة اللاحقة بصورة هائلة؛ إذ تعمل الإجراءات الاستدلالية المتقدمة أو أدوات بناء النماذج على مصفوفة المؤشرات الملخصة مباشرة، متجاوزة الحاجة إلى إعادة مسح البيانات الخام الضخمة في كل دورة تحليلية.
8.2 فهم وتوظيف المتغيرات التلقائية _TYPE_ و _FREQ_
عند استخدام عبارة CLASS مقترنة بعبارة OUTPUT OUT=، يولد إجراء PROC MEANS تلقائياً متغيرين داخليين إضافيين بالغي الأهمية في جدول البيانات الجديد، وهما المتغير التتبعي _TYPE_ والمتغير التكراري _FREQ_. يمثل المتغير التلقائي _TYPE_ معلماً رياضياً فريداً يشير إلى مستوى التجميع الهرمي (Level of Aggregation) الممثل في كل سطر من أسطر البيانات؛ حيث يقوم الإجراء بحساب الإحصاءات لكافة التوافيق التجميعية الممكنة، بدءاً من المستوى الإجمالي الشامل للعينة وصولاً إلى أعمق تقاطع فئوي ممكن بين متغيرات CLASS المعنية.
يأخذ المتغير _TYPE_ قيماً عددية صحيحة تتبع نظام الترميز الثنائي المشفر (Binary Bitmask) المحول إلى قيم عشرية؛ حيث تشير القيمة 0 دائماً إلى التجميع الكلي لكامل العينة دون أي تصنيف (Grand Total)، بينما تأخذ المستويات الهامشية للمتغيرات التصنيفية قيماً متدرجة (1، 2، 3…) بحسب الترتيب والتقاطع بين العوامل. يتيح هذا المتغير للمحلل فهماً كاملاً للهيكل الهرمي للبيانات المصدرة، ويمنحه أداة برمجية دقيقة لتصفية وانتقاء مستوى التجميع الذي يخدم تحليله عبر استخدام عبارة التصفية الشرطية WHERE داخل خطوات المعالجة التالية.
أما المتغير التلقائي الثاني _FREQ_، فهو يوثق عدد المشاهدات الأصلية التي شاركت فعلياً في توليد المقاييس الإحصائية المدرجة في ذلك السطر التجميعي المحدد. يوفر هذا المتغير سنداً رقابياً أساسياً للتأكد من أحجام العينات الممثلة في كل فئة، والتحقق الفوري من مدى اتزان التوزيعات التكرارية بين الخلايا المصنفة. إن الفهم العميق لآليات عمل _TYPE_ و _FREQ_ يحول الباحث من مجرد مستخدم للأرقام الجاهزة إلى محلل متمكن قادر على التحكم الكامل في تدفق البيانات واستخلاص أدق التفاصيل من المصفوفات المجمعة.
8.3 تكامل المخرجات الملخصة مع إجراءات التحليل المتقدمة
تفتح مخرجات عبارة OUTPUT آفاقاً واسعة للتكامل البرمجي والتحليلي داخل بيئة SAS؛ إذ تتيح تمرير الجداول التلخيصية المصنفة إلى إجراءات الرسوم البيانية المتطورة، وفي طليعتها إجراء PROC SGPLOT. فبدلاً من رسم البيانات الخام المشتتة، يستطيع الباحث استخدام المتوسطات والانحرافات المحسوبة والمصنفة لرسم أعمدة بيانية مقارنة (Bar Charts)، أو إنشاء خطوط بيانية ترصد اتجاهات التغير عبر الفئات، مع إضافة أشرطة الخطأ المعياري (Error Bars) المستندة مباشرة إلى فترات الثقة المستخرجة، مما يعطي التمثيل البصري قوة إقناع علمية ورصانة أكاديمية فائقة.
إلى جانب التصوير البياني، تُستخدم هذه الجداول الملخصة كمدخلات حاسمة لإجراء المقارنات البعدية المتقدمة واختبارات قياس حجم الأثر (Effect Size Measurements)؛ حيث يمكن استخدام المتوسطات والانحرافات المعيارية وأحجام المجموعات المستخرجة عبر عبارة CLASS في برمجة معادلات كوهين (Cohen’s d) أو حساب نسب التباين المفسر يدوياً وبرمجياً في خطوات DATA step لاحقة، مما يسهم في استكمال التوثيق الإحصائي للدراسة بما يتوافق مع توصيات المجلات العلمية الرائدة التي تشترط إرفاق أحجام التأثير بجانب قيم الدلالة الإحصائية.
علاوة على ذلك، يبرز التكامل في بناء مسارات المعالجة الآلية للبيانات (Automated Data Pipelines)، حيث يُدمج كود PROC MEANS المصنف ضمن وحدات الماكرو البرمجية (SAS Macros). يسمح هذا البناء بإجراء مسح دوري للبيانات المستحدثة، وتوليد المؤشرات الوصفية للطبقات المختلفة بصورة آلية ومستمرة، وتغذية لوحات القياس التحليلية ونماذج التنبؤ بمؤشرات محدثة وموثقة، مما يبرهن على القيمة التشغيلية والبحثية المتقدمة لهذا الإجراء في بيئات العمل الإنتاجية والأكاديمية على حد سواء.
9. معالجة القيم المفقودة وتحسين خيارات عبارة CLASS
9.1 إدارة القيم المفقودة باستخدام خيار MISSING
تشكل البيانات المفقودة (Missing Data) تحدياً منهجياً وقائماً في معظم البحوث الميدانية والتطبيقية، ويمتلك أسلوب معالجتها تأثيراً مباشراً على صدق النتائج وموثوقيتها. يتبع إجراء PROC MEANS سلوكاً افتراضياً صارماً عند مصادفة قيم مفقودة في المتغيرات المحددة داخل عبارة CLASS؛ حيث يقوم باستبعاد أي مشاهدة تحتوي على قيمة مفقودة في أي من متغيرات التصنيف استبعاداً كلياً من كافة العمليات الحسابية المجمعة. ورغم أن هذا السلوك يستهدف ضمان نقاء الفئات المكتملة، إلا أنه قد يؤدي إلى حذف نسبة معتبرة من العينة، مما يهدد تمثيلها الميداني ويشوه التقديرات الإحصائية.
لمواجهة هذا التحدي، يوفر نظام SAS خياراً علاجياً جوهرياً يتمثل في تفعيل محدد المفقودات MISSING، والذي يمكن إدراجه إما كخيار في عبارة PROC MEANS الرئيسية، أو كخيار مستقل يتبع عبارة CLASS مباشرة بعد علامة الخط المائل (/). يعمل هذا الخيار على توجيه النظام لاعتبار القيمة المفقودة (سواء تمثلت في نقطة ‘.’ للمتغيرات الرقمية أو فراغ ‘ ‘ للمتغيرات النصية) فئة تصنيفية صالحة ومستقلة بذاتها، ويتم تخصيص أسطر تحليلية كاملة لها في جداول المخرجات ترصد حجمها ومتوسطاتها وتشتتها كأي فئة طبيعية أخرى.
يحقق هذا الأسلوب شفافية منهجية بالغة الأهمية في التوثيق الأكاديمي؛ إذ يمنح الباحث القدرة على مراقبة النمط الإحصائي للحالات التي امتنعت عن تقديم بياناتها التصنيفية أو سقطت سهواً أثناء الجمع الميداني. فمن خلال فحص متوسطات الفئة المفقودة ومقارنتها بمتوسطات الفئات المكتملة، يستطيع المحلل استنتاج ما إذا كان الفقد عشوائياً تماماً (Missing Completely at Random) أو أنه يتبع نمطاً نظامياً محدداً يخفي وراءه انحيازاً معيناً، وهو ما يعد مدخلاً أساسياً لمعالجة البيانات المفقودة بالتعويض أو النمذجة المتقدمة في المراحل اللاحقة.
9.2 التحكم في مستويات التجميع عبر خياري TYPES و WAYS
كما أشرنا سابقاً، يقوم إجراء PROC MEANS افتراضياً عند توليد مجموعات البيانات المخرجة عبر عبارة CLASS بحساب كافة التوافيق التجميعية الممكنة، والتي يبلغ عددها رياضياً $2^k$ توليفة (حيث يمثل $k$ عدد متغيرات التصنيف المحددة). فإذا اشتمل التحليل على أربعة متغيرات CLASS، سيقوم النظام بحساب ستة عشر مستوى تجميعياً مختلفاً، بدءاً من الإجمالي العام وانتهاءً بالتصنيف الرباعي المتقاطع، مروراً بكافة التباديل الأحادية والثنائية والثلاثية. قد يشكل هذا التوسع التلقائي عبئاً برمجياً ينتج عنه آلاف الأسطر غير المرغوبة في جدول المخرجات، مما يستدعي ضبط مستويات التجميع بدقة.
يتيح إجراء PROC MEANS التحكم الصارم في هذا السلوك عبر توظيف عبارتي TYPES و WAYS البرمجيتين. تعمل عبارة TYPES كأداة انتقائية دقيقة تسمح للباحث بتحديد التقاطعات التصنيفية المحددة التي يرغب في حسابها بدقة، مع إسقاط ما سواها؛ كأن يُطلب حصر التحليل في التقاطع بين المتغير الأول والمتغير الثالث فقط دون المرور بباقي التوافيق الهامشية. يتم تحديد هذه التوليفات برمجياً بكتابة أسماء المتغيرات المستهدفة مفصولة بنجمة التقاطع أو بالمسافات داخل عبارة TYPES، مما يوجه المعالج إلى تركيز موارده على الأهداف البحثية المحددة سلفاً.
أما عبارة WAYS، أو خيار NWAY الشهير، فهي توفر آلية لتقييد التحليل وفق عدد أبعاد التجميع؛ حيث تتيح عبارة WAYS 1؛ قصر المخرجات على التجميعات الأحادية المنفردة لكل عامل، بينما تتيح WAYS 2؛ حصر النتائج في التفاعلات الثنائية فقط. ويأتي خيار NWAY، الذي يُدرج مباشرة في ترويسة الإجراء، ليمثل الأداة الأكثر شيوعاً في الممارسة الأكاديمية؛ حيث يجبر النظام على قصر جدول المخرجات المصدرة على أعلى مستوى تجميعي متقاطع فقط (أي المستوى الذي تتلاقى فيه كافة متغيرات CLASS المحددة)، مع استبعاد الإجمالي العام وكافة المجاميع الجزئية، مما ينتج جدولاً ملخصاً فائق النقاء والتركيز يخلو تماماً من التكرارات الهامشية.
9.3 خيارات CHARTYPE ودعم بنية البيانات الكبيرة
عند التعاطي مع التحليلات التصنيفية المعقدة التي تشتمل على عدد كبير من متغيرات CLASS، تبرز الحاجة إلى أدوات تتبع أكثر كفاءة وسرعة لتفسير قيم المتغير التلقائي _TYPE_؛ فالقيم الرقمية العشرية الافتراضية لهذا المتغير قد تصبح ملتبسة وصعبة القراءة والتتبع مع تزايد عدد التوافيق الهيكلية. ولتجاوز هذه الصعوبة التقنية، يقدم نظام SAS خيار CHARTYPE المتقدم، والذي يوضع ضمن خيارات استدعاء إجراء PROC MEANS.
يقوم خيار CHARTYPE بتغيير النمط التخزيني والتمثيلي للمتغير التلقائي _TYPE_ من رقم عشري إلى سلسلة حرفية ثنائية (Binary Character String) يتطابق طولها مع عدد متغيرات CLASS المدرجة في التحليل. يمثل كل حرف في هذه السلسلة أحد المتغيرات التصنيفية وفق ترتيب وروده في الكود؛ حيث تشير القيمة ‘0’ إلى أن المتغير غير داخل في عملية التجميع في ذلك السطر، بينما تشير القيمة ‘1’ إلى أن المتغير معتمد كعنصر تقسيم فعال في حساب المقاييس المعروضة. فعلى سبيل المثال، تعني القيمة ‘101’ في تحليل ثلاثي المتغيرات أن السطر يمثل تجميعاً متقاطعاً بين المتغير الأول والمتغير الثالث، مع استبعاد المتغير الثاني من معادلة التقسيم.
تكتسب هذه السلاسل الثنائية أهمية استثنائية في بيئات معالجة البيانات الكبيرة وتصميم المستودعات البيانية (Data Warehouses)؛ إذ تتيح للمحللين والمهندسين كتابة استعلامات ربط وتصفية فائقة السرعة باستخدام تعبيرات الفلترة النصية المباشرة (مثل: WHERE _TYPE_ = ‘111’). إن هذه الكفاءة البرمجية تمنع الأخطاء التفسيرية المرتبطة بالتحويلات العشرية، وتسرع عمليات المعالجة اللاحقة ضمن قواعد البيانات الضخمة، مبرهنة على الرقي الهندسي لمنظومة SAS في دعم مختلف مستويات التحليل الكمي بأقصى درجات الكفاءة الرياضية والبرمجية.
10. الأخطاء الشائعة، تشخيص الأعطال، وأفضل الممارسات الأكاديمية
10.1 الأخطاء البرمجية المتكررة وكيفية تصحيحها
يقع كثير من الممارسين والباحثين في عثرات برمجية ومنهجية متكررة عند توظيف عبارة CLASS داخل إجراء PROC MEANS؛ ويأتي في صدارة هذه الأخطاء الخلط الشائع بين المتغيرات المستمرة والمتغيرات الفئوية المتقطعة. فعند إدراج متغير عددي مستمر يحتوي على قيم قياس فردية متعددة (مثل إدراج متغير الدخل الفعلي أو الوزن بالجرام) ضمن عبارة CLASS بدلاً من عبارة VAR، يقوم النظام بمحاولة بناء فئة تجميعية مستقلة لكل قيمة متفردة، مما يؤدي إلى تضخم هائل في عدد الخلايا، واستنزاف كامل لذاكرة النظام العشوائية (Out of Memory)، وتوقف الإجراء عن العمل مصحوباً برسائل تحذيرية شديدة في سجل التشغيل.
لتصحيح هذا الخطأ، يجب التحقق الصارم من الخصائص التوزيعية للمتغيرات قبل إدراجها، ونقل كافة المتغيرات المستمرة إلى عبارة VAR، مع قصر عبارة CLASS على المتغيرات المصنفة في مستويات واضحة، أو اللجوء إلى إعادة ترميز المتغيرات المستمرة إلى فئات تجميعية (Binning) عبر خطوة المعالجة DATA step وصيغ FORMATS قبل إدخالها في التحليل المصنف. كما يبرز خطأ شائع آخر يتمثل في نسيان الفواصل المنقوطة بين العبارات، مما يجعل المترجم يدمج عبارة CLASS مع العبارات اللاحقة كعبارة VAR أو OUTPUT، مولداً أخطاء صرفية (Syntax Errors) توقف التنفيذ فوراً.
يمثل سجل التشغيل (SAS Log) المرجع التشخيصي الأول والأهم لفك شفرات هذه الأعطال وتصحيحها. يجب على المحلل تنمية مهارة القراءة النقدية لرسائل السجل، وتتبع مواقع التنبيهات (Notes) التي ترصد عدد المشاهدات المستبعدة، والتحذيرات (Warnings) التي تشير إلى عدم توفر موارد كافية للذاكرة أو وجود مشاكل في تنسيق المتغيرات. إن المراجعة المنهجية الواعية لنصوص السجل تضمن معالجة الأخطاء في مهدها، وتمنع مرور نتائج مشوهة أو غير مكتملة إلى مراحل التفسير النهائي، مما يحمي البحث من العيوب البرمجية الخفية.
10.2 أفضل الممارسات المنهجية في التوثيق الإحصائي
يقتضي الالتزام بالمعايير الأكاديمية الرصينة، وعلى رأسها دليل النشر العلمي الصادر عن جمعية علم النفس الأمريكية (APA Publication Manual – 7th Edition)، اتباع بروتوكولات توثيق صارمة ودقيقة عند الإبلاغ عن المقاييس الوصفية المستخرجة عبر عبارة CLASS. تتطلب هذه المعايير تقديم تقرير متكامل لكل مجموعة مصنفة يشتمل على الحجم الفعلي للعينة ($n$)، والمتوسط الحسابي ($M$)، والانحراف المعياري ($SD$)، مقربين إلى عدد موحد ومنطقي من المنازل العشرية (عادة منزلتين عشريتين)، مع تجنب الاكتفاء بالمتوسط بمفرده دون إقرانه بمقياس تشتت يعكس طبيعة التباين الداخلي.
كما تفرض النزاهة العلمية الشفافية التامة في الإبلاغ عن الحالات المفقودة (Missing Cases) وتوثيق حجمها بدقة ضمن الجداول الإحصائية؛ حيث ينبغي توضيح ما إذا كان الاستبعاد قد تم وفق النمط الافتراضي أو تم تمثيلها كفئة مستقلة عبر خيار MISSING، ومناقشة التداعيات المحتملة لهذا الفقد على القوة الإحصائية وتمثيل العينة. يمنح هذا الإفصاح المنهجي المحكم القارئ والمحكم فهماً دقيقاً للواقع الميداني للعينة، ويعزز الثقة في نتائج الدراسة وسلامة مسارها الإجرائي.
إلى جانب ذلك، تنص أفضل الممارسات على ضرورة التحقق الاستباقي من ملاءمة التوزيع الداخلي لكل فئة فرعية قبل اعتماد المتوسط الحسابي كمقياس أمثل للنزعة المركزية؛ فإذا أظهر فحص الفئات المصنفة وجود التواء حاد (Skewness) أو تباين واسع ناجم عن قيم شاذة داخل إحدى المجموعات، يتعين على الباحث إرفاق قيمة الوسيط الحسابي (Median) والمدى الربيعي (IQR) بجانب المتوسط الحسابي، أو الإشارة بوضوح إلى عدم تماثل التوزيع، مما يقي الدراسة من الوقوع في تضليل التعميم الرقمي غير المتسق مع واقع البيانات الفعلي.
10.3 إجراءات تدقيق الجودة وضمان موثوقية التحليل
تمثل إجراءات تدقيق الجودة وضمان الموثوقية (Quality Assurance and Reproducibility) خط الدفاع الأخير لضمان سلامة العمليات التحليلية في البحوث الاستدلالية والتطبيقية. تتضمن هذه الإجراءات قيام المحلل بإجراء فحوص تقاطعية داخلية (Cross-checks) للتحقق من الاتساق الحسابي للمخرجات؛ كأن يتم التأكد من أن مجموع تكرارات الفئات الفرعية الممثلة في المتغير التلقائي _FREQ_ يتطابق تطابقاً مطلقاً مع الحجم الإجمالي لعينة الدراسة الأصلية بعد استيفاء شروط القيم المفقودة، لضمان عدم سقوط أي مشاهدات أثناء المعالجة التجميعية في الذاكرة.
كما يوصى بمقارنة نتائج PROC MEANS المصنفة بنتائج إجراءات إحصائية أخرى تتبع خوارزميات حسابية مختلفة ولكنها متقاطعة موضوعياً، مثل استدعاء إجراء استكشاف البيانات PROC UNIVARIATE مع عبارة CLASS المقابلة، أو إجراء الجداول المتقاطعة PROC FREQ للمتغيرات التصنيفية. يتيح هذا التدقيق المقارن التحقق من ثبات التقديرات الإحصائية، ورصد أي شذوذ قد ينتج عن معالجة قيم الصفر أو الفراغات التنسيقية، مما يوفر طمأنينة رياضية مطلقة حول دقة الأرقام المقدمة في مسودة البحث.
تكتمل منظومة الجودة بالأرشفة المنهجية الشاملة لكود التحليل البرمجي وسجلات التشغيل المرتبطة به ضمن ملفات توثيقية آمنة (Audit Trails). يجب أن تشتمل هذه الأرشيفات على النص البرمجي الكامل، وبيانات البيئة التشغيلية ورقم إصدار SAS المستخدم، وتواريخ المعالجة، لضمان قابلية إعادة الإنتاج العلمي (Scientific Reproducibility) من قبل أي باحث أو جهة تحكيمية مستقلة. إن تبني هذا النهج التوثيقي الصارم يرسخ مبادئ الشفافية الأكاديمية، ويرفع من مصداقية النتائج المنشورة، مسهماً في بناء معرفة علمية متينة وقابلة للتراكم والتطوير المستمر.
خاتمة
قدم هذا المقال الأكاديمي الشامل دراسة مستفيضة ومتكاملة لواحد من أكثر الإجراءات الإحصائية أهمية ورسوخاً في بيئة SAS، متمثلاً في إجراء PROC MEANS مدعوماً بعبارة CLASS التصنيفية. وقد تجلت من خلال التحليل المنهجي المقارن الأهمية الحاسمة للانتقال من التوصيف الإجمالي العام للبيانات إلى التفكيك الطبقي الممنهج، ودوره في درء المغالطات الإحصائية وحماية مسارات الاستدلال من التفسيرات المضللة، فضلاً عن تقديم فهم دقيق للبنية التوزيعية للمتغيرات التابعة عبر مختلف المستويات الفئوية.
كما أبرزت المناقشات التقنية التفوق الحوسبي والوظيفي لعبارة CLASS في بناء الجداول التجميعية الموحدة دون الحاجة إلى الفرز المسبق، مع بيان حدودها الاستيعابية في مواجهة البيانات الضخمة مقارنة بعبارة BY، وتوضيح السبل البرمجية المتقدمة لضبط مستويات التجميع عبر خيارات NWAY و TYPES و WAYS وسلاسل CHARTYPE الثنائية. وتوجت هذه المحاور باستعراض دقيق لأفضل الممارسات الأكاديمية في توثيق المقاييس واختيارها ومعالجة الفقد والتدقيق النوعي بما يتوافق مع المعايير الدولية للنشر العلمي الرصين.
إن إتقان توظيف عبارة CLASS ضمن إجراء PROC MEANS يتجاوز كونه مجرد مهارة برمجية شكلية داخل نظام SAS، ليمثل كفاءة منهجية وتحليلية لا غنى عنها لكل باحث ومحلل يسعى إلى استنطاق البيانات المعقدة واستخلاص البراهين الاستكشافية القوية. ومن خلال الدمج الواعي بين الصرامة البرمجية والانضباط الإحصائي، يظل هذا الإجراء أداة محورية تسهم في تعزيز جودة البحوث الميدانية والتطبيقية، وتفتح آفاقاً رحبة لبناء نماذج استدلالية رصينة تدعم التقدم المعرفي واتخاذ القرارات المبنية على الأدلة في مختلف الميادين العلمية.
المراجع
- Barr, A. J., Goodnight, J. H., Sall, J. P., & Helwig, J. T. (1976). A user’s guide to SAS 76. SAS Institute Inc.
- Cody, R. (2018). Cody’s collection of popular SAS programming tasks and how to tackle them. SAS Institute Inc.
- Delwiche, L. D., & Slaughter, S. J. (2019). The little SAS book: A primer (6th ed.). SAS Institute Inc.
- Muller, K. E., & Fetterman, B. A. (2002). Regression and ANOVA: An integrated approach using SAS software. SAS Institute Inc.
- SAS Institute Inc. (2020). Base SAS 9.4 procedures guide: Statistical procedures (5th ed.). SAS Institute Inc. https://documentation.sas.com/
- Tukey, J. W. (1977). Exploratory data analysis. Addison-Wesley.