
يحتل برنامج مايكروسوفت إكسيل (Microsoft Excel) مكانة مركزية في بنية المعالجة الرقمية والتحليل الإحصائي عبر مختلف القطاعات الأكاديمية والصناعية والمالية. ومن بين التحديات الحسابية المتكررة التي تواجه الباحثين والمحللين، يبرز حساب مقاييس النزعة المركزية لعينات فرعية خاضعة لقواعد ترتيبية خاصة، وتحديداً استخراج المتوسط الحسابي لأعلى عدد محدد من القيم ($N$) ضمن نطاق بيانات محدد. لا تقتصر هذه المسألة على مجرد تطبيق دالة رياضية تقليدية، بل تمثل نموذجاً متقدماً لتقاطعات الجبر المصفوفي مع نمذجة البيانات، حيث تتطلب العملية استخلاص رتب معينة وتصفيتها من بين مئات أو آلاف السجلات قبل تطبيق المعالجة التجميعية النهائية.
تستند هذه العملية من الناحية المنهجية إلى ما يُعرف في الأدبيات الإحصائية بنظرية إحصاءات الرتب (Order Statistics)، وهي آلية حسابية واختزالية للبيانات (Computational and Data-Reduction Method) تهدف إلى عزل مستويات الأداء القصوى أو فترات الذروة لدراسة خصائصها واستبعاد التباينات العشوائية الدنيا. وعلى الرغم من بساطة الهدف ظاهرياً، فإن تنفيذه داخل بيئة إكسيل يفتح الباب واسعاً لاستعراض التطور البنيوي لمحرك الحساب في البرنامج؛ بدءاً من صيغ المصفوفات الكلاسيكية المقيدة بتركيبات لوحة المفاتيح المعقدة، ووصولاً إلى محركات الحساب الحديثة التي تعتمد المصفوفات الديناميكية المتدفقة وتوفر حلولاً تتسم بالمرونة الفائقة والصلابة البرمجية.
يهدف هذا الدليل المرجعي الشامل إلى تفكيك المسألة وتشريحها تحليلياً وبرمجياً من كافة جوانبها؛ بدءاً من التأصيل النظري والمفاهيمي لاختيار العينات الانتقائية، مروراً بالتشريح الدقيق للدوال المحورية مثل LARGE وAVERAGE وتوليد المتتاليات عبر ROW وSEQUENCE، وانتهاءً بتغطية سيناريوهات التعامل مع الشذوذ الإحصائي، وتصميم لوحات التحكم التفاعلية، ومعالجة البيانات الشرطية متعددة المستويات بأعلى معايير الدقة والتوثيق الأكاديمي.
1. مقدمة منهجية لحساب متوسط أعلى N قيم في إكسيل
1.1 المفهوم الإحصائي لاختيار القيم العليا وتحليلها
يمثل مفهوم العينة الانتقائية (Selective Sampling) في التحليل الإحصائي نهجاً يعتمد على استخلاص جزء محدد من التوزيع الاحتمالي للبيانات بناءً على معيار ترتيبي مسبق. عند استخراج أعلى $N$ قيم، يقوم المحلل بتطبيق عملية فرز مقيدة تعزل الجزء الأيمن المتطرف من التوزيع التكراري، وهو ما يُعرف في الأدبيات القياسية بالإحصاء الترتيبي غير المتماثل (Asymmetric Selection Procedure). يهدف هذا الإجراء المنهجي إلى التركيز على فترات الأداء الأقصى أو الحالات التي تمثل الطاقة التشغيلية القصوى للمنظومة محل الدراسة، متجاوزاً بذلك التذبذبات الطفيفة التي تحدث في المستويات الدنيا أو المتوسطة من التوزيع العام.
في سياق القياسات المعيارية والتقييم، يلعب حساب المتوسط الحسابي لأفضل القيم دوراً محورياً في بناء مؤشرات أداء موثوقة تعكس الكفاءة الكامنة الحقيقية. فعلى سبيل المثال، في الاختبارات السيكومترية أو قياس زمن الاستجابة في الدراسات السلوكية المعتمدة على النظرية الكلاسيكية للاختبارات ($X = T + E$)، يُستخدم استخراج أفضل المحاولات كأداة لتخفيض أثر الخطأ القياسي العشوائي ($E$) والاقتراب من الدرجة الحقيقية ($T$) للقدرة الكامنة، شريطة أن يُعامل هذا الإجراء كمعالجة اختزالية وحسابية للبيانات وليس كنظرية نفسية أو سلوكية مستقلة بحد ذاتها.
من الضروري التمييز الإحصائي الحاسم بين المتوسط العام للمجتمع ($\mu$) أو متوسط العينة الكلية ($\bar{X}$)، وبين متوسط العينة الفرعية المنتقاة ذات الرتب العليا ($\bar{X}_{TopN}$). يعكس المتوسط العام النزعة المركزية الشاملة لكافة التفاعلات وعناصر الظاهرة بما فيها الأنماط الضعيفة والمتردية، في حين يمثل متوسط القيم العليا معياراً استثنائياً يُظهر سقف الإنجاز أو الجدارة القصوى. إن الخلط بين هذين المقياسين يؤدي إلى انحيازات تفسيرية جسيمة؛ إذ لا يصلح متوسط العينة العليا لتعميم النتائج على المجتمع الإحصائي بأكمله، بل يقتصر دوره التحليلي على قياس فاعلية النخبة أو محاكاة سيناريوهات الأداء المثالي الخالي من العقبات التشغيلية الروتينية.
1.2 سياقات الاستخدام العملي في التحليلات الرقمية
تتعدد التطبيقات التطبيقية لحساب متوسط أفضل القيم عبر قطاعات الأعمال وإدارة العمليات، حيث تبرز الحاجة الماسة لقياس الكفاءة التشغيلية المتقدمة وتحديد أفضل مستويات الإنتاجية. تلجأ الشركات الصناعية ومراكز الاتصال إلى تحليل متوسط أفضل $N$ ساعات أو ورديات عمل لتحديد الطاقة الإنتاجية الممكنة للمعدات والكوادر البشرية عند توفر الظروف المثلى، مما يسهم في ضبط المستهدفات التشغيلية المستقبلية وتقليل الفجوة بين الأداء الفعلي والقدرة القصوى المثبتة تجريبياً.
وفي البيئات التعليمية والأكاديمية، يُعد هذا المقياس أداة تقييمية بالغة الأهمية لتطبيق سياسات التقييم العادل والمستمر؛ حيث تعتمد الجامعات والمؤسسات التعليمية سياسة احتساب متوسط أفضل درجات الاختبارات الدورية للطلاب واستبعاد الدرجات الدنيا الناتجة عن ظروف طارئة أو عوائق خارجة عن إرادة المتعلم. تسهم هذه الممارسة في تشجيع الطلاب على تحسين أدائهم المستمر دون خوف من تعثر مؤقت قد يدمر معدلهم التراكمي، كما تعكس المستوى المعرفي الحقيقي للطالب عبر فترات زمنية ممتدة بدلاً من الاعتماد على اختبار نهائي واحد قد تشوبه أخطاء القياس العشوائية.
أما في قطاع التحليل المالي ودراسة مؤشرات المبيعات الدورية، فإن استخراج متوسط أفضل الصفقات التجارية أو أعلى دورات الإيرادات الربع سنوية يمنح مديري المحافظ الاستثمارية وصناع القرار رؤى معمقة حول قدرة المنشأة على توليد التدفقات النقدية الضخمة. يساعد هذا المؤشر في تقييم مدى اعتماد المبيعات على قفزات موسمية استثنائية أو صفقات كبرى فردية، ومقارنة ذلك بالمتوسط العام لتقييم استقرار الأداء المالي واستدامته، وقياس العوائد الصافية الناتجة عن الحملات التسويقية المكثفة التي تتركز آثارها عادة في فترات زمنية محدودة متصدرة للأداء.
1.3 نظرة عامة على التركيب البنائي للمعادلة المركبة
تعتمد النمذجة الرياضية داخل برنامج إكسيل لحساب متوسط أعلى القيم على تضافر وظيفي منظم بين دوال ذات اختصاصات مختلفة، تندمج معاً لإنتاج حل ديناميكي متكامل ضمن صيغة رياضية واحدة ومحكمة. تتكامل الوظائف في هذه البنية بصورة تبادلية؛ حيث تتولى دوال فرز الرتب استخراج القيم المطلوبة حصراً وتمريرها في صورة مصفوفة ناتجة وسيطة، لتتلقفها بعد ذلك دالة الحساب التجميعي وتحولها إلى رقم إحصائي منفرد يمثل الوسط الحسابي النهائي للعينات المنتقاة دون الحاجة إلى إنشاء أعمدة وسيطة أو تكرار العمليات اليدوية.
يمثل هذا المنهج تحولاً جذرياً في فلسفة استخدام إكسيل، بالانتقال من المعالجة الفردية للبيانات المعتمدة على الخلايا المعزولة (Cell-by-Cell Calculation) إلى المعالجة المصفوفية الشاملة (Array Processing). في هذا الإطار، لا تتعامل الدوال مع قيمة واحدة تلو الأخرى بشكل متقطع، بل تتعامل مع نطاق البيانات ككيان رياضي موحد يخضع لعمليات التصفية والفرز والدمج في خطوة معالجة واحدة داخل الذاكرة المؤقتة لمحرك البرنامج، مما يضمن كفاءة حسابية عالية ويقلل من الأخطاء التنسيقية والمكانية في ورقة العمل.
تتمحور الصيغة الهيكلية العامة الأكثر استقراراً وشهرة في الإصدارات الكلاسيكية لإكسيل حول الجمع بين ثلاث دوال رئيسية، وهي الدالة التجميعية AVERAGE، ودالة استخراج القيم الترتيبية LARGE، ودالة توليد الأرقام التسلسلية ROW، لتأخذ المعادلة الشكل المرجعي الآتي: =AVERAGE(LARGE(DataRange, ROW(1:N))). يمثل هذا التكوين الثلاثي تدرجاً منطقياً تبدأ فيه ROW بتكوين مصفوفة الرتب المطلوبة من $1$ إلى $N$، لتستخدمها LARGE كمعاملات استخراج لفرز أعلى $N$ أرقام من النطاق المرجعي، ومن ثم تطبق AVERAGE عمليات الجمع والقسمة الحسابية على المصفوفة الناتجة، محققة بذلك النتيجة الإحصائية المطلوبة بدقة متناهية.
2. التشريح التركيبي لدالة LARGE ودورها في استخراج الرتب
2.1 البنية المرجعية والوسائط الرياضية لدالة LARGE
تُعد دالة LARGE في مايكروسوفت إكسيل الأداة المركزية المتخصصة في استخراج القيم الرقمية بناءً على موقعها التنازلي المترتب داخل مجموعة بيانات معينة. تتألف البنية التركيبية القياسية لهذه الدالة من وسيطين رياضيين إلزاميين، تُصاغ برمجياً على الهيئة: LARGE(array, k). يتمثل الوسيط الأول array في النطاق الجغرافي للبيانات أو مصفوفة الأرقام التي يرغب المحلل في مسحها، ويجب أن يحتوي هذا النطاق على عناصر رقمية صالحة للمعالجة، حيث يتجاهل البرنامج تلقائياً الخلايا النصية أو القيم المنطقية والفارغة المضمنة داخل النطاق.
أما الوسيط الثاني، وهو المعامل k، فيشير إلى الرتبة التنازلية الدقيقة للقيمة المستهدفة بالنسبة لأعلى نقطة في التوزيع؛ فإذا كانت قيمة $k=1$، فإن الدالة ترجع القيمة القصوى المطلقة، وإذا كانت $k=2$، فإنها تسترجع ثاني أعلى قيمة، وهكذا دواليك وصولاً إلى أدنى قيمة ممكنة في السلسلة. وتتحدد طبيعة عمل الدالة الرياضية وفقاً لقيمة هذا الوسيط ومدى اتساعه؛ إذ يمثل نقطة التحكم المحورية في عزل القيم المستهدفة بناءً على متطلبات التحليل الإحصائي المحدد مسبقاً من قبل المحلل.
تتميز دالة LARGE بمرونة تشغيلية فائقة تجعلها تتقبل المخرجات الفردية والمصفوفية على حد سواء؛ فعند تمرير قيمة مفردة للمتغير k، تعمل الدالة بصورة قياسية وتُخرج قيمة عددية واحدة في الخلية الحاضنة للصيغة. في المقابل، عندما يُمرر للمتغير k مصفوفة من الأرقام (مثل {1,2,3})، يتغير النمط التشغيلي للدالة لتقوم بعملية حسابية متعددة المسارات تعيد من خلالها مصفوفة متكاملة تحتوي على القيم المقابلة لتلك الرتب دفعة واحدة في ذاكرة الحساب المؤقتة، مما يجعلها تشكل حجر الزاوية في بناء الصيغ المصفوفية المركبة.
2.2 استخدام المصفوفات الثابتة داخل دالة LARGE
يعد استخدام ثوابت المصفوفة (Array Constants) الأسلوب الأكثر مباشرة واختصاراً لتوجيه دالة LARGE لاستخراج مجموعة محددة من القيم العليا دون الحاجة إلى دوال إضافية لتوليد المتتاليات. يتم إدخال هذه الثوابت يدوياً بين قوسين معقوفين { }، وتُفصل العناصر الرقمية داخلها إما بفواصل عادية , لتمثيل مصفوفة أفقية من الرتب، أو بفواصل منقوطة ; لتمثيل مصفوفة عمودية، كأن نكتب: =LARGE(A2:A100, {1,2,3})، وهو ما يوجه الدالة بشكل حاسم لاستخلاص القيم التي تحتل المراتب الأولى والثانية والثالثة ضمن النطاق المحدد.
تتجلى الميزة الأساسية للاعتماد على ثوابت المصفوفة في بساطتها المعمارية المطلقة وسرعة تنفيذها داخل محرك الحساب؛ إذ لا تتطلب استدعاء دوال فرعية أو إجراء حسابات وسيطة لتحديد أبعاد المصفوفة أو مواقع الصفوف، مما يقلل بشكل ملحوظ من الحمل الحسابي على المعالج ويوفر حلاً نظيفاً وسهل القراءة عند التعامل مع قيم ثابتة ومعروفة مسبقاً لـ $N$، لا سيما في النماذج التحليلية البسيطة التي لا تحتاج إلى تعديلات متكررة في حجم العينة المختارة.
مع ذلك، تصطدم هذه الطريقة بمحددات هيكلية وعملية بالغة الحرج عند توسيع نطاق التحليل أو الحاجة إلى جعل قيمة $N$ متغيرة وديناميكية. فإذا تطلب النموذج استخراج أعلى $20$ أو $50$ قيمة، تصبح كتابة الأرقام يدوياً داخل الأقواس المعقوفة أمراً مرهقاً وغير عملي وعرضة للخطأ البشري، فضلاً عن استحالة ربط ثوابت المصفوفة بخلية إدخال متغيرة في ورقة العمل بشكل مباشر دون اللجوء إلى حيل برمجية إضافية، مما يجعلها حلاً محدود الأفق ومقتصراً على النماذج الإحصائية الثابتة ذات الأبعاد الصغيرة.
2.3 الفروق الجوهرية بين دالتي LARGE وMAX
على الرغم من أن كلاً من دالتي MAX وLARGE تندرجان تحت تصنيف دوال تحديد القيم العليا في الجداول الإحصائية، إلا أن هناك فروقاً وظيفية وجوهرية عميقة في السلوك البرمجي والقدرة التحليلية لكل منهما. تقتصر دالة MAX من حيث التصميم على إرجاع القيمة القصوى الفردية المطلقة ضمن نطاق البيانات المعطى، أي أنها تمثل حالة خاصة جداً تعادل رياضياً تطبيق دالة LARGE عندما يكون معامل الرتبة $k=1$ حصراً، دون أي إمكانية لاستكشاف ما يلي تلك القيمة من مستويات أداء.
تتفوق دالة LARGE بقدرتها الفريدة على استخراج سلسلة تنازلية متعددة القيم واختراق عمق التوزيع الإحصائي للبيانات لاكتشاف الترتيب النسبي للعناصر. تتيح هذه الميزة للمحلل استخلاص القيم ذات الترتيب الثاني أو الخامس أو العاشر بشكل منفرد، أو استخراج مصفوفة كاملة من القيم العليا، وهو أمر تعجز عنه دالة MAX تماماً نظراً لبنيتها الرياضية البسيطة التي تقارن القيم ببعضها البعض وتطرح الفائز الوحيد بالقمة فقط دون تتبع مسار الرتب.
ينعكس هذا التباين التركيبي بشكل مباشر على الأداء الحسابي وسرعة المعالجة؛ حيث تتميز دالة MAX بخوارزمية فحص خطي شديدة السرعة تكتفي بالمرور السريع على الخلايا لمقارنة القيم بالرقم الأكبر المسجل، بينما تتطلب دالة LARGE، خصوصاً عند تزويدها بمصفوفة من الرتب، جهداً حسابياً أعلى يقوم على الفرز الجزئي للعناصر وحفظ المؤشرات الترتيبية في الذاكرة. ولذلك، يُعد اختيار الدالة المناسبة قراراً استراتيجياً يؤثر على سرعة استجابة نماذج المحاكاة الكبيرة وقواعد البيانات المليئة بملايين الصفوف الحسابية.
3. التوظيف التكاملي لدالة AVERAGE لاشتقاق الوسط الحسابي
3.1 المنطق الرياضي لدمج AVERAGE مع دوال الترتيب
يقوم المنطق الرياضي لدمج دالة AVERAGE مع دالة LARGE على فكرة تغذية مخرجات الأولى مباشرة كمدخلات حسابية للثانية عبر خط أنابيب بيانات متصل داخل الذاكرة المؤقتة. فعندما ترجع دالة الترتيب مصفوفة رقمية تمثل أفضل القيم المختارة (على سبيل المثال القيم: ${95, 90, 88}$)، تستقبل دالة AVERAGE هذه المصفوفة ككتلة واحدة من البيانات المستهدفة، متجاهلة تماماً باقي عناصر النطاق الأصلي التي لم تتمكن من حجز موقع لها ضمن المراتب العليا المعنية بالحساب.
تقوم دالة AVERAGE بعد ذلك بتطبيق الخوارزمية القياسية لحساب الوسط الحسابي، والتي تشمل عمليتي الجمع التراكمي لعناصر المصفوفة المنتقاة ثم قسمة الناتج الإجمالي على العدد الفعلي للقيم المستخلصة، وفق المعادلة الرياضية البديهية:
$$\bar{X} = \frac{\sum_{i=1}^{N} X_{(i)}}{N}$$
حيث تمثل $X_{(i)}$ إحصاءات الرتب التنازلية الصادرة عن LARGE. وتتم هذه السلسلة الحسابية بشكل آلي فوري دون تدخل المستخدم، مما يضمن دقة استخراج النتيجة وتجنب أخطاء القسمة أو الجمع غير المكتمل.
يحقق هذا التكامل استبعاداً تلقائياً ومحكماً لكافة القيم التي تقع خارج النطاق الترتيبي المستهدف؛ فبدلاً من تطبيق شروط تصفية معقدة باستخدام دوال المقارنة المنطقية لتحديد ما إذا كانت الخلية تتجاوز حداً معيناً أم لا، تتولى دالة LARGE مهمة التصفية الرتبوية الحصرية، مما يمنع تشوه الوسط الحسابي بالقيم المتوسطة أو المتدنية، ويضمن ثبات حجم العينة المحسوبة بدقة رياضية صارمة تتوافق مع القواعد الإحصائية المقررة للتحليل.
3.2 تتبع مسار الحساب الداخلي خطوة بخطوة
لفهم الآلية التي يعالج بها إكسيل هذه المعادلة المركبة بدقة، يُنصح دائماً بالاستعانة بأداة “تقييم الصيغة” (Evaluate Formula) المدمجة في شريط أدوات الصيغ الحسابية بالبرنامج. تتيح هذه الأداة للمحلل تفكيك المعادلة ومراقبة نبضات المعالجة خطوة بخطوة؛ حيث يبدأ البرنامج بتقييم الجزء الأعمق في التركيب البنائي، وهو الجزء المسؤول عن توليد مصفوفة الرتب المطلوبة، فيتحول التعبير الترتيبي من دالة نصية أو مرجعية إلى مصفوفة رقمية صريحة محددة المعالم داخل الذاكرة.
في الخطوة التالية من مسار التقييم الداخلي، يستبدل البرنامج وسيط النطاق المرجعي بمصفوفة القيم الأصلية، لتبدأ دالة LARGE عملية المطابقة والفرز التنازلي؛ حيث تُسقط مصفوفة الرتب على النطاق لاقتطاع القيم المقابلة بدقة متناهية. وتظهر شاشة تقييم الصيغة هذا التحول الدراماتيكي بوضوح، حيث يختفي النطاق العريض للبيانات ليحل محله متجه رقمي محصور لا يضم سوى الأرقام الفائزة بأعلى المراتب مرتبة تنازلياً بين قوسين معقوفين.
وأخيراً، تخضع المصفوفة المقتطعة لتأثير دالة AVERAGE التي تباشر فوراً عملية الجمع التجميعي لتلك القيم، وتتبعها بالقسمة على عدد عناصر المصفوفة الظاهرة، ليُختصر التركيب المعقد بالكامل إلى رقم إحصائي واحد يمثل المتوسط المطلوب ويُعرض في الخلية المستهدفة. يُعد تتبع هذا المسار وسيلة لا غنى عنها في تدقيق النماذج والتحقق من صحة العمليات، والتأكد من عدم وجود انحرافات حسابية ناتجة عن إساءة تفسير وسائط الدوال أو تشوه بنية المصفوفات الوسيطة.
3.3 التعامل مع المتتاليات في الذاكرة المؤقتة للبرنامج
تخضع معالجة المصفوفات الوسيطة في برنامج إكسيل لإدارة دقيقة وصارمة داخل ذاكرة الوصول العشوائي (RAM) المخصصة لمحرك الحساب. فعند تطبيق صيغ المصفوفات المركبة، لا يتم كتابة النتائج الجزئية في خلايا ورقة العمل الفيزيائية، بل يقوم البرنامج بتخصيص مساحات معزولة في الذاكرة اللحظية لحفظ المتجهات الترتيبية والمصفوفات الناتجة، وتخضع هذه البيانات المؤقتة لدورة حياة سريعة للغاية تنتهي بمجرد وصول دالة AVERAGE إلى الرقم النهائي وإرجاعه إلى الواجهة المرئية للمستخدم.
يرتبط حجم النطاق المرجعي ومقدار الرتبة $N$ بشكل وثيق بمعدل استهلاك موارد المعالج والذاكرة المؤقتة؛ فإذا كان النطاق يحتوي على عشرات الآلاف من الصفوف وتتطلب المعادلة معالجة مصفوفة رتب واسعة النطاق، فإن استهلاك الموارد يتزايد بشكل ملحوظ نظراً لأن عمليات الفرز الداخلي تتطلب تخصيص مسارات معالجة مكثفة لمقارنة القيم وترتيبها قبل اقتطاعها. لذلك، فإن إدراج نطاقات عمودية كاملة (مثل A:A) داخل دالة LARGE يمثل ممارسة برمجية سيئة ترهق محرك الحساب وتؤدي إلى تباطؤ ملحوظ في سرعة إعادة الحساب التلقائي للبرنامج.
لضمان الحفاظ على كفاءة الأداء وسرعة ورقة العمل، يُوصى باتباع أفضل الممارسات المنهجية التي تشمل تقييد النطاقات المرجعية بالحدود الحقيقية للبيانات المأهولة فقط، إما باستخدام جداول إكسيل المنظمة (Excel Tables) أو مراجع النطاقات الديناميكية. يضمن ذلك حصر تخصيص الذاكرة المؤقتة في حدود البيانات الفعلية، مما يحول دون استنزاف موارد النظام ويتيح الحفاظ على استجابة سلسة وفورية للنموذج الحسابي حتى في ظل تكرار العمليات الحسابية وتعدد المستخدمين على الملف المشترك.
4. توليد نطاقات الرتب ديناميكياً باستخدام دالة ROW
4.1 ميكانيكية عمل دالة ROW في توليد الأعداد التسلسلية
تمثل دالة ROW في بيئة إكسيل أداة ذكية وغير تقليدية لتوليد المتواليات العددية التسلسلية دون الحاجة إلى كتابتها يدوياً. تتمثل الوظيفة الأصلية والبديهية لهذه الدالة في استرجاع رقم الصف الفيزيائي لمرجع خلية معين؛ فعند كتابة ROW(A5)، ترجع الدالة الرقم 5 مباشرة. ولكن عند تغذية الدالة بنطاق رأسي متعدد الصفوف، مثل ROW(1:5) أو ROW(A1:A5)، وضمن سياق حساب مصفوفي، فإن الدالة تُنتج مصفوفة أحادية البعد تتألف من أرقام الصفوف الواقعة ضمن ذلك النطاق، لتصبح النتيجة متجهة رقمية منظمة بالشكل: {1; 2; 3; 4; 5}.
تُوظف هذه الميكانيكية بذكاء فائق لحل معضلة إدخال الرتب المتعددة؛ فبدلاً من التقيد بثوابت المصفوفة اليدوية الجامدة {1,2,3}، يُنشئ المحلل مصفوفة متسلسلة تبدأ من القيمة 1 وتتصاعد تباعاً بمقدار واحد صحيح وصولاً إلى الرتبة المستهدفة $N$. يتيح هذا النهج تكوين متواليات طويلة بدقة متناهية دون أدنى احتمال لإغفال رقم أو ارتكاب خطأ في الترقيم، مما يرفع من جودة البناء البرمجي للصيغ المعقدة ويمنحها اتساقاً حسابياً رفيع المستوى.
تُغذي هذه المتتالية التسلسلية المولدة وسيط الرتبة $k$ في دالة LARGE بشكل آلي كامل؛ حيث تُعامل دالة LARGE مصفوفة الصفوف وكأنها قائمة صريحة من الرتب التنازلية المدخلة يدوياً. وبذلك يتم سد الفجوة بين المعالجة الفردية للرتب والمعالجة الشاملة دفعة واحدة، مما يمنح النموذج التحليلي القدرة على استيعاب عينات موسعة بمجرد تغيير رقم الصف النهائي المحدد داخل وسيط دالة ROW.
4.2 صياغة التعبير النطاقي ROW(1:N) وقواعده
تتطلب صياغة التعبير النطاقي المعتمد على دالة ROW، والمكتوب عادة على الهيئة ROW(1:N) (حيث يُستبدل الحرف $N$ برقم حقيقي مثل ROW(1:10))، فهماً دقيقاً لقواعد الإسناد المرجعي في إكسيل. في هذه الحالة، لا يشير التعبير إلى خلايا فعلية تحتوي على بيانات داخل ورقة العمل، بل يُستخدم فقط كهيكل هندسي لتوجيه البرنامج نحو أرقام الصفوف الفيزيائية الأولية، بغض النظر عما تحتويه تلك الصفوف من نصوص أو أرقام أو فراغات، إذ ينصب التركيز بالكامل على الاستفادة من “أرقام المؤشرات” المكانية فقط.
تنطوي هذه الصياغة التقليدية على مخاطر هيكلية خفية يجب على المحلل المحترف التحوط لها بحذر؛ فأي عملية لاحقة يقوم بها المستخدم لإدراج صفوف جديدة في قمة ورقة العمل (أعلى الصف 1) ستؤدي حتماً إلى إزاحة النطاق المرجعي للدالة تلقائياً. فعلى سبيل المثال، إذا أُدرج صف جديد في قمة الورقة، فستتحول الصيغة تلقائياً إلى ROW(2:11)، مما يعني أن دالة LARGE ستبدأ بفرز القيم انطلاقاً من الرتبة الثانية وحتى الرتبة الحادية عشرة، متجاهلة بذلك القيمة العليا الأولى تماماً، وهو خطأ جسيم قد يمر دون ملاحظة فورية ويشوه دقة النتائج الإحصائية المستخرجة.
لتفادي أخطاء الإزاحة الناتجة عن تعديل تخطيط ورقة العمل، يلجأ المحللون إلى تثبيت الإسناد المرجعي، إما عن طريق استخدام مراجع مطلقة مثل ROW($A$1:$A$10) مع الحرص على عدم إدراج خلايا ضمن ذلك النطاق، أو من خلال اللجوء إلى التوليد النصي غير المباشر باستخدام دالة INDIRECT كما سيتم تفصيله لاحقاً. يضمن هذا التثبيت الصارم بقاء متتالية الأرقام ثابتة عند القيمة الابتدائية 1 دوماً، مما يحافظ على صلابة الصيغة ويحمي بنيتها المنطقية من التصدع نتيجة التعديلات التنسيقية المستمرة في بيئات العمل المشتركة.
4.3 المقارنة بين التعيين اليدوي والتعيين عبر المتتاليات
تكشف المقارنة التحليلية بين التعيين اليدوي لثوابت الرتب وبين توليدها عبر متتاليات دالة ROW عن فروق جوهرية ترتبط مباشرة بمرونة النماذج الإحصائية وتقليل نسبة الخطأ البشري. فعند إدارة مجموعات بيانات ضخمة تتطلب تحليل متوسط أفضل 50 أو 100 قيمة، يصبح الاعتماد على كتابة المصفوفة يدوياً أمراً غير منطقي وشديد القابلية لارتكاب الأخطاء الطباعية وإسقاط الفواصل، فضلاً عن المظهر غير الاحترافي للصيغة داخل شريط المعادلات، بينما يختصر تعبير المتتالية الرياضية تلك السلسلة الطويلة في كلمات معدودة ومحكمة الصياغة.
تمنح المتتاليات المولدة عبر ROW مرونة برمجية فائقة تتيح إعادة صياغة حجم العينة $N$ وتعديله في غضون ثوانٍ معدودة؛ فإذا قررت الإدارة تغيير معيار التقييم من احتساب أفضل 5 قيم إلى أفضل 15 قيمة، لا يحتاج المحلل سوى إلى تعديل رقم واحد فقط في نهاية نطاق الصفوف ليقوم النموذج بتحديث مخرجاته فوراً، بدلاً من الدخول في عمليات إعادة كتابة شاقة للثوابت المصفوفية المعقدة وما يرافقها من احتمالات الخلل الحسابي.
علاوة على ذلك، تسهم هذه المتتاليات في تبسيط الصيانة الدورية للنماذج المالية والإحصائية وتدقيقها من قبل المراجعين الخارجيين؛ حيث تُبرز الصيغة المركبة عبر ROW نية المصمم ومنطقه التحليلي بوضوح يسهل تتبعه وفهمه مقارنة بالقيم اليدوية الصامتة. يرسخ هذا النهج قواعد الحوكمة الرياضية للبيانات ويسهل نقل مسؤولية إدارة النموذج بين أعضاء الفريق الواحد دون الحاجة إلى تفكيك شفرات الثوابت اليدوية المعقدة التي يصعب فك طلاسمها في النماذج الكبيرة.
5. التطبيق العملي التفصيلي للصيغة القياسية خطوة بخطوة
5.1 تهيئة مصفوفة البيانات الأولية وتدقيقها
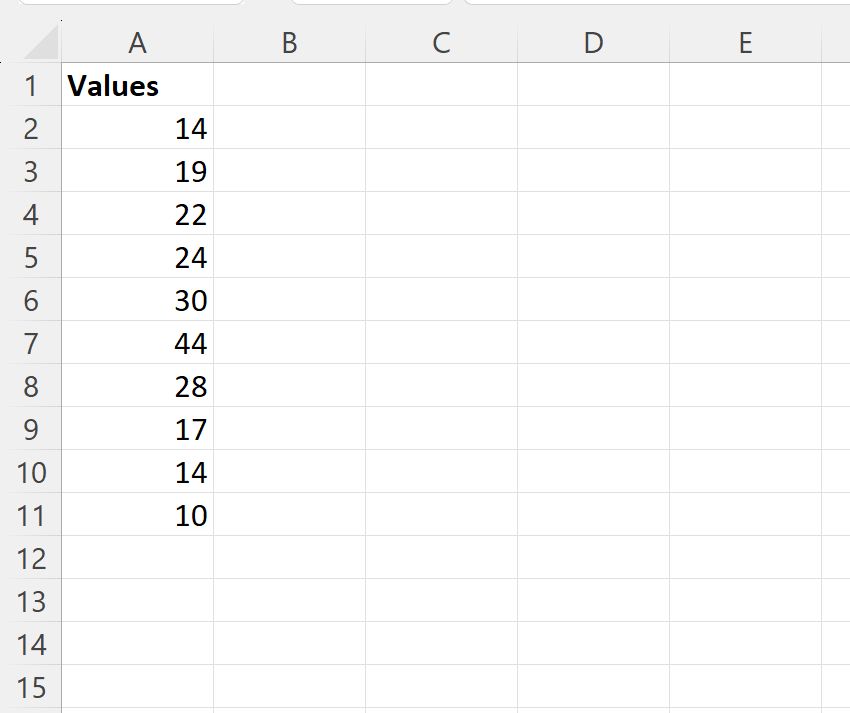
تبدأ الخطوة العملية الأولى لتحقيق حساب دقيق وخالٍ من العيوب لمتوسط أعلى $N$ قيم بتهيئة وتنظيم مصفوفة البيانات الأولية تدقيقياً ورقابياً. يجب تجميع الأرقام المستهدفة داخل نطاق عمودي موحد ومنتظم، وليكن النطاق المرجعي المفترض A2:A11، مع تجنب تشتيت البيانات في خلايا متباعدة أو عبر أوراق عمل متفرقة دون داعٍ تحليلي، حيث يضمن الترتيب المتصل سلاسة المعالجة الحسابية وسرعة قراءة الخلايا بواسطة محرك الحساب الداخلي للبرنامج.
يتعين على المحلل فحص البيانات وتدقيقها للتأكد المطلق من خلوها من الأخطاء التنسيقية الشائعة؛ مثل الأرقام المخزنة كنصوص نتيجة عمليات التصدير غير المنضبطة من قواعد البيانات الخارجية، أو وجود فراغات بيضاء غير مرئية تحيط بالأرقام، إذ تؤدي هذه الشوائب النصية إلى تجاهل دالة LARGE لتلك الخلايا تماماً واعتبارها قيماً غير صالحة، مما يترتب عليه تقليص حجم العينة الفعلية وتشويه الترتيب الحقيقي للرتب العليا.
عقب التأكد من سلامة البنية الرقمية، يجب تحديد حجم العينة المنتقاة ($N$) بدقة استناداً إلى المنطق الإحصائي للدراسة وليس بصورة عشوائية؛ فإذا كان النطاق يحتوي على 10 قيم فقط (كما في النطاق A2:A11)، فإن اختيار أعلى 3 قيم ($N=3$) يمثل عينة كافية لاستعراض قمة الأداء، مع التأكد التام من أن قيمة $N$ المختارة لا تتجاوز بحال من الأحوال إجمالي عدد القيم الرقمية المأهولة داخل النطاق المستهدف، تفادياً للأخطاء الحسابية القاتلة التي ستوقف عمل الصيغة برمتها.
5.2 إدخال الصيغة المركبة وتفعيلها برمجياً
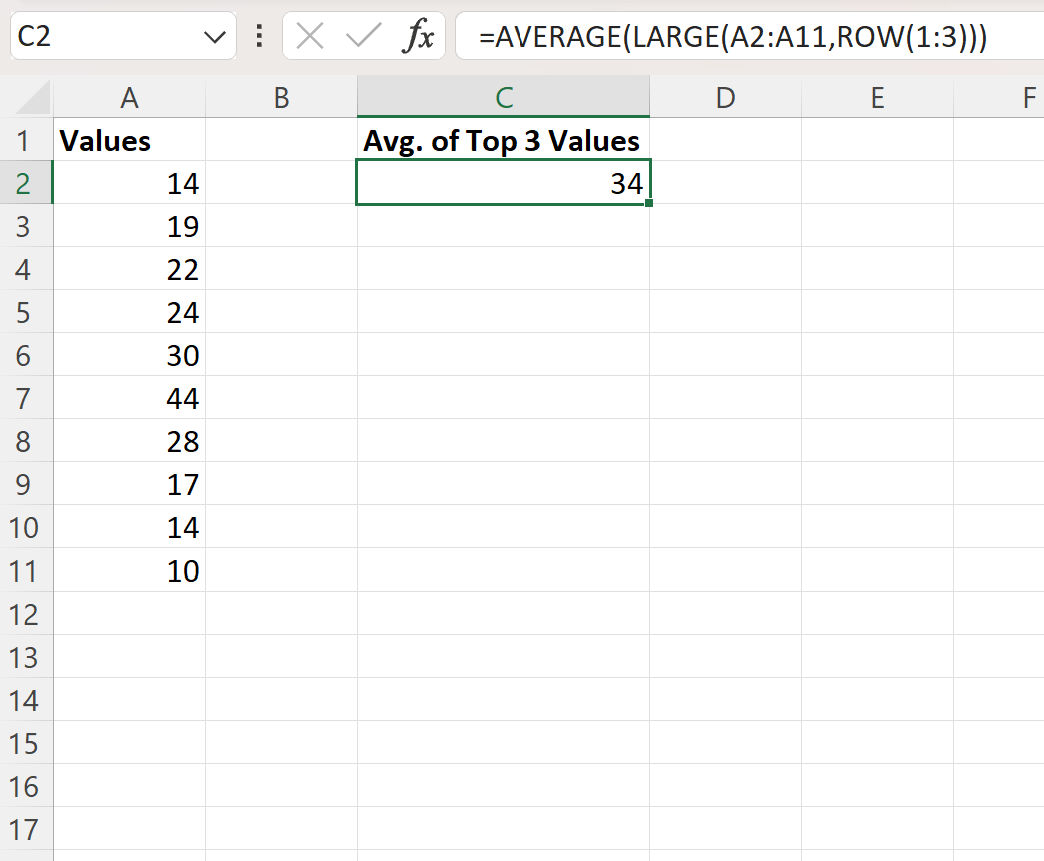
تتمثل المرحلة الإجرائية الحاسمة في إدخال الصيغة الرياضية المركبة داخل الخلية المستهدفة بعناية تامة، وذلك بكتابة البناء الآتي حرفياً: =AVERAGE(LARGE(A2:A11, ROW(1:3))). يبدأ المحلل باختيار الخلية المخصصة لعرض النتيجة، والتأكد من ضبط تنسيقها ليكون تنسيقاً رقمياً (Number) بدلاً من التنسيق النصي العام (Text) الذي قد يتسبب في ظهور المعادلة كحروف صامتة مجردة دون تنفيذ عملياتها الحسابية.
يستدعي تفعيل هذه الصيغة برمجياً التمييز الواعي بين أجيال وإصدارات برنامج إكسيل المختلفة؛ ففي الإصدارات الحديثة التي تدعم محرك المصفوفات الديناميكية (Dynamic Arrays) مثل Microsoft 365 وExcel 2021، يكفي إدخال الصيغة ثم الضغط على مفتاح الإدخال التقليدي Enter فقط، حيث يتعرف المحرك المحدث تلقائياً على الطبيعة المصفوفية لدالة ROW ويدير تدفق النتائج في الذاكرة دون الحاجة إلى إجراءات تنشيط إضافية.
في المقابل، عند العمل على الإصدارات الكلاسيكية والقديمة من إكسيل (Excel 2019 وما قبله)، تتطلب الصيغة تفعيلاً خاصاً يندرج تحت ما يُعرف تقنياً بصيغ CSE؛ حيث يلزم الضغط المتزامن على مفاتيح الاختصار Ctrl + Shift + Enter. يؤدي هذا الإجراء الإلزامي إلى إحاطة الصيغة تلقائياً بأقواس معقوفة تظهر في شريط الصيغ بالشكل {=AVERAGE(LARGE(A2:A11, ROW(1:3)))}، وهي إشارة دالة على أن محرك الحساب القديم قد تحول إلى وضع المعالجة المصفوفية المتعددة؛ وبدون هذا الاختصار ستقتصر دالة LARGE على قراءة الصف الأول فقط ($k=1$) محولة النتيجة إلى حساب متوسط أعلى قيمة وحيدة وتشويه الحساب بالكامل.
5.3 التحقق الرياضي التجريبي المستقل من صحة النتيجة
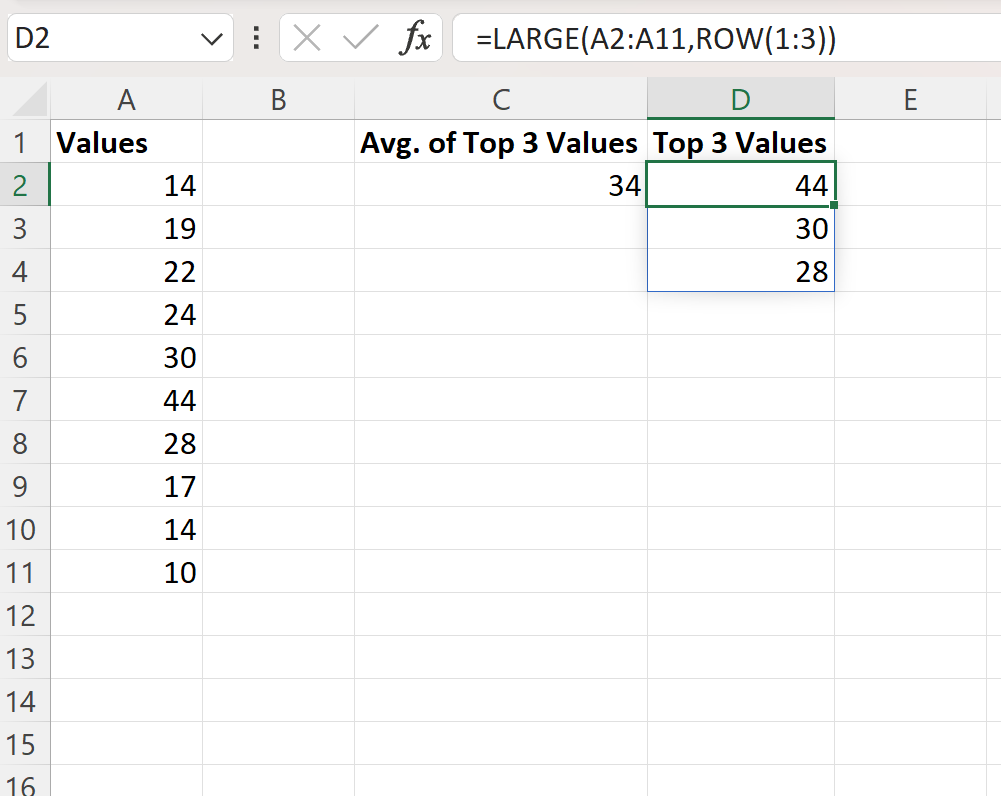
لا يكتمل العمل المنهجي الرصين دون إجراء تدقيق رياضي تجريبي مستقل للتأكد من مطابقة مخرجات الصيغة المركبة للحقيقة الإحصائية المطلقة للبيانات. تتمثل الخطوة الأولى للتحقق في استخراج القيم الثلاث العليا بشكل منفصل في خلايا مستقلة باستخدام دالة LARGE بصورتها الفردية البسيطة؛ فنكتب في خلية التحقق الأولى =LARGE(A2:A11, 1) لاسترجاع القيمة الأولى، وفي الخلية التالية =LARGE(A2:A11, 2) للثانية، ثم =LARGE(A2:A11, 3) للثالثة.
عقب استعراض القيم الثلاث الكبرى وملاحظتها بوضوح، يقوم المحلل بإجراء عملية حسابية يدوية مستقلة تطبق المعادلة الحسابية للوسط الحسابي، وذلك بجمع هذه القيم الثلاث المستخرجة وقسمتها على رقم 3، كأن يكتب: =(Val1 + Val2 + Val3) / 3. يتيح هذا الإجراء البسيط التحقق البصري المباشر من الأرقام الداخلة في الحساب والتأكد من عدم تسلل أي قيمة أدنى أو سقوط أي قيمة أعلى من الترتيب المعتمد.
تتمثل الخطوة التوثيقية النهائية في مطابقة الناتج اليدوي مع القيمة الرقمية الصادرة عن الصيغة المركبة =AVERAGE(LARGE(A2:A11, ROW(1:3)))؛ فإذا تطابقت النتيجتان بدقة متناهية ودون وجود أي كسور عشرية شاردة، يثبت بالدليل القاطع صحة البناء الرياضي للصيغة وسلامة تدفق المصفوفات في الذاكرة. يمنح هذا الاختبار المستقل المحلل ثقة مطلقة في اعتماد النموذج وتطبيقه على نطاقات أوسع تشمل آلاف السجلات مع ضمان سلامة البيانات المخرجة للإدارة ومتخذي القرار.
6. البدائل الحديثة المتقدمة باستخدام دوال المصفوفات الديناميكية
6.1 التوظيف المرن لدالة SEQUENCE كبديل متطور لدالة ROW
أحدث إطلاق محرك الحساب الديناميكي في إصدارات إكسيل الحديثة ثورة تقنية كبرى تجسدت في تقديم دالة SEQUENCE، والتي جاءت كبديل هندسي متطور وأكثر نظافة لدالة ROW التقليدية. تتميز هذه الدالة بقدرتها على بناء مصفوفة متتابعة من الأرقام الصحيحة الصافية وفق وسائط مباشرة، حيث يكتفي المحلل بتمرير وسيط عدد الصفوف المطلوب توليدها، لتصاغ المعادلة المعاصرة على الهيئة الآتية:
=AVERAGE(LARGE(DataRange, SEQUENCE(N)))
حيث يمثل $N$ عدد القيم العليا المستهدفة بصورة عددية صريحة دون أي تعقيد.
يقضي هذا التوظيف الحديث كلياً على الارتباط الفيزيائي بالمراجع المكانية لصفوف ورقة العمل؛ فدالة SEQUENCE لا تعتمد على عناوين خلايا مثل 1:N، بل تُنشئ المتوالية الرقمية برمجياً وبشكل خالص ومجرد في الذاكرة الحسابية للبرنامج. يسهم ذلك في التخلص النهائي من إشكاليات الإزاحة الهيكلية التي لطالما أرقت مصممي النماذج القديمة، ويحرر بنية المعادلة من التبعية المكانية المباشرة لجغرافية الجدول المحيط بها.
تكتسب الصيغة المعتمدة على SEQUENCE متانة برمجية استثنائية تجعلها مقاومة تماماً لكافة عمليات إعادة الهيكلة والتنسيق داخل ورقة العمل؛ فحتى لو قام المستخدم بحذف الصفوف العليا بالكامل أو إدراج عشرات السجلات الجديدة في قمة الجدول، تظل متتالية الأرقام الصادرة عن الدالة ثابتة تبدأ من 1 وتتصاعد بالدقة المطلوبة دون أي انحراف، مما يجعلها الخيار المعياري المفضل والمعتمد عالمياً في بناء النماذج المالية والتحليلية الحديثة والموثوقة.
6.2 الاقتران التحليلي باستخدام دالتي SORT وTAKE
قدمت التحديثات الأخيرة لمجموعة دوال إكسيل ثنائية تحليلية فائقة القوة تجمع بين دالتي SORT وTAKE، لتوفير أسلوب عمل بديل يحاكي لغات الاستعلام المتقدمة مثل SQL في استخراج قمم السجلات. يعتمد هذا الاقتران على منطق مباشر يقوم أولاً بفرز نطاق البيانات المستهدف تنازلياً بصورة كاملة باستخدام دالة الفرز: SORT(DataRange, 1, -1)، حيث يشير الرقم 1 إلى عمود الفرز، بينما يشير المعامل $-1$ إلى الترتيب التنازلي من الأكبر إلى الأصغر.
يأتي بعد ذلك دور دالة الاقتطاع المباشر TAKE، والتي صُممت خصيصاً لاستخلاص عدد محدد من الصفوف أو الأعمدة من بداية المصفوفة أو نهايتها؛ حيث تُوجَه لاقتطاع أعلى $N$ صفوف من المصفوفة المفرزة حديثاً عبر صياغة بسيطة: TAKE(SORT(DataRange, 1, -1), N). تقوم هذه الدالة بعزل الشريحة العليا المطلوبة بسرعة فائقة وتجاهل باقي المصفوفة تماماً دون الحاجة إلى استدعاء مصفوفات رتب متسلسلة أو تراكيب إضافية، مما يجعلها تجسيداً للكفاءة الإجرائية المباشرة.
تُمرر النتائج المقتطعة رأسياً بسلاسة مطلقة كمدخل مباشر لدالة AVERAGE لتبلغ المعادلة ذروة الاكتمال:
=AVERAGE(TAKE(SORT(DataRange, 1, -1), N))
يمتاز هذا التركيب بقدرته الاستثنائية على تسهيل قراءة التدفق المنطقي للحساب للمحللين والمراجعين، حيث تتضح مراحل المعالجة بوضوح جلي: فرز البيانات تنازلياً، اقتطاع الشريحة العليا، ثم حساب الوسط الحسابي، محاكياً بذلك التفكير التحليلي البشري بأعلى درجات الأناقة البرمجية.
6.3 مقارنة معيارية بين الصيغ الكلاسيكية والصيغ الحديثة
توضح المقارنة المعيارية الشاملة بين الصيغ الكلاسيكية المعتمدة على LARGE مع ROW، والصيغ المعاصرة المعتمدة على SEQUENCE أو SORT/TAKE، فروقاً محورية تمس قابلية الفهم والأداء الحسابي والتوافقية الهيكلية. فمن زاوية سهولة القراءة وتدقيق النماذج، تتفوق الصيغ الحديثة بشكل ساحق؛ إذ تبدو واضحة الدلالة والوظيفة لأي مراجع خارجي دون الحاجة لفك شفرات مصفوفات الصفوف القديمة أو التساؤل عن أسباب وجود دوال مكانية كدالة ROW داخل معادلة إحصائية بحتة.
أما على صعيد الأداء الحسابي وسرعة الاستجابة مع البيانات الضخمة (Big Data Sets)، فإن صيغة AVERAGE(LARGE(DataRange, SEQUENCE(N))) تسجل تفوقاً ملحوظاً في سرعة المعالجة على صيغة TAKE/SORT عند التعامل مع نطاقات تحتوي على مئات الآلاف من الصفوف. يرجع ذلك إلى أن دالة SORT تجبر المحرك على فرز كامل النطاق الضخم قبل الاقتطاع، بينما تعتمد دالة LARGE على خوارزميات اختيار جزئي (Partial Selection Algorithms) تكتفي باستخلاص أعلى $N$ عناصر دون إهدار وقت المعالج في فرز آلاف القيم المتدنية التي لا طائل من تنظيمها.
وتظل التوافقية العكسية (Backward Compatibility) مع إصدارات إكسيل السابقة نقطة التميز الوحيدة المتبقية للصيغة الكلاسيكية؛ حيث تعمل صيغة AVERAGE(LARGE(DataRange, ROW(1:N))) بكفاءة مستقرة على كافة إصدارات إكسيل التاريخية منذ أكثر من عقدين من الزمان. في المقابل، تفشل الدوال الحديثة مثل SEQUENCE وTAKE في العمل على الإصدارات التي تسبق Excel 2021 أو حزم الأوفيس المكتبية غير المتصلة بالسحابة، مظهرة خطأ الاسم #NAME?، مما يجعل اختيار الصيغة رهناً بطبيعة بيئة العمل البرمجية المعتمدة لدى كافة الأطراف المشتركة في استخدام وتدقيق النموذج.
7. معالجة الحالات الحدية والبيانات الشاذة في النطاق
7.1 التعامل مع تكرار القيم وتأثيره على ترتيب المراتب
يثير وجود قيم عددية متطابقة ومتكررة في قمة التوزيع الإحصائي للبيانات إشكاليات منهجية يجب على المحلل التعامل معها بدراية إحصائية عميقة. تسلك دالة LARGE سلوكاً ميكانيكياً محدداً عند مصادفة قيم متطابقة؛ حيث تعامل كل تكرار كرتبة مستقلة بذاتها. فعلى سبيل المثال، إذا كانت أعلى القيم في النطاق هي: 100، 100، 95، فإن استخراج أعلى رتبتين ($k=1, 2$) سيعيد الرقم 100 مرتين متتاليتين، معتبراً أن الرتبة الأولى تشغلها القيمة 100 والرتبة الثانية تشغلها القيمة 100 المكررة، مما يجعل متوسط أفضل قيمتين مساوياً لـ 100 تماماً.
يحمل هذا السلوك الحسابي أثراً إحصائياً مباشراً على مدلول العينة المنتقاة؛ فإذا كان الهدف التحليلي يركز على دراسة “أفضل الإنجازات المتمايزة”، فإن احتساب القيم المكررة يؤدي إلى حرمان قيم عالية أخرى مميزة من الدخول ضمن العينة، مما قد يضخم الوسط الحسابي أو يجعله يعبر عن حالة تفوق متكررة لنفس الكيان أو الشخص بدلاً من استعراض تنوع القمم الإحصائية، وهو ما يفرض على المحلل تحديد ما إذا كان التكرار ميزة تشغيلية مستهدفة أم تشويهاً للعينة.
في الحالات التي يتطلب فيها الإطار المنهجي فرز القيم الفريدة حصراً وتطبيق المتوسط على أعلى القيم المتمايزة دون تكرار، يجب دمج دالة UNIQUE ضمن البنية البرمجية للمعادلة. وتصاغ الصيغة الحديثة المتقدمة في هذه الحالة بالشكل الآتي:
=AVERAGE(LARGE(UNIQUE(DataRange), SEQUENCE(N)))
يقوم هذا التركيب الذكي بتنقية النطاق أولاً وإسقاط التكرارات المفرطة، لتباشر دالة LARGE بعد ذلك استخراج الرتب العليا من قائمة القيم الفريدة الصافية، مما يضمن خروج وسط حسابي عادل يعبر عن مستويات الأداء المتمايزة بدقة لا غبار عليها.
7.2 إدارة الخلايا الفارغة والمحتوى النصي غير المحسوب
تتمتع دالة LARGE بآلية تصفية مدمجة تجعلها تتجاهل بطبيعتها الخلايا الفارغة (Blank Cells) والمدخلات النصية الصريحة والقيم المنطقية (TRUE/FALSE) الموزعة عبر النطاق المرجعي، حيث تُسقط تلك الخلايا من مصفوفة الحساب وتركز حصرها على الخلايا الرقمية فقط. لا يؤدي وجود الفراغات أو النصوص في حد ذاته إلى توقف عمل الصيغة، شريطة أن يظل إجمالي عدد الخلايا الرقمية الصالحة المتبقية مساوياً على الأقل لقيمة الرتبة المستهدفة $N$، لتفادي وقوع الدالة في عجز عددي يمنعها من استكمال متتالية الرتب المطلوبة.
تبرز المشكلة الأكثر خطورة عندما تتسلل إلى النطاق أرقام تم إدخالها أو استيرادها بتنسيق نصي (Numbers Stored as Text)، كأن تُسبق الأرقام بفاصلة عليا خفية أو تصدر عبر أنظمة محاسبية قديمة. في هذه الحالة، يتجاهل البرنامج تلك الأرقام النصية بالكامل ويعاملها كنصوص صامتة غير قابلة للترتيب، مما يؤدي إلى استبعاد قيم عليا حقيقية قد تكون هي الأولى في التوزيع، وبالتالي تنحرف نتيجة المتوسط بشكل كارثي نتيجة خروج البيانات الحاسمة من نطاق الفرز والترتيب.
لمعالجة هذه المعضلة وضمان تجانس البيانات الرقمية قبل الشروع في بناء المعادلات المركبة، يتعين إجراء عمليات تطهير للبيانات الملوثة. يمكن الاعتماد على أدوات التحقق الإحصائي المسبقة واستخدام عمليات التحويل القسري عبر لصق خاص مع ضرب النطاق في الرقم واحد، أو تطبيق دوال المعالجة والتحويل مثل الدالة VALUE لتجريد الأرقام من صبغتها النصية، مما يضمن انخراط كافة القيم الإحصائية الحقيقية في التنافس على احتلال المراتب العليا تحت مظلة الدالة التجميعية.
7.3 معالجة القيم السالبة والأصفار وتأثيرها على النتيجة
تتعامل دالة LARGE مع خط الأعداد الرياضي بصرامة منطقية مطلقة؛ حيث ترتب كافة القيم الواقعة ضمن نطاقها ترتيباً تنازلياً جبرياً بغض النظر عن طبيعة إشارتها الحسابية، بحيث تتقدم القيم الموجبة على الأصفار، وتتقدم الأصفار بدورها على القيم السالبة (حيث يُعد الرقم $-1$ أكبر جبرياً من $-5$). في بيئات التحليل المالي أو دراسات التذبذب المناخي، قد يشهد النطاق وجود أرقام سالبة أو أصفار تمثل خسائر مالية أو درجات تجمد صريحة وتنافس على حجز مواقع ضمن أعلى الرتب التنازلية المتاحة.
إذا كان السياق التشغيلي للدراسة يستلزم عزل القيم الإيجابية فقط واستبعاد حالات التعادل الصفري أو الأداء الخاسر من الدخول في حساب متوسط القمة، فإن الصيغة القياسية غير المشروطة ستؤدي إلى تشويه التحليل؛ إذ قد تضطر دالة LARGE لسحب الأصفار أو الأرقام السالبة لتكملة مصفوفة الرتب المطلوبة إذا كان عدد الأرقام الموجبة المتاحة أقل من القيمة $N$. ويترتب على ذلك انخفاض حاد في المتوسط الحسابي لا يعبر بصدق عن واقع مستويات الإنتاج الفعالة التي تشترط الإيجابية في عناصرها.
تقتضي هذه الإشكالية تطبيق استراتيجيات عزل مسبقة للقيم غير المرغوبة عن طريق دمج الدوال المنطقية والتصفية المسبقة. في إصدارات إكسيل الحديثة، يُوظف الاقتران الشرطي باستخدام دالة FILTER لاستبعاد الأصفار والسلبيات قبل الشروع في الترتيب، لتصاغ المعادلة بالشكل الحصين الآتي:
=AVERAGE(LARGE(FILTER(DataRange, DataRange > 0), SEQUENCE(N)))
يضمن هذا الأسلوب المعماري عدم تسلل أي قيمة غير إيجابية إلى قائمة النخبة، محافظاً على نقاء المفهوم الإحصائي لأعلى مستويات الأداء التشغيلي الفعال.
8. تشخيص الأخطاء الشائعة واستكشاف المشكلات وإصلاحها
8.1 أسباب وحلول خطأ القيمة الإحصائية #NUM!
يعد خطأ القيمة الإحصائية الشهير #NUM! العائق البرمجي الأكثر شيوعاً وتكراراً عند تطبيق صيغ حساب متوسط أعلى $N$ قيم في إكسيل. ينفجر هذا الخطأ الحسابي الصريح في وجه المستخدم في لحظة محددة: عندما تتجاوز قيمة الرتبة $N$ المطلوبة إجمالي عدد القيم الرقمية الصالحة والمأهولة فعلياً داخل النطاق المرجعي المستهدف. فإذا طلب المحلل استخراج متوسط أعلى 10 قيم من نطاق لا يحتوي في واقعه التشغيلي سوى على 7 خلايا رقمية فقط، تعجز دالة LARGE عن إيجاد الرتبة الثامنة والتاسعة والعاشرة، مما يؤدي إلى انهيار العملية برمتها وإرجاع رسالة الخطأ الرقمي الفورية.
تتمثل المقاربة الوقائية المنهجية لحل هذه المشكلة في إرساء قيود ديناميكية محكمة تضبط حدود وسيط الرتبة ليتناسب طردياً ومرناً مع حجم العينة الفعلي المتوفر في ورقة العمل لحظة الحساب. يمكن تحقيق هذا الضبط الذكي عبر دمج دالة الإحصاء العددي COUNT مع دالة تحديد الحدود الدنيا MIN، بحيث يُلزم النموذج بعدم طلب رتب تتخطى السقف الواقعي للبيانات، مما يوفر حماية برمجية متقدمة للصيغة الرياضية ضد الانقطاعات الحسابية المفاجئة.
وتتبلور هذه الصياغة الوقائية المحكمة في إكسيل الحديث على النحو التالي:
=AVERAGE(LARGE(DataRange, SEQUENCE(MIN(N, COUNT(DataRange)))))
تضمن هذه التركيبة الرياضية المقيدة مرونة متناهية للنموذج؛ فحتى لو انخفض عدد البيانات المتاحة في النطاق لأي سبب طارئ ليصبح أقل من $N$ المستهدفة، تكتفي الصيغة تلقائياً بحساب متوسط كافة البيانات الرقمية المتوفرة فعلياً دون أن تتوقف عن العمل أو تطلق رسائل الخطأ، مما يعزز استمرارية التقارير الرقمية المؤتمتة وموثوقيتها التشغيلية.
8.2 تجنب خطأ عدم توافق البيانات #VALUE! والأخطاء المرجعية #REF!
ينشأ خطأ عدم توافق البيانات الإحصائي #VALUE! عادة عن خلل هيكلي في طبيعة المدخلات الممررة إلى وسائط الدوال المركبة، كأن يُمرر وسيط يحتوي على نصوص صريحة داخل مصفوفة يُنتظر منها أن تكون متتالية رقمية بحتة، أو عند ارتكاب أخطاء في صياغة الأقواس المعقوفة وتداخل المصفوفات متعددة الأبعاد داخل الدوال المصممة للتعامل مع متجهات أحادية البعد. كما يظهر هذا الخطأ بصورة متكررة في الإصدارات القديمة عند نسيان تفعيل صيغ المصفوفات بمفاتيح Ctrl + Shift + Enter عند التعامل مع تراكيب معقدة تفشل الدالة في معالجتها كنطاق خطي فردي.
أما الخطأ المرجعي القاتل #REF!، فيرتبط دائماً بحدوث انقطاع في الروابط المرجعية الجغرافية للخلايا؛ ويحدث هذا غالباً عند قيام أحد المستخدمين بحذف الصفوف الفيزيائية أو الأعمدة التي تعتمد عليها الدالة لتوليد نطاقها الحسابي. فعند استخدام صيغ تقليدية غير مؤمنة تعتمد على دالة ROW بطريقة الإسناد غير المحمي، ويتبع ذلك حذف للصفوف الحاضنة لتلك المراجع، تنقطع الصلة المرجعية فوراً وتتحول الصيغة إلى ROW(#REF!)، مما يدمر سلامة المعادلة ويفقدها القدرة على العمل نهائياً.
لتجنب الوقوع في هذه المنزلقات الهيكلية، يجب اتباع نهج صارم في التحقق من التنسيقات وتوحيد أبعاد المصفوفات؛ بحيث يتم التأكد من أن كافة وسائط الدوال المصفوفية تتطابق في اتجاهها وأبعادها المتجهة (أفقية أو عمودية). كما يُنصح بالابتعاد التام عن الإسنادات المكانية الهشة واستبدالها بالمراجع الهيكلية للجداول أو استخدام الدوال التوليدية الصافية التي لا ترتبط بالصفوف المكانية، مما يحصن ورقة العمل ضد التلف المرجعي ويمنع تعطل العمليات التحليلية في البيئات المزدحمة بالبيانات والتحديثات.
8.3 استخدام دوال المعالجة الوقائية IFERROR لتعزيز الصلابة
تمثل البرمجة الدفاعية (Defensive Programming) ركيزة جوهرية في إعداد النماذج التحليلية المتقدمة لبيئات الأعمال المعاصرة؛ حيث يتعين على مصمم النموذج توقع أسوأ السيناريوهات المحتملة للبيانات وبناء آليات احتواء مرنة تمنع ظهور رموز الأخطاء البرمجية الصريحة على واجهات لوحات القيادة (Dashboards) والتقارير التنفيذية. وتعد دالة IFERROR خط الدفاع الأول في معالجة هذه الحالات الشاذة وتطويق الصيغ المركبة بحزام أمان وقائي عالي الفاعلية.
يتم تطبيق هذا الإجراء الوقائي عن طريق تغليف الصيغة الحسابية المعقدة بأكملها داخل وسائط دالة IFERROR، بحيث تُحدد الدالة السلوك البديل الواجب اتخاذه في حال فشل المعادلة الداخلية في التقييم لأي سبب كان (سواء بسبب نقص البيانات أو عدم كفاية القيم المتاحة). وتصاغ المعادلة المحمية برمجياً بالشكل الآتي:
=IFERROR(AVERAGE(LARGE(DataRange, SEQUENCE(N))), "البيانات غير كافية للتحليل")
يتيح هذا التركيب استبدال رموز الأخطاء المزعجة مثل #NUM! أو #VALUE! برسائل توجيهية وإرشادية راقية ومفهومة تفيد متخذ القرار بأن النطاق لا يضم العدد الكافي من البيانات المكتملة لاستخلاص متوسط أعلى القيم.
كما يمكن توجيه دالة IFERROR برمجياً لإرجاع قيمة صفرية أو تطبيق معادلة بديلة كإجراء مساند؛ مثل حساب المتوسط العام للبيانات المتاحة بدلاً من ترك الخلية فارغة، مما يحافظ على التماسك البصري والهيكلي لواجهات التقارير ويدعم استمرارية تدفق الحسابات المرتبطة بتلك الخلية في خلايا وأوراق عمل أخرى. يسهم هذا النهج الاحترافي في رفع الجدارة الفنية للنماذج المنشأة ويجعلها مقاومة للتغيرات المفاجئة في حجم مجموعات البيانات الأولية عبر فترات التشغيل الدورية المتغيرة.
9. جعل قيمة N متغيرة وديناميكية بالاعتماد على مراجع الخلايا
9.1 ربط وسيط الحجم بخلية إدخال مستقلة
يعد الفصل المنهجي بين بنية المعادلات الحسابية وبين المتغيرات والمعايير التشغيلية (Separation of Parameters and Logic) من أهم القواعد الذهبية في هندسة النماذج المالية والتحليلية في إكسيل. إن دمج القيمة الرقمية للرتبة $N$ بصورة جامدة ومباشرة داخل كود المعادلة (Hardcoding)، كأن يُكتب الرقم 3 أو 5 مباشرة داخل الصيغة، يمثل خللاً تصميمياً يحد من مرونة النموذج ويجعل تعديله مستقبلاً عملية شاقة تتطلب البحث والتعديل اليدوي في أمعاء الخلايا الحسابية وما يرافقه من مخاطر إتلاف بنية الصيغة المركبة.
لتحقيق الأداء التفاعلي الأمثل، يتم تخصيص خلية مستقلة ومنعزلة بوضوح داخل ورقة العمل (ولتكن الخلية المرجعية C1) لتكون بمثابة لوحة إدخال لمعيار حجم العينة العليا ($N$). يُعطى هذا المرجع اسماً مميزاً أو تنسيقاً لونياً يعكس طبيعته التفاعلية كخلية متغيرة، ليقوم المحلل بعد ذلك بربط وسيط المتتالية في المعادلة بذلك المرجع مباشرة، لتصبح الصيغة مصاغة برقة هندسية عالية:
=AVERAGE(LARGE(DataRange, SEQUENCE(C1)))
يمكّن هذا التصميم التفاعلي مستخدمي النموذج من إجراء تحليلات الحساسية واستكشاف السيناريوهات المتعددة في أجزاء من الثانية دون لمس الصيغ الأصلية؛ فبمجرد كتابة الرقم 10 في الخلية C1، يقوم إكسيل فورياً بإعادة توليد متتالية الرتب لتشمل أفضل 10 قيم وحساب متوسطها الجديد على الفور، وإذا عُدل الرقم إلى 3 تنعكس النتائج في نفس اللحظة. يرسخ هذا الفصل تجربة مستخدم سلسة ويوفر واجهة تطبيقية آمنة تتوافق مع أعلى معايير تصميم النماذج المؤسسية المعتمدة عالمياً.
9.2 استخدام دالة INDIRECT والبدائل غير المتقلبة
في الإصدارات الكلاسيكية لإكسيل التي تفتقر لدالة SEQUENCE، تنشأ معضلة تقنية عند الرغبة في ربط حجم النطاق داخل دالة ROW بخلية متغيرة، نظراً لأن دالة ROW تتطلب مرجعاً نطاقياً صريحاً ولا تقبل الأرقام المنفصلة مباشرة. لتجاوز هذه العقبة في البيئات القديمة، يلجأ المحللون إلى دمج دالة INDIRECT لتركيب مرجع نصي ديناميكي يُحول إلى مرجع فيزيائي صالح داخل الذاكرة، وفق الصيغة المصفوفية:
=AVERAGE(LARGE(DataRange, ROW(INDIRECT("1:" & C1))))
حيث تقوم الدالة بدمج الرقم 1 مع محتوى الخلية المتغيرة وتمرير النطاق النصي الناتج إلى دالة ROW لتوليد مصفوفة الرتب المطلوبة بدقة.
على الرغم من النجاح الظاهري لهذه الحيلة البرمجية، إلا أنها تخلق معضلة كفاءة جسيمة؛ فدالة INDIRECT تصنف في بنية إكسيل بأنها دالة متقلبة (Volatile Function). يعني هذا التصنيف أن الدالة تُجبر محرك الحساب على إعادة تقييم المعادلة بالكامل عند حدوث أي تعديل أو ضغطة زر في أي خلية ضمن ورقة العمل بأكملها، حتى لو لم يكن التعديل متعلقاً بنطاق البيانات محل الحساب إطلاقاً، مما يؤدي إلى استنزاف هائل لطاقة المعالج وإصابة ملفات البيانات الكبيرة بالشلل والبطء المزعج.
كبديل منهجي فائق الكفاءة وغير متقلب (Non-Volatile Alternative) لحل هذه المعضلة في الإصدارات الكلاسيكية، يمكن للمحللين توظيف دالة INDEX لبناء النطاق المرجعي الآمن للمتتالية دون إرهاق موارد النظام، عبر الصياغة الرياضية المبتكرة:
=AVERAGE(LARGE(DataRange, ROW($A$1:INDEX($A:$A, C1))))
تقوم دالة INDEX هنا بإرجاع مرجع الخلية المقابل للرقم المحدد في C1، مما يخلق نطاقاً مقيداً من $A1$ إلى الخلية المحددة، متيحة لدالة ROW توليد المتتالية المطلوبة دون الوقوع في فخ التردد والتقلب المستمر، ومحافظةً على أقصى درجات سرعة الأداء والاستقرار البرمجي للملف.
9.3 إنشاء لوحة تحكم تفاعلية لاختبار السيناريوهات المتعددة
يرتقي التطبيق المنهجي لحساب متوسط أعلى $N$ قيم إلى مستويات التحليل المتقدمة عند إدماجه ضمن لوحات القيادة التفاعلية (Interactive Dashboards) لدعم اتخاذ القرار المؤسسي. يمكن تدعيم خلية التحكم في قيمة $N$ بعناصر تحكم النماذج المدمجة في إكسيل (Form Controls)، مثل أشرطة التمرير (Scroll Bars) أو أزرار الدوران (Spin Buttons)، أو من خلال قوائم التحقق من صحة البيانات المنسدلة (Data Validation Drop-down Lists)، مما يتيح للمديرين تصفح أحجام مختلفة لعينات القمة بسلاسة بصرية فائقة وبضغطة زر واحدة دون الحاجة للكتابة اليدوية إطلاقاً.
يتكامل هذا التصميم التفاعلي بشكل مذهل مع أدوات المحاكاة واختبار السيناريوهات؛ فعند ربط الصيغة الديناميكية بأشرطة التمرير، تتحدث نتائج حساب المتوسط الحسابي فورياً على الشاشة متزامنة مع الرسوم البيانية الإيضاحية. يمكن حينئذ تمثيل خط أفقي ديناميكي على المخطط البياني العام يرتفع وينخفض ليعكس قيمة متوسط النخبة مقارنة بالمتوسط العام للمجتمع، مما يمنح متخذ القرار تصميماً بصرياً فورياً يوضح الفجوة بين الأداء الاستثنائي والأداء الاعتيادي للمنظومة بدقة فائقة.
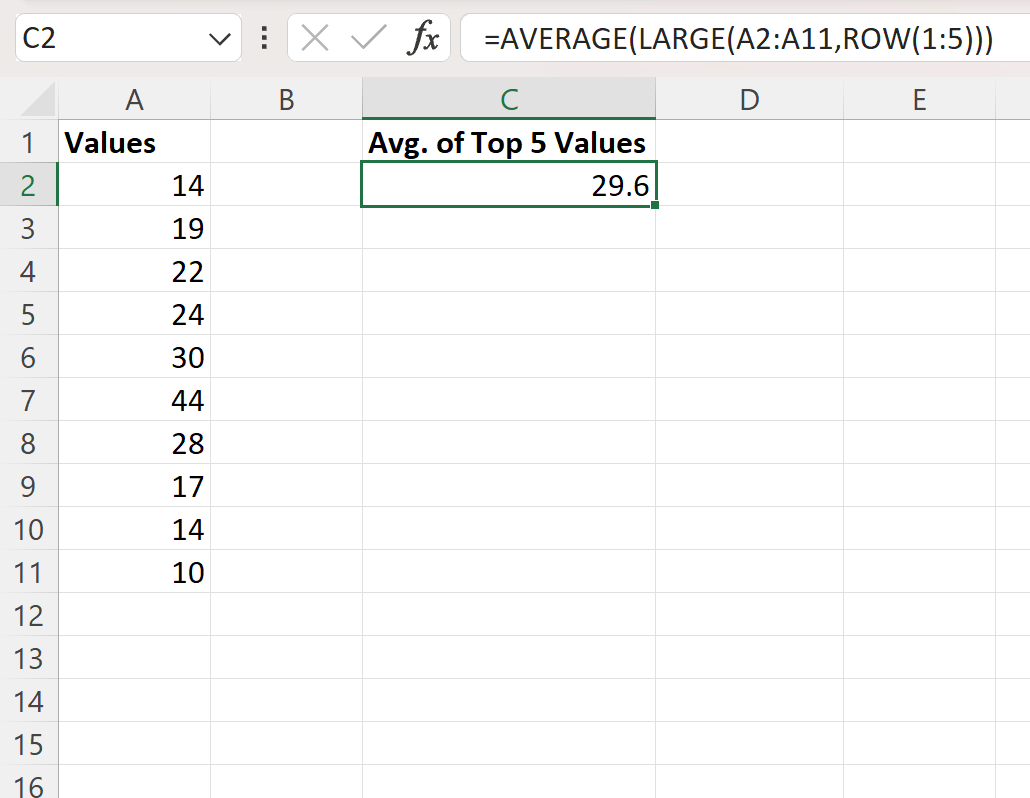
كما يدعم هذا التكوين المرن مقارنة الحساسية بين مختلف قطاعات الأعمال؛ حيث يمكن دراسة كيفية استجابة المتوسط لتغير $N$؛ فإذا كان المتوسط ينحدر انحداراً حاداً بمجرد الانتقال من $N=3$ إلى $N=5$، فإن ذلك يعطي دلالة إحصائية حاسمة بوجود تركز مفرط للأداء في قلة نادرة من الأفراد أو الأيام، يليه هبوط كبير في المستويات، في حين يشير استقرار المتوسط عند توسيع قيمة $N$ إلى تجانس كفاءة النخبة وقوة تماسك عناصر التوزيع العليا، وهي رؤى استراتيجية لا يمكن استنباطها إلا من خلال لوحات التحكم التفاعلية المتقنة.
10. تطبيقات منهجية متقدمة وأفضل الممارسات التحليلية
10.1 حساب المتوسط المشروط لأعلى N قيم وفق معايير إضافية
تتطلب التحديات التحليلية الواقعية في بيئات الأعمال في كثير من الأحيان تجاوز الفرز المطلق للنطاقات والانتقال نحو حساب المتوسط المشروط لأعلى $N$ قيم وفق معايير تصنيفية إضافية متعددة؛ كأن تطلب الإدارة حساب متوسط أعلى 5 صفقات مبيعات ولكن “لقسم تقنية المعلومات حصراً”، أو استخراج متوسط أفضل نتائج الاختبارات “لفرع معين دون غيره”. في هذه السيناريوهات، تصبح المعادلات الكلاسيكية البسيطة عاجزة عن الوفاء بالغرض، مما يستدعي بناء صيغ ترشيح مشروطة تسبق عملية الفرز الترتيبي.
يمثل التوظيف المشترك لدالتي FILTER وLARGE في إصدارات إكسيل الحديثة ذروة المرونة البرمجية لتحقيق هذا المطلب؛ حيث تقوم دالة FILTER أولاً بمسح قاعدة البيانات الكلية وعزل السجلات التي تستوفي الشرط المطلوب، لتقوم بعد ذلك بتمرير هذه الشريحة المصفاة حصرياً إلى دالة LARGE لاستخراج الرتب العليا وحساب متوسطها، وتصاغ المعادلة الاحترافية على النحو الآتي:
=AVERAGE(LARGE(FILTER(SalesRange, DeptRange = "تقنية المعلومات"), SEQUENCE(5)))
يضمن هذا التركيب عزل المعطيات الخارجية غير المستهدفة مسبقاً، واقتصار التنافس على الرتب العليا بين عناصر الفئة المحددة فقط.
عند الحاجة للتعامل مع شروط متعددة ومتشابكة (Multi-Criteria Selection)، يمكن توسيع وسائط دالة FILTER بالاعتماد على المنطق البوليني (Boolean Logic)؛ حيث تُدمج الشروط الإلزامية المتزامنة باستخدام معامل الضرب النقطي (*) لتمثيل بوابة العطف المنطقية (AND)، وتُدمج الشروط التخييرية التبادلية باستخدام معامل الجمع (+) لتمثيل بوابة الفصل المنطقية (OR). يتيح هذا النهج المتقدم استخراج متوسط أفضل القيم لقطاعات جغرافية محددة وخلال فترات زمنية دقيقة وبشروط مالية معينة في آن واحد وبمنتهى القوة البرمجية ودقة المعالجة الحسابية.
10.2 توثيق وتدقيق النماذج الرياضية في بيئات الأعمال
تفرض المعايير المهنية لحوكمة البيانات والمخاطر التشغيلية في بيئات الأعمال والمؤسسات المصرفية إخضاع كافة النماذج الرياضية المبنية داخل إكسيل لعمليات توثيق وتدقيق بالغة الصرامة؛ فالصيغ المصفوفية المركبة، على الرغم من فاعليتها الرياضية العالية، تُصنف في الأدبيات المهنية بأنها صيغ “شديدة التعقيد” ومعرضة لخطر سوء الفهم والإتلاف عند تداول ورقة العمل بين محللين متعددين، ما لم تكن مدعومة بتوثيق تفسيري شامل يشرح المسار المنطقي الداخلي لتدفق البيانات وتفاعلات المصفوفات.
تشمل أفضل الممارسات التوثيقية المعتمدة إدراج تعليقات توضيحية صريحة (Cell Notes/Comments) ملاصقة للخلية الحاضنة للمعادلة، توضح الغرض الإحصائي من احتساب أعلى $N$ قيم، وتبرز دلالة كل وسيط وسبب اختيار القيمة المعينة للمتغير $N$. بالإضافة إلى ذلك، يوصى بشدة بتحويل النطاقات المرجعية الصامتة (مثل A2:A100) إلى نطاقات مسماة رسمياً (Named Ranges) ذات دلالة لغوية مفهومة، كأن يُعاد صياغة المعادلة لتصبح:
=AVERAGE(LARGE(MonthlyRevenue, SEQUENCE(TopN_Param)))
مما يرفع قابلية الصيغة للقراءة الذاتية الفورية ويحد من غموض المراجع المكانية المباشرة.
تتضمن إجراءات التدقيق والرقابة الفنية الدورية استخدام أدوات تدقيق الصيغ المدمجة في إكسيل لمتابعة مسار الخلايا التابعة والسابقة (Trace Precedents and Dependents)، وفحص النماذج بصورة منتظمة للتأكد من عدم حدوث أي تآكل أو تمزق في بنية المصفوفات الناتجة عن إدخال بيانات مشوهة أو متجاوزة للأبعاد المنطقية. تسهم هذه الممارسات المؤسسية المنضبطة في ترسيخ الموثوقية وتسهل مهام المراجعين الداخليين والخارجيين في اعتماد مخرجات التحليل والاطمئنان لسلامة المؤشرات الرقمية المشتقة لاتخاذ القرارات الاستراتيجية الحساسة.
10.3 اعتبارات الأمان وحماية الصيغ في أوراق العمل المشتركة
تتضاعف الحاجة إلى حماية النماذج الحسابية وأمان أوراق العمل بصورة حرجة في بيئات العمل المشتركة والمنصات السحابية التعاونية الحديثة (مثل Microsoft OneDrive وSharePoint)، حيث تتعدد الأيدي التي تتعامل مع نفس الملف الرقمي في آن واحد. يزداد في هذه البيئات احتمال قيام مستخدم غير متمرس أو عن غير قصد بتعديل صيغة مركبة معقدة أو مسحها أو الضغط الخاطئ داخل شريط المعادلات، مما قد يؤدي إلى نسف المنطق المصفوفي للمعادلة وإفساد النتائج التراكمية في كافة الصفحات والتقارير المرتبطة بها.
لتحقيق الأمان الهندسي الكامل للنموذج، يجب تطبيق استراتيجية الإغلاق الانتقائي للخلايا (Cell Locking Strategy)؛ ويتم ذلك عبر إلغاء خاصية القفل عن خلايا الإدخال التفاعلية المخصصة للمستخدمين فقط (مثل خلية إدخال قيمة $N$ وخلايا إضافة البيانات الأولية)، في حين يتم الإبقاء على خاصية القفل التام (Locked) وتفعيل خاصية الإخفاء (Hidden) لكافة الخلايا الحاضنة للصيغ الرياضية المركبة، لمنع تعديلها أو حتى إظهار نص تركيبها الداخلي للمستخدمين غير المصرح لهم، وحماية الملكية الفكرية والمعمارية للنموذج المحاسبي.
تُتوج هذه الإجراءات بتفعيل حماية ورقة العمل (Protect Sheet) باستخدام كلمة مرور معتمدة ومقيدة للصلاحيات الإدارية، مع ضبط أذونات التحرير والمشاركة بدقة لمنع أي مساس بتخطيط الجداول أو بنية الأعمدة، وتحديد مساحات العمل الحصرية المسموحة للمتعاونين عبر أدوات إدارة الوصول السحابي. يضمن هذا التدرج الوقائي الصارم سلامة النموذج وصموده المستمر أمام العبث التشغيلي العشوائي، مانحاً المؤسسة ضماناً رياضياً وبرمجياً مستداماً لدقة وصحة مؤشراتها التحليلية المشتقة من متوسط القيم العليا تحت كافة ظروف الاستخدام التعاوني المكثف.
الخاتمة
استعرض هذا الدليل الأكاديمي الشامل كافة الأبعاد النظرية والتطبيقية لحساب متوسط أعلى $N$ قيم في برنامج مايكروسوفت إكسيل، مبرزاً الطفرة البنيوية التي شهدها البرنامج من تراكيب صيغ المصفوفات الكلاسيكية المعقدة المقيدة باختصارات لوحة المفاتيح والارتباطات المكانية لصفوف ورقة العمل، وصولاً إلى ثورة المصفوفات الديناميكية الحديثة التي جعلت من دوال مثل SEQUENCE وTAKE أدوات غاية في النظافة الرياضية والكفاءة البرمجية وسهولة التوثيق والتعديل.
وقد تبين بالبرهان التحليلي أن نجاح تطبيق هذه المعالجة الإحصائية لا يعتمد على حفظ الصيغ واستنساخها بشكل عشوائي، بل يتطلب فهماً عميقاً لطبيعة البيانات وتوزيعها التكراري، واستيعاباً دقيقاً لكيفية معالجة الحالات الحدية كالتكرارات، والأرقام السالبة، والأخطاء النطاقية، والفصل الصارم بين مدخلات المعايير والمنطق البرمجي، إلى جانب الالتزام بأرقى معايير التوثيق وحماية النماذج لضمان متانتها وحوكمتها عبر بيئات العمل المؤسسية المشتركة.
إن إتقان هذه التوليفات الحسابية المتقدمة يمنح المحللين وصناع القرار ميزة تنافسية كبرى لتحويل كميات البيانات المتراكمة إلى مقاييس أداء كمية دقيقة تعكس مستويات الجدارة والكفاءة التشغيلية القصوى، مما يسهم في ضبط المستهدفات المستقبلية وترشيد اتخاذ القرارات الاقتصادية والإدارية بناءً على أسس إحصائية بالغة الصلابة ومحققة علمياً وبرمجياً بأعلى درجات الدقة والاحترافية.
المراجع
- Microsoft Support. (2023). LARGE function. Microsoft Corporation. https://support.microsoft.com/en-us/office/large-function-3af014a3-1444-4b8b-a76c-673320f723ea
- Microsoft Support. (2023). AVERAGE function. Microsoft Corporation. https://support.microsoft.com/en-us/office/average-function-0402d371-f9fb-4a72-ac58-3714e6720b90
- Microsoft Support. (2023). SEQUENCE function. Microsoft Corporation. https://support.microsoft.com/en-us/office/sequence-function-57467a98-57e0-4817-9f14-2eb78519ca90
- Microsoft Support. (2023). TAKE function. Microsoft Corporation. https://support.microsoft.com/en-us/office/take-function-25382ff1-5da1-4f78-ab43-f33bd2e4e003
- Microsoft Support. (2023). Guidelines and examples of array formulas. Microsoft Corporation. https://support.microsoft.com/en-us/office/guidelines-and-examples-of-array-formulas-7d94a64e-3ff3-4686-9372-ecfd5caa57e7
- Alexander, M., Kusleika, D., & Walkenbach, J. (2019). Excel 2019 Bible. John Wiley & Sons.