
يحتل تحليل التباين (Analysis of Variance – ANOVA) مكانة مركزية في ترسانة المنهجيات الإحصائية التي يعتمد عليها الباحثون في مجالات العلوم السلوكية، وعلم النفس التجريبي، والعلوم الاجتماعية عموماً. يتيح هذا الأسلوب الإحصائي الرصين اختبار الفرضيات المتعلقة بالفروق بين متوسطات عدة مجموعات تجريبية أو ضابطة في آن واحد، مما يمنح الباحثين أداة دقيقة لفحص تأثير المتغيرات المستقلة التصنيفية على المتغيرات التابعة الكمية. وعلى الرغم من شيوع استخدام الحزم الإحصائية الرسومية الجاهزة، إلا أن منصة التحليل الإحصائي SAS (Statistical Analysis System) تظل المعيار الذهبي المفضل في مراكز البحوث المتقدمة والجامعات الكبرى بفضل صرامتها الرياضية الفائقة وقدرتها الهائلة على معالجة قواعد البيانات المعقدة والتصاميم التجريبية المتداخلة والمتوازنة وغير المتوازنة بدقة لا تضاهى.
تتطلب قراءة وتفسير مخرجات تحليل التباين في بيئة برمجية SAS إلماماً عميقاً بالبنية المفاهيمية للنماذج الخطية العامة، بدءاً من فهم تفكيك التباين الإجمالي إلى تباين راجع للنموذج وتباين ناجم عن الخطأ العشوائي، مروراً بتقدير دلالة النسبة الفائية (F-ratio)، وحساب أحجام الأثر، وانتهاءً بإجراء المقارنات البعدية المتعددة لضبط معدلات الخطأ التراكمي. إن القراءة السطحية للأرقام دون استيعاب دلالاتها السيكومترية والإحصائية قد تقود إلى استنتاجات مضللة حول فاعلية البرامج العلاجية أو التدخلات السلوكية؛ ولهذا، يهدف هذا الدليل الأكاديمي الشامل إلى تزويد الباحث والمحلل بخارطة طريق تفصيلية، خطوة بخطوة، للتعامل مع إجراءات تحليل التباين في SAS وتفسير جداولها المتشعبة بكفاءة واقتدار وفق أحدث المعايير العلمية.
1. مقدمة في تحليل التباين (ANOVA) وأهميته في البحوث النفسية
1.1 المفهوم الإحصائي لتحليل التباين أحادي الاتجاه
يقوم المفهوم الإحصائي لاختبار تحليل التباين أحادي الاتجاه (One-Way ANOVA) على مقارنة تباينين أساسيين: التباين القائم بين متوسطات المجموعات التجريبية المختلفة (Between-Groups Variance) والتباين الكامن داخل كل مجموعة على حدة (Within-Groups Variance). ويهدف هذا الاختبار إلى تحديد ما إذا كانت العينات المستقلة المسحوبة تنتمي في الأصل إلى مجتمع إحصائي واحد يشترك في نفس المتوسط الحسابي، أم أنها تمثل مجتمعات متباينة تأثرت بالمعالجات التجريبية المفروضة عليها. وتتجلى الضرورة المنهجية لاعتماد تحليل التباين بدلاً من اللجوء إلى إجراء اختبارات “ت” المستقلة (Student’s t-tests) المتكررة لمقارنة كل زوج من المجموعات في السيطرة الصارمة على ما يعرف إحصائياً بتضخم خطأ النوع الأول (Familywise Type I Error Inflation). فعندما يقوم الباحث بمقارنة ثلاث مجموعات تجريبية أو أكثر باستخدام اختبارات “ت” الثنائية، يتصاعد احتمال رفض الفرضية الصفرية الصحيحة خطأً من المستوى الاسمي المحدد عند 0.05 إلى مستويات تتجاوز ذلك بكثير وفق المعادلة الاحتمالية المعروفة: 1 مطروحاً منها (1 ناقص ألفا) مرفوعة لأس عدد المقارنات، مما يهدد المصداقية الداخلية للتجربة النفسية برمتها.
تتنوع تطبيقات تحليل التباين في السياقات النفسية والتجريبية بصورة واسعة؛ إذ يُستخدم على نطاق مكثف في تقييم فاعلية التدخلات الإكلينيكية والبرامج السلوكية والمعرفية. فعلى سبيل المثال، عند دراسة آليات الضبط الذاتي وتأثيرها على الأداء السلوكي كما تناولتها الأبحاث الكلاسيكية والحديثة في علم النفس (de Ridder et al., 2011)، قد يحتاج الباحث إلى مقارنة مجموعة تخضع لبرنامج التدريب على الإرادة، ومجموعة تخضع لاستراتيجيات تعديل البيئة، ومجموعة ثالثة ضابطة لم تتلق أي تدريب. وفي مثل هذه التصاميم، تتم صياغة الفرضية الصفرية لتنص على أن جميع متوسطات المجتمع متساوية عبر مستويات المعالجة المختلفة، بينما تنص الفرضية البديلة على وجود متوسط واحد على الأقل يختلف جوهرياً عن بقية المتوسطات الأخرى، دون تحديد مسبق للزوج المسؤول عن هذا التباين، وهو ما يستدعي لاحقاً استخدام المقارنات البعدية.
1.2 أهمية استخدام حزمة SAS الإحصائية في العلوم السلوكية
تتمتع حزمة SAS الإحصائية بوزن اعتباري استثنائي في الأوساط الأكاديمية والبحثية المتقدمة التي تركز على العلوم المعرفية والاضطرابات النفسية والسلوكية. وتعود هذه الأهمية إلى خوارزميات الحساب الرياضي عالية الدقة التي تعتمدها المنظومة، والتي تم تطويرها للتعامل مع أدق التفاصيل العددية وتجنب مشكلات التقريب الرقمي التي قد تقع فيها بعض البرمجيات التجارية الأخرى، لا سيما عند معالجة المصفوفات المعقدة ومصفوفات التغاير ذات الأبعاد المتعددة. هذا التدقيق البرمجي المتقن يمنح نتائج SAS موثوقية لا تضاهى عند فحص الفروق الدقيقة بين التصاميم التجريبية، خصوصاً تلك التي تتناول الفروق الفردية في سعة الذاكرة العاملة والتحكم الانتباهي كما بيّنت أبحاث علم النفس التجريبي (Kane et al., 2001).
علاوة على ذلك، تتميز SAS بقدرة فائقة على إدارة وتحليل قواعد البيانات الضخمة التي تشتمل على آلاف المشاهدات والبيانات المتعددة المستويات والممتدة زمنياً، وتوفر حلولاً برمجية بالغة النضج للتعامل مع البيانات المفقودة (Missing Data) وفق أساليب النمذجة الحديثة. إن المجلات العلمية المحكمة ذات معاملات التأثير المرتفعة الصادرة عن جمعية علم النفس الأمريكية (APA) وجمعية العلوم النفسية (APS) تثق ثقة مطلقة في المخرجات الصادرة عن إجراءات SAS التحليلية، نظراً لأن برمجيات SAS تلتزم بالمعايير القياسية للنمذجة الإحصائية وتوفر تفاصيل حسابية تمكن المراجعين العلميين من التحقق من صحة الفروض واختبارات الجودة ومؤشرات حجم الأثر بمنتهى الشفافية والوضوح.
2. الافتراضات الإحصائية لتحليل التباين وسبل التحقق منها في SAS
2.1 افتراض التوزيع الطبيعي واستقلالية المشاهدات
يستند تحليل التباين الكلاسيكي إلى منظومة من الافتراضات النظرية الصارمة التي تضمن صحة التوزيع الاحتمالي لإحصاء الاختبار الفائي. ويأتي في مقدمة هذه الفروض افتراض اعتدالية أو طبيعية التوزيع لدرجات المتغير التابع داخل كل مستوى من مستويات المتغير المستقل، أو اعتدالية توزيع البواقي والأخطاء العشوائية الناتجة عن النموذج الخطي. يمكن للباحث التحقق بدقة من هذا الفرض في بيئة SAS من خلال استدعاء الإجراء التحليلي المخصص للاستكشاف التوزيعي PROC UNIVARIATE مقروناً بعبارة NORMAL وPLOT. يتيح هذا الإجراء استخراج مؤشرات الالتواء (Skewness) والتفرطح (Kurtosis)، بالإضافة إلى إجراء الاختبارات الدلالية المعتمدة مثل اختبار شابيرو-ويلك (Shapiro-Wilk) المناسب للعينات الصغيرة والمتوسطة، واختبار كولموجوروف-سميرنوف (Kolmogorov-Smirnov) المعدل للعينات الكبيرة.
إلى جانب التوزيع الطبيعي، يمثل افتراض استقلالية المشاهدات (Independence of Observations) الركيزة الأكثر حساسية؛ حيث إن أي انتهاك لهذا الفرض يقود إلى تقديرات خاطئة تماماً لخطأ القياس المعياري، مما يرفع احتمالية الوقوع في أخطاء استدلالية جسيمة. وتتحقق الاستقلالية أساساً من خلال التصميم التجريبي المحكم، والذي يتطلب التعيين العشوائي الكامل للمشاركين على المجموعات، وعزل أفراد كل مجموعة تجريبية لمنع حدوث التفاعل أو التأثير المتبادل أثناء جلسات التدخل أو تطبيق مقاييس الاستجابة النفسية، وهو ما يضمن عدم ارتباط أخطاء القياس بين الأفراد عبر مختلف الشروط التجريبية.
2.2 افتراض تجانس التباين (Homogeneity of Variances)
يتمثل الافتراض الجوهري الثاني في ضرورة تحقق تجانس التباينات، والذي ينص على أن تباين درجات المجتمع في المتغير التابع متساوٍ عبر جميع المجموعات التجريبية التي تتم مقارنتها. إذا كان تباين إحدى المجموعات مضاعفاً لتباين مجموعة أخرى بصورة لافتة، فإن النسبة الفائية المحسوبة تصبح غير مستقرة، مما يهدد بتشويه معدل الخطأ من النوع الأول، لا سيما إذا كانت أحجام العينات داخل المجموعات غير متساوية. تقدم حزمة SAS أدوات متطورة لاختبار هذا الفرض داخل إجراءات النمذجة، وأشهرها إدراج خيار HOVTEST ضمن جملة التحليل لتوليد اختبار ليفين (Levene’s Test) واختبار بارتليت (Bartlett’s Test). يُفضل اختبار ليفين على نطاق واسع في البحوث النفسية نظراً لمرونته ومقاومته للانتهاكات الطفيفة في التوزيع الطبيعي مقارنة باختبار بارتليت الحساس للغاية للاعتدالية.
إذا أظهرت نتائج اختبار ليفين في SAS قيمة دلالية أقل من مستوى ألفا المعتمد (p < 0.05)، يُعد ذلك دليلاً إحصائياً على انتهاك فرض تجانس التباين. وفي هذه الحالة، لا يمكن الاعتماد على اختبار F التقليدي مباشرة دون اتخاذ إجراءات معالجة منهجية. تشمل هذه المعالجات تطبيق تحويلات رياضية على البيانات الخام (مثل التحويل اللوغاريتمي أو تحويل الجذر التربيعي) لتقليص التشتت، أو التحول نحو استخدام اختبارات معدلة لا تفترض تجانس التباين مثل اختبار ويلش (Welch’s ANOVA) المتوفر كخيار قياسي في بيئة SAS، مما يحمي الباحث من التوصل إلى استنتاجات خاطئة حول فاعلية المتغير المستقل.
3. إدخال البيانات وهيكلتها داخل بيئة برمجة SAS
3.1 بناء مجموعة البيانات باستخدام جملة DATA الخطوة بخطوة
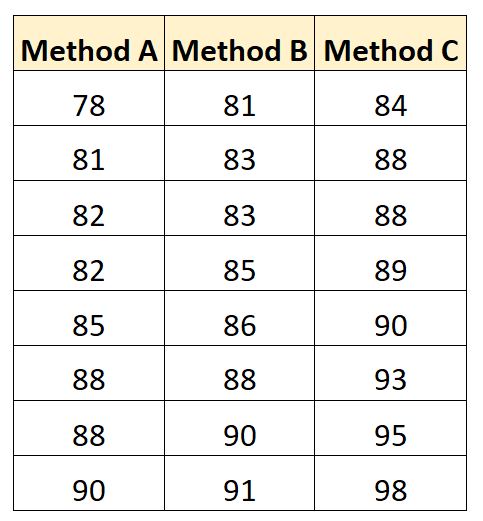
تبدأ الرحلة التطبيقية لتحليل البيانات داخل SAS من خلال كتابة الشفرة البرمجية لبناء مصفوفة البيانات في الذاكرة عبر خطوة إنشاء البيانات التقليدية التي تبدأ بعبارة DATA متبوعة باسم الجدول المطلوب، مثل DATA Psychological_Study. في هذه المرحلة، يقوم الباحث بتعريف المتغيرات وتحديد هويتها التصنيفية والكمية باستخدام جملة INPUT. لتوضيح ذلك، إذا كان لدينا دراسة تبحث أثر ثلاثة أنماط مختلفة من التدخلات النفسية على مستوى الرفاه الذاتي والرضا عن الحياة كما درستها أدبيات الإنفاق الاجتماعي الإيجابي (Aknin et al., 2010)، فإننا نقوم بتعريف المتغير المستقل الذي يمثل المجموعة ونلحقه برمز الدولار ($) للإشارة إلى كونه متغيراً نصياً فئوياً، بينما يترك المتغير التابع كمتغير رقمي مباشر.
تُدرج المشاهدات الفردية مباشرة في بيئة الشفرة البرمجية باستخدام جملة DATALINES أو CARDS، حيث يوضع كل سطر ليمثل استجابة مشارك واحد في التجربة، مفصولاً بمسافات منتظمة بين الرمز الفئوي للمجموعة والدرجة الرقمية الخام المحققة على المقياس النفسي. وتنتهي خطوة إدخال البيانات بفاصلة منقوطة مستقلة، تتبعها جملة التشغيل RUN؛ لتوجيه مفسر SAS نحو ترجمة الأسطر وتخزينها في جدول مؤقت داخل مكتبة العمل WORK، تمهيداً لإجراء الفحوصات الاستكشافية والتحليلات الاستدلالية المتقدمة.
3.2 فحص سلامة الترميز وتنظيم المتغيرات النفسية
عقب اكتمال خطوة إدخال البيانات، يتحتم على المحلل الإحصائي فحص جدول البيانات الناتج للتأكد من خلوه تماماً من أخطاء الرقن والإدخال غير المقصودة. يتحقق ذلك عملياً عبر استدعاء الإجراء PROC PRINT لعرض سجلات المشاهدات والتحقق من تطابقها مع السجلات الأصلية للتجربة. كما يوصى بإضفاء طابع منهجي رفيع على البيانات عبر استخدام جملة LABEL لتزويد المتغيرات بتسميات وصفية موسعة، مثل إعطاء المتغير التابع التسمية التوضيحية الكاملة (مقياس الرفاه الذاتي العام)، مما يضمن ظهور هذه التسميات بوضوح في الجداول والرسوم البيانية المخرجة، بدلاً من الاكتفاء بالرموز البرمجية المختصرة.
بالإضافة إلى ذلك، يلزم التحقق من سلامة تمثيل القيم المفقودة (Missing Values)؛ إذ يرمز SAS للبيانات الرقمية المفقودة بنقطة اعتيادية (.)، ويتعين التأكد من أن البرمجية لم تفسر أي قيمة خاطئة كبيانات صالحة مما قد يؤثر سلباً على حسابات متوسطات المجموعات ودرجات الحرية الكلية. إن تنقيح البيانات وفحص توزيع التكرارات لكل مستوى تجريبي عبر إجراء PROC FREQ يضمن للمحلل أن أحجام العينات موزعة وفق المخطط التجريبي المرسوم قبل الشروع في تشغيل نماذج تحليل التباين المعقدة.
4. تنفيذ إجراء PROC ANOVA وصياغة الأوامر الإحصائية
4.1 بنية الأوامر الأساسية لإجراء PROC ANOVA
صُمم الإجراء PROC ANOVA في SAS خصيصاً لتحليل التصاميم التجريبية المتوازنة التي تتساوى فيها أعداد المشاركين عبر جميع مستويات المتغير التجريبي المستقل. تبدأ البنية البرمجية باستدعاء الإجراء وتحديد مصفوفة البيانات عبر كتابة عبارة PROC ANOVA DATA=Psychological_Study. تلي هذه البداية جملة لا غنى عنها إطلاقاً وهي جملة التصنيف CLASS، والتي يُدرج فيها المتغير المستقل الفئوي. تلعب جملة CLASS دوراً محورياً في إبلاغ المحرك الإحصائي لـ SAS بضرورة معاملة هذا المتغير كمتغير اسمي تصنيفي يقوم بتقسيم المشاهدات إلى مستويات منفصلة، بدلاً من التعامل معه كمتغير انحداري كمي مستمر.
تأتي بعد ذلك جملة الصياغة الرياضية للنموذج التجريبي وهي جملة MODEL. تتخذ هذه الجملة شكلاً بنائياً مباشراً يتمثل في وضع المتغير التابع على يسار علامة المساواة، بينما يوضع المتغير المستقل (أو المتغيرات المستقلة والتفاعلات الثنائية بينها في النماذج المتعددة) على الجانب الأيمن، مثل: MODEL WellBeing_Score = Treatment_Group. تُنهى الأوامر البرمجية دائماً بعبارة RUN لتبدأ SAS عمليات الحساب المصفوفي، وتوليد مخرجات جدول تحليل التباين القياسي الذي يفصل التباينات ويحسب القيم الاختبارية ومستويات الدلالة الإحصائية المقابلة لها.
4.2 إدراج جملة MEANS لتحديد المقارنات البعدية
لا تقتصر حاجة الباحث النفسي على معرفة ما إذا كان هناك تأثير إجمالي ذو دلالة إحصائية للنموذج، بل تمتد لمعرفة الوصف الدقيق لأداء كل مجموعة على حدة واختبار الفروق البينية المحددة. ولتحقيق هذه الغاية، يتم إدراج جملة MEANS مباشرة أسفل جملة MODEL. تؤدي جملة MEANS وظيفة مزدوجة؛ فهي تقوم بحساب وعرض المتوسطات الحسابية والانحرافات المعيارية وأحجام العينات الفردية لكل مستوى من مستويات المتغير المستقل، مما يوفر القاعدة الوصفية الضرورية لقراءة اتجاه التأثير.
علاوة على التلخيص الوصفي، تتيح جملة MEANS تفعيل خيارات المقارنات البعدية المتقدمة التي تحمي التجربة من تراكم الخطأ، ويأتي خيار TUKEY على رأس هذه الخيارات لتطبيق اختبار توكي للفرق المعنوي الصادق (Tukey’s Honestly Significant Difference – HSD). كما يمكن تدعيم هذا الأمر بخيار CLDIFF الذي يوجه SAS نحو طباعة حدود فترات الثقة (Confidence Limits) للفروق بين كل زوج من المتوسطات، مما يمنح الباحث قراءة بصرية ورقمية شاملة لمدى تباعد المعالجات وتأثيراتها النسبية كما سنفصل لاحقاً.
5. التفسير المنهجي لجدول تحليل التباين الشامل ومستويات الدلالة
5.1 تفسير مصادر التباين ودرجات الحرية (Degrees of Freedom)
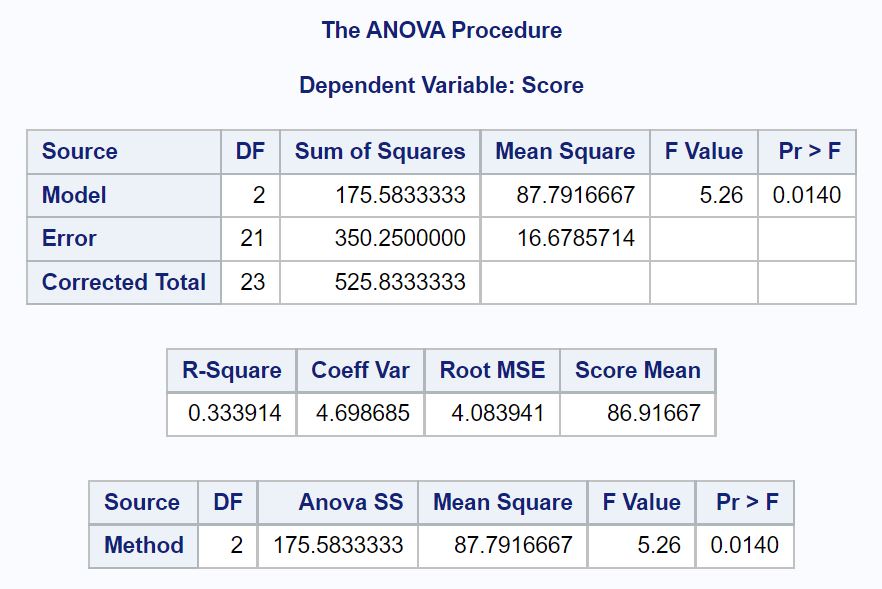
يقدم جدول مخرجات تحليل التباين في SAS تفكيكاً دقيقاً للتباين الكلي في المتغير التابع، حيث ينقسم الجدول عمودياً وأفقياً ليعرض مصادر التباين المختلفة (Source). يمثل المصدر الأول “النموذج” (Model)، وهو التباين النظامي الناتج عن تأثير المعالجة التجريبية أو المتغير المستقل الفئوي بين المجموعات. ويمثل المصدر الثاني “الخطأ” (Error)، والذي يُعرف بالتباين العشوائي غير المفسر أو التباين داخل المجموعات (Within-Groups Variance)، والناجم عن الفروق الفردية الكامنة بين أفراد العينة وأخطاء القياس غير المنضبطة. ويمثل المصدر الأخير “المجموع الكلي المصحح” (Corrected Total)، وهو مجموع تشتت كافة الدرجات حول المتوسط الحسابي العام لكامل العينة.
يقترن كل مصدر من هذه المصادر بدرجات حرية محددة (DF) تعكس عدد التقديرات المستقلة المتاحة في البيانات. تحسب درجات حرية النموذج (DF Model) عبر طرح واحد من عدد مستويات المتغير المستقل الكلي (k – 1). في حين تُحسب درجات حرية الخطأ (DF Error) بطرح عدد المجموعات من إجمالي عدد المشاركين في التجربة (N – k). وتكون درجات الحرية الكلية المصححة مساوية لحجم العينة الكلي مطروحاً منه واحد (N – 1). تعد درجات الحرية هذه مؤشراً بنيوياً حاسماً؛ حيث يحدد حجمها مدى قوة التصميم الإحصائي وحساسيته لرصد الفروق الواقعية وتوزيع القيمة الفائية في الجداول الاحتمالية النظرية.
5.2 تفسير مجموع المربعات ومتوسط المربعات وقيمة F الإحصائية
ينتقل الجدول الإحصائي بعد درجات الحرية إلى عرض عمود مجموع المربعات (Sum of Squares – SS). يعكس مجموع مربعات النموذج (Model SS) مقدار التباين التراكمي المفسر بفعل المعالجة التجريبية، بينما يعبر مجموع مربعات الخطأ (Error SS) عن مقدار التشتت غير المفسر. من خلال قسمة قيمة مجموع المربعات لكل مصدر على درجات الحرية المقابلة له، يولد SAS عموداً حيوياً هو متوسط المربعات (Mean Square – MS). وبالتالي، فإن متوسط مربعات النموذج يمثل التباين المفسر المنسوب لكل درجة حرية، ومتوسط مربعات الخطأ يمثل تباين الخطأ المنسوب لكل درجة حرية، وهو التقدير الأدق لتباين مجتمع الدراسة غير المقيد بالمعالجة.
تُشتق القيمة الإحصائية الفائية (F Value) بقسمة متوسط مربعات النموذج على متوسط مربعات الخطأ (MS Model / MS Error). تُعبر هذه النسبة الرياضية عن مقدار التباين النظامي مقارنة بتباين الخطأ العشوائي؛ فكلما تباعدت المتوسطات بين المجموعات التجريبية بفعل قوة المعالجة، ارتفعت قيمة F المحسوبة. يقوم SAS تلقائياً بمقارنة هذه القيمة بالتوزيع النظري لفشر-سنديكور لطباعة مستوى الدلالة الدقيق تحت عمود (Pr > F). فإذا كانت القيمة الاحتمالية المقروءة أقل من العتبة المعيارية 0.05، يرفض الباحث الفرضية الصفرية بثقة إحصائية، مؤكداً وجود فروق ذات دلالة بين مستويات المتغير المستقل لا يمكن عزوها إلى المصادفة وحدها.
6. تقييم جودة توفيق النموذج الإحصائي وحجم الأثر في SAS
6.1 تفسير معامل التحديد (R-Square) ومعامل الاختلاف (Coeff Var)
إلى جانب اختبار الفرضية الصفرية عبر القيمة الفائية، توفر مخرجات SAS في أعلى الجدول الإحصائي منظومة من المؤشرات التي تقيس جودة النموذج التنبؤي وتماسكه. ويبرز في مقدمة هذه المؤشرات معامل التحديد (R-Square). يمثل هذا المعامل النسبة المئوية الدقيقة للتباين في المتغير التابع النفسي التي استطاع المتغير المستقل تفسيرها، ويحسب رياضياً بقسمة مجموع مربعات النموذج على مجموع المربعات الكلي المصحح. فعلى سبيل المثال، إذا بلغت قيمة R-Square المستخرجة 0.35، فإن ذلك يعني علمياً أن المعالجة التجريبية مسؤولة عن تفسير 35% من التغيرات الملاحظة في درجات المشاركين، بينما تُعزى النسبة المتبقية (65%) إلى عوامل خارجية أو فروق فردية كامنة لم يشملها النموذج.
تطبع SAS كذلك معامل الاختلاف (Coeff Var)، وهو مؤشر نسبي يُعبر عن النسبة المئوية للانحراف المعياري للخطأ مقارنة بالمتوسط العام لدرجات المتغير التابع. يفيد هذا المقياس في مقارنة تشتت القياسات النفسية عبر أدوات مختلفة ذات وحدات قياس متباينة؛ فكلما انخفضت قيمة معامل الاختلاف، دل ذلك على استقرار النموذج ودقة أدوات القياس المستخدمة في جمع البيانات السلوكية. كما يُعرض في نفس الإطار جذر متوسط مربعات الخطأ (Root MSE)، والذي يمثل الانحراف المعياري للأخطاء العشوائية، وهو مقياس مطلق يعبر عن دقة التنبؤ بنفس وحدة قياس المتغير النفسي المدروس.
6.2 حساب وتقدير حجم الأثر الإحصائي (Eta-Squared و Partial Eta-Squared)
بات الإبلاغ عن حجم الأثر الإحصائي مطلباً إلزامياً لا غنى عنه في الكتابة السيكولوجية الحديثة؛ إذ إن الدلالة الإحصائية لقيمة F تخبر الباحث فقط بوجود فرق غير صفري، ولكنها تتأثر بشدة بحجم العينة ولا تعكس بالضرورة الأهمية العملية أو السريرية للنتائج. في تصاميم تحليل التباين أحادية الاتجاه، يتطابق مؤشر حجم الأثر المعروف بإيتا تربيع (Eta-Squared – $\eta^2$) تماماً مع قيمة معامل التحديد R-Square الصادرة في مخرجات SAS. يستخرج الباحث هذه القيمة ببساطة من الجدول، أو يحسبها يدوياً من خلال قسمة مجموع مربعات التأثير على مجموع المربعات الكلي.
تخضع هذه القيم المستخرجة لتقييم معياري يستند إلى المعايير التفسيرية التي أرساها كوهين (Cohen) في مجال العلوم النفسية والسلوكية. تُصنف قيمة إيتا تربيع التي تبلغ 0.01 كأثر صغير، بينما تمثل القيمة 0.06 أثراً متوسطاً، وتعد القيمة 0.14 فما فوق دلالة على حجم أثر كبير يعكس تأثيراً قوياً وواضحاً للمعالجة التجريبية في البيئة الواقعية. يساعد هذا التقدير الباحثين في تقييم مدى الفائدة الملموسة للبرامج التدخلية والسلوكية، بما يتجاوز مجرد الحصول على قيمة احتمالية دالة إحصائياً.
7. تفسير المقارنات البعدية واختبار توكي (Tukey’s Post-Hoc Test)
7.1 مبررات إجراء المقارنات البعدية بعد رفض الفرضية الصفرية
يُعد اختبار تحليل التباين اختباراً كلياً أو شاملاً (Omnibus Test)؛ فهو يجيب عن السؤال العام: هل تختلف المجموعات بشكل عام عن بعضها البعض؟ لكنه يقف عاجزاً بطبيعته الرياضية عن تحديد موضع هذا الاختلاف أو تحديد أي الأزواج المحددة من المجموعات هي التي حققت تفوقاً ذا دلالة إحصائية على المجموعات الأخرى. بناءً على ذلك، يصبح الانتقال نحو إجراء اختبارات المقارنات البعدية (Post-Hoc Tests) ضرورة علمية حتمية فور رفض الفرضية الصفرية الشاملة للنموذج، وذلك لتفكيك الفروق الفردية واستكشاف البنية التفصيلية للتأثيرات التجريبية دون الوقوع في شرك استنتاجات تعميمية غير دقيقة.
يبرز اختبار توكي للفرق المعنوي الصادق (Tukey’s HSD) كواحد من أكثر أساليب المقارنات البعدية توازناً ورصانة في الأبحاث النفسية المعاصرة. يتميز هذا الاختبار بقدرته الفائقة على الحفاظ على معدل الخطأ من النوع الأول عند مستوى 0.05 عبر جميع المقارنات الزوجية المحتملة في وقت واحد، دون التضحية المفرطة بالقوة الإحصائية للاختبار، وهو ما يجعله يتفوق على أسلوب تعديل بونفيروني (Bonferroni) الذي يميل إلى المبالغة في التحفظ والصرامة وتقليص القوة الاحتمالية لاكتشاف الفروق الواقعية، كما يتفوق على أسلوب شيفيه (Scheffé) المصمم بالأساس للمقارنات المركبة المعقدة وليس المقارنات الزوجية البسيطة.
7.2 تفسير مخرجات مجموعات توكي المتجانسة (Tukey Grouping)
تعرض حزمة SAS نتائج اختبار توكي بأسلوب بصري فريد يعرف بجدول “مجموعات توكي المتجانسة” (Tukey Grouping). في هذا الجدول، تُرتب المعالجات أو المجموعات التجريبية تنازلياً وفقاً لقيم متوسطاتها الحسابية، وتُعطى كل مجموعة حبراً أو حرفاً أبجدياً ترميزياً (مثل A، أو B، أو C). وتتلخص القاعدة المحورية في قراءة هذا الجدول في أن أي مجموعتين تشتركان في نفس الحرف الأبجدي لا يوجد بينهما فرق ذو دلالة إحصائية عند مستوى دلالة 0.05 المعتمد.
في المقابل، إذا انفردت إحدى المجموعات بحرف أبجدي مستقل (كأن تحوز المجموعة التجريبية المكثفة الحرف A بمفردها بينما حازت مجموعات التدخل البديل والضابطة الحرف B معاً)، فإن هذا يشير بوضوح لا لبس فيه إلى أن المجموعة الأولى تتفوق إحصائياً بفارق جوهري ومعنوي عن بقية المجموعات الأخرى. يتيح هذا العرض الأبجدي للمحلل استخلاص الاستنتاجات العلمية السريعة والعميقة حول الترتيب التفضيلي للتدخلات السلوكية أو الطرائق التعليمية، وتحديد أي البرامج هو الأفضل تطبيقياً لدعم جوانب مثل بناء المرونة النفسية والفاعلية الذاتية لدى الأفراد (Cassidy, 2015).
8. تفسير فترات الثقة والفروق الفردية الناتجة عن خيار CLDIFF
8.1 قراءة مصفوفة الفروق بين المتوسطات وحدود الثقة
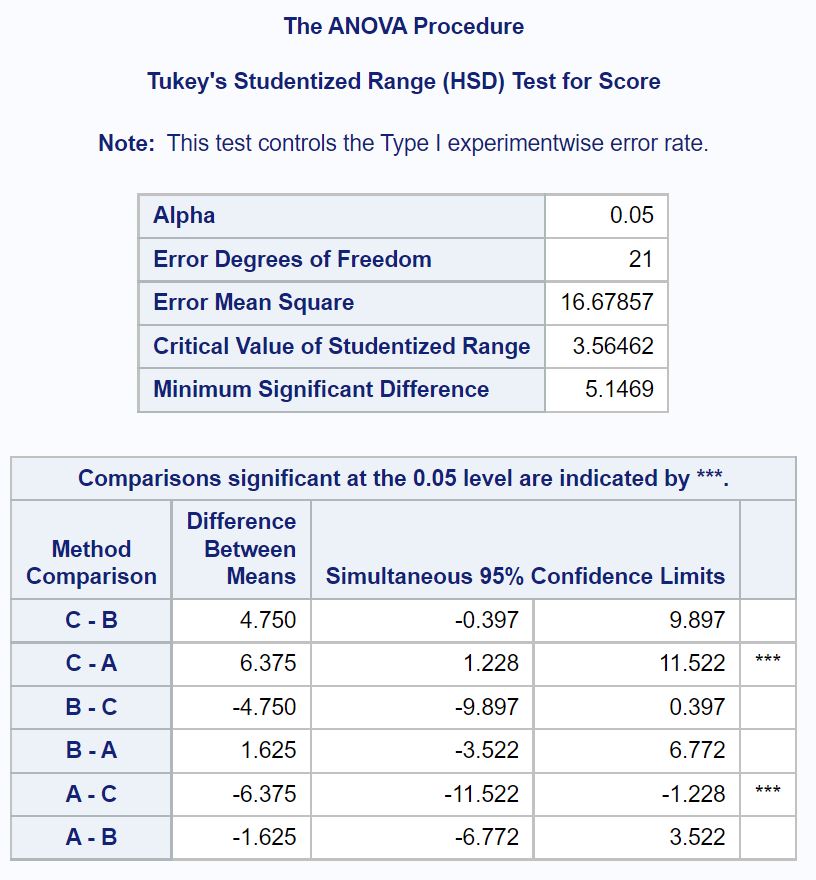
عند تفعيل خيار CLDIFF في جملة MEANS داخل بيئة SAS، تنتج المنظومة جدولاً تحليلياً مفصلاً يشتمل على مصفوفة الفروق الزوجية بين كل مجموعة وأخرى، مصحوبة بفترات الثقة عند مستوى 95% لكل فارق حسابي. يتضمن الجدول ثلاثة أعمدة رقمية متتابعة: الحد الأدنى لفترة الثقة (Lower Confidence Limit)، والفارق الفعلي المحسوب بين متوسطي المجموعتين (Difference Between Means)، والحد الأعلى لفترة الثقة (Upper Confidence Limit). توفر هذه المؤشرات الثلاثة رؤية احتمالية متكاملة لا تكتفي بتقرير وجود الفرق من عدمه، بل تحدد النطاق العددي المتوقع لمقدار هذا الفرق في مجتمع الدراسة الأصلي.
تستند القاعدة الإحصائية الذهبية في تفسير فترات الثقة إلى موقع القيمة صفر (Zero) بالنسبة لحدود الفترة. فإذا وقعت القيمة صفر داخل النطاق المحصور بين الحد الأدنى والحد الأعلى (بمعنى أن يكون أحدهما سالباً والآخر موجباً)، دل ذلك قطعياً على أن الفرق بين متوسطي المجموعتين ليس له دلالة إحصائية، إذ إن احتمال انعدام الفرق بينهما يظل فرضاً ممكناً ومعقولاً إحصائياً. أما إذا كانت كلتا النهايتين موجبتين تماماً أو سالبتين تماماً (أي أن فترة الثقة لا تشتمل على الصفر مطلقاً)، فإن الفارق يعتبر دالاً إحصائياً عند مستوى ثقة 95%، مما يثبت تباعد أثر المعالجتين بوضوح في المتغير النفسي المقاس.
8.2 تحديد المقارنات ذات الدلالة الإحصائية المعلمة بالرموز في SAS
تيسيراً على الباحث في قراءة الجداول المعقدة الناتجة عن خيار CLDIFF، تستخدم برمجية SAS ترميزاً بصرياً فورياً يتمثل في وضع سلسلة من علامات النجوم الثلاثية (***) في الهامش المقابل للزوج المقارن. تشير هذه النجوم إلى أن المقارنة بين هذين المستويين تحديداً دالة إحصائياً وتتجاوز عتبة الخطأ المسموح بها بعد تطبيق تعديل توكي الرياضي. يتيح هذا الترميز للمحلل تحديد المقارنات الفارقة بلمحة سريعة دون الحاجة إلى فحص أرقام الفترات يدوياً سطراً بسطر.
يرتبط حجم هذه الفروق وحدود فتراتها ارتباطاً وثيقاً بتباين البيانات الداخلي وحجم العينة في كل مجموعة تجريبية. فكلما كانت العينات متجانسة وحجمها كافياً، ضاقت فترات الثقة حول الفارق المحسوب، مما يعكس دقة قياس رفيعة للتدخل النفسي المدروس. تمكن هذه الدقة التحليلية الباحثين من صياغة قرارات حاسمة حول المفاضلة بين استراتيجيات تعديل السلوك، وتحديد ما إذا كان التدخل المكثف يحدث فارقاً نوعياً يتفوق بمراحل على التدخلات الاعتيادية أو المجموعات الضابطة، بما يتماشى مع أفضل الممارسات المنهجية في دراسات التدخلات السلوكية.
9. التعامل مع انتهاك الفروض الإحصائية وبدائل PROC ANOVA المتقدمة
9.1 الانتقال إلى إجراء PROC GLM في حال عدم توازن العينات
على الرغم من الكفاءة الحاسوبية العالية لإجراء PROC ANOVA، إلا أنه يعاني من قيد منهجي رئيس يتمثل في اشتراطه لتوازن التصميم التجريبي، أي تساوي أعداد المشاركين تماماً في جميع المجموعات (Balanced Designs). وفي الواقع الميداني للبحوث النفسية والإكلينيكية، نادراً ما يتحقق هذا الشرط التام بسبب تسرب المشاركين (Participant Attrition)، أو تغيب بعض الأفراد عن جلسات المتابعة، أو صعوبة الحصول على أعداد متكافئة من الحالات التشخيصية النادرة مثل اضطرابات الشخصية المعقدة (Cloître et al., 2014). وفي مثل هذه الحالات، يفقد إجراء PROC ANOVA دقته الرياضية وتصبح تقديراته لمربعات التباين غير أرثوذكسية أو مشوبة بالتحيز.
هنا يتحتم على الباحث الانتقال المنهجي نحو الإجراء الأشمل وهو إجراء النموذج الخطي العام PROC GLM (General Linear Model). يمتلك PROC GLM قدرة فائقة على التعامل مع التصاميم غير المتوازنة بفضل اعتماده على حساب مجموع المربعات من النوع الثالث (Type III Sum of Squares). يُقيم هذا النوع تأثير كل متغير مستقل أو تفاعل تجريبي بعد ضبط وعزل كافة التأثيرات الأخرى في النموذج (Partialing Out)، مما يضمن عدم تداخل التباينات نتيجة عدم تكافؤ أعداد الأفراد في الخلايا التجريبية، ويوفر نتائج دقيقة وموثوقة تتطابق مع المتطلبات المنهجية الرصينة.
9.2 معالجة عدم تجانس التباين والبدائل اللامعلمية
في حال كشفت الاختبارات الاستكشافية المبدئية عن انتهاك فرض تجانس التباين بين المجموعات التجريبية، فإن استخدام اختبار F التقليدي يرفع من خطر الوقوع في استنتاجات زائفة. توفر SAS بديلاً معلماً بالغ القوة يتمثل في تطبيق اختبار ويلش لتحليل التباين (Welch’s ANOVA). يمكن تفعيل هذا الاختبار بسهولة فائقة داخل إجراء PROC GLM من خلال إضافة خيار WELCH إلى جملة MEANS، مثل: MEANS Treatment / WELCH. يقوم هذا الإجراء بتعديل درجات حرية الخطأ تلقائياً وتقليصها بناءً على مدى التفاوت في تباينات المجموعات، مما ينتج قيمة فائية مصححة تحافظ على معدل خطأ النوع الأول عند مستواه الصحيح حتى في ظل التباين غير المتكافئ.
أما إذا اقترن عدم تجانس التباين بانحراف شديد عن التوزيع الطبيعي وصغر أحجام العينات، فإن المسار المنهجي الأنسب يفرض التحول نحو الاختبارات اللامعلمية (Non-parametric Tests). تتيح SAS تنفيذ اختبار كروسكال-واليس (Kruskal-Wallis) كبديل لا معلمي مباشر لتحليل التباين أحادي الاتجاه عبر استدعاء الإجراء PROC NPAR1WAY مقروناً بعبارة WILCOXON. يقوم هذا الإجراء بتحويل الدرجات الخام إلى رتب تصاعدية ومقارنة متوسطات هذه الرتب بين المجموعات. إن مقارنة القرارات الإحصائية بين النماذج المعلمية واللامعلمية في مثل هذه الظروف تمنح الباحث سنداً منهجياً قوياً للتحقق من أن النتائج الملاحظة تعكس تأثيرات حقيقية للمعالجات وليست مجرد انعكاس لتشوهات توزيعية في البيانات.
10. صياغة التقرير الإحصائي النهائي وفق معايير جمعية علم النفس الأمريكية (APA)
10.1 قواعد كتابة نتائج ANOVA واختبار توكي بأسلوب APA الإصدار السابع
تتطلب المعايير المنهجية التي وضعتها جمعية علم النفس الأمريكية في دليلها الأحدث (APA 7th Edition) توثيقاً دقيقاً وشاملاً لكافة المعلمات الإحصائية المستخرجة من تحليل التباين في متن البحث، وتجنب الاكتفاء بذكر القيمة الاحتمالية وحدها. يجب أن تتضمن الصياغة النصية الرمز المائل لقيمة الاختبار (F)، متبوعاً بدرجات الحرية الخاصة بالنموذج والخطأ بين قوسين مفصولين بفاصلة، ثم القيمة الفائية المحسوبة مقربة إلى منزلتين عشريتين، ثم القيمة الاحتمالية الدقيقة (p)، وأخيراً حجم الأثر مقاساً بمعامل إيتا تربيع الجزئي ($\eta_p^2$).
تُصاغ النتيجة النموذجية في النص على النحو التالي: “أظهرت نتائج تحليل التباين أحادي الاتجاه وجود تأثير دال إحصائياً لنوع التدخل النفسي على مستوى الرفاه الذاتي، F(2, 57) = 8.45, p < .001, $\eta_p^2$ = .23″. ويتبع ذلك مباشرة توثيق تفصيلي لنتائج المقارنات البعدية، مع الإشارة إلى المتوسطات الحسابية والانحرافات المعيارية لكل مجموعة؛ كأن يكتب: “وكشفت مقارنات توكي البعدية (Tukey’s HSD) عن تفوق ذي دلالة إحصائية لأفراد مجموعة التدخل السلوكي (M = 45.20, SD = 5.12) مقارنة بأفراد المجموعة الضابطة (M = 36.80, SD = 4.85, p = .002)، في حين لم يظهر فرق دال بين مجموعة التدخل السلوكي والتدخل المعرفي (M = 42.10, SD = 5.30, p = .154)”.
10.2 التمثيل البصري للنتائج وتجنب الأخطاء الشائعة في التفسير
لا تكتمل صياغة التقرير الإحصائي الرصين دون تدعيمه بالتمثيل البصري التوضيحي الذي يلخص الفروق بين المجموعات للمتلقي. توفر حزمة SAS أداة رسومية فائقة التطور عبر إجراء PROC SGPLOT، والذي يتيح إنشاء مدرجات بيانية ومخططات لأعمدة المتوسطات مع دمج أشرطة الخطأ المعياري (Standard Error Bars) أو فترات الثقة 95%. إن تضمين هذه الأشرطة الخطية يمنح القارئ انطباعاً بصرياً فورياً عن مدى تشتت البيانات وحجم التداخل التوزيعي بين المجموعات التجريبية، بما يعزز شفافية التقرير العلمي.
من الضروري للمحلل الإحصائي تجنب الوقوع في الأخطاء الشائعة أثناء كتابة النتائج وتفسيرها، ويأتي في مقدمتها الخلط الجسيم بين “الدلالة الإحصائية” و”الدلالة العملية أو الإكلينيكية”؛ فالحصول على قيمة احتمالية دالة إحصائياً (p < 0.05) في عينة ضخمة للغاية قد يقترن بحجم أثر بالغ الضآلة لا يمثل أي أهمية تطبيقية تذكر في الميدان النفسي. كما يجب الابتعاد التام عن إجراء مقارنات بعدية عند فشل النموذج الشامل في تحقيق الدلالة الإحصائية (إلا إذا كانت هناك فرضيات موجهة مسبقة مخطط لها)، والحرص التام على إتاحة الشفرات البرمجية ومصفوفات البيانات تماشياً مع حركة العلم المفتوح (Open Science) لتعزيز موثوقية وتكرارية البحوث المنشورة.
خاتمة
يمثل تحليل التباين (ANOVA) ركيزة منهجية واستدلالية لا غنى عنها في البحث النفسي والتجريبي الرصين، وتوفر برمجية SAS البيئة الحسابية الأكثر عمقاً وموثوقية لتنفيذ هذا التحليل وقراءة مخرجاته المتشعبة. إن الفهم الأكاديمي المكتمل لتفسير جداول SAS لا يتوقف عند قراءة القيم الاحتمالية الصادرة، بل يمتد إلى التحقق الدقيق من الفروض المسبقة، وفهم تفكيك التباين عبر درجات الحرية ومربعات التباين، وتقدير حجم الأثر لتحديد القيمة العملية للنتائج، وحسن توظيف المقارنات البعدية لضبط الأخطاء النوعية المتراكمة. ومن خلال الالتزام بالمعايير الصارمة لجمعية علم النفس الأمريكية في التوثيق والعرض البصري، يضمن الباحث تقديم إسهامات علمية متينة وقابلة للتكرار تسهم بفاعلية في تطوير المعرفة السلوكية ودعم الممارسات التدخلية القائمة على الأدلة والبراهين الإحصائية الدقيقة.
المراجع
- Aknin, L. B., Barrington-Leigh, C. P., Dunn, E. W., Helliwell, J. F., Burns, J., Biswas‐Diener, R., et al. (2010). Prosocial Spending and Well-Being: Cross-Cultural Evidence for a Psychological Universal. Journal of Personality and Social Psychology. https://doi.org/10.1037/a0031578
- Cassidy, S. (2015). Resilience Building in Students: The Role of Academic Self-Efficacy. Frontiers in Psychology. https://doi.org/10.3389/fpsyg.2015.01781
- Cloître, M., Garvert, D. W., Weiss, B. J., Carlson, E. B., & Bryant, R. A. (2014). Distinguishing PTSD, Complex PTSD, and Borderline Personality Disorder: A latent class analysis. European Journal of Psychotraumatology. https://doi.org/10.3402/ejpt.v5.25097
- de Ridder, D. T. D., Lensvelt‐Mulders, G., Finkenauer, C., Stok, F. M., & Baumeister, R. F. (2011). Taking Stock of Self-Control. Personality and Social Psychology Review. https://doi.org/10.1177/1088868311418749
- Kane, M. J., Bleckley, M. K., Conway, A. R. A., & Engle, R. W. (2001). A controlled-attention view of working-memory capacity. Journal of Experimental Psychology General. https://doi.org/10.1037//0096-3445.130.2.169