
تُمثّل معالجة السلاسل النصية واستخلاص البيانات الزمنية منها إحدى أهم الركائز المنهجية في إدارة قواعد البيانات وتحليلها عبر برمجية مايكروسوفت إكسل (Microsoft Excel). فعند التعامل مع مصفوفات البيانات الكبيرة المستخرجة من الأنظمة المؤتمتة، مثل سجلات تتبع الأنشطة الرقمية، وسجلات الخوادم، واستجابات الاستبيانات الإلكترونية، يواجه الباحثون والمحللون غالبًا تحدي اندماج التواريخ الحيوية داخل نصوص سردية غير متجانسة. وتكتسب هذه المهمة أهمية مضاعفة في سياقات البحث الكمي والعلوم المعرفية والسلوكية، حيث تتطلب دراسات التتبع الزمني ومعالجة البيانات الضخمة تحويل السجلات الخام إلى متغيرات زمنية معيارية قابلة للقياس الإحصائي، وهو ما يتطابق مع المعايير المنهجية المتبعة في إعداد قواعد البيانات المعجمية والتجريبية الكبرى لتنقيب البيانات وتدقيقها (Keuleers et al., 2011).
يتطلب التحول من مجرد قراءة بصرية للنص إلى استخراج حوسبي دقيق للتاريخ فهمًا معماريًا لكيفية تمثيل البيانات داخل محرك حسابات إكسل. فالنص بالنسبة للبرنامج هو مجرد تتابع لمجموعة من المحارف (Characters) التي لا تحمل في ذاتها أي دلالة تقويمية أو رياضية، في حين أن التواريخ تُعامل كأرقام تسلسلية صحيحة (Serial Numbers) تبدأ بالرقم 1 المقابل لليوم الأول من يناير لعام 1900. هذا التباين الجوهري بين التخزين النصي والتمثيل الرياضي يفرض تطبيق خوارزميات محددة تعتمد على تفكيك النصوص، ورصد الفواصل المكانية، واستقطاع الأنماط الرقمية، ثم تحويلها قسريًا إلى قيم تقويمية يمكن إدراجها في نماذج الانحدار والتحليلات الإحصائية المتقدمة.
يهدف هذا المقال الأكاديمي الموسّع إلى تقديم دليل إجرائي وتحليلي شامل للآليات الرياضية والمنطقية المتبعة لاستخراج التواريخ من السلاسل النصية المعقدة في برنامج إكسل. وسنتناول بالتفصيل التشريح البنيوي للمعادلات التقليدية المركبة بالاعتماد على دوال المواضع والاقتطاع، وكيفية تكييفها للتعامل مع مختلف الصيغ الدولية (مثل صيغ الشرطة المائلة والأفقية والنقاط)، وصولًا إلى توظيف الدوال المصفوفية الحديثة وتقنيات التعابير النمطية (Regular Expressions) المعتمدة في الإصدارات المعاصرة، مع التركيز على استراتيجيات تفادي الأخطاء البرمجية وضمان الموثوقية التامة للبيانات الناتجة.
1. الأسس النظرية لمعالجة السلاسل النصية والبيانات الزمنية في إكسل
1.1 طبيعة البيانات المختلطة وتحديات الفصل في جداول البيانات
تُعرّف السلسلة النصية في علوم الحوسبة وجداول البيانات بأنها متتالية خطية مرتبة من المحارف، تشمل الحروف الأبجدية، والأرقام، والرموز الخاصة، والمسافات البيضاء، وتُخزن في ذاكرة برنامج إكسل تحت نوع البيانات النصية (Text Data Type). تكمن المشكلة الجوهرية في قواعد البيانات التطبيقية في تدفق السجلات المختلطة الصادرة عن أنظمة المؤسسات وتطبيقات الويب، حيث يُدرج التاريخ غالبًا ضمن شروحات وصفية، مثل: “تم تسجيل المعاملة بتاريخ 12/05/2023 بواسطة المستخدم”، أو ضمن رموز تعريفية مشفرة مثل “BATCH_2023-11-15_V01”. في هذه الحالة، تفقد التواريخ طبيعتها الحسابية المستقلة، وتصبح مجرد رموز شكلية مدمجة ضمن الكيان النصي الأكبر، مما يعطل تمامًا قدرة البرنامج على تصنيفها أو فرزها زمنيًا بصورة تلقائية.
إن تباين أنماط تمثيل التواريخ في السجلات النصية الناتجة عن الأنظمة المحوسبة المتعددة يضاعف من هذا التعقيد المنهجي. فقد تستخدم بعض الأنظمة التنسيق الأمريكي الذي يُقدم الشهر على اليوم، بينما تعتمد أنظمة أخرى التنسيق الأوروبي أو المعايير الدولية مثل معيار أيزو (ISO 8601). ويؤدي وجود هذه البيانات غير المنظمة إلى تشويه التحليلات الإحصائية والأكاديمية؛ فالبيانات النصية تمنع المحلل من إجراء المقارنات الزمنية الطولية (Longitudinal Analysis)، أو دراسة السلاسل الزمنية، أو حتى تصفية السجلات بناءً على نوافذ زمنية محددة. من هنا، يصبح عزل المؤشرات الزمنية وتحويلها إلى متغيرات كمية مستقلة خطوة تنظيف تحضيرية حتمية لا غنى عنها لضمان سلامة الاستدلال الإحصائي ودقة النتائج الرياضية، تمامًا كما هو متبع في تنظيف المتغيرات المعجمية واللغوية في المشاريع البحثية الضخمة (Lété et al., 2004).
1.2 المنطق البرمجي للتعامل مع محددات المواقع داخل النصوص
يقوم المنطق البرمجي المعتمد لمعالجة النصوص في إكسل على مبدأ الفهرسة الموضعية المعتمدة على الأرقام الطبيعية (1-based Indexing)، حيث يُخصص لكل محرف في السلسلة رقم ترتيبي ثابت يمثل موقعه بدءًا من الطرف الأيمن أو الأيسر وفقًا لاتجاه النص ولغة الإدخال. لقراءة النصوص المعقدة واقتطاع أجزاء محددة منها، لا بد للمحلل من تحديد معالم استدلالية مرجعية (Anchors)، وهي محارف ذات دلالة نمطية متكررة يمكن استخدامها لتحديد نقطة البداية والنهاية للمعلومة المستهدفة. وفي سياق التواريخ، تلعب الرموز الفاصلة مثل الشرطة المائلة (/)، أو الشرطة الأفقية (-)، أو النقطة (.) دور هذه العلامات الاستدلالية المرجعية التي تكشف بدقة عن الموضع الذي يقع فيه التاريخ داخل الكتلة النصية.
تتباين استراتيجيات الاستخراج بين أسلوبين منهجيين: الفهرسة الثابتة (Static Indexing) والفهرسة الديناميكية (Dynamic Indexing). تُستخدم الفهرسة الثابتة حصريًا عندما تكون السلاسل النصية متطابقة في الطول والمحتوى الهيكلي، مثل الأكواد الوظيفية المعيارية حيث يبدأ التاريخ دائمًا عند المحرف العاشر وينتهي عند المحرف التاسع عشر. غير أن هذه الحالة نادرة الوجود في البيانات الواقعية المستخرجة من الأنظمة النصية غير المقيدة؛ إذ تتباين النصوص في أطوالها تبعًا لتباين عدد الكلمات السابقة للتاريخ. وهنا تبرز حتمية الفهرسة الديناميكية، وهي مقاربة خوارزمية تعتمد على استكشاف موضع الفواصل الزمنية برمجياً وتحديد حدود التاريخ المستهدف نسبيًا بصرف النظر عن موقعه الفيزيائي، مما يمنح النموذج الرياضي مرونة فائقة وقدرة على التكيف مع التباينات الطولية في مختلف السجلات.
2. التشريح المنهجي للمعادلة القياسية لاستخراج التاريخ
2.1 البنية التركيبية للمعادلة ومكوناتها الأساسية
تمثل المعادلة التركيبية الكلاسيكية المعتمدة على دمج دالتي البحث والاقتطاع الحل المعياري الأكثر انتشارًا وموثوقية في بيئات إكسل المختلفة، وتتخذ في صيغتها الرياضية العامة الشكل التالي:
=MID(” “&A2, FIND(“/”, ” “&A2, 1) – 2, 10)
يقوم هذا البناء التركيبي على تفكيك منهجي دقيق لمعاملات الدالتين لتحقيق هدفين متلازمين: العثور على الإحداثي المكاني للتاريخ، ثم اقتطاع عرضه المحرفي بالكامل. يبدأ التدخل الهندسي الأول في المعادلة بدمج مسافة بيضاء بادئة قبل نص الخلية الأصلية عبر التعبير " "&A2. هذه الإضافة، التي قد تبدو بديهية للوهلة الأولى، تؤدي وظيفة جوهرية تهدف إلى تفادي أخطاء الموضع الصفري أو السلبي؛ ففي حال كان التاريخ يقع في أول الخلية مباشرة دون أي بادئة نصية، فإن محاولة الرجوع خطوتين إلى الوراء من موضع أول فاصلة مائلة قد ينتج عنها قيمة فهرسة أقل من 1، مما يؤدي فورًا إلى انهيار المعادلة وتوليد خطأ رياضي.
يتحدد بعد ذلك موقع الانطلاق النسبي للاقتطاع عبر طرح إزاحة رقمية محددة (Offset) مقدارها خطوتان (-2) من ناتج دالة البحث. يستند هذا الرقم إلى الفرضية القياسية التي تفترض أن التاريخ يتبع بنية مكوّنة من خانتين لليوم أو الشهر تسبقان الشرطة المائلة مباشرة (مثل 05/ أو 12/). أما المعامل الأخير في دالة الاقتطاع، فقد حُدد بالرقم الثابت 10، وهو الطول النموذجي للتاريخ القياسي الكامل المكتوب بصيغة تتضمن أربعة أرقام للسنة، ورقمين للشهر، ورقمين لليوم، يربط بينهما فاصلان زمنيّان (2 + 1 + 2 + 1 + 4 = 10 محارف).
2.2 التسلسل المنطقي لتدفق العمليات الحسابية داخل المعادلة
تخضع عملية معالجة المعادلة داخل محرك حسابات إكسل لتسلسل تدفقي صارم يتبع قواعد الأسبقية الرياضية والمنطقية. تبدأ المعالجة في الذاكرة المؤقتة من الطبقات الأكثر عمقًا نحو السطح الخارجي للمعادلة؛ حيث يتم أولاً استدعاء معامل الربط النصي (Concatenation Operator) لدمج المسافة الفارغة بالنص الأصلي، منتجًا سلسلة نصية افتراضية جديدة لا تؤثر على مظهر الخلية ولكنها تُستخدم حصريًا كمجال بحث داخلي. تنتقل السلسلة الجديدة مباشرة إلى دالة البحث الموضعي FIND، التي تبدأ بمسح السلسلة خطيًا من المحرف الأول بحثًا عن أول ظهور للرمز الفاصل المحدد (/).
بمجرد أن ترصد الدالة الفاصلة الأولى، تُرجع فورًا قيمتها العددية التي تمثل فهرسها الموضعي. تُمرر هذه القيمة الرقمية إلى العملية الحسابية الفرعية للطرح؛ حيث تُطرح قيمة الإزاحة (2) من هذا الفهرس لتوليد الإحداثي الدقيق لموقع أول رقم من أرقام التاريخ داخل السلسلة المعدلة. في المرحلة الختامية، تتلقى دالة الاقتطاع MID هذا الإحداثي كنقطة انطلاق، وتبدأ في قراءة واقتطاع المحارف العشرة المتتالية التالية له. ينتج عن هذا التدفق المتسلسل نص معزول تمامًا يحتوي حصريًا على التاريخ المطلوب، محققًا بذلك الفصل الرياضي التام بين المحتوى التقويمي والزوائد السردية المجاورة له في السلسلة النصية الأصلية.
3. التحليل الوظيفي للدوال المدمجة: دالتا FIND و MID
3.1 دور دالة FIND في الرصد الدقيق لموقع الفواصل الزمنية
تمثل دالة FIND في بيئة إكسل أداة التحري الموضعي الأكثر دقة، حيث تختص بتحديد الموقع الرقمي لبداية سلسلة نصية فرعية داخل سلسلة نصية أخرى. تأخذ هذه الدالة ثلاثة معاملات رياضية: الأول هو النص المطلوب البحث عنه (find_text)، والثاني هو السلسلة النصية المستهدفة بالبحث (within_text)، والثالث هو معامل اختياري يحدد رقم المحرف الذي تبدأ عنده عملية البحث (start_num). وفي حال إغفال المعامل الثالث، فإن المحرك يفترض تلقائيًا البدء من المحرف الأول. وتتميز هذه الدالة بحساسيتها التامة لحالة الأحرف (Case-sensitive)، وهو ما يجعلها ذات كفاءة استثنائية وثبات عالٍ عند البحث عن الرموز الخاصة التي لا تقبل التعدد الشكلي مثل الفواصل الزمنية.
تعتمد استراتيجية استخراج التواريخ على الخاصية الجوهرية لدالة FIND المتمثلة في قدرتها على التوقف وإرجاع أول تطابق تلتقي به أثناء المسح الخطي للنص من اليمين إلى اليسار أو العكس بحسب لغة الإدخال. في السلاسل النصية التي تحتوي على تواريخ، تتكرر الفواصل الزمنية مرتين على الأقل (مثل الفاصلة بين اليوم والشهر، والفاصلة بين الشهر والسنة)، إلا أن الدالة تقتنص بدقة موضع الفاصلة الأولى متجاهلة الفواصل اللاحقة مؤقتًا. هذا السلوك يضمن نقطة استناد متجانسة وثابتة؛ حيث يمثل الفاصل الأول المحور التنسيقي الذي تُبنى عليه كافة حسابات الإزاحة العكسية لتحديد بداية التاريخ وبداية اقتطاعه.
3.2 دور دالة MID في استخلاص الجزء المستهدف بدقة مطلقة
تُعد دالة MID القلب التنفيذي لعمليات الاستقطاع النصي الانتقائي في إكسل، إذ صُممت خصيصًا لاستخراج عدد محدد من المحارف بدءًا من أي موضع وسيط داخل السلسلة النصية، بخلاف دالتي LEFT و RIGHT اللتين تقتصران على البدايات والنهايات فقط. تتكون الدالة من ثلاثة معاملات أساسية: السلسلة النصية الأصلية (text)، ورقم موضع البداية (start_num)، والعدد الإجمالي للمحارف المراد اقتطاعها (num_chars). تتجلى القوة الحسابية لهذه الدالة في قابليتها لاستقبال نتائج دوال رياضية أو نصية أخرى كمدخلات لمعاملاتها، مما يتيح مكننة تحديد نقطة الانطلاق بصورة ديناميكية كاملة.
يخضع معامل عدد المحارف (num_chars) لتقدير دقيق يرتبط بالبنية التقويمية؛ حيث تُحدد القيمة عادة بعشرة محارف لتغطية الصيغة الكاملة المكونة من اليوم والشهر والسنة والفواصل، أو ثمانية محارف في حال كانت السنة ممثلة برقمين فقط. وتتميز دالة MID بمرونة برمجية عالية في التعامل مع الحالات الحدية؛ فعندما يتجاوز عدد المحارف المطلوب اقتطاعه طول السلسلة النصية المتبقية بدءًا من نقطة الانطلاق، لا تُصدر الدالة أي خطأ حوسبي، بل تكتفي بإرجاع كافة المحارف المتاحة حتى نهاية السلسلة. ومع ذلك، فإن الإخفاق في ضبط إحداثي البداية بدقة يؤدي إلى تشويه المخرج النصي، إما باقتطاع جزء من التاريخ أو بدمج محارف أجنبية دخيلة تابعة للنص المجاور.
4. التطبيق العملي: استخراج التواريخ بصيغة الشرطة المائلة (MM/DD/YYYY)
4.1 الإعداد المنهجي للبيانات وإنشاء بيئة الاختبار التجريبية
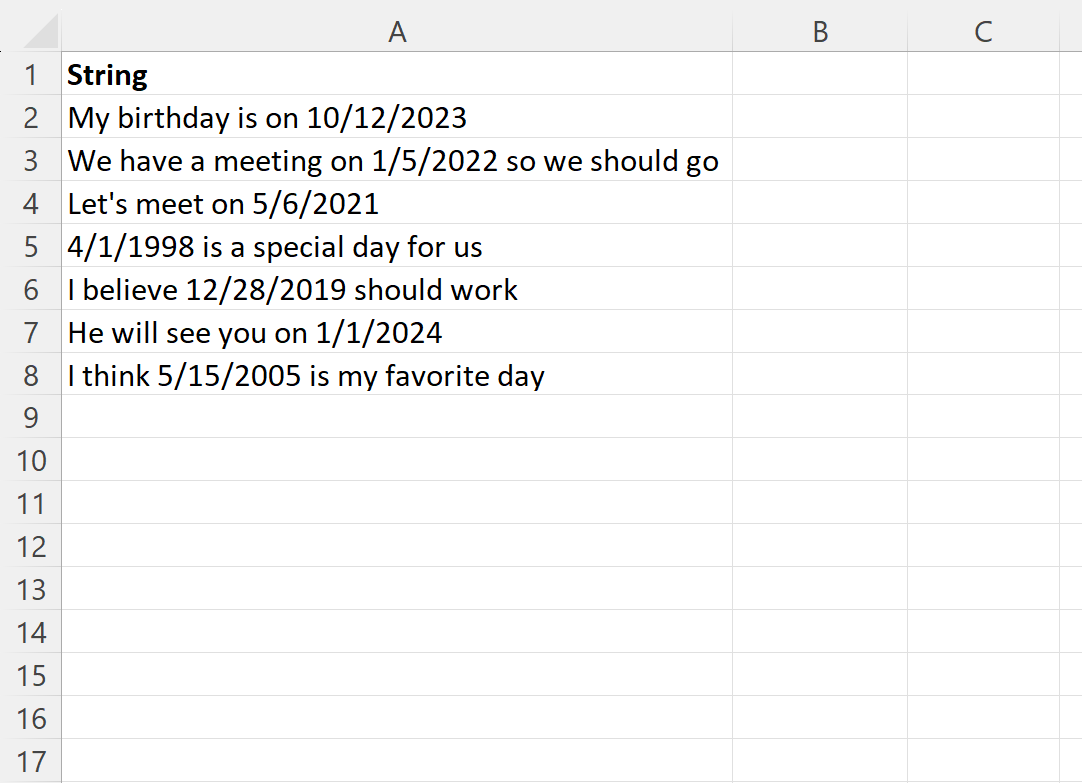
لضمان صحة النماذج الحسابية ودقتها قبل تعميمها على مجموعات البيانات الضخمة، يتعين على المحلل بناء بيئة اختبار تجريبية محكمة داخل ورقة العمل. يبدأ الإعداد المنهجي بهيكلة جدول بيانات يتألف من أعمدة محددة بوضوح: العمود الأول مخصص للنصوص الخام غير المنظمة (Source Text)، والعمود الثاني لصيغة الاستخراج المباشرة، بينما تُخصص الأعمدة اللاحقة لعمليات التحقق والتحويل التسلسلي. يجب أن تشتمل عينة الاختبار التجريبية على تنوع منهجي واسع في أنماط تموضع التاريخ، بحيث تضم سجلات يقع التاريخ في مستهلها، وأخرى يتوسطها، وثالثة يختتم بها النص السردي، لضمان قياس أداء المعادلة تحت كافة السيناريوهات المكانية الممكنة.
يتطلب الفحص الأولي للبيانات التأكد من خلو النصوص من الرموز الخفية ومسافات التوقف غير المرئية (Non-breaking Spaces) التي تُرمز غالبًا بالرمز ASCII 160، والتي تنتقل بشكل شائع عند نسخ البيانات من صفحات الإنترنت أو خوادم الأنظمة المركزية. هذه المحارف الخفية لا تُعامل كمسافات بيضاء عادية من قِبل دالة FIND، بل تُعامل كمحارف مستقلة، مما يربك حسابات الفهارس الموضعية ويتسبب في انزياح التاريخ المستخرج بمقدار حرف أو أكثر. يوضح الجدول التالي مصفوفة بيانات تجريبية معيارية لاختبار استخراج التاريخ بصيغة الشرطة المائلة:
جدول 1: مصفوفة بيانات تجريبية لاستخراج التاريخ بالشرطة المائلة
- السجل A2: “تم اعتماد الطلب في 04/15/2023 من المدير المالي” -> الهدف المستخرج: 04/15/2023
- السجل A3: “08/22/2022 سجل بدء التشغيل الأولي للمنظومة” -> الهدف المستخرج: 08/22/2022
- السجل A4: “تاريخ الانتهاء المالي المحدد للفترة هو 12/31/2024” -> الهدف المستخرج: 12/31/2024
4.2 التنفيذ الإجرائي للمعادلة وسحبها عبر المصفوفة البيانية
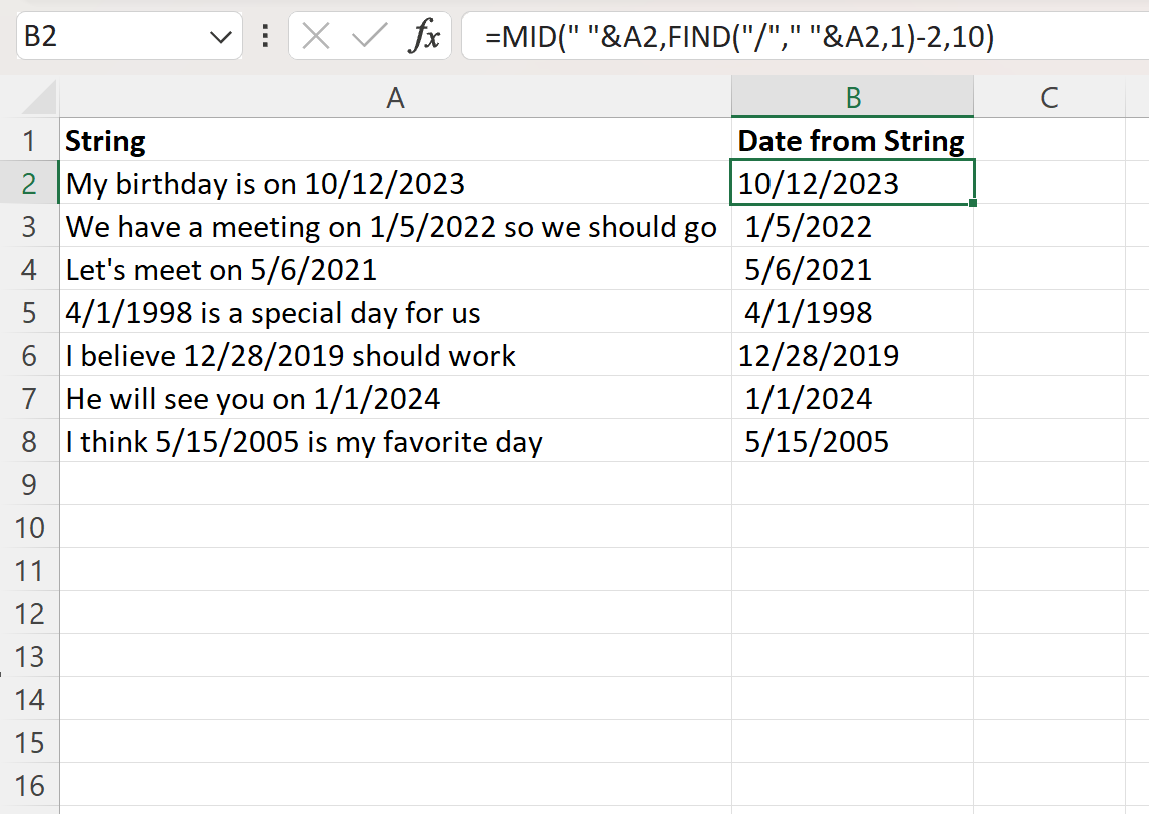
تبدأ الخطوة الإجرائية بكتابة المعادلة بدقة تامة داخل الخلية الأولى المخصصة للمخرجات (ولتكن الخلية B2)، مع مراعاة الإسناد المرجعي الصحيح للخلية الأصلية. تُكتب الصيغة كالتالي:
=MID(” “&A2, FIND(“/”, ” “&A2, 1) – 2, 10)
يجب على المحلل التأكد من استخدام الفاصلة المنقوطة (;) أو الفاصلة العادية (,) للفصل بين معاملات الدوال بناءً على الإعدادات الإقليمية لنظام التشغيل وحزمة أوفيس المثبتة على الحاسوب. بعد إدخال الصيغة وضغط مفتاح الإدخال، يتم التحقق بصريًا من أن القيمة المسترجعة في الخلية B2 تمثل التاريخ معزولاً بنقاء تام دون أي نقص في الأرقام أو تضمين لأي أحرف نصية أو مسافات فارغة غير مرغوب فيها.
لتطبيق المعادلة على كامل مصفوفة السجلات، يُستخدم مقبض التعبئة التلقائية (AutoFill Handle) من خلال النقر المزدوج على المربع الصغير الكائن في الزاوية اليسرى أو اليمنى السفلية لخلية المعادلة، مما يدفع إكسل إلى نسخ الصيغة رياضيًا مع تعديل مراجع الخلايا نسبيًا (A3, A4, A5…) على امتداد العمود. يُتبع ذلك بإجراء تدقيق بصري أولي عبر مسح عينة عشوائية من النتائج، لا سيما في السجلات التي يتغير فيها موضع التاريخ أو يتضمن نصوصًا عربية ولاتينية مختلطة، للتأكد من صمود المنطق الخوارزمي للمعادلة أمام التباينات السردية في مختلف الصفوف.
5. تكييف المعادلة مع الصيغ البديلة والفواصل المختلفة
5.1 التعامل مع صيغ الشرطة الأفقية (MM-DD-YYYY و YYYY-MM-DD)
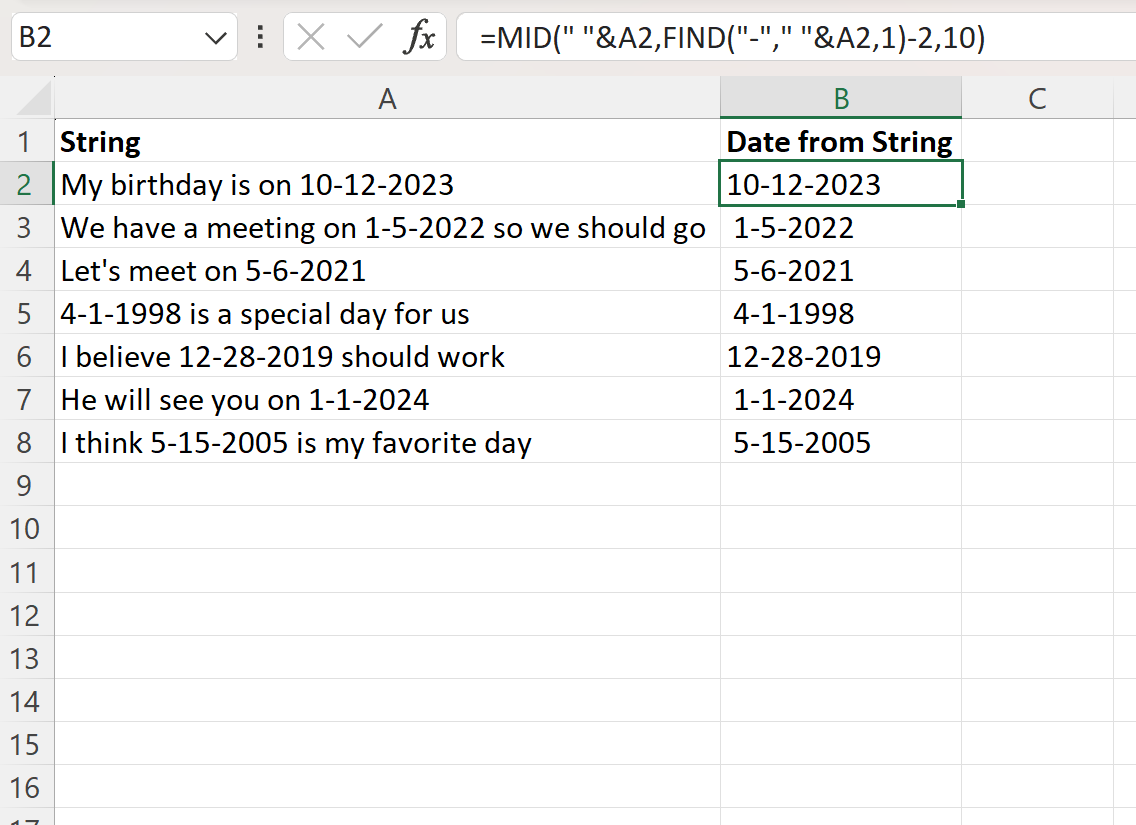
لا تقتصر بنية التواريخ على الشرطة المائلة، بل تشيع التنسيقات المعتمدة على الشرطة الأفقية (-) في العديد من قواعد البيانات، لا سيما قواعد البيانات العلائقية وأنظمة تخطيط موارد المؤسسات (ERP). لتكييف المعادلة مع هذه الحالات، يتعين أولاً استبدال معامل البحث في دالة FIND ليصبح “-” بدلاً من “/”. إذا كان التنسيق المعتمد هو التنسيق القياسي القصير (MM-DD-YYYY أو DD-MM-YYYY)، تظل قيمة الإزاحة وطول التاريخ متطابقين تمامًا مع المعادلة الأصلية، وتصبح الصيغة:
=MID(” “&A2, FIND(“-“, ” “&A2, 1) – 2, 10)
غير أن التعقيد يظهر بوضوح عند التعامل مع المعيار الدولي للتواريخ (ISO 8601) الذي يتبع التنسيق (YYYY-MM-DD)؛ حيث تتقدم السنة المكونة من أربعة أرقام السلسلة التاريخية. في هذا السيناريو، يؤدي طرح خانتين فقط (-2) من موضع الفاصلة الأولى إلى اقتطاع آخر رقمين فقط من السنة وفقدان أول رقمين، مما يُفسد التاريخ بالكامل. لمواجهة ذلك، يجب تعديل الإزاحة المكانية برمجياً؛ حيث تسبق الفاصلة الأولى أربعة أرقام مخصصة للسنة، وبالتالي يجب أن تصبح الإزاحة (-4) لضمان انطلاق الاقتطاع من بداية السنة، مع الإبقاء على طول الاقتطاع ثابتًا عند 10 محارف لتغطية السنة والشهر واليوم وفواصلهما، فتصاغ المعادلة كما يلي:
=MID(” “&A2, FIND(“-“, ” “&A2, 1) – 4, 10)
5.2 استخراج التواريخ المفصولة بنقاط (DD.MM.YYYY)
يُعد استخدام النقاط كفواصل زمنية (Dot Delimiters) السمة الغالبة في التنسيقات التقويمية الأوروبية والسويسرية على وجه الخصوص (مثل 25.12.2023). يفرض هذا النمط تحديًا حسابيًا دقيقًا داخل إكسل؛ إذ تُستخدم النقطة في الوقت ذاته كعلامة عشرية للأرقام الحسابية في العديد من الأنظمة. إذا كانت النصوص الأصلية تحتوي على أرقام نقدية أو نسب مئوية تتضمن فواصل عشرية تسبق التاريخ، فإن دالة FIND(“.”) سترصد بطريق الخطأ أول نقطة عشرية بدلاً من فاصلة التاريخ، مما يقود إلى استخراج مقتطفات عددية مشوهة لا علاقة لها بالتاريخ.
لتفادي هذا الخلط، يتوجب على المحلل التدقيق في بنية النص؛ فإذا كان التاريخ خاليًا من منافسة الفواصل العشرية، تُعدل المعادلة مباشرة باستهداف النقطة مع إزاحة مقدارها (-2) وطول اقتطاع مقداره 10 محارف:
=MID(” “&A2, FIND(“.”, ” “&A2, 1) – 2, 10)
أما في الحالات التي تُكتب فيها التواريخ بأرقام فردية غير مسبوقة بصفر (مثل 5.3.2023)، فإن الاقتطاع بطول ثابت (10 محارف) سيؤدي حتمًا إلى جلب محارف نصية مجاورة تقع بعد التاريخ، كما أن الإزاحة الثابتة (-2) قد تجلب مسافة فارغة تسبق الرقم الفردي، وهو ما يتطلب تدخلاً متقدمًا لضبط ديناميكية الأطوال كما سنبينه في المبحث التالي.
6. التعامل مع التواريخ متغيرة الأطوال والأنماط المعقدة
6.1 ديناميكية استخراج التواريخ غير القياسية (D/M/YYYY)
تُمثل التواريخ التي لا تلتزم بإضافة الأصفار التمهيدية للأرقام الأحادية (مثل كتابة 1/4/2023 بدلاً من 01/04/2023) أكبر تحدٍ أمام معادلات الاستخراج ذات الأطوال الثابتة؛ حيث يتراوح طول السلسلة التاريخية في هذه الأنماط بين 8 محارف في حدها الأدنى (D/M/YYYY) و10 محارف في حدها الأقصى (DD/MM/YYYY). إن الاعتماد على طول اقتطاع ثابت قدره 10 في مثل هذه البيانات ينتج عنه حتمًا استقطاع محارف نصية أو مسافات لاحقة للتاريخ القصير، مما يحول دون تحويله لاحقًا إلى رقم تسلسلي صحيح ويفسد البنية الرياضية لورقة العمل.
لحل هذه المعضلة جذريًا، يجب الانتقال إلى نموذج الفهرسة المزدوجة لاحتساب الطول الفعلي ديناميكيًا. يتحقق ذلك بتحديد موضع الفاصلة الأولى، ثم البحث عن موضع الفاصلة الثانية عبر توظيف المعامل الثالث لدالة FIND الذي يحدد بداية البحث كالتالي:
=FIND(“/”, A2, FIND(“/”, A2) + 1)
بمعرفة موضع الفاصلة الثانية، يمكن للمحلل الجزم بأن الأرقام الأربعة التالية لها تُمثل السنة بالكامل. بالتالي، يمكن حساب الطول الإجمالي للتاريخ عبر طرح موضع بداية التاريخ من موضع الفاصلة الثانية وإضافة 4 محارف إليها. يتيح هذا المنطق الرياضي استخراج التواريخ المكتوبة برقم واحد أو رقمين للشهر واليوم بكفاءة تامة، دون الاعتماد على أي تقديرات افتراضية مسبقة للأطوال.
6.2 دمج دالتي LEN و SUBSTITUTE لتحديد حدود النصوص الزمنية
في البيئات النصية شديدة التعقيد، قد تحتوي السلسلة الواحدة على محارف خاصة متعددة تشبه فواصل التواريخ، مثل وجود مسارات روابط إنترنت أو أكواد معقدة تتضمن شرطات متعددة. هنا تبرز تقنية دمج دالتي LEN (لحساب طول النص) و SUBSTITUTE (لاستبدال المحارف) كخوارزمية برمجية متقدمة داخل إكسل لتحديد وحصر عدد الفواصل بدقة تامة وفلترة السلاسل المضللة.
تقوم هذه التقنية على قياس طول النص الأصلي، ثم طرح طول النص ذاته بعد تفريغه من الرمز الفاصل باستخدام دالة الاستبدال عبر الصيغة التحليلية:
=LEN(A2) – LEN(SUBSTITUTE(A2, “/”, “”))
يُشير الناتج الرقمي لهذه الصيغة إلى التكرار الدقيق للرمز داخل الخلية. وإذا أردنا استهداف الفاصلة الزمنية تحديدًا وتجاهل الرموز المضللة الأخرى، يمكننا استخدام دالة SUBSTITUTE بمعاملها الرابع (Instance Number) لاستبدال الفاصلة المرتبطة بالتاريخ حصرًا برمز فريد وغير مكرر نهائيًا في النص (مثل الرمز ~ أو §). بعد هذا الاستبدال الموجه، تُوجّه دالة FIND للبحث عن هذا الرمز الفريد، مما يسمح بتحديد إحداثيات التاريخ بدقة هندسية مطلقة تضمن تصفية السلاسل المعقدة وعزل التواريخ المتداخلة مهما تباينت نصوص الخلايا في الطول والتعقيد التركيبي.
7. المقاربات المتقدمة: الدوال الحديثة في الإصدارات الأخيرة من إكسل
7.1 الاستخراج باستخدام دالتي TEXTBEFORE و TEXTAFTER
أحدثت التحديثات الأخيرة في حزمة مايكروسوفت 365 (Microsoft 365) نقلة نوعية في معالجة السلاسل النصية عبر تقديم دوال متخصصة تُلغي الحاجة إلى تركيبات المعادلات المعقدة المعتمدة على حساب الفهارس اليدوية. وتأتي في مقدمة هذه الأدوات دالتا TEXTBEFORE و TEXTAFTER اللتان تعملان بأسلوب منطقي يعتمد على المعالم النصية المباشرة بدلاً من الإحداثيات الرقمية للمحارف.
عندما يكون التاريخ مفصولاً بمسافات بيضاء عن بقية النص السردي، يمكن للمحلل عزله بخطوة واحدة غاية في البساطة والموثوقية؛ حيث تُستخدم دالة TEXTAFTER لتخطي النص السابق، متبوعة بدالة TEXTBEFORE لاقتطاع النص اللاحق، أو دمج الدالتين معًا في صيغة مركبة تستخلص النص الواقع بدقة بين محددين معروفين. فإذا علمنا أن التاريخ يقع مباشرة بعد كلمة معينة مثل “بتاريخ: “، يمكن كتابة الصيغة على النحو التالي:
=TEXTBEFORE(TEXTAFTER(A2, “بتاريخ “), ” “)
تتميز هذه المقاربة الحديثة بكونها أكثر قابلية للصيانة البرمجية والمراجعة الأكاديمية؛ فالصيغ واضحة المعالم، وتلغي بالكامل معادلات الطرح والإزاحة اليدوية التي يسهل الوقوع في الخطأ عند كتابتها، كما أنها توفر استهلاك الذاكرة وتسرع من وتيرة إعادة الحساب التلقائي داخل مصفوفات البيانات الكبيرة.
7.2 التكامل مع دوال التعابير النمطية (REGEX) في التحديثات المعاصرة
تُمثّل التعابير النمطية (Regular Expressions) أقصى درجات التطور في التعرف على الأنماط واستخراج النصوص داخل برمجيات الحوسبة الحديثة، وقد تم إدراجها مؤخرًا وبشكل أصيل في إصدارات إكسل الحديثة عبر مجموعة دوال تتقدمها دالة REGEXTRACT. لا تعتمد هذه الدالة على مواقع الفواصل أو المسافات، بل تعتمد على التوصيف الرياضي والشكلي للبنية التقويمية ذاتها بغض النظر عن موقعها داخل النص السردي أو نوع الفاصل المستخدم.
يُصاغ النمط التعبيري الموحد لاستخراج التاريخ عبر تحديد تتالي الأرقام والفواصل بصيغة محكمة، وتُكتب الصيغة الرياضية داخل إكسل كما يلي:
=REGEXTRACT(A2, “bd{1,2}[/-]d{1,2}[/-]d{2,4}b”)
يقوم محرك الدالة بتفسير هذا النمط عبر مسح السلسلة للعثور على حد كلمة (b)، يليه رقم أو رقمان يمثلان اليوم أو الشهر (d{1,2})، يليه فاصل إما شرطة مائلة أو أفقية ([/-])، ثم رقم أو رقمان، ثم فاصل مماثل، ثم سنتان أو أربع سنوات (d{2,4}). يحقق هذا النمط أعلى معدلات الكفاءة الحسابية الممكنة، إذ يتجاهل كافة النصوص والمسافات غير المتطابقة تلقائيًا وبصورة فورية، مما يوفر على الباحثين مئات الساعات من كتابة الشروط المنطقية المعقدة لتنظيف البيانات، ويرفع موثوقية التحليلات في المشروعات العلمية والتطبيقية المعقدة.
8. تحويل النصوص المستخرجة إلى قيم تسلسلية زمنية قابلة للحساب
8.1 إشكالية التخزين النصي وأثرها على العمليات الحسابية اللاحقة
يقع العديد من مستخدمي جداول البيانات في خطأ منهجي شائع يتمثل في الاكتفاء بالاستخراج البصري للتواريخ؛ حيث تبدو القيمة المستخرجة عبر دوال MID أو TEXTAFTER كتاريخ مكتمل الأركان أمام العين المجردة. غير أن الحقيقة الحوسبية داخل النظام تشير إلى أن نوع البيانات الناتج هو “نص” (Data Type = Text). في بيئة إكسل الداخلية، تظل السلسلة “15/05/2023” مساوية تمامًا لأي كلمة لغوية مثل “شجرة” أو “سيارة”، ولا تحمل أي قيمة تقويمية حقيقية.
يترتب على بقاء التواريخ بصيغتها النصية شلل تام في وظائف التحليل الزمني داخل المصنف؛ فالدوال الإحصائية والرياضية والشرطية التي تبحث عن فترات محددة (مثل SUMIFS، و COUNTIFS، و AVERAGEIFS) ستتجاهل هذه الخلايا تمامًا وتعتبرها قيماً صفرية أو غير مطابقة. كذلك، تفشل دالة الفروق الزمنية DATEDIF في احتساب الفارق بين تاريخين نصيين، كما يصبح من المستحيل تمثيل هذه البيانات زمنيًا على المحاور البيانية بشكل صحيح. يوضح الجدول التالي مقارنة جوهرية بين نمطي التخزين:
جدول 2: المقارنة المنهجية بين التخزين النصي والتمثيل التسلسلي للتواريخ في إكسل
- نوع البيانات النصي (Text): المحاذاة الافتراضية إلى اليسار؛ القيمة في الذاكرة عبارة عن سلسلة محارف مجردة؛ العمليات الحسابية غير ممكنة وتُرجع خطأ #VALUE!؛ لا يمكن فرزها زمنيًا بل أبجديًا فقط.
- الرقم التسلسلي الزمني (Serial Date): المحاذاة الافتراضية إلى اليمين؛ القيمة في الذاكرة رقم صحيح (مثلاً 45061)؛ العمليات الحسابية والرياضية وحساب الفترات ممكنة بدقة كاملة؛ الفرز والتصفية التقويمية التلقائية متاحة بنجاح.
8.2 طرق التحويل القسري والمباشر (DATEVALUE والعمليات الأحادية)
لتحويل النصوص المستخرجة إلى قيم تقويمية حقيقية صالحة للتحليل، تبرز طريقتان رئيستان تضمنان إجبار محرك إكسل على تحويل نوع البيانات (Type Coercion). الطريقة الأولى هي استخدام دالة التحويل المباشر DATEVALUE، حيث يتم تطويق معادلة الاقتطاع بالكامل داخل هذه الدالة كما يلي:
=DATEVALUE(MID(” “&A2, FIND(“/”, ” “&A2, 1) – 2, 10))
تتولى هذه الدالة قراءة النص وتفسير رموزه وفقًا لتقويم النظام، محولة إياه إلى الرقم التسلسلي المقابل. أما الطريقة الثانية، والتي يُفضلها خبراء النمذجة المالية والتحليل المتقدم نظرًا لسرعتها الحسابية العالية، فهي توظيف المعامل الأحادي المزدوج السالب (Double Unary Operator: --) في مستهل معادلة الاقتطاع النصي:
=–MID(” “&A2, FIND(“/”, ” “&A2, 1) – 2, 10)
تقوم الإشارة السالبة الأولى بتحويل النص إلى قيمة عددية سالبة قسرًا عبر إخضاعه لعملية حسابية أولية، ثم تقوم الإشارة السالبة الثانية بعكس القطبية ليعود الرقم إلى قيمته الموجبة الصحيحة. بعد إتمام التحويل بإحدى هاتين الطريقتين، سيظهر الناتج كرقم صحيح مجرد (مثل 45061 لليوم 15 مايو 2023). وهنا يتعين على المحلل الانتقال إلى الخطوة التنسيقية النهائية عبر ضبط تنسيق الخلية من تبويب “الصفحة الرئيسية” وتغييره من “عام” (General) إلى فئة “تاريخ” (Date) بالصيغة المرئية المرغوبة، ليكتمل التحول التقني من مجرد نص إلى كائن زمني متكامل.
9. إدارة الأخطاء الشائعة وحلول استكشاف الأعطال التقنية
9.1 تشخيص أسباب خطأ القيمة الشهير (#VALUE!) وطرق معالجته
يُعد خطأ القيمة الشهير #VALUE! العارض التقني الأكثر تكرارًا عند تطبيق معادلات استخراج التواريخ في إكسل. ينشأ هذا الخطأ في المقام الأول عندما تفشل دالة البحث الموضعي FIND في العثور على الرمز الفاصل المستهدف داخل السلسلة النصية للخلية؛ كأن تكون الخلية الأصلية فارغة، أو تحتوي على نص وصفي لا يتضمن أي تاريخ، أو تحتوي على تاريخ مكتوب بفاصل مغاير تمامًا للرمز المحدد في المعادلة (مثل وجود شرطة أفقية بدلاً من المائلة).
لتفادي توقف العمليات الحسابية وتشويه مظهر التقارير التحليلية، يجب تحصين المعادلة من خلال تطويقها بدالة إدارة الأخطاء IFERROR. تتيح هذه الدالة للمحلل التحكم في السلوك الحسابي عند تعثر الاستخراج، إما بإرجاع خلية فارغة تمامًا للحفاظ على النظافة البصرية للبيانات، أو بإرجاع رسالة تحذيرية محددة ترشد المدققين لوجود سجل معيب. وتأخذ الصيغة الوقائية المحصنة الشكل التالي:
=IFERROR(DATEVALUE(MID(” “&A2, FIND(“/”, ” “&A2, 1) – 2, 10)), “”)
يضمن هذا الأسلوب استمرار عمل الدوال التراكمية في كامل العمود دون انقطاع، ويتيح فرصة لعزل الصفوف التي تتطلب تدقيقًا يدويًا أو تنظيفًا مسبقًا بطريقة منهجية ومنظمة، مما يمنع انتقال الأخطاء إلى المراحل اللاحقة من النماذج الإحصائية.
9.2 معالجة أخطاء الانزياح اللوني والمحرفي ومشاكل التنسيق الإقليمي
تنشأ أخطاء الانزياح المحرفي عندما تسترجع المعادلة نصًا مبتورًا (مثل اقتطاع “4/15/202” بدلاً من “04/15/2023”)، أو عندما تسترجع التاريخ متبوعًا بمسافة بيضاء فارغة أو حرف أجنبي ملاصق. يعود السبب الجذري لهذا الانزياح إلى خطأ في معايرة قيمة الإزاحة الحسابية أو عدد خانات الاقتطاع. للتغلب على مشكلة المسافات الطفيلية التي قد تعلق بالبدايات أو النهايات دون أن تلحظها العين، يُنصح بدمج دالة التشذيب TRIM حول النص المستخرج مباشرة قبل تمريره إلى دوال التحويل:
=TRIM(MID(” “&A2, FIND(“/”, ” “&A2, 1) – 2, 10))
تتفاقم مشكلات التنسيق الإقليمي عند مشاركة جداول البيانات بين حواسيب تعتمد إعدادات دولية متباينة؛ حيث يتعارض التنسيق الأمريكي (شهر/يوم/سنة) تعارضًا صريحًا مع التنسيق المعياري والبريطاني (يوم/شهر/سنة). إذا حاول إكسل تحويل التاريخ النصي “05/08/2023” في بيئة تعتبر الرقم الأول شهرًا، فإنه سيفسر التاريخ على أنه الثامن من مايو، بينما سيفسره نظام آخر على أنه الخامس من أغسطس. لتفادي هذا الالتباس الخطير وتأثيره الكارثي على تسلسل البيانات، يجب تجاوز دوال التحويل التلقائية والاعتماد على التفكيك الصريح للأجزاء الثلاثة ثم إعادة تجميعها عبر دالة التاريخ المعيارية DATE(Year, Month, Day) كما يلي:
=DATE(MID(A2, y_start, 4), MID(A2, m_start, 2), MID(A2, d_start, 2))
يضمن هذا التفكيك اليدوي فرض الإحداثيات التقويمية لكل عنصر بدقة متناهية لا تتأثر مطلقًا بالإعدادات الإقليمية لنظام التشغيل أو لغة واجهة البرنامج.
10. أفضل الممارسات المنهجية لتوثيق وتدقيق جودة البيانات المستخرجة
10.1 التحقق المتقاطع والتأكد من موثوقية التواريخ الناتجة
يتطلب العمل التحليلي والبحثي الرصين إخضاع البيانات المستخرجة لسلسلة من اختبارات الجودة للتأكد من عدم تسرب أي تواريخ وهمية أو أرقام مشوهة إلى قاعدة البيانات النهائية. يعتمد التحقق المتقاطع على بناء مؤشرات تدقيق منطقية (Logical Flags) في أعمدة مستقلة مخصصة للفحص. يُبنى أول هذه الاختبارات على التأكد من منطقية نطاق السنوات المستخرجة باستخدام دالة YEAR؛ فإذا كانت بيانات الدراسة محصورة بين عامي 2020 و 2025، فإن أي ناتج يقع خارج هذا النطاق يُعد دليلاً قاطعًا على خطأ في إزاحة الاقتطاع.
كذلك، يجب فحص اتساق الأشهر والأيام برمجياً من خلال معادلات شرطية تتأكد من أن قيم دالة MONTH لا تتجاوز 12، وأن قيم دالة DAY تقع حصريًا بين 1 و 31، مع مراعاة القيود التقويمية للأشهر الفردية والزوجية والسنوات الكبيسة. يمكن تفعيل ذلك عمليًا من خلال تطبيق ميزة “التحقق من صحة البيانات” (Data Validation) على عمود التواريخ النهائي لمنع قبول أي مدخلات لا تقع ضمن النطاق الزمني المحدد للدراسة، مما يرفع من الموثوقية العلمية للبيانات المستخرجة ويهيئها للتحليلات الإحصائية المتقدمة دون أدنى شك في سلامتها الإجرائية.
10.2 الحفاظ على سلامة النماذج الحسابية وأرشفة البيانات الأصلية
تقتضي المعايير المنهجية لإدارة البيانات الفصل الصارم والدائم بين طبقة البيانات الخام الأصلية (Raw Data Layer)، وطبقة المعالجة الوسيطة (Processing Layer)، وطبقة المخرجات والنتائج النهائية (Presentation Layer). لا يجوز بأي حال من الأحوال إجراء عمليات الاستخراج والتنظيف على السجلات الأصلية مباشرة دون الاحتفاظ بنسخة غير معدلة مؤمنة ضد التغيير؛ وذلك لضمان إمكانية الرجوع إلى النصوص الأصلية والتحقق من السياقات السردية في حال اكتشاف أي خطأ لاحق في منطق المعادلات.
علاوة على ذلك، يُنصح بتوثيق المنطق الرياضي للمعادلات المستخدمة داخل ورقة مخصصة لدليل البيانات (Data Dictionary) تشرح سبب اختيار إزاحات معينة وتحدد القيود المفروضة على النصوص المقبولة. وعند الانتهاء التام من عمليات الاستخراج والتدقيق المتقاطع وثبات البيانات، يُفضل تقنيًا نسخ عمود التواريخ الناتجة ولصقها كقيم ثابتة (Paste as Values) لتجميدها. هذا الإجراء يحمي المصنف من استهلاك موارد وحدة المعالجة المركزية (CPU) في إعادة حساب المعادلات المعقدة مع كل تعديل يطرأ على ورقة العمل، ويزيل خطر انهيار المخرجات في حال حذف أو تعديل الأعمدة النصية الأصلية مستقبلاً.
الخاتمة
تُعد مهارة استخراج التواريخ من السلاسل النصية في برمجية إكسل عملية حوسبية وتحليلية تجمع بين فهم خصائص البنية التقويمية وإتقان توظيف المنطق الموضعي لدوال النصوص. وكما تبين عبر محاور هذا المقال، فإن الانتقال بالبيانات من حالتها السردية غير المنظمة إلى بنية رقمية تقويمية دقيقة يتطلب اتباع خطوات منهجية تبدأ برصد الفواصل المرجعية، وتحديد الإزاحات المكانية بدقة لتجنب الأخطاء الحدية، وتنتهي بالتحويل القسري للنصوص المستخلصة إلى أرقام تسلسلية زمنية قادرة على التفاعل مع أدوات التحليل الإحصائي والمالي.
إن التطور المستمر الذي تشهده حزم البرمجيات الحديثة، لا سيما مع إضافة دوال الاقتطاع المباشر ودوال التعابير النمطية، يفتح آفاقًا جديدة تُبسط من تعقيد هذه المهام التحضيرية وتختصر الكثير من الجهد البرمجي التقليدي. ومع ذلك، يظل الفهم العميق للمنطق الداخلي لمعادلات الفهرسة الموضعية التقليدية هو الضمان الحقيقي لقدرة المحلل على استكشاف الأعطال وحل مشكلات التنسيقات غير المتجانسة التي تفرضها بيئات البيانات الواقعية، مما يضمن الحفاظ على نقاء قواعد البيانات وسلامة مخرجاتها التحليلية.
المراجع
- Keuleers, E., Lacey, P., Rastle, K., & Brysbaert, M. (2011). The British Lexicon Project: Lexical decision data for 28,730 monosyllabic and disyllabic English words. Behavior Research Methods. https://doi.org/10.3758/s13428-011-0118-4
- Lété, B., Sprenger-Charolles, L., & Colé, P. (2004). MANULEX: A grade-level lexical database from French elementary school readers. Behavior Research Methods, Instruments, & Computers. https://doi.org/10.3758/bf03195560