
تعد معالجة السلاسل النصية وضبط هياكلها داخل برنامج مايكروسوفت إكسل (Microsoft Excel) ركيزة محورية في إدارة قواعد البيانات الضخمة، وتنقية مجموعات البيانات البحثية والإدارية. فعلى الرغم من أن الجداول الحسابية صُممت تاريخياً للتعامل مع العمليات المحاسبية والرياضية الرقمية، إلا أن النمو الهائل في أحجام البيانات الوصفية، والبيانات التعريفية للمشاركين في الدراسات الأكاديمية والسريرية، فرض على المحللين تطوير استراتيجيات متقدمة لإعادة هيكلة الأسماء والنصوص بكفاءة وموثوقية عالية.
يمثل استخراج الحرف الأول من الاسم الأول ودمجه مع اسم العائلة (أو اللقب) أحد أشهر نماذج التحويل النصي في بيئات العمل المهنية والبحثية؛ إذ يبرز هذا التنسيق كمعيار لا غنى عنه في صياغة الاقتباسات والمراجع وفق نمط جمعية علم النفس الأمريكية (APA Style)، وفي إجراءات نزع الهوية أو إخفاء المعالم الشخصية لحماية سرية المبحوثين مع الحفاظ على ترابط السجلات، فضلاً عن إنشاء المعرفات الرقمية وحسابات البريد الإلكتروني للموظفين والطلاب في المؤسسات الكبرى. ويتطلب هذا الإجراء تحكماً دقيقاً في الدوال النصية وفهماً عميقاً لمنطق فهارس المحارف لتجنب تشويه البيانات.
يتناول هذا الدليل الشامل والمعمق مختلف الآليات والمنهجيات المتاحة لتحقيق هذه الغاية التقنية في بيئة إكسل، بدءاً من البنية الرياضية للنصوص كمتجهات محارف، مروراً بالمعادلات الحديثة التي أطلقتها شركة مايكروسوفت مثل دالة TEXTAFTER، والبدائل الكلاسيكية التوافقية للإصدارات السابقة، وصولاً إلى الحلول المتقدمة مثل أداة الطاقة Power Query، وأكواد لغة Visual Basic for Applications (VBA)، وميزة التعرف على الأنماط Flash Fill، مع تسليط الضوء على آليات معالجة الأسماء المركبة، وتنقية الشوائب غير المرئية، وإدارة الأخطاء الشائعة باحترافية تامة.
1. مدخل نظري لمعالجة النصوص وتحليل الأسماء في برنامج إكسل
1.1 أهمية توحيد هياكل السلاسل النصية في قواعد البيانات الضخمة
يشكل التنسيق القياسي للبيانات النصية درعاً واقياً ضد الانحرافات والأخطاء المنهجية التي قد تصيب التحليلات الإحصائية ونماذج التعلّم الآلي. فعندما تُجمع البيانات من استطلاعات رأي متعددة، أو نماذج تسجيل رقمية مفتوحة، تتباين طرق كتابة الأسماء بشكل لافت؛ مما يؤدي إلى تضخم السجلات الفريدة ظاهرياً وتكرار الكيانات المتطابقة واقعياً. إن توحيد صيغ الأسماء عبر استخراج الحرف الأول من الاسم الأول ملحوقاً باسم العائلة يقلل من هذا التشتت، ويسهل عمليات المطابقة المتقاطعة والدمج بين الجداول المعقدة بدون فقدان للبيانات.
وعلاوة على تقليل معدلات الخطأ، يلعب التنسيق الموحد دوراً حيوياً في تحسين قابلية التشغيل البيني (Interoperability) بين منصات معالجة البيانات المختلفة. فغالباً ما تُصدّر البيانات من إكسل إلى بيئات برمجية وإحصائية متقدمة مثل حزم لغة R أو بيئة Python للتحليل الإحصائي، أو إلى أنظمة إدارة قواعد البيانات العلائقية (RDBMS) كـ SQL Server وPostgreSQL. وجود أسماء موحدة الصيغة يحمي خوارزميات الاستيراد من الانهيار الناجم عن الحقول غير المتجانسة، ويضمن تجانس مفاتيح الربط المستخدمة في الاستعلامات المعقدة.
من الناحية الأكاديمية والتوثيقية، تفرض المعايير الدولية للنشر العلمي، ومن أبرزها دليل النشر الصادر عن جمعية علم النفس الأمريكية في نسخته السابعة، قواعد صارمة لقوائم المراجع، حيث يُقلب اسم المؤلف ليظهر اللقب أولاً متبوعاً بالحرف الأول من اسمه الأول (أو العكس في سياقات الفهرسة الداخلية). كما تتطلب المعايير الأخلاقية لحماية المشاركين في التجارب والبحوث، مثل لوائح HIPAA، إخفاء الأسماء الصريحة الكاملة واستبدالها باختصارات رمزية كخطوة وسيطة قبل التشفير النهائي، مما يجعل هذه التقنية ضرورة توثيقية وأخلاقية وبحثية ملحة.
1.2 المفاهيم الرياضية والمنطقية للتعامل مع النصوص كمتجهات محارف
تتعامل نواة الحوسبة في برنامج إكسل مع أي سلسلة نصية (String) ليس ككتلة لغوية دلالية، بل كمصفوفة خطية مرتبة أحادية البعد من المحارف (Array of Characters). وفي هذه المصفوفة، يشغل كل محرف موقعاً رقمياً مجرداً يُعرف بالفهرس (Index)، حيث يبدأ الفهرس في إكسل دائماً من الرقم واحد (1-based index) للمحرف الواقع في أقصى بداية النص، متصاعداً بشكل تسلسلي وصولاً إلى آخر محرف، بما في ذلك المساحات الفارغة وعلامات الترقيم والرموز الخاصة.
تعتمد خوارزميات استخراج الأسماء على رصد هذا الفهرس وتتبع نقط التوقف الفاصلة (Delimiter Tracking). فعند البحث عن المسافة الفاصلة بين الاسم الأول واسم العائلة، تقوم الدالة الرياضية بفحص المتجه محرفاً تلو الآخر حتى تعثر على محرف الفراغ (ASCII 32)، لتقوم بحساب إحداثياته العددية بالنسبة لطول المصفوفة الكلي. هذا الحساب الإحداثي يحدد حدود الشريحة النصية (Substring slicing) التي ستُقتطع لاحقاً لتشكيل الحرف الابتدائي أو اسم العائلة المنفصل.
تختلف هذه الآلية المنطقية باختلاف الخصائص اللسانية للنظم الكتابية؛ فاللغات المعتمدة على الأبجديات اللاتينية أو الحروف العربية غير المتصلة برمجياً تفصل الكلمات بمسافات واضحة، إلا أن التحدي يكمن في اللغات أو الكتابات التي تستخدم علامات ربط مركبة أو تلك التي تكتب من اليمين إلى اليسار (RTL). ورغم أن إكسل يعتمد الترتيب المنطقي للتدفق بدلاً من الترتيب البصري الصرف، فإن تعيين بداية السلسلة ونهايتها يخضع دوماً لاتجاه المتجه الرقمي المخزن في الذاكرة الحسابية للبرنامج.
1.3 التحديات التقنية الشائعة عند التعامل مع الأسماء غير المتجانسة
تواجه عمليات معالجة النصوص في إكسل حزمة من العوائق التقنية الناتجة عن أخطاء الإدخال البشري أو تباين الهياكل اللغوية للأسماء. ومن أبرز هذه المعوقات وجود المسافات البادئة (Leading Spaces) أو المسافات اللاحقة (Trailing Spaces)، أو تكرار المسافات المتعددة بين الكلمات داخل حقول الإدخال. إن وجود مسافة واحدة غير مرئية في بداية الخلية يجعل دوال استخراج الحرف الأول تعود بقيمة فراغ فارغة تماماً، مما يفسد نتيجة التحويل بأكملها ويقود إلى تشوهات في المخرجات.
يتجلى التحدي الثاني في التباين الهيكلي لأطوال الأسماء؛ فالنماذج البرمجية البسيطة تفترض أن كل اسم يتألف من مقطعين فقط (اسم أول ولقب)، في حين تفيض قواعد البيانات بالأسماء الثلاثية والرباعية، والأسماء المسبوقة بألقاب تكريمية مثل (دكتور، مهندس، أستاذ، السيد)، أو تلك المنتهية بلاحقات نسب وأجيال مثل (الابن، الثالث، دكتوراه). هذه التفرعات تربك محددات الفصل النصية، وتتطلب بناء معادلات ذكية قادرة على تجاوز الكلمات غير الأساسية لتحديد اللقب الحقيقي بدقة متناهية.
أما التحدي الثالث، فيتمثل في النصوص متعددة اللغات وتأثير اتجاهات الكتابة والترميز الدولي (Unicode Encoding). فالبيانات المستوردة من منصات ويب أو أنظمة استبيانات سحابية قد تحتوي على محارف غير مرئية أو مسافات صلبة غير قابلة للكسر (Non-breaking Spaces)، تختلف جذرياً في ترميزها الرقمي عن المسافة القياسية؛ مما يمنع الدوال من التعرف على نقاط الفصل، ويولد أخطاء برمجية وحسابية غير متوقعة إذا لم يتم تطهير النص مسبقاً.
2. المعادلة الأساسية الحديثة: الجمع بين دالتي LEFT وTEXTAFTER
2.1 التحليل البنيوي لصيغة الاستخراج المباشرة
في بيئات العمل المعاصرة التي تعمل بإصدارات مايكروسوفت 365 (Microsoft 365) وإكسل 2024 والنسخ السحابية، أحدثت مايكروسوفت ثورة نوعية في معالجة النصوص عبر تقديم دوال المصفوفات النصية الحديثة. تتجلى الصيغة القياسية الأكثر أناقة وكفاءة لاستخراج الحرف الأول من الاسم الأول واسم العائلة في المعادلة التركيبية التالية:
=LEFT(A2, 1) & ". " & TEXTAFTER(A2, " ")
تمتاز هذه الصيغة ببنيتها الموجزة وقابليتها المباشرة للقراءة، متجاوزة التعقيدات الحسابية القديمة التي كانت تتطلب تركيب دوال متداخلة متعبة في الصيانة.
تتفكك هذه المعادلة وظيفياً إلى ثلاثة مكونات رئيسية متناغمة: الجزء الأول LEFT(A2, 1) يتولى عزل المحرف الابتدائي الأقصى، والجزء الأوسط & ". " & يمثل جسر الربط التركيبي ومحدد التنسيق البصري، بينما يتكفل الجزء الأخير TEXTAFTER(A2, " ") باقتناص الكتلة النصية اللاحقة للفراغ الفاصل. كل معامل من هذه المعاملات يمتلك حدوداً واضحة لمدخلاته ومخرجاته الرياضية، مما يسمح لنواة إكسل بمعالجتها بالتوازي وبأقل استهلاك ممكن لدورات المعالج الدقيق.
تتم جدولة تنفيذ هذه الصيغة داخل محرك الحسابات في إكسل عبر تسلسل محكم؛ حيث تُقيّم الخلية المرجعية أولاً في الذاكرة المؤقتة، ثم تُنفذ دالة الاقتطاع الأولي لإنتاج رمز نصي ذي طول قدره محرف واحد، وبالتزامن مع ذلك تقوم دالة البحث اللاحق بمسح السلسلة النصية حتى العثور على المسافة المحددة وإرجاع ما بعدها، وأخيراً يُستدعى معامل الربط المتسلسل لتجميع هذه النتائج المستقلة في سلسلة نصية واحدة تظهر للمستخدم النهائي في جزء من الثانية.
2.2 التوظيف التقني لدالة LEFT لعزل المحرف الأول
تعد دالة LEFT واحدة من أعرق الدوال النصية وأكثرها استقراراً في تاريخ برمجيات الجداول الحسابية منذ إطلاق النسخ الأولى لإكسل. تتطلب الدالة في بنيتها وسيطتين رئيسيتين: الوسيطة الإلزامية الأولى هي النص المصدري (Text) وتُمرر كإشارة صريحة إلى مرجع الخلية المستهدفة مثل A2، والوسيطة الثانية هي عدد المحارف المطلوبة (num_chars)، والتي تُضبط بدقة متناهية على الرقم 1 للحصول على الحرف الاستهلالي حصراً، وفي حال إغفال هذه الوسيطة تفترض الدالة تلقائياً القيمة 1 كإجراء افتراضي.
تعتمد كفاءة دالة LEFT على نقاء المحرف الأول المتواجد في الموقع الإحداثي رقم 1. فإذا كانت الخلية تحتوي على علامات ترقيم غير مقصودة، مثل الأقواس أو علامات التنصيص أو مسافات فارغة متقدمة، فإن الدالة ستستخرج ذلك الرمز غير الدلالي وتعتبره مخرجاً صحيحاً. لذلك، ينبغي التأكد من أن القيمة المخزنة تبدأ مباشرة بالحرف الأبجدي، وهو ما يتطلب تدخلاً تطهيرياً مسبقاً في حال تدني جودة البيانات المصدرية.
من الناحية اللغوية والترميزية، تتعامل الدالة مع الحروف اللاتينية بكفاءة عالية، ولكن عند تطبيقها على نصوص باللغة العربية يجب الانتباه إلى علامات التشكيل وحركات الإعراب (مثل الفتحة أو الضمة أو التنوين)؛ حيث يتعامل نظام الترميز في إكسل مع الحركات الصوتية أحياناً كمحارف مستقلة ذات ترميز منفصل وفق جدول اليونيكود، مما قد يؤدي إلى استخراج حركة التشكيل بدلاً من الحرف نفسه إذا كُتبت في بداية النص أو مع همزات الوصل والقطع، مما يبرز أهمية تدقيق الحقل المصدري برمجياً.
2.3 وظيفة دالة TEXTAFTER الحديثة في استرجاع اسم العائلة
تمثل دالة TEXTAFTER، التي أطلقتها مايكروسوفت ضمن تحديثات عام 2022 لدوال التلاعب بالنصوص، قفزة تقنية جوهرية اختصرت مسارات برمجية مضنية. يرتكز المفهوم الأساسي لهذه الدالة على تحديد “محدد الفصل” (Delimiter) داخل السلسلة النصية؛ وفي سياق الأسماء الثنائية، يُعين محدد الفصل بمسافة نصية فارغة محصورة بين علامتي تنصيص " ". تقوم الدالة تلقائياً بتجاوز كل ما يسبق الفراغ واسترجاع كامل النص الواقع بعده، وهو ما يمثل اسم العائلة في الحالات النمطية.
تتميز دالة TEXTAFTER بمرونة استثنائية بفضل وسيطاتها الاختيارية المتقدمة، وأهمها وسيطة “رقم التكرار” (instance_num). فعندما تُترك هذه الوسيطة افتراضياً على القيمة 1، تُعيد الدالة النص اللاحق لأول مسافة تصادفها. ولكن في قواعد البيانات الواقعية التي تتضمن أسماء ثلاثية أو أسماء وسطى، يمكن تغيير قيمة هذه الوسيطة إلى -1؛ وهذا التعديل البرمجي الذكي يوجه محرك البحث في إكسل للبدء من نهاية النص والرجوع إلى الخلف، مما يضمن استخراج اسم العائلة الحقيقي فقط مهما تعددت الأسماء والمسافات السابقة له.
يتسم السلوك الافتراضي للدالة بالحزم الإجرائي؛ فعندما تفشل في العثور على محدد الفصل المذكور داخل الخلية المرجعية (كأن يحتوي السجل على اسم فردي مجرد دون مسافات)، تطلق الدالة تلقائياً رمز الخطأ الحسابي #N/A. غير أن مطوري إكسل زودوا الدالة بوسيطة أمان إضافية هي (if_not_found)، والتي تتيح للمحلل تحديد استجابة بديلة مسبقة—مثل إرجاع الخلية الأصلية كاملة أو تركها فارغة—مما يحمي نموذج البيانات من الانهيار البصري والحسابي.
2.4 آلية الربط المتسلسل باستخدام معامل العطف والنصوص الثابتة
يمثل معامل العطف (Ampersand) المرموز له بالرمز & الأداة الأساسية للربط المتسلسل (Concatenation) في جداول إكسل؛ إذ يعمل كمشغّل حسابي منطقي يدمج المخرجات المستخرجة من دوال مستقلة تماماً داخل تدفق نصي متصل. في صيغتنا المستهدفة، يربط المعامل الأول الحرف المستخرج من دالة LEFT بالفاصلة النقطية والمسافة الثابتة ". "، ثم يربط المعامل الثاني هذا المزيج باسم العائلة المسترجع عبر TEXTAFTER، لإنتاج الهيكل النهائي الموحد.
تعد إضافة النصوص الثابتة خطوة تنسيقية فارقة لضمان الامتثال للمعايير الأكاديمية والمهنية. فإدراج النقطة والمسافة بين علامتي تنصيص ". " يمنح الناتج مظهراً رصيناً يميز الحرف المختصر كاختصار رسمي للاسم الأول (Initial)، ويمنع التصاق الحرف باسم العائلة مباشرة (مثل JSmith مقابل J. Smith). هذه الدقة في إدراج المسافات النصية ضرورية لتجنب تشوه البيانات عند استخدامها في المراسلات الرسمية أو طباعة الشهادات وقوائم المؤتمرات.
عند المقارنة المنهجية بين استخدام معامل العطف المباشر والدوال المدمجة للدمج، نجد تفوقاً عملياً لمعامل & من حيث سرعة الكتابة وخفة العبء الحسابي في التراكيب البسيطة. وعلى الرغم من أن دالتي CONCATENATE التقليدية وCONCAT الحديثة تؤديان الغرض ذاته، إلا أنهما تتطلبان صيغاً أطول. أما دالة TEXTJOIN، فتعتبر خياراً استثنائياً عندما يراد دمج سلاسل متعددة مع تجاوز الخلايا الفارغة تلقائياً، ولكن في إطار استخراج الحرف واسم العائلة، يبقى معامل العطف هو الخيار الأكثر كفاءة وسهولة في التدقيق البرمجي.
3. التطبيق العملي الإجرائي خطوة بخطوة في بيئة إكسل
3.1 إعداد ورقة البيانات وضبط نطاق العمل المصدري
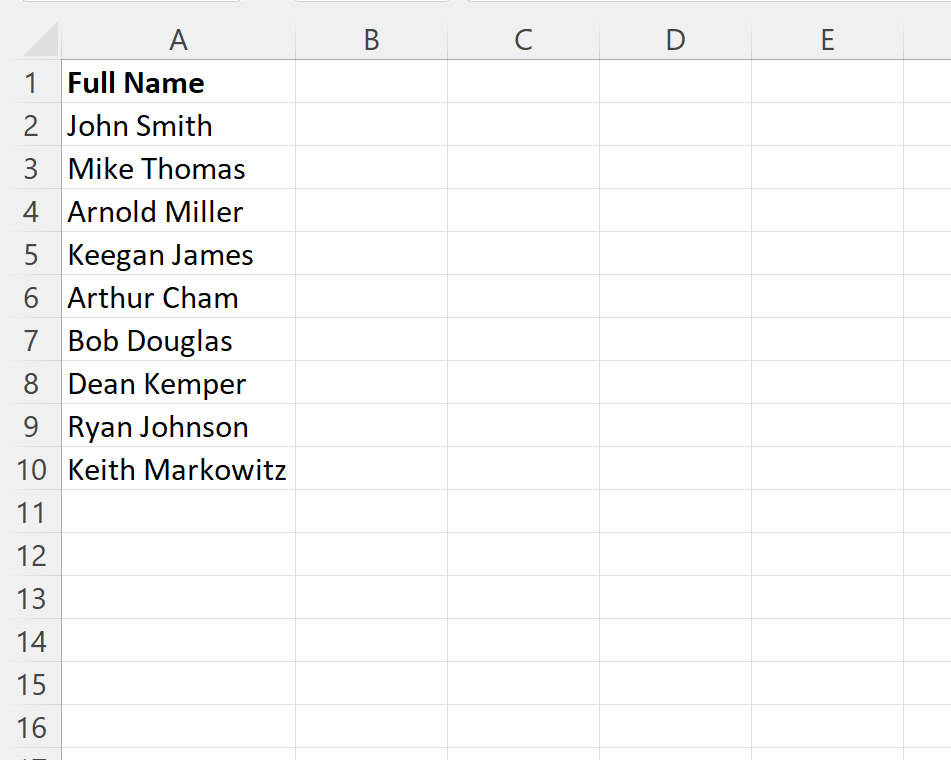
تبدأ الخطوة الأولى للتحويل النصي الناجح في التأسيس الهيكلي المنظم لورقة العمل. يجب على المحلل التأكد من تخصيص عمود مصدري مستقل للأسماء الكاملة غير المعالجة، ويُفضل تسميته بوضوح مثل Full Name في الخلية العلوية A1. يؤدي هذا التحديد الواضح للأعمدة إلى تجنب الخلط بين الحقول الأصلية والمشتقة، ويوفر بيئة عمل ملائمة لإنشاء الجداول الديناميكية الرسمية (Excel Tables) التي تسهل تتبع النطاقات المتغيرة باستمرار.
يتعين في هذه المرحلة فحص طبيعة البيانات المصدرية المتواجدة في النطاق، بدءاً من الخلية A2 وحتى نهاية العمود. يشمل الفحص الأولي التحقق البصري من عدم وجود أعمدة فارغة تماماً داخل النطاق، والتأكد من أن نوع بيانات العمود مهيأ كتنسيق “نص” (Text) أو “عام” (General) في شريط الأدوات الرئيسي، لتفادي أي تحويلات تلقائية غير مرغوبة قد يفرضها إكسل إذا احتوت الأسماء على أرقام أو رموز خاصة كجزء من المعرفات.
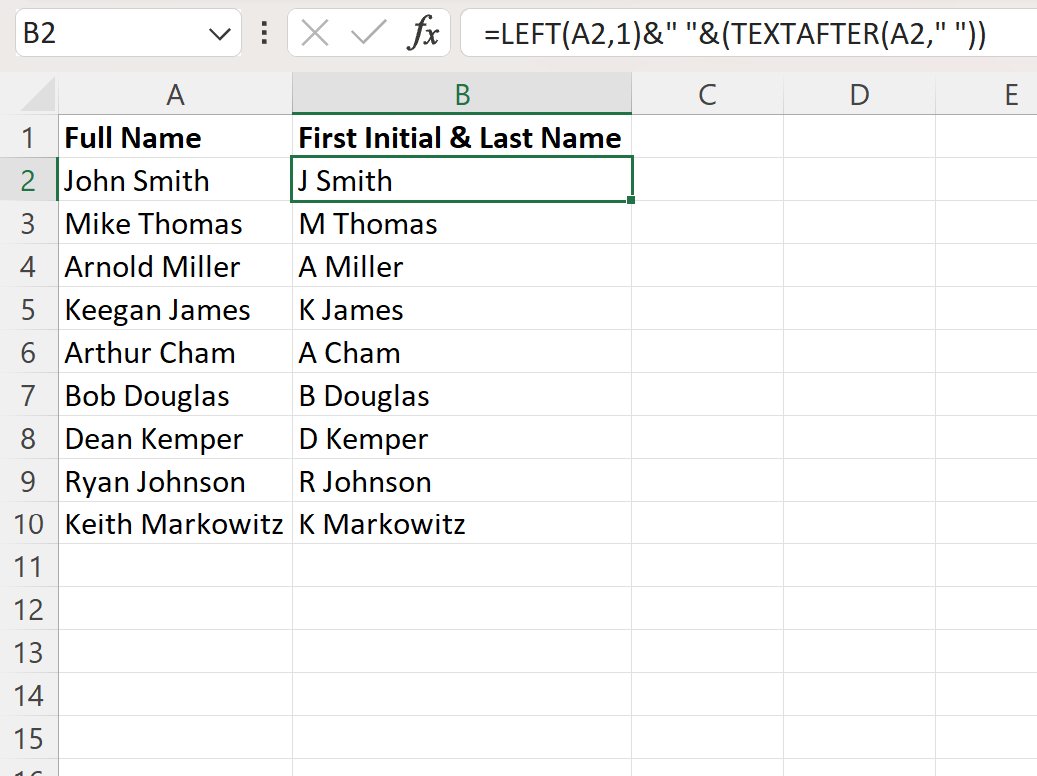
عقب تجهيز العمود المصدري، يُنشأ العمود المستهدف الجديد مباشرة إلى جوار البيانات الأصلية، ويُطلق عليه عنوان وصفي محدد مثل Formatted Name أو Initial & Surname في الخلية B1. يتم ضبط مؤشر التحديد على الخلية B2 لتكون الحاضنة الأولى للمعادلة الرياضية الدقيقة، مع التأكد من بقاء المساحة المحيطة خالية لتفادي أخطاء الانسكاب المصفوفي (Spill Errors) التي قد تحدث مع بعض الدوال التلقائية الحديثة.
3.2 كتابة الصيغة واختبار دقتها على العينة الأولى
في الخلية B2، يشرع المحلل في إدخال الصيغة التركيبية بدقة عبر شريط الصيغ الرياضية (Formula Bar). تبدأ الكتابة دائماً بعلامة التساوي = للإشارة إلى بدء تعبير حسابي، تليها كتابة الدالة:
=LEFT(A2, 1) & ". " & TEXTAFTER(A2, " ")
خلال الكتابة، يتيح محرر إكسل ميزة التلميح الذكي (IntelliSense) التي تظهر وسيطات الدوال بلون رمادي وتؤكد صحة بناء الجملة (Syntax validation)، مما يساعد على تجنب الأخطاء الإملائية في أسماء الدوال أو إغفال الفواصل المنقوطة وعلامات التنصيص.
بمجرد الضغط على زر الإدخال (Enter)، يظهر الناتج الفوري في الخلية B2. هنا تبدأ مرحلة المعاينة والتحقق التجريبي؛ فإذا كان الاسم المصدري في A2 هو “John Smith”، يجب أن تسفر النتيجة عن السلسلة الدقيقة “J. Smith”. يركز التدقيق على ثلاثة معايير حاسمة: سلامة الحرف الأول ورسمه الأبجدي الصحيح، ووجود النقطة المتبوعة بمسافة واحدة فقط دون زيادة أو نقصان، وانتقال اسم العائلة كاملاً دون أي بتر للمحارف الأولى أو الأخيرة.
إذا أظهرت الخلية أي خطأ بصري، مثل التصاق النصوص بدون فراغات أو ظهور أحرف مبتورة، يجب مراجعة النص المصدري فوراً. في كثير من الأحيان، تكشف العينة الأولى عن وجود فراغات مخفية في بداية الاسم الأصلي، مما يؤدي إلى ظهور مسافة فارغة كنتاج لدالة LEFT. هذا الاختبار المبدئي على سجل واحد يحمي المحلل من تعميم صيغة مشوبة بأخطاء منطقية على عشرات الآلاف من السجلات لاحقاً.
3.3 تعميم المعادلة على السجلات عبر مقبض التعبئة ومراجع الخلايا النسبية
بعد التحقق التام من كفاءة الصيغة في الخلية الفردية، تأتي مرحلة التعميم على كامل السجلات المدرجة في قاعدة البيانات. تعتمد هذه الخطوة على المفهوم الجوهري لمراجع الخلايا النسبية (Relative Cell References) في إكسل. فعند الإشارة إلى الخلية A2 بدون علامات التثبيت الدولارية ($)، يدرك البرنامج أن المقصود هو “الخلية الواقعة على مسافة عمود واحد إلى اليمين في نفس الصف”، مما يسمح بتحديث المرجع تلقائياً ليصبح A3 وA4 مع كل صف جديد.
لتطبيق النشر اليدوي، يوجه المستخدم مؤشر الفأرة إلى الزاوية السفلية اليسرى (أو اليمنى حسب اتجاه الواجهة) للخلية B2 حتى يتحول المؤشر من سهم أبيض سميك إلى علامة زائد سوداء دقيقة، وهي ما يُعرف تقنياً بمقبض التعبئة (Fill Handle). بالضغط المستمر والسحب للأسفل، يتم نسخ المعادلة الرياضية مع ضبط المراجع تلقائياً لتغطي النطاق المطلوب بدقة وبساطة فائقة.
أما في قواعد البيانات الكبيرة التي تحتوي على عشرات الآلاف أو مئات الآلاف من الصفوف، فإن طريقة السحب اليدوي تصبح بطيئة وغير عملية. الحل التقني الأمثل هو النقر المزدوج السريع (Double-Click) بزر الفأرة الأيسر على مقبض التعبئة ذاته. يقوم محرك إكسل بقراءة النطاق العمودي المجاور في A، ونشر المعادلة بسرعة فائقة لتهبط إلى آخر صف يحتوي على بيانات دون توقف، متوقفاً تلقائياً عند أول خلية فارغة بالكامل في العمود المقابل.
4. البدائل الكلاسيكية في الإصدارات القديمة من إكسل
4.1 الاستخراج التوافقي عبر دوال LEFT وRIGHT مع دالتي LEN وFIND
في بيئات العمل المؤسسية التي لا تزال تستخدم إصدارات إكسل القديمة مثل Excel 2019 و2016 و2013 والإصدارات السابقة، لا تتوفر دالة TEXTAFTER. يتطلب هذا الواقع التقني استخدام تركيبة كلاسيكية متوافقة تعتمد على دوال تاريخية راسخة، وتتمثل الصيغة القياسية الشاملة في المعادلة المركبة التالية:
=LEFT(A2, 1) & ". " & RIGHT(A2, LEN(A2) - FIND(" ", A2))
تعمل هذه الصيغة بتناغم ميكانيكي بحت لحساب مواقع المحارف رياضياً بدقة متناهية.
ينطلق منطق هذه الصيغة الكلاسيكية من دالة FIND(" ", A2)، التي تقوم بمسح الخلية المرجعية للبحث عن موقع أول محرف مسافة فارغة، وتعيد رقماً صحيحاً يمثل ترتيب ذلك الفهرس داخل السلسلة النصية. فإذا كان الاسم هو “Albert Einstein”، فإن دالة FIND ستعيد الرقم 7، وهو الموضع الدقيق للمسافة الفاصلة بين الاسمين، مما يوفر نقطة الارتكاز الحسابية لبقية أجزاء المعادلة.
بعد ذلك، تتدخل دالة الطول الإجمالي LEN(A2) لحساب عدد محارف النص بأكمله، وتطرح منه قيمة موقع الفراغ الناتج عن دالة FIND. الناتج من عملية LEN(A2) - FIND(" ", A2) يمثل بالضبط عدد الأحرف المتبقية المكونة لاسم العائلة فقط. وهنا يأتي دور دالة RIGHT التي تستقبل هذا الرقم وتقتطع ذلك العدد المحدد من الأحرف انطلاقاً من الطرف الأخير للسلسلة النصية، لتكتمل عملية استخلاص اللقب بأمان عبر كل إصدارات إكسل التاريخية.
4.2 استخدام دالة MID بالتكامل مع دالة SEARCH
يمثل التوليف البرمجي بين دالتي MID وSEARCH بديلاً كلاسيكياً آخر يتمتع بمرونة استثنائية في اقتطاع الأجزاء النصية الوسطى والطرفية. تعتمد دالة MID في بنيتها على تحديد نقطة انطلاق عددية وطول محدد للاقتطاع؛ وتصاغ المعادلة عادة بالشكل التالي:
=LEFT(A2, 1) & ". " & MID(A2, SEARCH(" ", A2) + 1, LEN(A2))
يتفادى هذا النموذج الحاجة لإجراء عمليات طرح متقدمة لحساب طول الجزء الأخير، مما يجعله مفضلاً لدى شريحة واسعة من مطوري الجداول الحسابية.
يكمن الفارق التقني الأبرز هنا في استخدام دالة SEARCH بدلاً من FIND. فبينما تتسم دالة FIND بالحساسية الصارمة لحالة الأحرف (Case-sensitive)، تأتي دالة SEARCH غير حساسة لحالة الأحرف وتدعم استخدام الرموز البديلة (Wildcards) مثل علامة النجمة (*) وعلامة الاستفهام (?). ومع أن البحث عن محرف المسافة لا يتأثر بحالة الأحرف الأبجدية، إلا أن استخدام SEARCH يوفر توافقاً أوسع وقدرة على التكيف في بيئات النصوص المختلطة.
تقوم المعادلة بتحديد نقطة بداية الاقتطاع عبر الصيغة SEARCH(" ", A2) + 1، أي المحرف الواقع مباشرة بعد الفراغ، بينما تُمرر دالة LEN(A2) كوسيطة لطول المقطع المقتطع. ونظراً لأن إكسل يقتطع النص المتبقي حتى نهايته دون أخطاء إذا تجاوز الطول المطلوب الحد الأقصى للأحرف الباقية، فإن تمرير الطول الكلي للخلية يضمن اقتطاع اسم العائلة بالكامل بأقل قدر من العمليات الحسابية المتداخلة في الذاكرة.
4.3 مقارنة منهجية وتحليلية بين TEXTAFTER والحلول المركبة القديمة
تكشف المقارنة التحليلية بين الحلول الحديثة المعتمدة على TEXTAFTER والحلول الكلاسيكية المركبة تفوقاً كاسحاً للنهج الحديث في مؤشرات سهولة القراءة البرمجية والصيانة المستمرة. فالصيغة المركبة القديمة (التي تدمج أربع دوال نصية في سطر واحد) ترفع من درجة التعقيد الإدراكي للمحلل، وتجعل عمليات تدقيق الصيغ وتعديلها عرضة لأخطاء الأقواس المفقودة أو الانحرافات الحسابية بمقدار محرف واحد (Off-by-one errors).
من زاوية كفاءة الأداء وسرعة المعالجة الحسابية (Calculation performance benchmarking)، تستهلك الدوال الحديثة دورات معالجة أقل ومساحة ذاكرة مؤقتة أدنى عند التعامل مع ملايين السجلات. يرجع ذلك إلى أن دالة TEXTAFTER مطبقة بلغة C++ التحتية المحسنة في نواة إكسل كعملية ذرية واحدة تبحث وتقتطع داخلياً، في حين تجبر الدوال الكلاسيكية المحرك الحسابي على تقييم مرجع الخلية عدة مرات لحساب LEN وFIND ومصفوفات الطرح قبل تفعيل RIGHT.
توضح المعايير العملية إمكانية إعادة الاستخدام وانخفاض معدلات الخطأ البشري لصالح TEXTAFTER؛ إلا أن نقطة الضعف الوحيدة للدوال الحديثة تبقى محصورة في مشكلة التوافق العكسي (Backward Compatibility). فإذا فُتح مصنف يحتوي على دالة TEXTAFTER في بيئة إكسل 2016 مثلاً، سيتحول محتوى الخلية إلى رمز الخطأ #NAME?، مما يجعل الحلول الكلاسيكية القديمة ضرورة حتمية في المؤسسات التي تتشارك الملفات مع أطراف خارجية تستخدم إصدارات برمجية غير محدثة.
5. معالجة الأسماء المعقدة والمتعددة المقاطع والأسماء المركبة
5.1 التعامل مع الأسماء الثلاثية والرباعية والأسماء الوسطى
تشكل الأسماء المحتوية على أسماء وسطى (Middle Names) أو أحرف وسطى عائقاً متكرراً أمام صيغ الاستخراج المباشرة. ففي حالات مثل “Robert Downey Junior” أو “John F. Kennedy”، يؤدي استخدام محدد الفصل القياسي في دالة TEXTAFTER أو دالة FIND الأولى إلى اعتبار الاسم الأوسط هو اللقب المطلوب، مما يسفر عن مخرجات خاطئة مثل “R. Downey” بدلاً من “R. Junior”، وهو ما يقوض موثوقية قواعد البيانات الإحصائية والبحثية.
يكمن الحل التقني المتقدم في استثمار القوة الكاملة لوسيطة رقم التكرار (instance_num) في دالة TEXTAFTER بضبط قيمتها على -1 وفق الصيغة التالية:
=LEFT(A2, 1) & ". " & TEXTAFTER(A2, " ", -1)
إن استخدام القيمة السالبة يقلب اتجاه خوارزمية البحث؛ فبدلاً من التحرك من اليسار إلى اليمين، تبدأ الدالة الفحص من الطرف الأيمن للسلسلة النصية متجهة يساراً، لتتعرف على المسافة الأخيرة في الاسم وتستخلص الكتلة النصية التي تليها مباشرة، ضامنة استخراج اسم العائلة الحقيقي بصرف النظر عن عدد الأسماء الوسطى المتقدمة عليه.
أما في الحالات التي تتطلب المعايير التوثيقية فيها الاحتفاظ بالأحرف الأولى لجميع الأسماء السابقة للاسم الأخير (كما في بعض صيغ توثيق المراجع الطبية والنفسية المتطرفة مثل تحويل “John Fitzgerald Kennedy” إلى “J. F. Kennedy”)، فإن الأمر يتطلب تفكيك النص عبر مصفوفات دالة TEXTSPLIT، ثم اقتطاع الحرف الأول من كل جزء، قبل إعادة دمجها مع استثناء الجزء الأخير ليظهر بشكله الكامل، وهو ما يبرز قدرة إكسل على التكيف مع أكثر متطلبات التوثيق صرامة.
5.2 معالجة الألقاب التشريفية والبادئات واللاحقات الأكاديمية
تحتوي قواعد البيانات المؤسسية غالباً على ألقاب تشريفية أو أكاديمية سابقة للأسماء مثل (Dr., Prof., Mr., Eng.)، أو في السياق العربي (دكتور، أستاذ، مهندس). إن تطبيق دالة LEFT المباشرة على سجل يحتوي على “Dr. Sarah Connor” سيقود حتماً إلى استخراج الحرف “D”، وهو ما يمثل الحرف الأول من اللقب العلمي وليس من الاسم الشخصي للمشارك؛ مما يشكل انحرافاً فادحاً في تصنيف البيانات.
لمعالجة هذه البادئات برمجياً، يتم دمج دالة SUBSTITUTE أو دالة TEXTAFTER المتداخلة لتطهير الاسم وتجريده من الألقاب قبل الشروع في استخراج الحروف. يمكن تطبيق معادلة تفحص بداية النص وتتجاهل المقطع الأول إذا تطابق مع قائمة الألقاب المعروفة، كما في الصيغة التوضيحية التالية:
=IF(OR(LEFT(A2, 3)="Dr.", LEFT(A2, 4)="Prof"), LEFT(TEXTAFTER(A2, " "), 1) & ". " & TEXTAFTER(A2, " ", -1), LEFT(A2, 1) & ". " & TEXTAFTER(A2, " ", -1))
تضمن هذه التركيبة المنطقية تجاوز اللقب الشرفي وتوجيه مؤشر LEFT إلى الاسم الشخصي الفعلي بدقة.
وعلى النقيض من ذلك، تظهر في نهاية الأسماء لاحقات جيلية أو عائلية مثل (Jr., Sr., III) أو لاحقات المؤهلات مثل (PhD, MD). في هذه الظروف، يقود استخدام التراجع العكسي TEXTAFTER(A2, " ", -1) إلى استخراج اللاحقة “Jr.” باعتبارها اسم العائلة. ويتطلب التغلب على هذا التحدي بناء صيغ متداخلة تبحث عن اللاحقات الشائعة وتستبدلها بنصوص فارغة، أو ترجع إلى الفهرس قبل الأخير instance_num = -2 لضمان استخلاص اللقب العائلي الجوهري دون شوائب وصفية.
5.3 التحديات اللغوية الخاصة بالأسماء المركبة والإضافية
تفرض الخصوصيات اللسانية للغات المختلفة تحديات كبرى على المعالجة الآلية للنصوص، وتتجلى هذه الصعوبة بوضوح في اللغتين العربية واللاتينية. ففي الأسماء ذات الأصول العربية، تنتشر ظاهرة الأسماء المركبة بالإضافة مثل (عبد الله، عبد الرحمن، نور الدين، أبو بكر)، حيث يمثل المقطعان اسماً أولاً واحداً للشخص. إذا عوملت هذه الأسماء بقواعد الفصل المعتمدة على الفراغ الصرف، فإن اسم “عبد الله أحمد” سيتحول خطأً إلى “ع. الله”، مما يؤدي إلى تشويه لغوي غير مقبول للاسم الأول وإسقاط اللقب الحقيقي بالكامل.
يتكرر هذا التحدي البنيوي في الأسماء الغربية التي تتضمن ألقاب عائلات مركبة مسبوقة بأدوات تعريف وجر تاريخية مثل (Van der Waals، De la Cruz، Von Bismarck، Di Pietro). في هذه الحالات، يتألف اسم العائلة من عدة كلمات مفصولة بمسافات نظامية؛ مما يعني أن خوارزميات الاقتطاع المعتمدة على المسافة الأخيرة حصراً ستقتطع “Waals” فقط وتتجاهل “Van der”، وهو ما يتعارض مع الدقة التاريخية والمعايير العالمية للفهرسة الببليوغرافية.
تتطلب مواجهة هذه المعضلات المعقدة بناء جداول استثناءات مرجعية واستخدام أدوات البحث والتعويض المتقدمة، أو توحيد الأسماء المركبة قبل معالجتها من خلال استبدال المسافة الفاصلة بين مقطعي الاسم المركب بمسافة صلبة غير مرئية أو واصلة قصيرة (Hyphen) مثل “عبد-الله” أو “Van-der-Waals”. هذا التحويل المؤقت يدمج الكلمتين في كتلة لغوية واحدة لا تلتقطها خوارزميات الفصل العادية، مما يسمح باستخراج الحرف الأول من المركب بأكمله متبوعاً باللقب العائلي دون أي بتر هيكلي.
6. تطهير وتنقية البيانات النصية كشرط مسبق للتحليل الدقيق
6.1 إزالة الفراغات غير المنتظمة والشوائب باستخدام دالة TRIM
يمثل التطهير المسبق للنصوص القاعدة الذهبية لضمان سلامة مخرجات الدوال؛ فالإدخال اليدوي للبيانات والنسخ من ملفات PDF أو نماذج الويب يترك عادة شوائب فراغية تعجز العين المجردة عن رصدها في خلايا إكسل. إن وجود مسافة واحدة تسبق الاسم في الخلية A2 كفيل بجعل دالة LEFT(A2, 1) تعيد فراغاً أبيض مجرداً، مما يؤدي إلى فشل الصيغة وظهور الناتج بصورة مشوهة مثل ” Smith” بدلاً من “J. Smith”.
لتحصين المعادلات ضد هذه الانحرافات، يجب دمج دالة TRIM في صلب الصيغة الرياضية قبل تمرير النص إلى دوال الاقتطاع. تقوم دالة TRIM بوظيفة مزدوجة بالغة الأهمية: التخلص النهائي من كافة المسافات البادئة في مستهل النص، وحذف المسافات اللاحقة في نهايته، فضلاً عن تقليص أي مسافات بينية متعددة لتصبح مسافة واحدة نظامية فقط. وتتجسد الصيغة المحصنة كالتالي:
=LEFT(TRIM(A2), 1) & ". " & TEXTAFTER(TRIM(A2), " ", -1)
إلى جانب المسافات النظامية، تبرز مشكلة المسافات غير القابلة للكسر (Non-breaking Spaces) ذات الرمز الكودي CHAR(160) في نظام ويندوز، والتي تفيض بها البيانات المستوردة من قواعد البيانات السحابية والمتصفحات. تعجز دالة TRIM القياسية عن إزالة هذا النوع الخاص من المسافات بمفردها؛ مما يتطلب تطويقها بدالة SUBSTITUTE لاستبدال الكود 160 بمسافة عادية CHAR(32) أو نص فارغ عبر الصيغة:
SUBSTITUTE(A2, CHAR(160), " ")
مما يضمن بيئة نصية نظيفة تماماً للعمليات الحسابية التالية.
6.2 تنظيف الرموز غير المرئية والمحارف غير القابلة للطباعة
تحتوي النصوص المستوردة من مصادر خارجية أو أنظمة قواعد البيانات القديمة على محارف تحكم غير مرئية (Non-printable characters) ومحارف فواصل أسطر برمجية (Line Breaks). تقع هذه المحارف عادة ضمن نطاق الأسكي (ASCII) من الرقم 0 إلى 31؛ ورغم أنها لا تظهر بصرياً في واجهة العرض ببرنامج إكسل، إلا أنها تحتل موقع الفهارس الأولى في متجهات النصوص وتتسبب في إرباك تام لدالة LEFT.
تنهض دالة CLEAN بمسؤولية استئصال هذه الرموز التالفة من السجلات النصية. من خلال تمرير الخلية المرجعية داخل الدالة عبر CLEAN(A2)، يتم تطهير السلسلة من أي فواصل أسطر مجهولة أو محارف تحكم مطبعية متسللة. إن إهمال هذه الخطوة قد يقود إلى احتساب فاصل السطر البرمجي كمحرف أول؛ مما يؤدي إلى خروج نواتج فارغة أو أخطاء حسابية يتعذر على المحلل تشخيص أسبابها بسهولة.
في المشروعات الكبرى التي تتسم بضخامة البيانات وتعدد مصادرها، يُنصح دائماً بعدم كتابة معادلات الاستخراج المباشرة على البيانات الخام مباشرة، بل بناء عمود وسيط يُخصص لتجهيز وتطهير النصوص (Staging Column). يدمج هذا العمود المعالج الأولي دوال التنظيف الشاملة:
=TRIM(CLEAN(SUBSTITUTE(A2, CHAR(160), " ")))
ليصبح هذا النطاق المطهر هو المرجع الوحيد الموثوق الذي تنطلق منه كافة صيغ استخراج الأحرف والأسماء اللاحقة باستقرار مطلق.
6.3 توحيد حالة الأحرف والتنسيق العام للنصوص المستخرجة
لا يكتمل التطهير الفعال للبيانات دون فرض التجانس الشكلي وحالة الأحرف (Letter Casing) على النصوص المستخرجة؛ ففي البيانات المكتوبة باللغات اللاتينية، تتفاوت مدخلات المستخدمين بين الكتابة بأحرف صغيرة بالكامل (lowercase)، أو أحرف كبيرة متصلة (UPPERCASE)، أو خليط عشوائي غير منظم. يضر هذا التفاوت البصري بمصداقية التقارير المؤسسية، ويخالف المعايير الصارمة لإعداد القوائم المرجعية الأكاديمية.
لضمان التنسيق القياسي، تدمج دالة PROPER مع اسم العائلة المستخرج لضمان كتابة الحرف الأول منه بحجم كبير (Capitalized) وبقية الأحرف بحجم صغير، بصرف النظر عن حالة النص الأصلي المدخل. وفي الوقت ذاته، يتم تطويق دالة اقتطاع الحرف الابتدائي بدالة UPPER لضمان رسملة الحرف المختصر بصورة دائمة وثابتة، وذلك وفق التركيبة الرياضية التالية:
=UPPER(LEFT(TRIM(A2), 1)) & ". " & PROPER(TEXTAFTER(TRIM(A2), " ", -1))
تضمن هذه الصياغة المركبة أعلى درجات الاتساق البصري والجمالي للمخرجات النهائية؛ فمدخل عشوائي مثل “jOHn sMITh” سيتحول بانسيابية تامة ونقاء هندسي إلى “J. Smith”. هذا المظهر القياسي الموحد يقلل من الجهد اليدوي المستهلك في المراجعة البصرية، ويوفر ملفات مخرجات جاهزة للطباعة المباشرة والدمج في المراسلات دون الحاجة إلى معالجات لاحقة.
7. أتمتة العملية باستخدام تقنية Power Query المتقدمة
7.1 تحميل البيانات وتأسيس بيئة التحويل في محرر الاستعلامات
تمثل تقنية باور كويري (Power Query)، المدمجة في صلب مايكروسوفت إكسل تحت علامة التبويب “بيانات” (Data)، الأداة الاحترافية الأقوى لبناء خطوط معالجة واستخراج قابلة للتكرار والأتمتة دون الحاجة إلى كتابة معادلات في خلايا الورقة. لاستخدام هذه البيئة، يتم تحديد نطاق الأسماء واختيار “من جدول/نطاق” (From Sheet/Table/Range)، ليفتح محرر الاستعلامات المتقدم الذي يعزل عمليات المعالجة الحسابية عن واجهة العرض العادية، مما يحمي موارد الجهاز ويمنع تلف البيانات.
توفر المعالجة الحسابية في بيئة Power Query مزايا استثنائية مقارنة بالصيغ المباشرة في الورقة؛ حيث تسجل التقنية كل خطوة تحويل كإجراء ثابت ومؤتمت يمكن إعادة تطبيقه بمجرد النقر على زر “تحديث” (Refresh) عند إضافة سجلات جديدة في المستقبل. كما توفر بيئة عمل آمنة تحفظ نسخة مكررة من العمود الأصلي الخام، مما يسمح للمحلل بإجراء التحويلات الجذرية وتفكيك النصوص مع الحفاظ على مرجعية البيانات الأساسية للرجوع إليها عند الحاجة.
بمجرد تحميل الجدول داخل المحرر، يظهر نوع البيانات تلقائياً كنص (Text)، وتُعرض المعاينات الفورية للقيم. يُنصح في هذه الخطوة التأسيسية بتكرار العمود الأصلي عبر النقر بزر الفأرة الأيمن واختيار “Duplicate Column”، ليبقى العمود الأصلي سليماً، وتُجرى كافة عمليات التقطيع والاستخراج والتجميع على العمود المكرر لضمان استقلالية العمليات التحليلية.
7.2 تقسيم واستخلاص المحارف عبر أدوات التحويل المدمجة
تتيح واجهة Power Query الرسومية تنفيذ عمليات التحويل المعقدة بنقرات معدودة وبدون كتابة أكواد؛ حيث يمكن تقسيم العمود المصدري بسهولة عبر أداة “تقسيم العمود حسب المحدد” (Split Column by Delimiter). يُحدد محرك الاستعلامات المسافة تلقائياً كفاصل أساسي، ويمكن للمستخدم اختيار التقسيم عند “المحدد الموجود في أقصى اليمين” (Right-most delimiter) لضمان عزل اسم العائلة في عمود منفصل، بغض النظر عن عدد الأسماء الأولى والوسطى السابقة له.
بعد إتمام عملية الفصل، ينتج لدينا عمودان: الأول يحوي الأسماء الأولى والوسطى، والآخر يحوي اسم العائلة النقي. يتجه المحلل إلى العمود الأول، ومن علامة تبويب “إضافة عمود” (Add Column) أو “تحويل” (Transform)، يختار قائمة “استخراج” (Extract) ثم ينقر على “الأحرف الأولى” (First Characters). في المربع الحواري المنبثق، يتم إدخال الرقم 1 ليقوم المحرك فوراً باقتطاع الحرف الاستهلالي وعزل ما سواه في خطوة فائقة السرعة.
تكتمل العملية في الواجهة الرسومية عبر تحديد عمود الحرف المستخرج وعمود اللقب معاً (بالضغط المستمر على مفتاح Ctrl)، ثم النقر بزر الفأرة الأيمن واختيار “دمج الأعمدة” (Merge Columns). يُعين الفاصل في نافذة الدمج كفاصل “مخصص” (Custom) وتُكتب النقطة متبوعة بمسافة . ، ويُسمى العمود الناتج بالاسم المرغوب، لتتشكل المخرجات المطلوبة بدقة هندسية مطلقة وبخطوات موثقة في لوحة إجراءات التحويل.
7.3 كتابة دوال استخراج متخصصة باستخدام لغة M البرمجية
للمحترفين الساعين وراء أقصى درجات الإيجاز والسرعة، تتيح لغة إم (M Language)—وهي لغة البرمجة الوظيفية التحتية التي تدير محرك Power Query—تنفيذ العملية بأكملها في خطوة تعبيرية واحدة دون الحاجة لتوليد أعمدة وسيطة متعددة. يتم ذلك عبر إضافة عمود مخصص (Custom Column) من شريط الأدوات وكتابة دالة مدمجة تجمع بين دوال النصوص الأساسية.
تُصاغ دالة M المخصصة بالاعتماد على دالتي Text.Start وText.AfterDelimiter، وفق التركيب البرمجي التالي:
Text.Start([FullName], 1) & ". " & Text.AfterDelimiter([FullName], " ", {0, RelativePosition.FromEnd})
يمثل الرمز [FullName] اسم العمود المصدري، وتتكفل دالة Text.Start باقتطاع المحرف الأول، في حين تقدم دالة Text.AfterDelimiter ميزة استثنائية عبر الوسيطة المتقدمة RelativePosition.FromEnd التي تجعل خوارزمية البحث ترصد الفراغ من نهاية النص وتقتطع اسم العائلة حصراً.
بعد اعتماد الكود، يقوم محرر الاستعلامات بتطبيق التحويل فوراً على كامل الجدول بكفاءة معالجة خارقة. وبالضغط على زر “إغلاق وتحميل” (Close & Load)، تُنقل البيانات المعالجة تلقائياً إلى ورقة إكسل في جدول جديد فائق التنسيق والتنظيم. وتظل هذه المنظومة متصلة ديناميكياً بمصدرها؛ فإذا أُضيف ألف اسم جديد إلى الجدول المصدر، يكفي النقر على “Refresh” لتتكرر العمليات الحسابية البرمجية وتظهر النتائج المستخرجة في أجزاء من الثانية.
8. الاستخراج الفوري عبر ميزة الإكمال السريع Flash Fill
8.1 الأساس الخوارزمي لميزة التعرف على الأنماط في إكسل
تمثل ميزة الإكمال السريع (Flash Fill)، التي ظهرت للمرة الأولى في إصدار Excel 2013، أحد أبرز تطبيقات الذكاء الاصطناعي وتقنيات توليف البرامج بالأمثلة (Program Synthesis by Example) في برمجيات الإنتاجية المكتبية. طُورت هذه الخوارزمية الرائدة في مختبرات مايكروسوفت للأبحاث (Microsoft Research)، وترتكز على تحليل السلوك البشري في إدخال البيانات واستنباط القواعد المنطقية للتحويلات النصية دون الحاجة إلى كتابة سطر برمجي أو معادلة رياضية واحدة.
يعمل المحرك الخوارزمي للإكمال السريع عبر مقارنة السلسلة النصية في العمود الأصلي بالسلسلة التي يكتبها المستخدم يدوياً في العمود المجاور. يقوم النظام بالبحث في مصفوفة الاحتمالات عن العمليات التي يمكن أن تحول النص الأصلي إلى النص الهدف؛ فيتعرف فوراً على أن المحرف “J” يمثل الحرف الأول من “John”، وأن الكلمة “Smith” تمثل الكلمة الأخيرة بعد المسافة، وأن النقطة والمسافة أُقحمتا كعناصر ثابتة في الهيكل، ومن ثم يصيغ المحرك قاعدة تحويل ديناميكية في الذاكرة لتطبيقها على بقية النطاق.
لنجاح هذه الخوارزمية الفائقة، يُشترط توفر بيئة بيانات واضحة؛ حيث يجب أن يكون عمود الإدخال ملاصقاً تماماً للعمود المصدري دون وجود أعمدة فارغة تفصل بينهما. كما تتطلب الخوارزمية تجانساً نسبياً في بنية الأسماء داخل العينة الاستدلالية الأولى لتكوين فرضيتها البرمجية بدقة وثقة عالية، وهو ما يجعلها أداة فريدة تختصر ساعات من العمل اليدوي في لحظات معدودة.
8.2 خطوات التنفيذ التفاعلي للإكمال السريع لاختصار الأسماء
يتميز التطبيق التفاعلي للإكمال السريع بالبساطة والسرعة المذهلة؛ تبدأ العملية بكتابة الصيغة المختصرة الأولى يدوياً في الخلية B2 المحاذية للاسم الكامل “David Miller” في A2، فيقوم المستخدم بكتابة “D. Miller” بدقة متناهية والضغط على مفتاح الإدخال (Enter) لتسجيل المثال التوجيهي الأول للنظام الخوارزمي.
بمجرد الانتقال إلى الخلية التالية B3، يبدأ المحلل في كتابة الحرف الأول من الاسم التالي؛ وفي هذه اللحظة الحية، يستشعر محرك الإكمال السريع النمط، ويُظهر قائمة رمادية شفافة وظلية تمتد على طول العمود تقترح التحويل المتوقع لكافة السجلات التالية (مثل “R. Downey”, “A. Einstein”). إذا بدت هذه التوقعات دقيقة، يكفي الضغط على زر (Enter) ليتم اعتماد النتائج وتوليد البيانات في كامل العمود بلمح البصر.
في حال عدم ظهور الاقتراح التلقائي، يمكن تشغيل الأداة قسرياً عبر اختصار لوحة المفاتيح الشهير Ctrl + E، أو من خلال التوجه إلى علامة تبويب “بيانات” (Data) في الشريط العلوي والنقر على أيقونة “الإكمال السريع” (Flash Fill) في مجموعة أدوات البيانات. يقوم إكسل فوراً بمسح العمود المصدري وتوليد المخرجات المختصرة لكامل السجلات بناءً على النموذج الأولي الذي قدمه المستخدم.
8.3 التقييم المقارن: متى يفضل استخدام Flash Fill ومتى تحظر؟
تحظى أداة Flash Fill بمكانة رفيعة في مهام المعالجة السريعة لمرة واحدة (Ad-hoc tasks)، حيث يحتاج المحلل إلى إعداد قائمة أسماء فورية لاجتماع طارئ أو تجهيز ملصقات أسماء لحضور ندوة أكاديمية في دقائق معدودة. إن سرعتها الفائقة وعدم حاجتها لتركيب دوال رياضية تجعلها الخيار المفضل للمستخدمين من مختلف مستويات الخبرة التقنية، وتوفر الوقت والجهد بشكل استثنائي في المهام غير المتكررة.
غير أن هذه الأداة تنطوي على عيب بنيوي جوهري يحظر استخدامها في خطوط إنتاج البيانات المستمرة والتقارير المالية والأكاديمية الديناميكية: إنها تنتج قيماً نصية ثابتة وميتة (Static Values) تفتقر تماماً للديناميكية. فإذا عُدّل الاسم في العمود المصدري A لاحقاً أو أضيفت صفوف جديدة في الأسفل، فإن مخرجات Flash Fill لن تتحدث مطلقاً ولن تشعر بأي تغيير، مما يتسبب في انفصال السجلات وفقدان اتساق البيانات بمرور الوقت.
علاوة على ذلك، تكمن خطورة Flash Fill في مخاطر “التعميم الخاطئ للأنماط”؛ فعندما تواجه الخوارزمية أسماء مركبة أو أسماء تحتوي على ألقاب تكريمية في منتصف السجلات دون تدريب مسبق، فإنها قد تطبق النمط الأساسي بصورة عمياء وتستخرج ألقاباً خاطئة، دون أن تُصدر أي رسالة خطأ تنبه المستخدم. لذلك، يحظر استخدامها في السجلات الحساسة دون إجراء تدقيق ومراجعة بصرية شاملة لكافة المخرجات الناتجة.
9. تطوير وظيفة مخصصة عبر Visual Basic for Applications (VBA)
9.1 تصميم دالة معرفة من قبل المستخدم (UDF) لاستخراج الأسماء
يمثل تطوير الدوال المخصصة للمستخدم (User-Defined Functions – UDF) عبر بيئة البرمجة المدمجة Visual Basic for Applications (VBA) الحل الهندسي الأرقى لإخفاء تعقيد المعادلات عن المستخدمين النهائيين وتوحيد معايير المعالجة في المؤسسات. يتيح هذا النهج إنشاء دالة مصممة خصيصاً تُستدعى داخل خلايا إكسل تماماً مثل الدوال القياسية المدمجة، حاملة اسماً واضحاً يعبر عن وظيفتها بدقة مثل ExtractInitialLastName(CellRef).
لتنفيذ هذه الوظيفة، يفتح المحلل محرر الأكواد عبر الضغط على Alt + F11، ثم يدرج وحدة نمطية قياسية جديدة (Standard Module) من قائمة Insert. يُكتب الكود البرمجي الذي يستفيد من دوال التلاعب بالنصوص البرمجية في فيجوال بيسك مثل الدالة السريعة Split التي تقسم النص إلى مصفوفة رقمية اعتماداً على محدد الفراغ، والدالة Left التي تقتطع الحرف الأول، وفق البنية البرمجية الرصينة التالية:
Function ExtractInitialLastName(rng As Range) As String

    Dim cleanText As String

    Dim parts() As String

    If rng.Cells.Count > 1 Or IsEmpty(rng.Value) Then Exit Function

    cleanText = Application.WorksheetFunction.Trim(rng.Value)

    parts = Split(cleanText, " ")

    If UBound(parts) = 0 Then

        ExtractInitialLastName = cleanText

    Else

        ExtractInitialLastName = UCase(Left(parts(0), 1)) & ". " & parts(UBound(parts))

    End If

End Function
بمجرد إدراج هذا الكود وحفظ المصنف بصيغة تدعم وحدات الماكرو (.xlsm)، تتاح الدالة الجديدة فوراً في واجهة الاستخدام. يمكن كتابة =ExtractInitialLastName(A2) في أي خلية، لتقوم الدالة بحساب النتيجة وعزل الحرف الأول واللقب الأخير بدقة متناهية، مما يمنح الفريق بيئة عمل موحدة تمنع الأخطاء البشرية الناتجة عن كتابة صيغ طويلة ومعقدة في شريط المعادلات.
9.2 برمجة ماكرو لمعالجة مجموعات البيانات الضخمة بدفعة واحدة
عندما تتضخم قواعد البيانات لتضم مئات الآلاف من السجلات، قد تصبح الدوال الرياضية المكتوبة في كل خلية عبئاً ثقيلاً يستهلك الذاكرة الحية ويؤدي إلى تجمد البرنامج أثناء عمليات إعادة الحساب التلقائي المستمرة. في مثل هذه البيئات المؤسسية الكبرى، يبرز استخدام الإجراءات الفرعية التكرارية (Subroutines) أو الماكرو لمعالجة البيانات بدفعة واحدة كحل تقني فائق الكفاءة والسرعة.
يعتمد الماكرو عالي الأداء على نقل بيانات النطاق بالكامل من خلايا الورقة إلى مصفوفة افتراضية في الذاكرة العشوائية (RAM Array)، وإجراء كافة عمليات التقطيع والدمج داخل الذاكرة الفائقة السرعة، ثم إعادة ضخ النتائج النهائية كقيم نصية ثابتة إلى العمود المستهدف دفعة واحدة. هذه الآلية ترفع سرعة التنفيذ آلاف المرات مقارنة بالقراءة والكتابة خلية تلو الأخرى، مما يوفر وقت المعالجة بشكل هائل.
لتحقيق أقصى استقرار وأداء ممكن، يتضمن الماكرو أوامر تقنية حيوية مثل تعطيل تحديث الشاشة التلقائي عبر Application.ScreenUpdating = False، وتعليق حسابات المصنف مؤقتاً عبر Application.Calculation = xlCalculationManual. هذه الإجراءات تمنع البرنامج من إعادة رسم الواجهة مع كل سجل يُعالج، وتضمن تكريس كامل قدرات وحدة المعالجة المركزية لإنهاء المهمة في ثوانٍ معدودة قبل إعادة تفعيل الإعدادات الطبيعية للمصنف.
9.3 بناء آليات متقدمة للتحقق واصطياد الاستثناءات برمجياً
تتميز البرمجة باستخدام VBA بقدرتها الاستثنائية على اصطياد الأخطاء والاستثناءات وتفادي توقف المعالجة المفاجئ عند الاصطدام ببيانات مشوهة أو خلايا تالفة. ففي مجموعات البيانات الواقعية، قد تحتوي بعض السجلات على قيم فارغة، أو أخطاء حسابية سابقة مثل #VALUE!، أو قيم رقمية مجردة، مما يؤدي إلى انهيار الدوال التقليدية ما لم تكن محصنة بأكواد تحقق متقدمة.
يتم تضمين جمل التحقق المنطقي في الكود مثل فحص نوع البيانات المدخلة وتفادي أخطاء عدم تطابق الأنواع (Type Mismatch Errors) باستخدام الدالة VarType أو التحقق من وجود نصوص عبر TypeName. كما يُستخدم التركيب البرمجي On Error Resume Next بحذر شديد مع فحص كائن الخطأ Err.Number لاقتناص أي انحراف غير متوقع وتوجيه البرنامج للتعامل معه بمرونة ودون انقطاع لسير العمل.
تتكامل أنظمة التحقق المتقدمة ببناء “سجل تدقيق” (Audit Log) مدمج؛ حيث يقوم الماكرو برصد أي سجل يتعذر تحليله (مثل السجلات التي لا تحتوي على أي حروف أو تحتوي على علامات خاصة فقط)، وتدوين رقم الصف وقيمة الخلية في ورقة عمل مستقلة تسمى “استثناءات المراجعة” (Review Exceptions). هذا الإجراء يمنح المحلل القدرة على التدخل اليدوي لمعالجة الحالات الشاذة مع ضمان استمرار المعالجة المؤتمتة لبقية السجلات السليمة بنجاح تام.
10. إدارة الأخطاء الشائعة وتحسين دقة وموثوقية المخرجات
10.1 التعامل مع أخطاء #N/A و#VALUE! والتطويع الوقائي عبر IFERROR
تعتبر رسائل الأخطاء مثل #N/A و#VALUE! من أكثر المشاهد إرباكاً في جداول إكسل؛ إذ تظهر هذه الأخطاء تلقائياً عندما تعجز الدوال عن تحقيق شروط تنفيذها المنطقية. ففي دالة TEXTAFTER، يؤدي غياب محدد الفراغ داخل النص المصدري إلى تفجر الخطأ #N/A، في حين تؤدي دالة FIND الكلاسيكية إلى إطلاق الخطأ #VALUE! إذا لم تعثر على المسافة المطلوبة في السلسلة النصية؛ مما يشوه المظهر العام للتقارير ويعطل أي دوال إحصائية تعتمد على ذلك العمود.
لمعالجة هذه المشكلة جذرياً وتأمين واجهة البيانات، يتم تطويق الصيغة التوليفية بدالة الحماية الوقائية IFERROR. تتيح هذه الدالة فحص مخرجات العملية الحسابية بأكملها؛ فإذا كانت النتيجة سليمة تُمرر كما هي، أما إذا نتج أي خطأ، فإنها تعيد مخرجاً بديلاً آمناً ومحدداً سلفاً، وتصاغ المعادلة المحصنة على النحو التالي:
=IFERROR(LEFT(A2, 1) & ". " & TEXTAFTER(A2, " ", -1), A2)
يرتكز هذا التصميم الذكي على منطق بديهي عالي الكفاءة: إذا تعذر استخراج اللقب بسبب عدم وجود مسافات فاصلة في الخلية، فإن الدالة تفترض تلقائياً أن القيمة المدخلة تمثل كياناً فردياً أو اسماً مستقلاً، فتقوم بإرجاع نص الخلية الأصلية A2 كاملاً كما هو دون إظهار أي رموز خطأ قبيحة. هذا الإجراء الوقائي يحافظ على انسيابية البيانات ويحمي النماذج التقريرية من التوقف أو التشوه.
10.2 معالجة حالات السجلات أحادية الاسم ومفقودة اللقب
تواجه قواعد البيانات الإنسانية واقعاً لغوياً لا مفر منه؛ وهو وجود أفراد يحملون اسماً أحادياً مفرداً دون اسم عائلة (Mononyms)، كما هو شائع في بعض الثقافات الآسيوية، أو نتيجة لخلل في ملء استمارات التسجيل واقتطاع اللقب أثناء النقل. إن إجبار هذه السجلات أحادية المقطع على الخضوع لصيغ استخراج الأحرف والمسافات يفرز نواتج مشوهة للغاية تقتصر على الحرف الأول فقط متبوعاً بنقطة، مما يفقد السجل هويته بالكامل.
يتمثل النهج الأكاديمي والتقني المتقن للتعامل مع هذه الحالات في استخدام بنية الشرط المنطقي IF للتحقق المسبق من احتواء الخلية على فراغ فاصل قبل محاولة تفعيل دوال الاستخراج. يُصاغ هذا الفحص عبر اختبار وجود المسافة باستخدام دالتي ISNUMBER وFIND وفق النموذج الرياضي التالي:
=IF(ISNUMBER(FIND(" ", TRIM(A2))), LEFT(TRIM(A2), 1) & ". " & TEXTAFTER(TRIM(A2), " ", -1), TRIM(A2))
يقوم هذا الفحص المنطقي باختبار الخلية: فإذا تأكد النظام من وجود محرف المسافة، يقوم بتطبيق معادلة استخراج الحرف الأول واللقب؛ أما إذا تبين أن الخلية تحتوي على كلمة يتيمة مجردة من المسافات، فإن الدالة تتجاوز إجراءات الاقتطاع تماماً وتُبقي على الاسم كاملاً كما هو. يحمي هذا الأسلوب سلامة السجلات الفردية، ويضمن عدم تشويه أي بيان داخل قاعدة البيانات المؤسسية.
10.3 أفضل الممارسات لتوثيق وتدقيق بيانات الأسماء في المؤسسات
يتطلب الحفاظ على موثوقية وجودة البيانات في المنظمات والمراكز البحثية بناء استراتيجية متكاملة تتجاوز مجرد كتابة الصيغ الحسابية إلى ترسيخ أفضل الممارسات التوثيقية والإجرائية. تبدأ هذه الخطوات الوقائية من المنبع، عبر تطبيق أدوات “التحقق من صحة البيانات” (Data Validation) في حقول الإدخال الأولية، لمنع المستخدمين من إدخال نصوص تحوي مسافات زائدة أو علامات ترقيم شاذة، وفرض حد أدنى لعدد الكلمات يضمن إدخال الاسم واللقب معاً.
وعقب الانتهاء من تطبيق الدوال الحسابية والتأكد من دقة المخرجات المستخرجة، يُعد عزل النتائج النهائية عن الصيغ البرمجية خطوة أمنية وتشغيلية لا غنى عنها في المعالجات المؤسسية. يتم ذلك عبر نسخ عمود النتائج بالكامل وإعادة تطبيقه فوق النطاق نفسه باستخدام ميزة “لصق كقيم” (Paste Values). يؤدي هذا الإجراء إلى تحويل الصيغ الرياضية الحية إلى سلاسل نصية صلبة ومستقرة، مما يحرر المصنف من أعباء إعادة الحساب المستمرة ويحمي النتائج من الانهيار في حال تم حذف أو تعديل الأعمدة المصدرية مستقبلاً.
تكتمل هذه الممارسات بصياغة “دليل إرشادي مؤسسي لتوحيد كتابة الأسماء” (Style and Governance Guide) يُعمم على أقسام تكنولوجيا المعلومات والباحثين ومحللي البيانات. يحدد هذا الدليل بوضوح المعايير القياسية المعتمدة لاختصارات الأسماء، وآليات التعامل مع الأسماء المركبة، ومسارات تنقية الشوائب غير المرئية، مما يضمن اتساق كافة التقارير الدورية الصادرة عن المؤسسة وتوافقها التام مع المعايير العلمية والمهنية الدولية.
خاتمة
استعرض هذا المقال الشامل مختلف الأبعاد والمسارات التقنية لاستخراج الحرف الأول من الاسم الأول واسم العائلة في برنامج مايكروسوفت إكسل، مبيناً أن العملية تتجاوز التنسيق البصري العابر لتشكل جزءاً أصيلاً من حوكمة البيانات وضبط موثوقيتها الأكاديمية والمهنية. وقد تتبعنا كيف تسهم البنية الرياضية للنصوص كمتجهات محارف في توجيه عمليات الاقتطاع والفصل بدقة عالية، وكيف أحدثت الدوال الحديثة في مايكروسوفت 365—وعلى رأسها دالة TEXTAFTER بالتكامل مع دالة LEFT—نقلة نوعية اختزلت المعادلات المعقدة في صيغ رشيقة فائقة الكفاءة.
كما تم الوقوف على المنهجيات الكلاسيكية البديلة التي تضمن التوافق العكسي التام مع الإصدارات القديمة من إكسل، مع تفصيل الآليات الإجرائية للتعامل مع الأسماء المركبة والمعقدة والألقاب التشريفية التي كثيراً ما تسبب أخطاء تحليلية إذا عولجت بصورة نمطية مبسطة. وتأكدت المحورية الحاسمة لمرحلة تنقية البيانات وتطهيرها من المسافات الشاذة والمحارف غير القابلة للطباعة قبل الشروع في أي تحويل، فضلاً عن استعراض الحلول المتقدمة المتمثلة في محرر الاستعلامات Power Query للتدفقات المؤتمتة، وأكواد VBA البرمجية للكتل البيانية العملاقة، وميزة Flash Fill للمهام الفورية السريعة.
إن تبني هذه التقنيات المتنوعة وفهم الفروق الجوهرية بينها يمكّن الباحثين ومحللي البيانات ومديري قواعد البيانات من تصميم نماذج عمل متينة ومستقرة، تضمن خفض معدلات الخطأ الحسابي إلى الصفر، وتحفظ التجانس الشكلي والتوثيقي المطلوب عالمياً في التقارير المؤسسية والدراسات العلمية المحكمة، مما يعزز موثوقية النظم البيانية وكفاءتها التشغيلية المستدامة.
المراجع
- American Psychological Association. (2020). Publication manual of the American Psychological Association (7th ed.). American Psychological Association.
- Billings, B. (2021). Data cleaning and text manipulation in spreadsheets. Academic Press.
- Jelen, B., & Syrstad, T. (2022). Microsoft Excel 2019 VBA and macros. Microsoft Press.
- Microsoft Support. (2022). TEXTAFTER function. Microsoft Corporation. https://support.microsoft.com/en-us/office/textafter-function-c8db26ae-32b3-40c3-9b82-6800bc7f3f86
- Microsoft Support. (2022). Using Flash Fill in Excel. Microsoft Corporation. https://support.microsoft.com/en-us/office/using-flash-fill-in-excel-3f9bcf1e-db93-4767-94a6-7e5426b7c367
- Walkenbach, J. (2015). Excel 2016 bible. John Wiley & Sons.