
تعد معالجة السلاسل النصية وتفكيك بنيتها المركبة في جداول البيانات ركيزة جوهرية من ركائز تنقية المدخلات الرقمية وإعدادها للتحليل الإحصائي والاستدلال المعرفي. في البيئات البحثية والتطبيقية المعاصرة، تتدفق البيانات غالباً في صيغ خام غير مهيكلة، حيث تختلط المعرفات الرقمية والرموز الاصطلاحية بالنصوص الوصفية ضمن الخلية الواحدة في برنامج مايكروسوفت إكسل (Microsoft Excel). ينشأ عن هذا التداخل تحدٍ منهجي يتمثل في ضرورة استخلاص مقاطع محددة بدقة بالغة، كعزل الأسماء المحصورة بين أقواس، أو اقتطاع الرموز الفنية الواقعة بين واصلتين، أو استخراج القيم المحددة بكلمات مفتاحية، وذلك تمهيداً لتحويلها إلى متغيرات كمية أو تصنيفية قابلة للاختبار والنمذجة.
يتطلب إتقان هذه المهارة إدراكاً عميقاً للمنطق البرمجي والرياضي الذي يحكم آليات الفهرسة وتحديد المواقع النسبية للمحارف داخل السلاسل النصية. لعقود طويلة، اعتمد مستخدمو إكسل على توليفات معقدة من الدوال الكلاسيكية مثل دالة الاقتطاع الأوسط ودوال البحث الموضعي، وهو ما كان يفرض عبئاً إدراكياً ملحوظاً ويرفع من احتمالات الوقوع في أخطاء الإزاحة الحسابية بمقدار خانة واحدة. ومع إطلاق التحديثات الجوهرية في بيئة مايكروسوفت 365 (Microsoft 365)، لا سيما الدوال النصية الديناميكية والتعبيرات النمطية المتقدمة، شهدت هندسة معالجة البيانات نقلة نوعية أتاحت للمحللين والباحثين كتابة صيغ فائقة الكفاءة وموجزة البنية تحقق أعلى درجات الدقة الإحصائية والتوافق المنهجي.
يهدف هذا المقال الأكاديمي الشامل إلى تقديم دراسة معمقة وتطبيقية لكافة المنهجيات والتقنيات المستخدمة في استخراج النصوص الواقعة بين حرفين أو رمزين أو كلمتين في برنامج إكسل. سنناقش بالتفصيل الأسس النظرية لبنية المحارف، والتشريح التركيبي للدوال الحديثة مثل TEXTAFTER وTEXTBEFORE، ومقارنتها بالصيغ الكلاسيكية القائمة على MID وSEARCH، وصولاً إلى استراتيجيات الأتمتة المتقدمة، ومعالجة القيم الشاذة، وبناء دوال مخصصة عبر LAMBDA وLET، بما يضمن تزويد الباحثين والمحللين بدليل تقني متكامل يلبي أعلى المعايير الهندسية في تنقية البيانات وإدارتها.
1. مقدمة نظرية لمعالجة النصوص وسلاسل المحارف في مايكروسوفت إكسل
1.1 أهمية تنظيف البيانات واستخلاص النصوص في التحليل الأكاديمي
تمثل جودة البيانات النصية المدخل الأساسي لضمان موثوقية النماذج التحليلية والإحصائية في شتى حقول المعرفة العلمية والتطبيقية. عندما يشرع الباحث في تفريغ مخرجات استبانات إلكترونية أو سجلات تجريبية ناتجة عن برمجيات الرصد السلوكي أو المختبري، يجد أن المتغيرات المجمعة قلما تأتي في صورة أرقام معزولة ومهيأة للتحليل المباشر؛ بل غالباً ما تكون مدمجة ضمن سياقات نصية مركبة تحتوي على نصوص شارحة، وهوامش توثيقية، وأكواد فنية. إن الفشل في تنقية هذه النصوص وعزل المتغيرات المستهدفة بدقة يؤدي إلى تلوث مصفوفة البيانات بأخطاء تصنيفية وقيم مفقودة مصطنعة، مما ينعكس سلباً على قوة الاختبارات الإحصائية وصدق النتائج المستخلصة، تماماً كما تتطلب قواعد البيانات المعجمية الدقيقة فصلاً صارماً للمفردات ومكوناتها المورفولوجية لتمكين الباحثين من قياس أزمنة التعرف البصري والقرارات المعجمية بدقة كمية بالغة، وهو ما برهنت عليه المنهجيات المتبعة في إعداد قواعد البيانات واسعة النطاق مثل دراسة كوليرز وآخرين (Keuleers et al., 2011).
تتجلى التحديات المنهجية بصورة أكثر وضوحاً عند التعامل مع مجموعات البيانات الضخمة التي يتم جمعها بطرق مؤتمتة؛ فالنصوص الخام تعاني من عدم التجانس في البنية، وتفاوت في أنماط المسافات الفاصلة، وتباين في استخدام الأحرف والرموز الخاصة. يفرض هذا التنوع على المحلل بناء خوارزميات استخلاص مرنة قادرة على تحويل المقاطع النصية ذات الدلالة إلى متغيرات رقمية أو فئوية دون الإخلال بسلامة العينة الإحصائية. إن تحويل النصوص غير المهيكلة إلى حقول منضبطة يعزز الاتساق المفاهيمي للبيانات، ويتيح تطبيق أدوات القياس المعقدة، مثل نماذج الانحدار الخطي والتحليل العاملي، دون الاضطرار للتدخل اليدوي العرضة للخطأ البشري، مما يحقق وفراً هائلاً في الموارد الزمنية ويرفع من الشفافية العلمية لإجراءات التنقية والمعالجة الأولية.
علاوة على ذلك، يمثل استخلاص النصوص عالي الدقة خطوة حاسمة في معالجة مصفوفات البيانات الضخمة الناتجة عن المنصات المتعددة، حيث تسجل المتغيرات الفسيولوجية والنفسية وسجلات الحركة الرقمية في خيوط نصية موحدة تتطلب تجزئة دقيقة قبل إخضاعها لنماذج التعلم الآلي أو البرمجيات الإحصائية المتخصصة، على غرار ما تشهده منصات تجميع البيانات متعددة الأنماط الحديثة (Cai et al., 2022). وبناءً عليه، لم تعد مهارة استخراج النصوص ترفاً تقنياً هامشياً، بل أضحت أداة منهجية متجذرة في صلب تصميم البحوث وتجهيز البيانات، توفر الجسر التقني اللازم للانتقال من فوضى النصوص الخام إلى رصانة التكميم القياسي والنمذجة الدقيقة.
1.2 المفاهيم الهيكلية للسلاسل النصية ومحددات الفواصل
في المنطق البنائي لبرنامج مايكروسوفت إكسل، تُعامل الخلية التي تحتوي على نص وصفي بوصفها سلسلة متصلة مرتبة من المحارف (String of Characters)، حيث يحتل كل محرف فيها — سواء كان حرفاً أبجدياً، أو رقماً، أو مسافة فارغة، أو رمزاً خاصاً — موقعاً فهرسياً محدداً يبدأ من الرقم واحد للرمز الأول في أقصى بداية النص ويستمر تصاعدياً حتى نهاية السلسلة. يُعرف المحدد الفاصل (Delimiter) في هذا السياق بأنه محرف أو مجموعة متتابعة من المحارف تُستخدم وظيفياً كعلامة حدودية للإشارة إلى بداية أو نهاية وحدة بيانية دلالية داخل الخلية، مما يمكّن البرمجية من التمييز بين البيانات الفعلية والمعلومات الوصفية المحيطة بها.
من الضروري في التحليل المتقدم التمييز بين المحددات الرمزية البسيطة، مثل الأقواس الهلالية والمربعة والفواصل والشرطات المائلة، وبين المحددات النصية المركبة التي تتألف من كلمات كاملة أو جمل قصيرة. تتطلب المحددات المركبة مطابقة تامة لعدد متتابع من المحارف بما فيها المسافات البينية لتحديد نقطة القطع بدقة، في حين تتسم المحددات الرمزية بكونها علامات إيقاف سريعة تتكرر كثيراً وتتطلب معالجة حذرة لتحديد أي تكرار منها يمثل الحد الفعلي للنص المستهدف. إن استيعاب هذا التمايز يحدد بدوره استراتيجية الاقتطاع الرياضي المتبعة والصيغة الواجب توظيفها.
يرتكز استخلاص النص بدقة متناهية على مفهوم إزاحة المؤشر الحسابي (Offset Pointer)، وهو المفهوم الذي يحدد الموقع الدقيق لبداية ونهاية المحتوى المطلوب بعد عزل علامات التحديد نفسها. عند الرغبة في استخراج ما بداخل قوسين على سبيل المثال، فإن موقع البداية الحقيقي للبيانات ليس موضع القوس الفاتح ذاته، بل موضع القوس مضافاً إليه طول القوس (إزاحة إيجابية بمقدار وحدة واحدة)، في حين يكون موضع النهاية هو موضع القوس المغلق مطروحاً منه وحدة واحدة لإلغاء إدراج الرمز ضمن الناتج المستخلص. يمثل هذا الضبط الإزاحي حجر الزاوية لتفادي أخطاء الاقتطاع النصي وضمان نقاء السلسلة المعزولة من أي زوائد رمزية مشوشة.
1.3 التطور التاريخي لدوال معالجة النصوص في بيئة إكسل
منذ إطلاق النسخة الأولى لبرنامج إكسل لأنظمة ماكنتوش في عام 1985 ثم لأنظمة ويندوز في عام 1987، كانت معالجة النصوص تعتمد بصورة كلية على مجموعة محدودة من الدوال النصية القياسية مثل MID وFIND وSEARCH وLEN وLEFT وRIGHT. استمرت هذه الدوال الكلاسيكية كمعيار أوحد طوال عقد التسعينيات والعقدين الأولين من الألفية الجديدة، مجبرة المحللين على كتابة معادلات جبرية تداخلية شديدة التعقيد لحساب الإحداثيات الموضعية لكل محرف استخلاص، مما جعل جداول البيانات عرضة لأخطاء بشرية متكررة ورفع من تكلفة الصيانة البرمجية للصيغ في المؤسسات الأكاديمية والبحثية.
شهد عام 2022 نقطة تحول ثورية في تاريخ البرنامج، حينما أعلنت شركة مايكروسوفت رسمياً عن إطلاق حزمة من الدوال النصية الديناميكية الموجهة حصرياً لمشتركي بيئة الحوسبة السحابية مايكروسوفت 365 وإصدارات إكسل الحديثة (Excel 2024+). تضمنت هذه الحزمة دوال رائدة صممت خصيصاً لاجتثاث التعقيد الرياضي الكلاسيكي، وتصدرتها دالتا TEXTAFTER وTEXTBEFORE، إلى جانب دالة تقسيم النصوص TEXTSPLIT. تميزت هذه الدوال بقدرتها على التعامل مع السلاسل النصية على مستوى المفاهيم الدلالية بدلاً من الفهارس الرقمية المجردة، حيث تتيح للمستخدم استخراج ما قبل أو ما بعد أي فاصل رمزي أو نصي دون الحاجة لحساب أطوال النصوص أو مواضع ظهورها التراكمية يدوياً.
تتجلى الفروق التشغيلية بين البيئات التقليدية والحديثة في التكلفة المعرفية المترتبة على المستخدم؛ فالصيغ القديمة تتطلب بناء تركيبات ذهنية متعددة الخطوات وتتبعاً دقيقاً لكل عملية طرح وإضافة للمؤشرات الفهرسية، الأمر الذي يفسر أهمية التحول نحو واجهات ودوال تخفض العبء الإدراكي وتسهل استيعاب المعلومات المعقدة في بيئات العمل الرقمية (Pollock et al., 2002). بينما تعمل الدوال الحديثة كطبقة تجريد هندسية متطورة تترجم النية التحليلية مباشرة إلى مخرجات نصية نظيفة، مع الحفاظ على التوافق التراجعي الكامل مع المصنفات المنشأة بالإصدارات السابقة عبر إبقاء محرك الحساب الكلاسيكي متاحاً وفعالاً.
2. البنية التركيبية المتقدمة لدالتي TEXTAFTER وTEXTBEFORE
2.1 التشريح التركيبي والوسائط المحددة لدالة TEXTAFTER
صُممت دالة TEXTAFTER لاقتطاع وعزل كافة المحارف التي تلي فاصلاً محدداً داخل السلسلة النصية، وتتميز ببنية مرنة وشاملة تستوعب مختلف السيناريوهات الميدانية. تتألف الدالة من وسيطتين إلزاميتين وأربع وسائط اختيارية، وتُكتب صياغتها المعيارية على النحو الآتي: TEXTAFTER(text, delimiter, [instance_num], [match_mode], [match_end], [if_not_found]). تمثل الوسيطة الأولى text السلسلة النصية المصدرية أو المرجع الخلوي المراد معالجته، في حين تحدد الوسيطة الثانية delimiter المحرف الفاصل أو الكلمة النصية التي يبدأ الاقتطاع فور انتهائها مباشرة، وهي الوسيطة الحاكمة لتحديد بوابة الانطلاق النصي.
تكتسب وسيطة رقم التكرار [instance_num] أهمية بالغة في ضبط موضع الفاصل المستهدف في حال تكراره عدة مرات داخل الخلية الواحدة؛ فالقيمة الافتراضية هي 1 (أي الاقتطاع بعد الظهور الأول للفاصل)، بينما يؤدي تمرير القيمة 2 أو 3 إلى توجيه محرك الحساب لتجاوز التكرارات الأولى والبدء حصراً بعد التكرار المحدد. علاوة على ذلك، يدعم إكسل تمرير أرقام سالبة لهذه الوسيطة (مثل -1)، مما يعكس اتجاه البحث كلياً ليبدأ المسح من نهاية السلسلة النصية باتجاه بدايتها، وهو أسلوب فائق الفعالية لاستخراج الامتدادات أو الأجزاء الأخيرة في المسارات الرقمية الطويلة دون الحاجة لحساب العدد الإجمالي للفواصل يدوياً.
تتيح وسيطة نمط المطابقة [match_mode] للمحلل الاختيار بين البحث الحساس لحالة الأحرف (القيمة 0، وهي الوضع الافتراضي للغات اللاتينية) أو التجاهل التام لحالة الأحرف (القيمة 1)، بينما تنظم وسيطة مطابقة النهاية [match_end] سلوك الدالة عندما يصل مؤشر القراءة إلى الطرف الأخير للنص دون العثور على تكرار إضافي للفاصل. أما وسيطة الإرجاع عند الفشل [if_not_found]، فتعد صمام أمان يمنع توقف الحسابات البرمجية، حيث تسمح بتحديد نص مخصص أو قيمة فراغ بديلة تظهر تلقائياً في حال غياب المحدد الفاصل من الخلية المصدرية.
2.2 التشريح التركيبي والوسائط المحددة لدالة TEXTBEFORE
تمثل دالة TEXTBEFORE النظير المتمم والمكافئ لدالة TEXTAFTER، حيث تختص بعزل كافة المحارف الواقعة قبل محدد فاصل معين، مع استبعاد المحدد نفسه من الناتج المستخلص. تتطابق وسائط هذه الدالة تركيبياً مع شقيقتها، وتُصاغ بالشكل التالي: TEXTBEFORE(text, delimiter, [instance_num], [match_mode], [match_end], [if_not_found]). تُسند في هذه الدالة مهمة تحديد سقف الاقتطاع النهائي إلى وسيطة delimiter، حيث يمسح محرك إكسل النص انطلاقاً من البداية حتى يصادف الفاصل المطلوب، ليقوم باقتطاع المحتوى الواقع على يساره أو يمينه بحسب اتجاه كتابة النص في الخلية وإرجاعه مصفوفياً.
يوفر التوظيف الذكي لوسيطة رقم التكرار السالبة في دالة TEXTBEFORE حلولاً رصينة لمعضلات برمجية كانت تستلزم في الماضي معادلات شاقة؛ فعند تحديد الوسيطة instance_num بالقيمة -1، يقوم محرك الحساب بالبحث عن آخر ظهور للمحدد الفاصل في النص بالكامل، ثم يقتطع كل ما يسبق هذا التكرار الأخير. يُعد هذا الإجراء في غاية الأهمية عند التعامل مع النصوص التي تتضمن تسلسلات زمنية أو تفريعات مسارية تتطلب بتر الجزء الأخير منها فقط مع الاحتفاظ بكافة الهياكل التمهيدية التي تسبقه بصورة متكاملة.
تسهم وسيطة معالجة الغياب [if_not_found] في تعزيز استقرار نماذج البيانات المعقدة؛ فعند غياب المحدد من السلسلة، تقوم الصيغة القياسية بتوليد خطأ عدم توفر القيمة المشهور (#N/A)، الأمر الذي يعطل كافة الدوال المعتمدة على هذه الخلية لاحقاً. من خلال تعيين قيمة فارغة مثل علامتي تنصيص متتاليتين (“”) أو كتابة نص إرشادي داخل هذه الوسيطة، تظل ورقة العمل نشطة ومستقرة، مما يتيح مواصلة المعالجات المصفوفية وعمليات التجميع الإحصائي دون انقطاع ناتج عن استثناءات فردية في صفوف البيانات المدخلة.
2.3 آلية التركيب التداخلي للجمع بين الدالتين بكفاءة
يتحقق الاستخراج الكامل لنص محصور بين حرفين أو محددين مختلفين عبر بناء هندسة تداخلية محكمة (Nested Architecture) تجمع بين دالتي TEXTAFTER وTEXTBEFORE في صيغة واحدة متكاملة. يرتكز المنطق الرياضي لهذا التركيب على مفهوم المعالجة المرحلية المتعاقبة، حيث تعمل الدالة الداخلية على تنقية السلسلة النصية من أحد جانبيها وتحريرها من المحدد الأول، لتمرر النتيجة الناتجة مباشرة بوصفها وسيطة الإدخال (text) للدالة الخارجية التي تتولى بدورها بتر الجانب المقابل واستبعاد المحدد الثاني بدقة بالغة.
تتمثل الصيغة النموذجية العامة لهذا التداخل في التركيب الرياضي التالي: TEXTBEFORE(TEXTAFTER(A1, “[“), “]”). في هذا الترتيب التنفيذي الأمثل، تبدأ دالة TEXTAFTER الداخلية بقراءة الخلية A1، وتلتقط الرمز الأول المعين كمحدد بداية (القوس المربع الفاتح في هذا المثال)، ثم تُرجع كل ما يقع بعده مباشرة متجاهلة كل ما قبله والرمز نفسه. في المرحلة التالية، تتلقى دالة TEXTBEFORE الخارجية هذا النص الجزئي المستخلص حديثاً، وتبحث فيه عن محدد النهاية (القوس المربع المغلق)، لتقتطع بدقة كل ما يسبقه. ينتج عن هذا التوليف المتقن عزل النص المحصور بين المحددتين عزلًا كاملاً وبشكل نقي ومجرد من الفواصل.
من الممكن أيضاً عكس الترتيب البرمجي ليصبح: TEXTAFTER(TEXTBEFORE(A1, “]”), “[“)، حيث يقوم محرك إكسل أولاً باقتطاع النص الواقع قبل القوس المغلق، ثم يقوم لاحقاً باقتطاع ما بعد القوس المفتوح من تلك السلسلة المصغرة. كلا النموذجين يحققان النتيجة المنطقية ذاتها، إلا أن الترتيب الأول (TEXTBEFORE الحاضنة لـ TEXTAFTER) يُعد المنهج الأكثر اتساقاً مع التدفق الطبيعي للقراءة ومعالجة البيانات من اليسار إلى اليمين أو من البداية إلى النهاية، كما يسهل تتبعه وتدقيقه برمجياً من قبل المحللين الإحصائيين وفرق مراجعة جودة البيانات.
3. التطبيق العملي لاستخراج النصوص الواقعة بين سلاسل نصية محددة
3.1 استخراج النصوص بين كلمات مفتاحية صريحة
لا تقتصر محددات النصوص في الواقع العملي على الرموز الفردية كالفواصل والأقواس، بل كثيراً ما تتطلب معالجة البيانات الأكاديمية والتسويقية عزل نصوص محصورة بين كلمات مفتاحية كاملة تمثل رؤوس موضوعات أو دلالات برمجية ضمن سجلات الرصد التلقائي. لنفترض وجود جملة وصفية مسجلة في الخلية A1 بالصيغة: “تبدأ الجلسة عند الساعة العاشرة وتنتهي عند اكتمال النصاب”. إذا كان المطلوب استخراج النص المحصور بين الكلمتين المفتاحيتين “عند ” و” وتنتهي”، فإن بناء الصيغة يعتمد على تمرير الكلمات كمدخلات نصية صريحة محاطة بعلامات تنصيص داخل التوليفة التداخلية.
تُصاغ المعادلة المعيارية في هذه الحالة كالتالي: TEXTBEFORE(TEXTAFTER(A1, “عند “), ” وتنتهي”). يتعامل محرك الحساب في مايكروسوفت إكسل مع السلسلة النصية للكلمة المحددة كوحدة بنيوية واحدة متصلة؛ لذا فإن تضمين المسافات الفارغة قبل الكلمة أو بعدها داخل علامتي التنصيص يلعب دوراً محورياً في تنقية المخرجات. إذا أغفل المحلل إدراج المسافة البينية بعد كلمة “عند”، فإن الناتج المستخرج سيبدأ بمسافة فارغة غير مرغوبة قد تسبب تشويهاً في العرض أو تعطيلاً لعمليات البحث والمطابقة اللاحقة، مما يبرز أهمية الفحص المجهري الدقيق لكافة المحارف غير المرئية المحيطة بالكلمات الحاكمة.
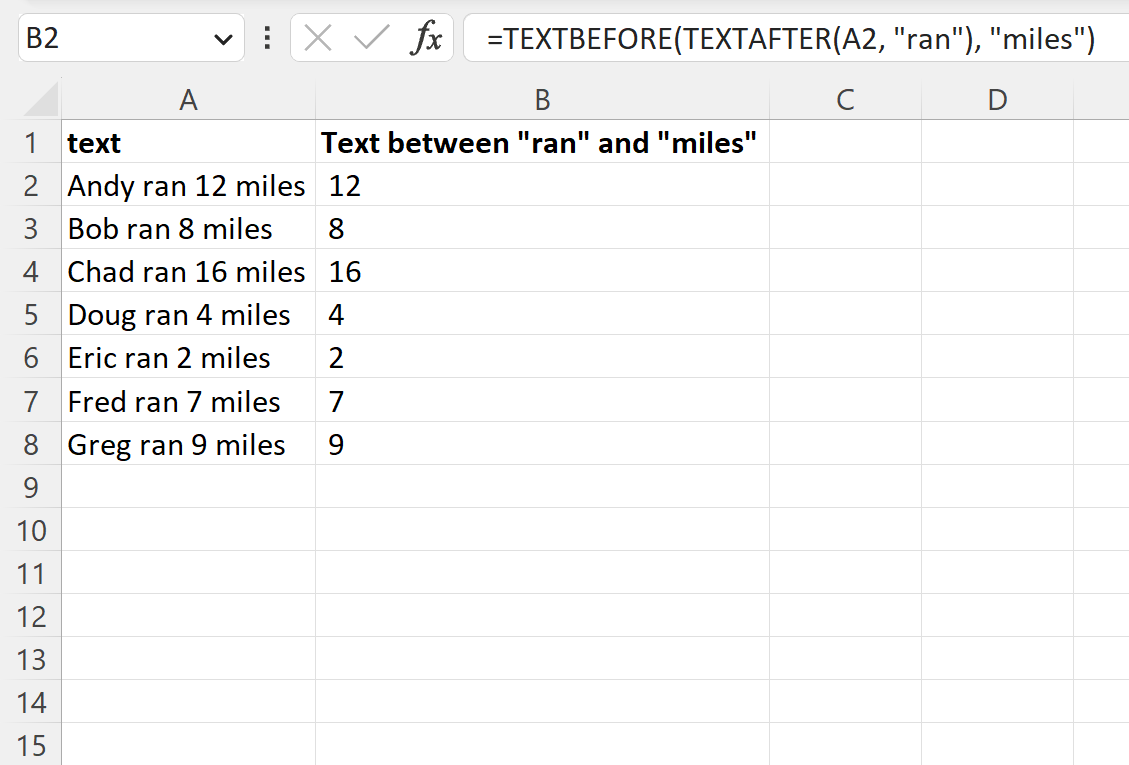
يتيح استخدام الكلمات المفتاحية مرونة فائقة عند تنقية التقارير الإدارية والمالية التي تدمج السرد اللغوي بالبيانات الكمية، حيث يمكن عزل القيم النقدية المحصورة بين عبارات مثل “المبلغ الإجمالي:” و”ريال سعودي” دون الالتفات إلى موقع تلك العبارات داخل الفقرة النصية أو تباين طول الجمل التي تسبقها من صف إلى آخر، مما يمنح النموذج التحليلي استقراراً هيكلياً ومناعة تشغيلية عالية تجاه التغيرات العشوائية في طول السجلات.
3.2 سحب الصيغ وتوسيع نطاق التطبيق على المصفوفات الضخمة
عند تعميم صيغة الاستخراج على مجموعات البيانات البحثية المتضخمة التي تضم عشرات الآلاف من الصفوف، يجب الانتباه الدقيق لكيفية استخدام مراجع الخلايا النسبية والمطلقة لضمان ديمومة الاتساق الرياضي أثناء استخدام مقبض التعبئة التلقائي (Fill Handle). يمثل مرجع الخلية المصدرية (مثل A2) مرجعاً نسبياً يتغير تلقائياً مع السحب الرأسي للأسفل ليصبح A3 وA4 بالتتابع، بينما يجب تثبيت المراجع إذا كانت محددات البداية والنهاية مستمدة من خلايا إسناد خارجية مستقلة باستخدام علامة الدولار (مثل $D$1 و$E$1) لضمان عدم انزياح نطاقات البحث المرجعية أثناء تعميم الحساب.
تؤثر آلية توسيع نطاق الصيغ المركبة تأثيراً مباشراً على استهلاك الذاكرة العشوائية وسرعة معالجة المعالج المركزي (CPU)، لا سيما في ملفات العمل الكبيرة التي تتجاوز مئات الآلاف من السجلات النصية. يؤدي التقييم المتكرر للصيغ التداخلية عبر آلاف الخلايا المستقلة إلى استنزاف موارد الجهاز وتأخير الاستجابة الحسابية للمصنف. لذا، ينصح في البيئات التحليلية الحديثة باستبدال تقنية السحب التقليدي بصيغ المصفوفات المنسكبة (Spill Ranges) التي تعتمد على تمرير نطاق العمود بأكمله كمدخل مباشر (مثل A2:A100000) ضمن صيغة وحيدة تُكتب في الخلية العلوية وتتولى معالجة البيانات دفعة واحدة بديناميكية مطلقة.
تقتضي معايير التدقيق المالي والإحصائي فحص مخرجات الصيغ الموسعة للتأكد من عدم حدوث انحراف في مؤشرات الاستخراج عبر الصفوف؛ ويتم ذلك عبر إنشاء أعمدة اختبارية تعتمد على دوال المطابقة المنطقية لمقارنة عينات عشوائية من النصوص المستخرجة بالسجلات الأصلية، مع استخدام التنسيق الشرطي لتمييز أي خلل بصري يطرأ نتيجة تغير مفاجئ في أنماط الكلمات المفتاحية في الطبقات السفلية لقاعدة البيانات الضخمة، لضمان أعلى معايير ضبط الجودة الإحصائية.
3.3 معالجة المسافات الزائدة وضبط الاتساق النصي
تشكل المسافات الفارغة غير المرئية أحد أخطر مصادر التلوث النصي في قواعد البيانات المستوردة من واجهات الاستخدام الرقمية أو مخرجات نماذج الويب؛ إذ كثيراً ما تحتوي النصوص الخام على مسافات بادئة أو لاحقة أو مسافات مزدوجة بين الكلمات، مما يحول دون تطابق المحددات النصية ويؤدي إلى توليد مخرجات مشوهة وغير موحدة التنسيق. تبرز هنا ضرورة الدمج التكاملي لدالة التشذيب المعيارية TRIM ضمن صلب صيغة الاستخراج لضمان إزالة كافة المسافات الزائدة وتحويل الفراغات المتعددة إلى مسافة مفردة منضبطة.
تُبنى الصيغة المنقحة عبر تطويق مخرجات التركيب التداخلي بالكامل بدالة التشذيب بالشكل الآتي: TRIM(TEXTBEFORE(TEXTAFTER(A1, “البداية”), “النهاية”))، أو من خلال تشذيب السلسلة المصدرية الأصلية أولاً قبل البدء في عمليات الاقتطاع كالتالي: TEXTBEFORE(TEXTAFTER(TRIM(A1), “البداية”), “النهاية”). يضمن الخيار الأول تنظيف النص المستخلص النهائي من أي شوائب فراغية علقت به نتيجة عملية القص، في حين يضمن الخيار الثاني أن المحددات النصية ستجد بيئة مطابقة مثالية خالية من المسافات العشوائية التي قد تفصل بين أحرف الكلمات المفتاحية وسياق الجملة الأصلي.
إن توحيد الأنماط النصية الناتجة عن هذه المعالجة الهندسية يرفع بشكل جذري من كفاءة توافقها مع قواعد البيانات التحليلية المتقدمة مثل برمجيات التحليل الإحصائي للعلوم الاجتماعية (SPSS) ولغة R، حيث تتطلب هذه البرمجيات تطابقاً حرفياً كاملاً لتصنيف المتغيرات الفئوية وتجميع السجلات المتشابهة دون ظهور فئات مكررة مصطنعة ناجمة عن مسافة فارغة إضافية في نهاية السلسلة لا يدركها البصر المجرد.
4. عزل النصوص المحصورة بين الرموز والعلامات الخاصة
4.1 تقنيات استخراج النصوص المحصورة بين الأقواس
يمثل استخراج النصوص المحصورة داخل الأقواس بمختلف أشكالها — سواء كانت أقواساً هلالية () أو معقوفة [] أو مجعدة {} — التطبيق العملي الأكثر شيوعاً في بيئات معالجة البيانات المعرفية والطبية؛ حيث تستخدم الأقواس عادة لحفظ المعرفات الفريدة، أو الأسماء اللاتينية، أو الأرقام التصنيفية للمتغيرات. لبناء صيغة عزل مخصصة للأقواس الهلالية في الخلية A1، تُكتب المعادلة الأساسية بالصورة: TEXTBEFORE(TEXTAFTER(A1, “(“), “)”)، حيث تتولى دالة TEXTAFTER استبعاد القوس المفتوح وما قبله، بينما تتولى TEXTBEFORE استبعاد القوس المغلق وما بعده مباشرة.
تتعقد المسألة المنهجية بصورة ملحوظة عند التعامل مع نصوص تشتمل على تكرار للأقواس، مثل النصوص الأكاديمية التي تحتوي على توثيقات مرجعية متعددة أو تراكيب هرمية متداخلة من قبيل: “أظهرت العينة الأولى (المجموعة الضابطة [ن=50]) استقراراً كلياً”. إذا كان الهدف عزل المستوى الداخلي المحصور بين القوسين المعقوفين، فإن تغيير وسائط التحديد إلى الرموز المستهدفة صراحة يكفل الوصول إلى النتيجة بدقة: TEXTBEFORE(TEXTAFTER(A1, “[“), “]”). أما إذا تكررت الأقواس الهلالية نفسها داخل الخلية، فيجب توظيف وسيطة رقم التكرار [instance_num] لتعيين أي قوس يراد استهدافه بالضبط، كأن نحدد التكرار الثاني لاقتطاع المحتوى الواقع داخل القوس الثاني في السلسلة النصية.
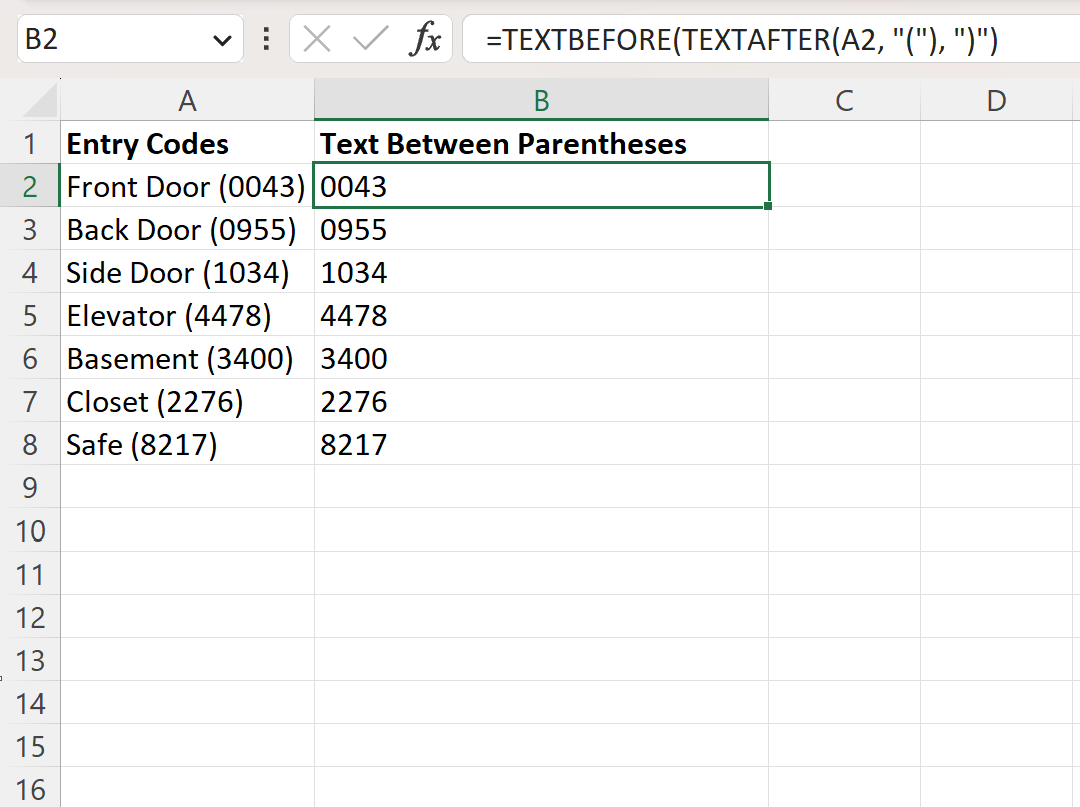
يساعد هذا العزل الدقيق في تفريغ وتنسيق المتغيرات في الدراسات الببليومترية والتحليل التلوي، حيث يتم فصل أسماء الباحثين وسنوات النشر المحصورة تقليدياً بين أقواس داخل مسميات المقالات، تمهيداً لبناء شبكات الاستشهاد المرجعي وتحليل الأنماط البحثية بدقة متناهية ودون أي تداخل مع العناوين النصية الأصلية.
4.2 التعامل مع علامات النجمة والمحارف البرمجية الخاصة
تفرض الرموز الخاصة التي تمتلك خصائص وظيفية برمجية في محرك إكسل — وعلى رأسها علامة النجمة (*) وعلامة الاستفهام (؟) وعلامة التلدة (~) — تحديات إضافية تتطلب معالجة هندسية واعية. في محركات البحث النصي التقليدية ودوال المطابقة الشاملة، تُعامل علامة النجمة كحرف بدل (Wildcard) يمثل أي عدد من المحارف العشوائية، مما قد يؤدي إلى سلوك غير متوقع عند محاولة استخدامها كمحدد فاصل عادي إذا ما استُخدمت ضمن دوال تعتمد نمط البحث الشامل.
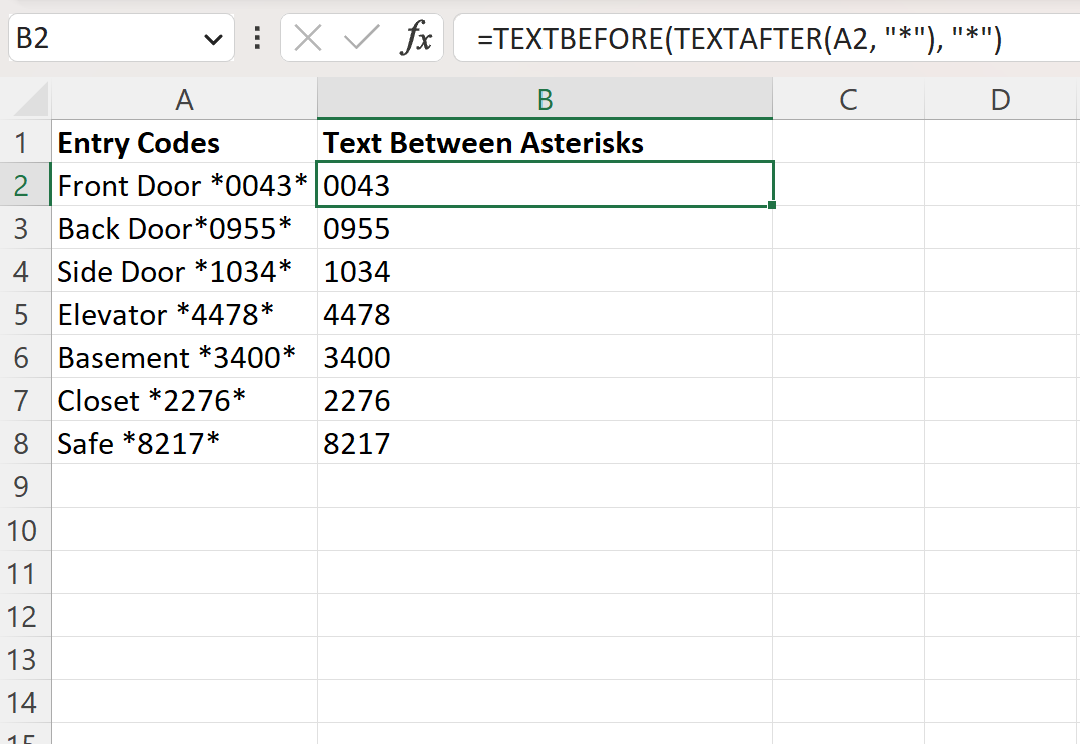
تتميز دالتا TEXTAFTER وTEXTBEFORE الحديثتان بتعاملهما مع علامة النجمة كمحرف نصي حرفي صريح (Literal Character) بشكل افتراضي، مما يتيح استخراج النصوص المحصورة بين نجمتين في الخلية A1 ببساطة متناهية من خلال كتابة: TEXTBEFORE(TEXTAFTER(A1, “*”), “*”). لكن في حال الانتقال إلى البيئات الكلاسيكية واستخدام دالة SEARCH، يتوجب على المحلل تحييد الخاصية البرمجية للنجمة عبر وضع علامة التلدة (~) قبلها مباشرة (أي كتابة “~*”) لتعطيل عملها كحرف بدل وتوجيه المحرك للبحث عنها كرمز طباعي مجرد داخل السلسلة النصية.
ينطبق المفهوم التحليلي ذاته على استخراج المقاطع المشفرة بين الفواصل المزدوجة (Quotes) والشرطات المائلة المزدوجة؛ حيث يتطلب إدراج علامة التنصيص المزدوجة كمحدد فاصل داخل الصيغة مضاعفتها برمجياً لتفادي اختلاطها بحدود الوسائط النصية للدالة نفسها، بحيث تُكتب الصيغة لعزل نص بين علامتي تنصيص كالتالي: TEXTBEFORE(TEXTAFTER(A1, “”””), “”””). تضمن هذه الصياغة الدقيقة عدم حدوث خطأ تركيبي في بنية المعادلة وتتيح قراءة الرموز الاصطلاحية المشفرة بدقة رياضية صارمة.
4.3 إدارة الرموز المتقاطعة والمتشابهة داخل الخلية الواحدة
في العديد من سيناريوهات البيانات الوصفية، يكون الرمز الفاصل المستخدم في بداية المقطع النصي ونهايته متطابقاً تماماً، كما هو الحال عند استخراج نص محصور بين علامتي فاصلة منقوطة متتابعتين، أو بين شرطتين مائلتين، أو بين علامتي نسبة مئوية. يكمن التحدي هنا في أن محرك الحساب إذا استدعى الرمز ذاته دون تحديد رتبي، فقد يقتطع الدالة النصية عند الظهور الأول للرمز في كلتا المرحلتين، مما يولد نتيجة فارغة أو مخرجات خاطئة منطقياً.
تُحل هذه المعضلة باستخدام أرقام التكرار الموجهة داخل الدالتين التداخليتين. إذا كانت الخلية تحتوي على سلسلة تتضمن فواصل منقوطة متعددة مثل: “عنصر1; متغير_مستهدف; عنصر3″، ونرغب في عزل “متغير_مستهدف” الواقع بين الفاصلة الأولى والفاصلة الثانية، فإن الصيغة الهندسية تقتضي توجيه TEXTAFTER للاقتطاع بعد الفاصلة الأولى بتحديد instance_num بالقيمة 1، ثم توجيه TEXTBEFORE الحاضنة للاقتطاع قبل الفاصلة التالية مباشرة، والتي تصبح الآن الفاصلة الأولى في السلسلة الفرعية الناتجة، مما يضمن اقتطاع المقطع النصي المحصور بينهما بدقة تامة.
أما في الحالات الشاذة التي تفتقر فيها السلسلة النصية إلى الرمز الختامي في نهاية الخلية مع وجود الرمز الافتتاحي فقط، فإن الصيغ غير المحصنة تنهار فورياً وتولد أخطاء حوسبية. تتطلب الإدارة الاحترافية لمثل هذه الاستثناءات تهيئة وسيطة match_end داخل الدوال الحديثة بالقيمة 1، مما يرشد محرك الحساب إلى اعتبار نهاية النص الفعلي كبديل منطقي للمحدد المفقود، وتفادي توقف المعالجة، مما يحافظ على استمرارية التدفق التحليلي للبيانات.
5. المنهجيات التقليدية البديلة لاستخراج النصوص في الإصدارات القديمة
5.1 الجمع التكاملي بين دوال MID وFIND وSEARCH
قبل الثورة الحسابية التي أحدثتها تحديثات مايكروسوفت 365، كانت المنهجية المعيارية المعتمدة لاستخراج نص محصور بين محرفين ترتكز على التوليف الجبري المحكم لثلاث دوال كلاسيكية: دالة الاقتطاع الأوسط MID، ودالتي البحث الموضعي FIND أو SEARCH. تعتمد دالة MID على ثلاثة مدخلات أساسية: النص المصدر، ورقم موضع بداية الاقتطاع (start_num)، والعدد الإجمالي للمحارف المراد اقتطاعها (num_chars). تتلخص المهمة الحسابية في توظيف دوال البحث لتوليد هذين الرقمين بدقة ديناميكية تتكيف مع تباين أطوال النصوص عبر الصفوف.
تبدأ العملية بتحديد موضع محرف البداية باستخدام الدالة: SEARCH(“(“, A1). ونظراً لأن هذا الرقم يشير إلى موضع الرمز الافتتاحي نفسه، يتم تطبيق إزاحة حسابية بإضافة 1 (أي: SEARCH(“(“, A1) + 1) لتوجيه مؤشر الاقتطاع ليبدأ من الحرف الأول الفعلي للنص الداخلي. الخطوة التالية والأكثر تعقيداً هي حساب طول النص المستهدف بدقة؛ ويتم ذلك عبر حساب المسافة الفاصلة بين موضعي رمز النهاية ورمز البداية من خلال طرح ناتج موضع البداية من ناتج موضع النهاية، ثم خصم واحد إضافي لعزل الرمز الختامي، وفق المتراجحة الحسابية: SEARCH(“)”, A1) – SEARCH(“(“, A1) – 1.
ينتج عن دمج هذه المكونات المعادلة الكلاسيكية الشهيرة: =MID(A1, SEARCH(“(“, A1) + 1, SEARCH(“)”, A1) – SEARCH(“(“, A1) – 1). تتجلى هنا دقة الفارق الجوهري بين FIND وSEARCH؛ فبينما تتسم FIND بكونها حساسة لحالة الأحرف ولا تدعم محارف البدل، تتميز SEARCH بتجاهلها التام لحالة الأحرف ودعمها لرموز المطابقة الموسعة. إن الفهم المنهجي لهذه التركيبة الجبرية يبرز حجم العبء الذهني الذي تحمله المحللون على مدار عقود لتنفيذ عملية تحويلية بسيطة نسبياً من منظور المعالجة الآلية للغات.
5.2 استخدام دوال LEFT وRIGHT وحساب أطوال السلاسل
برزت في بعض المدارس التحليلية الكلاسيكية منهجية بديلة تعتمد على دوال الأطراف LEFT وRIGHT مع الاستعانة بدالة قياس الطول الإجمالي للمحارف LEN. كانت هذه الطريقة تُوظف لا سيما عندما تتواجد المحددات بالقرب من حواف الخلية، أو عند الرغبة في تقليص النص المصدر تدريجياً عبر حركات متسلسلة لعزل المقطع النصي الواقع في المركز.
تعتمد هذه الهندسة الحسابية على تقليص السلسلة النصية أولاً من جهة اليمين أو اليسار لعزل محدد البداية، ثم إعادة تكرار العملية من الطرف المقابل. على سبيل المثال، يمكن استخدام الدالة RIGHT لاقتطاع الجزء الخلفي من النص بحساب الطول الكلي عبر LEN وطرح موضع محدد البداية منه، لتصبح السلسلة الناتجة محتوية فقط على النص المستهدف ومحدد النهاية وما يليه، ثم تُطبق دالة LEFT على هذه السلسلة المستحدثة لاقتطاع النص الواقع قبل محدد النهاية مباشرة. تظهر هذه المعادلات بصيغ مركبة شديدة الطول من قبيل: =LEFT(RIGHT(A1, LEN(A1) – FIND(“[“, A1)), FIND(“]”, RIGHT(A1, LEN(A1) – FIND(“[“, A1))) – 1).
تتمثل العيوب الهيكلية القاتلة لهذه الحلول الكلاسيكية القائمة على LEFT وRIGHT في تعقيدها البصري الفائق وتدني قابليتها للصيانة والتدقيق المرجعي؛ فالصيغة تعيد حساب المقاطع الفرعية عدة مرات وتكرر استدعاء دالة الطول مراراً، مما يرفع من احتمالات الخطأ الإملائي والتركيبي أثناء التعديل ويجعل قراءة النموذج من قبل باحثين آخرين أمراً في غاية المشقة، فضلاً عن كونها تفقد فعاليتها تماماً إذا ما تغيرت مواقع المحددات النصية تغيراً طفيفاً داخل الخلايا.
5.3 مقارنة الكفاءة الحسابية بين الأساليب الكلاسيكية والحديثة
عند تقييم الأداء الحسابي في بيئات المعالجة المكثفة للبيانات الضخمة، يتفوق التركيب الحديث المعتمد على TEXTAFTER وTEXTBEFORE تفوقاً كاسحاً على التركيبات الكلاسيكية المعقدة. في المعادلة القديمة القائمة على دالة MID، يضطر محرك إكسل إلى تقييم دالة البحث الموضعي SEARCH ثلاث مرات منفصلة للخلية الواحدة: مرة لتحديد موضع البداية، ومرتين إضافيتين لحساب طول النص الداخلي عبر الطرح. يتسبب هذا التكرار الحسابي العقيم في إهدار دورات المعالجة ومضاعفة وقت التنفيذ الحسابي عند تطبيق المعادلة على ملايين السجلات.
على النقيض من ذلك تماماً، تم تحسين الدوال الحديثة داخلياً في نواة برنامج إكسل بواسطة مهندسي مايكروسوفت لتعمل كدوال أحادية المسار (Single-pass Algorithms)، حيث يتم مسح السلسلة النصية واقتطاعها بالاعتماد على مؤشرات الذاكرة المباشرة دون الحاجة لإعادة تقييم مواضع المحددات عدة مرات في الذاكرة الفرعية. ينعكس هذا التحسين المعماري في خفض زمن المعالجة واستهلاك الذاكرة بنسب ملموسة، مما يمنح التطبيقات الحديثة سلاسة تشغيلية ملحوظة.
ومع ذلك، تظل الصيغ الكلاسيكية تحتفظ بميزة استراتيجية محددة تتعلق بالتوافق التراجعي الشامل (Backward Compatibility)؛ فالملفات المصممة باستخدام MID وFIND تظل قابلة للتشغيل التام ودون أي انقطاع وظيفي على كافة إصدارات إكسل التاريخية بما فيها إكسل 2010 و2013 و2016 و2019 المستقلة، بينما تفشل الدوال الحديثة كلياً في تلك البيئات وتظهر للمستخدم رسالة خطأ الدالة غير المعروفة (?NAME#)، مما يفرض على الباحث تقييم طبيعة البيئة البرمجية للمستفيدين النهائيين قبل اعتماد الصيغة المثلى للمشروع.
6. تقنيات معالجة التكرارات المتعددة للرموز في الخلية الواحدة
6.1 استهداف التكرارات المحددة عبر وسائط الترتيب
تتضمن سجلات البيانات الواقعية في كثير من الأحيان تكراراً متواصلاً لذات الرمز الفاصل ضمن الخلية الواحدة؛ كأن تشتمل السلسلة على مسار تسلسلي يفصل بين مكوناته برمز الشرطة المائلة (/) أو الفاصلة الأفقية (-). يقتضي المنهج التحليلي في مثل هذه الحالات استخراج النص المحصور بين تكرارات محددة بالرتبة، كعزل النص الواقع تحديداً بين الظهور الثاني والظهور الثالث لذات الرمز، دون التأثر بوجود تكرارات أخرى تسبقها أو تليها في السلسلة.
توفر دالتا TEXTAFTER وTEXTBEFORE حلاً مباشراً وأنيقاً لهذه المسألة عبر وسيطة رقم التكرار instance_num. إذا كانت الخلية A1 تحتوي على السلسلة: “أبجد-هوز-حطي-كلمن-سعفص”، ونرغب في استخراج المقطع “حطي” الواقع بين الشرطة الثانية والشرطة الثالثة، تُصاغ المعادلة كالتالي: TEXTBEFORE(TEXTAFTER(A1, “-“, 2), “-“). تعمل TEXTAFTER هنا على القفز المباشر فوق التكرارين الأول والثاني للشرطة لتقتطع كل ما يقع بعد الشرطة الثانية، لتصبح السلسلة الناتجة: “حطي-كلمن-سعفص”. بعد ذلك، تأتي دالة TEXTBEFORE لتقتطع كل ما يسبق الشرطة الأولى في هذه السلسلة الجديدة، وهو ما يعزل القيمة “حطي” بدقة رياضية متناهية.
يمكن توسيع هذا المنطق البرمجي للقيام بعمليات البحث العكسي؛ فإذا كان المطلوب هو عزل المقطع المحصور بين الشرطة الأخيرة والشرطة قبل الأخيرة في نص مجهول الطول الإجمالي للتكرارات، يكفي تمرير القيم السالبة لأرقام التكرار بالشكل: TEXTBEFORE(TEXTAFTER(A1, “-“, -2), “-“)، مما يحقق مرونة استثنائية تعفي الباحث من حساب التكرارات يدوياً وتتكيف ذاتياً مع أي تباين في عدد المقاطع النصية للصفوف المختلفة.
6.2 استخراج النصوص بين مثيلات غير متتالية لنفس الرمز
تنشأ متطلبات متقدمة في تنقية البيانات تتطلب استخراج نصوص ممتدة تفصل بين مثيلات غير متتالية لذات الرمز، كما هو الحال في معالجة روابط المواقع الإلكترونية (URLs) ومسارات تخزين الملفات الرقمية في الخوادم السحابية، حيث يحتاج المحلل لعزل نطاق فرعي محصور بين الشرطة المائلة الأولى والشرطة المائلة الرابعة، متجاهلاً بذلك المحددات الوسيطة الواقعة في هذا المسار النصي الممتد.
تتم معالجة هذا السيناريو عبر التوليف الموجه لوسائط التكرار في كلتا الدالتين؛ حيث يُحدد تكرار البداية بدقة في الدالة الداخلية، بينما يُحسب التكرار المتبقي في الدالة الخارجية استناداً إلى الموقع النسبي للمحدد المستهدف بعد الاقتطاع الأولي. لنفترض أن لدينا المسار: “خادم/مجلد1/مجلد2/مجلد3/ملف.بيانات”، ونريد استخراج المسار المدمج “مجلد1/مجلد2/مجلد3” المحصور بين التكرار الأول والتكرار الرابع للرمز “/”. تقتضي الصيغة توجيه TEXTAFTER للبدء بعد التكرار 1، مما يحذف المقطع “خادم/”، فتصبح السلسلة محتوية على التكرارات المتبقية الثلاثة؛ بعد ذلك يتم توجيه TEXTBEFORE لاقتطاع ما قبل التكرار 3 في السلسلة الجديدة، فتكون الصيغة: TEXTBEFORE(TEXTAFTER(A1, “/”, 1), “/”, 3).
تضمن هذه الاستراتيجية المحسوبة استخراج المقاطع الهيكلية المركبة بصورة متسقة وثابتة، وتمنع تفكك السلاسل النصية الحاملة للمسارات الرقمية المعقدة، مع الحفاظ على الفواصل الداخلية سليمة دون بتر غير مقصود، وهو إجراء محوري في أرشفة البيانات الرقمية وهندسة قواعد البيانات السحابية.
6.3 معالجة النصوص متعددة المستويات والطبقات المتداخلة
تمثل التراكيب النصية الهرمية التي تحتوي على طبقات متعددة من الأقواس المتداخلة — على غرار التعبيرات الرياضية والمنطقية المعقدة من نمط: “(المستوى1 (المستوى2 (الهدف)))” — أحد أكثر التحديات التحليلية تعقيداً في بيئات معالجة النصوص النصية في إكسل. يتطلب الوصول إلى النواة المركزية “الهدف” المعزولة داخل أعمق طبقة استراتيجية تفكيك متعاقبة يُطلق عليها في الأدبيات الهندسية “تقنية التقشير المتتابع” (Sequential Peeling).
تعتمد هذه التقنية على تكرار التركيب التداخلي للدوال النصية لتقشير الطبقات الخارجية طبقة تلو الأخرى. يتم أولاً اقتطاع ما بعد القوس المفتوح الداخلي وما قبل القوس المغلق المقابل له باستخدام دوال البحث الموجه؛ فإذا كان عدد مستويات التداخل ثابتاً، يمكن كتابة صيغة موحدة تستهدف التكرار الأخير للقوس المفتوح والتكرار الأول للقوس المغلق، وفق الصيغة: TEXTBEFORE(TEXTAFTER(A1, “(“, -1), “)”). تبحث TEXTAFTER(A1, “(“, -1) عن آخر قوس مفتوح في الخلية بالكامل (وهو القوس الملاصق للنواة مباشرة)، ثم تقتطع TEXTBEFORE كل ما يسبق أول قوس مغلق يظهر بعد تلك النقطة، مما يعزل النواة بنجاح فائق.
أما إذا كانت مستويات التداخل متغيرة عشوائياً بين الصفوف، فإن الحل الأكثر منهجية يتمثل في الاستعانة بدوال الاستبدال المصفوفي أو كتابة أكواد تعبيرات نمطية مخصصة، لضمان موازنة الأقواس رياضياً ومنع اختراق الحدود البنيوية للمستويات النصية غير المستهدفة، وهو ما سنتناوله تفصيلاً في الأقسام المتقدمة من هذا الدليل.
7. التعامل المنهجي مع الأخطاء والقيم الشاذة والمفقودة
7.1 تحليل أسباب ظهور خطأ عدم توفر القيمة والتعامل معه
عند بناء نماذج استخلاص النصوص في جداول إكسل، يواجه المحللون بصورة حتمية ظهور رسالة الخطأ الشهيرة عدم توفر القيمة (#N/A) أو خطأ القيمة غير الصالحة (#VALUE!). يشير هذا الخطأ التشغيلي إلى إخفاق محرك الحساب في مطابقة أحد المحددات النصية الممررة للصيغة داخل الخلية المستهدفة؛ كأن تفتقر الخلية كلياً لوجود القوس المفتوح أو أن يُفقد الفاصل الختامي نتيجة خطأ مطبعي في إدخال البيانات الميدانية.
تتنوع مسببات فشل المطابقة بين الأخطاء الإملائية البسيطة، والمسافات غير المرئية، والتباين في تشفير المحارف اللغوية (مثل الخلط بين همزات القطع والوصل في اللغة العربية، أو علامات الترقيم اللاتينية والعربية كالفواصل المقلوبة). إذا لم يتم تحصين الصيغة مسبقاً، فإن حدوث هذا الخطأ في صف واحد يمتد كعدوى برمجية ليعطل كافة المعادلات التجميعية والإحصائية اللاحقة المعتمدة على هذا العمود (مثل دوال العد والمتوسط والدمج)، مما يقوض موثوقية النموذج التحليلي بالكامل.
تتأكد هنا ضرورة تبني استراتيجيات هندسية فاحصة تعمل على عزل هذه الأخطاء، وتشخيص أسبابها الجذرية، ومنعها من تشويه مصفوفة البيانات الكلية، والتمييز بين الخطأ العارض الناجم عن غياب القيمة النصية والخطأ المنهجي الناجم عن عيب تركيبي في بنية المعادلة ذاتها، بما يضمن تدفقاً تحليلياً متماسكاً وقابلاً للمراجعة والتدقيق العلمي.
7.2 دمج دوال الحماية وضبط النتائج الافتراضية
يتمثل المنهج الوقائي القياسي في تطويق الصيغ المركبة بدوال الحماية البرمجية المخصصة لمعالجة الأخطاء، وعلى رأسها دالتا IFERROR وIFNA. تعمل هذه الدوال كجدار حماية محيط بالمعادلة؛ حيث تقوم باختبار النتيجة الحسابية المستخلصة، فإذا كانت قيمة نصية سليمة تم تمريرها كالمعتاد، أما إذا أسفرت العملية عن توليد خطأ حوسبي، تتدخل الدالة فوراً لإرجاع قيمة بديلة يحددها المحلل مسبقاً بدلاً من ترك رسالة الخطأ المشوهة.
تُصاغ المعادلة المحصنة كالتالي: IFERROR(TEXTBEFORE(TEXTAFTER(A1, “[“), “]”), “غير محدد”). في هذا النموذج، تؤدي أي خروقات في تطابق الأقواس إلى إرجاع التسمية الوصفية “غير محدد” أو قيمة فارغة (“”)، مما يحافظ على نظافة مصفوفة البيانات وقابليتها للفرز والتصفية اللاحقة. ومع ذلك، يوصي خبراء هندسة البيانات بتفضيل استخدام دالة IFNA تحديداً بدلاً من IFERROR الشاملة؛ حيث تقتصر IFNA على معالجة خطأ غياب المحددات (#N/A) دون كتمان الأخطاء التركيبية الأخرى الأكثر خطورة مثل خطأ المرجع المفقود (#REF!) أو خطأ التسمية غير المعرفة (#NAME?)، مما يتيح للمحلل رصد العيوب البنيوية الحقيقية في ورقة العمل دون التستر عليها دون قصد.
كما يمكن توظيف هذه التقنيات لتصميم رسائل تدقيق آلية ذكية، مثل كتابة: IFNA(TEXTBEFORE(TEXTAFTER(A1, “[“), “]”), “تنبيه: مراجعة إدخال السجل”)، مما يحول عمود الاستخراج إلى أداة مزدوجة الوظيفة تنجز التنقية النصية من جهة، وتعمل كمنظومة مراقبة جودة تكشف السجلات المعيبة في قواعد البيانات الضخمة من جهة أخرى.
7.3 توظيف الوسائط المدمجة للدوال للتعامل مع نهايات السلاسل
توفر الدوال الحديثة في مايكروسوفت 365 حلولاً ذاتية وأنيقة للتعامل مع الاستثناءات ونهايات السلاسل النصية دون الحاجة لتطويقها بدوال فحص خارجية إضافية، وذلك عبر استثمار الوسيطتين الاختياريتين: [match_end] و[if_not_found] المدمجتين في بنيتها التحتية.
تحدد وسيطة match_end ما إذا كان ينبغي معاملة نهاية السلسلة النصية كمحدد فاصل افتراضي في حال عدم العثور على المحدد الصريح في موضعه المتوقع. عند تمرير القيمة 1 لهذه الوسيطة في دالة TEXTBEFORE، فإن عدم وجود محدد النهاية لا يؤدي إلى انهيار المعادلة وتوليد خطأ، بل يوجه المحرك لاقتطاع كامل النص المتبقي حتى الحرف الأخير في الخلية، وهو حل بالغ الفعالية عند استخراج نصوص تفتقر فيها بعض السجلات غير المنتظمة إلى رمز الإغلاق النهائي ولكنها تبدأ بمحدد بداية سليم.
أما وسيطة if_not_found، فتسمح بتمرير النتيجة الافتراضية مباشرة داخل الدالة ذاتها بصيغة مقتضبة: TEXTAFTER(A1, “[“, , , , “رمز البداية غير موجود”). يؤدي هذا الدمج الداخلي المباشر للوسائط إلى تقليص الحجم البرمجي للمعادلات بنسبة النصف مقارنة بأسلوب التطويق بدوال IFERROR، مما يسرع من أزمنة المعالجة الحسابية بنسبة ملحوظة ويوفر بنية بصرية مريحة للعين تسهل مهام القراءة والمراجعة والتعديل المستقبلي لفريق العمل.
8. الأتمتة المتقدمة باستخدام التعبيرات النمطية ومصفوفات إكسل الديناميكية
8.1 تكامل التعبيرات النمطية الحديثة لاستخراج النصوص المعقدة
مع تدشين التعبيرات النمطية (Regular Expressions – Regex) في النسخ التجريبية والتحديثات المعاصرة لمايكروسوفت 365 (إصدارات منتصف عام 2024 فصاعداً)، دخل برنامج إكسل مرحلة جديدة من النضج البرمجي عبر توفير دوال رائدة مثل REGEXEXTRACT وREGEXTEST وREGEXREPLACE. تتيح هذه الأدوات المتقدمة تجاوز القيود الصارمة للمحددات الثابتة، والتعامل مع الأنماط النصية المتغيرة والمبهمة عبر توصيفات رياضية مجردة وفائقة المرونة.
تستخدم دالة REGEXEXTRACT لاستخراج النصوص المحصورة بين رمزين عبر صياغة نمط التقاط مخصص يحدد محددات البداية والنهاية ومجموعات الالتقاط الداعمة (Capture Groups). لعزل نص محصور بين قوسين هلاليين، تُكتب الصيغة على النحو التالي: REGEXEXTRACT(A1, “((.*?))”, 2). في هذا التعبير النمطي، تشير الرموز ( و ) إلى القوسين الحرفيين بعد تعطيل وظيفتهما البرمجية باستخدام الشرطة المائلة المعكوسة ()، بينما يمثل الرمز (.*?) مجموعة الالتقاط الحرة التي تطابق أي محارف واقعة بينهما بأقل قدر ممكن من التوسع (Non-greedy matching). أما الرقم 2 في الوسيطة الأخيرة، فيحدد وضع الإرجاع ليوجه الدالة حصراً لإرجاع محتوى مجموعة الالتقاط المستهدفة دون إدراج القوسين في الناتج النهائي.
تتجلى القوة الخارقة للتعبيرات النمطية عند استخراج نصوص تقع بين محددات غير متجانسة إملائياً، كأن تكون البداية رقماً حسابياً والنهاية رمزاً خاصاً، أو عند التعامل مع أكواد تتغير بنيتها عشوائياً بين الحروف الكبيرة والصغيرة؛ حيث يستطيع نمط تعبيري وحيد استيعاب كافة هذه التغيرات الهيكلية بمرونة بالغة تعجز عنها الدوال النصية التقليدية مهما تعقدت تركيباتها التداخلية.
8.2 المعالجة الشاملة للبيانات عبر المصفوفات الديناميكية ودالة الخريطة
أدى ظهور محرك المصفوفات الديناميكية في إكسل إلى تغيير جذري في كيفية تطبيق الصيغ عبر أعمدة البيانات بالكامل؛ حيث أصبح بالإمكان الاستغناء كلياً عن السحب اليدوي للمعادلات والاستعاضة عنه بصيغة واحدة ذاتية الانسكاب تتمركز في الخلية العلوية الأولى وتغطي النطاق الرأسي تلقائياً. تتعزز هذه المنظومة بصورة استثنائية عند دمج الدوال النصية مع دوال المعالجة المصفوفية التكرارية مثل دالة الخريطة MAP ودالة LAMBDA المساعدة.
تُبنى صيغة المعالجة الشاملة لعمود كامل من السجلات النصية الممتدة من A2 إلى A1000 بالصيغة التالية: =MAP(A2:A1000, LAMBDA(row, TEXTBEFORE(TEXTAFTER(row, “[“), “]”))). تعمل دالة MAP على تمرير كل صف من صفوف النطاق تباعاً إلى المتغير الوظيفي row داخل دالة LAMBDA، لتطبق عليه دالتي الاستخراج الداخليتين، ثم تسكب النتائج الكاملة للمصفوفة دفعة واحدة في العمود التحليلي المستهدف دون أي تدخل يدوي إضافي.
يقدم هذا الأسلوب المعماري فوائد جمة لإدارة البيانات الكبيرة؛ فهو يخفض حجم ملف العمل بدرجة هائلة لعدم تكرار تخزين تعريفات الصيغة الرياضية في كل خلية مستقلة، ويقضي تماماً على احتمالات الخطأ البشري الناتج عن نسيان سحب المعادلة لتغطية السجلات المضافة حديثاً في نهاية الجدول، مما يوفر بيئة تحليلية مرنة وقابلة للتوسع التلقائي كلما تم تحديث قواعد البيانات المصدرية.
8.3 الفرز والتقسيم المباشر كبدائل لاستخراج المقاطع النصية
توفر دالة تقسيم النصوص الحديثة TEXTSPLIT بديلاً هندسياً فائق الكفاءة لاستخراج المقاطع النصية المحصورة بين فواصل، وذلك عبر تفكيك السلسلة النصية برمتها إلى مصفوفة مجزأة من الخلايا بناءً على المحددات المعطاة، ثم استدعاء المقطع المطلوب مباشرة باستخدام دوال الفهرسة والاختيار المصفوفي مثل INDEX أو CHOOSECOLS.
إذا كانت الخلية A1 تتضمن نصاً متعدد الأقسام مثل: “كود1_المتغيرالمستهدف_كود2″، ونرغب في عزل “المتغيرالمستهدف” الواقع بين علامتي الشرطة السفلية (_)، يمكن استخدام دالة التقسيم لتجزئة الخلية عند هذا الفاصل إلى ثلاثة عناصر مصفوفية، ثم التقاط العنصر الثاني عبر دالة الفهرسة بالشكل: =INDEX(TEXTSPLIT(A1, “_”), 2). يتعامل هذا التكنيك مع السلسلة النصية كمتجه خطي منظم، مما يسهل الوصول إلى المقاطع الواقعة في الترتيب الأوسط دون الحاجة لبناء دوال مقتطعة من الجانبين.
يبرز التفضيل المنهجي لطريقة التقسيم والفرز المباشر في الحالات التي يراد فيها استخراج عدة مقاطع متفرقة في آن واحد وتوزيعها عبر أعمدة متجاورة، في حين تظل توليفة TEXTAFTER وTEXTBEFORE هي الخيار الأمثل والأنقى حسابياً عندما يكون المستهدف هو عزل مقطع فردي محدد بدقة دون تشويش الذاكرة بتوليد مصفوفات وسيطة غير مستغلة في مساحة العمل التحليلية.
9. دراسات حالة وتطبيقات عملية في معالجة البيانات التحليلية
9.1 استخراج المعرفات الرقمية والأكواد البحثية من سجلات القياس
في المختبرات البحثية وسجلات التجارب السريرية والسلوكية، تصدر أجهزة الرصد التلقائي ملفات نصية مدمجة تحتوي على أكواد تعريفية للمشاركين محاطة برموز قياسية مثل: “REC_2024_05_12_{ID#8841}_SESSION_01”. تتطلب المعالجة المنهجية عزل المعرف الرقمي الصافي “8841” المحصور بين البادئة “{ID#” والمحدد الختامي “}”، لتحويله إلى مفتاح أساسي يربط بين جداول القياسات التجريبية وقواعد البيانات الديموغرافية للمشاركين.
تتم هذه التنقية عبر صياغة المعادلة الدقيقة التالية: TEXTBEFORE(TEXTAFTER(A1, “{ID#”), “}”). عند إتمام عملية الاستخراج هذه، يجب الانتباه إلى حقيقة تقنية حاسمة: كافة مخرجات الدوال النصية في إكسل (سواء كانت MID أو TEXTAFTER أو TEXTBEFORE) تُنتج بيانات مصنفة برمجياً كنصوص (Text Strings)، حتى وإن كانت المحتويات المستخرجة عبارة عن أرقام حسابية صريحة. إذا ترك المعرف كقيمة نصية، فإن محاولات ربطه بجداول أخرى تحتوي على المعرف بتنسيق رقمي ستفشل تماماً في دوال المطابقة والبحث مثل VLOOKUP أو XLOOKUP.
لذا، تقتضي أفضل الممارسات المنهجية تحويل الناتج النصي فورياً إلى قيمة عددية صريحة (Numeric Coercion)، إما عبر تغليف الصيغة بدالة القيمة VALUE كالتالي: VALUE(TEXTBEFORE(TEXTAFTER(A1, “{ID#”), “}”))، أو باستخدام المعامل الأحادي المزدوج (Double Unary) ذي الكفاءة العالية بوضع علامتي ناقص قبل الدالة بالشكل: =–TEXTBEFORE(TEXTAFTER(A1, “{ID#”), “}”). تضمن هذه الخطوة الهندسية جاهزية البيانات الرقمية للدمج العلائقي والتحليل الإحصائي دون أي أخطاء في التعرف على الأنماط.
9.2 تنقية البيانات الوصفية المستخرجة من المنصات الرقمية
عند جمع البيانات الوصفية (Metadata) من المنصات الرقمية وواجهات برمجة التطبيقات (APIs)، تظهر سجلات الاتصال في صيغ نصية مدمجة مثل حقول المراسلات الرقمية: “اسم الباحث <[email protected]>”. يواجه المحلل هنا حاجة منهجية لعزل اسم المستخدم الجامعي الصافي “researcher.id” المحصور بين علامة القوس الزاوي الافتتاحي “<” وعلامة آت “@”، أو استخراج اسم النطاق الأكاديمي المحصور بين “@” وعلامة القوس الزاوي المغلق “>”.
تُحل هذه الإشكالية ببراعة عبر توظيف المحددات المتباينة داخل التركيب التداخلي؛ فلعزل اسم المستخدم يُطبق: TEXTBEFORE(TEXTAFTER(A1, “<“), “@”)، بينما يُستخرج النطاق بتطبيق: TEXTBEFORE(TEXTAFTER(A1, “@”), “>”). يتيح هذا الفصل المعياري للمحللين إمكانية تصنيف جهات الانتساب المؤسسي للمشاركين، وفرز عناوين البريد الإلكتروني بحسب الجامعات ومراكز البحوث المعتمدة، وتصفية البيانات المكررة بكفاءة مؤتمتة وسريعة تضمن نقاء العينة المستهدفة.
ينسحب التطبيق ذاته على السجلات الزمنية المشفرة بنمط ISO، مثل: “2024-10-31T14:30:00Z”، حيث يمكن عزل الساعات والدقائق بدقة عبر استخراج النص المحصور بين حرف “T” الفاصل وحرف “Z” النهائي عبر الصيغة: TEXTBEFORE(TEXTAFTER(A1, “T”), “Z”)، مما يسهل تقسيم السلاسل الزمنية إلى تواريخ وساعات مستقلة تمهيداً لحساب الفروق الزمنية بين الأحداث المرصودة ومعدلات الاستجابة السلوكية في التجارب الميدانية.
9.3 تحليل استجابات الاستبيانات والاستقصاءات المفتوحة
في بحوث العلوم الاجتماعية والسلوكية، تتضمن أدوات المسح الميداني أسئلة ذات نهايات مفتوحة يميل المشاركون فيها إلى تدوين ملاحظات توضيحية جانبية بين أقواس لتفسير خياراتهم الرقمية، كأن يكتب المستجيب: “أوافق بشدة (بشرط توافر الدعم الفني)”. يفرض المنهج التحليلي عزل هذا التعليق التفسيري المحصور بين القوسين لتحليله كيفياً وتصنيف أنماطه الدلالية، مع الإبقاء على الخيار الأصلي “أوافق بشدة” كمتغير ترتيبي كمي مستقل في مصفوفة التحليل الإحصائي.
يتم استخلاص الملاحظة النصية المكتوبة داخل الأقواس بتطبيق صيغة عزل الأقواس الهندسية: TEXTBEFORE(TEXTAFTER(A1, “(“), “)”)، بينما يتم استخراج الخيار الأساسي بتطبيق دالة الاقتطاع المسبق مع التشذيب: TRIM(TEXTBEFORE(A1, “(“)). يسهم هذا التقسيم الدقيق في تأمين تجانس المتغيرات النصية لتسهيل إجراء التحليل العاملي، وتحليل المحتوى النوعي، وتصنيف النصوص الآلي، وهو أمر جوهري لدراسة الاستجابات السلوكية والظواهر الإنسانية المعقدة وضبط الفروق الثقافية في التعبير واللغة، على نحو ما يتطلبه استيعاب السياقات المجتمعية المتعددة في القياسات المعرفية والسلوكية المقارنة (Fessler, 2004).
علاوة على ذلك، يتيح هذا العزل المزدوج للباحثين التحقق من اتساق استجابات المشاركين عبر مضاهاة الخيار الكمي بمحتوى التعليق النوعي الوارد بين القوسين، مما يكشف حالات التناقض المعرفي في الإجابات ويوفر معياراً إضافياً لغربلة البيانات واستبعاد الاستجابات غير الجادة قبل الانخراط في النمذجة الإحصائية النهائية.
10. أفضل الممارسات الهندسية لتحسين الأداء وتوثيق الصيغ في إكسل
10.1 هيكلة الصيغ وتوثيقها البرمجي باستخدام دالة LET
تمثل دالة LET نقلة نوعية كبرى في تحسين البنية البرمجية لصيغ إكسل؛ إذ تتيح للمحلل إسناد أسماء دلالية للمتغيرات النصية والنتائج الحسابية الوسيطة داخل المعادلة الواحدة، واستدعاء هذه المتغيرات مراراً دون إعادة حسابها برمجياً. يسهم هذا النهج في تحسين مقروئية الصيغ الطويلة بصورة استثنائية، ويسهل توثيقها للأغراض الأكاديمية والمراجعة المشتركة بين الباحثين.
عند تطبيق الاستخراج التداخلي المتقدم، يمكن استخدام دالة LET لتعريف النص المصدر ومحددات البداية والنهاية بوضوح تام عبر الصيغة التالية:
=LET(
rawText, A1,
startChar, “[“,
endChar, “]”,
trimmed, TRIM(rawText),
extracted, TEXTBEFORE(TEXTAFTER(trimmed, startChar), endChar),
IFERROR(extracted, “غير متوفر”)
)
يحقق هذا البناء الهندسي ميزتين جوهريتين: الميزة الأولى هي تخفيض استهلاك الذاكرة عبر حساب المتغير trimmed لمرة واحدة فقط بدلاً من إعادة تنفيذه في عدة مواقع، والميزة الثانية هي المرونة التامة في تعديل المحددات الفاصلة مستقبلاً؛ فإذا رغب الباحث في تغيير الأقواس المربعة إلى أقواس مجعدة، يكفي تعديل قيمة startChar وendChar في السطور الأولى للصيغة دون الحاجة للغوص في عمق المعادلة التركيبية وإعادة كتابة الدوال التداخلية المعقدة.
10.2 تحسين استهلاك موارد المعالج في مجموعات البيانات الضخمة
في مشاريع البيانات الضخمة التي تحتوي على مئات الآلاف من الصفوف، تصبح كفاءة استهلاك موارد المعالج المركزي (CPU) العامل الحاسم في استقرار بيئة العمل وسرعة استجابة جداول البيانات. إن أحد أخطر الأخطاء الشائعة هو كتابة صيغ نصية تشير إلى أعمدة كاملة غير محدودة مثل A:A؛ حيث يجبر هذا التوصيف محرك الحساب على مسح أكثر من مليون خلية في ورقة العمل حتى وإن كان معظمها فارغاً، مما يؤدي إلى تجميد البرنامج وبطء شديد في الاستجابة.
تتمثل الممارسة الهندسية المثلى في تحويل نطاق البيانات دائماً إلى جدول إكسل رسمي مهيكل (Excel Table) والاعتماد على مراجع الجداول المنضبطة مثل [@السجل النصي]. تتسم هذه المراجع بكونها ديناميكية تتوسع تلقائياً مع إضافة سجلات جديدة وتقيد الحسابات الحوسبية حصراً بنطاق البيانات الفعلي المأهول بالقيم. كما ينصح بشدة بالابتعاد عن استخدام الدوال المتقلبة (Volatile Functions) كمعاملات وسيطة في الصيغ النصية؛ لأن هذه الدوال تجبر إكسل على إعادة احتساب عمود الاستخراج بالكامل عند إجراء أي تعديل عشوائي في أي خلية مستقلة داخل المصنف.
في الحالات التي تتطلب تنفيذ تعديلات هيكلية واسعة على مصنفات العمل شديدة الضخامة، ينبغي تحويل وضع الحساب في إكسل مؤقتاً من التلقائي (Automatic) إلى اليدوي (Manual) من خلال تبويب “الصيغ”، لإيقاف العمليات الحسابية المتكررة ريثما ينتهي إدخال التعديلات وتثبيت المعادلات، ثم إعادة تفعيل الحساب التلقائي مرة واحدة، مما يمنع استنزاف موارد الجهاز ويوفر بيئة عمل تتسم بالانسيابية والسرعة.
10.3 بناء دوال استخراج مخصصة وقابلة لإعادة الاستخدام عبر دالة LAMBDA
تعتبر دالة LAMBDA التتويج النهائي للتطوير البرمجي في مايكروسوفت إكسل؛ حيث تتيح للمستخدمين ابتكار دوال مخصصة خاصة بهم دون الحاجة لكتابة أكواد بلغة فيجوال بيسك (VBA) أو استخدام وحدات الماكرو الخارجية. يمكن للمحلل تغليف معادلة الاستخراج التداخلية المركبة بالكامل في دالة نظيفة ومخصصة تحمل اسماً دلالياً واضحاً، مثل: EXTRACT_BETWEEN، واستدعائها في أي ورقة عمل كأي دالة قياسية مدمجة في البرنامج.
لبناء هذه الدالة، يفتح المحلل مدير الأسماء (Name Manager) من تبويب الصيغ، وينشئ اسماً جديداً يحدد وسائطه بالشكل التالي:
=LAMBDA(target_text, start_delim, end_delim,
TRIM(TEXTBEFORE(TEXTAFTER(target_text, start_delim), end_delim))
)
بمجرد حفظ هذا التعريف في مصنف العمل، يصبح بإمكان أي مستخدم في الفريق استدعاء الدالة المبتكرة في أي خلية بكل بساطة وسلاسة بكتابة: =EXTRACT_BETWEEN(A1, “[“, “]”). يتيح هذا التجريد المعماري تعميم المعايير المنهجية الموحدة بين الباحثين والمحللين المشاركين في المشروع، ويحمي الصيغ الأساسية من عبث التعديلات اليدوية العشوائية، فضلاً عن إمكانية تصدير هذه الدوال المخصصة وتوزيعها عبر قوالب العمل المشتركة لتصبح جزءاً من البنية التحتية القياسية لتحليل البيانات في المؤسسة الأكاديمية أو المهنية.
خاتمة
استعرض هذا المقال الأكاديمي الشامل الأبعاد النظرية والتطبيقية لعمليات استخراج النصوص المحصورة بين حرفين أو محددين في برنامج مايكروسوفت إكسل، متتبعاً المسار التطوري للمفاهيم الهيكلية للسلاسل النصية من الدوال الكلاسيكية الموضعية كدوال MID وSEARCH وFIND إلى الدوال الديناميكية المعاصرة كدالتي TEXTAFTER وTEXTBEFORE والتعبيرات النمطية المتقدمة REGEXEXTRACT. أظهر التحليل المقارن أن الانتقال نحو المنهجيات الحديثة لا يقتصر على مجرد تسهيل الصياغة البرمجية، بل يمتد ليشمل خفضاً جذرياً في التكلفة الإدراكية المفروضة على المحلل، وتحسيناً ملحوظاً في الكفاءة الحسابية واستهلاك موارد المعالجة عند التعاطي مع مصفوفات البيانات الضخمة، وتعزيزاً لموثوقية نماذج تنقية المتغيرات من الأخطاء التراكمية.
إن تبني أفضل الممارسات الهندسية — بدءاً من تحصين المعادلات بدوال الحماية مثل IFNA، وضبط الإزاحات الحسابية، وتطهير النصوص بدوال التشذيب TRIM، وصولاً إلى هيكلة المعادلات عبر LET وبناء دوال مخصصة وقابلة لإعادة الاستخدام عبر LAMBDA — يشكل حجر الزاوية في بناء قواعد بيانات بحثية تتسم بأعلى درجات الصدق المنهجي والنقاء الإحصائي. ومن خلال إدراك الفروق التشغيلية الدقيقة بين البيئات السحابية الحديثة والإصدارات التقليدية، يكتسب الباحث والمحلل المرونة الاستراتيجية الكافية لتصميم حلول معالجة نصية منضبطة تلبي احتياجات البحث العلمي وسرعة متطلبات قطاع الأعمال الحديث بكفاءة وتكامل لا نظير لهما.
المراجع
Cai, H., Yuan, Z., Gao, Y., Sun, S., Li, N., Tian, F., et al. (2022). A multi-modal open dataset for mental-disorder analysis. Scientific Data. https://doi.org/10.1038/s41597-022-01211-x
Fessler, D. M. T. (2004). Shame in Two Cultures: Implications for Evolutionary Approaches. Journal of Cognition and Culture. https://doi.org/10.1163/1568537041725097
Keuleers, E., Lacey, P., Rastle, K., & Brysbaert, M. (2011). The British Lexicon Project: Lexical decision data for 28,730 monosyllabic and disyllabic English words. Behavior Research Methods. https://doi.org/10.3758/s13428-011-0118-4
Pollock, E., Chandler, P., & Sweller, J. (2002). Assimilating complex information. Learning and Instruction. https://doi.org/10.1016/s0959-4752(01)00016-0