
تُعد معالجة السلاسل النصية وتجهيزها إحدى الركائز الأساسية في هندسة البيانات والتحليل الإحصائي التطبيقي، إذ تشير التقديرات المنهجية في علوم البيانات إلى أن الباحثين والمحللين يقضون ما يربو على ثمانين بالمئة من وقتهم الإجمالي في مرحلة إعداد البيانات وتنظيفها وتوحيد معاييرها الهيكلية. وفي بيئات الأعمال والمختبرات البحثية الأكاديمية التي تعتمد على برمجية مايكروسوفت إكسل (Microsoft Excel) بوصفها منصة محورية لإدارة الجداول الإلكترونية، تبرز إشكالية النصوص غير المهيكلة الواردة من مصادر خارجية متباينة—مثل سجلات التجارب السلوكية، وتفريغ الاستبيانات ذات الأسئلة المفتوحة، وتصديرات قواعد البيانات العتيقة—والتي تحتوي على بيانات مدمجة داخل خلية واحدة تفصل بينها محددات وفواصل غير متجانسة كالفواصل، والشرطات، والمسافات، والرموز الخاصة.
تاريخياً، شكّل تفكيك هذه السلاسل النصية المعقدة إلى عناصر ذرية قابلة للتحليل تحدياً برمجياً مضنياً تطلب صياغة معادلات تركيبية متداخلة وشديدة التعقيد تعتمد على استدعاء دوال كلاسيكية متعددة مثل دالة البحث النصي ودوال الاقتطاع من الأطراف والمنتصف، أو اللجوء إلى معالجات التبديل المتتالية لتنسيق الفواصل قسرياً قبل تقسيمها. ومع التحديثات الجوهرية التي أدخلتها مايكروسوفت على محرك الحسابات في برنامج إكسل، ولا سيما بعد إطلاق محرك المصفوفات الديناميكية وتقديم دالة التفكيك النصي المتطورة TEXTSPLIT في مطلع عام 2022، حدث تحول نوعي أتاح للمحللين استبدال مصفوفات الحساب المعقدة بحلول خوارزمية مرنة وديناميكية تختزل ساعات من العمل اليدوي وتلغي احتمالات الخطأ الإجرائي بصورة جذرية.
يهدف هذا المقال الأكاديمي الشامل إلى تقديم دليل منهجي وتطبيقي متكامل لاستيعاب وتطبيق تقنيات تقسيم السلاسل النصية استناداً إلى فواصل متعددة داخل برمجية إكسل. سنناقش بالتفصيل الأبعاد النظرية لهيكلة النصوص، والتشريح البنائي الدقيق لدالة TEXTSPLIT، والتعامل الاحترافي مع الفواصل المعقدة والمحارف المخفية، وسلوك الانسكاب المصفوفي وتطبيقاته، وصولاً إلى المقارنة المعيارية للأداء بين الصيغ الديناميكية، وأدوات باور كويري (Power Query) التكرارية، والصيغ التراثية المتداخلة، بما يُمكّن الباحثين ومحللي البيانات من بناء نماذج تحليلية عالية الكفاءة والموثوقية.
1. مقدمة نظرية حول معالجة السلاسل النصية المعقدة في برمجية إكسل
1.1 مفهوم السلاسل النصية وتحديات الفواصل غير المتجانسة
تُعرّف السلسلة النصية (String) في علوم الحاسوب ونظم معالجة جداول البيانات بأنها متتالية خطية أحادية البعد تتألف من محارف شفرية مرتبة، تشمل الحروف الهجائية، والأرقام، والرموز الخاصة، والمسافات الفاصلة ومحارف التحكم في الطباعة. وعند استيراد البيانات من مصادر خارجية مثل سجلات استجابات برمجيات الاختبارات النفسية كمنصات PsychoPy أو Qualtrics، أو واجهات برمجة التطبيقات (APIs)، يتم تمثيل السجلات المتعددة غالباً داخل حقل واحد على هيئة نصوص متصلة تفصل بين مقاطعها علامات ترقيم شتى. يكمن التحدي البنيوي في أن هذه المحددات ليست موحدة دائماً؛ فقد يحتوي الحقل الواحد على مسافة فاصلة، تتبعها فاصلة منقوطة، ثم شرطة سفلية أو خط مائل، وذلك نتيجة لتعدد بروتوكولات الإدخال أو لتغير سلوك التوثيق اليدوي بين المستخدمين عبر الزمن.
إن تباين محددات الفصل يمنع برمجيات التحليل من تمييز الحدود الفاصلة بين المتغيرات بصورة مباشرة، مما يُلزم المحلل بتطبيق عمليات المعالجة القبلية (Data Wrangling) لعزل المتغيرات التابعة والمستقلة ضمن أعمدة وصفوف منفصلة. ويُلقي هذا التباين بظلاله السلبية على البنية المنهجية للتحليل؛ حيث يؤدي الإخفاق في تقسيم النصوص بدقة إلى دمج متغيرات قياس نوعية مع بيانات كمية، أو اقتطاع أجزاء من المتغيرات الاسمية، الأمر الذي ينتهي بحدوث أخطاء جسيمة في تصنيف العينات، ويقود بالتالي إلى تحيزات غير مرئية في حساب المتوسطات، والانحرافات المعيارية، ونماذج الانحدار الخطي أو اللوجستي المبنية على تلك البيانات المشوهة.
1.2 التطور التاريخي لدوال وتقنيات معالجة النصوص في إكسل
مرت هندسة معالجة النصوص في برمجية مايكروسوفت إكسل بمراحل مفصلية تعكس تطور قدرات العتاد البرمجي ومحركات الحساب الرياضي. في الإصدارات الكلاسيكية السابقة لعام 2019، كان إكسل يعتمد على نموذج تقييم الخلية الواحدة (Single-cell execution)، حيث كانت محاولات استخراج الكلمات المفصولة بنصوص متعددة تستلزم بناء صيغ مصفوفية مفرطة التعقيد تدمج بين دوال LEFT وRIGHT وMID جنباً إلى جنب مع دالتي البحث الموضعي FIND وSEARCH. وكانت هذه الصيغ تُعاني من متلازمة الهشاشة البرمجية؛ إذ إن أي تغيير طفيف في بنية المحددات أو طول السلسلة كان يتسبب في ظهور أخطاء من نوع #VALUE! مما يتطلب إعادة هيكلة المعادلة بالكامل.
شهد عام 2018 نقطة التحول الكبرى في تاريخ المنصة مع إعلان مهندسي مايكروسوفت، بقيادة فريق جو ماكديد (Joe McDaid)، عن إطلاق محرك المصفوفات الديناميكية (Dynamic Array Engine). هذا المحرك مكّن الصيغة الحسابية الواحدة المكتوبة في خلية واحدة من توليد مصفوفة نتائج متعددة الأبعاد تتدفق تلقائياً في الخلايا المجاورة دون حاجة للضغط على تركيبة المفاتيح الشهيرة Ctrl + Shift + Enter. وتُوّج هذا التطور الثوري في عام 2022 بإطلاق حزمة الدوال النصية المتقدمة وعلى رأسها دالة TEXTSPLIT، والتي صُممت خصيصاً كحل خوارزمي متكامل يتعامل أصلياً وبكفاءة مع المصفوفات المتعددة للفواصل، محققة نقلة نوعية من المعالجة الثابتة الجامدة إلى المعالجة التكيفية فائقة السرعة.
1.3 الأهمية المنهجية لتنظيف البيانات النصية في سياق التحليل الرقمي
تمثل جودة البيانات النصية المنظفة المدخل الأساسي لأي مسار تحليلي موثوق، حيث يُسهم الاتساق الهيكلي للبيانات في حماية النماذج الإحصائية من الانحياز الناتج عن التكرارات الاصطناعية أو المسميات المشوهة. فعندما يتم تفكيك نص متعدد المحتويات—مثل استجابة متعددة الخيارات في دراسة ميدانية مسحية—بصورة متجانسة، يصبح من السهل بناء جداول التوزيع التكراري، وتطبيق اختبارات الاستقلالية ومقارنة التوزيعات دون مواجهة مشكلات تكرار الفئات المتقاربة لفظياً بسبب وجود فاصلة إضافية أو مسافة غير مرئية.
ترتكز معايير الجودة المنهجية للبيانات النصية على ثلاثة أركان رئيسية: الاكتمال (Completeness)، والدقة البنائية (Structural Accuracy)، والقابلية للتصنيف والفرز (Categorical Sortability). ويؤدي تطبيق أساليب الفصل الآلي متعدد المحددات إلى ضمان تحويل السلاسل النصية المعقدة إلى سجلات مطابقة للشكل الطبيعي المعياري الثالث (Third Normal Form) في قواعد البيانات، الأمر الذي يقلص زمن المعالجة الأولية بصورة جذرية ويمنح الباحثين متسعاً أكبر للتركيز على استنباط الأنماط التحليلية وتفسير الظواهر الإحصائية بدلاً من استنزاف مواردهم الإدراكية في الإصلاح اليدوي المتكرر للأخطاء النصية.
2. البنية التركيبية لدالة TEXTSPLIT وقواعدها الصياغية
2.1 المعاملات الإلزامية والاختيارية في صياغة دالة TEXTSPLIT
تتمتع دالة TEXTSPLIT ببنية صياغية دقيقة تتألف من معاملين إلزاميين وأربعة معاملات اختيارية تمنح المستخدم تحكماً خوارزمياً كاملاً في طريقة معالجة وتدفق المخرجات. الصيغة الرياضية العامة للدالة تُكتب على النحو التالي:
=TEXTSPLIT(text, col_delimiter, [row_delimiter], [ignore_empty], [match_mode], [pad_with])
المعامل الأول text يمثل السلسلة النصية المصدرية المراد تفكيكها، ويمكن أن يكون نصاً صريحاً موضوعاً بين علامتي تنصيص أو مرجعاً لخلية مفردة. المعامل الثاني col_delimiter يُحدد الرمز أو مصفوفة الرموز المستخدمة لتقسيم النص أفقياً عبر الأعمدة المتجاورة، وهو معامل إلزامي ما لم يُحدد المعامل الثالث. أما المعامل الثالث row_delimiter فيعمل على تجزئة النص عمودياً عبر الصفوف، مما يتيح إعادة تشكيل النص إلى قائمة رأسية بدلاً من امتداد أفقي.
تتكامل وظيفة الدالة من خلال المعاملات الاختيارية الثلاثة المتبقية؛ حيث يتيح المعامل الرابع ignore_empty تجاهل الخلايا الفارغة الناتجة عن تكرار الفواصل المتجاورة، بينما يتحكم المعامل الخامس match_mode في درجة حساسية الدالة لحالة الأحرف اللاتينية، وأخيراً يختص المعامل السادس pad_with بتعيين قيمة تعويضية في المصفوفات ثنائية الأبعاد عند تباين أطوال الصفوف الناتجة لتجنب الأخطاء الهيكلية.
2.2 سلوك المصفوفات الديناميكية وظاهرة الانسكاب (Spill Behavior)
تستند دالة TEXTSPLIT في جوهرها التشغيلي إلى معمارية الانسكاب التلقائي (Spill Mechanics)، حيث لا تتطلب الصيغة حجز نطاق مسبق من الخلايا أو سحب مقبض التعبئة يدوياً. بمجرد إدخال الصيغة في خلية الإسناد العلوية والضغط على مفتاح الإدخال، يقوم محرك إكسل بتقييم أبعاد النص وعدد المحددات، ثم ينشئ تلقائياً مصفوفة ذات حدود ديناميكية تتدفق عبر الخلايا المجاورة سواء باتجاه الأعمدة أو الصفوف وفق ما حددته معطيات الصيغة.
يتميز النطاق المنسكب بكونه وحدة بيانية موحدة غير قابلة للتعديل الجزئي؛ فلا يمكن للمستخدم تحرير إحدى خلايا النطاق المنسكب بصورة معزولة، بل يتم تعديل الصيغة الأم فقط. كما يوفر محرك إكسل ميزة متقدمة تتمثل في عامل تشغيل الانسكاب التلقائي المرموز له بعلامة التجزئة (#)، والذي يسمح لأي دالة أخرى في المصنف بالإشارة إلى كامل المصفوفة الناتجة عن TEXTSPLIT عبر كتابة عنوان الخلية الأولى متبوعاً بالعلامة، مثل: A2#، مما يضمن تحديث النطاقات التابعة تلقائياً وبصورة آنية حال تغير طول السلسلة المصدرية أو عدد المقاطع المفككة.
2.3 صياغة مصفوفات الثوابت النصية عبر الأقواس المعقوفة
تعتمد الميزة الأبرز لدالة TEXTSPLIT في قدرتها الفطرية على قبول مصفوفات الثوابت (Array Constants) كمعاملات للمحددات، وهو ما يلغي الحاجة إلى التقنيات البديلة المرهقة لتوحيد الرموز مسبقاً. في قواعد صياغة لغة إكسل، تُعرف المصفوفة الثابتة رياضياً بإحاطة عناصرها بالأقواس المعقوفة {}، مع وضع كل محدد نصي بين علامتي تنصيص مفردتين أو مزدوجتين وفق معايير الترقيم البرمجي، والفصل بين العناصر بواسطة الفاصلة العادية أو الفاصلة المنقوطة تبعاً لإعدادات المنطقة ونظام التشغيل.
عند صياغة مصفوفة محددات أفقية مثل {",", ";", "-"}، تقوم الخوارزمية الداخلية بمعالجة هذه الرموز كمدخلات متزامنة تخضع لمنطق الربط الانفصالي (OR)؛ بمعنى أن محرك الدالة يقوم بالمسح التسلسلي لمحارف السلسلة الأصلية، وعند مصادفة أي رمز من الرموز المضمنة في المصفوفة المعقوفة، يتم اعتباره نقطة انقطاع فورية وتوليد حد فاصل جديد في مصفوفة الإخراج. هذه الصياغة الأنيقة لا تختصر الكود البرمجي فحسب، بل تحسن من سرعة التنفيذ الحسابي للعملية بنسبة تتجاوز الصيغ التقليدية بمراحل.
3. التطبيق الإجرائي لتقسيم النصوص بالاعتماد على فواصل متعددة
3.1 صياغة مصفوفة الرموز: المسافات، الفواصل، والشرطات السفلية
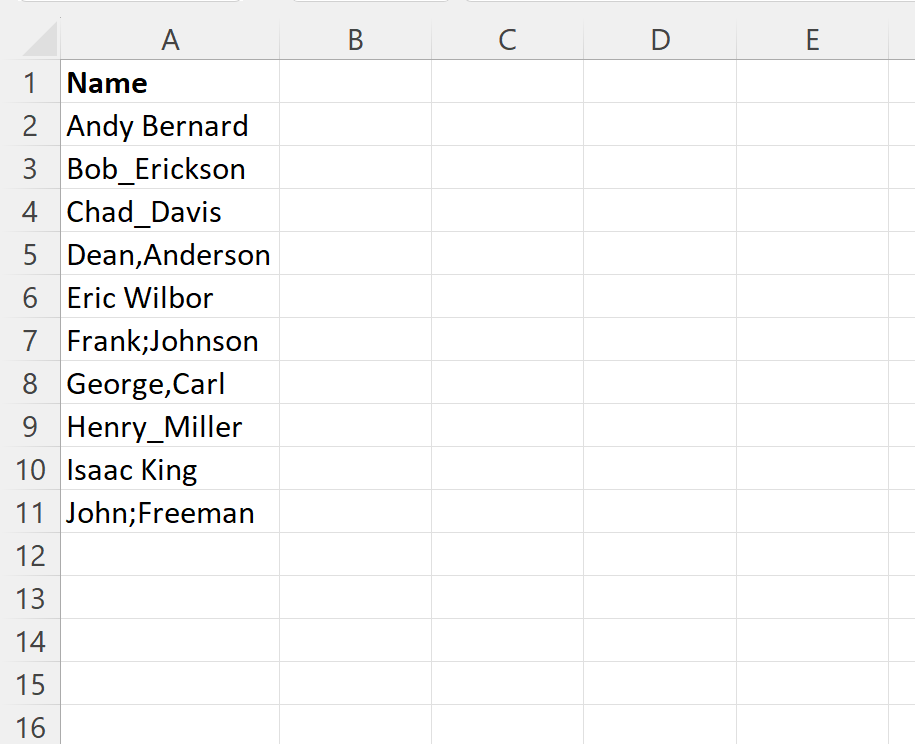
لتطبيق عملية تقسيم شاملة على سلسلة نصية معقدة تتضمن تنوعاً فوضوياً في الفواصل، يفترض الباحث أو المحلل صياغة المصفوفة التي تجمع بين كافة الاحتمالات الواردة في السجل. لنفترض وجود سجل نصي في الخلية A2 يحتوي على التركيبة التالية: "Data_Analysis,Quantitative;Survey 2024". نلاحظ هنا وجود أربعة محددات مميزة: الشرطة السفلية (_)، والفاصلة اللاتينية (,)، والفاصلة المنقوطة (;)، والمسافة الفارغة (" ").
تُصاغ دالة التقسيم في هذه الحالة عن طريق تجميع تلك المحددات داخل مصفوفة ثوابت أفقية ضمن المعامل الثاني:
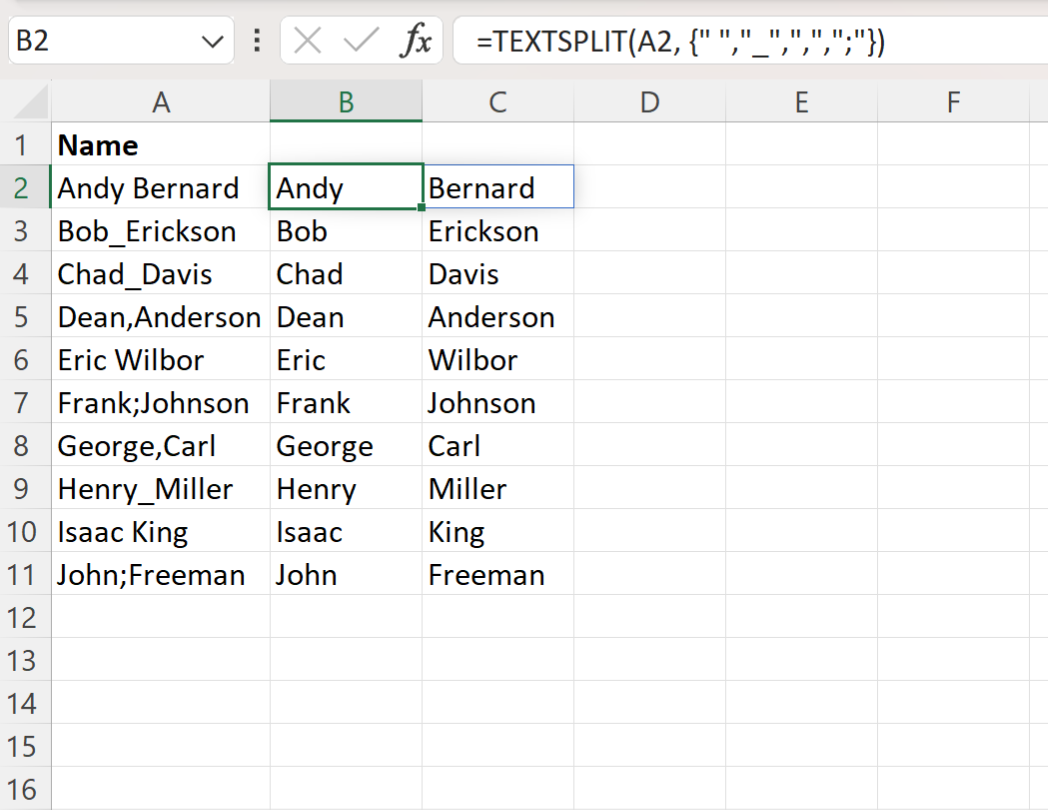
=TEXTSPLIT(A2, {" ", ",", ";", "_"})
يقوم المحرك الخوارزمي في إكسل بالتعامل مع عناصر المصفوفة بكفاءة متوازية. ومن الناحية الهندسية، لا يؤثر الترتيب الداخلي للرموز المفردة داخل المصفوفة على جودة التقسيم النهائي للأحرف المستقلة، غير أن إدراج الرموز غير المرئية كفواصل الأسطر (Line Breaks) المستدعاة عبر دالة CHAR(10) لنظام ويندوز أو CHAR(13) لأنظمة ماك، يتطلب دمج الدالة داخل المصفوفة بالصيغة: =TEXTSPLIT(A2, {",", ";", CHAR(10)})، مما يضمن معالجة النصوص المنقولة عبر وثائق PDF أو قواعد البيانات الشبكية بسلاسة تامة.
3.2 خطوات التنفيذ العملي وتطبيق الصيغة على النطاقات الكبيرة
عند الشروع في تطبيق الصيغة على مجموعات البيانات واسعة النطاق في بيئات العمل التطبيقية، تبدأ الخطوة الإجرائية باختيار خلية الإخراج المستهدفة في صف محاذٍ للبيانات الأصلية مع التأكد المطلق من خلو الأعمدة الواقعة إلى يمين الخلية من أي بيانات نصية أو رقمية مسبقة، لتجنب حجب تدفق مصفوفة الانسكاب. يتم كتابة الصيغة في الخلية الأولى ومطالعة سلوك التوزيع الأفقي للتأكد من انقسام السلسلة إلى وحداتها المعجمية المقصودة.
نظراً لأن دالة TEXTSPLIT صُممت أساساً لمعالجة خلية مفردة كمعامل إدخال للسلسلة النصية text، فإن تعميم العملية على عمود كامل يحتوي على مئات أو آلاف الصفوف يتطلب اتباع أحد منهجين منهجيين: إما سحب مقبض التعبئة الكلاسيكي للصيغة عمودياً عبر الخلايا المقابلة للنطاق، وهو ما يُنشئ مصفوفات انسكاب مستقلة لكل صف على حدة، أو دمج دالة TEXTSPLIT ضمن الدوال التكرارية المتقدمة للمصفوفات مثل دالة BYROW مع دالة LAMBDA، مما يسمح بحساب العمود بأكمله عبر صيغة ديناميكية مركزية واحدة دون الحاجة لتكرار إدخال الصيغ يدوياً في كل صف.
3.3 التحليل الميكانيكي لآلية التعرف على المحددات داخل الدالة
لفهم الدقة الرياضية التي تعمل بها دالة TEXTSPLIT، يجب تشريح الآلية الميكانيكية التي تتبعها الخوارزمية أثناء المعالجة؛ إذ تتبع الدالة أسلوب التفتيش التسلسلي المستند إلى مؤشر موضعي (Pointer-based Sequential Scan). يتحرك المؤشر عبر السلسلة النصية حرفاً بحرف من البداية وحتى النهاية، وفي كل موضع، يقارن المحرف الحالي أو المتتالية الحالية بكافة العناصر المسجلة في مصفوفة المحددات الممررة إليها.
عند تحقق التطابق المنطقي بين المحرف المفحوص وأي من رموز المصفوفة، تقوم الخوارزمية فورياً بقطع السلسلة عند الموضع الحالي، واقتطاع الجزء السابق كعنصر مستقل يتم ترحيله إلى سجل المصفوفة الناتجة، ثم يُعاد تعيين مؤشر البداية إلى المحرف التالي للمحدد المكتشف. وتستمر هذه الدورة الحسابية بسرعة فائقة في الذاكرة العشوائية (RAM) دون كتابة وسيطة، الأمر الذي يجعل مخرجات التفكيك المبدئية تتطابق بنيوياً مع التوقعات الرياضية الأكثر صرامة، متفوقة على أساليب التحليل السطحي التي تتبعها بعض البرمجيات الجاهزة.
4. معالجة النصوص المتقدمة: استبعاد الفراغات وتطهير المدخلات
4.1 توظيف المعامل ignore_empty لمعالجة الفواصل المتتالية
تتمثل إحدى أكثر المشكلات شيوعاً في قواعد البيانات الملوثة في ظاهرة “الفواصل المتتالية” (Consecutive Delimiters)، وتحدث عندما يقوم المستخدم بإدخال فاصلة تتبعها مسافة، أو نقطتين متتاليتين مثل: "Trial_1,,Group_B;;Control". عند تطبيق صيغة الفصل البسيطة على هذا النص، ستعتبر الخوارزمية أن المساحة المعدومة الواقعة بين الفاصلتين هي نص قائم بذاته ذو طول صفري (Zero-length string)، مما يولد خلايا فارغة مشوهة داخل النطاق المنسكب، تعيق عمليات الفرز والتجميع اللاحقة.
لحل هذه المعضلة الهيكلية، زودت مايكروسوفت الدالة بالمعامل الرابع ignore_empty. هذا المعامل المنطقي يقبل إحدى قيمتين: إما FALSE وهي الحالة الافتراضية التي تُبقي على السلاسل الصفرية، أو TRUE التي تُصدر أمراً مباشراً للخوارزمية بحذف أي مدخل فارغ ينشأ عن التقاء فاصلين متجاورين أو أكثر دون وجود محارف مفيدة بينهما:
=TEXTSPLIT(A2, {",", ";", "_"}, , TRUE)
يضمن تفعيل هذه القيمة المنطقية إنتاج مصفوفة متراصة خالية تماماً من الفجوات، حيث يتم تقليص الفواصل المتعددة المتتابعة خوارزمياً كما لو كانت فاصلاً موحداً واحداً، وهو ما يُعد خطوة تنظيف أساسية تسبق أي تحليل إحصائي وصفي.
4.2 التكامل الوظيفي بين دالتي TRIM وTEXTSPLIT
على الرغم من قدرة المعامل ignore_empty على التخلص من النصوص الفارغة، إلا أنه يقف عاجزاً أمام السلاسل التي تحتوي على مسافات بيضاء غير مرئية تفصل بين المحددات؛ فإذا احتوى النص على فاصلة تتبعها مسافة ", "، فإن إكسل يعتبر المسافة محرفاً مستقلاً ولا يُصنف الخلية على أنها فارغة، مما ينجم عنه ظهور نصوص ملوثة بمسافات بادئة أو لاحقة في النتائج المنسكبة. هنا يبرز الدور المحوري للتكامل الهيكلي مع دالة التطهير النصي TRIM.
تُستخدم دالة TRIM للتخلص المنهجي من كافة المسافات الزائدة في البدايات والنهايات مع تقليص المسافات البينية المتعددة إلى مسافة مفردة واحدة. ولتحقيق أعلى درجات الدقة، يُستحسن تطبيق دالة TRIM بصورة مدمجة إما على المدخل المصدري نفسه قبل تقسيمه، أو على مصفوفة النتائج الناتجة عن التقسيم لضمان تماسك البيانات:
=TRIM(TEXTSPLIT(A2, {",", ";", "-"}, , TRUE))
بالإضافة إلى ذلك، يواجه المحللون تحدي “المسافة غير القابلة للكسر” (Non-breaking Space) المعروفة بشفرة الآسكي CHAR(160) والتي تنشأ بكثرة عند نسخ البيانات من صفحات الويب ومستندات HTML؛ هذه المحارف لا تتأثر بدالة TRIM الاعتيادية، مما يستدعي دمج دالة الاستبدال SUBSTITUTE(A2, CHAR(160), " ") لتطهير السلسلة وتوحيدها مسبقاً قبل التمرير إلى محرك التقسيم.
4.3 تنقية البيانات من المحارف غير القابلة للطباعة بواسطة CLEAN
تشتمل البيانات المفرغة من الأنظمة المؤسسية القديمة أو المستوردة عبر منافذ الاتصال التسلسلي في الأجهزة المخبرية على طيف واسع من المحارف غير القابلة للطباعة (Non-printable Characters)، والتي تحتل المواقع من 0 إلى 31 في جدول شفرات ASCII القياسي. تتسبب هذه المحارف المخفية—مثل محرف الرجوع إلى أول السطر (Carriage Return) وعلامات الانتقال والجدولة المتداخلة—في إحداث خلل مفاجئ في استجابة محددات التقسيم، حيث قد تفصل بين أجزاء المحدد المركب وتمنع الدالة من مطابقة الرموز بدقة.
لمواجهة هذا الخلل، يتعين إدماج دالة التطهير المتخصصة CLEAN ضمن مسار المعالجة الأولي. تقوم الدالة CLEAN بمسح السلسلة وحذف جميع المحارف غير الرسومية التي لا تنتمي إلى نصوص اللغة العادية. ويتحقق البناء المعياري النموذجي للصيغة الدفاعية بتوحيد ثلاثي للدوال:
=TEXTSPLIT(CLEAN(TRIM(A2)), {",", ";", "/", "|"}, , TRUE)
يضمن هذا التسلسل المعياري تنقية النص من الشوائب الطباعية أولاً بواسطة CLEAN، يليه ضبط المسافات البيضاء بواسطة TRIM، لينتهي بتنفيذ تفكيك خوارزمي متجانس ومحصن ضد الأخطاء عبر TEXTSPLIT، مما يكفل استقرار النماذج التحليلية عند تشغيلها عبر منصات الحوسبة المتباينة سواء على أنظمة Windows أو macOS أو بيئات الويب السحابية.
5. إدارة حساسية حالة الأحرف والمحددات النصية المركبة
5.1 التحكم في حساسية الأحرف عبر المعامل match_mode
عند التعامل مع السلاسل النصية التي تستخدم كلمات هجائية أو أحرفاً محددة كفواصل للفصل—وهو نمط شائع في نصوص الأكواد الجينية في العلوم الحيوية أو رموز تصنيف البضائع والترميزات اللاتينية—تكتسب مسألة “حساسية حالة الأحرف” (Case Sensitivity) أهمية بالغة. يتيح المعامل الخامس في الدالة match_mode للمحلل الاختيار الصريح بين نوعين من سلوك المطابقة:
- المطابقة الحساسة لحالة الأحرف (القيمة 0): وهي القيمة الافتراضية للدالة؛ حيث تفرق بدقة متناهية بين الحرف الكبير (Uppercase) والحرف الصغير (Lowercase). فإذا حُدد الرمز
"x"كفاصل، فإن الحرف"X"الكبير لن يُعتبر فاصلاً على الإطلاق. - المطابقة غير الحساسة لحالة الأحرف (القيمة 1): تتيح هذه القيمة للدالة التغاضي التام عن حالة الحرف، وبالتالي يُعامل الرمز
"del"ومعادله"DEL"أو"Del"بنفس الكيفية الرياضية كأداة فصل معتمدة.
تتجلى فائدة هذه الميزة عند تقسيم سلاسل مثل "ItemA_AND_ItemB_and_ItemC"، فمن خلال تعيين المعامل على النحو التالي:
=TEXTSPLIT(A2, "and", , TRUE, 1)
تتمكن الدالة من تفكيك العناصر الثلاثة بنجاح وتجاهل الفروق الكتابية للمحدد، مما يجنب المحلل كتابة جميع التنويعات المحتملة لحالات الأحرف داخل مصفوفة الفواصل.
5.2 استخدام سلاسل نصية متعددة المحارف كفواصل مركبة
لا تقتصر كفاءة TEXTSPLIT على معالجة الرموز المفردة المنعزلة، بل تمتد لتشمل المحددات المركبة متعددة المحارف (Multi-character Delimiters)، كأن يفصل بين النصوص رمز شرطتين متتاليتين محاطتين بمسافتين " -- "، أو أقواس معينة متبوعة بشرطة مائلة "//>". وتكمن الصعوبة في هذه المحددات في احتمال تداخلها مع محددات جزئية أحادية في حال كانت الدالة تفتقر للدقة التفسيرية.
تسمح الدالة بدمج محددات أحادية ومركبة جنباً إلى جنب داخل نفس مصفوفة الثوابت المعقوفة بكل أريحية:
=TEXTSPLIT(A2, {";", " -- ", "///", "::"})
في هذا السياق الإجرائي، تتعامل الخوارزمية مع كل سلسلة فرعية داخل المصفوفة ككيان لغوي متكامل؛ فلا تقوم بتجزئة النص عند مصادفة شرطة مفردة إلا إذا تطابقت بدقة متوالية المحارف الثلاثية " -- " متضمنة المسافتين، مما يحفظ سلامة الكلمات التي تحتوي أصلاً على شرطات ربط داخلية مثل الكلمات المركبة (مثل: Well-being)، مانعاً اقتطاعها العرضي الخاطئ، وهو ما كان يشكل عائقاً لا يمكن حله بالصيغ الكلاسيكية القديمة دون تعقيدات صياغية غير مبررة.
5.3 التعامل مع حالات الغياب الجزئي لبعض المحددات في السلسلة
في الدراسات الميدانية الواقعية، تتسم سجلات البيانات بدرجة عالية من عدم التجانس؛ فقد يحتوي السجل الأول على فواصل مكونة من مسافات وشرطات، بينما يخلو السجل الثاني تماماً من الفواصل المنقوطة ويتضمن فقط فواصل لاتينية. تتجلى مرونة دالة TEXTSPLIT التكيفية في قدرتها على إدارة “الغياب الجزئي للمحددات” دون إلقاء أي نوع من أنواع رسائل الخطأ الحسابية.
عند تغذية الدالة بمصفوفة تحوي طيفاً واسعاً من المحددات المحتملة مثل {",", ";", "-", "/", "|"}، تقوم الخوارزمية باختبار توفر كل محدد داخل النص الحالي؛ وفي حال لم يُعثر على أحد الرموز، تتجاوزه الدالة تلقائياً وتواصل التفتيش عن بقية الرموز النشطة دون توقف دورة المعالجة. تتيح هذه القدرة للمحللين صياغة “مصفوفة فواصل جامعة” (Universal Delimiter Array) وتطبيقها بصورة موحدة عبر نطاق عمودي يضم آلاف السجلات غير المتجانسة، مطمئنين إلى أن الدالة ستتكيف آنياً مع التوزيع الطوبوغرافي للفواصل المتاحة في كل صف على حدة وبشكل آمن تماماً.
6. المقارنة المعيارية: TEXTSPLIT مقابل الأدوات والصيغ التقليدية
6.1 المقارنة مع أداة ‘النص إلى أعمدة’ (Text to Columns)
لطالما كانت أداة “النص إلى أعمدة” (Text to Columns) المدمجة ضمن شريط أدوات البيانات الحل التاريخي الأسهل لمستخدمي إكسل؛ غير أن التقييم المنهجي يبرز فوارق جوهرية تضعها في مرتبة أدنى من المعالجة البرمجية عبر دالة TEXTSPLIT. العيب الهيكلي الأكبر لأداة النص إلى أعمدة يكمن في كونها عملية جامدة وغير تفاعلية (Destructive and Static Process)؛ حيث تؤدي إلى تعديل مساحة ورقة العمل بشكل ثابت، ولا تعيد حساب النتائج في حال تم تعديل السجل المصدر أو إضافة بيانات جديدة، مما يفرض على المستخدم تكرار الخطوات اليدوية عند كل تحديث دوري للمصنف.
علاوة على ذلك، تعاني الأداة التقليدية من قيود صياغية حادة؛ إذ تسمح باختيار محددات تقليدية محدودة (مثل علامة الجدولة، والفاصلة، والمسافة)، مع توفير خانة واحدة يتيمة لمحدد مخصص (Other) لا يقبل سوى محرف واحد فقط، مما يجعلها عاجزة هيكلياً عن تفكيك السلاسل التي تتطلب عدة فواصل مخصصة في آن واحد. ويضاف إلى ذلك المخاطر الميدانية العالية للأداة في إمكانية قيامها بالكتابة الفوقية غير المقصودة (Accidental Overwriting) على بيانات الأعمدة المجاورة حال استطالة النصوص دون سابق إنذار، وهو ما يتلافاه نظام الأخطاء في المصفوفات الديناميكية كلياً.
6.2 المقارنة مع الصيغ المركبة التراثية (MID, SEARCH, SUBSTITUTE)
قبل الابتكار الخوارزمي لدالة TEXTSPLIT، كانت الطريقة الحسابية الوحيدة لتفكيك النصوص المتعددة الفواصل تعتمد على مسار استبدالي معقد من خلال دمج دوال التبديل المتداخلة SUBSTITUTE لتوحيد جميع المحددات المختلفة قسرياً وتحويلها إلى رمز فاصل قياسي واحد (مثل رمز الخط العمودي | أو علامة الهاشتاغ #)، يلي ذلك استدعاء خوارزميات الاقتطاع الرياضي المعقدة باستخدام دوال MID وSEARCH مضروبة في مصفوفات الأطوال، أو الاستعانة بدالة FILTERXML لتحويل النص إلى هيئة وسمية (XML Markup) وتجزئته.
توضح المعاينة التحليلية أن تلك الطرق التراثية تتسم بصعوبة إدراكية بالغة، وتتطلب مهارات صياغية متقدمة تجعل من عملية تتبع الأخطاء البرمجية (Debugging) ومراجعتها من قبل باحثين آخرين كابوساً تشغيلياً. كما أن تلك الصيغ تؤدي إلى استهلاك غير مبرر لموارد المعالجة عبر تكرار عمليات المسح والاستبدال داخل الذاكرة عدة مرات لكل محدد. بينما تتفوق TEXTSPLIT هندسياً بقدرتها على إنهاء هذه السلسلة في عملية تقييم واحدة مباشرة، مما يوفر شفافية توثيقية فائقة ويقلل من استهلاك الذاكرة بصورة ملحوظة.
6.3 الجدوى التشغيلية وكفاءة الأداء في مجموعات البيانات الكبيرة
في سياق البيانات الضخمة (Big Data Wrangling) التي تمتد لعشرات الآلاف من الصفوف داخل مصنفات إكسل، تصبح كفاءة الأداء ومؤشرات سرعة إعادة الحساب (Calculation Latency) عاملاً حاسماً في اختيار الحل البرمجي المناسب. خضعت دالة TEXTSPLIT لاختبارات معيارية لقياس سرعة التنفيذ مقارنة بالبدائل البرمجية، وأظهرت النتائج تفوقاً بنيوياً واضحاً لمحرك المصفوفات الديناميكية نظراً لبنائه الداخلي بلغة C++ عالية التحسين المدمجة في نواة إكسل.
بيد أن الاستخدام الموسع لمصفوفات الانسكاب عبر نطاقات مليونية قد يرفع من حجم ملف المصنف ويؤدي إلى عبء نسبي على المعالج نتيجة الحاجة إلى متابعة تبعيات الانسكاب المستمرة في شجرة الحسابات (Calculation Dependency Tree). وفي مثل هذه الحالات الحدية فائقة الضخامة، يوصى بالجمع بين كفاءة الدالة واستراتيجيات التجميد؛ حيث يتم تشغيل الدالة لاستخلاص العناصر، ومن ثم نسخ النتائج ولصقها كقيم ثابتة (Paste as Values) لقطع الارتباط الديناميكي وتفريغ الذاكرة للعمليات اللاحقة، أو التوجه مباشرة نحو محرك باور كويري كما سنفصل لاحقاً.
7. توظيف Power Query كحل بديل ومتقدم لتفكيك المحددات المتعددة
7.1 تفكيك الأعمدة باستخدام محددات متعددة في واجهة Power Query
يُمثل محرك “الحصول والتحويل” (Get & Transform) المعروف بمحرر باور كويري (Power Query) البيئة النموذجية الأرقى لإجراء معالجة البيانات النصية القابلة للتكرار والتدقيق العلمي (Reproducible Research). يستند باور كويري إلى فلسفة التدفق المرحلي للبيانات بطريقة غير إتلافية (Non-destructive pipeline)؛ حيث يتم استيراد البيانات من الجدول الأصلي وتطبيق سلسلة من التحويلات المسجلة دون المساس بمصدر البيانات الخام على الإطلاق.
من خلال واجهة المستخدم الرسومية لباور كويري، يتاح للمحلل استخدام أداة “تقسيم العمود” (Split Column) واختيار التقسيم استناداً إلى المحدد (By Delimiter). ورغم أن الواجهة الرسومية تركز افتراضياً على محدد أساسي واحد، إلا أنه يمكن للمحلل الاستفادة من الميزات المتقدمة بتكرار خطوة التقسيم لفواصل متعددة، أو توجيه المخرجات للتقسيم إلى صفوف رأسية ممتدة بدلاً من التوزيع العرضي للأعمدة، وهو ما يخدم تجهيز البيانات لعمليات النمذجة الإحصائية العلائقية وربط الجداول لاحقاً بمجرد النقر على زر التحديث المجدول.
7.2 صياغة دوال بلغة M للتعامل مع قوائم المحددات الديناميكية
تتجلى القوة المطلقة لمحرك باور كويري عند الانتقال من الواجهة البصرية إلى مستوى البرمجة الصريحة باستخدام لغة الاستعلامات إم (M Language). توفر هذه اللغة دوال نصية متخصصة ومصممة هندسياً للتعامل الفوري مع مصفوفات وقوائم المحددات المتعددة، وأبرز هذه الدوال هي دالة التجزئة المتقدمة Text.SplitAny.
تأخذ الدالة صيغة إجرائية مباشرة: Text.SplitAny(text as nullable text, separators as text) as list. على النقيض من دوال أوراق العمل، تُمرر المحددات في هذه الدالة ضمن سلسلة نصية واحدة متصلة تجمع كافة الرموز المطلوبة؛ فإذا أردنا تقسيم حقل [RawResponses] بناءً على الفواصل والشرطات والنقاط، يُصاغ الكود داخل محرر المتقدم على النحو التالي:
Text.SplitAny([RawResponses], ",;_-/| ")
يُنتج هذا الاستدعاء عموداً يحوي قوائم برمجية (Lists) تتضمن الكلمات المفككة، والتي يمكن للمحلل بعد ذلك توسيعها (Expand) إلى صفوف أو أعمدة بمرونة متناهية، فضلاً عن إمكانية كتابة خوارزميات مخصصة تستخدم الدالة List.Select لتنقية القوائم الناتجة تلقائياً من القيم الصفرية والخلايا الفارغة وفق معايير برمجية صارمة وموثقة بالكامل.
7.3 المفاضلة بين استخدام الدوال الرياضية واستعلامات Power Query
تخضع المفاضلة بين استخدام دالة ورقة العمل TEXTSPLIT والحلول المعتمدة على محرك Power Query لعدة معايير تشغيلية ومنهجية يمكن إجمالها في الجدول المفهومي التالي:
- زمن الاستجابة والتحديث: تتفوق دالة
TEXTSPLITبالحساب الفوري اللحظي؛ فأي تعديل في قيمة الخلية المصدر ينعكس في نفس الثانية على مصفوفة النتائج. بينما يتطلب باور كويري إصدار أمر “تحديث” (Refresh) يدوي أو مجدول لإعادة سحب ومعالجة البيانات. - منهجية العمل والتوثيق الأكاديمي: يتفوق باور كويري في الامتثال لمعايير العلم المفتوح (Open Science)؛ حيث يتم توثيق كل خطوة معالجة ككود برمجي تتابعي قابل للمراجعة والتدقيق النظير، مما يمنع التلاعب غير المقصود بالبيانات ويسهل مشاركة نموذج المعالجة مع باحثين آخرين.
- حجم ونطاق البيانات: تُعد
TEXTSPLITمثالية للبيانات المتوسطة والنماذج التفاعلية السريعة داخل المصنف، بينما يعد باور كويري الخيار الإلزامي عند التعامل مع ملايين السجلات المستوردة من مصادر خارجية متعددة لمنع انهيار موارد الذاكرة المخصصة لواجهة إكسل.
8. إدارة الأخطاء والحالات الحدية الناتجة عن عمليات التقسيم
8.1 تشخيص ومعالجة خطأ الانسكاب الشهير (#SPILL!)
يُعد خطأ الانسكاب المرموز له برمز #SPILL! الظاهرة الأكثر اقتراناً بالمصفوفات الديناميكية في إكسل. ينشأ هذا الخطأ عندما تحاول خوارزمية الدالة كتابة مصفوفة النتائج المنسكبة عبر النطاق المكاني المطلوب، فتصطدم بوجود عائق مادي يمنعها من استكمال التدفق الأفقي أو العمودي. وتتنوع الأسباب الجذرية لهذا العائق:
- وجود بيانات نصية أو رقمية سابقة في إحدى الخلايا الواقعة ضمن مسار الانسكاب المستهدف.
- وجود خلايا مدمجة (Merged Cells) تتقاطع مع نطاق الانسكاب، وهو ما يتعارض تماماً مع قواعد هيكلة المصفوفات المتصلة.
- امتداد السلسلة المفككة إلى حدود ورقة العمل النهائية (العمود XFD أو الصف 1,048,576)، مما يؤدي لفيضان المصفوفة خارج الحيز الفيزيائي للمصنف.
تتطلب الإدارة المنهجية لهذا الخطأ النقر على أيقونة التنبيه الذكية المصاحبة للخلية، واختيار “تحديد الخلايا المعيقة” (Select Obstructing Cells)، ثم تطهير ذلك النطاق بمسح المحتويات أو إلغاء دمج الخلايا. ولتفادي وقوع الخطأ برموز استباقية، يمكن تقييد حجم المصفوفة المنسكبة باستخدام دوال الاقتطاع المصفوفي الحديثة مثل دالة TAKE أو CHOOSEROWS لضمان عدم تجاوز النتائج للحدود الهندسية الآمنة لورقة العمل.
8.2 التعامل مع خطأ القيمة المفقودة (#N/A) وتوظيف المعامل pad_with
يبرز خطأ القيمة المفقودة #N/A بصفة خاصة عند استخدام دالة TEXTSPLIT في التقسيم ثنائي الأبعاد المتزامن (2D Splitting)؛ أي عند تعيين محددات للأعمدة col_delimiter ومحددات أخرى للصفوف row_delimiter في نفس الصيغة. في هذه الحالة المعقدة، تقوم الدالة بإنشاء جدول ثنائي الأبعاد، ولكن نظراً لعدم التساوي الرياضي الحتمي بين عدد العناصر في كل مقطع نصي، تتبقى فجوات في أطراف المصفوفة الهيكلية تُترجم برمجياً إلى أخطاء #N/A لعدم وجود بيانات مقابلة تسد هذا البعد.
للتغلب الأنيق على هذا القصور الشكلي، توفر الدالة المعامل السادس pad_with. يتيح هذا المعامل تحديد قيمة بديلة يتم إسقاطها تلقائياً في كافة الخلايا الشاغرة التي لا تحتوي على بيانات فعلية داخل مصفوفة التقسيم. يمكن تعيين نص صريح مثل "غير متوفر" أو فراغ نصي "" أو الرمز المرجعي "-":
=TEXTSPLIT(A2, ",", ";", TRUE, , "")
كما يمكن تعزيز استقرار التقارير التحليلية بتطويق الصيغة بأكملها بدوال التحقق الشرطي من الأخطاء مثل IFNA أو IFERROR، مما يضمن عرض الجداول المنسكبة بمظهر احترافي رصين وخالٍ من رموز الأخطاء النظامية الحادة.
8.3 الحالات الحدية للنصوص الفارغة والمحتويات التي تفتقر للمحددات
تتضمن الحالات الحدية (Edge Cases) التي تختبر صلابة الصيغ التحليلية مواجهة خلايا فارغة تماماً (Empty Cells) أو نصوص مفردة مصمتة لا تحتوي على أي من المحددات المعرفة في مصفوفة الإدخال. في الحالة الأولى، إذا تم تمرير مرجع لخلية فارغة تماماً، فإن الدالة سترجع خطأ #VALUE!، نظراً لأن خوارزمية التفتيش تتطلب وجود سلسلة نصية ذات طول محرفي موجب لمعالجتها.
أما في الحالة الثانية، فعند تمرير نص مصمت مثل "StandaloneText" إلى الدالة المجهزة بمحددات مثل {",", ";"}، فلن تتوقف الدالة ولن تصدر خطأ، بل ستتصرف بمنطق رياضي سليم؛ حيث تُرجع السلسلة النصية ذاتها كاملة داخل خلية الإسناد دون أي انسكاب جانبي، معتبرة أن النص يمثل مقطعاً أحادياً كاملاً لم يواجه أي نقطة انقطاع.
لتحصين الصيغ الرياضية في المصنفات الإنتاجية ضد مخاطر الخلايا الفارغة، يتم بناء صيغ دفاعية تعتمد على فحص الطول المحرفي المسبق باستخدام الدالة LEN أو التحقق المنطقي بواسطة IF:
=IF(OR(ISBLANK(A2), A2=""), "", TEXTSPLIT(A2, {",", ";", "-"}))
تكفل هذه الصياغة الوقائية الحفاظ على انسيابية حسابات الورقة ومنع انسكاب رسائل الخطأ غير المرغوبة عبر صفوف التحليل عند مصادفة مدخلات ناقصة.
9. دراسات حالة وتطبيقات عملية في تحليل البيانات الواقعية
9.1 تفكيك السجلات الببليوغرافية وبيانات الاقتباسات المرجعية
تعتمد الأبحاث الببليومترية وتحليلات الإنتاج العلمي على معالجة قواعد بيانات الاقتباسات الواردة من منصات مثل Scopus أو Web of Science. تأتي هذه البيانات في الغالب ضمن سجلات نصية طويلة ومدمجة بصيغة ترقيمية مركبة تشمل أسماء المؤلفين، تليها سنة النشر بين قوسين، ثم عنوان البحث مفصولاً بنقطة، يعقبه اسم الدورية ورقم المجلد والصفحات مفصولة بنقاط وفواصل وأقواس، كالمثال التالي: "Smith, J.; Doe, A. (2021). Cognitive Load Theory. Journal of Educational Psychology, 113(2), 245-258.".
لتفكيك هذا السجل الببليوغرافي متعدد الطبقات إلى مكوناته الأساسية داخل مصنف إكسل، نحدد مصفوفة الفواصل المعقدة التي تفصل بين المتغيرات الفرعية:
=TRIM(TEXTSPLIT(A2, {";", "(", ")", ".", ","}, , TRUE))
تؤدي هذه الصيغة إلى عزل كل مؤلف، واستخراج السنة التقويمية كمتغير زمني مستقل، وعزل عنوان الدراسة عن المجلد والصفحات، مما يمكن الباحث من إنشاء جداول وصفية منظمة تُخضع المتغيرات لتحليلات الارتباط الزمني، ومعدلات النشر السنوي، وشبكات التعاون البحثي بيسر تام ودون الحاجة لشراء برمجيات ببليوغرافية تخصصية باهظة الثمن.
9.2 معالجة مخرجات الاستبيانات متعددة الاستجابات ذات المدخلات الحرة
في استطلاعات الرأي والمسوح الميدانية السلوكية، تتضمن أدوات القياس أسئلة ذات نهايات مفتوحة تسمح للمشارك باختيار عدة إجابات أو كتابة خيارات مخصصة بصياغة حرة. تصدر منصات الاستبيان هذه الإجابات في حقل موحد يجمع خيارات المفحوص مفصولة بأساليب إدخال عشوائية؛ فقد يكتب المستجيب: "الخيار الأول، الخيار الثاني؛ الخيار الثالث - الخيار الرابع" مستخدماً تنويعات من الفواصل اللاتينية، والفواصل العربية (،)، والشرطات، والمسافات البيضاء.
تتم معالجة هذه التوليفة النصية المضطربة من خلال استدعاء مصفوفة محددات ثنائية اللغة تتطابق مع البيئة الميدانية:
=TEXTSPLIT(A2, {"،", ",", ";", "-", "؛"}, , TRUE)
علاوة على ذلك، ولتحويل البيانات من شكلها الأفقي المنسكب إلى عمود رأسي يسهل إدخاله في جداول التوزيع التكراري المحورية (Pivot Tables)، يمكن دمج الدالة TOCOL مع دالة التقسيم، مما يرتب كافة خيارات المستجيبين رأسياً في عمود موحد يتيح إجراء اختبارات الدلالة الإحصائية وحساب نسب الاستجابة بصورة فورية وموثوقة.
9.3 تنظيف وفهرسة بيانات الاتصال والعناوين الجغرافية المشتركة
تواجه أقسام إدارة العمليات وقواعد بيانات العملاء التسويقية إشكالية الحقول المشتركة للعناوين الجغرافية؛ حيث يُسجل العنوان في سطر واحد يحتوي على اسم الشارع، والحي، والمدينة، والرمز البريدي، ورقم الهاتف، مفصولة بشرطات مائلة وفواصل ونقاط، مثل: "شارع الملك فهد / حي العليا, الرياض - 12214 | هاتف: 0112345678".
يتطلب تنظيف وفهرسة هذا السجل لعزل المدينة والرمز البريدي وأرقام الاتصال تطبيق خوارزمية تفكيك تعتمد على محددات الأقسام الرئيسية:
=TRIM(TEXTSPLIT(A2, {"/", ",", "-", "|", "هاتف:"}, , TRUE))
ينتج عن هذه الصيغة توزيع هندسي منتظم لمكونات العنوان عبر خمسة أعمدة مستقلة تمثل الكيانات الجغرافية والاتصالية الدقيقة. يتيح هذا التفكيك للمؤسسات تصحيح السجلات المعيبة، وتطبيق خوارزميات التدقيق الجغرافي (Geocoding)، وحساب التكاليف اللوجستية لكل منطقة بدقة استناداً إلى الحقول المفككة والمطهرة بشكل آلي كامل.
10. أفضل الممارسات المنهجية وتحسين كفاءة المصنفات النصية
10.1 توثيق الصيغ الرياضية واستخدام الأسماء المعرفة (Defined Names)
تقتضي المعايير المنهجية في إدارة مشاريع تحليل البيانات المؤسسية تجنب استخدام “الأرقام والقيم السحرية المجهولة” (Magic Values) المضمنة عشوائياً داخل الصيغ الرياضية. ينطبق هذا المبدأ بصرامة على مصفوفات المحددات في إكسل؛ إذ إن تكرار كتابة مصفوفة معقدة مثل {",", ";", "-", "/", "|"} عبر مئات الخلايا في مصنف ضخم يرفع من مخاطر التباين الكتابي ويجعل من تعديل المحددات في المستقبل مهمة إدارية معقدة ومحفوفة بالخطأ.
الممارسة الفضلى تتمثل في استخدام ميزة “إدارة الأسماء” (Name Manager) في إكسل لتعريف اسم نطاق ثابت، مثل GlobalDelimiters، وإسناد مصفوفة الثوابت إليه في حقل المرجع. وبمجرد إنشاء هذا الاسم المعرف، يمكن صياغة الدالة بأسلوب هندسي نظيف وموثق ذاتياً:
=TEXTSPLIT(A2, GlobalDelimiters, , TRUE)
يُسهم هذا التجريد البنائي في توحيد معايير المعالجة النصية عبر كافة أوراق العمل في المصنف، وتوفير نقطة صيانة مركزية واحدة؛ بحيث يكفي تعديل مصفوفة الرموز داخل إدارة الأسماء لتتحدث على الفور كافة الصيغ المرتبطة بها في كامل المشروع، مما يعزز من قابلية المراجعة والتدقيق الإجرائي.
10.2 استخدام جداول إكسل الرسمية (Excel Tables) والتنسيق المنظم
يوفر تحويل النطاقات العادية إلى “جداول إكسل الرسمية” (ListObjects / Excel Tables) عبر الاختصار Ctrl + T ميزات هيكلية فائقة تشمل العنونة المنظمة التلقائية (Structured References) والتوسيع الذاتي للبيانات عند إضافة صفوف جديدة. ومع ذلك، يجب على المحلل أن يكون على دراية كاملة بالتحدي التقني الجوهري القائم بين معمارية جداول إكسل وسلوك المصفوفات الديناميكية؛ إذ تمنع مايكروسوفت مصفوفات الانسكاب من العمل داخل حدود الجداول الرسمية تجنباً للتعارض مع خصائص التمدد التلقائي لأعمدة الجدول، مما يؤدي لظهور خطأ الانسكاب حال كتابة TEXTSPLIT داخل خلية تابعة لجدول رسمي.
تتمثل الممارسة الهندسية المثلى لتجاوز هذا القيد الهيكلي في الحفاظ على جدول البيانات المصدرية كجدول رسمي، بينما تُصاغ دوال التقسيم المنسكبة في ورقة عمل موازية أو في نطاق حر خارج حدود الجدول، مع الإشارة إلى حقول الجدول بالاسم الهيكلي المباشر:
=TEXTSPLIT(Table1[@RawData], GlobalDelimiters, , TRUE)
يضمن هذا النموذج الهجين الاستفادة الكاملة من أمان واستقرار الجداول المنظمة من جهة، والتمتع بالمرونة الانسيابية للمصفوفات الديناميكية دون مواجهة قيود المنصة الهيكلية من جهة أخرى.
10.3 التوافقية بين إصدارات إكسل المختلفة وخيارات التصدير
تمثل “التوافقية العكسية” (Backward Compatibility) التحدي الأكبر عند بناء نماذج العمل المشتركة بين المؤسسات؛ فبينما يتمتع مستخدمو اشتراكات مايكروسوفت 365 (Microsoft 365) وإصدارات Excel 2024 ونسخ الويب السحابية بالدعم الكامل لدالة TEXTSPLIT، فإن فتح المصنف نفسه على إصدارات أقدم مثل Excel 2016 أو Excel 2019 سيؤدي إلى فشل الصيغ فورياً وظهور خطأ المرجع المجهول المرموز له برمز #NAME?، لعدم تعرف محرك الإصدار القديم على الشفرة المصدرية للدالة.
لضمان استمرارية الأعمال والمحافظة على سلامة البيانات المشتركة بين فرق العمل ذات البنى التحتية البرمجية المتباينة، يتعين على المحلل اتخاذ خطوات تأمينية منهجية، تتلخص في النقاط التالية:
- التحقق المسبق من البيئة التشغيلية لدى الأطراف المستفيدة من التقرير قبل اعتماد دوال المصفوفات الحديثة.
- بناء نماذج تحويل بديلة باستخدام باور كويري في الحالات التي تتطلب دعماً للإصدارات الأقدم؛ حيث يتمتع محرك باور كويري بتوافقية كاملة مع إصدارات إكسل ابتداءً من عام 2016 وما يليه.
- عند الانتهاء من المعالجة وقبل تسليم التقارير النهائية للمستويات الإدارية أو جهات النشر الأكاديمي، يجب تحويل مخرجات المصفوفات المنسكبة إلى بيانات ثابتة عبر خيار “نسخ ولصق كقيم” (Paste Values)، مما يجمد المصفوفات الحسابية ويمنع تعطل التقرير بصورة تامة بغض النظر عن منصة أو إصدار برنامج إكسل المستخدم في العرض.
خاتمة شاملة
تناول هذا المقال الأكاديمي الموسع الأبعاد النظرية والتطبيقية المتقدمة لتقسيم السلاسل النصية المعقدة استناداً إلى فواصل متعددة داخل برمجية مايكروسوفت إكسل. وخلصت دراستنا إلى أن التحول التاريخي من دوال الاقتطاع التراثية إلى بيئة المصفوفات الديناميكية ممثلة في دالة TEXTSPLIT لا يمثل مجرد تحديث تقني عابر، بل يعكس نقلة نوعية في فلسفة إدارة وتحوير البيانات غير المهيكلة، محولاً عمليات التنظيف المنهجية المرهقة إلى مسارات خوارزمية رشيقة وعالية الكفاءة.
إن استيعاب الخصائص الهندسية المتقدمة للدالة، ولا سيما القدرة على تمرير مصفوفات الثوابت للمحددات {}، والتحكم في استبعاد الفراغات عبر المعامل ignore_empty، وإدارة حساسية حالة الأحرف بواسطة match_mode، يُمكّن الباحثين ومحللي الأعمال من معالجة أعتى البيانات اللغوية والببليوغرافية والسلوكية الملوثة بدقة متناهية. ومع استمرار تكامل هذه الدوال مع محركات التحويل العملاقة كباور كويري، تصبح برمجية إكسل منصة متكاملة لهندسة البيانات قادرة على منافسة لغات البرمجة الإحصائية المتقدمة في معالجة وتحليل البيانات الأولية بدقة وموثوقية عالية.
المراجع
- Microsoft Support. (2022). TEXTSPLIT function. Microsoft Learn. https://support.microsoft.com/en-us/office/textsplit-function-b144174d-a7b5-4f4f-89eb-3833b194aafd
- Microsoft Support. (2020). Dynamic array formulas and spilled array behavior. Microsoft Learn. https://support.microsoft.com/en-us/office/dynamic-array-formulas-and-spilled-array-behavior-205c6b06-03ba-4151-8ab0-a1849348eedb
- Microsoft Support. (2022). Text.SplitAny – Power Query M. Microsoft Learn. https://learn.microsoft.com/en-us/powerquery-m/text-splitany
- Walkenbach, J. (2015). Excel 2016 Bible. John Wiley & Sons.
- Alexander, M., Kusleika, R., & Walkenbach, J. (2019). Excel Dashboards and Reports (2nd ed.). John Wiley & Sons.