
تمثل البيانات النصية غير المهيكلة والتصنيفات الوصفية تحدياً جوهرياً أمام المحللين والباحثين في بيئات العمل الإحصائية والمصرفية والأكاديمية، حيث تتطلب النماذج الرياضية وأدوات اتخاذ القرار المتقدمة في برنامج مايكروسوفت إكسل (Microsoft Excel) تحويل الكلمات والمصطلحات إلى قيم كمية دقيقة قابلة للمعالجة الجبرية والمنطقية. إن عملية تحويل النصوص إلى أرقام، أو ما يعرف بالترميز الرقمي للبيانات، ليست مجرد استبدال رمزي سطحي، بل هي إجراء منهجي يقوم على أسس نظرية القياس الإحصائي، ويهدف إلى تمكين محركات الحساب الآلي من استيعاب المتغيرات وتصنيفها وإخضاعها للاختبارات التحليلية المتقدمة.
يتناول هذا الدليل الشامل والمفصل آليات وتقنيات تعيين القيم الرقمية للسلاسل النصية داخل مصنفات إكسل، متدرجاً من المبادئ البنيوية للبرنامج إلى أحدث الدوال المنطقية والمرجعية وأدوات استخراج وتحويل البيانات الضخمة (ETL). سنستعرض بعمق كيفية توظيف الدوال الحديثة مثل SWITCH وXLOOKUP، والبدائل الكلاسيكية مثل IF المتداخلة وثنائية INDEX وMATCH، وصولاً إلى الأتمتة المتقدمة عبر بيئة Power Query وتطبيقات القياس السلوكي وفق مقاييس ليكرت، مع التركيز على تجنب الأخطاء الشائعة وضمان نظافة واتساق المصفوفات الحسابية.
يهدف هذا الطرح الأكاديمي الرصين إلى تزويد الباحثين ومحللي البيانات والمهنيين بالمهارات المنهجية اللازمة لبناء نماذج بيانات متينة وقابلة للتوسع والصيانة، مما يحول جداول البيانات من مجرد سجلات نصية جامدة إلى قواعد معلومات ديناميكية عالية الكفاءة تدعم استخراج المؤشرات، والنمذجة التنبؤية، والتحليل الإحصائي متناهي الدقة.
1. مقدمة منهجية لتحويل النصوص إلى قيم رقمية في إكسل
1.1 الأهمية الإحصائية والتحليلية للترميز الرقمي للنصوص
يشكل الترميز الرقمي للمتغيرات النصية والوصفية الركيزة الأساسية لأي تحليل كمي رصين. إن البيانات الوصفية، مثل استجابات الاستبيانات أو التقييمات النوعية للأداء أو التصنيفات الجغرافية، تحمل دلالات مفهومية للمستخدم البشري، لكنها تظل بمثابة عناصر عشوائية ومستعصية على المعالجة الرياضية المباشرة بالنسبة لمعالجات الحواسيب. ومن خلال إسناد قيم عددية محددة لكل فئة نصية، يستطيع الباحث تحويل المتغيرات الاسمية والرتبية إلى مصفوفات قابلة للتحليل الإحصائي، مما يسمح بحساب المعلمات الوصفية وتطبيق الاختبارات الاستدلالية المعقدة.
يسهم هذا التحويل في تمكين المحلل من تنفيذ خوارزميات إحصائية متطورة لا يمكن إجراؤها على الكلمات، ومن أبرزها تحليل الانحدار الخطي واللوجستي، واختبارات التباين، وقياس الارتباط، وتحديد المتوسطات الحسابية والانحرافات المعيارية التي تصف تشتت البيانات حول مراكزها. فضلاً عن ذلك، يؤدي استبدال السلاسل النصية الطويلة والمتكررة بمعرفات رقمية موجزة إلى تحسين ملحوظ في أداء مصنفات العمل، حيث يقل استهلاك ذاكرة الوصول العشوائي (RAM) وتتقلص المساحة التخزينية للملف، مما يرفع سرعة إعادة الحساب في الجداول الكبيرة التي تتضمن مئات الآلاف من السجلات.
علاوة على ذلك، يرسخ الترميز الرقمي معايير موحدة للقياس والتصنيف داخل المنظمات؛ فعندما تستخدم قواعد البيانات المتعددة رموزاً عددية موحدة للدلالة على نفس المفاهيم الوصفية، تختفي التناقضات الناجمة عن الاختلافات اللغوية أو الأخطاء الإملائية. ويشكل هذا التوحيد ركيزة لتكامل البيانات بين الأنظمة المختلفة (Interoperability)، ويدعم بناء مستودعات البيانات المؤسسية ذات الموثوقية العالية.
1.2 الفرق البنيوي بين السلاسل النصية والأرقام الحسابية في إكسل
يتعامل محرك الحساب الداخلي في إكسل مع البيانات بناءً على تصنيف نوعي صارم يفصل بين النصوص (Text Strings) والأرقام (Numeric Values). افتراضياً، يتعرف البرنامج على النصوص بوصفها سلاسل محارف متتالية مخصصة للعرض البصري فقط، ويقوم بمحاذاتها تلقائياً إلى الجانب الأيسر من الخلية (في الواجهات اللاتينية) أو الجانب الأيمن (في بعض إعدادات الواجهات المعربة عند استخدام اتجاه النص من اليمين لليسار)، في حين يعامل الأرقام كقيم كمية عائمة أو صحيحة يحاذيها إلى اليمين افتراضياً، ويمنحها قابلية الخضوع للعمليات الجبرية الأساسية والمنطقية المعقدة.
تتمتع القيم الرقمية بخصائص تركيبية تسمح بتطبيق تنسيقات الخلايا المختلفة دون المساس بالقيمة الجوهرية المخزنة؛ حيث يمكن إظهار الرقم كنسبة مئوية، أو عملة مالية، أو تاريخ زمني محدد، في حين تعجز النصوص عن استقبال هذه التنسيقات بشكل ديناميكي. تكمن الإشكالية الكبرى في سيناريوهات “الأرقام المخزنة كنصوص”، والتي تحدث كثيراً عند تصدير البيانات من أنظمة إدارة الموارد (ERP)، إذ تظهر القيمة في صورة رقم مثل “100” لكنها تعامل كنص، مما يؤدي إلى تجاهلها التام في دوال التجميع مثل SUM وAVERAGE، فتنتج مخرجات مضللة قد تقود إلى قرارات إدارية خاطئة تماماً.
إن فهم هذا التمايز البنيوي يفرض على المصمم التأكد من أن المخرجات الناتجة عن دوال التعيين الرياضي تمثل قيماً عددية حقيقية وليست مجرد نصوص رقمية محاطة بعلامات تنصيص. فالرمز “5” المكتوب بين علامتي تنصيص في صيغة شرطية لن يتم التعامل معه كرقم 5، ولن يساهم في العمليات التراكمية، مما يبرز أهمية بناء الدوال بصياغة رياضية صحيحة تضمن تصدير أرقام خالصة.
1.3 متطلبات إعداد مصفوفات البيانات قبل تطبيق معادلات التعيين
تتطلب كفاءة النمذجة الرياضية داخل إكسل تنظيفاً مسبقاً لمصفوفة البيانات النصية قبل الشروع في كتابة معادلات التحويل. يرجع ذلك إلى أن دوال المقارنة والبحث المرجعي تتسم بالدقة الحرفية، فأي اختلاف غير مرئي بين النص المدخل والنص المرجعي يؤدي فوراً إلى فشل عملية التعيين وظهور قيم الخطأ. تشمل العيوب الشائعة وجود مسافات بادئة أو لاحقة، أو تكرار المسافات بين الكلمات، مما يجعل إكسل ينظر إلى نص “موافق ” بوصفه كياناً مختلفاً كلياً عن “موافق”.
تتطلب مرحلة الإعداد أيضاً توحيد الصياغة الإملائية للمصطلحات؛ حيث تؤدي الفروق الطفيفة مثل استخدام الهمزات (أ، إ، ا) أو الياء المهملة والألف المقصورة (ي، ى) والتاء المربوطة والهاء (ة، هـ) إلى تشتت الفئة الواحدة عبر عدة فئات وهمية. يستوجب ذلك توظيف أدوات البحث والاستبدال الموحدة لضمان التطابق التام، بالإضافة إلى تدقيق السجلات والتخلص من الأحرف غير القابلة للطباعة التي تنشأ عادةً عند نسخ البيانات من صفحات الويب أو ملفات PDF.
من الناحية المنهجية، ينبغي للباحث الاستناد إلى مستويات القياس التي وضعها عالم النفس ستانلي سميث ستيفنز (Stanley Smith Stevens, 1946) في ورقته التأسيسية الشهيرة، والتي صنف فيها القياس إلى أربعة مستويات: الاسمي (Nominal)، والرتبي (Ordinal)، والفئوي (Interval)، والنسبي (Ratio). يحدد هذا التأصيل نوع المقياس الواجب اعتماده؛ فالترميز الاسمي، كما في تحويل أسماء المدن إلى أرقام، يعد تصنيفاً تحكمياً لا ينطوي على مفاضلة، في حين يتطلب الترميز الرتبي، مثل درجات الرضا الوظيفي، الحفاظ الصارم على التدرج المنطقي للأرقام ليعكس الأسبقية والترتيب بين الفئات النصية المختلفة.
2. استخدام دالة SWITCH كأداة رئيسية لتعيين الأرقام للنصوص
2.1 البنية التركيبية والصياغة البرمجية لدالة SWITCH
تمثل دالة SWITCH واحدة من أهم الإضافات البنيوية التي قدمتها شركة مايكروسوفت لتحديث محرك إكسل، حيث صُممت خصيصاً لاختبار تعبير منطقي واحد ومقارنته بقائمة متتالية من القيم المحددة، ثم إرجاع النتيجة المقابلة لأول تطابق يتم تحقيقه. تنهي هذه الدالة التعقيد الإنشائي المرتبط بفتح وإغلاق الأقواس اللانهائية في الصيغ القديمة، وتتيح صياغة برمجية بالغة النقاء تشبه جمل switch-case في لغات البرمجة العالية المستوى.
تتخذ الدالة صيغتها الرياضية القياسية على النحو التالي:
=SWITCH(expression, value1, result1, [value2, result2], ..., [default])
حيث يمثل الوسيط الأول (Expression) القيمة أو الخلية المستهدفة بالفحص، تليه أزواج متتابعة تتألف من القيمة النصية المراد مطابقتها (Value) والقيمة الرقمية المقابلة التي يجب إرجاعها (Result). وتتميز الدالة بقدرتها على استيعاب وسيط أخير اختياري يمثل القيمة الافتراضية (Default)، والتي يعتمدها البرنامج تلقائياً في حال فشل العثور على أي تطابق نصي مع القيم المسرودة، مما يمنع ظهور رسائل الأخطاء غير المحبذة.
2.2 تطبيق عملي: تعيين معرفات رقمية لفروع ومتاجر محددة
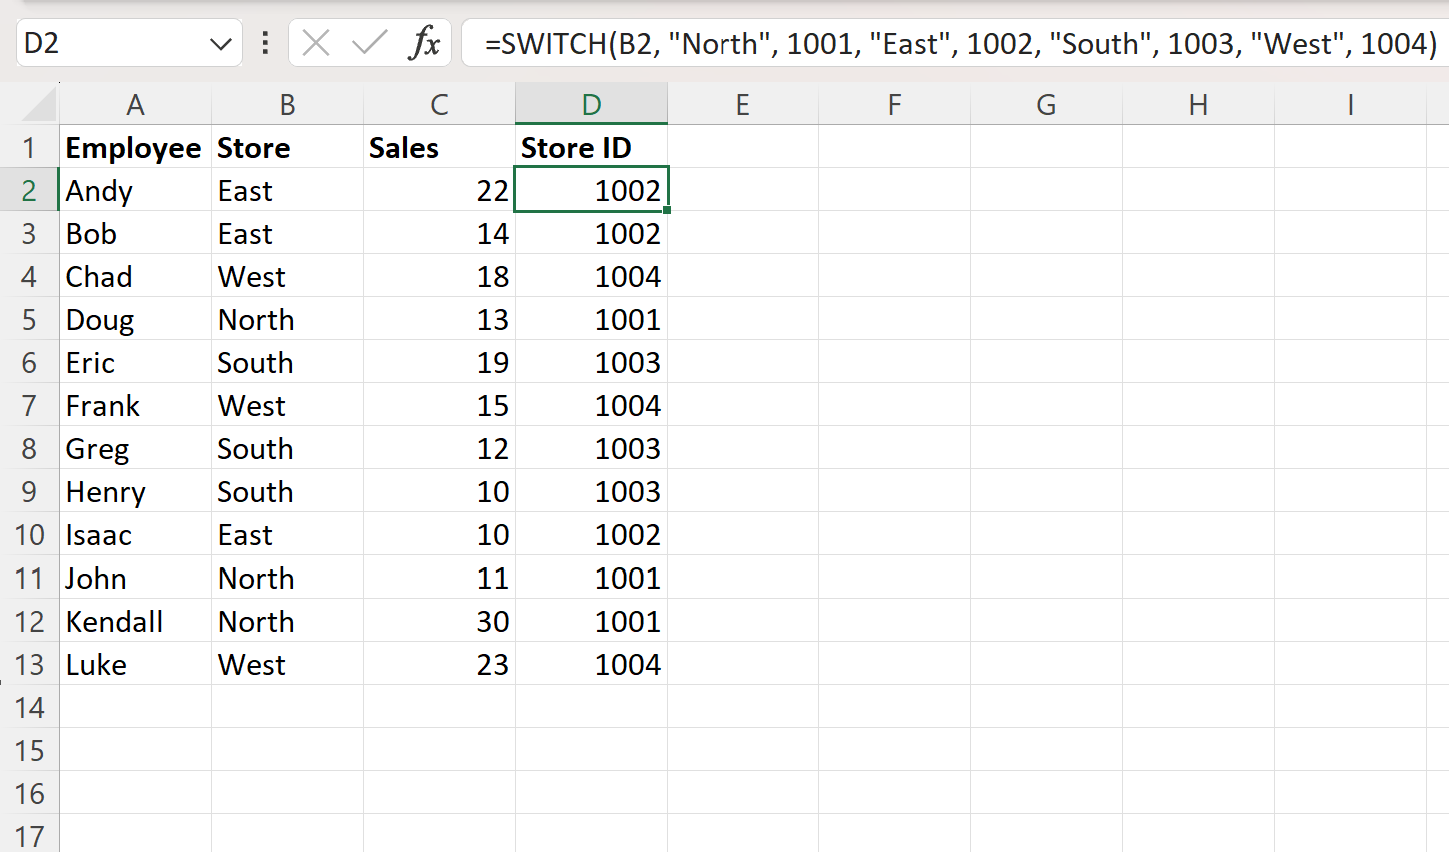
لتطبيق هذه المنهجية عملياً، نفترض وجود جدول بيانات مبيعات يتضمن عموداً للفروع الجغرافية للشركة، ويُراد تحويل أسماء الفروع إلى أكواد تشغيلية رقمية لتسهيل الربط بنظام المحاسبة المركزي. إذا كانت الفروع النصية موزعة بين “فرع الرياض”، “فرع جدة”، “فرع الدمام”، و”فرع مكة”، فيمكن صياغة الدالة في الخلية المقابلة للخلية A2 على النحو التالي:
=SWITCH(A2, "فرع الرياض", 101, "فرع جدة", 102, "فرع الدمام", 103, "فرع مكة", 104, 999)
في هذا التطبيق، تفحص الخلية A2؛ فإذا كان النص هو “فرع الرياض”، تعيد الدالة فوراً الرقم 101، وإذا كان “فرع جدة” تعيد 102، وهكذا وصولاً إلى القيمة 999 التي تخصص كمعرف افتراضي لأي إدخال نصي آخر غير مدرج أو غير متوقع. وبمجرد سحب مقبض التعبئة التلقائية (AutoFill) إلى أسفل العمود، يتم تعميم هذا المنطق بسرعة متناهية على آلاف الصفوف، مع ميزة التحديث الديناميكي الفوري؛ حيث يتبدل المعرف الرقمي آنياً بمجرد تعديل اسم الفرع في الخلية الأصلية دون الحاجة إلى إعادة بناء المعادلة.
2.3 مزايا واعتبارات استخدام دالة SWITCH مقارنة بالبدائل الأخرى
تتمثل الميزة التنافسية الكبرى لدالة SWITCH في مقروئيتها العالية وتنسيقها البصري المريح للمدققين ومطوري النماذج المالية؛ إذ يمكن للمحلل استعراض كافة الفئات النصية ونتائجها العددية في سطر برمجي واحد متصل، مما يقلل من احتمالات ارتكاب أخطاء الأقواس الشائعة. كما تتفوق الدالة في كفاءة المعالجة اللحظية؛ نظراً لأن محرك إكسل يقيّم الخلية المستهدفة مرة واحدة فقط في بداية التنفيذ بدلاً من تكرار تقييمها عند كل شرط كما في الدوال التقليدية، مما يوفر جزءاً من دورات المعالج المركزي عند التعامل مع مصفوفات ضخمة.
ومع ذلك، ينبغي مراعاة بعض القيود التقنية الهامة عند الاعتماد على هذه الدالة؛ إذ تقتصر SWITCH حصرياً على مطابقة التطابق التام لقيمة ثابتة، ولا تتيح استخدام المعاملات المنطقية المركبة مثل (أكبر من، أصغر من، أو النطاقات المركبة) داخل أزواج الاختبار بسهولة دون التحايل المنطقي على الوسيط الأول. علاوة على ذلك، تدعم الدالة ما يصل إلى 126 زوجاً من القيم والنتائج، وهو ما يكفي لأغلب التطبيقات الإدارية، إلا أنه قد يمثل عائقاً في حال وجود تصنيفات نصية تتجاوز هذا العدد الكبير، مما يوجب حينها اللجوء إلى جداول البحث المرجعي المنفصلة.
3. الدوال الشرطية المتداخلة IF كبديل كلاسيكي للترميز الرقمي
3.1 المنطق البنائي للشروط المتعددة باستخدام IF المتداخلة
تعد دالة IF المتداخلة (Nested IF) الأسلوب التقليدي والأكثر انتشاراً عبر تاريخ برمجيات الجداول الإلكترونية لمعالجة الشروط المتعددة وتعيين القيم الرقمية للنصوص. يقوم المنطق البنائي لهذا النهج على التفرع الثنائي المتعاقب (Binary Tree Logic)؛ حيث يتم اختبار صحة وجود النص الأول، فإن تحقق الشرط تُعاد القيمة الرقمية المحددة ويتوقف التنفيذ، وإن لم يتحقق، ينتقل إكسل إلى تقييم دالة IF التالية المضمنة في وسيط القيمة في حال الخطأ (value_if_false)، وتتكرر هذه السلسلة وصولاً إلى الاحتمال الأخير.
لبناء صيغة تعيين رقمية استناداً إلى هذا المنطق لتحويل فئات التقييم النصي (“ممتاز”، “جيد جداً”، “مقبول”) إلى أوزان نسبية (3، 2، 1)، تُكتب المعادلة وفق التسلسل الصارم الآتي:
=IF(A2="ممتاز", 3, IF(A2="جيد جداً", 2, IF(A2="مقبول", 1, 0)))
يتطلب هذا الهيكل انتباهاً خاصاً لإغلاق الأقواس في نهاية المعادلة، حيث يجب أن يتطابق عدد الأقواس المغلقة تماماً مع عدد دوال IF المفتوحة عبر السلسلة، وإلا سيعترض إكسل برسالة خطأ في بناء الجملة (Syntax Error)، ويتوقف عن قراءة المسار المنطقي بالكامل.
3.2 المقارنة التحليلية بين كفاءة SWITCH ودوال IF المتداخلة
عند إجراء موازنة تقنية وفنية بين دالة SWITCH وصيغ IF المتداخلة، يبرز تفوق واضح لدالة SWITCH في مجال هندسة الصيانة؛ إذ تتسم الأخيرة بوضوح تركيبي يقلل من الوقت المستغرق في اكتشاف الأخطاء أو تعديل الأوزان الرقمية. في المقابل، تزداد معادلات IF المتداخلة تعقيداً هندسياً كلما زادت الشروط، حيث تختلط الأقواس والفواصل داخل بنية متداخلة يصعب على المحللين الآخرين تفكيكها وتحديثها دون المخاطرة بكسر المنطق البرمجي للمعادلة.
من زاوية استهلاك الموارد الحاسوبية وسرعة المعالجة، تستهلك دوال IF المتداخلة وقتاً أطول نسبياً في المعالجة داخل الجداول العملاقة، نظراً لقيام المحرك بإنشاء مسار تفرعي جديد واختبار منطقي منفصل في كل حلقة تداخل. ومع ذلك، تظل هناك سيناريوهات لا غنى فيها عن استخدام IF المتداخلة؛ وتحديداً عندما يقترن التحويل النصي بشروط منطقية ورياضية مركبة تستوجب استخدام أدوات العطف والفصل المنطقي AND وOR بالتوازي مع النص المستهدف، وهو ما تعجز دالة SWITCH عن تحقيقه بمرونة مماثلة.
3.3 قيود دالة IF عند التعامل مع سلاسل نصية متعددة الفئات
يفرض استخدام IF المتداخلة تحديات منهجية وبصرية بالغة الحساسية، يُعرف أبرزها برمجياً باسم “ظاهرة كود السباغيتي” داخل الخلايا؛ حيث يفقد المستخدم الرؤية الشاملة للمعادلة بمجرد تجاوز أربعة أو خمسة مستويات من التداخل، مما يرفع احتمالية الخطأ البشري إلى مستويات حرجة. تزداد هذه الصعوبة عند التعامل مع سلاسل نصية متشابهة تتطلب تدقيقاً تفصيلياً؛ إذ قد تؤدي كتابة شرط نصي يمثل جزءاً من نص آخر بترتيب خاطئ إلى إطلاق تقييم إيجابي زائف للشرط الأول وإهمال الشرط الأدق التالي.
من الناحية المعمارية للبرنامج، يجب التذكير بالمحددات الصارمة لإصدارات إكسل؛ فرغم أن الإصدارات الحديثة (بدءاً من Excel 2007 وما بعده) تتيح تداخل ما يصل إلى 64 مستوى من دوال IF، فإن الإصدارات الأقدم (Excel 2003 وما قبله) كانت تقف عند حد أقصى لا يتجاوز 7 مستويات فقط. وبصرف النظر عن الحدود النظرية المتاحة، فإن أي معادلة تتجاوز 7 أو 8 مستويات تداخل في بيئات العمل المهنية تعد تصميماً برمجياً رديئاً (Anti-pattern) يجب استبداله فوراً بدوال البحث المرجعي الأكثر كفاءة وموثوقية.
4. توظيف دالة IFS لتبسيط إسناد الأرقام للقيم النصية المعقدة
4.1 التركيب الهيكلي لدالة IFS الحديثة في إكسل
جاءت دالة IFS كإحدى الحلول العصرية لمعالجة السلبيات الهيكلية المتأصلة في دوال IF المتداخلة؛ حيث تسمح للمستخدم باختبار سلسلة متتابعة من الشروط المنطقية دون الحاجة إلى تضمين دالة شرطية جديدة داخل أخرى. يتميز التركيب البنائي لهذه الدالة بالسلاسة المطلقة؛ إذ تتكون ببساطة من أزواج مسرودة تتضمن الشرط المنطقي المستقل متبوعاً بالقيمة الرقمية التي يجب إرجاعها فور تحقق ذلك الشرط.
تُكتب الدالة وفق النسق البنائي التالي:
=IFS(logical_test1, value_if_true1, [logical_test2, value_if_true2], ...)
لا تتطلب الدالة إغلاق أقواس متعددة في نهايتها مهما بلغت الشروط، بل يتم إغلاق قوس واحد فقط يشمل المنظومة بأكملها. ولتوفير قيمة افتراضية تعالج أي نص يخرج عن نطاق الشروط المحددة، يُتبع تقليد برمجي داخل IFS بإضافة الشرط المنطقي الدائم TRUE في نهاية المعادلة، ليعمل كشبكة أمان تلتقط أي حالة متبقية وتمنحها رقماً محدداً بدلاً من توقف الدالة عن العمل.
4.2 خطوات بناء نموذج تعيين رقمي بدون تعقيد برمجي
لبناء نموذج إسناد رقمي متين باستخدام دالة IFS، يجب أولاً ترتيب الشروط النصية ترتيباً منطقياً منسجماً. يرجع ذلك إلى أن دالة IFS تتبع أسلوب التقييم المتتابع المباشر؛ فأول شرط يتحقق منطقياً ستقوم الدالة باعتماده فوراً وتتجاهل كافة الشروط اللاحقة حتى وإن كانت منطبقة. لذلك، إذا كانت هناك شروط نصية أكثر تخصصاً أو تحتوي على تفاصيل إضافية، يجب وضعها في صدارة المعادلة قبل الشروط الأعم.
على سبيل المثال، إذا أردنا تحويل تصنيفات الأولويات في بيئة صيانة تقنية إلى أرقام تعبر عن مستوى الاستجابة الساعية، نقوم بصياغة المعادلة الآتية:
=IFS(A2="حرج جداً", 1, A2="حرج", 2, A2="متوسط", 4, A2="منخفض", 8, TRUE, 24)
تضمن هذه الصيغة تعيين الرقم 1 للأولوية الحرجة جداً، وتصل إلى 8 للمنخفضة، في حين تُسند القيمة 24 كخيار افتراضي لأي وصف نصي آخر يظهر في الخلية عبر المعامل TRUE الأخير. يُنصح دائماً باختبار هذه الصيغة على عينة صغيرة تحوي قيماً قياسية وأخرى شاذة أو فارغة للتحقق من استقرار السلوك الحسابي للمعادلة قبل تعميمها النهائي.
4.3 معالجة أخطاء التحقق وقيمة #N/A في دالة IFS
تتمثل نقطة الضعف الشائعة عند تطبيق دالة IFS في حساسيتها تجاه غياب التطابق؛ فإذا فُحصت خلية نصية لا تلبي أياً من الشروط المذكورة داخل الدالة، ولم يكن المعامل TRUE مدرجاً في نهاية الصيغة، فسيقوم محرك إكسل بإرجاع رمز الخطأ الشهير #N/A (غير متاح)، مما يؤدي إلى تشويه المظهر الجمالي للجداول وتعطيل المعادلات التراكمية اللاحقة التي تعتمد على هذه الخلية.
ولمعالجة هذه الإشكالية بأسلوب منهجي واحترافي، يُفضل دمج الدالة الوقائية IFNA أو الشاملة IFERROR مع دالة IFS، وتوجيهها لإرجاع كود رقمي بديل مثل الصفر (0) أو القيمة الفارغة المنطقية، وفق النمط البرمجي التالي:
=IFNA(IFS(A2="نعم", 1, A2="لا", 0), -1)
تضمن هذه البنية الوقائية إرجاع المعرف -1 كإشارة تشخيصية تدل على وجود مدخل نصي شاذ لم تتعرف عليه المعادلة، مما يسهل على المحلل إجراء التصفية اللاحقة وتدقيق سلامة البيانات الواردة دون أن تنكسر سلسلة الحسابات في المصنف.
5. استخدام دوال البحث المرجعي VLOOKUP وXLOOKUP لربط النصوص بأرقامها
5.1 إنشاء جدول مرجعي مخصص (Mapping Table) كقاعدة بيانات فرعية
يمثل الفصل المنهجي بين “بيانات المعاملات” و”البيانات المرجعية” المبدأ الأسمى في هندسة نظم المعلومات وقواعد البيانات. فبدلاً من تضمين السلاسل النصية والأرقام المقابلة لها مباشرة داخل صيغ الحساب كما هو الحال في SWITCH أو IF، يقتضي النهج الاحترافي إنشاء جدول مرجعي مستقل يسمى جدول المطابقة (Mapping Table) في ورقة عمل منفصلة. يعمل هذا الجدول كقاموس مصغر يحتوي عمودين رئيسيين: الأول يسرد القيم النصية الفريدة دون تكرار، والثاني يحتوي على القيم الرقمية المقابلة لكل نص بدقة.
تكمن قوة هذه الطريقة في سهولة صيانتها مستقبلاً؛ فعند الرغبة في تعديل كود رقمي لنص معين، أو إضافة فئة نصية جديدة تماماً، يتم التعديل داخل خلايا الجدول المرجعي لمرة واحدة فقط، دون الحاجة إلى تعديل ملايين الصيغ الرياضية في ورقة البيانات الأصلية. يُوصى بشدة بتحويل هذا النطاق المرجعي إلى جدول رسمي في إكسل بالضغط على اختصار لوحة المفاتيح (Ctrl + T)، مما يمنحه ميزة النطاق الديناميكي المهيكل (Structured Reference)، والذي يتمدد تلقائياً عند إضافة سجلات جديدة دون الإخلال بحدود المراجع المستخدمة في دوال البحث.
5.2 تطبيق دالة VLOOKUP لإسناد الأكواد الرقمية بدقة تامة
تعد دالة VLOOKUP من أعرق وأشهر دوال البحث الرأسي في إكسل، وتستخدم بكفاءة عالية لجلب القيم الرقمية من الجداول المرجعية استناداً إلى النص المدخل. تتطلب صياغة هذه الدالة اتباع قواعد رياضية دقيقة لتجنب الأخطاء الكارثية الناتجة عن الانزلاق المكاني لنطاق البحث. تبنى المعادلة على النحو الآتي:
=VLOOKUP(A2, $M$2:$N$20, 2, FALSE)
تتضمن هذه المعادلة أربعة وسائط محورية:
- وسيط القيمة المبحوث عنها (Lookup_value): وهي الخلية A2 التي تحوي السلسلة النصية المراد ترميزها.
- وسيط مصفوفة الجدول (Table_array): وهو النطاق المرجعي المحدد هنا بالخلايا
$M$2:$N$20، ويجب تثبيته بصورة مطلقة باستخدام علامات الدولار ($) لضمان ثبات النطاق عند نسخ وسحب الصيغة لأسفل العمود. - وسيط رقم عمود الاسترجاع (Col_index_num): ويمثل ترتيب العمود المستهدف داخل النطاق المرجعي، وهو العمود 2 الذي يحتوي على الأرقام.
- وسيط نوع المطابقة (Range_lookup): ويجب ضبطه حتماً على القيمة
FALSEأو الرقم0؛ وذلك لإجبار الدالة على إجراء مطابقة تامة للنص، وتفادي السلوك الافتراضي الذي يعتمد التطابق التقريبي، والذي قد يسند أرقاماً عشوائية وخاطئة كلياً في حال عدم ترتيب الجدول المرجعي أبجدياً.
5.3 المزايا المتطورة لدالة XLOOKUP في تعيين القيم ومعالجة الاستثناءات
أحدثت دالة XLOOKUP الحديثة ثورة تقنية في بيئة إكسل، متجاوزة كافة العيوب التاريخية المصاحبة لدالة VLOOKUP. تتمثل أولى المزايا الهيكلية لدالة XLOOKUP في قدرتها الفائقة على البحث في أي اتجاه عبر الأعمدة والصفوف دون أي قيد؛ حيث لم يعد يشترط وجود العمود النصي في أقصى يمين أو أقصى يسار الجدول المرجعي، بل يمكنها استرجاع الأرقام حتى لو كان عمود الأرقام يقع قبل عمود النصوص.
تتمتع الدالة أيضاً بدمج وسيط مخصص لمعالجة الأخطاء والقيم المفقودة دون الحاجة إلى تطويقها بدوال أخرى، وتعتمد المطابقة التامة كخيار افتراضي دون الحاجة إلى تحديد ذلك يدوياً. تتجسد صيغة التحويل الرقمي في هذا النموذج المتقدم كالآتي:
=XLOOKUP(A2, tbl_Codes[CategoryText], tbl_Codes[NumericID], 0)
في هذا التعبير، تبحث الدالة عن النص الموجود في A2 ضمن عمود النصوص بجدول المطابقة المسمى tbl_Codes، وتعيد فوراً الرقم المكافئ من عمود المعرفات الرقمية. وفي حال كان النص غير موجود في السجل، تعيد الدالة مباشرة القيمة 0 المحددة في وسيطها الرابع، مما يوفر حلاً متكاملاً وقوياً يتميز بالسرعة ومقاومة التغييرات التي قد تطرأ على بنية الأعمدة المرجعية.
6. التوليف المتقدم بين دالتي INDEX و MATCH لتعيين القيم الرقمية
6.1 الآلية الوظيفية لثنائية INDEX و MATCH
يعد الجمع بين دالتي INDEX وMATCH المعيار الذهبي المفضل لخبراء النمذجة المتقدمة في إكسل قبل ظهور دوال البحث الحديثة، ولا تزال هذه الثنائية تحتفظ بمكانتها التقنية كواحدة من أقوى آليات البحث المرجعي وأكثرها موثوقية. تعتمد الفلسفة التشغيلية لهذا التوليف على تقسيم مهمة البحث إلى خطوتين مستقلتين ومتكاملتين وظيفياً، مما يمنح المحلل تحكماً كاملاً في مصفوفات البيانات.
تبدأ العملية من خلال دالة MATCH، والتي تختص بمسح عمود النصوص المرجعي بحثاً عن النص المستهدف، لتستخرج إحداثي الموضع النسبي لذلك النص، أي رقم الصف الذي يحتله النص داخل المصفوفة:
MATCH(lookup_text, text_array, 0)
عقب ذلك، يتم تمرير هذا الموضع العددي الناتج مباشرة إلى وسيط الصف داخل دالة INDEX، والتي تتولى بدورها استخراج القيمة الرقمية المقابلة من عمود الأرقام المرجعي بناءً على رقم الصف المستخرج:
=INDEX(numeric_array, MATCH(A2, text_array, 0))
يحقق هذا الفصل التام بين مصفوفة البحث المرجعية ومصفوفة النتائج استقلالية هيكلية تحمي الصيغة من الانهيار، وتفصل تماماً بين مسارات المعالجة.
6.2 مقارنة الأداء الحسابي بين INDEX/MATCH ودوال البحث التقليدية
يتفوق توليف INDEX/MATCH تفوقاً نوعياً على دالة VLOOKUP التقليدية من منظورين رئيسيين: الأداء الحسابي والأمان المعماري. فعند استخدام VLOOKUP، يضطر إكسل إلى تحميل الجدول المرجعي بأكمله في ذاكرة المعالجة اللحظية، بما في ذلك الأعمدة الوسيطة غير المستخدمة، مما يؤدي إلى هدر موارد الذاكرة وبطء إعادة الحساب في الجداول التي تضم عشرات الآلاف من السجلات. في المقابل، تقتصر ثنائية INDEX/MATCH على استدعاء عمودين محددين فقط: عمود النصوص وعمود الأرقام، مما يخفف الحمل الحسابي ويسرع وقت الاستجابة بنسب كبيرة.
أما من جانب الاستقرار البنيوي، فإن إضافة أو حذف أي أعمدة داخل نطاق البحث يكسر معادلة VLOOKUP فوراً، ويؤدي إلى جلب بيانات غير صحيحة أو توليد خطأ مرجعي #REF!؛ نظراً لاعتمادها على رقم عمود ثابت (Hardcoded Index). على النقيض من ذلك، تظل ثنائية INDEX/MATCH محتفظة بسلامتها التشغيلية ودقتها الرياضية بصورة مطلقة حتى مع إدراج أعمدة جديدة بين مصفوفة النصوص ومصفوفة الأرقام، مما يجعلها الخيار المثالي للمصنفات التحليلية الكبرى والمشاريع الأكاديمية والمؤسسية الحساسة.
6.3 البحث متعدد المعايير لتعيين أرقام تستند إلى نصوص متعددة الأعمدة
تظهر القوة المتقدمة لثنائية INDEX/MATCH عند نشوء الحاجة إلى إسناد قيمة رقمية لا تعتمد على نص فردي واحد، بل تستند إلى تقاطع معيارين نصيين أو أكثر موزعين عبر أعمدة مختلفة. يتكرر هذا التحدي عندما تتشابه أسماء الفئات بين الأقسام المختلفة؛ مثل وجود تصنيف “صيانة” يخص “قسم تقنية المعلومات” ويقابله كود رقمي معين، بينما تصنيف “صيانة” ذاته يتبع “قسم الخدمات العامة” ويقابله كود رقمي مختلف تماماً.
يمكن حل هذه المسألة بصياغة مصفوفية ذكية تدمج الشروط النصية باستخدام معامل الدمج (&) داخل محرك MATCH دون الحاجة إلى استحداث أعمدة مساعدة، على النحو الآتي:
=INDEX(E2:E100, MATCH(1, (A2=C2:C100) * (B2=D2:D100), 0))
يقوم هذا المنطق الرياضي بإنشاء مصفوفة افتراضية ثنائية تتألف من الآحاد والأصفار الناتجة عن عملية الضرب المنطقي بين مصفوفتي الاختبار، حيث يتم استرجاع رقم الصف الذي تتحقق فيه كافّة المعايير النصية في آن واحد (حيث يمثل 1 التوافق التام للشرطين معاً)، مما يتيح إسناد الرقم الصحيح بدقة متناهية تراعي السياقات المتعددة للمفردات النصية.
7. تطبيقات التحويل الرقمي في استبيانات العلوم السلوكية ومقاييس ليكرت
7.1 ترميز الاستجابات السيكومترية من نصوص إلى درجات كمية
تمثل الاستبيانات الميدانية في العلوم الاجتماعية والنفسية والإدارية أحد أهم الميادين التطبيقية لتعيين القيم الرقمية للسلاسل النصية. يستند هذا الإجراء بصورة تاريخية وعلمية إلى الأطروحة التأسيسية التي صاغها عالم النفس رنسيس ليكرت (Rensis Likert, 1932) في دراسته الموسومة “تقنية لقياس الاتجاهات” (A Technique for the Measurement of Attitudes)، والتي أسست لسلالم القياس التراكمية، حيث يتم تحويل الاستجابات اللفظية المعبرة عن درجات الموافقة إلى قيم رتبية متدرجة تتيح القياس الكمي للسمات الكامنة.
في مقياس ليكرت الخماسي النمطي، يتم تعيين الأرقام الترتيبية وفق التنسيق القياسي الآتي:
- “أوافق بشدة” = 5
- “أوافق” = 4
- “محايد” = 3
- “لا أوافق” = 2
- “لا أوافق بشدة” = 1
تتم أتمتة هذه المعالجة على مئات الاستجابات داخل إكسل بصياغة دالة موحدة سريعة:
=SWITCH(C2, "أوافق بشدة", 5, "أوافق", 4, "محايد", 3, "لا أوافق", 2, "لا أوافق بشدة", 1, "")
إن الحفاظ على هذا الترتيب العددي يضمن عدم اختلال المنطق السيكومتري للمقياس، ويتيح الانتقال بالبيانات من مرحلة النصوص الإنشائية إلى مصفوفات رياضية جاهزة لاختبار الفرضيات الإحصائية المعتمدة.
7.2 الترميز العكسي (Reverse Coding) للفقرات السلبية برمجياً
تتضمن استبانات البحوث الموثوقة فقرات استقصائية مصاغة بصياغة إيجابية وأخرى مصاغة بصياغة سلبية؛ وذلك لكشف استجابات المشاركين غير المنتبهين أو تفادي ظاهرة “نزعة الموافقة الآلية” (Acquiescence Bias). تتطلب هذه الفقرات السلبية تطبيق إجراء إحصائي ومنهجي حتمي يعرف باسم “الترميز العكسي” (Reverse Coding)، حيث يجب قلب المقياس الرقمي المخصص للنص حتى تتسق معاني الدرجات مع البعد النفسي أو السلوكي المستهدف قياسه.
في المقياس الخماسي على سبيل المثال، يجب أن تقلب الدرجات بحيث تحصل الاستجابة النصية السلبية المتطرفة “أوافق بشدة” على الدرجة 1 بدلاً من 5، في حين تنال الاستجابة “لا أوافق بشدة” الدرجة 5. يمكن تحقيق هذا الترميز العكسي عبر صيغة SWITCH مخصصة، أو من خلال تطبيق معادلة التحويل الخطي الرياضي المعياري:
الدرجة المعكوسة = (الحد الأقصى للمقياس + الحد الأدنى للمقياس) - الدرجة الأصلية
والتي تترجم في إكسل بعد الترميز الأولي إلى الصيغة البسيطة:
= (5 + 1) - D2
حيث تمثل الخلية D2 الدرجة الأصلية. وتعد هذه الخطوة شرطاً أولياً لقياس الاتساق الداخلي للاستبانة بدقة واستخراج مؤشر ألفا كرونباخ (Cronbach’s Alpha) المعبر عن ثبات المقياس وموثوقيته.
7.3 احتساب الدرجات الكلية والمقاييس الفرعية بعد إتمام التحويل
بمجرد اكتمال تحويل السلاسل النصية للاستجابات السيكومترية إلى أرقام صحيحة وتدقيق الفقرات المعكوسة، تنتقل مصفوفة البيانات إلى مرحلة الحساب الإحصائي الإجمالي. يتم احتساب الدرجة الكلية لكل مفحوص وللمقاييس الفرعية (Subscales) باستخدام دوال التجميع الرياضية القياسية مثل SUM وAVERAGE، لتوليد مؤشرات كمية تصف الاتجاهات السلوكية بدقة وموضوعية تامة.
يتعين في هذه المرحلة التأكد من عدم تسرب أي استجابات نصية غير محولة أو نصوص فارغة إلى نطاقات الجمع؛ حيث إن وجود أخطاء مثل #VALUE! أو نصوص غير مطابقة قد يعطل احتساب المجاميع أو يؤدي إلى انحراف النتائج. يمكن دمج دالة SUM مع التحقق الوقائي عبر الصيغة الآتية:
=AVERAGEIF(E2:H2, ">0")
وذلك لضمان احتساب المتوسط بناءً على الفقرات المرقمة فعلياً فقط، وتوفير مؤشرات سليمة تخدم التحليلات الإحصائية المتطورة المقترحة في أبحاث السلوك المؤسسي والعلوم الاجتماعية.
8. أتمتة تعيين الأرقام للنصوص عبر أداة تحويل البيانات Power Query
8.1 إنشاء أعمدة شرطية (Conditional Columns) بدون كتابة أكواد معقدة
تمثل بيئة Power Query المدمجة في إكسل المعيار الأحدث والأقوى لإجراء عمليات استخراج وتحويل وتحميل البيانات (ETL). تتيح هذه المنصة أتمتة تعيين القيم الرقمية للنصوص دون الحاجة إلى كتابة صيغ رياضية داخل خلايا ورقة العمل، مما يرفع من استقرار النماذج وأمانها عند التعامل مع أحجام بيانات ضخمة تتجاوز ملايين السجلات.
يتم هذا الإجراء بسلاسة باتباع الخطوات الآتية داخل واجهة محرر Power Query:
- استيراد جدول البيانات النصية إلى المحرر عبر علامة التبويب “بيانات” (Data) ثم “من جدول/نطاق” (From Sheet/Table).
- الانتقال إلى علامة التبويب “إضافة عمود” (Add Column) واختيار أمر “عمود شرطي” (Conditional Column).
- تحديد اسم العمود النصي المستهدف وتعيين عامل التشغيل على “يساوي” (Equals).
- إدخال النص المستهدف في حقل القيمة وكتابة الرقم المقابل في حقل الناتج (Output).
- تكرار العملية عبر خيار “إضافة جملة” (Add Clause) لكافة الفئات النصية، مع وضع قيمة رقمية افتراضية في خانة Else.
يسجل المحرر هذه الخطوات في صورة تسلسل إجرائي تراكمي، مما يضمن تطبيق ذات التحويلات الرقمية تلقائياً على أي بيانات جديدة تضاف إلى الجدول بمجرد الضغط على زر “تحديث” (Refresh).
8.2 استخدام لغة M لبرمجة شروط استبدال النصوص بقيم رقمية
للمستخدمين المتقدمين، توفر لغة البرمجة الوظيفية M المضمنة خلف واجهة Power Query مرونة فائقة لكتابة شروط التحويل الرقمي المعقدة مباشرة عبر شريط الصيغ أو المحرر المتقدم (Advanced Editor). يتيح هذا الأسلوب التحكم البرمجي الكامل في معالجة السلاسل النصية واستبدالها بالقيم العددية المناسبة.
تتم كتابة الجملة الشرطية بلغة M بالهيكلية الصريحة الآتية:
if [StatusText] = "مكتمل" then 1 else if [StatusText] = "قيد التنفيذ" then 2 else if [StatusText] = "ملغي" then 0 else 99
فضلاً عن ذلك، يمكن إجراء الاستبدال المباشر للقيم النصية في نفس العمود الأصلي دون الحاجة إلى استحداث عمود جديد باستخدام الدالة الوظيفية Table.ReplaceValue. ومن الركائز المحورية في لغة M ضرورة الإعلان الصريح عن نوع البيانات عقب انتهاء التحويل؛ حيث يجب تغيير تصنيف نوع العمود من نوع type text إلى رقم صحيح Int64.Type أو رقم عشري type number لضمان استيعاب إكسل للمخرجات بوصفها أرقاماً حسابية قابلة للجمع عند تحميلها مجدداً إلى ورقة العمل.
8.3 دمج الجداول الاستعلامية (Merge Queries) لترميز فوري شامل
تعد تقنية “دمج الاستعلامات” (Merge Queries) في Power Query التطبيق المؤسسي الموازي لعمليات الربط العلائقي (SQL Joins) بين الجداول. فبدلاً من صياغة الشروط التراكمية الطويلة، يتم استيراد جدولين منفصلين إلى المحرر: “جدول البيانات التشغيلية” و”جدول الترميز المرجعي”.
يتم الربط بين الجدولين باختيار أمر Merge Queries وتحديد العمود النصي المشترك بينهما كحقل مفتاحي، مع تطبيق نوع الربط التوافقي الخارجي الأيسر (Left Outer Join). تتيح هذه الخطوة لمحرك التحويل مطابقة كافة السجلات فورياً وسحب عمود المعرفات الرقمية المقابلة وإدراجه داخل جدول المعاملات بدقة وسرعة حسابية تتفوق على جميع دوال أوراق العمل التقليدية. يُفرغ هذا الجدول المنقى نهائياً إلى المصنف جاهزاً للاستخدام الفوري، محصناً ضد أي تلاعب بالصيغ، وخالياً من عبء الحسابات اللحظية المتقاطعة.
9. معالجة الأخطاء الشائعة وضمان نظافة البيانات النصية قبل التعيين
9.1 تطهير النصوص وإزالة الفراغات غير المرئية باستخدام الدوال النصية
تعد المسافات الزائدة والأحرف غير المطبوعة من أبرز مسببات فشل معادلات التعيين والترميز في إكسل؛ إذ يتعامل البرنامج مع المسافة بوصفها محرفاً مستقلاً يحمل رمزاً رقمياً في جداول الترميز العالمية (مثل ASCII وUnicode). لذلك، تظهر أخطاء عدم المطابقة الشائعة بمجرد وجود مسافة غير مقصودة في نهاية النص المستهدف. ولتطهير البيانات من هذه الشوائب قبل الشروع في الترميز، يتم الاعتماد على منظومة الدوال النصية المتخصصة.
تتضمن استراتيجية التطهير تطبيق دالة TRIM للتخلص من المسافات البادئة واللاحقة في الخلية وتقليص المسافات البينية المتعددة بين الكلمات إلى مسافة واحدة، مدمجة مع دالة CLEAN لإزالة الأحرف غير القابلة للطباعة (ذات الرموز من 0 إلى 31 في نظام ASCII):
=TRIM(CLEAN(A2))
وفي الحالات المتقدمة التي تُستورد فيها السجلات من مواقع الإنترنت أو قواعد بيانات الويب، تظهر مسافات غير قابلة للكسر تعرف بـ (Non-breaking Spaces) وتحمل الرمز البرمجي CHAR(160)، وهي مسافات تعجز دالة TRIM وحدها عن حذفها. يُعالج هذا العائق بتطبيق دالة الاستبدال SUBSTITUTE لتحويلها إلى مسافات عادية أولاً ثم تنظيفها:
=TRIM(CLEAN(SUBSTITUTE(A2, CHAR(160), " ")))
يضمن تطبيق هذا التطهير الشامل انسيابية وموثوقية عمليات المطابقة اللاحقة دون أي توقف مفاجئ.
9.2 إدارة حساسية حالة الأحرف والتطابق التقريبي للنصوص اللاتينية والمترجمة
تتصرف دوال إكسل بطرق متفاوتة إزاء السلاسل النصية التي تستخدم الحروف اللاتينية أو الكلمات المترجمة والإنجليزية بناءً على مفهوم “حساسية حالة الأحرف” (Case Sensitivity). فالدوال القياسية مثل SWITCH وVLOOKUP وXLOOKUP غير حساسة افتراضياً لحالة الأحرف، وتعد نص “Excel” مطابقاً تماماً لنص “EXCEL” أو “excel”.
إذا كانت المتطلبات التحليلية تقتضي التفريق الدقيق بين حالتي الأحرف لإسناد قيم رقمية متمايزة (كأن يدل الرمز الصغير “a” على مستوى إداري مختلف عن الرمز الكبير “A”)، فإن دوال البحث التقليدية ستفشل حتماً. يكمن الحل المنهجي هنا في استخدام دالة EXACT المخصصة لمقارنة النصوص حرفياً بحساسية كاملة للحالة، مدمجة داخل ثنائية INDEX/MATCH مصفوفية، أو توحيد مظهر البيانات النصية قسرياً باستخدام دالتي UPPER أو LOWER لتفادي أي التباس في عمليات التعيين القياسية.
من جانب آخر، يمثل اللجوء إلى خيارات “التطابق التقريبي” (Approximate Match) في دوال البحث خطراً داهماً عند معالجة النصوص؛ إذ صُمم هذا الخيار لفرز الأرقام والنطاقات الكمية المرتبة، واستخدامه مع النصوص دون ضوابط محكمة يدفع البرنامج لإرجاع أقرب نص مرتب هجائياً، مما يقود إلى إسناد أرقام خاطئة كلياً لفئات نصية مجهولة، ويقتضي دائماً التثبيت الصارم على خيار المطابقة التامة (Exact Match).
9.3 التحقق من صحة المخرجات والتأكد من صفتها الرقمية الرياضية
عقب اكتمال عمليات التعيين وإسناد الأرقام للسلاسل النصية، يتعين التحقق الصارم من أن المخرجات التي تظهر في الأعمدة الجديدة تمثل قيماً عددية حقيقية جاهزة للعمليات الحسابية، وليست مجرد نصوص اتخذت مظهر الأرقام. يمكن إجراء هذا الفحص التشخيصي بسرعة عبر تطبيق الدالة المنطقية ISNUMBER:
=ISNUMBER(B2)
فإذا أرجعت الدالة القيمة المنطقية TRUE، دل ذلك على سلامة البنية الرياضية للخلية، أما إذا أرجعت FALSE، فهذا يعني أن الرقم مخزن في هيئة نصية تعطل الحسابات.
لتحويل النصوص الرقمية إلى أرقام صريحة بصورة قطعية، يمكن للمحلل استخدام المشغل الرياضي الثنائي الأحادي المعروف باسم “السالب المزدوج” (Double Unary Operator --) في بداية الصيغة، أو إضافة الصفر (+0)، أو استخدام دالة التحويل الصريح VALUE:
=VALUE(SWITCH(A2, "منخفض", "1", "مرتفع", "2"))
وكإجراء وقائي يضمن استدامة سلامة البيانات مستقبلاً، يُنصح بتطبيق أداة “التحقق من صحة البيانات” (Data Validation) على عمود الإدخال النصي؛ لتقييد خيارات المستخدم بقائمة منسدلة (Drop-down List) تحتوي حصرياً على المفردات المعتمدة، مما يمنع إدخال نصوص غير مبرمجة سلفاً ويغلق الباب أمام أخطاء الإدخال اليدوي العشوائية.
10. أفضل الممارسات المنهجية لتوثيق وتوسيع نماذج التعيين الرقمي
10.1 بناء وتوثيق كود البيانات (Codebook) داخل مصنف العمل
يمثل التوثيق العلمي الدقيق الركيزة التي تفصل بين الأعمال الاحترافية العالية الموثوقية والمصنفات العشوائية المعرضة للفشل. عند تحويل النصوص إلى أرقام، يتحول المصنف إلى نظام بيانات مشفر يستدعي بناء وتوثيق ما يعرف بـ “دليل البيانات” أو “قاموس المتغيرات” (Codebook). يُخصص لهذا القاموس ورقة عمل مستقلة داخل المصنف تعمل كمرجع شامل لكل من يطّلع على النموذج لاحقاً.
يتضمن هذا الدليل جداول واضحة توثق المفردات النصية، وما يقابلها من رموز عددية، والأساس المنطقي أو الإحصائي الذي استندت إليه عملية التعيين (كالاستناد إلى مقياس معتمد، أو كود وزاري، أو نظام تشغيلي). كما يشتمل على سجل تاريخي للإصدارات يوضح تواريخ التعديل، وهوية المطور، والتفسيرات الإجرائية الدقيقة التي تميز الفئات المتشابهة لتفادي سوء التفسير التحليلي من قبل فرق العمل المشتركة.
10.2 استخدام النطاقات المسماة (Named Ranges) لجعل الصيغ ذاتية التفسير
تتحول صيغ إكسل المعقدة التي تعتمد على مراجع الخلايا الجامدة مثل $AA$2:$AB$500 إلى ألغاز مبهمة يصعب تتبعها وتدقيقها من قبل المراجعين الخارجيين. وللارتقاء بجودة النموذج وتسهيل صيانته، تتجه أفضل الممارسات المنهجية نحو استخدام “النطاقات المسماة” (Named Ranges) أو الجداول الرسمية المعرفة بأسماء دلالية واضحة عبر إدارة الأسماء (Name Manager).
فعند إعادة تسمية نطاق جدول البحث من مراجع صماء إلى مسمى وصفي دقيق مثل tbl_LikertScale أو lkp_Branches، تتحول الصيغة الرياضية إلى تعبير ذاتي التفسير (Self-explanatory Formula) يتخذ المظهر الاحترافي التالي:
=XLOOKUP(A2, lkp_Branches[BranchName], lkp_Branches[BranchID])
يساعد هذا الأسلوب المطور والمحلل على استيعاب الغرض المنطقي من المعادلة فوراً، ويقلل من احتمالات الخطأ الناتجة عن إزاحة المراجع الخلوية عند نسخ ولصق الصيغ عبر أوراق عمل ومصنفات مختلفة، مما يضمن اتساقاً معمارياً عالياً للنموذج الرقمي بأكمله.
10.3 ضمان استدامة النماذج وقابليتها للتوسع مع نمو الفئات النصية
إن النماذج التحليلية المتقنة هي النماذج المصممة لتستوعب التوسع المستقبلي دون الحاجة إلى إعادة هندستها جذرياً عند ظهور متغيرات وفئات نصية جديدة. يقتضي هذا المبدأ الفصل المادي والمعماري التام داخل مصنف إكسل بين ثلاث طبقات أساسية:
- طبقة البيانات الخام (Raw Data Layer): وتخصص لاستقبال المدخلات والسجلات النصية دون معالجة معقدة.
- طبقة المعالجة والمطابقة (Processing & Lookup Layer): وتضم الجداول المرجعية ومحركات الربط ومصفوفات التحويل.
- طبقة التقارير ولوحات التحكم (Reporting & Dashboards Layer): وتختص بعرض المخرجات الرقمية والمؤشرات الحسابية التراكمية.
عند فصل هذه الطبقات والاعتماد على الجداول الديناميكية في طبقة المعالجة، تنعكس إضافة أي فئة نصية جديدة إلى الجدول المرجعي تلقائياً في سائر معادلات البحث دون أي تدخل يدوي إضافي. ويتوجب على المحلل وضع آليات تدقيق دورية مستمرة، مثل احتساب نسبة الخلايا غير المصنفة أو تلك التي ترجع القيمة الصفرية أو الافتراضية، للتأكد من شمولية التغطية الرمزية لجميع النصوص الواردة، واستدامة النظام الرقمي بكفاءة واقتدار.
خاتمة
إن عملية تعيين القيم الرقمية للسلاسل النصية في مايكروسوفت إكسل تتجاوز كونها مجرد حيلة برمجية أو معادلة عابرة داخل خلية؛ إنها عملية هندسية محورية تمثل الجسر الرابط بين البيانات الوصفية والتحليلات الكمية المتقدمة. لقد استعرضنا عبر هذه الأطروحة الشاملة التدرج التقني والمنهجي لهذه العملية، بدءاً من دوال التفرع الشرطي البسيطة مثل IF وSWITCH وIFS، وصولاً إلى منظومات البحث المرجعي المتينة عبر XLOOKUP وثنائية INDEX/MATCH، وتوجنا ذلك بالأتمتة المؤسسية الشاملة عبر بيئة Power Query المتقدمة.
إن نجاح المحلل في إدارة هذه التحويلات لا يتوقف فقط على اختيار الدالة المناسبة، بل يعتمد بالأساس على صرامة تنظيف البيانات، والتأكد من إزالة الشوائب النصية، والتحقق الدوري من الصفة الرياضية الحقيقية للمخرجات، إلى جانب توثيق النماذج وتأصيلها وفق نظريات القياس العلمي الرصينة. ومن خلال اتباع أفضل الممارسات المنهجية التي فصلناها في هذا الدليل، يستطيع المتخصصون والمحللون تحويل مصنفاتهم إلى قواعد معلومات رقمية صلبة، آمنة، وقابلة للتوسع المستقبلي، تدعم اتخاذ القرارات الدقيقة وتفتح آفاق التحليل الإحصائي الرصين.
المراجع
- Cohen, J. (1968). Multiple regression as a general data-analytic system. Psychological Bulletin, 70(6), 426–443. https://doi.org/10.1037/h0026714
- Likert, R. (1932). A technique for the measurement of attitudes. Archives of Psychology, 22(140), 1–55.
- Microsoft Corporation. (n.d.). SWITCH function. Microsoft Support. https://support.microsoft.com/en-us/office/switch-function-47ab33c0-28ce-4530-8a45-d532ec4aa25e
- Microsoft Corporation. (n.d.). XLOOKUP function. Microsoft Support. https://support.microsoft.com/en-us/office/xlookup-function-b7fd680e-6d10-43e6-84f9-88eae8bf5929
- Stevens, S. S. (1946). On the theory of scales of measurement. Science, 103(2684), 677–680. https://doi.org/10.1126/science.103.2684.677