
يمثل التعامل مع البيانات الرقمية الخام أحد أبرز التحديات المنهجية والعملية في مجالات الإحصاء التطبيقي، وتحليل البيانات، والعلوم السلوكية، وإدارة الأعمال. تتسم التدفقات البيانية الحديثة بضخامة أحجامها وتنوع مصادرها؛ إذ تصل إلى المحلل في صورة أرقام متصلة وقياسات خام تفتقر في شكلها الأولي إلى الدلالة التفسيرية المباشرة. من هنا، تبرز عملية تصنيف البيانات وتحويل المتغيرات الرقمية المستمرة إلى فئات ترتيبية أو اسمية كخطوة محورية لا غنى عنها في مسار معالجة البيانات، حيث تسهم في تحويل المقاييس الرياضية المعقدة إلى معلومات قابلة للفهم والاستنتاج، وتدعم اتخاذ القرارات الإدارية والتنظيمية بكفاءة وموثوقية عالية.
يقدم برنامج مايكروسوفت إكسل (Microsoft Excel) بيئة حاسوبية متكاملة توفر ترسانة واسعة من الأدوات والخوارزميات المصممة لهيكلة البيانات وفرزها وفق محددات كمية ونوعية دقيقة. لا تقتصر وظائف البرنامج على مجرد إجراء العمليات الحسابية التقليدية، بل تمتد لتشمل قدرات منطقية واسترجاعية متقدمة تتيح للمستخدمين تقسيم سلاسل البيانات المعقدة إلى قطاعات متجانسة بالاعتماد على معايير مرجعية محددة مسبقاً. إن إتقان هذه التقنيات يمثل الفارق الجوهري بين المعالجة السطحية للأرقام والتحليل الاستكشافي المعمق الذي يستجلي الأنماط الكامنة والاتجاهات الحرجة خلف الظواهر المدروسة.
يتناول هذا الدليل الشامل والمفصل الأسس النظرية والممارسات التطبيقية المتقدمة لفرز وتصنيف البيانات الرقمية داخل بيئة إكسل. سنستعرض عبر محاوره المختلفة آليات بناء الجداول المرجعية وتصميم النطاقات القياسية، وصياغة الدوال المنطقية المركبة ودوال البحث المتقدمة، وصولاً إلى استثمار الجداول المحورية وأدوات التنسيق البصري، مدعوماً برؤى مستمدة من مناهج القياس في العلوم الاجتماعية والسلوكية لضمان أعلى درجات الدقة الإحصائية والموثوقية التحليلية في معالجة مختلف السيناريوهات العملية.
1. مقدمة منهجية إلى تصنيف البيانات في برنامج إكسل
1.1 المفهوم النظري لتصنيف البيانات وأهميته التحليلية
يُعرَّف تصنيف البيانات الرقمية (Data Categorization or Binning) في الأدبيات الإحصائية بأنه العملية المنهجية التي يتم من خلالها تحويل المتغيرات الكمية المستمرة (Continuous Variables) أو الفترية (Interval Variables) إلى متغيرات نوعية فئوية (Categorical) أو ترتيبية (Ordinal). في الأصل، تقيس المتغيرات المستمرة خصائص يمكن أن تأخذ أي قيمة عددية ضمن مدى محدد، مثل درجات الاختبارات، أو نسب المبيعات، أو زمن الاستجابة الحركية. غير أن الإبقاء على هذه القيم في صيغتها الفردية المجردة يفرض عبئاً ذهنياً وحسابياً كبيراً أثناء محاولة تفسيرها واستخلاص الدلالات العامة منها، وهو ما يجعل إعادة هيكلتها ضمن فئات ذات مغزى خطوة تأسيسية لا غنى عنها في التحليل الاستكشافي.
يؤدي التصنيف دوراً حاسماً في خفض التعقيد الحسابي وتسهيل استقراء الأنماط والاتجاهات الكبرى التي قد تحجبها التفاصيل الدقيقة للفروق الفردية الهامشية. فعندما نقوم بدمج مئات القياسات المتناثرة داخل حاويات رقمية متسقة، يصبح من اليسير مراقبة تحولات التوزيع التكراري، وتحديد مراكز الثقل الإحصائي، واكتشاف الانحرافات الجوهرية. علاوة على ذلك، يكتسب التصنيف أهمية استثنائية في مجالات النمذجة الإحصائية وعلم البيانات؛ حيث تتطلب العديد من الخوارزميات، مثل نماذج الانحدار اللوجستي أو أشجار القرار وشبكات التصنيف الاحتمالية، مدخلات فئوية منضبطة لإجراء عمليات التنبؤ والمقارنة بفعالية، فضلاً عن أهميته البالغة في صياغة التقارير التنفيذية والسلوكية التي تتطلب عرض مؤشرات واضحة ومباشرة لصناع القرار.
1.2 التطبيقات العلمية والعملية لتصنيف المتغيرات الرقمية
تتعدد التطبيقات التطبيقية لفرز وتصنيف المتغيرات الرقمية لتشمل قطاعات بحثية ومؤسسية واسعة. ففي بيئات العمل والتقييم المؤسسي، يُعتمد تصنيف الدرجات الرقمية لتقييم الأداء الفردي والجماعي عبر تحويل نقاط التقييم السنوي إلى مستويات جدارة معيارية (مثل: دون التوقعات، يفي بالتوقعات، يتجاوز التوقعات). وقد وثقت دراسات السلوك التنظيمي، ومنها أبحاث Murnighan and Conlon (1991)، كيف أن تمايز مستويات الأداء وتحديد الفروق الفئوية داخل مجموعات العمل يسهم في فهم التفاعلات الديناميكية والتنسيق الوظيفي المعقد داخل الفرق المتخصصة.
وفي حقول القياس النفسي والسلوكي، تتجلى الحاجة الماسة للتصنيف عند التعامل مع استجابات مقاييس ليكرت (Likert Scales) والدرجات المعيارية المستمرة؛ حيث يجري تقسيم الأفراد وفق محددات السلوك التكيفي أو مؤشرات الصحة النفسية ومستويات الدافعية إلى فئات إكلينيكية وتشخيصية محددة. تسهم هذه الفئات في تيسير التدخلات السلوكية المصممة بعناية، وهو ما يتوافق مع ما أكده Carey et al. (2018) حول أهمية التحديد الدقيق لآليات التغيير السلوكي وتصنيف محددات الاستجابة الفردية لتحسين مخرجات البرامج التدخلية. كما يمتد التطبيق إلى التجارب المعملية والميدانية لفرز وتقسيم المجموعات التجريبية والضابطة بالاعتماد على القياسات القبلية، لضمان تكافؤ المجموعات وقياس مستويات التقدم والنمو المعرفي بدقة، وهو ما يدعم دراسات الأداء الإدراكي والقرائي كتلك التي حللها Delgado et al. (2018).
1.3 نظرة عامة على تقنيات الفرز والتصنيف المتاحة في إكسل
يوفر برنامج إكسل منظومة تقنية متكاملة لمعالجة وتصنيف القيم الرقمية، تتراوح من الصيغ المنطقية المباشرة إلى الأدوات التجميعية الديناميكية المتقدمة. تبرز في مقدمة هذه المنظومة تقنيات البحث والرجوع، وعلى رأسها دالة البحث التقليدية VLOOKUP بوضع المطابقة التقريبية، والتي صممت تاريخياً لتحديد الفئات بالاعتماد على جداول مرجعية مرتبة تصاعدياً، تليها الدالة الحديثة والمتطورة XLOOKUP التي أحدثت نقلة نوعية في مرونة تحديد نطاقات البحث والإرجاع والتعامل المستقل مع اتجاهات الفرز وحدود الفئات دون قيود صارمة على بنية الأعمدة.
وإلى جانب دوال البحث، تبرز التقنيات المنطقية القائمة على الشروط المتداخلة، مثل تركيبة دالة IF الكلاسيكية ودالة IFS متعددة الشروط، والتي تتيح للمحلل كتابة قيود رياضية تفصيلية ومخصصة مباشرة داخل شريط الصيغة دون الحاجة إلى إنشاء جداول خارجية في بعض الحالات المحدودة. ومن زاوية أخرى، يقدم إكسل أدوات تجميعية تفاعلية لا تتطلب كتابة صيغ رياضية معقدة، مثل الجداول المحورية (Pivot Tables) التي تحتوي على ميزة التجميع التلقائي (Grouping) للقيم الرقمية إلى فترات متساوية وفواصل منتظمة، فضلاً عن إمكانات التنسيق الشرطي (Conditional Formatting) التي تمنح التصنيفات بعداً بصرياً فورياً يسهل استيعاب البيانات بصورة حدسية.
2. إعداد البيانات وهيكلتها قبل الشروع في التصنيف
2.1 فحص سلامة البيانات الرقمية وضمان الجودة الإحصائية
تعد مرحلة تنظيف وإعداد البيانات حجر الزاوية لأي عملية تحليلية ناجحة؛ فالشروع في تصنيف بيانات تحتوي على تشوهات بنيوية يقود حتماً إلى نتائج مضللة وتصنيفات خاطئة. تتطلب هذه الخطوة إجراء فحص استكشافي شامل للكشف عن القيم الشاذة والمتطرفة (Outliers) التي قد تنشأ عن أخطاء إدخال يدوية أو أعطال في أجهزة القياس الرقمية. وجود مثل هذه القيم المتطرفة قد يمدد المدى الإجمالي للمتغير بصورة مصطنعة، مما يعيق تحديد فترات تصنيف متوازنة ومنطقية من الناحية الإحصائية.
كذلك يجب التحقق الصارم من خلو الحقول الرقمية من المسافات النصية غير المرئية أو الفراغات العشوائية التي تحول طبيعة الخلية في إكسل من صيغة رقمية إلى نصية، مما يعطل عمل دوال المقارنة الحسابية والبحث التقريبي. يتضمن ذلك استخدام دوال التطهير مثل TRIM وCLEAN وإعادة تحويل النصوص إلى أرقام عبر دالة VALUE أو ميزة التحويل المباشر. كما ينبغي توحيد أنظمة الفواصل العشرية وتحديد معيار ثابت للتعامل مع الحقول الفارغة أو البيانات المفقودة (Missing Data)، إذ يجب ترميزها بوضوح لتفادي قراءتها كقيم صفرية غير مقصودة من قبل معادلات التصنيف اللاحقة.
2.2 تحديد المتغيرات والمقاييس المرجعية ونطاقات القيم
يرتكز التصنيف الموضوعي على تعريف المتغير المستهدف بدقة متناهية، وضبط وحدة القياس المعتمدة بصورة تزيل أي لبس تحليلي. على سبيل المثال، يجب تحديد ما إذا كانت درجات الأداء تمثل نسباً مئوية محصورة بين 0 و100، أم درجات معيارية خام تمتد على مقياس متدرج غير مقيد. إن غياب هذا التحديد قد يقود إلى تطبيق عتبات تصنيفية غير ملائمة لطبيعة التوزيع الحسابي للمتغير المدروس.
يتطلب تحديد العتبات الرقمية الفاصلة بين الفئات الاستناد إلى أسس موضوعية ومسوغات منهجية معتبرة، وتجنب الاعتماد على التقديرات الحدسية أو التقسيمات العشوائية. في الدراسات النفسية والسلوكية، يُراعى في كثير من الأحيان توثيق المعايير النظرية للنطاقات، كالاستناد إلى توزيعات معيارية سابقة أو انحرافات معيارية مقننة عن المتوسط الحسابي. إن فهم الظواهر النفسية المتعلقة بالتقييم الذاتي والتحيزات الإدراكية، مثلما ناقشها Dunning, Heath, and Suls (2004) وAlicke and Sedikides (2009)، يوضح أن ضبط معايير القياس الخارجية المستقلة هو السبيل الوحيد لتفادي تضخيم الدرجات الذاتية وضمان أن تعكس الفئات الرقمية المستويات الحقيقية للكفاءة والأداء.
2.3 هيكلة النطاقات العددية بصيغة جداول مرجعية قياسية
لكي تتمكن دوال إكسل المتقدمة من قراءة معايير التصنيف وتنفيذها بدقة متناهية، ينبغي تنظيم هذه المعايير داخل جدول مرجعي قياسي منفصل ومستقل عن نطاق البيانات المصدرية. تعتمد الخوارزميات الحسابية للبحث التقريبي في إكسل على قراءة العتبة الدنيا (Lower Bound) لكل فئة وليس مداها الكامل؛ وعليه، يجب تخصيص العمود الأول في الجدول المرجعي لتسجيل الحد الأدنى الرقمي الذي تبدأ عنده كل فئة تصنيفية بشكل صريح ومباشر.
يعد الترتيب التصاعدي الصارم للقيم الرقمية في عمود الحدود الدنيا شرطاً بنيوياً لا يقبل المساومة لضمان توافق الجدول مع متطلبات خوارزميات البحث الثنائي التكراري؛ فالإخلال بهذا الترتيب يؤدي بالضرورة إلى إخفاق الدوال واسترجاع قيم عشوائية غير صحيحة. كما يحقق فصل جدول المعايير عن البيانات الأصلية مرونة تشغيلية فائقة؛ إذ يتيح للمحلل إمكانية تعديل حدود الفئات أو تغيير مسمياتها الوصفية مستقبلاً من موضع واحد مركزي، لتنعكس تلك التعديلات تلقائياً وفورياً على آلاف الصفوف والبيانات المصنفة دون الحاجة إلى تعديل الصيغ الحسابية في كل خلية على حدة.
3. تصنيف البيانات باستخدام دالة البحث التقريبي VLOOKUP
3.1 بناء جدول الحدود الدنيا والقيم المقابلة
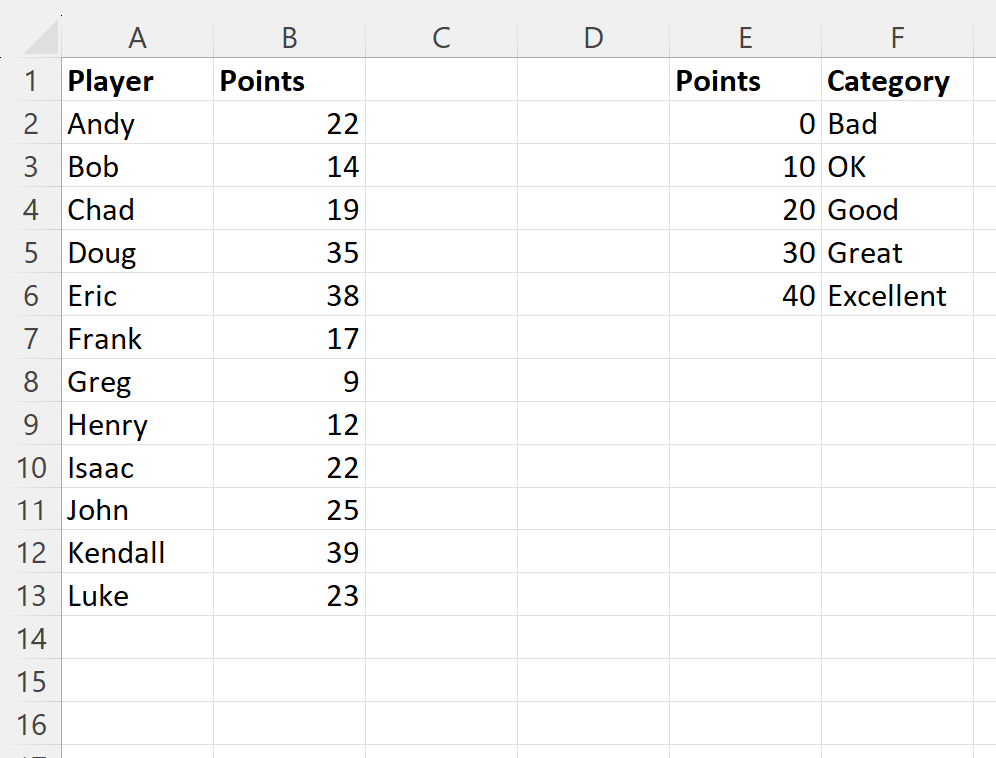
تعد دالة VLOOKUP واحدة من أكثر الأدوات كفاءة واستقراراً في تصنيف البيانات الرقمية عند ضبطها على نمط البحث التقريبي. لتطبيق هذه الدالة، يتم أولاً إنشاء جدول مرجعي مكون من عمودين رئيسيين على الأقل؛ يُخصص العمود الأيسر (أو الأول في مصفوفة البحث) لتسجيل الحدود الدنيا لكل شريحة رقمية، بينما يحتوي العمود الملاصق له على التسمية الفئوية أو الوصف النوعي المقابل لتلك الشريحة. فإذا كانت الفئات مستهدفة لتصنيف درجات أكاديمية، فإن الجدول يبدأ بالقيمة 0 المقابلة لوصف “راسب”، تليها القيمة 60 لوصف “مقبول”، ثم 70 لوصف “جيد”، ثم 80 لوصف “جيد جداً”، وتنتهي بالقيمة 90 لوصف “ممتاز”.
يجب التأكيد الصارم على ضرورة خلو جدول الحدود الدنيا من أي فجوات رقمية غير معالجة، وترتيب القيم من الأصغر إلى الأكبر بشكل مطلق. إن هذا البناء الهيكلي يضمن أن دالة البحث ستتمكن من مسح النطاق خطوة بخطوة، وعندما تصادف قيمة تقع بين حدين أدنيين، ستستقر تلقائياً عند الحد الأدنى للفئة التي تنتمي إليها القيمة المفحوصة، مما يمنع حدوث أخطاء عدم العثور على المدخلات ويعزز سلامة المخرجات التحليلية.
3.2 صياغة دالة VLOOKUP بالاعتماد على التطابق التقريبي
تتطلب كتابة صيغة VLOOKUP لغايات التصنيف ضبط وسائطها الأربع بدقة هندسية عالية. تُحدد الوسيطة الأولى lookup_value الخلية الفردية التي تحتوي على الرقم المراد تصنيفه ضمن سجل البيانات الأساسي (مثل الخلية A2). تليها الوسيطة الثانية table_array، وهي النطاق الجغرافي للجدول المرجعي للحدود الدنيا والتسميات (مثل $F$2:$G$6)، وهنا يبرز الإلزام المنهجي باستخدام علامات التثبيت المطلق (Absolute Reference $) لتجميد إحداثيات الجدول ومنع انزلاقها أثناء تعميم الصيغة على بقية الخلايا.
أما الوسيطة الثالثة col_index_num، فتحدد رقم عمود النتيجة المراد استرجاعها من الجدول المرجعي، وهو عادة العمود رقم 2 الذي يحمل المسميات الفئوية. وتأتي الوسيطة الرابعة والأهم [range_lookup]؛ حيث يجب تعيينها صراحة على القيمة المنطقية TRUE أو ما يعادلها رقمياً 1. هذا الضبط يوجه إكسل لاعتماد خوارزمية التطابق التقريبي (Approximate Match)، مما يسمح للبرنامج بمقارنة الرقم والبحث عن أقرب قيمة مطابقة أو أكبر قيمة تظل أصغر من أو تساوي القيمة المدخلة بدلاً من البحث عن تطابق حرفي متطابق تماماً.
3.3 تعميم المعادلة وتفسير مخرجات التصنيف
بمجرد اكتمال صياغة المعادلة والتأكد من صحتها في الخلية الأولى، يتم تعميمها عبر كامل سجلات قاعدة البيانات من خلال النقر المزدوج على مقبض التعبئة التلقائية (AutoFill Handle) أو سحبه لأسفل على امتداد العمود التحليلي المستهدف. تتولى البيئة الحسابية لإكسل تطبيق المنطق نفسه على كافة الصفوف تباعاً، مستفيدة من التثبيت المطلق للجدول المرجعي مع التحديث التلقائي للمرجع النسبي لقيمة الفحص الرقمية الخاصة بكل سجل على حدة.
تعتمد آلية التفسير البرمجية لمخرجات VLOOKUP التقريبية على قاعدة رياضية واضحة: إذا كانت القيمة المفحوصة تساوي 75، فإن الدالة تفحص جدول الحدود، فتجد أن 75 أكبر من 70 وأصغر من 80؛ وبناءً عليه، تتجاهل فئة الـ 80 وما فوق وتتوقف عند فئة الـ 70، لترجع التسمية المقابلة لها وهي “جيد”. يتعين على المحلل في هذه المرحلة إجراء تدقيق عيني لعينة عشوائية تشمل القيم الحدية الملاصقة تماماً للعتبات الرقمية (مثل فحص القيم 59.9 و60 و60.1) للتحقق القاطع من أن سلوك الخوارزمية ينطبق تماماً مع المنطق التصنيفي المستهدف دون أي إزاحة غير مقصودة في الفئات.
4. التصنيف الشرطي باستخدام الدوال المنطقية IF المتداخلة وIFS
4.1 بناء سلاسل منطقية باستخدام دالة IF المتعددة
تمثل صياغة الدوال المنطقية المتداخلة (Nested IF Functions) الأسلوب التقليدي الكلاسيكي لمعالجة الشروط المتعددة داخل شريط الصيغة مباشرة. تعتمد الفلسفة الحسابية لهذه الدالة على إجراء اختبار منطقي، وتحديد نتيجة في حال تحقق الشرط، بينما تُستبدل النتيجة البديلة (في حال عدم التحقق) بدالة IF أخرى تفحص شرطاً تالياً، وهكذا دواليك حتى استيفاء جميع الفئات المطلوبة.
يعد الترتيب الهرمي الصارم للشروط هو العامل الحاسم لنجاح هذه الصيغة؛ إذ يجب ترتيب الفحوص المنطقية باتجاه واحد متسق حصراً: إما من القيمة الأعلى إلى القيمة الأدنى، أو من القيمة الأدنى إلى القيمة الأعلى. فإذا بدأ المحلل بفحص ما إذا كانت الدرجة أكبر من أو تساوي 90 لاسترجاع “ممتاز”، يجب أن يكون الشرط التالي فحص ما إذا كانت أكبر من أو تساوي 80 لاسترجاع “جيد جداً”، لأن وضع شرط الأدنى أولاً في هذا السياق سيجعل كافة القيم الأعلى تقع في الفئة الأولى بصورة خاطئة وتتوقف الصيغة عن العمل. كما يتطلب هذا الأسلوب حرصاً فائقاً في إغلاق الأقواس التراكمية في نهاية المعادلة بما يتطابق تماماً مع عدد الدوال المفتوحة، لتفادي رسائل أخطاء بناء الصيغ الحسابية (Syntax Errors).
4.2 استخدام دالة IFS لتسهيل كتابة القيود المعقدة
جاء إطلاق مايكروسوفت لدالة IFS في الإصدارات الحديثة ليمثل حلاً جذرياً لمشكلة التداخل المعقد للأقواس وصعوبة قراءة الشروط المتعددة. تتميز دالة IFS ببنية خطية انسيابية مباشرة تعتمد على مبدأ الأزواج المنطقية؛ حيث تتكون كل وحدة فيها من جزأين متتاليين: الفحص المنطقي المستقل (Logical_test)، يليه مباشرة القيمة المعادة في حال تحققه (Value_if_true)، دون الحاجة لتكرار كتابة اسم الدالة أو فتح أقواس فرعية لا نهائية.
تُكتب الدالة وفق النمط التالي:
=IFS(A2>=90, "ممتاز", A2>=80, "جيد جداً", A2>=70, "جيد", A2>=60, "مقبول", TRUE, "راسب")
يوضح هذا البناء الانسيابي كيف يتم فحص الشروط تباعاً حتى الوصول إلى المعامل المنطقي الأخير TRUE. يعمل هذا المعامل كشبكة أمان وحارس نهائي (Default Fallback)؛ ففي حال فشلت جميع الشروط المنطقية السابقة في الانطباق على القيمة المفحوصة، يُلزم المعامل TRUE الدالة باسترجاع القيمة الافتراضية المحددة بعده (وهي “راسب” في هذا المثال)، مما يحمي النموذج من توليد أخطاء حسابية مزعجة عند ورود قيم غير متوقعة أو دون المستويات الدنيا.
4.3 مقارنة الكفاءة بين الحلول المنطقية وجداول البحث
على الرغم من الجاذبية المبدئية للحلول المنطقية المعتمدة على IF وIFS لكونها لا تتطلب إنشاء جداول إضافية في ورقة العمل، إلا أن التحليل المنهجي المتقدم يكشف عن عيوب جوهرية تحد من كفاءتها في البيئات الإنتاجية الموسعة. تبرز صعوبة الصيانة وإدارة التغيير كأول هذه العيوب؛ فإذا طرأ تعديل على إحدى العتبات الرقمية أو تقرر استبدال مسمى فئوي معين، يضطر المحلل إلى تعديل الصيغة النصية الطويلة وإعادة نسخها وتعميمها عبر آلاف السجلات، وهو إجراء محفوف بمخاطر الخطأ البشري العالي.
علاوة على ذلك، يؤدي تراكم الشروط المنطقية داخل ملفات العمل الضخمة إلى استهلاك موارد المعالجة الحاسوبية بصورة ملحوظة، مما يبطئ من سرعة إعادة الحساب التلقائي (Recalculation Speed) للبرنامج مقارنة بخوارزميات جداول البحث المرجعية. تتميز جداول البحث، مثل تلك المستخدمة مع VLOOKUP أو XLOOKUP، بمرونة فائقة وقابلية للتوسع والتطوير؛ إذ يتم تعديل المعايير مركزياً داخل الجدول المرجعي لتتحدث النتائج آنياً، مما يجعلها الخيار المهني المفضل في النمذجة المالية والتحليلات الإحصائية واسعة النطاق.
5. التصنيف المتقدم باستخدام دالتي XLOOKUP وINDEX/MATCH
5.1 استثمار الإمكانات الحديثة لدالة XLOOKUP في التطابق التقريبي
تمثل دالة XLOOKUP الذروة التطورية لدوال البحث داخل إكسل، متجاوزة كافة القيود الهيكلية والقصور الفني الذي لازم الدوال السابقة لعقود. في سياق تصنيف البيانات، تتيح XLOOKUP للمحلل فصل مصفوفة البحث (Lookup_array) التي تتضمن الحدود الرقمية، عن مصفوفة الإرجاع (Return_array) التي تضم التسميات الوصفية، مما يلغي الحاجة لكونهما متجاورتين أو في ترتيب هندسي ثابت من اليسار إلى اليمين.
الابتكار الأبرز في هذه الدالة يتمثل في وسيطة وضع المطابقة (Match_mode)؛ حيث يوفر إكسل الخيار -1 الذي يعني البحث عن تطابق تام، وفي حال عدم وجوده يتم استرجاع القيمة الأصغر التالية (Exact match or next smaller item)، وهو النمط المكافئ للتصنيف المعتمد على الحدود الدنيا التراكمية. والأكثر إثارة للمحللين هو توفير الخيار 1 الذي يسترجع القيمة الأكبر التالية (Exact match or next larger item)، وهو ما يسمح بتصنيف البيانات استناداً إلى الحدود القصوى (Upper Bounds) بدلاً من الحدود الدنيا، فضلاً عن دعم الدالة للترتيب التنازلي المباشر للبيانات عبر ضبط وسيطة نمط البحث (Search_mode)، مما يوفر مرونة نمذجة لا نظير لها.
5.2 التصنيف المركب بالجمع بين دالتي INDEX وMATCH
يحظى الاقتران الكلاسيكي بين دالتي INDEX وMATCH بمكانة رفيعة لدى كبار مطوري النماذج في إكسل نظراً لقوته الاستثنائية وسرعته الفائقة في معالجة مجموعات البيانات الهائلة. يعمل هذا الثنائي عبر توزيع المهام: حيث تتولى دالة MATCH مهمة تحديد الموقع النسبي (رقم الصف) للخلية الرقمية داخل مصفوفة الحدود، بينما تتولى دالة INDEX استخراج القيمة الوصفية المقابلة من مصفوفة الفئات استناداً إلى رقم الصف المسترجع.
لتحقيق التصنيف التقريبي المنضبط، تُصاغ دالة MATCH بتعيين وسيطة نوع التطابق (Match_type) على القيمة 1؛ وهو ما يوجه الدالة للبحث عن أكبر قيمة تكون أقل من أو تساوي القيمة المدخلة، شريطة أن تكون مصفوفة الحدود مرتبة تصاعدياً. يمنح هذا التركيب المعياري مرونة كاملة لتحريك مصفوفات البحث والإرجاع في أي مكان داخل المصنف، والتعامل بكفاءة مع التنسيقات الأفقية والعمودية دون أي قيود، متفوقاً بذلك على جمود دالة VLOOKUP في البيئات التحليلية المعقدة.
5.3 إدارة التصنيفات متعددة الأبعاد والاتجاهات
تتجاوز الاحتياجات التحليلية في كثير من الأحيان التصنيف الأحادي البسيط لتبحث عن تقييمات مركبة تعتمد على متغيرين رقميين في آن واحد (Two-Dimensional Categorization). تبرز هذه الحالة بوضوح في مصفوفات تقييم المخاطر؛ حيث يتم تصنيف الحدث بناءً على مقياسين متصلين: درجة “الاحتمالية” من جهة، وشدة “الأثر” من جهة أخرى، لتقاطع النتيجتين معاً ضمن جدول تقييم مزدوج يستخرج مستويات الخطر (مثل: منخفض، متوسط، حرج).
تتم إدارة هذه النماذج المتقدمة بدمج دالة INDEX مع دالتي MATCH مستقلتين؛ حيث تقوم الدالة الأولى بتحديد إحداثي الصف بناءً على المتغير الأول، في حين تتولى الدالة الثانية تحديد إحداثي العمود بناءً على المتغير الثاني. يتيح هذا الربط استخراج التصنيف الفئوي الدقيق الواقع عند نقطة التقاطع الهندسية للمتغيرين. يمثل هذا التوجه التطبيقي ركيزة أساسية في التحليلات السلوكية والتنظيمية المتشعبة، ويدعم الدراسات السريرية والصحية المتعددة المستويات مثل النماذج التدخلية التي استعرضها Liu et al. (2017)، حيث تتداخل العوامل المتعددة لتحديد التصنيف التشخيصي أو الإداري المناسب للحالة.
6. تجزئة وتصنيف البيانات الكمية إلى فئات وفواصل متساوية
6.1 أسس التقسيم الفئوي وتكوين الحاويات الرقمية (Binning)
يرتكز التحليل الإحصائي السليم على تحويل البيانات المتصلة إلى حاويات رقمية متساوية العرض (Equal-Width Binning) لتمكين قراءة التوزيع الاحتمالي للظاهرة محل الدراسة. تبدأ هذه العملية الرياضية بحساب المدى الإجمالي للبيانات (Range) عن طريق طرح أدنى قيمة مسجلة في العينة (باستخدام دالة MIN) من أعلى قيمة مسجلة (باستخدام دالة MAX). بعد ذلك، يحدد المحلل عدد الفئات المستهدفة (k)، والذي يخضع عادة لقواعد إحصائية معيارية مثل قاعدة ستورجز (Sturges’ Rule) التي تنص على أن: ( k = 1 + 3.322 log_{10}(N) )، حيث يمثل ( N ) إجمالي حجم العينة.
بمجرد تحديد عدد الفئات، يُحسب العرض الثابت للفئة (Bin Width) بقسمة المدى الإجمالي على عدد الفئات، مع تقريب الناتج تصاعدياً إلى أقرب رقم صحيح ذي دلالة عملية لتسهيل التفسير وتجنب الكسور المعقدة. من الأهمية المنهجية البالغة عند ضبط حدود الحاويات مراعاة تأمين الحاويتين الطرفيتين (الدنيا والقصوى) بهوامش أمان حسابية طفيفة؛ وذلك لضمان احتواء أطراف البيانات المتطرفة وعدم استبعاد أي قياس تجريبي يقع بدقة متناهية على الحد الأقصى أو الأدنى للتوزيع المدروس.
6.2 تطبيق الدالة الإحصائية المصفوفية FREQUENCY لتصنيف المجموعات
تقدم الدالة الإحصائية المتخصصة FREQUENCY حلاً رياضياً بالغ الفعالية لحساب التوزيع التكراري وتصنيف المجموعات الرقمية داخل الحاويات المحددة. تعمل هذه الدالة بصيغة مصفوفية صريحة؛ حيث تستقبل وسيطتين رئيسيتين: مصفوفة البيانات الخام (Data_array)، ومصفوفة الفواصل أو الحدود العليا للحاويات (Bins_array). ومن خلال ضغطة واحدة، تولد الدالة عموداً تكرارياً يوضح عدد الحالات الإحصائية التي استقرت في كل حاوية رقمية محددة بدقة رياضية متناهية.
تعتمد آلية احتساب دالة FREQUENCY منطق التضمين المزدوج للفترات؛ حيث تحتسب القيم التي تكون أكبر من الحد الأعلى للفئة السابقة وأصغر من أو تساوي الحد الأعلى للفئة الحالية. ومن خلال تحويل هذه التكرارات المطلقة إلى أوزان نسبية ومئوية بقسمتها على إجمالي العينة، يتمكن المحلل من توصيف البنية التوزيعية للمجتمع المدروس، وهي المنهجية المتبعة على نطاق واسع في بناء المعاجم النفسية واللغوية وتحديد أوزان المتغيرات المعرفية المعقدة، كما هو موضح في أبحاث التقييم اللغوي والعياري التي أنجزها Brysbaert, Warriner, and Kuperman (2013) في تصنيف آلاف الكلمات وفق مقاييس تجريدية متصلة.
6.3 التصنيف النسبي بالاعتماد على المئينات (Percentiles)
في العديد من البيئات التحليلية التنافسية أو غير المنتظمة إحصائياً، يصبح التقسيم الفئوي المتساوي ذا دلالة محدودة، ولا سيما عند وجود التواء حاد (Skewness) في توزيع البيانات. في هذه الحالات، يتجه المحللون المحترفون إلى اعتماد التصنيف النسبي الترتيبي المبني على المئينات ونقاط التقسيم الموضعية (Equal-Frequency Binning)؛ حيث تقسم البيانات إلى شرائح متساوية من حيث عدد الأفراد أو الحالات بصرف النظر عن المدى الحسابي الفاصل بين درجاتهم.
يتم إنجاز هذا التقسيم باستخدام دالة PERCENTILE.INC لحساب نقاط القطع المئينية المناسبة؛ كتقسيم البيانات إلى أربعة أرباع (Quartiles) باستخدام المئينات 25%، 50%، و75%، أو تقسيمها إلى أعشار (Deciles). تتجلى القوة التحليلية للتصنيف النسبي في تجاوزه لانحيازات المقاييس المطلقة؛ فالدرجة 70 قد تبدو منخفضة في سياق مطلق، ولكنها قد تضع الفرد ضمن شريحة أعلى 10% إذا كان الاختبار شديد الصعوبة على الجميع. يدعم هذا المنظور المعياري الفهم العميق للوظائف المعرفية واللغوية وسياقات المقارنة الإدراكية كالأطر النظرية التي ناقشها Carruthers (2002)، حيث ترتبط الدلالة التقييمية بالموضع النسبي للأداء ضمن شبكة المعايير المرجعية للمجموعة ككل.
7. أتمتة التصنيف الديناميكي عبر جداول إكسل المحورية (Pivot Tables)
7.1 تجميع القيم الرقمية تلقائياً في فئات منتظمة
تعتبر الجداول المحورية (Pivot Tables) في إكسل الأداة التفاعلية الأقوى لتلخيص وتصنيف البيانات الضخمة دون الحاجة إلى كتابة سطر واحد من الصيغ الرياضية. عند الرغبة في تصنيف متغير رقمي متصل، يقوم المحلل بإدراج جدول محوري ونقل الحقل الرقمي المعني مباشرة إلى منطقة الصفوف (Rows Area)، مما يؤدي مبدئياً إلى سرد كل قيمة رقمية فريدة في سطر مستقل.
تبدأ القوة الحقيقية بالاستفادة من ميزة التجميع التلقائي المدمجة (Grouping Feature)؛ حيث يتم النقر بزر الفأرة الأيمن على أي رقم داخل عمود الصفوف واختيار الأمر Group. تنبثق عندها نافذة تفاعلية تتيح للمستخدم تحديد نقطة البداية (Starting at) ونقطة النهاية (Ending at) وطول الفترة التجميعية الثابتة (By). بمجرد إدخال هذه المعلمات والضغط على زر الموافقة، يعيد إكسل تنظيم آلاف السجلات الفردية فورياً داخل فئات نصية منتظمة (مثل: 0-19، 20-39، 40-59)، مما يوفر رؤية ملخصة فائقة الدقة لتوزيع البيانات الإجمالي خلال ثوانٍ معدودة.
7.2 تخصيص تصنيفات غير متساوية عبر الحقول المحسوبة
على الرغم من براعة التجميع التلقائي في تكوين فترات متساوية، إلا أن المتطلبات التحليلية الواقعية تفرض أحياناً عزل شرائح رقمية معينة وفق أبعاد غير خطية؛ كأن تحتاج إدارة المخاطر إلى فئة واسعة للقروض منخفضة القيمة، وفئات بالغة الضيق والتفصيل للقيم المرتفعة ذات الحساسية التمويلية العالية. في هذه الظروف، يتيح إكسل إجراء التجميع المخصص يدوياً عن طريق تحديد خلايا رقمية معينة معاً داخل الجدول المحوري وتجميعها في كتلة مخصصة باسم فئوي مستقل.
علاوة على ذلك، يمكن تعزيز هذه البيئة التحليلية عبر بناء الحقول والعناصر المحسوبة (Calculated Fields & Items) التي تطبق أوزاناً نسبية ومعاملات تصنيفية معقدة تتجاوز مجرد الجمع البسيط للتكرارات. ومما يمنح هذه الطريقة موثوقيتها المؤسسية هو ارتباطها التلقائي بمصدر البيانات؛ فبمجرد إدراج بيانات جديدة في الجدول المصدر والضغط على أمر التحديث (Refresh)، تتسع الفئات والتجميعات المصممة لتستوعب المدخلات الحديثة تلقائياً وتدرجها ضمن شرائحها المستحقة دون تدخل يدوي إضافي.
7.3 استخراج المؤشرات الإحصائية لكل فئة ناتجة
لا تتوقف فائدة الجداول المحورية عند مجرد توزيع الأفراد على فئاتهم الرقمية، بل تمتد لتكون محطة توليد متكاملة للمؤشرات الإحصائية الوصفية لكل فئة مصنفة على حدة. عن طريق سحب المتغيرات الرقمية إلى منطقة القيم (Values Area) وتكرارها، يمكن للمحلل توجيه البرنامج لحساب مقاييس النزعة المركزية ومقاييس التشتت بالتوازي لكل فئة بصورة مستقلة.
يتيح ذلك حساب المتوسط الحسابي (Average)، والانحراف المعياري التقديري (Standard Deviation)، والقيم القصوى والدنيا لكل شريحة رقمية بضغطة زر. تسهم هذه المؤشرات المتقاطعة في قياس الكثافة التوزيعية ورصد درجة التجانس الداخلي لأفراد الفئة الواحدة مقارنة بالفئات الأخرى. كما تتيح تصدير هذه المخرجات التلخيصية بكفاءة عالية لتكون مدخلات معيارية في نماذج إحصائية عليا، مثل اختبارات التباين (ANOVA) وتحليلات الانحدار المتعدد المعقدة.
8. الترميز البصري للتصنيفات باستخدام التنسيق الشرطي
8.1 تطبيق مقاييس الألوان للتعبير عن المستويات الفئوية
يعد التنسيق الشرطي (Conditional Formatting) وسيلة اتصال بصرية لا غنى عنها لتحويل مخرجات التصنيف الرقمي إلى إشارات لونية تستجيب لها العين البشرية بسرعة وحدس فائقين. توفر ميزة مقاييس الألوان (Color Scales) في إكسل القدرة على إسقاط تدرجات لونية ثنائية أو ثلاثية الأبعاد على النطاقات الرقمية، بحيث تتدرج الألوان تلقائياً لتعكس المستويات الفئوية للقيم بصورة مستمرة وسلسة.
يتطلب التطبيق الأكاديمي والمهني المنضبط لهذه المقاييس الابتعاد عن الخيارات التلقائية الصارخة والحرص على معايرة نقاط التدرج يدوياً؛ حيث يتم تحديد قيمة الحد الأدنى باللون الأحمر الباهت، ونقطة المنتصف (التي يفضل ربطها بالمئين الخمسين أو المتوسط الحسابي) باللون الأصفر الحيادي، ونقطة الحد الأقصى باللون الأخضر الهادئ. يضمن هذا الضبط المدروس توجيه التباين اللوني بدقة تعبر عن الفئات التقييمية الحقيقية وتبرز التمايز بين مستويات الأداء، مع مراعاة راحة القارئ وتجنب التشتيت البصري الناتج عن تضارب الدرجات اللونية غير المتوازنة.
8.2 صياغة قواعد تنسيق مخصصة مرتبطة بمسميات الفئات
عندما ينتج عن معادلات التصنيف (مثل XLOOKUP أو IFS) عمود نصي يحتوي على مسميات الفئات الوصفية، تبرز الحاجة لتنسيق هذه المسميات بصرياً، أو تنسيق الصفوف المقابلة لها بالكامل، لإضفاء طابع احترافي منظم على التقارير وقواعد البيانات. يتم ذلك عبر إنشاء قواعد تنسيق شرطي مخصصة تعتمد على صيغ منطقية رياضية دقيقة (Use a formula to determine which cells to format).
لتلوين السجل بالكامل وفق فئته، يُنشئ المحلل قاعدة تحتوي على صيغة تشير إلى عمود الفئة مع تثبيت العمود نسبياً وتمرير الصفوف حراً (مثل =$E2="حرج")، واختيار خلفية تنسيقية مميزة لتلك الفئة. كما تتطلب الإدارة الاحترافية لهذه القواعد ضبط نافذة إدارة قواعد التنسيق (Rules Manager) بعناية فائقة، وترتيب أسبقية التطبيق والتحكم في خيار “إيقاف التقييم عند التحقق” (Stop If True)، لضمان عدم حدوث تداخل أو تضارب بين القواعد اللونية المتعددة عند معالجة الحالات التي قد تنطبق عليها أكثر من شريحة افتراضية.
8.3 دمج مجموعات الأيقونات لإبراز المؤشرات الترتيبية
تقدم مجموعات الأيقونات (Icon Sets) داخل بيئة إكسل حلاً مثالياً لتمثيل المتغيرات الترتيبية الناتجة عن عمليات التصنيف؛ حيث توفر حزماً متنوعة تشمل الأسهم الاتجاهية، والدوائر المرورية الملونة، وإشارات التحذير، ومؤشرات الأداء البيانية. تسهم هذه الأيقونات في تلخيص المستوى الفئوي لكل سجل في رمز بصري مصغر يظهر داخل الخلية بجوار القيمة أو بمفرده.
لكي تكتسب الأيقونات مصداقيتها التحليلية، ينبغي التخلي التام عن التوزيع المئوي الافتراضي الذي يفرضه إكسل تلقائياً، والدخول إلى إعدادات القاعدة لتحويل معايير الظهور من نوع “النسبة المئوية التلقائية” إلى نوع “القيمة الرقمية المطلقة” (Number). يتم عندها إدخال العتبات الرقمية المطابقة تماماً للجدول المرجعي للتصنيف المعتمد في النموذج، مما يضمن ظهور السهم الأخضر المرتفع، مثلاً، فقط عند تجاوز عتبة التميز المحددة رياضياً. كما يوفر خيار “إظهار الأيقونة فقط” (Show Icon Only) ميزة تصميمية راقية لبناء لوحات القياس التنفيذية (Dashboards)، حيث تختفي الأرقام الخام وتتبقى الرموز الدلالية التي تعطي تقييماً فورياً ومباشراً دون إرباك القارئ بتفاصيل رقمية زائدة.
9. معالجة الأخطاء الشائعة وضمان الدقة والصلابة الحسابية
9.1 معالجة أخطاء البحث وقيم عدم التطابق #N/A و#VALUE!
تواجه عمليات التصنيف المعتمدة على دوال البحث والرجوع أخطاء برمجية شائعة تؤدي إلى تشويه المظهر العام للتقارير وتعطل العمليات الحسابية اللاحقة. يبرز الخطأ الشهير #N/A في مقدمة هذه المشكلات عند استخدام VLOOKUP أو MATCH بنمط البحث التقريبي، ويحدث ذلك حصراً عندما تكون القيمة الرقمية المفحوصة أصغر تماماً من الحد الأدنى المسجل في الجدول المرجعي، مما يعجز الخوارزمية عن إيجاد أي فئة تقع القيمة في نطاقها.
لمعالجة هذه المعضلة وضمان صلابة النموذج، يجب تطويق دوال البحث بدوال الحماية والاستثناء، وعلى رأسها دالة IFNA أو الدالة الشاملة IFERROR. تتيح هذه الدوال تحديد مخرج بديل منضبط (مثل كتابة “خارج النطاق” أو إرجاع تصنيف افتراضي محدد مسبقاً) عند مصادفة خطأ غياب القيمة. من جانب آخر، ينشأ خطأ القيمة #VALUE! نتيجة التضارب النوعي في البيانات؛ كأن تحاول الصيغة مقارنة عدد مخزن بصيغة رقمية حقيقية مع قيم جدول مرجعي جرى استيرادها كنصوص مخزنة بصورة خاطئة، وهو ما يتطلب تدقيقاً شاملاً لنوعية البيانات المسجلة وتوحيد خواص تنسيق الخلايا لضمان تطابق المدخلات مع متطلبات الدوال الحسابية.
9.2 معالجة الفروقات الدقيقة بين القيم الحدية والتقريب
تمثل القيم الرقمية الحدية التي تقع بدقة متناهية على العتبات الفاصلة بين الفئات حقلاً شائكاً يتطلب معالجة هندسية واعية، وخاصة عند التعامل مع بيانات مستمرة تحتوي على كسور عشرية طويلة ناتجة عن عمليات قسمة أو أجهزة قياس بالغة الحساسية. على سبيل المثال، إذا كانت عتبة الفئة تبدأ عند الرقم 70، فإن قيمة مسجلة بنتيجة 69.9999 قد تؤدي إلى إسقاط السجل في فئة أدنى، في حين أن التقريب التلقائي للشاشة يظهرها كقيمة 70 كاملة، مما يولد ارتباكاً وشكوكاً حول نزاهة التصنيف.
لحل هذا التعارض، يجب إلزام النموذج باستخدام دوال التقريب الصريح، مثل ROUND لتثبيت عدد المنازل العشرية المقبولة قبل تمريرها لمعادلة التصنيف، أو استخدام دوال القطع الحسابي مثل FLOOR وCEILING للتحكم في اتجاه التقريب نحو الأدنى أو الأعلى بما يتوافق مع السياسة الإجرائية المعتمدة للمشروع. كما يتعين على المحلل تحديد وتوثيق الطبيعة الرياضية للفترات بوضوح قاطع: هل هي فترات “نصف مفتوحة” تشمل الحد الأدنى وتستبعد الحد الأعلى (تأخذ الصيغة: الحد الأدنى ≤ س < الحد الأعلى)، أم العكس؟ إن حسم هذا الاختيار يزيل أي غموض إجرائي ويضمن الاتساق الرياضي الكامل لجميع نتائج التصنيف.
9.3 تحسين أداء الملف عند معالجة قواعد بيانات ضخمة
عندما تتسع قواعد البيانات لتشمل عشرات أو مئات الآلاف من الصفوف السجلية، يتأثر الأداء الحسابي لبرنامج إكسل بصورة ملموسة؛ حيث قد يؤدي سوء صياغة معادلات التصنيف إلى استهلاك مفرط للذاكرة العشوائية وتوقف البرنامج لفترات طويلة لإعادة احتساب النتائج. يُعزى هذا التدهور غالباً إلى العادات الشائعة المتمثلة في تحديد أعمدة ورقة العمل كاملة (مثل A:A أو F:G) كمراجع لنطاقات البحث، مما يجبر محرك الحساب على فحص أكثر من مليون خلية في كل عملية مطابقة مفردة.
لرفع كفاءة المعالجة وضمان انسيابية العمل، ينبغي أولاً تقييد النطاقات لتشمل الخلايا المستغلة فعلياً فقط. والأفضل من ذلك هو تحويل نطاقات البيانات والجداول المرجعية إلى جداول إكسل المنظمة رسمياً (Excel Tables بالضغط على Ctrl + T)؛ حيث توفر هذه الجداول ميزة المراجع الهيكلية الديناميكية (Structured References) التي تتوسع تلقائياً مع إضافة البيانات وتتقلص مع حذفها، مما يمنح محرك الحساب أقصى سرعة ممكنة. كما يُنصح في الملفات العملاقة بتقديم جداول البحث المعتمدة على XLOOKUP أو INDEX/MATCH ذات التطابق التقريبي السريع على حساب الدوال المصفوفية الثقيلة، واستبدال الصيغ بقيمها الثابتة (Paste Values) للأرشيفات التاريخية التي لا تخضع للتحديث المستمر لتفريغ الذاكرة الحسابية.
10. دراسة تطبيقية متكاملة: تصنيف مستويات الأداء الرياضي
10.1 بناء النموذج العملي وإدخال بيانات نقاط اللاعبين
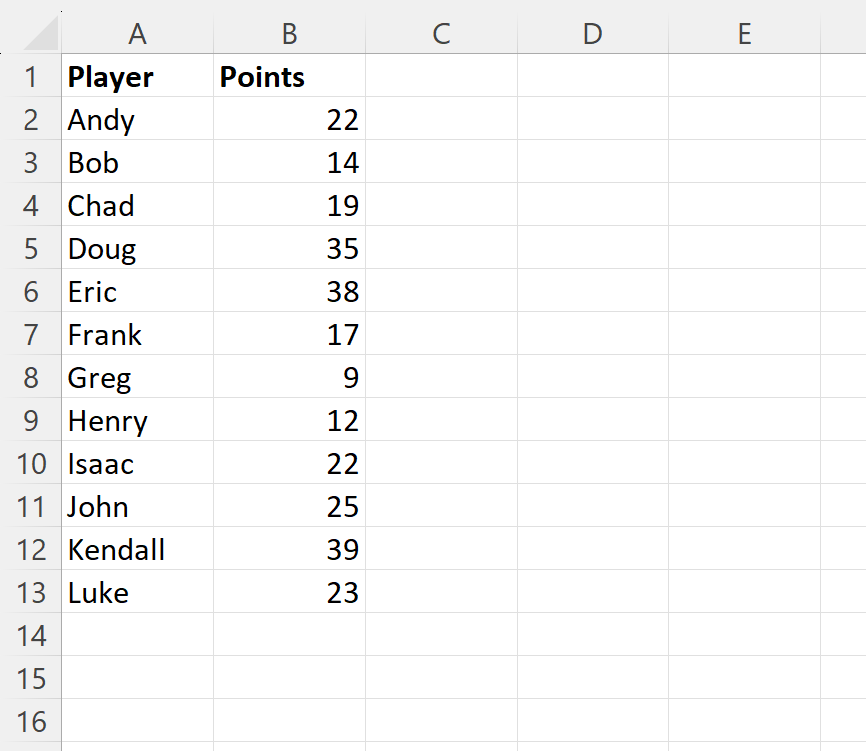
لتجسيد كافة المفاهيم والأدوات المتقدمة التي تم تأصيلها، نستعرض فيما يلي دراسة حالة تطبيقية متكاملة تهدف إلى تصنيف مستويات الأداء البدني والمهاري لعينة من الرياضيين استناداً إلى نتائج بطارية اختبارات مركبة تُسجل درجات مستمرة تتراوح نظرياً بين 0 و100 نقطة. تبدأ الخطوة الأولى بتهيئة جدول البيانات الميدانية، والذي يشتمل على المعرف الرقمي للاعب، واسمه الكامل، وإجمالي النقاط المكتسبة في التقييم.
في مساحة مخصصة من ورقة العمل، يتم تشييد الجدول المرجعي لمعايير الأداء بصورة منضبطة تصاعدياً، وفق الهيكلية المعيارية التالية:
- الحد الأدنى: 0 ← فئة الأداء: سيئ
- الحد الأدنى: 50 ← فئة الأداء: مقبول
- الحد الأدنى: 70 ← فئة الأداء: جيد
- الحد الأدنى: 85 ← فئة الأداء: رائع
- الحد الأدنى: 95 ← فئة الأداء: ممتاز
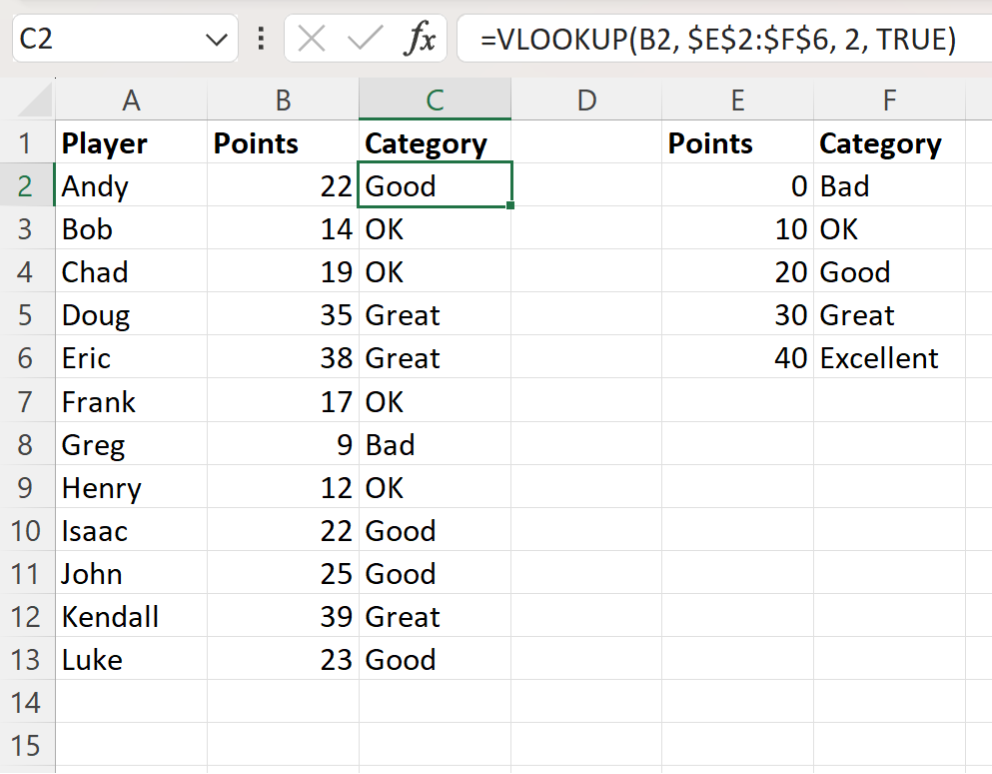
تتم كتابة معادلة التصنيف الآلية في عمود التقييم الفئوي المقابل لأول لاعب في السجل (الخلية C2) بالاعتماد على دالة البحث التقريبي الأكثر كفاءة واستقراراً:
=XLOOKUP(B2, $F$2:$F$6, $G$2:$G$6, "غير محدد", -1)
تقوم المعادلة بفحص درجة اللاعب المدخلة في B2، ومقارنتها بنطاق الحدود الدنيا $F$2:$F$6، واسترجاع المسمى المقابل فوراً من نطاق الفئات $G$2:$G$6. يضمن المعامل -1 استقرار البحث عند القيمة المطابقة أو الأصغر تالياً، مما يوزع اللاعبين على الفئات الخمس بدقة متناهية ودون أي لبس حسابي.
10.2 تحليل مخرجات التصنيف وتفسير التوزيع الفئوي للأفراد
بعد تعميم المعادلة على كامل عينة اللاعبين البالغة 150 لاعباً، تبدأ مرحلة استقراء النتائج وفحص التوزيع التكراري للفئات الناتجة. نستخدم دالة COUNTIF لحساب عدد اللاعبين الذين استقروا في كل مستوى من المستويات الخمسة، ثم تحويل الأعداد إلى نسب مئوية من الإجمالي العام للمجموعة للوقوف على التوزيع المنحني للأداء.
يكشف التحليل البياني غالباً عن تركز النسبة العظمى من الأفراد في الفئات الوسطى (“مقبول” و”جيد”) بما يتسق مع طبيعة التوزيع الطبيعي الغوسي، مع انحسار النسب في الفئتين الطرفيتين (“سيئ” و”ممتاز”). يتيح هذا التصنيف المنضبط للمحلل الرياضي والفريق الطبي فحص التباين والربط المنهجي بين هذه المخرجات والمتغيرات النفسية والبدنية للاعبين؛ كقياس أثر استراتيجيات المواجهة ومستويات المرونة التكيفية التي حللها Prati and Pietrantoni (2009) في تعزيز التكيف الإيجابي والأداء الإنساني تحت الضغوط الحادة. كما يساعد التصنيف في تسليط الضوء على “اللاعبين الحرجين” الذين يقفون على عتبات التحول الحسابية (مثل لاعب نال 69.8 نقطة وتفصله أعشار قليلة عن الانتقال من فئة “مقبول” إلى “جيد”)، مما يوجه الكادر الفني لإجراء تقييمات تكميلية دقيقة لدعم تقدمهم.
10.3 توظيف التصنيف في اتخاذ القرارات الإدارية والتأهيلية
تتحول مخرجات التصنيف في المحطة الأخيرة من مجرد توصيف إحصائي مجرد إلى أداة تنفيذية بالغة التأثير في صناعة القرارات الرياضية والإدارية. تخصص إدارة النادي مسارات وبرامج تدريبية وتأهيلية موجهة لكل مجموعة بناءً على تصنيفها الفئوي؛ فاللاعبون المصنفون في فئة “سيئ” يتم إلحاقهم فورياً ببرامج تأهيلية بدنية خاصة مكثفة لتصحيح مواطن القصور، في حين يوجه اللاعبون في فئتي “رائع” و”ممتاز” إلى برامج تطويرية متقدمة لتعزيز المهارات القيادية والتكتيكية التنافسية.
تُدمج هذه الفئات بعد ذلك ضمن لوحات قياس معلوماتية تفاعلية (Interactive Dashboards) مدعومة بشرائح التصفية التفاعلية (Slicers) ومخططات التوزيع التكراري، مما يمنح المديرين نظرة شمولية سريعة ومحدثة لحظياً حول بنية الكفاءة داخل المؤسسة الرياضية. والأهم من ذلك، يتيح هذا النموذج المنظم تتبع مسارات الأفراد عبر فترات القياس الزمنية المتتالية (Longitudinal Tracking)، لرصد مدى فاعلية البرامج التدريبية وتوثيق حركة انتقال اللاعبين الإيجابية من الفئات الدنيا إلى الفئات الأعلى على مدار الموسم الرياضي، محققاً بذلك الغاية التحليلية القصوى من وراء عملية تصنيف البيانات الرقمية في إكسل.
الخاتمة
استعرضنا عبر هذا الدليل التحليلي الموسع والشامل الأبعاد المنهجية والتطبيقية لفرز وتصنيف البيانات الرقمية في بيئة مايكروسوفت إكسل. يتضح جلياً أن تصنيف البيانات ليس مجرد إجراء روتيني لكتابة معادلة حسابية، بل هو عملية هندسة بيانات متكاملة تبدأ من الفهم النظري العميق لطبيعة المتغيرات ومستويات قياسها، مروراً بالتنظيف والفحص الإحصائي الصارم للبيانات وتحديد العتبات الموضوعية، وصولاً إلى اختيار وتطبيق الأداة الحسابية المثلى التي تلائم طبيعة وحجم المشروع التحليلي.
سواء وقع الاختيار على دوال البحث المرجعي المستقرة والمتطورة كـ VLOOKUP وXLOOKUP بفضل مرونتها الفائقة وسهولة صيانتها المركزية، أو تم الاعتماد على سلاسل الدوال المنطقية، أو استثمار القوة التحليلية التلقائية للجداول المحورية وأدوات التنسيق البصري، فإن العامل الحاسم للنجاح يكمن دائماً في ضبط اتساق الحدود العددية وتأمين النموذج ضد الأخطاء الحسابية المحتملة. إن التمكن الراسخ من هذه الأدوات التقنية يمنح الباحثين والمحللين في مختلف التخصصات العلمية والمؤسسية القدرة على تحويل الأرقام الصامتة إلى رؤى استراتيجية نافذة تدعم اتخاذ قرارات دقيقة وموثوقة ترتقي بمستوى الأداء الفردي والمؤسسي على حد سواء.
المراجع
- Alicke, M. D., & Sedikides, C. (2009). Self-enhancement and self-protection: What they are and what they do. European Review of Social Psychology. https://doi.org/10.1080/10463280802613866
- Brysbaert, M., Warriner, A. B., & Kuperman, V. (2013). Concreteness ratings for 40 thousand generally known English word lemmas. Behavior Research Methods. https://doi.org/10.3758/s13428-013-0403-5
- Carey, R., Bohlen, L. C., Johnston, M., Rothman, A. J., de Bruin, M., Kelly, M. P., et al. (2018). Behavior Change Techniques and Their Mechanisms of Action: A Synthesis of Links Described in Published Intervention Literature. Annals of Behavioral Medicine. https://doi.org/10.1093/abm/kay078
- Carruthers, P. (2002). The cognitive functions of language. Behavioral and Brain Sciences. https://doi.org/10.1017/s0140525x02000122
- Delgado, P., Vargas, C., Ackerman, R., & Salmerón, L. (2018). Don’t throw away your printed books: A meta-analysis on the effects of reading media on reading comprehension. Educational Research Review. https://doi.org/10.1016/j.edurev.2018.09.003
- Dunning, D. A., Heath, C., & Suls, J. M. (2004). Flawed Self-Assessment. Gothic.net. https://doi.org/10.1111/j.1529-1006.2004.00018.x
- Liu, N. H., Daumit, G. L., Dua, T., Aquila, R., Charlson, F., Cuijpers, P. J., et al. (2017). Excess mortality in persons with severe mental disorders: a multilevel intervention framework and priorities for clinical practice, policy and research agendas. World Psychiatry. https://doi.org/10.1002/wps.20384
- Murnighan, J. K., & Conlon, D. E. (1991). The Dynamics of Intense Work Groups: A Study of British String Quartets. Administrative Science Quarterly. https://doi.org/10.2307/2393352
- Prati, G., & Pietrantoni, L. (2009). Optimism, Social Support, and Coping Strategies As Factors Contributing to Posttraumatic Growth: A Meta-Analysis. Journal of Loss and Trauma. https://doi.org/10.1080/15325020902724271