
تمثل إدارة ومعالجة البيانات النصية داخل برمجية مايكروسوفت إكسل (Microsoft Excel) أحد الركائز الجوهرية للتحليل الكمي وإدارة السجلات الرقمية في البيئات المؤسسية والأكاديمية المعاصرة. فعلى الرغم من أن إكسل قد صُمم أساساً بوصفه جدول بيانات مخصصاً للعمليات الحسابية والمالية، إلا أن تعقيد التدفقات المعلوماتية الحديثة فرض واقعاً مغايراً تبرز فيه السلاسل النصية المدمجة بوصفها وعاءً ناقلاً لمعلومات مركبة ومتشابكة. ومن بين أعقد هذه التحديات وأكثرها تكراراً هي مسألة تجزئة وتفكيك السلاسل النصية استناداً إلى أطوال محددة من المحارف، حيث تتكدس المتغيرات في كتلة رقمية أو أبجدية واحدة تفتقر إلى الفواصل التقليدية، مما يتطلب منهجيات استخلاص دقيقة وممنهجة تضمن الحفاظ على تكامل البيانات وصحتها المعيارية.
تنبثق الحاجة إلى تقسيم السلسلة النصية حسب طول محدد من طبيعة الهياكل البيانية المنبثقة عن الأنظمة الإدارية القديمة (Legacy Systems)، وتدفقات أجهزة الرصد، وقواعد البيانات المركزية، فضلاً عن السجلات المستخلصة من الاختبارات النفسية والمسوح الميدانية. ففي كثير من هذه السياقات، لا تعتمد حقول البيانات على فواصل صريحة كالفواصل المعيارية أو علامات الجدولة، بل تعتمد على نظام إحداثي صارم يحدد فيه موقع كل محرف وطوله دلالة إحصائية أو تصنيفية محددة. إن الفشل في تفكيك هذه السلاسل بطرق علمية مدروسة يؤدي إلى تشويه المعطيات، وفقدان الأصفار البادئة الحيوية، واختلال التوزيع التكراري، مما ينعكس سلباً على نتائج التحليلات الإحصائية وعمليات اتخاذ القرار المؤسسي المبنية على تلك البيانات.
يقدم هذا المرجع الأكاديمي الشامل دليلاً تقنياً ومنهجياً متكاملاً لاستيعاب وتطبيق آليات تقسيم السلاسل النصية وفق طول ثابت في إكسل. ويتناول المقال استعراض الأدوات البصرية المباشرة مثل معالج تحويل النص إلى أعمدة، وتوظيف الترسانة الحسابية من الدوال الكلاسيكية والمصفوفات الديناميكية الحديثة، وصولاً إلى أتمتة الإجراءات عبر محرر استعلام الطاقة المتقدم (Power Query) والتعليمات البرمجية بلغة فيجوال بيسك للتطبيقات (VBA). كما يطرح تحليلاً معمقاً لكيفية تجاوز الانزلاقات الهيكلية الشائعة، متسلحاً بأفضل الممارسات الموثقة في علوم تنقية البيانات والتحليل الإحصائي الرصين لضمان قابلية تكرار العمليات واستدامتها.
1. مدخل نظري لمعالجة السلاسل النصية في برمجية إكسل
1.1 طبيعة السلاسل النصية ذات الطول الثابت وتطبيقاتها المعيارية
تُعرّف بنية البيانات النصية ذات الطول المتري الثابت في قواعد البيانات بأنها نمط تخزيني يشغل فيه كل حقل أو سجل نصي عدداً محدداً مسبقاً من الخانات أو البايتات، بصرف النظر عن القيمة الفعلية للمحتوى المخزن. ويعود هذا التقليد البنيوي إلى الحقب المبكرة من هندسة الحواسيب، حيث كان تخصيص المساحات التخزينية يعتمد على الفهارس الموضعية الثابتة لتقليل استهلاك الذاكرة وتسهيل قراءة الملفات الثنائية والملفات النصية المسطحة. إن هذا التشفير النصي المنتظم يلعب دوراً محورياً في توليد المعرفات الرقمية وسجلات الرصد البيئية والأكاديمية، حيث يتم حجز نطاقات ثابتة تمثل كل منها متغيراً نوعياً أو كمياً مستقلاً بذاته.
في البيئات المؤسسية والحكومية، تظهر هذه السلاسل بوضوح في أرقام الهوية المهنية والوطنية، وأكواد التصنيف الصناعي، وحسابات الحساب المصرفي الدولي (IBAN)، وسجلات المرضى في المستشفيات. فالمعرف الوظيفي على سبيل المثال قد يتكون من اثني عشر محرفاً مستمراً؛ تشير المحارف الأربعة الأولى منه إلى رمز المنشأة أو الإدارة، تليها محارف تمثل سنة التعيين، ثم مقطع يحدد الدرجة الوظيفية، وينتهي بالتسلسل الرقمي للموظف. إن تفكيك هذه التشفيرات المركبة يتطلب فهماً عميقاً لبنيتها الهندسية الثابتة، إذ إن غياب الرموز الفاصلة يجعل الاعتماد الكلي مستنداً إلى الموقع النسبي للمحرف داخل السلسلة ككل.
1.2 أهمية تجزئة النصوص في تحسين اتساق البيانات الأكاديمية
يمثل تنظيف وتجزئة البيانات النصية ركناً أساسياً في تجهيز البيانات للتحليلات الإحصائية المتقدمة. ففي الأبحاث الأكاديمية والعلوم المعرفية، تجمع المعطيات الخام أحياناً ككتل نصية مدمجة ناتجة عن أجهزة القياس السلوكي، أو منصات جمع الاستجابات الرقمية، أو قواعد البيانات المعجمية الكبرى كما يظهر في دراسات اللغويات النفسية المعاصرة (Keuleers et al., 2011). إن ترك هذه البيانات بصورتها الأحادية المدمجة يشكل عائقاً منهجياً يحول دون إجراء الفرز، والتصفية، واختبار الفرضيات الإحصائية كتحليل التباين أو الانحدار الخطي المتعدد.
تساعد تجزئة السلاسل النصية على تحويل البيانات الأحادية إلى مصفوفات ثنائية الأبعاد، تُمكّن الباحث من عزل المتغيرات المستقلة والتابعة بدقة متناهية، ومقارنة المقاييس الفرعية بسهولة. وعلاوة على ذلك، تسهم المعالجة الخوارزمية الموحدة في الحد الجذري من أخطاء الإدخال اليدوي، والتناقضات الإملائية، والتشوهات البنائية الناتجة عن التفريغ غير المنضبط للمعلومات. ومن خلال خفض العبء الإدراكي الواقع على كاهل المحلل الأكاديمي، تتيح المعالجة المنهجية للسلاسل استيعاب المعلومات المعقدة بدرجة أعلى من الموثوقية والموضوعية (Pollock et al., 2002).
1.3 التمييز المنهجي بين التقسيم عبر المحددات والتقسيم بالعرض الثابت
تتباين استراتيجيات معالجة السلاسل النصية في برمجية إكسل بناءً على الخصائص البنيوية للسلسلة المصدرية، وينقسم هذا التباين تقنياً إلى نهجين رئيسيين: التقسيم القائم على المحددات الصريحة (Delimited Parsing)، والتقسيم القائم على العرض الثابت (Fixed-Width Parsing). يعتمد التقسيم عبر المحددات على وجود رموز نصية أو علامات ترقيم خاصة، مثل الفاصلة (Comma)، أو النقطة والفاصلة (Semicolon)، أو المسافة (Space)، أو علامة الجدولة (Tab)، حيث يقوم المحرك البرمجي بمسح السلسلة واكتشاف هذه الإشارات ليتخذها نقاط قطع تفصل بين الكيانات البيانية المختلفة دون اشتراط تساوي أطوال المقاطع الناتجة.
في المقابل، يواجه المحلل مواقف منهجية تنعدم فيها أية فواصل دلالية داخل السلسلة، وتكون الأطوال المكانية للمحارف هي الضابط المعياري الوحيد لمعنى الكيان المشفر. في هذه الحالات، يفشل التقسيم عبر المحددات تماماً، ويصبح خيار العرض الثابت هو الأسلوب الرياضي والمنهجي الوحيد القادر على استخلاص المقاطع. يضمن نهج الطول المحدد استقرار بنية الجداول الناتجة، إذ تنبثق عنه أعمدة منتظمة بصورة موحدة عبر كافة الصفوف، مما يمنع انزياح البيانات الناجم عن تفاوت أطوال النصوص الفردية في السجلات غير المرمزة بفواصل.
2. الأسس التقنية لأداة النص إلى أعمدة (Text to Columns)
2.1 التموضع الوظيفي للأداة ضمن شريط البيانات (Data Tab)
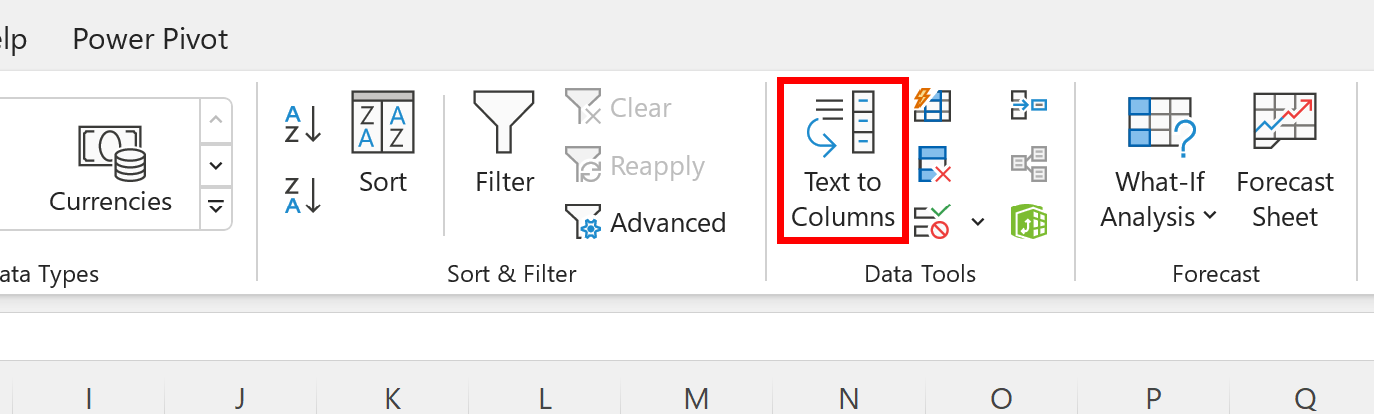
تستقر أداة “النص إلى أعمدة” (Text to Columns) ضمن حزمة أدوات البيانات المتقدمة (Data Tools) المتمركزة داخل علامة التبويب “بيانات” (Data Tab) في الشريط الرئيسي لبرمجية مايكروسوفت إكسل. صُممت هذه الأداة المعمارية لتكون واجهة تفاعلية وسريعة تسمح للمستخدم بإجراء تحويلات هيكلية جذرية على محتويات الأعمدة النصية دون الحاجة إلى كتابة صيغ رياضية مطولة أو نصوص برمجية معقدة. إن موقعها المحوري يعكس دورها الحيوي في مراحل تنقية وتجهيز البيانات (Data Wrangling) السابقة لمرحلة بناء النماذج التحليلية أو التقارير المحورية.
يتطلب تفعيل المعالج بنجاح استيفاء متطلبات إجرائية محددة، من أبرزها حصر التحديد في عمود واحد فقط في الوقت ذاته، حيث يمنع إكسل تشغيل الأداة عبر أعمدة متوازية متعددة لتفادي تداخل العمليات التخزينية. كما تقتضي الحيطة الفنية فحص وتفريغ الأعمدة الواقعة إلى اليمين مباشرة من النطاق المحدد (أو إلى اليسار بحسب اتجاه ورقة العمل)، وذلك لمنع الكتابة التلقائية غير القابلة للتراجع على سجلات سابقة، وهو ما يستوجب تدقيقاً صارماً قبل الشروع في التنفيذ الميكانيكي.
2.2 مفهوم العرض الثابت (Fixed Width) وآلية عمله البرمجية
يعتمد خيار “العرض الثابت” (Fixed Width) داخل معالج النصوص على آلية حوسبة موضعية تستند إلى فهرسة المحارف في الذاكرة اللحظية للحاسوب. يقرأ المحرك الداخلي لإكسل السلسلة النصية بوصفها مصفوفة أحادية من البايتات والمحارف المتتالية ذات الإحداثيات الرقمية الثابتة، حيث يبدأ الفهرس من الموضع الأول (1) ويزداد بمقدار محرف واحد لكل حركة أفقية. وعند تحديد نقطة فصل مكانية معينة، يقوم المحرك بإنشاء قواطع رأسية صارمة تشطر السلسلة النصية هندسياً عند تلك الإحداثية في جميع السجلات المحددة في النطاق بآن واحد.
تتميز هذه الآلية بخفة استهلاكها لموارد الذاكرة وسرعة معالجتها الفائقة مقارنة بالصيغ الحسابية الديناميكية؛ ذلك لأنها تطبق عملية فصل لمرة واحدة وتخزن النتائج مباشرة كقيم ثابتة في الخلايا المستهدفة دون إبقاء روابط حسابية نشطة تثقل كاهل وحدة المعالجة المركزية (CPU). ويعتبر هذا السلوك مثالياً للملفات الضخمة التي تضم مئات الآلاف من الصفوف المتجانسة بنيوياً، حيث تُنجز المعالجة في أجزاء من الثانية دون إحداث بطء في زمن استجابة المصنف المالي أو الإحصائي.
2.3 التهيئة الهيكلية للبيانات قبل بدء عملية الفصل الميكانيكي
تستدعي معايير ضبط الجودة الإحصائية إخضاع البيانات الخام لمرحلة مسبقة من التطهير والفحص الهيكلي قبل تمريرها إلى معالج التحويل الميكانيكي. وتأتي في مقدمة هذه الإجراءات التحقق من خلو السلاسل النصية من المسافات الزائدة البادئة أو اللاحقة، فضلاً عن المحارف غير المطبوعة ومحارف التحكم البرمجية التي قد تتسلل أثناء استيراد البيانات من ملفات النصوص المفصلة بترميزات غير متوافقة، حيث تؤدي هذه الشوائب إلى إزاحة فهارس المحارف بمقدار خانة أو أكثر، مما يشوه دقة الفصل بالكامل.
وعلاوة على التنقية النصية، تبرز ضرورة تقييم النطاق الجغرافي للبيانات داخل ورقة العمل عبر التأكد من توفر مساحات تخزينية كافية لاستيعاب الأعمدة الجديدة المتولدة عن التقسيم. ويُعد إنشاء نسخة احتياطية مطابقة للبيانات الخام في ورقة عمل مستقلة قاعدة ذهبية في المنهجية العلمية لحفظ السجلات الأصلية؛ نظراً لأن العمليات المعتمدة على معالج النص إلى أعمدة تعد عمليات تدميرية جزئياً (Destructive Operations) تعيد كتابة محتويات الخلايا، وقد يتعذر استرجاع نسقها الأصلي بسهولة عبر أوامر التراجع البسيطة في حال ارتكاب خطأ في تعيين مواقع الفواصل.
3. الدليل الإجرائي الميداني لتجزئة النصوص بطول ثابت عبر المعالج
3.1 تحديد النطاق وتدشين معالج تحويل النص إلى أعمدة
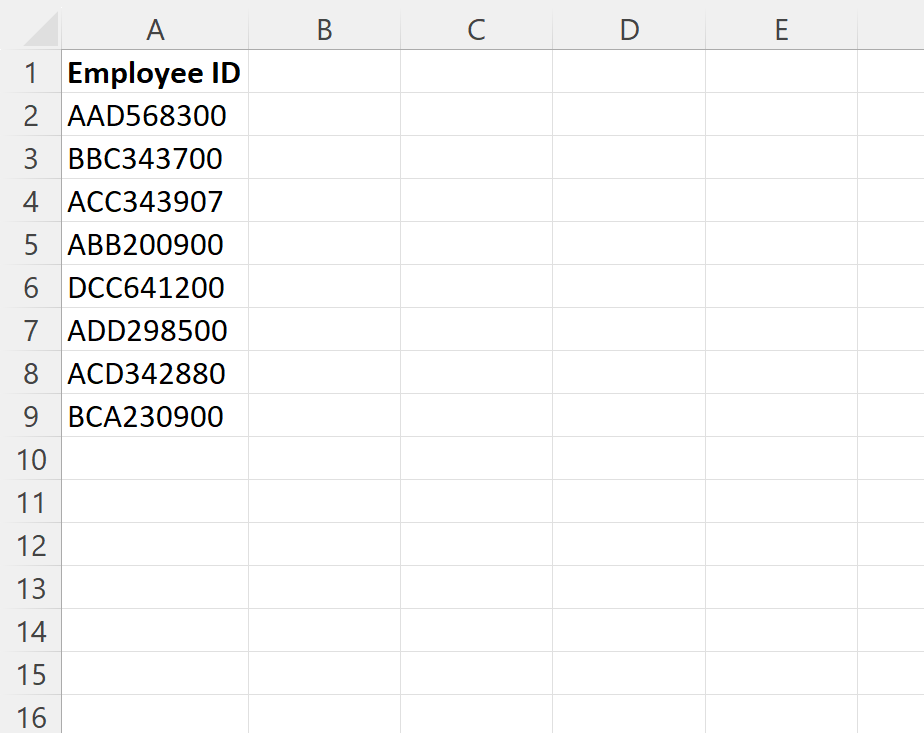
تبدأ الخطوات التنفيذية لتجزئة النصوص بطول ثابت بعزل خلايا الإدخال بدقة متناهية، وذلك عبر تظليل نطاق الخلايا النصية المراد معالجتها باستثناء صف الترويسة (Header)، إذ إن تضمين الترويسة قد يقود إلى تشويه تسمية المتغيرات إذا اختلفت أطوالها النصية عن المعرفات المشفرة في السجلات اللاحقة. يتم استدعاء الأداة من شريط “بيانات” بالضغط على زر “النص إلى أعمدة”، لتنبثق النافذة التفاعلية للخطوة الأولى من المعالج المكون من ثلاث خطوات متتابعة.
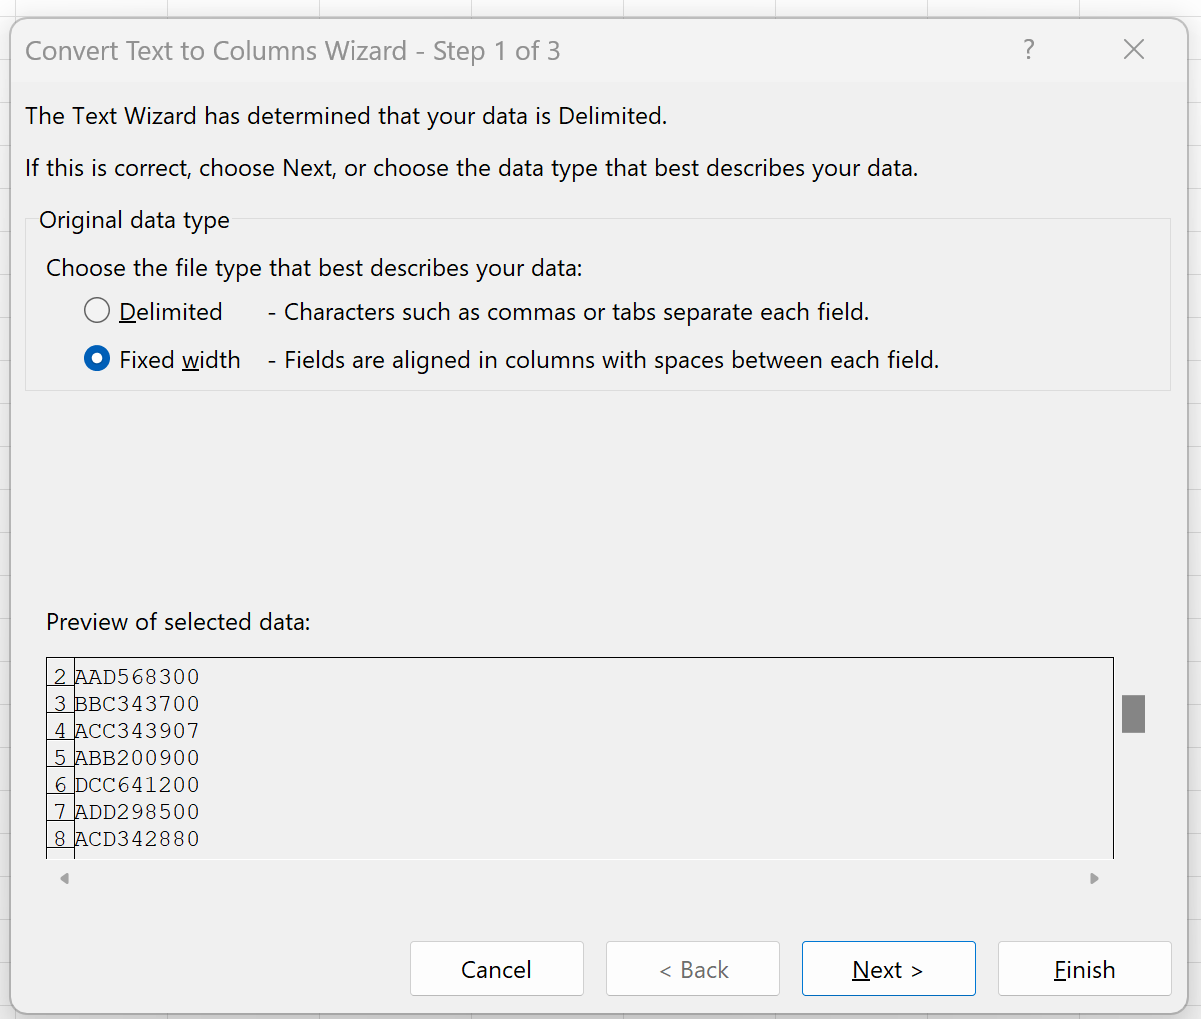
في هذه المرحلة التأسيسية، يُعرض للمستخدم خياران رئيسيان: “محدد” (Delimited) و”عرض ثابت” (Fixed width). يجب اختيار “عرض ثابت” بصورة حاسمة، وعندها يوفر إكسل في القسم السفلي من الواجهة شاشة عرض أولي تعكس نمط السجلات المختارة. تُمكن هذه المعاينة البصرية المحلل من التأكد من أن السلاسل النصية في الخلايا المختلفة مصطفة بشكل عمودي متسق تماماً، وهو المؤشر الأساسي على أن البيانات تتبع معياراً هندسياً موحداً قابلاً للفصل الموضعي الناجح.
3.2 إنشاء وضبط فواصل التقسيم الرأسية بصرياً
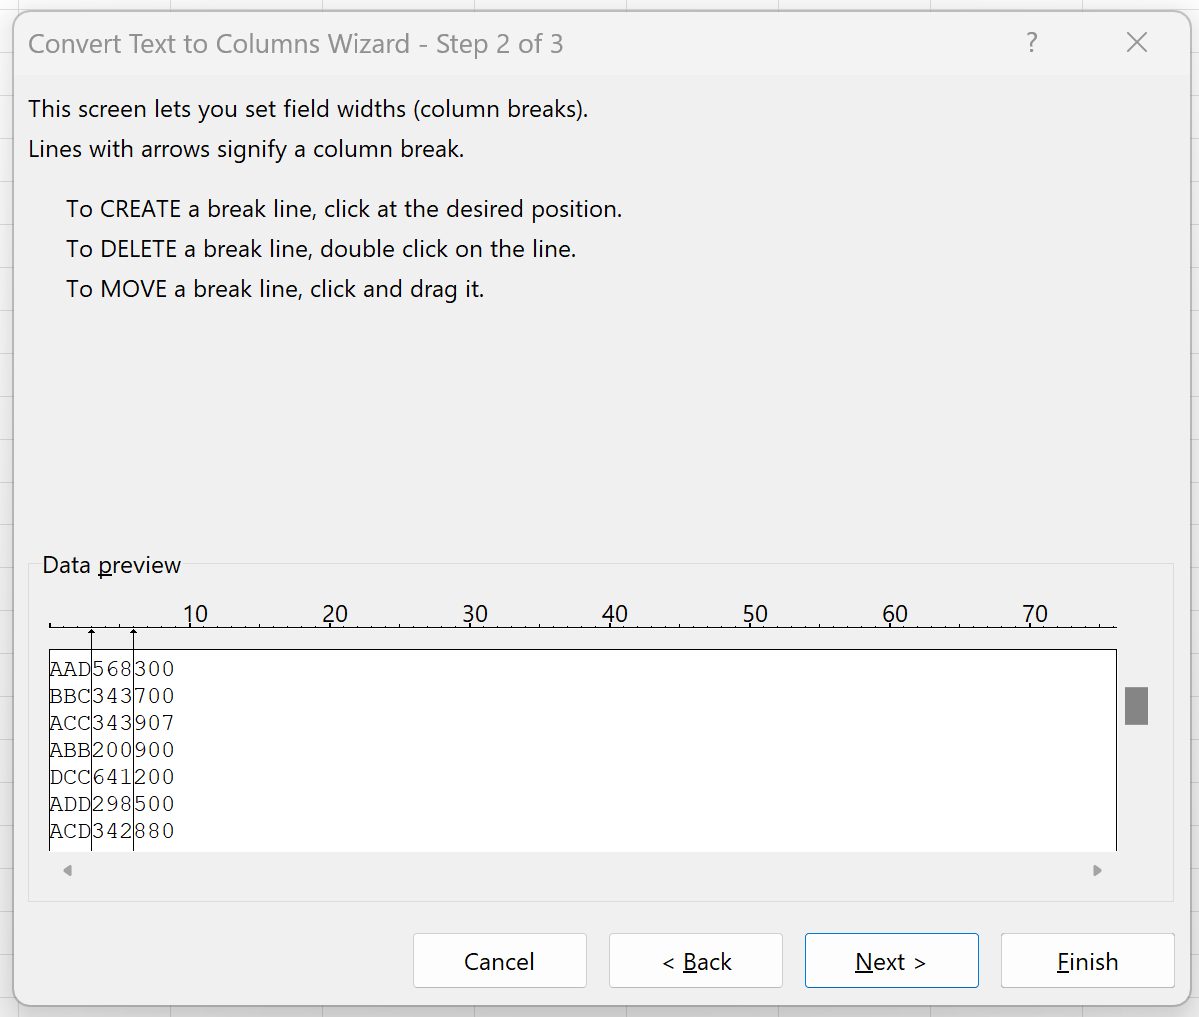
عند الانتقال إلى الخطوة الثانية من المعالج، تظهر مسطرة القياس التفاعلية التي تمثل الفهارس العددية للمحارف عبر المحور الأفقي للسلاسل النصية المعروضة. تُنفذ عمليات ضبط الفواصل الرأسية عبر آليات بصرية مباشرة؛ حيث يؤدي النقر المفرد بزر الفأرة الأيسر فوق أي موضع في المسطرة إلى إدراج خط فصل رأسي مصحوب بسهم يشير إلى النقطة التي سيتم عندها شطر السلسلة النصية إلى عمودين مستقلين.
تتيح الواجهة مرونة كاملة في التعديل والمواءمة الدقيقة، فإذا وُضع فاصل في مكان خاطئ، يمكن للمستخدم النقر المطول عليه وسحبه أفقياً لإعادة توجيهه إلى الموضع الدقيق، أو النقر المزدوج السريع على الخط الرأسي لإزالته نهائياً. فإذا كان الهدف على سبيل المثال تفكيك رمز تسلسلي مكوّن من تسعة محارف متجانسة إلى ثلاثة أقسام متساوية، يتم وضع خط الفصل الأول عند المؤشر رقم 3، وخط الفصل الثاني عند المؤشر رقم 6، ليتم بذلك تحديد ثلاثة قطاعات نصية بطول ثلاثة محارف لكل منها بدقة متناهية.
3.3 تحديد وجهة الإخراج وتنسيق أنواع البيانات الناتجة
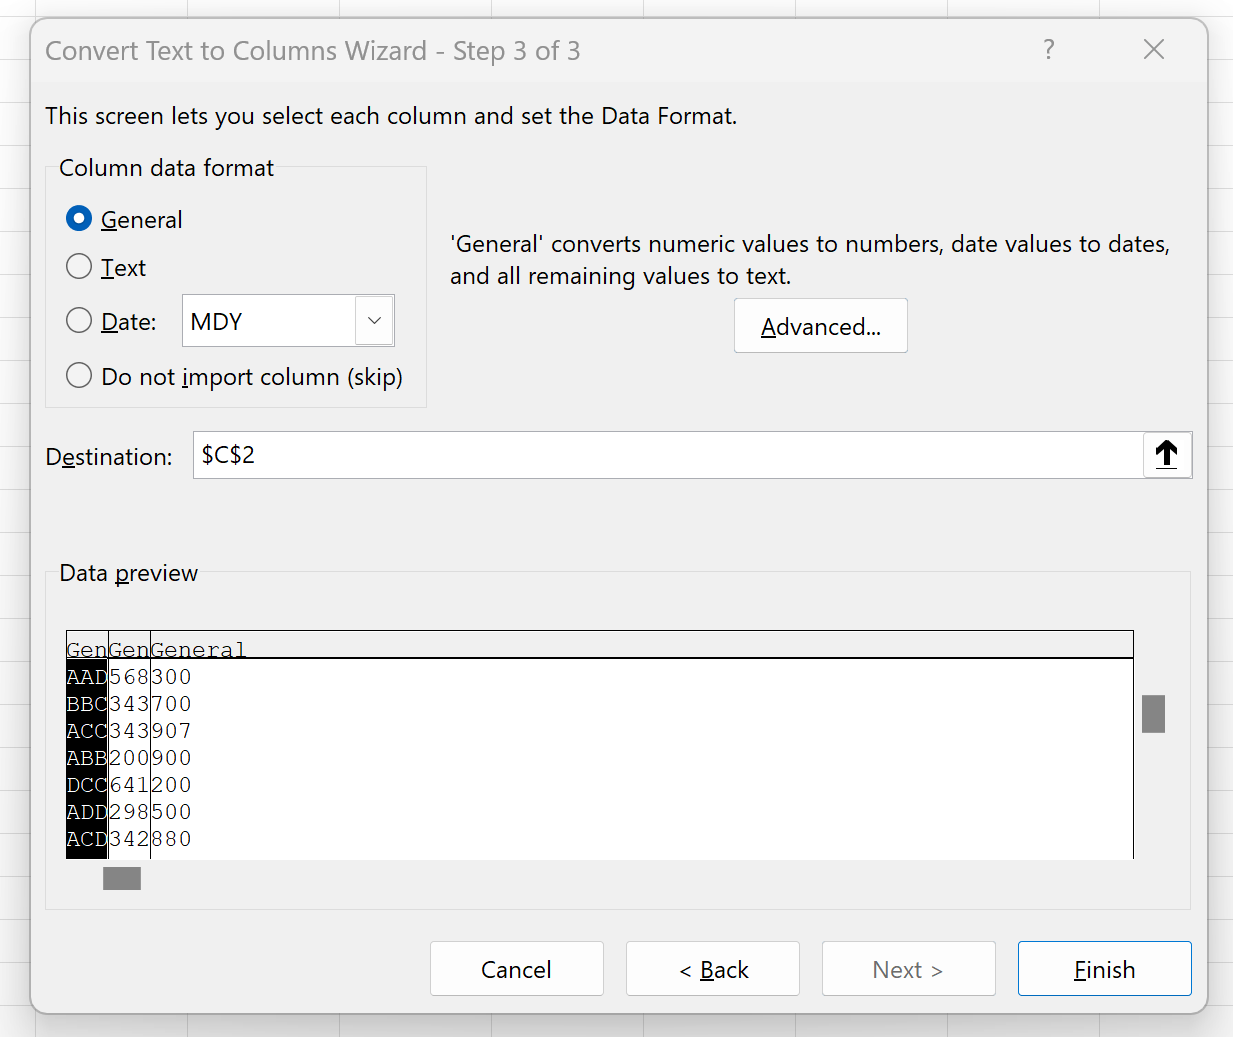
تمثل الخطوة الثالثة والأخيرة من معالج التحويل المحطة الأكثر حساسية لضمان سلامة النماذج البيانية، حيث يُتاح للمستخدم التحكم في نوع البيانات (Data Type) لكل عمود من الأعمدة المفصولة حديثاً، بالإضافة إلى تعيين مكان تفريغ النتائج. يتم النقر على كل عمود ضمن شاشة المعاينة وتحديد نوعه إما كـ “عام” (General) للقيم الرقمية والنصوص الاعتيادية، أو كـ “نص” (Text) لحفظ البيانات الوصفية كالأكواد التي تتضمن أصفاراً بادئة، أو اختيار “عدم استيراد العمود (تخطي)” لتجاهل قطاعات معينة لا فائدة منها في التحليل اللاحق.
علاوة على ذلك، يجب الانتباه بعناية فائقة لمربع إدخال “الوجهة” (Destination). فالإعداد الافتراضي لإكسل يضع عنوان أول خلية في العمود الأصلي نفسه (مثل $A$2)، مما يتسبب في محو البيانات المصدرية وإحلال الجزء الأول من المقاطع مكانها. لتفادي هذا السلوك وتأمين النسخ غير الإتلافي، يُستحسن تعديل هذا المرجع للإشارة إلى خلية في عمود مجاور فارغ تماماً (مثل $B$2)، مما يحافظ على العمود الأصلي دون مساس ويوزع الأجزاء الجديدة على الأعمدة التابعة بسلاسة وتنظيم.
3.4 اعتماد العملية ومراجعة تكامل السجلات المفصولة
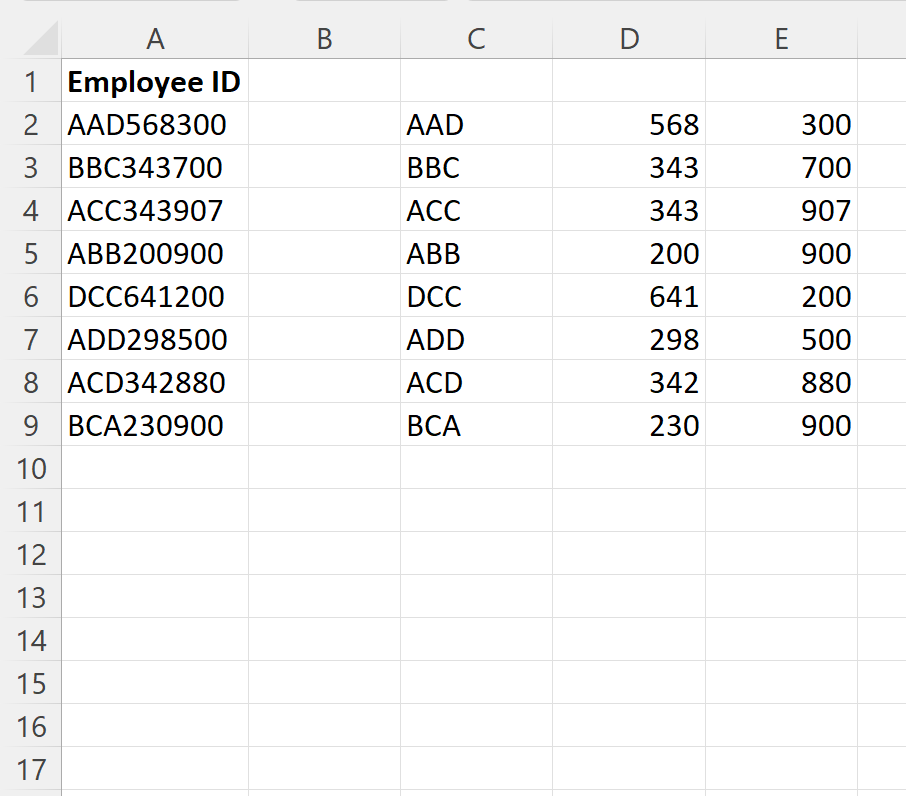
بمجرد النقر على زر “إنهاء” (Finish)، ينفذ محرك إكسل إجراءات الشطر الفوري، وتظهر المقاطع المستخلصة موزعة عبر الأعمدة المحددة وفق القواطع المعتمدة. يتعين على المحلل في هذه المرحلة الشروع في تدقيق إحصائي وفحص جودة سريع عبر فحص نهايات الأعمدة والتأكد من عدم حدوث اقتطاع جزئي للمحارف، لا سيما في السجلات الأخيرة من ورقة العمل التي قد تشهد أحياناً قيماً شاذة أو أطوالاً ناقصة.
يُنصح بالاعتماد على دوال المطابقة والفحص السريع للتحقق من أن مجموع أطوال الأعمدة الناتجة يعادل تماماً طول السلسلة النصية المصدرية قبل التقسيم، مع توثيق التعديلات في سجل إدارة المشروع التحليلي. هذا التحقق المنهجي يضمن الحفاظ على تكامل البيانات (Data Integrity) وجاهزيتها لدخول مسارات التحليل المتقدمة، سواء نُفذت لاحقاً داخل إكسل أو صُدّرت نحو بيئات الحوسبة الإحصائية التخصصية.
4. التقسيم الرياضي للنصوص باستخدام الدوال والصيغ الحسابية
4.1 توظيف الدوال النصية الكلاسيكية: MID و LEFT و RIGHT
توفر الصيغ الرياضية بديلاً ديناميكياً مرناً لمعالج النصوص الميكانيكي، وتتصدر الدوال النصية الكلاسيكية الثلاث: LEFT و MID و RIGHT خيارات المحللين عند استخلاص المقاطع ذات الطول الثابت. تعمل دالة LEFT على اقتطاع عدد محدد من المحارف بدءاً من أقصى يسار السلسلة (أو أقصى اليمين في واجهات اللغة العربية التلقائية)، وتتطلب وسيطتين رئيسيتين: مرجع الخلية المحتوية على النص، والعدد الصحيح للمحارف المراد استخلاصها. صيغتها النموذجية هي: LEFT(text, num_chars)، مما يجعلها الخيار المثالي لاستقطاع البوادئ المعيارية ورموز المناطق الإقليمية.
أما لاستخلاص المقاطع المتمركزة في جوف السلسلة النصية، فيتم استدعاء الدالة MID التي تمتلك بنية وسائط ثلاثية تشمل: النص المصدر، وموضع محرف البداية المحسوب رياضياً من بداية السلسلة، ثم عدد المحارف المطلوب سحبها، وفق النمط: MID(text, start_num, num_chars). ولتأمين المقاطع الختامية، تُوظف دالة RIGHT التي تستخرج المقاطع الطرفية المتبقية. وتكتسب هذه الدوال الكلاسيكية صلابة تشغيلية كبرى لتوافقها المطلق مع شتى إصدارات برمجية إكسل القديمة والحديثة، مما يمنح المصنفات استقراراً استثنائياً عند تداولها بين مستخدمين يعتمدون بيئات برمجية متباينة الأجيال.
4.2 توليد مصفوفات التقسيم الديناميكية عبر دالتي LEN و SEQUENCE
مع إطلاق محرك المصفوفات الديناميكية (Dynamic Arrays) في الإصدارات الحديثة من إكسل، غدا بالإمكان كتابة صيغة موحدة ومبتكرة داخل خلية مفردة لتتوسع تلقائياً وتفصل السلسلة النصية الكاملة إلى شرائح متساوية الطول دون الحاجة إلى نسخ الصيغ أفقياً عبر الأعمدة. يعتمد هذا البناء الحسابي المتقدم على تضافر أربع دوال رياضية هي: MID و SEQUENCE و ROUNDUP و LEN لتوليد متوالية حسابية لمواضع انطلاق الاقتطاع.
تُقاس البنية الهيكلية لهذه المعادلة بالصيغة التوليدية التالية لتقسيم محتوى الخلية A2 إلى أجزاء متساوية يبلغ طول كل منها N من المحارف:
=MID(A2, SEQUENCE(1, ROUNDUP(LEN(A2)/N, 0), 1, N), N)
تقوم دالة LEN بحساب إجمالي عدد محارف السلسلة، وتعمل دالة ROUNDUP على قسمة هذا الناتج على طول القطعة المستهدفة وتقريبه للأعلى لتحديد العدد الإجمالي للأعمدة اللازمة. ثم تنشئ دالة SEQUENCE مصفوفة أفقية متتالية تبدأ من الموضع 1 وتقفز بمقدار N محرفاً في كل خطوة، مما يغذي دالة MID بمتتالية فورية من فهارس البدء، لتفيض النتيجة تلقائياً عبر الخلايا الأفقية المجاورة في استعراض انسيابي للقدرات الحسابية الديناميكية المتقدمة.
4.3 التقسيم المعاصر باستخدام الدالة المتقدمة TEXTSPLIT
قدمت ميكروسوفت الدالة المبتكرة TEXTSPLIT بوصفها قفزة نوعية في ترسانة المعالجة النصية داخل إكسل، حيث صُممت لتفكيك النصوص عبر فواصل أفقية أو عمودية بمنتهى البساطة. وعلى الرغم من أن الدالة تركز وظيفياً على التقسيم المعتمد على المحددات، إلا أن دمجها الخوارزمي مع دوال الاستبدال النصي يتيح توظيفها في تجزئة النصوص بناءً على أطوال ثابتة بطرق التفافية بالغة الكفاءة والأناقة البنائية.
يمكن للمحلل على سبيل المثال استخدام صيغة تقوم بحقن محدد افتراضي فريد (كرمز الخط المائل العمودي أو رمز غير مستخدم مثل علامة الهاشتاغ) بعد كل عدد محدد من المحارف عبر توليفات الدوال المصفوفية، ثم تمرير الناتج مباشرة إلى الدالة TEXTSPLIT لتقوم بنشره فورياً في أعمدة أو صفوف وفق رغبة الباحث. توفر هذه الآليات الحديثة مرونة غير مسبوقة تضاهي إمكانات لغات البرمجة المتخصصة مثل بايثون ومكتباتها النصية، مع الحفاظ على بقاء العمليات التحليلية ضمن البيئة المألوفة لورقة عمل إكسل.
5. معالجة التحديات البنيوية في السلاسل النصية غير المتجانسة
5.1 إدارة المسافات الزائدة والمحارف غير المطبوعة (TRIM و CLEAN)
تُعد المسافات البادئة واللاحقة والمحارف غير المرئية من أخطر المهددات التي تواجه دقة تجزئة السلاسل ذات الأطوال الثابتة. فعندما تستقر مسافة خفية في بداية النص، فإنها تحتل الموقع الإحداثي رقم (1)، مما يؤدي بالضرورة إلى انزياح كافة المقاطع اللاحقة بمقدار خانة واحدة جهة اليمين، وبالتالي يقتطع كل عمود محرفاً خاطئاً من العمود المجاور. وللتعامل المنهجي مع هذا التحدي، يجب تغليف النصوص المصدرية بدالتي TRIM و CLEAN قبل الشروع في أي عملية شطر أو تجزئة.
تتولى دالة TRIM حذف المسافات العشوائية البادئة والختامية مع الإبقاء على مسافة مفردة معيارية بين الكلمات، بينما تتخصص دالة CLEAN في اكتشاف واستئصال أول 32 محرفاً في جدول ترميز أسكي القياسي (ASCII)، وهي محارف تحكم برمجية غير مطبوعة (مثل محارف الانتقال لسطر جديد ومحارف الرجوع) تتسلل باستمرار من أنظمة التشغيل الخادمة أو الاستبانات الرقمية المنشورة عبر الويب (Zagreus et al., 2004). إن دمج الصيغة في قالب تنظيف تكاملي: TRIM(CLEAN(cell_reference)) يضمن قياساً مترياً متطابقاً وثابتاً للمحارف عبر كافة سجلات العينة.
5.2 تحديات النصوص متعددة اللغات وتباين استهلاك المحارف
تفرض السلاسل النصية متعددة اللغات—والتي تجمع على سبيل المثال بين الأحرف العربية واللاتينية أو الرموز الصينية المركبة—تعقيدات حوسبية مرتبطة بنظام الترميز الموحد (Unicode) واختلاف استهلاك البايتات لكل محرف. ففي حين تكتفي المحارف الإنجليزية القياسية ببايت واحد وفق معايير ASCII، تتطلب الحروف العربية والمحارف الآسيوية المركبة بايتين أو أكثر لتمثيلها برمجياً في الذاكرة (Tse et al., 2016).
يتعامل إكسل عبر دواله القياسية مثل LEN و MID استناداً إلى “عدد المحارف” البصرية وليس “عدد البايتات”، مما يحل جانباً كبيراً من هذه الإشكالية، إلا أن التحدي يظل قائماً عند التعامل مع اتجاه الكتابة من اليمين إلى اليسار (RTL). فقد يظهر الاقتطاع بصرياً وكأنه يبدأ من اليمين بينما ينفذه المحرك البرمجي من اليسار استناداً للترتيب المنطقي لتخزين السلسلة في الذاكرة. يتطلب هذا الوضع توحيد اتجاهات المحاذاة، وفهم الفارق بين الترتيب البصري الظاهري والترتيب المنطقي للبيانات تجنباً لحدوث أخطاء هيكلية عند توزيع المقاطع متعددة اللغات في حقول متباينة.
5.3 التعامل مع السلاسل النصية ذات الأطوال المتفاوتة
في كثير من التطبيقات الواقعية، تتضمن حزم البيانات سلاسل نصية شاذة لا تستوفي الطول المعياري المستهدف، كأن يكون الطول المفترض للمعرف عشرة محارف بينما يحتوي أحد السجلات على ثمانية محارف فقط نتيجة سقوط خانات معينة أثناء الإدخال. إذا طُبقت خوارزمية الفصل الثابت مباشرة على هذه السجلات المعيبة، فستفشل الأجزاء الأخيرة في التقاط بياناتها الصحيحة أو سترجع قيماً فارغة مشوهة للتوزيع الإحصائي.
تتمثل المعالجة الرياضية المتطورة لهذه المعضلة في تطبيق تقنيات “الحشو النصي” (String Padding) باستخدام الدالة REPT لتوحيد أطوال النصوص قبل تفكيكها. فمن خلال دمج النص بدالة تكرار الرموز، يمكن إضافة محارف حشو اصطناعية (مثل المسافات أو الأصفار أو رمز النجمة) إلى نهاية أو بداية السلسلة لتكملة النقص حتى الوصول إلى الطول النظامي المطلوب. كما يمكن صياغة معادلات شرطية متكيفة باستخدام الدالة IF تفحص طول الخلية مسبقاً وتوجه مسار التقسيم أو تضع علامة تدقيق (Flag) على السجل الشاذ لمراجعته يدوياً من قبل مدقق الجودة.
6. دراسة مقارنة: الأداة المباشرة في مقابل الصيغ البرمجية
6.1 معايير الأداء واستهلاك موارد الحوسبة في البيانات الضخمة
يشكل حجم مصنف البيانات المعيار الحاسم للمفاضلة التقنية بين استخدام أداة “النص إلى أعمدة” المباشرة واستخدام الصيغ الحسابية. تتميز أداة التحويل المباشرة بأنها عملية ثابتة لمرة واحدة (Static In-place Execution)؛ حيث يستهلك معالجتها طاقة المعالج لفترة وجيزة أثناء التنفيذ فقط، ثم تُحفظ النتائج كقيم مجردة تستهلك مساحة تخزينية ثابتة في الذاكرة العشوائية (RAM)، مما يحافظ على سرعة فائقة للمصنف عند إجراء التمرير أو الفرز حتى لو اشتمل على ملايين السطور.
في المقابل، تؤدي كتابة الصيغ النصية المعقدة عبر مئات الآلاف من الصفوف إلى تشغيل “شجرة إعادة الحساب التلقائي” (Calculation Engine Chain) في إكسل. فمع كل تعديل طفيف يطرأ على أي خلية داخل المصنف، يضطر المحرك إلى إعادة تقييم واحتساب مصفوفات الدوال النصية المتشعبة، مما قد يقود إلى تجميد واجهة الاستخدام وحدوث اختناقات في موارد النظام، لا سيما في الأجهزة ذات الإمكانات المتواضعة. لذلك، تميل الكفة الحسابية في مشاريع البيانات الضخمة الراكدة نحو أدوات المعالجة المباشرة أو محول الاستعلامات.
6.2 خاصية التحديث الحي (Dynamic Updates) مقابل الثبات الإجرائي
على النقيض من معايير الأداء التخزيني، تبرز الصيغ الحسابية بوصفها الفائز المطلق عندما تكون متطلبات المشروع التحليلي قائمة على التحديث الحي والاستجابة الفورية للمدخلات الجديدة. فإذا كانت ورقة العمل تستقبل سجلات متدفقة بصورة دورية، فإن استخدام معالج “النص إلى أعمدة” يتطلب إعادة تدشين المعالج يدوياً في كل مرة تضاف فيها بيانات جديدة، وهو ما يفتح الباب واسعاً للأخطاء البشرية وتعطل دورات الإنتاج المؤسسي.
توفر الصيغ الرياضية (مثل معادلات MID و SEQUENCE الديناميكية) ترابطاً عضوياً بين حقول الإدخال ومصفوفات الإخراج؛ فبمجرد كتابة أو لصق معرف جديد في العمود المصدر، تفيض المقاطع المقتطعة تلقائياً في الأعمدة الفرعية المخصصة في جزء من الثانية دون أدنى تدخل بشري. تمنح هذه الخاصية ميزة وظيفية كبرى لنماذج لوحات المعلومات التفاعلية (Dashboards) والأنظمة الإدارية المؤتمتة التي تتطلب استمرارية وتناسقاً تشغيلياً على مدار الساعة.
6.3 مصفوفة اتخاذ القرار لاختيار الأسلوب المناسب للمشروع التحليلي
يتطلب اتخاذ قرار منهجي رشيد بين الأساليب المتاحة صياغة مصفوفة معايير تأخذ في الحسبان ثلاثة أبعاد رئيسية: حجم البيانات، وديناميكية التحديث، ومستوى المهارة التقنية للفريق المشرف على المصنف. يوضح الجدول المفاهيمي التالي خطوط التمايز التحليلية:
- أداة النص إلى أعمدة (Text to Columns): مثالية للمهام الفردية العاجلة، ومجموعات البيانات الضخمة الثابتة، والبيئات التي تتطلب التبسيط المطلق وتجنب تعقيد الدوال الرياضية في أيدي المستخدمين المبتدئين.
- الصيغ والمعادلات المصفوفية (Formulas & Dynamic Arrays): الخيار الأمثل للنماذج التحليلية النشطة، والبيانات المتغيرة باستمرار، وسياقات العمل التي تعتمد على أتمتة تدفقات الإدخال دون تدخل يدوي مكرر.
- محرر استعلام الطاقة (Power Query): الحل المعياري المتفوق للمشاريع الاحترافية وخطوط أنابيب البيانات (Data Pipelines) المتكررة، والتي تجمع بين ضخامة الحجم والحاجة إلى التوثيق المنهجي القابل للمراجعة والتدقيق العلمي.
7. أتمتة تقسيم النصوص عبر أداة تحويل البيانات المتقدمة (Power Query)
7.1 استيراد البيانات وتهيئتها في بيئة محرر Power Query
يمثل محرر استعلام الطاقة (Power Query) الواجهة الأكثر تطوراً ورصانة لمعالجة البيانات واستخراجها وتحويلها وتحميلها (ETL) ضمن المنظومة الحديثة لمايكروسوفت إكسل. لتدشين مسار التجزئة المتقدم، يُحدد الجدول النصي داخل ورقة العمل ثم يُنقر على خيار “من جدول/نطاق” (From Table/Range) المتواجد في تبويب “بيانات”، ليتم نقل السجلات فورياً إلى بيئة المحرر التفاعلية الآمنة والمعزولة تماماً عن شبكة الخلايا الأصلية للمصنف.
يتيح Power Query ميزة استثنائية تتمثل في توثيق وتسجيل كل نقرة وإجراء تحويلي على شكل خطوات مطبقة (Applied Steps) في لوحة التحكم الجانبية. هذا السلوك المعماري يضمن قابلية التدقيق الأكاديمي والتحقق المنهجي، حيث يمكن للباحث مراجعة أية خطوة، وتعديل ترتيبها، أو إلغائها دون إتلاف البيانات المصدرية. وعند تحديث البيانات المصدرية مستقبلاً، يكفي النقر على زر “تحديث” (Refresh) ليعيد المحرك تطبيق كافة عمليات التجزئة الصارمة تلقائياً على السجلات المستجدة.
7.2 تطبيق خاصية تقسيم العمود حسب عدد المحارف (Split by Number of Characters)
داخل واجهة محرر Power Query، يقف المحلل على رأس العمود النصي المستهدف، ثم يتوجه إلى علامة التبويب “تحويل” (Transform) أو “الصفحة الرئيسية” (Home)، ويختار أداة “تقسيم العمود” (Split Column) وينتقي منها الخاصية الدقيقة: “حسب عدد المحارف” (By Number of Characters). تفتح هذه الخطوة نافذة حوارية تتيح التحكم الهندسي في مقاييس القطع.
يُطلب من المستخدم في هذه النافذة تحديد عدد المحارف المخصص للاقتطاع بدقة رقمية، مع الاختيار بين ثلاثة خيارات منطقية للتقسيم: التقسيم “مرة واحدة، إلى أقصى اليسار بقدر الإمكان” لعزل البادئة فقط، أو “مرة واحدة، إلى أقصى اليمين بقدر الإمكان” لاقتطاع اللاحقة فقط، أو “بشكل متكرر” (Repeatedly). يمثل خيار التقسيم المتكرر الحل الحاسم للسلاسل الطويلة ذات النمط الدوري، حيث يقوم المحرك بتوليد عدد ديناميكي من الأعمدة الجديدة يستوعب كامل أجزاء السلسلة المفككة بحسب الطول المحدد، مما يوفر جهداً يدوياً هائلاً.
7.3 تعديل شيفرة لغة M البرمجية لضبط أطوال التقسيم بدقة مخصصة
خلف الواجهات الرسومية الأنيقة لمحرر Power Query، تكمن لغة البرمجة الوظيفية القوية M، والتي تمنح المحلل المتقدم سيطرة مطلقة على تفاصيل عمليات التحويل. عند تنفيذ أمر تقسيم العمود بعدد محارف ثابت، يولد المحرك تلقائياً تعليمة برمجية تعتمد على الدالة المتخصصة Table.SplitColumn المقترنة بالدالة المشغلة Splitter.SplitTextByRepeatedLengths في شريط الصيغ العلوي للاستعلام.
يمكن للمحلل تجاوز قيود التجزئة المتساوية عبر تعديل هذا السطر البرمجي يدوياً، واستبدال الدالة السابقة بالدالة Splitter.SplitTextByLengths، وتمرير مصفوفة رقمية مخصصة تضم أطوالاً متفاوتة بين أقواس معقوفة، مثل: {3, 4, 2}. تُمكن هذه الحيلة البرمجية المتقدمة من شطر السلسلة النصية إلى ثلاثة أعمدة متباينة الأطوال في خطوة حوسبية واحدة بالغة الأناقة والسرعة، مما يضغط خطوات التحويل المتتابعة ويسرع زمن معالجة مجموعات البيانات الكبيرة بصورة ملحوظة.
8. الأتمتة المتقدمة باستخدام لغة الفيجوال بيسك للتطبيقات (VBA)
8.1 تصميم روتين فرعي (Subroutine) مخصص لتجزئة النصوص بطول ثابت
توفر بيئة التطوير المدمجة للغة فيجوال بيسك للتطبيقات (VBA) ملاذاً برمجياً استثنائياً لأتمتة المهام المعقدة والمتكررة لتجزئة السلاسل النصية، خاصة في بيئات العمل التي تتطلب تخصيصاً دقيقاً لمعالجة أخطاء الإدخال والإزاحات المكانية. يبدأ الروتين الفرعي (Subroutine) بتعريف متغيرات النطاق المستهدف، ثم الدخول في حلقة تكرارية تفحص كل خلية على حدة، وتستخدم دوال المعالجة النصية المضمنة في محرك VBA مثل Mid و Len لتشريح السلسلة.
في الهيكل البرمجي المعياري، يتم حساب طول النص الداخلي في الخلية، ثم توظف حلقة تكرارية داخلية تقفز بمقدار الطول الثابت المستهدف (Step N)، وتقوم بكتابة المقاطع المستخلصة في الأعمدة المجاورة باستخدام خاصية الإزاحة الموضعية Offset لكائن الخلية النشطة. يمكّن هذا النهج البرمجي من إتمام عمليات معالجة مكثفة لملايين المقاطع النصية بلمسة زر واحدة، مع الحفاظ على عزل الإجراءات الحسابية عن واجهة العرض التفاعلية للمصنف.
8.2 تطوير دوال مخصصة للمستخدم (UDF) تدعم التوزيع المصفوفي
بالإضافة إلى وحدات الماكرو الإجرائية الثابتة، تتيح لغة VBA للمطورين صياغة “دوال مخصصة للمستخدم” (User-Defined Functions – UDFs) تسد الفجوات الوظيفية التي قد تفتقر إليها الدوال القياسية في الإصدارات القديمة من إكسل. يمكن بناء دالة مخصصة تستقبل وسيطتين أساسيتين: مرجع النص وطول الشريحة المراد اقتطاعها، لتقوم الدالة بحساب عدد الأجزاء وتعبئتها في مصفوفة أحادية الأبعاد ترجع قيمها مباشرة إلى ورقة العمل.
تتوافق هذه الدوال المخصصة الحديثة مع بنية “الانسكاب المصفوفي” في إكسل 365، حيث يكفي استدعاء الدالة المخصصة في خلية واحدة ليفيض ناتج التقسيم أفقياً أو عمودياً عبر الخلايا التابعة. وعلاوة على ذلك، يمكن تخزين هذه الدوال داخل ملف “مصنف ماكرو شخصي” (Personal Macro Workbook) أو تصديرها كإضافة برمجية بصيغة (Excel Add-in)، مما يجعلها أداة دائمة متاحة للاستخدام المباشر عبر شتى المشاريع والملفات التحليلية الخاصة بالمؤسسة أو الفريق البحثي.
8.3 إدارة الأخطاء وحماية أداء النظام أثناء معالجة آلاف السطور
تواجه الشيفرات البرمجية غير المحصنة خطر الانهيار الفجائي عند اصطدامها بسجلات شاذة، مثل الخلايا الفارغة أو القيم الخالية (Null Values) أو الخلايا التي تحتوي على رموز خطأ ناتجة عن عمليات سابقة مثل (#N/A). لذلك، تقتضي الممارسة البرمجية الرصينة دمج هياكل متقدمة لاعتراض وإدارة الأخطاء البرمجية باستخدام تعليمات On Error GoTo للتعامل مع الاستثناءات دون توقف التنفيذ، وتوجيه السجلات المعطوبة إلى سجل تدقيق نصي مخصص للفرز اللاحق.
ومن منظور كفاءة الحوسبة واستهلاك موارد النظام، يُعد إيقاف خاصية تحديث الشاشة التلقائي عبر الأمر Application.ScreenUpdating = False، وتعطيل الحساب التلقائي مؤقتاً عبر Application.Calculation = xlCalculationManual إجراءين جوهريين يجب تضمينهما في مقدمة كل كود برمجي يتعامل مع آلاف السطور. إن هذين الإجراءين يمنعان إكسل من إعادة رسم الواجهة الرسومية واحتساب الصيغ بعد كل محرف يتم اقتطاعه، مما يقلص زمن المعالجة الإجمالي بنسبة تصل إلى تسعين بالمئة في قواعد البيانات الضخمة، فضلاً عن منع وميض الشاشة وإجهاد الذاكرة.
9. الأخطاء الشائعة وحلولها التقنية أثناء تجزئة السلاسل النصية
9.1 معضلة فقدان الأصفار البادئة في المقاطع الرقمية المفصولة
يعد فقدان الأصفار البادئة (Leading Zeros) أحد أكثر الأخطاء التقنية شيوعاً وإحباطاً لمحللي البيانات في بيئة إكسل. تنشأ هذه المشكلة من ميل محرك البرنامج الافتراضي إلى محاولة استنتاج نوع البيانات تلقائياً وتحويل كل مقطع يبدو شبيهاً بالأرقام إلى “قيمة عددية مجردة” فور تجزئته. فعلى سبيل المثال، إذا كانت السلسلة النصية الأصلية تضم معرفاً وظيفياً كودياً مثل “00428”، فإن إكسل يميل إلى اختزاله وحذف الصفرين ليتحول إلى الرقم الرياضي “428”، وهو ما يدمر بنية التشفير الرقمي ويقود إلى فشل عمليات المطابقة والربط اللاحقة.
تتمثل الحماية الوقائية الأولى من هذا المأزق في تحديد تنسيق العمود المستهدف بشكل صريح كـ “نص” (Text) أثناء المرور بالخطوة الثالثة من معالج “النص إلى أعمدة”. أما في حال الاعتماد على الصيغ الرياضية، فيمكن التغلب على هذا السلوك عبر إجبار النتيجة على البقاء في النمط النصي، إما من خلال دمج المقطع المستخلص بسلسلة نصية فارغة، أو تغليفه بدالة التنسيق الرياضي TEXT بالصيغة: TEXT(MID(…), “00000”) لضمان إعادة توليد وحقن الأصفار المفقودة بناءً على القالب الرقمي المعياري المطلوب.
9.2 خطأ استبدال البيانات المجاورة وتدمير الخلايا غير الفارغة
يقع كثير من المستخدمين في خطأ فادح غير مقصود يتمثل في تدمير البيانات المجاورة والكتابة الفوقية عليها (Data Overwriting) عند تفعيل معالج تقسيم النصوص. يرجع ذلك إلى أن المعالج لا يقوم بإنشاء أعمدة جديدة ويزيح الأعمدة القائمة جانباً بصورة تلقائية، بل يقوم بتفريغ النتائج في الخلايا الفيزيائية القائمة بالفعل بدءاً من خلية الوجهة المحددة، فإذا كانت تلك الخلايا تحتوي على بيانات مسبقة، فإن إكسل يطمس محتوياتها دون إمكانية موثوقة للتراجع في بعض الأنماط التخزينية.
لتجنب هذه المخاطرة المدمرة، يجب اتباع بروتوكول صارم يقضي بإدراج أعمدة فارغة جديدة يدوياً بعدد المقاطع المتوقع إنتاجها قبل تدشين أي معالج، أو تحويل نطاق الوجهة المستهدف بعيداً عن كتل السجلات المأهولة. كما ينبغي تدريب الكوادر التحليلية على قراءة رسائل التحذير المنبثقة من النظام بعناية؛ حيث يصدر إكسل تنبيهاً صريحاً بنص: “توجد بيانات هنا بالفعل، هل تريد استبدالها؟”، ويجب أن يكون هذا التحذير بمثابة إشارة توقف فورية لإلغاء العملية والتحقق من سلامة النطاق المستهدف.
9.3 انزياح خطوط القطع الناتج عن تبديل تنسيق الخطوط والمحاذاة
يخلق استخدام الخطوط غير المتناسبة (Proportional Fonts) مثل خطوط Calibri و Arial خداعاً بصرياً خطيراً أثناء فحص النصوص داخل ورقة العمل؛ حيث تختلف المساحة الأفقية التي يشغلها كل حرف بناءً على رسمه الهندسي (فحرف “W” يشغل مساحة تفوق ثلاثة أضعاف المساحة التي يشغلها حرف “I”). يؤدي هذا التباين إلى ظهور السلاسل النصية ذات الأطوال المتطابقة عددياً وكأنها متفاوتة الأطوال بصرياً عند عرضها في الخلايا، مما يربك المحلل ويقوده إلى الظن الخاطئ بأن خطوط الفصل الموضعي غير منتظمة.
يتمثل العلاج المهني الرصين لهذه المعضلة في تغيير خط عرض الخلايا المستهدفة أثناء مرحلة المعالجة إلى أحد “الخطوط أحادية المسافة” (Monospaced Fonts) مثل خط Consolas أو Courier New. تضمن هذه الخطوط حجز مساحة أفقية متطابقة تماماً لكل محرف بصرف النظر عن شكله، مما يجعل السلاسل النصية تصطف في أعمدة عمودية بالغة الاستقامة والوضوح، مما يسهل الفحص البصري الدقيق ويمنع الانزياح الوهمي للمحارف، فضلاً عن التأكد من خلو الخلايا من علامات الترقيم الخفية المسببة لانزياح الفهارس.
10. تطبيقات ودراسات حالة عملية في الأبحاث والبيانات المؤسسية
10.1 تفكيك معرفات الموظفين والرموز الهيكلية المعيارية
في إطار دراسة تطبيقية على السجلات المؤسسية لأحد المستشفيات الجامعية الكبرى، واجه فريق التحليل قاعدة بيانات تضم ستين ألف سجل وظيفي، حيث دُمجت كافة بيانات التسكين الإداري في معرف وحيد مكون من تسعة محارف على النمط (ACC102035). هدفت الدراسة إلى تفكيك هذا الرمز لفرز الأطباء وفق التخصص، والمبنى الإداري، والتسلسل الرقمي المستقل لكل ممارس صحي.
نُفذت التجزئة المنهجية عبر تحديد خطوط الفصل الموضعية الثلاثية: تم حجز المقاطع الثلاثة الأولى بواسطة الصيغة =LEFT(A2, 3) لعزل رمز القسم الطبي (ACC)، واستُخرج المقطع الثاني المكون من محرفين باستخدام =MID(A2, 4, 2) لتحديد كود المبنى والفرع (10)، في حين أُفردت المحارف الأربعة الأخيرة باستخدام =RIGHT(A2, 4) لتحديد الرقم التسلسلي للفرد. أسهم هذا التفكيك الهيكلي في تمكين إدارة الموارد البشرية من إجراء تحليلات الارتباط، وبناء جداول محورية (Pivot Tables) تكشف كفاءة توزيع الكوادر عبر الأقسام الطبية المختلفة بدقة إحصائية متناهية.
10.2 معالجة سلاسل التواريخ والأوقات الخام المضغوطة بدون فواصل
تُصدر العديد من أجهزة الاستشعار البيئية وأنظمة الرصد الآلي سجلاتها الزمنية في صيغ نصية مضغوطة للغاية تفتقر لأية فواصل زمنية قياسية، كالنمط الرقمي المشهور (YYYYMMDDHHMMSS)؛ حيث يمثل التتابع “20231115143000” تاريخ الخامس عشر من نوفمبر لعام 2023 عند الساعة الثانية والنصف ظهراً تماماً. إن بقاء هذا التشفير بصورته النصية الصماء يعطل إمكانية حساب الفروق الزمنية أو إجراء تحليلات السلاسل الزمنية (Time Series Analysis) في إكسل.
تم تفكيك هذه السلاسل بالاعتماد على مصفوفات الدوال النصية المدمجة مع الدوال الزمنية المعيارية؛ حيث استُخلصت عناصر التاريخ الثلاثة عبر تجزئة الأطوال المحددة: أربعة محارف للسنة عبر LEFT، ومحرفان للشهر عبر MID(…, 5, 2)، ومحرفان لليوم عبر MID(…, 7, 2)، ثم حُقنت هذه الأجزاء داخل الدالة المعيارية DATE لتوليد كائن تاريخ حقيقي. وبالمثل، فُككت مقاطع الساعات والدقائق والثواني وحُولت عبر دالة TIME، ليتم جمعهما حسابياً في خلية واحدة عكست طابعاً زمنياً قياسياً مكّن الباحثين من قياس أزمنة الاستجابة البيئية بدقة جزء من الثانية.
10.3 إعادة هيكلة بيانات الاستبانات النفسية والمسوح الاجتماعية المرمزة
في أبحاث القياس النفسي والمسوح السلوكية الميدانية، تُصدر بعض منصات جمع البيانات القديمة نتائج اختبارات الشخصية واستبانات ليكرت المتعددة في شريط نصي متصل، حيث تُسجل إجابات المستجيب البالغة خمسين بنداً في سلسلة مفردة من خمسين رقماً متراصاً (مثل: “435124…”). يتطلب تقييم الاتساق الداخلي للاستبانة وحساب معامل ثبات ألفا كرونباخ تفكيك هذا الشريط المتصل إلى خمسين عموداً منفصلاً يمثل كل عمود منها بنداً نفسياً مستقلاً.
يمثل توظيف صيغة الانسدال المصفوفي الديناميكية =MID(A2, SEQUENCE(1, 50, 1, 1), 1) الحل الرياضي الأمثل لهذه الحالة الميدانية، حيث يُنشر الشريط النصي دفعة واحدة عبر خمسين عموداً فرعياً بطول محرف واحد لكل بند. يتيح هذا الإجراء التجهيزي تحويل الدرجات النصية مباشرة إلى قيم قياسية صالحة لحساب المتوسطات، والانحرافات المعيارية، وتصدير المصفوفة المفككة بدقة إلى الحزم الإحصائية المتقدمة للعلوم المعرفية والسلوكية، مما يعزز موثوقية الاستنتاجات العلمية ومطابقتها للمعايير الأكاديمية الصارمة المعمول بها في مجتمعات القياس النفسي الحديثة.
خاتمة
تُعد مهارة تقسيم السلاسل النصية حسب طول محدد في برمجية مايكروسوفت إكسل ركيزة محورية لا غنى عنها لأي محلل بيانات أو باحث أكاديمي يتعامل مع السجلات الرقمية المعقدة. لقد أثبت التحليل المنهجي استيعاب إكسل لترسانة واسعة ومتنوعة من الحلول التي تتدرج من الأدوات البصرية المباشرة المتمثلة في معالج “النص إلى أعمدة”، مروراً بالمرونة الحسابية الاستثنائية التي توفرها الدوال الكلاسيكية (MID و LEFT و RIGHT) والمصفوفات الديناميكية الحديثة (SEQUENCE و TEXTSPLIT)، وصولاً إلى منصات التحويل والأتمتة الرصينة في محرر Power Query والبرمجة المتقدمة بلغة VBA. إن نجاح عملية معالجة النصوص لا يتوقف فحسب على إتقان الجانب الإجرائي، بل يتطلب بالدرجة الأولى رؤية نقدية واعية بآليات تهيئة البيانات، والتعامل الوقائي مع التحديات الخفية كالأصفار البادئة، والمسافات غير المرئية، وضمان عدم تدمير السجلات الأصلية أو اختلال أبعادها الحسابية، وهو ما يؤسس لممارسات علمية تتسم بالدقة، والموثوقية، وقابلية التكرار في كافة الميادين البحثية والمؤسسية.
المراجع
- Ferrand, L., New, B., Brysbaert, M., Keuleers, E., Bonin, P., Méot, A., Augustinova, M., & Pallier, C. (2010). The French Lexicon Project: Lexical decision data for 38,840 French words and 38,840 pseudowords. Behavior Research Methods, 42(2), 488–500. https://doi.org/10.3758/brm.42.2.488
- Keuleers, E., Lacey, P., Rastle, K., & Brysbaert, M. (2011). The British Lexicon Project: Lexical decision data for 28,730 monosyllabic and disyllabic English words. Behavior Research Methods, 44(1), 287–304. https://doi.org/10.3758/s13428-011-0118-4
- Pollock, E., Chandler, P., & Sweller, J. (2002). Assimilating complex information. Learning and Instruction, 12(1), 61–86. https://doi.org/10.1016/s0959-4752(01)00016-0
- Tse, C.-S., Yap, M. J., Chan, Y.-L., Sze, W. P., Shaoul, C., & Lin, D. (2016). The Chinese Lexicon Project: A megastudy of lexical decision performance for 25,000+ traditional Chinese two-character compound words. Behavior Research Methods, 49(4), 1503–1519. https://doi.org/10.3758/s13428-016-0810-5
- Zagreus, L., Huizenga, C., Arens, E., & Lehrer, D. (2004). Listening to the occupants: a Web-based indoor environmental quality survey. Indoor Air, 14(s8), 65–74. https://doi.org/10.1111/j.1600-0668.2004.00301.x