
يُشكّل التعامل مع البيانات النصية غير المهيكلة وتنقيحها أحد أبرز التحديات المحورية في مجال الحوسبة المكتبية وإدارة قواعد البيانات التحليلية. في بيئة العمل الرقمية الحديثة، تتطلب جداول البيانات، مثل مايكروسوفت إكسيل (Microsoft Excel)، قدرات متقدمة تتيح للمستخدمين تنظيف المحتوى النصي، وإعادة هيكلته، واستبدال مقاطع محددة ضمن سلاسل نصية طويلة قد تحتوي على أخطاء طباعية أو زوائد تنسيقية. ورغم توافر ترسانة واسعة من الأدوات والدوال النصية المضمنة في البرنامج، تظل هناك فجوات وظيفية تتطلب فهماً هندسياً دقيقاً لسلوك محرك الحسابات في إكسيل، لا سيما عندما يتعلق الأمر بإجراء استبدالات ديناميكية تعتمد على الأنماط بدلاً من التطابقات الحرفية المطلقة.
تتربع دالة الاستبدال التماثلي SUBSTITUTE على عرش الدوال المخصصة لمعالجة المحارف، نظراً لسرعتها الفائقة وقدرتها على استبدال سلاسل نصية مستهدفة ببدائل جديدة دون الحاجة إلى معرفة رقم موضع البدء المسبق. غير أن المحللين والمطورين يصطدمون بعائق تقني حاسم عند محاولة دمج هذه الدالة مع ما يُعرف بـ “أحرف البدل” (Wildcards) مثل النجمة (*) وعلامة الاستفهام (؟)، حيث تتجاهل الدالة الخصائص النمطية لهذه الرموز وتعاملها كحروف نصية مصمتة. ينشأ هذا التباين من الاختلاف المعماري بين خوارزميات المطابقة الحرفية الصارمة وخوارزميات المطابقة النمطية؛ مما يجعل الحاجة ماسة إلى ابتكار حلول مركبة تستند إلى تفكيك الدوال وتوظيف الحسابات الموضعية الدقيقة لإنجاز ما يعجز عنه التطبيق المباشر.
يهدف هذا البحث التقني المفصل إلى تأصيل البنية التركيبية لدالة SUBSTITUTE، وتشريح أوجه القصور التقني التي تمنعها من دعم أحرف البدل بشكل تلقائي، ثم استعراض استراتيجية رياضية وهندسية شاملة لبناء صيغ بديلة بالغة الدقة تعتمد على تكامل دوال البحث والقياس والاستقطاع. وسنتناول كذلك الآليات المعاصرة لتجاوز هذه العقبة عبر أدوات أحدث مثل التعبيرات النمطية (Regular Expressions) وأداة دمج واستعلام البيانات (Power Query)، مع تقديم أمثلة تطبيقية مأخوذة من واقع معالجة بيانات المؤسسات الضخمة، لضمان أعلى درجات الموثوقية والدقة في بيئات العمل الإنتاجية.
1. مقدمة تأصيلية لدالة SUBSTITUTE في مايكروسوفت إكسيل ومحدداتها التقنية
1.1 التعريف الوظيفي والبنية التركيبية لدالة SUBSTITUTE
تُعرّف دالة SUBSTITUTE برمجياً في بيئة مايكروسوفت إكسيل بأنها دالة معالجة نصية متخصصة في البحث عن مقطع نصي محدد واستبداله بمقطع آخر ضمن سلسلة نصية أصلية. تأتي الصيغة القياسية للدالة على النحو التالي:
=SUBSTITUTE(text, old_text, new_text, [instance_num])
تتألف الدالة من أربع وسائط وظيفية؛ ثلاث منها إلزامية وواحدة اختيارية. الوسيطة الأولى هي text، وتُمثّل السلسلة النصية المرجعية الحاضنة للعملية، أو المرجع المباشر للخلية المراد معالجتها. الوسيطة الثانية هي old_text، وتُحدد السلسلة النصية الفرعية التي يرغب المستخدم في إزالتها أو تعديلها. أما الوسيطة الثالثة، new_text، فتُشير إلى المحتوى النصي البديل الذي سيحل بدقة محل السلسلة القديمة.
تتجلى قوة الدالة التوزيعية في الوسيطة الرابعة الاختيارية [instance_num]. في حال إغفال هذه الوسيطة، يقوم محرك الحسابات بتنفيذ استبدال كلي وشامل لكل ظهور للسلسلة old_text داخل النص الأصلي. أما إذا تم تعيين قيمة عددية صحيحة لهذه الوسيطة (مثل 1، 2، 3…)، فإن الدالة تنتقل إلى وضع الاستبدال الانتقائي، بحيث تقتصر عملية التبديل على التكرار المحدد برقم الوسيطة فقط، مع الإبقاء على كافة التكرارات الأخرى دون المساس بها.
من الخصائص الحاكمة لدالة SUBSTITUTE حساسيتها المطلقة لحالة الأحرف (Case Sensitivity) عند التعامل مع النصوص المكتوبة بالأبجديات اللاتينية. فإذا كانت القيمة المستهدفة في old_text مكتوبة بأحرف صغيرة، فلن يتم استبدال أي تكرار يحتوي على أحرف كبيرة مطابقة شكلياً. تُعد هذه الحساسية ميزة حاسمة في سيناريوهات التدقيق الإملائي الصارم وضبط الأكواد البرمجية، لكنها قد تتحول إلى عقبة إذا لم يُراعَ توحيد حالة النصوص مسبقاً.
1.2 الفروق الجوهرية بين دالتي SUBSTITUTE و REPLACE
غالباً ما يقع الالتباس لدى مستخدمي إكسيل المبتدئين وحتى المتوسطين في التمييز بين دالتي SUBSTITUTE وREPLACE، على الرغم من افتراقهما الجذري في فلسفة المعالجة وآلية الاستهداف الموضعي داخل الذاكرة:
- دالة REPLACE: تعتمد فلسفتها على الإحداثيات الهندسية المجردة. صيغتها الرياضية
=REPLACE(old_text, start_num, num_chars, new_text)تستوجب تزويدها بموقع البدء العددي (start_num) وعدد المحارف المراد حذفها (num_chars). لا تكترث هذه الدالة بماهية الحروف التي يتم استبدالها؛ إنها ببساطة تقتطع مساحة مكانية ثابتة وتضع مكانها المحتوى الجديد، مما يجعلها الخيار المثالي إذا كانت البيانات ذات أطوال ثابتة وهياكل موحدة (Fixed-width Data)، كأرقام الهويات الوطنية أو أكواد المنتجات القياسية. - دالة SUBSTITUTE: تعتمد على البحث الدلالي الحرفي (Content-based Matching). لا يهم أين تقع الكلمة في السلسلة، سواء كانت في أولها أو وسطها أو آخرها؛ تبحث الدالة عن السلسلة المستهدفة بالاسم الصريح وتستبدلها بصرف النظر عن موضعها الحسابي، مما يجعلها متفوقة بوضوح في التعامل مع النصوص ذات الأطوال المتغيرة (Variable-length Strings) والفقرات المفتوحة.
يتحدد الاختيار بين الدالتين بناءً على مصفوفة هيكلية البيانات المدخلة؛ فإذا كان التباين في موضع النص غير متوقع ولكن المحتوى المستهدف معروف سلفاً، فإن SUBSTITUTE تتفوق حتماً. وعلى النقيض من ذلك، إذا كان المحتوى المستهدف متغيراً في أحرفه ولكنه ثابت في إحداثياته المكانية، تُصبح REPLACE الخيار المنطقي الوحيد. وتجدر الإشارة إلى أن كِلا الدالتين تفتقران للأهلية الأصلية لمعالجة الأنماط النصية المعتمدة على أحرف البدل دون تدخلات برمجية مساعدة.
1.3 طبيعة البيانات النصية وأهمية عمليات المعالجة الآلية
تمثل النصوص غير المتجانسة تحدياً محورياً في خطوط إنتاج تحليلات البيانات الحديثة، حيث تتدفق المدخلات من مصادر متباينة تشمل واجهات برمجة التطبيقات (APIs)، وتفريغات قواعد البيانات العتيقة، ونماذج الإدخال البشري غير المنضبطة. يؤكد الباحثون المتخصصون في لسانيات المدونات وتحليل البيانات النصية الضخمة، مثل Friginal et al. (2014)، أن دقة استخراج الأنماط تعتمد جذرياً على جودة عمليات التنظيف والتنقيح المسبقة للنصوص الأصلية، إذ إن وجود فراغات زائدة أو رموز تنسيقية شاذة كفيل بإحداث تشوهات بنيوية في المعالجة الإحصائية اللاحقة.
تتطلب عمليات تنظيف البيانات (Data Cleansing) مرونة رياضية عالية داخل بيئات الجداول الإلكترونية لتفكيك السلاسل المعقدة، والتخلص من الشوائب النصية، وتوحيد التنسيقات غير المتسقة. ويشير Kim (2009) في دراسته حول المعالجة الذاتية للأخطاء اللغوية والنصية إلى أن التحول نحو أتمتة تصحيح النصوص وتنقيتها يقلل من احتمالات الخطأ اليدوي بنسب ملحوظة، مما يرفع الكفاءة التشغيلية للمؤسسات التي تعتمد على سجلات بيانات تتجاوز مئات الآلاف من الصفوف.
في هذا السياق، تكتسب التوليفات الدالية في إكسيل أهمية قصوى؛ فالأتمتة النصية ليست ترفاً تقنياً، بل هي ضمانة لبقاء النماذج المالية والتحليلية متسقة ومقاومة للاستثناءات المفاجئة. فعندما يعجز مسؤولو البيانات عن تطبيق خوارزميات برمجية خارجية، تُصبح الدوال المصفوفية والصيغ الهندسية المركبة خط الدفاع الأول لمعالجة السلاسل النصية وضمان تماسكها المنطقي.
2. مفهوم أحرف البدل (Wildcards) وآلية عملها النظرية في بيئة إكسيل
2.1 الرمزية الوظيفية لأحرف البدل الأساسية
أحرف البدل (Wildcards) هي رموز برمجية متفق عليها عالمياً في نظم التشغيل ومحركات الاستعلام الحوسبية، تُستخدم للإشارة إلى قيم غير محددة أو مجهولة أثناء عمليات البحث والمطابقة النصية. يوفر مايكروسوفت إكسيل دعماً قياسياً لثلاثة رموز بدل رئيسية:
- رمز النجمة (*): يمثل هذا الرمز أي عدد عشوائي من المحارف المتتالية، بدءاً من صفر من الحروف (غياب تام للمحرف) وصولاً إلى سلسلة لا نهائية من النصوص والأرقام والرموز. على سبيل المثال، فإن معيار البحث
"أحمد*"يطابق كلمات مثل “أحمد”، “أحمدي”، “أحمديان”، و”أحمد عبد الله”. - علامة الاستفهام (؟): تلعب دور الحجز الموضعي لمحرف فردي واحد ومحدد بدقة، بصرف النظر عن ماهية ذلك المحرف (حرف، رقم، مسافة، أو رمز خاص). فمعيار البحث
"س؟د"يطابق كلاً من “سعد”، و”سيد”، و”سود”، لكنه يفشل قطعياً في مطابقة كلمة “سعيد” نظراً لاحتوائها على محرفين بين السين والدال. - حرف المدة (~ – Tilde): يؤدي هذا الرمز وظيفة الهروب البرمجي (Escape Character) أو الإبطال الوظيفي. نظراً لأن النجمة وعلامة الاستفهام لهما سلوك تنفيذي ديناميكي، فإن الرغبة في البحث عن رمز النجمة الحقيقي أو علامة الاستفهام الفعلية داخل الخلية يتطلب وضع علامة المدة قبلهما مباشرة (أي
"~*"أو"~؟")، وبالمثل فإن البحث عن رمز المدة ذاته يتطلب تكراره"~~".
2.2 نطاق دعم أحرف البدل داخل الدوال القياسية
لا يُعد دعم أحرف البدل ميزة عامة أو شاملة لكافة دوال مايكروسوفت إكسيل؛ بل خُصص هذا السلوك لمجموعة وظيفية محددة تركز على التجميع المشروط والبحث والرجوع. تشمل قائمة الدوال الداعمة أصلياً لأحرف البدل ما يلي:
- دوال العد والتجميع الشرطي: مثل COUNTIF، وCOUNTIFS، وSUMIF، وSUMIFS، وAVERAGEIF، وAVERAGEIFS. تستقبل هذه الدوال معايير نصية وتُمررها عبر محرك داخلي يتعرف على النجمة وعلامة الاستفهام لتحقيق التطابق الجزئي.
- دوال البحث والتقاطع: مثل دالة MATCH الكلاسيكية عند ضبط وسيطة نوع المطابقة على القيمة الصفرية (0)، ودالة VLOOKUP، وكذلك دالة XLOOKUP الحديثة شريطة تعيين وسيطة match_mode على الرقم (2) لتفعيل وضع أحرف البدل صراحةً.
- دوال التحديد الموضعي: وأبرزها دالة SEARCH، والتي تختلف جوهرياً عن دالة FIND في أنها تدعم أحرف البدل كلياً ولا تفرق بين الحروف الكبيرة والصغيرة.
على النقيض من ذلك تماماً، تقف الدوال النصية المعنية بالمعالجة المادية للحروف—مثل SUBSTITUTE وFIND وEXACT وCONCATENATE—موقفاً حازماً يرفض هذا النمط، حيث تم تصميم بنيتها التحتية لمعاملة المدخلات ككتل نصية ثابتة ومغلقة رياضياً، تجنباً للاستهلاك المفرط للذاكرة العشوائية أثناء تكرار العمليات الخلوية.
3. التحدي التقني: أسباب عجز دالة SUBSTITUTE عن معالجة أحرف البدل
3.1 المعالجة الحرفية مقابل المعالجة النمطية للنصوص
يرجع عجز دالة SUBSTITUTE عن قراءة أحرف البدل إلى الهيكل الخوارزمي الذي بُنيت عليه داخل نواة محرك إكسيل الرياضي. تعتمد الدالة على خوارزمية فحص الحروف المتتالية البسيطة (Literal String Scanning)، وهي تقنية حوسبية تستهدف مطابقة مصفوفة البايتات الممثلة للمدخل النصي مع مصفوفة البايتات الممثلة للنص المبحوث عنه في ذاكرة النظام.
عندما يُدرج المستخدم رمز النجمة ضمن الوسيطة old_text، كأن يكتب =SUBSTITUTE(A1, "تقرير*", "جديد")، فإن محرك الحسابات لا يرى في هذا الرمز أية دلالة تمثيلية؛ بل يقوم بمقارنة الرمز مع جدول الترميز (مثل UTF-16 أو ASCII) ويبحث حرفياً عن محرف النجمة الممثل بالرمز الرقمي 42 (Unicode U+002A). وإذا لم تكن الخلية الأصلية تحتوي فعلياً على نجمة مطبوعة بداخلها، تُخفق العملية برمتها ويُعاد النص الأصلي تماماً كما هو دون إحداث أي استبدال.
يعود هذا القصور التاريخي إلى غياب محرك التعبيرات النمطية المدمج (RegEx Engine) في أجيال إكسيل التقليدية، وهو ما ناقشته الدراسات المتخصصة في أدوات حوسبة اللغات الطبيعية وتحليل النصوص مثل MacWhinney (2018)، حيث تبرز الحاجة دائماً لوجود محركات معالجة نحوية قادرة على التعرف على الحدود والأنماط المعقدة، بدلاً من الاكتفاء بالمسح الحرفي الصارم الذي يقيد عمليات التحليل الآلي.
3.2 التداعيات التحليلية لغياب الدعم المباشر
يفرض هذا النقص المعماري قيوداً تشغيلية قاسية على المحللين الماليين والبياناتيين؛ إذ يستحيل، على سبيل المثال، إزالة أو استبدال العبارات المتغيرة المحصورة بين هلالين أو أقواس معقوفة—مثل إزالة النصوص ذات الهيئة [كود: 1234] أو [كود: 9876]—عبر صيغة SUBSTITUTE مفردة وبسيطة كصيغة =SUBSTITUTE(A1, "[*]", ""). يواجه المحلل هنا فشلاً حتمياً يؤدي إلى بقاء الأكواد كما هي.
علاوة على ذلك، فإن استخدام حرف المدة (~) للهروب لا يُجدي نفعاً هنا إطلاقاً؛ فمحاولة إدخال ~* تدفع SUBSTITUTE للبحث الحرفي عن زوج المحارف المكون من المدة والنجمة معاً. هذه التداعيات تفرض تكلفة برمجية إضافية، حيث يضطر مهندسو البيانات إلى تأليف صيغ متداخلة بالغة التعقيد تستنزف وقتاً في التدقيق والصيانة. ومع ذلك، تبقى هذه الصيغ الهندسية هي السبيل الوحيد لمعالجة البيانات عند العمل في بيئات إكسيل القياسية التي لا تدعم الدوال السحابية الأحدث أو تمنع استخدام وحدات الماكرو لأسباب أمنية.
4. البديل الهندسي: تفكيك معادلة الاستبدال الديناميكي المتقدمة
4.1 الاستراتيجية الرياضية لعزل السلاسل النصية واستبدالها
لمحاكاة السلوك المفقود لأحرف البدل داخل إكسيل، لا بد من التحول الفكري من مفهوم “الاستبدال الداخلي السلبي” إلى مفهوم “الجراحة النصية النشطة” التي تعتمد على استراتيجية الاقتطاع الطرفي وإعادة الدمج. تقتضي هذه الاستراتيجية النظر إلى النص الأصلي بوصفه يتألف من ثلاثة مقاطع رئيسية متجاورة:
- المقطع الابتدائي الثابت (Prefix Segment): ويبدأ من أول حرف في الخلية ويمتد حتى نقطة بداية النص النمطي المراد التخلص منه.
- المقطع المستهدف المجهول (Variable Core): وهو النص الديناميكي المتغير الواقع بين نقطتي بداية ونهاية محددتين (كالأقواس، أو علامات التنصيص، أو كلمات مفتاحية دلالية ثابتة)، وهو ما كان يفترض أن يغطيه رمز النجمة (*).
- المقطع الانتهائي اللاحق (Suffix Segment): ويبدأ مباشرة بعد نهاية المقطع المستهدف ويمتد حتى الحرف الأخير من السلسلة الإجمالية.
بناءً على هذا التقسيم، تُصاغ الخوارزمية البديلة رياضياً عبر استئصال المقطع الابتدائي والمقطع الانتهائي وعزلهما بدقة، ثم حقن النص البديل الجديد في المنتصف، وإعادة ربط المكونات الثلاثة بواسطة معامل الربط النصي (Ampersand: &)، لتتشكل لدينا في النهاية سلسلة نصية معدلة تماماً كأنها خضعت لعملية استبدال بنمط النجمة المتغير.
4.2 البناء الهيكلي للصيغة المركبة البديلة
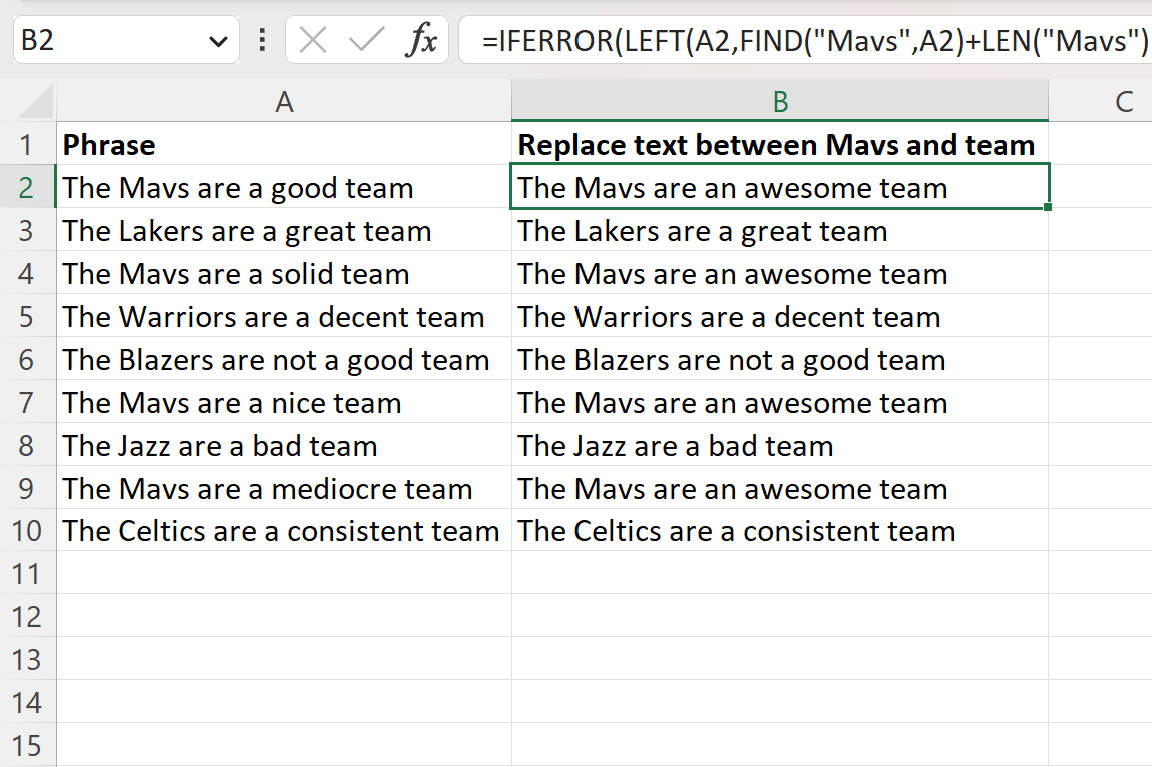
لترجمة الاستراتيجية السابقة إلى معادلة إكسيل تنفيذية، دعنا نفترض أن لدينا نصاً في الخلية A2 يحتوي على عبارة ديناميكية تبدأ بـ "<" وتنتهي بـ ">"، ونرغب في استبدال هذا المقطع وما بينهما بالنص "REPLACED". تتخذ المعادلة المركبة الهيكل العام التالي:
=LEFT(A2, FIND("<", A2) - 1) & "REPLACED" & RIGHT(A2, LEN(A2) - FIND(">", A2))
يقوم الجزء الأول من المعادلة LEFT(A2, FIND("<", A2) - 1) بحساب الموضع العددي للرمز الحاكم الأول "<" باستخدام دالة FIND، ثم يطرح منه واحداً لتفادي تضمين الرمز نفسه، ويقتطع كل ما يقع على يساره انطلاقاً من بداية النص. المكون الأوسط هو النص الجديد المراد إحلاله محل القيمة المتغيرة. أما الجزء الأخير RIGHT(A2, LEN(A2) - FIND(">", A2))، فيحسب المسافة العكسية من نهاية النص وصولاً إلى رمز الإغلاق ">"، مقتطعاً كل ما يلي ذلك الرمز باتجاه اليمين.
في حال أردنا استبدال النص الواقع بين كلمتين كاملتين بدلاً من مجرد رموز، مثل الكلمة "START" والكلمة "END"، يتم تعديل المعادلة لمراعاة أطوال الكلمات نفسها كالتالي:
=LEFT(A2, FIND("START", A2) - 1) & "NEW_TEXT" & RIGHT(A2, LEN(A2) - (FIND("END", A2) + LEN("END") - 1))
4.3 معادلة الحساب الموضعي وتحديد الإزاحات الرقمية
تتطلب هندسة هذه الصيغ عناية فائقة بضبط قيم “الإزاحة الموضعية” (Index Offsets)، حيث إن أي خطأ في زيادة أو نقصان رقم واحد يؤدي إلى أخطاء شائعة تُعرف في علم البرمجة بأخطاء “الزيادة أو النقصان بواحد” (Off-by-one errors). وتتحدد القيمة الرياضية للإزاحة وفق المعايير التالية:
- إذا كان المقطع النهائي المستهدف استبعاده يشمل رمز البداية، فإننا نستخدم
FIND(Delimiter1, Text) - 1لتحديد طول المقطع الأيسر المحتفظ به. أما إذا رغبنا في الإبقاء على رمز البداية واستبدال ما بعده فقط، فنستخدمFIND(Delimiter1, Text) + LEN(Delimiter1) - 1. - بالنسبة لدالة RIGHT، يتم استخراج عدد الأحرف المتبقية بطرح الموضع المطلق لنهاية الرمز الثاني من إجمالي طول السلسلة المأخوذ بواسطة LEN. يُحسب الموضع النهائي للرمز الثاني عبر المعادلة:
FIND(Delimiter2, Text) + LEN(Delimiter2) - 1. وبناءً عليه، يكون طول الطرف الأيمن:LEN(Text) - (FIND(Delimiter2, Text) + LEN(Delimiter2) - 1). - تستدعي الفواصل والمسافات البيضاء بين المفردات تدقيقاً إضافياً؛ إذ يؤدي الاستبدال في كثير من الأحيان إلى التصاق الكلمة الجديدة بالكلمات السابقة أو اللاحقة، مما يستوجب دمج مسافات صريحة داخل الصيغة مثل
& " NEW_TEXT " &أو استدعاء دوال التنقية اللاحقة.
5. تشريح الدوال المساعدة: دور كل دالة في المنظومة البديلة
5.1 دالة FIND ودورها في رصد الإحداثيات النصية بدقة
تؤدي دالة FIND دور الرادار الإحداثي في المنظومة البديلة، حيث تقوم بمسح السلسلة النصية حرفاً بحرف لتحديد الموقع الرقمي الصارم للظهور الأول لمحرف أو كلمة البحث. صيغتها الرياضية هي =FIND(find_text, within_text, [start_num]).
ما يميز دالة FIND هو حساسيتها المطلقة لحالة الأحرف ومطابقتها الثنائية غير القابلة للتأويل، مما يمنحها دقة بالغة عند التعامل مع وسوم التكويد أو البوادئ المتشابهة. عند تحديد الموضع العددي لبداية السلسلة، توفر الدالة الأساس المرجعي الذي تنبثق منه عمليات الاقتطاع.
يمكن التحكم في سلوك FIND عبر وسيطتها الثالثة start_num لتجاوز التكرارات المبكرة للكلمات المفتاحية في الجملة؛ فإذا كان النص يحتوي على فواصل متعددة ونريد الاستبدال بدءاً من الفاصل الثاني، يمكننا تعشيش دالة FIND ثانية داخل الوسيطة الثالثة لدالة FIND الأولى لتبدأ المسح مباشرة بعد الفاصل الأول.
5.2 دالة LEN ودورها في القياس الديناميكي لأطوال النصوص
تُعد دالة LEN من أبسط دوال إكسيل من حيث الاستدعاء =LEN(text)، لكنها الأكثر أهمية من الناحية الحسابية في المعادلات المركبة. تُعيد الدالة إجمالي عدد المحارف في الخلية، بما في ذلك الحروف، والأرقام، والرموز، والمسافات البيضاء بمختلف أنواعها.
تكمن الفائدة المحورية لدالة LEN في قدرتها على تحويل المواقع المكانية المطلقة التي ترصدها دالة FIND (والتي تحسب المسافة دوماً من أقصى اليسار أو بداية النص) إلى مقادير نسبية صالحة للاستخدام مع الدوال التي تقتطع من أقصى اليمين. فبدون معرفة الطول الإجمالي للخلية، يعجز محرك الحسابات عن استنتاج كمية الحروف الواجب اقتطاعها من الطرف الأيمن دون الإخلال بسلامة البنية النصية.
بالإضافة إلى ذلك، تُستخدم LEN(Delimiter) لقياس طول المحددات النصية ذاتها ديناميكياً، مما يضمن ثبات المعادلة واستقرارها حتى لو تم تغيير كلمة الفاصل أو المحدد في وقت لاحق إلى عبارة أطول دون الحاجة لإعادة كتابة الأرقام يدوياً داخل المعادلة.
5.3 دالتا LEFT و RIGHT لإعادة بناء السلسلة بعد الاستقطاع
تعمل دالتا LEFT وRIGHT بمثابة أدوات القص الميكانيكي على أطراف السلسلة المستهدفة. تقبل دالة LEFT وسيطتين: النص وعدد الأحرف المراد أخذها من البداية =LEFT(text, [num_chars])، في حين تفعل دالة RIGHT الشيء نفسه ولكن انطلاقاً من الحرف الأخير في الخلية وباتجاه الخلف =RIGHT(text, [num_chars]).
عندما تُغذى هاتان الدالتان بالأرقام المحسوبة ديناميكياً من تضافر FIND وLEN، تضمنان استخلاص الأجزاء السليمة من النص وتفادي المقطع المراد محوه بالكامل. إن هذا الفصل الفيزيائي للأجزاء وإعادة تجميعها يسمح للمحلل بفرض شروط إضافية على كل جزء بشكل مستقل؛ كإضافة بادئات، أو تحويل حالة الأحرف للطرف الأيسر وحده، قبل ربطه بالنص المستبدل والطرف الأيمن.
6. التطبيق العملي خطوة بخطوة: استبدال النصوص الواقعة بين علامتين
6.1 تهيئة بيئة الاختبار وإعداد جدول البيانات التجريبي
لفهم التطبيق العملي بعمق، سنفترض وجود جدول بيانات يحتوي على سجلات العملاء وتفاصيل الشحن في العمود A. تتضمن السجلات ملاحظات تحتوي على معرفات تتبع متغيرة الطول محصورة بين أقواس معقوفة، ونريد استبدال كافة تلك المعرفات بعبارة قياسية موحدة هي: [CONFIDENTIAL].
لتهيئة النموذج ومتابعة الحسابات الذهنية بدقة، نُنشئ أعمدة مساعدة مؤقتة قبل دمج الصيغة النهائية:
- الخلية A2:
"Customer Order ID: 49201 [Tracker: US-NY-8821] Shipped Via Express" - العمود B (موضع رمز البداية “[“): نكتب الصيغة
=FIND("[", A2)فتُنتج القيمة 26. - العمود C (موضع رمز النهاية “]”): نكتب الصيغة
=FIND("]", A2)فتُنتج القيمة 49. - العمود D (إجمالي طول النص الأصلي): نكتب الصيغة
=LEN(A2)فتُنتج القيمة 69.
من خلال هذه الإحداثيات، يتضح أن المقطع المحصور بين الموضع 26 والموضع 49 هو النطاق المستهدف بالاستبدال، وهو ما يماثل منطقياً استخدام حرف البدل "[*]" داخل السلسلة.
6.2 كتابة المعادلة المركبة وتطبيقها العملي في المصنف
نقوم الآن بتركيب المعادلة الكلية في العمود E دون الحاجة للاعتماد على الأعمدة المساعدة، عبر دمج كافة العمليات السابقة في خلية واحدة كالتالي:
=LEFT(A2, FIND("[", A2) - 1) & "[CONFIDENTIAL]" & RIGHT(A2, LEN(A2) - FIND("]", A2))
بتنفيذ هذه المعادلة، يقوم الجزء الأيسر LEFT(A2, 25) باقتطاع النص: "Customer Order ID: 49201 ". ثم يدمج المعامل النص البديل: "[CONFIDENTIAL]". بعد ذلك، تحسب دالة RIGHT عدد الأحرف المطلوبة من الطرف الأيمن: 69 - 49 = 20 محرفاً، فتقتطع بدقة: " Shipped Via Express".
تكون النتيجة النهائية المستخرجة في الخلية E2 هي:
"Customer Order ID: 49201 [CONFIDENTIAL] Shipped Via Express"
عند سحب مقبض التعبئة (Fill Handle) إلى باقي خلايا العمود، تتكيف الدالة تلقائياً مع السجلات الأخرى حتى وإن اختلف طول كود التتبع من خلية لأخرى (مثلاً: [Tracker: 12] أو [Tracker: GLOBAL-AIR-CARGO-9988231])، حيث يُعاد حساب المواقع والأطوال ديناميكياً لكل صف على حدة، محققة التطابق النمطي الكامل الذي تعجز عنه دالة SUBSTITUTE المفردة.
6.3 معالجة المسافات وعلامات الترقيم المحيطة بالنص المستبدل
تنشأ أحياناً عيوب تنسيقية إثر عمليات الاستبدال، مثل ظهور مسافات مزدوجة إذا تم تضمين مسافة في بداية النص البديل وكانت السلسلة الأصلية تحتوي بالفعل على مسافة قبل المحدد الأول. لحل هذه المعضلة الحسابية، يُوصى بتغليف الناتج الإجمالي داخل دالة TRIM لتطهير السلسلة من المسافات الزائدة:
=TRIM(LEFT(A2, FIND("[", A2) - 1) & " [CONFIDENTIAL] " & RIGHT(A2, LEN(A2) - FIND("]", A2)))
تضمن دالة TRIM إزالة أي فراغات متتالية غير ضرورية وتحويلها إلى مسافة فردية واحدة، بالإضافة إلى إزالة المسافات المتطرفة في أول النص وآخره. وإذا كانت النصوص تحتوي على علامات تنصيص كفواصل، يجب مضاعفة كتابة علامات التنصيص في صيغة FIND للهروب منها برمجياً، كأن نكتب FIND("""", A2) لرصد موضع علامة الاقتباس الفردية.
7. إدارة الاستثناءات وتأمين الصيغ الحسابية بواسطة دالة IFERROR
7.1 أسباب تولد خطأ #VALUE! في الصيغ النصية المركبة
تتميز الدوال النصية في إكسيل بأنها غير متسامحة مطلقاً مع الأخطاء؛ فإذا تم تطبيق المعادلة المركبة السابقة على صف يحتوي على نص لا يشتمل على أحد المحددين أو كلاهما (كأن يخلو السجل تماماً من القوس "[" أو "]")، فإن دالة FIND تخفق فوراً في رصد القيمة وترسل خطأ التنفيذ الحسابي الشهير #VALUE!.
لا يقف الخطأ عند حدود دالة FIND وحدها؛ بل إنه يتسلل تصاعدياً ليعطل عمل الدوال المحيطة مثل LEFT وRIGHT، مما يتسبب في شلل تام للصيغة في ذلك الصف. كما يمكن أن ينشأ الخطأ إذا كانت الخلية المرجعية فارغة، أو تحتوي على قيمة رقمية بحتة دون تحويلها المسبق إلى نص، أو إذا كانت مواضع المحددات مقلوبة منطقياً في النص (كأن يظهر قوس الإغلاق قبل قوس الفتح)، مما ينتج قيماً سالبة تتسبب في انهيار الحسابات.
7.2 تضمين دالة IFERROR لإنشاء مخرجات آمنة واحترافية
لتفادي تشويه لوحات البيانات ونماذج التقارير برموز الأخطاء، يتعين تغليف المعادلة المركبة بأكملها كمعامل أول داخل بنية دالة IFERROR الوقائية، وفق النمط التالي:
=IFERROR(LEFT(A2, FIND("[", A2) - 1) & "[CONFIDENTIAL]" & RIGHT(A2, LEN(A2) - FIND("]", A2)), A2)
في هذه التركيبة المحمية، يختبر إكسيل صحة الصيغة النصية؛ فإذا نجحت العملية ووجدت المحددات، يتم إخراج النص المستبدل بنجاح. أما إذا فشلت دالة FIND في العثور على المحددات وتولد خطأ #VALUE!، تتدخل IFERROR فوراً وتُعيد القيمة المحددة في وسيطتها الثانية، والتي جعلناها هنا A2. يؤدي هذا الإجراء الحصيف إلى الإبقاء على النص الأصلي سالماً دون تعديل، مما يمنع فقدان البيانات ويسمح لفرق التدقيق باكتشاف السجلات التي لم تستوفِ شروط النمط المعياري.
يمكن أيضاً تخصيص رسالة نصية توجيهية صريحة مثل "نمط غير مطابق" في حال رغبة المحلل في عزل السجلات الشاذة وفرزها لاحقاً لإجراء التدقيق اليدوي عليها.
8. مقاربة تقنية موسعة: بدائل متقدمة لمحاكاة أحرف البدل في إكسيل
8.1 استخدام دالة SEARCH بديلاً لدالة FIND لإلغاء حساسية الأحرف
في كثير من البيئات متعددة اللغات أو عند التعامل مع أكواد باللغة الإنجليزية ذات كتابة غير منضبطة (مزيج من الحروف الكبيرة والصغيرة)، تفشل دالة FIND إذا اختلفت حالة الأحرف عما هو محدد في الصيغة. هنا يبرز دور دالة SEARCH كبديل متطابق وظيفياً ولكن بميزتين فريدتين:
- تجاهل حالة الأحرف كلياً (Case-Insensitive)، مما يجعل البحث عن
"code"يطابق"CODE"و"Code"على حد سواء. - الدعم الأصلي لأحرف البدل بداخلها؛ حيث يمكن لدالة SEARCH أن تبحث بحد ذاتها عن أنماط مثل
"ID-???"أو"Ref*End"لرصد موضع البداية بدقة استثنائية.
يتم استبدال FIND بـ SEARCH في الصيغة المركبة دون أي تغيير على هيكلية الحسابات الرياضية:
=LEFT(A2, SEARCH("start", A2) - 1) & "NEW" & RIGHT(A2, LEN(A2) - (SEARCH("end", A2) + LEN("end") - 1))
يمنح هذا التعديل البسيط الصيغة مرونة هائلة في استيعاب التباينات الإملائية وتفادي تعطل الحسابات عند اختلاف كتابة النصوص من مدخل إلى آخر.
8.2 التعبيرات النمطية (Regular Expressions) عبر محرر برمجة VBA
عندما تزداد الأنماط تعقيداً، كأن نرغب في استبدال أي تسلسل نصي يحتوي على أرقام محصورة بين حروف معينة دون وجود فواصل ثابتة، تعجز الصيغ الحسابية التقليدية عن المتابعة بكفاءة. هنا يُعد اللجوء إلى لغة البرمجة المدمجة (VBA) لإنشاء دالة معرفة من قبل المستخدم (User Defined Function – UDF) تستند إلى كائن التعبيرات النمطية حلّاً برمجياً مثالياً.
يستند هذا الحل إلى استدعاء مكتبة VBScript.RegExp عبر الكود التالي:
Function RegExReplace(SourceText As String, Pattern As String, Replacement As String) As String

    Dim RegEx As Object

    Set RegEx = CreateObject("VBScript.RegExp")

    With RegEx

        .Global = True

        .IgnoreCase = True

        .Pattern = Pattern

    End With

    RegExReplace = RegEx.Replace(SourceText, Replacement)

End Function
تسمح هذه الدالة للمستخدم في ورقة العمل بكتابة صيغة مباشرة وأنيقة مثل =RegExReplace(A2, "[Tracker:.*?]", "[CONFIDENTIAL]"). وتتميز التعبيرات النمطية بقدرتها الفائقة على التعامل مع الأنماط المعقدة وحالات الجشع النمطي (Greedy vs. Lazy Matching)، وهو ما يعوض العجز التاريخي في إكسيل القديم. وتجدر الإشارة هنا إلى أن النسخ الحديثة من مايكروسوفت 365 بدأت أخيراً في تقديم دوال نمطية أصلية مثل =REGEXREPLACE(text, pattern, replacement)، والتي تُلغي الحاجة إلى كتابة أكواد ماكرو مخصصة في البيئات الحديثة.
8.3 توظيف أداة Power Query كحل استبدالي جذري ومستدام
بالنسبة للبيانات الضخمة التي تضم مئات الآلاف من السجلات، قد يؤدي استخدام آلاف الصيغ النصية المركبة إلى استهلاك الذاكرة وإبطاء إعادة الحساب في المصنف. هنا تتفوق أداة Power Query المدمجة كبيئة مثالية لمعالجة البيانات مسبقاً (ETL Pipeline).
توفر لغة M في باور كويري دوال استخلاص متقدمة للغاية، مثل:
Text.BetweenDelimiters(TextColumn, "[", "]")
أو استخدام الدالة التحويلية:
Table.ReplaceValue(SourceTable, each [DataColumn], each Text.Replace([DataColumn], Text.BetweenDelimiters([DataColumn], "[", "]"), "NEW"), Replacer.ReplaceText, {"DataColumn"})
تكمن الميزة الجذرية لباور كويري في أن كافة عمليات المعالجة النمطية تتم خارج نطاق شبكة الخلايا النشطة، وتُطبق التحويلات دفعة واحدة أثناء سحب وتحديث البيانات، مما يحافظ على خفة المصنف وسرعته الاستثنائية، فضلاً عن قدرة الأداة على حفظ خطوات التنظيف لإعادة تطبيقها آلياً على الملفات المحدثة شهرياً أو أسبوعياً.
9. الأخطاء الشائعة وحلول استكشاف الأعطال وإصلاحها في التطبيق
9.1 أخطاء التحديد الخاطئ لمواضع الحروف (Off-by-one errors)
يُعد خطأ الانزياح بمحرف واحد (Off-by-one) من أكثر العيوب شيوعاً عند كتابة معادلات الاستقطاع؛ حيث يتفاجأ المحلل ببقاء الحرف الأخير من الكود المرجعي (مثل بقاء القوس أو فاصلة منقوطة)، أو العكس باقتطاع الحرف الأول من الكلمة اللاحقة السليمة.
لتصحيح هذه الإزاحات، يجب تفكيك أرقام الطرح والجمع داخل الصيغة واللجوء إلى أداة تقييم الصيغة (Evaluate Formula) المتاحة في تبويب “صيغ” (Formulas). تتيح هذه الأداة تشغيل المعادلة خطوة بخطوة ومراقبة القيمة العددية الناتجة عن دوال FIND ومقارنتها بناتج دالة LEN، مما يكشف بدقة ما إذا كانت الإزاحة تتطلب +1 أو -1 لضبط حدود الاقتطاع بدقة بالغة على حواف النصوص المستهدفة.
9.2 مشاكل حساسية الأحرف وحالات عدم التطابق الكلي
تتولد أخطاء عدم المطابقة غالباً نتيجة الفروق الخفية بين الأحرف الكبيرة والصغيرة في الكلمات المستهدفة عند الاعتماد على دالة FIND الصارمة. ويمكن التغلب على ذلك إما بالتحول إلى دالة SEARCH كما أشرنا، أو بتوحيد حالة النصوص برمجياً داخل الصيغة عبر دالة UPPER أو LOWER كالتالي:
=FIND("CODE", UPPER(A2))
ثمة مشكلة خفية أخرى تتمثل في وجود المسافات غير القابلة للكسر (Non-breaking Spaces) الممثلة بالرمز CHAR(160) والتي تشيع في البيانات المنسوخة من صفحات الويب ومواقع الإنترنت؛ فهذه المسافات لا تستجيب لدالة TRIM العادية، مما يستدعي تطهيرها أولاً عبر دالة =SUBSTITUTE(A2, CHAR(160), " ") قبل تمرير السلسلة إلى معادلات البحث والاقتطاع.
9.3 تداخل المحددات وتكرار الكلمات المفتاحية في الجملة
عندما تحتوي الجملة الواحدة على تكرارات متعددة لنفس المحددات، مثل وجود أكثر من نص بين أقواس في السجل ذاته، على النحو التالي:
"Item [A] verified by [B] in warehouse [C]"
فإن الصيغة البسيطة ستقتطع من أول قوس فتح "[" وصولاً إلى أول قوس إغلاق "]" فقط، متجاهلة المقاطع اللاحقة، أو أنها قد تقع في فخ “المطابقة الجشعة” إذا تم استدعاء دالة تبحث عن القوس الأخير، مما يؤدي إلى مسح كل ما يقع بين القوس الأول والأخير دفعة واحدة بما في ذلك النصوص المفيدة.
للتحكم في ترتيب التكرار المستهدف، يتعين تطويع وسيطة start_num في دوال البحث، أو الاعتماد على التبديل التسلسلي بحيث تُنفذ العملية على مراحل متتابعة في أعمدة مستقلة، أو التوجه مباشرة نحو حلول التعبيرات النمطية المقيدة بآلية المطابقة غير الجشعة (Non-greedy Matching). كما يشير الباحثون في حوسبة اللغات إلى أهمية الضبط الهيكلي للتعابير النمطية لتجنب تداخل الأنماط المعقدة في النصوص الغنية بالبيانات (Hsu, 2020).
10. سيناريوهات مؤسسية وتطبيقات عملية متقدمة لاستبدال النصوص الديناميكية
10.1 تنظيف السجلات وتنسيق البيانات في أنظمة إدارة الموارد (ERP)
في بيئات المؤسسات الكبرى، تُصدر أنظمة تخطيط موارد المؤسسات (ERP مثل SAP وOracle) تقارير نصية تحتوي على تفاصيل الحسابات مدمجة ببادئات رقمية مشوهة تمثل رموز الأقسام ومراكز التكلفة المحصورة بين شُرط أو رموز خاصة، مثل: "EXP-DIV99-SALARY_MAIN".
يتطلب توحيد دليل الحسابات استبدال الأكواد الداخلية المتغيرة (مثل DIV99 أو DIV01) بمسمى قطاعي موحد. باستخدام صيغة الاقتطاع المتقدمة، يستطيع مدراء الحسابات عزل المقاطع النصية الواقعة بين علامتي الشرطة "-" واستبدالها بالقيمة القياسية المطلوبة في ثوانٍ معدودة عبر ملايين القيود المحاسبية، مما يُمهد لترحيل البيانات بسلاسة إلى مستودعات البيانات المركزية.
10.2 إدارة وتعديل مسارات الروابط (URLs) وبيانات المسوقين
يواجه خبراء التسويق الرقمي تحدياً مستمراً في إدارة حملات الروابط الموسومة بوسائط التتبع القياسية (UTM Parameters). في كثير من الأحيان، يتطلب تحديث الحملات استبدال مصدر الحملة الواقع بين "utm_source=" وفاصلة الربط "&" بمصدر جديد ومحدث، دون المساس بباقي معايير الرابط المستهدف.
تُصاغ المعادلة هنا باستهداف السلسلة "utm_source=" كنقطة بداية، والرمز "&" كنقطة نهاية، ثم حقن المصدر الجديد بينهما بسلاسة فائقة، مما يتيح لفريق التسويق تعديل عشرات الآلاف من الروابط التسويقية آلياً وتفادي الأخطاء البشرية التي قد تتسبب في انقطاع تتبع الإعلانات المدفوعة وخسارة عوائد التحليلات.
10.3 الممارسات الموصى بها لبناء نماذج مرنة وقابلة للتطوير المستقبلي
لضمان استدامة النماذج الحسابية في إكسيل وسهولة صيانتها من قبل فرق العمل المختلفة، يجب الالتزام بأفضل الممارسات الهندسية في تصميم الصيغ النصية، وتتلخص في المبادئ الآتية:
- عزل الثوابت والمتغيرات: تجنب تضمين الكلمات والمحددات النصية داخل نص الصيغة الحسابية مباشرة (Hardcoding). بدلاً من ذلك، يُفضل تخصيص خلايا مرجعية منفصلة لمدخلات البحث والاستبدال، والإشارة إليها بواسطة المراجع المطلقة (مثل
$F$1و$F$2)، مما يسمح بتعديل معايير الاستبدال دون لمس الصيغ البرمجية. - التوثيق الخلوي والتعليقات: يُستحسن دائماً إضافة ملاحظات توثيقية واضحة (Cell Notes) لشرح المنطق الرياضي الكامن وراء الإزاحات الموضعية (+1 أو -1)، لضمان فهمها وصيانتها لاحقاً من قبل المحللين الآخرين.
- اختبارات الحمل والضغط (Stress Testing): قبل تعميم الصيغ على مجموعات البيانات المؤسسية الضخمة، يجب اختبارها على عينات تشمل أقصى الحالات الشاذة الممكنة؛ كالسلاسل الخالية، والنصوص التي تفتقر للمحددات، والنصوص شديدة الطول، للتأكد من صمود منظومة الحساب وفاعلية معالجة الأخطاء عبر دالة IFERROR.
خاتمة
تظل دالة SUBSTITUTE أداة محورية وأساسية لا غنى عنها في ترسانة المعالجة النصية داخل مايكروسوفت إكسيل؛ غير أن عجزها البنيوي عن معالجة أحرف البدل (Wildcards) يفرض على المحلل المحترف الانتقال من الحلول السطحية المباشرة إلى الهندسة العكسية للصيغ. من خلال تفكيك السلاسل النصية وحساب أطوالها بدقة عبر دوال FIND وLEN وLEFT وRIGHT، استطعنا في هذا البحث بناء حل بديل متكامل يحاكي سلوك أحرف البدل بكفاءة مطلقة، مع ضمان الحماية الشاملة من الأخطاء عبر دالة IFERROR.
ومع استمرار تطور بيئات جداول البيانات السحابية وظهور دوال نمطية أصلية مثل REGEXREPLACE وأدوات معالجة ثورية مثل Power Query، بات أمام مهندسي البيانات خيارات متنوعة تتكامل فيما بينها لتوفير حلول تتراوح بين المعالجة اللحظية السريعة والتحويلات المجمعة الضخمة، مما يؤكد أن الإتقان الحقيقي لبرنامج إكسيل لا يقتصر على حفظ دواله بصورتها المجردة، بل يكمن في ابتكار المسارات الهندسية لتوظيفها وتجاوز محدداتها التقنية لخدمة أهداف التحليل المتقدمة.
المراجع
- Friginal, E., Walker, M., & Randall, J. B. (2014). Exploring mega-corpora: Google Ngram Viewer and the Corpus of Historical American English. EuroAmerican Journal of Applied Linguistics and Languages. https://doi.org/10.21283/2376905x.1.4
- Hsu, W. (2020). The Most Frequent Opaque Idioms in English News. PASAA. https://doi.org/10.58837/chula.pasaa.60.1.2
- Kim, Y.-J. (2009). Effectiveness of on-line corpus research in L2 writing: Investigation of proficiency in English writing through independent error correction. https://doi.org/10.12794/metadc12140
- MacWhinney, B. (2018). The CHILDES Project Part 2: The CLAN Programs. Figshare. https://doi.org/10.1184/r1/6618443