
تُعد جداول البيانات الإلكترونية، منذ نشأتها التاريخية مع إطلاق برنامج “فيزيكالك” (VisiCalc) في عام 1979 على يد دان بريكلن وبوب فرانكستون، مروراً ببرمجية “لوتس 1-2-3” (Lotus 1-2-3) عام 1983، ثم ظهور “مايكروسوفت إكسل” (Microsoft Excel) في منتصف الثمانينيات، الركيزة الأساسية لإدارة ومعالجة وتحليل البيانات في شتى المجالات المؤسسية والأكاديمية. ومع انتقال الحوسبة إلى السحابة الرقمية واستحواذ شركة جوجل في عام 2005 على شركة “2Web Technologies” المطورة لمحرك “XL2Web”، شهد شهر يونيو من عام 2006 إطلاق “جداول بيانات جوجل” (Google Sheets)، التي أعادت صياغة نماذج العمل التعاوني اللحظي والتحليل الموزع للبيانات الضخمة والمسوحات الميدانية المتنوعة.
في بيئات البحث العلمي وإدارة قواعد البيانات المعاصرة، تبرز مسألة فحص تقاطع المجموعات والتحقق من وجود قيم عمود داخل عمود آخر كواحدة من العمليات المنهجية الجوهرية. ولا تمثل هذه العملية مجرد إجراء تقني عابر، بل هي أداة حاسمة لغربلة السجلات وتنقية المدخلات وضمان الاتساق البنائي بين المجموعات التجريبية والضابطة، وتتبع المشاركين في الدراسات الطولية، واستبعاد التكرارات العرضية التي قد تؤدي إلى تشويه الاستدلال الإحصائي ونتائج التحليل البعدي. إن الدقة الحسابية في التحقق من وجود المعرفات الرقمية أو السجلات النصية تحمي المشاريع البحثية والتجارية من تكاليف فادحة تنشأ عن التحيزات المنهجية أو القرارات المبنية على بيانات مشوبة بالخلل.
يتناول هذا الدليل الشامل تفكيكاً نظرياً وإجرائياً متعمقاً للآليات الرياضية والبرمجية المعتمدة في جداول بيانات جوجل للتحقق مما إذا كانت قيمة عمود ما مدرجة ضمن عمود مرجعي آخر. وسنقوم بالتشريح الدقيق للصيغ التركيبية القياسية، واستكشاف البدائل الحسابية المتقدمة مثل دوال العد الشرطي والاستعلام الرأسي، والتعامل مع المعالجات المصفوفية الشاملة، فضلاً عن تقديم استراتيجيات معالجة الحالات الشاذة وإرساء حوكمة صارمة لحماية تدفقات البيانات التحليلية من الأخطاء الصامتة والانحرافات الحسابية.
1. المدخل المنهجي لمقارنة البيانات والتحقق من تطابقها في جداول بيانات جوجل
1.1 أهمية مطابقة القيم بين الأعمدة في إدارة قواعد البيانات والبحوث
تمثل مطابقة السجلات والتحقق التقاطعي بين المتجهات العمودية العمود الفقري لسلامة البيانات في المسوح الكمية والتطبيقات الوبائية والدراسات السلوكية الموسعة. عندما يتعامل الباحث مع مصفوفات ضخمة مستخرجة من منصات استطلاع الرأي، مثل Qualtrics أو Prolific، تظهر الحاجة الملحة لعزل المعرفات المكررة ومطابقة استجابات الأفراد عبر موجات القياس المتعددة لضمان موثوقية العينات وعدم تسرب بيانات غير مؤهلة إلى نماذج القياس البعدي. وقد وثق لومسدن وزملاؤه أهمية مراقبة مسارات المشاركين وحالات التسرب أو الانقطاع في الاختبارات المعرفية المستندة إلى الويب لضمان سلامة الاستنتاجات العلمية (Lumsden et al., 2017).
يتيح التدقيق المتقاطع بين الجداول التأكد من أن الهياكل المرجعية للمتغيرات المستقلة والتابعة تتوافق تماماً مع مخطط قاعدة البيانات المعتمد. إن وجود خطأ في مطابقة معرف مستخدم أو رمز مشارك قد يؤدي إلى تخصيص غير صحيح للبيانات، مما ينعكس سلباً على قوة الاختبارات الإحصائية وجودة التقديرات المعلمية، وبالتالي تتجلى أهمية أتمتة هذه العمليات كضرورة منهجية لا غنى عنها لضبط الجودة الإبستمولوجية للبحوث المنشورة.
1.2 المبادئ الرياضية والمنطقية لعمليات التحقق الثنائي (Boolean Logic)
تستند عمليات التحقق من التطابق بين الأعمدة إلى الجبر البولياني (Boolean Algebra) ونظرية المجموعات، حيث يتم التعامل مع كل عمود بوصفه مجموعة رياضية منتهية (Finite Set). عند فحص ما إذا كان العنصر المنتمي للمجموعة $A$ موجوداً في المجموعة $B$، فإننا نبحث عملياً في علاقة الانتماء الرياضي المباشر ($x in B$)، والتي تنتج عنها إحدى الحالتين المنطقيتين الثنائيتين: الصواب المطلق (TRUE) أو الخطأ المطلق (FALSE).
تتحول هذه المقارنة التقاطعية في بيئة الحوسبة السحابية لجداول البيانات إلى مؤشرات رقمية ثنائية التشفير (1 و 0)، مما يسهل دمجها لاحقاً في العمليات الشرطية والتجميعية المعقدة. إن تجريد البيانات النصية أو الرقمية إلى مخرجات بوليانية دقيقة يزيل الغموض الاحتمالي، ويؤسس لقواعد بيانات مصمتة تخلو من التناقضات المنطقية، مما يتيح للباحثين استخدام هذه المخرجات كمرشحات (Filters) آلية في خطوط المعالجة اللاحقة.
1.3 التحديات الإدراكية والتقنية الناتجة عن الفحص اليدوي للبيانات
يفرض الفحص البصري اليدوي لمطابقة الصفوف والأعمدة حملاً ذهنياً هائلاً (Cognitive Load) على المحللين والمدققين، خاصة مع تجاوز الجداول لحاجز المئات أو الآلاف من القيود. تشير الدراسات المعنية بالتعلم والأداء المهني إلى أن الواجهات الرقمية المنظمة والتعليمات الآلية الدقيقة تقلل بصورة ملحوظة من معدلات الخطأ الناتجة عن التشتت الذهني والإجهاد البصري للمشغلين (Letmathe & Rößler, 2021).
يتسم الإدراك البشري بمحدودية التركيز وسرعة التأثر بالتكرار النمطي، مما يؤدي إلى ما يُعرف بـ “الأخطاء الصامتة” أو الحالات السالبة الكاذبة والحالات الموجبة الكاذبة؛ حيث قد تتطابق قيمتان شكلياً بسبب التشابه الخارجي ولكنهما تختلفان في ترميز خفي (كوجود مسافة إضافية). من هنا، تكتسب حوسبة الفحص عبر خوارزميات الاسترجاع الآلية في جداول بيانات جوجل ميزة تفوق مطلقة من حيث توفير الوقت، وتحقيق الحتمية الإجرائية التي لا تتغير بتغير حالة الفاحص النفسية أو البدنية.
2. التحليل الهيكلي للصيغة القياسية: تفكيك دالات MATCH وISERROR وNOT
2.1 تشريح دالة MATCH: آليات البحث وتحديد المواقع النسبية
تُعد دالة MATCH من أكثر أدوات تحديد المواقع كفاءة في جداول البيانات، وتستقبل ثلاثة معاملات هيكلية محددة: قيمة البحث (lookup_value)، ونطاق الفحص المرجعي (lookup_range)، ونمط المطابقة (search_type). في السيناريو القياسي للتحقق الدقيق، يُشترط تثبيت المعامل الأخير على القيمة الصفرية (0)، للإشارة إلى البحث عن تطابق مطابق وحصري دون افتراض ترتيب مسبق للبيانات داخل المصفوفة.
تعمل الدالة على مسح المتجه المرجعي تتابعياً؛ فإذا تم العثور على القيمة المستهدفة، تُرجع الدالة عدداً صحيحاً يمثل الموضع الترتيبي النسبي للخلية المطابقة داخل النطاق المحدد (وليس رقم الصف في ورقة العمل بأكملها). أما في حالة عدم العثور على القيمة المطابقة، فإن سلوك الدالة التصميمي يتمثل في توليد خطأ مرجعي صريح هو #N/A، وهو ما يمثل مؤشراً حاسوبياً على انعدام التقاطع المجموعاتي للعنصر المفحوص داخل النطاق المستهدف.
2.2 دور دالة ISERROR في رصد الانقطاعات ومعالجة الأخطاء المرجعية
صُممت دالة ISERROR لاختبار صحة النتائج التعبيرية ورصد أي شذوذ حسابي ناجم عن العمليات السابقة، حيث تقوم بمسح الخلية المستهدفة أو التعبير الرياضي الداخلي وترجع قيمة بوليانية مباشرة. تمتاز الدالة بقدرتها الشاملة على التقاط شتى أصناف أخطاء جداول البيانات، بما في ذلك أخطاء القسمة على الصفر #DIV/0!، وأخطاء القيمة #VALUE!، وأخطاء عدم التوفر #N/A.
عندما تُدرج دالة MATCH الفاشلة داخل ISERROR، تلتقط الأخيرة رسالة الخطأ #N/A وتحولها فوراً إلى القيمة المنطقية TRUE، معلنة حدوث خلل في عملية المطابقة (أي أن العنصر غير موجود). في المقابل، إذا نجحت دالة MATCH وأرجعت موقعاً رقمياً (مثل 1 أو 5)، تقرأ دالة ISERROR هذا الرقم كعملية ناجحة خالية من الأخطاء، فترجع القيمة FALSE. بذلك تعمل هذه الدالة كقناة وسيطة تحمي الجدول من تراكم رموز الأخطاء المشوهة للبنية البصرية وتحولها إلى لغة منطقية قابلة للاستثمار المعرفي.
2.3 دالة NOT والتحويل المنطقي من نفي الخطأ إلى إثبات الوجود
تقوم دالة النفي المنطقي NOT بقلب القيمة البوليانية المدخلة إليها، محولة الصواب إلى خطأ والخطأ إلى صواب استناداً إلى مبادئ نفي النفي في الجبر الرياضي. في سياق بنيتنا التركيبية، نجد أن إخفاق المطابقة في MATCH ينتج خطأً، تقرأه ISERROR على أنه TRUE (أي: نعم، هناك خطأ، والعنصر مفقود)، بينما نجاة العنصر من الخطأ ينتج عنه FALSE (أي: لا يوجد خطأ، والعنصر تم العثور عليه بنجاح).
هنا يأتي دور دالة NOT لعكس هذا التوزيع الدلالي، لكي تصبح النتيجة النهائية معبرة بصرياً ومنطقياً عن “الوجود” بدلاً من “غياب الخطأ”. عند إدماج الدوال الثلاث في البنية الكلية:
=NOT(ISERROR(MATCH(A2,$B$2:$B$16,0)))
تتم معالجة التعبير من الداخل إلى الخارج: تبحث MATCH عن A2 في النطاق $B$2:$B$16؛ فإن وجدته، يرجع رقمه، فتعتبره ISERROR مدخلاً غير خاطئ (FALSE)، ثم تعكسه NOT إلى TRUE تأكيداً لوجوده. وبالمثل، يمكن تحقيق المعنى ذاته عبر التوليفة البديلة الأكثر رشاقة =ISNUMBER(MATCH(A2,$B$2:$B$16,0))، والتي تتجاوز الحاجة لدالة النفي من خلال فحص الطبيعة الرقمية المباشرة للموقع الترتيبي.
3. الدليل الإجرائي خطوة بخطوة لتنفيذ صيغة التحقق الأساسية
3.1 إعداد بيئة العمل وتنظيم نطاقات البيانات المصدرية
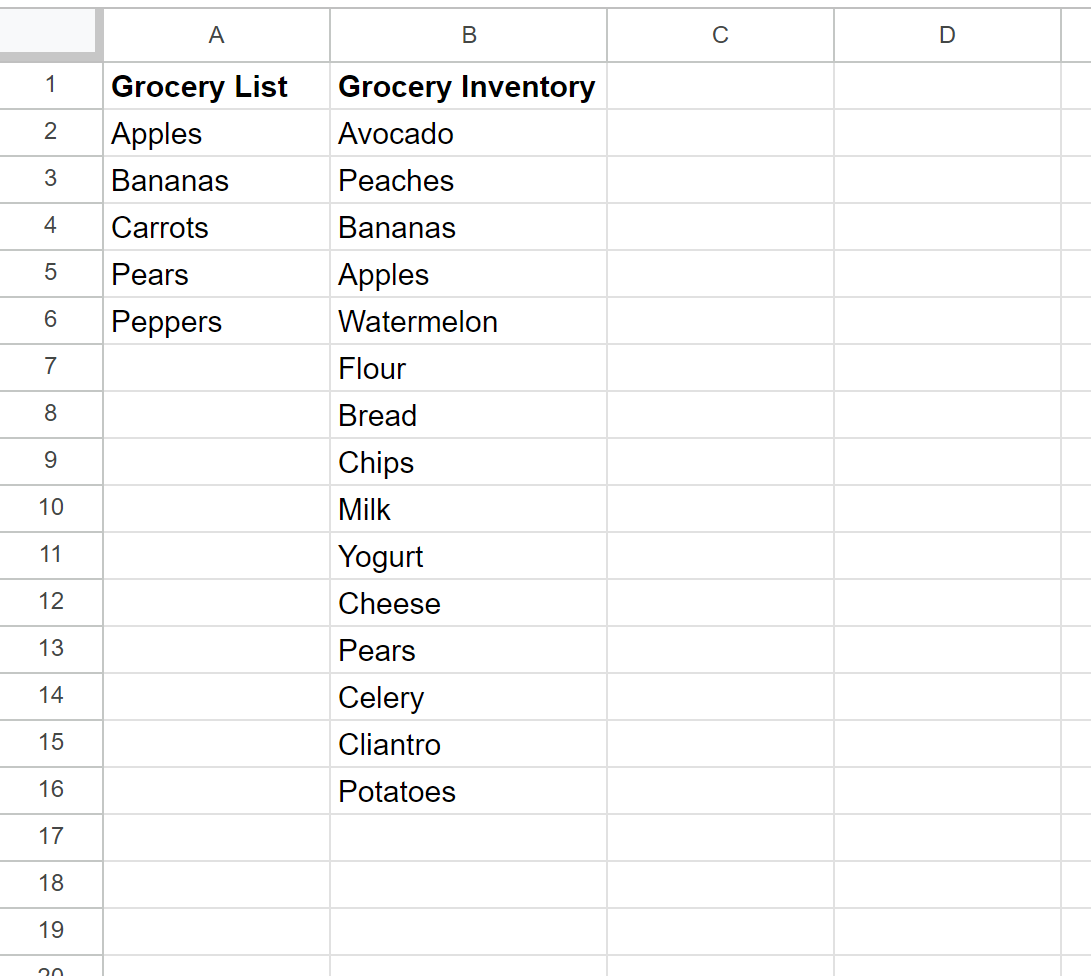
تبدأ الممارسة الرصينة لتنظيف البيانات بتهيئة البنية الجدولية وتنظيم الحقول وفق المعايير القياسية لنظم إدارة قواعد البيانات العلائقية. يجب تخصيص عمود مستقل للقائمة المطلوب فحصها (ولتكن مفردات العينة $A$)، وعمود آخر مجاور أو في نطاق منفصل للمجموعة المرجعية الشاملة (ولتكن المتغيرات الضابطة $B$). ينبغي إدراج ترويسة واضحة ومميزة في الصف الأول، مثل “العنصر المستهدف” في الخلية A1 و”قائمة الحصر” في الخلية B1 و”حالة التطابق” في الخلية C1.
من الضروري فحص سلامة الخلايا والتأكد الأولي من خلوها من التنسيقات المتضاربة أو الدمج الهيكلي للخلايا (Merged Cells)، حيث يشكل دمج الخلايا عائقاً جسيماً يفسد حسابات الإزاحة المكانية في دوال البحث. تضمن هذه الخطوة التنظيمية استقرار المراجع المكانية وتهيئة النطاق لتدفق العمليات التكرارية بسلاسة متناهية ودون انقطاعات ميكانيكية غير مبررة.
3.2 كتابة الصيغة وتطبيق التثبيت المطلق للمراجع المرجعية
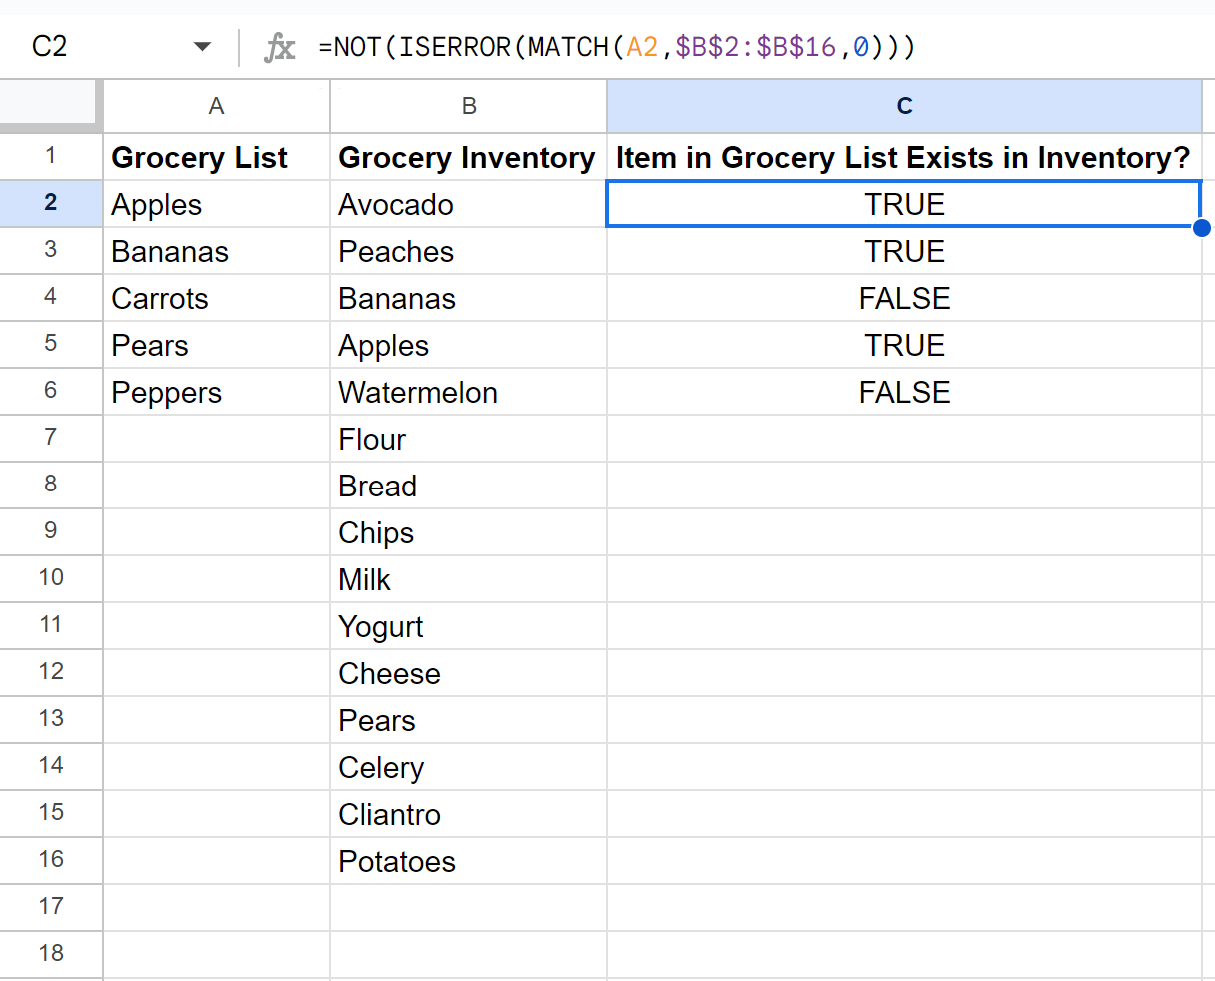
لتطبيق الفحص، ننتقل إلى الخلية التقييمية الأولى الموازية للمدخل الأول (غالباً الخلية C2)، ونبدأ بإدراج إشارة التساوي البرمجية (=) لبدء التقييم الحسابي. نقوم بكتابة التعبير مستهدفين فحص القيمة الأولى A2 مقابل كامل امتداد المتجه المرجعي عبر الصيغة التالية:
=NOT(ISERROR(MATCH(A2,$B$2:$B$16,0)))
يتجلى المطلب التقني الأكثر حساسية هنا في ضرورة استخدام علامة الدولار ($) لتثبيت حدود النطاق المرجعي ليصبح $B$2:$B$16 بدلاً من تركه كمرجع نسبي غير مقيد B2:B16. يرجع السبب الرياضي في ذلك إلى أنه عند نسخ المعادلة رأسياً، ستتحرك المراجع النسبية بمقدار خطوة واحدة مع كل صف لأسفل؛ مما يؤدي في حالة عدم التثبيت إلى انزلاق نطاق البحث تدريجياً لأسفل مسبباً حذف المدخلات العليا من مجال الفحص، وهو ما يولد أخطاء تصنيف جسيمة وحالات عدم تطابق وهمية (False Negatives).
3.3 تعميم الصيغة عبر السحب والتعبئة التلقائية وفهم النتائج
عقب إتمام إدخال الصيغة والتأكد من صوابها التكويني بالضغط على مفتاح الإدخال (Enter)، يتم توجيه مؤشر الفأرة نحو الزاوية اليسرى السفلى (أو اليمنى، بحسب واجهة البرنامج) من الخلية C2 حتى يتحول المؤشر إلى علامة التقاطع الرباعي السوداء المعروفة بـ “مقبض التعبئة” (Fill Handle). يتم النقر المزدوج فوق المقبض أو سحبه لأسفل ليغطي كامل طول السجلات الممتدة في العمود المقارَن.
تتم قراءة المخرجات المتولدة بتطبيق الاستدلال الثنائي المباشر: القيمة TRUE تمثل دليلاً قطعياً لا يقبل اللبس على أن القيمة المدخلة في الصف المقابل من العمود $A$ موجودة ومسجلة بالفعل داخل النطاق المرجعي للعمود $B$. في المقابل، تشير القيمة FALSE إلى الغياب التام للمدخل عن القائمة المرجعية، وهو ما يوجه الباحث أو المشغل الإداري لاتخاذ الإجراءات التصحيحية، سواء بالإضافة أو الاستبعاد أو التقصي الاستقصائي الإضافي للمدخل المفقود.
4. دراسة حالة تطبيقية: فحص تطابق قوائم المخزون مع السجلات الاستهلاكية
4.1 صياغة سيناريو الدراسة: مقارنة قائمة الاحتياجات بقائمة المتوفر
لتجسيد التطبيق العملي في بيئة أعمال ولوجستيات واقعية، نفترض سيناريو تشغيلياً داخل مستودع توريد غذائي يهدف إلى مراجعة الاحتياجات الطارئة لقسم الإعاشة مقابل محتويات المخزن الفعلي المتاحة للشحن الفوري. يتضمن العمود $A$ قائمة باحتياجات المطبخ اليومية (مثل: التفاح، البرتقال، الجزر، الموز، الكمثرى، البصل، السبانخ)، بينما يتضمن العمود $B$ السلع المتاحة حالياً على رفوف التخزين المصنفة كمدخلات مؤكدة التوفر.
الهدف الإداري والتحليلي المباشر هو فرز المتطلبات بصورة قاطعة دون الاعتماد على الحفظ الشخصي لمسؤولي التخزين، وذلك لفرز الأصناف التي يتعين شراؤها فوراً لعدم توفرها، عن تلك المتواجدة بالفعل والتي يتم توجيه عمال المناولة لتجهيزها، مما يحول دون التكرار الشرائي المهدر للسيولة المالية وتجنب العجز المفاجئ في متطلبات التشغيل.
4.2 التطبيق العملي للصيغة وتحليل المخرجات الناتجة
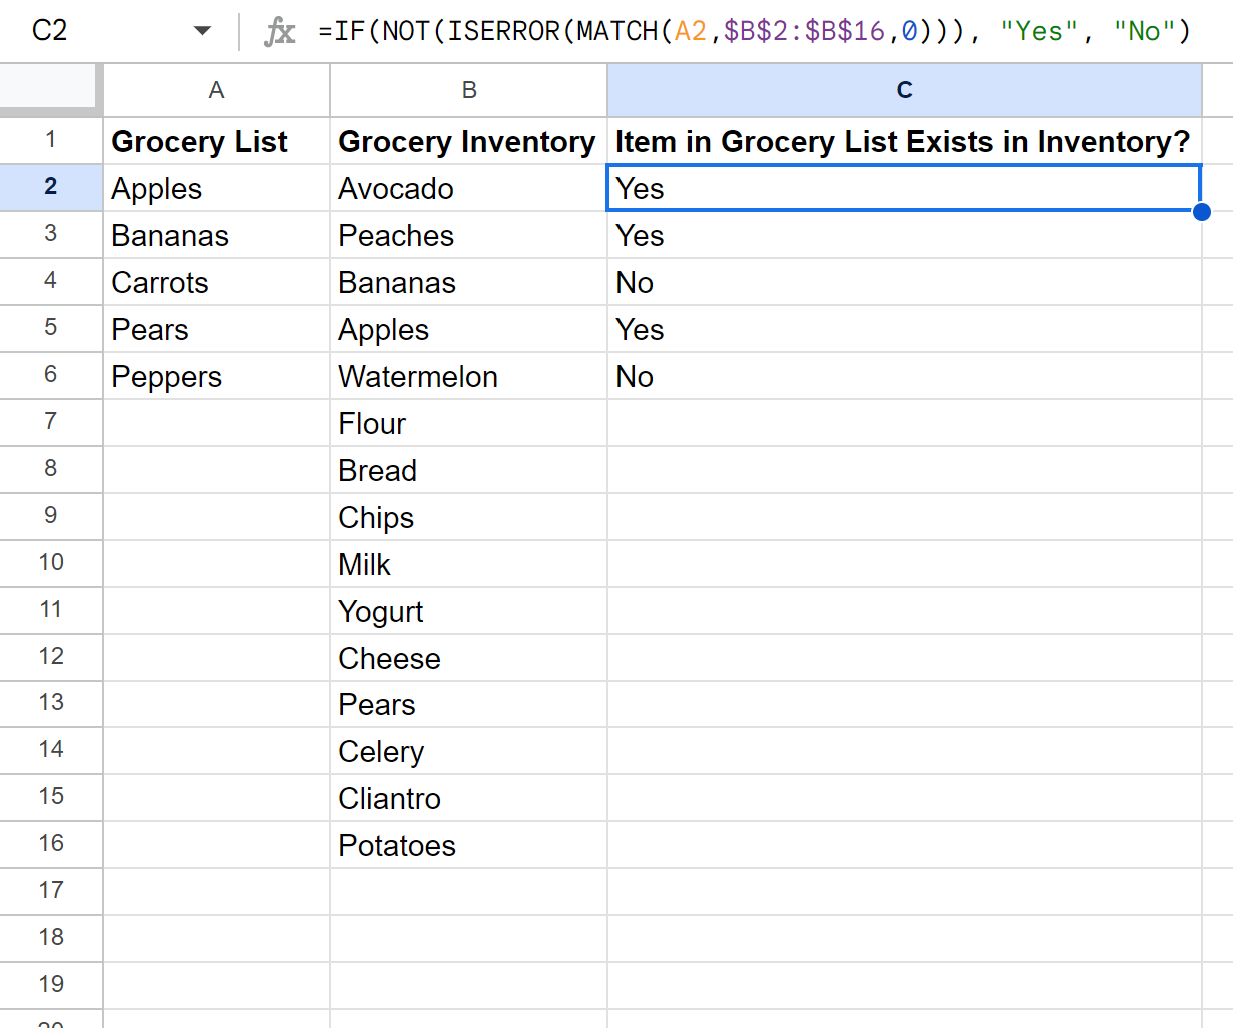
يتم إدخال الصيغة المعيارية =NOT(ISERROR(MATCH(A2,$B$2:$B$16,0))) في الخلية C2 ثم تعميمها على امتداد عمود النتائج المخصص. عند تتبع آلية المعالجة الحسابية لكل مدخل على حدة، ترصد الخوارزمية مطابقة صنف “التفاح” الواقع في الخلية A2 مع موقعه الترتيبي في العمود $B$، فتولد فوراً القيمة TRUE. وينطبق الأمر عينه على صنف “الموز”، مسجلاً سرعة استجابة برمجية متناهية الصغر تبلغ أجزاءً من الألف من الثانية.
بالمقابل، عند انتقال المؤشر الحسابي إلى فحص مدخل “الجزر” في الخلية A4، تعجز دالة MATCH عن رصد أي تواجد لرمز النص ضمن المصفوفة $B$2:$B$16، مما يطلق استثناء الخطأ الداخلي، فتلتقطه ISERROR وتحوله دالة NOT إلى المخرج القاطع FALSE. يتكرر هذا الأداء عند فحص مادة “الكمثرى”، مما يؤسس لمصفوفة بيانات موحدة ومفروزة بوضوح شديد ودون أي تداخل بين الحالات المتوفرة والمفقودة.
4.3 استخلاص النتائج والتعامل مع الفجوات التشغيلية
بإتمام التحليل الحسابي، يتحول العمود $C$ إلى لوحة قرارات رقمية واضحة المعالم، حيث يتيح للقيادة اللوجستية إجراء تصفية سريعة (Filter) لعزل جميع السجلات التي تحمل الوسم FALSE. تُجمع هذه العناصر غير المتوفرة وتُرسل مباشرة إلى مسؤولي المشتريات كأمر توريد حتمي ومستعجل خالٍ من أي ازدواجية تشغيلية.
تثبت هذه المنهجية التطبيقية جدوى حوسبة الفحص التقاطعي في تقليل معدلات الخطأ البشري، وتوفير الوقت مقارنة بالفحص الميداني اليدوي بين القوائم الورقية أو السجلات الرقمية المنفصلة. كما تمنح إدارة المستودع قاعدة موثقة للاعتماد الإداري، بما يضمن انسجام القرارات مع الواقع الفعلي للمخزون استناداً إلى أدلة رقمية واضحة وموثوقة بنسبة 100%.
5. البدائل الحسابية المتقدمة: توظيف دالتي COUNTIF وCOUNTIFS في التحقق
5.1 البنية التركيبية لدالة COUNTIF في التحقق الإحصائي الترددي
تقدم دالة العد الشرطي COUNTIF بديلاً حسابياً غاية في الأناقة والمرونة للتحقق من وجود القيم بين الأعمدة، دون الحاجة للتعامل مع معالجات الأخطاء المرجعية. تعتمد الدالة في بنائها على معاملين رئيسيين: نطاق الفحص المستهدف، والمعيار المشترط احتسابه، متخذة الصياغة التالية:
=COUNTIF($B$2:$B$16, A2)
لا تقتصر هذه الدالة على إثبات الوجود المجرد، بل ترجع عدداً صحيحاً يعبر عن التردد المطلق (Absolute Frequency) لتكرار العنصر A2 داخل النطاق المحدد. لتحويل هذا المخرج التكراري إلى تقرير بولياني مكافئ للصيغة السابقة، يتم إلحاق عامل مقارنة منطقي في نهاية الصيغة الرياضية ليصبح التعبير: =COUNTIF($B$2:$B$16, A2) > 0. فإذا تكرر العنصر مرة واحدة أو أكثر، تعيد الصيغة TRUE، بينما ينتج الصفر استجابة منطقية فورية بقيمة FALSE.
5.2 التحقق متعدد الشروط باستخدام دالة COUNTIFS
عندما تتعقد بنية الفحص لتشمل متغيرات تصنيفية متعددة، تبرز دالة COUNTIFS كأداة قوية تمكن الباحث من إجراء مقارنات متعددة الأبعاد بالتزامن. تسمح هذه الدالة بدمج عدة نطاقات فحص مع شروطها المقابلة، مما يتيح التحقق من وجود القيمة ليس فقط بصفتها المجردة، بل وبشرط اقترانها بمعايير ثانوية صارمة كالفرع الإداري، أو تاريخ الإدخال، أو الحالة التشغيلية.
على سبيل المثال، للتحقق مما إذا كان المشارك A2 مسجلاً في القائمة المرجعية $B$، وبشرط أن تكون حالته في العمود $C$ مصنفة كـ “مكتمل” (Completed)، تُصاغ المعادلة على النحو الآتي:
=COUNTIFS($B$2:$B$100, A2, $C$2:$C$100, "Completed") > 0
يوفر هذا المستوى من التدقيق متعدد الشروط عمقاً تحليلياً استثنائياً في المسوح الميدانية والدراسات السريرية، حيث يستلزم فرز السجلات عزل الحالات التي استوفت المعايير المنهجية المحددة سلفاً في بروتوكول البحث.
5.3 المفاضلة الحسابية والأدائية بين COUNTIF وMATCH
على الرغم من التشابه الظاهري في النتائج النهائية بين COUNTIF وMATCH، إلا أن هناك تبايناً ميكانيكياً جوهرياً في استهلاك الموارد الحسابية وسرعة معالجة المعالجات الدقيقة (CPU Execution Cycles) بين الدالتين، وهو ما ينعكس جلياً عند التعامل مع قواعد البيانات المليونية. تمتاز دالة MATCH المجهزة بنمط التطابق الدقيق (0) بتطبيق خوارزمية التوقف المبكر (Early Stopping)؛ فبمجرد عثورها على أول تطابق للعنصر، تقطع عملية البحث فوراً وترجع النتيجة محققة تعقيداً زمنياً مثالياً.
على النقيض من ذلك، تضطر دالة COUNTIF بطبيعتها الإحصائية إلى مواصلة مسح النطاق المرجعي بالكامل من الخلية الأولى إلى الأخيرة لحساب مجموع التكرارات التراكمي، مما يرفع العبء الحسابي بصورة ملحوظة في الجداول الممتدة. لذا، يُجمع مهندسو البيانات على تفضيل توليفة MATCH مع ISNUMBER لعمليات فحص الوجود البسيطة، وقصر استخدام COUNTIF على الحالات التي تتطلب توثيق حجم التكرار والأنماط التوزيعية للقيم المقارنة.
6. مقاربة البحث المرجعي الحديث: استخدام VLOOKUP وXLOOKUP للاختبار الوجودي
6.1 تكييف دالة VLOOKUP التقليدية للتحقق من وجود العناصر
تُعد دالة البحث الرأسي VLOOKUP من أعرق الأدوات المرجعية الموروثة في برمجيات الجداول الممتدة، ورغم أنها صُممت أساساً لاسترجاع بيانات مرتبطة من أعمدة مجاورة، إلا أنه يمكن توظيفها لاختبار الوجود من خلال تركيبة منطقية محددة:
=NOT(ISNA(VLOOKUP(A2, $B$2:$B$16, 1, FALSE)))
تكمن القيود البنيوية لدالة VLOOKUP في اشتراطها الصارم بأن يكون عمود الفحص هو العمود الأول والوحيد في النطاق المستهدف، إلى جانب حساسيتها العالية لأي تغيير يطرأ على ترتيب الأعمدة. علاوة على ذلك، فإن إهمال المعامل الأخير وتجاوز تعيينه الصريح على FALSE يؤدي إلى تفعيل نمط التطابق التقريبي الافتراضي، والذي يفترض ترتيب المصفوفة تصاعدياً، مما يوقع المحلل في فخ استرجاع تطابقات خاطئة تقوض دقة التحليل بأكمله.
6.2 المزايا المتقدمة لدالة XLOOKUP الحديثة في الفحص المتقاطع
يمثل إدخال دالة XLOOKUP في جداول بيانات جوجل قفزة نوعية تجاوزت كافة أوجه القصور الهيكلية التي عانت منها دوال البحث القديمة. تمتاز الدالة باستقلاليتها التامة؛ حيث تفصل بين مصفوفة البحث ومصفوفة الإرجاع، وتدعم البحث في كافة الاتجاهات الرأسية والأفقية مع اعتماد نمط التطابق التام كإعداد افتراضي أصيل دون الحاجة لتمرير معاملات إضافية معقدة.
ولعل الميزة الأبرز في سياق اختبار الوجود تكمن في المعامل المدمج if_not_found، الذي يتيح الاستغناء تماماً عن الدوال المغلفة لمعالجة الأخطاء. يمكن صياغة التحقق مباشرة بالصورة الرشيقة التالية:
=XLOOKUP(A2, $B$2:$B, TRUE, FALSE, 0)
تبحث الدالة عن A2 داخل المتجه المرجعي $B$2:$B، وترجع القيمة المنطقية TRUE عند التحقق، بينما تدفع بالقيمة FALSE فوراً عند غياب العنصر دون إثارة أخطاء النظام #N/A، مما يجعلها الخيار الأكثر عصرية ووضوحاً في التصميم الرياضي المتقدم للبيانات.
6.3 تقييم الكفاءة البرمجية بين أدوات البحث المختلفة
يتطلب التحليل المقارن بين خيارات البحث المختلفة موازنة دقيقة بين الكفاءة الحسابية، وسهولة القراءة، وقابلية الصيانة المستمرة للنماذج المنشأة. تظهر دراسات الأطر التعليمية والتصميمية أهمية وضوح الأدوات المعرفية لتقليل التعقيد المعرفي وتسهيل نقل المعرفة وتطبيق النماذج التقنية (Fotaris & Mastoras, 2022).
يوضح الجدول التحليلي التالي الفروق الجوهرية بين الأدوات الأربع الأساسية المستخدمة في التحقق من وجود القيم في جداول بيانات جوجل:
| الدالة / الصيغة | التعقيد الحسابي للأداء | حساسية البنية الهيكلية | إدارة الأخطاء التلقائية | التوافقية العكسية |
|---|---|---|---|---|
MATCH + ISNUMBER |
منخفض للغاية (توقف مبكر) | معدومة (مرونة تامة) | تتطلب دالة تغليف | عالية وشاملة لجميع الأنظمة |
COUNTIF > 0 |
متوسط (مسح كامل للنطاق) | معدومة | أصيلة (لا تولد أخطاء) | عالية جداً |
VLOOKUP + ISNA |
متوسط إلى منخفض | مرتفعة (العمود الأول حصراً) | تتطلب دالة تغليف | عالية جداً |
XLOOKUP المباشرة |
منخفض ومحسن للغاية | معدومة (استقلال تام للنطاقات) | مدمجة أصيلة (if_not_found) | تتطلب إصدارات بيئية حديثة |
توضح هذه المقارنة أن اختيار الصيغة ليس مجرد مسألة تفضيل شخصي، بل هو قرار حوسبي يرتبط بحجم البيانات، والقدرة التوافقية المستهدفة، واستدامة الصيانة والتطوير ضمن بنية جداول البيانات المعتمدة.
7. أتمتة الفحص الشامل وتوسيع العمليات عبر دالة ARRAYFORMULA
7.1 مفهوم المعالجة المصفوفية وديناميكية التوسع التلقائي
تمثل المعالجة المصفوفية في جداول بيانات جوجل نقلة نوعية من أسلوب العمليات الميكانيكية التقليدية القائمة على نسخ ولصق المعادلات الخلية تلو الأخرى، إلى نموذج المعالجة الموجهة للأشعة والمتجهات الحسابية (Vectorized Calculation). تتكفل دالة ARRAYFORMULA باستلام النطاقات كمدخلات مصفوفية متكاملة وإجراء الحسابات عبر كافة عناصرها دفعة واحدة، مما يقلل الحجم الكلي للملف المحفوظ على خوادم التخزين السحابي ويمنع تضخم الذاكرة العاملة.
تحمي هذه المقاربة النماذج التحليلية من أخطاء التعديل اليدوي العرضي، إذ يكفي كتابة الصيغة الرياضية في الخلية الرأسية الأولى ليتولى المحرك الحسابي تعميمها تلقائياً على امتداد السجلات، مانعاً بذلك حدوث أي اختلال في تسلسل المعادلات بين الصفوف المتعاقبة، وموفراً مظلة متماسكة للأمان الحسابي للبيانات.
7.2 دمج صيغة التحقق مع ARRAYFORMULA للتطبيق الفوري
لتحويل بنية التحقق القياسية إلى صيغة مصفوفية ديناميكية تغطي كامل سجلات العمود المقارَن، يتم إدماج نطاق ممتد بدلاً من الإشارة إلى خلية مفردة، وتغليف التعبير كلياً داخل دالة ARRAYFORMULA، وفق التركيب البرمجي التالي:
=ARRAYFORMULA(NOT(ISERROR(MATCH(A2:A, $B$2:$B$16, 0))))
بمجرد إدخال هذه الصيغة الفريدة في الخلية C2، يقوم محرك جداول بيانات جوجل بحساب وتوليد النتائج فورياً على امتداد العمود $C$ وصولاً إلى نهاية نطاق البيانات المتاح. وعند إدراج أي مدخل جديد لاحقاً في العمود $A$، يُستجيب المتجه الحسابي آنياً ويفحص القيمة الجديدة ضد النطاق المرجعي الثابت دون أي حاجة للتدخل البشري بالسحب أو التعديل.
7.3 إدارة النطاقات المفتوحة وتنقية النتائج من مدخلات الخلايا الفارغة
يترتب على استخدام النطاقات المفتوحة اللانهائية (مثل A2:A) تحدٍ تقني يتمثل في قيام الخوارزمية المصفوفية بتقييم الخلايا الفارغة في أسفل الجدول على أنها مدخلات قائمة بذاتها، مما يؤدي إلى توليد نتائج بوليانية غير مرغوبة تمتد إلى آلاف الصفوف الشاغرة وتتسبب في إرباك المظهر العام للتقرير وإهدار الموارد السحابية.
تتم السيطرة على هذه الظاهرة عبر تضمين دالة شرطية منطقية IF تختبر فراغ الخلية قبل معالجتها، كالتالي:
=ARRAYFORMULA(IF(ISBLANK(A2:A), , NOT(ISERROR(MATCH(A2:A, $B$2:$B$16, 0)))))
تضمن هذه الصياغة الوقائية بقاء الخلايا التقييمية المقابلة للصفوف الفارغة خالية تماماً، مما يضمن عرضاً تقريرياً فائق النقاء، ويحافظ على سلاسة المعالجة وخفة أداء ورقة العمل حتى مع التوسع المستمر في تسجيل المدخلات الجديدة.
8. الترميز البصري الفوري: دمج نتائج التحقق مع التنسيق الشرطي
8.1 الأسس المعرفية للترميز البصري في تخفيف عبء معالجة البيانات
يمثل التنسيق الشرطي واستخدام الإشارات اللونية ترجمة عملية لمبادئ علم النفس الإدراكي ونظرية الانتباه الانتقائي في معالجة المعلومات؛ إذ تبرز الألوان والرموز البصرية كمثيرات أولية فائقة السرعة تستوعبها القشرة البصرية للمحلل قبل أن يبدأ العقل في قراءة النصوص المعقدة. وقد وثقت الدراسات المنهجية دور التمايز الحسي المباشر في تعزيز دقة الملاحظة وتسريع التعرف على الأنماط والاستجابات السلوكية بدقة وموثوقية عالية (Clark et al., 2020).
يساعد الترميز اللوني المحللين ومدققي البيانات على عزل الحالات الشاذة والمطابقات الاستثنائية بلمحة بصرية واحدة، مما يقلص بصورة حاسمة الوقت المستغرق في التثبت الإحصائي. ويشترط في التطبيقات الأكاديمية والمؤسسية الالتزام بتدرجات لونية هادئة تحقق تبايناً مريحاً للعين، وتراعي المعايير العالمية لقابلية الوصول (Accessibility) لضمان تمييزها لدى المصابين بعمى الألوان.
8.2 خطوات إنشاء قواعد تنسيق شرطي مخصصة بالاعتماد على الصيغة
لتطبيق التمييز البصري الآلي دون الحاجة لإنشاء أعمدة نتائج وسيطة، يمكن حقن معادلة التحقق المنطقية مباشرة داخل محرك التنسيق الشرطي في جداول بيانات جوجل. يتم ذلك باتباع الخطوات الإجرائية التالية:
- تحديد كامل نطاق الخلايا المراد تلوينها في العمود المقارَن (مثل النطاق
A2:A100). - الانتقال إلى شريط الأدوات العلوي، والنقر على قائمة تنسيق (Format)، ثم اختيار تنسيق شرطي (Conditional formatting).
- في اللوحة الجانبية المنبثقة، يتم ضبط خانة “قواعد تنسيق الخلايا إذا…” واختيار الخيار الأخير: صيغة مخصصة هي (Custom formula is).
- إدراج المعادلة الحسابية المعتمدة في المربع المخصص:
=NOT(ISERROR(MATCH(A2, $B$2:$B$16, 0))). - تحديد نمط التنسيق المستهدف (مثل اختيار خلفية خضراء فاتحة مع نص داكن) لتمييز العناصر المتطابقة والموجودة، ثم الضغط على “تم”.
من الأهمية بمكان التأكد من كتابة الخلية الأولى بصيغة نسبية A2 مع الحفاظ على التثبيت المطلق للنطاق المرجعي $B$2:$B$16، لضمان قيام محرك التنسيق بتقييم كل خلية بالنسبة لموقعها الرأسي الخاص بمحاذاة النطاق المرجعي الثابت.
8.3 تصميم قواعد موازية لإبراز القيم المفقودة وغير المطابقة
لا تكتمل الكفاءة الإدراكية للوحة البيانات إلا بإنشاء قاعدة بصرية مضادة تعنى بإبراز الفجوات والغياب التشغيلي، أي إضاءة العناصر الموجودة في العمود $A$ والتي لا تتوفر في النطاق المرجعي $B$. لتحقيق ذلك، تضاف قاعدة ثانية داخل اللوحة الجانبية للتنسيق الشرطي تطبق على النطاق عينه A2:A100، باستخدام المعادلة المنطقية المعاكسة التالية:
=ISERROR(MATCH(A2, $B$2:$B$16, 0))
يتم تعيين نمط بصري تحذيري ملفت (مثل الخلفية الحمراء الفاتحة أو البرتقالية) لتمييز السجلات المفقودة. تتيح جداول بيانات جوجل ترتيب أولويات القواعد بالسحب والإفلات الرأسي في الشريط الجانبي؛ وتستجيب هذه القواعد ديناميكياً ولحظياً؛ فبمجرد إضافة قيمة مفقودة إلى العمود المرجعي، تتغير ألوان الخلايا بصورة تفاعلية وفورية تعكس التحديثات الحاصلة في البنية التحليلية بدقة بالغة.
9. إدارة الحالات الشاذة واستكشاف الأخطاء وتصحيحها (Troubleshooting)
9.1 معالجة مشكلات المسافات الزائدة والفروق النصية غير المرئية
تُعد المسافات البادئة واللاحقة والمخفية بين الكلمات من أكثر مصادر الأخطاء الصامتة شيوعاً في قواعد البيانات المجمعة من منصات استطلاع الرأي؛ إذ يتعامل محرك جداول بيانات جوجل مع النص "ID_104" بوصفه كياناً مستقلاً ومختلفاً جذرياً عن النص "ID_104 " لوجود مسافة لاحقة غير مرئية للمشغل، مما يؤدي إلى فشل دوال المطابقة التامة وتوليد نتائج سالبة كاذبة تخل بالتحليل.
للتعامل المنهجي مع هذه المعضلة، يُستحسن تغليف متغيرات البحث داخل دالة التنقية النصية TRIM، والتي تتولى حذف كافة المسافات الزائدة في البداية والنهاية وتختزل المسافات البينية إلى مسافة واحدة مفردة. وفي الحالات المستعصية التي تتضمن محارف تحكم غير قابلة للطباعة ناتجة عن التصدير من خوادم قديمة، يتم دمج دالة CLEAN وفق الصياغة المتقدمة التالية:
=NOT(ISERROR(MATCH(TRIM(CLEAN(A2)), $B$2:$B$16, 0)))
تضمن هذه المعالجة تنقية السجلات وتطهيرها من الشوائب التنسيقية قبل تمريرها لمعالجات الفحص، مما يرفع موثوقية النتائج ويمنع الأخطاء التقييمية الناتجة عن التشوهات غير المرئية.
9.2 حساسية حالة الأحرف (Case Sensitivity) في اللغات الأجنبية
تتسم دوال البحث القياسية في جداول بيانات جوجل، مثل MATCH وCOUNTIF وVLOOKUP، بكونها غير حساسة لحالة الأحرف اللاتينية (Case-Insensitive) بشكل افتراضي؛ فهي تعتبر الرمز "CodeA" مطابقاً تماماً للرمز "codea". يشكل هذا السلوك الافتراضي ميزة مريحة في الاستخدامات العامة، ولكنه قد يتحول إلى خلل منهجي جسيم عند فحص المعرفات المشفرة، أو مفاتيح التجزئة (Hash Keys)، أو الرموز الجزيئية الحساسة لحالة الحرف.
لفرض مطابقة صارمة تعتمد التطابق الحرفي الدقيق لحالة الأحرف (Case-Sensitive Match)، يجب مغادرة الدوال التقليدية وبناء معادلة مصفوفية متقدمة توظف دالة التطابق الحرفي الصارم EXACT المدمجة مع دالة التجميع SUMPRODUCT، كما يلي:
=SUMPRODUCT(--EXACT(A2, $B$2:$B$16)) > 0
تقوم دالة EXACT بمقارنة القيمة A2 بكل خلية في النطاق بصورة مصفوفية حرفية دقيقة، مولدة مصفوفة من قيم الصواب والخطأ. تحول الإشارتان السالبتان -- القيم البوليانية إلى أرقام ثنائية (1 و 0)، لتقوم SUMPRODUCT بجمعها؛ فإن زاد المجموع عن الصفر، كان ذلك إقراراً صريحاً بوجود تطابق تام يراعي حالة الأحرف بدقة فائقة.
9.3 تضارب أنواع البيانات وتوحيد الهياكل بين الأرقام والنصوص
يعد التباين في النوع البياني للمدخلات (Data Type Inconsistency) من الأسباب الخفية الشائعة وراء إخفاق عمليات التحقق، وتحدث هذه المشكلة بكثرة عند استيراد السجلات من ملفات CSV، حيث قد يُخزن الرقم 1042 في العمود الأول كقيمة عددية حقيقية تقبل العمليات الحسابية، بينما يُخزن المعرف المقابل في العمود المرجعي كنص برمجي صريح "1042" بسبب إلحاق علامة اقتباس أو تنسيق الخلية كنص.
في هذه الحالة، ترجع دوال المطابقة التامة القيمة FALSE حتماً، نظراً لأن جداول البيانات لا تساوي رياضياً بين الأرقام والنصوص حتى لو تماثلت أشكالها البصرية. لتجاوز هذا الانسداد، يتعين توحيد النمط البياني قسرياً داخل الصيغة عبر دالة التحويل النصي TO_TEXT، أو العكس عبر دالة القيمة العددية VALUE، كما توضح الصيغة المعالجة التالية:
=NOT(ISERROR(MATCH(TO_TEXT(A2), INDEX(TO_TEXT($B$2:$B$16)), 0)))
يكفل هذا التحويل القسري توحيد الهيكلية النمطية للمقارنة بين الطرفين، مما يقضي على الإخفاقات الصامتة الناجمة عن التباين البرمجي الداخلي لتخزين البيانات.
10. الحوكمة المتقدمة للبيانات واستراتيجيات المعالجة في النطاقات الكبرى
10.1 توثيق النماذج الحسابية وإرساء معايير ضبط الجودة
تتطلب الإدارة الرصينة لمشاريع البيانات المؤسسية والبحوث الأكاديمية إرساء بروتوكولات حوكمة صارمة لحماية تدفقات العمل من التلف العرضي أو التفسيرات الخاطئة. وقد أظهرت الأبحاث المتخصصة في كفاءات إدارة المشاريع والأنظمة التعليمية أهمية التوثيق المنهجي والضبط المعياري للنماذج في رفع كفاءة فرق العمل وضمان استمرارية المشاريع واستقرار مخرجاتها (Nijhuis et al., 2018).
يستلزم ذلك التوثيق الواضح لمنطق المعادلات الحسابية عبر إدراج التعليقات التوضيحية (Notes & Comments) داخل خلايا الترويسة لشرح طبيعة الفحص والهدف منه. كما يُنصح بشدة بالفصل المادي بين طبقة البيانات الخام المجمعة (Raw Data Layer) وطبقة التحليل والمعالجة (Processing Layer)، وتطبيق إجراءات حماية النطاقات (Protected Sheets and Ranges) لمنع التعديل غير المصرح به على الصيغ المحورية، فضلاً عن إجراء تدقيق متقاطع دوري للتأكد من صمود النماذج أمام المدخلات الجديدة غير المتوقعة.
10.2 تحسين الكفاءة الحسابية في قواعد البيانات الضخمة (Big Data Sheets)
عندما تتسع جداول البيانات لتضم عشرات الآلاف من الصفوف والأعمدة المتقاطعة، يتراجع الأداء الحسابي ويزداد زمن استجابة المتصفح للعمليات التفاعلية نتيجة إعادة حساب الصيغ المتطايرة في كل حركة للمستخدم. يفرض هذا التحدي تحسين استراتيجيات التصميم؛ ومن أولى الخطوات الإلزامية تجنب استخدام المراجع المفتوحة غير المحدودة داخل صيغ الصفوف الفردية المكررة، وحصر نطاقات الفحص بدقة متناهية (مثل $B$2:$B$5000 بدلاً من $B:$B).
كذلك، بمجرد استقرار عمليات التحقق من البيانات التاريخية التي لا تخضع للتغيير الدوري، يُوصى بتحويل الصيغ الحسابية إلى قيم ثابتة (Paste Special > Values only) لتخفيف العبء الحسابي عن ذاكرة المتصفح. وعند بلوغ الجداول حدودها التشغيلية القصوى، يكون من الأفضل الانتقال إلى برمجة نصوص جوجل التطبيقية (Google Apps Script) لتنفيذ المقارنات على الخادم السحابي وإرجاع النتائج النهائية فقط، أو تصدير العمليات البرمجية المعقدة إلى بيئات قواعد بيانات علائقية متخصصة كـ BigQuery.
10.3 التكامل مع دوال الاستعلام والتصفية المتقدمة (FILTER وQUERY)
لا تتوقف الفائدة المنهجية للتحقق من وجود القيم عند مجرد إظهار المؤشر البولياني TRUE أو FALSE، بل تمتد لتشكل مرشحاً ديناميكياً يغذي دوال التجميع والتحويل المتقدمة. تتيح دالة التصفية FILTER عزل السجلات المتطابقة واستخراجها بالكامل في جدول جانبي جديد ومستقل بنقرة واحدة، عبر استغلال مصفوفة التحقق كمعيار فرز:
=FILTER(A2:A, NOT(ISERROR(MATCH(A2:A, $B$2:$B$16, 0))))
علاوة على ذلك، يفتح الربط مع لغة الاستعلامات المدمجة QUERY آفاقاً واسعة لإجراء عمليات التجميع والفرز والتحليل الإحصائي المتقدم للمجموعات المطابقة، مما يتيح استخراج تقارير إدارية وتحليلية رفيعة المستوى. وتعد هذه البيانات المفروزة والمصفاة ركيزة صلبة لتصدير السجلات المنقاة إلى الحزم الإحصائية البرمجية المتقدمة (مثل R وSPSS وPython) لمواصلة التحليلات النمذجة والاستدلالية بأعلى درجات الموثوقية العلمية.
تتكامل المنهجيات المعرفية والتقنية لتشكل إطاراً شاملاً يتيح للباحثين والمحللين التحقق التام من موثوقية السجلات، مما يعزز دقة القياس، ويحد من الأخطاء المتراكمة في تدفقات البيانات الضخمة، كما وثقت دراسات مقارنة المناهج واسترجاع المعلومات أهمية الصرامة الإجرائية في تتبع العينات وتحقيق استقرار نتائج القياس المعرفي والاجتماعي (Marsden et al., 2018).
خاتمة
تناول هذا الدليل المتعمق الأبعاد المنهجية والرياضية والتقنية لعملية التحقق من وجود قيمة عمود في عمود آخر ضمن بيئة جداول بيانات جوجل (Google Sheets). فمن خلال تفكيك الصيغة القياسية =NOT(ISERROR(MATCH(lookup_value, lookup_range, 0))) ومكافئاتها مثل ISNUMBER وCOUNTIF وXLOOKUP، تبيّن أن اختيار الأداة المناسبة يرتبط بحجم البيانات، والتعقيد الحسابي، والحاجة لمعالجة الحالات الشاذة من مسافات زائدة وتضارب في الأنماط النصية والرقمية.
إن إتقان هذه التقنيات، وتتويجها بالأتمتة عبر ARRAYFORMULA والترميز البصري عبر التنسيق الشرطي، ينقل العمل الإداري والبحثي من الممارسات اليدوية المعرضة للأخطاء الإدراكية إلى حوسبة موثوقة وعالية الدقة. يشكل هذا الأساس المنطقي ضمانة جوهرية لسلامة البيانات في المسوح والمشاريع، مما يتيح اتخاذ قرارات مبنية على حقائق رقمية صلبة ومتحققة تضمن جودة الاستدلال الإحصائي واستدامة الأنظمة المعلوماتية.
المراجع
- Clark, E. A., Kessinger, J., Duncan, S. E., Bell, M. A., Lahne, J., Gallagher, D. L., et al. (2020). The Facial Action Coding System for Characterization of Human Affective Response to Consumer Product-Based Stimuli: A Systematic Review. Frontiers in Psychology. https://doi.org/10.3389/fpsyg.2020.00920
- Fotaris, P., & Mastoras, T. (2022). Room2Educ8: A Framework for Creating Educational Escape Rooms Based on Design Thinking Principles. Education Sciences. https://doi.org/10.3390/educsci12110768
- Letmathe, P., & Rößler, M. (2021). Should firms use digital work instructions?—Individual learning in an agile manufacturing setting. Journal of Operations Management. https://doi.org/10.1002/joom.1159
- Lumsden, J., Skinner, A., Coyle, D., Lawrence, N., & Munafo, M. R. (2017). Attrition from Web-Based Cognitive Testing: A Repeated Measures Comparison of Gamification Techniques. Journal of Medical Internet Research. https://doi.org/10.2196/jmir.8473
- Marsden, E. J., Morgan‐Short, K., Thompson‐Lee, S., & Abugaber, D. (2018). Replication in Second Language Research: Narrative and Systematic Reviews and Recommendations for the Field. Language Learning. https://doi.org/10.1111/lang.12286
- Nijhuis, S. A., Vrijhoef, R., & Kessels, J. (2018). Tackling Project Management Competence Research. Project Management Journal. https://doi.org/10.1177/8756972818770591