
تعد جداول بيانات جوجل (Google Sheets) إحدى الركائز التقنية الأساسية في بنية الحوسبة السحابية المعاصرة، حيث توفر للباحثين والمحللين ومهندسي البيانات بيئة مرنة لمعالجة البيانات الضخمة ونمذجتها وتنظيفها بفعالية فائقة. وتبرز معالجة النصوص والسلاسل المحرفية (String Manipulation) كأحد أكثر التحديات تعقيداً وأهمية في سياق هندسة البيانات؛ إذ غالباً ما ترد المدخلات النصية بصيغ متباينة وغير متجانسة تتطلب تفكيكاً دقيقاً واستخلاصاً منهجياً للمكونات الجوهرية. ومن بين هذه التحديات، يبرز التحدي المستمر المتمثل في استخراج المقطع النصي الأخير من سلسلة ذات طول متغير وعدد فواصل غير محدد مسبقاً، كاستخلاص ألقاب العائلات، أو الامتدادات الرقمية للملفات، أو المعرفات النهائية في المسارات الحاسوبية.
تعتمد النظم التقليدية لمعالجة السلاسل النصية على دوال ثابتة مثل LEFT وRIGHT وMID، غير أن هذه الدوال تقف عاجزة أمام البيانات الديناميكية التي تتغير فيها مواضع الفواصل ومحددات النصوص بشكل عشوائي. ومن هنا، يبرز توظيف دالة SPLIT التي تمثل الأداة التحويلية الأبرز لتقسيم النصوص وتفكيكها إلى مصفوفات أفقية ممتدة. ومع ذلك، فإن الطبيعة المصفوفية الناتجة عن هذه الدالة تولد تحديات إضافية تتعلق بكيفية عزل عنصر محدد من المصفوفة وحصره في خلية نهائية واحدة دون إحداث أخطاء تداخل البيانات أو الكتابة الفوقية غير المرغوبة، مما يستلزم بناء صيغ تكاملية تجمع بين تفكيك النصوص والدوال المرجعية المكانية.
يسعى هذا الدليل التقني المتقدم إلى تفكيك الآليات الرياضية والبرمجية المعنية بتجزئة السلاسل النصية في جداول بيانات جوجل، مسلطاً الضوء بصورة متعمقة على استراتيجيات اقتناص العنصر النهائي بدقة وإحكام. سنستعرض عبر هذا البحث المقارن البنية التركيبية الكلاسيكية القائمة على مزامنة دالتي INDEX وCOLUMNS، مروراً بالبدائل الحديثة التي توفرها الدوال المتطورة كدالة CHOOSECOLS، وصولاً إلى المعالجة المعيارية باستخدام التعابير النمطية المنطقية REGEXEXTRACT، مع تقديم إرشادات هندسية صارمة لضمان الكفاءة الحسابية وتفادي استنزاف موارد المعالجة السحابية في المشروعات التحليلية واسعة النطاق.
1. مقدمة منهجية لمعالجة النصوص المتقدمة في جداول بيانات جوجل
1.1 التحديات التقنية في تجزئة السلاسل النصية المتغيرة
تتسم البيانات النصية الخام في قواعد البيانات الرقمية بعدم التجانس الهيكلي؛ إذ نادراً ما تتطابق السجلات النصية في أطوالها المطلقة أو في أعداد الكلمات والمقاطع المكونة لها. ففي معالجة الأسماء الشخصية على سبيل المثال، قد يتألف الاسم في السجل الأول من مقطعين، بينما يمتد في سجلات أخرى إلى ثلاثة أو أربعة أو خمسة مقاطع متباينة، مما يجعل الاعتماد على اقتطاع عدد ثابت من المحارف أمراً غير ذي جدوى برمجياً. هذا التباين يفرض متطلبات صارمة على محركات المعالجة، التي يجب أن تتعامل مع فواصل تقع في إحداثيات مكانية متغيرة يصعب التنبؤ بها بصورة خطية بسيطة.
تكمن المعضلة الأساسية في غياب المؤشرات الثابتة التي تحدد بدقة متناهية بداية المقطع الأخير ونهايته ضمن السلسلة المحرفية الكلية. فإذا رغب المحلل في استخراج الكلمة الأخيرة، فإن البحث عن الفاصل من اليمين إلى اليسار لا تدعمه الدوال النصية البسيطة بصورة مباشرة في جداول البيانات التقليدية، والتي تبدأ عمليات البحث والمسح عادة من بداية النص جهة اليسار أو اليمين بحسب اتجاه اللغة دون قدرة أصلية على التحول العكسي التلقائي. إن محاولة تقدير مواضع الفواصل عبر تكرار دوال البحث النصي كدالة SEARCH أو FIND تؤدي سريعاً إلى صيغ معقدة وغير قابلة للصيانة، فضلاً عن كونها عرضة للانهيار البرمجي بمجرد ظهور نص غير متوقع.
من هذا المنطلق، تنشأ الحاجة الحتمية إلى ابتكار حلول ديناميكية مؤتمتة تمتلك القدرة الجوهرية على استشعار العمق التركيبي للسلسلة النصية واقتطاع المقطع المستهدف آلياً دون الحاجة إلى تدخل يدوي أو افتراضات مسبقة حول طول النص. إن أتمتة هذه العملية تعد مطلباً جوهرياً في خطوط معالجة وتنقية البيانات (Data Cleansing Pipelines)، حيث يوفر التحويل المنهجي للنصوص المعقدة إلى عناصر ذرية نقية الأساس المتين لعمليات الفهرسة، والربط العلائقي، والتحليل الإحصائي المتقدم الخالي من التشوهات الإدخالية.
1.2 البنية الوظيفية لدالة SPLIT وأدوارها التحليلية
تمثل دالة SPLIT في جداول بيانات جوجل نموذجاً لعمليات التحويل المصفوفي الموجه للنصوص؛ حيث تعرّف برمجياً بأنها أداة تحويلية تأخذ مدخلاً نصياً قياسياً مفرداً وتقوم بتقطيعه عند كل ظهور لفاصل محدد، ثم تُخرج المكونات الناتجة في صورة مصفوفة بيانات أفقية أحادية البعد (One-Dimensional Horizontal Array). هذه الطبيعة المصفوفية تميزها جوهرياً عن دوال التجزئة التقليدية، حيث لا تكتفي باقتطاع جزء وحيد، بل تعيد تمثيل النص الأصلي كمتجه رياضي يتألف من مجموعة من الخلايا المتجاورة، بحيث يمثل كل عنصر فيه مقطعاً نصياً مستقلاً جرى تحريره من رمز الفاصل المستخدم.
تعتمد الخوارزمية الداخلية للدالة على مسح السلسلة النصية المدخلة حرفاً بحرف، ومقارنة كل محرف بالقيمة المعطاة في معامل الفاصل. وبمجرد تحقق التطابق، يتم إسقاط الفاصل وإنشاء نقطة تفرع تؤدي إلى دفع النص المتراكم حتى تلك اللحظة إلى عنصر جديد في المصفوفة الناتجة. تضمن هذه الآلية مرونة استثنائية في التعامل مع مختلف أنماط النصوص، إلا أنها تضع على عاتق المستخدم عبء التعامل مع مخرجات تمتد أفقياً عبر الأعمدة، وهو ما قد يتعارض مع متطلبات النمذجة التي تقتضي في كثير من الأحيان بقاء النتيجة محصورة في نطاق العمود ذاته وفي خلية بعينها.
تبرز هنا الحدود المنهجية لدالة SPLIT عند العمل بشكل منفرد؛ فهي لا تمتلك معاملاً داخلياً يتيح لها اختيار أو عزل مقطع بعينه دون سواه. فالدالة مصممة بطبيعتها لتوليد كافة المقاطع دون تمييز، تاركة مهمة التصفية والانتقاء للدوال المرجعية الأخرى. هذا القصور الوظيفي المقصود في تصميم الدالة يتطلب بناء أطر تكاملية ودمجها مع دوال مصفوفية قادرة على توجيه المؤشر نحو الخلية النهائية واستخلاص قيمتها دون السماح لبقية عناصر المصفوفة بالانتشار في الجدول.
1.3 أهمية استخراج العنصر النهائي في تنظيف وتنظيم البيانات
يكتسب استخراج العنصر النهائي من السلاسل النصية أهمية بالغة في إدارة البيانات الضخمة والفهرسة الأكاديمية والتصنيف الببليوغرافي. ففي سياق معالجة الأسماء الشخصية، يمثل اللقب العائلي (Last Name أو Surname) المرتكز الأساسي في تصنيف الباحثين والمؤلفين وفق المعايير الأكاديمية الدولية، كمعيار الجمعية النفسية الأمريكية (APA) أو معايير الفهرسة القياسية. ونظراً لتفاوت تركيب الأسماء وتباين عدد الأسماء الوسيطة والبادئات، فإن استخلاص الاسم الأخير بدقة عبر خوارزميات ديناميكية يضمن تجنب أخطاء التصنيف اليدوي، ويتيح إعادة هيكلة قواعد البيانات لتصبح قابلة للفرز المعجمي الصارم.
يمتد هذا الاحتياج الوظيفي ليشمل معالجة البيانات التقنية والمسارات الرقمية في مستودعات البيانات السحابية. فعند التعامل مع مسارات الملفات التخزينية (File Paths) أو عناوين الويب (URLs)، يحتاج مهندس البيانات بصورة متكررة إلى عزل اسم الملف النهائي، أو استخلاص امتداد الصيغة (مثل .pdf أو .csv)، أو عزل المعرف الفريد للصفحة (Slug/ID) القابع في ذيل الرابط. وتساعد العمليات الرياضية المؤتمتة لاقتطاع الجزء الأخير في أرشفة هذه الموارد وتصنيفها برمجياً دون الحاجة لكتابة سكربتات برمجية معقدة خارج بيئة الجداول.
علاوة على ذلك، يلعب هذا الإجراء دوراً محورياً في تنقية مخرجات المسوح الإحصائية الرقمية والاستبانات الإلكترونية، حيث تتضمن الاستجابات أحياناً سلاسل مدخلة عشوائياً تتطلب استخلاص التقييم النهائي أو المتغير الأخير المسجل في ذيل الحقل. إن الدقة في هذا الاستخلاص ترفع من مصداقية التحليل الإحصائي وتقلل من الانحرافات الناتجة عن إقحام نصوص غير متجانسة في التحليلات اللاحقة، مما يرسخ مبدأ جودة البيانات (Data Integrity) كمتطلب مسبق لأي دراسة علمية رصينة.
2. التشريح التركيبي لدالة SPLIT ومحددات عملها الأساسية
2.1 المعاملات الإلزامية والاختيارية في صياغة الدالة
تخضع دالة SPLIT لبنية تركيبية دقيقة تشتمل على أربعة معاملات رئيسية، منها اثنان إلزاميان واثنان اختياريان، وتُصاغ رياضياً وفق الترتيب التالي: SPLIT(text, delimiter, [split_by_each], [remove_empty_text]). يمثل المعامل الأول text المدخل النصي الأساسي المراد تفكيكه، ويشترط أن يكون نصاً صريحاً أو مرجعاً لخلية تحوي قيمة نصية أو رقمية. أما المعامل الثاني delimiter، فيحدد الرمز أو السلسلة المحرفية المعيارية المعتمدة لقطع النص وفصله، كالمسافات البيضاء (” “)، أو الفواصل العادية (“,”)، أو الفواصل المنقوطة، أو أي رمز اصطلاحي آخر يتكرر بين المقاطع.
أما المعاملات الاختيارية، فتحكم السلوك الحسابي للدالة وتحدد كيفية قراءة الفواصل المعقدة وإدارة الفراغات. المعامل الثالث split_by_each هو قيمة منطقية تأخذ افتراضياً القيمة TRUE، وهي تعني أن الدالة ستتعامل مع كل محرف منفرد داخل معامل الفاصل كأداة تقسيم مستقلة. فعلى سبيل المثال، إذا تم تعيين الفاصل كرمزين مجتمعين مثل “, ” (فاصلة متبوعة بمسافة)، فإن القيمة الافتراضية ستؤدي إلى تقسيم النص عند كل فاصلة وعند كل مسافة بصورة منفصلة، وهو خطأ شائع يقع فيه العديد من المطورين. ولتجنب هذا السلوك وإجبار الدالة على التجزئة عند تسلسل الرمزين معاً كوحدة لا تتجزأ، يجب ضبط هذا المعامل صراحة على القيمة المنطقية FALSE.
المعامل الرابع remove_empty_text يحدد الموقف الإجرائي للدالة تجاه المقاطع الفارغة الناتجة عن تكرار الفواصل المتتالية، وتكون قيمته الافتراضية TRUE. في هذه الحالة، تسقط الدالة تلقائياً أي عنصر فارغ وتتجاهله في مصفوفة الإخراج، مما يمنع توليد خلايا بيضاء بين الكلمات. وفي حال تعديل هذا المعامل إلى FALSE، تحتفظ الدالة بالفراغات كمصفوفات نصية خالية، مما يترتب عليه تخصيص خلايا فعلية لها، وهو ما يؤثر بشكل مباشر على الحساب الرياضي لمواقع العناصر وإحداثياتها داخل المصفوفة كما سنفصل لاحقاً.
2.2 السلوك الافتراضي لمصفوفات الإخراج الأفقية
ينطوي السلوك الافتراضي لدالة SPLIT على ما يعرف بظاهرة الانتشار الديناميكي للمصفوفات (Array Expansion)؛ فبمجرد تطبيق الصيغة في خلية ما، يُلزم محرك جداول بيانات جوجل الخلايا المجاورة على المحور الأفقي (ضمن الصف ذاته) باستقبال المقاطع المجزأة بالتتابع. هذا الانتشار الأفقي التلقائي يعني أن الصيغة المدخلة في الخلية B2 مثلاً قد تمتد مخرجاتها لتشغل الخلايا C2 وD2 وE2 بحسب عدد الفواصل المتوفرة في النص الأصلي بالخلية A2، دون الحاجة إلى تطبيق دالة مصفوفية مسبقة كدالة ARRAYFORMULA.
يحمل هذا الانتشار الأفقي في طياته مخاطر تشغيلية جسيمة تعرف تقنياً بظاهرة التصادم البياني؛ فإذا صادف امتداد المصفوفة وجود بيانات نصية أو رقمية مسجلة مسبقاً في أي من الخلايا المجاورة الواقعة في مسار الانتشار، يتوقف المحرك فوراً عن معالجة الدالة ويطلق رسالة الخطأ المرجعي الشهيرة #REF! مع إشعار تحذيري يفيد بعدم إمكانية توسيع المصفوفة لأنها ستؤدي إلى الكتابة الفوقية على البيانات الحالية (Array result was not expanded because it would overwrite data).
تفرض هذه الخاصية المعمارية ضرورة منهجية للسيطرة على مخرجات الدالة وحصرها قسرياً داخل نطاق الخلية التي كُتبت فيها الصيغة، لا سيما في الجداول المنظمة التي تُخصص فيها الأعمدة بصورة صارمة لسمات محددة (مثل تخصيص عمود للقب العائلة فقط). إن السماح للبيانات بالتمدد الأفقي العشوائي يدمر التناسق الهيكلي لقواعد البيانات ويعيق عمليات المعالجة الجدولية اللاحقة، مما يبرز أهمية تغليف دالة SPLIT بأدوات حصر وانتقاء تقطع مسار الانتشار وتعيد عنصراً وحيداً حصرياً.
2.3 إدارة الفراغات والقيم الفارغة داخل النصوص المجزأة
تشكل المسافات البيضاء المتعددة وغير المنتظمة تشويهاً شائعاً في قواعد البيانات المجمعة من مصادر نصية مفتوحة؛ إذ يؤدي الضغط المزدوج على مفتاح المسافة أو وجود مسافات بادئة ولاحقة إلى توليد فراغات غير مرئية تفصل بين الكلمات. وعند تمرير هذه النصوص إلى دالة SPLIT مع ضبط معامل الفاصل على مسافة واحدة (” “)، فإن سلوك الدالة يتحدد بشكل حاسم بناءً على الحالة المعطاة للمعامل الرابع remove_empty_text؛ فإذا بقي على قيمته الافتراضية TRUE، تتجاوز الدالة المسافات المكررة بذكاء وتدمجها برمجياً لتعيد المقاطع النصية الفعلية فقط.
في المقابل، إذا أُلغيت هذه الخاصية عبر تعيين المعامل إلى FALSE، فإن كل مسافة بيضاء إضافية متتالية ستعامل كفاصل جديد يفصل بين نص موجود ونص معدوم، مما ينتج عنه حشو مصفوفة الإخراج بخلايا نصية فارغة القيمة ولكنها تشغل موقعاً مفهرساً ومحجوزاً في الذاكرة. ينعكس هذا السلوك سلباً وبصورة مباشرة على دقة الدوال الحسابية التي تقيس أبعاد المصفوفة؛ حيث تصبح الخلية الأخيرة المحسوبة مجرد فراغ وهمي، مما يؤدي إلى فشل ذريع في استرداد الكلمة الأخيرة الحقيقية من النص.
كما يجب التمييز الدقيق بين التجزئة بحرف مفرد والتجزئة بعبارة نصية متكاملة تتضمن مسافات وأحرفاً خاصة، كالفصل بواسطة ” – ” (مسافة، شرطة، مسافة). ففي هذا السياق، إذا لم يُضبط المعامل الثالث split_by_each على FALSE، ستعامل الدالة المسافة بمفردها كفاصل، والشرطة كفاصل آخر، مسببة تفتتاً كارثياً للنص الأصلي لا يعكس البنية الدلالية المرادة منه، مما يؤكد ضرورة الوعي الشامل بالترابط الميكانيكي بين معاملات الدالة الأربعة وضبطها بما يلائم بنية البيانات الخام.
3. التوليف المنهجي بين دالتي INDEX وCOLUMNS لتحديد العنصر الأخير
3.1 الدور الوظيفي لدالة INDEX في استرداد عناصر المصفوفة
تعد دالة INDEX إحدى أهم الدوال المرجعية في بيئات جداول البيانات السحابية؛ إذ تتجلى وظيفتها المركزية في توفير آلية وصول عشوائي مباشر ومحدد للقيم المخزنة داخل نطاق أو مصفوفة بيانات عبر تزويدها بالإحداثيات الرقمية لتلك الخلية. تُصاغ الدالة رياضياً وفق الشكل: INDEX(reference, [row], [column])، حيث تستقبل في معاملها الأول مصفوفة الإخراج الناتجة عن أي دالة فرعية، ثم تتولى استخراج القيمة القابعة عند تقاطع الصف المحدد والعمود المحدد بدقة متناهية ودون أي تأخير حسابي.
عند دمج دالة INDEX مع مصفوفة أفقية أحادية البعد ناتجة عن دالة SPLIT، يصبح معامل الصف ثابتاً تلقائياً عند الرقم (1)، نظراً لأن التجزئة الافتراضية تتم عبر صف أفقي واحد يمتد على عدة أعمدة. ومن ثم، يتحول الثقل الحسابي بأكمله إلى معامل العمود، حيث تتيح الدالة للمبرمج تحديد رقم الخلية الأفقية المراد استردادها بصورة انتقائية. تتميز دالة INDEX بقدرتها على التكيف مع المخرجات المصفوفية الافتراضية في الذاكرة دون الحاجة إلى كتابتها مسبقاً في نطاق فيزيائي على ورقة العمل، مما يتيح إجراء التصفية اللحظية داخل المعالج.
تتمثل القوة الهندسية الأبرز لدالة INDEX في هذا السياق في قدرتها على كبح وإلغاء سلوك الانتشار الأفقي المصاحب لدالة SPLIT؛ فعلى الرغم من أن الدالة الداخلية تنتج مصفوفة ممتدة تتألف من عدة عناصر، فإن تطويقها بدالة INDEX يؤدي إلى اقتطاع العنصر المحدد حصراً وإعادته كقيمة ذرية مفردة (Scalar Value). يضمن هذا الإجراء بقاء المخرجات محصورة بالكامل داخل حدود الخلية الأصلية، مانعاً حدوث أي تعارض مع البيانات المجاورة ومجنباً المستخدم أخطاء #REF! الناتجة عن الكتابة الفوقية غير المحسوبة.
3.2 استدعاء دالة COLUMNS لقياس البُعد الأفقي للمصفوفة
لكي تتمكن دالة INDEX من استرداد العنصر الأخير بدقة، فإنها تحتاج إلى معرفة الإحداثي الرقمي لذلك العنصر في بعد الأعمدة، وهو معطى مجهول ومتغير بتغير أطوال السلاسل النصية المدخلة في كل سجل. يبرز هنا الدور الوظيفي لدالة COLUMNS، وهي دالة قياسية متخصصة في حساب وإرجاع العدد الإجمالي للأعمدة المكونة لنطاق محدد أو مصفوفة بيانات. تُصاغ الدالة ببساطة عبر تمرير المصفوفة المراد قياسها: COLUMNS(array) لتنتج قيمة عددية صحيحة تمثل اتساع المصفوفة على المحور الأفقي.
تكتسب دالة COLUMNS مرونة فائقة مقارنة بمحاولات إدخال أرقام أعمدة ثابتة أو استخدام دالة COUNTA في بيئات غير منضبطة؛ فهي لا تقيس المحتوى أو نوعيته، بل تقيس الامتداد الهيكلي الدقيق للمصفوفة المتولدة في الذاكرة. فإذا كانت السلسلة النصية تحوي ثلاثة فواصل، فإن دالة SPLIT ستنتج مصفوفة مكونة من أربعة أعمدة، وهنا تقوم دالة COLUMNS برصد هذا التمدد وإرجاع الرقم (4) مباشرة بصورة ديناميكية تتكيف لحظياً مع كل صف على حدة ودون تدخل برمجي خارجي.
يحقق هذا القياس الديناميكي التوافق الرياضي الكامل بين مخرجات التجزئة وإحداثيات الاسترجاع؛ فالرقم الذي تعيده دالة COLUMNS يمثل في الوقت نفسه القيمة الإجمالية لعدد الأعمدة ورقم الإحداثي الفعلي للعنصر القابع في أقصى اليمين من تلك المصفوفة الأفقية. ومن ثم، يتحول هذا الرقم المولد تلقائياً إلى معطى إحداثي حاسم يتم تمريره إلى دالة INDEX لتوجيه مؤشر الاستخراج مباشرة نحو المقطع النهائي للنص أياً كان موقعه وعمقه التكراري.
3.3 تحليل منطق الصيغة المركبة المتكاملة
تتجسد الصيغة المركبة الكلاسيكية لاستخراج العنصر الأخير في التعبير الرياضي التالي: =INDEX(SPLIT(A2, " "), 1, COLUMNS(SPLIT(A2, " "))). ولإدراك عمق هذا التركيب، لا بد من تفكيكه تحليلياً وفق أسبقيات التنفيذ البرمجي ومسارات المعالجة الداخلية في محرك جداول بيانات جوجل. يبدأ المحرك أولاً بتقييم الدالة الداخلية الأكثر عمقاً، وهي SPLIT(A2, " ") المستدعاة داخل دالة COLUMNS؛ حيث يقوم بتفكيك النص في الخلية A2 اعتماداً على المسافة كفاصل، مما يولد مصفوفة افتراضية مؤقتة في الذاكرة.
في المرحلة الثانية، تتولى دالة COLUMNS فحص هذه المصفوفة الافتراضية وحساب عدد أعمدتها بدقة متناهية؛ فإذا كان النص مثلاً مكوناً من ثلاث كلمات، تُرجع الدالة القيمة الرقمية (3). بالتزامن مع ذلك، يجري تقييم الجزء الأول من الصيغة حيث تُستدعى دالة SPLIT(A2, " ") مرة ثانية لتوليد مصفوفة المقاطع ذاتها وتمريرها كمرجع إدخال أساسي لمعامل المصفوفة في دالة INDEX. في هذه اللحظة، تصبح المعادلة مكافئة منطقياً لـ: INDEX(المصفوفة المكونة من 3 عناصر, 1, 3).
تتولى دالة INDEX في الخطوة النهائية توجيه مؤشر القراءة إلى الصف الأول والعمود الثالث من المصفوفة الممررة إليها، وهو ما يطابق بالضرورة الكلمة الأخيرة من النص الأصلي. يتم بعد ذلك عزل هذه الكلمة وطرد كافة العناصر السابقة لها من الذاكرة اللحظية للمعالجة، وتُطبع النتيجة المنفردة داخل الخلية المستهدفة. تضمن هذه الآلية التكرارية دقة متناهية وتوافقاً رجعياً تاماً عبر كافة أجيال وتحديثات برمجيات جداول البيانات، محققة استقراراً حسابياً لا يتأثر بتغير أطوال السلاسل النصية المعالجة.
4. دراسة تطبيقية مفصلة: استخراج اللقب من الأسماء المركبة
4.1 إعداد نموذج البيانات وتجهيز النصوص الأولية
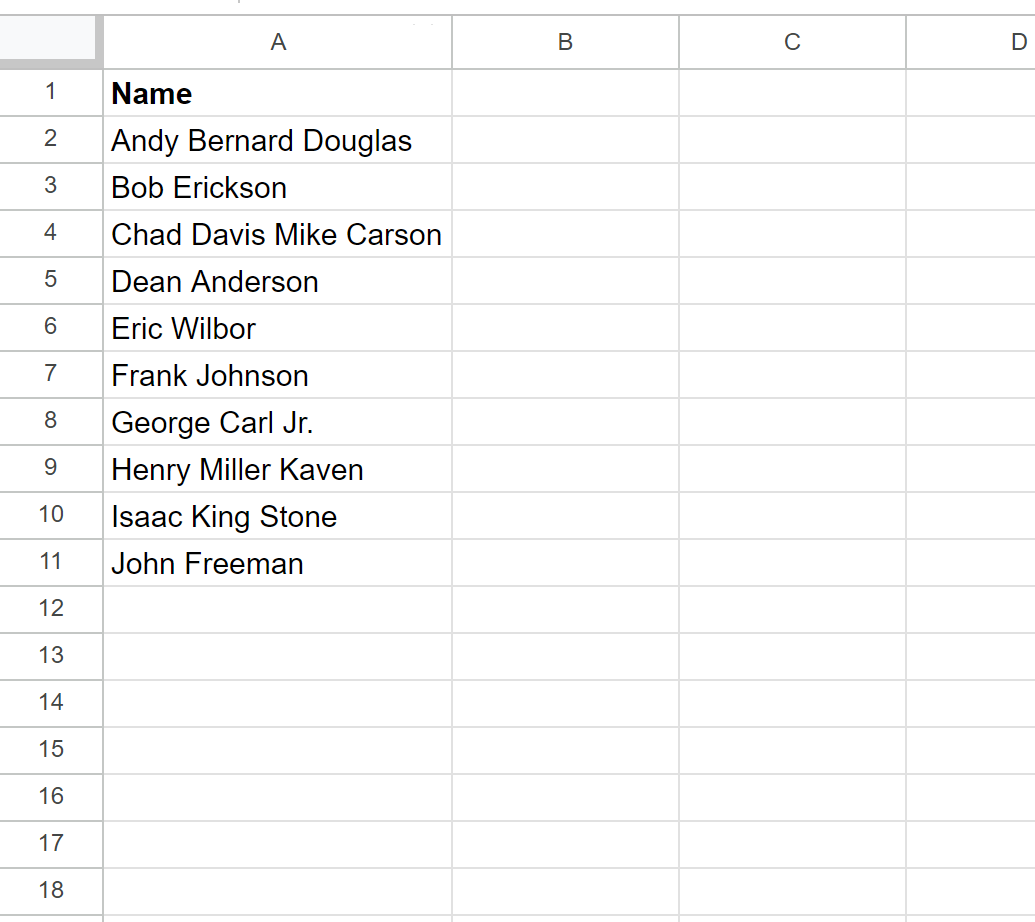
لتطبيق هذه المنهجية عملياً، نقوم بتصميم نموذج بيانات تجريبي يحاكي قواعد بيانات الموظفين أو الباحثين في مؤسسة أكاديمية. نخصص العمود الأول (A) لاستقبال الأسماء الكاملة للمشاركين تحت عنوان “الاسم الكامل”، مع مراعاة إدراج عينات متنوعة هيكلياً لاختبار متانة الصيغة المركبة؛ بحيث يشمل النموذج أسماءً ثنائية مثل “Mark Green”، وأسماءً ثلاثية مثل “Andy Bernard Douglas”، وأسماءً رباعية وخماسية معقدة تتضمن أسماء مركبة متباينة الطول والتركيب الصرفي.
قبل الشروع في تطبيق الصيغ الحسابية، يجب التأكد من الجاهزية البنيوية للنصوص المدخلة؛ فالبيانات المجمعة عبر النماذج الرقمية غالباً ما تشتمل على علامات ترقيم شاردة كالنواقص أو الفواصل غير المنسقة، أو قد تتضمن مسافات مزدوجة نجمت عن أخطاء مطبعية أثناء الإدخال البشري. يمثل الفحص البصري الأولي، المتبوع بتطبيق دوال الفحص النصي للتأكد من خلو البدايات والنهايات من المسافات الزائدة، خطوة تمهيدية أساسية لضمان عدم انحراف خوارزمية التجزئة عن مسارها المخطط له، ولتلافي احتساب مسافات الترقيم كمقاطع اسمية مستقلة.
يتم بعد ذلك تخصيص العمود المجاور (B) تحت وسم “اللقب الأخير المستخرج”، ليكون الحاوية النهائية للمخرجات الصافية. ويجب التأكد من أن هذا العمود مفرغ تماماً من أي صيغ أو نصوص سابقة، ومهيأ بتنسيق نصي عام يتيح استقبال القيم المسترجعة دون إجراء تحويلات تلقائية غير مرغوبة، مما يضع الأساس التقني لتطبيق واختبار الصيغة الرياضية في بيئة معزولة ومنضبطة تشغيلياً.
4.2 تطبيق المعادلة خطوة بخطوة مع المسافة كفاصل
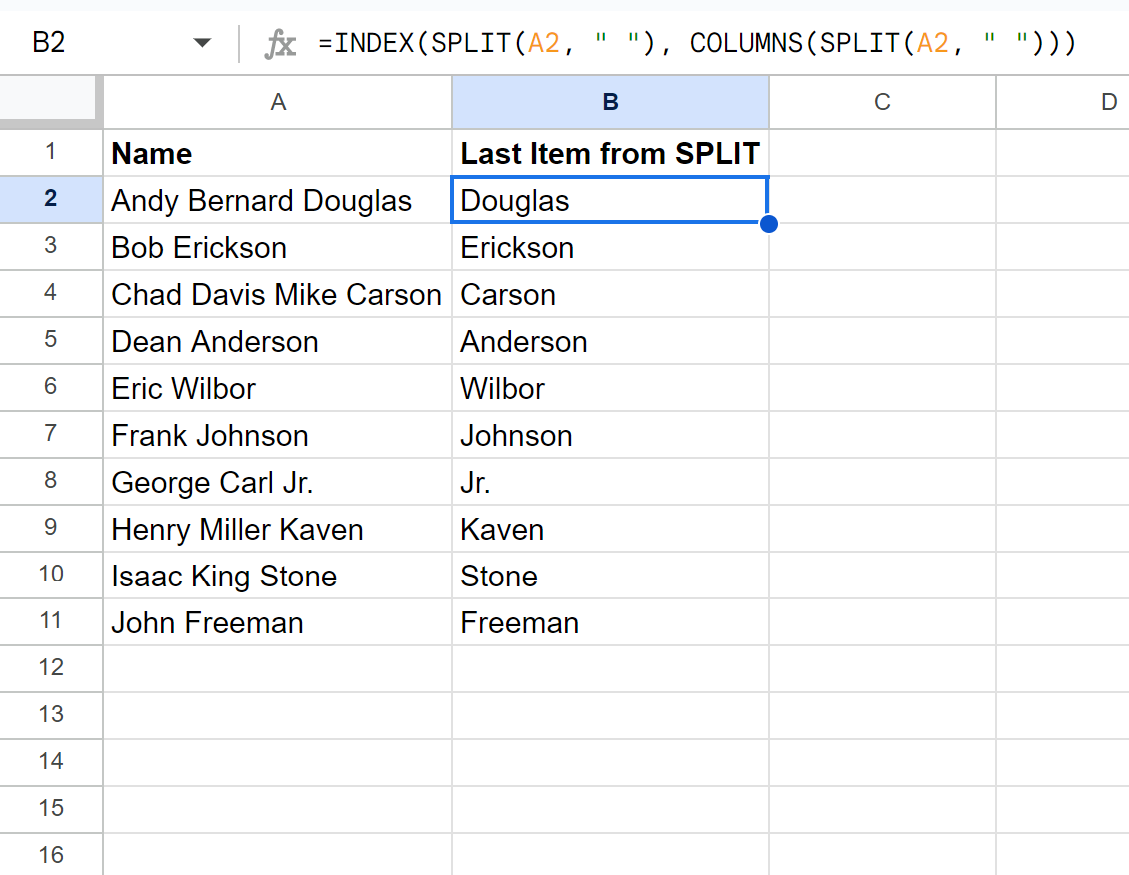
نبدأ بتفعيل الخلية المستهدفة B2 المقابلة للاسم الأول في السجل، ونقوم بإدخال الصيغة المعيارية المتكاملة بدقة: =INDEX(SPLIT(A2, " "), 1, COLUMNS(SPLIT(A2, " "))). يجب الانتباه هنا إلى كتابة معامل الفاصل كمسافة واحدة محصورة بين علامتي تنصيص متطابقتين " " دون إدراج أي محارف خفية إضافية، مع التأكد من إغلاق كافة الأقواس الرياضية للدوال المستدعاة وفق ترتيب فتحها التركيبي لمنع حدوث خطأ في بناء الجملة البرمجية (Syntax Error).
عند الضغط على مفتاح الإدخال لتنفيذ الصيغة على العينة النصية “Andy Bernard Douglas” الموجودة في A2، يبدأ محرك الحساب الداخلي بالعمل اللحظي؛ حيث تتولى دالة SPLIT تفكيك السلسلة إلى مصفوفة ثلاثية تحتوي: [“Andy”، “Bernard”، “Douglas”]. تتلقى دالة COLUMNS هذه المصفوفة لتعيد القيمة العددية 3، ومن ثم تقوم دالة INDEX بالتقاط العنصر الواقع في العمود الثالث، لترجع فوراً وبدقة متناهية اللقب “Douglas” منفرداً في الخلية B2، ودون أن تتأثر الخلايا C2 أو D2 بأي مخرجات إضافية.
يوضح هذا التطبيق العملي كيف تمكنت الصيغة من إهمال المقاطع السابقة (“Andy” و”Bernard”) دون الحاجة إلى معرفة مسبقة بوجودها، ودون الحاجة لتحديد عدد الحروف المكونة لكل مقطع منها. إن قدرة المعادلة على عزل اللقب في خطوة واحدة داخل خلية مفردة يمثل جوهر الفعالية الحسابية التي تبحث عنها المؤسسات في تنظيف سجلاتها الإدارية والأكاديمية بكفاءة وموثوقية عالية.
4.3 سحب الصيغة وتعميمها عبر السجلات المتعددة
بعد نجاح الاختبار على السجل الفردي، تبرز مرحلة التعميم الإحصائي على كامل قاعدة البيانات. يتم ذلك من خلال النقر على مقبض التعبئة التلقائية (Fill Handle) القابع في الزاوية السفلية اليسرى (أو اليمنى بحسب واجهة البرنامج) للخلية B2، وسحبه عمودياً ليشمل كافة الصفوف التي تضم أسماء في العمود A، أو عبر النقر المزدوج السريع على المقبض لإطلاق التعبئة التلقائية حتى نهاية النطاق النشط للبيانات.
تتجلى الميزة الكبرى للصيغة المركبة في هذه المرحلة من خلال تكيفها الديناميكي المرن مع كل سطر على حدة؛ فعندما تصل الصيغة إلى سطر يحتوي اسماً ثنائياً مثل “Mark Green”، فإن دالة COLUMNS ترصد وجود عمودين فقط وتعيد القيمة 2، فتستخرج دالة INDEX الكلمة “Green”. وعندما تنتقل إلى سطر يضم اسماً رباعياً، تقيس دالة COLUMNS أربعة أعمدة وتعيد القيمة 4، مستخرجة الكلمة الرابعة بدقة مطلقة ودون أدنى انزياح مكاني أو اختلال في المعالجة.
تتضمن الخطوة الختامية في هذه الدراسة التطبيقية إجراء مراجعة تدقيقية لعينة عشوائية من النتائج المستخرجة عبر السجلات المختلفة لمطابقتها مع المتطلبات المنهجية للدراسة. وتثبت هذه المراجعة الميدانية قدرة التركيب الدالي المزدوج على تلبية متطلبات فرز الأسماء بدقة تفوق التدخل البشري، موفرة مئات الساعات التشغيلية التي كانت تضيع في عمليات التحرير اليدوي الرتيبة والمعرضة للأخطاء الفردية.
5. معالجة النصوص ذات الفواصل المخصصة والأنماط المعقدة
5.1 التعامل مع الفواصل المركبة والرموز غير القياسية
لا تقتصر بنية البيانات الواقعية على المسافات البيضاء كفواصل معيارية؛ إذ تفرض قواعد البيانات المترابطة، وسجلات الأنظمة الخادمة (Server Logs)، وتنسيقات التبادل الرقمي استخدام فواصل مخصصة كالفاصلة المنقوطة (;)، أو الشرطة المائلة (/)، أو الخط العمودي (|)، أو الشَرطات المزدوجة. يتطلب التعامل مع هذه الأنماط ضبطاً دقيقاً لمعامل التجزئة في المعادلة المركبة لضمان مطابقة الرمز الفعلي وتجنب تفكيك النصوص في مواضع غير مقصودة.
تتضاعف الصعوبة التقنية عند وجود فواصل مركبة تتألف من أكثر من محرف، مثل تسلسل الفاصلة متبوعة بمسافة (", ") الشائع في كتابة القوائم والمراجع. كما أشرنا سابقاً، فإن تطبيق الصيغة: SPLIT(A2, ", ") دون تعديل المعاملات الإضافية سيؤدي إلى تفعيل الوضع الافتراضي الذي يقسم النص عند كل فاصلة وعند كل مسافة بصورة منفصلة، مما يمزق الكلمات المركبة ويفسد حساب أبعاد المصفوفة. وللتعامل المنهجي مع هذا النمط، يجب صياغة الدالة الداخلية على النحو التالي: SPLIT(A2, ", ", FALSE) لإلزام المحرك بالتعامل مع التتابع (فاصلة + مسافة) كوحدة تجزئة بنيوية غير قابلة للتجزؤ.
تضمن هذه الصياغة الدقيقة عدم تقسيم المقاطع الداخلية التي تحوي مسافات مفردة لا تسبقها فاصلة، مما يحافظ على التماسك الدلالي للعناصر المجزأة. وبدمج هذا التعبير المعدل داخل صيغة INDEX وCOLUMNS، تصبح المعادلة قادرة على استخلاص العنصر الأخير كاملاً حتى وإن كان يحتوي في ذاته على مسافات بيضاء، مما يوفر مرونة استثنائية في معالجة السجلات الببليوغرافية والقوائم المعجمية المعقدة بمهنية واقتدار.
5.2 استخراج المكون النهائي من الروابط والمسارات الرقمية
يمثل استخلاص المقاطع النهائية من عناوين الويب (URLs) والمسارات التخزينية للملفات الرقمية أحد أكثر التطبيقات طلباً في تحليلات البيانات الرقمية وهندسة المنصات السحابية. فعند التعامل مع رابط مثل: https://example.com/departments/research/reports/summary.pdf، يبرز الاحتياج التقني الملح لعزل المقطع الأخير summary.pdf الذي يمثل اسم الملف الفيزيائي، متجاوزاً كافة المسارات والمجلدات الفرعية السابقة دون الحاجة لتحديد عددها أو مستوياتها التفرعية.
تُحل هذه المعضلة بتعيين الشرطة المائلة للأمام (/) كمعيار تفكيك بنيوي للنص، فتصاغ المعادلة على النحو الآتي: =INDEX(SPLIT(A2, "/"), 1, COLUMNS(SPLIT(A2, "/"))). تتولى الدالة تفكيك الرابط عند كل شرطة مائلة، متجاهلة بروتوكول النقل https: والمجالات الفرعية والمجلدات المتعاقبة، حتى تصل دالة COLUMNS إلى قياس إجمالي المكونات الناتجة، لترجع دالة INDEX اسم الملف النهائي بدقة، مبرزة قدرة الخوارزمية على اختراق الهياكل الهرمية المعقدة للمسارات الحاسوبية.
تنطبق المنهجية ذاتها على أنظمة التشغيل التي تستخدم الشرطة المائلة العكسية () في مسارات أقراص التخزين المحلية، حيث يتم تمرير هذا الرمز إلى معامل الفاصل مع مراعاة خصائص الهروب البرمجي (Escape Characters) إن وُجدت. إن استخراج أسماء الملفات أو معرفات الصفحات الرقمية بهذه الطريقة المؤتمتة يسهل تنظيم آلاف المستندات الرقمية في ثوانٍ معدودة، مما يعزز الإنتاجية المؤسسية في إدارة الموارد التقنية.
5.3 معالجة النصوص الممزوجة بأرقام ورموز خاصة
تواجه عمليات تجزئة البيانات أحياناً سلاسل نصية هجينة تدمج المحارف الأبجدية بالأرقام والرموز الشريطية والرموز الاصطلاحية المشفرة، كما هو الحال في أرقام التتبع للشحنات، أو الأكواد المعيارية للقطع الصناعية مثل: PROD-2023-XYZ-98421. في هذه السيناريوهات، غالباً ما يمثل الرقم التسلسلي الأخير المعطى الحاسم لعمليات التحقق والجرد الإحصائي وضبط الجودة في سلاسل الإمداد ومستودعات التخزين.
عند استخدام الشرطة العادية (-) كفاصل في الصيغة المركبة، تتفكك هذه السلسلة بنجاح ليتم اقتناص القيمة 98421. غير أن التحدي التقني الذي يطرأ في هذه الحالة يتمثل في ميل جداول بيانات جوجل التلقائي إلى تحويل النصوص الرقمية النقية المستخرجة إلى صيغة أرقام حسابية مجردة، مما قد يترتب عليه فقدان الأصفار البادئة (Leading Zeros) إذا كان الرمز التسلسلي يبدأ برقم صفر مثل: 00421، وهو تشويه خطير قد يفسد المعرفات البرمجية.
للحفاظ الصارم على البنية النصية ومنع التحويل التلقائي غير المرغوب، يمكن تغليف الصيغة بدالة TO_TEXT، أو كتابتها بصيغة تضمن احتجاز المخرج كنص خالص: =TO_TEXT(INDEX(SPLIT(A2, "-"), 1, COLUMNS(SPLIT(A2, "-")))). يحمي هذا التدبير الوقائي سلامة البيانات الرقمية ويضمن بقاء كافة الخانات الصفرية ومحارف التشفير سليمة دون أدنى تحريف، مما يتيح إعادة دمجها في قواعد البيانات المركزية بدقة ومطابقة تامة.
6. البدائل التقنية المتقدمة: مقارنة الصيغة مع الدوال الحديثة
6.1 استخدام دالة CHOOSECOLS في جداول البيانات الحديثة
شهدت جداول بيانات جوجل تحديثات برمجية نوعية قدمت خلالها دوال مصفوفية حديثة ومتطورة قلبت موازين معالجة البيانات النصية، وتأتي دالة CHOOSECOLS في طليعة هذه الإضافات الثورية. تتميز هذه الدالة بقدرتها المتخصصة على استخراج أعمدة محددة من مصفوفة بيانات بناءً على أرقام الفهارس المعطاة، مع ميزة فريدة تتمثل في دعمها الأصلي للفهرسة العكسية باستخدام الأرقام السالبة، وهو ما كان مستحيلاً في دالة INDEX التقليدية.
تتيح الفهرسة السالبة للمطورين الإشارة إلى الأعمدة بدءاً من الطرف النهائي للمصفوفة باتجاه البداية، حيث يشير المؤشر -1 حصراً إلى العمود الأخير دائماً، بينما يشير -2 إلى العمود قبل الأخير، وهكذا دواليك. وبناءً على هذه الميزة الهندسية الفائقة، تصاغ المعادلة البديلة الحديثة ببساطة بالغة وأناقة برمجية لافتة: =CHOOSECOLS(SPLIT(A2, " "), -1)، دون أي حاجة لاستدعاء دالة COLUMNS أو إعادة حساب أبعاد المصفوفة على الإطلاق.
يقدم هذا الحل الحديث ميزتين جوهريتين؛ الأولى هي الاختزال البرمجي الكبير في طول الصيغة وقابليتها الفورية للقراءة والفهم، والثانية هي مضاعفة الكفاءة الحسابية؛ إذ يتم استدعاء دالة SPLIT مرة واحدة فقط داخل الذاكرة اللحظية بدلاً من استدعائها مرتين كما في الصيغة التقليدية. هذا التخفيف في العبء الإجرائي يجعل دالة CHOOSECOLS الخيار الهندسي الأول والأنسب للمشاريع الحديثة والبيئات السحابية المتوافقة.
6.2 التوظيف التحليلي للتعابير النمطية عبر دالة REGEXEXTRACT
يمثل توظيف التعابير النمطية (Regular Expressions) عبر دالة REGEXEXTRACT منهجاً تحليلياً متقدماً يتجاوز فكرة تقسيم النصوص إلى مصفوفات، متجهاً مباشرة نحو استخلاص الأنماط الحسابية للنصوص. تتيح هذه الدالة للمستخدم كتابة نمط رمزي محدد يفحص السلسلة النصية ويقتنص المقاطع المطابقة له بدقة جراحية فائقة، مما يغني تماماً عن توليد مصفوفات وسيطة في الذاكرة.
لاستخراج الكلمة الأخيرة من نص مفصول بمسافات، يُبنى نمط البحث المعتمد على التعابير النمطية بالصيغة الرياضية التالية: =REGEXEXTRACT(A2, "[^ ]+$"). يعتمد هذا التعبير المنطقي على تفكيك المحارف من النهاية؛ حيث يشير الرمز $ إلى المرساة النهائية للسلسلة النصية، وتحدد الأقواس المعقوفة [^ ] نمطاً يطابق أي محرف شريطة ألا يكون مسافة بيضاء، في حين تفرض علامة الجمع + تكرار هذا النمط لمطابقة أطول سلسلة ممكنة من المحارف غير البيضاء المتصلة مباشرة بنهاية النص.
تكمن القوة التحليلية لدوال التعبير النمطي في كفاءتها القصوى في استخدام الذاكرة؛ فهي لا تقسم النص ولا تفرقه عبر مسارات متعددة، بل تمسح السلسلة وتلتقط المقطع الأخير في نبضة معالجة واحدة. ومع ذلك، تتطلب هذه الطريقة دراية متخصصة بصياغة الرموز المنطقية المعقدة، وقد تصبح كتابتها وصيانتها عبئاً ذهنياً على المستخدمين غير المتمرسين في لغات البرمجة والتعابير النمطية القياسية مقارنة بالدوال المنطقية البسيطة.
6.3 المفاضلة المعيارية من حيث قابلية القراءة والصيانة
عند تقييم هذه الخيارات التقنية الثلاثة (تركيب INDEX+COLUMNS، وصيغة CHOOSECOLS الحديثة، وتعبير REGEXEXTRACT النمطي) في بيئات العمل المشتركة، تبرز مسألة الموازنة بين حداثة الحل وكفاءته من جهة، وسهولة قراءته وصيانته وتوافقه الشامل من جهة أخرى. يُظهر الجدول المقارن التالي أبرز الفوارق الجوهرية بين هذه المناهج:
- صيغة INDEX مع COLUMNS: تمتاز بأعلى درجات التوافق مع كافة الإصدارات والمنصات القديمة، ويسهل استيعابها من قبل المبتدئين في تحليل البيانات، لكنها تعاني من بطء نسبي في الملفات الضخمة بسبب تكرار معالجة النص مرتين وازدياد طول الكود المكتوب.
- صيغة CHOOSECOLS المباشرة: تمثل الخيار الهندسي الأمثل في بيئة جوجل الحديثة؛ فهي تجمع بين الأناقة البرمجية والسرعة الفائقة وتقليل استهلاك موارد المعالجة بمقدار النصف، إلا أنها تتطلب توافقاً برمجياً حديثاً قد لا يتوفر في بعض بيئات العمل المنعزلة أو برمجيات الجداول الأخرى عند التصدير.
- صيغة REGEXEXTRACT النمطية: تقدم أسرع زمن تنفيذ ممكن ولا تشغل الذاكرة بمصفوفات مؤقتة، وهي ممتازة للبيانات ذات الأنماط المشوشة، ولكنها تتسم بدرجة عالية من الغموض البرمجي لغير المتخصصين وصعوبة التعديل عند تغير طبيعة الفواصل النصية.
يتعين على مهندس البيانات اتخاذ القرار بناءً على طبيعة الفريق وبيئة الاستخدام؛ فإذا كان المشروع مخصصاً لجمهور واسع ذي مستويات متباينة في فهم الدوال، يظل تركيب INDEX هو الأكثر أماناً وموثوقية في نقل المعرفة البرمجية، بينما يفضل استخدام CHOOSECOLS للمشاريع الكبيرة المعاصرة التي تبحث عن أقصى درجات الفعالية الهندسية وسرعة الأداء.
7. التطبيق الموسع باستخدام الدوال المصفوفية على نطاقات واسعة
7.1 معضلة تعميم دالة SPLIT داخل مصفوفات ARRAYFORMULA
يواجه مستخدمو جداول بيانات جوجل معضلة برمجية مشهورة وموثقة عند محاولة توسيع نطاق دالة SPLIT لتشمل مئات أو آلاف الصفوف دفعة واحدة؛ حيث يتمثل التوجه التلقائي المعتاد في تغليف الصيغة بدالة ARRAYFORMULA الشهيرة بالصيغة: ARRAYFORMULA(INDEX(SPLIT(A2:A, " "), ...)). غير أن هذه المحاولة تبوء بفشل تقني ذريع وتتوقف عن العمل مخرجة أخطاء بنيوية غير قابلة للتصحيح.
يعود السبب الجوهري لهذا الإخفاق إلى القصور البنيوي في معمارية دالة SPLIT نفسها؛ إذ صُممت الدالة كدالة مصفوفية أفقية بطبيعتها الذاتية، ولا تمتلك القابلية الحسابية لتوسيع مصفوفاتها ذات البعدين (أفقي وعمودي) بالتزامن عبر مصفوفات الإدخال متعددة الصفوف. فعند محاولة إجبارها على معالجة نطاق عمودي كامل (مثل A2:A)، يفشل محرك الحوسبة في التمييز بين أبعاد الانتشار الأفقي لكل سطر وأبعاد التمدد العمودي للنطاق ككل، مما يؤدي إلى تجزئة السطر الأول فقط وتجاهل بقية السجلات أو انهيار الدالة بالكامل.
تفرض هذه العقبة التقنية على المطورين البحث عن حلول بديلة تتجاوز حدود ARRAYFORMULA التقليدية؛ فإما اللجوء إلى التعبئة اليدوية السطحية عبر سحب الصيغة في كل خلية على حدة — وهو حل يفتقر إلى الاحترافية ويثقل حجم الملف الحسابي — أو استدعاء الدوال التكرارية الحديثة القادرة على عزل المعالجة السطرية في دورات حسابية مستقلة ومؤتمتة بالكامل، وهو الخيار الأكثر كفاءة وملاءمة للأنظمة المتقدمة.
7.2 استخدام دوال LAMBDA وBYROW لأتمتة المعالجة السطرية
قدمت بيئة جداول بيانات جوجل حلاً حاسماً لمعضلة المعالجة السطرية للنطاقات من خلال تقديم دالة BYROW بالتكامل مع وظائف LAMBDA المخصصة. تتيح دالة BYROW تمرير نطاق عمودي متعدد الصفوف (مثل A2:A)، وتطبيق صيغة محددة على كل صف بشكل منفصل وديناميكي، مما يلغي تماماً تعارض المصفوفات ويسمح لدالة SPLIT بالعمل بأعلى درجات الكفاءة على كل سطر باستقلالية تامة.
تُصاغ هذه المنظومة البرمجية المتقدمة وفق النموذج المحكم التالي:
=BYROW(A2:A, LAMBDA(row, IF(ISBLANK(row), "", CHOOSECOLS(SPLIT(row, " "), -1))))
أو باستخدام الصيغة التقليدية التوافقية:
=BYROW(A2:A, LAMBDA(row, IF(row="", "", INDEX(SPLIT(row, " "), 1, COLUMNS(SPLIT(row, " "))))))
يعمل هذا التركيب الإجرائي بآلية متسلسلة؛ حيث تستقبل دالة LAMBDA كل خلية في النطاق كمتغير وسيط يحمل الاسم “row”. يقوم الفاحص المنطقي IF(ISBLANK(row)...) بالتأكد أولاً من وجود نص داخل السطر، فإن كان فارغاً يُرجع قيمة فارغة متجنباً أخطاء الحساب. أما إذا وجد نصاً، فإنه يمرره فوراً إلى دالة SPLIT ويستخلص العنصر الأخير عبر CHOOSECOLS أو INDEX، ثم ينتقل إلى الصف التالي بسلاسة مطلقة، مخرجاً عموداً متكاملاً من النتائج باستخدام صيغة واحدة موضوعة في رأس العمود فقط.
7.3 تعظيم كفاءة العمليات في السجلات البحثية الكبيرة
يوفر التوظيف الاستراتيجي لمنظومة BYROW المدمجة مع دوال التجزئة فوائد تشغيلية هائلة عند إدارة قواعد البيانات الضخمة التي تحتوي على عشرات الآلاف من السجلات البحثية والإحصائية. الفائدة الأولى والجوهرية هي التخلص التام من الحاجة للسحب اليدوي للمعادلات؛ إذ تظل الصيغة محصورة في خلية وحيدة في أعلى الجدول (B2 مثلاً)، وتقوم بتوليد كافة المخرجات للأسفل بصورة تلقائية، مما يخفض الحجم التخزيني للملف بصورة جذرية ويمنع تضخمه بآلاف النسخ المكررة من الصيغ.
تتمثل الفائدة الثانية في التحديث التلقائي اللحظي؛ فعند ربط الجدول بنماذج إدخال إلكترونية (مثل نماذج جوجل أو واجهات برمجة التطبيقات API)، فإن أي سجل جديد يُضاف في نهاية العمود سيتلقى المعالجة فوراً وسيتم استخراج عنصره الأخير دون أي تدخل من مدير النظام، مما يحقق الأتمتة الكاملة (End-to-End Automation) لخطوط معالجة وتنظيف النصوص.
علاوة على ذلك، تسهم هذه البنية في ضمان استقرار لوحات القيادة (Dashboards) والتقارير الإحصائية التفاعلية؛ حيث يحمي حصر المعادلة في خلية واحدة بقية السجلات من التعديل العرضي أو الحذف غير المقصود من قبل المستخدمين غير المصرح لهم، مؤصلاً مبدأ الفصل بين طبقة الحساب وطبقة العرض في التصميم الهندسي لجداول البيانات.
8. استراتيجيات تصحيح الأخطاء والتعامل مع الحالات الشاذة
8.1 معالجة أخطاء عدم تطابق الفواصل وغياب النصوص (#VALUE! و #N/A)
تتعرض خطوط معالجة البيانات النصية لمجموعة من الأخطاء التشغيلية الحتمية الناجمة عن شذوذ المدخلات؛ ويأتي في مقدمتها ظهور الخطأين الشائعين #VALUE! و#N/A. ينشأ خطأ #VALUE! في الغالب عندما تتلقى دالة SPLIT خلية فارغة تماماً دون معالجة مسبقة، أو عندما يُطلب منها التجزئة باستخدام فاصل غير موجود مطلقاً في النص مع ضبط معاملات تتطلب وجود الفاصل، مما يربك المحرك ويوقف السلسلة الحسابية في تلك الخلية.
أما السيناريو الأكثر إثارة للاهتمام، فهو التعامل مع النصوص الأحادية المقطع، كإدخال اسم مفرد مثل “Madonna” في حقل مخصص للأسماء الكاملة. في هذه الحالة، تفحص دالة SPLIT السلسلة فلا تجد أي مسافة فاصلة، ولكن بحسب تصميمها الهندسي، فإنها لا تنهار، بل تُرجع النص الأصلي كاملاً كعنصر وحيد داخل مصفوفة أحادية البعد مؤلفة من عمود واحد فقط. وهنا، تُرجع دالة COLUMNS القيمة الرقمية (1)، لتسترد دالة INDEX هذا العنصر الوحيد بنجاح، مما يعني أن الصيغة تمتلك حصانة ذاتية مقبولة في التعامل مع الكلمات المفردة، معيدة الكلمة نفسها باعتبارها المقطع الأول والأخير في آن واحد.
ومع ذلك، تظهر الأخطاء القاتلة عند تعيين فواصل متقدمة مع إجبار الدالة على معايير غير متحققة، أو عند الإشارة إلى خلايا تحوي قيماً منطقية أو أخطاء حسابية سابقة متوارثة من أعمدة أخرى. إن إهمال هذه الأخطاء المتناثرة يشوه التحليلات الإجمالية ويعطل دوال العد والتجميع في الجداول المركزية، مما يتطلب استراتيجيات وقائية متقدمة لتطويقها.
8.2 دمج دالة IFERROR لتأمين المعالجة الإحصائية المستمرة
لضمان تدفق البيانات دون انقطاع وتأمين المخرجات ضد الانهيارات البرمجية الناتجة عن شذوذ النصوص، يمثل دمج دالة IFERROR خط الدفاع الأول في التصميم الحسابي الرصين. تعمل هذه الدالة بمثابة صمام أمان يعترض الأخطاء البرمجية قبل وصولها إلى الواجهة المرئية للجدول، مستبدلة الرموز التحذيرية المربكة بقيم بديلة يحددها المطور وفق المنطق الإحصائي المعتمد.
تُصاغ المعادلة المحصنة بتطويق الصيغة المركبة بالكامل كما يلي: =IFERROR(INDEX(SPLIT(A2, " "), 1, COLUMNS(SPLIT(A2, " "))), ""). في حال نجاح عملية المعالجة وتوفر الفواصل المطلوبة، تمر النتيجة بسلاسة لتظهر الكلمة الأخيرة؛ أما إذا كانت الخلية الأصلية فارغة أو تسببت في أي خطأ حسابي غير متوقع، تلتقط دالة IFERROR الحدث وتُرجع نصاً فارغاً "" يحافظ على النظافة البصرية للجدول ويمنع تراكم الرموز التحذيرية المشوهة.
يمكن أيضاً توسيع هذا التكتيك لتقديم إشعارات إجرائية هادفة للمدققين بدلاً من إرجاع الفراغ، مثل صياغة المخرج البديل ليكون: "مقطع مفقود" أو "تنسيق غير مطابق"، مما يسهل على موظفي مراقبة الجودة فرز السجلات التي تحتاج إلى مراجعة وتصحيح يدوي، وبالتالي تحويل الخطأ البرمجي من عقبة تشغيلية إلى أداة تدقيق نوعية تدعم ضبط جودة البيانات المدخلة.
8.3 معالجة الحالات الحدية للنصوص المدخلة
تعتبر الحالات الحدية (Edge Cases) المصدر الأكبر لعدم دقة النتائج المستخرجة، وتتمثل بصورة أساسية في المسافات البيضاء الشاردة القابعة في نهاية النصوص؛ فإذا قام المستخدم بإدخال النص “John Smith ” (مع إضافة مسافة بعد الكلمة الأخيرة)، فإن تمرير النص بصورته الخام إلى بعض دوال التجزئة المخصصة أو استخدام فواصل خاصة قد يؤدي إلى اعتبار المسافة الأخيرة فاصلة لمقطع فارغ، مما ينتج عنه استخراج فراغ بدلاً من استخراج كلمة “Smith”.
لإلغاء هذا التهديد البنيوي بصورة قاطعة، يُلزم التحليل المتقدم بدمج دالة TRIM لتنظيف النصوص الخام مسبقاً وقبل الشروع في تمريرها إلى دالة SPLIT. تكمن وظيفة TRIM القياسية في حذف كافة المسافات البادئة والمسافات اللاحقة المتطرفة، واختزال المسافات المتعددة بين الكلمات إلى مسافة واحدة معيارية. تصبح الصياغة الاحترافية الكاملة للصيغة التقليدية كالتالي:
=IFERROR(INDEX(SPLIT(TRIM(A2), " "), 1, COLUMNS(SPLIT(TRIM(A2), " "))), "")
تمتد الحالات الحدية لتشمل أيضاً الفواصل غير المرئية كالأسطر الجديدة المضمنة داخل الخلية الواحدة (Line Breaks الناجمة عن الضغط على Ctrl+Enter)، أو علامات الجدولة (Tabs). وللتعامل مع هذه الحالات المعقدة، يمكن دمج دالة CLEAN قبل التجزئة للتخلص من المحارف غير القابلة للطباعة، أو استخدام الفاصل CHAR(10) المخصص لاقتناص الأسطر الجديدة في جداول جوجل، مما يضمن أعلى مستويات المتانة والمقاومة لكافة أشكال التشوه النصي المحتملة.
9. أفضل الممارسات لتحسين الأداء الحسابي في جداول البيانات الضخمة
9.1 تقليل العبء الحسابي الناتج عن تكرار استدعاء الدالة مرتين
تعتمد الصيغة الكلاسيكية المركبة INDEX(SPLIT(A2, " "), 1, COLUMNS(SPLIT(A2, " "))) في جوهرها على حساب دالة SPLIT مرتين متطابقتين لكل صف على حدة؛ الأولى داخل النطاق المرجعي لدالة INDEX، والثانية كمعامل لدالة COLUMNS. على الرغم من أن هذا التكرار الإجرائي لا يشكل عبئاً ملحوظاً في الجداول البسيطة التي تضم مئات الصفوف، فإنه يتحول إلى اختناق حوسبي كارثي عند تطبيقه عبر مئات الآلاف من السجلات النصية الضخمة.
يؤدي هذا التكرار إلى إجبار الخوادم السحابية لجداول بيانات جوجل على استهلاك ضعف الطاقة المعالجة المخصصة لتفكيك السلاسل، ومسح الذاكرة اللحظية المؤقتة مرتين لكل سطر، مما يترتب عليه بطء شديد في استجابة الملف، وتأخر مزمن في إعادة الحساب التلقائي (Calculation Lag)، وتكرار ظهور إشعار “جارٍ التحميل…” لمدد زمنية طويلة. هذا التراجع في الأداء الحسابي ينعكس سلباً على تجربة المستخدم ويهدد استقرار التقارير المؤسسية الحساسة.
تتضمن استراتيجيات التحسين الكلاسيكية التخفيف من هذا العبء عبر “الفصل المرحلي” للعمليات؛ من خلال تخصيص عمود وسيط خفي يقوم بتجزئة النص لمرة واحدة أو قياس عدد المقاطع، ثم الرجوع إليه في عمود الاستخراج النهائي. إلا أن التطور الأحدث في دوال جداول جوجل قدم حلولاً برمجية داخلية مدمجة تجنب المحلل عناء إنشاء أعمدة مساعدة وتوفر أعلى كفاءة ممكنة في سطر برمجي واحد، وهو ما يتحقق عبر دالة LET المتقدمة.
9.2 الاستعانة بدالة LET لإسناد المتغيرات وتحسين الكفاءة
تعد دالة LET نقلة نوعية في فلسفة البرمجة داخل بيئات جداول البيانات السحابية؛ إذ تتيح تعريف متغيرات محلية (Local Variables) وتسميتها وإسناد نتائج العمليات الحسابية المعقدة إليها داخل نطاق المعادلة الواحدة، وإعادة استخدام تلك النتائج لاحقاً لأكثر من مرة دون الحاجة لإعادة حسابها في كل استدعاء.
لتطبيق هذه الميزة الثورية على معادلة استخراج العنصر الأخير، نصوغ المعادلة بالنمط الهندسي المحسن التالي:
=LET(segments, SPLIT(TRIM(A2), " "), INDEX(segments, 1, COLUMNS(segments)))
تتجلى العبقرية البرمجية في هذا البناء من خلال قيام المحرك بتنفيذ تركيبة SPLIT(TRIM(A2), " ") لمرة واحدة فقط وبصورة قطعية، وتخزين المصفوفة الناتجة في المتغير المسمى segments. بعد ذلك، تستدعي دالتا INDEX وCOLUMNS هذه المصفوفة المحفوظة مسبقاً في الذاكرة دون بذل أي جهد إضافي لتفكيك النص الأصلي من جديد.
يقلل هذا النهج زمن التنفيذ الحسابي بمقدار النصف تقريباً، مما يخفض البصمة الكربونية لمعالجة السجلات في مراكز البيانات ويسرع من استجابة الملفات العملاقة بصورة فورية. إن دمج دالة LET يمثل ذروة الممارسة المهنية الاحترافية في كتابة الصيغ المركبة المعقدة، محققاً التوازن الأمثل بين البنية المقروءة والسرعة الحوسبية القصوى.
9.3 إرشادات التصميم الهندسي لقواعد البيانات داخل جداول جوجل
تتطلب الإدارة الرشيدة للبيانات في جداول بيانات جوجل تبني ضوابط هندسية صارمة لتحديد التوقيت الملائم لاستخدام الدوال الديناميكية في مقابل استخدام أدوات التحويل الثابتة. فإذا كانت البيانات النصية المعالجة تمثل سجلاً تاريخياً أرشفياً غير قابل للتغيير أو التحديث المستقبلي، فإن الإبقاء على مئات الآلاف من الصيغ الحسابية النشطة والمعقدة يمثل هدراً تقنياً صريحاً لموارد المعالجة السحابية المحدودة.
في مثل هذه السيناريوهات، تتمثل أفضل الممارسات في تطبيق الصيغ المركبة لاستخراج العناصر المستهدفة، والتأكد من دقتها ومطابقتها المنهجية، ثم القيام فوراً بنسخ عمود المخرجات بالكامل وإعادة لصقه في الموقع ذاته بصيغة “قيم فقط” (Paste Special > Values Only عبر الاختصار Ctrl+Shift+V). يؤدي هذا الإجراء الحاسم إلى تثبيت النتائج بصورة نهائية وتحرير الذاكرة من عبء الصيغ الديناميكية، مما يضمن احتفاظ الملف بسرعته وخفته الأصلية إلى الأبد.
علاوة على ذلك، يوصى بالالتزام الصارم بتوثيق كافة المعادلات المركبة المستخدمة داخل ورقة بيانات خاصة بـ “بيانات التعريف” (Metadata) أو من خلال إدراج تعليقات برمجية تفصيلية، لا سيما في المشاريع البحثية التي تخضع للتدقيق الأكاديمي الصارم. يساعد هذا التوثيق الباحثين والمراجعين المستقلين على تتبع خوارزميات استخلاص المتغيرات والتحقق من سلامة التحويلات الإحصائية، مما يرسخ مبادئ الشفافية وقابلية التكرار في البحث العلمي (Reproducibility).
10. استنتاجات وتطبيقات علمية في تنظيم البيانات وتحليلها
10.1 تلخيص المبادئ الحاكمة لاقتطاع العناصر المصفوفية
أظهر التحليل المفصل في هذا الدليل أن عملية اقتطاع العنصر الأخير من السلاسل النصية المتغيرة في جداول بيانات جوجل ليست مجرد مسألة تطبيق دالة منفردة، بل هي منظومة متكاملة من التفكير الرياضي والبرمجي الذي يجمع بين التفكيك النصي وقياس الأبعاد والاسترجاع الموضعي الحصري. إن الاستيعاب العميق لكيفية تحويل النصوص إلى مصفوفات أفقية عبر دالة SPLIT يمثل الخطوة الأولى في بناء حلول معالجة النصوص المرنة.
تتمثل القاعدة الذهبية الحاكمة لهذه المعالجات في تحديد الفاصل المناسب بعناية فائقة، وفهم سلوك المعاملات المنطقية التابعة للدوال؛ حيث يشكل إغفال ضبط هذه المعاملات سبباً رئيسياً لظهور تشوهات في البيانات المستخرجة. كما أثبتت التجارب الميدانية أن تطويق المخرجات المصفوفية بدوال موجهة كدالتي INDEX أو CHOOSECOLS يظل هو الضمانة الوحيدة لمنع تفشي البيانات عبر الخلايا المجاورة والحفاظ على البنية العمودية المنضبطة للجداول التحليلية.
إن الموازنة بين استخدام الصيغ الكلاسيكية المتوافقة والصيغ الحديثة الرشيقة يجب أن تحكمها معايير التوافقية وحجم البيانات؛ فالهدف النهائي دائماً هو تحقيق أقصى درجات الدقة بأقل تكلفة حوسبية ممكنة، مع ضمان سلامة الهياكل البيانية من الانهيار عند مواجهة مدخلات عشوائية أو غير متوقعة، وهو ما يبرز نضج المعماريات البرمجية المعتمدة في بيئات العمل السحابية المعاصرة.
10.2 مصفوفة توجيهية لاختيار الصيغة المثلى وفق طبيعة البيانات
لتسهيل اتخاذ القرار التقني على الباحثين ومحللي البيانات، توفر المصفوفة التوجيهية التالية معايير دقيقة لاختيار الصيغة الأكثر ملاءمة لطبيعة السجلات وحجم المشروع المتداول:
- حالات الجداول المشتركة والبيئات متعددة الإصدارات: يُوصى باعتماد تركيبة
INDEX + COLUMNSالكلاسيكية، نظراً لقدرتها الفائقة على العمل بثبات دون تأثر باختلاف إصدارات الحساب أو تحديثات المنصات، مما يجعلها الصيغة الأكثر أماناً لنقل البيانات وتبادلها مع برمجيات أخرى دون انقطاع. - قواعد البيانات الضخمة الحديثة في جوجل شيتس (Google Sheets Native): يمثل خيار
CHOOSECOLS(SPLIT(..., " "), -1)الخيار القياسي المعاصر؛ نظراً لما يوفره من تقليص لاستهلاك الذاكرة بمقدار النصف، وقابلية فائقة للقراءة والصيانة السريعة داخل الفرق التقنية المتقدمة. - النطاقات الموسعة التي تتطلب أتمتة كاملة (Full Column Ranges): يُنصح حصراً باستخدام تركيبة
BYROW + LAMBDAبالاقتران معCHOOSECOLSأوINDEX؛ لتجاوز قصورARRAYFORMULAوضمان تدفق الحساب السطري للبيانات المتجددة تلقائياً دون تدخل يدوي. - السلاسل النصية غير المنتظمة أو التي تحوي فواصل مشوشة: يفضل التوجه المباشر نحو دوال التعابير النمطية
REGEXEXTRACTلتجاوز قيود المصفوفات واقتناص المقاطع النهائية بناءً على محددات البنية الصرفية للنص.
تضمن هذه المصفوفة التوجيهية توجيه الموارد التقنية للمحلل نحو الحل الأمثل، متجنبة الوقوع في أخطاء التجربة العشوائية، وواضعة أسساً معيارية تسهم في توحيد الممارسات البرمجية داخل المؤسسات والفرق البحثية على حد سواء.
10.3 آفاق التكامل مع معالجات النصوص المتقدمة ونماذج التحليل
إن استخراج الألقاب والعناصر النهائية من النصوص ليس غاية في حد ذاته، بل هو خطوة تمهيدية أساسية تفتح آفاقاً واسعة للتكامل مع الدوال التحليلية الكبرى في جداول بيانات جوجل. فالبيانات النقية المستخلصة تصبح مؤهلة فوراً للتمرير إلى دالة الاستعلام المتقدمة QUERY، لتنفيذ عمليات التجميع الإحصائي المعقد (Aggregation)، وتوليد التقارير المحورية والفرز الآلي المتقدم دون أي تشويش دلالي.
كما تتيح هذه النتائج المنضبطة التكامل السلس مع دوال الفرز المعجمي المتقدم SORT والتصفية الشرطية FILTER، فضلاً عن سهولة تصدير هذه الحقول المستقلة إلى البرمجيات الإحصائية المتخصصة مثل SPSS وR وPython لمعالجة النماذج الإحصائية القياسية واختبار الفرضيات العلمية بثقة متناهية، متحررة من قيود النصوص المشوشة أو البيانات غير المتجانسة.
تجسد هذه المنهجية التطبيقية الدور الحيوي الذي تلعبه مهارات تنظيف البيانات الدقيقة في تعزيز موثوقية التحليلات العلمية؛ فالتحليل الإحصائي الرصين لا يبدأ من استدعاء النماذج الرياضية، بل من إحكام السيطرة على نقاء البيانات النصية في مهادها الأولي، وهو ما تجعله توليفة دوال جداول جوجل المتقدمة أمراً ممكناً بأعلى معايير الدقة والاحترافية البرمجية.
المراجع
- Google. (n.d.). CHOOSECOLS function. Google Docs Editors Help. https://support.google.com/docs/answer/13238126
- Google. (n.d.). INDEX function. Google Docs Editors Help. https://support.google.com/docs/answer/3098238
- Google. (n.d.). LET function. Google Docs Editors Help. https://support.google.com/docs/answer/13190449
- Google. (n.d.). REGEXEXTRACT function. Google Docs Editors Help. https://support.google.com/docs/answer/3098244
- Google. (n.d.). SPLIT function. Google Docs Editors Help. https://support.google.com/docs/answer/3094136