
تُعد معالجة البيانات الكمية وتحليلها حجر الزاوية في اتخاذ القرارات المنهجية ضمن مختلف الحقول المعرفية، بدءاً من القياسات النفسية والتربوية وصولاً إلى النمذجة المالية والبحوث التطبيقية المتقدمة. وفي إطار استخلاص مقاييس النزعة المركزية، يبرز المتوسط الحسابي كأحد أكثر المقاييس شيوعاً واستخداماً؛ إلا أن افتراض تساوي الأهمية النسبية لجميع المفردات ضمن مجموعة البيانات يمثل في كثير من الأحيان قصوراً منهجياً يتجاهل تباين الأوزان النوعية أو التكرارية للقيم المقاسة. من هنا تبرز الضرورة الرياضية لتطبيق مفهوم “المتوسط الحسابي المرجح” (Weighted Average)، والذي يُسند وزناً أو ثقلاً نوعياً لكل مفردة بما يعكس بدقة مساهمتها الحقيقية في الظاهرة الخاضعة للدراسة.
مع تطور أدوات الحوسبة السحابية وانتشار منصات تحليل البيانات المرنة، اكتسبت جداول بيانات جوجل (Google Sheets) مكانة بارزة كأداة بحثية وعملية قادرة على إدارة وتجهيز التدفقات البيانية المعقدة. ومع ذلك، يواجه المحللون تحدياً تقنياً يتمثل في غياب صيغة قياسية مباشرة ومدمجة مسبقاً تحمل اسم “AVERAGE.WEIGHTED.IF” قادرة على احتساب المتوسط المرجح بناءً على معايير شرطية محددة في خطوة واحدة، بخلاف دالة AVERAGEIFS التقليدية التي تقتصر على المتوسطات غير المرجحة. يستلزم هذا القصور البرمجي اللجوء إلى بناء معماريات حسابية مركبة تجمع بين المنطق البوليني (Boolean Logic) وتطبيقات ضرب المصفوفات، أو توليف دوال التصفية الديناميكية لتحقيق العزل المشروط للحالات الإحصائية المستهدفة.
يهدف هذا المقال الأكاديمي الشامل إلى تقديم تشريح بنيوي ورياضي معمق لكيفية صياغة واحتساب المتوسط الحسابي المرجح المشروط داخل جداول بيانات جوجل. سنستعرض تفصيلياً الأسس الرياضية للمتوسطات المرجحة ودواعي تقييدها بالشروط، يليه تفكيك منطقي للدوال الجوهرية مثل SUMPRODUCT وSUMIF وAVERAGE.WEIGHTED مع FILTER، مع تقديم دراسة حالة تطبيقية متكاملة لدرجات الطلاب، وتحليل آليات تدقيق الحسابات اليدوية، ومعالجة الأخطاء الشائعة، وصولاً إلى استعراض أفضل الممارسات لبناء نماذج قياس متينة وقابلة للتوسع البرمجي والتحليلي.
1. الأسس الرياضية والمفاهيمية للمتوسط الحسابي المرجح في تحليل البيانات
1.1 الفرق الجوهري بين المتوسط الحسابي البسيط والمتوسط المرجح
يقوم المتوسط الحسابي البسيط (Simple Arithmetic Mean) على افتراض متساوٍ لجميع القيم المرصودة ضمن العينة الإحصائية، حيث يتم تجميع القيم الإجمالية وقسمتها على العدد الكلي للمفردات ($n$). يُعبر عن هذا المقياس رياضياً بالمعادلة الكلاسيكية:
$$\bar{x} = \frac{1}{n}\sum_{i=1}^{n} x_i$$
وعلى الرغم من كفاءة هذا المقياس وسهولة حسابه وتفسيره، إلا أنه يعاني من قصور جوهري عندما تتباين وحدات القياس في أثرها النسبي، أو عند اختلاف حجوم العينات الفرعية الممثلة للبيانات، أو عند تفاوت الأهمية المعيارية للأنشطة والمهام المقاسة. على سبيل المثال، في التقييمات الأكاديمية لا يمكن مساواة اختبار فصلي يستغرق ساعتين ويغطي نصف المنهج باختبار قصير أسبوعي مدته عشر دقائق، حيث يؤدي استخدام المتوسط البسيط هنا إلى تشويه دلالة القياس وإغفال التباين النوعي للبيانات.
في المقابل، يتجاوز المتوسط الحسابي المرجح (Weighted Arithmetic Mean) هذا القصور المفاهيمي عبر إعطاء وزن ترجيحي ($w_i$) لكل قيمة ($x_i$). يمثل هذا الوزن دلالة إحصائية تعكس التكرار، أو حجم العينة، أو درجة الثقة، أو الموثوقية السيكومترية لأداة القياس. من الناحية الإحصائية، يعمل إدراج الأوزان على إعادة ضبط النزعة المركزية وتوجيهها نحو القيم الأكثر وزناً وأهمية، مما يقلل من أثر القيم المتطرفة الهامشية التي قد تملك أوزاناً منخفضة، أو العكس بتضخيم أثر القيم ذات الأوزان الكبيرة، وبالتالي يقلل من تشتت التوزيع ويعزز الصدق التنبؤي للبيانات المجمعة.
1.2 الصيغة الرياضية العامة لحساب المتوسط المرجح
تستند المعادلة الجبرية القياسية لحساب المتوسط المرجح إلى إيجاد حاصل الضرب التراكمي لكل مفردة من مفردات البيانات في الوزن المقابل لها، ومن ثم قسمة الناتج الإجمالي على مجموع الأوزان المستخدمة كافة، كما هو موضح في الصيغة الرياضية الآتية:
$$\bar{x}_w = \frac{\sum_{i=1}^{n} w_i x_i}{\sum_{i=1}^{n} w_i}$$
يشترط في هذه المعادلة التطابق الهيكلي بين مصفوفة البيانات ($X = [x_1, x_2, dots, x_n]$) ومصفوفة الأوزان المناظرة لها ($W = [w_1, w_2, dots, w_n]$). حيث يمثل البسط الضرب النقطي (Dot Product) للمتجهين، في حين يمثل المقام حاصل جمع عناصر متجه الأوزان. وتجدر الإشارة إلى أن هناك حالتين رئيسيتين للتعامل مع الأوزان في التطبيقات الإحصائية:
- الأوزان كنسب مئوية أو أجزاء نسبية: عندما تكون الأوزان معيرة مسبقاً بحيث تحقق الشرط الرياضي: $\sum w_i = 1$ (أو $100%$)، وفي هذه الحالة يختزل المقام الرياضي إلى الرقم واحد، وتصبح المعادلة مجرد مجموع حاصل ضرب القيم في أوزانها النسبية ($\bar{x}_w = \sum w_i x_i$).
- الأوزان كقيم عددية مطلقة: مثل الساعات المعتمدة في الجامعات، أو حجوم العينات في التحليلات التلوية (Meta-analyses)، أو تكرارات الحدوث. في هذا السياق، يكون المقام قيمة عددية حرة تتطلب بالضرورة إجراء عملية القسمة لضبط المقياس النهائي وإعادته إلى النطاق المعياري المطلوب.
1.3 أهمية تضمين المحددات الشرطية (IF) في التحليل الإحصائي
تتضمن مجموعات البيانات الواقعية في غالب الأحيان بنى معقدة وبيانات غير متجانسة تتطلب من الباحث عزل مجموعات فرعية معينة بناءً على محددات تصنيفية نوعية أو كمية. إن الحاجة إلى تضمين الشروط المنطقية (IF logic) في معادلات المتوسط المرجح تنبع من متطلبات تصنيف العينات؛ ففي القياسات النفسية والتربوية قد تتطلب الدراسة عزل درجات مجموعة تجريبية ومقارنتها بمجموعة ضابطة، أو تحليل نتائج التقييمات وفقاً للجنس، أو المستوى التعليمي، أو التخصص الدراسي، كما يظهر في دراسات السلوك والبيئات التعليمية المعاصرة (Hora & Oleson, 2017).
رياضياً، يتم التعبير عن المتوسط المرجح المشروط بتقييد نطاق الجمع على الحالات التي تستوفي معياراً منطقياً معيناً ($C$):
$$\bar{x}_{w|C} = \frac{\sum_{i in C} w_i x_i}{\sum_{i in C} w_i}$$
يساهم هذا الإجراء الرياضي في الحد من التحيز الإحصائي (Statistical Bias) الناجم عن تداخل الفئات المختلفة، حيث يضمن أن مجموع الأوزان في المقام لا يتضمن سوى أوزان الحالات التي استوفت الشرط حصراً، متجنباً التشويه الذي يطرأ عند قسمة نواتج الفئة المستهدفة على أوزان المجتمع الكلي للبيانات.
2. التشريح المنطقي والمعماري لصيغة المتوسط المرجح المشروط في Google Sheets
2.1 البنية التركيبية العامة للصيغة المدمجة
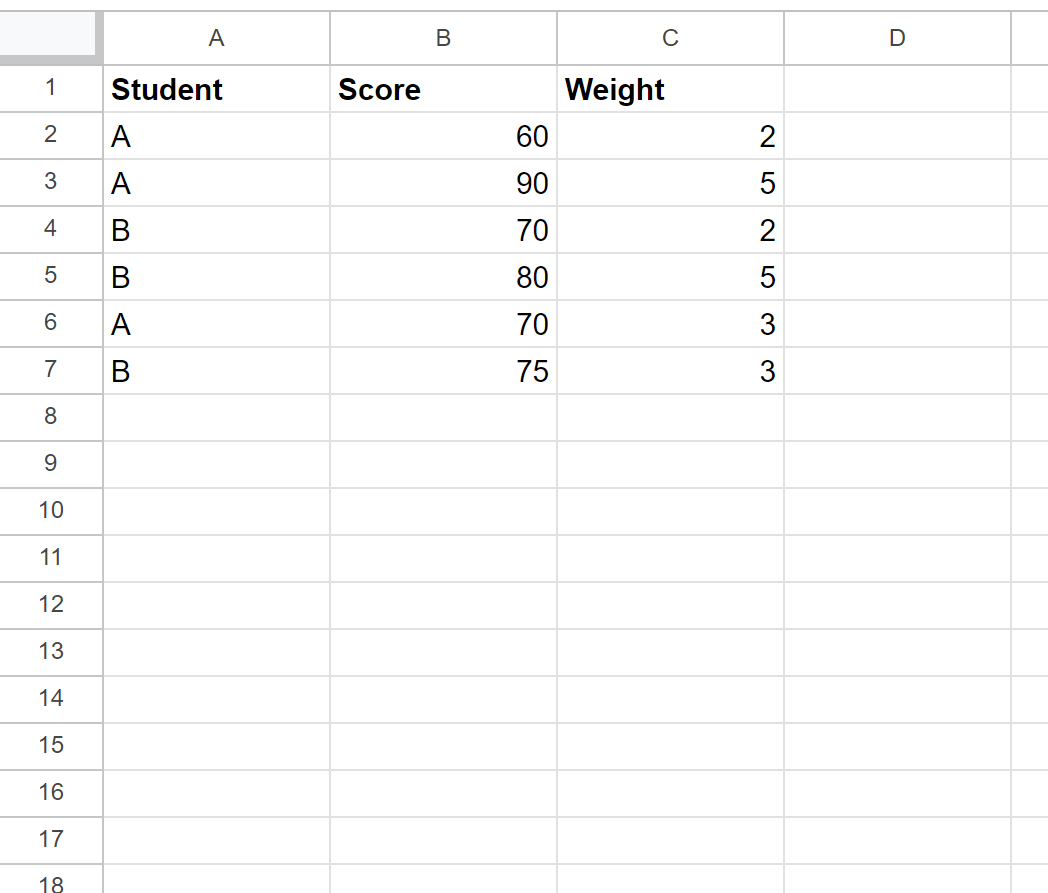
نظراً لعدم وجود دالة مفردة ومستقلة تحت اسم AVERAGE.WEIGHTED.IF في مكتبة دوال جداول بيانات جوجل، فإن الهيكل المنهجي الأكثر انتشاراً واعتمادية يعتمد على الدمج التركيبي بين دالتي SUMPRODUCT وSUMIF. تُبنى الصيغة القياسية وفق التركيبة التالية:
=SUMPRODUCT(--(Criteria_Range = "Condition"), Values_Range, Weights_Range) / SUMIF(Criteria_Range, "Condition", Weights_Range)
يقوم هذا البناء الحسابي بمحاكاة الكسر الرياضي الكلاسيكي؛ حيث تتولى دالة SUMPRODUCT حساب بسط الكسر من خلال عزل القيم المستهدفة وحساب حاصل ضربها في أوزانها، في حين تتولى دالة SUMIF حساب المقام عبر جمع أوزان المفردات التي ينطبق عليها المعيار فقط. يتطلب نجاح هذا التركيب تطابقاً صارماً في الأبعاد الهندسية للنطاقات الثلاثة المستدعاة (نطاق المعيار، نطاق القيم، نطاق الأوزان)، حيث يجب أن تبدأ وتنتهي عند نفس أرقام الصفوف داخل ورقة العمل تجنباً لحدوث أخطاء فادحة في معالجة المصفوفات.
2.2 وظيفة المشغل الثنائي المزدوج (–) والمنطق البوليني
عندما تُجري برمجية جداول البيانات تقييماً منطقياً مثل (Criteria_Range = "Condition")، فإنها تُنتج داخلياً مصفوفة بولينية افتراضية مكونة من قيم صحيحة وخاطئة {TRUE, FALSE, TRUE, ...}. ومع ذلك، فإن دالة SUMPRODUCT، بحكم تركيبها الرياضي الأصلي، تتجاهل القيم النصية والمنطقية داخل المصفوفات غير الرقمية ولا يمكنها إجراء عمليات حسابية مباشرة عليها إلا إذا تم تحويلها إلى قيم عددية صريحة.
هنا تبرز الأهمية الوظيفية للمشغل الثنائي المزدوج (Double Unary Operator --). تعمل العلامة السالبة الأولى على إجبار النظام على تحويل القيمة المنطقية إلى قيمة رقمية مع عكس إشارتها (بحيث يتحول TRUE إلى -1 وFALSE إلى 0)، بينما تعيد العلامة السالبة الثانية الإشارة إلى طبيعتها الموجبة (ليتحول -1 إلى 1). ينتج عن هذا المشغل مصفوفة ثنائية مكونة بالكامل من الآحاد والأصفار {1, 0, 1, ...}. عند ضرب هذه المصفوفة الثنائية في مصفوفتي القيم والأوزان، يتحول أي عنصر لا ينطبق عليه الشرط إلى صفر عبر خاصية المحايد الصفري في الضرب، مما يؤدي إلى استبعاده الحسابي الفعلي من ناتج الجمع التراكمي في البسط.
2.3 تكامل البسط والمقام في معادلة واحدة متسقة
تتحقق النزاهة الرياضية للنموذج من خلال المواءمة الكاملة بين مدخلات البسط والمقام. ففي البسط، تقوم دالة SUMPRODUCT بما يلي:
$$\text{Numerator} = \sum_{i=1}^{n} (\text{Condition}_i \times x_i \times w_i)$$
حيث تكون $\text{Condition}_i$ مساوية لـ $1$ إذا تحقق الشرط ومساوية لـ $0$ إذا لم يتحقق. ولضمان عدم حدوث تشويه نسبي، يجب أن يعكس المقام مجموع الأوزان الفعلية لهذه العناصر المستبقاة فقط:
$$\text{Denominator} = \sum_{i=1}^{n} (\text{Condition}_i \times w_i)$$
تؤدي دالة SUMIF هذا الدور بكفاءة متناهية من خلال تخصيص نطاق الفرز ليكون هو نفسه نطاق الشرط، وتمرير نفس المعيار المنطقي، واستدعاء نطاق الأوزان كنطاق للجمع. هذا التوافق الرياضي يحول دون ارتكاب الخطأ الشائع المتمثل في القسمة على إجمالي مصفوفة الأوزان دون تصفية، وهو خطأ يقود إلى تقليص القيمة الناتجة بشكل خاطئ عبر زيادة المقام بقيم أوزان لا تخص الفئة الخاضعة للدراسة.
3. تحليل متعمق لدالة SUMPRODUCT ودورها في معالجة المصفوفات المشروطة
3.1 ميكانيكية ضرب وجمع المصفوفات غير المتجانسة
صُممت دالة SUMPRODUCT في جداول البيانات للتعامل مع العمليات المتجهية الخطية دون الحاجة إلى اللجوء إلى صيغ المصفوفات المعقدة ذات التثبيت القسري (Ctrl+Shift+Enter) أو دالة ArrayFormula. تقبل الدالة عدة وسائط تمثل نطاقات من البيانات، وتقوم بإجراء عملية حساب تبادلي تراتبي بين العناصر المتناظرة في كل مصفوفة (Element-wise Multiplication)، يعقبها جمع إجمالي للنواتج المستخرجة في قيمة مفردة نهائية (Scalar Output).
تشترط الميكانيكية الداخلية للدالة تماثل أبعاد النطاقات المدخلة تماثلاً مطلقاً؛ فإذا كان نطاق المعيار يمتد من $A2$ إلى $A100$، فيجب حتماً أن تمتد نطاقات القيم والأوزان من الصف الثاني إلى المائة وضمن عمود واحد متجانس. يتيح هذا التصميم للدالة ضرب مصفوفة التحويل المنطقي الثنائية ذات البعد $(N \times 1)$ في مصفوفة القيم ذات البعد $(N \times 1)$ وفي مصفوفة الأوزان ذات البعد $(N \times 1)$، لتتحول العملية داخلياً إلى مسار متجهي أحادي سلس يتجنب استهلاك موارد النظام البرمجية.
3.2 تقييم العبارة الشرطية داخل بيئة الدالة
يتم تقييم العبارة الشرطية داخل دالة SUMPRODUCT وفق صياغات متعددة، سواء كان الشرط يعتمد على نص حرفي مثل Criteria_Range = "Quiz" أو مقارنة رقمية مثل Scores_Range >= 70. تظهر المرونة القصوى عند استخدام مراجع الخلايا الديناميكية (Dynamic Cell References) بدلاً من كتابة الشروط النصية الثابتة. على سبيل المثال، وضع المعيار في خلية مرجعية مستقلة كـ $F2$ وكتابة الصيغة بالهيئة Criteria_Range = F2 يتيح تحديث النموذج تلقائياً بمجرد تعديل محتوى الخلية الهدف.
عند تقييم المقارنات المنطقية، تتعامل جداول بيانات جوجل بحساسية خاصة تجاه الخلايا الفارغة؛ حيث تُعامل الخلية الفارغة في سياق المقارنات الرقمية كقيمة صفرية، بينما تُعامل في المقارنات النصية كسلسلة نصية فارغة "". لذلك، يُعد الضبط المحكم للشرط أساسياً لضمان عدم تضمين صفوف غير مقصودة في مصفوفة الوحدات المنطقية الناتجة.
3.3 الكفاءة الحسابية واستهلاك الذاكرة
من منظور الكفاءة الحسابية وهندسة الذاكرة في المتصفح، تُعتبر دالة SUMPRODUCT أكثر كفاءة واستقراراً من صياغة الدوال المتداخلة المتعددة (Nested IF Statements) المدمجة داخل صيغ المصفوفات الحرة. تتولى محركات المعالجة الداخلية في Google Sheets تنفيذ عمليات SUMPRODUCT عبر خوارزميات مكتوبة بلغات منخفضة المستوى تضمن سرعة التحويل والتجميع.
مع ذلك، يجب الحذر عند الإشارة إلى النطاقات المفتوحة بالكامل مثل A:A أو B:B، حيث تفرض هذه الممارسة على محرك الجداول فحص كافة الصفوف الافتراضية للورقة والتي قد تصل إلى ملايين الخلايا، مما يؤدي إلى تباطؤ ملحوظ في أداء الورقة وزيادة زمن إعادة الحساب. يفضل دائماً قصر النطاقات على حدود البيانات الفعلية (مثل A2:A500) أو استخدام النطاقات الديناميكية المرنة لترشيد استهلاك الذاكرة الحسابية.
4. تحليل دور دالة SUMIF في ضبط المقام واستبعاد القيم الزائفة
4.1 التركيب الوظيفي لدالة SUMIF في سياق المتوسط المرجح
تتكون دالة SUMIF القياسية من ثلاثة وسائط رئيسية: SUMIF(range, criterion, [sum_range]). في سياق حساب المتوسط المرجح المشروط، يمثل الوسيط الأول (range) النطاق الذي يحتوي على المتغير التصنيفي، بينما يمثل الوسيط الثاني (criterion) القيمة الشرطية المطلوب مطابقتها، في حين يمثل الوسيط الثالث (sum_range) نطاق الأوزان النسبية أو المطلقة التي يُراد جمعها.
يكمن الدور المحوري لهذه الدالة في عزل الكتلة الوزنية الخاصة بالمجموعة المستهدفة بدقة تامة. من خلال استبعاد أوزان السجلات التي لا ينطبق عليها الشرط، تضمن الدالة أن المقام الرياضي يمثل على وجه التحديد $\sum_{i in C} w_i$. هذا الاستبعاد الصارم يحفظ مبدأ المعايرة النسبية، إذ إن إدخال أي أوزان أجنبية عن المجموعة في المقام يؤدي حتماً إلى خفض مصطنع لقيمة المتوسط المرجح الإجمالي، وهو خطأ شائع يقع فيه العديد من المشتغلين بتحليل البيانات عند استخدام دالة SUM الإجمالية بدلاً من دالة الجمع الشرطي.
4.2 معالجة أخطاء القسمة على صفر (#DIV/0!) الناتجة عن المقام
في الحالات التي لا يتحقق فيها الشرط ضمن نطاق البحث—كأن يتم البحث عن طالب غير موجود في قاعدة البيانات، أو فئة تقييم لم تُعقد بعد—أو إذا كانت مجموع أوزان الفئة المستهدفة مساوياً لصفر تماماً، فإن مخرج دالة SUMIF في المقام سيكون صفراً رياضياً. واستناداً إلى استحالة القسمة على الصفر في الحساب الجبري، يطلق محرك جداول بيانات جوجل رسالة الخطأ الشهيرة #DIV/0!.
لتفادي انهيار النماذج التقريرية ولوحات المؤشرات نتيجة هذا الخطأ، يجب تغليف المعادلة الكلية بطبقة حماية وقائية باستخدام دالة IFERROR:
=IFERROR(SUMPRODUCT(--(A2:A10="Category"), B2:B10, C2:C10) / SUMIF(A2:A10, "Category", C2:C10), 0)
يمكن استبدال القيمة الصفرية المعادة عند الخطأ بأي نص إرشادي بديل مثل "لا تتوفر بيانات"، أو استخدام دالة IF المنطقية للتحقق المسبق من أن ناتج دالة SUMIF أكبر من الصفر قبل تمرير عملية القسمة، مما يمنح النموذج رصانة برمجية إضافية تضمن استمرارية التحليل واستقرار واجهات العرض.
4.3 التعامل مع الأوزان الصفرية والسالبة
من الناحية الرياضية الإحصائية، يُشترط في مصفوفة الأوزان أن تكون جميع عناصرها موجبة قطيعاً ($w_i > 0$)، أو على الأقل غير سالبة ($w_i ge 0$). إذا تضمنت البيانات أوزاناً مساوية للصفر، فإن أثرها الحسابي ينعدم في كل من البسط والمقام، ولا تؤدي إلى انحراف المتوسط، لكنها قد تعكس خللاً في إعداد أدوات القياس.
أما الكارثة الإحصائية الكبرى فتحدث عند احتواء البيانات على أوزان سالبة ($w_i < 0$). إن وجود أوزان سالبة ينفي المفهوم النظري للثقل النوعي، وقد يؤدي إلى نتائج متناقضة تماماً كأن يصبح مجموع الأوزان في المقام مساوياً للصفر في حال تعادلت الأوزان الموجبة مع السالبة، أو أن يخرج المتوسط المرجح عن النطاق الطبيعي لدرجات القيم المقاسة ($x_{\min} le \bar{x}_w le x_{\max}$). لذا، تبرز ضرورة تطبيق قواعد التحقق من صحة البيانات (Data Validation) لمنع إدخال أوزان سالبة، واستخدام دوال تنقية متقدمة لعزل هذه الحالات الشاذة قبل معالجتها إحصائياً.
5. تطبيق عملي خطوة بخطوة: دراسة حالة درجات الطلاب والاختبارات
5.1 إعداد وتنسيق جدول البيانات النموذجي
لتوضيح التطبيق العملي للصيغة المشروطة، سنعتمد دراسة حالة تطبيقية في القياس الأكاديمي والتحصيل التعليمي، وهو سياق منهجي وثيق الصلة بالأبحاث الميدانية التي تتناول عادات الاستذكار والتحصيل الأكاديمي في المقررات التخصصية (Hora & Oleson, 2017). لنفترض أن لدينا جدول بيانات يتضمن السجلات المبينة في الجدول التوضيحي التالي:
| الصف | العمود A (اسم الطالب) | العمود B (نوع التقييم) | العمود C (الدرجة المحرزة $x_i$) | العمود D (وزن التقييم $w_i$) |
|---|---|---|---|---|
| 2 | أحمد (Student A) | اختبار قصير 1 | 85 | 10 |
| 3 | أحمد (Student A) | مشروع بحثي | 92 | 30 |
| 4 | أحمد (Student A) | اختبار نهائي | 78 | 60 |
| 5 | خالد (Student B) | اختبار قصير 1 | 65 | 10 |
| 6 | خالد (Student B) | مشروع بحثي | 88 | 30 |
| 7 | خالد (Student B) | اختبار نهائي | 95 | 60 |
| 8 | أحمد (Student A) | مشاركة صفية | 100 | 5 |
| 9 | خالد (Student B) | مشاركة صفية | 70 | 5 |
من الناحية المنهجية، يجب التأكد من تنسيق العمودين C وD كأرقام عددية صحيحة أو عشرية صريحة (Number Format)، والتأكد من عدم وجود مسافات نصية فارغة في أسماء الطلاب في العمود A لتفادي مشاكل عدم التطابق النصي أثناء تطبيق الشروط المنطقية.
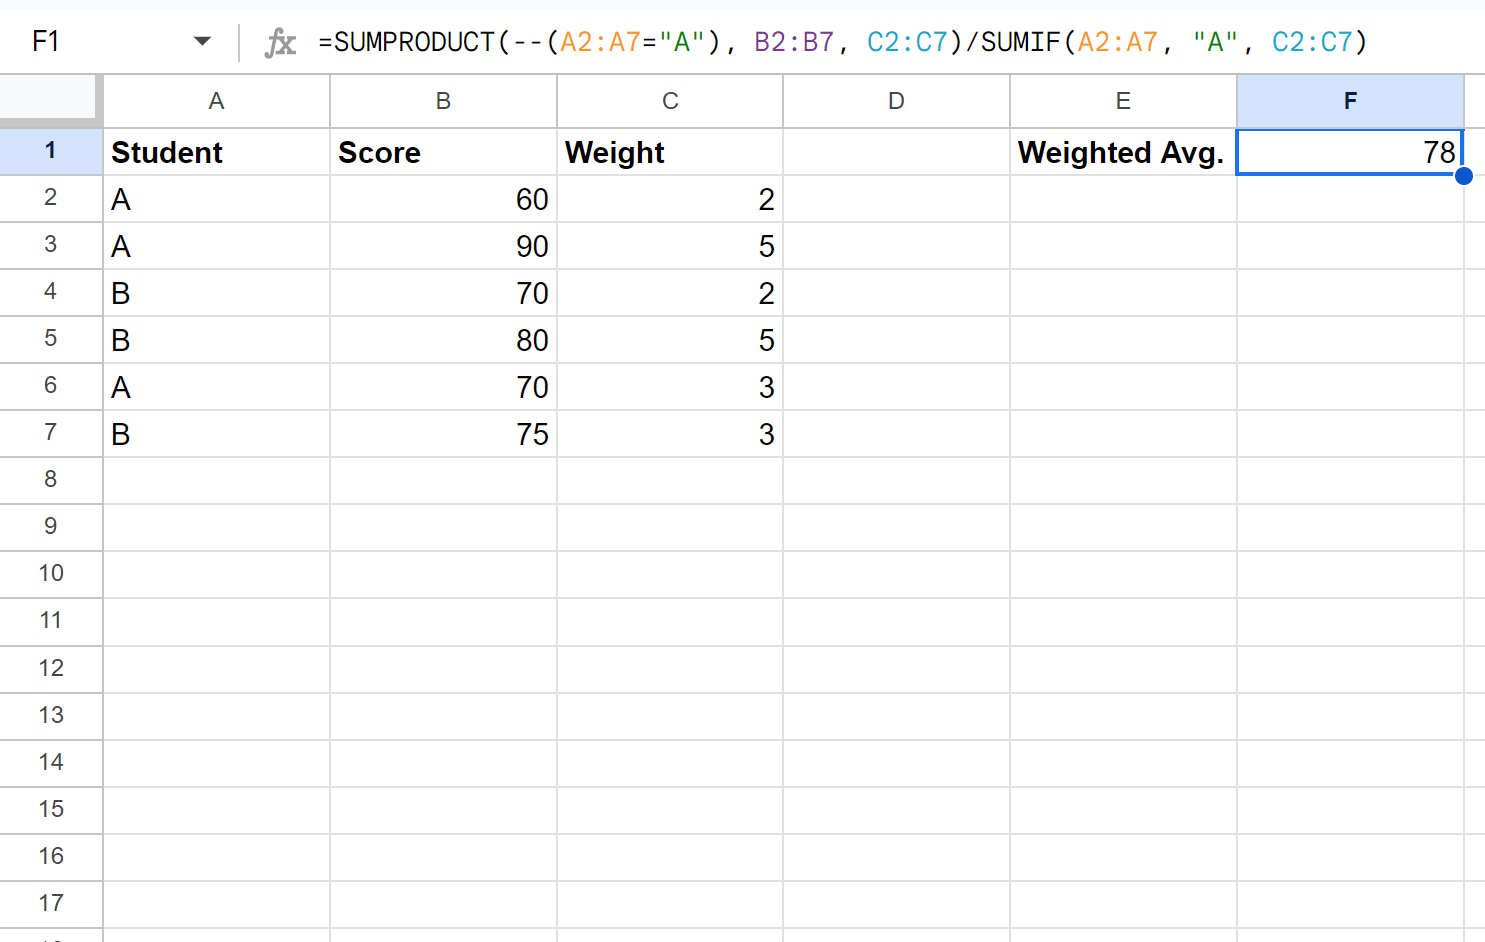
5.2 كتابة الصيغة واختبار مخرجاتها على سجل الطالب الأول
لحساب المتوسط المرجح لدرجات الطالب “أحمد” فقط، نتوجه إلى خلية مستقلة، ولتكن الخلية $F2$، حيث نضع اسم “أحمد” في الخلية $E2$ كمرجع معيار، ثم نكتب الصيغة المتكاملة في $F2$ وفق التركيب التالي مع استخدام التثبيت المطلق للنطاقات عبر علامة الدولار ($):
=SUMPRODUCT(--($A$2:$A$9 = E2), $C$2:$C$9, $D$2:$D$9) / SUMIF($A$2:$A$9, E2, $D$2:$D$9)
عند تنفيذ هذه الصيغة، يمر محرك المعالجة بالخطوات الآتية:
- تقييم النطاق
$A$2:$A$9 = "أحمد"ينتج المصفوفة البولينية:{TRUE; TRUE; TRUE; FALSE; FALSE; FALSE; TRUE; FALSE}. - يقوم المشغل
--بتحويلها إلى مصفوفة ثنائية:{1; 1; 1; 0; 0; 0; 1; 0}. - تقوم دالة SUMPRODUCT بضرب المتجهات الثلاثة:
$(1 \times 85 \times 10) + (1 \times 92 \times 30) + (1 \times 78 \times 60) + (0 \times 65 \times 10) + (0 \times 88 \times 30) + (0 \times 95 \times 60) + (1 \times 100 \times 5) + (0 \times 70 \times 5)$
$= 850 + 2760 + 4680 + 0 + 0 + 0 + 500 + 0 = 8790$. - تقوم دالة SUMIF بجمع الأوزان المقابلة للطالب “أحمد” فقط:
$10 + 30 + 60 + 5 = 105$. - تُجرى عملية القسمة: $8790 / 105 = 83.71428571$.
تظهر النتيجة في الخلية فورياً بدقة متناهية، معبرة عن المتوسط المرجح الدقيق لتحصيل الطالب أحمد وفقاً لأوزان الاختبارات المختلفة.
5.3 تعميم المعادلة على فئات دراسية متعددة
بفضل استخدام مراجع الخلايا النسبية للمعيار ($E2$) والمراجع المطلقة لنطاقات البيانات ($A$2:$A$9)، يمكن الآن تعميم هذه المعادلة بسهولة فائقة وسحبها عمودياً. إذا وضعنا اسم “خالد” في الخلية $E3$ وسحبنا مقبض التعبئة التلقائية من الخلية $F2$ إلى $F3$، ستتحدث الصيغة تلقائياً لتصبح:
=SUMPRODUCT(--($A$2:$A$9 = E3), $C$2:$C$9, $D$2:$D$9) / SUMIF($A$2:$A$9, E3, $D$2:$D$9)
ستقوم الصيغة بحساب بسط الطالب خالد:
$(65 \times 10) + (88 \times 30) + (95 \times 60) + (70 \times 5) = 650 + 2640 + 5700 + 350 = 9340$
وقسمته على مجموع أوزانه ($10 + 30 + 60 + 5 = 105$):
$9340 / 105 = 88.95238095$
يتيح هذا الترتيب المنهجي بناء جدول تلخيصي مدمج يضم مئات الطلاب في أوراق العمل الأكاديمية الكبيرة، كما يمكن تطبيق التنسيق الشرطي (Conditional Formatting) على عمود النتائج لتلوين الخلايا وفق معايير الأداء الجامعي، كإبراز الدرجات الأعلى من 85 بلون أخضر، مما يوفر رؤية بصرية فورية وموثوقة للفروق الفردية في التحصيل الأكاديمي.
6. المعايرة اليدوية والتدقيق الحسابي لصحة النتائج المستخرجة
6.1 التفكيك اليدوي لحسابات البسط والمقام لبيانات الحالة
تقتضي معايير النزاهة العلمية والتدقيق الإحصائي التحقق اليدوي التبادلي من الحسابات الخوارزمية، لا سيما في البيئات البحثية والمؤسسية الحساسة. لمعايرة أداء الصيغة للطالب “أحمد”، نقوم بتفكيك الحسابات إلى مكوناتها الأولية:
أولاً: حساب البسط اليدوي ($\sum w_i x_i$):
- الاختبار القصير الأول: $85 \times 10 = 850$
- المشروع البحثي: $92 \times 30 = 2760$
- الاختبار النهائي: $78 \times 60 = 4680$
- المشاركة الصفية: $100 \times 5 = 500$
- المجموع التراكمي للبسط: $850 + 2760 + 4680 + 500 = 8790$ وحدة درجة-وزن.
ثانياً: حساب المقام اليدوي ($\sum w_i$):
- مجموع أوزان التقييمات: $10 + 30 + 60 + 5 = 105$ وحدة وزن.
يتطابق هذان الرقمان اليدويان تطابقاً مطلقاً مع المخرجات الوسيطة المنفذة آلياً بواسطة دالتي SUMPRODUCT وSUMIF، مما يثبت صحة المسار المنطقي للمصفوفة الثنائية واستبعادها الناجح لكافة قيود الطالب خالد.
6.2 إجراء القسمة والتحقق من التطابق الرقمي
بقسمة الناتج الإجمالي للبسط على المقام يدوياً:
$$\bar{x}_w = \frac{8790}{105} = 83.71428571428571…$$
بالمقارنة مع المخرج الظاهر في الخلية $F2$ في Google Sheets، نجد تطابقاً كاملاً لكافة الخانات العشرية حتى حدود الدقة العائمة لبرمجية الحوسبة. تجدر الإشارة هنا إلى أهمية التمييز بين القيمة الفعلية المخزنة في ذاكرة البرنامج والقيمة المعروضة بصرياً؛ حيث يؤدي تقليص المنازل العشرية عبر أشرطة الأدوات إلى إظهار الرقم كـ $83.71$، وهو تقريب شكلي لا يؤثر على الدقة التراكمية في حال تم استدعاء هذه الخلية في عمليات حسابية استنتاجية لاحقة.
6.3 أهمية التدقيق التبادلي في النماذج الإحصائية الحساسة
يمثل التدقيق الحسابي التبادلي (Cross-Auditing) ممارسة جوهرية في الأبحاث السريرية والتحليلات التلوية (Meta-Analytic Reviews)، حيث تترتب على الأخطاء البرمجية الطفيفة عواقب وخيمة في اتخاذ القرارات العلاجية أو السياسات العامة. فعلى سبيل المثال، في دراسات تحليل مخاطر إيذاء الأطفال وفاعلية البرامج الإرشادية (van der Put et al., 2017; Gubbels et al., 2019)، يتم ترجيح حجوم التأثير للأدوات السلوكية بناءً على مقلوب التباين (Inverse Variance) أو حجوم العينات؛ وأي إزاحة غير مقصودة في نطاقات مصفوفات الأوزان تؤدي إلى نتائج مضللة تشوه موثوقية النموذج بأكمله. من هنا، يضمن التوثيق اليدوي والتدقيق المستقل حماية النماذج من أخطاء عدم المحاذاة الخفية (Misalignment Errors).
7. توسيع الصيغة لمعالجة الشروط المتعددة والمعايير المركبة
7.1 إضافة شروط إضافية باستخدام الضرب المنطقي في SUMPRODUCT
في العديد من البيئات التحليلية المتقدمة، لا يكفي تطبيق معيار شرطي مفرد، بل يتطلب التحليل تصفية متعددة الأبعاد (Multi-Criteria Filtering). على سبيل المثال، قد نرغب في حساب المتوسط المرجح لدرجات الطالب “أحمد” ولكن للاختبارات التحريرية فقط دون المشاريع أو المشاركات الصفية، أو حساب المتوسط المرجح لمقرر معين خلال فصل دراسي محدد.
يتيح المنطق الرياضي لدالة SUMPRODUCT استيعاب شروط متعددة مبنية على منطق المعية (Boolean AND Logic) عبر إضافة مصفوفات مقارنة متسلسلة وربطها بعملية الضرب الحسابي:
=SUMPRODUCT((Range1 = Cond1) * (Range2 = Cond2) * Values_Range * Weights_Range) / ...
في هذا التركيب، تعمل عملية الضرب المباشر (Range1 = Cond1) * (Range2 = Cond2) كمعامل منطقي يحقق وظيفة المشغل الثنائي المزدوج تلقائياً، حيث يحول مخرجات المقارنة إلى آحاد وأصفار. لن يُسجل العنصر القيمة $1$ إلا إذا تحقق الشرطان معاً في نفس الصف ($1 \times 1 = 1$)، بينما إذا سقط أحد الشرطين أو كلاهما، سيتحول الناتج إلى صفر ($1 \times 0 = 0$ أو $0 \times 0 = 0$)، مما يعزل الحالات المستهدفة بمنتهى الدقة الهندسية.
7.2 الترقية إلى دالة SUMIFS لحساب المقام متعدد الشروط
لضمان اتساق المقام مع البسط متعدد الشروط، لا يمكن استخدام دالة SUMIF الأحادية، بل يجب الترقية فوراً إلى دالة SUMIFS التي صُممت للتعامل مع معايير متعددة. تختلف دالة SUMIFS عن سابقتها في ترتيب المعاملات؛ حيث يأتي نطاق الجمع في البداية متبوعاً بأزواج نطاقات الشروط ومعاييرها:
SUMIFS(sum_range, criteria_range1, criterion1, criteria_range2, criterion2, ...)
وبالتالي تصبح الصيغة العامة للمتوسط المرجح المشروط متعدد المعايير كالتالي:
=SUMPRODUCT(($A$2:$A$100 = "أحمد") * ($B$2:$B$100 = "تحريري") * $C$2:$C$100 * $D$2:$D$100) / SUMIFS($D$2:$D$100, $A$2:$A$100, "أحمد", $B$2:$B$100, "تحريري")
تضمن هذه الصيغة المركبة تصفية الأوزان بدقة متناهية، بحيث لا يتضمن المقام إلا أوزان التقييمات التحريرية للطالب أحمد حصراً، مانعة أي اختلال في النسبة الإحصائية المركبة.
7.3 التعامل مع الشروط التناوبية (منطق OR)
عندما تقتضي المعالجة الإحصائية استيفاء أيٍّ من شرطين أو أكثر (منطق التناوب أو الإتاحة: Boolean OR Logic)—كأن نرغب في احتساب المتوسط المرجح لاختبارات الفصل الدراسي الأول “أو” الفصل الدراسي الثاني ضمن وعاء تحليلي واحد—يتم استبدال عملية الضرب بعملية الجمع الجبري للمصفوفات الشرطية داخل البسط:
((Criteria1 = "Term 1") + (Criteria2 = "Term 2") > 0)
يعد استخدام المقارنة > 0 في نهاية التعبير الشرطي خطوة رياضية وقائية بالغة الأهمية؛ ففي حال تحقق الشرطين معاً في سجل افتراضي واحد، فإن حاصل جمعهما سينتج الرقم $2$، وإذا ضُرب هذا الرقم في القيم والأوزان فإنه سيؤدي إلى مضاعفة احتساب الوزن والدرجة (Double Counting). إن إضافة الشرط > 0 يعيد تحويل أي مجموع أكبر من الصفر إلى القيمة المنطقية TRUE، والتي تتحول بعد ذلك إلى $1$، مما يضمن احتساب السجل مرة واحدة فقط بصرف النظر عن عدد الشروط المتطابقة.
أما في المقام، ونظراً لأن دالة SUMIFS لا تدعم منطق OR مباشرة بشكل مدمج، فإن المعالجة الأبسط والأكثر أماناً تتم عبر جمع دالتي SUMIF منفصلتين، أو استخدام دالة SUMPRODUCT متطابقة للمقام:
SUMPRODUCT(((Criteria1 = "Term 1") + (Criteria2 = "Term 2") > 0) * Weights_Range)
8. معالجة الأخطاء الشائعة وحالات الشذوذ في مدخلات الصيغة
8.1 تشخيص وحل خطأ عدم تطابق أبعاد المصفوفات (#VALUE!)
يعد ظهور الخطأ البرمجي #VALUE! من أكثر العوائق التقنية شيوعاً عند كتابة صيغ المتوسط المرجح المشروط في جداول بيانات جوجل. يرجع السبب المباشر لهذا الخطأ في أكثر من 95% من الحالات إلى عدم تطابق أبعاد النطاقات المدخلة في دالة SUMPRODUCT. على سبيل المثال، كتابة الصيغة على النحو التالي:
=SUMPRODUCT(--(A2:A10 = "Category"), B2:B10, C2:C9)
حيث يمتد النطاقان الأول والثاني عبر تسعة صفوف (من 2 إلى 10) بينما ينتهي النطاق الثالث عند الصف 9 (ثمانية صفوف فقط). في هذه الحالة، يعجز محرك الحساب عن إجراء الضرب التبادلي لعدم وجود عنصر متناظر في الصف الأخير، مما يؤدي فوراً إلى توقف الدالة وإطلاق رمز الخطأ.
لحل هذا الإشكال، يجب فحص حدود النطاقات بعناية بالغة والتأكد من أنها متناظرة تماماً في رقم البداية ورقم النهاية، لا سيما بعد إدراج صفوف جديدة في الجدول والتي قد تؤدي أحياناً إلى انزياح مراجع بعض الخلايا إذا لم تكن مثبتة بعناية.
8.2 إدارة البيانات غير الرقمية والنصوص الخفية والمسافات الزائدة
تتسبب البيانات النصية غير المنضبطة في إفساد المنطق الشرطي للنماذج. من أبرز هذه المشكلات وجود مسافات خفية بادئة أو لاحقة في الخلايا النصية (Trailing/Leading Whitespaces)؛ فإذا كانت الخلية تحتوي على القيمة "أحمد " (مع مسافة في النهاية)، فإن شرط المساواة المباشر مع "أحمد" سيُنتج القيمة FALSE، مما يؤدي إلى استبعاد السجل كلياً دون أن ينتبه المحلل لوجود خطأ ظاهري.
لمعالجة هذه المعضلة تنظيفياً، يُنصح بتطبيق دالة TRIM لتنقية البيانات قبل المعالجة، أو دمجها داخل مصفوفة الفحص كالتالي: TRIM(Criteria_Range) = "Condition". بالإضافة إلى ذلك، إذا كان عمود الدرجات أو الأوزان يحتوي على نصوص مفسرة كأرقام (مثل كتابة الدرجة كـ "85" بدلاً من 85)، فقد تفشل دالة SUMPRODUCT في معالجتها، مما يتطلب إخضاع العمود لعمليات التحويل القسري عبر الضرب في $1$ أو استخدام الدالة VALUE لضمان التنميط الرقمي الصارم للبيانات.
8.3 التعامل مع البيانات المفقودة والقيم الفارغة
يفرض التعامل مع القيم المفقودة (Missing Data) تحدياً منهجياً حقيقياً في الإحصاء التطبيقي. يجب التمييز الدقيق بين حالتين متمايزتين دلالياً:
- الخلية التي تحتوي على الرقم صفر ($0$): تعني أن الظاهرة تم قياسها بالفعل ولكن نتيجتها كانت معدومة (مثل طالب تقدم للاختبار وحصل على صفر). في هذه الحالة، يجب أن يشارك وزن هذا الاختبار في المقام كاملاً، لأنه جزء من العبء التقييمي الفعلي.
- الخلية الفارغة تماماً (Blank): تعني أن القيمة مفقودة أو أن التقييم لم يُجرَ بعد أو تم إسقاطه. إذا تُركت الخلية فارغة، فإن دالة SUMPRODUCT ستعاملها في البسط كصفر، لكن دالة SUMIF في المقام قد تجمع وزنها إذا لم يُقيد الشرط باستبعاد الفراغات، مما يؤدي إلى خفض غير عادل وغير صحيح للمتوسط.
لحل هذه المعضلة وضمان سلامة العينة الإحصائية، يجب إضافة شرط إضافي يستبعد السجلات التي تحتوي على خلايا فارغة في عمود القيم:
=SUMPRODUCT(($A$2:$A$10 = "أحمد") * ($C$2:$C$10 <> "") * $C$2:$C$10 * $D$2:$D$10) / SUMIFS($D$2:$D$10, $A$2:$A$10, "أحمد", $C$2:$C$10, "<>")
يضمن هذا الإجراء تنقية النطاق بحيث يقتصر احتساب الأوزان على التقييمات المكتملة فقط، محققاً أعلى معايير النزاهة في معالجة الحالات الناقصة.
9. البدائل المتقدمة: مقارنة الصيغة مع الدوال والتقنيات الحديثة
9.1 استخدام دالة AVERAGE.WEIGHTED مع دالة FILTER
تتفرد جداول بيانات جوجل عن برمجية مايكروسوفت إكسيل التقليدية بامتلاكها دالة قياسية مضمنة لحساب المتوسط المرجح تسمى AVERAGE.WEIGHTED. تقبل هذه الدالة صيغتها الأساسية: AVERAGE.WEIGHTED(values, weights). ورغم أنها لا تقبل الشروط المنطقية بشكل مباشر داخل وسائطها، إلا أنه يمكن ترقيتها بكفاءة عالية عبر دمجها مع دالة FILTER لتوليد صيغة بديلة فائقة الأناقة والوضوح:
=AVERAGE.WEIGHTED(FILTER(C2:C10, A2:A10 = "أحمد"), FILTER(D2:D10, A2:A10 = "أحمد"))
تقوم دالة FILTER بتصفية مصفوفة الدرجات ديناميكياً لتشمل سجلات الطالب أحمد فقط، وتصفي مصفوفة الأوزان بنفس المعيار، ثم تمرر هاتين المصفوفتين المصغرتين إلى دالة AVERAGE.WEIGHTED. تتفوق هذه الصيغة على صيغة SUMPRODUCT/SUMIF في كونها أكثر قابلية للقراءة البرمجية وتختصر كتابة البسط والمقام في دالة واحدة، فضلاً عن سرعتها العالية في المصفوفات الصغيرة والمتوسطة. ومع ذلك، قد تطلق دالة FILTER الخطأ #N/A إذا لم يتحقق الشرط لأي سجل، مما يستلزم أيضاً حمايتها بدالة IFERROR.
9.2 توظيف لغة الاستعلام الدلالي عبر دالة QUERY
تُعد دالة QUERY إحدى أقوى الأدوات في Google Sheets، حيث تتيح استخدام أوامر استعلامية شبيهة بلغة SQL للتعامل مع البيانات. على الرغم من أن دالة QUERY لا تحتوي على دالة تجميعية مدمجة لحساب المتوسط المرجح مباشرة (فهي تدعم avg البسيطة فقط)، إلا أنه يمكن استخدامها كأداة تحضير وتجهيز متقدمة لتغذية الصيغ الأخرى.
يمكن على سبيل المثال كتابة استعلام يقوم بتصفية البيانات الأولية واستبعاد القيم الشاذة، أو فرز البيانات وفق تواريخ معينة، أو ضرب عمودين مسبقاً عبر تعبيرات الاستعلام الرياضية مثل SELECT Col3 * Col4 WHERE Col1 = 'أحمد'. يتيح هذا النهج فصل معالجة البيانات الضخمة في طبقات هيكلية منظمة، إلا أن عيبه الأساسي يكمن في استهلاك موارد إضافية وبطء زمن الاستجابة مقارنة بالدوال الحسابية المباشرة عند تكرار الاستعلام في مئات الخلايا المتجاورة.
9.3 إنشاء دوال مخصصة عبر Google Apps Script
للمطورين والمحللين الذين يبحثون عن أقصى درجات التبسيط المعماري لواجهات أوراق العمل، يوفر محرك البرمجة النصية في جوجل (Google Apps Script) بيئة مبنية على لغة جافا سكريبت تتيح كتابة دوال مخصصة (Custom Functions / UDF). يمكن كتابة دالة مخصصة تحت اسم WEIGHTED_AVERAGE_IF على النحو التالي:
function WEIGHTED_AVERAGE_IF(criteriaRange, criterion, valuesRange, weightsRange) {

  let totalProduct = 0;

  let totalWeight = 0;

  for (let i = 0; i < criteriaRange.length; i++) {

    if (criteriaRange[i][0] == criterion) {

      let val = Number(valuesRange[i][0]);

      let wt = Number(weightsRange[i][0]);

      if (!isNaN(val) && !isNaN(wt) && wt > 0) {

        totalProduct += val * wt;

        totalWeight += wt;

      }

    }

  }

  return totalWeight > 0 ? totalProduct / totalWeight : 0;

}
يتيح هذا الكود للمستخدم استدعاء الدالة مباشرة في ورقة العمل تماماً مثل أي دالة قياسية: =WEIGHTED_AVERAGE_IF(A2:A10, "أحمد", C2:C10, D2:D10). تمنح هذه الطريقة مرونة استثنائية ونظافة فائقة للواجهة الحسابية، لكن يعيبها أن الدوال المخصصة في Google Apps Script تتطلب وقتاً أطول في التنفيذ مقارنة بالدوال الأصلية المكتوبة بلغة C++ في خوادم جوجل، مما يجعلها غير مفضلة في الملفات الحاوية على عشرات الآلاف من الصفوف الحسابية النشطة.
10. أفضل الممارسات لتصميم نماذج قياس متينة وقابلة للتوسع
10.1 تسمية النطاقات (Named Ranges) لتحسين وضوح وموثوقية المعادلات
تعد النطاقات المسماة (Named Ranges) من الأدوات التنظيمية بالغة الأهمية في هندسة جداول البيانات المتقدمة. بدلاً من الاعتماد على مراجع الخلايا الإحداثية المبهمة مثل $A$2:$A$100، يمكن تحديد العمود A وتسميته دلالياً باسم Students_List، وتسمية عمود الدرجات باسم Scores_Data، وعمود الأوزان باسم Weights_Config.
تتحول صيغة المتوسط المرجح المشروط عندئذٍ إلى تعبير دلالي ناطق يسهل تفسيره ومراجعته:
=SUMPRODUCT(--(Students_List = E2), Scores_Data, Weights_Config) / SUMIF(Students_List, E2, Weights_Config)
يقلل هذا النهج بصورة جذرية من احتمالات الخطأ البشري أثناء نسخ المعادلات ونقلها عبر أوراق العمل، كما يحمي الصيغ من التشوه عند إعادة هيكلة الجداول أو إضافة أعمدة جديدة، ويجعل عمليات التدقيق الإحصائي أسرع وأكثر موثوقية لفريق العمل البحثي.
10.2 التوثيق المنهجي للهياكل الحسابية وضبط جودة النماذج
تتطلب إدارة النماذج الحسابية المعقدة وضع ضوابط توثيقية صارمة (Model Governance). يوصى دائماً بإدراج تعليقات توضيحية داخل الخلايا (Cell Notes) توضح الفلسفة الرياضية للصيغة وأسباب استبعاد بعض الحالات أو آلية وزن المعايير. كما يُنصح ببناء ورقة عمل مخصصة تُسمى “لوحة التحكم” (Control Panel) أو “جدول المعايير” تُفصل فيها مصفوفات الأوزان بشكل مستقل عن سجلات الرصد اليومية، مما يسمح بتعديل الأوزان مركزياً دون الحاجة إلى التعديل المباشر داخل الصيغ المركبة.
علاوة على ذلك، يجب تفعيل ميزة “حماية النطاقات والأوراق” (Protect Sheets and Ranges) لقفل خلايا الصيغ الحسابية ومنع التعديل غير المقصود عليها من قبل المستخدمين النهائيين أو مدخلي البيانات، مما يحفظ سلامة البنية الخوارزمية للنظام الإحصائي.
10.3 بناء لوحات معلومات تفاعلية تستند إلى المتوسط المرجح المشروط
يمثل المتوسط المرجح المشروط المحرك الديناميكي الأبرز لتغذية لوحات المعلومات التفاعلية (Interactive Dashboards) المعاصرة. يمكن ربط المعيار الشرطي بقائمة منسدلة منشأة عبر التحقق من صحة البيانات (Data Validation Dropdown)، مما يمكن متخذ القرار من اختيار اسم القسم، أو الفئة العمرية، أو الطالب، لتتحدث مؤشرات المتوسط المرجح والرسوم البيانية المقترنة بها فورياً.
تتجلى أهمية هذه النماذج التفاعلية الموثوقة في دراسات القياس والتحليل التنبؤي المتطورة، مثل نظم المراقبة الذاتية والبيئات الذكية للسلامة العامة (Khan et al., 2023)، والتقييمات الطولية للسلوكيات الإدمانية والوقائية (Dowling et al., 2016)، فضلاً عن أبحاث التدخلات السلوكية والتربوية وقياس آثارها التراكمية (Rapp et al., 2022)، ودراسات استشراف المستقبل المهني وإدارة الموارد البشرية (Kooij et al., 2018). إن تحويل البيانات الأولية عبر المتوسطات المرجحة المشروطة إلى رؤى إحصائية بصرية يمنح القيادات الأكاديمية والمؤسسية أساساً برهانياً متيناً وموثوقاً لاتخاذ القرارات الإستراتيجية الحاسمة.
خاتمة
يمثل احتساب المتوسط الحسابي المرجح المشروط في جداول بيانات جوجل (Google Sheets) كفاءة منهجية وحسابية لا غنى عنها لأي باحث أو محلل يسعى إلى تحقيق أعلى درجات الدقة الإحصائية في معالجة البيانات غير المتجانسة. لقد برهن هذا التحليل المعمق على أنه على الرغم من غياب صيغة قياسية مستقلة تحت اسم “AVERAGE.WEIGHTED.IF”، إلا أن الهندسة المنطقية المركبة التي تجمع بين دالتي SUMPRODUCT وSUMIF، أو التوليف الحديث بين دالتي AVERAGE.WEIGHTED وFILTER، توفر للمحلل أدوات رياضية بالغة القوة والمرونة لتجاوز حدود التحليلات البسيطة.
إن إتقان العمليات الرياضية الدقيقة الكامنة خلف المشغلات الثنائية، والوعي المعماري باتساق أبعاد المصفوفات، واليقظة المنهجية لمعالجة الأخطاء الصفرية والبيانات المفقودة، ليست مجرد مهارات تقنية عابرة، بل هي متطلبات جوهرية لضمان سلامة النماذج التقديرية وجودة القرارات المترتبة عليها. ومن خلال تطبيق أفضل ممارسات الحوسبة السحابية—من تسمية النطاقات وحمايتها وبناء الواجهات التفاعلية المستندة إلى البراهين—يتحول جدول البيانات من مجرد سجل جامد للأرقام إلى منظومة قياس ديناميكية قادرة على تلبية متطلبات البحث الأكاديمي الرصين وصناعة القرار الاحترافي في مختلف العلوم التطبيقية.
المراجع
- Dowling, N. A., Merkouris, S., Greenwood, C. J., Oldenhof, E., Toumbourou, J. W., & Youssef, G. J. (2016). Early risk and protective factors for problem gambling: A systematic review and meta-analysis of longitudinal studies. Clinical Psychology Review. https://doi.org/10.1016/j.cpr.2016.10.008
- Gubbels, J., van der Put, C. E., & Assink, M. (2019). The Effectiveness of Parent Training Programs for Child Maltreatment and Their Components: A Meta-Analysis. International Journal of Environmental Research and Public Health. https://doi.org/10.3390/ijerph16132404
- Hora, M. T., & Oleson, A. K. (2017). Examining study habits in undergraduate STEM courses from a situative perspective. International Journal of STEM Education. https://doi.org/10.1186/s40594-017-0055-6
- Khan, M. A., Nawaz, T. H., Khan, U. S., Hamza, A., & Rashid, N. (2023). IoT-Based Non-Intrusive Automated Driver Drowsiness Monitoring Framework for Logistics and Public Transport Applications to Enhance Road Safety. IEEE Access. https://doi.org/10.1109/access.2023.3244008
- Kooij, D. T. A. M., Kanfer, R., Betts, M., & Rudolph, C. W. (2018). Future time perspective: A systematic review and meta-analysis. Journal of Applied Psychology. https://doi.org/10.1037/apl0000306
- Rapp, H., Wang Xu, J., & Enright, R. D. (2022). A meta-analysis of forgiveness education interventions’ effects on forgiveness and anger in children and adolescents. Child Development. https://doi.org/10.1111/cdev.13771
- van der Put, C. E., Assink, M., & Boekhout van Solinge, N. F. (2017). Predicting child maltreatment: A meta-analysis of the predictive validity of risk assessment instruments. Child Abuse & Neglect. https://doi.org/10.1016/j.chiabu.2017.09.016