
تُعد برمجيات جداول البيانات المعاصرة، وفي مقدمتها جداول بيانات جوجل (Google Sheets)، من الركائز الأساسية التي تستند إليها بيئات العمل الأكاديمي، والمختبرات البحثية، والمؤسسات التحليلية في إدارة وتنظيم البيانات الأولية. فعلى الرغم من المظهر البسيط الذي تبدو عليه شبكة الخلايا الافتراضية، إلا أنها تُخفي وراءها محركات حسابية ومنطقية معقدة صُممت لمعالجة أنواع متعددة من البيانات، تتدرج من المتغيرات الرقمية البسيطة والمتتالية وصولاً إلى الهياكل النصية والمرجعية المركبة. ومع ذلك، يواجه الباحثون ومحللو البيانات عائقاً تقنياً متكرراً يتمثل في قصور ميزة التعبئة التلقائية الكلاسيكية عن إدراك الترتيب الأبجدي للأحرف اللاتينية أو العربية بصورة فطرية، خلافاً لما تؤديه بكفاءة ملحوظة عند التعامل مع الأرقام الحسابية، والتواريخ، والشهور الميلادية.
إن هذا القصور الوظيفي الظاهري لا يعكس عيباً برمجياً بقدر ما يُعبر عن فلسفة تصميم المحركات الحسابية التي بُنيت أساساً على النمذجة الرياضية؛ فالأرقام تخضع لمتتاليات حسابية وهندسية بديهية يمكن للمُعالج استقراؤها والتنبؤ بها، في حين تُعامل النصوص الأبجدية كبيانات فئوية أو نوعية مستقلة لا تحمل بطبيعتها الرياضية المجردة دلالة الزيادة بمقدار واحد صحيح. ومن هنا، تبرز الحاجة المعرفية والعملية إلى سبر أغوار البنية التحتية لتمثيل المحارف في النظم الحاسوبية، وتحديداً معايير الترميز الدولية مثل أسكي (ASCII) ويونيكود (Unicode)، لاستنباط حلول خوارزمية ذكية قادرة على تحويل المشكلة النصية إلى عملية رياضية قابلة للتنفيذ السلس داخل بيئة الحوسبة السحابية.
يهدف هذا الدليل المرجعي الشامل إلى تقديم تفكيك منهجي وتطبيقي عميق لكيفية تحقيق التعبئة التلقائية للأحرف الأبجدية داخل جداول بيانات جوجل. وسيتناول البحث التحليل الهندسي لدوال التحويل والترميز، والخطوات الإجرائية التفصيلية لإنشاء السلاسل الفردية والمصفوفات الديناميكية المتطورة، واستعراض آليات تخطي الحدود الأبجدية التقليدية، وصولاً إلى معالجة خصوصية الحروف العربية والتطبيقات الميدانية في تصميم التجارب العلمية وإدارة العينات. ويمنح هذا الطرح الأكاديمي المتخصص مستخدمي الجداول الأدوات المعرفية التي تحول جهود الإدخال اليدوي المجهدة إلى عمليات مؤتمتة تتسم بالدقة الرياضية والاتساق المنهجي.
1. مقدمة نظرية حول التعبئة التلقائية وإدارة البيانات النصية في جداول بيانات جوجل
1.1 مفهوم التعبئة التلقائية (Autofill) وطبيعة معالجة السلاسل النصية
تُمثل ميزة التعبئة التلقائية (Autofill) في بيئات الجداول الإلكترونية خوارزمية تنبؤية تُعنى باستقراء الأنماط المنطقية من البيانات المدخلة في خلايا محددة، ثم تعميم ذلك النمط على نطاق ممتد من الخلايا المجاورة بمجرد سحب مقبض التعبئة. تهدف هذه الخاصية في جوهرها إلى تقليص الجهد الإجرائي والزمن المستغرق في إدخال البيانات المتكررة، مما ينعكس إيجاباً على الكفاءة التشغيلية للمستخدم. وتعتمد الخوارزمية على تقييم الفروق الحسابية أو الفترات الزمنية بين مدخلين متتاليين على الأقل لتحديد ما إذا كان النمط متتالية عددية بسيطة، أو تقدماً زمنياً دورياً (كأيام الأسبوع أو أشهر السنة).
غير أن هذه الأداة تُواجه قيوداً افتراضية جوهرية عندما تتعامل مع السلاسل النصية غير العددية؛ فمحرك جداول بيانات جوجل يُعامل النصوص المدخلة التي لا تندرج ضمن القوائم المعرفة مسبقاً في النظام باعتبارها بيانات ثابتة أو مسميات وصفية لا تحتمل الاستنتاج المتسلسل. ونتيجة لذلك، إذا قام المستخدم بإدخال الحرف “A” متبوعاً بالحرف “B” في الخلية اللاحقة ثم قام بتفعيل مقبض التعبئة، فلن تُكمل الخوارزمية الأحرف التالية (C، D، E)، بل ستلجأ إلى تكرار النمط المدخل ذاته بصورة دورية (A، B، A، B)، مما يُبرز فجوة تقنية بين قدرة الأداة على التنبؤ بالأرقام والتواريخ وعجزها عن استقراء الحروف الأبجدية المجردة.
تنشأ هذه الفجوة من غياب “القوائم المخصصة” القابلة للتهيئة المباشرة عبر واجهة المستخدم في جداول بيانات جوجل، وهي ميزة تتوافر في بعض البرمجيات المكتبية المنافسة مثل مايكروسوفت إكسل. هذا القصور الإداري في التعامل مع الأبجدية يفرض على المستخدمين اللجوء إلى معالجات برمجية بديلة وصيغ حسابية وسيطة، لتحويل السلاسل النصية إلى نسق يفهمه المحرك الحسابي ويستطيع استنساخه وتنميطه بالصورة المطلوبة في المشروعات البحثية والإدارية المعقدة.
1.2 الفوارق البنيوية بين التسلسلات الرقمية والرموز الأبجدية
ترجع الصعوبة التقنية في التعامل مع السلاسل الأبجدية إلى التباين الجذري في النمذجة الرياضية بين المتتاليات الحسابية والرموز اللغوية داخل الحواسب. المتتالية الرقمية تُعرّف وفق علاقة رياضية دقيقة؛ حيث يساوي كل حد الحد السابق له مضافاً إليه مقدار ثابت يُعرف بأساس المتتالية (d)، وهو ما يسهل برمجته كمعادلة خطية صريحة. في المقابل، فإن الحروف الأبجدية لا تمتلك في ذاتها الفيزيائية أو اللغوية قيمة كمية داخلية؛ فالحرف “B” لا يمثل ضعف الحرف “A”، ولا يحمل الحرف “C” قيمة مادية تزيد عن “B” بوحدة قياس كمية، بل ترتبط هذه الرموز بنظام تواضعي قائم على الترتيب الاصطلاحي الصرف.
ونتيجة لغياب هذا الترتيب الرياضي الفطري داخل بنية الذاكرة العشوائية للحواسيب، فإن جداول البيانات عاجزة عن تطبيق عمليات الجمع والضرب مباشرة على الأحرف النصية لتوليد الرموز اللاحقة دون تدخل وظيفي يربط الحرف بكيان رقمي موازٍ. هذا الاختلاف المعماري يوجب على مطوري ومحللي النظم ابتكار استراتيجيات اصطناعية تعتمد على إعادة تعريف الرموز الحرفية بصفتها مؤشرات رقمية تابعة لنظام ترميز موحد، مما يسمح بإجراء المتتالية الحسابية أولاً على المؤشر الرقمي، ثم إعادة تحويل الناتج إلى تمثيله الرمزي المقابل.
إن إدراك هذه الفوارق البنيوية يُعد الخطوة الأولى نحو بناء حلول متقدمة وقابلة للتوسع في إدارة قواعد البيانات الضخمة؛ إذ يتيح للباحث صياغة معادلات مركبة تتحكم في المسارات المتتالية بدقة متناهية، متجاوزاً بذلك عجز الواجهات الافتراضية، وموفراً بيئة معالجة تتسم بالمرونة الفائقة والقدرة على التكيف مع مختلف المتطلبات الحسابية والتصنيفية.
1.3 الأثر المعرفي والتنظيمي لأتمتة إدخال الرموز في الأبحاث والتحليلات
تحظى أتمتة إدخال الرموز الأبجدية بأهمية بالغة في مجالات الأبحاث الإمبريقية والتجارب السريرية وإدارة المشاريع، حيث تؤثر بصورة مباشرة على الحمل المعرفي (Cognitive Load) الملقى على عاتق الباحث أو جامع البيانات. عند قيام المحلل بإدخال مئات السلاسل الأبجدية يدوياً لترميز الاستبيانات أو تصنيف عينات الاختبار، يستنزف ذلك جزءاً كبيراً من انتباهه التنفيذي في مهام آلية نمطية، مما يزيد من احتمالية وقوع أخطاء الإجهاد الذهني والنسيان والانحرافات الطباعية غير المقصودة.
من الناحية التنظيمية، يُسهم الاستغناء عن التدخل البشري المباشر في إنشاء هذه التسلسلات في تعزيز الموثوقية الشاملة للبيانات (Data Reliability). فالخطأ البسيط في تخطي حرف واحد أو كتابة رمز مزدوج في جدول تصنيف العينات قد يؤدي إلى انزياح خطير في ربط النتائج بمتغيراتها التابعة أو المستقلة، وهو ما قد يقود بدوره إلى استنتاجات إحصائية مشوهة تؤثر سلباً على صلاحية البحث العلمي (Scientific Validity).
علاوة على ذلك، تُوفر الأتمتة المنهجية للتسلسلات الحرفية اتساقاً معيارياً يسهل عملية تصدير البيانات وتبادلها بين مختلف المنصات الإحصائية ولغات البرمجة المتخصصة مثل حزمة SPSS ولغتي R وPython. إن تأسيس قاعدة بيانات تتولد رموزها برمجياً يضمن تطابقاً تكنولوجياً يُقلل من وقت معالجة وتنظيف البيانات، مما يتيح للباحثين تركيز جهودهم المعرفية على استقراء الظواهر وتفسير النتائج بدلاً من الانشغال بمهام التدوين المتكررة.
2. الأسس الحوسبية: ترميز ASCII والتمثيل الرقمي للمحارف الأبجدية
2.1 ماهية معيار ASCII وتاريخ التمثيل الرقمي للحروف
يُمثل معيار الأسكي (ASCII)، وهو الاسم المختصر لـ “American Standard Code for Information Interchange” (الرمز القياسي الأمريكي لتبادل المعلومات)، نقطة تحول مفصلية في تاريخ الحوسبة الحديثة؛ إذ نشأ في ستينيات القرن العشرين بمبادرة من المعهد الأمريكي للمعايير لحل مشكلة التباين بين النظم الميكانيكية والإلكترونية المختلفة في قراءة وتفسير النصوص المكتوبة. تقوم الفلسفة الهيكلية لمعيار أسكي على إسناد قيمة رقمية ثنائية (وبالتالي عشرية) فريدة وغير متكررة لكل حرف من حروف الأبجدية، وعلامات الترقيم، ورموز التحكم في الطباعة.
تعتمد النظم الحاسوبية داخلياً على النظام الثنائي القائم على المفاتيح الكهربائية المنطقية (0 و1). وعليه، فإن أي نص يظهر للمستخدم على الشاشة هو في حقيقته تجسيد مادي لسلسلة من البايتات المخزنة في الذاكرة. ولترجمة هذه الإشارات إلى كيانات مفهومة، يعتمد محرك جداول بيانات جوجل على جداول المطابقة الترميزية المعتمدة دولياً، حيث تُخصص عناوين رقمية ثابتة لكل مدخل رمزي، مما يتيح للبرمجية إجراء التبادل السلس بين القيمة الرمزية والقيمة الحسابية المقابلة لها دون أي التباس بنيوي.
هذا الربط المتسق يُمكّن بيئة البرمجة الداخلية لجداول البيانات من إجراء العمليات المقارنة والتحويلية على المحارف؛ فالنظام لا يتعامل مع الحرف كصورة خطية مصمتة، بل كإحداثي عددي يقع على محور إحداثيات الترميز، وهو الأساس النظري الصارم الذي يسمح ببناء معادلات تحاكي منطق التعبئة التلقائية وتتجاوز الحواجز النصية الصلبة.
2.2 النطاق الرقمي للأحرف اللاتينية الكبيرة والصغيرة
في جدول أسكي القياسي ذي الـ 7 بت (والذي يحتوي على 128 موضعاً رقمياً تتراوح من 0 إلى 127)، تم توزيع الأحرف اللاتينية بنسقيها الكبير والصغير ضمن نطاقات عددية متصلة ومدروسة بدقة تامة لتسهيل المعالجة البرمجية. يمتد النطاق المخصص للأحرف اللاتينية الكبيرة (Uppercase) من الرقم العشري 65 الذي يمثل الحرف الأول “A” بصورة غير قابلة للتغيير، ويتدرج خطياً بمقدار وحدة واحدة لكل حرف، وصولاً إلى الرقم العشري 90 الذي يمثل الحرف الأخير “Z”.
في المقابل، تم تخصيص نطاق مختلف للأحرف اللاتينية الصغيرة (Lowercase)؛ حيث يبدأ من القيمة العشرية 97 المخصصة للحرف “a”، وينتهي بالقيمة 122 المخصصة للحرف “z”. ويُلاحظ هنا وجود فجوة عددية مقصودة تفصل بين الحرف “Z” (الرقم 90) والحرف “a” (الرقم 97)، تتألف من ستة رموز خاصة هي: القوس المعقوف الأيسر [ (91)، والشرطة المائلة العكسية (92)، والقوس المعقوف الأيمن ] (93)، ورمز الإقحام ^ (94)، والشرطة السفلية _ (95)، واللكنة الخلفية ` (96).
يعد إدراك هذا التوزيع العددي الدقيق أمراً بالغ الأهمية عند بناء صيغ برمجية لتوليد السلاسل النصية؛ إذ إن أي تجاوز للقيمة 90 دون ضوابط شرطية سينتج عنه محارف غير متوقعة ورموز طباعية تشوه تسلسل البيانات، كما أن الانتقال من حالة الأحرف الكبيرة إلى الصغيرة يتطلب فهماً رياضياً لحجم هذه الإزاحة العددية الثابتة (والتي تبلغ دائماً 32 رمزاً، أي 97 – 65 = 32).
2.3 استغلال المتتاليات العددية في توليد السلاسل النصية المنطقية
يتيح الفهم العميق للتمثيل الرقمي للمحارف تحويل مشكلة التكرار النصي المعقدة إلى مسألة متتالية عددية تزايدية بسيطة، تُحل بإضافة واحد صحيح (+1) في كل خطوة برمجية. وبما أن الأرقام العشرية من 65 إلى 90 متتالية حسابية متجانسة تماماً، يمكن لمحرك الجداول أن يتولى مهمة التوليد الرياضي للمؤشر الرقمي أولاً، ثم استدعاء المحرف النصي المتطابق معه في جدول المعايير ثانياً، مما يخلق جسراً دلالياً يدمج المنطق الحسابي بالإنتاج الرمزي.
هذا الجسر الحسابي-النصي يُرسي قاعدة بالغة البساطة في مظهرها وشديدة القوة في مخرجاتها: إذا استطعنا جعل كل خلية تقرأ القيمة الرقمية لخلية معينة وتزيد عليها المقدار الثابت المحدد للمتتالية، فإننا سنحصل بالضرورة على المعرف الرقمي للحرف التالي في الترتيب الأبجدي مباشرة. ومن خلال هذه الديناميكية، نتحايل على افتقار الأداة لميزة التعرف الذاتي على النصوص، محوّلين جدول البيانات إلى بيئة محاكاة مرنة قادرة على صياغة أي تتابع رمزي منتظم وبكفاءة رياضية مطلقة تضاهي سرعة ودقة التعامل مع الأرقام العادية.
3. التحليل الوظيفي والمعماري لدالتي CODE و CHAR
3.1 دالة CODE: استخراج القيمة الترميزية للمحرف
تُعد دالة CODE إحدى الدوال النصية المتخصصة في جداول بيانات جوجل، وتتمثل وظيفتها المعمارية في قراءة مدخل نصي محدد، واستخراج القيمة الرقمية العشرية المقابلة للمحرف الأول في ذلك النص وفقاً لجدول أسكي أو جدول يونيكود القياسي. يتسم التركيب النحوي (Syntax) لهذه الدالة بالبساطة المباشرة، حيث تأخذ وسيطاً واحداً فقط:
=CODE(text)
حيث يمثل الوسيط text النص أو مرجع الخلية المراد فحصه وتحليله. وعند تزويد الدالة بسلسلة نصية تحتوي على أكثر من حرف واحد، مثل كتابة “Alpha”، فإنها تتجاهل بطبيعتها الوظيفية جميع المحارف اللاحقة وتقوم باستخلاص الشفرة الرقمية للحرف الأول “A” فقط، لتعيد القيمة 65 دون أي تأثر بطول الكلمة أو محتواها التالي.
تتعامل الدالة بدقة بالغة مع الرموز الخاصة وحالات الأحرف والفراغات؛ فإذا كانت الخلية تحتوي على مسافة بيضاء قبل الحرف (مثل ” A”)، فإن الدالة ستقوم بإرجاع القيمة 32، وهي الشفرة الخاصة بالمسافة الفارغة، متجاهلة الحرف الذي يليها كلياً. يفرض هذا السلوك المعياري على مستخدم الجداول توخي الحذر الشديد عند إعداد البيانات المرجعية، والتأكد التام من نقاء المدخلات من أي محارف مخفية قد تُربك المخرجات المتوقعة وتفضي إلى أخطاء حسابية مضللة.
3.2 دالة CHAR: إعادة بناء الرمز انطلاقاً من المعرف العددي
على الطرف المقابل تماماً من المسار التحويلي، تقف دالة CHAR كمعكوس وظيفي متكامل لدالة CODE؛ إذ تضطلع بمهمة استقبال قيمة عددية صحيحة تقع ضمن نطاق الجداول الترميزية، وتقوم بترجمتها وتجسيدها في هيئة الحرف النصي أو الرمز الطباعي المقابل لها بصورة أحادية. وتأخذ الدالة التركيب النحوي الآتي:
=CHAR(table_number)
حيث يمثل الوسيط table_number عدداً صحيحاً معبراً عن موضع الرمز في جدول الترميز. فعلى سبيل المثال، إذا تم تزويد الدالة بالقيمة العددية 65، فإنها تُعيد فوراً الحرف النصي الكبير “A”، في حين تعيد الحرف الصغير “a” إذا ما أُدخلت فيها القيمة 97.
تتسم دالة CHAR بصرامة تشغيلية حيال الحدود العددية للمدخلات؛ فإذا كانت القيمة المدخلة سالبة أو تتجاوز الحدود القصوى المحددة لترميزات يونيكود المقبولة في بيئة جداول بيانات جوجل، فإنها تفشل في التفسير وتُرجع خطأ القيمة الشهير (#VALUE!). كما تبرز أهمية الدالة التقنية في قدرتها على توليد رموز غير قابلة للطباعة المباشرة من لوحة المفاتيح، مثل فواصل الأسطر التلقائية باستخدام الكود 10، مما يجعلها أداة محورية في تصميم مخرجات نصية معقدة ومتعددة المستويات داخل الخلية الواحدة.
3.3 التركيب الرياضي للصيغة المدمجة =CHAR(CODE(cell)+1)
عند دمج دالتي CODE و CHAR في علاقة رياضية تبادلية، نصل إلى واحدة من أكثر الصيغ كفاءة وأناقة برمجية لتجاوز عجز التعبئة التلقائية التقليدي للأحرف. تأخذ الصيغة المعيارية التكرارية الشكل الهندسي الآتي:
=CHAR(CODE(A1)+1)
تخضع هذه الصيغة لتسلسل معالجة خوارزمي صارم ومترابط؛ حيث تبدأ النواة الداخلية أولاً بتنفيذ دالة CODE(A1) لقراءة الحرف الموجود في الخلية الابتدائية ولتكن “A”، فتستخرج قيمته الرقمية 65. بعد ذلك مباشرة، يتدخل المشغل الحسابي لإجراء عملية الجمع البسيطة (+1) فيتحول الناتج الداخلي إلى القيمة 66. وفي الخطوة النهائية، تستقبل دالة CHAR هذا الناتج الجديد وتقوم بفك شفرته، لينبثق في الخلية التالية الحرف المقابل للقيمة 66، وهو الحرف المتتالي “B” بكل سلاسة واستقرار.
تتميز هذه الصيغة المركبة بكفاءتها العالية جداً في استهلاك موارد المعالجة؛ إذ لا تتطلب استدعاء استعلامات خارجية أو تراكيب برمجية معقدة مثل نصوص التطبيقات البرمجية (Apps Script)، مما يجعل المستند يحتفظ بسرعته وخفته حتى عند تعميم هذه المعادلة على مئات الخلايا في آن واحد، لتصبح حجر الزاوية في بناء التسلسلات الأبجدية الديناميكية الموجهة نحو السحب والإفلات.
4. الدليل الإجرائي المعياري للتعبئة التلقائية للأحرف من A إلى Z
4.1 تهيئة الخلية المرجعية وتأسيس نقطة الانطلاق
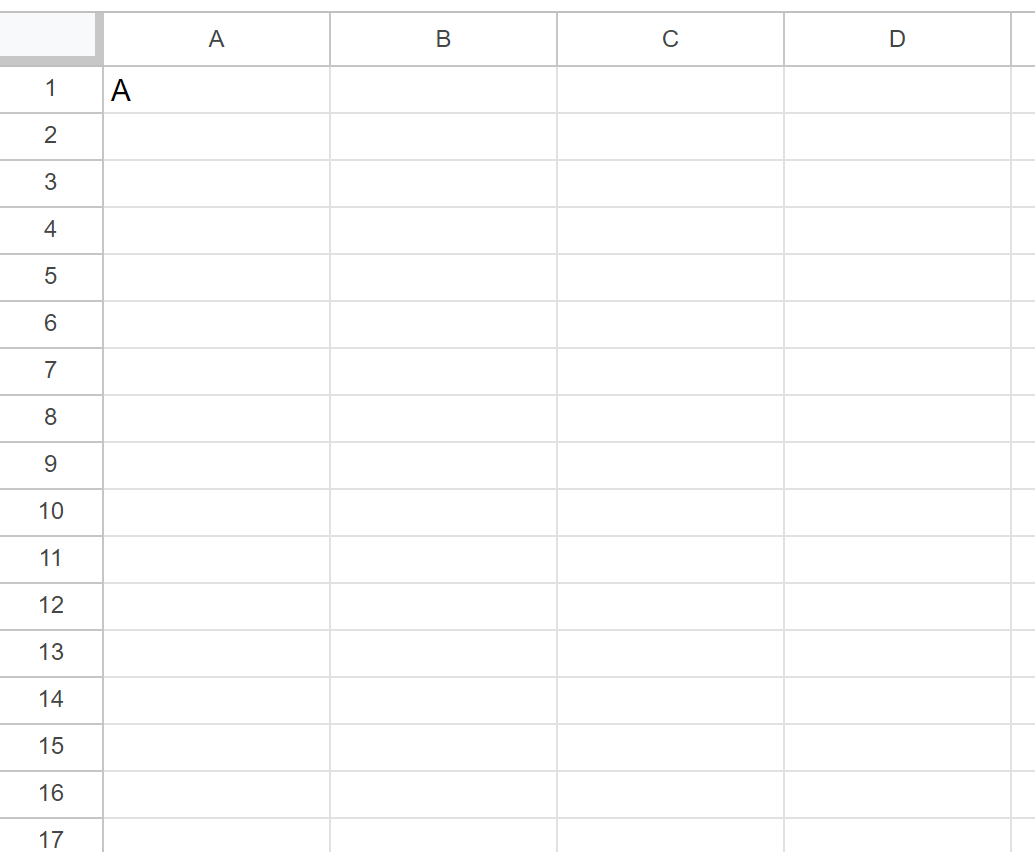
تبدأ العملية الإجرائية لبناء المتتالية الأبجدية بتحديد الخلية الابتدائية في ورقة العمل بدقة متناهية، ولتكن الخلية A1، حيث يقوم المستخدم بإدخال الحرف الأول من الأبجدية يدوياً بصيغته الكبيرة “A”. يمثل هذا الإدخال الأساس المرجعي الذي ستعتمد عليه كافة العمليات الخوارزمية التكرارية اللاحقة؛ إذ يفتقر النظام إلى نقطة بداية افتراضية ما لم يتم تحديدها بوضوح داخل الهيكل الشبكي للبيانات.
من الضروري للغاية في هذه المرحلة التأكد من عدم احتواء الخلية المرجعية على أي مسافات فارغة غير مقصودة، سواء سابقة للحرف أو لاحقة له، والتأكد من عدم تنسيق الخلية بنسق غير مناسب قد يغير من طبيعة البيانات المدخلة؛ فالخلية يجب أن تُعامل بصفتها “نصاً عادياً” (Plain Text). إن وجود أي تلوث في البيانات النصية داخل A1 سينتقل أثره فوراً إلى بقية الخلايا عبر المتتالية، متسبباً في أخطاء دائرية أو إرجاع رموز شاذة في السلسلة التراكمية.
يُفضل كذلك تعيين نمط الخط وحجمه ومحاذاته بصورة متسقة في هذه الخلية الأولية قبل الشروع في التوسيع؛ لأن جداول بيانات جوجل تميل إلى نسخ التنسيق البصري للخلية المصدر تلقائياً عبر نطاق التعبئة، مما يوفر جهداً إضافياً في إعادة الضبط الجمالي والتنظيمي لاحقاً.
4.2 إدخال الصيغة المتداخلة وتفعيل الانتقال المنطقي
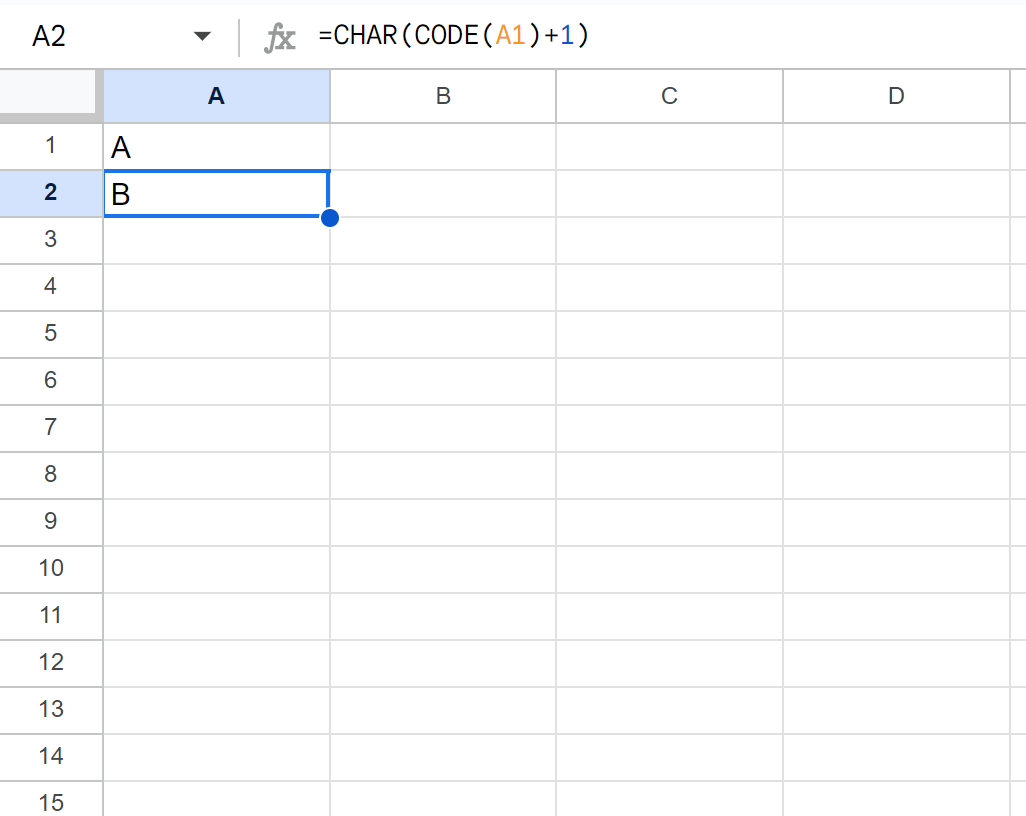
عقب تثبيت الحرف “A” في الخلية A1، ينتقل المستخدم مباشرة إلى الخلية الواقعة أسفلها مباشرة، وهي الخلية A2، لتأسيس حلقة الوصل الحسابية. يتم إدخال الصيغة التكرارية بصورة دقيقة كما يلي:
=CHAR(CODE(A1)+1)
بمجرد الضغط على زر الإدخال (Enter)، يقوم محرك البرنامج بتنفيذ الخطوات الحسابية الموصوفة سابقاً، ليظهر الحرف “B” فوراً داخل الخلية A2. تعتمد هذه الخلية كلياً على الحالة الراهنة للخلية A1 السابقة لها بمرجعية نسبية وليست مطلقة؛ أي أن المعادلة صُممت لتقرأ دائماً ما يعلوها بمقدار صف واحد وتزيد عليه خطوة معيارية واحدة في جدول أسكي.
تكمن قوة هذا الانتقال المنطقي في كونه يحرر الخلية A2 من الاعتماد على قيم ثابتة مشفرة، بل يجعلها جزءاً من سلسلة مترابطة حلقياً (Chained Logic)؛ فإذا قام المستخدم لاحقاً بتغيير محتوى الخلية A1 من الحرف “A” إلى الحرف “M”، ستتجاوب الخلية A2 تلقائياً وتتحول فوراً إلى الحرف “N”، مما يُبرهن على مرونة وقوة التصميم الخوارزمي في الاستجابة للتغيرات الفورية للمدخلات.
4.3 توظيف مقبض التعبئة (Fill Handle) ونشر السلسلة عمودياً
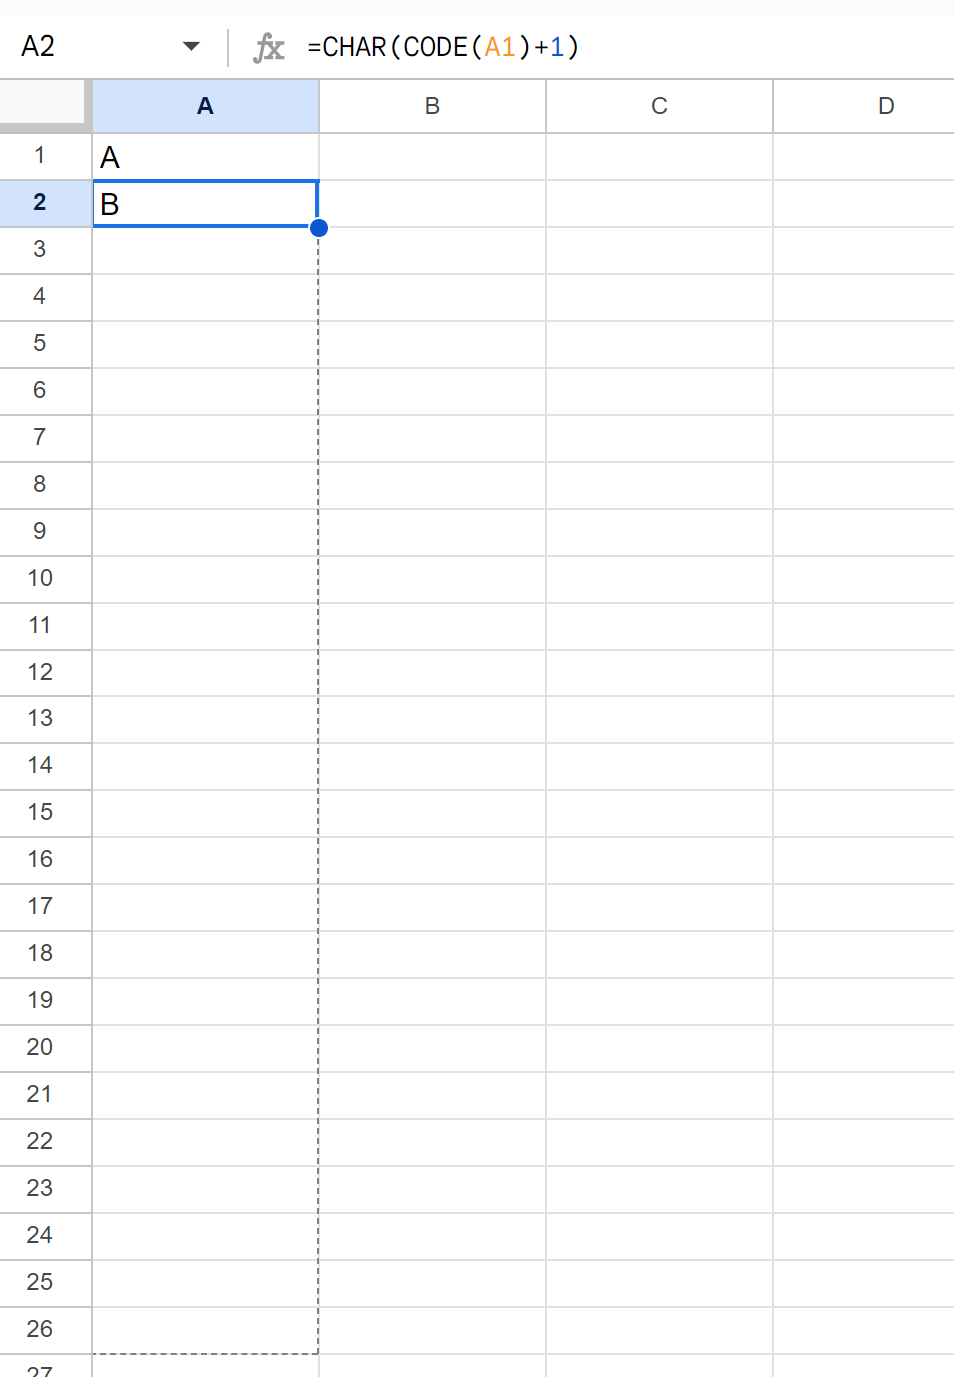
بعد التحقق من استقرار الصيغة في الخلية A2 وظهور الحرف “B” بنجاح، يُفعل المستخدم تقنية النشر المتسلسل باستخدام “مقبض التعبئة” (Fill Handle). يتمثل مقبض التعبئة في المربع الأزرق الصغير المصمت الواقع في الزاوية السفلية اليسرى (أو اليمنى وفقاً لاتجاه واجهة البرنامج من اليمين لليسار أو العكس) لإطار الخلية المحددة A2. وعند تحريك مؤشر الفأرة فوق هذا المربع، يتحول شكل المؤشر من السهم التقليدي إلى علامة متقاطعة داكنة (+).
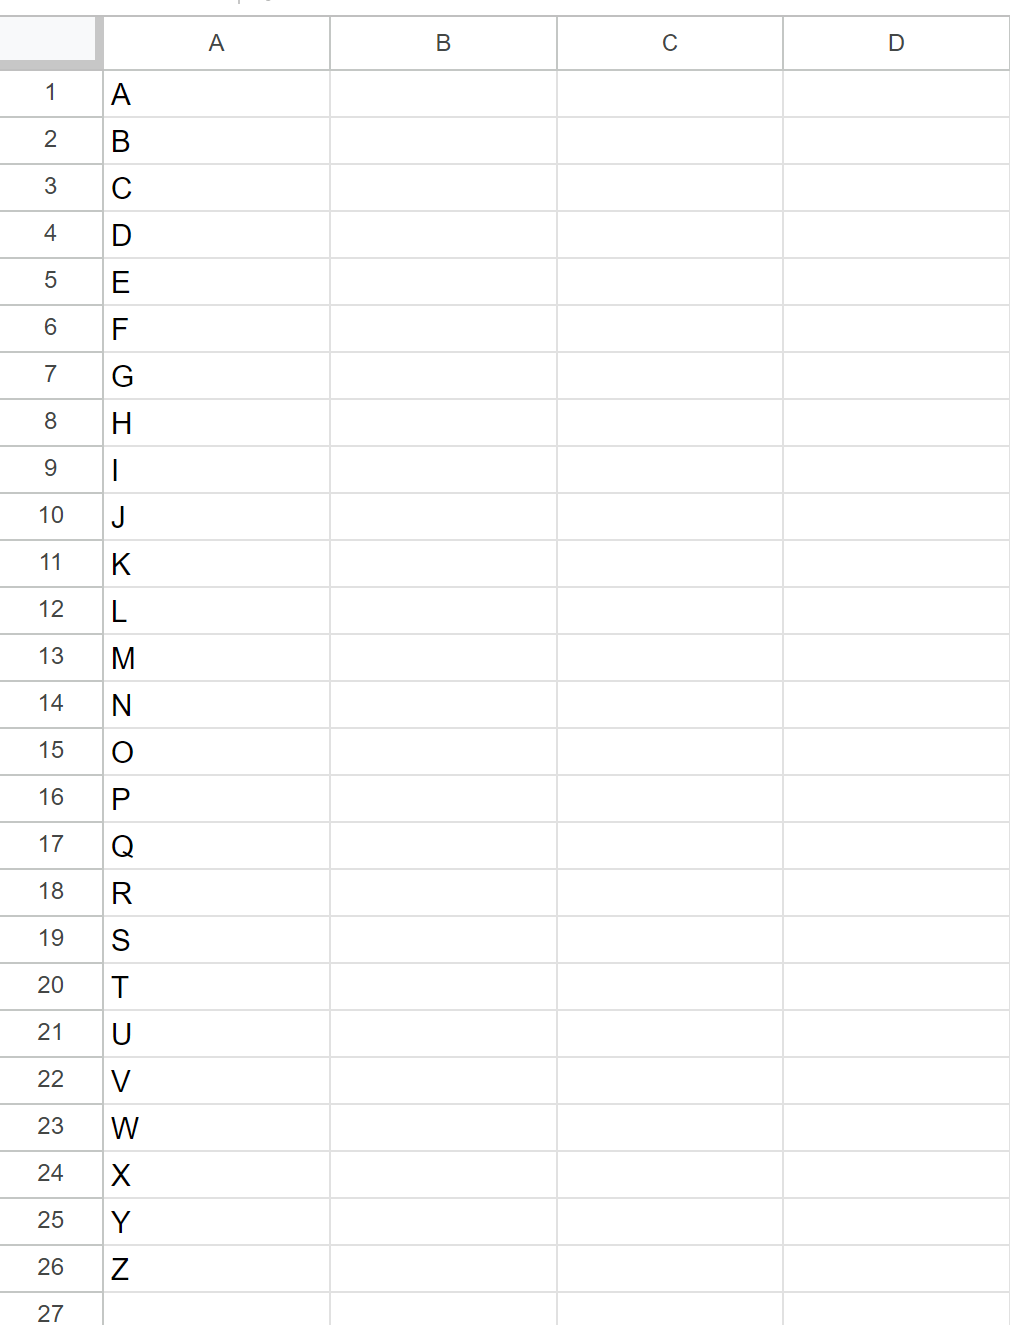
يتم النقر المستمر بزر الفأرة الأيسر على المقبض وسحبه عمودياً إلى الأسفل باتجاه الصفوف التالية حتى بلوغ الخلية A26. خلال عملية السحب، تقوم جداول بيانات جوجل بنسخ الصيغة مع تعديل المراجع النسبية تلقائياً؛ فتصبح الصيغة في A3 معتمدة على A2، وفي A4 معتمدة على A3، وهكذا دواليك في متتالية انسيابية تنتهي بظهور الحرف “Z” في الخلية A26 بدقة ميكانيكية متناهية.
وكطريقة بديلة أكثر سرعة للمحترفين: إذا كان هناك عمود مجاور ممتلئ بالبيانات مسبقاً حتى الصف 26، يكفي النقر المزدوج (Double-Click) السريع على مقبض التعبئة الخاص بالخلية A2؛ حيث سيتولى البرنامج استشعار حدود النطاق المجاور وقذف المتتالية الأبجدية للأسفل تلقائياً ليتوقف الحرف Z عند نقطة نهاية البيانات الموازية بدقة هندسية توفر الوقت والجهد.
5. التعبئة التلقائية للأحرف اللاتينية الصغيرة (Lowercase): الخصوصيات والتطبيق
5.1 الاستناد إلى النطاق المعياري الخاص بالأحرف الصغيرة
لا يختلف المنطق الرياضي لتوليد الأحرف اللاتينية الصغيرة (Lowercase) من “a” إلى “z” عن نظيره المتبع مع الأحرف الكبيرة، سوى في نقطة الانطلاق الرقمية المعتمدة في جدول الترميز. لتنفيذ هذا الإجراء، يتم الانتقال إلى الخلية المرجعية الابتدائية (ولتكن B1) وكتابة الحرف الصغير “a” يدوياً. هذا التغيير البسيط يُلزم دالة CODE بالعمل في فضاء رقمي مغاير يبدأ من القيمة 97 بدلاً من القيمة 65.
وعند تطبيق نفس الصيغة الرياضية المتداخلة في الخلية التالية B2:
=CHAR(CODE(B1)+1)
ستقوم الدالة الداخلية باستخراج القيمة 97 ثم إضافة 1 لتصبح 98، وهو الكود المقابل للحرف “b” الصغير في جدول أسكي، فتُظهره دالة CHAR بدقة مطلقة دون الحاجة إلى إدخال أي وسائط إضافية أو تعديل في بنية المعادلة. يثبت هذا السلوك التلقائي عبقرية الاعتماد على معيار أسكي المتسق؛ حيث تتطابق البنية الوظيفية للمعادلة بصورة مستقلة تماماً عن حالة الحرف (Case)، طالما أن النطاق الفرعي يمتلك تسلسلاً خطياً متواصلاً بمقدار 26 وحدة عددية.
يمكن بعد ذلك تعميم الصيغة عبر السحب العمودي حتى الوصول إلى الحرف “z” في الصف السادس والعشرين، مع الحفاظ على ذات المزايا الخوارزمية الخاصة بالأحرف الكبيرة من حيث السرعة والاستقرار وانعدام الأخطاء التحويلية.
5.2 دراسة مقارنة لسلوك الصيغة بين حالتي الأحرف (Case Sensitivity)
تتسم دوال جداول بيانات جوجل المتخصصة في التعامل مع المحارف، مثل CODE وCHAR، بحساسيتها العالية جداً لحالة الأحرف (Case Sensitivity)، وهو سلوك ينبغي الانتباه إليه بدقة عند تصميم النظم الإدارية. خلافاً لبعض الدوال المنطقية مثل VLOOKUP أو دالة التطابق البسيطة =A1=B1 التي قد تتجاهل الفوارق بين “A” و”a”، فإن دالة CODE تُفرق تماماً بينهما لاختلاف إحداثياتهما الرقمية في جدول الترميز.
إذا حدث خطأ إجرائي وقام المستخدم بمزج غير مقصود بين الأحرف الكبيرة والصغيرة في سلسلة يدوية متقطعة، كأن يُدخل “A” ثم “b” ثم يطبق المعادلة، فإن التسلسل سينكسر منطقياً؛ لأن الانتقال من الحرف الصغير “b” (الكود 98) بالزيادة الحسابية سينتج الحرف “c” (الكود 99)، مما يؤدي إلى ضياع الاتساق النمطي للملف ككل. لذلك، تتطلب المشروعات الحساسة استخدام دوال التوحيد النصي مثل دالة UPPER أو LOWER مسبقاً لضمان تجانس البيانات الأولية.
يسهم هذا الفصل الصارم بين النطاقين في إعطاء المحلل تحكماً دقيقاً في مسار البيانات؛ حيث يمكن الاعتماد على حساسية الدالة للترميز لبناء متتاليات تصنيفية معقدة تميز بوضوح بين المتغيرات الأساسية ذات الرموز الكبيرة والمتغيرات الثانوية المعبر عنها بالأحرف الصغيرة دون أدنى تداخل برمجي غير مرغوب.
5.3 التطبيقات المنهجية للأحرف الصغيرة في تصنيف المتغيرات التابعة
تحظى الأحرف الصغيرة بأهمية تطبيقية ومنهجية واسعة في تصميم الاستبيانات، والتجارب الإكلينيكية، ونماذج القياس النفسي والتربوي؛ إذ يُلجأ إليها تقليدياً لترميز المستويات الفرعية للمتغيرات المستقلة أو تصنيف البنود التفصيلية ضمن المحاور الرئيسية المرمزة بالأحرف الكبيرة. فعلى سبيل المثال، قد يحمل المحور الرئيسي للاختبار الرمز “A”، بينما تُرمز فقراته السلوكية الدقيقة بالأحرف “a, b, c, d” لتأسيس تدرج هرمي بصري ومنطقي واضح يمنع الالتباس لدى جامعي البيانات والمشاركين.
كذلك تُوظف الأحرف الصغيرة في الدراسات التجريبية لتمييز مجموعات القياس المكررة أو الشروط البيئية المصاحبة للمجموعات الضابطة، كأن يُشار إلى الجلسة العلاجية الأولى بالرمز “Condition a” والجلسة الثانية بالرمز “Condition b”. إن أتمتة هذه المتتاليات تضمن مطابقة المخرجات للمعايير المعتمدة في التوثيق الأكاديمي، مثل أدلة النشر الصادرة عن الجمعيات العلمية الدولية، والتي تشترط أنماطاً رمزية محددة تفرق بين المتغيرات الرئيسة والفئات الثانوية المشتقة منها.
تُتيح هذه الأساليب للباحث تصدير مصفوفات نظيفة ومرتبة مباشرة إلى برمجيات النمذجة الرياضية والتحليل متعدد المتغيرات، حيث تلعب التسميات الموحدة ذات التكوين القياسي دوراً حيوياً في تقليل زمن معالجة المتغيرات وتجنب أخطاء إعادة التسمية التي تعرقل أحياناً تنفيذ الأوامر البرمجية والتحليلات الإحصائية الدقيقة.
6. طرق متقدمة وبديلة: توليد الأبجدية باستخدام مصفوفات ARRAYFORMULA
6.1 التوليد التلقائي الشامل دون الحاجة للسحب والإفلات اليدوي
على الرغم من فعالية طريقة السحب والإفلات باستخدام الصيغة =CHAR(CODE(cell)+1)، إلا أنها تظل معتمدة على التدخل البشري الحركي، وتترك مئات الصيغ المكررة في خلايا متعددة، مما قد يجعلها عرضة للكسر أو الحذف العرضي إذا قام أحد المستخدمين بتعديل خلية وسيطة داخل الجدول التشاركي. ومن هنا تبرز الحاجة المعمارية إلى استخدام “صيغ المصفوفات” (Dynamic Array Formulas)، وهي ميزة حوسبية متطورة تنفرد بها بيئات الجداول المتقدمة، حيث تُكتب المعادلة مرة واحدة فقط في خلية منفردة، وتقوم هي تلقائياً بنشر النتائج عبر نطاق ممتد من الخلايا وفق حسابات متوازية.
تتمثل الفلسفة الجوهرية لاستخدام صيغة المصفوفة في مبدأ “المصدر الأحادي للحقيقة” (Single Source of Truth)؛ فالبيانات الناتجة لا تحتفظ بصيغ مستقلة داخل كل خلية، بل هي مخرجات ديناميكية صادرة عن الخلية الأم الحاضنة للمعادلة الرئيسية. وإذا حاول أي مستخدم مسح أو تعديل أي قيمة داخل النطاق المتولد، فإن النظام يمنع ذلك أو يعيد توليدها فوراً طالما بقيت الخلية الأصلية سالمة، مما يضفي حماية فائقة على تماسك البيانات.
علاوة على ذلك، توفر هذه التقنية ميزة التحسين البرمجي؛ فمحرك الحساب في جداول بيانات جوجل يتعامل مع المصفوفة ككتلة عملياتية واحدة تُعالج في دورة معالجة مركزية محددة بدلاً من استهلاك الموارد في تكرار استدعاء الدوال الحسابية بعدد الخلايا، وهو ما يضمن سرعة واستجابة استثنائية حتى في أوراق العمل المليئة بالمعادلات والرسوم البيانية المعقدة.
6.2 دمج دالتي SEQUENCE و CHAR لإنتاج الأبجدية الفورية
لتحقيق التوليد الأبجدي الفوري دون الاعتماد على مراجع مسبقة أو سحب يدوي، يتم دمج دالة ARRAYFORMULA مع دالتي CHAR وSEQUENCE في بناء تركيبي واحد يُعد المعيار الذهبي الحديث في جداول بيانات جوجل. الصيغة المعيارية لتوليد الأحرف اللاتينية الكبيرة من A إلى Z هي:
=ARRAYFORMULA(CHAR(SEQUENCE(26, 1, 65, 1)))
لتفكيك هذه الصيغة المتقدمة وفهم آلياتها، ينبغي تحليل معاملات دالة SEQUENCE التي تضطلع بتوليد مصفوفة الأرقام الحسابية، حيث تأخذ أربعة محددات رئيسية:
- المعامل الأول (26): يُحدد عدد الصفوف المراد ملؤها، وهو يطابق تماماً عدد أحرف الأبجدية اللاتينية.
- المعامل الثاني (1): يُحدد عدد الأعمدة التي ستشغلها المصفوفة، وتم ضبطه هنا على عمود واحد لإنتاج قائمة رأسية.
- المعامل الثالث (65): يُمثل نقطة الانطلاق الرقمية للقيمة الحسابية، وهو يوافق شفرة الحرف “A” في معيار أسكي.
- المعامل الرابع (1): يمثل مقدار الخطوة التزايدية الحسابية في كل صف تالٍ.
تقوم دالة SEQUENCE بإنتاج تتابع عددي متكامل يبدأ من 65 وينتهي عند 90 دفعة واحدة في الذاكرة المؤقتة. بعد ذلك، تستقبل دالة CHAR هذه المصفوفة المتكاملة من الأرقام، وتتولى دالة ARRAYFORMULA إلزام دالة CHAR بمعالجة كل عنصر في المصفوفة بصورة فردية وتحويله إلى رمزه الحرفي المقابل، لتنبثق قائمة الحروف الكاملة من A إلى Z في أقل من ثانية وبكتابة معادلة واحدة في الخلية العلوية فقط.
ولتوليد الأبجدية ذات الأحرف الصغيرة (Lowercase) باستخدام ذات التقنية، يكفي تعديل معامل البداية الرقمي في دالة SEQUENCE من 65 إلى 97، لتصبح الصيغة:
=ARRAYFORMULA(CHAR(SEQUENCE(26, 1, 97, 1)))
حيث تُفرغ هذه الصيغة فوراً الأحرف من a إلى z بدقة متناهية وسرعة فائقة تلغي تماماً الحاجة إلى أساليب السحب اليدوي التقليدية.
6.3 توليد السلاسل الأبجدية الأفقية مقابل العمودية
في كثير من الحالات التطبيقية لتصميم الجداول، مثل بناء نماذج استخراج الدرجات، أو إعداد تسميات أعمدة البيانات في التجارب متعددة القياسات، يحتاج المحلل إلى نشر الأحرف الأبجدية أفقياً عبر الصفوف (Row-wise) بدلاً من توجيهها رأسياً عبر الأعمدة (Column-wise). تتيح التراكيب المصفوفية المتقدمة تحقيق هذا المطلب الرياضي بمرونة بالغة عبر مسارين هندسيين رئيسيين.
المسار الأول يعتمد على التعديل المباشر لمعاملات دالة SEQUENCE؛ حيث يتم ضبط عدد الصفوف على 1، ورفع عدد الأعمدة إلى 26، مع الإبقاء على نقطة البداية 65 ومقدار الزيادة 1، لتصبح الصيغة كالتالي:
=ARRAYFORMULA(CHAR(SEQUENCE(1, 26, 65, 1)))
تنتشر الأحرف وفق هذه الصيغة مباشرة من الخلية الحاضنة وتتوسع أفقياً عبر 26 عموداً متتالياً على نفس الصف، مما يجعلها مثالية لتوليد عناوين الأعمدة التلقائية في التقارير الإدارية والتطبيقية.
أما المسار الثاني، فيعتمد على توظيف دالة التبديل والتدوير الرياضي للمصفوفات TRANSPOSE؛ حيث يمكن إحاطة الصيغة العمودية السابقة بدالة التحويل لعكس اتجاه المتجهات المكانية للمصفوفة كما يلي:
=TRANSPOSE(ARRAYFORMULA(CHAR(SEQUENCE(26, 1, 65, 1))))
يمنح هذا التكامل الوظيفي للمحلل القدرة الكاملة على توجيه مصفوفات البيانات وإعادة تشكيلها مكانياً وفق متطلبات التصميم الهندسي للمشروع، دون الإخلال بترابط المتتالية الأبجدية أو إجبار المستخدم على التعديل اليدوي المرهق للمحاور.
7. التعامل مع حدود الأبجدية وتجاوز الحرف Z (المتواليات المركبة)
7.1 إشكالية انكسار التسلسل بعد الحرف Z والظواهر الترميزية الناتجة
تظهر معضلة برمجية حتمية عند استخدام صيغ التعبئة البسيطة، مثل =CHAR(CODE(cell)+1)، بمجرد الوصول إلى نهاية الأبجدية عند الحرف “Z” (الموافق للرقم 90 في جدول أسكي) ومحاولة تمديد السلسلة إلى خلايا إضافية. فبما أن الخوارزمية مصممة للزيادة الحسابية المجردة بمقدار واحد صحيح، فإن الخلية التالية للحرف Z ستقوم بقراءة الكود 90 وإضافة 1 إليه، لترسل القيمة 91 إلى دالة CHAR.
واستناداً إلى خارطة أسكي المعيارية، فإن الكود 91 لا يمثل حرفاً أبجدياً مركباً مثل “AA”، بل هو الرمز المخصص للقوس المعقوف الأيسر [، يليه الرمز 92 للشرطة المائلة العكسية ، ثم 93 للقوس الأيمن ]، وهكذا دواليك عبر سلسلة من الرموز الخاصة التي لا تمت بصلة للمتتالية الأبجدية المتوقعة. يُحدث هذا الانكسار تشويهاً بصرياً وتنظيمياً خطيراً في قواعد البيانات، وقد يتسبب في تعطل العمليات الحسابية والمعادلات المرجعية التي تفترض مسبقاً بقاء المدخلات ضمن الفضاء الأبجدي الصرف.
يعكس هذا الفشل الإجرائي محدودية النظم الأحادية عند مواجهة مشكلات الترقيم الدوري أو متعدد المنازل؛ فالأبجدية اللاتينية تمثل نظام ترقيم ذي قاعدة 26 (Base-26 Numbering System)، وعند استنفاد كافة الرموز المتاحة في الخانة الواحدة، ينبغي الانتقال إلى الخانة الثنائية المركبة على غرار ما يحدث في النظام العشري عند الانتقال من الرقم 9 إلى 10، وهو ما تعجز عنه الصيغ الخطية البسيطة دون تطويرات بنيوية خاصة.
7.2 محاكاة ترقيم الأعمدة الثنائية (AA, AB, AC…) بصيغ رياضية متقدمة
لتوليد تسلسلات تتجاوز الحرف Z وتحاكي الترقيم التلقائي المعتمد في تسمية أعمدة الجداول ذاتها (A, B… Z, AA, AB… ZZ)، يتطلب الأمر بناء صيغ رياضية متقدمة قادرة على تفكيك المشكلة الحسابية إلى خانات رقمية، وتطبيق خوارزميات القسمة وبواقيها (Modulo Arithmetic)، أو توظيف دوال فك تشفير العناوين المرجعية للبرنامج.
تتمثل إحدى أكثر الطرق أناقة وموثوقية في استغلال دالتي ADDRESS وSUBSTITUTE داخل صيغة مصفوفية ذكية تطلب من محرك جداول بيانات جوجل استخراج اسم العمود الافتراضي المطابق للمؤشر الحسابي المتزايد، كما في الصيغة الآتية:
=ARRAYFORMULA(SUBSTITUTE(ADDRESS(1, SEQUENCE(52, 1, 1, 1), 4), "1", ""))
تعمل هذه الصيغة عبر توليد متتالية حسابية تبدأ من 1 وتستمر حتى 52 (أو أي رقم مستهدف) بواسطة SEQUENCE. تقوم دالة ADDRESS(1, column, 4) بتوليد العنوان النصي للخلية في الصف الأول والعمود المقابل وفق المرجعية النسبية (مثل “A1”, “Z1”, “AA1”). بعد ذلك، تتدخل دالة SUBSTITUTE لتبديل الرقم “1” وحذفه كلياً من السلسلة النصية، تاركة الحروف الأبجدية المفردة والمركبة نقية في الخلية (لتنتج بدقة: A، B… Z، AA، AB… AZ).
تتسم هذه الطريقة باستقرارها المعماري المطلق؛ لأنها لا تعتمد على حسابات تحويل المحارف يدوياً، بل تستفيد من المحرك الداخلي المتين لجداول بيانات جوجل المسؤول عن إدارة أبعاد الشبكة وتسمية الأعمدة اللانهائية، مما يوفر على الباحث عناء كتابة خوارزميات القسمة المطولة ويضمن دقة المتواليات المركبة المعقدة.
7.3 توظيف الدوال الشرطية لإيقاف السلسلة أو إعادة تدويرها
في العديد من البيئات التشغيلية، قد لا يرغب المستخدم في الانتقال إلى الترقيم المركب بعد الحرف Z، بل يتطلب التصميم الهندسي للملف إيقاف السلسلة كلياً عند بلوغ الحرف الأخير، أو إعادة تدويرها لتبدأ تلقائياً من الحرف “A” مرة أخرى لتشكيل دورات متكررة ومنتظمة من الرموز الأبجدية. يمكن تحقيق ذلك بكفاءة عالية عبر دمج الدالة الشرطية IF في الصيغة التكرارية.
لتحقيق الإيقاف التلقائي ومنع ظهور الرموز الغريبة المشوهة بعد الحرف Z، تُكتب الصيغة الشرطية الآتية في الخلية التالية (ولتكن A2 مع افتراض أن السلسلة بدأت في A1):
=IF(A1="Z", "", CHAR(CODE(A1)+1))
تقوم هذه الصيغة بفحص الخلية السابقة؛ فإذا بلغت الحرف “Z”، فإنها تُعيد سلسلة فارغة (“”) فوراً، مما يوقف التوليد بصورة نظيفة ومحكمة تمنع امتداد البيانات إلى ما وراء الأبجدية المقررة.
أما إذا كان الهدف هو بناء حلقة دائرية تكرارية تعيد تشغيل السلسلة من البداية لتصنيف مجموعات دورية مستمرة، فيتم تعديل المعامل الشرطي ليعيد توجيه المؤشر إلى الحرف الأول عند استنفاد الأبجدية كما يلي:
=IF(A1="Z", "A", CHAR(CODE(A1)+1))
تضمن هذه الآلية الشرطية استقرار قواعد البيانات وحمايتها من الأخطاء التراكمية، مانحة المستخدم أداة حوكمة رقمية تضبط اتساق المخرجات وتمنع حدوث أي تشوهات ترميزية غير متوقعة في بيئات العمل المشتركة.
8. الأخطاء الشائعة واستراتيجيات استكشاف الأخطاء وإصلاحها (Troubleshooting)
8.1 أخطاء التثبيت المرجعي النسبي والمطلق وتأثيرها على التعاقب
تُعد أخطاء المراجع من أكثر العثرات شيوعاً بين المستخدمين أثناء محاولة تطبيق السلاسل المتتالية؛ إذ يلجأ البعض، بدافع العادة عند كتابة معادلات الجداول، إلى تثبيت المرجع باستخدام رمز الدولار ($)، كأن يكتب في الخلية A2 الصيغة: =CHAR(CODE($A$1)+1). يؤدي هذا التثبيت المطلق (Absolute Reference) إلى تجميد نقطة القراءة الرياضية عند الخلية الأولى بشكل دائم؛ مما يتسبب في ظهور الحرف “B” في جميع الخلايا اللاحقة عند السحب للأسفل دون أن تتصاعد السلسلة إلى C وD؛ لأن كل خلية تقرأ القيمة ذاتها للخلية A1 الثابتة.
لتفادي هذا الخلل، يجب التأكد دائماً من استخدام المرجعية النسبية المجردة (Relative Reference) التي تشير إلى الخلية السابقة مباشرة دون أي علامات تثبيت (مثل A1 في الخلية A2، وA2 في الخلية A3). يسمح هذا التكوين للصيغة بتحديث مرجعها خطوة بخطوة بالتوازي التام مع حركة مقبض التعبئة التلقائية.
كما يجب الحذر من خطأ الاعتماد الدائري (Circular Dependency Error)، والذي يقع حين يقوم المستخدم بالإشارة إلى الخلية ذاتها داخل صيغتها (كأن يكتب في الخلية A1 المعادلة =CHAR(CODE(A1)+1))، مما يُدخل البرنامج في حلقة حسابية لا نهائية تفضي إلى تعطل الحساب وظهور إشعار الخطأ التشغيلي الشهير (#REF!).
8.2 مشكلات المسافات البيضاء والرموز المخفية وطرق معالجتها
تُمثل المسافات البيضاء والرموز المخفية التي تتسلل إلى الخلايا دون انتباه من المستخدم عائقاً تشغيلياً خفياً يؤدي إلى إفساد منطق التحويل الرقمي تماماً. نظراً لأن دالة CODE تستخلص القيمة الرقمية للمحرف الأول فقط، فإن وجود مسافة واحدة غير مرئية قبل الحرف (مثل مسافة بادئة ناتجة عن النسخ من وثيقة خارجية) يجعل الدالة تقرأ الكود 32 الخاص بالفراغ وتتجاهل الحرف الفعلي كلياً، مما ينتج عنه علامات ترقيم ورموز شاذة في الخلايا التالية مثل علامة التعجب (!)، التي تحمل الكود 33 (32+1).
لمعالجة هذه المعضلة وتطهير البيانات المرجعية قبل إخضاعها للمتتالية، يُنصح بتغليف المرجع داخل دالة تنظيف الفراغات TRIM ودالة التنظيف الطباعي CLEAN؛ حيث تعمل الأولى على إزالة المسافات الزائدة من البداية والنهاية، بينما تضطلع الثانية بحذف المحارف غير القابلة للطباعة الناتجة عن أخطاء نقل البيانات:
=CHAR(CODE(TRIM(CLEAN(A1)))+1)
يضمن هذا الإجراء الوقائي إخضاع النص لعملية فلترة صارمة تجرد الحرف المرجعي من أي شوائب رقمية كامنة، وتؤمن بقاء المتتالية ضمن إطارها الأبجدي الصحيح بصورة مستقرة ومحمية من عيوب الإدخال البشري غير المنضبط.
8.3 تلف الصيغ عند حذف أو إدراج صفوف وسيطة
من المخاطر الهيكلية المرتبطة بالاعتماد على طريقة السحب اليدوي البسيطة القائمة على المراجع النسبية تعرض السلسلة للتلف الفوري عند قيام أحد المحللين بحذف صف وسيط داخل نطاق العمل. فإذا احتوى الجدول على الأحرف من A إلى Z، وقام المستخدم بحذف الصف الخامس (الحرف E)، فإن الخلية التي كانت تحوي الحرف F ستفقد مرجعها المباشر الذي تم مسحه، ويتحول محتواها إلى خطأ المرجع المفقود (#REF!)، مما يؤدي فوراً إلى كسر السلسلة في كافة الخلايا الواقعة أسفلها وتوقف الحساب التراكمي في باقي الجدول.
لتلافي هذه الهشاشة الهيكلية، تبرز ميزتان تقنيتان؛ الأولى والأكثر تفضيلاً هي الاعتماد الحصري على صيغ المصفوفات الذاتية مثل =ARRAYFORMULA(CHAR(SEQUENCE(26, 1, 65, 1)))، والتي لا تعتمد على الإسناد التبادلي بين الخلايا، مما يجعلها منيعة تماماً ضد أخطاء حذف الصفوف الوسيطة، حيث تعيد بناء نفسها فورياً وتلقائياً لملء الفراغات.
أما الطريقة الثانية، في حال لزم الأمر استخدام السحب اليدوي، فتتمثل في ربط المعادلة بدالة الإسناد غير المباشر INDIRECT أو دالة OFFSET لقراءة الخلية التي تعلوها مكانياً بغض النظر عن هويتها الاسمية، مما يمنع انقطاع المسار البرمجي ويحافظ على تدفق التسلسل الأبجدي ثابتاً في بيئات العمل التعاونية النشطة.
9. التعبئة التلقائية للأبجدية العربية: التحديات والحلول التقنية الموازية
9.1 طبيعة ترميز الحروف العربية في يونيكود (Unicode) مقارنة بـ ASCII
عند الانتقال من معالجة النصوص اللاتينية إلى اللغة العربية، نغادر النطاق المحدود لمعيار أسكي الكلاسيكي لندخل فضاء نظام يونيكود (Unicode) الموسع، وهو المعيار العالمي الذي صُمم لتمثيل وتوثيق كافة الأنظمة اللغوية الحية والميتة في منظومة رقمية شاملة. تحتل الأبجدية العربية في معيار يونيكود كتلة ترميزية رئيسية تمتد إحداثياتها الرقمية عموماً من الموضع الست عشري 0600 إلى 06FF (وهو ما يقابل في النظام العشري النطاق من 1536 إلى 1791 تقريباً).
ومع ذلك، يواجه محلل البيانات تحدياً تقنياً وجوهرياً يتمثل في عدم التتالي الحسابي الصارم للأحرف الهجائية العربية في جدول يونيكود وفق الترتيب التعليمي السائد (أ، ب، ت، ث… إلخ). فقد تم توزيع المحارف في يونيكود استناداً إلى معايير التطور التاريخي والتقارب الشكلي واللغوي، مما أدى إلى تداخل الحروف الأساسية مع علامات التشكيل وحركات الإعراب والأشكال المختلفة للهمزات، بالإضافة إلى تضمين محارف إضافية مخصصة للغات أخرى تستخدم الأبجدية العربية مثل الفارسية والأردية.
بناءً على ذلك، فإن المحاولة الميكانيكية لتطبيق مبدأ الزيادة الحسابية البسيطة (+1) على الأبجدية العربية ستبوء بالفشل الحتمي؛ إذ سينتج عن إضافة 1 إلى كود حرف الألف ظهور أشكال متعددة للهمزات (مثل أ، إ، آ) أو علامات الضبط الطباعي مثل التنوين والفتحة بدلاً من الانتقال إلى حرف الباء، مما يفرض حلولاً برمجية بديلة ومغايرة في فلسفتها الهيكلية.
9.2 تطبيق دالتي UNICHAR و UNICODE لتوليد الأبجدية العربية
للتعامل مع الفضاء الرقمي الواسع للغة العربية في جداول بيانات جوجل، تُستبدل دالتا CHAR وCODE التقليديتان بنظيرتيهما المتقدمتين: UNICHAR وUNICODE. تمتلك هاتان الدالتان القدرة الحوسبية على التعامل مع الأرقام الكبيرة التي تتجاوز سقف 255 الخاص بنظام أسكي، وصولاً إلى استدعاء أي رمز من بين مئات الآلاف من الرموز الموثقة في معيار يونيكود العالمي.
على الرغم من إشكالية التشتت الترميزي للحروف، يمكن للمحلل استغلال دالة UNICHAR بالاشتراك مع مصفوفة محددة من الأكواد العشرية الدقيقة للأحرف العربية لإنتاج المتتالية دون تشوهات. فعلى سبيل المثال، يحمل حرف الألف المجرد “ا” القيمة العشرية 1575، بينما يحمل حرف الباء “ب” القيمة 1576، يليه حرف التاء “ت” عند القيمة 1578 (مع ملاحظة تخطي القيمة 1577 المخصصة للتاء المربوطة “ة”).
لتوليد تسلسل هجائي نظيف باستخدام هذه الدوال المتقدمة، يُلجأ إلى تغذية دالة UNICHAR بمصفوفة رقمية يتم تحديد قيمها سلفاً لتخطي الفجوات الترميزية الخاصة بعلامات التشكيل والحروف المهموزة، مما يسمح بإخراج قائمة هجائية عربية متطابقة مع المعايير اللغوية المعاصرة وقابلة للتطبيق السلس في مختلف التحليلات والمسوح الإحصائية.
9.3 إنشاء قوائم مخصصة للحروف العربية عبر مصفوفات الإسناد الثابتة
نظراً لتعقيد التوزيع العددي للحروف العربية في جداول الترميز وتجنباً للإجهاد البرمجي الناتج عن تتبع الأكواد الفردية، تبرز الاستراتيجية الأكثر نضجاً وموثوقية في بيئة جداول بيانات جوجل: إنشاء “مصفوفة إسناد ثابتة” يتم حفظها كمرجع افتراضي يتم استدعاؤه ديناميكياً بواسطة دوال البحث والتنظيم المتقدمة.
يمكن للمستخدم إنشاء هذه المصفوفة المستقلة في خطوة واحدة داخل خلية منفردة باستخدام دالة SPLIT لفصل نص مرجعي يحتوي على الأبجدية العربية الكاملة المفصولة بفاصلة معيارية كما في المعادلة التالية:
=TRANSPOSE(SPLIT("أ,ب,ت,ث,ج,ح,خ,د,ذ,ر,ز,س,ش,ص,ض,ط,ظ,ع,غ,ف,ق,ك,ل,م,ن,هـ,و,ي", ","))
تُنتج هذه الصيغة الفورية قائمة عمودية نقية تضم كافة الحروف العربية الهجائية مرتبة بدقة فائقة وبمعزل تام عن تعقيدات يونيكود، وتصبح هذه القائمة بمثابة “جدول مرجعي” (Lookup Table) للملف ككل.
يمكن بعد ذلك استدعاء أي حرف من هذه القائمة بسهولة وسرعة باستخدام دالة الفهرسة INDEX المقترنة برقم الصف المطلوب (مثل =INDEX(نطاق_الأحرف, 1) للألف، و=INDEX(نطاق_الأحرف, 2) للباء)، أو دمجها ضمن دوال السلاسل التلقائية، محققين بذلك توازناً استثنائياً بين البساطة الإجرائية والموثوقية اللغوية المطلقة التي تضمن خلو مخرجات التحليل العربي من أي أخطاء أو شذوذ ترقيمي.
10. التطبيقات العملية والأكاديمية: تنظيم البيانات وإدارة المتغيرات البحثية
10.1 ترميز خيارات الاستبيانات وأدوات القياس النفسي
يُمثل الترميز الأبجدي للبدائل والخيارات حجر الأساس في بناء أدوات القياس والاستبيانات الميدانية واختبارات قياس الكفاءة السلوكية والمعرفية. عند إعداد مصفوفات التحليل الخاصة بأسئلة الاختيار من متعدد (Multiple-Choice Items)، يحرص الباحثون على تذيل الفقرات بركائز حرفية معيارية مثل (A, B, C, D) لترميز البدائل وتجنب الانحيازات الإدراكية التي قد تنشأ عن استخدام الأرقام، والتي قد يربطها المفحوصون لا شعورياً بتدرجات تقييمية أو أوزان تفاضلية مسبقة.
من خلال توظيف التعبئة التلقائية للأحرف، يستطيع مصمم الاستبيان نشر تسميات البدائل عبر مئات الصفوف والأعمدة في لحظات معدودة، وتنسيقها بصيغة موحدة تمهد لمعالجة البيانات إحصائياً. هذا التوحيد يضمن التوافق المباشر مع متطلبات حزم البرمجيات الإحصائية المتطورة مثل SPSS وSAS ومكتبات R لتحليل البيانات؛ حيث يسهل تحويل المتغيرات الحرفية المنتظمة إلى بيانات فئوية (Categorical/Factor Variables) بخطوة برمجية واحدة، مما يمنع حدوث أخطاء التناقض أثناء المعالجة ويحمي البنية الاستدلالية للبحث.
كما تُسهم أتمتة الرموز في تسريع بناء مفاتيح التصحيح الآلي (Answer Keys)؛ فمن خلال ربط استجابات المشاركين بالقوائم الأبجدية المتتالية، يسهل تطبيق دوال المطابقة الشرطية لحساب الدرجات الإجمالية بدقة متناهية، مما يقلص بصورة حاسمة من فترات التحليل الميداني ويضمن تدفق البيانات بكفاءة علمية عالية.
10.2 تصميم خطط العينات العشوائية والتجارب المقسمة إلى قطاعات
في المنهجيات التجريبية المتقدمة، وتحديداً عند تطبيق التصاميم العاملية المعقدة (Factorial Designs) والتجارب المقسمة إلى قطاعات عشوائية (Randomized Complete Block Designs)، تلعب الأحرف الأبجدية دوراً بنيوياً في تمييز الكتل التجريبية وتسمية مستويات المعالجة المختلفة. يُتيح التوليد المنظم للرموز الحرفية للباحثين صياغة مصفوفات المربعات اللاتينية (Latin Squares) التي تستهدف ضبط المتغيرات الدخيلة والموازنة بين الشروط التجريبية المتداخلة بكفاءة عالية.
تُستخدم السلاسل الأبجدية كذلك كمعرفات فريدة ومجهولة (Anonymous Identifiers) للمشاركين في الدراسات الطبية والنفسية لحماية سرية البيانات والامتثال للمعايير الأخلاقية للأبحاث؛ حيث يتم ترميز المجموعات أو الأفراد بمتتاليات مركبة تتولد برمجياً، مما يضمن استحالة كشف الهويات الشخصية مع المحافظة على دقة التتبع اللوجستي لبيانات كل عينة على حدة.
إن بناء هذه التصاميم المتقدمة بالاعتماد على صيغ المصفوفات الذاتية لجداول بيانات جوجل يمنح الباحث القدرة على توسيع أو تقليص عدد المجموعات المعالجة آنياً؛ إذ تتكيف التسميات الحرفية تلقائياً مع تغير أعداد المجموعات التجريبية دون الحاجة لإعادة كتابة الأكواد والرموز يدوياً، وهو ما يعزز المرونة المنهجية ويقلل من احتمالات الخطأ التنظيمي في البيئات المختبرية الصارمة.
10.3 تحويل الصيغ الديناميكية إلى نصوص ثابتة لحماية البيانات
على الرغم من القيمة الحوسبية العالية للصيغ الديناميكية في توليد التسلسلات الأبجدية، إلا أن بقاء هذه السلاسل في صورة معادلات نشطة يمثل خطراً حقيقياً على سلامة قواعد البيانات الأكاديمية النهائية. فالصيغة الرياضية تظل في حالة ترقب واستجابة دائمة لأي تغيير في بيئتها الشبكية؛ مما يعني أن نقل خلية أو مسح مرجع وسيط في مراحل لاحقة من معالجة البيانات قد يؤدي إلى انكسار المعادلة وتحول البيانات الحرفية فجأة إلى رموز خطأ مشوهة تقوض استقرار قاعدة البيانات بأكملها.
لذا، تبرز الممارسة المعيارية الفضلى التي يؤكد عليها خبراء إدارة البيانات، والمتمثلة في ضرورة “تجميد” السلاسل الناتجة بمجرد اكتمال توليدها، وذلك عبر تقنية النسخ واللصق كقيم فقط (Paste Special as Values). يتم ذلك بتحديد نطاق الأحرف المولدة بالكامل، ونسخه (Ctrl + C)، ثم النقر بالزر الأيمن على نفس النطاق واختيار: “لصق خاص” ثم “لصق القيم فقط” (أو عبر الاختصار Ctrl + Shift + V).
يؤدي هذا الإجراء الحاسم إلى قطع الرابط البرمجي بين المخرجات ومعادلات التوليد، محولاً الصيغ الحسابية إلى نصوص مجردة وثابتة مخزنة بصورة مستقلة في خلاياها. يضمن هذا التجميد بقاء البيانات محصنة ضد التعديلات العرضية، ويوفر بيئة آمنة تماماً لحفظ وأرشفة وتصدير المستندات العلمية إلى التنسيقات الخارجية الثابتة كملفات CSV وExcel دون خوف من تغير التسلسلات أو فقدان المرجعيات الرقمية الدقيقة التي بُنيت عليها الدراسة.
خاتمة
في الختام، يتضح أن التعامل مع مسألة التعبئة التلقائية للأحرف الأبجدية في جداول بيانات جوجل يتجاوز كونه مجرد مهارة إجرائية مكتبية بسيطة، ليمثل درساً تطبيقياً عميقاً في كيفية تفاعل الواجهات البرمجية وتكاملها مع المعايير الحوسبية الدولية لتمثيل الرموز والنصوص. لقد كشف هذا الطرح التفصيلي عن السبب الجوهري وراء القصور الافتراضي لأداة السحب التقليدية في استقراء الحروف، والمتمثل في النمذجة الرياضية الصارمة لمحركات الجداول التي تعامل النصوص كبيانات فئوية جامدة لا تمتلك دلالة الزيادة الحسابية الفطرية، وهو ما يفرض فهماً واعياً للأسس الترميزية في معايير ASCII ويونيكود العالمية لبناء المعالجات البديلة المناسبة.
وقد استعرضنا عبر محاور هذا الدليل كيف يُمكّن الدمج التبادلي بين دالتي CODE و CHAR المستخدمين من تأسيس متتاليات أبجدية متصاعدة تحول الإحداثي الحسابي إلى رمز لغوي متسق، وتعرفنا على كيفية الارتقاء بهذه الآليات إلى آفاق الأتمتة المتقدمة باستخدام مصفوفات ARRAYFORMULA المقترنة بدالة SEQUENCE؛ مما يحرر الباحث من قيود السحب اليدوي ويوفر مصدراً أحادياً ومحمياً لتوليد السلاسل النصية على الصعيدين الأفقي والعمودي. كما جرى تفكيك معضلة تجاوز حدود الأبجدية عند الحرف Z، وتقديم بدائل رصينة لمحاكاة الترقيم الثنائي وضبط التدفق الحرفي عبر الشروط المنطقية الموجهة.
وعند الانتقال إلى الخصوصية الهيكلية للأبجدية العربية، اتضح جلياً الفارق المنهجي بين الأنظمة الخطية البسيطة والتعقيد التوزيعي لمحارف الضاد في معيار يونيكود، وتجلى الحل الأمثل في الاعتماد على مصفوفات الإسناد الثابتة التي تؤمن استدعاء الحروف بنقاء هجائي تام وموثوقية لغوية مطلقة. وأخيراً، فإن تتويج هذه المعالجات بالتحويل النهائي إلى نصوص ثابتة يُمثل الدرع الواقي لأصالة ونزاهة قواعد البيانات الأكاديمية والميدانية؛ بما يضمن توفير بيئة عمل إحصائية دقيقة، تختزل الحمل الإدراكي والوقتي، وترتقي بجودة الإنتاج البحثي إلى المعايير المنهجية الرصينة.
المراجع
- American National Standards Institute. (1986). Information Systems – Coded Character Sets – 7-Bit American National Standard Code for Information Interchange (7-Bit ASCII) (ANSI X3.4-1986). ANSI.
- Google. (n.d.). Google Sheets function list. Google Docs Editors Help. https://support.google.com/docs/table/25219
- International Organization for Standardization. (2020). Information technology — Universal Coded Character Set (UCS) (ISO/IEC 10646:2020). ISO.
- Unicode Consortium. (2023). The Unicode Standard, Version 15.0 – Core Specification. Unicode Consortium. https://www.unicode.org/versions/Unicode15.0.0/
- Walkenbach, J. (2015). Excel 2016 Bible. John Wiley & Sons.