
تُعد معالجة السلاسل النصية ومقارنتها بدقة ركيزة أساسية من ركائز إدارة البيانات الرقمية والتحليل الإحصائي في مختلف الحقول المعرفية. في بيئات جداول البيانات السحابية، مثل جداول بيانات جوجل (Google Sheets)، تتجاوز مسألة التحقق من تطابق النصوص مجرد المقارنة السطحية للأشكال الحرفية؛ إذ تمتد إلى تفكيك البنية التحتية لترميز المحارف الرقمي، وفهم الفروق الدقيقة بين الحساسية لحالة الأحرف (Case Sensitivity) وتجاهلها، والتعامل مع المحارف الخفية غير المرئية التي قد تفسد النماذج الإحصائية دون سابق إنذار. يتطلب العمل الأكاديمي والتحليلي الرصين فهماً عميقاً للآليات الرياضية والمنطقية التي تحكم دوال المقارنة لضمان عدم تسرب أخطاء القياس إلى النتائج النهائية للدراسات والمسوح الميدانية.
تكمن التحديات التشغيلية في جداول البيانات عند التعامل مع تدفقات ضخمة من البيانات غير المتجانسة، والتي غالباً ما تتضمن أخطاء بشرية ناتجة عن التباين في كتابة الأحرف الكبيرة والصغيرة في اللغات اللاتينية، أو التباين الإملائي في اللغات السامية كالعربية، أو حتى تسرب مسافات بيضاء هامشية ومحارف غير قابلة للطباعة عند استيراد البيانات من واجهات برمجية أو مواقع إلكترونية خارجية. إن الاعتماد العشوائي على عوامل المقارنة الافتراضية دون إدراك قيودها التشغيلية قد يقود الباحث إلى استنتاجات مضللة، مثل احتساب مدخلين مختلفين على أنهما متطابقان، أو العكس، مما يؤثر سلباً على قرارات الأعمال والنتائج العلمية المترتبة على تلك البيانات.
يهدف هذا الدليل الأكاديمي المفصل والشامل إلى تشريح كافة المنهجيات والتقنيات البرمجية والوظيفية لمقارنة السلاسل النصية في جداول بيانات جوجل. سنستعرض الأسس النظرية لتمثيل المحارف وترميزها الرقمي، ونفصل الميكانيكا الحسابية لدالة التطابق الصارم EXACT، ودوال تحويل الحالات النصية، مروراً باستخدام التعبيرات النمطية (Regular Expressions) وصيغ المصفوفات المتقدمة ARRAYFORMULA، وصولاً إلى استراتيجيات تنقية البيانات وتصحيح الأخطاء الخفية؛ لتزويد المحلل والباحث بمرجع منهجي متكامل لحوكمة ومعالجة النصوص بدرجة متناهية من الدقة والموثوقية.
1. الأسس النظرية لمعالجة ومقارنة السلاسل النصية في بيئات جداول البيانات
1.1 مفهوم السلاسل النصية وترميز المحارف الرقمي
تُعرّف السلسلة النصية (String) في علوم الحاسوب وهندسة البرمجيات بأنها متتالية خطية مرتبة من المحارف (Characters) التي قد تشتمل على حروف أبجدية، أو أرقام، أو علامات ترقيم، أو مسافات بيضاء، أو حتى محارف تحكم غير مرئية. في بيئة جداول بيانات جوجل، يتم تمثيل هذه السلاسل داخل خلايا الذاكرة ككائنات بيانات مستقلة تختلف في معالجتها الفيزيائية والمنطقية عن القيم الرقمية المجردة. فعند إدخال أي نص في خلية ما، يقوم المحرك الداخلي للبرنامج بإسناد نوع البيانات النصي تلقائياً لها، معتمداً على آليات التعرف المسبق على الأنماط، حيث يتم تخزين كل محرف استناداً إلى نقطة ترميز فريدة (Code Point) مسجلة ضمن معايير التشفير العالمية.
تعتمد النظم السحابية الحديثة، ومنها جداول بيانات جوجل، معيار الترميز الموحد UTF-8 (وهو جزء من نظام Unicode Consortium)، والذي يمثل امتداداً متوافقاً مع معيار ASCII التقليدي. بموجب هذا النظام، لا تُقارن النصوص بناءً على صورتها المرئية المجردة التي تظهر للمستخدم على الشاشة، بل تُقارن بالاستناد إلى القيم الثنائية (Binary) والقيم العشرية المخصصة لكل نقطة ترميز في جدول اليونيكود. فعلى سبيل المثال، يحمل الحرف اللاتيني الكبير P القيمة الرقمية 80 في معيار ASCII/Unicode، بينما يحمل الحرف الصغير p القيمة الرقمية 112. هذا الاختلاف العددي البسيط في مستوى البايت الواحد هو المسؤول عن جعل المقارنة الثنائية بين الحرفين تفضي إلى عدم التطابق البرمجي، على الرغم من تقاربهما الفونيمي والدلالي.
تتضح الفروق الهيكلية الدقيقة عندما تبدو النصوص متطابقة تماماً للعين البشرية المجردة ولكنها تفشل في اختبارات التطابق الحاسوبي الصارم؛ ويحدث ذلك غالباً بسبب وجود تباينات خفية في ترميز المسافات أو المحارف الصوتية. إن الدقة النصية في عمليات التدقيق الإحصائي والتحليل الأكاديمي ليست ترفاً تقنياً، بل هي ضمانة جوهرية لسلامة النتائج؛ فوجود اختلاف في بايت واحد قد يؤدي إلى تصنيف استجابتين استطلاعيتين متماثلتين كفئتين مستقلتين، مما يشوه دقة مؤشرات التشتت والتوزيع التكراري في البحوث التجريبية.
1.2 أهمية المقارنة النصية الدقيقة في البحوث وتحليل البيانات
تشكل المقارنة النصية الدقيقة حجر الزاوية في مراحل المعالجة القبلية للبيانات (Data Preprocessing) ضمن المشاريع البحثية والدراسات الاستقصائية واسعة النطاق. عند جمع البيانات عبر استبانات ميدانية مفتوحة النهاية أو تفريغ سجلات إدارية، يواجه المحللون تحديات ناجمة عن غياب التوحيد القياسي للمدخلات. تسهم المقارنة النصية المنهجية في التحقق من اتساق البيانات المدخلة، ورصد أي انحرافات قد تؤثر على موثوقية المتغيرات التابعة والمستقلة، مما يوفر بيئة نظيفة وصالحة للنمذجة الإحصائية المتقدمة والتحليل الاستدلالي الرصين.
تتجلى الأهمية التطبيقية لهذه المقارنة في كشف التكرارات الخفية (Hidden Duplicates) وتنقية قواعد البيانات الضخمة؛ حيث يؤدي تكرار السجلات بأسماء متباينة طفيفاً في التنسيق إلى تضخيم أحجام العينات بصورة وهمية. يساعد التدقيق النصي الدقيق في عزل الأخطاء الإملائية والشوائب الناتجة عن اختلاف لوحات المفاتيح أو عيوب التحويل البرمجي بين الأنظمة المختلفة. كما يضمن تماسك التحليلات النوعية (Qualitative Analysis) التي تعتمد على تصنيف الكلمات المفتاحية والمفاهيم المحورية، إذ يمنع تشتت الفئة الواحدة إلى فئات فرعية متعددة لا مبرر لها من الناحية المنهجية.
علاوة على ذلك، تُعزز المقارنة الدقيقة موثوقية النماذج التحليلية المعتمدة على الفرز والتصنيف الآلي وخوارزميات دمج الجداول (Joining Operations). إذا لم تكن المفاتيح الأساسية (Primary Keys) المستندة إلى نصوص متطابقة بنسبة مائة بالمائة من الناحيتين الهيكلية والترميزية، فإن دوال البحث والربط ستخفق في تجميع البيانات المتناظرة، مما يولد ثغرات معرفية وقيم مفقودة (Missing Values) تؤدي بدورها إلى تحيز النتائج الإحصائية وانخفاض القدرة التنبؤية للنماذج الرياضية المبنية عليها.
1.3 مستويات حساسية حالة الأحرف (Case Sensitivity) في معالجة اللغات
يعد التمييز بين الحساسية لحالة الأحرف (Case Sensitivity) وتجاهلها (Case Insensitivity) أحد أهم الفوارق المفاهيمية في هندسة معالجة اللغات الطبيعية وهيكلة قواعد البيانات. يظهر التباين الوظيفي بوضوح في اللغات التي تستخدم الأبجديات اللاتينية واليونانية والسيريلية، حيث يمتلك كل حرف صيغتين مختلفتين: الحرف الكبير (Uppercase) والحرف الصغير (Lowercase)، ولكل منهما دلالات نحوية واصطلاحية متمايزة؛ فالأحرف الكبيرة تُخصص تقليدياً لأسماء العلم، والبدايات النصية، والاختصارات الأكاديمية والمؤسسية، في حين تُستخدم الأحرف الصغيرة في متن النصوص والكلمات العامة.
على النقيض من ذلك، تتميز اللغات الخالية من هذا التقسيم الثنائي للحالات، مثل اللغة العربية والصينية واليابانية، ببنية مورفولوجية تعتمد على سياق الحرف وموقعه في الكلمة أو على الرموز التصويرية دون وجود تمييز رقمي بين “كبير” و”صغير”. ومع ذلك، تبرز التحديات عند بناء قواعد بيانات متعددة اللغات (Multilingual Databases)؛ حيث إن إهمال حالة الأحرف اللاتينية قد يؤدي إلى دمج مصطلحات علمية أو اختصارات تشير إلى مفاهيم متباينة تماماً، مما يفرز تشوهات دلالية جسيمة في نتائج التحليل الإحصائي المقارن للمجموعات السكانية أو الجغرافية.
يتعين على الباحث الأكاديمي تحديد المستوى المطلوب للمقارنة النصية بناءً على أهداف الدراسة؛ فإذا كان البحث يركز على تصنيف مصطلحات جينية مثل الرموز الأليلية، أو المعرفات الكيميائية، أو الرموز البرمجية وكلمات المرور، فإن الفصل الصارم بين الحالات اللغوية المختلفة يصبح ضرورة منهجية لا تقبل المساومة. أما في دراسات استطلاع الرأي العام والمسوح الميدانية العامة، فإن تجاهل حالة الأحرف وتوحيدها يعد الإجراء الأمثل لضمان شمل كافة الاستجابات المتطابقة دلالياً وتفادي تشتيت البيانات بفعل عشوائية إدخال المشاركين.
2. الطريقة الأولى: المقارنة الحساسة لحالة الأحرف باستخدام دالة EXACT
2.1 البنية التركيبية والميكانيكية التشغيلية لدالة EXACT
تُعد دالة EXACT الأداة القياسية الأكثر صرامة ودقة في جداول بيانات جوجل لمقارنة السلاسل النصية استناداً إلى تطابقها الحرفي والترميزي الكامل. تتبع الدالة صيغة رياضية مبسطة للغاية تتكون من وسيطين إجباريين فقط، وتأخذ البنية التركيبية التالية: =EXACT(string1, string2). تتلقى الدالة هذين الوسيطين سواء كانا نصوصاً مجردة محاطة بعلامات تنصيص مزدوجة (مثل "Data") أو مراجع لخلايا فردية داخل ورقة العمل (مثل A2 وB2)، ثم تبدأ دورة المعالجة الثنائية لفحص التكافؤ الميكانيكي بينهما.
تعتمد الميكانيكية التشغيلية للدالة على إجراء تقييم ثنائي متسلسل لكل محرف في السلسلة الأولى بمقابله المباشر في السلسلة الثانية، متتبعة الترتيب المكاني وقيمة الترميز الرقمي المقابلة في نظام UTF-8. لا تكتفي الدالة بالتحقق من الحروف الظاهرة فقط، بل تفحص بدقة متناهية المحارف غير المرئية كالمسافات البيضاء وعلامات الجدولة والرموز الخاصة. إذا تطابقت كافة المحارف في النوع والحالة والترتيب بصورة مطلقة، فإن الدالة تُنتج القيمة البولينية المنطقية TRUE؛ أما إذا اختلف محرف واحد في حالته (كبير مقابل صغير) أو وُجدت مسافة إضافية في أي طرف، فإنها تُنتج فوراً القيمة FALSE دون أي تساهل خوارزمي.
تتميز دالة EXACT بقدرتها الصارمة على عزل الفروق الدقيقة التي يتجاهلها عامل المقارنة التقليدي (علامة التساوي =). فعند مقارنة =EXACT("Research", "research")، تُرجع الدالة قيمة FALSE بصورة حاسمة، لأن الخوارزمية الداخلية تقارن القيم الثنائية للحرف الأول (82 لـ R مقابل 114 لـ r). هذا السلوك الحسابي الحازم يجعل الدالة بمثابة صمام أمان رقمي لا يقبل التخمين، ويضمن للمحلل أن النتيجة الإيجابية تعكس تطابقاً بنسبة مائة بالمائة على مستوى البايت الفيزيائي للنص.
2.2 المحددات الوظيفية والقيود الرياضية للدالة
على الرغم من القوة الرياضية لدالة EXACT في التحقق الحرفي، إلا أنها تعاني من محددات وظيفية هيكلية ينبغي على المحلل الإحصائي إدراكها بوضوح. أول هذه القيود يتمثل في عجز الدالة التام عن إجراء مطابقة جزئية (Partial Matching) أو التعامل مع الكلمات المتقاربة لغوياً؛ فالدالة تتبنى مبدأ “الكل أو لا شيء” (All-or-Nothing). إذا احتوت إحدى السلسلتين على حرف إضافي ناتج عن خطأ مطبعي عابر، أو إذا اختلف ترتيب الكلمات داخل الجملة، فإن النتيجة ستكون سالبة، مما يستدعي الاستعانة بدوال إضافية لمعالجة النصوص مسبقاً إذا كان الهدف هو المطابقة المفهومية وليس الشكلية.
يتمثل القيد الثاني في الحساسية الفائقة للمسافات البادئة واللاحقة (Leading and Trailing Spaces). ففي بيئات جمع البيانات الواقعية، يقوم المستخدمون غالباً بالضغط على مفتاح المسافة بعد كتابة الكلمة دون قصد واعي. إذا تمت مقارنة السلسلة "Matrix " بالسلسلة "Matrix"، فإن دالة EXACT ستسجل FALSE؛ والسبب هو أن المحرف الأخير في الأولى هو مسافة بيضاء تحمل الرمز الرقمي 32، بينما تفتقر الثانية لهذا المحرف تماماً، مما يولد فشلاً وهمياً في المطابقة يقود إلى أخطاء فادحة في تجميع البيانات وتصنيفها.
أما من الناحية الحوسبية، فإن استهلاك الموارد المادية ومعالجة الذاكرة يصبح عائقاً ملحوظاً عند تطبيق الدالة على مجموعات البيانات الضخمة (Big Data) التي تحتوي على مئات الآلاف من الصفوف المتزامنة داخل بيئة جداول بيانات جوجل السحابية. نظراً لأن الدالة تُجري فحصاً بايتياً متتابعاً (Byte-by-byte comparison) لكل زوج نصي، فإن استدعاءها المتكرر ضمن صيغ مركبة ومعقدة قد يؤدي إلى بطء في زمن الاستجابة، وتأخر إعادة الحساب التلقائي لورقة العمل، واستهلاك الحصص المخصصة لمعالجة العمليات السحابية.
2.3 حالات الاستخدام الأكاديمي والتحليلي للدالة الحساسة
تفرض الدقة المنهجية في البحوث العلمية والتحليلات المتخصصة استخدام دالة EXACT في سيناريوهات محددة لا تحتمل الخطأ أو التساهل اللغوي. يبرز هذا الاحتياج بصورة جلية عند التعامل مع المعرفات الفريدة ذات البنية المعقدة، مثل معرفات الكائنات الرقمية للأبحاث (Digital Object Identifiers – DOIs)، أو مفاتيح التشفير المتقدمة، أو الأكواد الجينية في علوم الأحياء الحاسوبية وسلاسل الحمض النووي (DNA/RNA)، حيث يؤدي التبديل بين الحرف الكبير والصغير إلى تغيير المعنى البيولوجي أو التقني للمتغير بصورة جذرية.
كما تُعد الدالة الأداة المثلى لإجراء عمليات التدقيق المالي ومراجعة السجلات المحاسبية في المؤسسات الأكاديمية والمصرفية. في هذه البيئات، تُستخدم أرقام الحسابات المشفرة، وأكواد الفواتير، ورموز المعاملات المصرفية وفق معايير برمجية حساسة لحالة الأحرف لمنع تزوير السجلات أو الخلط بين فروع المؤسسة المختلفة. تضمن الدالة أن كل قيد محاسبي يطابق القيد المقابل له في جداول التسوية بدقة مطلقة تمنع حدوث أي انحرافات حسابية أو تضارب في القيود المالية المجمعة.
علاوة على ذلك، تُستخدم الدالة في التحقق من اتساق الأكواد المتغيرة في التصنيفات الإحصائية المعيارية، مثل أكواد التصنيف الصناعي الدولي الموحد (ISIC) أو أكواد التوصيف الجغرافي والإداري للدول والمقاطعات. يتيح استخدام دالة EXACT في هذه التطبيقات تصفية البيانات بدقة فائقة وعزل أي شذوذ أو تباين في الإدخال اليدوي، مما يمنح الباحثين ثقة كاملة في تجانس عيناتهم قبل الشروع في تطبيق اختبارات الدلالة الإحصائية وتحليل التباين.
3. تطبيق عملي: مقارنة حساسة لحالة الأحرف باستخدام دالة EXACT (مع مثال)
3.1 إعداد بيئة البيانات وهيكلة جدول الاختبار التجريبي
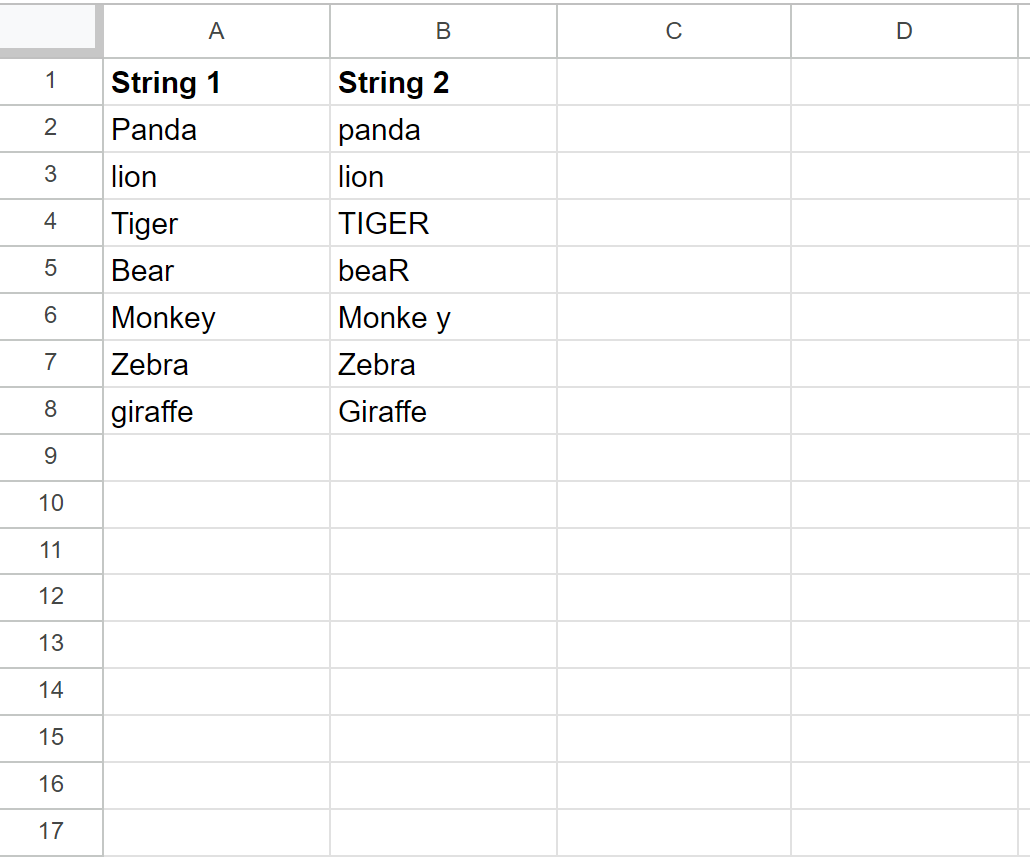
لإدراك الآلية الوظيفية لدالة EXACT بشكل منهجي، يتعين علينا بناء مصفوفة تجريبية متكاملة داخل بيئة جداول بيانات جوجل. سنقوم بإنشاء ورقة عمل اختبارية جديدة وتخصيص العمودين الأولين (العمود A والعمود B) لإدراج مجموعات متقابلة من السلاسل النصية المصممة بعناية لاختبار استجابة النظام لمختلف السيناريوهات اللغوية والترميزية المحتملة في سياق معالجة البيانات الواقعية.
تتضمن هيكلة جدول الاختبار التجريبي توزيع المتغيرات في أزواج نصية عبر الصفوف؛ حيث نخصص الصفوف لتمثيل تباينات دقيقة تبرز وظيفة الدالة الحساسة للأحرف. في الصف الثاني، سندرج النص Panda في الخلية A2 مقابل النص panda في الخلية B2، لتمثيل التباين الكلاسيكي في حالة الحرف الأول بين اللاتيني الكبير والصغير. وفي الصف الثالث، سندرج النص lion في الخلية A3 مقابلاً للنص المتطابق تماماً lion في الخلية B3 لاختبار التطابق المطلق الإيجابي. ونضيف حالات أخرى مثل Tiger مع مسافة لاحقة مقابل Tiger بدون مسافات، لتوثيق كافة أبعاد السلوك الخوارزمي في بيئة محكومة وموثقة أكاديمياً.
يبين الجدول التالي الهيكلية الأولية لبيانات الاختبار قبل إدخال المعادلات الحسابية المقارنة:
| رقم الصف | المدخل النصي الأول (العمود A) | المدخل النصي الثاني (العمود B) | الهدف التجريبي من الزوج النصي |
|---|---|---|---|
| 2 | Panda | panda | اختبار حساسية حالة الحرف الأول (كبير مقابل صغير) |
| 3 | lion | lion | اختبار التطابق الحرفي والترميزي التام |
| 4 | Elephant | Elephant | اختبار التطابق الإيجابي للأحرف الكبيرة |
| 5 | ZEBRA | zebra | اختبار التباين الشامل لحالة الأحرف في الكلمة بأكملها |
3.2 تنفيذ الصيغة وتوليد النتائج خطوة بخطوة
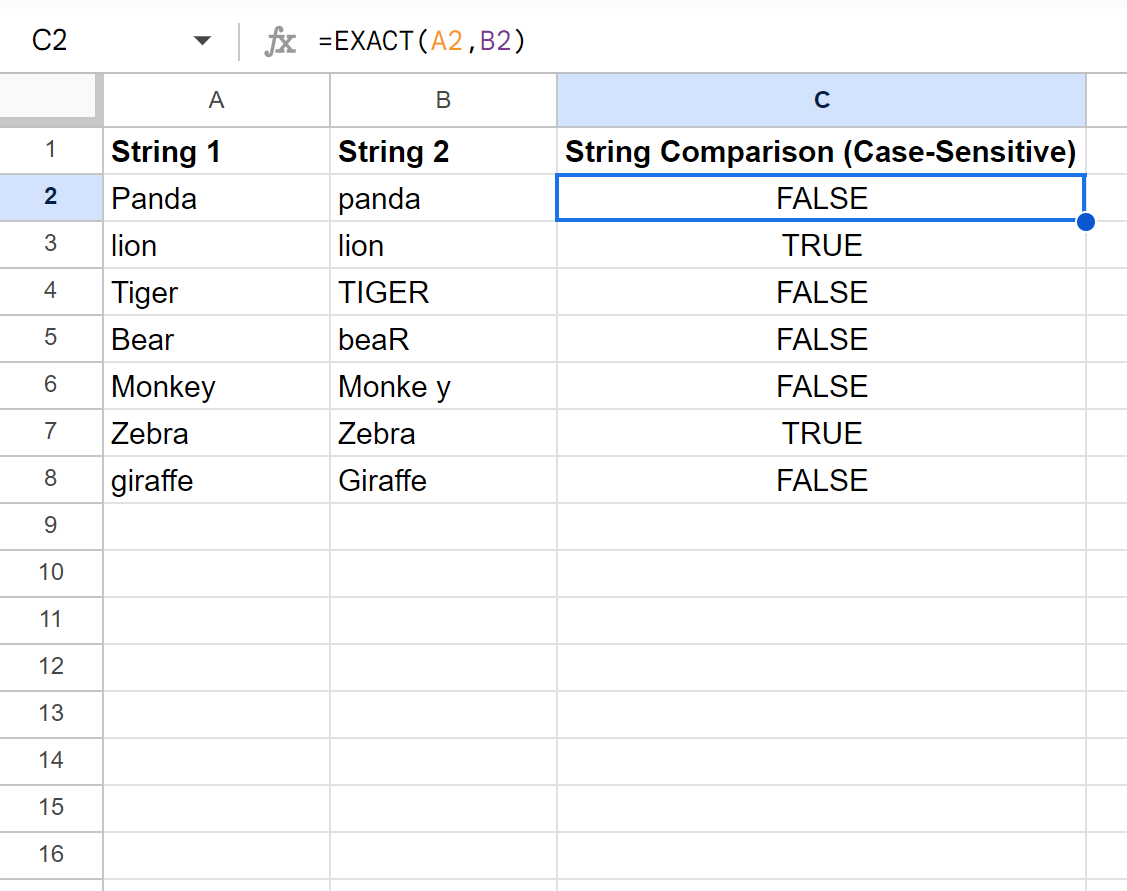
بعد تجهيز بيئة البيانات في ورقة العمل، نبدأ في تنفيذ المعالجة المنطقية خطوة بخطوة. ننتقل أولاً إلى الخلية C2، التي سنخصص عمودها لإظهار مخرجات الدالة الحساسة لحالة الأحرف. نقوم بالنقر المزدوج على الخلية وكتابة الصيغة الرياضية التالية بدقة: =EXACT(A2, B2). بمجرد الضغط على زر الإدخال (Enter)، يرسل البرنامج مدخلات الخليتين فوراً إلى النواة الحسابية لجداول بيانات جوجل، لتظهر النتيجة البولينية الأولى في كسر من الثانية معلنة عن التقييم المنطقي الأولي للزوج النصي في الصف الثاني.
لتعميم هذا الإجراء على باقي النطاق التجريبي دون إعادة كتابة المعادلة يدوياً، نستخدم “مقبض التعبئة” (Fill Handle). نحدد الخلية C2، ثم نحرك مؤشر الفأرة نحو المربع الأزرق الصغير الكائن في الزاوية اليسرى السفلية للخلية (أو اليمنى السفلية بحسب اتجاه واجهة المستخدم). عند تحول المؤشر إلى علامة التقاطع السوداء (+)، نقوم بالسحب نحو الأسفل عبر الخلايا C3، C4، وC5، أو بالنقر المزدوج السريع على المقبض ليتم نسخ الصيغة تلقائياً مع تحديث المراجع النسبية للخلايا المقابلة في كل صف بشكل متزامن ومنتظم.
تستجيب جداول بيانات جوجل لحظياً بتوليد المخرجات المنطقية المتباينة في العمود C، حيث نلاحظ ظهور القيمتين TRUE وFALSE وفق شروط التطابق الثنائي. يضمن هذا الإجراء المتدرج للباحث التحقق من سلامة البناء الهيكلي للصيغة، ويوفر سجلاً بصرياً سريعاً يتيح مراقبة التدفق المنطقي للعمليات والاطمئنان إلى أن الحسابات الآلية تتم وفق المعايير البرمجية المتوقعة لكل صف على حدة.
3.3 التحليل الاستدلالي لمخرجات المقارنة
يستدعي الفهم الأكاديمي لمخرجات الدالة في العمود C إجراء تحليل استدلالي مفصل يفسر الأسباب الحوسبية الكامنة وراء كل نتيجة مولدة. في الخلية C2، نجد أن الصيغة =EXACT(A2, B2) قد أنتجت القيمة المنطقية FALSE. يُعزى هذا الإخفاق في التطابق إلى أن الحرف الأول من الكلمة في A2 هو حرف لاتيني كبير (P) بنقطة ترميز Unicode U+0050، بينما الحرف المقابل في B2 هو حرف لاتيني صغير (p) بنقطة ترميز U+0070. ورغم تطابق الحروف الأربعة المتبقية (anda) في الكلمتين، إلا أن التباين في البايت الأول كان كافياً للنظام لرفض التكافؤ التام وإصدار حكم قاطع بعدم التطابق.
على العكس من ذلك، أظهرت الخلية C3 القيمة البولينية TRUE كنتيجة لمقارنة الزوج النصي lion وlion. يتوافق هذا المخرج مع المنطق الرياضي الصارم للدالة؛ حيث إن كافة المحارف الأربعة تشترك في نفس القيم الرقمية في جدول الترميز، وتتطابق في حالتها النصية الصغيرة، وتخلو من أي مسافات بيضاء دخيلة قبل السلسلة أو بعدها. يمثل هذا التقييم الإيجابي حالة المعايرة المعيارية التي تثبت سلامة أداء الدالة عند توافر شروط التطابق الشكلي والترميزي الحرفي الكامل.
يقودنا هذا التحليل الاستدلالي إلى استخلاص نتيجة منهجية مفادها أن دالة EXACT تمثل خياراً تقنياً ذا فاعلية استثنائية عندما يكون الهدف هو تحقيق أعلى درجات اليقين والصرامة الإجرائية في عزل الفروق الدقيقة. ومع ذلك، تؤكد النتائج أيضاً محدوديتها الشديدة إذا كان سياق البحث يتطلب مرونة في التعامل مع أخطاء التنسيق الناتجة عن إدخال غير مدرب؛ مما يستوجب الانتقال نحو استراتيجيات بديلة تجمع بين الدقة والمرونة وتستوعب التباينات اللغوية السطحية دون الإخلال بالمضمون الدلالي.
4. الطريقة الثانية: المقارنة غير الحساسة لحالة الأحرف بدمج دوال التحويل
4.1 المنطق التركيبي لدمج دالة EXACT مع دالة تحويل الحالات UPPER
في العديد من البيئات التحليلية والبحثية، تفرض طبيعة البيانات ضرورة التغاضي عن الفروق الشكلية في حالة الأحرف اللاتينية، مع الحفاظ على صرامة التحقق من تطابق تسلسل الحروف ذاتها. لتحقيق هذا التوازن المنطقي، نلجأ إلى بناء صيغة برمجية مركبة تدمج دالة التطابق الصارم EXACT مع إحدى دوال التحويل القياسي للحالات النصية، وهي دالة UPPER. تأخذ المعادلة المركبة الصيغة البنائية التالية: =EXACT(UPPER(A2), UPPER(B2)). يرتكز هذا الحل على مبدأ هندسة البرمجيات القائل بتوحيد المعايير (Standardization) قبل تنفيذ عمليات المقارنة المنطقية المعقدة.
يتضح التدفق الميكانيكي لهذه الصيغة من خلال تفكيك تسلسل العمليات الحسابية داخل النواة المنطقية لجداول جوجل. تبدأ العملية أولاً بتقييم الوسائط الداخلية المستقلة؛ حيث تتلقى الدالة UPPER(A2) القيمة النصية في الخلية الأولى وتُعيد بناءها في الذاكرة المؤقتة بحيث يتم تحويل كافة الأحرف الصغيرة إلى أحرف كبيرة مكافئة. وبشكل متوازٍ، تتلقى الدالة UPPER(B2) محتوى الخلية المقابلة وتجري عليه ذات التحويل الهيكلي. بعد اكتمال مرحلة التوحيد النصي، يتم تمرير المخرجين المعالجين كمدخلات نهائية لدالة EXACT، والتي تباشر فحص التطابق البايتي بين سلسلتين متماثلتين في الحالة حكماً.
تتمثل الجدوى الحسابية لهذا النهج في تحييد المتغير المشتت (حالة الأحرف) دون تشويه البيانات الأصلية المحفوظة في الخلايا المرجعية. بدلاً من إنشاء أعمدة مساعدة إضافية في ورقة العمل لتخزين النصوص الموحدة، يتم هذا التحويل “في الموقع” (In-memory Processing) داخل الخلية الحسابية ذاتها، مما يحافظ على نقاء الهيكل البصري لورقة البيانات ويمنع التكرار غير المبرر للمعلومات، مع تحقيق هدف المقارنة الموضوعية بكفاءة برمجية عالية.
4.2 البديل التناظري باستخدام دالة الحروف الصغيرة LOWER
من الناحية الرياضية والوظيفية، تقدم بيئة جداول بيانات جوجل بديلاً تناظرياً متكافئاً تماماً للصيغة السابقة، وذلك باستخدام دالة تحويل الحالات إلى الأحرف الصغيرة LOWER. تأخذ هذه الصيغة المكافئة الشكل التالي: =EXACT(LOWER(A2), LOWER(B2)). تعمل هذه الدالة بذات المنطق التحويلي، غير أنها تقوم باستبدال كافة الحروف الكبيرة في كلا الطرفين بنظائرها الصغيرة المسجلة في جدول الترميز الرقمي، لتتم المقارنة النهائية بين سلسلتين مكتوبتين بالكامل بأحرف صغيرة.
أظهرت اختبارات الأداء المعياري غياب أي فروق تشغيلية أو زمنية ذات دلالة بين استخدام UPPER أو LOWER عند معالجة اللغات المشتقة من الأبجديات الهندية الأوروبية كاللاتينية. إن الاختيار بين هاتين الدالتين لا تحكمه قيود تقنية، بل يعتمد غالباً على التفضيلات المؤسسية لتوحيد العرض، أو انسجام الصيغة مع المعايير البرمجية العامة المعتمدة في بيئة التحليل، أو الرغبة في الحفاظ على تناسق التعبير الدلالي للأكواد المكتوبة ضمن مشاريع تحليل البيانات الموسعة.
ومع ذلك، ينبغي على المحلل توخي الحذر عند تطبيق هذه الدوال على لغات ذات خصائص فريدة، مثل اللغة التركية التي تفرق بين حرف الـ I بنقطة والحرف بدونه (Dotted and Dotless I)، حيث قد تتطلب معايير المعالجة المحلية تدقيقاً خاصاً لمنع حدوث أخطاء تحويل شاذة أثناء المعالجة المؤقتة. لكن في سياق اللغة الإنجليزية واللغات القياسية الشائعة، يظل كلاً من UPPER وLOWER خيارين متطابقين وظيفياً يمنحان الباحث مرونة مطلقة لتحييد حساسية الأحرف وتأكيد التكافؤ الأبجدي الدقيق بين النصوص.
4.3 الكفاءة الحسابية للمعادلات المتداخلة في مجموعات البيانات الكبيرة
يثير التوسع في استخدام الدوال المركبة والمتداخلة (Nested Functions) تساؤلات جوهرية حول الكفاءة الحسابية ومعدلات استهلاك الذاكرة العشوائية وسرعة المعالجة المركزية، لاسيما عند تطبيق هذه المعادلات على مصفوفات ضخمة تتجاوز مئات الآلاف من السجلات. في الصيغة =EXACT(UPPER(A2), UPPER(B2))، تضطر النواة الحسابية لتنفيذ ثلاث عمليات متتالية لكل صف على حدة: عمليتين لتحويل السلاسل النصية في الذاكرة الحية، تتبعهما عملية المقارنة الثنائية البولينية؛ مما يضاعف التكلفة الحوسبية مقارنة باستدعاء دالة واحدة بسيطة.
تعتمد جداول بيانات جوجل على خوادم سحابية متعددة المستأجرين (Multi-tenant Cloud Architecture)، وتخضع حساباتها لقيود محددة في وقت التنفيذ وحصص المعالجة. عند تطبيق الصيغ المتداخلة بكثافة غير منضبطة عبر ورقة العمل بأكملها، قد يلاحظ المستخدم بطئاً في استجابة الملف، وظهور مؤشر التحميل المتكرر، وتأخر في إعادة حساب النتائج عند تعديل البيانات الأساسية. للتخفيف من هذه المشكلة، يُنصح بتجنب تطبيق الدوال المركبة على أعمدة مفتوحة بالكامل بدون تحديد لنهاية النطاق الفعلي للبيانات، واستبدال التكرار العشوائي بالصيغ المصفوفية المنظمة التي تُقلل من عمليات استدعاء الدوال المتعددة.
يتعين على مهندس البيانات والمحلل الأكاديمي إقامة موازنة دقيقة بين المرونة التحليلية وسرعة استجابة ورقة العمل السحابية. في المشاريع التي تتطلب معالجة مجموعات بيانات هائلة بصورة مستمرة، قد يكون من الأفضل تقنياً إجراء مرحلة تنقية وتوحيد شاملة لحالات الأحرف مسبقاً في خطوة منفصلة، وتخزين النصوص بصيغتها الموحدة، ثم تطبيق مقارنات بسيطة ومباشرة توفر الموارد الحسابية وتضمن انسيابية الأداء التقني وسرعة تدفق التقارير التحليلية.
5. تطبيق عملي: مقارنة غير حساسة لحالة الأحرف (مع مثال توضيحي)
5.1 تطبيق الصيغة المركبة في ورقة العمل وتتبع التدفق المنطقي
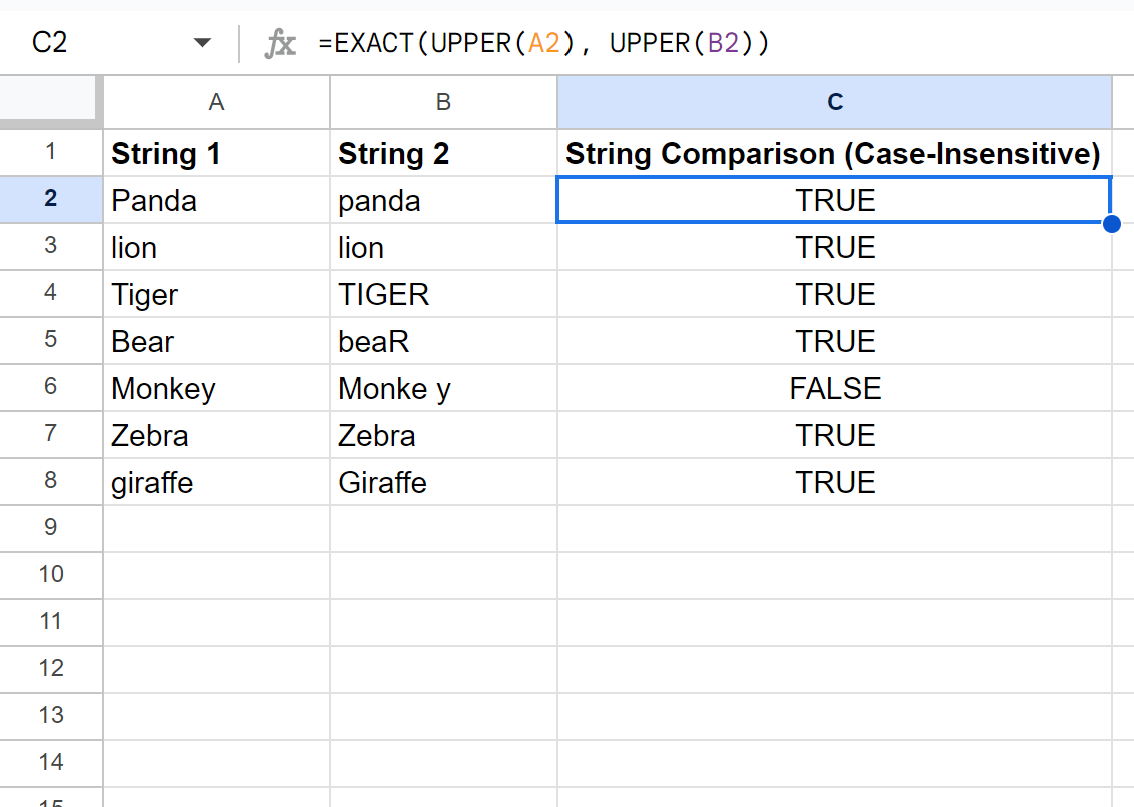
للانتقال بالجانب النظري إلى حيز التطبيق العملي المقارن، سنقوم بتوسيع جدول الاختبار التجريبي الذي أنشأناه سابقاً، عبر تخصيص العمود D ليكون منصة اختبار المقارنة غير الحساسة لحالة الأحرف. سنقوم بإدراج الصيغة المركبة في الخلية D2 عبر كتابة المعادلة الآتية: =EXACT(UPPER(A2), UPPER(B2)). عند النقر على مفتاح الإدخال، تتولى الخوارزمية سحب النص Panda من A2 وتحويله مؤقتاً إلى PANDA، بالتزامن مع سحب النص panda من B2 وتحويله إلى PANDA أيضاً، لتجري مقارنة دالة EXACT على هاتين النسختين الموحدتين كلياً.
نقوم بتعميم هذه الصيغة على باقي خلايا العمود D حتى الصف الخامس، من خلال النقر المزدوج على مقبض التعبئة الخاص بالخلية D2، أو نسخه وسحبه نزولاً. أثناء هذه الخطوة، يلاحظ الباحث تتبع التدفق المنطقي للمعادلة عبر مختلف الأنماط؛ حيث تجري العمليات الحسابية بصورة شفافة وآمنة دون المساس بالقيم الأصلية المعروضة للمستخدم في العمودين A وB. يوضح هذا الإجراء مرونة الجمع بين الدوال الوظيفية لبناء حلول منطقية متخصصة تلائم الاحتياجات الدقيقة للتحليل الإحصائي للبيانات.
من المزايا الجوهرية لهذه الصيغة المركبة أنها تتعامل مع النصوص التي تتضمن أرقاماً ورموزاً خاصة دون أي تشويه تشغيلي؛ إذ إن دالة UPPER تقتصر في تأثيرها على الأحرف الأبجدية اللاتينية فقط، متجاهلة الأرقام وعلامات الترقيم التي لا تمتلك حالات أصلاً. هذا السلوك البرمجي يضمن الحفاظ على سلامة الرموز الرياضية والهيكلية المدمجة في النصوص أثناء خضوعها لعملية التوحيد النصي، مما يحمي مخرجات المقارنة من الانحرافات العشوائية غير المتوقعة.
5.2 قراءة مقارنة للنتائج: فحص الفروق بين الطريقتين
يكشف الفحص الدقيق والمقارن للنتائج الصادرة في العمودين C وD عن اختلافات جوهرية تبرز القيمة الوظيفية لكل منهجية مقارنة. في الصف الثاني، سجلت الخلية C2 القيمة FALSE عند تطبيق المقارنة الصارمة للزوج Panda وpanda، بينما عكست الخلية D2 القيمة الإيجابية TRUE عند تطبيق الصيغة المركبة غير الحساسة للحالة. يعكس هذا التحول الجذري قدرة المنهجية الثانية على تجاوز التباين الطوبوغرافي السطحي والاعتراف بالتطابق المفاهيمي واللغوي للسلسلتين كاسم لنفس الكائن الحي المستهدف في العينة.
في المقابل، حافظ الزوج النصي في الصف الثالث (lion مقابل lion) على استقراره المطلق محققاً القيمة TRUE عبر كلا الطريقتين؛ مما يؤكد أن المنهجية غير الحساسة للحالة لا تُفسد التطابقات الإيجابية الصحيحة في حال وجودها أصلاً، بل تعززها وتوسع نطاق كشفها لتشمل الحالات التي تعاني من تباين طفيف في أسلوب الكتابة. تضمن هذه الخاصية بقاء معدلات التطابق الصادق محمية ومستقرة دون خطر استبعادها من التحليل الإحصائي التجميعي.
توثق هذه القراءة المقارنة قدرة المنهجية الثانية الفائقة على معالجة المشكلات الناجمة عن عشوائية الإدخال البشري غير المدرب، مثل نسيان المستخدمين الضغط على مفتاح التحويل (Shift) أثناء كتابة الأسماء أو الاختصارات. إن تجاوز هذه العشوائية يرفع من جودة البيانات المجمعة، ويضمن عدم هدر استجابات الباحثين أو تهميشها لمجرد خطأ في التنسيق الحرفي، مما يرتقي بدقة المعالجة ويدعم نزاهة التقييم الاستدلالي للنتائج.
5.3 بناء جدول مقارنة مرجعي لتحليل المخرجات في الحالات المختلفة
لتسهيل استيعاب هذه المقارنات الإجرائية من قِبل فرق البحث والمحللين، تم تصميم هذا الجدول التحليلي المرجعي الشامل. يجمع الجدول المدخلات المتنوعة ونواتج التطبيق العملي للصيغتين مع تقديم تفسير دقيق لطبيعة التغير في النتائج بين الطريقة الأولى الصارمة والطريقة الثانية المرنة:
| الخلية A (النص الأول) | الخلية B (النص الثاني) | الصيغة الصارمة: =EXACT(A, B) | الصيغة المرنة: =EXACT(UPPER(A), UPPER(B)) | التفسير والتحليل الأكاديمي للتباين في المخرجات |
|---|---|---|---|---|
| Panda | panda | FALSE | TRUE | اختلاف حالة الحرف الأول أدى لرفض الصارمة وقبول المرنة بعد توحيد الحالات. |
| lion | lion | TRUE | TRUE | تطابق كامل في الحروف والحالات والترميز، مما أسفر عن إجماع الدالتين على القبول. |
| Elephant | Elephant | TRUE | TRUE | تطابق حرفي تام لحالة الحرف الأول الكبير والحروف الصغيرة التالية. |
| ZEBRA | zebra | FALSE | TRUE | تباين كامل لحالات كافة الأحرف؛ ترفضه الدالة الصارمة بينما توحده الدالة المرنة. |
| Giraffe | Giraffe | FALSE | FALSE | وجود مسافة بيضاء لاحقة في النص الأول تسبب في رفض المقارنة في كلتا الطريقتين. |
يقودنا هذا الجدول المرجعي إلى صياغة خلاصة معيارية لاتخاذ القرار التحليلي: يجب اعتماد الطريقة الصارمة (EXACT المباشرة) عندما تكون السلاسل النصية بمثابة مفاتيح تعريف رقمية مشفرة تستوجب الدقة المطلقة في كل بايت، بينما يُفضل الاعتماد على الطريقة المركبة (EXACT المدمجة مع UPPER أو LOWER) في المسوح الاجتماعية والدراسات الميدانية وتطبيقات الأعمال العامة التي تستهدف توحيد التصنيفات المفاهيمية وتحييد الأخطاء الشكلية العابرة.
6. المنهجيات البديلة لمقارنة النصوص: استخدام عوامل التشغيل المنطقية والدوال الأساسية
6.1 استخدام عامل المقارنة المنطقي المباشر (=)
إلى جانب استخدام الدوال المدمجة المتخصصة، توفر جداول بيانات جوجل آلية فطرية ومباشرة لمقارنة السلاسل النصية عبر استخدام عامل المساواة المنطقي التقليدي، وذلك من خلال صياغة معادلة بسيطة مثل: =(A2 = B2). تتسم هذه الطريقة بطبيعتها التشغيلية الافتراضية غير الحساسة لحالة الأحرف تماماً؛ فعند مقارنة السلسلة "Apple" بالسلسلة "apple" باستخدام هذه الصيغة، تُنتج النواة الحسابية القيمة البولينية TRUE بصورة مباشرة ودون حاجة لتضمين دوال تحويل إضافية كـ UPPER أو LOWER.
تتمثل الفروق التشغيلية الأساسية بين عامل المساواة (=) ودالة EXACT في الفلسفة الحوسبية الكامنة وراء كل منهما. صُمم عامل المساواة لتسهيل العمليات المنطقية العامة وتوفير تجربة استخدام مرنة تتساهل مع الفروق الطوبوغرافية للأبجديات، في حين صُممت دالة EXACT لتطبيق معايير المقارنة الصارمة على مستوى البايت الثنائي. فضلاً عن ذلك، يتعامل عامل المساواة مع أنواع البيانات بقدر من التسامح مقارنة بدالة EXACT التي قد ترفض مقارنة النصوص بالأرقام المنسقة كنصوص، مما يجعله خياراً شائعاً في صياغة الشروط المنطقية اليومية البسيطة داخل أوراق العمل.
تتميز صيغة التساوي المباشر بسهولة قراءتها الفائقة ضمن بنية المعادلات، وتقلل من التعقيد التركيبي للملفات التحليلية. كما أنها تستهلك قدراً أقل من الموارد الحسابية السحابية مقارنة بالدوال المتداخلة، نظراً لأنها تستدعي تعليمة مقارنة منطقية منخفضة المستوى مباشرة في محرك الجداول دون إنشاء نصوص وسيطة في الذاكرة. ولذلك، تُعد هذه المنهجية الخيار الأمثل والأنسب لإجراء مقارنات سريعة وغير حساسة لحالة الأحرف في أوراق البيانات القياسية ذات الحجم المتوسط والبيانات المتجانسة.
6.2 مقارنة النصوص باستخدام دالة MATCH ودوال البحث المتقدم
تُمثل دالة MATCH منهجية محورية أخرى لمقارنة النصوص، لا سيما عندما يتجاوز الهدف مجرد فحص التطابق الثنائي بين خليتين متقابلتين إلى اختبار وجود سلسلة نصية معينة داخل نطاق أو مصفوفة بيانات محددة. تأخذ الصيغة البسيطة لاختبار التطابق بين خليتين الشكل التالي: =MATCH(A2, B2, 0)، حيث يُحدد الوسيط الثالث (0) نوع المطابقة لتكون تطابقاً تاماً غير تقريبي. إذا تطابق النصان، تُنتج الدالة القيمة الرقمية 1 (التي تعبر عن الموقع النسبي للنص في النطاق)، بينما تُنتج خطأ القيمة المفقودة الشهير #N/A في حال عدم التطابق.
تتطلب هذه الطبيعة التشغيلية تدخلاً برمجياً لمعالجة أخطاء عدم التطابق، ويتم ذلك عادة من خلال دمج دالة MATCH مع دالة معالجة الأخطاء ISNUMBER أو IFERROR، لتوليد قيم بولينية نقية يمكن البناء عليها في الحسابات الإحصائية اللاحقة؛ كأن نكتب: =ISNUMBER(MATCH(A2, B2, 0)). ومن الجدير بالذكر أن دالة MATCH تتصرف افتراضياً كأداة مقارنة غير حساسة لحالة الأحرف، مما يجعلها متوافقة مع متطلبات البحث المفاهيمي العام في قواعد البيانات غير الموحدة بدقة.
علاوة على ذلك، تتميز دالة MATCH، ومعها شقيقتها SEARCH، بقدرتها الاستثنائية على قبول المحارف البديلة (Wildcards) لإجراء مقارنات نصية مرنة وجزئية. يمكن للمحلل استخدام علامة النجمة (*) لتمثيل أي عدد عشوائي من المحارف، أو علامة الاستفهام (?) لتمثيل محرف مفرد مجهول؛ فعلى سبيل المثال، تتيح الصيغة =ISNUMBER(MATCH("P*nda", B2, 0)) التحقق من تطابق النص حتى مع وجود أحرف مشوهة في المنتصف. تفتح هذه الإمكانية آفاقاً واسعة للتحقق من سلامة البيانات في الدراسات المعقدة التي تتضمن نصوصاً متغيرة المقاطع أو غير مكتملة الإدخال.
6.3 توظيف دالة REGEXMATCH لمطابقة الأنماط النصية المعقدة
تُعد دالة REGEXMATCH الأداة الأكثر تقدماً وقوة في ترسانة جداول بيانات جوجل للتعامل مع مقارنة النصوص ومطابقتها وفق قواعد التعبيرات النمطية (Regular Expressions – Regex). تعتمد هذه الدالة على محرك التعبيرات النمطية القياسي (المتوافق برمجياً مع معايير RE2)، وتأخذ البنية التركيبية التالية: =REGEXMATCH(text, regular_expression). تختبر الدالة ما إذا كان النص المستهدف يحتوي على نمط نصي محدد، وتُنتج قيمة منطقية بولينية (TRUE أو FALSE) بناءً على نتيجة التحقق المنطقي من النمط.
تتميز دالة REGEXMATCH بحساسيتها الافتراضية لحالة الأحرف؛ حيث تتطلب تطابقاً دقيقاً بين النمط والنص المدخل. لإجراء مقارنة حساسة لحالة الأحرف للتحقق من تطابق النص في A2 مع B2 بالكامل، يمكن صياغة التعبير النمطي باستخدام مؤشرات بداية ونهاية السلسلة النصية: =REGEXMATCH(A2, "^" & B2 & "$"). أما في حال الرغبة في تحييد حساسية حالة الأحرف، فيمكن ببساطة دمج علم التجاهل القياسي في مقدمة التعبير النمطي، لتصبح المعادلة: =REGEXMATCH(A2, "(?i)^" & B2 & "$")، حيث يقوم العلم (?i) بتوجيه المحرك لتجاهل الفروق بين الحالات الكبيرة والصغيرة أثناء فحص السلسلة النصية.
يتجاوز توظيف REGEXMATCH قيود المقارنة الثابتة للمفردات إلى مطابقة التراكيب والأنماط البنيوية المتغيرة. يمكن للمحلل استخدامها للتحقق من تطابق السلاسل النصية مع هياكل محددة مثل صيغ البريد الإلكتروني الأكاديمي، أو أرقام الهويات الوطنية، أو أكواد التصنيف الدولي للأمراض (ICD)، أو التحقق من تطابق الكلمات حتى مع وجود فواصل زمنية أو أخطاء نمطية محددة. يمنح هذا العمق الوظيفي الباحثين سلطة مطلقة في التحكم في شروط قبول النصوص وإخضاعها لمعايير تحقق فائقة التعقيد تضمن نقاء البيانات قبل إدراجها في خطوط التحليل المتقدمة.
7. أتمتة المقارنة على النطاقات الواسعة باستخدام صيغ المصفوفات (Array Formulas)
7.1 آلية تحويل دوال المقارنة إلى صيغ مصفوفية عبر ARRAYFORMULA
عند إدارة مشروعات بيانات واسعة النطاق تضم آلاف السجلات المدخلة بصورة ديناميكية، يصبح النسخ اليدوي للمعادلات عبر مقبض التعبئة ممارسة غير عملية وتفتقر إلى الكفاءة البرمجية. توفر جداول بيانات جوجل حلاً متقدماً يتمثل في دالة ARRAYFORMULA، التي تتيح تحويل دوال المقارنة الفردية إلى صيغ مصفوفية تعالج أعمدة كاملة بضربة واحدة. تأخذ الصيغة النموذجية لمقارنة عمودين بالكامل باستخدام دالة التطابق الصارم الشكل التالي: =ARRAYFORMULA(EXACT(A2:A, B2:B))، وتوضع هذه المعادلة في الخلية العلوية الأولى من عمود النتائج (مثل C2).
تعتمد الميكانيكية التشغيلية للصيغ المصفوفية على مفهوم التوسع الذاتي للمصفوفات (Array Expansion). تستقبل دالة ARRAYFORMULA مجالات الخلايا المحددة (Ranges) كمتجهات رياضية متوازية؛ وتقوم بتطبيق دالة EXACT بالتتابع اللحظي على كل زوج متقابل من الخلايا (A2 مع B2، ثم A3 مع B3، وهكذا دواليك)، ثم تفرد النتائج المنطقية وتسكبها تلقائياً على امتداد العمود دون الحاجة لتكرار كتابة الصيغة في كل خلية على حدة. يضمن هذا النهج المعماري اتساقاً مطلقاً في منطق الحساب عبر كامل قاعدة البيانات وتفادي الأخطاء البشرية الناتجة عن نسيان تحديث الصيغ في بعض الصفوف.
تنعكس هذه الأتمتة إيجاباً على استدامة التحليل؛ فعند إدراج صفوف جديدة للبيانات بواسطة نماذج إدخال متزامنة (مثل نماذج جوجل)، تقوم الصيغة المصفوفية بالتقاط السجلات المضافة فوراً وإخضاعها للمقارنة النصية دون أي تدخل يدوي لاحق. يُسهم ذلك في تحسين بنية ورقة العمل وتسهيل صيانتها وتطويرها، فضلاً عن تقليل الأخطاء التشغيلية التي قد تنشأ عند مشاركة الملف مع فرق بحثية متعددة المستويات التقنية.
7.2 دمج الشروط المنطقية لمنع توليد نتائج غير مرغوبة للخلايا الفارغة
على الرغم من القوة التشغيلية الفائقة لصيغة =ARRAYFORMULA(EXACT(A2:A, B2:B))، إلا أنها تفرز تحدياً تقنياً يتمثل في معاملتها للخلايا الفارغة في نهاية ورقة العمل؛ حيث تقوم الدالة بمقارنة الخلية الفارغة في العمود A بالخلية الفارغة في العمود B، وتنتج القيمة TRUE لآلاف الصفوف الفارغة، مما يشوه التقرير الإحصائي ويؤدي إلى تضخم غير مبرر في حجم الملف وتأخر أدائه السحابي. يتطلب هذا الوضع دمج شروط منطقية حازمة لعزل الخلايا الفارغة وتجاوزها برمجياً.
لحل هذه المعضلة الهيكلية، يتم دمج دالة الشرط المنطقي IF مع دالة التحقق من الفراغ ISBLANK (أو اختبار السلسلة الفارغة ="") ضمن البناء المصفوفي. تأخذ الصيغة المصححة والمعتمدة أكاديمياً التنسيق التالي: =ARRAYFORMULA(IF(ISBLANK(A2:A), "", EXACT(A2:A, B2:B))). بموجب هذا التعديل المنطقي، تقوم الخوارزمية بفحص الخلية في العمود A أولاً؛ فإذا كانت فارغة، تترك خلية النتيجة فارغة تماماً؛ أما إذا احتوت على قيمة، فإنها تنتقل فوراً لتنفيذ مقارنة EXACT وإصدار النتيجة المقابلة بحسب واقع التطابق النصي الفعلي.
يحقق هذا البناء المنطقي المحكم نظافة هيكلية وبصرية للتقارير الجداولية، ويمنع تلوث العينات الإحصائية بمخرجات لا معنى لها ناجمة عن الفراغات الهامشية. كما أنه يحسن من استهلاك الموارد المادية للخوادم السحابية، حيث يتوقف محرك الحساب عن معالجة الصفوف التي تقع خارج النطاق الفعلي للمشروع البحثي، مما يضمن سرعة تحميل ورقة البيانات وتجاوبها السلس مع أدوات التحليل والفرز المتقدمة.
7.3 التطبيق المصفوفي للمقارنة غير الحساسة لحالة الأحرف
يمكن توسيع هذا المفهوم المصفوفي المتقدم ليشمل إجراء المقارنات غير الحساسة لحالة الأحرف عبر النطاقات الواسعة، وذلك من خلال دمج دوال توحيد الحالات النصية UPPER أو LOWER داخل إطار ARRAYFORMULA المحكوم بالشروط المنطقية. تأخذ الصيغة المركبة النهائية التنسيق المعياري التالي: =ARRAYFORMULA(IF(A2:A="", "", EXACT(UPPER(A2:A), UPPER(B2:B)))). تتيح هذه الصيغة تنفيذ مقارنة معيارية شاملة وغير حساسة للحالة لآلاف السجلات بضربة حسابية موحدة تنطلق من خلية رأسية واحدة.
عند اختبار زمن الاستجابة الحسابي (Latency Time) لهذه الصيغة المصفوفية في جداول بيانات تحتوي على عشرات الآلاف من السجلات، نجد أنها تتفوق بوضوح على تكرار الدوال الفردية المركبة في كل خلية؛ فالنواة الحسابية لجداول بيانات جوجل تقوم بحجز مصفوفة موحدة في الذاكرة الحية ومعالجة البيانات بنظام العمليات المتجهة (Vectorized Operations)، مما يقلل من النفقات العامة لتفسير الأكواد (Interpreter Overhead) ويسرع من زمن إصدار النتائج النهائية للباحثين والمحللين بصورة ملموسة.
توصي الممارسات المنهجية الرصينة في حوسبة البيانات السحابية بوضع هذه الصيغ المصفوفية المركبة في أوراق عمل مخصصة للتحليل الميكانيكي المستقل، بعيداً عن أوراق الإدخال الخام؛ لمنع حدوث التعديلات غير المقصودة بالصيغة الأساسية من قِبل المدخلين غير المتخصصين. يحقق هذا الفصل الوظيفي بين مستودع البيانات ومحرك المعالجة بيئة عمل آمنة تدعم التدقيق الدوري وتكفل أتمتة مستدامة لعمليات التحقق من موثوقية النصوص عبر مراحل المشروع البحثي المختلفة.
8. المعالجة المسبقة وتنقية النصوص لضمان عدالة المقارنة وموثوقيتها
8.1 تطهير النصوص من المسافات المخفية والزائدة باستخدام TRIM وCLEAN
تُمثل المسافات الهامشية والمحارف الخفية غير القابلة للطباعة أحد أكبر مصادر تلوث البيانات (Data Contamination) في جداول البيانات السحابية، والمسؤول الأول عن توليد أخطاء التطابق الزائفة (False Negatives). عند استيراد البيانات من ملفات CSV خارجية، أو سحبها عبر واجهات برمجة التطبيقات (APIs)، أو نسخها من صفحات الإنترنت، غالباً ما تتسلل مسافات بيضاء إضافية في بداية السلسلة النصية أو نهايتها، أو تتكرر بين الكلمات. هذه المسافات، رغم خفائها عن العين البشرية، تُعد محارف مستقلة بترميز بايتي خاص يؤدي حتماً إلى إفشال مقارنات دوال التطابق الصارم مثل EXACT.
للتغلب على هذا التشوه البنيوي، نلجأ إلى توظيف دالة TRIM التي تعمل على تطهير السلاسل النصية بكفاءة استثنائية؛ حيث تقوم بإزالة كافة المسافات البادئة واللاحقة في أطراف النص، مع اختزال المسافات المتكررة بين المفردات إلى مسافة بيضاء واحدة قياسية فقط. وإلى جانبها، تبرز دالة CLEAN كأداة حاسمة لإزالة أول 32 محرفاً غير قابل للطباعة في ترميز ASCII الموروث (من المحرف 0 إلى 31)، وهي محارف تحكم وظيفية قد تنتقل خلسة مع السجلات المصدرية وتفسد المساواة المنطقية بين النصوص المتطابقة ظاهرياً.
يضمن تطبيق هاتين الدالتين في مرحلة المعالجة المسبقة إخضاع النصوص لمقارنة عادلة وموضوعية ومحررة من الشوائب الطوبوغرافية الدخيلة. إذا تمت مقارنة =EXACT(TRIM(A2), TRIM(B2))، فإن أي تباين ناتج عن مسافة بيضاء لاحقة أضافها المستخدم بالخطأ في نهاية النص سيتم تحييده فوراً قبل تمرير البيانات لمحرك الفحص؛ مما يحمي نتائج التحليل الإحصائي من التشوهات ويوفر مئات الساعات التي قد تُهدر في البحث العبثي عن أسباب عدم تطابق السجلات المتشابهة بصرياً.
8.2 توحيد المعايير اللغوية ومعالجة الفروق الصوتية والإملائية
تفرض الخصائص الصوتية والمورفولوجية للغات الطبيعية تحديات إضافية تتجاوز مشكلة الحالات اللاتينية والمسافات الهامشية؛ وتبرز هذه المعضلة بجلاء عند التعامل مع معالجة اللغة العربية داخل جداول بيانات جوجل. تتميز اللغة العربية بتعدد الأشكال الهجائية للحرف الواحد وفق موقعه واستخداماته، مثل التباينات الشائعة في رسم الهمزات (أ، إ، آ، ا)، والخلط المتكرر بين التاء المربوطة والهاء في نهايات الكلمات (ـة / ـه)، فضلاً عن التناوب بين الياء البصرية والألف المقصورة (ي / ى). هذه التباينات الإملائية تقود دوال المقارنة الصارمة إلى تسجيل عدم تطابق حاسم رغم تطابق المعنى الدلالي للمفردات.
لتوحيد هذه المعايير اللغوية قبل إجراء المقارنة النصية، يتعين على المحلل بناء خوارزمية تطبيع إملائي (Spelling Normalization) باستخدام دالة الاستبدال SUBSTITUTE أو التعبيرات النمطية عبر REGEXREPLACE. يمكن صياغة سلسلة متتابعة من عمليات الاستبدال لتوحيد كافة أشكال الهمزات إلى ألف مجردة (ا)، واستبدال التاء المربوطة بالهاء، بحيث يتم تجريد الكلمات من الفروق الكتابية الشائعة التي تعود لقصور في مهارات الإدخال وليس لاختلاف المفاهيم المستهدفة بالدراسة والتحليل الإحصائي.
يمتد هذا التوحيد المعياري أيضاً إلى معالجة اللغات الأجنبية من خلال فك الاختصارات الشائعة وتوحيد أنماط الترقيم المعقدة (مثل توحيد علامات الشرطة الواصلة والفواصل العليا). تسهم هذه الخطوات في إرساء أرضية لغوية مشتركة تضمن أن المقارنة النصية اللاحقة ستعكس حقيقة الاتساق المفهومي للمصطلحات، وهو شرط إبستيمولوجي ومنهجي لا غنى عنه لتحقيق الصدق الداخلي (Internal Validity) في البحوث والدراسات القائمة على التحليل النصي والمحتوى.
8.3 بناء سلسلة متكاملة لمعالجة النصوص (Data Cleaning Pipeline) داخل الخلية
تتكامل هذه المبادئ في النهاية لتشكل ما يُعرف في هندسة البيانات بسلسلة تنقية البيانات (Data Cleaning Pipeline)، والتي يمكن تضمينها داخل خلية المقارنة الواحدة من خلال صياغة معادلة محكمة تجمع كافة دوال التنظيف والتوحيد قبل إطلاق حكم المقارنة المنطقي. يتجسد هذا النموذج التطبيقي الأكاديمي المتقدم في الصيغة المركبة التالية: =EXACT(TRIM(CLEAN(UPPER(A2))), TRIM(CLEAN(UPPER(B2)))).
يعمل هذا البناء التكاملي المتين وفق تسلسل هرمي صارم؛ حيث تبدأ النواة الحسابية بتنظيف المحارف غير القابلة للطباعة عبر CLEAN، تليها إزالة المسافات الزائدة والبادئة واللاحقة عبر TRIM، ثم توحيد حالة الأحرف اللاتينية إلى حالتها الكبيرة عبر UPPER، وتُجرى هذه الخطوات بصورة متطابقة ومتزامنة على المدخلين في الخليتين A2 وB2. بعد استكمال هذه التصفية الشاملة، تتلقى دالة EXACT مدخلين مطهرين بالكامل لتصدر حكمها البوليني القطعي استناداً إلى الحروف الفعلية المكونة للكلمتين فقط.
تُعد خطوة التنقية المتكاملة هذه شرطاً مسبقاً لا غنى عنه لبناء قواعد بيانات موثوقة تلبي معايير النشر في الدوريات العلمية المحكمة وتنسجم مع متطلبات المؤسسات الإحصائية الرائدة. إن حماية المقارنة النصية بسلسلة معالجة مسبقة يرفع من معامل الموثوقية العامة للبيانات، ويمنع تداخل المتغيرات الدخيلة، ويزود الباحثين بأداة حاسوبية فائقة الدقة تميز بثقة بين التباين المفهومي الحقيقي والتشوه الشكلي الطارئ على أدوات الجمع الميداني.
9. استثمار نتائج المقارنة في التحليل الشرطي وتوليد التقارير المتقدمة
9.1 التنسيق الشرطي التلقائي القائم على نتائج المقارنة النصية
لا تتوقف مخرجات مقارنة النصوص عند حدود توليد القيم البولينية المجردة، بل تمتد لتكون محركاً بصرياً فعالاً لأتمتة عمليات التدقيق والمراجعة عبر ميزة التنسيق الشرطي (Conditional Formatting) المدمجة في جداول بيانات جوجل. تتيح هذه الميزة للباحثين تصميم واجهات بصرية تفاعلية تُميز السجلات وتبرزها بالألوان استناداً إلى قواعد مطابقة النصوص المحددة، مما يقلل من الجهد الذهني المبذول في قراءة آلاف الصفوف ويسرع من عملية الاكتشاف البصري للشذوذ والانحرافات الإحصائية.
يمكن ضبط هذه القواعد لتمييز الخلايا غير المتطابقة تلقائياً باللون الأحمر الفاتح لإرسال تنبيه بصري فوري يفيد بوجود تباين يستوجب المراجعة، في حين تُظلل حالات التطابق التام باللون الأخضر الهادئ لتأكيد التجانس. يتم ذلك من خلال تحديد نطاق البيانات المراد مراقبته (مثل A2:B100)، واختيار “صيغة مخصصة” (Custom Formula) في لوحة التنسيق الشرطي، ثم كتابة الصيغة مباشرة دون الحاجة لأعمدة مساعدة؛ كأن نكتب القاعدة: =NOT(EXACT($A2,$B2)) لتلوين الخلايا المتباينة، مع مراعاة تثبيت العمود برمز الدولار ($) لضمان تطبيق التلوين المتوازي والمتناسق عبر الصف الواحد.
يساعد هذا التوظيف البصري لنتائج المقارنة فرق العمل الميدانية على إجراء مسح بصري سريع للبيانات فور تدفقها إلى ورقة العمل المشتركة. كما يوفر للباحثين آلية فورية لمراقبة الجودة تُمكّنهم من التدخل السريع لإصلاح الأخطاء الإملائية أو التحقق من موثوقية مصادر الجمع قبل أن تتراكم المشكلات الهيكلية وتتحول إلى عوائق تقنية تعطل المراحل المتقدمة من التحليل الرياضي للبيانات.
9.2 دمج نتائج المقارنة مع الدوال الشرطية IF وCOUNTIF لتوليد مؤشرات إحصائية
لتحويل القيم المنطقية البسيطة (TRUE وFALSE) إلى مخرجات ذات مغزى تطبيقي وإحصائي مفهوم لمتخذي القرار وفرق التحليل النوعي، نلجأ إلى دمج صيغ المقارنة النصية مع الدوال الشرطية مثل IF. يمكن صياغة معادلة تحويلية تترجم القيم المجردة إلى توصيفات لغوية مخصصة، كأن نكتب: =IF(EXACT(A2, B2), "مطابق", "غير مطابق"). يضفي هذا التخصيص طابعاً احترافياً على التقارير الجداولية، ويجعل مخرجات التحليل النصي قابلة للقراءة المباشرة من قِبل الباحثين غير المتمرسين في المصطلحات المنطقية البرمجية.
علاوة على ذلك، يشكل دمج هذه النتائج مع دوال الإحصاء الوصفي مثل COUNTIF وCOUNTA خطوة جوهرية لتوليد مؤشرات إحصائية تلخص جودة البيانات الإجمالية. يمكن للمحلل حساب إجمالي عدد السجلات المتطابقة باستخدام الصيغة: =COUNTIF(C2:C, TRUE)، ثم استخراج النسبة المئوية للتطابق عبر قسمة هذا الناتج على إجمالي السجلات المفحوصة بواسطة =COUNTIF(C2:C, TRUE) / COUNTA(A2:A) وتنسيق النتيجة كنسبة مئوية رقمية واضحة ومحددة.
تُستخدم هذه النسب والمؤشرات التجميعية في بناء مؤشرات جودة البيانات (Data Quality Metrics – DQMs)، والتي تمثل معايير قياس مؤسسية لتقييم كفاءة مدخلي البيانات وموثوقية مصادر التجميع المختلفة. إذا أظهر مؤشر التطابق انخفاضاً حاداً في إحدى العينات الميدانية مقارنة بغيرها، فإن ذلك يمثل دليلاً إحصائياً موجهاً للباحث لإعادة تقييم أدوات القياس المستخدمة في تلك العينة والتحقق من التزام جامعي البيانات بالمعايير الإجرائية المحددة في بروتوكول البحث الميداني.
9.3 توليد تقارير الاختلاف والفرز التلقائي للسجلات المتباينة
في المشروعات البحثية الكبرى التي تتعامل مع تدفقات بيانات مستمرة وتخضع لمراحل تدقيق متعددة المستويات، لا يكتفي المحلل بتحديد الخلايا المتباينة بصرياً، بل يحتاج إلى عزلها كلياً في تقارير مستقلة لمراجعتها وتصحيحها منهجياً. تقدم جداول بيانات جوجل دالة FILTER المتقدمة كأداة فائقة الكفاءة لأتمتة هذا الفرز التوليدي للسجلات المتناقضة استناداً إلى نتائج دوال المقارنة النصية.
يمكن بناء ورقة عمل مخصصة بالكامل لتدقيق الفروق، واستدعاء السجلات غير المتطابقة فقط من ورقة البيانات الأساسية عبر كتابة صيغة الفرز المباشرة التالية: =FILTER(Data!A2:B, EXACT(Data!A2:A, Data!B2:B) = FALSE). بمجرد تنفيذ هذه الصيغة، يقوم المحرك بمسح الجدول الرئيسي واستخراج كافة الصفوف التي تحتوي على نصوص متباينة، وتوليد تقرير ديناميكي مستقل يتحدث تلقائياً كلما تم تعديل أو تصحيح أي مدخل في الورقة المصدرية للبيانات.
تسهم هذه التقارير الديناميكية في أتمتة دورة مراجعة وتنقية البيانات؛ حيث يتم توجيه ملف الفروق المعزول إلى لجان التدقيق المختصة لمراجعة أسباب عدم التطابق الحرفي، وتحديد ما إذا كان الاختلاف ناتجاً عن خطأ إدخال يتطلب التصحيح، أو أنه يعبر عن تباين واقعي يستلزم الإبقاء عليه وتصنيفه كمتغير مستقل. يرفع هذا النهج المؤسسي من كفاءة الحوكمة البيانية ويوفر توثيقاً منهجياً شفافاً لكافة عمليات المعالجة التي خضعت لها العينات قبل صياغة التقرير الإحصائي النهائي.
10. دليل استكشاف الأخطاء وتصحيحها في مقارنة النصوص (Troubleshooting)
10.1 تشخيص مسببات النتيجة الخاطئة FALSE رغم التطابق البصري الظاهر
تعد مشكلة ظهور النتيجة المنطقية FALSE عند مقارنة سلسلتين نصيتين تبدوان متطابقتين تماماً للعين البشرية من أكثر المشكلات التقنية إرباكاً للمحللين والباحثين. يتطلب التعامل المنهجي مع هذه الحالة تفكيك المسببات الخفية وتشخيصها رقمياً. السبب الأكثر شيوعاً وشناعة هو وجود “مسافات الفضاء غير المنكسرة” (Non-breaking Spaces)، والتي تحمل الرمز الرقمي CHAR(160) في معايير HTML، وغالباً ما تتسرب إلى جداول البيانات عند نسخ المحتوى من متصفحات الويب أو الوثائق الرقمية المنشورة.
تكمن خطورة محرف المسافة غير المنكسرة CHAR(160) في أن دالة TRIM القياسية في جداول بيانات جوجل قد تعجز في بعض البيئات عن إزالته؛ لأنها مبرمجة أصلاً للتعامل مع مسافة ASCII التقليدية ذات الرمز CHAR(32). لتشخيص هذه المشكلة بدقة وحلها، ينبغي استبدال هذا المحرف الخفي برمجياً عبر استخدام دالة الاستبدال المركبة: =SUBSTITUTE(A2, CHAR(160), " ") ثم تطبيق دالة التنظيف والتطابق المعتادة لضمان التخلص التام من هذا الشائب الرقمي الخفي واستعادة الدقة الحسابية للمقارنة.
السبب الثاني يتمثل في عدم تجانس أنواع البيانات المخزنة؛ كأن تتم مقارنة رقم مجرد (Number) بقيمة رقمية تم إدخالها كـ “نص” (Text)، مثل مقارنة الرقم 100 بالنص “100”. هنا تُصدر دالة EXACT حكماً سالباً حاسماً لأن نوعي البيانات في الذاكرة غير متكافئين أساساً. ولتشخيص أي زوائد خفية أخرى، يُنصح دائماً باستخدام دالة قياس الطول النصي LEN؛ فإذا أظهرت الدالة أن طول السلسلة النصية في A2 هو 6 محارف، بينما يظهر في B2 بطول 5 محارف رغم تطابقهما الحرفي الظاهر، فهذا برهان رياضي قاطع على وجود محرف خفي في نهاية الكلمة يستوجب التطهير الفوري.
10.2 التعامل مع نصوص اللغات المتعددة والمحارف ذات الاتجاهين (BiDi)
تفرض بيئات البيانات متعددة اللغات (Multilingual Environments) تحديات حوسبية متقدمة عند مقارنة النصوص التي تمزج بين أحرف تكتب من اليمين إلى اليسار (RTL) كالعربية، وأحرف تكتب من اليسار إلى اليمين (LTR) كالإنجليزية والرموز الرياضية. عند اختلاط هذه الأنماط داخل خلية واحدة، تقوم جداول بيانات جوجل بحقن محارف تحكم غير مرئية لتنظيم اتجاه القراءة الحوسبي (BiDi Control Characters)، مثل محارف علامة اليمين إلى اليسار (RLM) وعلامة اليسار إلى اليمين (LRM)، وتؤدي هذه المحارف الخفية إلى كسر التطابق الثنائي لدوال EXACT دون أن يكون لها أي مظهر بصري في الخلية.
بالإضافة إلى ذلك، تبرز إشكالية علامات التشكيل وحركات الإعراب العربية (الفتحة، الضمة، الكسرة، التنوين، الشدة، والسكون). تُعامل بيئات البرمجة والترميز الدولي هذه العلامات كنقاط ترميز منفصلة تُضاف إلى تسلسل البايت الخاص بالحرف الأبجدي. وبالتالي، فإن مقارنة كلمة “عِلْمٌ” مشكولة بالكامل بكلمة “علم” مجردة باستخدام دالة EXACT ستسفر حتماً عن النتيجة FALSE؛ بسبب الاختلاف الجذري في عدد المحارف ونقاط الترميز المخزنة في الذاكرة الحية لكل منهما.
يتطلب التحليل الرصين للبيانات العربية استراتيجية واعية لتجريد النصوص من علامات التشكيل وحركات الإعراب قبل إخضاعها للمقارنة الموضوعية، ما لم يكن هدف الدراسة بحد ذاته هو التدقيق الصوتي أو اللغوي للتشكيل. يمكن استخدام التعبيرات النمطية عبر دالة REGEXREPLACE(A2, "[u064B-u0652]", "") لمسح كافة حركات التشكيل الشائعة برمجياً وضمان توحيد البنية النصية، وتجريد محارف الاتجاهين، مما يحقق مطابقة دلالية عادلة تعكس المحتوى الفعلي دون الوقوع في شراك التعقيدات التشفيرية للغات متعددة الاتجاهات.
10.3 أفضل الممارسات الأكاديمية لحوكمة البيانات النصية وضمان اتساقها
إن أفضل وسيلة للتعامل مع مشكلات مقارنة النصوص وتصحيح أخطائها هي منع وقوعها ابتداءً من مرحلة جمع البيانات، وذلك عبر تطبيق مبادئ حوكمة البيانات الصارمة (Data Governance Frameworks). تتمثل أولى هذه الممارسات الأكاديمية في تفعيل أدوات التحقق من صحة البيانات (Data Validation) داخل جداول بيانات جوجل؛ حيث يتم تقييد إدخال المستخدمين في حقول معينة بقوائم منسدلة مغلقة تفرض خيارات موحدة ومضبوطة مسبقاً، مما يمنع نهائياً تباينات الهجاء، واختلافات حالات الأحرف، والمسافات البيضاء العشوائية من المصدر الأساسي للإدخال.
تتمثل الممارسة الثانية في إعداد وتوثيق قواميس البيانات (Data Dictionaries) وأدلة المصطلحات الموحدة (Codebooks) وتوزيعها على جميع المشاركين في مراحل تفريغ البيانات وترميزها. توضح هذه الأدلة المعايير المتبعة بدقة في تسجيل المتغيرات النصية، مثل اشتراط استخدام الأحرف الكبيرة دائماً في الاختصارات، أو تحديد الصيغة الإملائية المعتمدة للمصطلحات التي تحتمل أكثر من رسم كتابي، مما يضمن اتساقاً أولياً يقلل الاعتماد المستمر على الصيغ الرياضية المعقدة لتنقية النصوص لاحقاً.
أخيراً، يتعين على المؤسسات البحثية والمحللين اعتماد بروتوكولات المراجعة الدورية للصيغ والتحول نحو المعالجة المؤتمتة عبر صيغ المصفوفات والأدوات البرمجية السحابية الموثقة، مع تقليل التدخل اليدوي لأدنى حد ممكن. إن اعتماد هذه الممارسات المتكاملة لا يحمي فقط سلامة التحليل الإحصائي من التشويه، بل يعزز أيضاً قابلية تكرار البحث والتحقق من نتائجه (Reproducibility) من قِبل باحثين ومؤسسات أخرى، وهو المعيار الأسمى للنزاهة والجودة في البحث الأكاديمي والتحليل العلمي المعاصر.
خاتمة
تناول هذا المقال الاستقصائي الشامل تفكيك الأبعاد النظرية والتطبيقية لمقارنة السلاسل النصية في جداول بيانات جوجل، مبرزاً التباين الجوهري بين آليات المقارنة الصارمة الحساسة لحالة الأحرف والمقارنات المرنة التي تحيد هذه الحساسية لضمان التطابق المفهومي. لقد رأينا كيف تشكل دالة EXACT أداة الفحص البايتي المباشر الأكثر دقة في بيئة الجداول الحسابية، وكيف يمكن تعزيز مرونتها وتوسيع إمكاناتها عبر دمجها مع دوال تحويل الحالات النصية مثل UPPER وLOWER، أو الاستعاضة عنها في سيناريوهات البحث العام بعوامل المقارنة المنطقية المباشرة ودوال التعبيرات النمطية المتقدمة مثل REGEXMATCH.
إن الركيزة الحقيقية لنجاح أي عملية تحليل نصي لا تكمن فقط في براعة كتابة الدوال المنطقية، بل تنبع أساساً من جودة المعالجة المسبقة والتنقية الهيكلية للبيانات؛ إذ تظل أدوات مثل TRIM وCLEAN وخوارزميات التطبيع اللغوي صمام الأمان الحقيقي لدرء الأخطاء الخفية الناجمة عن المسافات الزائدة والمحارف غير القابلة للطباعة وتناقضات الترميز الدولي. إن الإلمام بهذه المنهجيات وتمكينها عبر صيغ المصفوفات ARRAYFORMULA والتنسيق الشرطي التلقائي يمنح الباحثين والمحللين بنية تحتية رقمية رصينة تكفل استدامة التحليل وحوكمة البيانات وسلامة القرارات المبنية عليها.
المراجع
- Bobbitt, Z. (2023, May 11). How to compare strings in Google Sheets (with example). Statology. https://www.statology.org/google-sheets-compare-strings/
- Google. (n.d.). EXACT function – Google Docs Editors Help. Google Support. https://support.google.com/docs/answer/3094123
- Google. (n.d.). ARRAYFORMULA function – Google Docs Editors Help. Google Support. https://support.google.com/docs/answer/3093275
- Google. (n.d.). REGEXMATCH function – Google Docs Editors Help. Google Support. https://support.google.com/docs/answer/3098292
- The Unicode Consortium. (2023). The Unicode Standard, Version 15.0. Mountain View, CA: The Unicode Consortium. https://www.unicode.org/versions/Unicode15.0.0/
- Walkenbach, J. (2015). Excel 2016 formulas. John Wiley & Sons.