
تُعد السلاسل الزمنية من الركائز الأساسية في الإحصاء التطبيقي وتحليل البيانات المعاصرة؛ إذ تُمكّن الباحثين من تتبع الظواهر عبر الزمن، وفهم آلياتها التراكمية، والتنبؤ باتجاهاتها المستقبلية. سواء كُنّا بصدد دراسة مؤشرات اقتصادية كلية، أو متابعة تغيرات فسيولوجية ونفسية دقيقة، أو رصد تكرارات سلوكية عبر فترات متباعدة، فإن العامل الزمني يفرض قيوداً وتحديات منهجية لا تستطيع الأساليب الإحصائية التقليدية—المستندة إلى فرضية استقلال الملاحظات—التعامل معها بكفاءة. ومن هنا تبرز الحاجة إلى أدوات برمجية متخصصة قادرة على تمثيل الوقت ليس فقط كمتغير تفسيري إضافي، بل كهيكل بنيوي يحكم ترابط البيانات وتسلسلها التوليدي.
تحتل لغة البرمجة الإحصائية R مكانة رائدة في هذا المجال؛ نظراً لما توفره من بيئة حوسبية ثرية ومفتوحة المصدر صُممت خصيصاً على أيدي الإحصائيين لمعالجة البيانات المعقدة. تمثل دالة ts() النواة المركزية للتعامل مع السلاسل الزمنية داخل الحزمة الأساسية في R، حيث تُحوّل المتجهات والمصفوفات الرقمية الصامتة إلى كائنات رياضية واعية بالأبعاد الزمنية والأنماط الدورية. يمكّن هذا التحول الرياضي الباحثين من تطبيق طيف واسع من النماذج المتقدمة، بدءاً من نماذج التنعيم والتفكيك الدوري، وصولاً إلى نماذج الانحدار الذاتي والمتوسطات المتحركة المتكاملة، مستفيدين من البنية المتماسكة التي تمنحها هذه الفئة البرمجية للبيانات.
يهدف هذا المقال الأكاديمي الشامل إلى تقديم دليل عملي وتأصيلي دقيق لكيفية بناء، وإدارة، وفحص كائنات السلاسل الزمنية في بيئة R باستخدام دالة ts() وتطبيقاتها الموسعة. سنستعرض عبر محاوره المتعددة الأسس النظرية والبرمجية، وصيغ التعامل مع الترددات المختلفة من السنوية والشهرية إلى الدقيقة واليومية، بالإضافة إلى استكشاف السلاسل متعددة المتغيرات، واستراتيجيات التعامل المنهجي مع القيم المفقودة والتمثيل البصري عالي الدقة. يستند الشرح إلى أفضل الممارسات المتبعة في النمذجة الإحصائية لضمان سلامة الاستدلال وقابلية إعادة الإنتاج العلمي للبحوث التحليلية.
1. مقدمة إلى السلاسل الزمنية وأهمية تمثيلها في بيئة R الإحصائية
1.1 مفهوم كائن السلسلة الزمنية وأهميته في النمذجة الإحصائية
تُعرّف السلسلة الزمنية رياضياً بأنها متتالية مرتبة من الملاحظات الكمية، يُرمز لها بالرمز $Y_t$، حيث تُقاس هذه الملاحظات تباعاً عبر فترات زمنية محددة ومنتظمة $t in {1, dots, T}$. وتكتسب هذه المتتالية خصوصيتها الإحصائية من الارتباط الداخلي المتأصل بين نقاطها المتجاورة؛ إذ غالباً ما تعتمد القيمة الراهنة $Y_t$ على القيم السابقة لها $Y_{t-1}$ مضافاً إليها مكونات عشوائية أو اتجاهات منتظمة. في العلوم النفسية والسلوكية والوبائية، يُعد هذا الترتيب محورياً لدراسة التغيرات داخل الفرد الواحد عبر أدوات القياس اللحظي التقييمي المتكرر، بدلاً من الاقتصار على المقارنات المقطعية بين الأفراد. إن إغفال هذا البعد الزمني يؤدي بالضرورة إلى انتهاك فرضية استقلال الأخطاء، مما يجعل اختبارات الدلالة الإحصائية التقليدية مضللة وعرضة لأخطاء النوع الأول.
ومن منظور هندسة البرمجيات الإحصائية، فإن تمثيل هذه الملاحظات كمتجهات عددية بسيطة داخل R يُفرغ البيانات من سياقها التوليدي. فالمتجه العادي يتعامل مع الأرقام كعناصر معزولة داخل فضاء أحادي البعد دون إدراك للمسافات الزمنية أو الفواصل التقويمية الفاصلة بينها. في المقابل، يُضفي كائن السلسلة الزمنية، المعروف اصطلاحاً باسم ts object، فئة برمجية متخصصة تُدمج داخلها سمات فوقية تصف نقطة البداية، ونقطة النهاية، ومعدل التكرار الدوري. هذا التمايز الهيكلي يسمح لبيئة R بالتعامل مع المتغير كمسار حركي متصل، وتطبيق العمليات الرياضية الخاصة بإزاحة الفترات الزمنية وحساب الفروق دون الحاجة إلى إعادة صياغة الروابط الزمنية يدوياً.
تتجلى الفروق الهيكلية بين المتجهات العادية وكائنات ts في كيفية استجابة الدوال المدمجة في R لكل منهما؛ فعند تمرير متجه عادي إلى دالة الرسم البياني، تُعرض النقاط وفقاً لترتيبها الفهرسي من 1 إلى $n$ دون أي دلالة تقويمية. أما عند تمرير كائن سلسلة زمنية، فإن النظام يستدعي تلقائياً دالة التوزيع البصري المناسبة، معنوناً المحور السيني بالسنوات والشهور الدقيقة بناءً على السمات المدمجة. علاوة على ذلك، تعتمد مصفوفات التغاير ودوال الارتباط الذاتي على هذا الترتيب الداخلي لحساب معاملات التأخر الزمني، مما يبرز الدور المحوري لكائنات ts في حماية الباحث من أخطاء التحليل المنهجي.
1.2 دور بيئة R كمنصة متقدمة لتحليل الظواهر الزمنية والديناميكية
توفر بيئة R الحوسبية إطاراً متقدماً لدراسة التغير الطولي والظواهر الديناميكية بفضل تضافر خوارزميات الحساب العددي مع قدرات المعالجة المصفوفية الصارمة. إن دراسة الظواهر المعقدة، مثل تتبع تقلبات الحالات الوجدانية الإيجابية وأثرها على السلوك التكيفي عبر الزمن (Lyubomirsky et al., 2005)، تتطلب نمذجة رياضية تأخذ في الحسبان الاتجاهات العامة والتقلبات الموسمية الدورية. تقدم R بنية تحتية تمكّن الباحث من تفكيك السلاسل الزمنية إلى مركباتها الثلاث الرئيسية: الاتجاه العام، والموسمية، والتشويش العشوائي، عبر دوال قياسية محسوبة بدقة مثل decompose() وstl()، والتي تعتمد في مدخلاتها كلياً على البنية الهيكلية لكائنات ts.
يتجلى التكامل الوثيق في منظومة R من خلال قدرة كائنات السلاسل الزمنية على التفاعل المباشر مع الحزم الإحصائية المتقدمة للتنبؤ والتحليل الطيفي والشبكي. على سبيل المثال، تعتمد النماذج الديناميكية الحديثة لتقدير الشبكات النفسية الطولية وتطور الأعراض السريرية مع الوقت (Epskamp et al., 2016) على اتساق الفواصل الزمنية ودقة تمثيل التزامن بين المتغيرات المتعددة، وهو ما تضمنه المنصة البرمجية عبر التحقق التلقائي من الخصائص الزمنية للبيانات. يتيح هذا الترابط للباحث الانتقال السلس من مرحلة إعداد البيانات الوصفية إلى مراحل النمذجة المتقدمة ونماذج الفضاء الحركي دون فقدان دقة التوثيق الرياضي.
إلى جانب ذلك، تلتزم بيئة R بمعايير صارمة للتوثيق البرمجي والضبط الإحصائي، مما يجعل إدارة البيانات الطولية أمراً خاضعاً لقواعد التدقيق العلمي المعياري. وتضمن هذه المنظومة عدم حدوث تشوهات غير مقصودة في تواريخ الملاحظات أثناء عمليات التحويل الحسابي، وتمنح المستخدم تحكماً فائقاً في المعاملات الرياضية المرتبطة بالاستقرار الإحصائي ومحاذاة المؤشرات الزمنية، وهو ما يسهم في ترسيخ الشفافية وتعزيز قابلية التحقق وإعادة الإنتاج للنتائج المنشورة في الأدبيات الأكاديمية المحكّمة.
1.3 المتطلبات الأساسية وإعداد بيئة العمل لإنشاء السلاسل الزمنية
قبل الشروع في كتابة الأوامر البرمجية لبناء السلاسل الزمنية، يتعين ضبط بيئة العمل الحسابية لضمان كفاءة التنفيذ وتجنب تداخل المتغيرات في الذاكرة. يُفضل استخدام بيئة التطوير المتكاملة RStudio، حيث تتيح مراقبة فضاء العمل والذاكرة المتاحة وإدارة المخرجات الرسومية عبر واجهات متخصصة. يبدأ الإعداد المنهجي بتنظيف مساحة الذاكرة النشطة عبر الأمر البرمجي rm(list = ls())، لضمان عدم وجود كائنات سابقة قد تحمل أسماء متطابقة وتتداخل مع المتجهات الجديدة. كما يجب تحديد دليل العمل الجاري باستخدام setwd() لضمان استيراد الملفات وتصدير النتائج وفق مسار محدد وثابت.
تتميز دالة ts() الأساسية بكونها جزءاً لا يتجزأ من حزمة stats المضمنة افتراضياً في توزيعة R القاعدية، مما يعني أن الباحث ليس بحاجة إلى تثبيت أو استدعاء مكتبات خارجية لبدء بناء السلاسل وتحليلها الأولي. ومع ذلك، ينبغي التأكد من تحديث نسخة R الأساسية لتفادي أي سلوك برمجي غير متطابق في إدارة التواريخ الحسابية. تتطلب البيئة التحقق المسبق من تكامل البيانات العددية، والتأكد من عدم وجود تشوهات في ترميز النصوص إذا كانت التواريخ مستوردة من جداول بيانات خارجية مثل ملفات CSV أو قواعد البيانات العلائقية.
تخضع مرحلة تنظيم وتجهيز المتجهات الرقمية قبل إدخالها في الدالة لمعايير حاسمة؛ إذ يجب أن تكون القيم مرتبة ترتيباً تصاعدياً دقيقاً حسب زمن حدوثها الفعلي. إن حدوث أي خلل في هذا الترتيب يؤدي إلى إفساد التحليل بأكمله، نظراً لأن دالة ts() تفترض ضمنياً أن العنصر الأول في المتجه يسبق العنصر الثاني زمنياً بفارق خطوة واحدة محددة وفق التردد. كما يتوجب على المحلل تحويل أي ترميزات نصية أو رموز غير رقمية إلى صيغ عددية مقبولة، والتأكد من خلو المتجه من السلاسل الحرفية التي قد تحول الكائن الناتج قسراً إلى فئة نصية غير قابلة للحساب الرياضي.
2. البنية النحوية والرياضية للدالة الأساسية ts() في R
2.1 الصيغة العامة للدالة وتفكيك معاملاتها الأساسية
تعتمد دالة ts() في بيئة R على صياغة برمجية محددة تترجم المتجهات العددية إلى كائنات زمنية مهيكلة. تتخذ الصيغة العامة للدالة النحو التالي:
ts(data = NA, start = 1, end = numeric(), frequency = 1, deltat = 1, ts.eps = getOption("ts.eps"), class = , names = )
تتضمن هذه الصيغة مجموعة من المعاملات المحورية التي تحدد الخصائص الرياضية للكائن؛ حيث يمثل المعامل data المتجه أو المصفوفة الرقمية التي تحتوي على قيم القياس الفعلية المرصودة عبر التجربة أو المسح الميداني.
يتطلب كل معامل نوعاً بيانياً محدداً؛ فالمعامل start يحدد النقطة الزمنية لأول ملاحظة، ويُقبل كقيمة عددية مفردة للترددات السنوية، أو كمتجه ثنائي العناصر يمثل الوحدة الزمنية الكبرى والوحدة الفرعية داخل الدورة. في المقابل، يمثل المعامل end نقطة الختام للسلسلة، وهو معامل اختياري في أغلب الأحوال، إذ تستطيع خوارزمية الدالة اشتقاق قيمته الحسابية استناداً إلى طول متجه البيانات ونقطة البداية وقيمة التردد. أما المعامل frequency فيمثل عدد الملاحظات المتكررة ضمن الدورة الزمنية الواحدة الكاملة، وهو ما يقابله رياضياً المعامل البديل deltat الذي يعبر عن الفاصل الزمني بين كل ملاحظتين متتاليتين مقاساً ككسر من الوحدة الكبرى، وتتحقق العلاقة التبادلية بينهما بالمعادلة: $\text{frequency} = \frac{1}{\text{deltat}}$.
عند إغفال تمرير المعاملات غير الإلزامية، تتبنى الدالة سلوكاً افتراضياً محدداً؛ فإذا تم استدعاء ts(data) بتمرير متجه القيم فقط، تفترض R تلقائياً أن السلسلة تبدأ من الزمن $t = 1$ بتردد سنوي أو خطوي $frequency = 1$. وينتج عن ذلك كائن زمني مفهرس بأرقام صحيحة متعاقبة تعكس فقط عدد الملاحظات الكلي دون أي إسقاط على التقويم الفعلي. هذا السلوك التلقائي يضمن عدم توقف البرنامج عند غياب تفاصيل التقويم، ولكنه يضع على عاتق المحلل مسؤولية التصريح بالمعاملات بدقة عند الحاجة لإجراء نمذجة موسمية أو دورية واقعية.
2.2 المعامل data: تحويل المتجهات والمصفوفات إلى كائنات زمنية
يُعد المعامل data الوعاء الرقمي الرئيسي داخل دالة ts()، وهو يتميز بمرونة هيكلية تتيح له استقبال أنواع مختلفة من الهياكل البيانية. عندما يُمرر إليه متجه عددي أحادي البعد (Numeric Vector)، يُنتج كائناً زمنياً أحادي المتغير يمثل قياسات ظاهرة واحدة متتابعة عبر الزمن. وتُخزن الملاحظات داخله بتسلسل خطي يحافظ على الترتيب الأصلي الذي أُدخلت به، مع ربطها تلقائياً بالسمات الزمنية المشتقة من المعاملات الأخرى الممررة للدالة.
في الحالات التي تتطلب تمثيل ظواهر مترابطة تجري مراقبتها بالتزامن، يقبل المعامل data مصفوفات عددية ثنائية الأبعاد (Matrices) أو أطر بيانات (Data Frames) تحتوي على أعمدة رقمية متساوية الطول. في هذه الحالة، يتحول الكائن الناتج إلى سلسلة زمنية متعددة المتغيرات يُطلق عليها برمجياً اسم mts (Multivariate Time Series). تُمثل الأعمدة في هذا التشكيل المتغيرات المقاسة المختلفة، بينما تُمثل الصفوف اللحظات الزمنية المتزامنة، مما يتيح للباحث نمذجة التأثيرات المتبادلة والارتباطات الذاتية المتقاطعة بكفاءة دون الإخلال بوحدة الإطار الزمني للظاهرة المدروسة.
تشترط المعالجة الحسابية للدالة سلامة أنواع البيانات المدخلة؛ إذ يجب أن تقتصر القيم على الأرقام الحقيقية، سواء كانت أعداداً صحيحة أو عشرية. في حال احتواء المتجه على قيم نصية (Character) أو عوامل تصنيفية (Factor)، ستقوم لغة R بتحويل المتجه بالكامل قسراً إلى نمط نصي، مما يؤدي إلى فشل العمليات الحسابية اللاحقة كنماذج التنبؤ وتفكيك السلاسل. كما يقبل المعامل وجود القيم الخاصة مثل القيم المفقودة NA، ولكنه يتطلب معالجة حذرة للقيم اللانهائية Inf أو القيم غير المعرفة رياضياً NaN التي قد تتسبب في إيقاف تنفيذ خوارزميات التقدير الإحصائي التكرارية.
2.3 المعاملات start و end و frequency: تحديد الأبعاد الدورية
يشكل الثلاثي start وend وfrequency المحرك الرياضي الذي يضبط الأبعاد الدورية والتقويمية لكائن السلسلة الزمنية. يُصاغ المعامل start لتحديد التوقيت الدقيق لأول ملاحظة؛ وفي السلاسل التي تتضمن دورات فرعية كالأشهر أو الفصول، يُمرر كمتجه ثنائي القيمة على هيئة c(Year, Sub_period). على سبيل المثال، التعبير start = c(2021, 3) يعني أن الملاحظة الأولى سُجلت في الفترة الفرعية الثالثة من عام 2021، وهو ما يحدد زاوية الطور الابتدائية لكافة التقديرات الإحصائية التي تعتمد على المحاذاة الدورية.
أما المعامل end فيحدد نقطة الاختتام الزمني بنفس التنسيق المزدوج، ولكنه يخضع لقيود رياضية صارمة تربطه بالمعاملات الأخرى؛ فالترتيب الزمني يفرض أن تتحقق دائماً العلاقة:
$$\text{عدد الملاحظات} = (\text{End} – \text{Start}) \times \text{frequency} + 1$$
إذا قام الباحث بتحديد قيم غير متوافقة حسابياً لكل من start وend مع طول متجه البيانات، فإن R تعطي الأولوية لطول المتجه ومعامل البداية لتقوم بحساب نقطة النهاية الصحيحة تلقائياً، مع إصدار تحذير للمستخدم لتنبيهه إلى وجود عدم تطابق بين الإحداثيات المدخلة والحجم الفعلي للمصفوفة.
يحتل المعامل frequency المكانة الأكثر تأثيراً في تحديد التوصيف الرياضي للسلسلة؛ إذ يحدد عدد الملاحظات المكونة لدورة تقويمية كاملة. لا يعبر التردد هنا عن مجرد رقم تسلسلي، بل يحدد فترات التأخر المرافقة للموسمية في النماذج الإحصائية المتقدمة. فعند ضبط frequency = 12، تدرك R أن الظاهرة تكرر نمطها كل اثنتي عشرة خطوة زمنية (نمط شهري)، بينما يؤدي ضبط frequency = 4 إلى معالجة البيانات وفق منطق الفصول الأربعة، مما يؤثر جذرياً على مصفوفات الارتباط الذاتي وحسابات معاملات التنعيم الأسي.
3. إنشاء سلاسل زمنية ذات تردد شهري: تطبيق عملي مفصل
3.1 صياغة المتجه الأولي وتحديد نقطة الانطلاق الزمنية
لتطبيق هذه المفاهيم بشكل منهجي، سنقوم بإنشاء سيناريو تطبيقي عملي يُحاكي تتبع ظاهرة سلوكية أو قياسات نفسية متكررة تُجمع شهرياً على عينة محددة. لنفترض أن لدينا متجهاً عددياً يتكون من 20 ملاحظة متتالية تمثل مؤشرات قابلة للقياس، مثل تتبع مستويات الاجترار الفكري المرتبط بالحالات المزاجية، حيث تمثل هذه القياسات درجات مسجلة بانتظام عبر فترات زمنية متعاقبة، وذلك في سياق دراسة أنماط الاستجابة المعرفية واستمراريتها (Nolen–Hoeksema et al., 2008). سنقوم بتوليد هذا المتجه في R باستخدام دالة التوليد العشوائي أو بتعريف قيم ثابتة قابلة للمعاينة.
نقوم أولاً بتعريف المتجه العددي في فضاء عمل R عبر كتابة الكود التالي:
raw_data <- c(18.2, 19.5, 22.1, 24.0, 23.5, 21.0, 19.8, 17.5, 16.2, 18.0, 20.4, 22.8, 25.1, 26.3, 24.9, 22.0, 20.1, 18.9, 17.4, 19.2)
يمثل هذا المتجه مساراً رقمياً لظاهرة تتذبذب مع الزمن. ولإسقاط هذا المتجه على تقويم حقيقي، نحدد نقطة البداية لشهر أكتوبر من عام 2023. يتطلب ذلك صياغة متجه البداية على الصورة start = c(2023, 10)، حيث يشير الرقم الأول إلى السنة التقويمية، بينما يرمز الرقم الثاني إلى الشهر العاشر ضمن تلك السنة.
ولكي نلزم البيئة البرمجية بالتعامل مع هذا المتجه كبيانات شهرية منتظمة، يجب تعيين معامل التردد بصورة صريحة ليطابق عدد أشهر السنة التقويمية، أي frequency = 12. هذا الضبط الترددي يمنع R من اعتبار الملاحظات قياسات سنوية متعاقبة، ويؤسس لقاعدة زمنية مجزأة تسمح لاحقاً بالتحليل الموسمي والمقارنة بين الشهور المتناظرة عبر السنوات المختلفة التي تغطيها هذه السلسلة الممتدة.
3.2 تنفيذ كود R واستخراج السلسلة الشهرية
نقوم بدمج المتجه العددي مع المعاملات الزمنية المستهدفة عبر استدعاء دالة ts() وإسناد الناتج إلى كائن جديد يحمل اسماً ذا دلالة، ولتكن التسمية monthly_ts. يُصاغ الأمر البرمجي المتكامل على النحو التالي:
monthly_ts <- ts(data = raw_data, start = c(2023, 10), frequency = 12)
بمجرد تنفيذ هذا السطر البرمجي، تقوم R بإنشاء كائن جديد من الفئة ts، وتدمج داخله مصفوفة الخصائص التقويمية دون تعديل المتجه الأصلي raw_data، الذي يظل محفوظاً في الذاكرة بصيغته المجردة المستقلة.
وعند استعراض الكائن الناتج داخل نافذة الأوامر (Console) بكتابة اسم الكائن monthly_ts، نلاحظ تحولاً جذرياً في طريقة الإخراج البصري؛ إذ لا تظهر البيانات كشريط خطي من الأرقام، بل تُعرض في مصفوفة أنيقة ثنائية المحاور، تُمثل صفوفها السنوات التقويمية المتعاقبة، بينما تُمثل أعمدتها الشهور الميلادية الاثني عشر برؤوس أعمدة واضحة (Jan, Feb, Mar, …, Dec). يوضح الكود التالي طريقة استدعاء وطباعة هذا الكائن وفحص مخرجاته المصفوفية:
print(monthly_ts)
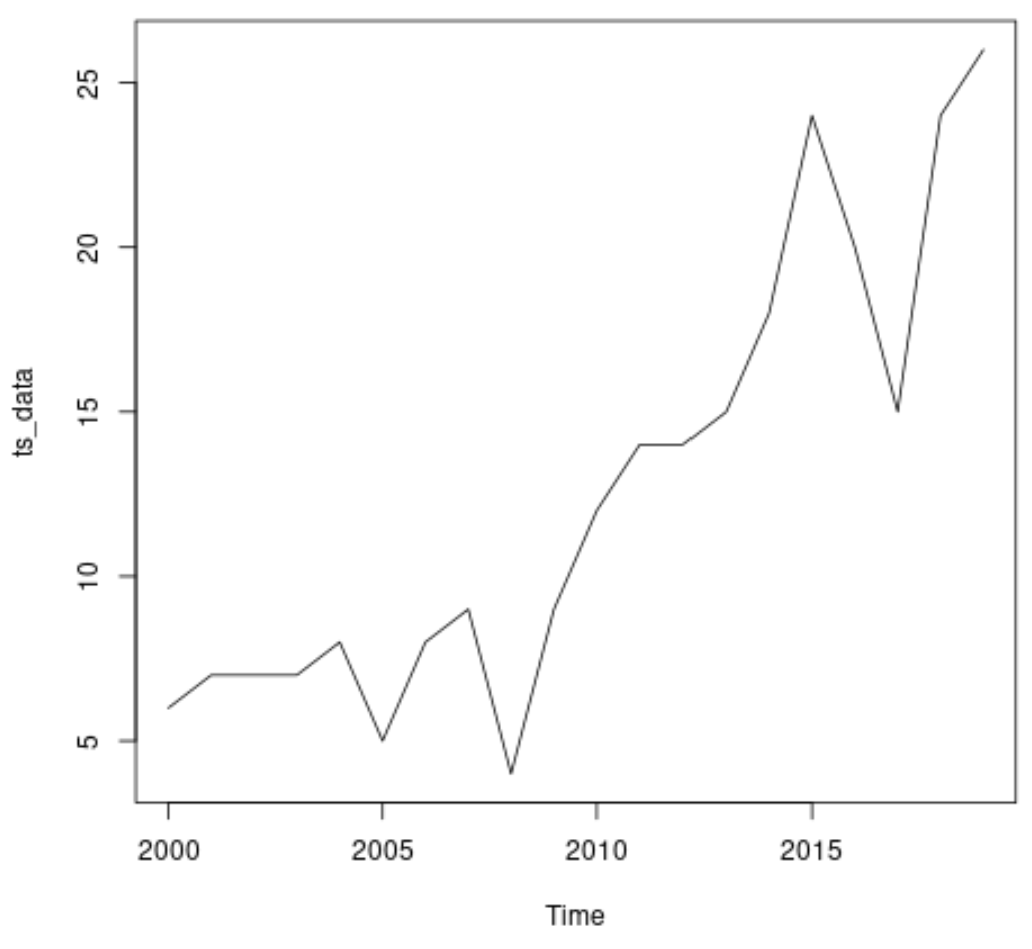
تُظهر مخرجات الطباعة توزع القيم العشرين بدقة؛ حيث تبدأ السلسلة في صف عام 2023 تحت عمود شهر أكتوبر (Oct) بالقيمة 18.2، ثم تستمر في ملء شهري نوفمبر (Nov) وديسمبر (Dec). وعند نقطة التحول السنوي، تنتقل السلسلة تلقائياً إلى صف عام 2024 لتبدأ من شهر يناير (Jan) وتستمر على مدار العام حتى شهر ديسمبر، ثم تنتقل بسلاسة إلى صف عام 2025 لتشغل الأشهر الخمسة الأولى منه (من يناير حتى مايو)، لتكتمل بذلك الملاحظات العشرون المكونة للمتجه.
3.3 التحقق من سلامة البنية الزمنية للمخرجات الشهرية
تقتضي معايير التدقيق الأكاديمي فحص مخرجات كائن السلسلة الزمنية والتأكد من مطابقتها التامة للفرضيات التصميمية قبل الانتقال للتحليل الرياضي. تبدأ هذه العملية بمراجعة حدود التغطية الزمنية عبر التحقق من أن الملاحظة الأخيرة في الجدول تقع تحديداً في شهر مايو من عام 2025. تُوفر لغة R دالة end() التي تستخرج النقطة النهائية آلياً، وعند تطبيقها على الكائن:
end(monthly_ts)
تُرجع البيئة المتجه c(2025, 5)، وهو ما يؤكد رياضياً أن السلسلة استوعبت الملاحظات العشرين بدقة انطلاقاً من أكتوبر 2023 وحتى مايو 2025 دون حدوث أي ترحيل خاطئ في الفواصل الزمنية.
تتضمن الخطوة التالية مراجعة التطابق بين قيم المتجه الأصلي والخلايا المقابلة لها في المصفوفة الناتجة. يمكن للمحلل مطابقة القيم يدوياً أو برمجياً عبر اختبار التساوي المنطقي. تضمن هذه المطابقة عدم حدوث أي تشويه أثناء التحويل عبر الدالة، وخاصة عند الانتقال بين الفترات السنوية. وتؤكد هذه النتيجة أن لغة R حافظت على القيمة الرياضية المجردة لكل ملاحظة، وأضافت إليها سمة الفهرسة الزمنية، مما يجعلها جاهزة للتطبيق في معادلات الانحدار الذاتي ونماذج المتسلسلات الزمنية دون خشية حدوث إزاحة في الترتيب.
أخيراً، يجب التأكد من عدم وجود فجوات تقويمية داخل السلسلة؛ إذ إن دالة ts() الكلاسيكية تفترض دائماً التتابع المنتظم اللحظي لكل نقطة زمنية. وبما أن المتجه الأصلي يحتوي على 20 عنصراً، وأن الفارق بين أكتوبر 2023 ومايو 2025 يمثل تحديداً عشرين شهراً تقويمياً شاملاً، فإن السلسلة توصف بأنها سلسلة متصلة خالية من الفواصل غير المحسوبة. يضمن هذا التماسك البنيوي عدم تولد قيم مفقودة تلقائية ناتجة عن خلل في المزامنة بين طول المتجه والتردد المعتمد، مما يمنح المخرجات موثوقية عالية للنمذجة الإحصائية المتقدمة.
4. إنشاء سلاسل زمنية ذات تردد ربع سنوي وسنوي
4.1 بناء سلاسل زمنية ربع سنوية (Quarterly Data)
تُعد البيانات ربع السنوية من أكثر الترددات شيوعاً في تقييم البرامج السلوكية طويلة المدى والسياسات الصحية العامة والاقتصاد التطبيقي. في سياق تصميم التدخلات السلوكية المتدرجة ومتابعة استدامتها عبر مصفوفات المهارات المكتسبة (Michie et al., 2013)، تُقاس المؤشرات عادة كل ثلاثة أشهر لرصد تغير الأداء وتثبيت العادات الجديدة. لبناء سلسلة زمنية ربع سنوية، نحدد المعامل frequency = 4، وهو ما يوجه المعالج إلى تقسيم السنة التقويمية الواحدة إلى أربعة أرباع متساوية يمثل كل منها فصلاً تشغيلياً مستقلاً.
يُصاغ معامل البداية في هذه الحالة كمتجه ثنائي يحدد سنة الانطلاق ورقم الربع المقابل من 1 إلى 4. لنفترض أن لدينا بيانات تمثل قياسات تتبعية امتدت على مدار 12 ربعاً سنوياً (أي ثلاث سنوات كاملة) بدأت من الربع الأول لعام 2020. يمكننا كتابة الكود البرمجي التالي لإنشاء الكائن الزمني:
quarterly_values <- c(102, 108, 115, 110, 118, 125, 130, 128, 135, 142, 150, 147)
quarterly_ts <- ts(data = quarterly_values, start = c(2020, 1), frequency = 4)
وعند طباعة هذا الكائن عبر الأمر print(quarterly_ts)، تُظهر R مخرجات مجدولة تحمل رؤوس الأعمدة الرمزية: Qtr1 و Qtr2 و Qtr3 و Qtr4، مع توزيع القياسات الإثني عشر عبر الأعوام 2020 و 2021 و 2022 بالتساوي وبواقع أربعة أرباع لكل عام، مما يسهل رصد النمط الموسمي المرتبط بفصول معينة بوضوح إحصائي دقيق.
4.2 نمذجة البيانات السنوية الممتدة (Annual Data)
عند التعامل مع الدراسات الطولية الممتدة لعقود، أو الأبحاث الوبائية التي تدرس الآثار الصحية المتأخرة عبر مراحل العمر المختلفة كدراسات الصدمات النمائية وتأثيراتها الصحية في مراحل الرشد (Felitti et al., 1998)، تكون الملاحظات مسجلة بمعدل مرة واحدة في كل عام تقويمي. في مثل هذه التصاميم البحثية، ينتفي وجود تقسيمات فرعية داخل السنة، وبالتالي يجب ضبط المعامل الترددي ليكون frequency = 1، أو إغفاله تماماً لكونه الخيار الافتراضي للدالة عند غياب التجزئة الدورية.
تتميز السلاسل السنوية ببساطة صياغة معامل الانطلاق start؛ إذ لا يتطلب متجهاً ثنائياً بل يُمرر كرقم صحيح مفرد يمثل سنة بداية التسجيل. فإذا أردنا تمثيل سلسلة زمنية لظاهرة ديموغرافية أو سلوكية سنوية مسجلة بين عامي 2010 و 2021، نقوم بكتابة الأمر التالي:
annual_values <- c(45, 48, 52, 50, 56, 61, 65, 63, 70, 74, 78, 82)
annual_ts <- ts(data = annual_values, start = 2010, frequency = 1)
يختلف سلوك الطباعة هنا عن السلاسل الشهرية أو الفصلية؛ إذ تظهر البيانات في سطر واحد طويل أو عمود مفرد يربط كل سنة بقيمتها مباشرة دون الحاجة لأعمدة فرعية. هذا التبسيط يترجم الطبيعة الخطية المباشرة للبيانات السنوية، والتي تُعنى أساساً بتتبع الاتجاه العام (Secular Trend) والتغيرات الهيكلية بعيدة المدى، دون الحاجة للتعامل مع التذبذبات الموسمية الدورية التي تميز الفترات الزمنية الأقصر.
4.3 المقارنة الهيكلية بين الترددات الدورية المختلفة
تنبع الفروق الهيكلية بين الترددات الزمنية المختلفة من القيمة المسندة لمعامل التردد وما يرتبط بها من مسافات رياضية داخلية بين الملاحظات، والتي تُعرف بدقة عبر المعامل deltat. في السلاسل السنوية يكون $\text{deltat} = 1.0$، بينما في السلاسل ربع السنوية يصبح $\text{deltat} = 0.25$، وفي السلاسل الشهرية ينخفض إلى $\text{deltat} \approx 0.0833$. هذه القيم لا تمثل مجرد أوزان تقويمية، بل تدخل مباشرة كقواسم ومعاملات إزاحة في كافة معادلات التحليل الزمني، كمعاملات حساب التباين التراكمي وتعيين درجات الحرية في النماذج الإحصائية الحركية.
ينعكس اختيار التردد بشكل جوهري على إمكانية تطبيق خوارزميات التفكيك الزمني (Decomposition)؛ فالنماذج التي تعتمد على استخراج المركبة الموسمية تشترط أن يكون التردد $frequency > 1$ وأن يغطي مدى البيانات دورتين كاملتين على الأقل. بناءً على ذلك، تفشل دالة decompose() أو نماذج التنعيم الشتوي من نوع Holt-Winters تلقائياً إذا طُبقت على كائن سنوي ذي $frequency = 1$، بينما تعمل بكفاءة على الكائنات ذات التردد 4 أو 12، حيث توفر الملاحظات المتكررة ضمن الدورة الواحدة التباين الكافي لعزل التأثير الفصلي عن الاتجاه العام والتغير العشوائي.
يخضع اختيار التردد المناسب في البحوث التجريبية والمسحية لطبيعة الظاهرة المدروسة وحساسية أداة القياس المستخدمة. فالإفراط في زيادة التردد (كقياس ظاهرة بطيئة التغير كالبناء الشخصي بشكل يومي) يقود إلى تضخيم التشويش العشوائي والارتباط الذاتي الزائف. في المقابل، يؤدي خفض التردد المفرط (كقياس مؤشرات المزاج الحركي بشكل سنوي) إلى طمس التباين الداخلي وتفويت الأنماط الدورية الحرجة، مما يبرز أهمية المواءمة الصارمة بين التصميم النظري للدراسة والمعاملات الرياضية لدالة ts() في R.
5. التعامل مع الترددات الدقيقة: البيانات الأسبوعية واليومية
5.1 إنشاء سلاسل زمنية بتردد أسبوعي (Weekly Data)
يواجه الباحثون تحديات منهجية خاصة عند الانتقال لتمثيل السلاسل الزمنية الأسبوعية، نظراً لعدم التطابق الرياضي التام بين الأسابيع والسنوات التقويمية الشمسية. تحتوي السنة العادية على 365 يوماً، مما ينتج عنه 52 أسبوعاً ويوماً إضافياً واحداً (أو يومين في السنوات الكبيسة). ومع ذلك، يُعد الضبط القياسي الأكثر شيوعاً في بيئة R هو تعيين المعامل frequency = 52، وهو افتراض تقريبي يعامل السنة ككتلة متجانسة تتألف من 52 وحدة أسبوعية منتظمة، مما يسمح بنمذجة الأنماط التي تتكرر دورياً في أسابيع محددة من العام.
تُصاغ نقطة البداية للسلاسل الأسبوعية بتحديد سنة البداية ورقم الأسبوع داخل تلك السنة باستخدام التنسيق المتجهي المألوف؛ فإذا بدأ التسجيل في الأسبوع العاشر من عام 2022، يُكتب المعامل كالتالي: start = c(2022, 10). يوضح الكود التالي كيفية إنشاء سلسلة أسبوعية تمتد لـ 30 أسبوعاً متتالياً:
weekly_values <- rnorm(30, mean = 50, sd = 5)
weekly_ts <- ts(data = weekly_values, start = c(2022, 10), frequency = 52)
تنشأ الإشكالية الرياضية عندما تمتد السلسلة الأسبوعية لعقود متصلة؛ إذ يؤدي التراكم التدريجي لأيام الفائض التقويمي إلى حدوث انزياح مرحلي بين تواريخ الأسابيع المحسوبة ومواقعها التقويمية الفعلية. وتظهر بعض السنوات بما يُعرف بـ “الأسبوع 53” وفق معايير المنظمة الدولية للمعايير (ISO 8601). تعجز دالة ts() التقليدية عن استيعاب هذا التباين الديناميكي؛ نظراً لجمود بنية معامل التردد الثابت، مما يتطلب من الباحث الانتباه إلى أن هذا التمثيل يظل نموذجاً تقريبياً ممتازاً للتحليلات قصيرة ومتوسطة المدى، ولكنه قد يحتاج إلى أدوات تكميلية إذا كانت الدقة التقويمية الحسابية الصارمة شرطاً للمشروع العلمي.
5.2 بناء كائنات السلاسل الزمنية اليومية (Daily Data)
يمثل القياس اليومي ركيزة حيوية في الدراسات المكثفة المعاصرة، لا سيما في متابعة التغيرات السلوكية والتدخلات الرقمية عبر مؤشرات تقاس يوماً بيوم. في دراسات تتبع النوايا التنفيذية والالتزام السلوكي بالأهداف اليومية (Gollwitzer, 1999)، يُعد تسجيل الاستجابة اليومية أساساً لفهم تكوين العادة. عند تمثيل البيانات اليومية باستخدام دالة ts()، يواجه المحلل خيارين منهجيين في ضبط معامل frequency، يعتمد كل منهما على السؤال البحثي وطبيعة الدورة المستهدفة بالتحليل.
يتمثل الخيار الأول في دراسة الأنماط الأسبوعية ذات الدورة القصيرة، حيث تتكرر التقلبات السلوكية بين أيام العمل وعطلات نهاية الأسبوع. في هذا السياق، يُضبط المعامل ليكون frequency = 7، وتُحدد البداية برقم الأسبوع واليوم من الأسبوع (مثلاً: start = c(1, 2) للإشارة إلى اليوم الثاني من الأسبوع الأول). يوضح الكود التالي هذا البناء:
daily_data <- c(12, 14, 15, 13, 19, 25, 22, 11, 13, 16, 14, 20, 26, 21)
weekly_cycle_ts <- ts(data = daily_data, start = c(1, 1), frequency = 7)
أما الخيار الثاني، فيستهدف دراسة التغير اليومي على مدار السنة الشمسية الكاملة، وهنا يُضبط المعامل على frequency = 365 أو frequency = 365.25 لأخذ أثر السنوات الكبيسة بالحسبان. غير أن هذه الطريقة تؤدي إلى تضخيم أبعاد مصفوفات التوزيع الموسمي وتتطلب حجماً كبيراً جداً من البيانات لتقدير معاملات المعالم بدقة، فضلاً عن صعوبة تمثيل التواريخ التي تتضمن أياماً غير مسجلة كأيام الراحة في بعض الدراسات المؤسسية، مما يستدعي تقييماً دقيقاً للمفاضلة بين الدورة الأسبوعية والسنوية.
5.3 إشكاليات الترددات العالية وحدود دالة ts() التقليدية
تظهر حدود دالة ts() الكلاسيكية بوضوح عند التعامل مع الترددات الزمنية العالية، كالبيانات اللحظية أو قياسات المقاييس النفسية المأخوذة عدة مرات يومياً عبر الأجهزة الذكية، وتطبيقات متابعة التلعيب السلوكي والنشاط المستمر (Hamari et al., 2014). تكمن المعضلة الرئيسية في ظاهرة “الموسمية المتعددة” (Multiple Seasonality)؛ فالبيانات المأخوذة كل ساعة مثلاً تتأثر بنمط يومي يتكرر كل 24 ساعة، وبنمط أسبوعي يتكرر كل 168 ساعة، وبنمط سنوي واسع. تعجز دالة ts() عن تمثيل أكثر من تردد دوري واحد في نفس الكائن الرياضي، إذ لا يقبل معامل frequency سوى قيمة عددية وحيدة موجبة.
للتغلب على هذه المحدودية البنيوية، يلجأ المجتمع الإحصائي في R إلى حزم متطورة تمثل امتداداً للكائنات الزمنية الكلاسيكية، ومن أبرزها حزمة zoo التي تتخصص في السلاسل الزمنية ذات الفواصل غير المنتظمة، وحزمة xts التي تدمج قوة المصفوفات الرياضية مع الفهرسة الصارمة القائمة على كائنات التوقيت الموحد (POSIXct). توفر هذه الحزم مرونة استثنائية في قراءة البيانات بناءً على طوابع زمنية حقيقية تتضمن الساعات والدقائق والثواني، متجاوزة تماماً افتراض التجانس والانتظام الفاصل المفروض في كائنات ts.
مع ذلك، يظل استخدام دالة ts() التقليدية كافياً ومثالياً في غالبية الدراسات الإحصائية القياسية التي تعتمد على ترددات منتظمة (شهرية، ربع سنوية، سنوية)، كما تمثل المدخل الأساسي لمعظم خوارزميات النمذجة الأكاديمية ونماذج التنبؤ الكلاسيكية مثل ARIMA. ويتعين على الباحث الانتقال إلى الهياكل المتقدمة فقط عندما تفرض البيانات تباعدات زمنية غير منتظمة، أو تواريخ تقويمية معقدة تتخللها فجوات زمنية حقيقية كأيام العطلات الرسمية، أو أنماطاً دورية متداخلة تتجاوز قدرة المعامل الفردي.
6. إنشاء سلاسل زمنية متعددة المتغيرات (Multivariate Time Series)
6.1 هيكلة المصفوفات متعددة الأعمدة لإنشاء كائنات mts
تقتضي النمذجة الإحصائية المتقدمة في كثير من التصميمات البحثية دراسة عدة مسارات متزامنة للتحقق من علاقات التأثير والتأثر المتبادل، بدلاً من الاقتصار على فحص متغير واحد معزول. في سياق النمذجة الديناميكية لعلم النفس التجريبي وشبكات الأعراض المترابطة، تتفاعل المؤشرات كمنظومة معقدة تتغير بمرور الوقت (Epskamp et al., 2016). تتيح بيئة R تمثيل هذه المنظومات المتزامنة من خلال فئة السلاسل الزمنية متعددة المتغيرات، المعروفة اختصاراً باسم كائنات mts، والتي تُبنى انطلاقاً من دمج مصفوفي للمتجهات الممثلة لكل متغير.
تبدأ الخطوة التنفيذية بتجميع المتجهات الفردية المتساوية في الطول ضمن مصفوفة موحدة باستخدام دالة الدمج العمودي cbind(). لنفترض أن لدينا ثلاثة مسارات سلوكية متزامنة جرى رصدها على مدار 15 شهراً؛ يُصاغ الإجراء البرمجي بتجميع هذه المتجهات الثلاثة في مصفوفة واحدة، ثم تمرير تلك المصفوفة مباشرة كمعامل data داخل دالة ts() الأساسية، مع تزويدها بمعاملات البداية والتردد الموحدة. يوضح الكود التالي هذه الآلية الإجرائية:
v1 <- rnorm(15, mean = 20, sd = 2)
v2 <- rnorm(15, mean = 50, sd = 5)
v3 <- rnorm(15, mean = 100, sd = 10)
multivariate_matrix <- cbind(v1, v2, v3)
mts_object <- ts(data = multivariate_matrix, start = c(2023, 1), frequency = 12)
يمتلك الكائن الناتج بنية مركبة تشترك فيها ثلاث فئات برمجية في آن واحد؛ إذ يُصنف برمجياً داخل R بأنه mts وts وmatrix معاً. هذه البنية الهجينة تمنح الكائن مرونة فريدة؛ فهو يحتفظ بجميع الخصائص الجبرية للمصفوفات الرقمية (كالضرب النقطي واستخراج المحددات وتحليل القيم الذاتية)، وفي الوقت نفسه يستجيب لدوال السلاسل الزمنية المتخصصة كحساب الفواصل والتأخير الزمني وعمليات التنعيم المشترك عبر التاريخ المحدد.
6.2 تسمية المتغيرات وضبط التزامن الزمني للملاحظات
تعد تسمية المتغيرات خطوة توثيقية حيوية لضمان سلامة التفسير الإحصائي وتفادي الخلط بين المسارات الرقمية المتعددة داخل الكائن الزمني. في حال عدم إسناد أسماء صريحة للأعمدة المدمجة، تمنح R افتراضياً تسميات عامة مستمدة من أسماء المتجهات الأصلية أو تكتفي بالأرقام الفهرسية. لضبط ذلك منهجياً، تُستخدم دالة colnames() لتعيين أسماء دالة تعكس المسميات العلمية للمتغيرات قيد الدراسة قبل أو بعد دمجها داخل دالة ts().
لنفترض أننا ندرس التزامن بين ثلاثة مؤشرات محورية في دراسات الصحة النفسية السلوكية: مستوى التوتر النفسي، ومستوى النشاط البدني، ومستوى جودة النوم، مسجلة شهرياً بدءاً من عام 2023. يوضح الكود التالي كيفية إنشاء السلسلة وضبط أسماء متغيراتها لضمان وضوح المخرجات التحليلية:
colnames(multivariate_matrix) <- c("Stress_Level", "Physical_Activity", "Sleep_Quality")
health_mts <- ts(multivariate_matrix, start = c(2023, 1), frequency = 12)
print(head(health_mts, n = 4))
يشترط بناء كائن mts دقة متناهية في التزامن الزمني للملاحظات؛ إذ تفترض الخوارزمية الرياضية أن الصف رقم $k$ في المصفوفة يمثل القياسات المأخوذة لجميع المتغيرات في نفس اللحظة الزمنية المحددة بالرمز $t_k$. إذا كان هناك تباوت في تواريخ البدء أو في معدل تكرار القياس بين متغير وآخر، فإن دمجها القسري عبر cbind() يؤدي إلى حدوث أخطاء فادحة في حساب مصفوفات التغاير والانحدار الذاتي المتقاطع. يتعين في هذه الحالة إجراء محاذاة مسبقة (Pre-alignment) للبيانات لضمان تطابق الفواصل الزمنية قبل الشروع في بناء الكائن الزمني المشترك.
6.3 استخراج السلاسل الفرعية والتعامل مع مكونات الكائن المتعدد
يوفر كائن mts آليات فهرسة مرنة لاستخراج السلاسل الفرعية أو عزل متغيرات معينة لمزيد من الفحص الإحصائي، مستفيداً من طبيعته المصفوفية الأصلية. يمكن للباحث استخدام الأقواس المربعة لاستخلاص عمود محدد، سواء باستخدام رقمه الفهرسي أو اسمه النصي؛ فعلى سبيل المثال، يؤدي الأمر البرمجي التالي إلى استخلاص مسار النشاط البدني كمتغير مستقل:
activity_ts <- health_mts[, "Physical_Activity"]
تتميز لغة R بمحافظتها الصارمة على السمات الزمنية عند إجراء هذه التجزئة؛ فالكائن الفرعي activity_ts المستخرج من مصفوفة health_mts لا يرتد إلى متجه رقمي عادي، بل يظل محتفظاً بفئته كسلسلة زمنية أحادية من الفئة ts، حاملاً نفس معاملات البداية والنهاية والتردد التي عُينت للمصفوفة الكلية، مما يتيح إخضاعه فوراً للنماذج الفردية دون الحاجة لإعادة ضبط إحداثياته الزمنية يدوياً.
تسمح هذه المرونة أيضاً بإجراء العمليات الحسابية المتقاطعة بين المسارات؛ مثل حساب الفروق النسبية أو تجميع المؤشرات في مركب كلي عبر الجمع أو الطرح المصفوفي المباشر، مع استمرار انطباق الخصائص الزمنية على السلاسل المركبة الناتجة. تضمن هذه الإمكانية تماسك الإجراءات التحليلية وتقلل من احتمالية ارتكاب الأخطاء اليدوية أثناء إعادة هيكلة البيانات داخل فضاء العمل.
7. فحص واستكشاف خصائص كائنات ts في بيئة R
7.1 استخدام الدوال الوصفية الأساسية: start() و end() و frequency()
بمجرد بناء كائن السلسلة الزمنية، يتوجب استكشاف خصائصه الوصفية للتحقق من اتساق الأبعاد الزمنية قبل الانخراط في تقدير المعالم الإحصائية. توفر بيئة R مجموعة من الدوال القياسية المتخصصة لهذا الغرض، تأتي في مقدمتها دالة start() التي تسترجع التوقيت الرياضي الدقيق للملاحظة الأولى. لا تُعيد الدالة مجرد أرقام تقريبية، بل تُرجع متجهاً ثنائياً يُظهر السنة والوحدة الفرعية المقابلة، مما يتيح التحقق المباشر من انطلاق السلسلة في موعدها المحدد تصميماً.
في الاتجاه المقابل، تقوم دالة end() بحساب وتأكيد الموضع التقويمي لآخر ملاحظة داخل السلسلة. وتكتسب هذه الدالة أهمية استثنائية عند التعامل مع مجموعات البيانات الكبيرة الممتدة عبر آلاف الملاحظات، حيث يتعذر الفحص البصري للمصفوفة؛ إذ تتيح المقارنة الآلية بين المخرج الفعلي والتاريخ المستهدف للانتهاء. أما دالة frequency() فتُستخدم للتأكد الحسابي من عدد الفترات الدورية المحسوبة لكل وحدة زمنية كاملة. يوضح الكود التالي كيفية استدعاء هذه الدوال الوصفية دفعة واحدة وفحص مخرجاتها:
start_time <- start(monthly_ts)
end_time <- end(monthly_ts)
data_freq <- frequency(monthly_ts)
cat("البداية:", start_time, "| النهاية:", end_time, "| التردد:", data_freq, "n")
تُشكل مخرجات هذه الدوال الوصفية الأساس البرمجي للأتمتة؛ حيث يمكن تضمينها داخل دوال شرطية واختبارات تحقق تفحص سلامة تدفق البيانات وتمنع تمرير السلاسل التي لا تتوافق خصائصها الزمنية مع متطلبات النماذج الإحصائية المعتمدة.
7.2 حساب الفواصل واستكشاف الإحداثيات عبر time() و deltat()
تتجاوز R التمثيل التقويمي الظاهري للسلاسل الزمنية إلى حساب إحداثيات رياضية حقيقية لكل نقطة زمنية عبر دالة time(). تُنتج هذه الدالة كائناً زمنياً يتكون من قيم كسرية عشرية تمثل التوزيع الرياضي للملاحظات على خط الأعداد الحقيقية؛ ففي السلسلة الشهرية مثلاً، يُمثل شهر يناير لعام 2023 بالرقم 2023.000، بينما يُمثل شهر فبراير بالرقم $2023 + \frac{1}{12} \approx 2023.083$. يُمكّن هذا التنسيق المتصل نماذج الانحدار الخطي والاتجاه العام من التعامل مع الوقت كمتغير مستمر يخضع للعمليات التفاضلية والاشتقاق الرياضي.
بالمقابل، تُعنى دالة deltat() باستخراج الفاصل الزمني الرياضي الصافي الذي يفصل بين كل نقطتين متعاقبتين. وتعكس النتيجة الحسابية مقلوب قيمة التردد بدقة متناهية؛ فإذا كان التردد 12، تُرجع الدالة القيمة 0.08333333، وإذا كان 4 تُرجع القيمة 0.25. يوضح الكود التالي طريقة استخراج هذه الإحداثيات والفواصل الزمنية:
time_points <- time(monthly_ts)
step_size <- deltat(monthly_ts)
print(head(time_points, n = 3))
print(step_size)
يساعد التحقق من قيم time() وdeltat() في الكشف المبكر عن أي تشوهات في الخطوات الحسابية الداخلية، ويوفر للباحث أداة حسابية مستقلة لربط الملاحظات بمتغيرات زمنية مساعدة في نماذج التنبؤ وتحديد مواضع الأثر التدخلي عبر تصاميم السلاسل الزمنية المتقطعة (Interrupted Time Series Design).
7.3 التحقق البرمجي من بنية الكائن عبر is.ts() و class() و print()
في مراحل بناء البرمجيات الإحصائية وحزم التحليل، يتطلب التحقق الأكاديمي استخدام دوال الاختبار المنطقي للتأكد من هوية الكائن البرمجي قبل تطبيق العمليات الرياضية عليه. تُقدم دالة is.ts() أداة تقييم منطقية تعيد القيمة TRUE إذا كان الكائن المفحوص ينتمي فعلياً إلى فئة السلاسل الزمنية، وتعيد FALSE إذا كان متجراً أو مصفوفة مجردة من السمات الزمنية. يتيح هذا الاختبار البرمجي بناء وظائف آمنة تمنع معالجة البيانات غير المتوافقة.
بالتوازي مع ذلك، تكشف دالة class() عن الفئات البنيوية التي تحكم سلوك الكائن، في حين تكشف دالة attributes() عن السمات الداخلية الخفية التي تُلحقها R بالكائن؛ وأبرزها السمة tsp. تحتوي هذه السمة على متجه رقمي ثلاثي العناصر يتضمن بدقة: القيمة الزمنية للبداية، والقيمة الزمنية للنهاية، ومعدل التردد الحسابي. يوضح الكود التالي كيفية استكشاف هذه السمات الهيكلية:
is_series <- is.ts(monthly_ts)
object_class <- class(monthly_ts)
meta_attributes <- attributes(monthly_ts)
print(meta_attributes$tsp)
إن إدراك الباحث لكيفية تخزين السمة tsp داخل بنية الكائن يعزز فهمه لآلية عمل R؛ فالنظام لا يقوم بإنشاء أعمدة وهمية لتخزين التواريخ، بل يكتفي بحفظ هذا المتجه الثلاثي الصغير في الذاكرة، ويقوم باشتقاق الإحداثيات الزمنية ديناميكياً لكل نقطة عند استدعاء دوال المعالجة أو الطباعة أو الرسم، مما يحقق كفاءة حوسبية فائقة في استهلاك الذاكرة وتسهيل المعالجة الرياضية الضخمة.
8. معالجة القيم المفقودة والشذوذ الإحصائي في كائنات ts
8.1 رصد القيم المفقودة (NA) وأسبابها في التصميمات الطولية
تُعد معضلة القيم المفقودة، المرموز لها برمجياً بالرمز NA، من أبرز التحديات المنهجية التي تواجه بحوث السلاسل الزمنية الميدانية والتجريبية. في الدراسات النفسية والسلوكية التي تعتمد على المتابعة التتبعية المستمرة، قد تنجم الفجوات الزمنية عن غياب المبحوثين المؤقت، أو حدوث خلل تقني في أجهزة الرصد الحركي، أو امتناع الأفراد عن الاستجابة في أيام معينة. يُقدم الكود التالي مثالاً لكائن سلسلة زمنية شهرية تتخلله ملاحظات مفقودة في مواضع مختلفة:
data_with_na <- c(10.5, 11.2, NA, 12.1, 13.0, NA, 14.2, 15.1, 14.8, 13.9, 12.5, 11.8)
ts_na <- ts(data_with_na, start = c(2023, 1), frequency = 12)
missing_indices <- which(is.na(ts_na))
print(missing_indices)
يتمثل المبدأ المنهجي الأهم في كائنات ts في وجوب الاحتفاظ بالقيمة المفقودة NA كعنصر حيزي داخل المتجه يحفظ موضع اللحظة الزمنية في المصفوفة، بدلاً من حذف الصف أو تجاهل الفترة. إن حذف الخلية يؤدي إلى انكماش طول المتجه بمقدار عدد النقاط المفقودة، مما يتسبب في زحزحة كافة الملاحظات اللاحقة للخلف وربطها بتواريخ خاطئة، وهو ما يدمر الهيكل الترددي بالكامل ويجعل التحليلات الدورية اللاحقة فاقدة للصلاحية الرياضية.
8.2 استراتيجيات الاستيفاء والتعويض الرياضي للقيم المفقودة
تتطلب السلاسل الزمنية التي تحتوي على قيم مفقودة تطبيق استراتيجيات تعويض رياضي واستيفاء مدروسة؛ نظراً لأن أغلب خوارزميات التنبؤ المتقدمة (مثل نماذج الفضاء الحركي ونماذج ARIMA القياسية) لا تقبل وجود قيم NA في مدخلاتها الحسابية. تتنوع هذه الاستراتيجيات بين الأساليب البسيطة كالاستيفاء الخطي (Linear Interpolation)، والأساليب المتقدمة التي تعتمد على استغلال الترابط الدوري ونماذج كالبدائل الديناميكية وتصفية كالمان (Kalman Filter).
في الحالات التي تكون فيها الفجوات محدودة وقصيرة المدى، يمكن تطبيق الاستيفاء الخطي عبر حزم متخصصة لتقدير القيم الواقعة على الخط المستقيم بين النقطة السابقة واللاحقة. أما في السلاسل التي تتميز بمركبة موسمية قوية، فإن الاعتماد على الاستيفاء الخطي وحده قد يؤدي إلى تسطيح التباين الدوري؛ لذا يُفضل استخدام الاستيفاء الموسمي عبر خوارزميات تأخذ نمط التكرار السنوي بالحسبان. يوضح الكود التالي تطبيقاً عملياً للاستيفاء الخطي التكميلي لاستبدال القيم المفقودة مع المحافظة على الصفة الزمنية للكائن:
# استخدام استيفاء خطي بسيط كإجراء تعويضي محلي
clean_values <- data_with_na
for(i in which(is.na(clean_values))) {
clean_values[i] <- mean(c(clean_values[i-1], clean_values[i+1]), na.rm = TRUE)
}
ts_imputed <- ts(clean_values, start = c(2023, 1), frequency = 12)
print(ts_imputed)
تسهم هذه المعالجة في سد الفجوات مع الحفاظ على التزامن التقويمي والموسمي السليم للسلسلة، مما يمهد الطريق لإجراء العمليات الحسابية المتقدمة دون تعريض السلسلة للتشويه التوليدي.
8.3 أثر المعالجة الخاطئة للملاحظات المفقودة على التحليل الزمني
يؤدي اللجوء غير المنضبط للحلول الجاهزة، مثل تطبيق دالة الحذف المباشر na.omit()، إلى كوارث إحصائية في بنية كائنات السلاسل الزمنية. تقوم هذه الدالة بإسقاط القيم المفقودة وتقليص أبعاد المتجه، مما يقود في R إلى تجريد الكائن جزئياً أو كلياً من خصائصه الدورية المتناغمة مع التقويم. وينتج عن هذا الحذف تلاصق ملاحظات متباعدة زمنياً، مما يرفع أو يخفض معاملات الارتباط الذاتي بصورة مصطنعة وزائفة.
تتجلى خطورة هذا الإجراء عند حساب دالة الارتباط الذاتي (Autocorrelation Function – ACF)؛ إذ تفترض هذه الخوارزمية أن الفاصل الزمني بين كل ملاحظة والتي تليها ثابت ومطابق للقيمة المقررة عبر $1/\text{frequency}$. وعند حدوث انقطاع غير مسجل نتيجة الحذف، تصبح التأخيرات الزمنية المحسوبة غير متجانسة في الواقع، مما يشوه المخطط الارتباطي ويوجه الباحث لاختيار رتب غير صحيحة لنماذج AR أو MA، مما يقود بالتبعية إلى تنبؤات مضللة وفقدان الصلاحية الاستدلالية للبحث المنشور.
تفرض المعايير المنهجية المعاصرة في الأبحاث الكمية توثيقاً صريحاً لكافة إجراءات المعالجة؛ إذ يجب الإفصاح عن نسبة الفقد ومواضعه الزمنية، وتقديم تبرير نظري وإحصائي لاختيار أسلوب تعويض دون غيره. كما يُستحسن إجراء تحليلات الحساسية (Sensitivity Analysis) عبر مقارنة نتائج النمذجة المستخرجة بطرق تعويض مختلفة، للتأكد من أن الاستنتاجات العلمية المتوصل إليها ليست وليدة الصدفة الحسابية الناتجة عن خوارزمية ملء الفجوات المعتمدة.
9. التمثيل البصري الأكاديمي لكائنات السلاسل الزمنية
9.1 توليد المخططات البيانية الأساسية عبر plot.ts() و plot()
يعد التمثيل البصري الخطوة الأولى والأهم في الاستكشاف الأكاديمي للسلاسل الزمنية؛ إذ يتيح للعين المجردة التقاط الاتجاهات العامة، والتقلبات الموسمية، والتغيرات المفاجئة في التباين، ونقاط التحول الهيكلي التي قد تعجز الأرقام المجردة عن إبرازها بوضوح. تتميز بيئة R بنظام رسومي مرن ومبرمج وفق أسس التوجيه الشيئي (Object-Oriented Dispatch)؛ فعند تمرير كائن يحمل الفئة ts إلى دالة الرسم العامة plot()، تستدعي R تلقائياً الدالة المتخصصة plot.ts() بدلاً من دالة الرسم المقطعي التقليدية.
تظهر الميزة الجوهرية لهذا الاستدعاء التلقائي في المحاذاة الدقيقة للمحور الأفقي؛ حيث لا تقوم R بترقيم المحور السيني بأرقام فهرسية صماء (1, 2, 3…)، بل تعتمد الإحداثيات المستمدة من دالة time()، مما ينتج عنه تدريج زمني تقويمي يعكس السنوات والشهور الحقيقية. ويوضح الكود التالي أبسط صيغة لتوليد رسم بياني مساري لسلسلة زمنية أحادية:
plot(monthly_ts, type = "l", col = "navy", lwd = 2)
يضمن استخدام المعامل type = "l" رسم خط متصل يربط بين النقاط الزمنية المتتالية، مما يبرز الاتجاه الحركي للملاحظات ويجسد مفهوم التغير الطولي المتصل، بينما يتيح المعامل lwd = 2 زيادة سمك الخط لتعزيز وضوح الرؤية البصرية في التقارير الأكاديمية المنشورة.
9.2 تخصيص الخصائص الرسومية وتوثيق المحاور والعناوين
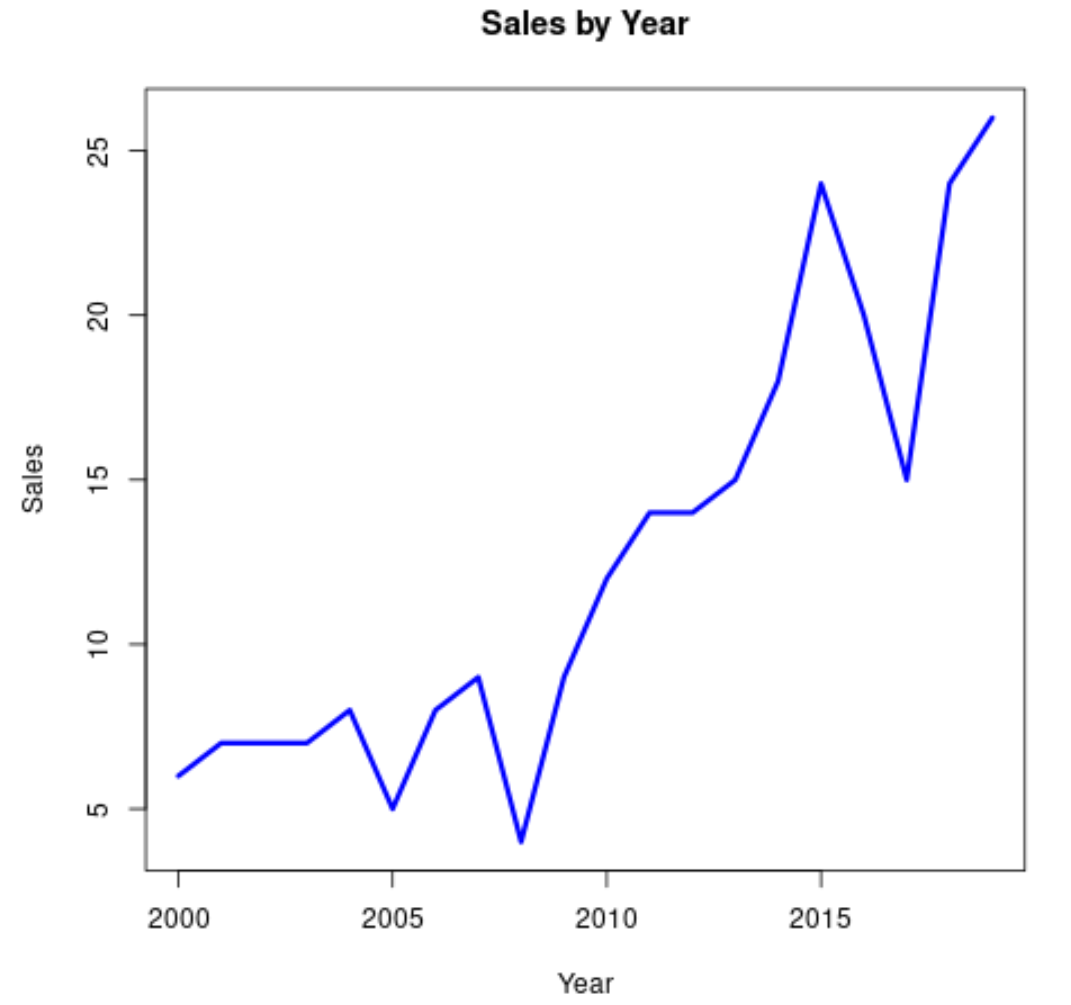
يتطلب النشر الأكاديمي والتوثيق المنهجي الصارم إثراء المخطط البياني بالمعلومات التفسيرية التي تضمن استقلاليته وقابليته للقراءة الذاتية دون الرجوع المستمر لمتن النص. ويشمل ذلك صياغة عنوان رئيسي جامع يوضح الظاهرة المقاسة ومداها الزمني عبر المعامل main، وتسمية المحاور بدقة متناهية؛ حيث يحدد المحور السيني عبر xlab البعد الزمني (مثل: السنوات التقويمية)، بينما يحدد المحور الصيني عبر ylab المقياس الكمي ووحدات القياس المستخدمة في الرصد.
إلى جانب ذلك، يمكن إضافة خطوط الشبكة المرجعية (Grid Lines) لتعزيز دقة القراءة وتسهيل مطابقة القمم والقيعان مع الفترات التقويمية ومستويات القياس المقابلة. يوضح الكود التالي كيفية إنشاء رسم بياني عالي الجودة بتنسيق أكاديمي متقدم:
plot(monthly_ts,
main = "تطور مسار القياسات النفسية التتبعية (2023 - 2025)",
xlab = "السنوات التقويمية",
ylab = "الدرجة المعيارية على المقياس",
col = "darkblue",
lwd = 2,
frame.plot = FALSE)
grid(nx = NULL, ny = NULL, col = "lightgray", lty = "dotted")
يضمن هذا التخصيص الرسومي إبراز الاتجاهات السلوكية بدقة، وإزالة الحدود الرسومية غير الضرورية عبر frame.plot = FALSE، مما يرفع من جودة الإخراج الطباعي ويوفر تمثيلاً بيانياً يتوافق مع أدلة النشر التابعة للجمعيات العلمية المحكمة.
9.3 الرسم المقارن للسلاسل الزمنية المتعددة في إطار موحد
عند دراسة كائنات السلاسل الزمنية متعددة المتغيرات mts، تتعدد الخيارات البصرية لعرض التباين المشترك والتفاعلات الديناميكية بين المتغيرات. يُتيح الخيار الأول، وهو السلوك الافتراضي لدالة plot(mts_object)، توليد لوحات رسومية رأسية منفصلة ولكنها متزامنة تماماً في المحور الأفقي؛ حيث يُخصص لكل متغير نافذة رسومية مستقلة تشترك في نفس التدريج التقويمي، مما يسهل مقارنة القمم والانخفاضات المتزامنة عبر المتغيرات المختلفة دون حدوث تداخل بصري ناتج عن اختلاف مقاييس الرسم.
أما الخيار الثاني فيتمثل في دمج السلاسل المتعددة داخل إطار رسومي موحد بمحور صادي مشترك، وهو أسلوب مثالي عندما تكون المتغيرات مقاسة بنفس الوحدات المعيارية؛ إذ يبرز مدى التقارب أو التباعد الحركي بينها بمرور الوقت. يتطلب هذا الإجراء استخدام دالة الرسم للسلسلة الأولى، ثم إضافة السلاسل اللاحقة تباعاً عبر دالة lines()، مع إدراج مفتاح توضيحي للخريطة (Legend) لتمييز كل متغير بلونه الخاص. يوضح الكود التالي هذا التطبيق المقارن:
plot(health_mts[, 1], col = "red", lwd = 2, ylim = c(10, 120),
main = "المقارنة التزامنية للمؤشرات السلوكية والصحية",
xlab = "الزمن", ylab = "القيم المقاسة")
lines(health_mts[, 2], col = "blue", lwd = 2, lty = 2)
lines(health_mts[, 3], col = "darkgreen", lwd = 2, lty = 3)
legend("topright", legend = colnames(health_mts),
col = c("red", "blue", "darkgreen"), lty = 1:3, lwd = 2)
يساعد هذا العرض البصري المركب في رصد العلاقات الاقترانية المعقدة واكتشاف التأثيرات المتأخرة زمنياً بين المسارات المختلفة، مما يثري النقاش المنهجي في تفسير النتائج الطولية.
10. أفضل الممارسات المنهجية والأخطاء الشائعة عند بناء كائنات السلاسل الزمنية
10.1 تجنب أخطاء التوافق بين حجم البيانات ومؤشرات التوقيت
من أكثر الأخطاء التقنية شيوعاً عند التعامل مع دالة ts() في بيئة R هو حدوث خلل التوافق الحسابي بين حجم متجه البيانات الفعلي والفواصل الزمنية المحصورة بين معلمتي البداية start والنهاية end. يقع العديد من المحللين في فخ التحديد اليدوي الصارم لكل من نقطة البداية ونقطة النهاية مع إدخال متجه لا يتطابق طوله مع ناتج المعادلة الزمنية الحاكمة لهما، مما يدفع R إما إلى تجاهل نقطة النهاية المحددة أو إعادة تدوير البيانات (Recycling) بشكل يفسد التحليل بالكامل.
ولتفادي هذا الخطأ المنهجي، تتمثل الممارسة الفضلى في تمرير نقطة البداية start والتردد frequency فقط، وترك مهمة حساب نقطة النهاية لخوارزمية الدالة الداخلية التي تعتمد بدقة على طول المتجه الفعلي length(data). كما يجب تصحيح الفهم الخاطئ الشائع الذي يخلط بين مفهوم “التردد” (Frequency) ومفهوم “إجمالي عدد الفترات”؛ فالتردد يمثل حصراً عدد الملاحظات في الدورة الواحدة (مثلاً: 12 للشهور، 4 للأرباع)، وليس الحجم الإجمالي للملاحظات المستقرة في السلسلة.
كذلك يجب التحقق من خلو البيانات المصدرية من أي قفزات تقويمية غير مرصودة قبل بناء الكائن. فإذا كانت البيانات المجمعة مفقوداً منها شهر معين بالكامل في السجلات الميدانية، فإن تحويل المتجه مباشرة إلى كائن ts() سيجعل الدالة تعتبر الشهر التالي هو الشهر المفقود، وتستمر في سحب الملاحظات للأمام مما يؤدي إلى انزياح زمني صامت لا تكتشفه رسائل الخطأ البرمجية. يتطلب ذلك دوماً فحص تسلسل التواريخ في جداول البيانات الخام والتأكد من مطابقة عدد الصفوف لعدد الفواصل التقويمية المتوقعة بدقة تامة.
10.2 المقارنة بين كائنات ts الكلاسيكية والهياكل الحديثة
شهدت منظومة R تطوراً متسارعاً في هندسة البيانات الزمنية خلال السنوات الأخيرة، مما أنتج بنيات بيانات حديثة تنافس كائن ts الكلاسيكي، وتحديداً ضمن حزم متقدمة مثل tsibble وzoo. تعتمد كائنات tsibble على مفهوم “أطر البيانات المرتبة” (Tidy Data Frames)، حيث يُخزن الوقت في عمود صريح كمتغير زمني حقيقي، وتُدار المتغيرات المتعددة ضمن بيئة متوافقة مع منظومة حزم tidyverse الشهيرة، مما يوفر سهولة فائقة في المعالجة والفلترة الرسومية المتقدمة عبر ggplot2.
توضح المقارنة المنهجية أن كائنات ts التقليدية تظل الخيار الأمثل والأنسب في العديد من السياقات الأكاديمية والبحثية؛ فهي تتمتع بكفاءة حوسبية هائلة وخفة في استهلاك الذاكرة، وتشكل اللغة البرمجية المشتركة التي تعتمد عليها أغلب خوارزميات ونماذج الاقتصاد القياسي والتحليل الزمني الكلاسيكي في R (مثل arima() وets() وHoltWinters()). وتعتبر هذه الدالة ركيزة أساسية في التدريس الأكاديمي الإحصائي لكونها تفرض انضباطاً صارماً في فهم المفاهيم الدورية والتأخر الزمني دون التشتت في تعقيدات المعالجة الجدولية.
يتيح الإلمام بكلا النوعين للمحلل التنقل المرن بينهما بحسب أهداف التحليل؛ إذ يمكن بناء السلسلة وتنظيفها الأولي واستكشافها بصرياً باستخدام البنى الحديثة مثل tsibble، ثم تحويلها بسلاسة عبر دالة as.ts() إلى الفئة الكلاسيكية عند الرغبة في تطبيق نماذج التنبؤ القياسية الصارمة، مما يجمع بين مرونة التنظيم الحديث ورصانة الخوارزميات التاريخية المستقرة في بيئة R.
10.3 بروتوكول التحقق والتوثيق لضمان قابلية إعادة الإنتاج العلمي
تقتضي معايير النزاهة العلمية المعاصرة وتوجيهات البحث المفتوح (Open Science) بناء نصوص برمجية تتسم بأعلى درجات الوضوح والتوثيق المنهجي، بما يضمن إمكانية تكرار التجربة الحسابية والوصول إلى نفس النتائج بدقة من قبل مراجعين مستقلين. يتطلب ذلك كتابة تعليمات برمجية نظيفة ومعلقة بأسلوب شارح يوضح مدلول كل متغير، ووحدات قياسه، وإحداثيات نقطة البداية، وأسباب اعتماد تردد معين دون غيره.
كما يشمل البروتوكول المنهجي حفظ وتصدير كائنات السلاسل الزمنية المنشأة باستخدام التنسيقات البرمجية الأصلية في R، مثل ملفات .rds أو .RData، عبر استخدام الدوال saveRDS() وsave(). يضمن هذا الحفظ الرقمي الاحتفاظ بكامل السمات الفوقية والزمنية المدمجة في الكائن (كالتردد ونقاط البداية ومصفوفة tsp)؛ بخلاف التصدير إلى ملفات نصية مجردة كـ CSV، والتي تؤدي إلى فقدان السمات الزمنية وإرغام الباحث اللاحق على إعادة صياغتها يدوياً مع احتمالية وقوع أخطاء مطبعية أو تفسيرية.
أخيراً، ينبغي توثيق مواصفات بيئة العمل الحسابية بالكامل ضمن ملحق البحث عبر استدعاء دالة sessionInfo()، والتي تسجل إصدار R الأساسي، ونظام التشغيل المعتمد، وإصدارات كافة الحزم المستدعاة أثناء التحليل. يمثل هذا التوثيق الشامل صمام أمان علمي يحمي النتائج من أي انحرافات قد تنتج عن تحديثات الخوارزميات في المستقبل، ويرسخ الشفافية المنهجية التي تميز البحوث الأكاديمية الرصينة في مجال نمذجة السلاسل الزمنية.
خاتمة
استعرض هذا المقال الأكاديمي الشامل الأسس النظرية والتطبيقية لبناء وإدارة كائنات السلاسل الزمنية في بيئة R الإحصائية باستخدام الدالة الأساسية ts(). لقد رأينا كيف يُحوّل هذا التمثيل البرمجي المتجهات الرقمية الصامتة إلى كائنات ديناميكية واعية بأبعادها التقويمية وأنماطها الدورية، بدءاً من تفكيك البنية النحوية لمعاملات الدالة، وتطبيقاتها عبر الترددات المختلفة من السنوية والشهرية إلى الترددات الدقيقة، ووصولاً إلى إدارة السلاسل متعددة المتغيرات واستراتيجيات معالجة الفقد والتمثيل البياني الرصين. إن استيعاب هذه القواعد لا يمثل مجرد إتقان لأداة تقنية، بل هو تدريب منهجي على التعامل الصارم مع البعد الزمني في الظواهر الطبيعية والسلوكية، مما يُمكّن الباحثين من صياغة نماذج تنبؤية دقيقة، واستخلاص استنتاجات علمية تتسم بالرصانة والشفافية وقابلية إعادة الإنتاج في المشهد البحثي المعاصر.
المراجع
- Cowan, N. (2001). The magical number 4 in short-term memory: A reconsideration of mental storage capacity. Behavioral and Brain Sciences. https://doi.org/10.1017/s0140525x01003922
- Epskamp, S., Borsboom, D., & Fried, E. I. (2016). Estimating Psychological Networks and their Accuracy: A Tutorial Paper. arXiv (Cornell University). https://doi.org/10.3758/s13428-017-0862-1
- Felitti, V. J., Anda, R. F., Nordenberg, D. F., Williamson, D. F., Spitz, A. M., Edwards, V. J., et al. (1998). Relationship of Childhood Abuse and Household Dysfunction to Many of the Leading Causes of Death in Adults. American Journal of Preventive Medicine. https://doi.org/10.1016/s0749-3797(98)00017-8
- Gollwitzer, P. M. (1999). Implementation intentions: Strong effects of simple plans. American Psychologist. https://doi.org/10.1037//0003-066x.54.7.493
- Hamari, J., Koivisto, J., & Sarsa, H. (2014). Does Gamification Work? — A Literature Review of Empirical Studies on Gamification. Proceedings of the … Annual Hawaii International Conference on System Sciences/Proceedings of the Annual Hawaii International Conference on System Sciences. https://doi.org/10.1109/hicss.2014.377
- Lyubomirsky, S., King, L., & Diener, E. (2005). The Benefits of Frequent Positive Affect: Does Happiness Lead to Success?. Psychological Bulletin. https://doi.org/10.1037/0033-2909.131.6.803
- Michie, S., Richardson, M. A., Johnston, M., Abraham, C., Francis, J., Hardeman, W., et al. (2013). The Behavior Change Technique Taxonomy (v1) of 93 Hierarchically Clustered Techniques: Building an International Consensus for the Reporting of Behavior Change Interventions. Annals of Behavioral Medicine. https://doi.org/10.1007/s12160-013-9486-6
- Nolen–Hoeksema, S., Wisco, B. E., & Lyubomirsky, S. (2008). Rethinking Rumination. Perspectives on Psychological Science. https://doi.org/10.1111/j.1745-6924.2008.00088.x