
تُعد معالجة البيانات الرقمية وتحويلها من مجرد قيم خام غير منتظمة إلى مؤشرات دلالية قابلة للتفسير حجر الزاوية في المنهجيات التحليلية الحديثة، سواء في حقول العلوم الطبيعية أو في تطبيقات العلوم السلوكية والاقتصادية والإدارية. ويحتل برنامج مايكروسوفت إكسيل (Microsoft Excel) موقع الصدارة كأحد أهم بيئات الحوسبة الجدولية التي يعتمد عليها الباحثون والممارسون في استخلاص الرتب، وبناء لوحات المؤشرات، وإجراء الاختبارات الإحصائية الاستدلالية. غير أن التحليل العملي للبيانات الواقعية يصطدم بحتمية إحصائية متكررة: وهي ظاهرة تكرار القياسات وتساوي القيم العددية بين وحدات المعاينة المختلفة، وهو ما يُعرف في الأدبيات التحليلية بمصطلح “التعادل” أو “تساوي الرتب” (Ties).
إن إغفال المعالجة المنهجية للقيم المتساوية لا يمثل مجرد عيب تنسيقي عابر، بل يمتد ليُحدث تشوهات هيكلية في التوزيع الاحتمالي للرتب، مما ينعكس سلبًا على الحسابات الإحصائية اللاحقة كمعاملات الارتباط اللامعلمية واختبارات الفروق، فضلًا عن تأثيره المباشر على مصداقية القرارات الإدارية والتنافسية كمنح المكافآت أو تصنيف المتقدمين لشغل الوظائف. ومن هنا، يبرز التساؤل المنهجي حول الكيفية التي يتعامل بها إكسيل مع هذه الظاهرة، والخيارات الحسابية المتاحة أمام المحلل للموازنة بين العدالة التنافسية والدقة الرياضية.
يهدف هذا المقال الأكاديمي الموسع إلى تقديم دليل تحليلي متكامل وشامل حول كيفية ترتيب القيم المتساوية في إكسيل من خلال ثلاثة مسارات رياضية ومنهجية متباينة: أسلوب الترتيب المتطابق القياسي، وأسلوب الترتيب الجزئي أو المتوسط الحسابي، وأسلوب كسر التعادل التتابعي الفريد. كما يستعرض المقال الأسس النظرية لكل أسلوب، مع تقديم دراسة مقارنة مدعومة بالأمثلة التطبيقية ومعالجة المشكلات الشائعة وربطها بالتطبيقات النفسية والبحثية، وصولًا إلى تقديم إطار ارشادي متماسك لصناع القرار والمحللين.
1. مقدمة منهجية لتحليل البيانات وتحدي القيم المتساوية في إكسيل
1.1 مفهوم الترتيب الرتبي في معالجة البيانات الإحصائية
يمثل الترتيب الرتبي (Ordinal Ranking) مستوى متقدمًا من مستويات القياس الإحصائي، حيث يتم نقل المتغيرات من فضاء الأرقام المطلقة إلى فضاء التفضيل والتفاضل النسبي. في المقاييس الإحصائية المعتمدة منذ تقسيمات ستيفنز الكلاسيكية لمستويات القياس، يقع المقياس الرتبي في مرتبة وسيطة تعلو المقاييس الاسمية (Nominal) وتسبق مقاييس المسافة والنسبة (Interval and Ratio). وتكمن الأهمية الجوهرية لهذا التحويل في التخلص من التأثيرات المشوهة للقيم المتطرفة (Outliers) التي قد تجعل المتوسطات الحسابية مضللة، والاستعاضة عنها بمواقع نسبية تعكس التوزيع الفعلي لمفردات العينة بشكل أكثر توازنًا.
يتجلى الفارق الجوهري بين القيم الخام (Raw Scores) والرتب المعيارية (Ranks) في أن القيم الخام تحمل دلالة كمية مطلقة تعبر عن مقدار السمة المقاسة، مثل تحقيق 95 درجة في اختبار معرفي أو تسجيل زمن قدره 12 ثانية في تجربة سلوكية، بينما تعبر الرتبة عن موضع تلك الدرجة بالنظر إلى مجمل الأداء الجماعي للمجموعة المقاسة. فالرتبة تُجرد الرقم من وزنه المطلق وتربطه بنظام نسبي متسلسل يبدأ من القيمة الأفضل أو الأسوأ وصولًا إلى الطرف المقابل، وهو ما يتيح إجراء مقارنات عادلة بين مجموعات معيارية مختلفة القياس والخصائص التوزيعية.
وفي هذا السياق، تطور برنامج مايكروسوفت إكسيل من مجرد آلة حاسبة رقمية بسيطة إلى منصة متكاملة للتعامل مع المصفوفات الحسابية المعقدة. تتيح أدوات إكسيل البرمجية تمثيل العلاقات الرياضية بين آلاف المتغيرات بمرونة فائقة، إلا أن تحويل القيم العددية إلى رتب داخل هذه البيئة الجدولية يتطلب فهمًا دقيقًا للخوارزميات الضمنية التي تحكم دوال الترتيب، لضمان عدم حدوث انحرافات حسابية تؤثر على موثوقية النتائج النهائية.
1.2 إشكالية التعادل وتساوي القيم (Ties) في عينات القياس
تنطلق النماذج الإحصائية الرياضية النظرية عند دراسة المتغيرات المستمرة من فرضية مفادها أن احتمال حدوث تساوي مطلق بين قيمتين عشوائيتين يقترب من الصفر من الناحية النظرية الرياضية الصرفة ($P(X_i = X_j) = 0$). إلا أن الممارسة التطبيقية والقياس الميداني يثبتان عكس ذلك تمامًا؛ حيث تظهر القيم المتكررة والمتساوية بانتظام في البحوث التجريبية والمسوح الميدانية. ويعود هذا التكرار إلى عدة عوامل، أبرزها محدودية أدوات القياس ودقتها، واستخدام مقاييس تدرج منفصلة مثل مقاييس ليكرت، أو عمليات تقريب الأعداد العشرية إلى أعداد صحيحة لتسهيل العرض الإداري والتحليلي.
تُحدث القيم المتساوية (Ties) تشويشًا منهجيًا مباشرًا في البنية التوزيعية للمتغيرات الرتبية. فإذا تساوى عنصران في الأداء، فإن السؤال الإحصائي الحتمي يبرز: هل يستحق كلاهما شغل المرتبة المتفوقة ذاتها، أم ينبغي اقتسام المرتبتين المتاحتين بينهما عبر حساب المتوسط، أم يتعين البحث عن معيار حتمي إضافي للفصل بينهما؟ إن الاختيار غير المدروس لكيفية معالجة هذا التعادل ينعكس على حساب مقاييس التشتت؛ إذ يؤدي التخصيص العشوائي أو التكرار غير المنضبط للرتب إلى تشويه التباين الرتبي وتقديم تقديرات غير دقيقة لمعاملات الانحدار والارتباط.
وعليه، تصبح الحاجة ملحة لتبني أسلوب منهجي موحد لمعالجة التعادل داخل مصفوفة البيانات قبل الشروع في التفسير النهائي. إن توحيد المعايير يحمي المحلل الإحصائي من التحيز الذاتي (Confirmation Bias)، ويضمن استقرار التحليلات المقارنة عبر مختلف أزمنة جمع البيانات أو عبر فئات العينة المتعددة، مما يجعل استخلاص النتائج مستندًا إلى قواعد حسابية صلبة ومعلنة.
1.3 أهمية الدقة الحسابية في إعداد التقارير والبحوث الكمية
تمتد حساسية التعامل مع الرتب المتساوية بصورة مباشرة إلى التطبيقات المنهجية في البحوث الكمية، ولا سيما عند توظيف الاختبارات الإحصائية اللامعلمية (Non-parametric Tests). تعتمد اختبارات شهيرة مثل اختبار مان-وتني للمجموعات المستقلة (Mann–Whitney U Test)، واختبار ولكوكسون للإشارات والرتب (Wilcoxon Signed-Rank Test)، واختبار كروسكال-واليس (Kruskal–Wallis H Test)، ومعامل ارتباط سبيرمان للرتب (Spearman’s Rank Correlation) على مجموع الرتب المفترضة كمحور أساسي لحساب إحصاءات الاختبار ومستويات الدلالة الإحصائية ($p$-value).
عندما تتضمن البيانات قيماً متساوية، تفترض معادلات هذه الاختبارات اللامعلمية تطبيق تصحيح رياضي مخصص للتعادل (Tie Correction). وإذا تم تصدير الرتب من برنامج إكسيل باستخدام أسلوب حسابي لا يراعي شروط هذه الاختبارات، فإن الدلالات الإحصائية المحسوبة قد تصبح زائفة، مما يقود إلى قبول فرضيات صفرية كان ينبغي رفضها، أو العكس، وهو ما يهدد الصدق الداخلي للبحث العلمي. إن الشفافية وقابلية تكرار النتائج (Replicability) تتطلبان توثيق الخوارزمية الدقيقة المستخدمة في استخراج الرتب في قسم الإجراءات المنهجية لأي تقرير تقني أو بحث محكم.
إضافة إلى ذلك، فإن تقارير الأعمال وتطبيقات إدارة الموارد البشرية التي تقيم الأداء الفردي والمؤسسي تتطلب معايير دقيقة لمنع نشوء نزاعات تنظيمية. إن خطأً برمجيًا طفيفًا ناجمًا عن سحب صيغة غير مقيدة، أو الاعتماد على معالجة يدوية عشوائية لفك التعادل بين موظفين متكافئين في الأرقام، قد يترتب عليه اتخاذ قرارات ترقية أو منح مكافآت معيبة، مما يبرز الأهمية العملية والمهنية للحساب الرياضي الدقيق داخل إكسيل.
2. الإطار الهيكلي لدوال الترتيب في برنامج مايكروسوفت إكسيل
2.1 التطور التاريخي لدوال الترتيب وتوافقها البرمجي
شهدت منظومة دوال الترتيب في برنامج مايكروسوفت إكسيل تحولًا نوعيًا مع إصدار عام 2010، وهو التحول الذي هدف إلى مواءمة أدوات البرنامج الحسابية مع المعايير القياسية للإحصاء الرياضي الحديث. فمنذ الإصدارات الأولى للبرنامج، كانت دالة RANK الكلاسيكية هي الأداة الوحيدة المتاحة للمستخدمين لحساب الرتب. ورغم فاعليتها العامة، إلا أنها كانت تطبق سلوكًا واحدًا حتميًا عند مصادفة القيم المتساوية، وهو منح جميع العناصر المتعادلة أعلى رتبة متاحة وتخطي الرتب التالية، وهو سلوك يخدم الاحتياجات التنافسية العامة لكنه يفتقر للمرونة اللازمة للتحليلات الإحصائية الدقيقة.
استجابة لهذه المتطلبات، قدمت مايكروسوفت دالتين متخصصتين بديلتين هما: RANK.EQ وRANK.AVG، بينما احتفظت بالدالة الأصلية RANK ضمن فئة دوال التوافق (Compatibility Functions). تهدف سياسة الإبقاء على الدالة القديمة إلى ضمان التوافق التراجعي (Backward Compatibility)، بحيث تظل أوراق العمل القديمة المبنية على إصدارات سابقة قادرة على العمل بكفاءة تامة دون أخطاء حسابية، في حين يُنصح المحللون في الإصدارات الحديثة بالاعتماد على الدوال المتخصصة لضمان وضوح الكود البرمجي والهدف الإحصائي للصيغة.
رافق هذا التطور المعماري تحسينات ملحوظة في خوارزميات المعالجة التكرارية داخل إكسيل، مما سمح بتسريع عمليات الترتيب عبر المصفوفات والنطاقات الضخمة التي تحتوي على مئات الآلاف من الصفوف. وقد ساعد هذا الانتقال على تقليل زمن استهلاك المعالج وتفادي تجمد الجداول عند التعامل مع مجموعات البيانات الكبيرة المعقدة، ما جعل إدارة الرتب عملية آنية وديناميكية بالكامل.
2.2 البنية التركيبية العامة ووسائط دالة الترتيب (Syntax and Arguments)
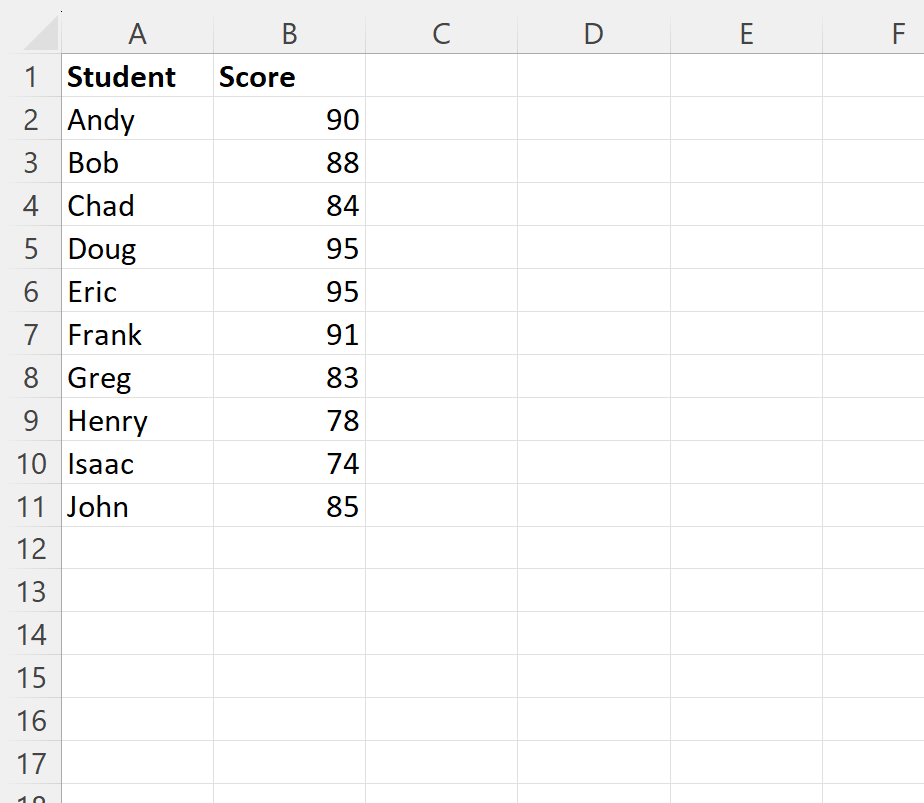
تتشارك دوال الترتيب القياسية في إكسيل (سواء كانت RANK أو RANK.EQ أو RANK.AVG) في بنية تركيبية متطابقة تتألف من ثلاثة وسائط رئيسية. تُكتب الصيغة العامة على النحو الآتي:
=RANK(number, ref, [order])
أو بصيغتها الحديثة المتخصصة:
=RANK.EQ(number, ref, [order])
تتطلب هذه الدوال فهمًا عميقًا لدور كل وسيط لضمان بنائها بصورة صحيحة:
- الوسيط الأول (Number): يمثل القيمة الرقمية المفردة المستهدفة بالتقييم وتحديد الرتبة. وعادة ما يكون هذا الوسيط عبارة عن مرجع لخلية فردية محددة ضمن صف البيانات، مثل الخلية
B2. - الوسيط الثاني (Ref): يمثل النطاق المرجعي الإجمالي أو المصفوفة العددية الكاملة التي يُقارن بها الرقم المستهدف، مثل النطاق
$B$2:$B$11. وتقتضي القواعد الحسابية الصارمة تثبيت هذا النطاق بعلامات الدولار لضمان بقائه مطلقًا أثناء نسخ الصيغة وتطبيقها على بقية صفوف الجدول. - الوسيط الثالث ([Order]): وسيط اختياري يحدد الاتجاه الحسابي لعملية الترتيب. فإذا تم إهمال هذا الوسيط أو أُسندت إليه القيمة الصفرية (0)، يُجري البرنامج ترتيبًا تنازليًا (Descending) يمنح فيه القيمة الكبرى الرتبة الأولى (1). أما إذا وُضعت فيه قيمة غير صفرية، مثل الرقم (1)، فإن الترتيب ينقلب ليصبح تصاعديًا (Ascending)، مما يمنح القيمة العددية الأصغر الرتبة الأولى، وهو أمر حيوي في مؤشرات قياس أزمنة الاستجابة أو معدلات الأخطاء.
2.3 فلسفة الفرز مقابل الترتيب الرياضي التلقائي
يخلط العديد من مستخدمي إكسيل المبتدئين بين عمليتي “الفرز” (Sorting) و”الترتيب” (Ranking)، على الرغم من الاختلاف الجوهري بينهما على المستويين البرمجي والمنهجي. تتمثل عملية الفرز في إعادة التنظيم الفيزيائي لصفوف الجدول ومواضع الخلايا، بنقل الأكبر إلى الأعلى أو الأدنى بصورة ساكنة. وتكمن المشكلة في أن الفرز اليدوي يدمر التسلسل الزمني أو الترتيب الأصلي لإدخال البيانات، ويتطلب إعادة تطبيقه يدويًا كلما أُضيفت قيم جديدة أو عُدلت درجات قديمة في المصفوفة.
في المقابل، تقوم فلسفة الترتيب الرياضي المعتمد على الدوال والصيغ البرمجية على استخراج مصفوفة رتب موازية في عمود مخصص، مع الحفاظ الصارم على البنية الترتيبية الأصلية لسجلات البيانات دون أي مساس بمواضعها المادية. تمنح هذه الآلية ورقة العمل ميزة التفاعلية الكاملة والديناميكية اللحظية؛ فبمجرد تعديل أي مدخلات رقمية في المصفوفة، تُعاد جدولة الرتب لجميع الحالات المتعادلة والمتباينة تلقائيًا في أجزاء من الثانية دون تدخل يدوي.
علاوة على ذلك، يتيح الترتيب الحسابي ربط الرتب بمجموعات متداخلة من التحليلات التكميلية، مثل التنسيق الشرطي التلقائي لأعلى عشر رتب، أو استدعاء سجلات المتفوقين عبر دوال البحث المتقدمة، مع الاحتفاظ بالسياق الميداني الأولي لجمع البيانات، وهو متطلب منهجي صارم في التصاميم التجريبية الطولية والمتكررة القياس.
3. الطريقة الأولى: تخصيص الترتيب الأعلى للقيم المتساوية عبر دالة RANK
3.1 الأساس الرياضي والنمط الحسابي لدالة RANK / RANK.EQ
تعتمد دالة RANK الكلاسيكية ونظيرتها الحديثة RANK.EQ (حيث يرمز المقطع EQ إلى كلمة Equal) خوارزمية تعرف في الأدبيات الإحصائية باسم “ترتيب المنافسة القياسي” (Standard Competition Ranking) أو الترتيب الأدنى المؤشر. يقوم هذا النمط الحسابي على قاعدة رياضية واضحة: إذا تساوت قيمتان أو أكثر في المصفوفة، تُمنح جميع العناصر المتطابقة نفس الرتبة الأفضل (أي الرتبة الرقمية الأصغر في الترتيب التنازلي)، وتُعامل ككتلة متكافئة لا فضل فيها لعنصر على آخر.
يترتب على هذا المنطق الرياضي بالضرورة ظهور ظاهرة تُعرف باسم “فجوة الرتب اللاحقة” أو تخطي الرتب (Rank Skipping). فإذا كان لدينا أربعة متسابقين وحصل اثنان منهم على أعلى درجة مشتركة، فإن كلاً منهما سيحصل على الرتبة (1)، ولكن المتسابق التالي لن يحصل على الرتبة (2)، بل سيقفز البرنامج مباشرة إلى الرتبة (3)؛ لأن الرتبتين الافتراضيتين (1 و2) قد استُهلكتا بواسطة العنصرين المتعادلين. وتتوسع هذه الفجوة كلما زاد عدد التكرارات؛ فتعادل أربعة عناصر على الرتبة الثانية يجعل الترتيب اللاحق يقفز رأسًا إلى الرتبة السادسة.
تتم صياغة الدالة النموذجية لاحتساب الرتب المتطابقة تنازليًا للبيانات الواقعة في العمود B بالصيغة الرياضية التالية:
=RANK.EQ(B2, $B$2:$B$11, 0)
تُفضي هذه الصيغة إلى الحفاظ على التقييم الأقصى المتاح لكل عنصر مكرر، مما يجعلها الصيغة الأكثر انتشارًا في البيئات الأكاديمية التنافسية ولوحات الشرف المدرسية والجامعية.
3.2 تطبيق عملي خطوة بخطوة على مصفوفة بيانات افتراضية
لتوضيح الآلية الإجرائية للدالة، نفترض وجود مصفوفة بيانات افتراضية تتضمن نتائج تقييم أداء عشرة باحثين أو موظفين، وتتوزع درجاتهم في النطاق من الخلية B2 إلى B11 على النحو الآتي: [95، 88، 88، 82، 79، 79، 79، 74، 70، 65]. نلاحظ فورًا وجود تعادل ثنائي عند الدرجة (88) وتعادل ثلاثي عند الدرجة (79).
لتنفيذ المعالجة الحسابية وفق الطريقة الأولى، يتم اتباع الخطوات التالية بدقة:
- الوقوف في الخلية المقابلة للدرجة الأولى
C2وإدخال الصيغة الحسابية:=RANK.EQ(B2, $B$2:$B$11)، مع إغفال المعامل الثالث لكون الترتيب الافتراضي تنازليًا. - الضغط على مفتاح الإدخال Enter لاحتساب رتبة القيمة الأولى، حيث ستعطي القيمة (95) الرتبة (1).
- النقر المزدوج على مقبض التعبئة التلقائية (AutoFill Handle) في الزاوية السفلى اليسرى للخلية
C2لنسخ المعادلة وتطبيقها تلقائيًا على كامل النطاق وصولًا إلى الخليةC11.
عند فحص المخرجات الحسابية للعمود، نجد الآتي: تحتل الدرجة (95) الرتبة 1. تليها الدرجتان المتساويتان (88) في الخليتين B3 وB4، فتحصل كلتاهما على الرتبة 2. ولكن عند الانتقال للدرجة التالية وهي (82)، نجد أن إكسيل منحها الرتبة 4، متخطيًا الرتبة 3 بصورة كاملة. وبالمثل، تتكرر الدرجة (79) ثلاث مرات فتحصل جميعها على الرتبة 5، بينما تقفز الدرجة اللاحقة (74) مباشرة لتشغل الرتبة 8، نتيجة استهلاك الرتب 5 و6 و7 ضمن كتلة التعادل الثلاثية.
3.3 مزايا ومحددات أسلوب الترتيب المتطابق القياسي
تتميز طريقة الترتيب المتطابق القياسي عبر RANK.EQ بالبساطة والاتساق المنطقي وسهولة الفهم من قِبل الجمهور العام غير المتخصص إحصائيًا. ففي السياقات التعليمية أو التنافسية، يسهل إقناع الطلاب أو المتسابقين بأن كل من حقق نفس الدرجة يستحق تقاسم الموقع الأول أو الثاني على قدم المساواة، مما يمنع الشعور بالإجحاف أو التمييز العشوائي. كما تتوافق هذه الطريقة تمامًا مع القواعد الرسمية المتبعة في احتساب الميداليات الأولمبية والمسابقات الرياضية العالمية.
على الجانب الآخر، تبرز محددات رياضية جوهرية تجعل هذا الأسلوب غير ملائم في كثير من التحليلات الكمية المتقدمة. يؤدي “تخطي الرتب” إلى تشويه التوزيع العددي لسلسلة الرتب؛ إذ ينكسر التسلسل الطبيعي للأعداد الصحيحة المتتالية، وتنشأ فجوات تجعل مصفوفة الرتب الناتجة غير متصلة. كما تتسبب هذه الفجوات في هبوط المجموع الحسابي الكلي للرتب إلى ما دون المجموع النظري المتوقع لمصفوفة خالية من التعادل، وهو ما سنفصله لاحقًا بالبرهان الرياضي.
تتجلى هذه المشكلة بوضوح عند الرغبة في استخدام الرتب كمعرفات فريدة لتوليد قوائم تمايز حتمية، أو عند ربط المخرجات بدوال الاسترجاع الشرطي مثل VLOOKUP أو INDEX-MATCH؛ حيث يؤدي تكرار رقم الرتبة إلى استرجاع السجل الأول فقط وتجاهل بقية السجلات المتعادلة، مما يتطلب تقنيات بديلة لعلاج القصور البرمجي.
4. الطريقة الثانية: تخصيص متوسط الرتب للقيم المتساوية عبر دالة RANK.AVG
4.1 المعادلة الإحصائية لمتوسط الرتب التنافسية
تمثل دالة RANK.AVG الحل الإحصائي المعتمد والمفضل في الأدبيات الرياضية لمعالجة مشكلة التعادل دون إحداث انحراف في المجموع الإجمالي للرتب. وتعتمد هذه الطريقة خوارزمية “الرتبة المتوسطة” (Mid-Rank Method) أو الرتب الكسرية (Fractional Ranking). وتنص القاعدة الرياضية على أنه إذا احتلت مجموعة من القيم المتطابقة عددها $t$ سلسلة من الرتب المتتالية تبدأ من الموضع $k$ وتنتهي عند الموضع $k + t – 1$، فإن كل عنصر من هذه العناصر يُمنح الوسط الحسابي لمواقع تلك الرتب الافتراضية بدلاً من تخصيص الرتبة الصغرى أو الكبرى للجميع.
تُحسب الرتبة المتوسطة $\bar{R}$ رياضيًا عبر المعادلة الدقيقة التالية:
$$\bar{R} = k + \frac{t – 1}{2}$$
أو بصيغة الجمع البسيط وقسمة الناتج على عدد العناصر المتعادلة:
$$\bar{R} = \frac{\sum_{j=0}^{t-1} (k + j)}{t}$$
لتطبيق هذه المعادلة الحسابية على مثال واقعي: إذا كان لدينا عنصران يتنافسان على المركزين الأول والثاني ($k=1$ و $t=2$)، فإن الرتبة المخصصة لكل منهما تحسب كالآتي: $(1 + 2) / 2 = 1.5$. ولو كان التعادل ثلاثيًا بين ثلاثة عناصر تشغل المراكز الرابع والخامس والسادس ($k=4$ و $t=3$)، فإن الرتبة الممنوحة لكل عنصر منهم ستكون متوسط تلك الرتب: $(4 + 5 + 6) / 3 = 15 / 3 = 5$. أما إذا كان التعادل رباعيًا ليشمل المراكز الثاني والثالث والرابع والخامس، فإن الرتبة تكون: $(2 + 3 + 4 + 5) / 4 = 14 / 4 = 3.5$.
4.2 التنفيذ الإجرائي للدالة =RANK.AVG(B2,$B$2:$B$11)
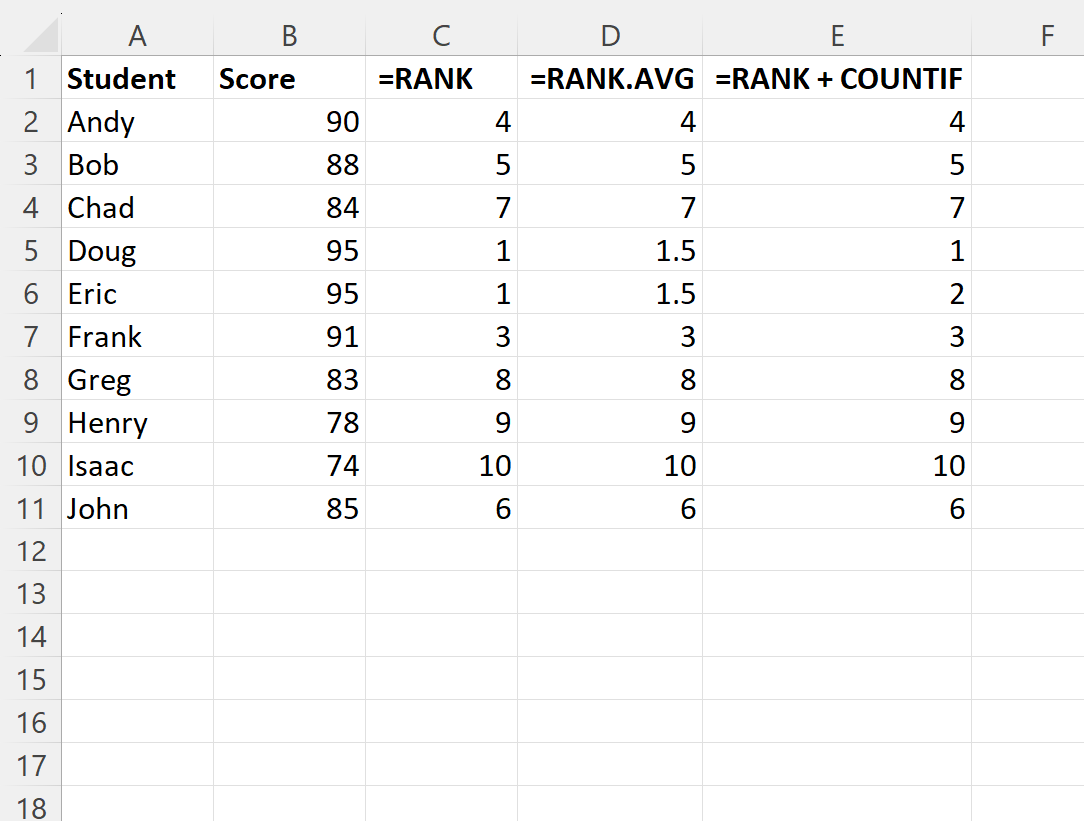
لا يختلف البناء الصوري لدالة RANK.AVG عن نظيرتها السابقة من حيث عدد ونوع الوسائط، ولكن الاختلاف يكمن بالكامل في المخرجات الرقمية المولدة. لإجراء الترتيب الإحصائي المتوسط على نفس العينة السابقة المكونة من عشر درجات في النطاق B2:B11، يتم تطبيق الإجراءات الآتية:
تُكتب الصيغة في الخلية D2 بالشكل التالي:
=RANK.AVG(B2, $B$2:$B$11, 0)
وبعد تعميم الصيغة عبر النقر المزدوج على مقبض التعبئة، تبدأ الخوارزمية في معالجة مصفوفة القيم المتساوية بأسلوب مغاير تمامًا:
- تحصل القيمة المنفردة (95) في الخلية
B2على الرتبة 1.0 لعدم وجود منافس لها. - تصل الصيغة إلى القيمتين المتساويتين (88) في الخليتين
B3وB4، وهما تشغلان الموقعين الترتيبيين 2 و3. بدلاً من منحهما الرتبة 2 كما فعلت دالةRANK.EQ، تقومRANK.AVGبجمع 2 مع 3 وقسمتهما على 2، فتنتج الرتبة الكسرية 2.5 لكلتا الخليتين. - تنتقل الدالة للدرجة التالية (82)، وتمنحها الرتبة 4.0 دون أدنى تخطٍ للوزن الإحصائي للمراكز السابقة.
- عند مصادفة التعادل الثلاثي للدرجة (79) في الخلايا من
B6إلىB8، والتي تشغل المواقع 5 و6 و7، تحسب الدالة المتوسط: $(5 + 6 + 7) / 3 = 6.0$، فتمنح كل خلية من الخلايا الثلاث الرتبة 6.0 بصورة متساوية ومنضبطة رياضيًا.
4.3 الأهمية الإحصائية والبحثية للرتب الكسرية
تتمتع دالة RANK.AVG بخاصية رياضية جوهرية تُعد بمثابة القاعدة الذهبية في الإحصاء اللامعلمي، وهي “حفظ المجموع التراكمي للرتب” (Preservation of Total Rank Sum). ففي أي مجموعة بيانات تحتوي على $N$ من المفردات، يجب أن يساوي المجموع الحسابي لكافة الرتب ناتج المعادلة التراكمية الشهيرة لغاوس:
$$\sum_{i=1}^N R_i = \frac{N(N + 1)}{2}$$
ففي عينة حجمها $N = 10$، يجب أن يكون مجموع الرتب دائماً مساوياً لـ: $(10 \times 11) / 2 = 55$. عند استخدام دالة RANK.EQ، يؤدي تخطي الرتب إلى انخفاض هذا المجموع بشكل ملحوظ؛ حيث يعطي جمع رتب العينة السابقة قيمة أقل بكثير من 55، مما يُخل بالمعادلات الاستدلالية. أما عند استخدام RANK.AVG، فإن الرتب الكسرية تعوض بدقة متناهية الفجوات الناتجة عن التعادل، ويظل المجموع الإجمالي ثابتًا عند الرقم 55 بدقة قطعية لا تقبل الشك.
لهذا السبب بالذات، تفرض حزم البرمجيات الإحصائية العالمية المتخصصة، مثل SPSS وR وSAS، الاعتماد الحصري على طريقة الرتب الكسرية (Mid-Ranks) كمدخل إلزامي لحساب اختبارات مثل مان-وتني وكروسكال-واليس وارتباط سبيرمان. إن قيام الباحث بحساب الرتب عبر RANK.AVG داخل إكسيل قبل نقل البيانات للتحليل المتقدم يضمن اتساق النتائج تمامًا ومطابقتها للمعايير الرياضية المعترف بها في أبحاث القياس النفسي والتربوي.
5. الطريقة الثالثة: كسر التعادل وفق أسبقية الظهور بالدمج بين RANK وCOUNTIF
5.1 المنطق البرمجي لحل التعادل استناداً إلى الموضع الميداني
على الرغم من الرصانة الإحصائية لدالة RANK.AVG، والعدالة التنافسية لدالة RANK.EQ، إلا أن بيئات العمل التطبيقية تواجه في كثير من الأحيان متطلبات إدارية وتشغيلية صارمة ترفض رفضًا قاطعًا وجود أي قيم كسرية أو مكررة في عمود الترتيب النهائي. يُعرف هذا المتطلب بـ “الترتيب الحتمي المتسلسل الفريد” (Deterministic / Unique Sequential Ranking)، حيث يُشترط أن يحصل كل سجل على رقم صحيح متسلسل لا يشاركه فيه أحد إطلاقًا من الرقم (1) إلى الرقم ($N$).
يبرز هذا المطلب الحيوي عند تصميم لوحات المؤشرات الإدارية التفاعلية (Dashboards)، أو عند بناء آليات الفرز التلقائي لطوابير الانتظار والمفاضلة على مقاعد محدودة غير قابلة للتجزئة. ولتحقيق هذا الفرز الصارم في ظل تكافؤ الدرجات الرقمية، يلجأ المحلل المنهجي إلى معيار ترجيح موضعي إضافي يستند إلى “أسبقية الظهور” أو الموضع الفيزيائي داخل جدول البيانات، بحيث يُمنح العنصر الأسبق في الإدخال الأفضلية الحسابية على نظيره المتأخر.
يتحقق هذا المنطق الرياضي والبرمجي عبر دمج ذكي واستثنائي بين دالة الترتيب الكلاسيكية RANK ودالة العد الشرطي التراكمي الممتد COUNTIF. تقوم هذه الصيغة المركبة بقياس رتبة العنصر الأساسية أولاً، ثم إضافة قيمة إزاحة تصاعدية (Offset) تعتمد على عدد المرات التي ظهرت فيها نفس القيمة في الصفوف السابقة للصف الحالي فقط، مما يكسر جمود التعادل ويمنع التكرار نهائيًا وبطريقة حسابية مؤتمتة بالكامل.
5.2 التشريح الدقيق للمعادلة المركبة =RANK(B2,$B$2:$B$11)+COUNTIF(B$2:B2,B2)-1
تُعد هذه الصيغة المركبة واحدة من أذكى التراكيب الخوارزمية في بيئة إكسيل، وتتخذ الشكل النموذجي الآتي في الخلية E2:
=RANK(B2, $B$2:$B$11) + COUNTIF(B$2:B2, B2) - 1
لفهم الآلية العميقة لهذه المعادلة، يتعين تفكيك مكوناتها الجبرية والوظيفية بدقة:
- الجزء الأول
RANK(B2, $B$2:$B$11): يحسب الرتبة القياسية العادية للقيمة. فإذا تكررت القيمة (88) مرتين، فإن هذا الشق سيعطي كلاهما الرتبة 2 مبدئيًا. - الجزء الثاني
COUNTIF(B$2:B2, B2): يمثل هذا الشق جوهر الابتكار الخوارزمي، ويُعرف بـ “النطاق التوسعي المرجعي” (Expanding Range). نلاحظ هنا التثبيت الجزئي الدقيق: فقد تم تثبيت نقطة بداية النطاق بعلامة الدولار قبل رقم الصفB$2، في حين تُركت نقطة النهاية حرة ومتحركةB2. هذا يعني أنه أثناء نسخ المعادلة للأسفل، سيتوسع النطاق تدريجيًا ليصبحB$2:B3ثمB$2:B4ثمB$2:B10، ليقوم بعدّ مرات تكرار القيمة الحالية من بداية الجدول وحتى موضع الصف الحالي حصراً، دون النظر لما يليه. - المعامل الرياضي الأخير
- 1: يؤدي هذا المعامل الحسابي وظيفة تعديلية محورية لتحييد الإزاحة عند الظهور الأول للرقم. فعندما تظهر القيمة لأول مرة في الصف، ترصد دالةCOUNTIFتكرارًا واحدًا (1)، وبطرح 1 تصبح النتيجة (صفر)، مما يحافظ على ناتج دالةRANKالأصلية دون أي تغيير. أما عند تكرار نفس القيمة في صف لاحق، فإن دالةCOUNTIFترصد التكرار الثاني (2)، وبطرح 1 تصبح الإزاحة (+1)، مما يرفع رتبة القيمة المكررة بمقدار مركز واحد، كاسرًا بذلك التعادل تلقائيًا.
5.3 تطبيق منهجي ودراسة فاعلية الصيغة المركبة
لتتبع الأداء الحسابي لهذه الصيغة التراكمية، نطبقها عمليًا على مصفوفتنا السابقة. نكتب الصيغة كاملة في الخلية E2 ثم نسحبها عموديًا حتى نهاية المصفوفة في E11، لنتتبع سلوك المعالجة خطوة بخطوة:
في الصف الثالث المقابل لأول ظهور للدرجة (88): تحسب RANK الرتبة 2. ويحسب النطاق COUNTIF(B$2:B3, B3) التكرار الأول للرقم (88) داخل النطاق الصغير فيكون 1. وتصبح المعادلة: $2 + 1 – 1 = 2$. وبالتالي يستقر الظهور الأول للرقم عند الرتبة 2.
في الصف الرابع المقابل لثاني ظهور لنفس الدرجة (88): تحسب RANK الرتبة 2 مجددًا. ولكن النطاق التوسعي في شق العد أصبح يغطي COUNTIF(B$2:B4, B4)، وهو يحتوي الآن على قيمتين متماثلتين (88)، فيعطي الناتج 2. تصبح المعادلة الحسابية: $2 + 2 – 1 = 3$. وهكذا تم كسر التعادل جبريًا ونقل النسخة الثانية من الرقم إلى الرتبة 3 المتتالية مباشرة!
تتجلى قوة هذه الصيغة بشكل أكبر عند معالجة التكرار الثلاثي للدرجة (79):
تحصل الدرجة الأولى (الصف السادس) على: $5 + 1 – 1 = 5$.
وتحصل الدرجة الثانية (الصف السابع) على: $5 + 2 – 1 = 6$.
بينما تحصل الدرجة الثالثة (الصف الثامن) على: $5 + 3 – 1 = 7$.
تنتج هذه المعادلة سلسلة رتب فريدة تمامًا وخالية من أي ثغرات أو فجوات، محققة التسلسل الرقمي المتصل من (1 إلى 10) بشكل لا تشوبه شائبة، وموفرة حلاً تقنياً جذرياً لمعضلات البحث والفرز التلقائي في قواعد بيانات إكسيل الضخمة.
6. دراسة مقارنة تفصيلية بين الطرق الثلاث لإدارة الترتيب في إكسيل
6.1 مقارنة النتائج الحسابية على مصفوفة بيانات موحدة
لتكوين رؤية تحليلية شاملة ومقارنة دقيقة بين الآليات الثلاث لمعالجة التعادل، يوضح الجدول التالي المخرجات الرقمية المحسوبة لنفس مصفوفة الدرجات الافتراضية ($N=10$) عبر تطبيق الدوال الثلاث في أعمدة متجاورة:
| معرف الحالة | الدرجة الخام (Raw) | الطريقة 1: RANK.EQ | الطريقة 2: RANK.AVG | الطريقة 3: RANK+COUNTIF |
|---|---|---|---|---|
| مشارك 01 | 95 | 1 | 1.0 | 1 |
| مشارك 02 | 88 | 2 | 2.5 | 2 |
| مشارك 03 | 88 | 2 | 2.5 | 3 |
| مشارك 04 | 82 | 4 | 4.0 | 4 |
| مشارك 05 | 79 | 5 | 6.0 | 5 |
| مشارك 06 | 79 | 5 | 6.0 | 6 |
| مشارك 07 | 79 | 5 | 6.0 | 7 |
| مشارك 08 | 74 | 8 | 8.0 | 8 |
| مشارك 09 | 70 | 9 | 9.0 | 9 |
| مشارك 10 | 65 | 10 | 10.0 | 10 |
يكشف الفحص المقارن لهذا الجدول عن ملامح الاختلاف الهيكلي بين الطرق الثلاث. فبينما تحافظ الطريقة الأولى على الأعداد الصحيحة المتطابقة مع إحداث قفزات مكانية واضحة في الترقيم، تلجأ الطريقة الثانية إلى توليد أعداد عشرية متوازنة تعبر عن موقع منتصف الفئة المتعادلة، في حين تقدم الطريقة الثالثة أعدادًا صحيحة متسلسلة بدقة متناهية تحاكي الفرز المطلق للعناصر.
6.2 معايير الأثر على المؤشرات الإحصائية العامة للبيانات
لا تتوقف الاختلافات بين الطرق الثلاث عند المظهر الشكلي للأرقام، بل تمتد لتُحدث تأثيرات إحصائية عميقة على المعالم الوصفية لبيانات الرتب، كما يلخص التحليل الآتي:
- المجموع التراكمي للرتب: يبلغ المجموع النظري المعياري لمصفوفة مؤلفة من 10 عناصر بدقة $\frac{10 \times 11}{2} = 55$. عند جمع رتب الطريقة الأولى (
RANK.EQ)، نجد أن المجموع يهبط إلى 48 فقط، بسبب الفجوات الناتجة عن إهمال المراكز المتتالية. أما في الطريقتين الثانية (RANK.AVG) والثالثة (RANK+COUNTIF)، فإن المجموع التراكمي يستقر تمامًا عند القيمة النظرية 55، وهو ما يحقق التوازن الرياضي التام للبيانات. - الانحراف المعياري للرتب: يؤدي تخطي الرتب في طريقة
RANK.EQإلى تقليص التباين الإجمالي لمصفوفة الرتب مقارنة بالبيانات المستمرة، بينما تؤدي الرتب الكسرية فيRANK.AVGإلى الحفاظ على التباين النسبي وتوزيعه بالتساوي حول المتوسط، في حين تقدم طريقةCOUNTIFتباينًا كاملًا مناظرًا لمصفوفة لا تتضمن أي تعادل على الإطلاق. - التوافق مع دوال الاسترجاع والفرز: تُعد طريقة
RANK+COUNTIFالأسلوب الوحيد من بين الأساليب الثلاثة المتوافق توافقًا مباشرًا مع دوال الاسترجاع مثلXLOOKUPوINDEX-MATCH؛ حيث يضمن التفرد المطلق لكل رقم رتبة استرجاع سجلات الموظفين أو الباحثين المتعادلين بصورة فردية ومستقلة، وتفادي فخ تكرار السجل الأول الذي تفرضه دالةRANK.EQ، وتفادي أخطاء تطابق الكسور العشرية لدالةRANK.AVG.
6.3 مصفوفة الاختيار الوظيفي وسيناريوهات التطبيق المثالية
يوفر التحليل المنهجي للمصفوفة المقارنة دليلاً إرشاديًا واضحًا للمحللين لتحديد متى يتعين استخدام كل طريقة بناءً على السياق الوظيفي للبيانات:
يُفضل استخدام الطريقة الأولى (RANK.EQ) في المسابقات التنافسية العامة، وإعلانات لوحات الصدارة والشرف الأكاديمية، والتقارير الإدارية الموجهة للجمهور العام؛ حيث يكون الهدف حماية الحق المعنوي لجميع المتكافئين في نيل نفس التكريم الشكلي دون تمييز عشوائي قد يثير النزاعات التنظيمية.
ويصبح اللجوء إلى الطريقة الثانية (RANK.AVG) إلزامياً عند إعداد البيانات لعمليات النمذجة الرياضية والتحليل الإحصائي المتقدم؛ خاصة عند حساب معاملات ارتباط سبيرمان، أو إجراء الاختبارات اللامعلمية لمقارنة المجموعات، أو عند معايرة مقاييس القياس النفسي التي تستوجب الحفاظ الرياضي الصارم على مجموع الرتب وتباعداتها المركزية.
بينما تُعد الطريقة الثالثة (RANK+COUNTIF) الخيار الذي لا غنى عنه لمهندسي البيانات ومصممي نماذج إكسيل التفاعلية المتقدمة؛ حيث تبرز الحاجة لتوليد جداول تمايز قطعية تتضمن أسماء أفضل 5 مرشحين، أو تنظيم خطوط الإمداد وطوابير المراجعين، أو أتمتة الفرز البرمجي دون السماح بوجود تكرار عددي يربك خوارزميات الاسترجاع اللاحقة.
7. التطبيقات التطبيقية في أبحاث القياس النفسي والعلوم السلوكية
7.1 معالجة بيانات مقاييس ليكرت والاستجابات النفسية المتكررة
تتميز بيانات أبحاث القياس النفسي (Psychometrics) والعلوم السلوكية بظاهرة التكتل الحتمي للاستجابات؛ إذ تعتمد الغالبية العظمى من أدوات القياس على مقاييس ليكرت الخماسية أو السباعية لقياس الاتجاهات والمشاعر والسمات الشخصية. وبسبب قصر هذا المدى التدرجي وضيق فضاء الاستجابة مقارنة بالمتغيرات المستمرة الحقيقية، تتكدس استجابات المفحوصين بصورة كثيفة حول الدرجات الوسطى أو القصوى، مما يولد مصفوفات بيانات مشبعة بالقيم المتساوية والتعادلات المتكررة، ولا سيما عند تقييم الكفاءة الذاتية والمشاعر والتقييمات الذاتية للأداء التي تتأثر عادة بالانحيازات الإدراكية للأفراد (Dunning et al., 2004).
في هذا السياق، تلعب دالة RANK.AVG دورًا جوهريًا في إعادة ضبط التوزيعات الرتبية للمفحوصين دون تشويه دلالات القياس. فعندما يتساوى عشرات الأفراد في الحصول على الدرجة الكاملة على مقياس الرضا الوظيفي أو سمة احترام الذات، فإن منحهم جميعًا الرتبة الكسرية المتوسطة يحول دون حدوث انزياح حاد في التوزيع التراكمي للمئينات (Percentiles). كما أن الرتب الكسرية الناتجة عن هذه المعالجة تضمن دقة احتساب المعايير السيكومترية، وتسمح بفرز مستويات الأفراد ضمن المدى الطبيعي دون افتعال تباينات زائفة لا تعكس الفروق النفسية الحقيقية بين المفحوصين، وهو أمر بالغ الأهمية عند دراسة التقييمات الذاتية والميول نحو حماية الذات وتعزيزها (Alicke & Sedikides, 2009).
علاوة على ذلك، يمتد هذا الضبط الرتبي المتوازن إلى الدراسات المقارنة عبر الثقافات؛ حيث تتفاوت الشعوب في نزعتها نحو تبني الاستجابات المتطرفة أو الوسيطة في أبعاد مثل المسافات الشخصية المفضلة والتواصل الاجتماعي (Sorokowska et al., 2017). إن توحيد الرتب باستخدام المتوسط الحسابي داخل إكسيل يسهم في معادلة التباين التوزيعي بين العينات المتعددة، مما يمهد الطريق لإجراء مقارنات لامعلمية رصينة وموضوعية تخلو من الانحياز التوزيعي الناجم عن أدوات القياس المنفصلة.
7.2 تقييم الكفاءة المهنية ومفاضلات التوظيف في علم النفس التنظيمي
تشكل مفاضلات التوظيف والترقية في بيئات الأعمال تحديًا سيكومتريًا وأخلاقيًا وتنظيميًا بارزًا؛ حيث يخضع المترشحون لاختبارات تقييم كفاءة متعددة المحاور غالبًا ما تنتهي بتسجيل نتائج رقمية متطابقة تمامًا بين متنافسين على وظيفة حصرية واحدة. في هذه اللحظة، يصبح الاعتماد على الفرز العشوائي أو الترتيب المعتمد على مجرد المصادفة أمرًا خطيرًا يهدد العدالة التنظيمية ويفجر النزاعات الداخلية، خاصة في ظل تنامي أنظمة التتبع الرقمي للأداء والقياس الذاتي الكمي في البيئات المؤسسية المعاصرة (Whitson, 2013).
هنا تبرز ضرورة توظيف نماذج كسر التعادل الموضوعي والشفاف عبر إكسيل. فبدلاً من تطبيق معادلة RANK+COUNTIF بصورة ساذجة تعتمد فقط على من تم إدخال اسمه أولاً في الجدول، يتم تطوير المعادلة لتعتمد على مصفوفة ترجيحية متعددة المعايير تعكس أبعاد القياس النفسي الوظيفي؛ كأن يتم اللجوء إلى درجات اختبار السمات القيادية أو ساعات التدريب الميداني أو تاريخ التقديم الفعلي لكسر التعادل الحسابي بدقة وشفافية مطلقة، بما يتسق مع المناهج الموجهة لتخصيص بيئات العمل وتحفيز الموظفين وفق مؤشرات كمية مدروسة (Klock et al., 2020).
يتيح تصميم ورقة عمل تفاعلية في إكسيل مبنية على هذه الصيغ المركبة للجان التوظيف والموارد البشرية إبراز الرتب التنافسية مع توثيق الأسباب الحسابية التي رجحت مرشحًا على آخر عند تساوي درجاتهما الأساسية. وتتحول عملية المفاضلة بذلك من قرار إداري غامض قد يشوبه الانحياز الشخصي إلى خوارزمية موضوعية معلنة تُحقق الشفافية، وترفع من ثقة الموظفين في منظومة العدالة الإجرائية داخل المؤسسة.
7.3 تحليل أزمنة الاستجابة ومعدلات الأداء في الاختبارات المعرفية
في تجارب علم النفس العصبي والتجريبي، يمثل زمن الرجع أو زمن الاستجابة (Reaction Time) مقياسًا شديد الحساسية للعمليات المعرفية وسرعة المعالجة الدماغية. وكثيرًا ما تظهر مشكلة التعادل في هذه التجارب عند تقريب القياسات الزمنية إلى أجزاء من الثانية، أو عند تعادل المفحوصين في عدد الأخطاء المرتكبة أثناء تنفيذ مهام عقلية معقدة ترتبط بأسس التعلم وتكيف السلوك الإنساني (Johnston, 1981). كما تبرز التعادلات بشكل خاص في تقييم الجوانب الوظيفية للجسد والأداء الإدراكي الحركي للمشاركين عبر مجموعات تجريبية متباينة (Alleva & Tylka, 2020).
يتطلب ترتيب أزمنة الاستجابة تطبيق الترتيب التصاعدي بدلاً من التنازلي؛ حيث يُعتبر الزمن الأقل هو الأداء الأفضل والأعلى كفاءة. ويتم ضبط هذا الإجراء في دوال إكسيل بسهولة عبر إسناد القيمة (1) للوسيط الثالث، كأن يُكتب: =RANK.AVG(B2, $B$2:$B$11, 1). يضمن هذا التحديد الحسابي حصول الباحثين الأسرع في زمن الرجع على الرتب الأولى، مع احتساب متوسط الرتب الكسرية بدقة لكل من سجلوا نفس زمن الاستجابة بالميلي ثانية.
عند بناء مؤشرات أداء تركيبية (Composite Indices) تجمع بين سرعة الاستجابة ودقة الإجابة (معدل الأخطاء)، يوفر إكسيل القدرة على استخراج رتب مستقلة لكل متغير، ثم دمج الرتبتين عبر معادلة ترجيحية موحدة لإنتاج رتبة معرفية شاملة. إن التوثيق المنهجي لمثل هذه المعالجات الحسابية في ملاحق الأوراق العلمية يُعد شرطًا لا غنى عنه لتمكين الباحثين المستقلين من محاكاة النتائج والتحقق من صحتها في دراسات القياس المعرفي اللاحقة.
8. الأخطاء الشائعة واستكشاف المشكلات البرمجية وإصلاحها
8.1 أخطاء المراجع النسبية وغياب التثبيت المطلق للنطاق
يُمثل إغفال التثبيت المطلق للنطاق المرجعي عبر علامة الدولار ($) أكثر الأخطاء المنهجية شيوعًا وفداحة بين مستخدمي إكسيل عند إنشاء صيغ الترتيب. فعندما يكتب المستخدم الصيغة في الخلية الأولى على النحو الآتي: =RANK(B2, B2:B11) دون وضع علامات الدولار لتثبيت الصفوف، تبدو النتيجة صحيحة في الصف الأول، مما يعطي إحساسًا زائفًا بسلامة الحساب.
لكن بمجرد سحب هذه الصيغة وتطبيقها على الصفوف التالية، يبدأ النطاق المرجعي في الانزلاق الحتمي للأسفل تبعًا لخاصية المراجع النسبية؛ فيتحول في الصف الثاني إلى B3:B12، وفي الصف الثالث إلى B4:B13. يؤدي هذا الانزياح إلى خروج القيم المتفوقة السابقة من فضاء المقارنة، وإدخال خلايا فارغة من أسفل الجدول ضمن النطاق، مما يترتب عليه تشويه كارثي لمصفوفة الرتب؛ حيث تظهر قيم متوسطة أو ضعيفة وكأنها تحتل الرتبة الأولى لمجرد أن القيم الأعلى منها قد سقطت من النطاق المقارن بعد تحركه.
لتفادي هذا الخطأ الجسيم، يجب دومًا استخدام مراجع النطاق المطلقة عبر الضغط على المفتاح F4 فور تحديد النطاق أثناء كتابة المعادلة، لتتحول صيغة النطاق تلقائيًا إلى $B$2:$B$11. كما يُنصح باختبار سلامة الصيغ عبر الانتقال إلى الخلية الأخيرة في الجدول ومراجعة شريط الصيغة للتحقق من أن النطاق المرجعي لا يزال يشمل جميع عناصر المصفوفة من الخلية الأولى وحتى الأخيرة دون أي تزحزح.
8.2 تباين تنسيقات البيانات ومشكلات الأرقام المخزنة كنصوص
من المشكلات البرمجية الخفية التي تؤدي إلى فشل دوال الترتيب وظهور رسائل الخطأ أو إصدار رتب خاطئة كليًا، مشكلة “الأرقام المخزنة كنصوص” (Numbers Stored as Text). تظهر هذه المعضلة بانتظام عند استيراد البيانات من قواعد بيانات خارجية، أو ملفات منسقة بصيغة CSV، أو استمارات الاستبيان الإلكترونية؛ حيث تبدو الأرقام للعين المجردة وكأنها قيم حسابية سليمة، بينما يعاملها محرك إكسيل الداخلي كسلاسل نصية جامدة لا تخضع للعمليات الحسابية.
عندما يصادف محرك دالة RANK أو RANK.AVG خلية رقمية مخزنة كنص، فإنه يعجز عن إجراء المقارنة الرياضية، مما يؤدي إما إلى ظهور خطأ القيمة غير المتوفرة (#N/A)، أو قيام الدالة بتجاهل هذه القيمة تمامًا وإسقاطها من الحساب الرتبي، وهو ما يشوه ترتيب بقية العناصر في المصفوفة. ويتفاقم هذا الخلل عند وجود مسافات بيضاء بادئة أو لاحقة غير مرئية حول الأرقام المستوردة، مما يجعل الدالة تعجز عن مطابقة القيم المتساوية بدقة.
لعلاج هذه المشكلة جذريًا، يتعين تنظيف البيانات وتوحيد تنسيقها قبل كتابة دوال الترتيب. يمكن تحقيق ذلك عبر تحديد العمود بالكامل واستخدام أداة “تحويل النص إلى أعمدة” (Text to Columns) لإعادة ضبط التنسيق على الوضع العام، أو ضرب العمود الحسابي في الرقم (1) باستخدام خيار اللصق الخاص (Paste Special – Multiply)، أو إدراج دالة التحويل الرقمي VALUE للتأكد القاطع من تحول كافة المدخلات إلى قيم عددية صالحة للمعالجة الحسابية.
8.3 معالجة الخلايا الفارغة والقيم النصية الشاذة داخل المصفوفة
في كثير من المسوح الميدانية وقواعد البيانات الكبيرة، تتضمن مصفوفة القياس خلايا مفقودة (Missing Values) أو قيماً شاذة ناتجة عن غياب بعض المفحوصين أو امتناعهم عن الإجابة. ورغم أن دوال الترتيب في إكسيل تتجاهل الخلايا الفارغة افتراضيًا ولا تعطيها رتبة، إلا أن وجود هذه الفجوات قد يربك الصيغ المركبة المتقدمة، ولا سيما معادلة RANK+COUNTIF، مما يولد مخرجات غير متسقة وفجوات مجهولة المصدر.
لتحصين ورقة العمل ضد هذه الاختلالات الحسابية وضمان مناعتها البرمجية، يُفضل تغليف دوال الترتيب بالدوال الشرطية مثل IF وISNUMBER لتقييد الحساب بالبيانات الصالحة فقط. وتُكتب الصيغة الوقائية في الخلية C2 على النحو الآتي:
=IF(ISNUMBER(B2), RANK.AVG(B2, $B$2:$B$11), "")
تضمن هذه الصيغة فحص الخلية أولاً؛ فإذا كانت تحتوي على قيمة عددية سليمة، يتم احتساب الرتبة بدقة، أما إذا كانت فارغة أو تحتوي على تعليق نصي كرمز الغياب “غ”، فإن الخلية الترتيبية تظل فارغة دون أن تؤثر سلبًا على ترتيب بقية السجلات أو تصدر رسائل خطأ تشوه واجهة التقرير.
كما يُنصح بتطبيق قواعد “التحقق من صحة البيانات” (Data Validation) على عمود الإدخال الأصلي، لمنع إدخال نصوص عشوائية أو أرقام سالبة خارج النطاق المنطقي للتقييم، مما يضمن تدفق بيانات نقية وصالحة رياضيًا إلى خوارزميات الترتيب.
9. التقنيات المتقدمة لإدارة الترتيب المعقد في الإصدارات الحديثة من إكسيل
9.1 استخدام مصفوفات إكسيل الديناميكية ودالتي SORT وSORTBY
أحدثت مصفوفات إكسيل الديناميكية (Dynamic Arrays)، التي قُدمت في إصدارات Microsoft 365 وما تلاها، ثورة حقيقية في طريقة كتابة الصيغ الحسابية؛ حيث انتقل البرنامج من فلسفة كتابة المعادلة في كل خلية على حدة ونسخها للأسفل، إلى مفهوم “صيغة الخلية الواحدة التي تفيض تلقائيًا” (Spill Functionality) لتغطي كامل النطاق الحسابي بمرونة فائقة.
في هذا الإطار المتطور، يمكن للمحلل الاستغناء عن كتابة معادلة RANK التقليدية وتكرارها، وبناء جداول صدارة متقدمة ومرنة عبر دمج دالتي SORT وSORTBY مع الدالة التوليدية SEQUENCE. على سبيل المثال، يمكن فرز أسماء الباحثين ودرجاتهم تنازليًا وتوليد عمود رتب متسلسل فريد في خطوة برمجية واحدة عبر كتابة صيغة موحدة تستدعي المصفوفة بالكامل:
=SORTBY(A2:B11, B2:B11, -1)
بمجرد إدخال هذه الصيغة في خلية فارغة، يفيض الجدول المرتب تلقائيًا في الخلايا المجاورة. وتكمن الميزة الاستثنائية لهذه التقنية في كفاءتها الحاسوبية المذهلة؛ إذ تتعامل مع نطاق البيانات كوحدة ذاكرة واحدة بدلاً من معالجة مئات الصيغ التكرارية المستقلة، مما يقلل بشكل حاسم من زمن إعادة الحساب في قواعد البيانات الضخمة التي تضم عشرات الآلاف من السجلات الميدانية.
9.2 كسر التعادل متعدد المعايير (Multi-Criteria Tie Breaking)
تتطلب التطبيقات المعقدة في مجالات الأعمال والبحوث المتطورة كسر التعادل بين المتنافسين استنادًا إلى مصفوفة شروط متسلسلة بدلاً من الاعتماد على أسبقية الظهور البسيطة. فإذا تساوى موظفان أو طالبان في الدرجة النهائية العامة، يُنظر إلى درجة الاختبار التخصصي، وإذا تساويا فيها يُنظر إلى سنوات الأقدمية أو العمر، وهكذا دواليك.
تتمثل إحدى أكثر الحيل الرياضية أناقة في إكسيل لمعالجة هذا السيناريو في استخدام “الجمع الموزون عبر المضاعفات العشرية الضئيلة” (Micro-Weighted Decimal Offsets). فإذا كانت الدرجة الأساسية مسجلة في العمود B، ودرجة المعيار المرجح الثاني مسجلة في العمود C، يتم بناء عمود مركب افتراضي أو إدماجه مباشرة في دالة الترتيب عبر الصيغة الآتية:
=RANK(B2 + (C2 / 10000), $B$2:$B$11 + ($C$2:$C$11 / 10000))
تقوم هذه المعادلة بإضافة جزء من عشرة آلاف من درجة المعيار الثانوي إلى الدرجة الأساسية. هذا الكسر متناهي الصغر لا يغير القيمة الحقيقية للدرجة الأساسية في العرض، ولكنه كافٍ تمامًا لخوارزمية إكسيل الداخلية لترجيح كفة صاحب المعيار الثانوي الأعلى وفك الارتباط الترتيبي بدقة مطلقة.
وفي الإصدارات الحديثة، يمكن صياغة هذه التركيبات المتقدمة بمنتهى الوضوح والأناقة عبر دالة LET البرمجية، التي تتيح تعريف المتغيرات وتسميتها داخل الصيغة ذاتها، مما يرفع من قابلية قراءة الكود وصيانته وتعديله من قِبل فرق العمل البرمجية دون الحاجة إلى إنشاء أعمدة مساعدة تشوه تنظيم ورقة العمل.
9.3 أتمتة الفرز والتصنيف باستخدام جداول إكسيل المنظمة (Excel Tables)
يمثل تحويل نطاق البيانات التقليدي العادي إلى “جدول إكسيل منظم” (بواسطة الاختصار Ctrl + T) قفزة نوعية في موثوقية نماذج الترتيب وأتمتتها. تتيح الجداول المنظمة استخدام ما يُعرف بـ “المراجع المهيكلة” (Structured References)، حيث يتم استبدال مراجع الخلايا الجامدة بأسماء الأعمدة الصريحة، فتتحول صيغة الترتيب من =RANK.AVG(B2, $B$2:$B$11) إلى:
=RANK.AVG([@الدرجة], [الدرجة])
تكمن القوة التشغيلية الكبرى لهذا التحول في “خاصية التوسع التلقائي للصيغ” (Calculated Columns). فعند إضافة مشارك جديد أو إدراج خمسين سجلاً إضافياً في أسفل الجدول، يتمدد الجدول المنظم ذاتيًا ليشمل المدخلات الجديدة، وتُعمم صيغة الترتيب تلقائيًا على كافة الصفوف المستحدثة، مع إعادة ضبط النطاق المرجعي ليشمل البيانات الجديدة فورًا ودون أي تدخل يدوي لإعادة سحب المعادلات أو تعديل حدود النطاق.
علاوة على ذلك، يسهل هذا الهيكل المنظم عمليات الربط المباشر مع أدوات ذكاء الأعمال المتقدمة، مثل محرك معالجة البيانات Power Query ومنصة Power BI؛ حيث تُقرأ أعمدة الرتب كسمات متسقة تضمن سلامة لوحات التحكم وسلاسة تدفق البيانات من الجداول الحسابية إلى التقارير التنفيذية العليا.
10. إرشادات اتخاذ القرار لاختيار الطريقة المثلى والخلاصة التوجيهية
10.1 مخطط انسيابي منهجي لاختيار أسلوب معالجة التعادل المناسب
لتسهيل الممارسة العملية للمحللين، يمكن تكثيف القواعد المنهجية لاختيار الأسلوب الأنسب لترتيب القيم المتساوية في مخطط تسلسلي متماسك ينطلق من الإجابة عن ثلاثة أسئلة محورية:
- السؤال الأول: ما هو الهدف النهائي لعملية الترتيب؟
- إذا كان الهدف استكشافيًا إحصائيًا، أو تجهيز البيانات لاختبارات فروق لامعلمية، أو بناء مصفوفات ارتباط لعينات مقاييس نفسية: يجب التوجه مباشرة وبلا تردد إلى الطريقة الثانية (
RANK.AVG) لحفظ المجموع التراكمي وتوازن التباين. - إذا كان الهدف تنافسيًا تحفيزيًا أو إداريًا معلنًا للجمهور: انتقل إلى السؤال الثاني.
- إذا كان الهدف استكشافيًا إحصائيًا، أو تجهيز البيانات لاختبارات فروق لامعلمية، أو بناء مصفوفات ارتباط لعينات مقاييس نفسية: يجب التوجه مباشرة وبلا تردد إلى الطريقة الثانية (
- السؤال الثاني: هل يقبل السياق التنظيمي وجود رتب كسرية أو تخطٍ للأرقام؟
- إذا كان الهدف إعلان نتائج بطولات أو لوحات شرف تقليدية تقبل التساوي الشكلي وتتخطى الرتب اللاحقة لحفظ الحقوق: اختر الطريقة الأولى (
RANK.EQ). - إذا كان المطلوب توزيعًا فريدًا وحتميًا للأفراد ولا يقبل التكرار إطلاقًا: انتقل إلى السؤال الثالث.
- إذا كان الهدف إعلان نتائج بطولات أو لوحات شرف تقليدية تقبل التساوي الشكلي وتتخطى الرتب اللاحقة لحفظ الحقوق: اختر الطريقة الأولى (
- السؤال الثالث: كيف يجب الفصل بين المتكافئين في الأداء؟
- إذا كانت أسبقية التسجيل أو موضع الصف هي المعيار الحاكم المقبول: طبق الطريقة الثالثة (
RANK + COUNTIF - 1). - إذا كانت هناك معايير كفاءة بديلة: طبق خوارزمية كسر التعادل متعدد المعايير عبر الجمع الموزون.
- إذا كانت أسبقية التسجيل أو موضع الصف هي المعيار الحاكم المقبول: طبق الطريقة الثالثة (
10.2 المحددات الأخلاقية والتفسيرية لتوزيع الرتب في الأبحاث والتقييم
ينطوي الترتيب الرتبي في جوهره على أثر سيكولوجي واجتماعي عميق يتجاوز مجرد المعالجة الرياضية الصامتة للأرقام. ففي المؤسسات الأكاديمية والمهنية، ينعكس احتلال رتبة دنيا أو فقدان مركز متقدم سلبًا على مفهوم الذات والشعور بالكفاءة لدى الأفراد، وقد يولد مشاعر الإحباط أو الخزي التنظيمي في حال افتقار آليات الفرز إلى العدالة والموضوعية (Fessler, 2004). كما تذكرنا التحليلات الفلسفية والأخلاقية حول الطبيعة البشرية بحساسية الفرد المفرطة تجاه التمييز والمفاضلة والتصنيف الطبقي داخل الجماعة (Lovejoy, 2019).
من هذا المنطلق، تبرز مسؤولية أخلاقية جسيمة تقع على عاتق محلل البيانات؛ إذ يجب تجنب الإيهام بالدقة المفرطة (False Precision) عبر استخدام أساليب كسر التعادل القسري لترجيح متنافس على آخر بناءً على فروق تافهة لا دلالة حقيقية لها، أو بناءً على مجرد أسبقية كتابة الاسم في ورقة العمل. إن الشفافية المطلقة تقتضي الإفصاح الصريح عن الخوارزمية الرياضية المستخدمة لترتيب الحالات في هوامش التقارير، وتوضيح ما إذا كانت الرتب الممنوحة تعبر عن استحقاق كلي متطابق، أو متوسط إحصائي كسري، أو أسبقية شكلية، مما يحمي القرارات من شبهات التحيز والمحسوبية.
10.3 خلاصة الممارسات الفضلى والتوصيات الختامية لمحللي البيانات
في الختام، يمثل إتقان التعامل مع القيم المتساوية في إكسيل مهارة مفصلية تميز المحلل المحترف عن المستخدم العادي. وتتلخص أبرز الممارسات الفضلى والتوصيات التقنية في النقاط الآتية:
- الابتعاد تمامًا عن المعالجة اليدوية للأرقام المتعادلة، والاعتماد الحصري على الصيغ البرمجية الديناميكية لضمان قابلية تكرار الحسابات وتحديثها التلقائي.
- التأكد الصارم من تثبيت النطاقات المرجعية باستخدام المراجع المطلقة ($) أو الاستعانة بمزايا الجداول المهيكلة لضمان استقرار الصيغ الحسابية ضد أخطاء السحب والإزاحة.
- استخدام طريقة الرتب الكسرية
RANK.AVGكخيار قياسي افتراضي لكافة الأعمال الإحصائية والأبحاث العلمية، مع قصر استخدامRANK.EQوRANK+COUNTIFعلى السياقات الإدارية والتنافسية المحددة. - إدراج صفوف توثيقية وشروح تفصيلية في مقدمة أو ملحق ورقة العمل توضح بنية المعادلات المركبة، لتمكين الزملاء والمراجعين من فهم النموذج الحسابي وصيانته وتطويره مستقبلاً دون أخطاء.
- مواكبة التحديثات الخوارزمية في الإصدارات الحديثة من إكسيل، واستثمار قدرات المصفوفات الديناميكية ودوال الفرز التلقائي لبناء نماذج تحليلية تتسم بالسرعة والرشاقة والدقة الرياضية العالية.
المراجع
Alicke, M. D., & Sedikides, C. (2009). Self-enhancement and self-protection: What they are and what they do. European Review of Social Psychology, 20(1), 1–48. https://doi.org/10.1080/10463280802613866
Alleva, J. M., & Tylka, T. L. (2020). Body functionality: A review of the literature. Body Image, 36, 149–171. https://doi.org/10.1016/j.bodyim.2020.11.006
Dunning, D. A., Heath, C., & Suls, J. M. (2004). Flawed self-assessment: Implications for health, education, and the workplace. Psychological Science in the Public Interest, 5(3), 69–106. https://doi.org/10.1111/j.1529-1006.2004.00018.x
Fessler, D. M. T. (2004). Shame in two cultures: Implications for evolutionary approaches. Journal of Cognition and Culture, 4(2), 207–262. https://doi.org/10.1163/1568537041725097
Johnston, T. D. (1981). Contrasting approaches to a theory of learning. Behavioral and Brain Sciences, 4(1), 125–139. https://doi.org/10.1017/s0140525x00007950
Klock, A. C. T., Gasparini, I., Pimenta, M. S., & Hamari, J. (2020). Tailored gamification: A review of literature. International Journal of Human-Computer Studies, 144, 102495. https://doi.org/10.1016/j.ijhcs.2020.102495
Lovejoy, A. O. (2019). Reflections on human nature. Johns Hopkins University Press. https://doi.org/10.1353/book.72149
Sorokowska, A., Sorokowski, P., Hilpert, P., Cantarero, K., Frąckowiak, T., Ahmadi, K., et al. (2017). Preferred interpersonal distances: A global comparison. Journal of Cross-Cultural Psychology, 48(4), 577–592. https://doi.org/10.1177/0022022117698039
Whitson, J. R. (2013). Gaming the quantified self. Surveillance & Society, 11(1/2), 163–176. https://doi.org/10.24908/ss.v11i1/2.4454