
يمثل الاستدلال الإحصائي الدعامة الجوهرية التي ترتكز عليها الدراسات العلمية والبحوث التجريبية الرامية إلى اختبار الفرضيات وفهم الظواهر المعقدة. وفي قلب هذا الإطار الرياضي والمنهجي، يحظى فحص تجانس التباين (Homogeneity of Variance) بمكانة مركزية بالغة الحساسية، إذ لا يقتصر دوره على كونه مجرد خطوة تمهيدية للتحقق من شروط الاختبارات المعلمية (Parametric Tests)، بل يمتد ليكون في حد ذاته أداة استكشافية حاسمة لتقييم مدى تشتت أو اتساق السلوكيات والظواهر المقاسة بين المجموعات التجريبية والضابطة. إن إهمال التحقق من تساوي التباين قد يجر الباحث إلى استنتاجات مضللة، ويزيد بصورة دراماتيكية من معدل الوقوع في الخطأ من النوع الأول (Type I Error) أو الخطأ من النوع الثاني (Type II Error).
تعد حزمة البرمجيات الإحصائية المتقدمة SAS (Statistical Analysis System) المعيار الذهبي المعتمد عالمياً في التحليلات الإحصائية المتقدمة، لا سيما في التجارب السريرية والأبحاث النفسية والاجتماعية والعلوم الاقتصادية. ومن بين الإجراءات الرصينة التي توفرها هذه المنظومة البرمجية، يبرز إجراء PROC TTEST ليس فقط للمقارنة بين المتوسطات الحسابية لعينتين مستقلتين، بل لكونه ينفذ تلقائياً اختبار F الكلاسيكي لفحص تساوي التباينات (Folded F-Test)، مقدماً حلاً هندسياً ذكياً يربط بين تقييم التشتت واختيار النموذج الرياضي الأنسب لتفسير الفروق في المتوسطات.
يتناول هذا الدليل الأكاديمي الشامل والمتعمق كيفية إجراء وتفسير وتشخيص اختبار F لتساوي التباينات باستخدام نظام SAS، مستعرضاً الأسس الرياضية للاختبار، وتطبيقاته في البحوث السلوكية والنفسية، والشروط المسبقة لتطبيقه، مع تقديم شرح تفصيلي للبنية البرمجية وطرق معالجة المخرجات والبدائل الإحصائية المتاحة عند انتهاك الافتراضات الكلاسيكية، وصولاً إلى دراسة حالة تطبيقية وقواعد النشر العلمي المعتمدة دولياً.
1. مقدمة منهجية لاختبار F لتساوي التباينات
1.1 تعريف اختبار F وأسسه الرياضية
يُعرف اختبار F في الأدبيات الإحصائية الكلاسيكية بأنه اختبار استدلالي بارامتري صُمم لتقييم الفرضية المتعلقة بتساوي تبايني مجتمعين إحصائيين مستقلين يتوزعان توزيعاً طبيعياً. ويرتكز هذا الاختبار إلى النسبة التباينية (Variance Ratio) التي اشتقها عالم الإحصاء الشهير رونالد فيشر، حيث يتم التعبير عن إحصائية الاختبار الرياضية بحساب النسبة المباشرة بين التباين الملاحظ في العينة الأولى والتباين الملاحظ في العينة الثانية. وتتجسد الصيغة الرياضية الأساسية للاختبار في المعادلة التالية:
$$F = \frac{S_1^2}{S_2^2}$$
حيث يمثل $S_1^2$ تباين العينة الأولى، بينما يمثل $S_2^2$ تباين العينة الثانية، بشرط أن يكون هذان التقديران مستقلين تماماً وغير متحيزين لتباين المجتمعين الأصليين المقابلين ($\sigma_1^2$ و $\sigma_2^2$).
تخضع إحصائية الاختبار في حال صحة الفرضية الصفرية لتوزيع F النظري، وهو توزيع احتمالي مستمر يمتلك خصائص رياضية فريدة تميزه عن التوزيع الاعتدالي؛ إذ إنه توزيع غير متماثل وموجب الالتواء (Positively Skewed)، وتبدأ قيمه دائماً من الصفر وتمتد نظرياً إلى ما لا نهاية دون أن تأخذ أي قيمة سالبة، نظراً لأن التباينات المحسوبة تمثل مربعات الانحرافات عن المتوسط. تتحدد معالم هذا التوزيع وشكل منحناه البياني استناداً إلى معلمتين أساسيتين هما درجات حرية البسط (Numerator Degrees of Freedom) ودرجات حرية المقام (Denominator Degrees of Freedom)، المحسوبتين وفق المعادلتين: $df_1 = n_1 – 1$ و $df_2 = n_2 – 1$، حيث يؤدي تزايد درجات الحرية في الطرفين إلى اقتراب منحنى التوزيع تدريجياً من التماثل والاعتدالية.
تعتمد حسابات النسبة في إجراءات SAS القياسية على تقنية رياضية تُعرف باسم “اختبار F المطوي” (Folded F-Test)، والتي تقتضي وضع التباين العيني الأكبر دائماً في بسط المعادلة، في حين يوضع التباين العيني الأصغر في مقامها، مما يضمن أن تكون قيمة إحصائية F المحسوبة دائماً مساوية أو أكبر من الواحد الصحيح ($F ge 1$). هذا الإجراء الرياضي يهدف إلى تبسيط المقارنة بالقيم الحرجة وتوفير معالجة متسقة لحساب القيم الاحتمالية ثنائية الذيل، مع مراعاة التعديل الإحصائي المضاعف للاحتمال المتولد عن هذا الترتيب المقيد للبسط والمقام في المنظومة التحليلية.
1.2 الصياغة الإحصائية للفرضيات الصفرية والبديلة
تبدأ أي ممارسة بحثية منهجية تستند إلى اختبار F بصياغة واضحة ومحددة للفرضيات الإحصائية التي تشكل بوصلة القرار الاستدلالي. تنص الفرضية الصفرية (Null Hypothesis – $H_0$) في اختبار تساوي التباينات على عدم وجود أي فروق ذات دلالة إحصائية بين تباين المجتمعين المسحوب منهما العينات المستقلة، وتُصاغ رياضياً على النحو الآتي:
$$H_0: \sigma_1^2 = \sigma_2^2 \quad \text{أو} \quad H_0: \frac{\sigma_1^2}{\sigma_2^2} = 1$$
وهي الفرضية التي يفترض الباحث صحتها مبدئياً ما لم تقدم البيانات التجريبية دليلاً إحصائياً قاطعاً يدحضها ويرجح خيار الاختلاف.
في المقابل، تشير الفرضية البديلة ثنائية الاتجاه (Two-Tailed Alternative Hypothesis – $H_1$) إلى وجود اختلاف حقيقي وجوهري بين تباين المجتمعين دون تحديد مسبق للاتجاه الذي يسلكه هذا التباين، ويتم التعبير عنها رياضياً بالصيغة:
$$H_1: \sigma_1^2 \neq \sigma_2^2 \quad \text{أو} \quad H_1: \frac{\sigma_1^2}{\sigma_2^2} \neq 1$$
وتكتسب هذه الصيغة ثنائية الاتجاه أهمية قصوى في غالبية الدراسات المقارنة، حيث لا يملك الباحث في كثير من الأحيان مبررات نظرية مسبقة تجزم بأن إحدى المجموعتين ستظهر بالضرورة تشتتاً أعلى من الأخرى، مما يجعل الاختبار الثنائي هو الخيار المنهجي الأكثر تحفظاً وملاءمة للنزاهة العلمية.
يتطلب اتخاذ القرار برفض أو قبول الفرضية الصفرية تحديداً مسبقاً لمستوى الدلالة الإحصائية ألفا ($\alpha$) قبل الشروع في فحص البيانات، وغالباً ما يُحدد هذا المستوى عند 0.05 أو 0.01 في البحوث السلوكية والطبية. يمثل هذا المستوى الحد الأقصى المقبول لاحتمالية رفض الفرضية الصفرية حينما تكون صحيحة في الواقع (الخطأ من النوع الأول). إن التحديد القبلي لمستوى ألفا يمنع أي تحيز قد ينشأ عن تعديل العتبات الاستدلالية بأثر رجعي للتوافق مع رغبات الباحث، مما يعزز الصرامة المنهجية للتحليل المنفذ عبر بيئة SAS.
1.3 تطبيقات اختبار F في البحوث السلوكية والنفسية
تحظى مسألة دراسة التباين باهتمام استثنائي في حقول علم النفس والعلوم السلوكية، حيث لا يُنظر إلى التشتت بوصفه مجرد خطأ قياس عشوائي، بل يُعد بحد ذاته مؤشراً نفسياً غنياً بالدلالات السلوكية والفروق الفردية. يُستخدم اختبار F بشكل مكثف للتحقق من تجانس التشتت السلوكي أو الاستجابات الانفعالية بين المجموعات التجريبية وتلك الضابطة؛ إذ إن عدم تجانس التباين قد يعكس تبايناً في استجابة الأفراد للتدخلات العلاجية، حيث قد يستجيب بعض المشاركين إيجابياً للتدخل بينما يتراجع أداء آخرين، مما يرفع تباين المجموعة التجريبية دون أن يظهر ذلك جلياً في المتوسط الحسابي بمفرده.
تتجلى هذه الأهمية في تقييم فعالية البرامج العلاجية والتأهيلية؛ ففي أبحاث التدخلات النفسية، قد يكون الهدف المنهجي ليس مجرد خفض معدلات الأعراض المرضية، بل زيادة استقرار الأداء والحد من التشتت الحاد في مستويات القلق أو الاكتئاب عبر الزمن. وقد ناقشت دراسات متعددة دور استقرار استجابة الأفراد في البرامج السريرية، مثل قياس مؤشرات شدة الأرق واستجابة المرضى للتدخلات النفسية السلوكية [2]، حيث يشير انخفاض التباين داخل المجموعة العلاجية إلى أن التدخل يحقق نتائج متسقة وموثوقة عبر مختلف فئات المرضى، بخلاف العلاجات التي تؤدي إلى اتساع الفجوة وتشتت الاستجابات.
وعلاوة على ذلك، يشكل اختبار F حجر الزاوية المنهجي لفحص الفرضيات التأسيسية التي تُبنى عليها المقارنات البارامترية بين المجموعات المستقلة، كاختبار t للعينات المستقلة (Independent Samples t-test) وتحليل التباين الأحادي (One-Way ANOVA). إن التحقق من شرط تجانس التباين بين المجموعات ليس خياراً ترفياً، بل هو شرط رياضي لا غنى عنه لصحة الاستدلال الإحصائي؛ إذ إن انهيار هذا الافتراض يؤدي إلى تشويه مستويات الدلالة الإحصائية الحقيقية وجعل اختبارات الفروق بين المتوسطات غير موثوقة، وهو ما يتطلب معالجات مخصصة في SAS تكفل حماية التحليل من النتائج الزائفة.
2. الافتراضات الإحصائية والشروط المسبقة لاختبار F
2.1 شرط التوزيع الطبيعي للبيانات في المجموعتين
يعد افتراض التوزيع الطبيعي للمتغير التابع في كل من المجتمعين الإحصائيين الشرط الأشد أهمية وحرجاً لتطبيق اختبار F التقليدي. يفترض هذا الاختبار أن البيانات الخام المستخلصة من كل عينة على حدة قد انبثقت من توزيع غاوسي (Gaussian Distribution) يتبع شكل الجرس المتماثل. يتأكد الباحث من تحقق هذا الشرط من خلال فحص مؤشرات الإحصاء الوصفي الاستكشافي، وفي مقدمتها معاملا الالتواء (Skewness) والتفرطح (Kurtosis)، حيث تشير القيم القريبة من الصفر إلى اقتراب معقول من التوزيع الطبيعي، في حين تنذر القيم التي تتجاوز العتبات المعيارية بوجود تشوهات في بنية التوزيع.
تكمن المعضلة المنهجية الكبرى لاختبار F في حساسيته الشديدة والمفرطة لأي انتهاك حتى وإن كان طفيفاً لافتراض الاعتدالية، مقارنة باختبارات إحصائية أخرى مثل اختبار t أو تحليل التباين التي تتمتع بقدر أكبر من الحصانة (Robustness) بفضل مبرهنة النهاية المركزية (Central Limit Theorem). إذا كانت البيانات في الواقع تتبع توزيعاً مفلطحاً (Platykurtic) أو مستدقاً (Leptokurtic) أو ملتوياً، فإن معدل الخطأ الفعلي للاختبار يبتعد تماماً عن مستوى ألفا الاسمي المحدد مسبقاً، مما قد يقود إلى رفض خاطئ للفرضية الصفرية وافتراض عدم تجانس التباين في حين أن التباينات الحقيقية متساوية.
ولهذا السبب، يلتزم الباحث المنهجي الصارم باستخدام حزم الاستكشاف التوزيعي في SAS مثل إجراء PROC UNIVARIATE لتطبيق اختبارات الاعتدالية الصارمة كاختبار شابيرو-ويلك (Shapiro-Wilk) وكولموجوروف-سميرنوف (Kolmogorov-Smirnov)، وفحص الرسوم البيانية الاحتمالية كمنحنيات Q-Q Plots قبل الاعتماد النهائي على نتائج اختبار F التقليدي، تفادياً للوقوع في فخ التفسيرات المضللة للبيانات غير المعتدلة.
2.2 استقلالية المشاهدات والعينات العشوائية
تشكل استقلالية المشاهدات ركيزة رياضية لا تقل وزناً عن شرط الاعتدالية؛ إذ يقتضي تطبيق اختبار F أن يتم سحب العينات بطريقة عشوائية ومستقلة تماماً من المجتمع المستهدف، بحيث لا يكون لاختيار أي مفردة في المجموعة الأولى أي تأثير على اختيار أو استجابة أي مفردة في المجموعة الثانية، فضلاً عن استقلالية المشاهدات داخل المجموعة الواحدة. يعني ذلك انتفاء أي شكل من أشكال التداخل أو الارتباط أو التزاوج الإحصائي بين أفراد المجموعتين قيد الدراسة.
إن خرق هذا الافتراض، كما يحدث عند استخدام عينات مترابطة (Paired Samples) أو قياسات متكررة (Repeated Measures) أو عندما يتشارك المشاركون في بيئة تجريبية واحدة تؤدي إلى التأثير المتبادل بينهم (Intra-cluster Correlation)، يترتب عليه خلل عميق في تقدير درجات الحرية الفعلية للاختبار. يترجم هذا الخلل إلى تشويه الخطأ المعياري وتضخيم معدل الخطأ من النوع الأول بصورة حادة تجعل الباحث يرصد فروقاً دالة إحصائياً في التشتت تعود في حقيقتها إلى الارتباط الذاتي بين البيانات وليس إلى تباين حقيقي في المجتمعات.
لذلك، يتوجب على الباحثين أثناء مرحلة التصميم التجريبي هندسة إجراءات جمع البيانات بعناية فائقة لعزل المتغيرات الدخيلة، وضمان عدم وجود أفراد مشتركين بين المجموعات، والامتناع التام عن تطبيق اختبار F المتاح عبر PROC TTEST المخصص للعينات المستقلة على بيانات مصممة وفق أطر القياس المتكرر أو الأزواج المتطابقة، واختيار النماذج الخطية المختلطة في SAS بدلاً منها عند وجود تبعية بين المشاهدات.
2.3 طبيعة المتغيرات وحجم العينة المطلوب
يستوجب اختبار F لتساوي التباينات أن يكون المتغير التابع المستهدف بالدراسة متغيراً كمياً مستمراً، مقاساً على مستوى فتري (Interval Scale) أو نسبي (Ratio Scale). لا يمكن تطبيق هذا الاختبار على المتغيرات الرتبية (Ordinal) أو الاسمية (Nominal)، نظراً لأن مفهوم التباين الإحصائي ذاته يرتكز رياضياً على حساب الفروق التربيعية عن المتوسط الحسابي، وهو مقياس يفقد دلالته الرياضية والمنهجية الرصينة في المقاييس غير الفترية.
يلعب حجم العينة وتوازنها العددي بين المجموعتين دوراً حاسماً في استقرار نتائج اختبار F وقوته الإحصائية (Statistical Power). بالرغم من أن الاختبار يستطيع من الناحية الرياضية التعامل مع عينات غير متساوية الحجم ($n_1 \neq n_2$)، إلا أن التفاوت الشديد في أحجام العينات، بالتزامن مع الانتهاكات الطفيفة للاعتدالية، يضعف كفاءة الاختبار ويجعله عرضة للأخطاء التقديرية. علاوة على ذلك، في العينات شديدة الصغر (أقل من 10 إلى 15 مشاهدة لكل مجموعة)، تصبح القوة الإحصائية للاختبار منخفضة للغاية، مما يجعل من الصعب رصد الفروق الحقيقية في التباين ما لم تكن هائلة الحجم.
وعلى النقيض من ذلك، في العينات الضخمة جداً، يصبح اختبار F مفرط الحساسية بحيث يميل إلى إظهار دلالة إحصائية للفروق الضئيلة للغاية في التباين، والتي لا تحمل في واقع الأمر أي معنى علمي أو تطبيقي. في مثل هذه الظروف، وبخاصة عند مواجهة عينات صغيرة أو عدم تحقق التوزيع الطبيعي، يفضل الإحصائيون المفاضلة بين اختبار F واختبارات التجانس البديلة الأكثر صلابة مثل اختبار ليفين (Levene’s Test) واختبار براون-فورسيت (Brown-Forsythe Test) اللذين توفرهما إجراءات أخرى متقدمة في بيئة SAS.
3. بنية وديناميكية إجراء PROC TTEST في SAS
3.1 لماذا يُستخدم إجراء PROC TTEST لتنفيذ اختبار F؟
يعد إجراء PROC TTEST في نظام SAS أحد أكثر الإجراءات الإحصائية أناقة وتكاملاً من الناحية الهندسية والبرمجية. لم يتم تصميم هذا الإجراء ليكون قاصراً على حساب اختبار t لعينتين مستقلتين فحسب، بل تم بناؤه داخلياً ليدرج اختبار F لتساوي التباينات كخطوة تشخيصية آلية مدمجة تسبق وترافق مقارنة المتوسطات. ينطلق هذا التصميم من وعي عميق بأسس الإحصاء الرياضي التي تشترط البت في مسألة تجانس التباين قبل تحديد الأسلوب المتبع لتقدير الخطأ المعياري للفروق بين المتوسطات.
يوفر هذا الدمج التلقائي جهداً برمجياً ووقتاً تحليلياً هائلاً على الباحثين؛ فبدلاً من كتابة كود مخصص لاختبار التباينات ثم كتابة كود آخر لمقارنة المتوسطات استناداً إلى نتائج الكود الأول، يقوم PROC TTEST بإنجاز هاتين المرحلتين في أمر برمجي واحد متماسك. تتكامل المخرجات المولدة لتزود المحلل برؤية شمولية تكشف خصائص التشتت جنباً إلى جنب مع مقاييس النزعة المركزية.
تتجلى قوة هذا التصميم في قدرته على دعم اتخاذ القرار المنهجي المتسق؛ حيث تُعرض نتائج اختبار F في مصفوفة مخرجات موحدة تتيح للباحث القراءة السريعة والمباشرة لقيمة F الاحتمالية، وتوجهه بصورة قطعية نحو اختيار صف النتائج الملائم لمقارنة المتوسطات (سواء كان يفترض تساوي التباينات أو عدم تساويها)، مما يقلل من احتمالات الخطأ البشري في تفسير البيانات المعقدة في بيئات البحوث الأكاديمية والسريرية المتقدمة.
3.2 البنية التركيبية العامة (Syntax) للأمر والخيارات المتاحة
تتميز البنية التركيبية لإجراء PROC TTEST بالوضوح والمرونة العالية التي تسمح بالتحكم الدقيق في مدخلات ومخرجات التحليل الإحصائي. يبدأ الأمر البرمجي دائماً بعبارة استدعاء الإجراء، متبوعة بتحديد اسم جدول البيانات المراد إخضاعه للتحليل عبر خيار DATA=. تتكامل هذه البنية مع مجموعة من التعليمات الإلزامية والاختيارية التي تحدد مسار المعالجة الرياضية. يوضح الكود التالي البنية المعيارية الأساسية للإجراء:
PROC TTEST DATA=dataset_name;

    CLASS grouping_variable;

    VAR analysis_variable;

RUN;
يتيح هذا الإجراء للمستخدم تضمين خيارات متقدمة ضمن عبارة PROC TTEST ذاتها لضبط معايير التحليل. من أبرز هذه الخيارات خيار ALPHA=value، الذي يمكن من خلاله تعديل مستوى الدلالة المعتمد من القيمة الافتراضية 0.05 إلى مستويات أخرى كـ 0.01 أو 0.10 لتحديد فترات الثقة المناسبة. كما يدعم الإجراء خيارات مثل SIDES=2 أو SIDES=U أو SIDES=L للتحكم في اتجاه الفرضية الصفرية لاختبار المتوسطات، على الرغم من أن اختبار F لتجانس التباينات يظل بطبيعته ثنائي الاتجاه داخل هذا الإجراء عبر خوارزمية الاختبار المطوي المعتمدة في النظام.
علاوة على ذلك، يتكامل هذا الإجراء بشكل تام مع نظام تسليم المخرجات (Output Delivery System – ODS)، مما يسمح للباحثين بتنشيط الرسوم البيانية التشخيصية عالية الدقة باستخدام خيار PLOTS=ALL، وتصدير الجداول الإحصائية الناتجة تلقائياً إلى صيغ رقمية مختلفة كملفات PDF أو Word أو قواعد بيانات لاستخدامها في إعداد التقارير العلمية ومقالات المجلات الأكاديمية المحكمة.
3.3 تحديد متغير التصنيف والمتغير المستهدف بدقة
تستند المعالجة الإحصائية الثنائية في PROC TTEST إلى التفاعل الوظيفي الدقيق بين عبارتين برمجيتين رئيسيتين: تعليمة CLASS وتعليمة VAR. تُخصص تعليمة CLASS لتعريف المتغير المستقل، وهو المتغير الفئوي أو التصنيفي الذي يقسم عينة الدراسة إلى المجموعتين المراد مقارنة تباينهما ومتوسطاتهما. يشترط نظام SAS بصرامة مطلقة أن يشتمل متغير التصنيف المدرج في عبارة CLASS على مستويين اثنين فقط لا غير (Two Distinct Levels).
في المقابل، تُستخدم تعليمة VAR لتحديد المتغير التابع المستمر، وهو المتغير الكمي الذي يُراد فحص تباينه وتشتته عبر مستويات متغير التصنيف. يمكن إدراج متغير كمي واحد أو قائمة متعددة من المتغيرات الرقمية ضمن تعليمة VAR الواحدة، وفي هذه الحالة سيقوم نظام SAS بتنفيذ اختبار F واختبار t المقابل لكل متغير من هذه المتغيرات على حدة وبصورة تسلسلية منظمة في شاشات المخرجات.
يعد الخطأ البرمجي المترتب على إدراج متغير تصنيفي يحتوي على أكثر من مستويين (كأن يحتوي على ثلاث مجموعات تجريبية مثلاً) من أكثر الأخطاء شيوعاً التي يواجهها المحللون المبتدئون. عند حدوث ذلك، يتوقف تنفيذ الإجراء فوراً ويصدر النظام رسالة خطأ في ملف السجل (SAS Log) مفادها أن متغير التصنيف يحتوي على أكثر من قيمتين، موضحاً أنه لا يمكن إجراء مقارنة ثنائية في هذه الحالة، مما يفرض على الباحث تصفية البيانات (Filtering) لاختيار مستويين فقط، أو الانتقال المنهجي إلى إجراء PROC GLM أو PROC ANOVA لمعالجة النماذج المتعددة المجموعات.
4. إعداد وإدخال مصفوفة البيانات في بيئة SAS
4.1 إنشاء مجموعة البيانات باستخدام خطوة DATA وDATALINES
تمثل خطوة DATA الخطوة التأسيسية الأولى في بيئة برمجة SAS، حيث يتم من خلالها بناء هيكل الجدول الإحصائي، وتسمية المتغيرات، وتحديد خصائص تخزينها في الذاكرة المؤقتة للبرنامج. تبدأ هذه الخطوة بتحديد اسم مجموعة البيانات الجديدة عبر الأمر DATA dataset_name;، يتبعها تحديد نمط قراءة البيانات عبر تعليمة INPUT التي تشرح للبرنامج كيفية قراءة وتفسير القيم الواردة في مصفوفة البيانات الخام.
تستخدم تعليمة DATALINES (أو تعليمة CARDS المرادفة لها في بيئات SAS التاريخية) لإعلام المترجم البرمجي بأن الأسطر التي تليها مباشرة تحتوي على قيم البيانات الفعلية. يجب ترتيب هذه البيانات في صفوف وأعمدة متناسقة تعكس المشاهدات والمتغيرات المحددة في أمر INPUT، مع التأكد من وضع مسافة بيضاء واحدة على الأقل بين القيم المتجاورة ما لم يُحدد منسق قراءة مخصص.
ينتهي إدخال البيانات بوضع فاصلة منقوطة منفردة على سطر مستقل بعد السطر الأخير من البيانات الخام، متبوعة بتعليمة RUN; التي تعطي إشارة التنفيذ لمعالجة مصفوفة البيانات وتجهيزها في مكتبة العمل المؤقتة (Work Library). توفر هذه الطريقة المباشرة وسيلة سريعة وشفافة لإعداد مجموعات البيانات التجريبية والتطبيقية دون الحاجة إلى استيراد ملفات خارجية في مراحل الفحص الإحصائي الأولي.
4.2 التحقق من ترميز المتغيرات المستقلة والتابعة
يتطلب التحليل الإحصائي السليم انضباطاً كبيراً في ترميز المتغيرات؛ فالمتغير المستقل المدرج في عبارة CLASS يجب أن يُعرف بترميز مناسب، سواء كان نصياً (Character) أو عددياً (Numeric). عند الرغبة في إدخال متغير نصي يعبر عن المجموعات (مثل ‘Control’ و ‘Treatment’)، يجب وضع علامة الدولار ($) مباشرة بعد اسم المتغير في تعليمة INPUT لإعلام النظام بأن هذا المتغير يحتوي على نصوص وليس أرقاماً.
في المقابل، يجب أن يخلو المتغير التابع الكمي من علامة الدولار ليتم التعامل معه كمتغير رقمي مستمر. يجب الاحتراز الشديد من إدراج أي رموز نصية أو علامات خاصة غير رقمية ضمن عمود المتغير التابع (مثل وضع علامات التعجب أو الحروف للدلالة على القيم الشاذة)، لأن ذلك سيؤدي إلى قراءة تلك القيم كقيم مفقودة (Missing Values) وتوليد رسائل تحذيرية في سجل النظام تشير إلى حدوث خطأ في تحويل البيانات (Invalid Data Warning).
ويفضل دائماً إسناد مسميات إيضاحية للمتغيرات باستخدام تعليمة LABEL داخل خطوة البيانات، لضمان ظهور أسماء مفصلة وشديدة الوضوح في الجداول الإحصائية النهائية، مما ييسر قراءة التقارير الأكاديمية ويفصل بين الترميزات البرمجية المختصرة والمعاني العلمية الدقيقة للمتغيرات المدروسة.
4.3 فحص البيانات واستكشاف القيم المفقودة والشاذة
قبل الشروع في تشغيل الإجراءات الاستدلالية كاختبار F، تقتضي قواعد التحليل الرصين إجراء فحص استكشفي أولي للبيانات. يُستخدم إجراء PROC PRINT لمعاينة مصفوفة البيانات والتأكد من مطابقة عدد المشاهدات المقروءة للعدد الفعلي المخطط له، ورصد أي انزياح في محاذاة الأعمدة قد يكون شوه قراءة القيم.
يتبعه بعد ذلك توظيف إجراء PROC MEANS لاستخراج المؤشرات الإحصائية الوصفية الأولية لكل مجموعة على حدة عبر تضمين تعليمة CLASS داخله. يوفر هذا الإجراء مقاييس النزعة المركزية والتشتت كالمتوسط الحسابي، والانحراف المعياري، وأصغر قيمة، وأكبر قيمة، وعدد القيم المفقودة. تتيح هذه المقاييس للباحث تقييم أولي للتباين الملاحظ؛ فإذا كان الانحراف المعياري لإحدى المجموعتين مضاعفاً بشكل كبير مقارنة بالمجموعة الأخرى، فإن ذلك يشكل مؤشراً أولياً على احتمالية عدم تجانس التباين.
كما يُعد هذا الفحص الاستكشافي ضرورياً لرصد القيم المتطرفة (Outliers) التي قد تنجم عن أخطاء إدخال أو ظروف قياس غير اعتيادية. إن وجود قيمة شاذة واحدة في عينة ما كفيل بتضخيم التباين العيني الخاص بها بصورة مصطنعة نظراً لأن حساب التباين يرفع الفروق إلى القوة التربيعية، مما قد يؤدي بدوره إلى تضخيم إحصائية F وإظهار عدم تجانس زائف للتباينات لا يعكس الواقع الحقيقي للمجتمع المدروس.
5. التطبيق العملي: تشغيل كود اختبار F خطوة بخطوة
5.1 كتابة الشيفرة البرمجية المباشرة لاختبار الفروق
لتطبيق اختبار F لتساوي التباينات عملياً في نظام SAS، نقوم بصياغة شيفرة برمجية كاملة ومتكاملة تبدأ بإنشاء مجموعة بيانات تجريبية تحاكي دراسة في علم النفس المعرفي، تهدف إلى مقارنة تشتت زمن الاستجابة (بالميللي ثانية) بين مجموعتين: مجموعة ضابطة وأخرى تلقت تدريباً نوعياً. يوضح الكود التالي كيفية إدخال البيانات وتشغيل الإجراء مباشرة:
DATA AttentionStudy;

    INPUT Group $ RT;

    DATALINES;

Control 450

Control 470

Control 460

Control 490

Control 455

Control 480

Control 465

Control 475

Trained 410

Trained 415

Trained 405

Trained 420

Trained 412

Trained 418

Trained 408

Trained 415

;

RUN;
PROC TTEST DATA=AttentionStudy;
CLASS Group;
VAR RT;
RUN;
في هذه الشيفرة، تم استدعاء إجراء PROC TTEST وتمرير جدول البيانات AttentionStudy إليه. حددت تعليمة CLASS Group; أن المتغير المستقل هو المتغير النصي الذي يميز بين المجموعتين (Control و Trained)، بينما حددت تعليمة VAR RT; أن المتغير المستهدف بالتحليل هو زمن الاستجابة. عند تنفيذ تعليمة RUN;، يعالج محرك SAS البيانات وينشئ تقريراً إحصائياً شاملاً يتضمن جدول اختبار F الخاص بتساوي التباينات في أسفل التقرير التحليلي.
5.2 معالجة الخيارات المتقدمة ومستويات الثقة في SAS
يوفر نظام SAS إمكانية تخصيص التحليل ليتماشى مع المتطلبات المنهجية الدقيقة للبحوث المتقدمة. عند الحاجة إلى خفض احتمالية الخطأ من النوع الأول في التجارب السريرية أو الاختبارات عالية الحساسية، يمكن تعديل مستوى الدلالة عبر خيار ALPHA=. يوضح الكود التالي كيفية ضبط مستوى الدلالة عند 0.01 بدلاً من 0.05، مع تفعيل نظام الرسوم البيانية التشخيصية الشاملة:
ODS GRAPHICS ON;

PROC TTEST DATA=AttentionStudy ALPHA=0.01 PLOTS=ALL;

    CLASS Group;

    VAR RT;

RUN;

ODS GRAPHICS OFF;
يؤدي تفعيل ODS GRAPHICS ON إلى توليد مجموعة من المخططات البصرية فائقة الجودة تشمل الرسوم البيانية الصندوقية (Box Plots)، ورسوم التوزيع التكراري مع منحنيات الكثافة، والمخططات الاحتمالية التي تعرض تباين وتشتت المجموعتين جنباً إلى جنب. تسهم هذه الرسوم في توفير دعم بصري فوري يؤكد ما إذا كان اتساع التشتت الملاحظ في إحدى المجموعتين حقيقياً أم مدفوعاً بقيم طرفية مفردة.
كما يمكن توجيه النتائج بدقة عبر نظام ODS لاستخراج جدول اختبار F بمفرده وحفظه في جدول بيانات دائم في SAS، باستخدام تعليمة ODS OUTPUT EqualityOfVariances=VarTestResults; ضمن كتلة الإجراء، مما يتيح للباحث توظيف القيم الاحتمالية لـ F لاحقاً في برمجة مسارات تحليلية مشروطة وتوليد تقارير مؤتمتة دون تدخل يدوي.
5.3 تشخيص الأخطاء البرمجية الشائعة أثناء التنفيذ
يتطلب العمل في بيئة SAS دقة متناهية، ومتابعة دؤوبة لملف السجل (SAS Log) الذي يسجل كل خطوة تنفيذية بالتفصيل. من الأخطاء النحوية الشائعة (Syntax Errors) نسيان الفاصلة المنقوطة (Semicolon) في نهاية إحدى التعليمات، مما يجعل النظام يدمج تعليمتين معاً ويوقف التنفيذ مع ظهور رسالة خطأ باللون الأحمر تشير إلى وجود تعليمة غير صالحة.
خطأ آخر متكرر يتمثل في عدم التطابق الحرفي بين اسم المتغير في خطوة DATA واسمه في تعليمتي CLASS أو VAR. على الرغم من أن لغة SAS لا تتأثر بحالة الأحرف (Case-insensitive) في أسماء المتغيرات، إلا أن أي خطأ إملائي في كتابة الحروف يقود إلى رسالة خطأ شهيرة: ERROR: Variable NOT found. كما يجب التحقق من عدم وجود مسافات إضافية غير مرئية داخل نصوص تصنيف المجموعات، والتي قد تجعل النظام يعتبر ‘Control ‘ و ‘Control’ فئتين منفصلتين تماماً، مما يرفع عدد الفئات إلى ثلاث ويؤدي إلى توقف إجراء PROC TTEST فوراً.
ومن أخطر الأخطاء الإحصائية التي يواجهها النظام حدوث تباين صفري (Zero Variance) داخل إحدى المجموعتين؛ ويحدث ذلك إذا كانت جميع قيم المشاركين في تلك المجموعة متطابقة تماماً. في هذه الحالة، يصبح المقام أو البسط في حساب إحصائية F مساوياً للصفر، مما يجعل العملية الرياضية غير معرّفة (Division by zero)، ويتسبب في ظهور رسائل تحذيرية في السجل البرمجي تشير إلى تعذر حساب مصفوفة التباين وتوقف إخراج نتائج الاختبار.
6. قراءة وتفسير مخرجات اختبار F في تقارير SAS
6.1 قراءة جدول تجانس التباين (Equality of Variances)
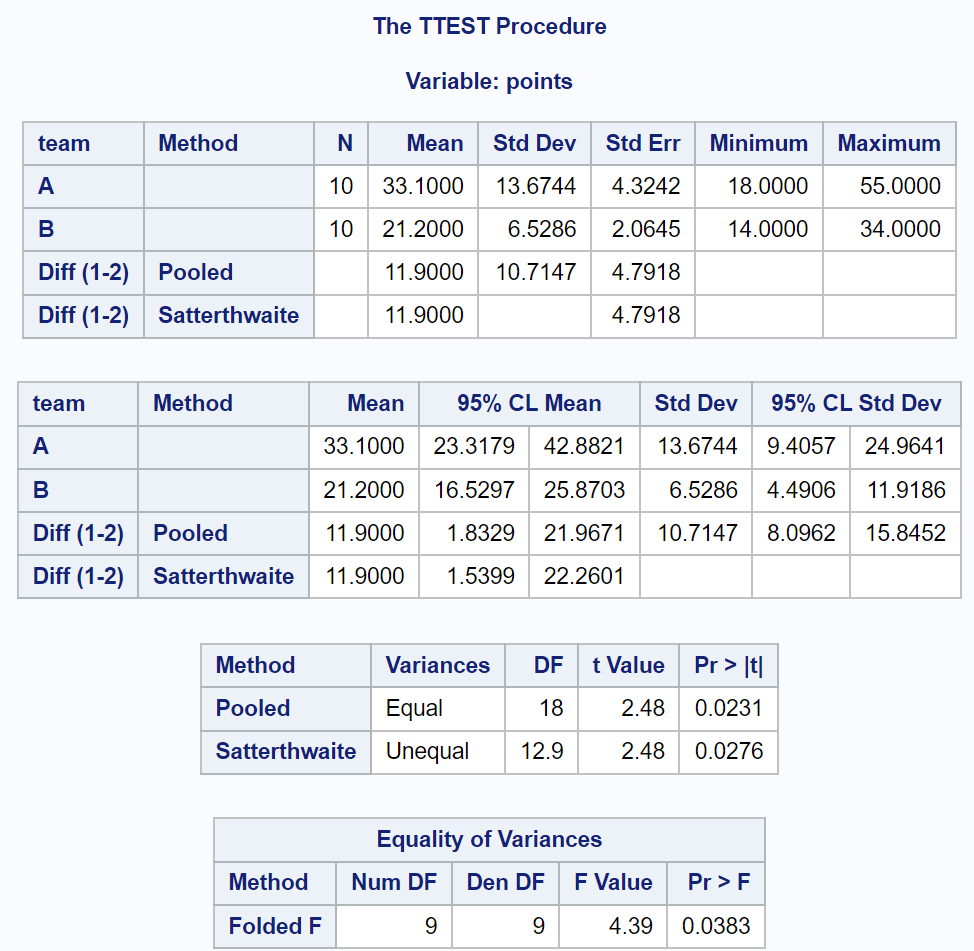
عند تشغيل إجراء PROC TTEST، يولد نظام SAS تقريراً يتألف من عدة جداول إحصائية متتالية. يقع جدول فحص تجانس التباينات في الجزء السفلي من التقرير تحت عنوان “Equality of Variances”. يعد هذا الجدول المرجع الحاسم الذي يجب على الباحث التوجه إليه مباشرة قبل الشروع في فحص أي نتيجة أخرى تتعلق بمقارنة المتوسطات.
يحتوي هذا الجدول عادة على خمسة أعمدة رئيسية: الطريقة المستخدمة (Method)، درجات حرية البسط (Num DF)، درجات حرية المقام (Den DF)، قيمة إحصائية F المحسوبة (F Value)، والقيمة الاحتمالية المرتبطة بها (Pr > F). في عمود الطريقة، يُدرج النظام عادة عبارة “Folded F”، وهي الإشارة البرمجية الدالة على أن SAS قام بتطبيق الخوارزمية الرياضية التي ترتب التباينين تلقائياً بحيث يكون التباين الأكبر في البسط والتباين الأصغر في المقام.
إن إدراك الباحث لهذه الآلية يزيل أي التباس قد ينشأ حول سبب ظهور قيمة F دائماً كقيمة موجبة تفوق الواحد الصحيح؛ فالنظام لا يقسم تباين المجموعة الأولى على الثانية اعتباطاً بناءً على ترتيب إدخالهما، بل يعتمد الترتيب التنازلي التلقائي للقيم التباينية العينية، ليضمن توافق الحسابات مع توزيع F المطوي واشتقاق القيمة الاحتمالية ثنائية الطرف الموزونة رياضياً.
6.2 تفسير درجات الحرية وإحصائية F المحسوبة
يتطلب التفسير الإحصائي الدقيق تفكيك مكونات جدول تجانس التباين خطوة بخطوة. يبدأ ذلك من عمودي درجات الحرية؛ حيث يمثل عمود Num DF (درجات حرية البسط) حجم عينة المجموعة التي أظهرت التباين الأكبر مطروحاً منها واحد ($n_{\text{larger}} – 1$). أما عمود Den DF (درجات حرية المقام)، فيمثل حجم عينة المجموعة التي أظهرت التباين الأصغر مطروحاً منها واحد ($n_{\text{smaller}} – 1$).
تُعرض قيمة إحصائية الاختبار في عمود F Value، وهي حاصل القسمة المباشر لتباين البسط على تباين المقام. في سياق الاستدلال الإحصائي الكلاسيكي، يمكن مقارنة هذه القيمة المحسوبة بالقيمة الحرجة المجدولة (Critical F Value) المستخرجة من جداول توزيع F عند مستوى دلالة $alpha/2$ ودرجات الحرية المحددة للبسط والمقام. فإذا كانت قيمة F المحسوبة أكبر من القيمة الحرجة، فإن ذلك يشير إلى أن الفارق بين التباينين كبير بدرجة لا يمكن إرجاعها إلى الصدفة الإحصائية وحدها.
ومع ذلك، وبفضل الحوسبة الإحصائية الحديثة في SAS، لم يعد الباحثون بحاجة إلى الرجوع للجداول الورقية الحرجة، حيث توفر حزمة SAS القيمة الاحتمالية الدقيقة المقابلة لإحصائية F مباشرة، مما يجعل عملية التفسير أكثر سرعة ودقة ومحصنة ضد أخطاء التقريب المرافقة للجداول المطبوعة.
6.3 قراءة القيمة الاحتمالية واتخاذ القرار الإحصائي المنهجي
تمثل القيمة الاحتمالية المعروضة تحت عمود Pr > F المحك النهائي لاتخاذ القرار المنهجي بخصوص فرضية تساوي التباينات. تشير هذه القيمة إلى احتمال الحصول على نسبة تباينات متطرفة أو أكثر تطرفاً من النسبة الملاحظة في العينة، بافتراض أن الفرضية الصفرية القائلة بتساوي تباينات المجتمعات الأصلية صحيحة تماماً.
تتم مقارنة هذه القيمة الاحتمالية بمستوى المعنوية المحدد مسبقاً (عادة $\alpha = 0.05$):
- إذا كانت القيمة الاحتمالية أكبر من أو تساوي 0.05 ($p ge 0.05$): يفشل الباحث في رفض الفرضية الصفرية، مما يعني عدم وجود دليل إحصائي كافٍ يثبت اختلاف التباينات، وبالتالي يُعد افتراض تجانس التباين قائماً ومقبولاً من الناحية التطبيقية.
- إذا كانت القيمة الاحتمالية أصغر من 0.05 ($p < 0.05$): يرفض الباحث الفرضية الصفرية لصالح الفرضية البديلة، ويستنتج رسمياً أن تباين المجموعتين غير متجانس، وأن إحدى المجموعتين تُظهر تشتتاً أعلى دالاً إحصائياً مقارنة بالأخرى.
إن اتخاذ هذا القرار ليس نهاية المطاف، بل هو الموجه الإلزامي الذي يحدد المسار المنهجي التالي للتعامل مع بقية تقرير مخرجات PROC TTEST المتعلقة باختبار الفروق بين المتوسطات، كما سيتم تفصيله في المحور التالي.
7. الربط المنهجي بين اختبار F واختبار t للعينات المستقلة
7.1 تطبيق افتراض التباين المجمع (Pooled Variance)
يوفر تقرير PROC TTEST في SAS جدولاً موازياً يحمل عنوان “t Tests”، يشتمل دائماً على صفين من المخرجات الإحصائية: صف يُسمى Pooled (التباين المجمع)، وصف يُسمى Satterthwaite (تباين ساتيرثويت المعدل). إن معيار الاختيار الصارم بين هذين الصفين يعتمد كلياً على مخرجات جدول Equality of Variances السابق شرحه.
عندما تكون نتيجة اختبار F غير دالة إحصائياً ($p ge 0.05$)، يثبت الباحث صلاحية افتراض تجانس التباينات، وفي هذه الحالة حصراً، يجب عليه قراءة وتفسير صف Pooled. يعتمد هذا الصف على المعادلة الرياضية الكلاسيكية التي تقوم بدمج أو تجميع تباين العينتين لحساب تقدير موحد وغير متحيز للتباين المشترك للمجتمع، وفق المعادلة:
$$S_p^2 = \frac{(n_1 – 1)S_1^2 + (n_2 – 1)S_2^2}{n_1 + n_2 – 2}$$
تكون درجات الحرية في هذا الصف عدداً صحيحاً دائماً يُحسب بجمع حجم العينتين ناقص اثنين ($df = n_1 + n_2 – 2$). يمثل هذا الصف الاختبار المعياري الأكثر قوة (Most Powerful) لاختبار الفروق بين المتوسطات طالما كانت التباينات متكافئة؛ إذ يتيح تجميع البيانات استغلال درجات الحرية كاملة لتقليل الخطأ المعياري، مما يرفع كفاءة الاستدلال الإحصائي إلى أقصى حد ممكن.
7.2 اللجوء إلى تباين ساتيرثويت (Satterthwaite Variance)
في الحالة المقابلة، عندما تأتي نتيجة اختبار F دالة إحصائياً ($p < 0.05$)، يسقط افتراض تجانس التباينات بصورة قطعية. في هذا الموقف، يصبح الاعتماد على صف Pooled خطأً منهجياً فادحاً يهدد الصدق الإحصائي للنتائج؛ إذ إن استخدام التباين المجمع في ظل عدم تساوي التباينات الحقيقية، خاصة مع عدم تساوي أحجام العينات، يؤدي إلى تضخم هائل في معدل الخطأ من النوع الأول أو انخفاض شديد في القوة الإحصائية.
هنا يفرض المسار العلمي الانتقال الإلزامي لقراءة صف Satterthwaite، وهو تعديل رياضي ابتكره الإحصائي فرانكلين ساتيرثويت لمعالجة ما يعرف في الأدبيات الإحصائية بمسألة “بيرنس-فيشر” (Behrens-Fisher Problem). لا يقوم هذا الإجراء بتجميع التباينات، بل يحسب الخطأ المعياري لكل عينة بصورة منفصلة، ويقوم بتعويض هذا التباين عبر تعديل وتخفيض درجات الحرية لتصبح رقماً كسرياً غير صحيح (Decimal Degrees of Freedom)، وفق صيغة مركبة تعتمد على أحجام العينات وتبايناتها الفردية.
يحمي هذا التعديل الصارم الاستدلال الإحصائي من التفسيرات الزائفة؛ حيث يؤدي تقليص درجات الحرية الكسرية إلى رفع القيمة الحرجة المطلوبة لتحقيق الدلالة، مما يجعل اختبار t أكثر تحفظاً ويضمن بقاء معدل الخطأ من النوع الأول عند مستوى ألفا الحقيقي المحدد مسبقاً، حتى في ظل تشتت البيانات وعدم استقرار التباينات بين المجموعات المقارنة.
7.3 خارطة طريق منهجية لاختيار مخرجات المقارنة الصحيحة
لضمان التوثيق العلمي الرصين وتجنب أي ارتباك أثناء تحليل البيانات في بيئة SAS، يمكن تلخيص الخوارزمية المنهجية المتبعة في الخطوات المتسلسلة التالية:
- فحص اختبار F أولاً: التوجه إلى جدول
Equality of Variancesوقراءة قيمةPr > F. - تقييم التجانس:
- إذا كانت $p ge 0.05$: استنتج تجانس التباين $\rightarrow$ توجه لصف Pooled في جدول اختبار t $\rightarrow$ اعتمد قيمة t المحسوبة، ودرجات الحرية الكلية الصحيحة، والقيمة الاحتمالية المقابلة لها.
- إذا كانت $p < 0.05$: استنتج عدم تجانس التباين $\rightarrow$ توجه لصف Satterthwaite في جدول اختبار t $\rightarrow$ اعتمد قيمة t المحسوبة، ودرجات الحرية الكسرية المعدلة، والقيمة الاحتمالية المقابلة لها.
- التوثيق المنهجي: كتابة فقرة تقريرية تشير بوضوح إلى نتيجة اختبار F المسبق، وتوضح الأساس المنطقي الذي بنى عليه الباحث اختياره لأحد الصفيْن دون الآخر.
إن إغفال هذه الخارطة المنطقية وتفسير نتائج المتوسطات دون الإشارة إلى وضع تجانس التباين يمثل ثغرة منهجية خطيرة تنعكس سلباً على مصداقية الأبحاث في المجلات المحكمة ذات المعايير الصارمة.
8. معالجة انتهاكات الافتراضات واختبارات التجانس البديلة في SAS
8.1 استخدام اختبار ليفين (Levene’s Test) عبر PROC GLM
كما تم التوضيح سابقاً، فإن نقطة الضعف القاتلة في اختبار F التقليدي المضمن في PROC TTEST تكمن في حساسيته المفرطة لانتهاك التوزيع الطبيعي. عندما تُظهر اختبارات الاستكشاف التوزيعي أن البيانات تعاني من التواء شديد أو تفرطح شاذ، فإن الاعتماد على اختبار F لتأكيد التجانس يصبح ممارسة غير مأمونة العواقب. يوفر نظام SAS في هذه الحالات بديلاً أكثر صلابة وموثوقية يتمثل في اختبار ليفين (Levene’s Test).
يقوم اختبار ليفين بحساب الانحرافات المطلقة لكل مشاهدة عن متوسط مجموعتها، ثم يطبق تحليل التباين (ANOVA) على تلك الانحرافات المطلقة ذاتها. ولاستدعاء هذا الاختبار في SAS، ينتقل الباحث إلى إجراء النماذج الخطية العامة PROC GLM مستخدماً خيار HOVTEST=LEVENE ضمن تعليمة MEANS، كما هو موضح في الكود التالي:
PROC GLM DATA=AttentionStudy;

    CLASS Group;

    MODEL RT = Group;

    MEANS Group / HOVTEST=LEVENE;

RUN;

QUIT;
يتميز اختبار ليفين بحصانة عالية ومقاومة ممتازة للتشوهات التوزيعية المعتدلة، مما يجعله الخيار الأول والمفضل لدى مراجعي المجلات العلمية في الدراسات السلوكية والنفسية، حيث تشير القيمة الاحتمالية لاختبار ليفين في حال ظهورها دالة إحصائياً إلى رفض تجانس التباين بأسلوب متين ومتحرر من قيود الاعتدالية الصارمة التي تكبل اختبار F الكلاسيكي.
8.2 اختبار براون-فورسيت (Brown-Forsythe) كخيار بديل
في السيناريوهات البحثية التي تتسم بوجود بيانات شديدة الالتواء أو تحتوي على قيم شاذة حادة (Heavy-Tailed Distributions) تفشل حتى معها صلابة اختبار ليفين القائم على المتوسط، يبرز اختبار براون-فورسيت (Brown-Forsythe Test) كأفضل البدائل الإحصائية المتاحة على الإطلاق في بيئة SAS. يتمثل الفارق الجوهري بين هذا الاختبار واختبار ليفين التقليدي في استبدال المتوسط بالوسيط الحسابي (Median) لكل مجموعة عند حساب الانحرافات المطلقة.
نظراً لأن الوسيط الحسابي مقياس نزعة مركزية شديد الحصانة لا يتأثر مطلقاً بالقيم المتطرفة، فإن اختبار براون-فورسيت يوفر تقديراً بالغ الدقة للتشتت الحقيقي بين المجموعات دون أن يتأثر بالشواذ. يمكن تشغيل هذا الاختبار بسهولة فائقة داخل إجراء PROC GLM عبر تضمين الخيار HOVTEST=BF على النحو الآتي:
PROC GLM DATA=AttentionStudy;

    CLASS Group;

    MODEL RT = Group;

    MEANS Group / HOVTEST=BF;

RUN;

QUIT;
عند تفسير مخرجات هذا الاختبار، ينظر الباحث إلى قيمة F المقابلة لـ Brown-Forsythe؛ فإذا تجاوزت قيمتها الاحتمالية 0.05، يطمئن الباحث إلى تجانس تباينات العينات حول وسيطاتها الحسابية، مما يمنحه سنداً إحصائياً متيناً للمضي قدماً في التحليلات اللاحقة حتى في ظل وجود تشوهات شكلية في التوزيع التكراري للبيانات الخام.
8.3 التحويلات الرياضية لمعالجة عدم استقرار التباين
عندما يثبت عدم تجانس التباينات، وتكون هناك رغبة منهجية في مواصلة استخدام النماذج البارامترية القياسية التي تشترط ثبات التباين والاعتدالية، يلجأ الإحصائيون إلى تقنية “تحويل البيانات” (Data Transformation). تهدف هذه التقنية إلى تطبيق دالة رياضية غير خطية على كل قيمة من قيم المتغير التابع لإعادة ضبط التشتت وتقليص التفاوت بين تباينات المجموعات، وتقريب المنحنى من التوزيع الطبيعي في آن واحد.
من أشهر هذه التحويلات المطبقة برمجياً في خطوة DATA داخل SAS:
- التحويل اللوغاريتمي (Logarithmic Transformation): ويتم عبر دالة
LOG(Y)أوLOG10(Y)، وهو علاج فعال جداً في حال كان الانحراف المعياري يتناسب طردياً مع المتوسط، أو عندما تكون البيانات موجبة بشدة وذات التواء يميني واضح. - تحويل الجذر التربيعي (Square Root Transformation): ويُنفذ عبر دالة
SQRT(Y)، وهو مثالي للبيانات التي تمثل تعدادات أو نسب وقوع الظواهر التكرارية المحدودة. - تحويل المقلوب (Reciprocal Transformation): ويتم عبر الصيغة
1/Y، ويستخدم عادة في مقاييس الزمن والسرعة لتقليص أثر القيم الشديدة التباعد.
يوضح الكود التالي كيفية إنشاء متغير متحول لوغاريتمياً وإعادة تطبيق اختبار F عليه في خطوة واحدة:
DATA TransformedData;

    SET AttentionStudy;

    Log_RT = LOG(RT);

RUN;
PROC TTEST DATA=TransformedData;
CLASS Group;
VAR Log_RT;
RUN;
إذا أظهر اختبار F في مخرجات البيانات المحولة قيمة غير دالة ($p ge 0.05$)، يكون التحويل قد نجح في تحقيق الاستقرار التبايني المطلوب (Variance Stabilization)، مما يجيز للباحث الاعتماد على صف Pooled للبيانات المحولة، مع مراعاة الإشارة إلى هذا التحويل عند تفسير المعاني العملية للمتوسطات ومناقشة الدلالة التطبيقية.
9. دراسة حالة تطبيقية: مقارنة تباين الأداء في القياس النفسي
9.1 صياغة المشكلة النفسية وبناء الفرضيات البحثية
في دراسة تجريبية استكشافية في مجال علم النفس المعرفي والإكلينيكي، سعى فريق بحثي إلى تقييم أثر تدخل معرفي قائم على التدريب المكثف على اليقظة الذهنية (Mindfulness-Based Attention Training) في تنظيم الأداء المعرفي وتقليص تشتت الانتباه تحت الضغوط النفسية. انطلقت الدراسة من الأطر النظرية الرصينة التي تؤكد أن اضطرابات القلق وتدهور الضبط التنفيذي ترفع تشتت الانتباه وتباين زمن الاستجابة في مهام الذاكرة العاملة وسعة الانتباه المنضبط [10]، فضلاً عن الدراسات الموسعة حول فاعلية تنظيم الذات والتحكم السلوكي في ضبط الاستجابات [6].
تم تقسيم عينة مكونة من 32 مشاركاً عشوائياً إلى مجموعتين متساويتين ($n_1 = 16, n_2 = 16$):
- المجموعة التجريبية (Trained): خضعت لبرنامج تدريبي لليقظة الذهنية والتركيز لمدة 8 أسابيع.
- المجموعة الضابطة (Control): بقيت على قائمة الانتظار دون تلقي أي تدريب منهجي.
خضع جميع المشاركين بعد انتهاء المدة لمهمة حاسوبية معقدة لقياس زمن الاستجابة في كشف المثيرات البصرية المتداخلة، حيث سُجل متوسط أزمنة الاستجابة بالميللي ثانية لكل مشارك.
صيغت الفرضية البحثية الرئيسية بأن التدريب على اليقظة لا يسهم فقط في خفض زمن الاستجابة، بل يؤدي بصورة جوهرية إلى “استقرار الأداء” وتقليص تباين وتشتت استجابات أفراد المجموعة التجريبية مقارنة بالمجموعة الضابطة. وترجمت هذه الفرضية إحصائياً إلى اختبار فرضية تساوي التباينات:
$$H_0: \sigma_{\text{Control}}^2 = \sigma_{\text{Trained}}^2 \quad \text{مقابل} \quad H_1: \sigma_{\text{Control}}^2 \neq \sigma_{\text{Trained}}^2$$
مع تحديد مستوى الدلالة الإحصائية الصارم عند $\alpha = 0.05$.
9.2 إدخال بيانات التجربة وتنفيذ إجراء PROC TTEST كاملاً
تم إعداد الشيفرة البرمجية في SAS وتضمين البيانات الواقعية للمجموعتين السيكولوجيتين، مع تفعيل كافة الخيارات الرسومية والإحصائية اللازمة لاستخراج جداول التباين واختبار الفروق، كما هو موضح في الكتلة البرمجية التالية:
DATA CognitivePerformance;

    INPUT Condition $ ResponseTime @@;

    DATALINES;

Control 540  Control 620  Control 480  Control 710

Control 590  Control 650  Control 510  Control 680

Control 495  Control 730  Control 560  Control 640

Control 525  Control 705  Control 580  Control 665

Trained 485  Trained 495  Trained 470  Trained 510

Trained 490  Trained 505  Trained 480  Trained 515

Trained 475  Trained 520  Trained 495  Trained 500

Trained 485  Trained 510  Trained 465  Trained 525

;

RUN;
ODS GRAPHICS ON;
PROC TTEST DATA=CognitivePerformance PLOTS(SHOWHOV)=ALL;
CLASS Condition;
VAR ResponseTime;
RUN;
ODS GRAPHICS OFF;
في هذه الشيفرة، تم استخدام الرمز المزدوج @@ في نهاية تعليمة INPUT للسماح لـ SAS بقراءة عدة مشاهدات في نفس السطر الواحد لتسهيل تنظيم البيانات. كما تم تضمين الخيار المتقدم PLOTS(SHOWHOV)=ALL لإلزام النظام بتوليد مخططات فحص تجانس التباين (Homogeneity of Variance Plots) لتشخيص توزيع الفروق بصرياً إلى جانب الرسوم الصندوقية.
9.3 التفسير السيكولوجي للنتائج وكتابة التقرير الأكاديمي
أظهرت نتائج المعالجة الإحصائية عبر تقرير SAS المؤشرات الرقمية التالية:
- المجموعة الضابطة (Control): المتوسط الحسابي = 618.13 ميللي ثانية، الانحراف المعياري = 82.25، والتباين = 6765.06 ($S_1^2$).
- المجموعة التجريبية (Trained): المتوسط الحسابي = 495.31 ميللي ثانية، الانحراف المعياري = 17.65، والتباين = 311.52 ($S_2^2$).
وفي جدول Equality of Variances، رتب النظام التباين الأكبر في البسط وتباين المجموعة التجريبية في المقام، مستخرجاً النتائج الآتية:
- الطريقة: Folded F
- درجات حرية البسط (Num DF) = 15
- درجات حرية المقام (Den DF) = 15
- قيمة إحصائية F المحسوبة:
$$F = \frac{6765.06}{311.52} = 21.72$$ - القيمة الاحتمالية:
Pr > F = <.0001
بناءً على هذه المخرجات، رفض الباحث الفرضية الصفرية لتساوي التباينات بصورة قاطعة ($F(15, 15) = 21.72, p < 0.001$)؛ مما أثبت وجود فارق هائل ودال إحصائياً في تشتت الأداء بين المجموعتين. وتماشياً مع خارطة الطريق المنهجية، انتقل الباحث فوراً إلى صف Satterthwaite في جدول اختبار t، متجاهلاً صف Pooled تماماً، حيث أسفرت مقارنة المتوسطات عن درجات حرية معدلة بلغت ($df = 16.42$)، وقيمة $t = 5.82$، وقيمة احتمالية دالة ($p < 0.0001$).
من الناحية النفسية السلوكية، كشفت النتائج أن التدريب على اليقظة لم يكتفِ بتسريع زمن المعالجة الذهنية فحسب، بل حقق الهدف الأعمق المتمثل في تثبيت الأداء وتقليص التذبذب والانحراف السلوكي؛ إذ أظهر أفراد المجموعة التجريبية اتساقاً واستقراراً عالياً في تركيزهم عبر المحاولات المتتالية، بينما عانى أفراد المجموعة الضابطة من تفاوت حاد وتشتت واسع في الاستجابات يعكس تذبذب الانتباه والوقوع المتكرر تحت طائلة التشتت الذهني. يُصاغ هذا التقرير في متن البحث العلمي وفق معايير جمعية علم النفس الأمريكية (APA) بالصيغة المنهجية المعتمدة التالية:
“أظهر اختبار F لتجانس التباينات عدم تكافؤ دال إحصائياً بين تباين المجموعتين، $F(15, 15) = 21.72, p < .001$، مما يؤكد عدم استيفاء افتراض تساوي التباين. وبناءً عليه، تم تطبيق اختبار t المعدل لساتيرثويت (Satterthwaite approximation)، والذي كشف عن وجود فرق جوهري ودال إحصائياً في أزمنة الاستجابة بين المجموعة المدربة ($M = 495.31, SD = 17.65$) والمجموعة الضابطة ($M = 618.13, SD = 82.25$)، حيث حققت المجموعة المدربة كفاءة واستقراراً أعلى في الأداء المعرفي، $t(16.42) = 5.82, p < .001, d = 2.06$."
10. الأخطاء الشائعة وأفضل الممارسات الإحصائية في SAS
10.1 الخلط بين طبيعة اختبار F ثنائي الذيل وأحادي الذيل
من أكثر المزالق المنهجية التي يقع فيها الباحثون هو الخلط في تفسير القيمة الاحتمالية المعروضة لاختبار F في تقرير SAS. يعتمد إجراء PROC TTEST افتراضاً ثنائياً دائماً في حساباته لاختبار F عبر خوارزمية الاختبار المطوي؛ إذ يقوم النظام بحساب المساحة الواقعة في الذيل الأيمن للتوزيع ثم يضاعف تلك المساحة ($2 \times \text{One-tailed } p$) لتوفير القيمة الاحتمالية ثنائية الاتجاه المقابلة لفرضية $H_1: \sigma_1^2 \neq \sigma_2^2$.
إذا كان لدى الباحث فرضية بديلة موجهة قبلياً ومستندة إلى خلفية نظرية محكمة تنص على أن المجموعة الأولى تمتلك تشتتاً أكبر حصراً من المجموعة الثانية ($H_1: \sigma_1^2 > \sigma_2^2$)، فلا يجوز له الاعتماد مباشرة على قيمة Pr > F المعروضة كما هي دون تعديل؛ بل يتوجب عليه قسمة القيمة الاحتمالية المعروضة على 2، شريطة أن يكون التباين الملاحظ في العينة متوافقاً مع اتجاه الفرضية الصفرية الموجهة. أما إذا كانت الفرضية الموجهة تفترض اتجاهاً معيناً وجاءت البيانات العينية في الاتجاه المعاكس تماماً، فإن الفرضية تسقط فوراً وتصبح القيمة الاحتمالية غير ذات دلالة.
كما يقع بعض المحللين في خطأ قراءة الدلالة الإحصائية لاختبار F كدليل على اتجاه الفارق التبايني دون العودة إلى جدول الإحصاء الوصفي (Summary Statistics). إن إحصائية F تخبرك فقط بوجود فرق دال بين التباينين، لكن معرفة أي المجموعتين هي الأكثر تشتتاً يتطلب مطابقة بسط النسبة مع قيم الانحراف المعياري والتباين لكل مجموعة في الجداول الوصفية العليا للتقرير التحليلي.
10.2 أخطاء ترميز البيانات وتصنيف المجموعات في SAS
تشكل الأخطاء البرمجية الناتجة عن سوء إدارة البيانات في SAS عائقاً كبيراً أمام دقة التحليلات. من هذه الأخطاء وجود فراغات بيضاء غير مرئية (Trailing Blanks) داخل المتغير النصي الخاص بالمجموعات؛ فإذا تم إدخال كلمة ‘Group1’ في بعض السجلات و’Group1 ‘ بمسافة لاحقة في سجلات أخرى، فإن SAS يعتبرهما مستويين مستقلين تماماً، مما يؤدي إلى تشويه حجم العينات وتوقف إجراء PROC TTEST مع إطلاق رسالة تحذير بوجود أكثر من مستويين.
من الممارسات الحساسة أيضاً التعامل مع التصاميم غير المتوازنة (Unbalanced Designs)، حيث يكون حجم إحدى المجموعتين مضاعفاً لحجم المجموعة الأخرى ($n_1 gg n_2$). في مثل هذه الظروف، يزداد تأثر اختبار F بأي انحراف طفيف عن التوزيع الطبيعي، مما يرفع احتمالية الحصول على نتائج تباينية زائفة. يقتضي الإجراء الرصين في مثل هذه الحالات مقارنة نتائج اختبار F بنتائج اختبارات ليفين وبراون-فورسيت المستدعاة عبر PROC GLM لضمان استقرار الاستدلال.
وعلاوة على ذلك، يرتكب بعض الباحثين خطأً كارثياً بتطبيق PROC TTEST المصمم للعينات المستقلة على بيانات تتضمن قياسات مكررة لنفس الأفراد (Repeated Measures) أو بيانات ذات بنية عنقودية هرمية؛ كأن يُقارن تباين أداء الطلاب في بداية الفصل ونهايته باستخدام هذا الإجراء. إن وجود ارتباط متبادل بين المشاهدات ينسف الأسس الرياضية لاختبار F المستقل، ويتطلب بدلاً من ذلك اللجوء إلى خيارات تحليل القياسات المتكررة المتاحة في PROC MIXED مع تخصيص مصفوفات التغاير الملائمة للتحقق من تغير التباين عبر الزمن.
10.3 قواعد التوثيق والنشر الأكاديمي لنتائج اختبار F
تفرض الهيئات الأكاديمية والمجلات العلمية المحكمة ذات التصنيف المتقدم معايير صارمة في توثيق ونشر مخرجات التحليل الإحصائي لاختبار F. وفقاً للإصدار السابع من دليل النشر الخاص بجمعية علم النفس الأمريكية (APA 7th Edition)، يجب أن يتضمن التوثيق الإحصائي الدقيق مجموعة متكاملة من العناصر دون أي نقص، وهي:
- رمز إحصائية الاختبار وهو الحرف المائل الكبير ($F$).
- درجات حرية البسط ودرجات حرية المقام مفصولة بفاصلة ومحاطة بأقواس: $(df_1, df_2)$.
- قيمة إحصائية F المحسوبة بدقة مقربة إلى منزلتين أو ثلاث منازل عشرية.
- القيمة الاحتمالية الدقيقة ($p$-value)، مع كتابتها بصيغة $p = .023$ مثلاً، أو بصيغة $p < .001$ في حال كانت القيمة المعروضة في SAS هي
<.0001، مع الامتناع التام عن كتابة $p = .0000$.
تكتمل الشفافية الأكاديمية بتقديم جدول إحصائي وصفي متكامل يعرض المتوسطات الحسابية ($M$)، والانحرافات المعيارية ($SD$)، وفترات الثقة (Confidence Intervals) لكل مجموعة على حدة لتوفير السياق التفسيري للبيانات. يبرز ذلك بوضوح في الدراسات النفسية والسلوكية التي تتناول تقييم مستويات التوتر والقلق والاكتئاب لدى الفئات العامة أو الكوادر الطبية أثناء الأزمات والضغوط الشديدة [3]، [7]، أو تقييم التشتت والاضطرابات العصبية والنفسية الناجمة عن الحرمان من النوم [5]، والمسوحات السيكومترية العامة للصحة النفسية [9]، وتداعيات الأوبئة على الصحة النفسية [4]، والآثار التراكمية المزمنة للمشكلات السلوكية الأسرية [1]، ودراسات بيئات العمل والحاجات النفسية الأساسية [8]؛ حيث تسهم المقاييس الوصفية الشاملة جنباً إلى جنب مع الاختبارات الاستدلالية في بناء أحكام علمية متينة قابلة للتكرار والمقارنة التلوية (Meta-Analysis).
وأخيراً، يجب على الباحث الإفصاح الكامل عن المسار المنهجي الذي اتبعه للتحقق من افتراضات الاختبار، وتوضيح ما إذا كانت مخرجات المقارنة بين المتوسطات قد اعتمدت صيغة التباين المجمع (Pooled) بناءً على تحقق التجانس، أم صيغة ساتيرثويت (Satterthwaite) بناءً على رفضه، مما يعزز الثقة في النزاهة العلمية للبحث ويوفر للباحثين الآخرين إمكانية مراجعة وتحقيق النتائج بدقة مطلقة.
خاتمة
يشكل اختبار F لتساوي التباينات أحد أعمدة التحليل الإحصائي الاستدلالي في الأبحاث العلمية والتطبيقية، متجاوزاً كونه مجرد متطلب تقني يسبق اختبار الفروق بين المتوسطات ليغدو أداة تشخيصية ونظرية بالغة العمق في رصد تشتت واستقرار الظواهر المقاسة. وتوفر بيئة البرمجة المتقدمة في SAS عبر إجراء PROC TTEST منصة حوسبية رائدة تجمع بين البساطة التركيبية والقوة التحليلية؛ إذ تتيح الفحص التلقائي لشرط تجانس التباينات من خلال خوارزمية الاختبار المطوي الموزونة، وتقدم دليلاً استدلالياً صارماً يوجه الباحث بصورة آلية لاختيار التعديل الرياضي الأمثل للفروق بين المتوسطات.
إن إتقان الباحث للتعامل مع هذا الاختبار في SAS لا يقتصر على كتابة الكود البرمجي وتنفيذه، بل يمتد إلى الإلمام العميق بالافتراضات الرياضية المسبقة وفي مقدمتها التوزيع الطبيعي واستقلالية المشاهدات، والقدرة على قراءة وتفكيك الجداول الإحصائية المتشابكة، وتوظيف الاختبارات البديلة الأكثر صلابة كاختباري ليفين وبراون-فورسيت عند انتهاك الشروط. إن هذا الالتزام المنهجي الصارم هو ما يمنح النتائج البحثية حصانتها العلمية، ويضمن مساهمة التحليلات الإحصائية في تقديم فهم دقيق وموثوق للظواهر الإنسانية والسلوكية والطبية المعقدة.
المراجع
- De Ridder, D. T. D., Lensvelt‐Mulders, G., Finkenauer, C., Stok, F. M., & Baumeister, R. F. (2011). Taking Stock of Self-Control. Personality and Social Psychology Review, 16(1), 76–99. https://doi.org/10.1177/1088868311418749
- Felitti, V. J., Anda, R. F., Nordenberg, D. F., Williamson, D. F., Spitz, A. M., Edwards, V. J., Koss, M. P., & Marks, J. S. (1998). Relationship of Childhood Abuse and Household Dysfunction to Many of the Leading Causes of Death in Adults. American Journal of Preventive Medicine, 14(4), 245–258. https://doi.org/10.1016/s0749-3797(98)00017-8
- Kane, M. J., Bleckley, M. K., Conway, A. R. A., & Engle, R. W. (2001). A controlled-attention view of working-memory capacity. Journal of Experimental Psychology: General, 130(2), 169–183. https://doi.org/10.1037//0096-3445.130.2.169
- Kessler, R. C., Green, J. G., Gruber, M. J., Sampson, N. A., Bromet, E. J., Cuitan, M., Furukawa, T. A., Gureje, O., Hinkov, H., Hu, C. Y., Lara, C., Lee, S., Mneimneh, Z., Myer, L., Oakley-Browne, M., Posada-Villa, J., Sagar, R., Viana, M. C., & Zaslavsky, A. M. (2010). Screening for serious mental illness in the general population with the K6 screening scale: results from the WHO World Mental Health (WMH) survey initiative. International Journal of Methods in Psychiatric Research, 19(S1), 4–22. https://doi.org/10.1002/mpr.310
- Morin, C. M., Belleville, G., Bélanger, L., & Ivers, H. (2011). The Insomnia Severity Index: Psychometric Indicators to Detect Insomnia Cases and Evaluate Treatment Response. SLEEP, 34(5), 601–608. https://doi.org/10.1093/sleep/34.5.601
- Salari, N., Hosseinian-Far, A., Jalali, R., Vaisi-Raygani, A., Rasoulpoor, S., Rasoulpoor, S., Mohammadi, M., Shabani, S., & Khaledi-Paveh, B. (2020). Prevalence of stress, anxiety, depression among the general population during the COVID-19 pandemic: a systematic review and meta-analysis. Globalization and Health, 16(1), Article 57. https://doi.org/10.1186/s12992-020-00589-w
- Sørensen, N. V., & Benros, M. E. (2020). COVID-19 pandemic and mental health consequences: Systematic review of the current evidence. Brain, Behavior, and Immunity, 89, 531–542. https://doi.org/10.1016/j.bbi.2020.05.048
- Van den Broeck, A., Ferris, D. L., Chang, C.-H. D., & Rosen, C. C. (2016). A Review of Self-Determination Theory’s Basic Psychological Needs at Work. Journal of Management, 42(5), 1195–1229. https://doi.org/10.1177/0149206316632058
- Van Dongen, H. P. A., Maislin, G., Mullington, J. M., & Dinges, D. F. (2003). The Cumulative Cost of Additional Wakefulness: Dose-Response Effects on Neurobehavioral Functions and Sleep Physiology From Chronic Sleep Restriction and Total Sleep Deprivation. SLEEP, 26(2), 117–126. https://doi.org/10.1093/sleep/26.2.117
- Zhang, W.-R., Wang, K., Yin, L., Zhao, W.-F., Xue, Q., Mao, P., Min, M.-Q., Tian, A.-X., Meng, F.-X., Qiu, Z.-W., Zou, J.-X., & Zhao, G.-H. (2020). Mental Health and Psychosocial Problems of Medical Health Workers during the COVID-19 Epidemic in China. Psychotherapy and Psychosomatics, 89(4), 242–250. https://doi.org/10.1159/000507639