
يعد اختبار توكي للفروق ذات الدلالة الحقيقية (Tukey’s Honestly Significant Difference Test) واحداً من أهم الأدوات الإحصائية وأكثرها استخداماً في معالجة إشكالية المقارنات المتعددة، لاسيما في مجالات العلوم السلوكية والنفسية والتربوية والطبية. فعندما يصمم الباحث تجربة تشتمل على ثلاث مجموعات تجريبية أو أكثر، مثل مقارنة فعالية عدة أساليب علاجية نفسية ضد مجموعة ضابطة، يواجه تحدياً منهجياً يتمثل في كيفية تحديد مواضع الاختلاف الفعلية بين هذه المجموعات دون الوقوع في شرك تضخم الخطأ الإحصائي من النوع الأول. إن تطبيق اختبارات المقارنة الثنائية البسيطة بشكل متكرر يؤدي حتماً إلى ارتفاع احتمالية قبول فروق زائفة لا وجود لها في مجتمع الدراسة الأصلي، وهو ما يجعل اللجوء إلى اختبارات بعدية رصينة ومحكمة رياضياً أمراً حتمياً لضمان مصداقية الاستنتاجات العلمية.
ويحتل نظام التحليل الإحصائي ساس (SAS) مكانة رائدة ومرجعية لدى الباحثين ومحللي البيانات الإكلينيكية حول العالم، بفضل ما يوفره من خوارزميات برمجية فائقة الدقة والقدرة على معالجة النماذج الإحصائية المعقدة والتصميمات التجريبية المتوازنة وغير المتوازنة. ولا يقتصر إجراء اختبار توكي عبر نظام ساس على استخراج قيم دلالية صماء، بل يتعداه إلى تقديم منظومة متكاملة من المؤشرات الإحصائية المتقدمة، تشمل فترات الثقة المتزامنة، ومصفوفات الحروف المجمعة لتصنيف المتوسطات، والرسوم البيانية التفاعلية للفروق، بالإضافة إلى التطبيق التلقائي لتعديل توكي-كريمر (Tukey-Kramer) عندما تختلف أحجام العينات بين المجموعات التجريبية.
يهدف هذا الدليل المرجعي الموسع إلى تقديم قراءة متعمقة وشاملة لكيفية تنفيذ واختبار وتفسير نتائج اختبار توكي باستخدام نظام SAS، مع التركيز على التطبيقات السيكومترية والنفسية. وسيتناول المقال المسار الإحصائي والبرمجي المتكامل، بدءاً من المنطلقات النظرية لتوزيع المدى المقيّس وافتراضات تحليل التباين، مروراً بهيكلة مجموعات البيانات واستدعائها، وكتابة الأوامر المتقدمة عبر إجراءات PROC ANOVA و PROC GLM، وصولاً إلى استيعاب مخرجات النظام وتوثيقها بدقة متناهية وفق معايير جمعية علم النفس الأمريكية (APA)، وتجنب المنزلقات المنهجية الشائعة.
1. مدخل نظري إلى المقارنات البعدية واختبار توكي في بحوث علم النفس
1.1 طبيعة اختبار توكي للفروق ذات الدلالة الحقيقية (Tukey’s HSD)
يمثل اختبار توكي للفروق ذات الدلالة الحقيقية، المعروف اختصاراً باسم اختبار Tukey’s HSD، إجراءً إحصائياً بعدياً صممه عالم الإحصاء الأمريكي جون توكي (John W. Tukey) في منتصف القرن العشرين، لمعالجة معضلة المقارنات الزوجية المتعددة التي تعقب تطبيق تحليل التباين الأحادي. يقوم الأساس النظري للاختبار على مقارنة جميع أزواج المتوسطات الممكنة في التجربة دفعة واحدة، مع تثبيت احتمال ارتكاب الخطأ من النوع الأول عند المستوى الاسمي المختار مسبقاً، والذي يحدد عادة عند مستوى دلالة 0.05. وتستند حسابات الاختبار إلى توزيع رياضي يعرف باسم توزيع المدى المقيّس للدرجات الطلابية (Studentized Range Distribution)، وهو التوزيع الاحتمالي للفرق بين أكبر وأصغر قيمة في عينة مأخوذة من مجتمع طبيعي، مقسوماً على التقدير المستقل للانحراف المعياري للخطأ المشترك.
تتجلى الأهمية المنهجية لاختبار توكي في كونه إجراءً بعدياً مشروطاً برفض الفرضية الصفرية العامة في اختبار تحليل التباين (ANOVA). فعندما يشير اختبار التباين إلى وجود تباين دال إحصائياً بين المجموعات المدروسة، يظل الباحث عاجزاً عن معرفة أصل هذا التباين، هل يرجع إلى تفوق المجموعة الأولى على الثانية، أم تباين الثالثة عن الأولى والثانية معاً. هنا يتدخل اختبار توكي كأداة تشريحية دقيقة لعزل وتحديد أزواج المجموعات التجريبية المسؤولة عن هذا التباين الإجمالي، من خلال حساب قيمة حرجة موحدة تُعرف باسم الفرق ذي الدلالة الحقيقية، وتُقارن الفروق المطلقة بين متوسطات المجموعات بهذه القيمة لتحديد مدى دلالتها.
في سياق بحوث علم النفس والعلوم السلوكية، يكتسب هذا الاختبار مكانة مركزية نظراً لطبيعة المتغيرات السيكولوجية التي تخضع للتجريب. فعند دراسة متغيرات مثل القلق، أو الاكتئاب، أو مهارات المعالجة المعرفية، يتعامل الباحث مع درجات حساسة ومعقدة تتأثر بالعديد من العوامل العشوائية والبيئية. ويوفر اختبار توكي ضمانة منهجية تحمي الدراسات النفسية من استنتاج فروق علاجية واهية، مما يمنح الممارسين الإكلينيكيين أساساً متيناً للبناء عليه عند اعتماد بروتوكولات التدخل العلاجي أو برامج التأهيل المعرفي.
1.2 الفرق بين اختبار التباين الأحادي واختبارات المقارنات الثنائية المتعددة
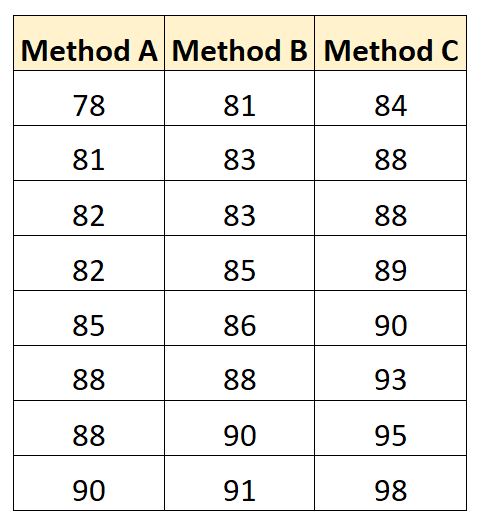
يقتصر اختبار تحليل التباين الأحادي (One-Way ANOVA) على اختبار فرضية صفرية شاملة مؤداها أن جميع متوسطات مجتمعات المجموعات التجريبية متساوية تماماً. ورغم القوة الإحصائية الكبيرة التي يتمتع بها اختبار فاء (F-test) في رصد التشتت بين المجموعات مقارنة بالتشتت داخلها، فإنه يعاني من عجز بنيوي أصيل؛ إذ يقدم استدلالاً كلياً يخبرنا فقط بوجود اختلاف في مكان ما داخل التصميم التجريبي، دون أن يقدم أي إشارة صريحة إلى موقع هذا الاختلاف أو اتجاهه. ولتجاوز هذه المحدودية، قد يلجأ بعض الباحثين غير المتمرسين إلى إجراء سلسلة من اختبارات “ت” للمجموعات المستقلة (Independent Samples t-tests) بين كل زوج من المجموعات، وهو مسار ينطوي على مخاطر إحصائية جسيمة.
يكمن الخطر الأكبر في استخدام اختبارات “ت” المتكررة في ظاهرة التراكم الرياضي للخطأ الإحصائي، والمعروفة باسم تضخم معدل الخطأ من النوع الأول. فإذا كان الباحث يدرس أربع مجموعات علاجية، فإن عدد المقارنات الثنائية المحتملة يصل إلى ست مقارنات زوجية. وإذا تم اختبار كل مقارنة بمستوى ألفا يساوي 0.05، فإن احتمال ارتكاب خطأ واحد على الأقل من النوع الأول لا يعود 5%، بل يقفز وفق الصيغة الاحتمالية لحساب الخطأ التراكمي إلى ما يقارب 26.5%. هذا التضخم الدراماتيكي يجعل الباحث يزعم وجود فروق جوهرية ذات دلالة بين علاجات نفسية متماثلة في الواقع، مما يهدر المعايير العلمية للضبط التجريبي.
لحل هذا الإشكال، طور علماء الإحصاء مفهوم معدل الخطأ العائلي، المعروف بمصطلح Family-Wise Error Rate ويرمز له اختصاراً بـ FWER. ويعبر هذا المفهوم عن الاحتمال الإجمالي لارتكاب خطأ إحصائي واحد أو أكثر من النوع الأول عبر جميع المقارنات التي تنتمي إلى نفس عائلة الفرضيات داخل التجربة. وتتجلى عبقرية اختبار توكي في قدرته الرياضية الصارمة على تثبيت معدل الخطأ العائلي عند المستوى الاسمي المحدد بدقة، مما يتيح للباحث في علم النفس فحص فعالية التدخلات العلاجية المتعددة والجرعات الدوائية أو السلوكية المختلفة، دون أي قلق من تزييف الدلالة الإحصائية أو تضخيم النتائج الإيجابية الكاذبة.
1.3 مبررات اختيار اختبار توكي مقارنة بالاختبارات البعدية الأخرى
تتنوع الاختبارات البعدية المتاحة في برمجيات التحليل الإحصائي، وتتفاوت فيما بينها من حيث مستويات التحفظ والجرأة في رصد الفروق، مما يضع الباحث السلوكي أمام معضلة المفاضلة المنهجية. فعلى سبيل المثال، يعد تعديل بونفيروني (Bonferroni) إجراءً شديد التحفظ يعتمد على تقسيم مستوى الدلالة ألفا على العدد الكلي للمقارنات؛ ورغم بساطة هذا الإجراء، فإنه يؤدي إلى انخفاض حاد في القوة الإحصائية (Statistical Power)، مما يرفع بصورة خطيرة احتمال ارتكاب الخطأ من النوع الثاني، أي الفشل في اكتشاف فروق حقيقية قائمة بالفعل بين العلاجات النفسية. ومن جهة أخرى، يتميز اختبار شيفيه (Scheffé) بمرونة فائقة تسمح باختبار التباينات الخطية المعقدة (Complex Contrasts)، إلا أن هذا الاتساع يجعله فائق التحفظ عندما تقتصر رغبة الباحث على المقارنات الزوجية البسيطة فقط.
يمثل اختبار توكي نقطة التوازن الذهبية بين هذه الاختبارات المتنافسة؛ فهو ليس مفرط التحفظ مثل شيفيه وبونفيروني، وليس متساهلاً بصورة غير مأمونة مثل اختبار الفرق الأقل دلالة لفيشر (Fisher’s LSD) الذي يفشل تماماً في ضبط معدل الخطأ العائلي عندما يتجاوز عدد المجموعات ثلاثاً. يمتلك اختبار توكي قوة إحصائية مثالية في رصد المقارنات البعدية الزوجية البسيطة بين المتوسطات، حيث يمنح الباحث أعلى حساسية ممكنة لاكتشاف الفروق الحقيقية، مع فرض سيطرة حديدية على معدل FWER في الوقت ذاته، مما يجعله الخيار الأول والأكثر توصيفاً في الأدبيات المنهجية للبحوث السلوكية.
علاوة على ذلك، يتميز اختبار توكي بقابلية رياضية للتكيف مع التصميمات التجريبية المتوازنة والتصميمات غير المتوازنة عبر امتداد توكي-كريمر (Tukey-Kramer Method)، وهو التعديل الذي أتاح المقارنة الدقيقة بين المجموعات التي تختلف في أحجام عيناتها دون الإخلال بتوزيع الخطأ. وفي بيئة دراسات التجريب السلوكي المخبري، حيث تخضع المتغيرات لضبط صارم وتقاس الاستجابات وفق أدوات دقيقة كأزمنة الرجع أو درجات الانتباه التنفيذي، يوفر اختبار توكي الشفافية الرياضية الموثوقة التي تشترطها الدوريات العلمية المحكمة لنشر النتائج التجريبية.
2. الافتراضات الإحصائية الواجب استيفاؤها قبل تطبيق اختبار توكي في SAS
2.1 افتراض استقلالية الملاحظات والقياسات
يقف افتراض استقلالية الملاحظات والقياسات على رأس الشروط المنهجية التي لا تقبل المساومة في تحليل التباين والاختبارات البعدية المشتقة منه. ويعني هذا الافتراض من الناحية الرياضية أن القيمة المقاسة لأي مشارك في التجربة لا تؤثر بأي شكل من الأشكال على القيمة المقاسة لأي مشارك آخر داخل نفس المجموعة أو عبر المجموعات المختلفة، وأن التباين المشترك للخطأ بين المشاهدات يساوي صفراً. وفي التصميمات النفسية، يتحقق هذا المطلب جوهرياً من خلال التطبيق الصارم للتخصيص العشوائي للمشاركين (Random Assignment) على الظروف التجريبية والضابطة، مما يضمن خلو البيانات من أي تحيز منهجي ناجم عن الاختيار الذاتي أو التأثيرات البيئية المتبادلة.
إن انتهاك افتراض الاستقلالية يؤدي إلى انهيار النموذج الإحصائي بأكمله، حيث يترتب على وجود ارتباط داخلي بين القياسات انخفاض تقدير تباين الخطأ الحقيقي، وهو ما يقود إلى انتفاخ قيم اختبارات الدلالة وظهور نتائج زائفة بشكل يصعب تصحيحه رياضياً. تتجلى هذه المشكلة بوضوح عند دراسة أفراد ينتمون إلى وحدات اجتماعية متفاعلة كالفصول الدراسية أو مجموعات العلاج النفسي الجمعي، أو عند قياس استجابة نفس المشارك عبر جلسات علاجية متعددة دون إدراج عامل الوقت كمتغير للقياسات المتكررة؛ إذ تصبح القياسات مرتبطة ومترابطة ذاتياً.
لمعالجة غياب الاستقلالية في بيئة الدراسات النفسية الإكلينيكية، يتعين على الباحث التحول من النماذج الخطية الكلاسيكية البسيطة إلى النماذج الخطية المختلطة (Linear Mixed Models) باستخدام إجراء PROC MIXED في ساس. يتيح هذا الإجراء نمذجة مصفوفات التباين والتباين المشترك للبيانات المرتبطة، وتعيين التأثيرات العشوائية للمشاركين أو البيئات العلاجية بدقة، مما يتيح إجراء مقارنات بعدية معدلة تتوافق مع طبيعة البيانات المتداخلة وتضمن سلامة الاستدلال الإحصائي.
2.2 افتراض التوزيع الطبيعي للمتغير التابع
يقضي افتراض التوزيع الطبيعي بضرورة أن تتبع درجات المتغير التابع التوزيع الطبيعي المعياري (الاعتدالي) داخل كل مجتمع من المجتمعات التجريبية التي سحبت منها العينات. وفي دراسات علم النفس السريري، تمثل درجات المقاييس السيكومترية كاختبارات الاكتئاب أو القلق أو التوافق المهني المتغير التابع الخاضع للفحص. ولا يطلب التحليل الإحصائي اعتدالية البيانات الكلية مجتمعة، بل اعتدالية توزيع البواقي (Residuals) أو توزيع الدرجات داخل كل مستوى تصنيفي للمتغير المستقل على حدة.
للتحقق من هذا الشرط داخل بيئة SAS البرمجية، يعتمد الباحث على الإجراء الفعال PROC UNIVARIATE، الذي يوفر حزمة متكاملة من الاختبارات الإحصائية الوصفية والاستدلالية، ومن أبرزها اختبار شابيرو-ويلك (Shapiro-Wilk) الموصى به بشدة للعينات الصغيرة والمتوسطة، واختبار كولموجوروف-سميرنوف (Kolmogorov-Smirnov) للعينات الكبيرة. بالإضافة إلى ذلك، يتيح SAS توليد رسوم الاحتمال الطبيعي (Q-Q plots)، حيث يعد اصطفاف النقاط التجريبية على طول الخط القطري المستقيم مؤشراً بصرياً قاطعاً على تحقق فرضية التوزيع المعتدل.
وعلى الرغم من الأهمية النظرية لهذا الفرض، يتميز اختبار توكي بدرجة ملحوظة من الصلابة الإحصائية (Robustness) تجاه الانحرافات الخفيفة إلى المعتدلة عن التوزيع الطبيعي، خاصة إذا كانت أحجام العينات متساوية وتتجاوز ثلاثين مشاركاً في كل مجموعة، استناداً إلى مبرهنة النهاية المركزية (Central Limit Theorem). ومع ذلك، إذا كانت البيانات النفسية تعاني من التواء حاد (Severe Skewness) أو تفرطح شاذ ناتج عن تأثيرات السقف والقاع، يصبح لزاماً على الباحث اللجوء إلى التحويلات الرياضية كتحويل اللوغاريتم، أو استخدام البدائل اللامعلمية لتفادي التفسيرات المضللة.
2.3 افتراض تجانس التباين (Homogeneity of Variance)
يفرض اختبار التباين الأحادي واختبار توكي المعياري شرطاً حيوياً يتمثل في تجانس التباين عبر المجموعات التجريبية (Homoscedasticity). ويعني هذا الافتراض أن تباين الخطأ في درجات المتغير التابع متماثل ومتساوٍ تقريباً داخل مجتمعات جميع المجموعات قيد المقارنة. تنبع الأهمية الرياضية لهذا الافتراض من كون معادلة توكي تعتمد على تقدير تباين موحد مستمد من متوسط مربعات الخطأ داخل المجموعات (Mean Square Error – MSE) في جدول ANOVA، كقاسم مشترك لتقدير الخطأ المعياري، وإذا كان التباين الحقيقي يختلف جذرياً من مجموعة إلى أخرى، فإن هذا التقدير المجمع يفقد دلالته وصلاحيته.
يمكن التحقق من شرط تجانس التباينات في برنامج SAS بمنتهى السهولة من خلال إضافة خيار اختبار ليفين (Levene’s Test) عبر جملة MEANS أو عبر إجراءات النمذجة المتقدمة. يختبر ليفين الفرضية الصفرية القائلة بتساوي تباينات المجموعات، وبالتالي فإن الحصول على قيمة احتمالية (p-value) أكبر من 0.05 يشير إلى تحقق فرضية التجانس بأمان. كما يوفر SAS اختبارات بديلة مرافقة مثل اختبار أوبراين (O’Brien) واختبار براون-فورسيث (Brown-Forsythe) لتدعيم القرار الإحصائي في الحالات الحدية.
وعند انتهاك فرض تجانس التباين مع تفاوت أحجام العينات، تصبح نتائج اختبار توكي التقليدي غير دقيقة وتفقد قدرتها على ضبط معدل الخطأ العائلي؛ إذ تؤدي إلى نتائج بالغة التحرر إن كانت العينات الأصغر هي الأكبر تبايناً، أو بالغة التحفظ إن كانت العينات الأكبر هي الأكثر تبايناً. وفي هذه البيئة المضطربة، ينصح علماء المنهجية بالانتقال إلى إجراءات لا تشترط تجانس التباين، مثل اختبار جيمس-هاويل (Games-Howell Test) أو اختبار دن-سيداك المعدل مع تحليل ويلش للتباين (Welch’s ANOVA)، وهي خيارات متقدمة يمكن تنفيذها بدقة داخل نظام SAS البرمجي.
3. إعداد وهيكلة البيانات النفسية داخل نظام SAS البرمجي
3.1 بناء مجموعة البيانات باستخدام جملة DATA وتنسيق المتغيرات
تبدأ الممارسة التحليلية الرصينة في نظام SAS ببناء مجموعة البيانات بصورة منضبطة ومطابقة لقواعد البرمجة الإحصائية. يتم إنشاء مجموعات البيانات عبر جملة DATA التي تمنح الملف اسماً تعريفياً يُحفظ في الذاكرة المؤقتة لمكتبة العمل (WORK Library) أو في مكتبة دائمة يحددها المستخدم. وفي سياق البحوث السيكولوجية، تتطلب المعالجة الناجحة تعريف متغير تصنيفي يمثل المجموعات العلاجية أو التجريبية (Independent Variable)، ومتغير متصل يقيس الدرجات السلوكية أو النفسية للمفحوصين (Dependent Variable).
يتم إدخال البيانات المجمعة من العينات النفسية مباشرة داخل بيئة المحرر باستخدام جملة DATALINES أو جملة CARDS التي تلي جملة الإدخال INPUT. ومن الضروري للباحث الانتباه إلى تعيين الخصائص المورفولوجية للمتغيرات بدقة متناهية؛ فإذا كان المتغير التصنيفي نصياً كأن يعبر عن أسماء العلاجات مثل سلوكي أو معرفي أو دوائي، يجب إلحاق اسم المتغير بعلامة الدولار في سطر الإدخال ليعرفه البرنامج كمتغير حرفي (Character Variable)، مع تحديد الطول التخزيني المناسب لتفادي بتر أسماء المجموعات.
وللتأكد القاطع من سلامة بنية البيانات المدخلة وخلوها من أخطاء التحول العمودي أو الإزاحة التنسيقية، يجب تشغيل الإجراء الاستطلاعي PROC PRINT فور الانتهاء من خطوة البناء. يقوم هذا الإجراء بعرض جدول تفصيلي للمشاهدات المدخلة، مما يتيح للباحث التحقق بالعين المجردة من صحة اقتران درجات المقاييس النفسية بالفئات التجريبية الصحيحة، والتأكد من عدم وجود بيانات مفقودة غير مقصودة نشأت عن أخطاء مطبعية أثناء الإدخال.
3.2 استيراد البيانات الخارجية من ملفات Excel و CSV إلى مكتبات SAS
في الدراسات النفسية الميدانية والمشاريع البحثية الواسعة، نادراً ما يدخل الباحثون البيانات يدوياً عبر محرر الأكواد؛ بل يتم تجميعها وتفريغها عادة في ملفات جداول البيانات الإلكترونية كملفات Microsoft Excel أو الملفات النصية المفصولة بفواصل من نوع CSV. يمتلك برنامج SAS مرونة استثنائية في سحب واستيراد هذه المصفوفات الخارجية عبر الإجراء المتخصص PROC IMPORT، والذي يختزل عمليات المعالجة اليدوية المعقدة في خطوات برمجية محكمة ومباشرة.
تتطلب كتابة كود PROC IMPORT تحديد مسار الملف الفيزيائي بدقة باستخدام جملة DATAFILE، متبوعة بالامتداد الصحيح للملف، وتحديد صيغة الإدخال عبر خيار DBMS كأن نكتب EXCEL أو CSV. كما تتضمن الأوامر جملة OUT لتسمية مجموعة البيانات الناتجة في SAS، وجملة GETNAMES=YES لضمان قراءة الصف الأول من الملف كمسميات رسمية للمتغيرات النفسية والديموغرافية، مما يحافظ على وضوح المعالجة وتكامل التعريفات السيكومترية.
يرافق استيراد البيانات الخارجية تحدٍ منهجي يتمثل في معالجة القيم المفقودة (Missing Values) التي تنشأ بكثرة في الاستبانات السيكولوجية نتيجة تغيب المشاركين أو رفضهم الإجابة عن بعض البنود الحساسة. يتعامل نظام SAS مع القيم المفقودة بوضع نقطة للمتغيرات الرقمية أو مسافة بيضاء للمتغيرات الحرفية، ويجب على الباحث تفحص سجل الأحداث (SAS Log) للتأكد من خلو مصفوفة التحليل من حالات الفقد غير المتوقعة، إذ إن وجود حالات مفقودة في المتغير التابع يؤدي تلقائياً إلى استبعاد المشارك من تحليل التباين والمقارنات البعدية اللاحقة.
3.3 استكشاف البيانات وفحص الإحصاءات الوصفية الأولية
يشكل الاستكشاف الإحصائي الأولي للبيانات خطوة إلزامية تسبق أي اختبار استدلالي؛ إذ يوفر فهماً بصرياً ورقمياً لسلوك المتغيرات ويحمي التحليل من التفسيرات المشوهة. يبرز إجراء PROC MEANS كأداة لا غنى عنها لحساب المتوسطات الحسابية والانحرافات المعيارية والخطأ المعياري، بالإضافة إلى الحدود الدنيا والعليا للدرجات النفسية مقسمة حسب كل مجموعة تجريبية. ويتم ذلك بتمرير المتغير التصنيفي ضمن جملة CLASS وتحديد المتغير التابع في جملة VAR.
ولدراسة الخصائص التوزيعية بشكل أكثر تعمقاً، يوفر إجراء PROC UNIVARIATE تفاصيل دقيقة تشمل مؤشرات النزعة المركزية، والوسيط، والمدى الربيعي، بالإضافة إلى قيم الالتواء (Skewness) والتفرطح (Kurtosis). وتعتبر هذه المؤشرات جوهرية للحكم المبدئي على مدى اقتراب توزيع درجات القلق أو الأداء المعرفي من الشكل الجرسي المعتدل، والتأكد من خلو البيانات من القيم المتطرفة الشاذة (Outliers) التي قد تجر المتوسط الحسابي وتؤثر سلباً على قرارات اختبار توكي اللاحقة.
تسهم قراءة هذه الجداول الوصفية الأولية في تكوين رؤية مبكرة للباحث حول الفروق الظاهرية بين طرق التدريب أو الأساليب العلاجية المفحوصة. فعندما يلاحظ الباحث أن متوسط إحدى المجموعات يبتعد بمقدار انحراف معياري كامل عن المجموعات الأخرى مع انخفاض التشتت الداخلي، تتولد لديه مؤشرات أولية تدعم فرضيات البحث وتساعده على التحقق اللاحق من اتساق نتائج المقارنات البعدية المعقدة مع الصورة الواقعية للمشاهدات.
4. تنفيذ اختبار التباين الأحادي (One-Way ANOVA) كمرحلة أولى
4.1 كتابة وتنفيذ إجراء PROC ANOVA للتصميمات المتوازنة
صُمم إجراء PROC ANOVA في بيئة SAS خصيصاً للتعامل السريع وعالي الكفاءة مع التصميمات التجريبية المتوازنة كلياً (Balanced Designs)، والتي يتساوى فيها عدد أفراد العينة تماماً في كل مجموعة تجريبية. ويعتمد هذا الإجراء على الخوارزميات الحسابية التقليدية لمجموع المربعات، مما يجعله فائق السرعة وأقل استهلاكاً لموارد النظام عند تحليل البيانات الضخمة الناتجة عن التجارب المعملية المقننة التي تضمن بقاء أعداد المشاركين متماثلة طوال فترة الدراسة.
تتألف البنية البرمجية الأساسية لإجراء PROC ANOVA من تحديد مجموعة البيانات عبر خيار DATA، متبوعة بجملة CLASS الإلزامية التي يحدد فيها الباحث المتغير المستقل الفئوي الذي يقسم المشاركين، مثل نوع العلاج أو طريقة التدريب. تلي ذلك جملة النموذج MODEL التي تصاغ وفق الترتيب الرياضي الصارم: المتغير التابع = المتغير المستقل. وبدون تحديد جملة CLASS بدقة، سيعامل البرنامج المتغير التصنيفي كمتغير كمي مستمر، مما يؤدي إلى فشل التحليل أو إصدار نتائج تحليل انحدار خطي بدلاً من تحليل التباين.
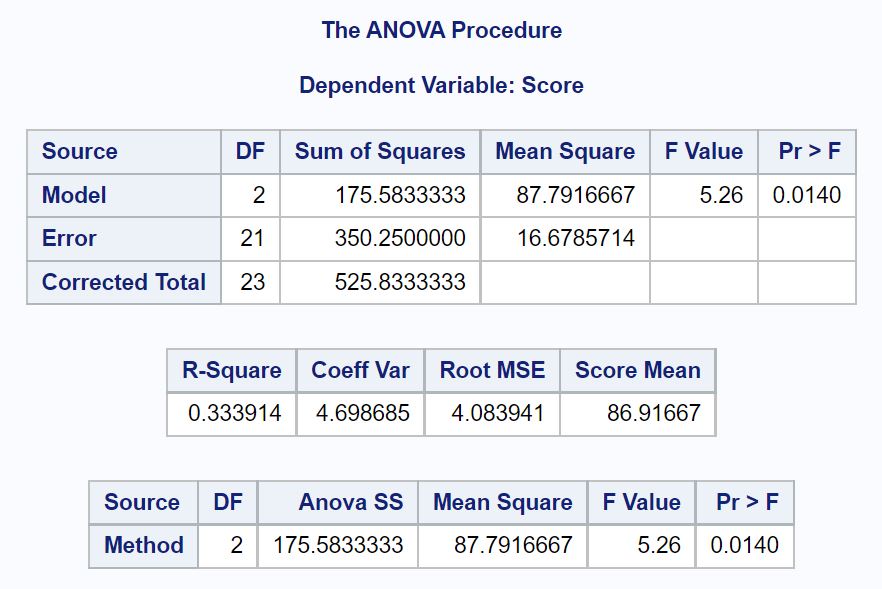
يقدم جدول مخرجات PROC ANOVA تقييماً شاملاً للنموذج التجريبي؛ حيث يبرز في واجهة الجدول مصدر التباين الكلي مقسماً إلى التباين بين المجموعات (Model) والتباين داخل المجموعات (Error)، مقترناً بدرجات الحرية ومجموع المربعات ومتوسط المربعات. ويتمثل المؤشر الحاسم هنا في قيمة اختبار فاء المحسوبة (F Value) والقيمة الاحتمالية المقترنة بها (Pr > F)؛ فإذا كانت القيمة الاحتمالية أقل من مستوى الدلالة المعتمد، يتم رفض الفرضية الصفرية العامة والتأكد من وجود تباين دال يعزى للمعالجة التجريبية.
4.2 كتابة وتنفيذ إجراء PROC GLM للتصميمات غير المتوازنة
تتميز البحوث النفسية والسريرية الميدانية بصعوبة الحفاظ على توازن أعداد المشاركين، حيث تؤدي ظروف التسرب الإكلينيكي أو غياب بعض المرضى عن جلسات القياس البعدي إلى وجود تفاوت في أحجام العينات (Unbalanced Data). وفي هذه الحالة الشائعة، يصبح استخدام إجراء PROC ANOVA خطأً منهجياً فادحاً يرفضه التحكيم العلمي؛ لأن خوارزمياته تعجز عن ضبط التداخل بين مجموع المربعات عند اختلال التوازن، وهنا تبرز الأهمية القصوى لإجراء النموذج الخطي العام PROC GLM (General Linear Model).
يوظف إجراء PROC GLM تقنية مجموع المربعات الجزئية من النوع الثالث (Type III Sum of Squares)، والتي تختبر التأثير الإحصائي لكل متغير بعد استبعاد آثار جميع المتغيرات الأخرى في النموذج، وهي المقاربة المعتمدة رياضياً لمعالجة البيانات غير المتوازنة. وتماثل صياغة الكود البرمجي في PROC GLM نظيرتها في PROC ANOVA من حيث استخدام جملتي CLASS و MODEL، إلا أن GLM يوفر بنية تحتية برمجية أعمق وأدق تمكنه من تقدير المتوسطات المعدلة وضبط التباينات المتباينة بكفاءة مطلقة.
يمثل التحقق من دلالة مصدر التباين بين المجموعات في مخرجات PROC GLM الشرط المنهجي الذي لا غنى عنه قبل الإقدام على قراءة وتفسير أي اختبارات بعدية. وتتيح دراسة قيم Type III F للباحث النفسي التيقن من أن المتغير المستقل يفسر نسبة معتبرة من التباين في السلوك المفحوص، بعد تحييد الخلل الناجم عن التفاوت العددي بين عينات المجموعات، مما يمنحه أرضية إحصائية صلبة للشروع في تفكيك الفروق الثنائية.
4.3 الربط المنطقي بين نتيجة دلالة F وتطبيق اختبار المقارنات البعدية
تحكم الانتقال من اختبار التباين الأحادي إلى اختبار المقارنات البعدية قاعدة قرار إحصائي صارمة تُعرف في المنهجية العلمية بشرط حماية الدلالة العامة؛ حيث ينص المسار المنطقي الكلاسيكي على عدم جواز فحص المقارنات البعدية إلا في حالة رفض الفرضية الصفرية في اختبار فاء الإجمالي عند مستوى الدلالة المحدد. إن تجاهل هذه القاعدة والشروع في قراءة المقارنات البعدية رغم غياب الدلالة في النموذج الكلي يمثل انتهاكاً لأصول الاستدلال الإحصائي؛ إذ يرفع احتمالية التقاط فروق كاذبة أفرزها التوزيع العشوائي للمشاهدات.
في المقابل، إذا جاءت قيمة F غير دالة إحصائياً، يتعين على الباحث التوقف منهجياً وقبول الفرضية الصفرية التي تقضي بعدم وجود فروق بين المجموعات التجريبية. وتجدر الإشارة إلى أن بعض الإحصائيين يرون استقلال اختبار توكي رياضياً بفضل اعتماده على توزيع المدى المقيّس الذي يضبط الخطأ العائلي ذاتياً، إلا أن الممارسة المستقرة في بحوث علم النفس تتطلب الالتزام بالتدرج الهرمي لحماية التصميم التجريبي من أي ادعاء مضلل.
ولا تكتمل الرؤية الإحصائية للنموذج الإجمالي بمجرد تسجيل الدلالة الإحصائية، بل يجب على الباحث توثيق حجم الأثر (Effect Size) للنموذج، والمعبر عنه عادة بقيمة إيتا المربعة (Eta Squared) أو إيتا المربعة الجزئية (Partial Eta Squared). يوضح حجم الأثر النسبة المئوية للتباين في المتغير التابع التي استطاع التدخل العلاجي أو التجريبي تفسيرها، مما يوفر بعداً عملياً مكملاً للدلالة الإحصائية؛ فالأثر قد يكون دالاً إحصائياً ولكنه تافه من الناحية السيكولوجية والواقعية إذا كانت قيمته متدنية للغاية.
5. خطوات إجراء اختبار توكي باستخدام جملة MEANS في SAS
5.1 بناء الكود البرمجي وإضافة خيار TUKEY في جملة MEANS
يمثل استخدام جملة MEANS المقترنة بخيار TUKEY الأسلوب الكلاسيكي المباشر لاستدعاء اختبار توكي في إجراءي PROC ANOVA و PROC GLM داخل بيئة SAS. تتم صياغة هذا الأمر عبر إدراج جملة MEANS متبوعة باسم المتغير التصنيفي المحدد مسبقاً في جملة CLASS، ثم وضع خط مائل (Slash) لإلحاق الخيارات الإحصائية المطلوبة، وفي مقدمتها الخيار المرجعي TUKEY. يعطي هذا الأمر تعليمات صريحة لمعالج SAS الحسابي بتطبيق معادلات المدى المقيّس على جميع التباديل الزوجية الممكنة لمتوسطات المجموعات.
يتيح البرنامج مرونة كاملة في تحديد مستوى الدلالة الإحصائية المعتمد؛ فرغم أن النظام يضبط القيمة الافتراضية لألفا عند 0.05، يمكن للباحث تعديل هذا المستوى بما يلائم متطلبات دراسته عبر إضافة خيار ALPHA=0.01 أو أي قيمة أخرى ضمن جملة MEANS. وتعتمد الخوارزمية الداخلية لساس عند تنفيذ هذا الخيار على استخراج القيمة الحرجة لتوزيع المدى المقيّس بناءً على درجات حرية الخطأ ومجموع المربعات المستخرج من جدول ANOVA، لتقييم الفروق الظاهرية بين المتوسطات الحسابية الخام المسجلة في العينة.
يوضح الكود التالي البنية النموذجية لإجراء التحليل باستخدام جملة MEANS في بيئة عمل ساس:
PROC ANOVA DATA=PsychStudy;
CLASS TreatmentGroup;
MODEL AnxietyScore = TreatmentGroup;
MEANS TreatmentGroup / TUKEY ALPHA=0.05;
RUN;
يقوم هذا التنفيذ بحساب الفروق بين أزواج المتوسطات الخام، مع إظهار تقييم إحصائي يوضح ما إذا كان الفرق المطلق بين كل زوج يتجاوز القيمة الحرجة المحسوبة، مما يمنح الباحث تقريراً أولياً عالي الدقة عن طبيعة التباينات الملاحظة في دراسته.
5.2 استخدام خيار LINES لتوليد مصفوفة الحروف المجمعة
يعد خيار LINES من أكثر الخيارات شيوعاً وتفضيلاً بين باحثي العلوم السلوكية عند استخدام جملة MEANS في SAS؛ نظراً لقدرته الفائقة على تبسيط قراءة النتائج الإحصائية المعقدة وتلخيصها في مصفوفة بصرية سهلة الفهم تعتمد على الحروف الأبجدية اللاتينية. فعند إضافة خيار LINES إلى جملة MEANS، يقوم النظام بترتيب متوسطات المجموعات تنازلياً أو تصاعدياً، ثم يضع خطوطاً أو يخصص حروفاً تجمع المجموعات التي لا توجد بينها فروق دالة إحصائياً.
تعتمد آلية تفسير مخرجات LINES على قاعدة منطقية حاسمة: المجموعات التي تشترك في نفس الحرف الأبجدي (كأن تحصل المجموعتان الأولى والثانية على الحرف A) هي مجموعات متماثلة إحصائياً ولا يختلف أداؤها المعرفي أو النفسي عن بعضها بدلالة معنوية عند مستوى ألفا المختار. في حين تشير الحروف المنفصلة (كالرمز B أو C) إلى وجود انفصال إحصائي دال يعبر عن تفوق أو تراجع إحدى المجموعات بصورة جوهرية عن نظيراتها.
تتجلى الفائدة المنهجية لمصفوفة LINES في الدراسات التجريبية السلوكية التي تشتمل على عدد كبير من المجموعات التجريبية، كأن تتم مقارنة خمسة أساليب مختلفة للتدريب المعرفي؛ حيث يصعب تتبع الجداول الرقمية المتقاطعة للمقارنات الثنائية. وتوفر هذه المصفوفة التلخيصية نظرة بانورامية سريعة تسهم في تصنيف العلاجات إلى مستويات أداء واضحة المعالم تدعم الصياغة التقريرية لبحث التخرج أو ورقة النشر الأكاديمي.
5.3 استخدام خيار CLDIFF لعرض فترات الثقة والفروق المباشرة
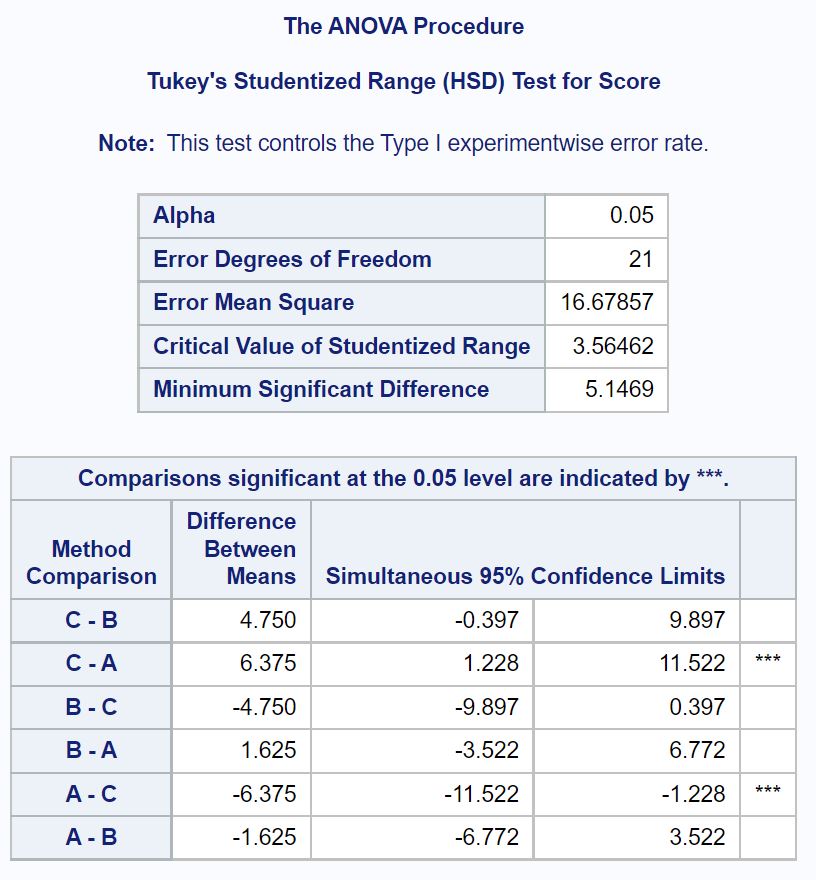
على النقيض من خيار LINES الذي يركز على التصنيف التجميعي، يوفر خيار CLDIFF (Confidence Limits for Differences) تفاصيل كمية دقيقة لا غنى عنها للباحثين المتمرسين الذين يفضلون الاستدلال الإحصائي القائم على التقدير عبر فترات الثقة بدلاً من الاكتفاء باختبار الفرضيات الصفرية النقطية. وعند تضمين خيار CLDIFF في جملة MEANS، ينتج ساس جدولاً تفصيلياً يوضح الفرق الحسابي المباشر بين كل زوج من المجموعات محاطاً بحدود فترة الثقة المتزامنة (الحد الأدنى والحد الأعلى).
تقوم قاعدة اتخاذ القرار الإحصائي عند قراءة مخرجات CLDIFF على فحص اشتمال فترة الثقة على القيمة صفر (Zero)؛ فإذا كانت فترة الثقة المحسوبة للفرق بين مجموعتين تتضمن الصفر داخل نطاقها (كأن تكون الحدود من سالب 1.25 إلى موجب 3.40)، فإن ذلك يعد دليلاً رياضياً قاطعاً على عدم وجود فرق دال إحصائياً بين المجموعتين عند مستوى الثقة المعتمد. أما إذا كانت حدود الفترة موجبة بالكامل أو سالبة بالكامل ولا تشتمل على الصفر، فإن الفرق بين المجموعتين يعتبر دالاً إحصائياً بحسب اختبار توكي.
يوفر خيار CLDIFF ميزة منهجية كبرى مقارنة بمخرجات الحروف المجردة؛ حيث يمنح الباحث تقديراً مباشراً لحجم التباين الفعلي بين المجموعات ومقدار الدقة في هذا التقدير عبر عرض اتساع الفترة. فالفترات الضيقة تشير إلى تقدير عالي الدقة للفروق العلاجية، مما يساعد الطبيب أو الأخصائي النفسي في تقييم الجدوى الإكلينيكية الحقيقية لبرنامج علاجي معين وليس مجرد قيمته الاحتمالية المجردة.
6. إجراء اختبار توكي المتقدم باستخدام جملة LSMEANS في PROC GLM
6.1 مفهوم المتوسطات التوافقية (Least Squares Means) وأهميتها
تعتبر المتوسطات التوافقية أو متوسطات المربعات الصغرى، والمعروفة في بيئة SAS بمصطلح LSMEANS (Least Squares Means)، ركيزة متقدمة من ركائز النمذجة الإحصائية الحديثة في تحليل التباين والتصميمات الخطية العامة. يكمن الفرق الجوهري بين المتوسطات الحسابية الخام (Raw Means) والمتوسطات التوافقية في أن المتوسطات الخام تحسب بجمع الدرجات وقسمتها على عدد أفراد المجموعة ببساطة ودون اعتبار لبنية النموذج التجريبي الكلي، مما يجعلها عرضة للتحيز والتضليل عند اختلال التوازن العددي بين الفئات أو عند وجود متغيرات مرافقة.
في المقابل، تمثل المتوسطات التوافقية LSMEANS تنبؤات النموذج الرياضي لمتوسطات المجموعات بعد تعديلها وموازنتها إحصائياً، وكأن كل خلية من خلايا التصميم التجريبي تحتوي على نفس العدد من المشاهدات. وفي بحوث علم النفس التي تعاني غالباً من عدم تساوي العينات نتيجة التخلف عن المتابعة أو الاستبعاد المنهجي لبعض المشاركين، تصبح هذه المتوسطات المعدلة هي المعيار العلمي الوحيد الصالح للمقارنة الموضوعية والموثوقة.
يقوم إجراء PROC GLM بحساب الأخطاء المعيارية للمتوسطات التوافقية وفق مصفوفة التباين المشترك للنموذج المقدر، مما يتيح اختبار الفروق بينها بدقة إحصائية متناهية لا يمكن للمتوسطات الخام بلوغها. ولهذا السبب، توصي جميع الهيئات الإحصائية العالمية والمراجع الأكاديمية باعتماد جملة LSMEANS كخيار قياسي وأساسي عند إجراء اختبار توكي البعدي في أي تصميم تجريبي غير متوازن.
6.2 صياغة خيارات المقارنة ADJUST=TUKEY في جملة LSMEANS
لتنفيذ اختبار توكي المتقدم في إجراء PROC GLM، يستعين الباحث بجملة LSMEANS متبوعة باسم المتغير التصنيفي وخيارات التعديل المناسبة. تأتي الصياغة النموذجية للأمر على النحو التالي: إضافة الخيار ADJUST=TUKEY لتعريف البرنامج بنوع التصحيح الإحصائي المطلوب للمقارنات المتعددة، مقترناً بالخيار الأساسي PDIFF (Pairwise Differences) الذي يصدر أوامره بتوليد جدول تفصيلي يعرض القيم الاحتمالية المعدلة لجميع المقارنات الثنائية الممكنة بين مستويات المتغير المستقل.
بالإضافة إلى ذلك، يمكن استدعاء خيار CL (Confidence Limits) ضمن جملة LSMEANS للحصول على حدود فترات الثقة المعدلة لكل متوسط ولكل فرق ثنائي وفق توزيع المدى المقيّس لتوكي. وتتجلى قوة هذه الصياغة البرمجية في التوليد الآلي للقيم الاحتمالية الدقيقة والمصححة لتضخم الخطأ العائلي، مما يمكن الباحث من مقارنة هذه القيم مباشرة بمستوى ألفا 0.05 دون الحاجة لإجراء أي حسابات يدوية مجهدة.
يوضح النموذج التالي كود إجراء PROC GLM المعتمد للمقارنات البعدية المتقدمة:
PROC GLM DATA=ClinicalTrials;
CLASS TherapyType;
MODEL DepressionScore = TherapyType;
LSMEANS TherapyType / ADJUST=TUKEY PDIFF CL LINES;
RUN;
QUIT;
يضمن هذا التركيب البرمجي استخراج تحليل متكامل يجمع بين تقدير المتوسطات التوافقية وتوليد فترات الثقة الدقيقة ومصفوفة الحروف التجميعية، مع الضبط التام للبيانات المتفاوتة في أحجامها.
6.3 استخراج الرسومات البيانية التفاعلية للمقارنات البعدية عبر ODS Graphics
يوفر نظام توصيل المخرجات الرسومية في ساس، المعروف باسم ODS Graphics (Output Delivery System)، قدرات تصويرية استثنائية تنقل التحليل الإحصائي من الأطر الرقمية الصماء إلى الفضاء البصري التفاعلي. لتفعيل هذا النظام الرسومي، يقوم الباحث بكتابة الأمر ODS GRAPHICS ON قبل تشغيل إجراء PROC GLM، مما يحفز النظام تلقائياً على إنتاج حزمة من المخططات التوضيحية الجاهزة للنشر والتحليل المتقدم.
من أبرز هذه المخططات ما يُعرف برسم بياني للفروق أو مخطط الفروق المتقاطعة (Diffogram / Mean Differences Plot). يمثل هذا الرسم البياني الفريد شبكة مصفوفية ثنائية الأبعاد، تتقاطع فيها خطوط المتوسطات لكل زوج من المجموعات بزاوية 45 درجة، وتظهر فترات الثقة للفروق كشرائح خطية مائلة. فإذا كانت شريحة فترة الثقة لزوج معين تتقاطع مع الخط المرجعي المحايد (خط الصفر)، يلونها البرنامج بلون باهت يشير إلى غياب الدلالة الإحصائية؛ أما إذا ابتعدت الشريحة عن خط الصفر، فإنها تضاء بلون مميز يعكس وجود فرق دال إحصائياً.
كما يولد النظام مخططات فترات الثقة للمقارنات الثنائية (Control and Interval Plots)، التي توضح المسافة بين كل متوسط وفترة الثقة المحيطة به، مما يسمح للباحث النفسي بإدراج هذه الأشكال عالية الدقة والوضوح ضمن التقارير العلمية وأوراق المؤتمرات؛ إذ تمنح القارئ استيعاباً حدسياً فورياً لحجم التباينات الإكلينيكية واتجاهاتها بين العلاجات دون الغرق في تفاصيل الجداول الرقمية المعقدة.
7. التعامل مع العينات غير المتساوية وتطبيق تعديل توكي-كريمر (Tukey-Kramer)
7.1 التحدي الإحصائي للأحجام المتفاوتة للعينات في الدراسات الإكلينيكية
يشكل تفاوت أحجام العينات بين المجموعات التجريبية تحدياً منهجياً متكرراً في بحوث الطب النفسي وعلم النفس الإكلينيكي؛ إذ نادراً ما تكتمل التدخلات العلاجية الطويلة بنفس الأعداد التي بدأت بها. تنشأ هذه الظاهرة نتيجة تسرب المشاركين (Participant Attrition) بداعي الشفاء المبكر، أو ظهور آثار جانبية غير محتملة لبعض التدخلات، أو التغيب عن جلسات المتابعة، فضلاً عن استبعاد بعض الحالات لعدم استيفاء المعايير الصارمة لبروتوكول التجربة بعد تجميع البيانات.
تكمن الخطورة المنهجية لهذا التفاوت في أن معادلة توكي الأصلية لعام 1953 قد اشتُقت رياضياً على افتراض تساوي حجم العينة في جميع المجموعات (n متساوية). وفي حال استخدام المعادلة الأصلية مع عينات غير متساوية، تفقد المعادلة قدرتها على ضبط معدل الخطأ العائلي؛ مما يقود إلى تضخم معدل الخطأ من النوع الأول عند المقارنة بين المجموعات الصغيرة، أو انخفاض حاد في القوة الإحصائية عند فحص المجموعات الكبيرة.
لتجاوز هذه العقبة الرياضية، قدم الإحصائي كلايد كريمر (Clyde Y. Kramer) في عام 1956 امتداداً عبقرياً لمعادلة توكي يرتكز على استخدام المتوسط التوافقي (Harmonic Mean) لأحجام عينات الأزواج المتباينة. وقد أثبتت الدراسات النظرية والمحاكاة الإحصائية أن تعديل توكي-كريمر ينجح في توفير حماية محافظة ومحكمة لمعدل الخطأ العائلي عبر جميع المقارنات الثنائية، بغض النظر عن مدى التفاوت في أحجام العينات داخل التصميم التجريبي.
7.2 تنفيذ اختبار توكي-كريمر تلقائياً داخل بيئة SAS
تتجلى قوة بيئة SAS البرمجية في معالجتها الذكية لمعضلة تباين أحجام العينات دون تحميل الباحث أعباء الحساب اليدوي أو كتابة دوال رياضية استثنائية. فعندما يكتشف إجراء PROC GLM وجود اختلاف في أعداد المشاركين بين فئات المتغير المصنف في جملة CLASS، ويطلب الباحث تطبيق خيار توكي سواء عبر جملة MEANS أو جملة LSMEANS، يقوم البرنامج تلقائياً بالتحول البرمجي الداخلي إلى خوارزمية توكي-كريمر (Tukey-Kramer Method).
يوثق برنامج SAS هذا التحول التلقائي بشفافية منهجية عالية داخل سجل الأحداث (SAS Log) وفي ترويسة جداول المخرجات المطبوعة؛ حيث يظهر تنبيه صريح يشير إلى استخدام تعديل توكي-كريمر للتعامل مع الأحجام غير المتساوية للعينات (Adjustment for Multiple Comparisons: Tukey-Kramer). ويقوم النظام بحساب خطأ معياري منفصل لكل مقارنة ثنائية محددة يعتمد على الحجم الفعلي للعينتين الداخلتين في تلك المقارنة، بدلاً من استخدام خطأ معياري عام وثابت.
وعلى العكس من ذلك، إذا تم تشغيل هذا النوع من البيانات عبر إجراء PROC ANOVA القديم، فإن النتائج الصادرة ستكون مضللة وغير صحيحة رياضياً؛ نظراً لعجز PROC ANOVA عن استيعاب التحوير الحسابي لكريمر. لذا، فإن الاعتماد على PROC GLM يمثل صمام الأمان المنهجي الذي يمنع الباحث من إطلاق ادعاءات زائفة بوجود فروق علاجية، ويضمن قبول التحليلات في كبرى الدوريات العلمية العالمية المحكمة.
7.3 تفسير اختلافات المخرجات بين الحالات المتوازنة وغير المتوازنة
يترتب على الانتقال من الحالات المتوازنة إلى الحالات غير المتوازنة تغيرات جوهرية في بنية مخرجات اختبار توكي يجب على الباحث استيعابها لتجنب سوء التفسير. يبرز التغير الأول في تفاوت اتساع فترات الثقة للمقارنات الزوجية المختلفة داخل نفس الجدول الإحصائي؛ ففي التصميمات المتوازنة تكون جميع فترات الثقة متماثلة في العرض والمسافة الحدية، بينما تتباين هذه الحدود في الحالات غير المتوازنة، حيث تتسع فترة الثقة وتصبح أكثر ضبابية بين المجموعات ذات العينات الصغيرة، وتضيق بدقة أعلى عند مقارنة المجموعات الكبيرة.
وينعكس هذا التفاوت الهيكلي بصورة مباشرة على القوة الإحصائية (Statistical Power) لكل مقارنة زوجية على حدة؛ إذ تتراجع قدرة الباحث على اكتشاف الفروق الحقيقية بين الأزواج التي تضم عينات متقلصة الحجم. وقد يترتب على ذلك ملاحظة مفارقة ظاهرية في النتائج، حيث يظهر فرق كبير في المتوسطات غير دال إحصائياً لصغر حجم عينات المقارنة، في حين يظهر فرق أصغر بكثير ذا دلالة إحصائية قوية لاشتراك مجموعات ذات أحجام عينات ضخمة.
لتفادي الآثار السلبية لهذا التفاوت في البحوث النفسية المستقبلية، يُنصح الباحثون بتكثيف جهود المتابعة الإكلينيكية للحد من التسرب، واعتماد أساليب المعاينة التوافقية، واستخدام تحليل القوة الإحصائية البعدي (Post-Hoc Power Analysis) لتقدير مدى تأثر المقارنات الزوجية المحددة بانخفاض العينة، وتقديم تفسيرات نقدية متوازنة تعترف بمحدودية القوة الإحصائية عند مناقشة النتائج غير الدالة.
8. تفسير وتحليل مخرجات اختبار توكي الصادرة عن برنامج SAS
8.1 تحليل جدول المقارنات الثنائية والقيم الاحتمالية المعدلة (Adjusted p-values)
يحتل جدول المقارنات الثنائية موقع الصدارة في تقرير مخرجات إجراء PROC GLM مع جملة LSMEANS؛ حيث يستعرض هذا الجدول مصفوفة تفصيلية تتضمن جميع أزواج المجموعات التجريبية، وقيمة الفرق التقديري بين المتوسطين التوافقيين (Estimate)، والخطأ المعياري المقدر لهذا الفرق، وقيمة إحصاء تاء المشتقة، والأهم من ذلك كله: القيمة الاحتمالية المعدلة لتوكي، والتي تظهر في جدول SAS تحت عمود Pr > |t|.
تعتمد عملية اتخاذ القرار على مقارنة القيمة الاحتمالية المعدلة Pr > |t| بمستوى الدلالة الاسمي المعتمد (0.05 عادة)؛ فإذا كانت القيمة أقل من 0.05، يرفض الباحث الفرضية الصفرية المقابلة بثقة، ويستنتج وجود فرق إحصائي حقيقي ذي دلالة بين هاتين المجموعتين العلاجيتين لا يمكن عزوه إلى الصدفة أو أخطاء المعاينة العشوائية. وتكمن الميزة هنا في أن هذه القيمة الاحتمالية قد خضعت للتعديل الصارم لتوزيع المدى المقيّس، مما يجعلها نقية وجاهزة للتفسير المباشر دون الحاجة لأي تصحيح إضافي.
علاوة على ذلك، ينبغي للباحث السلوكي فحص الإشارة الجبرية للفرق التقديري المسجل في عمود التقدير (Estimate)؛ فالإشارة الموجبة تشير إلى تفوق المجموعة الأولى على الثانية في درجات المتغير التابع، بينما تعكس الإشارة السالبة العكس. ويساعد هذا التدقيق على تحديد الاتجاه السيكولوجي للفروق، كأن نحدد بدقة ما إذا كان العلاج المعرفي السلوكي قد أدى إلى خفض أعراض الاكتئاب بمعدل أكبر من العلاج بالتحليل النفسي أو المجموعة الضابطة.
8.2 قراءة فترات الثقة المتزامنة بنسبة 95%
تعتبر فترات الثقة المتزامنة بنسبة 95% (Simultaneous 95% Confidence Intervals) المعيار الأكثر رصانة لتقييم النتائج في التحليلات الإحصائية المتقدمة. وتعني كلمة متزامنة أن مستوى الثقة 95% ينطبق على العائلة الكاملة لجميع المقارنات الثنائية مجتمعة داخل التجربة، وليس على كل مقارنة بمعزل عن الأخرى؛ مما يعني أن احتمال احتواء جميع الفترات المحسوبة على الفروق الحقيقية للمجتمعات الأصلية معاً في آن واحد يبلغ 95%.
تتضمن مخرجات SAS عمودين أساسيين يمثلان الحد الأدنى (Lower Confidence Limit) والحد الأعلى (Upper Confidence Limit) لفترة الثقة المعدلة وفق توزيع توكي. يستدل الباحث على الدلالة الإحصائية من عدم احتواء الفترة على الصفر؛ فإذا كانت الفترة تمتد مثلاً من [2.15 إلى 8.45]، فإن الفرق دال إحصائياً لصالح المجموعة الأولى، أما إذا كانت تمتد من [-1.10 إلى 4.20]، فإن الفرق غير دال لوجود احتمال معتبر بأن يكون الفرق الحقيقي في المجتمع مساوياً للصفر.
كما تسهم قراءة عرض فترة الثقة (Interval Width) في تقييم الدقة التقديرية للتجربة السيكولوجية؛ فالفترات الضيقة التي تنحصر في مدى ضيق تشير إلى موثوقية عالية وتجانس كبير في الاستجابة للعلاج، في حين تعكس الفترات المتسعة وجود تشتت كبير في استجابات المشاركين النفسية، مما ينبه الباحث إلى ضرورة مراعاة الفروق الفردية عند تعميم التطبيقات العلاجية.
8.3 فك شفرة تصنيفات مجموعات الحروف (Tukey Grouping)
يوفر جدول تصنيف الحروف (Tukey Grouping) الصادر عن خيار LINES تمثيلاً بيانياً مبسطاً لمصفوفة العلاقات بين المجموعات التجريبية. في هذا الجدول، يرتب ساس المجموعات وفق متوسطاتها الحسابية من الأعلى إلى الأدنى، ثم يعين أحرفاً أبجدية محايدة (مثل A, B, C) بجوار كل مجموعة، ليعكس بنية التقارب أو التباعد الإحصائي بينها.
تفك شفرة هذا الجدول وفق قاعدة صريحة: تشارك مجموعتين أو أكثر في نفس الحرف الأبجدي يرمز إلى غياب أي فرق ذي دلالة إحصائية بينها، حتى وإن وجدت فروق عددية ظاهرية في المتوسطات الخام. وعلى النقيض، إذا انفردت مجموعة معينة بحرف مستقل لم تشاركها فيه المجموعات الأخرى (كأن تحصل مجموعة العلاج المعرفي على الحرف A بينما حصلت المجموعة الضابطة على الحرف B)، فإن ذلك يثبت استقلالها الإحصائي وتفوقها المعنوي عن باقي الظروف التجريبية.
وقد يواجه الباحث السلوكي حالات تداخل معقدة (Overlapping Groups) تبدو مربكة في مظهرها الأولي؛ كأن تحصل مجموعة معينة على الحرفين AB معاً في نفس السطر. يعني هذا التداخل المركب أن هذه المجموعة بالذات لا تختلف دلالياً عن المجموعات التي تنتمي للتصنيف A، وفي الوقت ذاته لا تختلف دلالياً عن المجموعات التي تنتمي للتصنيف B. يعكس هذا الوضع وجود حالة وسيطة غالباً ما تنتج عن تدرج طبيعي في أثر المعالجة النفسية أو تدني القوة الإحصائية النسبية في التمييز بين المستويات المتقاربة.
9. صياغة وكتابة نتائج اختبار توكي في البحوث النفسية وفق دليل APA
9.1 معايير التوثيق النصي لنتائج المقارنات البعدية (الإصدار السابع من APA)
تتطلب المعايير الأكاديمية لجمعية علم النفس الأمريكية، وفق الإصدار السابع من دليل الصياغة (APA 7th Edition)، أسلوباً دقيقاً ومنهجياً في توثيق نتائج المقارنات البعدية داخل متن التقرير العلمي. يجب أن تبدأ الصياغة بتلخيص موجز لنتيجة اختبار تحليل التباين الإجمالي (ANOVA)، موضحاً قيمة فاء ودرجات الحرية والقيمة الاحتمالية وحجم الأثر، يليه الإفصاح المباشر عن تطبيق اختبار توكي البعدي للفروق ذات الدلالة الحقيقية لتحديد مواضع الفروق الدقيقة.
وعند توثيق المقارنات الزوجية نصياً، يتعين على الباحث إدراج المتوسطات الحسابية (أو المتوسطات التوافقية المعدلة) والانحرافات المعيارية (أو الأخطاء المعيارية) لكل مجموعة تجريبية بصورة صريحة داخل أقواس، إلى جانب القيمة الاحتمالية المعدلة لاختبار توكي وحدود فترة الثقة بنسبة 95% كلما كان ذلك متاحاً، مع كتابة الرموز الإحصائية (مثل M, SD, p) بخط مائل وفق متطلبات التنسيق المعتمدة.
وفيما يلي نموذج تطبيقي قياسي للصياغة المنهجية: “أشار تحليل التباين الأحادي إلى وجود تأثير دال إحصائياً لنوع التدخل العلاجي في خفض أعراض الاكتئاب، F(2, 42) = 8.45, p < .001, eta-squared = .29. وقد كشفت المقارنات البعدية باستخدام اختبار توكي (Tukey's HSD) عن تفوق دال إحصائياً لمجموعة العلاج المعرفي السلوكي (M = 14.20, SD = 3.10) على مجموعة قائمة الانتظار الضابطة (M = 22.80, SD = 4.05) بقيمة احتمالية (p < .001, 95% CI [-11.45, -5.75]). في المقابل، لم يظهر فرق ذو دلالة إحصائية بين مجموعة العلاج الداعم (M = 18.50, SD = 3.80) والمجموعة الضابطة (p = .082)."
9.2 تصميم وتضمين الجداول الإحصائية للمقارنات البعدية
تشترط معايير APA في تصميم الجداول الإحصائية البساطة والوضوح التام، وتجنب الخطوط العمودية، والاقتصار على الخطوط الأفقية الضرورية لفصل العناوين والملخصات. وعند إعداد جدول يوضح نتائج اختبار توكي، يفضل دمج المتوسطات والانحرافات المعيارية للمجموعات التجريبية في جدول موحد، مع استخدام نظام الحروف المرفوعة في أعلى الأرقام (Superscripts) للإشارة إلى الفروق الإحصائية، وهو الأسلوب الأكثر أناقة وقبولاً في مجلات علم النفس.
يتم وضع حرف أبجدي صغير مرفع بجوار كل متوسط حسابي، بحيث تشترك المتوسطات غير المتباينة دلالياً في نفس الحرف المرفع، بينما تعكس الحروف المختلفة وجود فروق دالة إحصائياً بينها عند مستوى 0.05. ويسهم هذا التصميم في تفادي تكرار الجداول الزوجية المتقاطعة الضخمة، ويمنح القارئ فهماً فورياً لترتيب وتمايز الأساليب العلاجية أو المستويات التجريبية.
ويعتبر كتابة الحاشية السفلية للجدول (Table Note) أمراً إلزامياً لشرح هذا النظام؛ إذ يجب تضمين ملاحظة في أسفل الجدول توضح نوع الاختبار الإحصائي ومستوى الدلالة، كأن يكتب الباحث: “ملاحظة: المتوسطات التي تشترك في نفس الحرف المرفع لا تختلف عن بعضها دالاً إحصائياً عند مستوى دلالة 0.05 بناءً على اختبار توكي للمقارنات البعدية (Tukey’s HSD post-hoc test).”
9.3 الربط بين النتائج الإحصائية والتفسير السيكولوجي النظري
لا تنتهي مسؤولية الباحث العلمي عند مجرد استخراج الأرقام الإحصائية وإثبات الدلالة الحسابية، بل تبدأ المهمة الجوهرية المتمثلة في تفسير هذه النتائج سيكولوجياً وربطها بالأطر النظرية المنبثقة منها دراسة الحالة. فالأرقام الصماء لا تكتسب قيمتها الحقيقية إلا حينما تترجم إلى معانٍ إكلينيكية وتربوية تصف التغير في السلوك الإنساني أو الوظائف العقلية المعرفية.
في هذا السياق، يجب على الباحث التمييز الدقيق بين الدلالة الإحصائية (Statistical Significance) والدلالة الإكلينيكية أو العملية (Clinical Significance). فقد يثبت اختبار توكي وجود فرق دال إحصائياً بمقدار درجتين على مقياس نفسي معين، ولكن هذا الفرق قد لا يعكس أي تحسن ملموس في جودة حياة المريض أو قدرته على التكيف الاجتماعي في الواقع اليومي؛ لذا يتعين مناقشة الفروق الزوجية بالاقتران مع مقاييس حجم الأثر مثل معامل كوهين (Cohen’s d) لكل مقارنة ثنائية.
كما يتطلب التقرير النفسي الرصين تحديد القيود المنهجية التي واجهت التجربة؛ كصغر حجم العينات في بعض المجموعات، أو محدودية أدوات التقرير الذاتي المستخدمة، مع اقتراح مسارات واضحة للبحوث المستقبلية للتأكد من استقرار الفروق الملاحظة عبر عينات مجتمعية أوسع وبيئات تجريبية مختلفة لتعزيز الصدق الخارجي للنتائج.
10. الأخطاء الشائعة وحلول المشكلات الإحصائية والبرمجية في SAS
10.1 الأخطاء البرمجية الشائعة في كتابة أوامر SAS وتصحيحها
يقع العديد من مستخدمي نظام SAS، خاصة من الباحثين المبتدئين في العلوم النفسية، في مجموعة من الأخطاء البرمجية النحوية والتنظيمية التي تؤدي إلى فشل التحليل وظهور رسائل تحذير حمراء في ملف السجل (SAS Log). ومن أكثر هذه الأخطاء شيوعاً نسيان إدراج المتغير المستقل داخل جملة CLASS في إجراء PROC GLM؛ حيث يؤدي هذا الإغفال إلى قيام البرنامج بمعاملة المتغير الفئوي كمتغير انحداري مستمر، مما ينتج عنه إلغاء حسابات توكي كلياً وظهور خطأ يوضح استحالة إجراء المقارنات المتعددة لمتغير متصل.
ويتمثل الخطأ الشائع الآخر في الخلط غير المبرر بين إجراء PROC ANOVA وإجراء PROC GLM في التصميمات التي تشتمل على عينات غير متساوية؛ حيث يصدر PROC ANOVA رسالة تحذير صريحة تشير إلى أن البيانات غير متوازنة وأن مجموع المربعات قد يكون غير دقيق، وهو ما يجب تلافيه فوراً بنقل الكود البرمجي كاملاً إلى بيئة PROC GLM المخصصة لذلك.
كما تسجل أخطاء شائعة ترتبط بالصياغة النحوية لخيارات جملتي MEANS و LSMEANS، مثل كتابة خيار ADJUST=TUKEY ضمن جملة MEANS (وهو خيار مخصص حصرياً لجملة LSMEANS)، أو وضع الخيار LINES بعد فاصلة منقوطة بدلاً من وضعه بعد الخط المائل (Slash). ويتطلب تصحيح هذه المشكلات البرمجية مراجعة دقيقة لسجل الأحداث وفهم الرسائل التشخيصية التي يقدمها SAS للوصول إلى كود برمجي منضبط.
10.2 المزالق المنهجية في تفسير دلالة الفروق بين المجموعات
إلى جانب الأخطاء البرمجية، يقع بعض المحللين في مزالق منهجية خطيرة تشوه صدق الاستنتاجات العلمية. يأتي في مقدمة هذه المزالق التسرع في فحص وتفسير نتائج اختبار توكي دون التحقق المسبق من تحقق الدلالة الإحصائية لاختبار فاء في النموذج العام لتحليل التباين؛ إذ إن التمسك بالصرامة المنهجية يفرض اعتبار الفروق الثنائية ملغاة حكماً إذا لم ينجح النموذج الإجمالي في دحض الفرضية الصفرية العامة.
ويبرز المنزلق المنهجي الثاني في التجاهل المتعمد لفحص افتراض تجانس التباينات عبر المجموعات، والإصرار على تطبيق اختبار توكي رغم فشل اختبار ليفين؛ مما يؤدي إلى تشويه خطير في معدلات الخطأ الإحصائي يجعل فترات الثقة الصادرة مضللة للغاية ولا يمكن الوثوق بها. ويجب على الباحث السلوكي ألا يخلط مطلقاً بين سهولة النقر على الخيارات في البرمجيات وسلامة الأساس الرياضي الذي تقوم عليه تلك الخيارات.
كما يتكرر الخلط الفكري بين الدلالة الإحصائية والدلالة السيكولوجية والواقعية؛ فالاعتماد المطلق على القيمة الاحتمالية p < 0.05 دون النظر إلى الفروق المطلقة وحجم الأثر وحدود فترة الثقة يقود إلى المبالغة في تصوير مكاسب علاجية هامشية لا تشكل أي فارق نوعي في الصحة النفسية للمرضى، مما يوقع الباحث في فخ التعميم غير المسؤول.
10.3 الخيارات البديلة عند تعذر استيفاء شروط اختبار توكي في SAS
عندما تظهر الفحوص الاستكشافية انتهاكاً حاداً للافتراضات الأساسية للتحليل البارامتري، لا يعود اختبار توكي الخيار المنهجي المناسب، ويجب على الباحث تفعيل البدائل الإحصائية القوية المتاحة في ترسانة SAS البرمجية. ففي حالة الانتهاك الشديد لفرضية التوزيع الطبيعي وصغر حجم العينة، يصبح اللجوء إلى الاختبارات اللامعلمية إلزامياً عبر استدعاء إجراء PROC NPAR1WAY، الذي ينفذ اختبار كروسكال-واليس (Kruskal-Wallis) لتحليل التباين الرتبي، مقترناً بالمقارنات البعدية المبنية على متوسط الرتب (Wilcoxon Two-Sample Tests) مع تعديل بونفيروني لضبط الخطأ العائلي.
أما إذا كانت فرضية البحث تقتصر حصرياً على مقارنة مجموعة من الأساليب العلاجية المستحدثة بمجموعة ضابطة مرجعية واحدة (Control Group) دون الاهتمام بمقارنة العلاجات ببعضها، فإن اختبار توكي يفقد كفاءته القصوى لمصلحة اختبار دونيت (Dunnett’s Test). يمكن تنفيذ هذا الاختبار بمنتهى البساطة داخل جملة LSMEANS في PROC GLM عبر كتابة الأمر:
LSMEANS TreatmentGroup / ADJUST=DUNNETT(‘Control’) PDIFF;
وهو خيار يوفر قوة إحصائية أعلى بكثير للمقارنات الموجهة ضد الضابط، لأنه يقلل العدد الإجمالي للمقارنات المفحوصة.
وفي السيناريو الشائع الذي ينتهك فيه التصميم التجريبي فرض تجانس التباين مع تفاوت أحجام العينات، يُحظر استخدام اختبار توكي، ويتعين تطبيق تحليل ويلش للتباين مع إجراء مقارنات جيمس-هاويل (Games-Howell) أو دانت-تامهين. وتوفر بيئة SAS أكواد ماكرو إحصائية متقدمة (SAS Macros) مبرمجة خصيصاً لحساب معادلات جيمس-هاويل استناداً إلى درجات حرية ويلش-ساترثويت (Welch-Satterthwaite)، مما يضمن سلامة الاستدلال الإحصائي وحماية معدل الخطأ العائلي حتى في أقسى ظروف اضطراب البيانات السلوكية.
خاتمة
يمثل اختبار توكي للفروق ذات الدلالة الحقيقية (Tukey’s HSD) أداة استدلالية رفيعة المستوى لا يستغني عنها أي باحث في العلوم السلوكية والنفسية يسعى إلى تفكيك التباينات المعقدة بدقة متناهية ودون التضحية بضبط معدل الخطأ العائلي عند المستوى الاسمي المطلوب. وقد أثبتت التجربة الإحصائية الممتدة أن الفهم العميق للأسس الرياضية لتوزيع المدى المقيّس، والالتزام الصارم باستيفاء الافتراضات المنهجية من استقلالية وتوزيع طبيعي وتجانس في التباينات، يشكلان الشرط الأساسي لسلامة أي استنتاج علمي يتم التوصل إليه.
وتوفر بيئة SAS البرمجية، عبر إجراءي PROC ANOVA و PROC GLM، منظومة تحليلية شديدة القوة تتيح للباحث التعامل بكفاءة متناهية مع مختلف التصميمات التجريبية، سواء كانت متوازنة أو غير متوازنة، بفضل التطبيق التلقائي لخوارزمية توكي-كريمر. إن الجمع الواعي بين استخراج المتوسطات التوافقية LSMEANS، وتفعيل خيارات فترات الثقة CLDIFF، وقراءة مصفوفات الحروف المجمعة LINES، إلى جانب توظيف الرسوم التفاعلية في ODS Graphics، يمنح الباحث رؤية متكاملة تدعم التوثيق الدقيق وفق معايير جمعية علم النفس الأمريكية (APA)، وترتقي بالبحث النفسي من مجرد حسابات رقمية إلى إضافات نظرية وتطبيقية موثوقة تسهم في تطوير المعرفة الإنسانية والممارسة الإكلينيكية الرصينة.
المراجع
- Kramer, C. Y. (1956). Extension of multiple range tests to group means with unequal numbers of replications. Biometrics, 12(3), 307–310. https://doi.org/10.2307/3001469
- SAS Institute Inc. (2020). SAS/STAT 15.2 User’s Guide: The GLM Procedure. SAS Institute Inc. https://support.sas.com/documentation/onlinedoc/stat/
- Tukey, J. W. (1949). Comparing individual means in the analysis of variance. Biometrics, 5(2), 99–114. https://doi.org/10.2307/3001913
- Tukey, J. W. (1953). The problem of multiple comparisons. Unpublished manuscript, Princeton University. (Reprinted in H. I. Braun (Ed.), 1994, The Collected Works of John W. Tukey: Multiple Comparisons, 1948–1983, Vol. 8, pp. 1–300. Chapman & Hall).