
يمثل افتراض تجانس التباين (Homogeneity of Variance أو Homoscedasticity) أحد الأركان الجوهرية التي تستند إليها الاختبارات الإحصائية المعلمية (Parametric Tests)، لا سيما النماذج الخطية العامة (General Linear Models) واختبارات تحليل التباين (ANOVA) بمختلف تصاميمها. في البحوث السلوكية والاجتماعية والعلوم النفسية، يشترط الباحثون استيفاء هذا الافتراض لضمان عدم انحياز التقديرات الإحصائية ولدقة اختبار الفرضيات المتعلقة بالفروق بين المتوسطات. إذا اختل هذا الافتراض، فإن النتائج المستخلصة قد تعطي انطباعاً زائفاً بوجود فروق ذات دلالة إحصائية بينما هي في الواقع ناجمة عن تشتت غير متكافئ بين المجموعات التجريبية أو الضابطة، مما يؤدي إلى تضخم معدل الخطأ من النوع الأول وتضليل القرارات العلمية والتطبيقية.
تاريخياً، اعتمد الإحصائيون على اختبارات تقليدية مثل اختبار بارتليت (Bartlett’s Test) لفحص تماثل التباينات، إلا أن هذه الاختبارات أظهرت حساسية مفرطة لأي انحراف طفيف عن التوزيع الطبيعي للبيانات، مما قاد الباحث هاوارد ليفين في عام 1960 إلى ابتكار أسلوب إحصائي متين لا يتأثر بشدة بالالتواء والتفرطح. يقوم اختبار ليفين (Levene’s Test) على فكرة رائدة تتمثل في تحويل المتغير الأصلي إلى انحرافات مطلقة أو مربعة عن مقياس النزعة المركزية للمجموعة، ثم إجراء تحليل تباين أحادي قياسي على تلك القيم المحولة، محولاً مسألة مقارنة التباينات إلى مقارنة متوسطات الانحرافات. وقد ترسخ هذا الاختبار كمعيار ذهبي معتمد في البرمجيات الإحصائية العالمية لموثوقيته العالية وقدرته على ضبط معدلات الخطأ بكفاءة عبر توزيعات مختلفة.
يعد نظام التحليل الإحصائي SAS (Statistical Analysis System) أحد أقوى البيئات الحاسوبية المتخصصة في التعامل مع المعالجات الرياضية المعقدة ومصفوفات البيانات الضخمة التي تفرزها الدراسات السلوكية المعاصرة. يقدم نظام SAS أدوات متقدمة لتنفيذ اختبار ليفين وصيغه المتطورة من خلال إجراءات متعددة، أبرزها إجراء النماذج الخطية العامة (PROC GLM) وإجراء تحليل التباين (PROC ANOVA). يهدف هذا الدليل الأكاديمي الشامل إلى تفكيك الأسس النظرية والرياضية لاختبار ليفين، وتقديم شرح تفصيلي لخطوات كتابة الشفرات البرمجية داخل بيئة SAS، وتحليل المخرجات الإحصائية وتفسيرها بدقة، إلى جانب استعراض الحلول المنهجية المتبعة عند خرق فرضية التجانس، وتوثيق النتائج وفقاً لأحدث معايير جمعية علم النفس الأمريكية (APA).
1. مدخل إلى اختبار ليفين وأهميته في التحليل الإحصائي السلوكي
1.1 مفهوم تجانس التباين في البحوث النفسية والاجتماعية
يُعرَّف افتراض تجانس التباين في إطار الإحصاء الاستدلالي بأنه الحالة التي تتساوى فيها تباينات المجتمعات الأصلية التي سُحبت منها عينات الدراسة المستقلة عبر جميع مستويات المتغير المستقل، ويُعبر عن ذلك رياضياً بالصيغة: $\sigma_1^2 = \sigma_2^2 = dots = \sigma_k^2$. في مجالات العلوم النفسية والتربوية، نادراً ما تتطابق تباينات المجموعات تطابقاً تاماً نتيجة التباين الطبيعي بين الأفراد والفروق الفردية في السمات المعرفية والسلوكية؛ لذلك يركز التحليل الإحصائي على التأكد من أن التباين المرصود يقع ضمن الحدود المقبولة التي لا تخل بكفاءة النماذج المعلمية المستخدمة.
إن خرق فرضية تجانس التباين يمثل تهديداً حقيقياً لصدق القرارات الإحصائية الداخلية للبحث (Internal Validity). عندما تكون تباينات المجموعات متباينة بشكل جوهري، ولا سيما في التصاميم غير المتوازنة (Unbalanced Designs) التي تختلف فيها أحجام العينات، فإن الخطأ المعياري المقدر للفروق بين المتوسطات يصبح غير دقيق. ففي الحالات التي ترتبط فيها العينة الأصغر حجماً بالتباين الأكبر، يؤدي ذلك إلى تضخم دراماتيكي في معدل الخطأ من النوع الأول (Type I Error Rate)، وهو احتمال رفض الفرضية الصفرية عندما تكون صحيحة في الواقع. ونتيجة لذلك، يزعم الباحثون وجود أثر للتدخل النفسي أو السلوكي في حين أن هذا الأثر ليس سوى صدى لاختلال التجانس بين العينات (Krieglstein et al., 2023).
تتطلب السياقات النفسية والإكلينيكية تحليلاً صارماً لتجانس التباين؛ إذ غالباً ما تؤدي الاضطرابات النفسية أو التدخلات العلاجية إلى زيادة تشتت استجابات المرضى مقارنة بالمجموعات الضابطة المستقرة. فعلى سبيل المثال، عند دراسة مستويات الضغوط النفسية أو الاكتئاب في ظل الأزمات المجتمعية (Saddik et al., 2021)، قد تُظهر المجموعات المعرضة للصدمات درجات تباين واسعة تتباين جذرياً عن الأفراد غير المتأثرين، مما يجعل من التحقق الإحصائي من ثبات التشتت شرطاً مسبقاً قبل الشروع في أي مقارنة لمتوسطات الدرجات الإجمالية.
1.2 طبيعة اختبار ليفين وتاريخ نشأته وميزاته المقارنة
نشأ اختبار ليفين في دراسة تاريخية نشرها عالم الإحصاء هاوارد ليفين عام 1960 كبديل لاختبار بارتليت الشائع آنذاك. كان اختبار بارتليت يعتمد اعتماداً كلياً على فرضية أن البيانات تتبع التوزيع الطبيعي الدقيق؛ مما جعله بالغ التأثر بأي انحراف طفيف في الالتواء (Skewness) أو التفرطح (Kurtosis). في تلك الظروف، كان اختبار بارتليت يسفر عن دلالة إحصائية خاطئة تعكس الابتعاد عن التوزيع السوي بدلاً من أن تعكس اختلاف التباينات الفعلي، مما وضع الباحثين في معضلة منهجية استدعت ابتكار مقياس يتسم بالمتانة (Robustness) الإحصائية.
ابتكر ليفين فكرة عبقرية تمثلت في تحويل درجات الأفراد إلى قيم تشتت من خلال حساب الانحرافات عن مقياس النزعة المركزية لكل مجموعة. أتاح هذا الأسلوب الاستفادة من متانة تحليل التباين نفسه؛ إذ أثبتت الدراسات التجريبية والمحاكاة أن إجراء اختبار ANOVA على درجات التشتت المحولة يوفر مقاومة استثنائية لمشكلات التوزيعات غير السوية، مع الحفاظ على معدل الخطأ الاسمي للنوع الأول عند الحدود الآمنة. ولم يعد الباحثون مضطرين للقلق البالغ من تأثيرات الالتواء المتوسط أو الذرى الحادة على دقة فحص تجانس التباين.
شهد الاختبار لاحقاً تطويراً جوهرياً عام 1974 على يد مورتون براون وألان فورسيث (Brown & Forsythe)، حيث اقترحا استخدام الوسيط (Median) أو المتوسط المبتور (Trimmed Mean) بدلاً من المتوسط الحسابي كمحور لحساب الانحرافات. أظهرت التعديلات المبنية على الوسيط كفاءة وقوة إحصائية متفوقة في التعامل مع البيانات شديدة الالتواء ذات الذيول الثقيلة الشائعة في العلوم السلوكية، مما جعل خيارات اختبار ليفين تتكامل داخل البرمجيات الإحصائية الحديثة لتمنح الباحث مرونة تحليلية تتطابق مع خصائص بياناته التوزيعية.
1.3 دور برنامج SAS في تيسير الحسابات الإحصائية المتقدمة
يمثل نظام SAS منصة برمجية رائدة في البيئات الأكاديمية والطبية والصناعية بفضل بنيته المعمارية المصممة للتعامل مع البيانات المعقدة والمصفوفات الإحصائية الضخمة. في الأبحاث النفسية والمسوح السلوكية الواسعة التي تضم آلاف المشاهدات والعديد من المتغيرات المتداخلة، يوفر SAS سرعة معالجة استثنائية وثباتاً حاسوبياً لا يتوافر في العديد من البرمجيات الرسومية البسيطة، متيحاً للباحثين تنفيذ تحليلات مسبقة لاختبار الفروض دون إجهاد موارد النظام الحاسوبية.
تكمن إحدى أبرز نقاط القوة في SAS في دقته الحسابية والعددية الصارمة؛ إذ يطبق خوارزميات الاستمثال العددي ذات الدقة المزدوجة (Double-Precision Floating-Point Arithmetic) لمعالجة التباينات، مما يحد من أخطاء التقريب التي قد تطرأ عند التعامل مع عينات شديدة التباين أو أرقام قياسية متناهية الصغر. هذه الدقة تجعل نتائج اختبار ليفين والاختبارات المرافقة داخل SAS متطابقة بدقة تامة مع المعايير الرياضية النظرية، وتوفر للباحثين موثوقية عالية عند تقديم نتائجهم للنشر في الدوريات العلمية المرموقة.
إضافة إلى ذلك، يتميز SAS بدمج اختبارات الفروض المسبقة -ومن بينها اختبار ليفين واختبارات فحص التوزيع الطبيعي- ضمن إجراءات النماذج الخطية العامة الأوسع نطاقاً، مثل إجراء PROC GLM. يتيح هذا التكامل للباحث السلوكي اختبار تجانس التباين، وتقييم الفروق الرئيسية بين المتوسطات، وفحص التفاعلات الإحصائية، وطلب التعديلات التصحيحية (مثل تصحيح ويلش) في عملية تنفيذية برمجية موحدة ومتماسكة، تضمن سلاسة تدفق العمل التحليلي وقابليته للمراجعة وإعادة الإنتاج العلمي الموثوق.
2. الأسس النظرية والرياضية لاختبار ليفين
2.1 المعادلات الرياضية لحساب إحصائية الاختبار
يعتمد الأساس الرياضي لاختبار ليفين على تحويل المتغير التابع الأصلي $Y_{ij}$ (الذي يمثل الدرجة الملاحظة للمفردة $j$ في المجموعة $i$) إلى متغير انتشار أو تشتت جديد يُرمز له بالرمز $Z_{ij}$. يتم حساب هذا المتغير الجديد إما بحساب القيمة المطلقة للانحراف عن متوسط المجموعة الحسابي ($\bar{Y}_{i\cdot}$) أو عن طريق تربيع تلك الانحرافات. تتحدد الصيغة الرياضية للتحويل وفق النموذج التالي:
$$Z_{ij} = |Y_{ij} – \bar{Y}_{i\cdot}| \quad \text{أو} \quad Z_{ij} = (Y_{ij} – \bar{Y}_{i\cdot})^2$$
بعد تحويل جميع الدرجات إلى قيم $Z_{ij}$، يتم تطبيق اختبار تحليل التباين الأحادي القياسي على المتغير المحول. يتطلب ذلك أولاً حساب المتوسط الحسابي لدرجات التشتت داخل كل مجموعة $\bar{Z}_{i\cdot}$، بالإضافة إلى المتوسط العام لدرجات التشتت عبر كامل العينات $\bar{Z}_{\cdot\cdot}$. بناءً على ذلك، يتم اشتقاق مجموع المربعات بين المجموعات (Sum of Squares Between – $SSB_Z$) ومجموع المربعات داخل المجموعات (Sum of Squares Within – $SSW_Z$) وفق المعادلات الإحصائية الكلاسيكية:
$$SSB_Z = \sum_{i=1}^k n_i (\bar{Z}_{i\cdot} – \bar{Z}_{\cdot\cdot})^2, \quad SSW_Z = \sum_{i=1}^k \sum_{j=1}^{n_i} (Z_{ij} – \bar{Z}_{i\cdot})^2$$
تُحسب إحصائية الاختبار النهائية، المعروفة بإحصائية فائية ليفين ($F_{\text{Levene}}$)، بقسمة متوسط المربعات بين المجموعات ($MSB_Z$) على متوسط المربعات داخل المجموعات ($MSW_Z$). إذا كانت تباينات المجموعات متقاربة، فإن متوسطات الانحرافات المطلقة ستكون متقاربة أيضاً، مما يجعل قيمة $F$ قريبة من الواحد الصحيح، بينما يؤدي الاختلاف الجوهري بين التشتت إلى زيادة ملموسة في بسط المعادلة وارتفاع قيمة إحصائية $F$:
$$F = \frac{SSB_Z / (k – 1)}{SSW_Z / (N – k)} = \frac{MSB_Z}{MSW_Z}$$
2.2 الفرضيات الصفرية والبديلة لاختبار ليفين
تتمحور الفرضية الصفرية ($H_0$) لاختبار ليفين حول إقرار التساوي الشامل لتباينات مجتمعات المجموعات قيد الفحص. تُصاغ هذه الفرضية رياضياً بالشكل الآتي: $H_0: \sigma_1^2 = \sigma_2^2 = dots = \sigma_k^2$، حيث تمثل $\sigma_i^2$ التباين الحقيقي في المجتمع للمجموعة $i$ من أصل $k$ مجموعة مستقلة. يعبر قبول الفرضية الصفرية إحصائياً عن تحقق شرط تجانس التباين، مما يشير إلى أن الفروق الملاحظة بين تباينات العينات السطحية تعود إلى مجرد خطأ المعاينة العشوائي.
في المقابل، تُصاغ الفرضية البديلة ($H_1$ أو $H_A$) بطريقة عدم الاتساق، وتنص على أن تباينات المجتمعات ليست جميعها متساوية؛ أي أنه يوجد على الأقل زوج واحد من المجموعات ($i \neq m$) يختلفان في تباينهما: $\exists i, m \text{ بحيث } \sigma_i^2 \neq \sigma_m^2$. تجدر الإشارة هنا إلى أن الفرضية البديلة لا تشترط اختلاف تباينات جميع المجموعات عن بعضها البعض، بل يكفي أن تشذ مجموعة واحدة بتباينها شذوذاً كبيراً لتسجيل دلالة إحصائية ورفض الفرضية الصفرية.
تخضع إحصائية الاختبار المحسوبة لتوزيع فيشر ($F$-Distribution) تحت مظلة الفرضية الصفرية، وتتحدد درجات الحرية بدقة عبر معيارين أساسيين: درجات حرية البسط (Numerator Degrees of Freedom) وتساوي عدد المجموعات مطروحاً منه واحد ($df_1 = k – 1$)، ودرجات حرية المقام (Denominator Degrees of Freedom) وتساوي الحجم الكلي للمشاهدات مطروحاً منه عدد المجموعات ($df_2 = N – k$). تضمن هذه المعايير تحديد التوزيع النظري الدقيق لحساب القيمة الاحتمالية المرتبطة بـ $F$.
2.3 مستوى الدلالة وقوة الاختبار الإحصائية
يعد تحديد مستوى الدلالة الإحصائية ($\alpha$) قراراً منهجياً حاسماً عند اختبار الفروض المسبقة للنماذج الإحصائية. في حين يُعد مستوى الدلالة 0.05 المعيار التقليدي في اختبارات الفروض الأساسية، فإن العديد من الإحصائيين المنهجيين في العلوم النفسية يوصون باعتماد مستوى دلالة أكثر تحفظاً، مثل $\alpha = 0.10$، عند تطبيق اختبار ليفين واختبارات فحص الافتراضات؛ والهدف من ذلك هو زيادة حساسية الاختبار لاكتشاف أي اختلال طفيف قد يؤثر سلباً على جودة النموذج الخطي وتفادي ارتكاب خطأ من النوع الثاني (Type II Error).
ترتبط قوة الاختبار الإحصائية (Statistical Power) بقدرته على رفض الفرضية الصفرية عندما تكون خاطئة بالفعل (أي عندما تكون التباينات غير متجانسة في المجتمع). تتأثر هذه القوة طردياً بحجم العينات المدروسة؛ فعند العمل بعينات صغيرة جداً، قد يعجز اختبار ليفين عن رصد الاختلافات الفعلية بين التباينات، مما يمنح الباحث ثقة زائفة باستيفاء الشروط. في المقابل، يؤدي تضخم حجم العينات إلى زيادة هائلة في القوة الإحصائية، مما يجعل الاختبار يكشف فروقاً تافهة في التشتت لا تنطوي على أي أثر عملي مدمر للنموذج الإحصائي.
لذا، يتعين على الباحث المنهجي إقامة توازن رصين بين القوة الإحصائية والحساسية المفرطة؛ إذ لا ينبغي الاعتماد بصورة عمياء على القيمة الاحتمالية وحدها في العينات الكبيرة جداً، بل يجب تعزيز الفحص الإحصائي بمؤشرات حجم الأثر للتفاوت في التباين ومقارنة نسب الانحرافات المعيارية بين المجموعات للتأكد من أن التباين المرصود يمتلك ثقلاً تطبيقياً يستدعي تدخلاً منهجياً حاسماً.
3. متطلبات إعداد وهيكلة البيانات داخل بيئة SAS
3.1 شروط البيانات الصالحة لتطبيق اختبار ليفين
يتطلب التطبيق الإحصائي الدقيق لاختبار ليفين توفر مجموعة من الشروط الهيكلية في البيانات الخام لضمان صدق الاستدلال وصلاحية النتائج. يتمثل الشرط الأول والأكثر أهمية في استقلالية المشاهدات (Independence of Observations)، والتي تعني أن قياسات كل مفردة داخل المجموعة لا ترتبط أو تؤثر بأي شكل على قياسات الأفراد الآخرين داخل نفس المجموعة أو في المجموعات المقابلة. يُعد خرق هذا الشرط، كالذي يحدث في تصاميم القياسات المتكررة دون ضبط إحصائي، مهدداً أساسياً لأي تحليل مشتق من تحليل التباين.
يتعلق الشرط الثاني بمستوى قياس المتغيرات؛ إذ يجب أن يكون المتغير التابع (Dependent Variable) مقاساً على مستوى مستمر فئوي أو نسبي (Interval or Ratio Scale) لضمان إمكانية حساب المتوسطات والانحرافات الرياضية بصورة موثوقة. أما المتغير المستقل (Independent Variable)، فيجب أن يكون متغيراً تصنيفياً نوعياً (Categorical/Nominal) يحدد بوضوح الانتماء إلى مجموعتين أو أكثر من المجموعات المعالجة أو المقارنة.
بالإضافة إلى ذلك، ينبغي للباحث الانتباه إلى طبيعة التصميم من حيث توازن أحجام العينات (Balanced vs. Unbalanced Designs). على الرغم من أن اختبار ليفين قادر نظرياً على التعامل مع التصاميم غير المتوازنة التي تختلف فيها أحجام العينات بين المجموعات، إلا أن عدم التساوي الشديد يقلل من مناعة الاختبار، ويزيد من تأثر معدلات الخطأ بالتباينات غير المتكافئة، مما يستوجب فحصاً استكشافياً دقيقاً لأحجام المجموعات قبل إطلاق الأوامر البرمجية في SAS.
3.2 خطوات إنشاء مجموعة البيانات البرمجية في SAS
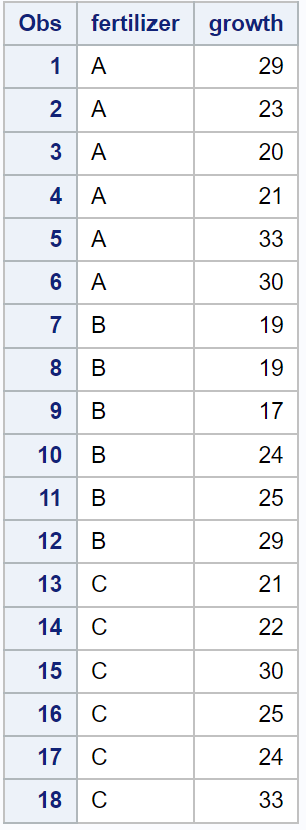
تبدأ معالجة البيانات في SAS من خلال خطوة البيانات (DATA Step)، وهي الهيكلية البرمجية المخصصة لتعريف الجداول والمتغيرات وتحديد أنواعها قبل إخضاعها للإجراءات التحليلية. يتم استخدام التعليمة DATA متبوعة باسم الجدول المطلوب إنشاؤه، يليها استخدام التعليمة INPUT لتعريف المتغير المستقل والمتغير التابع بدقة ووضوح.
في بيئة SAS، يتم تمييز المتغيرات النصية أو الفئوية بإضافة علامة الدولار ($) مباشرة بعد اسم المتغير في سطر الإدخال INPUT، بينما تُترك المتغيرات العددية والكمية دون أي إشارة إضافية. تتيح هذه التفرقة للنظام حجز المساحة الذاكرية المناسبة وتطبيق خوارزميات التصنيف الرياضي المخصصة للبيانات الاسمية والعددية بصورة آلية وسلسة.
عقب تعريف المتغيرات، تُستدعى التعليمة DATALINES (أو CARDS) لبدء إدخال صفوف البيانات الخام مباشرة داخل البرنامج، مع الفصل بين القيم بمسافات قياسية، أو من خلال استيراد ملفات خارجية باستخدام الإجراء PROC IMPORT. وتُختتم خطوة البيانات دائماً بتعليمة التشغيل RUN; لضمان قيام مترجم SAS ببناء الجدول الذاكري وتجهيزه للاستخدام اللاحق.
3.3 فحص البيانات والتأكد من خلوها من الأخطاء الإدخالية
يعد الفحص الاستكشافي للبيانات خطوة لا غنى عنها في الممارسات الإحصائية الرصينة؛ إذ يمكن للأخطاء المطبعية أو الإدخالية البسيطة أن تشوه حسابات التباين تشويهاً بالغاً. يُستخدم الإجراء PROC PRINT لمعاينة سجلات البيانات بعد إنشائها والتأكد من صحة تسكين المتغيرات ومطابقة عدد المشاهدات الفعلي للمخطط البحثي، مما يتيح اكتشاف أي إزاحة في الأعمدة أو خلل في الترتيب.
كما يُعد رصد القيم المفقودة (Missing Values) والتعامل معها بحذر أمراً حاسماً، حيث يرمز SAS للقيم الرقمية المفقودة بنقطة بسيطة (.). يؤدي وجود هذه القيم إلى استبعاد تلقائي للمشاهدات في نماذج تحليل التباين (Listwise Deletion)، مما قد يخل بتوازن العينات وتوزيعاتها، ويستدعي فحص نسب الفقد باستخدام إجراءات استكشافية متقدمة مثل PROC FREQ أو PROC MEANS لتقييم مدى عشوائية الفقد وتأثيره.
إلى جانب ذلك، يجب فحص البيانات للتحقق من خلوها من القيم الشاذة والمتطرفة (Outliers) التي تسهم بشكل زائف في تضخيم تباين مجموعة معينة دون غيرها. يمكن استخدام الإجراء PROC UNIVARIATE لاستخراج مقاييس التشتت التفصيلية، والمخططات الصندوقية، والقيم القصوى والدنيا، مما يمكن الباحث من التمييز بين التباين الحقيقي المرتبط بالظاهرة النفسية وبين التباين المصطنع الناجم عن شذوذ بعض الملاحظات.
4. تنفيذ اختبار ليفين باستخدام إجراء PROC GLM في SAS
4.1 بنية الأوامر البرمجية لإجراء PROC GLM
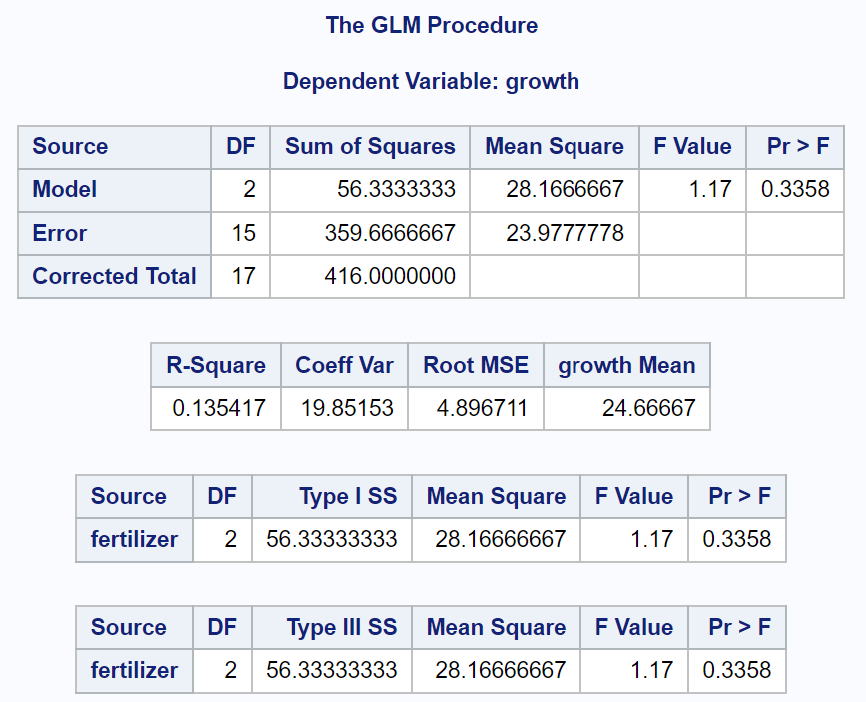
يُعد إجراء النماذج الخطية العامة (PROC GLM) الأداة الأكثر تنوعاً وقوة داخل SAS لتنفيذ النماذج الخطية وتحليل التباين بمختلف أشكاله، ولا سيما عند التعامل مع عينات غير متساوية الحجم. يبدأ السطر البرمجي باستدعاء الإجراء وتحديد مجموعة البيانات المستهدفة باستخدام الصيغة PROC GLM DATA=DatasetName;، مما يوجه محرك التحليل إلى المصفوفة المطلوبة مخبرياً.
تعتبر تعليمة التصنيف CLASS ركيزة إلزامية في هذا الإجراء، حيث يتم إدراج المتغيرات المستقلة الفئوية بعدها مباشرة. تعمل هذه التعليمة على إعلام النظام بأن المتغير المعني يمثل عوامل تجريبية أو مجموعات تصنيفية نوعية، مما يدفع المحرك لإنشاء مصفوفات التصميم (Design Matrices) والمتغيرات الوهمية الضرورية لإجراء تحليل التباين بشكل سليم.
تلي ذلك تعليمة النموذج MODEL، والتي تحدد العلاقة الرياضية بين المتغير التابع والمتغيرات المستقلة باستخدام الصيغة الكلاسيكية: MODEL DependentVar = IndependentVar;. تترجم هذه التعليمة المعادلة الخطية وتحدد المتغير المستهدف بالدراسة ودرجات الحرية المصاحبة لكل مصدر من مصادر التباين في التجربة.
4.2 تفعيل خيار اختبار ليفين ضمن خيارات تعليمة MEANS
يتم استدعاء اختبار ليفين لفحص تجانس التباين في إجراء PROC GLM من خلال إضافته كخيار متخصص ملحق بتعليمة MEANS. يتم كتابة اسم المتغير المستقل بعد التعليمة، ثم وضع شرطة مائلة (/) تتبعها العبارة المفتاحية HOVTEST=LEVENE (حيث تشير HOVTEST إلى Homogeneity of Variance Test). هذه البنية توجه SAS لحساب إحصائية ليفين للمجموعات المحددة بالتزامن مع استخراج المتوسطات الحسابية والانحرافات المعيارية.
من الأمور الفنية بالغة الأهمية التي يغفل عنها الكثير من الباحثين أن السلوك الافتراضي لبرنامج SAS عند كتابة HOVTEST=LEVENE هو حساب تحليل التباين على مربعات الانحرافات عن متوسط المجموعة ($Z_{ij} = (Y_{ij} – \bar{Y}_{i\cdot})^2$) بدلاً من الانحرافات المطلقة. وإذا كان الباحث يرغب في مطابقة الصيغة الكلاسيكية المعتمدة في المراجع المنهجية الشائعة أو مطابقة مخرجات حزم أخرى كبرنامج SPSS، فيجب عليه تحديد الخيار بدقة عبر كتابة: HOVTEST=LEVENE(TYPE=ABS)، والتي تلزم النظام بحساب الانحرافات المطلقة ($Z_{ij} = |Y_{ij} – \bar{Y}_{i\cdot}|$).
إلى جانب ذلك، يمكن للباحث تضمين خيارات مرافقة في تعليمة MEANS، مثل خيار اختبار ويلش WELCH، وخيارات الاختبارات البعدية المتينة. ويجب دائماً إنهاء مجموعة الأوامر بتعليمتي RUN; وQUIT; لضمان استكمال المعالجة الرياضية بالكامل وإغلاق الإجراء البرمجي دون تعليق الذاكرة النشطة للنظام.
4.3 نموذج برمجي كامل لاختبار ليفين عبر PROC GLM
لتوضيح التطبيق العملي، نفترض سيناريو بحثياً في علم النفس الإكلينيكي يقارن بين ثلاثة برامج علاجية لخفض حدة القلق: (1) العلاج المعرفي السلوكي (CBT)، (2) العلاج باليقظة الذهنية (Mindfulness)، (3) قائمة الانتظار الضابطة (Control). نقيس درجات القلق بعد التدخل لدى عينة من المشاركين. يوضح الكود التالي البناء المتكامل لخطوة البيانات وتطبيق الإجراء PROC GLM:
فيما يلي نص الشفرة البرمجية المعتمدة لاختبار تجانس التباين:
DATA Anxiety_Study;
INPUT Treatment $ Anxiety_Score;
DATALINES;
CBT 18
CBT 20
CBT 19
CBT 22
CBT 21
Mindfulness 24
Mindfulness 27
Mindfulness 23
Mindfulness 29
Mindfulness 22
Control 35
Control 40
Control 32
Control 38
Control 42
;
RUN;
PROC GLM DATA=Anxiety_Study;
CLASS Treatment;
MODEL Anxiety_Score = Treatment;
MEANS Treatment / HOVTEST=LEVENE(TYPE=ABS) WELCH;
RUN;
QUIT;
يقوم هذا الكود أولاً بإنشاء مصفوفة البيانات Anxiety_Study، ثم يستدعي PROC GLM معلناً أن Treatment متغير تصنيفي، ويطلب اختبار ليفين القائم على الانحرافات المطلقة TYPE=ABS بالإضافة إلى اختبار ويلش المعدل في حالة ثبوت اختلال التجانس. عند تنفيذ هذا الكود، تتولى بيئة SAS فحص سجل التشغيل (SAS Log) للتأكد من خلو الأوامر من الأخطاء التكويدية، ثم تصدر تقارير إحصائية كاملة تتضمن جدول اختبار ليفين، وجدول تحليل التباين، ونتائج اختبار ويلش المتين.
5. تنفيذ اختبار ليفين باستخدام إجراء PROC ANOVA في SAS
5.1 نطاق استخدام PROC ANOVA وحدوده مقارنة بـ PROC GLM
صُمم إجراء تحليل التباين (PROC ANOVA) في نظام SAS خصيصاً للتصاميم التجريبية المتوازنة (Balanced Designs) التي تتساوى فيها أعداد المشاهدات تماماً عبر جميع المعالجات والمجموعات. يتميز هذا الإجراء بسرعة حسابية فائقة تفوق إجراء PROC GLM بمراحل، نظراً لاعتماده على خوارزميات مباشرة لتحليل التباين لا تتطلب حساب مقلوب المصفوفات المعممة المعقدة، مما يجعله مثالياً لتحليل التجارب المعملية الضخمة متساوية العينات.
ومع ذلك، تبرز قيود منهجية خطيرة عند محاولة استخدام PROC ANOVA في دراسات تتضمن عينات غير متساوية الأعداد، وهو النمط السائد في البحوث النفسية والميدانية؛ إذ إن عدم التوازن يؤدي إلى اختلال التعامد (Orthogonality) بين مصادر التباين. في مثل هذه الحالات، يفشل PROC ANOVA في حساب مجاميع المربعات من النوع الثالث (Type III SS) بدقة، مما يفرز تقديرات متحيزة لإحصائيات الاختبار وقيم الدلالة.
لذا، تشدد الأدلة المنهجية المعتمدة في بيئة SAS على قصر استخدام PROC ANOVA على البيانات المتوازنة بدقة، مع التوصية الصريحة باللجوء دائماً إلى PROC GLM كخيار قياسي آمن وأكثر شمولية عند التعامل مع أي تصميم بحثي قد يطرأ عليه فقدان للمشاهدات أو تباين في أحجام العينات.
5.2 الصيغة البرمجية لاختبار ليفين في PROC ANOVA
تتشابه البنية النحوية لاستدعاء الأوامر في إجراء PROC ANOVA إلى حد كبير مع نظيرتها في PROC GLM، حيث تبدأ بالتعليمة PROC ANOVA DATA=DatasetName;، وتتطلب إدراج تعليمة CLASS لتعريف المتغيرات التصنيفية المستقلة، وتعليمة MODEL لربط المتغير التابع بالمتغير المستقل.
لتفعيل اختبار ليفين، تُستخدم تعليمة MEANS الملحقة بالإجراء، مع تضمين الخيار HOVTEST=LEVENE بالطريقة نفسها. يتيح الإجراء تحديد نوع الانحراف المطلوب، مثل الانحراف المطلق TYPE=ABS، كما هو موضح في البنية التالية:
PROC ANOVA DATA=Anxiety_Study;
CLASS Treatment;
MODEL Anxiety_Score = Treatment;
MEANS Treatment / HOVTEST=LEVENE(TYPE=ABS);
RUN;
QUIT;
عند تشغيل هذا الكود، يجب على الباحث فحص نافذة سجل النظام (SAS Log) بعناية فائقة؛ ففي حال رصد النظام عدم تساوٍ في أعداد المشاهدات بين المجموعات، سيقوم بطباعة تحذير صريح (Warning) يوضح أن التصميم غير متوازن، وينصح الباحث رسمياً بالانتقال إلى إجراء PROC GLM لتفادي أي أخطاء تقديرية محتملة في معالجة البيانات.
5.3 مقارنة عملية بين نتائج الإجراءين في SAS
عند تطبيق كلا الإجراءين (PROC GLM وPROC ANOVA) على مجموعة بيانات متوازنة تماماً—كما هو الحال في السيناريو السابق حيث تضم كل مجموعة من المجموعات الثلاث 5 مشاهدات متطابقة الحجم—تأتي النتائج الرقمية لاختبار ليفين وقيم إحصائية $F$ ودرجات الحرية والقيم الاحتمالية متطابقة تطابقاً تاماً حتى أدق المنازل العشرية. يعود هذا التطابق إلى أن الخوارزميات الحسابية لكلا الإجراءين تختزل إلى نفس الصيغة الجبرية في غياب اختلال التوازن.
أما عند حذف مشاهدة أو أكثر من إحدى المجموعات لخلق تصميم غير متوازن، فإن الاختلاف يظهر جلياً في المخرجات العامة لتحليل التباين؛ فبينما يواصل PROC GLM تقديم اختبارات دقيقة مبنية على مجموع المربعات المصحح (Type III SS)، قد تتعرض مخرجات PROC ANOVA لتشوهات في تقديرات التأثيرات الرئيسية، على الرغم من أن اختبار ليفين المحسوب على الانحرافات قد يظل قريباً عددياً، إلا أن موثوقية الاستنتاج العام تتزعزع.
تتلخص التوصية الأكاديمية الراسخة لعلماء القياس والإحصاء السلوكي في تفضيل اعتماد PROC GLM كمعيار افتراضي دائم في بحوث علم النفس والعلوم الاجتماعية؛ إذ يوفر هذا الإجراء حصانة تلقائية ضد التغيرات الطارئة في بنية البيانات، ويضمن اتساق التحليلات التمهيدية لتجانس التباين مع النماذج التفسيرية اللاحقة دون الحاجة إلى التبديل بين الإجراءات البرمجية.
6. قراءة وتحليل مخرجات اختبار ليفين في برنامج SAS
6.1 تفكيك جدول اختبار ليفين لتجانس التباين
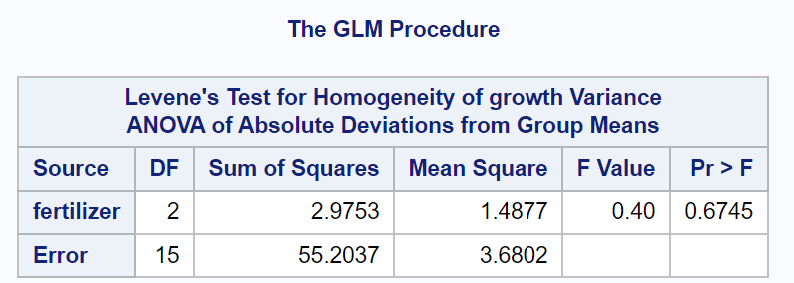
يقدم برنامج SAS نتائج اختبار ليفين في جدول مخصص ومستقل يظهر تحت عنوان “Levene’s Test for Homogeneity of Variance” ضمن نافذة المخرجات (Results Viewer). يتكون هذا الجدول من عدة أعمدة وعناصر إحصائية محددة يجب على الباحث تفكيكها بدقة لاستخلاص الاستنتاج الصحيح، وهي: مصدر التباين (Source)، ودرجات الحرية (DF)، ومجموع المربعات (Sum of Squares)، ومتوسط المربعات (Mean Square)، وقيمة إحصائية فائية (F Value)، والقيمة الاحتمالية المرافقة (Pr > F).
يظهر في عمود درجات الحرية (DF) صفان رئيسيان: يمثل الصف الأول درجات حرية البسط (Numerator DF) الخاصة بالمتغير المستقل وتساوي دائماً ($k – 1$)، حيث يمثل $k$ عدد المجموعات المقارنة. ويمثل الصف الثاني درجات حرية المقام أو الخطأ (Denominator DF / Subgroup Error) وتساوي ($N – k$)، حيث يمثل $N$ إجمالي عدد الأفراد في كامل العينات المشمولة بالتحليل. تشكل هاتان القيمتان المعيارين التوزيعيين لاختبار الدلالة الفائية.
يقابل هذه الصفوف في أقصى اليمين قيمة إحصائية $F$ المحسوبة، وهي ناتج قسمة متوسط مربعات الانحرافات بين المجموعات على متوسط مربعات الانحرافات داخل المجموعات. وإلى جانبها تظهر القيمة الاحتمالية بدقة فائقة تحت المسمى Pr > F، والتي تعبر عن احتمال الحصول بالصدفة على تفاوت في التشتت يساوي أو يفوق التفاوت الملاحظ فعلياً إذا كانت الفرضية الصفرية القائلة بتجانس التباينات صحيحة في المجتمع الأصلي.
6.2 قواعد اتخاذ القرار الإحصائي وفق القيمة الاحتمالية
يستند اتخاذ القرار الإحصائي بخصوص تجانس التباين إلى مقارنة القيمة الاحتمالية الناتجة (Pr > F) بمستوى الدلالة المحدد مسبقاً (عادة $\alpha = 0.05$). تندرج الحالات الناتجة تحت مسارين حاسمين:
- حالة تحقق التجانس ($p ge 0.05$): إذا كانت القيمة الاحتمالية أكبر من أو تساوي 0.05، يفشل الباحث في رفض الفرضية الصفرية ($H_0$). يعني هذا القرار الإحصائي أن الفروق الملاحظة بين تباينات المجموعات لا تتمتع بدلالة إحصائية ويمكن عزوها إلى تقلبات المعاينة العشوائية، مما يؤكد استيفاء شرط تجانس التباين، وصلاحية الاعتماد على اختبار ANOVA القياسي وتفسير نتائجه بأمان وثقة.
- حالة خرق التجانس ($p < 0.05$): إذا كانت القيمة الاحتمالية أقل من 0.05، تُرفض الفرضية الصفرية وتُقبل الفرضية البديلة ($H_1$). يثبت هذا القرار الإحصائي وجود اختلاف جوهري في التشتت بين مجموعة واحدة على الأقل وبقية المجموعات. في هذه الحالة، يصبح نموذج تحليل التباين الكلاسيكي غير موثوق، ويتعين على الباحث الامتناع عن تفسير قيم $F$ العادية وتفعيل البدائل الإحصائية المصححة فوراً.
من الأخطاء التحليلية الشائعة التي يقع فيها بعض المبتدئين في التحليل الإحصائي الخلط بين الدلالة الإحصائية لاختبار ليفين والدلالة الإحصائية للنموذج الرئيسي؛ فبينما يسعى الباحث عادة للحصول على قيمة $p < 0.05$ في جدول ANOVA الرئيسي لإثبات وجود أثر للعلاج أو المتغير المستقل، فإنه في اختبار ليفين يأمل الحصول على قيمة غير دالة ($p ge 0.05$) لضمان سلامة النموذج واستيفائه للافتراضات المعلمية.
6.3 كتابة وتوثيق النتائج وفق المعايير الأكاديمية (APA Style)
تفرض جمعية علم النفس الأمريكية في دليل نشرها المعتمد (APA 7th Edition) توثيقاً دقيقاً ومنهجياً لنتائج اختبارات الفروض المسبقة قبل استعراض النتائج الجوهرية للدراسة. يجب أن يتضمن التوثيق ذكر اسم الاختبار بوضوح، ونوع الانحرافات المستخدمة (مطلقة أو مربعة)، وتحديد درجات حرية البسط والمقام، وقيمة إحصائية $F$ المحسوبة مقربة إلى منزلتين عشريتين، والقيمة الاحتمالية بدقة متناهية، مع إبراز المؤشرات الوصفية للتباين كالانحرافات المعيارية لكل مجموعة.
يوضح النص النموذجي التالي كيفية صياغة هذه النتائج في متن الأبحاث النفسية المحكمة:
“للتحقق من استيفاء فرضية تجانس التباين قبل تطبيق تحليل التباين الأحادي، أُجري اختبار ليفين القائم على الانحرافات المطلقة عن المتوسط باستخدام بيئة SAS. أظهرت النتائج تحقق فرضية تجانس التباين عبر المجموعات العلاجية الثلاث، حيث لم تسجل إحصائية الاختبار دلالة إحصائية، $F(2, 12) = 0.85, p = .452$. وبناءً على استيفاء هذا الشرط الأساسي، تم المضي قدماً في تطبيق اختبار تحليل التباين الكلاسيكي (ANOVA) لتحديد الفروق في متوسطات درجات القلق.”
أما في حال خرق الفرضية وظهور دلالة إحصائية لاختبار ليفين، فيُصاغ التقرير على النحو التالي:
“أشار اختبار ليفين لتجانس التباين إلى وجود خرق جوهري لافتراض تماثل التشتت بين المجموعات التجريبية، $F(2, 12) = 4.92, p = .027$. ونظراً لعدم استيفاء هذا الافتراض المعلمي، تم تجاوز نتائج اختبار $F$ التقليدي والاعتماد على اختبار ويلش المصحح لتحليل التباين (Welch’s adjusted ANOVA) لتفسير الفروق بين المتوسطات بدقة وموثوقية.”
7. الحلول الإحصائية والبدائل عند خرق فرضية تجانس التباين في SAS
7.1 استخدام اختبار ويلش لتحليل التباين (Welch’s ANOVA)
يُعد اختبار ويلش لتحليل التباين (Welch’s ANOVA) الحل الإحصائي المعلمي الرائد والبديل الأكثر توصية من قِبل علماء القياس عند ثبوت خرق فرضية تجانس التباين، ولا سيما في الحالات التي تترافق فيها التباينات غير المتكافئة مع عينات غير متساوية الحجم. لا يفترض اختبار ويلش تماثل التباينات بين المجموعات، بل يقوم بوزن متوسط كل مجموعة بناءً على مقلوب تباينها الخاص، مما يمنح المجموعات ذات التباين المنخفض وزناً نسبياً أكبر في حساب الفروق.
لتفعيل اختبار ويلش في SAS، يكفي تضمين الخيار WELCH في تعليمة MEANS ضمن إجراء PROC GLM، كما يظهر في التركيب البرمجي:
PROC GLM DATA=StudyData;
CLASS Group;
MODEL Outcome = Group;
MEANS Group / HOVTEST=LEVENE(TYPE=ABS) WELCH;
RUN;
QUIT;
ينتج هذا الأمر جدولاً مخصصاً في مخرجات SAS يحمل عنوان “Welch’s ANOVA for Dependent Variable”. يتميز هذا الجدول بتعديل درجات حرية المقام عبر معادلة ويلش-سيمبسون الرياضية المعقدة لتتحول إلى درجات حرية كسرية غير صحيحة. توفر إحصائية ويلش الفائية حماية تامة ضد التضخم الزائف للخطأ من النوع الأول، وتوفر قوة إحصائية ممتازة تفوق محاولات التحويل الجبري للبيانات في أغلب الأحيان.
7.2 تطبيق التحويلات الرياضية على البيانات (Data Transformations)
يمثل التحويل الرياضي للمتغير التابع أحد الحلول الكلاسيكية الراسخة لاستعادة تجانس التباين وتعديل انحرافات التوزيع في آن واحد. تعمل هذه التحويلات على ضغط الذيول الطويلة في التوزيعات شديدة الالتواء الموجب، مما يؤدي إلى تقليص التشتت المتضخم في المجموعات ذات القيم الكبيرة وإعادة التباينات إلى مستويات متقاربة رياضياً.
من أبرز التحويلات المستخدمة في الدراسات السلوكية التحويل اللوغاريتمي الطبيعي ($log(Y)$ أو $log(Y+1)$ للبيانات التي تحتوي على أصفار)، والذي يتم تنفيذه برمجياً في خطوة البيانات في SAS عبر الدالة Log_Score = LOG(Score);. كما يُستخدم تحويل الجذر التربيعي SQRT(Score) لبيانات التكرارات والمعدلات، أو تحويل مقلوب القيمة 1/Score للحالات شديدة التباين. إضافة إلى ذلك، يوفر SAS إجراء التحويل المتقدم PROC TRANSREG لاستكشاف وتطبيق تحويلات بوكس-كوكس العائلية (Box-Cox Transformations) واختيار المعامل الأمثل ($lambda$) تلقائياً.
عقب إجراء أي تحويل رياضي، يتعين على الباحث إعادة تطبيق اختبار ليفين على المتغير الجديد المحول للتأكد تجريبياً من استعادة تجانس التباين بنجاح. إذا تحققت الفرضية، يمكن للباحث المضي في تطبيق ANOVA الكلاسيكي، مع الأخذ في الحسبان ضرورة توخي الدقة عند تفسير النتائج؛ إذ ستكون المتوسطات معبرة عن مقاييس الدرجات المحولة هندسياً وليس عن المقاييس الإكلينيكية الأصلية.
7.3 الانتقال إلى الاختبارات اللامعلمية (Non-Parametric Tests)
عندما تترافق مشكلة عدم تجانس التباين مع خرق شديد للتوزيع الطبيعي وصغر حجم العينات، يصبح الانتقال إلى الاختبارات اللامعلمية بديلاً منهجياً ضرورياً. يُعد اختبار كروسكال-واليس (Kruskal-Wallis Test) النظير اللامعلمي المباشر لتحليل التباين الأحادي، حيث يتخلى عن افتراضات التجانس والتوزيع الطبيعي من خلال تحويل الدرجات الخام إلى رتب تصاعدية (Ranks) وإجراء المقارنات بناءً على مجاميع الرتب ومواقعها الوسيطة (Marmolejo‐Ramos et al., 2013).
يتم تنفيذ اختبار كروسكال-واليس في SAS بكفاءة عالية باستخدام إجراء التحليلات اللامعلمية PROC NPAR1WAY عبر الشفرة التالية:
PROC NPAR1WAY DATA=StudyData WILCOXON;
CLASS Group;
VAR Score;
RUN;
يقوم الخيار WILCOXON بتوجيه SAS لحساب إحصائية كروسكال-واليس المبنية على تقريب مربع كاي ($\chi^2$). على الرغم من أن هذا الاختبار يتمتع بمناعة تامة ضد التباينات الشاذة، إلا أن الباحث يجب أن يدرك حدوده؛ فالاختبارات اللامعلمية قد تعاني من فقدان نسبي للقوة الإحصائية (Power Efficiency) مقارنة بالنماذج الخطية المعلمية المكافئة، ولا تتيح فحص التفاعلات المعقدة بين المتغيرات المستقلة بنفس السهولة والعمق المتوفرين في تحليل التباين المتعدد.
8. مقارنة اختبار ليفين بالاختبارات البديلة لتجانس التباين في SAS
8.1 اختبار براون-فورسيث (Brown-Forsythe Test)
يمثل اختبار براون-فورسيث (Brown & Forsythe, 1974) التعديل الأكثر شهرة وفاعلية لاختبار ليفين الكلاسيكي؛ إذ يعتمد على حساب الانحرافات المطلقة للدرجات عن وسيط المجموعة ($\tilde{Y}_{i\cdot}$) بدلاً من المتوسط الحسابي: $Z_{ij} = |Y_{ij} – \tilde{Y}_{i\cdot}|$. تنبع أهمية هذا التعديل من الحقيقة الإحصائية المعروفة بأن الوسيط مقياس نزعة مركزية شديد المتانة لا يتأثر بالقيم المتطرفة أو الذيول الملتوية، مما يمنع تشوه مؤشرات التشتت بفعل شذوذ بضع درجات مفردة.
يتم طلب هذا الاختبار المتقدم في SAS بكل سهولة من خلال إدراج الخيار HOVTEST=BF ضمن تعليمة MEANS في إجراء PROC GLM. يتفوق اختبار براون-فورسيث بوضوح على اختبار ليفين المعياري عندما تكون التوزيعات التكرارية للبيانات السلوكية تعاني من التواء واضح أو تفرطح عالٍ، حيث يحافظ على معدل الخطأ الاسمي للنوع الأول بدقة متناهية دون تضخم كاذب للدلالة.
لذا، تفضل المراجع الإحصائية المعاصرة استخدام اختبار براون-فورسيث كخيار أولي عندما تُظهر المؤشرات الاستكشافية المبدئية ابتعاد درجات الاستجابة عن التوزيع الطبيعي المتماثل، مما يجعله بديلاً مفضلاً في اختبار استقرار تباينات الاستجابات النفسية الميدانية.
8.2 اختبار بارتليت (Bartlett’s Test)
يعتمد اختبار بارتليت على مبدأ نسبة الإمكان الأعظم (Likelihood Ratio Test) لمقارنة تباينات العينات الموزونة بدرجات حريتها، ويخضع تقريبه لإحصائية مربع كاي. يتم استدعاء هذا الاختبار في بيئة SAS من خلال إدراج الخيار HOVTEST=BARTLETT داخل تعليمة MEANS. وعلى الرغم من قوته الإحصائية العالية عندما تكون البيانات مستوفية لشرط التوزيع السوي بدقة تامة، إلا أنه يواجه انتقادات منهجية واسعة النطاق.
تتمثل المعضلة الكبرى لاختبار بارتليت في حساسيته الفائقة والمفرطة لخرق التوزيع الطبيعي؛ فالبيانات التي تتسم بتفرطح خفيف أو التواء متواضع تؤدي إلى إسفار الاختبار عن دلالة إحصائية خاطئة، ترفض الفرضية الصفرية وتوحي بوجود خلل في تماثل التباين بينما الخلل في الواقع ينحصر في شكل التوزيع التكراري. هذا القصور يجعله اختباراً هشاًّ (Fragile Test) في التطبيقات النفسية والتربوية التي نادراً ما تتماثل فيها البيانات مع التوزيع المعياري المثالي.
وبناءً على هذه المعطيات، يُنصح الباحثون بتجنب الاعتماد على اختبار بارتليت كمعيار وحيد في تقييم تجانس التباين، واستبداله باختبار ليفين أو براون-فورسيث اللذين يوفران مناعة وحصانة رياضية ضد التشوهات التوزيعية الواقعية.
8.3 اختبار أوبراين (O’Brien’s Test)
يقدم اختبار أوبراين (Ralph G. O’Brien, 1979, 1981) مقاربة رياضية متقدمة لتعديل درجات التشتت؛ إذ يقوم بتحويل المتغير الأصلي إلى مؤشر انتشار موزون يدمج تباين العينة وتفرطحها (Sample Kurtosis) وحجمها، مما يمنحه قدرة ديناميكية على التكيف مع التوزيعات متباينة التفلطح. يتم استدعاء هذا الاختبار في SAS عبر كتابة الخيار HOVTEST=OBRIEN، ويستخدم البرنامج افتراضياً معامل وزن قدره $W = 0.5$.
تتلخص ميزة اختبار أوبراين في قدرته على تعويض أثر التفرطح دون التضحية بالقوة الإحصائية للاختبار، مما يجعله خياراً وسطاً ومثالياً بين اختبار ليفين الكلاسيكي واختبار بارتليت في عينات الدراسات النفسية متوسطة الحجم. تعكس مخرجات أوبراين في SAS جداول دقيقة تسمح للباحث بمقارنة الدلالة المعطاة مع مؤشرات ليفين وبراون-فورسيث لبناء رؤية استدلالية متكاملة.
توفر مصفوفة المفاضلة بين هذه الاختبارات داخل SAS مرونة منهجية نادرة؛ حيث يُنصح باعتماد بارتليت فقط في التوزيعات الطبيعية المؤكدة، واستخدام ليفين (TYPE=ABS) في التوزيعات المتماثلة عامة الخصائص، واعتماد براون-فورسيث (BF) للبيانات شديدة الالتواء، وتطبيق أوبراين (OBRIEN) للبيانات المتميزة بتفرطح ملحوظ وتوزيعات ذات قمم غير معيارية.
9. التطبيقات العملية لاختبار ليفين في البحوث النفسية والسلوكية
9.1 تطبيقات في دراسات القياس النفسي والتقييم الإكلينيكي
يحتل فحص تجانس التباين موقعاً محورياً في دراسات القياس النفسي وتطوير المقاييس الإكلينيكية، لا سيما عند تقييم استقرار الخصائص السيكومترية لأدوات قياس القلق، والاكتئاب، والسمات المعرفية عبر الفئات التشخيصية المتعددة (Falcone et al., 2010). فعند التحقق من الصدق التمييزي لأداة تقييمية جديدة، يُشترط أن تكون درجات التشتت متقاربة بين العينات المعيارية لضمان عدم تأثر البنية العاملية للمقياس بالتباينات العشوائية في التشتت الداخلي للاستجابات.
علاوة على ذلك، يبرز دور اختبار ليفين في دراسات المقارنة المعيارية والعدالة الاختبارية (Test Fairness) بين الجنسين (ذكور وإناث) أو بين الخلفيات الثقافية المتنوعة؛ حيث يتطلب إقرار تكافؤ المقاييس واستخدامها الآمن التأكد من تماثل تباين الأخطاء المعيارية للاستجابات، مما يضمن أن الفروق المرصودة في درجات الاختبارات النفسية تعكس تبايناً حقيقياً في السمة المقاسة وليست ناتجة عن عدم استقرار التباين في إحدى المجموعات (Seah et al., 2019).
إن إغفال فحص تجانس التباين في هذه السياقات قد يقود الأخصائيين النفسيين إلى قرارات تشخيصية خاطئة؛ إذ إن تضخم تباين درجات فئة معينة قد يوحي بوجود حالات شذوذ إكلينيكي حادة غير حقيقية، مما يؤكد أن اختبار ليفين يمثل صمام أمان منهجي لضمان دقة التقييمات النفسية الفردية والمؤسسية على حد سواء.
9.2 تطبيقات في علم النفس التجريبي وتجارب التدخلات السلوكية
في تصاميم علم النفس التجريبي التي تدرس فاعلية التدخلات العلاجية والسلوكية المعقدة، مثل برامج الدعم المعرفي أو برامج تقليل الضغوط الموجهة للكوادر المهنية (Rodríguez‐Rey et al., 2020)، يُطبق اختبار ليفين عادة لتقييم تماثل تباين مجموعات العلاج التجريبي مقارنة بمجموعات العلاج الوهمي (Placebo) أو التحكم. في هذه البيئات، لا يقتصر دور الاختبار على كونه شرطاً مسبقاً للتحليل، بل يتجاوز ذلك ليتحول إلى أداة استكشافية جوهرية تكشف ديناميكية الاستجابة للتدخل.
إن ظهور عدم تجانس دال إحصائياً في تباين درجات المجموعة التجريبية مقارنة بالمجموعة الضابطة—حتى بعد نجاح التدخل في تحسين المتوسط العام—يعد مؤشراً حيوياً على وجود “استجابات علاجية غير متجانسة” (Heterogeneous Treatment Effects) بين المشاركين (Stevenson et al., 2019). يعني ذلك أن التدخل قد أفاد بعض الأفراد بشدة بينما لم يتأثر به آخرون، مما وسع نطاق تشتت المجموعة بصورة استثنائية.
في مثل هذه الحالات المعملية المتقدمة، يوجه اختبار ليفين الباحثين إلى ضرورة البحث عن متغيرات معدلة كامنة (Moderator Variables)—مثل السمات الشخصية القاعدية، أو الفروق الجينية، أو الدعم الاجتماعي—تتفاعل مع التدخل وتفسر هذا التباين الداخلي المتنامي، مما ينقل التحليل من مجرد مقارنة متوسطات جامدة إلى فهم ديناميكي عميق لآليات التأثير السلوكي.
9.3 دراسات التطور والنمو السلوكي عبر الفئات العمرية
تتميز الدراسات النمائية والسلوكية التي تتناول مسار الحياة وتغير القدرات الإنسانية عبر المراحل العمرية المختلفة بظاهرة التباين المتزايد مع التقدم في السن (Pettay et al., 2007). فعند دراسة الوظائف التنفيذية، والذاكرة العاملة، وسرعة المعالجة الحسية بين فئات عمرية تمتد من الطفولة حتى مراحل الشيخوخة المتقدمة، يلاحظ الباحثون تصاعداً طبيعياً في تشتت الأداء؛ حيث يحافظ بعض المسنين على أداء معرفي متقد بينما يعاني آخرون من تدهور حاد، مما يؤدي إلى فروق هائلة في التباين الداخلي بين الأجيال.
كما تمتد هذه التأثيرات التطورية إلى كيفية تفاعل الأفراد وسلوكياتهم داخل البيئات المحيطة والأنشطة المجتمعية التشاركية عبر المراحل الحياتية (Chen et al., 2020؛ Peter et al., 2021). يتيح اختبار ليفين لعلماء النفس النمائي رصد التوقيت الزمني الدقيق الذي يبدأ فيه تباين القدرات في التباعد الإحصائي الجوهري، مما يسهم في تحديد المراحل الحساسة التي تتطلب تدخلاً تنموياً أو وقائياً.
عندما يسفر اختبار ليفين عن إثبات عدم تجانس التباين عبر الحقب العمرية، يصمم الباحثون استراتيجيات تحليلية مرنة، تتضمن استخدام نماذج التأثيرات المختلطة (Linear Mixed Models) أو تطبيق تصحيح ويلش داخل SAS؛ لضمان عدم طغيان التباين الطبيعي المتراكم عبر العمر على استنتاجات المقارنات المعرفية بين الفئات التطورية المختلفة.
10. أفضل الممارسات والأخطاء الشائعة عند تطبيق اختبار ليفين في SAS
10.1 أخطاء التكويد والصياغة في بيئة SAS وطرق تصحيحها
يواجه مستخدمو SAS مجموعة من الأخطاء التكويدية الشائعة عند كتابة أوامر اختبار ليفين، والتي قد تؤدي إما إلى توقف تنفيذ البرنامج أو استخراج نتائج مغايرة تماماً لما خطط له الباحث. يتمثل الخطأ الأول والأكثر شيوعاً في إغفال تعليمة التصنيف CLASS؛ فعند كتابة PROC GLM أو PROC ANOVA دون تعريف المتغير المستقل كمتغير فئوي ضمن تعليمة CLASS، يعامل SAS المتغير كمتغير كمي مستمر، مما يؤدي إلى فشل تنفيذ تعليمة MEANS بالكامل وظهور رسالة خطأ صريحة في سجل النظام تنص على: “ERROR: A CLASS statement is required for the MEANS statement.”
الخطأ البرمجي الآخر يرتبط بوضع خيارات الاختبار في مواقع غير صحيحة، مثل محاولة كتابة HOVTEST=LEVENE مباشرة في سطر تعليمة MODEL بدلاً من وضعها بعد الشرطة المائلة في تعليمة MEANS. لا يتعرف مترجم SAS على هذا الخيار داخل تعليمة النموذج، مما يؤدي إلى تجاهله أو توقف البرنامج. ولتفادي ذلك، يجب دائماً مراجعة الصياغة والتأكد من اقتران الاختبار باسم المتغير المستقل المستهدف في تعليمة المتوسطات.
كما يُعد تجاهل مراجعة نافذة السجل (SAS Log) ممارسة برمجية خاطئة؛ إذ يجب على الباحث فحص السجل بدقة بعد كل تشغيل للبحث عن أي تحذيرات زرقاء (Warnings) أو ملاحظات (Notes) تشير إلى وجود مشاهدات مستبعدة بسبب قيم مفقودة، أو تحذر من عدم توازن التصميم، أو توضح تطبيق نوع محدد من انحرافات ليفين، مما يضمن معالجة الثغرات البرمجية قبل اعتماد الجداول النهائية.
10.2 المحاذير المنهجية والتفسيرية لنتائج الاختبار
تتضمن الممارسة الإحصائية الرصينة تجنب الوقوع في مجموعة من المحاذير التفسيرية المرتبطة باختبار ليفين. يأتي في مقدمة هذه المحاذير “الاعتماد المفرط على القيمة الاحتمالية” دون مراعاة حجم العينة؛ ففي الدراسات المسحية الكبيرة ذات العينات الهائلة ($N > 5000$)، يكتسب اختبار ليفين قوة فائقة تجعله يكشف فروقاً ضئيلة وغير جوهرية في التشتت، مما يدفع الباحثين إلى رفض تجانس التباين دون مبرر عملي. في مثل هذه الظروف، يجب فحص نسبة التباين الأكبر إلى الأصغر؛ فإذا كانت النسبة أقل من 1.5 إلى 2، فإن النماذج الخطية تظل متينة عموماً.
من جهة أخرى، يقع بعض الباحثين في مغالطة منطقية مفادها أن عدم دلالة اختبار ليفين ($p ge 0.05$) يقدم دليلاً قاطعاً على “التماثل التام” بين تباينات المجموعات. في الواقع الإحصائي، كل ما يعنيه عدم رفض الفرضية الصفرية هو عدم توفر أدلة كافية في البيانات الحالية لإثبات التفاوت، ولا سيما في العينات الصغيرة التي تفتقر للقوة الإحصائية الكافية لكشف الفروق، مما يستوجب الحذر وعدم الجزم المطلق.
لتفادي هذه المنزلقات، توصي الأدبيات بضرورة الجمع الدائم بين الاختبارات الاستدلالية والفحص البصري التكميلي. يساعد توليد المخططات الصندوقية (Boxplots) ومخططات البواقي مقابل القيم المتنبأ بها (Residuals vs. Fitted Plots) عبر إجراءات SAS البيانية المتقدمة (مثل PROC SGPLOT) على تكوين رؤية حدسية واضحة لتوزيع التشتت، والتأكد من مطابقة الاستنتاج الإحصائي لواقع التوزيعات الميدانية.
10.3 قائمة تحقق الباحث الإحصائي قبل اعتماد نتائج تحليل التباين
قبل اعتماد النتائج النهائية لنماذج تحليل التباين وتقديمها للنشر العلمي، ينبغي للباحث السلوكي استيفاء قائمة مراجعة منهجية صارمة تتضمن المراحل والقرارات الإحصائية التالية:
- مراجعة مصفوفة الفروض الإحصائية: التأكد من استيفاء فرض استقلالية الملاحظات، وفحص التوزيع الطبيعي للبيانات عبر اختبارات شابيرو-ويلك أو كولموجوروف-سميرنوف في
PROC UNIVARIATE، متبوعاً باختبار ليفين لتجانس التباين فيPROC GLM. - تحديد صيغة ليفين المناسبة: التأكد من ملاءمة نوع الانحراف المختار لطبيعة البيانات؛ استخدام
TYPE=ABSلمطابقة المعايير الكلاسيكية، أوHOVTEST=BFفي حال وجود التواء في التوزيع التكراري للدرجات. - مواءمة القرار التحليلي: في حال دلالة اختبار ليفين ($p < 0.05$)، التحقق من تفعيل اختبار ويلش الملحق
WELCHفي الكود، أو إخضاع البيانات للتحويلات الرياضية، أو استخدام البدائل اللامعلمية المناسبة وتوثيق هذا المسار المنهجي بالكامل. - توثيق الشفافية البرمجية: حفظ شفرات SAS البرمجية وسجلات التشغيل المرتبطة بها لضمان قابلية التحليل للتكرار والتحقق العلمي (Reproducibility)، وتدوين كافة القيم الإحصائية بدقة وفق دليل النشر المعتمد لمجال التخصص.
خاتمة
يمثل اختبار ليفين لتجانس التباين أداة تشخيصية لا غنى عنها في ترسانة الباحث الإحصائي والسلوكي؛ إذ يحمي النماذج الخطية المعلمية من مخاطر التفسير الخاطئ، ويضبط معدلات الخطأ من النوع الأول عند مقارنة متوسطات المجموعات المستقلة. ومن خلال بيئة SAS القوية وتطبيقات إجراءاتها المتنوعة مثل PROC GLM وPROC ANOVA، يمتلك الباحثون القدرة على تنفيذ هذا الفحص الحاسم بأعلى مستويات الدقة الرياضية، مع إمكانية استدعاء الصيغ المتطورة كاختبار براون-فورسيث، وتفعيل المعالجات التصحيحية مثل اختبار ويلش في خطوة تنفيذية متكاملة تضمن الرصانة المنهجية والموثوقية العلمية للنتائج المنشورة.
المراجع
- Chen, C., Yılmaz, S., Pisello, A. L., De Simone, M., Kim, A. A., Hong, T., et al. (2020). The impacts of building characteristics, social psychological and cultural factors on indoor environment quality productivity belief. Building and Environment. https://doi.org/10.1016/j.buildenv.2020.107189
- Falcone, T., Fazio, V. J., Lee, C., Simon, B., Franco, K. S. N., Marchi, N., et al. (2010). Serum S100B: A Potential Biomarker for Suicidality in Adolescents?. PLoS ONE. https://doi.org/10.1371/journal.pone.0011089
- Krieglstein, F., Beege, M., Rey, G. D., Sanchez‐Stockhammer, C., & Schneider, S. (2023). Development and Validation of a Theory-Based Questionnaire to Measure Different Types of Cognitive Load. Educational Psychology Review. https://doi.org/10.1007/s10648-023-09738-0
- Marmolejo‐Ramos, F., Elosúa de Juan, M. R., Yamada, Y., Hamm, N. F., & Noguchi, K. (2013). Appraisal of Space Words and Allocation of Emotion Words in Bodily Space. PLoS ONE. https://doi.org/10.1371/journal.pone.0081688
- Peter, M., Diekötter, T., Kremer, K., & Höffler, T. N. (2021). Citizen science project characteristics: Connection to participants’ gains in knowledge and skills. PLoS ONE. https://doi.org/10.1371/journal.pone.0253692
- Pettay, J. E., Helle, S., Jokela, J., & Lummaa, V. (2007). Natural Selection on Female Life-History Traits in Relation to Socio-Economic Class in Pre-Industrial Human Populations. PLoS ONE. https://doi.org/10.1371/journal.pone.0000606
- Rodríguez‐Rey, R., Garrido‐Hernansaiz, H., & Bueno Guerra, N. (2020). Working in the Times of COVID-19. Psychological Impact of the Pandemic in Frontline Workers in Spain. International Journal of Environmental Research and Public Health. https://doi.org/10.3390/ijerph17218149
- Saddik, B. A., Hussein, A., Albanna, A., Elbarazi, I., Al-Shujairi, A., Sharif‐Askari, F. S., et al. (2021). The psychological impact of the COVID-19 pandemic on adults and children in the United Arab Emirates: a nationwide cross-sectional study. BMC Psychiatry. https://doi.org/10.1186/s12888-021-03213-2
- Seah, T. H. S., Aurora, P., & Coifman, K. G. (2019). Emotion Differentiation as a Protective Factor Against the Behavioral Consequences of Rumination: A Conceptual Replication and Extension in the Context of Social Anxiety. Behavior Therapy. https://doi.org/10.1016/j.beth.2019.05.011
- Stevenson, J. R., McMahon, E. K., Boner, W., & Haussmann, M. F. (2019). Oxytocin administration prevents cellular aging caused by social isolation. Psychoneuroendocrinology. https://doi.org/10.1016/j.psyneuen.2019.01.006