
يمثل إعداد البيانات وتنظيفها وتجهيزها مرحلة محورية حاسمة تسبق أي تحليل إحصائي رصين أو نمذجة تنبؤية متعددة المتغيرات. في البيئات البحثية والأكاديمية والصناعية المعاصرة، تتسم مجموعات البيانات غالباً بتنوع مقاييسها واختلاف أبعاد قياسها الفيزيائية والسلوكية والرياضية؛ حيث تتجاور المتغيرات المقاسة بآلاف الوحدات مع أخرى لا تتجاوز كسوراً عشرية دقيقة. هذا التفاوت الهائل في المقاييس العددية والتباينات الإحصائية يلقي بظلال سلبية مباشرة على النماذج الكمية، مؤدياً إلى تشويه حساب المسافات الإقليدية، وهيمنة المتغيرات ذات التباين المرتفع بصورة غير عادلة على الحسابات الإحصائية، وانحياز التحليلات متعددة المتغيرات كالتحليل العاملي والتحليل العنقودي وخوارزميات التعلم الآلي المعاقبة.
تعتبر بيئة التحليل الإحصائي SAS من أقوى المنصات البرمجية الرائدة في المعالجة الإحصائية المتقدمة للبيانات الضخمة، حيث توفر حزمة واسعة من الإجراءات المتخصصة في التعامل مع تحديات القياس والتوزيع. ومن بين هذه الأدوات، يبرز إجراء PROC STDIZE كأحد أكثر الإجراءات الإحصائية كفاءة ومرونة، ليس فقط في أداء التقييس والتحويل الخطي المعياري، بل وأيضاً في توفير منظومة متقدمة لمعالجة البيانات المفقودة، وتطبيق مقاييس الموضع والتشتت الرصينة (Robust measures) التي تضمن استقرار النتائج أمام الشذوذ الإحصائي والانحراف التوزيعي.
يهدف هذا الدليل المنهجي الموسع إلى تقديم تشريح أكاديمي وبرمجي شامل لكيفية استخدام إجراء PROC STDIZE في SAS. يستعرض المقال الأسس النظرية والرياضية العميقة للتحويلات المعيارية، مبرزاً الفروق الدقيقة بين التقييس والتطبيع، ومقدماً أمثلة برمجية واقعية مكتملة ومفصلة تبدأ من إدخال البيانات الأولية عبر خطوات البرمجة النصية، وتمر بالتحقق التشخيصي الرياضي والبصري، وصولاً إلى تطبيقات النمذجة المتقدمة وإدارة القيم المفقودة وتفادي الأخطاء الشائعة في بيئة SAS التنفيذية.
1. الأسس النظرية والرياضية لتقييس البيانات في التحليل الإحصائي
1.1 المفهوم الإحصائي للدرجة المعيارية ومعادلة التقييس
تمثل الدرجة المعيارية (Standardized Score) أحد أهم التحويلات الخطية في الإحصاء الوصفي والاستدلالي، حيث تهدف جوهرياً إلى توحيد المقاييس الإحصائية للمتغيرات ذات الوحدات القياسية المتباينة. يتم تعريف الدرجة المعيارية، والمعروفة رياضياً بدرجة Z-score، بأنها المسافة الموقعية التي تفصل القيمة الأصلية للمفردة عن المتوسط الحسابي للعينة، معبراً عنها بوحدات الانحراف المعياري. يتيح هذا التحويل للباحث إمكانية وضع قياسات غير متجانسة في الأصل على مسطرة قياس افتراضية موحدة ومحايدة، تتيح المقارنة النسبية الدقيقة بين عناصر مأخوذة من توزيعات رقمية ذات أبعاد مختلفة تماماً دون المساس بمواضع الحالات بالنسبة لبعضها البعض.
تعتمد الصيغة الرياضية الكلاسيكية لحساب الدرجة المعيارية على النموذج التالي:
Z = (X – μ) / σ
حيث تمثل X القيمة الأصلية للمتغير الخام، في حين تمثل μ المتوسط الحسابي للتوزيع (أو X̄ في العينات)، وتشير σ إلى الانحراف المعياري للمجتمع (أو s في العينات المقدرة). تنص الآلية الرياضية للتقييس في إجراء PROC STDIZE على نموذج تحويل خطي عام يتم التعبير عنه وفق العلاقة التالية:
Result = ADD + [MULT × ((Original – Location) / Scale)]
تتمثل القيم الافتراضية للمعاملات في أن تكون قيمة الإضافة ADD = 0 وقيمة المضاعف MULT = 1، بينما يُضبط معيار الموضع (Location) ليكون المتوسط الحسابي، ومعيار المقياس (Scale) ليكون الانحراف المعياري للعينة.
تتميز البيانات الناتجة عن عملية التقييس المعياري بخصائص جبرية وإحصائية صارمة تمنحها موثوقية عالية في التحليل الرياضي اللاحق؛ إذ يتحول المتوسط الحسابي للتوزيع المعياري حتماً ليساوي صفراً تماماً، بينما يصبح الانحراف المعياري والتباين مساويين للواحد الصحيح بدقة متناهية. تجدر الإشارة هنا إلى الفروق الدقيقة والجوهرية بين التقييس المعياري القائم على الانحراف المعياري، وبين إعادة التحجيم القائم على المدى (Range-based Rescaling)؛ فالأول يعتمد على عزم التوزيع الإحصائي ويحافظ على شكل التوزيع التكراري الأصلي ممتداً إلى اللانهاية النظرية، في حين يحصر الثاني القيم بصورة قطعية بين حدود جبرية ثابتة مثل الصفر والواحد.
1.2 مبررات تقييس المتغيرات في النماذج الإحصائية والقياس النفسي
تفرض المنهجيات الإحصائية المتقدمة والقياس السيكومتري ضرورة تقييس المتغيرات قبل إدخالها في النماذج التحليلية المعقدة لتجاوز مشكلة عدم التجانس في وحدات القياس. في الاختبارات النفسية والتربوية، على سبيل المثال، قد يُقاس متغير القلق باختبار يتراوح مداه العددي بين 0 و100 درجة، في حين يُقاس التحصيل الأكاديمي بمعدل تراكمي يتراوح بين 1.0 و4.0. إن محاولة دراسة العلاقة بين هذين البعدين دون اللجوء إلى التقييس تؤدي إلى جعل الفروق الفردية في مقياس القلق تبدو أضخم حسابياً بكثير من الفروق في المعدل التراكمي، مما يشوه الارتباطات الحقيقية ويفقد القياس النفسي دقته المرجعية في تفسير الفروق السلوكية.
علاوة على ذلك، يعد التقييس ركيزة لا غنى عنها لتحسين دقة خوارزميات التحليل متعدد المتغيرات (Multivariate Analysis). في تقنيات مثل تحليل المكونات الأساسية والتحليل العاملي الاستكشافي، تعتمد النماذج على مصفوفات التغاير المشترك؛ فإذا اختلفت المقاييس العددية للمتغيرات، فإن المتغير ذا التباين الخام الأكبر سيهيمن تلقائياً على استخراج العوامل والمكونات الأولى ويوجه تباين النموذج العام لصالحه بشكل زائف. كما تتأثر خوارزميات التصنيف والتحليل العنقودي كخوارزمية K-Means بصورة جذرية؛ نظراً لأنها تحسب المسافة الإقليدية الفاصلة بين الحالات، مما يجعل المتغيرات الكبيرة عددياً تتحكم تماماً في ترسيم المجموعات دون أي اعتبار للمتغيرات الدقيقة.
يمتد الأثر المنهجي للتقييس ليشمل النماذج التنبؤية والانحدارية المعاصرة، وخاصة عند دراسة المقارنات المقطعية والطولية في البيانات السلوكية المعقدة. يضمن التقييس المعياري مساواة الفرص الرياضية لجميع المتنبئات في تفسير التباين المشترك، ويتيح للباحث المقارنة المباشرة لمعاملات الانحدار المعيارية (Beta Coefficients) لتقييم الأثر النسبي لكل متغير مستقل بصورة علمية منصفة، متفادياً التشوهات الهيكلية التي قد تنجم عن المقاييس المتطرفة في رصد السلوك بمرور الزمن.
1.3 الفروق الجوهرية بين التقييس والتطبيع في تحضير البيانات
يخلط العديد من الباحثين ومحللي البيانات بين مفهومي التقييس (Standardization) والتطبيع (Normalization) في مرحلة معالجة البيانات الأولية. يرتكز التقييس الإحصائي، كما أشرنا، على إعادة تموضع البيانات بالاعتماد على معالم التوزيع الاحتمالي (المتوسط والانحراف المعياري)، مما يتيح للبيانات الناتجة الاحتفاظ بنطاق نظري غير محدود قد يتجاوز الدرجات المعيارية الثلاثة هبوطاً أو صعوداً بحسب طبيعة الحالات المتطرفة، وهو ما يجعله متسقاً بنيوياً مع التحليلات التي تفترض الاعتدال التوزيعي كاختبارات التباين والانحدار الخطي.
في المقابل، يشير مفهوم التطبيع، الذي يعرف تقنياً بتحجيم الأدنى والأعلى (Min-Max Scaling)، إلى إجراء تحويل خطي يحشر كافة القيم العددية قسراً داخل مدى عددي مغلق ومحدد مسبقاً، غالباً ما يكون النطاق [0, 1] أو [-1, 1]. تتم هذه العملية وفق المعادلة الحسابية:
X_norm = (X – X_min) / (X_max – X_min)
إن أثر كل أسلوب على خصائص التوزيع التكراري يختلف بصورة جذرية؛ فالتقييس المعياري يحافظ على مقاييس الشكل الأساسية كالتفرطح والالتواء، في حين يؤدي التطبيع المعتمد على القيم الدنيا والقصوى إلى ضغط التشتت الداخلي إذا احتوت البيانات على قيم شاذة، حيث تؤدي قيمة متطرفة وحيدة إلى تكدس النسبة الساحقة من الملاحظات ضمن نطاق ضيق جداً بالقرب من الصفر أو الواحد.
يتطلب اتخاذ القرار التحليلي بين التقييس والتطبيع فهماً عميقاً للخصائص التوزيعية للمتغيرات والنموذج الإحصائي المستهدف؛ فالتقييس المعياري هو الخيار الأمثل والمنهجي عندما تتبع المتغيرات السلوكية توزيعاً قريباً من التوزيع الطبيعي، أو عندما تكون الخوارزميات اللاحقة حساسة لافتراضات التغاير الخطي كالانحدار والتحليل العاملي. أما التطبيع، فيفضل تطبيقه عند التعامل مع خوارزميات تتطلب مدخلات مقيدة المدى مثل الشبكات العصبية الاصطناعية (Neural Networks) وبعض نماذج البرمجة الرياضية أو خوارزميات معالجة الصور الرقمية.
2. مقدمة إلى إجراء PROC STDIZE في بيئة التحليل الإحصائي SAS
2.1 التعريف بإجراء PROC STDIZE ووظائفه البرمجية الأساسية
يعتبر إجراء PROC STDIZE أحد الأدوات المتخصصة وفائقة القوة المدمجة في حزمة SAS/STAT، والمصممة هندسياً لإجراء عمليات التحويل والتقييس والتطبيع لمصفوفات البيانات الرقمية بدقة وكفاءة متناهية. لا تقتصر وظيفة هذا الإجراء على حساب الدرجات المعيارية التقليدية فحسب، بل يمتد دوره الوظيفي ليشمل تنفيذ أكثر من ثلاثين أسلوباً رياضياً وإحصائياً لتحجيم البيانات، بما يشمل الطرق البارامترية المعتمدة على معالم المجتمع، والطرق اللابارامترية الرصينة المصممة لتحييد تأثير الشذوذ العددي والتفرطح الشديد في العينات الواقعية.
تتجلى الميزة الكبرى لإجراء PROC STDIZE في كفاءته الحاسوبية المذهلة في معالجة مجموعات البيانات الضخمة (Big Data) التي تتضمن ملايين السجلات ومئات المتغيرات الرقمية. فعند إجراء التحويلات الحسابية يدوياً عبر خطوات معالجة البيانات التقليدية DATA Step، يضطر المحلل الإحصائي إلى قراءة البيانات عدة مرات لحساب المتوسطات والانحرافات في خطوة منفصلة، ثم دمجها مجدداً، مما يستهلك قدراً هائلاً من ذاكرة الوصول العشوائي وموارد المعالجة. بينما يقوم PROC STDIZE بتنفيذ تلك العمليات داخلياً عبر مسار برمجي فائق التحسين يتطلب استهلاكاً أدنى للذاكرة وزمن تشغيل قياسي.
تمنح المنظومة البرمجية المدمجة في الإجراء مرونة تحليلية فائقة للباحثين؛ إذ تتيح الانتقال بين تقييس البيانات التقليدي، والتحجيم المئوي، واحتساب الفروق المعيارية وفق معايير رصينة متعددة، بالإضافة إلى توفير معالجة فورية ومتقدمة للمشكلات البنيوية في مجموعات البيانات الإحصائية كتوليد أوزان للمتغيرات أو استبدال الملاحظات الشاذة، مما يجعله مكوناً لا غنى عنه في بنية أنابيب تجهيز البيانات (Data Pipelines) المتقدمة في SAS.
2.2 البنية النحوية العامة والشفرة القياسية للإجراء
تتبع شفرة PROC STDIZE في لغة SAS بنية نحوية قياسية تتسم بالوضوح والتركيب المنطقي المباشر. تبدأ الشفرة دوماً بعبارة الاستدعاء التنفيذية المتبوعة بمجموعة الخيارات الموجهة للعملية، وتأخذ الصيغة الهيكلية الأساسية الموضحة أدناه:
PROC STDIZE DATA=input_dataset OUT=output_dataset METHOD=method_name <options>;
    BY variable_list;
    VAR variable_list;
    FREQ variable;
    WEIGHT variable;
RUN;
في هذه البنية القياسية، يحدد الخيار DATA= مجموعة البيانات المدخلة المراد قراءتها ومعالجة متغيراتها، بينما يحدد الخيار OUT= اسم مصفوفة البيانات الجديدة التي ستستقبل المتغيرات المحولة مع الحفاظ على ملف البيانات الأصلي من التعديل المباشر. كما يلعب خيار METHOD= دور الموجه المنهجي الذي يحدد الخوارزمية الرياضية المتبعة في احتساب مقاييس الموضع والمقياس كما سيتم بيانه لاحقاً في هذا الدليل التخصصي.
تتكامل البنية النحوية عبر عبارات فرعية اختيارية تمنح الإجراء قدرات تصنيفية متقدمة؛ حيث تُستخدم عبارة VAR لتخصيص المتغيرات الرقمية المستهدفة بالتقييس حصرياً واستبعاد ما عداها، في حين تتيح عبارة BY تنفيذ عمليات المعايرة والتقييس المستقلة عبر المستويات الفئوية لمتغير تصنيفي محدد كالجنس أو المجموعة التجريبية. وتختتم العملية البرمجية دائماً بعبارة RUN; التنفيذية، التي تعطي الأوامر لمحرك المعالجة في SAS لبدء المسح الإحصائي وتوليد مجموعة البيانات الناتجة في بيئة العمل المحددة.
2.3 المزايا التحليلية لاستخدام PROC STDIZE في الأبحاث الكمية
يوفر استخدام PROC STDIZE في الأبحاث الكمية مزايا منهجية وإجرائية متقدمة لا يمكن تحقيقها بسهولة عبر الطرق التقليدية. تأتي في مقدمة هذه المزايا قدرة الإجراء الفائقة والمدمجة على استبدال وتعويض القيم المفقودة (Missing Data Imputation) بالتزامن مع إجراءات التحويل الإحصائي؛ حيث يمتلك الإجراء آليات برمجية ذكية تسمح بملء الفجوات المعطياتية باستخدام المتوسطات أو الوسائط الحسابية بأسلوب يحفظ توازن العينة ويقلل من فقدان درجات الحرية في التحليلات اللاحقة.
بالإضافة إلى ذلك، يوفر الإجراء للمحلل الإحصائي تحكماً هندسياً دقيقاً في تحديد معالم الموضع المستهدفة ومقاييس التشتت المطلوبة للمخرجات النهائية عبر خيارات متطورة مثل LOCATION= وSCALE=. يتيح ذلك للباحث إعادة تموضع البيانات نحو متوسط افتراضي محدد مسبقاً يختلف عن الصفر، أو ضبط الانحراف المعياري ليتطابق مع متطلبات مقاييس سيكومترية معينة (مثل مقياس الذكاء الذي يعتمد متوسطاً يساوي 100 وانحرافاً معيارياً يساوي 15)، وذلك كله ضمن خطوة معالجة واحدة ودون الحاجة لكتابة معادلات جبرية إضافية.
تسهم هذه المعمارية الموحدة في تقليل احتمالية الوقوع في الأخطاء الحسابية والبرمجية بصورة شبه تامة؛ إذ إن كتابة خوارزميات التقييس داخل خطوات DATA Step تنطوي غالباً على مخاطر مرتبطة بسوء التعامل مع القيم المفقودة، أو أخطاء التدوير في القيم العشرية، أو التداخل العرضي بين تسميات المتغيرات القديمة والمستحدثة، وهو ما يقضي عليه PROC STDIZE بالكامل عبر بروتوكولاته الصارمة والمختبرة رياضياً على أعلى المستويات الأكاديمية والتطبيقية.
3. إعداد وتجهيز مجموعة البيانات التوضيحية في SAS
3.1 إنشاء مجموعة البيانات التجريبية عبر خطوة DATA Step
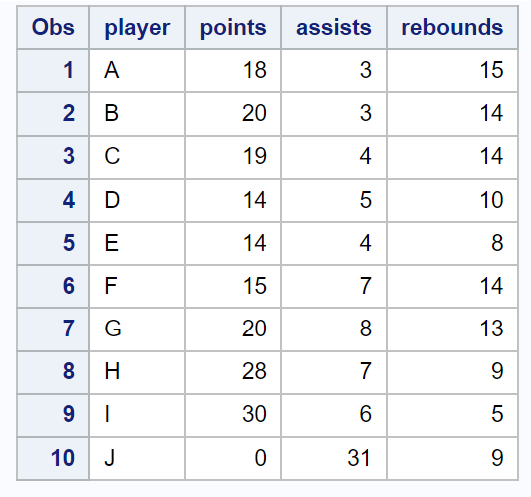
لضمان الاستيعاب العملي والتطبيقي لإجراءات التقييس، نقوم في هذا الجزء بتصميم وبناء مجموعة بيانات رقمية واقعية تمثل قياسات الأداء لمجموعة من الأفراد في تجربة سلوكية وتطبيقية. تضم مجموعة البيانات متغيرات ذات أبعاد ووحدات قياس شديدة التباين لتجسيد التحديات الإحصائية التي يواجهها المحلل في دراساته الميدانية؛ حيث تشتمل على متغير تعريفي اسمي للمشاركين، إلى جانب ثلاثة متغيرات عددية متباينة المقاييس بصورة واضحة: النقاط المحرزة (Points)، والمساعدات الإحصائية المقدمة (Assists)، والمتابعات الميدانية (Rebounds).
يتم بناء هيكل البيانات المذكور وإدخاله مباشرة في بيئة نظام SAS عبر كتابة خطوة معالجة قياسية باستخدام عبارة DATALINES وفق الشفرة البرمجية المعتمدة التالية:
DATA Work.Athlete_Performance;
    INPUT AthleteID $ Points Assists Rebounds;
    DATALINES;
ATH01 112 14 3
ATH02 85  22 8
ATH03 140 18 5
ATH04 95  35 12
ATH05 105 12 4
ATH06 130 28 9
ATH07 78  19 6
ATH08 120 40 15
ATH09 110 25 7
ATH10 90  15 2
;
RUN;
توضح الشفرة السابقة تعريف المتغير الاسمي AthleteID باستخدام الرمز $ للدلالة على طبيعته النصية، في حين عُرفت المتغيرات الثلاثة الأخرى كمتغيرات عددية خالصة. يضمن هذا التنسيق قراءة دقيقة لمصفوفة الملاحظات عبر محرك SAS مع تفادي أي مشكلات في إدخال القيم أو تشويه السجلات، مع إتاحة سياق بياني ملائم لدراسة أثر التقييس على التباين والتشتت ومقاييس النزعة المركزية في المراحل اللاحقة.
3.2 فحص البنية الهيكلية وتوزيع البيانات الأولية عبر PROC PRINT
عقب إتمام بناء مصفوفة البيانات في جدول Work.Athlete_Performance، يصبح من الضروري منهجياً استعراض جدول الملاحظات للتحقق من سلامة قراءة الحالات وضمان خلو عملية الإدخال من أي أخطاء طباعية أو تشوهات في محاذاة الأعمدة. يتم تنفيذ هذا التحقق الأولي بسهولة عبر استدعاء إجراء العرض القياسي PROC PRINT من خلال الشفرة البرمجية الآتية:
PROC PRINT DATA=Work.Athlete_Performance NOOBS;
    TITLE "المعاينة الأولية لمجموعة بيانات أداء الرياضيين الخام";
RUN;
يؤدي تشغيل هذا الأمر إلى توليد تقرير جدولي منسق يتضمن كافة سجلات الحالات العشر المسجلة في الذاكرة المؤقتة. ومن خلال المعاينة البصرية لمخرجات هذا الجدول، يظهر بجلاء التباين الشديد في النطاقات العددية للمتغيرات الثلاثة؛ حيث تدور قيم متغير النقاط (Points) في نطاق رقمي مرتفع يتراوح بين أواخر السبعينات ومطلع المئة والأربعين، بينما تقع قيم المساعدات (Assists) في مدى متوسط بين 12 و40، في حين تتسم قيم المتابعات (Rebounds) بأرقام متواضعة تنحصر في نطاق خانة واحدة أو اثنتين بحد أقصى (2 إلى 15).
هذا التفاوت الظاهر في موازين القياس يبرهن بصورة واضحة على استحالة إجراء مقارنة موضوعية مباشرة بين المتغيرات في صورتها الخام، أو حساب مؤشر إجمالي مركب للأداء عبر جمع تلك الدرجات جمعاً حسابياً بسيطاً؛ إذ إن أي جمع مباشر سيجعل متغير النقاط يستحوذ على الغالبية العظمى من القوة التفسيرية للدرجة الكلية، مما يهمش القيمة الحقيقية للمتغيرات الأخرى، وهو ما يفرض اللجوء الحتمي لأدوات التقييس الإحصائي لإعادة التوازن لمصفوفة القياس.
3.3 التحقق من الخصائص الإحصائية الأولية باستخدام PROC MEANS
تكتمل مرحلة التجهيز والاستكشاف المنهجي للبيانات بإجراء تشخيص كمي دقيق للخصائص الإحصائية الوصفية لمتغيرات الدراسة قبل الشروع في أي تحويل رقمي. يُعد إجراء PROC MEANS الأداة المثالية في SAS لحساب المتوسطات الحسابية والانحرافات المعيارية والحدود القصوى والدنيا لجميع المتغيرات العددية في آن واحد، وذلك كما توضحه الشفرة التالية:
PROC MEANS DATA=Work.Athlete_Performance N MEAN STD MIN MAX RANGE;
    VAR Points Assists Rebounds;
    TITLE "الإحصاءات الوصفية الأولية للمتغيرات قبل التقييس";
RUN;
يكشف جدول المخرجات الإحصائية الصادر عن هذا الإجراء خط الأساس التوصيفي للبيانات الخام؛ حيث نلاحظ أن متوسط النقاط يبلغ تقريباً 106.7 بانحراف معياري يقترب من 19.8 ومدى إجمالي يبلغ 62 وحدة قياس كاملة. في المقابل، يبلغ متوسط المساعدات حوالي 22.8 بانحراف معياري يناهز 8.9 ومدى يقدر بـ 28، في حين يستقر متوسط المتابعات عند 7.1 مع انحراف معياري قدره 4.2 ومدى لا يتعدى 13 وحدة فقط.
تثبت هذه الأرقام الرياضية التباين الصريح في مقاييس التشتت والنزعة المركزية لوحدات القياس الخام، وتضع بين يدي الباحث أساساً معيارياً موثوقاً يمكن الرجوع إليه لاحقاً لمقارنة هذه المؤشرات الوصفية الأولية بالنتائج التي سيفرزها إجراء التقييس، مما يؤكد سلامة التحويلات الرياضية ومطابقتها للمتطلبات المنهجية بدقة بالغة.
4. التطبيق العملي الأساسي لتقييس المتغيرات باستخدام PROC STDIZE
4.1 كتابة وتنفيذ شفرة التقييس الافتراضية الشاملة
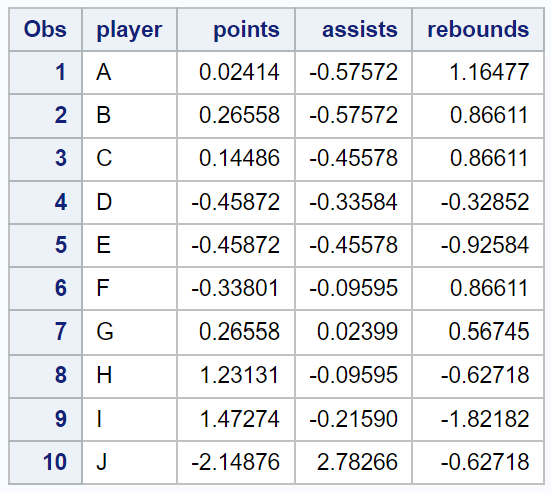
بعد التحقق من الخصائص الإحصائية الأولية، ننتقل مباشرة إلى التطبيق العملي لتقييس المتغيرات باستخدام PROC STDIZE. في حالته الافتراضية القياسية، يقوم الإجراء باحتساب درجات Z-score لجميع المتغيرات الرقمية في مصفوفة البيانات دون استثناء، مستنداً إلى طرح المتوسط الحسابي وقسمة الناتج على الانحراف المعياري، دون الحاجة إلى تحديد أي خيارات إضافية معقدة. يتم تنفيذ ذلك عملياً من خلال الشفرة البرمجية التالية:
PROC STDIZE DATA=Work.Athlete_Performance OUT=Work.Standardized_Default;
RUN;
تتسم هذه الصياغة بالبساطة والأمان المنهجي العالي؛ حيث وجهنا محرك SAS إلى قراءة جدول Work.Athlete_Performance وتصدير النتائج المحولة إلى جدول جديد يحمل اسم Work.Standardized_Default، مما يضمن الحفاظ التام على البيانات المصدرية الأصلية من أي تعديل لا رجعة فيه. يتعرف الإجراء بصورة آلية وفائقة الذكاء على المتغيرات المستهدفة؛ حيث يستبعد المتغير النصي الاسمي AthleteID تلقائياً من العمليات الحسابية الرياضية، ويحفظه في نفس الوقت داخل ملف المخرجات كمتغير تعريفي، مع قصر المعالجة الرياضية الصارمة على المتغيرات العددية الثلاثة.
4.2 قراءة وتفسير مخرجات جدول البيانات المعياري الجديد
لقراءة وفحص النتائج الناتجة عن تطبيق التقييس الافتراضي، نقوم باستدعاء إجراء العرض الجدولي PROC PRINT لعرض محتويات الجدول الجديد، مع تحديد تنسيق عرض الكسور العشرية لضمان الوضوح البصري للقيم المعيارية الناتجة:
PROC PRINT DATA=Work.Standardized_Default NOOBS;
    FORMAT Points Assists Rebounds 7.4;
    TITLE "بيانات أداء الرياضيين بعد التقييس المعياري الافتراضي (Z-Scores)";
RUN;
عند تأمل جدول البيانات الناتج، يتضح التحول الهيكلي الجذري الذي طرأ على مصفوفة القيم؛ إذ تم استبدال الأعداد الأصلية الكبيرة بدرجات معيارية مجردة تتأرجح غالبيتها الساحقة بين -2.0 و +2.0. يحمل ظهور الإشارة الموجبة أو السالبة دلالة إحصائية غاية في الوضوح والعمق؛ فالقيمة الموجبة تدل قطعياً على أن أداء الرياضي في هذا البعد المحدد يفوق متوسط أداء زملائه في العينة، بينما تعني القيمة السالبة تراجع أداء الرياضي عن متوسط المجموعة، في حين تشير القيمة التي تقترب من الصفر إلى أن أداء الرياضي يتطابق تماماً مع النزعة المركزية العامة للعينة.
على سبيل المثال، نجد أن الرياضي صاحب المعرف ATH03 الذي أحرز 140 نقطة كقيمة قصوى في البيانات الخام، قد تحولت نتيجته إلى درجة معيارية موجبة مرتفعة تقارب +1.68، مما يبرز تفوقه الرياضي بوحدات الانحراف المعياري. وفي الوقت ذاته، نجد أن قيمته في متغير المساعدات (18 مساعدة) قد تحولت إلى درجة معيارية سالبة تقارب -0.54 نظراً لأن أداءه في المساعدات كان أدنى من المتوسط العام للعينة (22.8)، مما يقدم للمحلل صورة سيكومترية ورياضية متكاملة ودقيقة للغاية كانت تختفي وراء التباين العددي للبيانات الأصلية.
4.3 التحقق الرياضي من خصائص التقييس في قاعدة البيانات الجديدة
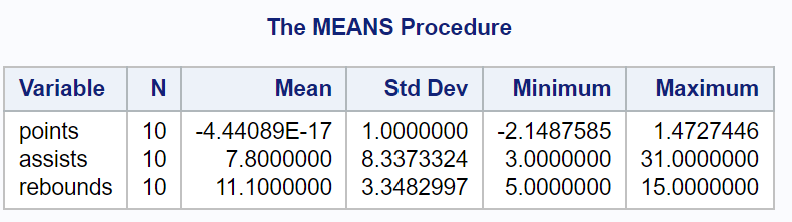
يقتضي الالتزام بالمعايير الأكاديمية الصارمة عدم الاكتفاء بالمعاينة الظاهرية للمخرجات، بل إخضاع جدول البيانات المعياري الجديد لتحقق رياضي إحصائي شامل للتأكد من انطباق القواعد الجبرية الصارمة للتقييس. يتم تنفيذ هذا التحقق عن طريق استدعاء إجراء PROC MEANS وتوجيهه لحساب معالم المتوسط والتباين والانحراف المعياري للبيانات المحولة حديثاً:
PROC MEANS DATA=Work.Standardized_Default N MEAN STD VAR MIN MAX;
    VAR Points Assists Rebounds;
    TITLE "التحقق الرياضي من خصائص التقييس: المتوسط والانحراف المعياري";
RUN;
يقدم تقرير SAS الصادر عن هذا الإجراء دليلاً قاطعاً على سلامة التقييس؛ حيث يُظهر التقرير أن المتوسط الحسابي (Mean) لجميع المتغيرات الثلاثة (Points, Assists, Rebounds) قد هبط بدقة متناهية إلى القيمة 0 (أو أرقام متناهية في الصغر تقترب تماماً من الصفر مثل 1.11E-16 بسبب حدود الدقة الحسابية المزدوجة لمعالجات الحاسوب). وفي الوقت ذاته، يُظهر التقرير تطابق قيمة الانحراف المعياري (Std Dev) والتباين (Variance) مع الرقم 1.00000 تماماً لجميع المتغيرات بلا استثناء، مما يثبت نجاح التحويل الرياضي وانتقال البيانات إلى فضاء القياس المعياري القياسي بنجاح تام.
5. التحكم في نطاق التقييس وتخصيص المتغيرات عبر عبارة VAR
5.1 تحديد متغيرات رقمية مستهدفة واستبعاد أخرى من التقييس
في كثير من التطبيقات الإحصائية والبحوث السلوكية الميدانية، لا يرغب الباحث في تقييس كافة المتغيرات العددية المتاحة في قاعدة البيانات دفعة واحدة؛ فهناك متغيرات تتطلب طبيعتها النظرية أو التحليلية الاحتفاظ بمقاييسها وأبعادها الخام الأصلية، كمتغيرات العمر الزمني، أو الأوزان، أو الدخل السنوي، أو متغيرات النتائج في نماذج الانحدار التي يُفضل تفسير معاملاتها في إطار وحدات القياس الفيزيائية الطبيعية. يتيح إجراء PROC STDIZE تحقيق هذا الفصل التحليلي الدقيق من خلال استخدام عبارة المتغيرات VAR.
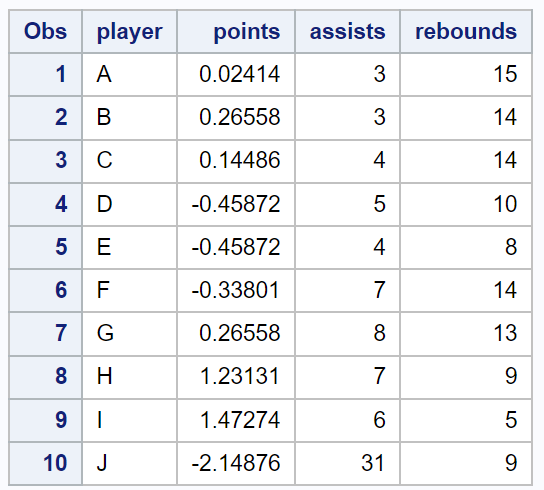
توضح الشفرة التالية كيفية حصر عملية التقييس المعياري على متغيرين فقط (Points وAssists)، مع الإبقاء المتعمد على متغير المتابعات (Rebounds) بمقاييسه الأصلية دون مساس:
PROC STDIZE DATA=Work.Athlete_Performance OUT=Work.Standardized_Selective;
    VAR Points Assists;
RUN;
عند تشغيل هذا الكود، يقوم محرك المعالجة في SAS بتطبيق خوارزمية التقييس الرياضية حصرياً على المتغيرات المدرجة في عبارة VAR. أما بالنسبة للمتغيرات العددية غير المدرجة في هذه العبارة (مثل متغير Rebounds في مثالنا)، فإن الإجراء يتعامل معها بسلاسة تامة؛ حيث ينسخ قيمها الخام وينقلها حرفياً كما هي إلى مجموعة البيانات الناتجة في جدول Work.Standardized_Selective دون إدخال أي تعديل على تباينها أو مقاييس نزعتها المركزية، مما يمنح الباحث مرونة قصوى في تصميم جداول بيانات هجينة تجمع بين الدرجات المعيارية والمقاييس الخام وفق مقتضيات التحليل.
5.2 الحفاظ على المتغيرات المعرفية والتصنيفية داخل مخرجات التحليل
تتمثل إحدى المشكلات الشائعة في بعض حزم المعالجة الإحصائية الأخرى في فقدان المتغيرات الوصفية أو المعرفية غير الرقمية عند إجراء التحويلات المصفوفية. أما في بيئة SAS، فقد صُمم إجراء PROC STDIZE لضمان الحفاظ الآمن والكامل على كافة المتغيرات المعرفية والتصنيفية (ID Variables / Categorical Variables) داخل ملف البيانات الناتج. فالمتغيرات من نوع السلاسل النصية، مثل متغير هوية الرياضي AthleteID، تظل محفوظة ومقترنة بسجلاتها المقابلة دون الحاجة لتدخل إضافي من الباحث.
يسهم هذا الترابط البنيوي في تفادي الأخطاء البرمجية الناتجة عن محاولة تقييس متغيرات نصية، ويضمن في ذات الوقت سهولة الدمج والربط اللاحق بين مصفوفة البيانات المعيارية وأي مجموعات بيانات أخرى تتضمن أبعاداً ديموغرافية أو معايير تقييم نوعية. يمكن للمحلل التأكد من هذا التوافق عبر فحص ملف الخرج والتأكد من اقتران الدرجات المعيارية المستحدثة بهوية كل حالة بدقة متناهية، وهو أمر جوهري لبناء التقارير الفردية في الاختبارات السيكومترية أو التشخيصات الإكلينيكية والطبية.
5.3 إجراء التقييس للطبقات والمجموعات الفرعية باستخدام عبارة BY
يمثل التقييس الطبقي أو التجميعي أحد أدق التطبيقات في القياس السيكومتري وبحوث العلوم الإنسانية؛ إذ لا يكون من المناسب إحصائياً في كثير من الأحيان معايرة أداء الأفراد استناداً إلى متوسط عام مختلط يدمج فئات متباينة بنيوياً. ففي قياس الخصائص السلوكية أو القدرات البدنية، قد يتطلب التحليل الأكاديمي حساب الدرجات المعيارية للذكور استناداً إلى متوسط وتباين فئة الذكور حصراً، وحساب درجات الإناث استناداً إلى معالم فئة الإناث فقط، أو معايرة الأداء وفقاً للفئات العمرية المختلفة لضمان العدالة المعيارية للروائز.
يتيح إجراء PROC STDIZE تنفيذ هذه المعايرة الفرعية المستقلة عبر استخدام عبارة BY. يشترط نظام SAS دائماً أن تكون مجموعة البيانات المصدرية مرتبة ومفروزة مسبقاً استناداً إلى المتغير التصنيفي قبل تمريرها لعبارة BY. توضح الشفرة التالية إضافة متغير تصنيفي يمثل الفريق (Team)، وفرز البيانات باستخدام PROC SORT، ثم تنفيذ التقييس المستقل لكل فريق على حدة:
DATA Work.Athlete_Teams;
    INPUT AthleteID $ Team $ Points Assists;
    DATALINES;
ATH01 Red  112 14
ATH02 Red  85  22
ATH03 Red  140 18
ATH04 Red  95  35
ATH05 Red  105 12
ATH06 Blue 130 28
ATH07 Blue 78  19
ATH08 Blue 120 40
ATH09 Blue 110 25
ATH10 Blue 90  15
;
RUN;

PROC SORT DATA=Work.Athlete_Teams;
    BY Team;
RUN;

PROC STDIZE DATA=Work.Athlete_Teams OUT=Work.Standardized_By_Team;
    BY Team;
    VAR Points Assists;
RUN;
عند تنفيذ هذه المنظومة البرمجية، يعامل محرك SAS كل مجموعة فرعية من المجموعات التي يحددها متغير Team كمجتمع إحصائي مستقل تماماً؛ حيث يحسب المتوسط والانحراف المعياري لأفراد الفريق الأحمر (Red) بصورة معزولة عن الفريق الأزرق (Blue)، ويجري التقييس الداخلي لكل لاعب بناءً على معايير فريقه الخاص. تبرز هذه التقنية كأداة لا غنى عنها في المعايرة السيكومترية المقارنة للأبحاث الاجتماعية والسلوكية متعددة البيئات.
6. طرق وأساليب التقييس المتقدمة عبر الخيار METHOD=
6.1 التقييس التقليدي عبر خيار METHOD=STD ومقارنته بالخيارات الأخرى
يمثل الخيار METHOD=STD الأسلوب المنهجي الافتراضي لإجراء PROC STDIZE في SAS، وهو التطبيق الحرفي لنموذج Z-score الإحصائي الكلاسيكي. يقوم هذا الخيار بضبط معيار الموضع ليكون مساوياً للمتوسط الحسابي للعينة، ومعيار المقياس ليكون مساوياً للانحراف المعياري، مستنداً إلى الافتراضات الرياضية التي تفترض تجانس التوزيع واعتداليته وخلوه من التشوهات الحادة. يتم كتابة هذا الخيار صراحة للتأكيد التوثيقي كما يلي:
PROC STDIZE DATA=Work.Athlete_Performance OUT=Work.Method_STD METHOD=STD;
    VAR Points Assists Rebounds;
RUN;
تتجلى قوة هذا الأسلوب القياسي عند التعامل مع متغيرات تتبع التوزيع الطبيعي أو تقترب منه إلى حد كبير، وحيث تكون التباينات مستقرة وممثلة للخصائص الجوهرية للظاهرة المدروسة. ولكن في المقابل، تظهر محدودية هذا الخيار المنهجي بحدة عند اختلال افتراضات التوزيع الطبيعي؛ نظراً لأن كلاً من المتوسط الحسابي والانحراف المعياري يعدان من الإحصاءات شديدة الحساسية والضعف (Low Breakdown Point) تجاه القيم المتطرفة؛ حيث يكفي وجود قيمة شاذة واحدة في العينة لإزاحة المتوسط وتضخيم الانحراف المعياري، مما يشوه الدرجات المعيارية لكافة المفردات المتبقية في العينة.
6.2 أساليب التقييس الرصينة للتعامل مع القيم الشاذة والمتطرفة
لتجاوز المعضلات المنهجية التي تفرضها القيم الشاذة (Outliers) والتوزيعات شديدة الالتواء، يدعم إجراء PROC STDIZE ترسانة برمجية واسعة من أساليب التقييس الرصينة (Robust Standardization Methods) التي تعتمد على إحصاءات موضع ومقياس لا تتأثر بالقيم المتطرفة. من أبرز هذه الأساليب خيار METHOD=MAD، الذي يحل فيه وسيط الانحرافات المطلقة (Median Absolute Deviation) كبديل رصين وموثوق للانحراف المعياري، مع اعتماد الوسيط الإحصائي بدلاً من المتوسط الحسابي لتمثيل النزعة المركزية.
كذلك يوفر الإجراء خيار METHOD=IQR، الذي يرتكز رياضياً على مقياس المدى الربيعي (Interquartile Range) كمؤشر للتشتت؛ حيث يقسم الفروق عن الوسيط على المسافة الفاصلة بين الربيع الثالث والربيع الأول للعينة. توضح الشفرة التالية كيفية تطبيق خياري التقييس الرصين في بيئة SAS:
/* التقييس الرصين باستخدام وسيط الانحرافات المطلقة */
PROC STDIZE DATA=Work.Athlete_Performance OUT=Work.Method_MAD METHOD=MAD;
    VAR Points Assists Rebounds;
RUN;

/* التقييس الرصين باستخدام المدى الربيعي */
PROC STDIZE DATA=Work.Athlete_Performance OUT=Work.Method_IQR METHOD=IQR;
    VAR Points Assists Rebounds;
RUN;
تكتسب هذه الأساليب الرصينة أهمية منهجية هائلة في معالجة درجات الاستجابة الشاذة في الاستبيانات السلوكية، أو سجلات البيانات المالية والطبية الحقيقية؛ حيث تضمن عدم انجراف معايير التحجيم بفعل الحالات النادرة المتطرفة، مع الحفاظ على الفروق النسبية الحقيقية بين أفراد العينة دون الحاجة إلى حذف الحالات المتطرفة وحرمان النموذج من تباينها الواقعي.
6.3 أساليب التقييس الخطية المعتمدة على المدى والحدود القصوى والدنيا
يوفر PROC STDIZE خيارات متخصصة لإعادة تحجيم البيانات وتطبيعها بالاعتماد على الحدود القصوى والدنيا ومقاييس المدى العددي، وهو التكنيك الذي يعرف في أوساط علوم البيانات بالتطبيع المحدود. من أهم هذه الخيارات خيار METHOD=RANGE، الذي يعيد تشكيل قيم المتغير لتصبح جميعها محصورة بدقة قطعية بين الصفر والواحد الصحيح [0, 1].
كما يدعم الإجراء خيار METHOD=MIDRANGE، الذي يقيس التباعد النسبي للبيانات استناداً إلى منتصف المدى، إلى جانب أساليب متقدمة لتحويل البيانات إلى نسب مئوية عبر خيار METHOD=SUM الذي يجعل مجموع قيم المتغير مساوياً للواحد الصحيح. توضح الشفرة التالية كيفية تطبيق أسلوب المدى (Min-Max Scaling) على مصفوفة البيانات:
PROC STDIZE DATA=Work.Athlete_Performance OUT=Work.Method_Range METHOD=RANGE;
    VAR Points Assists Rebounds;
RUN;
تعد البيانات المحولة وفق خيار METHOD=RANGE الخيار الأكثر ملاءمة لمعالجة المدخلات الموجهة نحو خوارزميات التعلم الآلي والشبكات العصبية الاصطناعية (Artificial Neural Networks)، حيث تتطلب دوال التنشيط غير الخطية (مثل دوال Sigmoid وTanh) مدخلات عددية مضبوطة المدى بدقة، لمنع تشبع الخلايا وتلاشي التدرجات الحسابية أثناء التدريب، مما يبرز التنوع المنهجي الفائق لإجراء PROC STDIZE وتلبيته لكافة متطلبات النمذجة الحديثة.
7. إدارة واحتساب القيم المفقودة بالتزامن مع التقييس الإحصائي
7.1 التعامل الافتراضي للإجراء مع القيم المفقودة وتأثيره على النتائج
تمثل مشكلة القيم المفقودة (Missing Data) تحدياً هيكلياً واسع الانتشار في الأبحاث السلوكية والاجتماعية والميدانية؛ حيث يتعذر في كثير من الحالات الحصول على استجابات مكتملة لكافة بنود المقاييس أو سجلات التقييم. في حالته الافتراضية، يتعامل إجراء PROC STDIZE مع البيانات المفقودة بمنهجية إحصائية تقليدية؛ حيث يستبعد السجلات التي تتضمن قيماً مفقودة استبعاداً مؤقتاً عند حساب معالم الموضع والمقياس (المتوسطات والانحرافات) لكل متغير على حدة، مما يضمن عدم تحيز تلك المؤشرات بالقيم الغائبة.
أما على مستوى مصفوفة المخرجات، فإن الإجراء يحافظ في وضعه الافتراضي على مواضع القيم المفقودة كما هي؛ فالمفردة التي لا تمتلك قيمة أصلية تظل قيمتها ممثلة بنقطة الفقدان (.) في جدول البيانات المعياري الناتج. ورغم الأمان الحسابي لهذا المسار الافتراضي، فإنه ينطوي على مخاطر منهجية بالغة إذا ما استُخدمت البيانات الناتجة لاحقاً في نماذج الانحدار متعدد المتغيرات، والتي تطبق الحذف الشامل للحالة (Listwise Deletion)، مما قد يؤدي إلى استبعاد عينات ضخمة من المبحوثين وتهديد صدق النتائج وتمثيلها للمجتمع الأصلي.
7.2 تقنيات استبدال وتعويض القيم المفقودة عبر الخيار REPONLY
يقدم إجراء PROC STDIZE في SAS ميزة فريدة وغير تقليدية قلما تتوفر في إجراءات التقييس الأخرى، وهي إمكانية استخدامه كأداة تعويض واستبدال مخصصة للقيم المفقودة دون المساس بمقاييس البيانات الأصلية أو تحويلها إلى درجات معيارية. يتم تفعيل هذه الميزة عبر استخدام خيار التعويض الحصري REPONLY (Replace Only)، الذي يعطي أمراً مباشراً للإجراء باستبدال مواضع الفقدان فقط والإبقاء على كافة القيم الحقيقية الأخرى كما هي بوحداتها ومقاييسها الخام.
لتوضيح ذلك تطبيقياً، نفترض وجود مجموعة بيانات تتضمن قيماً مفقودة في درجات الرياضيين، ونرغب في ملء تلك الفجوات الإحصائية دون إجراء التقييس، كما في الشفرة التالية:
DATA Work.Athlete_Missing;
    INPUT AthleteID $ Points Assists Rebounds;
    DATALINES;
ATH01 112 14 3
ATH02 .   22 8
ATH03 140 .  5
ATH04 95  35 12
ATH05 105 12 .
;
RUN;

PROC STDIZE DATA=Work.Athlete_Missing OUT=Work.Imputed_Only METHOD=MEAN REPONLY;
    VAR Points Assists Rebounds;
RUN;
عند تنفيذ هذه الشفرة المتقدمة، لا يغير الإجراء أي قيمة من القيم الأصلية المقاسة؛ حيث تظل النقاط كما هي للمشاركين ATH01 وATH03 وATH04 وATH05، في حين يقوم باستبدال النقطة المفقودة للمشارك ATH02 بحساب المتوسط الحسابي لمتغير النقاط وإدراجه حصرياً في ذلك الموضع. يوفر هذا الأسلوب أداة معالجة سريعة وفعالة للغاية لإصلاح عيوب جمع البيانات الميدانية قبل تصديرها للمراحل الإحصائية التالية.
7.3 تخصيص طرق التعويض بالمتوسط أو الوسيط أو قيم إحصائية مرجعية
يتجاوز PROC STDIZE مجرد الاستبدال البسيط ليتيح دمجاً مرناً بين التقييس والتعويض وفق آليات إحصائية متعددة تناسب الخصائص التوزيعية للمتغيرات. فعند تحديد الخيار METHOD=MEDIAN مع تفعيل التعويض، يقوم الإجراء بملء القيم المفقودة بالاعتماد على وسيط العينة بدلاً من متوسطها، وهو إجراء إحصائي رصين يُوصى به بشدة عند التعامل مع متغيرات تظهر التواءً إحصائياً واضحاً أو تحتوي على قيم متطرفة قد تشوه المتوسط الحسابي التعويضي.
علاوة على ذلك، يتيح الإجراء عبر استخدام خيار REPLACE المباشر دمج التقييس الشامل مع تعويض القيم المفقودة في خطوة حسابية واحدة وموحدة، حيث يتم تعويض المفقود بالمؤشر الإحصائي المختار ثم تحويل كامل السجل إلى الفضاء المعياري، كما هو موضح في النموذج التالي:
/* تقييس البيانات مع استبدال القيم المفقودة بالوسيط */
PROC STDIZE DATA=Work.Athlete_Missing OUT=Work.Standardized_Imputed METHOD=MEDIAN REPLACE;
    VAR Points Assists Rebounds;
RUN;
كما يمكن للباحث تحديد قيم عددية ثابتة ومحددة مسبقاً للتعويض (كأن يستبدل المفقود بصفر افتراضي يمثل عدم الاستجابة أو الحد الأدنى) من خلال تضمين خيار MISSING=value داخل عبارة الإجراء، مما يمنح المحلل الكمي سيطرة منهجية صارمة على سيناريوهات معالجة الفقدان وفق أسس إحصائية قابلة للتبرير والتوثيق الأكاديمي.
8. التحقق والتقييم التشخيصي لجودة البيانات بعد التقييس
8.1 الفحص البعدي للإحصاءات الوصفية ومصفوفة الارتباط
تشترط المنهجيات الإحصائية الدقيقة إخضاع البيانات المحولة لفحوص تشخيصية بعدية صارمة للتأكد من أن المعالجة الرياضية لم تُحدث أي تشوهات غير مرغوبة في العلاقات الهيكلية البينية للمتغيرات. ترتكز القاعدة الرياضية للتحويلات الخطية المعيارية على مبدأ الثبات الخطي (Linear Invariance)؛ مما يعني أن تحويل المتغير عبر طرح ثابت وقسمته على ثابت آخر يجب ألا يؤثر بأي حال من الأحوال على مصفوفة معاملات الارتباط الخطية (Pearson Correlation Coefficients) القائمة بين المتغيرات المدروسة.
للتحقق التطبيقي من هذا الثبات الرياضي، يتم استدعاء إجراء PROC CORR ومقارنة مصفوفة الارتباط المحسوبة من البيانات الخام بمصفوفة الارتباط المحسوبة من البيانات المعيارية الناتجة عن PROC STDIZE، وفق الشفرة البرمجية الآتية:
/* حساب مصفوفة الارتباط للبيانات الخام */
PROC CORR DATA=Work.Athlete_Performance NOPROB;
    VAR Points Assists Rebounds;
    TITLE "مصفوفة الارتباط للبيانات الأصلية الخام";
RUN;

/* حساب مصفوفة الارتباط للبيانات المعيارية */
PROC CORR DATA=Work.Standardized_Default NOPROB;
    VAR Points Assists Rebounds;
    TITLE "مصفوفة الارتباط للبيانات المعيارية الناتجة";
RUN;
تثبت المقارنة الدقيقة للمخرجات الجداولية تطابق معاملات الارتباط البينية حتى آخر خانة عشرية، مما يؤكد أن التحويل المعياري نجح في إزالة أثر تباين المقاييس ووحداتها دون المساس بقوة أو اتجاه العلاقات الارتباطية الكامنة بين المتغيرات، وهو ما يشكل ركيزة الاطمئنان الأساسية قبل الولوج في نمذجة المعادلات البنائية أو التحليل العاملي.
8.2 الفحص البصري البياني للتوزيعات المعيارية عبر PROC SGPLOT
لا يكتمل التقييم التشخيصي دون الفحص البصري (Visual Diagnostics) الذي يتيح للباحث قراءة سلوك التوزيعات التكرارية واكتشاف مواضع التمركز والتشتت. يوفر إجراء الرسوم الإحصائية المتقدمة PROC SGPLOT في SAS أدوات بصرية بالغة الدقة لتوليد المدرجات التكرارية (Histograms) ومنحنيات الكثافة ومخططات الصندوق والمؤشرات (Boxplots) للمتغيرات قبل وبعد التحويل المعياري.
توضح الشفرة التالية كيفية رسم مخطط التوزيع التكراري المقترن بمنحنى الكثافة الطبيعية لمتغير النقاط قبل وبعد التقييس لملاحظة إعادة التموضع حول الصفر:
/* رسم توزيع متغير النقاط الخام */
PROC SGPLOT DATA=Work.Athlete_Performance;
    HISTOGRAM Points / BINWIDTH=10 FILLATTRS=(COLOR=CX4A90E2);
    DENSITY Points / TYPE=NORMAL LINEATTRS=(COLOR=CXD0021B THICKNESS=2);
    TITLE "توزيع متغير النقاط قبل التقييس (المتوسط حول 106.7)";
RUN;

/* رسم توزيع متغير النقاط بعد التقييس */
PROC SGPLOT DATA=Work.Standardized_Default;
    HISTOGRAM Points / BINWIDTH=0.5 FILLATTRS=(COLOR=CX50E3C2);
    DENSITY Points / TYPE=NORMAL LINEATTRS=(COLOR=CXD0021B THICKNESS=2);
    TITLE "توزيع متغير النقاط بعد التقييس المعياري (المتمركز تماماً حول الصفر)";
RUN;
يظهر الفحص البصري للمخططات البيانية الناتجة تطابقاً شكلياً تاماً في هيئة التوزيع والتواء البيانات وتفرطحها، مع اختلاف وحيد يتمثل في زحزحة المحور الأفقي الأفقي؛ حيث أعيد تمركز مركز الثقل البياني من المتوسط القديم (106.7) ليستقر بدقة فوق النقطة صفر، مع تقلص المدى الأفقي للمتغير ليصبح ممتداً بين -2 و +2 انحراف معياري. يمنح هذا التمثيل البصري المحلل طمأنينة مطلقة حول احتفاظ البيانات بهيكليتها الطبيعية دون أي تشوه جائر.
8.3 التأكد من سلامة حفظ البيانات الوصفية وخصائص المتغيرات
تتضمن المرحلة الختامية للتحقق التشخيصي مراجعة البنية الوصفية (Metadata) لملف المخرجات المستخرج للتأكد من سلامة الخصائص الحاسوبية للمتغيرات وتوافقها التام مع متطلبات الحزم الإحصائية الملحقة. يتم هذا التدقيق عبر إجراء الفهرسة واستعراض القواميس PROC CONTENTS من خلال الأمر البرمجي التالي:
PROC CONTENTS DATA=Work.Standardized_Default;
    TITLE "فحص الخصائص الهيكلية وقاموس البيانات لجدول المخرجات المعياري";
RUN;
يستعرض تقرير PROC CONTENTS التفاصيل التقنية الدقيقة لجدول البيانات؛ بما في ذلك أسماء المتغيرات وأنواعها وأطوال حقولها وتسمياتها الوصفية (Labels). يتيح هذا الإجراء للمحلل التحقق من أن SAS قد احتفظ بترميز المتغيرات وسماتها وتسمياتها، ولم يغير صيغ التعريف الأساسية، وهو شرط حاسم لإدراج تلك المصفوفات المعيارية بسلاسة وأمان داخل إجراءات النمذجة المتقدمة كالتحليل العنقودي وانحدارات التعلّم الآلي دون التعرض لرسائل التحذير أو الأخطاء التنسيقية المعيقة.
9. الأخطاء الشائعة أثناء استخدام PROC STDIZE وكيفية تفاديها
9.1 مشكلة الكتابة الفوقية على مجموعة البيانات الأصلية وطرق تجنبها
يعد الخطأ الأكثر فداحة وشيوعاً بين ممارسي التحليل الإحصائي في بيئة SAS هو إغفال تحديد الخيار OUT= عند استدعاء إجراء PROC STDIZE. فعندما يكتب الباحث شفرة الإجراء مكتفياً بتحديد مصفوفة المدخلات مثل PROC STDIZE DATA=Work.RawData; RUN; دون كتابة عبارة الخرج صراحة، فإن السلوك الافتراضي لنظام SAS هو استبدال مجموعة البيانات الأصلية والكتابة الفوقية المباشرة (Overwriting) على جدول المدخلات ذاته.
يترتب على هذا الخطأ البرمجي فقدان لا رجعة فيه للقيم والوحدات الخام الأصلية، وهو ما ينسف أحياناً ساعات طويلة من العمل الميداني أو يتطلب إعادة استيراد قواعد البيانات الضخمة من مصادرها الخارجية. لتفادي هذا المأزق بصورة قاطعة، يُوصى بتطبيق بروتوكول برمجي صارم يقضي بكتابة الخيار OUT= بصورة إلزامية دائماً في كل استدعاء، وتسمية جدول المخرجات ببادئة أو لاحقة مميزة (مثل Std_ أو _Normalized)، مع الاحتفاظ الدائم بنسخ احتياطية مقفلة من قواعد البيانات المصدرية داخل مكتبات SAS للقراءة فقط (Read-Only Engines).
9.2 التعامل مع المتغيرات الثابتة وانعدام التباين الإحصائي
تواجه خوارزميات التقييس مأزقاً رياضياً بنيوياً حاداً عند التعامل مع متغيرات ثابتة القيمة (Zero-Variance Variables)، وهي الحالات التي تكون فيها جميع قياسات المبحوثين متطابقة تماماً (على سبيل المثال، إذا سجل كافة الرياضيين 10 نقاط). في هذه الحالة الرياضية الخاصة، يصبح الانحراف المعياري للمتغير مساوياً للصفر الحسابي المطلق، مما يجعل تطبيق معادلة التقييس القياسية مستحيلاً رياضياً بسبب حدوث معضلة القسمة على الصفر (Division by Zero).
عند محاولة تطبيق التقييس الافتراضي على متغير صفري التباين، يسجل سجل التشغيل في SAS (SAS Log) رسائل تحذيرية حادة أو يتوقف عن إتمام معالجة المتغير. لتفادي هذه المشكلة، يوفر PROC STDIZE خيارات متخصصة للتحكم في معيار المقياس وتفادي الانهيار الحسابي مثل خيار VARDEF= وخيار FUZZ=، بالإضافة إلى خيار الاستبدال المشروط الذي يضبط القيمة الناتجة تلقائياً لتكون صفراً معيارياً عند ثبوت التباين الصفري، كما هو موضح أدناه:
/* معالجة التباين الصفري وتفادي التوقف البرمجي */
PROC STDIZE DATA=Work.RawData OUT=Work.ZeroVar_Handled SNORM FUZZ=1E-12;
    VAR ConstantVar NormalVar;
RUN;
تضمن هذه الإعدادات المتقدمة فحص التباين والتحقق من تجاوزه حدود الصفر المطلق قبل تنفيذ عمليات القسمة، مما يحمي خطوط المعالجة الآلية ومسارات التحليل من التوقف المفاجئ في بيئات الإنتاج ومشاريع البيانات الضخمة.
9.3 معالجة أخطاء عدم تطابق الأنواع والمجموعات في عبارة BY
تنجم مجموعة أخرى من الأخطاء البرمجية الشائعة عن سوء تطبيق عبارة BY داخل إجراء PROC STDIZE؛ حيث يتفاجأ المحلل الإحصائي بتوقف التنفيذ وظهور رسالة خطأ صريحة في السجل تفيد بأن البيانات ليست مرتبة (Data set is not sorted in proper order). لا يمتلك الإجراء قدرة فرز تلقائية مدمجة للبيانات، مما يجعل من المستحيل تطبيق التقييس الطبقي دون استدعاء إجراء الفرز PROC SORT مسبقاً وبنفس الترتيب الهرمي للمتغيرات التصنيفية المستهدفة.
كذلك يقع بعض المبتدئين في خطأ إدراج متغيرات نصية أو تصنيفية ضمن عبارة VAR، متوقعين أن يقوم الإجراء بمعاملتها بطريقة فئوية؛ مما يؤدي إلى فشل فوري للخطوة البرمجية نظراً لأن عبارة VAR في PROC STDIZE لا تقبل إلا المتغيرات العددية الخالصة. إن الممارسة السليمة تقتضي حصر المتغيرات التصنيفية في عبارة BY، والمتغيرات الرقمية في عبارة VAR، ومتابعة نافذة SAS Log بدقة واهتمام بالغ لقراءة مؤشرات التنفيذ وتفادي أي تعارض في الأنواع البرمجية للبيانات المعالجة.
10. التطبيقات المتقدمة لنتائج PROC STDIZE في النمذجة متعددة المتغيرات
10.1 تهيئة مصفوفات البيانات لإجراء تحليل المكونات الأساسية (PCA)
يمثل تحليل المكونات الأساسية (Principal Component Analysis – PCA) أحد أبرز تطبيقات النمذجة الإحصائية التي تعتمد جوهرياً على التقييس المسبق للبيانات. يهدف التحليل إلى خفض الأبعاد عبر استخلاص تراكيب خطية جديدة (المكونات) تفسر أكبر قدر ممكن من التباين الإجمالي للمتغيرات. إذا تباينت مقاييس وحدات المتغيرات الأصلية، فإن المكون الأول سينجرف رياضياً ليتطابق مع المتغير ذي التباين الخام الأكبر، مما يجعل التحليل عديماً للجدوى العلمية.
على الرغم من أن إجراء PROC PRINCOMP في SAS يستطيع داخلياً حساب مصفوفة الارتباط (والتي تعادل تقييس البيانات ضمنياً)، إلا أن تمرير البيانات المعيارية المعدة مسبقاً عبر PROC STDIZE يوفر للمحلل سيطرة متفوقة؛ حيث يتيح له استخدام تقنيات تقييس رصينة (كالتقييس المعتمد على وسيط الانحرافات MAD أو المدى الربيعي IQR) والتي لا يوفرها إجراء المكونات الأساسية بمفرده. يتم الربط المنهجي المباشر بين الإجرائين وفق الشفرة الآتية:
/* تقييس البيانات أولاً باستخدام مقياس رصين لمقاومة الشذوذ */
PROC STDIZE DATA=Work.Athlete_Performance OUT=Work.PCA_Prepared METHOD=MAD;
    VAR Points Assists Rebounds;
RUN;

/* تنفيذ تحليل المكونات الأساسية على البيانات المعيارية المجهزة */
PROC PRINCOMP DATA=Work.PCA_Prepared COV OUT=Work.PCA_Scores;
    VAR Points Assists Rebounds;
RUN;
يضمن هذا الإجراء المتسلسل استخلاص مكونات أساسية رصينة وموضوعية تمثل الأبعاد السيكومترية والفيزيائية الحقيقية للمتغيرات بصورة عادلة، ويزيد من وضوح قيم التشبعات العاملية (Eigenvectors) وتفسير التباين المفسر بدقة أكاديمية فائقة.
10.2 تحسين كفاءة خوارزميات التحليل العنقودي (Cluster Analysis)
ترتكز خوارزميات التحليل العنقودي (Cluster Analysis)، بمختلف أشكالها الهرمية وغير الهرمية مثل إجراء PROC FASTCLUS وخوارزميات K-Means وPROC CLUSTER، على قياس المسافات الفاصلة بين الحالات في الفضاء الرياضي متعدد الأبعاد. وتعد المسافة الإقليدية (Euclidean Distance) المقياس الافتراضي الأكثر استخداماً لحساب تباعد الأفراد ومواقع المراكز العنقودية:
d(p, q) = √ [ Σ (p_i – q_i)² ]
يتضح من الصيغة الجبرية السابقة أن المتغيرات ذات الأرقام الكبيرة ستتحكم بصورة شبه مطلقة في حاصل جمع الفروق المربعة، في حين ستتلاشى مساهمة المتغيرات المقاسة بأرقام صغيرة تماماً. يحل التقييس عبر PROC STDIZE هذه المعضلة حلاً جذرياً عبر ضبط التباين لكافة الأبعاد ليصبح مساوياً للواحد الصحيح، مما يضمن أن كل بعد يشارك بوزن نسبي متساوٍ وعادل في رسم حدود العناقيد والمجموعات المصنفة.
توضح الشفرة التالية إعداد البيانات المعيارية وتمريرها المباشر إلى خوارزمية التصنيف العنقودي السريع:
/* تقييس المتغيرات لضمان عدالة حساب المسافات الإقليدية */
PROC STDIZE DATA=Work.Athlete_Performance OUT=Work.Cluster_Ready METHOD=STD;
    VAR Points Assists Rebounds;
RUN;

/* تنفيذ التحليل العنقودي السريع لفرز الحالات إلى مجموعتين */
PROC FASTCLUS DATA=Work.Cluster_Ready MAXCLUSTERS=2 OUT=Work.Clustered_Athletes;
    VAR Points Assists Rebounds;
RUN;
يثمر هذا التكامل المنهجي عن إنتاج عناقيد متوازنة وذات صدق تصنيفي مرتفع تعكس التقارب السلوكي والأدائي الحقيقي للمشاركين، بدلاً من تكوين تجمعات وهمية موجهة بفعل التباين العددي الفج للمقاييس الخام.
10.3 تجهيز المتغيرات المستقلة لنماذج الانحدار المعاقب ونماذج التعلم الآلي
تشهد بيئات التحليل الإحصائي الحديثة نمواً متسارعاً في استخدام نماذج الانحدار المعاقب (Penalized Regression Models)، مثل انحدار ريدج (Ridge Regression) وانحدار لاسو (Lasso Regression)، إلى جانب خوارزميات الانحدار الشبكي المرن (Elastic Net). تعتمد هذه الخوارزميات المتقدمة على فرض جزاء رياضي (Penalty Term) يعاقب تضخم معاملات الانحدار للحد من مشكلة التعدد الخطي العالي وتفادي فرط التخصيص (Overfitting).
تتمثل خطورة تطبيق هذه النماذج على بيانات خام في أن دالة الجزاء الرياضي لا تفرق بين المعاملات الكبيرة الناتجة عن قوة الأثر الحقيقي للمتغير، وتلك الناتجة عن صغر وحدة قياس المتغير الخام؛ مما يؤدي إلى تقليص معاملات المتغيرات ذات الوحدات الصغيرة بصورة جائرة وظالمة. لذلك، يعد التقييس عبر PROC STDIZE خطوة تحضيرية وإلزامية لا مفر منها قبل تطبيق إجراءات النمذجة المتقدمة مثل PROC GLMSELECT أو النماذج اللوجستية المصنفة، وفق النمط التالي:
/* تقييس المتنبئات لتجهيزها لانحدار لاسو */
PROC STDIZE DATA=Work.Athlete_Performance OUT=Work.Regression_Ready;
    VAR Points Assists;
RUN;

/* تطبيق نموذج الانحدار المعاقب على المتغيرات المستقلة المعيارية */
PROC GLMSELECT DATA=Work.Regression_Ready;
    MODEL Rebounds = Points Assists / SELECTION=LASSO(CHOOSE=CV);
RUN;
يحقق هذا الأسلوب العلمي تقارباً حسابياً فائق السرعة لخوارزميات التقدير العددي والتحسين الأمثل، ويجعل المقارنة بين أوزان الانحدار المعيارية ذات دلالة إحصائية علمية موثوقة تعكس الأثر الحقيقي لكل متنبئ في تفسير المتغير التابع.
الخاتمة
استعرض هذا الدليل المتعمق الأبعاد النظرية والتطبيقية لعمليات تقييس وتطبيع البيانات الإحصائية في بيئة التحليل الإحصائي الرائدة SAS، مسلطاً الضوء على الكفاءة الهائلة لإجراء PROC STDIZE. لقد أثبت التحليل المنهجي أن هذا الإجراء يتجاوز بمراحل مجرد كونه أداة بسيطة لحساب الدرجات المعيارية؛ إذ يمثل بيئة متكاملة تدمج بين التحويلات المعيارية الكلاسيكية، وتطبيقات التحجيم المحدود، وأساليب الإحصاء الرصين الصامدة أمام القيم المتطرفة والشاذة، فضلاً عن قدراته الفريدة في إدارة واحتساب وتعويض القيم المفقودة بدقة متناهية.
إن الاستخدام المنضبط والواعي لإجراء PROC STDIZE يمنح الباحثين ومحللي البيانات ضمانة علمية وأكاديمية راسخة لتفادي التشوهات التوزيعية وتحييد الهيمنة غير العادلة للمقاييس العددية المتباينة. كما يشكل الإجراء حجر الزاوية المنهجي لتهيئة مصفوفات البيانات قبل خوض غمار النمذجة المتقدمة متعددة المتغيرات، كتحليل المكونات الأساسية والتحليل العنقودي ونماذج الانحدار المعاقب والتعلم الآلي، مما يكرس إجراء PROC STDIZE كأحد أهم الأدوات التي لا غنى عنها في جعبة كل باحث كمي يسعى لتحقيق أعلى درجات الصدق والموثوقية في نتائجه الإحصائية.
المراجع
- SAS Institute Inc. (2020). SAS/STAT 15.2 User’s Guide: The STDIZE Procedure. Cary, NC: SAS Institute Inc. https://documentation.sas.com
- Cohen, J., Cohen, P., West, S. G., & Aiken, L. S. (2003). Applied Multiple Regression/Correlation Analysis for the Behavioral Sciences (3rd ed.). Lawrence Erlbaum Associates.
- Huber, P. J., & Ronchetti, E. M. (2009). Robust Statistics (2nd ed.). John Wiley & Sons.
- Johnson, R. A., & Wichern, D. W. (2007). Applied Multivariate Statistical Analysis (6th ed.). Pearson Prentice Hall.
- Tabachnick, B. G., & Fidell, L. S. (2019). Using Multivariate Statistics (7th ed.). Pearson.