
تُعد جداول البيانات الرقمية إحدى الركائز الأساسية التي تقوم عليها نظم معالجة المعلومات وإدارتها في البيئات المؤسسية والأكاديمية المعاصرة. ومنذ أن أطلقت شركة جوجل تطبيقها السحابي الرائد في يونيو عام 2006، والذي طُوّر بالأساس اعتماداً على نظام XL2Web المبتكر من قبل شركة 2Web Technologies التي أسسها جوناثان روشيل وفارزاد خوسروشاهي في عام 2005، شهدت بيئات العمل تحولاً جذرياً نحو التحرير التعاوني وإدارة السجلات المركزية عبر الحوسبة السحابية. ومع هذا التحول، برزت الحاجة الماسة إلى الحفاظ على سلامة بنية البيانات واتساقها التحليلي، ولا سيما عند التعامل مع المدخلات النصية الحيوية مثل أسماء الأفراد، التي تشكل العصب الرئيسي لقواعد بيانات الموارد البشرية، وقوائم الباحثين، وسجلات الطلبة، واستطلاعات الرأي الميدانية.
تمثل معالجة النصوص داخل جداول بيانات جوجل (Google Sheets) تحدياً تقنياً ذا أبعاد متعددة؛ حيث لا تنبع صعوبة تنظيم الأسماء من تعقيد البرمجية ذاتها، بل من الفجوة الهيكلية الكامنة بين أسلوب الإدخال البشري التلقائي والمتطلبات الصارمة لنمذجة البيانات العلائقية. فعندما تُسجل الأسماء الكاملة بصيغتها التقليدية (الاسم الأول متبوعاً باسم العائلة) داخل خلية فردية واحدة، تصبح عملية إعادة الترتيب الأبجدي المعتمدة على اللقب الأخير عملية معقدة تتطلب تفكيك البنية النصية وإعادة بنائها جبرياً أو برمجياً. إن غياب الفصل المادي بين مكونات الاسم يُلزم المحلل باللجوء إلى ترسانة من المعادلات الرياضية النصية أو التعابير النمطية البرمجية لعزل اللقب بدقة متناهية دون المساس بالبيانات الأصلية أو الإخلال بتوافق الصفوف وسياق السجلات.
يهدف هذا الدليل المرجعي الشامل إلى تقديم دراسة تحليلية وتطبيقية متعمقة لكيفية فرز الأسماء وترتيبها وفقاً لاسم العائلة في جداول بيانات جوجل، من خلال استعراض المناهج القياسية والبدائل المتقدمة، وتفكيك الأسس الخوارزمية التي تحكم معالجة السلاسل النصية ونظم الترتيب المعتمدة على معيار الترميز الموحد (Unicode Collation Algorithm). وسيتناول المقال تفصيلياً المسار الكامل بدءاً من إعداد مصفوفة البيانات الأولية، وتوظيف الصيغ المركبة، وصولاً إلى استراتيجيات الفرز الديناميكي وإدارة الحالات النصية الشاذة، بما يضمن للممارس الأكاديمي والمهني تحكماً مطلقاً في تدفق البيانات وضمان موثوقيتها الرياضية والإحصائية.
1. مقدمة تأسيسية: أهمية فرز البيانات النصية بالاعتماد على اسم العائلة
1.1 السياق الأكاديمي والمهني لترتيب الأسماء حسب اسم العائلة
يمتد الاعتماد المنهجي والتاريخي على اسم العائلة كمعيار رئيسي للفهرسة والتوثيق إلى قرون خلت في التقاليد الببليوغرافية الغربية والشرقية على حد سواء؛ حيث يُعد اللقب العائلي المرتكز المستقر الذي تُنسب إليه النتاجات الفكرية والمراكز القانونية. وفي الفضاء الأكاديمي المعاصر، تفرض كبرى جمعيات التدوين والتوثيق، مثل جمعية علم النفس الأمريكية (APA) ورابطة اللغات الحديثة (MLA)، تنظيم المراجع والمصادر بالاستناد الصارم إلى الحرف الأول من كنية المؤلف أو اسم عائلته. يرجع هذا التكريس المنهجي إلى حقيقة بنيوية مفادها أن الأسماء الأولى تشهد تكراراً إحصائياً هائلاً داخل المجتمعات المتجانسة، مما يقلل من قيمتها التمييزية عند البحث في فهارس تضم آلاف السجلات، بينما توفر الألقاب العائلية تنوعاً مورفولوجياً يسهم في تقليص التداخل الفهرسي وتيسير عمليات المطابقة والتحقق المرجعي.
ولا يقتصر هذا الأثر على سهولة الأرشفة فحسب، بل يمتد إلى ظواهر هيكلية أوسع تؤثر في البيئات المهنية والإنتاجية الأكاديمية؛ فقد وثقت دراسة رائدة أعدها الباحثان ليران عيناف وليات ياريف في عام 2006 ونُشرت في مجلة المنظورات الاقتصادية (Einav & Yariv, 2006) وجود انحياز أبجدي ملموس (Alphabetical Bias) يؤثر في الحياة المهنية للأكاديميين. وأظهرت الدراسة أن الباحثين في حقل علم الاقتصاد الذين تبدأ أسماء عوائلهم بحروف تقع في صدارة الترتيب الهجائي يحظون بفرص أعلى لنيل التثبيت الأكاديمي في الجامعات المرموقة، وتزداد وتيرة الاستشهاد بأبحاثهم مقارنة بنظرائهم الذين تبدأ ألقابهم بحروف متأخرة، وذلك نظراً لعرف الترتيب الأبجدي لأسماء المؤلفين في تلك الحقول. ومن منظور موازٍ في علم النفس المعرفي، أشار الباحث جوزيف نوتين عام 1985 في دراسته حول ما يُعرف بأثر حرف الاسم (Name-Letter Effect) إلى أن الأفراد يظهرون تفضيلاً غريزياً غير واعٍ للحروف المكونة لأسمائهم وألقابهم، مما ينعكس على تفاعلاتهم وسلوكياتهم التنظيمية (Nuttin, 1985).
من الناحية الوظيفية الإدارية، تتجلى الفروق الحاسمة بين الترتيب بالاسم الأول والترتيب باسم العائلة عند معالجة كشوفات الرواتب، وسجلات التأمين الصحي، ومصفوفات الملاحظات في الجامعات والمؤسسات الكبرى. فالترتيب بالاسم الأول يؤدي في البيئات العربية على سبيل المثال إلى تكدس هائل في مصفوفات البيانات تحت أسماء شائعة كـ “محمد” أو “أحمد” أو “عبد الله”، مما يُعطل سرعة المسح البصري ويضاعف من احتمالية وقوع أخطاء الإسناد البشري عند إدخال البيانات الحساسة كالأجور أو التقييمات السنوية. في المقابل، يؤدي اعتماد اسم العائلة كمعيار فرز أولي إلى تشتيت التكدس وتوزيع المدخلات توزيعاً متوازناً عبر الطيف الأبجدي، الأمر الذي يرفع من كفاءة التدقيق المتقاطع ويسهل عملية استخراج العينات العشوائية الطبقية في البحوث الميدانية والمسوح الديموغرافية واسعة النطاق.
1.2 تحديات المعالجة التلقائية للنصوص في جداول بيانات جوجل
تستند النظم الحديثة لقواعد البيانات إلى مبدأ الذرية (Atomicity) المستمد من قواعد الشكل الطبيعي الأول (First Normal Form – 1NF)، والذي ينص على وجوب احتواء كل حقل داخل الجدول على قيمة واحدة غير قابلة للتجزئة. ومع ذلك، تشهد الممارسة الميدانية في جداول بيانات جوجل خروجاً متكرراً عن هذا المبدأ؛ حيث يعمد المستخدمون غالباً، بدافع السرعة أو السهولة الظاهرية، إلى إدخال الاسم الكامل للشخص داخل خلية مفردة واحدة. هذا الدمج العضوي بين الاسم الأول، والأسماء الوسطى، واسم العائلة يخلق عقبة تقنية رئيسية أمام محركات الترتيب التلقائي، إذ تتعامل البرمجية مع النص المدمج بوصفه كتلة نصية متصلة من البايتات والمحارف تخضع في ترتيبها للحرف الاستهلالي الأول فقط، مما يجعل الترتيب المباشر وفق اللقب أمراً مستحيلاً دون إجراء تدخل تحويلي وسيط.
تزداد هذه الصعوبة تعقيداً بالنظر إلى آلية عمل محرك الفرز في جداول بيانات جوجل، والذي يتبع ترتيب معيار المحارف الموحد (Unicode Collation Algorithm) بناءً على القيم الرقمية لرموز المحارف المشفرة ونقاط الترميز (Unicode Code Points). فعند إصدار أمر فرز اعتيادي لعمود يحتوي على أسماء كاملة، يقوم المحرك بمقارنة السلاسل النصية حرفاً بحرف بدءاً من المحرف الأول من جهة اليمين أو اليسار بحسب اتجاه النص؛ وبالتالي فإن أي اسم مثل “زيد العمري” سيخضع للفرز استناداً إلى حرف “الزاء”، متجاهلاً تماماً القيمة الأبجدية للقب “العمري”. ولتحقيق الترتيب الموجه نحو اللقب دون الإخلال بسلامة البيانات الأصلية، يجد المحلل نفسه أمام حتمية بناء مسار تحليلي هندسي يعتمد على استخلاص الأجزاء الطرفية المستهدفة من السلسلة النصية وعزلها في بنية مساعدة أو توظيف دوال المصفوفات الديناميكية لتجاوز القيود الساكنة لبيئة الجداول غير العلائقية.
2. المتطلبات المسبقة وتجهيز مصفوفة البيانات الأولية
2.1 هيكلة جدول البيانات وإدخال قائمة الأسماء
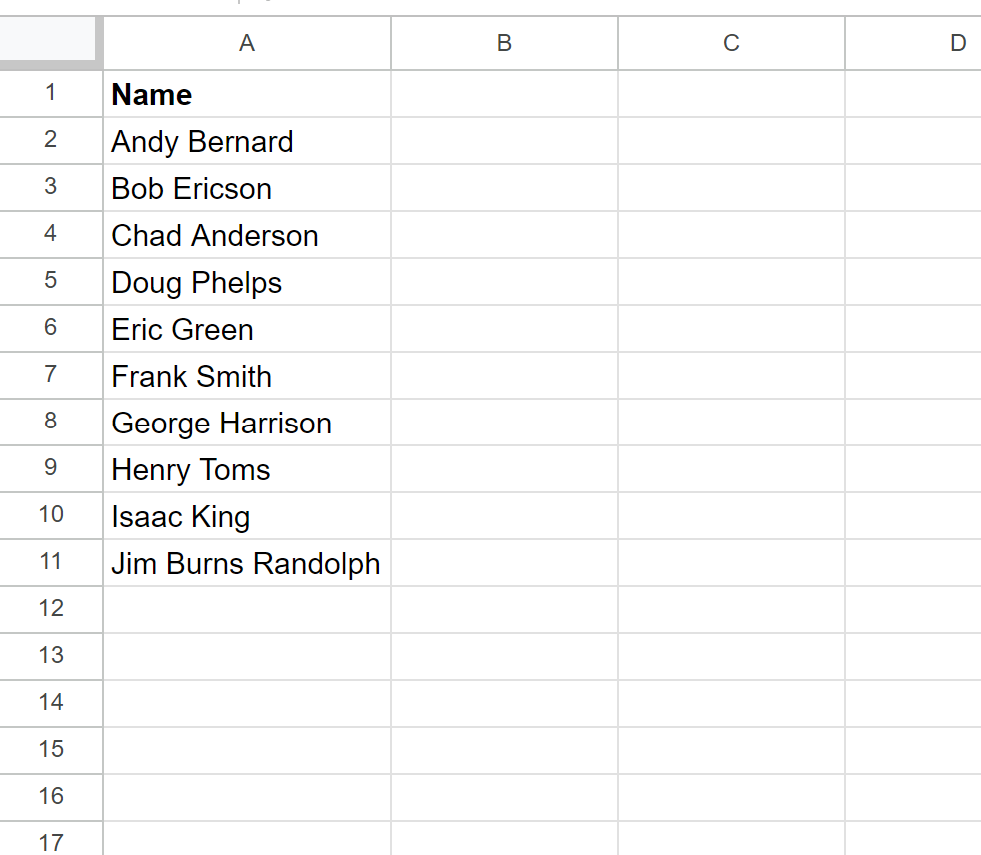
تتطلب الإدارة المهنية لمصفوفات البيانات في جداول بيانات جوجل صرامة منهجية في مرحلة التأسيس؛ إذ إن أي تشوه في الهيكل الأولي للجدول يمتد أثره سلبياً إلى كافة العمليات التحليلية والحسابية اللاحقة. تبدأ الخطوة الإجرائية الأولى بتعيين العمود المستهدف بوضوح وتخصيص الصف العلوي الأول ليكون صف الترويسة (Header Row)، مع وسم الخلية A1 بتسمية وصفية لا لبس فيها مثل “الاسم الكامل” (Full Name). يمنح هذا التحديد الهيكلي ورقة العمل معمارية واضحة تتيح لمحركات الترتيب التمييز الدقيق بين مسميات المتغيرات وقيم البيانات الفعلية الموزعة في النطاق التالي، والذي يفترض أن يبدأ من الخلية A2 ويمتد عمودياً ليشمل كافة السجلات المستهدفة، مثل النطاق المحصور بين الخلية A2 والخلية A11 في مصفوفة تجريبية أولية.
قبل الشروع في كتابة أي معادلة أو تطبيق أدوات الفرز، يجب إخضاع البيانات الخام لفحص بصري وتقني شامل للكشف عن العيوب الطباعية التي تُعد السبب الأكثر شيوعاً لفشل العمليات الخوارزمية اللاحقة. وتأتي المسافات المزدوجة العشوائية الواقعة بين مقاطع الأسماء أو الفراغات البيضاء المتسللة إلى نهاية السلاسل النصية في صدارة هذه المشكلات، حيث يعتبر محرك جداول جوجل كل مسافة فارغة محرفاً مستقلاً يحمل النقطة الرمزية U+0020 في جدول اليونيكود، مما يغير الطول الحسابي للنص ويشوه مخرجات دوال الاقتطاع. ويُعد الإجراء الأكثر حصافة في هذه المرحلة هو تأمين نسخة احتياطية مستقلة من ورقة العمل أو تكرار النطاق الأصلي في ورقة منفصلة؛ إذ يوفر هذا الإجراء شبكة أمان تضمن الرجوع إلى أصل البيانات غير المعالج في حال حدوث أي خطأ تشغيلي غير مقصود أثناء عمليات التحويل والفرز.
2.2 تصميم الأعمدة المساعدة لغايات الفرز المتخصص
يُمثل مفهوم “العمود المساعد” (Helper Column) حجر الزاوية في الممارسات المتقدمة لإدارة جداول البيانات؛ فهو ليس مجرد حيز إضافي لتخزين القيم، بل هو أداة هندسية وسيطة تُستخدم لاحتواء المتغيرات التحليلية المستخرجة التي لا تتوفر بصورة مستقلة في المصفوفة الأصلية. وعند استهداف ترتيب الأسماء بالاعتماد على اسم العائلة، يتجلى دور هذا العمود في استقبال نتائج المعادلات النصية التي تفكك السلسلة الاسمية وتعزل الكلمة الختامية في كل صف، مما يوفر للمحرك معياراً مرجعياً صلباً يمكن الفرز استناداً إليه دون إتلاف القيمة البصرية لعمود الاسم الكامل المركب الأصلي.
لإنشاء هذا العمود، يتم إدراج عمود جديد مجاور لعمود البيانات الخام مباشرة، بحيث يشغل العمود B على سبيل المثال، وتُخصص خليته العلوية B1 باسم وصفي محدد مثل “اسم العائلة” أو “اللقب المستخلص”. تتطلب حوكمة البيانات في هذه الخطوة ضبط التنسيق الخلوي للنطاق المساعد ليكون من النمط النصي الصافي (Plain Text)، وذلك عبر قائمة التنسيق المنسدلة؛ حيث يضمن هذا التحديد المسبق تفادي أي تفسير خاطئ من قِبل البرمجية للمخرجات النصية المستخرجة، ويمنع الخلط بين المعاملات الحرفية والأرقام في حال وجود ملاحق اسمية، مما يُمهد الطريق لتكامل رياضي متسق بين معطيات العمود A ومخرجات العمود B.
3. المنهجية القياسية: استخراج اسم العائلة باستخدام المعادلات النصية المركبة
3.1 صياغة المعادلة الرياضية النصية لاستخلاص الكلمة الأخيرة
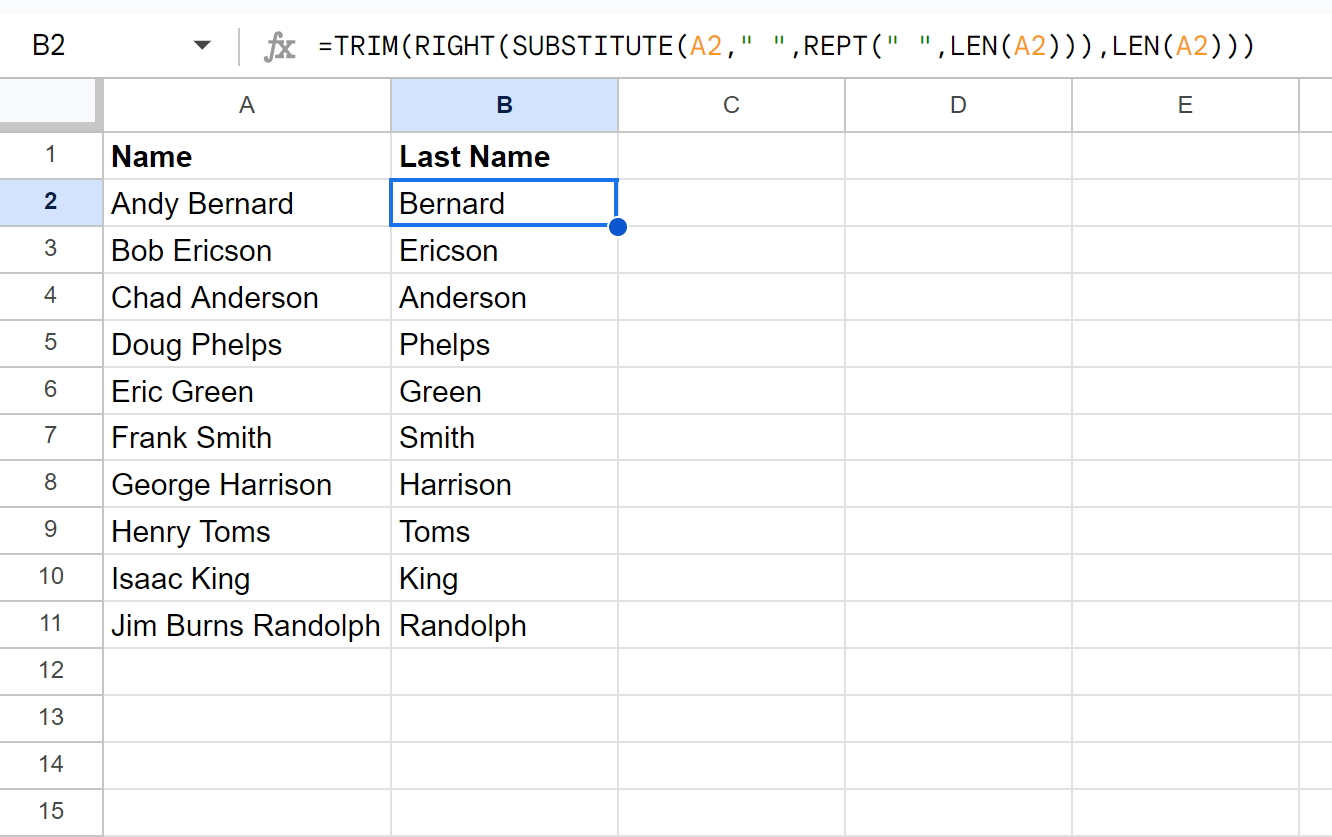
تعتمد المنهجية القياسية والأكثر متانة داخل بيئات الجداول الإلكترونية لاستخلاص الكلمة الختامية من سلسلة نصية عشوائية الطول على تجميع هندسي محكم لعدد من الدوال النصية الفردية التي تتكامل فيما بينها لتجاوز قيود الاقتطاع المباشر. تتجسد هذه الصياغة في المعادلة الرياضية النصية المركبة التالية، والتي تُكتب في أول خلية بيانات داخل العمود المساعد (الخلية B2):
=TRIM(RIGHT(SUBSTITUTE(A2," ",REPT(" ",LEN(A2))),LEN(A2)))
تعمل هذه الصيغة كآلية ميكانيكية دقيقة لمعالجة النصوص؛ فبمجرد إدخالها والضغط على مفتاح الإدخال، تبدأ دوال المعادلة بالعمل التتابعي المتداخل. يتم أولاً حساب طول السلسلة الاسمية الموجودة في A2 وتوليد حاجز فراغي هائل بين مقاطع الاسم، ثم يجري استبدال الفواصل الطبيعية بتلك المسافات الموسعة، قبل أن تقوم دالة الاقتطاع بسحب كتلة محارف مساوية لطول النص الأصلي من الطرف النهائي للسلسلة، لتتولى دالة التنظيف الختامية مهمة تجريد اللقب من الفراغات المحيطة به وإيداعه نقياً في الخلية. يستجيب محرك الحساب في جداول بيانات جوجل على الفور، كاشفاً عن اسم العائلة المنفرد بدقة استثنائية وبمعزل عن عدد المقاطع الاسمية السابقة له.
بعد التحقق من استخلاص اللقب بصورة صحيحة في الخلية الأولى، يتعين تعميم هذه المعادلة على كافة الصفوف المتتالية داخل النطاق التجريبي الممتد حتى B11. يتحقق ذلك عملياً من خلال تحديد الخلية B2 وتوجيه مؤشر الفأرة نحو الزاوية اليسرى السفلى (أو اليمنى، بحسب واجهة المستخدم) من إطار الخلية حتى يتحول شكل المؤشر إلى علامة التقاطع (+) المعروفة بمقبض التعبئة التلقائية (Fill Handle)، ثم سحب المقبض لأسفل ليغطي كامل نطاق البيانات المطلوب معالجته.
3.2 آلية عمل التعبئة التلقائية في جداول بيانات جوجل
توفر جداول بيانات جوجل ميزات متطورة لأتمتة نشر الصيغ وتكرارها، تتجاوز آلية السحب اليدوي التقليدية التي قد تكون عرضة للخطأ أو الإرهاق عند التعامل مع آلاف السجلات. وتتمثل التقنية الأكثر سرعة وكفاءة في استخدام “النقر المزدوج” (Double-Click) المباشر على مقبض التعبئة التلقائية للخلية الحاوية على الصيغة؛ حيث يقوم المحرك السحابي بمسح العمود المجاور أفقياً، والتعرف تلقائياً على حدود النطاق المشغول بالبيانات، ونشر الصيغة عمودياً حتى آخر صف يحتوي على مدخلات دون أي تدخل يدوي إضافي من المستخدم.
علاوة على ذلك، توظف المنصة خوارزميات ذكاء اصطناعي مدمجة تُعرف بميزة “التعبئة الذكية المقترحة” (Smart Fill)؛ فعند الشروع في استخراج الألقاب يدوياً أو كتابة الصيغة لأول مرة، يحلل النظام النمط التحويلي الذي يحاول المستخدم تطبيقه على النص، ويعرض نافذة اقتراح منبثقة تتضمن تعبئة العمود المساعد بالكامل إما عبر استنتاج النصوص أو عبر توليد الصيغة الرياضية المتكافئة تلقائياً. وهنا يتعين على المحلل مراجعة مطابقة الاقتراح للسياق الحسابي بدقة قبل الضغط على زر الموافقة للتأكد من أن الصيغة المقترحة تحافظ على مبدأ “المراجع النسبية” (Relative References)، والتي تضمن انتقال مرجع الخلية المحسوبة تلقائياً وبشكل ديناميكي من A2 إلى A3 ثم A4 صعوداً حتى نهاية السجلات، متفادية تجميد المرجع عبر علامة الدولار ($) التي قد تؤدي إلى تكرار غير مرغوب فيه لبيانات الصف الأول عبر كامل مصفوفة العمل.
4. التفكيك التحليلي والرياضي لدالة استخراج اللقب
4.1 تحليل دور دالتي LEN وREPT في مضاعفة المسافات الفاصلة
لفهم الأساس الخوارزمي الذي يجعل المعادلة المركبة =TRIM(RIGHT(SUBSTITUTE(A2," ",REPT(" ",LEN(A2))),LEN(A2))) تعمل بكفاءة رياضية مطلقة على أي سلسلة نصية بغض النظر عن لغتها أو عدد مقاطعها، يجب تفكيكها إلى عناصرها الأولية واستيعاب الدور المنوط بكل دالة. تبدأ العملية بالدالة LEN(A2)، وهي دالة قياس حجمي بحتة تقوم باحتساب العدد الإجمالي للمحارف المكونة للنص داخل الخلية A2، متضمنة الأحرف الهجائية، وعلامات الترقيم، والمسافات البينية القائمة. فإذا افترضنا أن الخلية تحتوي على الاسم “أحمد عبد العزيز الشمري”، فإن دالة LEN ستعيد القيمة العددية 23، ممثلة الحجم الكلي للمدخل النصي شاملاً المسافات.
يتحول هذا الناتج العددي مباشرة إلى معامل تشغيلي يغذي الدالة التالية وهي REPT(" ", LEN(A2)). تختص دالة التكرار REPT بتكرار محرف نصي محدد بعدد محدد من المرات؛ وفي هذه الحالة، يُطلب منها تكرار محرف “المسافة الفارغة” بعدد مرات مساوٍ لطول النص الأصلي (أي 23 مسافة فارغة متتالية). الغرض الرياضي من هذا التوليد هو بناء “كتلة فراغية ضخمة” أو مساحة عازلة اصطناعية (Padding Buffer) لا يمكن لأي كلمة مفردة داخل الاسم الأصلي أن تتجاوز طولها. هذا التوسع المتعمد يخلق فاصلاً ميكانيكياً شاسعاً يفصل بين كل مكون لغوي والمكون الذي يليه داخل السلسلة النصية قيد المعالجة.
4.2 دور دالة SUBSTITUTE في استبدال المسافات البينية
بمجرد جهوزية الكتلة الفراغية الناتجة عن REPT، يبرز الدور المحوري لدالة الاستبدال SUBSTITUTE. تأخذ هذه الدالة النص الأصلي في الخلية A2، وتبحث عن كل مسافة بيضاء اعتيادية واحدة تفصل بين الكلمات (” “)، ثم تقوم باستبدالها بالكتلة الفراغية الموسعة المكونة من 23 مسافة فارغة متصلة. النتيجة المباشرة لهذه الخطوة هي إعادة تشكيل جذرية للبنية الهندسية الداخلية للنص؛ حيث يتحول الاسم من صيغته المدمجة المضغوطة إلى شريط نصي طويل تتخلله فجوات واسعة تفصل بين مكوناته، مع الاحتفاظ الدقيق بالترتيب التتابعي الأصلي للكلمات.
يوفر هذا التحول بيئة خوارزمية مثالية تسمح لدوال الاقتطاع الطرفية بالعمل دون خوف من التداخل النصي. فبوجود فجوة فراغية بهذا الحجم بين كل مقطع وآخر، نكون قد ضمنا رياضياً أن الكلمة الأخيرة داخل الاسم (وهي اسم العائلة المنشود) أصبحت تسبح بمفردها في أقصى الطرف النهائي للسلسلة النصية الموسعة، وأنها باتت معزولة تماماً عن الكلمة التي تسبقها بمسافة بيضاء تتجاوز الطول الكامل للنص الأصلي بكثير، مما يجعلها مهيأة للاستخلاص الحسابي المباشر دون الاعتماد على أدوات التحليل اللغوي المعقدة.
4.3 تكامل دالتي RIGHT وTRIM للاقتطاع النهائي والتنظيف
تتدخل بعد ذلك دالة الاقتطاع من النهاية RIGHT، والتي تطلب من المحرك قراءة السلسلة النصية الموسعة المشكلة حديثاً والبدء باقتطاع كتلة نصية محددة الطول من الطرف النهائي (الطرف الأيمن في الترتيب اللاتيني والطرف الأخير في تدفق السلسلة). المفارقة الرياضية هنا تكمن في تحديد طول النص المقتطع؛ حيث يتم إسناد القيمة LEN(A2) كمعامل ثانٍ لدالة الاقتطاع. هذا يعني أن الدالة ستقوم باقتطاع عدد من المحارف من نهاية السلسلة مساوٍ تماماً للطول الكلي للاسم الأصلي (23 محرفاً في مثالنا السابق).
وبما أن طول الفجوة الفاصلة بين الكلمة الأخيرة وما قبلها يعادل 23 مسافة، وطول الكلمة الأخيرة وحدها يقل حتماً عن 23 محرفاً، فإن الكتلة المقتطعة ستتكون بالضرورة الرياضية الحتمية من جزأين فقط: الكلمة الأخيرة كاملة دون نقص، وعدد من المسافات الفارغة التي تسبقها والتي تم سحبها من الفجوة الهائلة التي ولدتها دالة SUBSTITUTE، بينما يستحيل فيزيائياً أن تمتد عملية الاقتطاع لتصل إلى أي حرف من أحرف الكلمة السابقة. هنا يأتي الملاذ التنفيذي الختامي متمثلاً في دالة التنظيف TRIM، التي تلتف حول المعادلة بأكملها لتتولى مهمة كنس وتجريد كافة المسافات البيضاء الزائدة الواقعة على أطراف الكلمة المقتطعة، لتعيد في نهاية المطاف القيمة النصية النقية والصافية لاسم العائلة، خالية من أي شوائب أو تشوهات ومؤهلة تماماً لتكون معياراً لفرز النطاق.
5. تطبيق عملية فرز النطاق اعتماداً على عمود اسم العائلة المستحدث
5.1 تحديد النطاق الشامل وحماية ارتباط البيانات
عقب إتمام عملية استخلاص ألقاب العوائل بنجاح داخل العمود المساعد، يدخل المستخدم في مرحلة إعادة الهيكلة الترتيبية الفعلية للبيانات. تتطلب هذه الخطوة وعياً هندسياً حاسماً بمفهوم النطاق الشامل (Comprehensive Range) لتجنب الوقوع في خطأ كارثي تدميري شائع؛ وهو فرز عمود الألقاب بمفرده بمعزل عن بقية الجدول. إن تحديد العمود المساعد فقط والضغط على زر الفرز يؤدي إلى إعادة ترتيب الألقاب أبجدياً مع إبقاء الأعمدة الأخرى (الأسماء الكاملة، والأرقام القومية، ومعدلات الأداء، وعناوين البريد الإلكتروني) ثابتة في مواضعها السابقة، مما يترتب عليه تفكك فوري في الارتباط البنيوي الأفقي للسجلات وتلف لا رجعة فيه لسلامة قاعدة البيانات.
لتفادي هذا الانفصال، يتعين على المحلل تحديد كامل مصفوفة البيانات، بما في ذلك عمود الأسماء الأصلية، وعمود الألقاب المستحدثة، وأي أعمدة بيانات وصفية أخرى ملحقة بالسجلات (كأن يتم تظليل النطاق كاملاً من الخلية A1 إلى الخلية B11 أو ما بعدها). علاوة على ذلك، يجب حماية صف الترويسة (Header Row) من الاندراج في عملية الترتيب حتى لا يُعامل عنوان العمود معاملة السجلات العادية ويتحرك إلى موضع عشوائي في قلب الجدول استناداً إلى ترتيبه الهجائي. وتتحقق هذه الحماية إما بتثبيت الصف الأول مسبقاً عبر قائمة “عرض” (View) ثم “تثبيت” (Freeze) واختيار “صف واحد” (1 row)، أو من خلال خيارات الفرز المتقدمة التي توفر للمستخدم مربع اختيار لتحديد احتواء البيانات على صف ترويسة مستقل.
5.2 تنفيذ إجراء الفرز عبر أدوات شريط البيانات
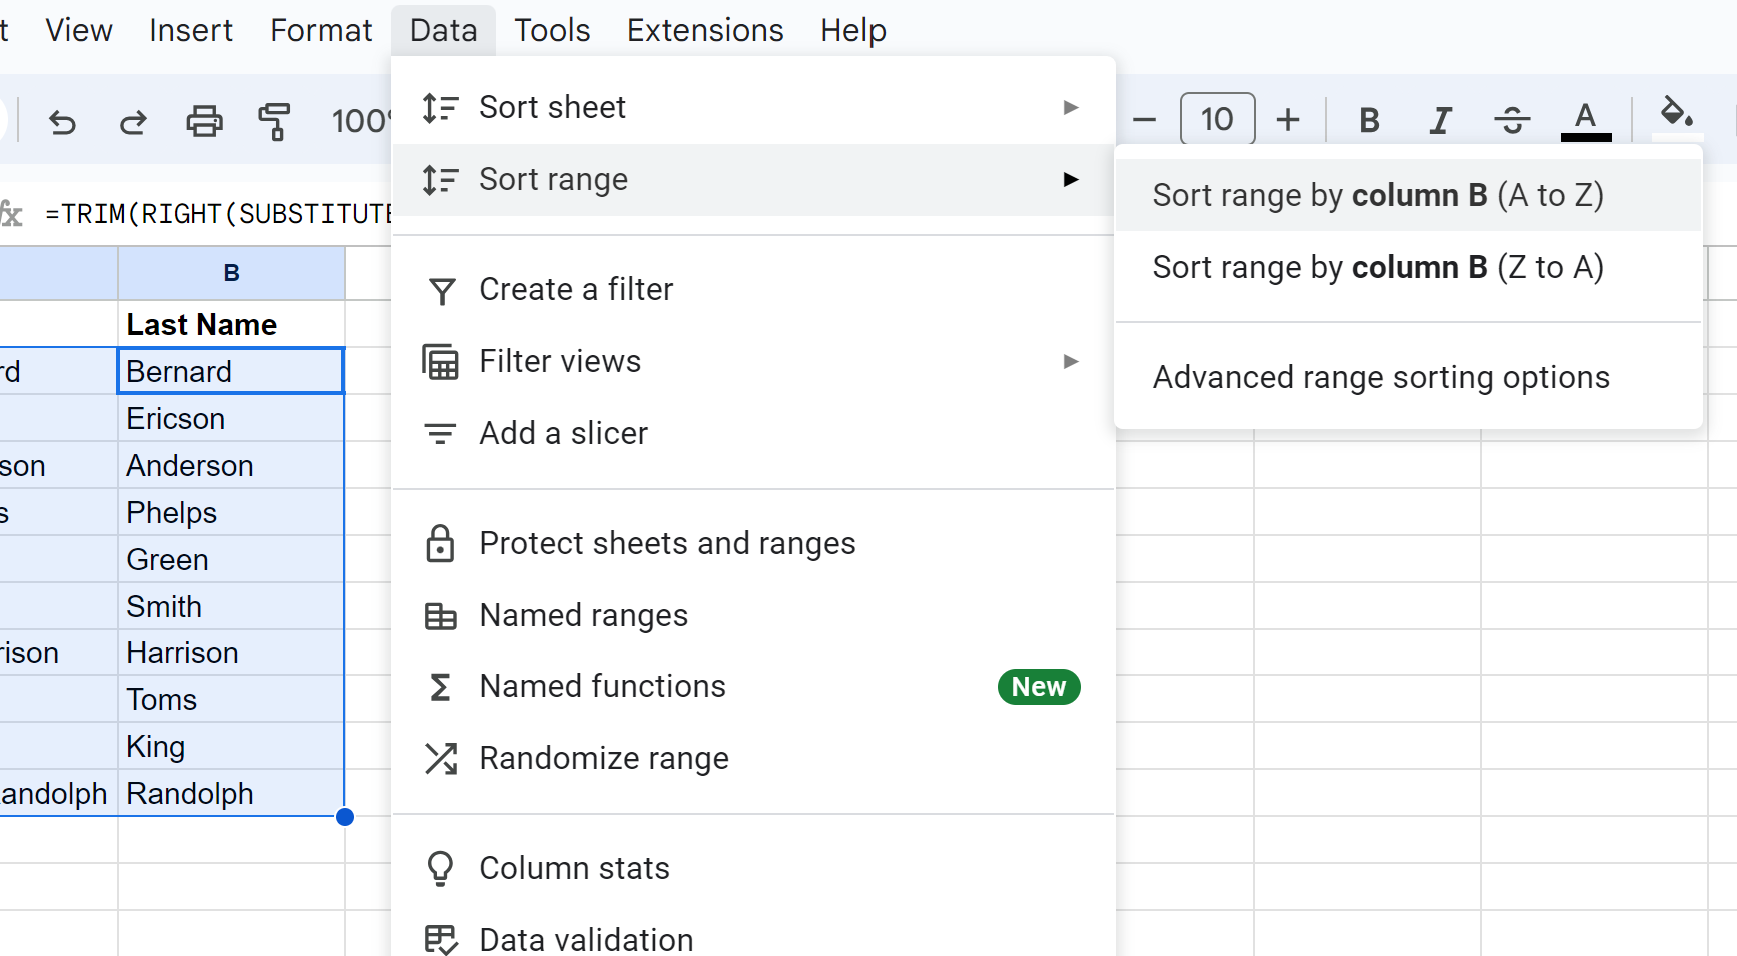
بعد التحقق من تحديد كامل المصفوفة وتأمين الترويسة، يتجه المستخدم إلى شريط القوائم العلوي وينقر على تبويب “البيانات” (Data). من القائمة المنسدلة، يجب تجاوز خيارات الفرز السريع الموجهة للصفحة بأكملها والتوجه مباشرة نحو خيار “فرز النطاق” (Sort range)، ثم النقر على “خيارات فرز النطاق المتقدمة” (Advanced range sorting options). يفتح هذا الإجراء نافذة تحكم مركزية تمنح المحلل سلطة كاملة لتحديد المعايير الموجهة لعملية إعادة التنظيم دون تعريض بيئة العمل للأخطاء الموضعية.
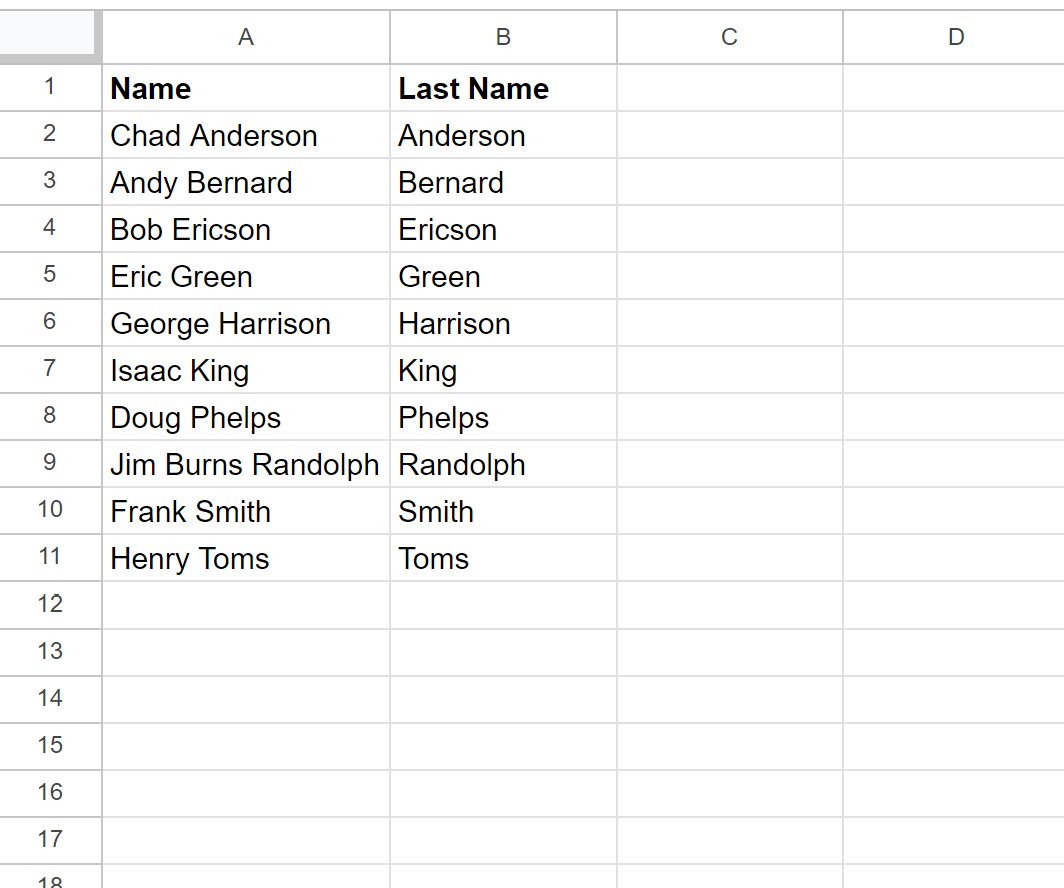
داخل نافذة الفرز المتقدمة، يتم تفعيل مربع الاختيار المعنون “تحتوي البيانات على صف رأس” (Data has header row) لضمان عزل العناوين نهائياً. بعد ذلك، تتيح القائمة المنسدلة اختيار معيار الترتيب؛ وهنا يتم تحديد العمود المساعد الموسوم بـ “اسم العائلة” بدلاً من عمود “الاسم الكامل”. يعقب ذلك تحديد الاتجاه الأبجدي المطلوب، سواء كان فرزاً تصاعدياً من الألف إلى الياء (A to Z) أو تنازلياً من الياء إلى الألف (Z to A). وبمجرد الضغط على زر “فرز” (Sort)، يعيد محرك جداول بيانات جوجل ترتيب كافة صفوف المصفوفة أفقياً كوحدات عضوية متماسكة بناءً على القيمة الهجائية للكنية المعزولة، مما ينتج عنه قائمة منظمة بدقة متناهية تحتفظ فيها كل شخصية بكافة بياناتها المرتبطة بها تاريخياً ومحاسبياً.
6. معالجة الحالات الخاصة والتراكيب الاسمية المعقدة
6.1 التعامل مع الأسماء الثلاثية والرباعية والأسماء الوسطى
تتجلى القوة المنهجية لصيغة التوسيع الفراغي المركبة =TRIM(RIGHT(SUBSTITUTE(...))) في قدرتها الفائقة على معالجة السجلات المتفاوتة ديموغرافياً ولغوياً من حيث عدد مقاطع الأسماء دون الحاجة إلى تعديل معاملات الدالة بين صف وآخر. ففي الكثير من قواعد البيانات المؤسسية، تختلط الأسماء الثنائية (مثل “خالد سالم”) بالأسماء الثلاثية (مثل “عمر فاروق الشريف”) والرباعية (مثل “محمد بن سلطان بن عبد العزيز المقرن”). تتعامل المعادلة مع كافة هذه الأشكال بتجريد رياضي صارم؛ إذ إنها مبرمجة بنيوياً لاقتناص الكتلة النصية الواقعة بعد آخر مسافة بيضاء في السلسلة كائناً ما كان، مما يمكنها من تجاوز سلاسل الأسماء الوسطى والنسب الطويلة والوصول إلى اللقب النهائي بدقة دون أن تتأثر بتباين أطوال الحقول الاسمية.
ومع ذلك، تفرض الممارسات الميدانية مواقف تتضمن ملحقات نصية لاحقة لاسم العائلة، وهي ظاهرة شائعة في التوثيق الأكاديمي والمهني؛ مثل إلحاق درجات القرابة والنسب بالأسماء الغربية (كالرمز Jr. أو Sr. أو الأرقام الرومانية II وIII)، أو إلحاق المؤهلات الوظيفية والعلمية (مثل Ph.D. أو ألقاب من قبيل “دكتور” و”مهندس” إذا أُدخلت في نهاية السجل). في مثل هذه الحالات الشاذة، ستفترض الصيغة الرياضية أن الملحق الأخير هو اسم العائلة وتستخلصه كناتج فرز، وهو ما يتطلب تدخلاً تنظيفياً يسبق المعالجة إما عبر البحث والاستبدال الموجه لإزالة تلك الملاحق، أو تحويل السجلات المخالفة إلى نمط توثيقي موحد يفصل بين الاسم الشرعي واللقب العلمي أو الرتبي.
6.2 إدارة الأسماء المركبة وسوابق الألقاب العائلية
تُمثل الأسماء والألقاب المركبة إحدى أعقد المعضلات اللغوية في مجال معالجة البيانات النصية؛ ففي البيئة العربية نجد الألقاب المصدرة بأدوات تعريف أو سوابق نسب منفصلة بمسافة، أو العوائل المصدرة بكلمة “آل” أو “أبو” أو “ذو” (مثل “آل الشيخ”، “أبو الفتوح”، “ابن رشيد”)، كما تتكرر الظاهرة ذاتها في الثقافات الغربية مع السوابق الإيبيرية واللاتينية والجرمانية (مثل van der Sar أو García Márquez أو de la Cruz). وإذا طُبقت المعادلة القياسية على اسم مثل “أحمد آل الشيخ”، فإن الخوارزمية ستعزل كلمة “الشيخ” وحدها وتسقط سابقة “آل”، مما يشوه دقة الفهرسة التوثيقية لاسم العائلة الكامل.
للتغلب على هذه المعضلة الهندسية، يُوصى باتباع منهجيتين رئيسيتين: المنهجية الأولى وقائية وتتمثل في إحلال “المسافة غير القابلة للكسر” (Non-Breaking Space ذات الرمز U+00A0 أو CHAR(160)) محل المسافة البيضاء الاعتيادية الفاصلة بين أجزاء اللقب المركب؛ حيث تجعل هذه المسافة محرك الجداول ينظر إلى مركب “آل الشيخ” بوصفه كتلة نصية واحدة غير منفصلة، مما يدفع دالة SUBSTITUTE لتجاوزه واعتباره الكلمة الأخيرة المتصلة بالكامل. أما المنهجية الثانية فتعتمد على بناء مصفوفة تدقيق مسبقة عبر استخدام تعابير شرطية متداخلة أو استبدال السوابق المشهورة بروابط وصل مؤقتة تدمج مقاطع اللقب قبل إطلاق أمر الاستخراج النهائي، بما يحافظ على الهوية اللغوية والتاريخية للعائلة في شجرة النسب الموثقة.
7. طرق بديلة: استخراج وفرز الأسماء عبر ميزة تقسيم النص إلى أعمدة
7.1 آلية استخدام ميزة تقسيم النص المدمجة في جداول جوجل
إلى جانب الحلول القائمة على المعادلات الرياضية، توفر جداول بيانات جوجل أداة واجهة مستخدم مدمجة تُعرف باسم “تقسيم النص إلى أعمدة” (Split text to columns). تعمل هذه الأداة كبديل إجرائي سريع يهدف إلى تفتيت السلاسل النصية ونشر مكوناتها عبر خلايا متجاورة. لتطبيق هذا الإجراء، يُحدد المحلل عمود الأسماء الكاملة (مثل العمود A)، ثم يتوجه إلى قائمة “البيانات” (Data) ويختار أمر “تقسيم النص إلى أعمدة”. تظهر فوراً نافذة تحكم صغيرة أسفل التحديد تُمكن المستخدم من تحديد نوع الفاصل (Separator)؛ حيث يتم اختيار “مسافة” (Space) كفاصل قياسي لتجزئة الاسم.
بمجرد تأكيد العملية، يقوم النظام بتفكيك كل اسم إلى عناصره المكونة وتوزيعها أفقياً؛ فيستقر الاسم الأول في العمود A، وتتحرك الكلمات التالية إلى الأعمدة B وC وD تبعاً لعدد المقاطع. هنا تبرز ضرورة التنبيه الأمني للبيانات؛ إذ إن ميزة التقسيم المباشر تُعد عملية تدميرية موضعية (In-Place Destructive Operation)، بمعنى أنها ستقوم بالكتابة فوق أي بيانات مسجلة في الأعمدة الواقعة على يسار أو يمين العمود المستهدف بحسب اتجاه الورقة. لذلك، يقتضي البروتوكول المهني التأكد المسبق من توفير أعمدة فارغة كافية لاستيعاب مخرجات الانشطار النصي، تفادياً لمسح السجلات الإحصائية أو الحسابية المجاورة دون قصد.
7.2 إجراء الترتيب والمقارنة المنهجية مع طريقة المعادلات
بعد اكتمال عملية التجزئة المادية للنص، يفترض المحلل أن اللقب الأخير قد أصبح في متناول اليد، إلا أن هذا الإجراء يكشف عن عيب جوهري خطير عند المقارنة بطريقة المعادلات. فبما أن الأسماء تتفاوت بطبيعتها في عدد المقاطع (ثنائية، ثلاثية، رباعية)، فإن أسماء العوائل لن تستقر في عمود واحد متناسق؛ فالاسم الثنائي سينتهي لقبه في العمود B، بينما يستقر لقب الاسم الثلاثي في العمود C، والرباعي في العمود D. هذا التشتت الأفقي يجعل من المستحيل تطبيق أمر فرز نطاق موحد؛ حيث لا يوجد عمود واحد يجمع كافة الألقاب العائلية للسجلات في آن معاً، مما يضطر المستخدم إلى معالجة يدوية مضنية لإعادة ضبط محاذاة أواخر الكلمات في عمود مشترك.
يقود هذا العيب إلى مفاضلة منهجية صارمة بين الطريقتين؛ فطريقة تقسيم النص إلى أعمدة تتسم بالجمود الساكن (Static Nature)، وتلائم فقط القوائم الموحدة معمارياً التي تقتصر حصراً على نمط (الاسم الأول + اسم العائلة)، كما أنها تقتطع السجلات الأصلية وتفقد ورقة العمل ديناميكيتها. في المقابل، تتمتع منهجية المعادلات النصية بطبيعة تفاعلية ديناميكية مرنة؛ فهي تحافظ على الاسم الكامل الأصلي سليماً في موضعه دون تشويه، وتستخلص الكلمة الأخيرة بصرف النظر عن موقعها الترتيبي بين الأعمدة، وتستجيب تلقائياً لأي تعديل أو إضافة لاحقة في البيانات دون حاجة لإعادة تفعيل إجراءات التقسيم اليدوية المجهدة.
8. استراتيجيات متقدمة: استخدام دوال REGEXEXTRACT والدوال الديناميكية
8.1 توظيف التعابير النمطية البرمجية عبر دالة REGEXEXTRACT
توفر جداول بيانات جوجل دعماً استثنائياً للتعابير النمطية (Regular Expressions – Regex) عبر دالة REGEXEXTRACT، وهي تقنية برمجية متطورة تتيح التعرف على الأنماط النصية المجردة واستخلاصها بكفاءة حسابية متناهية تتجاوز الدوال الرياضية المركبة من حيث الأناقة وسرعة التنفيذ. تكمن القوة الحقيقية لهذه الأداة في قدرتها على اختزال العمليات التوسيعية الطويلة داخل صياغة نمطية موجزة ومباشرة. ولعزل اسم العائلة من الخلية A2، تُكتب الصيغة النمطية التالية في الخلية المستهدفة:
=REGEXEXTRACT(TRIM(A2), "S+$")
يتحلل هذا التعبير النمطي بدقة فائقة: تقوم دالة TRIM أولاً بإزالة أي فراغات متطرفة قد تشوش على النمط، ثم يقوم المعامل "S+$" بعمله؛ حيث يمثل الرمز S أي محرف لا ينتمي إلى فئة المسافات البيضاء (Non-whitespace character)، وتدل علامة الجمع + على تكرار هذا المحرف لمرة واحدة أو أكثر لتشكيل كلمة كاملة، بينما يمثل الرمز $ مرساة نهاية السلسلة النصية (End of line anchor). بالتالي، يُصدر التعبير أمراً قاطعاً للمحرك باقتناص التتابع المتصل الأخير من الحروف الواقع في ختام السلسلة، والذي لا تفصله مسافات، وهو ما يطابق بدقة هندسية مطلقة اسم العائلة المنشود، دون إجهاد لبيئة الجداول بحسابات الفراغات الوهمية الناتجة عن دوال التكرار.
تتعاظم فائدة هذه التقنية عند دمجها مع دالة المصفوفات الشاملة ARRAYFORMULA، والتي تلغي نهائياً الحاجة لسحب المعادلات أو تطبيق مقبض التعبئة؛ حيث يمكن كتابة صيغة مصفوفية مفردة في قمة العمود المساعد (الخلية B2) تتولى قراءة ومعالجة العمود بالكامل حتى نهايته لحظياً وبشكل ديناميكي:
=ARRAYFORMULA(IF(A2:A="", "", REGEXEXTRACT(TRIM(A2:A), "S+$")))
تختبر هذه الصيغة النطاق العمودي بأكمله؛ فإذا كانت الخلية في A فارغة تترك الخلية المقابلة فارغة لتفادي إظهار رسائل الخطأ، وإذا احتوت على بيانات نصية استخلصت منها اسم العائلة على الفور، مما يوفر حلاً برمجياً متكاملاً يتمدد ذاتياً مع إضافة أي صفوف جديدة في المستقبل.
8.2 بناء مصفوفات فرز ديناميكية عبر دالتي SORT وQUERY
يمثل التوجه الحديث في معمارية البيانات داخل بيئات الحوسبة السحابية التحول من الفرز الموضعي الساكن (In-Place Static Sorting) إلى الترتيب الظاهري الديناميكي (Dynamic Virtualized Sorting). يتحقق هذا المستوى المتقدم عبر توظيف الدالة الرياضية المتطورة SORT لدمج معيار الفرز المستخلص في الذاكرة اللحظية المؤقتة (In-Memory) دون الحاجة أصلاً إلى إدراج أي عمود مساعد داخل ورقة العمل الأصلية. ولتحقيق ذلك، يمكن كتابة الصيغة الديناميكية التالية في خلية حرة داخل ورقة جديدة أو في مساحة شاغرة:
=SORT(A2:B, REGEXEXTRACT(TRIM(A2:A), "S+$"), TRUE)
تقوم هذه المعادلة بالتقاط النطاق المصدري كاملاً (الأسماء وبياناتها المرتبطة في A2:B)، وتُخضع عمود الأسماء A2:A خوارزمياً للتعبير النمطي لاستخراج الألقاب وتكوين مفتاح فرز وهمي في الذاكرة، ثم تُعيد طباعة المصفوفة كاملة مرتبة تصاعدياً (بناءً على المعامل TRUE) وفقاً لتلك الألقاب في الموقع الجديد، مع بقاء الجدول الخام الأصلي على حاله دون أي تغيير مادي في بنيته الحجمية أو ترتيبه الزمني الأولي.
يتكامل هذا النموذج الوظيفي تكاملاً عميقاً عند استدعاء دالة الاستعلامات المتقدمة QUERY، والتي توفر واجهة معالجة شبيهة بلغة الاستعلامات البنيوية (SQL) المستندة إلى معمارية واجهة معالجة بيانات جوجل (Google Visualization API Query Language). تتيح QUERY للمحلل ليس فقط إعادة ترتيب السجلات وفق معايير متعددة مشتقة، بل أيضاً تصفية الحقول غير المكتملة، وتحديد الأعمدة الواجب إظهارها، وتوليد تقارير ديناميكية مشتقة تتصل لحظياً بالمصدر الأساسي؛ بحيث ينعكس أي تصحيح أو إضافة اسم عائلة في الجدول الأولي بصورة تلقائية وفورية في الجدول المرتب، محققاً أعلى مستويات التكامل والأتمتة في بيئات العمل المشتركة.
9. تنظيف ورقة البيانات وإدارة الأعمدة المساعدة بعد اكتمال الترتيب
9.1 تحويل الصيغ إلى قيم ثابتة قبل حذف العمود المساعد
تعتمد سلامة استقرار جداول البيانات بعد الانتهاء من العمليات الحسابية المعتمدة على الفرز اليدوي الكلاسيكي على قاعدة إدارة حرجة تُعرف بـ “كسر الارتباط الديناميكي الحسابي” (Breaking Dynamic Formula Dependencies). فإذا قام المستخدم بفرز الجدول بناءً على المخرجات النصية للصيغة =TRIM(RIGHT(...))، ثم قرر التخلص من العمود المساعد عبر حذفه مباشرة بهدف إعادة الورقة إلى مظهرها الجمالي الأصلي، فإن بنية الحساب ستنهار بالكامل، وستتحول كافة المراجع المعتمدة إلى خطأ المرجع الشهير #REF!، مما يتسبب في إتلاف الربط البنيوي للبيانات وفقدان مصفوفة الفرز لقيمها التوجيهية.
لتجنب هذا الانهيار، يجب تجميد البيانات المستخرجة وتحويلها من “صيغ نشطة” دائمة الحساب إلى “قيم نصية ثابتة ومستقلة” (Static Constants). وتتم هذه العملية عبر تسلسل إجرائي صارم: يتم أولاً تظليل كافة خلايا العمود المساعد الحاوية على الألقاب المستخلصة ونسخها بالكامل إلى الحافظة باستخدام الاختصار Ctrl + C (أو Cmd + C على أجهزة الماك). بعد ذلك، ودون تحريك موضع التحديد، يتم النقر بزر الفأرة الأيمن والولوج إلى قائمة “لصق خاص” (Paste special)، واختيار أمر “لصق القيم فقط” (Paste values only)، أو استخدام الاختصار المباشر Ctrl + Shift + V. يترتب على هذا الإجراء استبدال الأكواد والمعادلات الرياضية الكامنة خلف الخلايا بنصوص الألقاب المجردة، مما يحرر البيانات من تبعيتها لعمود الأسماء الأصلية ويمنحها استقلالاً رياضياً تاماً يتيح للمستخدم التعامل معها دون أي ارتدادات برمجية سلبية.
9.2 الخيارات المنهجية لإدارة العمود المساعد: الحذف مقابل الإخفاء
بعد تحويل المخرجات إلى قيم ثابتة، يواجه مسؤول إدارة البيانات مفترق طرق تقني يتعلق بمصير العمود المساعد؛ فهل الأفضل حذفه نهائياً أم الاحتفاظ به مخفياً؟ إذا كان جدول البيانات يمثل تقريراً ختامياً ثابتاً غير خاضع للتطوير المستقبلي أو الإدخال الإضافي، وكان المطلوب حصر المساحة البصرية في عمود الاسم الكامل فقط، فإن حذف العمود المساعد (Delete column) يُعد خياراً آمناً لا غبار عليه ما دامت السجلات قد أُعيد فرزها ورُسخت أفقياً، وما دامت القيم قد فُصلت عن صيغها الأصلية في الخطوة السابقة.
أما في بيئات العمل الديناميكية التي تستقبل مدخلات جديدة بصفة مستمرة (مثل قواعد بيانات الطلاب المستجدين أو الموظفين الجدد)، فإن الإجراء المهني الموصى به هو “إخفاء العمود” (Hide column) بدلاً من حذفه. يتحقق ذلك بالنقر بالزر الأيمن على ترويسة الحرف المخصص للعمود المساعد واختيار “إخفاء العمود”. يتيح هذا الإخفاء إبقاء المعمارية الحسابية قائمة ومحجوبة عن الأعين في آن واحد؛ بحيث تظل الخلايا جاهزة لاستيعاب السجلات اللاحقة ومعالجتها دون إفساد النمط البصري العام للورقة. ويقتضي البروتوكول التوثيقي في هذه الحالة تدوين تعليق إداري أو ملاحظة تعريفية في الخلية الوصفية لتنبيه أي محلل أو مستخدم آخر يشارك في تحرير الورقة بوجود أعمدة مساعدة مخفية تُستخدم في عمليات الضبط الهيكلي للجدول، بما يرسخ معايير الشفافية التشغيلية في فرق العمل المؤسسية.
10. استكشاف الأخطاء الشائعة وحلولها التقنية أثناء فرز الأسماء
10.1 معالجة المسافات الخفية وأخطاء التنسيق الطباعي
تُعد العيوب النصية الميكروسكوبية أحد أخطر مصادر التشويش في خوارزميات الفرز؛ حيث يقف السلوك الطباعي البشري غير المنضبط وراء تسلل محارف غير مرئية تؤدي إلى إفساد الفرز الأبجدي. ومن أبرز هذه المشكلات وجود مسافة بيضاء إضافية غير مرئية في نهاية الاسم (مثل كتابة “محمد علي ” بدلاً من “محمد علي”). وفي حال عدم تنظيف النص مسبقاً، ستتعامل دالة استخراج الكلمة الأخيرة مع هذه المسافة الخفية بصفتها المحرف الختامي، مما ينتج عنه استخلاص قيمة فراغية فارغة أو تشويه عملية اقتطاع اللقب الحقيقي، ليتراجع موضع السجل بأكمله إلى ذيل أو صدر القائمة خلافاً لقيمته الهجائية الفعلية.
لمواجهة هذا التشوه وتوحيد الأنماط النصية، يجب تطبيق المعالجة المزدوجة التي تدمج بين الدالة TRIM والدالة CLEAN وفق الصياغة =TRIM(CLEAN(A2)). تختص دالة CLEAN بتجريد السلسلة من المحارف غير المطبوعة ومحارف التحكم (ASCII Control Characters من الرمز 0 إلى 31) التي تتسلل عادة عند استيراد البيانات من ملفات CSV أو قواعد بيانات قديمة، بينما تتكفل TRIM بمحو المسافات البادئة واللاحقة والمكررة. كما تبرز في البيئة العربية إشكالية تباين كتابة الهمزات والحروف الطرفية؛ مثل الخلط العشوائي بين الألف المهموزة والممدودة والمجردة (أ، إ، آ، ا)، أو التداخل بين الياء المقصورة والياء المهملة (ي، ى)، أو التاء المربوطة والهاء (ة، ه). يقتضي التصحيح المتقدم في هذه الحالة توظيف أداة “البحث والاستبدال” باستعمال التعابير النمطية لتوحيد صور الحروف قبل تطبيق الفرز، لضمان اصطفاف أبجدي متسق يخضع لنظام المعيار الموحد دون انزياحات ناتجة عن الفروق الإملائية.
10.2 تدارك اختلال التوافق بين الصفوف أثناء الفرز غير المكتمل
يُمثل “اختلال التوافق الأفقي” (Row Decoupling) الكابوس التقني الأكبر في إدارة جداول البيانات؛ ويحدث حين يُقدم المستخدم على فرز عمود نصي بمفرده دون توسيع نطاق التحديد ليشمل باقي أعمدة الصف المرتبطة به. في هذه الحالة، تتغير مواضع الأسماء وتترتب هجائياً، في حين تظل أرقام الهواتف، والعناوين الجغرافية، والرواتب المصرفية في صفوفها القديمة، مما يعني ربط بيانات أشخاص بأسماء أشخاص آخرين بالكامل وتدمير الموثوقية المعلوماتية للقاعدة. وعند اكتشاف مثل هذا الخطأ فور وقوعه، يُعد التدخل السريع عبر أمر التراجع الفوري (Undo) باستخدام الاختصار القياسي Ctrl + Z (أو Cmd + Z) هو طوق النجاة الأول والوحيد لاستعادة تماسك السجلات قبل أن تُغلق الجلسة.
أما إذا فُقدت القدرة على التراجع بسبب إغلاق الورقة أو مرور وقت طويل، فيوفر تطبيق جداول بيانات جوجل سجلاً زمنياً متقدماً للتحكم في الإصدارات يُعرف بـ “سجل التعديلات” (Version history)، ويمكن الوصول إليه من قائمة “ملف” (File) ثم اختيار “سجل التعديلات” والنقر على “الاطلاع على سجل التعديلات”. تتيح هذه النافذة استرجاع لقطة زمنية كاملة لقاعدة البيانات في اللحظة التي سبقت عملية الفرز الكارثية واستعادة سلامتها الهيكلية. وللحماية الاستباقية المطلقة من هذا الخطأ في بيئات العمل التعاونية المتعددة المستخدمين، يُنصح بالاعتماد المستمر على أداة “نطاقات التصفية” (Filter Views) بدلاً من الفرز الصلب للنطاق؛ حيث تُتيح التصفية للمستخدم فرز البيانات محلياً على شاشته دون تعديل الترتيب الفعلي للجدول المشترك، وتفرض تلقائياً تماسك الصفوف الأفقية ككتل موحدة يستحيل انفصالها، مما يقضي نهائياً على مخاطر اختلال السجلات أثناء الفرز والتحليل المستمر.
خاتمة
يمثل الترتيب الموجه بحسب اسم العائلة في جداول بيانات جوجل نموذجاً بارزاً لكيفية تطويع الأدوات الحسابية وتراكيب النصوص للتغلب على قيود البنية غير العلائقية للبيانات؛ حيث يتطلب إتقان هذه المهارة فهماً هندسياً دقيقاً يتكامل فيه المنطق الرياضي مع البعد اللغوي التوثيقي. وقد أظهرت التحليلات المفصلة في هذا الدليل أن محاولة الاعتماد على الإجراءات السطحية البسيطة، مثل التقسيم اليدوي للنص، غالباً ما تقود إلى تشوهات هيكلية وتفاوتات أفقية غير متسقة، ولا سيما عند معالجة البيانات المعقدة التي تزخر بالأسماء المركبة أو المتفاوتة في عدد مقاطعها الديموغرافية.
في المقابل، توفر الحلول التحليلية الرصينة—بدءاً من الصيغة الكلاسيكية المركبة =TRIM(RIGHT(SUBSTITUTE(...))) ووصولاً إلى التعابير النمطية الأنيقة =REGEXEXTRACT(...) ومصفوفات الترتيب الافتراضية عبر الدالة SORT—أعلى درجات الموثوقية والصلابة الرياضية، مما يضمن الحفاظ على سلامة الروابط العضوية بين السجلات وعزل المؤشرات الهجائية بدقة متناهية دون أدنى تشويه للبيانات المرجعية الأصلية. إن تبني هذه المنهجيات المعيارية، مقرونة ببروتوكولات التنظيف المسبق للنصوص والتحويل الواعي للقيم بعد الفرز، يُعد ركيزة أساسية لكل باحث أكاديمي ومدير بيانات يسعى إلى بلوغ أعلى مراتب الدقة والاحترافية في إدارة واستثمار الأصول المعلوماتية داخل المؤسسات المعاصرة.
المراجع
- Einav, L., & Yariv, L. (2006). What’s in a surname? The effects of surname initials on academic success. Journal of Economic Perspectives, 20(2), 175–188. https://doi.org/10.1257/jep.20.2.175
- Nuttin, J. M. (1985). Narcissism beyond Gestalt and awareness: The name letter effect. European Journal of Social Psychology, 15(3), 353–361. https://doi.org/10.1002/ejsp.2420150404
- Unicode Consortium. (2023). Unicode Technical Standard #10: Unicode Collation Algorithm. Unicode Consortium. https://www.unicode.org/reports/tr10/