
تتبوأ معالجة البيانات النصية غير المهيكلة مكانة جوهرية في منظومة التحليلات الإحصائية المتقدمة والبحوث السلوكية والاجتماعية المعاصرة. فمع تزايد الاعتماد على الاستبيانات المفتوحة، وسجلات التفاعل الرقمي، والمقابلات التفريغية، باتت الحاجة ملحة إلى أدوات برمجية دقيقة وفعالة تمتلك القدرة على تفكيك النصوص وتحويلها إلى مؤشرات كمية قابلة للقياس والنمذجة الرياضية. وفي هذا السياق، تبرز بيئة نظام التحليل الإحصائي (SAS) كواحدة من أكثر المنصات البرمجية رسوخاً وموثوقية في إدارة البيانات الكبيرة والمعقدة، موفرة حزمة واسعة من الدوال المصممة خصيصاً لمعالجة السلاسل النصية وضبط جودتها.
تعد دالة COUNTW واحدة من أبرز الدوال النصية التي قدمتها شركة SAS لتسهيل العمليات الحسابية المتعلقة بالبنية اللفظية للبيانات. إذ تعمل هذه الدالة على حساب عدد المفردات اللغوية أو الوحدات النصية (Word Tokens) داخل سلسلة محددة بدقة بالغة وكفاءة خوارزمية عالية، متفوقة بذلك على الأساليب التقليدية المجهدة التي كانت تتطلب كتابة خوارزميات مسح معقدة أو استخدام تعبيرات نمطية متشابكة. إن توظيف هذه الدالة يتجاوز مجرد العد السطحي للكلمات؛ فهو يمثل خطوة أساسية في تهيئة البيانات، واستكشاف أبعاد التعبير اللفظي، وفحص نزاهة الإجابات في البحوث المسحية.
يهدف هذا المقال الأكاديمي الشامل إلى تقديم تفكيك منهجي وتطبيقي متعمق لدالة COUNTW في نظام SAS. سنستعرض بنيتها التركيبية، ومعاملاتها المختلفة، وسلوكها الافتراضي والمخصص، بالإضافة إلى توضيح آليات دمجها مع محددات التعديل المتقدمة والوظائف البرمجية الأخرى. كما سنقدم دليلاً عملياً يتضمن بناء مجموعات بيانات واقعية، وتفسير المخرجات الإحصائية، ومعالجة التحديات الحاسوبية المرتبطة بالقيم المفقودة واللغات متعددة البايت، مما يوفر للباحثين والمحللين مرجعاً علمياً متكاملاً يدعم مشاريعهم التحليلية بأعلى معايير الدقة المنهجية.
1. مقدمة عامة حول دالة COUNTW وأهميتها في معالجة النصوص البرمجية
1.1 مفهوم دالة COUNTW ودورها الأساسي في نظام SAS
تُعرَّف دالة COUNTW في بيئة SAS بأنها دالة حاسوبية موجهة لمعالجة السلاسل الرمزية (Character Function)، تختص بحساب عدد الكلمات أو الوحدات النصية الفرعية ضمن تعبير نصي محدد، اعتماداً على فواصل بنيوية صريحة أو ضمنية. تم تقديم هذه الدالة رسمياً بواسطة معهد SAS (SAS Institute Inc.) ضمن حزمة التحديثات الجوهرية في إصدار SAS 9.2 عام 2008، بهدف سد فجوة إجرائية كانت تؤرق مبرمجي البيانات عند محاولة قياس الكثافة اللفظية للسجلات النصية دون الحاجة إلى اللجوء إلى حلقات تكرارية مضنية.
قبل ظهور هذه الدالة، كان المحللون يضطرون إلى كتابة شفرات مطولة تعتمد على الجمع بين دالة SCAN ومحددات الحلقات مثل DO WHILE، أو استخدام دوال البحث عن الأحرف لحساب المسافات البيضاء يدوياً مع تطبيق شروط استثنائية لمعالجة الفراغات المتكررة وعلامات الترقيم. قدمت دالة COUNTW حلاً متكاملاً ومحسناً على المستوى الداخلي لمحرك معالجة البيانات، حيث تعتمد على خوارزميات مسح أحادية التمرير (Single-pass parsing algorithms) تضمن سرعة فائقة في التنفيذ وتفادياً للأخطاء المنطقية الناجمة عن عدم اتساق المسافات.
تتجلى الكفاءة الحاسوبية للدالة عند تطبيقها على قواعد البيانات الضخمة التي تحتوي على مئات الآلاف أو الملايين من السجلات. فبدلاً من استنزاف الذاكرة العشوائية ووحدة المعالجة المركزية في تقطيع النصوص وتوليد مصفوفات وسيطة، تقوم دالة COUNTW بإرجاع قيمة عددية صحيحة تمثل العدد الكلي للمفردات مباشرة، مما يقلص زمن التشغيل بصورة جذرية ويجعلها الخيار المعياري المفضل في مراحل استيراد وتنظيف وتجهيز البيانات المعقدة (Data Wrangling).
1.2 مجالات التطبيق في تحليل البيانات النصية والاستبيانات المفتوحة
تحظى دالة COUNTW بأهمية خاصة في حقول القياس النفسي والعلوم السلوكية والاجتماعية التي تعتمد على المسوح الميدانية والأدوات الاستقصائية المشتملة على أسئلة مفتوحة النهاية (Open-ended questions). في مثل هذه السياقات، يمثل طول الإجابة النصية مؤشراً كمياً مباشراً على درجة مشاركة المستجيب (Respondent Engagement)، والجهد المعرفي المبذول في صياغة الفكرة، ومستوى الإسهاب في تفصيل الظاهرة محل الاستقصاء. يتيح حساب عدد المفردات تصنيف الاستجابات بدقة وتحديد المشاركين الذين قدموا شروحات تفصيلية مقابل أولئك الذين اكتفوا بإجابات مقتضبة.
علاوة على ذلك، تُستخدم الدالة كأداة تنقية أولية للكشف عن جودة البيانات المدخلة (Data Hygiene). ففي كثير من الأحيان، يقوم بعض المشاركين في الدراسات الإلكترونية بإدخال رموز عشوائية أو كلمات يتيمة للالتفاف على شرط الإلزام في نماذج جمع البيانات. من خلال وضع عتبات معيارية مستندة إلى دالة COUNTW، يستطيع الباحث تصفية الاستجابات التي يقل عدد كلماتها عن حد أدنى محدد مسبقاً، أو عزل السجلات المفرطة في الطول لدراسة احتمالية احتوائها على نسخ ولصق غير مبرر أو نصوص مكررة لا تخدم أهداف القياس.
يمتد التطبيق أيضاً إلى مجالات اللغويات الحاسوبية وهندسة السمات (Feature Engineering) للتحليلات التنبؤية المتقدمة. إذ يشكل متغير “عدد الكلمات” بعداً تفسيرياً مهماً يدخل كمتغير ضابط أو مستقل في نماذج الانحدار الخطي واللوجستي، ونماذج التعلّم الآلي الهادفة إلى تصنيف الآراء (Sentiment Analysis)، أو التنبؤ بتقييمات رضا العملاء، حيث تتلازم الكثافة اللفظية غالباً مع شدة المشاعر السلبية أو الإيجابية المعبّر عنها في النص.
1.3 الفروق الجوهرية بين عد الأحرف وعد الكلمات في تحليل المحتوى
من الناحية المنهجية، يقتضي التحليل الإحصائي الرصين التمييز القاطع بين قياس طول السلسلة النصية بناءً على عدد المحارف (Characters) وبين قياسها بناءً على عدد المفردات اللفظية (Words). توفر لغة SAS دوالاً متخصصة في حساب الأحرف مثل LENGTH وLENGTHN، إلا أن استخدام هذه الدوال كبديل عن قياس الكلمات يقود إلى استنتاجات مضللة ومتحيزة، نظراً لأن طول الكلمات يتفاوت بتفاوت البنى الصرفية والمفردات المستخدمة، مما يجعل عدد الأحرف مؤشراً على الطول الفيزيائي للسلسلة وليس على محتواها الدلالي والتركيبي.
تمثل “المفردة” في اللغويات وحدة تحليل مستقلة تحمل معنى نحوياً ودلالياً متكاملاً. وعند تفكيك الخطاب أو فحص استجابات الأفراد، فإن عدد الوحدات الدلالية هو الذي يعكس الثراء المعرفي وطلاقة التعبير، وليس عدد الرموز الطباعية. فالجملة المكونة من خمس كلمات طويلة قد تحتوي على عدد أحرف يماثل جملة مكونة من عشر كلمات قصيرة، إلا أن البنية الإخبارية والتواصلية للجملتين تختلف جذرياً في سياق تحليل المحتوى الكمي والأكاديمي.
بالإضافة إلى ذلك، فإن علامات الترقيم، والمسافات الزائدة، والمحارف غير المرئية تزيد من القيمة الرقمية المرجعة بواسطة دالة LENGTH، في حين تمتلك دالة COUNTW آليات مدمجة تمكنها من تحييد هذه الشوائب البنيوية والتركيز فقط على التكتلات اللفظية المفصولة وفق قواعد نحوية محددة. يضمن هذا التمييز تحقيق الاتساق الإجرائي والموضوعية في بناء المؤشرات اللغوية المشتقة، ويجنب الباحث الوقوع في أخطاء القياس الناتجة عن تباين أساليب الكتابة والترقيم بين المفحوصين.
2. بناء الجملة النحوية (Syntax) لدالة COUNTW وتفكيك معاملاتها
2.1 المعامل الأول: السلسلة النصية المستهدفة (String)
يمثل المعامل الأول المدخل الأساسي والإلزامي في دالة COUNTW، وهو يشير إلى التعبير النصي المراد فحصه وحساب عدد مفرداته. يمكن أن يكون هذا المعامل اسماً لمتغير نصي موجود مسبقاً في مجموعة البيانات، أو ثابتاً نصياً محاطاً بعلامات اقتباس فردية أو مزدوجة، أو ناتج تعبير برمجي مركب يعيد سلسلة رمزية. يتميز محرك SAS بمرونة التعامل مع هذا المعامل، حيث يتقبل المتغيرات النصية ذات الأطوال الثابتة والمتغيرة على حد سواء.
عند تعريف السلسلة النصية، يجب مراعاة حجم الذاكرة المخصص للمتغير (Storage Length) ونظام الترميز المستخدم في جلسة العمل. ففي بيئات SAS التقليدية المعتمدة على ترميز ASCII أو EBCDIC، يتم التعامل مع كل بايت كرمز واحد، بينما في البيئات الحديثة التي تعتمد ترميز UTF-8، قد تستهلك بعض المحارف غير اللاتينية، كالحروف العربية، بايتات متعددة. ومع ذلك، فإن دالة COUNTW مصممة لتتبع حدود الكلمات استناداً إلى المحارف والرموز وليس إلى البايتات المجردة، مما يحفظ سلامة التقدير العددي للمفردات عبر مختلف المنظومات البرمجية.
كما تتعامل الدالة بكفاءة تامة مع السلاسل النصية التي تحتوي على مساحات بيضاء متباينة في بدايتها أو نهايتها. ولا تتطلب الدالة من المبرمج تنفيذ عمليات تهيئة مسبقة لتجريد النص من الفراغات المحيطة باستخدام دوال التشذيب مثل TRIM أو STRIP، حيث تتولى الخوارزمية الداخلية تجاوز هذه الفراغات تلقائياً والبدء المباشر في تحديد مواقع التجمعات الحرفية التي تشكل الكلمات الفعلية.
2.2 المعامل الثاني: الحروف المحددة كفواصل (Character Delimiters)
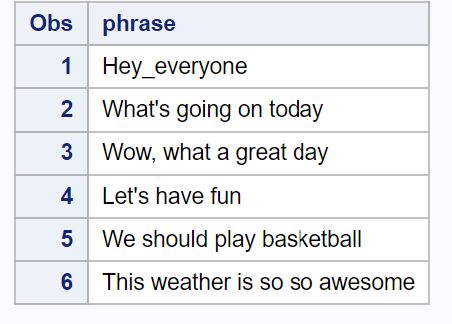
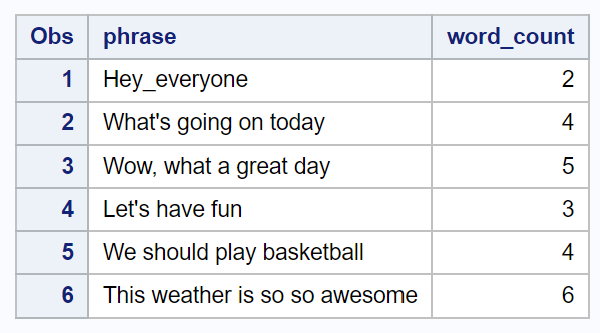
المعامل الثاني هو معامل اختياري (Optional Argument) يسمح للمبرمج بتجاوز الإعدادات الافتراضية للنظام وتحديد قائمة مخصصة من المحارف التي يعتبرها محرك SAS فواصل قاطعة بين الكلمات (Word Delimiters). يتم تمرير هذا المعامل كسلسلة نصية تحتوي على كافة الرموز المراد اعتمادها كحدود فاصلة، محاطة بعلامات اقتباس، مثل ' ,;._'. يتيح هذا الخيار إعادة صياغة مفهوم “الكلمة” بحسب السياق التحليلي والنوعي للبيانات المدروسة.
يلعب هذا المعامل دوراً حاسماً عند التعامل مع نصوص ذات طبيعة تقنية أو غير معيارية. على سبيل المثال، في قواعد البيانات التي تدمج بين النصوص وأرقام الهويات أو العناوين البريدية أو المعرفات المركبة بشرطات سفلية (Underscores) أو شرطات مائلة (Slashes)، قد لا يرغب المحلل في اعتبار الشرطة جزءاً من الكلمة بل فاصلاً مستقلاً. من خلال إدراج هذه الرموز صراحة في المعامل الثاني، يعيد النظام تجزئة النص وفق المنظور المحدد بدقة متناهية.
في حال إغفال هذا المعامل تماماً من استدعاء الدالة، ينتقل نظام SAS تلقائياً إلى تطبيق قائمته الافتراضية للفواصل، والتي تتضمن مسافات التباعد ومجموعة موسعة من علامات الترقيم والرموز الحسابية والخاصة. إلا أن الاعتماد على السلوك الافتراضي قد يؤدي أحياناً إلى نتائج غير متوقعة إذا كان النص يحتوي على تراكيب لغوية خاصة، مما يجعل التحديد الصريح للفواصل ممارسة برمجية فضلى في المشاريع الأكاديمية الحساسة.
2.3 المعامل الثالث: محددات التعديل والتحكم الإضافية (Modifiers)
يمثل المعامل الثالث أحد أقوى الإضافات الوظيفية التي زُودت بها دالة COUNTW في نظام SAS، وهو معامل اختياري يُمرر على هيئة رمز حرفي واحد أو سلسلة من الرموز الحرفية غير الحساسة لحالة الأحرف، ويهدف إلى تعديل آليات الفحص وقواعد التعرف على الفواصل والكلمات. تمنح هذه المحددات (Modifiers) المبرمج تحكماً دقيقاً في كيفية تفسير محارف السلسلة دون الحاجة إلى كتابة فواصل طويلة ومعقدة في المعامل الثاني.
من أبرز هذه المحددات نجد المحدد 'q' أو 'Q' (Quotation mark modifier)، والذي يوجه الدالة إلى تجاهل أي فواصل تقع داخل نصوص محاطة بأقواس اقتباس فردية أو مزدوجة، مما يتيح معاملة العبارات المقتبسة ككتلة واحدة أو استبعاد تفتيتها إذا كانت تمثل قيماً معيارية مدمجة. كذلك يبرز المحدد 'm' أو 'M' (Multiple delimiters modifier)، الذي يغير السلوك الافتراضي للدالة في دمج الفواصل المتتالية، حيث يجبرها على معاملة كل فاصل متتابع كحد فاصل لمفردة خالية (Null item)، وهو أمر شديد الأهمية في معالجة ملفات القيم المفصولة بفواصل (CSV).
بالإضافة إلى ذلك، توفر لغة SAS محددات مخصصة لفئات المحارف، مثل المحدد 'a' لإضافة كافة الحروف الأبجدية كفواصل، والمحدد 'd' لإضافة الأرقام كفواصل، والمحدد 'p' لإضافة كافة علامات الترقيم القياسية، والمحدد 's' لإضافة كافة الفراغات والمحارف البيضاء بما فيها علامات التبويب (Tabs). يمكن دمج عدة محددات معاً في نفس المعامل، مثل تمرير 'ps' لتوجيه الدالة لاستخدام كافة علامات الترقيم والفراغات البيضاء كفواصل مجتمعة، مما يوفر اختصاراً برمجياً أنيقاً يرفع من موثوقية الكود ويمنع نسيان أي رمز ترقيمي.
3. السلوك الافتراضي لدالة COUNTW وكيفية التعرف على الفواصل التلقائية
3.1 الفواصل النصية المعتمدة تلقائياً في بيئة SAS
عند استدعاء دالة COUNTW وتزويدها بالمعامل الأول فقط دون تحديد المعامل الثاني أو الثالث، ينشط السلوك الافتراضي لمحرك المعالجة النصية في SAS. يعتمد هذا السلوك على قائمة قياسية مسبقة التحديد من الرموز التي تعتبر بمثابة فواصل قاطعة بين الوحدات النصية. في بيئات التشغيل القائمة على ترميز ASCII القياسي، تشمل هذه القائمة الافتراضية المسافة الفارغة المعتادة (Blank Space) إضافة إلى حزمة واسعة من علامات الترقيم والرموز الخاصة الشائعة، وهي كالتالي:
- المسافة البيضاء (Blank space).
- علامات الترقيم الأساسية: النقطة (
.)، الفاصلة (,)، الفاصلة المنقوطة (;)، علامتا الاستفهام والتعجب (?و!). - الرموز الحسابية والمنطقية: الجمع (
+)، الطرح أو الشرطة العادية (-)، الضرب (*)، القسمة أو الخط المائل (/)، وعلامات المقارنة (<و>)، والرمز الرأسي (|)، ورمز النفي (^). - رموز أخرى: علامة النسبة المئوية (
%)، والدولار ($)، وعلامة العطف (&)، والأقواس الدائرية (( )).
يعني هذا التكوين التلقائي أن محرك SAS يعتبر أي حرف من هذه الحروف بمثابة جدار عازل ينهي الكلمة السابقة ويبدأ فحص الكلمة اللاحقة. ومع ذلك، هناك رموز شائعة لا تندرج ضمن القائمة الافتراضية، ومن أبرزها الشرطة السفلية (Underscore _) وعلامة الفاصلة العليا (Apostrophe ') في بعض السياقات وعلامات التنصيص. لذلك، فإن النصوص التي تحتوي على معرفات مركبة مثل Patient_ID_New ستعامل ككلمة واحدة في الوضع الافتراضي، لأن الشرطة السفلية لا تعد فاصلاً ضمن المعايير الأولية لنظام SAS.
3.2 تأثير المسافات البيضاء المتعددة والمتتالية
من أهم المزايا البنيوية لدالة COUNTW قدرتها الذاتية المتطورة على معالجة المسافات البيضاء المتعددة والمتتالية (Consecutive Blank Spaces) دون التأثير سلباً على صحة الناتج الإحصائي. ففي المعالجة البرمجية البدائية، كان وجود مسافتين أو أكثر بين كلمتين متتاليتين يربك خوارزميات التجزئة ويقود إلى احتساب “كلمات فارغة” وهمية بين المسافات، مما يتطلب تشذيباً مسبقاً وتطهيراً لسلسلة البيانات قبل مباشرة العد.
تتعامل خوارزمية COUNTW في وضعها القياسي مع أي كتلة من الفراغات المتصلة باعتبارها فاصلاً واحداً ممتداً. تبدأ الخوارزمية بفحص الرموز من اليسار إلى اليمين، وعند مواجهة مسافة فارغة، تقوم بتسجيل نهاية الكلمة الأولى، ثم تتجاهل كافة المسافات اللاحقة المتصلة بها مباشرة حتى تصطدم بأول محرف ينتمي إلى فئة الكلمات، لتعلن بداية الكلمة الثانية. يضمن هذا السلوك التلقائي ثبات النتيجة ودقتها بصرف النظر عن أسلوب التنسيق الطباعي، أو الأخطاء الشائعة المتمثلة في ضغط زر المسافة عدة مرات أثناء إدخال البيانات يدوياً من قبل المفحوصين.
كذلك، فإن المسافات البيضاء الواقعة في بداية الجملة (Leading blanks) أو في نهايتها (Trailing blanks) لا تحتسب إطلاقاً كحدود لكلمات خالية. فإذا كانت السلسلة النصية تبدأ بخمس مسافات فارغة متبوعة بثلاث كلمات وتنتهي بعشر مسافات، فإن الدالة ترجع القيمة 3 بثبات مطلق. هذا التجريد التلقائي للفراغات الزائدة يلغي الحاجة إلى دمج دوال مساعدة مثل COMPBL (المسؤولة عن تقليص الفراغات المتعددة إلى فراغ واحد) أو STRIP، مما يرفع من جودة الشفرة البرمجية ويحافظ على خفتها وسرعة معالجتها.
3.3 طبيعة الاستجابة لعلامات الترقيم المتلاصقة والرموز
يتشابه سلوك دالة COUNTW تجاه علامات الترقيم المتلاصقة مع سلوكها تجاه المسافات المتعددة، طالما أن تلك الرموز تندرج ضمن قائمة الفواصل المعتمدة. فعلى سبيل المثال، إذا انتهت الجملة بنقطة متبوعة بفاصلة وقوس إغلاق مثل .,) دون مسافات تفصل بينها، فإن النظام يعامل هذا التجمع الرمزي برمته كفاصل تركيبي واحد ولا يفترض وجود مفردات بينية خالية، ما لم يتم تفعيل المحدد 'm' كما أشرنا سابقاً.
تنشأ التعقيدات المنهجية حين تتداخل الرموز التي لا تصنف كفواصل افتراضية مع نصوص مكتوبة بلغات حية. ففي اللغة الإنجليزية على سبيل المثال، يثير استخدام الفاصلة العليا في اختصارات مثل don't أو صيغ الملكية user's إشكاليات في التجزئة النصية. وبالمثل، في اللغة العربية، قد تتصل علامات ترقيم معينة أو أقواس غير معيارية بالكلمات. فإذا لم تكن العلامة مدرجة ضمن الفواصل، تدمجها الدالة كجزء بنيوي من حروف الكلمة، مما لا يؤثر على العدد الإجمالي للكلمات في تلك الجملة ولكنه يؤثر على عمليات المطابقة والاستخراج اللاحقة عبر دوال أخرى كـ SCAN.
لهذا السبب، يتحتم على المحلل فحص توزيع الرموز وعلامات الترقيم في العينة المستهدفة قبل اعتماد العد التلقائي. فإذا كشف الفحص الاستكشافي عن وجود أنماط ترقيم معقدة أو استخدام متكرر لواصلات ورموز إلكترونية (مثل الروابط والمحارف البرمجية)، يصبح من الواجب الانتقال فوراً إلى التخصيص اليدوي للمعامل الثاني وإدراج تلك الرموز صراحة لتوجيه الدالة نحو التفكيك السليم للنسيج اللفظي.
4. مثال تطبيقي عملي: إنشاء مجموعة بيانات وحساب عدد الكلمات
4.1 بناء مجموعة البيانات الافتراضية باستخدام خطوة البيانات (DATA Step)
لتجسيد السلوك الإجرائي لدالة COUNTW بشكل تطبيقي مباشر، سنقوم ببناء مجموعة بيانات اختبارية في بيئة SAS تمثل حالات نصية متباينة تحاكي الاستجابات الفعلية المجمعة من استبيانات ميدانية. تتضمن هذه الحالات عبارات بسيطة، ونصوصاً تحتوي على مسافات متتالية، وجمل تتخللها علامات ترقيم متعددة، بالإضافة إلى عبارات مركبة باستخدام الشرطة السفلية لرصد الفارق بين الفواصل الافتراضية والمخصصة.
يتم تنفيذ ذلك عبر خطوة البيانات المعيارية (DATA Step)، وتسمية الجدول باسم research_corpus. سنستخدم التوجيه INFILE DATALINES المقترن بأمر الإدخال INPUT، مع تعريف متغير نصي يحمل اسم response_text، وتخصيص طول مناسب له باستخدام محدد التنسيق $CHAR60. لضمان الحفاظ على المسافات البيضاء البادئة كما هي دون أن يتم تشذيبها أثناء القراءة، كما يوضح البناء البرمجي التالي:
شفرة إنشاء البيانات التجريبية:
data research_corpus;

  length id 8 response_text $60;

  infile datalines truncover;

  input id response_text & $60.;

datalines;

1 Quantitative analysis requires rigor and precision.

2 Spatial   distance   affects   social   interactions.

3 Dr. Smith-Jones arrived early, didn't he?

4 Multi_word_constructs_present_analytical_challenges.

5 Comprehensive assessment; evaluation, diagnostics.

;

run;
يقدم هذا الجدول عينات غنية للفحص؛ فالسجل الأول يمثل نصاً قياسياً، والسجل الثاني يحتوي على مسافات ثلاثية بين الكلمات، بينما يشتمل السجل الثالث على خليط من النقط، والشرطات، وعلامات الترقيم المتلاصقة، في حين يحتوي السجل الرابع على نص متصل بالكامل بشرطات سفلية لا تدركها SAS كفواصل افتراضية، مما يمنحنا أرضية مثالية لتحليل نتائج المعالجة.
4.2 كتابة شفرة دالة COUNTW لاحتساب الكلمات في متغير جديد
في المرحلة التالية، نقوم بإنشاء خطوة بيانات جديدة تشتق من الجدول السابق وتطبق دالة COUNTW لحساب عدد الكلمات ضمن كل سجل نصي وتخزين الناتج في متغير رقمي جديد نطلق عليه اسم default_word_count. يعتمد هذا الإجراء على الصيغة القياسية الأكثر بساطة للدالة، دون تمرير أي معاملات اختيارية، للوقوف على كيفية إدارة محرك SAS الافتراضي لهذه الأنماط النصية.
شفرة تطبيق الدالة بحساباتها الافتراضية:
data analyzed_corpus;

  set research_corpus;

  default_word_count = countw(response_text);

run;
عند تنفيذ هذه الشفرة، يقوم محرك SAS بقراءة السجلات واحداً تلو الآخر، وتمرير محتوى المتغير response_text في كل دورة معالجة إلى دالة COUNTW. تقوم الدالة داخلياً بمسح السلسلة الرمزية، وتحديد نهايات الكلمات بناءً على الفواصل الافتراضية (المسافات وعلامات الترقيم الشائعة)، وتوليد عدد صحيح غير سالب يُسند مباشرة إلى المتغير default_word_count. بعد اكتمال التنفيذ، يجب على الباحث دائماً التحقق من سجل النظام (SAS Log) للتأكد من خلو العملية من أي رسائل تحذيرية أو أخطاء برمجية، وضمان قراءة كامل السجلات بنجاح.
4.3 استعراض النتائج وتحليل مخرجات PROC PRINT بالتفصيل
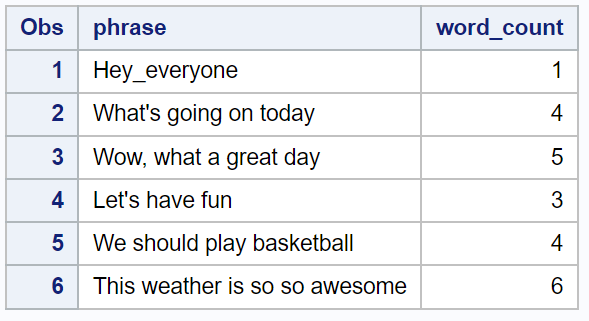
لعرض النتائج ومقارنتها بشكل مفصل، نستخدم الإجراء الإحصائي PROC PRINT مع تحديد المتغيرات الأساسية لإظهار النص الأصلي والعدد المحسوب للكلمات بجانبه، كما هو موضح أدناه:
شفرة استعراض المخرجات:
proc print data=analyzed_corpus noobs;

  var id response_text default_word_count;

run;
يقود فحص المخرجات الناتجة عن تنفيذ هذا الإجراء إلى كشف الأبعاد التشغيلية العميقة للدالة وتفسير سلوكها الرياضي، كما يتضح في الجدول التحليلي التالي:
| رقم السجل (ID) | النص الأصلي المدخل (response_text) | الناتج الافتراضي (default_word_count) | التفسير البرمجي والمنهجي للنتيجة |
|---|---|---|---|
| 1 | Quantitative analysis requires rigor and precision. | 6 | حساب قياسي مباشر؛ ست كلمات مفصولة بمسافات عادية مع استبعاد النقطة الختامية تلقائياً من الكلمة الأخيرة. |
| 2 | Spatial distance affects social interactions. | 5 | تجاهلت الدالة المسافات البيضاء المتعددة ودمجتها، معتبرة كل فراغ ممتد بمثابة فاصل وحيد، مما أنتج 5 كلمات دقيقة. |
| 3 | Dr. Smith-Jones arrived early, didn’t he? | 7 | تم اعتبار النقطة والشرطة الأفقية والفاصلة وعلامة الاستفهام فواصل، فقُسمت “Dr.” و”Smith-Jones” و”didn’t” ككلمات منفصلة. |
| 4 | Multi_word_constructs_present_analytical_challenges. | 1 | أظهرت الدالة القيمة (1) لأن الشرطة السفلية ليست فاصلاً افتراضياً في SAS، فعوملت العبارة كاملة ككتلة وحيدة. |
| 5 | Comprehensive assessment; evaluation, diagnostics. | 4 | اعتُبرت الفاصلة المنقوطة والفاصلة العادية فواصل شرعية، وتم حساب الكلمات الأربع بدقة وموضوعية تامة. |
يكشف هذا التحليل التفصيلي بوضوح أن النتيجة المرجعة للسجل الرابع (القيمة 1) تمثل قصوراً منهجياً ناجماً عن الاعتماد على السلوك التلقائي للدالة عند التعامل مع نصوص مركبة بأنماط تقنية كالتسميات البرمجية والمعرفات. يبرهن هذا القصور على ضرورة الانتقال إلى التخصيص المتقدم للفواصل عندما تقتضي طبيعة البيانات ذلك، وهو ما سنفصله في القسم التالي.
5. التخصيص المتقدم: التعامل مع فواصل الكلمات غير التقليدية
5.1 استخدام المعامل الثاني لتحديد فواصل مخصصة كالشرطات والرموز
للتغلب على القيود الناتجة عن الاعتماد الحصري على الفواصل الافتراضية، يتيح نظام SAS استدعاء دالة COUNTW مع تمرير المعامل الثاني لتحديد قائمة صارمة ومفصلة من المحارف التي يقرر المحلل اعتمادها كفواصل للكلمات. عند تزويد الدالة بهذا المعامل، يتوقف محرك SAS فوراً عن استخدام قائمته التلقائية، ويقتصر حصرياً على الرموز الواردة في السلسلة الممررة.
في حالة المتغيرات النصية التي تستخدم الشرطة السفلية أو الخطوط المائلة كأدوات للربط الدلالي بين المفردات، يمكن صياغة الدالة بالنحو التالي: countw(response_text, ' _.,'). في هذا المثال، تم توجيه الدالة لاعتماد أربعة فواصل محددة: المسافة الفارغة، الشرطة السفلية، النقطة، والفاصلة. بمجرد تضمين الشرطة السفلية، ستتمكن الدالة من تفكيك السجل الرابع في مثالنا السابق (Multi_word_constructs_present_analytical_challenges.) وإرجاع القيمة 6 بدلاً من القيمة 1، حيث يتم التعرف على كل جزء محاط بالشرطة كمفردة مستقلة.
من الأهمية بمكان التأكيد على أن استبعاد أي رمز من هذه القائمة المخصصة يترتب عليه اعتباره حرفاً أصيلاً ضمن الكلمة. فإذا حدد المبرمج المعامل الثاني كـ '_' فقط ونسي تضمين المسافة الفارغة ' '، فإن الدالة لن تعترف بالمسافات كفواصل إطلاقاً، وستعامل الجمل المتباعدة بمسافات عادية كأنها كلمة واحدة ممتدة. لذلك، يوصى دائماً بأن تتضمن قائمة الفواصل المخصصة المسافة البيضاء كعنصر رئيسي، ما لم يكن هدف المعالجة استبعاد المسافات عمداً وتجزئة النص استناداً إلى علامات تقطيع خاصة فقط.
5.2 إدارة النصوص ذات البنية المتشابكة والتفريغ الصوتي
تتسم نصوص التفريغ الصوتي (Verbatim Transcripts) للمقابلات الميدانية وبحوث المجموعات البؤرية (Focus Groups) بتعقيدات هيكلية ناتجة عن التوثيق الصوتي لترددات المفحوصين، كاستخدام علامات الحذف المتكررة (Ellipsis ...)، أو علامات التوقف الطويل (مثل --)، أو إدراج رموز توضيحية من قبل الباحثين مثل [ضحك] أو <توقف>. إن محاولة عد الكلمات في هذه المقاطع دون ضبط الفواصل يؤدي إلى احتساب تلك الرموز التوضيحية أو أجزاء التردد كمفردات غير حقيقية تشوه التحليل الدلالي.
تتطلب إدارة هذه النصوص استراتيجية ذات مستويين: أولاً، فحص متأنٍ لطبيعة الرموز غير المعيارية المستخدمة أثناء التفريغ وتضمينها ضمن محارف المعامل الثاني، كإدراج الأقواس المعقوفة والمثلثة والشرطات المزدوجة؛ وثانياً، توظيف آليات الاستبعاد الذاتي للحروف التي لا ينبغي أن تنفصل. فإذا تم التعامل مع عينات تحتوي على أرقام عشرية (مثل 3.14) أو رموز قياس ونسب مئوية، فإن إدراج النقطة كفاصل قد يقسم الرقم إلى كلمتين، بينما قد يرغب الباحث في اعتباره وحدة إحصائية واحدة.
لتفادي الوقوع في خطأ التجزئة الخاطئة للمفردات الفنية والمعادلات الرياضية المتداخلة مع النصوص السردية، ينبغي تجريب خيارات الفواصل على عينة عشوائية تمثيلية (Pilot Sample) من السجلات، ومراجعة نواتج العد يدوياً للتحقق من أن قائمة الفواصل تحقق التوازن المنهجي المطلوب بين تفكيك المفردات اللفظية والحفاظ على سلامة التراكيب المركبة التي تشكل في جوهرها دلالة واحدة لا تقبل التجزئة.
5.3 دراسة مقارنة: النتائج الافتراضية مقابل النتائج المخصصة
لإبراز الأثر الإحصائي الحاسم لتخصيص الفواصل، قمنا بتنفيذ خطوة بيانات جديدة تطبق صيغتين مختلفتين لدالة COUNTW على نفس مجموعة البيانات التجريبية: الأولى بالاعتماد على الفواصل الافتراضية، والثانية بتحديد قائمة فواصل مخصصة تشمل الشرطة السفلية والمسافات وعلامات الترقيم الأساسية عبر الصيغة countw(response_text, " _.,!?;-"). يوضح الجدول المقارن أدناه الفروق الجوهرية في النتائج الكمية الناتجة عن هذا التخصيص:
| النص المفحوص (Response Text) | العد الافتراضي (Default) | العد المخصص (Custom) | فارق القياس | التحليل المنهجي للتغير في النتيجة |
|---|---|---|---|---|
| Quantitative analysis requires rigor and precision. | 6 | 6 | 0 | تطابق تام نظراً لأن النص يعتمد على الفواصل القياسية الشائعة فقط. |
| Multi_word_constructs_present_analytical_challenges. | 1 | 6 | +5 | أدى إدراج الشرطة السفلية كفاصل مخصص إلى تحرير الكلمات الخمس المحتجزة وحسابها بدقة. |
| Dr. Smith-Jones arrived early, didn’t he? | 7 | 7 | 0 | تطابق في الحساب نتيجة تضمين كافة علامات الترقيم في كلتا الحالتين المعياريتين. |
توضح هذه المقارنة أن الإخفاق في تحديد الفواصل المخصصة قد يقود إلى تحيز قياسي حاد (Measurement Bias)، حيث انخفض التقدير الكمي في السجل الثاني بنسبة تزيد عن 83% في الوضع الافتراضي مقارنة بالوضع المخصص. في الدراسات السلوكية والنفسية، يمكن لمثل هذا التفاوت أن يدمر صدق وثبات المتغيرات المستقلة أو التابعة، مما يؤكد أن اختيار فواصل دالة COUNTW ليس مجرد خيار برمجي شكلي، بل هو قرار منهجي يتصل مباشرة بصدق القياس والأدوات البحثية المستخدمة.
6. توظيف محددات التعديل (Modifiers) لضبط خوارزمية البحث والعد
6.1 وظائف محددات التعديل الشائعة في معالجة نصوص SAS
تقدم محددات التعديل (Modifiers) في المعامل الثالث لدالة COUNTW بعداً متقدماً من المرونة البرمجية التي تتيح معالجة حالات استثنائية دون الاضطرار إلى كتابة سلاسل فواصل طويلة قد تكون عرضة للخطأ الإملائي. يتم تمرير هذه المحددات كحروف لاتينية بين علامات تنصيص، وتعمل كأوامر ضبط مباشرة لخوارزمية القراءة الداخلية في نظام SAS.
من أبرز هذه المحددات وأكثرها تأثيراً في معالجة الاستبيانات هو المحدد 'q' (Quotation modifier). في كثير من الأحيان، تتضمن النصوص المقتبسة أو استجابات الأفراد اقتباسات حرفية بين علامتي تنصيص "..."، مثل قول أحد المشاركين: He said “no way, absolutely not” and left. في الوضع القياسي، ستقوم الدالة بتفتيت ما بداخل علامات التنصيص ككلمات مستقلة. ولكن عند تمرير المحدد 'q'، يتم توجيه الدالة إلى اعتبار كل ما هو محاط بعلامات تنصيص بمثابة وحدة نصية واحدة لا تتجزأ، وتجاهل أي فواصل تقع بداخلها، مما يعزز دقة القياس في بحوث الخطاب التي تتعامل مع الكيانات المقتبسة كوحدات معنوية مستقلة.
كما يبرز المحدد 'i' (Ignore Case)، والذي تتجلى أهميته عند استخدام المحددات المعتمدة على تصنيف الحروف، حيث يلغي حساسية حالة الأحرف في تحديد الفواصل. كذلك يتيح المحدد 'v' أو 'k' (Inversion / Keep modifier) عكس منطق الفرز بالكامل؛ بحيث تصبح الأحرف الممررة في المعامل الثاني هي المحارف الوحيدة الصالحة لتكوين الكلمات، وتعتبر أي محارف أخرى خارج تلك القائمة فواصل بالضرورة، وهو أسلوب فائق الفاعلية في استخراج الأنماط المشفرة والبيانات البيولوجية والوراثية في البحوث الحيوية الإحصائية.
6.2 معالجة علامات الترقيم والمحارف الخاصة باستخدام المحددات
يواجه المبرمج في كثير من الأحيان تحدياً يتمثل في اتساع وتنوع علامات الترقيم الممكنة في النصوص المعقدة، مثل الفواصل المنقوطة، والنقاط، والشرطات، وعلامات الاستفهام والتعجب، والأقواس بأنواعها. بدلاً من إدخال كافة هذه الرموز يدوياً في المعامل الثاني، وفرت SAS المحدد الحرفي 'p' (Punctuation modifier) الذي يوجه الدالة تلقائياً إلى معاملة كافة علامات الترقيم المدعومة في معيار POSIX القياسي كفواصل رسمية.
عند استدعاء الدالة بالصيغة: countw(text, , 'p')، يترك المعامل الثاني فارغاً ويُمرر المحدد 'p' في المعامل الثالث. في هذه الحالة، تتولى الدالة تلقائياً رصد واستخدام مجموعة علامات الترقيم المعتمدة برمجياً، بما يضمن عدم إغفال أي رمز ترقيمي نادر أو غير معتاد قد يستخدمه المشاركون في الكتابة الحرة. كما يتكامل هذا المحدد بسلاسة مع لغات متعددة، متفادياً إشكالية إغفال الترقيم الخاص بالخطوط اللاتينية أو الحزم التوسيعية.
علاوة على ذلك، يمكن دمج المحدد 'p' مع محدد الفئات الرقمية 'd' (Digits) أو الحرفية 'a' (Alphabetic) لصياغة قواعد فرز متقدمة. فإذا رغب الباحث في اعتبار الأرقام الحسابية فواصل تقطع الكلمات النصية بدلاً من اعتبارها جزءاً من المفردات، يمكن تمرير الصيغة countw(text, , 'pd'). هذا الجمع التركيبي يوفر كفاءة استثنائية في تنقية وتجزئة النصوص التي تحتوي على سلاسل معقدة من الحروف والأرقام والرموز المتداخلة دون الحاجة إلى بناء تعبيرات نمطية مجهدة.
6.3 التحكم في حساسية الأحرف وتجاهل المحارف غير القابلة للطباعة
في البيئات التحليلية التي تستورد نصوصاً مجمعة عبر الويب (Web Scraping) أو أنظمة إدارة قواعد البيانات العلائقية الخارجية، غالباً ما تتلوث السجلات بمحارف تحكم غير قابلة للطباعة (Non-printable Control Characters)، مثل محارف نهاية السطر المزدوجة (Carriage Return / Line Feed – CR/LF)، ومحارف الجدولة الأفقية (Tabs)، والمسافات الصفرية غير المنكسرة (Non-breaking Spaces). هذه المحارف قد لا تظهر للعين المجردة عند فحص البيانات في واجهات SAS، لكنها قد تعطل محركات التجزئة النصية التقليدية أو تؤدي إلى أخطاء في عد الكلمات.
لحل هذه المعضلة الجذرية، تتيح دالة COUNTW استخدام المحدد 'c' (Control character modifier) والمحدد 's' (Space/Whitespace modifier). يقوم المحدد 'c' بإدراج كافة محارف التحكم البرمجية ونهايات السطور ضمن قائمة الفواصل المعتمدة، بينما يضمن المحدد 's' التعرف على كافة أنواع الفراغات وعلامات التبويب بمختلف ترميزاتها الحاسوبية وتصنيفها كفواصل بيضاء شرعية بين الكلمات.
إن تفعيل هذه المحددات مجتمعة من خلال صياغة احترافية مثل: countw(raw_text, , 'pcs') يضمن تطهيراً شاملاً للسلسلة الرمزية أثناء لحظة المعالجة؛ حيث تتعامل الدالة مع علامات الترقيم، ومحارف التحكم المخفية، وكافة الفراغات البيضاء كحدود فاصلة للكلمات. يحمي هذا الأسلوب التحليلات الإحصائية المتقدمة من التشويش الرقمي، ويوفر نتائج موثوقة بنسبة 100% حتى في ظل وجود بيانات نصية غير معيارية أو مستخرجة من مصادر خارجية شديدة الاضطراب.
7. مقارنة منهجية: دالة COUNTW مقابل الدوال النصية الأخرى في SAS
7.1 المقارنة التحليلية بين دالة COUNTW ودالة SCAN
ترتبط دالة COUNTW بعلاقة وثيقة وتكاملية مع دالة SCAN الكلاسيكية، والتي تمثل الدعامة الأساسية لاستخراج الكلمات وتجزئة النصوص في نظام SAS منذ إصداراته الأولى. تشترك الدالتان في نفس الخوارزمية المركزية للتعرف على حدود المفردات والفواصل وسلوك المحددات، إلا أن الهدف الوظيفي النهائي لكل منهما يختلف اختلافاً جذرياً؛ فبينما تُعنى دالة COUNTW بإرجاع القيمة العددية الإجمالية للمفردات داخل النص، تختص دالة SCAN باستخراج واقتطاع كلمة معينة بناءً على موقعها الترتيبي (مثل الكلمة الأولى أو الخامسة أو الأخيرة باستخدام المؤشرات السالبة).
يتجلى التكامل البرمجي الأبرز بين هاتين الدالتين في أتمتة معالجة النصوص عبر الحلقات التكرارية (Iterative Processing). ففي السابق، كان استخدام دالة SCAN داخل حلقة تكرارية لاستخراج كافة كلمات جملة ما يتطلب فحصاً مستمراً للشرط DO WHILE (SCAN(...) ne '') للتحقق من عدم الوصول إلى نهاية السلسلة. أما مع وجود دالة COUNTW، فقد بات بإمكان المبرمج إنشاء حلقة تكرارية محددة مسبقاً بدقة متناهية عبر بنية: DO i = 1 TO COUNTW(string) واستخراج كل كلمة عبر SCAN(string, i) مباشرة.
من حيث استهلاك موارد النظام، تتميز دالة COUNTW بكفاءة حاسوبية أعلى في مهام العد مقارنة بمحاولة تكرار دالة SCAN حتى الإخفاق لحساب الكلمات. فـ COUNTW لا تقوم بتخصيص مساحات في الذاكرة لتخزين مقاطع النصوص المقتطعة، بل تكتفي بتمرير عداد داخلي سريع على مؤشرات البداية والنهاية، مما يجعلها الخيار الرياضي والبرمجي الأمثل لتقييم الكثافة اللفظية قبل المضي قدماً في عمليات الاستخراج المعقدة.
7.2 الفروق التشغيلية بين دالة COUNTW ودالتي COUNT و COUNTC
يقع بعض المبرمجين المبتدئين في خطأ الخلط المنهجي بين دالة COUNTW ودالتي COUNT و COUNTC في SAS، على الرغم من التباين التام في المنطق التشغيلي لكل منها. تركز دالة COUNT على حساب عدد مرات تكرار نمط نصي محدد فرعي (Substring) داخل السلسلة الكبرى؛ فعلى سبيل المثال، تستخدم لحساب كم مرة وردت العبارة "data" داخل مقال كامل، بغض النظر عما إذا كانت تمثل كلمة مستقلة أو جزءاً من كلمة أخرى كـ "metadata".
من جانب آخر، تختص دالة COUNTC بعدّ وتتبع ظهور محارف مفردة منفصلة محددة مسبقاً. وقد يلجأ بعض المحللين بشكل خاطئ إلى استخدام دالة COUNTC لحساب عدد المسافات البيضاء داخل الجملة وافتراض أن عدد الكلمات يساوي عدد المسافات مضافاً إليه واحد. هذا المنطق التشغيلي البدائي ينهار تماماً أمام الواقع العملي للبيانات؛ حيث إن وجود مسافات مزدوجة بين الكلمات، أو مسافات في أول السطر وآخره، أو الاعتماد على علامات الترقيم وحدها دون مسافات للفصل بين الجمل، سيؤدي إلى تضخيم شاذ في العد وإفساد القياس الإحصائي.
بالمقابل، صُممت دالة COUNTW بنيوياً لتجاوز قيود الأحرف المفردة والأنماط الثابتة، حيث تطبق نموذجاً لغوياً لمعنى “الكلمة” باعتبارها كتلة نصية محصورة بين فواصل متباينة ومتغيرة ذاتياً. لذلك، فإن استخدام COUNTW هو المسار الإجرائي الوحيد الموثوق لحساب المفردات اللفظية، بينما تظل COUNT و COUNTC أدوات مخصصة للتحليلات التكرارية الدقيقة للأنماط والمحارف المستقلة.
7.3 المقارنة مع تقنيات التعبيرات النمطية (Perl Regular Expressions)
تتيح لغة SAS إمكانات هائلة في معالجة النصوص عبر حزمة دوال التعبيرات النمطية المشتقة من لغة بيرل (Perl Regular Expressions)، والمعروفة برمز PRX، ومنها دوال PRXPARSE و PRXMATCH و PRXCHANGE. تمتلك التعبيرات النمطية قدرة لا تضاهى في صياغة قواعد بحث بالغة التعقيد، والتعامل مع حالات لغوية استثنائية تعجز عنها الدوال المعيارية المباشرة.
ومع ذلك، فإن تفضيل دالة COUNTW على تقنيات PRX في مهام حساب الكلمات يستند إلى معايير حاسوبية وتطويرية واضحة. أولاً: تتطلب التعبيرات النمطية جهداً ذهنياً كبيراً في الصياغة والتحقق، ويتسم كودها البرمجي بالغموض النسبي وارتفاع احتمالية الخطأ البشري (Syntax complexity)، مما يصعّب مهمة مراجعته وتدقيقه في الفرق البحثية. ثانياً: يتطلب استدعاء محرك PRX في SAS ترجمة النمط النصي وبناء آلة حالات منتهية (Finite State Machine)، مما يولد عبئاً حاسوبياً ملموساً (Computational Overhead) يقلل من سرعة التنفيذ عند معالجة ملايين السجلات النصية.
تتفوق دالة COUNTW المضمنة أصلاً في نواة SAS بسرعتها الاستثنائية وخفتها على الذاكرة، إضافة إلى سهولة صيغتها البرمجية ومقروئيتها العالية. ولا يصبح الانتقال من COUNTW إلى تقنيات PRX مبرراً إلا في حالات نادرة تتطلب التحقق من صحة تراكيب نحوية سياقية صارمة لا يمكن تحديدها بمجرد قائمة فواصل أو محددات معيارية، مثل البحث عن كلمات تتبع نمطاً مورفولوجياً خاصاً محاطاً بسياق رقمي معقد.
8. تطبيقات بحثية: توظيف دالة COUNTW في تحليل الاستجابات السلوكية
8.1 قياس الإسهاب اللفظي ومؤشرات الطلاقة اللغوية للمفحوصين
في أبحاث علم النفس المعرفي والقياس النفسي، يعد الإسهاب اللفظي (Verbal Prolixity) والطلاقة التعبيرية من المتغيرات السلوكية ذات الأهمية البالغة. ففي اختبارات الاستدعاء الحر (Free Recall) واختبارات تفهم الموضوع (TAT)، يُطلب من المفحوص كتابة أو سرد قصص استجابةً لمثيرات بصرية محددة. يمثل عدد الكلمات المرجعة بواسطة دالة COUNTW مقياساً كمياً أولياً للإنتاجية اللفظية، والتي ترتبط في الأدبيات النفسية بمستويات الذكاء اللغوي، واليقظة المعرفية، والانفتاح على الخبرة.
كذلك يُستخدم هذا المؤشر لدراسة الأنماط الانفعالية والاضطرابات النفسية؛ حيث يُظهر الأفراد الذين يعانون من اضطرابات القلق أو الوسواس القهري أحياناً مستويات مرتفعة من الإسهاب والتفصيل المفرط في محاولة لتبرير إجاباتهم والسيطرة على الشكوك، بينما قد يشير الإيجاز اللفظي الشديد والانخفاض الحاد في عدد الكلمات لدى مفحوصين آخرين إلى أعراض الاكتئاب، أو الانسحاب الاجتماعي، أو التباطؤ الحركي النفسي. توفر دالة COUNTW أداة برمجية سريعة ومقننة لتحويل تلك الاستجابات السردية إلى بيانات عددية دقيقة يمكن ربطها بمقاييس التشخيص الإكلينيكي عبر معاملات الارتباط الإحصائي.
علاوة على ذلك، يتيح دمج عدد الكلمات مع المتغيرات الزمنية المسجلة إلكترونياً (مثل زمن الاستجابة في الاستبيانات الرقمية) حساب مقاييس إضافية بالغة الدقة مثل “معدل تدفق الكلمات في الدقيقة”. يمثل هذا المعدل مؤشراً على الكفاءة الإجرائية في صياغة الأفكار وتوليدها تحت الضغط، مما يفتح آفاقاً جديدة أمام الباحثين في تحليل ديناميكيات التفكير البشري أثناء التفاعل مع الاختبارات النفسية المقننة.
8.2 تنظيف وتصفية البيانات النصية قبل التحليل الإحصائي الاستدلالي
يمثل استبعاد البيانات الشاذة وغير الموثوقة خطوة جوهرية تسبق تطبيق أي أساليب إحصائية استدلالية، مثل تحليل التباين (ANOVA) أو نمذجة المعادلات الهيكلية (SEM). في الاستبيانات المفتوحة، يواجه الباحثون تحدي “الاستجابات الضحلة” التي لا يقدم أصحابها جهداً حقيقياً (Non-effortful responding)، ككتابة كلمات مقتضبة مثل “لا أعلم”، أو “جيد”، أو مجرد وضع رموز تعبيرية لا تثري البحث العلمي.
باستخدام دالة COUNTW داخل توجيهات التصفية في خطوة البيانات أو عبارة WHERE، يستطيع المحلل وضع شروط استبعاد منهجية واضحة وموثقة. على سبيل المثال، يمكن تنقية العينة باستبعاد أي استجابة يقل عدد مفرداتها عن خمس كلمات عبر الشرط: where countw(response_text) >= 5;. يضمن هذا الإجراء رفع جودة العينة التحليلية وحصر التحليلات المتقدمة على المستجيبين الذين قدموا مدخلات نوعية ذات دلالة إحصائية.
وبالمثل، تساهم الدالة في رصد القيم المتطرفة العليا (Upper Outliers)، حيث يقوم بعض المشاركين بنسخ فقرات كاملة من مقالات منشورة أو صفحات ويب ولصقها في مربعات الحوار. من خلال استخراج التوزيع التكراري وحساب المتوسط والانحراف المعياري لعدد الكلمات، يمكن التعرف على النصوص التي تتجاوز ثلاثة انحرافات معيارية عن المتوسط وفحصها بشكل يدوي مستقل للتحقق من أصالتها ومطابقتها لشروط الدراسة الاستقصائية.
8.3 أتمتة استخراج وتجزئة المتغيرات عبر الحلقات التكرارية (DO Loops)
تتجلى القوة المنهجية لدالة COUNTW عند توظيفها كموجه ديناميكي للتحكم في الحلقات التكرارية بهدف تحويل النصوص غير المهيكلة إلى جداول بيانات طولية مهيكلة (Restructuring from wide to long). ففي تحليلات التعدين اللغوي، يحتاج الباحث غالباً إلى تحويل الفقرة النصية الكاملة إلى سجلات منفصلة بحيث تمثل كل مفردة صفاً مستقلاً في قاعدة البيانات لغرض بناء قواميس الكلمات وحساب التكرارات المعجمية.
يوضح النموذج البرمجي التالي كيفية توظيف دالة COUNTW لضبط حلقة DO تكرارية تعمل على استخراج المفردات كلمة بكلمة باستخدام دالة SCAN المساعدة، مع إخراج كل كلمة في سجل منفرد عبر أمر OUTPUT:
شفرة تفكيك النص وأتمتة استخراج الكلمات:
data tokenized_words;

  set research_corpus;

  total_words = countw(response_text);

  do word_order = 1 to total_words;

    single_token = scan(response_text, word_order);

    output;

  end;

  keep id word_order single_token;

run;
تفتح هذه الأتمتة البرمجية الباب واسعاً أمام تطبيق مؤشرات لغوية متقدمة داخل بيئة SAS، مثل حساب مؤشر التنوع اللفظي (Type-Token Ratio – TTR) الذي يقيس نسبة المفردات الفريدة والفرعية إلى العدد الإجمالي للكلمات المحسوب بدالة COUNTW. يعد هذا المؤشر دليلاً حاسماً على غنى الحصيلة اللغوية والتعقيد المعرفي في نصوص المفحوصين، مما يسهل نقل البيانات المعالجة إلى برمجيات التحليل الإحصائي والنوعي المتخصصة بكل سلاسة.
9. معالجة الحالات الاستثنائية واستكشاف الأخطاء البرمجية الشائعة
9.1 إدارة القيم المفقودة (Missing Values) والسلاسل الفارغة
تعتبر إدارة البيانات المفقودة أحد التحديات المعيارية في التحليل الإحصائي. تتسم دالة COUNTW بالمتانة والاتساق البرمجي عند التعامل مع السلاسل النصية الفارغة تماماً أو المتغيرات التي تحتوي على قيم مفقودة (Missing character values). فعندما تمرر الدالة سلسلة نصية خالية أو مسافات بيضاء غير مشغولة، فإنها لا تصدر أي أخطاء تنفيذية ولا تعطل تدفق المعالجة، بل تعيد القيمة الرقمية الصفرية (0) بصورة قاطعة.
ومع ذلك، ينبغي على المبرمج الانتباه إلى الفارق المنهجي بين القيمة المفقودة الحقيقية كمتغير لم يُجب عليه المفحوص إطلاقاً، وبين الإجابة التي تمت بكلمة صفرية أو مسافات فقط. لضمان عدم حدوث تشويش في الحسابات الإحصائية اللاحقة (مثل حساب متوسط عدد الكلمات للعينة حيث يؤدي احتساب الأصفار إلى خفض المتوسط العام بشكل مصطنع)، يفضل الجمع بين دالة COUNTW ودالة MISSING الشرطية، كما في التركيب التالي:
شفرة ضبط الشروط المسبقة للبيانات المفقودة:
if missing(response_text) then word_count = .;

else word_count = countw(response_text);
يضمن هذا الإجراء إسناد القيمة المفقودة الرقمية القياسية في SAS (الممثلة بالنقطة .) عندما يكون المتغير النصي مفقوداً في الأصل، مع قصر القيمة العددية 0 على الحالات التي كُتب فيها نص ثم تم مسحه أو الحالات المعالجة برمجياً، مما يمنع التحيز في حساب مقاييس النزعة المركزية ويوفر قراءة إحصائية نزيهة وصادقة لبيانات العينة.
9.2 مشاكل الكلمات المركبة، الفواصل اللغوية، واللغات متعددة البايت
تفرض اللغات الطبيعية تحديات بنيوية فريدة أمام خوارزميات التجزئة النصية. ففي اللغة الإنجليزية والعديد من اللغات الأوروبية، تظهر الكلمات المركبة بواصلة (Hyphenated words) مثل state-of-the-art أو self-regulation. إذا اعتُمد السلوك الافتراضي لدالة COUNTW، فإن وجود الشرطة الأفقية سيؤدي إلى تفتيت هذه التراكيب إلى كلمات منفصلة، في حين قد يتطلب المنظور النظري للبحث معاملة المفهوم المركب كوحدة دلالية واحدة. في مثل هذه الحالات، يتعين على الباحث استبعاد الواصلة عمداً من قائمة الفواصل المخصصة لضمان عدم تجزئتها.
أما في اللغة العربية، فتزداد المسألة دقة نظراً لوجود أدوات وحروف متصلة بنيوياً بالكلمات وليست مفصولة بمسافات، وأبرزها “واو العطف” وحروف الجر كالباء والكاف واللام ولام التعريف. فعندما يكتب المفحوص “بالقلم والكتاب”، فإن دالة COUNTW ستعد هذه العبارة ككلمتين اثنتين فقط استناداً إلى المسافة الفاصلة، على الرغم من احتوائها تحليلياً على حرفي جر وحرف عطف ومفردتين معجميتين. يجب على الباحث الإفصاح عن هذه الحدود الإجرائية في منهجية بحثه، وتحديد ما إذا كان العد يستهدف الكتل اللفظية السطحية (Surface Tokens) أم الجذور المعجمية العميقة.
بالإضافة إلى ذلك، فإن تشغيل SAS في بيئات معتمدة على ترميز اليونيكود (UTF-8) يستدعي اليقظة البرمجية عند التعامل مع المحارف العربية متعددة البايت. على الرغم من أن دالة COUNTW تعمل على مستوى المحارف، فإن تداخل علامات التشكيل والحركات (Diacritics) وتطويل الحروف (التطويل أو الكشيدة) قد يعامل أحياناً كرموز غير متوقعة إذا لم يتم ضبط بيئة النظام بشكل صحيح. يوصى دائماً بتوحيد نصوص العينة وتجريدها من التشكيل غير الضروري وتوحيد كتابة الهمزات والياء والألف اللينة قبل إخضاعها لدوال التجزئة النصية.
9.3 تحسين الأداء الحسابي عند معالجة السجلات الضخمة (Big Data)
عندما تتسع قواعد البيانات لتشمل عشرات الملايين من السجلات النصية، كما هو الحال في منصات الاستماع الاجتماعي وسجلات الرعاية الصحية الإلكترونية الكبرى، تصبح الكفاءة الحاسوبية واستهلاك الموارد عاملاً حاسماً في نجاح التحليل. على الرغم من السرعة الذاتية لدالة COUNTW، فإن استدعاءها المتكرر ضمن بيئات غير محسنة قد يولد بطئاً إجرائياً ملموساً.
لتعظيم الأداء الحسابي، ينبغي الالتزام بمجموعة من الإرشادات البرمجية المتقدمة:
- ضبط أطوال المتغيرات بدقة: تجنب تعريف المتغيرات النصية بأطوال عشوائية ضخمة مثل
$32767إذا كانت النصوص لا تتجاوز بضع مئات من الأحرف، حيث يقلل تقليص طول المتغير من عمليات مسح الذاكرة الخاملة ويسرع فحص السلسلة. - تقليل التمريرات على البيانات: دمج استدعاء
COUNTWضمن خطوة بيانات واحدة تُجرى فيها كافة العمليات التحويلية الأخرى، وتجنب إنشاء جداول وسيطة غير ضرورية على القرص الصلب. - استخدام المعالجة المتعددة (Multi-threading): تفعيل خيارات المعالجة المتوازية مثل
OPTIONS THREADS;لتمكين SAS من توزيع السجلات النصية على خيوط معالجة متعددة داخل وحدة المعالجة المركزية. - المفاضلة بين DATA Step و PROC SQL: على الرغم من إمكانية استدعاء
COUNTWداخل استعلاماتPROC SQL، إلا أن تنفيذها داخل خطوة البيانات الكلاسيكيةDATA Stepيعد عموماً أكثر كفاءة وسرعة في استهلاك موارد المعالج والذاكرة المؤقتة.
10. أفضل الممارسات البرمجية والتوصيات لضمان دقة تحليل المحتوى في SAS
10.1 التوثيق البرمجي والمعيارية في بناء شفرات المعالجة النصية
تقتضي النزاهة العلمية وقواعد البحث الأكاديمي الصارم الالتزام الكامل بمعيارية التوثيق لكافة الشفرات البرمجية المستخدمة في تجهيز وتحليل البيانات. فعند استخدام دالة COUNTW، يجب ألا تترك معاملات الفواصل والمحددات كأرقام أو رموز غامضة دون تعليق برمجي وافٍ (In-code documentation) يشرح الأسباب المنهجية التي دفعت الباحث لاختيار فواصل معينة أو استبعاد أخرى.
ينبغي للباحث توثيق الأساس النظري لكيفية تعريف “الكلمة” في دراسته؛ هل تم اعتبار الاختصارات، والتراكيب الموصولة بواصلات، والأرقام، والرموز التعبيرية ككلمات مستقلة أم تم تحييدها؟ إن هذا التوثيق يضمن إمكانية إعادة إنتاج النتائج (Replicability) من قبل مراجعين مستقلين أو باحثين آخرين يعملون على نفس البيانات، وهو المبدأ الأساسي الذي تقوم عليه المنهجيات العلمية الحديثة.
علاوة على ذلك، يوصى ببناء وحدات ماكرو مخصصة (SAS Macros) تضم دوال COUNTW مع فواصلها المعيارية المعتمدة في المختبر البحثي أو المؤسسة. يساعد ذلك في توحيد معايير المعالجة النصية عبر مختلف المشاريع والدراسات، وتفادي الأخطاء الفردية الناتجة عن كتابة الشفرات بشكل مرتجل في كل مرة يتم فيها فحص نصوص جديدة.
10.2 التحقق المتكامل من صحة المخرجات (Data Validation Techniques)
لا يجوز الاعتماد على المخرجات البرمجية المؤتمتة لدوال المعالجة النصية دون تطبيق بروتوكول رقابي صارم للتحقق من صحة البيانات (Data Validation Protocol). تبدأ هذه العملية بسحب عينة عشوائية طبقية (Stratified Random Sample) من النصوص المعالجة، وإخضاعها للتدقيق والعد اليدوي من قبل باحثين مستقلين للتحقق من مدى مطابقة العد الآلي للواقع الدلالي للمفردات.
كما يُنصح باستخدام الإجراءات الإحصائية الوصفية مثل PROC UNIVARIATE و PROC FREQ لفحص التوزيع التكراري ومخططات الانتشار لمتغير عدد الكلمات المشتق. يتيح هذا الفحص رصد أي تشوهات في التوزيع، كوجود تراكم غير طبيعي للقيم عند الرقم 0 أو 1، أو وجود قفزات مفاجئة تشير إلى وجود فواصل لم تتم معالجتها بالشكل الصحيح.
يمكن أيضاً تطبيق اختبارات المطابقة المنطقية عبر مقارنة عدد الكلمات بطول السلسلة الإجمالي المحسوب بدالة LENGTH؛ فإذا أظهرت النتائج أن نصاً يبلغ طوله 500 حرف يحتوي على كلمة واحدة فقط، فإن هذا التناقض الصارخ يعد إنذاراً برمجياً بوجود خطأ في اختيار الفواصل (مثل جملة طويلة رُبطت بشرطات سفلية)، مما يستوجب التدخل الفوري لتصحيح شفرة المعالجة قبل تمرير المتغيرات لنماذج التحليل النهائي.
10.3 خلاصة إرشادية وتدريبات مقترحة لتعزيز مهارات التحليل النصي
لتثبيت المفاهيم الأكاديمية والتقنية المكتسبة حول دالة COUNTW، نلخص القواعد الذهبية للتعامل مع هذه الأداة في النقاط الإرشادية التالية:
- اعتمد السلوك الافتراضي للدالة فقط عندما تكون واثقاً من أن النصوص تتبع القواعد الإملائية والترقيمية القياسية وتخلو من الشرطات السفلية والرموز الاصطلاحية الخاصة.
- حدد دائماً فواصل المعامل الثاني بدقة متناهية متى ما كانت نصوصك تتضمن معرفات تقنية، أو رموز تفريغ صوتي، أو تراكيب إلكترونية معقدة، واحرص على تضمين المسافة الفارغة بينها.
- استفد من قوة محددات المعامل الثالث، لا سيما المحدد
'q'لعزل الاقتباسات، والمحدد'p'لشمول كافة علامات الترقيم، والمحدد's'لتطهير الفراغات المعقدة. - تعامل بوعي لغوي مع خصوصيات اللغات الطبيعية؛ وتذكر أن الكتل السطحية المفصولة بالفراغات قد لا تعكس بالضرورة عدد المفردات الصرفية في اللغات الالصاقية كالعربية.
ولتعميق الخبرة التطبيقية، يُقترح على الباحثين والمحللين تنفيذ تمارين تدريبية تشمل: إنشاء نصوص تحتوي على تعابير بريدية وعناوين ويب واستخراج عدد كلماتها بدقة؛ وكتابة كود برمجي يحسب مؤشر التنوع اللفظي (TTR) لفقرات تجريبية؛ ومحاكاة عملية فرز استبيان مفتوح وتصنيف استجاباته إلى فئات ثلاث (مقتضبة، متوسطة، مسهبة) استناداً إلى أرباع التوزيع التكراري لمخرجات دالة COUNTW. إن مثل هذه الممارسات تصقل المهارات التحليلية وتضمن توظيف إمكانات SAS الاستثنائية بأعلى درجات الاحتراف والموثوقية العلمية.
خاتمة
تمثل دالة COUNTW في نظام SAS ركيزة برمجية فائقة الأهمية لمعالجة وتحليل البيانات النصية في مختلف الميادين البحثية والأكاديمية. ومن خلال بنيتها التركيبية المرنة، وإمكاناتها المتقدمة في تخصيص الفواصل، وتكاملها مع محددات التحكم والوظائف الأخرى، توفر هذه الدالة أداة موثوقة لتحويل النصوص غير المهيكلة إلى مؤشرات كمية ذات دلالات سيكومترية وسلوكية بالغة الأهمية. إن الإلمام العميق بخصائص هذه الدالة، وتجنب الاعتماد الأعمى على سلوكها الافتراضي دون دراسة طبيعة البيانات، يشكل خطوة أساسية لضمان سلامة وجودة التحليلات الإحصائية، ويدعم الباحثين في استخلاص رؤى علمية دقيقة تتسم بأعلى معايير الصدق والموضوعية المنهجية.
المراجع
Cody, R. (2007). Learning SAS by example: A programmer’s guide. SAS Institute Inc.
Delwiche, L. D., & Slaughter, S. J. (2019). The little SAS book: A primer (6th ed.). SAS Institute Inc.
SAS Institute Inc. (2008). SAS 9.2 Language reference: Dictionary. SAS Institute Inc. https://support.sas.com
SAS Institute Inc. (2020). SAS functions and CALL routines: Reference (SAS 9.4 and SAS Viya). SAS Institute Inc. https://documentation.sas.com