
يمثل الاستدلال الإحصائي الركيزة الأساسية التي تقوم عليها المنهجيات العلمية الحديثة في مختلف الحقول المعرفية، بدءاً من العلوم السلوكية والنفسية، مروراً بالعلوم التربوية والاجتماعية، وصولاً إلى الدراسات الوبائية والطبية المتقدمة. وفي قلب هذا الاستدلال يقع التحدي المنهجي المتمثل في استنباط خصائص المجتمعات الإحصائية الشاملة انطلاقاً من ملاحظات كمية مستقاة من عينات محددة ومختارة بعناية. وتتخذ الظواهر المدروسة في كثير من الأحيان طابعاً تصنيفياً ثنائياً، حيث يكون الاهتمام منصباً على قياس نسبة تحقق خاصية معينة، مثل انتشار اضطراب نفسي، أو نجاح تدخل علاجي محدد، أو تبني سلوك اجتماعي معين. هنا تبرز الحاجة الماسة إلى أدوات إحصائية تمكن الباحث من الحكم بدقة وموضوعية على ما إذا كانت النسب الملاحظة تعكس حقائق أصيلة في المجتمع، أم أنها مجرد تباينات عشوائية تفرزها أخطاء المعاينة المتكررة.
يعد اختبار Z لنسبة واحدة (One Proportion Z-Test) من أبرز هذه الأدوات وأكثرها شيوعاً في التحليل البارامتري، نظراً لأناقته الرياضية وقوته الاستدلالية عند التعامل مع البيانات الفئوية الثنائية. يستند هذا الاختبار إلى الجسور النظرية التي تربط بين التوزيع ثنائي الحدين (Binomial Distribution) والتوزيع الطبيعي المعياري (Standard Normal Distribution)، وهي الجسور التي أرست دعائمها مبرهنة النهاية المركزية وقوانين التقريب الرياضي التي صاغها رواد علم الاحتمالات. يتيح هذا الاختبار للباحثين وضع فرضيات دقيقة حول معالم المجتمع، ومن ثم اختبارها عبر معايير رياضية صارمة تضبط معدلات الخطأ، وتسمح باتخاذ قرارات منهجية رشيدة تستند إلى براهين رقمية قاطعة لا لبس فيها.
يتناول هذا الدليل الشامل اختبار Z لنسبة واحدة من جميع أبعاده المفاهيمية، والرياضية، والمنهجية، والتطبيقية. سنستعرض الأسس النظرية التي يقوم عليها الاختبار، والشروط الصارمة الواجب توفرها في البيانات لضمان سلامة الاستنتاجات، وصيغته الرياضية الدقيقة مع تشريح مكوناتها خطوة بخطوة. كما يتضمن المقال مثالاً عملياً موسعاً مستمداً من السياق النفسي والعيادي، متبوعاً بمناقشة معمقة لفترات الثقة، والأخطاء الشائعة التي يقع فيها الباحثون، وكيفية تنفيذ الاختبار عبر أشهر البرمجيات الإحصائية المعتمدة، مع ربط كل ذلك برؤية نقدية توازن بين الدلالة الإحصائية المجردة والأهمية العملية للمخرجات.
1. مفهوم اختبار Z لنسبة واحدة والأسس النظرية
1.1 التعريف الإحصائي لاختبار Z لنسبة واحدة
يُعرَّف اختبار Z لنسبة واحدة بأنه فحص استدلالي معلمي يُستخدم لاختبار الفرضيات المتعلقة بمقارنة نسبة ملحوظة في عينة عشوائية بنسبة معيارية مفترضة أو معروفة مسبقاً في المجتمع الإحصائي الأم. ينتمي هذا الاختبار وظيفياً إلى فئة اختبارات المطابقة للنسبة، حيث يتعامل الباحث مع متغير عشوائي يتبع توزيع برنولي (Bernoulli Trial)، والذي تنحصر نتائجه في نتيجتين متنافيتين وشاملتين (مثل: مصاب/غير مصاب، متوافق/غير متوافق، نجاح/فشل). وبناءً على هذا التقسيم الثنائي، تصبح النسبة الملاحظة في العينة هي المعلمة المستهدفة بالدراسة، وتتم مقارنتها بالقيمة المرجعية النظرية لتحديد ما إذا كان الفرق الملاحظ بينهما فارقاً حقيقياً يحمل دلالة إحصائية، أم أنه نتاج طبيعي للتقلبات العشوائية في المعاينة.
يرتكز الموقع النظري للاختبار داخل عائلة الاختبارات المعلمية على حقيقة أنه يستغل خصائص التوزيع الطبيعي المعياري ذي المتوسط الحسابي المساوي للصفر والانحراف المعياري المساوي للواحد الصحيح. ورغم أن الطبيعة الأصلية للبيانات الثنائية متقطعة وتخضع لتوزيع ذي الحدين، إلا أن الاختبار يستفيد من خصائص التقريب الطبيعي التي تتيح تحويل الفروق في النسب إلى درجات معيارية تسمى درجات Z. تعبر هذه الدرجات المعيارية عن عدد الأخطاء المعيارية التي تفصل بين نسبة العينة والنسبة المفترضة في المجتمع، مما يسهل عملية تقييم الاحتمالات المرتبطة بحدوث مثل هذا الانحراف تحت مظلة فرضية العدم.
تكمن الأهمية الجوهرية لهذا الاختبار في قدرته على عزل أثر الصدفة في التجارب الإمبريقية؛ فالنسبة الملاحظة في العينة نادراً ما تتطابق رقمياً مع النسبة المفترضة في المجتمع، وهنا تبرز الحاجة إلى معيار احتمالي صارم يحدد ما إذا كان هذا التباين كبيراً لدرجة تستوجب رفض فرضية التطابق والاعتراف بوجود تأثير أو نمط مختلف في المجتمع المدروس. بالتالي، يمثل الاختبار صمام أمان منهجي يحول دون تبني استنتاجات خاطئة بناءً على تباينات سطحية لا وزن لها إحصائياً.
1.2 الأهمية المنهجية للاختبار في البحوث النفسية والاجتماعية
تحظى البيانات الفئوية بأهمية بالغة في العلوم الإنسانية، حيث تعتمد العديد من التشخيصات السريرية والمؤشرات السلوكية على تصنيف الأفراد وفقاً لتحقق معايير محددة. في هذا السياق، يوفر اختبار Z لنسبة واحدة أرضية منهجية صلبة لتقييم مدى انتشار اضطراب نفسي معين داخل شريحة اجتماعية محددة ومقارنتها بالمعدلات الوطنية أو العالمية المعروفة. فعلى سبيل المثال، عند دراسة اضطراب كرب ما بعد الصدمة أو اضطراب الحزن الممتد، يحتاج الباحثون لمقارنة معدل الإصابة الملاحظ في عينة من الناجين من الكوارث بالمعدل الأساسي الموثق في الأدبيات السريرية العامة لتقدير حجم الأثر النفسي للصدمة (Prigerson et al., 2009).
يمتد الدور المنهجي للاختبار إلى تقييم كفاءة التدخلات والبرامج العلاجية والوقائية؛ إذ لا تقتصر معايير النجاح العلاجي على قياس التغيرات في الدرجات المتصلة للمقاييس النفسية، بل تمتد لتشمل نسب الاستجابة والتعافي التام (Remission Rates). عندما يزعم مطورو بروتوكول علاجي جديد أنه يرفع نسبة التعافي من الاكتئاب لتتجاوز النسبة النمطية السائدة في الرعاية التقليدية والبالغة مثلاً خمسين بالمائة، فإن اختبار Z لنسبة واحدة يشكل الأداة الإحصائية الحاسمة لتوكيد أو دحض هذا الادعاء بدرجة يقين رقمية محددة. وتتضح هذه الحاجة أيضاً عند فحص مؤشرات الفعالية السريرية في اضطرابات النوم والبروتوكولات التشخيصية المرتبطة بها (Kushida et al., 2005).
وعلاوة على ذلك، يسهم الاختبار بفاعلية في دراسة الاتجاهات المعرفية والمواقف السلوكية داخل التجمعات السكانية، كقياس نسب الرضا المهني، أو الإقبال على استشارات الصحة النفسية، أو نسب تبني أنماط وسلوكيات تفضيل الشريك والاختيارات التطورية عبر الثقافات المختلفة (Conroy‐Beam et al., 2019). تتيح هذه التطبيقات للمؤسسات الصحية وصناع القرار صياغة سياسات وقائية وتدخلية مبنية على الأدلة والبراهين المستقاة من نسب موثوقة إحصائياً، وتوجيه الموارد المادية والبشرية نحو الفئات الأكثر عرضة للمخاطر النفسية والاجتماعية.
1.3 الفروق الجوهرية بين اختبار النسبة الواحدة والاختبارات الإحصائية الأخرى
يقتضي الاختيار المنهجي الرشيد إدراك الحدود الفاصلة بين اختبار Z لنسبة واحدة وبقية الاختبارات الاستدلالية المشابهة. تتجلى أولى هذه المقارنات عند تمييزه عن اختبار Z لنسبتين مستقلتين؛ فبينما يركز اختبار النسبة الواحدة على فحص عينة أحادية في مواجهة قيمة ثابتة مفترضة مسبقاً (معلمة مجتمع محددة نظرياً أو تاريخياً)، يقوم اختبار النسبتين بمقارنة نسبتين مشتقتين من عينتين تجريبيتين منفصلتين لاختبار ما إذا كانت إحداهما تتفوق على الأخرى، وهو ما يتطلب صياغة مختلفة تماماً للخطأ المعياري المشترك.
من جانب آخر، يتباين اختبار Z لنسبة واحدة مع اختبار T للمتوسط الحسابي الواحد (One-Sample t-test) من حيث طبيعة المتغير التابع ومستوى قياسه؛ فاختبار T يتعامل حصراً مع بيانات كمية متصلة مقاسة بمقياس فتروي أو نسبي (Interval/Ratio)، ويفترض التوزيع الطبيعي للدرجات الأصلية لحساب المتوسط الحسابي والانحراف المعياري للعينة. في المقابل، يُعنى اختبار Z لنسبة واحدة بالبيانات الاسمية الثنائية (Dichotomous/Nominal)، حيث لا تملك الأرقام دلالة كمية ذاتية، بل تعبر عن تصنيفات مجردة يتم تحويلها إلى تكرارات ونسب مئوية تمثل احتمالات الحدوث.
وعند المقارنة مع اختبار مربع كاي لجودة المطابقة (Chi-Square Goodness of Fit Test) للبيانات ثنائية التقسيم، يظهر تكافؤ رياضي ملحوظ، إذ إن مربع قيمة Z المحسوبة للاختبار ثنائي الطرف يساوي تماماً قيمة مربع كاي لنفس البيانات وبدرجة حرية واحدة. غير أن اختبار Z يتفوق بمرونته العالية وإمكانية صياغته كاختبار أحادي الطرف (One-tailed test) لاختبار اتجاه محدد (زيادة أو نقصان)، وهي ميزة لا يوفرها اختبار مربع كاي الذي يعتمد بطبيعته على مربعات الفروق، مما يجعله دوماً اختباراً ثنائي الطرف غير موجه. وتلخص المعايير التالية كيفية اختيار الفحص الإحصائي الأنسب:
- طبيعة المتغير: استخدام اختبار النسبة إذا كان المتغير فئوياً ثنائياً، واستخدام اختبار T إذا كان المتغير كمياً متصلاً.
- عدد العينات: استخدام اختبار النسبة الواحدة عند مقارنة عينة واحدة بقيمة معيارية ثابتة، واللجوء لاختبار النسبتين عند مقارنة مجموعتين مستقلتين.
- اتجاه الفرضية: تفضيل اختبار Z على مربع كاي إذا كان لدى الباحث سند نظري يدعم صياغة فرضية موجهة تتنبأ بزيادة النسبة أو انخفاضها.
2. الدوافع الإحصائية والعملية لإجراء الاختبار
2.1 استحالة الحصر الشامل للمجتمعات الإحصائية الكبيرة
تشكل مسألة الحصر الشامل (Census) للمجتمعات الإحصائية الكبيرة عائقاً منهجياً ولوجستياً بالغ التعقيد أمام الباحثين. فعند الرغبة في معرفة النسبة الحقيقية للأفراد الذين يعانون من اضطراب سلوكي محدد، أو يقبلون على سلوك معين في دولة ما، يصبح من المستحيل عملياً فحص كل فرد في ذلك المجتمع نظراً للملايين التي يتألف منها، وما يتطلبه ذلك من ميزانيات مالية باهظة، وكوادر بشرية ضخمة، وفترات زمنية طويلة قد تؤدي بحلول نهايتها إلى تغير الظاهرة ذاتها وتلاشي معالمها الأصلية.
تزداد هذه الصعوبة حدة في الدراسات النفسية والوبائية التي تتطلب أدوات فحص ومقابلات سريرية مقننة ومعمقة، لا يمكن إجراؤها سريعاً عبر استبيانات سطحية، بل تستلزم تفاعلاً مباشراً ومكلفاً مع كل مشارك. وهنا يظهر الاستدلال الإحصائي كضرورة علمية لا غنى عنها، حيث يسمح بسحب عينة عشوائية ممثلة ذات حجم مدروس ومناسب، تمكن الباحث من استخلاص استنتاجات موثوقة عن نسبة المجتمع ككل بدرجة مقبولة من الدقة وبأقل قدر من الهدر في الموارد.
يمثل اختبار Z لنسبة واحدة الأداة المنهجية التي تترجم بيانات هذه العينة المحدودة إلى استنتاج عام وشامل حول المجتمع الأم؛ فبدلاً من محاولة فحص المجتمع بأسره، نكتفي باختبار ما إذا كانت النسبة المستخرجة من العينة تتفق مع التقدير النظري للمجتمع، مما يمنح البحث العلمي مرونة فائقة وقدرة على مواكبة المتغيرات والتنبؤ بالسلوكيات دون الاصطدام بعقبات الحصر المستحيل.
2.2 التعامل مع تباين المعاينة والخطأ العشوائي
من القوانين البديهية في نظرية المعاينة الإحصائية أن الباحث لو قام بسحب عشرات العينات العشوائية المتتالية والمتساوية في الحجم من المجتمع ذاته، فإنه لن يحصل على النسبة نفسها تماماً في كل مرة. يُعرف هذا الاختلاف الطبيعي المتوقع بين نسب العينات بتباين المعاينة (Sampling Variability)، وهو ينشأ عن الخطأ العشوائي المتأصل في عملية سحب الأفراد وليس عن وجود عيب في أدوات القياس أو منهجية الجمع.
تتمثل المعضلة الكبرى التي يحلها اختبار Z لنسبة واحدة في التمييز الدقيق بين التباين السطحي الناجم عن المصادفة والتقلبات العشوائية البحتة، وبين الفروق الجوهرية ذات الدلالة الإحصائية التي تعكس تغيراً حقيقياً في بنية المجتمع. فعندما يلاحظ باحث أن نسبة التعافي في عينة دراسته بلغت ثلاثة وخمسين بالمائة بينما المعيار المعروف هو خمسون بالمائة، لا يمكنه الجزم بأن العلاج فعال لمجرد وجود هذا الفارق العددي، لاحتمال أن يكون الفرق ناتجاً عن الصدفة وحدها في اختيار أفراد هذه العينة المحددة.
يعمل الاختبار الإحصائي على تكميم هذه المصادفة وإخضاعها لقوانين الاحتمالات الصارمة من خلال حساب الخطأ المعياري؛ وبذلك يحمي الاختبار الباحثين من الانزلاق نحو قرارات متسرعة تبالغ في تفسير نتائج عابرة، أو تدعي وجود ظواهر لا أساس لها من الصحة، مما يضفي على النتائج رصانة منهجية ومصداقية علمية تمنع هدر الجهود في مسارات بحثية أو سريرية مضللة.
2.3 اختبار الفرضيات النظرية والمقارنة بالمعايير المرجعية
يتغذى التقدم العلمي على عملية الاختبار المستمر للنظريات والنماذج التفسيرية، والتي غالباً ما تقدم تنبؤات كمية صريحة حول نسب حدوث الظواهر. تتيح الفحوص الإحصائية مقارنة نسب السلوكيات الميدانية بالمعايير النظرية المقترحة للتحقق من صدق النظريات السيكولوجية والاجتماعية ومدى ثباتها أمام الاختبارات الإمبريقية، مثل دراسات ما وراء المعرفة والتنظيم الذاتي للتعلم التي تتنبأ بنسب محددة للنجاح في حل المشكلات (Schraw et al., 2006).
كما تمتد الحاجة للاختبار لمقارنة النسب الملاحظة في قطاع محدد بالبيانات الإحصائية الرسمية الصادرة عن التعدادات السكانية أو التقارير الوطنية للصحة العامة. فإذا أظهر تقرير وطني أن نسبة تعاطي المؤثرات العقلية بين المراهقين تبلغ اثني عشر بالمائة، ورغب أخصائي نفسي في فحص مدرسة معينة لمعرفة ما إذا كانت نسبة التعاطي فيها تتجاوز هذا المعدل الخطر، فإن اختبار Z لنسبة واحدة يقدم الوسيلة الإحصائية الدقيقة لتحديد ما إذا كانت المدرسة تستوجب تدخلاً وقائياً مكثفاً.
علاوة على ذلك، يعد الاختبار وسيلة فعالة لمراقبة التحولات عبر الزمن (Trend Monitoring) داخل المجتمعات؛ إذ يمكن استخدامه لمقارنة نسب انتشار ظاهرة معينة في الوقت الحاضر مع النسب التي وثقتها دراسات سابقة، بهدف رصد التحولات الفكرية، أو التغيرات في السلوكيات الصحية، أو تداعيات الأزمات الاقتصادية والاجتماعية على استقرار الأفراد وتوجهاتهم العامة.
3. شروط وافتراضات تطبيق اختبار Z لنسبة واحدة
3.1 عشوائية واستقلالية المعاينة
تشترط المنهجية الإحصائية السليمة لاختبار Z لنسبة واحدة أن تُجمع البيانات من خلال أسلوب المعاينة العشوائية البسيطة (Simple Random Sampling)، أو بأحد أشكال المعاينة الاحتمالية المكافئة، لضمان حصول كل عنصر في المجتمع على فرصة متكافئة ومستقلة للاختيار. تضمن العشوائية خلو العينة من التحيزات المنهجية التي تؤدي إلى تشويه النسبة الملاحظة، وتجعل العينة صورة مصغرة وصادقة للمجتمع المستهدف تعكس تبايناته بإنصاف.
يرتبط بشرط العشوائية شرط مكمل بالغ الأهمية وهو استقلالية المشاهدات (Independence of Observations)، والذي يقتضي ألا تؤثر استجابة أو حالة أي فرد في العينة على استجابة فرد آخر بأي شكل من الأشكال. ففي الدراسات السلوكية والنفسية، يؤدي جمع البيانات من أفراد يتفاعلون معاً (كالطلاب داخل نفس الفصل الدراسي، أو أفراد الأسرة الواحدة) دون ضبط مناسب إلى حدوث ارتباطات متبادلة تخرق شرط الاستقلالية، وتفرز ما يسمى بالارتباط الداخلي للمجموعات.
يترتب على خرق شرط الاستقلالية تداعيات وخيمة على بنية الاختبار، حيث يؤدي الارتباط بين الملاحظات إلى تضخيم غير واقعي لدقة العينة وتقليل مصطنع لقيمة الخطأ المعياري الفعلي. وهذا الخلل يقود بالتبعية إلى ارتفاع خطر ارتكاب الخطأ من النوع الأول (Type I Error)، مما يجعل الباحث يرفض فرضية العدم ويعلن عن وجود فروق دالة إحصائياً في حين أن تلك الفروق ناجمة عن تشابك الملاحظات وعدم استقلاليتها.
3.2 شرط حجم العينة والتقريب الطبيعي للتوزيع الثنائي
بما أن اختبار Z لنسبة واحدة يعتمد في جوهره على استبدال التوزيع ذي الحدين بالتوزيع الطبيعي المعياري، فإن هذا التقريب الرياضي لا يكون صالحاً وموثوقاً إلا إذا كان حجم العينة كبيراً بما يكفي لتجاوز مشكلة الالتواء المتأصلة في المتغيرات الفئوية. يتحقق هذا الشرط رياضياً من خلال التحقق الصارم من معيار النجاح والفشل، والذي يقضي بأن يكون حاصل ضرب حجم العينة في النسبة المفترضة مساوياً أو أكبر من عشرة، وكذلك حاصل ضرب حجم العينة في مكمل تلك النسبة مساوياً أو أكبر من عشرة.
يعتمد الأساس النظري لهذا المعيار على مبرهنة النهاية المركزية؛ فعندما تقترب النسبة المفترضة من القيمة نصف (0.5)، يكون التوزيع الثنائي متماثلاً تماماً بطبيعته حتى في العينات الصغيرة نسبياً. أما عندما تكون النسبة قريبة جداً من الأطراف (قريبة من الصفر أو الواحد الصحيح، كالظواهر النادرة للغاية)، فإن التوزيع يكون ملتوياً بشدة نحو اليمين أو اليسار، ولا يتحقق التماثل الذي يفترضه المنحنى الجرسي الطبيعي إلا بعينات أكبر بكثير تكفل تراكم عدد كافٍ من النجاحات والإخفاقات لتجاوز هذا الالتواء.
إذا اختل هذا الشرط ولم تبلغ المشاهدات المتوقعة للنجاح أو الفشل الحد الأدنى المشترط، فإن التقريب الطبيعي يفقد دقته العلمية ويتحيز الاختبار تحيزاً جسيماً في تقدير الاحتمالات، مما يوجب على الباحث في تلك الحالات التخلي عن اختبار Z واعتماد الاختبارات اللامعلمية الدقيقة البديلة، وفي مقدمتها اختبار ذي الحدين الدقيق (Exact Binomial Test) الذي يحسب الاحتمالات بدقة تامة دون الحاجة لأي تقريب.
3.3 حجم العينة مقارنة بحجم المجتمع الكلي
من الفروض الكلاسيكية في نظرية الاحتمالات أن تكون المحاولات المتتالية مستقلة تماماً، وهو ما يتطابق في عالم المعاينة مع أسلوب السحب مع الإرجاع (Sampling with Replacement). ومع ذلك، تُجرى الأبحاث الإمبريقية والتطبيقية في الميدان بأسلوب السحب دون إرجاع (Sampling without Replacement) لضمان عدم تكرار فحص الشخص نفسه مرتين، مما يعني نظرياً أن احتمال حدوث الخاصية يتغير طفيفاً جداً بعد سحب كل فرد من المجتمع.
للتغلب على هذه المعضلة وضمان بقاء المحاولات مستقلة تقريباً، وُضعت قاعدة منهجية صارمة تنص على ألا يتجاوز حجم العينة الإجمالي عشرة بالمائة من حجم المجتمع الكلي. فعندما يكون المجتمع كبيراً جداً مقارنة بالعينة، يظل الأثر الناتج عن استبعاد الأفراد المسحوبين ضئيلاً لدرجة يمكن إهمالها رياضياً دون أن يؤثر ذلك على دقة الحسابات، ويبقى التوزيع الثنائي نموذجاً ملائماً لوصف تباينات المعاينة.
أما إذا اضطر الباحث لسحب عينة ضخمة تتجاوز هذه العتبة (أكثر من عشرة بالمائة من مجتمع محدود وصغير الحجم)، فإن افتراض الاستقلالية يتعرض للاختلال، مما يستوجب إدخال معامل رياضي يسمى معامل تصحيح المجتمع المحدود (Finite Population Correction) لتعديل قيمة الخطأ المعياري. وفي حال إهمال هذا التصحيح عند تجاوز العتبة، فإن الخطأ المعياري يتعرض للتضخيم الاصطناعي، مما يقلل من حساسية الاختبار ويحرمه من رصد الفروق الحقيقية.
4. صياغة الفرضيات الإحصائية للاختبار
4.1 بناء الفرضية الصفرية بدقة أكاديمية
تمثل الفرضية الصفرية، أو فرضية العدم، نقطة الانطلاق الأساسية والمحور الرياضي الذي تُبنى عليه كافة إجراءات اختبار الفرضيات الإحصائية. تعبر هذه الفرضية عن الوضع الراهن أو نقطة التعادل، وتنص صراحة على عدم وجود فرق حقيقي بين النسبة الملاحظة في العينة والنسبة النظرية المرجعية في المجتمع، وأن أي اختلاف عددي يظهر في النتائج يُعزى حصراً إلى الصدفة وتذبذب المعاينة العشوائي.
تتم الصياغة الرمزية للفرضية الصفرية بوضع معلمة المجتمع الحقيقية (الممثلة بالرمز p) مساوية للقيمة العددية المحددة سلفاً (الممثلة بالرمز p0)، وتُكتب بصيغة رياضية واضحة: H0: p = p0. تشير هذه المساواة الرياضية الصارمة إلى أن المعلمة في المجتمع المستهدف لم يطرأ عليها أي تغيير، وأن العينة سُحبت بالفعل من مجتمع تنطبق عليه تلك القيمة المرجعية تماماً.
تكمن الأهمية المنهجية للفرضية الصفرية في أنها توفر النموذج الاحتمالي الرياضي الذي يُمكّن الباحث من بناء توزيع المعاينة وحساب الخطأ المعياري، إذ لا يمكن استخراج أي قيمة احتمالية أو تحديد مناطق الرفض والقبول دون الانطلاق من افتراض قاطع بصحة هذه الفرضية حتى يثبت الدليل العكسي القاطع بالأرقام.
4.2 صياغة الفرضيات البديلة: الاختبار ثنائي الطرف
تُصاغ الفرضية البديلة ثنائية الطرف (Two-tailed Alternative Hypothesis) في المواقف البحثية التي لا يملك فيها الباحث سنداً نظرياً مسبقاً أو دليلاً قاطعاً يوجه التوقع نحو زيادة النسبة أو انخفاضها، بل ينحصر اهتمامه المنهجي في التحقق مما إذا كانت النسبة مختلفة ومتباينة عن القيمة المرجعية في أي من الاتجاهين. وتأخذ هذه الفرضية الصياغة الرمزية: H1: p ≠ p0.
يترتب على صياغة الاختبار ثنائي الطرف توزيع منطقة الرفض الإحصائي (مستوى الدلالة ألفا) بالتساوي على كلا طرفي المنحنى الجرسي للتوزيع الطبيعي؛ فإذا اختار الباحث مستوى معنوية يبلغ خمسة بالمائة (0.05)، فإنه يخصص اثنين ونصف بالمائة (0.025) للطرف الأيمن العلوي، واثنين ونصف بالمائة (0.025) للطرف الأيسر السفلي. وبناءً على هذا التقسيم، يُرفض العدم إذا كانت نسبة العينة أعلى بكثير من المفترض أو أقل بكثير من المفترض بدرجة متطرفة.
يتميز هذا النمط من الاختبارات بالمحافظة والموضوعية المنهجية، إذ يغلق الباب أمام التحيزات الشخصية ولا يفترض مقدماً نجاح التدخل أو فشله. ويعد الخيار الأكثر أماناً في الأبحاث الاستكشافية التي تتناول ظواهر غير مستقرة أو متغيرات حديثة لم تتبلور اتجاهاتها في الأدبيات العلمية بصورة حاسمة بعد.
4.3 صياغة الفرضيات البديلة: الاختبار أحادي الطرف
يُلجأ إلى صياغة الفرضية البديلة أحادية الطرف (One-tailed Alternative Hypothesis) عندما تؤطر الدراسة خلفية نظرية متينة، أو تجارب استطلاعية سابقة تتنبأ بشكل لا لبس فيه باتجاه محدد للفرق. وينقسم هذا الاختبار إلى نمطين متميزين: الاختبار ذي الطرف الأيمن، والاختبار ذي الطرف الأيسر، وفقاً لطبيعة التأثير المتوقع ونوع الفرضية المصاغة.
في اختبار الطرف الأيمن، يُركز الباحث على إثبات أن النسبة في المجتمع تفوق النسبة المرجعية بشكل دال، وتُصاغ الفرضية البديلة رياضياً: H1: p > p0، وتوضع منطقة الرفض كاملة (بقيمة ألفا الإجمالية) في أقصى الطرف الأيمن من التوزيع. ويبرز هذا الاستخدام في تقييم البرامج الإرشادية الناجحة التي يُتوقع منها بصورة واضحة رفع نسب الإقلاع عن التدخين أو تحسين الكفاءة الذاتية لتتجاوز المعدلات الشائعة، كما يظهر في دراسات التفسير الذاتي وأثرها على تعزيز التعلم النشط (Michelene et al., 1989).
أما في اختبار الطرف الأيسر، فإن الاهتمام يتجه نحو إثبات انخفاض النسبة عن المعيار المتوقع، وتُكتب الفرضية البديلة: H1: p < p0، وتتركز منطقة الرفض بالكامل في أقصى الطرف الأيسر للمنحنى. ويُستخدم هذا الاختبار عادة للتحقق من نجاح برامج التدخل في خفض نسب الرسوب المدرسي أو تقليص نسب الانتكاسات السريرية لدى المرضى النفسيين. ويجب توخي الحذر الشديد وعدم اللجوء للاختبارات أحادية الطرف لتسهيل الوصول للدلالة الإحصائية، إذ إن استخدامها دون مبرر نظري مسبق وصارم يُعد إخلالاً بقواعد النزاهة المنهجية الرصينة.
5. الصيغة الرياضية للاختبار والتحليل الإحصائي لمكوناتها
5.1 المعادلة الأساسية لحساب الإحصائية Z لنسبة واحدة
تتجسد الصيغة الرياضية الكلاسيكية لاختبار Z لنسبة واحدة في العلاقة التي تقيس المسافة المعيارية بين المعلمة الملاحظة والمعلمة النظرية مقسومة على الخطأ المعياري المتوقع، وتتخذ المعادلة البنية الجبرية الآتية:
z = (p̂ − p0) / SE0
حيث يمثل الرمز p̂ (يُنطق: بي هات) نسبة العينة الملاحظة فعلياً في التجربة، وتُحسب عبر قسمة عدد الحالات الإيجابية أو حالات النجاح المحققة (x) على الحجم الإجمالي لعينة الدراسة (n)، أي أن p̂ = x / n. أما الرمز p0 فهو النسبة المفترضة في المجتمع بموجب فرضية العدم، والتي تُستخدم كنقطة ارتكاز مرجعية يتم الطرح منها في بسط المعادلة لحساب مقدار الانحراف المطلق للنسبة.
يعبر ناتج البسط (p̂ − p0) عن الفرق الخام غير المعاير بين الواقع التجريبي والافتراض النظري؛ فإذا كانت نسبة العينة مطابقة لنسبة المجتمع الافتراضية، تكون قيمة البسط صفراً وتصبح قيمة Z الناتجة صفراً تلقائياً، وهو ما يعني التطابق التام مع مركز التوزيع المعياري وعدم وجود أي دليل يدعو للشك في الفرضية الصفرية.
5.2 الخطأ المعياري للنسبة وطريقة حسابه
يمثل مقام المعادلة، والمشار إليه بالرمز SE0، الخطأ المعياري لتوزيع النسب تحت مظلة فرضية العدم، وهو المؤشر الإحصائي الذي يقيس مقدار التشتت أو الانحراف المعياري المتوقع لنسب العينات العشوائية حول النسبة الحقيقية عند تكرار سحب عينات بالحجم نفسه من ذلك المجتمع. ويُحسب هذا المكون وفق الصيغة الجذرية الدقيقة التالية:
SE0 = الجذر التربيعي لـ [ (p0 × (1 − p0)) / n ]
من الأهمية بمكان التأكيد على قاعدة منهجية وحسابية جوهرية: يجب في حساب اختبار Z لنسبة واحدة استخدام النسبة المفترضة الصفرية (p0) حصراً داخل هذا الجذر وليس نسبة العينة (p̂). يرجع هذا التمييز إلى أننا في اختبار الفرضيات نعمل دائماً تحت شرط افتراض صحة الفرضية الصفرية إلى أن يثبت العكس، وبالتالي فإن توزيع المعاينة النظري يجب أن يتأسس بالكامل على المعلمة الصفرية المفترضة.
يبرز التحليل الرياضي لهذه الصيغة الأثر البالغ لحجم العينة (n) الواقع في مقام الجذر؛ فمع تزايد عدد أفراد العينة، تتقلص قيمة الخطأ المعياري تدريجياً، مما يؤدي إلى تضييق توزيع المعاينة وزيادة حساسية الاختبار وقدرته على رصد الفروق الطفيفة وتضخيم قيمة Z الناتجة لأي فارق فعلي موجود بين نسبتي البسط.
5.3 تصحيح الاستمرارية ومتى يجب استخدامه
نظراً لأننا نقوم بتقريب متغير عشوائي متقطع هو عدد حالات النجاح المستمدة من توزيع ذي الحدين (والذي يقفز بقيم عددية صحيحة منفصلة) باستخدام منحنى التوزيع الطبيعي المتصل (الذي يقبل قيماً كسرية لا نهائية)، فقد تظهر فجوات رياضية دقيقة في حساب الاحتمالات خصوصاً عندما يكون حجم العينة متوسطاً أو صغيراً نسبياً. ولمعالجة هذا التباين البنيوي بين التوزيعين، اقترح الإحصائي فرانك ييتس ما يعرف بـ “تصحيح الاستمرارية” (Yates’ Continuity Correction).
يتضمن هذا التصحيح تقليص المسافة المطلقة في البسط بمقدار نصف وحدة على مقياس التكرارات، وهو ما يعادل خصم المقدار (1 / (2n)) من الفرق المطلق بين النسبة الملاحظة والنسبة المفترضة. وبناءً على ذلك، تأخذ المعادلة المعدلة بتصحيح الاستمرارية الشكل التالي:
zمعدل = ( |p̂ − p0| − (1 / (2n)) ) / SE0
مع مراعاة إرجاع الإشارة الجبرية الأصلية (الموجبة أو السالبة) للناتج بعد إجراء الطرح. يُحدث هذا التصحيح تعديلاً تحفظياً يجعل قيمة Z المحسوبة أقرب إلى الصفر بقليل، مما يرفع القيمة الاحتمالية ويوفر حماية إضافية ضد الرفض المتسرع للفرضية الصفرية. ومع ذلك، يدور جدل أكاديمي واسع حول مدى جدوى هذا التصحيح؛ فالعديد من الإحصائيين المعاصرين يشيرون إلى أنه يبالغ في التحفظ ويقلل من قوة الاختبار، خاصة في وجود عينات كبيرة تتجاوز المئات، حيث تتضاءل قيمة الكسر المخصوم حتى تنعدم فعاليتها عملياً.
6. الخطوات المنهجية المتكاملة لتنفيذ الاختبار
6.1 تحديد مستوى الدلالة وتحديد القيم الحرجة
تبدأ الخطوات الإجرائية الصارمة لتنفيذ الاختبار بتحديد مستوى المعنوية أو الدلالة الإحصائية (المعروف بالرمز الإغريقي ألفا: α)، وهو يمثل الحد الأقصى لاحتمال ارتكاب الخطأ من النوع الأول المسموح به في الدراسة (أي احتمال رفض الفرضية الصفرية وهي صحيحة في الواقع). يُحدد هذا المستوى مسبقاً قبل الاطلاع على البيانات الرقمية منعاً للانحياز، وتعد القيمة 0.05 هي المعيار الشائع في العلوم النفسية والاجتماعية، في حين يُلجأ إلى مستويات أكثر صرامة مثل 0.01 أو 0.001 في الدراسات الطبية والسريرية الحساسة.
بمجرد تحديد مستوى ألفا وطبيعة الفرضية البديلة (أحادية أم ثنائية)، يتم استخراج القيم الحرجة (Critical Values) المقابلة من جداول التوزيع الطبيعي المعياري Z. هذه القيم الحرجة تمثل الحدود الفاصلة على المحور الأفقي للمنحنى الجرسي، والتي تقسم مساحة التوزيع الإجمالية إلى “منطقة قبول أو عدم رفض الفرضية الصفرية” و”منطقة الرفض الإحصائي”. ففي الاختبار ثنائي الطرف عند مستوى دلالة 0.05، تُقسم مساحة الرفض البالغة خمسة بالمائة إلى طرفين متساويين، لتكون القيم الحرجة المعيارية هي ±1.96.
أما في حال صياغة اختبار أحادي الطرف بالاتجاه الأيمن عند مستوى الدلالة 0.05، فإن مساحة الرفض تتركز بكاملها في طرف واحد، وتكون القيمة الحرجة المقابلة هي +1.645، بينما تكون -1.645 في الاختبار أحادي الطرف الموجه لليسار. تشكل هذه القيم العتبة الصارمة التي ستقارن بها قيمة Z المحسوبة في المراحل اللاحقة للحكم على الدلالة.
6.2 حساب القيمة الاحتمالية واتخاذ القرار الإحصائي
تتمثل الخطوة التالية في حساب قيمة Z المحسوبة من خلال التعويض بالبيانات الميدانية في صيغة الاختبار، ومن ثم استخراج القيمة الاحتمالية المرتبطة بها (p-value). تُعرَّف القيمة الاحتمالية بأنها احتمال الحصول على نتائج في العينة مماثلة للنتائج الملاحظة أو أكثر منها تطرفاً، بافتراض أن الفرضية الصفرية صحيحة تماماً في المجتمع. وتُحسب هذه القيمة من خلال إيجاد المساحة الواقعة تحت منحنى التوزيع الطبيعي المعياري خلف قيمة Z المحسوبة باتجاه الطرف أو الأطراف المحددة في الفرضية البديلة.
يرتكز اتخاذ القرار الإحصائي على المقارنة المباشرة بين القيمة الاحتمالية ومستوى الدلالة ألفا المعتمد:
- إذا كانت القيمة الاحتمالية أصغر من أو تساوي مستوى الدلالة (p ≤ α): يتخذ الباحث قراراً حاسماً برفض الفرضية الصفرية وقبول الفرضية البديلة، معلناً أن النسبة الملاحظة تختلف عن النسبة المرجعية بدرجة دالة إحصائياً لا يمكن عزوها للمصادفة وحدها.
- إذا كانت القيمة الاحتمالية أكبر من مستوى الدلالة (p > α): يفشل الباحث في رفض الفرضية الصفرية (Fail to reject the null hypothesis)، وتخلص الدراسة إلى عدم توفر أدلة كافية تثبت وجود فرق جوهري بين النسبتين عند ذلك المستوى من اليقين.
يقابل هذه الطريقة، وتتطابق معها تماماً في النتائج، قاعدة القرار المعتمدة على الدرجات الحرجة؛ حيث تُرفض الفرضية الصفرية إذا وقعت قيمة Z المحسوبة داخل منطقة الرفض (أي إذا تجاوزت القيمة الحرجة المطلقة في الاختبارات ثنائية الطرف، أو فاقت القيمة الحرجة الموجهة في الاختبارات أحادية الطرف).
6.3 توثيق النتائج وفق معايير جمعية علم النفس الأمريكية
يتطلب إعداد التقارير العلمية صياغة النتائج الإحصائية بأسلوب منهجي موحد يعكس الشفافية والدقة، وتعتبر معايير جمعية علم النفس الأمريكية (APA) في نسختها السابعة المرجع القياسي الأكثر موثوقية في العلوم السلوكية والاجتماعية. يقتضي هذا النمط من التوثيق تضمين قيمة Z المحسوبة مقربة إلى منزلتين عشريتين، وحجم العينة الكلي، والقيمة الاحتمالية الدقيقة مسبوقة بالحرف اللاتيني p بخط مائل.
ولا يقتصر التوثيق السليم على الأرقام المجردة، بل يستلزم تقديم صياغة نصية واضحة تشرح المعنى النفسي أو السلوكي للنتيجة، مع ذكر النسب المئوية للمقارنة بين العينة والمجتمع، وتقديم حجم الأثر أو فترة الثقة لبيان الدقة التقديرية. وتصاغ النتيجة عادة على النحو الآتي: “أظهرت نتائج اختبار Z لنسبة واحدة أن نسبة الطلاب الذين يعانون من أعراض القلق بلغت 48%، وهي نسبة تزيد بصورة دالة إحصائياً عن المعدل الوطني المرجعي البالغ 40%، حيث كانت قيمة z = 2.31، وحجم العينة N = 200، والقيمة الاحتمالية p = .021″.
تمنع هذه الصياغة الدقيقة الوقوع في التعميمات الفضفاضة، وتتيح للقراء والمراجعين التحقق المستقل من سلامة الحسابات وملاءمة القرارات المنهجية التي بنيت عليها، مما يعزز التراكم العلمي الرصين.
7. مثال تطبيقي عملي مفصل في سياق نفسي وسلوكي
7.1 توصيف مشكلة البحث وجمع البيانات الأولية
لتجسيد كافة المفاهيم النظرية في إطار عملي واقعي، نفترض قيام فريق بحثي متخصص في الصحة النفسية الجامعية بدراسة ظاهرة تفشي القلق النفسي بين طلبة كليات الطب والعلوم الصحية في إحدى الجامعات الوطنية الكبرى. تشير السجلات والمسوح الصحية الوطنية المعتمدة رسمياً في الدولة إلى أن المعدل المرجعي لانتشار أعراض القلق المعمم بين عموم فئات الشباب الجامعي يبلغ أربعين بالمائة (0.40). لكن الفريق البحثي، واستناداً إلى ملاحظات ميدانية وضغوط البرامج الطبية المكثفة، تبنى فرضية موجهة تفيد بأن نسبة انتشار أعراض القلق بين طلبة الكليات الصحية تتجاوز هذا المعدل المرجعي العام بشكل واضح.
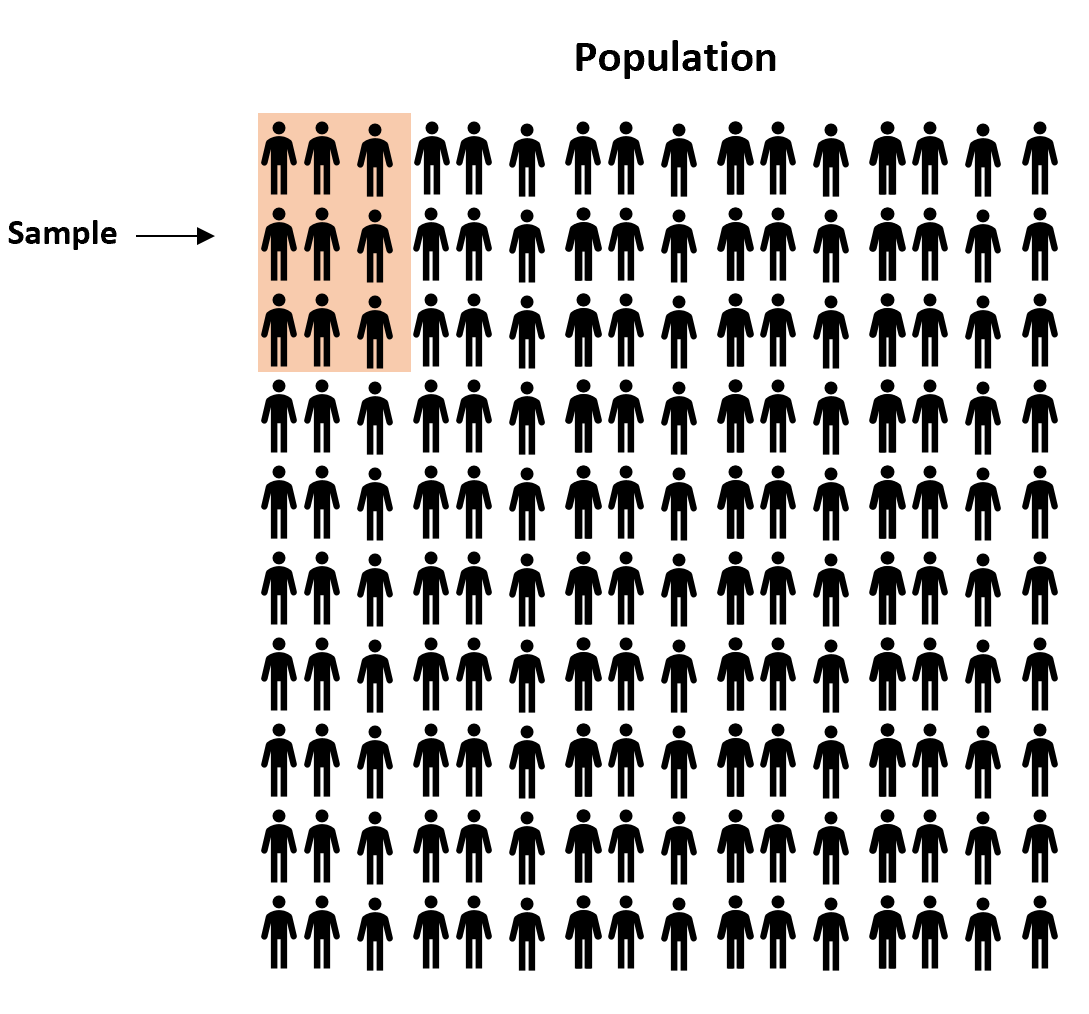
قام الباحثون بسحب عينة عشوائية بسيطة مؤلفة من مئتي طالب وطالبة (n = 200) من المجتمع الإجمالي لطلبة الكليات الصحية البالغ تعداده قرابة ثلاثة آلاف طالب. تم إخضاع جميع المشاركين لمقياس تشخيصي مقنن يتمتع بمؤشرات صدق وثبات سريرية عالية لتحديد ما إذا كان الطالب يستوفي معايير القلق المرتفع (تتحقق الخاصية) أم لا يستوفيها (لا تتحقق الخاصية). وبعد فرز النتائج، أظهرت السجلات أن ثمانية وتسعين طالباً (x = 98) من بين المئتي طالب قد صُنفوا بالفعل كحالات تعاني من أعراض القلق الإكلينيكي المرتفع.
7.2 التطبيق الحسابي اليدوي خطوة بخطوة للقيم الرقمية
نبدأ بتنفيذ الخطوات الإجرائية والحسابية للاختبار بصورة يدوية مفصلة:
أولاً: حساب نسبة العينة الملاحظة (p̂):
p̂ = x / n = 98 / 200 = 0.49 (أي 49%).
ثانياً: التحقق من شروط حجم العينة والتقريب الطبيعي:
نحسب النجاحات المتوقعة تحت فرضية العدم: n × p0 = 200 × 0.40 = 80.
نحسب الإخفاقات المتوقعة تحت فرضية العدم: n × (1 − p0) = 200 × (1 − 0.40) = 200 × 0.60 = 120.
بما أن كلا القيمتين (80 و120) أكبر بكثير من الحد الأدنى المشترط وهو 10، وبما أن حجم العينة (200) يمثل أقل من 10% من حجم المجتمع الكلي (3000)، فإن كافة شروط التقريب الطبيعي واستقلالية المشاهدات متحققة تماماً بصورة صلبة.
ثالثاً: صياغة الفرضيات الإحصائية:
الفرضية الصفرية: H0: p ≤ 0.40 (نسبة القلق بين طلبة الكليات الصحية لا تتجاوز المعدل الوطني العام).
الفرضية البديلة (أحادية الطرف الأيمن): H1: p > 0.40 (نسبة القلق بين طلبة الكليات الصحية أعلى دلالة من المعدل الوطني العام).
رابعاً: حساب الخطأ المعياري للنسبة (SE0):
باستخدام القيمة الصفرية المرجعية p0 = 0.40:
SE0 = الجذر التربيعي لـ [ (0.40 × 0.60) / 200 ]
SE0 = الجذر التربيعي لـ [ 0.24 / 200 ] = الجذر التربيعي لـ [ 0.0012 ] ≈ 0.034641.
خامساً: حساب إحصائية Z القياسية:
نعوض بالقيم المستخرجة في صيغة الاختبار الأساسية:
z = (p̂ − p0) / SE0
z = (0.49 − 0.40) / 0.034641 = 0.09 / 0.034641 ≈ 2.598 ≈ 2.60.
سادساً: استخراج القيمة الاحتمالية (p-value):
بالرجوع إلى جداول التوزيع الطبيعي المعياري لإيجاد المساحة الواقعة في الطرف الأيمن أبعد من القيمة المحسوبة z = 2.60، نجد أن المساحة التراكمية حتى 2.60 تساوي 0.9953، وبالتالي فإن القيمة الاحتمالية للطرف الأيمن تساوي:
p = 1 − 0.9953 = 0.0047.
7.3 قراءة وتفسير المخرجات النهائية للمثال
بمقارنة القيمة الاحتمالية المحسوبة بمستوى الدلالة المحدد مسبقاً (α = 0.05)، يتبين أن القيمة الاحتمالية (p = 0.0047) أصغر بكثير من مستوى الدلالة المعتمد. وتأكيداً على هذه النتيجة من خلال الدرجات الحرجة، نجد أن قيمة Z المحسوبة (2.60) تتجاوز بمراحل القيمة الحرجة للاختبار أحادي الطرف الأيمن والبالغة (+1.645)، مما يعني سقوط إحصائية الاختبار عميقاً داخل منطقة الرفض الإحصائي الحرجة.
بناءً على هذه المعطيات الرقمية الصارمة، يُتخذ القرار المنهجي برفض الفرضية الصفرية والتسليم بصحة الفرضية البديلة. ونخلص إلى وجود دليل إحصائي قاطع يدعم الاستنتاج بأن نسبة انتشار أعراض القلق النفسي بين طلبة الكليات الصحية والبالغة تسعة وأربعين بالمائة هي نسبة أعلى بشكل دال إحصائياً من المعدل الوطني الشائع البالغ أربعين بالمائة، ولا يمكن رد هذا الارتفاع البالغ تسع نقاط مئوية إلى الصدفة أو أخطاء المعاينة العشوائية.
يقود هذا الاستنتاج الإحصائي إلى توصيات سريرية ومؤسسية هامة؛ فالارتفاع الدال في معدلات القلق يعكس ضغوطاً متزايدة ترتبط ببيئة التعليم الطبي والتدريب الإكلينيكي الشاق. ويستدعي ذلك من عمادات الكليات الصحية وإدارات الرعاية النفسية والجامعية تصميم برامج دعم نفسي نوعية ووقائية، وتهيئة بيئة أكاديمية تخفف من حدة الضغوط النفسية المستمرة، وتوفر آليات متابعة مبكرة للحالات المعرضة لخطر الانهيار النفسي أو الإنهاك المهني والأكاديمي المبكر.
8. فترات الثقة لنسبة واحدة وعلاقتها باختبار Z
8.1 حساب فترة الثقة لنسبة المجتمع المجهولة
رغم الأهمية الاستدلالية لاختبار Z لنسبة واحدة في دحض الفرضيات المحددة، إلا أنه يظل اختباراً نقطياً يقتصر على الحكم بالرفض أو القبول دون توضيح المدى المحتمل للمعلمة الحقيقية في المجتمع. هنا تبرز فترات الثقة (Confidence Intervals) كأداة تقدير مكملة لا غنى عنها، حيث تقوم ببناء مجال من القيم المرجحة التي يُتوقع أن تقع المعلمة المجهولة للمجتمع (p) بين حديها بدرجة محددة من اليقين الإحصائي (غالباً 95%).
تعتمد الصيغة الكلاسيكية لفترة ثقة والد (Wald Interval) على مركزية نسبة العينة، وتأخذ الشكل الرياضي التالي:
فترة الثقة = p̂ ± [ z* × SEp̂ ]
حيث تمثل z* القيمة الحرجة المقابلة لمستوى الثقة المطلوب (وتساوي 1.96 لفترة ثقة 95%). ويكمن الفارق الحسابي المحوري بين هذا الإجراء واختبار الفرضيات في طريقة حساب الخطأ المعياري؛ فبينما يعتمد اختبار Z على النسبة المفترضة (p0) لحساب الخطأ المعياري لأننا نفترض صحتها، تعتمد فترات الثقة كلياً على نسبة العينة الملاحظة (p̂) داخل الجذر، وذلك لجهلنا التام بالقيمة الحقيقية للمجتمع وسعينا لتقديرها استناداً إلى بيانات العينة وحدها:
SEp̂ = الجذر التربيعي لـ [ (p̂ × (1 − p̂)) / n ]
إن التفسير الإحصائي السليم لفترة ثقة تبلغ 95% لا يعني أن هناك احتمالاً قدره 95% بأن تقع معلمة المجتمع الحقيقية داخل تلك الفترة المحسوبة تحديداً (إذ إن المعلمة ثابتة وليست متغيراً عشوائياً)، بل يعني أننا لو قمنا بسحب مئات العينات بالحجم ذاته وقمنا بحساب فترات الثقة لكل عينة، فإن خمسة وتسعين بالمائة من تلك الفترات المبنية ستتضمن المعلمة الحقيقية للمجتمع بين حديها بنجاح.
8.2 التكامل بين فترات الثقة واختبار الفرضيات
ترتبط فترات الثقة باختبارات الفرضيات ثنائية الأطراف بعلاقة تكامل عضوي عميق وازدواجية رياضية تامة؛ إذ يمكن للباحث الوصول للقرار الإحصائي ذاته الذي يفرزه اختبار Z ثنائي الطرف بمستوى دلالة خمسة بالمائة من خلال فحص حدود فترة الثقة المناظرة ذات الخمسة والتسعين بالمائة ببساطة ودقة:
- إذا وقعت القيمة المفترضة في الفرضية الصفرية (p0) خارج حدود فترة الثقة 95% (أي كانت أقل من الحد الأدنى أو أكبر من الحد الأعلى للفترة)، فإن هذا يكافئ تماماً رفض الفرضية الصفرية عند مستوى دلالة 0.05.
- إذا وقعت القيمة المفترضة (p0) داخل حدود فترة الثقة، فإن هذا يطابق الفشل في رفض الفرضية الصفرية، لكون تلك القيمة تعتبر حينها قيمة معقولة ومحتملة جداً للمعلمة في ضوء بيانات العينة المتاحة.
تتفوق فترات الثقة نوعياً على الاكتفاء بالقيمة الاحتمالية وحدها، لأنها تقدم معلومتين حيويتين في آن واحد: الدلالة الإحصائية، ومقدار عدم اليقين ومدى الدقة في التقدير عبر اتساع المسافة بين الحدين الأدنى والأعلى؛ فالفترة الضيقة تعكس عينة كبيرة ودقة عالية في القياس، بينما تشير الفترة الواسعة إلى تباين عريض وضعف في الدقة يفرض توخي الحذر عند التفسير.
8.3 فترات الثقة الدقيقة وبدائل عينات البيانات المحدودة
أظهرت التحليلات الإحصائية المتقدمة أن طريقة والد الكلاسيكية في حساب فترات الثقة تعاني من قصور حاد ومشاكل هيكلية حقيقية، لا سيما عندما تكون العينات صغيرة الحجم، أو عندما تكون النسب الملاحظة متطرفة وقريبة جداً من الصفر أو الواحد الصحيح. في مثل هذه البيئات الإحصائية، تتسع مساحات الخطأ وتتراجع مستويات التغطية الفعلية للفترة لتنخفض كثيراً عن نسبة 95% الاسمية المفترضة، مما يوهم الباحثين بدقة زائفة لا وجود لها.
لتفادي هذا القصور، طور الإحصائيون بدائل متقدمة وأكثر موثوقية، وفي مقدمتها فترة ثقة ويلسون (Wilson Score Interval)، التي تبني حدود الفترة استناداً إلى دالة احتمالية مقلوبة توفر معدلات تغطية مستقرة ومتزنة حتى مع أصغر العينات حجماً. ومن البدائل التطبيقية الشائعة أيضاً طريقة أغريستي-كول (Agresti-Coull Interval)، والتي تُعرف إجرائياً بإضافة حالتي نجاح وحالتي فشل إلى العينة الأصلية (Add 2 successes and 2 failures)، ثم حساب فترة والد التقليدية على تلك العينة المعدلة، مما يمنح الفترة حماية فائقة من عيوب التقريب.
وفي الدراسات الطبية والحيوية البالغة الحساسية، يُلجأ إلى فترة ثقة كلوبر-بيرسون الدقيقة (Clopper-Pearson Exact Interval)، وهي الطريقة التي لا تعتمد على أي تقريب طبيعي على الإطلاق، بل تحسب الحدود بالاستناد المباشر إلى التوزيع التراكمي لذي الحدين وتوزيع بيتا الرياضي. تضمن هذه الطرق الحديثة حماية القرارات السريرية من التضليل الإحصائي، خصوصاً عند تقييم نسب الحوادث السلبية النادرة أو مضاعفات العلاجات النفسية الجديدة.
9. الأخطاء الشائعة والاعتبارات المنهجية المتقدمة
9.1 الأخطاء الحسابية والمفاهيمية المتكررة
يكشف فحص الممارسات البحثية المنشورة عن وقوع العديد من الباحثين في حزمة من الأخطاء المتكررة عند تطبيق اختبار Z لنسبة واحدة. يتصدر هذه الأخطاء من الناحية الحسابية استخدام نسبة العينة الملاحظة (p̂) في مقام المعادلة لحساب الخطأ المعياري للاختبار، بدلاً من استخدام النسبة المفترضة في الفرضية الصفرية (p0)؛ ورغم أن الفارق قد يبدو طفيفاً في بعض العينات، إلا أنه يشكل خرقاً للأساس المنطقي للاختبار، الذي يفترض مسبقاً صحة فرضية العدم في كل عناصر التوزيع الاستدلالي.
من الناحية المنهجية، يغفل كثير من الباحثين التحقق الاستباقي من شروط كفاية المعاينة؛ حيث يُجرى الاختبار في عينات شحيحة لا تفي بشرط الحد الأدنى لحاصل ضرب الحجم في النسبة ومكملها، مما يؤدي إلى استخراج درجات Z مضللة وقيم احتمالية لا تمثل التوزيع الحقيقي المشوه. يضاف إلى ذلك الخلط المفاهيمي الشائع بين القيمة الاحتمالية (p-value) واحتمالية صحة الفرضية الصفرية؛ فالقيمة الاحتمالية لا تقيس أبداً مدى احتمالية أن تكون الفرضية الصفرية صادقة، بل تقيس فقط احتمال رصد البيانات الحالية أو أشد منها تطرفاً بافتراض أن الفرضية الصفرية صحيحة حكماً.
كما يقع البعض في خطأ صياغة فرضيات أحادية الطرف بعد رؤية البيانات والاطلاع على اتجاه نسبة العينة، وذلك بهدف استغلال انخفاض القيمة الحرجة واقتناص الدلالة الإحصائية؛ وهو تلاعب منهجي يضاعف من معدلات الخطأ من النوع الأول ويفقد النتائج العلمية مصداقيتها التراكمية، إذ يجب تحديد اتجاه الفرضية حصراً بناءً على أطر نظرية سابقة لجمع البيانات الميدانية.
9.2 قوة الاختبار الإحصائي وتحديد حجم العينة المطلوب مسبقاً
تعبر قوة الاختبار الإحصائي (Statistical Power)، والتي يرمز لها بالصيغة (1 − β)، عن احتمالية نجاح الاختبار في رفض الفرضية الصفرية عندما تكون خاطئة بالفعل في الواقع (أي القدرة على اكتشاف الأثر أو الفرق الحقيقي إن وجد). يرتبط انخفاض القوة بارتفاع معدل الخطأ من النوع الثاني (β)، والذي يعني الفشل في رصد الفروق القائمة وإهدار جهود بحثية وتجارب كان بإمكانها تقديم كشوفات واعدة.
تتأثر قوة اختبار Z لنسبة واحدة بثلاثة عوامل مركزية تتشابك فيما بينها رياضياً:
- مستوى الدلالة (α): فكلما كان المستوى أكثر تساهلاً (مثلاً 0.05 بدلاً من 0.01)، زادت قوة الاختبار على حساب التضحية بزيادة خطر الخطأ من النوع الأول.
- حجم الأثر (Effect Size): والمتمثل هنا في الفارق المطلق بين النسبة المفترضة والنسبة الحقيقية الجديدة في المجتمع؛ فالفروق الكبيرة يسهل رصدها بقوة إحصائية فائقة حتى في العينات المتوسطة، بينما تتطلب الفروق الهامشية عينات هائلة الحجم.
- حجم العينة (n): وهو العامل الأساسي الذي يخضع لسيطرة الباحث المباشرة؛ إذ يؤدي تكبير العينة إلى تقليص تباين المعاينة ورفع القوة الاستدلالية بصورة طردية.
لذا، تقتضي الأمانة العلمية إجراء تحليل القوة القبلية (A Priori Power Analysis) لتحديد حجم العينة المطلوب بدقة قبل الشروع في جمع البيانات الميدانية. وتوفر المعادلات الرياضية المعتمدة صيغاً دقيقة لحساب الحجم المستهدف استناداً إلى حجم الأثر المتوقع والمستوى المطلوب للقوة (والذي يحدد عادة عند 0.80 كحد أدنى مقبول عالمياً)، مما يضمن عدم هدر الوقت والميزانيات في دراسات ضعيفة لا تملك القدرة على إثبات فرضياتها.
9.3 التفريق بين الدلالة الإحصائية والأهمية السريرية
من أهم المعضلات الإبستيمولوجية في التحليل الإحصائي الكمي المعاصر الخلط بين الدلالة الإحصائية (Statistical Significance) والأهمية السريرية أو العملية (Clinical/Practical Significance). فالدلالة الإحصائية تعبر ببساطة عن أن الفرق الملاحظ لا يرجح أن يكون ناتجاً عن الصدفة، لكنها لا تقدم أي حكم قيمي حول ما إذا كان هذا الفرق ذا وزن وفائدة حقيقية في التطبيق الميداني والواقع السلوكي.
تتضح هذه المفارقة بصورة جلية عند تضخيم أحجام العينات بشكل استثنائي (تجاوز عشرات الآلاف من المشاهدات)؛ حيث تصبح إحصائية Z شديدة الحساسية وقادرة على رصد فروق متناهية في الصغر وإظهارها كفروق دالة إحصائياً بقيم احتمالية بالغة الصغر (مثل p < .001). فعلى سبيل المثال، لو أظهر تدريب سلوكي جديد رفع نسبة النجاح من 50% إلى 50.5% في عينة مؤلفة من عشرين ألف مشارك، ستكون هذه الزيادة البالغة نصف بالمائة دالة إحصائياً، لكنها تفتقر تماماً لأي قيمة عملية أو جدوى سريرية تبرر تبني البرنامج أو تحمل تكاليفه المادية.
لذلك، يجب على الباحثين في العلوم الإنسانية والاجتماعية ألا يكتفوا بإعلان الدلالة الإحصائية المجردة، بل يتعين عليهم تقييم حجم الأثر الناتج (Effect Size)، وربط النسب المحسوبة بالواقع الاجتماعي والسياق الإكلينيكي للأفراد. يتكامل هذا التحليل الكمي مع الفهم النوعي العميق للمشكلات السلوكية المدروسة لضمان ألا تتحول الأرقام إلى غاية في ذاتها تنفصل عن مصلحة الإنسان ورفاهيته.
10. التطبيق البرمجي لاختبار Z لنسبة واحدة وتفسير المخرجات
10.1 تنفيذ الاختبار باستخدام حزمة لغة R الإحصائية
تعد لغة R البيئة البرمجية القياسية للتحليل الإحصائي في الأوساط الأكاديمية والبحثية المتقدمة، وتوفر دالة مدمجة ومخصصة لاختبار النسب تسمى prop.test، بالإضافة إلى دالة اختبار Z المباشرة. عند استخدام دالة النسب في R لاختبار المثال التطبيقي السابق (حيث كان عدد النجاحات 98 من أصل 200، والنسبة المفترضة 0.40 مع فرضية أحادية)، يتم استدعاء الأمر التالي في سطر الأوامر:
prop.test(x = 98, n = 200, p = 0.40, alternative = "greater", correct = FALSE)
يتيح المعامل correct = FALSE للباحث إلغاء تصحيح الاستمرارية ليحصل بدقة على اختبار Z الكلاسيكي، في حين يؤدي تفعيله (وهو الخيار الافتراضي في R) إلى تطبيق تصحيح ييتس تلقائياً. تطبع لغة R مخرجات تفصيلية تشمل قيمة إحصائية الاختبار مقاسة بمربع كاي (التي تمثل مربع قيمة Z المحسوبة)، ودرجات الحرية (df = 1)، والقيمة الاحتمالية الدقيقة (p-value)، وحدود فترة الثقة أحادية الجانب للنسبة، متبوعة بتقدير النسبة الملاحظة في العينة.
كما يمكن للباحثين استخدام دالة binom.test في لغة R لإجراء اختبار ذي الحدين الدقيق عندما لا تتحقق شروط التقريب الطبيعي في العينات المحدودة، مما يبرز المرونة البرمجية الفائقة التي تتيحها بيئة R في التعامل مع شتى سيناريوهات تحليل النسب الفئوية.
10.2 إجراء الاختبار عبر لغة بايثون ومكتباتها العلمية
أصبحت لغة بايثون (Python) ركيزة أساسية في معالجة البيانات والبحث الإحصائي والذكاء الاصطناعي، وتوفر مكتبة النماذج الإحصائية statsmodels دعماً متكاملاً لاختبار Z لنسبة واحدة من خلال دالة proportions_ztest الموجودة داخل وحدة قياس النسب. تُستدعى الدالة البرمجية وتُمرر لها المدخلات عبر الكود التالي:
from statsmodels.stats.proportion import proportions_ztest
count = 98
nobs = 200
value = 0.40
stat, pval = proportions_ztest(count, nobs, value, alternative='larger', prop_var=0.40)
يعتبر المعامل prop_var=0.40 معلماً بالغ الأهمية المنهجية في بايثون؛ إذ يوجه البرنامج لحساب تباين المعاينة والخطأ المعياري بالاعتماد الصارم على النسبة الصفرية المفترضة (p0) بدلاً من نسبة العينة، مما يضمن التوافق التام مع الصيغة النظرية لاختبار Z وتجنب الانحرافات الشائعة التي تنتج عن الخيارات الافتراضية للبرمجيات. تُرجع الدالة تلقائياً قيمة Z المحسوبة وتطابقها مع القيمة الاحتمالية بدقة رقمية متناهية.
وعلاوة على العمليات الحسابية، تسمح مكتبات بايثون البيانية مثل matplotlib وseaborn برسم منحنى التوزيع الطبيعي المعياري وتظليل مناطق الرفض الحرجة وتحديد موقع قيمة Z المحسوبة بصرياً، مما يوفر أدوات إيضاح قوية تدعم التقارير الأكاديمية والعروض التقديمية للبيانات الميدانية المعقدة.
10.3 التطبيق عبر برنامج الحزم الإحصائية للعلوم الاجتماعية وتطبيقات الجداول
يحظى برنامج الحزم الإحصائية للعلوم الاجتماعية (SPSS) بشعبية واسعة في الكليات الإنسانية والتربوية لسهولة واجهته التفاعلية. في الإصدارات المعاصرة من البرنامج، يمكن إجراء الاختبار عبر نافذة “اختبار العينة الواحدة للنسب” (One-Sample Nonparametric Tests / One-Sample Proportions) من قائمة الاختبارات المتقدمة، حيث يتم إدخال المتغير الفئوي الثنائي وتحديد النسبة النظرية المفترضة في حقل المقارنة (0.40).
يقوم البرنامج بمعالجة البيانات وإصدار جدول مخرجات منظم يتضمن حجم العينة الفعلي، والنسبة الملاحظة، والانحراف المعياري، وقيمة Z المحسوبة، والقيمة الاحتمالية ثنائية أو أحادية الطرف بحسب رغبة الباحث، إضافة إلى فترات الثقة المحسوبة بطرق متعددة. ويتميز البرنامج بتنبيه الباحث تلقائياً في حال كانت شروط كفاية المعاينة غير مستوفاة وتحويل الحسابات نحو اختبار ذي الحدين تلقائياً لضمان سلامة النتيجة.
أما في تطبيقات جداول البيانات المكتبية الشائعة (مثل Microsoft Excel)، فيمكن بناء نموذج حسابي متكامل وسهل الاستخدام عبر الدوال الرياضية الأساسية؛ حيث تُحسب نسبة العينة بقسمة تكرار النجاح على المجموع، ويُحسب الخطأ المعياري باستخدام دالة الجذر SQRT بتطبيق الصيغة المباشرة، ثم استخراج القيمة الاحتمالية باستخدام دالة التوزيع الطبيعي المعياري NORM.S.DIST. يوفر هذا الأسلوب أداة تعليمية وعملية ممتازة لفهم الآليات الرياضية الداخلية للاختبار دون الاعتماد الأعمى على الصناديق السوداء للبرمجيات الإحصائية الآلية.
خاتمة
يظل اختبار Z لنسبة واحدة نموذجاً بارزاً لكيفية توظيف المبادئ الرياضية المجردة في معالجة القضايا والظواهر الإنسانية والاجتماعية المعقدة. فمن خلال الربط المتين بين قوانين التوزيع الطبيعي المعياري وخصائص البيانات الفئوية المتقطعة، منح هذا الاختبار الباحثين في العلوم السلوكية والطبية أداة قياس استدلالية تمتاز بالرصانة والوضوح، وقادرة على حسم التساؤلات العلمية المتعلقة بمقارنة النسب الميدانية بالمعايير النظرية بدقة متناهية.
ومع ذلك، فإن الكفاءة المنهجية للاختبار لا ترتبط فقط بصيغته الرياضية الأنيقة، بل تتوقف أساساً على التزام الباحث بالضوابط المنهجية المصاحبة لتطبيقه؛ بدءاً من ضمان العشوائية التامة واستقلالية المشاهدات، والتحقق المستمر من كفاية حجم المعاينة للتقريب الطبيعي، والحرص على استخدام النسبة المفترضة في حساب الخطأ المعياري للاختبار، وصولاً إلى الموازنة الحكيمة بين الدلالة الإحصائية والأهمية العملية والتطبيقية للمخرجات في الميدان.
إن الاستخدام المسؤول لاختبار Z لنسبة واحدة، المدعوم ببناء فترات الثقة الرصينة، والمدعم بالتوثيق الأكاديمي الشفاف وفق المعايير العالمية المعتمدة، يمثل ضمانة أكيدة لتحويل البيانات الميدانية الأولية إلى أدلة علمية صلبة ومعارف موثوقة تسهم في ارتقاء العلوم النفسية والاجتماعية، وتدعم صناعة القرارات التشخيصية والعلاجية على أسس متينة من اليقين الإحصائي والنزاهة المنهجية.
المراجع
- Conroy‐Beam, D., Buss, D. M., Asao, K., Sorokowska, A., Sorokowski, P., Aavik, T., et al. (2019). Contrasting Computational Models of Mate Preference Integration Across 45 Countries. Scientific Reports. https://doi.org/10.1038/s41598-019-52748-8
- Kushida, C. A., Littner, M. R., Morgenthaler, T. I., Alessi, C., Bailey, D. R., Coleman, J., et al. (2005). Practice Parameters for the Indications for Polysomnography and Related Procedures: An Update for 2005. SLEEP. https://doi.org/10.1093/sleep/28.4.499
- Michelene, T. H., Bassok, M., Lewis, M. W., Reimann, P., & Glaser, R. A. (1989). Self‐Explanations: How Students Study and Use Examples in Learning to Solve Problems. Cognitive Science. https://doi.org/10.1207/s15516709cog1302_1
- Prigerson, H. G., Horowitz, M. J., Jacobs, S., Parkes, C. M., Aslan, M., Goodkin, K., et al. (2009). Prolonged Grief Disorder: Psychometric Validation of Criteria Proposed for DSM-V and ICD-11. PLoS Medicine. https://doi.org/10.1371/journal.pmed.1000121
- Schraw, G. J., Crippen, K. J., & Hartley, K. (2006). Promoting Self-Regulation in Science Education: Metacognition as Part of a Broader Perspective on Learning. Research in Science Education. https://doi.org/10.1007/s11165-005-3917-8