
يمثل الاستدلال الإحصائي الدعامة المنهجية الكبرى التي ترتكز عليها البحوث التجريبية والكمية المعاصرة، إذ يتيح للباحثين الانتقال المنطقي والمبرر رياضياً من حيز العينة المحدودة إلى رحاب المجتمع الإحصائي الكلي. وفي قلب هذا البناء المعرفي يبرز مفهوم “الخطأ المعياري للمتوسط” (Standard Error of the Mean – SEM) بوصفه الحاكم الأساسي على مدى دقة المؤشرات الوصفية، والضابط الرياضي لمقدار الثقة التي نمنحها للنتائج المستخلصة. فبينما تقيس المقاييس الوصفية الكلاسيكية التباين القائم بين أفراد العينة الواحدة، يتجاوز الخطأ المعياري هذا المستوى المجهري ليقيس التباين المتوقع بين العينات الافتراضية اللانهائية إذا ما تكرر سحبها من المجتمع نفسه، مقدماً بذلك نافذة كمية لتقدير مدى اقتراب متوسط العينة الملاحظة من المعلمة الحقيقية المجهولة.
وعلى الرغم من التطور المتسارع للبرمجيات الإحصائية التخصصية المعقدة، يظل برنامج ميكروسوفت إكسيل (Microsoft Excel) المنصة الأكثر انتشاراً واستخداماً بين الأكاديميين والممارسين في شتى حقول المعرفة، ولا سيما في العلوم السلوكية والنفسية والاجتماعية، نظراً لمرونته وقدرته الفائقة على تتبع العمليات الحسابية خطوة بخطوة. ومع ذلك، يواجه الكثير من الباحثين تحدياً تقنياً يتمثل في خلو إكسيل من دالة أحادية مباشرة تحمل اسم “الخطأ المعياري”، مما يفرض ضرورة فهم الهيكل الرياضي للمفهوم لتركيب الصيغ الإجرائية الدقيقة التي تستند إلى دوال الانحراف المعياري وحجم العينة، أو اللجوء إلى أدوات التحليل الإحصائي المدمجة.
يهدف هذا الدليل المرجعي الموسع إلى تقديم تأصيل منهجي وتطبيقي شامل لحساب الخطأ المعياري للمتوسط عبر برنامج إكسيل، من خلال الربط الوثيق بين الجذور النظرية الراسخة للمفاهيم الإحصائية—الممتدة منذ أعمال رواد نظرية الاحتمالات ككارل فريدريش جاوس وبيير سيمون لابلاس وصولاً إلى صياغات كارل بيرسون وجورج أودني يول—وبين التطبيق الإجرائي الدقيق في بيئة الجداول الحسابية. وسنستعرض في ثناياه البناء الرياضي للمعادلات، والتمييز الجوهري بين الدوال المختلفة، وخطوات التحليل العملي، والتمثيل البياني المتقدم عبر أشرطة الخطأ وفق معايير النشر الأكاديمي الصارمة لجمعية علم النفس الأمريكية (APA).
1. مقدمة تأصيلية لمفهوم الخطأ المعياري للمتوسط في التحليل الإحصائي
1.1 التعريف النظري للخطأ المعياري للمتوسط وأهميته الاستدلالية
يُعرف الخطأ المعياري للمتوسط نظرياً ورياضياً بأنه الانحراف المعياري للتوزيع المعايني النظري لمتوسطات العينات (Standard Deviation of the Sampling Distribution of Sample Means). لتبسيط هذا المفهوم الجوهري، ينبغي أن نتصور مجتمعاً إحصائياً كلياً نسحب منه عدداً لا نهائياً من العينات العشوائية المستقلة والمتساوية في الحجم، ثم نحسب المتوسط الحسابي لكل عينة على حدة. إن هذه المتوسطات الناتجة لن تكون متطابقة، بل ستشكل توزيعاً تكرارياً خاصاً بها يُعرف بـ “توزيع المعاينة”. ويقيس الخطأ المعياري مدى تشتت وتباعد هذه المتوسطات الافتراضية حول المتوسط الحقيقي للمجتمع الكلي ($\mu$). ومن هنا، فهو لا يقيس تباين الأفراد المستجيبين، بل يقيس التقلب المتوقع للتقدير الإحصائي ذاته في حال إعادة التجربة أو المسح في ظروف متطابقة.
تتجلى الأهمية الاستدلالية البالغة للخطأ المعياري في كونه المؤشر المباشر لجودة ودقة التقدير الإحصائي النقطي (Point Estimation). فعندما يخرج باحث بمتوسط حسابي محدد لعينة دراسته، تظل القيمة الناتجة مجرد تقدير منفرد تحيط به احتمالات الخطأ العشوائي في المعاينة. ويعمل الخطأ المعياري كمعيار لقياس هذه “الضوضاء العشوائية”؛ فكلما تضاءلت قيمته العددية، دل ذلك على أن متوسط العينة يتمتع بموثوقية عالية، وأنه يقترب بدرجة وثيقة جداً من معلمة المجتمع الأصلية. وعلى العكس من ذلك، تشير القيمة الكبيرة للخطأ المعياري إلى أن التقدير يتسم بعدم الاستقرار وعرضة لتقلبات المعاينة الحادة، مما يحد من القدرة على التعميم العلمي للنتائج.
وفي مجال القياس السلوكي والعلوم التربوية والنفسية، يشكل الخطأ المعياري الركيزة التي لا غنى عنها لبناء التقديرات الفاصلية (Interval Estimation)، وتحديداً فترات الثقة (Confidence Intervals). إذ يستحيل بناء مجال ثقة معبر دون الاستناد إلى الخطأ المعياري للمتوسط؛ فهو الوحدة القياسية التي تُضرب في الدرجة المعيارية الحرجة لتحديد الحدود الدنيا والعليا التي يُتوقع أن يقع بينها متوسط المجتمع بنسبة ثقة معينة (مثل 95% أو 99%). وبالتالي، فإن الاستيعاب الدقيق لهذا المفهوم ينقل الباحث من مجرد الوصف السطحي لبيانات عينة محدودة إلى ممارسة استدلالية رصينة تتسم بالحذر والعمق الأكاديمي.
1.2 التمييز الإحصائي والمنهجي بين الانحراف المعياري والخطأ المعياري
يُعد الخلط بين مفهومي الانحراف المعياري (Standard Deviation – SD) والخطأ المعياري للمتوسط (Standard Error – SE) أحد أكثر المزالق المنهجية شيوعاً في الأدبيات البحثية المنشورة. ويعود هذا الخلط إلى تشابه التسمية الرياضية وتشاركهما في التعبير عن مقدار “التشتت”، إلا أن الفارق بينهما جوهري وحاسم من حيث طبيعة المتغير المرصود والمستوى التحليلي الذي يعالجه كل مقياس منهما. فالانحراف المعياري هو مقياس وصفي كلاسيكي بحت يهدف إلى قياس مدى تشتت أو انتشار قيم البيانات الفردية للمفحوصين حول المتوسط الحسابي للعينة ذاتها. إنه يخبرنا بدرجة تجانس أو تباين استجابات أفراد العينة؛ فعلى سبيل المثال، يوضح الانحراف المعياري في اختبار ذكاء كيف تختلف درجات الطلاب الأفراد عن متوسط درجات تلك المجموعة المحددة.
في المقابل، يرتقي الخطأ المعياري للمتوسط إلى مستوى استدلالي مفارق، فهو ليس مقياساً لتشتت درجات الأفراد، بل هو مقياس لتشتت التقدير الإحصائي ذاته عبر عينات مفترضة متكررة. وبصيغة أخرى، يمثل الانحراف المعياري مقدار التغير البيولوجي أو النفسي أو السلوكي الطبيعي المتأصل بين الكائنات أو المفردات قيد الدراسة داخل العينة، في حين يمثل الخطأ المعياري درجة عدم اليقين الرياضي المرتبطة بحجم تلك العينة في تقدير متوسط المجتمع الحقيقي. ولهذا السبب، فإن الانحراف المعياري لا يميل إلى الصفر مع زيادة حجم العينة، بل يستقر مقترباً من الانحراف المعياري الحقيقي للمجتمع ($\sigma$)، بينما يتضاءل الخطأ المعياري حتماً ويقترب من الصفر كلما تزايد حجم العينة، نظراً لأن زيادة البيانات تقلل من أثر خطأ المعاينة.
إن الفهم الدقيق لهذا التمييز يحمي الباحث من ارتكاب أخطاء فادحة في قراءة الظواهر السلوكية. فالاعتماد على الخطأ المعياري لتوصيف تجانس العينة يُعد خطأ فادحاً يقلل زيفاً من إدراك القارئ لمدى التباين الطبيعي بين الأفراد، كما أن استخدام الانحراف المعياري كبديل لشريط الخطأ عند اختبار الدلالة الإحصائية لفروق المتوسطات يحجب الدقة الحقيقية لحجم العينة المستخدمة. وتقتضي الأمانة المنهجية أن يحدد الباحث بوضوح طبيعة المقياس المستخدم وهدفه: الانحراف المعياري لوصف تشتت الأفراد، والخطأ المعياري لتقدير دقة الاستدلال على المجتمع.
1.3 موقع الخطأ المعياري في بحوث علم النفس والعلوم السلوكية
تحتل العلوم النفسية والسلوكية موقعاً فريداً في الميدان الإحصائي نظراً لطبيعة الظواهر التي تدرسها؛ فالسمات النفسية والقدرات المعرفية والاتجاهات الوجدانية لا تقاس بوحدات فيزيائية مادية مطلقة، بل من خلال مقاييس واختبارات نفسية متدرجة تكتنفها نسب متفاوتة من أخطاء القياس العشوائية والتباين الفردي الواسع. وفي هذا السياق، يصبح الخطأ المعياري للمتوسط أداة منهجية محورية لا غنى عنها لتقييم مدى صلابة النتائج المستخلصة من العينات السلوكية؛ إذ يتيح للباحثين النفسيين التحقق مما إذا كانت الفروق المرصودة بين المجموعات التجريبية والضابطة تعود إلى تأثير المتغير التجريبي الفعلي (كأسلوب علاجي معين أو تدخل تدريبي)، أم أنها مجرد انعكاس للتقلب العشوائي المتأصل في خطأ المعاينة.
علاوة على ذلك، يمثل الخطأ المعياري عنصراً جوهرياً في ضبط أثر الفروق الفردية داخل التجارب المعملية والميدانية في علم النفس المعرفي والاجتماعي. فعند رصد أزمنة الرجع (Reaction Times) أو معدلات التذكر والاسترجاع، تؤدي الاختلافات الفردية الكبيرة بين المشاركين إلى رفع قيمة التباين الكلي. وهنا يُظهر الخطأ المعياري مقدار الدقة التي يمكن للباحث الوثوق بها في تقدير الأداء المتوسط للمجتمع المستهدف، مساهماً في حساب حجم الأثر بدقة ومساعدة الباحثين في تجنب الوقوع في الخطأ من النوع الأول (رفض الفرض الصفري وهو صحيح) أو الخطأ من النوع الثاني (قبول الفرض الصفري وهو خاطئ).
وقد بلغت أهمية هذا المؤشر حداً جعل جمعية علم النفس الأمريكية (American Psychological Association – APA) تشدد في دليلها الإحصائي والتحريري المعتمد على ضرورة الإبلاغ الصريح والدقيق عن قيم الأخطاء المعيارية للمتوسطات عند استعراض النتائج في الجداول الإحصائية والرسوم البيانية. ولم يعد مقبولاً في النشر الأكاديمي الرصين الاكتفاء بتقديم المتوسطات الحسابية مجردة، بل أضحى لزاماً إقرانها بمؤشرات الخطأ المعياري أو فترات الثقة المشتقة منها، وذلك لتمكين المجتمع العلمي من إجراء التحليلات التلوية (Meta-Analyses) وتقييم القوة الإحصائية للدراسات النفسية عبر مختلف السياقات الثقافية والمؤسسية.
2. الأسس الرياضية لبناء معادلة الخطأ المعياري للمتوسط
2.1 تفكيك عناصر المعادلة الرياضية القياسية
تستند الصياغة الرياضية القياسية لحساب الخطأ المعياري للمتوسط إلى علاقة جبرية متسقة تعكس التفاعل بين تباين الظاهرة وحجم العينة قيد الفحص. إذا كانت معالم المجتمع الإحصائي الكلي معلومة، وتحديداً الانحراف المعياري للمجتمع ($\sigma$)، فإن الخطأ المعياري النظري للمتوسط ($\sigma_{\bar{x}}$) يُحسب بالمعادلة التالية:
$$\sigma_{\bar{x}} = \frac{\sigma}{\sqrt{n}}$$
حيث يمثل الرمز $n$ حجم العينة المسحوبة. غير أن الواقع التطبيقي في البحوث الاجتماعية والنفسية نادراً ما يتيح معرفة المعالم الحقيقية للمجتمع الكلي، مما يضطر الباحث إلى استخدام إحصاءات العينة لتقدير هذه المعالم المجهولة. وفي هذه الحالة، يُستعاض عن الانحراف المعياري للمجتمع بالانحراف المعياري المقدر للعينة، ويرمز للخطأ المعياري المقدر بـ ($SE_{\bar{x}}$) وتصاغ معادلته على النحو الآتي:
$$SE_{\bar{x}} = \frac{s}{\sqrt{n}}$$
عند تفكيك هذه المعادلة إلى عناصرها المكونة، نجد أن بسط المعادلة يتمثل في الانحراف المعياري للعينة ($s$)، وهو معامل التشتت الخام الذي يحسب من خلال استخراج الجذر التربيعي للتباين المطبق عليه تصحيح بيسل (Bessel’s Correction) لدرجات الحرية ($n – 1$):
$$s = \sqrt{\frac{\sum_{i=1}^n (x_i – \bar{x})^2}{n – 1}}$$
إن وجود الانحراف المعياري في البسط يعني وجود علاقة طردية مباشرة بين تشتت البيانات وقيمة الخطأ المعياري؛ فكلما كانت درجات الأفراد متباعدة ومتفاوتة بشدة، ازداد مقدار عدم اليقين في تقدير متوسط المجتمع، مما يرفع من قيمة الخطأ المعياري. أما مقام المعادلة، فيتمثل في الجذر التربيعي لحجم العينة ($\sqrt{n}$)، وهو العنصر التحويلي السحري الذي ينقل المقياس من مستوى تشتت الدرجات الفردية إلى مستوى تشتت التوزيع المعايني للمتوسطات. ويعمل هذا المقام كعامل كابح ومقلص لأثر التشتت الفردي؛ فكلما أضفنا مزيداً من المفردات إلى العينة، كبرت قيمة المقام، وبالتالي تراجعت القيمة الإجمالية للخطأ المعياري، مما يرفع دقة التقدير الإحصائي وموثوقيته.
2.2 أثر حجم العينة على تقليص الخطأ المعياري
ترتبط ديناميكية الخطأ المعياري للمتوسط ارتباطاً وثيقاً بما يُعرف في النظرية الإحصائية بـ “قانون الجذر التربيعي” (The $\sqrt{n}$ Law)، والذي يتكامل بنيوياً مع قانون الأعداد الكبيرة (Law of Large Numbers). يقضي هذا المبدأ بأن الخطأ المعياري يتناسب تناسباً عكسياً ليس مع حجم العينة المباشر، بل مع الجذر التربيعي لذلك الحجم. ويترتب على هذه العلاقة الرياضية غير الخطية أثر منهجي بالغ الأهمية عند تصميم التجارب والدراسات الميدانية؛ إذ إن مضاعفة حجم العينة بمقدار مرتين لا يؤدي إلى تقليص الخطأ المعياري إلى النصف، بل يتطلب تقليص الخطأ المعياري إلى النصف مضاعفة حجم العينة أربع مرات كاملة ($2^2 = 4$).
يوضح الجدول الرياضي المقارن الآتي هذه الديناميكية بجلاء، مفترضاً ثبات الانحراف المعياري للعينة عند القيمة ($s = 10$):
| حجم العينة ($n$) | الجذر التربيعي للحجم ($\sqrt{n}$) | الانحراف المعياري ($s$) | الخطأ المعياري للمتوسط ($SE_{\bar{x}}$) | نسبة التقليص في الخطأ المعياري |
|---|---|---|---|---|
| 16 | 4 | 10 | 2.500 | — |
| 64 | 8 | 10 | 1.250 | 50% (عند زيادة العينة 4 أضعاف) |
| 256 | 16 | 10 | 0.625 | 50% إضافية (عند زيادة العينة 4 أضعاف) |
| 1024 | 32 | 10 | 0.3125 | 50% إضافية (عند زيادة العينة 4 أضعاف) |
تسلط هذه الحقيقة الضوء على مفهوم “تناقص العوائد الإحصائية” (Diminishing Statistical Returns). ففي المراحل الأولى لزيادة حجم العينات الصغيرة (من 10 إلى 50 مثلاً)، يكون الهبوط في قيمة الخطأ المعياري حاداً وسريعاً، مما يعزز الحساسية الإحصائية للاختبارات الفرضية وقوة كشف الفروق الحقيقية بصورة ملحوظة وبتكلفة بحثية منخفضة. ولكن بمجرد بلوغ العينة حجماً كبيراً (كأن تتجاوز بضع مئات)، تصبح المكاسب المتحققة في تقليص الخطأ المعياري متواضعة للغاية وتتطلب استهلاك موارد مادية وبشرية باهظة لجمع مئات المستجيبين الإضافيين دون أن يقابل ذلك انخفاض ملموس في هامش الخطأ. ومن هنا تبرز مهارة الباحث المتمرس في الموازنة الدقيقة بين الجدوى المنهجية وحجم العينة الأمثل لتحقيق خطأ معياري مقبول إحصائياً دون إسراف غير مبرر.
2.3 الافتراضات التوزيعية اللازمة لصحة الحساب
لا يصح تطبيق معادلة الخطأ المعياري للمتوسط واستخدام نتائجها في الاستدلال العلمي إلا في ظل تحقق حزمة من الافتراضات الرياضية والمنهجية الصارمة. ويأتي في مقدمة هذه الافتراضات ما نصت عليه مبرهنة النهاية المركزية (Central Limit Theorem – CLT)، التي وضع أسسها التاريخية الأولى عالم الرياضيات الفرنسي بيير سيمون لابلاس (Pierre-Simon Laplace) في عام 1810 في أطروحته التاريخية حول تقريب صيغ الدوال ذات الأعداد الكبيرة. وتضمن هذه المبرهنة أنه إذا كانت المتغيرات مستقلة وموزعة بشكل متماثل وذات تباين محدود، فإن التوزيع المعايني لمتوسطات العينات يقترب حتماً من التوزيع الطبيعي المعتدل ($\mathcal{N}(\mu, \sigma^2/n)$) كلما كبر حجم العينة، وذلك بغض النظر عن الشكل التوزيعي للمجتمع الأصلي نفسه، شريطة ألا تكون البيانات الأصلية متطرفة الالتواء، وأن يبلغ حجم العينة حداً معقولاً (يصطلح عليه عادةً في الأدبيات الإحصائية بـ $n ge 30$).
أما الافتراض الثاني الحاسم فهو استقلالية الملاحظات والقياسات (Independence of Observations). يعني هذا الافتراض أن اختيار أو استجابة أي مفحوص داخل العينة لا يؤثر بأي شكل من الأشكال على اختيار أو استجابة مفحوص آخر، وألا تخضع البيانات للتداخل أو الارتباط الذاتي (Autocorrelation). ففي حال انتهاك هذا الافتراض—كما يحدث في الدراسات الطولية المتكررة على العينة نفسها دون تطبيق نماذج القياس المتكرر، أو في المعاينة العنقودية التي تفتقر إلى الضبط—تنهار دقة معادلة الخطأ المعياري الكلاسيكية، مؤدية إلى تقدير متحيز يقلل عادةً من الخطأ الحقيقي للمعاينة ويزيد من احتمالية ارتكاب الأخطاء الاستدلالية.
يتعلق الافتراض الثالث بطبيعة ومستوى قياس المتغير قيد التحليل. إذ تستوجب معادلة الخطأ المعياري للمتوسط أن تكون البيانات تابعة لمتغيرات كمية مستمرة مقاسة على مستوى فاصل (Interval) أو نسبي (Ratio). وتعتمد المقاييس النفسية المقننة—مثل مقاييس ليكرت المتعددة الفقرات واختبارات القدرات العقلية المقننة—على هذا الافتراض لاحتساب المتوسط الحسابي والانحراف المعياري بصورة مشروعة. أما استخدام هذه المعادلة مباشرة على متغيرات فئوية رتبية بحتة دون تدريج ملائم، فيعد خرقاً للمبادئ القياسية قد يفضي إلى نتائج رياضية مضللة لا تعكس البنية الحقيقية للظاهرة السلوكية.
3. الدوال الإحصائية المعتمدة في برنامج إكسيل لحساب المكونات
3.1 دوال الانحراف المعياري: STDEV مقابل STDEV.S و STDEV.P
يوفر برنامج ميكروسوفت إكسيل ترسانة من الدوال الرياضية والإحصائية المخصصة لاحتساب الانحراف المعياري، غير أن تعدد هذه المسميات يوقع العديد من الباحثين في حيرة منهجية قد تؤدي إلى نتائج غير صحيحة. تاريخياً، اعتمد البرنامج على الدالة الكلاسيكية STDEV، والتي صُممت لحساب الانحراف المعياري للعينة الاستدلالية استناداً إلى تصحيح بيسل بقسمة مجموع مربعات الانحرافات على درجات الحرية ($n – 1$). ومع إطلاق إصدار إكسيل 2010، قامت شركة ميكروسوفت بإعادة هيكلة شاملة لمكتبة الدوال الإحصائية بغية تحقيق مطابقة تامة مع المعايير القياسية لمنظمة المقاييس الدولية (ISO)، فاستحدثت دالتين متخصصتين هما STDEV.S و STDEV.P مع الاحتفاظ بالدالة القديمة لضمان التوافق العكسي (Backward Compatibility).
تُعد الدالة STDEV.S (حيث يرمز الحرف S إلى كلمة Sample) هي الدالة المنهجية المعتمدة والواجبة الاستخدام في غالبية الدراسات والبحوث العلمية الإنسانية والسلوكية؛ ذلك لأن الباحث يتعامل دوماً مع عينة ممثلة للمجتمع وليس مع كامل أفراده. وتطبق هذه الدالة المعادلة التي تستخدم المقام ($n – 1$) لإلغاء التحيز الإحصائي الطبيعي؛ فالانحراف المعياري المحسوب من عينة يميل رياضياً إلى التقليل من قيمة تباين المجتمع الأصلي، ويعمل طرح الرقم (1) من حجم العينة على تضخيم قيمة الناتج قليلاً لتعويض هذا النقص وتوليد تقدير غير متحيز (Unbiased Estimator) لمعلمة المجتمع.
في المقابل، صُممت الدالة STDEV.P (حيث يرمز الحرف P إلى كلمة Population) لاحتساب الانحراف المعياري لمجتمع إحصائي كلي ومغلق ومتاح بأكمله للدراسة دون استثناء مفردة واحدة، حيث تعتمد هذه الدالة في مقامها على حجم البيانات الكلي ($n$) دون أي تصحيح لدرجات الحرية. واستخدام الباحث لدالة STDEV.P في حساب الخطأ المعياري لعينة بحثية يعتبر خطأً منهجياً جسيماً؛ لأنه يفترض زيفاً أن العينة هي المجتمع الكلي، مما ينتج عنه انحراف معياري أصغر من الحقيقة، ويقود بالتالي إلى تقليص اصطناعي مغلوط في قيمة الخطأ المعياري للمتوسط، مما يمنح إيهاماً زائفاً بوجود دقة متناهية لا يسندها الواقع الرياضي للعينة.
3.2 دوال العد والإحصاء الحجمي: دالة COUNT وتحديات البيانات
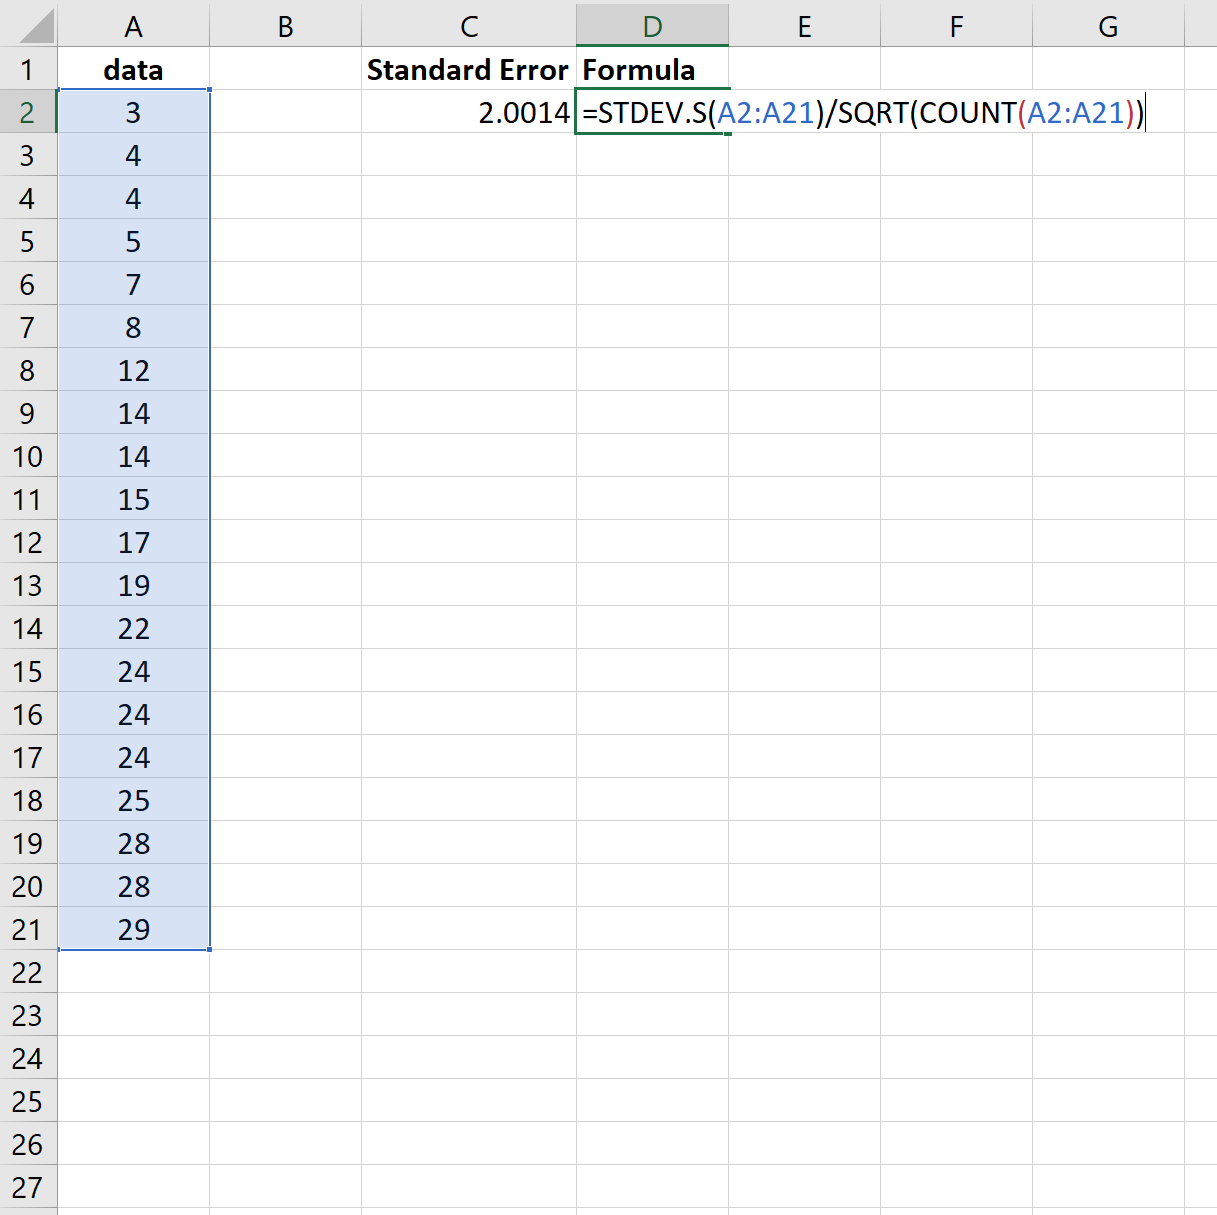
يمثل تحديد حجم العينة ($n$) بدقة بالغة الركيزة الثانية في بناء معادلة الخطأ المعياري، وفي بيئة إكسيل تتولى دالة العد الأساسية COUNT هذه المهمة الحيوية. وتتميز دالة COUNT بخصيصة برمجية جوهرية تجعلها الخيار الأكثر أماناً وموثوقية في التحليلات الإحصائية؛ إذ إنها مبرمجة حصرياً لحساب عدد الخلايا التي تحتوي على قيم عددية ورقمية فقط ضمن النطاق المحدد، متجاهلة بصورة تلقائية الخلايا الفارغة، والنصوص النصية، وقيم الأخطاء المنطقية. وهذا التجاهل التلقائي يحمي الباحث من تضخيم حجم العينة في حال وجود خلايا فارغة ناجمة عن انسحاب بعض المشاركين أو امتناعهم عن الإجابة.
ومع ذلك، تبرز تحديات منهجية وتقنية دقيقة عند تنظيف مصفوفات البيانات الكبيرة داخل إكسيل؛ فالكثير من قواعد البيانات المستوردة من منصات الاستبيانات الإلكترونية تسجل القيم المفقودة (Missing Values) بأشكال مختلفة، كأن توضع مسافة نصية بيضاء غير مرئية (Space) أو أحرف نصية خاصة مثل (“NA” أو “None”). في هذه الحالات، تنجح دالة COUNT في استبعاد النصوص، ولكن إذا كانت هناك مسافات فارغة مخفية، فقد تتعامل معها بعض الدوال كنصوص وتتجاهلها، بينما قد تقع دوال أخرى كـ COUNTA في الفخ؛ إذ إن COUNTA تقوم بعدّ أي خلية غير فارغة بما في ذلك النصوص والمسافات الخفية والصيغ التي ترجع نصوصاً فارغة ""، مما يرفع حجم العينة الاسمي بصورة مضللة ويقود إلى خطأ معياري غير سليم.
ولتجنب هذه الأخطاء، يُنصح الباحثون باستخدام دالة COUNTBLANK بالتوازي كأداة تدقيق وفحص لمصفوفة البيانات؛ حيث تتيح هذه الدالة رصد عدد الخلايا الشاغرة بدقة والتأكد من تطابق ناتج COUNT مضافاً إليه عدد القيم المفقودة مع العدد الإجمالي للمستجيبين المسجلين في التجربة. إن الضبط الصارم لحجم العينة الرقمية يمثل صمام الأمان لمنع تلوث المقام في معادلة الخطأ المعياري، وضمان توافق المدخلات الحسابية مع الواقع الفعلي لبيانات القياس.
3.3 دالة الجذر التربيعي SQRT وضبط العمليات الحسابية
تشكل دالة الجذر التربيعي SQRT في إكسيل الأداة الحسابية المباشرة المخصصة لاستخراج الجذر التربيعي الموجب لأي عدد حقيقي غير سالب، وهي المكون الأساسي لمقام معادلة الخطأ المعياري للمتوسط. تتسم بنية الدالة بالبساطة البرمجية الصريحة بصيغة =SQRT(number)، حيث يقبل الوسيط (Argument) إما رقماً صريحاً، أو مرجع خلية يحتوي على قيمة عددية، أو دالة إحصائية أخرى ينتج عنها مخرج عددي كما هو الحال عند تركيبها مع دالة العد: SQRT(COUNT(...)).
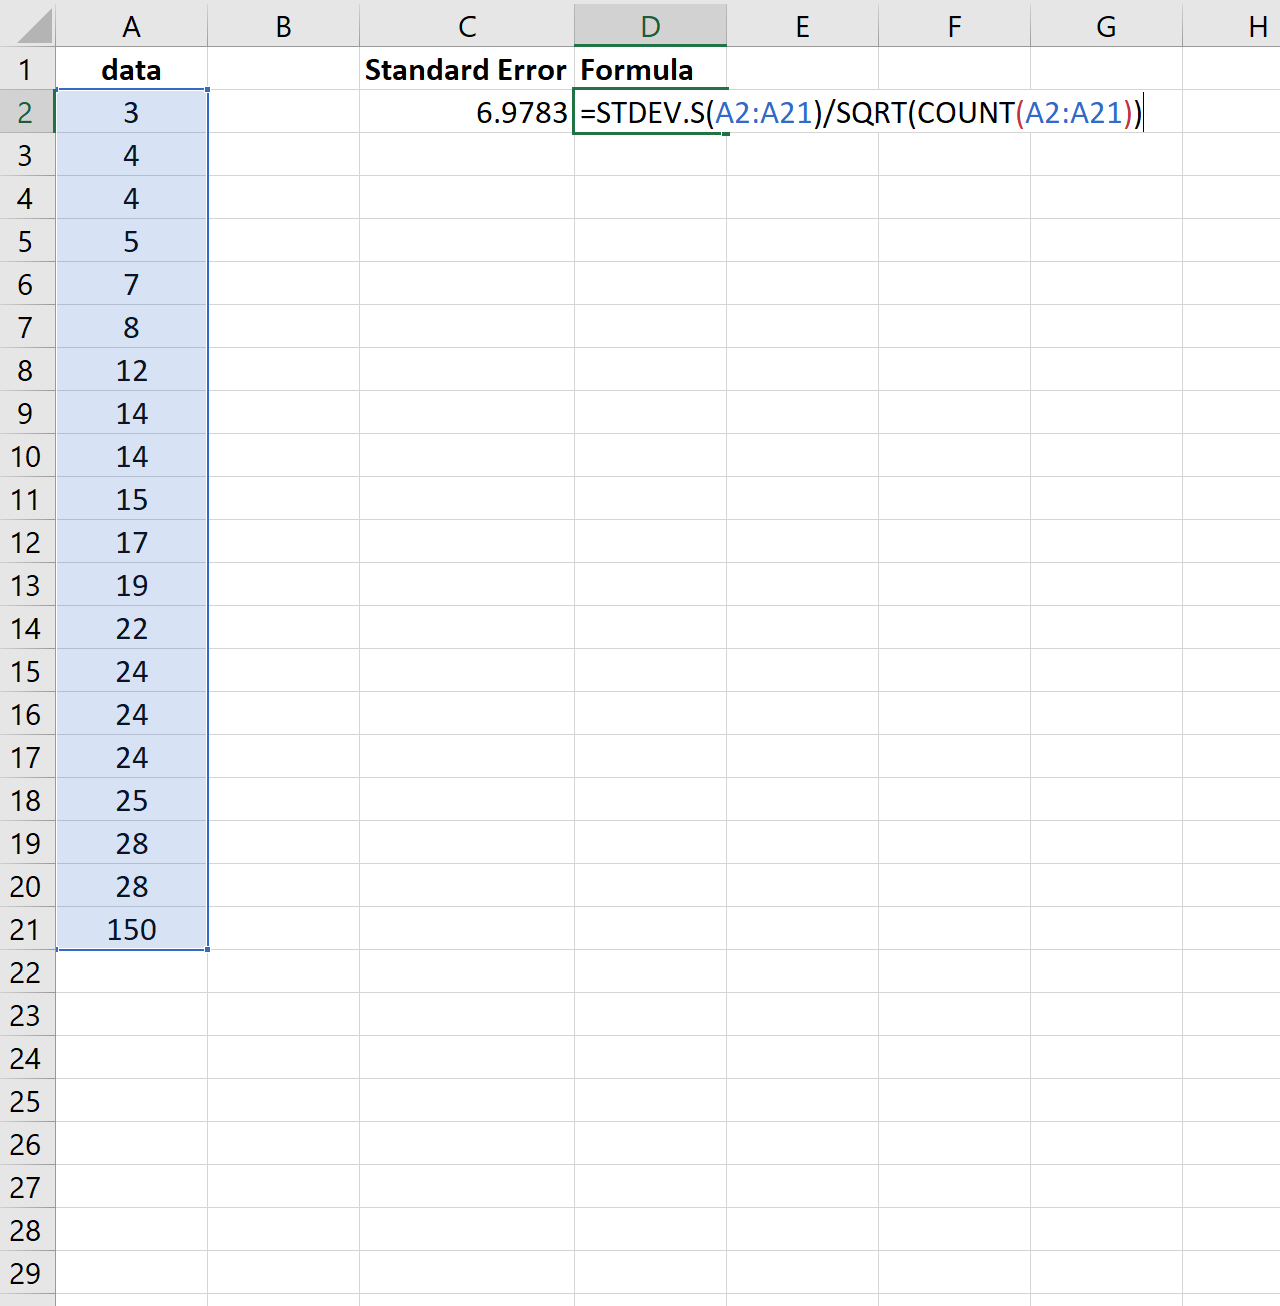
من الناحية الرياضية والتقنية، تتطلب دالة SQRT عناية خاصة بقواعد الأسبقية الحسابية (Operator Precedence) وضبط الأقواس الرياضية داخل شريط المعادلات في إكسيل. إن الخطأ في موضع قوس الإغلاق قد يؤدي إما إلى حدوث خطأ في بناء الجملة البرمجية (Syntax Error)، أو إلى خطأ حسابي منطقي لا يكتشفه البرنامج تلقائياً؛ كأن تُقسم القيمة على حجم العينة أولاً ثم يُستخرج الجذر للناتج الإجمالي، وهو تشويه كامل للمعادلة الاستدلالية. كما يجب الانتباه إلى أن دالة SQRT لا تقبل الأعداد السالبة؛ فإذا تم تمرير وسيط ذي قيمة سالبة، سترجع الدالة فوراً رمز الخطأ الحسابي الشهير #NUM!.
وعلى الرغم من أن حجم العينة ($n$) الناتج عن دالة COUNT يكون دوماً عدداً موجباً، إلا أن سيناريوهات الخطأ قد تنشأ إذا تمت تصفية البيانات ولم يتبق أي سجل رقمي في النطاق المحدد ($n = 0$)؛ حيث سترجع دالة COUNT القيمة صفر، مما يجعل وسيط SQRT(0) مساوياً للصفر، ويؤدي بالتالي عند إجراء القسمة إلى خطأ القسمة على صفر (#DIV/0!). إن الإدراك الواعي لكيفية تفاعل دالة SQRT داخل الصيغ المركبة يضمن للباحث كتابة كود حسابي قوي وقادر على التعامل السلس مع مختلف الحالات الحدية للبيانات الميدانية.
4. الصيغة المباشرة لحساب الخطأ المعياري في إكسيل خطوة بخطوة
4.1 بناء الصيغة المركبة في شريط المعادلات
نظراً لعدم وجود دالة مفردة مخصصة باسم الخطأ المعياري، فإن الطريقة القياسية الأكثر مرونة واحترافية لحسابه في برنامج إكسيل تتمثل في بناء صيغة مجمعة ومركبة (Nested Formula) تدمج الدوال الثلاث التي تم تأصيلها في محور واحد. يتم ذلك عن طريق كتابة التعبير الرياضي الذي يقسم الانحراف المعياري للعينة على الجذر التربيعي لحجمها مباشرة في خلية الهدف. الصيغة المعيارية المتكاملة تكتب بالشكل الآتي في شريط الصيغ (Formula Bar):
=STDEV.S(Data_Range)/SQRT(COUNT(Data_Range))
حيث يمثل Data_Range نطاق الخلايا الرقمية المستهدفة بالتحليل (على سبيل المثال: A2:A101 لمصفوفة بيانات تحتوي على درجات 100 مفحوص). ولتنفيذ هذا الإجراء بدقة، يقف الباحث على الخلية الفارغة المراد إظهار الناتج فيها، ثم يبدأ بإدخال إشارة التساوي (=) لتحفيز محرك الحساب في إكسيل، متبوعة بالدالة STDEV.S مع فتح القوس وتحديد نطاق البيانات بسحب الفأرة أو بكتابة المراجع يدوياً، ثم يغلق القوس ويضع إشارة القسمة (/)، ثم يكتب دالة الجذر SQRT ويفتح قوسها ويدرج داخلها دالة COUNT محتوية على نفس نطاق البيانات تماماً، ثم يغلق قوس دالة العد وقوس دالة الجذر تباعاً.
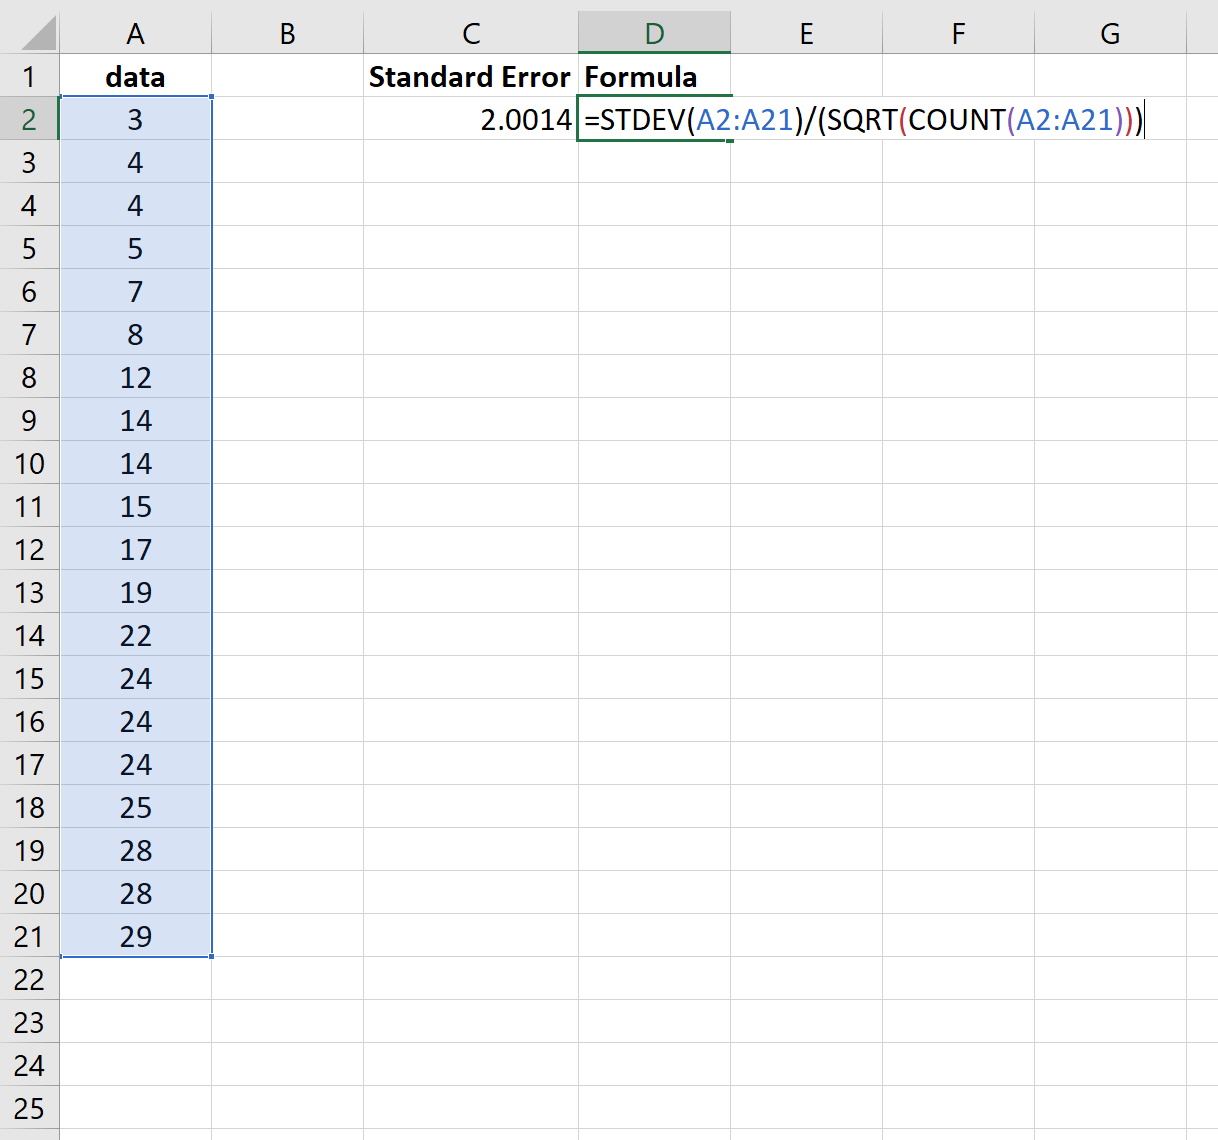
عند الضغط على مفتاح الإدخال (Enter)، يقوم محرك إكسيل الداخلي بتقييم الأولويات الحسابية بصورة بالغة الدقة؛ حيث يتم استدعاء دالة العد أولاً لحصر عدد القيم الرقمية الفعلية في النطاق، ثم تحسب دالة الجذر التربيعي القيمة المستخرجة للمقام، وبالتوازي يتم احتساب الانحراف المعياري للبيانات في البسط، لتجري عملية القسمة النهائية واستخراج القيمة النقطية الدقيقة للخطأ المعياري للمتوسط. ويُفضل دوماً تثبيت مراجع النطاق باستخدام الإسناد المطلق عبر وضع علامة الدولار (مثل: $A$2:$A$101) إذا كان الباحث يخطط لنسخ الخلية أو نقلها دون تغيير نطاق البيانات المرجعي.
4.2 المقارنة الرياضية للنتائج عبر دوال الانحراف المعياري البديلة
لتوضيح خطورة الاختيار غير الموفق لدوال الانحراف المعياري على المخرجات النهائية للخطأ المعياري، من المفيد إجراء مضاهاة رياضية تطبيقية. إذا افترضنا وجود عينة نفسية تتألف من درجات 10 طلاب في مقياس الذاكرة العاملة، وكانت القيم كالآتي: [12, 15, 14, 18, 20, 11, 16, 17, 19, 13].
عند تطبيق الدالة المحدثة للعينة STDEV.S (أو الدالة الكلاسيكية القديمة STDEV)، سنجد أن قيمة الانحراف المعياري الناتج تساوي تماماً 2.9814، وحجم العينة $n = 10$، وجذره التربيعي يساوي 3.1623. وبقسمة الأول على الثاني نحصل على الخطأ المعياري الصحيح للعينة:
$$SE_{\bar{x}} = \frac{2.9814}{3.1623} = 0.9428$$
أما إذا ارتكب الباحث الخطأ الشائع واستخدم دالة المجتمع الكلي STDEV.P، فإن البرنامج سيقسم مجموع مربعات الانحرافات على $n$ (أي 10) بدلاً من $n – 1$ (أي 9)، مما يعطي انحرافاً معيارياً زائفاً قيمته 2.8284. وعند قسمة هذا الناتج على جذر العينة (3.1623)، سيخرج لنا خطأ معياري مقداره 0.8944.
إن الفارق الرقمي هنا (بين 0.9428 و 0.8944) يمثل خفضاً وهمياً للخطأ بنسبة تقارب 5.1%. وعلى الرغم من أن هذا الفارق قد يبدو ضئيلاً في ظاهره، إلا أنه كفيل في الدراسات الحساسة بتضييق فترات الثقة بشكل مصطنع وتضخيم قيم الاختبارات التائية (t-values) مما قد يقود إلى إعلان دلالة إحصائية زائفة لنتائج لا تتمتع بالدلالة في الواقع، الأمر الذي يضرب مصداقية البحث الأكاديمي في مقتل. وتتطابق نتائج الدالة القديمة STDEV تماماً مع الدالة STDEV.S، ولكن يظل التحول إلى الدالة الأخيرة ضرورة ملحة لمواكبة التحديثات البرمجية الصارمة التي تعتمدها الدوريات العلمية المرموقة.
4.3 أتمتة الحساب لمجموعات فرعية متعددة في جدول واحد
في التجارب الميدانية والنفسية الواقعية، نادراً ما يقتصر التحليل على عمود بيانات وحيد، بل يمتد غالباً ليشمل مجموعات تجريبية وضابطة متعددة مرتبة في أعمدة متجاورة، أو قياسات قبلية وبعدية وتتبعية ممتدة. وتتيح مرونة إكسيل أتمتة حساب الخطأ المعياري عبر هذه المجموعات بضغطة زر واحدة من خلال الاستثمار الذكي لمراجع الخلايا النسبية (Relative Cell References).
لتحقيق ذلك بكفاءة، يتم بناء جدول تلخيصي أسفل مصفوفة البيانات أو في ورقة عمل مستقلة، بحيث يخصص صف للمتوسط الحسابي عبر دالة AVERAGE، وصف للانحراف المعياري عبر دالة STDEV.S، وصف لحجم العينة عبر دالة COUNT، وأخيراً صف للخطأ المعياري الذي يستند إلى مراجع الخلايا السابقة مباشرة؛ كأن تكتب الصيغة في الخلية B15 بالشكل: =B13/SQRT(B14) (حيث B13 هي خلية الانحراف و B14 هي خلية العدد للمجموعة الأولى). بعد ذلك، يكفي سحب مقبض التعبئة التلقائي (AutoFill Handle) أفقياً عبر الأعمدة المجاورة C و D و E لتتحدث المراجع تلقائياً وتُحسب الأخطاء المعيارية للمجموعات الأخرى دون الحاجة لإعادة كتابة المعادلات.
كما يُنصح بضبط التنسيق الرقمي لخلايا الخطأ المعياري؛ وذلك بالضغط بزر الفأرة الأيمن، واختيار “تنسيق الخلايا” (Format Cells)، ثم تحديد فئة “الرقم” (Number) وتثبيت المنازل العشرية عند منزلتين أو ثلاث منازل عشرية وفقاً لتقاليد التوثيق الأكاديمي المتبعة في تخصص الباحث. إن هذا التنظيم الهندسي الصارم للجدول يقلل من احتمالات الخطأ اليدوي ويضمن التحديث اللحظي لجميع الأخطاء المعيارية بمجرد تصحيح أو إضافة أي درجة في مصفوفة البيانات الأولية.
5. تطبيق عملي: حساب الخطأ المعياري لدرجات اختبار نفسي
5.1 تجهيز مصفوفة البيانات النفسية الافتراضية
لتقديم محاكاة واقعية متكاملة لخطوات التحليل، سنفترض دراسة نفسية تجريبية استهدفت قياس مستويات “القلق المعرفي” لدى عينة استطلاعية مكونة من 15 طالباً جامعياً قبل خوض الاختبارات النهائية. تم تطبيق مقياس مقنن للقلق المعرفي تتراوح درجاته بين (0) كحد أدنى و (50) كحد أقصى، حيث تمثل الدرجة الأعلى مستوى قلق أكثر حدة. وقد تم إدخال الدرجات الخام الناتجة في ورقة عمل إكسيل مرتبة ترتيباً رأسياً في العمود A ابتداءً من الخلية A2 وحتى الخلية A16، مع تخصيص الخلية A1 لوضع التسمية التوضيحية للمتغير: “درجات_القلق_المعرفي”.
تمثل البيانات الخام المدخلة الدرجات التالية للمشاركين الخمسة عشر:
[28, 32, 25, 34, 30, 22, 29, 31, 35, 27, 24, 33, 36, 26, 30]
قبل البدء بالعمليات الحسابية، تقتضي قواعد الرصانة الأكاديمية إجراء فحص مبدئي سريع لسلامة البيانات وموثوقية الإدخال؛ حيث يتم التأكد من عدم وجود أخطاء في الطباعة المادية كإدخال فواصل غير مقصودة، أو إدراج أرقام خارج النطاق المنطقي للمقياس (كأن يظهر الرقم 280 بدلاً من 28)، والتأكد من خلو العمود من أي قيم نصية عارضة قد تعيق تدفق الحسابات الرياضية داخل البرنامج.
5.2 التنفيذ الإجرائي للصيغة الحسابية واستخراج الناتج
بعد التحقق من استقرار مصفوفة البيانات، ننتقل إلى مرحلة التطبيق الإجرائي لاستخراج الخطأ المعياري للمتوسط بصورة مباشرة. سنختار الخلية C2 لعرض القيمة، ونقوم بكتابة الصيغة المركبة المستهدفة على نطاق درجات الاختبار الفعلي بالشكل التالي:
=STDEV.S(A2:A16)/SQRT(COUNT(A2:A16))
عند الضغط على مفتاح الإدخال، ينفذ إكسيل العمليات الحسابية بدقة متناهية مخرجاً القيمة العددية: 1.0504. ولإدراك الدلالة الإحصائية لهذا الرقم، يتعين مقارنته بالمؤشرات الوصفية الأساسية لنفس العينة؛ فباستخدام دالة =AVERAGE(A2:A16) يتبين أن المتوسط الحسابي لدرجات القلق يبلغ 29.4667، وباستخدام دالة =STDEV.S(A2:A16) نجد أن الانحراف المعياري لعينة الطلاب يبلغ 4.0685.
إن المقارنة بين الانحراف المعياري (4.07) والخطأ المعياري (1.05) تفتح المجال للتفسير العلمي السليم؛ فالقيمة الأولى تخبرنا بأن الدرجات الفردية للطلاب تتشتت حول متوسط المجموعة بمدى تذبذب يبلغ نحو 4 درجات في المتوسط، في حين يخبرنا الخطأ المعياري بأننا إذا كررنا سحب عينات مماثلة بحجم 15 طالباً من مجتمع الطلاب الجامعيين نفسه، فإن متوسطات تلك العينات الافتراضية ستتذبذب حول المتوسط الحقيقي للمجتمع بهامش تشتت ضئيل ومحكوم لا يتجاوز 1.05 درجة، مما يشير إلى درجة مقبولة من الدقة المعاينية لهذا النموذج الاستطلاعي المصغر.
5.3 التحقق الحسابي اليدوي لمطابقة نتائج إكسيل
لتعميق الثقة في سلامة البناء البرمجي للصيغ واستيعاب المنطق الميكانيكي لمحرك إكسيل، يُستحسن تفكيك المعادلة وإجراء تحقق يدوي خطوة بخطوة في خلايا منفصلة. يهدف هذا الإجراء التعليمي إلى مطابقة الناتج النهائي المركب مع نواتج العمليات الوسيطة المنفردة:
- الخطوة الأولى: حساب الانحراف المعياري للعينة في الخلية
C4بكتابة:=STDEV.S(A2:A16)، والناتج هو:4.068461. - الخطوة الثانية: حساب حجم العينة الفعلي في الخلية
C5بكتابة:=COUNT(A2:A16)، والناتج هو:15. - الخطوة الثالثة: حساب الجذر التربيعي لحجم العينة في الخلية
C6بكتابة:=SQRT(C5)، والناتج هو:3.872983. - الخطوة الرابعة: تنفيذ عملية القسمة اليدوية بين البسط والمقام في الخلية
C7بكتابة:=C4/C6.
يظهر الناتج النهائي للقسمة المستقلة القيمة: 1.050473، وهي تتطابق تطابقاً مطلقاً وكاملاً حتى آخر كسر عشري مع القيمة المستخرجة من الصيغة المركبة الأولى المطبقة في الخلية C2. يبرهن هذا الفحص التماثلي القاطع على موثوقية البناء الحسابي ويمنح الباحث طمأنينة رياضية مطلقة بعدم وجود أي خلل ناتج عن تضارب الأقواس أو خرق الأولويات الرياضية داخل شريط صيغ إكسيل.
6. طرق إحصائية بديلة ومتقدمة لحساب الخطأ المعياري في إكسيل
6.1 استخدام أداة التحليل الإحصائي المتقدمة Data Analysis Toolpak
بجانب الصيغ الحسابية اليدوية، يتضمن برنامج إكسيل ملحقاً إحصائياً احترافياً متقدماً يعرف بحزمة أدوات تحليل البيانات (Data Analysis ToolPak). وتتميز هذه الحزمة بكونها تقدم مسحاً إحصائياً شاملاً للمتغيرات بضغطة زر واحدة، متضمنة حساب الخطأ المعياري تلقائياً دون الحاجة إلى تركيب أي معادلات يدوية. ولكن نظراً لأن هذه الأداة لا تكون مفعلة بشكل افتراضي في التثبيت الأولي لبرنامج أوفيس، يتوجب على الباحث تفعيلها يدوياً باتباع الخطوات القياسية الآتية:
الذهاب إلى شريط القوائم العلوي والضغط على ملف (File)، ثم النقر على خيارات (Options). من النافذة المنبثقة، يتم اختيار تبويب الوظائف الإضافية (Add-ins)، وفي أسفل الصفحة يُحدد مربع خيار “إدارة” (Manage) على وظائف Excel الإضافية (Excel Add-ins) ثم النقر على زر انتقال (Go). تظهر قائمة تتضمن الأدوات المتاحة، حيث يتم وضع علامة صح في المربع المقابل لخيار Analysis ToolPak، ثم الضغط على “موافق” (OK). بمجرد إتمام ذلك، سيظهر تبويب فرعي جديد يحمل اسم “تحليل البيانات” (Data Analysis) في أقصى يمين شريط أدوات بيانات (Data) الرئيسي.
لحساب الخطأ المعياري عبر هذه الأداة، ينقر الباحث على تحليل البيانات (Data Analysis)، ثم يختار من القائمة التحليلية الإحصاء الوصفي (Descriptive Statistics) ويضغط على “موافق”. في النافذة الخاصة بالأداة، يتم تحديد نطاق الإدخال (Input Range) ليشمل درجات المتغير، واختيار الترتيب حسب الأعمدة، وتحديد خيار “تسميات في الصف الأول” (Labels in first row) إذا كان العنوان مشمولاً، ثم تحديد موضع مخرجات النتائج، والأهم من ذلك تفعيل مربع الاختيار الخاص بـ ملخص الإحصائيات (Summary statistics) ثم الضغط على “موافق”.
6.2 قراءة وتفسير مصفوفة المخرجات الإحصائية المجمعة
تولد أداة الإحصاء الوصفي في إكسيل جدولاً إحصائياً متكاملاً يتضمن أهم المعالم والمؤشرات الاستدلالية للمتغير المستهدف. ويظهر الخطأ المعياري للمتوسط صراحة في الصف الثاني من الجدول مباشرة تحت المتوسط الحسابي تحت مسمى “Standard Error”، مقدماً نفس القيمة المحسوبة بالصيغة اليدوية تماماً. يوفر هذا الإخراج المجمع نظرة بانورامية عميقة على بنية البيانات النفسية؛ إذ يتيح فحص الخطأ المعياري في سياق مقاييس النزعة المركزية والتشتت وشكل التوزيع في آن واحد.
يتضمن جدول المخرجات الوصفية القياسية العناصر الحيوية الآتية التي يعتمد عليها التقرير الإحصائي:
- المتوسط (Mean): نقطة الارتكاز المركزية لدرجات العينة.
- الخطأ المعياري (Standard Error): دقة تقدير المتوسط للمجتمع الإحصائي.
- الوسيط والمنوال (Median & Mode): مقاييس تمركز البيانات البديلة المقاومة للقيم المتطرفة.
- الانحراف المعياري (Standard Deviation): المشتت الأساسي لاستجابات الأفراد المحسوب بتصحيح العينة ($n – 1$).
- تباين العينة (Sample Variance): المربع الرياضي للانحراف المعياري.
- التفرطح والالتواء (Kurtosis & Skewness): مؤشرات حاسمة لفحص اعتدالية التوزيع واقترابه من التوزيع الطبيعي.
- المدى والحد الأدنى والأقصى (Range, Min, Max): إيضاح الحدود القصوى للانتشار العددي للدرجات.
- المجموع والعدد (Sum & Count): حاصل الجمع الكلي وعدد الحالات الإحصائية الصالحة والمفحوصة فعلياً.
تكمن الميزة الاستراتيجية لهذا الإخراج التلقائي في تسريع وتيرة العمل البحثي، ولا سيما عند صياغة التقارير الأكاديمية الأولية وكتابة الفصول الميدانية لرسائل الماجستير والدكتوراه؛ حيث يغني الباحث عن بناء جداول منفصلة لكل مؤشر، ويمنحه ثقة فورية بتناسق منظومة المؤشرات الرياضية وتكاملها المنهجي.
6.3 توظيف الدوال الحديثة والمصفوفات الديناميكية (Excel 365)
مع التطور البرمجي الهائل الذي شهده محرك ميكروسوفت إكسيل في إصدارات Microsoft 365، أصبحت الحسابات الإحصائية أكثر سلاسة ومرونة بفضل تقديم صيغ المصفوفات الديناميكية (Dynamic Arrays) والدوال البرمجية التخصيصية المتقدمة مثل FILTER و LAMBDA. وتمنح هذه الأدوات الحديثة الباحث قدرة فائقة على حساب الخطأ المعياري لعينات فرعية مشروطة دون الحاجة لفرز البيانات أو نسخها يدوياً في جداول مستقلة.
فعلى سبيل المثال، إذا تضمنت مصفوفة البيانات عموداً للجنس (ذكور وإناث) في العمود B، وأردنا حساب الخطأ المعياري لدرجات القلق في العمود A للذكور فقط، يمكن دمج دالة التصفية FILTER ضمن الصيغة المعيارية على النحو الآتي:
=STDEV.S(FILTER(A2:A100, B2:B100="Male")) / SQRT(COUNT(FILTER(A2:A100, B2:B100="Male")))
تقوم هذه الصيغة الذكية بتجريد مصفوفة الذكور ومعالجتها حسابياً في الذاكرة الحية للبرنامج واستخراج الخطأ المعياري لمجموعتهم دون أي تدخل يدوي، وتتحدث النتائج فورياً إذا تغير تصنيف أي فرد في قاعدة البيانات.
علاوة على ذلك، يتيح إكسيل الحديث بناء دالة مخصصة ذاتية باسم دائم عبر ميزة LAMBDA؛ حيث يستطيع الباحث الدخول إلى “إدارة الأسماء” (Name Manager) وتسمية دالة جديدة باسم SEM وربطها بالصيغة التجريدية:
=LAMBDA(x, STDEV.S(x)/SQRT(COUNT(x)))
وبمجرد حفظ هذا التعريف، يصبح بمقدور الباحث استدعاء الدالة في أي خلية داخل دفتر العمل بكتابة =SEM(A2:A100) كأي دالة قياسية مدمجة في إكسيل، مما يمثل قفزة نوعية في تقليص الجهد وتوحيد الصيغ عبر المشاريع البحثية الموسعة، ويضمن أعلى معايير الأناقة البرمجية والدقة الرياضية.
7. التمثيل البياني للخطأ المعياري باستخدام أشرطة الخطأ في إكسيل
7.1 إنشاء المدرج التكراري أو الأعمدة البيانية للمتوسطات
لا يكتمل التحليل الإحصائي الرصين دون تجسيد بصري أمين يعكس الفروق الجوهرية ومقدار عدم اليقين المرتبط بها. وتعد الرسوم البيانية العمودية (Column or Bar Charts) الشكل الأوسع انتشاراً في المنشورات الأكاديمية لعرض مقارنات المتوسطات الحسابية بين المجموعات التجريبية والضابطة، أو عبر فترات التدخل الزمني المتعاقبة. لإنشاء هذا المخطط، يقوم الباحث بتلخيص المتوسطات المحسوبة في جدول موجز ومستقل يضم أسماء المجموعات وقيم متوسطاتها المقابلة.
يتم تظليل هذا الجدول الصغير، ثم التوجه إلى شريط إدراج (Insert) واختيار مخطط عمودي ثنائي الأبعاد (2D Clustered Column). تظهر الأعمدة ممثلة لارتفاع المتوسطات الحسابية بدقة، وهنا تبدأ مرحلة الضبط الفني والأكاديمي للرسم؛ إذ يتوجب إزالة خطوط الشبكة الخلفية غير الضرورية (Gridlines)، وحذف وسيلة الإيضاح (Legend) إذا كان المخطط يمثل متغيراً تابعاً واحداً، وتسمية المحاور بدقة علمية واضحة؛ كأن يسمى المحور الرأسي “متوسط درجات القلق المعرفي” والمحور الأفقي “المجموعات التجريبية”.
يهدف هذا التجريد البصري الأولي إلى التخلص مما يسميه علماء تصميم البيانات بـ “الحبر غير المفيد” (Chartjunk)، وتحويل التركيز المعرفي للقارئ مباشرة نحو الارتفاعات النسبية للأعمدة تمهيداً لدمج أشرطة الدقة المعاينية التي تمثل صلب الموضوع الإحصائي.
7.2 تخصيص أشرطة الخطأ المعياري Error Bars وفق القيم المحسوبة
إن الخطوة الأكثر حساسية وأهمية في إعداد الرسم البياني الأكاديمي هي إضافة أشرطة الخطأ (Error Bars)، والتي يقع فيها أغلب مستخدمي إكسيل في أخطاء كارثية نتيجة الاعتماد على الخيارات الافتراضية الجاهزة. لإدراج هذه الأشرطة، ينقر الباحث على الأعمدة البيانية لتحديدها، ثم يضغط على زر عناصر المخطط (+) في الزاوية العلوية للمخطط، ويضع علامة صح أمام خيار أشرطة الخطأ (Error Bars).
هنا يرتكب البرنامج خطأً منهجياً فادحاً إذا تُرك دون تعديل؛ إذ يدرج إكسيل تلقائياً أشرطة خطأ بقيمة نسبة مئوية ثابتة أو بقيمة انحراف معياري موحدة لجميع الأعمدة لا تمت بصلة للبيانات الحقيقية. ولتصحيح ذلك وضبط الأشرطة لتطابق الخطأ المعياري الفعلي المحسوب بدقة، يتبع الباحث المسار التقني الإلزامي الآتي:
- النقر على السهم الصغير المجاور لخيار “أشرطة الخطأ” واختيار مزيد من الخيارات (More Options) لتفتح لوحة التنسيق الجانبية.
- من تبويب “خيارات شريط الخطأ” (Error Bar Options)، يتم التمرير للأسفل حتى الوصول إلى قسم “مقدار الخطأ” (Error Amount).
- تجاهل الخيارات الافتراضية مثل “قيمة ثابتة” و”نسبة مئوية” و”خطأ معياري” (حيث يطبق هذا الأخير خوارزمية مبسطة غير متوافقة مع مصفوفات العينات المتعددة)، واختيار الخيار الأخير حصراً: مخصص (Custom).
- الضغط على زر تحديد القيمة (Specify Value)، فتفتح نافذة منبثقة صغيرة تحتوي على حقلين: “قيمة الخطأ الموجبة” (Positive Error Value) و”قيمة الخطأ السالبة” (Negative Error Value).
- في حقل القيمة الموجبة، يقوم الباحث بمسح المحتوى الافتراضي بالكامل، ثم يحدد خلايا الخطأ المعياري المحسوبة في جدول التلخيص لكافة المجموعات.
- يكرر الباحث الإجراء ذاته في حقل القيمة السالبة محدداً نفس نطاق خلايا الخطأ المعياري تماماً، ثم يضغط على “موافق”.
بهذا الإجراء الحصري، تكتسب أشرطة الخطأ مصداقيتها العلمية؛ حيث يمتد كل شريط لأعلى ولأسفل المتوسط بمقدار الخطأ المعياري الخاص بتلك المجموعة تحديداً، مما يمنح المخطط دقته الرياضية الكاملة.
7.3 التوافق مع متطلبات النشر الأكاديمي وضوابط APA
تضع جمعية علم النفس الأمريكية معايير صلبة وصارمة لعرض الأشكال التوضيحية والرسوم البيانية في المقالات والكتب الأكاديمية. وأول هذه المعايير هو الوضوح المفاهيمي المطلق؛ إذ يُلزم دليل APA الباحث بأن يوضح صراحة في التسمية التوضيحية أو الحاشية السفلية للشكل (Figure Note) نوع شريط الخطأ المعروض بدقة لا تقبل اللبس؛ كأن يكتب: “تمثل أشرطة الخطأ في الشكل الخطأ المعياري للمتوسط ($\pm 1 \text{ SEM}$)”، أو “تمثل أشرطة الخطأ فترات الثقة 95% للمتوسطات”. إن إغفال هذا التوضيح يترك القارئ في حيرة؛ فهل يعبر الشريط عن التباين الخام (SD) أم عن دقة المعاينة (SE)؟
المعيار الثاني يتعلق بالجماليات البصرية والنزاهة الإدراكية؛ حيث تشدد الضوابط على تجنب الألوان الزاهية غير الضرورية والتدرجات اللونية المعقدة (3D effects) التي تشوه التناسب الموضوعي وتصعب طباعتها بالأبيض والأسود في المجلات الورقية المحكمة. وينبغي تنسيق أشرطة الخطأ بخطوط واضحة بلون أسود أو رمادي داكن وبسمك يتناسب مع حجم الأعمدة (نحو 1 إلى 1.5 نقطة)، مع ضبط أطرافها لتنتهي بعوارض أفقية صغيرة (Caps) تحدد بوضوح نهاية المدى العددي للخطأ.
أما من الناحية التفسيرية، فإن أشرطة الخطأ المستندة إلى الخطأ المعياري تمنح المحكمين والباحثين وسيلة بصرية استرشادية لتقييم الفروق الإحصائية؛ فالتداخل الواسع بين أشرطة الخطأ للمجموعتين المتقابلتين يشير مبدئياً إلى احتمال عدم وجود فروق دالة إحصائياً بين المتوسطات، في حين أن انفصال الأشرطة أو تباعدها الواضح يعطي مؤشراً أولياً قوياً على وجود أثر حقيقي للمتغير المستقل يستوجب توثيقه النهائي عبر الاختبارات الفرضية المقننة (كالاختبار التائي وتحليل التباين).
8. تفسير قيمة الخطأ المعياري وبناء فترات الثقة في التقارير الأكاديمية
8.1 التفسير الإحصائي الدقيق لقيمة الخطأ المعياري المستخرجة
يتطلب التفسير الإحصائي السليم لقيمة الخطأ المعياري للمتوسط حساسية منهجية بالغة تحول دون الانزلاق إلى تأويلات شائعة ولكنها مضللة في الأدبيات السلوكية. فالخطأ المعياري لا يعبر بأي حال عن “خطأ في التجربة” أو “زلل في القياس الميداني”، كما أنه لا يحدد مدى كفاءة الأداة السيكومترية في عزل المتغيرات الدخيلة، بل هو مجرد رقم يمثل الانحراف المعياري للتباين العشوائي الطبيعي في المعاينة. وبناءً على ذلك، فإن قيمة الخطأ المعياري المرتفعة تشير حصراً إلى أن التقدير النقطي لمتوسط العينة يتسم بدرجة منخفضة من الاستقرار الدقيق (Low Precision)، وأن سحب عينات عشوائية أخرى من المجتمع نفسه سينتج عنه تشتت واسع وتذبذب ملحوظ في قيم المتوسطات الناتجة.
في المقابل، تدل القيمة المتدنية والمنخفضة للخطأ المعياري على دقة تمثيلية استثنائية للعينة؛ حيث تعكس استقرار التقدير وتمركز متوسطات العينات المتكررة في نطاق ضيق جداً ومتقارب بشدة حول متوسط المجتمع الإحصائي الحقيقي ($\mu$). وهذا الاستقرار يمنح الباحث ثقة منهجية أكبر في تعميم النتائج وتطبيقها على الواقع العملي.
ومن الأهمية بمكان تفادي الخلط المنهجي الشائع بين التفسير النفسي للسمة والتفسير الرياضي للخطأ؛ فإذا أظهرت دراسة حول القلق خطأً معيارياً صغيراً، فهذا لا يعني إطلاقاً أن مستوى القلق لدى الأفراد منخفض أو أن التباين النفسي بينهم معدوم، بل يعني ببساطة أن متوسط القلق للمجموعة قد تم تقديره بقدر عالٍ جداً من الدقة والموثوقية الإحصائية. فالانحراف المعياري يفسر انتشار الأفراد وسلوكهم السيكولوجي، بينما يفسر الخطأ المعياري وثوقية الأدلة الاستدلالية التي يمتلكها الباحث حول المجتمع.
8.2 حساب وتفسير فترات الثقة 95% اعتماداً على الخطأ المعياري
تعتبر فترات الثقة (Confidence Intervals – CI) الامتداد الطبيعي والتطبيق الأعمق للخطأ المعياري للمتوسط؛ إذ تمثل مجالاً عددياً يُتوقع باحتمال إحصائي محدد (غالباً 95% أو 99%) أن يقع داخله المعلم الحقيقي للمجتمع. ويتم بناء فترة الثقة 95% في العينات الكبيرة اعتماداً على التوزيع الطبيعي المعياري من خلال المعادلة الاستدلالية الكلاسيكية:
$$CI_{95%} = \bar{x} \pm (1.96 \times SE_{\bar{x}})$$
حيث يمثل الرقم (1.96) القيمة الحرجة ($Z_{0.025}$) للتوزيع الطبيعي المعتدل. أما في حال العينات النفسية الصغيرة ($n < 30$)، فتقتضي الدقة المنهجية استخدام توزيع $t$ لستيودنت بدرجات حرية ($n – 1$) لتحديد القيمة الحرجة الملائمة ($t_{crit}$).
يتيح برنامج إكسيل حساب هذا الهامش بدقة متناهية عبر استخدام الدوال المخصصة، ومن أبرزها الدالة الحديثة CONFIDENCE.T الموجهة لعينات توزيع $t$ وفق الصيغة الآتية:
=CONFIDENCE.T(0.05, Standard_Deviation, Sample_Size)
تقوم هذه الدالة بحساب قيمة هامش الخطأ الإحصائي ($Margin of Error$) مباشرة، والذي يساوي حاصل ضرب القيمة الحرجة في الخطأ المعياري للمتوسط. وبمجرد استخراج هذا الهامش، يمكن استنتاج الحد الأدنى لفترة الثقة بطرحه من المتوسط الحسابي، واستنتاج الحد الأعلى بجمعه إلى المتوسط. ويتميز تفسير فترة الثقة 95% في النماذج النفسية بأنه يوفر إطاراً استدلالياً فائق القوة لاتخاذ القرارات العلمية؛ فإذا كان مجال الثقة لمتوسط الفروق بين مجموعتين لا يتقاطع مع الصفر، يمكن للباحث أن يجزم بثقة عالية بوجود تأثير ذي دلالة حقيقية للمتغير التجريبي.
8.3 الصياغة العلمية لنتائج الخطأ المعياري في البحوث النفسية
تخضع كتابة النتائج الإحصائية في متن التقارير والبحوث الأكاديمية لقواعد صياغة دقيقة ومقننة تنظمها معايير دليل النشر الأكاديمي الصادر عن جمعية علم النفس الأمريكية (APA 7th Edition). ولا يجوز كتابة الخطأ المعياري بصورة غامضة أو إدراجه ضمن جمل إنشائية غير منضبطة، بل ينبغي دمجه بإحكام بجانب المتوسط الحسابي وقيم الاختبارات الفرضية.
تتمثل الصياغة النصية القياسية لتوثيق المتوسط والخطأ المعياري في متن التقرير بالصيغتين الشائعتين الآتيتين:
“أظهرت النتائج أن متوسط درجات القلق المعرفي لدى المجموعة التجريبية بلغ 29.47 ($SE = 1.05$)، في حين بلغ متوسط المجموعة الضابطة 35.12 ($SE = 1.32$)…”، أو بصيغة الجمع القياسي: “($M = 29.47, SE = 1.05$)”، مع كتابة الرموز الإحصائية ($M$ و $SE$) بخط مائل وفق المعايير الدولية.
وفي الجداول الإحصائية المقارنة، يُفضل تخصيص عمود مستقل يوضح الخطأ المعياري لكل متغير أو مجموعة تحت عنوان $SE$ أو $SE_M$ بجانب عمودي المتوسط ($M$) والانحراف المعياري ($SD$). كما يجب ربط هذه المؤشرات الرقمية بصورة منهجية بمناقشة حدود الدراسة وعينتها؛ فالإبلاغ الصريح عن الأخطاء المعيارية يتيح للباحثين الآخرين في تخصصات العلوم الإنسانية تضمين هذه الأرقام في الدراسات التحليلية البعدية، مما يرفع من القيمة الأكاديمية والتراكمية للبحث المنشور في الأوساط العلمية الدولية.
9. الأخطاء المنهجية والتقنية الشائعة في إكسيل وكيفية تصحيحها
9.1 أخطاء اختيار الدوال وتأثيرها على صدق النتائج
يقع الكثير من الباحثين ومحللي البيانات في حزمة من الأخطاء المنهجية الصريحة المتعلقة باختيار الدوال الإحصائية غير الملائمة لطبيعة المسألة قيد البحث. ويأتي على رأس هذه المنزلقات الخلط المتكرر بين دالتي الانحراف المعياري STDEV.S و STDEV.P. إن الاعتماد العفوي على دالة STDEV.P في دراسات العينات لا يمثل مجرد هفوة برمجية شكلية، بل هو تشويه منهجي يقلل زيفاً من قيمة التشتت المحسوب بنسبة قد تصل إلى عدة درجات مئوية في العينات الصغيرة، مما يقود بالتبعية إلى تقليص مصطنع في قيمة الخطأ المعياري للمتوسط، ويمنح إيحاءً مضللاً بدقة متناهية زائفة في تقدير معالم المجتمع.
ومن الأخطاء ذات الصلة تطبيق دوال المتغيرات الكمية على متغيرات فئوية أو رتبية مشفرة رقمياً دون تمحيص؛ كأن يدخل الباحث عموداً يمثل الحالة الاجتماعية (حيث 1=أعزب، 2=متزوج، 3=مطلق) ويقوم بتطبيق دالة STDEV.S ومعادلة الخطأ المعياري عليه. إن الناتج المستخرج هنا، على الرغم من خروجه كرقم صحيح برمجياً داخل إكسيل، يعد هدراً علمياً ولاغياً من الناحية المنهجية لغياب المعنى الفاصل للوحدات الرقمية المقاسة.
علاوة على ذلك، يغفل باحثون كثر شروط العينات الصغيرة؛ حيث يتم استخدام أوزان التوزيع الطبيعي المعياري ($Z = 1.96$) بصورة عمياء بدلاً من توزيع $t$ المشروط بدرجات الحرية، متناسين أن الخطأ المعياري المقدر عبر العينة يحمل في طياته قدراً من عدم اليقين المتزايد يستوجب التعويض الإحصائي الصارم عبر نماذج ستيودنت التوزيعية، ولا سيما في القياسات المعملية ذات الأعداد المحدودة من المشاركين.
9.2 أخطاء الصيغ الحسابية وهيكل الخلايا
تنشأ أخطاء شائعة أخرى من البناء البرمجي المشوش للمعادلات داخل ورقة العمل؛ فمن أكثر الأخطاء التقنية تواتراً هو السقوط في فخ “خلل الأقواس الرياضية” عند كتابة الصيغة المركبة. فعلى سبيل المثال، تؤدي كتابة الصيغة على النحو الخاطئ: =STDEV.S(A2:A20)/SQRT(COUNT(A2:A20 مع نسيان أقواس الإغلاق في مواضعها الصحيحة، إلى قيام البرنامج بتصحيح ذاتي غير متوافق مع المنطق المنشود، أو ارتكاب خطأ بقسمة الانحراف المعياري على حجم العينة مباشرة دون استخراج جذره التربيعي إذا تم إدراج دالة SQRT خارج إطار المقام، مما يؤدي إلى تضخيم فلكي للخطأ المعياري المحسوب وتدمير حساسية النموذج.
يتمثل الخطر التقني الثاني في وجود خلايا تحتوي على مسافات بيضاء غير مرئية ناتجة عن الضغط العارض على مفتاح المسافة (Spacebar)، أو استيراد نصوص فارغة من استبانات الويب بصيغة "". في هذه السيناريوهات، قد تتصرف الدوال بصورة مربكة وغير متوقعة؛ مما يستوجب فحص البيانات بدقة عبر الدوال المنطقية أو استخدام دالة CLEAN و TRIM لتنظيف المصفوفة قبل تمريرها لمحرر الدوال.
أما عند ظهور رسالة الخطأ الرياضي الشهيرة #DIV/0!، والتي تدل على محاولة القسمة على صفر—وهي حالة متكررة الحدوث عند تصفية البيانات في جداول ديناميكية وتفريغ النطاق من القيم الرقمية—فينبغي معالجتها باحترافية عبر تغليف صيغة الخطأ المعياري بدالة الحماية المنطقية IFERROR، بحيث تُصاغ المعادلة على النحو الآتي:
=IFERROR(STDEV.S(A2:A20)/SQRT(COUNT(A2:A20)), "غير متاح")
يضمن هذا الإجراء الأنيق الحفاظ على المظهر الجمالي لدفتر العمل واستقرار التنسيقات العامة للجدول دون تشويه الرؤية الإحصائية برسائل الأخطاء النظامية المربكة.
9.3 المزالق المفاهيمية في تأويل المخرجات في الدراسات النفسية
تنتمي أخطر المزالق الإحصائية إلى الحقل المفاهيمي والتأويلي لنتائج التحليل في الدراسات السلوكية والنفسية؛ ويتمثل المنزلق الأبرز في الممارسة المؤسفة المتمثلة في الاستبدال المتعمد للانحراف المعياري بالخطأ المعياري في جداول الإحصاء الوصفي بهدف “تجميل البيانات” وإيهام القراء والمحكمين بصغر مقدار التشتت في العينة. ونظراً لأن الخطأ المعياري يكون دوماً أصغر حجماً من الانحراف المعياري بمقدار ($\sqrt{n}$)، فإن بعض الباحثين يلجأون إلى عرضه كبديل للتباين الفردي ليظهر التقرير وكأن الدرجات شديدة التجمع والتجانس، وهو تدليس منهجي يرفضه العرف العلمي الصارم ويفقد البحث أمانته القياسية.
المزلق المفاهيمي الثاني هو تجاهل فحص افتراضات التوزيع قبل تفسير الخطأ المعياري؛ فالاعتماد على المتوسط والخطأ المعياري في مصفوفات بيانات تعاني من التواء شديد (Extreme Skewness) أو تفرطح شاذ أو احتواء على قيم متطرفة شاردة (Outliers) يقدم صورة مشوهة وزائفة عن الواقع. ففي هذه الظروف التوزيعية غير المعتدلة، ينهار الأساس المنطقي لمبرهنة النهاية المركزية، وتصبح مقاييس النزعة المركزية اللامعلمية (كالوسيط والمدى الربيعي) هي المعبر الحقيقي عن الظاهرة، بينما يتحول الخطأ المعياري للمتوسط إلى رقم مضلل يفتقر للسند المنهجي السليم.
أخيراً، يقع الكثيرون في خطأ الاعتماد الحصري والمطلق على الفحص البصري لأشرطة الخطأ في الرسوم البيانية لإصدار أحكام قاطعة حول وجود الفروق المعنوية، دون إجراء الاختبارات الاستدلالية الفرضية المقننة. وعلى الرغم من أن أشرطة الخطأ توفر إرشاداً أولياً ثميناً، إلا أن تداخلها أو انفصالها الطفيف يخضع لاعتبارات معقدة تتعلق بكون التصميم التجريبي مستقلاً (Independent) أو مرتبطاً بالقياس المتكرر (Repeated Measures)، مما يجعل الاعتماد عليها وحدها مجازفة منهجية غير مأمونة العواقب في تقرير العلاقات السببية.
10. أفضل الممارسات المنهجية لإدارة وتحليل البيانات الإحصائية في إكسيل
10.1 تنظيم وتوثيق دفاتر العمل الإحصائية للبحوث العلمية
تتطلب إدارة المشاريع البحثية الاحترافية في بيئة إكسيل الانضباط الهيكلي والتنظيمي الصارم الذي يضمن الشفافية وإمكانية تكرار الحسابات ومراجعتها (Reproducibility). وتبدأ أولى قواعد الممارسة المثلى بفصل أوراق العمل بحسب الوظيفة المنهجية؛ حيث تُخصص ورقة العمل الأولى للبيانات الخام غير المعالجة (Raw Data) ويتم حظر إجراء أي تعديلات أو معادلات داخلها، وتخصص ورقة العمل الثانية للبيانات المنظفة والمفلترة (Cleaned Data)، بينما تُخصص ورقة عمل ثالثة للمخرجات الإحصائية وجداول التلخيص والمعادلات (Summary & Statistics).
تتمثل الممارسة الثانية في استخدام “التسميات النطاقية المحددة” (Named Ranges)؛ فبدلاً من الإشارة إلى نطاقات الخلايا بصيغ مادية صامتة مثل A2:A150، يقوم الباحث بتسمية النطاق باسم المتغير النفسي صراحة عبر شريط الصيغ (مثل: Anxiety_Scores). وبذلك تتحول معادلة الخطأ المعياري إلى نص مقروء ومنطقي للغاية بالشكل:
=STDEV.S(Anxiety_Scores)/SQRT(COUNT(Anxiety_Scores))
يسهل هذا الإجراء قراءة المعادلات، ويقلل من احتمالات الخطأ عند تمديد النطاقات، ويتيح مراجعة الكود الحسابي من قبل باحثين آخرين بسلاسة ويسر.
علاوة على ذلك، يُنصح بحماية الخلايا التي تحتوي على معادلات البناء الإحصائي لمنع التعديل غير المقصود عليها أثناء إدخال البيانات الميدانية، وتوثيق سجل التغييرات ومصادر الاستبيانات بوضوح عبر وضع تعليقات نصية توضيحية (Notes & Comments) في ترويسة كل عمود لبيان أبعاد المقاييس ووحداتها القياسية وظروف جمعها.
10.2 التحقق المسبق من اعتدالية البيانات في بيئة إكسيل
قبل الاعتماد النهائي على الخطأ المعياري للمتوسط واستخدامه في بناء فترات الثقة، يتعين على الباحث التحقق المسبق والمبرهن من مدى استيفاء البيانات لشرط التوزيع الطبيعي المعتدل. ويوفر برنامج إكسيل دوالاً مخصصة لاستكشاف الشكل التوزيعي للمتغيرات، وعلى رأسها دالتا الالتواء SKEW والتفرطح KURT.
تطبق دالة معامل الالتواء بالصيغة =SKEW(Data_Range) لفحص تماثل البيانات حول متوسطها؛ فإذا اقتربت القيمة من الصفر (بين -1 و +1 عموماً، أو بين -0.5 و +0.5 وفق المعايير الأكثر تشدداً)، دل ذلك على اعتدالية التوزيع وسلامة استخدام الخطأ المعياري. أما إذا تجاوزت القيمة هذه الحدود، فإن التوزيع يعتبر ملتوياً التواءً إيجابياً أو سلبياً يعيق التفسير القياسي. وبالمثل، تُستخدم دالة التفرطح =KURT(Data_Range) لتقييم مدى حدة قمة التوزيع وثقل أطرافه مقارنة بالتوزيع الطبيعي المعتدل (الذي تبلغ قيمة التفرطح الإضافي فيه صفراً في خوارزمية إكسيل).
ويتكامل هذا الفحص العددي مع التمثيل البصري من خلال إدراج المدرج التكراري (Histogram) لاستكشاف توزيع التكرارات ورصد القيم المتطرفة الشاردة بصرياً. فإذا كشف هذا الفحص المسبق عن اختلال صريح وغير قابل للتعديل في افتراض الاعتدالية، ينبغي للباحث اتخاذ قرار منهجي شجاع إما بإجراء تحويلات رياضية للبيانات (Data Transformations كالتحويل اللوغاريتمي) لاستعادة الاعتدالية، أو التحول الكامل نحو الإحصاء اللامعلمي واستخدام مقاييس عدم اليقين المستندة إلى الوسيط وطرائق إعادة المعاينة التوليدية (Bootstrapping) كبديل أكثر أماناً وصدقاً في التعبير عن الظاهرة المدروسة.
10.3 التكامل بين إكسيل والبرمجيات الإحصائية المتقدمة (SPSS و R)
لا ينبغي النظر إلى برنامج إكسيل كبديل نهائي ومطلق للحزم الإحصائية التخصصية الأكثر تعقيداً مثل SPSS أو بيئة لغة R أو SAS، بل يمثل في الواقع المنصة المثالية للتحضير الأولي للبيانات وضبط الجودة الحسابية السريعة والتمثيل البياني الأكاديمي. وتتمثل أفضل الممارسات في استثمار القوة النسبية لكل منصة لتحقيق أقصى درجات الكفاءة التحليلية.
يقوم الباحث بتنظيم البيانات وترميزها وإجراء عمليات التدقيق والتحقق من حسابات الخطأ المعياري للمتوسطات في إكسيل لمطابقتها مع الواقع الميداني وملاحظة أثر التعديلات اللحظية، ثم يتم تصدير مصفوفة البيانات المنظفة بسلاسة بصيغة .xlsx أو .csv إلى برمجية SPSS لإجراء التحليلات الاستدلالية المتقدمة مثل النمذجة البنائية وتحليل التباين المتعدد (MANOVA)، أو استيرادها إلى لغة البرمجة الإحصائية R لتطبيق النماذج الخطية المختلطة (Mixed-Effects Models) المتقدمة.
كما تتيح مضاهاة المخرجات الحسابية بين إكسيل وهذه البرمجيات التحقق المطلق من تطابق الخوارزميات المعتمدة؛ فظهور نفس قيمة الخطأ المعياري للبيانات في إكسيل وفي مخرجات جدول الإحصاء الوصفي لبرنامج SPSS وفي ناتج أمر sd(x)/sqrt(length(x)) في بيئة R يزيل أي شك حول وجود أخطاء برمجية في التعامل مع البيانات، مما يعزز الرصانة الشاملة للمشروع البحثي ويؤهل نتائجه للنشر في أرقى الدوريات العلمية ذات معامل التأثير المرتفع.
خاتمة
يعد الخطأ المعياري للمتوسط (SEM) حجر الزاوية الذي يرتكز عليه صرح الاستدلال الإحصائي، والضابط الرياضي الذي ينقل الباحث من حيز الوصف السطحي للعينة إلى رحاب الفهم الدقيق لمعالم المجتمع الإحصائي الكلي. ولقد تجلى من خلال هذا العرض التأصيلي والتطبيقي الشامل أن التعامل مع هذا المؤشر في بيئة برنامج إكسيل يتطلب وعياً مزدوجاً؛ وعياً رياضياً ومنهجياً بالأسس النظرية التي تحكم مبرهنة النهاية المركزية وديناميكيات حجم العينة وتصحيح درجات الحرية، ووعياً تقنياً دقيقاً بخصائص دوال البرنامج وقواعد بناء الصيغ المركبة وضبط الرسوم البيانية التخصصية.
إن إتقان حساب الخطأ المعياري عبر دمج دوال STDEV.S و SQRT و COUNT، أو توظيف حزمة Data Analysis ToolPak والدوال المصفوفية الحديثة، مع الالتزام بتخصيص أشرطة الخطأ بدقة وصياغة النتائج وفقاً لمعايير جمعية علم النفس الأمريكية (APA)، يمثل مهارة جوهرية لا غنى عنها لكل باحث يسعى للرصانة والمصداقية العلمية في العلوم النفسية والسلوكية. وفي نهاية المطاف، تظل الجداول الحسابية مجرد أدوات تنفيذية تعتمد كفاءتها ونزاهتها على دقة الباحث وأمانته المنهجية في فهم ما وراء الأرقام وتطبيقه الأمين لأصول القياس العلمي الرصين.
المراجع
- American Psychological Association. (2020). Publication manual of the American Psychological Association (7th ed.). American Psychological Association. https://doi.org/10.1037/0000165-000
- Gauss, C. F. (1809). Theoria motus corporum coelestium in sectionibus conicis solem ambientium. Perthes et Besser.
- Gauss, C. F. (1823). Theoria combinationis observationum erroribus minimis obnoxiae. Dieterich.
- Laplace, P.-S. (1810). Mémoire sur les approximations des formules qui sont fonctions de très grands nombres et sur leur application aux probabilités. Mémoires de l’Académie des Sciences de Paris, 1809, 353–415.
- Pearson, K. (1894). Contributions to the mathematical theory of evolution. Philosophical Transactions of the Royal Society of London (A), 185, 71–110. https://doi.org/10.1098/rsta.1894.0003
- Yule, G. U. (1897). On the theory of correlation. Journal of the Royal Statistical Society, 60(4), 812–854. https://doi.org/10.2307/2979746