
تعد عملية معالجة النصوص وتنقيتها من الشوائب الرقمية إحدى الركائز الأساسية في إدارة البيانات الضخمة وضبط جودة النظم المعلوماتية الحديثة. فعند التعامل مع قواعد البيانات المستوردة من مصادر متعددة، كاستبيانات البحوث الميدانية، وسجلات العملاء، والبيانات المستخرجة آلياً عبر تقنيات كشط الويب (Web Scraping)، تبرز إشكالية تداخل الأرقام مع النصوص بصورة عشوائية داخل الخلية الواحدة؛ مما يشكل عائقاً جوهرياً أمام عمليات التصنيف والتحليل الدلالي والتسوية المعجمية. إن الحفاظ على سلامة المتن النصي يستدعي توظيف حلول خوارزمية رصينة قادرة على فرز وتجريد المحارف بدقة دون المساس بالبنية الصرفية أو النحوية للكلمات.
تقدم منصة جداول بيانات جوجل (Google Sheets) بيئة حوسبة سحابية متقدمة تدمج بين سهولة الاستخدام الحسابي وقوة المعالجة البرمجية المعتمدة على التعابير النمطية (Regular Expressions). وتعتبر هذه الأدوات امتداداً تاريخياً لأبحاث المنطق الرياضي ونظرية اللغات الصورية التي أسسها عالم الرياضيات الأمريكي ستيفن كول كليني (Stephen Cole Kleene) في منتصف القرن العشرين؛ حيث تتيح للمحللين والباحثين صياغة محددات دقيقة للغاية لعزل الفئات المحرفية غير المرغوبة وإزالتها بصورة آلية وقابلة للتطوير على نطاقات واسعة.
يتناول هذا الدليل التخصصي دراسة منهجية شاملة وموسعة لآليات إزالة الأرقام من السلاسل النصية في بيئة جداول بيانات جوجل. وسنستعرض في هذا البحث التفصيلي البنية المنطقية والرياضية للدوال المدمجة، وفي مقدمتها دالة REGEXREPLACE، مع استعراض البدائل المتقدمة كالمعالجة المصفوفية عبر ARRAYFORMULA وتطوير الدوال المخصصة باستخدام نصوص Google Apps Script، متطرقين إلى معالجة الأرقام بمختلف ترميزاتها العالمية، ولا سيما الأرقام المشرقية المستخدمة في السياقات العربية، مع وضع تدابير وقائية لضمان استقرار قواعد البيانات وحمايتها من التشويه والتحيز التحليلي.
1. مقدمة منهجية لمعالجة وتطهير البيانات النصية في جداول بيانات جوجل
1.1 أهمية تنقية البيانات النصية في التحليل الإحصائي
يمثل تداخل القيم الرقمية والنصية في الخلايا المستقلة خطأ هيكلياً فادحاً يؤثر بصورة مباشرة على الدقة العلمية والمخرجات الإحصائية في الدراسات الأكاديمية والتطبيقية. في كثير من الأحيان، تؤدي الحقول المدمجة (مثل دمج الاسم بالرقم الوظيفي أو الكود البريدي مع اسم المدينة) إلى تعذر قراءة المتغيرات من قِبل برمجيات النمذجة الرياضية والتحليل الإحصائي كحزم لغة R وبيئات لغة Python، حيث تفشل هذه البرمجيات في التعرف على نوع البيانات (Data Type)، وتتعامل مع الحقول النصية كمتغيرات نوعية شاذة بدلاً من تصنيفها السليم.
تتطلب معايير الجودة المتبعة في إعداد قواعد البيانات توفير مدخلات متجانسة وخالية من التلوث الرمزي، إذ إن إخضاع النصوص الملوثة بالأرقام لعمليات الفهرسة أو خوارزميات معالجة اللغة الطبيعية (NLP) يتسبب في حسابات مضللة لتردد الكلمات (Term Frequency) ومقاييس التشابه الدلالي. ومن هنا يبرز مفهوم توحيد صيغ المدخلات لتحقيق الاتساق المنهجي، حيث تسهم عمليات التنقية المسبقة في خفض الانحرافات المعيارية للأخطاء الناتجة عن التدخلات البشرية والتحرير اليدوي، مما يضمن اتساقاً مطلقاً في جداول التحليل.
1.2 تحديات استخراج النصوص النقية من السجلات المدمجة
تنبع صعوبة تنقية السلاسل النصية من التعقيد التركيبي للبيانات المجمعة؛ فالأرقام المعرفية لا تتخذ نمطاً ثابتاً في موضعها، فقد تأتي في مستهل النص كأرقام تسلسلية، أو تتوسط العبارات كأكواد فرعية، أو تقبع في نهايات الجمل كسنوات تقويمية وتواريخ توثيق. هذا التباين الشديد في التموضع يحول دون استخدام أساليب الاقتصاص الجزئي الكلاسيكية كدوال القص المباشر، ويتطلب استراتيجيات قادرة على مسح السلسلة بالكامل والتعرف على طبيعة المحرف بغض النظر عن سياقه المكاني.
علاوة على ذلك، تفرز عمليات الدمج غير المنضبطة مشكلات جمة ترتبط بظهور المسافات البيضاء الفائضة والمحارف غير المرئية كفواصل الأسطر والترميزات الخاصة غير المطبوعة (Non-printable characters)، والتي تظل عالقة داخل النص حتى بعد إزالة الأرقام الظاهرة. وتتعقد هذه المعضلة بصورة كبرى في البيئات ثنائية اللغة أو النصوص التي تجمع بين الأرقام العربية اللاتينية (0-9) والأرقام العربية المشرقية (٠-٩)، الأمر الذي يجعل أدوات التحرير والاستبدال البسيطة قاصرة عن إنجاز المهمة بكفاءة وموثوقية عالية.
1.3 نظرة عامة على أدوات المعالجة المتاحة في جداول بيانات جوجل
توفر جداول بيانات جوجل منظومة متكاملة من الأدوات للتعامل مع هذا التحدي البرمجي، تتراوح ما بين الأدوات اليدوية التفاعلية والحلول الرياضية الديناميكية المتقدمة. تبرز أداة “البحث والاستبدال” كأبسط الحلول لمعالجة التعديلات السريعة والمحدودة، إلا أنها تفتقر إلى قابلية التكرار الآلي وتتطلب تدخلاً بشرياً مباشراً يعرض البيانات الأصلية لخطر التعديل غير القابل للتراجع إذا لم يتم اتخاذ الاحتياطات اللازمة لإنشاء نسخ احتياطية متزامنة.
على النقيض من ذلك، تتيح الدوال الرياضية المدعومة بالتعابير النمطية (Regular Expressions) مستوى فائقاً من الكفاءة والأتمتة؛ حيث تتميز هذه الدوال بالقدرة على مسح السلاسل النصية ومطابقة أنماط معقدة دون المساس بالبيانات الأصلية، وذلك عن طريق استخراج النصوص في أعمدة محاذية بصورة ديناميكية تتكيف فورياً مع أي تعديل أو إضافة في السجلات المدخلة. وتمنح هذه المرونة لقواعد البيانات السحابية قابلية توسع هائلة تتيح معالجة عشرات الآلاف من الصفوف في أجزاء من الثانية.
2. الأساس النظري والمنطقي لدالة REGEXREPLACE
2.1 تعريف دالة REGEXREPLACE وبنيتها الصرفية
تمثل دالة REGEXREPLACE الأداة الرياضية الأكثر قوة وتخصصاً في جداول بيانات جوجل لمعالجة وتعديل السلاسل الرمزية عبر استبدال النصوص الجزئية التي تطابق نمطاً منتظماً محدداً بنص بديل تختاره المعايير البرمجية. تعمل هذه الدالة بمثابة محرك تحويلي يتلقى المدخلات النصية، ويخضعها لسلسلة من الاختبارات المنطقية المبنية على نظريات الحوسبة الصورية لتحديد مواضع التطابق ومن ثم إعادة هيكلتها وفقاً للوسائط المدخلة.
تتألف البنية الصرفية للدالة من ثلاثة وسائط رئيسية إلزامية تتم صياغتها كالتالي: =REGEXREPLACE(text, regular_expression, replacement). يُعنى الوسيط الأول (text) بتحديد السلسلة النصية الأصلية المراد تنقيتها أو الإحالة إلى المرجع الخلوي الذي يستضيف تلك البيانات. أما الوسيط الثاني (regular_expression) فيمثل القاعدة النمطية المصاغة بلغة التعابير المنطقية لتحديد الرموز المستهدفة بالفرز، في حين يحدد الوسيط الثالث (replacement) السلسلة البديلة التي ستحل محل الرموز المكتشفة، وتستخدم علامتا الاقتباس الفارغتان "" لتمثيل الحذف الخالص للمحارف المحددة.
2.2 المنطق البرمجي لمطابقة الأنماط النصية
يعتمد المحرك الداخلي لدالة REGEXREPLACE في جداول بيانات جوجل على خوارزميات محايدة لحالات الأحرف والمحارف تقوم بقراءة السلسلة النصية بصورة متسلسلة من المحرف الأول إلى الأخير، وفقاً لترميز اليونيكود (Unicode). يختبر هذا المحرك كل رمز أو تكتل رمزي مقابل المعيار المحدد في التعبير النمطي، فإذا تحقق التطابق المنطقي بين المحرف والقاعدة، يتم توجيه أمر للنظام بتجاوزه واستبداله بالقيمة المحددة في الوسيط الثالث فوراً.
يعتبر استخدام الفراغ النصي "" كقيمة بديلة وسيلة منطقية متقدمة لتنفيذ أمر “المحو الإحلالي”؛ فبدلاً من استبدال الرمز برمز آخر، يتم محوه من الذاكرة الإخراجية للسلسلة النصية، مع الحفاظ الكامل على تسلسل وترتيب الرموز الأخرى غير المطابقة. يضمن هذا النهج عدم تشويه الروابط اللغوية بين الحروف والكلمات، باستثناء المسافات التي قد تصبح فائضة نتيجة اقتطاع الكتل الرمزية من مواضعها الأصلية داخل الجملة المعالجة.
3. شرح الرموز النمطية المستخدمة لإزالة الأرقام
3.1 الرمز المرجعي العالمي للأرقام (d)
يعد الرمز المائل العكسي متبوعاً بحرف الدال d أحد أشهر الاختصارات الفئوية في هندسة التعابير النمطية، ويطلق عليه عالمياً “محدد الأرقام العشرية” (Digit Metacharacter). يتمثل الأساس البرمجي للرمز المائل العكسي في إبطال المعنى الحرفي للحرف اللاتيني اللاحق وتحويله إلى أمر رمزي خاص يفهمه محرك التحليل، حيث يغطي هذا الرمز جميع الأرقام العشرية الصريحة المحصورة بين الصفر والتسعة في الترميزات القياسية.
يمتاز الرمز d بالبساطة والإيجاز البرمجي، غير أن سلوكه في بعض البيئات الحاسوبية قد يرتبط بحساسيات تشفير اليونيكود المعقدة، حيث يقتصر عمله في بعض المحركات على الأرقام الغربية اللاتينية القياسية دون غيرها. ورغم ذلك، فإنه يوفر أقصى درجات الكفاءة وسرعة المعالجة الحسابية عند الرغبة في تطهير السجلات من الأرقام القياسية الأساسية في المنظومات المؤسسية وقواعد البيانات الرقمية العامة.
3.2 استخدام الفئات المحرفية الصريحة ([0-9])
توفر الفئات المحرفية الصريحة التي تستخدم الأقواس المعقوفة، مثل النمط [0-9]، أسلوباً بنيوياً فائق الدقة والموثوقية لتحديد المجالات الرقمية المستهدفة. يعمل القوسان المعقوفان كحاوية منطقية تعني “طابق أي محرف مفرد يقع ضمن هذه الحدود”، وتعمل إشارة الشرطة - كعامل لتحديد النطاق الشامل بدءاً من المحرف الأدنى وحتى المحرف الأقصى المقابل له في جدول التشفير المعتمد.
تمنح هذه الفئات الصريحة للمحلل الرياضي مرونة استثنائية مقارنة بالرموز العامة، حيث تمكّنه من تخصيص نطاقات فرعية إذا اقتضت طبيعة التحليل ذلك، كأن يستهدف الباحث حذف الأرقام من خمسة إلى تسعة فقط عبر صياغة [5-9]، واستبقاء الأرقام الأخرى. كما تضمن الفئات المحرفية وضوحاً كاملاً للكود البرمجي للمراجعين، مما يسهل عمليات التدقيق التقني واستكشاف الأخطاء وتصحيحها في البيئات السحابية المشتركة.
3.3 التعامل مع الأرقام التكرارية والمجمعة (+)
يلعب محدد التكرار الإيجابي المتمثل في رمز الجمع + دوراً محورياً في رفع كفاءة التعابير النمطية وتوجيه سلوكها نحو المعالجة الشاملة والتراكمية. عند إلحاق علامة الزائد بأي محرف أو فئة رقمية مثل d+ أو [0-9]+، يتحول المعيار من البحث عن رقم منفرد إلى استهداف “تكتل رقمي متصل يتكون من رقم واحد أو أكثر”، مما يحدث فارقاً تقنياً كبيراً في آليات المعالجة.
في حين تقوم الصيغة الفردية d باستهداف كل رقم كحالة مستقلة وإجراء عملية استبدال منفصلة لكل خانة في الأرقام المركبة (كالرقم 1984 الذي يتطلب أربع عمليات متسلسلة)، تقوم الصيغة التراكمية d+ باحتواء الرقم المركب كاملاً في عملية استبدال واحدة. يسهم هذا النهج التراكمي في تسريع الاستجابة الزمنية للنظام الحسابي بصورة ملحوظة عند التعامل مع سجلات ضخمة تتضمن ملايين الرموز، مما يوفر استهلاك الذاكرة المؤقتة لمحركات جوجل السحابية.
4. التطبيق العملي خطوة بخطوة: صياغة المعادلة الأساسية
4.1 إعداد بيئة العمل وهيكلة الأعمدة
يتطلب التطبيق العلمي الناجح لعمليات تنقية البيانات تنظيماً مسبقاً لهيكلية ورقة العمل لتجنب أي تداخل غير مرغوب بين البيانات الخام ومخرجات المعالجة. يتعين في البداية تخصيص العمود الأصلي (وليكن العمود A) كمصدر غير قابل للتعديل المباشر، وتسميته بوضوح عبر ترويسة معيارية تعكس طبيعته مثل “النصوص الأصلية المدمجة”، مع إبقاء البيانات بصيغتها الأولية لتكون مرجعاً للتحقق والمقارنة اللاحقة.
عقب ذلك، يتم إنشاء عمود مستقل ومجاور للنتائج (وليكن العمود B) تحت ترويسة “النصوص المصفاة”، وهو الحقل الذي سيستقبل المعادلات الديناميكية. يجب التأكد من ضبط تنسيق خلايا هذا العمود على هيئة “نص عادي” (Plain Text) لتفادي أي محاولات تفسيرية خاطئة من قِبل جوجل شيتس للمخرجات المستخلصة، وتوثيق المعايير القياسية لخصائص النصوص المستهدفة قبل تدشين الصيغ الحسابية بصورة رسمية.
4.2 كتابة الصيغة =REGEXREPLACE(A2, “d”, “”) وتطبيقها
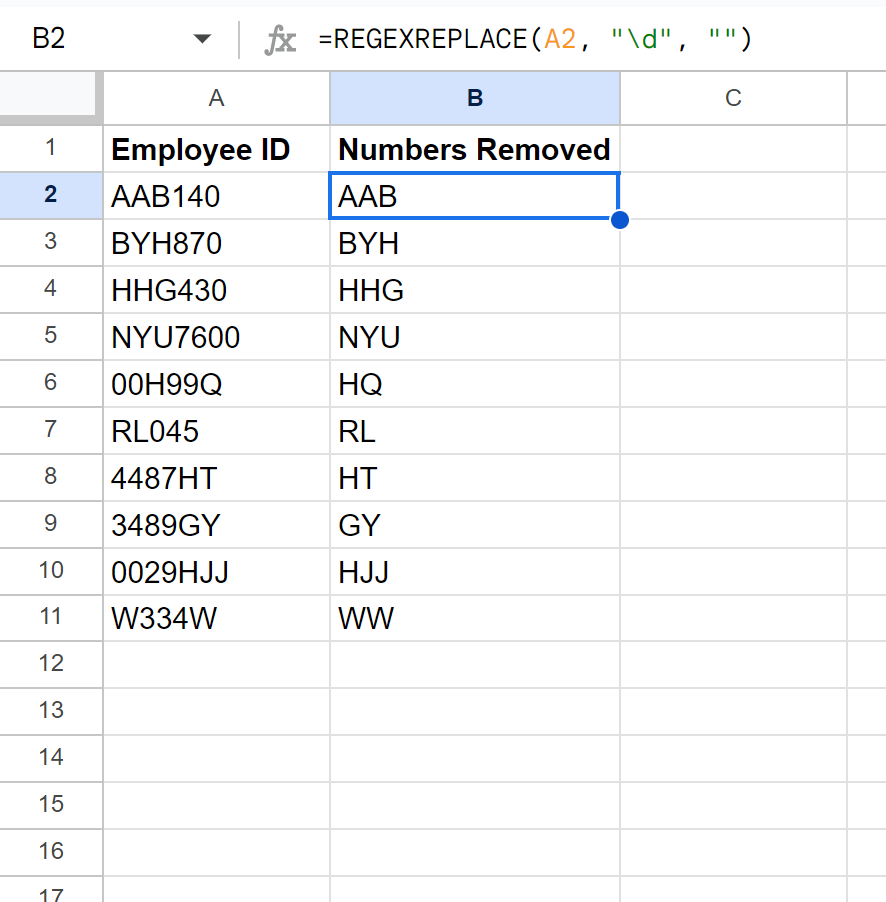
للبدء في المعالجة العملية، يتم النقر على أول خلية فارغة مخصصة للنتائج (الخلية B2)، ثم إدخال الصيغة الحسابية بدقة متناهية: =REGEXREPLACE(A2, "d", "") أو باستخدام النطاق التكراري المفضل: =REGEXREPLACE(A2, "d+", ""). بمجرد الضغط على زر الإدخال (Enter)، يقوم محرك البرنامج بقراءة محتويات الخلية A2 وعزل كافة المحارف الرقمية المتداخلة، وإرجاع السلسلة النصية النقية دون أرقام.
بعد التحقق البصري من نجاح العملية واختفاء العناصر الرقمية تماماً من المخرج في الخلية B2، يمكن تعميم المعادلة على بقية الصفوف التابعة عبر تفعيل خاصية التعبئة التلقائية (Auto-fill)؛ ويتم ذلك إما بسحب مقبض التعبئة الأزرق الصغير في الزاوية اليسرى السفلية للخلية نحو الأسفل، أو بالنقر المزدوج عليه لنشر الصيغة على امتداد البيانات المقابلة في العمود المصدر، مما يتيح التطهير الفوري لكامل السجلات في لحظات معدودة.
4.3 مقارنة النتائج بين الصيغة الفردية والصيغة التراكمية
من الناحية الظاهرية، يؤدي استخدام الصيغة الفردية =REGEXREPLACE(A2, "d", "") والصيغة التراكمية =REGEXREPLACE(A2, "d+", "") إلى النتيجة نفسها فيما يخص تجريد النص من الأرقام، حيث تختفي الأرقام بالكامل في الحالتين. إلا أن الفارق الجوهري يكمن في البنية الداخلية لعملية الحذف؛ فالصيغة الفردية تمحو الأرقام على دفعات متتالية محرفاً تلو الآخر، مما قد يترك فراغات دقيقة تتباين باختلاف التنسيقات المرافقة للنصوص.
علاوة على الكفاءة الحسابية المتفوقة للنمط التراكمي، فإن فهم الاختلاف بينهما يصبح حاسماً عند تطوير التعابير النمطية لاحقاً لاستبدال الأرقام برمز تعويضي موحد (مثل استبدال الأرقام بكلمة [رقم]). ففي حال استخدام النمط الفردي مع نص تعويضي، سيتحول الرقم “2024” إلى “[رقم][رقم][رقم][رقم]”، بينما يضمن استخدام النمط التراكمي d+ استبدال الكتلة الرقمية بأكملها لمرة واحدة لتصبح “[رقم]”، وهو ما يثبت تفوق النمط التراكمي في الحفاظ على الهيكل العام للنصوص المنقحة.
5. التعامل مع الأرقام في سياقات النصوص العربية المعقدة
5.1 إزالة الأرقام المشرقية (الهندية المستعملة عربياً)
تفرض اللغة العربية تحديات تقنية فريدة في معالجة البيانات، نظراً للاستخدام الواسع النطاق للأرقام المشرقية (٠، ١، ٢، ٣، ٤، ٥، ٦، ٧، ٨، ٩) بجانب الأرقام الغربية. يرجع هذا التحدي إلى التباين الجذري في شفرات اليونيكود؛ حيث تقع الأرقام اللاتينية في النطاق المحرفي من U+0030 إلى U+0039، في حين تشغل الأرقام المشرقية مجالاً برمجياً مستقلاً تماماً يمتد من U+0660 إلى U+0669، مما يؤدي إلى فشل الرمز النمطي البسيط d أو [0-9] في مطابقتها وإزالتها.
لمعالجة هذه الفجوة البرمجية، يتعين على المحلل صياغة تعبير نمطي شامل يستهدف النطاق المشرقي تحديداً عبر الفئة المحرفية [٠-٩]. وتتجسد الصيغة الاحترافية المثالية في توحيد المجالين اللاتيني والمشرقي داخل فئة محرفية مركبة وموحدة بالصيغة التالية: =REGEXREPLACE(A2, "[0-9٠-٩]+", ""). يمتاز هذا التركيب بقدرته الشاملة على رصد وتجريد كافة الصيغ الرقمية المتداولة في العالم العربي في خطوة واحدة، مع ضمان عدم المساس بتشكيل الحروف العربية أو الهمزات المتشابهة في الترميز.
5.2 الحفاظ على الرموز الخاصة وعلامات الترقيم النصية
عند تنفيذ عمليات تنقية السلاسل النصية، يقع العديد من المحللين في فخ الحذف الجائر الذي يجتث علامات الترقيم اللغوية المهمة كالفواصل والنقاط، أو الرموز الرياضية والنسب المئوية العالقة بالأرقام. إذا كانت السلسلة النصية تحتوي على نص مثل: “بلغ معدل النمو 15% في الربع الأول.”، فإن إزالة الأرقام وحدها باستخدام التعبير النمطي الافتراضي ستترك رمز النسبة المئوية % تائهاً وسط الجملة، ليصبح الناتج: “بلغ معدل النمو % في الربع الأول.”، وهو مخرج يفتقر إلى الرصانة اللغوية والدلالية.
لتفادي هذا الخلل، يمكن توسيع النمط النمطي ليشمل الرموز الملحقة بالأرقام بصورة دقيقة عبر الاستعانة بالفئات الشاملة أو التحديد الرمزي المنضبط. فإذا أردنا التخلص من الأرقام والرموز الرياضية التابعة لها مع الإبقاء الصارم على علامات الترقيم الإنشائية والواصلات النصية التي تربط الكلمات المركبة، يمكن تخصيص النمط النمطي مثل: =REGEXREPLACE(A2, "[0-9٠-٩%#$]+", "")، مع الحرص التام على عدم تضمين الفواصل وعلامات الاستفهام والتعجب ضمن قائمة الاستبعاد لضمان سلامة البناء المعنوي للجمل.
6. توسيع النطاق والأتمتة باستخدام دالة ARRAYFORMULA
6.1 مفهوم المعالجة المصفوفية المتكاملة
تعد المعالجة المصفوفية نقلة نوعية في كفاءة إدارة جداول البيانات السحابية، حيث تتيح دالة ARRAYFORMULA تنفيذ العمليات الحسابية والمنطقية على نطاق كامل من الخلايا دفعة واحدة عبر معادلة مفردة تتمركز في الخلية العليا للعمود. ينهي هذا الأسلوب الحاجة إلى سحب المعادلات يدوياً وتكرارها في آلاف الخلايا المستقلة، مما يخفف العبء الحسابي الواقع على متصفح المستخدم ومحركات المعالجة المركزية لخوادم جوجل.
تتمثل الميزة الاستراتيجية الكبرى للمصفوفات الديناميكية في قدرتها على التوسع الذاتي المستمر؛ فعند إدخال أي سجلات نصية جديدة في أسفل الجدول، تلتقط المعادلة المصفوفية البيانات المدخلة وتجري المعالجة والتنقية عليها تلقائياً دون أي تدخل بشري. يضمن هذا النهج أتمتة كاملة لخطوط معالجة البيانات، ويحول دون وقوع الأخطاء التشغيلية الناتجة عن نسيان سحب المعادلات إلى الصفوف المضافة حديثاً.
6.2 بناء الصيغة المصفوفية لإزالة الأرقام
لتحقيق التطبيق العملي الأمثل للمعالجة المصفوفية، يتم دمج دالة الاستبدال النمطي داخل دالة المصفوفة، مع إضافة شرط منطقي لتجاوز الخلايا الفارغة لمنع ظهور أخطاء برمجية أو احتلال المساحات غير المستخدمة في الجدول. يتم كتابة الصيغة المركبة التالية في الخلية B2 حصراً:
=ARRAYFORMULA(IF(A2:A="", "", REGEXREPLACE(A2:A, "[0-9٠-٩]+", "")))
يتحكم هذا البناء الهيكلي في حركة المعالجة عبر ثلاثة مستويات متناغمة: يقوم الجزء الشرطي IF(A2:A="", "") بفحص كل خلية على امتداد النطاق المفتوح A2:A، فإذا كانت الخلية المقابلة خالية من البيانات يترك الخلية المستهدفة فارغة تماماً. أما في حال احتواء الخلية على مدخلات، فيتولى شق REGEXREPLACE مهمة تطهير السلسلة من كافة الأرقام اللاتينية والمشرقية دفعة واحدة. تمتاز هذه الصيغة بقدرتها على معالجة قواعد بيانات ضخمة تتجاوز مئات الآلاف من الصفوف بسلاسة فائقة وسرعة استجابة زمنية قياسية.
7. معالجة المسافات والتنسيقات الناتجة عن حذف الأرقام
7.1 تنظيف الفراغات المتبقية باستخدام دالة TRIM
تخلف عمليات استئصال الأرقام من السلاسل النصية تشوهات بصرية وهيكلية واضحة، تظهر غالباً في هيئة مسافات بيضاء مزدوجة أو فراغات متبقية في صدر الكلمات أو أعقابها. فعند حذف رقم محاط بمسافتين فاصليتن (مثل: “قسم 104 الموارد”)، يؤدي الاستئصال إلى تلاقي المسافتين لتصبح الجملة: “قسم الموارد”، مما يخل بالتنسيق العام ويؤثر سلباً على عمليات المطابقة النصية التلقائية والبحث اللاحق.
يمثل الدمج الوظيفي بين دالتي TRIM و REGEXREPLACE المعيار الاحترافي الذهبي للتخلص التام من هذه الشوائب المكانية. تختص دالة TRIM بإزالة كافة المسافات البادئة واللاحقة في السلسلة النصية، مع تقليص المسافات البينية المتعددة بين الكلمات إلى مسافة قياسية واحدة. تتم صياغة المعادلة التكاملية على النحو التالي:
=TRIM(REGEXREPLACE(A2, "[0-9٠-٩]+", ""))
تضمن هذه الصياغة المحكمة إخراج نصوص منقاة بدرجة عالية من النقاء الهيكلي والدلالي، حيث تستعيد الكلمات تباعدها الطبيعي الصحيح والمطابق للمعايير الطباعية واللغوية دون أي أثر للمحارف المحذوفة.
7.2 توحيد حالة الأحرف والتحسين الطباعي
تتطلب معالجة السلاسل النصية متعددة اللغات (كالسجلات التي تضم نصوصاً عربية وأخرى إنجليزية محتوية على أرقام) خطوات تحسين إضافية لضمان الاتساق البصري التام. غالباً ما ترتبط الأرقام برموز تنسيق غير مرئية أو فواصل سطرية إجبارية (Line Breaks) تفرز فجوات شاذة داخل جداول البيانات، وتستلزم تدخلاً برمجياً إضافياً يطهر المتن من هذه الفواصل عبر تعابير نمطية متقدمة تستهدف محارف التحكم الخفية كرمز n و r.
علاوة على ذلك، في السياقات اللاتينية المرافقة، يوصى بربط النتائج بدوال ضبط التنسيق النصي مثل دالة PROPER لجعل الحرف الأول من كل كلمة كبيراً، أو LOWER لتوحيد النصوص بالصيغة الصغيرة، مما يضفي على المخرجات النهائية طابعاً مؤسسياً موحداً. تسهم هذه السلسلة من الإجراءات التحسينية في تسليم نصوص معالجة لغوياً ومحررة طباعياً بأعلى درجات الموثوقية والدقة.
8. بدائل متقدمة: استخدام نصوص Google Apps Script لتنقية السلاسل
8.1 الأساس البرمجي لإنشاء دالة مخصصة (Custom Function)
على الرغم من القوة الفائقة للدوال المدمجة، إلا أن الاعتماد على الدوال الحسابية المستمرة داخل الخلايا قد يؤدي أحياناً إلى بطء استجابة الملف عند التعامل مع مصفوفات هائلة الحجم تحوي مئات الآلاف من القيود الحسابية الحية. وهنا يبرز التحول نحو البرمجة الإجرائية المخصصة باستخدام نصوص تطبيقات جوجل (Google Apps Script)، وهي بيئة تطوير سحابية قائمة على لغة جافا سكريبت (JavaScript) تتيح التفاعل المباشر مع بيانات الورقة وتخصيص دوال ذات منطق متقدم.
يتم الولوج إلى هذه البيئة عبر قائمة جداول البيانات من خلال النقر على “أدوات” (Extensions) ثم اختيار “نصوص البرمجة النصية” (Apps Script). تتيح كتابة دالة مخصصة تجريد النصوص من الأرقام بطريقة معيارية قابلة لإعادة الاستخدام عبر كامل الملف، واستدعائها داخل أي خلية بنفس الطريقة التي تُستدعى بها الدوال الأصلية، مما يمنح المطورين سيطرة تامة على استثناءات البيانات والتعامل المنطقي مع المدخلات الشاذة.
8.2 صياغة وتطبيق دالة مخصصة لإزالة الأرقام
لبناء دالة مخصصة عالية الكفاءة قادرة على معالجة المدخلات الفردية والنطاقات المتعددة مع التخلص من كافة الأشكال الرقمية اللاتينية والمشرقية والمسافات الفائضة، يمكن إدراج الشفرة البرمجية المحكمة التالية في محرر النصوص البرمجية:
function REMOVE_DIGITS(input) {

  if (!input) return "";

  var regex = /[0-9u0660-u0669]+/g;

  if (Array.isArray(input)) {

    return input.map(function(row) {

      return row.map(function(cell) {

        return typeof cell === 'string' ? cell.replace(regex, '').replace(/s+/g, ' ').trim() : cell;

      });

    });

  }

  return typeof input === 'string' ? input.replace(regex, '').replace(/s+/g, ' ').trim() : input;

}
تعتمد هذه الدالة على الترميز العالمي الموحد لليونيكود لتحديد الأرقام المشرقية u0660-u0669 جنباً إلى جنب مع الأرقام اللاتينية، وتقوم بفحص نوع البيانات لتفادي وقوع أخطاء في حال تمرير قيم منطقية أو فارغة. بعد حفظ السكربت، يستطيع المستخدم كتابة =REMOVE_DIGITS(A2) داخل الجدول، لتعمل الدالة بمرونة تامة مع التحديث التلقائي لكافة الحقول المستهدفة.
8.3 تنفيذ المعالجة الجماعية على نطاقات ثابتة بدون دوال مستمرة
يمثل تنفيذ المعالجة المباشرة وتعديل القيم في مواضعها (In-place Processing) الاستراتيجية القصوى لتحسين أداء جداول البيانات الكبرى التي تعاني من ثقل الحسابات وإجهاد الذاكرة. بدلاً من إبقاء الدوال والمعادلات تعمل في خلفية الملف بشكل دائم، يقوم هذا النهج على كتابة سكربت إجرائي يقوم بقراءة البيانات من الخلايا المحددة، وتنفيذ التجريد الرقمي في ذاكرة المحرك، ثم إعادة كتابة القيم النصية النقية المجردة فوق البيانات الأصلية مباشرة دون استخدام أي معادلات وسيطة.
يمكن ربط هذا السكربت الإجرائي بقائمة مخصصة (Custom Menu) تُضاف إلى شريط القوائم العلوي لواجهة جداول جوجل تحت مسمى “أدوات تطهير البيانات”، أو ربطه بزر تحكم رسومي. وبمجرد أن يقوم المستخدم بتظليل العمود المستهدف والضغط على خيار التنظيف بنقرة واحدة، تُستبدل السلاسل الملوثة بالأرقام بقيم نصية ثابتة ومطهرة نهائياً، مما يحذف العبء الحسابي من الورقة ويقلل حجم الملف ويسرع عمليات التصدير والمشاركة.
9. الأخطاء الشائعة واستراتيجيات التحقق ومعالجة الاستثناءات
9.1 التعامل مع الخلايا التي تتحول إلى قيم فارغة
تتمثل إحدى أبرز المفاجآت التي تواجه محللي البيانات أثناء استخدام دوال التجريد النمطي في تحول بعض الخلايا إلى قيم فارغة تماماً دون سابق إنذار. ينشأ هذا السلوك الحتمي عندما تكون الخلية الأصلية محتوية على محارف رقمية فقط دون وجود أي حرف لغوي معها (كالخلايا التي تتضمن سنوات تقويمية مستقلة أو معرفات تسلسلية فقط). في هذه الحالة، يؤدي مسح الأرقام إلى تفريغ المحتوى بالكامل وإرجاع سلسلة فارغة "".
لتجنب هذا التشوه في الجداول وضمان وضوح السجلات للمراجعين، يجب اعتماد استراتيجية التحقق المشروط باستخدام دالة IF جنباً إلى جنب مع دالة الاستبدال. تتيح الصيغة التالية فحص المخرج مسبقاً، وتعيين قيمة بديلة كعبارة “[بيانات رقمية محذوفة]” أو إبقاء الخلية الأصلية كما هي إذا كان تجريدها سيقود إلى فراغ تام:
=IF(REGEXREPLACE(A2, "[0-9٠-٩]+", "")="", "[بيانات رقمية فقط]", TRIM(REGEXREPLACE(A2, "[0-9٠-٩]+", "")))
تسهم هذه الآلية الوقائية في حماية السجلات من الثغرات الخفية، وتوفر للمحلل مؤشراً دقيقاً على وجود صفوف شاذة تتطلب معالجة خاصة أو إعادة تدقيق يدوي.
9.2 الوقاية من فقدان البيانات وحماية النصوص الأصلية
تقتضي معايير إدارة البيانات الحصيفة الالتزام الصارم بمبدأ “عزل البيانات الخام” وعدم المساس بالأعمدة المصدرية نهائياً أثناء عمليات التنظيف والتطهير. إن تطبيق أي استبدال مباشر دون إنشاء نسخة احتياطية مستقلة يعرض المؤسسة لخطر الفقدان الدائم للمعلومات الرقمية التي قد تكون مرجعاً تشغيلياً أو قانونياً لا يمكن استرجاعه في حال حدوث خطأ في صياغة الأنماط النمطية المستخدمة.
يوصى دائماً بإنشاء ورقة عمل إضافية لحفظ النسخة الأصلية للبيانات وتفعيل ميزة “تاريخ الإصدارات” (Version History) المدمجة في جداول جوجل لمراقبة كافة التغييرات الهيكلية بدقة. بالإضافة إلى ذلك، ينبغي إجراء تدقيق إحصائي دوري عبر مقارنة عدد الصفوف المعالجة بإجمالي الصفوف الأصلية بواسطة دالة COUNTA، والتحقق من عدم حدوث أي انزياح أو اقتطاع عشوائي في السجلات الحساسة قبل اعتماد البيانات المصفاة في المراحل التحليلية المتقدمة.
9.3 معالجة الخلل الناتج عن الرموز المعكوسة واتجاهات اللغات
يؤدي التداخل بين النصوص العربية التي تُكتب من اليمين إلى اليسار (RTL) والأرقام اللاتينية التي تُقرأ من اليسار إلى اليمين (LTR) إلى مشكلات معقدة في خوارزميات المحاذاة والاتجاه ثنائي اللغة (Bidirectional Text Algorithm). فعند حذف الأرقام الفاصلة بين نصين، قد يحدث انزياح فجائي في ترتيب الكلمات اللغوية الظاهرة على الشاشة أو تنقلب مواقع علامات الترقيم كالأقواس والنقاط لتظهر في مواضع معكوسة تخل بالقراءة المتسلسلة.
تتم معالجة هذا الخلل البصري من خلال ضبط إعدادات الاتجاه للعمود بأكمله ليكون متسقاً وصريحاً من اليمين إلى اليسار، مع التأكد من تجريد النص من الرموز الخفية المتحكمة في الاتجاه مثل علامات التوجيه الثنائي لليونيكود (RLM و LRM) التي قد تعلق بالبيانات أثناء عمليات الاستيراد الخارجي. يضمن ضبط هذه الإعدادات الموضعية استقرار المظهر الطباعي للمخرجات وعرض الجمل العربية وفقاً لنسقها اللغوي السليم.
10. دراسات حالة وتطبيقات عملية عبر تخصصات متعددة
10.1 تطهير أسماء الموظفين من الأرقام الوظيفية المدمجة
في أقسام الموارد البشرية بالمؤسسات الضخمة، كثيراً ما تتلقى قواعد البيانات سجلات يتم فيها تصدير الأسماء مقرونة بالأكواد الوظيفية في حقل مشترك نتيجة قيود بعض المنظومات البرمجية القديمة (مثال: “أحمد عبد الله 88472 نائب المدير”). يمثل هذا الدمج عقبة أمام إعداد الخطابات الرسمية أو بطاقات العمل التعريفية أو تصدير القوائم لمنصات التأمين المؤسسي التي تتطلب حقلاً نصياً خالصاً للاسم الوظيفي.
عبر تطبيق الصيغة المركبة المعتمدة على الدوال المدمجة:
=TRIM(REGEXREPLACE(A2, "[0-9٠-٩]+", ""))
يتم عزل الأكواد الوظيفية بدقة متناهية والتخلص من المسافات البينية المزدوجة الناتجة عن الحذف، فيتحول السجل إلى “أحمد عبد الله نائب المدير”. يتيح هذا الإجراء التطهيري السريع إعادة استخدام هذه البيانات النصية مباشرة في مراسلات المنظمة وأنظمتها الإدارية بأعلى درجات الاحترافية ودون أدنى حاجة للمراجعة والتدقيق اليدوي المرهق.
10.2 تنقية البيانات البحثية في العلوم الاجتماعية والسلوكية
في ميدان البحوث الاجتماعية والسلوكية، يعتمد الباحثون على الاستبانات المقننة لجمع آراء المفحوصين وإجاباتهم النوعية على الأسئلة المفتوحة. في كثير من الأحيان، تصدر منصات جمع البيانات السحابية إجابات المبحوثين مسبوقة بترميزات رقمية ترتبط بتسلسل السؤال أو رتبة المقياس (مثال: “3- أشعر بالرضا التام عن جودة الخدمات”). هذه الأرقام تشوش على برامج التحليل النوعي والتحليل الدلالي لمحتوى المقابلات.
تتيح تنقية هذه البيانات عبر التعابير النمطية تجريد إفادات المبحوثين من الأرقام المعرفية والواصلات المرافقة لها، مما يهيئ النصوص للتحليل المعجمي وحساب مصفوفات التوافق اللفظي بصورة نزيهة وعلمية. كما تخدم هذه العملية التزام الباحثين الأخلاقي الصارم بحماية سرية البيانات وتحييد المعرفات الرقمية الشخصية، بما يضمن عدم إمكانية تتبع هوية الأفراد أو ربط الإجابات بأرقام استبياناتهم الأصلية أثناء النشر الأكاديمي للنتائج الميدانية.
10.3 معالجة سجلات العناوين والمستودعات في التجارة الإلكترونية
تواجه شركات التجارة الإلكترونية والمنصات اللوجستية تحدياً دائماً يتمثل في عشوائية مدخلات العناوين التي يكتبها العملاء، حيث تتداخل أسماء الشوارع والمدن مع الأرقام البريدية وأرقام المباني بشكل عشوائي غير منظم (مثال: “الرياض 12211 شارع الملك فهد 45”). إن محاولة تصنيف الشحنات وتوجيهها حسب المناطق تتطلب فصل الأسماء الجغرافية عن المعرفات الرقمية المتداخلة لتوحيد مراكز الفرز في المستودعات المركزية.
باستخدام الصيغ المصفوفية المؤتمتة عبر أعمدة العناوين، يتم عزل المدن والمناطق كنصوص جغرافية نقية، مما يسهل عمليات المطابقة التلقائية مع جداول التوزيع الجغرافي وحساب مسارات التوصيل بدقة فائقة. يقلل هذا التدبير التقني من نسب الشحنات المرتجعة الناتجة عن أخطاء القراءة الآلية لملصقات الشحن، ويرفع كفاءة الفهرسة والبحث المتقدم في قواعد بيانات المستودعات اللوجستية الضخمة بصورة ملحوظة ومستدامة.
خاتمة
استعرضنا في هذا الدليل التخصصي الأبعاد المنهجية والتطبيقية لعمليات إزالة الأرقام وتطهير السلاسل النصية في جداول بيانات جوجل. وقد تبين بجلاء أن التعابير النمطية، المتمثلة في دالة REGEXREPLACE وتكاملها مع الدوال المصفوفية كـ ARRAYFORMULA ودوال التهيئة الطباعية كـ TRIM، تشكل حجر الزاوية في بناء خطوط معالجة بيانات سحابية متقدمة ومرنة وقابلة للتطوير المستمر. وتتعاظم أهمية هذا الفهم الدقيق عند التعاطي مع تعقيدات النصوص العربية ثنائية الاتجاه والأرقام المشرقية، حيث يصبح الوعي بترميزات اليونيكود شرطاً لازماً لسلامة التحليل الإحصائي والنوعي اللاحق.
إن تبني أفضل الممارسات في تنقية البيانات—بدءاً من عزل البيانات الخام وحمايتها، مروراً باختيار الصيغ البرمجية الأنسب لكل حالة، وصولاً إلى استشراف الأخطاء واستثناءات الفراغات النصية—يعد ضمانة أساسية لرفع موثوقية قواعد البيانات المؤسسية والبحثية والتقنية. ومع التطور المتسارع للبيئات السحابية وأدوات الحوسبة المتقدمة، يظل التمكن من هندسة الأنماط النصية مهارة جوهرية لا غنى عنها لكل محلل بيانات يسعى إلى تحويل المدخلات المشوشة إلى ركائز معلوماتية رصينة تدعم اتخاذ القرارات السليمة.
المراجع
- Google Workspace Support. (2023). REGEXREPLACE function. Google Support. https://support.google.com/docs/answer/3098245
- Kleene, S. C. (1951). Representation of events in nerve nets and finite automata (Research Memorandum RM-704). RAND Corporation. https://www.rand.org/pubs/research_memorandums/RM0704.html
- Unicode Consortium. (2023). The Unicode Standard, Version 15.0 – Core Specification. Unicode Consortium. https://www.unicode.org/versions/Unicode15.0.0/
- Walkenbach, J. (2015). Excel 2016 Bible. John Wiley & Sons.
- Friedl, J. E. (2006). Mastering regular expressions (3rd ed.). O’Reilly Media.